
L’exploration empirique du réel repose sur la quantification systématique des phénomènes observés, une démarche qui transcende les clivages disciplinaires entre sciences exactes, biométrie médicale et sciences humaines. Dès lors que la recherche s’affranchit de la simple description monographique pour s’engager dans l’investigation des structures relationnelles, l’analyse univariée cède le pas à l’analyse bivariée. Ce saut qualitatif et quantitatif permet d’appréhender non plus un attribut isolé au sein d’une cohorte, mais la dynamique conjointe, la covariation et les interdépendances potentielles reliant deux métriques distinctes mesurées sur une même entité observationnelle.
Dans les contextes écologiques et professionnels contemporains, marqués par une surabondance informationnelle sans précédent, la donnée bivariée constitue l’armature fondamentale sur laquelle reposent les premiers modèles prédictifs et décisionnels. Qu’il s’agisse pour une organisation d’optimiser l’allocation de ses ressources en évaluant l’élasticité de son chiffre d’affaires face aux investissements promotionnels, pour un cardiologue d’interpréter le déclin physiologique de la fréquence cardiaque au repos au prisme du vieillissement cellulaire, ou pour un psychologue du travail d’objectiver le coût humain du stress perçu, la paire de données ordonnées s’avère être la brique élémentaire indispensable à toute démarche d’inférence scientifique.
Cependant, le passage de la collecte brute à l’interprétation rigoureuse exige un cadre théorique robuste. Une association observée sur un plan cartésien ne saurait être assimilée de facto à une relation d’engendrement ou de causalité linéaire directe. L’investigateur doit naviguer avec rigueur entre les écueils du réductionnisme statistique, les artéfacts de mesure, les biais d’échantillonnage et les mirages de la corrélation fallacieuse. Cet article propose une analyse approfondie des fondements épistémologiques, des instruments d’investigation et des applications concrètes des données bivariées à travers cinq cas d’étude emblématiques ancrés dans la réalité quotidienne, économique et clinique.
1. Fondements théoriques et conceptuels des données bivariées
1.1 Définition épistémologique de la donnée bivariée
D’un point de vue épistémologique, une donnée bivariée se définit comme l’appariement indissociable de deux observations distinctes, qualitatives ou quantitatives, recueillies sur une seule et même unité d’échantillonnage statistique. Contrairement à l’analyse univariée, dont la vocation première demeure strictement descriptive — s’attachant à synthétiser la distribution d’une variable unique au moyen d’indices de tendance centrale et de dispersion tels que la moyenne, la médiane ou l’écart-type —, l’analyse bivariée inaugure une démarche relationnelle. Elle postule que la mise en regard conjointe de deux caractéristiques morphologiques, comportementales ou environnementales peut révéler une structure d’association sous-jacente qui demeurerait imperceptible lors d’un examen parcellaire et disjoint de chaque composante.
Cet appariement formel, généralement consigné sous la forme d’un vecteur bidimensionnel ou d’une paire ordonnée $(X_i, Y_i)$ pour chaque individu statistique $i$, nécessite impérativement l’homogénéité ontologique de l’unité observée. Que cette unité soit un organisme vivant, une organisation commerciale, un intervalle temporel circonscrit ou une aire géographique délimitée, la mesure simultanée ou séquentielle des deux attributs doit être rattachée sans ambiguïté au même substrat empirique. Si l’analyse multivariée complexe englobe l’examen concomitant de trois variables ou davantage afin de démêler des réseaux d’interdépendance réticulaires, la configuration bivariée conserve un statut heuristique cardinal : elle incarne le seuil minimal de complexité à partir duquel la question du lien statistique, de la covariation et de l’association fonctionnelle peut être rigoureusement posée et testée.
Dans les sciences comportementales et appliquées, le recours aux données bivariées reflète une volonté d’échapper au solipsisme descriptif pour tester des hypothèses de travail portant sur des mécanismes régulateurs ou adaptatifs. L’investigation empirique moderne s’appuie sur ce format pour vérifier si les variations systématiques observées dans un phénomène $Y$ manifestent une dépendance probabiliste à l’égard des fluctuations documentées dans un phénomène $X$, ouvrant ainsi la voie à la formalisation mathématique des régularités observées dans le monde phénoménal.
1.2 Variables indépendantes et dépendantes dans les contextes écologiques
L’attribution des statuts fonctionnels aux termes de la paire bivariée constitue une étape théorique décisive qui transcende le simple formalisme algébrique. Dans la taxonomie méthodologique classique, la variable $X$ se voit assigner le rôle de variable indépendante, prédictive ou explicative, tandis que la variable $Y$ est qualifiée de variable dépendante, critère ou de réponse. Cette asymétrie fonctionnelle découle généralement d’un postulat théorique orienté, au sein duquel $X$ est présumée exercer une influence, déterminer ou précéder temporellement les manifestations de $Y$. L’investigateur postule ainsi une relation orientée : $Y = f(X) + varepsilon$, où $varepsilon$ représente la fraction stochastique incompressible non expliquée par le modèle.
Néanmoins, dans les contextes écologiques — c’est-à-dire lors d’observations menées in situ, sans manipulation expérimentale ni randomisation contrôlée en laboratoire —, cette séparation binaire s’avère souvent poreuse. Nombreuses sont les situations d’interdépendance symétrique où la désignation d’une variable comme régresseur et de l’autre comme réponse relève d’une convention purement heuristique ou opérationnelle. Deux grandeurs physiologiques ou deux traits de personnalité peuvent covarier étroitement sans qu’aucune antériorité logique ou temporelle ne justifie la subordination de l’une à l’autre. Dans ce contexte, forcer une asymétrie causale artificielle expose le chercheur à de graves biais d’attribution fonctionnelle.
L’opérationnalisation rigoureuse des variables exige dès lors une documentation scrupuleuse des conditions de recueil. L’analyste doit expliciter si le dispositif relève d’un plan corrélationnel passif — où l’interdépendance est observée sans contrainte imposée sur $X$ — ou d’un devis quasi-expérimental où $X$ est une variable de stratification écologique. Cette vigilance conceptuelle évite de confondre une simple concomitance métrique avec un protocole de causalité directe, préservant ainsi la validité interne des inférences ultérieures.
1.3 Objectifs scientifiques de l’analyse bivariée
La mobilisation scientifique des données bivariées poursuit trois finalités interdépendantes : la qualification typologique de la relation, la quantification de son intensité directionnelle, et la génération d’équations prédictives pragmatiques. En premier lieu, l’investigation s’attache à caractériser la forme géométrique et fonctionnelle sous-tendue par le nuage d’observations. Il convient de déterminer si le lien empirique se conforme à une relation linéaire — où un accroissement unitaire de $X$ engendre une variation constante de $Y$ —, à une tendance monotone non linéaire, ou à une trajectoire curviligne présentant des points d’inflexion ou des seuils de saturation biologique ou économique.
En second lieu, l’analyse vise à calculer une métrique standardisée capable de résumer la magnitude de l’association, indépendamment des échelles de mesure brutes employées lors de l’acquisition des données. Cette étape permet d’évaluer le degré de certitude probabiliste avec lequel la position d’un individu sur l’axe des abscisses informe sur sa coordonnée le long de l’axe des ordonnées, isolant ainsi le signal statistique du bruit de fond inhérent à toute mesure environnementale.
Enfin, l’objectif ultime réside fréquemment dans la modélisation à des fins d’intervention pratique. En établissant une fonction mathématique articulant formellement les deux domaines de mesure, le chercheur ou le gestionnaire acquiert la capacité de formuler des prédictions quantitatives assorties d’intervalles d’incertitude. Ces prédictions guident l’arbitrage stratégique dans le pilotage des investissements, l’élaboration de diagnostics d’orientation clinique, ou l’anticipation de perturbations sociales au sein d’une collectivité donnée.
2. Instruments statistiques d’analyse des données bivariées
2.1 Le diagramme de dispersion comme exploration visuelle primordiale
L’investigation rigoureuse d’un jeu de données bivariées débute immanquablement par la construction d’un diagramme de dispersion, ou nuage de points (scatterplot). Cette représentation graphique bidimensionnelle projette chaque observation appariée $(x_i, y_i)$ dans un repère cartésien orthogonal orthogonalisé, matérialisant visuellement la topographie de la distribution conjointe. L’inspection visuelle minutieuse de cet espace planétaire constitue un prérequis heuristique fondamental, agissant comme un garde-fou contre les dérives computationnelles aveugles.
Cette cartographie permet la détection immédiate de patterns structurels macroscopiques inaccessibles aux seuls indicateurs agrégés. L’analyste y discerne les concentrations denses d’observations formant des regroupements distincts (clusters), révélateurs de potentielles sous-populations sous-jacentes non identifiées a priori. Elle met également en exergue les valeurs aberrantes (outliers) ou influentes, dont la présence excentrique aux marges de la distribution globale est susceptible de fausser lourdement les estimations paramétriques standard.
De surcroît, le nuage de points permet de porter une appréciation préliminaire essentielle sur la validité des postulats classiques d’homoscédasticité — relative à la constance de l’étalement des points le long de l’axe prédictif — et de linéarité globale. Néanmoins, l’interprétation purement oculaire recèle des périls cognitifs majeurs : la subjectivité du regard humain, la manipulation pernicieuse du ratio d’aspect des axes ou le tronquage visuel peuvent induire l’illusion d’une régularité inexistante ou occulter une hétérogénéité cruciale. L’exploration graphique ne saurait par conséquent s’émanciper d’une validation par des métriques analytiques formelles.
2.2 Les coefficients de corrélation : métriques d’association
Pour dépasser l’appréciation descriptive du graphique de dispersion, les sciences quantitatives s’appuient sur des coefficients d’association standardisés. Le plus universellement sollicité demeure le coefficient de corrélation linéaire r de Pearson. Conçu pour évaluer la covariance normalisée de deux variables continues, $r$ s’exprime selon la formule :
$$r = \frac{\sum (X_i – \bar{X})(Y_i – \bar{Y})}{\sqrt{\sum (X_i – \bar{X})^2 \sum (Y_i – \bar{Y})^2}}$$
Son application rigoureuse est conditionnée par des critères stricts : normalité bivariée de la distribution conjointe, stricte linéarité de la relation sous-jacente et absence de valeurs extrêmes disruptives, auxquelles sa formule algébrique confère une sensibilité aiguë.
Lorsque les données s’écartent du paradigme gaussien, qu’elles présentent des distributions hautement asymétriques ou qu’elles s’expriment à un niveau de mesure purement ordinal, les statisticiens recourent à des indices non paramétriques. Le coefficient rhô ($rho$) de Spearman et le tau ($tau$) de Kendall procèdent par substitution des valeurs métriques brutes par leurs rangs respectifs au sein de l’échantillon. Ils évaluent la monotonicité globale de la relation — c’est-à-dire la tendance conjointe et univoque à croître ou décroître — sans imposer une stricte proportionnalité géométrique affine.
L’ensemble de ces coefficients fluctue rigidement au sein de l’intervalle fermé $[-1, +1]$. Une valeur de $+1$ dénote une association positive fonctionnelle parfaite, tandis que $-1$ traduit une relation négative inverse intégrale. La valeur zéro signale l’absence absolue de dépendance linéaire, sans toutefois exclure l’existence d’une liaison non linéaire complexe. L’analyste averti distingue scrupuleusement l’intensité statistique formelle du coefficient (mesurée par sa distance à zéro et confirmée par une valeur $p$ de significativité) de la magnitude physique, opérationnelle ou clinique du phénomène, laquelle dépend irréductiblement du champ disciplinaire étudié.
2.3 Régression linéaire simple : modélisation et inférence
Tandis que la corrélation quantifie symétriquement le degré d’association conjointe sans subordonner une mesure à l’autre, la régression linéaire simple opère un saut conceptuel asymétrique orienté vers la modélisation conditionnelle et la prédiction déterministe. Elle postule l’existence d’une droite mathématique théorique capable d’exprimer la valeur espérée de $Y$ conditionnellement à chaque valeur prise par $X$. L’estimation des paramètres de cette droite repose classiquement sur le principe des moindres carrés ordinaires (MCO), dont la finalité algorithmique consiste à minimiser la somme quadratique des résidus verticaux séparant les observations effectives de la trajectoire modélisée.
L’équation canonique de la droite d’ajustement s’écrit $\hat{Y} = b_0 + b_1 X$. Au sein de cette formalisation, l’ordonnée à l’origine ($b_0$, ou intercept) quantifie le niveau théorique attendu de la variable dépendante lorsque le régresseur $X$ s’annule strictement, un paramètre dont l’interprétabilité dépend intimement de la plausibilité écologique d’une valeur nulle pour $X$. La pente de régression ($b_1$), pour sa part, mesure le taux de variation marginal conditionnel : elle indique avec précision la magnitude de l’accroissement ou de la diminution moyenne de $Y$ induit par l’augmentation d’une unité physique de la variable explicative $X$.
L’efficacité explicative de ce modèle est condensée au sein du coefficient de détermination ($R^2$), équivalent au carré du coefficient de Pearson dans le cadre bivarié simple. Le $R^2$ matérialise la proportion exacte de la variance totale de $Y$ comptabilisée et résorbée par l’ajustement linéaire à $X$. Néanmoins, l’inférence statistique valide de ces paramètres — par le truchement de tests de Student et d’analyses de variance (ANOVA) — demeure suspendue à l’analyse rigoureuse des résidus ($e_i = Y_i – \hat{Y}_i$). Ces écarts individuels doivent impérativement satisfaire aux hypothèses d’indépendance mutuelle, d’homoscédasticité et de normalité distributionnelle pour conférer aux estimations le statut d’estimateurs linéaires sans biais à variance minimale (théorème de Gauss-Markov).
3. Exemple 1 : Dépenses publicitaires et chiffre d’affaires en gestion d’entreprise
3.1 Contextualisation de la relation marketing-finance
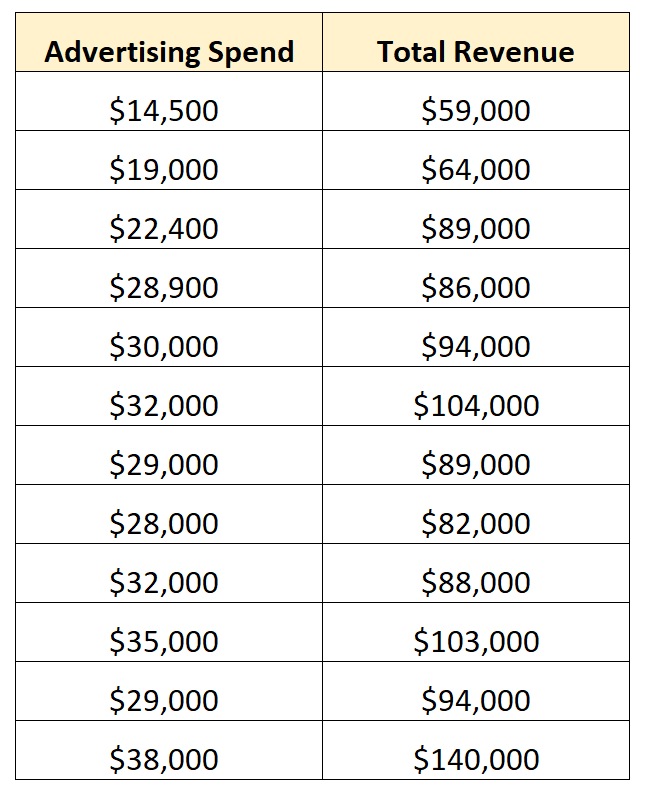
L’arbitrage budgétaire alloué aux campagnes de communication constitue l’un des défis décisionnels les plus récurrents pour les comités exécutifs des entreprises contemporaines. Dans un univers concurrentiel caractérisé par la volatilité des marchés, la direction financière exige l’objectivation rigoureuse du retour sur investissement publicitaire (ROAS). L’investigation empirique se traduit par le recueil longitudinal de séries bivariées appariées, consignant de manière systématique les montants des investissements promotionnels trimestriels bruts ($X$) et les chiffres d’affaires correspondants ($Y$) réalisés au sein d’une unité commerciale homogène sur plusieurs dizaines de cycles d’activité consécutifs.
Les deux grandeurs mobilisées appartiennent à la classe des variables quantitatives continues mesurées sur une échelle de rapport dotée d’un zéro absolu naturel. L’objectif premier de cette modélisation bivariée réside dans la rationalisation des budgets de stimulation commerciale : il s’agit d’identifier si l’impulsion financière accordée aux campagnes média (télévision, affichage urbain, canaux programmatiques numériques) génère un écho commercial statistiquement mesurable et financièrement rentable, ou si les fluctuations du chiffre d’affaires demeurent régies par des composantes macroéconomiques totalement autonomes.
L’analyste financier compile ainsi des chroniques comptables rigoureusement purgées des variations d’inflation monétaire. Cette rigueur méthodologique préalable garantit que chaque observation $(x_i, y_i)$ reflète fidèlement la réalité des flux économiques réels sans subir de distorsion monétaire exogène. La confrontation bivariée devient alors le premier filtre décisionnel guidant la prospective budgétaire de la gouvernance d’entreprise.
3.2 Application de la régression linéaire simple
Considérons l’ajustement économétrique appliqué à un jeu d’observations réelles représentatives d’une franchise de distribution commerciale. L’estimation par la méthode des moindres carrés ordinaires aboutit à l’équation paramétrique formalisée suivante :
$$\text{Chiffre d’affaires} = 14,942{,}75 + 2{,}70 \times (\text{Dépenses publicitaires})$$
Dans ce cadre fonctionnel explicite, la pente de régression ($b_1 = 2{,}70$) fournit une métrique de rentabilité marginale immédiate : pour chaque tranche additionnelle de 1,00 $ injectée dans les canaux d’activation publicitaire, l’organisation enregistre une expansion moyenne attendue de 2,70 $ de son chiffre d’affaires consolidé. Dès lors que la marge commerciale brute de l’organisation excède le seuil de rentabilité unitaire de cet incrément, l’investissement se justifie économiquement.
L’ordonnée à l’origine ($b_0 = 14,942{,}75 $X = 0$).
L'analyse de variance rattachée au modèle produit un coefficient de détermination $R^2 = 0{,}68$, attestant que 68 % de la variance historique du chiffre d'affaires est formellement expliquée par l'intensité de l'effort publicitaire consenti. Les 32 % résiduels capturent les turbulences exogènes imprévisibles, telles que les variations climatiques saisonnières, les mouvements agressifs de la concurrence ou les modifications sporadiques du pouvoir d'ac\hat des ménages au sein de la zone de chalandise.
<h3>3.3 Considérations psychologiques et comportementales sous-jacentes</h3>
L'illusion d'une droite de régression infiniment croissante se heurte toutefois aux réalités neurocognitives de la réception du message commercial par le consommateur. Derrière la linéarité apparente des MCO se dissimule une dynamique psychologique complexe. L'efficacité du stimulus marketing repose sur des phénomènes d'attention sélective, de mémorisation de marque et d'incitation conative. À mesure que les dépenses promotionnelles s'intensifient au sein d'une période restreinte, le public cible subit une saturation cognitive croissante, marquée par l'usure publicitaire (advertising wearout) et l'irritation subliminale.
Ce mécanisme psychologique engendre le phénomène universel des rendements marginaux décroissants : chaque dollar supplémentaire procure un impact psychologique marginal inférieur au dollar précédent. L'ajustement linéaire strict ne constitue donc qu'une approximation locale valable au sein d'un corridor d'exploitation budgétaire délimité. Au-delà d'un seuil critique, la réponse s'aplatit inéluctablement sous l'effet de l'épuisement de l'attention disponible.
Par ailleurs, l'analyse bivariée ins\tantanée ignore structurellement le phénomène psychodynamique de rémanence ou de latence temporelle (carryover effect). L'exposition répétée à un message publicitaire au cours du mois $M$ mature souvent dans l'inconscient du consommateur pendant plusieurs semaines avant de déclencher le passage à l'acte transactionnel au cours du mois $M+1$ ou $M+2$. La réduction unilatérale de l'analyse à une synchronie contemporaine sous-estime l'efficacité réelle de la communication en imputant son impact ultérieur à l'inertie basale du système.
<h2>4. Exemple 2 : Âge chronologique et fréquence cardiaque au repos en biométrie médicale</h2>
<h3>4.1 Problématique physiologique et protocole de mesure</h3>
Dans le domaine de la physiologie clinique et de la cardiologie préventive, l'investigation des interactions entre le vieillissement chronologique d'un individu et l'efficience de sa fonction cardiovasculaire basale représente une ligne de recherche majeure. Le rythme cardiaque basal au repos, couramment quantifié en battements par minute (b\pm), constitue un biomarqueur fondamental de l'activité neurovégétative et de l'intégrité myocardique. Ce paramètre est confronté à l'âge chronologique individuel, exprimé en années révolues, au sein d'études épidémiologiques transversales de grande envergure visant à documenter les invariants sénescents du corps humain.
La validité des données bivariées recueillies dans ce contexte clinique dép\end d'un protocole d'acquisition rigoureusement standardisé. La mesure de la fréquence cardiaque au repos ($Y$) ne peut s'affranchir de contraintes environnementales strictes : le patient doit être mainte\nu en décubitus dorsal dans une pièce thermoneutre et silencieuse depuis au moins quinze minutes, à distance de toute prise récente de stimulants pharmacologiques (caféine, nicotine) ou d'efforts physiques intenses.
Ces précautions méthodologiques ont pour finalité d'annihiler les artéfacts psychosomatiques transitoires, au premier rang desquels figure le syndrome de la blouse blanche, caractérisé par une décharge adrénergique réflexe déclenchée par l'anxiété contextuelle de l'examen médical. Isoler la signature physiologique pure de l'âge chronologique ($X$) exige cette asepsie procédurale, sans laquelle le nuage bivarié traduirait des réactions de stress aigu plutôt que l'usure biologique fondamentale du système circulatoire.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/bivariate13-1.png" alt="" /></figure>
<h3>4.2 Exploration corrélationnelle et analyse de dispersion</h3>
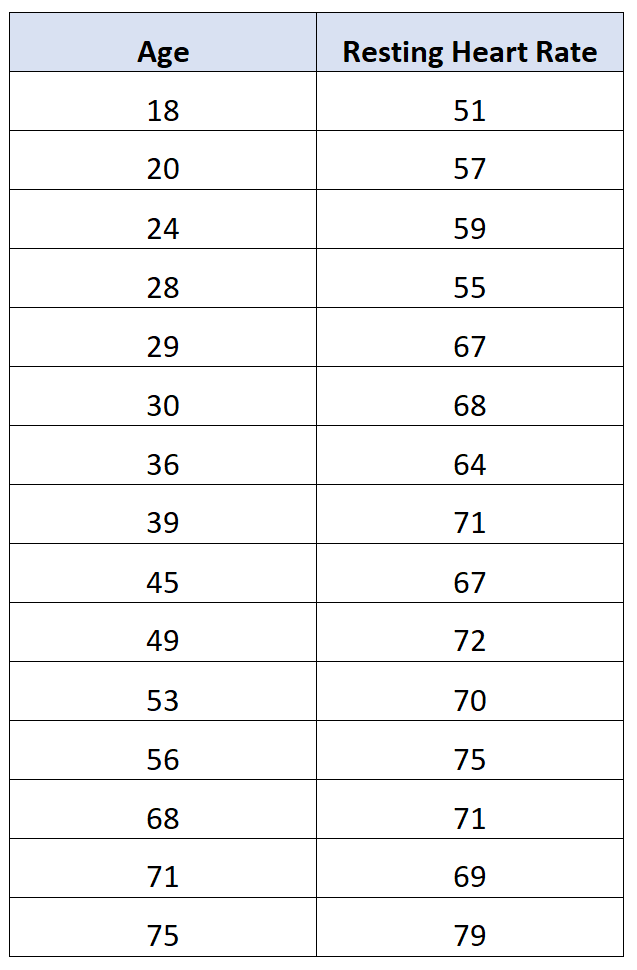
L'exploration d'un jeu de données bivariées colligeant l'âge et la fréquence cardiaque chez des adultes sains non sédentaires met généralement en évidence un diagramme de dispersion caractérisé par une très large nébuleuse de points. Contrairement aux relations mécaniques observées en physique, le calcul du coefficient de corrélation linéaire de Pearson révèle ici une association modeste à modérée, oscillant couramment entre $r = -0{,}15$ et $r = -0{,}35$ selon les tranches d'âge investiguées et le degré de contrôle des facteurs de confusion comportementaux.
Cette magnitude corrélationnelle relativement contenue s'explique par la très forte variabilité interindividuelle qui caractérise le processus de sénescence biologique. L'examen attentif du nuage de points permet aux cliniciens d'identifier visuellement des sous-groupes morphologiques ou capacitaires distincts. Les profils d'individus hautement entraînés à l'endurance aérobie se démarquent de manière spectaculaire, se regroupant dans le quadrant inférieur gauche et médian du repère cartésien a\vec des fréquences de repos oscillant entre 40 et 50 b\pm (bradycardie sinusale physiologique induite par le remodelage ventriculaire athlétique).
À l'opposé, les profils sédentaires ou marqués par des altérations métaboliques précoces s'inscrivent systématiquement au-dessus de la ligne d'ajustement médian. La dispersion bivariée illustre ainsi la dissociation conceptuelle capitale entre l'âge chronologique — invariant temporel purement légal — et l'âge biologique tissulaire, lequel module l'automaticité du nœud sinusal et l'élasticité artérielle de manière hautement hétérogène au sein de la cohorte d'étude.
<h3>4.3 Interactions a\vec les dimensions psychologiques de l'anxiété</h3>
La fréquence cardiaque au repos n'est pas un baromètre purement mécanique de l'âge valvulaire ou myocardique : elle constitue le réceptacle permanent des tensions affectives de l'individu par l'intermédiaire du système nerveux autonome. La composante parasympathique (via le tonus vagal) exerce un freinage cardiomodérateur physiologique, tandis que la branche orthosympathique déclenche l'accélération tachycardisante. Or, au fil des décennies d'existence, l'accumulation de stress perçu, l'érosion des ressources psychologiques d'adaptation (<a href="https://fr.wikipedia.org/wiki/Strat%C3%A9gies_d%27adaptation">coping</a>) et les manifestations d'anxiété chronique perturbent ce fragile équilibre homéostasique.
Cette réactivité émotionnelle permanente représente une variable de confusion majeure dans la lecture de la donnée bivariée. Une élévation anormale du rythme cardiaque basal chez un sujet de 60 ans peut refléter non pas un effondrement organique structurel de sa contractilité myocardique, mais l'empreinte psychosomatique d'une charge allostatique sévère résultant d'une existence soumise à des stresseurs continus non régulés. L'anxiété chronique majore les taux circulants de catécholamines plasmatiques, maintenant une tachycardie relative de repos qui vient masquer l'effet intrinsèque de la sénescence.
L'approche bivariée simple atte\int ici ses limites intrinsèques : en isolant artificiellement le couple (Âge, Fréquence), elle fusionne au sein d'une même variance résiduelle des altérations cardiologiques tissulaires pures et des dérèglements de la régulation neuro-émotionnelle. Ce constat met en lumière la nécessité clinique d'adjoindre des inventaires psychométriques d'anxiété-trait pour décanter adéquatement la part attribuable au vieillissement chronologique de celle qui résulte des tourments de la psyché.
<h2>5. Exemple 3 : Heures de sommeil et performance cognitive chez les étudiants</h2>
<h3>5.1 Cadre théorique de la psychologie cognitive et du sommeil</h3>
L'optimisation des trajectoires d'apprentissage académique en milieu universitaire dép\end étroitement de la préservation de l'architecture neurobiologique du sommeil. En psychologie cognitive et en neuroergonomie de l'éducation, les relations reliant la durée du repos nocturne aux capacités d'assimilation et d'expression intellectuelle font l'objet d'une documentation scientifique foisonnante. La consolidation mnésique — qu'il s'agisse de la mémoire déclarative épisodique ou des habiletés procédurales complexes — s'opère préférentiellement au cours des cycles successifs de sommeil lent profond et de sommeil paradoxal (REM).
Dans ce cadre expérimental ou observationnel, la variable indépendante $X$ est opérationnalisée par le nombre d'heures effectives de sommeil nocturne enregistré précédant une session d'évaluation standardisée, une information recueillie soit par auto-questionnaire d'agenda de sommeil validé, soit par actigraphie biométrique au poignet. La variable dépendante $Y$ est objectivée au moyen de métriques cognitives calibrées, telles que des scores d'attention visuo-spatiale soutenue (Continuous Performance Test) ou les performances quantitatives obtenues à un examen universitaire académique standardisé.
L'intérêt de cette analyse bivariée réside dans sa capacité à fournir aux acteurs pédagogiques et aux étudiants eux-mêmes des repères empiriques fondés sur la réalité biologique du fonctionnement cérébral. Elle confronte la croyance estudiantine répandue selon laquelle le sacrifice unilatéral du sommeil au profit de révisions nocturnes intensives améliore la performance finale à l'épreuve des faits statistiques.
<h3>5.2 Nature bivariée et modélisation de la relation d'attention</h3>
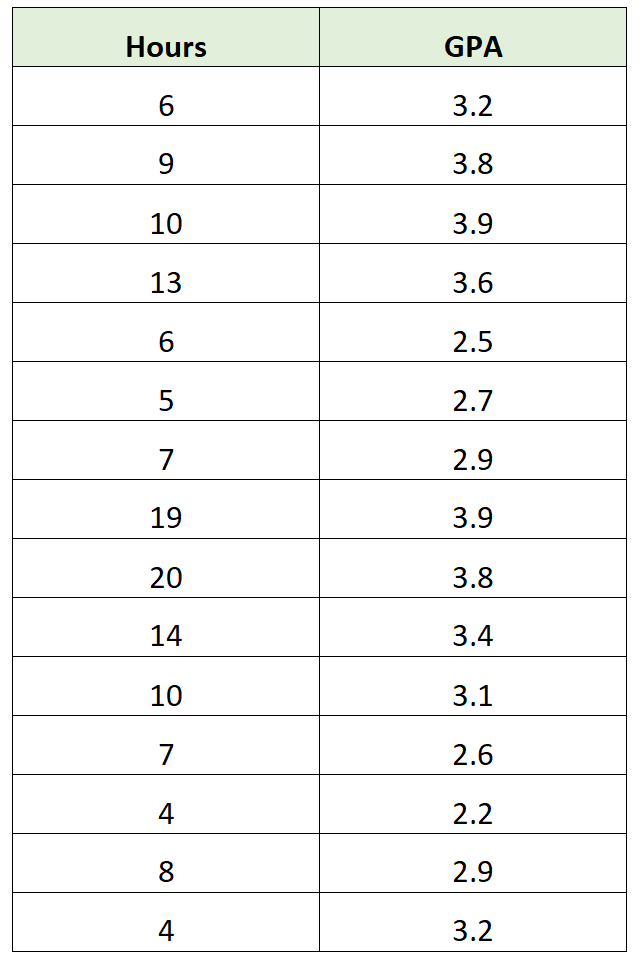
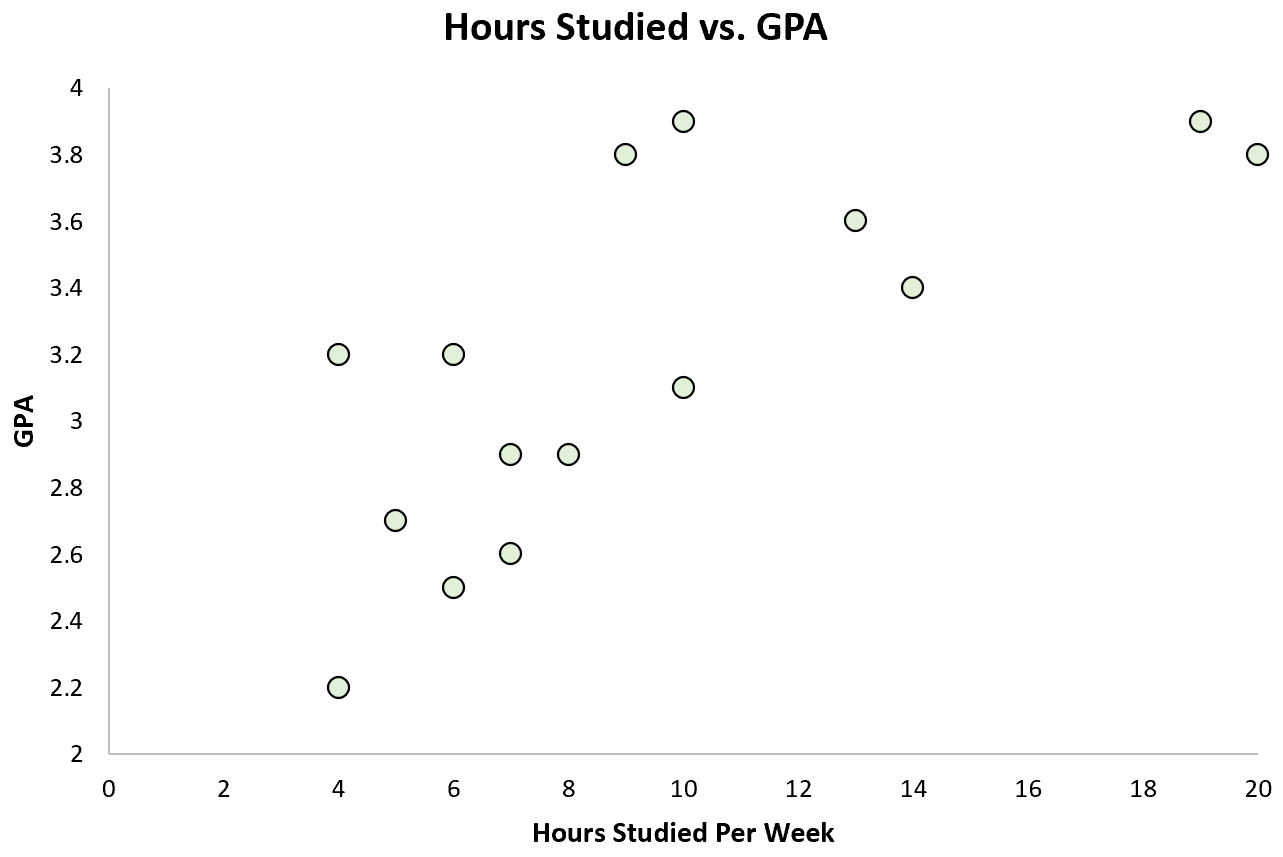
Lorsque l'analyse se cantonne à une amplitude de repos comprise entre 4 et 8 heures de sommeil chez des cohortes d'étudiants soumises à de fortes charges de travail, la configuration bivariée se structure de manière remarquablement prévisible. Les diagrammes de dispersion mettent en lumière une corrélation linéaire positive robuste ($r \approx 0{,}60$ à $0{,}75$). L'ajustement par régression linéaire simple atteste d'une trajectoire ascendante continue : chaque heure de sommeil supplémentaire récupérée sur le déficit chronique induit une élévation significative des performances attentionnelles et des résultats académiques.
Le coefficient de détermination calculé au sein de cette plage ($R^2 \approx 0{,}45$) révèle que près de la moitié de la variabilité interindividuelle des scores d'efficience cognitive peut être directement imputée à la durée de la récurrence du repos cérébral. Les représentations graphiques révèlent un décrochage particulièrement brutal lors des privations aiguës sévères, lorsque les sujets basculent sous le seuil critique des 5 heures : le taux d'erreurs d'inattention, d'omissions et les temps de réaction s'effondrent de manière concomitante.
Ce modèle linéaire restre\int valide l'hypothèse cognitive centrale : la reconstitution des réserves énergétiques cérébrales (adénosine triphosphate) et la clairance des métabolites neurotoxiques via le système gly\mphatique durant les phases de repos lent constituent des catalyseurs indispensables au maintien d'une vigilance focalisée et d'une flexibilité exécutive optimale lors des sollicitations académiques diurnes.
<h3>5.3 Détection d'une non-linéarité subtile à grande échelle</h3>
Toutefois, la modélisation mathématique révèle ses failles conceptuelles fondamentales dès lors que l'on élargit le cha\mp de recueil des données bivariées à l'ensemble du spectre comportemental humain, en intégrant des durées de sommeil atypiques s'échelonnant de 8 à 12 heures quotidiennes. L'adjonction de ces observations excentriques provoque une métamorphose radicale de la structure géométrique du nuage de points, brisant l'hypothèse de linéarité globale au profit d'une relation nettement curviligne et non monotone en forme de U inversé.
Cette inflexion négative de la performance cognitive au-delà d'un plateau optimal situé entre 7 et 8 heures et demie de sommeil correspond à un phénomène neurophysiologique bien documenté : la léthargie post-hypnique prolongée et la désynchronisation circadienne. Les sujets dormant régulièrement au-delà de 9 à 10 heures présentent fréquemment une somnolence diurne résiduelle, des altérations de la vitesse de traitement perceptif et une apathie motivationnelle qui dégradent les performances intellectuelles aussi sévèrement qu'une privation modérée.
Sur le plan théorique, cette configuration rappelle les préceptes de la célèbre <a href="https://fr.wikipedia.org/wiki/Loi_de_Yerkes-Dodson">loi de Yerkes-Dodson</a>, initialement formulée pour relier l'éveil motivationnel à l'efficience comportementale. L'application mécanique d'une droite de régression linéaire de Pearson sur un tel jeu de données globales produirait une grave erreur d'inférence, écrasant la pente réelle et masquant le p\oint de bascule optimal. Ce cas d'école illustre l'impérieuse nécessité de confronter systématiquement les présupposés algorithmiques à la plausibilité non linéaire des lois gouvernant la biologie et le comportement humain.
<h2>6. Exemple 4 : Niveau de stress perçu et absentéisme en psychologie organisationnelle</h2>
<h3>6.1 Opérationnalisation des variables en milieu professionnel</h3>
La dégradation du climat psychosocial au travail et ses répercussions financières sur la productivité des entreprises contemporaines ont propulsé la recherche en comportement organisationnel vers la modélisation empirique des mécanismes d'attrition et de désengagement. L'analyse bivariée du lien entre la détresse psychologique ressentie par les salariés et la fréquence des défections professionnelles pour motifs de santé constitue un jalon méthodologique fondamental pour les directions des ressources humaines soucieuses de déployer une politique préventive rationnelle.
L'opérationnalisation scientifique de cette dynamique impose l'emploi d'instruments psychométriques standardisés pour quantifier la variable prédictive $X$. On recourt couramment à des outils psychométriquement validés à l'échelle internationale, tels que l'Échelle de Stress Perçu de Cohen (<a href="https://en.wikipedia.org/wiki/Perceived_Stress_Scale">PSS-10</a>) ou l'inventaire d'épuisement professionnel de Maslach (MBI). Ces instruments convertissent l'état affectif subjectif du travailleur en un score métrique conti\nu fiable.
La variable dépendante $Y$, quant à elle, s'incarne dans une mesure administrative objective : le relevé annuel consolidé du nombre de journées d'arrêt de travail pour congé de maladie ordinaire prescrit par le corps médical. En écartant délibérément les congés d'accidents du travail majeurs ou de maternité, l'analyste isole une métrique d'absentéisme réactif permettant d'évaluer le coût humain et organisationnel engendré par l'exposition prolongée à des contraintes professionnelles délétères.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/bivariate15.png" alt="" /></figure>
<h3>6.2 Analyse paramétrique et non paramétrique de l'association</h3>
L'exploitation statistique d'un tel jeu de données bivariées est immédiatement confrontée à un défi distributionnel structurel. Si le score de stress perçu adopte fréquemment une allure gaussienne symétrique le long de l'échantillon, la distribution du nombre de journées d'absentéisme est systématiquement caractérisée par une forte asymétrie positive (skewness prononcée) : une majorité substantielle d'employés n'enregistre aucune absence ou seulement un ou deux jours annuels, tandis qu'une minorité présente des arrêts cumulés de plusieurs semaines ou mois.
Cette non-normalité flagrante de la variable dépendante disqualifie l'usage exclusif du coefficient paramétrique de Pearson, dont le résultat serait artificiellement tiré par la traîne des valeurs extrêmes. Le statisticien avisé privilégie le recours au <a href="https://fr.wikipedia.org/wiki/Corr%C3%A9lation_de_Spearman">coefficient rhô de Spearman</a> ou au \tau de Kendall, lesquels évaluent l'alignement ordinal des rangs d'épuisement et des rangs d'absence. Les résultats mettent généralement en relief une association positive hautement significative ($r_s \approx 0{,}40$ à $0{,}55$, $p < 0{,}001$).
Cette confirmation métrique permet de chiffrer précisément ce que l'ergonomie moderne désigne comme les « coûts cachés d'évitement » : les employés situés dans le tertile supérieur de détresse psychologique présentent un ratio de cotes d'absence maladie massivement supérieur à la moyenne. L'organisation peut ainsi modéliser les gains économiques induits par des programmes de remédiation ergonomique et de prévention du burn-out en termes de réduction directe des jours d'inactivité rémunérée.
<h3>6.3 Facteurs modérateurs et limites d'inférence bivariée</h3>
Malgré l'évidente solidité empirique de la relation bivariée reliant le stress perçu aux défections sanitaires, toute conclusion univoque d'ordre déterministe s'avère méthodologiquement fallacieuse en raison de l'omission délibérée de variables tierces modératrices majeures au sein d'un modèle strictement à deux dimensions. L'impact du stress sur le passage à l'acte de l'arrêt maladie n'est pas uniforme : il est tamponné ou amplifié par le capital de ressources individuelles et environnementales disponibles.
Au premier rang de ces modérateurs psychosociaux figure le soutien social perçu au travail, qu'il émane des pairs ou du supérieur hiérarchique direct (modèle de Karasek). Un travailleur soumis à un niveau de stress psychologique d'intensité 9 sur une échelle de 10 pourra maintenir une présence active et régulière s'il opère au sein d'un collectif soudé, bienveillant et solidaire, trouvant dans son environnement immédiat des soupapes régulatrices efficaces. Inversement, un stress modéré combiné à un isolement relationnel ou un harcèlement latent précipitera l'effondrement somatique et l'arrêt de travail immédiat.
De surcroît, l'analyse bivariée se heurte à la dualité conceptuelle de l'absentéisme : elle échoue à discriminer l'absentéisme subi — caractérisé par une décompensation somatique objective avérée (ulcère gastrique, pathologie musculo-squelettique induite par la tension musculaire) — de l'absentéisme de retrait ou d'autoconservation psychologique délibérée, où l'arrêt constitue une stratégie défensive face à une souffrance morale insoutenable. Ignorer la culture d'entreprise, la précarité statutaire ou les mécanismes de <a href="https://fr.wikipedia.org/wiki/Pr%C3%A9sent%C3%A9isme">présentéisme</a> compensatoire (venir travailler en étant malade) limite drastiquement la portée causale d'une modélisation restreinte à ces deux seuls indicateurs.
<h2>7. Exemple 5 : Température ambiante et comportements agressifs en psychologie sociale</h2>
<h3>7.1 Hypothèse thermo-agressive et données de terrain</h3>
L'exploration des interactions entre les stimuli environnementaux physiques et les comportements violents au sein des espaces urbains denses constitue l'un des volets les plus stimulants de la psychologie sociale écologique et de la criminologie environnementale contemporaine. Depuis les travaux précurseurs de Carlsmith et Anderson dans les années 1970 et 1980, l'investigation empirique s'est attachée à tester la validité de l'hypothèse thermo-agressive (heat hypothesis), selon laquelle les températures environnementales excessivement élevées abaissent le seuil de déclenchement des conduites hostiles.
Pour mettre à l'épreuve cette hypothèse sur le terrain sans recourir à des artifices de laboratoire, les chercheurs collectent de vastes bases de données bivariées fusionnant les relevés météorologiques officiels de la température quotidienne moyenne ou maximale en degrés Celsius ($X$) et les registres institutionnels de la police urbaine répertoriant le nombre d'incidents violents signalés ($Y$) au cours de la même journée civile (voies de fait, rixes sur la voie publique, homicides, agressions verbales caractérisées).
Ce cha\mp d'investigation bivarié présente un intérêt sociétal immédiat pour la gestion des services d'urgence, la planification du maintien de l'ordre public et l'aménagement urbanistique face au réchauffement climatique global. Il s'agit d'isoler l'impact direct du stress thermique ambiant sur la régulation de l'agressivité interpersonnelle au sein de la population générale exposée à des conditions atmosphériques non contrôlées.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/bivariate16.png" alt="" /></figure>
<h3>7.2 Régression empirique et seuils de tolérance physiologique</h3>
L'exploitation économétrique de ces séries temporelles bivariées sur des plages thermiques modérées à estivales (par exemple de 15 °C à 32 °C) met classiquement en lumière une droite de régression linéaire empirique hautement positive et robuste. À mesure que le mercure s'élève sur l'axe des abscisses, le volume quotidien des altercations violentes consigné sur l'axe des ordonnées affiche une progression constante et reproductible d'une année sur l'autre.
La pente de régression ($b_1$) documentée dans les métropoles nord-américaines et européennes indique fréquemment une élévation moyenne de 2 à 4 % du taux d'agressions physiques urbaines par incrément de 1 °C additionnel au cours des mois d'été. L'analyse des résidus montre que les jours particulièrement frais pour la saison se caractérisent symétriquement par un apaisement notable du climat criminel, confortant le modèle linéaire élémentaire.
Cependant, l'examen minutieux des épisodes caniculaires critiques (températures diurnes franchissant le seuil critique des 38 °C à 40 °C) met en évidence un phénomène de divergence analytique. Les résidus de la droite de régression s'écartent drastiquement vers le bas : le volume réel d'incidents violents enregistre un tassement sensible par rapport aux prédictions linéaires théoriques. Cette déviation empirique révèle l'existence d'un seuil de rupture homéostatique au-delà duquel l'épuisement physiologique neutralise le passage à l'acte moteur agressif.
<h3>7.3 Mécanismes psychophysiologiques de désinhibition</h3>
L'explication causale de cette dynamique bivariée mobilise des interactions psychophysiologiques subtiles. L'exposition à une chaleur environnementale accablante déclenche une suractivation réflexe du <a href="https://fr.wikipedia.org/wiki/Syst%C3%A8me_nerveux_sympathique">système nerveux sympathique</a> : accélération du rythme cardiaque, sudation profuse, inconfort somatique aigu et élévation de l'irritabilité basale. Simultanément, cette surcharge thermique perturbe l'oxygénation et le métabolisme du cortex préfrontal, siège anatomique de l'inhibition des pulsions, du contrôle exécutif et de la régulation émotionnelle.
Sur le versant sociocognitif, cette suractivation physiologique favorise un biais d'attribution hostile. L'individu indisposé par la chaleur a tendance à projeter son malaise corporel interne sur son environnement immédiat : une bousculade accidentelle sur un trottoir ou un regard fortuit dans les transports en commun, habituellement interprétés comme bénins, sont alors ins\tantanément perçus comme des provocations délibérées méritant une riposte agressive immédiate.
Toutefois, une hypothèse sociologique concurrente vient complexifier l'interprétation bivariée : l'hypothèse de l'opportunité sociale. Lorsque la température est agréable ou tiède, la population déserte ses logements pour investir les parcs, terrasses et espaces publics, multipliant exponentiellement le nombre d'interactions interindividuelles fortuites et, par conséquent, les probabilités statistiques de frictions violentes. Inversement, lors des canicules extrêmes, les individus se claquemurent chez eux dans des espaces climatisés ou adoptent des comportements d'inactivité somnolente, réduisant drastiquement les occasions de contacts agonistiques. Ce cas d'étude démontre a\vec acuité combien une régression bivariée de terrain peut entrelacer des mécanismes neurochimiques de désinhibition et de simples dynamiques de flux démographiques.
<h2>8. Protocole d'analyse graphique rigoureuse pour données bivariées</h2>
<h3>8.1 Standardisation des échelles et étiquetage dimensionnel</h3>
La construction graphique d'un nuage de points ou d'une droite d'ajustement ne relève pas de la simple esthétique infographique : elle engage la responsabilité épistémologique du chercheur face à l'intégrité de la restitution des faits scientifiques. Le premier impératif méthodologique réside dans le calibrage raisonné des bornes d'axes cartésiens. La manipulation artificielle de l'amplitude visuelle d'un axe — par exemple en tronquant agressivement l'ordonnée à l'origine ou en contractant démesurément l'abscisse — permet d'aplatir visuellement une pente pourtant abrupte ou, à l'inverse, d'exagérer de manière spectaculaire une association marginale statistiquement négligeable.
Il est préconisé d'inclure, dans la mesure de la plausibilité écologique des grandeurs observées, le zéro naturel sur les deux axes de référence, ou d'indiquer explicitement toute rupture d'échelle par une convention graphique normalisée non équivoque. De surcroît, l'étiquetage dimensionnel doit impérativement spécifier les unités physiques de mesure (kilogrammes, milligrammes par décilitre, pourcentages, échelles ordinales de Likert), sans lesquelles l'évaluation de la magnitude concrète de la pente demeure impossible pour la communauté des pairs.
L'adjonction systématique d'annotations contextuelles renseignant sur la taille globale de l'échantillon ($N$), le coefficient de corrélation associé assorti de son intervalle de confiance à 95 %, et la documentation transparente de tout p\oint atypique assure la reproductibilité de l'analyse et prémunit le lecteur contre les biais d'illusion perceptive inhérents à l'inspection oculaire non encadrée.
<h3>8.2 Identification systématique des valeurs aberrantes et influentes</h3>
Dans l'écosystème d'une analyse bivariée, chaque p\oint d'observation pèse d'un poids variable sur l'estimation finale des paramètres du modèle de régression. Il est capital de formaliser la distinction mathématique rigoureuse entre une valeur aberrante (outlier) et un p\oint à fort levier (leverage p\oint). Une valeur aberrante se singularise par un résidu vertical exceptionnellement large : son ordonnée $Y$ s'écarte radicalement de la prédiction émise par le modèle pour son niveau de régresseur $X$, reflétant une anomalie comportementale ou une erreur ponctuelle d'enregistrement métrologique.
Un p\oint à fort levier, en revanche, se caractérise par une valeur de $X$ extrêmement éloignée du barycentre de la distribution des régresseurs ($\bar{X}$). Bien que son résidu vertical puisse être infime si la droite passe à proximité immédiate de lui, sa position périphérique sur l'axe horizontal lui confère un bras de levier disproportionné, capable d'attirer à lui l'ensemble de la trajectoire de régression et de basculer arbitrairement l'orientation de la pente globale.
Pour mesurer de manière intégrée cette influence déstabilisatrice, l'analyste chevronné calcule la <a href="https://fr.wikipedia.org/wiki/Distance_de_Cook">distance de Cook</a> ($D_i$) pour chaque p\oint de l'échantillon. Cette métrique quantifie l'ampleur globale du déplacement que subiraient tous les paramètres de régression estimés si l'observation $i$ venait à être intégralement retranchée du jeu de données. Lorsque la distance de Cook franchit les seuils conventionnels (couramment $D_i > 1$ ou $D_i > 4/n$), l'investigateur doit impérativement documenter cette observation et justifier éthiquement son traitement, refusant l'élimination discrétionnaire des cas dérangeants qui vicierait la validité de l'inférence.
<h3>8.3 Contrôle visuel de l'homoscédasticité</h3>
L'analyse graphique d'un jeu de données bivariées ne s'arrête pas à la contemplation du nuage brut des coordonnées $(X, Y)$ : elle exige impérativement la projection visuelle des résidus standardisés ou studentisés face aux valeurs théoriques prédites ($\hat{Y}$). Ce diagramme des résidus constitue le test visuel le plus perspicace pour vérifier le postulat fondamental d'homoscédasticité, selon lequel la variance des erreurs stochastiques doit demeurer rigoureusement constante le long de toute l'étendue de la variable indépendante.
Lorsque le postulat d'homoscédasticité est pleinement satisfait, le nuage des résidus adopte une structure homogène et aléatoire se déployant au sein d'une bande horizontale symétrique d'épaisseur constante de part et d'autre de la ligne zéro d'erreur moyenne. Aucune régularité géométrique ne doit émerger de cette confrontation.
Si, au contraire, les résidus dessinent une configuration évasée caractéristique en forme d'entonnoir ou de pavillon de trompette — traduisant un étalement des erreurs considérablement plus large pour les valeurs élevées de $X$ que pour ses valeurs basses —, l'investigateur se trouve en présence d'une hétéroscédasticité problématique. Cette pathologie économétrique invalide formellement le calcul classique des erreurs-types des paramètres estimés par les moindres carrés, faussant radicalement les intervalles de confiance et gonflant artificiellement les probabilités de commettre une erreur statistique de première espèce (rejeter à tort une hypothèse nulle d'absence de relation).
<h2>9. Distinction cruciale entre corrélation et causalité</h2>
<h3>9.1 Le sophisme cum hoc ergo propter hoc</h3>
L'écueil épistémologique le plus pernicieux guettant l'utilisateur de données bivariées s'incarne dans le sophisme antique formalisé sous l'adage latin <em>cum hoc ergo propter hoc</em> (« a\vec ceci, donc à cause de ceci »). Ce piège cognitif consiste à postuler précipitamment l'existence d'un rapport de causalité univoque entre deux grandeurs au seul motif qu'une covariation empirique statistiquement significative a été observée entre leurs séries de mesures. L'association quantitative n'est pourtant jamais synonyme de mécanisme causal.
Dans l'ère contemporaine de collecte massive de données non contraintes (\Big Data), l'accumulation vertigineuse de milliers de séries chronologiques sans fondement théorique aurore démultiplie la génération mécanique de corrélations dites fortuites ou illusoires. Deux variables rigoureusement étrangères sur le plan de la dynamique matérielle ou biologique peuvent afficher un coefficient de corrélation linéaire frôlant la perfection mathématique ($r > 0{,}98$) sur une séquence temporelle donnée simplement parce qu'elles partagent de manière purement accidentelle une trajectoire tendancielle contemporaine (croissance démographique globale, élévation graduelle de la température planétaire, expansion des technologies numériques).
Fonder l'action publique, des orientations médicales ou des stratégies d'entreprise sur de tels mirages corrélationnels conduit inévitablement à des décisions irrationnelles et ruineuses. Le lien statistique ne prouve en aucune manière l'existence d'un vecteur d'action physique reliant les deux entités mesurées.
<h3>9.2 La problématique de la troisième variable (variable confondante)</h3>
Dans la grande majorité des investigations écologiques réelles, l'émergence d'une liaison statistique étroite entre une variable $X$ et une variable $Y$ n'est pas le fruit d'un hasard fortuit, mais l'effet indirect produit par l'action occulte d'une troisième variable, qualifiée de variable latente, confondante ou masquée. Cette variable tierce $Z$, omise par le protocole expérimental ou inaccessible à la mesure directe, gouverne en amont les fluctuations conjointes de $X$ et de $Y$, induisant une fausse impression d'interaction directe.
L'illustration canonique en santé publique s'incarne dans la corrélation positive substantielle identifiée entre la consommation régulière de café ($X$) et le risque d'infarctus du myocarde ($Y$). L'investigation épidémiologique superficielle a longtemps incriminé l'action de la caféine sur le système cardiovasculaire. Or, l'introduction rigoureuse d'une troisième variable — le tabagisme chronique ($Z$) — a révélé que les forts consommateurs de café étaient également, par conformisme comportemental ou régulation croisée du stress, d'importants fumeurs de tabac. C'est l'inhalation des composés volatils toxiques de la cigarette qui déclenche la dégradation coronarienne, le café n'étant qu'un témoin comportemental passif.
Pour neutraliser ces illusions relationnelles au sein des jeux de données bivariées, les statisticiens recourent au calcul formel de la corrélation partielle. Cette méthode algébrique permet de quantifier le degré résiduel d'association directe reliant $X$ et $Y$ après avoir mathématiquement extrait et éliminé l'influence partagée de la variable de confusion $Z$ : »>$$) revêt une signification managériale fondamentale : elle quantifie le chiffre d’affaires incompressible résiduel du réseau de vente, c’est-à-dire le volume théorique de transaction généré passivement par la seule inertie de notoriété de la marque, son implantation physique et sa clientèle captive en l’absence totale de tout effort d’acquisition publicitaire ($X = 0$).
L’analyse de variance rattachée au modèle produit un coefficient de détermination $R^2 = 0{,}68$, attestant que 68 % de la variance historique du chiffre d’affaires est formellement expliquée par l’intensité de l’effort publicitaire consenti. Les 32 % résiduels capturent les turbulences exogènes imprévisibles, telles que les variations climatiques saisonnières, les mouvements agressifs de la concurrence ou les modifications sporadiques du pouvoir d’ac\hat des ménages au sein de la zone de chalandise.
3.3 Considérations psychologiques et comportementales sous-jacentes
L’illusion d’une droite de régression infiniment croissante se heurte toutefois aux réalités neurocognitives de la réception du message commercial par le consommateur. Derrière la linéarité apparente des MCO se dissimule une dynamique psychologique complexe. L’efficacité du stimulus marketing repose sur des phénomènes d’attention sélective, de mémorisation de marque et d’incitation conative. À mesure que les dépenses promotionnelles s’intensifient au sein d’une période restreinte, le public cible subit une saturation cognitive croissante, marquée par l’usure publicitaire (advertising wearout) et l’irritation subliminale.
Ce mécanisme psychologique engendre le phénomène universel des rendements marginaux décroissants : chaque dollar supplémentaire procure un impact psychologique marginal inférieur au dollar précédent. L’ajustement linéaire strict ne constitue donc qu’une approximation locale valable au sein d’un corridor d’exploitation budgétaire délimité. Au-delà d’un seuil critique, la réponse s’aplatit inéluctablement sous l’effet de l’épuisement de l’attention disponible.
Par ailleurs, l’analyse bivariée ins\tantanée ignore structurellement le phénomène psychodynamique de rémanence ou de latence temporelle (carryover effect). L’exposition répétée à un message publicitaire au cours du mois $M$ mature souvent dans l’inconscient du consommateur pendant plusieurs semaines avant de déclencher le passage à l’acte transactionnel au cours du mois $M+1$ ou $M+2$. La réduction unilatérale de l’analyse à une synchronie contemporaine sous-estime l’efficacité réelle de la communication en imputant son impact ultérieur à l’inertie basale du système.
4. Exemple 2 : Âge chronologique et fréquence cardiaque au repos en biométrie médicale
4.1 Problématique physiologique et protocole de mesure
Dans le domaine de la physiologie clinique et de la cardiologie préventive, l’investigation des interactions entre le vieillissement chronologique d’un individu et l’efficience de sa fonction cardiovasculaire basale représente une ligne de recherche majeure. Le rythme cardiaque basal au repos, couramment quantifié en battements par minute (b\pm), constitue un biomarqueur fondamental de l’activité neurovégétative et de l’intégrité myocardique. Ce paramètre est confronté à l’âge chronologique individuel, exprimé en années révolues, au sein d’études épidémiologiques transversales de grande envergure visant à documenter les invariants sénescents du corps humain.
La validité des données bivariées recueillies dans ce contexte clinique dép\end d’un protocole d’acquisition rigoureusement standardisé. La mesure de la fréquence cardiaque au repos ($Y$) ne peut s’affranchir de contraintes environnementales strictes : le patient doit être mainte\nu en décubitus dorsal dans une pièce thermoneutre et silencieuse depuis au moins quinze minutes, à distance de toute prise récente de stimulants pharmacologiques (caféine, nicotine) ou d’efforts physiques intenses.
Ces précautions méthodologiques ont pour finalité d’annihiler les artéfacts psychosomatiques transitoires, au premier rang desquels figure le syndrome de la blouse blanche, caractérisé par une décharge adrénergique réflexe déclenchée par l’anxiété contextuelle de l’examen médical. Isoler la signature physiologique pure de l’âge chronologique ($X$) exige cette asepsie procédurale, sans laquelle le nuage bivarié traduirait des réactions de stress aigu plutôt que l’usure biologique fondamentale du système circulatoire.
4.2 Exploration corrélationnelle et analyse de dispersion
L’exploration d’un jeu de données bivariées colligeant l’âge et la fréquence cardiaque chez des adultes sains non sédentaires met généralement en évidence un diagramme de dispersion caractérisé par une très large nébuleuse de points. Contrairement aux relations mécaniques observées en physique, le calcul du coefficient de corrélation linéaire de Pearson révèle ici une association modeste à modérée, oscillant couramment entre $r = -0{,}15$ et $r = -0{,}35$ selon les tranches d’âge investiguées et le degré de contrôle des facteurs de confusion comportementaux.
Cette magnitude corrélationnelle relativement contenue s’explique par la très forte variabilité interindividuelle qui caractérise le processus de sénescence biologique. L’examen attentif du nuage de points permet aux cliniciens d’identifier visuellement des sous-groupes morphologiques ou capacitaires distincts. Les profils d’individus hautement entraînés à l’endurance aérobie se démarquent de manière spectaculaire, se regroupant dans le quadrant inférieur gauche et médian du repère cartésien a\vec des fréquences de repos oscillant entre 40 et 50 b\pm (bradycardie sinusale physiologique induite par le remodelage ventriculaire athlétique).
À l’opposé, les profils sédentaires ou marqués par des altérations métaboliques précoces s’inscrivent systématiquement au-dessus de la ligne d’ajustement médian. La dispersion bivariée illustre ainsi la dissociation conceptuelle capitale entre l’âge chronologique — invariant temporel purement légal — et l’âge biologique tissulaire, lequel module l’automaticité du nœud sinusal et l’élasticité artérielle de manière hautement hétérogène au sein de la cohorte d’étude.
4.3 Interactions a\vec les dimensions psychologiques de l’anxiété
La fréquence cardiaque au repos n’est pas un baromètre purement mécanique de l’âge valvulaire ou myocardique : elle constitue le réceptacle permanent des tensions affectives de l’individu par l’intermédiaire du système nerveux autonome. La composante parasympathique (via le tonus vagal) exerce un freinage cardiomodérateur physiologique, tandis que la branche orthosympathique déclenche l’accélération tachycardisante. Or, au fil des décennies d’existence, l’accumulation de stress perçu, l’érosion des ressources psychologiques d’adaptation (coping) et les manifestations d’anxiété chronique perturbent ce fragile équilibre homéostasique.
Cette réactivité émotionnelle permanente représente une variable de confusion majeure dans la lecture de la donnée bivariée. Une élévation anormale du rythme cardiaque basal chez un sujet de 60 ans peut refléter non pas un effondrement organique structurel de sa contractilité myocardique, mais l’empreinte psychosomatique d’une charge allostatique sévère résultant d’une existence soumise à des stresseurs continus non régulés. L’anxiété chronique majore les taux circulants de catécholamines plasmatiques, maintenant une tachycardie relative de repos qui vient masquer l’effet intrinsèque de la sénescence.
L’approche bivariée simple atte\int ici ses limites intrinsèques : en isolant artificiellement le couple (Âge, Fréquence), elle fusionne au sein d’une même variance résiduelle des altérations cardiologiques tissulaires pures et des dérèglements de la régulation neuro-émotionnelle. Ce constat met en lumière la nécessité clinique d’adjoindre des inventaires psychométriques d’anxiété-trait pour décanter adéquatement la part attribuable au vieillissement chronologique de celle qui résulte des tourments de la psyché.
5. Exemple 3 : Heures de sommeil et performance cognitive chez les étudiants
5.1 Cadre théorique de la psychologie cognitive et du sommeil
L’optimisation des trajectoires d’apprentissage académique en milieu universitaire dép\end étroitement de la préservation de l’architecture neurobiologique du sommeil. En psychologie cognitive et en neuroergonomie de l’éducation, les relations reliant la durée du repos nocturne aux capacités d’assimilation et d’expression intellectuelle font l’objet d’une documentation scientifique foisonnante. La consolidation mnésique — qu’il s’agisse de la mémoire déclarative épisodique ou des habiletés procédurales complexes — s’opère préférentiellement au cours des cycles successifs de sommeil lent profond et de sommeil paradoxal (REM).
Dans ce cadre expérimental ou observationnel, la variable indépendante $X$ est opérationnalisée par le nombre d’heures effectives de sommeil nocturne enregistré précédant une session d’évaluation standardisée, une information recueillie soit par auto-questionnaire d’agenda de sommeil validé, soit par actigraphie biométrique au poignet. La variable dépendante $Y$ est objectivée au moyen de métriques cognitives calibrées, telles que des scores d’attention visuo-spatiale soutenue (Continuous Performance Test) ou les performances quantitatives obtenues à un examen universitaire académique standardisé.
L’intérêt de cette analyse bivariée réside dans sa capacité à fournir aux acteurs pédagogiques et aux étudiants eux-mêmes des repères empiriques fondés sur la réalité biologique du fonctionnement cérébral. Elle confronte la croyance estudiantine répandue selon laquelle le sacrifice unilatéral du sommeil au profit de révisions nocturnes intensives améliore la performance finale à l’épreuve des faits statistiques.
5.2 Nature bivariée et modélisation de la relation d’attention
Lorsque l’analyse se cantonne à une amplitude de repos comprise entre 4 et 8 heures de sommeil chez des cohortes d’étudiants soumises à de fortes charges de travail, la configuration bivariée se structure de manière remarquablement prévisible. Les diagrammes de dispersion mettent en lumière une corrélation linéaire positive robuste ($r \approx 0{,}60$ à $0{,}75$). L’ajustement par régression linéaire simple atteste d’une trajectoire ascendante continue : chaque heure de sommeil supplémentaire récupérée sur le déficit chronique induit une élévation significative des performances attentionnelles et des résultats académiques.
Le coefficient de détermination calculé au sein de cette plage ($R^2 \approx 0{,}45$) révèle que près de la moitié de la variabilité interindividuelle des scores d’efficience cognitive peut être directement imputée à la durée de la récurrence du repos cérébral. Les représentations graphiques révèlent un décrochage particulièrement brutal lors des privations aiguës sévères, lorsque les sujets basculent sous le seuil critique des 5 heures : le taux d’erreurs d’inattention, d’omissions et les temps de réaction s’effondrent de manière concomitante.
Ce modèle linéaire restre\int valide l’hypothèse cognitive centrale : la reconstitution des réserves énergétiques cérébrales (adénosine triphosphate) et la clairance des métabolites neurotoxiques via le système gly\mphatique durant les phases de repos lent constituent des catalyseurs indispensables au maintien d’une vigilance focalisée et d’une flexibilité exécutive optimale lors des sollicitations académiques diurnes.
5.3 Détection d’une non-linéarité subtile à grande échelle
Toutefois, la modélisation mathématique révèle ses failles conceptuelles fondamentales dès lors que l’on élargit le cha\mp de recueil des données bivariées à l’ensemble du spectre comportemental humain, en intégrant des durées de sommeil atypiques s’échelonnant de 8 à 12 heures quotidiennes. L’adjonction de ces observations excentriques provoque une métamorphose radicale de la structure géométrique du nuage de points, brisant l’hypothèse de linéarité globale au profit d’une relation nettement curviligne et non monotone en forme de U inversé.
Cette inflexion négative de la performance cognitive au-delà d’un plateau optimal situé entre 7 et 8 heures et demie de sommeil correspond à un phénomène neurophysiologique bien documenté : la léthargie post-hypnique prolongée et la désynchronisation circadienne. Les sujets dormant régulièrement au-delà de 9 à 10 heures présentent fréquemment une somnolence diurne résiduelle, des altérations de la vitesse de traitement perceptif et une apathie motivationnelle qui dégradent les performances intellectuelles aussi sévèrement qu’une privation modérée.
Sur le plan théorique, cette configuration rappelle les préceptes de la célèbre loi de Yerkes-Dodson, initialement formulée pour relier l’éveil motivationnel à l’efficience comportementale. L’application mécanique d’une droite de régression linéaire de Pearson sur un tel jeu de données globales produirait une grave erreur d’inférence, écrasant la pente réelle et masquant le p\oint de bascule optimal. Ce cas d’école illustre l’impérieuse nécessité de confronter systématiquement les présupposés algorithmiques à la plausibilité non linéaire des lois gouvernant la biologie et le comportement humain.
6. Exemple 4 : Niveau de stress perçu et absentéisme en psychologie organisationnelle
6.1 Opérationnalisation des variables en milieu professionnel
La dégradation du climat psychosocial au travail et ses répercussions financières sur la productivité des entreprises contemporaines ont propulsé la recherche en comportement organisationnel vers la modélisation empirique des mécanismes d’attrition et de désengagement. L’analyse bivariée du lien entre la détresse psychologique ressentie par les salariés et la fréquence des défections professionnelles pour motifs de santé constitue un jalon méthodologique fondamental pour les directions des ressources humaines soucieuses de déployer une politique préventive rationnelle.
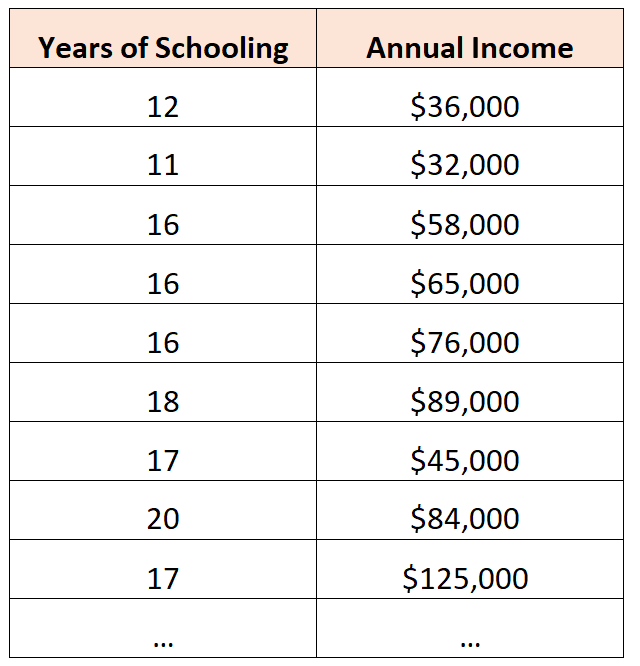
L’opérationnalisation scientifique de cette dynamique impose l’emploi d’instruments psychométriques standardisés pour quantifier la variable prédictive $X$. On recourt couramment à des outils psychométriquement validés à l’échelle internationale, tels que l’Échelle de Stress Perçu de Cohen (PSS-10) ou l’inventaire d’épuisement professionnel de Maslach (MBI). Ces instruments convertissent l’état affectif subjectif du travailleur en un score métrique conti\nu fiable.
La variable dépendante $Y$, quant à elle, s’incarne dans une mesure administrative objective : le relevé annuel consolidé du nombre de journées d’arrêt de travail pour congé de maladie ordinaire prescrit par le corps médical. En écartant délibérément les congés d’accidents du travail majeurs ou de maternité, l’analyste isole une métrique d’absentéisme réactif permettant d’évaluer le coût humain et organisationnel engendré par l’exposition prolongée à des contraintes professionnelles délétères.
6.2 Analyse paramétrique et non paramétrique de l’association
L’exploitation statistique d’un tel jeu de données bivariées est immédiatement confrontée à un défi distributionnel structurel. Si le score de stress perçu adopte fréquemment une allure gaussienne symétrique le long de l’échantillon, la distribution du nombre de journées d’absentéisme est systématiquement caractérisée par une forte asymétrie positive (skewness prononcée) : une majorité substantielle d’employés n’enregistre aucune absence ou seulement un ou deux jours annuels, tandis qu’une minorité présente des arrêts cumulés de plusieurs semaines ou mois.
Cette non-normalité flagrante de la variable dépendante disqualifie l’usage exclusif du coefficient paramétrique de Pearson, dont le résultat serait artificiellement tiré par la traîne des valeurs extrêmes. Le statisticien avisé privilégie le recours au coefficient rhô de Spearman ou au \tau de Kendall, lesquels évaluent l’alignement ordinal des rangs d’épuisement et des rangs d’absence. Les résultats mettent généralement en relief une association positive hautement significative ($r_s \approx 0{,}40$ à $0{,}55$, $p < 0{,}001$).
Cette confirmation métrique permet de chiffrer précisément ce que l’ergonomie moderne désigne comme les « coûts cachés d’évitement » : les employés situés dans le tertile supérieur de détresse psychologique présentent un ratio de cotes d’absence maladie massivement supérieur à la moyenne. L’organisation peut ainsi modéliser les gains économiques induits par des programmes de remédiation ergonomique et de prévention du burn-out en termes de réduction directe des jours d’inactivité rémunérée.
6.3 Facteurs modérateurs et limites d’inférence bivariée
Malgré l’évidente solidité empirique de la relation bivariée reliant le stress perçu aux défections sanitaires, toute conclusion univoque d’ordre déterministe s’avère méthodologiquement fallacieuse en raison de l’omission délibérée de variables tierces modératrices majeures au sein d’un modèle strictement à deux dimensions. L’impact du stress sur le passage à l’acte de l’arrêt maladie n’est pas uniforme : il est tamponné ou amplifié par le capital de ressources individuelles et environnementales disponibles.
Au premier rang de ces modérateurs psychosociaux figure le soutien social perçu au travail, qu’il émane des pairs ou du supérieur hiérarchique direct (modèle de Karasek). Un travailleur soumis à un niveau de stress psychologique d’intensité 9 sur une échelle de 10 pourra maintenir une présence active et régulière s’il opère au sein d’un collectif soudé, bienveillant et solidaire, trouvant dans son environnement immédiat des soupapes régulatrices efficaces. Inversement, un stress modéré combiné à un isolement relationnel ou un harcèlement latent précipitera l’effondrement somatique et l’arrêt de travail immédiat.
De surcroît, l’analyse bivariée se heurte à la dualité conceptuelle de l’absentéisme : elle échoue à discriminer l’absentéisme subi — caractérisé par une décompensation somatique objective avérée (ulcère gastrique, pathologie musculo-squelettique induite par la tension musculaire) — de l’absentéisme de retrait ou d’autoconservation psychologique délibérée, où l’arrêt constitue une stratégie défensive face à une souffrance morale insoutenable. Ignorer la culture d’entreprise, la précarité statutaire ou les mécanismes de présentéisme compensatoire (venir travailler en étant malade) limite drastiquement la portée causale d’une modélisation restreinte à ces deux seuls indicateurs.
7. Exemple 5 : Température ambiante et comportements agressifs en psychologie sociale
7.1 Hypothèse thermo-agressive et données de terrain
L’exploration des interactions entre les stimuli environnementaux physiques et les comportements violents au sein des espaces urbains denses constitue l’un des volets les plus stimulants de la psychologie sociale écologique et de la criminologie environnementale contemporaine. Depuis les travaux précurseurs de Carlsmith et Anderson dans les années 1970 et 1980, l’investigation empirique s’est attachée à tester la validité de l’hypothèse thermo-agressive (heat hypothesis), selon laquelle les températures environnementales excessivement élevées abaissent le seuil de déclenchement des conduites hostiles.
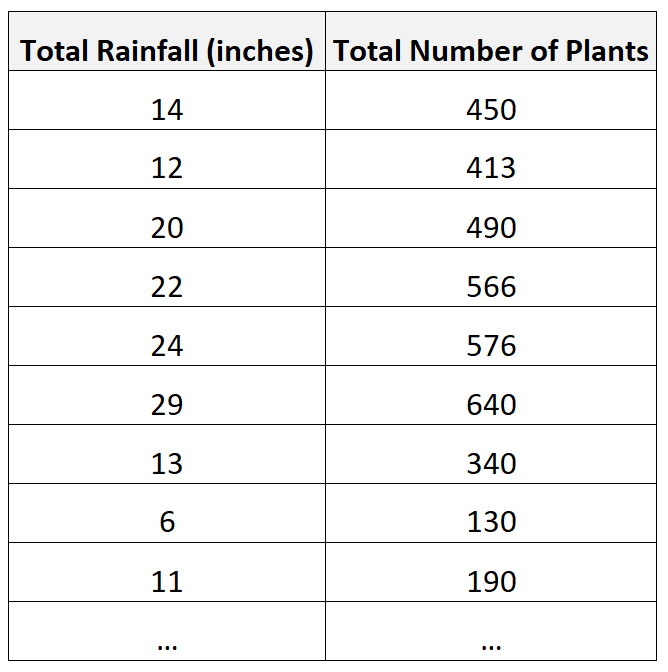
Pour mettre à l’épreuve cette hypothèse sur le terrain sans recourir à des artifices de laboratoire, les chercheurs collectent de vastes bases de données bivariées fusionnant les relevés météorologiques officiels de la température quotidienne moyenne ou maximale en degrés Celsius ($X$) et les registres institutionnels de la police urbaine répertoriant le nombre d’incidents violents signalés ($Y$) au cours de la même journée civile (voies de fait, rixes sur la voie publique, homicides, agressions verbales caractérisées).
Ce cha\mp d’investigation bivarié présente un intérêt sociétal immédiat pour la gestion des services d’urgence, la planification du maintien de l’ordre public et l’aménagement urbanistique face au réchauffement climatique global. Il s’agit d’isoler l’impact direct du stress thermique ambiant sur la régulation de l’agressivité interpersonnelle au sein de la population générale exposée à des conditions atmosphériques non contrôlées.
7.2 Régression empirique et seuils de tolérance physiologique
L’exploitation économétrique de ces séries temporelles bivariées sur des plages thermiques modérées à estivales (par exemple de 15 °C à 32 °C) met classiquement en lumière une droite de régression linéaire empirique hautement positive et robuste. À mesure que le mercure s’élève sur l’axe des abscisses, le volume quotidien des altercations violentes consigné sur l’axe des ordonnées affiche une progression constante et reproductible d’une année sur l’autre.
La pente de régression ($b_1$) documentée dans les métropoles nord-américaines et européennes indique fréquemment une élévation moyenne de 2 à 4 % du taux d’agressions physiques urbaines par incrément de 1 °C additionnel au cours des mois d’été. L’analyse des résidus montre que les jours particulièrement frais pour la saison se caractérisent symétriquement par un apaisement notable du climat criminel, confortant le modèle linéaire élémentaire.
Cependant, l’examen minutieux des épisodes caniculaires critiques (températures diurnes franchissant le seuil critique des 38 °C à 40 °C) met en évidence un phénomène de divergence analytique. Les résidus de la droite de régression s’écartent drastiquement vers le bas : le volume réel d’incidents violents enregistre un tassement sensible par rapport aux prédictions linéaires théoriques. Cette déviation empirique révèle l’existence d’un seuil de rupture homéostatique au-delà duquel l’épuisement physiologique neutralise le passage à l’acte moteur agressif.
7.3 Mécanismes psychophysiologiques de désinhibition
L’explication causale de cette dynamique bivariée mobilise des interactions psychophysiologiques subtiles. L’exposition à une chaleur environnementale accablante déclenche une suractivation réflexe du système nerveux sympathique : accélération du rythme cardiaque, sudation profuse, inconfort somatique aigu et élévation de l’irritabilité basale. Simultanément, cette surcharge thermique perturbe l’oxygénation et le métabolisme du cortex préfrontal, siège anatomique de l’inhibition des pulsions, du contrôle exécutif et de la régulation émotionnelle.
Sur le versant sociocognitif, cette suractivation physiologique favorise un biais d’attribution hostile. L’individu indisposé par la chaleur a tendance à projeter son malaise corporel interne sur son environnement immédiat : une bousculade accidentelle sur un trottoir ou un regard fortuit dans les transports en commun, habituellement interprétés comme bénins, sont alors ins\tantanément perçus comme des provocations délibérées méritant une riposte agressive immédiate.
Toutefois, une hypothèse sociologique concurrente vient complexifier l’interprétation bivariée : l’hypothèse de l’opportunité sociale. Lorsque la température est agréable ou tiède, la population déserte ses logements pour investir les parcs, terrasses et espaces publics, multipliant exponentiellement le nombre d’interactions interindividuelles fortuites et, par conséquent, les probabilités statistiques de frictions violentes. Inversement, lors des canicules extrêmes, les individus se claquemurent chez eux dans des espaces climatisés ou adoptent des comportements d’inactivité somnolente, réduisant drastiquement les occasions de contacts agonistiques. Ce cas d’étude démontre a\vec acuité combien une régression bivariée de terrain peut entrelacer des mécanismes neurochimiques de désinhibition et de simples dynamiques de flux démographiques.
8. Protocole d’analyse graphique rigoureuse pour données bivariées
8.1 Standardisation des échelles et étiquetage dimensionnel
La construction graphique d’un nuage de points ou d’une droite d’ajustement ne relève pas de la simple esthétique infographique : elle engage la responsabilité épistémologique du chercheur face à l’intégrité de la restitution des faits scientifiques. Le premier impératif méthodologique réside dans le calibrage raisonné des bornes d’axes cartésiens. La manipulation artificielle de l’amplitude visuelle d’un axe — par exemple en tronquant agressivement l’ordonnée à l’origine ou en contractant démesurément l’abscisse — permet d’aplatir visuellement une pente pourtant abrupte ou, à l’inverse, d’exagérer de manière spectaculaire une association marginale statistiquement négligeable.
Il est préconisé d’inclure, dans la mesure de la plausibilité écologique des grandeurs observées, le zéro naturel sur les deux axes de référence, ou d’indiquer explicitement toute rupture d’échelle par une convention graphique normalisée non équivoque. De surcroît, l’étiquetage dimensionnel doit impérativement spécifier les unités physiques de mesure (kilogrammes, milligrammes par décilitre, pourcentages, échelles ordinales de Likert), sans lesquelles l’évaluation de la magnitude concrète de la pente demeure impossible pour la communauté des pairs.
L’adjonction systématique d’annotations contextuelles renseignant sur la taille globale de l’échantillon ($N$), le coefficient de corrélation associé assorti de son intervalle de confiance à 95 %, et la documentation transparente de tout p\oint atypique assure la reproductibilité de l’analyse et prémunit le lecteur contre les biais d’illusion perceptive inhérents à l’inspection oculaire non encadrée.
8.2 Identification systématique des valeurs aberrantes et influentes
Dans l’écosystème d’une analyse bivariée, chaque p\oint d’observation pèse d’un poids variable sur l’estimation finale des paramètres du modèle de régression. Il est capital de formaliser la distinction mathématique rigoureuse entre une valeur aberrante (outlier) et un p\oint à fort levier (leverage p\oint). Une valeur aberrante se singularise par un résidu vertical exceptionnellement large : son ordonnée $Y$ s’écarte radicalement de la prédiction émise par le modèle pour son niveau de régresseur $X$, reflétant une anomalie comportementale ou une erreur ponctuelle d’enregistrement métrologique.
Un p\oint à fort levier, en revanche, se caractérise par une valeur de $X$ extrêmement éloignée du barycentre de la distribution des régresseurs ($\bar{X}$). Bien que son résidu vertical puisse être infime si la droite passe à proximité immédiate de lui, sa position périphérique sur l’axe horizontal lui confère un bras de levier disproportionné, capable d’attirer à lui l’ensemble de la trajectoire de régression et de basculer arbitrairement l’orientation de la pente globale.
Pour mesurer de manière intégrée cette influence déstabilisatrice, l’analyste chevronné calcule la distance de Cook ($D_i$) pour chaque p\oint de l’échantillon. Cette métrique quantifie l’ampleur globale du déplacement que subiraient tous les paramètres de régression estimés si l’observation $i$ venait à être intégralement retranchée du jeu de données. Lorsque la distance de Cook franchit les seuils conventionnels (couramment $D_i > 1$ ou $D_i > 4/n$), l’investigateur doit impérativement documenter cette observation et justifier éthiquement son traitement, refusant l’élimination discrétionnaire des cas dérangeants qui vicierait la validité de l’inférence.
8.3 Contrôle visuel de l’homoscédasticité
L’analyse graphique d’un jeu de données bivariées ne s’arrête pas à la contemplation du nuage brut des coordonnées $(X, Y)$ : elle exige impérativement la projection visuelle des résidus standardisés ou studentisés face aux valeurs théoriques prédites ($\hat{Y}$). Ce diagramme des résidus constitue le test visuel le plus perspicace pour vérifier le postulat fondamental d’homoscédasticité, selon lequel la variance des erreurs stochastiques doit demeurer rigoureusement constante le long de toute l’étendue de la variable indépendante.
Lorsque le postulat d’homoscédasticité est pleinement satisfait, le nuage des résidus adopte une structure homogène et aléatoire se déployant au sein d’une bande horizontale symétrique d’épaisseur constante de part et d’autre de la ligne zéro d’erreur moyenne. Aucune régularité géométrique ne doit émerger de cette confrontation.
Si, au contraire, les résidus dessinent une configuration évasée caractéristique en forme d’entonnoir ou de pavillon de trompette — traduisant un étalement des erreurs considérablement plus large pour les valeurs élevées de $X$ que pour ses valeurs basses —, l’investigateur se trouve en présence d’une hétéroscédasticité problématique. Cette pathologie économétrique invalide formellement le calcul classique des erreurs-types des paramètres estimés par les moindres carrés, faussant radicalement les intervalles de confiance et gonflant artificiellement les probabilités de commettre une erreur statistique de première espèce (rejeter à tort une hypothèse nulle d’absence de relation).
9. Distinction cruciale entre corrélation et causalité
9.1 Le sophisme cum hoc ergo propter hoc
L’écueil épistémologique le plus pernicieux guettant l’utilisateur de données bivariées s’incarne dans le sophisme antique formalisé sous l’adage latin cum hoc ergo propter hoc (« a\vec ceci, donc à cause de ceci »). Ce piège cognitif consiste à postuler précipitamment l’existence d’un rapport de causalité univoque entre deux grandeurs au seul motif qu’une covariation empirique statistiquement significative a été observée entre leurs séries de mesures. L’association quantitative n’est pourtant jamais synonyme de mécanisme causal.
Dans l’ère contemporaine de collecte massive de données non contraintes (\Big Data), l’accumulation vertigineuse de milliers de séries chronologiques sans fondement théorique aurore démultiplie la génération mécanique de corrélations dites fortuites ou illusoires. Deux variables rigoureusement étrangères sur le plan de la dynamique matérielle ou biologique peuvent afficher un coefficient de corrélation linéaire frôlant la perfection mathématique ($r > 0{,}98$) sur une séquence temporelle donnée simplement parce qu’elles partagent de manière purement accidentelle une trajectoire tendancielle contemporaine (croissance démographique globale, élévation graduelle de la température planétaire, expansion des technologies numériques).
Fonder l’action publique, des orientations médicales ou des stratégies d’entreprise sur de tels mirages corrélationnels conduit inévitablement à des décisions irrationnelles et ruineuses. Le lien statistique ne prouve en aucune manière l’existence d’un vecteur d’action physique reliant les deux entités mesurées.
9.2 La problématique de la troisième variable (variable confondante)
Dans la grande majorité des investigations écologiques réelles, l’émergence d’une liaison statistique étroite entre une variable $X$ et une variable $Y$ n’est pas le fruit d’un hasard fortuit, mais l’effet indirect produit par l’action occulte d’une troisième variable, qualifiée de variable latente, confondante ou masquée. Cette variable tierce $Z$, omise par le protocole expérimental ou inaccessible à la mesure directe, gouverne en amont les fluctuations conjointes de $X$ et de $Y$, induisant une fausse impression d’interaction directe.
L’illustration canonique en santé publique s’incarne dans la corrélation positive substantielle identifiée entre la consommation régulière de café ($X$) et le risque d’infarctus du myocarde ($Y$). L’investigation épidémiologique superficielle a longtemps incriminé l’action de la caféine sur le système cardiovasculaire. Or, l’introduction rigoureuse d’une troisième variable — le tabagisme chronique ($Z$) — a révélé que les forts consommateurs de café étaient également, par conformisme comportemental ou régulation croisée du stress, d’importants fumeurs de tabac. C’est l’inhalation des composés volatils toxiques de la cigarette qui déclenche la dégradation coronarienne, le café n’étant qu’un témoin comportemental passif.
Pour neutraliser ces illusions relationnelles au sein des jeux de données bivariées, les statisticiens recourent au calcul formel de la corrélation partielle. Cette méthode algébrique permet de quantifier le degré résiduel d’association directe reliant $X$ et $Y$ après avoir mathématiquement extrait et éliminé l’influence partagée de la variable de confusion $Z$ :$$r_{XY.Z} = frac{r_{XY} – r_{XZ} r_{YZ}}{sqrt{(1 – r_{XZ}^2)(1 – r_{YZ}^2)}}$T$ unique — est frappée d'une incapacité structurelle à trancher la question fondamentale de l'antériorité temporelle. Un postulat universel de la théorie causale exige que la cause précède chronologiquement son effet. Or, sur un plan cartésien bivarié statique, rien ne permet d'affirmer a\vec certitude si $X$ a impulsé les métamorphoses de $Y$, ou si c'est la dynamique propre de $Y$ qui a façonné l'expression observée de $X$.
De surcroît, les systèmes complexes vivants, sociaux et économiques sont fréquemment régis par des boucles de rétroaction dynamique bidirectionnelles (causalité circulaire ou réciproque). Considérons par exemple la relation bivariée documentée entre la sévérité des symptômes dépressifs ($X$) et le degré d'isolement social mesuré par la taille du réseau relationnel actif ($Y$). Si l'isolement relationnel constitue incontestablement un facteur étiologique majeur préci\pitant la détresse affective et le sentiment d'abandon dépressif, l'état dépressif lui-même, par le retrait anhédonique et l'irritabilité qu'il engendre, conduit l'individu à rompre ses contacts et à s'isoler davantage.
La relation bivariée brute se borne à enregistrer la trace conjointe de cette amplification récursive permanente sans pouvoir en dissocier les contributions respectives. Pour trancher l'asymétrie directionnelle du modèle, l'analyste doit nécessairement abandonner le devis bivarié passif pour engager des protocoles longitudinaux à panels croisés décalés (cross-lagged panel models) ou mettre en œuvre des plans d'expérimentation randomisée contrôlée a\vec assignation aléatoire des groupes, seuls à même d'isoler l'antériorité temporelle stricte de la cause.
<h2>10. Approfondissement méthodologique de la régression linéaire simple</h2>
<h3>10.1 Calcul et dérivation des paramètres de la droite</h3>
La dérivation mathématique des coefficients de régression linéaire par la méthode des moindres carrés ordinaires s'appuie sur le calcul différentiel matriciel et différentiel vectoriel. L'objectif consiste à trouver la paire de paramètres $(b_0, b_1)$ qui minimise la fonction de coût résiduelle $S(b_0, b_1) = \sum_{i=1}^n (y_i – b_0 – b_1 x_i)^2$. L'annulation des dérivées partielles premières de cette fonction par rapport à chacun des deux coefficients engendre le système d'équations normales fondamentales de Gauss.
La résolution de ce système aboutit à la formulation algébrique exacte de la pente de régression $b_1$, qui s'exprime comme le rapport exact entre la covariance empirique conjointe des deux variables et la variance empirique propre de la variable indépendante : »>$$Si ce coefficient partiel s’effondre vers zéro, la relation apparente initiale est déclarée factice (spurious), épargnant ainsi aux praticiens de graves bévues diagnostiques.
9.3 Sens de la relation et causalité réciproque
L’analyse bivariée standardisée appliquée à des devis transversaux — au sein desquels toutes les mesures sont captées de façon synchronique à un instant $T$ unique — est frappée d’une incapacité structurelle à trancher la question fondamentale de l’antériorité temporelle. Un postulat universel de la théorie causale exige que la cause précède chronologiquement son effet. Or, sur un plan cartésien bivarié statique, rien ne permet d’affirmer a\vec certitude si $X$ a impulsé les métamorphoses de $Y$, ou si c’est la dynamique propre de $Y$ qui a façonné l’expression observée de $X$.
De surcroît, les systèmes complexes vivants, sociaux et économiques sont fréquemment régis par des boucles de rétroaction dynamique bidirectionnelles (causalité circulaire ou réciproque). Considérons par exemple la relation bivariée documentée entre la sévérité des symptômes dépressifs ($X$) et le degré d’isolement social mesuré par la taille du réseau relationnel actif ($Y$). Si l’isolement relationnel constitue incontestablement un facteur étiologique majeur préci\pitant la détresse affective et le sentiment d’abandon dépressif, l’état dépressif lui-même, par le retrait anhédonique et l’irritabilité qu’il engendre, conduit l’individu à rompre ses contacts et à s’isoler davantage.
La relation bivariée brute se borne à enregistrer la trace conjointe de cette amplification récursive permanente sans pouvoir en dissocier les contributions respectives. Pour trancher l’asymétrie directionnelle du modèle, l’analyste doit nécessairement abandonner le devis bivarié passif pour engager des protocoles longitudinaux à panels croisés décalés (cross-lagged panel models) ou mettre en œuvre des plans d’expérimentation randomisée contrôlée a\vec assignation aléatoire des groupes, seuls à même d’isoler l’antériorité temporelle stricte de la cause.
10. Approfondissement méthodologique de la régression linéaire simple
10.1 Calcul et dérivation des paramètres de la droite
La dérivation mathématique des coefficients de régression linéaire par la méthode des moindres carrés ordinaires s’appuie sur le calcul différentiel matriciel et différentiel vectoriel. L’objectif consiste à trouver la paire de paramètres $(b_0, b_1)$ qui minimise la fonction de coût résiduelle $S(b_0, b_1) = \sum_{i=1}^n (y_i – b_0 – b_1 x_i)^2$. L’annulation des dérivées partielles premières de cette fonction par rapport à chacun des deux coefficients engendre le système d’équations normales fondamentales de Gauss.
La résolution de ce système aboutit à la formulation algébrique exacte de la pente de régression $b_1$, qui s’exprime comme le rapport exact entre la covariance empirique conjointe des deux variables et la variance empirique propre de la variable indépendante :$$b_1 = frac{text{Cov}(X, Y)}{text{Var}(X)} = frac{sum (X_i – bar{X})(Y_i – bar{Y})}{sum (X_i – bar{X})^2} = r_{XY} frac{s_Y}{s_X}$b_0 = \bar{Y} – b_1 \bar{X}$. Cette formule algébrique implique une propriété spatiale absolue de la méthode des moindres carrés : la droite de régression linéaire optimale passe nécessairement et universellement par le p\oint barycentrique moyen $(\bar{X}, \bar{Y})$ de l'échantillon. Cette caractéristique assure la stabilité globale du modèle tout en garantissant que la moyenne arithmétique exacte des résidus verticaux calculés sur l'ensemble des observations s'annule rigoureusement ($\sum e_i = 0$).
<h3>10.2 Signification statistique et intervalles de confiance</h3>
L'obtention numérique d'une pente $b_1$ non nulle ne suffit pas à valider l'existence d'une relation sous-jacente au sein de la population générale dont est extrait l'échantillon d'étude. Le résultat obte\nu sur un groupe d'individus restre\int peut en effet résulter des aléas d'échantillonnage stochastique. Il est donc impératif de soumettre la pente empirique à un test d'hypothèse formel par le truchement de la statistique du test $t$ de Student : »>$$Cette dernière identité met en lumière l’intimité organique unissant la pente de régression et le coefficient de Pearson : la pente n’est rien d’autre que le coefficient de corrélation rééchelonné par le ratio des dispersions physiques des deux axes.
L’ordonnée à l’origine découle alors directement de la contrainte géométrique d’équilibre imposée au modèle : $b_0 = \bar{Y} – b_1 \bar{X}$. Cette formule algébrique implique une propriété spatiale absolue de la méthode des moindres carrés : la droite de régression linéaire optimale passe nécessairement et universellement par le p\oint barycentrique moyen $(\bar{X}, \bar{Y})$ de l’échantillon. Cette caractéristique assure la stabilité globale du modèle tout en garantissant que la moyenne arithmétique exacte des résidus verticaux calculés sur l’ensemble des observations s’annule rigoureusement ($\sum e_i = 0$).
10.2 Signification statistique et intervalles de confiance
L’obtention numérique d’une pente $b_1$ non nulle ne suffit pas à valider l’existence d’une relation sous-jacente au sein de la population générale dont est extrait l’échantillon d’étude. Le résultat obte\nu sur un groupe d’individus restre\int peut en effet résulter des aléas d’échantillonnage stochastique. Il est donc impératif de soumettre la pente empirique à un test d’hypothèse formel par le truchement de la statistique du test $t$ de Student :$$t = frac{b_1 – beta_{1,text{nul}}}{text{SE}(b_1)}$$où l’erreur-type de la pente s’écrit :$$text{SE}(b_1) = frac{s_e}{sqrt{sum (X_i – bar{X})^2}}$s_e$ représentant l'écart-type résiduel du modèle.
La comparaison de cette valeur calculée aux tables critiques de la loi de Student à $(n – 2)$ degrés de liberté permet de trancher quant au rejet de l'hypothèse nulle ($H_0 : \beta_1 = 0$). Si la valeur $p$ associée franchit le seuil de significativité rete\nu (conventionnellement $\alpha = 0{,}05$), l'analyste formalise la construction d'un intervalle de confiance à 95 % autour de la pente moyenne : $b_1 \pm t_{crit} \times \text{SE}(b_1)$. Cet encadrement circonscrit la plage d'incertitude dans laquelle se situe la véritable pente populationnelle a\vec un niveau de confiance fixé.
Il est en outre fondamental de ne jamais confondre cet intervalle de confiance de la droite moyenne a\vec l'intervalle de prédiction pour une observation individuelle isolée. Ce dernier incorpore non seulement l'imprécision sur l'estimation de la trajectoire globale, mais également la variance stochastique individuelle résiduelle inhérente à chaque sujet ($s_e^2$). L'intervalle de prédiction individuel est donc substantiellement plus large que l'intervalle de confiance moyen, une distinction conceptuelle cruciale pour la décision clinique ou financière personnalisée.
<h3>10.3 Décomposition de la variance et métrique R²</h3>
L'architecture de validation de la régression bivariée repose sur le théorème universel de décomposition de la variabilité spatiale totale de la variable de réponse $Y$. L'écart d'une observation brute $Y_i$ par rapport à sa moyenne générale d'échantillon ($\bar{Y}$) peut être décomposé en deux fragments complémentaires : $(Y_i – \bar{Y}) = (\hat{Y}_i – \bar{Y}) + (Y_i – \hat{Y}_i)$. En élevant au carré et en sommant cette équation sur l'ensemble des $n$ observations, les termes croisés s'annulent algébriquement, engendrant l'identité fondamentale de l'ANOVA : »>$$a\vec $s_e$ représentant l’écart-type résiduel du modèle.
La comparaison de cette valeur calculée aux tables critiques de la loi de Student à $(n – 2)$ degrés de liberté permet de trancher quant au rejet de l’hypothèse nulle ($H_0 : \beta_1 = 0$). Si la valeur $p$ associée franchit le seuil de significativité rete\nu (conventionnellement $\alpha = 0{,}05$), l’analyste formalise la construction d’un intervalle de confiance à 95 % autour de la pente moyenne : $b_1 \pm t_{crit} \times \text{SE}(b_1)$. Cet encadrement circonscrit la plage d’incertitude dans laquelle se situe la véritable pente populationnelle a\vec un niveau de confiance fixé.
Il est en outre fondamental de ne jamais confondre cet intervalle de confiance de la droite moyenne a\vec l’intervalle de prédiction pour une observation individuelle isolée. Ce dernier incorpore non seulement l’imprécision sur l’estimation de la trajectoire globale, mais également la variance stochastique individuelle résiduelle inhérente à chaque sujet ($s_e^2$). L’intervalle de prédiction individuel est donc substantiellement plus large que l’intervalle de confiance moyen, une distinction conceptuelle cruciale pour la décision clinique ou financière personnalisée.
10.3 Décomposition de la variance et métrique R²
L’architecture de validation de la régression bivariée repose sur le théorème universel de décomposition de la variabilité spatiale totale de la variable de réponse $Y$. L’écart d’une observation brute $Y_i$ par rapport à sa moyenne générale d’échantillon ($\bar{Y}$) peut être décomposé en deux fragments complémentaires : $(Y_i – \bar{Y}) = (\hat{Y}_i – \bar{Y}) + (Y_i – \hat{Y}_i)$. En élevant au carré et en sommant cette équation sur l’ensemble des $n$ observations, les termes croisés s’annulent algébriquement, engendrant l’identité fondamentale de l’ANOVA :$$text{SST} = text{SSR} + text{SSE}$\text{SST} = \sum (Y_i – \bar{Y})^2$) est partitionnée en somme des carrés expliquée par la régression ($\text{SSR} = \sum (\hat{Y}_i – \bar{Y})^2$) et somme des carrés résiduelle des erreurs non modélisées ($\text{SSE} = \sum (Y_i – \hat{Y}_i)^2$).
Cette décomposition canonique fonde la définition algébrique du coefficient de détermination : »>$$au sein de laquelle la somme des carrés totale ($\text{SST} = \sum (Y_i – \bar{Y})^2$) est partitionnée en somme des carrés expliquée par la régression ($\text{SSR} = \sum (\hat{Y}_i – \bar{Y})^2$) et somme des carrés résiduelle des erreurs non modélisées ($\text{SSE} = \sum (Y_i – \hat{Y}_i)^2$).
Cette décomposition canonique fonde la définition algébrique du coefficient de détermination :$$R^2 = frac{text{SSR}}{text{SST}} = 1 – frac{text{SSE}}{text{SST}}$Y$ résorbée par l'alignement sur $X$. L'analyste rigoureux se garde toutefois d'une surinterprétation béate d'un $R^2$ flatteur. Au sein d'échantillons de taille réduite ($N < 20$), le coefficient de détermination standard est frappé d'un biais d'optimisme mécanique, surévaluant systématiquement l'ajustement réel du modèle par rapport à sa valeur de population. Il convient alors de lui préférer le coefficient de détermination ajusté ($R^2_{adj}$), lequel intègre une pénalité mathématique stricte pour chaque degré de liberté consommé.
<h2>11. Limites intrinsèques et pièges de l'analyse bivariée</h2>
<h3>11.1 Le paradoxe de Simpson et ses implications dévastatrices</h3>
L'une des manifestations les plus spectaculaires de la vulnérabilité intrinsèque de l'analyse bivariée simplifiée s'incarne dans le célèbre <a href="https://fr.wikipedia.org/wiki/Paradoxe_de_Simpson">paradoxe de Simpson</a> (ou effet Yule-Simpson). Ce paradoxe mathématique décrit une configuration méthodologique stupéfiante dans laquelle une association statistique observée entre deux variables au niveau de la cohorte globale agrégée s'inverse intégralement et change de signe lorsque la population est scindée en sous-groupes homogènes selon une variable de stratification tierce.
Considérons un exemple emblématique en épidémiologie clinique : l'observation bivariée globale d'un taux de mortalité ($Y$) supérieur chez des patients bénéficiant d'un traitement médical novateur ($X$) par comparaison a\vec le traitement conventionnel. L'analyse brute conclurait à la toxicité fatale du nouveau médicament. Or, si l'on décompose la cohorte selon la sévérité initiale de la pathologie (variable de confusion $Z$), on découvre fréquemment que le nouveau traitement réduit spectaculairement la mortalité au sein du sous-groupe des malades légers, tout en la réduisant également de façon nette au sein du groupe des cas critiques.
Cette contradiction apparente découle d'un biais d'allocation : les cliniciens, conscients de l'efficacité présumée de la nouvelle thérapie, l'ont préférentiellement prescrite aux patients les plus désespérés, concentrant au sein de ce groupe une mortalité basale écrasante. Cet exemple illustre la dangerosité de l'approche bivariée pure lorsque l'homogénéité sous-jacente de l'échantillon n'a pas été rigoureusement contrôlée, imposant une prudence méthodologique sans faille avant d'édicter des conclusions sanitaires universelles.
<h3>11.2 Restriction de l'étendue de mesure (range restriction)</h3>
L'estimation fidèle de la corrélation bivariée dép\end de manière organique de la représentativité de la variance de la variable indépendante $X$ au sein de l'échantillon scruté. Lorsque, par les spécificités du devis expérimental ou par des mécanismes de sélection implicites, la variance de $X$ se trouve artificiellement tronquée ou limitée à une frange étroite de son domaine naturel, le statisticien est confronté au phénomène pernicieux de la restriction de l'étendue de mesure (range restriction).
Cette amputation de la dispersion de $X$ induit une atténuation mathématique immédiate du coefficient de corrélation calculé, lequel sous-estime drastiquement l'intensité du lien réel existant dans la population non filtrée. Le cas le plus universel s'observe en psychométrie du travail et dans les concours d'admission universitaires : si l'on tente d'évaluer la validité prédictive des scores à un test cognitif d'admission ($X$) par rapport à la réussite académique finale ($Y$) en étudiant uniquement la cohorte des étudiants ayant effectivement été admis, la corrélation s'avère souvent anémique voire nulle.
Ce résultat n'indique pas l'inutilité prédictive du test : il découle simplement de l'élimination préalable par le concours de tous les candidats ayant obte\nu des notes basses ou moyennes. Pour rétablir l'estimation de la véritable validité prédictive populationnelle, les psychométriciens doivent recourir aux formules d'ajustement correctif de Thorndike, sous peine de disqualifier à tort des instruments de mesure pertinents par méconnaissance des lois régissant la distribution conjointe.
<h3>11.3 Relations non linéaires occultées par les indices linéaires</h3>
L'indice paramétrique $r$ de Pearson est structurellement aveugle à toute forme de régularité qui s'écarte du paradigme strict de la ligne droite cartésienne. Deux variables peuvent entretenir une dépendance fonctionnelle déterministe intégrale sans que le coefficient linéaire ne soit capable d'en capter la moindre trace. Si une relation physique ou comportementale obéit à une équation parabolique symétrique parfaite de type $Y = X^2$ sur un intervalle centré en zéro $[-5, +5]$, le calcul algorithmique de la covariance produit un résultat rigoureusement nul, aboutissant à un coefficient $r = 0{,}00$.
L'illustration historique la plus magistrale de cette aporie computationnelle demeure le célèbre <a href="https://fr.wikipedia.org/wiki/Quartet_d%27Anscombe">quartet d'Anscombe</a>, élaboré par le statisticien Francis Anscombe en 1973. Ce jeu d'épreuve est constitué de quatre configurations bivariées présentant des propriétés statistiques agrégées strictement identiques (moyenne de $X = 9{,}0$, moyenne de $Y = 7{,}5$, variance de $X = 11{,}0$, variance de $Y = 4{,}12$, droite de régression $\hat{Y} = 3{,}0 + 0{,}5X$, et coefficient $R^2 = 0{,}67$).
Or, la projection de ces jeux de données sur un diagramme de dispersion dévoile des réalités visuelles incompatibles : le premier nuage incarne une relation linéaire propre classique ; le second trace une parabole curviligne pure où le modèle linéaire est totalement inadapté ; le troisième illustre un alignement parfait brisé par une valeur aberrante unique ; le quatrième présente une distribution verticale compacte dont la pente est entièrement dictée par un p\oint unique excentrique à très fort levier. Ce cas d'école réaffirme l'impératif méthodologique suprême : le calcul algébrique ne saurait en aucun cas supplanter l'analyse graphique approfondie de la donnée bivariée.
<h2>12. Synthèse scientifique et transition vers la modélisation avancée</h2>
<h3>12.1 La donnée bivariée comme tremplin heuristique</h3>
Malgré les limites intrinsèques inhérentes à son format bidimensionnel, l'analyse bivariée demeure l'assise heuristique incontournable sur laquelle s'échafaude l'édifice de la science empirique moderne. Elle incarne le stade transitoire obligé permettant à l'investigateur de s'émanciper du simple inventaire monographique descriptif pour aborder le territoire fertile de l'exploration relationnelle. Sa clarté géométrique et la relative simplicité de son formalisme en font un vecteur irremplaçable pour la diffusion des connaissances auprès des décideurs institutionnels, des bailleurs de fonds et de la communauté citoyenne.
Toutefois, la restitution académique rigoureuse d'une étude bivariée ne saurait se satisfaire de raccourcis superficiels. Les standards méthodologiques internationaux contemporains, incarnés par les directives de l'<a href="https://www.apa.org">American Psychological Association (APA)</a> et les critères STROBE en épidémiologie, exigent une transparence totale dans la diffusion des données : mention scrupuleuse de la taille effective des échantillons, report systématique des intervalles de confiance à 95 % encadrant tant les corrélations que les pentes d'ajustement, et présentation explicite de la distribution des résidus d'estimation.
C'est à cette condition de probité procédurale que la donnée bivariée conserve son pouvoir de réfutation poppérien, offrant un rempart robuste contre les spéculations idéologiques tout en préparant méthodologiquement le terrain pour des explorations computationnelles plus sophistiquées.
<h3>12.2 Extension vers la régression multiple et les modèles structuraux</h3>
L'observation attentive des dynamiques réelles — qu'elles soient économiques, somatiques, neurocognitives ou sociales — met en lumière une évidence ontologique : aucun phénomène complexe n'est le produit exclusif de l'influence isolée d'un déterminant unitaire unique. L'analyse bivariée doit par conséquent être appréhendée non comme une finalité descriptive ultime, mais comme l'étape propédeutique indispensable précédant l'immersion au sein de la modélisation multivariée avancée.
Le passage naturel à la régression linéaire multiple permet d'insérer un vecteur élargi de covariables prédictives ($X_1, X_2, dots, X_p$) au sein d'une équation conditionnelle globale : »>$$Cette statistique unitaire synthétise la proportion exacte de l’hétérogénéité initiale de $Y$ résorbée par l’alignement sur $X$. L’analyste rigoureux se garde toutefois d’une surinterprétation béate d’un $R^2$ flatteur. Au sein d’échantillons de taille réduite ($N < 20$), le coefficient de détermination standard est frappé d'un biais d'optimisme mécanique, surévaluant systématiquement l'ajustement réel du modèle par rapport à sa valeur de population. Il convient alors de lui préférer le coefficient de détermination ajusté ($R^2_{adj}$), lequel intègre une pénalité mathématique stricte pour chaque degré de liberté consommé.
11. Limites intrinsèques et pièges de l’analyse bivariée
11.1 Le paradoxe de Simpson et ses implications dévastatrices
L’une des manifestations les plus spectaculaires de la vulnérabilité intrinsèque de l’analyse bivariée simplifiée s’incarne dans le célèbre paradoxe de Simpson (ou effet Yule-Simpson). Ce paradoxe mathématique décrit une configuration méthodologique stupéfiante dans laquelle une association statistique observée entre deux variables au niveau de la cohorte globale agrégée s’inverse intégralement et change de signe lorsque la population est scindée en sous-groupes homogènes selon une variable de stratification tierce.
Considérons un exemple emblématique en épidémiologie clinique : l’observation bivariée globale d’un taux de mortalité ($Y$) supérieur chez des patients bénéficiant d’un traitement médical novateur ($X$) par comparaison a\vec le traitement conventionnel. L’analyse brute conclurait à la toxicité fatale du nouveau médicament. Or, si l’on décompose la cohorte selon la sévérité initiale de la pathologie (variable de confusion $Z$), on découvre fréquemment que le nouveau traitement réduit spectaculairement la mortalité au sein du sous-groupe des malades légers, tout en la réduisant également de façon nette au sein du groupe des cas critiques.
Cette contradiction apparente découle d’un biais d’allocation : les cliniciens, conscients de l’efficacité présumée de la nouvelle thérapie, l’ont préférentiellement prescrite aux patients les plus désespérés, concentrant au sein de ce groupe une mortalité basale écrasante. Cet exemple illustre la dangerosité de l’approche bivariée pure lorsque l’homogénéité sous-jacente de l’échantillon n’a pas été rigoureusement contrôlée, imposant une prudence méthodologique sans faille avant d’édicter des conclusions sanitaires universelles.
11.2 Restriction de l’étendue de mesure (range restriction)
L’estimation fidèle de la corrélation bivariée dép\end de manière organique de la représentativité de la variance de la variable indépendante $X$ au sein de l’échantillon scruté. Lorsque, par les spécificités du devis expérimental ou par des mécanismes de sélection implicites, la variance de $X$ se trouve artificiellement tronquée ou limitée à une frange étroite de son domaine naturel, le statisticien est confronté au phénomène pernicieux de la restriction de l’étendue de mesure (range restriction).
Cette amputation de la dispersion de $X$ induit une atténuation mathématique immédiate du coefficient de corrélation calculé, lequel sous-estime drastiquement l’intensité du lien réel existant dans la population non filtrée. Le cas le plus universel s’observe en psychométrie du travail et dans les concours d’admission universitaires : si l’on tente d’évaluer la validité prédictive des scores à un test cognitif d’admission ($X$) par rapport à la réussite académique finale ($Y$) en étudiant uniquement la cohorte des étudiants ayant effectivement été admis, la corrélation s’avère souvent anémique voire nulle.
Ce résultat n’indique pas l’inutilité prédictive du test : il découle simplement de l’élimination préalable par le concours de tous les candidats ayant obte\nu des notes basses ou moyennes. Pour rétablir l’estimation de la véritable validité prédictive populationnelle, les psychométriciens doivent recourir aux formules d’ajustement correctif de Thorndike, sous peine de disqualifier à tort des instruments de mesure pertinents par méconnaissance des lois régissant la distribution conjointe.
11.3 Relations non linéaires occultées par les indices linéaires
L’indice paramétrique $r$ de Pearson est structurellement aveugle à toute forme de régularité qui s’écarte du paradigme strict de la ligne droite cartésienne. Deux variables peuvent entretenir une dépendance fonctionnelle déterministe intégrale sans que le coefficient linéaire ne soit capable d’en capter la moindre trace. Si une relation physique ou comportementale obéit à une équation parabolique symétrique parfaite de type $Y = X^2$ sur un intervalle centré en zéro $[-5, +5]$, le calcul algorithmique de la covariance produit un résultat rigoureusement nul, aboutissant à un coefficient $r = 0{,}00$.
L’illustration historique la plus magistrale de cette aporie computationnelle demeure le célèbre quartet d’Anscombe, élaboré par le statisticien Francis Anscombe en 1973. Ce jeu d’épreuve est constitué de quatre configurations bivariées présentant des propriétés statistiques agrégées strictement identiques (moyenne de $X = 9{,}0$, moyenne de $Y = 7{,}5$, variance de $X = 11{,}0$, variance de $Y = 4{,}12$, droite de régression $\hat{Y} = 3{,}0 + 0{,}5X$, et coefficient $R^2 = 0{,}67$).
Or, la projection de ces jeux de données sur un diagramme de dispersion dévoile des réalités visuelles incompatibles : le premier nuage incarne une relation linéaire propre classique ; le second trace une parabole curviligne pure où le modèle linéaire est totalement inadapté ; le troisième illustre un alignement parfait brisé par une valeur aberrante unique ; le quatrième présente une distribution verticale compacte dont la pente est entièrement dictée par un p\oint unique excentrique à très fort levier. Ce cas d’école réaffirme l’impératif méthodologique suprême : le calcul algébrique ne saurait en aucun cas supplanter l’analyse graphique approfondie de la donnée bivariée.
12. Synthèse scientifique et transition vers la modélisation avancée
12.1 La donnée bivariée comme tremplin heuristique
Malgré les limites intrinsèques inhérentes à son format bidimensionnel, l’analyse bivariée demeure l’assise heuristique incontournable sur laquelle s’échafaude l’édifice de la science empirique moderne. Elle incarne le stade transitoire obligé permettant à l’investigateur de s’émanciper du simple inventaire monographique descriptif pour aborder le territoire fertile de l’exploration relationnelle. Sa clarté géométrique et la relative simplicité de son formalisme en font un vecteur irremplaçable pour la diffusion des connaissances auprès des décideurs institutionnels, des bailleurs de fonds et de la communauté citoyenne.
Toutefois, la restitution académique rigoureuse d’une étude bivariée ne saurait se satisfaire de raccourcis superficiels. Les standards méthodologiques internationaux contemporains, incarnés par les directives de l’American Psychological Association (APA) et les critères STROBE en épidémiologie, exigent une transparence totale dans la diffusion des données : mention scrupuleuse de la taille effective des échantillons, report systématique des intervalles de confiance à 95 % encadrant tant les corrélations que les pentes d’ajustement, et présentation explicite de la distribution des résidus d’estimation.
C’est à cette condition de probité procédurale que la donnée bivariée conserve son pouvoir de réfutation poppérien, offrant un rempart robuste contre les spéculations idéologiques tout en préparant méthodologiquement le terrain pour des explorations computationnelles plus sophistiquées.
12.2 Extension vers la régression multiple et les modèles structuraux
L’observation attentive des dynamiques réelles — qu’elles soient économiques, somatiques, neurocognitives ou sociales — met en lumière une évidence ontologique : aucun phénomène complexe n’est le produit exclusif de l’influence isolée d’un déterminant unitaire unique. L’analyse bivariée doit par conséquent être appréhendée non comme une finalité descriptive ultime, mais comme l’étape propédeutique indispensable précédant l’immersion au sein de la modélisation multivariée avancée.
Le passage naturel à la régression linéaire multiple permet d’insérer un vecteur élargi de covariables prédictives ($X_1, X_2, dots, X_p$) au sein d’une équation conditionnelle globale :$$hat{Y} = b_0 + b_1 X_1 + b_2 X_2 + dots + b_p X_p$$
Ce saut méthodologique autorise le contrôle statistique des facteurs de confusion par l’évaluation de l’effet propre de chaque régresseur « toutes choses égales par ailleurs » (ceteris paribus). Il ouvre également l’accès à l’analyse formelle des interactions modératrices (où l’impact de $X_1$ sur $Y$ fluctue en fonction de la valeur prise par $X_2$).
Enfin, les développements contemporains de la modélisation en équations structurelles (SEM) permettent de fusionner l’analyse factorielle confirmatoire et l’analyse de trajectoire causale au sein de réseaux mathématiques complexes. Ces instruments modélisent les flux d’influence réciproques, séparent la variance d’erreur de mesure de la variance latente réelle, et restituent au comportement humain toute son épaisseur systémique sans sacrifier la rigueur de l’inférence quantitative.
12.3 Directives pratiques pour l’exploitation rigoureuse des données bivariées
Pour assurer la pérennité et la fiabilité scientifique de l’exploitation opérationnelle des données bivariées au quotidien, les praticiens et chercheurs sont invités à respecter un protocole décisionnel articulé en plusieurs jalons incontournables. En amont de toute démarche d’acquisition, l’analyste doit effectuer un calcul de puissance statistique a priori (notamment via des outils calibrés tels que le logiciel G*Power). Cette démarche prospective détermine la taille d’échantillon minimale ($N$) requise pour détecter une taille d’effet théoriquement plausible tout en maintenant le risque d’erreur de deuxième espèce ($\beta$) sous le seuil critique des 20 %.
En second lieu, la vérification instrumentale de la validité de construit et de la fidélité de consistance interne des outils de collecte (stabilité temporelle test-retest, coefficient alpha de Cronbach ou oméga de McDonald) doit être systématiquement opérée avant de figer la matrice appariée finale. L’existence d’une erreur de mesure aléatoire substantielle sur les variables est en effet connue pour induire une atténuation systématique des corrélations calculées (formule d’atténuation de Spearman), conduisant à des faux négatifs dommageables.
Enfin, la présentation des conclusions analytiques doit s’inscrire dans une démarche éthique et déontologique d’honnêteté intellectuelle. Le praticien se doit d’exposer avec une rigueur égale les relations validées et les limites intrinsèques de son devis : non-normalité résiduelle, sensibilité aux valeurs influentes, risques de restriction d’étendue ou plausibilité d’influences latentes non modélisées. C’est à ce prix d’exigence méthodologique que l’analyse des données bivariées révèle sa pleine puissance scientifique, transformant la dispersion désordonnée des observations du monde phénoménal en un savoir rigoureux, transparent et actionnable.
Références
- Anderson, C. A. (1989). Temperature and aggression: Ubiquitous effects of heat on occurrence of human violence. Psychological Bulletin, 106(1), 74–96. https://doi.org/10.1037/0033-2909.106.1.74
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Cohen, S., Kamarck, T., & Mermelstein, R. (1983). A global measure of perceived stress. Journal of Health and Social Behavior, 24(4), 385–396. https://doi.org/10.2307/2136404
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Howell, D. C. (2016). Fundamental statistics for the behavioral sciences (9th ed.). Cengage Learning.
- Karasek, R. A. (1979). Job demands, job decision latitude, and mental strain: Implications for job redesign. Administrative Science Quarterly, 24(2), 285–308. https://doi.org/10.2307/2392498
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Stickgold, R. (2005). Sleep-dependent memory consolidation. Nature, 437(7063), 1272–1278. https://doi.org/10.1038/nature04286
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503