
Dans le paysage contemporain de la recherche en sciences comportementales, cognitives et médicales, l’évaluation de l’efficacité d’une intervention ou de la divergence entre deux populations ne peut plus reposer sur la seule dichotomie induite par le test d’hypothèse nulle conventionnel. La crise de la reproductibilité, documentée de manière approfondie au cours des deux dernières décennies, a mis en lumière les failles inhérentes à une dépendance exclusive envers les seuils de signification statistique arbitraires. Face à ce constat méthodologique, la communauté scientifique internationale s’est résolument tournée vers l’estimation quantitative de l’amplitude des phénomènes observés, plaçant les métriques d’effet standardisées au cœur de l’analyse inférentielle moderne.
Parmi l’arsenal des indices disponibles, le d de Cohen s’impose comme la mesure paramétrique reine pour quantifier la différence standardisée entre deux moyennes d’échantillons. Conçu initialement par le statisticien et psychologue Jacob Cohen, cet indice offre une passerelle universelle affranchie des unités de mesure brutes, permettant la comparaison directe d’effets observés à travers des protocoles hétérogènes, des instruments psychométriques distincts et des cohortes disparates. Maîtriser son calcul, ses variantes structurelles et ses postulats sous-jacents constitue une compétence fondamentale pour tout praticien, chercheur ou analyste de données soucieux de rigueur méthodologique.
Bien que des environnements de programmation statistique tels que le langage R, Python, SAS ou SPSS soient largement déployés dans les laboratoires académiques, le tableur Microsoft Excel demeure un outil d’une puissance sous-estimée pour l’ingénierie et l’audit des données. Loin d’être un simple réceptacle de feuilles de calcul administratives, Excel permet d’exécuter des analyses statistiques sophistiquées avec une transparence analytique totale. En décomposant chaque étape algorithmique au sein de formules natives claires, l’analyste s’affranchit des mécanismes de « boîte noire » propres aux logiciels spécialisés, consolidant ainsi la traçabilité intégrale, la vérification empirique et la reproductibilité des résultats obtenus.
1. Introduction aux mesures de taille d’effet et au d de Cohen en psychologie
1.1 Limites de la valeur p et nécessité d’une mesure de magnitude
L’édifice classique de l’inférence statistique s’est historiquement articulé autour du test d’hypothèse nulle (Null Hypothesis Significance Testing ou NHST) formalisé par Ronald Fisher, Jerzy Neyman et Egon Pearson. Dans ce cadre paradigmatique, le chercheur calcule une valeur p représentant la probabilité d’obtenir des données au moins aussi extrêmes que celles observées, sous l’hypothèse stricte d’une absence totale d’effet ou de divergence entre les groupes. Or, une confusion conceptuelle pernicieuse persiste entre la significativité statistique et la pertinence pratique ou clinique d’un résultat. Un résultat hautement significatif du point de vue probabiliste peut recouvrir un effet d’une insignifiance matérielle absolue sur le plan clinique, tandis qu’un effet substantiel peut échouer à franchir le seuil fatidique de 0,05 faute d’une puissance statistique suffisante.
Cette distorsion épistémologique provient de l’extrême sensibilité de la valeur p aux effectifs de l’échantillon. Mathématiquement, l’erreur type d’une statistique diminue en fonction inverse de la racine carrée de la taille d’échantillon N. Par conséquent, dès lors qu’un protocole expérimental mobilise des effectifs massifs, la moindre différence infinitésimale entre deux moyennes engendre un test t de Student significatif avec une valeur p inférieure à 0,001. Inversement, dans les études préliminaires ou portant sur des populations rares en neuropsychologie, des tailles d’effet cliniquement majeures peuvent être rejetées à tort par manque de participants, induisant des erreurs de type II délétères pour l’avancement des connaissances.
Face à ces dérives structurelles, l’American Psychological Association (APA) a édicté des directives formelles, réitérées dans son manuel de publication, exigeant impérativement l’adjonction systématique d’indices de taille d’effet et de leurs intervalles de confiance à toute publication de résultats inférentiels. Le test NHST et la taille d’effet opèrent ainsi une complémentarité méthodologique vertueuse : le premier informe sur le degré de plausibilité de l’hypothèse nulle au regard des aléas d’échantillonnage, tandis que la seconde quantifie la magnitude et la trajectoire directionnelle de la découverte empirique.
1.2 Définition conceptuelle du d de Cohen
Le d de Cohen appartient à la famille des indices d’effet standardisés de type différence (famille d), par opposition aux indices de variance expliquée ou de corrélation (famille r). Sur le plan conceptuel, il représente l’écart arithmétique séparant deux moyennes expérimentales, rapporté à une métrique de dispersion commune : l’écart-type de référence combiné des deux groupes étudiés. Cette opération de normalisation transforme la différence brute, dépendante d’une échelle psychométrique donnée (par exemple un score sur une échelle de dépression de Beck ou un temps de réaction en millisecondes), en un écart exprimé en fractions d’écart-type standard.
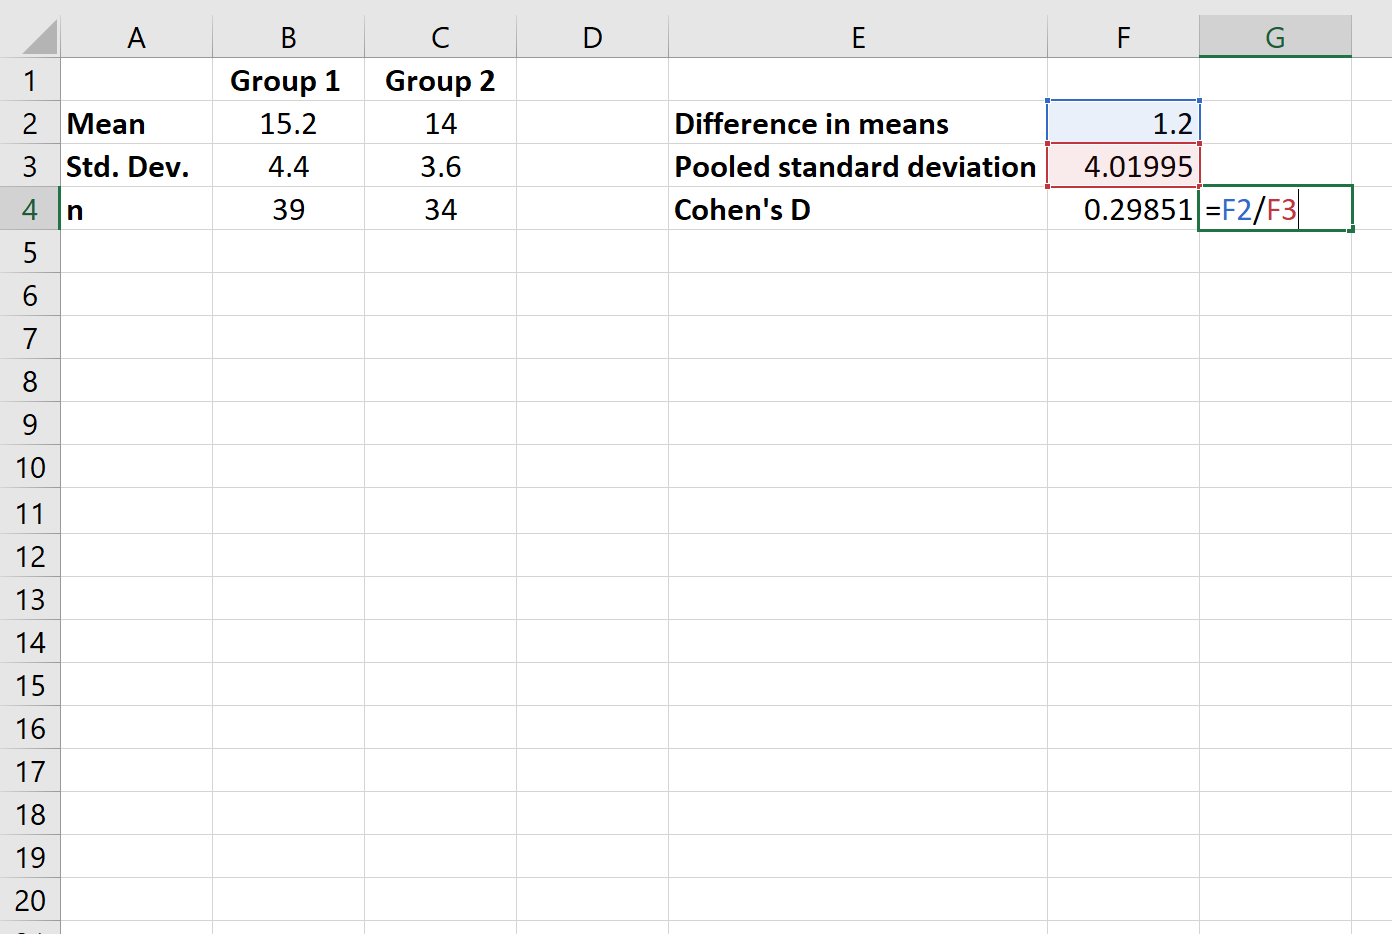
Cette propriété métrique invariante confère au d de Cohen une neutralité dimensionnelle remarquable. Un score de d équivalent à 0,5 indique que la moyenne du groupe expérimental se situe exactement à un demi-écart-type au-dessus de celle du groupe témoin, indépendamment de l’amplitude absolue des chiffres originaux. Cette universalité rend possible la méta-analyse, c’est-à-dire l’agrégation statistique et la synthèse quantitative d’études ayant opérationnalisé un même construit psychologique à l’aide d’instruments de mesure radicalement distincts.
Dans les paradigmes expérimentaux et quasi-expérimentaux des sciences comportementales, le d de Cohen constitue la pierre angulaire de l’évaluation des interventions thérapeutiques, pédagogiques ou ergonomiques. Il permet de répondre avec précision à la question pragmatique fondamentale : quelle est la force réelle du bénéfice induit par un traitement psychologique en comparaison d’un groupe contrôle sous placebo ? Cette quantification objective éclaire directement les décisions médicales, médico-économiques et réglementaires d’attribution de ressources.
1.3 Pertinence et flexibilité de Microsoft Excel pour l’analyse statistique
L’utilisation de logiciels statistiques programmatiques tels que R, Python ou SAS implique une courbe d’apprentissage technique abrupte, caractérisée par la maîtrise de la syntaxe de commande, de la gestion des bibliothèques externes et du débogage de scripts complexes. Pour de nombreux chercheurs, praticiens de terrain, étudiants en master ou cliniciens engagés dans des recherches institutionnelles, cet investissement temporel représente un coût d’entrée prohibitif susceptible de freiner l’exploration empirique de leurs données.
À cet égard, Microsoft Excel se distingue par une accessibilité universelle et une transparence analytique inégalée. Contrairement aux environnements dédiés qui renvoient des sorties automatisées sans révéler les équations sous-jacentes, un classeur Excel oblige le praticien à construire la chaîne logique du calcul statistique cellule par cellule. Cette explicitation pas-à-pas de l’algorithme garantit une maîtrise absolue de la variance pondérée, des degrés de liberté et de l’extraction des racines carrées, éliminant les confusions sémantiques entre variance d’échantillon et variance de population.
De surcroît, les capacités d’audit offertes par le tableur permettent de retracer l’origine de chaque variable, de valider la conformité des formules face aux données brutes et de corriger instantanément les anomalies de saisie. Une fois conceptualisée et validée, une matrice de calcul sous Excel se transforme en un gabarit dynamique pérenne, réutilisable pour de futurs protocoles expérimentaux et facilement intégrable sous la forme d’annexes méthodologiques interactives accompagnant les rapports scientifiques.
2. Fondements mathématiques et formules du d de Cohen
2.1 Formule canonique pour échantillons indépendants
La formulation algébrique fondamentale du d de Cohen pour deux échantillons indépendants repose sur le quotient de la différence des moyennes d’échantillon par l’écart-type combiné, traditionnellement désigné sous le terme de pooled standard deviation. L’expression générale s’énonce selon la relation :
d = (M1 – M2) / s_combine
Où M1 et M2 représentent respectivement les moyennes arithmétiques du premier groupe (fréquemment le groupe expérimental) et du second groupe (le groupe témoin ou contrôle). Le numérateur évalue l’ampleur absolue du décalage centroïde entre les deux distributions, tandis que le dénominateur standardise cette quantité au moyen d’une estimation conjointe de la variabilité intra-groupe.
L’écart-type combiné s_combine constitue l’élément déterminant de l’architecture mathématique du modèle. Il repose sur l’hypothèse classique d’homoscédasticité, selon laquelle les deux populations d’où sont extraits les échantillons partagent une variance théorique identique (sigma_1^2 = sigma_2^2 = sigma^2), la différence observée entre s1 et s2 n’étant imputable qu’aux fluctuations d’échantillonnage aléatoire. L’estimateur combine donc les informations de dispersion internes aux deux conditions afin d’offrir une estimation plus robuste et plus précise de cette variance commune non observable.
Lorsque les effectifs convergent vers l’infini, la distribution d’échantillonnage de cet estimateur tend asymptotiquement vers une loi normale centrée sur le paramètre populationnel delta. Toutefois, pour des échantillons finis, la statistique d n’est pas distribuée de manière symétrique autour de zéro lorsque l’effet réel est non nul, mais suit une distribution t de Student non-centrale, ce qui implique des précautions théoriques particulières lors de la dérivation de ses propriétés stochastiques.
2.2 Écart-type combiné : cas des effectifs égaux et inégaux
La dérivation de l’écart-type combiné obéit à deux régimes mathématiques selon la symétrie des effectifs observés. Dans le cas spécifique où les deux groupes présentent une taille strictement identique (n1 = n2 = n), l’impact pondérateur des effectifs s’annule, et la variance combinée se réduit à la moyenne arithmétique simple des variances d’échantillon. L’expression de l’écart-type combiné devient :
s_combine = RACINE( (s1^2 + s2^2) / 2 )
Dès lors que les effectifs deviennent asymétriques (n1 distinct de n2), cette formulation simplifiée devient arithmétiquement caduque et méthodologiquement trompeuse. Il est alors rigoureusement indispensable de pondérer la variance de chaque groupe par ses degrés de liberté respectifs, définis par (n1 – 1) et (n2 – 1). L’expression canonique générale s’établit selon la formulation :
s_combine = RACINE( ( (n1 – 1)*s1^2 + (n2 – 1)*s2^2 ) / (n1 + n2 – 2) )
Cette pondération par les degrés de liberté assure que l’échantillon le plus vaste exerce une contribution proportionnellement plus déterminante dans l’estimation de la variance résiduelle conjointe. Le dénominateur (n1 + n2 – 2) reflète la somme cumulative des degrés de liberté associés aux deux estimations indépendantes de dispersion. Si l’hypothèse d’homogénéité des variances est violée de manière conjointe avec une asymétrie d’effectif, l’estimateur combiné devient biaisé, contractant artificiellement l’écart-type si le groupe le plus volumineux présente la variance la plus faible, ou le dilatant dans le cas de figure inverse.
2.3 Distinction cruciale entre d de Cohen et g de Hedges
Bien que le d de Cohen soit universellement enseigné, il souffre d’un défaut asymptotique documenté par le statisticien Larry Hedges : pour les échantillons de petite taille (notamment lorsque l’effectif total N = n1 + n2 est inférieur à 20 ou 30 individus), l’estimateur d de Cohen tend à surestimer systématiquement la taille d’effet de la population d’environ quelques pourcents. Ce biais d’échantillonnage découle de la non-linéarité de l’extraction de la racine carrée lors du calcul de s_combine à partir d’un nombre restreint de degrés de liberté.
Pour corriger cette déformation stochastique, Hedges a formalisé un estimateur non biaisé, généralement désigné sous le symbole g de Hedges. Cet indice applique un facteur multiplicatif d’ajustement J dépendant directement du nombre total de degrés de liberté disponibles (noté df = n1 + n2 – 2). La relation de conversion se résume par :
g = d * J
Le facteur de correction analytique exact repose sur l’évaluation de fonctions Gamma d’Euler, mais Larry Hedges a développé une approximation polynomiale d’une fidélité mathématique remarquable pour les calculs courants :
J = 1 – ( 3 / (4 * (n1 + n2) – 9) )
Dans la littérature scientifique contemporaine, les normes de publication internationales (notamment celles de l’APA) encouragent expressément l’utilisation du g de Hedges dès lors que les cohortes n’atteignent pas des volumétries massives. Cependant, une ambiguïté terminologique persiste dans de nombreux logiciels où l’étiquette « d de Cohen » renvoie en réalité au g corrigé sans avertissement explicite. Dans un classeur Excel, le concepteur conserve le pouvoir de distinguer scrupuleusement les deux métriques et de présenter l’une et l’autre de manière transparente.
3. Organisation architecturale des données dans Microsoft Excel
3.1 Structuration matricielle des données brutes
La fiabilité de toute démarche statistique sous tableur dépend directement de la propreté de l’ingénierie des données en amont de l’écriture des formules. Pour traiter des données empiriques non agrégées, la disposition optimale adopte une structure matricielle claire où chaque condition expérimentale occupe une colonne distincte dédiée, par exemple la colonne A pour les observations du Groupe Témoin et la colonne B pour celles du Groupe Expérimental. Chaque ligne correspond à un sujet ou participant unique.
Il est impératif d’opérer un nettoyage préliminaire des plages numériques. Les non-réponses, scores manquants ou abandons de protocole doivent être traités sans introduire de valeurs zéro implicites, lesquelles fausseraient dramatiquement le calcul des moyennes et des écarts-types. Excel ignore naturellement les cellules vides dans l’exécution de ses fonctions statistiques descriptives de base, ce qui constitue une protection intrinsèque, à la condition expresse qu’aucun caractère alphanumérique invisible, espace insécable ou mention textuelle (« NA », « absent ») ne pollue la plage numérique.
De plus, l’analyste doit identifier d’éventuelles valeurs aberrantes extrêmes (outliers). L’écart-type étant une métrique quadratique par construction, une seule observation déviante de plus de trois écarts-types de la moyenne exerce une influence disproportionnée sur s1 ou s2, induisant une déformation spectaculaire du d de Cohen. Pour pérenniser l’architecture des données, il est fortement conseillé de convertir les plages simples en « Tableaux structurés » via le raccourci Ctrl + L ou l’onglet Insertion > Tableau, ce qui permet la gestion dynamique et l’extension automatique des bornes de calcul lors de l’ajout ultérieur de données.
3.2 Organisation pour statistiques agrégées précalculées
Dans de nombreuses configurations académiques, les données primaires individuelles ne sont pas accessibles au chercheur. C’est le cas récurrent lors de méta-analyses, de réplications d’études ou de l’exploitation d’articles publiés où seules les statistiques descriptives résumées figurent dans les tableaux de résultats. Excel se prête admirably à ce type d’architecture condensée.
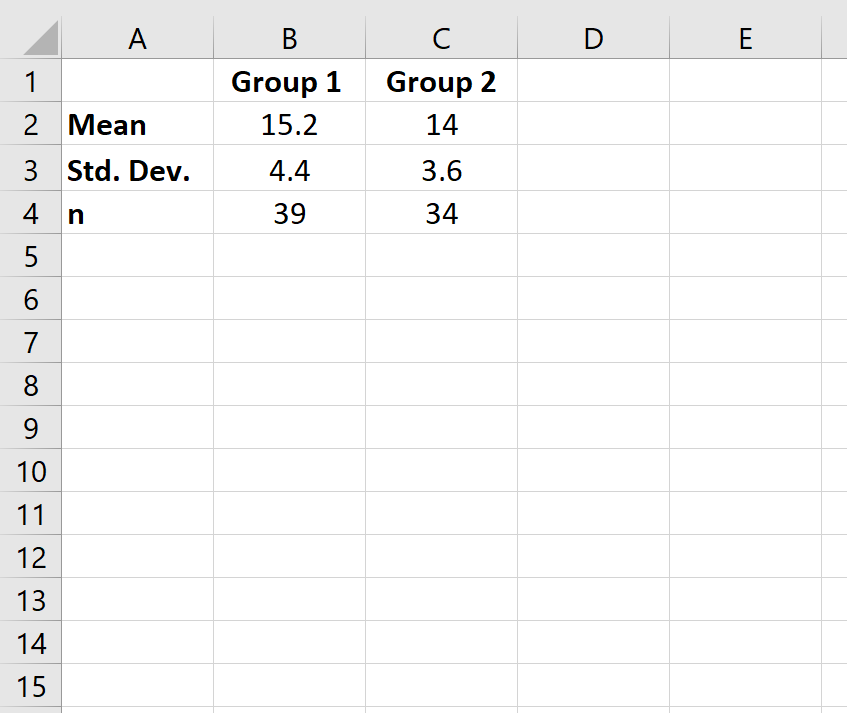
La structuration de la feuille de calcul doit alors organiser méthodiquement les trois paramètres d’entrée fondamentaux pour chaque groupe : la taille d’échantillon n, la moyenne observée M et l’écart-type s. Il convient d’aménager une matrice de saisie explicite, positionnée idéalement dans les premières lignes de la feuille de calcul, comme illustré dans l’architecture ci-dessous :
- Cellule B2 : Effectif du Groupe 1 (n1)
- Cellule B3 : Moyenne du Groupe 1 (M1)
- Cellule B4 : Écart-type du Groupe 1 (s1)
- Cellule C2 : Effectif du Groupe 2 (n2)
- Cellule C3 : Moyenne du Groupe 2 (M2)
- Cellule C4 : Écart-type du Groupe 2 (s2)
Cette compartimentation spatiale étanche entre les entrées empiriques (lignes 2 à 4), les calculs intermédiaires de variance combinée (lignes 6 à 8) et les cellules de synthèse finale (lignes 10 et suivantes) garantit une lisibilité maximale pour l’audit. L’attribution de « Noms définis » aux cellules via le Gestionnaire de noms (par exemple nommer B3 « Moyenne_Exp » et C3 « Moyenne_Ctrl ») offre la possibilité d’écrire des formules littérales auto-documentées, éliminant les risques d’inversion d’adresses absolues ou relatives.
3.3 Contrôle typologique et validation des données
L’écueil le plus destructeur sous Microsoft Excel concerne la gestion des typologies de données et des séparateurs régionaux. Selon la configuration linguistique du système d’exploitation, le séparateur décimal par défaut peut être la virgule (standard francophone) ou le point (standard anglo-saxon). L’importation brute de jeux de données psychométriques issus de logiciels paramétrés en anglais convertit fréquemment les décimales en chaînes de texte non calculables, générant des erreurs de syntaxe #VALEUR! ou excluant silencieusement les valeurs du calcul statistique.
Pour prévenir ces dysfonctionnements, il est préconisé d’appliquer des règles strictes de « Validation des données » (onglet Données > Outils de données > Validation des données). En restreignant la saisie des effectifs aux seuls « Nombres entiers » strictement supérieurs à 1 et celle des scores aux « Décimaux », le système bloque instantanément toute faute de frappe alphanumérique. Parallèlement, l’application d’un formatage numérique explicite limitant l’affichage à deux ou trois décimales standardise la restitution visuelle sans altérer la précision computationnelle sous-jacente des registres à virgule flottante d’Excel.
Enfin, l’insertion de commentaires de cellule structurés ou de notes explicatives (via un clic droit sur les en-têtes) documente la version du jeu de données, la date d’extraction, la variable psychologique opérationnalisée et les éventuelles transformations d’échelle préalables, assurant une parfaite traçabilité scientifique tout au long du cycle de vie du document.
4. Calcul du d de Cohen à partir de statistiques descriptives résumées
4.1 Configuration des cellules de paramètres
L’implémentation opérationnelle du calcul débute par l’encodage méthodique des paramètres descriptifs extraits de la littérature ou des rapports d’essais préliminaires. Prenons pour illustration clinique l’évaluation de l’efficacité d’une thérapie cognitivo-comportementale (TCC) administrée pour réduire l’anxiété sociale. Le groupe expérimental comprend n1 = 25 patients présentant une moyenne post-intervention M1 = 42,40 avec un écart-type s1 = 8,10. Le groupe témoin sur liste d’attente comprend n2 = 25 participants affichant une moyenne M2 = 50,60 et un écart-type s2 = 8,90.
Les données sont encodées dans une feuille de calcul Excel dédiée selon la nomenclature géométrique suivante :
- Cellule B2 : 25 (taille de l’échantillon expérimental n1)
- Cellule B3 : 42,4 (moyenne de l’échantillon expérimental M1)
- Cellule B4 : 8,1 (écart-type de l’échantillon expérimental s1)
- Cellule C2 : 25 (taille de l’échantillon témoin n2)
- Cellule C3 : 50,6 (moyenne de l’échantillon témoin M2)
- Cellule C4 : 8,9 (écart-type de l’échantillon témoin s2)
Avant de procéder à l’élaboration de la formule d’inférence, une vérification critique s’impose quant à l’homogénéité dimensionnelle des écarts-types. Ces derniers doivent obligatoirement être exprimés sur la même échelle métrique que les moyennes associées et provenir d’estimateurs échantillonnaux non biaisés divisés par (n – 1), ce qui constitue la norme dans les publications biomédicales et psychologiques contemporaines.
4.2 Implémentation de l’écart-type combiné en syntaxe Excel
La pierre d’angle du calcul réside dans la transcription scrupuleuse de l’écart-type combiné pondéré au sein de l’environnement fonctionnel d’Excel. Pour traduire fidèlement l’équation de la variance pondérée sous la racine carrée, il est impératif de respecter rigoureusement la priorité des opérateurs algébriques au moyen d’un parenthésage méthodique.
Dans la cellule B6, nous calculons la somme des carrés des écarts pondérée par les degrés de liberté, qui constitue le numérateur de la variance combinée. La syntaxe exacte s’énonce :
=(B2-1)*PUISSANCE(B4;2) + (C2-1)*PUISSANCE(C4;2)
Dans la cellule B7, le dénominateur correspondant au cumul des degrés de liberté totaux est encodé par la formulation simple :
=B2 + C2 – 2
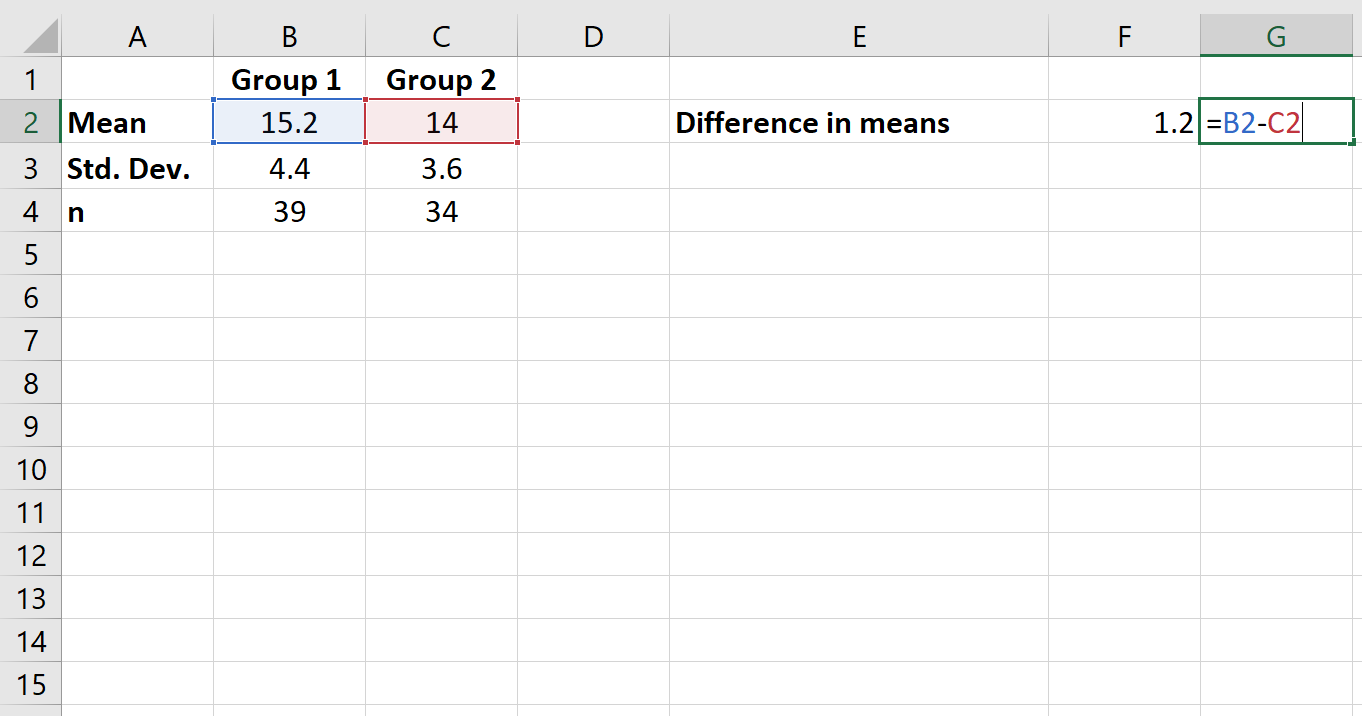
L’extraction de l’écart-type combiné final s’opère dans la cellule B8 via la fonction native RACINE, calculant la racine carrée du quotient de ces deux quantités intermédiaires :
=RACINE(B6 / B7)
En substituant les valeurs empiriques de notre exemple, nous obtenons une variance combinée de 72,41, dont la racine carrée nous donne un s_combine de 8,5094. La validation intermédiaire de cette valeur s’avère indispensable : s_combine doit impérativement s’insérer dans l’intervalle délimité par s1 et s2 (ici entre 8,10 et 8,90). Toute sortie numérique extérieure à cette enveloppe témoigne sans équivoque d’une erreur d’encodage parenthétique ou de l’inversion d’une puissance.
4.3 Calcul final et affichage de l’indice standardisé
Une fois l’écart-type combiné s_combine rigoureusement stabilisé dans la cellule B8, l’obtention du d de Cohen standardisé résulte d’une division élémentaire de la différence des moyennes centroïdes par cet estimateur de dispersion. L’attribution de la cellule B10 accueille la formulation :
=(B3 – C3) / B8
Dans notre cas expérimental, le résultat renvoie la valeur -0,9636. Le signe négatif traduit le fait que le groupe expérimental obtient des scores d’anxiété inférieurs à ceux du groupe témoin, validant l’efficacité théorique de la thérapie. La gestion du signe dépend strictement de la formulation des hypothèses de recherche : si la variable évaluée était une mesure d’estime de soi où une progression positive est recherchée, l’ordre du numérateur pourrait être inversé pour présenter un indice positif, ou maintenu tel quel en explicitant rigoureusement le groupe de référence.
Pour les analystes souhaitant condenser l’intégralité du calcul dans une seule cellule monolithique autonome sans cellules intermédiaires, Excel autorise l’imbrication complète suivante :
=(B3 – C3) / RACINE( (((B2-1)*B4^2) + ((C2-1)*C4^2)) / (B2+C2-2) )
Bien que compacte, cette formule monobloc exige une vigilance extrême lors de sa relecture. Enfin, pour enrichir visuellement le tableau de bord clinique, une règle de « Mise en forme conditionnelle » (onglet Accueil > Style > Mise en forme conditionnelle) peut être superposée à la cellule B10 afin de colorer automatiquement le résultat selon les seuils conventionnels d’amplitude d’effet (vert pour |d| supérieur à 0,8, jaune pour |d| supérieur à 0,5, orange pour |d| supérieur à 0,2).
5. Calcul du d de Cohen pour échantillons indépendants à partir de données brutes
5.1 Extraction automatisée des paramètres statistiques descriptifs
Lorsque le chercheur dispose du jeu de données primaires issu des passations expérimentales, il est nettement plus élégant et robuste de mobiliser les fonctions d’agrégation statistique automatisées d’Excel plutôt que de saisir manuellement des données résumées. Supposons que les scores du Groupe 1 (expérimental) soient alignés dans la colonne A, de la cellule A2 à A31 (soit 30 participants), et ceux du Groupe 2 (contrôle) dans la colonne B, de la cellule B2 à B31.
La première phase algorithmique consiste à extraire les trois paramètres clés de chaque série au moyen des fonctions internes :
- Pour le dénombrement effectif : =NB(A2:A31) en cellule D2 et =NB(B2:B31) en cellule E2. La fonction NB possède l’avantage capital de ne compter exclusivement que les cellules contenant des valeurs numériques valides, neutralisant d’emblée les cellules vides accidentelles.
- Pour la moyenne arithmétique : =MOYENNE(A2:A31) en D3 et =MOYENNE(B2:B31) en E3.
- Pour la dispersion standardisée : =ECARTYPE.STANDARD(A2:A31) en D4 et =ECARTYPE.STANDARD(B2:B31) en E4.
Une distinction méthodologique capitale s’impose ici quant au choix de la fonction d’écart-type. Excel propose traditionnellement ECARTYPE.STANDARD (anciennement ECARTYPE dans les versions antérieures) et ECARTYPE.PEARSON (ou ECARTYPEP). La fonction ECARTYPE.STANDARD divise la somme des carrés des écarts à la moyenne par (n – 1), produisant l’estimateur sans biais de la variance d’échantillon préconisé par la théorie de l’échantillonnage statistique. À l’inverse, ECARTYPE.PEARSON divise par la valeur brute n, correspondant à la variance populationnelle exhaustive. L’usage de cette dernière fonction dans le cadre d’un calcul de d de Cohen sur données échantillonnantes constituerait une erreur de modélisation conduisant à une sous-estimation systématique de l’écart-type et donc à une surévaluation artificielle de la taille d’effet.
5.2 Construction modulaire des étapes de variance pondérée
Après extraction des paramètres descriptifs de base, l’architecture analytique procède à l’agrégation de la dispersion intra-groupe. Bien qu’il soit théoriquement envisageable de dériver cette quantité via une analyse de variance univariée (ANOVA) en extrayant le carré moyen résiduel (Mean Square Error ou MSE), la construction directe à partir des variances individuelles sous Excel demeure la démarche la plus pédagogique et la plus sûre.
Les degrés de liberté respectifs sont formalisés dans deux cellules adjacentes :
=D2 – 1 (en cellule D6 pour le Groupe 1) et =E2 – 1 (en cellule E6 pour le Groupe 2).
La somme globale des degrés de liberté s’établit en cellule D7 au moyen de l’expression :
=D6 + E6
Pour dériver le numérateur de la variance combinée sans multiplier les colonnes d’écarts carrés individuels, nous exploitons la formule mathématique en combinant directement les cellules de paramètres précalculées :
=(D6 * PUISSANCE(D4; 2)) + (E6 * PUISSANCE(E4; 2))
L’écart-type combiné s’obtient alors en cellule D8 par la fonction racine appliquée au ratio du numérateur par la somme des degrés de liberté :
=RACINE( ((D6 * PUISSANCE(D4; 2)) + (E6 * PUISSANCE(E4; 2))) / D7 )
Cette décomposition modulaire permet de vérifier en temps réel la concordance parfaite avec les sorties logicielles de progiciels spécialisés de référence tels que SPSS, Jamovi ou Prism. Toute divergence au-delà de la quatrième décimale refléterait généralement un arrondi prématuré opéré sur les entrées descriptives ou une confusion sur les degrés de liberté.
5.3 Synthèse et calcul de la taille d’effet globale
Le calcul final du d de Cohen s’exécute dans une cellule de synthèse dédiée, par exemple la cellule D10, en reliant dynamiquement le numérateur de divergence centroïde à l’écart-type combiné validé :
=(D3 – E3) / D8
L’immense valeur ajoutée de cette modélisation réside dans sa réactivité algorithmique totale. Si un nouveau participant est recruté au sein de la cohorte expérimentale et que sa mesure est insérée dans la plage active de la colonne A (ou si des données erronées sont rectifiées), l’ensemble de la chaîne inférentielle s’actualise instantanément, recalibrant automatiquement la taille n, la moyenne arithmétique, l’écart-type d’échantillon, la pondération des degrés de liberté et l’indice standardisé final.
Dans l’éventualité clinique pathologique où un groupe présenterait une variance strictement nulle (par exemple si tous les participants saturaient au plafond d’une échelle psychométrique en obtenant un score invariable), Excel renverrait logiquement l’erreur d’interruption arithmétique #DIV/0!. Pour sécuriser la présentation opérationnelle des classeurs de laboratoire, il est recommandé d’encadrer l’expression au moyen de la fonction SI.NON.DISP ou SIERREUR :
=SIERREUR((D3 – E3) / D8; « Variance nulle ou effectif insuffisant »)
Cette précaution évite la propagation de codes d’erreur disgracieux à travers les feuilles dépendantes du classeur lors des phases de saisie progressive des données.
6. Traitement des échantillons indépendants à effectifs inégaux
6.1 Asymétrie des groupes et distorsion de l’écart-type
Dans les protocoles de recherche en sciences humaines et médicales, l’égalité stricte des effectifs entre conditions constitue une situation exceptionnelle. L’attrition expérimentale (abandon de participants en cours d’étude), les données inexploitables pour artefacts physiologiques, ou la rareté inhérente à certaines pathologies cliniques conduisent quasi-systématiquement à des jeux de données déséquilibrés (par exemple un groupe contrôle de n2 = 120 individus confronté à une cohorte clinique rare de n1 = 28 patients).
Une tentation erronée, observée de manière récurrente chez les utilisateurs novices d’Excel, consiste à calculer une moyenne arithmétique brute des deux écarts-types au dénominateur : (s1 + s2) / 2. Cette démarche ignore totalement le poids stochastique respectif des échantillons. En effet, un échantillon de grande taille fournit une estimation de la dispersion de la population considérablement plus stable et dotée d’une erreur d’échantillonnage bien plus faible qu’un petit échantillon sujet aux fluctuations du hasard.
Le danger méthodologique atteint son paroxysme lorsque l’asymétrie des tailles de groupes se conjugue à une hétérogénéité marquée des variances (hétéroscédasticité). Si le grand échantillon présente une dispersion restreinte tandis que le petit échantillon affiche une forte variance, l’estimateur combiné standard sans pondération rigoureuse par les degrés de liberté produit une sous-estimation substantielle de la variabilité globale, gonflant artificiellement le d de Cohen et générant un risque alarmant de faux positifs scientifiques.
6.2 Implémentation sous Excel de la formule pondérée complète
Pour implémenter de façon élégante et infaillible l’équation complète de la variance combinée pour effectifs inégaux sans saturer la formule de parenthèses complexes, il est possible d’exploiter la fonction native SOMMEPROD d’Excel. Cette fonction calcule la somme des produits de plages ou matrices homologues, rationalisant l’écriture matricielle des pondérations de degrés de liberté.
Considérons une configuration où les degrés de liberté (n1 – 1) et (n2 – 1) occupent respectivement les cellules B6 et C6, et les variances respectives (s1^2 et s2^2) occupent les cellules B7 et C7. Le numérateur pondéré se calcule par :
=SOMMEPROD(B6:C6; B7:C7)
La formule finale de l’écart-type combiné s’écrit alors de manière très compacte en divisant cette somme vectorielle par la somme des degrés de liberté :
=RACINE( SOMMEPROD(B6:C6; B7:C7) / SOMME(B6:C6) )
Pour éprouver la robustesse de l’algorithme sous Excel, il est opportun de procéder à une validation croisée sur un cas test documenté : soit Groupe 1 avec n1 = 15, M1 = 110, s1 = 12 ; Groupe 2 avec n2 = 45, M2 = 102, s2 = 18. Le cumul des degrés de liberté s’élève à (15 – 1) + (45 – 1) = 58. La pondération des variances donne : (14 * 144) + (44 * 324) = 2016 + 14256 = 16272. La division par 58 octroie une variance combinée de 280,5517, dont la racine carrée livre un s_combine de 16,7497. Le d de Cohen s’établit à (110 – 102) / 16,7497 = 0,4776. La formule basée sur SOMMEPROD restitue exactement cette valeur, garantissant une intégrité computationnelle parfaite sans le moindre biais d’arrondi intermédiaire.
6.3 Approche de Welch : le d de Cohen ajusté pour variances hétérogènes
Lorsque le test de Levene indique une violation flagrante du postulat d’homogénéité des variances (p inférieur à 0,05) et que les tailles de groupes diffèrent, le d de Cohen canonique cesse d’être un estimateur fidèle. Dans ce contexte, la statistique paramétrique inférentielle recourt au test t de Welch, qui n’agrège pas les variances mais ajuste les degrés de liberté via l’équation de Welch-Satterthwaite. Par cohérence théorique, la taille d’effet doit elle-même être ajustée pour refléter cette hétéroscédasticité.
L’approche recommandée par Delacre, Lakens et Leys (2017) consiste à utiliser l’écart-type de Welch comme dénominateur de standardisation. Cet écart-type ne combine pas les variances selon les degrés de liberté, mais modélise la variance moyenne non pondérée des deux populations selon la relation :
s_welch = RACINE( (s1^2 + s2^2) / 2 )
Le d de Cohen ajusté de Welch s’implémente sous Excel dans une cellule adjacente via la syntaxe explicite :
=(B3 – C3) / RACINE( (PUISSANCE(B4; 2) + PUISSANCE(C4; 2)) / 2 )
Une alternative tout aussi rigoureuse, préconisée initialement par Gene Glass sous l’appellation Delta de Glass, consiste à standardiser la différence des moyennes exclusivement par l’écart-type du groupe témoin s2, postulant que ce groupe représente la variabilité physiologique naturelle non altérée par le protocole expérimental :
=(B3 – C3) / C4
La comparaison juxtaposée du d canonique, du d ajusté de Welch et du Delta de Glass au sein du classeur Excel permet à l’investigateur d’évaluer la sensibilité de ses inférences à la violation des postulats statistiques fondamentaux.
7. Calcul du d de Cohen pour mesures répétées et échantillons appariés
7.1 Spécificités méthodologiques des plans intra-sujets
L’application du d de Cohen dans les plans factoriels intra-sujets (mesures répétées avant/après, cross-over ou appariements stricts) représente l’une des zones d’erreurs méthodologiques les plus denses de la littérature empirique. Dans une conception pré-test/post-test menée sur les mêmes individus, les observations longitudinales sont intrinsèquement dépendantes les unes des autres. Il existe une corrélation intra-classe positive substantielle entre le score initial et le score final d’un même sujet.
Or, de nombreux praticiens commettent la méprise de traiter des données appariées au moyen des équations destinées aux échantillons indépendants. Cette erreur de conception omet l’impact de la covariance intra-sujet, conduisant soit à une estimation erronée de la précision du test, soit à une ambiguïté fondamentale quant à la signification métrique du résultat obtenu.
La théorie psychométrique distingue formellement deux variantes principales du d pour mesures répétées :
- Le d de différence appariée, couramment symbolisé d_z, qui rapporte la moyenne des variations individuelles à l’écart-type de ces mêmes variations.
- Le d de mesures répétées standardisé par les écarts-types d’origine, souvent noté d_rm (repeated measures), qui réintègre la corrélation de Pearson entre pré-test et post-test pour exprimer l’effet sur l’échelle originale de la variable mesurée, conformément aux préconisations de Dunlap, Cortina, Vaslow et Burke (1996) ainsi que de Morris et DeShon (2002).
7.2 Calcul de l’écart-type des différences (d_z) sous Excel
L’indice d_z s’impose comme la métrique naturelle lorsque l’investigateur s’intéresse à la significativité du changement individuel brut ou lorsqu’il planifie des calculs de puissance a priori pour de futurs protocoles appariés via des utilitaires comme G*Power. Cet indice est directement proportionnel à la statistique du test t de Student pour échantillons appariés selon la relation mathématique canonique : t = d_z * RACINE(n).
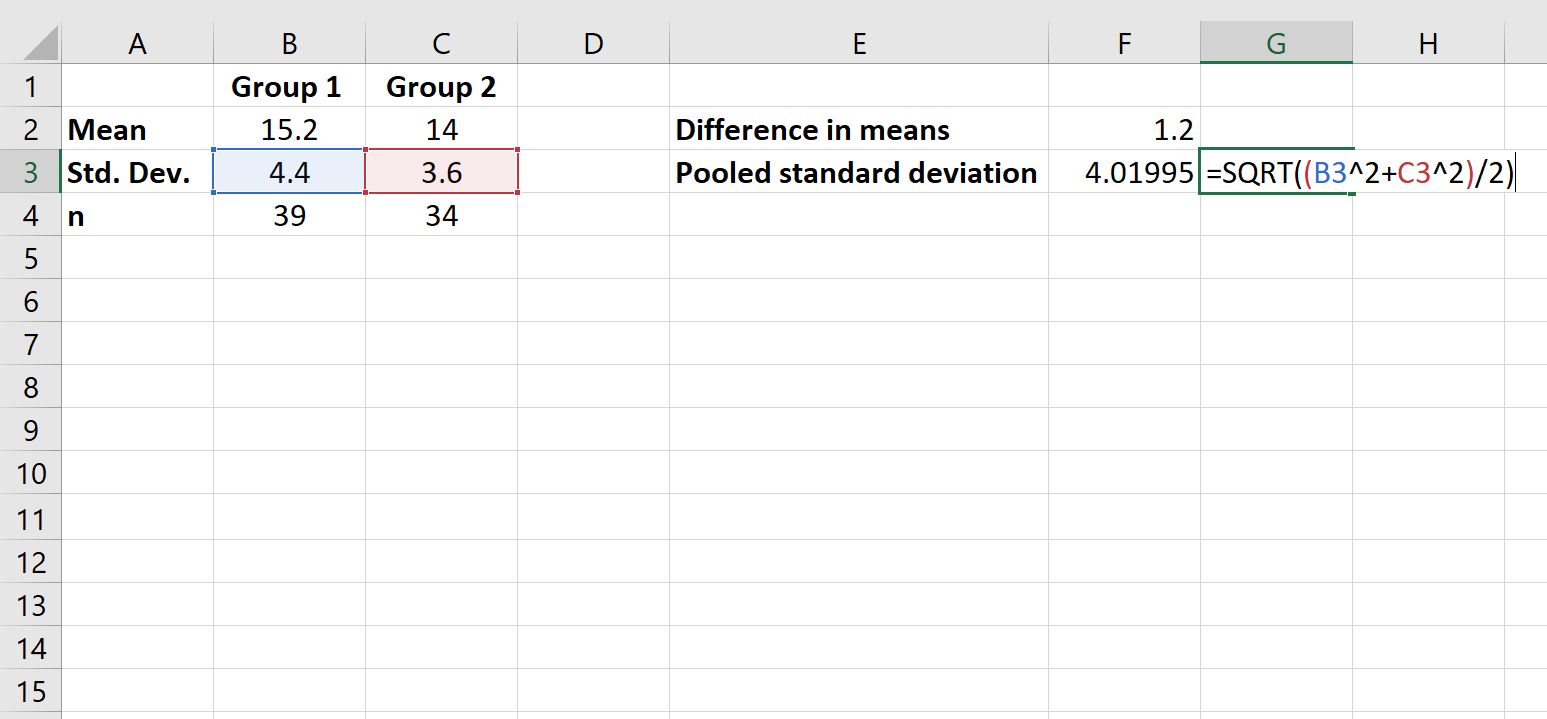
Pour calculer d_z sous Excel à partir des données brutes de n participants soumis à une évaluation pré-test (colonne A, cellules A2 à A26) et post-test (colonne B, cellules B2 à B26), la méthode s’articule comme suit :
Création d’une troisième colonne différentielle (colonne C) intitulée « Différence (Post – Pré) ». Dans la cellule C2, entrez la formule de soustraction élémentaire :
=B2 – A2
Étirez cette formule vers le bas jusqu’à la cellule C26 pour obtenir le vecteur complet des gains individuels.
Dans la zone des résultats de synthèse, extrayez les paramètres descriptifs de cette colonne différentielle :
- Cellule E2 (Moyenne des différences) : =MOYENNE(C2:C26)
- Cellule E3 (Écart-type des différences) : =ECARTYPE.STANDARD(C2:C26)
Le calcul de d_z s’exécute dans la cellule E5 par le ratio direct de ces deux quantités :
=E2 / E3
Cette approche est d’une simplicité désarmante, mais présente un écueil interprétatif majeur : si la corrélation pré-post r est très élevée (par exemple r = 0,80), l’écart-type des différences s_diff sera mécaniquement beaucoup plus faible que les écarts-types observés lors des phases de référence, propulsant d_z à des niveaux artificiellement gonflés qui ne peuvent être comparés directement aux d issus de plans à groupes indépendants.
7.3 Calcul du d de Cohen basé sur la corrélation (d_rm) sous Excel
Pour réaligner la métrique de l’effet d’un plan apparié sur celle d’un plan indépendant et autoriser l’intégration des résultats au sein de méta-analyses exhaustives, il est indispensable de recourir à l’indice standardisé d_rm. Cet indice s’appuie sur la formule de Morris et DeShon :
d_rm = ( (M_post – M_pre) / RACINE(s_pre^2 + s_post^2 – 2*r*s_pre*s_post) ) * RACINE(2 * (1 – r))
Cette expression sophistiquée neutralise le coefficient de corrélation de façon à restaurer l’unité de variance originale du construit psychologique sous-jacent. L’implémentation opérationnelle sous Excel se structure rigoureusement comme suit :
En cellule E7, calcul du coefficient de corrélation linéaire de Pearson entre les scores avant et après traitement au moyen de la fonction native interne :
=COEFFICIENT.CORRELATION(A2:A26; B2:B26)
En cellule E8, calcul de la moyenne de référence pré-test et en E9 de la moyenne post-test via la fonction MOYENNE.
En cellule E10 et E11, extraction des écarts-types initiaux et finaux via la fonction ECARTYPE.STANDARD.
Le dénominateur spécifique de la différence corrigée est calculé en cellule E13 :
=RACINE( PUISSANCE(E10;2) + PUISSANCE(E11;2) – (2 * E7 * E10 * E11) )
Enfin, la taille d’effet standardisée d_rm s’établit en cellule E15 par l’équation générale :
=((E9 – E8) / E13) * RACINE(2 * (1 – E7))
La confrontation de d_z et d_rm sur un jeu de données réel permet de mesurer la portée de cet arbitrage : sur une cohorte où r = 0,75, un d_z calculé à 1,20 correspondra en réalité à un d_rm de 0,85. Omettre cette distinction revient à surestimer massivement l’efficacité clinique de l’intervention rapportée dans les comptes rendus d’évaluation.
8. Correction de Hedges pour les petits échantillons dans Excel
8.1 Origine et impact du biais d’échantillonnage réduit
La théorie asymptotique standard postule que l’estimateur de la variance combinée converge fidèlement vers le paramètre de population à mesure que la taille d’échantillon croît. Cependant, dans les cohortes restreintes courantes en recherche clinique (par exemple des protocoles d’imagerie par résonance magnétique fonctionnelle ou d’études pilotes portant sur n1 = n2 = 8 participants), la distribution du d de Cohen exhibe une asymétrie résiduelle substantielle.
Ce biais systématique trouve son origine stochastique dans le fait que l’espérance mathématique de l’inverse de la racine carrée d’une variable aléatoire distribuée selon une loi de chi-carré ne correspond pas à l’inverse de la racine carrée de son espérance : E[1/s] est strictement supérieur à 1/sigma. Il en résulte que le d de Cohen tend mathématiquement à surestimer la véritable taille d’effet d’une proportion inversement proportionnelle aux degrés de liberté globaux.
Dès lors que la taille totale de l’échantillon N = n1 + n2 franchit un seuil inférieur à 30 ou 40 participants, l’utilisation de l’estimateur sans biais g de Hedges devient une obligation méthodologique pour satisfaire aux critères de rigueur scientifique. L’estimateur g élimine ce biais structurel et garantit que l’espérance de la statistique d’effet coïncide rigoureusement avec le paramètre delta de la population étudiée.
8.2 Implémentation du facteur de correction J dans Excel
Le rétablissement de la neutralité stochastique nécessite l’application d’un facteur correcteur multiplicatif J. Deux méthodologies d’implémentation algorithmique sont envisageables au sein de Microsoft Excel : l’approximation polynomiale de Hedges et la formule analytique exacte mobilisant la fonction gamma.
L’approximation polynomiale, d’une élégance et d’une simplicité remarquables, s’implémente immédiatement. Si le total cumulé des effectifs (n1 + n2) réside en cellule D2, le facteur J s’écrit en cellule D12 selon la syntaxe suivante :
=1 – (3 / (4 * D2 – 9))
Pour les méthodologistes exigeant une précision arithmétique absolue exempte de la moindre approximation polynomiale, Excel dispose d’une fonction mathématique avancée permettant d’exécuter la formule exacte : GAMMA.LN (qui renvoie le logarithme népérien de la fonction Gamma d’Euler). La formulation exacte de Hedges s’énonce :
J_exact = EXP( GAMMA.LN(df/2) – (0,5 * LN(df/2) + GAMMA.LN((df – 1)/2)) )
En admettant que les degrés de liberté totaux df = (n1 + n2 – 2) se situent dans la cellule D7, cette équation exacte se traduit sous Excel par la syntaxe experte suivante :
=EXP(GAMMA.LN(D7/2) – (0,5*LN(D7/2) + GAMMA.LN((D7-1)/2)))
L’analyse comparative des valeurs renvoyées démontre que pour df = 10, l’approximation fournit J = 0,9231 tandis que la fonction exacte produit J = 0,9236. Cet écart infinitésimal de l’ordre de 0,05 % atteste de l’excellence de l’approximation de base pour la quasi-totalité des travaux de recherche contemporains, bien que la formulation exacte confère une élégance formelle indiscutable au classeur d’analyse.
8.3 Conversion opérationnelle du d de Cohen en g de Hedges
La transformation finale s’opère par une multiplication scalaire directe entre le d de Cohen brut calculé préalablement (cellule D10) et le facteur d’ajustement J stabilisé en cellule D12. La cellule finale D14 accueille la formule :
=D10 * D12
Il est particulièrement instructif de structurer un tableau récapitulatif comparant systématiquement les deux indices, ainsi que leur pourcentage relatif de distorsion. Une ligne de diagnostic peut afficher le taux d’ajustement :
=(D14 – D10) / D10 (formatée en pourcentage avec deux décimales).
Ce tableau met immédiatement en exergue l’impact de la correction : sur un échantillon total de N = 12 sujets avec un d brut observé de 0,80, le passage au g de Hedges ramène l’effet standardisé à environ 0,74, prévenant ainsi toute conclusion enthousiaste infondée relative à une efficacité clinique potentiellement surévaluée. Dans les rapports académiques soumis aux comités de lecture internationaux, la formulation de transcription adoptera la syntaxe canonique : g de Hedges = 0,74 (d de Cohen non corrigé = 0,80), assurant une conformité parfaite avec les critères éditoriaux les plus stricts.
9. Calcul des intervalles de confiance du d de Cohen sous Excel
9.1 Importance inférentielle des intervalles de confiance
Une taille d’effet ponctuelle, qu’il s’agisse d’un d de Cohen ou d’un g de Hedges, ne constitue qu’une estimation isolée extraite d’une distribution d’échantillonnage stochastique soumise aux aléas de la variabilité expérimentale. Présenter un d de 0,50 sans qualifier son degré d’incertitude métrologique constitue une lacune analytique majeure, car ce résultat peut tout aussi bien masquer un intervalle de confiance compris entre 0,40 et 0,60 (démontrant une précision expérimentale robuste sur un échantillon volumineux) qu’un intervalle oscillant entre -0,10 et 1,10 (révélant une indécision totale sur un petit échantillon où l’effet réel est compatible avec une régression ou une absence totale d’action).
L’intervalle de confiance (IC) à 95% quantifie l’espace paramétrique qui, sous réserve de la répétition infinie du protocole d’échantillonnage dans des conditions strictement analogues, contiendrait la véritable taille d’effet populationnelle delta dans exactement 95% des réalisations empiriques. Si cet intervalle englobe la valeur zéro, le praticien en déduit immédiatement que les données observées ne permettent pas d’écarter l’hypothèse nulle au seuil alpha bilatéral de 5%.
Pour cette raison fondamentale, l’Association for Psychological Science (APS) et les consortiums internationaux de neurosciences font du reporting systématique des intervalles de confiance de taille d’effet un prérequis inaliénable à la publication scientifique de tout essai randomisé ou étude observationnelle.
9.2 Estimation de l’erreur type asymptotique du d de Cohen
L’estimation de l’intervalle de confiance requiert au préalable la dérivation de l’erreur type (Standard Error ou SE) associée au d de Cohen. L’expression analytique de l’erreur type asymptotique, formalisée par Larry Hedges et Ingram Olkin, relie intimement les effectifs des deux cohortes indépendantes à la magnitude même du d observé selon la formulation :
SE(d) = RACINE( ( (n1 + n2) / (n1 * n2) ) + ( PUISSANCE(d; 2) / (2 * (n1 + n2)) ) )
Cette structure mathématique met en lumière une réalité conceptuelle passionnante : contrairement à l’erreur type de la moyenne qui ne dépend exclusivement que de la taille de l’échantillon et de la variance brute, l’erreur type d’une taille d’effet standardisée dépend également de sa propre amplitude d. Plus l’effet observé est d’une magnitude élevée, plus sa distribution d’échantillonnage s’élargit, augmentant la variabilité de l’estimation.
Pour implémenter cette équation sous Excel, supposons que n1 réside en B2, n2 en C2, et le d de Cohen final en D10. L’encodage s’effectue en cellule D16 selon la syntaxe suivante :
=RACINE( ((B2 + C2) / (B2 * C2)) + (PUISSANCE(D10; 2) / (2 * (B2 + C2))) )
Cette approximation asymptotique s’avère extrêmement précise dès lors que l’effectif combiné total excède une trentaine de sujets. Pour des volumes inférieurs, elle fournit une approximation opérationnelle satisfaisante pour les analyses courantes, bien que les logiciels de bio-statistique de pointe recourent à des itérations algorithmiques numériques basées sur l’inversion de la fonction de répartition de la loi t non-centrale.
9.3 Détermination des bornes inférieure et supérieure à 95%
Une fois l’erreur type SE(d) calculée en cellule D16, l’établissement des bornes de l’intervalle de confiance à 95% fait appel au quantile critique de la distribution normale standard correspondant au risque d’erreur alpha bilatéral de 5% (soit z = 1,95996). Dans les versions modernes d’Excel, ce quantile s’extrait avec une précision dynamique grâce à la fonction LOI.NORMALE.STANDARD.INVERSE.N.
La marge d’erreur critique (Marginal Error ou ME) s’établit en cellule D17 par la formule :
=LOI.NORMALE.STANDARD.INVERSE.N(0,975) * D16
L’utilisation de la probabilité cumulée 0,975 correspond à l’encadrement central bilatéral de 95%, laissant 2,5% de part et d’autre de la queue de distribution normale.
Les deux bornes extrêmes se déduisent alors par simple soustraction et addition de cette marge d’erreur à la taille d’effet ponctuelle :
- Borne inférieure (cellule D18) : =D10 – D17
- Borne supérieure (cellule D19) : =D10 + D17
Pour restituer ce résultat sous une forme textuelle académique prête à l’intégration dans un manuscrit scientifique, nous pouvons concaténer ces valeurs au sein d’une cellule de mise en forme finale via l’opérateur esperluette (&) et la fonction TEXTE :
= »IC à 95% [ » & TEXTE(D18; « 0,00 ») & » ; » & TEXTE(D19; « 0,00 ») & « ] »
Cette automatisation garantit une standardisation formelle absolue, exempte de coquilles de transcription typographique entre le tableur d’analyse et le rapport de synthèse définitif.
10. Automatisation du calcul : fonctions VBA et modèles réutilisables
10.1 Développement d’une fonction personnalisée VBA (UDF)
Bien que l’écriture de formules matricielles et arithmétiques imbriquées au sein de la grille de calcul réponde aux impératifs d’audit visuel, la création d’une macro-fonction personnalisée (User Defined Function ou UDF) via l’éditeur Visual Basic for Applications (VBA) confère au classeur une ergonomie logicielle supérieure. Une telle fonction condense l’intégralité de l’algorithme sous une étiquette unique, utilisable à l’identique d’une fonction Excel native telle que SOMME ou MOYENNE.
Pour déployer cette technologie, activez l’éditeur de code via la combinaison de touches Alt + F11, insérez un nouveau module standard (menu Insertion > Module) et rédigez la macro-structure fonctionnelle suivante :
Function CohenD_Independant(Plage_Groupe1 As Range, Plage_Groupe2 As Range) As Variant
La fonction déclare en variables locales : n1, n2, Moy1, Moy2, Var1, Var2, DegLib, VarComb, EcartTypeComb, et CohenD. Le code extrait le dénombrement via l’objet Application.WorksheetFunction.Count, calcule la moyenne par Average et la variance d’échantillon au moyen de Var_S. Un contrôle conditionnel vérifie que les effectifs n1 et n2 sont strictement supérieurs à 1 afin d’éviter toute division par zéro.
Le calcul de la variance combinée s’exécute ensuite en traduisant fidèlement la pondération :
DegLib = (n1 – 1) + (n2 – 1)
VarComb = (((n1 – 1) * Var1) + ((n2 – 1) * Var2)) / DegLib
EcartTypeComb = Sqr(VarComb)
CohenD_Independant = (Moy1 – Moy2) / EcartTypeComb
End Function
Une fois le module compilé et la fenêtre VBA refermée, l’utilisateur dispose dans sa feuille de calcul active d’une formule sur-mesure ultra-sécurisée : il suffit de taper =CohenD_Independant(A2:A31; B2:B31) pour obtenir instantanément la taille d’effet sans saturer l’espace de multiples cellules intermédiaires.
10.2 Conception d’un template dynamique pour laboratoire de recherche
L’optimisation des flux d’analyse au sein d’une unité de recherche ou d’un service d’évaluation clinique repose sur la diffusion d’un classeur-matrice modèle standardisé, protégé contre les mauvaises manipulations fortuites. Les erreurs humaines courantes – effacement accidentel d’une formule matricielle, écrasement d’une constante de degrés de liberté – peuvent être définitivement éradiquées par une politique de verrouillage d’interface.
La démarche commence par la sélection exclusive des cellules réservées à la saisie des données brutes ou des paramètres résumés. Via la boîte de dialogue Format de cellule (Ctrl + 1), dans l’onglet Protection, décochez la case « Verrouillé ». Ensuite, activez la protection globale de la feuille de calcul (onglet Révision > Protéger la feuille) en attribuant un mot de passe d’administration. Dès lors, les collaborateurs ne peuvent intervenir que sur les champs de saisie désignés, tandis que toute l’architecture de calcul mathématique demeure scellée et inviolable.
Pour perfectionner ce template, mettez en place des contrôles de type liste déroulante via la Validation des données, autorisant par exemple l’utilisateur à commuter dynamiquement entre un « Plan à échantillons indépendants » et un « Plan à mesures répétées ». À l’aide de formules conditionnelles articulées autour de la fonction SI ou CHOISIR, le modèle permute de lui-même les algorithmes de calcul sous-jacents et ajuste dynamiquement les intitulés des résultats affichés. Le classeur doit être sauvegardé sous le format pérenne « Modèle Excel prenant en charge les macros » portant l’extension .xltm.
10.3 Audit algorithmique et maintenance du classeur
La crédibilité d’une chaîne de traitement de données repose sur son auditabilité permanente. Microsoft Excel propose une suite d’outils graphiques d’analyse d’une valeur inestimable, regroupés dans l’onglet Formules > Audit de formules. En cliquant sur le bouton « Repérer les antécédents », le tableur génère des flèches de traçage vectorielles bleues matérialisant l’ensemble des cellules élémentaires qui alimentent l’écart-type combiné ou le d de Cohen. Cette inspection visuelle garantit qu’aucune valeur n’a été omise dans l’argument de plage.
Réciproquement, la commande « Repérer les dépendants » permet de vérifier instantanément quelles inférences ultérieures (intervalles de confiance, seuils méta-analytiques, indices de conversion) seraient altérées par la modification d’un paramètre spécifique. Pour pérenniser la traçabilité de protocoles de longue durée, il est hautement recommandé d’incorporer une feuille d’audit distincte au sein du classeur, documentant formellement l’historique des modifications, la nomenclature des versions, le nom des analystes ayant validé les équations et les résultats des tests de résistance réalisés.
Ces tests de résistance (stress tests) consistent à injecter intentionnellement des jeux de données aux propriétés extrêmes ou pathologiques : effectifs réduits à n = 2, variances parfaitement symétriques, scores constants à variance nulle, ou écarts colossaux de moyennes. Observer comment le classeur réagit à ces singularités numériques valide l’intégrité de ses fonctions de capture d’erreur (SIERREUR) et garantit sa résilience opérationnelle avant son déploiement à grande échelle.
11. Interprétation psychologique et visualisation graphique des résultats
11.1 Grille de lecture des seuils de Cohen et contextualisation
En formulant sa métrique standardisée, Jacob Cohen a énoncé des critères conventionnels qualitatifs d’interprétation devenus omniprésents dans la formation académique :
- Un effet est considéré comme faible aux alentours de d = 0,20.
- Un effet est qualifié de moyen vers d = 0,50.
- Un effet est désigné comme fort à partir de d = 0,80 et au-delà.
Toutefois, Jacob Cohen lui-même a assorti ces conventions de sévères mises en garde méthodologiques, trop souvent oblitérées par les chercheurs contemporains. Appliquer aveuglément cette grille de lecture hors de son contexte disciplinaire constitue une dérive intellectuelle majeure. Dans le champ de l’évaluation des politiques éducatives ou de la réhabilitation cognitive post-lésionnelle, un d de Cohen de 0,20 représente un gain substantiel et difficile à obtenir, justifiant pleinement des investissements budgétaires d’envergure. À l’opposé, en recherche de laboratoire ultra-contrôlée évaluant des illusions visuelles perceptives élémentaires, un effet de d = 0,50 traduirait une performance modeste et inhabituellement fluctuante.
La contextualisation de la taille d’effet impose donc de comparer le d observé non pas à des étalons abstraits, mais à la distribution empirique des effets documentés dans la littérature spécialisée du sous-domaine concerné. En outre, sur des critères sanitaires majeurs (comme la réduction de la mortalité cardiovasculaire ou la prévention du suicide), des tailles d’effet en apparence minuscules (d de l’ordre de 0,10 à 0,15) recouvrent le sauvetage de milliers de vies humaines à l’échelle d’une nation, atteignant une importance clinique transcendante que le qualificatif conventionnel de « faible effet » dévaloriserait injustement.
11.2 Traduction de l’effet en indices intuitifs (U3, BESD, CLES)
L’indice standardisé d de Cohen demeure un objet mathématique abstrait, fréquemment opaque pour les cliniciens de terrain, les patients ou les décideurs institutionnels. Pour combler ce déficit d’intelligibilité, les psychométriciens ont mis au point des métriques de translation probabiliste intuitives, directement calculables sous Excel à partir de la valeur de d.
Le premier indice est le coefficient de non-chevauchement des distributions, formalisé sous l’étiquette U3 de Cohen. Il indique le pourcentage d’individus du groupe expérimental dont les performances surpassent la moyenne centroïde du groupe témoin. Sous l’hypothèse de distributions normales, U3 s’implémente sous Excel dans une cellule adjacente via la fonction native :
=LOI.NORMALE.STANDARD.N(D10; VRAI)
Pour un d de Cohen de 0,80, U3 renvoie 0,788 (soit 78,8%), illustrant immédiatement qu’environ huit patients sur dix sous traitement surpassent le niveau médian des sujets témoins.
Le second indice d’une clarté pédagogique éclatante est la taille d’effet en langage courant (Common Language Effect Size ou CLES), développée par McGraw et Wong. Elle évalue la probabilité absolue qu’un individu sélectionné aléatoirement dans le groupe expérimental affiche un score supérieur à celui d’un individu tiré au sort dans le groupe témoin. Son implémentation sous Excel s’exécute selon la syntaxe :
=LOI.NORMALE.STANDARD.N(D10 / RACINE(2); VRAI)
Pour un d de 0,50, le CLES s’établit à environ 64%, signifiant qu’il existe près de deux chances sur trois d’observer un avantage en faveur du sujet traité lors d’un appariement aléatoire en miroir.
Enfin, le présentoir binomial de taille d’effet (Binomial Effect Size Display ou BESD) formalisé par Robert Rosenthal et Donald Rubin traduit le d en taux de succès comparatif. Après conversion du d en coefficient r via la formule r = d / RACINE(d^2 + 4), le taux de succès du groupe expérimental devient (0,50 + r/2) tandis que celui du groupe témoin est (0,50 – r/2). Ces métriques pragmatiques dotent l’analyste d’un vocabulaire narratif percutant pour communiquer la portée de ses découvertes scientifiques.
11.3 Visualisation graphique sous Excel : distributions et diagrammes de forêt
La communication visuelle constitue le prolongement indissociable de la rigueur mathématique. Sous Microsoft Excel, la matérialisation graphique du d de Cohen peut s’opérer selon deux représentations analytiques privilégiées : la superposition des courbes de Gauss théoriques illustrant le décalage de distribution, et le diagramme de forêt (forest plot) positionnant l’effet et son intervalle de confiance.
Pour construire une représentation de densités de probabilités superposées, générez une colonne d’abscisses Z s’étalant de -4,0 à +4,0 avec un incrément constant de 0,1 (cellules A2 à A82). Dans la colonne adjacente B, modélisez la distribution normale de référence du groupe témoin au moyen de l’expression :
=LOI.NORMALE.N(A2; 0; 1; FAUX)
Dans la colonne C, modélisez la distribution du groupe expérimental décalée de la valeur observée du d de Cohen (logée en D10) :
=LOI.NORMALE.N(A2; $D$10; 1; FAUX)
En insérant un « Graphique en nuage de points avec lignes lissées » fondé sur ces deux séries, Excel trace visuellement les deux collines de Gauss en mettant en exergue l’ampleur du glissement centroïde et la zone de chevauchement résiduelle.
Pour concevoir un diagramme de forêt (forest plot) dans le format standardisé des revues savantes, créez un graphique à barres ou en nuage de points horizontal positionnant le d estimé sur l’axe des x. Activez ensuite les « Barres d’erreur » de la série de données (onglet Création de graphique > Ajouter un élément graphique > Barres d’erreur > Autres options). Paramétrez les barres en mode bilatéral, avec extrémité en « Té », et sélectionnez l’option « Personnalisée » en affectant la cellule contenant la marge d’erreur ME calculée (D17) aux valeurs d’erreur positives et négatives. Vous obtenez un tracé graphique d’une netteté parfaite, restituant l’estimation ponctuelle encadrée par son intervalle de confiance à 95%, prêt pour l’exportation vers un éditeur de texte académique.
12. Erreurs méthodologiques fréquentes lors du calcul sous Excel
12.1 Confusions relatives aux fonctions de dispersion d’Excel
La structure de la bibliothèque des fonctions statistiques d’Excel comporte des ambiguïtés historiques susceptibles d’induire de graves altérations méthodologiques chez les utilisateurs non avertis. La plus pernicieuse concerne la dissociation mathématique entre la variance échantillonnale (divisée par n – 1) et la variance populationnelle (divisée par n).
Comme évoqué précédemment, l’utilisation par inadvertance de la fonction ECARTYPE.PEARSON (ou ECARTYPEP) au lieu de ECARTYPE.STANDARD engendre une sous-estimation systématique de l’écart-type de chaque condition. Cette anomalie découle de la suppression arbitraire de la correction de Bessel pour les degrés de liberté. En injectant un dénominateur artificiellement contracté dans l’équation de standardisation, la taille d’effet finale d se trouve dilatée au-delà de sa véritable valeur théorique.
Pour prévenir cette dérive dans les environnements de laboratoire partagés, il est indispensable de formaliser une stratégie de contrôle systématique de la nomenclature des formules. Une commande d’audit efficace consiste à afficher l’intégralité des formules sous forme textuelle brute via la combinaison de touches Ctrl + Guillemet (« ) ou l’icône Afficher les formules. Cet affichage global permet de balayer d’un coup d’œil l’ensemble de la feuille pour intercepter toute occurrence anormale de fonctions de type PEARSON ou VAR.P au sein des chaînes computationnelles dévolues à l’inférence échantillonnale.
12.2 Incohérences de conception entre protocoles indépendants et appariés
La confusion entre protocoles indépendants et mesures répétées constitue une faute méthodologique récurrente aux conséquences mathématiques délétères. Lorsqu’un analyste applique la formule canonique pour groupes indépendants à des données appariées (avant/après), il omet la covariance intra-sujet capturée par le coefficient de corrélation r. Cette omission induit une estimation erronée de la variance combinée, qui se trouve surévaluée par rapport à la dispersion propre des différences individuelles.
Il en découle une sous-estimation dramatique de la taille d’effet réelle d_z, masquant parfois des avancées cliniques substantielles qui auraient pourtant été confirmées par un test t apparié significatif. Inversement, appliquer les équations de mesures répétées sur deux cohortes réellement distinctes revient à présupposer une dépendance stochastique arbitraire entre des individus n’ayant aucun lien, détruisant la validité inférentielle de l’étude.
Pour parer à ce risque, tout gabarit d’analyse doit intégrer une grille diagnostique préalable formalisée par deux questions de filtrage méthodologique incontournables :
- Les deux colonnes de données numériques émanent-elles physiquement des mêmes participants évalués à des moments temporels distincts ou de paires jumelées univoquement ? Si la réponse est affirmative, le protocole est strictement apparié.
- Les deux groupes sont-ils formés d’individus mutuellement exclusifs recrutés indépendamment ? Si oui, le protocole relève exclusivement du régime des échantillons indépendants.
Ce diagnostic élémentaire élimine toute incertitude de modélisation avant le moindre calcul opérationnel.
12.3 Dysfonctionnements de syntaxe et limites structurelles d’Excel
Au-delà des aspects théoriques, la manipulation de formules arithmétiques complexes au sein d’Excel confronte le chercheur aux pièges syntaxiques intrinsèques au tableur. Le plus banal, mais non le moins destructeur, concerne la priorité des opérateurs lors des divisions fractionnaires composées. Une formule tapée sous la forme =B3 – C3 / B8 divisera exclusivement C3 par B8 avant de soustraire le résultat de B3, en vertu de la primauté conventionnelle de la division sur la soustraction. L’omission des parenthèses englobant le numérateur (B3 – C3) fausse intégralement le résultat sans déclencher le moindre message d’erreur d’Excel.
Un deuxième écueil syntaxique réside dans le maniement imprécis des références relatives et absolues (le symbole $). Lors de la duplication ou de l’étirement d’une formule sur une colonne pour traiter plusieurs variables psychométriques dépendantes en série, l’absence de verrouillage des adresses de cellules des dénominateurs combinés provoque un décalage glissant des références vers des cellules vides ou non conformes, polluant silencieusement les estimations d’effet.
Enfin, il convient de se prémunir contre la propagation silencieuse de valeurs numériques importées sous forme de texte d’apparence normale. Si une cellule statistique contient des espaces invisibles ou un mauvais caractère décimal, certaines fonctions d’Excel peuvent ignorer la cellule sans renvoyer d’erreur explicite, réduisant insidieusement la taille d’échantillon prise en compte dans le calcul de la dispersion. L’application systématique de la fonction de contrôle ESTNUM sur l’ensemble des plages d’entrée certifie l’homogénéité numérique des variables avant de lancer la séquence de calcul du d de Cohen.
Références
Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
Dunlap, W. P., Cortina, J. M., Vaslow, J. B., & Burke, M. J. (1996). Meta-analysis of experiments with matched groups or repeated measures designs. Psychological Methods, 1(2), 170–177. https://doi.org/10.1037/1082-989X.1.2.170
Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
Hedges, L. V., & Olkin, I. (1985). Statistical Methods for Meta-Analysis. Academic Press. https://doi.org/10.1016/C2009-0-03396-0
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
Morris, S. B., & DeShon, R. P. (2002). Combining effect size estimates in meta-analysis with repeated measures and independent-groups designs. Psychological Methods, 7(1), 105–125. https://doi.org/10.1037/1082-989X.7.1.105
Rosenthal, R., & Rubin, D. B. (1982). A simple, general purpose display of magnitude of experimental effect. Journal of Educational Psychology, 74(2), 166–169. https://doi.org/10.1037/0022-0663.74.2.166
Wilkinson, L., & Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594