
L’inférence statistique appliquée aux sciences empiriques repose traditionnellement sur la comparaison de paramètres de tendance centrale entre deux populations indépendantes. Au cœur de cette démarche, le test t développé initialement par William Sealy Gosset sous le pseudonyme de Student a longtemps constitué la méthode de référence pour évaluer la significativité des écarts observés entre deux moyennes d’échantillons. Toutefois, l’architecture mathématique du test standard de Student repose sur une hypothèse restrictive d’homogénéité des variances populationnelles, également désignée sous le terme d’homoscédasticité. Lorsque cette condition d’égalité des variances est compromise, particulièrement en présence de tailles d’échantillons inégales, la validité des conclusions inférentielles se dégrade considérablement, exposant le chercheur à une inflation incontrôlée de l’erreur de première espèce ou à une chute drastique de la puissance statistique.
Face à cette vulnérabilité méthodologique, l’adaptation conçue par le statisticien Bernard Lewis Welch en 1947 apporte une solution analytique robuste. En refusant de contraindre les variances à une valeur combinée artificielle et en ajustant judicieusement les degrés de liberté selon une formule d’approximation spécifique, le test t de Welch s’est imposé dans la littérature scientifique moderne comme l’approche par défaut la plus sécurisante pour la comparaison de deux groupes indépendants. Dans le domaine des sciences psychologiques, de la biomédecine et des sciences sociales, où les distributions réelles dérogent fréquemment aux idéaux de laboratoire, l’utilisation systématique de cette procédure permet de préserver la rigueur épistémologique des analyses.
L’environnement statistique SAS (Statistical Analysis System) intègre de manière native et élégante les outils nécessaires à la conduite, à l’interprétation et à la restitution graphique du test de Welch à travers sa puissante procédure PROC TTEST. Ce guide approfondi a pour vocation de décomposer l’ensemble des fondements théoriques, des mécanismes computationnels et des pratiques opérationnelles indispensables pour maîtriser le test t de Welch dans SAS. Du diagnostic préliminaire des distributions jusqu’à la mise en forme finale des résultats selon les normes académiques internationales de l’American Psychological Association (APA), chaque étape fait l’objet d’un examen minutieux afin d’outiller méthodologiquement les analystes et chercheurs les plus exigeants.
1. Fondements théoriques du test t de Welch et pertinence méthodologique
1.1 Origine statistique et résolution du problème de Behrens-Fisher
Le développement du test t de Welch s’inscrit directement dans la quête séculaire d’une solution au redoutable problème de Behrens-Fisher, formalisé dans les années 1930. Ce défi statistique fondamental concerne l’inférence sur la différence entre les moyennes de deux populations distribuées normalement lorsque le rapport de leurs variances respectives demeure totalement inconnu et potentiellement non unitaire. Le test classique de Student, formulé au début du vingtième siècle, postule expressément que les variances des deux populations sont identiques, ce qui autorise le regroupement des sommes de carrés pour calculer une variance combinée unique, souvent désignée sous le terme de variance poolée. Lorsque cette prémisse s’avère violée, la statistique pivotale sous-jacente ne suit plus rigoureusement une distribution t de Student canonique, faussant irrémédiablement le calcul des valeurs critiques et des probabilités associées.
Pour contourner cette aporie mathématique, Bernard Lewis Welch a proposé en 1947 une approche novatrice reposant sur l’abandon pur et simple du regroupement des variances d’échantillons. Au lieu d’agréger les variances sous le postulat illusoire d’une homoscédasticité parfaite, Welch utilise les variances empiriques distinctes calculées au sein de chaque groupe d’observation. L’innovation majeure de sa contribution réside dans le développement d’une approximation asymptotique élégante, formulée conjointement avec les travaux de Franklin E. Satterthwaite sur les combinaisons linéaires de carrés moyens. Cette méthode permet d’estimer des degrés de liberté effectifs ajustés qui compensent la déformation de la distribution d’échantillonnage de la statistique de test. Grâce à cette dérivation mathématique, le problème de Behrens-Fisher trouve une résolution pratique satisfaisante pour l’échantillonnage issu de lois normales.
L’approximation de Welch-Satterthwaite ne contraint plus les degrés de liberté à être des nombres entiers correspondant à la somme des effectifs diminuée de deux unités. Elle produit au contraire une valeur réelle fractionnaire, directement modulée par la discordance relative entre les variances d’échantillons et le ratio des effectifs des sous-groupes. Cette élégance algorithmique assure que, quelle que soit la disparité des dispersions sous-jacentes, la distribution de la statistique de test converge étroitement vers la loi t théorique appropriée, restituant ainsi au praticien un outil décisionnel fiable et exempt des biais inhérents à l’inférence classique sous hétéroscédasticité.
1.2 Pertinence et application en sciences psychologiques
Dans le champ des sciences psychologiques, neuropsychologiques et comportementales, les plans d’expérience et quasi-expérimentaux génèrent de façon quasi ubiquitaire des données caractérisées par une hétérogénéité marquée des variances. Les cohortes cliniques, par exemple des patients présentant un trouble dépressif majeur ou des traumatismes crâniens, manifestent intrinsèquement une dispersion de leurs réponses cognitives beaucoup plus étendue que celle observée au sein d’échantillons de contrôle neurotypiques. De surcroît, le recrutement de populations cliniques spécifiques se heurte fréquemment à des contraintes logistiques sévères, aboutissant inévitablement à des effectifs inégaux entre les conditions expérimentales. Cette conjonction entre asymétrie des effectifs et divergence des variances constitue un piège statistique dévastateur pour le chercheur non averti.
Lorsque le groupe présentant l’effectif le plus restreint est également celui qui exhibe la variance la plus volumineuse, le test t standard de Student devient excessivement libéral. Dans une telle configuration, le taux d’erreur de type I réel peut aisément dépasser les quinze à vingt pour cent pour un seuil nominal fixé à cinq pour cent, conduisant à des faux positifs intempestifs et à la publication de conclusions fallacieuses. À l’inverse, si le groupe le plus volumineux possède la variance la plus forte, le test de Student devient excessivement conservateur, écrasant la puissance statistique et empêchant la détection d’effets thérapeutiques ou cognitifs pourtant réels. Face à cette instabilité chronique, les méthodologistes contemporains préconisent l’abandon pur et simple du réflexe consistant à employer le test de Student classique au profit du test t de Welch.
L’adoption par défaut du test de Welch en psychométrie offre une protection immédiate et universelle contre ces distorsions inferentielles. Contrairement à une idée reçue tenace, l’application du test de Welch en situation de parfaite égalité des variances n’entraîne qu’une perte infinitésimale de puissance statistique, généralement estimée à moins de quelques millièmes. Les bénéfices en matière de contrôle de l’erreur de type I surpassent infiniment ce coût négligeable, justifiant pleinement la recommandation actuelle des comités éditoriaux des revues de l’American Psychological Association d’ériger le test de Welch en norme standard de comparaison de deux moyennes indépendantes.
1.3 Comparaison structurelle : Student, Welch et Mann-Whitney
Pour appréhender la portée méthodologique du test de Welch, il convient de le situer au sein du triptyque analytique classique comprenant le test t de Student et le test non paramétrique de Wilcoxon-Mann-Whitney. Structurellement, le test t de Student opère via une standardisation de la différence des moyennes en divisant cette dernière par une erreur type conjointe calculée à partir de la moyenne pondérée des deux variances d’échantillons. Cette démarche repose sur le postulat fondamental que les deux échantillons proviennent de populations de variances strictement identiques. Le test de Welch brise cette symétrie imposée en conservant l’individualité de l’erreur type de chaque groupe, formulant ainsi une erreur type globale équivalente à la racine carrée de la somme des variances d’échantillons divisées par leurs effectifs respectifs.
Le test de Wilcoxon-Mann-Whitney, quant à lui, évacue l’exigence de normalité métrique en transformant les valeurs quantitatives continues en rangs ordinaux. Si cette conversion assure une robustesse séduisante face aux distributions fortement asymétriques ou polluées par des valeurs extrêmes, elle altère profondément la nature de l’hypothèse mise à l’épreuve. Le test non paramétrique de Mann-Whitney ne teste pas formellement l’égalité des moyennes arithmétiques, mais plutôt la dominance stochastique entre deux distributions, ce qui correspond à l’égalité des médianes uniquement lorsque les formes et les dispersions des distributions des deux groupes sont rigoureusement identiques. Dès lors que l’hétéroscédasticité s’accompagne d’une dissemblance des formes de distribution, le test de Mann-Whitney échoue également à contrôler le taux d’erreur de type I, rendant son utilisation inappropriée pour pallier un simple problème d’inégalité des variances.
En matière de puissance statistique, le test de Welch domine le test de Mann-Whitney dès lors que les données sous-jacentes respectent une normalité approximative, tout en surpassant le test de Student en matière de robustesse lorsque les variances divergent. Des simulations de Monte Carlo de grande envergure ont démontré que le test de Welch maintient le taux d’erreur de type I à son niveau nominal alpha à travers une multitude de configurations de ratios de variances et de déséquilibres d’effectifs, ce qui en fait l’outil le plus équilibré et le plus résilient pour l’analyse comparée de deux conditions indépendantes.
2. Formulation des hypothèses et modèle mathématique sous-jacent
2.1 Définition des hypothèses nulle et alternative
L’élafication formelle du cadre d’inférence statistique nécessite une spécification rigoureuse des hypothèses statistiques mises en concurrence. Dans le cadre du test t de Welch pour deux échantillons indépendants, l’espace des paramètres est défini par les moyennes théoriques respectives des deux populations mères, notées traditionnellement mu un et mu deux. L’hypothèse nulle, désignée par H zéro, stipule l’absence de différence entre ces paramètres de tendance centrale. Elle s’énonce mathématiquement sous la forme mu un égal à mu deux, ou de façon équivalente, mu un moins mu deux égal à une constante delta, cette constante étant presque universellement fixée à zéro dans les études empiriques cherchant à valider l’existence d’une différence de traitement.
L’hypothèse alternative, notée H un, peut prendre une forme bilatérale ou unilatérale selon les fondements théoriques et les postulats préalables du chercheur. Dans sa déclinaison bilatérale ou non directionnelle, la plus couramment adoptée pour préserver l’impartialité épistémique, H un affirme simplement que mu un est différent de mu deux, impliquant que la soustraction de mu deux à mu un aboutit à une valeur non nulle. Dans le contexte d’interventions comportementales, cliniques ou éducatives, des formulations unilatérales directionnelles peuvent être avancées, affirmant que mu un est strictement supérieur à mu deux ou, à l’opposé, strictement inférieur à mu deux. Ces spécifications directionnelles exigent toutefois une justification théorique inattaquable pour éviter tout écueil de sélection opportuniste a posteriori des hypothèses statistiques.
Sur le plan conceptuel, le rejet de l’hypothèse nulle au profit de l’hypothèse alternative dans le cadre du test de Welch confère une validation statistique forte quant à l’efficacité différentielle d’un traitement expérimental face à une condition contrôle. Parce que le test n’impose pas l’artefact d’une variance commune, la conclusion d’un rejet de H zéro garantit que la divergence constatée entre les groupes porte authentiquement sur l’emplacement des moyennes de population, sans que cette inférence ne soit corrompue par l’hétérogénéité structurelle des dispersions intra-groupes.
2.2 Mécanisme de calcul de la statistique t de Welch
Le calcul de la statistique d’épreuve du test t de Welch découle d’une modification structurelle de la formule de standardisation de la différence des moyennes d’échantillons. Soient deux échantillons aléatoires indépendants d’effectifs respectifs n un et n deux, présentant des moyennes empiriques X barre un et X barre deux, ainsi que des variances non biaisées d’échantillon notées s un au carré et s deux au carré. La statistique t de Welch est formellement définie par le ratio suivant : le numérateur correspond à la différence observée entre les moyennes empiriques moins la différence théorique postulée sous H zéro, tandis que le dénominateur représente l’erreur type estimée de cette différence.
Ce dénominateur s’exprime comme la racine carrée de la somme de la variance du premier groupe divisée par son effectif et de la variance du second groupe divisée par son effectif propre. Mathématiquement, nous avons donc au dénominateur la racine carrée de l’expression s un au carré sur n un plus s deux au carré sur n deux. Cette formulation refuse catégoriquement toute mise en commun pondérée des variances, assurant que chaque groupe contribue à l’erreur type totale strictement au prorata de sa propre variabilité et de sa taille d’échantillon. Cette séparation des composantes de variance protège la statistique contre la distorsion d’échelle induite par un groupe hyper-dispersé de petit effectif.
L’étape computationnelle déterminante concerne l’estimation des degrés de liberté associés à cette statistique t, désignés par la lettre grecque nu. Selon l’approximation de Welch-Satterthwaite, ces degrés de liberté sont calculés selon l’expression ratio suivante : au numérateur, on élève au carré la somme de s un au carré sur n un et de s deux au carré sur n deux. Au dénominateur, on calcule la somme de deux termes : le premier terme est le carré de s un au carré sur n un, divisé par n un moins un ; le second terme est le carré de s deux au carré sur n deux, divisé par n deux moins un. Le résultat de cette formule est une valeur continue qui reflète fidèlement la répartition relative de l’incertitude entre les deux sous-populations échantillonnées.
Le comportement asymptotique de cette statistique d’épreuve est remarquable d’efficacité. Lorsque les effectifs n un et n deux tendent vers l’infini, la statistique t de Welch converge en loi vers une distribution normale standard centrée réduite, conformément au théorème central limite. Pour des échantillons finis, la statistique suit de manière extrêmement précise la distribution t de Student correspondant aux degrés de liberté ajustés fractionnaires nu, permettant un calcul exact des probabilités critiques sans nécessiter d’ajustements empiriques complexes ou de tables statistiques particulières, les algorithmes de SAS exécutant ces calculs avec une précision numérique totale.
3. Conditions d’application et vérification diagnostique préalable
3.1 Indépendance des observations et échantillonnage
Bien que le test de Welch s’affranchisse de l’hypothèse classique d’homoscédasticité, il demeure strictement assujetti au postulat fondamental d’indépendance des observations. En psychologie expérimentale et en recherche biomédicale, ce postulat requiert que l’attribution d’un score à une unité d’observation donnée au sein d’un groupe ne conditionne ni n’influence en aucune manière le score d’une autre unité d’observation, que ce soit au sein du même groupe ou dans le groupe opposé. La violation de cette indépendance stochastique fausse irrémédiablement l’estimation de l’erreur type, introduisant des corrélations résiduelles qui détruisent la validité de l’inférence statistique globale.
Les risques associés aux violations d’indépendance émergent fréquemment lors de l’application indue du test de Welch à des plans factoriels à mesures répétées, des conceptions pré-test post-test non appariées, ou des dispositifs d’échantillonnage en grappes non contrôlés. Par exemple, si des participants sont évalués au sein de dyades interactives, de groupes de thérapie ou de salles de classe partagées sans modélisation de l’effet d’appartenance au groupe, une dépendance intra-classe positive en résultera inévitablement. Une telle situation gonfle artificiellement la précision apparente et peut transformer une absence d’effet en résultat faussement significatif. Dans ces situations, le recours aux modèles linéaires mixtes s’avère méthodologiquement indispensable.
Le contrôle rigoureux des biais d’échantillonnage constitue le rempart primordial pour préserver la validité interne du dispositif expérimental. La randomisation pure des sujets entre les conditions de traitement et de contrôle, combinée à une administration standardisée en double aveugle des protocoles de recueil, permet de garantir que l’indépendance statistique des erreurs résiduelles est respectée. En l’absence d’assignation aléatoire, l’analyste doit contrôler scrupuleusement l’existence d’éventuels facteurs de confusion susceptibles d’induire des covariations cachées entre les sujets échantillonnés.
3.2 Évaluation de la normalité des distributions
Le modèle mathématique sous-jacent au test de Welch postule que la variable dépendante continue suit une loi normale au sein de chacune des deux populations sous-jacentes. L’évaluation de cette hypothèse de normalité constitue une étape préalable incontournable dans tout pipeline analytique. Dans l’écosystème SAS, cette vérification est idéalement orchestrée à l’aide de la procédure PROC UNIVARIATE, enrichie de l’instruction NORMAL, qui déclenche automatiquement le calcul d’une batterie complète d’indices distributionnels et de tests formels d’adéquation.
Le test de Shapiro-Wilk, généré par PROC UNIVARIATE pour les échantillons dont la taille est inférieure à deux mille observations, constitue le test d’hypothèse de normalité le plus puissant de la littérature contemporaine. Une p-value inférieure au seuil alpha conventionnel de zéro virgule zéro cinq indique un rejet de l’hypothèse de normalité univariée. Toutefois, dans les échantillons volumineux, ce test acquiert une puissance telle qu’il tend à rejeter la normalité pour des écarts infinitésimaux et méthodologiquement bénins. C’est pourquoi l’analyste chevronné confronte toujours cette statistique aux coefficients d’asymétrie, désignés sous le terme de skewness, et d’aplatissement, désignés sous le terme de kurtosis. Des valeurs d’asymétrie situées entre moins un et plus un, associées à un kurtosis inférieur en valeur absolue à deux ou trois, témoignent d’un éloignement tolérable par rapport à la normalité théorique.
L’inspection visuelle à l’aide des diagrammes quantile-quantile, communément appelés Q-Q plots, complète indispensablement l’examen numérique. Dans PROC UNIVARIATE, l’instruction QQPLOT permet de tracer les quantiles empiriques de l’échantillon contre les quantiles théoriques issus d’une loi normale standardisée. Si les points observés s’alignent fidèlement le long de la bissectrice droite de référence, l’hypothèse de normalité peut être considérée comme plausible. Tout décrochage systématique sous forme de courbe en S ou d’écart prononcé aux extrémités signale la présence de queues de distribution épaisses ou d’une asymétrie marquée, incitant à la prudence ou au recours à des méthodes d’estimation robustes.
3.3 Diagnostic de la variance et hétérogénéité
L’examen approfondi des dispersions intra-groupes représente la justification première du choix entre le test standard de Student et l’ajustement de Welch. Bien que le test de Student possède une robustesse modérée face à l’hétérogénéité des variances lorsque les effectifs des deux sous-groupes sont parfaitement équilibrés, cette résilience s’effondre dramatiquement dès lors que les effectifs diffèrent, même de façon modérée. Un ratio de variance excédant un facteur de un virgule cinq ou deux, conjugué à un ratio d’échantillonnage de un pour un virgule cinq, suffit amplement à déséquilibrer les propriétés de rejet du test t classique.
L’exploration descriptive des paramètres de dispersion s’amorce par la comparaison systématique des écarts-types et des écarts interquartiles calculés au sein de chaque groupe. L’écart interquartile, insensible aux points extrêmes, permet de confirmer que la divergence des écarts-types n’est pas le simple artefact d’une observation unique aberrante, mais bien l’expression d’une hétérogénéité structurelle de la dispersion globale de la population cible. Si le rapport entre la variance maximale et la variance minimale s’avère substantiel, la nécessité empirique de recourir à l’ajustement de Welch s’impose de facto.
Toutefois, la pratique historique consistant à conditionner le choix de la méthode de test au résultat d’un pré-test formel d’homoscédasticité, tel que le test F de Fisher ou le test de Levene, est aujourd’hui vigoureusement réprouvée par les statisticiens méthodologistes. Ce processus conditionnel en deux étapes altère le taux global d’erreur de type I de l’analyse globale. L’hétérogénéité diagnostiquée sur le plan descriptif, conjuguée aux arguments théoriques inhérents au domaine de recherche, justifie pleinement l’adoption proactive et inconditionnelle du test t de Welch sans soumettre l’analyste aux aléas des pré-tests d’homoscédasticité.
4. Structuration et encodage des données dans l’environnement SAS
4.1 Architecture du jeu de données expérimental
Pour exécuter un test t de Welch au sein de SAS via les procédures dédiées, les données empiriques doivent impérativement être structurées selon un format tabulaire dit long ou univarié. Contrairement au format large où chaque groupe expérimental occuperait une colonne distincte, le format long consolide l’ensemble des observations quantitatives de la variable dépendante au sein d’une seule et unique colonne numérique. Une seconde variable, de nature catégorielle ou de classification, est simultanément requise pour expliciter l’appartenance de chaque observation à l’un des deux sous-groupes comparés.
La variable de classification doit être rigoureusement binaire au sein du périmètre d’analyse considéré. Elle peut être encodée sous la forme d’une variable numérique prenant des valeurs conventionnelles telles que zéro et un, ou sous la forme d’une variable alphanumérique textuelle courte identifiant distinctement les modalités expérimentales, par exemple Controle versus Traitement. Il est fondamental de veiller à ce qu’aucun troisième groupe ou modalité parasite ne subsiste dans le vecteur de sélection, sous peine de déclencher des erreurs de traitement lors de l’appel des procédures SAS conçues exclusivement pour des comparaisons dyadiques.
Le typage des variables lors de l’étape DATA revêt une importance capitale. La variable dépendante continue doit être déclarée sans ambiguïté comme numérique à double précision pour éviter toute troncature prématurée des décimales lors des calculs d’erreurs types. De surcroît, l’attribution préalable de libellés clairs via l’instruction LABEL et de formats d’affichage via l’instruction FORMAT permet d’enrichir considérablement l’intelligibilité des sorties ODS générées ultérieurement par les moteurs d’analyse de SAS.
4.2 Syntaxe de saisie directe via les instructions DATALINES
L’intégration directe d’un jeu de données au sein d’un script SAS s’effectue traditionnellement par le biais d’une étape DATA utilisant les instructions combinées INPUT et DATALINES. Cette approche est particulièrement utile dans le cadre d’études pilotes, d’exemples de démonstration ou pour des cohortes de taille modeste issues d’évaluations d’efficacité pédagogique ou clinique. Le programmeur définit les attributs de ses variables dans l’instruction INPUT, en faisant suivre le nom de la variable d’un signe dollar si celle-ci est de type caractère, puis énumère ligne par ligne les observations empiriques après l’instruction DATALINES.
Considérons l’exemple concret d’une recherche en psychopédagogie cognitive évaluant l’efficacité d’une méthode d’apprentissage immersif comparée à un enseignement conventionnel. L’étape DATA commence par la déclaration du nom de la table cible dans l’espace de travail WORK, par exemple DATA WORK.EfficacitePeda. L’instruction INPUT définit ensuite deux variables fondamentales : la variable Groupe, spécifiée comme alphanumérique par le symbole dollar, et la variable Score, définie implicitement comme quantitative continue. Les lignes de données sont ensuite directement saisies entre l’instruction DATALINES et le point-virgule terminal marquant la clôture du bloc de saisie.
Une fois l’étape DATA compilée et exécutée par le moteur SAS via l’instruction RUN, la validation systématique de l’intégrité de la table résultante s’opère au moyen de la procédure PROC PRINT. Cette commande élémentaire permet d’afficher l’intégralité du contenu tabulaire dans le visualiseur de résultats afin de s’assurer de l’absence de décalage de colonnes, de fautes de frappe dans les codes de groupe ou d’omissions inopinées de valeurs numériques, garantissant ainsi que la table en mémoire est prête pour l’étape inférentielle.
4.3 Importation de fichiers externes pour larges cohortes
Dans le contexte d’études épidémiologiques ou de vastes collectes de données psychométriques multivariées, les observations brutes sont quasi systématiquement hébergées au sein de fichiers externes, tels que des fichiers délimités par des virgules (CSV), des classeurs Microsoft Excel (XLSX) ou des bases de données relationnelles structurées. L’extraction de ces volumineux gisements informationnels vers l’espace SAS s’effectue principalement au moyen de la procédure PROC IMPORT, qui automatise la lecture des formats tabulaires modernes.
L’instruction PROC IMPORT exige la spécification précise de plusieurs paramètres d’environnement : l’instruction DATAFILE localise le chemin physique d’accès au fichier source sur le système d’exploitation, l’option OUT nomme la table SAS résultante, et le mot-clé DBMS explicite le format du pilote de lecture à mobiliser, tel que CSV ou XLSX. L’instruction optionnelle GETNAMES=YES ordonne au compilateur d’utiliser la première ligne du fichier externe pour extraire et attribuer automatiquement les noms des variables correspondantes. En outre, l’analyste peut déployer l’instruction REPLACE afin d’autoriser l’écrasement dynamique de la table si le script est exécuté de manière itérative.
La gestion rigoureuse des données manquantes constitue une exigence critique lors de l’importation. Les champs vides sont conventionnellement traduits par SAS sous la forme d’un point pour les variables numériques. Enfin, la procédure PROC CONTENTS doit être immédiatement sollicitée après l’exécution de PROC IMPORT. Cette procédure d’audit dresse un inventaire exhaustif des métadonnées de la table : nombre total d’observations, volumétrie des variables, typage formel et longueur de stockage en octets. Cet examen permet d’éliminer en amont tout risque d’incompatibilité de type avant de lancer les calculs du test t de Welch.
5. Exécution du test t de Welch via la procédure PROC TTEST
5.1 Syntaxe fondamentale de PROC TTEST
L’exécution computationnelle du test t de Welch repose au premier chef sur la procédure SAS dédiée aux comparaisons de moyennes : la procédure PROC TTEST. Conçue pour offrir une synthèse statistique exhaustive en un minimum d’instructions, PROC TTEST ne requiert que deux commandes structurelles fondamentales en complément de sa déclaration initiale : l’instruction CLASS et l’instruction VAR. Cette économie de syntaxe dissimule un moteur algorithmique d’une remarquable sophistication mathématique.
L’instruction CLASS désigne la variable indépendante de classification dichotomique qui scinde l’échantillon en deux sous-ensembles indépendants. L’instruction VAR, quant à elle, spécifie la variable dépendante continue sur laquelle porte la comparaison des moyennes. Par exemple, si l’on souhaite tester la divergence des scores d’anxiété entre un groupe témoin et un groupe traité, la séquence minimale s’articule comme suit : on initialise la procédure par PROC TTEST DATA=NomDeLaTable, on déclare CLASS GroupeTraitement, on indique VAR ScoreAnxiete, et l’on clôt la séquence par l’instruction RUN.
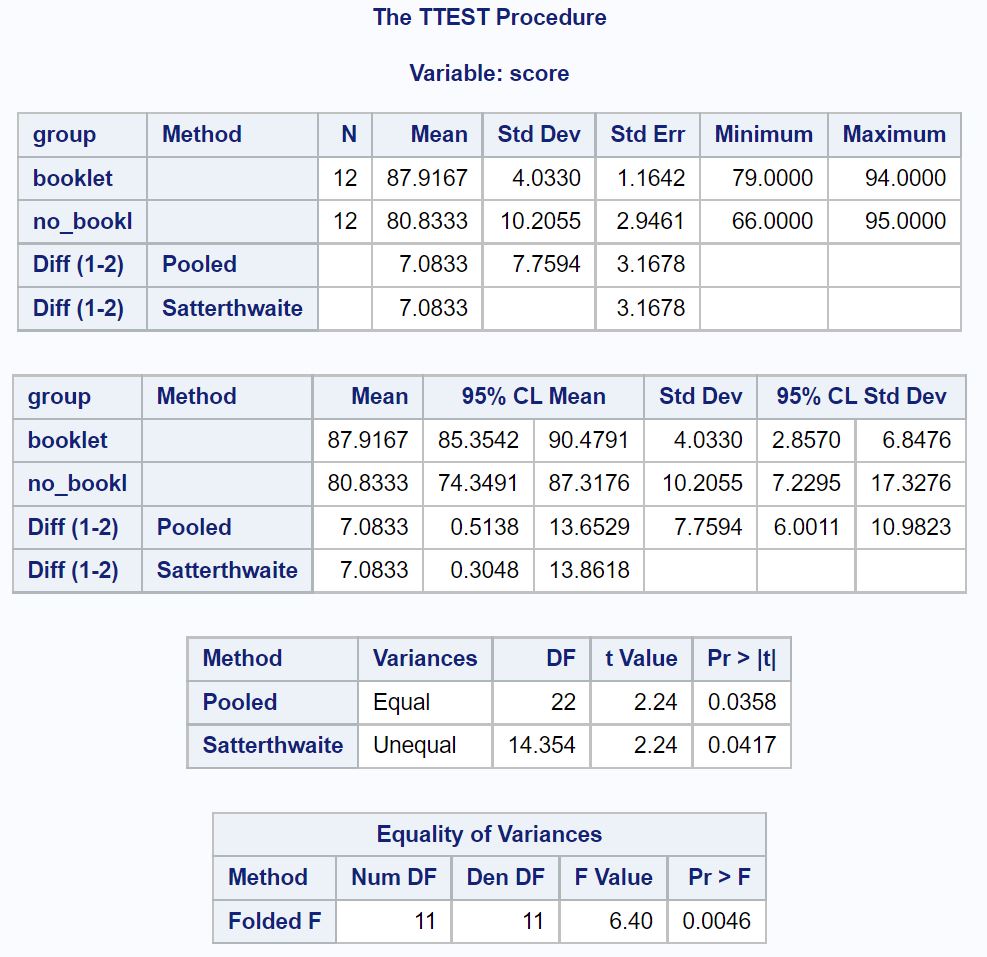
Le comportement intrinsèque de PROC TTEST illustre la philosophie d’exhaustivité de SAS : par défaut, la procédure ne contraint pas l’utilisateur à choisir a priori entre le test t classique et le test de Welch. Au lieu de cela, SAS calcule et présente systématiquement, au sein du même tableau de sortie d’épreuve d’hypothèses, deux lignes de résultats distinctes : la ligne Pooled, correspondant au test classique de Student fondé sur l’hypothèse d’homogénéité des variances, et la ligne Satterthwaite, qui constitue précisément la mise en œuvre de l’ajustement de Welch pour variances inégales. L’analyste dispose ainsi d’une visibilité comparative immédiate sur les deux démarches inférentielles.
5.2 Options avancées pour la personnalisation du calcul
La procédure PROC TTEST met à la disposition des chercheurs une vaste gamme d’options avancées permettant de calibrer avec précision les conditions du test d’hypothèse selon les exigences méthodologiques du protocole expérimental. Parmi ces paramètres, l’option ALPHA=, insérée directement sur l’instruction de déclaration PROC TTEST, permet de moduler le niveau de risque de première espèce toléré. Bien que la valeur par défaut soit conventionnellement fixée à zéro virgule zéro cinq pour correspondre à un intervalle de confiance bilatéral de quatre-vingt-quinze pour cent, le chercheur peut déclarer par exemple ALPHA=0.01 pour exiger un seuil de rigueur de quatre-vingt-dix-neuf pour cent, ou ALPHA=0.10 dans le cadre d’études exploratoires précoces.
Une autre option déterminante réside dans le paramètre SIDES=, qui gouverne la directionnalité de l’épreuve d’hypothèse. Par défaut, SAS applique un test bilatéral non directionnel, modélisé par l’expression SIDES=2. Si le cadre conceptuel justifie formellement une hypothèse unilatérale directionnelle prédisant que le premier groupe surpasse le second, l’analyste spécifiera l’option SIDES=U pour évaluer si la moyenne du premier groupe est supérieure à celle du second. Réciproquement, la déclaration SIDES=L permet de tester l’infériorité unilatérale. L’ajustement de ces options recalculera instantanément les degrés de liberté, les intervalles de confiance unilatéraux et la probabilité critique p sans qu’il soit nécessaire d’effectuer des divisions manuelles de probabilités sujettes à des erreurs de calcul.
De surcroît, l’option H0= autorise la modification de la valeur postulée sous l’hypothèse nulle. Si le praticien ne cherche pas à établir une simple différence par rapport à zéro, mais désire tester si la différence entre deux interventions dépasse un seuil d’équivalence clinique ou d’efficacité minimale pré-établi de cinq unités métriques, il lui suffit d’adjoindre le paramètre H0=5 sur la ligne d’appel de la procédure. Cette grande flexibilité paramétrique fait de PROC TTEST un instrument d’une adaptabilité exemplaire pour l’ensemble des besoins de la recherche translationnelle.
5.3 Optimisation des sorties avec le système ODS
Le système de distribution des sorties de SAS, universellement désigné par l’acronyme ODS (Output Delivery System), confère une maîtrise absolue sur l’affichage, le filtrage et l’exportation des métriques générées par PROC TTEST. En amont de l’analyse, l’activation du sous-système graphique au moyen de l’instruction globale ODS GRAPHICS ON déploie l’ensemble des fonctionnalités de rendu visuel haute résolution, produisant nativement des représentations visuelles synchronisées avec les estimateurs statistiques.
Pour rationaliser l’espace d’affichage et focaliser l’attention analytique sur les composantes de Welch, l’instruction ODS SELECT s’avère particulièrement efficace. En spécifiant ODS SELECT ConfLimits TTests, le compilateur SAS masque les panneaux superflus pour n’imprimer dans le flux de sortie que le tableau des intervalles de confiance et la table des statistiques d’épreuve t. Cette sélection rigoureuse permet de nettoyer les rapports d’analyse de tout encombrement informatif inutile, facilitant ainsi la revue de synthèse par les pairs.
Au-delà du simple filtrage visuel, l’instruction ODS OUTPUT offre la possibilité d’intercepter directement les tables de données internes générées par la procédure pour les convertir en nouvelles tables permanentes ou temporaires de l’environnement SAS. Par exemple, l’instruction ODS OUTPUT TTests=WORK.ResultatsWelch transfère instantanément la statistique t, les degrés de liberté décimaux et la probabilité critique p au sein d’une table dédiée. Cette fonctionnalité ouvre la voie à l’automatisation complète de méta-analyses, de pipelines de rapports itératifs ou d’intégrations dynamiques dans des documents de publication via ODS RTF ou ODS PDF.
6. Analyse du test d’égalité des variances dans la sortie SAS
6.1 Décryptage du test d’égalité des variances Folded F
Chaque exécution standard de la procédure PROC TTEST génère en fin de rapport un tableau spécifique intitulé « Equality of Variances », matérialisant le test d’égalité des variances traditionnellement désigné sous l’appellation de test F plié (Folded F test). Ce test paramétrique repose sur le calcul d’un ratio de variances conçu pour que le numérateur soit systématiquement la plus grande des deux variances d’échantillons, tandis que le dénominateur représente la plus petite. Cette construction technique assure que la statistique F observée est toujours supérieure ou égale à un, d’où le qualificatif de pliée conféré à sa distribution d’échantillonnage.
L’interprétation de la valeur p associée à cette statistique F fournit une indication formelle sur la plausibilité de l’hypothèse nulle d’homogénéité des variances. Si la probabilité calculée par SAS est inférieure au seuil alpha conventionnel de zéro virgule zéro cinq, l’hypothèse d’homogénéité des variances de population est statistiquement rejetée. Une telle conclusion alerte formellement l’analyste sur la présence d’une hétérogénéité significative des dispersions intra-groupes, disqualifiant l’utilisation du test classique de Student.
Toutefois, la communauté biométrique moderne souligne avec insistance les faiblesses conceptuelles de cette dépendance vis-à-vis du test Folded F. D’une part, ce test est d’une sensibilité exacerbée à la violation de la normalité univariée : une asymétrie modérée ou des queues de distribution épaisses suffisent à fausser la valeur F, conduisant à diagnostiquer une hétérogénéité des variances là où il n’y a qu’une déviation de forme. D’autre part, en présence d’échantillons réduits, le test Folded F manque cruellement de puissance statistique, échouant fréquemment à détecter des écarts de variance pourtant dévastateurs pour le test t classique. Ces limitations confirment la pertinence d’adopter le test de Welch par défaut, s’affranchissant ainsi du pré-test F.
6.2 Distinction formelle entre méthode Pooled et méthode Satterthwaite
Le cœur décisionnel du rapport généré par la procédure PROC TTEST réside dans la table « T-Tests », au sein de laquelle SAS juxtapose deux paradigmes mathématiques rigoureusement distincts matérialisés par les libellés « Pooled » et « Satterthwaite ». La ligne Pooled formalise l’application du test classique de Student : elle utilise la somme pondérée des variances pour établir les degrés de liberté, qui correspondent strictement à un nombre entier égal à la somme des effectifs n un et n deux diminuée de deux unités. Cette ligne n’est méthodologiquement valide que si l’hypothèse d’homoscédasticité parfaite est indubitablement satisfaite.
La ligne Satterthwaite, quant à elle, constitue la matérialisation opérationnelle exacte du test t de Welch dans SAS. Le terme Satterthwaite réfère à la méthode de pondération des degrés de liberté adoptée par le logiciel, qui découle de la combinaison linéaire des estimateurs de variance. En observant cette rangée, le praticien constate immédiatement que les degrés de liberté affichés ne sont plus des entiers mais comportent des décimales précises. La statistique t figurant sur cette ligne est ajustée d’après l’erreur type non mise en commun, offrant la garantie d’une inférence valide face à l’hétérogénéité des variances.
L’impact de la discordance entre ces deux lignes de résultats sur les conclusions méthodologiques peut s’avérer déterminant pour le sort d’une hypothèse de recherche. Dans le cas fréquent où le sous-groupe le plus restreint présente la dispersion la plus élevée, la ligne Pooled sous-estime drastiquement l’erreur type réelle et gonfle artificiellement la statistique t, générant une p-value faussement significative. En observant la ligne Satterthwaite, l’analyste constate souvent que la p-value repasse au-dessus du seuil critique, évitant ainsi la publication d’un faux positif destructeur pour la réplicabilité de la science. Réciproquement, la ligne Satterthwaite peut restaurer une significativité injustement masquée par la méthode Pooled lorsque le plus grand groupe est le plus dispersé.
7. Interprétation statistique détaillée des résultats de Welch
7.1 Lecture des degrés de liberté fractionnaires
L’une des caractéristiques les plus déroutantes pour le chercheur profane abordant la sortie Satterthwaite de PROC TTEST concerne la présence de degrés de liberté fractionnaires, c’est-à-dire non entiers, comportant plusieurs décimales. Dans le cadre de la théorie classique des probabilités, les degrés de liberté renvoient intuitivement au nombre d’éléments d’information indépendants qui sont libres de varier lors de l’estimation d’un paramètre, concept qui suggère nécessairement un décompte d’unités entières. Toutefois, dans le cadre de l’approximation de Welch-Satterthwaite, les degrés de liberté ne représentent plus une simple entité de dénombrement physique, mais un paramètre d’ajustement mathématique continu.
La valeur fractionnaire des degrés de liberté Satterthwaite est directement modulée par l’ampleur de la divergence relative entre les variances des deux groupes rapportée à leurs effectifs respectifs. Plus l’écart entre les rapports variance sur effectif des deux groupes est prononcé, plus les degrés de liberté effectifs se rapprochent de la taille du groupe le plus instable diminuée d’une unité, sanctionnant ainsi l’incertitude pesant sur l’estimation de l’erreur type globale. À l’inverse, si les variances et les effectifs des deux échantillons sont approximativement symétriques, les degrés de liberté calculés par l’algorithme s’approcheront très près de la valeur théorique maximale entière de n un plus n deux moins deux.
La conservation de la précision décimale intégrale des degrés de liberté dans les calculs de SAS est primordiale pour la détermination exacte de l’intégrale de la loi t de Student régissant le calcul de la probabilité critique p. Lors de la restitution académique des données, arrondir ces degrés de liberté à l’entier le plus proche constitue une entorse méthodologique formelle qui dégrade la reproductibilité numérique de la recherche. Le rapportage textuel doit donc impérativement consigner ces degrés de liberté avec au minimum une ou deux décimales de précision.
7.2 Évaluation de la p-value et prise de décision
Le processus décisionnel d’inférence statistique s’articule autour de la confrontation de la probabilité critique, désignée par l’expression Pr > |t| dans le tableau des sorties de SAS, au seuil de significativité alpha prédéterminé par le protocole expérimental. Cette p-value représente la probabilité d’obtenir une statistique d’épreuve au moins aussi extrême que celle observée dans les données d’échantillon, sous l’hypothèse absolue que l’hypothèse nulle d’égalité parfaite des moyennes de populations soit vraie. Si cette valeur est inférieure ou égale à alpha, conventionnellement zéro virgule zéro cinq, l’analyste conclut au rejet de H zéro au profit de l’hypothèse alternative.
La rigueur scientifique impose de s’abstraire d’une vision binaire et réductrice de la p-value, qui consisterait à assimiler tout franchissement de seuil à une démonstration irréfutable de vérité biologique ou psychologique. L’évaluation de la probabilité critique issue de la méthode de Welch doit systématiquement être mise en balance avec la puissance du dispositif d’échantillonnage et la plausibilité théorique de l’effet examiné. Une p-value de zéro virgule zéro quarante-huit obtenue au sein d’une cohorte marginalement dimensionnée requiert une interprétation prudente et invite impérativement à des réplications empiriques ultérieures indépendantes.
Il est en outre essentiel de rappeler la distinction épistémologique fondamentale entre significativité statistique et importance clinique ou pratique. Le rejet de l’hypothèse nulle via le test de Welch confirme simplement que la divergence observée entre les moyennes est peu susceptible d’être imputable aux seules fluctuations d’échantillonnage aléatoire. Elle ne préjuge en rien de la portée concrète, de l’ampleur substantielle ou de l’utilité clinique du gain mesuré. Cette dimension quantitative de l’effet ne peut être appréhendée que par l’examen conjoint des intervalles de confiance et le calcul formalisé des tailles d’effet standardisées.
7.3 Analyse des intervalles de confiance de la différence
L’estimation ponctuelle de la différence de moyennes ne livre qu’une perspective incomplète de la réalité sous-jacente ; c’est pourquoi la table « Confidence Limits » générée par PROC TTEST constitue une composante d’interprétation incontournable. Sur la ligne Satterthwaite, SAS calcule l’intervalle de confiance bilatéral pour la différence des moyennes des populations, défini par la différence empirique observée plus ou moins le produit de l’erreur type non mise en commun de Welch et du quantile critique de la distribution t correspondant aux degrés de liberté ajustés fractionnaires au niveau de couverture requis, généralement quatre-vingt-quinze pour cent.
L’analyse inférentielle de cet intervalle de confiance procure une double lecture méthodologique. Sur le plan de la décision d’hypothèse, si la borne inférieure et la borne supérieure de l’intervalle à quatre-vingt-quinze pour cent possèdent le même signe mathématique, c’est-à-dire si l’intervalle exclut entièrement la valeur zéro, l’analyste dispose d’une confirmation visuelle directe du rejet de l’hypothèse nulle au seuil de cinq pour cent. À l’inverse, l’inclusion du chiffre zéro dans l’étendue de l’intervalle atteste de l’impossibilité de rejeter H zéro, révélant qu’une différence nulle demeure pleinement compatible avec les données empiriques recueillies.
Sur le plan de l’estimation de précision, l’étendue de cet intervalle de confiance informe de manière transparente sur la certitude de la mesure empirique. Un intervalle extrêmement large, même s’il exclut zéro, témoigne d’un manque de précision méthodologique inhérent à une dispersion intra-groupe massive ou à un effectif restreint, signalant que la véritable valeur populationnelle de la différence d’intervention pourrait tout aussi bien être dérisoire ou considérable. Réciproquement, un intervalle étroitement resserré borne avec exactitude l’amplitude du bénéfice attendu, conférant une robustesse décisionnelle essentielle pour orienter des choix de santé publique ou des politiques éducatives.
8. Estimation de l’ampleur de l’effet en contexte d’hétérogénéité
8.1 Limites du d de Cohen classique avec variances inégales
La statistique inférentielle moderne conditionne la validité des comptes rendus empiriques à la présentation systématique d’une mesure d’ampleur d’effet standardisée, affranchie de l’unité de mesure initiale. Le standard historique le plus largement répandu pour la comparaison de deux moyennes est le d de Cohen, qui exprime l’écart entre deux moyennes en unités d’écart-type. Toutefois, dans sa formulation conventionnelle, le d de Cohen standardise la différence des moyennes en divisant cette dernière par l’écart-type combiné ou poolé, une démarche qui postule implicitement l’égalité formelle des variances de population.
Lorsque cette présomption d’homogénéité s’effondre, l’utilisation de l’écart-type combiné classique biaise lourdement l’estimation de la taille d’effet réelle. Si le sous-groupe doté de la plus grande variance présente également un effectif prédominant, l’écart-type poolé sera massivement tiré vers le haut, compressant artificiellement le d de Cohen et sous-estimant grossièrement l’ampleur réelle de l’effet d’intervention. Réciproquement, si le groupe de fort effectif possède la variance la plus faible, l’écart-type poolé sera artificiellement affaissé, produisant un d de Cohen hypertrophié qui survendra l’efficacité de la manipulation expérimentale.
Ces dérives systématiques ont conduit les méthodologistes de la psychométrie contemporaine à proscrire l’usage du d de Cohen canonique en situation d’hétéroscédasticité confirmée. Il devient impératif d’adopter des estimateurs d’effet dont l’équation de standardisation neutralise l’impact de l’asymétrie des effectifs et préserve la fidélité de l’ampleur métrique face à la disparité des dispersions de groupe.
8.2 Calculs alternatifs : d de Cohen ajusté et g de Hedges
Pour restaurer la précision de l’estimation en présence de variances hétérogènes, plusieurs métriques alternatives s’offrent à l’analyste. L’une des solutions les plus élégantes consiste à employer un d de Cohen ajusté pour l’hétérogénéité des variances, parfois désigné sous le nom de d de Welch. Cet estimateur substitue à l’écart-type combiné pondéré la racine carrée de la moyenne arithmétique simple des deux variances d’échantillons. En accordant un poids strictement égal aux deux variances indépendamment des effectifs sous-jacents, cette standardisation élimine le biais d’attraction exercé par le groupe d’échantillonnage le plus massif.
Dans le contexte d’échantillons de taille réduite, généralement lorsque les effectifs de groupe sont inférieurs à vingt ou trente unités, le d de Cohen a tendance à surestimer légèrement la taille d’effet populationnelle. Larry Hedges a développé un facteur de correction sans biais, donnant naissance au g de Hedges. Ce facteur multiplicatif, formulé en fonction des degrés de liberté totaux, réduit légèrement la magnitude ponctuelle pour éliminer ce biais d’échantillonnage. En contexte d’hétérogénéité, ce facteur de correction de Hedges est avantageusement appliqué au dénominateur ajusté de Welch pour maximiser la neutralité de l’estimation finale.
Au sein de SAS, bien que PROC TTEST puisse fournir des indices de taille d’effet, l’automatisation d’un calcul sur mesure du d de Cohen ajusté et de son g de Hedges correspondant peut être facilement programmée par l’entremise de la procédure interactive de calcul matriciel PROC IML ou à travers une simple étape DATA alimentée par les tables d’estimation générées via l’instruction ODS OUTPUT. Cette rigueur algorithmique garantit la conformité totale de la restitution statistique avec les standards méthodologiques les plus pointus.
8.3 Interprétation contextuelle de la taille d’effet
L’évaluation quantitative des tailles d’effet s’est longtemps référée de manière quasi dogmatique aux seuils conventionnels formulés par Jacob Cohen dans ses ouvrages pionniers : un d avoisinant zéro virgule deux étant qualifié d’effet faible, un d de zéro virgule cinq de moyen, et un d atteignant ou dépassant zéro virgule huit de fort. Bien que ces repères fournissent une première grille d’orientation générale, la psychologie et la biomédecine contemporaines mettent fermement en garde contre l’application aveugle de ces frontières rigides et décontextualisées.
La véritable signification d’une taille d’effet dépend intrinsèquement de la nature de la variable examinée, du champ disciplinaire et de la finalité de l’intervention. Dans le cadre d’un protocole d’intervention en psychologie de la santé portant sur la réduction de comportements addictifs ou l’amélioration des fonctions cognitives chez des patients atteints de démence débutante, une taille d’effet modeste oscillant entre zéro virgule vingt et zéro virgule trente peut revêtir une portée clinique et sociétale monumentale. Réciproquement, dans un cadre de psychologie cognitive expérimentale évaluant des temps de réaction sous paradigme de laboratoire ultra-contrôlé, un d de zéro virgule cinquante peut être considéré comme trivial au regard de la faible variabilité écologique de la tâche.
Par conséquent, l’interprétation moderne de l’ampleur d’effet ne saurait se limiter au simple rapport d’une valeur ponctuelle isolée. Elle requiert la présentation de son intervalle de confiance empirique à quatre-vingt-quinze pour cent, couplée à une discussion substantive mettant en relation la métrique standardisée avec les échelles de mesure concrètes et les retombées pratiques observées dans la littérature spécialisée du domaine.
9. Visualisation avancée des données avec les procédures graphiques SAS
9.1 Exploration visuelle avec les diagrammes en boîte (PROC SGPLOT)
La rigueur de l’exploration statistique exige d’accompagner systématiquement les résultats inférentiels numériques d’une communication visuelle percutante et accessible. Dans l’arsenal graphique de SAS, la procédure PROC SGPLOT s’impose comme l’outil privilégié pour élaborer des diagrammes en boîte à moustaches comparatifs, indispensables pour faire appréhender d’un coup d’œil l’hétérogénéité des variances et la dissymétrie des dispersions entre les deux groupes expérimentaux.
Au moyen de l’instruction VBOX déclarée au sein de PROC SGPLOT, l’analyste spécifie la variable dépendante continue sur l’axe des ordonnées et affecte la variable de classification au paramètre CATEGORY. Cette commande génère une représentation synthétique matérialisant pour chaque groupe la médiane par une ligne centrale, l’écart interquartile par le corps de la boîte délimité par le premier et le troisième quartile, ainsi que l’amplitude globale par les moustaches calculées selon la règle de Tukey à un virgule cinq fois l’écart interquartile. Cette géométrie visuelle permet de saisir instantanément l’asymétrie des étendues de dispersion qui disqualifie le test classique de Student.
Un atout déterminant de PROC SGPLOT réside dans sa capacité à identifier et localiser les observations atypiques ou extrêmes sous la forme de points isolés au-delà des moustaches. L’analyste peut ainsi détecter d’éventuelles valeurs aberrantes influentes qui contribuent de façon démesurée à gonfler la variance d’un groupe particulier. L’adjonction de l’option CATEGORYORDER=RESPONSEDESC ou l’enrichissement graphique par l’instruction DATALABEL permet de styliser le rendu afin de produire des figures directement exploitables pour des présentations en colloque ou des publications dans des périodiques de premier rang.
9.2 Superposition des densités et courbes de distribution
Bien que les diagrammes en boîte illustrent admirablement les paramètres d’écartement médian et interquartile, ils masquent parfois des particularités de distribution sous-jacentes telles que la bimodalité ou des concentrations locales de données. Pour pallier cette lacune visuelle, la cartographie conjointe d’histogrammes et de courbes d’estimation de densité par noyau, couramment appelées KDE (Kernel Density Estimation), offre une perspective morphologique incomparablement plus riche.
Cette approche s’opérationnalise avec élégance dans SAS en exploitant à nouveau la flexibilité de PROC SGPLOT. En utilisant simultanément l’instruction HISTOGRAM et l’instruction DENSITY, l’analyste peut superposer sur le même graphique la distribution discrète des fréquences empiriques et l’estimation continue lissée de la densité pour chaque groupe expérimental via l’option GROUP=. Cette juxtaposition met en lumière non seulement l’écartement relatif des sommets de distribution, matérialisant la divergence des moyennes, mais également l’aplatissement différentiel et l’épaisseur des queues de courbe illustrant graphiquement l’hétéroscédasticité.
La commande DENSITY autorise en outre la spécification du paramètre TYPE=NORMAL pour tracer la courbe gaussienne théorique ajustée sur chaque groupe en parallèle de la courbe empirique de noyau obtenue avec TYPE=KERNEL. Cette double projection offre un outil d’inspection clinique de premier ordre pour évaluer visuellement la conformité à l’hypothèse de normalité requise par le test de Welch, tout en démontrant sans artifice la divergence structurelle des largeurs de distribution caractérisant les populations investiguées.
9.3 Graphiques natifs générés par ODS Graphics dans PROC TTEST
L’activation préalable de la commande globale ODS GRAPHICS ON transforme la simple exécution de PROC TTEST en un générateur automatisé d’infographies diagnostiques et analytiques de pointe. Dès lors que cette option système est opérationnelle, la procédure compile et restitue nativement un panneau récapitulatif multidimensionnel, intitulé « Summary Panel », regroupant sur un tableau de bord unifié les éléments visuels clés de la comparaison de moyennes.
Ce panneau intègre par défaut une double représentation combinant des histogrammes fins adossés à des courbes d’estimation par noyau pour chaque groupe, surmontés de diagrammes en boîte stylisés alignant les moyennes par des marqueurs distinctifs et les médianes par des lignes continues. Ce synoptique visuel complet permet à l’examinateur de vérifier instantanément et simultanément la centralité, la dispersion relative, l’asymétrie et la présence d’éventuels points marginaux, constituant une synthèse visuelle d’une efficacité méthodologique inégalée pour valider la décision d’emprunter la route de Welch.
Par ailleurs, PROC TTEST génère un graphique spécifique dédié aux intervalles de confiance, visualisant l’estimation ponctuelle de la différence des moyennes flanquée de ses barres d’erreur correspondant aux méthodes Pooled et Satterthwaite. L’écartement différentiel des barres d’erreur entre ces deux méthodes matérialise graphiquement l’impact de l’ajustement de Welch sur l’incertitude décisionnelle. L’intégration de ces figures dans des manuscrits scientifiques s’opère sans dégradation de résolution grâce aux pilotes vectoriels de SAS capables d’exporter directement au format EMF, TIFF haute définition ou PDF éditorial.
10. Rédaction et normalisation des résultats selon le style APA
10.1 Règles formelles de présentation des statistiques de Welch (APA 7e)
La restitution académique des analyses quantitatives au sein des revues scientifiques internationales exige une stricte conformité aux canons éditoriaux de l’American Psychological Association, dont la septième édition du manuel de publication définit des règles typographiques et structurelles d’une extrême précision. Dans le cadre spécifique du test t de Welch, le formatage doit refléter de façon explicite la nature ajustée des degrés de liberté afin de lever toute ambiguïté quant à la procédure mathématique mobilisée.
La convention de rapportage impose de consigner la statistique t en caractère italique minuscule, suivie immédiatement entre parenthèses des degrés de liberté de Satterthwaite, lesquels doivent impérativement comporter au moins une décimale pour signaler sans équivoque qu’il s’agit d’une estimation de Welch et non d’un test t classique d’échantillons indépendants. Cette parenthèse est ensuite suivie du signe égal, de la valeur numérique de la statistique t arrondie à deux décimales, d’une virgule, puis de la valeur de la p-value avec trois décimales, précédée du signe égal ou du signe inférieur strict à zéro virgule zéro zéro un si la probabilité calculée par SAS est infinitésimale.
De surcroît, les normes APA prescrivent d’accompagner systématiquement la statistique d’épreuve des indicateurs de tendance centrale et de dispersion pour chaque groupe expérimental, à savoir la moyenne empirique (M en italique) et l’écart-type (SD en italique), présentés avec deux décimales de précision. Enfin, la mention de la taille d’effet standardisée, telle que le d de Cohen ajusté ou le g de Hedges, ainsi que son intervalle de confiance à quatre-vingt-quinze pour cent, constitue un réquisit impératif pour satisfaire aux critères de transparence et d’intégrité de la recherche moderne.
10.2 Modèles de phrases types pour publications académiques
Afin d’illustrer la mise en pratique de ces exigences typographiques, examinons un modèle de rédaction standard pour un résultat attestant d’une divergence statistiquement significative entre deux conditions d’apprentissage : « En raison d’une hétérogénéité marquée des variances confirmée par l’examen descriptif des dispersions, un test t de Welch pour échantillons indépendants a été conduit afin de comparer les performances cognitives des participants. Les analyses révèlent une supériorité statistiquement significative des scores obtenus par le groupe ayant suivi la méthode d’apprentissage immersif (M = 78,42, SD = 14,18) comparativement au groupe témoin soumis à l’enseignement traditionnel (M = 64,15, SD = 6,85), t(32,4) = 4,12, p < ,001, différence moyenne = 14,27, IC 95 % [7,15, 21,39]. L’ampleur de cet effet d’intervention s’avère substantielle, g de Hedges ajusté = 1,24, IC 95 % [0,58, 1,90]. »
Dans la configuration inverse où le traitement expérimental n’induit aucune modification probante du comportement et où l’hypothèse nulle ne peut être rejetée, le compte rendu s’articulera selon la structure suivante : « L’évaluation de l’efficacité thérapeutique au moyen d’un test t de Welch pour groupes indépendants n’indique aucune différence statistiquement significative entre les patients traités (M = 52,10, SD = 11,30) et les sujets placés sous placebo (M = 49,85, SD = 5,40), t(28,7) = 0,81, p = ,424, différence moyenne = 2,25, IC 95 % [-3,42, 7,92], d ajusté = 0,25. L’inclusion du zéro au sein de l’intervalle de confiance étendu souligne l’incompatibilité des données avec l’existence d’un effet thérapeutique cliniquement pertinent. »
Il est fondamental de noter que dans les deux exemples, la justification du recours à la méthode de Welch est explicitement formulée dès l’entame du paragraphe. Cette transparence méthodologique signale aux évaluateurs que le choix statistique n’a pas été opéré de manière arbitraire, mais répond rigoureusement aux propriétés distributionnelles intrinsèques des données observées.
10.3 Conception de tableaux récapitulatifs aux normes éditoriales
La présentation de résultats comparatifs impliquant de multiples variables dépendantes ou des décompositions sous-groupées bénéficie grandement de l’insertion de tableaux récapitulatifs synthétiques conformes aux normes APA. La mise en forme de ces tables prohibe formellement les quadrillages verticaux intempestifs et limite l’usage des bordures horizontales à trois lignes principales : une ligne sous le titre de la table, une ligne démarquant l’en-tête des colonnes et une ligne de clôture inférieure scellant les données au-dessus des notes explicatives.
L’organisation typique des colonnes articule successivement l’intitulé de la condition ou de la variable évaluée, l’effectif valide de chaque groupe, les moyennes empiriques flanquées de leurs écarts-types respectifs placés entre parenthèses, la valeur de la statistique t de Welch avec mention explicite des degrés de liberté fractionnaires associés, la p-value exacte et la mesure de taille d’effet standardisée. L’en-tête de la colonne statistique comportera avantageusement une annotation précisant que les degrés de liberté ont été ajustés selon la méthode de Satterthwaite.
Sous le tableau, des notes de bas de page standardisées apportent les éclaircissements méthodologiques indispensables. La mention générale, introduite par le mot « Note » en italique, explicitera la méthode de calcul mobilisée, par exemple : « Les tests d’inférence reposent sur l’approximation de Welch-Satterthwaite pour variances inégales. » Des notes spécifiques subsidiaires définiront les niveaux de significativité conventionnels à l’aide d’astérisques. L’exportation de ces matrices tabulaires depuis SAS vers un traitement de texte moderne est grandement facilitée par la destination ODS RTF, qui préserve la structure vectorielle et la rigueur typographique directement compatible avec les exigences des comités éditoriaux.
11. Résolution des problèmes fréquents et diagnostics d’erreurs dans SAS
11.1 Analyse des messages du journal SAS (SAS Log)
La console d’exécution de SAS, communément désignée sous le terme de journal ou SAS Log, constitue le centre névralgique de détection des dysfonctionnements programmatiques et des incohérences de données. L’absence de sortie graphique ou tabulaire après la soumission d’une procédure PROC TTEST signale invariablement l’émission d’un message d’erreur bloquant de couleur rouge dans le journal, que l’analyste se doit de décoder méthodiquement.
L’erreur la plus récurrente rencontrée par les praticiens concerne la déclaration de l’instruction CLASS et s’énonce classiquement sous la forme : « ERROR: The CLASS variable has more than 2 levels ». Cette interruption critique survient dès lors que la variable de classification spécifiée contient trois modalités distinctes ou davantage, ou lorsqu’une valeur mal saisie, une variation de casse de caractères (par exemple « Controle » et « controle ») ou une espace parasite crée artificiellement une modalité surnuméraire. La résolution exige un nettoyage immédiat de la variable dans une étape DATA préalable ou le déploiement d’une instruction WHERE conditionnelle, telle que WHERE Groupe IN (‘GroupeA’, ‘GroupeB’), afin de restreindre explicitement l’analyse à une comparaison binaire licite.
Un autre avertissement fréquent dans le journal signale l’exclusion d’observations comportant des valeurs manquantes : « NOTE: Number of observations with missing values: X ». SAS traite par défaut les données manquantes par une exclusion totale au niveau de l’observation (listwise deletion). L’analyste doit contrôler attentivement si ces suppressions automatiques n’amputent pas dramatiquement la taille d’échantillon effective, risquant de fausser la représentativité de la cohorte résiduelle ou d’induire un déséquilibre d’effectif imprévu.
11.2 Gestion des problèmes de convergence et de petits échantillons
L’application de l’approximation de Welch-Satterthwaite au sein de cohortes présentant des effectifs drastiquement réduits, par exemple des groupes de quatre à six participants fréquemment observés dans des études de cas cliniques de neuropsychologie, expose l’inférence à une fragilité structurelle spécifique. Bien que la statistique de Welch demeure sans biais d’estimation, la modélisation asymptotique sous-tendant l’ajustement des degrés de liberté peut souffrir d’une instabilité substantielle lorsque les estimations des variances d’échantillons reposent sur un nombre insuffisant d’unités de mesure.
Dans ce scénario d’extrême petitesse d’échantillonnage, la variance d’échantillon s au carré constitue elle-même une variable aléatoire dotée d’une très forte dispersion d’échantillonnage. En conséquence, les degrés de liberté effectifs nu calculés par la formule de Satterthwaite peuvent chuter dramatiquement pour atteindre des valeurs comprises entre deux et trois, réduisant la puissance statistique du test à un niveau infinitésimal et rendant la détection de tout effet pratiquement impossible, sauf à observer des divergences inter-groupes colossales. L’analyste doit être conscient que la robustesse nominale de Welch ne saurait suppléer miraculeusement à l’absence intrinsèque d’information statistique.
Pour fiabiliser l’inférence dans ce contexte d’effectifs réduits, il est recommandé de confronter systématiquement les sorties de PROC TTEST à des stratégies diagnostiques alternatives, telles que le calcul d’intervalles de confiance par rééchantillonnage bootstrap ou le recours à des tests de permutation exacte. Ces démarches empiriques permettent de s’assurer que la décision d’inférence n’est pas le simple produit d’un artefact numérique issu de l’écrasement des degrés de liberté de Satterthwaite.
11.3 Impact des données aberrantes sur la variance
Le talon d’Achille de tout test paramétrique fondé sur la moyenne arithmétique et la somme des carrés des écarts réside dans son extrême vulnérabilité face aux données aberrantes ou atypiques, désignées sous l’anglicisme d’outliers. Une unique valeur extrême résidant à quatre ou cinq écarts-types de la moyenne d’un groupe suffit à contaminer doublement l’analyse : elle tire mécaniquement la moyenne vers son pôle d’attraction et gonfle de manière disproportionnée la variance empirique de ce sous-groupe, cette dernière étant calculée à partir des carrés des déviations.
Au sein du test de Welch, une telle distorsion génère des répercussions contradictoires. Si la valeur aberrante apparaît dans le groupe expérimental dont la moyenne est la plus élevée, elle peut amplifier la différence observée au numérateur ; simultanément, elle fait exploser le terme variance sur n correspondant au dénominateur, élargissant l’erreur type et comprimant les degrés de liberté Satterthwaite. L’évaluation de l’effet peut ainsi basculer arbitrairement de part et d’autre du seuil de significativité sous l’influence exclusive d’un seul point de donnée mal calibré.
Pour neutraliser ce péril méthodologique, la réalisation systématique d’une analyse de sensibilité s’impose comme une démarche de salubrité épistémique indispensable. Cette procédure consiste à exécuter PROC TTEST sur l’échantillon complet, puis à réitérer l’analyse après exclusion temporaire ou winsorisation des valeurs aberrantes documentées. Si les conclusions inférentielles, les niveaux de significativité et l’ordre de grandeur de la taille d’effet demeurent qualitativement invariants à travers ces deux itérations, l’analyste peut affirmer la robustesse de ses conclusions de recherche. Dans le cas contraire, la publication conjointe des deux jeux d’analyses s’avère impérative pour préserver l’honnêteté scientifique de l’étude.
12. Alternatives analytiques en cas d’échec des hypothèses fondamentales
12.1 Recours aux tests non paramétriques (PROC NPAR1WAY)
Lorsque les données empiriques recueillies violent de façon flagrante et simultanée les postulats de normalité univariée et de symétrie, caractérisées par des asymétries sévères ou des échelles de mesure ordonnées ne satisfaisant pas les prérequis de la métrique d’intervalle, la persistance dans la voie du test t de Welch devient méthodologiquement discutable. Dans cette conjoncture, le transfert vers l’univers de l’analyse non paramétrique s’opérationnalise aisément dans SAS au moyen de la procédure PROC NPAR1WAY.
PROC NPAR1WAY permet d’exécuter avec une grande rigueur le test de la somme des rangs de Wilcoxon, fonctionnellement équivalent au test U de Mann-Whitney. La syntaxe reproduit fidèlement celle de PROC TTEST en mobilisant les instructions CLASS et VAR. Toutefois, il convient d’alerter le chercheur sur la transformation profonde de l’objet d’étude opérée par ce basculement méthodologique. En substituant aux mesures originales leur ordre de rang relatif, PROC NPAR1WAY n’évalue plus l’égalité des moyennes arithmétiques, mais teste l’hypothèse nulle d’équivalence stochastique globale des deux distributions.
De plus, une méconnaissance méthodologique largement partagée consiste à croire que le test de Wilcoxon constitue une panacée absolue face à l’hétéroscédasticité. Comme souligné précédemment, si les variances diffèrent en raison d’une dissemblance structurelle de la forme même des distributions (l’une étant fortement asymétrique à droite et l’autre aplatie ou symétrique), le test de Wilcoxon voit son taux d’erreur de première espèce substantiellement altéré. Son emploi doit donc être réservé aux situations où les distributions des deux groupes partagent une morphologie semblable mais s’écartent conjointement du modèle gaussien.
12.2 Approches par rééchantillonnage et bootstrap dans SAS
Pour s’affranchir des contraintes paramétriques distributionnelles tout en conservant pour cible d’inférence authentique la comparaison des moyennes arithmétiques, la méthodologie moderne plébiscite les approches par rééchantillonnage, au premier rang desquelles figure le bootstrap non paramétrique. Cette stratégie computationnelle génère des milliers de pseudo-échantillons par tirage aléatoire avec remise au sein des données empiriques disponibles, permettant de reconstruire de manière empirique la distribution d’échantillonnage exacte de la différence des moyennes, affranchie de toute hypothèse formelle de normalité théorique.
Au sein de SAS, l’architecture d’un bootstrap robuste s’orchestre avec une grande puissance en combinant la procédure PROC SURVEYSELECT pour orchestrer les tirages itératifs avec remise, et la procédure PROC MEANS ou PROC TTEST pour calculer la différence des moyennes sur chaque réplique bootstrap. Les séries d’estimateurs ainsi produites sont ensuite consolidées au moyen d’étapes DATA afin d’en extraire les quantiles empiriques délimitant l’intervalle de confiance bootstrap corrigé des biais et accéléré (intervalle BCa).
L’obtention d’un intervalle de confiance bootstrap qui exclut zéro apporte une validation convergente irréfutable attestant de la significativité de la divergence des moyennes, y compris sous des régimes distributionnels fortement dégradés où les tests analytiques traditionnels perdent leur assise théorique. Cette intégration méthodologique consolide remarquablement la posture du chercheur lors de la soumission de ses travaux à des revues à fort facteur d’impact.
12.3 Modélisation linéaire généralisée et modèles mixtes
Le test t de Welch, bien qu’irremplaçable dans son champ d’application binaire élémentaire, demeure intrinsèquement cantonné à la comparaison de deux groupes isolés en l’absence de tout contrôle de covariables. Dès lors que le protocole expérimental se complexifie, intégrant des facteurs de confusion continus, des structures factorielles à plusieurs variables indépendantes ou des mesures répétées dans le temps, le chercheur doit étendre le cadre conceptuel de Welch vers la modélisation statistique avancée via la procédure PROC MIXED de SAS.
PROC MIXED incarne la généralisation la plus aboutie de la philosophie de Welch dans le cadre du modèle linéaire général. Grâce à l’instruction REPEATED adjointe à l’option GROUP=NomDeLaVariable, PROC MIXED autorise formellement la modélisation explicite de l’hétéroscédasticité en estimant une composante de variance résiduelle propre et distincte pour chaque modalité du facteur d’intérêt. Conjointement, l’adjonction de l’option DDFM=SATTERTHWAITE sur l’instruction d’appel de la procédure ordonne au moteur SAS d’ajuster les degrés de liberté du modèle général selon l’algorithme exact de Satterthwaite-Welch.
Cette méthodologie unifiée permet d’exécuter un test rigoureusement identique au test de Welch pour les comparaisons dyadiques, tout en ouvrant simultanément la voie à l’inclusion de covariables d’ajustement (ANCOVA avec variances inégales) ou à l’analyse de plans d’expérience factoriels complexes sous hétérogénéité des matrices de covariance. Par cette transition vers PROC MIXED, l’analyste dépasse les frontières traditionnelles du test t élémentaire pour embrasser un paradigme d’inférence flexible et souverainement résilient face aux défis posés par la variabilité du monde réel.
Références
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student’s t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. https://doi.org/10.1093/beheco/ark016
- SAS Institute Inc. (2023). SAS/STAT 15.3 User’s Guide: The TTEST Procedure. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/statug/statug_ttest_overview.htm
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press.
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222