
L’analyse des interrelations entre variables quantitatives constitue le socle fondamental sur lequel repose une part prépondérante de l’inférence statistique moderne, de la psychométrie empirique, de l’épidémiologie clinique et de la science des données. Dans les disciplines quantitatives, la capacité à évaluer avec exactitude la nature, l’intensité et la direction des liens unissant des séries d’observations empiriques conditionne non seulement la validation de théories scientifiques complexes, mais oriente également les choix ultérieurs de modélisation prédictive ou explicative. L’exploration bivariée et multivariée des associations ne saurait être réduite à un simple calcul mécanique d’indices numériques ; elle exige une compréhension rigoureuse des postulats distributionnels, des dynamiques de covariance sous-jacentes et des limites inhérentes aux métriques employées.
Le système SAS (Statistical Analysis System) demeure, depuis plusieurs décennies, la plateforme de référence au sein des institutions de recherche biomédicale, des agences de régulation pharmaceutique et des grands organismes d’études sociologiques à l’échelle planétaire. Doté d’une robustesse computationnelle éprouvée, le module SAS/STAT met à disposition des chercheurs et des analystes des outils spécialisés d’une puissance remarquable, au premier rang desquels figure la procédure PROC CORR. Ce moteur analytique ne se limite pas à produire un tableau sommaire de corrélations linéaires usuelles ; il constitue un écosystème statistique complet, capable d’intégrer des analyses paramétriques et non paramétriques, des contrôles partiels multivariés, des procédures d’ajustement inférentiel pour tests multiples et des flux de visualisation hautement personnalisables grâce au système ODS (Output Delivery System).
Ce traité exhaustif a pour vocation de guider l’analyste, le statisticien et le chercheur à travers toutes les dimensions théoriques, méthodologiques et programmatiques du calcul de corrélation sous SAS. En articulant les fondements mathématiques rigoureux des coefficients classiques et de rang avec une implémentation logicielle pas à pas, ce guide expose les meilleures pratiques de prétraitement, les nuances relatives à la gestion des observations manquantes, l’interprétation inférentielle des probabilités critiques et les stratégies avancées de publication académique. L’objectif est d’offrir une référence incontournable permettant de transformer une simple série d’enregistrements bruts en constats scientifiques reproductibles, fiables et conformes aux plus hauts standards internationaux.
1. Fondements théoriques et mathématiques de la corrélation linéaire
1.1 Définition formelle du coefficient de corrélation de Pearson
Le coefficient de corrélation produit-moment de Pearson, universellement désigné par le symbole r lorsqu’il caractérise un échantillon empirique et par la lettre grecque ρ (rhô) lorsqu’il renvoie au paramètre théorique de la population, constitue la mesure princeps de l’association linéaire entre deux variables aléatoires quantitatives continues. Développé par le mathématicien et biostatisticien Karl Pearson à la fin du dix-neuvième siècle à partir des intuitions initiales de Francis Galton, cet indice standardise la covariance observée entre deux grandeurs en la divisant par le produit géométrique de leurs écarts-types respectifs. Mathématiquement, la formulation canonique s’exprime comme le rapport de la somme des produits croisés des écarts à leurs moyennes respectives sur la racine carrée du produit des sommes des carrés des écarts pour chaque variable.
Cette normalisation confère au coefficient de Pearson une propriété algébrique remarquable : son amplitude est strictement bornée au sein du continuum numérique fermé s’étendant de -1,00 à +1,00. Une valeur exactement égale à +1,00 dénote une association linéaire positive parfaite, signifiant que toute augmentation proportionnelle de la variable prédictive s’accompagne d’un accroissement mathématiquement déterministe et constant de la variable réponse sur une trajectoire strictement rectiligne. À l’inverse, un coefficient atteignant précisément -1,00 traduit une association linéaire négative parfaite, au sein de laquelle les deux entités évoluent dans des directions rigoureusement opposées selon un taux de variation invariable. La valeur médiane de 0,00 indique l’absence totale de relation linéaire entre les deux distributions, sans pour autant exclure l’existence d’une dépendance stochastique ou non linéaire complexe.
Dans le domaine des sciences psychologiques, de l’éducation et de la recherche comportementale, l’interprétation substantielle de la magnitude de r requiert une prudence méthodologique constante. L’analyste se réfère fréquemment aux balises heuristiques formulées initialement par Jacob Cohen, suggérant qu’un coefficient absolu compris entre 0,10 et 0,29 reflète un effet de faible ampleur, qu’une valeur oscillant de 0,30 à 0,49 signale une intensité modérée, et qu’un seuil égal ou supérieur à 0,50 traduit une association forte. Néanmoins, ces seuils abstraits doivent impérativement être contextualisés à l’aune du domaine empirique étudié : en recherche psychométrique de fidélité test-retest, une corrélation inférieure à 0,70 est jugée suspecte, tandis qu’en épidémiologie sociale ou en génétique comportementale, un coefficient modeste de 0,15 peut recouvrir une signification clinique ou sociétale majeure.
1.2 Hypothèses sous-jacentes au coefficient de Pearson
La validité des conclusions issues du calcul du coefficient de Pearson repose sur un ensemble strict de postulats mathématiques et structurels que l’analyste se doit de tester avant toute inférence statistique. Le premier de ces critères impératifs réside dans la linéarité absolue de la relation fonctionnelle unissant les deux variables. Le modèle de Pearson postule que la fonction d’espérance conditionnelle d’une variable par rapport à l’autre peut être adéquatement représentée par une droite géométrique de régression. Si le couplage réel des données obéit à une dynamique curviligne, sinusoïdale ou quadratique (telle que décrite par exemple par la loi de Yerkes-Dodson reliant l’éveil motivationnel et la performance cognitive), le coefficient de Pearson sous-estimera dramatiquement l’intensité réelle de l’interdépendance empirique, pouvant aboutir à une valeur proche de zéro alors même que la liaison déterministe est absolue.
Le second postulat critique concerne la distribution des variables, qui exige idéalement le respect de la normalité bivariée au sein de la population parente. Cette condition théorique implique non seulement que chacune des deux variables marginales suive une loi de distribution gaussienne univariée, caractérisée par une symétrie et un aplatissement conformes aux paramètres théoriques normaux, mais également que pour chaque valeur donnée de la première variable, les valeurs de la seconde se distribuent de manière normale, et réciproquement. Bien que l’estimation ponctuelle de la corrélation échantillonnale fasse preuve d’une certaine robustesse face à de modérées déviations de la normalité en vertu du théorème central limite dès lors que les tailles d’échantillons sont substantielles, les procédures de test d’hypothèse et le calcul des intervalles de confiance demeurent particulièrement vulnérables aux distributions présentant des asymétries prononcées ou des queues lourdes.
Enfin, l’homoscédasticité et la vulnérabilité aux observations aberrantes constituent deux éléments déterminants de l’équation méthodologique. L’homoscédasticité impose que la dispersion ou la variance conditionnelle des résidus demeure rigoureusement constante sur l’ensemble du spectre des valeurs mesurées. Concomitamment, le coefficient de Pearson présente une sensibilité extrême aux valeurs aberrantes univariées et multivariées (souvent qualifiées de points de levier statistiques). L’introduction d’un seul point déviant positionné à l’extrémité de l’espace multidimensionnel suffit à faire basculer artificiellement un coefficient statistiquement nul vers un niveau hautement significatif, ou inversement, à oblitérer une corrélation robuste partagée par 99 % de l’échantillon analysé.
1.3 Distinction épistémologique entre association linéaire et causalité
Il est de règle axiomatique en épistémologie statistique d’affirmer avec la plus grande fermeté que la simple constatation d’une corrélation numérique, aussi puissante et statistiquement irréfutable soit-elle, n’autorise en aucun cas l’inférence immédiate d’un lien de causalité asymétrique entre les entités mesurées. Le calcul d’un indice de corrélation est une opération commutative et parfaitement symétrique : la corrélation de la variable X avec la variable Y est strictement identique à celle de Y avec X. Par conséquent, la métrique ne possède en elle-même aucun opérateur directionnel permettant de déduire si les fluctuations de X gouvernent celles de Y, si Y conditionne l’émergence de X, ou si les deux grandeurs évoluent de concert sans interaction fonctionnelle directe.
Cette impossibilité d’inférer une causalité découle principalement de la vulnérabilité intrinsèque des études d’observation au phénomène bien documenté de la confusion statistique, incarné par l’action occulte de variables tierces ou confondantes. Dans le champ des sciences humaines et du comportement, d’innombrables associations fortes rapportées dans la littérature se sont révélées purement illusoires (dites « fallacieuses » ou spurious) une fois contrôlée l’influence d’un facteur sous-jacent commun. Par exemple, la corrélation positive classique observée entre la taille du vocabulaire chez l’enfant et sa pointure de chaussures n’indique nullement une quelconque influence somatique sur l’appareil linguistique, mais s’explique intégralement par l’effet modérateur et régulateur de l’âge chronologique des participants.
L’analyse de corrélation conserve néanmoins une utilité heuristique irremplaçable lorsqu’elle est appréhendée comme une démarche exploratoire et diagnostique préalable à la construction de modèles statistiques plus ambitieux. Bien que la présence d’une corrélation ne prouve jamais la causalité, son absence constitue souvent une preuve robuste réfutant l’existence d’une relation causale linéaire directe, sous réserve de la validité des mesures. L’examen des matrices de corrélation représente ainsi la première étape indispensable pour cartographier les réseaux nomologiques, détecter les éventuelles colinéarités entre régresseurs avant l’exécution de régressions linéaires multiples, et poser les jalons des équations structurelles destinées à tester formellement des hypothèses causales complexes.
2. Introduction à l’environnement SAS et à la procédure PROC CORR
2.1 Structure syntaxique générale de l’instruction PROC CORR
Au sein de l’architecture logicielle intégrée de SAS, l’évaluation des interdépendances statistiques entre variables quantitatives s’articule autour d’une procédure dédiée hautement optimisée : la procédure PROC CORR. Conçue pour traiter des volumes massifs d’enregistrements avec une consommation minimale de mémoire vive, cette instruction mobilise des algorithmes d’accumulation en double précision garantissant la stabilité numérique des calculs de sommes de carrés et de produits croisés, évitant ainsi les erreurs d’arrondi fréquentes dans d’autres environnements de calcul moins rigoureux.
La syntaxe de base de l’instruction d’appel adopte le formalisme canonique du langage SAS : l’énoncé PROC CORR DATA=nom_de_la_table; lance la compilation de la procédure sur le jeu de données spécifié. Si aucun modificateur n’est adjoint et qu’aucune instruction secondaire n’est fournie, la procédure exécutera automatiquement le calcul des coefficients de corrélation linéaire de Pearson pour l’intégralité des variables numériques répertoriées dans le dictionnaire de la table, produisant une matrice carrée exhaustive assortie de statistiques descriptives élémentaires univariées (moyenne, écart-type, somme, minimum et maximum).
Le contrôle chirurgical des paires de variables à soumettre au moteur d’analyse s’opère principalement par l’intermédiaire de deux énoncés complémentaires : l’instruction VAR et l’instruction WITH. L’instruction VAR permet de restreindre l’analyse à une sous-catégorie rigoureusement sélectionnée de colonnes numériques. Lorsqu’elle est utilisée isolément, SAS génère la matrice croisée complète de toutes les variables inscrites dans cette liste. En revanche, l’adjonction de l’instruction WITH transforme radicalement la géométrie de la restitution : SAS calcule alors uniquement les coefficients de corrélation unissant chaque variable de la liste VAR à chacune des variables spécifiées dans la liste WITH, générant une matrice rectangulaire d’une grande clarté conceptuelle.
2.2 Chargement et inspection préliminaire des jeux de données
L’expérimentation pratique et l’assimilation pédagogique des fonctionnalités de PROC CORR s’appuient fréquemment sur l’exploitation des jeux de données de démonstration préinstallés au sein de la bibliothèque intégrée en lecture seule désignée sous l’appellation SASHELP. Cette bibliothèque offre un accès immédiat à des tables réputées dans l’histoire de la statistique, à l’instar de SASHELP.IRIS (le célèbre recueil morphométrique de Fisher recensant les mesures de sépales et pétales sur trois espèces d’iris), SASHELP.CARS (base multidimensionnelle documentant les caractéristiques techniques et de consommation du parc automobile) ou encore SASHELP.HEART (vaste cohorte épidémiologique issue de l’étude de Framingham).
Avant de lancer toute modélisation bivariée, le statisticien avisé procède systématiquement à une inspection oculaire et structurelle des données brutes. L’invocation conjointe de la procédure PROC CONTENTS permet de vérifier les métadonnées intrinsèques des variables : type de stockage (numérique versus caractère), longueur d’encodage, présence de formats associés et libellés documentaires. Une variable stockée par inadvertance sous format alphanumérique sera invariablement ignorée par PROC CORR, générant des messages d’avertissement dans le journal système (SAS Log).
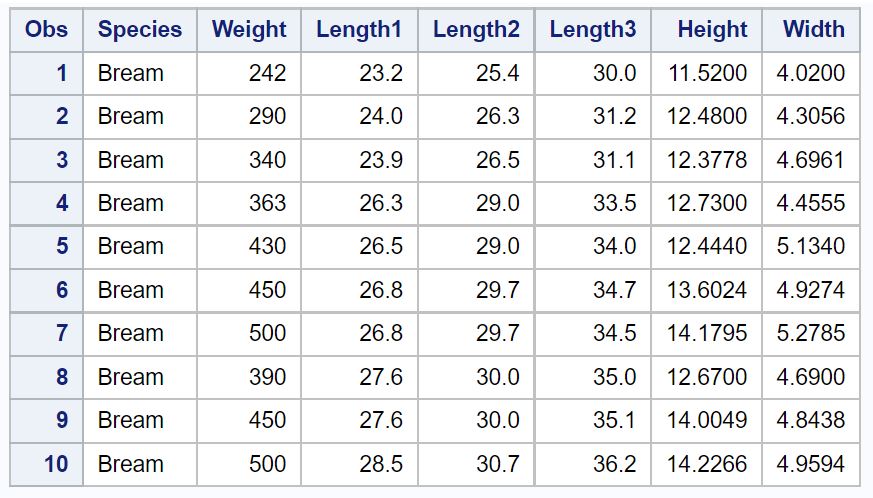
De surcroît, la visualisation des premiers enregistrements au moyen d’une commande telle que PROC PRINT DATA=SASHELP.IRIS(OBS=10); RUN; autorise un contrôle de vraisemblance direct sur la structure des vecteurs d’observations. Ce contrôle initial permet de s’assurer de l’adéquation entre les noms de colonnes appelés dans les scripts et la réalité du schéma relationnel de la table sous-jacente, éliminant en amont les erreurs d’exécution syntaxique les plus communes lors du paramétrage des instructions de corrélation.
2.3 Options globales du système et gestion de l’affichage ODS
Le système ODS (Output Delivery System) de SAS représente une couche architecturale d’interfaçage qui dissocie la logique computationnelle interne des procédures de leur mise en forme visuelle finale. Par défaut, PROC CORR produit une sortie HTML ou standard particulièrement riche, incorporant un tableau exhaustif de statistiques descriptives univariées en préambule à la restitution des coefficients matriciels. Dans les contextes où l’analyste recherche une lisibilité synthétique maximale, notamment lors de l’exploration préliminaire de tables comportant plusieurs dizaines de variables, cette prolixité par défaut peut rapidement saturer l’espace visuel.
L’adjonction de l’option NOSUMMARY directement sur la ligne d’ouverture de l’instruction (PROC CORR DATA=ma_table NOSUMMARY;) instruit le compilateur de neutraliser totalement l’édition du tableau récapitulatif des paramètres descriptifs élémentaires. Cette simple commande épure la sortie finale pour ne conserver que la matrice d’association, facilitant l’intégration des rapports dans des documents de synthèse. D’autres options textuelles, telles que NOPROB, permettent de masquer l’affichage systématique des probabilités critiques (p-values) sous chaque coefficient, allégeant substantiellement la densité typographique de la grille de résultats.
De façon plus globale, l’utilisation stratégique des instructions de redirection ODS SELECT ou ODS EXCLUDE couplée aux noms d’objets internes de la procédure (tels que PearsonCorr, KendallCorr, SpearmanCorr ou SimpleStats) procure un pouvoir de personnalisation sans équivalent. Le chercheur peut ainsi filtrer précisément les composantes analytiques destinées à l’écran, aux fichiers PDF ou aux flux RTF académiques, transformant des calculs hautement techniques en représentations visuelles rigoureuses, élégantes et immédiatement exploitables dans un cadre institutionnel.
3. Préparation et exploration préalable des données
3.1 Exploration descriptive univariée avant l’analyse relationnelle
L’exécution précipitée d’une matrice de corrélations sans investigation minutieuse des distributions individuelles constitue l’une des défaillances méthodologiques les plus communes dans la pratique analytique contemporaine. L’évaluation descriptive univariée préalable n’est pas une simple formalité protocolaire : elle conditionne directement le choix fondamental de la métrique d’association appropriée (paramétrique ou non paramétrique) et permet de repérer les asymétries distributionnelles qui menacent la validité des inférences futures basées sur le test de Student.
L’utilisation de la procédure PROC UNIVARIATE s’impose ici comme le standard de rigueur. Au-delà des simples mesures de tendance centrale (moyenne arithmétique, médiane robuste, mode) et de dispersion (variance, écart-type, écart interquartile), cette procédure génère les moments d’ordre supérieur indispensables que sont le coefficient d’asymétrie de Fisher-Pearson (skewness) et le coefficient d’aplatissement (kurtosis). Une distribution manifestant une asymétrie absolue supérieure à 2,0 ou un aplatissement supérieur à 7,0 s’écarte substantiellement des propriétés de la loi normale, signalant à l’analyste que le calcul ultérieur d’un r de Pearson encourt un risque sérieux de distorsion de son erreur-type.
L’inspection des tests formels d’adéquation à la normalité fournis par SAS au sein de cette même procédure — notamment le test de Shapiro-Wilk (hautement préconisé pour les échantillons de taille inférieure à 2000 observations) et le test de Kolmogorov-Smirnov corrigé par Lilliefors — fournit des balises probabilistes précieuses. Si les hypothèses nulles de distribution gaussienne sont massivement rejetées à un seuil critique inférieur à 0,001, l’analyste devra envisager soit une transformation mathématique préalable des données (logarithmique, racine carrée ou Box-Cox), soit l’abandon délibéré de la corrélation de Pearson au profit d’approches fondées sur les rangs relatifs.
3.2 Détection visuelle et statistique des valeurs aberrantes
Le calcul du produit croisé des écarts à la moyenne rend la covariance intrinsèquement vulnérable à l’influence disproportionnée des valeurs s’écartant radicalement du centroïde des données. En présence de points extrêmes atypiques, l’estimateur de Pearson peut faire preuve d’une instabilité rédhibitoire. Il est ainsi indispensable de déployer une double stratégie diagnostique, combinant détection univariée rigoureuse et inspection multivariée de l’espace géométrique des observations.
Sur le plan univarié, l’identification des observations aberrantes repose traditionnellement sur la standardisation des scores en scores centrés réduits (Z-scores) ou sur l’analyse de l’intervalle interquartile de Tukey formalisée par les diagrammes en boîte à moustaches. Toute mesure excédant trois écarts-types par rapport à la moyenne empirique doit susciter un examen clinique attentif visant à discriminer une erreur matérielle de saisie d’une variation biologique ou psychologique authentique mais rare. Sur le versant multivarié, le calcul de la distance de Mahalanobis permet de repérer les configurations d’observations qui, bien que situées dans des limites acceptables sur chaque variable prise isolément, constituent une anomalie relationnelle flagrante lorsqu’elles sont considérées conjointement.
La production systématique de diagrammes de dispersion bivariés (scatterplots) au moyen de la procédure PROC SGPLOT constitue l’antidote par excellence aux pièges statistiques. L’examen graphique permet de visualiser instantanément si l’association apparente est l’apanage d’une tendance partagée par l’immense majorité des sujets ou si elle est artificiellement entretenue par deux ou trois observations isolées situées dans les quadrants extrêmes. Face à des valeurs atypiques véridiques mais influentes, des stratégies de traitement transparentes doivent être documentées : analyse de sensibilité comparant les estimations avec et sans les cas critiques, winsorisation contrôlée ou basculement vers des estimateurs de corrélation robustes.
3.3 Vérification des exigences de métrique d’échelle
L’une des fautes les plus récurrentes en psychométrie appliquée et en sciences sociales consiste à appliquer indifféremment le coefficient de corrélation linéaire de Pearson à des données qui ne répondent pas aux exigences métriques formelles de la théorie de la mesure de Stevens. Le formalisme mathématique de Pearson postule impérativement que les grandeurs mesurées relèvent d’une échelle d’intervalles constants ou d’une échelle de rapports (ratios). Sur ces échelles, la distance séparant deux unités consécutives possède une signification quantitative rigoureusement identique tout au long de l’axe de mesure, autorisant l’exécution licite d’opérations d’addition, de soustraction et de calcul de moyennes arithmétiques.
Or, la recherche empirique fait un usage massif d’échelles d’évaluation ordonnées, au premier rang desquelles trônent les items de type Likert (souvent gradués en 4, 5 ou 7 ancrages textuels allant de « pas du tout d’accord » à « tout à fait d’accord »). Les distances séparant subjectivement ces ancrages qualificatifs ne sauraient être postulées équidistantes d’un point de vue métrologique strict : rien ne garantit que l’intervalle psychologique séparant un score de 1 et de 2 soit identique à celui séparant un score de 4 et de 5. L’application du r de Pearson sur des items ordinaux pris individuellement viole donc les fondements algébriques du modèle, introduisant des distorsions imprévisibles dans l’estimation de l’intensité de la relation.
La prudence méthodologique commande dès lors de réserver la corrélation de Pearson soit à des variables physiques ou temporelles parfaitement continues, soit à des scores composites ou totaux issus de l’agrégation d’un nombre substantiel d’items psychométriques (score global à un inventaire de dépression, par exemple), pour lesquels la distribution cumulée se rapproche d’un continuum d’intervalle continu satisfaisant le théorème de la limite centrale. Dès lors que l’analyste se trouve confronté à des items isolés, à des échelles de rangs ou à des ordonnancements qualitatifs stricts, le recours impératif aux méthodes de Spearman ou de Kendall s’impose d’un point de vue épistémologique.
4. Calcul de la corrélation bivariée simple de Pearson sous SAS
4.1 Implémentation de l’instruction de base pour deux variables
La mise en œuvre du calcul de la corrélation bivariée de Pearson au sein du logiciel SAS illustre l’élégance et la concision de sa grammaire analytique. Pour évaluer la liaison linéaire fondamentale reliant deux paramètres quantitatifs — par exemple, la longueur des sépales (SepalLength) et la longueur des pétales (PetalLength) au sein du jeu de données classique SASHELP.IRIS —, le programmeur rédige une séquence élémentaire composée de l’appel à la procédure, du ciblage des variables et de l’ordre d’exécution.
Le bloc opérationnel s’articule comme suit :
PROC CORR DATA=sashelp.iris;
VAR SepalLength PetalLength;
RUN;
Cette instruction minimaliste déclenche une séquence complète de traitements internes. SAS commence par numériser l’ensemble des 150 enregistrements contenus dans la table d’entrée, isole les deux colonnes spécifiées et écarte temporairement toute observation présentant une valeur absente pour l’un ou l’autre de ces vecteurs. L’algorithme calcule dans un premier temps les métriques univariées standard pour SepalLength et PetalLength (taille d’échantillon valide, moyenne empirique, écart-type, somme arithmétique, minima et maxima), puis procède à l’évaluation du produit scalaire des déviations standardisées pour déduire la matrice de Pearson.
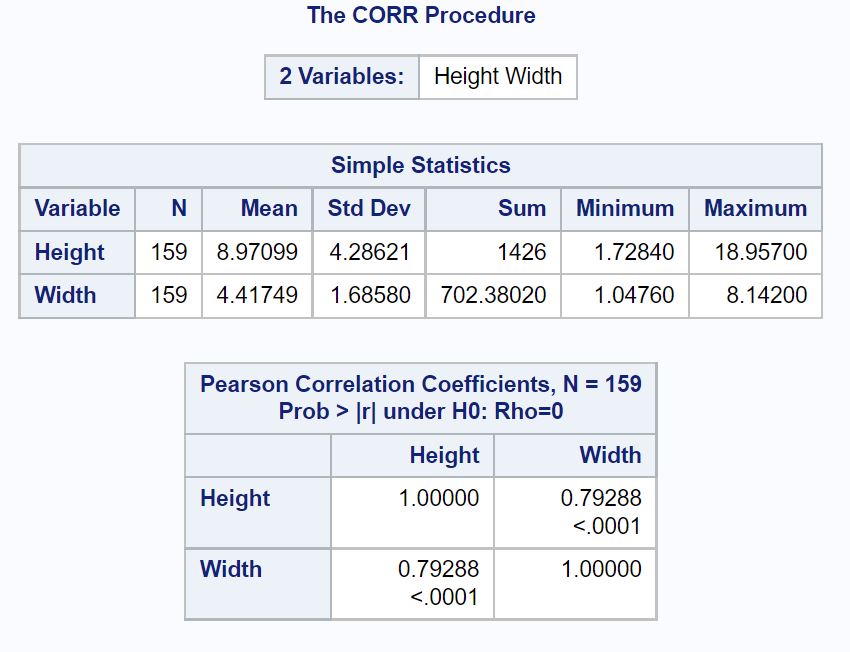
Le tableau résultant édité dans l’interface de sortie présente une structure matricielle carrée de dimension 2×2. Chaque cellule d’intersection affiche deux valeurs capitales superposées verticalement : la valeur numérique exacte du coefficient de corrélation r de Pearson (affichée par défaut avec cinq décimales de précision), et immédiatement en dessous, la valeur de la probabilité critique asymptotique bilatérale (p-value) calculée sous l’hypothèse nulle. La diagonale principale affiche immanquablement la valeur 1,00000, attestant de l’association parfaite d’une variable avec elle-même, tandis que les cellules hors-diagonale révèlent le coefficient d’interrelation reliant les deux caractères étudiés.
4.2 Séparation des variables cibles avec l’instruction WITH
Lorsque la structure de recherche n’est plus purement exploratoire et symétrique, mais s’inscrit dans un paradigme d’analyse directionnel confrontant une variable d’intérêt clinique ou psychologique majeure (variable dépendante ou critère) à une ou plusieurs variables prédictives, la génération d’une matrice carrée standard s’avère inutilement complexe et visuellement redondante. C’est précisément dans cette configuration que l’instruction WITH démontre toute sa pertinence méthodologique et ergonomique.
En formulant la requête suivante :
PROC CORR DATA=sashelp.iris;
VAR SepalWidth PetalLength PetalWidth;
WITH SepalLength;
RUN;
l’analyste modifie la topologie du tableau de restitution. SAS structure alors la sortie non plus sous la forme d’un tableau d’intercorrélations carrées entre les quatre variables, mais sous la forme rigoureuse d’une matrice rectangulaire d’une seule ligne (la variable SepalLength définie dans l’énoncé WITH) croisée avec trois colonnes distinctes correspondant aux éléments listés dans l’énoncé VAR. Ce compartimentage conceptuel isole de façon immaculée les corrélations du critère d’intérêt avec l’ensemble de ses covariables candidates.
Cette distinction s’avère particulièrement précieuse lors du traitement d’échantillons volumineux issus d’essais cliniques ou d’enquêtes sociologiques comportant des centaines d’indicateurs potentiels. L’instruction WITH agit comme un réducteur de dimension visuelle, concentrant l’effort cognitif du chercheur uniquement sur les associations théoriquement signifiantes et réduisant le risque de surcharge informationnelle propre aux matrices d’intercorrélations multidimensionnelles classiques.
4.3 Interprétation de la significativité statistique (p-value)
Chaque coefficient de Pearson calculé par la procédure PROC CORR est indissociable du test d’hypothèse inférentiel qui lui est adjoint. L’inférence canonique repose sur la formulation d’un test bilatéral articulé autour de deux postulats mutuellement exclusifs : l’hypothèse nulle (H0 : ρ = 0), stipulant l’absence totale de relation linéaire entre les deux variables au sein de la population théorique parente, face à l’hypothèse alternative (H1 : ρ ≠ 0), affirmant l’existence d’une dépendance linéaire d’ampleur non nulle. La statistique de test mobilisée suit rigoureusement une distribution t de Student à (N – 2) degrés de liberté, où N représente l’effectif des paires d’observations complètes.
La probabilité critique générée par SAS (notée Prob > |r| under H0: Rho=0) quantifie la probabilité d’observer un coefficient au moins aussi extrême en valeur absolue que celui calculé à partir de l’échantillon empirique, sous l’assomption formelle que l’hypothèse nulle soit vérifiée dans la population. Par convention académique héritée des travaux de Ronald Fisher, si cette valeur de probabilité s’avère strictement inférieure au seuil alpha prédéterminé (usuellement fixé à 0,05 ou 0,01), le chercheur est autorisé à rejeter l’hypothèse nulle et à déclarer le coefficient de corrélation statistiquement significatif au seuil considéré.
Cependant, une mise en garde épistémologique cruciale s’impose quant à l’interdépendance mécanique reliant la significativité statistique et l’effectif de l’échantillon. La statistique t étant proportionnelle à la racine carrée de N, une taille d’échantillon massive (courante dans l’ère du Big Data avec des millions d’enregistrements) confère une puissance statistique phénoménale au test, conduisant à qualifier de hautement significatifs (p < 0,0001) des coefficients d’une faiblesse insigne, tels que r = 0,02. Un tel résultat, bien que non imputable au hasard d’échantillonnage d’un point de vue strictement probabiliste, traduit une absence quasi-totale de variance commune (le coefficient de détermination n’étant que de 0,04 %) et possède une portée clinique ou décisionnelle rigoureusement nulle. L’analyste doit donc impérativement dissocier la significativité statistique de la taille de l’effet substantive.
5. Matrices de corrélation multivariée entre plusieurs variables
5.1 Génération d’une matrice carrée complète
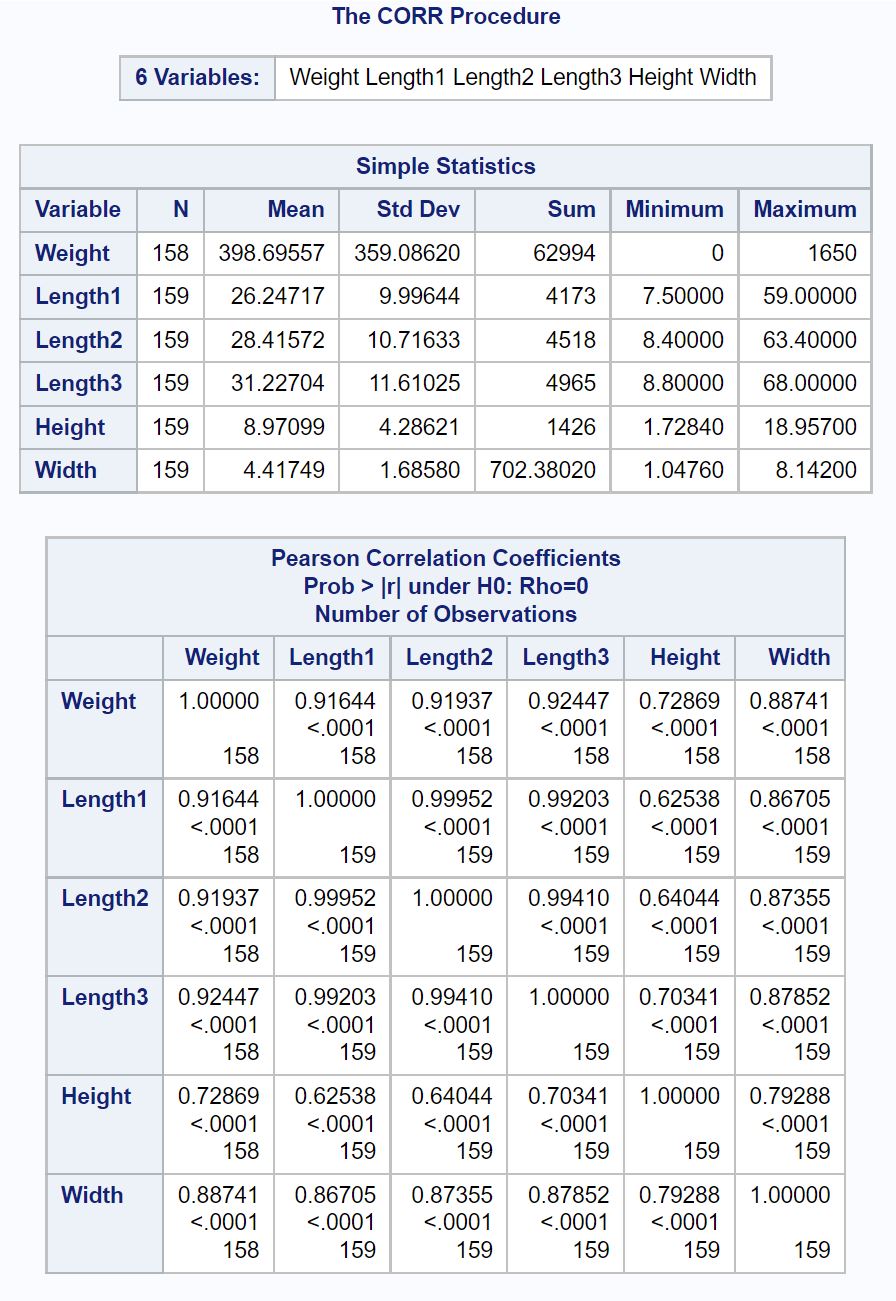
L’exploration d’un système complexe requiert fréquemment l’évaluation simultanée de multiples dimensions quantitatives afin de cartographier l’architecture globale de leurs interrelations. Lorsque la commande PROC CORR est mobilisée en spécifiant une pluralité d’attributs numériques au sein de l’instruction VAR, sans adjoindre d’énoncé WITH, le moteur computationnel compile une matrice d’intercorrélations carrée complète, dont l’ordre dimensionnel (k × k) correspond rigoureusement au nombre k de variables soumises à investigation.
Dans un contexte d’ingénierie automobile utilisant la base SASHELP.CARS, une commande ciblant la puissance (Horsepower), le poids (Weight), la longueur (Length) et la consommation sur autoroute (MPG_Highway) génère une matrice 4×4 exhaustive. Une telle matrice présente des propriétés mathématiques invariables : elle est obligatoirement symétrique par rapport à sa diagonale principale en vertu de la commutativité du produit scalaire des déviations, signifiant que la cellule située à la coordonnée (ligne i, colonne j) est rigoureusement identique en valeur numérique et en niveau de significativité à celle occupant la position (ligne j, colonne i).
La diagonale principale est exclusivement composée de coefficients unitaires (r = 1,00000), chaque vecteur manifestant une colinéarité parfaite avec lui-même. L’examen attentif des triangles supérieur et inférieur permet d’identifier instantanément des grappes ou « clusters » de variables fonctionnellement solidaires. Par exemple, le statisticien remarquera une très forte corrélation positive unissant la puissance et le poids du véhicule, concomitamment à une association négative tout aussi prononcée entre ces deux grandeurs et le rendement énergétique, posant ainsi les fondations d’un diagnostic d’espace factoriel ou de colinéarité multivariée.
5.2 Construction de matrices rectangulaires via l’instruction WITH
Bien que la matrice carrée complète constitue l’outil exploratoire standard, elle devient rapidement inadaptée lorsque le nombre de variables s’accroît, engendrant des tables surdimensionnées de plusieurs dizaines de lignes et de colonnes où l’information substantielle se noie dans une masse de redondances symétriques. La structuration de matrices asymétriques ou rectangulaires via la combinaison des clauses VAR et WITH apporte une réponse méthodologique optimale pour les études épidémiologiques ou psychométriques structurées selon un schéma différentiel.
Supposons une recherche clinique transversale visant à évaluer l’impact de marqueurs physiologiques fondamentaux (pression artérielle systolique, indice de masse corporelle, taux de cholestérol sérique et triglycérides) sur des échelles d’évaluation de la qualité de vie psychologique, du fonctionnement physique et du niveau d’épuisement vital. L’inscription des indicateurs physiologiques sous l’instruction VAR et des scores de santé sous l’instruction WITH permet de scinder nettement l’espace des prédicteurs de celui des critères de santé.
La sortie résultante présente une géométrie condensée de dimensions p × q (où p représente le nombre de critères WITH et q le nombre de variables VAR). Non seulement cette disposition réduit de manière drastique l’encombrement spatial des résultats au sein des manuscrits et rapports institutionnels, mais elle neutralise également les calculs superflus des intercorrélations internes aux blocs physiologiques ou psychologiques, ciblant l’effort inférentiel exclusivement sur les ponts transversaux unissant ces deux domaines distincts de mesure.
5.3 Formatage et tri de la matrice pour une lisibilité accrue
Face à des jeux de données d’une très grande envergure intégrant des centaines de tests psychométriques ou de panels génomiques, la lecture manuelle séquentielle d’une matrice devient une tâche humainement prohibitive. Conscient de ce défi d’ergonomie cognitive, SAS/STAT propose des options intégrées avancées destinées à filtrer, trier et ordonner dynamiquement les sorties matricielles de la procédure PROC CORR directement à la source.
L’option BEST=n constitue un filtre quantitatif puissant. En incorporant cette instruction dans l’en-tête (par exemple PROC CORR DATA=ma_table BEST=5;), le logiciel ordonne, pour chaque variable du modèle, les associations calculées par ordre décroissant de magnitude absolue et restreint l’affichage uniquement aux n coefficients les plus intenses. Cette approche permet de procéder à un tamisage ou criblage préliminaire d’une remarquable efficacité, écartant d’emblée la myriade de coefficients triviaux ou non significatifs pour focaliser l’attention sur les signaux les plus saillants du réseau relationnel.
Parallèlement, l’option RANK instruit la procédure d’ordonner l’ensemble des résultats selon la force relative des corrélations calculées plutôt que de suivre l’ordre d’énumération textuelle des variables dans le script. Les coefficients les plus puissants sont ainsi automatiquement hissés au sommet de la hiérarchie de restitution. Conjuguées à l’utilisation sélective de l’option NOSUMMARY, ces fonctionnalités de mise en forme avancée transforment un exercice statistique fastidieux en un processus analytique rationalisé, particulièrement prisé lors des phases de calibration d’inventaires multidimensionnels ou d’analyses de validité de construit.
6. Corrélations non paramétriques : Spearman et Kendall dans SAS
6.1 Coefficient de corrélation des rangs de Spearman (rho)
Lorsque les données recueillies enfreignent de manière indéniable les postulats théoriques régissant le coefficient de Pearson — notamment en cas de violation manifeste de la normalité bivariée, de présence d’asymétries marquées ou lorsque la relation fonctionnelle unissant les attributs est monotone mais fondamentalement non linéaire —, l’analyste doit impérativement migrer vers des méthodologies statistiques non paramétriques dites de distribution libre (distribution-free). Le coefficient de corrélation des rangs de Charles Spearman, universellement désigné par la lettre grecque ρ (rho) ou r_s, constitue l’alternative non paramétrique la plus éprouvée.
Le fondement mathématique de la corrélation de Spearman repose sur une transformation élégante : plutôt que de manipuler les valeurs numériques brutes, l’algorithme procède préalablement au classement séquentiel des observations de chaque vecteur, attribuant à chaque donnée individuelle un rang entier croissant allant de 1 (pour la valeur la plus faible) à N (pour l’observation maximale), les valeurs ex-aequo se voyant affecter le rang moyen de leur groupe de liaison. Le coefficient de Spearman n’est rien d’autre que l’application exacte de la formule du coefficient de Pearson exécutée non pas sur les mesures originelles, mais sur ces rangs préalablement substitués. Il évalue ainsi la perfection avec laquelle la relation entre deux variables peut être décrite par une fonction strictement monotone, qu’elle soit linéaire ou non.
Sous l’environnement SAS, l’obtention de cet estimateur robuste s’opère avec une facilité déconcertante via l’adjonction du mot-clé SPEARMAN sur la ligne de déclaration de la procédure :
PROC CORR DATA=mes_donnees SPEARMAN;
VAR Echelle_Anxiete Score_Performance;
RUN;
SAS compile alors simultanément ou alternativement (selon la présence ou non de l’option PEARSON) la matrice des rangs de Spearman assortie des probabilités critiques asymptotiques exactes adaptées à cette métrique ordinalisée.
6.2 Tau de Kendall (tau-b et tau-c) pour petits échantillons et ex-aequo
Le coefficient tau de Maurice Kendall représente une alternative non paramétrique d’une profondeur théorique supérieure à celle de Spearman, particulièrement préconisée dans le cadre d’échantillons de taille réduite ou en présence de grilles de mesure discrètes comportant une proportion massive d’ex-aequo (ties), telles que les échelles de Likert à faible granularité. Alors que Spearman convertit l’information en rangs avant d’en calculer la covariance linéaire, le tau de Kendall repose sur une combinatoire probabiliste directe portant sur l’ensemble des paires possibles d’observations au sein de l’échantillon.
Pour chaque paire constituée de deux sujets distincts i et j, l’algorithme examine la concordance directionnelle de leurs scores respectifs sur les deux variables. Une paire est dite strictement concordante si la direction de la différence entre les deux sujets sur la première variable est identique à celle observée sur la seconde (les deux scores augmentent ou diminuent conjointement). Elle est qualifiée de discordante si la trajectoire s’inverse. Le coefficient tau quantifie l’excédent relatif de paires concordantes sur les paires discordantes, normalisé par le nombre total de combinaisons factorielles possibles. SAS implémente principalement le Tau-b de Kendall, qui intègre une correction algébrique rigoureuse pénalisant la présence d’ex-aequo tant sur la première que sur la seconde variable.
L’implémentation logicielle sous SAS requiert simplement la spécification de l’option KENDALL dans l’instruction de base :
PROC CORR DATA=mes_donnees KENDALL;
VAR Item1 Item2 Item3;
RUN;
L’un des avantages majeurs du Tau-b de Kendall réside dans la vitesse de convergence de sa distribution d’échantillonnage vers la normalité, autorisant des inférences de significativité statistique bien plus fiables et stables que celles du rho de Spearman lorsque l’effectif global N chute en deçà de 30 observations.
6.3 Comparaison méthodologique entre Pearson, Spearman et Kendall
Le choix raisonné entre les coefficients de Pearson, Spearman et Kendall ne saurait procéder d’une sélection arbitraire au gré de la significativité la plus séduisante (une pratique méthodologiquement condamnable assimilable à du p-hacking), mais doit s’ancrer dans une analyse objective de la nature des échelles et de la distribution des données. Les conséquences d’un arbitrage méthodologique erroné peuvent lourdement impacter l’exactitude des inférences produites.
Sur un plan numérique universel, lorsque les postulats de normalité bivariée sont rigoureusement respectés, le coefficient de Pearson offre l’efficacité statistique maximale (la puissance d’échantillonnage la plus élevée pour rejeter l’hypothèse nulle lorsque celle-ci est fausse). En revanche, face à une contamination par des valeurs aberrantes ou en présence de distributions exponentielles ou fortement asymétriques, Pearson s’effondre dramatiquement, générant des coefficients hautement biaisés. Dans cette conjoncture, Spearman et Kendall préservent leur intégrité analytique grâce à leur insensibilité géométrique aux distances absolues des queues de distribution.
Entre Spearman et Kendall, la distinction méthodologique s’opère sur la structure des données et l’objectif d’interprétation. Le coefficient rho de Spearman tend à afficher une valeur numérique systématiquement plus élevée en magnitude que le tau de Kendall sur un même ensemble de données (le ratio empirique se situant couramment autour de 1,5 fois le tau), mais cette divergence ne traduit aucune supériorité de liaison : elle reflète simplement des échelles d’estimation mathématiquement divergentes. Kendall bénéficie d’une interprétation probabiliste directe d’une limpidité incomparable (la différence nette entre la probabilité de concordance et de discordance de deux observations tirées au hasard) et s’avère nettement plus robuste mathématiquement dès lors que l’échantillon contient un nombre élevé de valeurs identiques.
7. Gestion des données manquantes dans la procédure PROC CORR
7.1 Suppression par paire (Pairwise Deletion) par défaut
Dans la pratique courante de la recherche empirique, la présence d’enregistrements lacunaires au sein desquels certaines variables ne sont pas renseignées constitue la norme plutôt que l’exception. La manière dont un logiciel statistique gère ces omissions conditionne l’exactitude des calculs matriciels. Par défaut, la procédure PROC CORR de SAS applique une stratégie d’exclusion dite « par paire » ou exclusion bivariée locale (pairwise deletion).
Ce mécanisme par défaut signifie que pour chaque coefficient de corrélation calculé entre une variable X et une variable Y, SAS prend en compte la totalité des observations qui possèdent simultanément des valeurs valides pour ce binôme spécifique, indépendamment du statut d’omission de ces mêmes sujets sur les autres variables incluses par ailleurs dans la commande VAR. Si un participant a omis de répondre à la variable Z mais présente des données complètes sur X et Y, son observation sera scrupuleusement conservée pour le calcul du lien entre X et Y, et écartée exclusivement lors de l’estimation des corrélations impliquant Z.
Si cette approche présente l’attrait indéniable de maximiser la puissance statistique en mobilisant la totalité de l’information empirique disponible pour chaque paire, elle recèle des faiblesses méthodologiques majeures. D’une part, l’effectif effectif N fluctue d’une case à l’autre au sein de la même matrice de résultats, ce qui complique les comparaisons directes d’intensité d’association. D’autre part et surtout, la matrice de corrélation ou de covariance résultante peut perdre sa propriété d’être semi-définie positive. Cette pathologie mathématique empêche son inversion matricielle ultérieure, vouant à l’échec toute tentative d’exploitation de cette matrice au sein de procédures de régression multivariée, d’analyse factorielle ou de modélisation par équations structurelles.
7.2 Suppression par observation complète (Listwise Deletion)
Pour pallier les déséquilibres structurels et les anomalies algébriques engendrés par l’exclusion bivariée par paire, SAS intègre une option fondamentale assurant une consistance absolue à la matrice générée : l’option NOMISS. Dès lors que cette directive est explicitée dans la ligne d’appel (PROC CORR DATA=ma_table NOMISS;), le moteur SAS bascule instantanément vers une stratégie d’exclusion par observation complète ou suppression par liste (listwise deletion).
Sous ce régime d’exécution strict, SAS passe en revue l’intégralité des variables déclarées dans les énoncés VAR et WITH pour chaque ligne du tableau. Si une observation quelconque présente une valeur manquante sur une seule des variables de la liste, l’enregistrement tout entier est impitoyablement purgé de l’ensemble des analyses computationnelles de la procédure. Il en découle que tous les coefficients de la matrice, sans exception, sont calculés sur un échantillon invariant d’observations rigoureusement complètes, garantissant un effectif N universellement homogène sur toute la surface de la table de sortie.
Bien que cette stratégie garantisse que la matrice de covariance soit parfaitement semi-définie positive et pleinement compatible avec des modélisations causales ultérieures, elle présente un coût statistique potentiellement rédhibitoire : la déperdition drastique de puissance statistique. Dans des protocoles longitudinaux ou des enquêtes comportementales longues comportant un taux diffus de données manquantes (par exemple 5 % d’omissions réparties aléatoirement sur 20 variables), l’exclusion complète peut conduire à l’élimination pure et simple de 40 à 60 % de l’échantillon initial, réduisant considérablement la précision des estimateurs.
7.3 Considérations méthodologiques sur les mécanismes de données manquantes
D’un point de vue épidémiologique et méthodologique contemporain, le choix entre les options par défaut et NOMISS de PROC CORR ne saurait s’abstraire d’une théorisation rigoureuse des mécanismes générateurs de données manquantes, tels que formalisés par le statisticien Donald Rubin. Ces mécanismes se subdivisent en trois régimes stochastiques distincts : les données manquantes de manière totalement aléatoire (MCAR – Missing Completely at Random), les données manquantes de manière aléatoire conditionnelle (MAR – Missing at Random) et les données manquantes de manière non aléatoire (MNAR – Missing Not at Random).
La suppression par liste autorisée par l’option NOMISS ne produit des estimations non biaisées des coefficients de corrélation que si et seulement si le mécanisme sous-jacent relève strictement du régime MCAR, signifiant que la probabilité d’omission d’une donnée est totalement indépendante tant des valeurs observées que des valeurs manquantes elles-mêmes. Cette hypothèse s’avère fréquemment irréaliste en recherche clinique ou sociale, où l’omission d’une réponse (par exemple sur des questionnaires de consommation de substances ou de revenus financiers) est hautement corrélée à des caractéristiques latentes du participant.
Si les données sont MAR ou MNAR, l’utilisation aveugle de PROC CORR avec ou sans NOMISS introduira des biais d’estimation substantiels dans la magnitude des coefficients. Dans ces configurations complexes, les standards méthodologiques actuels préconisent d’abandonner l’analyse directe sur données brutes lacunaires au profit de procédures modernes d’imputation multiple sous SAS au moyen de la procédure PROC MI, suivie de l’estimation des corrélations sur chaque table imputée, pour enfin synthétiser les résultats finaux selon les règles combinatoires de Rubin via la procédure PROC MIANALYZE.
8. Analyse de corrélation partielle et semi-partielle
8.1 Fondements de la corrélation partielle dans SAS
L’observation empirique d’une relation étroite entre deux variables quantitatives peut, comme nous l’avons souligné, s’avérer totalement spécieuse lorsqu’elle est médiée ou parasitée par l’influence conjointe d’un tiers facteur non isolé. La corrélation partielle constitue la réponse mathématique élégante à cette problématique fondamentale : elle mesure avec exactitude le degré d’association linéaire subsistant entre deux variables d’intérêt une fois que l’effet linéaire exercé par une ou plusieurs covariables spécifiées a été mathématiquement contrôlé, neutralisé et extrait des deux variables initiales.
Conceptuellement, le calcul d’une corrélation partielle d’ordre 1 (contrôlant une seule covariable Z) équivaut à régresser linéairement la variable X sur Z d’une part, puis la variable Y sur Z d’autre part, et enfin à calculer le coefficient de corrélation de Pearson standard directement sur les deux séries de résidus issus de ces deux régressions respectives. Les résidus représentant la part de variance de chaque entité qui est rigoureusement indépendante et orthogonale aux fluctuations de Z, la corrélation entre ces résidus capture la relation bivariée pure, totalement purgée de l’influence confondante de Z.
Sous SAS, la transition d’une analyse bivariée classique vers un modèle d’ajustement partiel s’effectue sans aucune complexité algorithmique par l’adjonction de l’instruction PARTIAL dans le corps de la procédure PROC CORR :
PROC CORR DATA=mes_donnees;
VAR Volume_Ventes Depenses_Marketing;
PARTIAL Anciennete_Marque Taille_Magasin;
RUN;
Cette commande permet d’obtenir immédiatement la corrélation épurée unissant le volume des ventes et les dépenses de marketing, en neutralisant simultanément l’impact de l’ancienneté commerciale et de la superficie des points de vente.
8.2 Interprétation des degrés de liberté et coefficients ajustés
L’introduction d’une ou de plusieurs variables d’ajustement au sein de l’instruction PARTIAL modifie directement les paramètres mathématiques de l’inférence statistique, à commencer par le nombre de degrés de liberté (DF – Degrees of Freedom) associés aux tests de significativité. Dans le calcul standard d’un coefficient de Pearson, les degrés de liberté sont définis par la formule (N – 2). Dès lors que l’analyste conditionne la relation sur un ensemble de k variables de contrôle au moyen de l’instruction PARTIAL, le nombre de degrés de liberté est systématiquement réajusté à la baisse selon la formule (N – 2 – k).
Cette amputation mécanique des degrés de liberté reflète la perte d’information statistique concédée pour estimer les coefficients de régression des variables de contrôle. Elle se traduit par une légère élévation du seuil critique de Student nécessaire pour atteindre la significativité statistique, imposant une discipline de parcimonie dans la sélection des variables à partialiser afin de ne pas éroder inutilement la puissance du test sur des échantillons restreints.
L’interprétation conjointe de la corrélation d’ordre zéro (la corrélation brute non ajustée) et de la corrélation partielle ajustée constitue un outil diagnostique exceptionnel pour caractériser la nature des systèmes multivariés. Si la corrélation partielle s’effondre vers zéro alors que la corrélation initiale était puissante, l’analyste apporte la preuve formelle que la relation de départ était fallacieuse ou totalement médiée par le bloc de contrôle. À l’inverse, si la corrélation partielle augmente substantiellement en magnitude par rapport à la corrélation brute, le chercheur met en évidence un effet de suppression statistique (suppressor effect), la covariable neutralisée ayant agi comme un filtre absorbant la variance d’erreur non pertinente.
8.3 Applications pratiques en psychologie différentielle et clinique
Les champs de la psychologie clinique, de la neuropsychologie et de l’épidémiologie cognitive fournissent des illustrations éclatantes de la nécessité méthodologique absolue de recourir à l’instruction PARTIAL de PROC CORR. Lors de l’investigation du déclin cognitif lié au vieillissement, l’analyste cherche fréquemment à identifier l’association reliant la vitesse de traitement de l’information (évaluée par des tests chronométrés) et la performance en mémoire épisodique de travail chez des adultes âgés de 50 à 90 ans.
Une simple corrélation bivariée mettra invariablement en évidence une relation hautement significative entre ces deux fonctions cognitives. Cependant, cette observation brute est largement imputable à la sénescence biologique générale du système nerveux central qui altère simultanément l’ensemble des modules psychomoteurs au fil des décennies. En introduisant l’âge chronologique des participants ainsi que leur niveau d’éducation formelle (en années d’études) au sein de la clause PARTIAL Age Education;, le chercheur parvient à isoler la covariance intra-individuelle spécifique existant entre la vitesse et la mémoire, indépendamment du vieillissement normal et de la réserve cognitive.
De même, en psychopathologie quantitative, l’étude des liens unissant les traits de personnalité du modèle à cinq facteurs (Big Five) et des marqueurs comportementaux à risque (addictions, impulsivité alimentaire) exige quasi systématiquement le contrôle statistique de l’affect négatif généralisé ou du névrosisme. La détresse émotionnelle diffuse ayant tendance à colorer artificiellement l’ensemble des réponses aux auto-questionnaires, la partialisation de cette variable par PROC CORR permet de déterminer si le construit théorique ciblé conserve une validité incrémentielle propre ou s’il constitue un simple épiphénomène de l’anxiété générale du patient.
9. Visualisation graphique des corrélations avec SAS
9.1 Intégration d’ODS Graphics pour des représentations automatiques
L’analyse statistique moderne récuse l’interprétation aveugle d’indices purement numériques sans validation visuelle concomitante de la structure morphologique des distributions, une exigence rendue célèbre par le célèbre quartet d’Anscombe illustrant comment des jeux de données aux propriétés géométriques radicalement dissemblables peuvent partager un coefficient de Pearson rigoureusement identique. Au sein de SAS, l’architecture ODS Graphics s’intègre harmonieusement à la procédure PROC CORR pour générer des représentations graphiques diagnostiques sophistiquées en une seule ligne de code.
Pour activer cette machinerie visuelle de pointe, l’analyste doit au préalable s’assurer de l’activation globale du sous-système au moyen de la commande ODS GRAPHICS ON;, puis spécifier l’option PLOTS= au sein de l’instruction PROC CORR. L’option standard la plus puissante s’articule comme suit :
ODS GRAPHICS ON;
PROC CORR DATA=sashelp.iris PLOTS=SCATTER(ALPHA=0.05);
VAR SepalLength PetalLength;
RUN;
ODS GRAPHICS OFF;
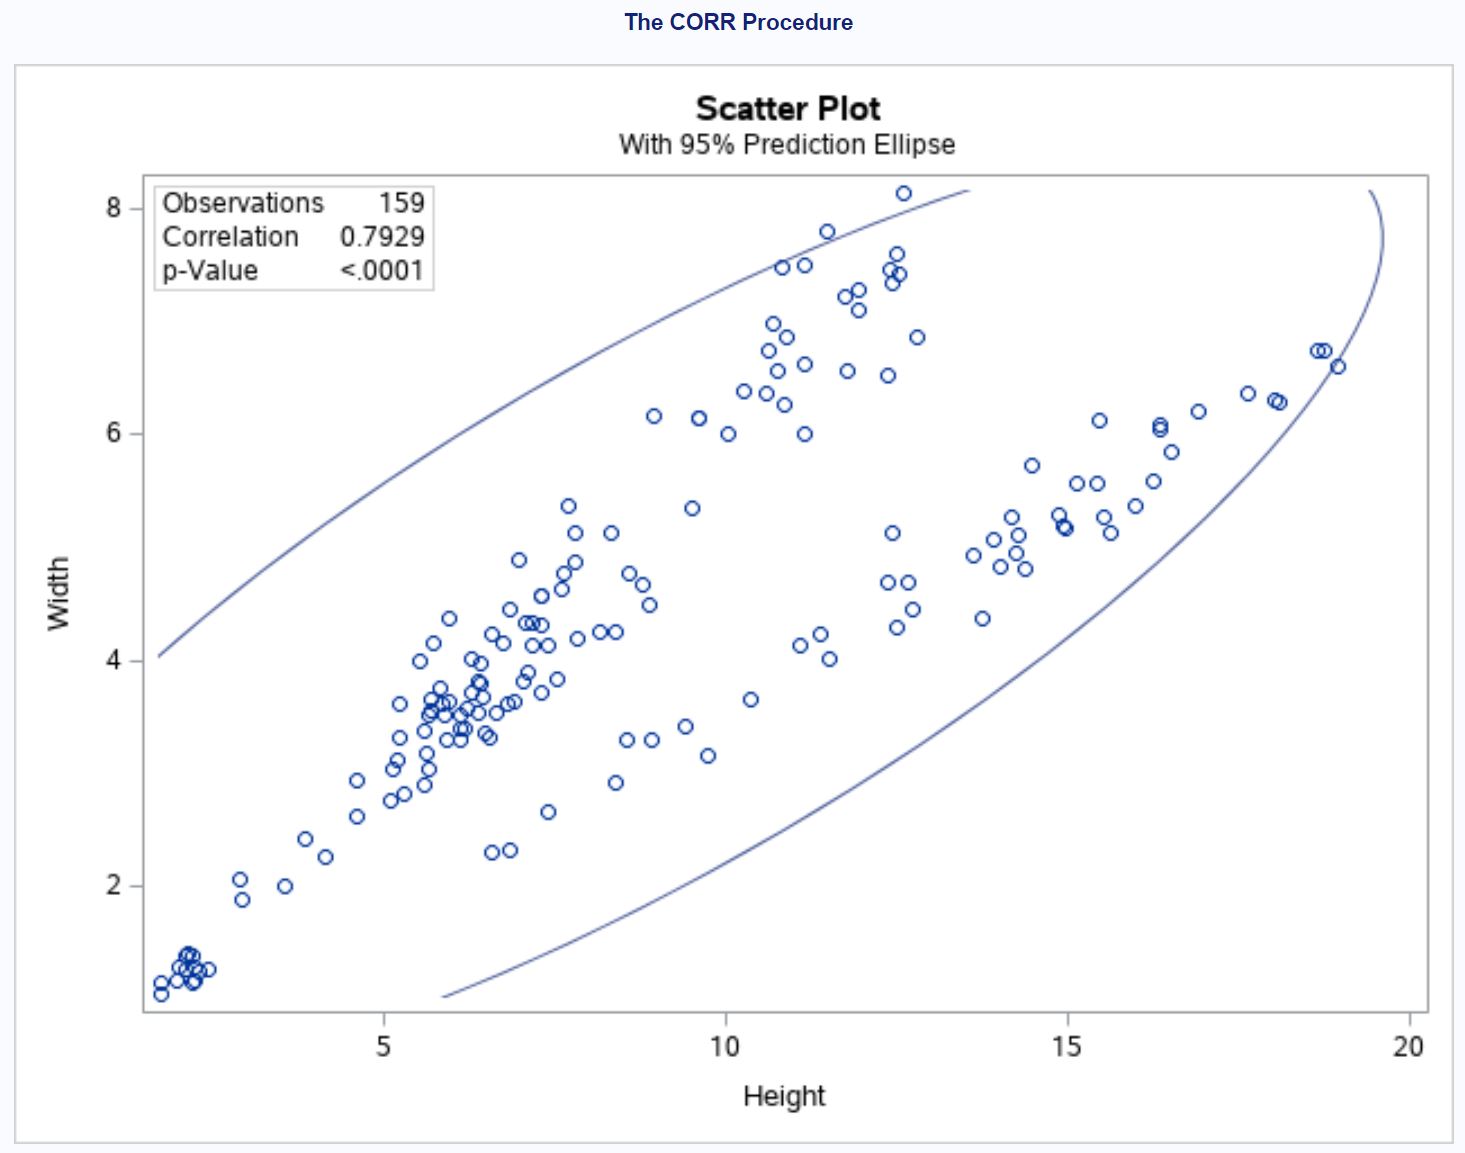
Cette formulation produit automatiquement un graphique de dispersion enrichi d’un raffinement statistique exceptionnel. La figure intègre les observations individuelles, la droite de régression linéaire ajustée par la méthode des moindres carrés, et surtout, une ellipse de confiance bivariée paramétrée au seuil spécifié (ici 95 % via l’argument ALPHA=0.05). L’orientation, l’excentricité et la surface de cette ellipse fournissent une lecture spatiale directe de la variance conjointe : une ellipse très effilée et inclinée à 45 degrés signale une corrélation frôlant l’unité, tandis qu’une morphologie circulaire trahit une indépendance statistique absolue.
9.2 Cartes thermiques de corrélation (Heatmaps) sous SAS
Lorsque la structure de données intègre un nombre élevé de dimensions, l’examen d’une matrice graphique composée de dizaines de nuages de points bivariés miniatures (scatterplot matrix, générée via PLOTS=MATRIX) s’avère cognitivement éprouvant. La mise en œuvre de cartes thermiques de corrélation (communément désignées sous l’anglicisme heatmaps) constitue la réponse visuelle par excellence pour communiquer la structure globale d’un réseau de mesures au sein de publications scientifiques de haut niveau.
Bien que PROC CORR propose une option graphique de type PLOTS=CORR qui génère une matrice synthétique ombrée par défaut, l’obtention d’un rendu hautement esthétique conforme aux normes graphiques des revues internationales s’opère par le couplage de PROC CORR avec les procédures de graphisme analytique PROC TEMPLATE et PROC SGRENDER, ou plus directement via la procédure PROC SGPLOT exploitant l’instruction HEATMAPPARM.
Le protocole technique consiste à exporter dans un premier temps les coefficients de corrélation calculés vers une table SAS structurée grâce au système ODS OUTPUT (en ciblant la table PearsonCorr). Une fois ces valeurs tabulées sous un format relationnel unissant une variable en abscisse et une variable en ordonnée, l’analyste applique un gradient chromatique continu divergent (oscillant classiquement du bleu profond pour les corrélations négatives intenses au rouge écarlate pour les associations positives maximales, en passant par le blanc ou le gris neutre pour la valeur zéro). Cette cartographie thermique offre une lisibilité instantanée, révélant immédiatement les blocs de colinéarité et les architectures modulaires au sein de vastes batteries de tests.
9.3 Graphiques bivariés détaillés avec PROC SGPLOT
Pour l’élaboration de figures destinées aux comités de rédaction des périodiques scientifiques à comité de lecture, l’automatisation de PROC CORR peut être avantageusement relayée par la flexibilité programmatique sans égale de la procédure PROC SGPLOT. Cette dernière permet une superposition modulaire de couches graphiques paramétriques et non paramétriques sur un même espace de coordonnées bivariées.
Une démarche particulièrement rigoureuse consiste à superposer sur le nuage de points non seulement la droite de régression linéaire classique (instruction REG) assortie de ses intervalles de confiance sur la moyenne et de prédiction sur les individus, mais également une courbe d’estimation non paramétrique de type Loess ou spline de lissage pénalisée (instruction LOESS). Cette confrontation visuelle immédiate entre l’ajustement linéaire contraint et l’ajustement non paramétrique souple permet de vérifier de visu la stricte validité de l’hypothèse de linéarité imposée par le modèle de Pearson.
Par ailleurs, l’environnement SAS permet de paramétrer directement la résolution géométrique et typographique des figures générées au moyen d’instructions ODS spécifiques configurant les pilotes de sortie (par exemple ODS LISTING IMAGE_DPI=300;). Cette configuration garantit que les diagrammes de dispersion bivariés exportés au format TIFF ou EPS satisfont sans aucune dégradation vectorielle aux exigences de résolution minimale imposées par les éditeurs académiques pour l’impression finale des articles scientifiques.
10. Inférence statistique avancée et intervalles de confiance
10.1 Transformation en Z de Fisher pour l’estimation d’intervalles
L’une des erreurs inférentielles les plus pernicieuses constatées dans les rapports empiriques consiste à calculer l’intervalle de confiance d’un coefficient de corrélation de Pearson de manière symétrique en ajoutant et retranchant simplement deux erreurs-types à l’estimateur ponctuel, selon la formule naïve r ± 1.96 * SE. Cette démarche est fondamentalement erronée d’un point de vue mathématique en raison de la nature asymétrique et bornée de la distribution d’échantillonnage de r. Dès lors que le paramètre dans la population s’écarte de zéro, la distribution empirique de r devient fortement asymétrique, se comprimant contre les bornes asymptotiques de -1,00 ou +1,00.
Pour résoudre cette distorsion, Sir Ronald Fisher a développé en 1921 sa transformation logarithmique canonique, universellement désignée sous le nom de transformation z de Fisher (ou fonction tangente hyperbolique inverse, arctanh). Cette fonction mathématique convertit l’éventail borné [-1, +1] en un continuum infini ]-∞, +∞[ au sein duquel la distribution de la nouvelle variable z converge à une vitesse spectaculaire vers une loi normale parfaite, dont la variance ne dépend mathématiquement que de la taille de l’échantillon, selon la relation élégante 1 / (N – 3).
Sous SAS, l’obtention des intervalles de confiance rigoureux construits via la méthode de Fisher s’active par l’adjonction de l’option FISHER dans l’instruction d’en-tête de PROC CORR :
PROC CORR DATA=mes_donnees FISHER(ALPHA=0.05);
VAR Score_Test_A Score_Test_B;
RUN;
Le compilateur SAS prend en charge l’ensemble de la cinématique algorithmique : il convertit le r empirique en son score z équivalent, calcule l’intervalle symétrique à 95 % au sein de l’espace transformé, puis réapplique la transformation inverse (tangente hyperbolique standard) sur les bornes résultantes pour restituer un intervalle de confiance asymétrique rigoureusement exact sur l’échelle originelle de corrélation.
10.2 Comparaison de deux coefficients de corrélation indépendants
Une problématique analytique récurrente en psychologie différentielle et en médecine comparée consiste à évaluer si l’intensité du couplage linéaire unissant deux paramètres diverge de manière statistiquement significative entre deux sous-populations distinctes et indépendantes — par exemple entre les hommes et les femmes, entre un groupe recevant un traitement actif et un groupe placebo, ou entre deux cohortes générationnelles distinctes.
Pour conduire ce test d’hypothèse comparative sous SAS, l’analyste peut déployer l’instruction BY au sein de PROC CORR pour stratifier le calcul des coefficients par sous-groupe, sous réserve d’avoir préalablement trié la table d’entrée au moyen de la procédure PROC SORT. Cependant, la simple juxtaposition visuelle de deux coefficients (par exemple r = 0,45 chez les femmes et r = 0,25 chez les hommes) ne suffit en aucun cas à affirmer qu’ils diffèrent statistiquement, même si l’un est déclaré significatif et l’autre non.
La statistique formelle de comparaison requiert le calcul de l’écart standardisé entre les deux coefficients préalablement convertis via la transformation z de Fisher. L’erreur-type de la différence entre deux z indépendants s’exprime comme la racine carrée de la somme [1/(N1 – 3) + 1/(N2 – 3)]. Le quotient de la différence observée par cette erreur-type suit une loi normale centrée réduite (Z-score). L’analyste peut soit programmer cette formule élémentaire au sein d’une courte étape DATA step exploitant les sorties capturées par PROC CORR, soit mobiliser les options avancées de la procédure pour exécuter automatiquement le test d’homogénéité des corrélations entre sous-groupes.
10.3 Correction pour tests multiples dans les matrices étendues
L’estimation aveugle de vastes matrices de corrélation croisant des dizaines de variables expose le chercheur à une inflation dramatique du risque d’erreur de type I (l’erreur consistant à rejeter indûment l’hypothèse nulle alors qu’elle est véridique, c’est-à-dire identifier des corrélations purement fortuites). En vertu des lois de la combinatoire probabiliste, le calcul d’une matrice carrée portant sur 30 variables engendre 435 corrélations bivariées distinctes. Si l’analyste évalue chacun de ces tests au seuil alpha nominal habituel de 0,05, la probabilité cumulée de déclarer faussement significative au moins une association totalement inexistante (taux d’erreur par famille) avoisine mathématiquement 100 %.
Pour juguler cette inflation stochastique, la procédure PROC CORR met à disposition des options d’ajustement inférentiel hautement rigoureuses. L’adjonction de l’option ADJUST=BONFERRONI recalibre immédiatement l’ensemble des probabilités critiques en multipliant chaque p-value brute par le nombre total de comparaisons effectuées au sein de la matrice. Bien que la méthode de Bonferroni garantisse un contrôle irréprochable du risque de type I, elle s’avère particulièrement conservatrice et peut accroître indûment le risque d’erreur de type II (manquer des associations réelles par manque de puissance).
Une alternative méthodologique plus moderne et équilibrée consiste à adopter le contrôle du taux de fausses découvertes (FDR – False Discovery Rate) formalisé par Benjamini et Hochberg. SAS permet d’appliquer cette approche par l’intermédiaire de l’instruction ADJUST=FDR ou par le recours à la procédure spécialisée PROC MULTTEST nourrie par les tables d’ODS OUTPUT issues de PROC CORR. Cette stratégie contrôle la proportion attendue de faux rejets parmi l’ensemble des découvertes déclarées significatives, offrant un compromis optimal entre rigueur inférentielle et puissance de détection dans les études génomiques ou psychométriques à haute dimensionnalité.
11. Exportation, automatisation et intégration des sorties SAS
11.1 Capture des résultats structurés via ODS OUTPUT
L’utilisation optimale de SAS dans des chaînes de traitement statistique industrielles ou des pipelines d’analyses reproductibles impose de s’affranchir de la lecture visuelle des résultats dans la fenêtre d’affichage pour capturer programmatiquement les métriques calculées sous forme de tables de données directement requêtables. Le mécanisme ODS OUTPUT représente la clé de voûte de cette architecture de capture structurée.
Chaque composant édité par la procédure PROC CORR correspond à un nom d’objet relationnel interne standardisé documenté dans la bibliothèque du système. Pour la matrice de Pearson bivariée standard, l’objet cible est baptisé PearsonCorr ; pour les statistiques univariées, il s’intitule SimpleStats ; pour la matrice non paramétrique de Spearman, il répond au libellé SpearmanCorr. La syntaxe de capture s’implémente par une simple ligne déclarative intercalée avant l’instruction RUN :
PROC CORR DATA=sashelp.iris NOSUMMARY;
VAR SepalLength SepalWidth PetalLength PetalWidth;
ODS OUTPUT PearsonCorr=MaTableCorrelations;
RUN;
À l’issue de l’exécution, SAS stocke l’intégralité de la matrice numérique, des noms de variables, des effectifs et des probabilités critiques au sein de la table de travail permanente MaTableCorrelations. L’analyste dispose dès lors de la liberté totale de manipuler ces estimateurs au moyen d’étapes DATA step successives, de requêtes SQL (PROC SQL) ou d’opérations de transposition matricielle (PROC TRANSPOSE), autorisant un filtrage automatisé des associations satisfaisant simultanément à des critères doubles d’amplitude d’effet (ex: |r| > 0,40) et de significativité stricte (ex: p < 0,001).
11.2 Exportation des tableaux vers Word, PDF et Excel
La transcription manuelle de matrices de corrélation complexes depuis l’interface statistique vers des traitements de texte de bureau représente une source notoire d’erreurs typographiques involontaires, en plus de constituer une déperdition majeure de temps pour les équipes de recherche. Le système ODS de SAS résout intégralement ce goulot d’étranglement par ses canaux de routage direct vers les formats documentaires institutionnels standards que sont Microsoft Word (RTF), Adobe PDF et Microsoft Excel.
Pour exporter une matrice de corrélation formalisée selon les critères esthétiques stricts requis pour la révision par les pairs académique, l’analyste encapsule l’instruction PROC CORR entre des balises de destination ODS, comme l’illustre la séquence suivante :
ODS RTF FILE= »C:RechercheMatrice_Correlation.rtf » STYLE=Journal;
PROC CORR DATA=mes_donnees NOSUMMARY;
VAR V1 V2 V3 V4;
RUN;
ODS RTF CLOSE;
L’utilisation de la feuille de style prédéfinie Journal applique automatiquement une mise en page d’une remarquable sobriété typographique : suppression des quadrillages verticaux superflus, encadrement horizontal épuré conforme aux normes de présentation de l’American Psychological Association (APA), et alignement numérique décimal irréprochable. De façon analogue, la destination ODS EXCEL génère des classeurs multi-onglets au sein desquels les résultats sont directement intégrés sous forme de cellules de calculs numériques prêtes pour d’éventuelles consolidations financières ou actuarielles.
11.3 Automatisation par Macro-programmation SAS
Dans les contextes de suivi longitudinal, de monitorage d’essais cliniques multicentriques ou de traitement de panels transactionnels massifs, l’analyste est régulièrement confronté à l’obligation de réitérer des calculs de corrélation sur des sous-populations mouvantes, sur des fenêtres temporelles glissantes ou à travers de multiples strates démographiques. Le puissant langage de macro-programmation de SAS permet d’encapsuler la logique de PROC CORR au sein de routines paramétriques réutilisables à l’infini.
La conception d’une macro-commande commence par la déclaration %MACRO acceptant des arguments dynamiques tels que le nom de la table, les variables d’analyse, le mode de gestion des données manquantes et le seuil d’ajustement. À l’intérieur de cette coquille, les variables macro (désignées par le préfixe ampersand &) sont résolues dynamiquement lors de la compilation :
%MACRO CalculerCorr(TableIn=, VarX=, VarY=, Groupe=);
PROC SORT DATA=&TableIn OUT=TempSort;
BY &Groupe;
RUN;
PROC CORR DATA=TempSort NOMISS FISHER;
BY &Groupe;
VAR &VarX &VarY;
RUN;
%MEND CalculerCorr;
L’invocation ultérieure d’une simple ligne de code telle que %CalculerCorr(TableIn=sashelp.cars, VarX=Horsepower, VarY=MPG_City, Groupe=Origin); exécute instantanément l’analyse complète stratifiée par pays d’origine du constructeur. Ce niveau d’abstraction programmatique élimine toute duplication redondante de code source, garantit une standardisation méthodologique rigoureuse à travers tous les départements d’une organisation et sécurise l’auditabilité des résultats.
12. Pièges méthodologiques, erreurs fréquentes et recommandations
12.1 Dépendance fallacieuse : restriction d’étendue et sous-échantillonnage
Parmi les écueils méthodologiques les plus destructeurs pour la fidélité des inférences statistiques se trouve le phénomène de restriction d’étendue de la variance (range restriction). Le coefficient de corrélation de Pearson étant directement dépendant de la dispersion des observations autour de leur centroïde, toute sélection artificielle ou truncation imposée sur l’échantillon analysé réduit mécaniquement la variance apparente et comprime drastiquement la magnitude du coefficient de corrélation calculé, conduisant à une sous-estimation sévère de l’interdépendance réelle existant dans la population globale.
Ce biais est omniprésent dans les études de sélection académique ou professionnelle. Imaginons un chercheur mesurant l’association reliant les scores obtenus à un examen standardisé d’admission universitaire et les résultats académiques ultérieurs obtenus en troisième cycle. Si l’analyse est conduite exclusivement sur les candidats effectivement admis au sein du cursus (lesquels possèdent obligatoirement des scores d’admission très élevés et homogènes), la corrélation empirique observée sous SAS s’avérera fréquemment faible, voire proche de zéro. Cette faiblesse ne prouve nullement l’inefficacité prédictive du test, mais reflète simplement l’amputation de l’éventail complet des notes éliminées lors de la phase de filtrage.
Pour remédier à cette atténuation pathologique, la psychométrie computationnelle a développé des formulations correctives, au premier rang desquelles figure la célèbre formule de correction d’atténuation de Thorndike. L’analyste appliquant SAS doit être capable de transposer ces ajustements théoriques par l’intégration d’étapes de recalibration logicielle réinjectant la variance estimée de la population totale, afin de restituer l’estimation non biaisée du coefficient d’intérêt opérationnel.
12.2 Paradoxe de Simpson et hétérogénéité non observée
Le paradoxe de Simpson désigne une configuration géométrique et probabiliste hautement troublante au sein de laquelle une corrélation observée avec une direction donnée au niveau de l’ensemble d’une population agrégée s’inverse totalement lorsque l’analyse est conduite séparément au sein de chacune des sous-populations ou strates composant cette même cohorte. Ce paradoxe survient lorsqu’une variable latente de confusion, souvent qualitative et non intégrée dans le modèle bivarié simple, entretient des liaisons puissantes et croisées avec les deux variables analysées.
Supposons une étude clinique évaluant l’association entre le dosage d’un médicament expérimental et le taux de guérison pathologique sans tenir compte de la gravité clinique initiale des patients. À l’échelle globale, l’analyste calculant la corrélation avec PROC CORR peut constater avec stupeur l’émergence d’une corrélation négative statistiquement significative, suggérant fallacieusement que plus le dosage augmente, moins le patient guérit. Toutefois, en stratifiant l’analyse à l’aide de l’instruction BY Gravite_Maladie;, la corrélation s’avère vigoureusement positive dans le sous-groupe des cas légers comme dans celui des cas sévères : les médecins avaient simplement administré de manière préférentielle les doses les plus fortes aux patients présentant le pronostic clinique le plus sombre.
Ce phénomène souligne avec acuité l’impératif méthodologique de ne jamais se fier aveuglément à une matrice de corrélation agrégée exécutée sur une population hétérogène. La vérification de l’invariance structurelle de la covariance à travers les sous-groupes démographiques, environnementaux ou temporels constitue une précaution élémentaire indispensable avant de poser une quelconque conclusion nomothétique sur la réalité d’une association linéaire.
12.3 Bonnes pratiques de rapportage selon les normes APA
La communication des résultats statistiques au sein des publications de psychologie, d’éducation et de sciences de la santé obéit aux conventions typographiques et méthodologiques formalisées par le manuel de style de l’American Psychological Association (APA, 7e édition). La transcription des sorties brutes fournies par SAS dans un manuscrit académique exige une transposition rigoureuse respectant des normes d’écriture millimétrées.
Sur le plan textuel, chaque paramètre statistique doit être symbolisé par sa lettre canonique en italique majuscule ou minuscule selon les règles établies : le coefficient de Pearson s’écrit avec un r minuscule italique, le coefficient de Spearman avec r_s ou ρ, et les degrés de liberté sont systématiquement inscrits entre parenthèses immédiatement après la lettre. Les normes APA imposent une règle de parcimonie numérique stricte concernant l’omission du zéro initial : pour toute statistique qui ne peut mathématiquement jamais excéder la valeur 1,00 (ce qui est précisément le cas du coefficient de corrélation et des valeurs de probabilités critiques p), il est formellement exigé d’omettre le zéro précédant la virgule ou le point décimal (ex: r(148) = .42, et non pas 0.42).
De surcroît, le rapportage moderne proscrit les mentions vagues de significativité binaire de type « p < .05 » dès lors que les valeurs exactes sont disponibles. L’analyste se doit d’indiquer la probabilité critique exacte produite par SAS (ex: p = .023), la formulation « p < .001 » étant strictement réservée aux valeurs infiniment petites que le système affiche sous la forme <.0001. Enfin, une rigueur scientifique exemplaire commande d’accompagner systématiquement l’estimation ponctuelle de la taille de l’effet de son intervalle de confiance à 95 % (IC95%), permettant ainsi aux lecteurs d’apprécier la précision métrologique de la mesure indépendamment de l’effet d’amplification mécanique induit par la taille de l’échantillon.
Références
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Fisher, R. A. (1921). On the « probable error » of a coefficient of correlation deduced from a small sample. Metron, 1, 3-32. https://digital.library.adelaide.edu.au/dspace/handle/2440/15169
Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81-93. https://doi.org/10.1093/biomet/30.1-2.81
Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons.
Pearson, K. (1895). Notes on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240-242. https://doi.org/10.1098/rspl.1895.0041
SAS Institute Inc. (2021). SAS/STAT 15.2 User’s Guide: The CORR Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/index.html
Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72-101. https://doi.org/10.2307/1412159
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.