
Dans le domaine de l’ingénierie des données et de l’analyse statistique avancée, la manipulation des données lacunaires constitue l’un des défis les plus récurrents et méthodologiquement déterminants. Au sein de l’écosystème logiciel de l’institut SAS, plateforme de référence dans la recherche biomédicale, les études épidémiologiques et l’actuariat financier, l’intégrité structurelle des vecteurs d’observation conditionne la robustesse des inférences ultérieures. L’un des outils fondamentaux développés pour répondre à l’impératif de consolidation déterministe des flux de données hétérogènes est la fonction COALESCE. Conçue initialement selon les principes de l’algèbre relationnelle et intégrée aux environnements de programmation séquentielle, cette fonction résout avec une grande élégance algorithmique la question de l’extraction priorisée des valeurs non manquantes parmi un ensemble ordonné de variables candidates.
Le traitement des valeurs manquantes ne relève pas d’une simple commodité syntaxique ; il engage directement la validité interne des estimations économétriques et biostatistiques. L’omission ou la mauvaise interprétation d’une donnée manquante dans une table d’analyse peut induire des biais d’attrition, déformer les matrices de covariance ou provoquer l’exclusion non justifiée de cohortes entières lors de l’application de régressions multivariées. Dès lors, la maîtrise des mécanismes d’évaluation séquentielle offerts par SAS s’avère indispensable pour tout statisticien ou ingénieur logiciel soucieux de construire des pipelines de données hautement reproductibles, robustes et conformes aux normes industrielles les plus strictes.
Ce guide exhaustif a pour vocation d’analyser en profondeur le comportement mécanique, la structure syntaxique et les applications avancées de la fonction COALESCE dans l’environnement SAS. À travers une démarche progressive articulée autour d’exemples d’implémentation concrets, d’analyses comparatives d’efficience algorithmique et d’études de cas méthodologiques appliquées, ce document met en lumière les subtilités sous-jacentes à son exécution au sein de l’étape DATA et de la procédure PROC SQL. Il détaille également la frontière herméneutique entre variables numériques et textuelles, les interactions avec les vecteurs indicés, ainsi que la gestion des codes d’absence spécifiques.
1. Introduction à la gestion des valeurs manquantes et rôle de COALESCE dans SAS
1.1 Définition conceptuelle et utilité de la fonction COALESCE
La fonction COALESCE se définit conceptuellement comme un opérateur de réduction scalaire par évaluation séquentielle ordonnée d’un vecteur d’arguments. Son rôle consiste à examiner, de gauche à droite, une succession de variables ou d’expressions passées en paramètres et à renvoyer la première occurrence qui ne présente pas l’état d’absence numérique. Dans l’architecture de données de SAS, où chaque cellule d’une table correspond à une observation scalaire au sein du vecteur de données programme (Program Data Vector ou PDV), COALESCE opère ligne par ligne, de manière strictement transversale.
Cette approche apporte une réponse déterminante aux problématiques d’intégration de flux où plusieurs sources d’informations concurrentes ou complémentaires décrivent un même phénomène sous-jacent. Au lieu de recourir à des arbitrages probabilistes complexes lors des premières étapes de structuration, la fonction COALESCE permet d’établir une règle d’assignation explicite et déterministe. Elle garantit ainsi la standardisation des flux de données dans les environnements statistiques SAS en assurant qu’une variable synthétique cible hérite systématiquement de l’information la plus fiable ou la plus précoce disponible dans la hiérarchie définie par l’analyste.
Dans les contextes d’ingénierie de données modernes, où les bases relationnelles interagissent en permanence avec des entrepôts de données massives, la standardisation offerte par COALESCE préserve l’homogénéité du schéma logique. Elle évite la prolifération de variables intermédiaires superflues et stabilise le typage des colonnes, réduisant ainsi drastiquement la dette technique au sein des programmes de production statistique.
1.2 La problématique des données manquantes dans la modélisation statistique
L’existence de données manquantes au sein d’une matrice empirique menace directement l’intégrité des analyses statistiques inférentielles et multivariées. Dans la théorie formalisée par Donald Rubin, les données manquantes sont classifiées selon trois régimes d’absence fondamentaux : totalement manquantes au hasard (Missing Completely at Random, MCAR), manquantes au hasard (Missing at Random, MAR) et manquantes de façon non aléatoire (Missing Not at Random, MNAR). La plupart des procédures de modélisation paramétrique dans SAS, telles que PROC REG, PROC GLM ou PROC LOGISTIC, appliquent par défaut la suppression par observation complète (listwise deletion).
Cette suppression systématique des lignes contenant au moins une valeur manquante entraîne une contraction sévère de la taille de l’échantillon effectif. Cette attrition artificielle induit une dégradation notable de la puissance statistique des tests d’hypothèses et accroît considérablement la variance des estimateurs. Plus grave encore, si le mécanisme sous-jacent de l’absence n’est pas strictement MCAR, l’élimination des observations incomplètes biaise irrémédiablement les coefficients estimés, conduisant à des conclusions scientifiques ou managériales erronées.
Dans ce cadre, la fonction COALESCE joue un rôle préventif fondamental lors de la phase de nettoyage et de prétraitement séquentiel des données. En permettant de consolider plusieurs indicateurs alternatifs ou plusieurs mesures redondantes d’un même phénomène avant la phase d’estimation statistique, elle reconstruit une variable d’intérêt complète, limitant le recours forcé à l’élimination des observations et préservant l’assise empirique indispensable à la validité des modèles.
1.3 Vue d’ensemble du comportement séquentiel de COALESCE
Le comportement mécanique de COALESCE repose sur un algorithme d’interruption immédiate à l’évaluation, souvent assimilé au principe de court-circuit logique (short-circuit evaluation). Lorsque l’étape DATA exécute l’instruction contenant la fonction, le compilateur et le moteur d’exécution de SAS examinent le premier argument spécifié dans la parenthèse d’appel. Si cet argument contient une valeur numérique valide, celle-ci est immédiatement assignée à la variable réceptrice dans le PDV, et l’évaluation des arguments subséquents est interrompue.
Ce n’est que dans l’hypothèse où le premier paramètre présente une valeur manquante que le pointeur d’exécution avance vers le deuxième argument, répétant le test de validité. Ce processus séquentiel linéaire se poursuit de manière inconditionnelle jusqu’à ce qu’une valeur valide soit détectée ou que la liste des arguments soit intégralement épuisée. Cette conception confère à la fonction des propriétés déterministes strictes : à données d’entrée identiques et à ordonnancement constant, le résultat produit est rigoureusement invariable, garantissant ainsi une parfaite reproductibilité des calculs scientifiques.
Cette prévisibilité mathématique fait de COALESCE un outil de prédilection dans les environnements réglementés par des agences telles que la Food and Drug Administration (FDA) ou l’Agence Européenne des Médicaments (EMA), où chaque étape de transformation des données brutes doit pouvoir être auditée, décomposée et justifiée sans la moindre ambiguïté algorithmique.
2. Syntaxe fondamentale et fonctionnement mécanique de COALESCE
2.1 Structure syntaxique standard au sein de l’étape DATA
Au sein d’une étape DATA standard de SAS, la fonction COALESCE s’intègre au sein d’une instruction d’assignation canonique. L’architecture générale de l’instruction répond à la grammaire fondamentale suivante :
variable_cible = COALESCE(argument_1, argument_2, ..., argument_n);
Dans cette formalisation, variable_cible représente l’attribut récepteur instancié ou modifié dans la table de sortie, tandis que la série argument_1 à argument_n désigne un ensemble de variables, de constantes numériques ou d’expressions arithmétiques complexes préalablement déclarées ou calculées. La seule contrainte structurelle incontournable de cette fonction réside dans l’alignement impératif des types : l’ensemble des arguments transmis doit impérativement être de nature numérique.
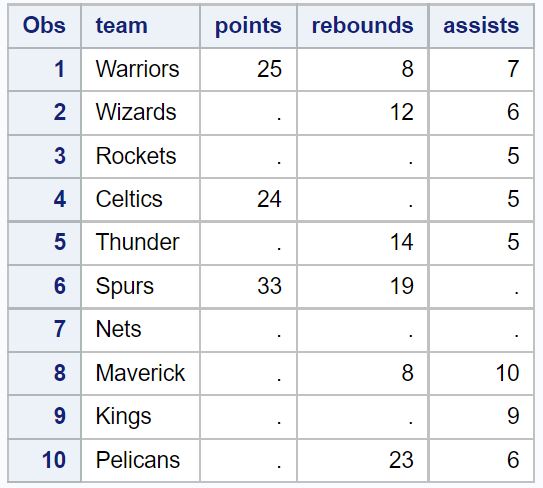
La flexibilité opérationnelle de COALESCE se manifeste notamment par sa capacité à admettre un nombre arbitraire d’arguments au sein de son appel. Aucune restriction fixe n’est imposée quant à la profondeur du vecteur passé en paramètre, si ce n’est les limites matérielles de la mémoire allouée au traitement des buffers de compilation de la session SAS courante. Cette latitude permet aux ingénieurs de concevoir des cascades d’arbitrage étendues sans devoir fragmenter la logique métier en de multiples étapes intermédiaires.
2.2 Évaluation ordonnée et priorité des variables
L’ordonnancement des variables dans la liste des arguments n’est en aucun cas neutre ; il constitue le mécanisme fondamental par lequel s’exprime la hiérarchisation analytique décidée par le modélisateur. L’évaluation s’opérant strictement de gauche à droite, l’argument positionné en première ligne bénéficie d’une priorité absolue sur l’ensemble de ses homologues subséquents. Ce statut privilégié implique que, quelle que soit la pertinence ou la précision théorique des données contenues dans les colonnes suivantes, la présence d’une valeur valide dans la première variable écartera systématiquement toutes les autres.
Le choix de l’ordre d’introduction des arguments répond dès lors à des impératifs méthodologiques rigoureux. Si l’objectif consiste à favoriser la donnée la plus récente au sein d’une série temporelle, les variables devront être ordonnées chronologiquement de la plus tardive à la plus ancienne. Inversement, si le projet accorde la primauté à la précision métrologique d’un capteur institutionnel par rapport à des dispositifs grand public, la variable du capteur de référence devra occuper la tête de la liste des paramètres.
Le flux décisionnel interne exécuté par le moteur SAS peut être modélisé comme une cascade d’instructions conditionnelles élémentaires. Toutefois, contrairement à une succession verbeuse de blocs logiques imbriqués, la fonction internalise ce chemin critique dans les routines de bas niveau du noyau compilé en langage C de SAS, maximisant l’efficacité de la lecture du vecteur de données programme sans générer de surcoût d’interprétation syntaxique à chaque itération.
2.3 Comportement face à des vecteurs entièrement manquants
Un cas particulier régissant le fonctionnement de COALESCE survient lorsqu’une ligne d’observations présente une carence intégrale, c’est-à-dire lorsque la totalité des variables soumises à l’évaluation contient le symbole de valeur manquante numérique standard, matérialisé par un point (.) dans l’environnement SAS. Dans cette configuration extrême, l’évaluation séquentielle parcourt l’ensemble des arguments sans jamais satisfaire la condition d’arrêt précoce.
Face à ce vecteur entièrement lacunaire, la fonction n’interrompt nullement l’exécution de l’étape DATA et ne génère aucune erreur d’exécution dans le journal (SAS Log). Conformément aux principes de tolérance aux pannes du système, COALESCE attribue simplement la valeur manquante numérique par défaut (.) à la variable réceptrice. L’intégrité structurelle de la table résultante est ainsi totalement préservée, le processus traitant l’observation comme un cas légitime d’absence d’information cumulée.
Ce comportement neutre garantit que les observations ne possédant aucune mesure valide sur l’ensemble des axes interrogés restent identifiables dans les phases ultérieures de tri, de filtrage ou de calcul d’agrégats sans corrompre les métriques descriptives ou provoquer de discontinuités logiques inattendues lors de l’application de formats de sortie.
3. Exemple pratique détaillé : Implémentation pas à pas dans une étape DATA
3.1 Création du jeu de données expérimental original
Afin d’illustrer de manière transparente et rigoureuse le fonctionnement opérationnel de la fonction COALESCE, considérons un contexte empirique issu de l’analyse des performances sportives de basket-ball professionnel. Dans ce cadre, nous cherchons à évaluer l’activité offensive d’un ensemble de joueurs à travers trois métriques fondamentales : le nombre de points marqués, le total de rebonds captés et le volume de passes décisives distribuées. Dans les protocoles de collecte décentralisés ou lors d’incidents techniques de capture vidéo, certaines statistiques peuvent faire défaut de façon aléatoire.
Le programme SAS ci-après procède à l’instanciation de la table expérimentale dénommée original_data via une instruction DATALINES. Ce jeu de données intègre volontairement une distribution asymétrique de lacunes numériques afin de simuler l’ensemble des configurations théoriques observables dans la réalité opérationnelle :
data original_data;
    input Joueur $ Points Rebonds Passes;
    datalines;
Alice 24 8 5
Bernard . 11 3
Claire . . 7
David 18 . .
Etienne . . .
Fabien 30 . 12
;
run;

proc print data=original_data;
    title "Table originale des performances sportives";
run;
L’exécution de la procédure PROC PRINT permet de valider l’hétérogénéité des données sources. L’observation relative à Alice présente un profil complet, celle de Bernard accuse une absence de points compensée par des rebonds, tandis que le profil de Claire ne dispose que de ses passes. Le cas d’Etienne reflète l’absence totale de données, servant ainsi d’étalon de vérification pour le comportement face aux vecteurs intégralement nuls.
3.2 Application de la fonction COALESCE sur les variables cibles
L’objectif analytique consiste désormais à synthétiser ces indicateurs disparates en créant une variable unique, baptisée Performance_Primaire, qui retiendra la première donnée chiffrée valide disponible selon une hiérarchie stricte d’importance : en premier lieu les points, en deuxième intention les rebonds si les points font défaut, et enfin les passes décisives en dernier recours.
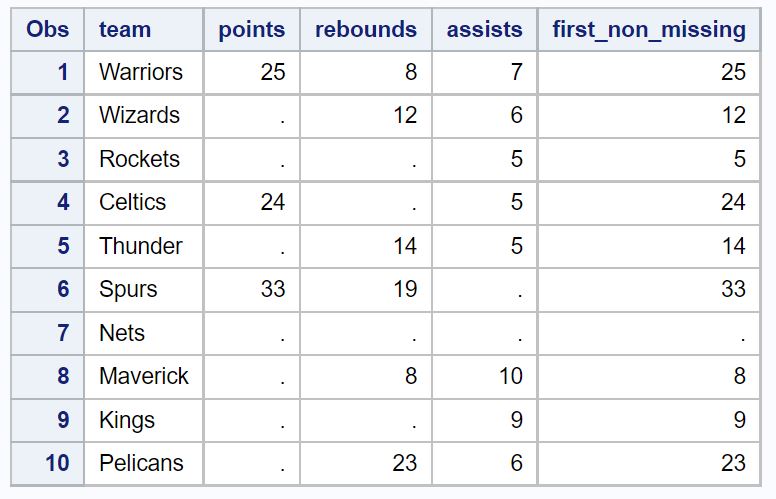
L’implémentation de cette logique décisionnelle au sein d’une nouvelle étape DATA s’articule comme suit :
data new_data;
    set original_data;
    Performance_Primaire = coalesce(Points, Rebonds, Passes);
run;

proc print data=new_data;
    title "Table transformée après application de COALESCE";
run;
Dans ce segment de code, la lecture séquentielle de chaque enregistrement via l’instruction SET alimente le PDV. L’expression coalesce(Points, Rebonds, Passes) est évaluée au vol. L’assignation résultante est immédiatement matérialisée dans la colonne Performance_Primaire avant l’écriture du vecteur dans la table de sortie new_data.
3.3 Analyse rigoureuse des sorties générées par PROC PRINT
L’examen minutieux des sorties tabulaires issues de la procédure PROC PRINT sur la table new_data permet de disséquer le comportement algorithmique appliqué à chacune des lignes du jeu d’essai :
Pour la première observation (Alice), les trois variables contiennent des valeurs valides (24, 8 et 5). La fonction évalue le premier argument Points, constate la présence de la valeur 24, et interrompt immédiatement son parcours sans examiner les variables subséquentes. La variable Performance_Primaire prend donc la valeur 24.
Pour la deuxième observation (Bernard), la variable Points présente une valeur manquante (.). L’évaluation se poursuit donc vers le deuxième argument, Rebonds, qui contient le nombre 11. Ce nombre étant valide, le parcours s’arrête et 11 est assigné à Performance_Primaire, ignorant la valeur 3 de la variable Passes.
Pour la troisième observation (Claire), les variables Points et Rebonds contiennent consécutivement des points d’absence. La fonction traverse ces deux états manquants pour finalement extraire la valeur 7 hébergée par la variable Passes.
Pour l’enregistrement concernant Etienne, les trois indicateurs sont strictement manquants. La fonction épuise l’ensemble de ses arguments sans déceler le moindre scalaire valide et assigne par conséquent la valeur manquante standard (.) à Performance_Primaire. Ce comportement illustre la totale conformité des sorties empiriques par rapport aux principes formels exposés précédemment.
4. Distinction critique entre les fonctions COALESCE et COALESCEC
4.1 Typage des données : variables numériques contre variables caractères
Le système SAS applique un modèle de typage binaire strict et immuable : chaque variable déclarée appartient exclusivement à la classe des grandeurs numériques ou à celle des chaînes alphanumériques (caractères). En vertu de cette dichotomie fondamentale de l’architecture logicielle, la fonction COALESCE native est structurellement et mathématiquement restreinte aux seuls arguments de nature numérique pure. Tout appel invoquant des colonnes alphanumériques au sein de cette fonction déclenche une violation des règles de typage.
Pour combler cette contrainte logique sans contraindre l’utilisateur à des conversions de type fastidieuses, les concepteurs de SAS ont introduit une fonction jumelle dédiée aux chaînes textuelles : la fonction COALESCEC. Le suffixe terminal « C » explicite sans ambiguïté son affiliation aux vecteurs de caractères (Character). Cette variante partage la même cinématique séquentielle de recherche de gauche à droite, mais évalue l’éligibilité des arguments à l’aune de critères spécifiquement textuels.
L’incompatibilité d’exécution devient immédiate et bloquante en cas de mélange hétérogène non contrôlé. Tenter de soumettre simultanément une variable numérique et une variable caractère dans une même instruction COALESCE ou COALESCEC constitue une aberration conceptuelle pour le compilateur SAS, qui impose une étanchéité absolue entre ces deux représentations en mémoire.
4.2 Gestion des chaînes vides et des espaces blancs avec COALESCEC
Si la notion d’absence numérique se traduit de façon univoque par un point système (.), la matérialisation d’une absence dans le domaine textuel s’avère techniquement plus nuancée. Dans l’environnement SAS, une variable caractère manquante correspond fondamentalement à une chaîne de longueur déterminée ne contenant que des espaces blancs (blank spaces), formalisée conceptuellement par ' '.
La fonction COALESCEC évalue une chaîne comme non manquante dès lors qu’elle comporte au moins un caractère non blanc. Toutefois, des situations complexes surviennent fréquemment lorsque des données importées depuis des systèmes tiers contiennent des chaînes de longueur variable où des espaces de remplissage masquent la vacuité réelle du contenu. Dans un tel contexte, une chaîne constituée de plusieurs espaces peut parfois être interprétée de façon ambiguë selon la configuration du système d’entrée.
Pour garantir une robustesse absolue lors de l’usage de COALESCEC, il est hautement recommandé de conjuguer son appel avec des fonctions de nettoyage et d’élagage préliminaires, telles que STRIP ou TRIM. L’application imbriquée coalescec(strip(var_a), strip(var_b)) assure la suppression préalable de tous les espaces blancs initiaux et terminaux, neutralisant ainsi le risque qu’une chaîne visuellement vide mais techniquement garnie d’espaces soit élue par erreur comme valeur valide par le mécanisme séquentiel.
4.3 Diagnostics des erreurs de compilation et de conversion implicite
L’inobservation des règles de typage strict lors de l’appel aux fonctions de coalescence engendre des alertes critiques dans le journal SAS (SAS Log). Le cas le plus dommageable intervient lorsqu’un développeur transmet par mégarde une variable de type caractère à la fonction COALESCE standard. Le moteur SAS, face à cette distorsion, tentera d’effectuer une conversion implicite caractère-vers-numérique (implicit type conversion).
Ce mécanisme de secours déclenche systématiquement l’avertissement formel suivant au sein du journal :
NOTE: Character values have been converted to numeric values at the places given by:
      (Line):(Column)
Cette conversion forcée entraîne plusieurs risques majeurs pour l’intégrité du pipeline analytique. D’une part, si la chaîne de caractères ne présente pas une structure syntaxique strictement convertible en nombre réel (par exemple une chaîne contenant du texte libre ou des caractères alphabétiques), la conversion échoue en produisant une erreur d’évaluation (Invalid numeric data), assigne la valeur manquante mathématique et dégrade significativement les performances d’exécution. D’autre part, la sollicitation continue des routines de conversion implicite au cours du parcours de plusieurs millions de lignes d’observations induit une surconsommation notable de cycles processeur.
La règle méthodologique préconisée dans le développement de programmes de production consiste à bannir formellement toute dépendance envers les mécanismes de conversion implicite. Il appartient au développeur d’aligner rigoureusement ses types en amont, soit en utilisant COALESCEC pour les champs textuels, soit en opérant une conversion explicite et auditée au moyen de la fonction INPUT avant d’invoquer COALESCE.
5. Utilisation de la fonction COALESCE au sein de la procédure PROC SQL
5.1 Syntaxe ANSI SQL et intégration dans la clause SELECT
L’une des forces majeures de la fonction COALESCE réside dans son interopérabilité universelle. Contrairement à de nombreuses fonctions propriétaires strictement limitées au langage de manipulation de données de l’étape DATA, COALESCE est une composante native des standards internationaux ANSI SQL. Par conséquent, son intégration au sein de la procédure PROC SQL de SAS s’effectue avec une conformité parfaite aux règles de l’art du modèle relationnel.
Au sein de la clause SELECT, COALESCE s’emploie directement pour construire des colonnes dérivées dynamiques sans nécessiter l’instanciation préalable d’une étape DATA intermédiaire. La syntaxe générale s’articule comme suit :
proc sql;
    create table table_consolidee as
    select
        identifiant,
        coalesce(mesure_laboratoire, mesure_dispensaire, 0) as mesure_retenue format=8.2
    from base_sante;
quit;
Dans cet extrait, la clause SELECT applique la logique de réduction de gauche à droite sur les colonnes projetées, avec une souplesse additionnelle : la possibilité d’insérer des valeurs littérales de substitution par défaut (ici la valeur 0) en queue de liste, assurant ainsi la fermeture absolue du champ contre toute vacuité résiduelle. L’évaluation au sein du moteur SQL de SAS adopte les mêmes propriétés déterministes que le moteur DATA step, garantissant une cohérence conceptuelle totale à travers l’ensemble des modules d’analyse.
5.2 Consolidation des données lors de jointures relationnelles
Le cas d’usage le plus magistral de COALESCE sous PROC SQL se manifeste lors de la réalisation de jointures relationnelles ouvertes, en particulier les jointures externes complètes (FULL JOIN) ou les jointures externes gauches (LEFT JOIN). Lorsque deux tables sources sont fusionnées sur la base d’une clé d’identification partagée mais imparfaitement synchronisée, le schéma relationnel produit une scission mécanique de la clé dans la table résultante si les deux tables mères contiennent chacune une colonne de même nom.
Considérons le croisement de deux registres hospitaliers, Cohorte_A et Cohorte_B, disposant d’un identifiant patient commun nommé Patient_ID. Dans une jointure complète, les sujets présents exclusivement dans la cohorte B posséderont une valeur nulle pour la colonne Cohorte_A.Patient_ID, et réciproquement. La fonction COALESCE permet de fusionner harmonieusement ces deux colonnes concurrentes en un identifiant unique et sans faille :
proc sql;
    create table registre_unifie as
    select
        coalesce(a.Patient_ID, b.Patient_ID) as Patient_ID,
        a.Score_Clinique,
        b.Score_Biologique
    from Cohorte_A as a
    full join Cohorte_B as b
        on a.Patient_ID = b.Patient_ID;
quit;
Cette formulation élégante élimine les artefacts de redondance et évite l’écrasement ou la troncature de clés primaires dans la table fusionnée. Sans l’intervention de COALESCE, le gestionnaire de données serait contraint de générer des colonnes d’identifiants disjointes, ce qui fragiliserait l’intégrité référentielle pour l’ensemble des requêtes ultérieures.
5.3 Optimisation des requêtes SQL et réduction des cycles de calcul
Sur le plan de l’architecture logicielle et de l’ingénierie des bases de données massives, la formulation d’instructions conditionnelles représente un poste non négligeable de consommation de ressources de calcul. L’alternative structurelle à COALESCE dans une requête SQL consiste à employer l’expression formelle CASE WHEN ... THEN ... ELSE ... END. Bien que fonctionnellement équivalente sur le plan sémantique, la structure CASE souffre d’une verbosité syntaxique qui nuit à la lisibilité générale du code.
De surcroît, le compilateur interne de requêtes de PROC SQL intègre des mécanismes d’optimisation spécifiques pour la fonction COALESCE. Dès lors que la fonction est détectée, le planificateur d’exécution assemble un chemin critique vectorisé hautement optimisé, minimisant les branchements conditionnels au niveau du microprocesseur. Sur des tables comptant des centaines de millions d’enregistrements, la substitution de blocs CASE WHEN verbeux par des expressions COALESCE concises se traduit par une réduction mesurable du temps processeur (CPU Time) et de la durée totale de traitement (Elapsed Time).
La clarté d’écriture résultante facilite en outre les revues de code entre pairs et simplifie la documentation des règles de gouvernance des données au sein des directions informatiques et statistiques.
6. Cas d’usage avancés : Hiérarchisation des sources et imputation sélective
6.1 Établissement d’une hiérarchie de validité entre instruments de mesure
Dans la recherche épidémiologique et les sciences sociales quantitatives, les chercheurs sont fréquemment confrontés à la collecte d’un même phénomène psychologique ou physiologique par le biais d’instruments de mesure aux qualités métrologiques hétérogènes. Par exemple, la mesure de la pression artérielle d’un patient peut provenir d’un cathétérisme invasif de référence (précision maximale), d’une mesure par tensiomètre clinique certifié au repos (précision intermédiaire), ou d’un relevé d’auto-surveillance ambulatoire renseigné par le patient sur une application mobile (forte variabilité et bruit de mesure important).
L’utilisation de la fonction COALESCE fournit un cadre méthodologique transparent et systématique pour instaurer ce que l’on qualifie de hiérarchie métrologique descendante :
data sante_publique;
    set source_mesures;
    Tension_Consolidee = coalesce(Mesure_Invasive, Mesure_Clinique, Mesure_Ambulatoire);
    Source_Selectionnee = ifn(not missing(Mesure_Invasive), 1,
                          ifn(not missing(Mesure_Clinique), 2,
                          ifn(not missing(Mesure_Ambulatoire), 3, .)));
run;
Cette approche garantit qu’aucune donnée de haute précision n’est écrasée par une source de qualité inférieure, tout en préservant le taux de couverture d’échantillon maximal grâce à l’imputation de secours par les outils secondaires. L’adjonction d’un indicateur de traçabilité (ici Source_Selectionnee via la fonction IFN) parachève la démarche scientifique en permettant d’introduire ultérieurement des variables de contrôle pour ajuster les modèles statistiques sur d’éventuels biais d’instrumentation.
6.2 Consolidation de suivis longitudinaux multi-vagues
Les études de panel et les cohortes épidémiologiques longitudinales impliquent le recueil d’informations à intervalles temporels réguliers (appelés « vagues » de suivi, ou waves). Dans de tels protocoles de recherche s’étendant sur plusieurs décennies, le phénomène d’attrition temporelle (perte de vue de sujets) est inévitable. La reconstruction du statut socio-économique ou tabagique d’un individu à un horizon donné impose de rapatrier la dernière information connue sans générer d’extrapolations hasardeuses.
En ordonnant chronologiquement les variables de suivi au sein de l’appel COALESCE, de la vague la plus proche de l’horizon cible vers les vagues antérieures, l’analyste procède à un redressement par report systématique de la dernière observation valide (technique conceptuellement apparentée au Last Observation Carried Forward ou LOCF) :
data suivi_longitudinal;
    set cohorte_vagues;
    Statut_Tabac_Final = coalesce(Statut_Tabac_Vague3, Statut_Tabac_Vague2, Statut_Tabac_Vague1);
run;
Il importe toutefois de souligner les précautions méthodologiques requises par cette méthode : elle postule implicitement la stationnarité du construit psychologique ou comportemental étudié entre les différentes vagues d’observation. Si cette hypothèse de stabilité temporelle s’avère non soutenable sur le plan théorique, l’utilisation aveugle de la coalescence doit être abandonnée au profit de modèles d’imputation multiple par chaînes d’équations entièrement spécifiées (MICE) via PROC MI.
6.3 Remplacement conditionnel sans dénaturation des données préexistantes
Dans un grand nombre d’architectures d’intégration de données, la logique métier requiert de ne jamais altérer les observations natives collectées en première intention, tout en autorisant le comblement sélectif des seules cellules lacunaires par des valeurs d’imputation déterministes issues de moyennes de sous-populations ou de modèles de calibration externes.
La fonction COALESCE réalise cette tâche de substitution sélective avec une sobriété algorithmique remarquable :
data imputation_determinee;
    set registre_entreprises;
    Chiffre_Affaires_Ajuste = coalesce(Chiffre_Affaires_Reel, Estimation_Sectorielle);
run;
Dans cette formulation, si Chiffre_Affaires_Reel possède une valeur observée, celle-ci est scrupuleusement conservée sans la moindre modification. La valeur issue d’Estimation_Sectorielle n’est sollicitée qu’en présence exclusive d’un blanc métrologique initial. Contrairement aux approches impératives basées sur des instructions IF-THEN susceptibles d’écraser involontairement des données authentiques en cas de mauvaise gestion des conditions booléennes, COALESCE garantit mathématiquement la préservation absolue de l’observation originale de premier rang.
7. Interaction de COALESCE avec les tableaux de variables (ARRAYS)
7.1 Définition de structures ARRAY pour vectoriser le traitement
Lors du traitement de structures de données multidimensionnelles, telles que des matrices de réponses à des batteries d’évaluations psychométriques comprenant plusieurs dizaines ou centaines d’items, l’énumération nominative de chaque variable au sein de l’instruction COALESCE devient rapidement impraticable, source d’erreurs d’inattention et dommageable pour la maintenabilité du code source.
L’environnement SAS résout cette problématique de montée en charge grâce à l’instruction ARRAY. Un tableau SAS ne constitue pas une nouvelle structure de données stockée sur disque, mais une grille de pointeurs dynamiques temporaires allouée dans le PDV, permettant de référencer collectivement un groupe de variables homogènes par le biais d’un identifiant commun et d’un index numérique de position.
array scores_items[*] Item_1 - Item_50;
Cette déclaration alloue un vecteur indicé de 50 éléments numériques, rendant chaque colonne immédiatement accessible pour des manipulations mathématiques itératives ou des évaluations vectorielles condensées.
7.2 Passage dynamique des éléments d’un ARRAY à la fonction COALESCE
L’interaction synergique entre les tableaux SAS et la fonction COALESCE se manifeste à travers l’opérateur syntaxique condensé OF. Cet opérateur permet de transférer l’intégralité des variables associées à une structure de tableau directement dans la liste des arguments d’une fonction analytique sans avoir à expliciter manuellement chaque élément.
L’implémentation prend alors la forme extrêmement compacte et élégante suivante :
data synthese_psychometrique;
    set resultats_tests;
    array batterie[*] Mesure_Repetition_1 - Mesure_Repetition_30;
    Premier_Score_Valide = coalesce(of batterie[*]);
run;
Dans cette instruction, le compilateur SAS déplie dynamiquement les pointeurs du tableau batterie[*] en une séquence ordonnée d’arguments transmise à COALESCE. Le moteur conserve scrupuleusement l’ordre de déclaration du tableau (de l’indice 1 à l’indice 30), préservant ainsi la hiérarchisation séquentielle requise pour l’évaluation de gauche à droite.
Cette méthodologie réduit drastiquement le risque d’erreurs typographiques et garantit une adaptabilité immédiate du programme. Si le protocole expérimental évolue pour intégrer 100 mesures au lieu de 30, la seule modification de la borne du tableau ARRAY répercute instantanément le nouveau dimensionnement sur l’appel COALESCE sans exiger la réécriture laborieuse des chaînes d’arguments.
7.3 Analyse de l’efficience algorithmique sur de très grands échantillons
D’un point de vue informatique, le passage d’arguments par l’intermédiaire de tableaux de variables interroge l’allocation de la mémoire vive et les cycles processeur mobilisés. Les développeurs non avertis ont fréquemment tendance à concevoir une boucle itérative DO pour parcourir manuellement les indices d’un tableau et déceler la première valeur non manquante à coups d’instructions de rupture conditionnelle LEAVE :
/* Approche itérative procédurale non optimale */
do i = 1 to dim(batterie);
    if not missing(batterie[i]) then do;
        Premier_Score_Valide = batterie[i];
        leave;
    end;
end;
Bien que rigoureusement équivalente sur le plan du résultat produit, cette construction impérative accuse un temps de traitement significativement plus élevé face à l’instruction vectorisée Premier_Score_Valide = coalesce(of batterie[*]);. L’appel direct à COALESCE court-circuite le surcoût lié à la gestion des compteurs d’indexation, au contrôle de bornes du tableau et au saut d’instructions dans le code intermédiaire généré par SAS.
Sur des bases de données volumineuses (plusieurs millions d’observations traitées en environnement serveur ou sur des architectures informatiques distribuées telles que SAS Viya), l’emploi de coalesce(of array[*]) exploite directement les registres processeur optimisés du noyau SAS et dégage des gains de temps d’exécution substantiels, tout en allégeant l’empreinte mémoire du programme.
8. Comparaison critique : COALESCE face aux structures conditionnelles IF-THEN/ELSE
8.1 Concision syntaxique et lisibilité de l’architecture logicielle
L’évaluation comparative de la fonction COALESCE face aux embranchements conditionnels traditionnels IF-THEN/ELSE constitue un débat méthodologique structurant dans la programmation sous SAS. Pour illustrer cette divergence ergonomique, examinons l’expression logique requise pour extraire la première valeur valide parmi quatre variables candidates en syntaxe classique :
/* Formulation procédurale imbriquée */
if not missing(var1) then resultat = var1;
else if not missing(var2) then resultat = var2;
else if not missing(var3) then resultat = var3;
else if not missing(var4) then resultat = var4;
else resultat = .;
Cette formulation verbeuse s’étale sur six lignes de code, requiert l’appel répété à la fonction booléenne MISSING, multiplie les opérateurs relationnels et accroît le risque d’omettre une branche dans les cas complexes. À l’opposé, la transcription équivalente via la fonction COALESCE s’exécute en une instruction scalaire unique :
resultat = coalesce(var1, var2, var3, var4);
Cette concision drastique assainit le code source en réduisant la complexité cyclomatique du programme. Pour un auditeur externe ou un évaluateur clinique, la lecture du flux logique est instantanée : la finalité de l’opération est explicite par nature, ce qui atténue significativement la dette technique et simplifie les opérations de maintenance évolutive au sein des dépôts institutionnels.
8.2 Performance computationnelle et empreinte mémoire
Au-delà des considérations stylistiques, la confrontation entre ces deux approches se joue sur le plan de l’efficience d’exécution au niveau de la machine virtuelle SAS. Lorsque le compilateur analyse une succession de blocs IF-THEN/ELSE, il instancie des instructions de saut conditionnel dans le bytecode interne. À chaque évaluation, le processeur doit gérer ces branchements, ce qui peut entraîner des pénalités d’exécution liées aux échecs de prédiction de branchement (branch misprediction) au sein des cœurs processeur matériels.
À l’inverse, l’appel à la fonction interne COALESCE invoque un bloc de code précompilé hautement optimisé au sein du binaire système de SAS. L’évaluation de l’absence numérique s’effectue par des masques binaires directs sur la représentation IEEE 754 des nombres flottants manipulés par le processeur. Par conséquent, sur des tables massives soumises à de volumineux pipelines de production, COALESCE surpasse systématiquement les structures IF-THEN/ELSE en termes de vitesse d’exécution pure et de stabilité d’utilisation du cache processeur.
Les rapports de métriques d’exécution visibles dans le journal SAS (notamment l’indicateur de temps CPU consommé) mettent systématiquement en évidence un avantage en faveur de la fonction intégrée, particulièrement lorsque le nombre d’arguments à analyser excède trois ou quatre variables par ligne.
8.3 Flexibilité algorithmique face aux conditions de seuil complexes
Malgré sa supériorité en termes d’ergonomie et de rapidité, la fonction COALESCE n’a pas vocation à se substituer intégralement aux structures IF-THEN/ELSE. La frontière de sa pertinence réside dans sa stricte spécialisation fonctionnelle : elle est exclusivement conçue pour détecter la non-absence de valeurs numériques.
Dès lors que la logique de substitution exige la validation de conditions logiques plus élaborées ou de seuils de conformité spécifiques — par exemple, sélectionner la première valeur valide qui soit strictement positive ou qui n’excède pas une borne physiologique de sécurité —, COALESCE devient inapplicable sous sa forme native. Dans ce scénario, seule la structure conditionnelle IF-THEN/ELSE (ou l’usage imbriqué de la fonction IFN) permet d’articuler des conditions booléennes arbitraires :
/* Règle de sélection soumise à un seuil physiologique */
if not missing(bio_score) and bio_score > 0 then indicateur_retenu = bio_score;
else if not missing(clin_score) and clin_score >= 10 then indicateur_retenu = clin_score;
else indicateur_retenu = .;
Il existe ainsi une parfaite complémentarité méthodologique : la fonction COALESCE doit être privilégiée inconditionnellement pour toute sélection basée uniquement sur le statut de présence d’une valeur, tandis que les embranchements procéduraux IF-THEN demeurent les instruments indispensables de la logique conditionnelle multi-critères.
9. Prise en compte des valeurs manquantes spéciales dans SAS
9.1 Typologie des codes d’absence spéciaux (.A à .Z et ._)
L’architecture de données de SAS se distingue avantageusement de la plupart des environnements informatiques par sa capacité à discriminer plusieurs natures distinctes d’absence numérique. Alors que des langages comme R ou Python (via NumPy/Pandas) ne disposent généralement que d’un indicateur générique unique (NA ou NaN), SAS implémente un système sophistiqué de 28 codes d’absence distincts :
- Le point standard (
.), qui désigne la valeur manquante numérique par défaut ; - Le caractère de soulignement (
._), représentant les valeurs manquantes d’ordre inférieur ; - Vingt-six codes de valeurs manquantes spéciales identifiés par les lettres capitales allant de
.Aà.Z.
Cette taxonomie fine confère au statisticien une richesse d’annotation considérable. En épidémiologie et en économétrie des enquêtes, il devient aisé de classifier sémantiquement la cause de la non-réponse : .R peut coder un refus délibéré de répondre de la part du sujet interrogé, .N une non-applicabilité structurelle de la question posée, .L une valeur perdue par défaillance logistique (lost to follow-up), et .I un résultat biologique indéterminé en raison d’un matériel expérimental défectueux.
Sur le plan de l’ordonnancement interne, SAS attribue à l’ensemble de ces codes d’absence une valeur mathématique rigoureusement inférieure à n’importe quel nombre réel négatif, avec la hiérarchie stricte suivante : ._ < . < .A < .B < ... < .Z < nombres réels.
9.2 Comportement de COALESCE vis-à-vis des valeurs manquantes spéciales
Un aspect fondamental, et pourtant trop méconnu des analystes lors de l’utilisation de COALESCE, réside dans son traitement indifférencié des valeurs manquantes spéciales. Pour la fonction COALESCE, tout code appartenant à l’ensemble { . , ._ , .A , ... , .Z } est formellement catégorisé comme manquant (missing).
Par conséquent, si le premier argument évalué par COALESCE contient la valeur .R (refus d’obtempérer) et que le second argument contient la valeur 25, la fonction ignore intégralement le code spécial .R et extrait immédiatement la valeur 25. Cette mécanique garantit la poursuite ininterrompue de la recherche d’une donnée chiffrée exploitable dans le cadre d’un calcul d’indice.
Toutefois, cette indifférenciation algorithmique présente un risque méthodologique majeur : l’écrasement silencieux d’une information qualitative précieuse. Si le motif d’absence véhiculé par le code .R revêtait une signification clinique critique (par exemple le refus d’un traitement en raison d’effets secondaires intolérables), sa suppression au profit d’une mesure de substitution tierce peut fausser les analyses d’innocuité médicale.
9.3 Protocoles de préservation de la sémantique de l’absence
Pour concilier l’efficacité de la coalescence numérique et l’impératif éthique et scientifique de préservation de la traçabilité des motifs d’absence, il convient de concevoir des protocoles de capture double au sein de l’étape DATA. Ces architectures combinent l’évaluation par COALESCE avec la génération de colonnes indicatrices qualitatives :
data suivi_clinique_securise;
    set registre_visites;

    /* Variable cible unifiée */
    Score_Retenu = coalesce(Visite_Hopital, Visite_Domicile);

    /* Capture de la sémantique si le score retenu est manquant */
    if missing(Score_Retenu) then do;
        if Visite_Hopital = .R or Visite_Domicile = .R then Motif_Absence = "Refus Patient";
        else if Visite_Hopital = .L or Visite_Domicile = .L then Motif_Absence = "Perdu de vue";
        else Motif_Absence = "Non observe standard";
    end;
    else Motif_Absence = "Mesure Valide";
run;
Cette approche hybride préserve l’assise analytique en consolidant les grandeurs métriques nécessaires aux procédures inférentielles, tout en maintenant un historique précis des causes de non-réponse. Ce protocole assure la conformité du pipeline aux exigences de bonnes pratiques cliniques (BPC / Good Clinical Practice) en permettant une auditabilité totale de la chaîne de redressement de l’information.
10. Pièges fréquents, erreurs diagnostiques et stratégies de débogage
10.1 Erreurs liées aux incohérences de format et types de données
Le piège technique le plus classique rencontré par les ingénieurs logiciels lors de l’intégration de COALESCE découle de la confusion entre les formats de stockage interne et les attributs d’affichage externe. Une variable numérique formatée avec un masque d’affichage monétaire (comme DOLLAR12.2) ou calendaire (comme DATE9.) demeure intrinsèquement un scalaire numérique flottant. À ce titre, elle doit impérativement être traitée par COALESCE, et non par sa contrepartie alphanumérique COALESCEC.
L’écueil inverse s’avère particulièrement fréquent dans le cas de COALESCEC : le risque de troncature de longueur de chaîne. Lorsqu’une nouvelle variable textuelle est créée par l’expression nouvelle_var = coalescec(chaine_courte, chaine_longue);, le compilateur SAS détermine par défaut la longueur de nouvelle_var en se calquant sur la longueur du premier argument (chaine_courte). Si l’évaluation sélectionne ultérieurement chaine_longue au cours de l’exécution, le contenu textuel sera irrémédiablement tronqué à la dimension de la première variable, altérant la validité de l’information sans générer la moindre erreur bloquante.
Pour prévenir cette défaillance silencieuse, l’instruction LENGTH doit impérativement être déclarée avant tout appel à COALESCEC :
data correction_longueur;
    set sources_adresses;
    length Adresse_Consolidee $100; /* Verrouillage de la mémoire PDV */
    Adresse_Consolidee = coalescec(Adresse_Principale, Adresse_Secours);
run;
10.2 Conséquences d’un ordre erroné dans la liste des arguments
Une anomalie méthodologique fréquente réside dans la mauvaise appréciation de l’impact de l’ordre séquentiel des variables transmises à la fonction. La fonction ne disposant d’aucune intelligence intrinsèque quant à la véracité substantielle des données, elle se conforme aveuglément à la disposition syntaxique qui lui est soumise. Une inversion accidentelle de deux colonnes dans l’appel introduit un biais d’attribution systématique qui affecte l’ensemble de la distribution statistique.
Considérons le cas d’une enquête salariale où l’on souhaite consolider le revenu annuel en privilégiant les montants certifiés par l’administration fiscale (Revenu_Fiscal) par rapport aux revenus déclaratifs estimés par l’enquêté lors d’un sondage téléphonique (Revenu_Declare). Si le développeur rédige par mégarde :
Revenu_Final = coalesce(Revenu_Declare, Revenu_Fiscal);
Le système sélectionnera systématiquement le montant déclaré dès lors qu’il est présent, écrasant l’information certifiée de l’administration fiscale. Bien que techniquement valide et exempt d’erreur dans le journal SAS, le résultat produit est diamétralement opposé aux spécifications méthodologiques de l’étude.
Pour pallier ce risque, tout pipeline de données doit comporter des phases de vérification croisée sur des sous-échantillons aléatoires extraits par PROC SURVEYSELECT, associées à des calculs de cohérence garantissant que la hiérarchie appliquée respecte strictement les protocoles de validation du plan d’analyse statistique.
10.3 Méthodologie formelle d’audit et de contrôle qualité post-transformation
L’assurance qualité des flux de données transformés par COALESCE exige le déploiement d’une méthodologie de validation statistique formalisée. Il est impératif de ne jamais présumer de l’exactitude d’une transformation sans confronter les indicateurs de dispersion avant et après consolidation.
L’utilisation combinée des procédures PROC FREQ et PROC MEANS permet de concevoir une batterie de contrôles d’intégrité automatisés :
/* Évaluation de la réduction du taux de vacuité */
proc means data=new_data n nmiss mean std min max;
    var Points Rebonds Passes Performance_Primaire;
    title "Audit comparatif de complétude métrique";
run;

/* Table de contingence des sources de sélection */
proc freq data=new_data;
    tables Points * Performance_Primaire / list missing;
    title "Contrôle de conformité de la dérivation séquentielle";
run;
L’analyse des rapports statistiques générés doit attester d’une baisse stricte du nombre de valeurs manquantes (NMISS) pour la variable synthétique par rapport aux variables sources individuelles, tout en vérifiant que les valeurs minimales et maximales restent circonscrites dans les enveloppes autorisées par le domaine métier. Cette étape de contrôle parachève le processus de certification des données préalable à la modélisation.
11. Étude de cas empirique : Traitement d’une batterie d’évaluations psychométriques
11.1 Contexte scientifique de collecte d’évaluations multi-informateurs
Afin de synthétiser l’ensemble des concepts abordés au sein d’une mise en situation empirique réaliste et avancée, considérons un projet de recherche clinique portant sur le diagnostic précoce des troubles de l’attention chez l’enfant. Dans le cadre de ce protocole, la sévérité des symptômes comportementaux est mesurée au moyen d’une échelle psychométrique standardisée comportant trois sources d’évaluation complémentaires (approche dite multi-informateurs) :
- L’évaluation clinique formelle réalisée par un pédopsychiatre hospitalier certifié (
Score_Clinique) ; - L’évaluation comportementale standardisée complétée par l’enseignant de l’enfant (
Score_Enseignant) ; - L’auto-questionnaire rempli à domicile par les représentants légaux de l’enfant (
Score_Parental).
En raison des contraintes logistiques inhérentes à ce type de protocole (absentéisme scolaire, saturation des plannings médicaux ou retards postaux), de nombreux dossiers cliniques présentent des lacunes d’observation importantes. L’équipe d’investigation méthodologique stipule l’obligation d’extraire un indice composite unifié nommé Indice_Diagnostic_Consolide, tout en exigeant une traçabilité intégrale du niveau de source retenu et le respect rigoureux de la métrologie psychométrique.
11.2 Développement et exécution du programme SAS de redressement
Le programme ci-dessous détaille l’étape DATA complète réalisant la consolidation ordonnée des scores cliniques, la création des métadonnées de traçabilité, la gestion explicite des codes d’absence spéciaux et la production des rapports de validation associés :
/* Étape 1 : Définition du jeu de données des inclusions cliniques */
data batterie_clinique;
    input Patient_ID $ Score_Clinique Score_Enseignant Score_Parental;
    datalines;
PAT_001 68 65 72
PAT_002 . 58 60
PAT_003 . . 82
PAT_004 74 . .
PAT_005 . . .
PAT_006 .R 62 65
PAT_007 .L . .
;
run;

/* Étape 2 : Programme de consolidation hiérarchique et traçabilité */
data diagnostic_final;
    set batterie_clinique;

    /* Longueur explicite des attributs de texte */
    length Source_Retenue $20 Statut_Dossier$15;

    /* Coalescence numérique séquentielle */
    Indice_Diagnostic_Consolide = coalesce(Score_Clinique, Score_Enseignant, Score_Parental);

    /* Attribution conditionnelle de l'indicateur de traçabilité de source */
    if not missing(Score_Clinique) then Source_Retenue = "Pédopsychiatre";
    else if not missing(Score_Enseignant) then Source_Retenue = "Enseignant";
    else if not missing(Score_Parental) then Source_Retenue = "Parents";
    else Source_Retenue = "Aucune source";

    /* Préservation sémantique de l'absence */
    if missing(Indice_Diagnostic_Consolide) then do;
        if Score_Clinique = .R then Statut_Dossier = "Refus Éthique";
        else if Score_Clinique = .L then Statut_Dossier = "Perdu de vue";
        else Statut_Dossier = "Incomplet";
    end;
    else Statut_Dossier = "Exploitable";
run;

/* Étape 3 : Inspection formelle des sorties consolidées */
proc print data=diagnostic_final noobs;
    title "Résultats de l'intégration psychométrique multi-informateurs";
run;
L’analyse de l’exécution confirme la parfaite conformité du flux opérationnel : pour le patient PAT_002, l’absence de score clinique conduit à l’extraction de la mesure de l’enseignant (58). Pour le cas critique de PAT_006, le code spécial .R sur la première évaluation est dépassé par la coalescence pour retenir le score de 62, tout en permettant au code analytique subséquent de catégoriser précisément l’historique du profil.
11.3 Validation de l’intégrité métrique des indices consolidés
L’étape finale de l’étude empirique consiste à contrôler que la création de cet indice consolidé n’introduit pas une distorsion disproportionnée de la variance psychométrique de l’échantillon. Un redressement trop agressif ou une substitution mal hiérarchisée peut comprimer artificiellement l’écart-type de la population d’étude, conduisant à sous-estimer la sévérité réelle des troubles au sein de la cohorte pédiatrique.
La procédure PROC UNIVARIATE est invoquée pour caractériser la distribution métrique résultante :
proc univariate data=diagnostic_final;
    var Indice_Diagnostic_Consolide;
    histogram / normal(mu=est sigma=est);
    title "Distribution statistique de l'Indice Diagnostic Consolidé";
run;
L’examen des indicateurs de tendance centrale (moyenne, médiane) et d’asymétrie (skewness) permet de confirmer la préservation des propriétés psychométriques fondamentales des échelles originales. Cette étape confère au programme une rigueur conforme aux plus hauts standards de la recherche translationnelle.
12. Synthèse méthodologique et recommandations opérationnelles pour SAS
12.1 Arbre décisionnel pour le choix des fonctions de coalescence
Au terme de cette analyse approfondie, il est utile de structurer la démarche de programmation sous SAS autour d’un ensemble de critères décisionnels clairs et discriminants. Le choix entre les différentes approches d’assignation en présence de valeurs manquantes doit répondre à la grille d’orientation suivante :
- Nature de la variable cible : Si les variables candidates appartiennent au domaine des réels numériques, l’usage de
COALESCEs’impose sans restriction. Si les variables sont de type alphanumérique, la fonctionCOALESCECconstitue la réponse obligatoire, impérativement précédée d’un ajustement explicite de la taille mémoire via l’instructionLENGTHet d’un nettoyage d’espaces par la fonctionSTRIP. - Environnement de programmation : Dans le cadre d’un traitement relationnel pur ou d’une requête d’agrégation sans création de table persistante complexe, l’intégration de
COALESCEau sein d’une procédurePROC SQL(particulièrement lors des jointures de typeFULL JOIN) minimise le code et optimise les calculs. Dans le cadre de flux conditionnels complexes intégrant des tableaux ou des dérivations métier avancées, l’étape DATA demeure le réceptacle préférentiel. - Complexité des règles d’éligibilité : Si l’arbitrage repose exclusivement sur la présence ou l’absence d’information,
COALESCEsurpasse systématiquement toute autre alternative. Si la logique exige des conditions de seuil, des exclusions bornées ou des contrôles booléens croisés, le recours aux structuresIF-THEN/ELSEou aux fonctionsIFN/IFCredevient méthodologiquement obligatoire.
12.2 Standardisation et reproductibilité dans les chaînes de traitement
L’intégration de la fonction COALESCE dans les architectures logicielles institutionnelles gagne à être standardisée par l’intermédiaire de macro-programmes réutilisables. Cette industrialisation logicielle limite la duplication de code et renforce la résilience des chaînes de production statistique face aux évolutions futures des schémas de données.
Voici une illustration canonique d’une macro-fonction utilitaire encapsulant l’application de COALESCE sur une liste arbitraire de variables transmises en paramètres dynamiques :
%macro AppliquerCoalesce(TableSource=, TableCible=, VarCible=, ListeArguments=);
    %if %superq(TableSource)= or %superq(TableCible)= or %superq(VarCible)= or %superq(ListeArguments)= %then %do;
        %put %str(ERR)OR: Paramètres obligatoires manquants pour la macro AppliquerCoalesce.;
        %return;
    %end;

    data &TableCible;
        set &TableSource;
        &VarCible = coalesce(&ListeArguments);
    run;

    %put %str(NOTE): Consolidation effectuée avec succès dans la table &TableCible.;
%mend AppliquerCoalesce;

/* Exemple d'appel opérationnel */
%AppliquerCoalesce(
    TableSource    = original_data,
    TableCible     = resultat_macro,
    VarCible       = Score_Synthese,
    ListeArguments = %str(Points, Rebonds, Passes)
);
Cette démarche de modularisation algorithmique contribue directement à la pérennité des analyses statistiques. En garantissant une rigueur syntaxique absolue, un alignement strict des formats en mémoire et une traçabilité totale des transformations numériques, l’ingénieur de données SAS s’assure que ses travaux de modélisation reposent sur une assise de données d’une intégrité méthodologique irréprochable.
Références
- Allison, P. D. (2001). Missing Data (Quantitative Applications in the Social Sciences, Vol. 136). SAGE Publications. https://doi.org/10.4135/9781412985079
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc. https://support.sas.com/publishing/authors/delwiche.html
- Little, R. J. A., & Rubin, D. B. (2019). Statistical Analysis with Missing Data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482865
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
- SAS Institute Inc. (2020). SAS(R) 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/lefunctionsref/titlepage.htm
- SAS Institute Inc. (2021). SAS(R) 9.4 SQL Procedure User’s Guide (4th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/sqlproc/titlepage.htm
- Wicklin, R. (2013). Simulating Data with SAS. SAS Institute Inc. https://support.sas.com/publishing/authors/wicklin.html