
Dans l’écosystème de l’analyse décisionnelle et du traitement statistique avancé, le logiciel SAS (Statistical Analysis System) s’impose depuis plusieurs décennies comme une référence industrielle incontournable. Utilisé massivement au sein des institutions financières, des laboratoires pharmaceutiques, des organismes gouvernementaux et des centres de recherche épidémiologique, SAS gère des téraoctets de données complexes à travers des architectures distribuées et hautement régulées. Cependant, la robustesse même de cette infrastructure logicielle impose une discipline méthodologique stricte en ce qui concerne la manipulation des ressources informatiques. L’accumulation incontrôlée de jeux de données, qu’ils soient temporaires ou persistants, constitue l’un des écueils les plus fréquents menaçant la stabilité et la vélocité des chaînes de traitement analytique.
La question de la suppression méthodique des tables de données SAS transcende la simple commodité de programmation. Elle s’inscrit au cœur des impératifs d’optimisation des flux d’entrées/sorties (I/O), de gouvernance du cycle de vie de l’information et d’atténuation des risques d’intégrité logicielle. Trop souvent, les développeurs novices se reposent sur la réinitialisation brutale de la session de travail ou sur des écritures itératives écrasant des tables préexistantes, sans appréhender les mécanismes d’allocation de mémoire, de pagination sur disque ni l’impact des verrous d’infrastructure. Une telle imprudence se traduit inévitablement par une dégradation progressive des temps d’accès aux sous-systèmes de stockage, voire par des interruptions bloquantes lors des traitements par lots en environnement de production hautement sollicité.
Le présent article propose une exploration académique et pratique des stratégies de purge de jeux de données dans l’environnement SAS. En examinant en détail l’architecture sous-jacente des bibliothèques, l’efficacité différentielle des descripteurs de métadonnées et la procédure spécialisée PROC DATASETS, nous analyserons les protocoles optimaux pour administrer l’espace de stockage. À travers trois exemples concrets et rigoureusement documentés — de la suppression d’une table unique jusqu’au vidage intégral d’un espace de travail, en passant par l’élimination sélective groupée —, nous doterons le programmeur SAS des clés théoriques et pratiques nécessaires à la mise en œuvre de pipelines analytiques performants, résilients et parfaitement rationalisés.
1. Introduction à la gestion des ressources et à la suppression des tables dans SAS
1.1 Importance de la gestion de l’espace disque et de la mémoire vive
L’exécution de processus analytiques avancés, tels que la modélisation statistique prédictive, le partitionnement de données volumineuses ou les jointures relationnelles à grande échelle, requiert une mobilisation continue des sous-systèmes de calcul. Au sein de l’architecture SAS, chaque opération transforme, structure ou agrège des flux d’enregistrements dont le volume peut rapidement atteindre des centaines de gigaoctets. Lorsque de multiples étapes de programmation s’enchaînent sans un nettoyage scrupuleux des artefacts intermédiaires, le système de fichiers sous-jacent subit une saturation progressive. Cette accumulation de tables volumineuses dégrade substantiellement la bande passante des unités de stockage locales ou distantes, provoquant des congestions majeures d’accès aux disques.
Dans les pipelines de traitement de données quantitatives, les tables intermédiaires servent régulièrement de passerelles de transition : filtres préliminaires, normalisation des formats, imputations de valeurs manquantes ou tris séquentiels. Si ces structures transitoires continuent d’occuper de l’espace de stockage physique bien après la complétion de leur rôle fonctionnel, elles réduisent l’espace contigu nécessaire à l’allocation des fichiers d’échange temporaires et aux zones de pagination du moteur d’exécution. La saturation qui en résulte conduit inéluctablement à l’interruption inopinée des programmes, se manifestant par les redoutables erreurs système indiquant l’épuisement de l’espace alloué, qui paralysent l’ensemble de la chaîne d’ordonnancement en environnement d’entreprise.
Au-delà de la seule dimension mécanique du stockage, la gestion rigoureuse de la mémoire vive et de l’espace temporaire conditionne la clarté structurelle des environnements d’analyse. Des répertoires encombrés de jeux de données orphelins obscurcissent la cartographie des données, augmentant drastiquement le risque d’erreurs humaines. Un statisticien ou un ingénieur de données naviguant dans un espace saturé d’artefacts dépréciés peut involontairement orienter une modélisation sur une table transitoire erronée plutôt que sur le jeu de données finalisé. La purge délibérée et systématique s’affirme donc comme un principe fondamental de bonne hygiène de programmation, garantissant la traçabilité des transformations et la reproductibilité des résultats scientifiques.
1.2 Principes régissant le cycle de vie des données SAS
Le cycle de vie des données au sein de la plateforme SAS s’articule autour de trois phases canoniques : la génération, la transformation et l’archivage ou destruction. Durant la phase d’initialisation, les données sont ingérées à partir de sources externes — telles que des bases de données relationnelles via des protocoles SAS/ACCESS, des fichiers plats délimités ou des flux d’API — ou générées directement par l’intermédiaire d’une étape DATA d’extraction. Dès cet instant, le fichier acquiert une existence formelle sous l’égide du moteur de stockage SAS, qui instancie à la fois une portion de descripteurs de métadonnées et un espace réservé à la charge utile des observations.
Durant les étapes de transformation subséquentes, orchestrées par diverses procédures statistiques telles que PROC SORT, PROC SUMMARY ou des étapes de manipulation conditionnelle, de multiples versions intermédiaires de la table initiale sont matérialisées. C’est à ce stade précis que s’impose la planification stratégique de la destruction contrôlée. Contrairement aux langages interprétés modernes qui gèrent la mémoire par un ramasse-miettes (garbage collector) automatique basé sur le comptage des références d’objets, l’environnement SAS délègue l’entière responsabilité du cycle de vie des tables à l’architecte du code. Toute table créée demeure physiquement ancrée sur le disque ou dans l’espace alloué tant qu’un ordre explicite de destruction n’est pas envoyé au moteur sous-jacent.
Il convient également d’établir une distinction conceptuelle fondamentale entre la suppression logique et la suppression physique des enregistrements. La suppression logique consiste à appliquer des attributs de masquage ou des clauses de filtrage qui excluent certaines lignes de la lecture séquentielle tout en préservant le fichier global sur le système d’exploitation hôte. En revanche, la suppression physique — cœur de notre étude — entraîne la restitution immédiate des blocs d’allocation de stockage au système d’exploitation et la radiation définitive du fichier du catalogue de la bibliothèque SAS. Comprendre cette distinction permet d’éviter les confusions où le développeur pense avoir allégé l’empreinte disque alors qu’il n’a fait qu’altérer la visibilité logique des observations.
2. Architecture des bibliothèques SAS : distinction entre bibliothèques temporaires et permanentes
2.1 Fonctionnement et particularités de la bibliothèque WORK
L’architecture de stockage logique de SAS repose sur le paradigme des bibliothèques, identifiées par des préfixes nommés librefs. Parmi celles-ci, la bibliothèque WORK occupe un rôle central dans l’écosystème SAS. Définie par défaut au lancement de chaque session, la bibliothèque WORK constitue un espace temporaire dont la vocation exclusive est de recueillir les données de calcul, les tables de tri transitoires et les sous-produits d’analyses statistiques. Sur le plan de l’infrastructure, la bibliothèque WORK est directement mappée sur un répertoire temporaire désigné par le système d’exploitation hôte, souvent situé sur des disques à haut débit ou des systèmes de fichiers configurés en mémoire partagée.
La particularité distinctive de la bibliothèque WORK réside dans sa nature éphémère et volatile : à l’instant précis où la session SAS est close de façon nominale, un processus système automatisé d’épuration est déclenché pour détruire l’intégralité des fichiers contenus dans ce répertoire physique. Toutefois, se fier aveuglément à ce mécanisme de fin de session constitue une lacune opérationnelle majeure. Dans les contextes d’entreprise où les sessions SAS demeurent actives durant plusieurs semaines — notamment au sein de serveurs SAS Studio, SAS Enterprise Guide ou de processeurs de batch distribués continuels —, la bibliothèque WORK ne bénéficie d’aucun recyclage spontané. Elle accumule indéfiniment les reliquats d’exécutions passées, augmentant le risque d’un dépassement de quota d’espace disque.
Par conséquent, l’intégration de purges manuelles programmées à l’intérieur même du déroulé du script s’avère hautement bénéfique. En libérant proactivement l’espace de la bibliothèque WORK à l’issue de chaque bloc analytique majeur, le programmeur s’assure que son programme ne dépend pas de l’achèvement de la session pour retrouver une empreinte système saine. Cette approche garantit en outre la réentrance et la scalabilité des processus, prévenant toute interférence entre différentes phases d’une analyse lourde s’exécutant sur le même fil de traitement.
2.2 Gestion des bibliothèques permanentes assignées via LIBNAME
À l’opposé du caractère transitoire de la bibliothèque WORK, les bibliothèques permanentes représentent les dépôts de données stratégiques de l’organisation. L’assignation d’une bibliothèque permanente s’effectue au moyen de l’instruction canonique LIBNAME, qui lie un identifiant logique (le libref) à un chemin physique pérenne au sein du système d’exploitation, qu’il s’agisse d’un système de fichiers local sous Windows, d’un point de montage NFS sous Linux, ou d’une infrastructure de stockage en réseau en nuage. Les tables créées sous l’autorité d’un libref permanent sont automatiquement sérialisées sous la forme de fichiers à extension .sas7bdat, accompagnées le cas échéant de leurs fichiers d’index .sas7bndx associés.
La persistance de ces structures implique qu’aucune destruction automatique n’interviendra à la fermeture de la session utilisateur. Une opération de suppression ciblée sur une bibliothèque permanente constitue donc un acte lourd de conséquences, entraînant l’effacement direct du fichier physique sur le disque sous-jacent. En milieu de recherche scientifique, clinique ou bancaire, où les tables renferment des données brutes issues de collectes pluriannuelles ou des cohortes de patients non reproductibles, la perte d’un fichier .sas7bdat en raison d’une commande de purge mal formulée peut s’avérer catastrophique et irréversible, le moteur SAS ne disposant pas d’un mécanisme natif de corbeille de récupération.
Dès lors, l’application de protocoles de sécurité rigoureux s’impose avant toute instruction de suppression au sein d’une bibliothèque permanente. Ces mesures incluent la mise en place de listes de contrôle d’accès (ACL) restrictives au niveau du système d’exploitation, l’emploi systématique de clauses de validation conditionnelle, et la formalisation de sauvegardes incrémentales. L’analyste de données doit faire preuve d’une vigilance accrue lors de la désignation de la bibliothèque cible afin d’isoler hermétiquement les zones de travail temporaires des répertoires de production institutionnels.
3. Fondements techniques de la procédure PROC DATASETS
3.1 Mécanismes internes et efficacité de PROC DATASETS
Pour orchestrer la maintenance structurelle de ses bibliothèques, SAS met à disposition un outil de premier plan : la procédure PROC DATASETS. Conçue dès les premières itérations de SAS pour opérer au niveau des métadonnées du système de gestion de données, cette procédure se distingue fondamentalement des étapes DATA traditionnelles par son mode d’interaction avec les fichiers. Tandis qu’une étape DATA traite les tables par lecture séquentielle et réécriture des observations — mobilisant un volume considérable de cycles processeur et de transferts d’entrées/sorties —, la procédure PROC DATASETS dialogue directement avec le catalogue d’en-tête de la bibliothèque et les portions descriptives des fichiers SAS.
Lorsqu’un ordre d’effacement est adressé à PROC DATASETS, la procédure n’ouvre pas le fichier pour en inspecter le contenu. Elle interagit exclusivement avec la table d’allocation de la bibliothèque et le descripteur de fichier du système d’exploitation hôte pour notifier l’annulation de l’enregistrement et rendre les secteurs de données immédiatement disponibles. Ce fonctionnement purement axé sur les métadonnées confère à la procédure une vitesse d’exécution quasi instantanée, indépendamment du fait que la table ciblée comporte dix observations ou dix millions d’enregistrements. L’économie en termes d’entrées/sorties physiques est colossale, faisant de PROC DATASETS la solution d’ingénierie par excellence pour le nettoyage de données massives.
Un autre trait distinctif capital de PROC DATASETS réside dans son comportement interactif (run-interactive). Contrairement à la majorité des procédures SAS dont l’exécution se clôture dès la première instruction RUN;, PROC DATASETS demeure active en arrière-plan et conserve son contexte d’exécution tant qu’une instruction explicite QUIT; ne lui a pas été signifiée. Omettre l’instruction QUIT; peut maintenir des verrous logiques sur la bibliothèque ou provoquer des effets de bord inattendus lors de l’exécution séquentielle de programmes complexes, rendant impérative la présence systématique de ce délimiteur final.
3.2 Rôle et utilité de l’option NOLIST
Par défaut, l’invocation de PROC DATASETS déclenche une analyse exhaustive du contenu de la bibliothèque désignée et génère un rapport récapitulatif détaillé affiché dans la fenêtre de sortie ou intercepté par le système ODS (Output Delivery System). Ce rapport répertorie l’ensemble des membres, leurs types, leurs dates de création et leurs volumétries respectives. Si cette restitution visuelle se révèle informative lors d’explorations manuelles en phase de développement interactif, elle devient un lourd facteur d’inefficacité au sein des traitements industriels automatisés.
L’adjonction de l’option NOLIST dans l’instruction d’ouverture PROC DATASETS permet d’inhiber intégralement la production de ce compte-rendu imprimable. En supprimant cette émission superflue vers les flux ODS, le compilateur économise de précieuses fractions de seconde processeur et prévient l’encombrement des rapports de restitution. Ceci s’avère particulièrement crucial dans le cadre de boucles itératives, de macros de calcul intensif ou d’environnements d’exécution par lots (batch processing), où la production de milliers de lignes de rapports de métadonnées non sollicités surcharge inutilement les serveurs d’impression et les fichiers journaux.
En outre, l’usage de l’option NOLIST rationalise la lisibilité du journal d’exécution (le SAS Log). Seuls les messages formels de validation ou les avertissements critiques y sont alors consignés, permettant aux ingénieurs d’exploitation d’auditer avec netteté les événements survenus durant le cycle de vie du programme. La combinaison de la robustesse de PROC DATASETS et de la sobriété de l’option NOLIST matérialise le standard d’excellence pour tout nettoyage scripté au sein de projets d’envergure.
4. Méthode 1 : Suppression ciblée d’un jeu de données unique
4.1 Syntaxe générale de l’instruction DELETE pour une table
La suppression chirurgicale d’une table unique répond à une logique de précision visant à débarrasser la session d’un artefact spécifique sans compromettre la stabilité des structures avoisinantes. L’instruction fondamentale régissant cette action est l’instruction DELETE, invoquée dans le giron de la procédure PROC DATASETS. La formulation canonique de cette commande nécessite d’abord de spécifier rigoureusement la bibliothèque de travail au moyen de l’argument LIBRARY= (ou LIB=) au sein de la ligne introductive de la procédure, assurant ainsi un aiguillage sans équivoque vers l’espace cible.
La syntaxe s’articule de manière directe : l’instruction DELETE est immédiatement suivie du nom du jeu de données dont l’annihilation est requise. Contrairement aux étapes DATA classiques où les noms de tables peuvent requérir la notation à deux niveaux (libref.table), l’instruction DELETE dans PROC DATASETS prend comme référence la bibliothèque contextualisée par l’argument d’en-tête, rendant superflue la répétition du libref devant le nom de l’objet. L’ensemble de la séquence est scellé par un point-virgule d’instruction, suivi de l’instruction de clôture QUIT;.
L’élégance de cette syntaxe réside dans son épure et son absence totale d’ambiguïté pour le compilateur de commandes SAS. En éliminant toute couche d’abstraction supplémentaire, le moteur exécute la directive d’effacement dès l’interprétation de la commande, garantissant un traitement synchrone et immédiat. Cette méthode constitue l’approche préconisée pour délester la mémoire de masse immédiatement après l’achèvement d’une étape de consolidation, évitant ainsi que des données intermédiaires ne polluent inutilement le périmètre d’exécution ultérieur.
4.2 Contrôle d’existence et gestion des verrous système
L’opération de suppression d’une entité isolée expose le programmeur à des aléas liés à l’état du système d’exploitation et au cycle de partage des données. Le premier écueil concerne la tentative de suppression d’une table inexistante, qui survient fréquemment lors de l’exécution de scripts modulaires dont certaines branches conditionnelles ont été sautées. En l’absence de vérifications préalables, SAS émet un avertissement formel dans le journal système (WARNING: File … does not exist), signalant l’échec de la résolution de la directive. Bien que non bloquante dans la plupart des contextes, cette alerte peut corrompre l’analyse automatisée de la qualité d’exécution des chaînes de production régies par un contrôle strict des codes de retour.
Le second enjeu technique, infiniment plus complexe, relève de la politique de gestion des verrous d’accès aux fichiers (locks). Dans une architecture multi-utilisateurs ou au sein de sessions concurrentes partageant les mêmes répertoires, un jeu de données SAS peut être verrouillé en lecture exclusive ou partagée par un autre processus ou par une visionneuse interactive (telle que l’explorateur de bibliothèques d’une interface graphique ouverte par un analyste). Lorsqu’une instruction DELETE frappe une table sous le coup d’un verrou d’accès, le moteur SAS est dans l’impossibilité d’altérer le descripteur physique du fichier.
Face à cette contention, le système réagit en émettant une erreur critique signifiant l’indisponibilité du fichier (ERROR: File … is in use). Le processus peut alors s’interrompre brusquement si les options de gestion des erreurs de session sont paramétrées sur un mode strict. La maîtrise des mécanismes de déverrouillage, l’évaluation préalable de l’état d’ouverture des fichiers via des fonctions spécialisées et la synchronisation ordonnancée des flux applicatifs constituent les piliers garantissant le déroulement sans heurt des opérations de suppression ciblée.
5. Exemple 1 : Mise en œuvre de la suppression d’une seule table (data2)
5.1 Configuration de l’environnement de test avec trois tables
Afin de valider expérimentalement l’efficacité de la suppression unitaire et de fournir un socle empirique reproductible, nous concevons un environnement d’évaluation contrôlé au sein de la bibliothèque temporaire WORK. Ce protocole repose sur la genèse automatisée de trois tables distinctes arbitrairement désignées sous les vocables de data1, data2 et data3. La génération de ces entités est orchestrée au moyen de trois étapes DATA successives simples, peuplées d’observations synthétiques représentatives permettant d’instancier des structures de métadonnées complètes.
Le code d’initialisation se structure comme suit :
data work.data1;
input identifiant score_a;
datalines;
101 45.2
102 78.9
103 62.1
;
run;
data work.data2;
input identifiant statut $ code_region;
datalines;
201 ACTIF 12
202 SUSPENDU 45
203 ACTIF 88
;
run;
data work.data3;
input identifiant metric_valeur;
datalines;
301 0.0045
302 0.0092
303 0.0018
;
run;
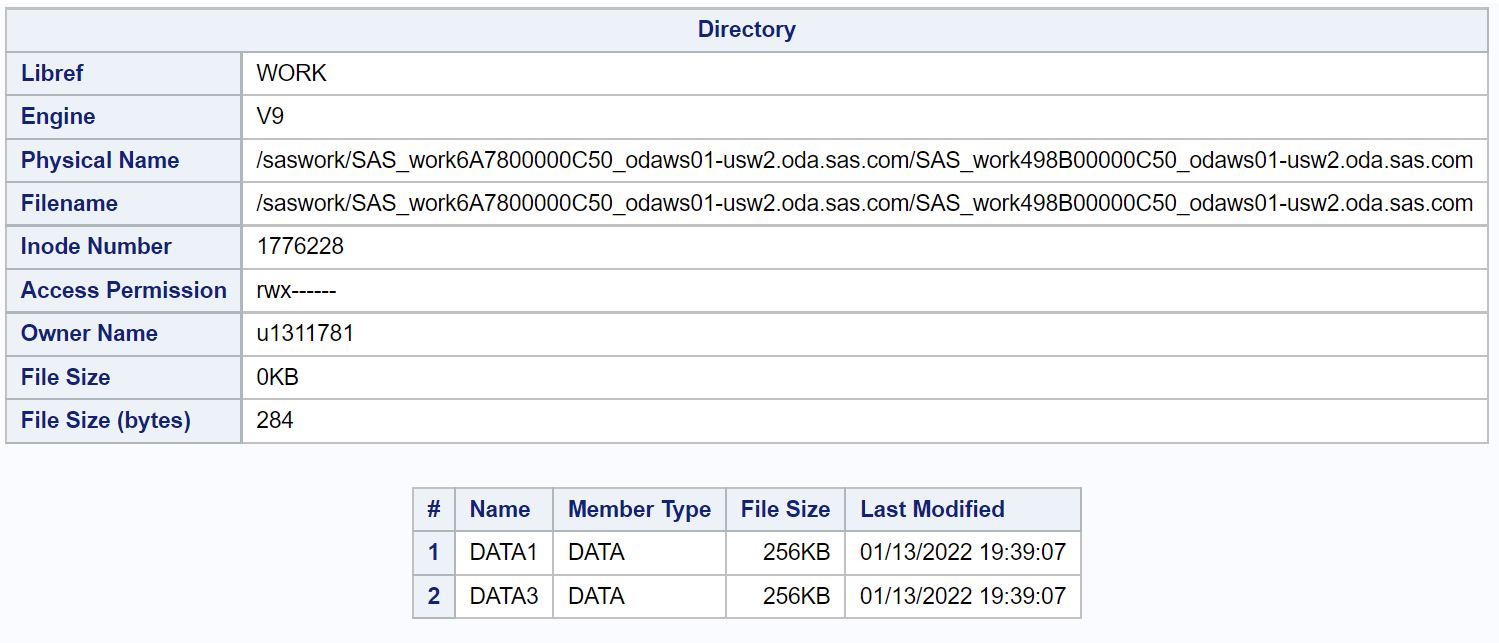
L’inspection initiale de la bibliothèque WORK via les mécanismes d’exploration internes de SAS confirme la coexistence pacifique des trois tables, chacune occupant son espace mémoire respectif avec ses spécifications attributaires propres. Notre objectif méthodique consistera à neutraliser exclusivement la table intermédiaire data2 tout en préservant scrupuleusement l’intégrité et la disponibilité opérationnelle des jeux de données data1 et data3.
5.2 Exécution du code de suppression de la table data2
L’annihilation sélective de l’entité data2 est matérialisée par l’implémentation de la procédure PROC DATASETS paramétrée avec l’option NOLIST. Le script appliqué adopte la séquence standardisée ci-après :
proc datasets library=work nolist;
delete data2;
quit;
L’exécution de cette commande mobilise le processeur pour une durée infinitésimale. L’analyse du journal d’exécution (SAS Log) corrobore instantanément la prise en compte de la directive. SAS y appose une mention sans équivoque, généralement formulée sous la forme : NOTE: Deleting WORK.DATA2 (memtype=DATA). Ce message atteste que le moteur d’exécution a correctement résolu le chemin logique de la bibliothèque WORK, identifié le membre nommé data2 de type table de données (DATA), et sollicité le système d’exploitation pour révoquer l’allocation du fichier physique correspondant.
Pour attester rigoureusement du maintien de l’isolation contextuelle des structures restantes, une commande de vérification restreinte aux métadonnées des membres de type DATA peut être invoquée :
proc datasets library=work memtype=data;
quit;
La restitution du catalogue résultant met en exergue la présence intacte de data1 et data3. La table data2 a été radiée sans générer la moindre altération structurelle sur les fichiers contigus, démontrant la précision chirurgicale de l’instruction DELETE unitaire.
6. Méthode 2 : Élimination simultanée de plusieurs jeux de données
6.1 Syntaxe de l’instruction DELETE pour une sélection multiple
Dans le cadre de flux décisionnels complexes, les étapes analytiques intermédiaires génèrent fréquemment une pluralité d’artefacts secondaires — tels que des tables de permutations statistiques, des segments d’échantillonnage croisés ou des index de partitionnement — qui deviennent simultanément obsolètes à une même étape du traitement. Procéder à leur élimination par une suite répétée d’instructions unitaires au sein de blocs distincts représenterait une approche inélégante et inutilement verbeuse. La syntaxe de PROC DATASETS autorise heureusement la formulation d’instructions de suppression groupée au sein d’une unique transaction logique.
Pour opérer une purge multitable, l’instruction DELETE accepte une liste continue d’identifiants de jeux de données, délimités simplement par des espaces typographiques. Le formalisme syntaxique s’énonce comme suit : après l’appel de l’instruction DELETE, le développeur énumère l’ensemble des cibles désignées avant de sceller l’expression par le point-virgule réglementaire. Le sous-système de traitement de PROC DATASETS effectue alors une boucle interne optimisée pour traiter séquentiellement ou en bloc l’ensemble des suppressions requises sans jamais relâcher l’environnement de la procédure.
Cette approche groupée minimise les surcoûts d’initialisation et de clôture de procédure (procedure overhead). En concentrant la suppression d’une dizaine ou d’une centaine de tables au sein d’une seule instruction, l’empreinte processeur liée à l’instanciation de la tâche s’en trouve substantiellement allégée. De surcroît, elle améliore la maintenabilité du code source en rassemblant dans un même bloc logique toutes les déclarations de fin de vie des données auxiliaires associées à un jalon algorithmique déterminé.
6.2 Utilisation des listes de variables et de caractères génériques
L’efficacité de la suppression collective au sein de SAS est considérablement enrichie par la prise en charge de syntaxes raccourcies et de conventions de nommage sélectives. Lorsque le plan de nommage des tables obéit à une nomenclature systématique, le développeur peut exploiter des listes abrégées pour désigner de vastes ensembles de données sans devoir énumérer explicitement chaque entité individuelle. Cette flexibilité repose notamment sur l’usage des listes numériques séquentielles et des préfixes génériques.
Par exemple, si une suite d’itérations statistiques a engendré une succession de tables nommées de tab1 à tab50, l’instruction DELETE tab1-tab50; permet de signifier au moteur la destruction de l’intégralité de la série ordonnée continue. SAS résout cette expression au moment de la compilation de l’instruction, vérifiant la présence effective de chaque membre de l’intervalle numérique spécifié. Cette construction évite des lignes de programmation redondantes et diminue drastiquement le risque d’oubli d’une table intermédiaire au cœur d’une suite séquentielle.
Toutefois, il importe de souligner les limites inhérentes à l’usage des caractères génériques traditionnels (les jokers ou wildcards, tels que l’astérisque * ou le point d’interrogation ?) directement dans le corps de l’instruction DELETE de PROC DATASETS. Contrairement aux interfaces de lignes de commande de systèmes d’exploitation comme UNIX ou Linux, PROC DATASETS ne supporte pas nativement l’instruction de suppression par motif générique arbitraire (comme DELETE temp_*;) sous sa forme brute. Pour contourner cette contrainte et exécuter des suppressions basées sur des motifs de chaînes complexes, le programmeur doit recourir à l’introspection dynamique du dictionnaire de métadonnées couplée au macro-langage SAS, un mécanisme sophistiqué que nous détaillerons dans les sections avancées de cet ouvrage.
7. Exemple 2 : Purge conjointe de multiples tables (data2 et data3)
7.1 Initialisation du cas pratique et état de la bibliothèque
Afin d’illustrer concrètement la suppression multitable, nous réinstancions notre environnement d’essai dans un état rigoureusement identique à la configuration initiale. Cette démarche méthodique permet d’isoler l’effet direct de la commande d’élimination groupée sans biais rétrospectif. Les trois jeux de données synthétiques — data1, data2 et data3 — sont à nouveau compilés dans l’espace temporaire WORK à l’aide de données d’échantillonnage calibrées pour simuler un pipeline opérationnel standard.
Dans ce scénario d’application, supposons que les tables data2 et data3 représentent deux sorties d’ajustements statistiques intermédiaires destinées à calibrer les variables de la table principale data1. L’étape de calcul étant désormais achevée et les métriques d’intérêt ayant été agrégées dans data1, le maintien en mémoire de ces deux composantes subsidiaires n’a plus de raison d’être et représente une charge résiduelle inutile.
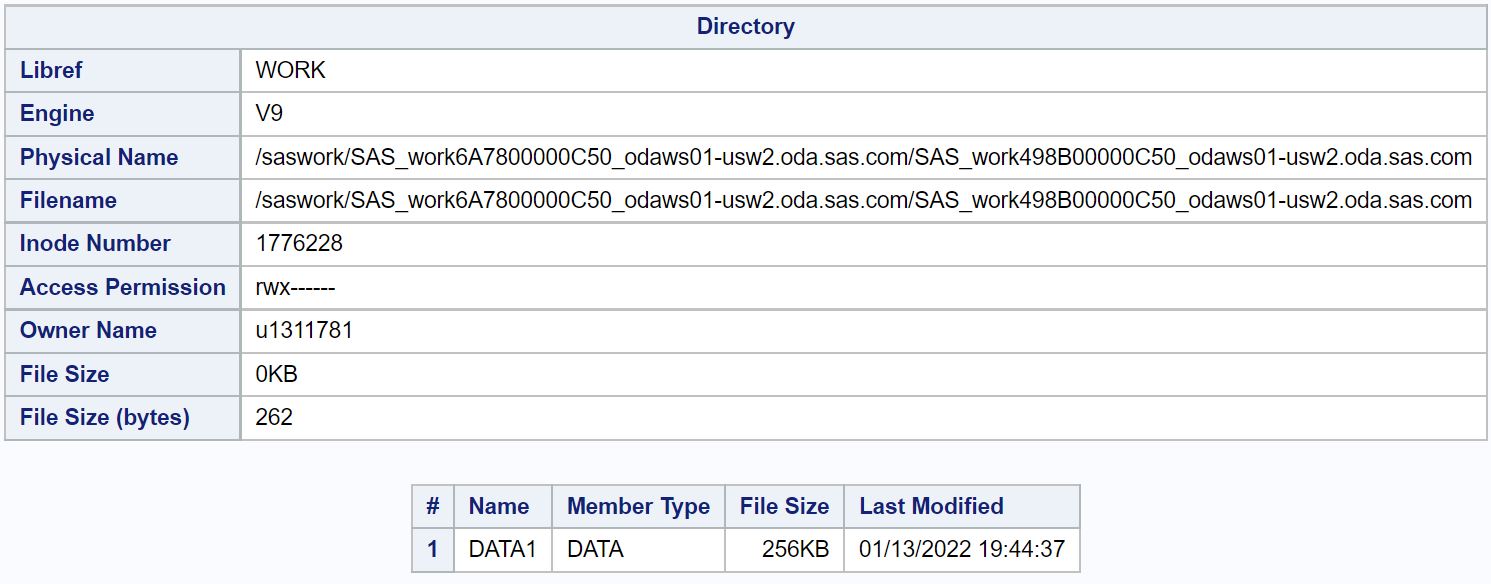
Avant d’engager la commande de purge, une lecture des tables d’allocation atteste que le répertoire WORK contient bien les trois fichiers indépendants. La stratégie d’intervention repose sur l’émission d’un ordre unique ciblant conjointement data2 et data3, tout en garantissant que le réceptacle analytique data1 demeure parfaitement hermétique à cette action destructrice coordonnée.
7.2 Code d’exécution et vérification finale de l’inventaire
La mise en œuvre de la purge collective s’effectue au moyen du segment de programme suivant, combinant l’efficacité de l’option NOLIST et l’énumération par arguments séparés au sein de l’instruction DELETE :
proc datasets library=work nolist;
delete data2 data3;
quit;
Dès la transmission de ce bloc au compilateur SAS, le sous-système de traitement procède à l’exécution séquentielle interne immédiate des deux annulations de métadonnées. L’examen critique du journal d’exécution (SAS Log) révèle la double attestation d’éradication :
NOTE: Deleting WORK.DATA2 (memtype=DATA).
NOTE: Deleting WORK.DATA3 (memtype=DATA).
Ces deux lignes d’enregistrement dans le log apportent la confirmation indubitable que les portions d’observations et les descripteurs des deux tables sélectionnées ont été effacés de concert. Afin d’établir la preuve formelle de la conservation exclusive de l’entité résiduelle, un contrôle d’inventaire est diligenté par le biais de la même procédure, cette fois orientée vers la description des membres :
proc datasets library=work memtype=data;
quit;
Le compte-rendu textuel produit confirme l’état désiré de l’infrastructure de stockage : seule la table data1 figure désormais dans la liste des membres actifs de la bibliothèque WORK. L’objectif d’épuration simultanée a été atteint avec un coût de transaction réduit au strict minimum.
8. Méthode 3 : Purge intégrale d’une bibliothèque via l’option KILL
8.1 Compréhension du mécanisme destructif de l’option KILL
Il est des phases dans le cycle de traitement de données quantitatives où la sélectivité chirurgicale n’est plus de mise, cédant le pas à la nécessité d’une réinitialisation globale et radicale de l’environnement de travail. Lorsqu’un processus séquentiel volumineux achève un jalon déterminant et s’apprête à entamer une phase analytique complètement découplée, le maintien des dizaines voire des centaines d’artefacts accumulés devient contre-productif. Pour répondre à cette exigence de remise à zéro totale, la procédure PROC DATASETS intègre une directive particulièrement puissante : l’option KILL.
Placée directement sur l’instruction d’en-tête de la procédure (PROC DATASETS LIBRARY=nom_libref KILL;), cette option déclenche un mécanisme destructif intégral et inconditionnel. Dès son activation, la procédure balaie la totalité de la bibliothèque spécifiée et ordonne la suppression sans exception de chaque membre qui y réside. Ce mécanisme ne se cantonne pas uniquement aux tables de données traditionnelles (memtype=DATA) : il frappe indistinctement l’ensemble des typologies d’objets hébergés dans la bibliothèque, y compris les vues SQL (memtype=VIEW), les catalogues d’éléments graphiques ou de formats (memtype=CATALOG), ainsi que les index structurels sous-jacents.
L’un des aspects les plus critiques du fonctionnement de l’option KILL réside dans son absence absolue d’interactivité suspensive en mode d’exécution scripté. Le moteur SAS ne présente aucune invite de commande d’avertissement, ni aucune boîte de dialogue requérant une confirmation de l’opérateur. L’ordre est immédiatement exécuté au niveau le plus profond de l’interface du système de fichiers, provoquant une éradication complète de la matière numérique contenue dans la bibliothèque ciblée en une fraction de seconde.
8.2 Précautions impératives avant l’emploi de l’option KILL
En raison de sa nature irrémédiable et de sa portée universelle sur le périmètre désigné, l’emploi de l’option KILL exige une rigueur opérationnelle quasi militaire de la part du programmeur. Le risque majeur, aux conséquences potentiellement dévastatrices en milieu institutionnel, réside dans l’assignation erronée du paramètre LIBRARY=. Une simple faute de frappe conduisant à désigner une bibliothèque de production permanente — renfermant des bases relationnelles d’archives médicales ou financières — au lieu de la bibliothèque temporaire WORK provoque l’effacement immédiat et irréversible de l’ensemble du patrimoine informationnel du répertoire.
Pour prémunir les organisations contre de telles défaillances dramatiques, plusieurs règles de gouvernance technique doivent être érigées en prérequis absolus. D’une part, l’usage de l’option KILL doit, par convention d’ingénierie, être strictement confiné à la bibliothèque transitoire WORK. Toute application de cette commande sur un libref permanent devrait être prohibée par les revues de code entre pairs, sauf exceptions hautement documentées et encadrées par des scripts de déploiement sécurisés.
D’autre part, dans les infrastructures critiques où des purges massives doivent impérativement intervenir sur des répertoires pérennes, des procédures d’isolement préventif s’imposent. Celles-ci consistent à implémenter préalablement des mécanismes d’archivage miroir (snapshots de disques, sauvegardes incrémentales compressées ou copies sur supports froids) garantissant un point de restauration fiable en cas d’incident d’exécution. La commande KILL ne doit être envisagée que comme l’ultime étape d’une chaîne où la sécurité des données a été mathématiquement et structurellement garantie en amont.
9. Exemple 3 : Réinitialisation globale et vidage complet de la bibliothèque WORK
9.1 Préparation de l’environnement multi-tables
Pour mettre en scène la puissance opératoire et la complétude de l’option KILL, nous configurons une nouvelle fois notre cadre d’expérimentation standardisé en réinjectant l’écosystème tripartite constitué des tables data1, data2 et data3 dans le giron de la bibliothèque WORK. Afin de rendre l’exercice plus représentatif d’une session de travail réelle ayant cumulé divers types de charges, nous pourrions également considérer que cet espace héberge des métadonnées sous-jacentes telles que des dictionnaires de variables.
Avant d’initier la commande de réinitialisation, il est impératif d’opérer un contrôle d’état pour s’assurer qu’aucun verrou interprocessus n’est actif sur l’une quelconque des tables de la bibliothèque. Si un fichier s’avérait être ouvert en lecture par une fenêtre d’exploration active ou par une tâche de fond non achevée, l’instruction KILL purgerait l’intégralité des fichiers déverrouillés mais achopperait sur le fichier protégé, générant une rupture dans l’homogénéité de la réinitialisation.
Pour matérialiser l’état préexistant à la destruction globale, nous pouvons interroger la table système des métadonnées de SAS, à savoir le dictionnaire des tables via la vue intégrée sashelp.vtable. L’exécution d’une requête sélective sur cette vue confirme sans ambiguïté la présence active et l’allocation physique de nos trois tables de démonstration dans le répertoire associé au libref WORK, dressant l’inventaire exact de la zone à balayer.
9.2 Application de la commande KILL et validation du résultat
Une fois les conditions de sécurité satisfaites, l’ordre d’éradication totale est consigné et soumis au compilateur SAS selon la syntaxe suivante :
proc datasets library=work kill nolist;
quit;
Il est à noter que l’adjonction de l’instruction RUN; demeure facultative devant QUIT; en raison de la nature dynamique de PROC DATASETS, bien que sa présence soit tolérée par le parseur. En transmettant cette directive unifiée, le sous-système de maintenance parcourt la liste de l’ensemble des membres et les détruit simultanément de la table d’allocation de la bibliothèque WORK.
Le journal d’exécution (SAS Log) reflète la radicalité de l’opération en consignant le compte-rendu exhaustif des désallocations opérées :
NOTE: Deleting WORK.DATA1 (memtype=DATA).
NOTE: Deleting WORK.DATA2 (memtype=DATA).
NOTE: Deleting WORK.DATA3 (memtype=DATA).
Afin de valider de manière irréfutable l’obtention d’un état vierge absolu, nous interrogeons formellement le dictionnaire de données du système par une requête d’inspection :
proc sql;
select memname from sashelp.vtable where libname = ‘WORK’;
quit;
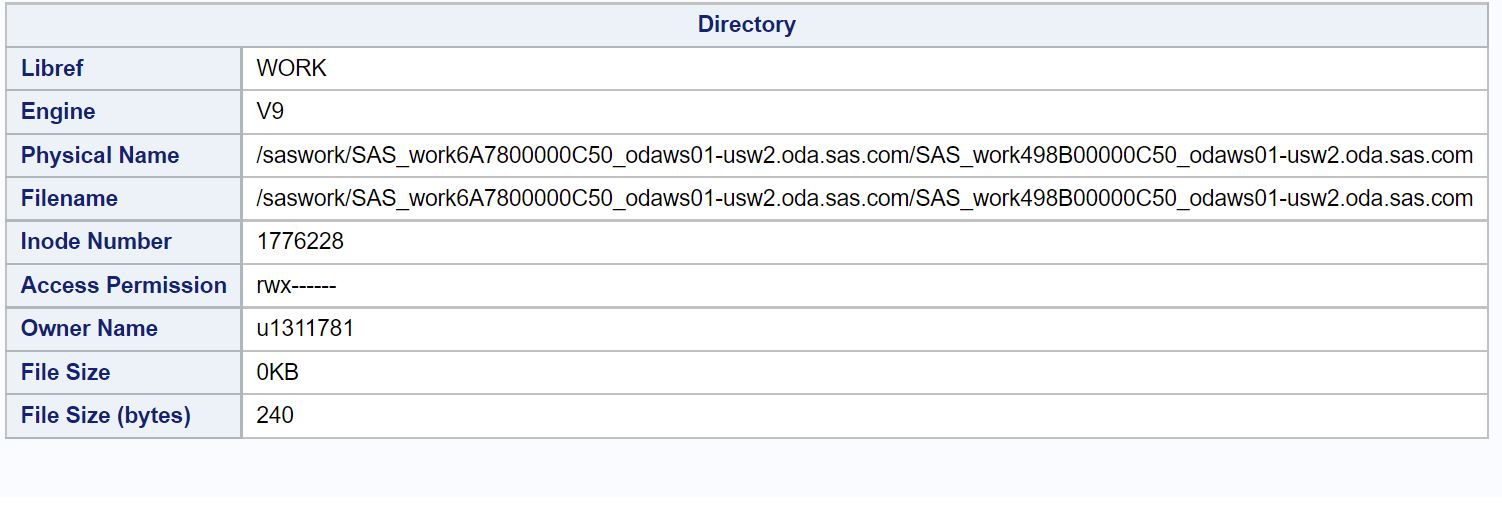
Le moteur SQL ne retourne aucun enregistrement, attestant que la table d’allocation de la bibliothèque temporaire est désormais intégralement purgée. L’espace de stockage a été restitué sans résidu, offrant un contexte immaculé pour l’initialisation d’un nouveau cycle de calcul sans nécessiter la fermeture physique ou le redémarrage de la session SAS de l’utilisateur.
10. Comparaison approfondie des approches alternatives de suppression
10.1 Utilisation de la procédure PROC SQL pour la suppression de tables
Bien que la procédure PROC DATASETS constitue la référence doctrinale recommandée par SAS Institute pour les tâches d’administration de bibliothèques, il existe des paradigmes alternatifs notables au sein du système. Le premier d’entre eux réside dans le recours à la procédure PROC SQL, implémentation par SAS du standard Structured Query Language. Au sein de cet environnement relationnel, la directive standard d’éradication s’incarne dans la commande DROP TABLE.
La syntaxe de PROC SQL pour supprimer des structures de données adopte un formalisme conforme à la norme ANSI :
proc sql;
drop table work.data1, work.data2;
quit;
Cette approche présente un avantage indiscutable en termes de portabilité conceptuelle : pour les ingénieurs de données ou les développeurs issus du monde des bases de données relationnelles traditionnelles (telles qu’Oracle, PostgreSQL ou SQL Server), la formulation DROP TABLE s’avère immédiatement familière et intuitive. De surcroît, elle autorise la séparation des entités à éliminer par de simples virgules, simplifiant la rédaction dans les scripts de pipeline orientés SQL.
Cependant, en matière de performance brute et d’adhérence au système hôte, la comparaison technique tourne à l’avantage de PROC DATASETS. Le parseur de PROC SQL est soumis à des étapes d’analyse grammaticale, d’optimisation de requête et de validation de dictionnaires relationnels qui induisent une surcharge de calcul minime mais réelle. De plus, PROC SQL ne propose pas d’équivalent universel aussi direct et sécurisé que l’option KILL pour vider une bibliothèque en bloc. L’approche DROP TABLE s’avère donc parfaitement acceptable pour des suppressions unitaires au sein de segments écrits en pur SQL, mais s’incline devant PROC DATASETS dès lors que des opérations massives ou répétitives sont engagées.
10.2 Suppression via l’étape DATA et fonctions intégrées
Une confusion persiste régulièrement chez les praticiens SAS quant au rôle dévolu à l’instruction DELETE au sein d’une étape DATA standard comparativement à la procédure de maintenance de fichiers. Au cœur d’un bloc DATA, l’instruction DELETE n’a aucune prise sur le fichier de données lui-même ni sur son allocation physique : elle intervient exclusivement sur le vecteur de ligne (Program Data Vector – PDV) au cours du traitement itératif. Son rôle consiste à stopper le traitement de l’observation courante et à empêcher son écriture dans la table de sortie, réalisant ainsi un filtrage conditionnel de lignes et non une destruction du jeu de données.
Néanmoins, l’écosystème de programmation de SAS offre des fonctionnalités avancées capables de détruire physiquement des tables depuis une étape DATA ou un environnement macro sans passer par des procédures déclaratives. Cela s’articule autour des fonctions d’accès aux fichiers du système d’exploitation, au premier rang desquelles trône la fonction FDELETE. Associée à la fonction FILENAME, elle permet d’adresser directement un ordre de suppression au descripteur de fichier de la machine hôte :
data _null_;
rc = filename(‘mon_fichier’, ‘/chemin/physique/data1.sas7bdat’);
if rc = 0 then do;
rc_del = fdelete(‘mon_fichier’);
rc_clean = filename(‘mon_fichier’);
end;
run;
Ce procédé opérant via FDELETE agit au niveau le plus bas de la couche de stockage. Son utilisation est toutefois déconseillée pour la gestion courante des jeux de données SAS : elle contourne les couches de métadonnées du logiciel, expose à des risques d’incohérence si des fichiers d’index subsistent isolément sans leur table mère, et s’avère bien plus fastidieuse à scripter que la commande native PROC DATASETS. Son emploi reste réservé aux scripts d’administration système gérant des fichiers d’échanges externes délimités ou des fichiers journaux bruts.
11. Sécurité, gestion des exceptions et intégrité des métadonnées
11.1 Gestion des erreurs et codes de retour système
L’industrialisation de pipelines de données au sein d’architectures d’entreprise impose une résilience absolue face aux incidents d’exécution. Dans cet univers exigeant, exécuter une suppression en faisant l’aveugle hypothèse de son succès constitue une faute méthodologique. La gestion moderne des flux SAS repose sur la capture et l’interprétation fine des codes de retour d’état émis par le compilateur, notamment par l’intermédiaire de la variable automatique globale &SYSCC.
La variable &SYSCC (System Condition Code) enregistre le niveau de sévérité le plus élevé rencontré durant la session ou l’exécution du bloc courant. Une valeur nulle (0) atteste d’une exécution immaculée ; une valeur égale à 4 signale la présence d’avertissements (WARNINGS) — typiquement consécutifs à la tentative de suppression d’une table inexistante — ; tandis qu’une valeur égale ou supérieure à 8 consigne une erreur critique (ERROR), consécutive par exemple à une violation de verrou d’accès ou à une corruption de fichier.
Pour sécuriser une séquence de suppression, il est d’usage d’implémenter des mécanismes de contrôle conditionnel. Ces scripts interceptent l’état de la bibliothèque avant d’engager la procédure de destruction. Si une anomalie survient, telle qu’une ressource verrouillée par un processus concurrent, le script peut capturer l’exception, réinitialiser la variable &SYSCC à zéro après avoir loggué un message d’alerte contextualisé dans un journal d’audit, et dérouler une stratégie de repli programmée plutôt que de laisser le pipeline s’effondrer de façon non contrôlée.
11.2 Intégrité référentielle et dépendance des objets dérivés
La suppression physique d’un jeu de données au sein d’une bibliothèque SAS ne s’effectue pas en vase clos : elle résonne au travers de tout le tissu relationnel et référentiel qui a pu être tissé autour de cette entité durant l’analyse. Le premier foyer de dépendance réside dans les vues logiques (SQL Views ou DATA step views). Une vue ne stocke aucune observation physique, mais uniquement l’instruction compilée d’une requête interrogeant une table sous-jacente. Si la table maîtresse est supprimée via PROC DATASETS, la vue demeure inscrite dans le dictionnaire mais devient instantanément orpheline et invalide. Toute tentative future de sélection au travers de cette vue provoquera un crash immédiat lors de l’exécution.
Le second enjeu majeur concerne l’intégrité des index structurels simples ou composites associés à un fichier .sas7bdat. Les fichiers d’index portent l’extension physique .sas7bndx. L’avantage prépondérant de PROC DATASETS par rapport à des méthodes manuelles d’effacement réside dans sa prise en charge native de ces dépendances : lorsque l’instruction DELETE cible une table dotée d’index, la procédure assure l’éradication simultanée et propre de l’ensemble des fichiers d’indexations subsidiaires, préservant le système de fichiers hôte de tout artefact fantôme.
Enfin, l’architecte de données SAS doit évaluer l’impact sur les contraintes d’intégrité référentielle (telles que les clés primaires et étrangères) liant des tables entre elles. Supprimer unilatéralement une table parente sans avoir préalablement dénoué les contraintes associées au niveau des tables enfants génère des anomalies d’intégrité sévères bloquant l’injection de nouvelles données. Une cartographie préalable des liens de causalité et de dépendance au sein de la base s’avère donc impérative avant d’ordonner la destruction définitive de tables mères.
12. Automatisation et intégration dans des macro-programmes avancés
12.1 Encapsulation de la suppression dans une macro SAS réutilisable
Afin de transcender les approches purement statiques et de prémunir le code d’erreurs récurrentes, l’ingénierie logicielle sous SAS préconise l’encapsulation de la logique de destruction au sein de macro-programmes réutilisables, paramétrés et robustes. L’objectif est de concevoir un composant fonctionnel capable de vérifier dynamiquement la présence d’une table, d’évaluer ses verrous et d’appliquer la commande de purge de manière totalement silencieuse et sécurisée.
Le macro-langage SAS met à notre disposition des fonctions de résolution puissantes, au premier rang desquelles figure la fonction système %SYSFUNC, permettant d’exécuter des fonctions du langage de base au sein de la phase de précompilation macroscopique. La fonction EXIST permet ainsi de tester l’existence physique et logique d’une table avant toute soumission d’instructions à PROC DATASETS.
Considérons l’implémentation macro ci-après, conçue pour illustrer ce principe de résilience industrielle :
%macro purger_table(bibliotheque=WORK, table=);
%local lib_u tab_u;
%let lib_u = %upcase(&bibliotheque);
%let tab_u = %upcase(&table);
%if %sysfunc(exist(&lib_u..&tab_u)) %then %do;
proc datasets library=&lib_u nolist;
delete &tab_u;
quit;
%put NOTE: La table &lib_u..&tab_u a ete supprimee avec succes.;
%end;
%else %do;
%put NOTE: Operation ignoree. La table &lib_u..&tab_u est introuvable.;
%end;
%mend purger_table;
Ce macro-programme évalue d’abord la présence effective de la ressource. Si l’entité existe, l’instruction DELETE est exécutée dans un bloc PROC DATASETS silencieux ; dans le cas inverse, aucun avertissement ni erreur n’est généré dans le log, préservant la propreté de la variable d’état &SYSCC. De telles structures modulaires permettent d’automatiser le nettoyage des pipelines sans alourdir le code applicatif principal de tests conditionnels répétitifs.
12.2 Bonnes pratiques de gouvernance pour les chaînes de traitement analytique
Au-delà de la virtuosité technique des syntaxes de programmation, la gestion pérenne des ressources de données s’adosse à une gouvernance méthodologique formalisée. En milieu professionnel, où des centaines de scripts s’exécutent quotidiennement de façon orchestrée via des planificateurs d’entreprise (comme BMC Control-M, Apache Airflow ou SAS Job Execution), le nettoyage des tables ne doit rien laisser au hasard ou à l’inspiration ponctuelle du développeur.
La première règle de bonne gouvernance consiste à formaliser un découpage modulaire strict des programmes. Chaque tâche analytique doit comporter trois sections normées : une section d’initialisation instanciant les ressources et vérifiant l’état de l’environnement, une section de calcul et de transformation pure, et une section finale systématique d’épuration (housekeeping). Dans cette dernière section, toutes les tables intermédiaires créées exclusivement pour les besoins du bloc doivent être formellement détruites via PROC DATASETS, garantissant que le module ne laisse aucun artefact polluant après son passage.
La deuxième règle impose une traçabilité exemplaire au sein des journaux d’audit. Toute commande de destruction appliquée à une bibliothèque permanente doit être documentée par des messages explicites consignés dans le journal de traitement, mentionnant la date, l’heure, l’identifiant de la table purgée et la volumétrie libérée. Cette pratique s’avère indispensable pour satisfaire aux exigences de conformité réglementaire — telles que les audits de traçabilité dans l’industrie pharmaceutique imposés par la FDA ou les normes comptables bancaires de Bâle III — où la preuve formelle de la non-altération accidentelle des séries de calcul originales est requise.
Enfin, la standardisation des conventions de nommage au niveau de l’organisation constitue la pierre angulaire facilitant le nettoyage automatisé. En préfixant de manière immuable l’ensemble des tables transitoires par un terme réservé (tel que TMP_ ou WRK_), les administrateurs de plateformes peuvent implémenter des routines de macro-balayage capables d’identifier et de purger les tables orphelines sans jamais risquer d’altérer les jeux de données pérennes. La gestion raisonnée de la mémoire de masse et des tables SAS s’érige ainsi en un pont fondamental unissant la rigueur statistique à l’efficience de l’ingénierie informatique de pointe.
Références
- Burlew, M. M. (2014). SAS Macro Programming Made Easy (3e éd.). SAS Institute. https://support.sas.com/publishing/authors/burlew.html
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6e éd.). SAS Institute. https://www.sas.com/store/books/categories/usage-and-reference/the-little-sas-book-a-primer-sixth-edition/prodBK_68868_en.html
- SAS Institute Inc. (2020). Base SAS 9.4 Procedures Guide (7e éd.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/proc/titlepage.htm
- SAS Institute Inc. (2021). SAS(R) 9.4 SQL Procedure User’s Guide (4e éd.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/sqlproc/titlepage.htm
- SAS Institute Inc. (2023). SAS(R) Companion for UNIX Environments. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/hostunx/titlepage.htm
- Virgile, R. (2012). SAS Storage and Performance Optimization. SAS Global Forum Proceedings. https://support.sas.com/resources/papers/proceedings12/035-2012.pdf