
Dans l’écosystème de l’ingénierie statistique et du traitement des données massives sous SAS (Statistical Analysis System), la gestion des dimensions temporelles constitue une compétence pivotale à l’intersection de la rigueur mathématique et de l’analyse décisionnelle. Qu’il s’agisse d’évaluer la survie globale de cohortes cliniques au sein de protocoles oncologiques hautement normés, de quantifier la persistance thérapeutique dans des cohortes observationnelles ou de modéliser le comportement de risque dans le secteur bancaire et assurantiel, la mesure exacte des intervalles séparant deux événements temporels détermine la validité de l’ensemble de la chaîne inférentielle. Une appréciation erronée de la distance temporelle sépare parfois des conclusions statistiques robustes de biais systématiques majeurs, susceptibles d’invalider des mois de recherches empiriques ou d’induire des non-conformités réglementaires critiques.
Le système SAS propose une architecture temporelle à la fois sophistiquée et historique, articulée autour de variables numériques transformées par des systèmes d’encodage calendaire spécifiques. Contrairement à des environnements de programmation contemporains où les structures d’objets temporels encapsulent des métadonnées complexes et hétérogènes, SAS privilégie un paradigme numérique continu. Cette spécificité d’implémentation procure une vitesse d’exécution inégalée sur des tables comportant plusieurs dizaines de millions d’enregistrements, mais elle requiert en contrepartie une maîtrise théorique sans faille de la part de l’analyste. L’évaluation de l’écart temporel entre deux dates ne se résume pas à une opération arithmétique élémentaire ; elle implique des notions de frontières d’intervalles, de continuité discrète, de régimes bissextiles et d’ajustements calendaires institutionnels.
Ce guide exhaustif a pour vocation de déconstruire, analyser et formaliser les mécanismes de calcul d’intervalles temporels au sein de l’environnement SAS. En explorant en profondeur la fonction maîtresse INTCK et ses modificateurs discrets et continus, en la confrontant aux fonctions spécialisées telles que YRDIF, DATDIF ou INTNX, et en étudiant son intégration au sein de l’étape DATA et de la procédure SQL, cet article fournit aux statisticiens, biostatisticiens, data scientists et chercheurs une référence technique et méthodologique de premier ordre pour appréhender toute la complexité du temps calendaire dans leurs programmes analytiques.
1. 1. Introduction aux structures temporelles et à la gestion des dates dans SAS
1.1 1.1 Importance de la précision temporelle dans l’analyse de données
La chronométrie occupe une position nodale dans la structuration des protocoles méthodologiques expérimentaux et longitudinaux. Dans les études de cohortes prospectives, l’intervalle séparant l’inclusion d’un sujet de la survenue d’un événement clinique d’intérêt (telle qu’une récidive, un décès ou une rémission) constitue la variable dépendante fondamentale des modèles de survie semi-paramétriques de Cox ou des estimateurs non paramétriques de Kaplan-Meier. L’introduction d’une erreur d’assignation temporelle, même minime, modifie la fonction de risque instantané (hazard ratio) et peut déplacer artificiellement la significativité statistique d’une modalité thérapeutique, faussant les conclusions d’essais cliniques multicentriques soumis à des régulateurs internationaux stricts tels que la Food and Drug Administration ou l’Agence Européenne des Médicaments.
Au-delà de la recherche biomédicale, les sciences sociales, la psychométrie et l’économétrie appliquée reposent également de manière critique sur l’exactitude de ces différentiels de dates. L’évaluation de l’impact des politiques publiques requiert l’alignement précis des séries chronologiques avant et après intervention, sous peine de biaiser l’estimation des doubles différences. Au fil de ses versions successives, le progiciel SAS Institute a fait évoluer ses modules de base pour intégrer une flexibilité croissante dans la gestion de ces dimensions, passant de mécanismes rudimentaires de calcul à des algorithmes de pointe capables d’absorber les irrégularités historiques des calendriers grégoriens. Cette formalisation mathématique rigoureuse élimine l’arbitraire et garantit l’alignement sur les standards de reproductibilité computationnelle les plus élevés.
1.2 1.2 Représentation interne et arithmétique de base des dates sous SAS
Pour appréhender la mécanique du calcul différentiel, il est indispensable de comprendre le substrat informatique des dates dans le moteur SAS. Une date SAS n’est fondamentalement rien d’autre qu’un nombre entier à virgule flottante double précision, stocké par défaut sur 8 octets, représentant le nombre exact de jours écoulés depuis une date d’origine arbitraire fixée au 1er janvier 1960. Ainsi, le 1er janvier 1960 porte la valeur numérique 0. Les dates ultérieures adoptent des valeurs entières positives (par exemple, le 2 janvier 1960 est stocké sous la valeur 1, et le 1er janvier 2024 sous la valeur 23376), tandis que les dates antérieures au point zéro sont encodées par des valeurs négatives (le 31 décembre 1959 équivaut à -1).
Cette représentation scalaire confère à l’environnement SAS une remarquable efficacité algorithmique : pour évaluer un intervalle brut en nombre de jours, une simple soustraction arithmétique (Date_Fin – Date_Debut) suffit sur le plan formel. Néanmoins, cette simplicité s’effondre dès lors que la question de recherche bascule d’une métrique purement physique en jours calendaires vers des grandeurs temporelles non linéaires, telles que les mois, les trimestres ou les années civiles. Un mois ne correspond pas à une durée constante, son étendue oscillant entre 28 et 31 jours. Par conséquent, diviser une différence arithmétique brute de jours par 30 ou par 365,25 induit une dérive mathématique inacceptable dans les analyses fines. De surcroît, il convient de dissocier hermétiquement la valeur stockée en mémoire (le compteur scalaire) du format d’affichage visuel (par exemple DATE9., DDMMYY10. ou WORDDATE.), ce dernier n’étant qu’un masque de présentation n’altérant aucunement la nature intrinsèque de la donnée.
1.3 1.3 Problématique du calcul d’écart temporel : continuité versus frontière calendaire
L’une des ambiguïtés majeures de l’analyse temporelle réside dans la dialectique entre le temps continu écoulé et le franchissement de frontières calendaires institutionnelles. Lorsqu’un chercheur formule la question : « Quel est le délai entre ces deux dates ? », la réponse diverge radicalement selon le référentiel cognitif et réglementaire sous-jacent. Considérons un sujet suivi médicalement entre le 31 décembre à 23h59 et le 1er janvier suivant à 00h01. Sur le plan chronologique absolu, deux minutes seulement se sont écoulées ; pourtant, sur le plan institutionnel et administratif, une frontière d’année civile a été franchie, ce qui peut amener un algorithme naïf à déclarer un écart d’une année calendaire entière.
Ce phénomène d’arrondi implicite lié au franchissement de seuil constitue la source principale d’erreurs méthodologiques chez les analystes débutants sur SAS. La modélisation de trajectoires individuelles, qu’il s’agisse de périodes d’hospitalisation, de temps de récidive ou de durées de souscription assurantielle, exige de clarifier si l’analyse s’attache à dénombrer les barrières calendaires franchies (jours de calendrier, changements de mois, clôtures d’exercices fiscaux) ou à quantifier une complétude de temps réel (durée effective d’exposition). Un calcul décontextualisé introduit des distorsions qui se répercutent de façon cumulative dans les strates d’agrégation, faussant les moyennes périodiques et gonflant artificiellement la variance au sein des échantillons de données.
2. 2. Fondements théoriques et syntaxe générale de la fonction INTCK
2.1 2.1 Décomposition syntaxique exhaustive de la fonction INTCK
La fonction INTCK (acronyme de Interval Check) représente l’instruction matricielle dédiée au décompte des intervalles de temps sous SAS. Sa syntaxe générale obéit à la structure suivante :
INTCK(‘intervalle’, date_debut, date_fin <, ‘methode’>)
Le premier argument, obligatoirement spécifié sous la forme d’une chaîne de caractères littérale entre guillemets ou d’une expression résolue renvoyant un libellé textuel valide, détermine la nature de l’unité de mesure temporelle. Le panel d’intervalles pris en charge s’étend des unités élémentaires (‘DAY’, ‘WEEK’, ‘MONTH’, ‘QTR’, ‘YEAR’) aux subdivisions d’horodatage fin (‘HOUR’, ‘MINUTE’, ‘SECOND’, ‘DTHOUR’) ainsi qu’à des déclinaisons calendaires avancées (‘WEEKDAY’, ‘SEMIYEAR’). Les deuxième et troisième arguments constituent les bornes temporelles de l’évaluation, fournies sous forme de variables de dates SAS valides, de constantes de date (ex. ’01JAN2024’D) ou d’expressions retournant un scalaire numérique temporel.
Le quatrième argument, facultatif dans les versions historiques mais désormais fondamental dans la pratique contemporaine, correspond au modificateur de méthode. Cet argument accepte principalement deux valeurs : ‘D’ pour la méthode discrète (comportement historiquement appliqué par défaut si omis) et ‘C’ pour la méthode continue. L’omission délibérée ou accidentelle de ce paramètre conduit le compilateur SAS à adopter le calcul basé sur les bornes calendaires discrètes, ce qui engendre régulièrement des biais d’interprétation pour les profils non avertis.
2.2 2.2 Mécanisme algorithmique sous-jacent à l’évaluation des intervalles
Sur le plan algorithmique interne, le compilateur de l’étape DATA exécute la fonction INTCK en dénombrant le nombre exact de frontières temporelles prédéfinies traversées lors du trajet vectoriel de la date de départ vers la date d’arrivée. Chaque intervalle temporel sous SAS dispose de points d’ancrage fixes et immuables dans le temps calendaire. Pour l’intervalle ‘YEAR’, par exemple, la frontière est mathématiquement située sur le passage exact de minuit entre le 31 décembre et le 1er janvier de l’année suivante. Pour l’intervalle ‘MONTH’, la frontière se matérialise lors du passage du dernier jour d’un mois au premier jour du mois consécutif.
Ce mode opératoire confère à la fonction des propriétés algébriques spécifiques. Si la date de fin est strictement identique à la date de début, aucun franchissement de frontière ne se produit, et la fonction renvoie invariablement la valeur zéro. Si le vecteur temporel est inversé, c’est-à-dire que la date de départ est chronologiquement postérieure à la date de fin, SAS procède à un décompte négatif, préservant ainsi l’orientation vectorielle du temps. De plus, la fonction vérifie la propriété d’antisymétrie : INTCK(intervalle, A, B) = – INTCK(intervalle, B, A). En revanche, la transitivité parfaite n’est respectée que sous certaines conditions de modélisation continue, car la somme des passages de frontières peut diverger de l’intervalle direct lors de l’enchaînement de sous-périodes discontinues, ce qui impose d’extrêmes précautions lors du découpage d’études longitudinales en micro-intervalles.
2.3 2.3 Prise en main pratique : premier jeu de données minimaliste
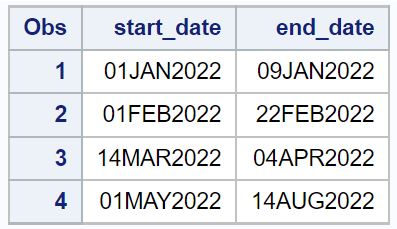
Afin de concrétiser la logique opératoire d’INTCK, considérons un environnement expérimental restreint au sein d’une étape DATA. L’analyste saisit deux dates distinctes représentant la visite initiale d’un patient et son premier contrôle post-thérapeutique. Le traitement des données nécessite de spécifier explicitement l’informat d’entrée pour que les chaînes textuelles soient convenablement converties en scalaires de date SAS, ainsi qu’un format d’affichage garantissant l’intelligibilité des impressions tabulaires.
Dans ce cadre élémentaire, l’instruction déclare une variable Debut valorisée au 15 décembre 2023 et une variable Fin établie au 15 janvier 2024 via les constantes littérales ’15DEC2023’D et ’15JAN2024’D. En appliquant la fonction INTCK avec l’intervalle ‘MONTH’ sans modificateur additionnel, la routine évalue le passage de la frontière entre décembre et janvier. Bien que l’écart temporel absolu ne soit que de 31 jours réels, le système renvoie la valeur 1, car une transition de mois calendaire a été opérée. L’inspection des résultats via la procédure PROC PRINT valide ce comportement structurel. Cette première formalisation met en lumière la singularité d’INTCK : la fonction ne calcule pas le quotient d’une durée divisée par la longueur standard d’un mois, mais atteste du franchissement effectif d’un seuil institutionnel.
3. 3. Comparaison approfondie des méthodes de calcul : Discrète (‘D’) versus Continue (‘C’)
3.1 3.1 La méthode discrète par défaut (‘D’) : logique de franchissement
La méthode discrète, explicitée par l’argument ‘D’ ou adoptée tacitement par défaut dans les programmes traditionnels, obéit à la stricte arithmétique des passages de frontières. Elle ignore délibérément la distance temporelle fractionnaire qui sépare chaque date de sa borne périodique la plus proche. Pour cette méthode, l’unique critère décisionnel réside dans l’incrémentation d’un compteur d’unités dès lors que la trajectoire temporelle traverse la ligne de démarcation calendaire établie par les spécifications de l’intervalle.
L’illustration la plus emblématique de cette approche réside dans ce que les spécialistes de la programmation SAS désignent couramment comme le « paradoxe du Nouvel An ». Considérons deux observations : la première débute le 31 décembre 2023 pour s’achever le 1er janvier 2024 ; la seconde s’étend du 1er janvier 2023 au 30 décembre 2023. Dans le premier scénario, la durée absolue n’est que de 24 heures (un seul jour écoulé), mais la frontière du 1er janvier a été coupée : INTCK(‘YEAR’, Debut, Fin, ‘D’) renvoie la valeur 1. Dans le second scénario, 363 jours entiers se sont écoulés, soit pratiquement une année complète au sens physique ; or, aucune frontière d’année civile n’ayant été traversée, la même fonction renvoie la valeur 0. Ce constat démontre le risque de biais d’évaluation si la méthode discrète est appliquée sans discrimination à des protocoles de suivi clinique ou psychométrique.
3.2 3.2 La méthode continue (‘C’) : exigence de complétude temporelle
Face aux limites inhérentes à la méthode discrète pour le suivi d’individus ou de processus physiques, SAS a introduit la méthode continue, stipulée par l’argument ‘C’ (pour Continuous). Cette modalité modifie en profondeur la logique interne de calcul : elle ne se contente plus de repérer le passage d’une démarcation, mais exige l’accomplissement d’un cycle temporel complet, d’anniversaire à anniversaire ou de jalon à jalon, pour incrémenter l’unité d’intervalle.
Sous la méthode continue, pour que l’écart temporel INTCK(‘MONTH’, Debut, Fin, ‘C’) produise la valeur 1, il ne suffit pas d’entamer le mois suivant ; il est impératif que le quantième de la date de fin soit supérieur ou égal au quantième de la date de départ. Si une étude longitudinale débute le 15 janvier, un mois complet ne sera comptabilisé que si le sujet franchit ou atteint effectivement le 15 février. Tout point d’observation intermédiaire, par exemple le 14 février, retournera la valeur 0. Cette exigence d’intégralité temporelle élimine instantanément les faux positifs d’intervalles qui polluent régulièrement les études épidémiologiques basées sur des extractions administratives, offrant une mesure hautement fidèle de la durée effective d’exposition ou de traitement.
3.3 3.3 Analyse comparative par matrice de cas limites
Pour formaliser la distinction opérationnelle entre ces deux méthodologies, la construction d’une matrice d’évaluation des cas limites s’avère indispensable. En confrontant les sorties générées par ‘D’ et ‘C’ sur un spectre de dates critiques, l’analyste peut théoriser précisément la zone de divergence entre les deux approches mathématiques.
- Cas 1 : Du 31/01/2024 au 01/02/2024. L’approche discrète (‘D’) pour l’intervalle ‘MONTH’ produit la valeur 1 en raison du passage de janvier à février. L’approche continue (‘C’) produit la valeur 0, car un seul jour s’est écoulé sur les 29 jours requis pour compléter le cycle mensuel.
- Cas 2 : Du 15/03/2023 au 15/03/2024. L’approche discrète (‘D’) pour l’intervalle ‘YEAR’ génère 1 (passage du réveillon). L’approche continue (‘C’) génère également 1, le cycle annuel exact ayant été parfaitement accompli d’un point à un autre du calendrier.
- Cas 3 : Du 15/03/2023 au 14/03/2024. L’approche discrète (‘D’) renvoie 1 (la frontière de l’année civile a été franchie au 1er janvier). L’approche continue (‘C’) renvoie 0, car l’anniversaire calendaire n’est pas encore atteint à un jour près.
- Cas 4 : Du 28/02/2023 au 28/02/2024 (année bissextile). L’approche continue (‘C’) pour ‘YEAR’ valide le cycle complet et retourne 1, le système gérant avec rigueur les décalages induits par l’insertion du 29 février.
Le choix méthodologique dépend exclusivement de la nature de la question inférentielle. Si l’objectif consiste à quantifier des périodes budgétaires, des exercices comptables, des trimestres fiscaux ou des présences administratives globales au sein d’une période donnée, la méthode discrète (‘D’) s’impose comme la référence institutionnelle. En revanche, dès lors que l’investigation porte sur des phénomènes biologiques, psychologiques, pharmacologiques ou mécaniques où la durée d’exposition réelle gouverne les lois statistiques du phénomène, l’usage de la méthode continue (‘C’) devient un impératif méthodologique incontournable.
4. 4. Calcul des intervalles élémentaires : Jours, Semaines et Jours ouvrés
4.1 4.1 Mesure en jours : confrontation entre INTCK(‘DAY’) et soustraction simple
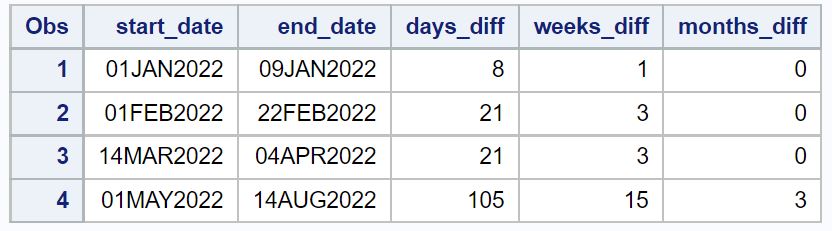
La quantification des intervalles à l’échelle du jour calendaire représente le socle de l’arithmétique temporelle. Au sein de SAS, l’analyste dispose de deux alternatives d’implémentation : la soustraction arithmétique brute (Date_Fin – Date_Debut) ou l’appel formel à la fonction INTCK(‘DAY’, Date_Debut, Date_Fin). Sur le plan théorique et mathématique, ces deux opérations sont rigoureusement équivalentes lorsque les variables manipulées contiennent des valeurs de dates SAS pures, dépourvues de composante horaire. Les deux démarches évaluent la distance linéaire en nombre de rotations diurnes terrestres entières écoulées.
Néanmoins, sous l’angle de l’ingénierie logicielle et de l’optimisation des temps de calcul sur de volumineuses bases de données (tables de plusieurs dizaines de gigaoctets), la soustraction arithmétique directe présente un avantage d’exécution mesurable, car elle sollicite directement l’unité de calcul arithmétique du processeur sans induire la surcharge liée à l’appel d’une fonction interne et à la validation de ses arguments. Cependant, la fonction INTCK(‘DAY’) reprend l’ascendant technique lorsque les structures de données en entrée s’avèrent hétérogènes ou lorsque le code nécessite une standardisation formelle uniforme. En outre, une vigilance absolue s’impose quant aux variables d’horodatage DATETIME : si l’on applique une soustraction simple sur des variables DATETIME, le résultat est exprimé en secondes, alors que l’application de fonctions spécialisées requiert l’extraction préalable du jour pour éviter des écarts d’échelle gigantesques d’un facteur 86400.
4.2 4.2 Intervalles hebdomadaires : granularité et définition du jour pivot
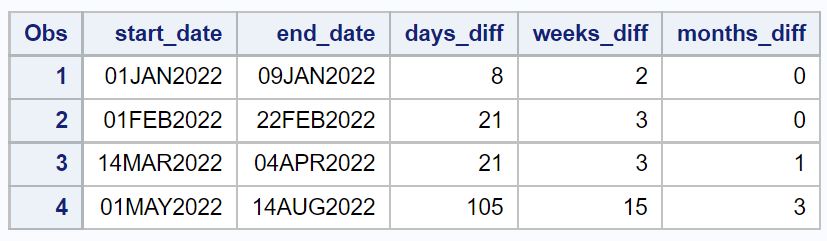
Le traitement des intervalles hebdomadaires via l’identifiant ‘WEEK’ révèle toute la technicité de l’ancrage calendaire sous SAS. Par défaut, la frontière hebdomadaire d’un intervalle standard ‘WEEK’ est positionnée sur le passage du samedi au dimanche. Ainsi, INTCK(‘WEEK’, Date_Debut, Date_Fin, ‘D’) comptera le nombre de dimanches traversés entre les deux dates. Si une intervention commence le vendredi pour se conclure le mardi suivant, le passage du dimanche intermédiaire conduira la fonction à comptabiliser un intervalle d’une semaine, même si seulement quatre jours se sont écoulés.
SAS autorise toutefois des raffinements syntaxiques cruciaux grâce à la notation déclinée ‘WEEK.n’, où l’indice numérique n (variant de 1 pour dimanche à 7 pour samedi) ou des modificateurs spécifiques permettent de repositionner le jour pivot d’amorce de la semaine. Par exemple, pour ancrer les semaines sur la norme internationale ISO 8601 débutant le lundi, l’analyste peut invoquer l’intervalle ‘WEEK.2’ ou recourir à l’identifiant ‘WEEKDAY’. Dans le cadre d’essais cliniques évaluant l’efficacité de thérapies psychologiques hebdomadaires, l’usage d’INTCK(‘WEEK’, Debut, Fin, ‘C’) s’avère indispensable : il garantit que le patient a cumulé au minimum sept jours pleins de suivi entre deux jalons thérapeutiques avant d’incrémenter le rang ordinal de sa semaine de traitement.
4.3 4.3 Traitement des jours ouvrés et exclusion des jours non travaillés
Dans de nombreuses applications d’évaluation de protocoles d’administration hospitalière, de délais de réponse médico-légaux ou de gestion de processus opérationnels, la mesure temporelle brute doit obligatoirement évincer les jours chômés, à savoir les week-ends et les jours fériés institutionnels. L’intervalle de base ‘WEEKDAY’ sous SAS fournit une réponse partielle à cette problématique en excluant arithmétiquement les samedis et les dimanches du décompte des frontières d’intervalles traversées. L’appel à INTCK(‘WEEKDAY’, Debut, Fin) restitue le volume de jours de semaine (du lundi au vendredi inclusivement) contenus entre les deux bornes.
Cependant, l’intervalle ‘WEEKDAY’ ignore par nature les jours fériés légaux propres à chaque juridiction nationale ou sectorielle (par exemple le 1er mai, le 14 juillet ou le lundi de Pentecôte en France). Pour combler cette limitation intrinsèque, les architectures d’entreprise avancées combinent la programmation par boucles itératives au sein de l’étape DATA avec les fonctions calendaires spécialisées telles que HOLIDAY ou s’appuient sur des tables de référence institutionnelles. Dans ces dispositifs industriels, une table dimensionnelle de calendrier balise chaque jour calendaire comme ouvré ou chômé, et le décompte de l’écart s’opère par sommation conditionnelle, INTCK assurant l’évaluation macroscopique préalable pour délimiter les bornes de la scrutation.
5. 5. Calcul des intervalles calendaires intermédiaires : Mois, Trimestres et Semestres
5.1 5.1 La mesure mensuelle (‘MONTH’) et l’hétérogénéité de la durée des mois
L’unité mensuelle cristallise les difficultés théoriques les plus prononcées en raison de la variabilité structurelle de sa composition : les mois alternent entre 28, 29, 30 et 31 jours. Cette hétérogénéité empêche toute conversion par facteur multiplicatif constant et impose l’usage d’algorithmes tenant compte des longueurs variables des sous-cycles calendaires. L’argument ‘MONTH’ résout ce défi avec une souplesse remarquable, mais requiert une compréhension parfaite de ses réactions face aux fins de mois consécutifs.
Sous la méthode continue (‘C’), l’algorithme doit traiter des situations singulières où le quantième de la date de départ n’existe pas dans le mois de la date d’arrivée. Considérons une prescription thérapeutique initiée le 31 janvier : quel sera le statut de cette observation au 28 février (ou au 29 février lors d’une année bissextile) ? Dans ce scénario critique, le compilateur SAS considère que le dernier jour du mois d’arrivée satisfait l’exigence d’anniversaire complet lorsque le jour cible dépasse la capacité calendaire du mois d’échéance. Ainsi, INTCK(‘MONTH’, ’31JAN2024’D, ’29FEB2024’D, ‘C’) renverra la valeur 1. Cette robustesse algorithmique prévient l’apparition d’aberrations statistiques dans les cohortes de suivi psychopharmacologique, où les renouvellements d’ordonnances s’opèrent traditionnellement en fin de mois civil sans coïncidence numérique absolue des jours calendaires.
5.2 5.2 Les intervalles trimestriels (‘QTR’) dans le suivi périodique
Dans l’organisation des cohortes observationnelles pluriannuelles et la production de rapports d’activité clinique, le trimestre (représenté par le paramètre ‘QTR’) constitue l’unité d’agrégation temporelle standard. Le moteur SAS segmente l’année civile en quatre blocs trimestriels immuables : Q1 (1er janvier au 31 mars), Q2 (1er avril au 30 juin), Q3 (1er juillet au 30 septembre) et Q4 (1er octobre au 31 décembre). Les passages de frontières s’opèrent rigoureusement à l’amorce de chaque premier jour des mois d’avril, juillet, octobre et janvier.
L’évaluation des cohortes pluriannuelles via INTCK(‘QTR’, Debut, Fin, ‘D’) permet d’identifier immédiatement le nombre de clôtures trimestrielles traversées par un patient au sein du système de soins, ce qui simplifie grandement l’appariement avec les bases de remboursement médico-économiques. Inversement, si le protocole de recherche médicale exige une exposition ininterrompue de trois mois révolus pour qualifier un trimestre de suivi valide, l’analyste privilégiera l’instruction continue INTCK(‘QTR’, Debut, Fin, ‘C’). Cette dernière requiert l’écoulement d’une distance calendaire équivalente à trois mois de quantième à quantième, empêchant ainsi qu’un patient recruté le 28 mars et revu le 2 avril ne soit faussement qualifié pour deux trimestres d’activité clinique.
5.3 5.3 Les intervalles semestriels (‘SEMIYEAR’) et découpages spécifiques
Pour les suivis à plus large échelle, l’intervalle semestriel paramétré par ‘SEMIYEAR’ regroupe les mois en deux blocs annuels de six mois (1er janvier au 30 juin, et 1er juillet au 31 décembre). Cet intervalle trouve une application privilégiée dans les études d’épidémiologie longitudinale où les collectes de données sont indexées sur des semestres universitaires ou hospitaliers. À l’instar des trimestres, le franchissement discret mesure l’exposition administrative à travers les pivots du 1er juillet et du 1er janvier.
La standardisation des tables de restitution épidémiologique bénéficie grandement de ces découpages formels. L’usage d’INTCK avec l’unité ‘SEMIYEAR’ supprime les biais liés à la présence d’années bissextiles ou aux longueurs inégales des deux semestres civils (le second semestre comptant 184 jours contre 181 ou 182 pour le premier). La fonction absorbe ces asymétries physiques en garantissant une segmentation analytique parfaitement reproductible à travers les différentes décennies d’un registre de santé publique.
6. 6. Calcul des intervalles annuels et calcul rigoureux de l’âge chronologique
6.1 6.1 Mesure en années civiles (‘YEAR’) : nuances et pièges méthodologiques
La conversion du temps en années représente l’une des opérations les plus communes et paradoxalement les plus sujettes aux erreurs conceptuelles en programmation SAS. L’usage non maîtrisé de l’intervalle ‘YEAR’ sous la méthode discrète (‘D’) constitue un risque statistique d’une gravité exceptionnelle. Appliquer INTCK(‘YEAR’, Date_Naissance, Date_Visite, ‘D’) pour estimer l’âge d’un individu conduit invariablement à calculer la différence entre les millésimes des deux dates. Ainsi, un enfant né le 31 décembre 2023 et examiné le 1er janvier 2024 sera étiqueté comme étant âgé d’un an, alors que sa vie extra-utérine ne s’élève qu’à 24 heures.
Cette distorsion possède des répercussions cliniques et juridiques majeures : elle peut induire une fausse classification d’inclusion dans des essais thérapeutiques réservés aux adultes, fausser le calcul de posologies pédiatriques tributaires de tranches d’âge strictes ou induire en erreur l’estimation de la majorité légale. Par conséquent, pour toute démarche visant à modéliser l’âge chronologique individuel, le recours au modificateur de méthode continue ‘C’ est une condition de validité scientifique absolue. L’expression Age = INTCK('YEAR', Date_Naissance, Date_Reference, 'C'); évalue avec une exactitude totale si l’anniversaire du sujet a été célébré à la date de référence ou antérieurement, intégrant sans faille les décalages induits par les années bissextiles et le cas limite des personnes nées un 29 février.
6.2 6.2 Confrontation fonctionnelle : INTCK(‘YEAR’, …) versus YRDIF
Outre la fonction INTCK, le système SAS intègre une fonction alternative hautement spécialisée dans le calcul d’écarts annuels : la fonction YRDIF (pour Year Difference). Sa structure d’appel se présente comme suit :
YRDIF(date_debut, date_fin, ‘base’)
La divergence conceptuelle entre INTCK et YRDIF réside dans la nature du résultat produit. Tandis qu’INTCK retourne structurellement un nombre entier tronqué d’unités révolues (en mode ‘C’) ou de seuils coupés (en mode ‘D’), YRDIF renvoie un nombre à virgule flottante représentant la durée fractionnaire exacte écoulée en années. De surcroît, YRDIF exige la sélection explicite d’une convention de calcul actuariel (la « base »), parmi lesquelles :
- ‘ACT/ACT’ : Modèle réel/réel calculant le nombre de jours exacts écoulés divisé par la longueur exacte de chaque année civile traversée (365 ou 366 jours). C’est la référence absolue dans les essais cliniques et la recherche épidémiologique sous les directives de la FDA.
- ’30/360′ : Convention comptable et financière classique postulant que chaque mois contient uniformément 30 jours et chaque année 360 jours.
- ‘ACT/360’ : Mesure basée sur le nombre de jours réels divisé par une base conventionnelle de 360 jours.
- ‘ACT/365’ : Mesure basée sur le nombre de jours réels divisé par une base constante de 365 jours, neutralisant l’impact des années bissextiles.
Pour dériver l’âge entier à l’inclusion, un biostatisticien peut formuler soit Age = INTCK('YEAR', DNaiss, DInclus, 'C'); soit Age = INT(YRDIF(DNaiss, DInclus, 'ACT/ACT'));. Ces deux instructions aboutissent à un résultat parfaitement concordant, mais YRDIF présente la propriété supérieure de pouvoir conserver la part décimale de l’âge (ex. 45,73 ans), variable explicative continue indispensable lors de l’ajustement de modèles de régression multivariée.
6.3 6.3 Synthèse applicative : algorithme de calcul d’âge de référence
Dans un contexte de standardisation des pratiques de programmation biomédicale, l’algorithme de dérivation de l’âge doit être codifié de manière univoque au sein de l’étape DATA. Le protocole implique l’assainissement préalable des variables sources, la gestion des dates de naissance documentées au format partiel et la restitution contrôlée des paramètres de distribution.
La formulation canonique de l’étape DATA associe le contrôle de validité des dates sources par exclusion des valeurs aberrantes ou manquantes, l’affectation du format numérique adéquat et le double calcul simultané : l’âge civil en années révolues (via INTCK avec le paramètre ‘C’) pour la constitution des classes d’âge catégorielles, et l’âge actuariel exact (via YRDIF ‘ACT/ACT’) pour l’analyse statistique continue. La vérification ultérieure de l’intégrité de la variable dérivée s’opère par la procédure PROC UNIVARIATE, permettant de s’assurer de l’absence totale de valeurs d’âge négatives (qui trahiraient une inversion chronologique dans la saisie des dates) et de confirmer la plausibilité biologique de la distribution au sein de la cohorte.
7. 7. Utilisation des intervalles multiples et personnalisés (Shifted Intervals)
7.1 7.1 Multiplicateurs d’intervalles pour cycles temporels non standards
La flexibilité du compilateur temporel SAS autorise la création d’intervalles composites par l’adjonction d’un multiplicateur numérique entier immédiatement adossé au nom de l’intervalle de base, sous la forme syntaxique 'INTERVALLEn'. Cette capacité permet de s’affranchir des contraintes des découpages calendaires traditionnels pour analyser des cycles temporels spécifiques propres à des protocoles de recherche ou des exigences organisationnelles.
Parmi les formulations courantes, l’intervalle 'YEAR5' segmente le temps par pas de cinq années entières, outil privilégié pour l’étude des cohortes épidémiologiques longitudinales par quinquennat. De même, 'MONTH2' instaure une échelle bimestrielle, 'MONTH6' constitue une formulation alternative au semestre, et 'DAY14' permet de suivre des protocoles d’administration thérapeutique par quinzaines strictes. Lors de l’utilisation de multiplicateurs, SAS aligne les frontières d’intervalles à partir du point d’origine absolu du calendrier (le 1er janvier 1960). Par conséquent, les blocs quinquennaux s’ancrent invariablement sur les années 1960, 1965, 1970, etc. L’analyste doit impérativement intégrer cette règle d’ancrage absolu afin de ne pas interpréter de travers les franchissements de bornes lors de l’application de méthodes discrètes sur des séries chronologiques décalées.
7.2 7.2 Décalage des points de départ d’intervalles (Shifted Intervals)
Dans de nombreuses configurations opérationnelles, les cycles temporels d’intérêt ne coïncident pas avec le premier jour des mois ou le 1er janvier des années civiles. C’est notamment le cas des exercices fiscaux d’entreprises, des années académiques ou des fenêtres d’inclusion d’études cliniques multicentriques dont le point de départ est fixé à une date fixe arbitraire. SAS permet de répondre à cette exigence par le mécanisme des intervalles décalés (Shifted Intervals), dont la syntaxe s’exprime par l’adjonction d’un point suivi d’un paramètre de translation : 'INTERVALLE.s'.
Le paramètre de décalage s peut être spécifié sous la forme d’un nombre entier ou d’un libellé textuel correspondant à une unité sous-jacente. Ainsi, l’intervalle 'YEAR.7' redéfinit la frontière annuelle au 1er juillet de chaque année civile, calquant parfaitement le décompte des intervalles sur l’exercice budgétaire traditionnel de nombreux organismes publics. Pour les intervalles hebdomadaires, 'WEEK.2' déplace l’ancrage du dimanche au lundi, alignant le traitement sur les cycles ouvrés standards. Si l’on souhaite quantifier des intervalles mensuels débutant systématiquement le quinzième jour de chaque mois, la syntaxe 'MONTH.15' implémente cette ligne de démarcation avec une précision totale, transformant profondément le comportement de franchissement de frontière d’INTCK.
7.3 7.3 Synergie des multiplicateurs et décalages temporels
L’apogée de la personnalisation temporelle sous SAS réside dans l’imbrication simultanée d’un multiplicateur d’échelle et d’un décalage d’ancrage, matérialisée par la syntaxe unifiée 'INTERVALLEn.s'. Cette construction algorithmique avancée permet de modéliser des structures calendaires extrêmement sophistiquées au sein d’une unique instruction INTCK, éliminant le besoin de multiples étapes de transformation de données préalables.
Considérons par exemple l’analyse de bilans de santé semestriels institutionnels dont les cycles s’amorcent le 1er avril. L’instruction syntaxique mobilise alors l’intervalle 'MONTH6.4', ce qui instruit SAS de compter des segments de six mois dont l’ancrage initial débute au quatrième mois de l’année civile (avril). Cette souplesse conceptuelle exige néanmoins une rigueur documentaire irréprochable de la part du programmeur. Le code source doit impérativement documenter de manière explicite les rationalités médicales ou administratives de ces paramétrages complexes afin de préserver l’auditabilité et la reproductibilité du traitement au sein des équipes de recherche collaboratives.
8. 8. Fonctions alternatives et complémentaires : INTNX, DATDIF et arithmétique avancée
8.1 8.1 La relation de réciprocité entre INTCK et INTNX
L’architecture calendaire de SAS repose sur une dualité fondamentale : tandis que la fonction INTCK évalue la distance entre deux dates données en dénombrant des intervalles, la fonction INTNX (acronyme d’Interval Next) effectue l’opération inverse en générant une nouvelle date par incrémentation ou décrémentation d’une date de référence à partir d’un pas d’intervalle déterminé. Sa syntaxe s’énonce comme suit :
INTNX(‘intervalle’, date_depart, n <, ‘alignement’>)
Le paramètre n indique le nombre d’unités d’intervalle à additionner ou à soustraire, tandis que l’argument d’alignement (acceptant les valeurs ‘B’ pour Beginning, ‘M’ pour Middle, ‘E’ pour End et ‘S’ pour Same) spécifie la position de la date résultante au sein de l’intervalle d’arrivée. La synergie entre INTCK et INTNX permet la mise en place de protocoles de validation croisée bidirectionnelle. Par exemple, après avoir estimé le nombre de mois complets séparant deux jalons cliniques via INTCK, l’application d’INTNX avec la valeur issue d’INTCK permet de recalculer la date exacte du dernier anniversaire temporel ou de projeter la date limite de conformité réglementaire pour une visite médicale de suivi.
8.2 8.2 La fonction DATDIF pour les écarts exprimés en jours réels
À côté de l’instruction YRDIF conçue pour les fractions d’années, SAS propose la fonction spécialisée DATDIF, dédiée spécifiquement au calcul de la différence en jours selon des bases de décompte prédéfinies. Sa signature s’écrit :
DATDIF(date_debut, date_fin, ‘base’)
Bien que la soustraction arithmétique brute demeure la voie privilégiée pour extraire le nombre de jours entre deux dates SAS pures, DATDIF s’impose lorsque des conventions réglementaires bancaires ou actuarielles exigent l’application de la base ’30/360′. Sous cette dernière convention, DATDIF calcule un écart conventionnel fondé sur l’hypothèse de mois standards de 30 jours, un résultat impossible à obtenir par une simple différence arithmétique. Cependant, pour la recherche biomédicale et la majorité des applications en sciences sociales où le calendrier réel prévaut, la convention ‘ACT/ACT’ de DATDIF équivaut rigoureusement à la soustraction arithmétique ordinaire, cette dernière demeurant alors plus rapide à l’exécution.
8.3 8.3 Prise en charge des variables mixtes DATE et DATETIME
Une source critique de dysfonctionnement dans les calculs d’intervalles provient de la confusion fréquente entre les variables SAS de type DATE et celles de type DATETIME. Une variable DATE compte des jours depuis le 1er janvier 1960, tandis qu’une variable DATETIME enregistre le nombre total de secondes écoulées depuis le 1er janvier 1960 à minuit. Confronter ou soustraire directement une variable DATE et une variable DATETIME sans conversion d’échelle génère des résultats mathématiquement aberrants, l’écart d’ordre de grandeur atteignant un ratio de 1 à 86 400.
Pour mesurer des intervalles temporels fins sur des variables DATETIME, SAS dispose d’intervalles spécialisés reconnus par INTCK, notamment 'DTHOUR', 'DTMINUTE', 'DTSECOND' et 'DTDAY'. Ces identifiants indiquent au compilateur que les scalaires en entrée sont calibrés en secondes et non en jours. Alternativement, lorsque l’analyste souhaite uniquement extraire l’écart calendaire sans considération de l’horodatage fin, il convient de recourir systématiquement à la fonction d’extraction DATEPART (ex. Date_Pure = DATEPART(Variable_DateTime);) avant de soumettre les valeurs à la fonction standard INTCK(‘DAY’, …). Cette étape préliminaire garantit l’homogénéité des échelles de mesure et immunise les programmes contre les erreurs de troncature temporelle.
9. 9. Gestion des valeurs manquantes, des erreurs d’horodatage et validation des données
9.1 9.1 Traitement des dates manquantes ou incomplètes
Dans les registres épidémiologiques et les bases médico-administratives de grande envergure, les données temporelles souffrent fréquemment d’incomplétude : dates d’apparition de symptômes renseignées uniquement par l’année et le mois, perdus de vue sans date de sortie documentée, ou erreurs de saisie générant des valeurs manquantes (représentées par le point . sous SAS). La soumission d’une valeur manquante à l’un des paramètres de date de la fonction INTCK provoque la propagation immédiate de la valeur manquante dans la variable réceptrice, sans arrêt bloquant de l’étape DATA mais en consignant une trace d’avertissement dans le journal d’exécution (le SAS Log).
Pour préserver l’intégrité des analyses sans tronquer drastiquement la puissance statistique des échantillons, les programmes doivent implémenter des tests de validation préalables via les fonctions NMISS ou CMISS. En cas d’incomplétude partielle (par exemple un jour de naissance omis), des protocoles d’imputation déterministe standardisés sont couramment déployés selon les normes du secteur (par exemple imputer le 15 du mois pour un jour manquant, ou le 1er juillet pour une année sans précision de mois), sous réserve d’étiqueter chaque observation par un indicateur binaire d’imputation autorisant des analyses de sensibilité stratifiées ultérieures.
9.2 9.2 Détection et correction des inversions chronologiques
L’inversion de l’ordre séquentiel des événements — où la date réputée finale est documentée comme étant chronologiquement antérieure à la date initiale — représente une anomalie structurelle fréquemment observée lors de l’intégration de fichiers multicentriques. Ainsi qu’il a été établi dans les fondements théoriques, la fonction INTCK retourne un scalaire négatif lorsque la date de début est plus récente que la date de fin.
Si dans certaines modélisations vectorielles le signe négatif est attendu, il constitue dans les modèles de survie ou les études de parcours de soins une aberration logique susceptible d’induire la non-convergence des algorithmes d’estimation de paramètres (comme l’invalidation des hypothèses de proportionnalité dans PROC PHREG). La routine de programmation doit donc intégrer une vérification conditionnelle systématique. L’usage aveugle de la fonction de valeur absolue ABS pour forcer un résultat positif doit être formellement proscrit : masquer une inversion temporelle sans investigation sous-jacente équivaut à corrompre la chronologie causale des événements cliniques. Les observations inversées doivent impérativement être interceptées, réorientées vers des tables d’audit d’anomalies et corrigées à la source par rapprochement documentaire.
9.3 9.3 Stratégies de validation automatisée avec PROC TRANSPOSE et PROC MEANS
L’assurance qualité des tables finales requiert l’exécution de pipelines de validation automatisés visant à certifier l’absence d’artefacts temporels résiduels. La combinaison des procédures analytiques standard PROC MEANS et PROC TRANSPOSE offre un moyen performant pour inspecter la distribution empirique de l’ensemble des écarts temporels dérivés au sein d’une table d’étude.
La mise en œuvre d’une macro-étape PROC MEANS paramétrée sur les variables d’intervalles calculées permet d’extraire instantanément un résumé statistique exhaustif comportant l’effectif, le nombre de valeurs manquantes (NMISS), la moyenne, l’écart-type, ainsi que les extrema absolus (MIN et MAX). La présence d’une valeur minimale négative dans un délai censé quantifier une durée d’exposition post-inclusion signale immédiatement une anomalie chronologique. De même, l’observation d’un intervalle maximal excédant la durée physiologique de la vie humaine (par exemple un âge supérieur à 125 ans) met en évidence une corruption des formats ou informats de dates lors de l’ingestion initiale des fichiers plats.
10. 10. Calculs de dates dans l’écosystème PROC SQL et comparaison DATA Step
10.1 10.1 Implémentation directe de la fonction INTCK au sein de requêtes PROC SQL
L’universalité de la fonction INTCK se traduit par sa compatibilité native au sein de la procédure PROC SQL de SAS. Les analystes formés à la manipulation relationnelle de bases de données peuvent ainsi transposer directement leurs métriques d’intervalles temporels dans des requêtes d’agrégation sans avoir à opérer une étape DATA préliminaire.
Dans la clause SELECT, INTCK s’utilise avec une syntaxe strictement identique à celle du compilateur DATA step. Elle permet de générer des colonnes dérivées dynamiques évaluant les délais d’intervention, de filtrer les enregistrements au sein d’une clause WHERE (par exemple pour restreindre l’extraction aux seuls patients ayant plus de 18 ans révolus via la condition WHERE INTCK('YEAR', Date_Naissance, TODAY(), 'C') >= 18), ou encore de servir de critère de regroupement dans une clause GROUP BY. Cette fluidité expressive accélère la création de tables intermédiaires pour l’alimentation de tableaux de bord décisionnels et de revues périodiques.
10.2 10.2 Calcul d’intervalles entre observations successives (LAG et auto-jointures)
Une problématique analytique fréquente réside dans la mesure de l’écart temporel séparant non pas deux colonnes d’un même enregistrement, mais deux observations consécutives au sein d’une trajectoire individuelle longitudinale (par exemple le délai séparant la visite i de la visite i-1 d’un même patient). L’arbitrage technique oppose alors l’étape DATA équipée de la fonction LAG à la procédure SQL articulée autour d’une auto-jointure (self-join).
Dans l’étape DATA, l’usage de la fonction LAG(Date_Visite) conjointement à l’instruction de tri BY Patient_ID représente l’approche computationnelle la plus économe en ressources. Le système extrait en temps réel la date de l’enregistrement précédent sans solliciter d’espace disque auxiliaire :
Si l’observation en cours correspond au premier enregistrement d’un sujet (FIRST.Patient_ID), l’écart temporel est initialisé à une valeur manquante pour éviter de calculer un faux intervalle entre deux patients distincts. À l’inverse, sous PROC SQL, l’obtention de cet écart inter-visites requiert la construction d’une auto-jointure non équitable ou l’appariement sur des rangs ordonnés, générant des tables temporaires massives et consommant une volumétrie mémoire exponentielle. L’étape DATA s’avère donc indiscutablement supérieure pour ce type d’architecture séquentielle.
10.3 10.3 Portabilité du code SQL et fonctions temporelles natives
Lors de l’interaction avec des systèmes de gestion de bases de données relationnelles distants (SGBDR) tels qu’Oracle, Teradata, PostgreSQL ou Snowflake via le module SAS/ACCESS, l’exécution des fonctions temporelles soulève des enjeux d’optimisation architecturale majeurs. Le compilateur SAS SQL tente par défaut d’opérer un déport d’exécution (Pass-Through implicite) vers le moteur de la base distante pour y faire exécuter le calcul au plus près du stockage des données.
Cependant, la fonction INTCK n’étant pas une fonction standard du standard SQL ANSI, le moteur distant ne dispose généralement d’aucun équivalent syntaxique direct. Deux comportements d’exécution peuvent alors survenir : soit SAS désactive le transfert de code et rapatrie la totalité des lignes non filtrées sur le serveur SAS local pour y appliquer la fonction INTCK en mémoire (provoquant un goulet d’étranglement réseau massif sur les tables volumineuses), soit la requête échoue en cas d’utilisation dans une clause SQL Pass-Through explicite. Dans ce contexte de programmation distribuée, le développeur doit arbitrer entre l’utilisation de fonctions temporelles natives du SGBD distant (telles que DATEDIFF ou les opérations d’intervalles SQL natives) au sein du bloc Pass-Through ou le rapatriement maîtrisé d’un sous-ensemble pré-filtré vers SAS pour traitement via INTCK.
11. 11. Cas pratiques appliqués à la recherche clinique, épidémiologique et psychologique
11.1 11.1 Évaluation du taux d’attrition et des délais de suivi en psychothérapie
L’investigation de l’efficacité des protocoles thérapeutiques en psychologie clinique se heurte structurellement au phénomène d’attrition (perte de sujets au fil des séances) et à l’hétérogénéité des intervalles réels de consultations. Dans le cadre d’un essai randomisé contrôlé comparant les thérapies cognitives et comportementales (TCC) à une prise en charge standard pour des troubles anxieux, la variable primaire d’analyse réside dans le délai exact de rétention en soins avant abandon éventuel.
La modélisation de ces données via l’étape DATA fait intervenir le calcul continu des jours écoulés entre la séance d’évaluation initiale (baseline) et chaque jalon d’évaluation intermédiaire programmé (à 4 semaines, 8 semaines, 12 semaines et 24 semaines). Grâce à l’évaluation continue INTCK('DAY', Date_Baseline, Date_Seance, 'C'), le statisticien définit des fenêtres d’acceptabilité protocolaire (par exemple une visite à 4 semaines est jugée conforme si elle survient à 28 jours ± 3 jours). Tout patient dont la visite franchit la borne de conformité est réassigné selon les règles du plan d’analyse statistique pré-établi, et la durée exacte de maintien en traitement sert ensuite de variable de censure pour l’ajustement de modèles à risques proportionnels de Cox visant à identifier les prédicteurs psychométriques du décrochage thérapeutique.
11.2 11.2 Analyse de l’observance médicamenteuse et des intervalles de renouvellement
En pharmaco-épidémiologie, la quantification de l’observance thérapeutique à partir des bases de remboursement médico-administratives de l’assurance maladie constitue une application phare des fonctions calendaires SAS. L’un des indicateurs internationaux de référence est le MPR (Medication Possession Ratio), qui mesure le rapport entre le nombre cumulé de jours de médicaments théoriquement détenus par un assuré et la durée totale de la période d’observation thérapeutique.
Le traitement des données nécessite d’ordonner chronologiquement les dates de délivrance de chaque boîte de traitement en officine et d’évaluer, pour chaque intervalle inter-délivrances, la durée effective de couverture assurée par les unités délivrées. L’utilisation d’INTCK permet de confronter le délai réel séparant deux délivrances successives avec le volume théorique de comprimés fournis (par exemple 30 jours de traitement). Si l’écart calculé par INTCK(‘DAY’, Date_Dispensation_1, Date_Dispensation_2) est supérieur à 30, un intervalle d’interruption médicamenteuse (gap) est formalisé. À l’inverse, si l’intervalle est inférieur à 30, un chevauchement est comptabilisé. L’algorithme itératif agrège ces fractions temporelles pour calculer le MPR individuel final, permettant de classifier les patients en observants ou non-observants selon le seuil épidémiologique conventionnel de 80 % de couverture.
11.3 11.3 Étude de la réactivité émotionnelle dans les protocoles d’échantillonnage de l’expérience (ESM)
La recherche contemporaine en psychologie cognitive et comportementale mobilise intensément les protocoles d’échantillonnage de l’expérience écologique (Experience Sampling Methodology ou ESM), où les participants répondent plusieurs fois par jour à des micro-questionnaires sur leurs téléphones intelligents en vie quotidienne. La modélisation de la réactivité émotionnelle et de l’inertie affective dépend de la mesure chronologique ultra-fine des délais écoulés entre la notification sonore (le « bip ») et la validation effective du questionnaire par l’utilisateur.
Les variables enregistrées dans les journaux de bord numériques comportent des horodatages complets au format DATETIME20. Pour nettoyer ces jeux de données massifs, les statisticiens emploient la fonction INTCK à l’échelle de la minute :
L’expression Delai_Reponse = INTCK('DTMINUTE', DateHeure_Notification, DateHeure_Soumission); quantifie précisément la latence décisionnelle du sujet. Tout enregistrement présentant un délai de réponse supérieur à un seuil protocolaire critique (par exemple plus de 15 minutes) est exclu de l’analyse en raison du risque de biais de rappel mnésique. Par la suite, l’écart temporel réel en minutes entre deux questionnaires consécutifs sert à pondérer les modèles autorégressifs multiniveaux d’inertie affective, où l’autocorrélation entre les états émotionnels successifs décroît en fonction directe de l’intervalle temporel physique écoulé.
12. 12. Optimisation des performances, macro-programmation et synthèse méthodologique
12.1 12.1 Écriture de macro-fonctions réutilisables pour le calcul standardisé d’intervalles
L’industrialisation des chaînes de traitement statistique au sein d’unités de biostatistique ou de centres de recherche requiert l’encapsulation de la logique algorithmique au sein de macro-fonctions réutilisables. Ce paradigme de conception centralise les règles de validation, uniformise les conventions de calcul et garantit une maintenance aisée du code analytique face aux évolutions réglementaires.
Une macro-fonction robuste dédiée au calcul d’intervalles doit valider dynamiquement la conformité des arguments soumis (vérifier que l’intervalle demandé figure parmi une liste blanche prédéfinie, s’assurer de l’existence des variables d’entrée dans la table de travail), insérer les modificateurs de complétude appropriés (‘C’ ou ‘D’) et générer des alertes explicites dans le SAS Log en cas de détection d’anomalies structurelles. Le déploiement de ces modules sous la forme de macros autocall intégrées aux bibliothèques institutionnelles de l’entreprise confère aux équipes une productivité décuplée et immunise les programmes de production contre la récurrence des biais méthodologiques élémentaires liés au calcul des dates.
12.2 12.2 Performances de calcul sur les bases de données volumineuses (Big Data)
Dans le traitement de référentiels de données massives comptant des dizaines ou des centaines de millions de lignes (tels que les entrepôts de données hospitaliers nationaux ou les flux de télémesure continue), l’impact computationnel du choix de la méthode de calcul d’intervalle cesse d’être théorique pour devenir un enjeu de consommation de ressources et de temps processeur critique.
Les benchmarks de performance démontrent que l’appel d’INTCK sous la méthode continue 'C' mobilise approximativement 15 % à 25 % de cycles CPU supplémentaires par rapport à la méthode discrète 'D', en raison des tests logiques additionnels exécutés pour comparer les quantièmes de jours et déterminer l’accomplissement des anniversaires temporels complets. Néanmoins, ce surcoût algorithmique demeure largement compensé par la justesse scientifique des résultats dérivés. D’autre part, la soustraction arithmétique directe (lorsqu’elle est conceptuellement recevable pour un décompte en jours) s’exécute jusqu’à deux à trois fois plus rapidement qu’un appel formel à la fonction INTCK('DAY', ...). Dans les infrastructures analytiques modernes distribuées telles que SAS Viya et son moteur CAS (Cloud Analytic Services), ces opérations sont parallélisées sur des nœuds multiples, mais la rationalisation du code dans les blocs de manipulation séquentielle conserve une incidence directe sur l’empreinte carbone et l’efficacité globale des pipelines d’extraction, transformation et chargement (ETL).
12.3 12.3 Synthèse des règles d’or et guide de décision algorithmique
Pour parachever ce traité exhaustif, il convient de synthétiser les principes directeurs gouvernant la manipulation des différentiels temporels dans l’environnement SAS sous la forme d’un protocole décisionnel formalisé :
- Règle 1 : Règle de l’unité fondamentale. Pour tout calcul de distance en nombre de jours purs entre deux dates de format DATE, privilégier la soustraction arithmétique directe (Date_Fin – Date_Debut) pour des raisons d’efficience computationnelle.
- Règle 2 : Règle de complétude physique. Pour toute modélisation de processus biologiques, démographiques, psychométriques ou cliniques mesurant des durées d’exposition, d’âge ou de survie exprimées en mois ou en années, l’application du modificateur continu ‘C’ dans la fonction INTCK est obligatoire pour éliminer les faux positifs de franchissement de frontière.
- Règle 3 : Règle de conformité administrative. Lorsque la question analytique porte sur le franchissement de clôtures comptables, de trimestres fiscaux ou d’exercices budgétaires indépendamment de la durée écoulée exacte, la méthode discrète ‘D’ (ou le comportement par défaut d’INTCK) constitue la modalité méthodologique appropriée.
- Règle 4 : Règle des fractions continues. Si l’analyse multivariée requiert la conservation de fractions décimales d’années sans arrondi discret à l’entier inférieur, mobiliser systématiquement la fonction YRDIF avec la base conventionnelle de calcul stipulée par le protocole (ex. ‘ACT/ACT’).
- Règle 5 : Règle de non-contamination des horodatages. Ne jamais appliquer directement d’opérations d’intervalles calendaires standards sur des variables d’horodatage DATETIME sans extraction préalable de la composante jour via DATEPART, ou spécifier explicitement les intervalles d’horodatage fin (‘DTHOUR’, ‘DTDAY’, etc.) pour éviter des distorsions d’échelles cataclysmiques.
En intégrant ces préceptes algorithmiques au sein de leurs pratiques quotidiennes de développement, les analystes de données garantissent la fiabilité inébranlable de leurs métriques temporelles, consolidant ainsi la robustesse, la reproductibilité et l’intégrité scientifique de l’ensemble de leurs productions sous l’écosystème SAS.
Références
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- SAS Institute Inc. (2023). SAS(R) 9.4 Functions and CALL Routines: Reference. SAS Documentation. https://documentation.sas.com/
- Whitlock, I. (2006). How to Think About SAS Dates and Times. Proceedings of the SAS Users Group International (SUGI) 31, Paper 244-31.
- Zender, P. R. (2011). A Serious Look at SAS Date, Time, and Datetime Functions. Proceedings of the SAS Global Forum 2011 Conference, Paper 044-2011.