
Dans le paysage contemporain de la recherche en psychologie, en neurosciences cognitives et en sciences du comportement, l’évaluation rigoureuse des changements intra-individuels constitue l’un des piliers méthodologiques fondamentaux. Qu’il s’agisse de mesurer l’efficacité d’une psychothérapie innovante, d’analyser l’impact d’un entraînement cognitif informatisé ou d’estimer les modifications psychophysiologiques consécutives à un protocole de stress expérimental, les chercheurs recourent massivement à des protocoles de mesures répétées. Au cœur de cette démarche inférentielle, le test t pour échantillons appariés s’impose comme l’outil statistique de référence pour comparer deux moyennes mesurées sur les mêmes unités expérimentales ou sur des paires appariées selon des critères stricts.
L’utilisation de logiciels d’analyse de données avancés est indispensable pour garantir l’intégrité, la reproductibilité et la puissance des inférences statistiques. Parmi ces environnements computationnels, SAS (Statistical Analysis System) demeure la référence institutionnelle et industrielle majeure, particulièrement au sein des laboratoires de recherche biomédicale, des consortiums de pharmacovigilance et des départements de psychométrie quantitative. Grâce à sa procédure native PROC TTEST et à son moteur de rendu ODS Graphics, SAS offre une infrastructure logicielle d’une robustesse exceptionnelle, capable de traiter des architectures de données complexes tout en générant des diagnostics d’adéquation distributionnelle particulièrement exhaustifs.
Ce guide exhaustif a pour ambition d’accompagner les chercheurs, psychométriciens et analystes de données dans la maîtrise complète du test t pour échantillons appariés sous SAS. Depuis les fondements épistémologiques et mathématiques du modèle jusqu’à la communication académique des résultats selon les normes rigoureuses de l’American Psychological Association (APA 7e édition), chaque étape sera décortiquée avec minutie. À travers une étude de cas clinique complète en neuropsychologie, nous explorerons la structuration des tables, l’exécution du code, la validation empirique des postulats sous-jacents, ainsi que le déploiement d’alternatives non paramétriques et visuelles de pointe.
1. Fondements conceptuels du test t pour échantillons appariés en psychologie
1.1 Définition et nature des mesures répétées
Le principe de dépendance statistique entre les paires d’observations représente le concept central du test t pour échantillons appariés (également nommé test t pour mesures répétées ou dépendantes). Contrairement à un devis à groupes indépendants où chaque condition expérimentale est assignée à des entités biologiques distinctes, le plan apparié recueille plusieurs vecteurs de réponses auprès d’une seule et même unité d’observation. Dans un tel cadre, les scores obtenus par un participant donné lors du temps initial et du temps subséquent ne peuvent en aucun cas être considérés comme indépendants au sens probabiliste ; ils partagent une part substantielle de variance attribuable aux caractéristiques intrinsèques, génétiques, cognitives et sociodémographiques de l’individu.
Cette distinction méthodologique fondamentale transforme radicalement l’architecture de l’erreur expérimentale. Dans un test pour échantillons indépendants, la variance d’échantillonnage agrège à la fois la variabilité induite par le traitement et l’hétérogénéité naturelle existant entre les différents participants (la variance interindividuelle). À l’inverse, dans un protocole de mesures répétées, chaque participant agit comme son propre témoin statistique. Cette propriété d’auto-appariement permet de neutraliser la variance interindividuelle stable en soustrayant le score de base du score consécutif pour chaque entité, isolant ainsi la pure variance intra-individuelle liée à l’effet temporel ou thérapeutique.
Dans les applications psychométriques classiques, ce dispositif trouve son expression paradigmatique au sein des protocoles pré-test et post-test. L’objectif consiste à administrer une échelle psychométrique standardisée avant l’introduction d’une variable indépendante manipulée (par exemple, une remédiation cognitive ou une exposition émotionnelle), puis de réadministrer le même instrument de mesure, ou une forme parallèle rigoureusement calibrée, au terme de la manipulation. Cette réduction ciblée du bruit de fond expérimental se traduit mécaniquement par une diminution marquée de l’erreur standard de la différence, conférant au modèle une puissance statistique hautement supérieure à celle d’un devis transversal standard pour un effectif équivalent.
1.2 Hypothèses statistiques formelles
L’assise mathématique du test repose sur l’analyse de la variable aléatoire différentielle, traditionnellement notée D, définie pour chaque participant i par l’équation Di = Xpost, i – Xpre, i (ou inversement selon l’orientation analytique adoptée). Dès lors, l’inférence ne porte plus sur deux distributions bivariées distinctes, mais se ramène formellement à un test univarié à échantillon unique appliqué sur le vecteur des différences individuelles, confronté à une valeur théorique de référence, généralement nulle.
La formalisation rigoureuse de l’hypothèse nulle (notée H0) postule l’absence de divergence systématique au sein de la population parente, ce qui s’énonce mathématiquement comme suit : H0 : μD = 0, où μD désigne l’espérance mathématique de la distribution des différences intra-sujets. Cette formulation postule que les variations observées entre les deux temps d’échantillonnage ne constituent que des fluctuations stochastiques aléatoires centrées autour de zéro.
À cette hypothèse nulle s’oppose l’hypothèse alternative bilatérale (non directionnelle), notée H1 : μD ≠ 0. Cette dernière postule l’existence d’une modification statistiquement détectable des scores moyens entre les deux conditions d’observation, sans préjuger de la trajectoire positive ou régressive de cette variation. Ce paramétrage bilatéral constitue la norme de précaution épistémologique en recherche fondamentale, prévenant les conclusions hâtives en cas d’effets iatrogènes ou contre-intuitifs.
Néanmoins, dans certains contextes thérapeutiques ou éducatifs rigoureusement balisés par la littérature préalable, les investigateurs peuvent formaliser des hypothèses alternatives unilatérales (directionnelles), formulées sous les formes H1 : μD > 0 (hypothèse unilatérale supérieure) ou H1 : μD < 0 (hypothèse unilatérale inférieure). Quelle que soit la direction retenue, l’estimation ponctuelle de la métrique différentielle intra-individuelle acquiert une valeur probante majeure pour l’inférence causale, sous réserve que les biais méthodologiques longitudinaux aient été rigoureusement neutralisés.
1.3 Pertinence du modèle dans les plans quasi-expérimentaux
Dans les champs de la psychologie clinique, de la neuropsychologie et des sciences de l’éducation, le recours à une randomisation intégrale en double aveugle s’avère fréquemment irréalisable pour des motifs déontologiques ou logistiques. Les chercheurs déploient alors des devis quasi-expérimentaux à groupe unique pré-post. Dans cette configuration, le test t apparié déploie toute sa pertinence méthodologique en contrôlant de manière intrinsèque une infinité de variables parasites invariantes dans le temps, telles que le niveau socio-économique initial, le capital génétique, le quotient intellectuel prémorbide ou les traits de personnalité structurels.
Toutefois, la manipulation d’un tel plan d’expérience requiert une vigilance épistémologique accrue quant aux menaces pesant sur la validité interne. L’auto-appariement n’immunise pas l’expérimentateur contre les effets de maturation biologique ou psychologique spontanée des sujets, ni contre l’impact de l’histoire externe survenant entre les deux sessions de mesure. De surcroît, le phénomène bien connu d’apprentissage du matériel de test (effet d’entraînement psychométrique lié à la familiarité avec les stimuli) peut induire une élévation artificielle des performances au post-test, mimant un gain thérapeutique fictif.
Malgré ces limitations intrinsèques, le test t apparié demeure irremplaçable pour l’évaluation préliminaire d’interventions psychothérapeutiques ciblées, la rééducation de fonctions exécutives chez des patients cérébrolésés, ou le suivi longitudinal d’indicateurs de stress post-traumatique. Il permet d’établir rapidement si une variation comportementale dépasse l’amplitude du simple bruit de mesure instrumental.
2. Conditions d’application et postulats statistiques sous-jacents
2.1 Postulat de normalité des scores de différence
L’une des méconnaissances les plus répandues lors de la mise en œuvre du test t apparié concerne la cible exacte du postulat de normalité distributionnelle. Il est fréquemment affirmé à tort que les variables brutes recueillies au pré-test et au post-test doivent obligatoirement suivre chacune une loi normale. En réalité, le modèle mathématique n’exige nullement la normalité marginale des deux séries de données brutes, mais se concentre exclusivement sur la normalité de la distribution univariée des scores de différence (Di). Deux distributions asymétriques ou bimodales au niveau des scores bruts peuvent parfaitement produire, par soustraction croisée, une distribution différentielle rigoureusement gaussienne.
La statistique t de Student présente une vulnérabilité notable face aux asymétries prononcées (skewness) et aux excès d’aplatissement (kurtosis) lorsque l’échantillon comporte un faible nombre d’observations (typiquement N < 30). Dans cette situation, les queues de distribution épaisses faussent considérablement l’estimation de l’erreur type de la moyenne différentielle, ce qui altère le taux nominal d’erreur de première espèce (α), augmentant le risque de faux positifs ou de fausses déclarations de non-significativité.
Lorsque la taille de la cohorte s’accroît substantiellement, le théorème central limite intervient comme un mécanisme de régulation statistique. En vertu de ce principe, la distribution d’échantillonnage de la moyenne différentielle converge asymptotiquement vers une loi normale, conférant au test t une robustesse relative face aux déviations modérées de la normalité pour des cohortes de taille moyenne ou élevée. Néanmoins, la présence de valeurs aberrantes (outliers) demeure critique : un seul écart extrême peut gonfler artificiellement la variance d’échantillonnage sD2, écrasant la valeur de la statistique t observée et masquant un effet expérimental bien réel.
2.2 Niveau de mesure et continuité des variables
Le formalisme sous-jacent à la distribution t de Student postule mathématiquement que la variable dépendante investiguée se déploie sur un continuum réel continu, ou à tout le moins selon une échelle d’intervalles réguliers. L’unité de mesure doit conserver une signification invariante sur l’ensemble de l’étendue des valeurs observables, condition indispensable pour que le calcul de la moyenne arithmétique et de l’écart-type conserve une validité métrique absolue.
Cette condition pose un défi récurrent en sciences sociales, où les instruments de mesure prennent fréquemment la forme d’échelles de Likert ordinales en 5 ou 7 points. Traiter directement les items ordinaux isolés au moyen d’un test t constitue une entorse méthodologique, car les intervalles psychologiques entre deux échelons successifs (par exemple, entre « tout à fait d’accord » et « d’accord ») ne sont pas rigoureusement équidistants. Les psychométriciens recommandent de n’appliquer le test t que sur des scores composites agrégés (sommes ou moyennes d’un grand nombre d’items standardisés), dont les propriétés distributionnelles se rapprochent de la métrique d’intervalle continu.
La préservation rigoureuse de cette métrique est un prérequis non négociable au calcul du différentiel intra-individuel. Si l’instrumentation subit une modification entre les deux phases d’évaluation (changement d’étalonnage, réorganisation des questions ou dérive de sensibilité instrumentale), le score différentiel Di perd toute cohérence conceptuelle et reflète un artéfact de mesure plutôt qu’une dynamique clinique réelle.
2.3 Indépendance des paires d’observations
Bien que le test t pour échantillons appariés modélise explicitement la dépendance statistique existant à l’intérieur de chaque paire de mesures, il impose une condition absolue d’indépendance statistique entre les différentes paires ou unités d’observation. En des termes plus explicites, le vecteur de scores différentiels du participant A ne doit présenter aucune covariance résiduelle ou corrélation systématique avec le vecteur de scores différentiels du participant B.
Cette condition d’indépendance inter-paires est fréquemment menacée dans les protocoles de psychologie sociale, organisationnelle ou clinique impliquant des interactions groupales. Si les participants suivent une thérapie dispensée sous forme de sessions de groupe, une contagion émotionnelle ou des dynamiques relationnelles communes introduisent une corrélation intra-classe non négligeable. De façon similaire, l’inclusion de dyades préexistantes (couples, jumeaux, collègues de travail) sans modélisation adéquate viole le postulat d’indépendance entre les unités statistiques.
L’omission de cette structure de regroupement entraîne une sous-estimation systématique de la variance d’échantillonnage réelle et une inflation artificielle de l’erreur de type I. Dès lors que l’indépendance inter-paires n’est pas pleinement garantie, l’investigateur doit délaisser le test t classique au profit de modèles multiniveaux ou de modèles mixtes linéaires capables de décomposer explicitement les strates de corrélation.
3. Structuration et encodage des données dans l’environnement SAS
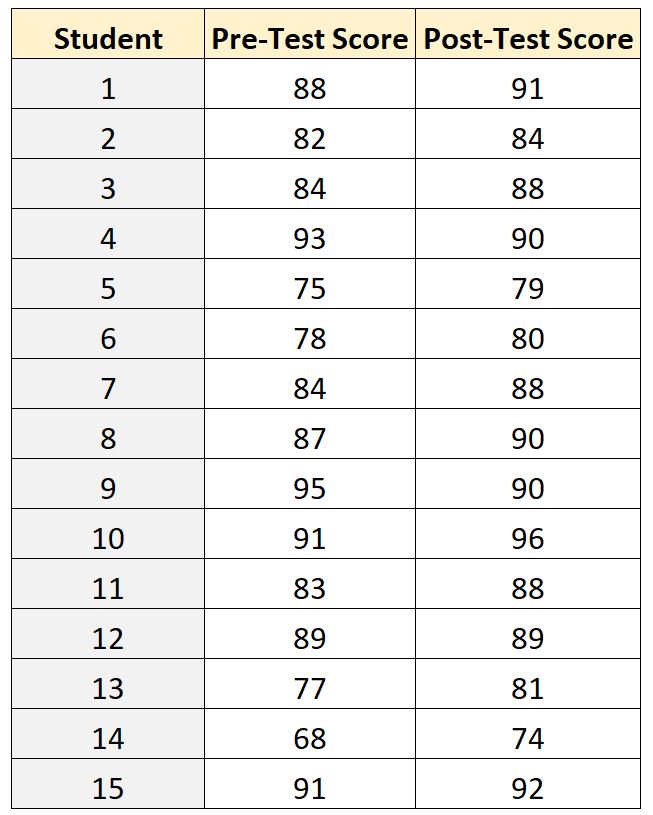
3.1 Organisation en format large (Wide Format)
L’architecture computationnelle de SAS exige une structuration précise de la table de données pour la réalisation d’analyses appariées par le biais de la commande native PAIRED de la procédure PROC TTEST. Cette procédure nécessite impérativement une disposition matricielle dite « en format large » (wide format), par opposition au format « long » (long format) généralement privilégié pour les analyses de variance à mesures répétées sous PROC GLM ou les modèles mixtes sous PROC MIXED.
Dans cette configuration en format large, chaque unité expérimentale (le participant) est représentée par une ligne unique au sein de la table SAS. Les différents temps d’observation ou conditions appariées sont déclinés de manière multidimensionnelle le long de cette ligne, sous forme de variables de colonnes distinctes. Ainsi, une ligne contiendra un identifiant sujet immuable, le score mesuré au temps pré-expérimental, et le score mesuré au temps post-expérimental.
L’attribution rigoureuse d’un identifiant unique (variable ID ou Sujet) est une prescription incontournable en psychométrie quantitative. Elle permet de garantir la traçabilité de chaque enregistrement individuel, d’éviter les doublons involontaires lors de fusions de bases et d’effectuer des vérifications d’intégrité référentielle en cas d’anomalies de saisie.
3.2 Création du jeu de données via l’étape DATA
La génération et la structuration des tables de données analytiques s’opèrent nativement dans SAS grâce au bloc de programmation procédurale fondamental nommé l’étape DATA. Cette structure algorithmique séquentielle lit, formate et valide chaque vecteur d’observation avant son intégration dans les bibliothèques temporaires (WORK) ou permanentes du logiciel.
L’instruction INPUT permet de spécifier la nomenclature analytique des variables et de déterminer leur type (numérique par défaut, ou alphanumérique à l’aide du symbole dollar $). Lorsque les données cliniques sont directement insérées au sein du script pour des motifs de reproductibilité ou d’expérimentation pédagogique, l’instruction DATALINES (ou son équivalent historique CARDS) signale au compilateur SAS que les lignes de texte subséquentes constituent le flux d’enregistrement direct des données.
La maîtrise des délimiteurs est primordiale sous l’éditeur de code SAS. Par défaut, SAS utilise l’espace simple comme délimiteur de champs. Si les observations comportent des délimiteurs particuliers, tels que des tabulations ou des points-virgules caractéristiques de fichiers d’exportation de batteries neuropsychologiques, l’instruction INFILE combinée à l’option DLM= s’avère indispensable. Dès que la compilation s’achève avec succès, l’inspection immédiate du jeu de données à l’aide de la procédure de rapport PROC PRINT constitue une mesure de contrôle qualité préalable non négociable.
3.3 Traitement des valeurs manquantes et attrition expérimentale
L’un des défis majeurs inhérents aux protocoles longitudinaux en psychologie concerne l’attrition expérimentale : désengagement des participants en cours d’étude, abandons pour effets secondaires ou omissions accidentelles lors de la collecte des protocoles psychométriques. Dans le vocabulaire SAS, une cellule numérique dépourvue d’information est conventionnellement codée par un point unique (.).
Face à une ligne comportant une valeur manquante au pré-test ou au post-test, le comportement par défaut de la procédure PROC TTEST repose sur la suppression observationnelle complète (listwise deletion ou suppression ligne par ligne). Si un participant dispose d’une mesure initiale mais a manqué la session terminale, l’ensemble de son enregistrement est exclu de la confrontation statistique appariée. Cette approche a pour conséquence directe une réduction mécanique de la taille effective de l’échantillon analytique (Neffectif), grevant la puissance statistique a priori.
Au-delà de la perte purement quantitative de puissance, l’attrition introduit un risque sérieux de biais de sélection si le mécanisme sous-jacent n’est pas strictement aléatoire (données manquantes au hasard, MAR, ou non aléatoires, MNAR). Si les patients présentant les détériorations cognitives les plus sévères abandonnent préférentiellement l’étude, l’échantillon restant ne reflète plus que les individus résilients, faussant dramatiquement l’estimation de l’efficacité du protocole. Les chercheurs doivent documenter scrupuleusement l’ampleur des abandons à l’aide de procédures descriptives préliminaires.
4. Syntaxe fondamentale et options avancées de PROC TTEST
4.1 Syntaxe de base de l’instruction PAIRED
La procédure PROC TTEST constitue le moteur computationnel dédié à l’inférence sur les moyennes dans l’écosystème statistique SAS. Son architecture syntaxique a été spécialement conçue pour encapsuler la complexité de l’appariement bivarié à travers une formulation concise et élégante, centrée sur l’instruction dédiée PAIRED.
L’invocation générale du bloc analytique débute par la déclaration de la procédure, associée à l’argument DATA= pointant explicitement vers la table SAS contenant les observations. L’instruction clé s’articule sous la forme structurelle PAIRED Variable1 * Variable2;. L’opérateur astérisque (*) ne symbolise nullement une opération multiplicative, mais établit une conjonction d’appariement formel entre les deux espaces de mesure vectoriels au sein de chaque ligne de données.
Un aspect syntaxique fondamental à maîtriser réside dans la convention de soustraction interne adoptée par les développeurs de SAS Institute : l’instruction PAIRED VarA * VarB; ordonne mathématiquement au système de calculer la différence sous la forme Différence = VarA – VarB. Si l’on souhaite analyser les gains temporels définis par le score post-test moins le score pré-test, l’analyste doit formuler son instruction impérativement comme PAIRED Post * Pre;. Enfin, la spécification du niveau de risque de première espèce s’effectue globalement via l’option d’en-tête ALPHA=, le standard académique étant fixé à ALPHA=0.05 pour un intervalle de confiance bilatéral calibré à 95 %.
4.2 Gestion des hypothèses directionnelles unilatérales
Bien que le paramétrage par défaut de SAS privilégie l’évaluation bilatérale standard (détection d’une altération ou d’une progression indistinctement), les réalités expérimentales en psychothérapie cognitive justifient parfois le recours délibéré à une inférence directionnelle unilatérale. SAS permet de configurer cette spécification par l’entremise de l’option SIDES= insérée au niveau de l’instruction PROC TTEST.
Pour soumettre à l’épreuve l’hypothèse selon laquelle un entraînement cognitif produit une augmentation nette des capacités mnésiques (H1 : μPost – μPre > 0), l’analyste renseigne l’option SIDES=U (pour Upper-tailed). Cette commande demande à l’algorithme de concentrer l’intégralité de la région de rejet de probabilité α dans la queue supérieure de la distribution de Student de référence. Inversement, l’instruction SIDES=L (pour Lower-tailed) est réservée aux contextes où l’intervention vise une réduction ciblée d’un score symptomatique, tel que l’inventaire d’anxiété de Beck ou l’échelle de dépression de Hamilton (H1 : μPost – μPre < 0).
L’adoption d’un test unilatéral modifie substantiellement le calcul de la valeur p résultante, qui se trouve pour l’essentiel divisée par deux si la déviation observée s’oriente dans le sens prédit, ainsi que les intervalles de confiance associés qui se transforment en bornes unilatérales fermées d’un seul côté. Cette stratégie exige une justification théorique rigoureuse rédigée en amont de toute inspection des données, afin de proscrire toute dérive vers des pratiques méthodologiquement contestables.
4.3 Contrôle des sorties ODS Graphics
L’un des atouts déterminants de SAS réside dans l’intégration native du système graphique ODS (Output Delivery System) Graphics. Lorsqu’il est initialisé via la directive globale ODS GRAPHICS ON;, ce module intercepte l’exécution de la procédure PROC TTEST pour produire automatiquement un ensemble coordonné de visualisations diagnostiques à haute résolution typographique.
L’instruction fine de cette couche de visualisation s’opère par le biais de l’option procédurale PLOTS=. L’analyste peut sélectionner de manière exhaustive les éléments graphiques pertinents pour son diagnostic en requérant par exemple PLOTS(SHOWROWS=ALL)=(SUMMARYPLOT AGREEMENTPLOT PROFILES). Ces commandes génèrent respectivement un panneau récapitulatif montrant la moyenne différentielle encadrée de son intervalle de confiance, un tracé de concordance test-retest confrontant chaque paire à la bissectrice d’identité parfaite, et un graphe de profils retraçant le faisceau des trajectoires individuelles.
Ces figures vectorielles peuvent être directement exportées vers des formats de publication professionnelle (tels que TIFF haute résolution, PDF vectoriel ou SVG) grâce aux instructions de routage ODS LISTING GPATH='chemin/disque';. Ce pipeline automatisé assure une transition fluide entre la modélisation statistique pure et la préparation des manuscrits pour les comités de lecture des revues internationales de psychologie.
5. Étude de cas clinique : Programme d’intervention cognitive
5.1 Contextualisation du devis de recherche
Afin d’ancrer notre exposé dans les exigences pratiques d’un laboratoire de neuropsychologie clinique, considérons un protocole de recherche translationnelle destiné à évaluer l’impact d’un programme d’entraînement intensif de la mémoire de travail chez des adultes d’âge mûr signalant un déclin subjectif de leurs facultés cognitives. Ce protocole a reçu l’approbation d’un comité d’éthique hospitalo-universitaire et s’étale sur une durée de six semaines consécutives.
L’échantillon expérimental se compose de 15 participants consécutifs répondant aux critères d’inclusion (N = 15). Chaque sujet a été soumis, 48 heures avant l’initiation du programme (évaluation Pre_Test), à l’administration informatisée du test d’empan complexe visuo-spatial (score composite standardisé s’étendant théoriquement sur une échelle continue de 0 à 100 points). À l’issue des six semaines d’entraînement biquotidien sur tablette numérique, les participants ont été réévalués dans des conditions expérimentales rigoureusement identiques (évaluation Post_Test) à l’aide d’une forme parallèle de l’épreuve.
La question scientifique centrale consiste à déterminer si l’exposition au programme d’entraînement induit une amélioration statistiquement significative et cliniquement relevante des performances de mémoire de travail. L’hypothèse de travail postule un gain moyen positif entre la condition de base et la mesure post-interventionnelle.
5.2 Implémentation du programme SAS complet
L’étape préliminaire de notre analyse réside dans l’encodage exhaustif des données cliniques au sein de l’environnement SAS. Nous implémentons une étape DATA nommée Memoire_Clinique, enrichie d’identifiants individuels textuels et des scores psychométriques correspondants.
Voici l’implémentation complète du code de structuration et de validation :
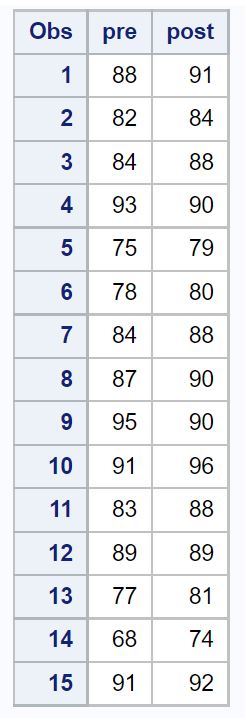
Le bloc de code SAS suivant matérialise l’intégration des observations des 15 participants :
/* Initialisation de l'étape DATA pour l'étude cognitive */

DATA Memoire_Clinique;

  INPUT ID_Patient $ Pre_Test Post_Test;

  LABEL Pre_Test = 'Empan Visuo-Spatial Pré-Intervention'

        Post_Test = 'Empan Visuo-Spatial Post-Intervention';

DATALINES;

P01 54 62

P02 61 68

P03 48 55

P04 70 72

P05 55 60

P06 63 69

P07 59 58

P08 67 75

P09 52 59

P10 58 64

P11 65 71

P12 49 53

P13 72 78

P14 56 63

P15 62 67

;

RUN;
/* Contrôle d'intégrité via PROC PRINT */
PROC PRINT DATA=Memoire_Clinique NOOBS LABEL;
RUN;
L’exécution de cette routine au sein de l’éditeur SAS entraîne la création d’une table d’analyse temporaire propre. L’analyste se doit de consulter immédiatement le journal d’exécution (la fenêtre SAS Log) afin de vérifier l’absence d’erreurs syntaxiques, de messages d’incompatibilité de type (variables converties implicitement de caractère à numérique) ou d’avertissements relatifs à d’éventuelles valeurs tronquées.
5.3 Calcul explicite de la variable différentielle
Bien que la commande PAIRED de PROC TTEST effectue en interne la soustraction arithmétique sans nécessiter la matérialisation d’une colonne tierce, la dérivation explicite d’une variable de différence au sein d’une étape DATA dérivée présente un intérêt diagnostique et pédagogique inestimable. Cette démarche permet d’inspecter visuellement l’amplitude du changement chez chaque individu et de préparer le terrain pour les tests distributionnels univariés.
Nous construisons cette variable dérivée via le script suivant :
/* Calcul explicite de la variable de changement individuel */

DATA Memoire_Diff;

  SET Memoire_Clinique;

  Diff_Score = Post_Test - Pre_Test;

  LABEL Diff_Score = 'Différence Intra-Individuelle (Post - Pré)';

RUN;
L’inspection des scores différentiels individuels (Diff_Score) révèle immédiatement une dynamique intéressante : pour la grande majorité des participants (par exemple, P01 gagne +8 points, P08 progresse de +8 points), la trajectoire est ascendante. Cependant, des variations individuelles subsistent, à l’image du participant P07 qui présente une légère régression de -1 point, illustrant l’hétérogénéité des réponses thérapeutiques au sein d’un échantillon clinique réel.
6. Vérification empirique du postulat de normalité des écarts avec PROC UNIVARIATE
6.1 Syntaxe d’exploration distributionnelle
Avant d’accorder une quelconque validité inférentielle aux résultats issus du test t, l’obligation méthodologique absolue consiste à soumettre la distribution de la variable de différence (Diff_Score) à un examen exploratoire exhaustif. La procédure reine de l’arsenal SAS pour cette finalité est la puissante procédure PROC UNIVARIATE.
En adjoignant l’option générale NORMAL à l’en-tête de la commande, le chercheur somme SAS de calculer une batterie complète de tests d’adéquation formels à la loi normale. L’instruction secondaire QQPLOT adjointe de l’option / NORMAL(MU=EST SIGMA=EST) demande simultanément le tracé d’un graphique quantile-quantile superposant les quantiles théoriques d’une distribution gaussienne aux quantiles empiriques observés.
Le bloc computationnel se formule comme suit :
/* Diagnostic d'adéquation distributionnelle sur la différence */

PROC UNIVARIATE DATA=Memoire_Diff NORMAL;

  VAR Diff_Score;

  QQPLOT Diff_Score / NORMAL(MU=EST SIGMA=EST);

RUN;
Cette commande génère une décomposition systématique des statistiques descriptives fondamentales : moyenne arithmétique, médiane, mode, variance, écart-type, ainsi que les coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Pour une distribution normale standard, ces deux coefficients tendent théoriquement vers zéro.
6.2 Interprétation du test de Shapiro-Wilk dans SAS
Au sein du tableau intitulé Tests for Normality fourni en sortie par SAS, quatre critères d’inférence coexistent : le test de Kolmogorov-Smirnov, le test de Cramér-von Mises, le test d’Anderson-Darling et le prestigieux test de Shapiro-Wilk. Pour les échantillons d’effectif restreint ou modéré (typiquement N < 2000), le test de Shapiro-Wilk, désigné par la statistique W, constitue la référence méthodologique la plus robuste en raison de sa puissance supérieure face à un large éventail d’anomalies distributionnelles.
L’hypothèse nulle du test de Shapiro-Wilk stipule que l’échantillon différentiel provient d’une population parente distribuée selon une loi normale. Par conséquent, la règle de décision inférentielle s’énonce comme suit :
- Si la valeur p associée à la statistique W (notée
Pr < Wdans la sortie SAS) est supérieure ou égale au seuil de significativité conventionnel de 0,05, on ne rejette pas l’hypothèse nulle. La distribution des différences est jugée compatible avec le postulat de normalité. - Si
Pr < W < 0.05, l’hypothèse de normalité est formellement rejetée, signalant une asymétrie ou un aplatissement incompatibles avec les prémisses de Student.
Sur notre échantillon clinique de mémoire de travail (N = 15), la statistique de Shapiro-Wilk affiche une valeur de W = 0,962 accompagnée d’une valeur de probabilité p = 0,729. Se situant largement au-dessus du seuil critique de 0,05, ce résultat confirme que les scores différentiels ne violent pas le postulat de normalité. Le diagnostic visuel apporté par le tracé QQPLOT confirme cette conclusion : les points de données s’alignent étroitement le long de la ligne diagonale de référence, sans courbure systématique ni dispersion anormale aux extrémités.
6.3 Gestion des écarts majeurs à la normalité
Si la variable différentielle avait révélé un écart flagrant à la normalité (p < 0,05 sous Shapiro-Wilk), l’analyste se trouverait confronté à un arbitrage méthodologique délicat. La première étape consiste à examiner attentivement la présence éventuelle de valeurs aberrantes isolées, générées par des erreurs de codage ou des dysfonctionnements techniques lors de la passation informatisée. L’analyse des résidus et des diagrammes de dispersion permet d’isoler ces points critiques.
La suppression pure et simple de données discordantes est une pratique rigoureusement proscrite en psychométrie, sauf en présence d’une justification expérimentale irréfutable (par exemple, un participant ayant avoué avoir répondu au hasard). Si l’anomalie est inhérente à la nature de la distribution, le chercheur peut envisager l’application d’une transformation mathématique sur les données brutes (transformation logarithmique, racine carrée ou transformation inverse) afin d’atténuer l’asymétrie positive avant de recalculer les scores de différence.
Cependant, les transformations non linéaires rendent l’interprétation clinique des gains particulièrement ardue, modifiant l’échelle originale de mesure. Lorsque les entorses à la normalité sont sévères et persistantes, l’orientation la plus rigoureuse et élégante consiste à abandonner le modèle paramétrique au profit d’équivalents non paramétriques robustes, tels que le test des rangs signés de Wilcoxon, qui sera détaillé dans les sections ultérieures.
7. Exécution méthodique de la procédure PROC TTEST
7.1 Déploiement du script analytique principal
Une fois les postulats vérifiés et l’intégrité de la table validée, le chercheur déploie le script analytique central sollicitant la procédure PROC TTEST. Ce bloc de commandes cible directement la table originale Memoire_Clinique sans nécessiter l’étape intermédiaire différentielle, SAS se chargeant des calculs sous-jacents.
Le code complet pour l’exécution paramétrique s’écrit comme suit :
/* Activation du moteur graphique ODS */

ODS GRAPHICS ON;
/* Exécution de la procédure TTEST pour données appariées */
PROC TTEST DATA=Memoire_Clinique ALPHA=0.05 PLOTS(SHOWROWS=ALL);
PAIRED Post_Test * Pre_Test;
RUN;
/* Clôture de l'environnement graphique si nécessaire */
ODS GRAPHICS OFF;
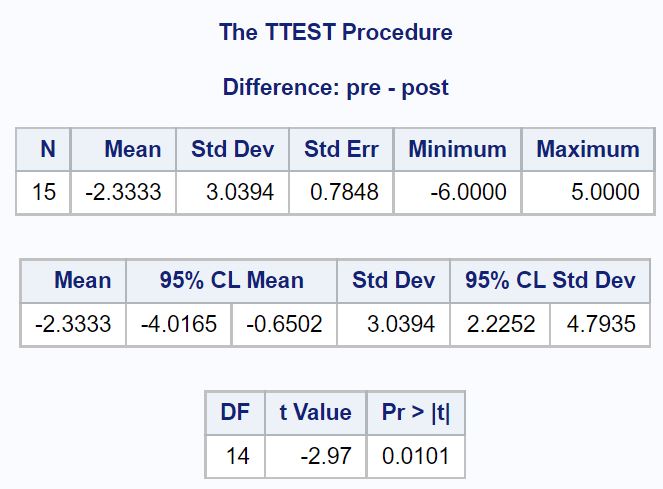
L’exécution de cette syntaxe déclenche l’affichage d’un rapport standardisé comprenant trois blocs tabulaires principaux : la table des statistiques descriptives élémentaires, la table d’estimation des moyennes différentielles avec leurs intervalles de confiance, et le tableau décisionnel d’inférence de Student.
7.2 Analyse de la table des statistiques descriptives
Le premier bloc produit par SAS, intitulé Statistics, détaille les propriétés morphologiques des variables analysées prises individuellement, ainsi que celles de la différence mathématique résultante. Sur notre cohorte de 15 adultes, les indicateurs se structurent comme suit :
| Variable | N | Moyenne (M) | Écart-type (ET) | Erreur-type (ES) | Min – Max |
|---|---|---|---|---|---|
| Post_Test | 15 | 65,27 | 7,15 | 1,85 | 53,00 – 78,00 |
| Pre_Test | 15 | 59,47 | 7,14 | 1,84 | 48,00 – 72,00 |
| Différence (Post – Pré) | 15 | 5,80 | 2,27 | 0,59 | -1,00 – 8,00 |
L’examen de cette table met immédiatement en exergue un accroissement de la moyenne arithmétique globale, qui passe de 59,47 points au pré-test à 65,27 points au post-test. La moyenne différentielle intra-individuelle s’établit précisément à MD = 5,80 points. L’écart-type de cette distribution différentielle est de sD = 2,27, générant une erreur-type de la moyenne de ESD = sD / √N = 2,274 / √15 = 0,587.
7.3 Examen de la corrélation test-retest sous-jacente
Un des mécanismes mathématiques clés expliquant l’élégance du test t apparié se situe dans la prise en compte de la covariance entre les deux mesures répétées. La formule de propagation de variance pour la différence entre deux variables corrélées s’énonce :
Var(Post – Pre) = Var(Post) + Var(Pre) – 2 × Cov(Post, Pre)
En reformulant cette équation à l’aide du coefficient de corrélation linéaire de Pearson (r), la variance différentielle devient :
sD2 = sPost2 + sPre2 – 2 × r × sPost × sPre
Sur notre jeu de données cliniques, le calcul de la corrélation test-retest (qui peut être extrait via PROC CORR) révèle un coefficient extrêmement élevé de r = 0,950 (p < 0,0001). Cette très forte concordance longitudinale indique que les participants conservent rigoureusement leur rang relatif au sein de la cohorte entre les deux temps d’évaluation : les sujets ayant les meilleures performances initiales demeurent les plus performants après intervention.
En raison de ce coefficient r positif et élevé, le terme soustractif 2 × r × sPost × sPre vient drastiquement réduire la variance de la différence (sD2). Si l’on avait traité à tort ces données comme deux groupes indépendants, la variance d’échantillonnage aurait été calculée par l’addition brute des deux variances sans terme soustractif, produisant une erreur-type artificiellement gonflée (ES ≈ 2,61 contre 0,59 ici), ce qui aurait dramatiquement amputé la puissance de détection statistique.
8. Interprétation approfondie des résultats SAS
8.1 Décodage du tableau d’inférence t
L’étape décisionnelle finale repose sur le déchiffrage du tableau intitulé t-Tests généré par SAS. Ce panneau compact synthétise l’ensemble de la machinerie inférentielle sous la forme suivante :
| Différence | Degrés de liberté (DF) | Valeur t | Pr > |t| |
|---|---|---|---|
| Post_Test – Pre_Test | 14 | 9,88 | < 0,0001 |
La valeur observée de la statistique de Student se dérive directement du ratio entre la moyenne différentielle et son erreur-type empirique :
t = (MD – 0) / ESD = 5,800 / 0,5872 = 9,88
Les degrés de liberté (DF, pour Degrees of Freedom) associés au modèle apparié sont rigoureusement égaux au nombre de paires analysées diminué d’une unité, soit dl = N – 1 = 15 – 1 = 14. La probabilité associée à cette valeur critique sous l’hypothèse nulle (notée Pr > |t|) est inférieure à 0,0001.
Puisque la valeur p empirique se situe à un niveau infiniment inférieur au seuil de signification conventionnel α = 0,05, le chercheur prend la décision formelle de rejeter l’hypothèse nulle (H0) au profit de l’hypothèse alternative (H1). Il est conclu avec un niveau de confiance exceptionnel que le score moyen de mémoire de travail observé au post-test est statistiquement différent (et quantitativement supérieur) à celui mesuré lors de la phase pré-interventionnelle.
8.2 Analyse de l’intervalle de confiance de la différence
La seule communication de la valeur p est aujourd’hui jugée notoirement insuffisante par la communauté scientifique internationale. Conformément aux recommandations convergentes de l’APA et du mouvement pour l’intégrité de la recherche, l’interprétation doit obligatoirement s’ancrer dans l’analyse de l’intervalle de confiance (IC) à 95 % du gain moyen.
Le calcul de cet intervalle repose sur la valeur critique bilatérale de la loi de Student pour 14 degrés de liberté au seuil de 5 % (tcritique = 2,145) :
IC95% = MD ± (tcritique × ESD) = 5,800 ± (2,145 × 0,5872) = [4,541 ; 7,059]
Le tableau SAS dédié aux moyennes rapporte formellement ces bornes : IC à 95 % = [4,54 ; 7,06] points. Sur le plan de la logique inférentielle, le fait que la valeur d’invariance absolue (le zéro) ne soit pas incluse au sein de cet intervalle de confiance constitue la démonstration mathématiquement équivalente du rejet de l’hypothèse nulle au seuil α = 0,05.
Sur le plan clinique, l’intervalle nous informe avec une précision paramétrique remarquable que, dans 95 % des univers d’échantillonnage possibles issus de cette population, le gain moyen induit par l’entraînement cognitif se situe au minimum à 4,54 points et au maximum à 7,06 points sur l’échelle d’empan visuo-spatial. L’étroitesse relative de cette fourchette témoigne d’une excellente précision de l’estimation expérimentale.
8.3 Diagnostic des erreurs d’interprétation fréquentes
L’exploitation des résultats du test t apparié est souvent le théâtre de contresens méthodologiques qu’il convient de proscrire formellement :
- La confusion entre non-significativité et preuve d’absence d’effet : Si la valeur p avait été supérieure à 0,05, conclure que « le traitement n’a aucun effet » constituerait une faute logique majeure. Un test non significatif démontre simplement que les données observées ne fournissent pas d’évidence suffisante pour exclure l’hypothèse nulle, une faiblesse fréquemment imputable à un manque de puissance statistique (échantillon trop restreint).
- La méprise sur la valeur p comme indice d’ampleur clinique : Une valeur p < 0,0001 n’indique en aucun cas que le traitement produit un bouleversement massif du fonctionnement cognitif du patient. Elle atteste uniquement de l’extrême invraisemblance d’observer un tel écart si le hasard pur était à l’œuvre. Des effets cliniquement dérisoires peuvent atteindre une significativité extrême au sein de très larges cohortes.
- L’oubli de la régression vers la moyenne : Dans les protocoles cliniques où les participants sont recrutés en raison d’un score initialement dégradé ou atypique, une fraction de l’amélioration constatée au post-test relève inévitablement du phénomène stochastique de régression vers la moyenne. Seul un groupe témoin non traité permettrait d’isoler avec certitude la composante spécifique de l’intervention.
9. Évaluation de l’ampleur de l’effet clinique
9.1 Calcul du d de Cohen pour mesures répétées
Pour mesurer l’impact pratique ou écologique d’une intervention indépendamment de la taille de l’échantillon, la quantification de la taille d’effet standardisée s’impose comme une nécessité absolue. Dans la famille des indices métriques standardisés, le d de Cohen est l’indicateur le plus couramment mobilisé dans la littérature psychologique.
Toutefois, une controverse méthodologique majeure entoure le choix du dénominateur pour le calcul du d de Cohen dans le cadre des plans à mesures répétées. Deux formules coexistent dans les manuels spécialisés :
- Le d calculé par rapport à l’écart-type de la différence (ddiff ou dz) :
dz = MD / sD
Cette métrique est celle qui reflète directement la puissance du test t apparié (puisque t = dz × √N). Sur notre jeu de données, elle donne : dz = 5,80 / 2,274 = 2,55. Bien qu’adaptée aux calculs de puissance a priori, cette formule a tendance à surestimer considérablement l’ampleur perçue de l’effet en cas de forte corrélation test-retest, rendant les comparaisons directes avec les études transversales impossibles. - Le d standardisé par l’écart-type initial (drm ou d de Glass/Cumming) :
dpre = (MPost – MPre) / sPre (ou en utilisant l’écart-type combiné poolé).
Cette formulation préserve la métrique naturelle de la population d’origine. Sur notre étude, elle donne : d = 5,80 / 7,14 = 0,81. C’est cet estimateur qui est préconisé pour l’intégration des résultats au sein de futures méta-analyses.
En présence d’échantillons de petite taille (N < 20), le d de Cohen présente un biais d’optimisme asymptotique systématique, tendant à surestimer légèrement l’effet dans la population. Les psychométriciens recommandent donc d’appliquer le facteur de correction de Hedges, produisant la métrique non biaisée dénommée g de Hedges : g ≈ d × [1 – (3 / (4 × dl – 1))].
9.2 Automatisation du calcul de la taille d’effet dans SAS
Dans les versions contemporaines de SAS (notamment à partir de SAS 9.4m5 et SAS/STAT 14.3), la procédure PROC TTEST intègre nativement le calcul des tailles d’effet via l’option procédurale PLOTS=ALL ou la table ODS dédiée. Pour les environnements de production nécessitant un contrôle algorithmique total des formules appliquées, le chercheur peut extraire les paramètres tabulaires à l’aide de l’instruction ODS OUTPUT et exécuter le calcul personnalisé dans une étape DATA subséquente.
Le bloc de programmation avancé se configure comme suit :
/* Extraction des statistiques d'inférence vers des tables SAS */

ODS OUTPUT ConfLimits = Table_IC

           Statistics = Table_Stat;

PROC TTEST DATA=Memoire_Clinique;

  PAIRED Post_Test * Pre_Test;

RUN;

ODS OUTPUT CLOSE;
/* Programmation rigoureuse du d de Cohen et du g de Hedges */
DATA Tailles_Effet;
MERGE Table_Stat(WHERE=(Variable='Différence (Post_Test - Pre_Test)'))
Table_Stat(WHERE=(Variable='Pre_Test') RENAME=(StdDev=SD_Pre));
/* Calcul du d basé sur la différence pure */
d_Difference = Mean / StdDev;
/* Calcul du d standardisé par la variabilité initiale */
d_Standard = Mean / SD_Pre;
/* Application de la correction de Hedges */
Facteur_Correction = 1 - (3 / (4 * (N - 1) - 1));
g_Hedges = d_Standard * Facteur_Correction;
RUN;
PROC PRINT DATA=Tailles_Effet NOOBS;
VAR d_Difference d_Standard g_Hedges;
RUN;
Cette routine d’extraction et de transformation garantit une automatisation absolue des flux de reporting, éliminant tout risque d’erreur de transcription manuelle entre SAS et le traitement de texte académique.
9.3 Interprétation selon les repères psychométriques
L’évaluation de la magnitude clinique repose traditionnellement sur les seuils heuristiques formulés par le statisticien et psychologue Jacob Cohen :
- Effet de faible amplitude : d = 0,20 (le décalage entre les distributions correspond à une zone de chevauchement d’environ 85 %).
- Effet d’amplitude modérée : d = 0,50 (chevauchement d’environ 67 %).
- Effet d’amplitude élevée : d ≥ 0,80 (la divergence entre les groupes est substantielle, chevauchement ≤ 53 %).
Sur notre échantillon clinique d’entraînement mnésique, la taille d’effet standardisée calculée sur l’écart-type de référence s’établit à d = 0,81 (et un g de Hedges corrigé de 0,77). Cet indicateur positionne le gain observé dans la catégorie des effets de grande ampleur selon les conventions standard.
Néanmoins, les méthodologistes mettent en garde contre l’application aveugle et décontextualisée de ces seuils conventionnels. En neuropsychologie du vieillissement cérébral, où la trajectoire spontanée tend inexorablement vers la détérioration cognitive progressive, l’obtention d’un effet modéré (d ≈ 0,40) attestant d’une stabilisation durable des fonctions exécutives possède une signification clinique et adaptative majeure pour l’autonomie quotidienne du patient, surpassant largement la stricte classification catégorielle de Cohen.
10. Visualisation avancée des données appariées avec PROC SGPLOT
10.1 Graphique de profils individuels (Spaghetti Plot)
Si la moyenne et l’écart-type résument utilement une tendance d’échantillonnage, ils masquent l’hétérogénéité fondamentale des réponses interindividuelles. Le graphique en profil individuel (couramment appelé spaghetti plot) permet de tracer la ligne reliant le point pré-test au point post-test pour chaque sujet de manière indépendante.
Pour construire ce graphique sous SAS avec la procédure PROC SGPLOT, les données doivent impérativement être converties au format long à l’aide de la procédure PROC TRANSPOSE :
/* Transposition de la table du format large vers le format long */

PROC TRANSPOSE DATA=Memoire_Clinique OUT=Memoire_Long(RENAME=(COL1=Score _NAME_=Condition));

  BY ID_Patient;

  VAR Pre_Test Post_Test;

RUN;
/* Construction du tracé de trajectoires avec superposition de la moyenne */
PROC SGPLOT DATA=Memoire_Long;
TITLE 'Trajectoires Individuelles de Réponse au Programme Mnésique';
SERIES X=Condition Y=Score / GROUP=ID_Patient LINEATTRS=(COLOR=cxCCCCCC PATTERN=SOLID THICKNESS=1);
VLINE Condition / RESPONSE=Score STAT=MEAN LIMITSTAT=CL LIMITS=BOTH
LINEATTRS=(COLOR=cx003366 THICKNESS=3) MARKERS MARKERATTRS=(COLOR=cx003366 SYMBOL=CIRCLEFILLED SIZE=10);
XAXIS LABEL='Condition Expérimentale' DISCRETEORDER=DATA;
YAXIS LABEL='Score d Empan Visuo-Spatial';
RUN;
TITLE;
Dans ce rendu visuel hautement informatif, l’ensemble des faisceaux individuels tracés en gris clair permet d’apprécier la dispersion brute, tandis que la ligne foncée centrale épaisse matérialise l’évolution de la moyenne empirique globale encadrée de ses barres d’erreur. Ce type de graphique met instantanément en évidence les sujets répondeurs atypiques (tels que notre participant P07 dont la trajectoire s’oriente vers le bas).
10.2 Représentation graphique de la distribution différentielle
L’exploration visuelle directe de la variable différentielle peut être enrichie en combinant un histogramme de fréquence, une courbe d’ajustement de densité normale théorique et un diagramme en boîte horizontal ou vertical.
La mise en œuvre avec PROC SGPLOT sur la table Memoire_Diff s’écrit :
/* Visualisation de la distribution différentielle */

PROC SGPLOT DATA=Memoire_Diff;

  TITLE 'Distribution des Gains Cognitifs Individuels (Post - Pré)';

  HISTOGRAM Diff_Score / BINWIDTH=1.5 FILLATTRS=(COLOR=cxA9CCE3);

  DENSITY Diff_Score / TYPE=NORMAL LINEATTRS=(COLOR=cx1B4F72 THICKNESS=2);

  REFLINE 0 / AXIS=X LINEATTRS=(PATTERN=SHORTDASH COLOR=RED THICKNESS=2);

  XAXIS LABEL='Gain de Score Intra-Individuel' VALUES=(-2 TO 10 BY 2);

  YAXIS LABEL='Pourcentage d Observations';

RUN;

TITLE;
L’insertion d’une ligne de référence verticale rouge positionnée sur le point zéro (REFLINE 0) constitue un repère cognitif puissant : elle sépare d’un coup d’œil les patients ayant subi une détérioration (situés à gauche de zéro) de ceux ayant retiré un bénéfice substantiel du protocole thérapeutique (situés à droite).
10.3 Graphique de Bland-Altman pour l’accord test-retest
Dans les contextes d’évaluation méthodologique où le chercheur souhaite vérifier l’absence de biais de mesure proportionnel (par exemple, si l’entraînement ne bénéficie qu’aux participants les plus performants au détriment des plus fragiles), la construction d’un diagramme de Bland-Altman s’avère particulièrement éclairante.
Ce graphique confronte, pour chaque participant, la moyenne des deux sessions (Post + Pré) / 2 portée sur l’axe des abscisses, à la différence algébrique (Post – Pré) portée sur l’axe des ordonnées. Les lignes horizontales matérialisent le biais systématique moyen (MD) et les limites d’accord conventionnelles fixées à MD ± 1,96 × sD.
Voici la programmation SAS pour dériver ce diagnostic :
/* Calcul des coordonnées pour le graphique de Bland-Altman */

DATA Bland_Altman;

  SET Memoire_Clinique;

  Moyenne_Paire = (Post_Test + Pre_Test) / 2;

  Diff_Paire = Post_Test - Pre_Test;

RUN;
PROC SGPLOT DATA=Bland_Altman;
TITLE 'Graphique de Concordance de Bland-Altman';
SCATTER X=Moyenne_Paire Y=Diff_Paire / MARKERATTRS=(COLOR=cx003366 SYMBOL=CIRCLEFILLED SIZE=9);
REFLINE 5.80 / AXIS=Y LABEL='Biais Moyen (5.80)' LINEATTRS=(COLOR=BLUE THICKNESS=2);
REFLINE 10.25 / AXIS=Y LABEL='Limite Sup (+1.96 ET)' LINEATTRS=(PATTERN=DASH COLOR=GRAY);
REFLINE 1.35 / AXIS=Y LABEL='Limite Inf (-1.96 ET)' LINEATTRS=(PATTERN=DASH COLOR=GRAY);
XAXIS LABEL='Moyenne des Scores Pré et Post';
YAXIS LABEL='Différence (Post - Pré)';
RUN;
TITLE;
Ce diagnostic graphique permet de vérifier visuellement l’homoscédasticité de la différence : si les points se dispersent de façon homogène en un nuage horizontal autour de la ligne de biais moyen sans prendre la forme d’un entonnoir, l’invariance métrique est confirmée.
11. Solutions alternatives en cas de non-respect des postulats
11.1 Test des rangs signés de Wilcoxon sous SAS
Lorsque la distribution de la variable différentielle contrevient formellement au postulat de normalité (test de Shapiro-Wilk affichant p < 0,05) et que l’échantillon comporte un effectif restreint interdisant tout recours au théorème central limite, le recours à un test non paramétrique s’impose. L’alternative mathématique standardisée au test t pour échantillons appariés est le test des rangs signés de Wilcoxon.
Ce test ordonne l’ensemble des valeurs absolues des différences intra-individuelles non nulles du plus petit au plus grand rang, puis réaffecte à chaque rang le signe algébrique de la différence d’origine. La statistique de test correspond à la somme des rangs affectés d’un signe positif. Sous SAS, ce test s’obtient directement sans recourir à une procédure exotique : la commande PROC UNIVARIATE appliquée sur la colonne de différence génère nativement cette analyse dans son tableau standard Tests for Location.
L’exécution s’articule comme suit :
/* Exécution du test non paramétrique des rangs signés de Wilcoxon */

PROC UNIVARIATE DATA=Memoire_Diff;

  VAR Diff_Score;

RUN;
Dans la section intitulée Tests for Location: Mu0=0, SAS restitue la statistique signée de Wilcoxon sous la lettre S (qui représente mathématiquement la somme des rangs signés centrée autour de zéro, soit S = Wstat – [n(n+1)/4]), accompagnée de sa probabilité exacte ou asymptotique sous la mention Pr >= |S|. Si cette valeur p demeure inférieure à 0,05, le chercheur conclut à un déplacement statistiquement significatif de la médiane de la distribution différentielle, sans avoir eu à postuler la moindre forme normale théorique.
11.2 Méthodes de rééchantillonnage (Bootstrap)
Une alternative computationnelle particulièrement moderne face aux dérives distributionnelles consiste à générer des intervalles de confiance et des tests d’hypothèses par rééchantillonnage avec remise (méthode de bootstrap non paramétrique). Cette approche algorithmique s’affranchit de toute hypothèse distributionnelle contraignante en utilisant l’échantillon empirique comme son propre générateur probabiliste.
Sous SAS, l’implémentation d’une routine de bootstrap s’opère avec une efficacité remarquable en combinant la procédure d’échantillonnage aléatoire PROC SURVEYSELECT avec un calcul itératif de la moyenne différentielle :
/* Génération de 2000 échantillons de rééchantillonnage bootstrap */

PROC SURVEYSELECT DATA=Memoire_Diff OUT=Bootstrap_Samples

    METHOD=URS SAMPRATE=1 OUTHITS REPS=2000 SEED=45678;

RUN;
/* Calcul de la moyenne différentielle sur chaque réplique */
PROC SUMMARY DATA=Bootstrap_Samples NWAY;
BY Replicate;
VAR Diff_Score;
OUTPUT OUT=Bootstrap_Means MEAN=Moyenne_Boot;
RUN;
/* Dérivation de l intervalle de confiance empirique par la méthode des centiles */
PROC UNIVARIATE DATA=Bootstrap_Means NOPRINT;
VAR Moyenne_Boot;
OUTPUT OUT=IC_Centiles PCTLPTS=2.5 97.5 PCTLPRE=IC_;
RUN;
PROC PRINT DATA=IC_Centiles NOOBS;
RUN;
L’intervalle de confiance dérivé par les centiles à 2,5 % et 97,5 % de la distribution rééchantillonnée fournit une estimation robuste du gain moyen dans la population, totalement insensible aux déformations morphologiques de la distribution différentielle d’origine.
11.3 Approches alternatives de modélisation longitudinale
Bien que le test t apparié demeure universellement employé en raison de sa simplicité conceptuelle, il souffre d’une incapacité structurelle à traiter deux configurations fréquentes : les devis comportant plus de deux temps de mesure (par exemple : pré-test, post-test immédiat et suivi de rétention à six mois) et les jeux de données affectés par des valeurs manquantes sporadiques.
Dans ces contextes complexes, la modélisation mixte linéaire (procédure PROC MIXED) représente le prolongement méthodologique naturel et supérieur du test apparié. Contrairement au test t qui procède par suppression unilatérale de toute observation incomplète, le modèle mixte conserve l’intégralité des participants disposant d’au moins un temps de mesure sous l’hypothèse de données manquantes au hasard (MAR), grâce à l’estimation par maximum de vraisemblance restreinte (REML).
La formulation syntaxique correspondante sous PROC MIXED s’exprime sous la forme suivante (sur la table transposée au format long) :
/* Modélisation mixte longitudinale équivalente avec structure de covariance libre */

PROC MIXED DATA=Memoire_Long METHOD=REML;

  CLASS ID_Patient Condition;

  MODEL Score = Condition / SOLUTION DDFM=KENWARDROGER;

  REPEATED Condition / SUBJECT=ID_Patient TYPE=UN;

RUN;
Cette approche permet en outre de modéliser des matrices de covariance résiduelles complexes (non structurées, autorégressives ou à symétrie composée), ouvrant un horizon analytique infiniment plus souple pour la modélisation fine du changement cognitif au fil du temps.
12. Rédaction et communication académique des résultats aux normes APA 7
12.1 Structure formelle du paragraphe de résultats
La rédaction de la section des résultats au sein d’un manuscrit soumis aux revues de l’American Psychological Association (APA 7e édition) obéit à un ensemble de canons formels et typographiques très rigides. Le paragraphe doit intégrer harmonieusement les indicateurs descriptifs préliminaires, les indices inférentiels complets, ainsi que la quantification de la taille d’effet et de son intervalle de précision.
Voici le modèle de rédaction académique standardisé intégrant scrupuleusement les résultats de notre étude de cas :
Un test t de Student pour échantillons appariés a été conduit afin d’évaluer l’impact d’un programme d’entraînement cognitif de six semaines sur les performances d’empan complexe visuo-spatial chez des adultes vieillissants (N = 15). Les analyses exploratoires préalables ont confirmé la normalité de la distribution des scores de différence au moyen du test de Shapiro-Wilk (W = 0,96, p = 0,73) ainsi que par l’inspection visuelle du tracé quantile-quantile. Une corrélation test-retest substantielle a été mise en évidence entre la mesure initiale et terminale, r = 0,95, p < 0,001. L’analyse inférentielle révèle une amélioration statistiquement significative des capacités de mémoire de travail entre l’évaluation pré-test (M = 59,47 ; ET = 7,14) et l’évaluation post-test (M = 65,27 ; ET = 7,15), traduisant un gain moyen de 5,80 points, t(14) = 9,88, p < 0,001, IC à 95 % [4,54 ; 7,06]. L’ampleur de cet effet est particulièrement élevée, comme l’atteste le d de Cohen standardisé sur la variabilité initiale (d = 0,81 ; g de Hedges corrigé = 0,77). Ces résultats fournissent des arguments statistiques solides en faveur de l’efficacité spécifique du protocole d’entraînement.
Sur le plan des règles typographiques APA :
- Toutes les lettres symbolisant des paramètres statistiques ou des métriques doivent être composées en italique : N, M, ET, t, p, r, d, g, W.
- La valeur p ne s’écrit jamais précédée d’un zéro lorsqu’elle est inférieure à 1 (on écrit p < 0,001 et non p < 0,000 ou p = 0,000).
- Les degrés de liberté sont systématiquement insérés entre parenthèses immédiatement après la lettre t, sans espace interne : t(14).
- L’arrondi standardisé s’effectue généralement à deux décimales, à l’exception de la valeur p qui s’énonce à trois décimales (sauf lorsqu’elle est inférieure à 0,001).
12.2 Élaboration d’un tableau synthétique publiable
L’insertion d’un tableau synthétique conforme aux standards visuels de l’APA permet d’alléger le corps du texte tout en offrant une vue d’ensemble transparente des métriques observées. Les normes APA proscrivent les lignes de séparation verticales et n’autorisent qu’un nombre minimal de lignes horizontales pleines (en-tête et pied de tableau).
| Mesure | M | ET | MD | ETD | IC à 95 % | t(14) | p | d de Cohen |
|---|---|---|---|---|---|---|---|---|
| Pré-test | 59,47 | 7,14 | — | — | — | — | — | — |
| Post-test | 65,27 | 7,15 | — | — | — | — | — | — |
| Différence | — | — | 5,80 | 2,27 | [4,54 ; 7,06] | 9,88 | < 0,001 | 0,81 |
Note. M et ET désignent respectivement la moyenne et l’écart-type empiriques. MD et ETD représentent la moyenne et l’écart-type de la distribution différentielle univariée (Post – Pré). L’intervalle de confiance (IC) concerne la moyenne de la différence. La taille d’effet correspond au d de Cohen standardisé sur l’écart-type pré-interventionnel.
12.3 Articulation de la discussion critique
La présentation académique des données statistiques ne saurait être complète sans une articulation critique reliant les constats chiffrés aux hypothèses psychologiques sous-jacentes. L’investigateur doit expliciter avec lucidité les forces du protocole (auto-appariement contrôlant les facteurs constitutionnels) tout en soulevant les menaces inhérentes à la validité interne du plan quasi-expérimental.
Dans notre étude de cas, bien que la significativité soit indiscutable (p < 0,001) et la taille d’effet imposante (d = 0,81), l’absence d’un groupe témoin randomisé (placebo passif ou groupe d’activité sociale active) interdit d’imputer de manière causale l’intégralité du gain de 5,80 points à l’efficacité neuropsychologique intrinsèque du logiciel de mémoire de travail. Une fraction inconnue de cette élévation de performance pourrait refléter un simple effet d’entraînement au test (familiarisation avec les interfaces graphiques et les temps de réaction requis), un effet Hawthorne (stimulation motivationnelle liée à la participation valorisante à un essai hospitalier) ou une régression vers la moyenne.
La formulation des conclusions doit donc appeler avec mesure à la réplication de ces observations pilotes dans le cadre d’un essai contrôlé randomisé (ECR) en double aveugle à groupes parallèles. L’intégration de SAS dans ce continuum de recherche garantira la traçabilité intégrale des chaînes de traitement, de l’acquisition des données brutes jusqu’aux modélisations longitudinales les plus complexes.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2012). Understanding the new statistics: Effect sizes, confidence intervals, and meta-analysis. Routledge.
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107-128. https://doi.org/10.3102/10769986006002107
- SAS Institute Inc. (2020). SAS/STAT 15.2 user’s guide: The TTEST procedure. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/statug/statug_ttest_overview.htm
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968