
Dans le domaine de l’analyse statistique moderne et de l’économétrie appliquée, l’exploration graphique préliminaire constitue le socle indispensable sur lequel repose toute entreprise de modélisation inférentielle rigoureuse. Face à l’accroissement exponentiel des volumes de données et à la complexification des structures relationnelles au sein des bases de données contemporaines, le chercheur ou l’analyste quantitatif ne peut se contenter d’indicateurs numériques agrégés tels que la moyenne, la variance ou la médiane. En effet, des ensembles d’observations aux propriétés univariées rigoureusement identiques peuvent masquer des architectures d’association fondamentalement divergentes, des bifurcations non linéaires ou des groupements hétérogènes que seuls des outils de visualisation bivariée hautement résolutifs permettent de mettre en lumière de manière immédiate et intuitive.
Au sein de l’écosystème logiciel SAS (Statistical Analysis System), reconnu mondialement pour sa robustesse algorithmique, sa conformité aux exigences réglementaires les plus strictes de la Food and Drug Administration (FDA) et sa puissance de calcul sur des volumétries massives, la représentation graphique bivariée a connu une mutation structurelle profonde. L’introduction du système d’affichage graphique ODS (Output Delivery System Graphics) et, plus particulièrement, de la procédure statistique intégrée PROC SGPLOT, a redéfini les standards de production visuelle en supplantant définitivement les modules historiques SAS/GRAPH. Cette transition technologique a permis d’allier une rigueur mathématique sans compromis à une flexibilité esthétique sans précédent, offrant aux statisticiens un contrôle typographique, chromatique et géométrique absolu sur leurs productions académiques.
Le présent traité méthodologique se propose de déconstruire, d’analyser et d’illustrer de façon exhaustive l’ensemble des mécanismes sous-jacents à la génération, la personnalisation et l’interprétation avancée des nuages de points sous SAS. À travers un jeu de données expérimental rigoureusement documenté modélisant les performances sportives de collectifs professionnels, nous explorerons pas à pas la syntaxe fondamentale de l’instruction SCATTER, la manipulation microscopique des attributs vectoriels des marqueurs, la stratification multidimensionnelle par groupes, ainsi que la superposition élégante d’estimateurs paramétriques et non paramétriques. Cette démarche méthodique permettra à tout chercheur d’élever ses livrables graphiques aux plus hauts standards de publication scientifique internationale, tout en garantissant une fidélité analytique irréprochable.
1. Introduction à la visualisation bivariée avec SAS
1.1 Importance du nuage de points en analyse quantitative
Le nuage de points, ou diagramme de dispersion cartésien, constitue le standard méthodologique par excellence pour scruter la relation empirique existant entre deux variables quantitatives continues. D’un point de vue épistémologique, l’affichage conjoint de deux dimensions numériques permet d’examiner la distribution spatiale simultanée des couples d’observations sans imposer d’emblée une forme fonctionnelle rigide issue d’un a priori théorique. Cette étape fondamentale de l’analyse exploratoire des données, conceptualisée historiquement par le statisticien John Tukey, autorise l’identification visuelle immédiate des associations linéaires positives ou négatives, mais également la mise en évidence d’effets de seuil, de courbures polynomiales, d’asymptotes ou de ruptures de continuité structurelles qu’un simple coefficient de corrélation linéaire de Pearson serait intrinsèquement incapable de capturer fidèlement.
Par ailleurs, le nuage de points joue un rôle sentinelle déterminant dans le diagnostic des valeurs aberrantes (dites outliers) et des observations à fort effet de levier. Au sein d’un échantillon multidimensionnel, une observation peut présenter des valeurs marginales tout à fait plausibles lorsqu’elle est examinée de façon univariée le long de chaque axe, tout en constituant une anomalie flagrante au sein de l’espace bivarié en raison de son éloignement drastique par rapport à la structure de covariance générale de la population. La détection précoce de ces configurations atypiques conditionne directement la validité des modélisations ultérieures, dans la mesure où les estimateurs des moindres carrés ordinaires (MCO) démontrent une vulnérabilité notoire face aux points extrêmes distaux, dont l’influence indue peut biaiser drastiquement les pentes de régression estimées.
Enfin, le nuage de points prépare le terrain conceptuel à l’inférence causale et à la modélisation statistique avancée. En confrontant directement la variable explicative postulée à la variable dépendante d’intérêt, l’expérimentateur évalue visuellement le respect de postulats fondamentaux tels que l’homoscédasticité — c’est-à-dire la constance de la variance des résidus sur l’ensemble de l’étendue des valeurs prédictives — ainsi que la normalité bivariée. Négliger cette étape exploratoire visuelle au profit d’un passage immédiat aux algorithmes d’estimation paramétrique expose le praticien au célèbre paradoxe d’Anscombe, où quatre distributions bivariées aux propriétés descriptives élémentaires identiques révèlent sous le regard du nuage de points des réalités phénoménologiques radicalement hétérogènes.
1.2 Le rôle central de la procédure SGPLOT dans SAS
Dans l’architecture logicielle de SAS, la procédure SGPLOT (pour Statistical Graphics Plot) incarne l’aboutissement d’une refonte paradigmatique majeure initiée avec le développement du moteur graphique ODS Graphics. Historiquement, la production de figures sous SAS dépendait du module SAS/GRAPH et de procédures telles que PROC GPLOT, lesquelles imposaient une syntaxe souvent lourde, tributaire d’instructions de bas niveau complexes (déclarations SYMBOL, AXIS et GOPTIONS) et déconnectées des structures de données relationnelles contemporaines. En outre, ces procédures ancestrales produisaient des représentations graphiques vectorielles matricielles dont la pixellisation et le rendu typographique peinaient à satisfaire les exigences esthétiques des revues scientifiques modernes à fort facteur d’impact.
La procédure SGPLOT émancipe le chercheur de ces contraintes archaïques en s’appuyant sur le langage sous-jacent GTL (Graph Template Language). Ce système compile des modèles graphiques dynamiques compilés de haute précision, capables de gérer automatiquement l’allocation spatiale, le calcul des espacements d’axes, l’évitement des collisions typographiques et la gestion intelligente des palettes chromatiques. Contrairement aux anciennes approches, SGPLOT intègre nativement la sémiologie graphique moderne théorisée par Jacques Bertin et Edward Tufte, maximisant de facto le ratio données-sur-encre tout en limitant la pollution visuelle inutile (le fameux chartjunk).
Au cœur de la procédure SGPLOT, l’instruction SCATTER se distingue par sa polyvalence fonctionnelle remarquable. Loin de se limiter à la simple projection de coordonnées cartésiennes sur une grille plane, cette instruction opère comme une primitive graphique hautement modulaire. Elle est capable d’interagir symbiotiquement avec des déclarations de regroupement catégoriel, de moduler dynamiquement la taille, la géométrie, l’opacité et l’étiquetage textuel de chaque observation, tout en conservant une vitesse de calcul optimale sur des tables de données comptant plusieurs millions de lignes. Cette combinaison unique de robustesse computationnelle et d’élégance déclarative confère à SGPLOT un statut incontournable dans l’arsenal de tout programmeur SAS chevronné.
1.3 Syntaxe générale et structure de base de l’instruction SCATTER
L’implémentation opérationnelle d’un graphique bivarié élémentaire sous SAS requiert la formulation d’un bloc procédural articulé autour de mots-clés normalisés. La structure générique minimale s’articule systématiquement autour de la déclaration d’ouverture PROC SGPLOT, complétée par l’option explicite DATA= qui désigne de manière univoque la table SAS source hébergée dans la bibliothèque de travail temporaire ou permanente. Cette spécification rigoureuse garantit que le compilateur associe les descripteurs de variables appropriés aux vecteurs numériques correspondants sans ambiguïté référentielle.
Au sein du bloc délimité par l’appel procédural et l’instruction finale de terminaison, l’instruction SCATTER est invoquée pour spécifier la topologie du nuage de points. Cette instruction exige au minimum deux arguments obligatoires : X=nom_variable_abscisse et Y=nom_variable_ordonnee. La convention épistémologique veut que l’argument X héberge la variable prédictive, indépendante ou exogène, tandis que l’argument Y accueille la variable réponse, dépendante ou endogène. Dès lors que cette affectation géométrique est établie, le moteur graphique se charge d’extraire la distribution numérique des colonnes désignées pour calibrer l’échelle du repère orthogonal.
L’étape procédurale est ensuite formalisée et soumise à l’interpréteur de commandes par l’instruction RUN;, conventionnellement suivie de l’instruction QUIT; dans les environnements interactifs pour libérer les contextes d’exécution résidents en mémoire vive. D’un point de vue de la syntaxe SAS canonique, la formulation prend la structure séquentielle suivante :
PROC SGPLOT DATA=nom_de_la_table;

    SCATTER X=variable_abscisse Y=variable_ordonnee;

RUN;
Cette économie de moyens syntaxiques n’altère en rien la puissance du mécanisme sous-jacent : en trois lignes d’instructions élémentaires, SAS mobilise des algorithmes de balayage de distribution, détermine les marges du canevas graphique, configure le maillage de fond et génère une sortie graphique directement vectorisable au sein du gestionnaire ODS actif.
2. Préparation et inspection du jeu de données expérimental
2.1 Définition du jeu de données de travail dans l’étape DATA
Afin d’ancrer nos développements théoriques dans une réalité empirique concrète et vérifiable, nous concevons un jeu de données expérimental issu du domaine de l’analytique sportive de haut niveau. Dans cet environnement d’étude, nous souhaitons évaluer la relation biomécanique et tactique existant entre le volume offensif déployé par des équipes professionnelles de basket-ball (mesuré par le nombre total de points inscrits au cours d’une rencontre) et leur efficacité défensive sous les panneaux (quantifiée par le nombre de rebonds captés). Ce contexte offre l’avantage de manipuler des grandeurs quantitatives continues ou discrètes à large étendue, couplées à un facteur d’identification qualitatif.
Pour instancier cette table au sein de l’environnement d’exécution SAS, nous utilisons l’étape fondamentale DATA. Cette étape met en œuvre l’instruction INPUT qui définit la séquence de lecture des colonnes et la nature typologique des variables : la variable nominale team, assortie du suffixe textuel dollar ($) pour signaler son statut de chaîne de caractères alphanumérique, suivie des deux variables quantitatives numériques directes points et rebounds. Les observations sont ensuite injectées manuellement au sein du flux séquentiel via l’instruction d’insertion directe DATALINES;, garantissant l’autonomie et la reproductibilité immédiate du code sans dépendance à l’égard de fichiers externes.
Voici la déclaration scripturale complète de notre table expérimentale, baptisée basketball_data :
DATA basketball_data;

    INPUT team $ points rebounds;

    DATALINES;

A 12 8

A 15 10

A 18 11

A 22 13

A 24 14

A 25 15

A 28 17

A 30 18

B 10 5

B 14 7

B 16 7

B 19 9

B 21 10

B 23 11

B 26 12

B 29 13

;

RUN;
Cette formulation permet d’alimenter la mémoire de travail SAS avec seize observations bivariées distinctes, partitionnées à parité exacte entre deux collectifs distincts (l’équipe A et l’équipe B), fournissant un substrat idéal pour tester tant des analyses bivariées simples que des stratifications multidimensionnelles complexes.
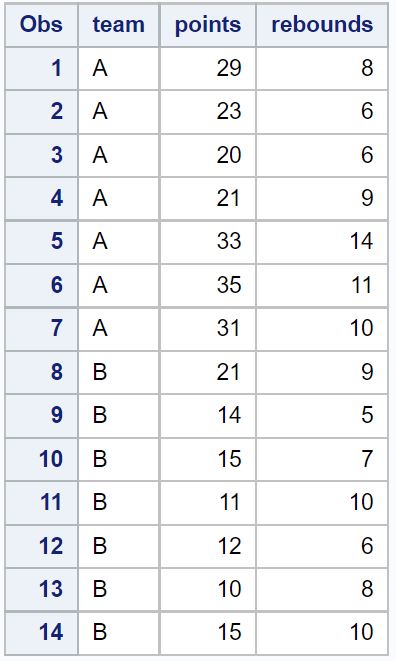
2.2 Validation et contrôle d’intégrité via PROC PRINT
En conformité absolue avec les standards de la recherche quantitative et de l’ingénierie des données, aucune procédure de modélisation ou de rendu visuel ne devrait être exécutée sans une vérification préalable scrupuleuse de la structure de la table SAS compilée. Des anomalies de saisie, des décalages d’alignement dans le flux DATALINES ou des troncatures involontaires de chaînes de caractères peuvent altérer insidieusement la distribution des variables et conduire à des artéfacts d’interprétation visuelle désastreux.
Pour opérer cet audit d’intégrité préliminaire, le statisticien fait appel à la procédure standardisée PROC PRINT. En adjoignant l’option d’étiquetage formel LABEL ou en restreignant le flux d’affichage si nécessaire, cette procédure restitue en console la transcription textuelle exacte du descripteur de table et des observations en mémoire. La syntaxe canonique de contrôle s’établit comme suit :
PROC PRINT DATA=basketball_data NOOBS;

RUN;
L’argument NOOBS est délibérément inséré pour supprimer la colonne incrémentale d’indexation numérique propre à SAS, allégeant ainsi le journal de sortie et focalisant l’attention de l’analyste sur la stricte matrice des variables d’intérêt. L’inspection méticuleuse du rapport textuel confirme que les variables points et rebounds ne contiennent aucune valeur manquante non déclarée (représentée conventionnellement par un point . dans les colonnes numériques SAS) et que chaque observation est rigoureusement associée à son étiquette d’équipe A ou B.
2.3 Implications statistiques de la distribution des variables
L’examen analytique des propriétés intrinsèques de notre table d’échantillon met en exergue des distributions numériques dont l’étendue et la granularité doivent dicter les choix de paramétrage graphique. Concernant la variable points, l’amplitude s’étend d’une valeur minimale de 10 unités à un sommet de 30 unités, dessinant un spectre de variation continue de 20 points. Quant à la dimension rebounds, les mesures oscillent entre 5 et 18 prises, soit une étendue de 13 unités. Ces grandeurs, bien que relevant du dénombrement discret, présentent une dispersion suffisante pour être traitées conceptuellement comme des variables continues dans le cadre d’un repère orthonormé.
Le ratio d’échelle entre les deux axes avoisine un rapport de un pour deux : l’axe des abscisses s’étendra sur une plage globale d’environ trente unités tandis que l’axe vertical couvrira une amplitude de l’ordre de vingt unités. Cette asymétrie d’échelle intrinsèque constitue un paramètre critique : si les échelles ne sont pas calibrées avec discernement, l’observateur visuel peut être victime d’une distorsion cognitive de la pente perçue, amplifiant artificiellement l’intensité de la corrélation apparente.
De surcroît, le partitionnement binaire de la variable team pose les jalons d’une exploration comparée féconde. Il conviendra d’observer si les couples de coordonnées (points, rebounds) occupent des zones homothétiques du plan euclidien ou si des phénomènes de ségrégation spatiale émergent entre les deux formations, traduisant des signatures tactiques distinctes qui nécessiteront une différenciation graphique explicite.
3. Méthode 1 : Création d’un nuage de points simple
3.1 Implémentation pas à pas de la syntaxe minimale
La génération d’une représentation bivariée brute dans SAS repose sur une application directe des principes exposés précédemment. Dès lors que la table de données basketball_data est instanciée et validée au sein de la bibliothèque de session WORK, la procédure PROC SGPLOT peut être sollicitée sans artifice complexe. Le programmeur rédige alors l’instruction minimale en déclarant sans ambiguïté les assignations vectorielles requises pour les axes cartésiens.
Le script SAS permettant de générer cette première ébauche graphique s’énonce selon la formulation suivante :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds;

RUN;
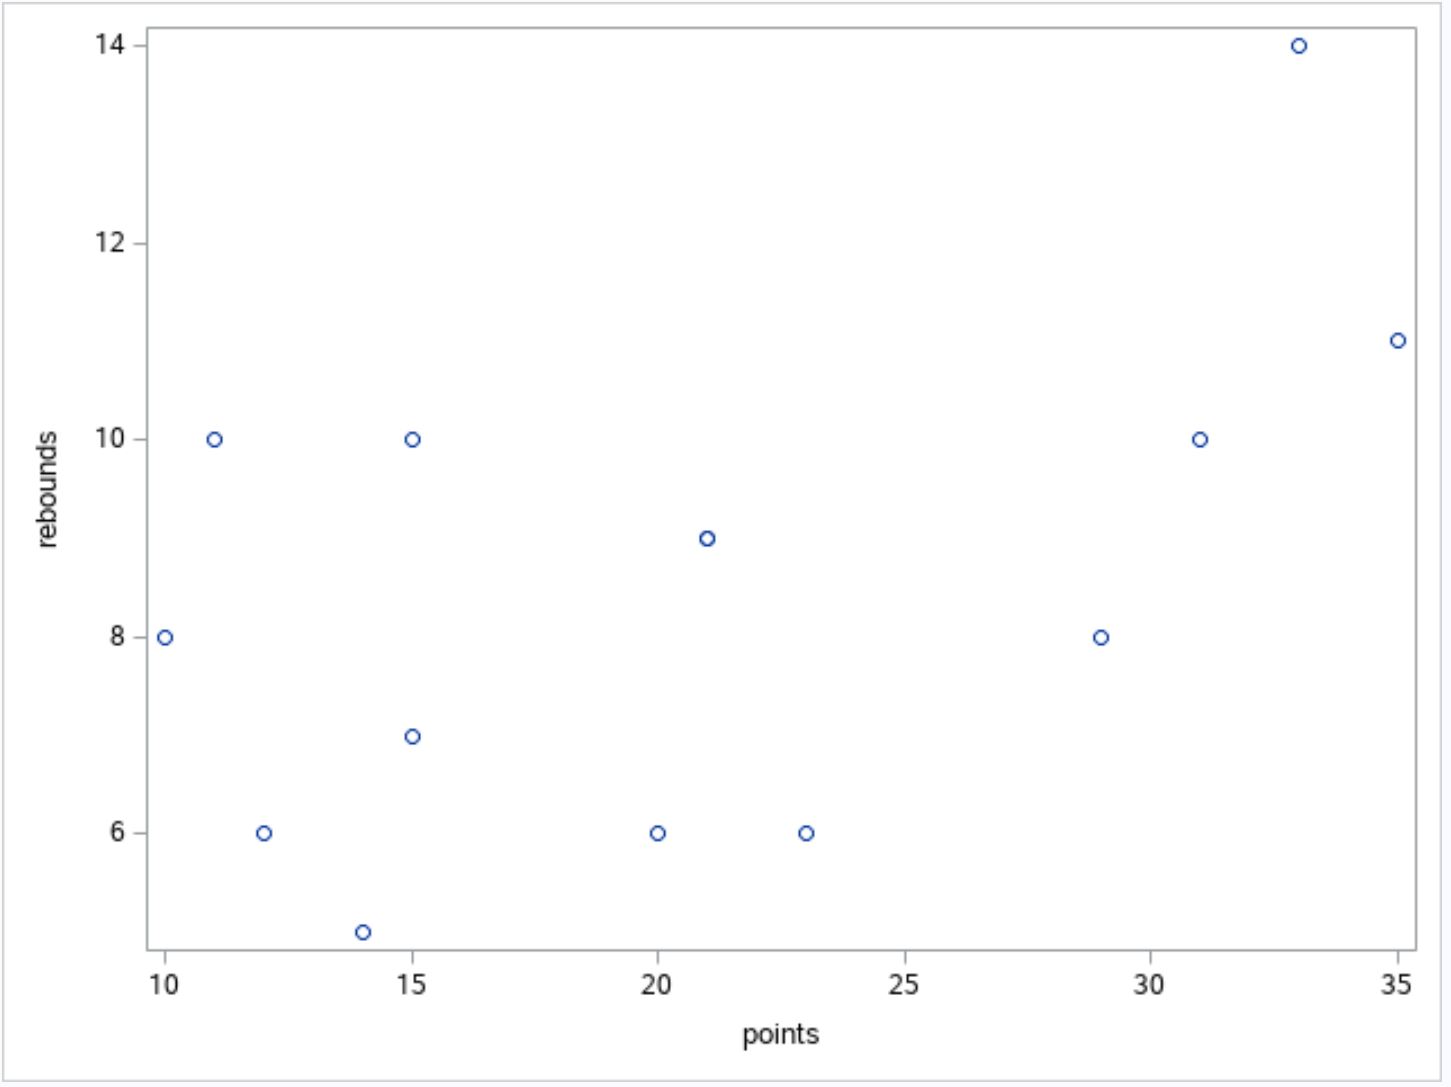
Lors de la soumission de ce bloc au compilateur, le sous-système ODS Graphics intercepte les flux de données, initialise un environnement graphique vectoriel temporaire en mémoire vive, et calcule les métriques d’affichage géométrique. L’instruction SCATTER commande alors le tracé de cercles discrets non remplis ou légèrement teintés à l’intersection exacte des coordonnées projetées pour chacune des seize observations. Le résultat est instantanément encapsulé dans la destination ODS courante (qu’il s’agisse de la fenêtre interactive de résultats SAS, d’une page HTML5 ou d’un canevas de prévisualisation ODS Graphics Designer).
3.2 Analyse de la disposition des axes cartésiens
L’observation attentive du rendu produit par défaut par PROC SGPLOT met en lumière la sophistication algorithmique du moteur de rendu d’axes de SAS. Par défaut, le compilateur ne contraint pas l’origine des axes à coïncider avec la valeur zéro absolue si cela devait entraîner une concentration artificielle des points dans le quadrant supérieur droit de l’image. Au contraire, le logiciel applique un algorithme de fenêtrage automatique qui encadre étroitement l’étendue empirique des données tout en conservant une marge périphérique esthétique (le data offset), évitant ainsi que les marqueurs extrêmes ne viennent heurter la bordure externe du graphique.
Sur l’axe horizontal des abscisses (X), assigné à la variable explicative points, SAS échelonne des graduations majeures régulières réparties par pas de cinq unités, couvrant généralement l’intervalle allant de 10 à 30 points. Sur l’axe vertical des ordonnées (Y), alloué à la variable réponse rebounds, l’échelle automatique adopte un pas de deux ou de cinq unités pour englober la trajectoire de 5 à 20 rebonds. Les libellés d’axes adoptent automatiquement le nom brut des colonnes de la table en l’absence d’étiquettes formellement déclarées via l’instruction LABEL.
Ce partitionnement automatique garantit une lisibilité immédiate, mais impose une vigilance quant à l’interprétation des distances relatives. En étirant l’axe pour maximiser le remplissage de la zone de traçage, SAS optimise l’utilisation de l’espace visuel disponible, mais soustrait la perspective du point zéro absolu, ce qui empêche une évaluation immédiate des proportions relatives sans un regard attentif porté aux graduations numériques de référence.
3.3 Lecture analytique de la configuration des points
D’un point de vue strictement analytique et interprétatif, ce nuage de points élémentaire dévoile immédiatement une structure relationnelle marquée. Les seize marqueurs ne se distribuent pas de manière aléatoire ou uniforme sur la surface du plan cartésien : ils s’alignent le long d’un couloir diagonal ascendant orienté du coin inférieur gauche vers le coin supérieur droit. Cette topologie constitue la signature visuelle incontestable d’une association bivariée positive et substantielle entre le nombre de points marqués et le volume de rebonds engrangés.
Cette configuration suggère qu’à mesure que l’intensité offensive d’une équipe s’accroît, son rendement aux rebonds progresse de concert. La dispersion orthogonale autour de la trajectoire médiane apparaît relativement contenue et constante sur l’ensemble de l’étendue observée, ce qui tend à corroborer l’hypothèse sous-jacente d’une corrélation linéaire robuste couplée à une absence flagrante d’hétéroscédasticité manifeste. Aucune anomalie d’éloignement extrême ne vient perturber la cohésion d’ensemble de la trajectoire empirique observée.
Toutefois, cette configuration graphique standard montre rapidement ses limites dans un contexte de publication professionnelle ou académique rigoureuse. L’absence de titres contextualisés, la rusticité des libellés d’axes réduits aux noms techniques des variables du modèle de données, l’impossibilité de distinguer visuellement l’équipe A de l’équipe B, ainsi que la pâleur relative des marqueurs standards exigent une prise en main avancée des options esthétiques et typographiques offertes par PROC SGPLOT.
4. Personnalisation graphique et esthétique des marqueurs
4.1 Modification des attributs des marqueurs via MARKERATTRS
L’ajustement géométrique et chromatique des éléments discrets constitue le premier levier de raffinement visuel. Par défaut, SAS applique la palette institutionnelle associée au style ODS actif (bien souvent le style HTMLBlue), lequel privilégie de discrets cercles évidés ou partiellement teintés de bleu céruléen. Bien que séduisante pour un affichage sur écran d’ordinateur, cette configuration s’avère souvent inadaptée à l’impression monochrome ou aux critères de contraste stricts imposés par les comités de rédaction des revues scientifiques de premier rang.
L’option MARKERATTRS=, insérée immédiatement après la barre oblique (/) qui sépare les arguments structurels des options de personnalisation dans l’instruction SCATTER, confère au développeur un contrôle chirurgical sur les propriétés morphologiques des symboles. Cette option accepte une liste imbriquée de sous-arguments encadrés par des parenthèses, permettant de paramétrer simultanément le symbole géométrique (SYMBOL=), la taille métrique du point (SIZE=) et sa teinte colorimétrique (COLOR=).
Considérons l’implémentation suivante, conçue pour densifier l’impact visuel des observations :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds /

        MARKERATTRS=(SYMBOL=CircleFilled SIZE=11px COLOR=DarkBlue);

RUN;
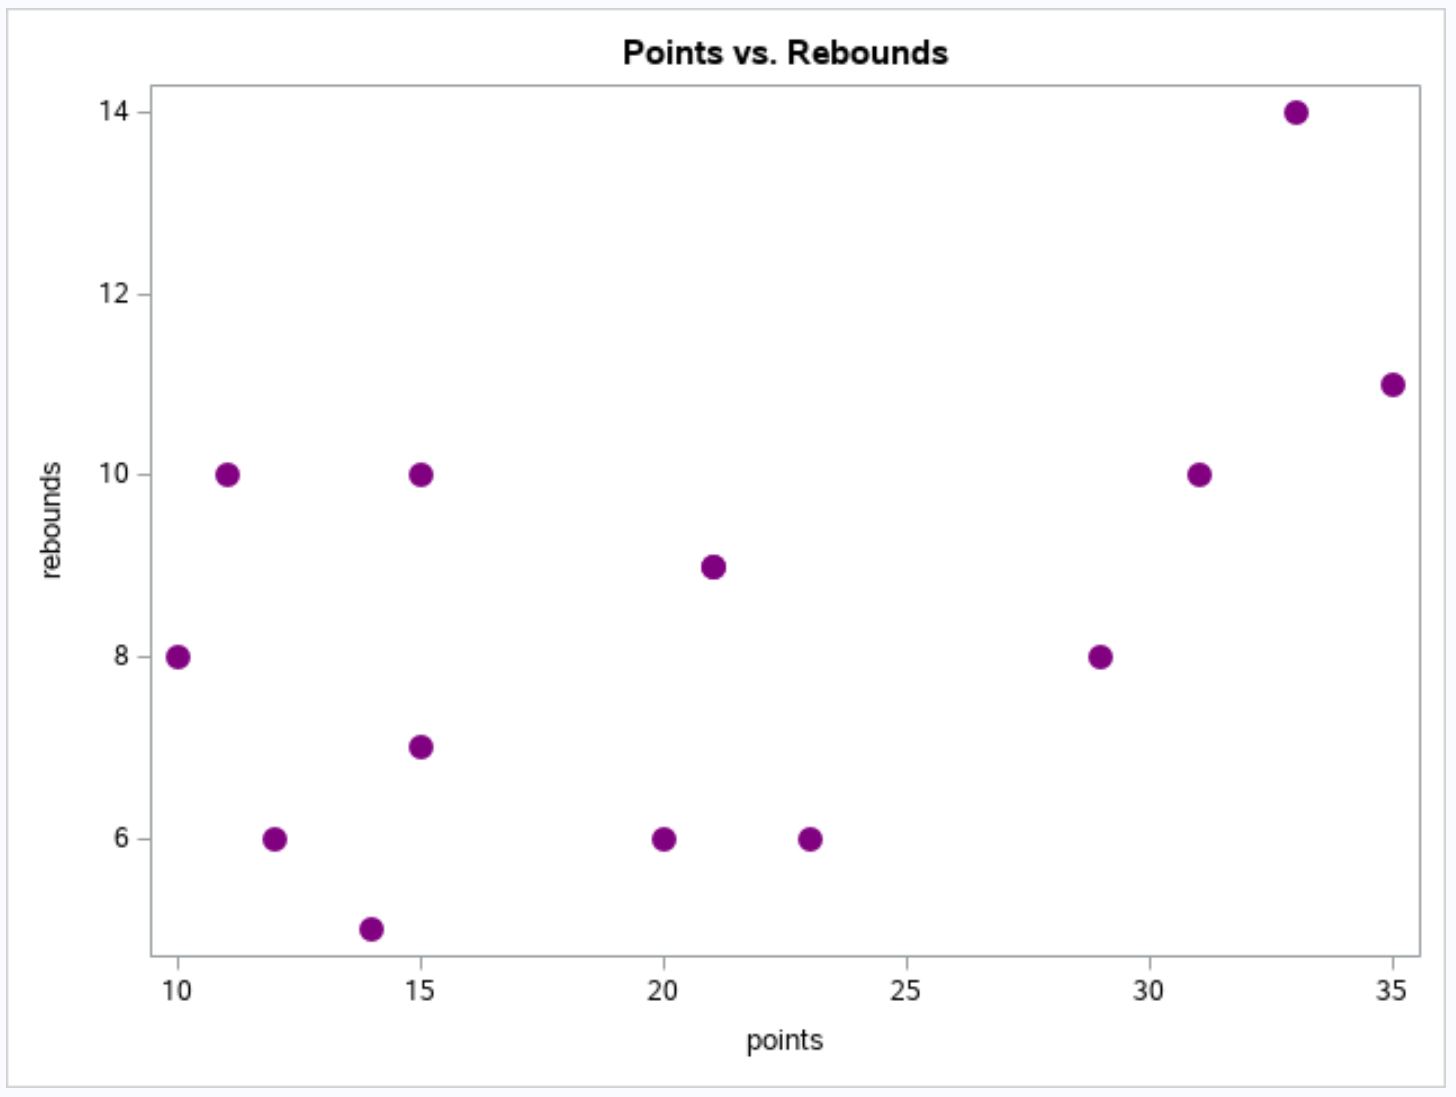
Dans cet extrait de code, la primitive SYMBOL=CircleFilled substitue un disque plein au contour évidé initial, garantissant une empreinte optique plus dense. L’argument SIZE=11px étalonne précisément le diamètre du marqueur sur onze pixels, évitant ainsi que les points ne se noient dans l’arrière-plan maillé. Enfin, la sélection chromatique COLOR=DarkBlue remplace la nuance pastel par un bleu profond à haut contraste, conforme aux exigences de lisibilité visuelle préconisées par la sémiologie graphique contemporaine.
4.2 Gestion de la transparence pour contrer le chevauchement
L’un des défis majeurs inhérents à la représentation des données quantitatives volumineuses ou à forte densité réside dans le phénomène de surreprésentation visuelle, plus communément désigné sous le terme anglo-saxon d’overplotting. Lorsque plusieurs observations partagent des coordonnées identiques ou extrêmement proches, leurs marqueurs géométriques respectifs se superposent exactement au même emplacement cartésien. Dans une représentation totalement opaque, l’observateur est incapable de déterminer visuellement si un point isolé traduit une occurrence unitaire ou la condensation de plusieurs dizaines d’individus statistiques distincts, ce qui biaise gravement l’appréciation intuitive de la masse de probabilité conjointe.
Pour neutraliser ce biais perceptif sans recourir à des algorithmes de décalage aléatoire (dits de jittering) qui altèrent la précision géométrique des coordonnées réelles, PROC SGPLOT propose l’option de canal alpha TRANSPARENCY=. Cette option reçoit un coefficient flottant compris strictement entre 0 (opacité intégrale, valeur par défaut) et 1 (transparence totale, rendant les marqueurs totalement invisibles). En paramétrant une valeur intermédiaire, par exemple TRANSPARENCY=0.4 ou 0.6, chaque marqueur transmet une fraction de la luminance du plan sous-jacent.
Lorsque deux ou plusieurs marqueurs semi-transparents se superposent sur le canevas, leurs densités chromatiques respectives se cumulent selon les règles de la synthèse soustractive des couleurs. Il en résulte un assombrissement spontané et proportionnel des zones géographiques du nuage concentrant une forte densité de points. Cette technique offre au statisticien un mécanisme passif extrêmement élégant pour visualiser instantanément la topologie des modes bivariés au sein de son échantillon d’étude.
4.3 Ajout d’étiquettes individuelles sur les points
Dans certaines configurations expérimentales impliquant des cohortes restreintes, des études de cas cliniques ou des analyses d’unités macroéconomiques (telles que des États souverains ou des conglomérats industriels), il est capital de préserver l’identité univoque de chaque point d’observation directement sur le tracé graphique. L’instruction SCATTER répond à cette exigence par l’intermédiaire de l’option DATALABEL=.
Cette option reçoit en paramètre le nom de la variable dont le contenu textuel doit être projeté à proximité immédiate de chaque marqueur. Dans le cadre de notre table basketball_data, il est possible d’annoter chaque point par son appartenance à l’équipe via DATALABEL=team, ou d’exploiter une colonne d’indexation pour référencer le numéro chronologique de la rencontre observée. De concert avec DATALABEL, l’option DATALABELATTRS= permet de formater avec une grande rigueur la police, la graisse, la taille en points typographiques et la couleur du libellé pour éviter toute agression visuelle.
Il importe toutefois de manier l’annotation textuelle avec une extrême modération ergonomique. Dès lors que l’échantillon excède quelques dizaines d’unités, la prolifération des étiquettes engendre inéluctablement des collisions de texte et un encombrement typographique préjudiciable à la clarté d’ensemble. Si SAS intègre des routines internes de déplacement automatique des étiquettes pour limiter les superpositions de texte, la surcharge cognitive guette dès que la densité des observations croît au-delà d’un seuil critique.
5. Structuration formelle : titres, sous-titres et notes documentaires
5.1 Insertion et hiérarchisation des titres avec TITLE
Un graphique statistique dépourvu d’une armature documentaire rigoureuse s’expose à de multiples contresens interprétatifs. La transmission claire d’un message analytique exige une hiérarchisation textuelle explicite, matérialisée par des énoncés de titrage sans équivoque. Dans l’environnement de programmation SAS, la gestion des en-têtes graphiques s’opère par l’intermédiaire de déclarations globales TITLE, lesquelles viennent chapeauter les sorties générées par la procédure graphique sous-jacente.
Le système SAS offre la possibilité de superposer jusqu’à dix niveaux de titres hiérarchisés numérotés de TITLE1 à TITLE10. L’instruction TITLE1 formule conventionnellement la problématique de recherche ou l’objet analytique central de la figure, tandis que l’instruction TITLE2 affine le contexte empirique en précisant la sous-population examinée, la période temporelle couverte ou les restrictions d’échantillonnage appliquées. Une attention méthodologique scrupuleuse doit être portée à la réinitialisation de ces instructions : une instruction TITLE; vierge soumise sans argument a pour effet d’effacer immédiatement tous les titres précédemment définis, empêchant ainsi la propagation inopportune de libellés contextuels obsolètes sur les procédures subséquentes de la chaîne de traitement.
La formulation suivante illustre la mise en œuvre d’un titrage hiérarchique adapté à notre étude empirique :
TITLE1 "Analyse Bivariée de la Performance Sportive";

TITLE2 "Corrélation entre Volume de Points et Rendement aux Rebonds";

PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds /

        MARKERATTRS=(SYMBOL=DiamondFilled SIZE=9px COLOR=Crimson);

RUN;

TITLE;
Ce bloc garantit que l’artefact graphique produit arbore un en-tête parfaitement explicite, guidant instantanément la cognition du lecteur avant même qu’il n’aborde l’analyse géométrique du plan cartésien.
5.2 Documentation méthodologique à l’aide de FOOTNOTE
Complément indissociable du titrage supérieur, la documentation inférieure assure la traçabilité scientifique et la reproductibilité institutionnelle des résultats présentés. L’instruction globale FOOTNOTE (déclinable de FOOTNOTE1 à FOOTNOTE10) permet d’ancrer au pied de la figure l’ensemble des métadonnées indispensables à l’évaluation critique de l’analyse bivariée. Cela englobe la source primaire des données, la volumétrie totale de l’échantillon analysé (le traditionnel N méthodologique), les règles de gestion des éventuelles valeurs manquantes ou encore la mention des conventions statistiques appliquées.
Dans un contexte de publication conforme aux exigences éditoriales académiques, les bas de page graphiques accueillent également les seuils d’inférence critique, les précisions d’unités de mesure physiques non explicites sur les axes cartésiens, ou les avertissements relatifs aux transformations logarithmiques préalables. À l’instar des titres, l’émission d’une commande FOOTNOTE; isolée sans assignation textuelle purge l’environnement d’exécution des déclarations antérieures, évitant ainsi toute pollution croisée entre différents blocs analytiques d’un même rapport de recherche.
L’intégration harmonieuse d’une note de bas de page s’illustre comme suit :
FOOTNOTE1 J=L "Source : Ligue Professionnelle, Saison Régulière (N = 16).";

FOOTNOTE2 J=L "Note : Données agrégées par match pour les formations A et B.";

PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds;

RUN;

FOOTNOTE;
L’argument syntaxique J=L (pour Justify Left) force l’alignement typographique à gauche sur la marge du graphique, respectant ainsi scrupuleusement les canons de mise en page préconisés par les manuels de style statistique internationaux.
5.3 Uniformisation typographique et mise en page
L’excellence d’un graphique scientifique se mesure également à son uniformité stylistique globale. Une figure présentant une cacophonie de polices de caractères, des graisses incohérentes ou des contrastes mal dosés entre les titres, les axes et les étiquettes nuit gravement à la crédibilité institutionnelle du travail présenté. SAS permet d’harmoniser l’ensemble de ces composantes textuelles en assignant des attributs typographiques unifiés au sein même des instructions procédurales ou via la configuration des feuilles de style ODS sous-jacentes.
Au sein des instructions de titrage et d’annotation, des modificateurs inline permettent de contraindre la famille de police (comme l’indémodable Arial, Helvetica ou Times New Roman), la taille exprimée en points (HEIGHT=12pt), ainsi que la graisse typographique (BOLD, ITALIC). Cette rigueur formelle permet de préserver l’alignement du graphique avec la charte graphique de la publication ou du consortium de recherche au sein duquel s’insère le document final.
La rationalisation de la mise en page passe également par le contrôle de l’espacement vertical et périphérique. En réduisant les marges mortes et en calibrant rigoureusement la taille des polices de manière proportionnelle à l’emprise physique de l’image (définie dans les options d’exportation ODS), le chercheur s’assure que son nuage de points conservera une lisibilité parfaite tant lors de sa projection sur un écran de conférence que lors de son impression sur une colonne étroite d’un périodique imprimé.
6. Configuration avancée des axes cartésiens (XAXIS et YAXIS)
6.1 Personnalisation des libellés et des unités de mesure
L’un des écueils les plus récurrents dans la production graphique consiste à abandonner par défaut les noms informatiques des variables sur les axes cartésiens. Des chaînes abrégées, condensées ou écrites en majuscules (telles que PTS_TOT ou REB_DEF) trahissent un travail inachevé et obligent le lecteur à un effort de décodage cognitif superflu. La procédure PROC SGPLOT offre à cet égard deux instructions de contrôle dédiées d’une richesse remarquable : XAXIS pour l’axe horizontal et YAXIS pour l’axe vertical.
L’option LABEL=, déclarée au sein de ces instructions axiales, permet de substituer instantanément une formulation formelle, exhaustive et élégante aux identifiants bruts des colonnes. Il est impératif d’intégrer systématiquement au sein de cette étiquette l’unité de mesure exacte entre parenthèses, formalisant sans équivoque la grandeur physique ou économique représentée. Parallèlement, l’option LABELATTRS= autorise la spécification fine des paramètres typographiques de l’étiquette (taille, police, couleur), assurant ainsi une hiérarchisation visuelle limpide entre le libellé de l’axe et les valeurs des graduations numériques qui le ponctuent.
L’implémentation opérationnelle de ces raffinements s’articule comme suit :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds /

        MARKERATTRS=(SYMBOL=CircleFilled SIZE=9px COLOR=SteelBlue);

    XAXIS LABEL="Volume Offensif (Points Marqués)"

          LABELATTRS=(FAMILY="Arial" SIZE=10pt WEIGHT=BOLD);

    YAXIS LABEL="Efficacité Défensive (Nombre Total de Rebonds)"

          LABELATTRS=(FAMILY="Arial" SIZE=10pt WEIGHT=BOLD);

RUN;
Ce niveau de précision textuelle élimine toute ambiguïté sémantique et confère à la figure une autonomie interprétative totale, condition sine qua non de son inclusion au sein d’un article évalué par les pairs.
6.2 Gestion des échelles, des limites et des pas d’incrémentation
L’étalonnage mathématique des axes constitue un enjeu analytique majeur. Bien que les routines d’ajustement automatique de SAS soient généralement fiables, certaines configurations exigent une standardisation manuelle rigoureuse des bornes cartésiennes. C’est particulièrement le cas lorsque l’on souhaite comparer plusieurs graphiques juxtaposés ou garantir que l’emprise visuelle couvre l’intégralité du champ théorique de variation d’un phénomène.
L’option VALUES=, intégrable indifféremment dans les déclarations XAXIS et YAXIS, permet de définir explicitement la séquence exacte des graduations majeures qui structureront l’axe cartésien. La syntaxe accepte la notation séquentielle condensée de SAS, prenant la forme borne_inferieure TO borne_superieure BY pas_incrementation. Par ailleurs, les options complémentaires MIN= et MAX= permettent de borner l’axe sans nécessairement forcer l’affichage de chaque graduation intermédiaire.
Examinons ce calibrage millimétré à travers la syntaxe suivante :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds /

        MARKERATTRS=(SYMBOL=CircleFilled SIZE=9px COLOR=Navy);

    XAXIS VALUES=(5 TO 35 BY 5) GRID;

    YAXIS VALUES=(0 TO 20 BY 2) GRID;

RUN;
Dans cet exemple, l’adjonction de l’option logique GRID commande le traçage discret d’un quadrillage orthogonal en arrière-plan, synchronisé avec les pas majeurs spécifiés. Ce maillage subtil facilite la projection visuelle des points vers leurs repères numériques respectifs, réduisant substantiellement la charge cognitive requise pour extraire la valeur quantitative précise d’une observation spécifique.
6.3 Ajout de lignes de référence avec l’instruction REFLINE
L’analyse bivariée gagne considérablement en profondeur lorsqu’elle confronte la distribution empirique des données à des repères statistiques cardinaux, tels que la moyenne arithmétique de l’échantillon, la médiane robuste ou un seuil d’intervention réglementaire prédéfini. L’instruction complémentaire REFLINE permet de projeter ces lignes d’étalonnage avec une flexibilité totale directement sur le plan de dispersion de PROC SGPLOT.
L’instruction REFLINE peut être orientée indifféremment sur l’axe horizontal ou vertical via son premier argument numérique ou vectoriel, complété par l’option d’assignation axiale / AXIS=X ou / AXIS=Y. Il est également possible de personnaliser intégralement le style de tracé de ces droites afin de ne pas saturer le plan graphique : l’option LINEATTRS= autorise le choix de motifs en pointillés ou tiretés (PATTERN=ShortDash), d’une épaisseur allégée (THICKNESS=1px) et de nuances chromatiques atténuées.
Illustrons cette contextualisation statistique par l’intégration des valeurs moyennes de notre échantillon :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds /

        MARKERATTRS=(SYMBOL=CircleFilled SIZE=9px COLOR=MidnightBlue);

    REFLINE 21.0 / AXIS=X LINEATTRS=(PATTERN=Dash COLOR=DarkGray THICKNESS=1px)

                  LABEL="Moyenne Points (21.0)" LABELPOS=TOP;

    REFLINE 11.75 / AXIS=Y LINEATTRS=(PATTERN=Dash COLOR=DarkGray THICKNESS=1px)

                   LABEL="Moyenne Rebonds (11.75)" LABELPOS=RIGHT;

    XAXIS GRID;

    YAXIS GRID;

RUN;
Cette double ligne de référence partitionne immédiatement le plan cartésien en quatre quadrants distincts, permettant de classer visuellement chaque équipe selon qu’elle surperforme ou sous-performe la moyenne générale du collectif simultanément sur les deux dimensions stratégiques évaluées.
7. Méthode 2 : Nuage de points stratifié par groupe
7.1 Mise en œuvre de l’option GROUP
L’un des apports majeurs de l’analyse bivariée moderne réside dans sa capacité à intégrer une troisième dimension d’information de nature catégorielle au sein d’une projection cartésienne plane à deux dimensions continues. Ce partitionnement, ou stratification, permet d’éviter l’écueil classique de l’agrégation aveugle des données, où des dynamiques de sous-groupes opposées s’annulent mutuellement lorsqu’elles sont amalgamées au sein d’un nuage de points unique. Dans PROC SGPLOT, cette fonctionnalité est accessible de manière directe via l’option structurelle GROUP=.
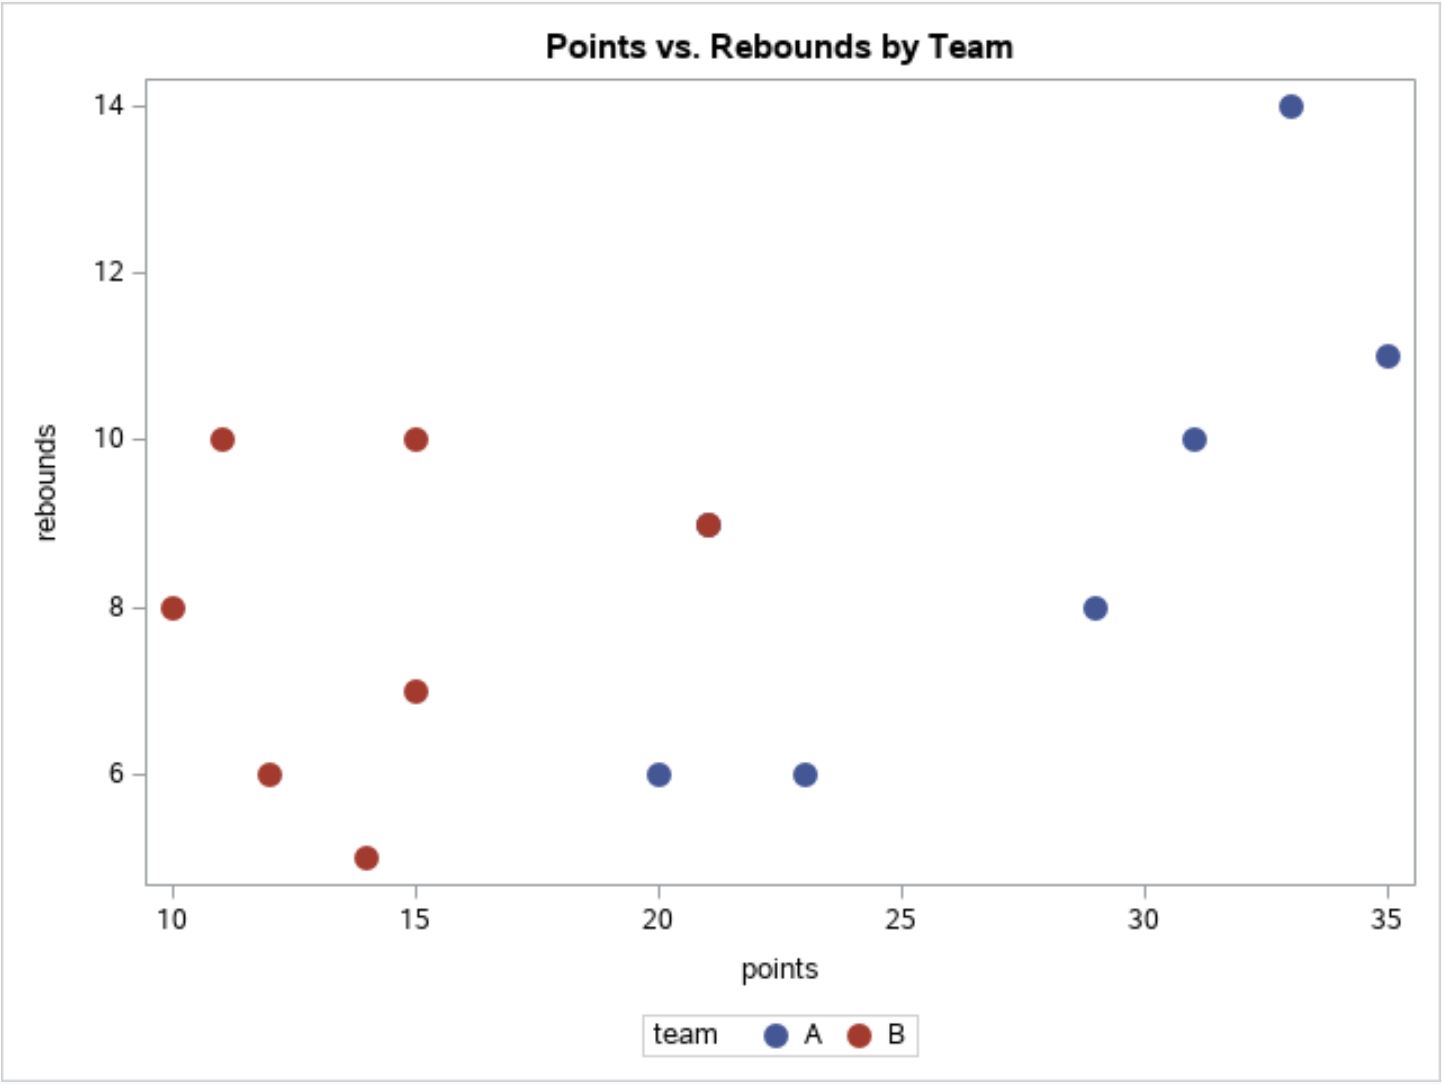
L’activation de l’option GROUP=nom_variable_categorielle au sein de l’instruction SCATTER enclenche un traitement algorithmique différencié. SAS segmente le flux d’observations selon les modalités uniques de la variable nominale désignée (dans notre cas d’espèce, la variable team, comportant les modalités exclusives A et B). De manière totalement autonome, le système assigne à chaque strate un vecteur d’attributs graphiques exclusif combinant une teinte colorimétrique singulière et un symbole morphologique distinct, tout en générant automatiquement une légende explicative sur le bord du canevas.
La mise en œuvre canonique de ce partitionnement se matérialise comme suit :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds / GROUP=team;

    XAXIS LABEL="Points Inscrits" GRID;

    YAXIS LABEL="Rebonds Captés" GRID;

RUN;
En une seule instruction déclarative, la figure passe d’un nuage indifférencié à une représentation stratifiée haute résolution, rendant visible la structure interne de l’échantillon sans requérir d’étapes de programmation préparatoires lourdes ou de découpages artificiels de la table mère.
7.2 Interprétation des divergences intergroupes
L’analyse visuelle du graphique stratifié produit par ce code révèle des enseignements substantiels qu’un nuage unifié masquait totalement. Bien que les deux formations sportives affichent une dynamique interne ascendante positive (la corrélation positive entre points et rebonds se vérifiant au sein de chacune des deux équipes), la trajectoire de l’équipe A se positionne systématiquement au-dessus de celle de l’équipe B sur la quasi-totalité de l’étendue des abscisses.
Cette séparation spatiale nette met en évidence ce que l’économétrie et l’épidémiologie modélisent sous la forme d’un effet de modération catégorielle ou d’un décalage d’ordonnée à l’origine (effet niveau). Pour un même volume offensif donné — par exemple autour de 20 à 25 points marqués —, l’équipe A maintient une production de rebonds significativement supérieure à celle de l’équipe B d’environ 3 à 5 prises par rencontre. Cette divergence met en évidence une efficacité sous les panneaux structurellement supérieure pour l’équipe A, indépendamment de son rendement offensif immédiat.
Sur le plan méthodologique, cette stratification visuelle préserve le chercheur du risque majeur d’écologie trompeuse ou de régression fallacieuse : elle prouve sans ambiguïté que l’association observée n’est pas le simple produit d’une hétérogénéité d’échantillonnage dissimulée, mais qu’elle opère de manière différentielle au sein de chaque strate sous-jacente.
7.3 Personnalisation des styles de groupes avec STYLEATTRS
Si la gestion automatisée des couleurs par l’option GROUP= s’avère remarquable d’efficacité pour des explorations itératives rapides, elle présente l’inconvénient d’assujettir le rendu aux conventions arbitraires de la feuille de style active de SAS. Or, dans le cadre d’un rapport corporate ou d’une soumission à une revue académique internationale, le chercheur doit se conformer à des directives chromatiques strictes, incluant la compatibilité avec l’impression en niveaux de gris et l’accessibilité pour les personnes affectées de dyschromatopsies (comme le daltonisme).
L’instruction STYLEATTRS comble ce besoin en permettant de surcharger explicitement les palettes par défaut de la procédure graphique sans avoir à redéfinir un modèle de style ODS global par PROC TEMPLATE. Placée en amont des instructions de traçage au sein de PROC SGPLOT, elle permet de déclarer des listes ordonnées de teintes via l’option DATACOLORS=, ainsi que des séries ordonnées de symboles géométriques via l’option DATASYMBOLS=.
L’exemple suivant démontre l’application d’une palette contrastée accessible et de symboles différenciés :
PROC SGPLOT DATA=basketball_data;

    STYLEATTRS DATACOLORS=(SteelBlue Firebrick)

               DATASYMBOLS=(CircleFilled TriangleFilled);

    SCATTER X=points Y=rebounds / GROUP=team MARKERATTRS=(SIZE=10px);

    XAXIS GRID;

    YAXIS GRID;

RUN;
Dans ce scénario rigoureusement paramétré, la première modalité de la variable team (l’équipe A) se verra systématiquement assigner la teinte SteelBlue couplée au symbole géométrique d’un disque plein, tandis que la seconde modalité (l’équipe B) sera matérialisée par la couleur Firebrick et la forme d’un triangle plein. Cette double redondance sémiotique (couleur plus forme) garantit une lisibilité parfaite même en cas de reproduction monochrome sur papier journal ou de dégradation de la restitution chromatique.
8. Gestion et personnalisation experte de la légende
8.1 Positionnement stratégique avec KEYLEGEND
L’introduction d’un partitionnement par groupe dans un nuage de points déclenche la génération systématique d’une légende explicative, localisée par défaut au bas du canevas de traçage. Si cet agencement est fonctionnel, il a pour inconvénient de comprimer la dimension verticale du plan cartésien. L’instruction KEYLEGEND offre une latitude de configuration exhaustive pour orchestrer le positionnement spatial et la géométrie interne de cette composante informative essentielle.
L’option POSITION= permet de migrer la légende vers n’importe quelle coordonnée cardinale périphérique : TOP (en haut), BOTTOM (en bas), LEFT (à gauche) ou RIGHT (à droite). Plus remarquable encore pour optimiser la compacité visuelle, il est possible d’insérer la légende à l’intérieur même du plan de traçage grâce à des localisations combinées telles que TOPLEFT (coin supérieur gauche) ou BOTTOMRIGHT (coin inférieur droit), à condition que la zone choisie ne contienne pas de points de données actifs. L’option LOCATION=INSIDE formalise cette intégration endogène.
La structure syntaxique suivante illustre cette optimisation spatiale :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds / GROUP=team MARKERATTRS=(SIZE=9px);

    KEYLEGEND / POSITION=TOPLEFT LOCATION=INSIDE ACROSS=1 NOBORDER;

    XAXIS GRID;

    YAXIS GRID;

RUN;
L’adjonction de l’argument ACROSS=1 force l’empilement vertical des éléments de la légende sur une seule colonne, tandis que l’option NOBORDER supprime le cadre d’encadrement rectangulaire par défaut, éliminant ainsi toute lourdeur visuelle superflue au profit d’un minimalisme graphique de haute tenue.
8.2 Édition du titre et des libellés de la légende
Un défaut fréquemment constaté dans les productions graphiques intermédiaires réside dans la reproduction mécanique du nom technique de la variable de groupe en en-tête de la légende. Dans notre configuration, la légende porterait par défaut le simple intitulé team. Pour garantir une restitution formelle irréprochable, l’instruction KEYLEGEND permet de reconfigurer ou de neutraliser intégralement cet en-tête textuel.
L’option TITLE= reçoit une chaîne de caractères textuelle formalisée entre guillemets doubles, autorisant par exemple la substitution par TITLE="Collectif Sportif :". Alternativement, lorsque la nature des modalités présentées au sein de la légende est totalement univoque et ne laisse place à aucune ambiguïté sémantique, il est méthodologiquement recommandé d’éliminer totalement le titre de la légende pour alléger la composition globale. Cette purge s’effectue simplement en déclarant une chaîne vide via TITLE="".
Parallèlement, les attributs typographiques des descripteurs de modalités peuvent être modulés à volonté via l’option VALUEATTRS=(FAMILY="Arial" SIZE=9pt). Ces ajustements garantissent que les étiquettes de légende s’intègrent organiquement à la trame générale du document final sans entrer en concurrence visuelle avec les axes ou les points de données.
8.3 Désactivation conditionnelle de la légende
Dans certaines architectures de mise en page spécialisées, la présence même de la légende s’avère redondante, voire préjudiciable à la clarté informative globale. C’est particulièrement manifeste lorsque les groupes sont déjà explicitement documentés au moyen d’annotations directes superposées sur le nuage de points via l’instruction TEXT, ou lorsque le graphique fait partie d’une séquence de planches comparatives où les codes chromatiques et géométriques ont déjà été formalisés en amont dans le corps du texte méthodologique.
Pour neutraliser l’émission spontanée de la légende sous SAS sans altérer la segmentation par groupe opérée au sein de l’instruction SCATTER, il suffit d’insérer au sein du bloc procédural la commande d’extinction directe :
KEYLEGEND / NOAUTOLEGEND;
Alternativement, l’option globale NOAUTOLEGEND peut être invoquée directement au niveau de la déclaration d’ouverture procédurale :
PROC SGPLOT DATA=basketball_data NOAUTOLEGEND;
Cette disposition syntaxique écarte radicalement la boîte de légende de l’espace de rendu. La totalité de la surface géométrique allouée au conteneur ODS Graphics est alors dévolue au plan de traçage cartésien, maximisant la résolution spatiale des observations et offrant une amplitude de lecture optimale pour les nuages denses.
9. Superposition de modèles statistiques et courbes de tendance
9.1 Intégration d’une droite de régression linéaire avec REG
L’exploration empirique par nuage de points atteint son plein potentiel heuristique lorsqu’elle est couplée à la projection d’un modèle mathématique traduisant la tendance centrale de l’association observée. Au lieu de contraindre l’analyste à exécuter une procédure d’estimation séparée (telle que PROC REG) pour ensuite en réinjecter laborieusement les coefficients dans un graphique, PROC SGPLOT propose une intégration directe remarquable via l’instruction REG.
L’instruction REG X=points Y=rebounds calcule en temps réel, à l’intérieur même du moteur de rendu, les estimateurs des moindres carrés ordinaires de l’ordonnée à l’origine (bêta zéro) et de la pente (bêta un) du modèle de régression univarié classique. Elle projette instantanément la droite d’ajustement linéaire résultante au travers du nuage d’observations. L’instruction permet en outre d’afficher le coefficient de détermination sous-jacent (le R-carré empirique) directement sur le canevas sans intervention computationnelle externe.
Voici la mise en œuvre de cette superposition conjointe au sein d’une seule étape procédurale :
PROC SGPLOT DATA=basketball_data;

    REG X=points Y=rebounds /

        LINEATTRS=(COLOR=DarkRed THICKNESS=2px)

        MARKERATTRS=(SYMBOL=CircleFilled SIZE=8px COLOR=SteelBlue);

    XAXIS GRID LABEL="Volume Offensif (Points)";

    YAXIS GRID LABEL="Rendement Défensif (Rebonds)";

RUN;
Il est fondamental de noter que l’instruction REG génère nativement à la fois le nuage de points résidents et la droite ajustée. L’analyste peut ainsi omettre l’instruction SCATTER dès lors que REG est déclarée avec les options de formatage des marqueurs appropriées, simplifiant substantiellement la lisibilité de la séquence de code.
9.2 Affichage des intervalles de confiance et de prédiction
Une droite d’ajustement isolée présente le risque épistémologique de masquer l’incertitude d’échantillonnage inhérente à toute inférence statistique. Pour pallier cette faiblesse, SAS autorise la quantification graphique immédiate des marges d’erreur par la modélisation de bandes de confiance paramétriques calibrées selon la distribution de Student au seuil de signification bilatéral alpha sélectionné (conventionnellement 0.05 pour un intervalle à 95 %).
Deux options complémentaires peuvent être mobilisées au sein de l’instruction REG :
- L’option
CLM(Confidence Limits for Mean) : Elle déploie une zone ombrée de part et d’autre de la droite représentant l’intervalle de confiance encadrant l’espérance mathématique conditionnelle de la variable réponse pour chaque valeur de la variable prédictive. Cette bande adopte une forme d’hyperboloïde étranglée, dont l’épaisseur minimale coïncide avec le centre de gravité bivarié de l’échantillon. - L’option
CLI(Confidence Limits for Individual Prediction) : Elle matérialise des limites plus distantes encadrant la zone de probabilité au sein de laquelle une observation individuelle future issue de la même population a 95 % de chances de se positionner, intégrant de fait à la fois la variance de l’estimateur et la variance du terme d’erreur stochastique résiduel.
L’activation de ces bandes d’incertitude critique s’implémente comme suit :
PROC SGPLOT DATA=basketball_data;

    REG X=points Y=rebounds / CLM CLI

        LINEATTRS=(COLOR=DarkGreen THICKNESS=2px)

        CLMATTRS=(CLCOLOR=LightGreen TRANSPARENCY=0.5);

    XAXIS GRID;

    YAXIS GRID;

RUN;
La présence de ces zones délimitées offre une appréciation visuelle rigoureuse de la précision de l’ajustement : plus l’échantillon est restreint ou plus la dispersion résiduelle est forte, plus la zone CLM s’évase, rappelant au lecteur que la tendance estimée n’est pas un absolu déterministe mais une trajectoire probabiliste assujettie aux fluctuations d’échantillonnage.
9.3 Modélisation non paramétrique avec LOESS et PBSPLINE
L’hypothèse d’une relation strictement linéaire constitue bien souvent une simplification excessive du monde réel. Lorsque la théorie sous-jacente n’impose aucune contrainte fonctionnelle rigide ou lorsque le statisticien souhaite explorer la possibilité de concavités, de saturations ou de rendements marginaux décroissants, les méthodes d’ajustement non paramétriques locales se révèlent incontournables.
SAS intègre à cet effet au sein de PROC SGPLOT l’instruction LOESS (pour Locally Estimated Scatterplot Smoothing) et l’instruction PBSPLINE (splines de pénalisation). L’algorithme LOESS procède par régression polynomiale pondérée locale : pour chaque point du plan, une régression est ajustée en n’accordant du poids qu’aux observations situées dans un voisinage restreint, défini par un paramètre de lissage (le bandwidth ou smoothing parameter).
L’implémentation opérationnelle d’une courbe de lissage LOESS s’exécute ainsi :
PROC SGPLOT DATA=basketball_data;

    SCATTER X=points Y=rebounds / MARKERATTRS=(SIZE=8px);

    LOESS X=points Y=rebounds /

        SMOOTH=0.6 CLM

        LINEATTRS=(COLOR=DarkOrange THICKNESS=2px);

    XAXIS GRID;

    YAXIS GRID;

RUN;
L’argument SMOOTH=0.6 calibre l’ampleur de la fenêtre locale sur 60 % de l’effectif total. Un paramètre de lissage trop faible induit un surapprentissage manifeste (surajustement) où la courbe épouse chaque soubresaut stochastique du jeu de données, tandis qu’un paramètre trop élevé force la courbe à converger vers une simple droite des moindres carrés. Le bon réglage permet de déceler visuellement les véritables inflexions fonctionnelles qui échapperaient à une régression paramétrique aveugle.
10. Extension multivariée : exploration par matrices avec PROC SGSCATTER
10.1 Fondements de l’analyse bivariée généralisée
Dès lors que le champ d’investigation statistique s’élargit pour embrasser non plus deux, mais trois, quatre ou plusieurs dizaines de variables quantitatives interconnectées, la génération séquentielle de nuages de points unitaires via PROC SGPLOT devient fastidieuse et inefficace. Dans les phases préliminaires de fouille de données (data mining) ou lors de l’inspection de matrices de covariance complexes, l’analyste a besoin d’une vue synoptique globale capable de révéler en un coup d’œil l’ensemble des interrelations bivariées du système.
Pour répondre à cette problématique d’échelle sans saturer les lignes de script, SAS propose la procédure spécialisée PROC SGSCATTER. Alors que SGPLOT est conçue pour optimiser le rendu micro-ajusté d’un canevas unifié, SGSCATTER est architecturée spécifiquement pour concevoir des matrices et des réseaux orthogonaux de nuages de points interconnectés, automatisant la synchronisation des échelles axiales et la disposition symétrique des projections multidimensionnelles.
Cette approche matricielle s’avère particulièrement précieuse pour identifier instantanément les problèmes de multicolinéarité sévère entre variables prédictives avant d’engager des régressions linéaires multiples ou des modélisations par équations structurelles.
10.2 Syntaxe de l’instruction MATRIX
L’instruction reine au sein de PROC SGSCATTER est l’instruction MATRIX. Contrairement à l’instruction SCATTER qui impose la dissociation rigide entre un axe X et un axe Y, MATRIX reçoit une simple énumération non ordonnée de variables quantitatives continues. La procédure génère alors une grille carrée de dimension $P \times P$, où $P$ représente le nombre de variables déclarées dans la commande.
La diagonale principale de cette matrice héberge généralement le nom de chaque dimension ou, de manière beaucoup plus informative, des histogrammes univariés ou des courbes d’estimation de densité par noyau (kernel density estimation). Toutes les cases hors diagonale projettent les nuages de points croisés respectifs, la case $(i, j)$ illustrant la relation entre la variable $i$ et la variable $j$.
Considérons l’application de cette matrice à une version étendue de notre table sportive, intégrant par exemple une variable supplémentaire minutes :
PROC SGSCATTER DATA=basketball_data;

    MATRIX points rebounds /

        DIAGONAL=(HISTOGRAM KERNEL)

        GROUP=team

        MARKERATTRS=(SIZE=7px);

RUN;
L’option DIAGONAL=(HISTOGRAM KERNEL) enchâsse sur la médiane de la matrice la distribution univariée de chaque dimension via un histogramme à pas automatique surmonté d’une courbe de densité lissée non paramétrique. Cette syntaxe condense en quelques lignes une somme colossale d’informations univariées et bivariées stratifiées par groupe.
10.3 Comparaison fonctionnelle entre SGPLOT et SGSCATTER
Le choix entre PROC SGPLOT et PROC SGSCATTER ne relève pas d’une préférence stylistique subjective, mais d’une adéquation fonctionnelle stricte aux objectifs de la phase analytique dans laquelle se situe le chercheur. Le tableau conceptuel ci-après résume les lignes de démarcation majeures régissant l’emploi de ces deux procédures au sein du pipeline SAS :
- Objectif premier :
SGSCATTERexcelle dans le criblage exploratoire préliminaire et la cartographie bivariée exhaustive de variables multiples, tandis queSGPLOTest optimisée pour la finalisation hautement millimétrée de figures ciblées destinées à la publication finale. - Contrôle des axes et annotations :
SGPLOToffre un contrôle absolu et microscopique sur chaque axe cartésien (XAXIS,YAXIS, graduations secondaires, seuilsREFLINE, bandes de surbrillance). En revanche,SGSCATTERapplique des conventions d’axes harmonisées et standardisées à l’ensemble des cellules de la matrice, sacrifiant le raffinement individuel au profit de la cohérence d’ensemble. - Capacités de modélisation intégrée :
SGPLOTpermet de superposer simultanément des régressions paramétriques, des intervalles de prédiction, des courbes LOESS et des barres d’erreur sur un même repère.SGSCATTERoffre des options de lissage et d’ajustement linéaire globales au sein des cellules matricielles via l’optionELLIPSEouREG, mais avec une granularité de personnalisation nécessairement plus restreinte.
En pratique empirique, le statisticien intègre ces deux outils de manière séquentielle et complémentaire : PROC SGSCATTER sert à identifier les interactions bivariées les plus significatives au sein d’une masse de données, puis PROC SGPLOT est déployée pour isoler, magnifier et documenter avec une précision chirurgicale les relations déterminantes retenues pour le livrable final.
11. Exportation haute résolution et conformité aux standards académiques
11.1 Configuration des paramètres ODS GRAPHICS
La production d’un graphique esthétiquement irréprochable au sein de la session interactive SAS ne préjuge en rien de sa qualité lors de son inclusion dans un manuscrit édité ou un rapport de recherche imprimé. Par défaut, les moteurs de rendu graphique génèrent des fichiers d’une résolution nominale de 96 à 100 DPI (dots per inch), ce qui s’avère amplement suffisant pour un affichage sur moniteur informatique, mais engendre une pixellisation désastreuse et un flou cinétique marqué lors de l’impression sur presse typographique ou au sein d’un document PDF haute définition.
Pour contraindre SAS à produire des livrables conformes aux exigences des éditeurs scientifiques internationaux, il est impératif de paramétrer rigoureusement l’environnement sous-jacent via l’instruction globale ODS GRAPHICS. Cette commande maîtresse permet de verrouiller la résolution spatiale, les dimensions physiques absolues et le nom de l’artefact généré avant le lancement de la procédure graphique :
ODS GRAPHICS ON /

    RESET=ALL

    IMAGENAME="Scatter_Points_Rebounds_HR"

    IMAGEFMT=TIFF

    HEIGHT=12cm

    WIDTH=16cm

    DPI=300;
PROC SGPLOT DATA=basketball_data;
SCATTER X=points Y=rebounds / GROUP=team;
RUN;
Dans ce bloc d’instructions, l’argument DPI=300 élève la densité d’échantillonnage de l’image à trois cents points par pouce, franchissant le seuil critique de netteté standard imposé par les comités de lecture scientifique. Les dimensions métriques explicites (WIDTH=16cm et HEIGHT=12cm) évitent tout redimensionnement homothétique anarchique par le logiciel de traitement de texte en aval, préservant ainsi l’intégrité exacte des tailles relatives des polices de caractères et des marqueurs.
11.2 Sélection des formats de sortie adaptés aux revues
Le choix de l’extension de fichier matricielle ou vectorielle constitue un maillon critique du processus de publication. Une décision erronée sur ce plan peut anéantir des heures de réglages typographiques minutieux. L’instruction IMAGEFMT= au sein de ODS GRAPHICS supporte une large gamme d’encodages spécialisés :
- Les formats vectoriels (SVG, PDF, EMF) : Pour une intégration au sein d’un document compilé via LaTeX ou un flux d’édition numérique vectoriel pur, le format SVG (Scalable Vector Graphics) ou PDF vectoriel est sans conteste l’option suprême. Les points, les lignes d’axes et les polices de caractères ne sont pas traduits sous forme de matrice de pixels discrets, mais encodés sous forme de primitives mathématiques géométriques. Il en résulte une netteté absolue et infinie, quel que soit le facteur d’agrandissement opéré sur la figure, tout en conservant un poids de fichier extrêmement contenu.
- Les formats matriciels non destructifs (TIFF, PNG) : Lorsque l’éditeur refuse les formats vectoriels et exige une matrice de pixels figée, le format TIFF (Tagged Image File Format) sans compression destructive (ou compressé via l’algorithme LZW) s’impose comme le standard historique absolu de l’industrie de l’imprimerie. Il préserve la fidélité colorimétrique intégrale sans introduire les artefacts de quantification caractéristiques de la compression JPEG. Le format PNG constitue une alternative d’une grande rigueur pour les livrables web haute résolution ou les présentations interactives.
Il est formellement déconseillé d’exporter des nuages de points statistiques au format JPEG : la compression par transformée en cosinus discrète propre à ce format génère un halo de bruit visuel flou autour des contours nets des disques et des lettres, détériorant irrémédiablement la qualité perçue du travail scientifique.
11.3 Alignement sur les normes de publication APA
L’American Psychological Association (APA), à travers les spécifications rigoureuses de son manuel de style (7e édition), a défini un corpus de règles extrêmement précis régissant la morphologie des figures statistiques destinées à la publication scientifique. L’alignement d’un graphique PROC SGPLOT sur les canons de l’APA impose des arbitrages méthodologiques stricts qu’il convient de formaliser directement dans la programmation SAS :
- Suppression des fioritures décoratives (Chartjunk) : Les standards APA proscrivent formellement les fonds colorés, les ombrages portés sous les marqueurs, les bordures extérieures entourant la totalité du graphique et les effets tridimensionnels sans pertinence statistique. Le canevas de fond doit impérativement être blanc pur et les lignes de quadrillage secondaire réduites au strict minimum ou totalement effacées si elles ne sont pas requises pour la lecture directe des valeurs critiques.
- Organisation structurelle des libellés : Selon les normes APA 7, le numéro de la figure (ex : Figure 1) doit apparaître au-dessus du graphique, aligné à gauche et formulé en caractères gras. Le titre descriptif de la figure doit s’insérer sur la ligne immédiatement inférieure, en italique, avec une casse en majuscule au début de chaque mot significatif (Title Case). Les explications détaillées de la légende et des symboles doivent préférentiellement être intégrées sous la figure au sein d’une note formelle débutant par le mot Note. en italique.
- Contraste monochrome et accessibilité : La figure doit conserver une intelligibilité intégrale en l’absence totale de couleur. Les marqueurs doivent être différenciés par des géométries exclusives (cercles pleins versus triangles vides ou croix) plutôt que par de simples variations subtiles de nuances de bleu ou de vert.
L’application scrupuleuse de ces directives au sein du script SAS garantit que la figure traversera l’étape de relecture éditoriale sans soulever la moindre réserve formelle de la part des relecteurs académiques les plus sourcilleux.
12. Diagnostic des anomalies fréquentes et bonnes pratiques de codage
12.1 Gestion rigoureuse des données manquantes
Le comportement algorithmique de SAS face aux données incomplètes constitue une source fréquente de perplexité pour l’analyste non averti. Lorsqu’une observation présente une valeur manquante (codée par une valeur point .) sur la variable d’abscisse X ou sur la variable d’ordonnée Y, le moteur de PROC SGPLOT applique systématiquement une politique d’exclusion par paire (pairwise deletion). L’observation correspondante est purement et simplement écartée du tracé cartésien, dans la mesure où il est géométriquement impossible de projeter une coordonnée indéterminée sur un plan euclidien fini.
Toutefois, cette exclusion automatique silencieuse s’accompagne d’un message d’avertissement dans le journal d’exécution (le fameux SAS Log), stipulant par exemple que « NOTE: 3 observations were not plotted because they contain missing values ». Négliger la lecture de ce diagnostic textuel expose le chercheur à présenter un graphique dont la taille d’échantillon effective est substantiellement inférieure à la volumétrie déclarée dans la méthodologie de l’article, faussant insidieusement les statistiques descriptives déduites visuellement.
Avant toute restitution graphique, il est donc impératif de procéder à un inventaire exhaustif des valeurs manquantes au moyen d’une procédure analytique préalable telle que PROC FREQ ou PROC MEANS adossée à l’option NMISS :
PROC MEANS DATA=basketball_data N NMISS MIN MAX MEAN;

    VAR points rebounds;

RUN;
Si la variable catégorielle de groupe (team) contient elle-même des valeurs manquantes, SAS crée par défaut une modalité de groupe spécifique matérialisée par un marqueur distinct. Si cette inclusion passive n’est pas désirée, il convient de filtrer formellement la table source au préalable via une clause conditionnelle explicite WHERE team IS NOT MISSING; directement intégrée au sein de la déclaration PROC SGPLOT.
12.2 Résolution des erreurs de syntaxe et avertissements courants
L’environnement de programmation de PROC SGPLOT, bien que remarquablement tolérant, obéit à une logique de compilation stricte qui ne pardonne aucune ambiguïté lexicale. L’erreur la plus prévalente réside dans l’incompatibilité de type des variables déclarées dans l’instruction SCATTER. L’assignation d’une variable alphanumérique (de type chaîne de caractères) sur l’axe horizontal X= ou vertical Y= sans recourir à des instructions spécialisées dédiées aux échelles discrètes (comme les diagrammes en boîte ou les tracés de catégories) déclenche une interruption immédiate de la procédure, signalée en rouge vif dans le journal SAS par une erreur de type : « ERROR: A character variable was passed to a numeric axis argument ».
Un autre foyer fréquent d’anomalies concerne les conflits d’options croisées. Par exemple, la tentative de combiner une personnalisation manuelle unitaire des marqueurs via MARKERATTRS= tout en sollicitant simultanément une segmentation catégorielle via GROUP= peut induire des comportements inattendus : selon la version de la maintenance SAS installée, MARKERATTRS peut écraser totalement la différenciation chromatique générée par GROUP, forçant l’ensemble des groupes à adopter la même couleur uniforme. Pour pallier ce conflit, la bonne pratique syntaxique consiste impérativement à déléguer le contrôle des attributs de groupe à l’instruction dédiée STYLEATTRS, comme explicité au sein de la section 7.3 de ce guide.
Enfin, la règle d’or immuable de tout développeur SAS consiste à pratiquer un audit systématique du fichier journal (SAS Log) après chaque exécution : aucun script ne peut être considéré comme valide tant qu’il subsiste le moindre message d’erreur (ERROR) ou d’avertissement (WARNING), ce dernier dissimulant souvent des suppressions inopportunes de libellés ou des redéfinitions tacites de bornes géométriques.
12.3 Recommandations méthodologiques pour le chercheur
Pour pérenniser la qualité de la production visuelle et garantir une reproductibilité parfaite des figures au sein d’une équipe de recherche, il est vivement préconisé d’adopter une discipline de programmation modulaire et standardisée. L’écriture de scripts monolithiques imbriquant la manipulation des données brutes et la génération graphique dans un flux continu non structuré est une source majeure d’erreurs méthodologiques et de déperdition de temps lors des cycles de révision scientifique.
Le chercheur avisé encapsulera ses modules graphiques au sein de macros SAS paramétrées (%MACRO). Cette approche permet de formaliser des modèles graphiques standardisés d’institution — fixant une fois pour toutes les polices, les marges, les formats d’exportation haute résolution ODS et les palettes conformes aux standards d’accessibilité —, qu’il suffit ensuite d’appeler dynamiquement en lui passant en argument le nom de la table et le couple de variables à scruter. Cette modularité assure une homogénéité esthétique absolue sur l’ensemble des planches d’un rapport ou d’une thèse de doctorat tout en réduisant considérablement la redondance de code.
Enfin, la visualisation ne doit jamais être conçue comme un artifice de rhétorique destiné à masquer les fragilités d’un modèle empirique, mais comme un instrument de probité et d’honnêteté scientifique. Le respect intransigeant des proportions d’échelles, l’évitement délibéré de tout cadrage tronqué artificiel visant à exagérer une pente modeste, la documentation transparente de la dispersion stochastique par des bandes de confiance, et l’explication exhaustive des critères d’exclusion d’échantillon constituent les piliers éthiques indispensables sur lesquels repose la crédibilité de la science quantitative moderne sous SAS.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17-21. https://doi.org/10.1080/00031305.1973.10478966
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- SAS Institute Inc. (2021). SAS/GRAPH: ODS Graphics Procedures Guide (Sixth Maintenance Release for SAS 9.4). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/grstatproc/titlepage.htm
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0