
L’exploration des données quantitatives en psychologie, en neurosciences cognitives et en sciences du comportement repose fondamentalement sur la compréhension des relations qui unissent de multiples variables observées. Qu’il s’agisse d’évaluer la structure interne d’une batterie de tests neuropsychologiques, de valider un inventaire de personnalité ou d’analyser les réponses à des échelles de bien-être subjectif, le premier réflexe méthodologique réside dans l’examen minutieux des interdépendances linéaires ou monotones. Dans cet écosystème analytique, la matrice de corrélation s’érige comme un monument cardinal, synthétisant sous une forme condensée des centaines de relations bivariées qui seraient autrement impossibles à appréhender de manière globale.
Le langage de programmation Python, soutenu par son écosystème de calcul scientifique composé de bibliothèques telles que Pandas, NumPy, SciPy et Seaborn, offre un environnement d’une puissance et d’une souplesse incomparables pour manipuler, calculer et visualiser ces structures matricielles. Cependant, le calcul d’une matrice de corrélation ne se résume pas à l’exécution mécanique d’une fonction algorithmique. Il engage une responsabilité épistémologique et méthodologique de premier ordre : le choix d’un coefficient adapté aux propriétés de distribution des données, le traitement rigoureux des valeurs manquantes, le contrôle de l’inflation de l’erreur de type I et la détection d’artéfacts statistiques susceptibles de biaiser les inférences cliniques ou expérimentales.
Ce guide exhaustif a été conçu pour accompagner le chercheur, l’étudiant avancé et le data scientist à travers l’ensemble du cycle de vie de l’analyse corrélationnelle en psychométrie. En alliant rigueur théorique, fondements mathématiques et implémentations techniques en Python, nous aborderons pas à pas la construction de matrices robustes, l’évaluation de leur significativité inférentielle, leur représentation graphique selon les standards internationaux de publication, ainsi que le diagnostic des pathologies statistiques comme la multicolinéarité et les biais d’agrégation. L’objectif est de transformer une simple opération de calcul matriciel en un instrument de découverte scientifique à la fois précis, reproductible et élégant.
1. Introduction théorique aux matrices de corrélation en psychométrie
1.1 Définition formelle et pertinence en sciences du comportement
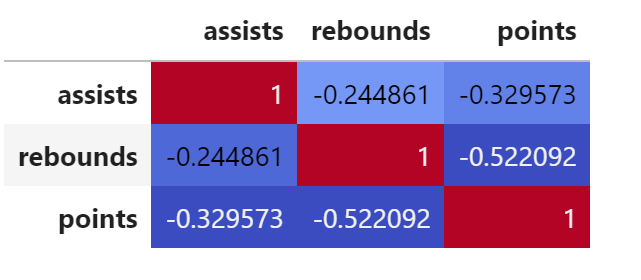
D’un point de vue algébrique et statistique, une matrice de corrélation est une structure tabulaire carrée de dimension p × p, où p représente le nombre de variables aléatoires intégrées à l’investigation. Chaque élément situé à l’intersection de la ligne i et de la colonne j correspond au coefficient de corrélation quantifiant la force et la direction de la relation bivariée entre la variable Xi et la variable Xj. Par définition, cette matrice jouit de propriétés mathématiques remarquables : sa diagonale principale est exclusivement composée de valeurs unitaires (une variable étant parfaitement corrélée avec elle-même), elle est strictement symétrique par rapport à cette diagonale dans la mesure où l’association entre deux variables ne dépend pas de leur ordre de présentation, et elle constitue une matrice semi-définie positive, ce qui garantit la cohérence géométrique de l’espace vectoriel sous-jacent.
Dans le domaine des sciences du comportement, la matrice de corrélation joue un rôle pivot qui dépasse largement la simple juxtaposition de statistiques descriptives. Le psychologue ou le chercheur en sciences sociales opère presque toujours sur des construits latents, c’est-à-dire des entités théoriques inobservables directement telles que l’anxiété, l’intelligence fluide, l’extraversion ou l’estime de soi. Ces entités sont approchées par l’intermédiaire d’indicateurs manifestes, typiquement des items de questionnaires psychométriques, des temps de réaction chronométriques ou des scores composites à des épreuves cognitives. La matrice de corrélation permet de cartographier de façon exhaustive le réseau nomologique qui lie ces indicateurs, fournissant ainsi la matière première nécessaire à l’évaluation de la cohérence interne des instruments de mesure.
L’exploration préliminaire d’échelles de mesure et d’inventaires psychologiques s’appuie systématiquement sur cette formalisation matricielle. Avant d’engager des modélisations causales plus complexes ou des démarches diagnostiques individuelles, le praticien doit impérativement s’assurer que les items conçus pour mesurer une même dimension partagent une variance commune suffisante, tout en conservant une relative indépendance vis-à-vis des indicateurs évaluant des construits distincts. La matrice devient alors un tableau de bord analytique indispensable, révélant d’un coup d’œil les synergies, les incohérences métrologiques et les potentielles défaillances de formulation au sein d’un protocole expérimental.
1.2 Distinction fondamentale entre covariance et corrélation
Pour appréhender la portée d’une matrice de corrélation, il convient de la situer par rapport à son ancêtre direct : la matrice de covariance. La covariance entre deux variables quantitatives capture la tendance conjointe de ces variables à dévier simultanément de leurs moyennes respectives. Cependant, la covariance est une mesure brute, non standardisée, dont l’amplitude numérique dépend intrinsèquement des unités de mesure dans lesquelles les variables sont exprimées. Si l’on évalue l’association entre le niveau de cortisol salivaire mesuré en nanomoles par litre et le score à un inventaire de dépression mesuré sur une échelle allant de 0 à 63 points, la valeur absolue de leur covariance sera tributaire de ces échelles arbitraires, rendant impossible toute comparaison intuitive avec une autre paire de variables.
La corrélation résout cette limitation par un processus de standardisation élégant. En divisant la covariance de deux variables par le produit de leurs écarts-types respectifs, on élimine totalement l’impact des échelles métriques d’origine. Cette opération projette l’estimation au sein d’un intervalle strictement borné entre -1 et +1. Une valeur de +1 signale une relation linéaire positive parfaite, où toute augmentation d’une unité standardisée sur une variable s’accompagne d’une augmentation proportionnelle sur l’autre ; une valeur de -1 traduit une relation inverse parfaite, tandis qu’une valeur de 0 reflète une absence totale d’association linéaire.
Cette standardisation confère à la matrice de corrélation une propriété fondamentale en analyse comportementale : la comparabilité trans-échelles. Il devient possible de confronter directement la force de l’association reliant des biomarqueurs physiologiques, des temps de réponse milliseconde par milliseconde et des réponses subjectives sur des échelles de Likert au sein d’un cadre géométrique universel. C’est cette invariance d’échelle qui autorise les méta-analyses, la standardisation des normes diagnostiques internationales et l’agrégation de données multi-sites en neuropsychologie clinique.
1.3 Objectifs analytiques de la matrice dans la recherche quantitative
L’usage de la matrice de corrélation en recherche quantitative poursuit trois objectifs méthodologiques fondamentaux. Le premier réside dans l’identification rapide de la redondance informationnelle entre les indicateurs psychométriques. Dans le développement d’une échelle psychologique, l’inclusion d’items quasi-synonymes engendre une inflation artificielle de la consistance interne et alourdit inutilement le fardeau de passation pour les participants. L’examen des cellules matricielles permet de repérer instantanément des corrélations suspectes, généralement supérieures à 0,85 ou 0,90, signalant qu’un item n’apporte aucune valeur ajoutée par rapport à un autre et devrait faire l’objet d’une suppression ou d’une reformulation lors du calibrage de l’outil.
Le deuxième objectif majeur constitue le préalable méthodologique indispensable à toute procédure de réduction dimensionnelle. Qu’il s’agisse de l’analyse factorielle exploratoire (AFE), de l’analyse factorielle confirmatoire (AFC) ou de l’analyse en composantes principales (ACP), ces algorithmes d’algèbre linéaire n’opèrent pas directement sur les données individuelles brutes, mais sur la matrice de corrélation ou de covariance. Les propriétés spectrales de cette matrice, notamment ses valeurs propres et ses vecteurs propres, déterminent le nombre de dimensions latentes nécessaires pour résumer l’espace des données sans perte substantielle d’information. Une matrice dont les intercorrélations seraient uniformément proches de zéro interdirait toute tentative de factorisation, signifiant que chaque item mesure une dimension strictement isolée.
Enfin, la matrice de corrélation remplit une fonction heuristique essentielle : la détection fortuite ou exploratoire d’associations théoriques non formulées a priori. Dans les grands jeux de données épidémiologiques ou les cohortes longitudinales en santé mentale, l’examen panoramique des corrélations croisées entre variables environnementales, traits de personnalité et marqueurs psychopathologiques permet d’identifier des motifs de co-variation inattendus. Ces découvertes empiriques servent alors de tremplin à la formulation de nouvelles hypothèses de recherche, qui devront être ultérieurement mises à l’épreuve au moyen de devis expérimentaux contrôlés.
2. Fondements mathématiques et sélection du coefficient approprié
2.1 Le coefficient r de Pearson et ses postulats
Le coefficient de corrélation produit-moment de Karl Pearson, noté r, demeure l’estimateur paramétrique le plus largement employé dans la littérature scientifique. Il quantifie la covariance standardisée de deux variables continues selon la formule mathématique suivante :
r = ∑((Xi – X̄)(Yi – Ȳ)) / [√(∑(Xi – X̄)2) × √(∑(Yi – Ȳ)2)]
Ce calcul repose sur des postulats statistiques stricts dont la violation compromet gravement la validité des conclusions inférentielles. Le premier postulat exige que les deux variables soient distribuées selon une loi normale bivariée, ce qui implique que chaque variable prise isolément présente une distribution univariée normale (gaussienne) et que leurs distributions conditionnelles soient également normales et homoscédastiques. Le second postulat fondamental est celui de la linéarité : le coefficient de Pearson ne mesure rigoureusement que la composante linéaire de l’association. Si la relation sous-jacente adopte une trajectoire quadratique, logarithmique ou exponentielle, le coefficient r sous-estimera dramatiquement l’intensité réelle de l’interdépendance, pouvant afficher une valeur proche de zéro alors même qu’une relation fonctionnelle déterministe unit les variables.
Une autre vulnérabilité critique du coefficient de Pearson réside dans son extrême sensibilité aux valeurs aberrantes (outliers) et aux distributions fortement asymétriques. Un unique point de donnée déviant situé à la périphérie du plan factoriel peut gonfler artificiellement une corrélation par effet de levier ou, à l’inverse, faire chuter une association robuste préexistante dans le reste de l’échantillon. En psychométrie, le recours à Pearson est donc rigoureusement justifié lorsque l’on analyse des scores continus issus de tests standardisés composites (comme les scores de quotient intellectuel ou les temps de réponse agrégés) dont la métrique se rapproche d’un continuum d’intervalle et dont les distributions ne s’écartent pas excessivement de la courbe en cloche.
2.2 Le coefficient rho de Spearman pour données ordinales
Lorsque les données recueillies ne satisfont pas aux exigences distributionnelles paramétriques ou qu’elles sont intrinsèquement mesurées sur une échelle ordinale, le coefficient rho (ρ) de Charles Spearman s’impose comme l’alternative non paramétrique privilégiée. Le principe mathématique sous-jacent est d’une grande limpidité conceptuelle : il consiste à remplacer les valeurs numériques brutes de chaque variable par leurs rangs respectifs au sein de la série statistique, puis à appliquer la formule de Pearson sur ces données transformées en rangs.
En opérant sur les rangs, Spearman s’affranchit du postulat de linéarité pour évaluer un critère plus large et souvent plus réaliste en sciences sociales : la monotonicité. Une relation monotone stipule que lorsqu’une variable augmente, l’autre variable croît (ou décroît) de manière systématique, sans que cette variation conjointe ait besoin d’être strictement proportionnelle ou constante à chaque échelon de la mesure. Cette caractéristique confère au coefficient une robustesse remarquable face aux échelles de Likert (échelles d’accord en 5 ou 7 points fréquemment employées dans les questionnaires de personnalité) et aux scores d’évaluation subjectifs formulés par des évaluateurs cliniques.
De plus, la transformation par rangs neutralise l’impact délétère des valeurs aberrantes univariées. Un score pathologique extrêmement élevé sera simplement assigné au rang le plus élevé (par exemple, le rang 100 sur un échantillon de 100 participants), éliminant de facto l’effet de levier numérique démesuré qu’il aurait exercé sur le calcul de la moyenne et des sommes de carrés de Pearson. Ainsi, face à des distributions asymétriques, plafonnées ou planchers, Spearman offre un compromis idéal entre robustesse statistique et fidélité phénoménologique de la mesure.
2.3 Le tau de Kendall pour les petits échantillons cliniques
Bien que le coefficient de Spearman soit largement répandu, le coefficient tau (τ) de Maurice Kendall représente, d’un point de vue théorique et asymptotique, une alternative encore plus robuste pour l’analyse ordinale, particulièrement au sein d’échantillons cliniques restreints ou en présence de nombreuses observations ex aequo (ties). Le tau de Kendall repose sur l’analyse combinatoire des paires d’observations concordantes et discordantes. Si l’on considère deux sujets i et j au sein d’une cohorte, la paire est dite concordante si le sujet qui présente le rang le plus élevé sur la variable X présente également le rang le plus élevé sur la variable Y ; elle est dite discordante si l’ordre hiérarchique est inversé entre les deux variables.
La statistique du tau de Kendall calcule la différence nette entre le nombre de paires concordantes et discordantes, rapportée au nombre total de combinaisons bivariées possibles. Les formulations modernes de ce coefficient, notamment le tau-b de Kendall, intègrent des corrections analytiques sophistiquées pour tenir compte des ex aequo répétés sur les deux variables, situation omniprésente lorsque l’on emploie des questionnaires courts comportant peu de modalités de réponse face à un échantillon clinique de 20 ou 30 patients.
Les propriétés mathématiques du tau de Kendall sont supérieures à celles de Spearman dans les études à petit effectif. Sa distribution d’échantillonnage converge beaucoup plus rapidement vers une loi normale, autorisant des calculs de valeurs p et d’intervalles de confiance nettement plus fiables lorsque n est inférieur à 50. De surcroît, le tau possède une interprétation probabiliste directe : il exprime la différence de probabilité que les paires observées soient dans le même ordre relatif plutôt que dans l’ordre inverse, fournissant une signification clinique tangible pour le chercheur médical.
3. Configuration de l’environnement de calcul scientifique en Python
3.1 Installation et importation des bibliothèques fondamentales
La mise en place d’un environnement de calcul scientifique moderne pour l’analyse de données psychométriques repose sur une pile logicielle rigoureusement articulée. Les gestionnaires de paquets tels que pip ou les environnements distribués comme conda constituent la porte d’entrée pour déployer ces outils. Le socle de base requiert impérativement trois bibliothèques numériques : NumPy, qui fournit les structures de données matricielles sous-jacentes et les primitives d’algèbre linéaire optimisées en langage C ; Pandas, qui enrichit ces tenseurs d’une couche d’indexation tabulaire de haut niveau (les DataFrames) idéale pour manipuler des scores d’items et des métadonnées expérimentales ; et SciPy, qui rassemble les routines inférentielles, les fonctions de distribution statistique et les algorithmes d’optimisation.
Pour la dimension esthétique et la restitution visuelle des matrices, deux outils complémentaires forment le standard de facto : Matplotlib, le moteur de rendu graphique vectoriel fondamental de l’écosystème Python, et Seaborn, une surcouche de haut niveau spécifiquement calibrée pour la visualisation de modèles statistiques complexes. Seaborn simplifie considérablement la configuration d’éléments visuels sophistiqués tels que les cartes thermiques chromatiques (heatmaps) ou les regroupements hiérarchiques, tout en s’interfaçant de manière transparente avec les structures de données Pandas.
Dans un contexte de rédaction universitaire ou de publication au sein de revues à comité de lecture, il est crucial de paramétrer dès l’initialisation du script les styles de rendu graphique globaux. L’ajustement des paramètres d’exécution de Matplotlib permet de définir une typographie sans serif harmonieuse, une résolution d’affichage élevée (points par pouce ou DPI) et un contraste chromatique répondant aux normes d’accessibilité visuelle. Ces configurations initiales garantissent que les figures générées s’intégreront avec élégance dans les manuscrits scientifiques finaux sans nécessiter de retouches manuelles fastidieuses dans des logiciels de dessin tiers.
3.2 Bonnes pratiques de reproductibilité du code
La reproductibilité computationnelle représente l’un des piliers de l’éthique scientifique contemporaine. Trop souvent, des analyses statistiques publiées s’avèrent impossibles à répliquer en raison de variations silencieuses dans les versions des bibliothèques logicielles ou de dépendances implicites à l’environnement de la machine hôte. Pour prémunir le chercheur contre ces écueils, l’isolation de l’espace d’exécution par l’intermédiaire d’environnements virtuels (tels que ceux créés par le module standard venv ou par des gestionnaires de dépendances déterministes comme Poetry et Conda-lock) est une exigence méthodologique incontournable.
Un autre aspect critique de la reproductibilité concerne la manipulation d’algorithmes stochastiques. Bien que le calcul direct d’une matrice de corrélation paramétrique soit une opération mathématique strictement déterministe, les procédures avancées qui s’y greffent fréquemment — telles que le rééchantillonnage par bootstrap pour estimer les intervalles de confiance, l’imputation multiple par chaînes d’équations ou les permutations aléatoires de validation croisée — font appel à des générateurs de nombres pseudo-aléatoires. La fixation explicite d’une graine aléatoire (via numpy.random.seed ou le passage d’une instance de default_rng) au début de chaque session garantit que les simulations produiront rigoureusement les mêmes résultats numériques à chaque exécution du pipeline.
Enfin, l’organisation structurelle du code doit respecter une architecture modulaire conforme aux meilleures pratiques du génie logiciel scientifique. Il est vivement conseillé de séparer distinctement les scripts de nettoyage et de validation des données brutes, les modules de modélisation mathématique et les scripts de visualisation graphique. L’intégration d’assertions logiques et de contrôles de typage tout au long du script permet d’interrompre l’exécution dès qu’une anomalie métrologique est détectée, évitant ainsi la propagation d’erreurs silencieuses jusqu’au rapport d’analyse final.
4. Préparation et structuration des jeux de données avec Pandas
4.1 Chargement et typage des variables psychométriques
L’amorce de tout protocole de calcul matriciel débute par l’ingestion fiable des données de passation psychométrique. Qu’elles proviennent de plateformes d’expérimentation en ligne sous format CSV ou de logiciels d’enquêtes hébergés sous format Excel, ces données brutes sont généralement chargées via les fonctions pandas.read_csv() ou pandas.read_excel(). Cette étape inaugurale ne doit jamais être passive : elle nécessite la vérification minutieuse des encodages de caractères (généralement UTF-8), des séparateurs de champs et de la reconnaissance des délimiteurs décimaux, une discordance courante entre les standards francophones et anglo-saxons pouvant convertir silencieusement des scores continus en chaînes de texte.
Une fois la table instanciée sous forme de DataFrame, le contrôle rigoureux du typage des colonnes devient une priorité technique absolue. Dans un questionnaire psychométrique, certaines variables qualitatives codées numériquement (par exemple, le sexe biologique codé 1 et 2, ou le groupe diagnostique codé 0, 1 et 2) ne doivent en aucun cas être traitées comme des variables d’intervalle continues sans transformation adéquate. Inversement, il arrive fréquemment que des items de Likert contenant des cellules vides ou des réponses textuelles d’exclusion soient assignés au type générique object par Pandas, bloquant ainsi tout calcul matriciel ultérieur.
L’inspection des types de données s’opère par l’interrogation systématique des métadonnées de la table de données. Le chercheur doit appliquer des conversions de type explicites en forçant la conversion numérique par des fonctions appropriées, tout en traitant les symboles non conformes comme des valeurs manquantes formalisées. Ce typage strict prémunit l’analyste contre l’omission involontaire de variables lors de l’appel aux méthodes de corrélation automatisées, qui écartent silencieusement les colonnes non reconnues comme purement numériques.
4.2 Sélection et filtrage des variables d’intérêt
Les fichiers de données brutes issus des protocoles d’évaluation clinique et comportementale contiennent une quantité importante d’informations périphériques indispensables à l’administration du protocole, mais dénuées de pertinence pour la modélisation psychométrique. Ces métadonnées incluent les identifiants anonymisés des participants, les horodatages précis d’enregistrement, les adresses IP, les consentements éclairés numériques ou encore des indices de performance technique du matériel expérimental. La première opération de filtrage consiste à élaguer systématiquement ces colonnes pour ne préserver au sein du sous-ensemble d’analyse que les variables manifestes pertinentes.
L’étape subséquente implique une restructuration conceptuelle et fonctionnelle des colonnes conservées. Dans les inventaires standardisés, tels que l’inventaire de personnalité des Big Five (NEO-PI ou BFI) ou l’inventaire de dépression de Beck (BDI-II), les items sont généralement regroupés par sous-échelles théoriques. Il est méthodologiquement recommandé d’ordonner et de renommer les variables de manière à refléter cette taxonomie interne. L’utilisation d’une nomenclature explicite facilite le repérage intuitif des blocs d’items lors de l’analyse visuelle de la matrice finale.
Avant d’agréger les items individuels en scores composites dimensionnels ou d’inclure les items bruts dans une grande matrice inter-items, il est indispensable de vérifier la cohérence interne des sous-échelles. Cette vérification implique souvent l’inversion préalable des items inversés (reverse-scored items), une manipulation psychométrique courante destinée à déjouer les biais d’acquiescement chez les répondants. Omettre d’inverser numériquement un item inversé conduira inexorablement à l’apparition de coefficients de corrélation négatifs aberrants avec les autres items du même domaine, perturbant la structure globale du construit analysé.
4.3 Inspection exploratoire des distributions individuelles
L’arbitrage entre les différents coefficients de corrélation (Pearson, Spearman ou Kendall) repose directement sur la forme géométrique des distributions univariées observées dans l’échantillon. Avant de calculer la matrice, une exploration descriptive détaillée s’impose donc pour chaque variable. Deux indices statistiques fournissent des indications précieuses : le coefficient d’asymétrie (skewness), qui évalue la dissymétrie de la distribution par rapport à sa moyenne, et le coefficient d’aplatissement (kurtosis), qui quantifie l’épaisseur des queues de distribution et la concentration des valeurs autour du centre par rapport à une loi normale théorique.
Selon les conventions méthodologiques admises en psychométrie, des valeurs de skewness dont la valeur absolue excède 2,0 et des valeurs de kurtosis dépassant 7,0 signalent un éloignement substantiel de la normalité, justifiant l’abandon du coefficient de Pearson au profit d’alternatives non paramétriques. Ces calculs numériques gagnent à être systématiquement corroborés par une inspection visuelle globale, notamment par le tracé d’histogrammes superposés de densités de probabilité ou de diagrammes quantile-quantile (Q-Q plots).
Cette analyse exploratoire des distributions individuelles permet de poser un diagnostic méthodologique éclairé. Si l’ensemble des variables présente une allure gaussienne continue avec des écarts minimes à la symétrie, l’estimation par la méthode de Pearson garantira une puissance statistique optimale. Si, en revanche, l’investigateur constate une forte concentration des réponses sur les modalités extrêmes (effets de plafond ou de plancher caractéristiques des échelles cliniques dans les populations saines), le basculement vers Spearman ou Kendall devient une nécessité scientifique pour éviter toute sous-estimation artificielle des intercorrélations.
5. Calcul algorithmique de la matrice de corrélation avec Pandas
5.1 Utilisation de la méthode native DataFrame.corr()
Au cœur de l’écosystème d’analyse de données en Python, la méthode DataFrame.corr() constitue la passerelle canonique pour générer des matrices d’association bivariée. Développée pour offrir une efficacité algorithmique remarquable en s’appuyant sur les bibliothèques d’algèbre vectorielle bas niveau de NumPy, cette fonction traite simultanément l’ensemble des paires de colonnes numériques présentes dans la structure tabulaire pour retourner un nouveau DataFrame parfaitement symétrique.
Par défaut, l’appel à la méthode sans argument explicite calcule le coefficient de corrélation linéaire de Pearson. Cependant, la signature de la fonction intègre le paramètre stratégique method, permettant de modifier l’algorithme sous-jacent avec une flexibilité totale. En spécifiant method='pearson', method='spearman' ou method='kendall', l’utilisateur dicte à la machine le formalisme mathématique à appliquer sur les vecteurs de données. Le résultat obtenu est immédiatement manipulable comme n’importe quel tableau Pandas : les lignes et les colonnes héritent des noms d’origine des variables, rendant la lecture, l’indexation conditionnelle et le découpage spatial de la matrice particulièrement simples.
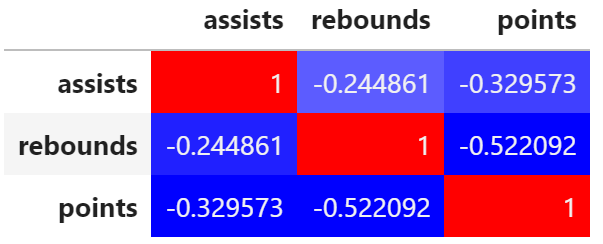
Le calcul s’exécute de manière entièrement vectorisée, ce qui permet de traiter des jeux de données volumineux — comprenant plusieurs centaines de variables psychométriques et des milliers de sujets — en quelques fractions de seconde. Le DataFrame résultant possède une valeur diagonale strictement égale à 1,0 (aux imprécisions de virgule flottante près) et des dimensions rigoureusement identiques à celles du nombre de variables sélectionnées, matérialisant l’espace relationnel complet du protocole de mesure.
5.2 Spécification du seuil minimal d’observations
Dans les enquêtes psychologiques sur le terrain ou les études longitudinales en milieu hospitalier, la complétion intégrale des protocoles est une exception plutôt qu’une règle. Il arrive fréquemment que certains participants abandonnent le questionnaire en cours de route ou que certains items soient ignorés. Lorsque Pandas calcule les corrélations bivariées entre deux variables quelconques, il n’utilise par défaut que les observations pour lesquelles les deux scores sont simultanément renseignés. Cela signifie que la taille d’échantillon effective peut varier de manière spectaculaire d’une cellule à l’autre au sein de la même matrice.
Cette variation pose un risque méthodologique critique : certaines cellules périphériques de la matrice pourraient être calculées sur un sous-groupe de sujets extrêmement réduit (par exemple, seulement cinq ou six participants ayant répondu à la fois à un item optionnel en début de test et à une question finale), conduisant à des estimations statistiques totalement instables, imprécises et dénuées de validité inférentielle. Pour parer à cette dérive, Pandas propose le paramètre min_periods au sein de sa méthode de corrélation.
En assignant une valeur entière positive à min_periods (par exemple, en exigeant un minimum de 30 ou 50 observations valides pour chaque paire), l’analyste force l’algorithme à renvoyer une valeur non définie (NaN) dès lors que le nombre d’observations conjointes n’atteint pas ce seuil de représentativité minimal. Cette contrainte technique évite d’incorporer des coefficients trompeurs dans les visualisations ultérieures ou de propager des estimations erratiques dans des procédures d’analyse factorielle en aval.
5.3 Génération de sous-matrices ciblées
L’exploration d’un grand protocole de recherche ne nécessite pas toujours l’inspection intégrale d’une matrice carrée p × p. Dans de nombreux scénarios de recherche comportementale, les scientifiques s’intéressent exclusivement aux interrelations reliant deux ensembles conceptuellement disjoints de variables : par exemple, la manière dont un bloc de cinq traits de personnalité majeurs covarie avec un bloc distinct de dix indicateurs de bien-être au travail, ou la relation entre des biomarqueurs physiologiques et des indices cognitifs. Calculer et afficher la matrice carrée complète engendre une surcharge cognitive inutile en forçant la lecture de zones sans intérêt théorique immédiat.
Pandas autorise une sélection et un découpage chirurgical des matrices d’association via ses mécanismes d’indexation explicite. Après avoir calculé la matrice globale, il est trivial de restreindre les lignes à un sous-ensemble prédéfini de variables indépendantes et les colonnes à un ensemble de variables dépendantes en utilisant l’opérateur d’indexation par étiquettes .loc[]. Le résultat obtenu est une sous-matrice rectangulaire m × k (où m ≠ k), concentrant l’attention du chercheur sur les corrélations croisées d’intérêt théorique exclusif.
Outre l’avantage d’une clarté perceptive accrue lors de la restitution des données, cette approche permet d’optimiser l’allocation de mémoire vive et la vitesse de traitement lorsque l’on manipule des bases de données massives issues de questionnaires ouverts ou d’évaluations ambulatoires répétées au fil du temps. L’isolement de sous-matrices thématiques constitue l’une des fondations de l’analyse exploratoire ciblée dans les approches multi-méthodes.
6. Gestion des données manquantes et impact sur l’estimation matricielle
6.1 Suppression par paire (pairwise) versus suppression par liste (listwise)
Le traitement des données manquantes lors de l’estimation d’une matrice de corrélation constitue un sujet de controverse statistique majeur en psychométrie. La méthode native DataFrame.corr() de Pandas applique systématiquement ce que la littérature nomme la suppression par paire (pairwise deletion). Dans ce régime, chaque coefficient rij est calculé en utilisant tous les cas disponibles pour lesquels les variables i et j sont documentées, en ignorant les données manquantes sur l’ensemble des autres variables. L’avantage immédiat de ce procédé est de maximiser la puissance statistique en conservant le volume d’information empirique le plus élevé possible pour chaque calcul élémentaire.
Cependant, la suppression par paire entraîne un coût mathématique non négligeable : la matrice finale résultante peut ne plus être strictement définie positive. Étant donné que chaque cellule est calculée sur un sous-échantillon potentiellement distinct, l’espace géométrique des variables peut présenter des incohérences topologiques (des relations impossibles sur le plan tridimensionnel, semblables à des angles dont les cosinus seraient collectivement incompatibles). Cela peut bloquer l’inversion de la matrice lors de l’ajustement de modèles d’équations structurelles ou provoquer l’apparition de valeurs propres négatives fictives en analyse factorielle.
À l’opposé, la suppression par liste (listwise deletion, exécutée via df.dropna() avant le calcul matriciel) contraint l’analyse à ne conserver que les sujets dont la ligne d’observation est intégralement renseignée sur toutes les variables retenues. La matrice issue de cette procédure est mathématiquement robuste et garantie définie positive (ou semi-définie positive). Toutefois, elle présente le défaut de sacrifier une quantité parfois colossale de données : si un individu a omis un unique item parmi cent, l’ensemble de ses réponses est irrémédiablement éliminé, réduisant drastiquement la puissance statistique et risquant d’introduire des biais d’échantillonnage sévères si l’absence d’information n’est pas strictement aléatoire.
6.2 Typologie des données manquantes en contexte de questionnaire
Pour faire un choix éclairé entre la suppression par liste, la suppression par paire ou l’imputation, le psychologue doit impérativement caractériser la nature des mécanismes qui sous-tendent l’absence d’information, selon la taxonomie fondatrice de Donald Rubin. La première modalité est le manque totalement aléatoire (Missing Completely at Random, MCAR), situation dans laquelle la probabilité qu’une donnée soit manquante est strictement indépendante tant des valeurs observées que des valeurs inobservées. Ce cas de figure, souvent imputable à des incidents techniques ou à un saut de page accidentel, est le seul où la suppression par liste ou par paire garantit des estimations non biaisées de la moyenne et de la corrélation.
La seconde modalité est le manque aléatoire (Missing at Random, MAR), où l’absence dépend des valeurs observées sur d’autres variables, mais pas de la valeur de la variable manquante elle-même. Par exemple, les sujets plus âgés peuvent être moins enclins à répondre aux sections informatisées, mais au sein de chaque tranche d’âge, l’omission est purement fortuite. Enfin, la troisième modalité, la plus problématique en psychométrie, est le manque non aléatoire (Missing Not at Random, MNAR). Ce cas survient lorsqu’une attrition différentielle frappe spécifiquement les variables émotionnellement sensibles : des individus souffrant de détresse psychologique aiguë refuseront plus volontiers de renseigner les items évaluant les idéations suicidaires ou la consommation de substances psychoactives.
Lorsque des données relèvent du mécanisme MAR ou MNAR, l’application aveugle des méthodes de suppression conventionnelles tronque arbitrairement la variance des construits les plus vulnérables. Cette restriction d’étendue (range restriction) engendre un affaiblissement systématique de l’amplitude des corrélations estimées dans la matrice, faussant la structure dimensionnelle déduite et induisant des conclusions erronées sur la dynamique psychologique de la population cible.
6.3 Approches d’imputation adaptées avant calcul matriciel
Face aux écueils de la suppression de cas, le recours aux techniques d’imputation s’est largement démocratisé. Il convient toutefois de mettre en garde contre une pratique obsolète encore trop répandue : l’imputation naïve par la moyenne. Remplacer systématiquement les valeurs manquantes d’une variable par la moyenne arithmétique de ses valeurs observées réduit artificiellement la variance de l’item et sous-estime drastiquement la covariance avec les autres indicateurs. Cette pratique affaiblit l’ensemble des coefficients de la matrice de corrélation et augmente fallacieusement la précision apparente des estimations (gonflement de l’erreur de type I par rétrécissement des erreurs types).
Pour préserver l’intégrité de la structure de corrélation, il est impératif d’utiliser des algorithmes qui tiennent compte de la structure de covariance multivariée préexistante. L’imputation par les k-plus proches voisins (KNNImputer de la bibliothèque scikit-learn) remplace les valeurs absentes d’un sujet en calculant une moyenne pondérée des réponses fournies par les participants qui partagent le profil de réponse le plus similaire sur les autres items. Cette approche préserve fidèlement les associations locales entre variables.
Le standard méthodologique le plus rigoureux réside cependant dans l’imputation multiple par équations chaînées (MICE, implémentée via l’estimateur IterativeImputer de scikit-learn). Cet algorithme modélise itérativement chaque variable incomplète comme une fonction de régression de toutes les autres variables du système. En intégrant un terme résiduel stochastique à chaque étape, l’imputation multiple reflète parfaitement l’incertitude liée aux données absentes, garantissant que la matrice de corrélation finale reflète sans distorsion les paramètres de la population parente.
7. Visualisation graphique avancée avec Seaborn et Matplotlib
7.1 Génération d’une carte thermique (Heatmap) ergonomique
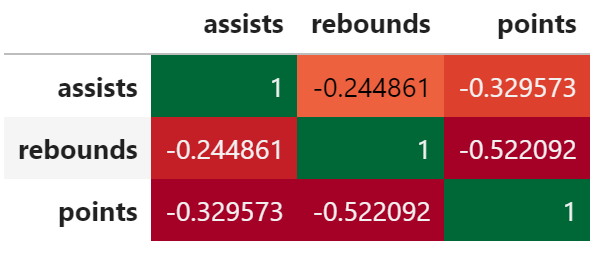
La lecture visuelle d’un tableau numérique dense comportant des dizaines de coefficients de corrélation s’avère cognitivement éprouvante et peu propice à l’identification de patterns sous-jacents. La cartographie thermique (heatmap) transpose ce réseau numérique abstrait en une représentation spatiale continue, où l’intensité et la teinte de chaque pixel encodent la valeur du coefficient associé. La bibliothèque Seaborn, par le biais de sa fonction dédiée sns.heatmap(), simplifie la mise en œuvre de ces graphiques statistiques tout en autorisant une personnalisation poussée.
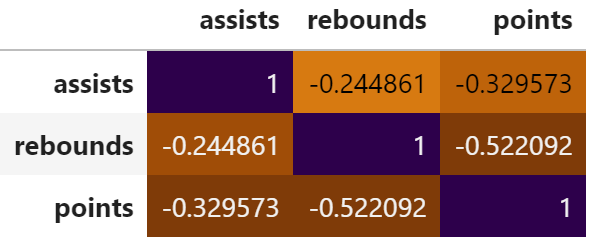
Le choix de la palette chromatique est un élément déterminant de l’ergonomie visuelle. En psychométrie, où les corrélations évoluent typiquement entre -1 et +1, l’utilisation de palettes de couleurs divergentes centrées sur zéro (comme les palettes coolwarm, vlag ou icefire) est impérative. Ces palettes attribuent une teinte spécifique (par exemple, le rouge) aux corrélations positives élevées, une teinte opposée (par exemple, le bleu) aux corrélations négatives fortes, et une couleur neutre (le blanc ou un gris très pâle) aux valeurs proches de zéro. Cette configuration permet à l’œil humain de discerner instantanément la bipolarité des relations psychologiques étudiées.
Pour maximiser l’utilité informative de la figure, il est d’usage d’inclure des annotations textuelles numériques au centre de chaque cellule en configurant le paramètre annot=True. Ces annotations doivent faire l’objet d’un formatage rigoureux (par exemple, limitation à deux décimales via fmt='.2f') et d’un dimensionnement typographique adapté à la résolution globale du tracé pour éviter tout chevauchement textuel susceptible d’altérer la lisibilité.
7.2 Application de masques pour les matrices triangulaires
En vertu de la symétrie inhérente à la matrice de corrélation, présenter l’intégralité du carré d’analyse constitue une redondance graphique superflue : la moitié supérieure droite contient rigoureusement les mêmes informations que la moitié inférieure gauche, séparées par une diagonale unitaire dépourvue d’intérêt inférentiel. Cette duplication alourdit la charge cognitive du lecteur et disperse l’attention visuelle sans apporter aucune valeur ajoutée. L’application d’un masque booléen permet d’élaguer cette zone miroir pour ne laisser apparaître que le triangle inférieur de la matrice.
La fonction numpy.triu() de NumPy permet de générer ce masque avec élégance. En créant une matrice binaire de même dimension que la matrice de corrélation, où les éléments situés sur et au-dessus de la diagonale principale sont assignés à la valeur booléenne True, on peut injecter ce filtre directement dans l’argument mask de la fonction sns.heatmap(). Seaborn omettra alors automatiquement l’affichage des cellules masquées, produisant une figure triangulaire inférieure sobre et parfaitement conforme aux recommandations de présentation visuelle de l’American Psychological Association (APA).
Pour parfaire le rendu esthétique, le chercheur veillera à ajuster l’épaisseur des lignes séparatrices entre les cellules (paramètre linewidths) et à fixer la couleur d’arrière-plan de l’espace graphique. L’orientation des étiquettes textuelles situées sur les axes abscisse et ordonnée doit être orientée de façon à demeurer parfaitement lisible horizontalement, évitant ainsi au lecteur toute torsion céphalique lors de la consultation du document de synthèse.
7.3 Regroupement hiérarchique avec clustermap
Lorsque le chercheur est confronté à un grand nombre de variables sans structure ordonnée a priori, l’organisation spatiale des lignes et des colonnes par ordre d’apparition dans le questionnaire ne facilite pas la mise au jour des dimensions latentes. La fonction sns.clustermap() de Seaborn transcende cette limite en couplant le calcul de la carte thermique à un algorithme de classification ascendante hiérarchique (hierarchical clustering). Les variables ne sont plus présentées selon leur ordre d’indexation brut, mais réorganisées de manière à rapprocher spatialement les items partageant des profils de corrélation hautement similaires.
L’algorithme calcule une matrice de distance (souvent basée sur la métrique euclidienne appliquée aux corrélations) et agrège successivement les variables les plus proches selon un critère d’agglomération défini (comme la méthode de Ward ou le lien moyen). Le résultat visuel se matérialise par l’apparition de dendrogrammes arborescents greffés sur les bords de la carte thermique. Ces embranchements schématisent fidèlement les sous-dimensions émergentes et matérialisent les blocs de variables qui convergent vers une même entité psychométrique.
L’utilisation de la clustermap s’avère particulièrement éclairante lors de la phase exploratoire d’un inventaire clinique. Elle permet de découvrir empiriquement la structure factorielle des données, de détecter les items transversaux qui oscillent entre deux dimensions distinctes et d’isoler visuellement les indicateurs parasites qui ne s’agrègent à aucun groupe cohérent, accélérant ainsi la phase d’épuration des échelles de mesure avant modélisation confirmatoire.
8. Évaluation de la significativité statistique et calcul des p-values
8.1 Limites de Pandas et recours à SciPy ou Pingouin
Bien que la bibliothèque Pandas excelle dans le calcul rapide de la matrice des coefficients, elle présente une lacune méthodologique majeure pour la recherche académique : sa méthode DataFrame.corr() ne renvoie aucune estimation de l’erreur standard, aucun intervalle de confiance et aucune valeur p (p-value) associée aux coefficients estimés. Or, en psychologie scientifique, un coefficient de corrélation r = 0,25 n’a pas la même portée s’il a été observé sur un échantillon de 15 sujets (statistiquement indifférenciable de zéro au seuil α = 0,05) ou sur une cohorte épidémiologique de 2 000 participants (hautement significatif avec une précision asymptotique élevée).
Pour combler ce déficit inférentiel, les chercheurs doivent combiner les calculs matriciels avec les fonctions de distribution de SciPy (telles que scipy.stats.pearsonr ou scipy.stats.spearmanr) ou, plus avantageusement encore, mobiliser la bibliothèque spécialisée Pingouin. Pingouin a été spécifiquement conçue par des chercheurs en neurosciences cognitives pour combler le fossé entre les routines statistiques de R et l’univers Python. Sa fonction rcorr() calcule en une seule instruction la matrice complète des corrélations tout en générant automatiquement la matrice des p-values correspondantes.
Pour les environnements où Pingouin ne peut être déployé, il est aisé d’écrire une fonction Python sur mesure. En s’appuyant sur la relation mathématique exacte qui lie le coefficient r de Pearson à la statistique de Student t comportant n – 2 degrés de liberté :
t = r × √(n – 2) / √(1 – r2)
on peut utiliser la fonction de répartition cumulative (survival function sf) de la distribution de Student disponible dans SciPy pour dériver la probabilité bilatérale exacte de chaque cellule. Cette approche hybride garantit que chaque coefficient calculé s’accompagne de son ancrage inférentiel formel.
8.2 Ajustement pour comparaisons multiples
L’évaluation simultanée d’une multiplicité d’hypothèses statistiques au sein d’une même matrice expose l’analyste au redoutable problème des comparaisons multiples. Si une matrice comporte 20 variables, elle totalise 190 corrélations bivariées uniques. Si l’on teste chacune de ces relations au seuil nominal classique de α = 0,05 sans précaution méthodologique, la probabilité d’observer au moins un faux positif (erreur de type I) par simple fluctuation d’échantillonnage aléatoire s’élève selon la formule du taux d’erreur par famille (Family-Wise Error Rate) :
FWER = 1 – (1 – α)k = 1 – (1 – 0,05)190 ≈ 0,9999
En d’autres termes, il est quasi mathématiquement certain que l’analyste identifiera de prétendues corrélations significatives qui ne reflètent que du bruit stochastique. Pour préserver l’intégrité de la démarche scientifique, l’ajustement des valeurs p s’impose impérativement. La correction la plus classique est celle de Bonferroni, qui divise le seuil α par le nombre total de comparaisons k. Bien que rigoureuse, elle s’avère excessivement conservative lorsque les variables sont elles-mêmes interdépendantes (ce qui est toujours le cas au sein d’un questionnaire), provoquant une hausse dramatique de l’erreur de type II (rejet à tort d’associations théoriques pourtant réelles).
Dans ce contexte, les procédures de contrôle du taux de fausse découverte (False Discovery Rate ou FDR), initialement formalisées par Yoav Benjamini et Yosef Hochberg, offrent une alternative méthodologique supérieure. La procédure Benjamini-Hochberg (accessible via le module statsmodels.stats.multitest.multipletests) ordonne les valeurs p brutes et applique un seuil séquentiel adaptatif. Cela permet de juguler l’inflation des faux positifs tout en conservant une puissance statistique satisfaisante pour détecter les corrélations réellement structurantes.
8.3 Affichage conditionnel des niveaux de significativité sur la heatmap
Une fois les p-values corrigées calculées, l’intégration de cette information inférentielle directement au sein de la visualisation graphique apporte une valeur ajoutée substantielle aux manuscrits académiques. L’analyste peut choisir entre deux stratégies visuelles : la superposition d’étoiles de significativité conventionnelles ou le masquage systématique des corrélations non significatives.
La première technique consiste à générer une matrice d’annotations textuelles personnalisées. Dans cette matrice de chaînes de caractères, chaque cellule contient le coefficient numérique enrichi d’un marqueur typographique standardisé : un astérisque (*) pour p < 0,05, deux astérisques (**) pour p < 0,01, et trois astérisques (***) pour p < 0,001. Cette table d’annotations est ensuite injectée dans le paramètre annot de la fonction sns.heatmap(), permettant au lecteur d’apprécier d’un seul regard tant l’amplitude de l’effet que son niveau de certitude statistique selon les canons graphiques de l’APA.
La seconde modalité, particulièrement appréciée dans les présentations de grand format, repose sur un masquage sélectif. En combinant le masque triangulaire supérieur avec une condition logique basée sur la significativité (par exemple, p_values > 0,05), on peut effacer purement et simplement les cellules qui n’atteignent pas le seuil de significativité statistique requis. Seules demeurent visibles et colorées les associations robustes, ce qui élimine le bruit visuel et focalise le débat scientifique sur les relations empiriquement étayées.
9. Interprétation psychologique et psychométrique des résultats matriciels
9.1 Graduation de la force d’association selon les conventions académiques
L’obtention d’un coefficient statistiquement significatif ne dispense pas d’une analyse méticuleuse de sa pertinence clinique ou comportementale. Dans son ouvrage de référence sur l’analyse de puissance statistique, Jacob Cohen a proposé des seuils empiriques devenus canoniques dans les sciences comportementales pour qualifier la taille d’effet d’une corrélation : un coefficient r de 0,10 reflète une association faible, une valeur de 0,30 dénote une force modérée, tandis qu’une valeur de 0,50 ou plus traduit une association forte.
Néanmoins, l’application rigide de ces bornes théoriques doit être modulée en fonction du domaine d’investigation spécifique. Dans les études neuropsychologiques explorant des processus élémentaires très circonscrits, observer une corrélation de 0,30 entre un temps de décision sensori-moteur et l’intégrité de la substance blanche cérébrale peut constituer une découverte de premier plan. Inversement, lors de la corrélation de deux sous-échelles d’anxiété mesurées par auto-questionnaire, un coefficient de 0,40 peut être jugé relativement modeste, compte tenu de la variance de méthode partagée inhérente à l’outil d’évaluation.
Un danger méthodologique récurrent réside dans la surinterprétation d’effets ténus sur de très grands échantillons. Grâce aux propriétés de l’inférence asymptotique, une corrélation de r = 0,08 calculée sur un échantillon de 10 000 participants affichera une valeur p infinitésimale (largement inférieure à 0,0001). Pourtant, ce coefficient n’explique que 0,64 % de la variance partagée (r2 = 0,0064) entre les deux phénomènes, ce qui rend son impact diagnostique individuel quasiment insignifiant. Le chercheur doit donc impérativement dissocier la significativité statistique de la pertinence pratique.
9.2 Évaluation de la validité convergente et discriminante
Au sein d’un programme d’évaluation psychométrique, la matrice de corrélation constitue la pierre angulaire de l’analyse de la validité de construit. Cette dernière s’articule traditionnellement autour de deux piliers formalisés par Donald Campbell et Donald Fiske : la validité convergente et la validité discriminante. La validité convergente postule que des instruments distincts conçus pour mesurer le même construit sous-jacent doivent présenter des intercorrélations substantielles et positives. Si une nouvelle échelle de dépression affiche un coefficient de Pearson de r = 0,78 avec l’inventaire BDI-II préexistant, la validité convergente est empiriquement étayée.
À l’opposé, la validité discriminante exige que l’échelle ne soit pas excessivement corrélée avec des construits théoriquement orthogonaux ou distincts. Si notre nouvel outil évaluant la dépression présente une corrélation de r = 0,85 avec une échelle mesurant l’anxiété généralisée, cela indique que l’instrument échoue à discriminer la détresse dépressive spécifique du spectre anxieux plus large. Dans ce cas, la validité discriminante est compromise par un chevauchement conceptuel excessif ou une incapacité des items à capturer la spécificité du trouble.
Ces principes trouvent leur expression méthodologique la plus aboutie dans la matrice multi-traits multi-méthodes (MTMM). Cette approche consiste à croiser systématiquement au moins deux traits psychologiques distincts mesurés chacun par au moins deux méthodes d’évaluation différentes (par exemple, un auto-questionnaire et une évaluation par un pair hétéro-rapportée). L’inspection de la sous-matrice permet de quantifier précisément la part de variance attribuable au trait réel par rapport à la variance parasite induite par la méthode de mesure.
9.3 Distinction impérative entre corrélation et causalité
Bien que cet axiome soit enseigné dès les premiers cycles universitaires, la confusion épistémologique entre covariation statistique et relation de cause à effet demeure l’un des biais d’interprétation les plus persistants de la recherche empirique. La découverte d’une forte corrélation positive entre le temps passé sur les réseaux sociaux et les scores d’isolement social chez les adolescents ne permet en aucun cas de conclure que les réseaux sociaux provoquent le repli relationnel. Il est tout aussi plausible que l’isolement social préexistant incite les individus à rechercher des connexions de substitution en ligne (causalité inverse).
Ce défi interprétatif est incarné par le problème classique de la troisième variable, ou variable de confusion (confounding variable). Deux variables peuvent covarier fortement simplement parce qu’elles se trouvent sous l’influence commune d’un tiers facteur non mesuré ou négligé dans le modèle. Ainsi, une association positive apparente entre la consommation de café et l’incidence des maladies cardiovasculaires s’évanouit ou diminue drastiquement lorsque l’on neutralise le tabagisme, les fumeurs ayant historiquement une tendance plus marquée à consommer simultanément du café.
Dans les devis de recherche transversaux — où l’ensemble des données est collecté à un instant t unique sans déploiement longitudinal —, la directionnalité temporelle est par définition absente. Les auteurs de rapports scientifiques et d’articles cliniques se doivent donc d’adopter une neutralité terminologique stricte dans la formulation de leurs résultats : proscrire systématiquement les verbes actifs à connotation causale tels que « induit », « détermine » ou « génère », pour leur préférer des formulations rigoureusement descriptives comme « est significativement associé à », « covarie positivement avec » ou « partage une variance commune substantielle avec ».
10. Diagnostic de la multicolinéarité et implications statistiques
10.1 Identification du risque d’instabilité des modèles multivariés
L’un des rôles diagnostiques fondamentaux de la matrice de corrélation réside dans la détection précoce de la multicolinéarité avant l’ajustement de modèles explicatifs plus complexes, au premier rang desquels figure la régression linéaire ou logistique multivariée. La multicolinéarité désigne une situation où deux ou plusieurs variables prédictives (indépendantes) sont fortement corrélées entre elles. Lorsqu’un chercheur intègre au sein d’un même modèle deux prédicteurs dont le coefficient de corrélation mutuel dépasse le seuil critique de 0,80 ou 0,85, les algorithmes matriciels sous-jacents se heurtent à une condition de quasi-singularité.
Les conséquences statistiques de cette pathologie sont lourdes. Bien que la performance globale du modèle (mesurée par exemple par le R2) ne soit pas altérée, la variance d’échantillonnage des coefficients de régression partiels (les poids bêta) gonfle démesurément. Les erreurs types deviennent si élevées que des prédicteurs majeurs perdent toute significativité statistique individuelle. Pire encore, les coefficients peuvent subir des inversions de signe aberrantes (un prédicteur corrélé positivement avec le critère en analyse bivariée peut hériter d’un bêta négatif au sein du modèle multivarié), rendant l’interprétation des contributions relatives totalement chaotique.
L’inspection minutieuse des corrélations hors-diagonale constitue le premier rempart contre ces défaillances. Si deux items ou échelles présentent un coefficient supérieur à 0,80, l’analyste doit immédiatement s’interroger sur l’opportunité de conserver ces deux indicateurs dans le même modèle d’ajustement, sous peine de rendre l’édifice explicatif particulièrement fragile et impossible à répliquer sur un nouvel échantillon.
10.2 Calcul du facteur d’inflation de la variance (VIF) en Python
Si la matrice de corrélation bivariée permet de repérer les colinéarités simples entre paires de variables, elle s’avère aveugle face aux colinéarités d’ordre supérieur, c’est-à-dire les cas où une variable est parfaitement prédite par une combinaison linéaire de trois ou quatre autres prédicteurs, sans pour autant partager une corrélation bivariée extrême avec aucun d’entre eux isolément. Pour diagnostiquer ces situations plus insidieuses, le calcul du facteur d’inflation de la variance (Variance Inflation Factor ou VIF) s’impose comme le standard méthodologique absolu.
Le VIF d’une variable j est mathématiquement défini par la formule :
VIFj = 1 / (1 – Rj2)
où Rj2 représente le coefficient de détermination obtenu en régressant la variable Xj sur l’ensemble des autres variables explicatives du modèle. En Python, l’implémentation de cette métrique s’opère facilement par l’intermédiaire du module statsmodels via sa routine variance_inflation_factor située dans statsmodels.stats.outliers_influence.
Les seuils d’alerte méthodologiquement consacrés établissent qu’une valeur de VIF supérieure à 5 signale une colinéarité préoccupante, tandis qu’un VIF supérieur à 10 exige une intervention corrective immédiate. Face à de tels scores, le chercheur dispose de plusieurs options opérationnelles : fusionner les variables redondantes en créant un score composite agrégé (moyenne ou somme standardisée), supprimer la variable la moins fiable sur le plan psychométrique, ou recourir à des méthodes de régression pénalisée régularisée (telles que Ridge ou ElasticNet) spécifiquement conçues pour stabiliser les estimations sous forte colinéarité.
10.3 Transitions vers des méthodes de modélisation avancées
Le constat des limites inhérentes aux corrélations bivariées brutes incite fréquemment le chercheur à franchir un palier méthodologique vers les analyses de corrélation partielle et semi-partielle. La corrélation partielle évalue l’association résiduelle reliant deux variables d’intérêt une fois que l’influence linéaire d’une ou plusieurs covariables de contrôle (par exemple, l’âge, le genre biologique, le niveau d’éducation ou un score d’intelligence globale) a été mathématiquement neutralisée sur les deux variables cibles. La bibliothèque Pingouin permet de calculer directement des matrices entières de corrélations partielles via sa fonction pcorr().
Cette approche est précieuse dans les protocoles cliniques où les comorbidités sont fréquentes. Par exemple, si l’on cherche à évaluer la relation propre unissant les ruminations mentales à la qualité du sommeil, il est indispensable de partialiser les scores de dépression générale, sous peine de mesurer une association largement médiée par l’humeur dépressive globale. La corrélation semi-partielle, quant à elle, ne retire l’influence de la covariable que sur un seul des deux indicateurs, fournissant une métrique directe de l’incrément de variance expliqué utile lors de l’intégration hiérarchique de blocs de variables.
Enfin, la matrice de corrélation traitée et nettoyée constitue le socle quantitatif direct à partir duquel se construisent les modélisations par équations structurelles (Structural Equation Modeling ou SEM), qu’il s’agisse de modèles de mesure confirmatoires ou de modèles de trajectoire causale (path analysis). L’intégrité numérique, la normalité conjointe et la non-singularité de cette matrice conditionneront directement la capacité des algorithmes d’estimation du maximum de vraisemblance à converger vers une solution stable et théoriquement interprétable.
11. Personnalisation technique et exportation pour publication académique
11.1 Exportation sous format tabulaire normé
La mise en forme manuelle de tableaux de corrélation dans un traitement de texte représente une source récurrente d’erreurs typographiques et une perte de temps considérable pour les équipes de recherche. Pour garantir l’intégrité des résultats et fluidifier le flux de travail académique, la conversion automatisée de la matrice calculée en une table directement intégrable dans des manuscrits normés LaTeX ou Microsoft Word constitue une bonne pratique incontournable. Pandas met à disposition des méthodes de sérialisation très directes telles que to_latex() et to_csv().
Selon les normes de publication internationales prescrites par le manuel de style de l’APA (7e édition), les tableaux de corrélation doivent respecter des conventions typographiques strictes : omission systématique du zéro avant la virgule décimale pour les statistiques bornées entre -1 et +1 (on écrira .34 et non 0.34), alignement décimal rigoureux, remplacement de la diagonale unitaire par des tirets d’omission et affichage exclusif du triangle inférieur de la matrice. L’écriture d’une routine de post-traitement en Python permet d’appliquer ces règles de manière totalement automatisée.
Le code d’exportation peut être encapsulé dans une fonction utilitaire qui parcourt les cellules du tableau, convertit les nombres à virgule flottante au format textuel adéquat, efface les valeurs supérieures du masque triangulaire et adjoint les notes de bas de page répertoriant les seuils de significativité statistique (* p < .05, ** p < .01, *** p < .001). L’exportation directe du code source LaTeX résultant permet une compilation immédiate dans des compilateurs académiques comme Overleaf sans aucune manipulation intermédiaire.
11.2 Exportation vectorielle haute définition des visualisations
Si la restitution tabulaire demeure indispensable pour les annexes métrologiques, la présentation visuelle sous forme de heatmap haute définition constitue souvent la figure maîtresse d’une publication scientifique. L’exportation de cette figure ne doit jamais être effectuée par de simples captures d’écran, sous peine de produire des images pixelisées, floues et refusées par les comités éditoriaux des revues scientifiques. Il est impératif d’utiliser la méthode savefig() de Matplotlib en configurant explicitement les paramètres de sortie géométrique et colorimétrique.
Le choix du format de fichier est la première décision technique : pour les publications papier ou numériques imprimables, les formats vectoriels tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics) doivent être privilégiés car ils conservent une netteté absolue quelle que soit l’échelle d’agrandissement, les polices de caractères et les tracés géométriques étant encodés sous forme d’instructions mathématiques vectorielles. Si un format matriciel (raster) est exigé par l’éditeur (comme le TIFF ou le PNG), la résolution doit être explicitement fixée à un seuil minimal de 300 DPI, voire 600 DPI (dots per inch) via le paramètre dpi=300.
Un autre raffinement concerne l’optimisation de l’emprise spatiale de la figure via le paramètre bbox_inches='tight', qui élimine automatiquement les marges blanches périphériques excessives générées par défaut autour des graphiques. Il convient également de s’assurer que la figure conserve toute sa clarté informative si elle est reproduite en niveaux de gris ou imprimée en noir et blanc, une contrainte fréquente dans les tirages papier universitaires traditionnels.
12. Pièges méthodologiques courants et recommandations finales
12.1 Le paradoxe de Simpson et les effets de sous-groupes
L’un des pièges statistiques les plus déroutants lors de l’analyse corrélationnelle est incarné par le paradoxe de Simpson. Ce phénomène survient lorsqu’une association bivariée observée au niveau d’un échantillon global agrégé s’atténue, disparaît totalement, ou pire, s’inverse radicalement lorsque les données sont désagrégées en sous-groupes homogènes (par exemple, selon le genre biologique, des tranches d’âge distinctes, ou le statut de contrôle clinique versus patient hospitalisé).
Imaginons une investigation évaluant l’association entre le niveau de stress perçu et la performance cognitive globale au sein d’une cohorte hétérogène regroupant des adultes jeunes et des personnes âgées. Au niveau de la population totale fusionnée, on pourrait observer une corrélation positive inattendue (les scores de stress et de performance augmentant conjointement). Toutefois, si l’on stratifie la matrice par groupe d’âge, on peut découvrir qu’au sein de chaque sous-groupe pris isolément, le stress est négativement associé à la performance cognitive. Ce paradoxe découle du fait que le groupe des adultes jeunes présente simultanément des scores de performance brute structurellement plus hauts et un niveau d’anxiété de base plus élevé que le groupe âgé, créant un artefact de corrélation fallacieux lors du mélange des distributions.
Pour prévenir cette illusion méthodologique, le chercheur ne doit jamais se contenter d’une matrice unique aveugle calculée sur l’ensemble de la base de données. Il est indispensable d’exécuter des analyses stratifiées systématiques via des regroupements conditionnels (en utilisant l’opération groupby() de Pandas). L’examen comparatif des matrices de corrélations obtenues au sein de chaque strate permettra de vérifier l’invariance de mesure de l’instrument et d’éviter des extrapolations théoriques erronées sur la population générale.
12.2 Non-linéarité et déformation par valeurs aberrantes
La confiance aveugle accordée au coefficient r de Pearson en l’absence de vérification graphique préalable constitue une autre source majeure de biais analytiques. Le quartette d’Anscombe illustre cette vulnérabilité de façon saisissante : quatre jeux de données artificiels présentant des propriétés statistiques descriptives rigoureusement identiques (mêmes moyennes, mêmes variances et une corrélation linéaire de Pearson identique de r = 0,816) révèlent en réalité, dès lors qu’ils sont visualisés sous forme de nuages de points, des structures sous-jacentes totalement dissemblables (une relation linéaire classique, une trajectoire parabolique quadratique parfaite, une relation linéaire parfaite dégradée par une valeur aberrante unique, et une distribution verticale constante articulée autour d’un unique point de levier latéral).
En sciences cognitives et comportementales, de nombreuses lois psychologiques fondamentales adoptent une morphologie strictement non linéaire. L’exemple le plus célèbre est la loi de Yerkes-Dodson, qui postule une relation en « U inversé » entre le niveau d’éveil attentionnel (arousal) et la performance à une tâche complexe : une activation trop faible altère la vigilance, une activation modérée optimise l’efficacité, tandis qu’une anxiété aiguë entraîne un effondrement de la performance. Appliquer un coefficient de Pearson sur une telle trajectoire produira une corrélation proche de zéro, masquant une relation fonctionnelle puissante.
Il est donc impératif de coupler systématiquement le calcul de la matrice de corrélation avec une inspection graphique exploratoire de quelques nuages de points représentatifs (par exemple via la fonction sns.pairplot() sur les sous-ensembles de variables clés). De surcroît, la mise en œuvre d’estimateurs de corrélation robustes — tels que le coefficient biconcordant (biweight midcorrelation) ou la corrélation basée sur le déterminant de covariance minimale (Minimum Covariance Determinant ou MCD) disponibles dans scikit-learn — permet de mesurer les associations en neutralisant l’influence des points aberrants extrêmes sans recourir à des suppressions manuelles arbitraires de données.
12.3 Synthèse des étapes clés pour un flux de travail rigoureux
Pour garantir la validité scientifique, l’élégance algorithmique et la reproductibilité computationnelle de vos analyses de corrélation en Python, il est salutaire de structurer votre démarche méthodologique selon un flux de travail standardisé et rigoureux :
- Étape 1 : Audit et prétraitement métrologique : Inspection du dictionnaire des variables, conversion stricte des types numériques dans Pandas, codage des modalités d’exclusion et inversion préalable des items psychométriques inversés.
- Étape 2 : Exploration distributionnelle univariée : Calcul du skewness et du kurtosis pour chaque indicateur, corroboré par des diagrammes de densité ou Q-Q plots, afin de décider rationnellement de l’usage de Pearson (données normales continues) ou de Spearman/Kendall (données ordinales, asymétriques ou petits échantillons).
- Étape 3 : Traitement raisonné des données manquantes : Diagnostic du mécanisme d’omission (MCAR, MAR, MNAR) et sélection entre suppression par liste, par paire contrôlée (avec seuil
min_periods), ou imputation multivariée via des estimateurs algorithmiques comme KNN ou MICE. - Étape 4 : Calcul matriciel et inférence statistique : Génération de la matrice d’association par
df.corr(), suivie obligatoirement du calcul des p-values exactes (via SciPy ou Pingouin) et de l’ajustement systématique pour comparaisons multiples (correction Benjamini-Hochberg ou Bonferroni). - Étape 5 : Visualisation ergonomique et sélective : Restitution sous forme de heatmap divergente centrée sur zéro (via Seaborn), masquage du triangle supérieur redondant, annotation des niveaux de significativité par étoiles conventionnelles ou filtrage des cellules non significatives.
- Étape 6 : Diagnostic multivarié et exploration structurelle : Vérification de l’absence de colinéarité excessive (seuils critiques r > 0,80 ou calcul du VIF > 5) avant modélisation en régression, et réorganisation éventuelle par classification hiérarchique (
clustermap). - Étape 7 : Exportation académique et documentation : Sauvegarde automatisée des tableaux formatés selon les directives de l’APA (au format LaTeX ou CSV nettoyé) et exportation des graphiques en haute résolution vectorielle (PDF/SVG à 300 DPI minimum), accompagnée du gel déterministe de l’environnement Python pour assurer la réplication indépendante des résultats.
En observant cette rigueur méthodologique à chaque jalon de votre analyse, vous transformez une opération technique élémentaire en un instrument de démonstration scientifique irréprochable. L’écosystème Python offre une flexibilité sans égale pour mener ces investigations à terme, permettant au psychologue, au neuroscientifique et au chercheur en sciences sociales d’extraire la substantifique moelle de leurs données comportementales avec un degré de fidélité et de clarté optimal.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://apastyle.apa.org/
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the False Discovery Rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.2307/2332226
- Little, R. J. A., & Rubin, D. B. (2019). Statistical Analysis with Missing Data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1928-005
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., … & Duchesnay, É. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825–2830. https://jmlr.org/papers/v12/pedregosa11a.html
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Vallat, R. (2018). Pingouin: Statistics in Python. Journal of Open Source Software, 3(31), 1026. https://doi.org/10.21105/joss.01026
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021