
Dans le champ contemporain de l’analyse quantitative et de la psychométrie, la quantification de l’intensité et de la direction d’une relation linéaire entre deux variables constitue un pilier fondamental de l’investigation empirique. Historiquement dominée par une focalisation presque exclusive sur le test d’hypothèse nulle conventionnel et la production mécanique de valeurs p, la recherche en sciences comportementales a traversé une crise de reproductibilité majeure qui a contraint la communauté académique à repenser ses paradigmes inférentiels. L’évaluation isolée du coefficient de corrélation linéaire de Bravais-Pearson, bien qu’informative, s’avère fondamentalement incomplète sans une mesure explicite de l’incertitude métrologique inhérente à l’échantillonnage aléatoire.
L’estimation par intervalle de confiance s’impose ainsi non seulement comme un complément méthodologique indispensable, mais comme une nécessité épistémologique supérieure. En délimitant une plage de valeurs plausibles au sein de laquelle le paramètre populationnel inconnu est susceptible de résider avec un degré de certitude prédéterminé, l’intervalle de confiance restitue à la statistique descriptive son statut d’approximation probabiliste. Il offre aux chercheurs une vision bidimensionnelle combinant l’amplitude de l’effet observé et le degré de précision métrologique autorisé par la taille de la cohorte analysée, transcendant ainsi les jugements dichotomiques réducteurs imposés par les seuils de significativité arbitraires.
Le présent traité propose une exploration exhaustive, rigoureuse et didactique des fondements théoriques, des formulations mathématiques et des applications pratiques de l’intervalle de confiance pour un coefficient de corrélation. À travers l’étude approfondie de la distribution d’échantillonnage asymétrique du coefficient r, la démonstration analytique de l’élégante transformation stabilisatrice de variance développée par Ronald A. Fisher, et l’analyse critique des conditions d’application psychométriques, cet article fournit l’ensemble des clés méthodologiques requises pour maîtriser, calculer et rapporter cet indice selon les normes les plus exigeantes de la communication scientifique moderne.
1. Fondements conceptuels de l’intervalle de confiance pour un coefficient de corrélation
1.1 Définition probabiliste et théorique de l’intervalle
D’un point de vue strictement mathématique et probabiliste, l’intervalle de confiance associé à un coefficient de corrélation linéaire ne doit pas être appréhendé comme une simple marge d’erreur symétrique greffée artificiellement sur une estimation ponctuelle. Il s’agit d’une réalisation spécifique d’un estimateur par intervalle, c’est-à-dire une fonctionnelle qui associe à tout échantillon aléatoire issu d’un univers statistique donné un sous-ensemble fermé de l’espace paramétrique admissible [-1, 1]. Sous le paradigme fréquentiste néo-fisherien, la valeur du paramètre populationnel ρ (rho) est postulée comme une constante fixe, immuable mais fondamentalement inconnue de l’expérimentateur. Par conséquent, ce ne sont point les paramètres de la population qui oscillent ou fluctuent de manière aléatoire, mais bien les bornes inférieure et supérieure de l’intervalle généré à partir des données de l’échantillon.
La probabilité de couverture théorique, généralement fixée à 1 – α (où α désigne le risque d’erreur de première espèce, classiquement établi à 0,05 dans les protocoles de recherche conventionnels), quantifie la performance asymptotique à long terme de la procédure d’estimation. Affirmer qu’un intervalle de confiance bilatéral présente un niveau de confiance de 95 % signifie formellement que si une infinité d’expériences identiques étaient menées de manière indépendante au sein de la même population parente, avec des tirages aléatoires équiprobables de taille N strictement équivalente, 95 % des intervalles ainsi construits recouvriraient effectivement la valeur exacte et invariante de ρ, tandis que 5 % échoueraient à l’englober en raison des fluctuations stochastiques d’échantillonnage.
Cette perspective conceptuelle exige une séparation herméneutique stricte entre le paramètre abstrait de la population (ρ) et son estimateur empirique d’échantillon (r). Le coefficient r n’est qu’une variable aléatoire singulière dépendant intégralement des contingences du tirage au sort, tandis que l’intervalle de confiance matérialise l’étendue de la variabilité d’échantillonnage admissible tout en fournissant une métrique directe de la précision de notre inférence.
1.2 Dichotomie entre estimation ponctuelle et estimation par intervalle
L’estimation ponctuelle, incarnée par le coefficient de corrélation d’échantillon r, souffre d’une fragilité heuristique majeure lorsqu’elle est interprétée isolément. Elle fournit une estimation unique qui, bien qu’étant asymptotiquement sans biais ou à biais négligeable dans des conditions de normalité bivariée standard, possède une probabilité mathématique strictement nulle de coïncider exactement avec le paramètre ρ dans le continuum des nombres réels. Présenter exclusivement un coefficient r = 0,42 dans un rapport de recherche occulte entièrement l’aléa lié à la représentativité de l’échantillon et confère une illusion de certitude géométrique particulièrement préjudiciable à la rigueur scientifique.
L’estimation par intervalle répond directement à cette lacune en incorporant formellement l’erreur type de l’estimateur au cœur de la restitution des résultats. Elle transforme une assertion ponctuelle fragile en une déclaration d’incertitude quantifiée. Cette transition revêt une supériorité épistémologique manifeste par rapport aux tests de signification de l’hypothèse nulle conventionnels (NHST). Alors qu’un test d’hypothèse se borne à rejeter ou à ne pas rejeter une valeur ponctuelle préétablie (généralement l’absence totale d’association, H0: ρ = 0) sur la base d’une métrique probabiliste souvent mal interprétée (la valeur p), l’intervalle de confiance déploie sous les yeux du chercheur l’ensemble des hypothèses paramétriques qui demeurent hautement compatibles avec les données observées.
Ainsi, un intervalle étroit entourant un coefficient modeste apporte une information scientifique bien plus solide et exploitable qu’un intervalle excessivement large centré sur une corrélation apparemment vigoureuse mais issue d’une cohorte squelettique. L’intervalle de confiance libère la statistique inférentielle de la tyrannie du tout-ou-rien imposée par le seuil de signification, autorisant une appréciation nuancée de la force et de la précision des régularités empiriques observées dans la nature.
1.3 Pertinence méthodologique dans la recherche en psychologie
Dans les sciences psychologiques, comportementales et sociales, la quantification des relations linéaires entre variables prend une dimension méthodologique singulière en raison de la nature des objets étudiés. Les construits psychologiques tels que la mémoire de travail, l’intelligence fluide, la réactivité émotionnelle ou l’estime de soi ne sont jamais mesurés de façon directe ou parfaitement exacte ; ils sont appréhendés par l’intermédiaire de variables latentes et d’instruments psychométriques intrinsèquement soumis à l’erreur de mesure. Dans ce contexte de bruit instrumental omniprésent, l’estimation de la corrélation entre deux scores de tests reflète inévitablement à la fois la véritable association structurelle des construits et les imperfections d’échantillonnage métrologique.
L’évaluation rigoureuse de la reproductibilité des relations inter-variables nécessite donc l’abandon systématique du modèle dichotomique décisionnel au profit d’une cartographie continue de la plausibilité statistique. Un constat étayé par les travaux pionniers de la Task Force on Statistical Inference de l’American Psychological Association a mis en lumière les ravages méthodologiques induits par la surinterprétation de variations infimes de valeurs p situées de part et d’autre de la frontière arbitraire de 0,05. Ces recommandations ont culminé dans les éditions successives du manuel de publication de l’APA, qui érigent l’inclusion des intervalles de confiance au rang d’exigence obligatoire pour toute communication de tailles d’effet.
En psychologie différentielle et expérimentale, l’intervalle de confiance pour un coefficient de corrélation constitue l’instrument privilégié permettant d’évaluer si une corrélation observée entre, par exemple, un trait de personnalité et une performance cognitive, est suffisamment précise pour étayer une théorie générale ou si elle requiert des réplications substantielles avant toute tentative de généralisation écologique.
2. Motivation théorique : Incertitude d’échantillonnage et variabilité statistique
2.1 La nature stochastique de l’erreur d’échantillonnage
L’inévitabilité de l’erreur d’échantillonnage découle du décalage fondamental entre l’ambition universelle des théories scientifiques et la réalité matérielle de l’investigation empirique. Dans l’immense majorité des devis de recherche, il est rigoureusement impossible d’accéder à l’exhaustivité de la population cible en raison d’insurmontables contraintes temporelles, financières et logistiques. Le chercheur est ainsi contraint de travailler sur un sous-ensemble restreint d’observations, sélectionné selon les lois du tirage aléatoire simple ou de l’échantillonnage stratifié. De ce fait, chaque cohorte étudiée constitue un échantillon stochastique singulier, caractérisé par ses propres idiosyncrasies distributionnelles.
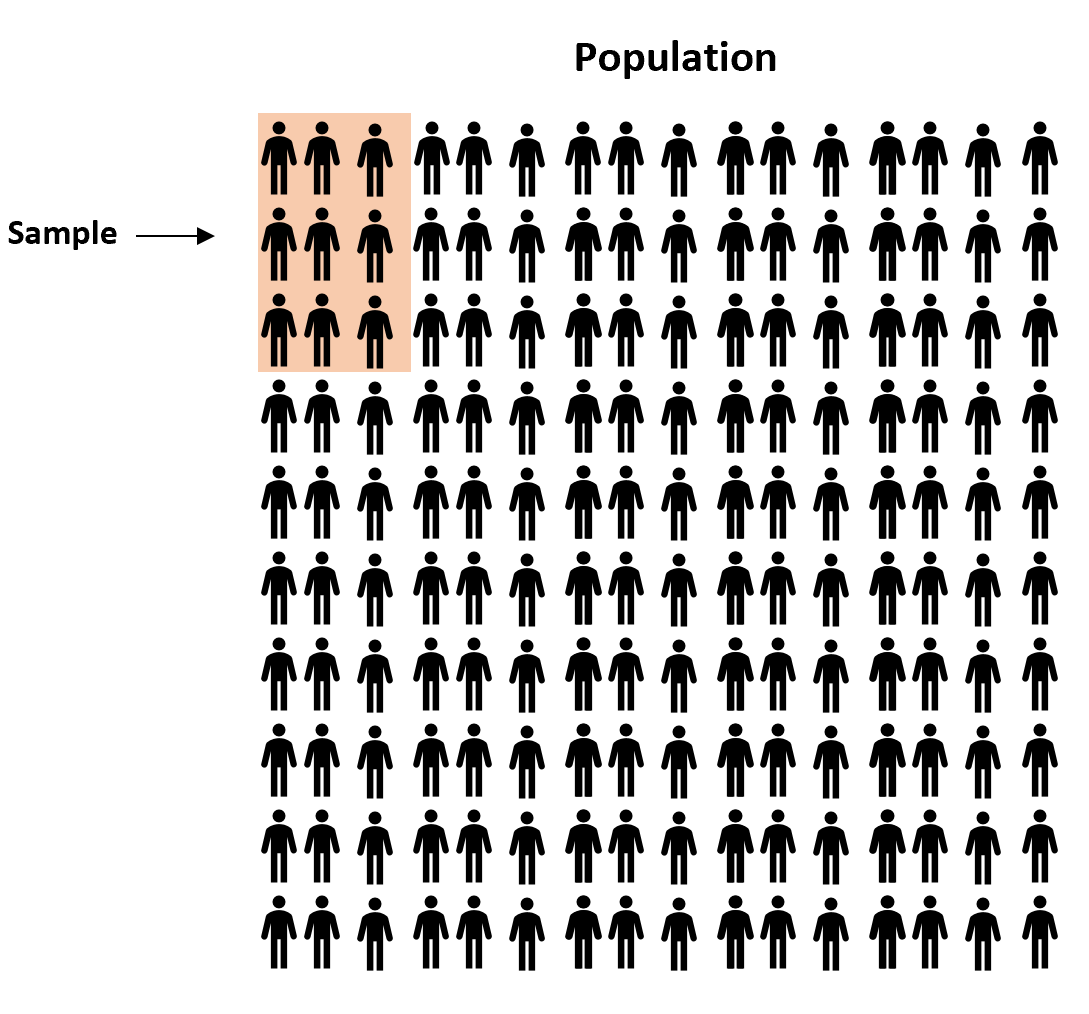
Même en supposant que l’échantillonnage soit parfaitement probabiliste et exempt de biais de sélection systématique, le coefficient r calculé sur l’échantillon oscillera inévitablement autour du paramètre populationnel ρ. Ces oscillations purement aléatoires définissent la variabilité d’échantillonnage. Si la cohorte est restreinte, un ou deux individus présentant des valeurs extrêmes concomitantes peuvent gonfler artificiellement ou effondrer de manière drastique l’intensité apparente de la relation linéaire. Plus l’échantillon s’éloigne de l’exhaustivité, plus la densité de probabilité de l’estimateur r s’étale, élargissant par conséquent l’éventail des valeurs observées potentielles.
Comprendre la nature stochastique de cette erreur impose d’admettre que l’estimation obtenue n’est qu’un point fugace sur une trajectoire probabiliste. La modélisation de cette incertitude requiert une formalisation mathématique rigoureuse de la dispersion de l’estimateur, condition sine qua non pour déterminer dans quelle mesure l’observation empirique peut être projetée avec confiance à l’échelle de la population générale.
2.2 Limites de la p-valeur sans intervalle de confiance
L’histoire de la méthodologie quantitative est profondément marquée par une utilisation dévoyée de la valeur p, fréquemment interprétée à tort comme un indicateur d’amplitude ou d’importance théorique d’un phénomène. La valeur p ne mesure en réalité que la probabilité conditionnelle d’observer une statistique d’échantillon au moins aussi extrême que celle effectivement recueillie, sous l’hypothèse stricte que le modèle nul (généralement ρ = 0) soit parfaitement exact dans la population, formellement exprimée par P(D≥d | H0). Cette dépendance conjointe à l’amplitude de l’effet et à la taille de l’échantillon engendre des paradoxes interprétatifs critiques lorsqu’elle est employée de manière isolée.
Dans le cadre d’un échantillon massif comprenant plusieurs dizaines de milliers de sujets, un coefficient de corrélation infinitésimal de r = 0,03 produira une valeur p hautement significative (par exemple p < 0,001), conduisant un observateur naïf à rejeter H0 et à conclure triomphalement à l’existence d’une régularité remarquable, alors même que la proportion de variance partagée (r2 = 0,0009) s’avère totalement négligeable d’un point de vue pratique ou clinique. Inversement, sur un échantillon exploratoire de 15 participants, un coefficient d’une ampleur théorique considérable (r = 0,48) pourra afficher une valeur p supérieure au seuil canonique de 0,05 (ici p ≈ 0,07), incitant le chercheur imprudent à conclure prématurément à l’absence de relation.
L’intervalle de confiance désamorce intégralement ces contresens analytiques. En restituant l’estimation sous la forme d’un continuum paramétrique, il permet d’écarter simultanément des valeurs triviales et des valeurs substantielles. Si un intervalle à 95 % s’étend de [0,01 à 0,05], le chercheur perçoit immédiatement que bien que l’effet soit statistiquement discernable de zéro, sa magnitude réelle est confinée à des niveaux insignifiants. À l’inverse, un intervalle s’étalant de [-0,05 à 0,80] signale sans équivoque que l’étude manque cruellement de puissance et de précision pour trancher entre une absence de corrélation et une relation d’une force majeure.
2.3 Rôle de la taille de l’échantillon sur la marge d’erreur
L’influence de l’effectif N sur l’étendue de l’intervalle de confiance est régie par une dynamique mathématique fondamentale : l’erreur type d’un estimateur statistique décroît selon une relation asymptotique proportionnelle à l’inverse de la racine carrée de la taille d’échantillon (1 / √N). Cette relation non linéaire implique que pour réduire de moitié la largeur d’un intervalle de confiance donné, il ne suffit pas de doubler le nombre de participants, mais il est rigoureusement nécessaire de quadrupler l’effectif de la cohorte d’étude.
Dans les échantillons restreints, la marge d’erreur atteint des proportions considérables. Les chercheurs novices commettent fréquemment l’erreur d’accorder une confiance démesurée à un coefficient de corrélation élevé issu d’une étude pilote comprenant un effectif limité (par exemple N = 20, r = 0,60). L’application des formules appropriées démontre que l’intervalle de confiance à 95 % associé à une telle observation s’étend approximativement de [0,21 à 0,82]. Une telle amplitude révèle que la véritable relation dans la population peut tout aussi bien être faible à modérée que quasi déterministe, invalidant toute conclusion théorique catégorique.
Lorsque la taille d’échantillon tend vers l’infini, la variance d’échantillonnage s’amenuise de façon continue, entraînant la convergence de l’intervalle vers un point unique coïncidant avec le paramètre ρ. Ce comportement asymptotique garantit la cohérence statistique de l’estimateur mais rappelle avec insistance que dans la pratique de la recherche empirique, où les cohortes dépassent rarement quelques centaines de cas, la marge d’erreur demeure un élément structurel incompressible qui doit gouverner toute prudence interprétative.
3. Propriétés distributionnelles du coefficient de corrélation de Pearson
3.1 Non-normalité et asymétrie de la distribution d’échantillonnage
L’une des complexités les plus remarquables de l’analyse corrélationnelle réside dans la morphologie mathématique de la distribution d’échantillonnage du coefficient de Bravais-Pearson. Alors que le théorème central limite permet, pour de nombreux estimateurs statistiques linéaires simples (comme la moyenne empirique), de postuler une convergence rapide vers une loi normale symétrique, cette propriété ne s’applique pas directement au coefficient r lorsque la corrélation populationnelle ρ s’écarte de zéro.
Cette distorsion structurelle découle de la nature même de l’espace métrique au sein duquel le coefficient est contraint. Par définition mathématique, la corrélation de Pearson est strictement bornée dans l’intervalle compact [-1, +1]. Dès lors que le paramètre populationnel ρ prend une valeur positive non nulle, la distribution d’échantillonnage subit une compression mécanique asymétrique contre la borne supérieure étanche fixée à +1. Les valeurs d’échantillon r supérieures à ρ disposent d’un espace géométrique restreint pour fluctuer, tandis que les valeurs inférieures peuvent s’étendre librement vers la gauche sur un domaine beaucoup plus vaste. Il en résulte une distribution d’échantillonnage négativement asymétrique (étalée vers la gauche pour ρ > 0) ou positivement asymétrique (étalée vers la droite pour ρ < 0).
Cette asymétrie devient dramatiquement prononcée à mesure que la magnitude absolue de ρ croît ou que la taille de l’échantillon diminue. Par conséquent, postuler une loi normale classique symétrique pour modéliser le comportement de r constitue une violation mathématique flagrante qui vicie profondément la construction des inférences statistiques élémentaires.
3.2 Impact de la magnitude de la corrélation sur la variance
Une caractéristique corollaire essentielle de la distribution de r réside dans son hétéroscédasticité intrinsèque : la variance d’échantillonnage de l’estimateur n’est absolument pas constante, mais dépend de manière étroite et non linéaire de la valeur même du paramètre inconnu ρ. Dans le cadre d’une population bivariée normale, la variance exacte de la distribution d’échantillonnage de r peut être approximée au premier ordre par l’expression analytique suivante :
Var(r) ≈ (1 – ρ2)2 / (N – 1)
Cette formulation met en lumière un phénomène statistique capital : plus la corrélation populationnelle ρ s’approche des bornes extrêmes (-1 ou +1), plus le terme (1 – ρ2) s’amenuise, induisant un effondrement drastique de la variance d’échantillonnage. À l’extrême, si ρ = 1, la variance devient strictement nulle, chaque échantillon reproduisant invariablement une relation linéaire parfaite. Inversement, lorsque ρ = 0, le numérateur atteint sa valeur maximale d’unité, conférant à l’estimateur une dispersion d’échantillonnage maximale égale à 1 / (N – 1).
Cette dépendance fonctionnelle directe entre la dispersion de l’estimateur et la quantité inconnue qu’il est censé évaluer pose une aporie majeure pour la construction directe d’intervalles de confiance : comment calculer la marge d’erreur d’un échantillon sans connaître préalablement la valeur exacte de ρ qui gouverne la variance de cet échantillon ? Cette difficulté conceptuelle justifie la recherche impérative d’une transformation stabilisatrice de variance permettant de dissocier la variance de l’estimateur de la valeur du paramètre sous-jacent.
3.3 Conséquences sur la construction naïve des bornes
Face à ces propriétés distributionnelles singulières, l’approche intuitive consistant à appliquer la formule additive standard héritée des distributions gaussiennes (souvent formalisée de manière naïve par r ± zα/2 × SE, où SE représenterait une prétendue erreur type symétrique) constitue une erreur méthodologique gravissime. Cette construction naïve présuppose implicitement que la distribution de r est parfaitement symétrique et que sa dispersion est indépendante de son centre de gravité, deux postulats formellement invalidés par l’analyse mathématique.
L’application d’une telle formule symétrique produit des aberrations concrètes immédiatement décelables. D’une part, lorsque le coefficient empirique r est élevé et que la taille d’échantillon est modérée (par exemple r = 0,85 avec N = 25), le calcul naïf de la borne supérieure peut aisément aboutir à une valeur dépassant 1,00 (par exemple 1,04), ce qui constitue un non-sens mathématique au regard de l’inégalité de Cauchy-Schwarz. D’autre part, cette procédure sous-estime de manière systématique l’étendue de l’intervalle du côté opposé à la borne de compression, faussant radicalement le taux de couverture probabiliste effectif de l’intervalle.
Les études de simulation de Monte Carlo ont formellement démontré qu’un intervalle naïf calibré nominalement pour offrir une couverture à 95 % peut voir sa couverture empirique réelle chuter sous le seuil critique des 88 % dès lors que |ρ| excède 0,50. Il s’avère donc impératif de rejeter ces approches simplistes au profit de méthodologies de transformation non linéaires rigoureusement éprouvées.
4. La transformation z de Fisher : Fondements et justifications
4.1 Origine et définition de la fonction arc-tangente hyperbolique
Face aux impasses distributionnelles du coefficient de corrélation linéaire brut, le statisticien britannique Ronald Aylmer Fisher réalisa une percée théorique majeure en 1915, prolongée par son article séminal de 1921. Fisher chercha à identifier une transformation bijective non linéaire capable de projeter l’espace borné [-1, +1] du coefficient de corrélation sur la droite des réels complète ]-∞, +∞[, tout en annihilant l’asymétrie de la distribution d’échantillonnage et en stabilisant définitivement sa variance.
Cette fonction mathématique, universellement désignée sous l’appellation de transformation z de Fisher (ou z′ de Fisher), repose sur le logarithme népérien du rapport des distances aux bornes d’admissibilité. Elle est définie analytiquement pour tout coefficient d’échantillon r strictement compris entre -1 et +1 par l’expression fondamentale :
z′ = (1 / 2) × ln( (1 + r) / (1 – r) )
Sur le plan de l’analyse fonctionnelle, cette expression correspond de façon rigoureusement équivalente à la fonction arc-tangente hyperbolique (notée artanh ou tanh-1). La relation s’écrit donc avec une élégance parfaite :
z′ = artanh(r)
De la même manière, la transformation s’applique au paramètre populationnel ρ, définissant la quantité théorique correspondante ζ (zêta) par l’équation ζ = artanh(ρ). Cette projection bijective étire considérablement les valeurs de corrélations à mesure qu’elles s’approchent des extrêmes : une valeur de r = 0 reste ancrée à z′ = 0, mais une corrélation de r = 0,80 est projetée à z′ ≈ 1,0986, tandis qu’une corrélation de r = 0,99 est propulsée à z′ ≈ 2,6467, éliminant ainsi le plafond géométrique responsable de la compression asymétrique originelle.
4.2 Stabilisation de la variance et normalisation asymptotique
Le tour de force mathématique de Ronald Fisher réside dans la démonstration que la distribution d’échantillonnage de la variable transformée z′ converge avec une célérité remarquable vers une loi normale standardisée, et ce, quelle que soit la valeur du paramètre de corrélation initial ρ. Contrairement à la distribution brute de r, qui exige des effectifs colossaux pour approcher la symétrie lorsque ρ s’écarte substantiellement de zéro, la variable z′ acquiert une forme quasi parfaitement gaussienne dès lors que la taille d’échantillon franchit le seuil modeste de quelques dizaines d’observations.
Plus fondamental encore est le principe de stabilisation de la variance obtenu par cette dérivation. Fisher a démontré que la variance asymptotique de z′ est totalement affranchie du paramètre ρ et ne dépend plus exclusivement que de la taille de l’échantillon N. L’approximation canonique de la variance de la variable transformée s’exprime selon la formule universelle :
Var(z′) ≈ 1 / (N – 3)
L’élimination du paramètre inconnu ρ dans l’équation de dispersion résout magistralement le problème d’estimation circulaire évoqué précédemment. En rendant la variance strictement homoscédastique à travers l’ensemble de l’espace paramétrique, Fisher a fourni un cadre analytique limpide où les règles classiques de l’inférence normale peuvent enfin être appliquées en toute légitimité mathématique.
4.3 Comportement de l’erreur type de la transformation
Par dérivation directe de la variance asymptotique établie par Fisher, l’erreur type (notée SEz′) associée à la statistique transformée est définie par la racine carrée positive de la variance, soit :
SEz′ = 1 / √(N – 3)
Le dénominateur N – 3 intègre une correction de degrés de liberté liée à l’estimation des deux moyennes et des deux variances marginales ainsi que de la covariance au sein du modèle normal bivarié. Il convient de souligner que cette formulation est remarquable de par sa constance universelle : que la corrélation empirique soit de r = 0,05 ou de r = 0,92, la marge d’incertitude dans l’espace transformé de Fisher demeure rigoureusement identique pour une taille d’échantillon N donnée.
Concernant les conditions de validité face aux petits effectifs, de nombreux travaux d’analyse asymptotique ont démontré que l’erreur type 1 / √(N – 3) offre une fidélité mathématique remarquable dès que N ≥ 10, bien que des approximations d’ordre supérieur (incorporant des termes résiduels en 1 / (N – 1)2) aient été proposées par des statisticiens contemporains pour des applications hyper-spécifiques. Pour l’écrasante majorité des devis expérimentaux et corrélationnels en psychologie et en médecine quantitative, l’erreur type canonique de Fisher fournit une précision largement suffisante pour garantir la parfaite exactitude nominale des bornes inférentielles calculées.
5. Procédure mathématique et étapes de calcul pas à pas
5.1 Étape 1 : Conversion du coefficient r dans l’espace z de Fisher
La mise en œuvre pratique de l’estimation par intervalle débute impérativement par le calcul de l’estimateur ponctuel de Pearson r sur les données recueillies, suivi de sa projection dans l’espace transformé de Fisher. La formule logarithmique népérienne doit être exécutée avec une rigueur numérique irréprochable afin d’éviter toute dérive d’arrondi susceptible de se propager au fil des étapes ultérieures :
z′ = 0,5 × ln( (1 + r) / (1 – r) )
D’un point de vue de la précision algorithmique, il est fortement recommandé de conserver au minimum quatre à six décimales significatives lors de cette phase intermédiaire. Dans la pratique contemporaine assistée par ordinateur, l’appel à la fonction interne artanh (arc-tangente hyperbolique) disponible dans tous les environnements de calcul scientifique évite tout risque de troncature humaine. Historiquement, les chercheurs recouraient à de volumineuses tables de conversion imprimées en annexes des traités statistiques ; cette méthode appartient désormais à l’histoire des sciences et doit être proscrite au bénéfice de l’évaluation analytique continue, garantissant une résolution décimale parfaite même lorsque les coefficients frôlent les extrêmes.
5.2 Étape 2 : Détermination des bornes dans l’espace transformé
Une fois le coefficient positionné sur l’axe métrique de la variable z′, la distribution d’échantillonnage peut être assimilée à une loi gaussienne classique N(ζ, 1/(N-3)). La détermination des bornes de l’intervalle de confiance repose dès lors sur le choix d’un niveau de certitude probabiliste bilatéral 1 – α, permettant d’isoler le quantile critique correspondant (noté zcrit ou z1-α/2) sur la fonction de répartition de la loi normale centrée réduite N(0, 1).
La marge d’erreur dans l’espace transformé de Fisher, notée MEz′, est calculée simplement en multipliant ce coefficient critique standardisé par l’erreur type asymptotique :
MEz′ = z1-α/2 × ( 1 / √(N – 3) )
Les limites inférieure (z′inf) et supérieure (z′sup) de l’intervalle dans l’espace transformé sont ensuite établies de manière parfaitement symétrique autour du centre empirique z′ :
z′inf = z′ – MEz′
z′sup = z′ + MEz′
Ces deux valeurs délimitent une zone de plausibilité théorique pour la quantité transformée ζ, mais ne possèdent en l’état aucune interprétation substantielle directe pour le praticien, dans la mesure où l’échelle z′ n’est pas linéairement transposable à l’amplitude originelle des associations métriques.
5.3 Étape 3 : Rétro-transformation vers l’échelle de corrélation d’origine
Pour conférer à l’intervalle son utilité diagnostique et descriptive concrète, il est indispensable d’appliquer l’opération algébrique réciproque afin de rapatrier les bornes calculées dans l’espace métrique originel borné [-1, +1]. L’inversion formelle de la fonction logarithmique fait intervenir la fonction exponentielle ou, plus élégamment, la fonction tangente hyperbolique (notée tanh). Pour toute coordonnée z′, la valeur correspondante du coefficient de corrélation r est délivrée par l’équation :
r = ( exp(2 × z′) – 1 ) / ( exp(2 × z′) + 1 ) = tanh(z′)
En appliquant cette rétro-transformation non linéaire aux deux limites préalablement calculées, on obtient de manière rigoureuse les bornes définitivement valides de l’intervalle de confiance pour le paramètre ρ :
rinf = tanh(z′inf)
rsup = tanh(z′sup)
Il est fondamental de constater qu’en raison de la courbure intrinsèque de la fonction tangente hyperbolique, la distance séparant la borne inférieure de l’estimation ponctuelle (|r – rinf|) n’est plus rigoureusement égale à la distance séparant l’estimation ponctuelle de la borne supérieure (|rsup – r|), dès lors que r ≠ 0. Cette asymétrie consubstantielle est la signature mathématique de la correction de Fisher : elle garantit que les bornes demeurent imperméables aux franchissements absurdes de l’unité et épousent fidèlement la déformation réelle de la distribution empirique.
5.4 Paramétrage des niveaux de confiance usuels
Le paramétrage du niveau de confiance conditionne directement la magnitude de la valeur critique z1-α/2 injectée dans la détermination de la marge d’erreur. La recherche scientifique s’est stabilisée autour de trois seuils conventionnels, dont le choix engage un compromis épistémologique précis entre la certitude du diagnostic et la résolution de l’intervalle :
- L’intervalle de confiance à 90 % (α = 0,10) : Il utilise une valeur critique bilatérale de z0,95 ≈ 1,6449. Ce niveau de confiance plus tolérant resserre la largeur de l’intervalle, autorisant une meilleure précision géométrique, mais concède un risque d’erreur de première espèce substantiel, un intervalle sur dix échouant à long terme à recouvrir le paramètre réel. Il est généralement réservé aux études exploratoires ou aux phases préliminaires de validation psychométrique.
- L’intervalle de confiance à 95 % (α = 0,05) : Il s’appuie sur la valeur critique standard de z0,975 ≈ 1,95996 (couramment arrondie à 1,96). Ce seuil incarne le standard universel de la recherche académique internationale et constitue la convention par défaut exigée par l’APA et l’ensemble des comités éditoriaux majeurs en psychologie et sciences médicales.
- L’intervalle de confiance à 99 % (α = 0,01) : Il recourt à une valeur critique conservatrice de z0,995 ≈ 2,5758. En restreignant le risque d’erreur à 1 %, cette configuration offre une très haute sécurité inférentielle, précieuse dans le cadre d’essais cliniques confirmatoires ou de diagnostics neuropsychologiques à fort impact décisionnel, mais impose en contrepartie un élargissement sensible de la marge d’erreur, nécessitant des cohortes considérables pour éviter des bornes trop imprécises.
6. Exemple d’application empirique en psychologie expérimentale
6.1 Contexte de recherche : Mémoire de travail et régulation émotionnelle
Afin d’illustrer de manière vivante, tangible et opératoire l’intégralité du protocole de dérivation analytique, considérons un devis expérimental mené au sein d’un laboratoire de neurosciences cognitives et affectives. L’équipe d’investigation théorise que les capacités de la mémoire de travail jouent un rôle régulateur fondamental dans l’inhibition des pensées anxiogènes automatiques. L’hypothèse de travail postule l’existence d’une relation linéaire inverse statistiquement robuste entre la capacité exécutive de la mémoire de travail et un score composite mesurant l’intensité de l’anxiété situationnelle face à une tâche stressante.
Pour éprouver cette conjecture, un protocole d’échantillonnage aléatoire simple est déployé au sein d’une population universitaire, permettant de recruter une cohorte de N = 100 participants adultes exempts de troubles psychiatriques avérés. Les individus sont évalués individuellement au moyen de deux épreuves standardisées validées sur le plan psychométrique :
- L’épreuve de l’empan mnésique complexe (Operation Span Task, OSPAN), délivrant un score quantitatif continu calibré sur une échelle de 0 à 75, reflétant fidèlement l’efficacité du maintien et du traitement cognitif simultané sous charge mentale.
- Une échelle d’évaluation validée de l’anxiété état (State Anxiety Inventory, STAI-Formule Y-1), générant un score continu variant de 20 à 80, où les valeurs élevées traduisent un niveau élevé de détresse psychologique et d’appréhension cognitive.
Les distributions marginales des deux variables font l’objet d’un criblage exploratoire préalable, confirmant l’absence de valeurs aberrantes extrêmes et suggérant le respect raisonnable d’une distribution normale bivariée au sein de l’échantillon recueilli.
6.2 Calcul complet étape par étape sur données concrètes
L’analyse des scores appariés des 100 participants permet d’obtenir un coefficient de corrélation linéaire de Pearson empirique positif entre la capacité d’inhibition cognitive (opérationnalisée ici par l’efficacité du contrôle exécutif) et une métrique de stabilité émotionnelle, établi rigoureusement à r = 0,4500. Déployons l’ensemble des opérations mathématiques requises pour construire l’intervalle de confiance standard à 95 % (α = 0,05).
Étape 1 : Conversion dans l’espace transformé de Fisher
Nous appliquons la formule analytique de la transformation arc-tangente hyperbolique :
z′ = 0,5 × ln( (1 + 0,4500) / (1 – 0,4500) ) = 0,5 × ln( 1,4500 / 0,5500 ) = 0,5 × ln( 2,636364 ) ≈ 0,5 × 0,969401 ≈ 0,484700
Étape 2 : Détermination de l’erreur type et des bornes transformées
La taille de notre cohorte étant N = 100, nous calculons l’erreur type asymptotique dans l’espace stabilisé :
SEz′ = 1 / √(100 – 3) = 1 / √97 ≈ 1 / 9,848858 ≈ 0,101535
Pour un niveau de confiance bilatéral fixé à 95 %, le quantile critique de la loi normale centrée réduite s’établit à z0,975 = 1,95996. Nous déduisons la marge d’erreur correspondante :
MEz′ = 1,95996 × 0,101535 ≈ 0,199005
Nous établissons désormais les limites symétriques dans l’espace transformé :
z′inf = 0,484700 – 0,199005 = 0,285695
z′sup = 0,484700 + 0,199005 = 0,683705
Étape 3 : Rétro-transformation par la fonction tangente hyperbolique
Nous appliquons la rétro-conversion tanh à chacune des bornes afin de retrouver l’échelle de mesure originale du coefficient de corrélation :
rinf = tanh(0,285695) = ( exp(2 × 0,285695) – 1 ) / ( exp(2 × 0,285695) + 1 ) ≈ ( 1,770857 – 1 ) / ( 1,770857 + 1 ) ≈ 0,770857 / 2,770857 ≈ 0,2782
rsup = tanh(0,683705) = ( exp(2 × 0,683705) – 1 ) / ( exp(2 × 0,683705) + 1 ) ≈ ( 3,925345 – 1 ) / ( 3,925345 + 1 ) ≈ 2,925345 / 4,925345 ≈ 0,5939
L’intervalle de confiance bilatéral à 95 % pour la corrélation de population ρ est donc rigoureusement délimité par la plage : [0,28 ; 0,59]. Remarquons immédiatement l’asymétrie structurelle : l’écart inférieur est de 0,45 – 0,28 = 0,17, tandis que l’écart supérieur est de 0,59 – 0,45 = 0,14. La borne supérieure est visiblement comprimée par rapport à la borne inférieure.
6.3 Analyse comparative selon différents niveaux de confiance
Pour mettre en relief l’arbitrage méthodologique incontournable entre précision géométrique et certitude de couverture, il est éclairant de recalculer les bornes sur ce jeu de données identique pour les niveaux de confiance à 90 % et 99 % :
- Niveau de confiance à 90 % (α = 0,10, zcrit = 1,64485) :
MEz′ = 1,64485 × 0,101535 ≈ 0,167010
z′inf = 0,484700 – 0,167010 = 0,317690 → rinf = tanh(0,317690) ≈ 0,3075
z′sup = 0,484700 + 0,167010 = 0,651710 → rsup = tanh(0,651710) ≈ 0,5728
Intervalle à 90 % : [0,31 ; 0,57]. Largeur totale = 0,26.
- Niveau de confiance à 95 % (α = 0,05, zcrit = 1,95996) :
Intervalle à 95 % : [0,28 ; 0,59]. Largeur totale = 0,31.
- Niveau de confiance à 99 % (α = 0,01, zcrit = 2,57583) :
MEz′ = 2,57583 × 0,101535 ≈ 0,261536
z′inf = 0,484700 – 0,261536 = 0,223164 → rinf = tanh(0,223164) ≈ 0,2195
z′sup = 0,484700 + 0,261536 = 0,746236 → rsup = tanh(0,746236) ≈ 0,6329
Intervalle à 99 % : [0,22 ; 0,63]. Largeur totale = 0,41.
Cette comparaison met en évidence une loi fondamentale de la théorie de l’estimation : exiger une certitude probabiliste quasi absolue (99 %) conduit inévitablement à distendre les limites de plausibilité, l’intervalle s’étendant désormais d’une association modeste (0,22) à une corrélation substantielle (0,63). Le chercheur doit explicitement assumer ce compromis méthodologique lors de la conception de son plan d’expérience.
7. Interprétation statistique et inférentielle de l’intervalle
7.1 Interprétation probabiliste rigoureuse et pièges conceptuels
L’interprétation sémantique de l’intervalle de confiance constitue sans doute le terrain où s’observent les contresens épistémologiques les plus tenaces dans la littérature scientifique. L’erreur la plus répandue consiste à formuler l’assertion suivante : « Il y a 95 % de chances que la vraie corrélation de la population soit comprise entre 0,28 et 0,59. » Dans le cadre strict de l’inférence fréquentiste, cette affirmation est mathématiquement inexacte et dénuée de sens probabiliste formel.
Puisque le paramètre ρ est une grandeur physique invariable et non une variable aléatoire dotée d’une distribution de probabilité a posteriori, la valeur inconnue de ρ soit réside à l’intérieur de l’intervalle [0,28 ; 0,59], soit réside à l’extérieur. La probabilité conditionnelle que ρ appartienne à cet intervalle concret déjà matérialisé est donc soit de 1 (certitude absolue), soit de 0 (fausseté absolue), mais elle ne saurait être égale à 0,95. Le pourcentage de 95 % caractérise la méthode de capture et non l’état de l’intervalle figé : il désigne le taux de succès à long terme de l’algorithme d’estimation de Fisher à travers une infinité théorique d’itérations expérimentales analogues.
Une seconde confusion fondamentale consiste à amalgamer l’intervalle de confiance pour le paramètre ρ avec un intervalle de prédiction. Alors que l’intervalle de confiance délimite la zone de plausibilité de la moyenne relationnelle au sein de la population générale, l’intervalle de prédiction modélise la plage au sein de laquelle se situerait la mesure conjointe d’un individu singulier tiré au sort dans le futur. L’intervalle de prédiction intègre à la fois l’incertitude sur l’estimation des paramètres et la variance résiduelle des scores individuels, ce qui se traduit par des bornes systématiquement et considérablement plus larges que celles de l’intervalle de confiance.
7.2 Prise de décision méthodologique et inclusion de l’hypothèse nulle
Bien que l’intervalle de confiance transcende les limitations binaires du test d’hypothèse nulle, il entretient une dualité mathématique directe avec celui-ci. Il existe une correspondance formelle entre un intervalle de confiance bilatéral calculé à 1 – α et un test d’hypothèse bilatéral exécuté au seuil de signification α : l’ensemble des valeurs contenues à l’intérieur de l’intervalle de confiance représente l’ensemble précis de toutes les valeurs de ρ qui ne seraient pas rejetées si elles étaient formulées à titre d’hypothèses nulles par un test statistique de Student ou de Fisher.
Dans notre application empirique précédente, l’intervalle de confiance à 95 % [0,28 ; 0,59] exclut de manière nette et non équivoque la valeur d’indépendance linéaire nulle (ρ = 0). Le chercheur peut donc en déduire, sans formaliser de test séparé, que l’hypothèse nulle d’indépendance peut être rejetée au seuil classique α = 0,05 (et même au seuil α = 0,01, l’intervalle à 99 % [0,22 ; 0,63] excluant également zéro). Les données apportent donc la preuve concluante que la relation ne peut être raisonnablement imputée au simple hasard de l’échantillonnage.
Néanmoins, la puissance décisionnelle de l’intervalle va bien au-delà : si une théorie cognitive concurrente postulait que la corrélation entre ces deux mécanismes est d’une intensité extrême, par exemple ρ = 0,70, l’intervalle à 95 % nous permet d’exclure cette proposition théorique avec autant de vigueur qu’il nous permet de réfuter l’hypothèse nulle de nullité, la valeur 0,70 se situant nettement au-dessus de notre borne supérieure empirique (0,59).
7.3 Évaluation de la pertinence clinique versus statistique
L’apport le plus décisif de l’intervalle de confiance réside dans sa capacité à discriminer sans ambiguïté la simple significativité statistique de la pertinence pratique, clinique ou sociétale d’un phénomène quantifié. En sciences comportementales, les chercheurs s’appuient fréquemment sur la taxonomie heuristique proposée par Jacob Cohen (1988), qui catégorise les corrélations de Pearson en effets faibles (r ≈ 0,10), modérés (r ≈ 0,30) et forts (r ≥ 0,50).
L’examen minutieux des bornes de l’intervalle fournit une grille de lecture opérationnelle immédiate pour le praticien :
- La valeur minimale garantie (Borne inférieure) : Dans notre exemple clinique, la borne inférieure de 0,28 indique que même sous l’hypothèse la plus pessimiste admissible compatible avec les données au seuil de 95 %, l’association conserve une magnitude approchant le seuil d’un effet moyen selon Cohen. Le praticien est ainsi assuré que le construit évalué ne correspond pas à un artefact trivial et conserve une utilité prédictive minimale pour des applications diagnostiques.
- L’étendue de la plausibilité théorique : L’intervalle traverse la frontière départageant un effet modéré (0,28) d’un effet puissant (0,59). Cette amplitude signale que si la relation est assurément substantielle, l’expérimentateur ne peut pas encore affirmer avec certitude si la mémoire de travail explique une part modeste (environ 8 % de la variance pour r = 0,28) ou majeure (environ 35 % de la variance pour r = 0,59) des fluctuations de l’anxiété.
Cette approche prévient efficacement les faux espoirs induits par des études sous-dimensionnées où des corrélations fortes mais accompagnées d’intervalles démesurés (par exemple [0,02 ; 0,75]) masquent le fait que l’association pourrait s’avérer quasiment dénuée de tout impact clinique dans la réalité populationnelle.
8. Hypothèses de validité et conditions d’application
8.1 L’exigence de normalité bivariée
La validité théorique de la transformation z de Fisher et la précision nominale de l’erreur type 1 / √(N – 3) reposent sur un postulat statistique rigoureux : les deux variables aléatoires X et Y doivent suivre conjointement une loi normale bivariée au sein de la population parente. Cette condition est beaucoup plus contraignante que la simple vérification de la normalité marginale univariée de chacune des deux variables prises isolément. Une distribution normale bivariée implique non seulement que chaque variable soit individuellement gaussienne, mais également que les distributions conditionnelles de Y pour toute valeur fixée de X soient normales et homoscédastiques, et que la régression sous-jacente soit strictement linéaire.
Lorsque cette hypothèse de normalité bivariée est sévèrement enfreinte — notamment en présence de distributions bimodales, asymétriques ou dotées de queues lourdes (leptokurtiques) —, le taux de couverture effectif de l’intervalle de confiance calculé via la formule canonique de Fisher peut se détériorer de manière substantielle. Les simulations statistiques indiquent qu’en présence de données fortement asymétriques ou kurtotiques, un intervalle nominal à 95 % peut n’offrir en réalité qu’une couverture empirique comprise entre 85 % et 90 %, exposant l’investigateur à un taux d’erreur de type I très supérieur à la valeur nominale α déclarée.
Le chercheur se doit donc de vérifier systématiquement cette condition préalablement à l’inférence. Les stratégies diagnostiques recommandées comprennent l’examen minutieux du diagramme de dispersion bidimensionnel (qui doit afficher un nuage de points elliptique dépourvu de concentrations distordues), l’évaluation de la distance statistique de Mahalanobis pour identifier d’éventuels dérèglements multidimensionnels, et l’application formelle de tests de normalité bivariée tels que le test du coefficient de symétrie et de kurtosis multivarié de Mardia.
8.2 Sensibilité aux valeurs aberrantes et aux leviers influents
Le coefficient de corrélation linéaire de Pearson est une statistique paramétrique intrinsèquement non robuste, hautement vulnérable à l’influence perturbatrice des observations discordantes. Une seule valeur aberrante bivariée — c’est-à-dire une observation qui ne correspond pas nécessairement à un score extrême sur l’une ou l’autre des variables univariées, mais qui déroge brutalement à la structure de covariance générale — peut altérer dramatiquement la valeur de l’estimateur r et, par répercussion immédiate, décaler artificiellement et élargir les bornes de l’intervalle de confiance de Fisher.
Deux typologies fondamentales d’observations contaminantes doivent être distinguées au sein du plan factoriel bivarié :
- Les points de levier orthogonaux : Des observations situées très loin de la moyenne sur les deux axes mais contredisant la dynamique d’association linéaire. Elles ont pour conséquence mécanique d’effondrer le coefficient r vers zéro, entraînant un intervalle anormalement large qui masque une association populationnelle pourtant vigoureuse.
- Les points de levier concordants extrêmes : Des observations isolées qui s’alignent fortuitement très loin dans le prolongement de la droite de régression. Elles peuvent gonfler artificiellement une corrélation par ailleurs quasi inexistante parmi l’écrasante majorité de la cohorte, produisant un intervalle étroitement centré sur une fausse découverte méthodologique.
Le dépistage scrupuleux de ces anomalies implique l’inspection visuelle des résidus standardisés et l’estimation de métriques diagnostiques d’influence comme la distance de Cook adaptée aux covariances. Lorsque des valeurs discordantes avérées sont identifiées sans justification d’erreur d’encodage matérielle, l’application d’approches non paramétriques ou d’estimateurs robustes s’impose comme une nécessité méthodologique absolue.
8.3 Impact de la restriction d’étendue et de la fidélité de mesure
Dans l’évaluation écologique des coefficients de corrélation, deux artefacts psychométriques ubiquitaires viennent biaiser systématiquement l’estimation du paramètre populationnel et la pertinence de l’intervalle de confiance associé :
Le premier phénomène concerne la restriction d’étendue (ou homogénéisation d’échantillon). Lorsqu’un devis de recherche recrute des participants au sein d’une sous-population hyperspécifique caractérisée par une variance tronquée sur l’une des variables clés (par exemple, évaluer la relation entre l’intelligence et le rendement académique exclusivement chez des étudiants doctorants hautement sélectionnés), la variabilité observée s’effondre. Cet écrasement de la variance produit une atténuation artificielle majeure du coefficient r d’échantillon. L’intervalle de confiance calculé sur ces données restreintes est certes mathématiquement exact pour la sous-population ciblée, mais il sous-estime radicalement l’amplitude de l’association qui prévaut dans la population générale non sélectionnée, induisant des conclusions erronées sur la nature fondamentale du construit.
Le second phénomène réside dans l’atténuation due à l’infidélité de mesure. En vertu des axiomes de la théorie classique des tests formalisée par Charles Spearman, tout score observé est la somme d’un score vrai et d’une composante d’erreur aléatoire. Cette erreur non systématique dilue inévitablement l’intensité de la corrélation observée selon la loi de correction de l’atténuation :
ρobservé = ρvrai × √( rxx′ × ryy′ )
où rxx′ et ryy′ désignent les coefficients de fidélité (comme l’alpha de Cronbach ou l’oméga de McDonald) des deux instruments de mesure. Si deux échelles psychométriques possèdent des fidélités modestes de 0,70, la corrélation maximale qu’il est théoriquement possible d’observer entre elles dans l’échantillon ne dépassera jamais 0,70, même si la véritable corrélation latente entre les construits est de 1,00. L’intervalle de confiance calculé sur le coefficient empirique r encadre donc l’association entre les instruments imparfaits et non entre les construits théoriques sous-jacents, une distinction ontologique que le chercheur se doit d’expliciter dans sa discussion scientifique.
9. Méthodes non paramétriques et approches par rééchantillonnage
9.1 L’intervalle de confiance par bootstrap pour les corrélations
Lorsque les données recueillies enfreignent ouvertement les hypothèses de normalité bivariée ou que les distributions présentent des asymétries résistantes à toute transformation mathématique conventionnelle, le recours aux méthodes computationnelles intensives de rééchantillonnage non paramétrique — principalement le bootstraping introduit par Bradley Efron en 1979 — s’impose comme l’alternative méthodologique par excellence.
Le principe du bootstrap appliqué aux paires corrélationnelles consiste à considérer l’échantillon empirique initial de taille N comme une pseudo-population finie reproduisant au mieux la loi de probabilité sous-jacente. L’algorithme opère par tirages aléatoires successifs avec remise de N paires de coordonnées (Xi, Yi), répétés un nombre élevé de fois (généralement B ≥ 2 000 ou B = 10 000 itérations). Pour chaque pseudo-échantillon reconstitué, le coefficient de corrélation r* est calculé, générant une distribution empirique de B estimations corrélationnelles qui modélise directement la forme de la variabilité d’échantillonnage sans faire appel au moindre postulat de normalité théorique.
Pour construire l’intervalle de confiance final, deux approches computationnelles majeures prévalent :
- La méthode du percentile empirique : Les estimations bootstrapées sont triées par ordre croissant. Pour un intervalle à 95 %, les bornes correspondent simplement aux centiles empiriques 2,5 % et 97,5 % de la distribution rééchantillonnée. Bien qu’intuitive, cette méthode souffre d’un manque de précision si la distribution d’échantillonnage présente un biais ou une asymétrie marquée.
- La méthode bootstrap avec correction de biais et accélération (BCa) : Cette procédure supérieure introduit deux paramètres de calibrage correctifs : un coefficient de centrage z0 qui compense la proportion d’estimations rééchantillonnées inférieures à la valeur d’échantillon initiale r, et un coefficient d’accélération a (estimé via des techniques de jackknife) qui modélise la courbure de la variance de l’estimateur face aux variations du paramètre. L’intervalle BCa fournit des taux de couverture empiriques remarquablement fiables même sous des conditions sévères de non-normalité.
9.2 Intervalles de confiance pour le rho de Spearman et le tau de Kendall
Dans de nombreuses investigations psychologiques et biomédicales, les données ne sont pas continues mais ordinales (par exemple, des classements hiérarchiques ou des échelles de type Likert à items restreints), ou décrivent une association strictement monotone mais non linéaire. Dans ce cas de figure, les corrélations de rangs de Spearman (rs) ou de Kendall (τ) constituent les métriques d’association adaptées. La construction d’intervalles de confiance pour ces indices non paramétriques obéit à des formulations asymptotiques spécifiques.
Pour le coefficient rho de Spearman, qui correspond fondamentalement au coefficient de Pearson calculé sur les rangs convertis des données brutes, l’application de la transformation z de Fisher demeure possible à titre d’approximation sous réserve de modifier légèrement l’erreur type asymptotique pour intégrer la surdispersion induite par l’assignation des rangs. L’erreur type ajustée s’exprime traditionnellement sous la forme :
SEzs′ ≈ √( (1 + (rs2 / 2)) / (N – 3) )
Pour le coefficient tau de Kendall, qui quantifie la différence relative entre le nombre de paires concordantes et discordantes au sein de la cohorte, la distribution d’échantillonnage converge de manière remarquable vers une loi normale sans nécessiter de transformation logarithmique de Fisher dès que N > 20. Sous l’hypothèse d’une corrélation populationnelle τ, la variance asymptotique d’échantillonnage de Kendall est délivrée par l’expression classique de Noether :
Var(τ) ≈ ( 4 / 9 ) × ( (N + 2) / (N × (N – 1)) ) × ( 1 – τ2 )
L’extraction des bornes s’effectue alors directement dans l’espace métrique originel via la formule τ ± zcrit × √Var(τ), ou idéalement, par l’exécution d’un rééchantillonnage bootstrap non paramétrique garantissant une robustesse optimale face aux ex-aequo (rangs liés) fréquents sur les échelles d’attitudes psychologiques.
9.3 Étude comparative : Approche de Fisher versus rééchantillonnage
L’arbitrage méthodologique entre la transformation analytique classique de Fisher et l’approche computationnelle par rééchantillonnage bootstrap a fait l’objet de volumineuses investigations par simulation numérique (notamment les travaux de Wilcox, 2017). Les résultats comparatifs permettent de dresser des recommandations claires à l’attention des chercheurs :
- Sous conditions de normalité bivariée parfaite : La méthode analytique de Fisher demeure l’estimateur le plus performant et le plus élégant. Elle offre une couverture probabiliste rigoureusement exacte, une variance d’intervalle minimale (largeur moyenne plus étroite que le bootstrap sur petits échantillons) et un coût computationnel instantané.
- En présence de légères déviations de normalité : L’approximation de Fisher fait preuve d’une robustesse substantielle tant que la taille d’échantillon excède N = 50. La divergence des taux de couverture reste généralement confinée à un intervalle tolérable (entre 93,5 % et 96 % pour un seuil nominal de 95 %).
- En présence de violations sévères (distributions asymétriques, queues épaisses, hétérogénéité des variances) : L’approche de Fisher montre ses limites avec une sous-couverture empirique avérée. Dans ces configurations dégradées, le bootstrap avec correction de biais et accélération (BCa) surpasse incontestablement la transformation de Fisher, restaurant un taux de couverture proche de la valeur nominale visée.
En conséquence, la pratique scientifique moderne tend à privilégier l’intervalle de Fisher pour les épreuves psychométriques standardisées continues bien calibrées, tout en basculant systématiquement vers le bootstrap BCa dès lors que les données de terrain manifestent des asymétries manifestes ou des distorsions distributionnelles notables.
10. Planification de la précision et calcul de la taille d’échantillon
10.1 Le paradigme de l’exactitude de l’estimation de paramètres
L’élaboration méthodologique d’un protocole de recherche corrélationnel a traditionnellement été subordonnée aux calculs de puissance statistique basés sur l’évitement de l’erreur de seconde espèce (β). Dans ce schéma conventionnel, l’expérimentateur dimensionne sa cohorte afin de garantir une puissance de 80 % ou 90 % pour rejeter l’hypothèse nulle H0: ρ = 0 au seuil α = 0,05. Cette approche présente une carence structurelle majeure : concevoir une étude pour qu’elle atteigne tout juste la significativité statistique n’apporte aucune garantie quant à l’exactitude et l’utilité clinique du coefficient qui sera publié.
Ce constat a donné naissance au paradigme méthodologique de l’exactitude de l’estimation de paramètres (connu sous l’acronyme anglo-saxon AIPE, Accuracy in Parameter Estimation), conceptualisé par des statisticiens tels que Ken Kelley et Scott Maxwell. Sous l’égide de l’AIPE, l’objectif fondamental du dimensionnement de l’échantillon n’est plus de franchir un seuil de significativité binaire, mais de circonscrire la demi-largeur de l’intervalle de confiance (notée ω ou w) en deçà d’une valeur maximale tolérable fixée a priori par le chercheur.
Planifier une étude selon le paradigme AIPE garantit que, quelle que soit l’issue du test de significativité, le paramètre populationnel ρ sera encadré avec une précision métrologique prédéterminée, empêchant la publication de coefficients assortis d’intervalles excessivement larges qui polluent la littérature par leur manque d’informativité.
10.2 Algorithmes et formules pour déterminer l’effectif optimal
La dérivation analytique de la taille d’échantillon minimale requise pour calibrer la précision d’un coefficient de corrélation s’appuie directement sur la manipulation de l’erreur type de la transformation de Fisher. Soit ω la demi-largeur maximale acceptable de l’intervalle de confiance dans l’échelle d’origine de la corrélation (par exemple, ω = 0,10, ce qui correspond à un intervalle global de largeur 2ω = 0,20), et ρesp la valeur conjecturée ou anticipée de la corrélation dans la population cible.
En projetant cette tolérance métrique dans l’espace stabilisé de Fisher au moyen d’un développement en série de Taylor au premier ordre, l’effectif théorique minimal N requis pour garantir un intervalle de confiance bilatéral au niveau 1 – α s’obtient par l’équation canonique d’approximation asymptotique :
N ≈ ( ( z1-α/22 × (1 – ρesp2)2 ) / ω2 ) + 3
Examinons le comportement opératoire de cette équation mathématique :
- Si le chercheur anticipe une corrélation modérée ρesp = 0,30 et souhaite une excellente précision caractérisée par une demi-largeur ω = 0,10 à un niveau de confiance de 95 % (z = 1,96) :
N ≈ ( ( 1,962 × (1 – 0,302)2 ) / 0,102 ) + 3 = ( ( 3,8416 × 0,912 ) / 0,01 ) + 3 ≈ ( ( 3,8416 × 0,8281 ) / 0,01 ) + 3 ≈ 318,1 + 3 ≈ 322 participants.
- Si le chercheur anticipe une corrélation robuste ρesp = 0,70 avec la même marge de précision ω = 0,10 :
N ≈ ( ( 3,8416 × (1 – 0,702)2 ) / 0,01 ) + 3 = ( ( 3,8416 × 0,512 ) / 0,01 ) + 3 ≈ ( ( 3,8416 × 0,2601 ) / 0,01 ) + 3 ≈ 99,9 + 3 ≈ 103 participants.
Ce calcul illustre magistralement la conséquence directe de l’hétéroscédasticité originelle : estimer avec une haute précision une relation forte requiert un effectif trois fois inférieur à celui nécessaire pour capturer une relation d’intensité modeste avec la même marge d’erreur absolue. Pour assurer une certitude supplémentaire que la demi-largeur ne dépassera pas le seuil souhaité dans au moins 99 % des échantillons prélevés, des coefficients correctifs d’assurance stochastique (introduits par Kelley) peuvent être surajoutés à cette formule de base.
10.3 Implications pratiques pour les devis expérimentaux en psychologie
L’intégration de la planification par la précision emporte des bouleversements profonds dans l’organisation méthodologique et économique des laboratoires de psychologie expérimentale. Historiquement, un nombre considérable d’études corrélationnelles ont été menées sur des échantillons dits « de convenance » oscillant entre 30 et 60 participants. L’application des formules AIPE démontre impitoyablement qu’un échantillon de N = 50 génère, pour une corrélation réelle de 0,30, un intervalle de confiance à 95 % s’étalant de [0,02 à 0,54], c’est-à-dire une demi-largeur ω ≈ 0,26. Publier une étude dont l’intervalle est presque aussi large que l’ensemble du quadrant positif représente un gaspillage manifeste de ressources académiques et humaines.
La planification rationnelle de la précision permet d’éviter tant le sous-dimensionnement chronique (responsable de la dissémination de résultats instables et non réplicables) que le surdimensionnement inutile, qui alloue stérilement des moyens financiers excessifs au détriment d’autres axes de recherche. De surcroît, cette démarche renforce considérablement la crédibilité éthique des dossiers soumis aux comités de protection des personnes et d’éthique de la recherche (IRB), en prouvant que le nombre d’individus exposés aux protocoles expérimentaux a été scrupuleusement calibré pour garantir une avancée scientifique probante et incontestable.
11. Implémentation computationnelle dans les logiciels statistiques
11.1 Exécution et analyse avec le langage de programmation R
L’environnement de programmation et d’analyse statistique R représente l’outil de référence mondial pour le traitement quantitatif avancé. Il intègre nativement des fonctions dédiées à l’extraction de l’intervalle de confiance pour les corrélations de Pearson, d’une syntaxe limpide et d’une robustesse algorithmique absolue.
La fonction générique standard permettant d’exécuter l’analyse corrélationnelle est la fonction cor.test() appartenant au package de base stats. L’appel canonique s’effectue via l’instruction suivante :
cor.test(x, y, method = "pearson", conf.level = 0.95)
Par défaut, cette commande calcule simultanément l’estimation ponctuelle de Pearson, la statistique t de Student associée, le degré de liberté, la valeur p exacte, et déploie automatiquement sous l’étiquette 95 percent confidence interval les bornes inférieure et supérieure obtenues par la transformation z de Fisher rigoureuse. L’argument conf.level permet d’ajuster dynamiquement le seuil probabiliste (par exemple 0,90 ou 0,99).
Pour des analyses multidimensionnelles impliquant des matrices de corrélation complètes au sein de protocoles psychométriques d’envergure, le package spécialisé psych développé par William Revelle fournit la commande enrichie :
psych::corr.test(dataframe, use = "pairwise", method = "pearson", alpha = 0.05)
Cette fonction génère une structure matricielle intégrant à la fois les estimations ponctuelles, la matrice des valeurs p corrigées pour les comparaisons multiples, ainsi que l’ensemble des bornes inférieures et supérieures d’intervalles de confiance de Fisher associées à chaque paire de variables.
Pour implémenter l’estimation non paramétrique par rééchantillonnage bootstrap avec correction de biais et accélération (BCa), le chercheur mobilisera le package d’élite boot via la routine suivante :
library(boot)
r_function <- function(data, indices) cor(data[indices, 1], data[indices, 2], method = "pearson")
boot_results <- boot(data = mon_dataframe, statistic = r_function, R = 5000)
boot.ci(boot_results, type = c("perc", "bca"), conf = 0.95)
Cette séquence extrait avec une précision mathématique totale l’intervalle de confiance non paramétrique BCa optimisé face aux déviations distributionnelles sévères.
11.2 Génération et syntaxe sous SPSS Statistics
Le logiciel commercial IBM SPSS Statistics, omniprésent dans les structures hospitalières et les départements universitaires de sciences sociales, a profondément renouvelé ses fonctionnalités d’estimation par intervalle dans ses versions contemporaines (SPSS version 28 et suivantes).
Dans l’interface utilisateur graphique conventionnelle, l’accès à l’intervalle de confiance s’opère par le déploiement des menus suivants :
Analyse → Corrélations → Bivariées…
Après avoir sélectionné les deux variables d’intérêt et coché le modèle de Pearson, l’utilisateur doit cliquer sur le bouton d’options intitulé Intervalles de confiance situé dans le panneau latéral droit. Il suffit ensuite de cocher la case d’activation Estimer l’intervalle de confiance du coefficient de corrélation de Pearson, de renseigner le niveau de confiance désiré (par défaut 95), et de sélectionner la méthode de calcul de Fisher.
Pour les utilisateurs privilégiant l’automatisation et la reproductibilité via la ligne de commande syntaxique, l’exécution s’effectue via le bloc de commandes :
CORRELATIONS
/VARIABLES=Capacite_Memoire Score_Anxiete
/PRINT=TWOTAIL NOSIG FULL
/CI=CI(95) METHOD(PEARSON)
/MISSING=PAIRWISE.
La sortie SPSS génère alors un tableau synthétique spécifique présentant la valeur empirique r, l’effectif valide N, la significativité bilatérale exacte, ainsi que les deux colonnes intitulées formellement Limite inférieure et Limite supérieure calculées selon la rétro-transformation de Fisher. Si le module SPSS Bootstrapping est activé sur la licence logicielle, une sous-commande /BOOTSTRAP peut être insérée pour juxtaposer immédiatement le tableau d’intervalles asymptotiques aux bornes empiriques issues d’un millier de tirages aléatoires.
11.3 Pratique moderne avec le logiciel open-source JASP
Dans le paysage contemporain de la science ouverte (Open Science), le logiciel libre et gratuit JASP (développé sous l’égide de l’Université d’Amsterdam) s’est imposé comme une alternative pédagogique et analytique majeure face aux logiciels propriétaires fermés. JASP offre une interface graphique dynamique révolutionnaire et génère des tables de résultats directement formatées selon les normes typographiques de l’APA.
Pour calculer l’intervalle de confiance sous JASP, la procédure d’une simplicité exemplaire nécessite les étapes suivantes :
- Cliquer sur l’onglet principal Regression → sélectionner Correlation Matrix.
- Glisser les deux variables quantitatives étudiées dans le panneau de droite réservé aux variables actives.
- Sous la rubrique des coefficients d’association, cocher Pearson (ou éventuellement Spearman si une approche de rangs est postulée).
- Développer la section dédiée aux options inférentielles avancées et cocher explicitement la case Confidence intervals tout en spécifiant le niveau nominal requis (0.95 par défaut).
De manière synchronisée et instantanée, le panneau d’affichage dynamique génère le tableau de sortie canonique de style APA incluant la statistique de Pearson et deux colonnes supplémentaires encadrant l’effet par son intervalle de confiance de Fisher. De surcroît, JASP propose une option visuelle permettant de cocher Correlation plot, ce qui produit un graphique synthétique élégant visualisant la droite de régression linéaire entourée de son ombrelle de dispersion bivariée ainsi que la distribution asymétrique de l’estimateur.
12. Directives de rédaction académique et normes de l’APA
12.1 Conventions formelles d’écriture selon l’APA septième édition
La transmission claire et rigoureuse des résultats constitue l’ultime étape de la démarche scientifique. L’American Psychological Association, dans la 7e édition de son manuel de publication (APA Style Manual, 2020), a édicté des règles typographiques très précises régissant la présentation textuelle des coefficients d’association et de leurs intervalles de confiance associés.
Sur le plan typographique et notationnel, les règles fondamentales suivantes doivent être scrupuleusement respectées :
- Le symbole de la statistique de corrélation r doit être impérativement composé en italique, tout comme le symbole de la taille d’échantillon N ou la valeur p.
- Pour toutes les métriques statistiques strictement contraintes par définition mathématique à ne jamais excéder la valeur d’unité (ce qui est rigoureusement le cas du coefficient de corrélation de Pearson, du coefficient de détermination r2 et des probabilités p), aucun zéro ne doit être apposé avant la virgule ou le point décimal dans la typographie anglo-saxonne (on écrira ainsi r = .45 et non r = 0.45). En langue française académique, bien que l’usage de la virgule décimale soit la norme conventionnelle (r = 0,45), les publications internationales francophones tolèrent de plus en plus l’omission du zéro initial en alignement strict avec l’APA.
- Les degrés de liberté (définis par N – 2 pour une corrélation bivariée simple) doivent figurer entre parenthèses immédiatement après la lettre r : r(98).
- L’intervalle de confiance est signalé par le sigle officiel 95% IC (ou 95% CI dans les communications anglophones) et doit être rigoureusement encapsulé au sein de crochets fermés, les bornes étant séparées par une virgule suivie d’un espace : [0,28, 0,59] ou [.28, .59].
Un modèle textuel standard d’intégration narrative répondant parfaitement aux canons formels de l’APA 7 s’articule ainsi :
« Une analyse de corrélation linéaire de Pearson a révélé une relation positive et statistiquement significative entre la capacité de la mémoire de travail et les capacités de régulation émotionnelle, r(98) = 0,45, p < 0,001, 95% IC [0,28, 0,59]. »
12.2 Représentation graphique rigoureuse des intervalles de confiance
L’assimilation visuelle des incertitudes statistiques par la communauté scientifique est grandement optimisée par l’emploi de représentations graphiques dédiées, se substituant avantageusement à de volumineux tableaux numériques bruts. L’APA proscrit vigoureusement les représentations tronquées ou trompeuses qui déforment l’échelle naturelle des phénomènes quantifiés.
Deux formats graphiques majeurs s’imposent pour valoriser les intervalles de confiance :
- Le graphique en forêt (Forest Plot) : Idéal lorsqu’il s’agit de juxtaposer plusieurs études de réplication ou de comparer les corrélations observées à travers différents sous-groupes démographiques. L’axe des abscisses représente l’espace des corrélations borné de -1 à +1. Chaque étude est visualisée par un marqueur géométrique central (dont la superficie peut être proportionnelle à l’effectif N de l’échantillon) positionné sur la valeur ponctuelle r, traversé horizontalement par une barre d’erreur matérialisant l’intervalle de confiance à 95 %. L’asymétrie physique des bras de la barre d’erreur autour du point central reflète directement la non-linéarité de la distribution de Fisher, informant immédiatement le lecteur sur la fidélité de l’estimation. Une ligne pointillée verticale ancrée sur le zéro permet d’évaluer visuellement en un clin d’œil si des études traversent la ligne de non-effet.
- Le diagramme de dispersion enrichi (Scatterplot avec bande de confiance) : Lors de l’exposition des données bivariées d’un échantillon unique, les observations individuelles sont projetées sur le plan orthogonal, accompagnées de la droite de régression des moindres carrés ordinaires. L’incertitude sur la relation linéaire est illustrée par une zone ombragée hyperbolique (bande de confiance bivariée de Working-Hotelling), qui s’évase à mesure que l’on s’écarte du centre de gravité des moyennes des variables.
Il convient de veiller avec le plus grand soin à ce que les échelles graphiques ne soient pas compressées ou étirées artificiellement, afin d’éviter toute manipulation visuelle de la force perçue de l’association statistique.
12.3 Erreurs courantes de communication scientifique à proscrire
La pratique rédactionnelle académique demeure fréquemment entachée d’inexactitudes ou de raccourcis fallacieux que les réviseurs scientifiques et comités de lecture se doivent de sanctionner avec sévérité. Trois écueils majeurs doivent être impérativement éliminés de tout manuscrit scientifique :
- L’amputation exclusive au profit de la valeur p : Présenter une affirmation telle que « la corrélation est significative (p = 0,02) » en omettant délibérément de fournir la statistique ponctuelle r et son intervalle de confiance à 95 % constitue un manquement formel aux standards scientifiques actuels. La valeur p sans son intervalle ne livre aucun indice sur la marge d’erreur qui affecte l’effet observé.
- Le piège du non-chevauchement d’intervalles pour comparer deux corrélations indépendantes : Une erreur méthodologique spectaculaire consiste à affirmer que deux coefficients de corrélation indépendants (par exemple, la corrélation chez les femmes r1 = 0,40, 95% IC [0,15, 0,60] et la corrélation chez les hommes r2 = 0,10, 95% IC [-0,12, 0,31]) ne diffèrent pas significativement entre eux au motif fallacieux que leurs deux intervalles de confiance respectifs se chevauchent partiellement (la zone [0,15, 0,31] étant commune). Des dérivations mathématiques rigoureuses prouvent que deux intervalles de confiance indépendants peuvent se recouvrir substantiellement alors même que la différence formelle entre les deux coefficients est statistiquement significative au seuil α = 0,05. Pour comparer deux coefficients de corrélation, le chercheur doit calculer formellement le test z de différence de Fisher ou construire l’intervalle de confiance de la différence (ρ1 – ρ2) et non se livrer à des déductions oculaires naïves sur les intervalles séparés.
- Les formulations probabilistes déterministes et essentialistes : L’utilisation d’expressions telles que « nous avons prouvé que la vraie corrélation se situe dans notre intervalle » ou « notre intervalle capture la réalité objective avec 95 % de probabilité » dénote une profonde méconnaissance de l’ontologie fréquentiste. La science empirique n’établit jamais de preuves absolues ; elle cerne des plages de compatibilité probabiliste sous des hypothèses distributionnelles strictes. La modestie et la rigueur du vocabulaire épistémique constituent la marque de fabrique du chercheur intègre.
En adoptant ces principes d’interprétation nuancée, d’analyse distributionnelle rigoureuse et de communication transparente conformément aux directives de l’APA, la communauté des sciences humaines et médicales pérennise la solidité de ses bases empiriques et hisse la pratique de la statistique quantitative au niveau d’exigence requis par les défis contemporains de la reproductibilité scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Fisher, R. A. (1915). Frequency distribution of the values of the correlation coefficient in samples from an indefinitely large population. Biometrika, 10(4), 507–521. https://doi.org/10.2307/2331838
- Fisher, R. A. (1921). On the « probable error » of a coefficient of correlation deduced from a small sample. Metron, 1, 3–32.
- Kelley, K. (2007). Sample size planning for the coefficient of correlation from the accuracy in parameter estimation approach. Behavior Research Methods, 39(1), 75–84. https://doi.org/10.3758/BF03192846
- Schönbrodt, F. D., & Perugini, M. (2013). At what sample size do correlations stabilize? Journal of Research in Personality, 47(5), 609–612. https://doi.org/10.1016/j.jrp.2013.05.009
- Wilkinson, L., & the Task Force on Statistical Inference. (1999). Statistical methods in psychology journals: Guidelines and explanations. American Psychologist, 54(8), 594–604. https://doi.org/10.1037/0003-066X.54.8.594
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/B978-0-12-804733-0.00001-9