
L’analyse statistique constitue le socle fondamental sur lequel repose la validité des conclusions scientifiques modernes, particulièrement au sein des sciences humaines, de la médecine et de la psychologie cognitive. Lorsque les chercheurs s’interrogent sur l’efficacité relative d’un traitement thérapeutique, l’impact de différents paradigmes d’apprentissage ou les variations comportementales induites par des stimuli environnementaux contrastés, ils sont systématiquement confrontés à la nécessité de comparer des mesures quantitatives recueillies auprès d’échantillons distincts. Dans ce contexte épistémologique, l’analyse de variance à un facteur — couramment désignée sous l’acronyme anglophone One-Way ANOVA — s’impose comme une méthodologie d’inférence statistique d’une puissance et d’une élégance remarquables, conceptualisée initialement par le statisticien et généticien britannique Sir Ronald Aylmer Fisher au début du vingtième siècle.
Bien que le test t de Student permette de comparer rigoureusement deux groupes d’observations indépendantes, la réalité de la démarche expérimentale implique fréquemment la manipulation de variables indépendantes comportant trois modalités ou davantage. Tenter d’élucider des questions scientifiques complexes par une simple juxtaposition de tests bivariés expose le chercheur à des écueils méthodologiques majeurs, au premier rang desquels figure une inflation dramatique de l’erreur d’inférence statistique. L’analyse de variance résout cette impasse conceptuelle en proposant un cadre unifié capable d’évaluer simultanément la variabilité observée entre plusieurs groupes d’individus, tout en la calibrant par rapport à la variabilité inhérente aux individus eux-mêmes.
Le présent article propose une exploration exhaustive, rigoureuse et didactique de l’ANOVA à un facteur. De ses fondations théoriques à son application empirique détaillée dans le domaine de la recherche psychologique, nous décortiquerons son architecture mathématique, les postulats indispensables à sa validité, la logique de décomposition de la somme des carrés, ainsi que les procédures d’interprétation post-hoc et le calcul de la taille de l’effet. Ce guide vise à fournir aux chercheurs, cliniciens, statisticiens et étudiants une compréhension approfondie de cette pierre angulaire de l’inférence paramétrique.
1. Introduction et fondements conceptuels de l’ANOVA à un facteur
1.1 Définition théorique de l’analyse de variance unidirectionnelle
L’analyse de variance à un facteur, ou analyse de variance unidirectionnelle, est une méthode statistique paramétrique conçue pour tester l’hypothèse nulle selon laquelle les moyennes d’une variable continue mesurée au sein de k populations distinctes (où k ≥ 3) sont rigoureusement identiques. D’un point de vue structural, cette technique représente le prolongement mathématique naturel du test t de Student pour échantillons indépendants. En réalité, lorsque le chercheur analyse exactement deux modalités (k = 2), la statistique résultante F de l’ANOVA est strictement égale au carré de la statistique t de Student (F = t²), démontrant la parfaite continuité théorique unissant ces deux outils inférentiels au sein du modèle linéaire généralisé.
Dans la formalisation de l’ANOVA univariée, l’architecture des données repose impérativement sur la distinction nette entre deux types de variables. D’une part, la variable dépendante (VD) doit impérativement être de nature quantitative continue, mesurée à l’aide d’une échelle d’intervalles ou de rapports (par exemple, un temps de réaction en millisecondes, un score d’inventaire psychométrique standardisé ou une concentration sérique). D’autre part, la variable indépendante (VI), également appelée le facteur expérimental, est obligatoirement qualitative ou catégorielle nominale. Ce facteur est subdivisé en un nombre fini de niveaux ou modalités mutuellement exclusives, représentant les différents groupes ou conditions soumis à investigation comparative.
La finalité primordiale de l’ANOVA à un facteur réside dans la détermination du caractère statistiquement significatif des disparités observées entre les moyennes d’échantillons. Elle permet d’établir formellement si ces variations reflètent de véritables divergences structurelles entre les populations sous-jacentes, induites par les conditions expérimentales, ou si elles peuvent être attribuées de manière plausible aux simples fluctuations d’échantillonnage inhérentes à tout processus de mesure stochastique.
1.2 Rôle et pertinence méthodologique en recherche psychologique
Au sein des sciences psychologiques, l’analyse de variance unidirectionnelle occupe une place prépondérante, car les paradigmes expérimentaux et quasi-expérimentaux s’articulent très couramment autour de designs multiphases ou multicartes. Dans le champ de la psychologie clinique et de la psychiatrie expérimentale, par exemple, un chercheur évaluant des interventions thérapeutiques pour le traitement du trouble dépressif majeur ne se contente que rarement d’opposer une thérapie active à un placebo. Il est bien plus pertinent d’évaluer de front l’efficacité comparée d’une thérapie cognitivo-comportementale (TCC), d’un protocole pharmacologique standardisé, d’une intervention combinée et d’un groupe contrôle placé sur liste d’attente. L’ANOVA permet de déterminer sans ambiguïté si l’allégeance thérapeutique ou le mode d’intervention influe significativement sur le score symptomatique global après traitement.
Dans le domaine de la psychologie cognitive et des neurosciences comportementales, l’ANOVA est systématiquement déployée pour disséquer les mécanismes attentionnels et perceptifs. Considérons une expérience chronométrique mesurant l’interférence cognitive induite par des distracteurs environnementaux : un chercheur soumet des participants à une tâche de discrimination visuelle sous quatre conditions distinctes (absence de distracteur, distracteur auditif linguistique, distracteur auditif musical non verbal et distracteur visuel dynamique). En mesurant le temps d’accès lexical ou le temps de réaction moteur, l’ANOVA à un facteur révèle si la nature intrinsèque de la charge sensorielle parasite altère la vitesse d’allocation des ressources cognitives dans la mémoire de travail.
Enfin, en psychologie sociale et organisationnelle, l’ANOVA permet d’analyser les dynamiques d’influence, d’attribution causale ou de cohésion de groupe. Qu’il s’agisse d’évaluer la modification des attitudes politiques sous trois cadrages discursifs contrastés, d’observer la propension au conformisme face à des tailles de majorité variables, ou de mesurer la motivation intrinsèque des employés exposés à diverses modalités managériales, cette procédure inférentielle fournit la rigueur quantitative indispensable pour valider des modèles théoriques complexes régissant les conduites humaines.
1.3 Le principe fondamental du fractionnement de la variance
L’appellation même d’« analyse de variance » peut sembler paradoxale de prime abord : pour vérifier l’égalité de plusieurs moyennes arithmétiques, l’algorithme ne calcule pas directement des écarts bruts entre ces moyennes, mais décompose et compare des composantes distinctes de variabilité. Ce principe fondamental, formulé avec une lucidité géniale par Fisher, repose sur le fractionnement de la dispersion totale observée au sein de l’ensemble du corpus de données en deux entités mathématiques totalement indépendantes et additives.
La variabilité globale, ou variance totale, correspond à la somme des écarts quadratiques de l’ensemble des scores individuels par rapport à la moyenne arithmétique générale de l’échantillon, sans tenir compte de l’appartenance des participants à tel ou tel sous-groupe. L’intuition maîtresse de l’ANOVA consiste à postuler que cette variance totale peut être intégralement résolue en deux sources causales distinctes :
- La variance intergroupes (dite « entre groupes » ou Between-groups variance) : Elle reflète la dispersion des moyennes de chaque sous-groupe autour de la moyenne globale de l’échantillon. Cette composante capture simultanément l’effet systématique induit par la variable indépendante (le facteur manipulé par le chercheur) ainsi que la part d’erreur d’échantillonnage aléatoire affectant ces moyennes.
- La variance intragroupe (dite « à l’intérieur des groupes » ou Within-groups variance, couramment qualifiée de variance d’erreur résiduelle) : Elle quantifie l’hétérogénéité des scores des participants à l’intérieur même de leur groupe d’assignation respectif, par rapport à la moyenne locale de ce groupe. Puisque tous les individus d’un même groupe reçoivent un traitement expérimental strictement identique, les fluctuations observées à ce niveau ne peuvent découler de la variable indépendante ; elles traduisent les différences interindividuelles préexistantes (traits de personnalité, aptitudes biologiques, motivation) et les aléas non contrôlés de la mesure.
Conceptuellement, l’ANOVA à un facteur réalise donc une estimation rigoureuse du rapport signal/bruit dans le dispositif d’expérimentation. Le « signal » correspond à l’ampleur de la divergence induite par le facteur expérimental (variance intergroupes), tandis que le « bruit » correspond aux interférences et à l’imprécision statistique basale (variance intragroupe). Lorsque le signal émerge significativement du bruit résiduel de fond, l’analyste est fondé à inférer un impact réel et systématique du facteur sous étude.
2. Motivation méthodologique : Les limites des tests t multiples
2.1 L’inflation de l’erreur de première espèce (Erreur de Type I)
Face à une problématique impliquant la comparaison de k groupes d’individus, la tentation intuitive mais fondamentalement erronée pour un statisticien novice consisterait à multiplier les tests bilatéraux t de Student pour échantillons indépendants sur chacune des paires de moyennes concevables. Par exemple, avec quatre conditions expérimentales distinctes (notées A, B, C et D), il serait possible d’exécuter successivement les comparaisons A contre B, A contre C, A contre D, B contre C, B contre D, et enfin C contre D, soit un total de six tests inférentiels indépendants. Cette pratique méthodologiquement délétère est formellement proscrite en raison du phénomène probabiliste connu sous le nom d’inflation de l’erreur de première espèce (ou erreur de type I), dénotée classiquement par la lettre grecque α.
Le risque α nominal, classiquement fixé au seuil conventionnel de 0,05 dans les sciences empiriques, représente la probabilité de rejeter à tort l’hypothèse nulle lorsqu’elle est vérifiée dans la population parente, ce qui revient à conclure à l’existence d’un effet inexistant (un faux positif). Le nombre de paires uniques qu’il est possible de former à partir de k conditions expérimentales est déterminé par la formule combinatoire suivante :
c = k(k – 1) / 2
Si l’on postule l’indépendance statistique des comparaisons effectuées au niveau du seuil nominal unitaire α, la probabilité de ne commettre aucune erreur de première espèce sur l’ensemble des c tests successifs équivaut à (1 – α)c. Par voie de conséquence directe, la probabilité globale de commettre au moins une fausse découverte au cours de cette batterie de tests, appelée le taux d’erreur par famille de tests (Familywise Error Rate ou FWER), se calcule par l’équation exponentielle suivante :
αcumulé = 1 – (1 – α)c = 1 – (1 – α)[k(k – 1) / 2]
L’application numérique de cette loi révèle une détérioration critique de la maîtrise du risque d’erreur :
- Pour k = 3 groupes (3 comparaisons possibles) : αcumulé = 1 – (0,95)3 = 1 – 0,8574 ≈ 14,26 %.
- Pour k = 4 groupes (6 comparaisons possibles) : αcumulé = 1 – (0,95)6 = 1 – 0,7351 ≈ 26,49 %.
- Pour k = 5 groupes (10 comparaisons possibles) : αcumulé = 1 – (0,95)10 = 1 – 0,5987 ≈ 40,13 %.
- Pour k = 10 groupes (45 comparaisons possibles) : αcumulé = 1 – (0,95)45 = 1 – 0,0994 ≈ 90,06 %.
Ces calculs démontrent avec éclat qu’en recourant à des tests t multiples sans correction statistique, un chercheur examinant dix groupes observerait une différence statistiquement « significative » dans plus de 9 cas sur 10, quand bien même les traitements ne posséderaient rigoureusement aucune efficacité. Cette dérive méthodologique est directement impliquée dans la crise de reproductibilité frappant les sciences biomédicales et psychologiques.
2.2 Avantages de l’approche inférentielle globale
L’analyse de variance à un facteur contourne élégamment ce biais structurel en proposant ce que la littérature statistique qualifie de test « omnibus » ou test inférentiel global. Plutôt que de morceler le problème en une myriade d’interrogations locales au niveau des sous-échantillons, l’ANOVA formalise une évaluation globale et simultanée de l’effet induit par la variable catégorielle sur l’ensemble du système de données en un seul temps d’épreuve probabiliste.
Le bénéfice primordial de cette approche réside dans la préservation rigoureuse du risque d’erreur α nominal. Lorsque l’analyste calibre son modèle au seuil de 5 %, la probabilité maximale de déclarer à tort que le facteur expérimental produit un effet global au sein de la population demeure strictement contrainte à 0,05, indépendamment du nombre de niveaux k que comporte le facteur. Cette protection intégrale de l’intégrité de la décision statistique préserve la communauté scientifique de l’accumulation de faux positifs délétères.
De surcroît, l’ANOVA offre une remarquable économie computationnelle et une plus grande puissance statistique. En estimant la variance d’erreur résiduelle à partir de l’intégralité des observations (l’ensemble de la taille d’échantillon N), elle maximise le nombre de degrés de liberté associés au dénominateur du test, ce qui accroît substantiellement la précision de l’estimation de l’erreur commune comparativement à des tests bivariés restreints à de petits sous-groupes pris isolément.
3. Les postulats fondamentaux et conditions d’application
3.1 Indépendance des observations et échantillonnage
Pour que les résultats délivrés par l’ANOVA à un facteur possèdent une validité mathématique irréprochable, plusieurs conditions d’application — ou postulats statistiques — doivent être satisfaites. La première et la plus critique de ces conditions réside dans le postulat d’indépendance statistique des observations et des erreurs résiduelles.
Concrètement, cette condition impose que le score obtenu par un individu donné au sein de l’échantillon ne soit en aucune manière corrélé, prédictible ou influencé par le score obtenu par un autre participant, qu’il appartienne à la même condition expérimentale ou à un groupe concurrent. Sur le plan méthodologique, la garantie de cette indépendance repose sur la mise en œuvre rigoureuse d’une randomisation intégrale, impliquant à la fois l’échantillonnage aléatoire dans la population cible et l’assignation aléatoire des sujets aux différents niveaux du facteur expérimental.
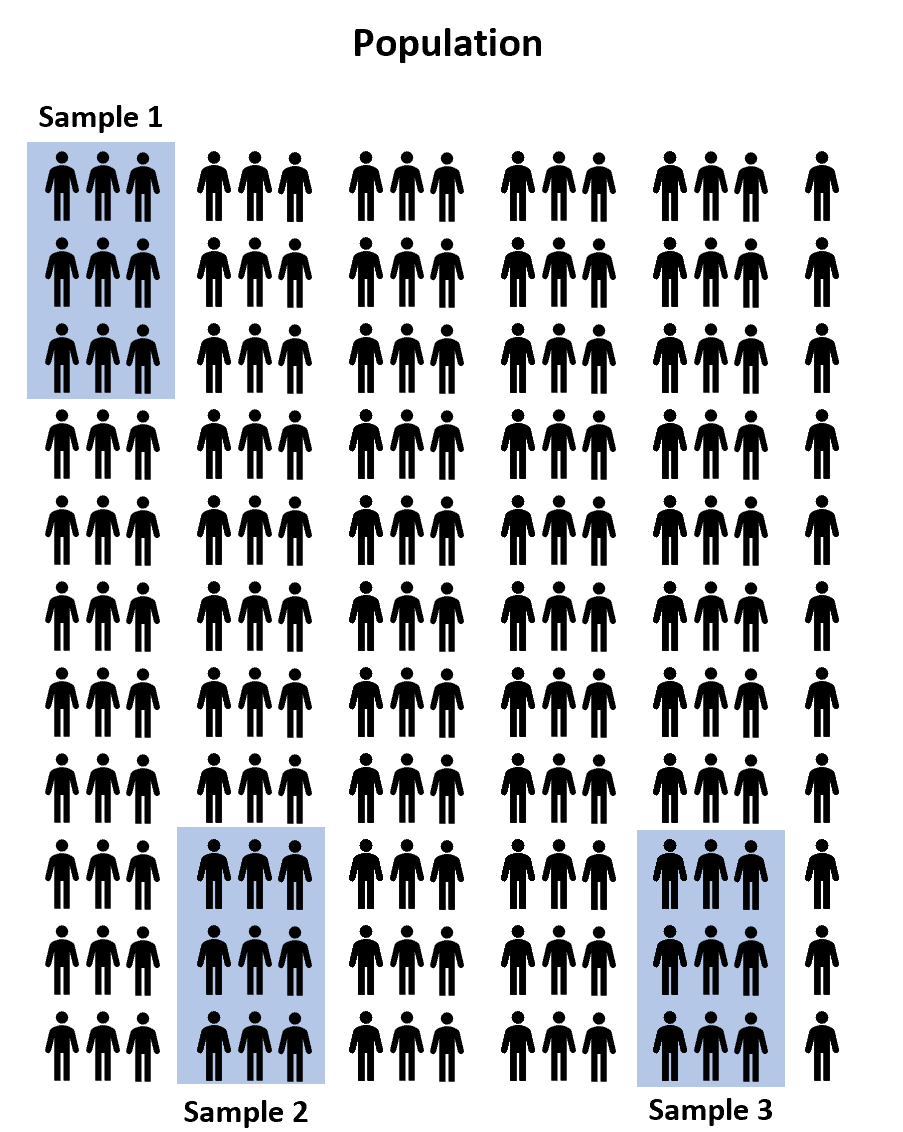
Une violation du postulat d’indépendance (par exemple, tester des individus réunis en dyades communicantes, des élèves partageant la même classe sans contrôler l’effet d’enseignant, ou répéter des mesures dans le temps sur les mêmes sujets) constitue la menace la plus dévastatrice pour l’ANOVA classique. Contrairement à d’autres déviations statistiques que le modèle tolère avec une certaine robustesse, une autocorrélation des résidus, même modeste (ex. r = 0,10), fausse dramatiquement les degrés de liberté réels, réduisant l’erreur standard théorique et propulsant le taux d’erreur de Type I réel à des niveaux pouvant atteindre 30 à 40 % au lieu des 5 % nominaux escomptés.
3.2 Normalité de la distribution au sein des groupes
Le second postulat postule que la variable dépendante continue suit une distribution normale (gaussienne) au sein de chacune des k populations sous-jacentes définies par les niveaux du facteur. Algébriquement, cela équivaut à affirmer que les erreurs résiduelles du modèle linéaire, définies par la déviation individuelle εij = Yij – μj, sont réparties de façon indépendante et identiquement distribuée selon une loi normale centrée d’espérance nulle et de variance constante : εij ∼ N(0, σ²).
Le diagnostic de cette normalité intra-groupe s’articule autour d’outils analytiques et visuels complémentaires :
- Les tests d’hypothèse formels : Le test de Shapiro-Wilk, largement reconnu comme le plus puissant et sensible pour les échantillons petits à modérés (n < 50), ainsi que le test de Kolmogorov-Smirnov corrigé par Lilliefors ou le test d’Anderson-Darling pour les corpus plus volumineux. Une valeur p non significative (p > 0,05) invite à ne pas rejeter la conformité à la distribution normale.
- L’inspection graphique : L’examen scrupuleux des histogrammes de densité et, par-dessus tout, des diagrammes quantile-quantile (Q-Q plots) normaux. Dans un tracé Q-Q optimal, les résidus standardisés s’alignent étroitement le long de la bissectrice théorique diagonale, les déviations structurelles aux extrémités signalant la présence d’asymétrie (skewness) ou d’aplatissement anormal (kurtosis).
Il importe toutefois de souligner la remarquable robustesse intrinsèque de l’ANOVA face aux entorses modérées de la normalité. En vertu du théorème central limite, la distribution d’échantillonnage des moyennes converge asymptotiquement vers une loi normale dès lors que les tailles d’échantillons intra-groupes atteignent un volume suffisant (généralement n ≥ 30 par cellule), garantissant la fiabilité des décisions inférentielles, sous réserve que la distribution ne présente pas une asymétrie multimodale prononcée ou la présence de points aberrants extrêmes (outliers).
3.3 Homoscédasticité ou homogénéité des variances
Le troisième postulat fondamental de l’ANOVA est celui de l’homogénéité des variances, techniquement désigné sous le terme d’homoscédasticité. Ce principe postule que la variance intrinsèque de la variable dépendante au sein de la population est rigoureusement identique à travers l’ensemble des k conditions expérimentales, soit formellement : σ1² = σ2² = … = σk² = σ².
L’évaluation empirique de l’homoscédasticité s’effectue généralement par le biais de tests statistiques dédiés :
- Le test de Levene : Fondé sur l’analyse de variance des écarts absolus des scores individuels par rapport à la moyenne du groupe (ou par rapport à la médiane dans sa version fiabilisée dite de Brown-Forsythe). Il est universellement privilégié en raison de sa robustesse face aux déviations de la normalité.
- Le test de Bartlett : Plus sensible mais excessivement tributaire de la stricte normalité des distributions ; toute déviation de la normalité conduit à son rejet erroné, même lorsque les variances sont homogènes.
L’impact d’une rupture d’homoscédasticité (hétéroscédasticité) dépend crucialement de la symétrie du design expérimental :
Dans un design équilibré (où les effectifs de chaque groupe sont rigoureusement égaux, n1 = n2 = … = nk), l’ANOVA démontre une robustesse exceptionnelle. Le ratio F conserve une distribution quasi-exacte tant que le rapport entre la variance la plus élevée et la variance la plus faible ne dépasse pas un facteur de 3 ou 4.
En revanche, dans un design déséquilibré (effectifs inégaux), l’hétéroscédasticité induit des distorsions sévères. Si les échantillons les plus petits présentent les variances les plus volumineuses, le test devient excessivement libéral (inflation majeure du risque α bien au-delà de 0,05, entraînant des faux positifs). À l’inverse, si les groupes les plus larges affichent les plus grandes variances, le test devient indûment conservateur (effondrement de la puissance statistique et risque accru d’erreurs de Type II). Dans de telles circonstances, l’application d’alternatives ajustées s’avère incontournable.
4. Formulation formelle des hypothèses statistiques
4.1 L’hypothèse nulle (H0) et sa signification clinique
Toute démarche d’inférence sous le paradigme neymano-pearsonien exige la formulation préliminaire et explicite d’un couple d’hypothèses statistiques antagonistes. L’hypothèse nulle, immuablement symbolisée par H0, pose le postulat d’une absence d’effet de la variable indépendante sur les paramètres de la population. Dans le cadre de l’ANOVA unidirectionnelle à k niveaux, son écriture mathématique formelle s’établit comme suit :
H0 : μ1 = μ2 = μ3 = … = μk
où les termes μ1, μ2, …, μk représentent les espérances mathématiques respectives de la variable dépendante au sein de chacune des k sous-populations d’intérêt.
Sur le plan conceptuel et substantiel, l’acceptation (ou plus exactement le non-rejet) de l’hypothèse nulle véhicule une implication directe : elle signifie que l’assignation des participants à des modalités expérimentales contrastées ne produit aucune différenciation mesurable sur l’échelle de réponse. Dans un essai clinique évaluant des molécules anxiolytiques, H0 stipule formellement que le nouveau principe actif, la molécule standard de référence et la pilule placebo induisent une diminution moyenne strictement superposable de la symptomatologie. Sous cette hypothèse, les divergences arithmétiques observées entre les moyennes d’échantillons (les valeurs Ȳj) sont considérées comme de simples fluctuations d’échantillonnage aléatoire, dépourvues de signification clinique ou théorique.
4.2 L’hypothèse alternative (H1) et sa portée omnibus
L’hypothèse alternative, notée H1 ou Ha, constitue la négation logique rigoureuse de l’hypothèse nulle. Elle stipule qu’il existe, au minimum, une divergence statistiquement démontrable entre les populations. Son expression formelle ne postule nullement que toutes les moyennes diffèrent mutuellement entre elles, mais requiert simplement :
H1 : ∃ (i, j) tel que μi ≠ μj (avec i ≠ j)
Ce formalisme met en relief la nature intrinsèquement omnibus et non directionnelle de l’analyse de variance à un facteur. Le test inférentiel s’avère parfaitement agnostique quant à la configuration précise des contrastes sous-jacents. Le rejet de H0 au profit de H1 peut découler d’une multitude infinie de scénarios empiriques :
- Un scénario où une modalité unique se détache radicalement de toutes les autres, ces dernières demeurant parfaitement équivalentes (μ1 ≠ μ2 = μ3 = μ4).
- Un patron ordonné monotone linéaire où chaque condition surpasse la précédente (μ1 < μ2 < μ3 < μ4).
- Une situation de divergence binaire par blocs (μ1 = μ2 ≠ μ3 = μ4).
Ainsi, la détection d’une valeur F statistiquement significative informe formellement le chercheur que la variable indépendante « fait une différence » au plan populationnel, mais elle demeure totalement impuissante à localiser avec exactitude quelles paires spécifiques de sous-groupes se différencient, ni quelle est la direction géométrique de cette divergence. Cette indétermination structurelle justifie méthodologiquement le recours ultérieur aux procédures d’analyse post-hoc.
5. Décomposition mathématique de la somme des carrés
5.1 La somme des carrés totale (SCT)
L’opération fondamentale au cœur de l’ANOVA consiste à quantifier la dispersion numérique absolue des données au moyen de la métrique des sommes de carrés d’écarts (désignée universellement par l’acronyme SC ou SS pour Sum of Squares). La somme des carrés totale (SCT ou SSTotal) exprime la variabilité cumulative intégrale manifestée par chaque observation individuelle par rapport au barycentre de l’ensemble du jeu de données, à savoir la grande moyenne générale (notée Ȳ.. ou simplement Ȳ).
Soit Yij le score observé pour le i-ème individu (avec i = 1, 2, …, nj) imbriqué au sein du j-ème groupe expérimental (avec j = 1, 2, …, k), et soit N la taille globale de l’échantillon (N = Σ nj). La formulation algébrique de la SCT s’écrit sous la forme de la double sommation suivante :
SCT = Σj=1k Σi=1nj (Yij – Ȳ..)²
Sur le plan géométrique, cette métrique mesure la distance euclidienne multidimensionnelle reliant le vecteur de toutes les observations individuelles au vecteur représentant la moyenne universelle. Le nombre de degrés de liberté (dl) associés à cette quantité est naturellement égal au nombre total d’observations indépendantes minoré de l’unique constante estimée à partir des données (la grande moyenne), soit :
dlTotal = N – 1
5.2 La somme des carrés intergroupes (SCB / SC_inter)
La somme des carrés intergroupes — conventionnellement désignée sous les sigles SCinter, SCB (pour Sum of Squares Between) ou SSTreatment — isole et quantifie la part de dispersion totale qui est exclusivement imputable aux différences observées entre les moyennes empiriques de chacun des sous-groupes (Ȳ.j) et la grande moyenne générale (Ȳ..).
Dans ce calcul, chaque individu au sein d’un groupe donné se voit symboliquement attribuer la moyenne de son propre groupe d’appartenance, ce qui neutralise toute variation résiduelle interne. La somme des écarts quadratiques est pondérée par la taille respective de chaque échantillon nj afin de refléter fidèlement son poids statistique dans la structure expérimentale globale :
SCinter = Σj=1k nj (Ȳ.j – Ȳ..)²
Cette somme de carrés mesure concrètement l’amplitude de l’effet produit par la manipulation expérimentale ou la séparation factorielle. Le nombre de degrés de liberté assigné à la SCinter découle directement du nombre de groupes indépendants k contraints par l’estimation préalable de la grande moyenne :
dlinter = k – 1
5.3 La somme des carrés intragroupe (SCW / SC_intra ou Erreur)
La troisième composante de la décomposition variance-analytique est la somme des carrés intragroupe, également nommée SCintra, SCW (pour Sum of Squares Within) ou SSError. Cette entité capture la dispersion purement résiduelle, c’est-à-dire l’amplitude des déviations individuelles de chaque sujet Yij par rapport à la moyenne spécifique de son propre groupe d’assignation Ȳ.j :
SCintra = Σj=1k Σi=1nj (Yij – Ȳ.j)²
Puisque chaque participant est ici comparé au groupe exact ayant reçu le même traitement expérimental sous les mêmes conditions de laboratoire, ces divergences sont structurellement imperméables à l’effet de la variable indépendante. La SCintra quantifie donc l’erreur d’échantillonnage, les singularités idiosyncrasiques des participants et les imperfections de métrologie.
Ses degrés de liberté s’obtiennent en cumulant les degrés de liberté propres à chaque groupe (nj – 1) :
dlintra = Σj=1k (nj – 1) = N – k
L’un des théorèmes cardinaux régissant l’algèbre de l’ANOVA stipule l’exacte additivité orthogonale de ces sommes de carrés et de leurs degrés de liberté respectifs :
SCT = SCinter + SCintra
dlTotal = dlinter + dlintra ⇔ (N – 1) = (k – 1) + (N – k)
6. Calculs des carrés moyens et formalisation mathématique
6.1 Calcul du carré moyen intergroupes (CM_inter)
Bien que les sommes de carrés (SC) constituent les blocs de construction algébriques indispensables de la variabilité, elles ne peuvent être comparées directement pour inférer des propriétés sur les populations parentes. En effet, la magnitude numérique brute d’une somme de carrés augmente de manière mécanique avec le volume d’observations collectées et le nombre de conditions expérimentales. Pour convertir ces valeurs cumulatives en estimateurs de variance non biaisés et comparables, il est impératif de normaliser chaque somme de carrés par son nombre correspondant de degrés de liberté, générant ainsi les quantités dénommées « carrés moyens » (CM ou MS pour Mean Squares).
Le carré moyen intergroupes (CMinter ou MSBetween) est formellement défini par le quotient de la somme des carrés intergroupes divisée par ses degrés de liberté associés :
CMinter = SCinter / dlinter = SCinter / (k – 1)
Sur le plan de la théorie statistique asymptotique, l’espérance mathématique du carré moyen intergroupes, notée E(CMinter), obéit à la structure suivante :
E(CMinter) = σ² + [ Σj=1k nj (μj – μ)² / (k – 1) ]
Cette dérivation formelle est fondamentale pour saisir la mécanique décisionnelle de l’ANOVA : elle démontre que CMinter fournit une estimation non seulement de la variance d’erreur basale (σ²), mais qu’il incorpore également un terme strictement positif représentant la véritable dispersion des effets de traitement de la population (μj – μ). Si l’hypothèse nulle H0 est rigoureusement exacte, le second terme s’annule intégralement, et l’espérance mathématique de CMinter devient strictement égale à la variance d’erreur pure σ².
6.2 Calcul du carré moyen intragroupe (CM_intra)
De manière symétrique, le carré moyen intragroupe (CMintra ou MSWithin, fréquemment labellisé MSError) est dérivé en divisant la somme des carrés des déviations internes par ses degrés de liberté résiduels :
CMintra = SCintra / dlintra = SCintra / (N – k)
Le carré moyen intragroupe représente en réalité la moyenne pondérée exacte des variances d’échantillon calculées au sein de chacun des k groupes distincts. L’espérance mathématique de cette grandeur statistique présente la propriété remarquable d’être absolument insensible et invariante à l’égard de l’effet du traitement expérimental :
E(CMintra) = σ²
En d’autres termes, que l’hypothèse nulle H0 soit vraie ou fausse, que le traitement thérapeutique révolutionne la condition des patients ou qu’il s’avère parfaitement inefficace, le CMintra demeure en toutes circonstances un estimateur non biaisé de la variance d’erreur σ² au sein de la population. Il constitue ainsi la référence d’étalonnage — le dénominateur fondamental — vis-à-vis duquel l’effet du facteur sera mis en perspective.
7. La statistique de test F et le tableau de l’ANOVA
7.1 Dérivation du ratio F de Fisher-Snedecor
La statistique inférentielle d’épreuve de l’ANOVA à un facteur, consacrée sous la dénomination historique de ratio F en hommage aux travaux précurseurs de Ronald Fisher et développée par George Snedecor, se définit formellement comme le ratio d’évaluation du carré moyen intergroupes sur le carré moyen intragroupe :
F = CMinter / CMintra
La logique mathématique sous-tendant ce ratio découle directement des espérances mathématiques démontrées à la section précédente :
F ≈ [ σ² + effet du traitement ] / σ²
Sous l’hypothèse nulle d’égalité des moyennes populationnelles (H0 : μ1 = … = μk), l’effet du traitement est nul. Par conséquent, le numérateur et le dénominateur estiment exactement la même variance théorique d’erreur pure (σ²). Le ratio F converge alors en espérance mathématique vers une valeur proche de l’unité (plus précisément, la valeur théorique moyenne d’une distribution F sous H0 est égale à dl2 / (dl2 – 2) pour dl2 > 2, ce qui s’approche de 1 dès que l’échantillon s’accroît).
En revanche, lorsque l’hypothèse alternative H1 est valide, la présence d’un effet différentiel substantiel induit par le facteur majore significativement le numérateur CMinter, tandis que le dénominateur CMintra demeure stable. Il en résulte un ratio F empirique substantiellement supérieur à 1. Lorsque les conditions de normalité et d’homoscédasticité sont respectées, ce ratio d’épreuve suit rigoureusement la loi de probabilité continue théorique de Fisher-Snedecor, paramétrée par deux degrés de liberté distincts : les degrés de liberté du numérateur dl1 = k – 1 et les degrés de liberté du dénominateur dl2 = N – k.
7.2 Structure normalisée du tableau récapitulatif de l’ANOVA
Dans la littérature scientifique et les logiciels de biostatistique (tels que R, SPSS, SAS ou JASP), les étapes successives de la décomposition de la variance sont synthétisées au sein d’une matrice standardisée dénommée « tableau de l’ANOVA ». Cette présentation ordonnée permet à l’examinateur de vérifier instantanément la cohérence arithmétique globale des résultats.
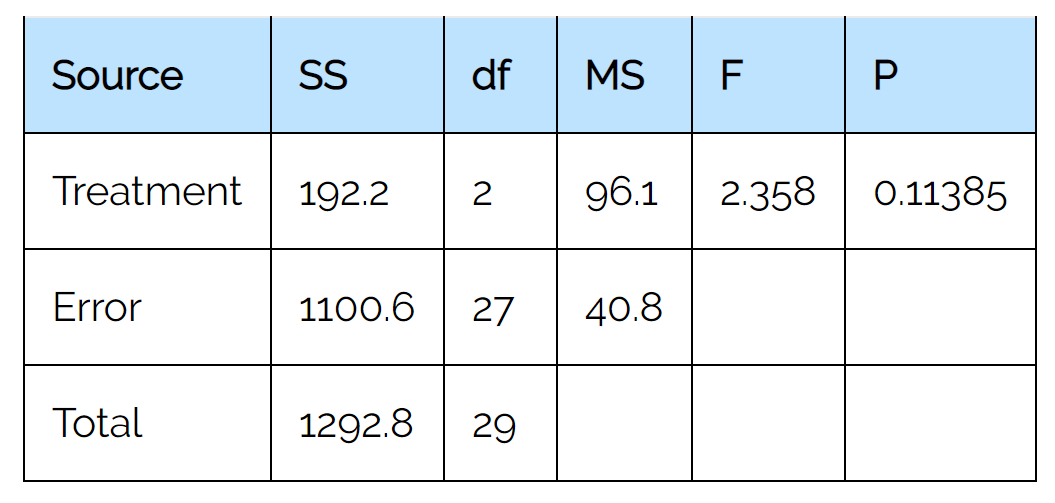
La disposition conventionnelle de ce tableau récapitulatif s’organise selon les colonnes et lignes suivantes :
- Source de variation (Source) : Identifie l’origine causale de la décomposition (Facteur/Intergroupes, Résiduelle/Intragroupe, et Totale).
- Somme des carrés (SC / SS) : Les montants cumulatifs SCinter, SCintra et SCT.
- Degrés de liberté (dl / df) : Les valeurs respectives k – 1, N – k et N – 1.
- Carrés moyens (CM / MS) : Obtenus exclusivement pour les lignes Inter et Intra par le quotient SC / dl.
- Statistique F (F-Value) : Le ratio CMinter / CMintra, affiché sur la ligne du facteur.
- Valeur p (Sig. / Pr > F) : La probabilité asymptotique associée à la valeur F observée sous la loi théorique de Fisher.
La structure formelle matricielle s’établit selon le schéma suivant :
| Source de variation | Somme des Carrés (SC) | Degrés de liberté (dl) | Carré Moyen (CM) | F observé | p-valeur |
|---|---|---|---|---|---|
| Intergroupes (Facteur) | SCinter | k – 1 | SCinter / (k – 1) | CMinter / CMintra | P(Fk-1, N-k ≥ Fobs) |
| Intragroupe (Erreur) | SCintra | N – k | SCintra / (N – k) | – | – |
| Total | SCT | N – 1 | – | – | – |
7.3 Règle de décision statistique et valeur p
L’inférence conclusive repose sur la confrontation de la métrique empirique aux seuils probabilistes établis a priori. Le chercheur dispose traditionnellement de deux voies convergentes pour asseoir sa décision statistique :
La première démarche, historique, repose sur l’utilisation des tables statistiques de la loi F de Fisher. Pour un niveau de risque α nominal spécifié (usuellement 0,05 ou 0,01), et en fonction des coordonnées de degrés de liberté (dl1, dl2), l’analyste extrait une valeur seuil dite critique, dénotée Fcritique. Si la valeur empirique calculée vérifie l’inégalité Fobs > Fcritique, la statistique d’épreuve se situe au sein de la région critique de rejet unilatérale droite. Dès lors, l’hypothèse nulle H0 est formellement rejetée.
La seconde modalité, universellement adoptée à l’ère computationnelle, s’appuie sur le calcul de la valeur p (p-value). Celle-ci correspond à l’intégrale de la fonction de densité de probabilité de Fisher de la valeur observée Fobs jusqu’à l’infini :
p = P(F(k-1, N-k) ≥ Fobs | H0 est vraie)
La règle décisionnelle s’applique alors avec une clarté binaire :
- Si p ≤ α : L’écart observé est déclaré statistiquement significatif. L’hypothèse nulle d’égalité des moyennes est rejetée. On conclut avec un risque d’erreur consenti de 5 % que le facteur produit un impact substantiel sur la variable dépendante au sein de la population.
- Si p > α : Les données ne fournissent pas d’évidence empirique suffisante pour disqualifier l’hypothèse nulle. On échoue à rejeter H0. L’analyste conclut que les divergences d’échantillonnage observées sont parfaitement compatibles avec le simple aléa stochastique.
8. Exemple empirique complet : Comparaison de thérapies pour l’anxiété
8.1 Présentation du cadre de l’étude clinique et des données
Afin d’ancrer ces développements théoriques dans une réalité tangible, développons une application empirique détaillée étape par étape. Imaginons un essai clinique interventionnel mené dans une unité de recherche en psychopathologie cognitive. L’investigateur principal souhaite évaluer l’efficacité différentielle de protocoles thérapeutiques brefs pour réduire les manifestations anxieuses chroniques chez des patients présentant un trouble de l’anxiété généralisée.
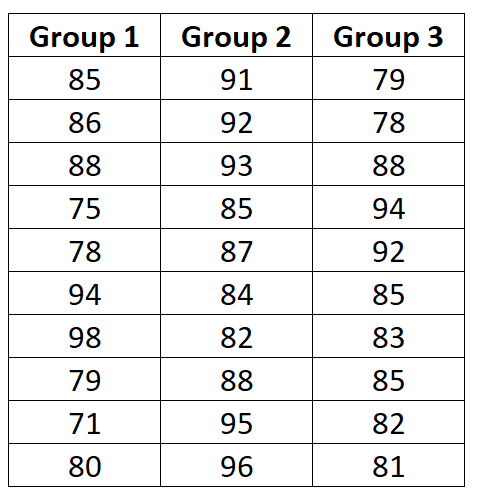
Le protocole comporte trois conditions expérimentales (k = 3) distinctes :
- Groupe 1 (TCC) : Participation à un protocole de Thérapie Cognitivo-Comportementale manuelle axée sur la restructuration cognitive et l’exposition intéroceptive.
- Groupe 2 (Pleine Conscience / Mindfulness) : Participation à un programme de réduction du stress basé sur la pleine conscience (MBSR).
- Groupe 3 (Liste d’attente / Témoin) : Condition contrôle passive dans laquelle les patients sont placés sur liste d’attente sans intervention active.
L’échantillon comprend N = 15 participants assignés de manière strictement aléatoire à raison de n = 5 individus par modalité thérapeutique. La variable dépendante mesurée à l’issue des huit semaines de suivi est le score brut standardisé obtenu à l’Inventaire d’Anxiété de Beck (BAI – Beck Anxiety Inventory), un instrument psychométrique où un score élevé indique une intensité sévère des symptômes anxieux.
Les observations quantitatives recueillies au terme du protocole se déclinent comme suit :
- Groupe 1 – TCC (j = 1) : 14, 18, 12, 16, 15
- Groupe 2 – Pleine Conscience (j = 2) : 20, 24, 22, 19, 25
- Groupe 3 – Témoin (j = 3) : 28, 32, 26, 30, 34
8.2 Calcul manuel détaillé des moyennes et des sommes de carrés
Procédons avec minutie au calcul pas à pas de l’ensemble des métriques d’échantillonnage et des sommes de carrés.
Étape 1 : Calcul des moyennes locales de groupe
La moyenne arithmétique de chaque modalité s’obtient par la sommation des scores unitaires divisée par la taille intra-groupe (nj = 5) :
- Moyenne TCC (Ȳ.1) = (14 + 18 + 12 + 16 + 15) / 5 = 75 / 5 = 15,0
- Moyenne Pleine Conscience (Ȳ.2) = (20 + 24 + 22 + 19 + 25) / 5 = 110 / 5 = 22,0
- Moyenne Contrôle (Ȳ.3) = (28 + 32 + 26 + 30 + 34) / 5 = 150 / 5 = 30,0
Étape 2 : Calcul de la grande moyenne générale (Ȳ..)
Puisque le design est rigoureusement équilibré (n1 = n2 = n3 = 5), la grande moyenne équivaut à la moyenne simple des trois moyennes de groupe, ou au cumul des 15 scores divisé par N = 15 :
Ȳ.. = (75 + 110 + 150) / 15 = 335 / 15 = 22,3333
Étape 3 : Calcul de la Somme des Carrés Intergroupes (SC_inter)
Appliquons la formule de la dispersion intergroupes pondérée par les effectifs de cellule :
SCinter = Σ nj (Ȳ.j – Ȳ..)²
SCinter = 5 × (15,0 – 22,3333)² + 5 × (22,0 – 22,3333)² + 5 × (30,0 – 22,3333)²
SCinter = 5 × (-7,3333)² + 5 × (-0,3333)² + 5 × (7,6667)²
SCinter = 5 × (53,7778) + 5 × (0,1111) + 5 × (58,7778)
SCinter = 268,889 + 0,556 + 293,889 = 563,333
Étape 4 : Calcul de la Somme des Carrés Intragroupe (SC_intra)
Calculons la somme des écarts quadratiques des scores individuels par rapport à leur propre moyenne de traitement :
Pour le Groupe 1 (TCC, moyenne = 15) :
(14 – 15)² + (18 – 15)² + (12 – 15)² + (16 – 15)² + (15 – 15)²
= (-1)² + (3)² + (-3)² + (1)² + (0)² = 1 + 9 + 9 + 1 + 0 = 20,0
Pour le Groupe 2 (Pleine Conscience, moyenne = 22) :
(20 – 22)² + (24 – 22)² + (22 – 22)² + (19 – 22)² + (25 – 22)²
= (-2)² + (2)² + (0)² + (-3)² + (3)² = 4 + 4 + 0 + 9 + 9 = 26,0
Pour le Groupe 3 (Témoin, moyenne = 30) :
(28 – 30)² + (32 – 30)² + (26 – 30)² + (30 – 30)² + (34 – 30)²
= (-2)² + (2)² + (-4)² + (0)² + (4)² = 4 + 4 + 16 + 0 + 16 = 40,0
Par sommation sur les trois groupes :
SCintra = 20,0 + 26,0 + 40,0 = 86,0
Étape 5 : Vérification formelle par la Somme des Carrés Totale (SCT)
Calculons indépendamment la SCT en évaluant l’écart de chacun des 15 scores par rapport à la grande moyenne (22,3333) :
Somme des scores au carré (Σ Y²) = 14² + 18² + 12² + 16² + 15² + 20² + 24² + 22² + 19² + 25² + 28² + 32² + 26² + 30² + 34²
= 196 + 324 + 144 + 256 + 225 + 400 + 576 + 484 + 361 + 625 + 784 + 1024 + 676 + 900 + 1156 = 8131.
Le terme de correction globale T² / N = (335)² / 15 = 112225 / 15 = 7481,667.
SCT = Σ Y² – (T² / N) = 8131 – 7481,667 = 649,333.
Vérifions l’additivité fondamentale orthogonale :
SCT = SCinter + SCintra = 563,333 + 86,0 = 649,333.
L’identité arithmétique est vérifiée avec une exactitude absolue.
8.3 Construction du tableau final et prise de décision
Déterminons désormais les degrés de liberté :
- dlinter = k – 1 = 3 – 1 = 2
- dlintra = N – k = 15 – 3 = 12
- dlTotal = N – 1 = 15 – 1 = 14
Calculons les carrés moyens respectifs :
- CMinter = SCinter / dlinter = 563,333 / 2 = 281,667
- CMintra = SCintra / dlintra = 86,0 / 12 = 7,167
Dérivons la valeur d’épreuve F observée :
Fobs = CMinter / CMintra = 281,667 / 7,167 = 39,30
Dressons le tableau récapitulatif de l’analyse :
| Source de variation | Somme des Carrés (SC) | Degrés de liberté (dl) | Carré Moyen (CM) | F observé | p-valeur |
|---|---|---|---|---|---|
| Thérapie (Inter) | 563,333 | 2 | 281,667 | 39,30 | < 0,0001 |
| Erreur (Intra) | 86,000 | 12 | 7,167 | – | – |
| Total | 649,333 | 14 | – | – | – |
Consultons la distribution théorique de Fisher pour dl1 = 2 et dl2 = 12 au seuil nominal α = 0,05. La table indique une valeur critique de Fcritique(2, 12) = 3,89. Pour un seuil encore plus strict de α = 0,001, la valeur critique est de Fcritique(2, 12) = 12,97.
Puisque notre statistique empirique Fobs = 39,30 dépasse de manière écrasante le seuil critique (p < 0,0001), nous rejetons formellement l’hypothèse nulle H0 au profit de l’hypothèse alternative H1. Nous concluons avec une certitude statistique extrêmement élevée que le type d’intervention thérapeutique produit un effet significatif sur l’intensité des symptômes d’anxiété mesurés à 8 semaines.
9. Quantification de la taille de l’effet en psychologie
9.1 Le coefficient Eta-carré (eta^2)
L’obtention d’une valeur p hautement significative informe formellement le chercheur sur l’existence d’une divergence populationnelle non imputable au hasard, mais elle n’apporte strictement aucun renseignement sur l’amplitude clinique ou la pertinence pratique de l’effet découvert. En effet, dans des échantillons de grande taille, un effet microscopique et sans aucune utilité clinique peut atteindre des seuils de significativité extrêmes (ex. p < 0,001). C’est la raison pour laquelle les standards de publication modernes imposent l’estimation systématique de la taille de l’effet (effect size).
La mesure descriptive la plus universellement rapportée pour l’ANOVA est le coefficient de détermination factorielle, baptisé Êta-carré (η²). Il exprime la proportion exacte de la variance globale de la variable dépendante qui est expliquée ou prédite par l’assignation factorielle aux différents groupes. Sa formule s’établit très simplement par le quotient de la somme des carrés intergroupes sur la somme des carrés totale :
η² = SCinter / SCT
En reprenant les données numériques de notre essai clinique sur l’anxiété :
η² = 563,333 / 649,333 = 0,8676 (soit 86,76 %)
Cette valeur signifie que 86,76 % de la dispersion des scores d’anxiété de Beck au sein de notre échantillon est directement attribuable au protocole thérapeutique suivi. Toutefois, les épistémologues et méthodologistes soulignent un écueil structurel de l’η² : il s’agit d’une statistique descriptive d’échantillon qui souffre d’un biais systématique d’estimation positive (surévaluation de l’effet réel au niveau populationnel), un défaut particulièrement prononcé dans les cohortes restreintes (comme notre étude à N = 15).
9.2 L’Omega-carré (omega^2) comme estimateur ajusté
Afin de corriger le biais d’optimisme inhérent à l’η², William Hays a développé un estimateur beaucoup moins biaisé fondé sur la variance de la population : l’Oméga-carré (ω²). Cet indice ajuste la magnitude observée en soustrayant le carré moyen de l’erreur résiduelle au numérateur et en pondérant le dénominateur par ce même terme d’erreur :
ω² = [ SCinter – (dlinter × CMintra) ] / [ SCT + CMintra ]
Injectons les paramètres calculés de notre expérimentation :
ω² = [ 563,333 – (2 × 7,167) ] / [ 649,333 + 7,167 ] = [ 563,333 – 14,334 ] / 656,500 = 548,999 / 656,500 = 0,8363 (soit 83,63 %)
Bien que légèrement inférieur à l’η² (83,63 % contre 86,76 %), l’ω² atteste d’une efficacité thérapeutique absolument majeure. Pour interpréter ces métriques au sein de la littérature comportementale et psychologique, le statisticien Jacob Cohen a formulé des balises d’étalonnage conventionnelles relatives aux tailles d’effets expliquées :
- Effet faible : η² ou ω² ≈ 0,01 (le facteur explique 1 % de la variance totale).
- Effet modéré / moyen : η² ou ω² ≈ 0,06 (le facteur explique 6 % de la variance totale).
- Effet fort / substantiel : η² ou ω² ≥ 0,14 (le facteur explique 14 % ou plus de la variance totale).
Avec un ω² atteignant plus de 0,83, notre essai clinique se positionne bien au-delà des seuils conventionnels d’effets larges, documentant un impact thérapeutique d’une ampleur clinique déterminante pour la prise en charge de la pathologie anxieuse.
10. Analyses post-hoc et comparaisons multiples
10.1 Nécessité théorique des procédures a posteriori
L’obtention d’un ratio F statistiquement significatif (comme illustré par notre valeur empirique de 39,30) valide le rejet de l’hypothèse nulle globale omnibus, ce qui confirme que les trois modalités de traitement ne partagent pas une même moyenne dans la population. Cependant, comme explicité lors de l’examen de l’hypothèse alternative H1, cette décision globale n’indique en rien quelles paires spécifiques de conditions expérimentales diffèrent de manière significative.
Le chercheur se trouve face à trois interrogations précises :
- La thérapie cognitivo-comportementale (TCC) est-elle significativement supérieure à la condition contrôle sur liste d’attente ?
- La méditation de pleine conscience produit-elle une amélioration statistiquement dissociable du groupe contrôle ?
- La TCC surpasse-t-elle significativement la pleine conscience, ou ces deux modalités actives sont-elles cliniquement comparables ?
Pour trancher ces questions sans réintroduire l’écueil méthodologique d’inflation du risque d’erreur globale α (FWER), le recours à des tests de comparaison multiple a posteriori — communément appelés tests post-hoc — est mathématiquement incontournable. Il convient de distinguer conceptuellement ces démarches exploratoires des contrastes planifiés a priori. Ces derniers sont paramétrés avant la collecte de données sur la base de déductions théoriques strictes et bénéficient d’une puissance supérieure, alors que les analyses post-hoc inspectent la totalité des combinaisons bilatérales possibles après avoir constaté la significativité du test omnibus.
10.2 Le test HSD de Tukey (Honestly Significant Difference)
Parmi l’arsenal des procédures post-hoc, le test HSD de John Tukey (Honestly Significant Difference) s’impose comme la référence d’excellence méthodologique lorsque l’expérimentateur compare toutes les paires possibles de moyennes au sein d’un design présentant des tailles de cellules équilibrées et des variances homogènes.
Le test de Tukey repose sur la distribution statistique de l’étendue standardisée ou étendue studentisée (notée q). Pour comparer deux moyennes d’échantillons quelconques Ȳi et Ȳj, la statistique q observée s’établit selon la formule suivante :
q = | Ȳi – Ȳj | / √(CMintra / n)
Alternativement, le test permet de calculer une différence minimale critique (la valeur HSD). Tout écart absolu entre deux moyennes d’échantillons qui surpasse ce seuil critique est formellement déclaré statistiquement significatif au seuil global choisi (typiquement α = 0,05) :
HSD = qcritique(α, k, dl_intra) × √(CMintra / n)
Appliquons cette procédure à nos données cliniques sur l’anxiété :
Nous disposons de k = 3 groupes, dlintra = 12, et n = 5. Consultons la table théorique de l’étendue studentisée pour α = 0,05 avec ces coordonnées. La table fournit la valeur seuil : qcritique(0,05; 3; 12) = 3,77.
Calculons l’erreur standard de la différence :
SE = √(CMintra / n) = √(7,167 / 5) = √(1,4334) ≈ 1,1972.
Dérivons la valeur minimale critique HSD de Tukey :
HSD = 3,77 × 1,1972 = 4,513.
Évaluons désormais les écarts arithmétiques observés entre nos trois moyennes :
- Comparaison TCC vs Pleine Conscience : | 15,0 – 22,0 | = 7,0. Puisque 7,0 > 4,513, la différence est significative (p < 0,05). La TCC réduit significativement plus l’anxiété que la pleine conscience.
- Comparaison Pleine Conscience vs Témoin : | 22,0 – 30,0 | = 8,0. Puisque 8,0 > 4,513, la différence est significative (p < 0,05). La pleine conscience est significativement supérieure à l’absence de thérapie.
- Comparaison TCC vs Témoin : | 15,0 – 30,0 | = 15,0. Puisque 15,0 > 4,513, la différence est hautement significative (p < 0,001).
Le test de Tukey permet également d’édifier des intervalles de confiance simultanés garantissant exactement un taux de couverture nominal de 95 % pour l’ensemble des contrastes appariés.
10.3 Ajustement de Bonferroni et méthode de Scheffé
D’autres approches algorithmiques sont fréquemment déployées en fonction des caractéristiques du protocole expérimental :
L’ajustement de Bonferroni : Cette technique repose sur l’inégalité booléenne de Fréchet-Bonferroni. Elle consiste à diviser le seuil nominal α par le nombre exact de comparaisons bilatérales menées (c), fixant un seuil de décision local α’ = α / c. Dans notre exemple, pour 3 comparaisons, α’ = 0,05 / 3 ≈ 0,0167. Bien que remarquablement simple et universellement applicable (y compris sur des designs complexes ou non orthogonaux), la correction de Bonferroni pèche par son caractère extrêmement conservateur lorsque le nombre de comparaisons s’accroît. En réduisant drastiquement le seuil de rejet, elle majore substantiellement le taux d’erreurs de type II (perte notable de puissance statistique).
La méthode de Scheffé : Conçue par Henry Scheffé, cette procédure est la plus conservatrice et la plus polyvalente de toutes les techniques post-hoc. Elle maintient le taux d’erreur par famille à exactement 5 %, non seulement pour toutes les comparaisons bivariées simples, mais également pour l’ensemble infini des contrastes linéaires complexes concevables (par exemple, comparer la moyenne combinée des groupes TCC et Pleine Conscience à celle du groupe témoin : [μ1 + μ2]/2 vs μ3). En contrepartie de cette protection absolue contre les faux positifs sur les contrastes post-hoc non anticipés, sa puissance statistique sur les comparaisons simples de paires est inférieure à celle du test de Tukey, ce qui justifie la préférence accordée à Tukey pour les études classiques par paires.
11. Violations des postulats et approches alternatives
11.1 L’ANOVA de Welch en cas d’hétéroscédasticité
Lorsque le postulat d’homoscédasticité est transgressé — situation attestée par un test de Levene statistiquement significatif (p < 0,05) — et que les tailles d’échantillons des groupes sont inégales, l’application de l’ANOVA de Fisher classique entraîne des distorsions sévères du taux d’erreur. Face à ce défi méthodologique, l’alternative paramétrique standard recommandée par l’ensemble des biostatisticiens contemporains est l’ANOVA de Welch (ou test F de Welch pour moyennes hétéroscédastiques).
Le principe fondamental de la correction de Welch consiste à pondérer chaque moyenne de groupe non pas par son seul effectif brut, mais par l’inverse de sa variance d’échantillon (définissant ainsi des poids wj = nj / sj²). Les groupes présentant une variance résiduelle instable et hypertrophiée se voient ainsi attribuer un poids inférieur dans l’estimation de la moyenne centrale et de la dispersion globale.
Parallèlement, l’ANOVA de Welch recalcule les degrés de liberté du dénominateur (dl2) selon une formule d’ajustement analogue à la correction de Welch-Satterthwaite du test t :
dlWelch = [ k² – 1 ] / [ 3 × Σj=1k ( (1 – wj / W)² / (nj – 1) ) ]
(où W = Σ wj).
Des études de simulation par méthode de Monte Carlo ont largement démontré que l’ANOVA de Welch contrôle remarquablement le taux d’erreur de Type I au seuil nominal théorique de 5 %, tout en conservant une puissance statistique optimale face aux variances hétérogènes, même en présence de déviations modérées de la normalité. De nombreux méthodologistes préconisent aujourd’hui l’utilisation de l’ANOVA de Welch par défaut dans les logiciels de traitement de données.
11.2 Le test non paramétrique de Kruskal-Wallis
Lorsque la variable dépendante continue viole sévèrement le postulat de distribution gaussienne (par exemple, des distributions fortement asymétriques, plurimodales, ou comportant des valeurs aberrantes impossibles à régulariser par transformation mathématique), ou lorsque la variable mesurée relève d’une échelle strictement ordinale (comme une échelle de Likert à 5 points sans continuité métrique), l’ANOVA paramétrique devient inappropriée. Il convient alors de recourir au test de Kruskal-Wallis (ou ANOVA à un facteur sur rangs).
Le fondement mathématique de Kruskal-Wallis réside dans le remplacement préalable de la totalité des N scores bruts de l’échantillon combiné par leurs rangs statistiques ascendants ordonnés (du rang 1 assigné à la plus faible valeur jusqu’au rang N alloué au score le plus élevé). La statistique d’épreuve, dénotée H, évalue l’écart quadratique des sommes de rangs cumulées par groupe (Rj) par rapport à l’espérance théorique des rangs sous l’hypothèse nulle :
H = [ 12 / (N(N + 1)) ] × [ Σj=1k (Rj² / nj) ] – 3(N + 1)
Sous l’hypothèse nulle d’identité des distributions populationnelles, la statistique H converge asymptotiquement vers une loi de distribution du Chi-deux (χ²) à k – 1 degrés de liberté. Si le test de Kruskal-Wallis s’avère significatif, les comparaisons multiples par paires s’exécutent au moyen du test de Dunn sur les sommes de rangs, assorti des corrections d’usage pour comparaisons multiples (telles que les ajustements de Holm ou de Benjamini-Hochberg pour contrôler le taux de fausses découvertes).
11.3 Méthodes de rééchantillonnage et bootstrap
Une alternative moderne de plus en plus plébiscitée dans la recherche expérimentale de pointe réside dans l’utilisation des méthodes non paramétriques intensives en calcul, au premier rang desquelles figure le bootstrap empirique. Conceptualisé par Bradley Efron, le bootstrap s’affranchit totalement de toute hypothèse distributionnelle théorique relative à la normalité ou à l’homogénéité des variances.
Dans le cadre d’une ANOVA à un facteur par rééchantillonnage, l’ordinateur génère un nombre massif d’itérations stochastiques (typiquement B = 5 000 ou 10 000 réplicats virtuels). À chaque étape, des pseudo-échantillons sont extraits avec remise à partir des données empiriques originelles. Pour chaque jeu régénéré, le ratio F ou les contrastes de différences de moyennes sont recalculés. Cette procédure génère une distribution d’échantillonnage empirique directe de la statistique de test.
Cette distribution empirique permet de dériver des intervalles de confiance bootstrap corrigés et accélérés (BCa – Bias-Corrected and Accelerated confidence intervals) pour les différences intergroupes. Cette démarche s’avère inestimable dans les recherches en neurosciences ou en psychologie clinique exploratoire où les effectifs sont drastiquement contraints (n ≤ 8 par modalité) et où les conditions formelles des modèles gaussiens ne peuvent être garanties.
12. Implémentation pratique et restitution des résultats selon l’APA
12.1 Syntaxe et exécution sous R, SPSS et Python
L’exécution informatique d’une ANOVA à un facteur s’opère de nos jours avec une grande fluidité algorithmique au sein des principaux environnements de calcul scientifique.
Environnement R : Dans le langage open-source R, la procédure standard utilise le modèle linéaire ou la fonction dédiée aux plans d’expérience :
L’estimation classique s’effectue via l’instruction modele <- aov(anxiete ~ groupe, data = donnees), dont l’extraction analytique complète est délivrée par la commande summary(modele). Pour obtenir directement les tailles d’effets standardisées et les tests post-hoc de Tukey, les fonctions eta_squared(modele) du package effectsize et TukeyHSD(modele) sont déployées. En cas de violation d’homogénéité des variances, l’ANOVA de Welch est appelée instantanément au moyen de la syntaxe native oneway.test(anxiete ~ groupe, data = donnees, var.equal = FALSE).
Environnement IBM SPSS Statistics : L’utilisateur peut naviguer par l’interface graphique via les menus déroulants : Analyser > Comparer les moyennes > ANOVA à 1 facteur (One-Way ANOVA). Il convient d’insérer la variable dépendante continue dans le champ Liste des variables dépendantes et le facteur catégoriel dans le champ Facteur. Dans le sous-menu Post-Hoc, cocher la case Tukey garantit l’analyse multiple par paires. Dans le sous-menu Options, cocher Homogénéité des variances (test de Levene) et Welch permet de parer à toute hétérogénéité structurelle.
Environnement Python : Sous l’écosystème scientifique Python, l’analyse requiert les bibliothèques spécialisées pandas, scipy.stats et statsmodels. L’ANOVA omnibus rapide s’exécute via la syntaxe from scipy.stats import f_oneway suivie de l’instruction f_stat, p_val = f_oneway(groupe1, groupe2, groupe3). Pour une sortie détaillée modélisée, on utilise statsmodels :
import statsmodels.api as sm
from statsmodels.formula.api import ols
modele = ols('anxiete ~ C(groupe)', data=df).fit()
anova_table = sm.stats.anova_lm(modele, typ=2).
Le test HSD de Tukey s’obtient au moyen de la classe pairwise_tukeyhsd extraite du module statsmodels.stats.multicomp.
12.2 Normes de rédaction statistique selon l’APA (7e édition)
La diffusion des résultats d’une analyse de variance au sein des revues scientifiques à comité de lecture exige une conformité rigoureuse avec les canons de standardisation édictés par l’American Psychological Association (APA, 7e édition). Les normes typographiques stipulent que les symboles statistiques désignant des paramètres d’échantillons ou des statistiques d’épreuve (tels que F, p, M, SD, η²) doivent obligatoirement être composés en caractères italiques.
La structure formelle de restitution de la statistique F obéit au gabarit suivant :
F(dlinter, dlintra) = [valeur de F arrondie à deux décimales], p = [valeur p exacte à trois décimales ou < ,001], η² = [taille d’effet à deux décimales].
Voici l’exemple textuel de restitution narrative intégrale pour l’expérience clinique analysée précédemment :
« Une analyse de variance unidirectionnelle inter-sujets (ANOVA à un facteur) a été conduite afin d’évaluer l’impact de différentes modalités thérapeutiques sur le niveau d’anxiété des participants mesuré à l’aide de l’Inventaire d’Anxiété de Beck (BAI). L’analyse révèle un effet principal statistiquement hautement significatif du protocole thérapeutique, F(2, 12) = 39,30, p < ,001, η² = ,87, ω² = ,84. Les scores d’anxiété moyens se distinguent substantiellement selon les conditions : le groupe ayant suivi la Thérapie Cognitivo-Comportementale (M = 15,00, SD = 2,24) présente une symptomatologie moindre comparativement au groupe soumis au protocole de Pleine Conscience (M = 22,00, SD = 2,55) ainsi qu’au groupe témoin placé sur liste d’attente (M = 30,00, SD = 3,16). Des comparaisons multiples post-hoc conduites à l’aide du test HSD de Tukey au seuil critique de 5 % démontrent que toutes les comparaisons bilatérales s’avèrent statistiquement significatives : la TCC surpasse significativement la pleine conscience (p = ,003, différence moyenne = -7,00, IC 95 % [-11,51, -2,49]) ainsi que la condition contrôle (p < ,001). Enfin, l’intervention par pleine conscience permet une réduction symptomatique significativement supérieure au groupe contrôle (p = ,001, différence moyenne = -8,00, IC 95 % [-12,51, -3,49]). Ces résultats corroborent notre hypothèse clinique relative à la supériorité de la prise en charge cognitivo-comportementale. »
12.3 Représentation graphique rigoureuse des moyennes
La publication scientifique des résultats d’une ANOVA ne saurait être complète sans une médiation visuelle fidèle, rigoureuse et immédiatement accessible de la structure des données. La représentation graphique la plus courante repose sur le diagramme en barres (bar chart) ou le graphique en nuage de points avec lignes de connexion des moyennes d’échantillons (interaction plot ou mean-and-error plot).
Sur le plan méthodologique, un graphique scientifique ne doit jamais se limiter à l’affichage des moyennes brutes. Il est impératif d’intégrer des barres d’erreur (error bars) dont la nature métrique doit être explicitement précisée dans la légende du graphique :
- L’écart-type (SD – Standard Deviation) : Illustre la dispersion empirique brute des individus autour de la moyenne au sein de l’échantillon. Il informe sur la variabilité interindividuelle naturelle.
- L’erreur standard de la moyenne (SEM – Standard Error of the Mean) : Divise l’écart-type par la racine carrée de la taille du sous-groupe (SEM = SD / √n). Elle quantifie la précision de l’estimation de la moyenne populationnelle par l’échantillon.
- L’intervalle de confiance à 95 % (IC 95 %) : Calculé par M ± tcritique × SEM. C’est l’indicateur visuel le plus robuste et le plus recommandé par les normes APA. Deux barres d’intervalles de confiance à 95 % qui ne se chevauchent pas visuellement signalent généralement une différence statistiquement significative au seuil α = 0,05.
Enfin, les critères contemporains de transparence scientifique invitent les auteurs à superposer aux barres de moyennes les points de données brutes individuelles (sous forme de jittered dot plots ou de graphiques en violon). Cette démarche permet au lecteur d’apprécier d’un coup d’œil l’absence de valeurs aberrantes masquées, la symétrie réelle des distributions et la densité empirique des observations au sein de chaque niveau du facteur expérimental.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Hays, W. L. (1994). Statistics (5th ed.). Harcourt Brace College Publishers.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Scheffé, H. (1959). The analysis of variance. John Wiley & Sons.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3/4), 330–336. https://doi.org/10.2307/2332579