
L’analyse multivariée contemporaine repose sur une prémisse fondamentale : la capacité de quantifier avec exactitude et pertinence théorique la divergence ou la ressemblance entre des entités complexes décrites par de multiples variables. Qu’il s’agisse de comparer la structure taxonomique de deux écosystèmes forestiers, de mesurer l’évolution spatiotemporelle d’un microbiote intestinal sous traitement thérapeutique, ou de caractériser la divergence clinique entre les répertoires symptomatiques de deux patients en psychiatrie computationnelle, le choix de la métrique d’association constitue le pivot méthodologique déterminant l’ensemble des inférences statistiques ultérieures. Parmi la vaste pléthore d’indices élaborés au cours du XXe siècle, la dissimilarité de Bray-Curtis occupe une place prépondérante, s’érigeant en véritable standard de facto dans les disciplines manipulant des matrices d’abondances clairsemées et hétérogènes.
Conçue initialement pour répondre aux impasses méthodologiques des distances géométriques classiques face aux inventaires floristiques, cette mesure a rapidement transcendé son cadre disciplinaire d’origine. Les écologues J. Roger Bray et John Thomas Curtis ont introduit une formulation algébrique à la fois intuitive et d’une redoutable efficacité, capable d’intégrer l’intensité quantitative des descripteurs tout en neutralisant le biais structurel induit par les absences conjointes. Alors que la distance euclidienne tend à distordre la réalité écologique en traitant l’absence simultanée d’un taxon comme une preuve de ressemblance, la métrique de Bray-Curtis concentre son pouvoir discriminant sur l’information biologique positivement partagée et sur les différentiels réels d’abondance.
La robustesse conceptuelle de cette mesure explique son adoption généralisée bien au-delà de la phytoécologie, trouvant des applications décisives en bio-informatique, en métagénomique environnementale et, plus récemment, dans la psychométrie des réseaux et l’analyse dimensionnelle du comportement. Comprendre la dissimilarité de Bray-Curtis implique d’explorer ses fondements historiques, de disséquer son appareil mathématique, d’analyser ses propriétés métriques particulières — notamment son statut formel de semi-métrique — et de maîtriser son implémentation algorithmique au sein des architectures modernes d’ordination multivariée. Cette analyse exhaustive propose un parcours théorique, méthodologique et appliqué à travers l’une des métriques les plus influentes de la statistique multivariée appliquée.
1. Origines historiques et fondements théoriques de la mesure de Bray-Curtis
1.1 Le contexte d’émergence en écologie quantitative
L’écologie végétale des années 1950 traversait une profonde révolution conceptuelle et méthodologique. Sous l’impulsion de chercheurs visionnaires à l’Université du Wisconsin à Madison, la vision holistique et organismale des communautés végétales, longtemps défendue par Frederic Clements, commençait à céder le pas face au concept individualiste de l’association végétale formalisé par Henry Gleason. Dans ce paradigme émergent, les espèces végétales ne sont plus perçues comme des entités indissociables formant des supra-organismes discrets, mais comme des populations indépendantes se distribuant de manière continue et individualisée le long de gradients écologiques et environnementaux complexes. C’est dans ce bouillonnement intellectuel que J. Roger Bray et John Thomas Curtis publièrent en 1957 leur étude fondatrice consacrée aux communautés forestières des hautes terres du sud du Wisconsin, intitulée An Ordination of the Upland Forest Communities of Southern Wisconsin.
À cette époque, les écologues quantitatifs étaient confrontés à une barrière méthodologique majeure : l’absence d’outils analytiques adaptés pour quantifier de façon réaliste la ressemblance entre des stations d’échantillonnage écologiquement diversifiées. Les coefficients d’association disponibles étaient pour la plupart restreints à des formulations qualitatives binaires d’occurrence, telles que l’indice de Jaccard ou le coefficient de Sørensen. Bien que ces mesures permettent d’évaluer le simple partage de présence ou d’absence d’espèces, elles s’avéraient totalement impuissantes à capturer les variations subtiles mais déterminantes de l’abondance relative, de la dominance démographique et de la biomasse végétale. Deux peuplements forestiers partageant les mêmes essences arborées mais dans des proportions radicalement inverses — l’un dominé par le chêne blanc avec de rares érables, l’autre écrasé par la canopée de l’érable avec de sporadiques chênes résiduels — étaient jugés mathématiquement indiscernables par les métriques qualitatives de l’époque.
Conscients de cette lacune critique, Bray et Curtis comprirent qu’une véritable analyse de gradient, appelée ordination polaire dans leurs travaux fondateurs, nécessitait une fonction de calcul capable d’intégrer harmonieusement les comptages réels, les densités relatives ou les fréquences de recouvrement des espèces. En adaptant les principes de comparaison proportionnelle aux abondances absolues ou standardisées, les deux chercheurs élaborèrent une mesure qui allait devenir la pierre angulaire de l’ordination floristique, ouvrant la voie à la transition définitive de l’écologie descriptive vers une écologie numérique rigoureuse, mathématisée et empiriquement vérifiable.
1.2 Philosophie de la mesure des communautés et des profils
La philosophie sous-jacente à la dissimilarité de Bray-Curtis repose sur un postulat écologique fondamental : deux communautés vivantes se ressemblent d’autant plus qu’elles partagent des volumes concrets d’individus appartenant aux mêmes taxons, et non pas simplement des identités taxonomiques abstraites. Dans la nature, la structure d’un assemblage écologique est définie par le flux d’énergie et la matière que chaque population mobilise au sein du biotope. Ainsi, la véritable ressemblance entre deux écosystèmes découle du partage matériel de leurs abondances réelles. Cette conception s’oppose radicalement aux approches purement géométriques qui considèrent les descripteurs comme de simples dimensions orthogonales au sein d’un espace vectoriel abstrait.
Sur le plan épistémologique, Bray et Curtis ont introduit une distinction cruciale entre la dissemblance d’échantillonnage écologique et la distance spatiale euclidienne. Dans un repère physique tridimensionnel, la distance entre deux points est invariante par rapport aux propriétés intrinsèques de l’espace. En revanche, dans l’espace des profils écologiques, la distance perçue est conditionnée par la biologie des organismes : un site où aucune espèce n’est observée ne peut être considéré comme infiniment proche d’un autre site vide sur la base d’une proximité géométrique. La mesure de Bray-Curtis pose pour principe que la quantité d’information partagée réside dans le minimum d’abondance d’un descripteur commun aux deux unités d’échantillonnage. Si une espèce est présente avec une abondance de 50 individus sur le site A et de 20 individus sur le site B, le niveau d’échange, d’interaction partagée ou de compatibilité écologique pour cette espèce est strictement borné par les 20 unités communes.
Cette approche relationnelle a exercé une influence colossale sur le développement de l’écologie numérique moderne, théorisée ultérieurement par des figures tutélaires telles que Pierre Legendre et Louis Legendre. Elle a permis de conceptualiser les assemblages biologiques non pas comme des vecteurs inertes plongés dans une géométrie rigide, mais comme des profils dynamiques dont la proximité mutuelle doit refléter fidèlement le chevauchement fonctionnel et démographique réel au sein des écosystèmes observés.
1.3 Du paradigme écologique aux sciences comportementales
Bien que forgée au cœur des forêts feuillues nord-américaines, la dissimilarité de Bray-Curtis possède des propriétés mathématiques intrinsèques qui la rendent universellement applicable à tout système complexe caractérisé par des répertoires hétérogènes et des profils d’intensité. C’est ainsi que la psychométrie quantitative et les sciences comportementales se sont progressivement approprié cette métrique au cours des dernières décennies. En psychologie clinique et en psychopathologie quantitative, la description d’un individu s’opère traditionnellement via l’évaluation d’une multiplicité de symptômes, dont la sévérité est scorée sur des échelles d’intensité continues ou ordinales (par exemple les échelles de dépression, d’anxiété ou de désorganisation cognitive).
Dans ce contexte, la transposition conceptuelle est directe et féconde : un individu ou un patient peut être modélisé mathématiquement de la même manière qu’un site d’échantillonnage écologique, tandis que les symptômes cliniques correspondent aux différentes espèces végétales ou animales composant le profil global. Deux patients consultant pour des troubles de l’humeur ne présentent presque jamais des constellations sémiologiques binaires ; ils exhibent des variations d’amplitude considérables sur des dimensions telles que l’insomnie, l’anhédonie, l’agitation motrice ou les idéations suicidaires. L’adoption de la métrique de Bray-Curtis permet de formaliser la distance inter-individuelle en se fondant sur l’intensité exacte des traits cliniques manifestés, tout en résolvant un problème psychométrique majeur : le traitement des symptômes absents.
La validité conceptuelle de la comparaison de répertoires comportementaux au moyen de Bray-Curtis s’avère particulièrement pertinente dans l’analyse des patrons d’activation comportementale et l’éthologie humaine. Lorsque des chercheurs enregistrent les durées quotidiennes allouées par différents individus à une typologie étendue d’activités (travail, loisirs passifs, interactions sociales, pratiques sportives, sommeil), la similarité de mode de vie ne dépend pas seulement de la nature des activités pratiquées, mais du volume temporel minimal partagé au sein de chaque catégorie comportementale. La métrique de Bray-Curtis capture cette réalité empirique avec une précision que les coefficients de corrélation linéaire ou les distances euclidiennes ne peuvent atteindre, consolidant ainsi son statut d’outil transdisciplinaire incontournable.
2. Définition mathématique et formulation formelle de la dissimilarité
2.1 Équation canonique et décomposition des termes
La formulation algébrique canonique de la dissimilarité de Bray-Curtis entre deux unités d’échantillonnage, désignées conventionnellement par les indices $i$ et $j$, s’articule autour du rapport entre le volume d’abondances minimales partagées et la masse globale des observations recensées sur les deux sites. Soit un ensemble de $p$ descripteurs (espèces, gènes, items psychologiques ou comportements) mesurés sur deux unités distinctes. Le vecteur d’observation associé à l’échantillon $i$ est noté $\mathbf{x}_i = (x_{i1}, x_{i2}, dots, x_{ip})$ et celui de l’échantillon $j$ est noté $\mathbf{x}_j = (x_{j1}, x_{j2}, dots, x_{jp})$, où $x_{ik}$ représente l’abondance, la fréquence ou l’intensité du descripteur $k$ au sein de l’unité $i$.
L’expression mathématique standardisée de la dissimilarité de Bray-Curtis, notée $BC_{ij}$, s’énonce selon la relation canonique suivante :
$$BC_{ij} = 1 – \frac{2 C_{ij}}{S_i + S_j}$$
Dans cette équation, le terme $C_{ij}$ représente la covariance minimale ou la somme des minima d’abondances partagées entre les deux profils pour l’ensemble des $p$ descripteurs recensés. Ce terme fondamental est formellement défini par la sommation :
$$C_{ij} = \sum_{k=1}^{p} \min(x_{ik}, x_{jk})$$
Cette sommation isole rigoureusement la quantité d’abondance effective que les deux échantillons possèdent en commun pour chaque variable $k$. Parallèlement, les termes $S_i$ et $S_j$ représentent respectivement les sommes marginales totales des abondances observées au sein de chacune des deux unités comparées :
$$S_i = \sum_{k=1}^{p} x_{ik} \quad \text{et} \quad S_j = \sum_{k=1}^{p} x_{jk}$$
La somme combinée $S_i + S_j$ exprime donc l’effectif cumulé total de l’ensemble des spécimens, intensités ou occurrences dénombrés sur les deux profils. Le ratio fractionnaire $(2 C_{ij}) / (S_i + S_j)$ constitue quant à lui l’indice de similarité de Bray-Curtis (ou coefficient de similarité de Sørensen quantitatif). En soustrayant ce ratio de l’unité scalaire, on obtient la mesure complémentaire directe : la dissimilarité de Bray-Curtis, dont les valeurs sont rigoureusement confinées dans l’intervalle fermé $[0, 1]$.
2.2 Formulations algébriques alternatives et équivalentes
Bien que la formulation canonique exposée ci-dessus mette l’accent sur la notion de partage d’abondance via l’opérateur du minimum, il existe une formulation algébrique alternative strictement équivalente qui explicite la métrique sous la forme d’un rapport normalisé de différences absolues. Cette formulation démontre que la dissimilarité de Bray-Curtis est l’expression directe de la somme des écarts absolus composante par composante, divisée par la somme totale des abondances des deux vecteurs :
$$BC_{ij} = \frac{\sum_{k=1}^{p} |x_{ik} – x_{jk}|}{\sum_{k=1}^{p} (x_{ik} + x_{jk})} = \frac{\sum_{k=1}^{p} |x_{ik} – x_{jk}|}{S_i + S_j}$$
L’équivalence mathématique entre ces deux expressions se démontre avec aisance en exploitant l’identité fondamentale liant la valeur absolue, la somme et le minimum de deux réels positifs. Pour toute paire de scalaires réels $a ge 0$ et $b ge 0$, la relation algébrique universelle suivante est vérifiée :
$$|a – b| = (a + b) – 2 \min(a, b)$$
En substituant cette propriété au sein du numérateur de l’expression des différences absolues, on retrouve immédiatement la formulation canonique :
$$\sum_{k=1}^{p} |x_{ik} – x_{jk}| = \sum_{k=1}^{p} (x_{ik} + x_{jk}) – 2 \sum_{k=1}^{p} \min(x_{ik}, x_{jk}) = (S_i + S_j) – 2 C_{ij}$$
En divisant chaque terme par $(S_i + S_j)$, l’expression se scinde en $1 – (2 C_{ij}) / (S_i + S_j)$, confirmant l’identité mathématique parfaite des deux approches.
Cette écriture algébrique dévoile la filiation étroite entre la mesure de Bray-Curtis et d’autres coefficients d’association historiques. En statistique numérique, cette métrique est formellement identique au coefficient de dissemblance de Czekanowski quantitatif ainsi qu’à l’indice de Steinhaus appliqué aux vecteurs d’abondance. De plus, lorsque les données d’entrée sont préalablement réduites à des variables binaires d’occurrence (où $x_{ik} in {0, 1}$), la formule se simplifie instantanément pour donner le coefficient classique de Sørensen pour données qualitatives, soulignant la continuité élégante entre les métriques de présence-absence et leurs généralisations quantitatives continues.
2.3 Hypothèses mathématiques sous-jacentes
L’application rigoureuse du coefficient de dissimilarité de Bray-Curtis repose sur un ensemble de contraintes et de postulats mathématiques stricts qu’il est indispensable de vérifier lors du traitement de données expérimentales. La condition première et incontournable est l’exigence de positivité stricte ou de nullité des données d’entrée :
$$\forall i, \forall k, \quad x_{ik} ge 0$$
L’algorithme de Bray-Curtis est structurellement incompatible avec les valeurs négatives. Si une variable présente des scores négatifs (comme cela peut survenir après un centrage statistique autour de la moyenne, ou lors de l’utilisation d’échelles psychométriques bipolaires s’étendant de -3 à +3), la signification géométrique et écologique de l’opérateur $\min(x_{ik}, x_{jk})$ s’effondre totalement, conduisant à des dissimilarités qui peuvent sortir de l’intervalle canonique $[0, 1]$ et perdre toute cohérence interprétative.
Une seconde caractéristique mathématique cruciale réside dans la sensibilité structurelle de la métrique à l’échelle absolue des abondances brutes. Contrairement à des coefficients normalisés par descripteur (tels que la distance de Gower ou le coefficient de corrélation de Pearson), le calcul de Bray-Curtis accorde un poids mathématique directement proportionnel à l’amplitude numérique brute de chaque descripteur. Par conséquent, une espèce ou un item clinique affichant des comptages se chiffrant en centaines ou en milliers d’unités exercera une influence écrasante sur la valeur finale de $BC_{ij}$, reléguant les variables à faibles effectifs à un rôle marginal, voire négligeable, dans l’évaluation de la ressemblance globale.
Enfin, le comportement asymptotique de la métrique face aux descripteurs nuls partagés mérite une attention particulière. Si pour une composante $k$ donnée, les deux échantillons présentent une valeur nulle ($x_{ik} = 0$ et $x_{jk} = 0$), cette composante contribue pour exactement 0 au numérateur ($|0 – 0| = 0$ et $min(0, 0) = 0$) ainsi qu’au dénominateur ($0 + 0 = 0$). Les doubles zéros n’altèrent donc en rien les sommes marginales ni la covariance minimale. Il en résulte que le calcul de Bray-Curtis est strictement invariant face à l’adjonction arbitraire de descripteurs totalement absents des deux unités comparées, une propriété fondatrice qui le distingue radicalement des distances spatiales conventionnelles.
3. Propriétés métriques et caractéristiques de l’espace de dissimilarité
3.1 Non-respect de l’inégalité triangulaire et statut de semi-métrique
En topologie générale et en géométrie métrique, pour qu’une fonction de dissimilarité $d(x, y)$ soit formellement qualifiée de véritable métrique ou de distance au sens strict, elle doit satisfaire simultanément à quatre axiomes fondamentaux pour tous points $x, y, z$ appartenant à l’ensemble considéré :
- La non-négativité : $d(x, y) ge 0$
- L’identité des indiscernables : $d(x, y) = 0 iff x = y$
- La symétrie : $d(x, y) = d(y, x)$
- L’inégalité triangulaire : $d(x, z) le d(x, y) + d(y, z)$
Si la dissimilarité de Bray-Curtis satisfait pleinement aux trois premiers critères (sous réserve que l’on traite des profils contenant au moins une observation non nulle), elle échoue à respecter systématiquement le quatrième axiome fondamental : l’inégalité triangulaire. Pour cette raison, la mesure de Bray-Curtis n’est pas une métrique pure, mais possède le statut mathématique de semi-métrique (ou pseudo-métrique de ressemblance).
L’échec de l’inégalité triangulaire peut être aisément démontré par un contre-exemple numérique simple. Considérons trois profils univariés ou multivariés réduits à trois espèces distinctes, représentés par les vecteurs d’abondance suivants :
$$\mathbf{x} = (10, 0, 0), \quad \mathbf{y} = (10, 10, 0), \quad \mathbf{z} = (0, 10, 10)$$
Calculons successivement les dissimilarités de Bray-Curtis pour chaque paire :
Pour la paire $(\mathbf{x}, \mathbf{y})$ : les sommes valent $S_x = 10$, $S_y = 20$. Le minimum commun pour l’espèce 1 est $min(10, 10) = 10$. D’où :
$$BC(\mathbf{x}, \mathbf{y}) = 1 – \frac{2 \times 10}{10 + 20} = 1 – \frac{20}{30} = \frac{1}{3} \approx 0{,}333$$
Pour la paire $(\mathbf{y}, \mathbf{z})$ : les sommes valent $S_y = 20$, $S_z = 20$. Le minimum commun pour l’espèce 2 est $min(10, 10) = 10$. D’où :
$$BC(\mathbf{y}, \mathbf{z}) = 1 – \frac{2 \times 10}{20 + 20} = 1 – \frac{20}{40} = \frac{1}{2} = 0{,}500$$
Pour la paire $(\mathbf{x}, \mathbf{z})$ : les vecteurs n’ont rigoureusement aucune espèce en commun. Le numérateur de similarité est nul ($C_{xz} = 0$). D’où :
$$BC(\mathbf{x}, \mathbf{z}) = 1 – \frac{0}{10 + 20} = 1{,}000$$
Examinons à présent l’inégalité triangulaire pour le trajet direct entre $\mathbf{x}$ et $\mathbf{z}$ en passant par l’intermédiaire $\mathbf{y}$ :
$$BC(\mathbf{x}, \mathbf{y}) + BC(\mathbf{y}, \mathbf{z}) = \frac{1}{3} + \frac{1}{2} = \frac{5}{6} \approx 0{,}833$$
Or, nous constatons que :
$$BC(\mathbf{x}, \mathbf{z}) = 1{,}000 > 0{,}833 = BC(\mathbf{x}, \mathbf{y}) + BC(\mathbf{y}, \mathbf{z})$$
L’inégalité triangulaire est ici formellement violée ($1{,}000 > 0{,}833$). Les conséquences géométriques de cette violation sont majeures : l’espace relationnel engendré par une matrice de dissimilarité de Bray-Curtis est non euclidien. Il est impossible de projeter directement et sans distorsion l’ensemble des points d’une telle matrice dans un espace euclidien rigide à $k$ dimensions sans générer des valeurs propres négatives lors d’une analyse en coordonnées principales (PCoA). C’est précisément cette non-linéarité fondamentale qui impose le recours préférentiel à des méthodes d’ordination non métriques, au premier rang desquelles figure le positionnement multidimensionnel non métrique (NMDS).
3.2 Propriété d’invariance et indépendance des doubles zéros
L’une des propriétés les plus admirables et écologiquement signifiantes de la dissimilarité de Bray-Curtis est son invariance absolue face à l’adjonction de doubles zéros, souvent qualifiée de propriété de neutralité des absences conjointes. Dans l’analyse quantitative de communautés naturelles ou de profils cliniques, l’absence simultanée d’une espèce ou d’un symptôme chez deux individus distincts constitue une information hautement ambiguë. Deux forêts tempérées échantillonnées en hiver ne présentent ni palmiers tropicaux, ni cactus désertiques, ni mousses alpines ; cela justifie-t-il pour autant de considérer que ces deux forêts sont hautement similaires parce qu’elles partagent l’absence de milliers d’espèces tropicales ?
En écologie numérique, répondre affirmativement à cette question constitue une erreur méthodologique gravissime connue sous le nom de paradoxe des doubles zéros. Les métriques géométriques conventionnelles, telles que la célèbre distance euclidienne ou la distance de Manhattan non normalisée, sont lourdement sujettes à ce biais :
$$d_{\text{Euclidienne}}(\mathbf{x}_i, \mathbf{x}_j) = \sqrt{\sum_{k=1}^{p} (x_{ik} – x_{jk})^2}$$
Si l’on enrichit la matrice d’étude de dix espèces supplémentaires totalement absentes des deux sites ($x_{ik} = 0$ et $x_{jk} = 0$), chaque terme $(0 – 0)^2 = 0$ s’additionne sous le radical sans altérer la distance absolue. Toutefois, si l’on calcule des indices de ressemblance proportionnels ou des distances statistiques normalisées, la présence massive de zéros fait gonfler artificiellement la proximité globale perçue entre les sites. La distance euclidienne tend à regrouper fallacieusement deux sites désertiques ou deux stations polaires biologiquement très pauvres simplement parce qu’ils partagent une immense majorité de zéros taxonomiques.
La dissimilarité de Bray-Curtis neutralise mathématiquement ce problème par construction. Reprenons sa formulation alternative :
$$BC_{ij} = \frac{\sum_{k=1}^{p} |x_{ik} – x_{jk}|}{\sum_{k=1}^{p} (x_{ik} + x_{jk})}$$
Si pour un descripteur arbitraire $k$, $x_{ik} = 0$ et $x_{jk} = 0$, nous obtenons $|0 – 0| = 0$ au numérateur et $0 + 0 = 0$ au dénominateur. Ce descripteur n’apporte strictement aucune contribution à la valeur de la fraction. Que la matrice initiale contienne 10 espèces ou que l’on y adjoigne 10 000 espèces hypothétiques jamais observées sur le terrain d’étude, la valeur numérique de $BC_{ij}$ demeure rigoureusement identique au millième près. Bray-Curtis focalise donc l’analyse sur les présences confirmées et les intensités partagées, écartant avec une rigueur absolue le bruit d’illusion d’association induit par les absences ubiquitaires.
3.3 Symétrie et bornes de l’espace d’association
Sur le plan structural, l’opérateur de dissimilarité de Bray-Curtis est caractérisé par une symétrie mathématique parfaite. Pour toute paire de vecteurs d’observation $\mathbf{x}_i$ et $\mathbf{x}_j$, la relation d’invariance par permutation est strictement satisfaite :
$$BC_{ij} = BC_{ji}$$
La preuve formelle découle de la commutativité inhérente aux opérateurs sous-jacents d’addition et de minimisation dans l’ensemble des nombres réels :
$$\min(x_{ik}, x_{jk}) = \min(x_{jk}, x_{ik}) implies C_{ij} = C_{ji}$$
$$x_{ik} + x_{jk} = x_{jk} + x_{ik} implies S_i + S_j = S_j + S_i$$
Il s’ensuit que la matrice d’association de Bray-Curtis générée pour un jeu de données contenant $n$ unités d’échantillonnage est une matrice carrée $\mathbf{D}$ d’ordre $n \times n$, dont la diagonale principale est exclusivement composée de zéros ($BC_{ii} = 0$ pour tout $i$), et qui est parfaitement symétrique par rapport à cette diagonale ($D_{ij} = D_{ji}$). Cette propriété de symétrie garantit la cohérence des structures topologiques dérivées lors des procédures de classification hiérarchique ou d’ordination globale.
Concernant le domaine de définition et les bornes scalaires, la dissimilarité de Bray-Curtis est une fonction strictement bornée dans l’intervalle réel $[0, 1]$, à la condition absolue que les vecteurs d’entrée contiennent au moins une valeur strictement positive (afin d’éviter une indétermination mathématique du type $0/0$ au dénominateur). Lorsque deux profils sont quantitativement identiques dans leur structure et leurs amplitudes, la dissimilarité atteint sa borne inférieure absolue : $BC_{ij} = 0$. À l’autre extrémité, lorsque deux profils ne partagent absolument aucun descripteur commun ($C_{ij} = 0$), le numérateur de similarité s’annule complètement et la dissimilarité atteint sa borne supérieure unitaire : $BC_{ij} = 1$.
Le comportement analytique de la métrique lors de variations unilatérales extrêmes s’avère particulièrement stable. Considérons un système où un échantillon $i$ conserve une composition fixe tandis que l’échantillon $j$ voit l’abondance d’un taxon exclusif tendre vers l’infini ($x_{jm} to +\infty$). Dans ce cas de figure, le dénominateur $S_i + S_j$ croît de manière illimitée tandis que le numérateur des minima partagés $C_{ij}$ demeure plafonné par les abondances limitées du vecteur $\mathbf{x}_i$. Le ratio de similarité $(2 C_{ij}) / (S_i + S_j)$ tend alors asymptotiquement vers zéro, et la dissimilarité $BC_{ij}$ converge de façon fluide et monotone vers sa borne unitaire $1$, sans jamais diverger vers l’infini comme le ferait une distance euclidienne non normalisée.
4. Guide de calcul pas à pas : Exemple empirique complet
4.1 Présentation du jeu de données expérimentales
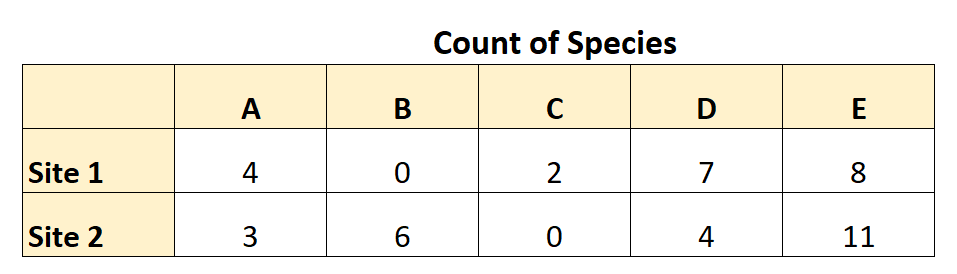
Afin d’ancrer les concepts théoriques dans une réalité calculatoire tangible, déroulons l’intégralité des opérations algébriques sur un jeu de données empiriques concret. Imaginons une étude comparative portant sur deux profils d’observation distincts. Selon le prisme disciplinaire choisi, ces profils peuvent représenter :
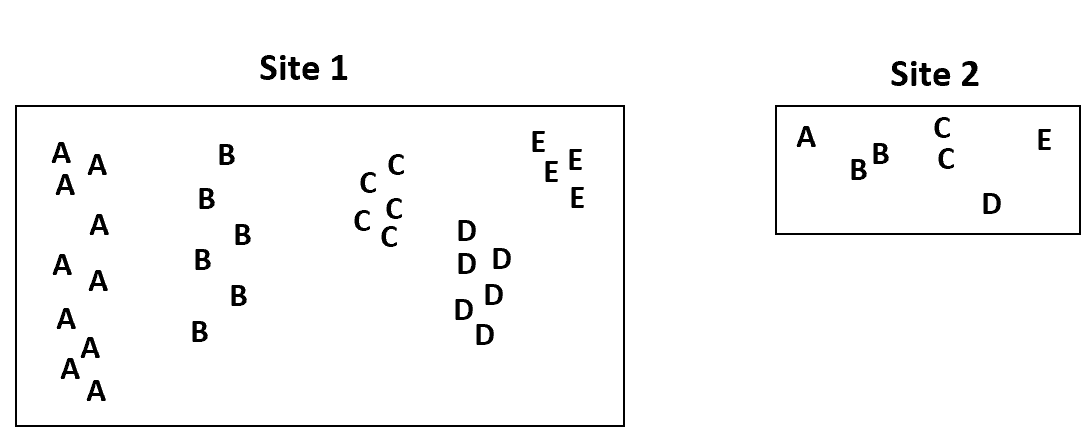
- En écologie végétale : deux parcelles forestières distinctes (Site 1 et Site 2) au sein desquelles on a recensé le nombre d’individus matures pour cinq essences ligneuses majeures (Arbres A, B, C, D et E).
- En psychopathologie quantitative : deux profils cliniques de patients (Sujet A et Sujet B) évalués sur une échelle de sévérité symptomatique graduée de 0 à 50 pour cinq dimensions psychopathologiques distinctes (Symptômes A, B, C, D et E).
Structurons notre matrice de données brutes contenant les vecteurs d’observation $\mathbf{x}_1$ (représentant le Site 1 ou Sujet A) et $\mathbf{x}_2$ (représentant le Site 2 ou Sujet B) pour les $p = 5$ variables d’intérêt :
- Variable A : $x_{1A} = 10 \quad ; \quad x_{2A} = 20$
- Variable B : $x_{1B} = 25 \quad ; \quad x_{2B} = 10$
- Variable C : $x_{1C} = 0 \quad ; \quad x_{2C} = 5$
- Variable D : $x_{1D} = 15 \quad ; \quad x_{2D} = 15$
- Variable E : $x_{1E} = 50 \quad ; \quad x_{2E} = 30$
Ces données présentent un éventail représentatif de situations concrètes : des variables où le profil 1 domine (Variable B et E), des variables où le profil 2 domine (Variable A), une variable marquée par une stricte égalité d’abondance (Variable D), et une variable illustrant une absence unilatérale (Variable C, totalement absente du profil 1 mais observée dans le profil 2).
4.2 Calcul méthodique des sommes d’abondance marginales
La première phase calculatoire de la procédure de Bray-Curtis consiste à établir les sommes marginales vectorielles pour chacun des deux profils d’observation. Cette opération permet de quantifier la masse d’échantillonnage globale ou l’intensité totale manifestée par chaque unité statistique indépendamment de l’autre.
Calculons en premier lieu la somme d’abondance marginale pour le profil 1, notée $S_1$ :
$$S_1 = \sum_{k=A}^{E} x_{1k} = x_{1A} + x_{1B} + x_{1C} + x_{1D} + x_{1E}$$
$$S_1 = 10 + 25 + 0 + 15 + 50 = 100$$
Le profil 1 totalise donc exactement 100 unités cumulées (qu’il s’agisse de tiges d’arbres inventoriées ou de points cumulés de charge symptomatique globale).
Calculons ensuite la somme d’abondance marginale pour le profil 2, notée $S_2$ :
$$S_2 = \sum_{k=A}^{E} x_{2k} = x_{2A} + x_{2B} + x_{2C} + x_{2D} + x_{2E}$$
$$S_2 = 20 + 10 + 5 + 15 + 30 = 80$$
Le profil 2 totalise ainsi 80 unités cumulées. L’effectif global du second profil est donc inférieur de 20 % à celui du premier, une situation classique de variation de l’effort d’échantillonnage ou de la réactivité globale du sujet.
La sommation marginale combinée, qui constituera le dénominateur de notre fraction canonique, se résout immédiatement par l’addition des deux scalaires obtenus :
$$S_1 + S_2 = 100 + 80 = 180$$
La masse totale des observations déployées sur l’ensemble du système comparatif s’établit précisément à 180 unités.
4.3 Identification et sommation des valeurs minimales partagées
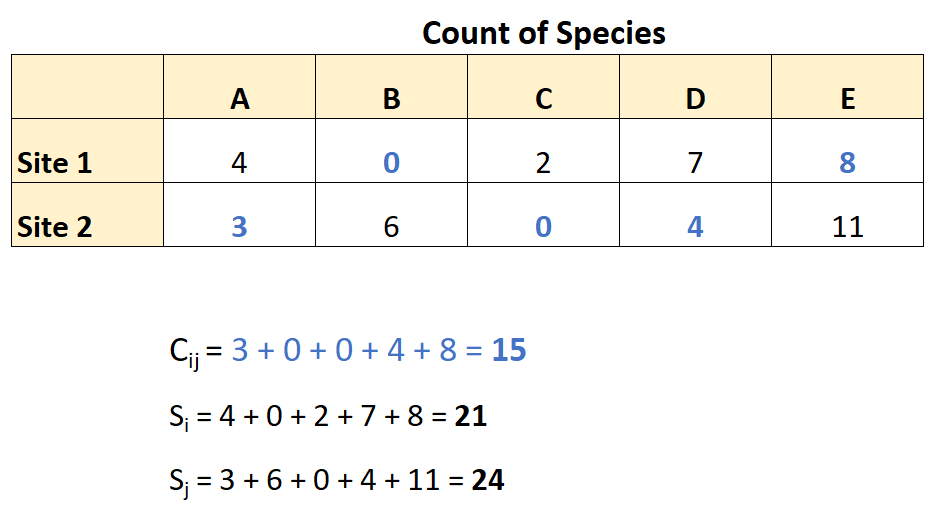
La deuxième étape analytique constitue le cœur mécanique de la métrique : elle vise à extraire pour chaque variable $k$ la composante commune aux deux profils, matérialisée par l’infimum ou la valeur minimale partagée $\min(x_{1k}, x_{2k})$. Procédons à cette extraction méthodique item par item :
- Pour la Variable A : $\min(x_{1A}, x_{2A}) = \min(10, 20) = 10$. Les deux profils partagent 10 unités de cette variable ; les 10 unités excédentaires observées sur le profil 2 constituent une divergence unilatérale.
- Pour la Variable B : $\min(x_{1B}, x_{2B}) = \min(25, 10) = 10$. La valeur commune est bornée à 10 unités par la limitation du profil 2.
- Pour la Variable C : $\min(x_{1C}, x_{2C}) = \min(0, 5) = 0$. Le profil 1 présentant un effectif nul, il ne peut exister aucune quantité commune partagée pour cette dimension. La contribution à la similarité est rigoureusement nulle.
- Pour la Variable D : $\min(x_{1D}, x_{2D}) = \min(15, 15) = 15$. La coïncidence numérique étant parfaite, l’intégralité de l’abondance de cette variable (15 unités) entre dans le domaine du partage effectif.
- Pour la Variable E : $\min(x_{1E}, x_{2E}) = \min(50, 30) = 30$. Le volume commun maximal est défini par l’effectif du profil 2, soit 30 unités partagées.
Nous pouvons à présent sommer l’ensemble de ces contributions partielles pour obtenir la valeur consolidée du paramètre fondamental $C_{12}$ :
$$C_{12} = \sum_{k=A}^{E} \min(x_{1k}, x_{2k}) = 10 + 10 + 0 + 15 + 30 = 65$$
Le volume cumulé des abondances positivement partagées entre les profils 1 et 2 s’élève à 65 unités. Dans l’architecture de la formule canonique, ce terme doit être doublé afin de rendre compte de la présence de ces unités dans chacun des deux vecteurs d’observation :
$$2 \times C_{12} = 2 \times 65 = 130$$
4.4 Résolution finale et déduction du coefficient de dissemblance
Disposant de toutes les composantes scalaires nécessaires, nous pouvons procéder à la résolution arithmétique de la similarité, puis à la déduction immédiate de la dissimilarité de Bray-Curtis.
Calculons en premier lieu l’indice de similarité de Sørensen quantitatif :
$$\text{Similarité}_{12} = \frac{2 C_{12}}{S_1 + S_2} = \frac{130}{180}$$
En simplifiant cette fraction par leur plus grand commun diviseur (10), nous obtenons :
$$\text{Similarité}_{12} = \frac{13}{18} \approx 0{,}7222$$
Les deux profils partagent ainsi environ 72,22 % de leur structure quantitative globale d’abondance.
La dissimilarité de Bray-Curtis se déduit directement en soustrayant ce taux de l’unité :
$$BC_{12} = 1 – \text{Similarité}_{12} = 1 – \frac{130}{180} = \frac{180 – 130}{180} = \frac{50}{180} = \frac{5}{18} \approx 0{,}2778$$
Pour attester de la parfaite rigueur de notre calcul, appliquons la seconde formulation algébrique basée sur la somme des différences absolues :
$$\sum_{k=A}^{E} |x_{1k} – x_{2k}| = |10 – 20| + |25 – 10| + |0 – 5| + |15 – 15| + |50 – 30|$$
$$\sum_{k=A}^{E} |x_{1k} – x_{2k}| = |-10| + |15| + |-5| + |0| + |20| = 10 + 15 + 5 + 0 + 20 = 50$$
Divisons cette somme d’écarts absolus par la masse d’abondance totale $(S_1 + S_2 = 180)$ :
$$BC_{12} = \frac{50}{180} = \frac{5}{18} \approx 0{,}2778$$
La concordance algorithmique est totale et parfaite. La dissimilarité de Bray-Curtis entre les deux unités s’établit rigoureusement à 0,2778 (soit une divergence structurelle de 27,78 % de l’ensemble du profil d’abondance partagé).
5. Interprétation analytique du continuum de valeurs de 0 à 1
5.1 Signification théorique et clinique d’une dissimilarité nulle (BC = 0)
L’obtention d’une valeur de dissimilarité de Bray-Curtis strictement égale à zéro ($BC_{ij} = 0$) correspond à une similarité parfaite ($1{,}00$ ou 100 %) entre les deux unités d’échantillonnage comparées. Sur le plan formel, cette condition n’est satisfaite que si et seulement si les deux vecteurs d’observation présentent une égalité numérique absolue composante par composante :
$$BC_{ij} = 0 iff \forall k in {1, dots, p}, \quad x_{ik} = x_{jk}$$
Dans un contexte phytoécologique, un coefficient $BC = 0$ indique que les deux parcelles recensées abritent rigoureusement les mêmes espèces avec des nombres d’individus ou des biomasses strictement identiques pour chacune d’entre elles. En psychométrie clinique, cela signifie que deux patients expriment un tableau psychopathologique parfaitement superposable, manifestant la même intensité exacte sur chacun des items de l’échelle d’évaluation dimensionnelle.
Il est primordial de souligner une nuance conceptuelle critique : la dissimilarité de Bray-Curtis n’est pas invariante par changement d’échelle scalaire unilatérale. Cela signifie que si le profil $j$ est un multiple scalaire strict du profil $i$ (par exemple $x_{jk} = 2 \times x_{ik}$ pour tout $k$, traduisant une colinéarité vectorielle parfaite avec un angle nul entre les vecteurs), la dissimilarité de Bray-Curtis ne sera pas égale à zéro. Calculons la valeur théorique pour un tel cas : si $x_{jk} = 2 x_{ik}$, alors $S_j = 2 S_i$, et $\min(x_{ik}, x_{jk}) = x_{ik}$, donc $C_{ij} = S_i$. Le dénominateur vaut $S_i + 2 S_i = 3 S_i$. La similarité s’élève à $(2 S_i) / (3 S_i) = 2/3 \approx 0{,}667$, et la dissimilarité de Bray-Curtis s’établit à $1 – 2/3 = 1/3 \approx 0{,}333$. Cette sensibilité aux amplitudes absolues distingue fondamentalement Bray-Curtis des mesures angulaires ou de corrélation (comme le cosinus de Salton ou le coefficient de Pearson), qui considèrent deux profils homothétiques comme strictement identiques.
5.2 Compréhension de la dissimilarité maximale unitaire (BC = 1)
À l’autre extrémité du continuum d’association, une valeur unitaire ($BC_{ij} = 1$) signale une divergence totale et absolue entre les deux entités observées. Algébriquement, cette valeur limite est atteinte dès lors que la covariance minimale partagée est strictement nulle :
$$BC_{ij} = 1 iff C_{ij} = 0 iff \forall k in {1, dots, p}, \quad \min(x_{ik}, x_{jk}) = 0$$
Cette condition signifie que pour chaque descripteur $k$ évalué, l’un au moins des deux échantillons présente une abondance nulle. En d’autres termes, les deux unités comparées ne partagent strictement aucune composante positive en commun ; leurs répertoires d’observation sont totalement disjoints :
$$\text{Support}(\mathbf{x}_i) \cap \text{Support}(\mathbf{x}_j) = \emptyset$$
En écologie des communautés, un indice de $1{,}00$ caractérise deux biotopes appartenant à des biomes totalement irréconciliables, par exemple un écosystème benthique abyssal et une toundra arctique, où aucun taxon n’est capable de franchir la barrière physiologique de l’autre habitat. Sur le plan de la nosologie psychiatrique, un $BC = 1$ matérialise une divergence symptomatique absolue : l’un des patients présente un syndrome d’agitation maniaque pur avec logorrhée et fuite des idées, tandis que le second souffre d’un coma catatonique akinétique sans aucune manifestation clinique commune. Ils évoluent dans des sphères pathologiques distinctes ne partageant aucune dimension commune.
5.3 Graduation et lecture critique des valeurs intermédiaires
Dans la pratique empirique des sciences naturelles et sociales, les valeurs extrêmes ($0$ ou $1$) ne représentent qu’une fraction marginale des observations ; la quasi-totalité des confrontations numériques s’inscrit au sein du continuum ouvert $]0, 1[$. L’interprétation de ces valeurs intermédiaires requiert une solide compréhension de la distribution sous-jacente des données et des seuils conventionnels établis par la littérature spécialisée.
Bien que toute grille d’évaluation comporte une part d’arbitraire contextuel, les praticiens de l’écologie numérique s’accordent généralement sur la stratification heuristique suivante :
- $BC_{ij} < 0{,}30$ (Forte similarité / Faible dissimilarité) : Les profils comparés présentent un recouvrement taxonomique ou structural prépondérant. Les espèces dominantes sont partagées dans des proportions comparables, et les écarts constatés résultent principalement de fluctuations démographiques mineures, de variabilité intra-stationnelle ou de légères imprécisions de mesure.
- $0{,}30 le BC_{ij} le 0{,}70$ (Zone de divergence modérée à marquée) : Cette plage médiane reflète des transitions écologiques significatives (écotones) ou des profils symptomatiques partiellement concordants. Les entités partagent un socle substantiel de variables communes, mais exhibent des inversions de dominance notables ou des remplacements progressifs de descripteurs intermédiaires.
- $BC_{ij} > 0{,}70$ (Forte dissimilarité / Renouvellement majeur) : Les communautés biologiques opèrent un renouvellement quasi-complet (diversité bêta très élevée). Seules quelques espèces ubiquistes, pionnières ou opportunistes maintiennent un lien de continuité entre les sites. En clinique, cela caractérise des sous-types nosologiques clairement distincts partageant tout au plus quelques symptômes non spécifiques de détresse psychologique générale.
Il importe toutefois de manipuler ces seuils avec précaution. La valeur absolue de $BC_{ij}$ dépend fortement de la richesse totale en espèces du jeu de données, du degré d’agrégation taxonomique (niveau de l’espèce, du genre ou de la famille) et du protocole d’échantillonnage employé. Dans les systèmes hautement diversifiés comme les forêts néotropicales ou les profils métagénomiques du microbiote bactérien comprenant plusieurs milliers d’unités taxonomiques opérationnelles (OTU), la valeur moyenne de Bray-Curtis entre sites naturels avoisine couramment des niveaux élevés ($0{,}75$ à $0{,}90$) en raison de la rareté inhérente de l’immense majorité des micro-organismes recensés.
6. Comparaison méthodologique : Bray-Curtis versus autres métriques
6.1 Confrontation avec la distance euclidienne et ses variantes
Pour saisir toute la pertinence méthodologique de la dissimilarité de Bray-Curtis, il est éclairant de la confronter aux propriétés de la distance euclidienne canonique. Dans l’histoire de la morphométrie et de la statistique descriptive classique, la distance euclidienne s’est imposée naturellement par analogie directe avec la géométrie de l’espace physique tridimensionnel :
$$d_E(\mathbf{x}_i, \mathbf{x}_j) = \sqrt{\sum_{k=1}^{p} (x_{ik} – x_{jk})^2}$$
Toutefois, lorsqu’elle est appliquée à des matrices d’abondances biologiques ou de répertoires comportementaux hautement hétérogènes, la distance euclidienne engendre ce que Legendre et Gallagher ont formellement qualifié de paradoxe de l’espace euclidien. Ce paradoxe découle de deux tares conceptuelles majeures :
En premier lieu, comme examiné précédemment, la distance euclidienne viole le principe de neutralité des absences conjointes. Pour la distance euclidienne, le fait que deux sites ne possèdent aucun individu de l’espèce $k$ ($0 – 0 = 0$) contribue à les rapprocher géométriquement avec le même poids que s’ils possédaient tous deux 100 individus de cette espèce ($100 – 100 = 0$). Cela conduit à une absurdité écologique : des stations totalement arides et stériles sont regroupées comme hautement apparentées uniquement par la grâce de leur vide biologique partagé.
En second lieu, l’élévation au carré des écarts différentiels $(x_{ik} – x_{jk})^2$ confère une prépondérance disproportionnée aux descripteurs hypersurchargés, tout en écrasant littéralement le signal apporté par les descripteurs modérés ou rares. Une différence de 50 individus sur une espèce arborée hyper-dominante pèsera $(50)^2 = 2500$ unités dans la somme sous le radical, tandis qu’une divergence de présence/absence sur 5 espèces rares générera un impact dérisoire de $5 \times (1 – 0)^2 = 5$ unités. La distance euclidienne tend donc à masquer l’organisation globale de la communauté au profit de fluctuations démographiques aléatoires survenant sur les quelques taxons ubiquistes. En divisant la somme des écarts absolus par la masse totale des abondances, Bray-Curtis assure une mise à l’échelle proportionnelle qui préserve la texture écologique et psychologique fine des jeux de données réels.
6.2 Distinction avec la dissimilarité de Jaccard
La dissimilarité de Jaccard est sans conteste l’indice de ressemblance qualitatif le plus célèbre et le plus ancien de la littérature biologique. Conçu par le botaniste suisse Paul Jaccard en 1901, cet indice s’applique originellement à des données binaires de présence-absence codées sous forme d’une table de contingence bivariée comprenant :
- $a$ : le nombre d’espèces présentes simultanément sur les deux sites ($1, 1$)
- $b$ : le nombre d’espèces présentes uniquement sur le premier site ($1, 0$)
- $c$ : le nombre d’espèces présentes uniquement sur le second site ($0, 1$)
- $d$ : le nombre d’espèces absentes des deux sites ($0, 0$)
L’indice qualitatif de Jaccard s’énonce selon le ratio bien connu :
$$J_{\text{binaire}} = 1 – \frac{a}{a + b + c} = \frac{b + c}{a + b + c}$$
Bien que Jaccard respecte l’invariance aux doubles absences (le terme $d$ est totalement exclu du calcul), il présente une limite majeure : il est strictement aveugle aux variations d’abondance quantitative. Pour remédier à cette restriction, l’écologue Milan Ružička a formulé en 1958 l’extension quantitative continue de l’indice de Jaccard, connue sous le nom de distance de Ružička :
$$R_{ij} = 1 – \frac{\sum_{k=1}^{p} \min(x_{ik}, x_{jk})}{\sum_{k=1}^{p} \max(x_{ik}, x_{jk})} = \frac{\sum_{k=1}^{p} |x_{ik} – x_{jk}|}{\sum_{k=1}^{p} \max(x_{ik}, x_{jk})}$$
La confrontation entre Bray-Curtis et Ružička dévoile une parenté mathématique très intime. Rappelons que dans Bray-Curtis, le dénominateur est la somme simple des abondances $S_i + S_j$. Or, pour toute paire de nombres positifs, nous savons que :
$$x_{ik} + x_{jk} = \min(x_{ik}, x_{jk}) + \max(x_{ik}, x_{jk})$$
Il existe par conséquent une relation analytique exacte permettant de convertir directement l’indice de similarité de Bray-Curtis (noté ici $S_{BC}$) en similarité de Ružička (notée $S_R$) :
$$S_R = \frac{S_{BC}}{2 – S_{BC}} iff S_{BC} = \frac{2 S_R}{1 + S_R}$$
Sur le plan topologique, la distance de Ružička possède un avantage théorique formel sur Bray-Curtis : elle satisfait pleinement l’inégalité triangulaire et constitue donc une véritable métrique dans l’espace multidimensionnel. Toutefois, dans les analyses d’ordination empirique (notamment la NMDS), les résultats fournis par Bray-Curtis et Ružička sont virtuellement indiscernables en raison de la relation de monotonicité stricte qui lie ces deux fonctions sur l’intervalle $[0, 1]$. Bray-Curtis demeure néanmoins historiquement plus plébiscité en raison de la simplicité intuitive de son dénominateur marginal.
6.3 Comparaison avec la distance de Manhattan et l’indice de Morisita-Horn
Une autre perspective comparative essentielle consiste à analyser les relations entre Bray-Curtis, la métrique L1 de Manhattan et les coefficients basés sur les probabilités de rencontre inter-individuelle comme l’indice de Morisita-Horn.
La distance de Manhattan (ou distance géodésique en damier) s’exprime comme la somme brute des écarts absolus non pondérés :
$$d_M(\mathbf{x}_i, \mathbf{x}_j) = \sum_{k=1}^{p} |x_{ik} – x_{jk}|$$
En observant cette équation, on constate immédiatement que le numérateur de la formulation alternative de Bray-Curtis est rigoureusement identique à la distance de Manhattan. Ainsi, la dissimilarité de Bray-Curtis peut être théoriquement interprétée comme une distance de Manhattan normalisée à l’échelle locale par la biomasse ou l’effectif d’échantillonnage cumulé de la paire considérée ($S_i + S_j$). La distance de Manhattan classique n’est pas bornée supérieurement ; elle diverge proportionnellement à la richesse brute du milieu, rendant impossible la comparaison d’assemblages floristiques prélevés à des intensités divergentes.
À l’inverse, l’indice de Morisita (1959), adapté ultérieurement par Horn (1966) pour des densités numériques continues, aborde la mesure de ressemblance sous un angle probabiliste inspiré de l’indice de diversité de Simpson :
$$C_H = \frac{2 \sum_{k=1}^{p} x_{ik} x_{jk}}{\left( \frac{\sum x_{ik}^2}{S_i^2} + \frac{\sum x_{jk}^2}{S_j^2} \right) S_i S_j}$$
L’indice de Morisita-Horn quantifie la probabilité que deux individus tirés au sort au hasard, l’un dans l’échantillon $i$ et l’autre dans l’échantillon $j$, appartiennent à la même espèce, standardisée par les probabilités d’identité intra-site. Cet indice possède une résistance mathématique exceptionnelle aux variations d’effort d’échantillonnage et aux fluctuations de taille globale des collectes, surpassant sur ce point précis la métrique de Bray-Curtis. En contrepartie, Morisita-Horn est hypersensible à la composition de l’unique espèce la plus dominante du lot, son terme quadratique ($x_{ik}^2$) amplifiant l’influence des taxons surreprésentés bien plus violemment que l’opérateur linéaire du minimum présent dans Bray-Curtis.
7. Sensibilité aux transformations mathématiques et aux biais d’échantillonnage
7.1 Effet de dominance des variables hypersurchargées
En dépit de sa remarquable robustesse face aux absences conjointes, le calcul non corrigé de la dissimilarité de Bray-Curtis présente une vulnérabilité inhérente liée à sa formulation linéaire : sa propension mécanique à laisser les descripteurs à très fortes abondances dominer unilatéralement le résultat numérique. Dans les systèmes naturels, la distribution des espèces au sein d’une communauté suit presque universellement une loi log-normale ou une distribution géométrique en série de Motomura, caractérisée par une infime minorité d’espèces hyper-abondantes côtoyant une longue traîne d’espèces rares ou accidentelles.
Imaginons un inventaire entomologique où une espèce de moustique opportuniste est capturée à raison de 5 000 individus sur le site 1 et 2 000 individus sur le site 2, tandis que vingt espèces rares de coléoptères spécialistes présentent des abondances variant entre 0 et 3 individus par station. L’écart sur l’espèce commune générera à lui seul une différence absolue de $|5000 – 2000| = 3000$ unités, écrasant totalement la contribution combinée des vingt coléoptères rares dont la divergence cumulée n’excédera pas 30 unités. La métrique de Bray-Curtis brute sera quasiment à 100 % le reflet de la dynamique démographique du moustique, ignorant l’information bio-indicatrice précieuse véhiculée par le cortège des espèces rares.
Ce phénomène d’écrasement se retrouve à l’identique dans l’évaluation psychométrique ou comportementale. Si un questionnaire intègre des variables comportementales à fréquence quotidienne élevée (par exemple le nombre de minutes passées sur un smartphone, s’élevant à 300 ou 400 unités) aux côtés de cotations d’actes d’auto-agression ou d’attaques de panique (variant de 1 à 3 épisodes par semaine), le score de Bray-Curtis calculé sur les données brutes sera un artefact presque exclusif du temps d’écran, occultant la divergence critique touchant les variables psychiatriques sévères. Cette distorsion impose la mise en œuvre systématique de transformations mathématiques préalables.
7.2 Transformations préalables recommandées : racine carrée et log
Pour restaurer l’équité informationnelle entre les composantes à forte charge numérique et les descripteurs de faible amplitude, la pratique biostatistique moderne recommande d’appliquer une transformation monotone concave sur la matrice brute des abondances avant le calcul de la dissimilarité de Bray-Curtis. Trois approches dominent la méthodologie quantitative :
La transformation par racine carrée ($y_{ik} = \sqrt{x_{ik}}$) constitue la modération la plus douce. Elle réduit l’écart relatif entre ordres de grandeur sans altérer la hiérarchie fondamentale des descripteurs. Pour des asymétries de distribution plus prononcées, la transformation par racine quatrième ($y_{ik} = x_{ik}^{1/4} = \sqrt{\sqrt{x_{ik}}}$) est couramment désignée comme le standard d’excellence dans les analyses d’écologie benthique marine selon les protocoles établis par Clarke et Warwick.
La seconde alternative majeure est la transformation logarithmique, formalisée sous la forme :
$$y_{ik} = \log(x_{ik} + 1) \quad \text{ou} \quad y_{ik} = \log_{10}(c \cdot x_{ik} + 1)$$
L’adjonction de la constante pseudo-compte $+1$ est strictement indispensable pour gérer harmonieusement les valeurs nulles du tableau d’origine, garantissant que $log(0 + 1) = log(1) = 0$, et préservant ainsi la nature des absences fondamentales. L’opérateur logarithmique comprime drastiquement les échelles numériques étendues, permettant aux taxons d’abondance intermédiaire et faible d’exercer un poids statistique proportionnel à leur valeur diagnostique.
Enfin, la transformation de double standardisation du Wisconsin (Wisconsin double standardization) représente un protocole d’harmonisation particulièrement élégant. Elle consiste à diviser dans un premier temps l’abondance de chaque descripteur par le maximum observé pour ce descripteur à travers l’ensemble des échantillons (alignant ainsi toutes les variables sur une échelle continue de 0 à 1), puis à diviser dans un second temps ces valeurs par la somme totale du profil de l’échantillon. L’application de Bray-Curtis sur une matrice prétraitée par le Wisconsin neutralise à la fois les disparités d’échelle entre variables et les distorsions liées au volume global d’échantillonnage, fournissant l’une des ordinations les plus stables et reproductibles de la statistique multivariée.
7.3 Normalisation et standardisation des profils
Une question méthodologique récurrente concerne l’opportunité de transformer la matrice des comptages bruts en une matrice d’abondances relatives ou de pourcentages intra-échantillon avant de calculer la dissimilarité de Bray-Curtis. Cette standardisation marginale par ligne s’exprime mathématiquement par :
$$p_{ik} = \frac{x_{ik}}{\sum_{m=1}^{p} x_{im}} = \frac{x_{ik}}{S_i}$$
Lorsque cette opération est appliquée, la somme totale de chaque vecteur d’observation devient rigoureusement égale à l’unité :
$$\forall i, \quad S_i^* = \sum_{k=1}^{p} p_{ik} = 1{,}00$$
Injectons cette propriété d’équilibrage dans la formule canonique de Bray-Curtis :
$$BC_{ij}^* = 1 – \frac{2 \sum_{k=1}^{p} \min(p_{ik}, p_{jk})}{1{,}00 + 1{,}00} = 1 – \sum_{k=1}^{p} \min(p_{ik}, p_{jk})$$
Ou, de manière équivalente via la formulation des différences absolues :
$$BC_{ij}^* = \frac{1}{2} \sum_{k=1}^{p} |p_{ik} – p_{jk}|$$
L’équation obtenue démontre que l’application de Bray-Curtis sur des profils de pourcentages standardisés se simplifie en une demi-distance de Manhattan (également connue sous le vocable d’indice de dissemblance de Whittaker). Les conséquences conceptuelles de ce choix sont substantielles : la standardisation par les totaux élimine définitivement toute influence liée à la taille brute absolue des échantillons. Si deux stations abritent des espèces dans des proportions strictement identiques mais que l’une a fait l’objet d’un inventaire dix fois plus exhaustif que l’autre ($N = 1000$ contre $N = 100$), leur dissimilarité de Bray-Curtis brute sera de $0{,}818$, tandis que leur dissimilarité sur profils normalisés s’effondrera à $0{,}000$. Le chercheur doit donc arbitrer en pleine conscience : souhaite-t-il évaluer la divergence de la taille absolue des populations ou isoler la pure structure compositionnelle des proportions relatives ?
8. Implémentation algorithmique en langages R et Python
8.1 Traitement sous R avec le package vegan
L’environnement statistique open-source R s’impose comme l’écosystème de référence historique pour l’analyse écologique et multivariée, en grande partie grâce au développement continu du package spécialisé vegan, maintenu par Jari Oksanen et ses collaborateurs. Au sein de cette bibliothèque, la fonction maîtresse dédiée au calcul des matrices d’association est vegdist.
L’exécution du calcul de Bray-Curtis s’opère de façon hautement optimisée. La fonction accepte directement en entrée une matrice de données ou un data frame où les lignes matérialisent les unités d’échantillonnage et les colonnes représentent les différents descripteurs mesurés. L’appel standardisé requiert la spécification de l’argument de méthode sous la forme method = "bray". Par défaut, la routine prend en charge les abondances brutes, mais il est d’usage courant d’encapsuler l’appel au sein de transformations préalables en utilisant la fonction complémentaire decostand.
Pour des architectures de données massives — telles que les tables d’inventaire générées par le séquençage à haut débit d’amplicons métagénomiques (16S rRNA ou ITS) comprenant plusieurs milliers d’échantillons et des dizaines de milliers d’OTU — la fonction vegdist démontre une vélocité computationnelle remarquable en s’appuyant sur des sous-routines internes compilées en langage C, évitant ainsi les goulots d’étranglement inhérents aux boucles interprétées en R pur.
8.2 Calcul en Python via Scipy et Scikit-Bio
Dans l’écosystème Python, dédié aux pipelines de science des données, d’apprentissage automatique et de bio-informatique computationnelle, la dissimilarité de Bray-Curtis bénéficie d’implémentations standardisées au sein des bibliothèques fondamentales SciPy et Scikit-Bio.
Au niveau le plus élémentaire, le module spatial de SciPy offre la fonction scipy.spatial.distance.braycurtis. Cette fonction prend en arguments deux tableaux unidimensionnels NumPy de même dimension et renvoie la valeur scalaire de la dissimilarité de Bray-Curtis. L’implémentation algorithmique sous-jacente de SciPy exploite formellement la version de la somme des écarts absolus normalisée par la somme totale des éléments :
$$\text{braycurtis}(u, v) = \frac{\sum |u_k – v_k|}{\sum |u_k + v_k|}$$
Il convient de noter que si les vecteurs d’entrée contiennent des valeurs négatives, SciPy n’émet pas d’erreur bloquante mais applique la formule littérale ci-dessus, ce qui confirme l’impérieuse nécessité pour le praticien de veiller à la non-négativité stricte de ses données avant tout appel de routine.
Pour le calcul de matrices complètes d’association à grande échelle au sein de structures de données multidimensionnelles, la bibliothèque scikit-bio s’avère nettement plus adaptée. Sa fonction skbio.diversity.beta.beta_diversity permet d’exécuter le calcul parallélisé sur des matrices creuses (objets scipy.sparse), optimisant radicalement l’empreinte mémoire vive lors du traitement de répertoires hautement clairsemés contenant jusqu’à 95 % de zéros structurels, typiques des profils de séquençage métagénomique moderne.
8.3 Création d’une fonction personnalisée en script
La compréhension intime d’un algorithme passe idéalement par sa reconstruction intégrale sans le recours à des bibliothèques externes opaques. La mise en œuvre d’une routine vectorisée calculant la matrice symétrique complète de Bray-Curtis illustre la transition directe de la théorie mathématique vers le code opérationnel.
Dans une perspective algorithmique vectorisée, le calcul optimisé pour une paire de vecteurs $\mathbf{u}$ et $\mathbf{v}$ se condense en trois étapes clés :
- Évaluation de la condition d’arrêt : vérification de la positivité des données et confirmation que la somme combinée des deux vecteurs est strictement supérieure à zéro (afin de prémunir l’interpréteur contre une division par zéro non définie).
- Calcul simultané du numérateur d’écart et du dénominateur d’échelle au moyen d’opérations vectorielles hautement parallélisables sur microprocesseur (opérations SIMD) : soustraction élément par élément, calcul des valeurs absolues, et sommation par réduction rapide.
- Division scalaire finale du numérateur par le dénominateur pour déduire la valeur exacte de la semi-métrique.
L’élimination formelle des boucles itératives au profit d’opérations d’algèbre matricielle (broadcasting en Python ou vectorisation matricielle sous R) permet d’accélérer le calcul des matrices de dissimilarité d’un facteur de 50 à 100 fois par rapport à une double boucle imbriquée conventionnelle, garantissant des performances adaptées aux exigences actuelles du traitement des données massives.
9. Applications en écologie quantitative et dynamique des communautés
9.1 Suivi des successions écologiques temporelles
L’une des contributions les plus spectaculaires de la métrique de Bray-Curtis à l’écologie fondamentale réside dans l’analyse quantitative des successions écologiques temporelles et des processus de restauration environnementale. Lorsqu’un écosystème subit une perturbation majeure (incendie de forêt, crue dévastatrice, abandon d’une parcelle agricole ou pollution industrielle des sols), la communauté biologique résidente s’engage dans une trajectoire de recolonisation dynamique marquée par le renouvellement progressif des espèces au fil des ans.
En échantillonnant régulièrement un même biotope sur une chronoséquence pluriannuelle, les écologues calculent la dissimilarité de Bray-Curtis entre la composition observée à l’instant initial ($t_0$) et les états successifs franchis par la communauté ($t_1, t_2, dots, t_n$). Cette démarche permet de tracer des vecteurs de trajectoire écologique dans l’espace multidimensionnel. L’allure de la courbe de dissimilarité renseigne directement sur la vitesse et la dynamique du retour vers l’état de référence : une décroissance progressive et monotone de la dissimilarité témoigne d’une résilience écologique réussie, tandis qu’une stagnation du coefficient à des valeurs très élevées ($BC > 0{,}80$) signale l’enfermement de l’écosystème dans un état alternatif stable dégradé.
De surcroît, la métrique de Bray-Curtis offre une sensibilité remarquable pour la détection précoce des points de basculement écologique (tipping points). Avant qu’un écosystème ne s’effondre brutalement sous l’effet du changement climatique ou de la surfertilisation anthropique, les abondances relatives des populations périphériques se mettent à fluctuer de manière asynchrone, induisant une instabilité de la dissimilarité de Bray-Curtis d’une année sur l’autre, qui opère ainsi comme un bio-indicateur d’alerte précoce hautement diagnostique.
9.2 Analyse de gradients biogéographiques et environnementaux
L’analyse des patrons spatiaux de la biodiversité repose au niveau fondamental sur le concept de diversité bêta, défini par Robert Whittaker comme le taux de renouvellement de la composition en espèces d’un habitat à un autre le long d’un gradient géographique ou environnemental continu. La dissimilarité de Bray-Curtis s’affirme comme le descripteur opérationnel d’excellence pour quantifier cette diversité bêta dans l’espace physique.
Lors d’études menées le long de gradients altitudinaux en montagne ou de transects d’aridité en milieu sahélien, la matrice de dissimilarité de Bray-Curtis entre paires de stations est confrontée à la matrice des distances physiques (en kilomètres) et à la matrice des écarts environnementaux (différences de température moyenne, d’humidité édaphique ou de concentration en matière organique). Par le truchement de tests statistiques d’association matricielle non paramétriques, tels que le test de Mantel, les écologues quantifient l’impact respectif de l’isolement par la distance (dispersion limitée) et du filtrage environnemental sur la structuration des communautés.
En outre, l’intégration de Bray-Curtis dans des procédures avancées de partitionnement de la variance multivariée permet de décomposer précisément la variabilité spatiale totale observée : quelle proportion de la divergence compositionnelle découle directement des facteurs climatiques abiotiques, quelle part revient à la configuration spatiale autocorrélée du paysage, et quelle fraction résiduelle demeure attribuable aux processus stochastiques d’échantillonnage ? Cette puissance explicative confère à la métrique un rôle moteur dans la conception contemporaine des réseaux d’aires naturelles protégées.
9.3 Études de métagénomique et du microbiote
L’avènement des technologies de séquençage de nouvelle génération (NGS) a propulsé la dissimilarité de Bray-Curtis au premier rang de la recherche biomédicale via l’analyse du microbiome humain et environnemental. Dans une expérience typique de métagénomique ciblée (par exemple le séquençage de la région hypervariable V4 du gène de l’ARN ribosomique 16S), les lectures brutes sont regroupées en unités taxonomiques opérationnelles (OTU) ou en variants de séquences d’amplicons (ASV). Les jeux de données qui en résultent se matérialisent sous la forme de tables d’abondance massives contenant des millions de comptages répartis sur des centaines d’échantillons cliniques.
Dans ce contexte, la matrice de Bray-Curtis sert à mesurer la distance taxonomique globale séparant les profils microbiens de cohortes de sujets sains et de patients atteints de pathologies chroniques telles que les maladies inflammatoires chroniques de l’intestin (MICI), le diabète de type 2 ou l’obésité morbide. Le calcul de la dissimilarité de Bray-Curtis permet de formaliser mathématiquement le concept clinique de dysbiose intestinale : les profils microbiens des patients malades s’éloignent significativement du nuage de points resserré formé par les témoins sains, traduisant une rupture profonde de l’homéostasie bactérienne symbiotique.
De plus, l’utilisation conjointe de la dissimilarité de Bray-Curtis avec des variables physiologiques ou sériques (taux de cytokines pro-inflammatoires, perméabilité intestinale, indices de résistance à l’insuline) permet d’établir des corrélations robustes reliant des modifications structurelles globales de la flore microbienne à l’évolution des marqueurs systémiques de l’hôte, ouvrant la voie à des approches novatrices de médecine translationnelle personnalisée.
10. Transposition et applications en psychométrie et sciences du comportement
10.1 Mesure de la dissimilarité inter-individuelle des profils symptomatiques
La nosologie psychiatrique contemporaine fait face à une crise épistémologique majeure quant à la validité des catégories diagnostiques discrètes formalisées dans les manuels de référence tels que le DSM-5. L’extrême hétérogénéité clinique constatée au sein d’une même étiquette diagnostique — deux patients diagnostiqués avec un épisode dépressif caractérisé pouvant ne partager qu’un seul symptôme marginal en commun — incite les chercheurs à privilégier une modélisation purement quantitative et dimensionnelle de la souffrance psychique.
Dans cette perspective dimensionnelle novatrice, un individu est théoriquement assimilé à un écosystème biologique complexe, et chaque symptôme évalué correspond à une entité pondérée dont la sévérité reflète l’abondance. En appliquant la dissimilarité de Bray-Curtis à des batteries cliniques validées comprenant de multiples items continus — telles que l’échelle des syndromes positif et négatif de la schizophrénie (PANSS) ou l’inventaire de dépression de Beck (BDI) — les psychopathologues construisent des espaces géométriques d’association inter-individuelle d’une fidélité sans précédent.
Contrairement aux approches par score total cumulé (qui masquent des configurations cliniques radicalement divergentes sous un même chiffre récapitulatif arbitraire), la matrice de Bray-Curtis capture l’architecture fine des profils de sévérité. L’analyse typologique issue de cette métrique permet d’isoler des sous-groupes cliniques homogènes (ou endophénotypes comportementaux), facilitant ainsi le repérage de trajectoires évolutives différentielles et l’identification de profils de vulnérabilité spécifiques face aux interventions pharmacologiques ou psychothérapeutiques.
10.2 Modélisation en réseaux psychologiques et écologie comportementale
La théorie des réseaux psychologiques, formalisée notamment par Denny Borsboom, postule que les troubles mentaux ne résultent pas d’une entité causale latente sous-jacente (comme un virus ou une lésion cérébrale unique), mais émergent des interactions dynamiques directes et auto-entretenues s’exerçant entre les symptômes eux-mêmes (par exemple : l’insomnie engendre la fatigue, qui précipite la perte de concentration, laquelle induit l’anxiété de performance, renforçant en retour l’insomnie).
L’intégration de la méthode d’échantillonnage de l’expérience (Experience Sampling Method ou ESM) — consistant à administrer aux sujets des micro-questionnaires sur smartphone plusieurs fois par jour au cours de leur vie quotidienne — génère des séries temporelles multivariées à haute résolution temporelle. La dissimilarité de Bray-Curtis s’affirme ici comme un opérateur privilégié pour évaluer la distance entre les patrons dynamiques d’activation comportementale et affective de différents sujets ou d’un même sujet à travers différentes phases de vie.
En calculant le coefficient de Bray-Curtis entre les répertoires d’affects et d’activités quotidiens, les chercheurs parviennent à quantifier le degré d’inflexibilité psychologique ou de rigidité comportementale des sujets. Deux individus affichant les mêmes scores d’anxiété moyenne peuvent présenter des dynamiques de réactivité environnementale totalement disjointes : l’un conservant une dispersion harmonieuse de ses temps d’activités, l’autre voyant son répertoire comportemental se rétracter massivement autour de routines d’évitement, une divergence que la métrique de Bray-Curtis isole avec une remarquable acuité.
10.3 Analyse de réponses aux tests de personnalité et questionnaires d’attitudes
L’évaluation psychométrique de la personnalité normale et pathologique repose usuellement sur des inventaires auto-rapportés à choix multiples explorant un large éventail de facettes psychologiques, à l’instar du modèle en cinq facteurs (Big Five Inventory / NEO-PI-R) ou de l’inventaire multiphasique de personnalité du Minnesota (MMPI). Dans ce cadre analytique, la comparaison des profils individuels au moyen de métriques de distance traditionnelles se heurte fréquemment à des biais statistiques majeurs.
Le recours à la dissimilarité de Bray-Curtis élimine de façon décisive l’artéfact d’absence commune de traits pathologiques. Lors de l’administration du MMPI à une population générale non clinique, la vaste majorité des items mesurant des traits sévères d’aliénation mentale, de paranoïa délirante ou de déviance psychopathique sont cotés à zéro par l’écrasante majorité des répondants. Une distance euclidienne conventionnelle tendrait à décréter que deux individus ont des personnalités quasi identiques simplement parce qu’aucun des deux ne manifeste de délires hallucinatoires. Bray-Curtis concentre au contraire l’analyse de ressemblance sur les dimensions de personnalité positivement exprimées (extraversion, ouverture, amabilité, conscience).
De surcroît, la métrique se révèle particulièrement précieuse dans les protocoles longitudinaux d’évaluation de l’efficacité psychothérapeutique. En mesurant la dissimilarité de Bray-Curtis entre le profil d’attitudes d’un patient à l’admission en thérapie et ses évaluations successives au fil des mois, les cliniciens disposent d’un indice scalaire objectif documentant la restructuration globale de sa personnalité et l’atténuation graduelle de ses mécanismes de défense dysfonctionnels.
11. Visualisation multivariée : Intégration dans l’ordonnancement NMDS
11.1 Le positionnement multidimensionnel non métrique (NMDS)
Comme démontré formellement dans la section consacrée aux propriétés métriques, la dissimilarité de Bray-Curtis constitue une semi-métrique qui viole occasionnellement l’inégalité triangulaire, rendant son espace topologique incompatible avec les contraintes d’une projection linéaire directe en géométrie euclidienne pure. Tenter d’analyser une matrice de Bray-Curtis au moyen d’une analyse en composantes principales (ACP) conventionnelle relève de l’hérésie mathématique. La technique d’ordination reine, universellement reconnue comme la compagne méthodologique naturelle de Bray-Curtis, est le positionnement multidimensionnel non métrique (Non-Metric Multidimensional Scaling ou NMDS), conceptualisé par Shepard et formalisé par Kruskal (1964).
Le principe algorithmique de la NMDS se distingue radicalement des méthodes d’ordination factorielle classiques : au lieu de chercher à préserver fidèlement les grandeurs absolues des distances géométriques, la NMDS s’assigne pour objectif exclusif de préserver le rang relatif des dissimilarités au sein d’un espace géométrique de dimension réduite arbitrairement fixé à l’avance (généralement $k = 2$ ou $k = 3$ pour des raisons évidentes de visualisation graphique).
L’ajustement optimal de la configuration spatiale des points dans le repère bidimensionnel est guidé par une fonction de perte itérative non linéaire, appelée le stress de Kruskal :
$$\text{Stress} = \sqrt{\frac{\sum_{i < j} (d_{ij} – \hat{d}_{ij})^2}{\sum_{i < j} d_{ij}^2}}$$
Dans cette formulation, $d_{ij}$ représente la distance euclidienne mesurée entre les points $i$ et $j$ sur le plan graphique d’ordination, tandis que $\hat{d}_{ij}$ représente la distance prédite déduite d’une régression monotone (isotonique) ajustée sur les rangs des dissimilarités de Bray-Curtis réelles d’origine ($BC_{ij}$). L’évaluation de la qualité de la représentation graphique s’effectue via l’examen du diagramme de Shepard (qui confronte visuellement les distances d’ordination aux dissimilarités observées) et l’interprétation de la valeur finale du stress :
- $\text{Stress} < 0{,}05$ : Représentation d'une précision exceptionnelle, exempte de tout risque de mauvaise interprétation graphique.
- $0{,}05 le \text{Stress} < 0{,}10$ : Excellent ajustement, configuration spatiale pleinement représentative des structures écologiques ou cliniques sous-jacentes.
- $0{,}10 le \text{Stress} < 0{,}20$ : Représentation globale exploitable et informative, bien que les détails des proximités locales entre points voisins doivent être interprétés avec circonspection.
- $\text{Stress} ge 0{,}20$ : Ajustement médiocre à trompeur ; il devient impératif d’augmenter le nombre de dimensions de projection ($k = 3$) pour éviter des distorsions visuelles majeures.
11.2 Classification ascendante hiérarchique (CAH) basée sur Bray-Curtis
Outre l’ordination par NMDS, les matrices de dissimilarité de Bray-Curtis constituent le matériau d’entrée privilégié pour les algorithmes de classification ascendante hiérarchique (CAH), visant à structurer les unités d’échantillonnage en clusters discrets emboîtés sous forme d’arbres phylogénétiques ou écologiques appelés dendrogrammes.
Dans ce cadre classificatoire, le choix du critère d’agrégation liant les groupes de profils revêt une importance cruciale :
- Le critère de la liaison moyenne (UPGMA – Unweighted Pair Group Method with Arithmetic Mean) est incontestablement le plus respectueux de la topologie de Bray-Curtis. À chaque étape fusionnelle, la dissimilarité entre deux clusters $A$ et $B$ est définie comme la moyenne arithmétique exacte des coefficients de Bray-Curtis séparant l’ensemble des paires d’échantillons intra-groupes. Ce critère maximise le coefficient de corrélation phénétique entre la matrice de distance originale et la matrice dérivée du dendrogramme.
- La méthode de Ward, bien qu’extrêmement populaire pour sa tendance à former des groupes compacts et d’effectifs équilibrés, repose originellement sur le calcul de la somme des carrés des écarts à la moyenne dans un espace strictement euclidien. L’application directe de l’algorithme classique de Ward à une matrice de Bray-Curtis non corrigée est théoriquement contestable en raison de la nature semi-métrique du coefficient, et expose au risque d’inversions dendrogrammiques. Pour employer légitimement un critère de type Ward sur des dissimilarités de Bray-Curtis, il convient d’appliquer au préalable une transformation par racine carrée ($\sqrt{BC_{ij}}$) ou d’exécuter une correction par coordonnées principales de Cailliez ou de Lingoes garantissant l’euclidianité du tableau d’entrée.
Pour déterminer de manière objective le nombre optimal de clusters à partitionner le long du dendrogramme, les praticiens couplent usuellement la CAH à l’analyse des largeurs de silhouette de Rousseeuw ou à l’indice de Calinski-Harabasz adapté aux dissimilarités arbitraires.
11.3 Interprétation graphique et inférence statistique multivariée
L’exploration visuelle d’un plan d’ordination NMDS issu d’une matrice de Bray-Curtis gagne immensément en puissance lorsqu’elle est combinée à des techniques d’analyse explicative et d’inférence statistique formelle. Dans le cadre de l’analyse multivariée moderne, la simple inspection qualitative d’un nuage de points est systématiquement corroborée par des tests d’hypothèses rigoureux.
La première technique d’enrichissement graphique consiste à projeter des vecteurs environnementaux ou cliniques sur le plan d’ordination (procédure envfit sous R). Les gradients continus (pH du sol, température, score d’âge ou taux sanguin de cortisol) sont projetés sous forme de flèches orientées dont la direction indique la pente d’accroissement maximal de la variable et dont la longueur est strictement proportionnelle à la force de corrélation ($r^2$) établie entre le gradient et la configuration d’ordination globale.
Sur le plan de l’inférence confirmatoire, la méthode de référence absolue pour tester des hypothèses de différenciation de groupes structurés a priori est l’analyse de variance multivariée par permutations (PERMANOVA), formalisée par Marti J. Anderson (2001) et implémentée via la fonction adonis2. Contrairement à la MANOVA paramétrique classique qui exige la stricte multinormalité des résidus et l’égalité des matrices de variance-covariance, la PERMANOVA opère directement sur la matrice de dissimilarité de Bray-Curtis :
Elle calcule une statistique pseudo-$F$ quantifiant le rapport de dispersion entre les différents groupes expérimentaux par rapport à la dispersion intra-groupe, puis évalue la significativité statistique ($p$-value) par le biais de milliers de permutations aléatoires des étiquettes des échantillons. Ce test non paramétrique permet de statuer sans équivoque : l’appartenance à un habitat distinct ou à une sous-catégorie pathologique engendre-t-elle une séparation statistiquement significative des structures de composition biologique ou clinique ?
Enfin, pour garantir la validité d’une PERMANOVA, il est indispensable de vérifier que la dispersion multivariée intra-groupe (l’étendue du nuage de points au sein de chaque modalité) est relativement homogène, une étape réalisée par le test non paramétrique de dispersion multivariée PERMDISP (analogue multivarié direct du test d’homoscédasticité de Levene). L’articulation coordonnée de Bray-Curtis, de la NMDS, de la PERMANOVA et de PERMDISP forme aujourd’hui le socle méthodologique standard de l’analyse multivariée non paramétrique dans les sciences de la vie et du comportement.
12. Limites méthodologiques, pièges fréquents et recommandations pratiques
12.1 Le piège de la dépendance à l’échelle des unités de mesure
En dépit de son élégance mathématique et de son universalité opérationnelle, la dissimilarité de Bray-Curtis recèle plusieurs chausse-trappes méthodologiques qu’un analyste rigoureux doit impérativement maîtriser afin d’éviter des erreurs d’interprétation critiques. Le premier piège réside dans l’obligation formelle d’homogénéité dimensionnelle absolue entre l’ensemble des descripteurs composant la matrice d’observation.
La formulation algébrique de Bray-Curtis additionne les valeurs brutes de différentes colonnes au sein d’une même somme marginale ($S_i = \sum x_{ik}$). Cette opération de sommation n’a de sens physique et statistique que si et seulement si toutes les variables $k$ sont mesurées rigoureusement dans la même unité scalaire et partagent le même ordre de grandeur fondamental. Si une matrice agrège par inadvertance des comptages d’individus entiers (variant de 0 à 500 individus), des mesures de biomasse exprimées en milligrammes (variant de 0 à 10 000 mg) et des pourcentages de recouvrement foliaire (bornés de 0 à 100 %), la métrique de Bray-Curtis perd toute cohérence mathématique : elle additionne littéralement des grandeurs incommensurables.
Face à des jeux de données composites regroupant des variables environnementales ou psychologiques hétérogènes (par exemple le revenu annuel en euros, le niveau d’anxiété sur échelle de Likert de 1 à 7 et la durée de sommeil en minutes), l’utilisation directe de Bray-Curtis doit être formellement proscrite. Dans ce cas de figure précis, il convient de s’orienter vers des coefficients spécifiquement conçus pour l’hétérogénéité dimensionnelle, au premier rang desquels figure le coefficient de dissimilarité de Gower, qui standardise de manière autonome chaque descripteur par son amplitude d’échantillonnage avant d’en calculer la moyenne pondérée.
12.2 Problèmes de saturation pour les sites ou sujets totalement distincts
Une seconde limite structurelle inhérente à la dissimilarité de Bray-Curtis est le phénomène d’asymptote de saturation à l’unité ($BC = 1$). Dès lors que deux unités d’échantillonnage ne partagent strictement aucune variable commune en raison d’un remplacement complet des espèces ou des symptômes, la valeur de dissimilarité atteint son plafond absolu de $1{,}00$. Or, sur le plan écologique ou clinique, tous les couples d’échantillons disjoints ne sont pas nécessairement séparés par la même distance biologique ou fonctionnelle sous-jacente.
Considérons trois sites disposés le long d’un vaste gradient thermique continental : le site A héberge une communauté de toundra alpine, le site B abrite une steppe tempérée sans aucune espèce commune avec A ($BC_{AB} = 1{,}00$), et le site C est une forêt pluviale équatoriale n’ayant aucune espèce commune ni avec B ($BC_{BC} = 1{,}00$), ni avec A ($BC_{AC} = 1{,}00$). Dans l’espace de Bray-Curtis brut, le site A est jugé exactement à la même distance du site B que du site C ($1{,}00$). L’indice est incapable de retranscrire le fait que le site B est écologiquement bien plus proche du site A que ne l’est l’écosystème équatorial C.
Ce phénomène d’écrasement ou d’effet de troncature conduit à des distorsions sévères lors des ordinations spatiales, les sites totalement disjoints étant artificiellement repliés les uns sur les autres sur le pourtour périphérique des représentations NMDS (artefact dit en fer à cheval ou effet d’arche). Pour pallier cette saturation lors de l’étude de gradients d’une ampleur biogéographique majeure, il est recommandé de recourir à l’algorithme des dissimilarités étendues (Extended Dissimilarities de De’ath) ou à la distance géodésique de plus court chemin calculée sur un graphe de voisinage écologique (algorithme Isomap), qui rétablissent la métrique sous-jacente en cheminant à travers une chaîne d’échantillons intermédiaires connectés.
12.3 Bonnes pratiques pour une utilisation rigoureuse en recherche
Pour conclure cette analyse approfondie, il est utile de synthétiser les recommandations méthodologiques incontournables sous la forme d’un protocole décisionnel destiné à sécuriser l’emploi de la dissimilarité de Bray-Curtis dans les protocoles de recherche contemporains :
- Vérification de la nature des variables : S’assurer scrupuleusement que les données d’entrée sont toutes non négatives ($x_{ik} ge 0$) et mesurées rigoureusement dans la même unité physique ou psychométrique d’intensité.
- Diagnostic de la distribution des abondances : Réaliser une analyse exploratoire de l’asymétrie de distribution des variables. En présence de descripteurs hyper-dominants exerçant un effet d’écrasement statistique, appliquer impérativement une transformation préalable par racine carrée, racine quatrième ou logarithme ($log(x+1)$).
- Arbitrage sur l’effort d’échantillonnage : Déterminer en amont si la taille totale absolue des collectes constitue une information écologique signifiante ou un biais d’échantillonnage à neutraliser. Dans le second cas, convertir les profils bruts en proportions relatives standardisées ($\sum x_{ik} = 1$) avant le calcul de Bray-Curtis.
- Choix réfléchi du mode d’ordination : Bannir formellement les projections linéaires euclidiennes directes (ACP) au profit de méthodes d’ordination non métriques robustes basées sur les rangs (NMDS) ou d’analyses en coordonnées principales (PCoA) intégrant des corrections d’euclidianité pour valeurs propres négatives.
- Transparence computationnelle absolue : Documenter explicitement dans la section méthodologique des publications le logiciel utilisé, le package employé (ex. vegan sous R, scipy sous Python), la fonction exacte appelée ainsi que la chaîne complète des transformations appliquées à la matrice de données brutes.
En respectant scrupuleusement ces canons méthodologiques, la dissimilarité de Bray-Curtis déploie toute sa puissance analytique, offrant aux chercheurs un instrument statistique d’une sensibilité et d’une pertinence théorique incomparables pour démêler la complexité multivariée du vivant et du comportement humain.
Références
- Anderson, M. J. (2001). A new method for non-parametric multivariate analysis of variance. Austral Ecology, 26(1), 32–46. https://doi.org/10.1111/j.1442-9993.2001.01070.pp.x
- Borsboom, D. (2017). A network approach to psychopathology. World Psychiatry, 16(1), 5–13. https://doi.org/10.1002/wps.20375
- Bray, J. R., & Curtis, J. T. (1957). An ordination of the upland forest communities of southern Wisconsin. Ecological Monographs, 27(4), 325–349. https://doi.org/10.2307/1942268
- Clarke, K. R., & Warwick, R. M. (2001). Change in marine communities: An approach to statistical analysis and interpretation (2nd ed.). PRIMER-E, Plymouth.
- De’ath, G. (1999). Extended dissimilarity: A method of robust estimation of ecological distances from high beta diversity data. Plant Ecology, 144(2), 191–199. https://doi.org/10.1023/A:1009848526547
- Gleason, H. A. (1926). The individualistic concept of the plant association. Bulletin of the Torrey Botanical Club, 53(1), 7–26. https://doi.org/10.2307/2479933
- Horn, H. S. (1966). Measurement of « overlap » in comparative ecological studies. The American Naturalist, 100(914), 419–424. https://doi.org/10.1086/282436
- Jaccard, P. (1901). Étude comparative de la distribution florale dans une portion des Alpes et du Jura. Bulletin de la Société Vaudoise des Sciences Naturelles, 37, 547–579.
- Kruskal, J. B. (1964). Nonmetric multidimensional scaling: A numerical method. Psychometrika, 29(2), 115–129. https://doi.org/10.1007/BF02289565
- Legendre, P., & Gallagher, E. D. (2001). Ecologically meaningful transformations for ordination of species data. Oecologia, 129(2), 271–280. https://doi.org/10.1007/s004420100716
- Legendre, P., & Legendre, L. (2012). Numerical ecology (3rd English ed.). Elsevier Science BV. https://www.elsevier.com/books/numerical-ecology/legendre/978-0-444-53868-0
- Mantel, N. (1967). The detection of disease clustering and a generalized regression approach. Cancer Research, 27(2), 209–220. https://doi.org/10.1111/j.1469-1809.1967.tb01267.x
- Morisita, M. (1959). Measuring of interspecific association and similarity between communities. Memoirs of the Faculty of Science, Kyushu University, Series E (Biology), 3(1), 65–80. https://doi.org/10.1007/BF02518851
- Oksanen, J., Blanchet, F. G., Friendly, M., Kindt, R., Legendre, P., McGlinn, D., Minchin, P. R., O’Hara, R. B., Simpson, G. L., Solymos, P., Stevens, M. H. H., Szoecs, E., & Wagner, H. (2020). vegan: Community ecology package (R package version 2.5-7). https://cran.r-project.org/package=vegan
- Ružička, M. (1958). Anwendung mathematisch-statistischer Methoden in der Geobotanik (synthetische Bearbeitung von Aufnahmen). Biológia (Bratislava), 13, 647–661.
- Sørensen, T. (1948). A method of establishing groups of equal amplitude in plant sociology based on similarity of species content and its application to analyses of the vegetation on Danish commons. Kongelige Danske Videnskabernes Selskab, Biologiske Skrifter, 5(4), 1–34.
- Whittaker, R. H. (1960). Vegetation of the Siskiyou Mountains, Oregon and California. Ecological Monographs, 30(3), 279–338. https://doi.org/10.2307/1943563