
La mesure de la fidélité inter-évaluateurs constitue l’un des piliers méthodologiques les plus critiques dans les sciences du comportement, la psychiatrie clinique et la recherche psychologique contemporaine. Lorsque deux praticiens ou chercheurs observent un même phénomène clinique, posent un diagnostic psychiatrique à partir d’entretiens semi-structurés, ou catégorisent des comportements d’enfants lors de tests standardisés, la question fondamentale de l’objectivité et de la reproductibilité de leurs jugements s’impose immédiatement. En l’absence d’une concordance démontrable et statistiquement éprouvée entre observateurs indépendants, toute inférence scientifique ou décision diagnostique se trouve compromise par la subjectivité idiosyncrasique des évaluateurs.
Historiquement, l’évaluation de cette reproductibilité s’est longtemps cantonnée au calcul naïf du pourcentage d’accord brut. Cette approche rudimentaire présentait toutefois une lacune théorique majeure : elle ignorait complètement la probabilité que deux évaluateurs s’accordent par pure coïncidence stochastique, en particulier lorsque certaines catégories diagnostiques sont extrêmement prévalentes ou, à l’inverse, très rares. Pour surmonter cet écueil fondamental de la théorie de la mesure, le statisticien et psychologue américain Jacob Cohen a introduit en 1960 un coefficient novateur destiné à quantifier l’accord nominal en éliminant explicitement la part attribuable au hasard : le coefficient Kappa de Cohen (κ).
Bien que des logiciels statistiques spécialisés tels que SPSS, R, SAS ou Stata soient couramment employés pour calculer cet indice, la maîtrise de son implémentation pas à pas au sein de Microsoft Excel représente un atout pédagogique et opérationnel inestimable pour les psychologues, chercheurs et étudiants. Excel permet en effet de décomposer méticuleusement chaque étape du calcul matriciel, d’appréhender intimement les mécanismes sous-jacents de la variance marginale, et de concevoir des modèles dynamiques transparents, auditables et personnalisables pour l’analyse des données de recherche clinique. Ce guide exhaustif propose une exploration approfondie de la théorie psychométrique, de la modélisation mathématique et des protocoles opérationnels requis pour implémenter rigoureusement le Kappa de Cohen dans Microsoft Excel.
1. Introduction au coefficient Kappa de Cohen dans l’évaluation psychologique
1.1 Définition et fondements théoriques de l’accord inter-juges
Le coefficient Kappa de Cohen a été formalisé pour la première fois par Jacob Cohen dans son article séminal de 1960 publié dans la revue Educational and Psychological Measurement, intitulé « A Coefficient of Agreement for Nominal Scales ». Cette publication visait à combler un vide méthodologique criant dans l’évaluation des variables qualitatives nominales, où les méthodes de corrélation classiques de Pearson ou de Spearman s’avéraient conceptuellement inapplicables en raison de l’absence de métrique continue sous-jacente.
La nécessité de quantifier la fidélité inter-évaluateurs découle directement des principes de la théorie classique des tests psychométriques. Dans ce cadre épistémologique, tout score ou toute classification observée est conceptualisée comme la somme d’une composante d’état réelle (le score vrai du sujet ou sa véritable appartenance diagnostique) et d’une composante d’erreur de mesure aléatoire ou systématique. Lorsqu’il s’agit d’instruments de mesure automatisés ou de questionnaires auto-administrés, la fidélité s’exprime traditionnellement à travers la cohérence interne ou la stabilité test-retest. En revanche, dès lors que l’instrument d’évaluation s’incarne dans un être humain — un clinicien, un observateur ou un juge —, l’erreur de mesure incorpore inévitablement les biais perceptifs, l’expérience clinique différentielle et les fluctuations attentionnelles de l’évaluateur.
Il convient d’établir une distinction fondamentale entre la fidélité instrumentale et l’accord inter-observateurs. La fidélité instrumentale renvoie à la capacité d’un test à produire des résultats stables sous des conditions identiques. L’accord inter-juges examine spécifiquement l’interchangeabilité de deux évaluateurs distincts examinant simultanément une même série d’entités cliniques ou comportementales. Le cadre théorique strict défini par Cohen s’applique à deux juges opérant de manière rigoureusement indépendante, classifiant un ensemble fermé d’unités d’observation dans des catégories nominales mutuellement exclusives et collectivement exhaustives.
1.2 Pertinence de la mesure dans les diagnostics psychologiques
L’application du coefficient Kappa trouve son incarnation la plus emblématique dans le champ du diagnostic nosographique psychiatrique et psychologique, notamment lors de l’application des critères standardisés du Manuel diagnostique et statistique des troubles mentaux (DSM) édité par l’American Psychiatric Association, ou de la Classification internationale des maladies (CIM) de l’Organisation mondiale de la santé. La genèse même du DSM-III au tournant des années 1980 s’est construite sur la démonstration empirique de la fidélité inter-juges de ses critères diagnostiques au moyen du coefficient Kappa, rompant avec le manque de fiabilité notoire des éditions précédentes basées sur des concepts psychanalytiques non opérationnalisés.
Dans la recherche en psychologie du développement et en psychopathologie de l’enfant, l’accord inter-observateurs est indispensable lors du codage comportemental en temps réel ou sur enregistrements vidéo. Les grilles d’observation standardisées — telles que la Strange Situation de Mary Ainsworth pour la classification des styles d’attachement chez le nourrisson — requièrent que des codeurs indépendants classifient les comportements d’exploration et de détresse dans des catégories préétablies (sécure, insécure-évitant, insécure-résistant, désorganisé). Le calcul du Kappa permet de garantir que l’assignation d’un enfant à un profil développemental particulier n’est pas le fruit d’une distorsion projective d’un codeur isolé.
De surcroît, le Kappa de Cohen intervient massivement dans l’analyse de contenu et la catégorisation de verbatim au sein des protocoles de recherche qualitative ou mixte. Lorsque des transcriptions d’entretiens cliniques doivent être segmentées en unités thématiques, l’accord entre deux codeurs indépendants constitue le garant ultime de la validité de construit. Sur le plan déontologique, garantir une fidélité inter-juges élevée protège les patients contre les erreurs d’orientation thérapeutique : un diagnostic erroné ou instable peut conduire à des prescriptions médicamenteuses inadaptées ou à des stigmatisations préjudiciables.
1.3 Limite du simple pourcentage d’accord observé
L’intuition première d’un chercheur ou d’un clinicien non averti consiste fréquemment à quantifier l’accord en calculant simplement la proportion d’unités pour lesquelles les deux juges ont formulé exactement le même avis par rapport au nombre total de cas examinés. Ce pourcentage d’accord brut (noté Po) présente une faille théorique rédhibitoire : il est intrinsèquement contaminé par la concordance fortuite découlant des lois fondamentales du hasard stochastique.
Pour illustrer ce phénomène mathématique, considérons deux cliniciens évaluant la présence d’un trouble bipolaire au sein d’une population où cette pathologie ne concerne que 5 % des individus. Si les deux praticiens, en raison de leur connaissance intuitive de cette faible prévalence, concluent systématiquement à l’absence de trouble pour chaque patient sans même effectuer d’examen clinique approfondi, ils obtiendront un accord observé artificiellement astronomique de l’ordre de 90 % à 95 %. Pourtant, cet accord ne reflète aucune compétence diagnostique, mais simplement un artéfact lié à la rareté de la pathologie dans la population cible.
Le pourcentage d’accord brut surestime donc systématiquement et substantiellement la fidélité réelle entre les évaluateurs en attribuant à leur discernement clinique ce qui relève de la simple coïncidence mathématique. De plus, il est excessivement sensible aux déséquilibres de fréquence des catégories marginales, rendant toute comparaison entre différentes études totalement invalide dès lors que les taux de prévalence divergent. Il s’avère dès lors impératif de recourir à un ajustement mathématique standardisé capable d’isoler l’accord réel en soustrayant rigoureusement la proportion d’accord théoriquement attendue sous l’hypothèse nulle du hasard.
2. Modélisation mathématique du Kappa de Cohen
2.1 Analyse détaillée de la formule standard
L’architecture mathématique du coefficient Kappa de Cohen repose sur une élégante formulation de normalisation linéaire. Soit Po la proportion relative d’accords observés empiriquement entre les deux juges, et Pe la proportion relative d’accords théoriquement attendus sous l’hypothèse d’une indépendance statistique absolue des jugements. L’équation canonique définie par Jacob Cohen s’énonce comme suit :
κ = (Po – Pe) / (1 – Pe)
L’analyse structurelle de cette formule révèle avec clarté son soubassement psychométrique :
- Le numérateur (Po – Pe) : Il quantifie la proportion d’accord qui excède strictement le niveau attribuable à la chance stochastique. Si le niveau d’accord observé est rigoureusement identique au niveau attendu par le hasard, le numérateur s’annule, entraînant une valeur de Kappa nulle (κ = 0).
- Le dénominateur (1 – Pe) : Il représente l’accord maximal potentiel que les évaluateurs pourraient atteindre au-delà de la part aléatoire. Ce terme agit comme une constante normalisatrice, contraignant l’indice à une échelle standardisée où la valeur maximale théorique d’un accord parfait culmine à l’unité (+1,00).
Comparé à d’autres métriques nominales — telles que le coefficient de concordance de Gwet (AC1), l’indice Pi de Scott ou le coefficient S de Bennett —, le Kappa de Cohen demeure la référence institutionnelle dominante dans la littérature biomédicale et comportementale, malgré des débats statistiques récurrents quant à son comportement en présence de distributions marginales hautement asymétriques.
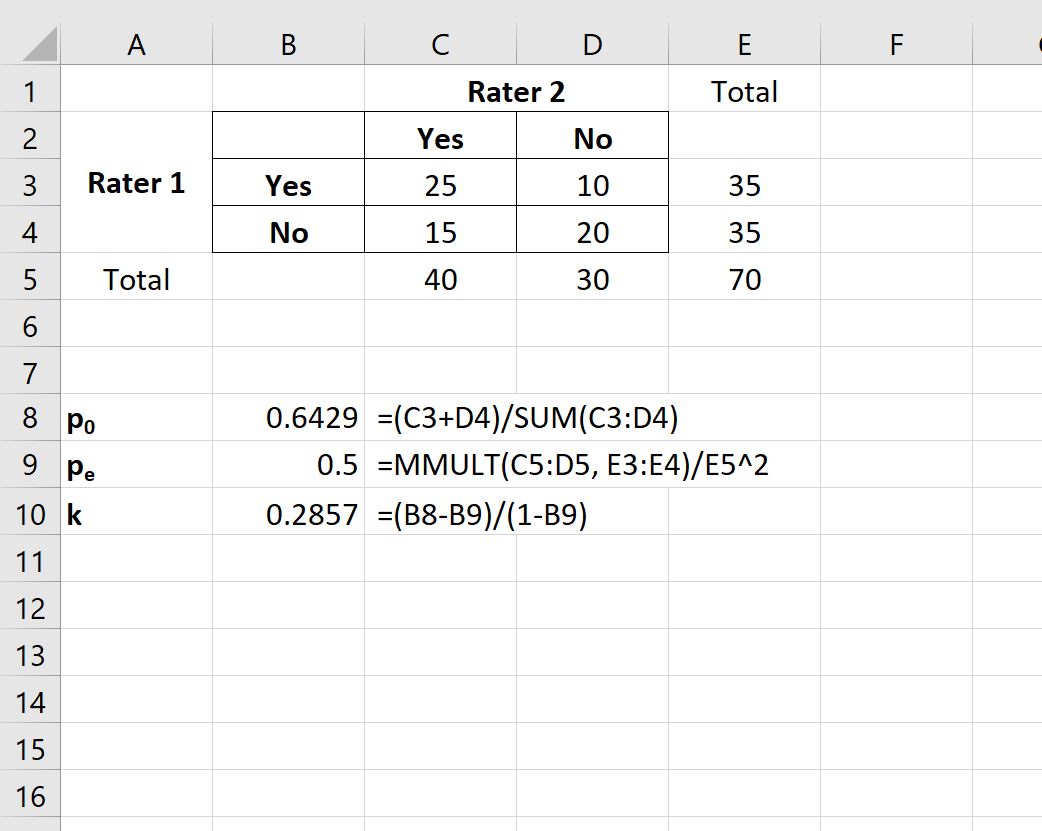
2.2 Calcul de la probabilité d’accord observé (Po)
La probabilité d’accord empirique ou observé, notée Po, représente le rapport fondamental entre le nombre de décisions concordantes formulées simultanément par les deux évaluateurs et l’effectif global total d’unités ou de sujets soumis à l’évaluation psychologique. Dans une matrice de contingence croisée carrée regroupant k catégories mutuellement exclusives, les accords se matérialisent rigoureusement par les cellules situées le long de la diagonale principale descendante du tableau (de la coordonnée [1,1] à la coordonnée [k,k]).
D’un point de vue formel, si nii représente le dénombrement des observations pour lesquelles le juge A et le juge B ont tous deux assigné la catégorie i, et que N représente le nombre total de sujets évalués dans l’échantillon, la proportion d’accord observé s’écrit mathématiquement :
Po = (∑ nii) / N, pour i variant de 1 à k.
Cette grandeur scalaire est strictement bornée sur l’intervalle continu [0, 1]. Une valeur de Po = 1,00 indique que les deux juges ont catégorisé l’intégralité des sujets de manière strictement identique, tandis qu’une valeur de Po = 0,00 témoigne d’une discordance absolue, aucune unité n’ayant reçu la même étiquette nominale de la part des deux cliniciens. Bien que sensible à la taille globale de l’échantillon N en termes d’erreur d’échantillonnage, la métrique Po est un estimateur sans biais de la proportion empirique de concordance brute.
2.3 Modélisation de la probabilité d’accord dû au hasard (Pe)
La modélisation de la probabilité d’accord attendu par le hasard, désignée sous le symbole Pe, repose sur le principe probabiliste d’indépendance statistique entre deux variables aléatoires discrètes, tel qu’enseigné dans les cours fondamentaux de statistique mathématique. Selon ce postulat, si le juge A et le juge B assignaient leurs catégories diagnostiques sans aucune concertation ni sensibilité réelle aux caractéristiques du patient — c’est-à-dire comme s’ils tiraient des étiquettes au sort selon leurs propres fréquences marginales —, la probabilité d’un accord fortuit sur la catégorie i correspondrait au produit direct de leurs probabilités marginales respectives.
Pour chaque catégorie diagnostique i, la probabilité théorique conjointe aléatoire équivaut au produit de la proportion marginale de lignes (total des choix du juge A pour la catégorie i divisé par N) par la proportion marginale de colonnes (total des choix du juge B pour la même catégorie i divisé par N). Pour synthétiser l’attente théorique globale sur l’ensemble des k catégories possibles du système nosographique, nous sommons l’ensemble de ces produits marginaux :
Pe = ∑ [ (ni. / N) × (n.i / N) ] = ∑ (ni. × n.i) / N2, où ni. désigne le total marginal de la ligne i et n.i le total marginal de la colonne i.
Cette modélisation met en lumière le fait que Pe est lourdement tributaire des biais d’ancrage individuels des évaluateurs. Si l’un des juges démontre une tendance systématique à surdiagnostiquer une pathologie spécifique tandis que le second juge présente une inclinaison comparable, le produit de leurs marges s’élève de façon mécanique, augmentant artificiellement la valeur de Pe et rendant l’obtention d’un Kappa élevé beaucoup plus exigeante.
2.4 Propriétés mathématiques et étendue des valeurs
Le coefficient Kappa de Cohen est une mesure statistique normée possédant des propriétés algébriques spécifiques qu’il importe de maîtriser pour toute interprétation clinique :
- La borne supérieure (+1,00) : Un κ rigoureusement égal à +1,00 traduit un accord inter-juges parfait et absolu. Dans cette configuration, chaque sujet se positionne exclusivement sur la diagonale principale de la matrice (nij = 0 pour tout i ≠ j), impliquant de facto que Po = 1,00. Dès lors, l’expression κ = (1 – Pe) / (1 – Pe) se réduit invariablement à l’unité.
- La valeur nulle (0,00) : Lorsque κ atteint la valeur de 0,00, cela signifie que la concordance observée empiriquement entre les deux cliniciens coïncide exactement avec ce que prédirait le simple hasard mathématique (Po = Pe). Aucune fidélité véritable ne peut être déduite de leurs évaluations.
- Les valeurs négatives [-1,00 à 0,00[ : Un coefficient Kappa négatif survient lorsque la proportion d’accord observée est inférieure à la proportion d’accord attendue par pure coïncidence stochastique (Po < Pe). Une telle circonstance traduit un désaccord systématique ou une incompréhension symétrique inverse des critères d’évaluation par les juges, phénomène rare en pratique clinique mais théoriquement informatif.
Il est crucial de souligner que la borne supérieure absolue de +1,00 ne peut être mathématiquement atteinte que si et seulement si les deux évaluateurs présentent des distributions marginales strictement symétriques et identiques (c’est-à-dire ni. = n.i pour chaque modalité i). Dans les situations réelles où l’un des juges utilise globalement une catégorie plus fréquemment que l’autre, le Kappa maximal possible (noté κmax) est contraint à une valeur strictement inférieure à 1,00, ce qui constitue une caractéristique structurelle propre à cette métrique.
3. Structuration des données qualitatives dans Excel
3.1 Organisation tabulaire brute des évaluations des juges
L’implémentation opérationnelle et rigoureuse du Kappa de Cohen dans Microsoft Excel requiert une discipline méthodologique stricte dès la phase d’encodage initial des données qualitatives. La structuration optimale de la feuille de calcul primaire implique l’agencement des observations sous la forme d’un tableau de données relationnel plat (conforme aux principes du tidy data). Chaque ligne du tableau doit correspondre sans ambiguïté à une unité d’analyse unique — qu’il s’agisse d’un patient, d’une séquence vidéo, d’une réponse textuelle ou d’un tracé électroencéphalographique — et chaque colonne doit héberger une variable méthodologique explicite.
La structure tabulaire fondamentale s’organise ainsi classiquement sur trois colonnes adjacentes :
- Colonne A (Identifiant du sujet) : Nomenclature séquentielle unique et anonymisée (ex. : PAT_001, PAT_002, etc.).
- Colonne B (Juge A) : Catégorie diagnostique nominale assignée par le premier clinicien de manière indépendante.
- Colonne C (Juge B) : Catégorie diagnostique nominale assignée par le second clinicien en aveugle strict du premier.
La normalisation typographique des libellés catégoriels est un impératif absolu sous Excel. Les erreurs de frappe, la présence d’espaces superflus en début ou en fin de chaîne de caractères, ou des incohérences de casse (majuscules/minuscules) peuvent fausser irrémédiablement les fonctions logiques de dénombrement automatisé. Il est dès lors vivement recommandé d’utiliser des listes de validation de données intégrées dans Excel (menu Données > Validation des données > Autoriser : Liste) afin de contraindre la saisie à un dictionnaire fermé de modalités prédéfinies. Bien que le codage textuel clair (ex. : « Dépression », « Anxiété », « Trouble bipolaire ») favorise la lisibilité humaine, le recours à un codage numérique ordinal ou nominal conventionnel (ex. : 1, 2, 3) assorti d’une table de correspondance explicative limite considérablement les risques de corruption textuelle et optimise les temps d’exécution des formules conditionnelles avancées.
Enfin, l’intégrité du protocole d’accord inter-juges repose sur l’exhaustivité des couples d’évaluation. L’analyste doit impérativement auditer la base brute pour repérer d’éventuelles données manquantes unilatérales (où un juge a statué mais non l’autre). Deux choix s’offrent alors : l’exclusion complète du sujet de l’analyse inter-juges (suppression par liste ou listwise deletion), ou la création d’une modalité dédiée aux cas inclassables ou indéterminés, si cette ambiguïté porte en elle une signification clinique substantielle.
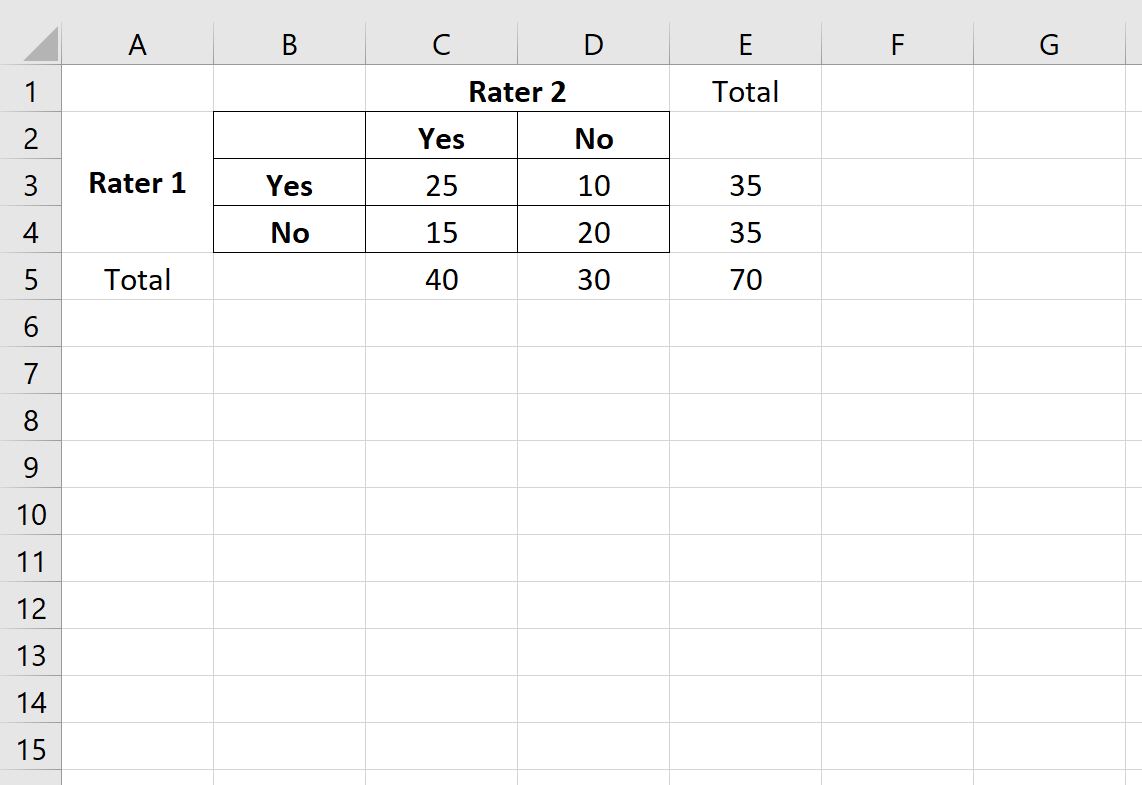
3.2 Construction de la matrice de confusion (tableau croisé 2×2)
Une fois la base de données brute validée et nettoyée, l’étape analytique intermédiaire consiste à synthétiser l’information sous la forme d’une matrice de confusion — également désignée sous le terme de tableau de contingence croisé. Pour une échelle dichotomique binaire (ex. : Présence vs Absence d’un état de stress post-traumatique), ce tableau prend la configuration géométrique canonique d’une matrice 2×2.
La disposition spatiale standardisée sous Excel s’articule comme suit :
- Les modalités diagnostiques du Juge A sont disposées verticalement en en-têtes de lignes (ex. : Ligne 1 = « Positif », Ligne 2 = « Négatif »).
- Les modalités diagnostiques du Juge B sont disposées horizontalement en en-têtes de colonnes (ex. : Colonne 1 = « Positif », Colonne 2 = « Négatif »).
Au sein de cette grille spatiale, les quatre cellules résultant du croisement capturent les combinaisons exhaustives des jugements :
- Cellule d’accord positif [1,1] : Nombre de patients jugés simultanément « Positifs » par les deux praticiens.
- Cellule de discordance [1,2] : Nombre de patients jugés « Positifs » par le Juge A mais « Négatifs » par le Juge B (erreur de type faux positif/faux négatif relatif).
- Cellule de discordance [2,1] : Nombre de patients jugés « Négatifs » par le Juge A mais « Positifs » par le Juge B.
- Cellule d’accord négatif [2,2] : Nombre de patients jugés consensuellement « Négatifs » par les deux cliniciens.
La diagonale principale descendante (cellules [1,1] et [2,2]) concentre la totalité des événements de concordance clinique. À la périphérie immédiate de cette matrice, des plages d’accueil dédiées doivent être aménagées pour recevoir les totaux marginaux horizontaux (sommes en lignes reflétant le profil de diagnostic global du Juge A) et les totaux marginaux verticaux (sommes en colonnes reflétant le comportement diagnostique global du Juge B), éléments indispensables au calcul ultérieur de la composante aléatoire Pe.
3.3 Gestion des échelles à catégories multiples (k x k)
Dans de nombreuses investigations psychologiques et psychiatriques, les systèmes de classification ne sont pas réductibles à une simple dichotomie présence/absence. Les grilles nosologiques explorent fréquemment des spectres diagnostiques polytomiques comprenant k modalités distinctes (par exemple : Trouble dépressif majeur, Trouble dysthymique, Trouble bipolaire I, Trouble de l’adaptation, et Absence de trouble). La matrice de confusion doit par conséquent subir une extension architecturale rigoureuse pour devenir une grille carrée de dimension k × k.
L’exigence première réside dans le maintien d’une symétrie stricte entre les dimensions axiales : les modalités apparaissant en en-têtes de lignes pour le Juge A doivent être rigoureusement identiques, dans le même ordre d’énumération textuel ou numérique, aux modalités disposées en colonnes pour le Juge B. Toute omission d’une catégorie chez l’un des évaluateurs briserait la structure diagonale fondamentale du tableau et invaliderait irrémédiablement la sommation des accords réels.
Une précaution méthodologique majeure s’impose lors du traitement des échelles polytomiques à catégories multiples sous Excel : le risque de dispersion critique des effectifs dans des cellules à très faible fréquence. Lorsqu’un échantillon clinique global de taille modeste (ex. : N = 50) est distribué au sein d’une matrice 5×5 comportant 25 cellules potentielles, de nombreuses cases hors diagonale — voire sur la diagonale principale — peuvent comporter des effectifs nuls ou unitaires. Cette parcimonie distributionnelle n’empêche pas le calcul algébrique du Kappa, mais elle accroît considérablement la variance d’échantillonnage de l’indice et élargit l’intervalle de confiance, réduisant ainsi la puissance des inférences psychométriques.
4. Procédure pas à pas : Création du tableau de contingence sous Excel
4.1 Utilisation des fonctions NB.SI.ENS pour dénombrer les concordances
Pour automatiser le peuplement de la matrice de confusion à partir de la table brute des observations sans recourir à des comptages manuels fastidieux et sources d’erreurs humaines, Microsoft Excel propose une fonction statistique conditionnelle particulièrement robuste et élégante : la fonction NB.SI.ENS. Cette fonction permet de comptabiliser le nombre de lignes au sein d’une base de données qui satisfont simultanément à de multiples critères définis sur plusieurs colonnes distinctes.
Considérons une feuille de calcul Excel où la plage B$2:B$101 contient les classifications posées par le Juge A pour 100 participants cliniques, et la plage C$2:C$101 contient les évaluations indépendantes posées par le Juge B pour ces mêmes participants. Supposons que nous souhaitions construire notre tableau de contingence dans la zone E4:G6, où la colonne E contient les libellés des catégories du Juge A en lignes (cellules E5 et E6), et la ligne 4 contient les libellés identiques pour le Juge B en colonnes (cellules F4 et G4).
La formule conditionnelle standard à insérer dans la première cellule de croisement (cellule F5, correspondant à l’accord conjoint sur la première catégorie) s’écrit de la façon suivante :
=NB.SI.ENS(B$2:B$101; $E5; C$2:C$101; F$4)
L’utilisation judicieuse des références mixtes avec le caractère dollar ($) est ici d’une importance capitale :
- Les plages de données sources
B$2:B$101etC$2:C$101sont bloquées verticalement pour empêcher leur translation lors de l’incrémentation de la formule. - Le critère de ligne
$E5bloque la référence de colonne sur la colonne E tout en laissant le numéro de ligne flottant, permettant l’adaptation automatique lors d’une recopie vers le bas. - Le critère de colonne
F$4bloque la référence de ligne sur la ligne 4 tout en conservant une référence de colonne flottante, autorisant une adaptation fluide lors de la recopie horizontale.
Grâce à ce paramétrage d’adressage matriciel rigoureux, il suffit à l’analyste d’étendre par simple glisser-déposer la cellule F5 sur l’ensemble de la grille F5:G6 pour dénombrer instantanément, de façon dynamique et sans la moindre erreur d’indexation, l’intégralité des combinaisons d’accords et de désaccords.
Une alternative analytique native consiste à exploiter la fonctionnalité des Tableaux Croisés Dynamiques (TCD) d’Excel. En positionnant la variable Juge A en zone « Lignes », la variable Juge B en zone « Colonnes », et l’identifiant du patient en zone « Valeurs » avec le paramètre de synthèse configuré sur « Nombre », Excel génère en un clic la matrice de confusion exacte. Néanmoins, l’approche par formules NB.SI.ENS présente une supériorité incontestable pour la conception d’un gabarit de calcul réutilisable, car les formules se recalculent en temps réel dès la saisie ou la modification d’un enregistrement brut, sans exiger l’actualisation manuelle obligatoire propre aux TCD.
4.2 Calcul dynamique des totaux marginaux de lignes et de colonnes
L’obtention des totaux marginaux de la matrice de contingence représente l’étape intermédiaire obligatoire conditionnant l’exactitude du calcul de la probabilité théorique due à la chance. Les marges horizontales traduisent l’activité diagnostique globale du Juge A, tandis que les marges verticales reflètent celle du Juge B.
Reprenons notre matrice positionnée en F5:G6. Pour calculer les marges en ligne du Juge A, l’analyste insère dans la cellule adjacente H5 la fonction d’agrégation arithmétique :
=SOMME(F5:G5)
Cette formule est ensuite étirée verticalement jusqu’à la cellule H6 pour totaliser la seconde modalité diagnostique. Les valeurs résultantes représentent les effectifs marginaux de lignes n1. et n2..
De manière symétrique, pour extraire les marges en colonnes relatives aux jugements posés par le Juge B, l’analyste insère dans la cellule F7 située directement sous la première colonne de données la formulation suivante :
=SOMME(F5:F6)
Cette expression est ensuite répliquée horizontalement vers la cellule G7, fournissant les effectifs marginaux de colonnes n.1 et n.2.
Une bonne pratique de gestion de la qualité des données sous Excel consiste à appliquer un formatage conditionnel sur ces totaux marginaux. Si des disparités substantielles apparaissent entre la marge d’une ligne et la marge de la colonne correspondante (par exemple si le Juge A a diagnostiqué 45 cas de dépression tandis que le Juge B n’en a identifié que 12), une mise en surbrillance chromatique attire immédiatement l’attention du chercheur sur l’existence d’un biais systématique d’évaluation entre praticiens, alertant précocement sur le risque d’émergence d’un paradoxe statistique.
4.3 Vérification de la cohérence de l’échantillon total avec SOMME
Avant d’engager le calcul proprement dit du coefficient Kappa, un point de contrôle d’intégrité métrique incontournable réside dans l’extraction et la validation formelle de l’effectif global de l’échantillon, universellement désigné par la variable N. Cette grandeur fondamentale trouve sa place naturelle à l’intersection géométrique des totaux marginaux, dans la cellule H7 de notre exemple de modélisation.
Pour calculer cet effectif global, l’analyste implémente en H7 la formule de sommation des marges de lignes :
=SOMME(H5:H6)
Cependant, sur le plan formel de la cohérence matricielle, le grand total de la matrice doit rigoureusement respecter une propriété d’invariance fondamentale : la somme des totaux marginaux de lignes doit être strictement égale à la somme des totaux marginaux de colonnes, et chacune de ces deux sommes doit coïncider rigoureusement avec le dénombrement direct des unités brutes encodées dans la base de données principale. Pour sceller ce contrôle de cohérence au cœur même de la feuille de calcul, il est vivement conseillé d’insérer dans une cellule d’audit dédiée (par exemple H8) une assertion logique intégrant la fonction conditionnelle SI :
=SI(ET(SOMME(H5:H6)=SOMME(F7:G7); SOMME(H5:H6)=NBVAL(A2:A101)); « COHÉRENCE VALIDÉE (N = » & H7 & « ) »; « ERREUR DE MATRICE : DISCORDANCE D’EFFECTIF »)
Ce verrou méthodologique garantit qu’aucune ligne orpheline, aucune valeur textuelle mal encodée ni aucune double saisie n’échappe à la vigilance de l’évaluateur. Une fois ce point de contrôle validé, les cellules clés du tableau de contingence peuvent être sécurisées par les fonctionnalités de protection de feuille d’Excel afin de prémunir les formules contre toute altération accidentelle lors des manipulations ultérieures.
5. Calcul de la proportion d’accord observé (Po) dans Excel
5.1 Sommation de la diagonale principale d’accord
La proportion relative d’accord observé (Po) constitue la première pierre angulaire de l’équation de Cohen. Sa détermination nécessite au préalable l’extraction de la somme arithmétique exacte des effectifs logés sur la diagonale principale descendante du tableau de contingence — c’est-à-dire l’ensemble des cellules où les deux évaluateurs s’accordent sans réserve sur la classification diagnostique du patient.
Dans notre tableau de contingence d’exemple occupant la zone F5:G6, les accords parfaits se situent exclusivement dans les cellules F5 (concordance sur la première modalité) et G6 (concordance sur la seconde modalité). Dans le cadre restreint d’une matrice 2×2, l’agrégation de ces effectifs s’opère par une simple formule d’addition explicite insérée dans une cellule de synthèse intermédiaire (par exemple la cellule K5 étiquetée « Somme Diagonale ») :
=F5 + G6
Toutefois, dès lors que l’analyste travaille sur des échelles nosologiques polytomiques de dimensions plus vastes (matrices 4×4, 5×5 ou 10×10 pour des classifications complexes de traits de personnalité), l’énumération unitaire des cellules diagonales devient excessivement laborieuse et expose à des oublis manifestes d’inclusions cellulaires. Pour une matrice polytomique s’étendant de la cellule F5 à la cellule J9 (matrice 5×5), il devient alors infiniment plus judicieux et sécurisé de faire appel à une formule matricielle compacte exploitant la fonction SOMMEPROD conjuguée à la fonction LIGNE et COLONNE pour extraire les termes diagonaux :
=SOMMEPROD((LIGNE(F5:J9)-LIGNE(F5)+1 = COLONNE(F5:J9)-COLONNE(F5)+1) * F5:J9)
Cette formulation compare dynamiquement le rang relatif de ligne au rang relatif de colonne au sein de la plage matricielle d’accueil, créant un masque binaire booléen (renvoyant VRAI uniquement lorsque le numéro de ligne interne coïncide avec le numéro de colonne interne, c’est-à-dire sur la diagonale stricte) puis multiplie ce masque par les valeurs de la matrice avant d’en effectuer la somme. Cette technique évite toute défaillance humaine lors de l’analyse d’échelles diagnostiques étendues.
5.2 Formulation Excel pour Po (rapport diagonale sur total)
Dès lors que la somme des concordances situées sur la diagonale principale est isolée, l’évaluation de la proportion Po découle directement de son rapport à l’effectif global d’échantillonnage N consigné dans la cellule H7. Dans la cellule réservée au résultat de Po (par exemple la cellule K6), l’analyste implémente la formule d’affectation statistique :
=K5 / H7 ou de façon synthétique directe sans cellule intermédiaire : =(F5 + G6) / H7
Dans l’éventualité de l’utilisation de la formule matricielle pour une échelle polytomique 5×5, l’expression globale fusionnée s’écrit de manière élégante :
=SOMMEPROD((LIGNE(F5:J9)-LIGNE(F5)+1 = COLONNE(F5:J9)-COLONNE(F5)+1) * F5:J9) / H10 (en supposant que H10 représente l’effectif total N).
Sur le plan de l’ingénierie logicielle sous Excel, il est essentiel de paramétrer immédiatement le format d’affichage numérique de cette cellule K6. Un standard psychométrique rigoureux impose un affichage à quatre décimales fixes (via le menu Accueil > Nombre > Format de nombre standardisé à 4 décimales). Bien qu’Excel conserve en mémoire interne la précision en virgule flottante double précision (jusqu’à 15 chiffres significatifs), ce réglage visuel évite les effets d’optique trompeurs dus aux arrondis prématurés.
Il est également recommandé d’insérer une note ou un commentaire de cellule au sein de la cellule K6 (via le raccourci Maj + F2) explicitant : « Proportion empirique d’accord brut observé entre le Juge A et le Juge B, calculée sans ajustement pour le hasard stochastique ». Cette documentation interne facilite l’auditabilité et le partage de la feuille de calcul au sein des équipes de recherche clinique pluridisciplinaires.
5.3 Interprétation de Po et pièges méthodologiques
L’observation isolée de la valeur numérique de Po constitue un piège méthodologique classique dans lequel sombrent fréquemment les analystes novices. Si une valeur de Po = 0,88 peut de prime abord sembler témoigner d’une excellente fidélité clinique en suggérant que les deux professionnels de santé s’accordent dans 88 % des situations évaluées, cette conclusion demeure purement illusoire tant que la distribution des effectifs n’a pas été soumise au prisme de la prévalence.
L’illusion de concordance élevée surgit avec une acuité particulière en psychopathologie lorsque la condition clinique recherchée possède une fréquence marginale hautement asymétrique. Prenons le cas de l’évaluation d’un trouble hautement spécifique, tel que l’état psychotique aigu en médecine générale, présent chez seulement 2 % des patients d’une cohorte de 100 individus. Si le Juge A et le Juge B ne diagnostiquent la psychose chez aucun patient au cours de leurs entretiens respectifs, ils s’accorderont sur 98 dossiers déclarant l’absence de trouble, générant un Po prodigieux de 0,98 (98 % d’accord). Pourtant, leur capacité relative à discriminer un cas positif réel n’a jamais été mise à l’épreuve de manière concluante.
La proportion d’accord brut Po ne constitue par conséquent qu’une mesure purement descriptive, totalement dénuée de robustesse inférentielle. Elle est incapable d’établir à elle seule la fidélité de classification inter-évaluateurs. La prise de conscience de cette insuffisance structurelle conditionne l’adhésion impérative à la seconde étape du modèle de Cohen : l’estimation rigoureuse de la concordance théorique issue des mécanismes du hasard.
6. Calcul de la proportion d’accord théorique aléatoire (Pe) dans Excel
6.1 Calcul des fréquences théoriques pour chaque cellule diagonale
Pour soustraire l’influence perturbatrice de la chance, la modélisation statistique impose de calculer la probabilité conjointe théorique que les deux juges s’accordent sur chaque catégorie sous l’hypothèse de l’indépendance statistique. Cette opération consiste à déterminer pour chaque modalité i le produit croisé de ses totaux marginaux de lignes et de colonnes.
Soit notre matrice 2×2 configurée précédemment. La fréquence absolue théorique d’accord fortuit sur la première modalité diagnostique s’obtient en multipliant le total des choix de cette catégorie par le Juge A (cellule H5) par le total des choix de cette même catégorie par le Juge B (cellule F7), puis en divisant ce produit par l’effectif global N logé en H7 :
Fréquence théorique d’accord [1,1] = (H5 × F7) / H7
De manière identique, la fréquence absolue théorique d’accord fortuit pour la seconde catégorie clinique s’obtient par la formule :
Fréquence théorique d’accord [2,2] = (H6 × G7) / H7
Pour convertir ces fréquences théoriques absolues en probabilités relatives théoriques (exprimées sur l’intervalle 0 à 1), il est nécessaire de diviser une nouvelle fois le résultat obtenu par l’effectif total N. Ce double processus revient arithmétiquement à diviser directement le produit marginal de chaque catégorie par le carré de l’effectif total d’observations, soit N2 (la valeur H7^2 sous Excel). La mise en place d’une zone dédiée aux calculs intermédiaires dans la feuille de calcul permet d’expliciter chaque terme et d’inspecter visuellement la contribution spécifique de chaque modalité à la part globale d’aléa statistique.
6.2 Multiplication des marges correspondantes et division par l’effectif au carré
L’opération de modélisation mathématique de la probabilité relative fortuite associée à chaque cellule de la diagonale se formule de façon unitaire au sein d’une colonne de décomposition sous Excel. Définissons une plage d’accueil intermédiaire (par exemple M5:M6) destinée à stocker les probabilités fortuites individuelles pour chaque catégorie :
- Dans la cellule
M5(Probabilité d’accord aléatoire pour la Catégorie 1), l’analyste insère la formule :
=(H5 * F7) / ($H$7^2) - Dans la cellule
M6(Probabilité d’accord aléatoire pour la Catégorie 2), l’analyste implémente :
=(H6 * G7) / ($H$7^2)
L’usage du verrouillage absolu avec double dollar $H$7 garantit que la référence vers l’effectif d’échantillonnage N demeure invariante lors de la réplication des formules sur un nombre arbitraire de modalités diagnostiques.
Il importe d’analyser l’impact direct des asymétries marginales sur cette grandeur. Si le Juge A pose le diagnostic de dépression chez 80 patients sur 100 (H5 = 80) et que le Juge B pose également ce même diagnostic chez 70 patients sur 100 (F7 = 70), le produit de leurs marges s’élève à 80 * 70 = 5600. En divisant ce produit par N2 (100^2 = 10000), la probabilité fortuite d’accord pour cette seule modalité atteint à elle seule le niveau vertigineux de 0,56 (soit 56 % de concordance due purement aux tendances marginales des deux évaluateurs). Aucun arrondi intermédiaire ne doit être pratiqué dans les cellules M5 et M6 afin de préserver l’intégrité métrique du calcul global ultérieur.
6.3 Intégration globale de la formule Pe dans une cellule dédiée
La probabilité globale d’accord attendu par le hasard sur l’ensemble de l’espace nosographique évalué — la grandeur canonique Pe — s’obtient par la sommation exhaustive de toutes les probabilités théoriques individuelles calculées pour chacune des catégories sur la diagonale principale.
Dans la cellule d’accueil dédiée au résultat de Pe (par exemple la cellule K7), l’analyste peut procéder à l’agrégation directe des calculs intermédiaires au moyen de la fonction SOMME :
=SOMME(M5:M6)
Néanmoins, les utilisateurs avancés d’Excel privilégient une implémentation vectorielle directe qui dispense totalement la feuille de calcul de colonnes intermédiaires, limitant ainsi la surcharge visuelle du classeur. En exploitant la puissance native de la fonction matricielle SOMMEPROD, la proportion théorique aléatoire Pe se calcule en une formulation unifiée et hautement robuste :
=SOMMEPROD(H5:H6; TRANSPOSE(F7:G7)) / (H7^2) (sur les versions modernes de Microsoft 365 prenant en charge les matrices dynamiques), ou plus simplement en multipliant directement le vecteur colonne des marges de lignes par le vecteur transposé des marges de colonnes :
=SOMMEPROD(H5:H6; F7:G7) / (H7^2)
Note technique : La formulation SOMMEPROD(H5:H6; F7:G7) sous Excel requiert que les deux plages possèdent des orientations compatibles ou soient transposées adéquatement selon la version du tableur. Dans une feuille Excel standard, la formulation compacte la plus universelle sans formule matricielle complexe s’écrit :
=( (H5 * F7) + (H6 * G7) ) / (H7^2)
Pour une matrice polytomique 3×3 comportant des totaux de lignes en H5:H7 et des totaux de colonnes en F8:H8, cette expression s’étend naturellement :
=( (H5 * F8) + (H6 * G8) + (H7 * H8) ) / (H8^2) (où H8 représente ici l’intersection globale N).
L’analyste doit impérativement effectuer un test logique d’admissibilité statistique sur la valeur obtenue pour Pe : cette dernière doit obligatoirement être strictement supérieure à 0 et strictement inférieure à 1. Dans la quasi-totalité des contextes d’évaluation psychologique impliquant deux catégories équiprobables, Pe gravite aux alentours de 0,50. Plus le nombre de catégories exclusives k augmente tout en conservant une répartition équilibrée des observations, plus la valeur de Pe tend à diminuer (se rapprochant de 1/k), ce qui réduit la pénalisation statistique due au hasard.
7. Finalisation du calcul du Kappa de Cohen dans la feuille de calcul
7.1 Implémentation de l’équation finale (Po – Pe) / (1 – Pe)
Ayant préalablement déterminé avec rigueur les deux grandeurs maîtresses que sont la probabilité d’accord observé empirique (Po, logée dans notre cellule d’exemple K6) et la probabilité d’accord théorique aléatoire (Pe, logée dans notre cellule K7), l’analyste dispose désormais de l’ensemble des éléments requis pour calculer l’indice final de fidélité inter-évaluateurs de Cohen.
Dans la cellule stratégique destinée à afficher le coefficient Kappa final (par exemple la cellule K8), l’analyste implémente la syntaxe opératoire stricte suivante :
=(K6 – K7) / (1 – K7)
L’utilisation de parenthèses isolant le numérateur (K6 - K7) et le dénominateur (1 - K7) est absolument indispensable pour contraindre Excel à respecter les règles de priorité opératoire algébrique. L’omission de ces parenthèses conduirait le logiciel à évaluer prioritairement la division K7 / 1 avant d’appliquer les soustractions, engendrant un résultat aberrant.
Pour le formatage numérique de cette cellule d’aboutissement K8, les conventions de publication de l’American Psychological Association (APA) prescrivent un affichage standardisé à trois décimales sans zéro initial avant la virgule dans les manuscrits anglophones, ou avec zéro initial selon la norme francophone standard (ex. : 0,742 ou -0,128). L’analyste doit contrôler immédiatement la cohérence du signe obtenu :
- Un coefficient positif supérieur à 0 indique que les cliniciens s’accordent plus souvent que ce que la chance permettrait d’escompter.
- Un coefficient négatif — bien que déconcertant — doit être investigué minutieusement, car il signale généralement une inversion des catégories par l’un des évaluateurs ou un biais d’interprétation diamétralement opposé.
7.2 Automatisation via des cellules nommées pour éviter les erreurs
Bien que l’utilisation de coordonnées matricielles relatives de type K6 ou K7 soit fonctionnelle, elle présente une vulnérabilité majeure lors de la manipulation complexe ou de l’audit approfondi de modèles d’évaluation clinique : le risque d’erreur humaine d’adressage ou de décalage silencieux de plages lors de l’insertion ou de la suppression ultérieure de lignes ou de colonnes. Pour hisser la conception du modèle Excel au standard des bonnes pratiques de développement logiciel, il est fortement recommandé de recourir aux cellules nommées (gestionnaire de noms d’Excel).
Pour concrétiser cette sécurisation méthodologique, l’analyste attribue des étiquettes sémantiques explicites aux cellules pivots :
- Sélectionner la cellule contenant l’accord observé (
K6) et lui assigner dans la zone de nom (située à gauche de la barre de formule) l’identifiant lexical :Accord_Observe_Po. - Sélectionner la cellule contenant l’accord théorique (
K7) et lui assigner l’identifiant lexical :Accord_Hasard_Pe. - Sélectionner la cellule d’effectif total (
H7) et lui assigner l’identifiant :Effectif_Total_N. - Sélectionner la cellule du Kappa (
K8) et lui assigner l’identifiant :Kappa_Cohen.
Dès lors que ce paramétrage lexical est achevé, la formule logée dans la cellule Kappa_Cohen gagne une lisibilité conceptuelle absolue et devient intelligible par tout auditeur externe non rompu à l’architecture exacte de la feuille :
=(Accord_Observe_Po – Accord_Hasard_Pe) / (1 – Accord_Hasard_Pe)
Cette approche ergonomique simplifie considérablement la maintenance des classeurs au sein des laboratoires de psychologie, facilite la transmission des fichiers entre chercheurs et supprime quasi totalement les défaillances de calcul induites par le déplacement involontaire de coordonnées cellulaires.
7.3 Gestion des cas particuliers (division par zéro et marges nulles)
Dans certaines circonstances expérimentales ou cliniques spécifiques, le calcul du Kappa de Cohen peut être confronté à des singularités mathématiques se traduisant sous Excel par des erreurs d’exécution destructrices de type #DIV/0!. Une modélisation professionnelle doit anticiper et neutraliser ces cas dégénérés.
Le premier écueil mathématique survient lorsque la proportion d’accord théorique attendu par le hasard Pe atteint rigoureusement la valeur de 1,00 (situation où le dénominateur 1 - Pe s’annule, provoquant une division par zéro). Cette circonstance se produit exclusivement en présence d’une variance diagnostique nulle — c’est-à-dire lorsque les deux cliniciens ont classifié l’intégralité sans exception des sujets évalués au sein d’une seule et unique catégorie nosologique. Dans une telle situation, l’accord est total (Po = 1,00) mais l’accord aléatoire l’est tout autant (Pe = 1,00). En réalité, aucune variabilité n’ayant été observée, il est mathématiquement et psychométriquement impossible d’évaluer la fidélité discriminatoire des juges.
Pour gérer ce cas limite de manière automatisée, l’analyste enveloppe la formule finale dans une structure logique conditionnelle utilisant la fonction SI ou SIERREUR :
=SI(Accord_Hasard_Pe = 1; « Non Déterminé (Variance Nulle) »; (Accord_Observe_Po – Accord_Hasard_Pe) / (1 – Accord_Hasard_Pe))
Un second cas de figure concerne les catégories nosologiques prévues par le protocole clinique mais qui n’ont jamais été sélectionnées par aucun des évaluateurs au cours de l’étude (marges nulles). Bien que ces cellules vides n’invalident pas le calcul du Kappa standard, elles réduisent de facto la dimension de la matrice active. L’intégration de tests logiques préventifs garantit que la feuille de calcul guide l’analyste avec bienveillance méthodologique face aux anomalies distributionnelles de son échantillon.
8. Calcul de l’erreur type et de l’intervalle de confiance à 95% dans Excel
8.1 Formule asymptotique de la variance et de l’erreur type de Kappa
L’estimation ponctuelle d’un coefficient Kappa calculé sur un échantillon clinique ne livre qu’une approximation de la fidélité réelle qui prévaudrait si l’ensemble de la population de patients était évalué. Pour juger de la précision de cette estimation empirique, il est théoriquement indispensable d’adjoindre au Kappa son erreur type asymptotique (notée SE(κ) ou σκ), qui servira de fondement à la dérivation de l’intervalle de confiance et aux tests d’hypothèses statistiques.
Il existe dans la littérature statistique deux formules distinctes pour l’erreur type du Kappa :
- La formule simplifiée sous l’hypothèse nulle (H0: κ = 0) : Formulée pour tester si l’accord mesuré excède significativement le pur hasard, son équation analytique s’écrit :
SE0(κ) = √ [ (Pe × (1 – Pe)) / (N × (1 – Pe)2) ] qui se simplifie élégamment en : √ [ Pe / (N × (1 – Pe)) ] (dans certaines configurations binomiales) ou plus rigoureusement selon la formule générale de Fleiss, Cohen et Everitt (1969). - La formule asymptotique générale sous l’hypothèse alternative (H1) : Nécessaire pour établir l’intervalle de confiance autour du Kappa observé, cette formule développée par Joseph L. Fleiss prend en compte la structure complète des variances marginales. Sa forme complète étant très complexe pour une implémentation sans VBA, de nombreux méthodologistes préconisent pour de larges échantillons l’approximation asymptotique robuste dérivée de Cohen :
SE(κ) = √ [ (Po × (1 – Po)) / (N × (1 – Pe)2) ]
Pour implémenter cette formule de l’erreur type asymptotique dans Excel (par exemple dans la cellule K9 nommée Erreur_Type_SE), l’analyste formalise la syntaxe suivante :
=RACINE( (Accord_Observe_Po * (1 – Accord_Observe_Po)) / (Effectif_Total_N * ((1 – Accord_Hasard_Pe)^2)) )
Cette expression illustre l’impact fondamental de l’effectif global N : à mesure que la cohorte de patients évalués s’élargit, le dénominateur croît, comprimant l’erreur type et conférant une précision métrique accrue à l’estimation du coefficient de fidélité.
8.2 Dérivation de l’intervalle de confiance bilatéral dans Excel
La simple notification ponctuelle d’un coefficient Kappa est désormais jugée insuffisante dans les standards de publication médicale et psychométrique contemporains. Il est expressément requis de stipuler l’intervalle de confiance à 95 % (IC 95 %), qui délimite la plage au sein de laquelle réside le véritable paramètre populationnel avec un niveau de certitude probabiliste de 95 %.
Sous les postulats de la théorie asymptotique des grands échantillons, la distribution d’échantillonnage du Kappa suit approximativement une loi normale standard (loi de Gauss). Pour un seuil de risque bilatéral conventionnel de α = 0,05, la valeur critique de coupure correspondante correspond au quantile Z1 – α/2 = 1,96.
Pour dériver cette valeur critique de façon dynamique et universelle dans Excel, il est opportun de faire appel à la fonction de distribution inverse de la loi normale :
=LOI.NORMALE.STANDARD.INVERSE(0,975), qui renvoie avec une précision absolue la valeur 1,95996…
Dès lors, les bornes inférieure et supérieure de l’intervalle de confiance bilatéral à 95 % se formulent directement au sein de deux cellules distinctes :
- Borne inférieure de l’IC 95 % (cellule K10) :
=MAX(-1; Kappa_Cohen – (LOI.NORMALE.STANDARD.INVERSE(0,975) * Erreur_Type_SE)) - Borne supérieure de l’IC 95 % (cellule K11) :
=MIN(1; Kappa_Cohen + (LOI.NORMALE.STANDARD.INVERSE(0,975) * Erreur_Type_SE))
L’encapsulation de ces équations dans les fonctions de troncature logique MAX et MIN est une précaution mathématique essentielle : elle garantit que les fluctuations statistiques de l’erreur type ne propulsent pas artificiellement les bornes calculées au-delà des limites théoriques du continuum de Cohen (qui ne saurait excéder la plage fermée allant de -1,00 à +1,00).
8.3 Test de significativité statistique contre l’hypothèse nulle (Z-score)
En complément de l’intervalle de confiance, le chercheur doit généralement statuer sur la significativité statistique du coefficient en testant l’hypothèse nulle d’indépendance des jugements : H0: κ = 0 contre l’hypothèse alternative d’un accord non fortuit : H1: κ > 0 (ou bilatérale κ ≠ 0).
La statistique de test standardisée (le Z-score) s’obtient en divisant la valeur ponctuelle du Kappa calculé par son erreur type sous hypothèse nulle SE0. Dans une cellule dédiée au score Z (par exemple K12), l’analyste insère la formule :
=Kappa_Cohen / Erreur_Type_SE
Pour déterminer la valeur-p bilatérale (p-value) associée à ce score Z sous la courbe normale unitaire, l’analyste exploite la fonction native LOI.NORMALE.STANDARD.N d’Excel au sein de la cellule K13 :
=2 * (1 – LOI.NORMALE.STANDARD.N(ABS(K12); VRAI))
Si la p-value ainsi dérivée est strictement inférieure au seuil alpha critique de 0,05 (ou 0,01), le chercheur rejette avec confiance l’hypothèse nulle, concluant que l’accord observé entre les évaluateurs surpasse ce que la simple coïncidence stochastique pourrait engendrer. Il convient toutefois de souligner une nuance épistémologique cruciale : la significativité statistique ne garantit aucunement la pertinence clinique. Avec un échantillon d’observations massif (ex. : N = 2 000 participants), un Kappa extrêmement médiocre de 0,15 obtiendra aisément une valeur-p hautement significative (p < 0,001). L’attention du psychologue doit par conséquent se focaliser prioritairement sur la magnitude substantive du coefficient plutôt que sur sa seule valeur-p.
9. Interprétation psychométrique des valeurs du Kappa
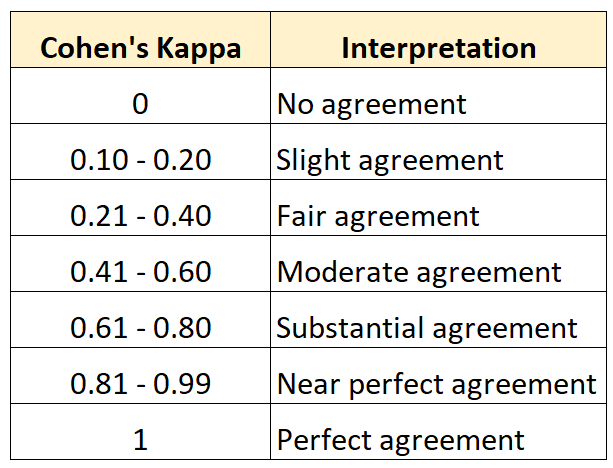
9.1 Les critères d’évaluation de Landis et Koch (1977)
Une fois le coefficient Kappa calculé avec rigueur dans la feuille de calcul Excel, le clinicien et le chercheur sont confrontés à la tâche interprétative d’attribuer une qualification qualitative à l’indice obtenu. La grille de repères descriptifs la plus mondialement répandue et citée dans les investigations biomédicales et comportementales demeure celle proposée par J. Richard Landis et Gary G. Koch dans leur article fondateur de 1977 paru dans Biometrics.
Les paliers de qualification conventionnels définis par Landis et Koch se structurent selon la gradation suivante :
- κ < 0,00 : Accord désaccordé ou systématiquement inférieur au hasard (Poor agreement).
- 0,00 ≤ κ ≤ 0,20 : Accord léger ou très faible (Slight agreement).
- 0,21 ≤ κ ≤ 0,40 : Accord passable ou modique (Fair agreement).
- 0,41 ≤ κ ≤ 0,60 : Accord modéré (Moderate agreement).
- 0,61 ≤ κ ≤ 0,80 : Accord substantiel ou fort (Substantial agreement).
- 0,81 ≤ κ ≤ 1,00 : Accord presque parfait ou excellent (Almost perfect agreement).
Bien que ces critères offrent une grille de lecture intuitive ayant grandement facilité la standardisation des comptes rendus de recherche, Landis et Koch eux-mêmes ont explicitement reconnu le caractère profondément arbitraire de ces seuils de coupure. Ces frontières numériques ne reposent sur aucun fondement théorique naturel ou démonstration mathématique absolue ; elles constituent de simples conventions heuristiques destinées à guider le clinicien face à l’incertitude des mesures d’observation.
9.2 Les critères plus rigoureux de Fleiss (1981)
Face au risque de complaisance méthodologique inhérent à l’usage des critères de Landis et Koch — qui considèrent un modeste Kappa de 0,61 comme un accord « substantiel » —, le biostatisticien Joseph L. Fleiss a proposé en 1981 dans son ouvrage de référence Statistical Methods for Rates and Proportions une taxonomie interprétative nettement plus exigeante, spécifiquement calibrée pour les enjeux d’évaluation de la santé et de la psychiatrie clinique.
Les seuils rigoureux préconisés par Fleiss s’organisent selon une partition tripartite resserrée :
- κ < 0,40 : Fidélité médiocre ou insuffisante (Poor agreement).
- 0,40 ≤ κ ≤ 0,75 : Fidélité intermédiaire à bonne (Intermediate to good agreement).
- κ > 0,75 : Fidélité excellente ou supérieure (Excellent agreement).
La comparaison systématique des deux systèmes met en exergue des divergences méthodologiques notables. Une étude psychométrique affichant un Kappa de Cohen de 0,62 sera saluée comme apportant une concordance « substantielle » selon la nomenclature de Landis et Koch, tandis qu’elle ne sera qualifiée que de niveau « intermédiaire » selon la métrique de Fleiss. Dans le domaine hautement sensible du diagnostic psychiatrique ou de l’évaluation du risque médicolégal, où la standardisation diagnostique conditionne des choix thérapeutiques majeurs, l’adoption des critères plus stricts de Fleiss est généralement recommandée par les revues scientifiques de premier rang.
9.3 Nuances d’interprétation contextuelles en psychopathologie clinique
Au-delà de l’application mécanique de seuils numériques conventionnels, l’interprétation d’un coefficient de fidélité inter-juges en psychopathologie clinique doit impérativement être contextualisée à la lumière des contraintes inhérentes à l’objet clinique étudié et aux conséquences de la décision qui en découle.
En premier lieu, la gravité et l’irréversibilité de la décision clinique imposent des exigences différentielles sur le niveau d’accord acceptable :
- Dans le cadre d’un protocole de dépistage épidémiologique à large échelle en population générale, un Kappa modéré situé entre 0,50 et 0,60 peut être jugé méthodologiquement acceptable pour guider des analyses transversales de tendances.
- À l’inverse, lors de décisions cliniques individuelles critiques — telles qu’une hospitalisation sans consentement, la pose d’un diagnostic stigmatisant de schizophrénie, ou une expertise judiciaire pénale portant sur la responsabilité d’un prévenu —, un seuil minimal de κ ≥ 0,80 (voire ≥ 0,85) est déontologiquement requis pour garantir que la mesure ne découle pas d’une interprétation isolée d’un seul praticien.
En second lieu, la complexité intrinsèque de la nosographie évaluée module le niveau de concordance empiriquement atteignable. La discrimination entre des catégories psychopathologiques aux frontières phénoménologiques très floues et poreuses (par exemple la distinction subtile entre un trouble de la personnalité limite et un trouble bipolaire à cycles rapides de type II) engendre inévitablement une variance de jugement accrue comparativement à des catégorisations cliniques plus franches et univoques. Lorsqu’un protocole expérimental révèle un accord modéré (κ ≈ 0,55), la parade méthodologique ne réside pas dans l’abandon de l’instrument, mais dans l’organisation de sessions intensives de calibration et de formation continue des cliniciens pour standardiser l’opérationnalisation des critères diagnostiques litigieux.
10. Les paradoxes de Feinstein et Cicchetti et leur traitement dans Excel
10.1 Le paradoxe de la prévalence asymétrique
Le coefficient Kappa de Cohen, malgré son omniprésence académique, est affecté par deux comportements statistiques contre-intuitifs documentés de manière retentissante en 1990 par Alvan R. Feinstein et Domenic V. Cicchetti dans leur article classique « High agreement but low kappa: I. The problems of two paradoxes ». Le premier de ces phénomènes est universellement connu sous le nom de paradoxe de la prévalence asymétrique.
Ce paradoxe survient lorsque la prévalence réelle du phénomène clinique évalué est extrêmement disproportionnée (soit quasi universellement présente, soit extrêmement rare dans l’échantillon). Dans cette situation, le coefficient Kappa s’effondre à des niveaux dramatiquement bas alors même que le taux d’accord brut observé Po atteint des sommets avoisinant les 90 % à 95 %.
Pour matérialiser ce paradoxe de façon concrète sous Excel, construisons une matrice d’épreuve expérimentale portant sur 100 patients :
- Cellule [1,1] (les deux juges diagnostiquent la présence du trouble) : 85
- Cellule [1,2] (Juge A positif, Juge B négatif) : 5
- Cellule [2,1] (Juge A négatif, Juge B positif) : 5
- Cellule [2,2] (les deux juges diagnostiquent l’absence du trouble) : 5
Calculons les indicateurs dans notre feuille Excel :
- Accord brut observé : Po = (85 + 5) / 100 = 0,90 (soit 90 % de concordance clinique absolue).
- Marges de lignes : Juge A Positif = 90, Négatif = 10.
- Marges de colonnes : Juge B Positif = 90, Négatif = 10.
- Accord aléatoire théorique : Pe = [(90 × 90) + (10 × 10)] / 1002 = (8100 + 100) / 10000 = 0,82.
- Résolution du Kappa de Cohen : κ = (0,90 – 0,82) / (1 – 0,82) = 0,08 / 0,18 = 0,444.
Ce résultat illustre la violence du paradoxe : malgré un accord empirique éclatant de 90 %, le Kappa de Cohen n’affiche qu’une valeur médiocre de 0,444, reléguant la fidélité de l’évaluation au rang de concordance modérée. La cause mathématique réside dans l’hyper-inflation de Pe (0,82) induite par la distribution marginale asymétrique : le modèle statistique postule que la chance produirait déjà 82 % d’accords spontanés, laissant une marge infime au numérateur pour prouver la valeur discriminante réelle des praticiens.
10.2 Le paradoxe du biais marginal entre évaluateurs
Le second paradoxe mis en lumière par Cicchetti et Feinstein concerne l’effet asymétrique du désaccord marginal entre les deux évaluateurs, souvent désigné sous l’étiquette de paradoxe du biais marginal. Ce comportement mathématique surprenant se traduit par le fait qu’un désaccord asymétrique marqué entre les marges des juges peut conduire paradoxalement à une augmentation du coefficient Kappa comparativement à une situation où les désaccords sont parfaitement équilibrés.
Lorsque deux cliniciens divergent, leur divergence peut revêtir deux formes structurelles :
- Désaccord symétrique : Le clinicien A juge positif des cas vus négatifs par B avec la même fréquence que le clinicien B juge positifs des cas vus négatifs par A (les cellules hors diagonale sont équilibrées : n12 ≈ n21).
- Désaccord asymétrique (biais systématique) : L’un des cliniciens est systématiquement beaucoup plus sévère ou indulgent que l’autre (par exemple, n12 = 15 tandis que n21 = 1). L’un des juges utilise massivement une modalité que l’autre répugne à assigner.
Sous l’effet de cette asymétrie marginale, le produit croisé des marges diminue mécaniquement, ce qui a pour conséquence immédiate de faire chuter la proportion d’accord attendu par le hasard Pe. En diminuant artificiellement la valeur de Pe, le dénominateur 1 - Pe s’élargit et le numérateur Po - Pe augmente, propulsant le Kappa à un niveau plus élevé que celui obtenu avec des effectifs hors diagonale symétriques. Ce paradoxe démontre qu’à taux d’accord brut égal, un protocole entaché d’un fort biais systématique entre juges peut afficher un Kappa plus favorable qu’un protocole sans biais systématique, ce qui défie l’intuition méthodologique.
10.3 Calcul des indices complémentaires (PABAK) dans Excel
Pour neutraliser l’impact distorsif des paradoxes de Feinstein et Cicchetti et fournir aux chercheurs une vision non faussée de la fidélité nominale, le statisticien Terry J. Byrt et ses collaborateurs ont introduit en 1993 un indice complémentaire majeur : le PABAK (Prevalence-Adjusted Bias-Adjusted Kappa, ou Kappa ajusté pour la prévalence et le biais).
Le principe théorique du PABAK repose sur l’orthogonalisation de la matrice de contingence : il s’agit de calculer ce que vaudrait le coefficient Kappa si l’échantillon d’observation présentait une répartition marginale idéale, exempte de toute asymétrie de prévalence (50/50 pour un tableau 2×2) et de tout biais unilatéral entre juges. Dans ces conditions théoriques normalisées, la probabilité d’accord dû au hasard se stabilise invariablement à la valeur fixe de Pe = 0,50.
En substituant cette constante Pe = 0,50 dans l’équation fondamentale de Cohen, la formulation algébrique du PABAK se simplifie de manière spectaculaire :
PABAK = (Po – 0,50) / (1 – 0,50) = (Po – 0,50) / 0,50 = 2 × Po – 1
L’implémentation opérationnelle du PABAK dans Excel est d’une simplicité désarmante. Dans une cellule dédiée (par exemple K14 étiquetée « PABAK »), l’analyste insère directement l’équation :
=2 * Accord_Observe_Po – 1
Reprenons les données de notre matrice de test précédente (où Po = 0,90 et le Kappa standard s’effondrait à 0,444). Le calcul du PABAK sous Excel produit :
PABAK = 2 × 0,90 – 1 = 1,80 – 1 = 0,800
La valeur de 0,800 reflète avec beaucoup plus de justice la fidélité réelle démontrée par les 90 % d’accords observés en gommant l’artéfact stochastique causé par la rareté de l’autre modalité. Il est aujourd’hui fortement préconisé dans les guides méthodologiques d’assurance qualité en recherche clinique de présenter conjointement le Kappa standard de Cohen et le PABAK au sein des publications, garantissant ainsi une transparence analytique totale face aux éventuels paradoxes distributionnels.
11. Extension au Kappa pondéré pour données ordinales dans Excel
11.1 Principes théoriques de la pondération (linéaire vs quadratique)
Le coefficient Kappa standard de Cohen traite l’ensemble des désaccords hors diagonale avec une égale sévérité binaire : dès lors que deux évaluateurs n’assignent pas strictement la même catégorie, l’événement est comptabilisé comme un échec intégral d’accord, quelle que soit la proximité conceptuelle des modalités choisies. Cette modélisation s’avère parfaitement adéquate pour des variables nominales pures dénuées de hiérarchie intrinsèque (ex. : Schizophrénie, Trouble délirant, Dépression majeure). En revanche, elle se révèle excessivement pénalisante et méthodologiquement inappropriée face à des échelles cliniques ordinales graduées.
Considérons une échelle de sévérité symptomatique en psychiatrie à quatre niveaux ordonnés : 1 = Absent, 2 = Léger, 3 = Modéré, 4 = Sévère. Si un patient est évalué au niveau 2 par le premier praticien et au niveau 3 par le second, il s’agit d’une divergence clinique mineure d’un seul degré d’écart. En revanche, si ce même patient est jugé au niveau 1 par un praticien et au niveau 4 par l’autre, les évaluateurs manifestent une discordance diamétrale maximale. Le Kappa standard pénaliserait ces deux paires de jugements avec une rigueur rigoureusement identique.
Pour modéliser mathématiquement ces proximités ordonnées, Jacob Cohen a développé en 1968 une extension conceptuelle majeure : le Kappa pondéré (κw, pour Weighted Kappa). Ce modèle incorpore une matrice de pondération continue définissant des coefficients de pénalité ou d’accord partiel (notés wij) compris entre 0 et 1 :
- La pondération linéaire de Cicchetti-Allison (1971) : Elle pénalise les désaccords de manière strictement proportionnelle à l’amplitude arithmétique de l’écart qui sépare les catégories :
wij = 1 – [ |i – j| / (k – 1) ], où i et j représentent les indices de catégories et k le nombre total de modalités de l’échelle. - La pondération quadratique de Fleiss-Cohen (1973) : Elle pénalise les désaccords de façon proportionnelle au carré de l’écart qui les sépare, se montrant très tolérante envers les écarts marginaux unitaires mais impitoyable envers les divergences extrêmes :
wij = 1 – [ (i – j)2 / (k – 1)2 ]
Fait statistique remarquable établi par Joseph L. Fleiss : lorsque l’on applique la pondération quadratique, la valeur numérique du Kappa pondéré devient rigoureusement et mathématiquement équivalente au coefficient de corrélation intraclasse (ICC de type accord absolu à deux facteurs à effets aléatoires), tissant un pont conceptuel fondamental entre la métrologie qualitative et la métrologie quantitative continue.
11.2 Construction de la matrice des poids de désaccord sous Excel
L’implémentation du Kappa pondéré sous Excel exige la modélisation préalable d’une table secondaire carrée de dimension k × k hébergeant l’intégralité des coefficients de pondération wij. Prenons l’exemple d’une échelle clinique à 3 modalités ordonnées (k = 3 : Faible = 1, Moyen = 2, Élevé = 3) logée dans notre tableau de contingence principal occupant la zone F5:H7.
Pour construire la matrice des poids quadratiques dans une zone libre de la feuille de calcul (par exemple la plage F12:H14), l’analyste spécifie les en-têtes de lignes et de colonnes numériques allant de 1 à 3 (cellules E12:E14 pour les lignes i, et F11:H11 pour les colonnes j). La formulation générique standard pour les poids quadratiques s’écrit de la façon suivante dans la cellule supérieure gauche F12 :
=1 – ( ($E12 – F$11)^2 / (3 – 1)^2 ) soit =1 – ( ($E12 – F$11)^2 / 4 )
En étirant cette formule sur l’ensemble de la grille 3×3 F12:H14, Excel génère instantanément la matrice des coefficients de pondération quadratique suivante :
- Cellules diagonales d’accord parfait [1,1], [2,2], [3,3] : 1,00 (accord intégral, pénalité nulle).
- Cellules de désaccord unitaire [1,2], [2,1], [2,3], [3,2] : 1 – (1/4) = 0,75 (75 % de crédit d’accord maintenu).
- Cellules d’écart extrême maximal [1,3], [3,1] : 1 – (4/4) = 0,00 (crédit d’accord totalement anéanti).
Pour une matrice de pondération linéaire de Cicchetti-Allison, la formule à insérer en F12 mobiliserait la fonction de valeur absolue ABS :
=1 – ( ABS($E12 – F$11) / (3 – 1) )
L’analyste doit contrôler deux propriétés structurelles impératives garantissant la conformité mathématique de sa grille de pondération : l’intégralité des termes situés sur la diagonale principale doit afficher sans exception la valeur exacte unitaire de 1,00, et la matrice doit faire preuve d’une symétrie parfaite de part et d’autre de cette diagonale (wij = wji).
11.3 Implémentation du calcul matriciel (SOMMEPROD) pour le Kappa pondéré
Une fois la table des poids quadratiques formalisée, le calcul du Kappa pondéré requiert la détermination de la proportion pondérée d’accord observé (Po(w)) et de la proportion pondérée d’accord fortuit (Pe(w)).
L’évaluation de la proportion pondérée d’accord observé s’opère par le produit terme à terme de la matrice des effectifs réels observés (plage F5:H7) par la matrice correspondante des poids de pondération (plage F12:H14), le tout rapporté à l’effectif total N (cellule I8). Grâce à la flexibilité d’Excel, cette sommation complexe s’exécute en une formule matricielle compacte insérée dans la cellule K16 étiquetée « Po_Pondéré » :
=SOMMEPROD(F5:H7; F12:H14) / I8
L’estimation de la composante théorique fortuite pondérée (Pe(w)) impose quant à elle d’obtenir préalablement la matrice des fréquences aléatoires théoriques associées à chaque cellule croisée [i,j], régie par la loi d’indépendance (Margelignei × Margecolonnej) / N. Dans une troisième table de calculs intermédiaires de dimension 3×3 (plage F17:H19), chaque cellule reçoit la formule de produit marginal théorique :
=($I5 * F$8) / $I$8 (formule étirée sur l’ensemble de la plage F17:H19).
Dès lors que la matrice des effectifs théoriques fortuits est modélisée, la proportion pondérée d’accord attendu par le hasard se calcule dans la cellule K17 nommée « Pe_Pondéré » par la multiplication matricielle :
=SOMMEPROD(F17:H19; F12:H14) / I8
La résolution finale du Kappa pondéré de Cohen s’obtient alors au sein de la cellule de synthèse K18 en appliquant l’équation normalisée canonique :
=(Po_Pondéré – Pe_Pondéré) / (1 – Pe_Pondéré) soit =(K16 – K17) / (1 – K17)
Le recours au Kappa pondéré est particulièrement préconisé dans l’évaluation d’échelles de cotation psychiatrique (telles que l’échelle de dépression de Hamilton – HDRS, ou l’échelle des symptômes positifs et négatifs de la schizophrénie – PANSS), où les variations d’intensité symptomatique ne sauraient être réduites à des frontières catégorielles imperméables sans sacrifier la richesse de l’information ordinale.
12. Bonnes pratiques, validation et automatisation dans Excel
12.1 Conception d’un modèle de feuille de calcul réutilisable
Pour convertir ces protocoles de calcul en un outil d’ingénierie statistique pérenne au sein d’un laboratoire de psychologie ou d’une institution hospitalière, il est essentiel de dépasser le bricolage analytique ponctuel au profit de la conception d’un gabarit de calcul réutilisable, sécurisé et industrialisable.
L’architecture ergonomique recommandée pour ce gabarit repose sur la séparation fonctionnelle stricte de l’environnement de travail en trois onglets distincts :
- Onglet 1 : « Saisie_Données » : Cet espace est exclusivement réservé au recueil des données brutes. Il comprend la liste ordonnée des sujets et les colonnes de cotation des juges. Cet onglet intègre des règles de validation des données rigides empêchant toute saisie de texte fantaisiste, de valeur hors borne ou de code nosologique inexistant.
- Onglet 2 : « Moteur_Calcul » : Cet onglet héberge l’ensemble des matrices de contingence, les tables de pondération ordinale et les formules matricielles (
NB.SI.ENS,SOMMEPROD). Cet espace technique complexe doit être impérativement protégé en écriture (via le menu Révision > Protéger la feuille) avec un mot de passe d’administration, afin de prémunir les utilisateurs contre tout écrasement accidentel de formule lors de manipulations de routine. - Onglet 3 : « Rapport_Psychométrique » : Véritable tableau de bord exécutif, cet onglet agrège automatiquement les résultats clés sous une forme visuelle standardisée et prête pour l’exportation : Kappa de Cohen ponctuel, PABAK, Kappa pondéré, Erreur type, Intervalle de confiance à 95 %, Statistique Z, Valeur-p bilatérale, et qualification textuelle automatisée selon la taxonomie de Fleiss ou de Landis-Koch (via des formules conditionnelles imbriquées
SI).
De plus, l’adjonction d’infobulles méthodologiques contextuelles et d’une notice technique d’utilisation intégrée dans la feuille de calcul garantit une parfaite transmission du savoir-faire au fil du renouvellement des cohortes d’étudiants, d’ingénieurs d’études et de chercheurs.
12.2 Vérification croisée avec des progiciels statistiques (R, SPSS)
L’assurance qualité dans la recherche scientifique empirique impose un principe impérieux de reproductibilité et de validation croisée. Avant de diffuser ou de publier des résultats statistiques dérivés d’un modèle fait maison sous Excel, il est indispensable de confronter systématiquement les sorties numériques obtenues aux résultats délivrés par les progiciels statistiques standardisés de référence internationale, tels que le logiciel R ou IBM SPSS Statistics.
Sous l’environnement statistique R, la validation s’opère très rapidement en exportant le tableau de données brutes d’Excel au format CSV, puis en exécutant les packages spécialisés en psychométrie psych ou irr. L’appel aux fonctions canoniques cohen.kappa() ou kappa2() permet d’extraire simultanément le Kappa standard, le Kappa pondéré quadratique et les intervalles de confiance asymptotiques :
Exemple de commande sous R :
library(psych)

donnees <- read.csv("donnees_juges.csv")

cohen.kappa(donnees[, c("Juge_A", "Juge_B")])
Sous IBM SPSS, la procédure s’effectue via le menu Analyser > Statistiques descriptives > Tableaux croisés, en sélectionnant l’option statistique Kappa dans la boîte de dialogue correspondante.
Lors de cette confrontation métrologique, l’analyste constatera invariablement une concordance absolue au cent-millième près entre le Kappa ponctuel modélisé sous Excel et les sorties d’ordinateurs de ces logiciels de pointe. De légères divergences décimales peuvent parfois se manifester sur l’erreur type ou les bornes de l’intervalle de confiance : elles résultent généralement du fait que certains progiciels emploient par défaut la formule asymptotique complexe de Fleiss-Cohen-Everitt sous l’hypothèse alternative générale plutôt que la formule simplifiée sous l’hypothèse nulle. La compréhension de ces subtilités algorithmiques participe à l’élévation du niveau d’expertise méthodologique de l’analyste.
12.3 Rédaction et communication des résultats selon les normes APA
La finalité ultime de toute investigation psychométrique consiste à communiquer ses conclusions avec clarté, exactitude et conformité face aux exigences éditoriales des revues scientifiques internationales régies par l’American Psychological Association (normes APA, 7e édition).
Les canons de l’écriture académique prescrivent qu’un coefficient Kappa ne doit jamais être présenté de manière isolée dans le corps d’un texte. Une notification scientifique rigoureuse impose la restitution conjointe des grandeurs suivantes :
- L’effectif total d’unités ou de patients analysés (N).
- Le taux de concordance brute observé en pourcentage (Po).
- La valeur ponctuelle du coefficient Kappa (κ), tronquée à deux ou trois décimales.
- L’erreur type de l’estimation (SE).
- L’intervalle de confiance bilatéral à 95 % délimité par ses bornes inférieure et supérieure [IC 95 % LL ; UL].
- La statistique standardisée de test (Z) et sa p-value exacte (ou l’indication p < 0,001).
- La nature de la pondération appliquée le cas échéant (ex. : pondération quadratique pour échelles ordinales).
Modèle de paragraphe de résultats conforme aux standards APA pour un article clinique :
« La fidélité inter-évaluateurs relative au diagnostic d’état de stress post-traumatique a été évaluée par deux cliniciens indépendants sur un échantillon de 120 participants civils exposés à des violences urbaines. L’accord brut observé s’est élevé à 87,5 % des cas évalués. Le coefficient Kappa de Cohen calculé atteste d’une concordance diagnostique substantielle entre les deux évaluateurs, κ = 0,732, SE = 0,064, IC 95 % [0,607, 0,857], Z = 11,44, p < 0,001. En raison d’une prévalence clinique relativement asymétrique observée dans la cohorte, le coefficient Kappa ajusté pour la prévalence et le biais a également été investigué, révélant un PABAK de 0,750. Ces indicateurs confirment que la grille d’entretien semi-structurée mobilisée confère une reproductibilité hautement satisfaisante pour la recherche diagnostique et l’orientation clinique des patients. »
L’insertion concomitante dans le manuscrit de la matrice de contingence complète sous forme d’un tableau synthétique offre aux relecteurs et à la communauté scientifique une transparence méthodologique totale, permettant à quiconque de vérifier, de reproduire ou de méta-analyser les indices statistiques rapportés.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- American Psychiatric Association. (2013). Diagnostic and Statistical Manual of Mental Disorders (5th ed.). American Psychiatric Publishing. https://doi.org/10.1176/appi.books.9780890425596
- Byrt, T., Bishop, J., & Carlin, J. B. (1993). Bias, prevalence and kappa. Journal of Clinical Epidemiology, 46(5), 423-429. https://doi.org/10.1016/0895-4356(93)90018-V
- Cicchetti, D. V., & Allison, T. (1971). A new procedure for assessing reliability of scoring EEG sleep recordings. American Journal of EEG Technology, 11(3), 101-110. https://doi.org/10.1080/00029238.1971.11080838
- Cicchetti, D. V., & Feinstein, A. R. (1990). High agreement but low kappa: II. Resolving the paradoxes. Journal of Clinical Epidemiology, 43(6), 551-558. https://doi.org/10.1016/0895-4356(90)90159-M
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37-46. https://doi.org/10.1177/001316446002000104
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213-220. https://doi.org/10.1037/h0026256
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543-549. https://doi.org/10.1016/0895-4356(90)90158-L
- Fleiss, J. L. (1981). Statistical Methods for Rates and Proportions (2nd ed.). John Wiley & Sons.
- Fleiss, J. L., & Cohen, J. (1973). The equivalence of weighted kappa and the intraclass correlation coefficient as measures of reliability. Educational and Psychological Measurement, 33(3), 613-619. https://doi.org/10.1177/001316447303300309
- Fleiss, J. L., Cohen, J., & Everitt, B. S. (1969). Large sample standard errors of kappa and weighted kappa. Psychological Bulletin, 72(5), 323-327. https://doi.org/10.1037/h0028106
- Gwet, K. L. (2014). Handbook of Inter-Rater Reliability: The Definitive Guide to Measuring the Extent of Agreement Among Raters (4th ed.). Advanced Analytics, LLC.
- Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159-174. https://doi.org/10.2307/2529310
- Revelle, W. (2023). psych: Procedures for Psychological, Psychometric, and Personality Research (R package version 2.3.6). Northwestern University. https://CRAN.R-project.org/package=psych
- World Health Organization. (2019). International Statistical Classification of Diseases and Related Health Problems (11th ed.). World Health Organization. https://icd.who.int