
L’estimation de la dispersion statistique constitue l’un des piliers méthodologiques fondamentaux de l’analyse quantitative moderne, conditionnant directement la validité des inférences tirées de données empiriques. Dans de nombreuses disciplines scientifiques, et plus particulièrement au sein des sciences comportementales, de l’économétrie et de la psychométrie, les observations collectées ne possèdent que rarement une valeur informative ou une fiabilité strictement équivalente. Qu’il s’agisse de corriger les distorsions induites par des plans de sondage stratifiés, de modéliser des précisions de mesure hétérogènes ou d’agréger des résultats d’études au moyen de méta-analyses, l’hypothèse classique d’homoscédasticité et d’équiprobabilité d’échantillonnage s’avère fréquemment caduque.
Face à cette hétérogénéité structurelle, le recours à l’écart-type arithmétique simple engendre des biais systématiques majeurs, susceptibles de fausser les conclusions théoriques et d’invalider la réplicabilité des résultats. L’introduction de coefficients de pondération différentiels s’impose alors comme un impératif analytique. Dès lors, le calcul de l’écart-type pondéré ne se réduit pas à une simple transposition technique de la formule usuelle, mais engage une compréhension théorique profonde de la nature des poids assignés, des corrections requises pour compenser la perte de degrés de liberté, et de la fidélité numérique des algorithmes mis en œuvre.
Le langage de programmation Python s’est imposé comme l’environnement computationnel de référence pour le traitement de ces architectures de données complexes, grâce à son écosystème scientifique articulé autour de bibliothèques majeures telles que NumPy, Pandas et Statsmodels. Cet article propose un examen exhaustif et rigoureux de l’écart-type pondéré en Python. Depuis ses fondements épistémologiques et ses justifications algébriques jusqu’à son implémentation logicielle optimisée et son application à des cas d’études cliniques et psychométriques réels, ce guide a vocation à fournir aux chercheurs et aux praticiens de la science des données les clés conceptuelles et méthodologiques nécessaires pour modéliser adéquatement la variabilité pondérée.
1. Fondements théoriques et conceptuels de l’écart-type pondéré
1.1 Distinction épistémologique entre dispersion simple et dispersion pondérée
L’évaluation de la dispersion statistique au sein d’un échantillon vise à caractériser l’amplitude des fluctuations individuelles autour d’une valeur centrale de référence. Dans le cadre de la statistique descriptive classique, l’écart-type non pondéré repose sur le postulat implicite d’une égale contribution de chaque unité statistique à la variabilité globale du système observé. Ce modèle canonique présuppose un échantillonnage aléatoire simple et une fidélité instrumentale strictement uniforme entre toutes les observations recueillies. Toutefois, la réalité empirique contredit régulièrement ces idéalisations, notamment lorsque les cohortes étudiées proviennent de sous-populations structurellement hétérogènes, stratifiées ou hiérarchisées.
Lorsque des données stratifiées sont traitées au moyen de l’écart-type arithmétique standard, les estimateurs résultants subissent des distorsions préjudiciables. L’incapacité de la formule conventionnelle à prendre en compte l’importance différentielle des unités expérimentales conduit soit à une surreprésentation artificielle des groupes marginaux suréchantillonnés, soit à une dilution des strates minoritaires mais prépondérantes sur le plan clinique ou démographique. L’hétérogénéité des variances locales, phénomène désigné sous le terme d’hétéroscédasticité, aggrave cette vulnérabilité en faussant l’estimation de la variance vraie de la population parente.
D’un point de vue épistémologique, l’écart-type pondéré introduit une transformation fondamentale du statut de l’observation. Au lieu de considérer chaque observation comme une entité autotélique de poids unitaire, le formalisme pondéré assigne à chacune une masse d’évidence proportionnelle à son pouvoir informatif ou à sa représentativité sociologique. Cette démarche mathématique permet de restaurer l’équité inférentielle et de générer un paramètre de dispersion robuste, apte à refléter la variabilité sous-jacente sans subir les artéfacts induits par les protocoles de recueil ou les déséquilibres d’exposition.
1.2 Origine et signification des coefficients de pondération
La formulation rigoureuse de la dispersion pondérée exige une clarification typologique préalable de la nature des coefficients attribués à chaque point de données. On distingue principalement trois grandes familles de pondérations dans la littérature méthodologique : les poids d’échantillonnage représentatifs, les poids de précision instrumentale, et les poids de fréquence. Chacune de ces catégories obéit à une logique conceptuelle distincte et implique des propriétés formelles spécifiques lors de l’estimation de la variance.
Les pondérations d’échantillonnage, souvent appelées poids de sondage ou de calage, sont conçues pour compenser les probabilités inégales de sélection des individus au sein d’une enquête. En attribuant l’inverse de la probabilité d’inclusion à chaque sujet, le statisticien neutralise les biais de sélection et rétablit artificiellement la distribution théorique de la population cible. À l’opposé, les poids de précision, ou de fiabilité, découlent d’une perspective métrologique : ils sont généralement définis comme l’inverse de la variance d’erreur associée à chaque mesure spécifique, conférant une influence accrue aux observations issues d’instruments hautement fidèles ou de protocoles expérimentaux hautement contrôlés.
Enfin, les poids de fréquence, ou de répétition, possèdent une nature strictement arithmétique et discrète. Ils permettent de condenser d’immenses bases de données en indiquant le nombre d’occurrences exactes d’un profil vectoriel donné dans l’échantillon global. Quelles que soient leurs origines expérimentales, les coefficients de pondération doivent satisfaire à des contraintes analytiques strictes : une positivité rigoureuse, excluant formellement toute valeur négative dépourvue de sens physique, ainsi qu’une sommabilité finie assurant la convergence des opérateurs statistiques.
1.3 Pertinence dans le champ des sciences comportementales et psychométriques
Les sciences comportementales et la psychométrie contemporaine constituent un terreau d’application privilégié pour la modélisation de la dispersion pondérée. Dans le cadre de l’élaboration de tests psychologiques standardisés, la construction de scores composites requiert fréquemment la sommation pondérée de dimensions sous-jacentes. La dispersion de ces scores composites standardisés ne peut être fidèlement appréhendée sans tenir compte de la contribution différentielle de chaque échelle élémentaire, calibrée selon sa cohérence interne ou sa saturation factorielle.
Dans le domaine des revues systématiques et des méta-analyses quantitatives, l’évaluation de la dispersion inter-études repose impérativement sur des pondérations fonction de la taille d’échantillon ou de l’erreur standard de chaque publication incluse. Ignorer la disparité des effectifs mènerait à attribuer un poids statistique identique à un essai clinique portant sur dix sujets et à une vaste cohorte longitudinale incluant dix mille participants, compromettant l’intégrité de la synthèse scientifique.
De surcroît, le traitement des paradigmes expérimentaux en neuropsychologie cognitive, tels que les temps de réaction chronométriques, bénéficie de l’intégration de pondérations basées sur la précision ou l’exactitude des réponses. L’évaluation de la fidélité des construits psychologiques sous des plans d’échantillonnage complexes exige ainsi une maîtrise absolue de l’écart-type pondéré, garantissant que l’estimation de la variabilité interindividuelle ne soit pas contaminée par les fluctuations aléatoires des mesures les plus instables.
2. Formulation mathématique rigoureuse de la variance et de l’écart-type pondérés
2.1 Définition de la moyenne pondérée comme pivot central
L’estimation de la dispersion d’une distribution statistique nécessite au préalable la détermination d’une mesure de tendance centrale servant de point d’ancrage aux calculs des déviations individuelles. Pour un vecteur d’observations quantitatives X = (x1, x2, …, xn) associé à un vecteur de poids strictement positifs W = (w1, w2, …, wn), la moyenne pondérée globale, notée x̄w, est définie par le quotient de la combinaison linéaire des valeurs par la masse totale des poids :
x̄w = ( ∑i=1n wi xi ) / ( ∑i=1n wi )
Cette formulation analytique illustre la linéarité de l’opérateur d’espérance mathématique sous un système de mesures pondérées. La moyenne pondérée minimise la somme des carrés des écarts pondérés, constituant ainsi l’unique barycentre optimal au sens des moindres carrés. Cependant, cette sensibilité structurelle implique qu’une observation extrême, si elle se voit attribuer un coefficient de pondération substantiel, exercera une attraction disproportionnée sur la valeur centrale, déplaçant le pivot de dispersion et modifiant substantiellement l’évaluation subséquente de la variance.
Sur le plan asymptotique, l’estimateur de la moyenne pondérée converge presque sûrement vers l’espérance théorique de la variable aléatoire sous réserve que la somme des poids diverge vers l’infini et qu’aucun poids individuel ne domine la distribution totale de manière dégénérée. Cette condition de stabilité conditionne directement l’impartialité de l’écart-type pondéré calculé autour de cette référence empirique.
2.2 Expression analytique de la variance pondérée de population
Une fois le centre de gravité pondéré établi, la variance pondérée de population, notée σw2, formalise la moyenne des déviations quadratiques par rapport à cette moyenne, chaque résidu quadratique étant amplifié ou atténué par son poids spécifique. L’équation canonique de la variance pondérée de population se structure comme suit :
σw2 = ( ∑i=1n wi (xi – x̄w)2 ) / ( ∑i=1n wi )
Cette expression fondamentale respecte scrupuleusement le théorème de décomposition de Huygens sous formulation pondérée. En développant les termes quadratiques, la variance peut être réécrite comme la différence entre la moyenne pondérée des carrés des observations et le carré de la moyenne pondérée des observations :
σw2 = [ ( ∑i=1n wi xi2 ) / ( ∑i=1n wi ) ] – (x̄w)2
Bien que cette seconde formule s’avère séduisante d’un point de vue analytique pour le calcul manuel rapide, elle présente une vulnérabilité numérique majeure lors de son exécution informatique sur des données de grande amplitude. La transition de cette variance théorique de population vers une variance d’échantillon nécessite d’ajuster le dénominateur de manière à corriger le biais inductif résultant de l’utilisation de la moyenne empirique en lieu et place du paramètre universel inconnu.
2.3 Formulation de l’écart-type pondéré et passage à la racine carrée
L’écart-type pondéré de population, traditionnellement désigné par le symbole σw, s’obtient par l’extraction de la racine carrée arithmétique positive de la variance pondérée :
σw = √[ ( ∑i=1n wi (xi – x̄w)2 ) / ( ∑i=1n wi ) ]
Le passage par la racine carrée revêt une signification métrologique essentielle : il rétablit la dimensionnalité de la mesure dans l’unité originale de la variable psychométrique ou clinique étudiée. Alors que la variance s’exprime dans des unités quadratiques fréquemment dénuées de sens intuitif (telles que des millisecondes au carré ou des points d’échelle standardisée au carré), l’écart-type restitue une métrique directement interprétable sur le continuum d’évaluation psychologique.
Sur le plan fonctionnel, l’écart-type pondéré jouit de propriétés fondamentales d’invariance d’échelle sous transformations affines. Si l’ensemble des observations subit une translation de constante c et une mise à l’échelle par un facteur multiplicatif k, l’écart-type résultant sera rigoureusement égal à |k| σw, démontrant son insensibilité aux modifications d’origine arbitraire. D’un point de vue géométrique dans l’espace euclidien à n dimensions, l’écart-type pondéré correspond à la distance hilbertienne normalisée séparant le vecteur d’observations du sous-espace orthogonal dirigé par le vecteur unité, sous une métrique riemannienne définie par la matrice diagonale des coefficients de pondération.
3. Gestion des degrés de liberté et correction du biais d’échantillonnage
3.1 Origine du biais dans l’estimation de la variance empirique pondérée
Lorsque le statisticien cherche à estimer la variance ou l’écart-type d’une population globale à partir d’un échantillon fini de taille n, l’utilisation directe de la formule de population conduit inéluctablement à une sous-estimation systématique de la dispersion réelle. Cette distorsion structurelle provient du fait que les déviations résiduelles sont calculées par rapport à la moyenne pondérée de l’échantillon x̄w, et non par rapport à l’espérance théorique vraie μ de la distribution parente. Puisque la moyenne empirique est précisément le point qui minimise la somme des carrés pondérés de l’échantillon disponible, la somme empirique ∑ wi (xi – x̄w)2 est systématiquement inférieure ou égale à la somme théorique ∑ wi (xi – μ)2.
Pour neutraliser ce biais négatif et restaurer l’espérance mathématique de l’estimateur, une correction des degrés de liberté s’avère indispensable. Dans les écosystèmes informatiques comme Python, ce mécanisme est contrôlé par le paramètre ddof (Delta Degrees of Freedom). Cependant, la modélisation mathématique du dénominateur d’ajustement dépend radicalement de la nature épistémique des poids employés. La distinction entre pondérations de fréquence et pondérations de fiabilité ou de sondage conditionne directement la forme analytique du facteur de correction.
Une confusion entre ces typologies de pondération engendre des erreurs d’estimation majeures. Si des poids de sondage normalisés sont traités comme des poids de fréquence arithmétique, le logiciel présumera une taille d’échantillon artificielle, conduisant soit à une surévaluation dramatique de la confiance inférentielle, soit à une correction aberrante de la dispersion résiduelle.
3.2 Correction de Bessel adaptée aux pondérations de fréquence
Dans la configuration stricte où les coefficients wi représentent des fréquences de réplication discrètes — c’est-à-dire le nombre d’occurrences indépendantes d’une valeur observée au sein d’un échantillonnage aléatoire simple —, la taille effective totale de l’échantillon correspond exactement à la somme arithmétique des poids, notée N = ∑i=1n wi. L’estimation sans biais de la variance d’échantillon découle alors directement de l’application classique de la correction de Bessel.
L’ajustement consiste à substituer au dénominateur N le terme corrigé N – 1, ce qui correspond à la perte d’un degré de liberté imputable à l’estimation préalable de la moyenne de l’échantillon. La formule de la variance pondérée empirique sans biais pour des fréquences s’énonce ainsi :
sw, freq2 = ( ∑i=1n wi (xi – x̄w)2 ) / ( ( ∑i=1n wi ) – 1 )
Cette approche est couramment employée lors de l’analyse d’inventaires de personnalité administrés à grande échelle, où les données brutes sont condensées dans des tables de contingence pour économiser de la mémoire computationnelle. Néanmoins, cette formule devient formellement invalide lorsque les coefficients de pondération sont des nombres réels continus, issus de procédures de calage sociodémographique ou de variances inverses, car le retrait d’une unité entière au total des poids continus introduit une distorsion arbitraire fonction de l’échelle d’arbitrage de normalisation de ces poids.
3.3 Correction de Kish pour les pondérations de sondage et de précision
Lorsque les pondérations traduisent la fiabilité relative des instruments de mesure ou des probabilités inégales de sélection issues d’enquêtes complexes, la somme des poids ne reflète plus le volume d’observations indépendantes. Pour résoudre cette limitation théorique majeure, le statisticien Leslie Kish a développé un cadre méthodologique quantifiant la « taille effective de l’échantillon » (effective sample size), notée neff. L’expression de la taille effective dépend non seulement de la somme des poids, mais également de la concentration de leur distribution via la somme des carrés des poids :
neff = ( ∑i=1n wi )2 / ( ∑i=1n wi2 )
En transposant la correction de Bessel à l’échelle de cette taille effective, l’estimateur non biaisé de la variance pondérée sous pondérations de sondage et de fiabilité adopte la formulation analytique de Kish, intégrée notamment dans les grands logiciels d’économétrie et de sociologie quantitative :
sw, Kish2 = [ ( ∑i=1n wi ) / ( ( ∑i=1n wi )2 – ∑i=1n wi2 ) ] × ∑i=1n wi (xi – x̄w)2
Cette formulation remarquable possède la propriété d’invariance d’échelle par rapport aux poids : la multiplication de l’ensemble du vecteur W par une constante scalaire quelconque ne modifie en rien la variance estimée. De plus, si tous les poids sont rigoureusement égaux entre eux, neff devient égal à l’effectif nominal n, et l’équation se simplifie parfaitement pour redevenir la variance d’échantillon standard divisée par n – 1. Le choix éclairé entre la correction de Bessel pour fréquences et la correction de Kish constitue ainsi une étape méthodologique incontournable pour assurer la validité inférentielle des analyses.
4. Configuration de l’environnement Python et bibliothèques scientifiques
4.1 L’écosystème scientifique Python pour le calcul statistique
L’attrait exceptionnel de Python pour la recherche expérimentale et la modélisation statistique avancée réside dans son architecture modulaire et ses bibliothèques hautement spécialisées. Au cœur de cette infrastructure figure le paquet NumPy, qui fournit l’abstraction du tableau multidimensionnel homogène (ndarray) et orchestre le calcul vectoriel compilé en langage C ou Fortran. Cette approche permet de contourner les goulots d’étranglement de performance inhérents aux boucles interprétées standard de Python, garantissant une exécution quasi-instantanée des opérations matricielles de grande dimension.
En complément, la bibliothèque SciPy étend ces capacités fondamentales en proposant des modules d’analyse numérique, d’optimisation et d’évaluation probabiliste des distributions continues. Dans le cadre précis de l’inférence statistique et de l’économétrie appliquée, Statsmodels s’affirme comme l’outil privilégié, offrant des classes spécifiquement conçues pour l’estimation de modèles sous pondérations complexes. Enfin, la bibliothèque Pandas unifie ces technologies en fournissant les structures de données DataFrame et Series, indispensables pour manipuler des tableaux cliniques associant identifiants, variables indépendantes, étiquettes diagnostiques et colonnes de pondération associées.
4.2 Configuration technique et gestion des dépendances
Pour assurer la pérennité et la reproductibilité computationnelle des calculs statistiques, la mise en place d’un environnement virtuel isolé constitue une prescription méthodologique incontournable. L’utilisation d’outils tels que venv ou conda permet de figer les versions précises des paquets mathématiques et de prévenir d’éventuels conflits de liaison binaire. L’installation déterministe s’effectue généralement au moyen de gestionnaires de dépendances, en veillant à garantir l’alignement des compilateurs sous-jacents.
La déclaration explicite des versions des dépendances garantit la stabilité des API analytiques au fil des mises à niveau du système. En particulier, la cohérence des structures internes entre NumPy et Statsmodels doit être scrupuleusement surveillée, les modifications des conventions de typage ou de diffusion matricielle (broadcasting) pouvant occasionnellement altérer le comportement des algorithmes de variance. Par ailleurs, l’ajustement fin de la précision des types flottants — en privilégiant systématiquement le format 64 bits à virgule flottante (float64) plutôt que les représentations 32 bits — constitue un prérequis pour prévenir la dégradation progressive des décimales lors de la sommation de résidus quadratiques volumineux.
4.3 Préparation des structures de données pour l’analyse
Avant d’engager le calcul proprement dit de la dispersion pondérée, une série de validations prophylactiques sur les structures de données s’impose. La première étape consiste à garantir un alignement dimensionnel strict entre le vecteur des observations X et le vecteur des coefficients de pondération W. Toute disparité dans la cardinalité des tableaux déclencherait une erreur d’exécution ou, pire encore, un décalage d’indexation insidieux modifiant radicalement les associations empiriques.
La conversion systématique des structures natives de Python, telles que les listes de nombres, en tableaux unidimensionnels numpy.ndarray assure l’homogénéité du typage et permet l’exploitation des routines d’algèbre linéaire hautement vectorisées. Il est impératif d’intégrer des vérifications préventives vérifiant la stricte positivité des poids et l’absence totale de valeurs indéterminées (NaN) ou infinies. Enfin, selon le cadre théorique adopté, une étape de normalisation préalable des poids — de sorte que leur somme totale coïncide avec la taille de l’échantillon nominal ou avec l’unité — peut être entreprise pour clarifier l’interprétation sémantique des calculs ultérieurs.
5. Calcul de l’écart-type pondéré avec Statsmodels via DescrStatsW
5.1 Présentation de la classe DescrStatsW du module statsmodels.stats.weightstats
La bibliothèque Statsmodels héberge dans son module statsmodels.stats.weightstats un composant logiciel particulièrement abouti : la classe DescrStatsW. Spécifiquement conçue pour automatiser les calculs descriptifs et inférentiels sur des ensembles d’observations assortis de poids, cette classe encapsule une infrastructure complète permettant d’extraire la tendance centrale, la matrice de covariance, les intervalles de confiance et la dispersion corrigée.
L’architecture interne de DescrStatsW repose sur l’instanciation d’un objet recevant comme arguments obligatoires le tableau des données empiriques et le vecteur correspondant des pondérations. Le constructeur propose également le paramètre critique ddof, qui régit l’application des degrés de liberté soustraits au dénominateur lors de l’évaluation de la variance. Par défaut, DescrStatsW implémente une logique formelle adaptée aux poids de fréquence et de sondage, garantissant que l’utilisateur puisse moduler avec une précision absolue la nature de l’estimateur souhaité, qu’il s’agisse de la variance de population ou de la variance d’échantillon corrigée.
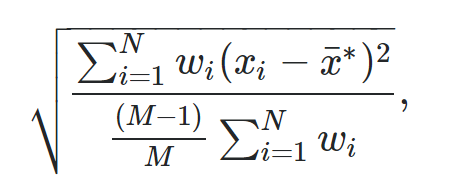
5.2 Mise en œuvre pas à pas sur l’exemple de référence
Pour illustrer concrètement la méthodologie, considérons une série expérimentale issue d’une étude en psychologie cognitive évaluant la flexibilité attentionnelle. Supposons un vecteur de scores standardisés représenté par le tableau [65, 72, 88, 54, 91] auquel sont assignés des coefficients de fiabilité expérimentale proportionnels à la robustesse du protocole de mesure, définis par le vecteur de poids [1.2, 0.8, 2.5, 0.5, 1.8]. L’objectif consiste à estimer l’écart-type pondéré de l’échantillon en tenant compte d’un degré de liberté correctif (ddof égal à un).
L’initialisation de l’instance s’effectue en passant ces deux vecteurs convertis en tableaux NumPy à la classe DescrStatsW, en spécifiant formellement le paramètre ddof=1. L’interrogation subséquente de la propriété std exposée par l’objet instancié déclenche immédiatement l’évaluation vectorielle des écarts à la moyenne pondérée, retournant la valeur précise de la dispersion. Pour ce jeu de données spécifique, le calcul produit un écart-type pondéré d’approximativement 13,85, démontrant la capacité du module à pondérer adéquatement l’influence des scores extrêmes en fonction de leur coefficient de crédibilité scientifique respectif.
5.3 Extraction conjointe de la variance pondérée et propriétés dérivées
Au-delà de l’accès direct à l’écart-type par l’attribut std, la classe DescrStatsW permet de préserver une traçabilité analytique complète au sein des pipelines de recherche. L’attribut var met à disposition la variance pondérée exacte, assurant une parfaite concordance quadratique avec la dispersion estimée et permettant de documenter rigoureusement la métrique avant extraction de la racine.
Simultanément, l’attribut mean délivre la moyenne pondérée ayant servi de centre de gravité pour la somme des carrés résiduels, garantissant qu’aucun décalage d’arrondi ne vienne corrompre l’alignement des paramètres du modèle. La classe propose également des méthodes d’inférence avancées, telles que std_mean pour l’erreur standard de la moyenne pondérée, ainsi que tconfint_mean, qui génère automatiquement les intervalles de confiance bilatéraux pour la moyenne de la population parente sous loi de Student. Cette approche unifiée élimine le risque d’erreurs logicielles résultant de l’assemblage disparate de fonctions autonomes et garantit l’homogénéité méthodologique de l’analyse quantitative.
6. Implémentation vectorielle manuelle avec NumPy
6.1 Algorithme vectorisé natif pour pondérations de fréquence
Bien que l’utilisation d’abstractions de haut niveau comme Statsmodels soit recommandée pour la clarté conceptuelle, la mise en œuvre manuelle d’algorithmes vectorisés via NumPy présente un intérêt fondamental pour les environnements à haute intensité computationnelle nécessitant une exécution sans surcoût d’instanciation. L’implémentation directe d’une fonction de dispersion pour pondérations de fréquence s’articule autour de primitives optimisées écrites en C.
Le calcul débute par l’évaluation de la moyenne pondérée au moyen de la fonction numpy.average, en spécifiant l’argument vectoriel weights. Dans un second temps, le principe de diffusion matricielle (broadcasting) de NumPy permet de soustraire de façon instantanée ce scalaire moyen à l’ensemble du vecteur des observations pour obtenir les résidus centrés. L’élévation de ces déviations à la puissance deux, leur multiplication terme à terme par le vecteur des poids et leur sommation via numpy.sum s’effectuent sans aucune boucle Python explicite. Enfin, la somme des carrés résiduels pondérés est divisée par la somme totale des poids diminuée de la valeur de ddof, avant que l’extraction finale de la racine carrée ne soit exécutée par numpy.sqrt.
6.2 Implémentation de l’estimateur de Kish pour pondérations de fiabilité
Pour traiter de manière analytiquement rigoureuse les pondérations de sondage ou de précision métrologique, il est nécessaire de coder explicitement la correction de Kish. La fonction personnalisée doit alors calculer conjointement la somme scalaire des poids, notée S1 = ∑ wi, et la somme quadratique des coefficients, notée S2 = ∑ wi2.
Le dénominateur de l’estimateur n’est plus simplement S1 – 1, mais intègre le terme de normalisation quadratique Kish :
Dénominateur = S1 – (S2 / S1)
Ce dénominateur s’obtient également par la formulation équivalente S1 (1 – ∑ w̃i2), où w̃ représente le vecteur des poids normalisés à une somme unitaire. L’intégration de cette formule dans une fonction Python générale enrichie de paramètres conditionnels permet de sélectionner dynamiquement le mode de correction (fréquence versus fiabilité). La validation unitaire de cet algorithme face à des cas limites analytiquement connus — tel qu’un vecteur de poids strictement identiques convergeant vers l’écart-type d’échantillon classique — garantit l’absence totale de dérive calculatoire.
6.3 Gestion de la stabilité numérique et prévention du dépassement de capacité
L’évaluation naïve de la variance par la formule de décomposition de Huygens présente des risques sévères d’instabilité numérique. Le calcul de la différence entre la somme pondérée des carrés et le carré de la somme pondérée est susceptible de provoquer une « annulation catastrophique » (catastrophic cancellation) lorsque la dispersion réelle est minime par rapport à l’amplitude absolue des valeurs observées, aboutissant occasionnellement à des variances négatives dues aux erreurs d’arrondi de l’arithmétique à virgule flottante IEEE 754.
Pour immuniser les calculs contre ce phénomène destructeur, il convient d’adopter des algorithmes à deux passages centrés, ou bien d’implémenter l’algorithme récursif de West ou de Welford adapté aux pondérations arbitraires. La méthode de Welford met à jour de façon séquentielle la moyenne pondérée et la somme cumulative des écarts au fur et à mesure de l’itération à travers les données, garantissant que les résidus restent continuellement d’un ordre de grandeur comparable à la variance elle-même. Cette rigueur algorithmique élimine tout risque de dépassement de capacité (overflow) ou d’évanouissement numérique lors du traitement de volumétries massives.
7. Intégration et manipulation dans l’écosystème Pandas
7.1 Application de fonctions pondérées sur des DataFrames psychologiques
Dans les contextes réels d’analyse de données, les observations empiriques sont rarement stockées sous forme de vecteurs isolés, mais s’inscrivent au sein de tableaux de données structurés où chaque ligne correspond à un participant et chaque colonne à une variable d’intérêt ou à un identifiant méthodologique. L’écosystème Pandas offre la flexibilité nécessaire pour conjuguer la rigueur des calculs pondérés avec l’expressivité de manipulation des DataFrames.
Pour appliquer l’écart-type pondéré à un ensemble de dimensions psychométriques simultanées — par exemple, les sous-échelles d’anxiété, de dépression et de somatisation au sein d’une cohorte clinique —, il est optimal d’encapsuler la classe DescrStatsW ou l’algorithme vectoriel NumPy au sein d’une fonction réutilisable. Cette fonction extrait la colonne dédiée aux poids pour calibrer le dénominateur avant d’itérer sur les colonnes cibles. L’utilisation du chaînage de méthodes (method chaining) garantit une lisibilité maximale du script analytique et prévient les copies redondantes de données en mémoire.
7.2 Agrégation par sous-groupes démographiques avec groupby
L’évaluation comparative de la dispersion intra-groupe selon des catégories sociodémographiques (telles que le genre, la tranche d’âge ou le niveau d’éducation) constitue une démarche centrale des études épidémiologiques et psychologiques. La méthode groupby de Pandas structure cette décomposition, mais l’application d’un calcul pondéré nécessite une précaution particulière : chaque sous-groupe extrait doit impérativement conserver l’association ligne à ligne entre ses scores cliniques et ses coefficients de pondération respectifs.
L’approche recommandée consiste à passer une fonction personnalisée à la méthode groupby.apply. Cette fonction traite chaque sous-ensemble en tant que mini-DataFrame autonome, instancie l’estimateur pondéré sur les données de la strate, et retourne une série indexée par sous-groupe. Cette démarche permet de documenter les situations critiques où la taille effective de certains sous-échantillons devient trop restreinte pour autoriser une estimation fiable de la variance, prévenant ainsi la publication d’inférences trompeuses sur des segments sous-représentés de la population générale.
7.3 Séries temporelles psychologiques et fenêtres glissantes pondérées
L’essor des méthodes d’évaluation écologique instantanée (Ecological Momentary Assessment, ou EMA) dans la recherche comportementale a introduit l’usage de séries temporelles denses documentant les variations affectives des patients au cours de leur vie quotidienne. Dans ces contextes longitudinaux, l’observation présente est souvent jugée plus pertinente pour caractériser l’état psychodynamique actuel que des événements survenus plusieurs jours auparavant.
Pour modéliser cette dynamique, on applique une pondération temporelle exponentielle décroissante, où le coefficient de chaque point temporel décroît en fonction de son éloignement par rapport à l’instant d’évaluation. Le calcul d’un écart-type glissant pondéré (rolling weighted standard deviation) permet alors de quantifier l’instabilité affective avec une grande finesse. La comparaison graphique et statistique entre la dispersion glissante standard et la formulation pondérée met en exergue les phases de déstabilisation psychique aiguë, le modèle pondéré réagissant promptement aux augmentations brutales de variabilité émotionnelle sans subir la latence d’inertie des fenêtres arithmétiques uniformes.
8. Analyse comparative de performance et étalonnage algorithmique
8.1 Protocole de banc d’essai et métriques d’évaluation
Afin de déterminer l’architecture computationnelle la plus appropriée selon les exigences de charge et la volumétrie des jeux de données, la réalisation d’un banc d’essai systématique s’avère indispensable. Le protocole d’étalonnage consiste à générer des distributions synthétiques reproduisant les asymétries et les aplatissements classiquement observés dans les inventaires de personnalité, en faisant varier la taille de l’échantillon de 102 à 107 observations.
Les métriques d’évaluation mobilisées incluent la durée moyenne d’exécution mesurée avec précision au moyen du module standard timeit, la consommation de mémoire vive surveillée en temps réel via l’utilitaire tracemalloc, ainsi que la fidélité numérique évaluée par rapport aux résultats produits par des progiciels statistiques de référence tels que le package de sondage de l’environnement R. Ce protocole rigoureux permet d’établir une cartographie précise des compromis existant entre expressivité conceptuelle du code et performance algorithmique brute.
8.2 Confrontation directe : DescrStatsW, NumPy vectorisé et SciPy
La confrontation empirique révèle des disparités de profil significatives entre les différentes solutions logicielles. L’utilisation de DescrStatsW de Statsmodels impose un surcoût d’instanciation lié à l’initialisation des attributs internes et à la vérification approfondie des types. Bien que ce surcoût soit totalement négligeable sur des échantillons uniques de taille modérée (quelques millisecondes pour dix mille observations), il peut devenir limitant lors de procédures de rééchantillonnage intensif de type bootstrap impliquant des centaines de milliers d’itérations répétées.
À l’inverse, l’implémentation vectorisée native avec NumPy pur affiche une vitesse d’exécution supérieure d’un à deux ordres de grandeur sur les cohortes massives, grâce à l’élimination des couches d’encapsulation logicielle. Concernant SciPy, l’absence d’une fonction d’écart-type pondéré dédiée avec gestion configurable des degrés de liberté relègue souvent son usage à des transformations préliminaires. Le choix de l’outil dépend donc intimement des contraintes de l’étude : pour l’analyse descriptive exploratoire et la modélisation économétrique unitaire, DescrStatsW demeure le choix de référence par son exhaustivité conceptuelle ; pour les boucles de calcul intensif et le traitement de mégadonnées, la vectorisation NumPy s’impose sans ambiguïté.
8.3 Accélération numérique pour les mégadonnées avec Numba
Lorsque les corpus de données atteignent des dimensions épidémiologiques majeures excédant plusieurs dizaines de millions d’enregistrements, ou lors de simulations de Monte-Carlo hautement parallélisées, les limites de performance de l’interpréteur Python peuvent être dépassées. La compilation juste-à-temps (Just-In-Time, JIT) via le compilateur open source Numba permet d’atteindre des performances comparables à celles du langage C pur.
En décorant une fonction itérative implémentant l’algorithme de Welford pondéré avec @numba.jit(nopython=True, fastmath=True), le code Python est directement compilé en code machine optimisé pour l’architecture du processeur hôte. De surcroît, la désactivation du verrou global de l’interpréteur (Global Interpreter Lock, GIL) autorise l’exécution simultanée des boucles de dispersion sur l’ensemble des cœurs de calcul disponibles via le paramètre parallel=True. Cette stratégie assure un passage à l’échelle linéaire sur des cohortes massives, réduisant des temps de calcul de plusieurs heures à une fraction de seconde tout en maintenant une stabilité numérique absolue.
9. Applications empiriques approfondies en recherche psychologique
9.1 Méta-analyses et synthèse quantitative de la littérature
La méta-analyse constitue le sommet de la hiérarchie des preuves scientifiques en médecine factuelle et en psychologie empirique. L’agrégation rigoureuse des tailles d’effet issues d’études indépendantes repose sur l’hypothèse que les recherches conduites avec de grands effectifs et des protocoles standardisés doivent exercer un poids prépondérant dans la synthèse des résultats par rapport aux travaux exploratoires à faible puissance statistique.
Dans ce modèle, les coefficients de pondération correspondent systématiquement à l’inverse de la variance de la taille d’effet de chaque étude, formalisant un schéma de pondération de précision (inverse-variance weighting). L’écart-type pondéré de ces tailles d’effet ne quantifie pas simplement la variabilité résiduelle, mais constitue un descripteur direct de l’hétérogénéité sous-jacente des interventions thérapeutiques ou éducatives. L’identification d’une dispersion pondérée anormalement élevée déclenche l’investigation de biais de publication ou de modérateurs cachés, permettant d’établir des intervalles de prédiction réalistes pour la réussite de futures réplications expérimentales.
9.2 Théorie de réponse aux items (TRI) et calibrage des tests
La psychométrie moderne s’est largement émancipée de la théorie classique des tests pour adopter les modèles de la théorie de réponse aux items (TRI). Dans ce paradigme, la précision de mesure d’un instrument psychologique n’est plus postulée comme uniforme le long de l’ensemble de l’échelle, mais est reconnue comme dépendant formellement du niveau de trait latent θ (thêta) évalué chez le sujet.
La fonction d’information du test (TIF) fournit une erreur type de mesure conditionnelle qui varie selon la localisation de l’individu sur le continuum psychologique. Lors du calibrage d’échelles de personnalité ou de tests d’efficience intellectuelle, l’évaluation de la dispersion des scores parmi des sous-populations spécifiques exige de pondérer les observations individuelles par la fonction d’information correspondante. Cette démarche garantit que les estimations de variabilité du trait ne soient pas artificiellement gonflées par l’incertitude de mesure intrinsèque aux zones extrêmes du test où la fidélité de l’instrument s’étiole.
9.3 Échantillonnage en population générale et redressement démographique
La passation d’enquêtes de santé mentale ou de sondages d’opinion à l’échelle d’une nation se heurte inévitablement à des taux de non-réponse différentiels qui altèrent la structure sociodémographique de l’échantillon brut par rapport aux données du recensement officiel. Pour remédier à ces distorsions, les méthodologistes appliquent des procédures de redressement démographique, telles que le calage sur marges (raking ratio estimation), attribuant un coefficient statistique spécifique à chaque participant afin de rétablir les proportions réelles de sexe, d’âge, de profession et de zone géographique.
L’estimation de la dispersion des scores cliniques, tels que les indices de détresse psychologique ou de bien-être subjectif, doit alors être impérativement conduite via l’écart-type pondéré de type Kish. L’omission de cette étape conduirait à refléter la variabilité d’une population biaisée — typiquement composée de profils plus disponibles ou plus diplômés —, privant les décideurs de santé publique d’une appréciation fidèle de l’ampleur des disparités psychologiques réelles traversant le tissu sociétal.
10. Traitement rigoureux des cas limites, anomalies et valeurs manquantes
10.1 Gestion des données manquantes dans les scores et les pondérations
L’occurrence de valeurs manquantes constitue une pathologie omniprésente dans la collecte des données expérimentales et cliniques. Face à cette situation, il est crucial de classifier la nature du mécanisme sous-jacent selon la typologie établie par Donald Rubin : données manquantes complètement au hasard (MCAR), données manquantes au hasard (MAR), ou données manquantes non aléatoires (MNAR). En contexte de calcul pondéré, l’omission d’une valeur peut survenir soit sur la variable observée X, soit sur le coefficient de pondération W lui-même.
La stratégie simpliste consistant en une suppression par liste (listwise deletion) non contrôlée détruit l’intégrité de la structure de pondération : la somme des poids résiduels ne coïncide plus avec le calage démographique d’origine, induisant un biais de sélection secondaire. Dans les chaînes de traitement Python, le filtrage conjoint des paires (valeur, poids) doit s’effectuer de manière simultanée pour assurer un alignement parfait. Lorsque le volume de données manquantes est substantiel, le recours à l’imputation multiple par équations chaînées (MICE) devient impératif, le calcul de l’écart-type pondéré devant alors être exécuté sur chaque jeu de données imputé avant d’agréger les variances selon les règles formelles de combinaison de Rubin.
10.2 Pathologies du vecteur de poids : zéros, négativité et dominance
Le vecteur des coefficients de pondération peut occasionnellement contenir des valeurs aberrantes ou pathologiques qui compromettent la stabilité des opérateurs statistiques. La présence de poids nuls, bien que théoriquement tolérable puisqu’elle équivaut à ignorer purement et simplement l’observation correspondante, réduit artificiellement le nombre effectif de degrés de liberté et fausse le décompte des observations participantes si l’algorithme ne les filtre pas explicitement en amont.
En revanche, la détection de poids négatifs constitue une anomalie logique absolue au regard de la théorie de la mesure et de la probabilité d’échantillonnage. Tout pipeline logiciel rigoureux doit intégrer une clause d’assertion formelle rejetant irrévocablement les vecteurs comportant des valeurs inférieures à zéro. Enfin, le phénomène d’hyper-concentration du poids — lorsqu’une fraction infime de sujets cumule une part disproportionnée de la masse totale de sondage — induit une instabilité extrême de l’estimateur de dispersion. Face à cette dominance, l’application de techniques d’écrêtement des poids (weight trimming ou winsorisation) permet de plafonner les valeurs extrêmes et de restaurer la robustesse de l’écart-type estimé sans altérer excessivement la représentativité globale.
10.3 Comportement asymptotique sous faible effectif effectif
Une défaillance majeure survient lorsque la taille effective de l’échantillon calculée selon Kish, neff, tend vers des valeurs critiques inférieures ou égales à l’unité. Cette dégénérescence mathématique se produit lorsque le dénominateur de la formule de variance corrigée s’annule ou devient négatif, provoquant une indétermination algébrique (division par zéro) ou une tentative d’extraction de racine carrée d’un terme négatif, renvoyant la valeur indéfinie NaN.
Pour prévenir l’interruption imprévue des pipelines de traitement automatisés, des gardes-fous programmatiques doivent être instaurés en Python. Ces mécanismes consistent à intercepter les exceptions d’évaluation, à vérifier en amont que neff excède un seuil minimal prédéfini (par exemple, neff ≥ 5), et à lever des avertissements explicites ou des erreurs métier documentées. Dans ces configurations d’effectifs effectifs dégradés, le statisticien doit renoncer aux corrections asymptotiques et se tourner vers des méthodologies d’inférence non paramétriques, telles que le rééchantillonnage bootstrap pondéré, pour estimer empiriquement les intervalles de fluctuation de la dispersion.
11. Visualisation graphique de la dispersion pondérée avec Matplotlib et Seaborn
11.1 Histogrammes pondérés et estimation de densité par noyau
La représentation graphique fidèle d’une distribution statistique conditionne la compréhension intuitive de sa variabilité interne. Lors de la construction d’un histogramme conventionnel, chaque observation contribue pour une unité à la hauteur des barres de fréquence. Dans le cadre de données stratifiées ou pondérées, cette représentation s’avère profondément trompeuse en masquant la véritable distribution de masse de probabilité.
L’utilisation de la bibliothèque Matplotlib permet de corriger cette lacune visuelle en transmettant le vecteur des pondérations au paramètre weights de la fonction matplotlib.pyplot.hist. Les barres graphiques reflètent alors la somme des poids cumulés dans chaque intervalle de classe, fournissant un profil visuel en adéquation avec les paramètres pondérés calculés. La superposition sur ce graphique de lignes verticales matérialisant la moyenne pondérée ainsi que les bornes délimitant la plage de ± 1 écart-type pondéré permet d’apprécier immédiatement la cohérence entre la mesure de dispersion et l’étalement pondéré réel de l’échantillon.
11.2 Diagrammes de dispersion et représentations en bulles dimensionnées
Pour explorer conjointement la distribution des scores psychométriques et la distribution des coefficients de pondération, le diagramme de dispersion bidimensionnel ou le graphique à bulles (bubble plot) constitue un vecteur de restitution visuelle d’une remarquable éloquence pédagogique. Dans cette configuration, l’axe des abscisses représente les identifiants ou le rang des observations, tandis que l’axe des ordonnées affiche la valeur du score clinique mesuré.
L’apport méthodologique central réside dans la modulation de l’aire des marqueurs graphiques proportionnellement au coefficient de pondération assigné à chaque observation. En traçant des bandes de confiance horizontales délimitant l’intervalle de dispersion [x̄w – sw, x̄w + sw], le chercheur perçoit instantanément la force d’attraction gravitationnelle exercée par les observations dotées d’une masse élevée. Ce type de restitution met en lumière le fait qu’une valeur apparemment aberrante, si elle est assortie d’un poids minime, n’exerce qu’une influence marginale sur l’enveloppe de dispersion globale du modèle.
11.3 Boîtes à moustaches pondérées et graphiques de violon modifiés
Les boîtes à moustaches conventionnelles (boxplots) développées par John Tukey reposent sur le décompte ordinal non pondéré des rangs pour établir la médiane et les quartiles de la distribution. Appliquées sans altération à des données d’enquêtes complexes, elles fournissent une image inexacte de la dispersion interquartile, en contradiction flagrante avec l’écart-type pondéré calculé analytiquement par ailleurs.
Pour préserver l’intégrité de la présentation graphique, il convient de construire des diagrammes personnalisés dont les percentiles sont évalués selon la fonction de répartition cumulative pondérée. De même, les graphiques de violon (violin plots) générés via Seaborn doivent incorporer une estimation de densité par noyau (KDE) recevant formellement les poids statistiques. Cette adaptation garantit que l’enveloppe de densité reflète fidèlement la concentration des masses statistiques, produisant des figures de publication conformes aux critères de rigueur éditoriale des revues scientifiques les plus exigeantes.
12. Bonnes pratiques d’ingénierie logicielle et erreurs méthodologiques récurrentes
12.1 Erreurs conceptuelles fréquentes dans l’usage des degrés de liberté
L’analyse des pratiques computationnelles en recherche quantitative met en lumière plusieurs erreurs méthodologiques récurrentes relatives à l’application des degrés de liberté. La confusion la plus préjudiciable consiste à appliquer la formule de correction de Bessel arithmétique N – 1 à des pondérations dont l’échelle a été arbitrairement normalisée de sorte que leur somme totale vaille l’unité (∑ wi = 1). Dans cette hypothèse, le dénominateur devient égal à zéro, provoquant une défaillance logicielle critique ou une valeur aberrante.
Une seconde erreur conceptuelle majeure réside dans l’oubli fréquent du paramètre ddof=1 au sein des scripts automatisés. Par défaut, la plupart des algorithmes d’optimisation numérique ou de calcul matriciel opèrent sous le postulat d’une variance de population (ddof=0). L’omission de cette spécification sur des échantillons cliniques restreints engendre une sous-estimation persistante de l’écart-type, susceptible de biaiser les conclusions inférentielles subséquentes. La vérification scrupuleuse des postulats statistiques préalablement à toute dissémination de résultats scientifiques constitue ainsi une obligation déontologique et méthodologique.
12.2 Conception d’un module utilitaire réutilisable et documenté
Dans une perspective d’ingénierie logicielle professionnelle et de science ouverte, les routines de calcul de l’écart-type pondéré doivent être encapsulées au sein d’un module utilitaire robuste, modulaire et exhaustivement testé. Cette formalisation s’appuie en premier lieu sur l’adjonction de directives de typage statique (Type Hints), explicitant les structures acceptées telles que Union[np.ndarray, pd.Series] et clarifiant les types de retour scalaires.
La rédaction de docstrings exhaustives rédigées selon les standards de la communauté (styles NumPy ou Google) permet de documenter les équations mathématiques sous-jacentes, les paramètres acceptés, les exceptions levées et les références bibliographiques justificatives. De surcroît, le déploiement d’une suite de tests unitaires automatisés sous la bibliothèque pytest permet de valider le comportement du module face à des scénarios critiques : vecteurs constants, poids uniformes, présence de zéros, et confrontation des résultats à des tolérances flottantes strictes (numpy.testing.assert_allclose). Enfin, l’émission d’avertissements explicites via le module standard warnings permet de guider l’utilisateur en cas de détection d’une faible taille effective d’échantillon.
12.3 Directives de restitution des résultats selon les normes scientifiques
La publication des résultats statistiques dans les revues académiques internationales requiert une conformité formelle avec les directives de standardisation, telles que celles édictées par l’American Psychological Association (APA 7e édition). Dans la section méthodologique des manuscrits, il ne suffit pas d’énoncer le recours à un écart-type pondéré ; il est impératif de documenter précisément la nature des pondérations mobilisées, la méthode de redressement des degrés de liberté adoptée (correction de Kish ou de Bessel) et l’environnement logiciel employé avec mention explicite de ses numéros de version.
Dans la section des résultats, la restitution quantitative de la dispersion doit systématiquement associer la moyenne pondérée, l’écart-type pondéré d’échantillon ainsi que la taille effective de l’échantillon neff, fournissant aux lecteurs et aux réviseurs une métrique transparente de la puissance statistique réelle sous-jacente. Enfin, le dépôt public des scripts de traitement Python au sein d’archives ouvertes pérennes (telles que le Center for Open Science ou Zenodo) constitue le garant ultime de la reproductibilité scientifique, consacrant l’alliance de la rigueur mathématique et de l’excellence informatique au service du progrès des connaissances.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bessel, F. W. (1815). Über die Entstehung der astronomischen Instrumente. Astronomische Nachrichten.
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95. https://doi.org/10.1109/MCSE.2007.55
- Kish, L. (1965). Survey Sampling. John Wiley & Sons.
- Kish, L. (1992). Weighting for unequal Pi. Journal of Official Statistics, 8(2), 183-200.
- Lam, S. K., Pitrou, A., & Seibert, S. (2015). Numba: A LLVM-based Python JIT compiler. In Proceedings of the Second Workshop on the LLVM Compiler Infrastructure in HPC (pp. 1-6). https://doi.org/10.1145/2833157.2833162
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (pp. 56-61). https://doi.org/10.25080/Majora-92bf1922-00a
- Rubin, D. B. (1987). Multiple Imputation for Nonresponse in Surveys. John Wiley & Sons. https://doi.org/10.1002/9780470316696
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. In Proceedings of the 9th Python in Science Conference (pp. 92-96). https://doi.org/10.25080/Majora-92bf1922-011
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- Wasmuth, J., & Welford, B. P. (1962). Note on a method for calculating corrected sums of squares and products. Technometrics, 4(3), 419-420. https://doi.org/10.1080/00401706.1962.10490022
- West, D. H. D. (1979). Updating mean and variance estimates: An improved method. Communications of the ACM, 22(9), 532-535. https://doi.org/10.1145/359146.359153