
Le calcul scientifique moderne et l’apprentissage automatique reposent fondamentalement sur la manipulation efficace de structures de données multidimensionnelles au sein d’écosystèmes vectorisés. Dans l’écosystème Python, la bibliothèque NumPy s’est imposée comme le socle incontournable de cette infrastructure computationnelle, offrant une abstraction performante au-dessus de bibliothèques d’algèbre linéaire de bas niveau telles que BLAS et LAPACK. Cependant, cette puissance d’abstraction s’accompagne d’exigences géométriques rigoureuses relatives à l’alignement des axes tensoriels lors des opérations arithmétiques.
L’une des anomalies les plus fréquemment rencontrées par les chercheurs, ingénieurs et analystes de données est l’erreur explicite signalée par l’interpréteur sous le libellé ValueError: operands could not be broadcast together with shapes. Loin de constituer un simple bogue fortuit de syntaxe, cette exception matérialise une rupture fondamentale dans le protocole de diffusion implicite des dimensions, révélant une inadéquation géométrique entre les opérandes impliqués dans un calcul élément par élément. Comprendre les fondements théoriques, les mécanismes matériels et les manifestations concrètes de cette exception est indispensable pour quiconque aspire à concevoir des architectures logicielles numériques robustes et déterministes.
Le présent traité propose une analyse exhaustive de cette exception, depuis son anatomie bas niveau au sein du moteur C de NumPy jusqu’aux paradigmes de résolution avancés applicables aux tenseurs d’ordre supérieur. À travers une exploration détaillée des règles formelles d’alignement rétrograde des axes, des distinctions sémantiques entre le produit de Hadamard et le produit matriciel classique, ainsi que des techniques de restructuration morphologique, ce guide constitue une référence méthodologique complète pour diagnostiquer, corriger et prévenir durablement les divergences dimensionnelles au sein des chaînes de traitement de données contemporaines.
1. Introduction et anatomie de l’exception ValueError en calcul matriciel
Dans l’architecture du langage Python, les exceptions ne sont pas de simples interruptions d’exécution, mais des mécanismes précis de notification sémantique informant le runtime qu’un contrat d’interface logique ou mathématique n’a pas pu être respecté. Lorsque l’on manipule des tableaux multidimensionnels, la rigueur algébrique impose que chaque opération binaire repose sur des postulats dimensionnels stricts.
1.1 Définition formelle de l’exception dans l’écosystème NumPy
La classe d’exception ValueError est définie dans le modèle objet standard de Python comme une anomalie déclenchée lorsqu’une fonction ou un opérateur reçoit un argument dont le type est formellement approprié, mais dont la valeur intrinsèque se révèle inadéquate pour l’opération computationnelle requise. Dans le cadre spécifique de NumPy et des bibliothèques dérivées, cette exception acquiert une signification géométrique très ciblée : elle est émise dès lors que deux tableaux (ou plus), bien qu’étant tous deux des instances valides de la classe ndarray, présentent des formes géométriques mutuellement incompatibles au regard des règles du protocole de diffusion vectorielle.
Il est crucial d’établir une différenciation structurelle nette entre cette anomalie de valeur et une contrainte de type telle que TypeError. Si un utilisateur tentait d’additionner un tableau matriciel avec une chaîne de caractères non convertible ou un objet de classe non numérique dépourvu de méthode arithmétique compatible, l’interpréteur lèverait immédiatement une TypeError, signifiant l’impossibilité de résoudre la table des symboles d’opérateurs pour ces types de données. En revanche, dans le cas de l’exception ValueError liée au broadcasting, les types sous-jacents sont parfaitement compatibles, généralement des scalaires à virgule flottante ou des entiers contigus en mémoire. Le problème se situe exclusivement au niveau des métadonnées de forme, c’est-à-dire le tuple renvoyé par l’attribut shape.
Cette exception joue le rôle central d’un garde-fou algorithmique essentiel. En l’absence d’une interruption stricte du flux d’instructions, le moteur de calcul serait contraint soit d’extrapoler arbitrairement des valeurs manquantes, ce qui introduirait une corruption silencieuse des données, soit de procéder à des accès mémoires non autorisés au-delà des zones allouées pour les tampons d’éléments. En sanctuarisant l’intégrité structurelle des tenseurs, NumPy garantit que chaque coefficient calculé provient d’un alignement théoriquement valide, évitant ainsi la propagation d’erreurs d’arrondi ou de biais imperceptibles au sein des modèles prédictifs.
1.2 Origine computationnelle et contexte d’apparition récurrent
L’occurrence de l’erreur de diffusion survient principalement lors de la phase de transition délicate où un algorithme, initialement conceptualisé sous forme d’équations mathématiques formelles ou de boucles impératives séquentielles, est transcrit vers une implémentation vectorisée à haute performance. Dans la littérature mathématique, les notations matricielles supposent fréquemment des conventions implicites, telles que l’adaptation contextuelle d’un vecteur ligne à un vecteur colonne, ou l’omission d’un opérateur de projection. Lorsque le développeur omet de traduire ces conventions en ajustements dimensionnels explicites, l’interpréteur se heurte à des dimensions non superposables.
Ce phénomène s’observe de manière critique dans les pipelines d’apprentissage automatique contemporains. Lors des étapes d’extraction de caractéristiques, de normalisation par lots ou d’évaluation de fonctions de perte, les données subissent des transformations morphologiques successives. Une incompatibilité typique se produit lorsqu’un vecteur contenant les biais d’un modèle linéaire est soustrait d’une matrice d’activations dont la dimension de batch a été modifiée par un sous-échantillonnage imprévu, ou lorsque les dimensions spatiales d’une image matricielle ne correspondent plus aux filtres de convolution appliqués.
De surcroît, les interactions complexes entre structures de données hétérogènes constituent un terrain fertile pour cette anomalie. Lorsqu’un analyste combine des structures tabulaires issues de la bibliothèque Pandas avec des tenseurs NumPy purs, les mécanismes sous-jacents d’alignement peuvent entrer en conflit. Si une série unidimensionnelle est convertie sans que son orientation axiale ne soit explicitée, sa forme peut osciller entre un vecteur plat et une matrice unicolonne, provoquant une divergence fatale dès qu’elle rencontre un tableau bidimensionnel lors d’une opération arithmétique élémentaire.
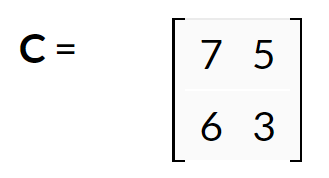
1.3 Conséquences systémiques de l’échec de diffusion sur l’exécution du code
Sur le plan de l’architecture logicielle, le déclenchement non géré d’une ValueError de diffusion entraîne l’interruption synchrone immédiate du graphe de calcul en cours. Contrairement aux environnements de script permissifs qui tolèrent des approximations numériques, le noyau de calcul vectoriel interrompt l’évaluation de l’arbre syntaxique, ce qui invalide l’ensemble de la chaîne de traitement située en aval. Pour des calculs distribués ou des applications scientifiques de longue durée, une telle interruption représente une perte substantielle de ressources informatiques si aucun mécanisme de reprise sur incident n’a été implémenté.
La difficulté de diagnostic est décuplée lorsque cette exception se manifeste au sein de pipelines asynchrones, d’architectures de microservices de calcul ou d’entraînements distribués sur des grappes de processeurs graphiques. Dans ces contextes, la trace d’appels peut être obscurcie par des couches d’abstraction d’ordonnancement, rendant complexe la localisation du tenseur source responsable de la divergence. Le message d’erreur se contente souvent de spécifier les dimensions observées au niveau de l’opérateur le plus bas, sans fournir le contexte historique des transformations ayant conduit à cet état de fait géométrique.
Il apparaît donc impératif de dépasser le simple correctif ad hoc consistant à modifier aléatoirement la taille des axes jusqu’à ce que l’erreur disparaisse. Une compréhension rigoureuse des mécanismes sous-jacents du moteur d’exécution de NumPy est indispensable pour appréhender les causes profondes de ces divergences, garantissant ainsi la pérennité et la reproductibilité des implémentations numériques face à des volumétries de données variables et des architectures d’exécution hétérogènes.
2. Les fondements théoriques du mécanisme de broadcasting dans NumPy
Le concept de diffusion, universellement désigné par l’anglicisme broadcasting, constitue l’un des piliers de l’efficacité computationnelle des calculs matriciels modernes. Conçu pour concilier l’élégance syntaxique et les performances matérielles extrêmes, ce mécanisme permet d’effectuer des opérations arithmétiques entre des tableaux de dimensions dissemblables sans subir les pénalités de coût mémoire associées à la duplication physique des données.
2.1 Le paradigme de la vectorisation sans duplication mémoire
Au niveau de l’architecture matérielle, l’allocation et le transfert de mémoire vive représentent des goulots d’étranglement bien plus pénalisants pour les performances que les cycles d’instructions des unités de calcul arithmétique et logique. Le paradigme du broadcasting repose sur une optimisation fondamentale : il permet d’étendre virtuellement un tableau de données le long d’un ou plusieurs axes sans allouer le moindre octet supplémentaire dans la mémoire vive du système. Cette prouesse technique est rendue possible par la manipulation astucieuse des métadonnées internes des structures ndarray, et tout particulièrement du concept de foulée ou pas d’incrémentation, couramment désigné par le terme technique strides.
Dans la structure interne en langage C de NumPy, le pointeur de foulée indique le nombre d’octets que le processeur doit sauter en mémoire pour passer d’un élément à l’élément suivant le long d’une dimension donnée. Lorsqu’une dimension de taille unitaire est étendue par broadcasting pour correspondre à une dimension cible de taille arbitraire, NumPy fixe la foulée associée à cet axe précis à la valeur zéro. Par conséquent, lors du parcours des boucles internes optimisées en C, l’adresse mémoire lue reste rigoureusement identique pour chaque itération le long de cet axe virtuel, réutilisant ainsi le même coefficient déjà présent dans le cache rapide du processeur central sans exiger de duplication physique du tampon.
Cette approche contraste de façon éclatante avec les approches itératives manuelles programmées à l’aide de boucles natives Python. Une boucle séquentielle traditionnelle entraîne une surcharge d’interprétation pour chaque élément accédé, incluant l’inspection dynamique des types et le déréférencement d’objets. Le broadcasting natif exécute l’intégralité du calcul au sein de routines compilées hautement optimisées, capables de tirer parti des jeux d’instructions vectorielles SIMD (Single Instruction, Multiple Data) offerts par les processeurs modernes, décuplant ainsi le débit computationnel global.
2.2 La règle formelle d’alignement des axes de droite à gauche
Pour déterminer si deux opérandes peuvent faire l’objet d’une opération de diffusion, le moteur de calcul applique un algorithme strict et déterministe d’alignement des axes, gouverné par la règle d’analyse rétrograde. Cette règle stipule expressément que la comparaison des formes géométriques doit obligatoirement s’effectuer en partant de la dimension la plus à droite (la dimension terminale ou trailing dimension) et en progressant de manière séquentielle vers la gauche, c’est-à-dire vers les dimensions de tête.
Deux dimensions comparées sont formellement déclarées compatibles si et seulement si elles satisfont à l’un des deux critères fondamentaux suivants :
- Les deux dimensions possèdent des valeurs numériques strictement identiques.
- L’une des deux dimensions possède une valeur exactement égale à l’unité (taille 1).
Lorsque les tableaux impliqués ne possèdent pas le même rang, c’est-à-dire le même nombre total de dimensions ou ndim, le tableau possédant le plus petit nombre d’axes est automatiquement préfixé par la gauche avec des dimensions virtuelles de taille 1 jusqu’à ce que le nombre total d’axes s’aligne sur celui du tenseur de rang supérieur. Une fois cet alignement virtuel accompli, l’algorithme procède à la comparaison de droite à gauche. La forme du tableau résultant est alors calculée mathématiquement en retenant, pour chaque axe analysé, la valeur maximale observée parmi l’ensemble des opérandes en compétition. Si, à n’importe quel stade de cette régression de droite à gauche, deux dimensions s’avèrent différentes sans qu’aucune d’elles ne soit égale à 1, le protocole échoue immédiatement et lève l’exception de non-concordance.
2.3 Le rôle charnière des dimensions unitaires
La présence d’une dimension de valeur 1 confère au tableau une propriété fondamentale d’élasticité topologique au sein de l’espace computationnel. Sur le plan mathématique, une dimension unitaire signifie que le tenseur ne possède qu’un seul hyperplan ou une seule coordonnée le long de cet axe particulier. Le moteur de calcul dispose donc de la licence théorique de projeter cette unique coordonnée à travers l’ensemble des positions possibles requises par le tableau partenaire, sans violer le principe de cohérence relationnelle des données.
Il existe toutefois une distinction mathématique et informatique absolue entre un axe inexistant et un axe unitaire explicite, bien que leur taille puisse paraître équivalente au premier regard. Un tableau unidimensionnel de forme (N,) ne possède qu’un seul axe topologique sans orientation spatiale définie. À l’inverse, un tableau bidimensionnel de forme (N, 1) possède deux axes formalisés, le second étant explicitement contraint à l’unité, ce qui en fait un vecteur colonne rigoureux au sens matriciel. Inversement, une forme (1, N) représente un vecteur ligne formel.
Cette distinction est le pivot sur lequel repose l’intégralité du calcul tensoriel multidimensionnel. En manipulant délibérément l’emplacement de ces dimensions unitaires, le développeur peut contraindre le broadcasting à s’opérer de manière asymétrique, autorisant par exemple la réplication d’un ensemble de paramètres scalaires ou vectoriels le long d’une dimension temporelle, spatiale ou d’échantillonnage spécifique, tout en préservant l’intégrité invariante des autres composantes matricielles de l’algorithme.
3. Reproduction empirique de l’erreur : analyse du conflit de dimensions
Afin de disséquer avec une rigueur clinique les mécanismes conduisant au rejet d’un calcul par l’interpréteur, il convient d’élaborer une configuration expérimentale minimale mais représentative, au sein de laquelle l’incompatibilité géométrique se manifeste de manière indiscutable lors de l’exécution.
3.1 Construction d’un cas d’école : matrices (2,2) et (2,3)
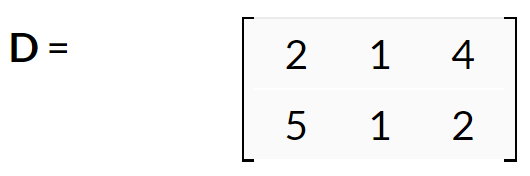
Considérons l’initialisation programmatique de deux matrices distinctes au moyen de l’interface standard de NumPy. Soit une première matrice, désignée conventionnellement par la variable C, instanciée avec une morphologie bidimensionnelle de dimensions (2, 2), contenant par exemple quatre valeurs scalaires réparties sur deux lignes et deux colonnes. Soit simultanément une seconde matrice, désignée par la variable D, structurée avec des dimensions (2, 3), signifiant qu’elle comporte deux lignes et trois colonnes d’éléments numériques.
Lorsque le programmeur tente d’évaluer l’expression arithmétique C * D, l’interpréteur Python invoque la méthode spéciale __mul__ de l’objet C en lui passant D comme argument. Cette méthode délègue instantanément le calcul à la routine interne en langage C chargée d’effectuer le produit élément par élément. Dès l’amorce du calcul, l’interpréteur interrompt brutalement l’exécution et renvoie dans le flux de sortie d’erreur standard le message formel suivant :
ValueError: operands could not be broadcast together with shapes (2,2) (2,3)
Le refus opposé par le moteur d’exécution est absolu. Malgré le fait que les deux matrices partagent une dimension de ligne rigoureusement identique (le nombre 2 apparaissant comme la première composante de leurs formes respectives), le moteur C refuse catégoriquement d’engager le traitement numérique. Cette réaction découle directement de l’application inviolable de l’algorithme d’alignement rétrograde préalablement exposé, confirmant que la coïncidence de taille sur le premier axe est totalement impuissante à compenser une divergence sur les axes ultérieurs.
3.2 Décomposition axiale de l’incompatibilité
Pour expliciter rationnellement l’échec de cette opération, décomposons pas à pas la trajectoire algorithmique suivie par le vérificateur de broadcasting lors de l’évaluation conjointe des tuples dimensionnels (2, 2) et (2, 3) :
- Étape 1 : Alignement initial des axes de rang équivalent. Les deux matrices possèdent chacune un rang égal à 2 (deux dimensions chacune). Il n’y a donc pas lieu d’insérer de dimensions unitaires préfixées à gauche. L’alignement s’établit directement paire par paire en partant de la droite.
- Étape 2 : Évaluation critique du dernier axe (axe 1, les colonnes). Le moteur extrait la dimension la plus à droite de chaque tableau. Pour la matrice C, cette valeur est égale à 2. Pour la matrice D, cette valeur est égale à 3. Le système confronte ces deux entiers : 2 et 3 sont numériquement inégaux.
- Étape 3 : Recherche d’une condition d’élasticité unitaire. Le système vérifie si au moins l’un des deux opérandes présente la valeur 1 sur cet axe. Ni la dimension de C (qui vaut 2) ni la dimension de D (qui vaut 3) n’est égale à 1. Aucune extension virtuelle par foulée nulle n’est donc mathématiquement permise.
- Étape 4 : Déclenchement de l’interruption. La condition de compatibilité stricte n’étant pas satisfaite, le moteur interrompt l’analyse immédiatement sans même examiner l’axe 0 (les lignes), et synthétise le message d’exception ValueError.
Cette décomposition met en lumière la nature géométrique de l’impasse : le moteur d’exécution ne dispose d’aucun moyen formel pour mapper deux éléments de la matrice C sur trois éléments distincts de la matrice D au sein d’une même rangée horizontale sans inventer arbitrairement une règle d’extrapolation ou répéter un coefficient de manière arbitraire, ce qui dénaturerait la sémantique de l’opération demandée.
3.3 Traçage de la pile d’exécution et diagnostic des messages de console
Face à une telle interruption, l’analyse méthodique de la trace d’appels (communément désignée sous le terme de traceback) constitue la première démarche de remédiation diagnostique. La trace fournie par l’interpréteur Python détaille la séquence exacte des appels de fonctions ayant précédé le point de rupture, isolant précisément le numéro de ligne où l’opérateur d’évaluation binaire a échoué.
La lecture critique de ce message doit se focaliser sur l’ordre textuel des formes mentionnées dans l’énoncé de l’exception. La formulation operands could not be broadcast together with shapes (2,2) (2,3) indique systématiquement que le premier opérande rencontré dans l’expression arithmétique correspond à la première forme signalée, et le second opérande à la suivante. Cette identification spatiale permet d’isoler immédiatement les variables incriminées au sein du scope local d’exécution.
Dans un flux d’instructions volumineux, où les matrices peuvent être générées dynamiquement par des fonctions intermédiaires sans noms de variables évidents, le réflexe diagnostique impose de vérifier immédiatement les propriétés intrinsèques des objets en amont immédiat de la ligne incriminée. L’observation passive du code est généralement insuffisante ; seule la validation empirique de l’état des métadonnées au moment de l’exécution permet de comprendre l’origine de l’asymétrie structurelle ayant mené à l’invalidation du calcul.
4. Multiplication élément par élément versus produit matriciel algébrique
Une part prépondérante des erreurs de broadcasting recensées dans les projets de calcul scientifique découle d’une confusion conceptuelle profonde entre deux opérations mathématiques distinctes qui partagent, dans le langage naturel ou dans d’anciens environnements de calcul, des désignations et des symboles similaires : le produit élément par élément et le produit matriciel algébrique.
4.1 Le produit de Hadamard et l’opérateur arithmétique (*)
Dans le formalisme de l’algèbre linéaire, l’opération consistant à multiplier deux matrices de dimensions identiques en calculant simplement le produit scalaire de chaque paire d’éléments partageant les mêmes indices est connue sous le nom de produit de Hadamard, ou produit de Schur. Si nous considérons une matrice $A$ de dimensions $(M, N)$ et une matrice $B$ de dimensions $(M, N)$, leur produit de Hadamard $C = A odot B$ est une matrice de dimensions strictement identiques $(M, N)$ dont chaque coefficient est défini par la relation élémentaire :
$$C_{i,j} = A_{i,j} \cdot B_{i,j}$$
Dans la syntaxe de base de NumPy, l’opérateur arithmétique astérisque (*) est réservé de manière exclusive à la mise en œuvre de ce produit de Hadamard, éventuellement étendu par les règles du broadcasting lorsque l’un des opérandes possède des dimensions unitaires. Cet opérateur n’effectue en aucun cas une composition linéaire de transformations géométriques. Il exige par définition une correspondance biunivoque entre les coordonnées spatiales des deux opérandes.
Le produit de Hadamard trouve des applications légitimes et cruciales dans de multiples domaines scientifiques, notamment lors du filtrage fréquentiel par masque binaire ou continu en traitement du signal, lors de l’application de fonctions d’activation pondérées dans les réseaux de neurones, ou encore lors de l’ajustement du contraste et des canaux chromatiques en traitement d’images numériques. Cependant, son application présume que chaque case du tableau source possède une contrepartie directe dans le tableau récepteur, condition qui faisait précisément défaut dans notre tentative de multiplication des formes (2, 2) et (2, 3).
4.2 Le produit matriciel classique au sens de l’algèbre linéaire
À l’opposé fondamental du produit de Hadamard se situe le produit matriciel classique, issu de la théorie de la composition des applications linéaires entre espaces vectoriels de dimension finie. Pour que le produit algébrique de deux matrices $A$ et $B$ soit mathématiquement défini, une condition de concordance dimensionnelle stricte doit être honorée : le nombre de colonnes de la matrice de gauche ($A$) doit être rigoureusement égal au nombre de lignes de la matrice de droite ($B$).
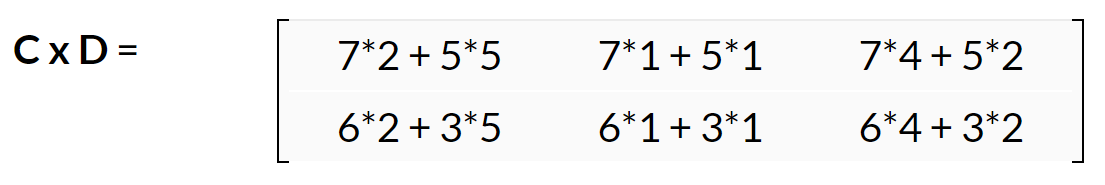
Si la matrice $A$ est de dimensions $(M, K)$ et que la matrice $B$ est de dimensions $(K, P)$, leur composition linéaire génère une matrice résultante dont les dimensions extérieures sont $(M, P)$. Chaque coefficient de la matrice résultante n’est pas le produit de deux valeurs isolées, mais la somme contractée d’une série de produits scalaire-vecteur le long de l’axe intérieur partagé, formalisée par la sommation canonique :
$$C_{i,j} = \sum_{k=1}^{K} A_{i,k} \cdot B_{k,j}$$
Cette contraction tensorielle sur l’axe intérieur implique des dynamiques algorithmiques et des complexités temporelles radicalement distinctes. Alors que le produit de Hadamard présente une complexité asymptotique linéaire proportionnelle au nombre total d’éléments, soit $\mathcal{O}(M \cdot N)$, le produit matriciel classique requiert dans son implémentation naïve une complexité cubique $\mathcal{O}(M \cdot K \cdot P)$, optimisée par les algorithmes de pointe (tels que Strassen ou les routines BLAS d’assemblage par blocs) à des seuils avoisinant $\mathcal{O}(N^{2.81})$ ou $\mathcal{O}(N^{2.37})$. Confondre ces deux opérations ne constitue donc pas seulement une erreur d’incompatibilité de forme, mais une méprise complète sur la nature de la transformation appliquée aux données.
4.3 Origine cognitive de la confusion chez les développeurs
L’émergence récurrente de cette confusion trouve en grande partie son origine dans l’héritage historique et la sémantique divergente des langages dédiés au calcul numérique. Dans des environnements tels que MATLAB classique, l’opérateur de base astérisque (*) désignait historiquement le produit matriciel algébrique, contraignant l’utilisateur à employer un opérateur pointé spécifique (.*) pour signifier son intention d’exécuter un produit élément par élément. Cette convention plaçait la transformation algébrique au rang de comportement par défaut.
Lors de la conception de Python et de l’intégration des types numériques vectorisés, les concepteurs ont pris le parti de respecter scrupuleusement la sémantique native du langage. En Python pur, les opérateurs arithmétiques standards s’appliquent sur des grandeurs scalaires individuelles. Transposer l’opérateur astérisque aux structures de conteneurs numériques impliquait logiquement de préserver cette intuition d’action élément par élément. Par conséquent, les ingénieurs migrant d’environnements mathématiques traditionnels vers Python écrivent machinalement l’expression C * D en postulant qu’ils réalisent une composition linéaire matricielle standard.
Face à nos deux matrices C de dimensions (2, 2) et D de dimensions (2, 3), l’intention mathématique réelle de l’ingénieur était presque systématiquement de réaliser la composition algébrique classique, car le nombre de colonnes de C (qui vaut 2) est parfaitement égal au nombre de lignes de D (qui vaut 2). L’erreur ValueError de diffusion n’est donc survenue que parce que le développeur a sollicité, par inadvertance syntaxique, une opération de Hadamard qu’il n’avait jamais eu l’intention théorique de requérir.
5. Résolution par l’utilisation de numpy.dot() et de l’opérateur @
Une fois identifiée la nature réelle du calcul souhaité, la résolution de l’exception devient évidente : il s’agit d’abandonner l’opérateur élément par élément au profit des interfaces logicielles dédiées au produit matriciel algébrique au sens strict.
5.1 Application de numpy.dot() pour le calcul du produit scalaire
La première voie historique mise à disposition par la bibliothèque pour satisfaire à cette exigence réside dans la fonction numpy.dot(), accessible également sous la forme d’une méthode attachée aux instances de tableaux. Pour des arguments strictement bidimensionnels, cette fonction applique avec exactitude le calcul canonique de produit de matrices explicité au chapitre précédent.
Considérons l’application de cette méthode à nos matrices d’exemple C de forme (2, 2) et D de forme (2, 3). La signature fonctionnelle s’exprime sous la forme np.dot(C, D) ou C.dot(D). L’algorithme interne valide immédiatement la contrainte géométrique : l’axe 1 de C présente une cardinalité de 2, et l’axe 0 de D présente une cardinalité de 2. La concordance étant établie, la contraction s’opère sans encombre, générant une nouvelle matrice résultante dont la forme est rigoureusement égale à (2, 3).
Sur le plan des performances, la fonction numpy.dot() redirige le flux d’exécution directement vers les bibliothèques C et Fortran sous-jacentes du système d’exploitation, exploitant pleinement les routines GEMM (General Matrix Multiplication). De surcroît, cette fonction accepte un paramètre optionnel out, qui permet au développeur de fournir un tableau préalloué pour accueillir le résultat du calcul, éliminant ainsi toute allocation dynamique intermédiaire au sein de boucles de traitement intensives.
5.2 L’opérateur moderne @ introduit par la PEP 465
Bien que fonctionnelle, la syntaxe préfixée basée sur l’appel explicite de fonctions alourdissait considérablement l’écriture d’expressions algébriques complexes impliquant des enchaînements successifs de produits et d’additions matricielles, aboutissant à une imbrication d’appels fonctionnels peu lisible. Pour remédier à cette lacune stylistique, la communauté Python a approuvé et intégré l’opérateur binaire infixé dédié, symbolisé par l’arobase (@), formalisé dans la PEP 465 lors de la sortie de Python 3.5.
L’introduction de cet opérateur répondait à une demande historique de la communauté du calcul scientifique : doter le langage d’un symbole dédié sans compromettre la signification canonique de l’opérateur astérisque. En rédigeant désormais l’instruction C @ D, l’ingénieur exprime avec une clarté typologique absolue sa volonté de réaliser une multiplication matricielle. L’interpréteur résout cette syntaxe en invoquant la méthode spéciale __matmul__ implémentée par le type ndarray.
Sur le plan sémantique et computationnel, l’opérateur @ est rigoureusement équivalent à l’invocation de la fonction universelle numpy.matmul(). Il en résulte un gain substantiel en élégance syntaxique, les formules d’algèbre linéaire s’écrivant désormais d’une manière presque indiscernable de leur formulation théorique sur papier, tout en prévenant de façon explicite toute confusion involontaire avec le mécanisme de broadcasting inhérent à l’opérateur astérisque.
5.3 Différences subtiles entre numpy.dot() et numpy.matmul()
Bien que numpy.dot() et numpy.matmul() (et par extension l’opérateur @) produisent des résultats strictement superposables lorsqu’ils opèrent sur des matrices bidimensionnelles canoniques, leurs comportements divergent de manière critique dès lors que l’on traite des tenseurs d’ordre supérieur ou des scalaires d’ordre zéro.
Les divergences fondamentales se résument ainsi :
- Traitement des scalaires : numpy.dot() tolère des opérandes scalaires de dimension zéro et se comporte alors comme une multiplication arithmétique ordinaire. À l’opposé, numpy.matmul() interdit formellement les arguments de dimension zéro, levant une exception si l’un des membres est un scalaire isolé.
- Calculs tensoriels multidimensionnels (Batching) : Face à des tableaux dont le rang est strictement supérieur à 2 (par exemple de formes (10, 2, 2) et (10, 2, 3)), numpy.matmul() interprète les deux dernières dimensions comme des matrices individuelles et diffuse les dimensions de tête comme un ensemble de lots (batch processing). numpy.dot(), pour sa part, effectue une contraction générale de tenseur en sommant sur le dernier axe du premier tableau et l’avant-dernier axe du second, produisant une topologie de sortie radicalement différente et souvent inattendue.
Dans les projets d’ingénierie logicielle contemporains et les pipelines d’apprentissage automatique, les standards de codage recommandent quasi unanimement l’usage exclusif de l’opérateur @ ou de la fonction explicite numpy.matmul(), leur comportement par lot s’alignant précisément sur les besoins structurels des réseaux neuronaux et du traitement de données multidimensionnelles en flux continu.
6. Résolution par la restructuration dimensionnelle : reshape et transpose
Il advient fréquemment que le besoin computationnel relève bel et bien d’un produit élément par élément de type Hadamard, mais que les tableaux en présence, issus de requêtes d’extraction ou de traitements en amont, ne présentent pas l’orientation géométrique appropriée. Dans cette situation, la résolution de l’exception de diffusion nécessite une restructuration explicite de la topologie spatiale des opérandes.
6.1 Transformation de la topologie matricielle via reshape
La méthode reshape() permet de réorganiser l’agencement interne des éléments d’un tableau pour lui assigner une forme géométrique nouvelle, sous la contrainte absolue et invariable que le nombre total d’éléments (égal au produit des composantes du tuple dimensionnel, accessible par la propriété size) demeure strictement identique avant et après l’opération.
Considérons à nouveau notre matrice C de dimensions initiales (2, 2), comptant donc 4 éléments au total. Si un algorithme exige impérativement une interaction élément par élément avec une matrice unidimensionnelle de taille 4, ou si l’on souhaite autoriser un broadcasting particulier, modifier sa forme vers (4, 1) ou (1, 4) modifie radicalement les capacités d’alignement rétrograde de l’opérande sans introduire d’incohérence mémoire. NumPy propose par ailleurs l’argument d’inférence automatique matérialisé par la valeur -1 : en spécifiant par exemple C.reshape(-1, 1), le moteur déduit automatiquement la taille de la première dimension en divisant la taille globale par le produit des autres axes spécifiés.
Il est primordial de souligner que l’application de reshape() ne modifie pas, par défaut, la disposition physique des octets enregistrés au sein du tampon mémoire de bas niveau lorsque l’ordre de lecture des éléments en mémoire respecte la contiguïté conventionnelle du langage C (ordonnancement ligne par ligne). L’opération se contente d’altérer l’en-tête de métadonnées de l’objet, en recalculant instantanément le tuple des foulées, ce qui en fait une opération à coût algorithmique quasi nul $\mathcal{O}(1)$ en temps d’exécution.
6.2 Permutation des axes géométriques avec transpose et .T
La transposition matricielle constitue une autre manipulation morphologique majeure pour réconcilier des axes en conflit géométrique. Dans un espace bidimensionnel, la transposition consiste à inverser formellement les lignes et les colonnes. Au sein de NumPy, cette opération s’exécute de manière élégante via l’accès direct à la propriété .T ou par l’invocation de la méthode plus générale transpose().
Reprenons notre matrice D possédant la morphologie (2, 3). L’évaluation de l’attribut D.T génère instantanément une vue géométrique dont la forme devient (3, 2). Supposons qu’un algorithme requière un produit algébrique entre une matrice quelconque de dimensions (4, 3) et notre matrice D originelle de dimensions (2, 3). Une telle composition directe déclencherait une erreur de compatibilité car les axes intérieurs (3 et 2) ne concordent pas. En revanche, en écrivant explicitement l’expression faisant intervenir la transposée D.T, la structure de droite présente désormais les dimensions (3, 2), autorisant une contraction matricielle valide qui produit une matrice de sortie de dimensions (4, 2).
Un aspect critique d’ingénierie logicielle réside dans la distinction entre vue (view) et copie physique (copy). La transposition ne duplique jamais les données en mémoire vive ; elle se borne à inverser les foulées associées à chaque axe. Par voie de conséquence, un tableau initialement contigu selon les conventions du C (C-contiguous) cesse de l’être une fois transposé, adoptant une disposition contiguë selon les règles du Fortran (F-contiguous). Si des routines BLAS sous-jacentes ou des bibliothèques externes exigent une mémoire strictement contiguë en ligne, il devient nécessaire de forcer une matérialisation physique contiguë via l’appel à numpy.ascontiguousarray().
6.3 Redimensionnement destructif ou adaptatif avec resize
Une confusion syntaxique périlleuse consiste à amalgamer la méthode reshape() avec l’instruction resize(). Dans l’écosystème NumPy, il existe une scission comportementale entre la fonction numpy.resize() et la méthode attachée ndarray.resize() qu’il convient de manier avec une extrême circonspection :
- La fonction numpy.resize(a, new_shape) : Cette fonction alloue et renvoie un nouveau tableau indépendant doté de la forme demandée. Si la nouvelle capacité globale est supérieure au volume du tableau source, la fonction duplique de manière cyclique les éléments d’origine pour combler l’espace manquant. Si la forme cible est plus petite, les données excédentaires sont purement tronquées.
- La méthode interne a.resize(new_shape) : Cette méthode mute directement le tableau sur place au sein de son propre espace mémoire. Si la taille requise dépasse l’allocation actuelle, elle tente d’agrandir le tampon système ou le réalloue en initialisant les nouveaux éléments avec des zéros. Toutefois, cette opération est formellement rejetée par le système et lève une exception si le tableau partage sa mémoire avec une autre variable sous la forme d’une vue.
En ingénierie logicielle appliquée aux calculs matriciels, la mutation d’état par resize() est fermement proscrite dans les pipelines déterministes. Introduire des duplications cycliques de coefficients ou contraindre des réallocations de tampons sur place constitue une source majeure de bogues silencieux et d’effets de bord imprévisibles, devant être systématiquement rejetée au profit d’opérations de restructuration explicites et pures.
7. Extension artificielle des dimensions : np.newaxis et numpy.expand_dims
L’une des stratégies les plus puissantes pour débloquer le mécanisme de broadcasting sans dénaturer la sémantique de l’opération consiste à introduire artificiellement des dimensions unitaires au sein de la signature géométrique des opérandes. Cette démarche permet d’activer sélectivement les règles d’étirement spatial de NumPy sur des axes précis.
7.1 Insertion d’axes virtuels avec np.newaxis
La constante spéciale numpy.newaxis est un alias direct de l’objet None de Python, employé au sein des expressions de découpage (slicing) de tableaux. Son insertion au sein d’une expression d’indexation signale au moteur de calcul qu’une nouvelle dimension unitaire de taille 1 doit être intercalée à cette position précise dans le tuple de forme de l’objet résultant.
Cette technique est fondamentale pour résoudre le problème récurrent des tableaux unidimensionnels. Considérons un vecteur v contenant $N$ éléments, dont la propriété shape renvoie simplement le tuple (N,). Si nous souhaitons soustraire ce vecteur à chaque ligne d’une matrice $M$ de dimensions (N, K), une opération directe M – v échouera ou produira un alignement erroné sur la dernière dimension. En écrivant :
v_colonne = v[:, np.newaxis]
La forme de v_colonne devient instantanément (N, 1). Dès lors, lorsqu’il est confronté à la matrice de dimensions (N, K), l’algorithme d’alignement rétrograde compare la dernière dimension (1 face à K) et procède à l’étirement unitaire le long de chaque colonne. La première dimension présente quant à elle une identité stricte ($N$ face à $N$). L’opération arithmétique s’exécute ainsi avec une conformité géométrique absolue.
Cette technique permet également la vectorisation élégante des opérations dites extérieures (outer operations). En appliquant simultanément A[:, np.newaxis] et B[np.newaxis, :] à deux vecteurs unidimensionnels, l’évaluation arithmétique de leur produit croisé génère une matrice complète bidimensionnelle de dimensions $(N, M)$ en une seule instruction C sans boucle explicite, illustrant la puissance de la manipulation spatiale des axes unitaires.
7.2 Utilisation explicite de numpy.expand_dims()
Bien que la syntaxe utilisant np.newaxis soit plébiscitée pour sa concision dans le code algorithmique interactif, elle peut parfois masquer l’intention fonctionnelle au détriment de la lisibilité dans des bases de code industrielles volumineuses. Pour pallier cet inconvénient, NumPy fournit la fonction déclarative numpy.expand_dims().
Cette fonction accepte deux paramètres principaux : le tableau à modifier et l’argument axis, qui spécifie l’indice ou le tuple d’indices auxquels les nouvelles dimensions unitaires doivent être intercalées. Par exemple, convertir un vecteur de forme (N,) en tenseur tridimensionnel de dimensions (1, N, 1) s’exprime de manière transparente et auto-documentée par l’instruction :
numpy.expand_dims(v, axis=(0, 2))
L’emploi de cette formulation explicite prévient les erreurs de comptage d’indices de découpage, particulièrement lorsque les dimensions réelles du tenseur sont paramétrables ou déterminées dynamiquement à l’exécution. En spécifiant explicitement les axes visés, le développeur sécurise le contrat d’interface et facilite le travail des réviseurs de code et des outils d’analyse statique.
7.3 Compression dimensionnelle inverse avec numpy.squeeze()
À l’exact opposé de l’expansion dimensionnelle, la présence involontaire de dimensions unitaires superflues constitue une cause insidieuse de blocage de diffusion. Lors de filtrages, de sélections partielles ou d’opérations d’agrégation, un tableau peut se retrouver pourvu d’une forme telle que (1, 2, 1, 3). Si cet objet doit interagir avec une matrice plane de dimensions (2, 3), la disparité du rang global peut perturber l’alignement attendu.
La fonction numpy.squeeze() a pour mandat de décompresser la géométrie d’un tenseur en élaguant systématiquement l’ensemble des axes dont la taille est strictement égale à 1. Appliquée à notre tenseur d’exemple, elle produit instantanément une vue propre de forme (2, 3), restituant la compacité nécessaire au tableau pour s’insérer sans friction dans des opérations algébriques ultérieures.
Il est toutefois impératif de respecter une règle de prudence : l’appel à numpy.squeeze() sans spécification d’argument compresse aveuglément toutes les dimensions unitaires présentes. Si un tenseur représentait un lot d’apprentissage d’un seul échantillon (batch de taille 1), un squeeze global effacerait cette dimension de lot essentielle, entraînant des ruptures en cascade en aval. Il convient donc de privilégier systématiquement l’usage du paramètre explicite, tel que numpy.squeeze(x, axis=0), pour cibler chirurgicalement l’axe dont la neutralisation est délibérément recherchée.
8. Diagnostic systématique et inspection des formes dimensionnelles
La résolution pérenne des conflits de diffusion ne saurait reposer sur une suite de tentatives intuitives non documentées. L’adoption d’une méthodologie d’audit rigoureuse et l’intégration de barrières défensives dès la phase d’ingénierie permettent d’éradiquer ces anomalies à la source.
8.1 Audit d’état avec ndarray.shape, ndarray.ndim et ndarray.size
Dès l’apparition d’un conflit de forme au sein d’un bloc computationnel, le premier réflexe de débogage consiste à interroger les attributs structurels fondamentaux exposés par chaque objet matriciel impliqué dans l’opération fautive :
- ndarray.shape : Renvoie le tuple d’entiers décrivant la géométrie absolue du tableau. L’inspection visuelle de ce tuple permet de confronter directement les longueurs d’axes selon la règle d’alignement de droite à gauche.
- ndarray.ndim : Indique le rang tensoriel global (le nombre total d’axes). Ce paramètre est crucial pour identifier si un opérande a subi une promotion ou une dégradation dimensionnelle inattendue au cours des étapes antérieures du pipeline.
- ndarray.size : Quantifie le nombre total d’éléments scalaires physiques alloués. Ce diagnostic confirme si l’objet contient effectivement les données attendues ou s’il se trouve dans un état vide ou tronqué.
L’un des pièges les plus dévastateurs pour les praticiens réside dans la manipulation des vecteurs de dimension 1 sans orientation spatiale, caractérisés par la notation (N,). Un tel vecteur n’est ni une ligne ni une colonne : c’est un tableau de rang 1. Selon la position qu’il occupe dans l’expression arithmétique, le broadcasting appliquera son alignement d’une manière qui peut entrer en collision frontale avec des représentations bidimensionnelles attendues. Auditer systématiquement l’attribut ndim permet d’identifier immédiatement ces structures plates et d’imposer leur requalification explicite.
8.2 Programmation par assertions et tests de cohérence prédictifs
Dans une optique de conception logicielle défensive, les fonctions mathématiques complexes doivent formaliser leurs prérequis géométriques dès l’entrée de leur corps d’instructions, bien avant que le moteur de calcul n’entreprenne la première opération binaire. L’incorporation d’instructions assert explicites constitue une pratique industrielle hautement recommandée.
En vérifiant formellement l’égalité des axes terminaux ou la compatibilité des dimensions intérieures préalablement à l’évaluation arithmétique, l’ingénieur substitue à l’exception générique de bas niveau de NumPy un message de diagnostic explicite et porteur de sens métier. Par exemple, l’assertion suivante documente immédiatement l’attente algorithmique :
assert matrice_a.shape[1] == matrice_b.shape[0], f »Discordance dimensionnelle : {matrice_a.shape} vs {matrice_b.shape} »
Pour des suites de validation plus élaborées, le sous-module spécialisé numpy.testing met à disposition des fonctions d’assertions avancées, capables de valider non seulement la stricte identité des formes, mais également les tolérances numériques appliquées aux valeurs calculées, consolidant ainsi la robustesse des barrières de contrôle architecturales.
8.3 Outils de typage statique appliqués aux dimensions matricielles
Historiquement, le typage statique au sein de Python ne permettait de qualifier que le type conteneur générique, indiquant par exemple qu’un paramètre était une instance de np.ndarray, sans aucune indication relative à son rang ou à ses dimensions intérieures. Les erreurs de diffusion ne pouvaient donc être interceptées qu’au moment de l’exécution dynamique du code.
Cette limitation est désormais surmontée grâce à l’émergence d’écosystèmes d’annotation avancés et de vérificateurs statiques spécialisés tels que nptyping ou jaxtyping. Ces outils permettent d’annoter les signatures de fonctions avec des dimensions formalisées :
Une fonction peut ainsi déclarer explicitement qu’elle attend un opérande de type NDArray[Shape[« Batch, Features »], Float] et un second opérande de type NDArray[Shape[« Features, Outputs »], Float]. Dès lors, un analyseur statique de code exécuté lors de la phase d’intégration continue est capable d’intercepter les incohérences d’alignement matriciel avant même que le moindre test unitaire ne soit exécuté sur une machine physique, réduisant considérablement la surface d’apparition de l’erreur ValueError en production.
9. Analyse des cas d’usage multidimensionnels et tenseurs d’ordre supérieur
L’accroissement de la complexité algorithmique, notamment dans les domaines du traitement d’images numériques, du traitement automatique du langage naturel et de la modélisation en physique théorique, impose de manipuler des tenseurs d’ordre supérieur à deux. Dans ces topologies multidimensionnelles, l’application du broadcasting requiert une rigueur d’abstraction accrue.
9.1 Broadcasting sur des volumes de données et tenseurs 3D/4D
Dans l’ingénierie des réseaux de neurones profonds, la manipulation de flux d’images s’opère canoniquement sous la forme de tenseurs d’ordre 4. Une convention standard structure ces données sous le format (N, H, W, C), où $N$ désigne la dimension du lot (taille du batch), $H$ la hauteur spatiale en pixels, $W$ la largeur spatiale, et $C$ le nombre de canaux chromatiques (par exemple 3 pour les canaux Rouge, Vert, Bleu).
Supposons que nous souhaitions appliquer une étape de normalisation statistique consistant à soustraire une moyenne et à diviser par un écart-type calculés indépendamment pour chaque canal chromatique sur l’ensemble du jeu de données. Le vecteur de normalisation contiendra $C$ composantes, se présentant sous la forme (C,). Si nous tentons d’effectuer l’opération arithmétique directe entre le tenseur de données de forme (N, H, W, C) et ce vecteur de normalisation (C,), le calcul s’effectue avec un succès absolu sans la moindre erreur.
Ce succès découle directement de la règle de comparaison rétrograde :
- Le vecteur (C,) est aligné avec la dimension la plus à droite du tenseur, qui vaut précisément $C$. L’identité numérique étant vérifiée, le critère est validé.
- Le vecteur est ensuite virtuellement étendu vers la gauche en lui attribuant implicitement les formes 1 pour l’ensemble des axes restants, se comportant comme un tenseur de forme (1, 1, 1, C).
- Le moteur de diffusion duplique virtuellement les valeurs scalaires le long de la hauteur $H$, de la largeur $W$, et à travers l’ensemble des échantillons du lot $N$, garantissant une application rigoureusement uniforme du traitement sans requérir la moindre boucle explicite ni consommer de mémoire supplémentaire.
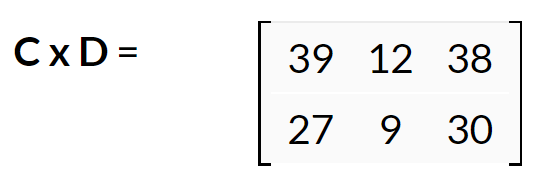
9.2 Multiplication matricielle par lots (Batch Matrix Multiplication)
Une situation computationnelle courante survient lors de la mise en œuvre des mécanismes d’attention au sein des architectures de type Transformer. Ces opérations requièrent d’exécuter des multiplications matricielles simultanées sur des collections volumineuses de représentations vectorielles, encapsulées au sein de tenseurs tridimensionnels ou quadridimensionnels.
Considérons deux tenseurs $Q$ et $K$ représentant respectivement des requêtes et des clés, dont les dimensions s’établissent à (B, H, L, D) pour le premier et à (B, H, D, S) pour le second, où $B$ représente la taille du batch, $H$ le nombre de têtes d’attention, $L$ et $S$ des longueurs de séquences de texte, et $D$ la dimension interne de projection. L’application de l’opérateur matriciel Q @ K déclenche le mécanisme de multiplication matricielle par lots.
Dans ce contexte, le moteur matmul isole les deux dernières dimensions de chaque tenseur, à savoir (L, D) et (D, S), pour exécuter les produits matriciels individuels en contractant l’axe intérieur partagé $D$. Simultanément, il soumet l’ensemble des dimensions supérieures (les dimensions dites de batch B et H) aux règles canoniques du broadcasting standard. Si l’un des tenseurs présentait une tête d’attention unique sous la forme (B, 1, D, S), cette dimension unitaire serait automatiquement diffusée pour matcher le nombre de têtes $H$ du tenseur partenaire, illustrant la convergence sophistiquée entre composition matricielle et diffusion tensorielle simultanées.
9.3 Utilisation de numpy.einsum pour un contrôle absolu des contractions
Lorsque la structure dimensionnelle atteint un degré de complexité tel que la lisibilité des opérateurs infixés et des fonctions de restructuration s’effondre, l’emploi de la fonction numpy.einsum(), reposant sur la notation de sommation d’Einstein, s’impose comme l’alternative computationnelle la plus robuste et la plus élégante.
La notation d’Einstein élimine toute ambiguïté relative au broadcasting en contraignant le développeur à étiqueter explicitement chaque axe dimensionnel au moyen d’un caractère alphabétique unique au sein d’une chaîne de formatage déclarative. Reprenons le problème de la multiplication de nos matrices C de forme (2, 2) et D de forme (2, 3). Cette opération s’exprime par l’instruction :
resultat = np.einsum(‘ik,kj->ij’, C, D)
L’analyse de cette chaîne textuelle explicite sans équivoque la mécanique sous-jacente :
- L’indice $i$ parcourt les lignes de la matrice $C$.
- L’indice $k$ parcourt simultanément les colonnes de $C$ et les lignes de $D$, matérialisant l’axe de contraction intérieure.
- L’indice $j$ parcourt les colonnes de $D$.
- La flèche spécifie la morphologie exacte du tenseur attendu en sortie, constitué des axes libres $i$ et $j$, soit une forme finale de (2, 3).
Si le développeur avait eu l’intention erronée d’exécuter un produit de Hadamard, la spécification d’indices répétés sans contraction aurait été rejetée dès l’analyse lexicale de l’expression. Par cette explicitation formelle des indices, numpy.einsum procure une immunité presque totale contre les erreurs d’alignement rétrograde imprévues tout en optimisant le parcours de la mémoire par le choix automatique des ordonnancements de calcul les plus performants.
10. Interactions avec d’autres bibliothèques de l’écosystème Python
Le calcul matriciel contemporain ne s’effectue que rarement en autarcie au sein de scripts NumPy purs. Les données transitent en permanence entre diverses bibliothèques spécialisées, chacune appliquant ses propres abstractions et règles de gestion des métadonnées, ce qui multiplie les risques de rupture dimensionnelle.
10.1 Conflits dimensionnels avec Pandas DataFrame et Series
La bibliothèque Pandas, dédiée à l’ingénierie et à l’analyse de données tabulaires, repose structurellement sur NumPy pour le stockage interne de ses blocs de données. Toutefois, son modèle computationnel introduit un niveau d’abstraction supplémentaire déterminant : l’alignement explicite par les index de lignes et les noms de colonnes.
Lorsqu’un utilisateur exécute une opération arithmétique binaire entre deux instances de DataFrame ou entre une DataFrame et une Series, Pandas ne se contente pas d’examiner la géométrie brute des blocs en mémoire : il tente en priorité de fusionner les index textuels ou temporels. Si les index ne se recouvrent pas intégralement, la bibliothèque ne lève pas nécessairement une ValueError, mais introduit des valeurs manquantes (NaN) sur les zones d’incohérence, ce qui peut masquer le problème géométrique sous-jacent.
Le conflit de diffusion pur surgit de manière explosive lorsqu’un tableau NumPy natif interagit directement avec un objet Pandas. Dans cette situation, le protocole de diffusion de NumPy prend le pas sur l’alignement d’index, mais la conversion implicite de la Series (qui possède souvent une forme unidimensionnelle (N,) sans index de colonne) peut se désynchroniser totalement de la matrice bidimensionnelle sous-jacente. Pour éviter ces écueils, il est fortement recommandé d’extraire explicitement les tableaux sous-jacents via la propriété .to_numpy() ou d’utiliser les méthodes d’alignement avec spécification stricte de l’axe, telles que df.add(series, axis=0).
10.2 Parallélisme avec PyTorch et TensorFlow
Les infrastructures d’apprentissage profond majeures, au premier rang desquelles figurent PyTorch et TensorFlow, ont scrupuleusement repris les conventions de broadcasting introduites par NumPy. Cette homogénéité conceptuelle permet aux chercheurs de transférer leurs intuitions mathématiques sans réapprentissage syntaxique. Néanmoins, les messages d’erreurs et les contraintes de typage présentent des particularismes propres.
Sous PyTorch, l’échec de diffusion lors d’une opération élément par élément ne lève pas une ValueError de type NumPy, mais une exception de type RuntimeError dont la formulation explicite précise :
RuntimeError: The size of tensor a (2) must match the size of tensor b (3) at non-singleton dimension 1
Bien que le vocabulaire diffère, désignant les dimensions unitaires sous le vocable de singleton dimensions, la cause mathématique demeure rigoureusement identique : un refus d’alignement le long de l’axe 1 en l’absence de taille unitaire permissive. Les méthodes de remédiation suivent un parallélisme absolu : la méthode torch.unsqueeze() se substitue à np.expand_dims(), la méthode torch.view() émule le comportement de reshape(), et l’opérateur @ demeure le standard immuable pour invoquer les routines BLAS optimisées pour le calcul sur processeur graphique.
10.3 Traitement de matrices creuses via Scipy Sparse
Lors du traitement de graphes à grande échelle, de problèmes d’éléments finis ou d’analyses textuelles basées sur des sacs de mots, la majorité des coefficients matriciels sont nuls. L’utilisation de représentations matricielles denses deviendrait prohibitive pour la mémoire vive. Le sous-module scipy.sparse fournit des formats de stockage compressés spécialisés, tels que le format CSR (Compressed Sparse Row) et CSC (Compressed Sparse Column).
Ces structures creuses appliquent des restrictions géométriques particulièrement rigoureuses :
- Le mécanisme de broadcasting implicite généralisé y est délibérément restreint, voire totalement désactivé pour la plupart des opérations non linéaires, afin de prévenir la densification accidentelle de la matrice, ce qui saturerait instantanément la mémoire vive du système.
- Toute tentative d’additionner un tableau dense unidimensionnel avec une matrice creuse CSR sans alignement dimensionnel strict lève immédiatement une exception d’incompatibilité morphologique.
- La composition matricielle creuse requiert une concordance dimensionnelle absolue et l’usage de méthodes dédiées, imposant au développeur de convertir explicitement les composantes denses en formats creux compatibles avant toute opération arithmétique.
11. Bonnes pratiques d’ingénierie logicielle pour prévenir les erreurs de diffusion
L’élimination définitive des anomalies de broadcasting dans les systèmes logiciels complexes ne relève pas de la correction empirique au cas par cas, mais de l’application rigoureuse de patrons de conception (design patterns) et de principes d’ingénierie logicielle éprouvés.
11.1 Conception de fonctions mathématiques pures et idempotentes
Au sein des modules de calcul scientifique, la maintenabilité du code est directement proportionnelle à l’absence d’effets de bord non documentés. Une fonction computationnelle doit se comporter comme une fonction pure au sens mathématique : elle doit produire un résultat dépendant exclusivement de ses paramètres d’entrée, sans altérer l’état interne de ces derniers.
Il est impératif d’isoler toutes les opérations de redimensionnement et d’expansion dimensionnelle au sein d’unités logiques closes. Modifier directement la forme d’un tableau transmis en paramètre d’entrée peut impacter silencieusement les autres sections du programme qui partagent une référence ou une vue sur cette même structure mémoire. Les bonnes pratiques imposent de traiter les arguments d’entrée comme des objets immutables, en instanciant systématiquement de nouvelles vues explicites lorsque des ajustements de morphologie s’avèrent nécessaires.
De surcroît, la documentation des fonctions via des docstrings formelles (suivant par exemple le standard NumPy Docstring) doit préciser sans ambiguïté les préconditions géométriques requises. Spécifier clairement que le paramètre d’entrée doit respecter la forme générique (N, C) ou (N, H, W) fournit un contrat de développement clair, permettant aux utilisateurs de l’API de calibrer leurs tenseurs en amont de l’appel.
11.2 Gestion rigoureuse du cas pathologique des tableaux 1D
Comme nous l’avons souligné à plusieurs reprises, le tableau unidimensionnel de forme (N,) constitue la source prépondérante des régressions silencieuses et des exceptions inattendues en calcul matriciel. Sa neutralité topologique en fait un objet ambigu que l’interpréteur tente d’adapter selon des règles qui ne coïncident pas nécessairement avec les intentions de l’ingénieur.
Pour immuniser un projet contre ces dérives, il est hautement recommandé d’adopter une convention d’orientation explicite dès l’entrée des pipelines computationnels. Tout tableau destiné à subir des opérations d’algèbre linéaire doit être formellement promu au rang de structure bidimensionnelle canonique :
- Les vecteurs colonnes doivent être explicitement instanciés ou convertis sous la forme (N, 1).
- Les vecteurs lignes doivent être rigoureusement structurés sous la forme (1, N).
L’implémentation de fonctions d’assainissement en entrée de module (fonctions dites de standardisation dimensionnelle) permet d’intercepter les structures plates et d’imposer cette bidimensionnalité de manière automatique, garantissant que l’ensemble des modules aval opère sur des représentations géométriques stables et exemptes d’ambiguïté.
11.3 Intégration de tests unitaires ciblés sur les cas limites dimensionnels
La validation de la robustesse d’un algorithme numérique ne doit pas se limiter à vérifier l’exactitude des calculs sur un échantillon unique idéalement dimensionné. Les suites de tests d’intégration et de tests unitaires, orchestrées par des frameworks tels que pytest, doivent explorer méthodiquement les cas limites dimensionnels.
Les tests paramétrés doivent soumettre les fonctions à une variété contrôlée de topologies d’entrées :
- Évaluation sur des tenseurs contenant des dimensions de taille 1 (cas limites d’activation du broadcasting).
- Validation sur des lots réduits à un échantillon unitaire unique (batch de taille 1) pour vérifier l’absence d’effondrement dimensionnel destructif suite à un appel imprudent à squeeze().
- Test intentionnel de passage d’arguments dimensionnellement discordants pour vérifier que l’architecture logicielle réagit de manière prévisible en levant les exceptions adéquates plutôt qu’en générant des résultats corrompus.
En automatisant ces tests au sein des chaînes d’intégration continue (CI/CD), l’équipe de développement s’assure qu’aucune modification ultérieure du code ou qu’aucune mise à jour de l’interpréteur n’introduira de régression dimensionnelle latente dans les modules critiques de calcul.
12. Synthèse méthodologique et arbre décisionnel de débogage
Pour conclure cette étude approfondie, il convient de synthétiser les concepts exposés au sein d’une grille méthodologique opérationnelle, permettant à l’ingénieur confronté à l’exception ValueError: operands could not be broadcast together with shapes d’engager une résolution déterministe et structurée.
12.1 Arbre décisionnel pas à pas face à ValueError
Dès l’apparition de l’erreur dans la console d’exécution, la trajectoire diagnostique doit suivre les étapes chronologiques suivantes :
- Étape 1 : Clarification de la finalité mathématique. Interrogez formellement la sémantique de l’opération requise. Recherchez-vous une transformation élément par élément (produit de Hadamard, masquage, normalisation statistique) ou une composition linéaire au sens de l’algèbre vectorielle (produit matriciel canonique) ? Si l’opération visée est un produit matriciel classique, substituez immédiatement l’opérateur infixé @ ou la fonction np.matmul() à l’opérateur astérisque *.
- Étape 2 : Inspection instrumentale des métadonnées. Imprimez ou observez dans l’environnement de débogage les tuples retournés par l’attribut .shape de l’ensemble des tableaux participant à l’expression arithmétique litigieuse. Notez explicitement l’ordre des formes mentionnées dans le message d’exception.
- Étape 3 : Application manuelle de l’alignement rétrograde. Alignez visuellement les dimensions de droite à gauche. Identifiez précisément l’axe où se manifeste la rupture d’égalité sans présence de la valeur 1. Si une dimension plate de rang 1 (N,) est présente, qualifiez son orientation désirée.
- Étape 4 : Sélection et application du correcteur morphologique approprié.
- Pour orienter un vecteur plat : insérez un axe unitaire via v[:, np.newaxis] ou np.expand_dims(v, axis).
- Pour aligner des colonnes et des lignes inversées : permutez les axes avec la transposition .T ou np.transpose().
- Pour adapter une volumétrie préservée : réagencez la grille par .reshape().
- Pour des architectures tensorielles complexes : formalisez l’opération sans ambiguïté via np.einsum().
- Étape 5 : Validation géométrique du tenseur résultant. Vérifiez que le résultat renvoyé possède rigoureusement la forme géométrique théoriquement attendue et que les calculs numériques ne contiennent pas d’artefacts d’extrapolation inattendus.
12.2 Tableau récapitulatif des divergences d’opérateurs
Le tableau suivant met en regard les principaux outils d’interaction matricielle et tensorielle de la bibliothèque NumPy, récapitulant leurs préconditions géométriques et leurs caractéristiques computationnelles respectives :
| Opérateur / Méthode | Type d’opération réalisée | Conditions d’admissibilité des formes | Impact mémoire et exécution |
|---|---|---|---|
| Opérateur * | Produit de Hadamard (élément par élément) | Broadcasting strict de droite à gauche : égalité des axes ou présence de la dimension 1. | Optimal en temps $\mathcal{O}(N)$ ; aucune allocation redondante grâce aux foulées nulles. |
| Opérateur @ / np.matmul() | Produit matriciel classique (composition) | L’avant-dernier axe du premier opérande doit correspondre au dernier axe du second. Diffusion par lot sur les axes supérieurs. | Complexité cubique ou sous-cubique ; délègue aux routines BLAS hautement vectorisées. Interdit les scalaires. |
| np.dot() | Produit scalaire / Contraction d’axes | Dernier axe du premier opérande égal à l’avant-dernier axe du second opérande. | Similaire à matmul sur matrices 2D ; réalise une contraction tensorielle globale imprévue sur tenseurs de rang > 2. |
| np.einsum() | Sommation tensorielle d’Einstein | Conformité absolue aux étiquettes d’indices spécifiées dans l’équation textuelle. | Contrôle absolu ; optimise les chemins de contraction sans copie mémoire superflue. |
| np.reshape() | Restructuration morphologique | Le produit des composantes de la nouvelle forme doit égaler le nombre total d’éléments (size). | Coût nul $\mathcal{O}(1)$ si la mémoire est contiguë (génération d’une simple vue sans copie). |
12.3 Recommandations finales pour la robustesse du code de calcul
La maîtrise du calcul vectoriel dans l’écosystème Python exige de dépasser la complaisance syntaxique au profit d’une rigueur d’ingénierie absolue. La concision apparente offerte par les mécanismes implicites de NumPy, si elle accélère le prototypage exploratoire, devient une source de vulnérabilité technique majeure lorsqu’elle n’est pas adossée à une compréhension lucide des structures sous-jacentes.
Il est impératif de privilégier systématiquement l’explicite face à l’implicite, conformément aux préceptes fondamentaux de la philosophie logicielle de Python. Documenter précisément les dimensions au sein des signatures d’interfaces, proscrire les vecteurs unidimensionnels non orientés dans les fonctions d’algèbre linéaire, préférer les opérateurs modernes dédiés tels que l’arobase (@) et recourir à la notation d’Einstein pour les calculs multidimensionnels complexes sont les fondements d’une pratique d’ingénierie numérique de haut niveau.
En abordant l’exception ValueError: operands could not be broadcast together with shapes non comme un obstacle imprévu mais comme le rappel rigoureux d’une vérité géométrique incontournable, le développeur et le chercheur transforment un point de blocage en une opportunité d’assainir, d’optimiser et de pérenniser leurs architectures de calcul matriciel.
Références
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- NumPy Developers. (2023). Broadcasting. NumPy Documentation. Consulté le 15 octobre 2023 à l’adresse https://numpy.org/doc/stable/user/basics.broadcasting.html
- Python Software Foundation. (2014). PEP 465 – A dedicated infix operator for matrix multiplication. Python Enhancement Proposals. Consulté le 15 octobre 2023 à l’adresse https://peps.python.org/pep-0465/
- van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22–30. https://doi.org/10.1109/MCSE.2011.37
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2