
L’analyse de variance à deux facteurs, communément désignée sous l’appellation anglo-saxonne de two-way ANOVA, constitue l’un des piliers méthodologiques les plus robustes et les plus répandus au sein du modèle linéaire général. Conçue à l’origine par le statisticien Ronald Aylmer Fisher pour évaluer simultanément l’impact de plusieurs interventions agronomiques, cette approche s’est rapidement imposée comme un standard incontournable dans les sciences expérimentales, la recherche biomédicale, le marketing quantitatif et, tout particulièrement, la psychologie et les sciences du comportement. En permettant d’examiner non seulement l’influence isolée de deux variables explicatives catégorielles sur une variable dépendante continue, mais également leur potentiel effet synergique ou antagoniste au travers du terme d’interaction, l’ANOVA factorielle transcende les limites analytiques inhérentes à la juxtaposition d’analyses unifactorielles indépendantes.
Dans l’écosystème du traitement des données statistiques massives et hautement régulées, l’environnement SAS (Statistical Analysis System) représente la référence historique et institutionnelle de prédilection. Grâce à des procédures dédiées telles que PROC GLM et PROC ANOVA, le logiciel offre une puissance de calcul matriciel, une flexibilité de paramétrage et une précision numérique inégalées. Toutefois, l’utilisation rigoureuse de SAS pour exécuter une analyse de variance factorielle ne se résume pas à l’écriture machinale de quelques lignes de code. Elle exige une compréhension intime des fondements mathématiques sous-jacents, une vigilance constante quant au respect des postulats d’application, et une maîtrise subtile de la décomposition des sommes des carrés, particulièrement en présence de plans expérimentaux déséquilibrés où l’orthogonalité des facteurs se trouve compromise.
Ce guide exhaustif a été conçu pour accompagner pas à pas les chercheurs, les biostatisticiens et les analystes de données dans la mise en œuvre, l’interprétation et la communication d’une ANOVA à deux facteurs au moyen du logiciel SAS. De la formalisation algébrique du modèle linéaire aux subtilités syntaxiques de l’estimation des moyennes des moindres carrés (LS-means), en passant par les diagnostics résiduels approfondis, les analyses d’effets simples (simple effects) et la rédaction académique conforme aux normes internationales de l’American Psychological Association (APA 7e édition), cet article propose une immersion méthodologique complète, rigoureuse et directement applicable à vos travaux de recherche empirique.
1. Fondements théoriques et mathématiques de l’ANOVA à deux facteurs
1.1 Définition, objectifs et principes du modèle linéaire général
L’analyse de variance factorielle à deux critères de classification représente une extension directe et naturelle de l’analyse de variance à un facteur. Alors que l’ANOVA simple se borne à évaluer l’impact d’une unique variable nominale ou ordinale découpée en plusieurs modalités sur une réponse quantitative continue, l’ANOVA à deux facteurs permet d’intégrer conjointement deux dimensions explicatives au sein d’un même dispositif analytique. Cette démarche s’inscrit pleinement dans le cadre du modèle linéaire général, qui postule que toute observation quantitative individuelle peut être décomposée en une somme pondérée d’effets constants associés aux catégories d’appartenance de l’individu, augmentée d’une composante aléatoire résiduelle inexpliquée représentant l’erreur de mesure et les variations interindividuelles fortuites.
Sur le plan fondamental de la théorie statistique, le principe cardinal de l’ANOVA repose sur la partition méthodique de la variance totale observée au sein de l’échantillon. La variabilité globale de la variable dépendante est fractionnée en sous-composantes additives et mutuellement exclusives : la variance attribuable au premier facteur principal (noté arbitrairement facteur A), la variance attribuable au second facteur principal (facteur B), la variance imputable à l’interaction conjointe des deux facteurs (produit croisé A × B), et la variance intra-groupe ou résiduelle. Cette décomposition analytique permet d’évaluer dans quelle mesure la dispersion des moyennes cellulaires s’éloigne de ce qui serait attendu sous le seul effet des fluctuations aléatoires d’échantillonnage.
L’écriture mathématique formelle du modèle linéaire factoriel pour deux facteurs indépendants à effets fixes s’exprime traditionnellement de la manière suivante pour chaque observation individuelle :
$$Y_{ijk} = \mu + \alpha_i + \beta_j + (\alpha\beta)_{ij} + \epsilon_{ijk}$$
Dans cette équation paramétrique :
- $Y_{ijk}$ représente la valeur quantifiée de la variable dépendante mesurée pour le $k$-ième individu appartenant à la $i$-ième modalité du facteur A et à la $j$-ième modalité du facteur B.
- $\mu$ désigne la moyenne générale théorique (ou grand mean) de l’ensemble de la population de référence.
- $\alpha_i$ correspond à l’effet fixe spécifique induit par l’appartenance à la $i$-ième modalité du facteur A, mesuré sous la contrainte d’identifiabilité usuelle $\sum \alpha_i = 0$.
- $\beta_j$ symbolise l’effet fixe propre rattaché à la $j$-ième modalité du facteur B, satisfaisant la contrainte $\sum \beta_j = 0$.
- $(\alpha\beta)_{ij}$ matérialise le terme d’interaction bidimensionnelle entre la modalité $i$ du facteur A et la modalité $j$ du facteur B, reflétant l’écart entre la réponse observée et la stricte additivité des effets principaux, sous les contraintes marginales $\sum_i (\alpha\beta)_{ij} = 0$ et $\sum_j (\alpha\beta)_{ij} = 0$.
- $\epsilon_{ijk}$ incarne le terme d’erreur résiduelle stochastique, supposé indépendant et identiquement distribué selon une loi normale centrée d’espérance nulle et de variance constante $\sigma^2$, soit $\epsilon_{ijk} \sim \mathcal{N}(0, \sigma^2)$.
Sur cette base structurelle, le chercheur formule trois séries distinctes d’hypothèses statistiques bivalentes. Pour le premier effet principal, l’hypothèse nulle stipule l’égalité parfaite des moyennes marginales du facteur A :
$$H_0^{(A)} : \alpha_1 = \alpha_2 = dots = \alpha_I = 0 \quad \text{contre} \quad H_1^{(A)} : \exists , i \text{ tel que } \alpha_i \neq 0$$
De manière analogue, l’hypothèse nulle relative au second effet principal pose l’invariance des effets marginaux du facteur B :
$$H_0^{(B)} : \beta_1 = \beta_2 = dots = \beta_J = 0 \quad \text{contre} \quad H_1^{(B)} : \exists , j \text{ tel que } \beta_j \neq 0$$
Enfin, l’hypothèse nulle relative au terme d’interaction postule la stricte additivité linéaire des influences des deux facteurs, signifiant qu’aucun ajustement conjoint spécifique n’est requis au niveau des cellules factorielles :
$$H_0^{(AB)} : (\alpha\beta)_{ij} = 0 \quad \forall , (i,j) \quad \text{contre} \quad H_1^{(AB)} : \exists , (i,j) \text{ tel que } (\alpha\beta)_{ij} \neq 0$$
1.2 Distinction conceptuelle entre effets principaux et effets d’interaction
La distinction conceptuelle entre effets principaux et effets d’interaction constitue le cœur épistémologique de l’analyse factorielle. Un effet principal quantifie l’influence moyenne globale et isolée d’un facteur expérimental sur la variable dépendante, calculée en agrégeant l’ensemble des données par-dessus les modalités du second facteur. Autrement dit, l’effet principal du facteur A évalue si les moyennes marginales associées à chaque niveau de A diffèrent significativement les unes des autres, comme si le facteur B n’existait pas ou était maintenu parfaitement constant par homogénéisation statistique. Cette métrique offre une vue panoramique de l’impact moyen d’une variable de classification dans la population étudiée.
À l’inverse, l’effet d’interaction traduit une réalité beaucoup plus nuancée : il signale formellement que l’impact d’un facteur sur la variable réponse ne demeure pas invariant, mais varie en magnitude ou en direction selon le niveau spécifique occupé par le second facteur. L’interaction capture ainsi la non-additivité des effets. D’un point de vue clinique ou sociologique, cela signifie par exemple que l’efficacité d’un traitement pharmacologique (facteur A) dépend étroitement de la tranche d’âge ou du profil génétique des patients (facteur B), rendant illusoire toute conclusion uniforme et universelle qui occulterait cette contingence.
Il existe une hiérarchie interprétative universellement admise dans la communauté des biostatisticiens : l’examen critique du terme d’interaction doit impérativement précéder l’interprétation des effets principaux. En effet, en présence d’une interaction statistiquement significative et de grande magnitude, les effets principaux peuvent être profondément trompeurs, voire dépourvus de toute validité empirique. Si les effets se compensent mutuellement selon les strates du second facteur, un effet principal peut sembler nul alors que le facteur exerce une influence déterminante mais opposée d’un sous-groupe à l’autre. Inversement, un effet principal fortement significatif peut n’être tiré que par une seule cellule factorielle atypique.
Dans ce cadre, la littérature méthodologique opère une différenciation formelle entre les interactions dites ordinales et les interactions désordinales :
- L’interaction ordinale : les profils de réponse représentés graphiquement ne sont pas parallèles, reflétant une modulation de l’intensité de l’effet, mais les lignes de pente ne se croisent jamais. La hiérarchie relative entre les modalités du premier facteur demeure inchangée quel que soit le niveau du second facteur. Dans une telle configuration, l’effet principal conserve une signification pratique directionnelle incontestable, bien que son amplitude doive être modulée lors du compte-rendu.
- L’interaction désordinale (ou croisée) : les courbes de moyennes se coupent franchement sur le graphique factoriel. La direction même de l’effet s’inverse en fonction des niveaux de l’autre variable : un traitement s’avère supérieur chez les hommes mais inférieur chez les femmes. Face à une interaction désordinale majeure, l’interprétation isolée des effets principaux devient méthodologiquement invalide et potentiellement dangereuse dans la prise de décision thérapeutique ou managériale.
1.3 Pertinence méthodologique en psychologie et sciences du comportement
Dans les disciplines empiriques explorant la complexité de l’esprit et des interactions humaines, à l’instar de la psychologie cognitive, de la neuropsychologie, de la psychiatrie et des sciences organisationnelles, la causalité unifactorielle simple s’avère presque toujours insuffisante pour modéliser la réalité phénoménologique. Les comportements humains émergent en effet constamment du croisement dynamique entre des variables dispositionnelles internes (traits de personnalité, vulnérabilité génétique, statut cognitif basal) et des variables situationnelles externes (stress environnemental, type de consigne expérimentale, nature de l’amorce contextuelle). L’ANOVA à deux facteurs offre le cadre analytique parfait pour formaliser ces modèles interactionnistes classiques, popularisés notamment par les théories diathèse-stress.
Au-delà de la découverte de synergies conceptuelles, l’intégration d’un second facteur dans un plan d’expérience répond à un impératif méthodologique crucial : le contrôle statistique des variables parasites et la neutralisation des facteurs de confusion. Lorsqu’une variable d’arrière-plan susceptible d’influencer la réponse — comme le sexe biologique, le niveau sociodémographique ou le centre d’inclusion clinique — est explicitement intégrée comme facteur de stratification dans le modèle linéaire, sa contribution à la variabilité de la variable réponse est mathématiquement isolée et retirée de la variance résiduelle.
Cette élimination calculatoire de la variance parasite entraîne un bénéfice direct et immédiat sur la performance de l’appareil inférentiel : l’optimisation drastique de la puissance statistique. En réduisant la somme des carrés de l’erreur au dénominateur du ratio de Fisher ($F$), la valeur observée du test augmente mécaniquement pour un effet principal donné. L’analyste se dote ainsi d’une capacité considérablement accrue à rejeter l’hypothèse nulle lorsqu’elle est effectivement fausse, sans pour autant devoir gonfler démesurément la taille globale de sa cohorte expérimentale. La formalisation multifactorielle maximise donc le rendement informationnel de chaque observation recueillie.
2. Conditions d’application et postulats statistiques préalables
2.1 L’hypothèse de normalité distributionnelle des résidus
L’inférence paramétrique adossée à l’analyse de variance repose sur la dérivation de lois de probabilités exactes régies par le ratio de deux distributions de khi-deux indépendantes. Cette élégante mécanique mathématique requiert impérativement que la variable dépendante suive une loi normale au sein de chacune des populations sous-jacentes définies par les cellules du plan factoriel, ce qui équivaut rigoureusement à postuler la normalité de la distribution des erreurs résiduelles du modèle global.
Le test $F$ de Fisher présente une sensibilité différentielle aux écarts à la normalité selon la nature de la distorsion. Il s’avère modérément vulnérable aux asymétries prononcées (skewness), qui déplacent la moyenne cellulaire à distance de la médiane et faussent l’estimation de l’erreur quadratique, mais se montre particulièrement sensible aux anomalies d’aplatissement (kurtosis). La présence de distributions leptokurtiques, caractérisées par des queues épaisses et une surreprésentation d’observations extrêmes, comprime artificiellement la variance résiduelle moyenne tout en produisant des écarts atypiques qui augmentent le taux de faux positifs au-delà du seuil de tolérance nominal fixé par le chercheur.
Il convient néanmoins de souligner la remarquable robustesse du modèle linéaire général face aux violations modérées de la normalité, en vertu des propriétés asymptotiques formalisées par le théorème central limite. Dès lors que les effectifs par cellule atteignent un seuil raisonnable (couramment établi à au moins vingt à trente observations par sous-groupe dans un design factoriel équilibré), la distribution des moyennes d’échantillonnage converge rapidement vers la normalité, préservant la validité nominale des valeurs $p$ délivrées par la procédure SAS.
Une confusion récurrente observée chez les praticiens juniors réside dans l’objet même de l’évaluation distributionnelle. Il est formellement erroné d’exiger la normalité de la variable dépendante brute agrégée sur l’ensemble de la cohorte. Si les facteurs du plan exercent des effets marqués sur la réponse, la distribution globale de la variable prendra inévitablement une allure bimodale ou plurimodale. Le postulat de normalité ne concerne strictement que les résidus conditionnels intra-cellulaires, c’est-à-dire les déviations des individus par rapport à la moyenne estimée de leur groupe d’appartenance.
2.2 L’homogénéité des variances intra-cellulaires (homoscédasticité)
Le postulat d’homoscédasticité stipule que la dispersion des erreurs aléatoires doit demeurer strictement invariable à travers toutes les combinaisons factorielles composant le plan de recherche. En termes formels, chaque cellule $(i,j)$ du croisement des facteurs doit être caractérisée par une variance résiduelle théorique identique, notée $\sigma_{ij}^2 = \sigma^2$. Cette exigence découle directement du fait que l’ANOVA mutualise l’ensemble des variances internes aux cellules pour forger un estimateur composite unique de l’erreur expérimentale au dénominateur du test de Fisher : le carré moyen résiduel.
La violation de cette homogénéité — qualifiée d’hétéroscédasticité — engendre des distorsions sévères sur les propriétés inférentielles de l’analyse. Lorsqu’elle survient, l’utilisation d’un carré moyen d’erreur combiné ne reflète plus adéquatement la variabilité propre à chaque groupe, ce qui conduit à une altération majeure du taux d’erreur de première espèce (le risque d’erreur $\alpha$). Dans certaines configurations, le test statistique devient excessivement libéral, déclarant hautement significatives des différences purement aléatoires ; dans d’autres cas, il devient exagérément conservateur, étouffant des effets thérapeutiques ou psychologiques pourtant substantiels.
Le péril statistique de l’hétéroscédasticité atteint son paroxysme lorsqu’elle s’articule à un déséquilibre d’effectifs entre les cellules expérimentales :
- Le cas appariement conservateur : lorsque les cellules à petits effectifs présentent les variances résiduelles les plus faibles, tandis que les grandes cellules affichent une forte dispersion, le test $F$ devient artificiellement conservateur. La puissance statistique s’effondre de manière drastique, masquant de véritables découvertes scientifiques.
- Le cas appariement libéral : à l’inverse, si les petits groupes expérimentaux concentrent la plus forte variabilité interne tandis que les grands groupes sont très homogènes, le test $F$ devient dramatiquement libéral. Le taux de faux positifs effectif peut s’envoler pour atteindre 15 % ou 20 % pour un seuil nominal théorique programmé à 5 %, induisant les investigateurs en erreur de façon critique.
2.3 Indépendance des observations et structure d’échantillonnage
Parmi l’ensemble des postulats probabilistes adossés à l’analyse de variance à deux facteurs inter-sujets, celui de l’indépendance mutuelle des observations constitue de loin le plus intransigeant et le moins négociable. Le modèle suppose que l’erreur résiduelle associée à une mesure n’apporte strictement aucune information quantifiée sur l’erreur résiduelle d’une autre mesure. Cette condition exigeante est garantie en amont par la qualité de l’architecture méthodologique : échantillonnage probabiliste rigoureux, recrutement non corrélé et assignation aléatoire des sujets au sein des différentes conditions expérimentales.
Sur le plan structural, le chercheur doit opérer une distinction taxonomique limpide entre les facteurs inter-sujets (dits between-subjects) et les facteurs intra-sujets (dits within-subjects ou à mesures répétées). L’ANOVA factorielle standard exécutée sous la syntaxe élémentaire de PROC GLM requiert impérativement que chaque sujet statistique n’apparaisse que dans une et une seule cellule du plan factoriel. Dès lors qu’un même participant est évalué à plusieurs reprises dans le temps, ou qu’il est exposé successivement à l’ensemble des conditions expérimentales, l’indépendance s’effondre du fait de la corrélation intra-individuelle inhérente à la biologie et à la psychologie des sujets.
La présence pernicieuse d’une structure de corrélation non modélisée — issue de mesures répétées omises, de regroupements naturels (patients imbriqués au sein d’hôpitaux, élèves regroupés au sein de classes scolaires) ou de mesures longitudinales sérielles — détruit l’intégrité du calcul des degrés de liberté. La statistique de Fisher surestime de façon spectaculaire les degrés de liberté réels de l’erreur, générant une cascade d’erreurs de type I massives. En présence de telles architectures hiérarchisées ou corrélées, l’analyste SAS se doit d’abandonner l’ANOVA factorielle classique à effets fixes pour basculer vers les modèles linéaires mixtes implémentés dans PROC MIXED.
3. Structuration et préparation des données dans l’environnement SAS
3.1 Syntaxe de l’étape DATA et saisie directe des observations
L’amorce de toute démarche analytique au sein de l’environnement SAS requiert la formalisation d’une table de données impeccablement structurée au travers de la classique étape DATA. Dans l’architecture SAS, une observation correspond impérativement à une ligne physique unique dans la table (format long), et chaque colonne représente une caractéristique spécifique mesurée : les identifiants, les facteurs de classification nominale ou ordinale, et la variable dépendante continue d’intérêt métrique.
Lors de la saisie manuelle de données de recherche au moyen de l’instruction INPUT, l’analyste doit veiller à déclarer explicitement le typage des variables. Les variables qualitatives destinées à jouer le rôle de facteurs de classification factorielle doivent être assorties du spécificateur alphanumérique dollar ($) lorsqu’elles comportent des libellés textuels. La variable dépendante continue, quant à elle, demeure purement numérique par défaut. L’injection physique des valeurs est prise en charge via l’instruction historique DATALINES; (ou son équivalent sémantique CARDS;).
Afin d’assurer la clarté et la pérennité documentaire du programme, il est hautement recommandé d’associer des métadonnées d’attributs dès l’étape d’initialisation. L’instruction LABEL permet d’assigner des descriptions textuelles élégantes qui seront automatiquement reproduites sur l’ensemble des rapports et graphiques générés ultérieurement par les procédures statistiques. De surcroît, l’instruction FORMAT peut être mobilisée conjointement avec une procédure PROC FORMAT préalable afin de masquer des codages numériques bruts (par exemple 0 et 1) derrière des étiquettes sémantiques explicites, garantissant ainsi l’intelligibilité des sorties analytiques.
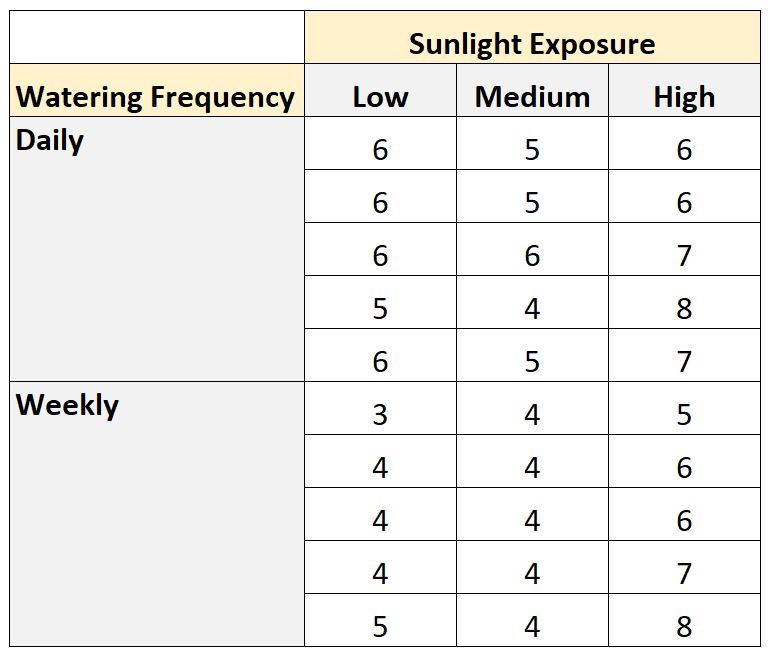
Voici l’illustration concrète d’une étape DATA SAS configurant une recherche factorielle 2×3 évaluant les scores d’anxiété en fonction du sexe du patient et du type de protocole thérapeutique administré :
DATA EssaiClinique;

    INPUT Sexe $ Traitement $ ScoreAnxiete @@;

    LABEL Sexe = "Sexe biologique du patient"

          Traitement = "Protocole thérapeutique expérimental"

          ScoreAnxiete = "Score d'anxiété post-intervention (STAI)";

    DATALINES;

Femme Placebo 45 Femme Placebo 48 Femme TCC 32 Femme TCC 29 Femme Mindfulness 35 Femme Mindfulness 38

Homme Placebo 52 Homme Placebo 50 Homme TCC 41 Homme TCC 39 Homme Mindfulness 42 Homme Mindfulness 44

;

RUN;
3.2 Importation et nettoyage de fichiers externes avec PROC IMPORT
Dans la pratique scientifique contemporaine, le recueil des données s’opère rarement par saisie directe dans l’éditeur de programmes SAS ; il transite plutôt par des classeurs Microsoft Excel, des fichiers tabulaires délimités de type CSV, ou des extractions brutes issues d’entrepôts de données relationnels (bases SQL, plateformes REDCap). L’automatisation de ce processus est confiée à la procédure système PROC IMPORT, conçue pour ingérer rapidement des matrices externes tout en tentant d’inférer intelligemment la nature des colonnes.
Néanmoins, l’importation automatisée nécessite une rigueur de contrôle absolue sous peine de corrompre l’ensemble des étapes analytiques subséquentes. L’analyste doit vérifier méthodiquement dans la fenêtre du journal (le Log SAS) qu’aucune variable qualitative n’a été tronquée en raison d’une largeur de chaîne insuffisante par défaut. Il convient également de veiller à ce que les modalités de facteurs ne soient pas polluées par des hétérogénéités typographiques silencieuses, telles que des espaces insécables parasites, des divergences de casse (par exemple Placebo versus placebo) ou des accents mal encodés qui transformeraient une modalité unique en deux niveaux distincts aux yeux du compilateur SAS.
Le nettoyage post-importation s’effectue habituellement par une étape DATA de sécurisation employant des fonctions de normalisation textuelle telles que UPCASE(), STRIP() ou COMPBL(). De surcroît, la détection des enregistrements redondants s’opère sans équivoque via la procédure PROC SORT assortie de l’option de déduplication NODUPKEY, garantissant que chaque ligne du jeu de données final corresponde rigoureusement à un sujet statistique unique et authentique.
3.3 Exploration descriptive préliminaire du plan factoriel
Avant d’engager le moindre calcul inférentiel paramétrique, une inspection descriptive systématique de l’architecture du plan d’expérience s’impose comme une règle de bonne pratique inaliénable. La première interrogation à laquelle l’analyste doit répondre avec certitude concerne l’équilibre du dispositif expérimental. La procédure PROC FREQ fournit l’outil idéal pour dresser un tableau de contingence croisant l’ensemble des modalités du facteur A et du facteur B :
PROC FREQ DATA=EssaiClinique;

    TABLES Sexe * Traitement / LIST MISSING NOROW NOCOL NOPERCENT;

RUN;
Ce diagnostic d’effectifs cellulaires permet d’attester sans ambiguïté si le plan factoriel est parfaitement équilibré (orthogonal), c’est-à-dire doté d’un nombre $n$ rigoureusement identique d’observations dans chacune des cellules, ou s’il s’agit d’un plan déséquilibré consécutif à une attrition expérimentale ou à un échantillonnage d’observation non contrôlé. L’orthogonalité confère à l’ANOVA la propriété mathématique remarquable d’indépendance parfaite entre les sommes des carrés partielles, simplifiant considérablement le paysage inférentiel.
Dans un second temps, le calcul des indicateurs de tendance centrale et de dispersion par sous-groupe factoriel est orchestré via la procédure PROC MEANS. En ventilant les observations au moyen de l’instruction CLASS Sexe Traitement;, SAS produit un inventaire exhaustif des effectifs valides, des moyennes arithmétiques, des écarts-types, des erreurs-types et des intervalles de confiance pour chaque combinaison de facteurs. Cette étape d’exploration empirique fournit un aperçu descriptif immédiat de la plausibilité de l’interaction et permet d’identifier visuellement d’éventuels déséquilibres flagrants de dispersion intra-cellulaire avant même d’engager les tests formels d’homoscédasticité.
4. Mise en œuvre de l’ANOVA à deux facteurs avec PROC GLM
4.1 Architecture générale de l’instruction PROC GLM
La procédure PROC GLM (General Linear Model) constitue la clé de voûte logicielle de SAS pour le traitement exhaustif des modèles d’analyse de variance, qu’ils soient unifactoriels, factoriels ou à mesures répétées. Contrairement à des outils plus élémentaires, PROC GLM a été conçue pour résoudre les équations normales associées au modèle linéaire au travers de techniques d’inversion matricielle généralisée, lui conférant une polyvalence intégrale face à n’importe quelle configuration d’échantillonnage, y compris les dispositifs hautement déséquilibrés.
La syntaxe opératoire de PROC GLM s’articule autour de directives fondamentales obligatoires :
- L’instruction
CLASS: elle déclare solennellement à SAS quelles variables explicatives doivent être traitées comme des variables catégorielles de stratification. Tout facteur qualitatif doit impérativement figurer dans l’instructionCLASSsous peine d’être interprété à tort comme une covariable numérique continue au sein d’une régression linéaire simple. - L’instruction
MODEL: elle formalise la structure de l’équation statistique sous la forme immuableVARIABLE_DEPENDANTE = EFFETS_EXPLICATIFS / OPTIONS;. SAS convertit automatiquement les facteurs mentionnés en variables indicatrices binaires (dummy variables) selon un codage matriciel par défaut reposant sur la suppression de la dernière modalité comme catégorie de référence.
Au-delà de l’estimation standard, PROC GLM permet d’intercepter directement les résultats calculatoires intermédiaires. L’instruction subsidiaire OUTPUT offre la possibilité d’extraire vers une nouvelle table SAS les valeurs ajustées par le modèle (prédites) ainsi que l’ensemble des résidus bruts ou studentisés, pavant ainsi la voie à une analyse diagnostique approfondie des hypothèses du modèle statistique.
PROC GLM DATA=EssaiClinique PLOTS=ALL;

    CLASS Sexe Traitement;

    MODEL ScoreAnxiete = Sexe Traitement Sexe*Traitement / SS3;

    OUTPUT OUT=DiagResidus PREDICTED=Y_Chapeau RESIDUALS=ResiduBrut STUDENT=ResiduStudent;

RUN;

QUIT;
4.2 Spécification formelle des effets principaux et du terme d’interaction
Dans l’instruction MODEL de PROC GLM, la modélisation formelle des effets peut être rédigée selon plusieurs conventions syntaxiques rigoureusement équivalentes sur le plan algorithmique. L’écriture explicite complète énumère individuellement les composantes factorielles : d’abord le facteur principal $A$, puis le facteur principal $B$, et enfin leur terme de croisement représenté par un astérisque : A B A*B. Cette écriture séquentielle présente l’avantage pédagogique de rendre parfaitement apparente la hiérarchisation des degrés de liberté attribués à chaque terme.
Cependant, SAS dispose d’un opérateur syntaxique condensé hautement élégant : la barre verticale (|). En stipulant simplement MODEL Y = A | B;, le compilateur SAS interprète automatiquement cette directive comme une instruction d’expansion factorielle totale. Le système génère automatiquement l’ensemble des effets principaux ainsi que toutes les interactions d’ordre supérieur possibles (en l’espèce, l’effet d’interaction d’ordre 2 A*B). Si l’on travaillait sur un modèle à trois facteurs, l’instruction A | B | C développerait spontanément les trois effets principaux, les trois interactions d’ordre 2 et l’interaction triple d’ordre 3.
Il est fondamental de noter que dans les plans expérimentaux déséquilibrés, l’ordre séquentiel d’entrée des prédicteurs dans l’instruction MODEL influe directement sur les sommes des carrés dites de Type I (séquentielles), mais ne possède absolument aucun impact sur les sommes des carrés de Type III (marginales), ces dernières étant systématiquement évaluées après ajustement complet pour l’ensemble des autres termes présents dans l’équation.
Enfin, si une analyse empirique préalable solidement documentée ou des considérations théoriques impératives démontrent que l’interaction entre les deux facteurs est strictement absente ($\alpha\beta_{ij} = 0$), l’analyste a toute latitude pour estimer un modèle factoriel purement additif en retirant délibérément le terme croisé de l’instruction MODEL : MODEL Y = A B;. Cette simplification structurelle réattribue les degrés de liberté de l’interaction à la variance résiduelle de l’erreur, maximisant potentiellement la puissance statistique liée aux tests des effets principaux résiduels.
4.3 Comparaison méthodologique entre PROC GLM et PROC ANOVA
L’une des interrogations les plus fréquentes des utilisateurs de SAS porte sur l’arbitrage méthodologique entre les procédures sœurs PROC GLM et PROC ANOVA. Bien qu’elles partagent une syntaxe presque jumelle, leurs fondements mathématiques sous-jacents et leurs spectres de validité computationnelle sont radicalement divergents.
La procédure PROC ANOVA exploite des algorithmes de calcul direct formulés spécifiquement pour les plans d’expérience orthogonaux parfaitement équilibrés. Elle calcule les sommes des carrés par simple agrégation des moyennes des cellules, sans recourir à l’inversion de la matrice d’information $(X’X)$. Cette optimisation technique confère à PROC ANOVA une vélocité computationnelle exceptionnelle et une économie substantielle de mémoire vive lorsqu’elle traite des bases de données massives comportant des centaines de milliers de lignes, pourvu que chaque combinaison factorielle possède un effectif $n$ rigoureusement identique.
Cependant, cette rapidité s’accompagne d’une rigidité fatidique : PROC ANOVA est structurellement incapable de traiter convenablement les plans à effectifs inégaux. Dès lors qu’une cellule factorielle présente un effectif discordant d’une seule unité par rapport aux autres, l’orthogonalité est anéantie, et les calculs standards de sommes des carrés délivrés par PROC ANOVA deviennent mathématiquement erronés. Pour sa part, PROC GLM utilise des algorithmes d’inversion matricielle généralisée (décomposition de Cholesky ou méthode de balayage SWEEP) qui résolvent intégralement le système sans supposer l’orthogonalité du design.
En conséquence, la recommandation académique et biostatistique universelle est sans appel : à l’exception de simulations massives exécutées sur des plans d’expérience parfaitement régulés en laboratoire, l’utilisation de PROC GLM doit être systématique pour toute recherche observationnelle ou empirique en sciences humaines et de la santé.
5. Exécution spécialisée avec PROC ANOVA pour les plans équilibrés
5.1 Conditions strictes d’éligibilité de la procédure PROC ANOVA
L’utilisation de la procédure PROC ANOVA en lieu et place de PROC GLM est soumise à des critères d’admissibilité statistiques d’une extrême rigueur. La condition sine qua non réside dans l’égalité parfaite des effectifs au sein de l’intégralité des cellules définies par le croisement factoriel :
$$n_{11} = n_{12} = dots = n_{ij} = n$$
Cette stricte homométrie cellulaire garantit la préservation absolue de l’orthogonalité des sous-espaces vectoriels associés aux facteurs. Dans un dispositif orthogonal, la variabilité partagée entre les facteurs est rigoureusement nulle, ce qui implique que la somme des carrés totale du modèle équivaut exactement à l’addition arithmétique pure des sommes des carrés individuelles associées au facteur A, au facteur B et à l’interaction A*B.
Lorsque cette condition est scrupuleusement honorée, PROC ANOVA déploie toute son efficacité algorithmique. Dans le contexte de méga-données agronomiques, industrielles ou génomiques où les plans de croisement contrôlés génèrent des millions de réplicats par bloc sans aucune perte expérimentale, cette procédure évite la surcharge mémoire induite par l’inversion de gigantesques matrices d’indicatrices binaires, produisant des résultats instantanés avec une consommation minimale de ressources processeur.
5.2 Implémentation syntaxique et options fondamentales
La mise en œuvre pratique de PROC ANOVA s’opère selon une structure syntaxique familière, calquée sur celle des modèles linéaires de SAS. Les instructions maîtresses demeurent CLASS et MODEL, régies par les mêmes règles de spécification des facteurs et du croisement interactif.
Sous PROC ANOVA, l’instruction analytique privilégiée pour inspecter les résultats est la commande MEANS. Cette instruction permet d’ordonner le calcul instantané des moyennes arithmétiques empiriques marginales et croisées, tout en offrant la possibilité de greffer directement des tests de comparaisons multiples classiques :
PROC ANOVA DATA=EssaiCliniqueEquilibre;

    CLASS Sexe Traitement;

    MODEL ScoreAnxiete = Sexe Traitement Sexe*Traitement;

    MEANS Sexe Traitement Sexe*Traitement / TUKEY CLDIFF;

RUN;

QUIT;
Si la procédure détecte au cours de son exécution le moindre écart d’effectif entre les cellules, le compilateur SAS émet immédiatement un avertissement sévère dans le journal d’exécution (Log), signalant textuellement que les données sont déséquilibrées (unbalanced data) et que les valeurs des statistiques de Fisher calculées ainsi que les seuils de signification $p$ associés ne peuvent en aucun cas être considérés comme fiables ou valides pour l’inférence statistique.
5.3 Vulnérabilité analytique face aux données manquantes
Dans la recherche vivante impliquant des sujets humains ou des modèles biologiques, la préservation d’un équilibre parfait d’effectifs relève le plus souvent de la fiction théorique. L’apparition inopinée de données manquantes, causée par l’attrition des participants, la perte d’échantillons biologiques, le refus ponctuel de répondre à un item ou un incident technique en cours de protocole, suffit à détruire instantanément l’orthogonalité d’un dispositif initialement équilibré.
L’utilisation persistante de PROC ANOVA sur des données ayant subi une telle perte introduit un biais structural direct dans l’estimation des carrés moyens. Les sommes des carrés fournies par cette procédure ne compensent pas les pondérations différentielles entre strates, ce qui entraîne une confusion inextricable entre les effets principaux et le terme d’interaction. Les sources de variation se superposent partiellement, brisant l’indépendance statistique des tests de Fisher.
Dès lors qu’une inspection exploratoire préliminaire révèle la présence de la moindre valeur omise ou d’un déséquilibre quantitatif quelconque, le protocole méthodologique impose une transition immédiate et sans compromis vers PROC GLM. Cette dernière prendra automatiquement en charge l’orthogonalité compromise en calculant les estimateurs des moindres carrés pondérés via la métrique des sommes des carrés partielles de Type III.
6. Interprétation approfondie des sorties statistiques de SAS
6.1 Analyse du tableau global d’ajustement du modèle
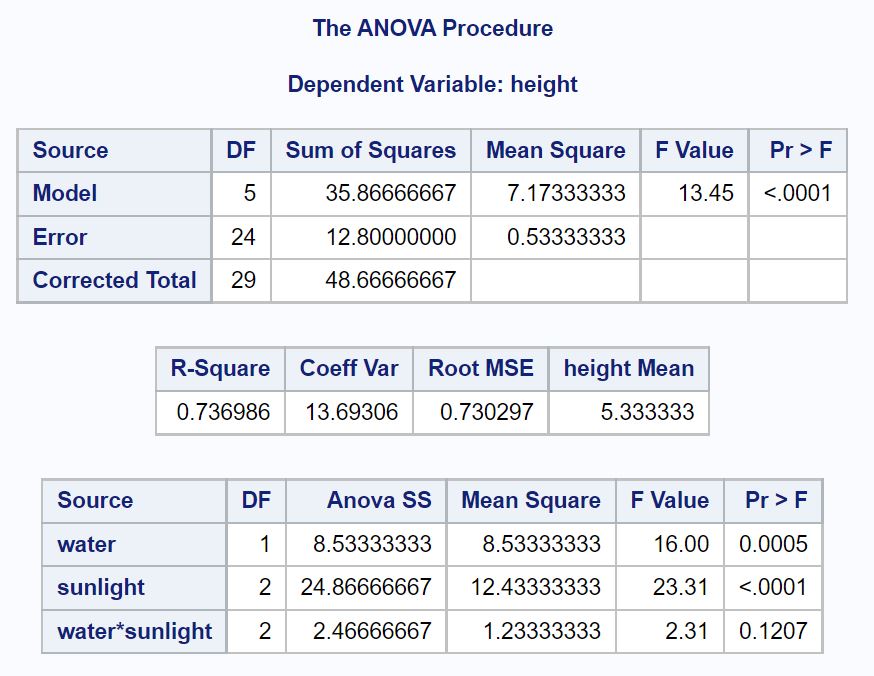
L’exécution de PROC GLM sous SAS engendre une série de tableaux d’affichage analytique particulièrement denses. Le premier bloc informatif livré à l’analyste résume la qualité globale d’ajustement du modèle linéaire factoriel testé sur l’ensemble des données d’échantillonnage.
Le paramètre le plus scruté est sans conteste le coefficient de détermination ($R^2$ ou R-Square). Cette grandeur sans dimension, bornée sur l’intervalle $[0, 1]$, quantifie la proportion exacte de la variance totale de la variable dépendante qui se trouve collectivement expliquée par l’ensemble des prédicteurs inclus dans le modèle (effet du facteur A, effet du facteur B et leur interaction). Un $R^2$ de 0,42 indique par exemple que 42 % de la variabilité globale des scores d’anxiété est capturée par la combinaison des variables de sexe et de traitement, les 58 % restants relevant de l’erreur résiduelle inexpliquée.
Ce tableau d’ajustement présente également d’autres métriques descriptives complémentaires :
- Le coefficient de variation (Coeff Var) : exprimé en pourcentage, il correspond au rapport entre l’écart-type résiduel estimé et la moyenne générale de la réponse, multiplié par cent. Il évalue la dispersion relative résiduelle et constitue un excellent indicateur de la précision expérimentale.
- L’erreur quadratique moyenne racine (Root MSE) : elle désigne la racine carrée du carré moyen de l’erreur résiduelle. Elle exprime la dispersion moyenne typique des observations autour des valeurs ajustées, directement dans l’unité de mesure native de la variable dépendante.
- La moyenne générale de la variable dépendante (Mean of Response) : elle matérialise l’espérance arithmétique globale calculée sans distinction de sous-groupes.
Enfin, la ligne supérieure de ce bloc synthétique délivre le test $F$ global du modèle. Fondé sur le rapport entre le carré moyen expliqué par l’ensemble du modèle et le carré moyen de l’erreur résiduelle, ce test évalue l’hypothèse nulle conjointe selon laquelle aucun des facteurs ni l’interaction n’exercerait d’effet mesurable. Si la valeur de probabilité associée ($p$-value ou Pr > F) est inférieure au seuil conventionnel de 0,05, l’analyste conclut que le modèle linéaire pris dans son ensemble explique une part de variance statistiquement significative, autorisant la décomposition détaillée des effets partiels.
6.2 Différenciation critique entre sommes des carrés de Type I et Type III
Le point d’achoppement le plus complexe dans la maîtrise de l’analyse factorielle sous SAS réside dans l’arbitrage fondamental entre les différentes décompositions des sommes des carrés (Sum of Squares ou SS), matérialisées dans les sorties sous les appellations respectives de Type I SS et Type III SS.
Les sommes des carrés de Type I sont des sommes séquentielles hiérarchiques. Elles évaluent l’incrément de variance expliqué par chaque facteur au moment précis où il est injecté dans le modèle, en tenant compte uniquement des termes introduits avant lui dans l’instruction MODEL :
- Le premier facteur listé (disons $A$) est testé de manière brute, comme dans une ANOVA unifactorielle, sans aucun ajustement pour $B$ ni pour $A*B$.
- Le second terme ($B$) est évalué pour sa contribution marginale additionnelle, après avoir retiré la part de variance préalablement capturée par $A$.
- Le terme croisé ($A*B$) est évalué en dernier, conditionnellement à la présence préalable de $A$ et de $B$.
En présence d’un plan factoriel déséquilibré, modifier l’ordre syntaxique des variables (en écrivant MODEL Y = B A A*B; au lieu de MODEL Y = A B A*B;) bouleverse totalement les valeurs numériques des sommes des carrés de Type I, ce qui rend cette approche problématique pour tester des hypothèses scientifiques autonomes.
À l’opposé, les sommes des carrés de Type III (souvent désignées sous le vocable de sommes des carrés partielles ou marginales) reposent sur un principe d’ajustement orthogonal complet. Chaque source de variation est évaluée pour la part de variance spécifique et unique qu’elle explique, en ajustant simultanément pour l’intégralité des autres composantes du modèle, y compris les interactions d’ordre supérieur. La somme des carrés de Type III du facteur A quantifie ce que A apporte de manière exclusive au modèle, après avoir déjà pris en compte l’effet de B et l’effet de l’interaction A*B.
Dans la recherche scientifique empirique, il existe un consensus universel : seules les sommes des carrés de Type III doivent servir de fondement décisionnel pour valider ou rejeter les hypothèses de recherche dans un plan factoriel à deux voies. Elles garantissent une invariance stricte des résultats statistiques quel que soit l’ordre arbitraire de codification des variables explicatives au clavier dans le programme SAS.
Les Types II et IV possèdent des champs d’application plus spécialisés : le Type II est pertinent dans des modèles additifs stricts sans interaction pour maximiser la puissance de test des effets principaux en respectant le principe de marginalité hiérarchique, tandis que le Type IV est réservé aux designs exceptionnels comportant des cellules factorielles totalement vides (absence totale d’observations dans certains sous-groupes).
6.3 Prise de décision statistique sur les tests F partiels
L’examen du tableau des sommes des carrés de Type III guide la prise de décision statistique rigoureuse. Pour chaque terme de l’architecture factorielle (Facteur A, Facteur B, et Interaction A*B), SAS fournit une ligne d’inférence détaillée comprenant :
- Les degrés de liberté (DF) : calculés comme $(I – 1)$ pour le facteur A à $I$ modalités, $(J – 1)$ pour le facteur B à $J$ modalités, et $(I – 1) \times (J – 1)$ pour l’interaction croisée.
- La somme des carrés de Type III (Type III SS) : quantifiant la variabilité propre dévolue au prédicteur considéré.
- Le carré moyen (Mean Square) : calculé mathématiquement comme le quotient exact de la somme des carrés par ses degrés de liberté propres ($MS = SS / DF$).
- La statistique de Fisher (F Value) : obtenue en divisant le carré moyen de l’effet examiné par le carré moyen de l’erreur résiduelle ($F = MS_{effet} / MS_{erreur}$).
- La probabilité critique (Pr > F) : reflétant la probabilité d’obtenir par simple fluctuation d’échantillonnage une valeur de $F$ au moins aussi extrême que celle observée, sous l’hypothèse nulle d’absence d’effet.
La règle décisionnelle s’applique alors avec fermeté. Si la valeur de Pr > F associée à l’effet d’interaction $A*B$ est inférieure au seuil alpha prédéterminé (traditionnellement $\alpha = 0,05$), l’hypothèse nulle de pure additivité est formellement rejetée. L’analyste conclut à l’existence d’une interaction statistiquement significative entre les deux facteurs. Dès cet instant précis, la dynamique interprétative est dictée par ce constat : il est formellement proscrit de conclure directement sur les effets principaux sans avoir préalablement décomposé et explicité la nature exacte de cette interaction au moyen d’analyses d’effets simples.
7. Décomposition et analyse détaillée des effets d’interaction
7.1 Diagnostic approfondie de la non-parallélisme des réponses
La détection d’une interaction statistiquement significative au sein des sorties de PROC GLM marque non pas l’aboutissement, mais le point de départ de l’investigation statistique. D’un point de vue géométrique et conceptuel, la présence d’une interaction se traduit graphiquement par la perte manifeste de parallélisme entre les profils de réponses moyennes tracés pour chaque niveau d’un facteur au fil des modalités de l’autre. Lorsque les lignes de profils divergent, convergent ou se croisent, la modélisation linéaire additiviste cesse d’être opérationnelle.
Il est capital que le chercheur ne confonde pas la significativité statistique brute (l’obtention d’une $p$-valeur inférieure à 0,05) avec l’amplitude empirique et la portée clinique de l’interaction mise au jour. Dans de très grands échantillons de données, une déviation infime et parfaitement triviale par rapport au parallélisme théorique peut générer un ratio de Fisher fortement significatif, sans pour autant altérer la pertinence pratique d’une conclusion formulée à l’échelle des effets principaux. À l’inverse, dans de petits échantillons exploratoires, une interaction croisée substantielle peut échouer de justesse à franchir le seuil fatidique de 5 % faute d’une puissance statistique suffisante.
L’erreur la plus dommageable consisterait à poursuivre une lecture machinale des effets principaux en présence d’une interaction croisée majeure. Conclure par exemple qu’un antidépresseur n’exerce « globalement aucun effet principal sur l’anxiété » parce que sa moyenne marginale est identique à celle du placebo constitue une faute d’interprétation grave si la décomposition cellulaire démontre en réalité que la molécule réduit spectaculairement les symptômes chez les femmes tout en aggravant significativement la symptomatologie chez les hommes. Dans un tel scénario, l’effet principal agrégé masque la vérité empirique.
7.2 Analyse des effets simples conditionnels avec l’instruction SLICE
Pour disséquer avec rigueur une interaction factorielle significative, le protocole méthodologique standard préconise le recours à l’analyse des effets simples (simple effects analysis). Un effet simple évalue l’impact spécifique d’un premier facteur $A$ à l’intérieur d’un niveau unique et fixé du second facteur $B$. Au lieu d’agréger les données, le plan factoriel bidimensionnel est temporairement découpé en tranches unifactorielles indépendantes.
Sous SAS, l’instruction reine dédiée à cette manœuvre analytique au sein de PROC GLM est l’option SLICE adossée à l’instruction des moyennes des moindres carrés (LSMEANS). Cette syntaxe particulièrement concise et puissante ordonne à SAS de partitionner automatiquement la somme des carrés de l’interaction en sous-modèles conditionnels :
PROC GLM DATA=EssaiClinique;

    CLASS Sexe Traitement;

    MODEL ScoreAnxiete = Sexe Traitement Sexe*Traitement / SS3;

    LSMEANS Sexe*Traitement / SLICE=Sexe SLICE=Traitement;

RUN;

QUIT;
Dans cet exemple, l’option SLICE=Sexe commande l’exécution d’un test $F$ partiel examinant l’effet du Traitement spécifiquement chez les femmes, puis séparément chez les hommes. De manière réciproque, l’option SLICE=Traitement teste la différence entre hommes et femmes successivement sous la condition Placebo, sous TCC et sous Mindfulness. L’avantage méthodologique immense de SLICE par rapport à une partition manuelle de la base de données via une clause BY réside dans le fait que SLICE utilise le carré moyen de l’erreur résiduelle pooled (global) du modèle complet, préservant ainsi l’intégralité des degrés de liberté de l’erreur et garantissant une puissance statistique maximale.
Face à la multiplication de ces tests d’effets simples, l’analyste doit néanmoins faire preuve de circonspection quant au risque d’inflation du taux d’erreur de première espèce à l’échelle de l’expérience, nécessitant l’application d’un ajustement conservateur du seuil de décision (par exemple par la méthode séquentielle de Bonferroni-Holm).
7.3 Représentation graphique de l’interaction avec PROC SGPLOT
Bien que l’examen des tableaux numériques chiffrés soit indispensable à la validation formelle des hypothèses, la restitution visuelle de l’interaction demeure le vecteur de communication le plus éloquent pour l’esprit humain. SAS offre, au travers de la puissante procédure graphique PROC SGPLOT, tous les outils typographiques requis pour générer des graphiques d’interaction répondant aux standards esthétiques les plus exigeants des revues internationales à comité de lecture.
Pour construire ce graphique de profils, il convient d’extraire préalablement les estimations des moyennes des moindres carrés et leurs erreurs-types associées dans une table de travail via l’option ODS OUTPUT LSMEANS=TableLSMeans; insérée dans PROC GLM. Par la suite, PROC SGPLOT est mobilisée pour tracer simultanément les courbes de tendances avec l’instruction SERIES et les points de moyennes assortis de leurs intervalles de confiance à 95 % ou barres d’erreur-type au moyen de l’instruction SCATTER avec options d’erreurs :
PROC SGPLOT DATA=TableLSMeans;

    SERIES X=Traitement Y=LSMean / GROUP=Sexe LINEATTRS=(THICKNESS=2);

    SCATTER X=Traitement Y=LSMean / GROUP=Sexe YERRORLOWER=LowerCL YERRORUPPER=UpperCL

            MARKERATTRS=(SYMBOL=CircleFilled SIZE=9);

    XAXIS LABEL="Modalité Thérapeutique Expérimentale";

    YAXIS LABEL="Moyenne des Moindres Carrés (Score STAI)";

    KEYLEGEND / TITLE="Sexe du Groupe" POSITION=TOPRIGHT NOBORDER;

RUN;
Ce type de restitution graphique permet d’identifier au premier regard si l’interaction observée relève d’une dynamique ordinale ou désordinale. La juxtaposition des barres d’erreur donne immédiatement corps à la dispersion intra-cellulaire, illustrant avec clarté la robustesse empirique des contrastes constatés.
8. Tests de comparaisons multiples et analyses post-hoc dans SAS
8.1 Choix méthodologique des procédures d’ajustement du taux alpha
Dès lors qu’un facteur principal comportant au moins trois modalités ou qu’un terme d’interaction bidimensionnel s’avère statistiquement significatif au test $F$ global, l’analyste se trouve confronté à une énigme inférentielle : le test de Fisher nous indique qu’au moins deux sous-groupes diffèrent de façon non fortuite, mais il demeure par nature incapable d’identifier quelles paires de moyennes spécifiques s’écartent significativement l’une de l’autre. Le recours aux tests de comparaisons multiples — couramment dénommés tests post-hoc — devient impératif.
Cependant, l’exécution répétée de comparaisons deux à deux non planifiées au moyen de tests de Student classiques entraîne inévitablement le fléau de l’inflation de l’erreur de type I (le familywise error rate). Si l’on réalise par exemple six comparaisons indépendantes à un seuil individuel $\alpha = 0,05$, la probabilité cumulée de déclarer à tort au moins une différence significative par pur hasard s’élève à :
$$\alpha_{cumule} = 1 – (1 – 0,05)^6 \approx 0,265$$
Soit plus d’une chance sur quatre de commettre un faux positif scientifique. Pour juguler cette dérive probabiliste, différentes stratégies algorithmiques de correction d’alpha ont été modélisées dans SAS :
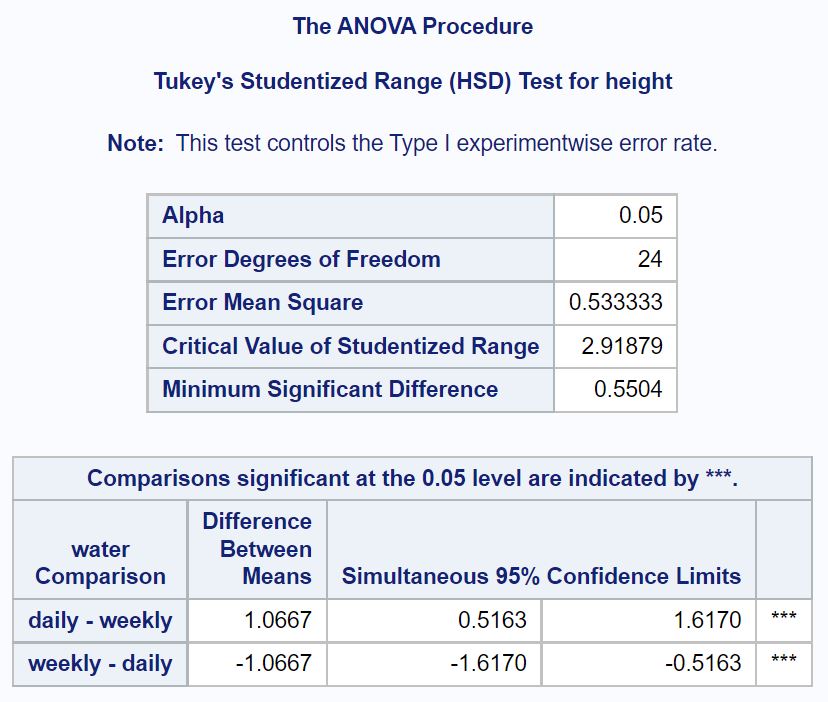
- La procédure HSD de Tukey-Kramer (Honestly Significant Difference) : elle constitue le standard méthodologique d’excellence pour l’ensemble des comparaisons par paires (all-pairwise comparisons). Conçue à l’origine par John Tukey pour les plans équilibrés au travers de la distribution de l’étendue studentisée, elle a été étendue mathématiquement par Kramer pour absorber les effectifs cellulaires inégaux. Elle offre un compromis idéal entre la protection rigide du taux alpha global et le maintien d’une puissance statistique élevée.
- L’ajustement de Bonferroni : approche hautement conservative divisant le seuil $\alpha$ par le nombre total de contrastes $k$. Bien qu’infaillible pour juguler les faux positifs, sa sévérité mathématique paralyse la puissance statistique dès que le nombre de comparaisons dépasse quatre ou cinq tests. Son usage doit être strictement réservé à un ensemble restreint de contrastes ciblés et pré-spécifiés.
- La méthode de Scheffé : méthode d’une robustesse mathématique absolue, elle maintient le risque global d’erreur de première espèce quel que soit le nombre et la complexité des contrastes linéaires formulés a posteriori (y compris des contrastes non orthogonaux complexes comparant la moyenne de deux cellules à la moyenne de trois autres). En contrepartie de cette invulnérabilité théorique, elle s’avère la plus conservatrice de toutes les procédures, exigeant des écarts de moyennes considérables pour franchir le cap de la significativité.
- Le test de Dunnett : procédure spécialisée conçue spécifiquement pour comparer une série de conditions expérimentales multiples contre un groupe témoin ou contrôle unique de référence. En évitant d’évaluer les comparaisons mutuelles entre les groupes expérimentaux eux-mêmes, Dunnett préserve une puissance de test bien supérieure à celle de Tukey.
8.2 Syntaxe et options des instructions LSMEANS et MEANS
Dans l’environnement de PROC GLM, l’exécution des tests de comparaisons multiples peut techniquement être déclenchée soit par l’instruction historique MEANS, soit par la directive supérieure LSMEANS. Il existe toutefois une distinction théorique colossale entre ces deux approches, qui trace la frontière entre l’amateurisme analytique et la rigueur biostatistique professionnelle.
L’instruction MEANS opère sur les moyennes arithmétiques brutes des échantillons. Par conséquent, en présence de plans d’expérience déséquilibrés, elle calcule des contrastes pollués par le déséquilibre démographique des strates factorielles. À l’inverse, l’instruction LSMEANS calcule les moyennes des moindres carrés (les least squares means ou moyennes marginales estimées), c’est-à-dire les valeurs prédites par le modèle linéaire général en neutralisant formellement l’hétérogénéité des effectifs des autres facteurs et en maintenant les covariables à leur niveau moyen théorique. Dans toute ANOVA multifactorielle, LSMEANS est la seule instruction méthodologiquement recevable.
La syntaxe de configuration de LSMEANS sous PROC GLM permet d’activer avec une extrême finesse les algorithmes d’ajustement souhaités via l’option ADJUST= :
PROC GLM DATA=EssaiClinique;

    CLASS Sexe Traitement;

    MODEL ScoreAnxiete = Sexe Traitement Sexe*Traitement;

    LSMEANS Traitement / ADJUST=TUKEY PDIFF=ALL CL;

    LSMEANS Sexe*Traitement / ADJUST=BON PDIFF=ALL CL PLOTS=(DIFFPLOT);

RUN;

QUIT;
L’option PDIFF=ALL enjoint à SAS de générer une matrice carrée exhaustive de l’ensemble des valeurs $p$ différentielles ajustées pour chaque paire de moyennes factorielles comparées. L’option CL ordonne la génération simultanée des intervalles de confiance ajustés pour chaque différence moyenne estimée. Enfin, l’option graphique intégrée PLOTS=(DIFFPLOT) ordonne au système ODS Graphics de produire un diagramme de diffusion différentielle visuelle particulièrement intuitif : chaque segment traversant la ligne d’indifférence zéro signale immédiatement une absence de divergence statistique, tandis que les segments s’isolant hors de l’axe central marquent les contrastes statistiquement significatifs au seuil paramétré.
8.3 Formulation de contrastes linéaires spécifiques a priori
Si les tests post-hoc sont indispensables dans les cadres exploratoires, la démarche hypothético-déductive la plus vertueuse sur le plan épistémologique consiste à formuler des contrastes linéaires a priori, élaborés avant le recueil des observations sur la base directe du corpus théorique établi. Les contrastes planifiés présentent l’immense mérite de maximiser la puissance statistique en s’épargnant les pénalités d’ajustement sévères inhérentes aux comparaisons exhaustives tous azimuts.
Un contraste linéaire $L$ s’exprime mathématiquement comme une combinaison linéaire pondérée des moyennes de populations théoriques :
$$L = \sum_{k=1}^K c_k \mu_k \quad \text{a\vec la contrainte impérative} \quad \sum_{k=1}^K c_k = 0$$
Deux contrastes $L_1 = \sum c_k \mu_k$ et $L_2 = \sum d_k \mu_k$ sont dits formellement orthogonaux si la somme du produit de leurs coefficients respectifs s’annule : $\sum c_k d_k = 0$. L’orthogonalité garantit que les deux questions scientifiques posées sont totalement indépendantes et non redondantes au plan informationnel.
Sous PROC GLM, la matérialisation de ces hypothèses ciblées s’effectue au moyen de deux instructions majeures :
- L’instruction
CONTRAST: elle soumet le contraste linéaire à un test de Fisher à 1 degré de liberté ($F$-test) pour trancher sur sa significativité statistique vis-à-vis de l’hypothèse nulle $L = 0$. - L’instruction
ESTIMATE: complément indispensable de la précédente, elle calcule l’estimation ponctuelle chiffrée de la différence d’effet matérialisée par le contraste, son erreur-type d’échantillonnage, la valeur du $t$ de Student associé, ainsi que son intervalle de confiance paramétrique.
Voici l’illustration d’une syntaxe évaluant le contraste théorique opposant spécifiquement le groupe Placebo à la moyenne conjointe des deux approches psychothérapeutiques actives (TCC et Mindfulness) :
PROC GLM DATA=EssaiClinique;

    CLASS Sexe Traitement;

    MODEL ScoreAnxiete = Sexe Traitement Sexe*Traitement;

    CONTRAST 'Placebo vs Psychothérapies Actives' Traitement 2 -1 -1;

    ESTIMATE 'Placebo vs Psychothérapies Actives' Traitement 2 -1 -1 / DIVISOR=2;

RUN;

QUIT;
L’utilisation judicieuse du paramètre / DIVISOR=2 au sein de l’instruction ESTIMATE normalise mathématiquement les coefficients pour que l’estimation chiffrée finale corresponde exactement à la différence métrique brute entre la moyenne du placebo et la moyenne moyenne combinée des deux thérapies, assurant une intelligibilité clinique immédiate.
9. Évaluation empirique des postulats du modèle dans SAS
9.1 Diagnostic graphique et formel de la normalité des résidus
La validation empirique du modèle linéaire factoriel ne saurait être considérée comme achevée sans un diagnostic minutieux du respect des postulats gaussiens. Comme établi précédemment, l’investigation doit se focaliser exclusivement sur la distribution des erreurs résiduelles générées par le modèle final. L’extraction de ces résidus s’opère par l’adjonction de l’instruction OUTPUT dans la procédure PROC GLM, générant une nouvelle table SAS enrichie des résidus bruts et des résidus studentisés.
Le contrôle de la forme distributionnelle est ensuite confié à la procédure PROC UNIVARIATE, qui déploie un ensemble exhaustif d’outils analytiques graphiques et d’indicateurs numériques formels :
PROC UNIVARIATE DATA=DiagResidus NORMAL PLOT;

    VAR ResiduStudent;

    HISTOGRAM ResiduStudent / NORMAL(MU=0 SIGMA=EST) CFILL=STEEL;

    QQPLOT ResiduStudent / NORMAL(MU=0 SIGMA=EST) SQUARE;

RUN;
L’interprétation conjointe s’appuie sur deux piliers indissociables :
- Le diagramme quantile-quantile (Q-Q plot) : il confronte les quantiles empiriques des résidus studentisés aux quantiles théoriques d’une loi normale standard. Un alignement harmonieux et rigoureusement rectiligne des points d’observation le long de la diagonale de référence confirme l’adéquation distributionnelle. Des courbures en forme de « S » signalent des déformations d’aplatissement (queues lourdes ou légères), tandis qu’une concavité unilatérale trahit une asymétrie marquée.
- Les tests d’ajustement d’hypothèse formels : l’option
NORMALdélivre les résultats de quatre tests statistiques d’ajustement. Sur les cohortes de taille modeste à modérée ($N < 2000$), le test de Shapiro-Wilk ($W$) représente le standard le plus puissant et le plus fiable. Pour les échantillons massifs, les tests de Kolmogorov-Smirnov (modifié par Lilliefors), de Cramér-von Mises et d’Anderson-Darling complètent l’évaluation. Un seuil $p > 0,05$ conduit à ne pas rejeter l’hypothèse nulle de normalité résiduelle.
En présence d’une asymétrie sévère invalidant l’inférence, le statisticien dispose de techniques d’inflexion non linéaires de la variable dépendante d’origine. Les transformations mathématiques traditionnelles — la fonction logarithmique naturelle $ln(Y)$ pour les distributions étirées vers la droite, la racine carrée $\sqrt{Y}$ pour les données de comptage poissonniennes, ou l’inversion $1/Y$ — permettent souvent de restaurer la normalité résiduelle. Pour une approche systématisée et automatisée, l’évaluation de la famille paramétrique de transformations de Box-Cox via la procédure PROC TRANSREG identifie la valeur optimale du paramètre exponentiel $lambda$ minimisant l’écart à la normalité.
9.2 Vérification formelle de l’homogénéité des variances
Le contrôle de l’homoscédasticité intra-cellulaire constitue le second volet impératif du diagnostic post-estimation. Sous SAS, l’instruction maîtresse permettant de tester formellement l’égalité des variances à travers les cellules factorielles est la directive HOVTEST (Homogeneity of Variance Test), directement intégrée au sein de l’instruction MEANS de PROC GLM :
PROC GLM DATA=EssaiClinique;

    CLASS Sexe Traitement;

    MODEL ScoreAnxiete = Sexe Traitement Sexe*Traitement;

    MEANS Sexe*Traitement / HOVTEST=LEVENE(TYPE=ABS);

    MEANS Sexe*Traitement / HOVTEST=BF;

    MEANS Sexe*Traitement / HOVTEST=OBRIEN;

RUN;

QUIT;
Le système propose plusieurs variantes algorithmiques majeures du test de Levene classique :
- Le test de Levene original : il opère une ANOVA simple sur les déviations absolues des scores individuels par rapport à la moyenne de leur groupe ($|Y_{ijk} – \bar{Y}_{ij.}|$). Bien que répandu, il souffre d’une sensibilité excessive à la non-normalité, tendant à déclarer les variances hétérogènes dès que les queues de distribution sont épaisses.
- Le test de Brown-Forsythe (
HOVTEST=BF) : il substitue judicieusement la médiane cellulaire à la moyenne arithmétique pour le calcul des écarts absolus ($|Y_{ijk} – \tilde{Y}_{ij.}|$). Cette modification confère au test une robustesse exceptionnelle face aux asymétries et aux distributions non gaussiennes. C’est l’indicateur de choix recommandé dans la quasi-totalité des scénarios pratiques. - Le test d’O’Brien (
HOVTEST=OBRIEN) : il introduit une correction pondérée ajustée sur le kurtosis empirique des cellules, convenant tout particulièrement aux données légèrement platykurtiques.
Si la valeur critique délivrée par le test de Brown-Forsythe ou de Levene présente un seuil $p < 0,05$, le postulat d’homogénéité des variances est formellement réfuté. L’analyste se trouve alors dans l’obligation méthodologique de récuser l’ANOVA factorielle standard de PROC GLM. La solution de référence sous SAS consiste alors à migrer vers la procédure PROC MIXED. Grâce à son instruction REPEATED / GROUP=Sexe*Traitement;, PROC MIXED permet d’estimer un modèle linéaire généralisé à variances hétérogènes, modélisant une variance résiduelle propre $\sigma_{ij}^2$ pour chaque cellule factorielle tout en ajustant automatiquement les degrés de liberté du dénominateur via l’approximation de Kenward-Roger ou de Satterthwaite.
9.3 Détection et traitement des valeurs aberrantes et influentes
La présence silencieuse d’observations discordantes ou atypiques — communément désignées sous le vocable d’outliers — peut exercer une influence délétère disproportionnée sur les estimateurs du modèle linéaire factoriel, distordant dramatiquement les moyennes des moindres carrés et gonflant artificiellement le carré moyen de l’erreur résiduelle. L’identification de ces observations doit combiner l’analyse de l’amplitude de l’écart résiduel et l’évaluation de l’effet de levier.
Le diagnostic de l’extrémisme résiduel s’appuie préférentiellement sur les résidus studentisés externes (résidus jackknife ou RSTUDENT sous SAS). Contrairement au résidu brut, le résidu studentisé externe divise l’écart par une erreur-type calculée en omettant délibérément l’observation concernée. Par convention statistique rigoureuse, toute observation dont la valeur absolue du résidu studentisé dépasse le seuil critique de 2 (dans les petits échantillons) ou de 3 (dans les grands échantillons) doit être isolée comme suspecte.
Au-delà de l’écart brut, il importe d’évaluer le levier (leverage, noté $h_{ii}$) et l’influence globale de l’observation sur le faisceau des coefficients estimés au moyen de la classique distance de Cook ($D_i$). Une distance de Cook approchant ou excédant la valeur seuil de 1 (ou $4/N$) signale qu’une observation unique modifie à elle seule de façon substantielle l’architecture paramétrique du modèle factoriel.
Face à la détection de cas atypiques avérés, l’analyste ne doit en aucun cas procéder à une suppression aveugle et machinale. La première démarche exige de vérifier dans les cahiers d’observation l’absence d’une erreur de saisie typographique grossière. Si la valeur atypique est biologiquement ou comportementalement authentique, la conduite scientifique préconise l’exécution d’une analyse de sensibilité exhaustive : les résultats complets de l’ANOVA sous PROC GLM sont présentés successivement avec l’intégralité des données, puis en excluant de manière transparente les cas influents. Si les conclusions substantielles et le patron d’interaction demeurent invariants, la robustesse empirique des résultats s’en trouve puissamment consolidée.
10. Traitement des plans factoriels déséquilibrés et des données manquantes
10.1 Origine et conséquences méthodologiques des plans non équilibrés
Dans la recherche observationnelle ou les études cliniques prospectives, le plan d’expérience factoriel équilibré ($n$ identique par cellule) relève d’une exception quasi miraculeuse. La survenue d’un déséquilibre quantitatif dans les effectifs cellulaires découle de multiples contingences empiriques incompressibles :
- L’attrition expérimentale différentielle : les participants quittent prématurément le protocole de recherche pour des motifs variés (déménagement, intolérance à un principe actif, perte de motivation).
- La stratification démographique naturelle : lors de l’étude de croisements de variables non manipulées (par exemple, Genre × Pathologie Rare), la prévalence épidémiologique réelle impose des déséquilibres structurels massifs qu’il serait méthodologiquement inopportun de forcer artificiellement.
- Les valeurs accidentellement omises : survenue d’artéfacts techniques lors de la numérisation des signaux ou d’omissions sélectives sur des échelles de mesure psychométriques.
La conséquence mathématique immédiate de ce déséquilibre quantitatif réside dans la destruction irrémédiable de l’orthogonalité des facteurs. Dans un design non orthogonal, les colonnes indicatrices de la matrice de modèle $X$ cessent d’être linéairement indépendantes. Les sous-espaces vectoriels associés aux facteurs A et B se chevauchent partiellement, ce qui signifie qu’une portion de la variance expliquée de la variable dépendante est partagée de façon indissociable entre les différents prédicteurs.
Il en résulte une propriété analytique troublante : la non-additivité des sommes des carrés partielles. Dans un plan déséquilibré, l’addition arithmétique de la somme des carrés du facteur A, de la somme des carrés du facteur B et de la somme des carrés de l’interaction n’égale plus la somme des carrés totale du modèle :
$$SS_{Modèle} \neq SS(A) + SS(B) + SS(A*B)$$
L’utilisation irréfléchie d’outils de décomposition de variance classiques fondés sur l’orthogonalité engendre dès lors des distorsions sévères et des calculs d’inférence fallacieux.
10.2 Primauté des moyennes des moindres carrés (LSMEANS) sur les moyennes brutes
L’un des périls majeurs induits par les plans factoriels déséquilibrés réside dans le piège interprétatif généré par l’observation des moyennes arithmétiques brutes (délivrées par exemple par une procédure PROC MEANS ou par l’instruction MEANS de PROC GLM). Les moyennes simples calculent en effet le barycentre brut des observations sans tenir compte de la surreprésentation ou de la sous-représentation démographique relative de certaines cellules factorielles.
Ce phénomène d’illusion statistique est une manifestation directe du célèbre paradoxe de Simpson. Imaginons une recherche factorielle 2×2 croisant le Sexe (Hommes, Femmes) et l’Appartenance à une Catégorie Clinique (Témoins, Patients sévères) sur une mesure d’anxiété. Si, en raison d’un biais de recrutement, l’échantillon des femmes comprend 90 % de patientes sévères (hautement anxieuses) et seulement 10 % de témoins, alors que l’échantillon des hommes est composé à 90 % de sujets témoins très calmes, la moyenne brute agrégée des femmes semblera considérablement plus élevée que celle des hommes, même si, à niveau clinique rigoureusement équivalent, aucune différence de sexe n’existe réellement. La moyenne brute confond l’effet de genre avec le déséquilibre d’effectifs du statut clinique.
C’est précisément pour neutraliser ce biais structural que la théorie du modèle linéaire a forgé le concept de moyennes des moindres carrés (LS-means ou moyennes marginales estimées). Une LS-mean est calculée comme la valeur prédite par l’équation du modèle linéaire général pour une cellule ou une marge factorielle donnée, sous la contrainte mathématique idéale selon laquelle toutes les autres cellules du plan contiendraient un effectif théoriquement égal et équilibré. L’instruction LSMEANS de PROC GLM recalcule l’équivalent d’un plan expérimental parfaitement orthogonal et homométrique.
C’est également cette propriété d’orthogonalisation corrective mathématique qui justifie l’utilisation exclusive des sommes des carrés de Type III dans les plans factoriels déséquilibrés. Le test $F$ adossé aux Type III SS teste rigoureusement l’égalité des moyennes des moindres carrés (les LS-means) et non celle des moyennes arithmétiques brutes polluées par le déséquilibre de l’échantillonnage.
10.3 Stratégies face aux cellules totalement vides
Le degré ultime de complexité dans le traitement des plans d’expérience survient lorsqu’une ou plusieurs cellules factorielles sont totalement dépourvues de la moindre observation empirique ($n_{ij} = 0$). Cette incomplétude structurelle du design factoriel pose un défi mathématique insurmontable aux procédures standards : la matrice de variance-covariance devient structurellement singulière au-delà du rang normal, et il devient rigoureusement impossible d’estimer l’ensemble complet des paramètres du modèle incluant l’interaction bidimensionnelle intégrale.
Sous PROC GLM, la survenue de cellules vides entraîne l’émission d’avertissements explicites indiquant que certaines fonctions estimables ne peuvent être calculées. Les sommes des carrés de Type III cessent d’être invariantes face à la paramétrisation matricielle employée. Face à une telle impasse méthodologique, l’analyste dispose de plusieurs réorientations stratégiques formalisées :
- Le recours aux sommes des carrés de Type IV (
SS4) : développées spécifiquement par SAS pour amortir les designs comportant des cellules manquantes, les sommes des carrés de Type IV construisent des contrastes partiels en ignorant les cellules vides. Toutefois, la composition exacte de ces contrastes dépend de l’architecture spécifique des données disponibles, ce qui rend leur interprétation scientifique parfois ardue et controversée. - La reconfiguration conceptuelle du modèle linéaire : l’approche la plus saine sur le plan théorique consiste souvent à fusionner deux modalités sémantiquement proches afin de repeupler la cellule vacante, ou à supprimer temporairement du modèle la modalité orpheline pour concentrer l’ANOVA factorielle sur le sous-ensemble orthogonal du design.
- Le reparamétrage en modèle unifactoriel équivalent (Cell-Means Model) : cette stratégie élégante consiste à concaténer les deux facteurs en un facteur de classification unique comportant autant de modalités qu’il y a de cellules non vides réellement renseignées (par exemple, transformer un croisement 2×3 amputé d’une cellule en un facteur simple à 5 niveaux). L’analyste utilise ensuite l’instruction
CONTRASTpour interroger spécifiquement et proprement les seules hypothèses théoriques demeurant biologiquement ou psychologiquement testables, sans s’encombrer des artefacts d’une interaction globale devenue incalculable.
11. Quantification de la taille de l’effet et analyse de puissance statistique
11.1 Estimation des métriques de taille d’effet : Êta-carré et Oméga-carré
L’inférence paramétrique classique guidée par la recherche de la significativité statistique (la sacro-sainte $p$-valeur inférieure à 0,05) renseigne exclusivement sur la probabilité de rejeter l’hypothèse nulle sous l’hypothèse qu’elle soit vraie ; elle ne livre en revanche strictement aucune information quant à l’amplitude réelle, la force clinique ou la pertinence concrète de l’effet mis au jour. Dès lors, les standards éditoriaux contemporains imposent d’adjoindre systématiquement à chaque test de Fisher une métrique rigoureuse de la taille de l’effet (effect size).
Dans le périmètre de l’ANOVA factorielle à deux voies, la métrique descriptive la plus communément exploitée est l’êta-carré partiel (noté $\eta_p^2$ ou Partial Eta Squared). Il quantifie le ratio de la variabilité spécifiquement attribuable à l’effet considéré rapporté à la somme de cette même variabilité et de la variabilité résiduelle inexpliquée, en faisant abstraction des parts de variance capturées par les autres facteurs du modèle :
$$\eta_p^2 = \frac{SS_{Effet}}{SS_{Effet} + SS_{Erreur}} = \frac{F \times DF_{Effet}}{F \times DF_{Effet} + DF_{Erreur}}$$
Sous PROC GLM, l’obtention automatisée de cette métrique est déclenchée sans effort en apposant l’option EFFECTSIZE au sein de l’instruction MODEL, ce qui ordonne à SAS de générer une colonne dédiée répertoriant les valeurs exactes de $\eta_p^2$ ainsi que leurs intervalles de confiance paramétriques associés.
Toutefois, l’êta-carré partiel présente une faiblesse mathématique majeure : il constitue un estimateur purement descriptif et systématiquement biaisé vers le haut dans l’échantillon. En présence de petits effectifs d’échantillonnage, $\eta_p^2$ tend à surestimer de façon non négligeable la part réelle de variance expliquée au sein de la population parente. Pour pallier cette distorsion, les méthodologistes préconisent le recours à l’oméga-carré partiel ($\omega_p^2$ ou Partial Omega Squared). Cette métrique intègre le carré moyen de l’erreur dans sa formule pour corriger le biais d’échantillonnage :
$$\omega_p^2 = \frac{DF_{Effet} \times (MS_{Effet} – MS_{Erreur})}{DF_{Effet} \times MS_{Effet} + (N – DF_{Effet}) \times MS_{Erreur}}$$
Pour l’interprétation qualitative de ces indices dans les sciences comportementales, la communauté scientifique se réfère couramment aux repères heuristiques standardisés établis par Jacob Cohen :
- $\eta_p^2 \approx 0,01$ (ou $\omega_p^2 \approx 0,01$) : Effet de faible magnitude (taille d’effet mineure).
- $\eta_p^2 \approx 0,06$ (ou $\omega_p^2 \approx 0,06$) : Effet d’amplitude moyenne (taille d’effet modérée).
- $\eta_p^2 ge 0,14$ (ou $\omega_p^2 ge 0,14$) : Effet de forte magnitude (taille d’effet majeure).
11.2 Analyse de puissance statistique avec PROC POWER
La planification vertueuse d’un protocole expérimental requiert impérativement la conduite d’une analyse de puissance statistique a priori. La puissance statistique — formalisée par le complément de l’erreur de deuxième espèce ($1 – \beta$) — désigne la probabilité mathématique que possède le test inférentiel de détecter et déclarer statistiquement significative une différence factorielle dès lors que cette différence existe véritablement dans la population d’intérêt. Les recommandations internationales préconisent une puissance minimale conventionnelle fixée à 0,80 (soit au moins 80 % de chances de détecter l’effet théorique attendu).
Sous SAS, cette démarche prospective est exécutée avec une remarquable précision algorithmique grâce à la procédure dédiée PROC POWER. Dans le cadre d’une analyse de variance factorielle à deux voies, l’instruction maîtresse MULTREG ou ONENOWAY peut être mobilisée, mais l’utilisation spécialisée du module TWOSAMPLEMEANS ou de la syntaxe matricielle générale de PROC POWER permet de calibrer directement la taille d’échantillon totale requise :
PROC POWER;

    MULTREG

    MODEL = TWOWAY

    NFULLPRED = 5

    NTESTPRED = 2

    RSQUAREDIFF = 0.08

    RSQUAREFULL = 0.25

    ALPHA = 0.05

    POWER = 0.80

    NTOTAL = .;

RUN;
L’attribution de la valeur point (.) à l’argument NTOTAL indique au compilateur SAS que la taille globale d’échantillon constitue la variable cible à calculer en fonction des postulats de taille d’effet incrémentale (RSQUAREDIFF) et de risque d’erreur $\alpha$ spécifiés en amont.
Il importe en revanche de formuler une mise en garde méthodologique formelle à l’encontre de la pratique de l’analyse de puissance dite « a posteriori » (calculée après coup sur la base des données recueillies et de la $p$-valeur obtenue). Les mathématiciens et les statisticiens ont formellement démontré que la puissance post-hoc ne constitue qu’une transformation monotone directe de la $p$-valeur d’observation (le « sophisme du joueur »). Elle n’apporte strictement aucune information scientifique nouvelle et doit être rigoureusement bannie des publications académiques au profit du calcul transparent d’intervalles de confiance autour des tailles d’effet empiriques.
11.3 Pertinence clinique et psychologique versus significativité statistique
La confusion intellectuelle entre significativité statistique et pertinence substantielle constitue l’un des écueils majeurs de la science quantifiée contemporaine. En vertu des propriétés intrinsèques de l’erreur-type, qui décroît mécaniquement en fonction de la racine carrée de la taille d’échantillon ($\sigma / \sqrt{n}$), n’importe quelle différence empirique microscopique et rigoureusement dénuée de sens pratique finira inéluctablement par être déclarée hautement significative ($p < 0,001$) si l’analyste mobilise un jeu de données massif comprenant des dizaines ou des centaines de milliers d’enregistrements.
À l’inverse, dans le cadre d’essais cliniques portant sur des pathologies rares ou de recherches neuropsychologiques complexes limitées à quelques dizaines de patients, une divergence d’amplitude majeure — traduisant par exemple un gain substantiel de rémission thérapeutique — peut échouer à franchir le cap nominal de $p = 0,05$ par simple manque de puissance d’échantillonnage. Le chercheur chevronné se doit donc de dissocier hermétiquement le diagnostic probabiliste binaire (le rejet de $H_0$) de l’évaluation de la portée concrète du phénomène observé.
Cette distinction devient particulièrement critique lors de la prise de décision stratégique, médicale ou organisationnelle consécutive à l’analyse d’une interaction. La détection d’une interaction modeste mais statistiquement confirmée entre un module de formation professionnelle et la catégorie d’âge des employés justifie-t-elle le coût financier et logistique colossal de déployer deux programmes pédagogiques distincts au sein d’une multinationale ? La réponse à cette interrogation n’émerge pas de la $p$-valeur calculée par PROC GLM, mais de l’analyse fine des intervalles de confiance de la taille de l’effet, confrontés aux seuils de rentabilité opérationnelle ou de bénéfice clinique minimalement important (Minimal Clinically Important Difference ou MCID).
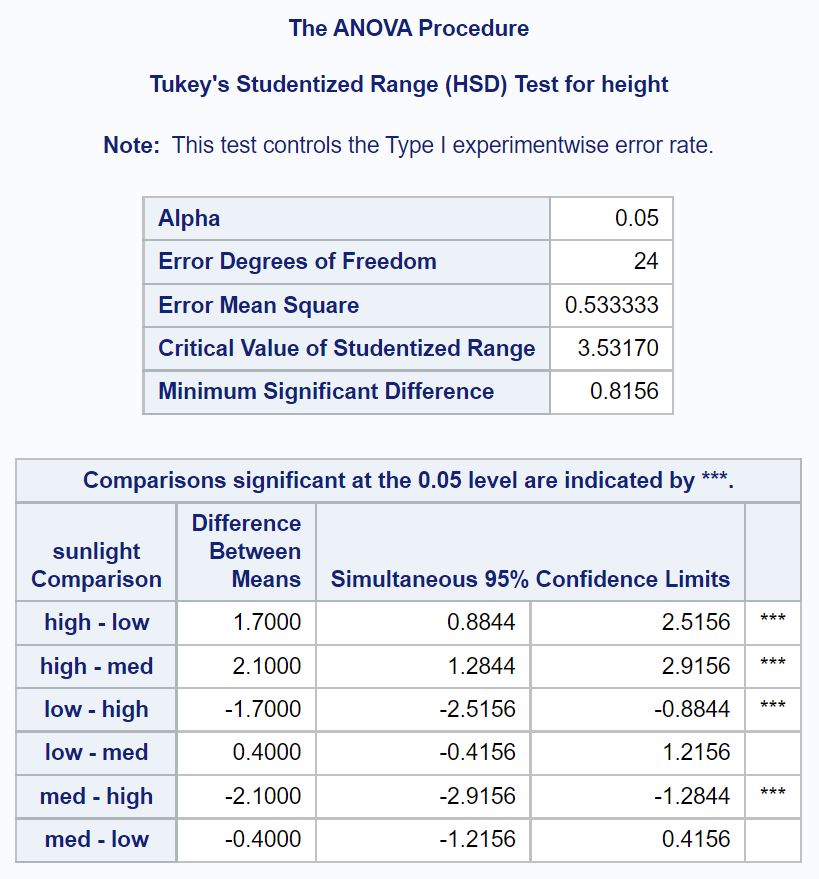
12. Rédaction académique des résultats et conformité aux normes APA
12.1 Normes formelles de présentation des statistiques d’inférence
La diffusion des résultats d’une analyse de variance à deux facteurs au sein de revues scientifiques internationales exige une conformité absolue aux standards typographiques et rédactionnels édictés par l’American Psychological Association (APA, 7e édition). Cette standardisation garantit la comparabilité immédiate des découvertes et leur reproductibilité au sein des méta-analyses futures.
Sur le plan du formalisme typographique strict, l’ensemble des lettres et symboles désignant des entités statistiques algébriques doivent être obligatoirement composés en caractères italiques : $F$, $p$, $t$, $\eta_p^2$, $M$ (moyenne), $SD$ (écart-type). En revanche, les chiffres numériques, les valeurs d’indices, les parenthèses et les degrés de liberté demeurent impérativement en typographie romaine droite.
Les règles de précision d’arrondi et de notation des seuils de probabilité s’articulent selon des impératifs bien précis :
- Les valeurs de la statistique de Fisher ($F$) et de la taille d’effet ($\eta_p^2$) s’arrondissent systématiquement à deux décimales après la virgule (par exemple : $F(2, 54) = 4,87$).
- Les degrés de liberté associés à l’effet et à l’erreur résiduelle doivent figurer entre parenthèses immédiatement après la lettre $F$, séparés par une virgule et une espace.
- La $p$-valeur s’arrondit obligatoirement à trois décimales après la virgule. De surcroît, la probabilité $p$ ne pouvant mathématiquement excéder l’unité, elle s’écrit selon les normes anglophones sans zéro initial devant le point décimal ($p = .014$). En cas de valeur extrêmement infinitésimale délivrée par SAS sous la forme
<.0001, il est formellement interdit d’écrire $p = .000$ ; la seule formulation APA recevable est : $p < .001$.
Voici des gabarits textuels modèles conformes aux exigences de l’APA 7e édition pour la formalisation des différents constats statistiques :
- Effet principal statistiquement significatif : « L’analyse de variance factorielle à deux voies révèle un effet principal statistiquement significatif du type de traitement administré sur le score d’anxiété des participants, $F(2, 54) = 8,42$, $p < .001$, $\eta_p^2 = .24$. Les comparaisons post-hoc ajustées au moyen de la méthode de Tukey-Kramer indiquent que le protocole de TCC ($M = 35,50$, $SD = 5,12$) induit une réduction d’anxiété significativement supérieure à celle observée sous placebo ($M = 48,75$, $SD = 6,34$, $p < .001$). »
- Effet principal non significatif : « L’effet principal du sexe biologique du participant ne s’avère pas statistiquement significatif, $F(1, 54) = 1,15$, $p = .288$, $\eta_p^2 = .02$, suggérant des scores d’anxiété moyens équivalents entre les femmes ($M = 40,10$, $SD = 8,20$) et les hommes ($M = 42,30$, $SD = 7,95$). »
- Effet d’interaction bidimensionnelle significatif : « Une interaction statistiquement significative entre le sexe du patient et le protocole thérapeutique a été mise en évidence, $F(2, 54) = 4,96$, $p = .011$, $\eta_p^2 = .16$. La décomposition par analyse d’effets simples (instruction
SLICE) démontre que l’impact du traitement s’avère hautement prononcé chez les femmes, $F(2, 54) = 11,28$, $p < .001$, mais n’atteint pas le seuil de significativité chez les hommes, $F(2, 54) = 2,10$, $p = .132$. »
12.2 Construction de tableaux récapitulatifs d’ANOVA selon les standards de publication
L’intégration d’un tableau récapitulatif complet d’ANOVA factorielle s’impose dès lors qu’un protocole comporte des décompositions factorielles multiples ou que le texte narratif s’en trouverait excessivement alourdi. La typographie des tableaux APA obéit à une règle esthétique célèbre : l’élimination totale de l’ensemble des bordures et lignes verticales. Seules trois lignes horizontales principales doivent structurer l’affichage (au-dessus et en-dessous de l’en-tête de colonnes, et une ligne finale bordant la clôture inférieure du tableau).
Le tableau factoriel standardisé s’articule autour des colonnes canoniques suivantes :
- Source de variation (Source) : énumérant les prédicteurs, l’interaction, l’erreur résiduelle et le total.
- Somme des carrés de Type III (Type III SS).
- Degrés de liberté (df).
- Carré moyen (MS).
- Statistique de Fisher observée ($F$).
- Probabilité critique ($p$).
- Taille de l’effet partiel ($\eta_p^2$).
L’environnement SAS offre un pont direct vers le traitement de texte académique au travers de son système ODS (Output Delivery System). En encapsulant la procédure PROC GLM entre des instructions ODS RTF ou ODS PDF munies de styles graphiques épurés (tels que le style natif JOURNAL), SAS compile directement des tableaux prétraités parfaitement conformes aux canons typographiques de l’APA, s’épargnant ainsi les risques d’erreurs humaines inhérents au recopiage manuel des valeurs :
ODS RTF FILE="Tableau_ANOVA_APA.rtf" STYLE=JOURNAL;

ODS SELECT ModelANOVA;

PROC GLM DATA=EssaiClinique;

    CLASS Sexe Traitement;

    MODEL ScoreAnxiete = Sexe Traitement Sexe*Traitement / SS3 EFFECTSIZE;

RUN;

QUIT;

ODS RTF CLOSE;
L’instruction ODS SELECT ModelANOVA; filtre sélectivement la sortie pour n’exporter que le tableau synthétique des tests d’hypothèses de Type III, garantissant une intégration immédiate et sans retouche au sein du manuscrit scientifique.
12.3 Reproductibilité, gestion du code SAS et partage des données
À l’ère contemporaine de la crise de la reproductibilité scientifique, la publication de résultats d’ANOVA factorielle ne peut plus s’exonérer des impératifs stricts de la science ouverte (Open Science). Les comités de lecture des revues internationales de premier rang exigent désormais couramment la mise à disposition des jeux de données anonymisés ainsi que des scripts informatiques intégraux ayant présidé à l’analyse.
La traçabilité exemplaire d’un programme SAS factoriel repose sur un ensemble de bonnes pratiques de développement :
- La documentation explicative exhaustive : chaque bloc syntaxique (étape
DATA, transformations de variables,PROC GLM, calculs post-hoc) doit être minutieusement précédé de commentaires circonstanciés explicitant les fondements théoriques des choix méthodologiques arrêtés. - L’intégrité absolue de la fenêtre de journalisation (Log SAS) : avant toute soumission, l’analyste doit vérifier méthodiquement l’intégralité du Log SAS pour s’assurer de l’absence totale d’avertissements (WARNING), de messages d’erreurs (ERROR) ou d’alertes silencieuses signalant des conversions automatiques non contrôlées ou des valeurs manquantes générées par accident.
- La gestion de version et l’archivage pérenne : le code source SAS (fichiers d’extension
.sas) et les tables associées doivent être déposés sur des entrepôts académiques publics et certifiés (tels que l’Open Science Framework – OSF, Zenodo ou Dataverse), assortis d’un identifiant numérique d’objet pérenne (DOI).
En respectant scrupuleusement l’ensemble de ces préceptes méthodologiques, biostatistiques et typographiques au fil de vos analyses sous SAS, vous garantissez à vos recherches empiriques une rigueur scientifique inattaquable, une élégance de restitution formelle irréprochable et une contribution durable au progrès des connaissances dans votre discipline.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001466
Levene, H. (1960). Robust tests for equality of variances. In I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow, & H. B. Mann (Eds.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (pp. 278–292). Stanford University Press.
Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
SAS Institute Inc. (2023). SAS/STAT 15.3 user’s guide: The GLM procedure. SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/statug/statug_glm_overview.htm
Scheffé, H. (1959). The analysis of variance. John Wiley & Sons.
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913