
L’élucidation des liens de causalité constitue le fondement épistémologique sur lequel repose l’ensemble des sciences empiriques contemporaines. Qu’il s’agisse de mesurer l’impact réel d’une psychothérapie cognitive sur les symptômes dépressifs, de quantifier l’influence du niveau d’instruction sur le déclin cognitif lié à l’âge, ou de déterminer si l’exposition prolongée aux environnements numériques altère l’équilibre psychologique des adolescents, la recherche se heurte systématiquement à un obstacle méthodologique majeur : l’impossibilité d’isoler parfaitement les causes de leurs conséquences dans un univers observationnel complexe et intriqué. Alors que le schéma idéal de l’expérimentation en double aveugle demeure l’étalon-or, de nombreux champs d’investigation ne peuvent s’y conformer pour des raisons éthiques, logistiques ou déontologiques évidentes.
Dans ce contexte où l’expérimentateur ne peut manipuler arbitrairement les conditions de vie des sujets, la simple régression statistique se révèle souvent trompeuse. Les corrélations brutes observées entre deux variables reflètent trop fréquemment des dynamiques sous-jacentes inobservées, des mécanismes d’auto-sélection individuelle ou des phénomènes de causalité circulaire. L’économétrie et l’épidémiologie moderne désignent ce phénomène invalidant sous le concept d’endogénéité. Face à cette aporie scientifique, la méthode des variables instrumentales s’impose depuis plusieurs décennies comme l’un des dispositifs d’inférence causale les plus ingénieux et rigoureux jamais conçus. En s’appuyant sur des variations exogènes opportunes fournies par la nature, les institutions ou le hasard génétique, cette approche permet de recréer artificiellement les conditions d’un essai contrôlé randomisé au cœur même de données strictement observationnelles.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes théoriques, les fondements mathématiques et les applications pratiques de l’approche par variables instrumentales. Conçu pour les chercheurs, les cliniciens et les analystes de données confrontés aux défis de l’observation humaine, cet ouvrage didactique détaille pas à pas les conditions impératives de validité d’un instrument, le fonctionnement algorithmique de l’estimation en deux étapes, ainsi que les risques critiques liés aux instruments faibles et aux violations de la restriction d’exclusion. À travers une multitude d’exemples issus de la psychologie, de l’économie comportementale et de la psychiatrie biologique, nous explorerons comment cet outil conceptuel permet de transformer des corrélations opaques en certitudes causales exploitables pour la décision clinique et publique.
1. Introduction à l’inférence causale et au problème de l’endogénéité
1.1 La quête de la causalité en recherche psychologique et comportementale
L’histoire de la psychologie scientifique et des sciences du comportement est indissociable de la recherche constante d’une preuve causale irréfutable. Établir qu’une variable X produit un effet mesurable sur une variable Y ne relève pas d’une simple curiosité académique ; cela conditionne la validité des interventions psychothérapeutiques, la conception des programmes de santé mentale et l’allocation des ressources de santé publique. Pourtant, la distinction épistémologique fondamentale entre corrélation et causalité continue de poser un défi d’envergure. Deux phénomènes peuvent évoluer de concert dans le temps ou l’espace sans qu’aucun lien génératif direct n’existe entre eux, la covariance observée résultant soit du hasard d’échantillonnage, soit de l’action coordonnée d’un troisième facteur dissimulé.
Les devis observationnels, largement prédominants en psychologie clinique, en neuropsychologie et en sociologie médicale, présentent des vulnérabilités intrinsèques face à cette problématique. Dans une étude de cohorte où les individus choisissent librement leurs habitudes de vie, s’engagent spontanément dans un suivi thérapeutique ou sont exposés à des environnements familiaux différenciés, le groupe recevant le « traitement » et le groupe témoin diffèrent presque systématiquement sur une myriade d’attributs préexistants. Ces disparités systématiques introduisent un biais de sélection persistant qui empêche de comparer des trajectoires contrefactuelles pures.
Dans un monde idéal, l’expérimentation aléatoire permettrait de contourner ce problème en assignant les participants par tirage au sort à différentes conditions d’exposition. Néanmoins, il est rigoureusement impossible, d’un point de vue éthique et pratique, d’assigner aléatoirement des facteurs de risque majeurs. Un comité de protection des personnes refuserait légitimement un protocole visant à contraindre des sujets sains à consommer des stupéfiants pendant plusieurs années, à subir un stress professionnel chronique ou à vivre dans un isolement social délibéré pour évaluer leur propension à développer une pathologie dépressive. La recherche comportementale se trouve ainsi contrainte de naviguer dans l’univers imparfait des données observationnelles, nécessitant des solutions analytiques sophistiquées pour démasquer la véritable structure causale des phénomènes observés.
1.2 Le biais de variable omise et les facteurs de confusion
L’obstacle le plus récurrent rencontré lors de l’estimation des modèles de régression linéaire standard est le biais de variable omise. Ce phénomène mathématique survient dès lors qu’un facteur déterminant de la variable de réponse (le critère de jugement) est corrélé avec la variable explicative (l’exposition d’intérêt), mais n’est pas inclus dans le modèle économétrique ou statistique, soit parce qu’il n’a pas été mesuré, soit parce qu’il demeure intrinsèquement inobservable. Dans cette configuration, le coefficient de régression estimé par la méthode des moindres carrés ordinaires absorbe indûment l’influence de la variable absente, conduisant à une surévaluation ou une sous-évaluation drastique de l’effet causal réel.
Considérons à titre d’illustration l’étude classique reliant le niveau de stress perçu en milieu professionnel et l’élévation de la pression artérielle systolique. Si un chercheur modélise naïvement la pression artérielle en fonction unique des scores de stress obtenus à un inventaire psychométrique, les résultats indiqueront vraisemblablement une association positive hautement significative. Cependant, cette relation est lourdement contaminée par des facteurs de confusion latents, tels que les habitudes nutritionnelles, le tabagisme compensatoire ou la qualité du sommeil. Un individu confronté à un stress aigu tend souvent à détériorer son hygiène de vie, en adoptant une alimentation riche en sodium ou en réduisant son temps de repos nocturne, deux facteurs exerçant un effet direct et documenté sur la pression vasculaire. Si ces variables comportementales ne sont pas minutieusement contrôlées, la régression attribue au stress psychologique une charge causale qui revient en réalité aux dérèglements métaboliques induits par le mode de vie.
Les répercussions sur la validité interne des estimations statistiques sont délétères. Le modèle de régression linéaire simple repose sur l’hypothèse d’orthogonalité stricte, stipulant que l’espérance conditionnelle du terme d’erreur sachant les variables explicatives est nulle. Dès lors qu’une variable de confusion non observée est reléguée dans le terme d’erreur résiduel, cette hypothèse est violée de facto. Le régresseur devient corrélé à l’erreur du modèle, biaisant irrémédiablement l’estimateur qui perd sa consistance asymptotique : même avec une taille d’échantillon approchant l’infini, l’estimation ne converge jamais vers la véritable valeur du paramètre de population.
1.3 La causalité inverse et l’erreur de mesure
Au-delà du biais de variable omise, deux autres sources majeures alimentent l’endogénéité en recherche comportementale : la causalité inverse et l’imprécision des instruments psychométriques. La causalité inverse correspond à une dynamique de rétroaction bidirectionnelle, où la variable dépendante influence simultanément la variable explicative supposée. Cette problématique est omniprésente dans l’étude des comorbidités psychiatriques. Lorsque l’on observe une forte corrélation entre la gravité d’un trouble de l’humeur et la pratique de comportements sexuels ou financiers à risque, il s’avère particulièrement ardu de démêler la chronologie causale : les conduites désordonnées sont-elles la manifestation clinique d’un état maniaque sous-jacent, ou constituent-elles l’élément déclencheur d’un effondrement dépressif réactionnel face aux conséquences sociales désastreuses qu’elles engendrent ? Sans stratégie méthodologique d’identification, l’analyse transversale reste impuissante à isoler le sens prédominant du flux causal.
L’erreur de mesure, quant à elle, représente une plaie endémique pour les sciences psychologiques. Les états mentaux, les traits de personnalité et les perceptions subjectives ne se mesurent pas avec la précision millimétrique d’un instrument physique de laboratoire. Les auto-questionnaires souffrent d’une variance d’erreur substantielle due au biais de désirabilité sociale, à la mémoire sélective des participants ou à l’instabilité transitoire de l’attention lors de la passation des tests. Sur le plan statistique, la présence d’une erreur de mesure aléatoire dans une variable indépendante ne se contente pas d’accroître l’imprécision des estimations ; elle induit un biais d’atténuation structurel. Le coefficient estimé est systématiquement compressé vers zéro, sous-estimant la force réelle de la relation causale sous-jacente.
Ces différents mécanismes convergent vers une même formalisation mathématique : le problème d’endogénéité. Si l’on écrit la relation structurelle sous la forme matricielle classique Y = Xβ + ε, la condition d’exogénéité stipule que la covariance entre le vecteur des régresseurs X et le vecteur des perturbations inobservables ε doit être rigoureusement nulle, soit Cov(X, ε) = 0. Dès lors que cette égalité est rompue (Cov(X, ε) ≠ 0), que ce soit par l’effet d’un facteur de confusion omis, d’une rétroaction causale de Y vers X ou d’une erreur de mesure classique sur X, l’estimateur conventionnel par les moindres carrés ordinaires devient biaisé et inconsistant. Il est alors impératif de faire appel à une information extérieure au modèle pour extraire la composante non biaisée de la relation : c’est le rôle de la variable instrumentale.
2. Qu’est-ce qu’une variable instrumentale ? Définition formelle
2.1 Définition conceptuelle de l’instrument
Le concept de variable instrumentale (souvent abrégé VI ou IV en littérature anglophone) repose sur une intuition élégante : si la variable explicative X est corrompue par des influences endogènes qui la lient au terme d’erreur du modèle, il convient de trouver une variable tierce Z capable d’agir comme une source de variation extérieure et propre. L’instrument Z sert de levier exogène qui vient faire bouger la variable explicative X sans entretenir la moindre connexion avec les perturbations non observées affectant la variable finale Y. En isolant la portion de variance de X qui est strictement imputable aux fluctuations de Z, le chercheur extrait une variation « nettoyée » de tout biais de confusion, restaurant ainsi la capacité d’estimer un impact causal authentique.
L’analogie la plus parlante est celle de l’expérience naturelle ou de la quasi-randomisation. Imaginez une situation où un groupe de personnes choisit de participer ou non à une formation intensive à la gestion du stress. Les participants les plus motivés, ou ceux disposant de davantage de temps libre, sont les plus susceptibles de s’inscrire, créant un biais de sélection flagrant. Supposons maintenant que l’organisme formateur, face à une demande excessive, ait distribué des coupons de réduction ou des invitations prioritaires par tirage au sort. Ce tirage au sort (Z) influence considérablement la décision finale d’assister à la formation (X), mais il est totalement déconnecté des traits psychologiques ou de la motivation intrinsèque des candidats (ε). En observant comment les coupons modifient le taux de participation et, consécutivement, comment le stress s’en trouve réduit, on reconstitue un essai contrôlé au sein même de la population d’étude.
Sur le plan de l’histoire des sciences, les racines de cette découverte remontent aux travaux précurseurs du biologiste et généticien des populations Sewall Wright et de son père Philip Wright dans les années 1920. Confrontés à l’évaluation empirique des courbes d’offre et de demande agricoles dans leur ouvrage fondamental sur le commerce du lin et des huiles végétales, ils cherchaient à déterminer comment les quantités échangées influençaient les prix sur les marchés, alors même que les prix influençaient simultanément les quantités. Sewall Wright a conceptualisé l’usage de variables décalées et de facteurs climatiques imprévisibles pour déplacer l’une des courbes tout en maintenant l’autre fixe, posant ainsi les bases formelles de ce que l’économétrie moderne développera plus tard sous le nom d’équations simultanées et de variables instrumentales.
2.2 Représentation graphique via les modèles causaux structuraux (DAG)
L’avènement des graphes acycliques dirigés (Directed Acyclic Graphs ou DAGs), popularisés par Judea Pearl dans le cadre de la théorie causale moderne, offre un cadre visuel et mathématique d’une clarté remarquable pour appréhender le statut des variables instrumentales. Un DAG se compose de nœuds représentant les variables et de flèches orientées illustrant les relations de dépendance causale directe entre ces entités, excluant toute boucle de rétroaction immédiate.
Dans un DAG modélisant l’estimation instrumentale type, nous retrouvons quatre éléments fondamentaux : la variable instrumentale Z, l’exposition ou traitement X, le résultat d’intérêt Y, et une variable latente U regroupant l’intégralité des facteurs de confusion inobservés. La structure du réseau obéit à une configuration très stricte :
- Une flèche causale part de l’instrument vers le traitement : Z → X. Cette liaison démontre que Z induit une modification effective du niveau de X.
- Une flèche causale relie le traitement au résultat final : X → Y. Il s’agit précisément de la relation causale théorique que l’analyste cherche à quantifier sans biais.
- La variable de confusion inobservée U émet deux flèches simultanées : U → X et U → Y. C’est ce chemin bidirectionnel non bloqué qui crée l’endogénéité en générant une association fallacieuse entre X et Y.
- De façon capitale, il n’existe aucune flèche directe reliant Z à Y (absence du chemin Z → Y), ni aucune flèche entre U et Z (absence de liaison U ↔ Z).
Grâce aux principes du critère de d-séparation énoncé par Pearl, la topologie du DAG démontre que l’instrument Z n’est connecté à Y que par une unique voie active : le chemin dirigé Z → X → Y. Toutes les voies secondaires potentielles qui passeraient par les variables de confusion U sont structurellement bloquées. Par conséquent, toute corrélation statistique mesurée empiriquement entre l’instrument Z et le critère Y est nécessairement transmise à travers la modification de la variable X. L’instrument permet d’ouvrir une fenêtre d’observation parfaitement étanche aux interférences du monde extérieur.
2.3 Formulation mathématique de l’estimateur instrumental
La transcription formelle de l’estimateur par variable instrumentale repose sur l’analyse structurelle des covariances. Considérons l’équation de régression linéaire sous-jacente au niveau individuel pour un échantillon de taille N :
Yi = β0 + β1Xi + εi
Dans ce modèle, le régresseur scalaire Xi est endogène, signifiant que la covariance Cov(X, ε) est différente de zéro, rendant l’estimateur conventionnel des Moindres Carrés Ordinaires (MCO) biaisé. Soit Zi une variable instrumentale valide respectant l’orthogonalité vis-à-vis du résidu, soit Cov(Z, ε) = 0. En calculant la covariance théorique de chaque membre de l’équation avec l’instrument Z, nous obtenons le développement suivant :
Cov(Z, Y) = Cov(Z, β0 + β1X + ε)
Par linéarité de l’opérateur de covariance, l’expression se décompose ainsi :
Cov(Z, Y) = β1Cov(Z, X) + Cov(Z, ε)
Sous la condition essentielle d’exogénéité selon laquelle Cov(Z, ε) s’annule, le second terme de l’addition disparaît purement et simplement. Si l’instrument est pertinent, c’est-à-dire si la covariance entre l’instrument et la variable endogène n’est pas nulle (Cov(Z, X) ≠ 0), nous pouvons isoler le coefficient causal d’intérêt β1 par une simple opération de division :
β1 = Cov(Z, Y) / Cov(Z, X)
L’estimateur instrumental empirique, souvent qualifié d’estimateur de Wald dans le cas où l’instrument Z est une variable binaire indicatrice (prenant les valeurs 0 ou 1), s’exprime par le ratio des différences de moyennes d’échantillon :
β̂IV = [Ē(Y | Z = 1) – Ē(Y | Z = 0)] / [Ē(X | Z = 1) – Ē(X | Z = 0)]
Ce ratio remarquable met en lumière la mécanique fondamentale de l’instrumentation : le numérateur capture l’effet global de l’instrument sur la variable de réponse finale (la forme réduite), tandis que le dénominateur évalue dans quelle mesure l’instrument altère le degré d’exposition au traitement. En divisant la variation globale par le taux d’adoption du traitement, l’estimateur rescale l’effet pour l’attribuer exclusivement à l’unité de variation de X. Les propriétés asymptotiques démontrent que cet estimateur converge en probabilité vers le paramètre réel β1 lorsque N tend vers l’infini, garantissant sa consistance mathématique là où les MCO demeurent irrémédiablement faussés.
3. Les conditions fondamentales de validité d’un instrument
3.1 La condition de pertinence (Relevance Condition)
Pour qu’une variable candidate puisse prétendre au statut d’instrument, elle doit impérativement franchir une série d’exigences théoriques et statistiques intransigeantes. La première d’entre elles est la condition de pertinence, parfois désignée sous le terme de validité de premier niveau. Cette condition requiert que l’instrument Z soit corrélé de manière robuste, tangible et non fortuite avec la variable explicative endogène X, une fois contrôlées toutes les autres covariables exogènes incluses dans le modèle.
Sur le plan mathématique, cette exigence se traduit formellement au sein de l’équation de régression de premier niveau par :
Xi = γ0 + γ1Zi + Wi‘γ2 + ui
La condition de pertinence impose que le paramètre de pente γ1 soit strictement différent de zéro (γ1 ≠ 0). En termes probabilistes, la distribution conditionnelle de X sachant Z ne doit pas être invariante : la connaissance de la valeur de l’instrument doit fournir une quantité d’information substantielle sur l’état attendu de l’exposition au traitement. Contrairement aux autres hypothèses fondamentales de l’inférence causale qui reposent sur des entités inobservables, la pertinence présente l’avantage inestimable d’être directement vérifiable et quantifiable sur les données de l’échantillon à l’aide de tests d’hypothèses standards.
Le manquement à cette condition soulève le risque d’employer ce que la littérature nomme un instrument faible. Si γ1 est infinitésimal ou proche de zéro, le dénominateur de l’estimateur instrumental s’approche d’une division par zéro, entraînant une explosion exponentielle de la variance de l’estimation et générant une imprécision statistique massive. De surcroît, comme nous l’analyserons ultérieurement, un instrument faiblement corrélé est incapable de résister à la moindre imperfection de ses autres postulats, amplifiant les biais d’estimation au lieu de les réduire.
3.2 La condition d’exogénéité ou d’indépendance
La deuxième exigence cardinale est la condition d’exogénéité, souvent appelée condition d’indépendance dans le vocabulaire de l’épidémiologie clinique et de la statistique bayésienne. Elle stipule que la variable instrumentale Z doit être totalement distribuée au hasard par rapport à l’ensemble des caractéristiques individuelles inobservées qui influencent la variable dépendante Y. Autrement dit, l’instrument ne doit partager aucune corrélation statistique, directe ou indirecte, avec le terme d’erreur structurel ε de l’équation principale.
En notation probabiliste, cette condition s’exprime par l’indépendance statistique stricte :
Z ⫫ ε ou, au minimum, Cov(Z, ε) = 0
Dans la perspective des modèles à résultats potentiels popularisés par Donald Rubin, cette condition signifie que les résultats potentiels que présenterait un individu sous différents états de traitement (notés Y(x)) doivent être complètement indépendants de la valeur effective assignée à l’instrument : Y(x) ⫫ Z. L’instrumentation n’a de validité que si les individus assignés à une valeur donnée de Z possèdent, en moyenne, les mêmes caractéristiques latentes de base que les individus assignés à une autre valeur de Z.
Il est fondamental de comprendre qu’il est absolument impossible de valider empiriquement cette condition d’exogénéité par un test statistique direct. Le terme d’erreur ε n’étant par essence jamais collecté dans le monde réel (puisqu’il agrège l’ensemble des variables latentes, de la génétique fine aux micro-événements de la vie quotidienne), le chercheur ne peut calculer directement la corrélation entre Z et ε. La défense de cette hypothèse repose exclusivement sur un argumentaire théorique, institutionnel ou physique robuste. Le chercheur doit pouvoir justifier de manière convaincante que le mécanisme générateur de données garantit une assignation de Z équivalente à une véritable loterie naturelle.
3.3 La restriction d’exclusion (Exclusion Restriction)
La troisième condition indispensable, souvent amalgamée avec l’exogénéité mais conceptuellement distincte, est la restriction d’exclusion. Elle impose que la variable instrumentale n’exerce aucune influence causale directe sur la variable finale Y, et qu’elle n’agisse sur elle à travers aucune autre voie indirecte que celle passant exclusivement par le régresseur endogène X. L’intégralité de l’effet produit par Z sur Y doit obligatoirement être canalisée par la modification de l’intensité de X.
Dans la grammaire des équations structurelles, cela signifie que si nous formulions un modèle englobant où Z et X sont simultanément introduits pour expliquer la réponse clinique ou comportementale :
Yi = β0 + β1Xi + αZi + εi
La restriction d’exclusion impose la contrainte d’identification absolue : α = 0. Si l’instrument Z possède une efficacité propre à modifier Y de manière autonome, ou s’il déclenche l’activation d’un médiateur M non pris en compte dans le modèle, le dispositif instrumental s’effondre. Le numérateur de l’estimateur de Wald (Cov(Z, Y)) se trouvera gonflé par cet effet direct parasite, et l’analyste commettra l’erreur fatale d’imputer l’ensemble de cette dynamique causale au seul régresseur X.
Tout comme la condition d’exogénéité, la restriction d’exclusion constitue une hypothèse non testable dans un système exactement identifié où le nombre d’instruments équivaut strictement au nombre de variables endogènes. Sa plausibilité ne repose que sur la profondeur de la connaissance du domaine d’application dont fait preuve le scientifique. Elle exige d’envisager, d’explorer et d’écarter systématiquement chaque chemin causal alternatif concevable susceptible de relier l’instrument au critère d’évaluation sans transiter par la variable intermédiaire ciblée.
4. La méthode des moindres carrés en deux étapes (2SLS / MC2E)
4.1 Première étape : Décomposition et purge de l’endogénéité
Lorsque le modèle statistique fait intervenir des covariables continues ou multiples, l’estimateur élémentaire de Wald cède la place à un algorithme d’estimation universel et généralisable : la méthode des Moindres Carrés en Deux Étapes (Two-Stage Least Squares ou 2SLS en anglais ; MC2E en français). Cette technique, formalisée indépendamment par Henri Theil et Robert Basmann dans les années 1950, consiste à décomposer la dynamique de la variable endogène pour en soustraire l’influence perturbatrice des variables de confusion.
La première étape de cet algorithme procède à la régression de la variable explicative endogène X sur l’instrument Z et sur l’ensemble des variables de contrôle exogènes (notées W) au moyen d’un ajustement classique par les moindres carrés :
Xi = γ̂0 + γ̂1Zi + Wi‘γ̂2 + ûi
L’opération fondamentale réside ensuite dans la récupération systématique des valeurs prédites (ou valeurs ajustées) par cette équation pour chaque individu de l’échantillon, notées X̂i :
X̂i = γ̂0 + γ̂1Zi + Wi‘γ̂2
Cette première étape réalise une opération de filtrage statistique majeure. La variable originale Xi se trouve scindée en deux composantes mathématiquement orthogonales : la prédiction X̂i et le résidu estimé ûi. Par construction, X̂i n’est constituée que de combinaisons linéaires de grandeurs strictement exogènes (l’instrument Z et les contrôles W). Elle représente la part de la variabilité du traitement qui est entièrement découplée des facteurs de confusion latents encapsulés dans l’erreur structurelle. Le résidu ûi, quant à lui, séquestre l’ensemble des influences endogènes problématiques et des contaminations parasitaires.
4.2 Seconde étape : Estimation de l’effet causal non biaisé
La seconde étape de la procédure consiste à estimer l’équation structurelle de départ reliant la variable d’intérêt final Y au traitement, mais en opérant une substitution déterminante : la variable endogène originale brute Xi est formellement remplacée par sa valeur prédite purifiée X̂i calculée à l’issue de la première étape :
Yi = β0 + β1X̂i + Wi‘β2 + ei
Puisque la variable explicative X̂i a été expurgée de toute corrélation avec les termes d’erreur latents par l’intermédiaire de l’instrumentation, la régression par moindres carrés ordinaires exécutée lors de cette seconde étape fournit un estimateur non biaisé et asymptotiquement convergent du véritable coefficient structurel β1. L’effet marginal ainsi mesuré correspond à l’impact causal authentique produit par une unité de variation additionnelle de la variable de traitement sur le critère de jugement.
Cependant, une mise en garde méthodologique fondamentale doit être formulée quant au calcul des variances et des erreurs-types. Si un chercheur venait à exécuter manuellement ces deux étapes consécutives à l’aide de deux fonctions de régression standard successives dans un logiciel classique, les erreurs-types et les intervalles de confiance affichés pour la seconde étape seraient totalement erronés et sous-estimés. En effet, un algorithme d’ajustement standard traiterait les valeurs X̂i comme des données observées fixes et certaines, ignorant l’incertitude d’échantillonnage inhérente à l’estimation des paramètres γ̂ lors de la première étape.
Pour obtenir une inférence statistique exacte, il est indispensable de faire appel à des procédures intégrées d’estimation 2SLS (telles qu’implémentées dans les modules économétriques spécialisés). Ces algorithmes recalculent les résidus structurels définitifs à partir des valeurs réelles Xi (êi = Yi – β̂0 – β̂1Xi – Wi‘β̂2) et réajustent la matrice de variance-covariance asymptotique en conséquence, garantissant des statistiques de test t et des valeurs p rigoureusement exactes.
4.3 Extensions multivariées et instruments multiples
Le cadre conceptuel de la méthode 2SLS démontre toute sa flexibilité dans les contextes de sur-identification, c’est-à-dire les situations empiriques avantageuses où l’analyste parvient à mobiliser plusieurs variables instrumentales valides distinctes (Z1, Z2, …, Zm) pour expliquer une seule et unique variable endogène X. Dans cette éventualité, la première étape modélise simplement l’exposition à partir d’une projection linéaire englobant l’intégralité des instruments disponibles :
Xi = γ0 + γ1Z1i + γ2Z2i + … + γmZmi + Wi‘γk + ui
L’utilisation combinée d’instruments multiples présente un bénéfice statistique évident : l’accroissement de la puissance de prédiction lors du premier stade. En associant plusieurs sources de variations exogènes complémentaires, la proportion de variance expliquée de la variable endogène (le coefficient R2 du premier stade) s’élève de manière substantielle. Par ricochet, la variance d’échantillonnage de l’estimateur de seconde étape diminue, ce qui produit des erreurs-types plus étroites et confère au chercheur une capacité accrue à détecter de légers effets causaux avec une forte significativité statistique.
Ce gain d’efficacité statistique s’accompagne toutefois d’un arbitrage délicat. Chaque instrument additionnel introduit dans le modèle représente une source potentielle d’échec méthodologique. Si un seul des instruments agrégés au sein du vecteur Z viole la restriction d’exclusion en maintenant un lien direct résiduel avec Y, ou présente une corrélation insidieuse avec un facteur de confusion, l’ensemble du système de projection s’en trouve contaminé. L’analyste se trouve confronté à un arbitrage permanent entre la recherche d’une variance minimale (favorisée par l’accumulation d’instruments) et l’impératif de minimiser le biais d’invalidation causale (favorisé par une sélection ultra-rigoureuse d’un instrument unique incontestable).
5. Exemples classiques en sciences sociales et comportementales
5.1 L’effet de l’éducation sur les fonctions cognitives et les revenus
L’une des illustrations historiques les plus célèbres et pédagogiques de la méthode des variables instrumentales a été formulée par Joshua Angrist et Alan Krueger dans leur article séminal publié en 1991. L’interrogation de départ portait sur le rendement économique et cognitif des années de scolarisation supplémentaires. Comparer naïvement les revenus ou les scores aux bilans neuropsychologiques d’adultes ayant quitté l’école à 16 ans avec ceux de diplômés de l’enseignement supérieur expose à un biais massif d’aptitude innée (le classique « ability bias ») et de milieu socio-éducatif parental. Les individus poursuivant des études prolongées possèdent en moyenne un capital socio-économique initial et des facilités d’apprentissage préalables supérieurs, facteurs qui faciliteraient leur épanouissement même en l’absence de diplômes académiques.
Pour rompre cette endogénéité inextricable, Angrist et Krueger ont exploité une caractéristique institutionnelle singulière du système éducatif américain : la date légale d’entrée à l’école combinée aux lois sur l’obligation scolaire. Aux États-Unis, les enfants nés au premier trimestre d’une année civile débutent l’école à un âge légèrement plus avancé que ceux nés en fin d’année. Parallèlement, la législation de nombreux États autorisait les élèves à quitter définitivement le système scolaire le jour exact de leur seizième anniversaire. Par conséquent, les adolescents nés au début de l’année atteignaient l’âge légal d’émancipation en ayant accompli moins de trimestres de scolarité effectifs que leurs camarades nés plus tard dans l’année.
Le trimestre de naissance devient alors une variable instrumentale idéale :
- Il est hautement prédictif du nombre total de mois passés sur les bancs de l’école (condition de pertinence validée).
- Le trimestre de naissance dépend de processus biologiques de conception répartis au hasard de l’année au sein de la population générale (condition d’exogénéité satisfaite).
- Il apparaît difficilement concevable que le simple fait de naître en janvier plutôt qu’en octobre exerce par lui-même une influence directe sur les capacités cognitives d’un individu à 45 ans, en dehors de la scolarité qu’il a reçue (condition de restriction d’exclusion).
Les estimations instrumentales ont révélé que chaque année supplémentaire d’études forcée par l’obligation scolaire conférait un gain salarial réel et un maintien substantiel des scores cognitifs, réfutant l’idée que ces observations découlaient d’un simple mirage de prédisposition génétique.
5.2 La proximité géographique des infrastructures comme instrument
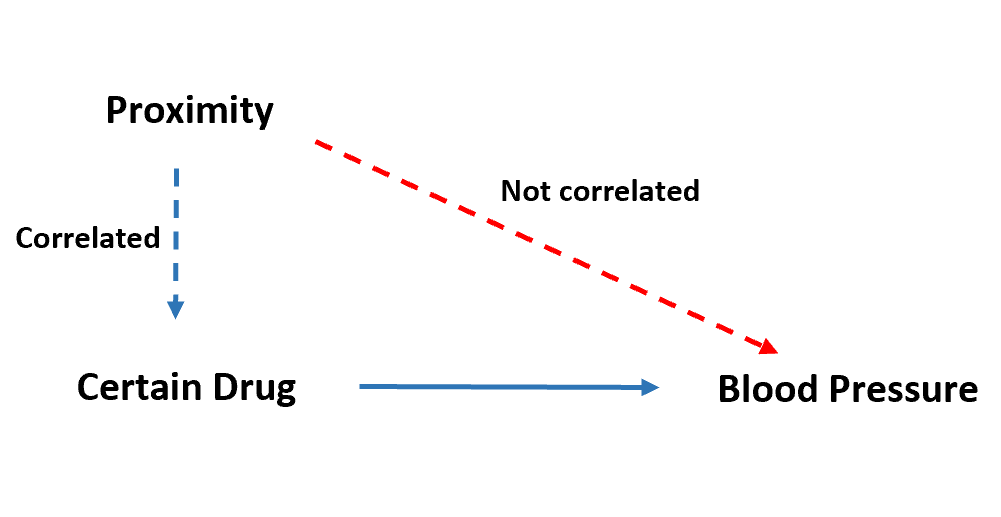
Dans l’évaluation de l’efficacité des soins en santé mentale et en addictologie, l’éloignement physique par rapport aux structures de prise en charge spécialisées fournit un cadre d’instrumentation spatial très fréquemment mobilisé. Prenons l’exemple d’une étude observationnelle visant à mesurer l’impact de la participation assidue à des séances de psychothérapie cognitivo-comportementale sur la réduction de l’anxiété généralisée. Il est documenté que les patients qui s’engagent spontanément dans un suivi psychothérapeutique au long cours présentent un niveau de motivation au changement, une introspectivité et des ressources d’auto-régulation affective sans commune mesure avec ceux qui abandonnent prématurément le parcours de soins.
Pour contourner ce biais d’auto-sélection comportementale, les épidémiologistes utilisent la distance kilométrique séparant le domicile du patient du centre médico-psychologique le plus proche comme un instrument de l’observance thérapeutique. La distance physique agit comme un coût de transaction direct : plus le centre est éloigné, plus la probabilité de participation effective aux consultations régulières diminue (la pertinence est hautement confirmée). D’un point de vue clinique, il n’existe aucune justification théorique permettant d’affirmer que vivre à deux kilomètres d’une clinique plutôt qu’à quinze modifie directement les mécanismes neurobiologiques de l’anxiété généralisée (validité prima facie de la restriction d’exclusion).
Cette approche exige toutefois un contrôle statistique minutieux de l’auto-sélection spatiale. Si les familles favorisées ou les individus les plus sensibilisés aux questions de santé mentale choisissent délibérément d’emménager au sein des hypercentres urbains à proximité immédiate des grands plateaux hospitaliers, la distance géographique redevient endogène. Il est donc fondamental, dans ce type d’architecture d’analyse, d’inclure des contrôles rigoureux sur la densité médicale locale, le niveau socio-économique du quartier de résidence et les coûts fonciers pour préserver l’indépendance de l’instrument.
5.3 L’impact des politiques publiques et changements législatifs
Les réformes institutionnelles inopinées, les modifications des seuils d’admissibilité à des dispositifs sociaux et les disparités géographiques dans l’application de la loi constituent un vivier inépuisable de variables instrumentales, souvent regroupées sous l’appellation de quasi-expériences institutionnelles. En santé comportementale, les variations brutales des cadres réglementaires permettent de découpler l’action de son contexte subjectif individuel.
Une configuration démonstrative concerne l’étude des conséquences des hausses brutales des taxes d’accise sur les spiritueux et le tabac sur les hospitalisations d’urgence en psychiatrie. Les décisions fiscales sont votées par les parlements sous la pression de contraintes budgétaires macroéconomiques globales sans considération directe de la dynamique individuelle des personnes vulnérables d’un territoire donné. Lorsqu’un État frontalier augmente unilatéralement ses tarifs fiscaux de 25 %, l’analyste peut utiliser le niveau de taxation locale comme instrument exogène du volume de consommation d’alcool chez les individus dépendants. L’instrument permet d’éliminer la confusion résultant du fait que la consommation individuelle fluctue selon des événements de vie privés déstabilisants (ruptures sentimentales, licenciements) qui sont eux-mêmes des causes majeures de passage à l’acte pathologique.
De même, les variations chronologiques de l’âge d’ouverture des droits aux allocations de retraite ou les modifications réglementaires des barèmes de remboursement des actes de psychologie par l’assurance maladie ont permis de mesurer avec une rigueur inédite le lien causal liant la cessation de l’activité professionnelle à la décélération du vieillissement cérébral, isolant le choc de rythme de vie de l’état de morbidité préexistant des travailleurs.
6. Applications concrètes en psychologie et en psychiatrie
6.1 Non-observance thérapeutique dans les essais cliniques randomisés
L’une des utilisations les plus élégantes des variables instrumentales réside au cœur même des protocoles expérimentaux sous la forme de l’ajustement pour non-observance thérapeutique. Dans un essai clinique randomisé évaluant une nouvelle thérapie d’acceptation et d’engagement contre la dépression réfractaire, l’assignation initiale des patients par tirage au sort (groupe intervention vs groupe témoin sur liste d’attente) est, par définition, parfaitement exogène. Cependant, dans la réalité clinique quotidienne, une proportion substantielle de participants assignés au protocole actif refuse d’y assister, manque les séances ou abandonne prématurément le parcours en raison d’effets indésirables ou d’un découragement psychologique.
L’approche d’analyse épidémiologique conventionnelle dite en « Intention de Traiter » (Intention-To-Treat ou ITT) compare l’intégralité des participants selon leur groupe d’assignation initial, sans égard pour leur participation effective. Si l’ITT protège impérieusement l’exogénéité du devis expérimental, elle sous-estime l’efficacité pharmacologique ou psychologique intrinsèque du protocole, diluant l’effet thérapeutique réel au milieu de la non-observance. À l’inverse, comparer naïvement les seuls sujets observant le protocole aux non-observants (l’analyse per-protocole) réintroduit instantanément le biais de sélection : les patients observant assidûment une thérapie complexe sont généralement dotés d’un soutien social plus solide et d’un meilleur pronostic clinique initial.
L’estimation par variable instrumentale résout magistralement cette aporie. Le chercheur utilise l’assignation aléatoire initiale (Z = 0 ou 1) comme un instrument parfait pour prédire la réception effective de l’intervention (X = nombre de séances suivies). L’assignation aléatoire satisfait par définition la condition d’exogénéité (garantie par l’algorithme de tirage au sort) et la restriction d’exclusion (le fait d’être placé formellement sur une liste n’améliore pas en soi l’état psychique si le patient ne reçoit aucun suivi). En divisant l’effet ITT par la proportion de patients observants, l’estimateur de Wald instrumental identifie ce que la statistique appelle l’effet moyen du traitement chez les observants (Complier Average Causal Effect ou CACE), fournissant aux psychiatres et aux psychologues une mesure non biaisée de l’efficacité réelle de l’intervention lorsqu’elle est concrètement délivrée.
6.2 Consommation de substances et comorbidités anxio-dépressives
L’intrication étiologique entre l’usage précoce de substances psychoactives et la survenue de décompensations anxio-dépressives ou psychotiques constitue l’un des débats les plus polarisés de la psychiatrie moderne. Les études observationnelles longitudinales documentent de façon constante que les consommateurs réguliers de cannabis à l’adolescence affichent un risque multiplié par deux à quatre de développer un épisode psychotique ou un trouble dépressif caractérisé à l’âge adulte. Néanmoins, ces résultats demeurent la cible permanente de controverses scientifiques : cette relation est-elle purement causale, ou reflète-t-elle une hypothèse d’automédication où des adolescents présentant des prodromes anxieux utilisent le tétrahydrocannabinol (THC) pour moduler leur affect négatif ? De surcroît, des vulnérabilités neurobiologiques et environnementales communes (précarité, maltraitance infantile) prédisposent conjointement à la toxicomanie et aux troubles mentaux.
Pour apporter une réponse causale à cette controverse, les chercheurs ont tiré parti des disparités géographiques et des calendriers d’ouverture des dispensaires de cannabis thérapeutique ou récréatif entre différents comtés ou cantons administratifs. Ces décisions de libéralisation ou de restriction de l’accès légal introduisent des variations exogènes massives dans la disponibilité de proximité et les coûts monétaires du produit, induisant des chocs d’accessibilité qui influencent directement la probabilité de consommation chez les jeunes résidents locaux.
En employant l’indice d’accessibilité légale spatiale comme instrument de la consommation effective de cannabis, les études d’inférence causale les plus robustes ont pu épurer l’association des vulnérabilités psychiques préexistantes. Les résultats de ces modélisations confirment une fraction causale non négligeable : même après neutralisation des facteurs de confusion latents, l’exposition substantielle à de fortes concentrations de cannabinoïdes pendant les phases critiques de maturation synaptique de l’adolescence conserve un impact déstabilisateur indépendant sur les scores d’intégration affective et le risque d’épisodes dissociatifs ultérieurs.
6.3 Temps d’écran et détresse psychologique chez les adolescents
La dégradation contemporaine des indicateurs de bien-être mental chez les jeunes générations a coïncidé de manière spectaculaire avec l’expansion généralisée des ordiphones et des plateformes de réseaux sociaux. De multiples enquêtes corrélationnelles rapportent une courbe ascendante conjointe entre le temps d’écran quotidien auto-déclaré et les scores mesurés d’anxiété sociale, de dysmorphophobie et d’idéations suicidaires. Pourtant, le spectre du biais de sélection et de la causalité bidirectionnelle fragilise les conclusions alarmistes : est-ce le flux continu d’images idéalisées sur les réseaux qui génère la détresse, ou les adolescents déjà fragilisés, socialement marginalisés ou insomniaques qui passent davantage d’heures nocturnes isolés devant leurs écrans par défaut d’alternatives relationnelles ?
Pour trancher empiriquement ce dilemme d’endogénéité, plusieurs équipes de recherche ont conçu des stratégies d’instrumentation basées sur le calendrier technologique de déploiement des infrastructures de télécommunication. La transition de la connexion mobile 3G vers les réseaux à très haut débit (4G puis 5G) ou l’extension géographique de la fibre optique ne se sont pas opérées de façon uniforme : elles ont obéi à des contraintes techniques strictes, liées au relief topographique, aux tracés historiques des lignes ferroviaires ou à des priorités d’aménagement du génie civil totalement imperméables aux traits psychologiques des riverains.
L’arrivée progressive du très haut débit au sein d’une zone résidentielle stimule massivement le temps passé sur les applications vidéo immersives par les jeunes ménages (pertinence de l’instrument). En comparant l’évolution des marqueurs de détresse psychologique des adolescents vivant dans des zones connectées précocement à celle de zones aux profils socio-économiques similaires mais connectées plus tardivement en raison de contraintes physiques de génie civil, l’approche par variable instrumentale a révélé des nuances capitales : si l’effet global d’un temps d’écran passif s’avère modeste, l’instrumentation isole un effet causal particulièrement toxique et spécifique de l’usage interactif nocturne sur la dysrégulation émotionnelle des jeunes adolescentes, un résultat que la régression naïve diluait dans l’imprécision des mesures agrégées.
7. La randomisation mendélienne : La génétique comme instrument naturel
7.1 Principes de la randomisation mendélienne en épidémiologie psychiatrique
Au confluent de la génétique statistique et de l’économétrie de l’évaluation se trouve l’une des déclinaisons les plus puissantes de l’approche instrumentale : la randomisation mendélienne (Mendelian Randomization ou MR). Conceptualisée par George Davey Smith et Shah Ebrahim au début des années 2000, cette méthodologie exploite la transmission des allèles parentaux lors de la méiose comme une loterie biologique grandeur nature pour déduire des causalités certaines entre biomarqueurs modifiables et phénotypes complexes.
Le fondement théorique repose sur les deux lois fondamentales de Gregor Mendel. La loi de ségrégation indépendante garantit que chaque individu hérite d’une combinaison d’allèles assignée au hasard au moment de la fécondation. La distribution des polymorphismes nucléotidiques simples (Single Nucleotide Polymorphisms ou SNP) s’apparente ainsi à un essai randomisé planifié par la nature dès la conception. Cette chronologie biologique confère à la randomisation mendélienne deux atouts méthodologiques inattaquables :
- Immunité totale contre la causalité inverse : le patrimoine génétique constitutionnel d’un sujet étant fixé in utero et invariable au cours de l’existence, un trouble psychiatrique déclaré à l’âge adulte ne peut en aucun cas modifier rétroactivement les allèles hérités à la conception.
- Protection robuste contre la majorité des facteurs de confusion environnementaux : la répartition des variants génétiques au sein d’une population homogène est globalement indépendante des facteurs socio-économiques, des modes de vie individuels ou des choix professionnels ultérieurs.
Dans ce paradigme, un ou plusieurs SNP connus pour moduler précisément l’expression d’un marqueur biologique intermédiaire (une enzyme, un taux d’hormone circulant, une protéine inflammatoire) sont érigés en variables instrumentales pour évaluer sans biais l’impact de ce biomarqueur sur un trouble neuropsychiatrique donné.
7.2 Exemples d’application aux biomarqueurs et troubles mentaux
La randomisation mendélienne a permis de clarifier des controverses majeures en psychiatrie biologique, à commencer par le rôle de l’inflammation systémique dans l’étiologie du trouble dépressif majeur. De multiples études de laboratoire ont relevé des taux sanguins anormalement élevés de protéine C-réactive (CRP) et d’interleukine-6 (IL-6) chez les patients en phase dépressive aiguë. Pour savoir si cette inflammation chronique de bas grade constituait une cause directe de l’altération de l’humeur ou une simple conséquence somatique du stress chronique et des mauvaises habitudes de vie associées à la dépression, des études de randomisation mendélienne ont sélectionné des variants génétiques localisés dans le gène du récepteur de l’IL-6 (IL6R), connus pour réguler naturellement le tonus inflammatoire de l’organisme tout au long de la vie.
Les estimations instrumentales ont révélé que les personnes génétiquement programmées pour avoir des niveaux d’interleukine-6 fonctionnelle plus élevés présentaient un risque accru de dépression clinique au cours de leur existence, apportant la première preuve causale véritable justifiant le développement pharmacologique d’antidépresseurs aux propriétés ciblées anti-inflammatoires pour les sous-groupes de patients résistants.
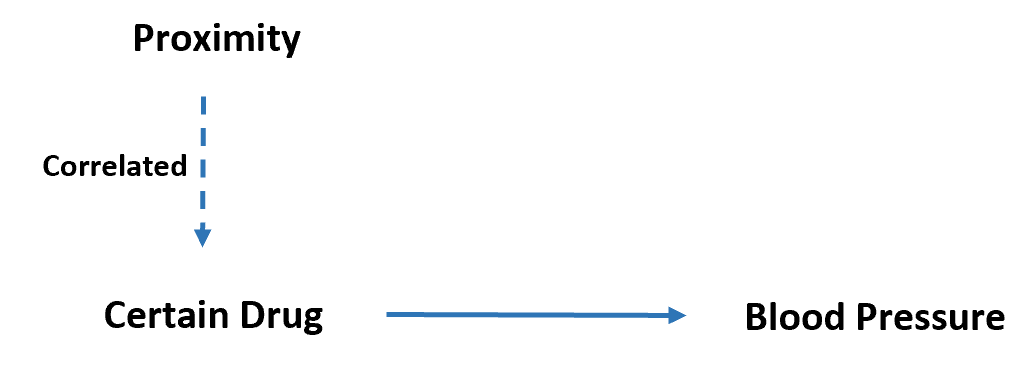
Un autre champ d’application florissant concerne l’investigation causale bidirectionnelle entre architecture du sommeil et troubles bipolaires. L’usage de scores de risque polygénique (Polygenic Risk Scores ou PRS) instrumentant la prédisposition au chronotype matinal versus vespéral a permis de démontrer qu’une propension génétique à la veille nocturne altère durablement la stabilité des neurotransmetteurs dans les circuits cortico-limbiques, précipitant l’alternance d’épisodes maniaques et dépressifs. De manière analogue, la randomisation mendélienne a pu dissocier l’impact causal propre de l’indice de masse corporelle (IMC) sur la dégradation de l’estime de soi des biais socio-culturels environnants, prouvant qu’une part essentielle de la souffrance psychologique mesurée découlait de la stigmatisation sociale plutôt que de contraintes métaboliques directes.
7.3 Défis majeurs : Pléiotropie horizontale et stratification de population
En dépit de son élégance mathématique, la randomisation mendélienne se heurte à des défis redoutables d’ordre biologique qui menacent constamment la restriction d’exclusion et l’exogénéité de l’instrument. Le premier de ces écueils est la pléiotropie horizontale. On parle de pléiotropie horizontale lorsqu’un même variant génétique Z, sélectionné initialement pour instrumenter un biomarqueur spécifique X, exerce également une influence régulatrice sur une ou plusieurs autres voies biologiques indépendantes W qui agissent directement sur la maladie psychiatrique Y.
Si un polymorphisme utilisé pour mesurer l’impact de la CRP régule également le métabolisme lipidique ou l’activité des récepteurs sérotoninergiques, la restriction d’exclusion est frontalement violée : l’effet du gène sur l’humeur ne passe plus exclusivement par l’intermédiaire de la protéine inflammatoire ciblée. Pour diagnostiquer et neutraliser cette pléiotropie horizontale, les méthodologistes ont élaboré des raffinements statistiques de pointe, à l’instar de la régression MR-Egger. En ajustant une régression pondérée avec ordonnée à l’origine non contrainte, MR-Egger permet de tester formellement la présence de pléiotropie (si l’ordonnée à l’origine s’écarte significativement de zéro) et d’obtenir un estimateur causal corrigé de ce biais systématique.
Le second péril structurel réside dans la stratification de population. Les fréquences alléliques des variants génétiques fluctuent naturellement entre différentes populations d’origines géographiques distinctes, de même que les prévalences de base de certains traits culturels ou psychopathologiques. Si l’échantillon d’analyse réunit des individus d’ascendances différentes sans stratification rigoureuse, une association purement fallacieuse peut émerger entre l’instrument génétique et la variable de santé mentale en raison d’une confusion introduite par la sous-structure ancestrale. L’inclusion systématique des composantes principales de l’ADN génomique (les axes d’ascendance calculés par analyse en composantes principales) au sein des covariables de contrôle W est devenue le standard méthodologique impératif pour sécuriser l’indépendance exogène de l’instrument.
8. Le problème des instruments faibles (Weak Instruments)
8.1 Mécanisme et conséquences de la faiblesse instrumentale
L’utilisation d’une variable instrumentale n’est pas un remède miracle exempt de risques statistiques majeurs. Le danger le plus insidieux auquel s’expose l’analyste réside dans l’utilisation d’un instrument dont la corrélation avec la variable endogène est réelle, mais d’une intensité numérique minime. C’est le problème fondamental des instruments faibles (« weak instruments »), documenté magistralement dans les travaux pionniers de Nelson et Startz (1990) ainsi que de Bound, Jaeger et Baker (1995).
Pour comprendre les conséquences désastreuses de cette faiblesse, il convient de se pencher sur l’expression analytique approchée du biais d’échantillon fini de l’estimateur des Moindres Carrés en Deux Étapes. Soit N la taille de l’échantillon, K le nombre total d’instruments mobilisés, et F la statistique de test évaluant la significativité globale des instruments lors de la première étape de régression. Le ratio du biais de l’estimateur instrumental (β̂2SLS – β) par rapport au biais classique de l’estimateur par les moindres carrés ordinaires (β̂OLS – β) s’approxime asymptotiquement par la formule de Bound :
E(β̂2SLS – β) / E(β̂OLS – β) ≈ 1 / (F – 1)
Cette relation théorique révèle un comportement statistique particulièrement inquiétant :
- Lorsque la statistique F devient petite (proche de 1 ou inférieure), le biais de l’estimateur 2SLS ne tend pas vers zéro ; au contraire, il converge directement vers le biais des Moindres Carrés Ordinaires !
- Loin de purger l’endogénéité, un instrument faible reproduit fidèlement la contamination du modèle naïf tout en décuplant la variance d’échantillonnage de manière exponentielle.
En présence d’un instrument faible, les distributions d’échantillonnage des estimateurs cessent d’obéir à la loi normale canonique. Elles deviennent asymétriques, leptokurtiques et présentent des queues de distribution extrêmement épaisses (« heavy tails »). Les tests d’hypothèse de Wald classiques subissent une distorsion catastrophique de leur taux d’erreur de première espèce (taux de faux positifs) : un chercheur croyant tester un seuil d’incertitude standard à 5 % peut en réalité opérer avec un taux d’erreur empirique de 20, 30 ou 50 %, rejetant à tort l’hypothèse nulle d’absence d’effet et publiant des découvertes causales totalement fictives.
8.2 La règle empirique du test F de premier niveau
Face à la menace des faux positifs induits par la faiblesse instrumentale, la communauté économétrique a développé des règles de décision empiriques rigoureuses pour valider la robustesse des modèles avant toute interprétation causale. La règle la plus universellement célèbre a été énoncée par Douglas Staiger et James Stock dans leur publication de référence de 1997 : la règle empirique de F > 10.
Cette règle stipule que dans le cas d’un modèle linéaire comportant une unique variable endogène, l’analyste doit impérativement examiner la statistique F de Fisher associée au test de significativité conjointe des instruments dans la régression de première étape (testant l’hypothèse nulle H0 : γ1 = … = γm = 0). Si cette statistique F est strictement inférieure au seuil de 10 (F < 10), les instruments doivent être déclarés faibles, et les inférences issues de l’estimateur 2SLS conventionnel doivent être rejetées comme méthodologiquement non fiables.
Par la suite, James Stock et Motohiro Yogo (2005) ont considérablement formalisé et raffiné cette heuristique en publiant des tables de valeurs critiques quantitatives basées sur des critères d’erreur stochastique précis. Leurs tables établissent des seuils minimaux de la statistique F en fonction :
- Du niveau d’amplification maximale du biais toléré par rapport aux moindres carrés ordinaires (par exemple, tolérer un biais instrumental n’excédant pas 5 %, 10 % ou 20 % du biais MCO).
- De la distorsion maximale admissible de la taille du test statistique de Student à un seuil nominal de 5 % (par exemple, tolérer que le test à 5 % rejette au maximum dans 10 %, 15 % ou 25 % des réplications sous l’hypothèse nulle).
Ces développements modernes démontrent que dès que le nombre d’instruments s’élève, le seuil sécuritaire de 10 devient souvent largement insuffisant. Dans de nombreuses configurations multi-instrumentales, la statistique F requise pour garantir une inférence robuste sans distorsion de taille de test peut aisément grimper à des valeurs de 20, 30, voire dépasser 100.
8.3 Approches et estimateurs alternatifs face aux instruments faibles
Lorsqu’un chercheur est irrémédiablement confronté à des instruments dont la force d’identification s’avère modeste (ce qui constitue la règle plutôt que l’exception en épidémiologie génétique où chaque variant individuel n’explique qu’une fraction infime de la variance phénotypique), il est impératif d’abandonner l’estimateur 2SLS standard au profit de méthodologies d’estimation et d’inférence robustes à la faiblesse de l’identification.
L’alternative paramétrique la plus éprouvée est l’estimateur du Maximum de Vraisemblance à Information Limitée (Limited Information Maximum Likelihood ou LIML). Bien que mathématiquement équivalent à l’estimateur 2SLS dans un cadre de grand échantillon avec instruments infiniment puissants, le LIML se comporte de manière infiniment supérieure dans les échantillons de taille finie confrontés à de multiples instruments faibles. Le LIML possède un biais médian asymptotique rigoureusement nul. Il ne se laisse pas attirer de manière asymétrique vers les estimations biaisées des moindres carrés ordinaires, préservant ainsi une neutralité centrale remarquable dans l’estimation de l’amplitude de l’effet causal.
Sur le plan des tests d’hypothèses et de la construction des intervalles de confiance, le standard absolu repose sur la statistique d’Anderson-Rubin (test AR) développée dès 1949. L’immense supériorité du test d’Anderson-Rubin réside dans sa robustesse exacte : la distribution de cette statistique sous l’hypothèse nulle obéit rigoureusement à une loi de Chi-deux ou de Fisher, quelle que soit la force réelle de l’instrument, même si le coefficient du premier stade est strictement nul (γ = 0) ! En « inversant » le test d’Anderson-Rubin, le chercheur génère des intervalles de confiance causaux dont le niveau de couverture nominal (par exemple 95 %) est invariablement garanti, protégeant l’investigation scientifique de toute conclusion triomphale prématurée.
9. Violation de la restriction d’exclusion et biais d’endogénéité résiduel
9.1 Les pièges fréquents dans la sélection des instruments
Trouver un instrument à la fois fortement prédictif et théoriquement exogène relève souvent du tour de force intellectuel. Dans cette quête méthodologique ardue, les analystes tombent fréquemment dans le piège de la fausse exogénéité, sélectionnant des variables dont le lien avec le critère final semble absent au premier regard mais s’avère insidieusement actif sous l’angle de la psychologie différentielle ou des médiations sociales.
L’un des pièges les plus emblématiques réside dans l’utilisation aveugle de variables macroéconomiques globales pour instrumenter des statuts personnels. Considérons une étude s’intéressant à l’impact de la perte d’emploi individuelle (traitement endogène) sur la sévérité des symptômes dépressifs (résultat final), en utilisant le taux de fermeture industrielle régionale comme instrument exogène. L’argumentaire avancé prétend que les faillites d’usines surviennent suite à la mondialisation des échanges et ne dépendent pas des compétences propres des ouvriers licenciés.
La restriction d’exclusion d’une telle construction est pourtant lourdement compromise :
- Une vague massive de faillites dans un bassin d’emploi ne produit pas uniquement du chômage individuel ; elle dégrade profondément le tissu économique communautaire, affaisse la valeur du patrimoine immobilier des ménages et restreint les budgets des municipalités alloués aux services sociaux.
- Ce délitement de l’environnement social altère directement la qualité de vie, l’anxiété générale et la santé mentale des habitants de la région, y compris de ceux qui sont parvenus à conserver leur poste de travail.
- L’instrument Z (le choc industriel) frappe donc directement le résultat Y (le moral psychologique) à travers une multitude de chemins parallèles n’impliquant pas la perte d’emploi du sujet considéré.
Un autre écueil classique émerge de la négligence des mécanismes d’anticipation psychologique. Si une modification législative imminente concernant l’âge de départ à la retraite est annoncée publiquement trois ans avant son application formelle, les salariés ajustent immédiatement leur épargne, leur investissement psychologique au travail et leur niveau de stress existentiel. Utiliser la date calendrier d’entrée en vigueur de la réforme comme un instrument brutal viole l’exclusion, car l’anticipation de la politique a commencé à altérer la santé mentale des sujets bien avant le passage réel du seuil administratif.
9.2 Analyse de sensibilité aux déviations de l’exclusion
Face à l’impossibilité d’apporter une preuve formelle empirique de l’étanchéité absolue de la restriction d’exclusion, l’attitude scientifique moderne ne consiste plus à affirmer péremptoirement que l’instrument est inviolable, mais à quantifier la robustesse des conclusions causales face à d’éventuelles entorses modérées à ce postulat. C’est l’objectif de l’analyse de sensibilité pour instruments imparfaits (« Plausibly Exogenous »), formalisée par Timothy Conley, Christian Hansen et Peter Rossi dans leur contribution méthodologique majeure de 2012.
L’approche de Conley et de ses coauteurs propose de réintroduire explicitement le terme de violation directe dans l’équation structurelle de seconde étape :
Yi = β0 + β1Xi + γZi + εi
Au lieu de poser dogmatiquement l’hypothèse γ = 0, l’analyste modélise γ comme un paramètre dont l’amplitude peut dévier modérément autour de zéro selon une distribution de probabilité a priori fixée par l’expertise du domaine (par exemple, en postulant que γ suit une loi normale d’espérance 0 et d’écart-type calibré sur les connaissances théoriques du problème). Cette technique permet de calculer des bornes causales pour le paramètre β1 sous différents scénarios d’imperfection de l’instrument.
Si l’intervalle de confiance estimé pour le coefficient causal β1 exclut la valeur zéro même dans l’hypothèse où l’instrument transmettrait directement 10 %, 15 % ou 20 % de variance parasite vers la variable d’intérêt, le chercheur peut conclure avec sérénité à la solidité de sa démonstration clinique ou comportementale. Si, à l’inverse, la moindre fluctuation infinitésimale de γ autour de zéro suffit à faire basculer l’effet causal estimé dans la non-significativité ou à en inverser le sens algébrique, la fragilité de la stratégie d’instrumentation se trouve mise à nu avec une transparence exemplaire.
9.3 Conséquences empiriques d’une violation conjointe
Lorsque la condition d’exogénéité ou la restriction d’exclusion est enfreinte au sein d’une modélisation empirique, les dommages statistiques sur l’estimation causale sont souvent infiniment plus pernicieux que le simple biais initial des moindres carrés ordinaires. En présence d’un instrument imparfait dont la corrélation avec l’erreur est non nulle (Cov(Z, ε) ≠ 0), la valeur asymptotique vers laquelle converge l’estimateur de Wald s’établit comme suit :
plim β̂IV = β + [Corr(Z, ε) / Corr(Z, X)] × [σε / σX]
Cette décomposition met en lumière la redoutable dynamique du ratio de contamination. Le terme d’erreur résiduel n’est pas simplement additionné au paramètre réel ; il est divisé par le coefficient de corrélation reliant l’instrument à la variable de traitement (Corr(Z, X)). Cette structure mathématique emporte des conséquences radicales :
- Si l’instrument sélectionné ne présente qu’une liaison modérée avec la variable explicative (faible dénominateur Corr(Z, X)), la moindre violation infinitésimale de la restriction d’exclusion (numérateur Corr(Z, ε) très légèrement positif) se trouve amplifiée de manière disproportionnée par l’opération de division.
- Le biais de l’estimateur par variable instrumentale peut ainsi facilement dépasser le biais originel des MCO d’un facteur 2, 5 ou 10 !
- Pis encore, le signe du biais instrumental peut devenir opposé au signe du biais naïf, conduisant l’équipe de recherche à observer et à commenter un effet thérapeutique prétendument bénéfique là où l’intervention clinique s’avère en réalité neutre, voire délétère pour les patients.
Ce constat d’une extrême vulnérabilité confirme une règle méthodologique d’or : une modélisation observationnelle naïve honnêtement discutée est toujours préférable à une mauvaise régression instrumentale reposant sur un instrument contaminé, dont l’apparence de sophistication algorithmique ne fait que masquer une déformation exponentielle de la réalité causale.
10. Diagnostics statistiques et tests empiriques des instruments
10.1 Test d’endogénéité de Durbin-Wu-Hausman
La mobilisation d’une variable instrumentale ne doit jamais constituer un automatisme aveugle. Dans la mesure où l’estimateur des variables instrumentales (2SLS) paie son absence théorique de biais par une perte drastique de précision statistique (ses erreurs-types étant systématiquement supérieures à celles des MCO), il n’y a aucun intérêt méthodologique à y recourir si le régresseur d’intérêt n’est pas fondamentalement endogène. Le test d’endogénéité de Durbin-Wu-Hausman (communément désigné sous le terme de test de Hausman) répond précisément à cette question d’arbitrage.
Le test de Durbin-Wu-Hausman compare directement le vecteur des coefficients estimés par les moindres carrés ordinaires (β̂OLS) avec celui produit par l’estimateur instrumental (β̂2SLS). La logique sous-jacente s’articule autour de deux hypothèses concurrentes :
- Sous l’hypothèse nulle (H0) : La variable explicative X est parfaitement exogène (Cov(X, ε) = 0). Dans cette situation, les deux estimateurs sont consistants et convergent vers la même valeur, mais l’estimateur MCO est asymptotiquement plus efficace (sa variance est minimale).
- Sous l’hypothèse alternative (H1) : La variable explicative X est effectivement endogène (Cov(X, ε) ≠ 0). Dans ce cas de figure, l’estimateur MCO est biaisé et inconsistant, tandis que l’estimateur instrumental demeure consistant.
La statistique de test suit asymptotiquement une distribution de Chi-deux, calculée à partir de la différence quadratique normalisée entre les deux estimations :
H = (β̂2SLS – β̂OLS)’ [Var(β̂2SLS) – Var(β̂OLS)]-1 (β̂2SLS – β̂OLS)
Si la valeur p associée au test s’avère statistiquement significative (généralement p < 0,05), l’hypothèse nulle d’exogénéité est formellement rejetée. L’analyste dispose alors d’une preuve quantitative que le modèle conventionnel est sévèrement corrompu par un biais d’endogénéité, justifiant pleinement le recours à l’arsenal plus lourd et moins précis des variables instrumentales.
10.2 Test de sur-identification de Sargan-Hansen (Test J)
S’il est théoriquement impossible de tester la validité de la restriction d’exclusion lorsqu’un chercheur dispose d’un instrument unique pour une seule variable endogène (modèle exactement identifié), la situation méthodologique bascule radicalement dès lors que le modèle est sur-identifié, c’est-à-dire lorsqu’il comporte davantage d’instruments que de régresseurs endogènes (par exemple, deux ou trois instruments Z1, Z2, Z3 pour un traitement X). Dans ce cadre privilégié, le test de sur-identification de Sargan-Hansen (ou statistique J de Hansen) permet de tester la cohérence mutuelle de l’ensemble des instruments postulés.
Le test J repose sur une intuition fondamentale : si l’intégralité des instruments mobilisés est rigoureusement exogène et respecte la restriction d’exclusion, les résidus structurels de l’estimation de seconde étape (ê2SLS = Y – Xβ̂2SLS) ne doivent présenter aucune corrélation statistiquement significative avec aucun des instruments du vecteur Z. La procédure consiste à régresser les résidus de seconde étape sur l’ensemble des instruments disponibles et des covariables exogènes, puis à examiner la statistique de détermination R2 de cette régression auxiliaire.
La statistique de Sargan correspond au produit de la taille d’échantillon par ce coefficient de détermination :
J = N × R2
Sous l’hypothèse nulle (H0) stipulant que tous les instruments sont conjointement valides et non corrélés au terme d’erreur structurel, la statistique J suit asymptotiquement une loi de Chi-deux dont les degrés de liberté sont égaux au degré de sur-identification (nombre d’instruments K moins nombre de variables endogènes L). Si le test débouche sur un rejet significatif de l’hypothèse nulle (p < 0,05), le verdict est sans appel : au moins un des instruments mobilisés est invalide, soit parce qu’il n’est pas exogène, soit parce qu’il exerce une influence directe non autorisée sur la variable dépendante Y. Bien que le test ne puisse désigner nominativement quel instrument précis est coupable de défaillance, il enjoint impérativement l’analyste à purger son modèle des instruments suspects.
10.3 Diagnostics de sous-identification et de faible identification
Au-delà de l’endogénéité et de la sur-identification, une analyse économétrique contemporaine exige la vérification méthodique du rang de la matrice des projections de premier niveau afin d’écarter toute menace de sous-identification ou d’identification déficiente. Ces diagnostics évaluent si la relation statistique liant le sous-espace des instruments à la variable endogène est suffisamment robuste pour autoriser une inversion matricielle stable.
Le test de sous-identification évalue l’hypothèse nulle stipulant que le modèle n’est tout simplement pas identifié, ce qui équivaut à affirmer que la matrice des coefficients des instruments dans l’équation de premier niveau est de rang incomplet (absence de corrélation globale). Deux statistiques principales dominent la pratique :
- La statistique du multiplicateur de Lagrange d’Anderson (Anderson LM Test) dans l’hypothèse classique d’erreurs indépendantes et homoscédastiques.
- La statistique de Kleibergen-Paap (LM Test) conçue spécifiquement pour rester rigoureusement valide lorsque les données violent l’hypothèse d’homoscédasticité ou présentent une autocorrélation groupée en grappes (« cluster-robust »).
Un rejet clair de l’hypothèse nulle (valeur p hautement significative) assure que le modèle franchit le seuil minimal de l’identification matricielle : les instruments prédisent de façon vérifiable la variable de traitement.
Dans un second temps, l’analyste se doit d’évaluer la faible identification à l’aide de la statistique de Wald de Cragg-Donald (sous hypothèse d’homoscédasticité) ou de la statistique de Wald de Kleibergen-Paap rk (sous hétéroscédasticité). Cette statistique scalaire unique est alors directement confrontée aux tables de valeurs critiques de Stock-Yogo pour déterminer si l’instrument dépasse les seuils minimaux de tolérance de distorsion de biais et de taille. Ces diagnostics d’identification forment désormais la batterie de tests obligatoire exigée par les comités de lecture des revues scientifiques les plus exigeantes avant d’accorder la moindre crédibilité aux prétentions causales d’un travail d’évaluation.
11. Effet de traitement moyen local (LATE) et hétérogénéité des effets
11.1 Définition et typologie des populations selon Imbens et Angrist
L’une des avancées conceptuelles les plus remarquables de l’inférence causale moderne, couronnée par l’attribution du Prix Nobel d’Économie à Guido Imbens et Joshua Angrist en 2021, réside dans la réinterprétation de ce que mesure précisément une variable instrumentale en présence d’hétérogénéité des effets de traitement au sein de la population. Dans les populations humaines réelles, l’impact d’une psychothérapie, d’un médicament ou d’une expérience de vie n’est jamais constant ni universellement homogène ; il oscille considérablement selon les singularités biologiques et psychologiques de chaque individu.
Dans ce contexte hétérogène réaliste, Imbens et Angrist (1994) ont démontré que pour un instrument binaire Z et un traitement binaire X, la population globale se subdivise rigoureusement en quatre sous-groupes comportementaux latents distincts, définis par leur manière de réagir à la présence de l’instrument :
- Les Observants (Compliers) : Il s’agit des individus qui adoptent le traitement lorsqu’ils reçoivent l’instrument (ou l’incitation), et qui ne le prennent pas en son absence (X = 1 si Z = 1 ; X = 0 si Z = 0). Leur comportement est directement gouverné par la variation exogène de l’instrument.
- Les Bénéficiaires Permanents (Always-takers) : Ces individus s’exposent systématiquement au traitement, qu’ils soient incités ou non par l’instrument (X = 1 quelle que soit la valeur de Z). Leur forte motivation ou leurs ressources personnelles rendent l’action de l’instrument totalement indifférente.
- Les Réfractaires Permanents (Never-takers) : Ces sujets refusent catégoriquement le traitement sous toutes les circonstances, même lorsqu’ils sont formellement assignés à l’instrument ou reçoivent une incitation maximale (X = 0 quelle que soit la valeur de Z).
- Les Défieurs (Defiers) : Ce groupe théorique paradoxal adopte le comportement inverse exact de l’incitation fournie par l’instrument : ils prennent le traitement lorsqu’on leur refuse l’instrument, et s’abstiennent lorsqu’on les y incite (X = 0 si Z = 1 ; X = 1 si Z = 0).
Pour autoriser l’identification causale, la théorie impose l’hypothèse de monotonicité (ou absence de défieurs). Cette hypothèse postule que l’instrument affecte la probabilité de traitement de tous les individus dans le même sens : l’instrument peut pousser certaines personnes à adopter le traitement, mais il ne dissuade personne qui l’aurait pris en son absence. Sous cette condition fondamentale, l’estimateur par variable instrumentale mesure exclusivement ce que les auteurs nomment l’Effet de Traitement Moyen Local (Local Average Treatment Effect ou LATE) : l’effet causal moyen du traitement circonscrit strictement et uniquement au sous-groupe des individus observants (Compliers).
11.2 Différences entre LATE, ATE et ATT en recherche clinique
La découverte du LATE bouleverse profondément la portée des conclusions cliniques et comportementales en introduisant une démarcation conceptuelle nette entre différents paramètres causaux de population. Les analystes distinguent classiquement trois grandeurs fondamentales :
- L’Effet Moyen du Traitement dans la population globale (Average Treatment Effect ou ATE) : Il représente l’impact moyen hypothétique qui serait observé si l’intégralité sans exception des individus de la population recevait le traitement par rapport à une situation où personne ne le recevrait.
- L’Effet Moyen du Traitement chez les Traités (Average Treatment Effect on the Treated ou ATT) : Il évalue l’impact causal moyen constaté exclusivement chez les personnes qui se soumettent concrètement au traitement dans les conditions réelles d’observation.
- L’Effet Moyen Local (LATE) : Comme défini précédemment, il ne capture l’effet causale moyen que pour la frange spécifique de la population qui modifie son comportement d’exposition sous l’effet de l’instrument utilisé.
Le piège interprétatif majeur consiste à assimiler le LATE à l’ATE global. Dans la grande majorité des investigations en psychiatrie ou en psychologie sociale, le sous-groupe des « compliers » ne constitue pas un échantillon représentatif de l’ensemble des patients. Les observants sont précisément les individus se situant à la marge de l’indécision, dont la vulnérabilité ou la flexibilité comportementale les rend perméables à une incitation extérieure (l’instrument). Les individus souffrant des pathologies dépressives les plus extrêmes et invalidantes peuvent appartenir massivement à la classe des réfractaires permanents (never-takers), insensibles aux programmes de relance téléphonique ou aux aides de déplacement.
Par conséquent, généraliser inconsidérément une estimation LATE à l’ensemble du spectre clinique d’une pathologie constitue une faute de validité externe. L’estimateur instrumental documente une efficacité réelle indéniable, mais cette efficacité est intrinsèquement contextualisée par le profil psychologique et social particulier des individus dont l’action a été catalysée par le levier de l’instrument.
11.3 Facteurs contextuels modifiant l’interprétation du LATE
Une conséquence fascinante et déroutante de la théorie du LATE réside dans le fait que l’effet causal mesuré d’un même traitement X dépend intimement de l’instrument Z sélectionné par le chercheur. Imaginons deux équipes d’épidémiologistes évaluant les vertus d’une activité sportive régulière sur le ralentissement du vieillissement cognitif au sein d’une même métropole :
- La première équipe utilise comme instrument une subvention financière municipale réduisant drastiquement le coût d’inscription aux clubs de gymnastique locaux. Les « observants » de cet instrument seront majoritairement des individus aux revenus modestes mais motivés par l’activité physique, pour lesquels la barrière tarifaire constituait le seul frein à l’engagement sportif.
- La seconde équipe utilise comme instrument l’aménagement d’une piste cyclable sécurisée reliant les zones résidentielles aux bassins d’emploi. Les « observants » de ce second instrument seront des actifs urbains soucieux de rentabiliser leur temps de transport quotidien.
Bien que les deux recherches analysent rigoureusement la même relation causale (sport et fonctions exécutives cérébrales), elles estimeront fort probablement deux LATE statistiquement divergents ! Le premier LATE quantifiera l’impact de l’exercice chez des personnes en situation de précarité monétaire, tandis que le second évaluera l’effet chez des salariés urbains dynamiques. Chacune des estimations est parfaitement exacte et non biaisée, mais chacune reflète une réalité locale distincte façonnée par l’instrument.
Il est donc impératif, dans tout rapport d’évaluation scientifique, de caractériser sociologiquement et cliniquement la sous-population des observants. En analysant la proportion de compliers au sein de l’échantillon et en documentant leurs variables pré-interventionnelles (âge médian, niveau socio-culturel de base, sévérité clinique initiale), les chercheurs transforment le LATE d’une apparente limitation statistique en un formidable outil de médecine personnalisée et d’intervention comportementale ciblée.
12. Guide pratique de mise en œuvre et bonnes pratiques méthodologiques
12.1 Arbre de décision pour le recours aux variables instrumentales
L’engagement dans une stratégie de variables instrumentales ne doit se concrétiser qu’au terme d’un processus délibératif méthodique, guidé par un arbre de décision rigoureux. L’analyste doit successivement franchir plusieurs étapes de validation théorique et opérationnelle avant d’arrêter son choix méthodologique :
- Évaluation de la plausibilité de l’endogénéité : Existe-t-il des raisons théoriques impérieuses ou des antécédents empiriques suggérant que la variable de traitement est corrélée aux résidus du modèle (biais de confusion inobservé, biais de sélection volontaire, causalité inverse, erreur psychométrique de mesure) ? Si la réponse est négative et que l’ensemble des facteurs de confusion majeurs sont minutieusement observés, la régression par ajustement multivarié ou l’appariement sur score de propension doivent être privilégiés pour préserver la précision statistique.
- Identification d’un instrument naturel ou quasi-expérimental : Dispose-t-on d’une variable qui influence mécaniquement le traitement sans entretenir de lien avec le phénomène d’intérêt ? L’assignation de cette variable ressemble-t-elle à un tirage au sort physique, institutionnel ou génétique ?
- Audit impitoyable de la restriction d’exclusion : Existe-t-il le moindre mécanisme biologique, psychologique, économique ou relationnel direct reliant l’instrument au résultat final ? Peut-on dresser la liste de toutes les voies médiatrices envisageables et vérifier qu’elles sont totalement neutralisées ?
- Arbitrage biais-variance préalable : La taille d’échantillon disponible est-elle suffisante pour tolérer la dégradation inhérente de puissance statistique induite par l’estimation en deux étapes ? Une étude portant sur un échantillon modeste de 100 individus résiste rarement aux exigences de variance d’une analyse instrumentale.
Si toutes ces balises sont franchies avec succès, le recours à la méthode des variables instrumentales s’impose alors comme la voie royale pour extraire une inférence causale transparente et incontestable.
12.2 Implémentation informatique avec R, Python et Stata
L’exécution computationnelle de l’estimation par variables instrumentales bénéficie aujourd’hui d’implémentations standardisées hautement performantes au sein des trois environnements de programmation statistique dominants de la recherche scientifique.
Sous l’environnement R, le package de référence historique est le module AER (Applied Econometrics with R), qui fournit la célèbre fonction ivreg(). La syntaxe repose sur une séparation élégante par une barre verticale (« | »), où la partie gauche de la barre spécifie les régresseurs de seconde étape et la partie droite liste l’ensemble des variables exogènes et des instruments :
modele_iv <- ivreg(Y ~ X + W1 + W2 | Z + W1 + W2, data = mon_dataframe)
Pour les données de panel de grande dimension comportant des effets fixes multiples (par exemple des effets fixes individus et des effets fixes temporels), le package moderne fixest et sa commande feols() offrent des performances de calcul prodigieuses, intégrant automatiquement des calculs de matrice de variance-covariance robustes aux grappes d’échantillonnage.
Dans l’écosystème Python, l’analyse instrumentale moderne s’articule autour de la bibliothèque spécialisée linearmodels. La classe IV2SLS permet d’instancier un modèle complet en spécifiant explicitement les variables dépendantes, les variables exogènes de contrôle, les variables endogènes ciblées et le vecteur des instruments :
from linearmodels.iv import IV2SLS
modele = IV2SLS(dependent=df['Y'], exog=df[['const', 'W1']], endog=df['X'], instruments=df['Z']).fit(cov_type='robust')
Sous le logiciel Stata, traditionnellement plébiscité par les revues biomédicales et économiques, la commande intégrée ivregress 2sls assure l’estimation complète avec une batterie automatique de diagnostics post-estimation :
ivregress 2sls Y W1 (X = Z), vce(robust)
estat firststage
estat overid
estat endogenous
Ces commandes post-estimation automatisent en une fraction de seconde le calcul des statistiques F de premier stade, les tests d’Anderson-Rubin, le test de Durbin-Wu-Hausman ainsi que le test de sur-identification de Sargan, fournissant au chercheur une vue panoramique instantanée sur l’intégrité statistique de son modèle.
12.3 Checklist de transparence pour la publication scientifique
Afin de garantir la reproductibilité méthodologique et de satisfaire aux standards de rigueur des plus grandes revues internationales à comité de lecture, tout article scientifique mobilisant l’approche par variables instrumentales devrait impérativement inclure dans son corps de texte ou en annexe méthodologique la checklist de transparence suivante :
- Plausibilité narrative de l’exclusion : Développer un paragraphe argumenté et référencé détaillant pourquoi l’instrument choisi ne viole pas la restriction d’exclusion, en explorant et réfutant explicitement les hypothèses de médiation alternative.
- Publication transparente de la première étape : Rapporter systématiquement et sans restriction les coefficients complets de l’équation de régression de premier niveau, accompagnés de leurs erreurs-types et du R2 partiel attribuable aux seuls instruments.
- Statistique F de premier stade : Fournir systématiquement la statistique F de Cragg-Donald ou de Kleibergen-Paap évaluant la force des instruments, en la comparant explicitement aux valeurs critiques de Stock-Yogo. Bannir définitivement l’interprétation d’instruments affichant un F inférieur à 10 sans tests robustes d’Anderson-Rubin associés.
- Présentation comparative des résultats : Publier côte à côte, au sein d’un même tableau récapitulatif, les estimations obtenues par les Moindres Carrés Ordinaires (MCO/OLS) et celles issues des Moindres Carrés en Deux Étapes (2SLS/IV), en commentant la magnitude et la direction du déplacement des coefficients causaux.
- Batterie de diagnostics d’endogénéité et de sur-identification : Mentionner systématiquement les valeurs p exactes du test de Hausman et, dans les modèles sur-identifiés, du test de Sargan-Hansen (Test J).
- Discussion explicite du LATE et de la population observante : Spécifier clairement que les conclusions causales s’appliquent en priorité au sous-groupe des observants (compliers), en évitant toute généralisation excessive et non régulée à l’intégralité de la population clinique cible.
L’application rigoureuse de ces standards d’intégrité méthodologique transforme l’outil des variables instrumentales en une passerelle scientifique irremplaçable, permettant aux sciences du comportement d’accéder à une compréhension authentiquement causale de la complexité humaine.
Références
- Anderson, T. W., & Rubin, H. (1949). Estimation of the parameters of a single equation in a complete system of stochastic equations. The Annals of Mathematical Statistics, 20(1), 46-63. https://doi.org/10.1214/aoms/1177730030
- Angrist, J. D., & Krueger, A. B. (1991). Does compulsory school attendance affect schooling and earnings? The Quarterly Journal of Economics, 106(4), 979-1014. https://doi.org/10.2307/2937954
- Angrist, J. D., Imbens, G. W., & Rubin, D. B. (1996). Identification of causal effects using instrumental variables. Journal of the American Statistical Association, 91(434), 444-455. https://doi.org/10.1080/01621459.1996.10476902
- Basmann, R. L. (1957). A generalized classical method of linear estimation of coefficients in a structural equation. Econometrica, 25(1), 77-83. https://doi.org/10.2307/1907743
- Bound, J., Jaeger, D. A., & Baker, R. M. (1995). Problems with instrumental variables estimation when the correlation between the instruments and the endogenous explanatory variable is weak. Journal of the American Statistical Association, 90(430), 443-450. https://doi.org/10.1080/01621459.1995.10476536
- Conley, T. G., Hansen, C. B., & Rossi, P. E. (2012). Plausibly exogenous. Review of Economics and Statistics, 94(1), 260-272. https://doi.org/10.1162/REST_a_00139
- Davey Smith, G., & Ebrahim, S. (2003). ‘Mendelian randomization’: can genetic epidemiology contribute to understanding environmental determinants of disease? International Journal of Epidemiology, 32(1), 1-22. https://doi.org/10.1093/ije/dyg070
- Hausman, J. A. (1978). Specification tests in econometrics. Econometrica, 46(6), 1251-1271. https://doi.org/10.2307/1913827
- Imbens, G. W., & Angrist, J. D. (1994). Identification and estimation of local average treatment effects. Econometrica, 62(2), 467-475. https://doi.org/10.2307/2951620
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Sargan, J. D. (1958). The estimation of economic relationships using instrumental variables. Econometrica, 26(3), 393-415. https://doi.org/10.2307/1907619
- Staiger, D., & Stock, J. H. (1997). Instrumental variables regression with weak instruments. Econometrica, 65(3), 557-586. https://doi.org/10.2307/2171753
- Stock, J. H., & Yogo, M. (2005). Testing for weak instruments in linear IV regression. In D. W. K. Andrews & J. H. Stock (Eds.), Identification and inference for econometric models: Essays in honor of Thomas Rothenberg (pp. 80-108). Cambridge University Press. https://doi.org/10.1017/CBO9780511614491.006
- Theil, H. (1953). Repeated least squares applied to complete systems of equations. Central Planning Bureau, The Hague.
- Wright, P. G. (1928). The tariff on animal and vegetable oils. The Macmillan Company.