
Dans l’architecture de la recherche scientifique contemporaine, la modélisation statistique constitue la pierre angulaire permettant de traduire des hypothèses théoriques abstraites en relations empiriques vérifiables. Qu’il s’agisse de disséquer les mécanismes sous-jacents aux fonctions exécutives en psychologie cognitive, d’évaluer la trajectoire des symptômes au sein d’essais cliniques randomisés, ou de sonder les dynamiques d’influence au sein des organisations, les chercheurs sont inévitablement confrontés à la nécessité de conceptualiser la structure du réseau causal reliant leurs observations. Au cœur de cette démarche d’abstraction réside une distinction fondamentale, souvent méconnue ou simplifiée à l’excès : la dichotomie entre variables endogènes et variables exogènes.
Héritée des travaux fondateurs de l’économétrie formelle et de la théorie de la modélisation causale, cette catégorisation transcende la simple nomenclature technique. Elle délimite la frontière épistémologique entre ce qui est généré, entretenu et expliqué par le système étudié d’une part, et ce qui provient de l’extérieur, agissant sur le système sans être rétroactivement altéré par lui d’autre part. Loin d’être une simple propriété inhérente aux objets du monde réel, le statut endogène ou exogène d’une variable dépend fondamentalement de la manière dont le chercheur délimite les contours de son modèle d’investigation. Une variable considérée comme exogène dans un paradigme expérimental circonscrit peut immédiatement basculer dans le champ de l’endogénéité dès lors que l’on élargit le cadre d’analyse à une échelle longitudinale ou écosystémique.
La mauvaise appréhension de cette distinction constitue l’une des sources majeures de biais méthodologiques dans la littérature scientifique quantitative. Ignorer l’endogénéité d’un prédicteur au sein d’une équation de régression revient à violer les postulats probabilistes les plus élémentaires, menant inéluctablement à des estimations incohérentes, à une confusion entre simple corrélation et véritable relation de cause à effet, et ultimement à des conclusions erronées aux conséquences pratiques potentiellement désastreuses. Cet article propose une analyse approfondie, rigoureuse et multidimensionnelle des variables endogènes et exogènes, offrant aux chercheurs et praticiens une boussole théorique et méthodologique indispensable pour concevoir, estimer et interpréter des modèles statistiques robustes.
1. Introduction aux variables endogènes et exogènes en modélisation
1.1 Origine épistémologique et conceptualisation dans les sciences du comportement
L’émergence des concepts d’endogénéité et d’exogénéité trouve ses racines historiques dans l’essor de l’économétrie structurelle durant les années 1930 et 1940, sous l’impulsion décisive des travaux de la Cowles Commission for Research in Economics. Des figures tutélaires telles que Trygve Haavelmo, lauréat du prix Nobel, et Jan Tinbergen ont été les premières à formaliser la nécessité d’isoler les influences extérieures des dynamiques internes au sein d’équations simultanées. Face à des phénomènes macroéconomiques interconnectés où les prix, l’offre et la demande s’influencent mutuellement, il était devenu impératif de distinguer les variables dont la trajectoire était régie par les lois internes du marché de celles introduites comme chocs ou impulsions d’origine extérieure, telles que les politiques fiscales ou les conditions météorologiques.
Au fil des décennies, cette conceptualisation a franchi les frontières disciplinaires pour s’enraciner profondément dans les sciences du comportement, la psychologie différentielle, la sociologie quantitative et la psychiatrie computationnelle. Les sciences humaines ont en effet rapidement pris conscience que l’esprit, le comportement individuel et les structures sociales forment des systèmes ouverts hautement complexes. Formaliser des relations causales au sein de ces systèmes exigeait un vocabulaire mathématique capable de dépasser le déterminisme unilatéral simpliste. En adoptant les termes « endogène » (issu des racines grecques endon, « en dedans », et gennan, « engendrer ») et « exogène » (de exo, « dehors »), les méthodologues des sciences comportementales ont introduit un langage rigoureux pour décrire l’origine ontologique des variations observées.
L’évolution contemporaine de la terminologie en psychologie et en psychopathologie reflète cette maturité épistémologique croissante. Dans les modèles nosographiques actuels, à l’instar du consortium HiTOP (Hierarchical Taxonomy of Psychopathology) ou des approches par réseaux de symptômes, l’évaluation des troubles mentaux ne repose plus sur l’illusion d’une entité clinique isolée. Au contraire, les symptômes sont appréhendés comme des éléments d’un réseau dynamique où la délimitation précise des frontières du modèle détermine si une vulnérabilité psychologique, un événement traumatique ou une réaction biologique doit être traitée comme un paramètre régulateur externe ou comme un produit direct des interactions intérieures du système cognitif.
1.2 Importance de la catégorisation dans l’analyse quantitative
D’un point de vue strictement statistique, la distinction entre variables endogènes et exogènes ne relève pas d’une simple convention philosophique ; elle conditionne directement la validité mathématique des inférences causales dérivées de modèles statistiques multivariés. Dans toute démarche inférentielle, le chercheur aspire à estimer la magnitude et la direction d’un effet structurel, c’est-à-dire l’impact théorique qu’aurait la manipulation délibérée d’une variable prédictive sur un indicateur de résultat. Or, la possibilité même d’attribuer une interprétation causale à un coefficient de régression repose sur le respect scrupuleux de l’hypothèse d’exogénéité, laquelle garantit que le prédicteur n’entretient aucune dépendance systématique avec les facteurs inobservés relégués dans la composante stochastique résiduelle.
La négligence de cette catégorisation engendre immanquablement des biais d’estimation massifs, regroupés sous la qualification générique de « biais d’endogénéité ». Lorsqu’une variable intrinsèquement endogène est intégrée dans un modèle sous l’hypothèse naïve de son exogénéité, la validité interne de l’étude est intégralement compromise. Les coefficients estimés par les techniques standards, telles que la méthode des moindres carrés ordinaires, deviennent biaisés et non convergents, ce qui signifie que même une augmentation infinie de la taille de l’échantillon ne permettra pas de converger vers la véritable valeur du paramètre populationnel. Ce dérèglement analytique conduit fréquemment la communauté scientifique à postuler des relations illusoires ou, inversement, à masquer des mécanismes d’action réels mais dissimulés par des phénomènes de confusion statistique.
Au-delà du traitement purement algorithmique, la qualification correcte des variables pilote l’ensemble de la conception méthodologique d’une étude quantitative. Elle dicte le choix des estimateurs — imposant le passage de régressions linéaires standards à des estimateurs par variables instrumentales, des équations structurelles multivariées ou des modèles longitudinaux à effets fixes —, oriente la structuration des protocoles de recueil de données, et guide la sélection des variables de contrôle indispensables pour neutraliser les chemins de causalité parasites dans le diagramme d’investigation.
1.3 Objectifs pédagogiques et cadre méthodologique du document
L’ambition première de cet article est de fournir une clarification conceptuelle et mathématique exhaustive des notions d’endogénéité et d’exogénéité, en éliminant les ambiguïtés sémantiques qui polluent fréquemment les écrits de recherche et les manuels d’introduction. En clarifiant la distinction formelle entre ces termes et des notions périphériques telles que « variable indépendante », « variable dépendante », « covariable » ou « variable manipulée », nous entendons offrir aux chercheurs une grille d’analyse immédiatement opérationnelle pour disséquer leurs objets d’étude.
Le cadre méthodologique mobilisé dans ce document repose sur l’intégration harmonieuse de trois piliers fondamentaux de la modélisation statistique moderne :
- L’algèbre linéaire appliquée aux modèles de régression et l’économétrie des séries temporelles et de panel ;
- La modélisation par équations structurelles (SEM, Structural Equation Modeling), formalisée par l’école psychométrique ;
- La théorie computationnelle de la causalité formalisée par Judea Pearl et ses collaborateurs, fondée sur l’usage des graphes acycliques dirigés (DAG, Directed Acyclic Graphs) et l’opérateur d’intervention do(·).
À travers cette triangulation conceptuelle, le lecteur sera guidé depuis les fondements probabilistes les plus abstraits jusqu’aux applications empiriques les plus concrètes en psychologie cognitive, clinique et organisationnelle. Cette approche garantira non seulement une compréhension intuitive des dynamiques en jeu, mais dotera également l’analyste des réflexes diagnostiques nécessaires pour identifier, prévenir et corriger les perturbations liées à l’endogénéité au sein de ses propres dispositifs de recherche.
2. Fondements théoriques : Qu’est-ce qu’une variable endogène ?
2.1 Définition mathématique et structurelle
Dans le formalisme de la modélisation statistique, une variable endogène se définit rigoureusement comme une entité dont la variabilité et les fluctuations observées sont expliquées, en tout ou partie, par d’autres composantes intégrées à l’intérieur du modèle d’analyse. Mathématiquement, pour un individu ou une unité observationnelle notée i, une variable $Y_i$ est dite endogène au sein d’un système d’équations si elle apparaît au moins une fois comme le terme de gauche d’une équation structurelle, traduisant le fait que son espérance conditionnelle dépend formellement d’un ensemble de prédicteurs internes au modèle :
$$Y_i = \alpha + boldsymbol{\beta}^top \mathbf{X}_i + \varepsilon_i$$
Dans cette formulation, $\mathbf{X}_i$ représente un vecteur de variables explicatives (pouvant elles-mêmes être endogènes ou exogènes), $boldsymbol{\beta}$ est un vecteur de paramètres structurels traduisant l’intensité des liaisons fonctionnelles, et $\varepsilon_i$ désigne le terme d’erreur stochastique. La caractéristique architecturale d’une variable endogène réside dans sa dépendance causale explicite vis-à-vis du vecteur de variables explicatives. Elle constitue la manifestation quantitative d’un processus récepteur au sein du modèle.
Sur le plan structurel, une variable endogène n’est pas cantonnée au rôle traditionnel de variable dépendante finale ou d’indicateur ultime d’aboutissement (outcome). Dès lors que le modèle prend la forme d’un système multivarié ou d’un réseau d’équations structurelles, toute variable servant d’intermédiaire, c’est-à-dire qui subit l’influence d’un prédicteur amont tout en exerçant une force d’attraction causale sur une composante aval, hérite automatiquement du statut structurel d’endogénéité. Ce statut signifie que sa variance totale se décompose mathématiquement en deux fractions distinctes : une variance expliquée par les déterminants systémiques du modèle, et une variance résiduelle, représentée par son terme d’erreur spécifique, qui capture les influences exogènes non mesurées par l’investigateur.
2.2 Rôle des variables endogènes dans les chaînes causales
Au sein des architectures théoriques complexes élaborées pour rendre compte du comportement humain, les variables endogènes opèrent principalement comme des mécanismes de transmission ou de transformation de l’information causale. Elles incarnent les variables médiatrices au sens défini par l’école méthodologique de Baron et Kenny et modernisé par les approches de l’inférence causale contrefactuelle. Dans ce contexte, une variable endogène intermédiaire capte l’impulsion initiée par un facteur initial et la propage, par des canaux cognitifs, affectifs ou physiologiques, vers d’autres segments de l’appareil psychologique.
Cette position nodale expose particulièrement les variables endogènes aux phénomènes de rétroaction (feedback loops) et aux dynamiques bidirectionnelles. Dans un système dynamique complexe, une variable endogène $Y_1$ peut influencer une autre variable endogène $Y_2$, qui à son tour, de manière synchrone ou différée dans le temps, altère la trajectoire future de $Y_1$. Par exemple, le niveau d’anxiété ressenti par un individu influence négativement ses performances cognitives, dont la dégradation perçue vient en retour amplifier l’anxiété initiale. Cette réciprocité transforme la variable endogène en un élément à la fois dépendant et explicatif, générant une intrication fonctionnelle qui interdit toute modélisation linéaire unidirectionnelle simpliste.
Il convient dès lors d’opérer une distinction méthodologique rigoureuse entre deux classes de variables endogènes :
- Les variables endogènes intermédiaires : Celles-ci reçoivent des flèches causales en provenance d’autres variables du modèle et en émettent simultanément vers d’autres composantes du système (rôle de médiateurs) ;
- Les variables endogènes terminales : Celles-ci occupent l’extrémité des chaînes causales ; elles reçoivent des influences explicatives mais n’en exercent aucune sur les autres variables formalisées au sein du modèle considéré.
2.3 Manipulabilité et contrôle empirique
Une propriété centrale des variables endogènes réside dans leur manipulabilité théorique et pratique par l’intermédiaire des leviers internes au système. Puisque leur valeur est mathématiquement fonction des composantes qui leur sont structurellement antérieures, il est théoriquement concevable d’altérer la trajectoire d’une variable endogène en modifiant la configuration des prédicteurs qui la gouvernent. Dans le domaine de l’ingénierie comportementale ou de la clinique psychologique, la quasi-totalité des cibles thérapeutiques — qu’il s’agisse de l’humeur dépressive, du sentiment d’auto-efficacité, ou de la vitesse d’exécution motrice — sont des variables endogènes que le praticien tente de modifier indirectement en agissant sur des leviers cognitifs, relationnels ou pharmacologiques.
Toutefois, une intervention ciblée sur une variable endogène produit des répercussions systémiques qui dépassent le simple ajustement local. En vertu de la théorie causale contemporaine développée par Judea Pearl, intervenir artificiellement sur une variable endogène en fixant sa valeur via l’opérateur $do(Y = y)$ équivaut à sectionner chirurgicalement les liens causaux qui la reliaient à ses prédicteurs habituels. Une telle intervention modifie l’équilibre global du système, rompant les corrélations naturelles observées en régime stationnaire et réorientant les flux de covariance à travers l’ensemble des ramifications en aval.
Néanmoins, la possibilité de contrôler empiriquement une variable endogène se heurte fréquemment à d’inextricables contraintes éthiques et méthodologiques au sein des laboratoires de sciences humaines. S’il est aisé d’assigner aléatoirement des sujets à des conditions de luminosité environnementale différentes (variable exogène), il s’avère infiniment plus complexe, voire moralement inacceptable, de manipuler directement et isolément des variables endogènes profondes telles que le sentiment de désespoir existentiel, le niveau d’attachement insécure ou l’estime de soi fondamentale sans mobiliser une cascade d’autres processus psychologiques non maîtrisés.
3. Fondements théoriques : Qu’est-ce qu’une variable exogène ?
3.1 Propriétés statistiques et indépendance de l’erreur
À l’opposé structurel des variables endogènes, une variable exogène se définit formellement par son extériorité totale par rapport au mécanisme générateur de données formalisé dans le modèle. Dans le cadre d’un système mathématique d’équations, une variable $Z_i$ est rigoureusement qualifiée d’exogène si sa variabilité n’est en aucune manière gouvernée ou expliquée par les autres variables incluses dans le périmètre du système. Elle ne figure jamais sur le membre gauche d’une équation structurelle ; elle n’agit qu’exclusivement en tant que force initiatrice, transmettant sa variance sans jamais la recevoir en retour d’aucune composante du réseau.
Sur le plan stochastique, la propriété définissant de manière fondamentale l’exogénéité repose sur l’hypothèse d’orthogonalité ou d’indépendance conditionnelle absolue entre la variable considérée et le terme d’erreur de l’équation où elle apparaît. Soit l’équation standard $Y_i = \beta_0 + \beta_1 Z_i + \varepsilon_i$, la variable $Z_i$ est formellement exogène si et seulement si l’espérance mathématique du terme résiduel, conditionnellement à la valeur prise par $Z_i$, est identiquement nulle pour toute valeur du support :
$$\mathbb{E}[\varepsilon_i mid Z_i] = 0$$
Cette condition implique en corollaire immédiat que la covariance entre le régresseur exogène et le terme d’erreur stochastique est rigoureusement nulle : $\text{Cov}(Z_i, \varepsilon_i) = 0$. En termes substantiels, cela certifie que la variable $Z_i$ ne partage aucune cause commune non observée avec la variable dépendante $Y_i$, et qu’elle n’est contaminée par aucun bruit de mesure systématique corrélé avec le processus modélisé. Elle se comporte mathématiquement comme une condition initiale fixe ou un paramètre externe préétabli, introduit de manière autonome au sein du champ d’expérimentation.
3.2 Origine contextuelle et non-manipulabilité
L’origine de l’exogénéité d’une variable s’ancre généralement dans sa nature structurelle, environnementale ou biologique invariante à l’échelle temporelle de l’étude. Dans les recherches empiriques, certaines dimensions s’imposent à l’observateur et au système comportemental avec la force de l’irréversibilité. Les données relatives au profil génétique d’un individu (comme la présence d’un allèle spécifique pour le transporteur de la sérotonine), à sa date de naissance, aux conditions météorologiques atmosphériques lors d’une session de recueil ou aux chocs macroéconomiques majeurs constituent des archétypes de variables exogènes. Le système psychologique individuel ne dispose d’aucun mécanisme causal permettant d’altérer rétroactivement ces grandeurs objectives.
Cette extériorité confère aux variables exogènes une propriété remarquable de stabilité temporelle et d’immunité face aux perturbations internes du modèle. Alors qu’un changement survenant dans le réseau cognitif d’un sujet (par exemple, une poussée d’anxiété) réverbère ses effets sur une myriade d’autres dimensions internes, il demeure structurellement incapable d’altérer l’âge chronologique du sujet ou l’intensité du tremblement de terre auquel il a pu être exposé. L’expérimentateur ne peut modifier directement ces variables au sein du laboratoire pour en fabriquer de nouvelles modalités artificielles ; il est contraint de les intégrer comme des conditions de fait imposées par la réalité contextuelle.
Cette non-manipulabilité empirique n’entrave aucunement leur pouvoir heuristique au sein du modèle statistique. Au contraire, elle fait des variables exogènes des ancrages causaux incomparables. Puisqu’elles ne subissent aucune pression systémique provenant de l’intérieur du modèle, toute covariation statistique détectée entre une variable strictement exogène et une variable endogène aval peut être interprétée avec une très haute confiance directionnelle : le sens de la relation s’écoule nécessairement du facteur exogène vers la réponse endogène, et jamais l’inverse.
3.3 Exogénéité stricte versus exogénéité faible
Dans le domaine avancé de la modélisation économétrique et de l’analyse des séries temporelles ou des données de panel, la littérature méthodologique affine le concept en introduisant une distinction technique essentielle entre exogénéité stricte (strict exogeneity) et exogénéité faible (weak exogeneity), formalisée notamment par Engle, Hendry et Richard (1983). Cette gradation épistémologique traite de la dimension temporelle de l’indépendance de l’erreur.
Une variable explicative $X_{it}$ mesurée au temps $t$ est dite strictement exogène si son indépendance vis-à-vis du terme d’erreur stochastique est totale à travers l’ensemble des périodes temporelles passées, présentes et futures :
$$\mathbb{E}[\varepsilon_{it} mid \mathbf{X}_{i1}, \mathbf{X}_{i2}, dots, \mathbf{X}_{iT}] = 0 \quad \forall t in {1, dots, T}$$
Cette exigence draconienne stipule non seulement que les résidus actuels ne sont pas corrélés avec le prédicteur au même moment (absence d’endogénéité contemporaine), mais également que les valeurs futures du prédicteur ne réagissent en aucun cas aux chocs résiduels passés du système. À l’opposé, l’exogénéité faible, souvent assimilée dans les modèles dynamiques au concept d’exogénéité séquentielle ou de prédétermination, requiert uniquement que la variable soit orthogonale aux termes d’erreur contemporains et futurs, autorisant ainsi une corrélation avec les réalisations passées du résidu :
$$\mathbb{E}[\varepsilon_{it} mid \mathbf{X}_{it}, \mathbf{X}_{it-1}, dots, \mathbf{X}_{i1}] = 0$$
Cette nuance emporte des conséquences considérables pour l’inférence asymptotique des coefficients de régression. Si l’exogénéité faible suffit pour obtenir des estimateurs non biaisés des paramètres instantanés par le biais de régressions autorégressives, seule l’exogénéité stricte autorise l’application sans risque des estimateurs à effets fixes sur données de panel sans distorsion asymptotique. Ignorer la violation de l’exogénéité stricte dans des devis de recherche longitudinaux expose l’analyste au redoutable biais de Nickell, invalidant les inférences dynamiques même lorsque les prédicteurs semblent temporellement antérieurs aux effets observés.
4. Critères opérationnels de distinction entre variables endogènes et exogènes
4.1 La délimitation du système et la relativité contextuelle
L’un des paradoxes les plus féconds de la modélisation statistique réside dans le fait que la nature endogène ou exogène d’une variable ne constitue pas une étiquette ontologique figée gravée dans le réel, mais résulte d’une décision méthodologique prise par l’analyste : la fixation délibérée des frontières du système modélisé. Une variable donnée ne saurait être proclamée « intrinsèquement exogène » dans l’absolu ; elle ne l’est que relativement à un modèle formellement circonscrit par des choix théoriques précis.
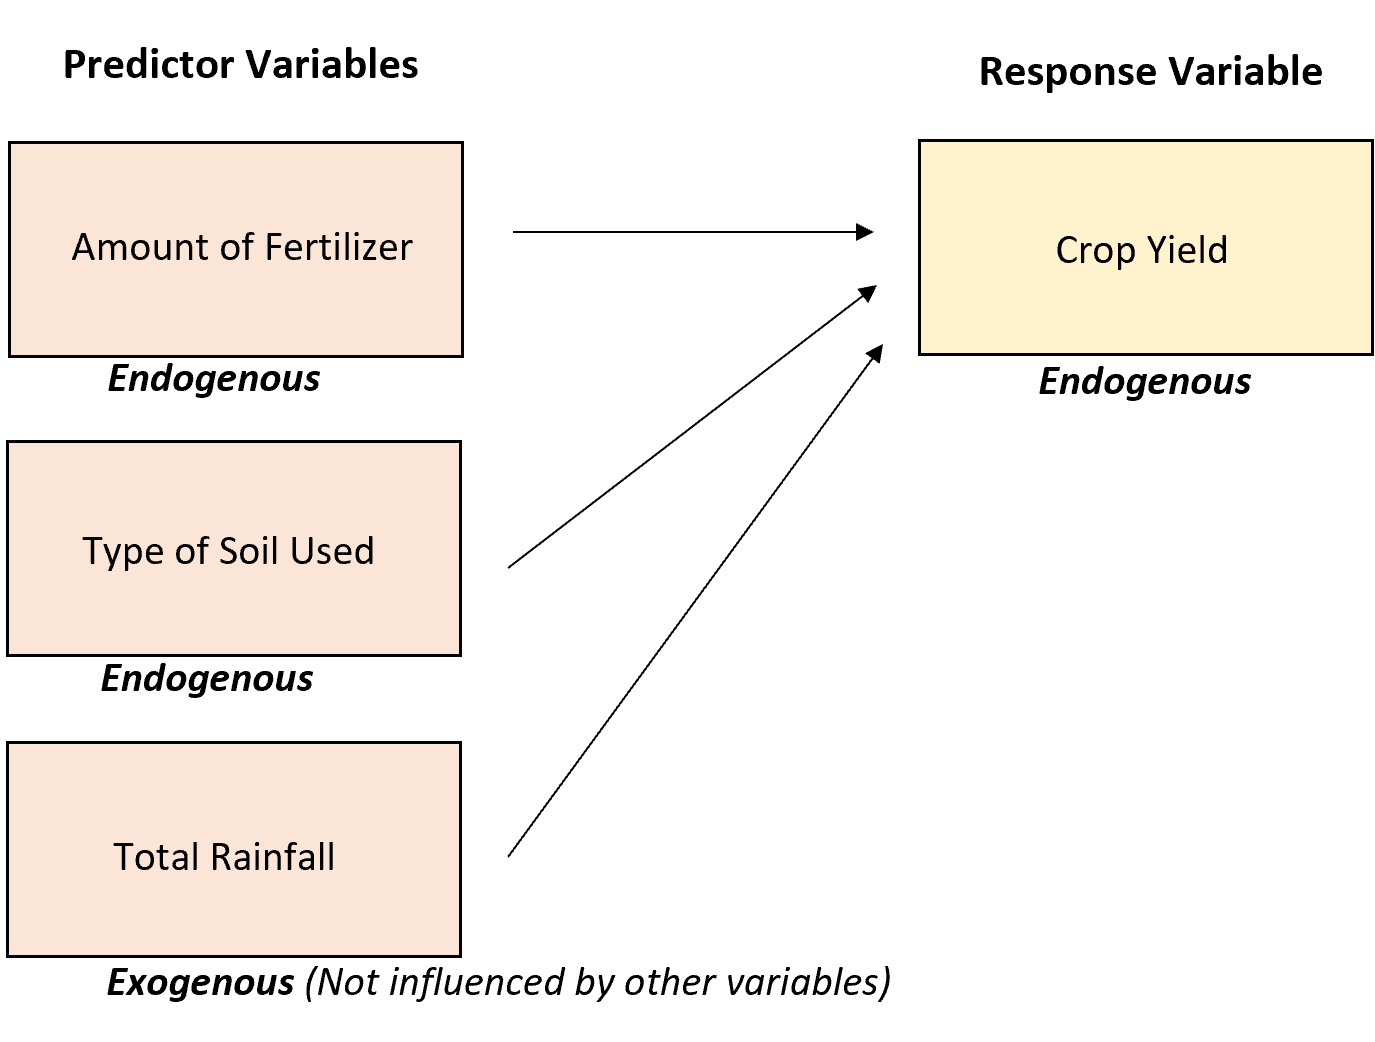
Considérons, à titre d’illustration, l’étude de la consommation de caféine sur la vigilance cognitive au sein d’un protocole expérimental de deux heures en laboratoire. Dans ce système restreint, la quantité de caféine administrée est imposée de manière externe par le protocole ; elle se positionne indiscutablement comme une variable exogène. En revanche, si l’investigateur élargit considérablement les frontières de son modèle pour étudier le rythme de vie d’individus sur six mois dans un cadre d’observation longitudinale écologique, la consommation journalière de caféine devient tributaire du niveau de stress professionnel, de la qualité du sommeil de la nuit précédente et de l’anxiété chronique du sujet. Dès cet instant, la consommation de caféine bascule instantanément dans la sphère de l’endogénéité : elle n’est plus une cause externe première, mais un comportement adaptatif intermédiaire généré par la dynamique interne du système psychobiologique de l’individu.
Ce caractère conventionnel et relatif impose une responsabilité théorique majeure aux scientifiques. La transition d’une variable du statut exogène au statut endogène s’opère mécaniquement à chaque fois que le chercheur décide de compléter son édifice conceptuel en formulant des hypothèses destinées à expliquer la genèse d’un prédicteur jusque-là considéré comme acquis. Il en résulte que le choix de reléguer une variable dans l’exogénéité découle d’un compromis réfléchi : le chercheur décide délibérément de suspendre son analyse de l’amont causal pour concentrer sa capacité de mesure et sa puissance de calcul sur les mécanismes avals du modèle.
4.2 Le critère de manipulabilité expérimentale
Pour clarifier sur le terrain empirique cette frontière souvent poreuse, le cadre mathématique de l’inférence causale moderne, développé principalement par Judea Pearl à travers le formalisme du do-calculus, propose un critère opérationnel puissant : le test d’invariance sous intervention expérimentale directe. Ce critère permet d’établir une partition pragmatique entre les variables qui font l’objet d’une action directe et les contraintes factuelles inhérentes aux sujets étudiés.
Lorsqu’un chercheur est capable d’intervenir physiquement sur une variable sans avoir à modifier préalablement aucune autre variable du système — ce qui correspond à assigner aléatoirement une condition expérimentale $X$ de manière totalement découplée des caractéristiques individuelles des participants —, la distribution de $X$ devient strictement indépendante de toute cause antécédente interne au système. Cette opération d’assignation confère artificiellement mais incontestablement à $X$ le statut de variable exogène parfaite. Dans ce cadre, $X$ est qualifiée de variable de traitement au sens strict, et la covariance observée entre $X$ et le résultat $Y$ reflète exclusivement l’effet causal de $X$ sur $Y$ :
$$\mathbb{P}(Y mid do(X = x)) = \mathbb{P}(Y mid X = x)$$
En revanche, lorsque nous nous tournons vers des covariables observationnelles — telles que le niveau socio-économique, l’intelligence émotionnelle, ou le degré d’introversion —, l’application de cet opérateur d’intervention physique s’avère impossible ou illusoire. Ces variables de fait ne peuvent être manipulées indépendamment de l’histoire développementale, biologique et contextuelle de l’individu. Tout mécanisme visant à modifier artificiellement l’intelligence émotionnelle impliquerait une intervention étendue qui altérerait conjointement une multitude d’autres fonctions psychiques. Faute d’invariance sous intervention directe, ces variables demeurent fondamentalement ancrées dans le statut de variables endogènes au sein des systèmes d’observation de la psychologie et des sciences sociales.
4.3 Analyse formelle des termes d’erreur
Au-delà des considérations théoriques, le diagnostic fondamental de la ligne de démarcation entre endogénéité et exogénéité réside dans l’analyse mathématique rigoureuse de la structure résiduelle des équations d’estimation. Dans un modèle statistique, le terme d’erreur stochastique n’est pas un simple bruit blanc dénué de substance ; il est le réceptacle invisible de l’ensemble des déterminants omis, des forces non mesurées et des aléas microscopiques qui influencent la variable dépendante mais ne sont pas explicitement isolés dans la structure mathématique de la régression.
Dès lors, l’exogénéité d’un ensemble de régresseurs $\mathbf{X}$ repose sur l’hypothèse de leur indépendance conditionnelle vis-à-vis de cette réserve d’influences masquées. Si un régresseur $X_j$ partage une cause commune quelconque avec la variable de réponse $Y$, cette cause commune se retrouve instantanément encapsulée au sein du résidu $varepsilon$. Par voie de conséquence, toute variation de cette cause commune fait osciller simultanément le terme d’erreur $varepsilon$ et la variable explicative $X_j$, rompant instantanément l’hypothèse d’orthogonalité :
$$\text{Cov}(X_j, \varepsilon) \neq 0$$
La violation de cette hypothèse signe sans ambiguïté la métamorphose de $X_j$ en variable endogène contaminée. Pour modéliser visuellement et diagnostiquer cette contamination, les chercheurs contemporains recourent massivement aux graphes acycliques dirigés (DAG). Au sein d’un DAG, une variable $X$ est endogène à l’égard de $Y$ s’il existe une liaison non bloquée par le truchement de « chemins de traverse » (backdoor paths), c’est-à-dire de séquences causales reliant $X$ et $Y$ par l’intermédiaire de variables confondantes non conditionnées, symbolisant l’intrusion de la dépendance stochastique au cœur même du processus d’estimation.
5. Représentation dans les modèles de régression et équations structurelles
5.1 Spécification en régression linéaire classique (MCO)
La régression linéaire univariée ou multivariée estimée par la méthode des moindres carrés ordinaires (MCO) représente le cadre analytique standard le plus fréquemment déployé en recherche empirique. Dans cette formulation conventionnelle, les variables sont généralement réparties en deux catégories opérationnelles binaires : les variables dites indépendantes ou explicatives ($X_1, X_2, dots, X_k$) et la variable dite dépendante ($Y$). Cependant, cette nomenclature opérationnelle dissimule une exigence théorique impérative : pour que les variables indépendantes méritent rigoureusement leur titre sur le plan causal, elles doivent satisfaire à l’hypothèse fondamentale d’exogénéité stricte des régresseurs.
Cette condition est inscrite au cœur même du célèbre théorème de Gauss-Markov, lequel établit que les estimateurs MCO constituent les meilleurs estimateurs linéaires sans biais (BLUE, Best Linear Unbiased Estimator) si et seulement si l’espérance conditionnelle des perturbations stochastiques sachant les régresseurs est identiquement nulle ($\mathbb{E}[\varepsilon mid \mathbf{X}] = 0$), et que la matrice de variance-covariance des erreurs est scalaire (homoscédasticité et absence d’autocorrélation). Sous ces hypothèses strictes, le vecteur des coefficients estimés $\hat{boldsymbol{\beta}}_{\text{MCO}}$ converge en probabilité vers la valeur réelle du paramètre structurel $boldsymbol{\beta}$ :
$$\text{p\lim}_{n to \infty} \hat{boldsymbol{\beta}}_{\text{MCO}} = boldsymbol{\beta} + \text{p\lim}_{n to \infty} \left( \frac{\mathbf{X}^top \mathbf{X}}{n} \right)^{-1} \left( \frac{\mathbf{X}^top boldsymbol{\varepsilon}}{n} \right) = boldsymbol{\beta} + \mathbf{Q}_{XX}^{-1} \cdot \mathbf{0} = boldsymbol{\beta}$$
En revanche, dès lors qu’un des régresseurs inclus dans la matrice $\mathbf{X}$ devient endogène — signifiant qu’il existe une corrélation non nulle entre ce prédicteur et le vecteur d’erreurs stochastiques —, la quantité asymptotique $\text{p\lim} (n^{-1} \mathbf{X}^top boldsymbol{\varepsilon})$ ne converge plus vers le vecteur nul. Il en découle un biais de régression irréductible et une perte totale de convergence. L’estimateur MCO attribue alors fallacieusement au coefficient de régression une magnitude qui n’a rien à voir avec le véritable impact de la variable, agrégeant sans distinction l’effet structurel direct et la covariance parasite induite par les facteurs non contrôlés résidant dans l’erreur.
5.2 Modélisation par équations structurelles (SEM)
Face aux limites inhérentes à la régression classique pour appréhender des réseaux complexes de dépendance, la modélisation par équations structurelles (SEM, Structural Equation Modeling) s’est imposée comme le paradigme de référence dans les sciences psychologiques et comportementales. Au sein du formalisme LISREL ou de la notation RAM (Reticular Action Model), la distinction entre variables endogènes et exogènes quitte le statut d’hypothèse implicite pour devenir la grammaire formelle constitutive de l’architecture du modèle.
Dans un modèle d’équations structurelles, le système segmente explicitement les vecteurs de variables en variables latentes exogènes, conventionnellement dénotées par le vecteur $boldsymbol{\xi}$ (ksi), et variables latentes endogènes, formalisées par le vecteur $boldsymbol{\eta}$ (êta). La relation structurelle fondamentale liant ces construits inobservables s’écrit sous la forme matricielle matricielle compacte :
$$boldsymbol{\eta} = \mathbf{B}boldsymbol{\eta} + boldsymbol{\Gamma}boldsymbol{\xi} + boldsymbol{\zeta}$$
Dans cette équation structurelle :
- $\mathbf{B}$ représente la matrice des coefficients régissant les influences réciproques liant directement les variables endogènes entre elles, dont la diagonale principale est astreinte à zéro pour interdire l’auto-causation instantanée ;
- $boldsymbol{\Gamma}$ constitue la matrice des coefficients quantifiant les impacts directs des variables purement exogènes $boldsymbol{\xi}$ sur les différentes composantes endogènes $boldsymbol{\eta}$ ;
- $boldsymbol{\zeta}$ représente le vecteur des perturbations structurelles, c’est-à-dire les termes d’erreur résiduels spécifiques aux équations des variables endogènes.
Cette approche apporte une clarté méthodologique inégalée : l’exogénéité se manifeste par l’absence d’équation d’explication pour $boldsymbol{\xi}$ — dont la matrice de covariance interne $boldsymbol{\Phi}$ est librement estimée sans contrainte structurelle —, tandis que les variables endogènes $boldsymbol{\eta}$ font l’objet d’un calcul explicite de variance décomposée. De plus, l’identification formelle du modèle impose d’évaluer scrupuleusement la matrice de covariance des erreurs structurelles $boldsymbol{\Psi} = \mathbb{E}[boldsymbol{\zeta}boldsymbol{\zeta}^top]$, permettant de détecter immédiatement si des covariances résiduelles inexpliquées persistent entre des composantes théoriquement disjointes.
5.3 Modèles de médiation et de modération
L’analyse empirique moderne fait un usage extensif des devis de médiation et de modération, dont l’interprétation repose sur une manipulation rigoureuse des statuts endogènes et exogènes. Dans un modèle de médiation simple ($X to M to Y$), le schéma conceptuel intègre trois variables dont la distribution des statuts doit être scrupuleusement cartographiée :
$$M = \alpha_1 + a X + \varepsilon_M$$
$$Y = \alpha_2 + c’ X + b M + \varepsilon_Y$$
Dans cette topologie causale élémentaire, la variable $X$ occupe le statut de variable exogène (à condition que son assignation ou sa genèse soit découplée des erreurs du modèle). La variable médiatrice $M$ hérite sans équivoque du statut de variable endogène intermédiaire : elle subit la poussée causale directe de $X$ à travers le paramètre $a$, tout en disposant de son propre terme d’erreur structurel $\varepsilon_M$. Enfin, la variable $Y$ s’affirme comme la variable endogène terminale, recevant conjointement l’influence directe de la variable exogène via $c’$ et l’influence indirecte transmise par la variable endogène intermédiaire par l’intermédiaire du paramètre $b$. L’effet indirect global est synthétisé par le produit algébrique des coefficients $a \times b$.
La situation méthodologique diverge substantiellement lorsque l’on introduit une variable modératrice $W$ dans un modèle d’interaction conditionnelle ($Y = \beta_0 + \beta_1 X + \beta_2 W + \beta_3 (X \times W) + \varepsilon$). Dans la très grande majorité des spécifications robustes, la variable modératrice $W$ est posée comme une variable exogène indépendante du processus causal primaire. Elle n’est pas engendrée par $X$, ni modulée par $Y$ ; elle agit en tant que régulateur contextuel externe modifiant l’ampleur du flux de transmission reliant $X$ à $Y$ sans absorber de variance provenant du système. Confondre une variable modératrice (qui conditionne la force d’un lien) avec une variable médiatrice endogène (qui transporte ce lien) constitue l’une des aberrations conceptuelles les plus dévastatrices de la psychométrie appliquée.
6. Exemples d’application en psychologie cognitive et expérimentale
6.1 Étude de la charge cognitive et de la mémoire de travail
Pour ancrer ces concepts abstraits dans la réalité empirique, examinons un protocole classique d’investigation en psychologie cognitive portant sur l’impact de la charge cognitive sur la mémoire de travail et la restitution d’informations complexes. Un laboratoire souhaite évaluer comment la complexification progressive d’un environnement de tâche altère les capacités d’encodage et de rappel mnésique chez de jeunes adultes.
Dans le montage méthodologique d’une telle expérience, l’expérimentateur manipule rigoureusement deux paramètres fondamentaux : le niveau de complexité de la tâche (par exemple, la résolution d’une tâche de double détection auditive et visuelle de type N-back avec trois niveaux de difficulté calibrés : 1-back, 2-back, 3-back) et la durée d’exposition aux stimuli textuels (fixée arbitrairement à 500 millisecondes contre 1500 millisecondes). Ces deux dimensions constituent des variables exogènes pures : elles sont déterminées par un générateur d’assignation informatique, n’entretiennent aucune relation de dépendance avec les particularités intrinsèques des sujets avant le début de l’essai, et leur variance est intégralement contrôlée par le chercheur.
Dès l’instant où le sujet est confronté à la tâche, des modifications physiologiques et cognitives internes se déploient. L’activation cérébrale mesurée par le signal BOLD en imagerie par résonance magnétique fonctionnelle (IRMf) au sein du cortex préfrontal dorsolatéral, ainsi que la variabilité de la fréquence cardiaque (indicateur physiologique d’effort mental), s’affirment immédiatement comme des variables endogènes intermédiaires. Leur fluctuation résulte directement de la contrainte imposée par les variables exogènes de difficulté, tout en étant modulée par les résidus spécifiques de chaque individu (vulnérabilité métabolique, état de veille résiduel).
Enfin, la performance finale au test de rappel libre différé (quantifiée par le score exact d’items correctement remémorés sur un barème de 0 à 100) incarne la variable endogène terminale du système. Cette performance finale ne tombe pas du ciel : elle constitue l’aboutissement structurel fonctionnel déterminé conjointement par la complexité initiale (effet exogène direct), mais surtout par l’amplitude de l’activation du cortex préfrontal et la mobilisation efficace de l’effort attentionnel (effets endogènes médiateurs).
6.2 Temps de réaction et paradigmes attentionnels
Les protocoles chronométriques d’évaluation de l’attention visuo-spatiale, fondés sur le paradigme classique de Michael Posner, offrent une autre illustration limpide de l’articulation entre ces composantes. Supposons une expérience évaluant le filtrage de distracteurs sensoriels au sein de laquelle des sujets doivent réagir à l’apparition d’une cible lumineuse sur un écran d’ordinateur.
Le chercheur module avec précision les facteurs physiques de l’environnement expérimental : l’intensité lumineuse des stimuli (mesurée en candelas par mètre carré) et le niveau de bruit blanc diffusé dans le casque des participants (paramétré aléatoirement à 40 dB, 60 dB ou 80 dB). Ces conditions physiques environnementales interviennent sans contestation possible en tant que variables exogènes. Elles préexistent à la passation de l’essai et ne sauraient être altérées par les processus cognitifs des sujets.
À un niveau intermédiaire, le niveau de fatigue subjective auto-rapporté par les sujets au fil des blocs expérimentaux (mesuré sur une échelle visuelle analogique toutes les dix minutes) opère comme une composante endogène dynamique. Ce niveau de fatigue n’est pas exogène : il s’accroît sous l’action prolongée de l’exposition au bruit (variable exogène) et en fonction du temps passé sur la tâche, tout en étant grevé d’une variance résiduelle individuelle liée à la dette de sommeil antérieure du participant.
Les variables d’intérêt final du dispositif — à savoir le temps de réaction moteur exprimé en millisecondes et le taux d’erreur de détection (omissions et fausses alarmes) — représentent les résultats endogènes ultimes du modèle. L’équation structurelle régissant le temps de réaction montre que celui-ci est simultanément influencé par les variables exogènes de signal (l’intensité du stimulus lumineux accélérant la détection perceptive) et par la variable endogène intermédiaire de fatigue (qui ralentit la vitesse d’initiation du programme moteur cortical). Traiter la fatigue comme une variable exogène dans ce cadre constituerait une faute d’analyse majeure, occultant son rôle de vecteur de transmission de la charge temporelle.
6.3 Modèles d’apprentissage et de renforcement
Dans le domaine du conditionnement opérant et des modèles computationnels de l’apprentissage par renforcement (modèles de type Q-learning ou équations de Rescorla-Wagner), la dichotomie structurelle régit l’ensemble de la formalisation mathématique de l’évolution des comportements adaptatifs.
Le chercheur configure de manière informatique le calendrier de distribution des renforçateurs : la probabilité de délivrance d’une récompense monétaire conditionnelle à un choix particulier (par exemple, un calendrier à ratio variable de 50 % contre 20 %) est fixée par le code algorithmique du protocole. Ce calendrier de renforcement se positionne de manière indiscutable comme la variable exogène directrice. Les sujets n’ont aucun moyen de modifier les paramètres stochastiques sous-tendant cette distribution de contingences objectives.
Au fil des blocs d’apprentissage, la motivation intrinsèque fluctuante du participant et la valeur subjective attribuée aux récompenses (la variable latente $Q$-value décrivant l’attractivité attendue d’une option) se structurent en tant que variables endogènes dynamiques. À chaque pas temporel $t$, la mise à jour de la valeur subjective dépend mathématiquement de l’erreur de prédiction de la récompense (reward prediction error, $\delta_t$), elle-même issue de la divergence entre le renforçateur reçu (exogène) et l’estimation interne antérieure (endogène) :
$$Q_{t+1}(a) = Q_t(a) + \alpha \delta_t$$
Enfin, la vitesse d’acquisition comportementale observée — concrétisée par le nombre d’essais nécessaires pour atteindre un critère de maîtrise de 80 % de sélections optimales — constitue la variable de réponse endogène terminale. Cette vitesse est l’expression phénotypique macroscopique de l’ajustement séquentiel des variables endogènes intermédiaires de valeur sous la contrainte exogène du calendrier de rétribution imposé par le dispositif scientifique.
7. Exemples d’application en psychopathologie et psychologie clinique
7.1 Modèle diathèse-stress des troubles dépressifs
L’exploration des étiologies de la dépression majeure illustre l’intégration des variables endogènes et exogènes au sein des cadres nosographiques complexes, en particulier à travers le paradigme éprouvé du modèle diathèse-stress.
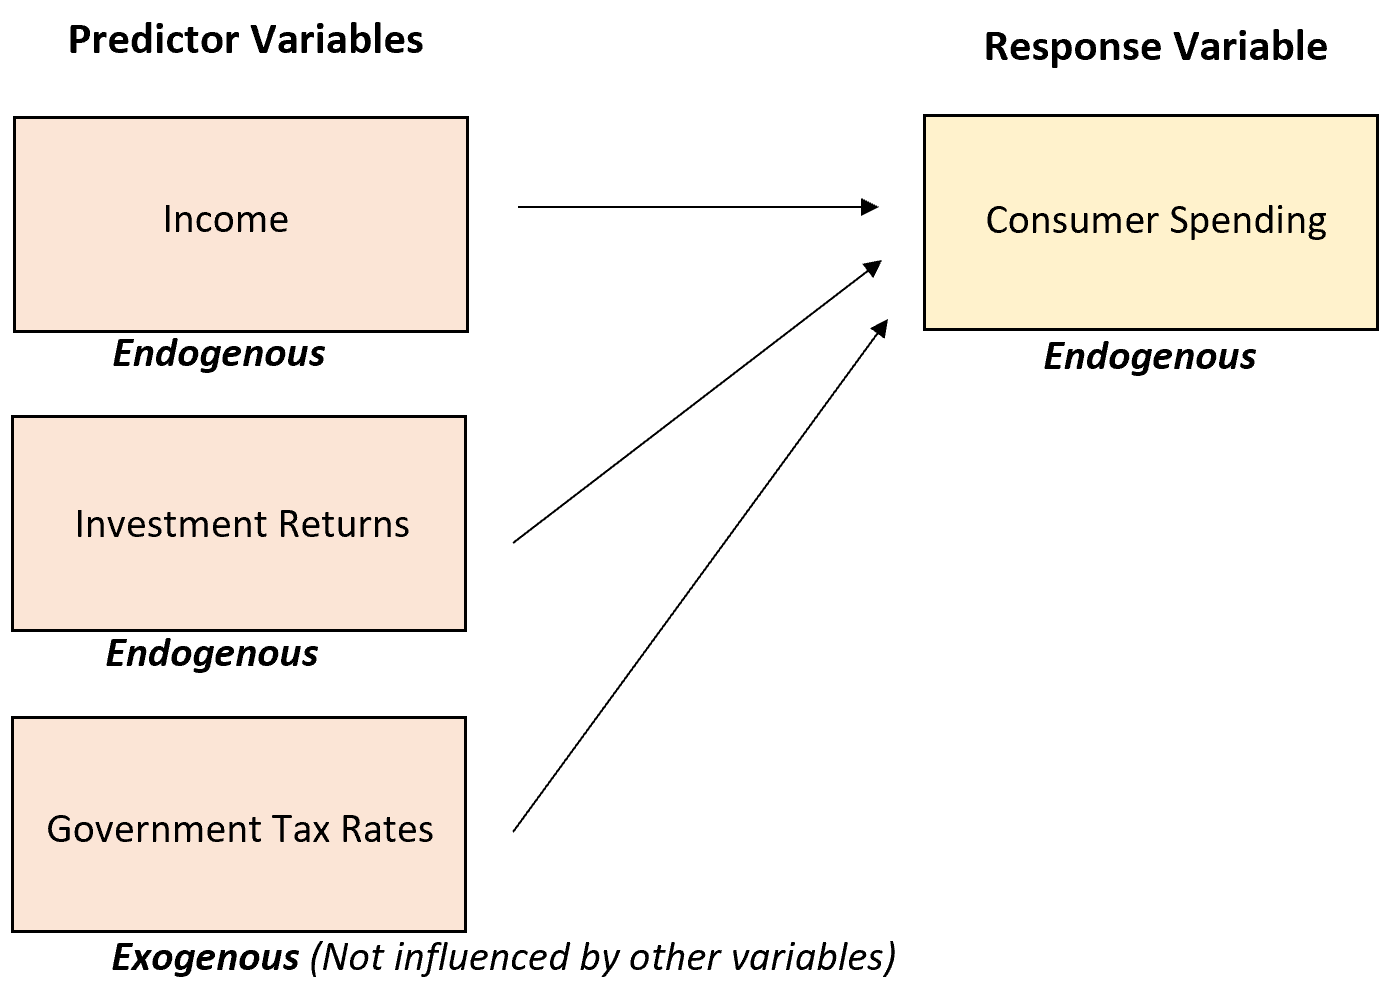
Dans cette architecture conceptuelle, la diathèse est matérialisée par la prédisposition génétique de l’individu (telle que le polymorphisme fonctionnel de la région promotrice du gène codant pour le transporteur de la sérotonine, 5-HTTLPR) ou par des antécédents familiaux multigénérationnels de troubles de l’humeur. Sur le plan opérationnel de l’épisode dépressif adulte, cette vulnérabilité biologique native se comporte comme un prédicteur rigoureusement exogène. L’individu hérite de ce profil sans possibilité de le modifier rétroactivement au cours de son existence, et son état psychologique actuel ne peut en aucun cas réécrire sa séquence nucléotidique fondamentale.
Parallèlement, la survenue d’événements de vie négatifs majeurs indépendants (tels qu’un deuil soudain consécutif à un accident de la route ou une catastrophe naturelle dévastant le lieu d’habitation) agit sous la forme de variables exogènes environnementales impromptues. Ces événements s’abattent de manière orthogonale aux dynamiques comportementales préalables du patient, constituant des ruptures de trajectoire d’origine externe.
Cependant, la traduction de cette diathèse et de ce stress en morbidité clinique passe par l’activation de médiateurs internes : l’émergence de styles cognitifs dysfonctionnels, la tendance aux ruminations cognitives stériles (mesurées par l’échelle RRS) et l’effondrement de la neurogenèse hippocampique. Ces mécanismes constituent des variables endogènes centrales. Sous l’action conjointe de la vulnérabilité génétique et du choc environnemental, les ruminations s’emballent, générant une cascade de modifications neurobiologiques qui aboutissent à la sévérité globale des symptômes dépressifs (score sur l’échelle de Hamilton pour la dépression, HDRS), variable endogène sommitale du système clinique.
7.2 Trouble du stress post-traumatique (TSPT)
La nosologie du Trouble du stress post-traumatique (TSPT) offre une mise en abyme particulièrement nette des contraintes d’exogénéité, en raison de l’ancrage diagnostique du trouble autour d’un événement déclencheur initial obligatoire, documenté dans le Critère A du manuel diagnostique et statistique des troubles mentaux (DSM-5-TR).
L’exposition directe ou indirecte à un événement traumatique objectif d’une violence inouïe (acte terroriste, bombardement militaire, catastrophe ferroviaire) remplit rigoureusement le rôle de variable exogène historique princeps. Cette exposition initiale constitue l’impulsion externe exogène sans laquelle le modèle étiopathogénique du TSPT ne saurait être mathématiquement identifié. L’événement objectif s’inscrit en amont absolu du processus psychopathologique.
Néanmoins, l’observation clinique démontre qu’à sévérité traumatique équivalente, seule une fraction des individus développe un TSPT chronique, attestant de l’intervention de médiateurs endogènes puissants. Les capacités de régulation émotionnelle post-choc, la réactivité psychophysiologique de sursaut (mesurée par la conductance cutanée électrodermale) et le soutien social subjectivement perçu se déploient en tant que variables endogènes intermédiaires. Le soutien social perçu, bien qu’ancré dans un réseau relationnel réel, est endogène car il est profondément biaisé et altéré par le retrait social du patient traumatisé et ses biais d’interprétation cognitive de méfiance généralisée.
Ces dynamiques endogènes intermédiaires vont ultimement déterminer la manifestation et la cristallisation de l’évitement comportemental phobique et des reviviscences intrusives involontaires, qui représentent les indicateurs endogènes d’expression phénotypique du trouble. L’erreur consisterait ici à traiter le soutien social comme une variable exogène objective : le délitement du réseau social est souvent une conséquence endogène directe du comportement de retrait du patient, créant une redoutable boucle de causalité simultanée.
7.3 Évaluation de l’efficacité d’une psychothérapie
L’évaluation quantitative des interventions thérapeutiques en psychiatrie et psychologie clinique, notamment au sein des essais contrôlés randomisés (ECR), repose intégralement sur la manipulation délibérée des frontières d’exogénéité pour valider les allégations d’efficacité.
Dans un protocole expérimental rigoureux, l’assignation aléatoire à l’un des bras thérapeutiques — qu’il s’agisse d’un protocole standardisé de thérapie cognitive et comportementale (TCC), d’un traitement pharmacologique de référence ou d’une condition témoin sur liste d’attente — constitue la variable exogène instrumentale absolue. Par construction stochastique, la probabilité d’assignation à un groupe est déconnectée des traits de personnalité, de la gravité basale de la pathologie ou des dispositions d’esprit du patient, conférant au statut d’intervention une exogénéité stricte.
Cependant, le déploiement de la thérapie engendre des variables de processus qui sont, par nature, profondément endogènes. L’alliance thérapeutique forgée au fil des séances entre le thérapeute et le patient (mesurée par l’inventaire WAI, Working Alliance Inventory), l’adhésion scrupuleuse aux exercices inter-séances et la restructuration des schémas cognitifs constituent des variables endogènes médiatrices. L’alliance thérapeutique ne se décrète pas de manière exogène : elle émerge de l’interaction dynamique entre le protocole du thérapeute (exogène) et les capacités d’attachement et de coopération propres au patient (endogènes).
Enfin, la réduction tangible des scores cliniques post-traitement et le taux de rémission fonctionnelle globale constituent les variables endogènes d’issue clinique. Les méthodologistes cliniques les plus lucides reconnaissent que le traitement d’une psychothérapie comme une simple « boîte noire » exogène est insuffisant : comprendre l’échec ou la réussite thérapeutique exige de décomposer la part attribuable à l’impulsion exogène initiale du protocole et celle gouvernée par la dynamique endogène de l’alliance relationnelle.
8. Exemples d’application en psychologie sociale et des organisations
8.1 Épuisement professionnel et modèle exigences-ressources (JD-R)
Dans le domaine du travail et de la psychologie organisationnelle, le modèle Exigences-Ressources au travail (Job Demands-Resources, JD-R), formalisé par Arnold Bakker et Evangelia Demerouti, structure les déterminants du bien-être et de l’épuisement professionnel à travers un réseau articulé de variables exogènes et endogènes.
Au niveau des macro-conditions organisationnelles, les exigences structurelles du poste — telles que les horaires de travail postés imposés par l’activité industrielle, les quotas d’appels téléphoniques contractuels en centre de relation client, et le cadre réglementaire du secteur d’activité — s’analysent comme des variables exogènes institutionnelles. À court et moyen terme, le salarié individuel est dans l’incapacité de modifier unilatéralement ces contraintes formelles, qui s’imposent à lui comme des intrants organisationnels objectifs.
En regard, la manière dont ces exigences sont métabolisées fait intervenir les ressources psychologiques personnelles de l’individu (le capital psychologique incluant optimisme, résilience et sentiment d’auto-efficacité) et le job crafting (les ajustements spontanés que le travailleur réalise pour remodeler son activité). Ces composantes opèrent en tant que variables endogènes d’ajustement. Elles fluctuent sous la pression des contraintes exogènes du poste tout en étant déterminées par la trajectoire biographique et le soutien des pairs.
Au terme de cette dynamique d’usure ou d’engagement, l’épuisement émotionnel (composante nodale du burnout mesurée par le Maslach Burnout Inventory) et l’intention formelle de démissionner de l’organisation s’affirment comme les variables endogènes de sortie ultime. Les modélisations structurelles attestent que les exigences exogènes n’induisent pas mécaniquement la démission ; elles épuisent d’abord les variables endogènes d’auto-régulation psychique, dont l’effondrement déclenche en cascade la décision de rupture contractuelle.
8.2 Dynamique des groupes et leadership transformationnel
La recherche sur l’efficacité collective et les styles de direction offre un terrain d’application particulièrement riche pour illustrer comment des contraintes matérielles exogènes modèlent des processus sociopsychologiques endogènes.
Considérons une enquête déployée au sein d’une multinationale structurée en centaines d’équipes de projet autonomes. Les contraintes structurelles que sont la taille formelle de l’équipe (nombre exact de collaborateurs affectés par la direction des ressources humaines), l’indice de dispersion géographique des membres (équipes colocalisées versus équipes distribuées sur plusieurs fuseaux horaires), et la structure formelle de reporting hiérarchique représentent des variables exogènes de contexte. Ces paramètres sont décidés au niveau de la gouvernance supérieure de l’entreprise et s’imposent comme des données fixes aux membres des équipes.
À l’intérieur de ce cadre structurel prédéfini, l’émergence perçue d’un leadership transformationnel (mesuré par le Multifactor Leadership Questionnaire, MLQ) et le degré de cohésion socio-opératoire de l’équipe se configurent comme des variables endogènes de processus collectif. L’adoption de comportements inspirants par le manager ou la fluidité de la communication informelle ne sont pas indépendantes de l’environnement : il est structurellement plus malaisé de maintenir une communication dense et cohésive au sein d’une équipe éclatée sur cinq continents (contrainte exogène) que dans un bureau partagé.
Les indicateurs finaux de réussite — à savoir la performance collective objective de l’équipe (atteinte des objectifs contractuels chiffrés en fin d’exercice) et le climat de sécurité psychologique au sein du collectif (concept théorisé par Amy Edmondson) — représentent les variables endogènes résultantes. Vouloir mesurer l’impact du style de leadership sur la sécurité psychologique sans contrôler pour la contrainte exogène de la taille de l’équipe induirait un biais d’omission flagrant, le leadership et le climat étant tous deux sous l’emprise des conditions spatiales et quantitatives de l’organisation du travail.
8.3 Conformisme et influence normative
Les paradigmes expérimentaux fondateurs de la psychologie sociale, initiés par Solomon Asch et prolongés par Stanley Milgram ou Serge Moscovici, reposent sur la manipulation délibérée de leviers exogènes afin d’engager des variables endogènes psychologiques intimes.
Dans un paradigme d’influence sociale contemporain répliqué en laboratoire numérique, la variable manipulée de main de maître par l’expérimentateur réside dans la proportion de réponses erronées générées par de faux participants (compères ou algorithmes d’intelligence artificielle simulant d’autres répondants). Cette pression normative unanime (par exemple, 0 %, 30 %, 70 % ou 100 % d’avis contraires à la réalité factuelle évidente) constitue la variable exogène environnementale d’influence. Son intensité est mathématiquement verrouillée par le protocole scientifique.
La réception de cette pression discordante déclenche chez le participant candide une vive tension intrapsychique : la magnitude de la dissonance cognitive éprouvée (mesurée par des indices d’activation autonomique comme l’arythmie sinusale respiratoire ou via des auto-questionnaires d’inconfort psychologique) se manifeste en tant que variable endogène intermédiaire. Cette dissonance n’est pas exogène : elle est enfantée par la confrontation entre la perception visuelle correcte du sujet et l’agression informationnelle extérieure de la norme du groupe.
Enfin, l’adhésion publique au comportement ou au jugement erroné du groupe — matérialisée par le taux effectif de conformisme sur l’ensemble des essais critiques — constitue la variable de comportement endogène terminale. La dynamique sous-jacente met en évidence que l’impact de la contrainte exogène de la taille de la majorité s’exerce majoritairement à travers la variable endogène médiatrice de l’inconfort de dissonance, démontrant l’impérieuse nécessité d’une modélisation intégrée pour comprendre les ressorts de la soumission sociale.
9. La problématique de l’endogénéité dans la recherche quantitative
9.1 L’omission de variables pertinentes (confounding)
L’omission de variables pertinentes dans l’équation de régression — désignée sous le concept d’effet de confusion ou de confounding — constitue sans doute la pathologie méthodologique la plus fréquente et la plus insidieuse conduisant à l’endogénéisation pernicieuse d’un régresseur théoriquement supposé exogène. Supposons qu’un chercheur formule le modèle structural théorique suivant :
$$Y_i = \beta_0 + \beta_1 X_i + \gamma Z_i + u_i$$
Si, pour des motifs d’inaccessibilité de mesure, d’ignorance théorique ou de coût logistique, l’investigateur omet d’inclure la variable $Z_i$ dans son protocole empirique et estime la relation par une régression bivariée simplifiée :
$$Y_i = \alpha_0 + \alpha_1 X_i + \varepsilon_i$$
Le terme d’erreur stochastique de cette équation tronquée s’avère contenir mathématiquement la variable délaissée : $\varepsilon_i = \gamma Z_i + u_i$. Dès lors, si la variable omise $Z_i$ entretient la moindre corrélation empirique avec le régresseur $X_i$ (c’est-à-dire si $\text{Cov}(X_i, Z_i) \neq 0$), l’hypothèse d’orthogonalité est instantanément brisée :
$$\text{Cov}(X_i, \varepsilon_i) = \text{Cov}(X_i, \gamma Z_i + u_i) = \gamma \text{Cov}(X_i, Z_i) \neq 0$$
La variable explicative $X_i$ devient mathématiquement endogène. L’estimateur des moindres carrés ordinaires $\hat{\alpha}_1$ absorbe fallacieusement une partie de l’effet de $Z_i$, générant un biais asymptotique bien connu sous le nom de biais d’omission de variable :
$$\text{p\lim} , \hat{\alpha}_1 = \beta_1 + \gamma \frac{\text{Cov}(X_i, Z_i)}{\mathbb{V}\text{ar}(X_i)}$$
En psychologie, les manifestations de ce biais pullulent en raison de la prévalence de l’hétérogénéité individuelle non observée. Par exemple, si l’on cherche à évaluer l’impact du nombre d’heures de soutien scolaire ($X$) sur la réussite académique ($Y$) sans contrôler scrupuleusement pour le niveau de motivation intrinsèque de l’enfant ou l’investissement éducatif parental ($Z$), l’effet estimé du soutien scolaire sera tragiquement biaisé. Si les parents investissent davantage de soutien pour les élèves initialement les plus en difficulté, $\text{Cov}(X, Z) < 0$, conduisant l'analyse naïve à conclure que le soutien scolaire dégrade les performances des enfants, ce qui constitue une aberration interprétative née de l'oubli du facteur confondant.
9.2 La causalité inverse et la simultanéité
La seconde source majeure d’endogénéité réside dans la violation de l’unidirectionnalité de la relation causale, phénomène regroupé sous les concepts de causalité inverse (reverse causality) et de simultanéité. Cette défaillance analytique culmine au sein des devis de recherche purement transversaux (cross-sectional designs), au sein desquels l’ensemble des mesures est recueilli à un horizon temporel unique.
Considérons un modèle bivarié simple où un chercheur postule que le niveau de détresse psychologique ($X$) détériore la qualité du fonctionnement social ($Y$) :
$$Y_i = \beta_0 + \beta_1 X_i + \varepsilon_i$$
Cependant, en vertu des dynamiques comportementales réelles, un fonctionnement social altéré (isolement, conflits interpersonnels) constitue en lui-même une source puissante de détresse psychologique. Il existe donc une équation de rétroaction structurelle opérant simultanément :
$$X_i = \alpha_0 + \alpha_1 Y_i + \nu_i$$
En substituant la première équation au sein de la seconde, nous découvrons que la variable $X_i$ s’écrit formellement :
$$X_i = \frac{\alpha_0 + \alpha_1 \beta_0 + \alpha_1 \varepsilon_i + \nu_i}{1 – \alpha_1 \beta_1}$$
Il apparaît avec une netteté mathématique implacable que le régresseur $X_i$ est structurellement dépendant du terme d’erreur $\varepsilon_i$ de l’équation de $Y_i$, dès lors que $\alpha_1 \neq 0$ :
$$\text{Cov}(X_i, \varepsilon_i) = \frac{\alpha_1}{1 – \alpha_1 \beta_1} \mathbb{V}\text{ar}(\varepsilon_i) \neq 0$$
Cette imbrication mutuelle rend la variable $X_i$ irrémédiablement endogène. L’estimateur MCO de $\beta_1$ mélange indistinctement la force causale de $X$ sur $Y$ et la poussée en sens inverse de $Y$ sur $X$. Les coefficients estimés s’avèrent structurellement inconsistants et ne reflètent que la résultante d’un équilibre dynamique indéchiffrable. En l’absence de protocoles expérimentaux ou de décalages temporels fins, déduire la causalité d’une corrélation issue d’un système à simultanéité constitue une pure illusion inférentielle.
9.3 L’erreur de mesure dans les variables explicatives
La troisième porte d’entrée majeure de l’endogénéité dans les sciences du comportement découle des imperfections intrinsèques de l’appareil psychométrique : le phénomène de l’erreur de mesure affectant les variables explicatives. En psychologie et dans les sciences médicales, la quasi-totalité des construits d’intérêt — l’anxiété-trait, l’intelligence générale, la cohésion de groupe — sont mesurés par l’intermédiaire d’échelles ou de questionnaires comportementaux soumis à des fluctuations stochastiques non négligeables.
Soit $X^*$ la véritable valeur latente inobservable du construit psychologique d’un sujet, régissant le résultat $Y$ selon l’équation structurelle :
$$Y_i = \beta_0 + \beta_1 X^*_i + \varepsilon_i$$
Le chercheur ne dispose pas de la mesure directe de $X^*_i$, mais recueille un score proxy imparfait noté $X_i$, pollué par un bruit de mesure classique $w_i$ supposé non corrélé avec $X^*_i$ et $\varepsilon_i$ :
$$X_i = X^*_i + w_i$$
Lorsque le chercheur procède à l’estimation de la régression en utilisant la variable observée $X_i$, l’équation devient :
$$Y_i = \beta_0 + \beta_1 (X_i – w_i) + \varepsilon_i = \beta_0 + \beta_1 X_i + (\varepsilon_i – \beta_1 w_i)$$
Le nouveau terme résiduel global s’écrit désormais $e_i = \varepsilon_i – \beta_1 w_i$. Si l’on évalue à présent la covariance entre notre régresseur mesuré $X_i$ et ce nouveau terme d’erreur composite, la distorsion apparaît immédiatement :
$$\text{Cov}(X_i, e_i) = \text{Cov}(X^*_i + w_i, \varepsilon_i – \beta_1 w_i) = -\beta_1 \mathbb{V}\text{ar}(w_i) \neq 0$$
L’introduction d’une erreur de mesure classique convertit instantanément un prédicteur théoriquement exogène en une variable opérationnellement endogène. Cette contamination engendre le fameux biais d’atténuation : la valeur asymptotique du coefficient estimé est mécaniquement rétractée vers zéro :
$$\text{p\lim} , \hat{\beta}_{1, \text{MCO}} = \beta_1 \left( \frac{\sigma^2_{X^*}}{\sigma^2_{X^*} + \sigma^2_w} \right) = \beta_1 \lambda$$
Où $lambda$ représente l’indice de fidélité psychométrique de la mesure (borné entre 0 et 1). Ignorer ce mécanisme d’endogénéisation par le bruit conduit systématiquement la recherche quantitative à sous-estimer la force d’impact des facteurs psychologiques fondamentaux, conduisant parfois à des abandons erronés de pistes théoriques pourtant hautement explicatives.
10. Stratégies méthodologiques et statistiques pour résoudre l’endogénéité
10.1 L’approche expérimentale par assignation aléatoire
Face à la menace constante du biais d’endogénéité, l’approche méthodologique reine, érigée au rang de standard d’or par la méthodologie scientifique contemporaine, demeure le devis contrôlé randomisé (RCT, Randomized Controlled Trial). La force épistémologique irréductible de l’expérimentation par randomisation réside dans sa capacité mathématique à fabriquer artificiellement une exogénéité stricte.
Lorsque des unités expérimentales (patients, élèves, consommateurs) sont assignées à différentes modalités d’une variable de traitement $T$ au moyen d’un processus stochastique formalisé (tirage au sort par générateur pseudo-aléatoire cryptographique), la distribution de cette variable $T$ est garantie d’être strictement orthogonale à toute caractéristique préexistante, observée ou non mesurée, propre aux sujets :
$$T perp ! ! ! perp (\mathbf{X}_{\text{omises}}, \varepsilon)$$
En détruisant toute dépendance systématique entre l’allocation du traitement et les résidus, la randomisation neutralise instantanément les risques d’omission de variables et d’hétérogénéité individuelle non observée. De surcroît, parce que l’intervention précède de manière incontestable la mesure du résultat $Y$ et découle d’un algorithme extérieur aux unités, elle éradique définitivement toute possibilité de causalité inverse ou de rétroaction simultanée.
Toutefois, la panacée de l’assignation aléatoire se heurte à des frontières infranchissables au sein de pans entiers de la recherche en sciences humaines et médicales. L’impossibilité d’appliquer la randomisation pour des motifs éthiques patents (assigner des individus à une condition d’isolement social prolongé ou de consommation de substances addictives est proscrit), des contraintes logistiques colossales ou des exigences d’écologie comportementale réelle force fréquemment les investigateurs à opérer sur des données strictement observationnelles, exigeant le déploiement d’outils statistiques correctifs hautement sophistiqués.
10.2 L’estimation par variables instrumentales (2SLS)
Développée initialement en économétrie pour pallier la présence de régresseurs endogènes sans pouvoir recourir à des interventions de laboratoire, la méthode des variables instrumentales (IV), particulièrement mise en œuvre à travers l’estimateur des doubles moindres carrés (2SLS, Two-Stage Least Squares), constitue l’une des inventions analytiques les plus raffinées du XXe siècle.
Le principe fondamental consiste à identifier une variable extérieure, notée $Z$ (l’instrument), qui affecte la variable dépendante $Y$ exclusivement à travers son influence sur la variable explicative endogène $X$. Pour qu’une variable $Z$ soit déclarée comme un instrument valide, elle doit satisfaire simultanément à deux conditions formelles strictes :
- La pertinence de l’instrument : L’instrument doit être fortement corrélé avec le régresseur endogène après contrôle des autres covariables exogènes : $\text{Cov}(Z, X) \neq 0$. Cette condition est testée au premier stade par l’obtention d’une statistique de Fisher substantielle (conventionnellement $F > 10$).
- La restriction d’exclusion (orthogonalité) : L’instrument doit être strictement exogène par rapport à l’équation structurelle de sortie, ce qui signifie qu’il ne doit entretenir aucune corrélation directe avec le terme d’erreur stochastique : $\text{Cov}(Z, \varepsilon) = 0$. En d’autres termes, $Z$ n’exerce aucun effet causal direct sur $Y$ en dehors de celui transmis par la variable endogène $X$.
La mise en œuvre des 2SLS se décompose alors mathématiquement en deux stades analytiques successifs :
Premier stade : On régresse la variable endogène $X$ sur l’instrument $Z$ et l’ensemble des variables exogènes incluses dans le modèle :
$$X_i = \pi_0 + \pi_1 Z_i + boldsymbol{\pi}_2^top \mathbf{W}_i + \nu_i$$
On extrait ensuite les valeurs prédites $\hat{X}_i = \hat{\pi}_0 + \hat{\pi}_1 Z_i + \hat{boldsymbol{\pi}}_2^top \mathbf{W}_i$. Par construction probabiliste, ces valeurs prédites sont totalement purifiées du terme d’erreur endogène originel $\nu_i$ et de ses liaisons avec $\varepsilon_i$.
Deuxième stade : On régressera la variable de résultat final $Y$ non pas sur la variable endogène contaminée $X$, mais sur sa version purifiée et synthétisée au premier stade $\hat{X}$ :
$$Y_i = \beta_0 + \beta_{1, \text{2SLS}} \hat{X}_i + boldsymbol{\gamma}^top \mathbf{W}_i + \epsilon_i$$
L’estimateur $\hat{\beta}_{1, \text{2SLS}}$ qui en résulte offre la propriété d’être asymptotiquement non biaisé et convergent, isolant la composante de variance strictement exogène de $X$. Néanmoins, la recherche en psychologie se heurte chroniquement à la rareté de variables instrumentales crédibles et incontestables, la restriction d’exclusion étant particulièrement difficile à défendre face à l’enchevêtrement des fonctions psychiques.
10.3 Modèles longitudinaux et approches à effets fixes
Lorsque les données peuvent être recueillies de manière répétée au fil du temps sur un même échantillon d’individus (données de panel ou devis longitudinaux multi-vagues), une approche puissante pour neutraliser l’endogénéité liée aux facteurs inobservés consiste à mobiliser les modèles à effets fixes (fixed effects models).
Le postulat de cette méthodologie repose sur la décomposition analytique du terme d’erreur composite $\varepsilon_{it}$ en deux composantes stochastiques distinctes : une composante invariable dans le temps propre à chaque individu, notée $\mu_i$ (l’hétérogénéité individuelle invariante, telle que le patrimoine génétique, les traits profonds de personnalité ou l’histoire développementale précoce), et un terme d’erreur idiosyncratique variant dans le temps, noté $\nu_{it}$ :
$$Y_{it} = \beta_0 + boldsymbol{\beta}^top \mathbf{X}_{it} + \mu_i + \nu_{it}$$
Si l’endogénéité de $\mathbf{X}_{it}$ procède du fait que les régresseurs sont corrélés avec les caractéristiques immuables non mesurées de l’individu ($\text{Cov}(\mathbf{X}_{it}, \mu_i) \neq 0$), l’approche à effets fixes permet de pulvériser cette source de biais sans même avoir à mesurer $\mu_i$. En appliquant la transformation within (soustraction des moyennes intra-individuelles temporelles calculées sur l’ensemble des vagues $T$) :
$$\bar{Y}_i = \frac{1}{T}\sum_{t=1}^T Y_{it}, \quad \bar{\mathbf{X}}_i = \frac{1}{T}\sum_{t=1}^T \mathbf{X}_{it}, \quad \bar{\mu}_i = \mu_i$$
L’équation centrée s’écrit alors :
$$(Y_{it} – \bar{Y}_i) = boldsymbol{\beta}^top (\mathbf{X}_{it} – \bar{\mathbf{X}}_i) + (\nu_{it} – \bar{\nu}_i)$$
La composante fixe $\mu_i$ disparaît totalement de l’équation mathématique par différenciation. En éliminant toute la variance inter-individuelle pour n’exploiter exclusivement que la variabilité intra-individuelle de chaque sujet au fil du temps, le modèle à effets fixes purge automatiquement les estimateurs de l’ensemble des facteurs confondants invariables dans le temps, restaurant les conditions de validité interne requises pour l’inférence causale.
10.4 Analyses de sensibilité et modélisation causale avancée
Lorsque les contraintes de recueil ne permettent ni l’assignation aléatoire, ni le panel longitudinal, ni l’instrumentation 2SLS, les chercheurs contemporains doivent impérativement mobiliser des analyses de sensibilité poussées et des méthodes d’inférence causale avancées.
Parmi ces approches, les méthodes d’appariement par score de propension (propensity score matching) et de pondération inverse de la probabilité de traitement (IPTW, Inverse Probability of Treatment Weighting) permettent de rééquilibrer artificiellement des groupes observationnels sur l’ensemble d’un vaste vecteur de covariables mesurées. Bien qu’elles reposent sur l’hypothèse non testable d’ignorabilité forte du traitement (absence de confusion non observée), ces techniques réduisent considérablement le biais induit par la sélection endogène dans les groupes.
Conjointement, le développement récent des analyses de sensibilité causale — exemplifiées par le calcul de la valeur $E$ (E-value) conceptualisée par VanderWeele et Ding (2017) — offre une méthode quantitative pour évaluer la robustesse des inférences face à une éventuelle violation de l’exogénéité. La valeur $E$ quantifie l’intensité minimale qu’un facteur confondant non mesuré devrait entretenir conjointement avec le régresseur et le résultat pour réduire à néant l’effet causal estimé. Si la valeur $E$ calculée est extraordinairement élevée, le chercheur peut raisonnablement arguer que le biais d’endogénéité résiduel est peu susceptible de renverser ses conclusions.
Enfin, l’utilisation formelle des graphes acycliques dirigés (DAG) et de la méthode du backdoor criterion formalisée par Pearl permet de déterminer algorithmiquement l’ensemble minimal de conditionnement requis pour bloquer tous les chemins de confusion parasites. Grâce à des plateformes algorithmiques telles que DAGitty, les analystes peuvent aujourd’hui prouver rigoureusement quelles variables doivent obligatoirement être contrôlées et quelles variables doivent au contraire impérativement être exclues (notamment les colliseurs) pour préserver l’exogénéité des relations investiguées.
11. Comparaison synthétique et erreurs d’interprétation fréquentes
11.1 Tableau synoptique comparatif
Pour ancrer durablement la distinction opérationnelle entre ces deux classes fondamentales de variables, il est opportun de synthétiser leurs propriétés divergentes au sein d’une matrice comparative exhaustive :
| Critère d’analyse | Variable endogène ($Y, eta$) | Variable exogène ($X, xi, Z$) |
|---|---|---|
| Origine de la variance | Engendrée, expliquée et régie par les relations internes au modèle. | Extérieure au modèle ; déterminée en dehors des mécanismes formalisés. |
| Liaison avec le terme d’erreur | Fréquemment corrélée aux termes résiduels en présence de causalité inverse ou d’omissions. | Strictement ou séquentiellement orthogonale : $\text{Cov}(X, \varepsilon) = 0$. |
| Position dans les équations | Figure obligatoirement au moins une fois à gauche du signe égal au sein du système. | Ne figure jamais sur le membre de gauche d’une équation structurelle du système. |
| Manipulabilité pratique | Modifiée indirectement par le truchement des variables en amont ; cible clinique classique. | Assignée unilatéralement par le chercheur (expérimentation) ou subie comme fait de nature. |
| Rôle structural dans les DAGs | Cible de flèches directionnelles (médiateur, colliseur ou descripteur de résultat). | Nœud racine : n’émet que des flèches causales sans en recevoir aucune du réseau. |
11.2 Confusion fréquente entre variable indépendante et variable exogène
L’une des confusions conceptuelles les plus persistantes dans l’enseignement et la pratique des statistiques quantitatives réside dans l’utilisation interchangeable et erronée des termes « variable indépendante » et « variable exogène ». Cette synonymie approximative, véhiculée par de nombreux manuels introductifs, constitue une source majeure de fausses inférences.
Le terme « variable indépendante » est une désignation opérationnelle héritée de la syntaxe logicielle des modèles de régression : il signale simplement que la variable a été placée sur le flanc droit de l’équation statistique par l’analyste, en tant que prédicteur potentiel. En revanche, le terme « variable exogène » constitue une qualification théorique et probabiliste rigoureuse qui exige l’indépendance de ce régresseur par rapport à l’erreur stochastique du processus générateur de données.
Dès lors, dans une étude observationnelle, toute variable indépendante n’est pas nécessairement exogène. Si un psychologue intègre le niveau d’estime de soi comme « variable indépendante » pour prédire la réussite universitaire, cette variable reste opérationnellement indépendante dans son logiciel d’analyse, mais elle est très probablement structurellement endogène au sein du phénomène humain étudié. Les raccourcis rédactionnels proclamant péremptoirement que « l’effet indépendant de $X$ démontre son impact causal » relèvent d’un sophisme statistique qu’une écriture académique exigeante doit rigoureusement proscrire.
11.3 L’illusion de l’exogénéité universelle
Une seconde dérive méthodologique fréquente consiste à conférer par automatisme intellectuel un statut d’exogénéité pure aux caractéristiques sociodémographiques ou biologiques des individus — telles que le niveau de revenu, le statut matrimonial, ou même certaines comorbidités médicales.
Cette illusion d’exogénéité universelle ignore superbement les phénomènes universels de sélection endogène et de causalité inverse. Considérons, par exemple, le statut matrimonial d’un individu dans une étude sur la dépression. Présenter le mariage comme un facteur purement exogène protégeant contre la détresse psychologique revient à occulter le mécanisme d’assortiment sélectif : les individus disposant initialement d’une meilleure santé mentale et de traits de personnalité plus stables sont statistiquement plus susceptibles de trouver un partenaire et de stabiliser une relation de couple (sélection positive). Le statut matrimonial n’est pas tombé du ciel comme une variable aléatoire exogène ; il est le fruit endogène de l’histoire psychologique antérieure du sujet.
Il en va de même pour les variables économiques au sein des études épidémiologiques. Le niveau de revenu est fréquemment affecté rétroactivement par l’émergence insidieuse des premiers signes de déclin cognitif ou de souffrance psychiatrique (effet de dérive sociale ou social drift). En conséquence, postuler l’exogénéité absolue d’une variable au seul motif qu’elle relève d’un registre matériel, civil ou biologique constitue une faute d’analyse susceptible de vicier l’intégralité d’un programme d’investigation empirique.
12. Recommandations de bonnes pratiques pour les chercheurs
12.1 Formalisation rigoureuse du cadre conceptuel a priori
Afin de prémunir les projets de recherche contre les pièges destructeurs de l’endogénéité, la première recommandation méthodologique impérative réside dans la formalisation exhaustive et explicite du modèle théorique avant même l’engagement de la collecte de données sur le terrain.
Les chercheurs doivent abandonner l’illusion positiviste consistant à espérer qu’une approche purement guidée par les données (data-driven) révélera magiquement la structure causale d’un système. Il est impératif d’élaborer systématiquement des graphes acycliques dirigés (DAG) formels, ancrés dans une revue scrupuleuse de la littérature théorique et empirique préexistante. Chaque flèche causale postulée, chaque absence de flèche (hypothèse d’indépendance conditionnelle) et chaque statut attribué aux variables (exogène versus endogène) doit faire l’objet d’une justification rationnelle documentée.
Cette formalisation conceptuelle gagne à s’inscrire dans la démarche contemporaine de la science ouverte par le biais du pré-enregistrement des hypothèses et des plans d’analyse (preregistration). En déclarant a priori quelles variables sont considérées comme exogènes, quelles variables sont suspectées d’endogénéité et quelles stratégies de contrôle statistique seront déployées pour neutraliser les facteurs confondants, le chercheur s’interdit les pratiques de « pêche aux coefficients » (p-hacking) et garantit la reproductibilité authentique de ses inférences.
12.2 Diagnostic systématique de l’endogénéité résiduelle
La seconde prescription fondamentale relève du déploiement sans concession d’une batterie d’outils de diagnostic statistique pour éprouver la plausibilité de l’exogénéité revendiquée par les modèles spécifiés.
Dans les configurations d’estimation où des variables instrumentales sont mobilisées ou disponibles, il est impératif d’exécuter systématiquement le test de spécification de Durbin-Wu-Hausman. Ce test probabiliste compare formellement la divergence matricielle entre l’estimateur MCO (efficace sous l’hypothèse nulle d’exogénéité, mais biaisé sous l’hypothèse alternative) et l’estimateur 2SLS (convergent dans les deux cas, mais moins efficace). Si la statistique de Hausman s’avère significativement différente de zéro :
$$H = (\hat{boldsymbol{\beta}}_{\text{2SLS}} – \hat{boldsymbol{\beta}}_{\text{MCO}})^top \left[ \mathbb{V}\text{ar}(\hat{boldsymbol{\beta}}_{\text{2SLS}}) – \mathbb{V}\text{ar}(\hat{boldsymbol{\beta}}_{\text{MCO}}) \right]^{-1} (\hat{boldsymbol{\beta}}_{\text{2SLS}} – \hat{boldsymbol{\beta}}_{\text{MCO}}) \sim \chi^2(k)$$
L’hypothèse d’exogénéité du régresseur doit être rejetée sans équivoque, confirmant la présence d’une contamination endogène nécessitant impérativement l’abandon des estimateurs linéaires standards.
De surcroît, les chercheurs doivent examiner avec la plus grande vigilance les matrices de corrélations résiduelles dans les équations structurelles, évaluer les facteurs d’inflation de la variance (VIF) pour dépister les collinéarités destructrices, et procéder à des analyses de robustesse systématiques en faisant varier la spécification des covariables pour observer la stabilité numérique des coefficients d’intérêt.
12.3 Transparence rédactionnelle et discussion des limites
La dernière recommandation s’adresse à la responsabilité éthique et rédactionnelle des chercheurs lors de la phase de dissémination de leurs résultats au sein des revues scientifiques à comité de lecture.
La transparence exige que les auteurs énoncent sans ambiguïté dans la section méthodologique quelles variables ont été traitées sous l’hypothèse d’exogénéité stricte, et quelles sont les limites théoriques entourant cette présomption au regard du devis de recueil utilisé. L’usage abusif et imprudent de verbes à connotation causale explicite (« modifier », « déterminer », « réduire », « impacter ») doit être rigoureusement proscrit dès lors que le modèle ne dispose pas des garanties formelles d’exogénéité (absence de randomisation, absence d’instrumentation crédible ou absence de données longitudinales à effets fixes).
Enfin, la section de discussion doit réserver un espace substantiel à la formulation critique des menaces pesant sur la validité interne : identification ouverte des variables confondantes potentielles non mesurées, explicitation des mécanismes plausibles de causalité inverse, et formulation de recommandations ciblées pour les futures réplications empiriques. C’est uniquement par cette discipline épistémologique et cette clarté conceptuelle que les sciences du comportement et la modélisation statistique préserveront leur intégrité et leur capacité à éclairer les mécanismes réels régissant la complexité humaine.
Références
- Bakker, A. B., & Demerouti, E. (2007). The Job Demands-Resources model: state of the art. Journal of Managerial Psychology, 22(3), 309-328. https://doi.org/10.1108/02683940710733115
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173-1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Edmondson, A. (1999). Psychological safety and learning behavior in work teams. Administrative Science Quarterly, 44(2), 350-383. https://doi.org/10.2307/2666999
- Engle, R. F., Hendry, D. F., & Richard, J. F. (1983). Exogeneity. Econometrica, 51(2), 277-304. https://doi.org/10.2307/1912246
- Haavelmo, T. (1943). The statistical implications of a system of simultaneous equations. Econometrica, 11(1), 1-12. https://doi.org/10.2307/1905714
- Hausman, J. A. (1978). Specification tests in econometrics. Econometrica, 46(6), 1251-1271. https://doi.org/10.2307/1913827
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2e éd.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pearl, J., Glymour, M., & Jewell, N. P. (2016). Causal Inference in Statistics: A Primer. John Wiley & Sons. https://www.wiley.com/en-us/Causal+Inference+in+Statistics%3A+A+Primer-p-9781119186847
- Stock, J. H., & Watson, M. W. (2020). Introduction to Econometrics (4e éd.). Pearson. https://www.pearson.com/en-us/subject-catalog/p/introduction-to-econometrics/P200000006489
- VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: introducing the E-value. Annals of Internal Medicine, 167(4), 268-274. https://doi.org/10.7326/M16-2607
- Wooldridge, J. M. (2010). Econometric Analysis of Cross Section and Panel Data (2e éd.). MIT Press. https://mitpress.mit.edu/9780262232586/econometric-analysis-of-cross-section-and-panel-data/