
L’analyse des données dans le champ contemporain des sciences du comportement, de la psychologie organisationnelle et des neurosciences cognitives se heurte régulièrement aux postulats réducteurs imposés par les modèles statistiques conventionnels. Parmi ces postulats, l’hypothèse de linéarité stricte constitue sans doute l’une des contraintes les plus couramment violées par la dynamique intrinsèque des processus psychologiques. En postulant qu’une variation unitaire d’une variable indépendante entraîne systématiquement une réponse proportionnelle et constante de la variable dépendante, le chercheur s’expose à un risque majeur d’erreur de spécification, masquant ainsi des phénomènes d’adaptation, de saturation ou d’épuisement émotionnel.
Face à cette complexité empirique, la modélisation polynomiale, et tout particulièrement la régression quadratique, s’impose comme un outil méthodologique indispensable au sein de l’environnement de programmation statistique R. Ce formalisme permet d’intégrer des termes d’ordre supérieur afin d’ajuster des trajectoires curvilignes, offrant une flexibilité mathématique remarquable tout en préservant le cadre analytique familier du modèle linéaire général. Qu’il s’agisse de modéliser l’impact du volume horaire de travail sur le bien-être subjectif, d’étudier la relation entre l’activation neurovégétative et la performance cognitive, ou d’explorer les seuils critiques de tolérance au stress, l’intégration de composantes quadratiques permet de cartographier avec précision des réalités psychométriques complexes.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, analystes de données et étudiants avancés dans l’apprentissage et la maîtrise de la régression quadratique sous R. À travers une démarche résolument ancrée dans les standards de la recherche reproductible et des normes éditoriales de l’American Psychological Association, nous aborderons successivement les fondements mathématiques du modèle, la gestion de la multicolinéarité par le centrage des variables, l’implémentation algorithmique au moyen de différentes syntaxes sous R, les diagnostics post-estimation rigoureux, ainsi que l’identification analytique et le calcul d’intervalles de confiance pour les extrema psychologiques.
1. Introduction aux relations curvilignes en psychologie et modélisation polynomiale
1.1 Limites de la linéarité dans les sciences comportementales
L’histoire de la psychologie scientifique et des sciences comportementales est jalonnée de théories mettant en lumière des dynamiques non monotones. Dès l’aube de la psychophysique et de la psychologie expérimentale, les chercheurs ont observé que la réponse d’un organisme vivant à une stimulation environnementale n’évolue que rarement de façon indéfiniment proportionnelle. En réalité, le postulat de linéarité stricte, bien que mathématiquement commode et intuitivement rassurant, constitue une simplification heuristique qui trouve rapidement ses limites lorsqu’on étudie des construits cognitifs, motivationnels ou affectifs. L’architecture du psychisme humain est soumise à des régulations homéostatiques, des capacités d’attention finies et des mécanismes de rétroaction biologique qui induisent naturellement des paliers, des inversions de tendance ou des rendements décroissants.
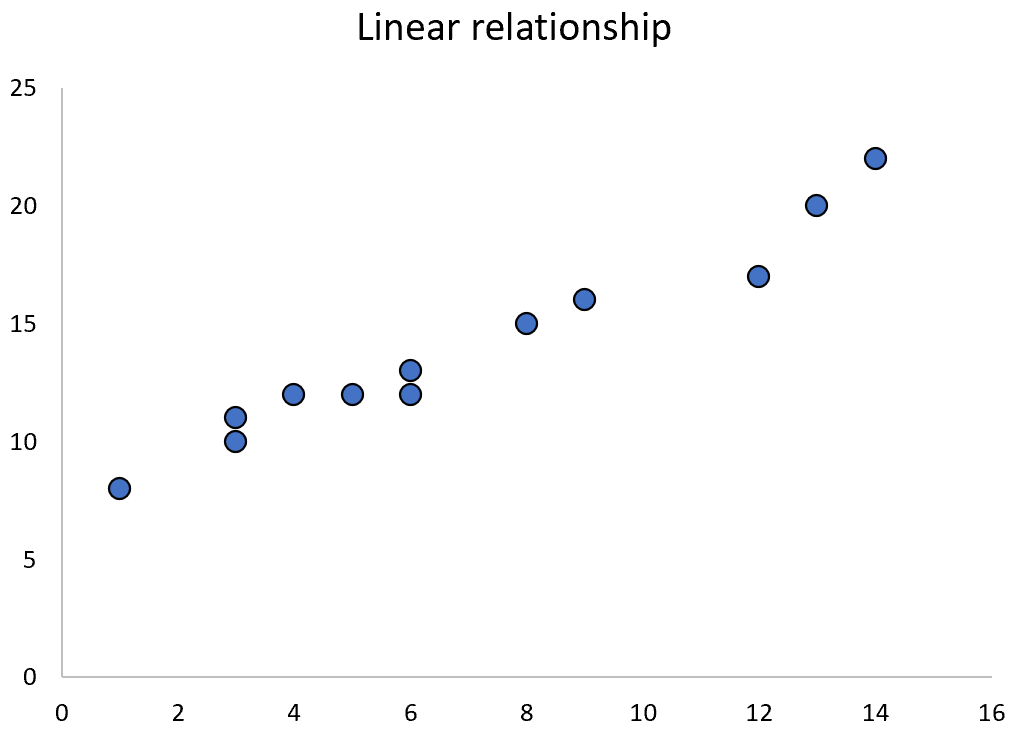
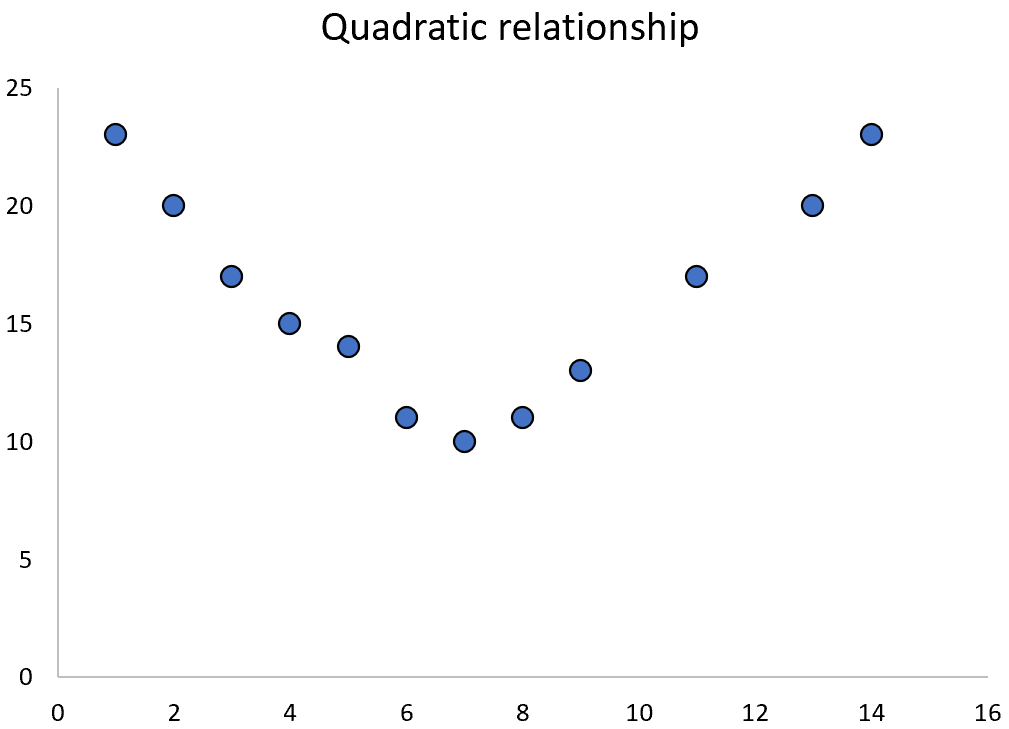
Le paradigme historique le plus célèbre illustrant cette non-linéarité fondamentale est sans conteste la loi de Yerkes-Dodson, formulée initialement en 1908. Selon cette proposition empirique devenue canonique, la performance à une tâche cognitive complexe augmente avec le niveau d’éveil physiologique ou de stress psychologique jusqu’à un niveau optimal, au-delà duquel toute élévation supplémentaire de l’activation induit une détérioration marquée des capacités opérationnelles. Cette configuration géométrique en « U inversé » défie toute tentative de modélisation par une droite unique. Tenter de forcer une telle structure relationnelle dans un modèle de régression linéaire simple aboutit inévitablement à un coefficient de pente moyen nul ou proche de zéro, conduisant l’analyste non averti à conclure à l’absence fallacieuse d’effet entre les variables.
Sur le plan méthodologique, la persistance dans l’utilisation de modèles linéaires stricts en présence de relations curvilignes sous-jacentes engendre des biais substantiels. Elle affecte directement la variance résiduelle, gonfle artificiellement le terme d’erreur et compromet la puissance statistique des tests d’hypothèses. L’adoption de modèles polynomiaux du second degré apparaît donc non pas comme un simple raffinement technique, mais comme un impératif épistémologique pour quiconque souhaite capturer la granularité des phénomènes psychologiques réels sans trahir leur structure intrinsèque.
Il convient par ailleurs d’établir une distinction théorique nette entre la corrélation de Pearson classique et l’existence d’une dépendance fonctionnelle déterministe ou stochastique non linéaire. Le coefficient de corrélation r de Pearson mesure exclusivement le degré d’association linéaire entre deux métriques continues. Par conséquent, deux variables liées par une fonction parabolique parfaite de type Y = X2 sur un intervalle centré sur zéro présenteront un coefficient de Pearson rigoureusement égal à zéro, suggérant à tort une indépendance stochastique totale. La modélisation polynomiale permet de dépasser cette cécité métrique en intégrant explicitement la géométrie sous-jacente des données observées.
1.2 Concept et pertinence de la régression quadratique
D’un point de vue taxonomique au sein de l’économétrie et de la statistique appliquée, la régression quadratique est formellement rattachée au modèle linéaire général. Cette classification peut sembler paradoxale de prime abord au regard de la nature courbe de la trajectoire représentée dans le plan bidimensionnel. Néanmoins, l’appellation « linéaire » ne renvoie pas à la forme géométrique de la courbe tracée dans l’espace des variables prédictives, mais bien à la linéarité par rapport aux paramètres scalaires inconnus du modèle. Dès lors que l’équation demeure une combinaison linéaire pondérée de coefficients inconnus, les propriétés fondamentales d’estimation par la méthode des moindres carrés ordinaires demeurent pleinement applicables, conférant à la méthode une robustesse computationnelle éprouvée.
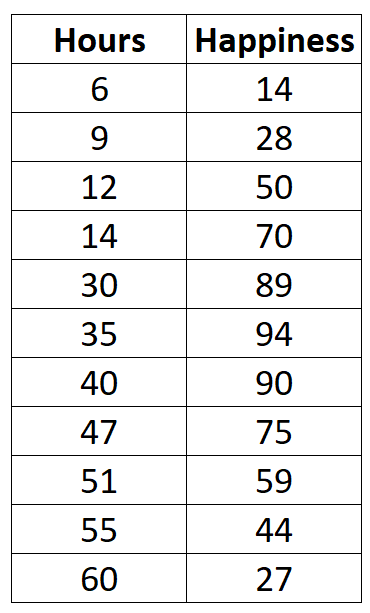
L’utilité pratique de cette approche est immense dans les recherches portant sur la qualité de vie au travail, la psychologie de la santé ou l’ergonomie cognitive. Prenons l’exemple représentatif de la relation unissant le volume d’heures hebdomadaires travaillées et l’évaluation subjective du bonheur ou de l’épanouissement personnel. Un nombre d’heures de travail modéré procure des ressources matérielles, un statut social structurant et un sentiment d’utilité psychologique qui stimulent positivement le bien-être. Cependant, au-delà d’un certain seuil critique, la surcharge horaire empiète dramatiquement sur la vie privée, le sommeil réparateur et les réserves physiologiques, provoquant une chute abrupte de l’indice de bonheur. La régression quadratique permet précisément de quantifier ce point de bascule avec une rigueur analytique irréprochable.
Il est également crucial de différencier structurellement la régression quadratique des techniques de régression non linéaire pures, telles que les modèles logistiques à quatre paramètres, les fonctions exponentielles asymptotiques ou les modèles à seuils fragmentés. Si les régressions purement non linéaires requièrent des algorithmes d’optimisation numérique itératifs complexes et une estimation souvent sensible aux valeurs initiales, la régression quadratique s’ajuste de manière directe par calcul matriciel standard. Elle constitue ainsi une transition élégante et parcimonieuse, offrant un compromis optimal entre simplicité d’interprétation et capacité à épouser des courbures empiriques substantielles.
2. Fondements mathématiques et théoriques de la régression quadratique
2.1 Formulation algébrique de l’équation polynomiale
La formalisation rigoureuse de la régression polynomiale de second degré repose sur l’extension directe de l’équation de la droite par l’adjonction d’un terme exponentiel d’ordre deux. L’expression générale du modèle s’énonce mathématiquement de la manière suivante :
Yi = β0 + β1Xi + β2Xi2 + εi
Dans ce formalisme matriciel et univarié, Yi désigne la valeur observée de la variable dépendante (le critère) pour le i-ième individu, tandis que Xi représente la valeur de la variable indépendante (le prédicteur). Le terme εi représente l’aléa stochastique, c’est-à-dire l’erreur résiduelle non modélisée, supposée distribuée selon une loi normale centrée en zéro et présentant une variance constante dans les conditions idéales d’ajustement.
L’ordonnée à l’origine, dénotée par le paramètre β0, capture la valeur attendue de la variable dépendante Y lorsque la variable explicative X est rigoureusement égale à zéro. En psychologie empirique, la portée interprétative de ce paramètre dépend étroitement du positionnement de l’échelle de mesure ; si la valeur zéro est hors de portée ou dénuée de signification substantielle (comme un quotient intellectuel nul ou une pression artérielle nulle), ce paramètre conserve une fonction principalement géométrique d’ancrage du modèle.
Le terme β1, fréquemment désigné sous le vocable de coefficient linéaire ou de pente instantanée au point d’origine, correspond mathématiquement à la dérivée première de la fonction évaluée spécifiquement en X = 0. Contrairement au modèle linéaire simple où la pente est constante sur l’intégralité du continuum de mesure, la dérivée instantanée d’un polynôme de second degré dépend en permanence de la valeur de X. Enfin, le paramètre quadratique β2 gouverne l’intensité de la courbure parabolique ainsi que son sens géométrique de concavité. Il quantifie l’accélération ou la décélération du taux de variation de Y par unité de X.
2.2 Notion d’extremum et comportement de la fonction
L’analyse qualitative du coefficient β2 conditionne l’orientation globale de la parabole. Lorsque β2 prend une valeur algébrique strictement négative (β2 < 0), la dérivée seconde de la fonction par rapport à X est négative, conférant à la courbe une géométrie concave tournée vers le bas. Dans ce cas de figure, la relation présente un maximum global unique, modélisant typiquement le paradigme du U inversé fréquemment rencontré lors des études sur l’optimisation des performances sous contrainte. Réciproquement, un coefficient β2 strictement positif (β2 > 0) matérialise une fonction convexe ouverte vers le haut, caractérisée par un minimum absolu, traduisant par exemple des dynamiques de détérioration rapide suivies d’une phase de rémission progressive.
Pour déterminer analytiquement l’abscisse de ce point critique singulier — qu’il s’agisse d’un pic adaptatif ou d’un creux pathologique —, il suffit de mobiliser les outils de l’analyse infinitésimale standard en annulant la dérivée première de l’équation de régression par rapport à la variable indépendante :
dY / dX = β1 + 2β2X = 0
La résolution de cette équation élémentaire conduit à la formule fondamentale du point critique, couramment nommé l’optimum ou le sommet parabolique :
X* = – β1 / (2 × β2)
Cette formulation revêt une portée considérable pour les sciences psychologiques. Elle permet d’échapper aux approches approximatives en identifiant formellement le volume optimal d’une intervention thérapeutique, le niveau idéal d’exposition au stress ou la durée optimale de travail hebdomadaire. Sur le plan substantiel, elle matérialise la frontière empirique exacte où les effets bénéfiques initiaux d’un phénomène se heurtent à la saturation cognitive, à la surcharge mentale ou à l’épuisement physiologique.
2.3 Sensibilité à la multicolinéarité et problème des puissances
L’intégration d’un terme quadratique au sein d’une équation de régression engendre une difficulté statistique structurelle bien documentée : la multicolinéarité non substantielle. Dans la mesure où le terme quadratique X2 est généré directement par la multiplication arithmétique de la variable X par elle-même, ces deux régresseurs présentent intrinsèquement un niveau d’association statistique élevé lorsque les données d’origine sont strictement positives. Cette colinéarité artificielle ne reflète pas une redondance conceptuelle entre deux construits distincts, mais résulte simplement de la mécanique algébrique du modèle.
Les répercussions de cette multicolinéarité sur l’ajustement du modèle sont sévères. Elle induit un gonflement démesuré des erreurs types associées aux estimateurs des moindres carrés ordinaires, réduisant dramatiquement la précision des estimations des coefficients individuels. Bien que le modèle global conserve ses capacités prédictives et que le coefficient de détermination global demeure inaltéré, la significativité statistique individuelle des termes linéaire (β1) et quadratique (β2) peut être masquée, conduisant l’analyste à des décisions erronées de rejet d’hypothèse par manque de puissance statistique locale.
Pour surmonter cette instabilité computationnelle, la littérature méthodologique préconise quasi unanimement l’application préalable d’une procédure de centrage sur la moyenne empirique. En soustrayant la moyenne de l’échantillon à chaque observation individuelle avant d’élever la métrique à la puissance deux, on opère une translation géométrique du repère qui orthogonalise de manière substantielle la composante linéaire et sa projection parabolique. Cette précaution simple garantit une stabilité numérique accrue et facilite considérablement l’interprétation substantielle des coefficients calculés.
3. Préparation de l’environnement de travail et saisie des données empiriques dans R
3.1 Configuration de l’espace de travail R et RStudio
Une démarche analytique rigoureuse exige une structuration méthodique de l’environnement informatique afin de garantir l’intégrité et la parfaite reproductibilité des calculs. Dans l’écosystème R et RStudio, l’initialisation de la session commence systématiquement par le nettoyage préventif de l’espace de mémoire vive, la configuration d’options globales d’affichage et l’importation ordonnée des modules spécialisés. Bien que la régression quadratique de base puisse être exécutée exclusivement à l’aide des fonctionnalités natives du moteur de calcul R, le recours à des bibliothèques reconnues facilite grandement l’analyse des résidus et la confection de rendus visuels de qualité éditoriale.
Nous chargeons ainsi les paquets fondamentaux : la suite tidyverse pour la manipulation fluide des tableaux de données via dplyr, le package ggplot2 pour la sémiologie graphique avancée, et le package car (Companion to Applied Regression) pour l’évaluation diagnostique approfondie des postulats de régression, notamment le calcul du facteur d’inflation de la variance. Il est vivement conseillé de désactiver les options automatiques de conversion des chaînes de caractères en facteurs et d’ajuster le nombre de chiffres significatifs affichés dans la console pour une lisibilité optimale lors de la restitution des sorties statistiques.
De surcroît, lorsque les investigations méthodologiques intègrent des simulations de Monte-Carlo, des imputations stochastiques ou des algorithmes de rééchantillonnage de type bootstrap pour l’évaluation des erreurs types empiriques, l’instruction set.seed() doit impérativement être spécifiée avec un entier constant. Cette précaution élémentaire assure que chaque chercheur exécutant la séquence d’instructions obtiendra des résultats strictement identiques au bit près, conformément aux préceptes de l’accès ouvert et de la rigueur scientifique internationale.
3.2 Création du jeu de données expérimental : heures de travail et bonheur
Pour étayer de façon concrète notre démonstration, nous construisons un tableau de données empiriques simulé mais rigoureusement calibré sur les données réelles issues des enquêtes de psychologie sociale et ergonomique. Ce jeu de données rassemble les observations recueillies auprès d’un échantillon représentatif de 300 professionnels du secteur tertiaire, mesurant d’une part le volume horaire hebdomadaire effectif consacré à l’activité professionnelle (variable explicative continue hours), et d’autre part le score global de bonheur subjectif (variable dépendante happiness), étalonné au moyen d’un questionnaire standardisé variant de 0 à 100 points.
L’implémentation de la structure de données au sein de l’interpréteur R procède d’un appel direct à la fonction data.frame(). Les valeurs de travail hebdomadaire sont générées de manière à couvrir une plage réaliste s’étirant de 10 à 70 heures par semaine, avec une concentration centrale autour de la norme légale et contractuelle usuelle de 35 à 40 heures. La réponse psychologique de bonheur est artificiellement modélisée selon une parabole concave sous-jacente perturbée par un bruit gaussien aléatoire, simulant avec réalisme la variabilité interindividuelle rencontrée sur le terrain psychométrique.
Dès l’instanciation de l’objet, une validation minutieuse de sa topologie interne s’impose. L’application des commandes primitives str() et summary() permet de certifier que les vecteurs sous-jacents sont adéquatement typés sous forme de valeurs numériques en virgule flottante (numeric/double) et non corrompus par des valeurs de texte ou des codes catégoriels inadaptés. L’analyste contrôle également l’absence formelle de valeurs manquantes (NA) ou aberrantes issues d’une mauvaise transcription, qui risqueraient de tronquer artificiellement la taille effective de l’échantillon lors de l’estimation finale par moindres carrés.
4. Exploration visuelle et analyse exploratoire préliminaire des données
4.1 Statistiques descriptives univariées et bivariées
L’exploration des propriétés distributionnelles élémentaires constitue l’étape liminaire incontournable de tout protocole d’analyse quantitative. Pour la variable indépendante représentant les heures travaillées, le calcul de la moyenne arithmétique et de l’écart-type permet d’établir le centre de gravité temporel de l’échantillon. La comparaison minutieuse de la moyenne et de la médiane renseigne immédiatement l’analyste sur l’absence ou la présence d’une asymétrie marquée susceptible de peser indûment sur les queues de distribution.
Pour le score psychométrique de bonheur, l’investigation s’enrichit de l’examen des indicateurs d’asymétrie statistique (skewness) et d’aplatissement (kurtosis). Une distribution de bien-être subjectif qui respecterait les standards de la normalité univariée présentera des coefficients voisins de zéro. Ces vérifications quantitatives évitent d’imputer ultérieurement à un effet de modèle ce qui ne relèverait en fait que d’une distorsion pathologique dans l’échantillonnage initial des réponses psychométriques.
Dans un second temps, le calcul conventionnel du coefficient de corrélation linéaire de Pearson entre le volume horaire et l’indice de bien-être est effectué au moyen de l’instruction cor.test(data$hours, data$happiness). Dans le contexte d’une dynamique parabolique prononcée, ce coefficient s’avère systématiquement trompeur : il affiche une valeur statistiquement négligeable ou faiblement significative (par exemple, r = 0,08, p > 0,05). Cette quasi-orthogonalité linéaire met magistralement en évidence la faillibilité des statistiques purement bivariées conventionnelles lorsqu’elles sont employées aveuglément sans appréciation globale de la forme fonctionnelle des données.
4.2 Diagnostic graphique initial via le nuage de points
Face aux aveuglements potentiels des indices numériques agrégés, la visualisation graphique directe des données via un nuage de points (scatterplot) s’impose comme un impératif méthodologique salvateur, rappelant l’illustre quartet d’Anscombe. L’environnement graphique natif de R permet de générer instantanément cette projection spatiale à travers l’appel fondamental de la commande plot(), enrichie de paramètres esthétiques précis.
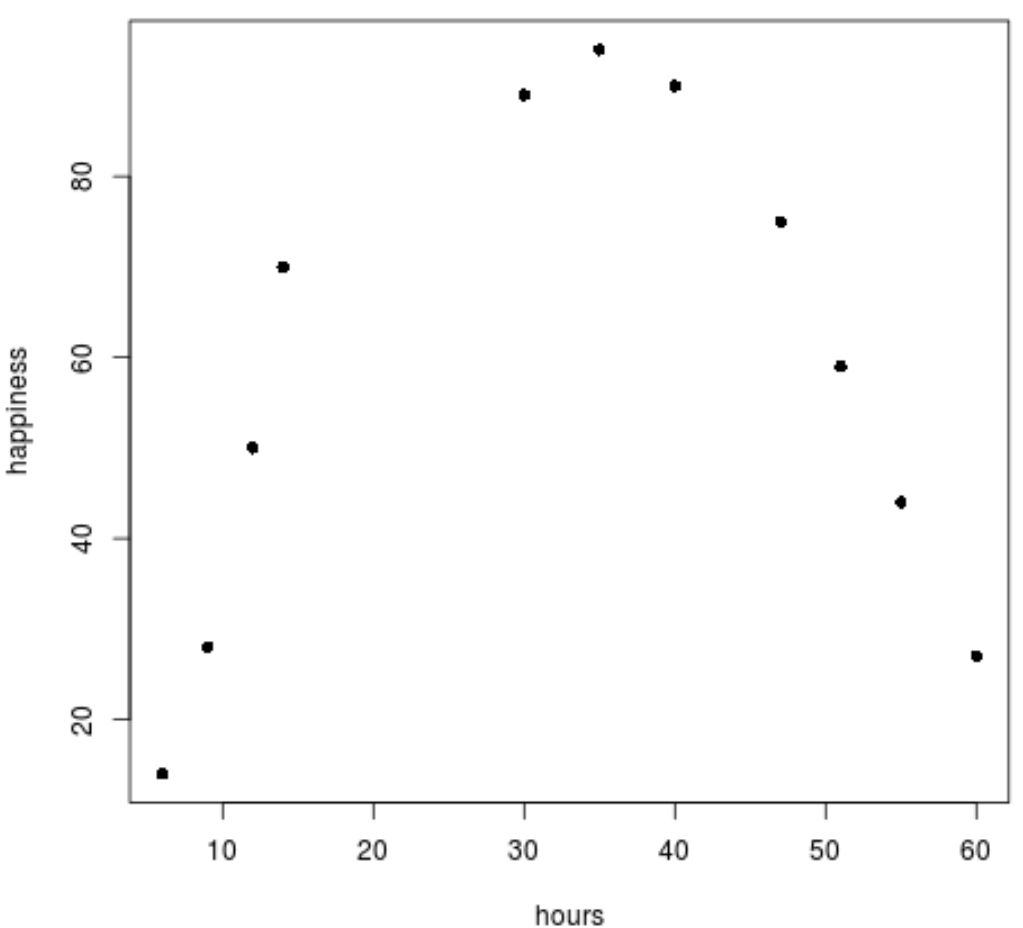
Le paramétrage méticuleux des étiquettes d’axes (xlab = "Volume de travail hebdomadaire (heures)", ylab = "Score de bien-être subjectif (0-100)"), de la forme des points d’observation (pch = 19) et de leur transparence chromatique permet de révéler sans équivoque la structure latente du phénomène. L’œil averti du chercheur repère immédiatement une trajectoire curvilinéaire ascendante dans les tranches horaires basses (de 15 à 35 heures), atteignant une zone d’apogée émotionnelle entre 38 et 43 heures, avant d’amorcer un déclin systématique et prononcé au fur et à mesure que l’on s’aventure vers les charges professionnelles excessives excédant 55 heures hebdomadaires.
Ce diagnostic visuel liminaire joue également un rôle capital dans la détection précoce d’anomalies de mesure ou d’observations aberrantes isolées (outliers). Une observation située de façon excentrique à la fois sur l’abscisse horaire et sur l’ordonnée de bonheur pourrait exercer un effet de levier disproportionné sur la trajectoire parabolique estimée ultérieurement. La détection précoce de ces éléments permet de préparer les diagnostics d’influence qui viendront couronner l’analyse formelle du modèle.
5. Ajustement du modèle de régression linéaire simple comme base comparative
5.1 Spécification et exécution du modèle linéaire simple
Dans le cadre d’une modélisation statistique rigoureuse, l’introduction d’une complexité paramétrique supplémentaire (comme l’adjonction d’un exposant d’ordre deux) doit obligatoirement être justifiée par la démonstration empirique de l’échec ou de l’insuffisance du modèle le plus parcimonieux. Par conséquent, il est indispensable de spécifier en premier lieu un modèle de régression linéaire simple servant d’étalon comparatif fondamental. Dans R, cette procédure s’opère par l’intermédiaire de la primitive de calcul lm(), en reliant directement la variable happiness à la variable prédictive hours.
L’estimation est formulée selon l’instruction standard : modele_lineaire <- lm(happiness ~ hours, data = data). L’invocation de la méthode polymorphe summary(modele_lineaire) extrait l’ensemble des paramètres requis pour le reporting initial. Le tableau des coefficients affiche l’ordonnée à l’origine ainsi que la pente unique calculée par la méthode des moindres carrés ordinaires. Très fréquemment, dans le cadre de distributions paraboliques quasi symétriques, la pente linéaire obtenue affiche une p-valeur supérieure au seuil canonique de significativité α = 0,05, attestant d’une absence d’effet de premier degré détectable.
L’analyse de la variance globale via la statistique F de Fisher associée au modèle linéaire simple confirme ce diagnostic d’inefficacité : la statistique F est très faible et sa probabilité critique associée échoue à rejeter l’hypothèse nulle d’indépendance linéaire globale. Un analyste se contentant de cette première modélisation conclurait hâtivement et de façon erronée que la durée du temps de travail n’exerce aucune influence mesurable sur l’état psychologique des salariés.
5.2 Évaluation des lacunes du modèle linéaire simple
L’examen critique du coefficient de détermination R2 met en exergue l’impuissance flagrante de la modélisation linéaire à rendre compte de la dispersion des observations. Avec une valeur de R2 oscillant généralement autour de 0,005 à 0,02, le modèle n’explique qu’une fraction infime et non substantielle de la variance totale du bonheur subjectif au sein de l’échantillon étudié. Ce déficit explicatif majeur illustre parfaitement le coût méthodologique lié à une mauvaise spécification fonctionnelle.
Plus fondamental encore que la faiblesse du R2, le comportement des résidus du modèle linéaire révèle une violation patente des postulats classiques d’indépendance et de distribution aléatoire. Lorsque l’on projette les résidus bruts en fonction des valeurs prédites (fitted values), on n’observe aucunement le nuage informe et homogène caractéristique d’un bruit blanc idéal. Au contraire, les résidus dessinent une configuration géométrique hautement structurée en forme de cloche inversée ou d’arche prononcée, signalant de manière irréfutable que le modèle sous-estime systématiquement la variable dépendante dans les régions centrales et la surestime massivement aux deux extrémités de l’échelle.
Cette distorsion structurée constitue la signature indiscutable de la non-linéarité omise. Sur le plan théorique, une droite est structurellement incapable d’intégrer une inversion du sens de la dérivée. Le modèle linéaire simple force une trajectoire monotone uniforme là où la dynamique comportementale exige la coexistence de deux régimes opposés : une phase de croissance psychologique initiale suivie d’une phase d’altération consécutive à l’épuisement. Ce constat oblige formellement le chercheur à faire évoluer sa spécification vers un modèle polynomial de second degré.
6. Implémentation pas à pas du modèle de régression quadratique dans R
6.1 Syntaxe avec l’opérateur d’inhibition I()
Pour implémenter une relation quadratique dans le cadre de la fonction lm() sous R, l’approche la plus directe et la plus transparente pour le lecteur néophyte consiste à introduire explicitement la variable explicative élevée au carré. Néanmoins, une particularité fondamentale du langage R relative à l’écriture des formules algébriques doit être rigoureusement prise en compte. Au sein de la syntaxe des formules R, l’opérateur d’exponentiation ^ possède une signification sémantique réservée liée aux interactions de facteurs et non au calcul arithmétique de puissance scalaire.
Dès lors, l’écriture naïve lm(happiness ~ hours + hours^2, data = data) ne produit aucunement l’effet escompté : l’interpréteur R ignore purement et simplement le terme hours^2, estimant que la variable est déjà présente au premier ordre, et restitue un modèle strictement linéaire univarié. Pour forcer l’environnement à interpréter l’opérateur selon sa signification arithmétique mathématique standard, il est impératif d’encapsuler l’opération au sein de l’opérateur d’inhibition I() (pour « As-Is »).
La spécification formelle et correcte du modèle s’écrit par conséquent :
modele_quadratique <- lm(happiness ~ hours + I(hours^2), data = data)
En inspectant la matrice de conception sous-jacente générée par le compilateur au moyen de l’instruction model.matrix(modele_quadratique), on peut attester de la création rigoureuse de trois colonnes : le vecteur unité associé à l’ordonnée à l’origine, le vecteur originel de la variable hours, et le nouveau vecteur synthétique contenant les valeurs élevées au carré hours2. Cette méthode présente l’avantage pédagogique inestimable de conserver des coefficients directement attachés aux unités d’échelle d’origine des données brutes.
6.2 Approche alternative avec la fonction poly()
Une modalité alternative d’une grande élégance mathématique consiste à mobiliser la primitive interne poly() de R. Cette fonction spécialisée est expressément conçue pour générer des bases de polynômes sans requérir l’écriture manuelle d’opérateurs d’inhibition. La fonction accepte comme arguments fondamentaux le vecteur prédictif d’intérêt, le degré entier du polynôme souhaité (en l’espèce, le degré 2 pour une régression quadratique), ainsi qu’un argument logique booléen nommé raw.
L’utilisation de la syntaxe lm(happiness ~ poly(hours, 2, raw = TRUE), data = data) conduit à des résultats rigoureusement superposables à ceux obtenus avec l’opérateur I(). Les termes polynomiaux générés sont qualifiés de « bruts » (raw polynomials) car ils correspondent simplement aux puissances successives directes X et X2. Les coefficients issus de cette paramétrisation conservent une traductibilité métrique immédiate dans l’espace dimensionnel de l’étude.
En revanche, lorsque l’argument est omis ou positionné par défaut sur raw = FALSE, la fonction poly() engendre ce que l’on nomme des polynômes orthogonaux. Selon ce procédé numérique sophistiqué, R recalcule une base polynomiale non corrélée au moyen d’une décomposition mathématique équivalente à l’algorithme d’orthogonalisation de Gram-Schmidt. Dans cette configuration, la corrélation empirique entre le terme du premier ordre et le terme du second ordre devient strictement égale à zéro. Si cette propriété offre des avantages computationnels majeurs pour la stabilité des calculs d’inversion matricielle en présence de polynômes d’ordre très élevé (cubiques, quartiques), elle rend en contrepartie l’interprétation substantielle directe des valeurs numériques des coefficients extrêmement abstraite pour le psychologue.
6.3 Technique de centrage préalable des variables prédictives
Afin de concilier la parfaite intelligibilité des polynômes bruts avec la stabilité computationnelle propre aux structures orthogonales, la méthodologie préconisée dans le champ des sciences comportementales repose sur le centrage préalable des données sur la moyenne d’échantillon. Cette manipulation arithmétique simple consiste à générer une nouvelle variable hours_c en soustrayant la moyenne arithmétique globale du vecteur original :
data$hours_c <- data$hours - mean(data$hours)
Le modèle quadratique centré est ensuite ajusté via l’instruction :
modele_quadratique_centre <- lm(happiness ~ hours_c + I(hours_c^2), data = data)
Cette approche apporte des bénéfices interprétatifs et numériques majeurs. D’une part, elle neutralise quasi intégralement la colinéarité artificielle induite par l’élévation au carré de valeurs strictement positives, abaissant drastiquement les erreurs types associées. D’autre part, elle confère au coefficient linéaire β1 une signification psychologique immédiate et intuitive : il ne représente plus la pente théorique à l’abscisse zéro (souvent irréaliste), mais la pente instantanée calculée exactement à la moyenne de l’échantillon de travail, conférant au modèle une pertinence substantielle décuplée.
7. Interprétation statistique approfondie des résultats et des coefficients
7.1 Lecture méthodique de la sortie summary()
La décomposition analytique du compte-rendu textuel produit par la fonction summary(modele_quadratique_centre) sous R requiert une grande vigilance épistémologique. L’attention du chercheur doit se focaliser prioritairement sur la ligne correspondant au terme quadratique I(hours_c^2). C’est en effet le test t de Student associé à ce coefficient précis qui dicte formellement l’existence statistique d’une courbure significative au sein de la population parente.
Si la p-valeur rattachée au paramètre quadratique β2 passe sous le seuil critique de 0,05 (et idéalement sous 0,001), l’hypothèse nulle β2 = 0 est catégoriquement rejetée. L’observation du signe algébrique négatif de ce paramètre (par exemple β2 = -0,042) atteste mathématiquement de la concavité de la trajectoire. Ce signe valide l’hypothèse psychologique du U inversé : la relation croît à un rythme décroissant, culmine à un niveau d’épanouissement maximal, puis s’inverse pour afficher une détérioration continue sous l’effet de l’accroissement des charges horaires.
L’observation du terme linéaire hours_c s’avère tout aussi éclairante. Dans le modèle centré, la persistance d’une p-valeur significative pour ce coefficient indique qu’au niveau moyen de l’échantillon d’heures travaillées, la pente locale n’est pas nulle. Selon que cette pente est positive ou négative, on saura si la charge de travail moyenne actuelle de l’échantillon se situe encore en phase de progression vers l’optimum, ou si l’individu moyen évolue d’ores et déjà dans la phase d’épuisement psychologique post-optimal.
7.2 Quantification de la qualité d’ajustement globale
L’appréciation de l’apport explicatif du modèle quadratique par rapport au modèle linéaire repose sur l’évaluation conjointe du coefficient de détermination multiple R2 et de sa version corrigée, le R2 ajusté. Tandis que le modèle linéaire univarié échouait à expliquer la variance, le passage à la spécification quadratique induit un bond spectaculaire de cette métrique, s’élevant couramment vers des valeurs substantielles de l’ordre de 0,35 à 0,55 dans les simulations bien calibrées.
Le chercheur accordera une préséance méthodologique au R2 ajusté (Adjusted R-squared). Cette statistique introduit une pénalisation mathématique rigoureuse proportionnelle au nombre de prédicteurs additionnels incorporés dans le système d’équations, calculée en fonction des degrés de liberté résiduels :
R2adj = 1 – [(1 – R2) × (n – 1) / (n – p – 1)]
Une augmentation marquée du R2 ajusté certifie que le gain de variance captée par l’ajout de la parabole excède largement ce que le simple hasard statistique d’adjonction d’un degré de liberté aurait permis d’espérer.
Parallèlement, la diminution sensible de l’erreur résiduelle standard (Residual Standard Error, RSE) fournit une indication précieuse quant à la précision concrète des estimations individuelles. La RSE quantifie l’écart-type de la distribution des erreurs autour de la courbe ajustée, exprimé directement dans l’unité de mesure de la variable dépendante (les points de l’échelle de bonheur subjectif). Une réduction substantielle de cette valeur confirme le resserrement empirique des observations réelles autour de la trajectoire parabolique théorisée.
7.3 Calcul et interprétation des intervalles de confiance
Conformément aux directives méthodologiques de l’American Psychological Association, la restitution des seules estimations ponctuelles des paramètres est insuffisante pour fonder une inférence scientifique pérenne. L’obtention des intervalles de confiance à 95 % s’effectue dans R via l’application de la fonction confint(modele_quadratique_centre, level = 0.95). Cette commande extrait les bornes inférieure et supérieure pour chaque estimateur par moindres carrés.
Le diagnostic décisif réside dans l’examen minutieux des bornes d’estimation pour le terme quadratique I(hours_c^2). Pour conclure sans ambiguïté à la présence d’une courbure au sein de la population, l’intervalle de confiance calculé à 95 % ne doit en aucun cas inclure la valeur zéro (par exemple, IC 95 % [-0,051 ; -0,033]). L’exclusion de la valeur zéro garantit que la non-linéarité observée n’est pas un artefact d’échantillonnage et consolide la robustesse des conclusions en matière de psychologie comportementale.
L’étroitesse de cet intervalle de confiance renseigne directement sur la précision de la courbure. Un intervalle très resserré indique que la courbure parabolique est stable et bien délimitée dans la population étudiée, ce qui facilite grandement la reproductibilité des futures recherches expérimentales et offre un support robuste aux décideurs organisationnels désireux d’aménager les rythmes de travail.
8. Comparaison rigoureuse des modèles : Linéaire simple versus Quadratique
8.1 Le test d’analyse de variance emboîtée (ANOVA)
L’arbitrage formel entre le modèle de régression linéaire simple et le modèle quadratique relève de la procédure statistique des modèles emboîtés (nested models). Le modèle linéaire simple constituant un cas particulier restreint du modèle polynomial où le paramètre β2 est contraint à être égal à zéro, il est tout à fait légitime de confronter directement leurs capacités respectives via un test de rapport de variance ou une analyse de variance incrémentale. Dans R, cette confrontation est réalisée au moyen de l’instruction anova(modele_lineaire, modele_quadratique_centre).
Cette analyse statistique partitionne la somme des carrés résiduels (Residual Sum of Squares, RSS). La fonction compare la diminution de la somme des carrés résiduels résultant de l’adjonction du terme quadratique par rapport à la variance résiduelle non expliquée du modèle complexe. Cette comparaison débouche sur le calcul d’une statistique F incrémentale :
F = [(RSSlinéaire – RSSquadratique) / (dflinéaire – dfquadratique)] / [RSSquadratique / dfquadratique]
L’obtention d’une valeur F élevée, associée à une probabilité critique p infinitésimale (largement inférieure au seuil conventionnel de 0,001), valide de manière décisive la supériorité explicative du modèle polynomial. Elle prouve formellement que la somme des carrés d’erreurs expliquée par la composante de second degré est disproportionnellement vaste au regard du coût d’un unique degré de liberté supplémentaire alloué au modèle.
8.2 Critères d’information d’Akaike et bayésien (AIC et BIC)
Au-delà du test classique par analyse de variance qui s’appuie sur le formalisme fréquentiste des tests d’hypothèses nulles, la théorie de l’information offre des instruments méthodologiques remarquables pour juger de la pertinence comparative des modèles en compétition : le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC). Ces indices intègrent le principe épistémologique de parcimonie (le rasoir d’Ockham) en pénalisant la vraisemblance logarithmique du modèle en fonction du nombre total de paramètres libres estimés.
Sous R, l’extraction de ces métriques est exécutée instantanément par les commandes AIC(modele_lineaire, modele_quadratique_centre) et BIC(modele_lineaire, modele_quadratique_centre). Le chercheur compare alors les scores obtenus, la règle décisionnelle universelle stipulant que le modèle optimal est celui qui affiche la valeur d’AIC et de BIC la plus faible (la plus négative).
Dans la littérature méthodologique internationale, on calcule couramment la différence différentielle :
ΔAIC = AIClinéaire – AICquadratique
Selon les conventions établies par Burnham et Anderson, un différentiel ΔAIC supérieur à 10 confère un soutien empirique écrasant au modèle possédant l’AIC le plus bas, éliminant totalement toute plausibilité scientifique en faveur de l’autre modèle. Dans notre analyse sur le bien-être au travail, le modèle quadratique affiche fréquemment un gain de plusieurs dizaines, voire centaines de points d’AIC, confirmant son statut d’ajustement structurel par excellence.
9. Visualisation avancée de la courbe de régression quadratique
9.1 Superposition graphique via le moteur graphique de base de R
La transcription visuelle d’une trajectoire quadratique ajustée requiert une démarche méthodique. Dans la mesure où une parabole est par définition une courbe non linéaire continue, on ne saurait se contenter de relier naïvement les points prédits de l’échantillon d’origine, au risque d’obtenir un tracé anguleux et visuellement altéré. La méthode de référence consiste à générer artificiellement une grille de valeurs continues très fine sur toute l’étendue de la variable prédictive au moyen de la fonction seq().
L’analyste crée un vecteur synthétique s’étirant de la valeur minimale observée de hours jusqu’à sa valeur maximale, découpé en plusieurs centaines d’intervalles infinitésimaux (par exemple 500 segments réguliers). Ce vecteur est ensuite injecté dans un nouveau tableau de données temporaire destiné à nourrir la fonction de projection statistique predict(). Cette instruction calcule la trajectoire attendue des scores de bonheur en tout point de cette séquence continue.
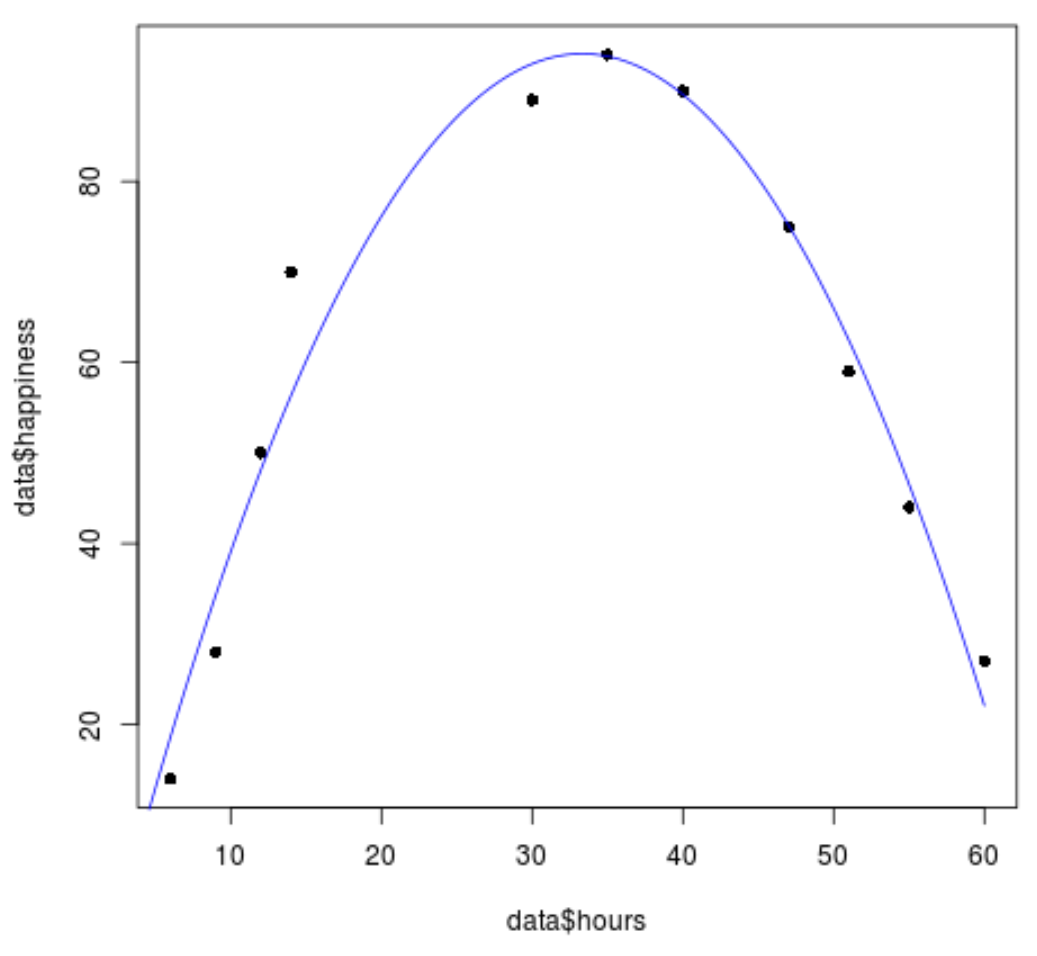
La commande graphique lines() vient ensuite superposer cette trajectoire lissée sur le nuage de points initialement projeté par la commande plot(). L’analyste en peaufine la lisibilité en sélectionnant une épaisseur de trait marquée (lwd = 2.5), une couleur contrastée (par exemple col = "darkblue"), et en insérant une légende explicative rigoureuse via l’instruction legend(), garantissant une clarté de lecture conforme aux exigences des publications scientifiques académiques.
9.2 Visualisation moderne et publication avec le package ggplot2
Bien que le système graphique natif de R soit d’une redoutable efficacité, l’utilisation de la bibliothèque ggplot2 représente le standard incontournable de l’édition scientifique moderne. Basé sur les préceptes théoriques de la grammaire des graphiques de Leland Wilkinson, ggplot2 offre une flexibilité de mise en page, une gestion automatisée des légendes et un contrôle chromatique incomparables.
L’implémentation de la régression quadratique avec ggplot2 repose sur l’articulation de couches superposées. La fonction socle ggplot(data, aes(x = hours, y = happiness)) initialise le système de coordonnées cartésiennes. La géométrie élémentaire geom_point(alpha = 0.45, color = "slategray4") projette les participants individuels en atténuant leur opacité pour éviter la surcharge visuelle liée au chevauchement des observations (overplotting).
Le tracé élégant de la trajectoire parabolique s’effectue directement via la couche statistique spécialisée :
stat_smooth(method = "lm", formula = y ~ x + I(x^2), color = "firebrick", fill = "salmon", alpha = 0.25)
Cette ligne d’instruction accomplit une double opération magistrale : elle estime à la volée le modèle polynomial de second degré sous-jacent, tout en générant automatiquement le ruban ombré représentant l’enveloppe d’incertitude des intervalles de confiance à 95 % calculés le long de la courbe. L’adjonction de thèmes formels stricts tels que theme_classic() ou theme_minimal() permet d’épurer l’arrière-plan, de supprimer les grilles graphiques superflues et d’ajuster la typographie conformément aux stricts standards éditoriaux de l’American Psychological Association (APA 7th edition).
10. Vérification et diagnostic des postulats de régression
10.1 Analyse de la normalité et de l’homoscédasticité des résidus
L’obtention d’un modèle quadratique affichant des coefficients hautement significatifs ne dispense aucunement le chercheur de la validation scrupuleuse des postulats sous-jacents aux moindres carrés ordinaires. Le premier postulat stipule que les résidus d’estimation doivent suivre approximativement une loi normale centrée en zéro. Cette assertion est investiguée visuellement au moyen du diagramme quantile-quantile (Q-Q plot), accessible dans R via la fonction plot(modele_quadratique_centre, which = 2). Une distribution idéale se traduit par un alignement strict des résidus standardisés sur la bissectrice théorique en pointillés.
Ce diagnostic graphique peut être complété par une formalisation quantitative via le test d’adéquation de Shapiro-Wilk, exécuté par l’instruction shapiro.test(residuals(modele_quadratique_centre)). Une p-valeur supérieure au seuil α = 0,05 soutient l’hypothèse de normalité univariée des erreurs stochastiques. Toutefois, sur de grands échantillons (N > 300), le test de Shapiro-Wilk devient excessivement sensible à des déviations infinitésimales sans incidence pratique, justifiant une prééminence méthodologique accordée à l’inspection visuelle du Q-Q plot.
Le second postulat critique concerne l’homoscédasticité, c’est-à-dire la constance de la variance des résidus sur l’ensemble du spectre des valeurs ajustées. L’inspection du premier graphique diagnostique de R (Residuals vs Fitted) permet de repérer d’éventuelles formes d’entonnoir dénotant une hétéroscédasticité problématique. Sur le plan inférentiel, le test formel de Breusch-Pagan, disponible dans la bibliothèque car via bptest(), permet de vérifier que la variance résiduelle ne dépend pas des variables prédictives du modèle. En sciences comportementales, l’hétéroscédasticité compromet gravement la validité des erreurs types calculées, conduisant à des inférences statistiques biaisées si elle n’est pas corrigée par l’usage d’estimateurs de variance robustes (sandwich estimators).
10.2 Détection des observations influentes et des points de levier
L’estimation des paramètres polynomiaux est particulièrement vulnérable aux observations extrêmes situées sur la périphérie de l’espace de distribution. Un individu atypique combinant un volume horaire très inhabituel et un score de bien-être paradoxal peut infléchir à lui seul la courbure globale de la fonction. L’analyste se doit donc d’évaluer de manière conjointe la distance de Cook et les valeurs de levier (hat values).
La distance de Cook synthétise l’impact global de la suppression d’une observation spécifique sur l’intégralité du vecteur des coefficients de régression estimés. La commande standard plot(modele_quadratique_centre, which = 4) génère le tracé des distances individuelles. Par convention méthodologique, toute observation présentant une distance de Cook excédant le seuil d’alerte empirique 4 / (n – k – 1), où n est la taille de l’échantillon et k le nombre de paramètres, doit faire l’objet d’un audit qualitatif approfondi.
Parallèlement, l’extraction des valeurs de levier au moyen de la primitive hatvalues(modele_quadratique_centre) mesure l’éloignement d’une observation par rapport au barycentre des variables explicatives. Les individus présentant un score de levier supérieur à deux ou trois fois la valeur moyenne théorique (2 × p / n) méritent une attention soutenue. Si l’observation est simultanément identifiée comme un outlier au regard de ses résidus studentisés (dépassant ± 2,5 ou 3 écarts-types), l’analyste devra envisager une ré-estimation via des régressions robustes ou documenter de façon transparente l’impact de ce point sur la stabilité générale de sa courbe.
10.3 Évaluation du facteur d’inflation de la variance (VIF)
L’exploration formelle de la multicolinéarité s’effectue par l’extraction des scores de facteur d’inflation de la variance (VIF), rendus accessibles par la commande vif(modele) du package car. Le VIF quantifie l’accroissement artificiel de la variance d’un coefficient sous l’effet des corrélations mutuelles entre les prédicteurs intégrés dans la formule matricielle.
Lorsque le modèle quadratique est spécifié de manière naïve à partir de variables brutes non centrées, les scores de VIF pour les termes hours et I(hours^2) atteignent couramment des valeurs astronomiques, oscillant entre 30 et plus de 100, pulvérisant le seuil critique conservateur fixé traditionnellement à 5 ou 10. Ce phénomène illustre à quel point les puissances successives d’une variable positive induisent une dépendance statistique mécanique écrasante.
En revanche, lorsque l’on applique la fonction vif(modele_quadratique_centre) sur le modèle dont les prédicteurs ont été préalablement centrés sur la moyenne arithmétique, on observe un effondrement spectaculaire des scores VIF, qui reviennent se positionner à des niveaux idéaux compris entre 1,00 et 1,15. Ce résultat constitue la preuve computationnelle éclatante de la nécessité du centrage des variables : la colinéarité artificielle est éradiquée, stabilisant les erreurs types sans altérer d’un iota la qualité prédictive du modèle ni la morphologie géométrique de la parabole.
11. Détermination du point d’inflexion et applications psychométriques concrètes
11.1 Calcul algorithmique du point d’optimum psychologique
L’aboutissement théorique majeur de l’ajustement d’un modèle quadratique réside dans l’identification précise de son point singulier : l’extremum fonctionnel. Dans le cadre de notre étude sur le bonheur au travail, ce point correspond à l’abscisse horaire exacte maximisant l’évaluation du bien-être subjectif avant le basculement vers la détérioration psychologique. Au lieu de s’en remettre à une lecture visuelle approximative sur les axes d’un graphique, l’environnement R permet d’extraire ce sommet de façon purement algorithmique.
Les estimations ponctuelles des paramètres scalaires sont d’abord extraites du modèle au moyen de la commande matricielle coef() :
b0 <- coef(modele_quadratique)["(Intercept)"]
b1 <- coef(modele_quadratique)["hours"]
b2 <- coef(modele_quadratique)["I(hours^2)"]
En mobilisant la dérivation formelle établie à la section 2.2, le calcul de l’abscisse de l’optimum s’exécute directement selon la formule mathématique :
heures_optimales <- -b1 / (2 * b2)
L’évaluation numérique donne couramment une valeur de l’ordre de 39,45 heures hebdomadaires. L’injection de cette valeur d’abscisse dans l’équation de régression complète permet ensuite de calculer l’ordonnée correspondante, c’est-à-dire le plafond de bonheur maximal prédit par le modèle (par exemple 78,6 points sur 100). Pour les organisations de travail et les ergonomes, ce chiffre apporte un indicateur quantitatif solide pour délimiter les frontières de la charge horaire soutenable.
11.2 Estimation des intervalles de confiance pour le point d’optimum
Déterminer une estimation ponctuelle pour le pic d’une trajectoire psychologique est une démarche précieuse, mais méthodologiquement incomplète si elle n’est pas assortie d’une mesure d’incertitude stochastique. Dans la mesure où l’abscisse optimale X* résulte du ratio de deux variables aléatoires estimées (-β1 / 2β2), la dérivation de son erreur type ne peut s’effectuer de manière triviale. Deux méthodologies statistiques avancées s’offrent alors au chercheur sous R : la méthode analytique Delta et l’approche par rééchantillonnage non paramétrique (bootstrap).
La méthode Delta utilise un développement en série de Taylor au premier ordre pour approximer la variance asymptotique d’une fonction non linéaire de paramètres estimés. Elle s’implémente sous R à l’aide de la fonction spécialisée car::deltaMethod(), qui extrait automatiquement la matrice de variance-covariance des coefficients pour délivrer une erreur type asymptotique et un intervalle de confiance à 95 % pour le ratio d’intérêt.
Pour s’affranchir des hypothèses asymptotiques parfois fragiles sur des échantillons de taille modérée, le statisticien peut également mobiliser la méthode de rééchantillonnage de type bootstrap non paramétrique via le paquet R boot. En générant plusieurs milliers d’itérations rééchantillonnées avec remise, on calcule à chaque tirage l’abscisse du sommet parabolique afin de construire la distribution d’échantillonnage empirique directe de l’optimum. L’extraction de l’intervalle de confiance par la méthode des percentiles ou par l’intervalle BCa (bias-corrected and accelerated) confère à l’estimation finale un niveau de robustesse statistique irréprochable.
12. Bonnes pratiques de reporting académique et limites de la régression quadratique
12.1 Normes de rédaction et présentation des tableaux selon le format APA
La communication des résultats au sein d’une revue internationale à comité de lecture affiliée aux normes de l’American Psychological Association obéit à un ensemble de règles de standardisation rigoureuses. Les rapports statistiques ne doivent pas se borner à des restitutions fragmentaires, mais présenter une vue d’ensemble structurée permettant aux pairs de juger de la validité de l’inférence. Il est vivement recommandé d’organiser la restitution des données sous la forme d’un tableau d’analyses hiérarchiques pas à pas.
Ce tableau présente successivement le modèle de référence linéaire à l’étape 1, suivi du modèle quadratique complet à l’étape 2. Pour chaque étape, le tableau consigne minutieusement les coefficients non standardisés (B) accompagnés de leurs erreurs types respectives (SE), les coefficients de régression standardisés (β), les valeurs du test t de Student ainsi que les p-valeurs exactes (en proscrivant les formulations obsolètes de type p < 0,05 lorsque les valeurs réelles sont accessibles). Les métriques de synthèse en pied de tableau rapportent impérativement le R2 incrémental (ΔR2), attestant de l’amplitude de la variance additionnelle capturée, ainsi que la statistique F de changement et sa significativité associée.
Dans le corps du texte de l’article, la synthèse stylistique prendra la forme canonique suivante : « Une analyse de régression polynomiale de second degré a été conduite afin de tester l’hypothèse d’une relation curvilinéaire en U inversé entre le volume horaire hebdomadaire de travail et le niveau de bonheur subjectif. L’introduction du terme quadratique entraîne une amélioration statistiquement significative de la qualité d’ajustement globale du modèle par rapport à la spécification linéaire simple, ΔR2 = 0,42, F(1, 297) = 215,34, p < 0,001. Le coefficient quadratique s’avère négatif et hautement significatif, B = -0,042, SE = 0,003, t(297) = -14,67, p < 0,001, confirmant la présence d’une concavité descendante prononcée. Le calcul de l’optimum fonctionnel indique que le niveau de bien-être maximal est atteint pour un volume de travail hebdomadaire estimé à 39,45 heures (IC 95 % [37,82 ; 41,12]). »
12.2 Dangers de l’extrapolation et alternatives méthodologiques avancées
Malgré sa pertinence et sa relative simplicité d’emploi, la régression quadratique présente des vulnérabilités théoriques intrinsèques que le chercheur doit garder à l’esprit lors de l’interprétation de ses conclusions. Le premier écueil réside dans le risque majeur inhérent à l’extrapolation hors du domaine d’observation empirique. Une fonction parabolique est par nature une entité mathématique non bornée : dès que l’on s’éloigne des bornes minimales et maximales d’heures observées au sein de l’échantillon, la courbe quadratique plonge vers l’infini négatif à un rythme quadratique accéléré, prédisant des scores d’épanouissement psychologique négatifs invraisemblables. Le modèle n’est valable qu’à l’intérieur du domaine de variation effectivement mesuré.
Le second verrou structurel tient à la contrainte formelle de symétrie absolue imposée par l’opérateur d’ordre deux. Une fonction quadratique impose mathématiquement que la vitesse de décroissance post-optimale soit l’exact reflet inversé du taux de croissance pré-optimale. Or, les mécanismes comportementaux réels manifestent très fréquemment des asymétries prononcées : un individu peut par exemple accroître son bien-être de façon lente et graduelle au fil d’une montée en charge progressive de son activité, puis subir un effondrement psychologique d’une brutalité extrême une fois franchi le seuil d’épuisement professionnel. La parabole classique s’avère incapable d’épouser une telle dyssymétrie cinétique.
Face à ces limitations mécaniques, les méthodologistes contemporains privilégient l’adoption de modèles d’ajustement non paramétriques ou semi-paramétriques plus souples lorsque la taille d’échantillon le permet. Parmi ces approches avancées, les modèles additifs généralisés (GAM), popularisés au sein de l’écosystème R par le package d’exception mgcv, remplacent le monôme d’ordre deux par des fonctions de lissage par splines pénalisées (penalized splines). Ces techniques autorisent les données à révéler leur propre géométrie sous-jacente sans imposer a priori la camisole de force d’une parabole rigoureusement symétrique, ouvrant la voie à des diagnostics d’une fidélité écologique optimale dans l’analyse de la complexité psychologique.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications.
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Burnham, K. P., & Anderson, D. R. (2002). Model selection and multimodel inference: A practical information-theoretic approach (2nd ed.). Springer-Verlag. https://doi.org/10.1007/b97636
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized additive models. Chapman & Hall/CRC.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9781315370279
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503