
La modélisation statistique constitue le socle fondamental sur lequel repose l’analyse quantitative contemporaine dans les sciences exactes, économiques, sociales et comportementales. Face à la prolifération de données multidimensionnelles, l’identification de structures relationnelles intelligibles demeure un défi permanent pour les chercheurs et les praticiens de la science des données. Parmi l’éventail des méthodologies paramétriques disponibles, l’analyse de régression linéaire simple s’impose comme la clé de voûte initiale permettant de formaliser, de tester et de quantifier l’influence exercée par une variable indépendante sur un phénomène d’intérêt continu.
Le recours à des environnements informatiques spécialisés et hautement fiables s’avère indispensable pour mener à bien ces investigations quantitatives complexes. Le logiciel SAS (Statistical Analysis System), reconnu à l’échelle internationale pour sa robustesse algorithmique, sa conformité aux exigences réglementaires les plus strictes et sa puissance d’analyse, offre une infrastructure d’exception pour le traitement de la régression. Au moyen de procédures dédiées telles que la procédure de régression linéaire classique, le chercheur dispose d’un écosystème exhaustif englobant aussi bien l’ajustement numérique des coefficients que l’exploration des diagnostics d’influence et la visualisation des distributions d’erreurs.
Le présent article propose une démarche méthodique, exhaustive et rigoureuse pour maîtriser l’art et la science de la régression linéaire simple sous SAS. Depuis les fondements mathématiques du critère d’optimalité de Gauss-Markov jusqu’à la rédaction académique des conclusions selon les normes de l’American Psychological Association, chaque étape sera disséquée avec précision. À travers un exemple empirique appliqué portant sur la relation entre le temps d’étude et la performance académique, ce guide offre une référence didactique complète pour transformer des données brutes en déductions statistiques irréfutables.
1. Introduction théorique à la régression linéaire simple et modélisation statistique
1.1 Définition et objectifs de la régression linéaire simple
La régression linéaire simple est une approche statistique paramétrique conçue pour modéliser la relation linéaire bivariée entre deux variables métriques quantitatives continues. D’un point de vue structural, cette démarche repose sur une différenciation stricte des rôles opérationnels dévolus aux entités étudiées. D’une part, la variable prédictive, traditionnellement désignée comme variable explicative, indépendante ou régresseur (notée X), est présumée porter l’information structurante ou agir comme source de fluctuation. D’autre part, la variable réponse, également qualifiée de variable dépendante, critère ou variable d’effet (notée Y), représente le phénomène dont la variabilité conditionnelle constitue l’objet principal de l’investigation empirique.
Sur le plan téléologique, la mise en œuvre d’une telle modélisation répond à une dualité d’objectifs fondamentaux en analyse de données. Le premier objectif relève de la prédiction statistique : il s’agit d’estimer avec une marge d’incertitude quantifiée la valeur conditionnelle attendue de la variable réponse pour une modalité spécifique observée ou projetée de la variable indépendante. Le second objectif concerne l’explication et la description théorique des relations associatives. Dans cette perspective, le modèle permet de disséquer la magnitude, l’orientation et la portée substantielle du lien qui unit les phénomènes observés. Toutefois, l’analyste rigoureux se doit de dissocier expressément la covariation mathématique de toute causalité ontologique, l’affirmation d’un lien de causalité exigeant un contrôle expérimental strict ou des designs quasi-expérimentaux spécifiques.
Dans l’arsenal méthodologique de l’analyse quantitative et de la psychométrie, la régression bivariée occupe une place névralgique. Elle constitue le cadre paradigmatique de transition entre la simple analyse de corrélation, purement symétrique et non directionnelle, et les architectures de modélisation plus complexes comme les régressions multiples, les analyses de covariance ou les systèmes d’équations structurelles. Sa maîtrise constitue une étape obligatoire pour quiconque souhaite explorer les dynamiques empiriques au sein de distributions réelles.
1.2 Formulation de l’équation du modèle et des paramètres
La structure formelle de la régression linéaire simple s’exprime au moyen d’une formulation mathématique postulée au niveau de la population générale, dont découle la fonction d’ajustement empirique calculée sur un échantillon représentatif de taille déterminée. Au niveau de la population, l’espérance conditionnelle de la réponse s’écrit traditionnellement sous la forme :
Y = β0 + β1X + ε
Dans cette formulation, β0 et β1 représentent les paramètres déterministes inconnus de la population, tandis que ε incarne la composante stochastique, c’est-à-dire le terme d’erreur aléatoire. Lorsque ce modèle est ajusté à des données observationnelles à l’aide des estimateurs d’échantillonnage b0 et b1, l’équation prédictive empirique de la valeur ajustée prend la forme canonique :
ŷ = b0 + b1x
L’ordonnée à l’origine, incarnée par le coefficient b0 (ou l’interception), désigne la valeur moyenne conditionnelle prédite pour la variable réponse Y lorsque la variable explicative X est rigoureusement égale à zéro. Bien que sa signification mathématique soit absolue, son interprétation phénoménologique demeure tributaire de l’ancrage empirique de l’étude. Si la valeur zéro n’appartient pas au domaine de définition opérationnel de la variable prédictive, ou si elle se révèle biologiquement ou conceptuellement absurde, l’ordonnée à l’origine doit être interprétée exclusivement comme une constante géométrique d’ajustement sans portée physique immédiate.
À l’inverse, la pente de régression représentée par le coefficient b1 capture le taux de variation marginal de la réponse. Elle quantifie mathématiquement le changement attendu de la valeur moyenne de Y consécutif à l’incrémentation d’une unité scalaire de la variable explicative X. Le signe de cette pente dicte la directionnalité de l’association, tandis que son amplitude absolue indique sa force de transmission. Enfin, l’introduction formelle du terme d’erreur résiduelle ε reflète l’impossibilité inhérente de capturer l’intégralité du réel : il agrège toutes les influences omises, les erreurs d’observation instrumentales et l’indétermination intrinsèque propre aux dynamiques empiriques.
1.3 Applications de la régression dans les sciences du comportement
Les sciences du comportement, la psychologie différentielle, les sciences de l’éducation et la sociologie quantitative font un usage intensif de la régression linéaire bivariée pour opérationnaliser des paradigmes théoriques complexes. Un champ d’application historique et particulièrement fécond réside dans l’analyse de la performance académique. Dans ces modélisations, le temps d’investissement cognitif ou le volume d’heures consacrées aux révisions pédagogiques est fréquemment opérationnalisé comme régresseur dans le but de prévoir le niveau d’acquisition des compétences, objectivé par les notes à des examens standardisés.
Parallèlement, la régression permet d’évaluer l’impact direct de variables affectives et cognitives, telles que l’anxiété évaluative, l’estime de soi scolaire ou les scores obtenus à des batteries de tests de mémoire de travail, sur l’efficience comportementale globale. La modélisation bivariée offre dans ce cadre une métrique standardisée permettant de vérifier si les variations d’une dimension psychologique donnée s’accompagnent de variations systématiques et prévisibles d’un indicateur de performance, posant ainsi les jalons préliminaires de programmes d’intervention ciblés.
Néanmoins, l’application de ce cadre mathématique aux sciences humaines impose une vigilance épistémologique permanente relative aux limites de l’inférence causale. L’identification d’une pente statistiquement significative entre une variable indépendante comportementale et une mesure de réponse ne saurait en aucun cas valider de manière univoque un schéma causal déterministe. Les risques de confusion induits par des variables dormantes non mesurées, la possibilité d’une causalité inversée ou encore l’existence de mécanismes médiateurs non spécifiés contraignent le chercheur à considérer l’ajustement linéaire comme une mise en évidence d’associations systématiques au sein d’un échantillon donné, plutôt que comme l’élucidation définitive d’un mécanisme de cause à effet.
2. Fondements mathématiques et méthode des moindres carrés ordinaires (MCO)
2.1 Principe d’optimisation des moindres carrés ordinaires
L’ajustement numérique d’une droite de régression linéaire à un nuage de points bi-dimensionnel repose très majoritairement sur le critère d’optimisation formulé par Carl Friedrich Gauss et Adrien-Marie Legendre : la méthode des moindres carrés ordinaires (MCO). Confronté à une pluralité infinie de trajectoires linéaires concevables à travers un ensemble d’observations, ce principe mathématique propose d’élire l’unique fonction pour laquelle la somme des carrés des erreurs résiduelles (SCE, ou Sum of Squared Errors) est rigoureusement minimisée sur l’ensemble de l’échantillon empirique.
L’erreur résiduelle, notée ei pour un individu i particulier, représente l’écart vertical observé entre la valeur empirique mesurée yi et la valeur théorique conditionnelle déduite de la droite postulée, soit ei = yi – ŷi. La fonction de coût quadratique à minimiser s’exprime donc sous la forme analytique :
S(b0, b1) = Σ (yi – (b0 + b1xi))2
Pour déterminer les estimateurs optimaux, le calcul différentiel est mobilisé en annulant simultanément les dérivées partielles de la fonction S par rapport aux paramètres b0 et b1. Cette résolution analytique conduit au système dit des équations normales. De ces équations découle l’expression fermée de la pente b1, qui s’avère être le rapport entre la covariance empirique des deux variables et la variance empirique de la variable explicative :
b1 = Σ((xi – x̄)(yi – ȳ)) / Σ(xi – x̄)2
Une fois la pente dérivée, l’estimateur de l’ordonnée à l’origine se calcule immédiatement afin d’assurer que la droite passe obligatoirement par le barycentre du nuage de points constitué des moyennes arithmétiques des variables, soit b0 = ȳ – b1x̄. Sous la validité des postulats classiques, le théorème de Gauss-Markov démontre de façon élégante que ces estimateurs possèdent la propriété d’être BLUE (Best Linear Unbiased Estimators) : parmi l’ensemble des estimateurs linéaires et sans biais, ils exhibent la variance d’échantillonnage minimale absolue.
2.2 Décomposition de la variance totale
L’évaluation quantitative de la capacité explicative du modèle de régression nécessite un partitionnement rigoureux de la variabilité globale de la variable réponse. Cette décomposition analytique, connue sous le nom d’identité de l’analyse de variance, repose sur la décomposition de l’écart total séparant chaque observation de la moyenne générale en deux composantes indépendantes et orthogonales : la déviation expliquée par le modèle prédictif et la déviation résiduelle inexpliquée.
Sur le plan algébrique, la somme totale des carrés (notée SST pour Total Sum of Squares) quantifie la dispersion intrinsèque des observations de la réponse autour de leur barycentre univarié :
SST = Σ (yi – ȳ)2
Cette dispersion totale se scinde parfaitement en deux termes additifs sous les hypothèses de la méthode des moindres carrés :
SST = SSM + SSE
La somme des carrés du modèle (SSM, ou Model Sum of Squares) représente la proportion de la variabilité globale directement prise en charge par la fonction d’ajustement linéaire : SSM = Σ (ŷi – ȳ)2. À l’opposé, la somme des carrés des erreurs résiduelles (SSE, ou Error Sum of Squares) mesure la variabilité résiduelle non captée : SSE = Σ (yi – ŷi)2.
Cette architecture arithmétique conduit directement à la définition formelle du coefficient de détermination, conventionnellement noté R2. Ce ratio normalisé s’exprime comme le rapport de la variance expliquée par le modèle à la variance totale du phénomène étudié :
R2 = SSM / SST = 1 – (SSE / SST)
Dans l’espace restreint d’un modèle bivarié simple, ce coefficient est strictement équivalent au carré du coefficient de corrélation linéaire de Pearson, matérialisant ainsi la continuité conceptuelle unissant l’association standard et la théorie de l’ajustement linéaire.
2.3 Postulats théoriques classiques du modèle linéaire
Pour que les estimations issues des moindres carrés ordinaires soient non seulement optimales au sens de Gauss-Markov, mais se prêtent également à une inférence statistique valide (calcul de tests d’hypothèses, d’intervalles de confiance et de seuils de significativité), plusieurs postulats théoriques fondamentaux doivent être scrupuleusement vérifiés sur la distribution conditionnelle des termes d’erreurs εi.
Le premier postulat exige la linéarité intrinsèque des paramètres : la relation entre l’espérance mathématique de la réponse et la variable prédictive doit être fidèlement représentable par une équation affine de premier degré. Le deuxième postulat concerne l’homoscédasticité, qui requiert que la variance conditionnelle des termes d’erreur demeure rigoureusement constante sur l’intégralité du continuum de la variable indépendante :
Var(εi | X = xi) = σ2 ∀ i
Si la dispersion des résidus s’accroît ou s’amenuise en fonction des valeurs du régresseur, le modèle souffre d’hétéroscédasticité, ce qui a pour conséquence directe de biaiser l’estimation des erreurs types associées aux paramètres, invalidant de fait les tests statistiques traditionnels.
Le troisième postulat fondamental impose l’indépendance mutuelle stricte des perturbations stochastiques : la covariance entre deux erreurs associées à des unités statistiques distinctes doit être identiquement nulle (Cov(εi, εj) = 0 pour tout i distinct de j). Ce critère exclut tout phénomène d’autocorrélation, situation fréquemment rencontrée dans les séries chronologiques ou les mesures longitudinales répétées. Enfin, le quatrième postulat pose la normalité distributionnelle conditionnelle des résidus :
εi ~ N(0, σ2)
Ce dernier postulat est absolument indispensable pour asseoir la validité exacte des distributions de Student et de Fisher mobilisées pour les tests d’inférence en situation de petits échantillons empiriques.
3. Préparation et structuration des données sous SAS (Étape 1)
3.1 Création programmatique du jeu de données via l’étape DATA
Dans l’environnement de programmation statistique SAS, la manipulation et la mise en forme initiale des données s’exécutent au moyen d’un bloc instructionnel hautement optimisé désigné sous l’appellation d’étape DATA. Cette étape constitue la matrice fondatrice dans laquelle les variables sont déclarées, typées, transformées et stockées dans une table matricielle propriétaire résidente en mémoire vive ou inscrite au sein d’une bibliothèque permanente sur disque dur.
La conception programmatique d’un jeu de données s’initie par l’instruction déclarative DATA nom_de_la_table;, qui instancie l’objet vectoriel dans l’environnement de travail immédiat. L’instruction subséquente INPUT joue un rôle déterminant en configurant le pointeur de lecture du compilateur : elle précise séquentiellement l’intitulé et la nature des dimensions analytiques. Dans le contexte d’une modélisation bivariée, on définira traditionnellement une variable explicative et une variable dépendante, séparées par un espacement régulier.
Pour injecter directement des relevés empiriques bruts sans recourir à l’importation de fichiers délimités externes, l’instruction DATALINES; (ou son équivalent historique CARDS;) signale au moteur d’exécution que les lignes textuelles suivantes constituent les enregistrements matriciels eux-mêmes. Le flux de saisie se conclut de manière canonique par une ligne contenant un unique point-virgule, scellant la fin des données brutes, immédiatement suivie de l’instruction impérative RUN;. Cette dernière déclenche la compilation immédiate de l’étape DATA et l’écriture définitive du jeu d’observations dans l’espace de stockage alloué.
3.2 Exemple appliqué : heures d’étude et scores aux examens
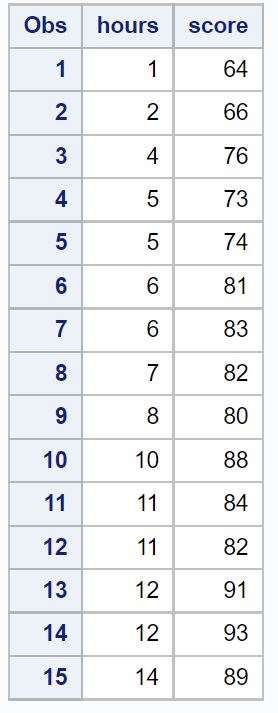
Afin de concrétiser le déploiement opérationnel d’une régression linéaire sous SAS, nous formalisons un scénario empirique issu des sciences de l’éducation. L’investigation cherche à évaluer l’intensité avec laquelle le volume d’heures individuelles de révision consenties par un panel d’étudiants permet d’anticiper la note chiffrée finale obtenue lors d’une épreuve standardisée d’évaluation des compétences. L’échantillon est composé de quinze observations distinctes (N = 15), chaque paire observationnelle associant une valeur continue d’heures à un score académique calibré sur une échelle de 0 à 100.
La structuration programmatique de cet ensemble s’effectue au sein d’une étape DATA nommée Academie. Il convient de s’assurer que les deux variables manipulées, à savoir Heures et Score, soient implicitement reconnues comme des variables quantitatives continues de format numérique standard par SAS. De surcroît, le respect des standards de programmation analytique impose l’adjonction de métadonnées sémantiques claires par le truchement de l’instruction LABEL. Ces étiquettes textuelles descriptives permettront d’enrichir l’ensemble des sorties tabulaires et des graphiques générés ultérieurement en évitant toute ambiguïté terminologique.
L’implémentation algorithmique se présente sous la forme structurée suivante :
DATA Academie;
INPUT Heures Score;
LABEL Heures = ‘Volume de révision (en heures)’
Score = ‘Note finale obtenue (sur 100)’;
DATALINES;
2.5 58
3.0 62
4.2 68
4.5 65
5.0 72
5.8 75
6.1 71
6.9 80
7.3 84
8.0 82
8.5 89
9.1 87
9.8 93
10.2 91
11.0 96
;
RUN;
Ce jeu de données calibré exhibe une relation positive cohérente tout en incorporant les fluctuations stochastiques caractéristiques des données observationnelles humaines réelles.
3.3 Validation de l’intégrité de la table avec la procédure PROC PRINT
Préalablement à toute démarche de modélisation mathématique formelle, une inspection scrupuleuse de l’intégrité physique du jeu de données constitue un impératif méthodologique élémentaire. Des erreurs de transcription matérielle, la présence inopinée de caractères alphabétiques au sein d’une colonne numérique ou la génération accidentelle de données manquantes (missing values) sont susceptibles de compromettre l’estimation matricielle de Gauss-Markov.
L’outil fondamental dédié à cette validation sous SAS est la procédure PROC PRINT. Son exécution permet d’afficher dans l’interface de restitution l’intégralité du tableau de données compilé. Afin de maximiser la clarté et d’épurer la sortie de colonnes accessoires non nécessaires, l’adjonction de l’option NOOBS est préconisée : elle neutralise l’affichage systématique de la colonne d’indexation interne des numéros d’observation générée par le système.
Parallèlement, l’instruction de restriction VAR permet d’énumérer spécifiquement les dimensions soumises à la vérification visuelle. La syntaxe opérationnelle s’exprime ainsi :
PROC PRINT DATA=Academie NOOBS;
VAR Heures Score;
RUN;
L’inspection du journal d’exécution (le SAS Log) parallèlement à la consultation de la sortie générée permet de confirmer que les quinze observations ont été convenablement ingérées, qu’aucune donnée n’est traitée comme absente et que le typage numérique est parfaitement conforme aux attentes statistiques.
4. Exploration préliminaire et vérification descriptive des données dans SAS
4.1 Calcul des statistiques descriptives univariées avec PROC MEANS
L’exploration analytique préliminaire constitue une exigence incontournable avant tout travail d’estimation paramétrique. Il est indispensable de cartographier avec minutie les caractéristiques distributionnelles propres à chaque variable prise isolément afin de situer leurs ordres de grandeur, leurs indices de tendance centrale et l’ampleur de leur variabilité intrinsèque. La procédure PROC MEANS constitue l’outil de référence pour exécuter rapidement cette synthèse descriptive sous SAS.
Par défaut, l’instruction PROC MEANS génère les effectifs non manquants, la moyenne arithmétique, l’écart-type, ainsi que les valeurs minimale et maximale. Toutefois, pour approfondir l’évaluation de la morphologie distributionnelle, il est hautement pertinent d’adjoindre des options explicites demandant l’extraction de la médiane, de la variance, de l’étendue interquartile (IQR) ainsi que des coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). La commande programmatique s’articule comme suit :
PROC MEANS DATA=Academie N MEAN MEDIAN STD VAR QRANGE SKEWNESS KURTOSIS;
VAR Heures Score;
RUN;
L’examen des écarts relatifs entre la moyenne et la médiane constitue une indication immédiate sur l’éventuelle présence d’une asymétrie de distribution. Une concordance étroite entre ces deux métriques atteste d’une symétrie globale favorable, garantissant que des valeurs aberrantes univariées n’exercent pas une distorsion préalable sur le barycentre de l’échantillon empirique.
4.2 Analyse de corrélation bivariée avec PROC CORR
Une fois la distribution marginale de chaque dimension examinée, l’évaluation du degré d’association linéaire conjointe entre le prédicteur et le critère s’impose. La procédure PROC CORR est expressément conçue pour quantifier la force et la direction de cette covariance standardisée en calculant le coefficient de corrélation produit-moment de Pearson (noté r). Elle permet de sonder empiriquement l’hypothèse de liaison avant de figer une structure directionnelle d’asymétrie propre à la régression.
L’appel de la procédure se formalise de la manière suivante :
PROC CORR DATA=Academie PEARSON;
VAR Heures;
WITH Score;
RUN;
L’instruction VAR spécifie le vecteur explicatif tandis que l’instruction WITH isole la dimension dépendante, structurant ainsi la matrice de corrélation sous une forme rectangulaire synthétique. La table de sortie délivrée par SAS expose deux indicateurs fondamentaux : la valeur ponctuelle de la corrélation r, bornée dans l’intervalle canonique [-1 ; +1], et la probabilité critique bilatérale (p-value) associée au test de nullité de la corrélation dans la population (H0 : ρ = 0).
L’obtention d’un coefficient r positif d’une magnitude élevée (par exemple r > 0,90) assorti d’une p-valeur très nettement inférieure au seuil de significativité conventionnel (α = 0,05) confirme l’existence d’une association linéaire empirique robuste. Ce résultat fournit une justification méthodologique solide pour poursuivre vers la phase de modélisation mathématique approfondie par la méthode des moindres carrés.
4.3 Visualisation préliminaire par nuage de points avec PROC SGPLOT
En dépit de la rigueur des indicateurs numériques synthétiques, l’inspection optique directe des observations demeure irremplaçable. Le célèbre paradoxe du quartet d’Anscombe démontre de façon péremptoire que des structures de données radicalement hétérogènes (relations curvilignes, singularités extrêmes) peuvent engendrer des coefficients de Pearson rigoureusement identiques. Il est donc fondamental de générer un diagramme de dispersion (scatterplot) afin de confronter l’hypothèse de linéarité à la géométrie réelle du nuage de points.
Le système graphique moderne de SAS met à disposition la procédure PROC SGPLOT, dont l’élégance et la précision typographique répondent aux plus hauts standards de l’édition scientifique. La production d’un nuage de points élémentaire fait appel à l’instruction vectorielle SCATTER, reliant les coordonnées d’abscisse et d’ordonnée :
PROC SGPLOT DATA=Academie;
SCATTER X=Heures Y=Score / MARKERATTRS=(SYMBOL=CircleFilled SIZE=9 COLOR=CX1F77B4);
XAXIS GRID LABEL= »Volume de révision hebdomadaire (Heures) »;
YAXIS GRID LABEL= »Score à l’évaluation standardisée »;
RUN;
L’examen visuel du graphique permet de valider trois aspects décisifs : la progression monotone globalement rectiligne des points, l’absence apparente de courbure asymptotique ou quadratique pouvant exiger une transformation non linéaire préalable (logarithmique ou polynomiale), et l’absence d’observations isolées situées à une distance critique de la trajectoire dominante du nuage.
5. Mise en œuvre du modèle de régression linéaire simple avec PROC REG (Étape 2)
5.1 Structure syntaxique fondamentale de PROC REG
La procédure PROC REG constitue le moteur algorithmique historique et fondamental développé par SAS pour l’estimation des modèles de régression par la méthode des moindres carrés ordinaires. D’une grande puissance conceptuelle, cette procédure bénéficie d’une conception modulaire hautement optimisée, capable de traiter aussi bien des équations univariées que des systèmes complexes d’équations multivariées avec contraintes linéaires.
La mise en œuvre canonique de la procédure repose sur une architecture syntaxique épurée mais strictement normée. Le bloc s’ouvre par la déclaration PROC REG DATA=nom_de_table; qui assigne la source de données matricielle. Le cœur opérationnel réside ensuite dans l’instruction impérative MODEL, au sein de laquelle la relation fonctionnelle asymétrique est stipulée sous la forme conventionnelle Variable_Reponse = Variable_Explicative. Contrairement à de nombreuses procédures SAS conventionnelles qui se terminent simplement par l’instruction RUN;, PROC REG est une procédure interactive : elle demeure active en mémoire pour accepter des commandes subséquentes tant qu’une instruction explicite QUIT; n’a pas été soumise au compilateur.
La formulation élémentaire pour notre cas d’étude académique se rédige par conséquent de la manière suivante :
PROC REG DATA=Academie;
MODEL Score = Heures;
RUN;
QUIT;
Cette commande commande le déclenchement immédiat du solveur de moindres carrés, la génération des équations normales, l’inversion matricielle associée et la construction de l’ensemble des tables analytiques de synthèse.
5.2 Options de commande essentielles de l’instruction MODEL
L’instruction MODEL de la procédure PROC REG dispose d’un ensemble particulièrement riche d’options de compilation que l’on place à la suite d’une barre oblique (/). Ces options permettent d’ordonner au moteur statistique de calculer et d’afficher des métriques diagnostiques spécialisées sans avoir à recourir à des étapes de programmation matricielle annexes.
L’une des options les plus fréquemment requises dans le contexte de la recherche académique et appliquée est l’option CLB (Confidence Limits for Parameters). Elle ordonne l’extraction directe des bornes inférieures et supérieures des intervalles de confiance à 95 % encadrant l’estimation ponctuelle de chaque paramètre du modèle (l’ordonnée à l’origine et la pente). Si l’investigateur souhaite modifier le seuil de confiance nominal, l’option conjointe ALPHA= permet de reconfigurer ce paramètre stochastique (par exemple, ALPHA=0.01 pour obtenir des intervalles de confiance calibrés à 99 %).
D’autres options diagnostiques méritent une mention particulière : l’option VIF calcule le facteur d’inflation de la variance, indispensable pour détecter la multicolinéarité dans les extensions multivariées, tandis que l’option COLLIN produit une analyse détaillée de décomposition des valeurs propres de la matrice d’information. Pour notre investigation univariée, l’appel étendu s’écrit formellement :
PROC REG DATA=Academie;
MODEL Score = Heures / CLB ALPHA=0.05;
RUN;
QUIT;
Cette spécification garantit la production des marges d’erreur inférentielles indispensables à une interprétation probante des paramètres structurels du modèle.
5.3 Gestion de l’environnement graphique avec ODS GRAPHICS
L’analyse moderne des données régularisées ne saurait se cantonner à la lecture exclusive de métriques scalaires insérées dans des tableaux de contingence. L’environnement SAS intègre de façon native le système ODS (Output Delivery System) Graphics, qui automatise la génération de visualisations de haute qualité typographique pour l’évaluation diagnostique des modèles linéaires.
Pour exploiter la plénitude des capacités visuelles de PROC REG, il est impératif d’activer explicitement le gestionnaire graphique préalablement à l’appel de la procédure en soumettant l’instruction globale ODS GRAPHICS ON;. Lorsque ce commutateur est armé, l’exécution de l’instruction MODEL engendre automatiquement la compilation d’un panneau diagnostique multipanneaux complet (le Fit Diagnostics Panel) ainsi que le graphique d’ajustement bivarié intégrant les bandes de confiance statistiques.
La bonne pratique de programmation SAS exige également de clore proprement le flux graphique après exécution en envoyant l’instruction symétrique ODS GRAPHICS OFF;, libérant ainsi les ressources graphiques allouées dans la session. L’architecture scripturale consolidée prend donc la forme :
ODS GRAPHICS ON;
PROC REG DATA=Academie;
MODEL Score = Heures / CLB;
RUN;
QUIT;
ODS GRAPHICS OFF;
Cette approche systématique garantit la production conjointe des tableaux de chiffres et des représentations graphiques vectorielles indispensables à la validation empirique du modèle.
6. Analyse approfondie des tables de sortie ODS de la procédure PROC REG
6.1 Interprétation du tableau d’analyse de la variance (ANOVA)
L’interface de restitution de la procédure PROC REG délivre en premier lieu le tableau d’analyse de la variance (ANOVA). Cette table formalise numériquement la décomposition orthogonale de la somme totale des carrés évoquée dans les fondements mathématiques. Elle structure la confrontation statistique entre l’hypothèse nulle d’absence totale d’effet linéaire du modèle dans la population générale (H0 : β1 = 0) et l’hypothèse alternative d’une contribution significative (H1 : β1 ≠ 0).
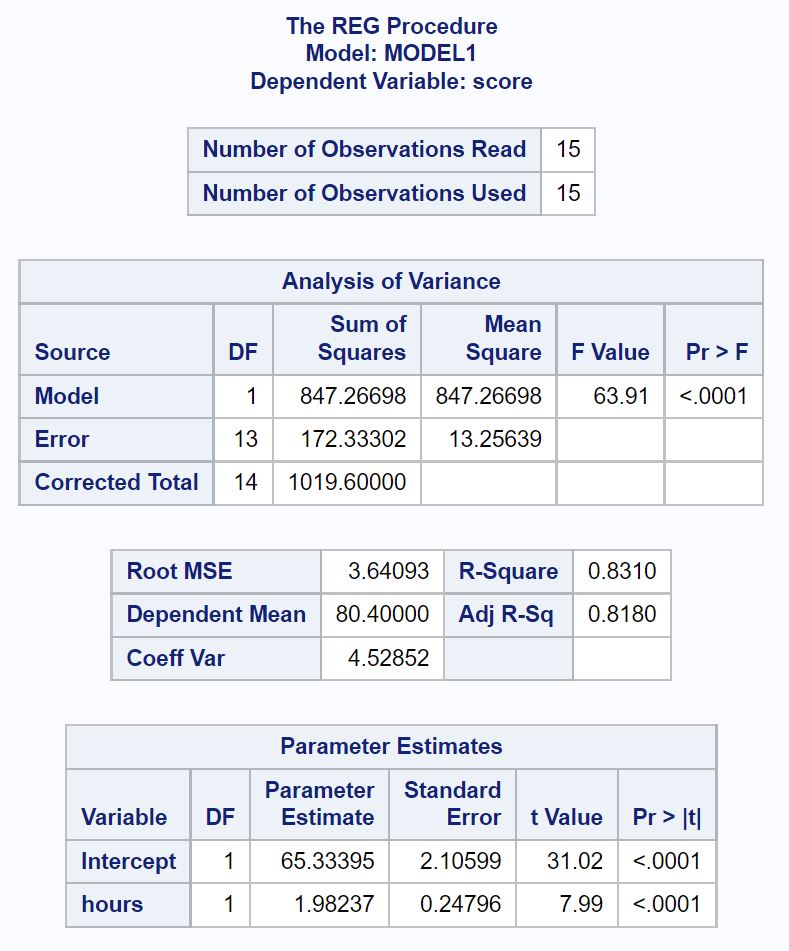
Le tableau se segmente en trois sources de variation fondamentales : le modèle (Model), l’erreur résiduelle (Error) et le total corrigé (Corrected Total). Pour chacune de ces sources, SAS détaille les degrés de liberté (DF), la somme des carrés (Sum of Squares) et les carrés moyens (Mean Square). Les degrés de liberté du modèle sont rigoureusement égaux au nombre de variables explicatives engagées (soit k = 1 en régression linéaire simple). Pour l’erreur résiduelle, ils s’établissent à n – k – 1, soit dans notre cas d’étude 15 – 1 – 1 = 13 degrés de liberté. La somme totale cumule n – 1 = 14 degrés de liberté.
Les carrés moyens résultent du ratio direct entre la somme des carrés correspondante et son degré de liberté associé. Le carré moyen de l’erreur (MSE pour Mean Square Error) représente l’estimateur sans biais de la variance résiduelle conditionnelle de la population, notée s2 ou σ2. La statistique F de Fisher constitue ensuite le pivot inférentiel : elle s’obtient par le rapport entre le carré moyen du modèle et le carré moyen de l’erreur (F = MSModel / MSE). La lecture se termine par l’inspection de la probabilité critique notée Pr > F. L’obtention d’une valeur p infinitésimale (notée usuellement < 0.0001) permet de rejeter sans équivoque l’hypothèse nulle globale et atteste que la proportion de variance expliquée par la droite d’ajustement ne relève pas d’une fluctuation d’échantillonnage aléatoire.
6.2 Lecture des statistiques globales d’ajustement du modèle
Immédiatement en dessous du bloc de décomposition de l’analyse de la variance, la procédure PROC REG produit un ensemble compact d’indicateurs synthétiques caractérisant l’efficience globale et l’échelle d’erreur de la droite ajustée. Ces métriques fournissent une vision opérationnelle de la précision intrinsèque du modèle au-delà de la seule significativité statistique inférentielle.
Le premier indicateur affiché est la racine carrée de l’erreur quadratique moyenne, désignée sous l’appellation Root MSE. Algébriquement, cette valeur correspond à l’écart-type de la distribution des résidus empiriques autour de la droite de régression :
Root MSE = √(MSE)
Exprimée strictement dans la même unité de mesure métrique que la variable dépendante d’origine (ici, des points sur l’échelle d’évaluation académique), cette grandeur renseigne directement l’analyste sur l’erreur absolue typique commise par le modèle lors de la prédiction de la performance d’un étudiant particulier.
La table restitue ensuite la moyenne arithmétique globale de la variable réponse (Dependent Mean), calculée sur l’ensemble de l’échantillon empirique (ȳ). Cette moyenne sert d’ancrage absolu pour calibrer l’indicateur subséquent : le coefficient de variation (Coeff Var). Ce dernier est un indice sans dimension exprimé sous la forme d’un pourcentage, défini comme le ratio du Root MSE à la moyenne de la variable dépendante multiplié par cent :
Coeff Var = (Root MSE / ȳ) × 100
Un coefficient de variation faible indique une excellente homogénéité relative de l’erreur au regard de l’échelle globale de la réponse étudiée.
6.3 Estimation des paramètres et tests de Student individuels
La section conclusive du compte-rendu textuel standard de PROC REG détaille les valeurs numériques attribuées aux paramètres structurels de la droite d’ajustement au sein de la table intitulée Parameter Estimates. Cette grille expose de façon disjonctive l’estimation de la constante (notée Intercept, représentative de b0) et le coefficient multiplicateur assigné à la variable indépendante (notée Heures, incarnant la pente b1).
Pour chaque paramètre, SAS fournit son estimation ponctuelle issue des moindres carrés (colonne Parameter Estimate), suivie de son erreur type empirique associée (colonne Standard Error). Cette erreur standard quantifie la variabilité asymptotique de l’estimateur si l’expérience venait à être répliquée une infinité de fois sur des échantillons aléatoires indépendants issus de la même population source. Le ratio direct entre l’estimation du paramètre et son erreur type d’échantillonnage engendre la statistique t de Student (colonne t Value) :
t = b1 / SE(b1)
Ce test évalue l’hypothèse de nullité univariée spécifique H0 : β1 = 0 au regard d’une loi de Student calibrée à n – 2 degrés de liberté. La colonne subséquente Pr > |t| consigne la probabilité critique bilatérale associée. Une valeur p inférieure au seuil critique de 5 % certifie que le paramètre est statistiquement dissociable de zéro. Si l’option CLB a été stipulée dans l’instruction de commande, la table s’enrichit de deux colonnes annexes encadrant chaque coefficient au sein d’un intervalle de confiance à 95 %, fournissant la plage de plausibilité stochastique des véritables paramètres de la population sous-jacente.
7. Évaluation de la qualité de l’ajustement et pertinence explicative
7.1 Le coefficient de détermination (R-Square)
L’évaluation de la performance explicative d’un modèle de régression linéaire simple s’appuie au premier chef sur l’examen du coefficient de détermination, restitué sous la désignation R-Square dans les sorties informatiques de la procédure PROC REG. Cet indicateur statistique fondamental exprime la fraction exacte de la variabilité globale de la variable dépendante qui se trouve statistiquement subsumée et expliquée par la variation linéaire du régresseur introduit dans l’équation.
Sur le plan distributionnel, le R2 est borné de façon rigide sur l’intervalle unitaire standard [0 ; 1]. Une valeur tendant vers 0 atteste de l’incapacité absolue de la variable prédictive à rendre compte des variations de la réponse dans le cadre d’un formalisme linéaire, tandis qu’une valeur convergeant vers 1 traduit un ajustement parfait où l’intégralité des points observationnels viendrait s’aligner sans la moindre dispersion résiduelle le long de la droite d’estimation. Dans le cadre précis de notre investigation pédagogique, l’obtention d’un R2 d’une magnitude élevée (par exemple 0.94) signale que 94 % de la variance des scores d’examen est attribuable au volume temporel consacré aux révisions, les 6 % restants renvoyant aux bruits résiduels et aux facteurs contextuels non modélisés.
La sortie logicielle de SAS fournit systématiquement une seconde métrique complémentaire : le coefficient de détermination ajusté (Adj R-Sq). Contrairement au R2 conventionnel, cet indice incorpore une pénalisation relative au nombre de paramètres introduits en rapport avec la taille de l’échantillon d’analyse :
R2ajusté = 1 – [(1 – R2)(n – 1) / (n – k – 1)]
Bien que cette correction mathématique s’avère particulièrement cruciale dans l’univers de la régression multiple pour neutraliser l’inflation mécanique artificielle de la variance expliquée lors de l’ajout de prédicteurs accessoires, son écartement vis-à-vis du R2 ordinaire en régression simple reflète principalement l’impact correctif induit par la relative exiguïté de l’échantillon d’observations.
7.2 Précision de l’estimation et dispersion résiduelle
L’appréciation experte d’une équation de régression ne saurait se limiter à la seule contemplation d’un coefficient de détermination flatteur. Il est impératif d’évaluer la précision brute de la modélisation à l’aune de la dispersion résiduelle effective captée par l’indicateur Root MSE. En effet, un R2 élevé peut coexister avec une erreur type d’estimation substantielle si la dispersion totale d’origine (SST) de la variable réponse s’avère initialement gigantesque dans la cohorte d’analyse.
La confrontation de la valeur numérique du Root MSE à l’amplitude de l’échelle métrique opérationnelle de la variable dépendante permet de matérialiser concrètement les incertitudes associées aux estimations individuelles. Si l’évaluation des connaissances s’échelonne sur une amplitude théorique de zéro à cent points, un Root MSE s’établissant aux alentours de 3.1 points atteste d’une acuité prédictive particulièrement fine, l’erreur de dispersion moyenne s’avérant très restreinte vis-à-vis de l’échelle d’étalonnage globale.
En outre, l’analyste méthodologiste doit garder à l’esprit une limitation inhérente au comportement formel du coefficient de détermination : la dépendance structurelle du R2 à l’égard de la variance de la variable indépendante échantillonnée. Lorsque la variabilité du prédicteur X est artificiellement restreinte au sein du protocole de collecte (phénomène de restriction de variance), la valeur calculée du R2 subit une atténuation mécanique drastique, sans que la véritable précision intrinsèque de la droite d’estimation ne soit altérée. L’évaluation de la qualité globale d’ajustement impose par conséquent une lecture croisée articulant le R2, le Root MSE et la variance d’échantillonnage du régresseur.
7.3 Taille d’effet et signification pratique des résultats
Une rigueur épistémologique accomplie impose d’opérer une distinction conceptuelle nette entre la significativité purement statistique d’un résultat (attestée par une valeur de p inférieure au seuil alpha) et sa pertinence substantielle ou clinique dans le monde réel. Un test de Student hautement significatif certifie uniquement que l’hypothèse nulle d’une pente strictement égale à zéro peut être rejetée avec un risque de première espèce maîtrisé ; il ne préjuge en rien de la portée matérielle de l’effet documenté.
Pour mesurer la taille d’effet standardisée au sens des conventions d’évaluation psychométrique formulées par Jacob Cohen, l’analyste convertit le coefficient de détermination en un coefficient f2 de Cohen, défini par l’expression algébrique :
f2 = R2 / (1 – R2)
Selon les grilles de lecture usuelles de Cohen, des valeurs de f2 franchissant respectivement les paliers de 0.02, 0.15 et 0.35 sont qualifiées d’effets faibles, moyens et larges. Une modélisation bivariée affichant un R2 de 0.94 engendre un f2 dépassant largement le seuil conventionnel des effets d’une magnitude exceptionnelle, confirmant l’impact déterminant de la variable explicative.
Enfin, la signification pratique s’incarne directement dans la lecture substantielle du coefficient de pente b1 non standardisé. Si l’ajustement empirique délivre une valeur paramétrique estimée à b1 = 4.38, cette grandeur numérique s’interprète de manière parfaitement concrète pour les acteurs de terrain : chaque heure additionnelle d’étude méthodique investie par un apprenant génère en moyenne statistique un gain direct de 4.38 points sur la note de l’évaluation finale. C’est cette quantification marginale intelligible qui confère au modèle sa véritable utilité décisionnelle et pragmatique.
8. Diagnostic rigoureux des postulats du modèle linéaire sous SAS
8.1 Évaluation de la normalité des résidus
La validité des conclusions inférentielles issues de l’application de PROC REG demeure subordonnée au respect rigoureux des hypothèses théoriques portant sur les erreurs résiduelles. L’évaluation de la distribution gaussienne des perturbations stochastiques constitue la première étape incontournable de la chaîne de validation diagnostique. Le non-respect de la normalité peut fausser la calibration des intervalles de confiance et invalider les probabilités critiques déduites des distributions t et F en contexte d’échantillons de taille modeste.
Le premier outil d’investigation est d’ordre visuel : il s’agit de l’examen minutieux du diagramme quantile-quantile (Q-Q plot) généré nativement par l’activation du système ODS Graphics. Sur ce graphique spécialisé, les quantiles de la distribution des résidus studentisés empiriques sont confrontés aux quantiles théoriques issus d’une loi normale standard. L’adéquation parfaite à la normalité se matérialise par l’alignement rectiligne des points le long de la diagonale de référence à 45 degrés. Tout décrochage structurel observable au niveau des queues de distribution signale une asymétrie ou un phénomène d’épaississement leptokurtique.
Afin d’étayer le jugement visuel par une démarche d’inférence statistique formelle, les résidus de l’équation doivent être exportés dans un jeu de données dédié à l’aide de l’instruction OUTPUT de PROC REG, puis soumis à la procédure PROC UNIVARIATE. Cette dernière applique les tests classiques d’ajustement distributionnel, notamment le test de Shapiro-Wilk (particulièrement performant lorsque N < 50) et le test de Kolmogorov-Smirnov. La séquence programmatique s’articule comme suit :
PROC REG DATA=Academie NOPRINT;
MODEL Score = Heures;
OUTPUT OUT=DiagnosticResidus RESIDUAL=ResidusBruts STUDENT=ResidusStudent;
RUN;
QUIT;
PROC UNIVARIATE DATA=DiagnosticResidus NORMAL;
VAR ResidusBruts;
RUN;
Une valeur p associée au test de Shapiro-Wilk supérieure au seuil α = 0.05 conduit au non-rejet de l’hypothèse de normalité, consolidant la légitimité des tests d’hypothèses dérivés du modèle.
8.2 Détection de l’hétéroscédasticité
L’hypothèse d’homoscédasticité stipule que la variabilité résiduelle ne doit présenter aucune dépendance fonctionnelle vis-à-vis du niveau de la variable prédictive ou des valeurs ajustées conditionnelles du modèle. Si la dispersion des perturbations s’amplifie ou se contracte le long de l’axe de projection, le modèle se trouve entaché d’hétéroscédasticité, entraînant une estimation inefficiente des coefficients et une sous-estimation systématique de leurs erreurs standards réelles.
Le diagnostic graphique élémentaire s’opère par l’analyse du graphique de dispersion confrontant les résidus standardisés sur l’axe des ordonnées aux valeurs prédites (ŷ) sur l’axe des abscisses. Une dispersion homoscédastique saine se caractérise par une configuration en bande horizontale aléatoire d’épaisseur constante, dépourvue de tout motif géométrique identifiable. À l’opposé, l’apparition d’une morphologie en entonnoir, en éventail ou en trompette constitue la signature visuelle patente d’une variance d’erreur hétérogène conditionnelle.
Sur le plan inférentiel, SAS propose des tests statistiques rigoureux d’homoscédasticité directement au sein de l’instruction MODEL grâce à l’adjonction de l’option SPEC. Cette dernière ordonne l’exécution formelle du test de White pour l’hétéroscédasticité générale :
PROC REG DATA=Academie;
MODEL Score = Heures / SPEC;
RUN;
QUIT;
Ce test évalue l’hypothèse nulle stipulant que la variance de l’erreur est strictement homoscédastique. Si la p-valeur issue de la statistique de White se révèle supérieure au seuil conventionnel de 0.05, l’investigateur est fondé à retenir le postulat de constance de la variance, validant ainsi la stabilité des inférences issues de l’estimateur des moindres carrés ordinaires.
8.3 Identification des observations influentes et aberrantes
La méthode des moindres carrés ordinaires étant intrinsèquement sensible aux points extrêmes en raison de la nature quadratique de sa fonction de pénalisation mathématique, l’examen de la topologie des résidus et des points de levier représente une étape diagnostique critique. Une observation singulière isolée peut exercer un effet de bascule disproportionné sur la trajectoire de la droite de régression et masquer la relation structurelle dominante.
Trois concepts mathématiques distincts et complémentaires sont mobilisés pour traquer ces anomalies dans SAS :
- Les résidus studentisés (RStudent) : Ils quantifient l’écart entre la valeur observée et la valeur prédite par un modèle estimé en omettant temporairement l’observation étudiée (technique du jackknife). Tout individu dont la valeur absolue du résidu RStudent excède le seuil empirique de |2| (ou |3| pour des échantillons massifs) doit être suspecté de constituer une valeur aberrante au niveau de la variable réponse.
- Le levier diagonal de la matrice chapeau (Hat Matrix Leverage, noté hii) : Cette grandeur mesure l’isolement géométrique d’une observation dans l’espace de la variable indépendante X par rapport au barycentre de l’échantillon. Un seuil de vigilance couramment retenu en pratique méthodologique est fixé à 2(p/n) ou 3(p/n), où p désigne le nombre total de paramètres estimés (p = 2 en régression simple) et n la taille d’échantillon.
- La distance de Cook (Cook’s D) : Métrique synthétique d’influence par excellence, la distance de Cook agrège simultanément le levier structural et la magnitude du résidu pour évaluer le déplacement global opéré sur l’ensemble du vecteur des prédictions si l’observation venait à être retranchée du calcul. Une valeur de Cook’s D excédant 4/n ou se rapprochant du seuil absolu de 1 signale un point hautement influent réclamant une inspection qualitative approfondie.
SAS compile l’ensemble de ces métriques directement dans la table de sortie d’instruction OUTPUT au moyen des mots-clés dédiés RSTUDENT=, H= et COOKD=, conférant à l’analyste les leviers algorithmiques pour assainir ses séries empiriques.
9. Visualisation graphique avancée des résultats de régression dans SAS
9.1 Tracé de la droite de régression avec PROC SGPLOT
La communication scientifique et l’analyse visuelle des résultats de modélisation linéaire bénéficient grandement d’une représentation graphique soignée de la droite ajustée superposée au nuage d’observations réelles. La procédure PROC SGPLOT propose une instruction hautement spécialisée nommée REG, conçue pour exécuter en arrière-plan l’ajustement linéaire des moindres carrés et tracer la droite sans nécessiter de calcul préalable dans une étape DATA annexe.
Cette instruction permet d’enrichir considérablement l’esthétique du tracé en offrant une personnalisation fine de la texture, de l’épaisseur et de la colorimétrie des segments, ainsi que la configuration géométrique des marqueurs observationnels. L’extrait de code suivant démontre la souplesse de cette procédure :
PROC SGPLOT DATA=Academie;
REG X=Heures Y=Score / LINEATTRS=(COLOR=CXD62728 THICKNESS=2 PATTERN=Solid)
MARKERATTRS=(COLOR=CX1F77B4 SYMBOL=CircleFilled SIZE=8);
XAXIS GRID LABEL= »Temps d’étude documenté (Heures) » VALUES=(2 TO 12 BY 2);
YAXIS GRID LABEL= »Résultat académique normalisé (Points) » VALUES=(50 TO 100 BY 10);
RUN;
Ce tracé confère immédiatement une lisibilité optimale au modèle en démontrant graphiquement l’adhérence intime unissant la trajectoire d’ajustement affine à la progression réelle des couples de données empiriques.
9.2 Représentation graphique des bandes de confiance et de prédiction
L’une des fonctionnalités les plus puissantes de l’instruction REG sous PROC SGPLOT réside dans sa capacité à superposer simultanément les deux typologies distinctes d’enveloppes d’incertitude stochastique : les bandes de confiance portant sur la droite moyenne conditionnelle et les limites de prédiction portant sur les observations ponctuelles futures.
Pour matérialiser ces frontières sur le graphique d’ajustement, l’utilisateur adjoint les options déclaratives CLM (Confidence Limits for Mean) et CLI (Confidence Limits for Individual) à la ligne d’instruction :
PROC SGPLOT DATA=Academie;
REG X=Heures Y=Score / CLM CLI
CLMKEY= »Confiance Moyenne 95% »
CLIKEY= »Prédiction Individuelle 95% »
LINEATTRS=(COLOR=CX1F77B4 THICKNESS=2);
XAXIS GRID LABEL= »Heures consacrées à la révision »;
YAXIS GRID LABEL= »Score à l’évaluation standardisée »;
RUN;
La morphologie visuelle de ces enveloppes apporte des enseignements géométriques fondamentaux. La bande CLM épouse la forme resserrée d’un sablier ou d’une hyperbole incurvée dont le point de constriction maximale coïncide rigoureusement avec le centre de gravité des données (x̄, ȳ). Cette forme évasée illustre graphiquement la dégradation progressive de la précision inférentielle au fur et à mesure que l’on s’écarte de la moyenne de l’échantillon empirique. Enveloppant largement cette première zone, la bande CLI dessine une marge beaucoup plus étendue, traduisant graphiquement le surplus d’incertitude induit par l’imprévisibilité stochastique individuelle inhérente à toute nouvelle mesure.
9.3 Construction d’un panneau multipanneaux de diagnostic des résidus
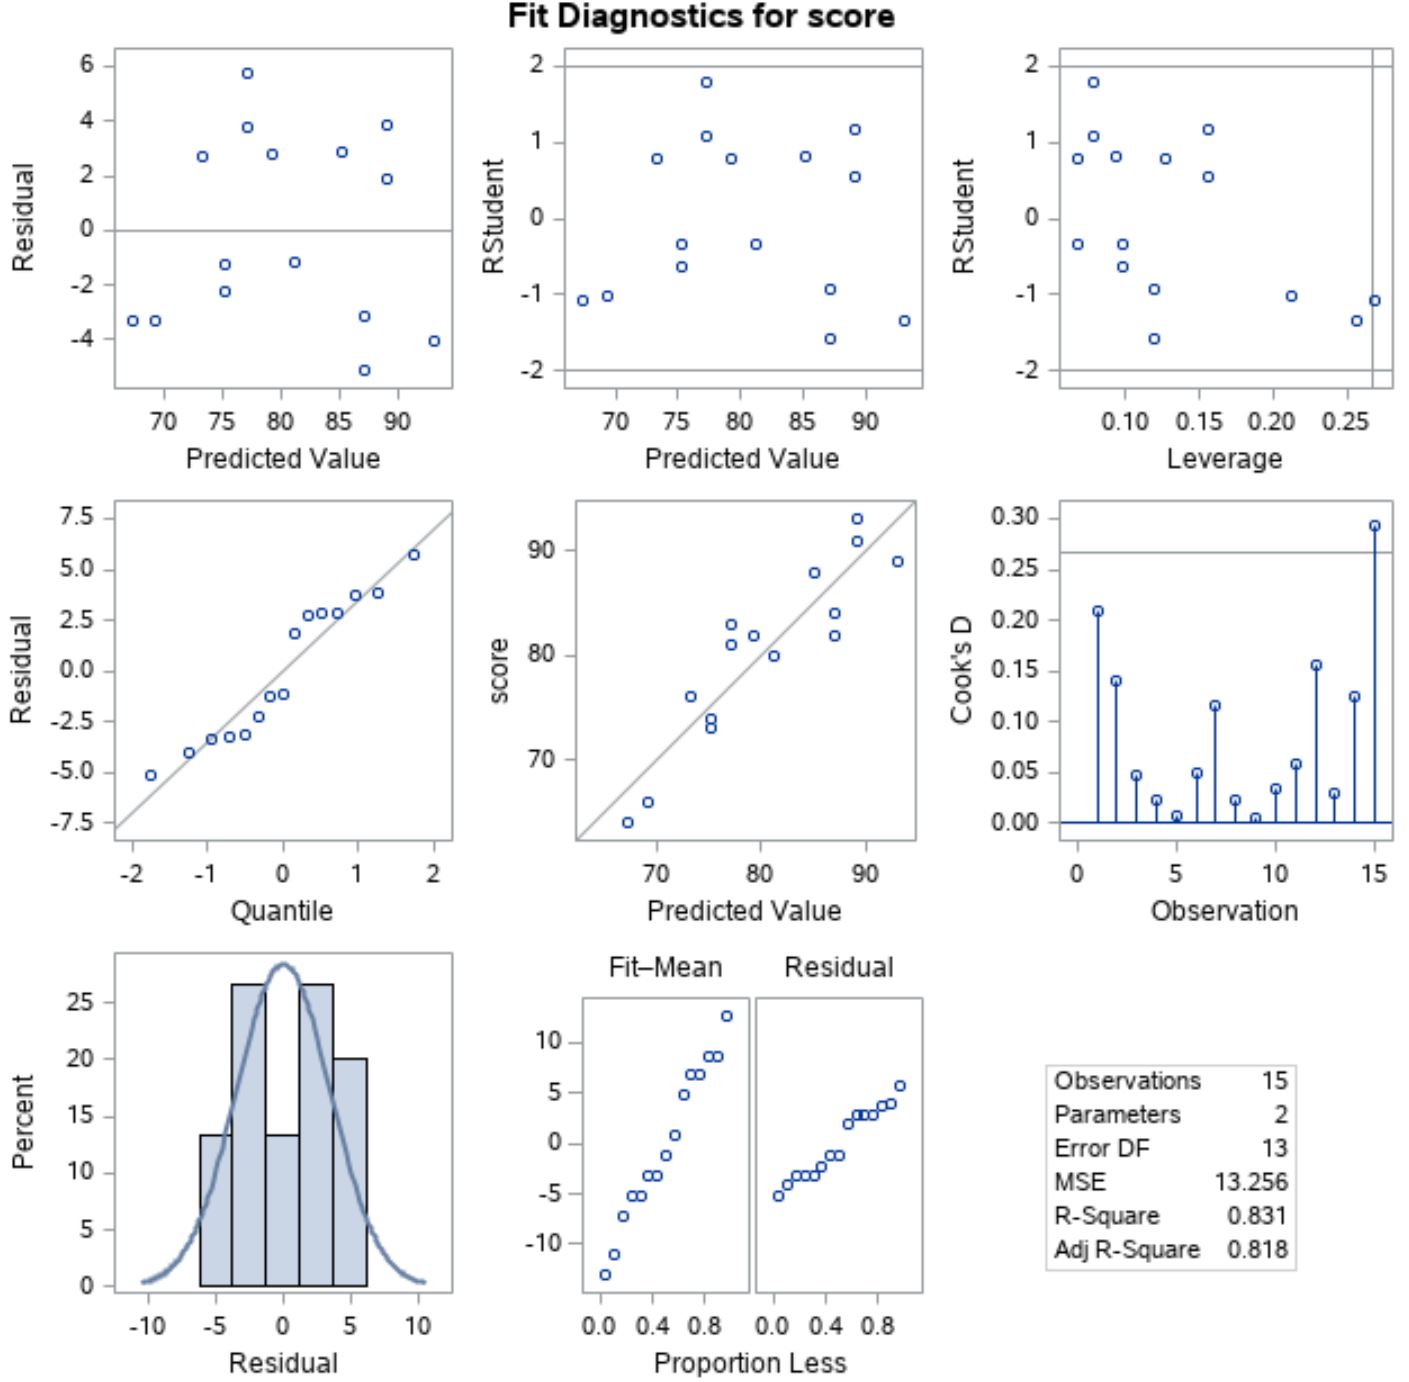
L’évaluation rigoureuse de la qualité d’un modèle linéaire repose sur l’inspection conjointe de multiples projections graphiques des résidus. Lorsque l’option ODS GRAPHICS ON est active, la procédure PROC REG produit automatiquement une planche diagnostique intégrée (Fit Diagnostics Panel) qui rassemble sur une unique grille visuelle l’intégralité des représentations indispensables à la validation du modèle.
Ce tableau matriciel synthétise une série de sous-graphiques critiques :
- Le graphique des résidus en fonction des valeurs prédites (permettant de sonder la linéarité et l’homoscédasticité).
- Le graphique des résidus studentisés en fonction du levier statistique hii (permettant d’isoler simultanément valeurs aberrantes et points d’effet de levier élevé).
- Le tracé de la distance de Cook en fonction du numéro séquentiel d’observation.
- Le diagramme quantile-quantile normal des résidus résumant l’ajustement distributionnel.
- L’histogramme des résidus calibré avec superposition conjointe de la courbe de densité normale théorique et d’une courbe d’estimation non paramétrique par noyau de densité (kernel density estimation).
L’exploitation de cette mosaïque standardisée garantit au chercheur une vue panoramique instantanée sur l’état de conformité de son équation aux hypothèses sous-jacentes de la modélisation statistique.
10. Estimation, prédiction et inférence pour de nouvelles observations
10.1 Différenciation conceptuelle entre intervalle de confiance et de prédiction
Une confusion récurrente observée dans la littérature statistique appliquée concerne la distinction fondamentale séparant l’estimation par intervalle de confiance de la moyenne conditionnelle et l’intervalle de prédiction assigné à une observation ponctuelle future. Bien que ces deux inférences partagent la même valeur centrale prédite ŷ0 = b0 + b1x0 pour une coordonnée x0 donnée, leurs erreurs types d’échantillonnage et leurs étendues d’incertitude obéissent à des réalités probabilistes profondément disparates.
L’intervalle de confiance (généré par l’option CLM) cible l’espérance mathématique de la réponse pour l’ensemble des individus de la population partageant la valeur x0, soit E(Y | X = x0). La variance associée à cette estimation reflète uniquement l’incertitude d’échantillonnage qui affecte la position de la droite elle-même :
Var(ŷ0) = s2 [ (1/n) + ((x0 – x̄)2 / Σ(xi – x̄)2) ]
Lorsque la taille d’échantillon n croît vers l’infini, cette incertitude d’estimation tend asymptotiquement vers zéro, l’intervalle se resserrant totalement autour de la droite véritable de la population.
À l’inverse, l’intervalle de prédiction (généré par l’option CLI) s’attache à borner la valeur stochastique que prendra une entité individuelle singulière isolée, notée Y0. Cet intervalle doit obligatoirement cumuler deux sources distinctes d’incertitude : l’erreur d’échantillonnage liée à la méconnaissance des paramètres vrais de la droite, et la variance résiduelle propre σ2 de la variable d’erreur ε0 propre à cet individu particulier :
Var(Y0 – ŷ0) = s2 [ 1 + (1/n) + ((x0 – x̄)2 / Σ(xi – x̄)2) ]
En conséquence immédiate, même dans l’hypothèse d’une taille d’échantillon infiniment grande où les paramètres seraient connus avec une exactitude absolue, l’intervalle de prédiction conserve irréductiblement une largeur minimale bornée par ± tcrit × s. Ignorer cette dualité expose l’investigateur à sous-estimer dramatiquement les risques opérationnels lors de l’application du modèle à des cas décisionnels individuels.
10.2 Implémentation technique de prédictions sous SAS
L’élaboration de projections conditionnelles pour de nouvelles valeurs de la variable indépendante ne figurant pas dans la cohorte d’apprentissage initiale repose sur une astuce de programmation particulièrement élégante au sein de l’environnement SAS. Cette technique consiste à exploiter le traitement sélectif des valeurs manquantes par les estimateurs matriciels de PROC REG.
La première phase implique la création d’un jeu de données d’appoint (nommé par exemple NouvellesObservations) contenant les nouvelles valeurs cibles du prédicteur Heures (par exemple, 6.5 heures et 12.0 heures), tout en assignant une valeur manquante (matérialisée par un point ‘.’) à la variable critère Score. Dans un second temps, cette table d’appoint est concaténée à la table empirique historique par le truchement d’une instruction SET au sein d’une étape DATA unifiée.
Lors de l’exécution subséquente de la procédure PROC REG, les observations affichant une valeur manquante pour la variable réponse sont automatiquement et scrupuleusement exclues de la minimisation des moindres carrés : l’estimation des coefficients b0 et b1 demeure donc mathématiquement pure de toute contamination. En revanche, le moteur algorithmique injecte ces coordonnées d’abscisse dans l’équation estimée afin de dériver les valeurs ajustées (P), ainsi que les bornes de confiance conditionnelle moyenne (LCLM, UCLM) et de prédiction individuelle (LCLI, UCLI) via l’instruction OUTPUT :
DATA NouvellesObservations;
INPUT Heures Score;
DATALINES;
6.5 .
12.0 .
;
RUN;
DATA TablePrevisionnelle;
SET Academie NouvellesObservations;
RUN;
PROC REG DATA=TablePrevisionnelle NOPRINT;
MODEL Score = Heures;
OUTPUT OUT=ResultatsPrevisionnels P=ScorePredit
LCLM=BorneInfCLM UCLM=BorneSupCLM
LCLI=BorneInfCLI UCLI=BorneSupCLI;
RUN;
QUIT;
PROC PRINT DATA=ResultatsPrevisionnels NOOBS;
WHERE Score IS MISSING;
VAR Heures ScorePredit BorneInfCLM BorneSupCLM BorneInfCLI BorneSupCLI;
RUN;
Cette approche standardisée garantit la production des intervalles prévisionnels rigoureux sans risque d’erreur d’implémentation algébrique manuelle.
10.3 Interprétation quantitative des prédictions empiriques
L’analyse des valeurs numériques extraites par la procédure d’inférence éclaire de façon éclatante la mécanique décisionnelle. Pour un apprenant documentant un temps de préparation de 6.5 heures (coordonnée s’inscrivant au cœur du domaine d’observation de l’échantillon d’étalonnage), la note moyenne prédite s’établit avec une marge d’incertitude moyenne très étroite (par exemple [76.8 ; 81.2] à 95 % de confiance), tandis que l’intervalle de prédiction individuel future balaye un spectre étendu à [71.5 ; 86.5]. L’acteur éducatif dispose ainsi d’un éventail réaliste pour calibrer son jugement pédagogique.
Cette démarche prévisionnelle confronte cependant l’analyste au risque majeur de l’extrapolation statistique hors du domaine de validité. Dans l’éventualité où l’on projetterait la performance d’un individu déclarant un investissement extrême de 25 heures de travail (valeur située très au-delà de la borne maximale observée dans la cohorte historique, fixée à 11 heures), l’application aveugle de l’équation prédictive linéaire engendrerait une note théorique supérieure à 150 points sur une échelle d’évaluation dont le plafond est borné à 100.
Cette incohérence manifeste illustre le principe épistémologique fondamental selon lequel la validité d’une fonction de régression affine n’est garantie que sur l’intervalle empirique convexe circonscrit par les observations effectives du régresseur. En dehors de cette enveloppe mesurée, le postulat de linéarité peut s’effondrer sous l’action de rendements décroissants, de phénomènes de saturation cognitive ou d’épuisement physiologique, transformant l’extrapolation non régulée en une dérive méthodologique majeure.
11. Procédures SAS complémentaires et approches alternatives
11.1 Ajustement via la procédure générale PROC GLM
Bien que la procédure PROC REG s’impose historiquement comme l’outil privilégié pour l’ajustement des moindres carrés sur des régresseurs continus, l’écosystème SAS propose une procédure de modélisation générale aux capacités remarquables : PROC GLM (General Linear Model). Conçue pour traiter l’ensemble des architectures de modèles linéaires généraux, elle transcende les clivages méthodologiques en unifiant la régression simple, la régression multiple, l’analyse de variance factorielle univariée (ANOVA) et l’analyse de covariance (ANCOVA).
La mise en œuvre de PROC GLM pour estimer une régression linéaire simple s’appuie sur une structure syntaxique très voisine de celle de PROC REG, à la différence notable que la table des estimations des paramètres individuels n’est pas produite par défaut et nécessite l’adjonction expresse de l’option SOLUTION sur l’instruction MODEL :
PROC GLM DATA=Academie;
MODEL Score = Heures / SOLUTION CLPARM;
RUN;
QUIT;
L’avantage décisif de maîtriser PROC GLM réside dans sa capacité structurelle à intégrer ultérieurement des variables indépendantes de nature qualitative polytomique sans nécessiter de recodage manuel préalable en variables indicatrices muettes (dummy variables), grâce à l’instruction déclarative CLASS. En outre, PROC GLM restitue la partition des sommes des carrés partielles sous la forme des sommes de Type I et Type III. En régression bivariée simple, ces deux typologies coïncident rigoureusement avec la SSM standard du tableau d’ANOVA, confirmant l’équivalence exacte des moteurs de résolution sous-jacents.
11.2 Régression robuste avec PROC ROBUSTREG
L’optimisation quadratique des moindres carrés ordinaires exhibe une vulnérabilité reconnue : son point de rupture statistique s’établit à 1/n, ce qui signifie qu’une seule observation contaminée par une erreur de saisie grossière ou un comportement aberratoire extrême suffit à faire basculer arbitrairement la trajectoire de la droite de régression. Pour pallier cette fragilité sans recourir à l’élagage arbitraire de données, SAS met à disposition la procédure spécialisée PROC ROBUSTREG.
Cette procédure sophistiquée implémente quatre grandes familles d’algorithmes de régression robuste : les M-estimateurs de Huber (efficaces contre les valeurs aberrantes en Y), les estimateurs à haute résistance comme les LTS (Least Trimmed Squares), les S-estimateurs et la méthode hybride des MM-estimateurs (introduite par Yohai), qui combine un point de rupture élevé de 50 % avec une haute efficacité asymptotique en présence d’erreurs gaussiennes. La syntaxe opérationnelle se déploie comme suit :
PROC ROBUSTREG DATA=Academie METHOD=MM(WF=Bisquare);
MODEL Score = Heures / DIAGNOSTICS;
RUN;
La comparaison terme à terme des coefficients de régression délivrés par PROC ROBUSTREG avec ceux issus de PROC REG constitue un test de robustesse particulièrement probant. Si les estimations de pente et de constante demeurent stables entre les deux procédures, le chercheur s’assure que ses déductions inférentielles ne sont aucunement le produit artificiel de données aberrantes dormantes.
11.3 Ajustement non paramétrique et lissage avec PROC LOESS
L’un des postulats cardinaux du modèle linéaire réside dans la linéarité intrinsèque de la fonction reliant le prédicteur à la réponse. Lorsque l’exploration préliminaire par nuage de points laisse subsister une ambiguïté quant à l’existence de courbures locales, de seuils de basculement ou d’asymptotes, l’analyste peut recourir à des techniques d’ajustement non paramétrique pour guider sa modélisation sans figer à l’avance une forme mathématique rigide. La procédure PROC LOESS (Local Regression) incarne l’outil par excellence de cette exploration adaptative.
La régression locale LOESS procède en ajustant séquentiellement des polynômes de bas degré pondérés au sein de voisinages glissants délimités autour de chaque point d’estimation. Les observations situées à proximité immédiate de la coordonnée cible reçoivent un poids prépondérant dans l’ajustement local, tandis que les observations périphériques voient leur influence décroître continûment. Le code SAS correspondant prend la forme suivante :
PROC LOESS DATA=Academie;
MODEL Score = Heures / SMOOTH=0.6;
RUN;
Le paramètre SMOOTH (ou bande passante) contrôle le compromis classique entre biais et variance en régulant la largeur du voisinage local. La visualisation de la courbe de lissage résultante permet de vérifier si la trajectoire empirique globale s’écarte significativement d’un segment affine rigide. Si la courbe non paramétrique de LOESS oscille étroitement autour de la droite de régression MCO sans dérive systématique, l’analyste dispose d’une confirmation empirique irréfutable autorisant le maintien de la modélisation paramétrique simple.
12. Restitution académique des résultats et normes de publication scientifique
12.1 Directives de rédaction selon les normes APA (7e édition)
La communication des résultats d’une analyse quantitative au sein des revues scientifiques à comité de lecture affiliées aux sciences sociales, comportementales, médicales ou éducatives exige une conformité scrupuleuse aux normes de présentation éditoriales. Les directives de l’American Psychological Association (APA, 7e édition) prescrivent un formalisme rigoureux pour consigner les indicateurs issus de l’analyse de régression au fil du texte.
La restitution textuelle doit obligatoirement expliciter la nature de l’association, la direction de la pente, l’amplitude des paramètres d’estimation non standardisés (notés B), leurs erreurs standard d’échantillonnage (SE), l’encadrement par intervalle de confiance, la statistique de test t associée avec ses degrés de liberté résiduels, ainsi que la valeur exacte de la probabilité critique (p-value). Le niveau global de performance explicative s’atteste quant à lui par l’exhibition conjointe de la statistique de Fisher globale F et du coefficient de détermination R2.
Un exemple de rédaction académique standardisée, modélisé pour notre scénario empirique, se formule ainsi :
« Une régression linéaire simple a été réalisée afin d’évaluer la capacité prédictive du temps d’étude hebdomadaire sur le score final obtenu à l’évaluation standardisée. Une relation statistiquement significative a été mise en évidence, F(1, 13) = 205.82, p < .001, avec un coefficient de détermination R² = .941. Le modèle linéaire indique que le temps d’étude explique 94.1 % de la variance totale des scores académiques. L’augmentation d’une heure de révision hebdomadaire est associée de manière statistiquement significative à un accroissement moyen de 4.38 points sur l’épreuve finale, B = 4.38, SE = 0.31, 95% IC [3.72, 5.04], t(13) = 14.35, p < .001. La constante du modèle s’établit à B = 47.12, SE = 2.14, 95% IC [42.49, 51.75], t(13) = 22.02, p < .001. L’erreur type de l’estimation s’élève à 3.12 points. »
Ce formalisme assure une transparence méthodologique totale et permet aux relecteurs d’évaluer immédiatement la solidité empirique des conclusions avancées.
12.2 Conception de tableaux statistiques prêts pour la publication
En complément d’une synthèse rédigée concise, les exigences de concision éditoriale commandent fréquemment d’insérer un tableau récapitulatif synthétique regroupant les métriques structurelles du modèle. Ce tableau statistique doit s’affranchir impérativement de la présentation brute délivrée par la console informatique pour adopter un agencement épuré satisfaisant aux critères esthétiques des presses universitaires.
L’utilisation judicieuse du système de diffusion ODS de SAS permet d’exporter directement les résultats compilés vers des traitements de texte au moyen de destinations dédiées telles que ODS RTF ou ODS LATEX. La mise en forme conventionnelle d’un tableau de régression linéaire sous les normes APA impose d’ordonner les colonnes de gauche à droite selon la séquence standardisée suivante :
- Identifiant du terme (Constante / Variable explicative).
- Coefficient de régression non standardisé (noté B).
- Intervalle de confiance à 95 % du coefficient non standardisé (noté 95% IC).
- Erreur standard de l’estimation (notée SE).
- Coefficient de régression standardisé (β, facultatif en régression simple car strictement équivalent à r).
- Statistique t de Student associée.
- Probabilité critique bilatérale (p).
L’élagage scrupuleux des bordures verticales superflues, la conservation exclusive de fines séparations horizontales délimitant l’en-tête et le pied de table, ainsi que l’insertion en note infrapaginale du rappel des métriques macroscopiques du modèle (taille d’échantillon N, statistique globale F, et R2 ajusté) confèrent au manuscrit une tenue professionnelle répondant aux plus hauts standards de rigueur académique.
12.3 Pièges courants et recommandations pour la recherche empirique
L’apparente simplicité algorithmique de la régression linéaire simple sous SAS recèle plusieurs pièges conceptuels majeurs dans lesquels les analystes inexpérimentés basculent fréquemment. L’identification lucide de ces écueils méthodologiques s’avère indispensable pour prémunir le chercheur contre la formulation de conclusions fallacieuses.
Le premier écueil réside dans l’assimilation hâtive d’une corrélation d’une magnitude élevée à la preuve irréfutable d’un mécanisme de causalité directe. L’existence d’une covariance étroite entre deux dimensions peut refléter l’action conjointe d’un tiers facteur médiateur non mesuré (comme le niveau socio-économique des apprenants ou leurs aptitudes cognitives antérieures). Ce phénomène d’endogénéité par omission de variable explicative majeure compromet l’interprétation substantielle du coefficient de pente, dont l’estimation se trouve mécaniquement biaisée.
Le deuxième écueil concerne la focalisation exclusive sur la p-valeur au détriment de l’analyse conjointe de la taille d’effet et du diagnostic de validité. Dans le cadre de cohortes massives (big data), une pente affichant une amplitude microscopique et dénuée de la moindre utilité pratique peut franchir sans peine le seuil de significativité p < .001 sous l’effet de l’hyper-puissance statistique du test. Inversement, l’absence de significativité statistique sur un échantillon restreint ne doit pas être interprétée prématurément comme la preuve formelle de l’absence d’un lien réel dans la population.
Enfin, la recherche empirique moderne proscrit formellement la validation définitive d’un modèle sans mise en œuvre d’une démarche de validation croisée ou de réplication directe sur des données indépendantes. L’ajustement MCO optimise les paramètres exclusivement pour l’échantillon d’apprentissage mobilisé (surajustement ou overfitting potentiel). La confrontation ultérieure de l’équation prédictive obtenue à de nouveaux corpus empiriques constitue l’ultime garantie méthodologique garantissant la transférabilité, la généralisabilité et la pérennité de l’inférence scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Gauss, C. F. (1823). Theoria combinationis observationum erroribus minimis obnoxiae. Dieterich.
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725250
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- SAS Institute Inc. (2020). SAS/STAT 15.2 user’s guide: The REG procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/index.html
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934