
La quantification des phénomènes observables constitue le pivot méthodologique sur lequel repose l’ensemble des sciences contemporaines, qu’il s’agisse de la psychologie cognitive, de l’épidémiologie clinique, de la sociologie quantitative ou des neurosciences comportementales. Dans cette quête de formalisation empirique, le chercheur est constamment confronté à une tension fondamentale entre la complexité continue de la réalité et la nécessité d’une catégorisation intelligible. Au cœur de cette tension se déploie un outil métrologique d’une apparente simplicité mais d’une portée analytique redoutable : la variable dichotomique. Capable de réduire l’espace des états possibles d’un phénomène à une alternative binaire irréductible, cette structure de données gouverne une immense portion des décisions empiriques, de l’admission d’un patient dans un protocole thérapeutique à la validation d’une théorie neurocomputationnelle du traitement du signal.
Pourtant, sous cette simplicité opérationnelle se dissimulent des enjeux conceptuels et mathématiques profonds. Qualifier une variable de dichotomique ne consiste pas simplement à constater l’existence de deux étiquettes textuelles distinctes dans un fichier de données. Cela implique d’adhérer à des postulats précis concernant l’exhaustivité des catégories, leur étanchéité mutuelle, ainsi que la nature sous-jacente du construit mesuré. Une confusion fréquente persiste entre les dichotomies qui relèvent de la structure ontologique même de l’objet d’étude et celles qui résultent d’un acte volontaire, parfois délétère, de discrétisation imposé par le chercheur sur un continuum latent. La manipulation de ces variables conditionne directement le choix des modèles probabilistes, la préservation de la puissance statistique et la validité des inférences causales qui en découlent.
Cet article propose une exploration encyclopédique et rigoureuse de la variable dichotomique au sein de l’édifice statistique moderne. À travers une articulation systématique entre fondements épistémologiques, développements métrologiques, formulations probabilistes et applications computationnelles, nous examinerons la place unique qu’occupe le codage binaire dans les sciences empiriques. Du positionnement de ces variables dans la taxonomie de Stevens jusqu’aux subtilités algorithmiques de la régression logistique et de l’analyse des tables de contingence, cette monographie dresse un panorama exhaustif des théories, des controverses historiques et des impératifs méthodologiques indispensables à tout praticien de la recherche quantitative.
1. Introduction et fondements conceptuels de la variable dichotomique
1.1 Définition formelle et caractéristiques intrinsèques
Sur le plan métrologique et mathématique, une variable dichotomique — fréquemment désignée sous les vocables de variable binaire ou variable à deux états — est une variable statistique dont l’espace échantillonnal, traditionnellement noté $\Omega$, est partitionné en exactement deux modalités qualitatives ou quantitatives. La première caractéristique fondamentale de cette structure réside dans le principe d’exclusion mutuelle : pour toute unité d’observation $i$ appartenant à la population cible, la réalisation de la variable ne peut prendre qu’une seule et unique modalité à un instant $t$ donné. Si nous notons les deux modalités $A$ et $B$, l’intersection de ces deux sous-ensembles est rigoureusement vide ($A cap B = emptyset$). Aucune observation ne peut donc être simultanément assignée aux deux catégories, ce qui élimine toute ambiguïté taxonomique au niveau de l’enregistrement de la donnée.
La seconde caractéristique cardinale est le principe d’exhaustivité. L’union des deux modalités couvre l’intégralité de l’espace des réalisations possibles pour le phénomène considéré ($A \cup B = \Omega$). Dans le champ de la collecte de données psychométriques et cliniques, ce postulat impose que chaque participant puisse être sans équivoque classé dans l’un des deux compartiments théoriques prévus par le protocole expérimental. Cette exhaustivité garantit la fermeture du système descriptif et permet l’application des axiomes fondamentaux des probabilités de Kolmogorov, où la probabilité associée à la modalité $B$ découle immédiatement de celle de la modalité $A$ par la relation de complémentarité $P(B) = 1 – P(A)$.
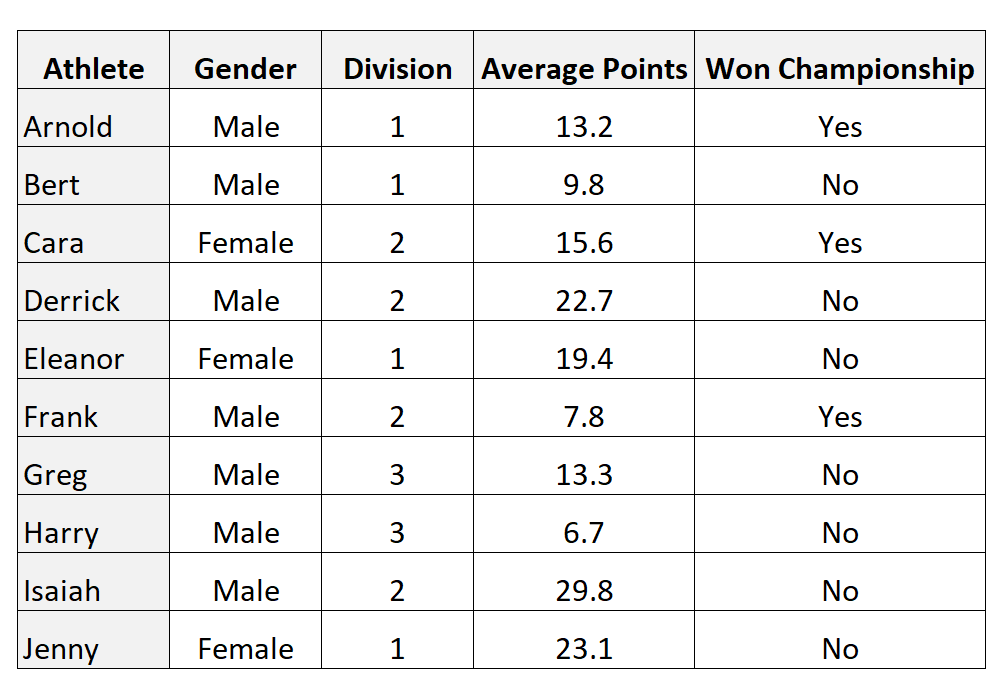
Dans l’opérationnalisation empirique, ces variables jouent un rôle crucial de simplification des observables comportementaux et cliniques. Face à des dynamiques psychologiques hautement intriquées, l’assignation binaire permet de condenser un ensemble massif de micro-comportements en un état synthétique unique (par exemple, la survenue ou la non-survenue d’une crise d’angoisse). Néanmoins, cette simplification impose d’opérer une distinction conceptuelle capitale entre une dichotomie naturelle (ou authentique) et une dichotomie artificielle. Une dichotomie naturelle renvoie à un état du monde dont la manifestation intrinsèque est discrète et binaire par essence biologique, physique ou administrative (par exemple, la survie d’un organisme, le statut d’une commande informatique exécutée ou non). En revanche, la dichotomie artificielle correspond à la discrétisation arbitraire d’un continuum sous-jacent continu (comme classer les individus en « dépressifs » versus « non dépressifs » sur la base d’une note seuil arbitraire sur une échelle continue de sévérité). Cette démarcation conceptuelle gouverne l’ensemble des choix analytiques ultérieurs.
1.2 Origine étymologique et repères historiques en métrologie
D’un point de vue philologique, le vocable « dichotomie » trouve sa racine dans la langue grecque ancienne, formé par la fusion du préfixe dicha- (διχᾶ), signifiant « en deux parties », « doublement » ou « scindé », et du suffixe verbal -tomia, dérivé du verbe temnein (τέμνειν), qui se traduit par « couper » ou « trancher ». Dans la tradition philosophique platonicienne et aristotélicienne, la méthode dichotomique constituait l’instrument dialectique privilégié de la division logique (diairesis), consistant à scinder un genre général en deux espèces opposées et complémentaires afin de cerner l’essence d’un concept. Cette racine étymologique traduit avec une remarquable précision la nature de l’opération statistique contemporaine : un sectionnement net de l’espace empirique qui refuse toute forme de gradation intermédiaire.
L’introduction formelle de la mesure binaire au sein des sciences quantitatives s’accélère au XIXe siècle avec la naissance de la psychophysique, discipline inaugurée par Gustav Theodor Fechner dans ses célèbres Elemente der Psychophysik (1860). En cherchant à quantifier les relations mathématiques unissant l’énergie d’un stimulus physique à la sensation psychologique éprouvée, Fechner dut formaliser la notion de « seuil absolu » (Absolutschwelle). Dans ce cadre, la réponse du sujet expérimental est fondamentalement binaire : « oui, je perçois » ou « non, je ne perçois pas ». La mesure quantitative continue de la sensibilité sensorielle émergeait ainsi de l’agrégation probabiliste de jugements dichotomiques répétés, jetant les ponts initiaux entre le qualitatif discret et le continu latent.
Presque simultanément, le mathématicien britannique George Boole publiait en 1854 son traité An Investigation of the Laws of Thought, établissant l’algèbre binaire (algèbre booléenne) où les propositions logiques ne prennent que deux valeurs de vérité : le Vrai (1) et le Faux (0). Au tournant du XXe siècle, la fusion conceptuelle entre l’algèbre booléenne et le calcul des probabilités, portée par des pionniers de la statistique moderne tels que Karl Pearson et George Udny Yule, permit de transposer la logique binaire vers l’analyse empirique des populations. Les controverses acharnées entre Pearson et Yule quant à la façon d’estimer l’association entre deux caractères binaires ont constitué le creuset duquel sont nés les coefficients de corrélation modernes, ouvrant la voie aux méthodologies statistiques avancées qui structurent la recherche contemporaine.
1.3 Importance de la conceptualisation binaire en recherche psychologique
Au sein de la recherche psychologique et psychiatrique, la conceptualisation binaire répond à des exigences théoriques, méthodologiques et pragmatiques de premier ordre. Sur le plan nosographique, l’ensemble des systèmes de classification contemporains, à l’image du Manuel diagnostique et statistique des troubles mentaux (DSM-5) élaboré par l’American Psychiatric Association, repose sur une architecture décisionnelle dichotomique. Bien que la symptomatologie clinique d’un patient présente une variabilité phénoménologique continue, le système médical requiert impérativement une décision binaire : le trouble est soit présent, soit absent. Cette formalisation conditionne l’accès aux prises en charge thérapeutiques, la prescription médicamenteuse standardisée et l’inclusion rigoureuse des participants dans les essais cliniques randomisés.
Sur le plan expérimental, la réduction de l’observation comportementale à une réponse binaire constitue le socle des paradigmes d’évaluation sensorielle et cognitive élémentaire. Dans le cadre de la théorie de la détection du signal (TDS), développée initialement par David Green et John Swets, le comportement d’un individu face à une scène perceptive ambigüe est décomposé en une matrice élémentaire croisant l’état du monde (stimulus présent ou absent) avec la réponse motrice ou verbale du sujet (détection ou non-détection). Ce dispositif permet d’isoler expérimentalement la sensibilité perceptive intrinsèque ($d’$) du biais de réponse cognitif ($\beta$). Sans cette épuration dichotomique initiale, l’évaluation conjointe de ces paramètres sous-jacents demeurerait méthodologiquement insoluble.
Enfin, les protocoles psychométriques et neurocognitifs exploitent massivement les paradigmes à choix forcé à deux alternatives (communément désignés par l’acronyme 2AFC, pour Two-Alternative Forced Choice). Qu’il s’agisse de mesurer le temps d’accès au lexique mental dans des tâches de décision lexicale (le stimulus présenté constitue-t-il un mot réel ou un pseudo-mot ?), d’évaluer la reconnaissance mnésique d’items préalablement encodés (item ancien versus item nouveau), ou d’enregistrer des potentiels évoqués en électroencéphalographie lors d’un paradigme de type oddball (stimulus standard versus stimulus déviant), l’architecture dichotomique confère une précision opérationnelle maximale en éliminant les stratégies parasites de compromis ou de réponses indécises chez le participant.
2. Taxonomie statistique : Place des variables dichotomiques parmi les échelles de mesure
2.1 La typologie de Stevens et l’échelle nominale
Pour comprendre la place spécifique des variables dichotomiques dans l’échafaudage statistique, il convient de se référer à la classification paradigmatique formalisée par le psychologue Stanley Smith Stevens dans son article fondateur de 1946 publié dans la revue Science, intitulé On the Theory of Scales of Measurement. Stevens a structuré la métrologie des sciences empiriques en quatre niveaux d’échelles hiérarchisées selon les opérations mathématiques qu’elles autorisent : nominale, ordinale, d’intervalles et de rapports. Dans cette classification, la variable dichotomique s’inscrit au niveau le plus fondamental de la mesure : l’échelle nominale.
L’échelle nominale se définit exclusivement par des relations d’équivalence ($=$) ou de non-équivalence ($\neq$) entre les entités observées. Les nombres qui peuvent être assignés à ses modalités n’ont aucune signification quantitative intrinsèque ; ils ne constituent que des étiquettes ou des désignateurs symboliques conventionnels. En conséquence, cette échelle possède la propriété d’être invariante sous toute transformation univoque (ou bijective). Cela signifie que remplacer les codes numériques conventionnels ${0, 1}$ par ${1, 2}$, ${10, 100}$ ou même par les symboles textuels ${\text{Échec}, \text{Succès}}$ n’altère en rien l’intégrité de l’information statistique contenue dans la distribution. La préservation stricte des identités qualitatives représente la condition nécessaire et suffisante de la validité de l’échelle nominale.
Au sein de cette catégorie nominale, il importe toutefois de distinguer formellement la variable dichotomique stricte des variables nominales polytomiques. Ces dernières admettent trois catégories ou davantage sans relation d’ordre (par exemple, le groupe sanguin ABO, l’affiliation religieuse ou la spécialité médicale d’un praticien). Si une variable nominale polytomique à $k$ modalités nécessite la manipulation de $k-1$ degrés de liberté pour être entièrement décrite dans un espace multidimensionnel, la variable dichotomique ($k=2$) condense cette information en un degré de liberté unique. Cette singularité lui confère des propriétés mathématiques exceptionnelles qui transcendent les restrictions habituelles imposées aux échelles nominales classiques.
2.2 Propriétés ordinales des variables dichotomiques ordonnées
Bien que la variable dichotomique relève structurellement du niveau nominal, une grande partie des variables binaires utilisées en sciences humaines présente une asymétrie sémantique intrinsèque. Lorsque les deux modalités reflètent un gradient d’intensité, de compétence ou d’accumulation d’un trait latent — comme l’opposition entre l’échec et la réussite à un test cognitif, ou la distinction entre un niveau d’anxiété faible et un niveau élevé —, la variable acquiert immédiatement les propriétés d’une échelle ordinale. La relation de non-équivalence se double d’une relation d’ordre strict non symétrique et transitive ($A < B$).
Cette propriété ordinale constitue le fondement direct des modèles de cumulativité psychométrique, dont l’archétype est l’échelle de Guttman (ou scalogramme de Guttman). Dans un instrument d’évaluation construit selon cette logique, une série d’items dichotomiques est ordonnée le long d’un continuum d’endossement ou de difficulté croissante. L’acceptation d’un item situé à un niveau d’exigence $k$ implique mathématiquement l’acceptation de tous les items de niveau inférieur ($k-1, k-2, dots, 1$). Les réponses binaires individuelles ${0, 1}$ ne sont plus de simples descripteurs nominaux désordonnés ; elles reflètent directement la progression d’un individu le long d’une échelle ordinale sous-jacente.
Sur le plan méthodologique, l’attribution d’un ordre formel à une variable binaire autorise un traitement quasi-quantitatif dans de nombreuses procédures d’analyse de données. En fixant arbitrairement l’ordre $0 < 1$, la valeur $1$ dénote conventionnellement une présence plus marquée du construit psychologique mesuré (aptitude supérieure, pathologie plus sévère, accord idéologique plus net). Dès lors, le chercheur peut légitimement calculer des corrélations de rang (telles que le tau de Kendall ou le rho de Spearman) ou employer des modèles de régression ordinale sans violer les hypothèses fondamentales relatives à la structure sous-jacente des données.
2.3 Comparaison structurelle avec les échelles d’intervalles et de rapports
Pour appréhender les frontières analytiques de la variable dichotomique, il est impératif de la confronter aux échelles de mesure supérieures définies par Stevens : l’échelle d’intervalles (qui dispose d’une unité de mesure constante mais d’un zéro arbitraire, comme la température en degrés Celsius ou les scores standardisés de quotient intellectuel) et l’échelle de rapports (qui possède un zéro absolu et universel, comme la durée d’un temps de réaction mesurée en millisecondes ou la concentration sanguine d’une hormone en picogrammes par millilitre).
La variable dichotomique souffre par nature d’une absence absolue de métrique intrinsèque : il n’existe aucune distance géométrique ou physique objective séparant l’état $0$ de l’état $1$. Il est impossible de postuler que l’écart qualitatif entre l’absence et la présence d’un trouble psychiatrique équivaut à un intervalle standardisé constant susceptible d’être reporté le long d’un axe linéaire. Par conséquent, les opérations arithmétiques fondamentales telles que l’addition, la soustraction ou la multiplication directe des modalités qualitatives brutes sont conceptuellement dénuées de sens. Calculer la moyenne arithmétique de deux étiquettes qualitatives est une absurdité sémiotique.
Cependant, une propriété mathématique remarquable émerge lorsque les modalités binaires sont codées numériquement par les valeurs $0$ et $1$. Dans cette situation précise, la moyenne arithmétique de l’échantillon d’observations, notée $\bar{X}$, perd son statut de mesure de tendance centrale spatiale pour devenir rigoureusement équivalente à la proportion empirique d’individus présentant la modalité codée $1$. Si nous observons un échantillon de taille $N$ où $k$ individus ont la valeur $1$ et $N-k$ individus ont la valeur $0$, la formulation mathématique classique de la moyenne donne :
$$\bar{X} = \frac{1}{N} \sum_{i=1}^N X_i = \frac{k \times 1 + (N-k) \times 0}{N} = \frac{k}{N} = p$$
Cette convergence fondamentale permet d’intégrer une variable initialement nominale dans des calculs analytiques quantitatifs continus, sous réserve d’interpréter systématiquement la moyenne arithmétique obtenue non pas comme un score individuel observable, mais comme une probabilité marginale d’appartenance à la catégorie cible au sein de l’échantillon analysé.
3. Exemples appliqués dans les sciences du comportement et la recherche clinique
3.1 Variables démographiques et statuts individuels
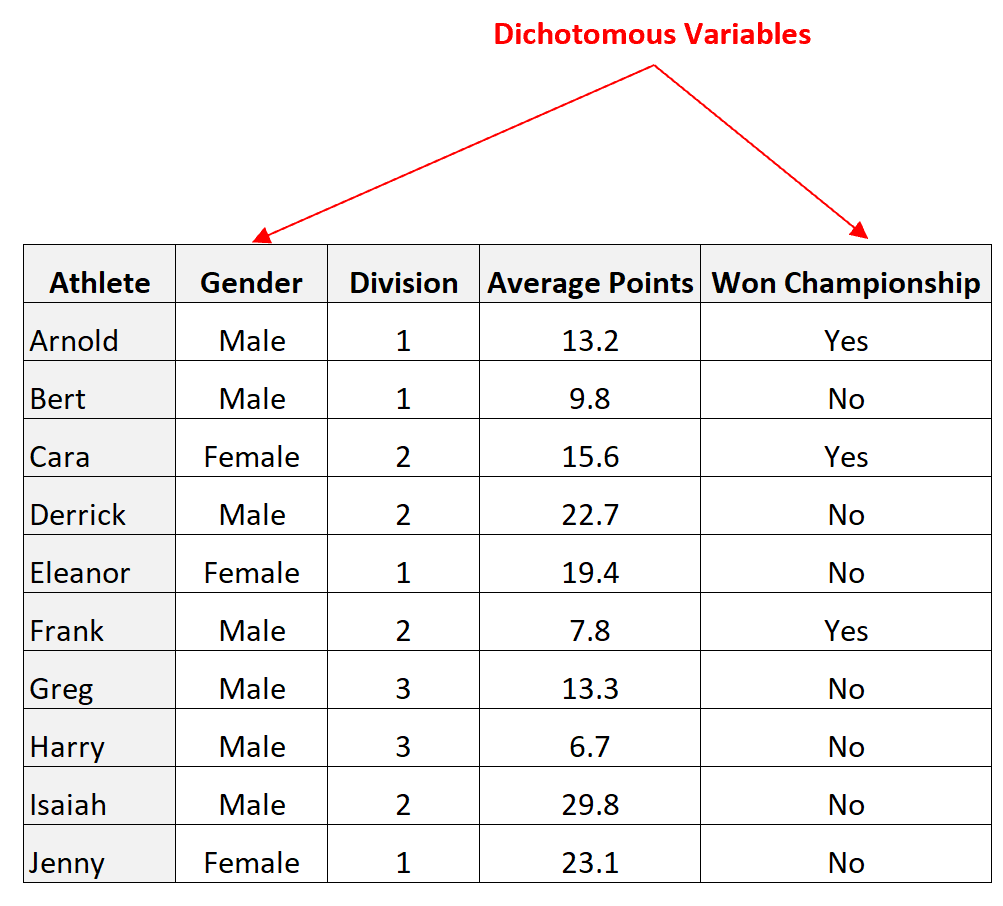
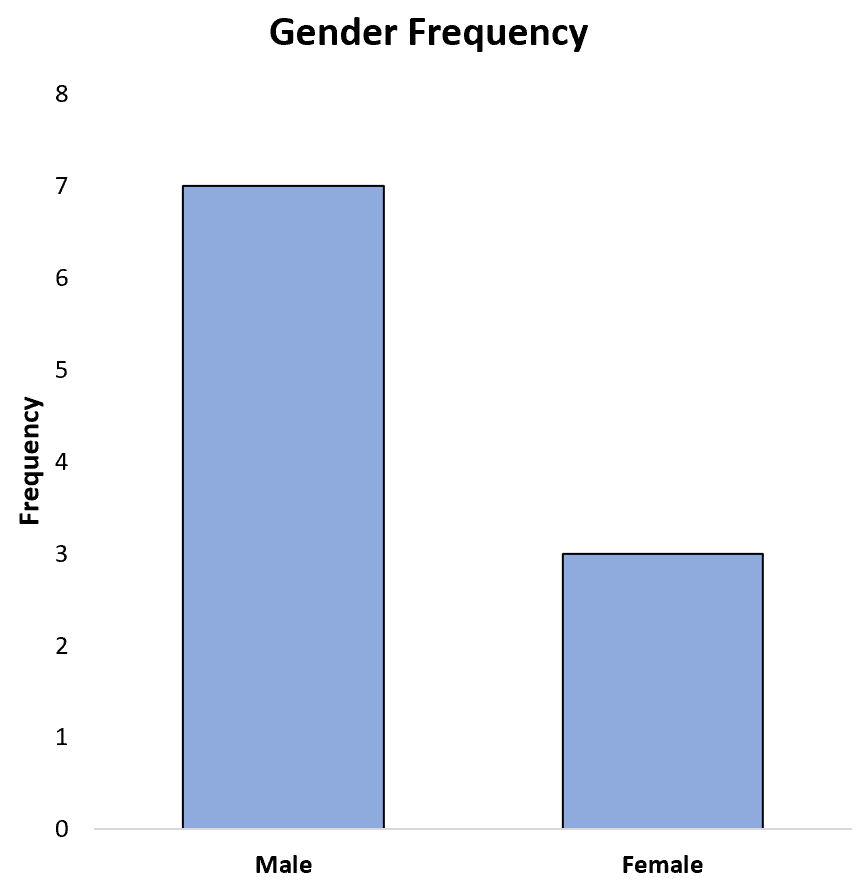
Dans la recherche empirique appliquée à la sociologie, à la psychologie sociale et à la médecine du sport, les variables dichotomiques constituent des facteurs de stratification démographique largement sollicités. L’exemple le plus répandu réside dans le sexe biologique individuel, historiquement catégorisé sous une forme strictement binaire : masculin versus féminin. Bien que les débats biologiques et sociologiques contemporains soulignent la nuance entre sexe chromosomique, assignation anatomique et identité de genre non binaire, les études épidémiologiques standardisées exploitent encore massivement cette dichotomie fondamentale afin d’étudier les dimorphismes sexuels dans l’expression des maladies cardiovasculaires ou la vulnérabilité différentielle aux dépressions majeures.
Un autre exemple classique issu des sciences de l’activité physique et de la psychologie de la performance concerne le statut d’athlète. Dans une multitude d’investigations s’intéressant à la régulation du stress compétitif ou aux fonctions exécutives spatiales, les participants sont assignés de façon bivalente soit au groupe des athlètes professionnels (soumis à un entraînement intensif rémunéré et régulier), soit au groupe des athlètes amateurs (ou individus pratiquant une activité sportive à titre récréatif non structuré). Ce découpage binaire permet d’opérationnaliser un contraste environnemental net pour évaluer l’impact d’une surcharge d’entraînement sur la plasticité cérébrale.
Enfin, en psychologie environnementale et en sociologie urbaine, les recherches écologiques exploitent fréquemment la nature de l’habitat individuel comme variable indépendante dichotomique : milieu de vie résidentiel versus milieu commercial (ou urbain dense versus rural). Cette partition binaire sert de proxy analytique pour estimer l’exposition différentielle à la pollution sonore, aux îlots de chaleur ou au stress chronique induit par la densité démographique, fournissant ainsi des prédicteurs macroscopiques dans les équations structurelles de bien-être subjectif.
3.2 Indicateurs cliniques, diagnostiques et psychopathologiques
Le champ de la psychopathologie clinique fournit incontestablement l’illustration la plus concrète des impératifs de la variable dichotomique. Lors de la passation d’un entretien semi-structuré validé tel que la Structured Clinical Interview for DSM-5 (SCID-5), le clinicien évalue méthodiquement la présence ou l’absence d’un trouble de l’humeur. Bien que les manifestations affectives varient de façon continue d’un jour à l’autre, le résultat synthétique de l’évaluation diagnostique demeure résolument binaire : le patient répond aux critères du trouble dépressif majeur, ou bien il n’y répond pas.
Dans le domaine de l’évaluation de l’efficacité thérapeutique des psychothérapies, le statut de rémission post-intervention constitue la variable dépendante princeps de tout essai clinique contrôlé. À l’issue d’un protocole standardisé de thérapie cognitivo-comportementale (TCC) de douze semaines ciblant les troubles paniques, chaque participant est assigné à l’une des deux modalités suivantes : « succès thérapeutique » (rémission symptomatique complète objectivée par la négativation des critères d’inclusion) versus « échec thérapeutique » (persistance d’attaques de panique invalidantes ou abandon précoce du protocole). Cette simplification est indispensable pour calculer des indicateurs de santé publique tels que le nombre de sujets à traiter (Number Needed to Treat, NNT).
De même, dans les démarches de dépistage épidémiologique à large échelle, les instruments d’auto-évaluation tels que le Patient Health Questionnaire-9 (PHQ-9) ou le General Health Questionnaire (GHQ-12) font l’objet d’un seuillage standardisé. Le clinicien ne retient pas l’infinité des nuances du score composite global, mais détermine si un seuil clinique de détresse psychologique est formellement atteint ou non atteint. Ce franchissement binaire déclenche de façon algorithmique l’orientation du patient vers une consultation psychiatrique approfondie ou vers des investigations complémentaires, démontrant l’alignement strict entre mesure binaire et action médicale.
3.3 Mesures cognitives et paradigmes de performance
Au sein des sciences cognitives, de la neuropsychologie et de la psychométrie scolaire, la réponse comportementale à l’échelle de l’item unitaire est presque universellement modélisée sous forme dichotomique. Dans les batteries standardisées d’intelligence générale telles que les échelles de Wechsler (WAIS-IV, WISC-V), la réussite d’un individu à un item spécifique — qu’il s’agisse de reproduire un arrangement géométrique à l’aide de cubes bicolores ou de fournir la définition précise d’un mot rare — est encodée de façon bivalente : réussite (1 point) versus échec (0 point). C’est la sommation probabiliste de ces réussites dichotomiques qui engendre ensuite les scores composites continus étalonnés.
Dans les paradigmes chronométriques informatisés étudiant l’attention sélective, comme la tâche de Stroop ou la tâche de Flanker, la variable d’intérêt immédiate enregistrée à chaque essai est l’exactitude de la réponse motrice : la frappe sur la touche du clavier est soit correcte (concordance avec la consigne expérimentale), soit incorrecte (erreur de sélection ou omission). L’analyse de cette modalité binaire permet d’alimenter les modèles de diffusion de drift (Drift-Diffusion Models), où la probabilité d’une décision correcte est couplée au temps de réaction pour isoler la vitesse d’accumulation de l’information neuronale du temps d’exécution motrice périphérique.
Enfin, dans le contexte de la docimologie et des examens académiques standardisés (concours médicaux, certifications professionnelles, examens du barreau), la décision finale d’évaluation se condense de façon irréversible en une variable dichotomique universelle : admis versus recalé. Quelles que soient l’extrême finesse de l’échelle de notation initiale (par exemple, des moyennes chiffrées calculées au millième de point près) et la distribution des compétences cognitives réelles des candidats, l’exigence sociétale et administrative force l’écrasement de la variance continue au profit d’un verdict binaire non négociable.
4. Distinction comparative : Dichotomie, polytomie et continuité
4.1 Variables dichotomiques versus polytomiques qualitatives
La distinction entre variables dichotomiques et variables polytomiques s’articule autour de la cardinalité de la partition imposée à l’espace échantillonnal. Alors qu’une variable dichotomique scinde rigoureusement la réalité en deux classes ($k=2$), une variable nominale polytomique découpe cet espace en un nombre fini de catégories supérieur à deux ($k > 2$). Cette extension du nombre de classes altère profondément la nature des relations combinatoires et la complexité des modèles statistiques requis.
Considérons à titre d’illustration le domaine de la sociologie sportive : l’évaluation d’un athlète peut s’effectuer par le prisme d’une variable binaire de succès (ayant remporté au moins un titre au cours de la saison versus n’ayant remporté aucun titre) ou par une variable de division sportive polytomique (Division 1, Division 2, Division 3, Division Régionale). Alors que la première modalité capture un contraste monolithique, la seconde introduit une multiplicité de comparaisons par paires possibles, précisément au nombre de $\frac{k(k-1)}{2}$, soit six comparaisons bilatérales distinctes pour quatre divisions sportives.
Cette prolifération de classes entraîne des conséquences directes sur la taille minimale d’échantillon nécessaire pour garantir la robustesse des analyses inférentielles. Dans une table de contingence polytomique, le nombre de cellules croisées s’accroît de façon exponentielle avec le nombre de modalités des variables en jeu. Or, pour que les tests asymptotiques d’indépendance (comme le test du Chi-deux de Pearson) soient valides, les effectifs théoriques dans chaque cellule ne doivent pas descendre en deçà d’un certain seuil critique (habituellement fixé à 5 individus par case). L’éclatement des données sur de multiples catégories polytomiques fragmente l’échantillon, génère des cellules sous-peuplées et effondre dramatiquement la puissance statistique des tests, là où le format dichotomique maximise la concentration des effectifs dans un nombre restreint de cellules d’analyse.
4.2 Variables dichotomiques versus variables quantitatives continues
La divergence entre une variable dichotomique et une variable quantitative continue relève d’un abîme informationnel. Une variable continue, telle que la moyenne de points inscrits par match par un basketteur sur une saison complète, ou la pression artérielle systolique mesurée en millimètres de mercure, est définie sur un intervalle non dénombrable de la droite des nombres réels ($\mathbb{R}$). Elle possède une granularité théoriquement infinie, limitée uniquement par la précision technologique de l’instrument de mesure.
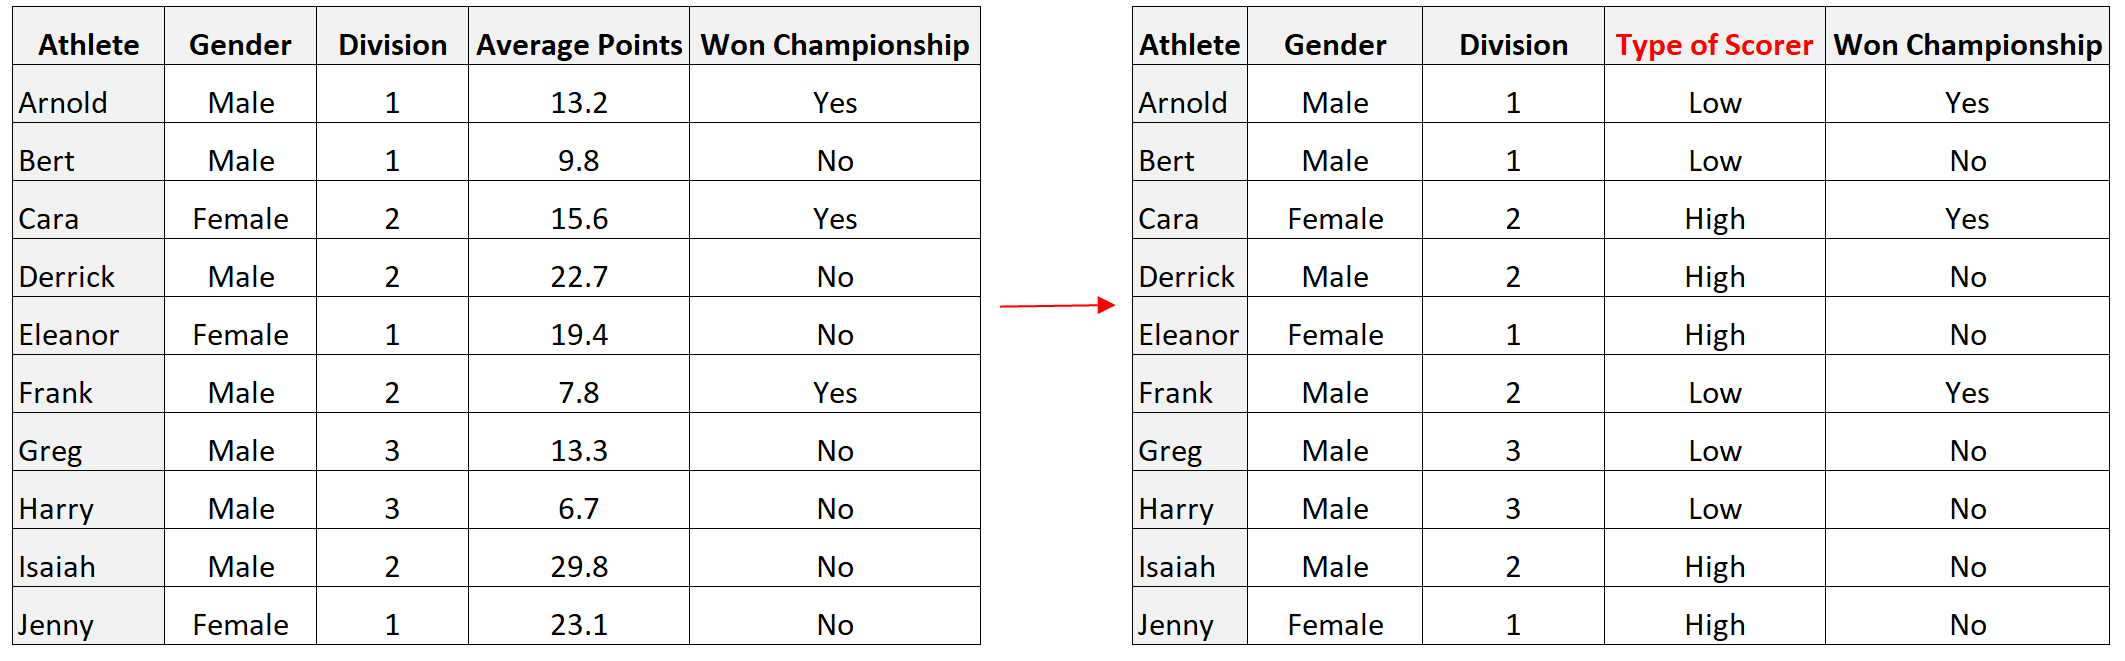
À l’opposé, la conversion d’une telle dynamique en une variable dichotomique (par exemple, classer les joueurs en « performants » si leur moyenne dépasse 20 points par match versus « non performants » dans le cas contraire) opère une réduction drastique de la granularité informationnelle. Deux athlètes affichant respectivement 20,1 points et 38,5 points par match sont artificiellement assimilés à la même classe d’équivalence (« performant »), tandis qu’un joueur affichant 19,9 points se trouve exclu et projeté dans la catégorie opposée aux côtés d’individus n’ayant inscrit aucun point de la saison.
Cette discrétisation brutale engendre une perte inhérente de variance phénoménologique. Dans la théorie statistique classique, la variance d’une variable quantitative mesure l’étendue des différences interindividuelles réelles au sein de la population. En écrasant ces distances métriques au sein de deux blocs rigides, le chercheur détruit irréversiblement une part considérable de la covariance potentielle liant cette mesure à d’autres construits psychologiques. La fidélité de la mesure s’en trouve diminuée, et les relations fonctionnelles complexes (linéaires, polynomiales ou exponentielles) sont nivelées en une simple différence de moyennes entre deux groupes artificiellement homogénéisés.
4.3 Tableau récapitulatif des divergences conceptuelles
Afin de synthétiser les caractéristiques discriminantes régissant ces trois grandes familles de variables métrologiques, le tableau ci-dessous explicite leurs divergences structurales en matière de niveau de mesure formel, de flexibilité opérationnelle, d’erreur de mesure et d’adéquation écologique.
| Critère d’évaluation | Variable dichotomique | Variable nominale polytomique | Variable quantitative continue |
|---|---|---|---|
| Niveau de mesure de Stevens | Nominale (avec propriétés ordinales émergentes si ordonnée). | Nominale stricte (ou ordinale si les classes présentent une hiérarchie intrinsèque). | Intervalles ou rapports selon l’existence d’un zéro absolu. |
| Granularité informationnelle | Minimale : partition bivalente de l’espace ($k=2$). | Intermédiaire : partition multinomiale finie ($k > 2$). | Maximale : infinité théorique de valeurs réelles ordonnées. |
| Flexibilité analytique | Très élevée pour la modélisation probabiliste (régression logistique, probit). | Modérée : nécessite des paramétrisations multinomiales complexes et des corrections d’alpha. | Extrême : accessible à tous les tests paramétriques, modélisations linéaires et non-linéaires. |
| Risque d’erreur de classification | Critique au niveau du seuil si la variable est une dichotomie artificielle. | Modéré à élevé : confusion inter-classes adjacentes fréquente. | Réduit à l’erreur technique métrologique continue de l’instrument. |
| Pertinence écologique décisionnelle | Maximale pour les décisions cliniques, légales ou administratives binaires. | Élevée pour la cartographie typologique et les classifications descriptives. | Faible pour la décision immédiate, maximale pour l’explication théorique fine. |
Ce tableau met en exergue les arbitrages stratégiques auxquels est confronté le méthodologiste : opter pour une variable dichotomique garantit une communicabilité immédiate et une adéquation totale avec les contraintes décisionnelles réelles, mais se paie au prix fort d’une dégradation de la richesse métrique originelle.
5. Méthodologie de dichotomisation des variables continues
5.1 Techniques de seuillage empirique et rationnel
Malgré les avertissements récurrents de la communauté des statisticiens, la pratique de la dichotomisation — consistant à transformer une variable initialement recueillie sous une forme continue en une variable binaire — demeure omniprésente dans la littérature appliquée. Deux approches principales guident cette transformation : le seuillage purement empirique et le seuillage fondé sur des critères rationnels ou épidémiologiques.
La technique empirique la plus célèbre et la plus controversée est sans conteste la scission par la médiane (median split). Son principe mathématique est d’une désarmante simplicité : on calcule la médiane empirique $Me$ de la variable continue $X$ au sein de l’échantillon observé, puis on assigne la modalité $0$ (catégorie « faible ») à tous les individus dont le score vérifie $X_i le Me$, et la modalité $1$ (catégorie « élevé ») à tous ceux dont le score vérifie $X_i > Me$. La séduction exercée par cette technique repose sur la garantie d’obtenir deux groupes d’effectifs parfaitement symétriques et équilibrés ($N/2$), ce qui procure une sensation rassurante de puissance expérimentale maximale pour les plans factoriels d’analyse de variance (ANOVA).
À l’opposé de cette approche data-dépendante, le seuillage rationnel repose sur l’introduction de points de coupure étalonnés en amont par des enquêtes épidémiologiques rigoureuses ou des critères physiologiques universels. C’est le cas, par exemple, de la définition de l’obésité clinique fixée à un indice de masse corporelle (IMC) strictement supérieur à 30 kg/m², ou du seuil de glycémie à jeun de 1,26 g/L pour diagnostiquer le diabète de type 2. Dans ces conditions, la frontière binaire ne dépend pas des fluctuations idiosyncrasiques de l’échantillon analysé, mais reflète une discontinuité biologique documentée où le risque de morbidité s’accroît de façon non-linéaire.
5.2 Scission par centiles extrêmes et exclusion du tiers médian
Conscients de la zone de flou entourant les individus situés immédiatement de part et d’autre d’une médiane centrale, certains chercheurs adoptent une stratégie alternative agressive : la méthode des groupes extrêmes. Cette technique consiste à partitionner la distribution continue initiale en terciles ou en quartiles, puis à éliminer délibérément de l’ensemble des analyses statistiques les participants appartenant au segment central (le tiers médian ou les deux quartiles intermédiaires), pour ne conserver que les deux groupes extrêmes opposés (par exemple, le premier tercile versus le troisième tercile).
L’objectif avoué de ce protocole est de maximiser artificiellement le contraste expérimental en comparant des phénotypes ou des profils cognitifs résolument polarisés (les scores exceptionnellement bas opposés aux scores exceptionnellement hauts). Sur le plan visuel et descriptif, cette manipulation garantit une séparation spectaculaire des moyennes de groupes et assure l’obtention de valeurs de $p$ spectaculairement significatives lors des tests d’hypothèse de Student.
Néanmoins, les vices méthodologiques inhérents à cette démarche sont colossaux. En premier lieu, l’éviction de 30 % à 50 % des participants collectés représente un gaspillage éthique et financier inadmissible des ressources allouées à la recherche. En second lieu, cette procédure introduit une distorsion majeure de la distribution des données, conduisant à une inflation artificielle monumentale de la taille d’effet apparente (comme le $d$ de Cohen ou le $\eta^2$). Les conclusions tirées d’un tel échantillon tronqué sont absolument incapables de se généraliser à la population générale, au sein de laquelle les profils intermédiaires modérés constituent précisément la majorité statistique écrasante.
5.3 Algorithmes de classification optimale et arbres de décision
Avec l’avènement de l’apprentissage automatique (machine learning) et de la modélisation non paramétrique, la fixation des seuils de dichotomisation a été automatisée par des algorithmes d’optimisation mathématique de partitionnement récursif, dont le chef de file est l’algorithme CART (Classification and Regression Trees) formalisé par Leo Breiman et ses collaborateurs (1984).
Dans ce cadre computationnel, le logiciel évalue exhaustivement l’ensemble des valeurs possibles de la variable continue prédictive afin d’identifier le point de coupure unique $c^*$ qui maximise l’homogénéité interne des deux sous-groupes résultants par rapport à une variable cible dépendante. Cette recherche de séparation optimale s’appuie sur la minimisation de critères mathématiques rigoureux d’impureté, au premier rang desquels figurent l’indice d’impureté de Gini et l’entropie informationnelle de Shannon. Le seuil retenu est celui qui maximise le gain d’information (Information Gain) en divisant le nœud parent en deux nœuds terminaux aussi purs que possible.
Bien que séduisante par son objectivité mathématique apparente, cette approche algorithmique présente un risque critique : le surapprentissage (overfitting). Dans la mesure où l’algorithme exploite opportunistement les variations aléatoires et le bruit d’échantillonnage propres au jeu de données d’entraînement pour caler le point de coupure, le seuil identifié présente une probabilité d’instabilité extrême d’un échantillon à un autre. Pour conjurer cette fragilité intrinsèque, il est méthodologiquement impératif d’intégrer des protocoles stricts de validation croisée (k-fold cross-validation) ou d’appliquer des techniques d’élagage (pruning) sur des cohortes indépendantes de réplication avant de considérer le seuil dichotomique comme généralisable.
6. Implications épistémologiques et controverses autour de la dichotomisation
6.1 Perte d’information et réduction drastique de la puissance statistique
La critique épistémologique la plus virulente dirigée contre la dichotomisation artificielle des variables continues a été magistralement formulée par le statisticien et psychologue Jacob Cohen dans son article programmatique de 1983, intitulé The Cost of Dichotomization. Cohen y démontre mathématiquement que lorsqu’une variable normalement distribuée est dichotomisée au niveau de sa médiane, l’opération détruit irrémédiablement environ un cinquième ($\approx 20%$) de sa variance explicative lorsqu’elle est corrélée à une autre variable continue, et jusqu’à 38 % de sa variance lorsque deux variables continues sont simultanément dichotomisées.
Pour appréhender la magnitude de ce désastre méthodologique, il a été prouvé par Irwin et McClelland (2003) ainsi que par MacCallum, Zhang, Preacher et Rucker (2002) dans un article de référence paru dans Psychological Methods, que dichotomiser une variable continue indépendante équivaut, en termes de perte de puissance statistique, à supprimer purement et simplement entre un tiers et la moitié de l’échantillon de recherche. En d’autres termes, un chercheur ayant recruté et testé laborieusement 300 participants réduit l’efficacité de son dispositif d’inférence à celle d’un échantillon de 150 à 200 sujets dès l’instant où il convertit ses prédicteurs continus en deux classes ordinales simplistes.
Sur le plan géométrique, cette perte s’illustre par l’atténuation artificielle de la corrélation linéaire. Si deux variables $X$ et $Y$ partagent une corrélation bivariée de Bravais-Pearson $\rho_{XY} = 0.50$, la dichotomisation par la médiane de la variable $X$ convertit cette mesure en une corrélation point-bisériale dont la limite asymptotique maximale est bornée par :
$$r_{pb} = \rho_{XY} \times \sqrt{\frac{2}{\pi}} \approx 0.50 \times 0.798 = 0.399$$
Le chercheur sous-estime donc systématiquement la force réelle de la relation sous-jacente d’au moins 20 %, augmentant dramatiquement le risque de commettre une erreur de type II ($\beta$) en échouant à rejeter l’hypothèse nulle d’absence de relation alors même que le phénomène existe bel et bien dans la population parente.
6.2 Risque d’erreurs de type I et corrélations fallacieuses
Si la réduction de la puissance statistique représente un préjudice méthodologique sévère, les travaux novateurs de Maxwell et Delaney (1993) ont mis en lumière un danger plus pernicieux encore : l’inflation spectaculaire du taux de faux positifs (erreur de type I, $\alpha$). Contrairement à l’intuition naïve suggérant que la perte d’information ne fait qu’affaiblir les tests, ces auteurs ont démontré que dans des modèles multivariés impliquant deux variables indépendantes initialement corrélées, la dichotomisation de l’un ou des deux régresseurs peut faire émerger des interactions statistiques purement fallacieuses et des effets principaux factices inexistants dans les données réelles.
Ce phénomène s’explique par le fait que la discrétisation binaire redistribue de manière non linéaire la covariance résiduelle entre les facteurs. Lorsque deux prédicteurs continus $X_1$ et $X_2$ sont substantiellement corrélés entre eux et prédisent conjointement une variable dépendante $Y$, la dichotomisation de $X_1$ altère la capacité du modèle à contrôler statistiquement la variance partagée avec $X_2$. Une portion de la variance de $X_1$ est alors artificiellement transférée à l’effet de $X_2$ ou projetée dans le terme d’interaction $X_1 \times X_2$, conduisant le logiciel à afficher une significativité statistique ($p < 0.05$) entièrement imputable à l’artéfact de codage.
De surcroît, la liberté laissée à l’investigateur de choisir le seuil de dichotomisation après avoir visualisé la distribution des données constitue l’une des armes les plus destructrices du p-hacking (flexibilité des degrés de liberté du chercheur). En testant successivement une scission par la médiane, par la moyenne, par le 40e centile ou par les quartiles extrêmes, un praticien peu scrupuleux peut presque systématiquement dénicher une partition arbitraire qui fait basculer la valeur de $p$ sous le seuil fatidique de $0.05$, publiant ainsi une relation empirique incapable de résister à la moindre tentative de réplication indépendante.
6.3 Cas légitimes et impératifs pratiques de dichotomisation
Face à ce réquisitoire statistique sans concession, il convient néanmoins de s’interroger sur l’existence de contextes empiriques dans lesquels la dichotomisation d’une variable s’avère non seulement admissible, mais conceptuellement et pratiquement indispensable. Le premier cas de figure relève de l’impératif d’action catégorielle. En médecine d’urgence, en psychiatrie d’intervention ou en sélection des ressources humaines, la prise de décision est par essence indivisible : prescrire une antibiothérapie ou s’abstenir, hospitaliser un patient suicidaire sous contrainte ou le laisser retourner à son domicile, embaucher un candidat ou rejeter son dossier. Dans ces scénarios pragmatiques, la nuance métrique continue doit impérativement s’effacer au profit d’un seuil d’action binaire clair et sans ambiguïté opérationnelle.
Le second cas légitime concerne l’amélioration de la communicabilité des résultats auprès des décideurs publics et des professionnels de terrain non statisticiens. Annoncer qu’un programme national de prévention permet de réduire de 35 % la cote d’apparition du décrochage scolaire (odds ratio de 0.65) est incomparablement plus accessible et persuasif pour les tutelles administratives que d’expliquer une régression montrant qu’un accroissement d’un écart-type sur un indice d’engagement pédagogique composite engendre une déviation de 0.18 unité standardisée sur une échelle multidimensionnelle d’ajustement scolaire.
Enfin, sur le plan purement méthodologique, la dichotomisation se justifie pleinement lorsque la variable mesurée présente des asymétries distributionnelles extrêmes et irrécupérables par les transformations mathématiques conventionnelles (comme la transformation logarithmique ou de Box-Cox). C’est le cas des distributions hautement censurées à gauche, dites de « plancher massif », où 95 % de l’échantillon affiche un score rigoureusement nul (par exemple, le nombre de tentatives de suicide antérieures ou le nombre de jours d’incarcération chez de jeunes adultes scolarisés). Dans une telle configuration, tenter de modéliser le continuum métrique viole dramatiquement les hypothèses de normalité des résidus ; convertir la variable en une modalité binaire stricte (présence versus absence d’événement) constitue la réponse analytique la plus robuste et la plus honnête sur le plan mathématique.
7. Codage numérique et préparation des données bivariées
7.1 Le codage binaire canonique (0 / 1) ou variable muette
La préparation d’un jeu de données quantitatives intégrant des variables dichotomiques requiert une rigueur formelle absolue lors de l’assignation des valeurs numériques dans la matrice logicielle. La modalité de paramétrisation standardisée par excellence est le codage binaire canonique, universellement désigné dans la littérature sous l’anglicisme de dummy coding (ou codage indicateur). Il repose sur l’attribution de la valeur $0$ à une modalité définie comme groupe de référence sociologique ou clinique, et de la valeur $1$ à la modalité d’intérêt focal ou expérimental :
$$X_i = \begin{\cases} 1 &a\mp; \text{si l’unité } i \text{ possède la caractéristique cible} 0 &a\mp; \text{si l’unité } i \text{ appartient à la catégorie de référence} \end{\cases}$$
Ce codage confère des propriétés algébriques exceptionnelles à la variable, simplifiant considérablement le calcul de son espérance mathématique. Dans le cadre d’un échantillonnage aléatoire suivant une loi de Bernoulli de paramètre $p$, où $p$ représente la probabilité théorique de succès ($X=1$), l’espérance $E(X)$ correspond directement à cette probabilité :
$$E(X) = (1 \times P(X=1)) + (0 \times P(X=0)) = 1 \times p + 0 \times (1-p) = p$$
Dans un modèle d’analyse de régression linéaire classique, l’intégration d’un régresseur codé sous cette forme indicatrice facilite l’interprétation des coefficients estimés par les moindres carrés ordinaires. L’ordonnée à l’origine (constante $\beta_0$) quantifie précisément la moyenne espérée de la variable dépendante au sein du seul groupe de référence ($X=0$), tandis que la pente de régression ($\beta_1$) mesure directement et rigoureusement l’écart arithmétique entre la moyenne du groupe cible ($X=1$) et celle de ce groupe de référence. Le test de Student associé à $\beta_1$ devient alors strictement équivalent au test de comparaison de deux moyennes indépendantes.
7.2 Le codage par contraste ou codage d’effet (-1 / 1)
Une modalité alternative de codage, particulièrement prisée au sein de la communauté de la psychologie expérimentale et des plans factoriels complexes d’analyse de variance (ANOVA), est le codage d’effet (effect coding), également désigné sous le terme de système de contraste symétrique. Dans ce système de numérisation, les deux modalités ne sont plus codées ${0, 1}$, mais sont assignées aux valeurs entières symétriques ${-1, +1}$ :
$$X_i = \begin{\cases} +1 &a\mp; \text{si l’unité } i \text{ appartient au groupe expérimental} -1 &a\mp; \text{si l’unité } i \text{ appartient au groupe contrôle} \end{\cases}$$
L’avantage conceptuel fondamental de cette paramétrisation réside dans l’élimination de l’asymétrie induite par le groupe de référence du codage indicateur. Dans un modèle linéaire paramétré par codage d’effet avec des effectifs équilibrés au sein des cellules, l’ordonnée à l’origine ($\beta_0$) ne capture plus la performance isolée d’une catégorie particulière, mais s’interprète rigoureusement comme la grande moyenne non pondérée de l’ensemble de la population d’étude ($\mu$). Le coefficient de pente associé $\beta_1$ quantifie quant à lui la déviation exacte du groupe assigné à $+1$ par rapport à cette moyenne générale (la déviation du groupe $-1$ étant symétriquement égale à $-\beta_1$).
En outre, sur le plan computationnel, l’usage de contrastes centrés sur zéro ($\sum X_i = 0$) assure l’orthogonalité géométrique stricte entre le vecteur de la variable binaire et le vecteur constant de l’ordonnée à l’origine. Cette propriété élimine toute colinéarité structurelle entre ces termes dans la matrice de conception ($X^TX$), ce qui stabilise grandement l’inversion matricielle et confère une robustesse accrue à l’estimation des effets principaux au sein des modèles factoriels intégrant des termes d’interactions d’ordre supérieur ($X_1 \times X_2$).
7.3 Gestion des données manquantes et audit de codage
L’une des vulnérabilités majeures guettant l’analyste de données réside dans la confusion logicielle entourant le typage informatique des variables dichotomiques et le traitement insidieux des valeurs manquantes (missing values). Dans de nombreux environnements de calcul statistique historiques (tels que SAS ou certaines extensions SPSS), il était fréquent que les non-réponses ou les données manquantes soient codées numériquement par les valeurs $-99$, $999$ ou même par un point ($.$). Si l’analyste omet de déclarer explicitement ces modalités comme des codes d’exclusion système, le compilateur traitera ces entiers astronomiques comme des réalisations empiriques continues, dévastant instantanément le calcul des proportions et l’ajustement des modèles.
De surcroît, lors de la mise en œuvre de procédures modernes d’imputation multiple par équations chaînées (comme l’algorithme MICE sous l’environnement R), le chercheur doit scrupuleusement auditer le typage interne de la variable. Si une variable binaire codée ${0, 1}$ est malencontreusement laissée sous le format numérique continu (numeric ou float) au lieu d’être formellement convertie en facteur nominal binaire (factor en R, ou category sous Python Pandas), l’algorithme d’imputation appliquera par défaut une régression linéaire standard. Cette bévue mathématique produira des valeurs imputées aberrantes sous forme de fractions continues décimales (telles que $0.42$ ou $0.87$), détruisant la cohérence ontologique bivalente du système d’observation.
Pour parer à ces écueils, l’analyste doit impérativement prescrire une routine d’audit pré-analytique systématique : vérification des tables de fréquences marginales, validation du caractère strictement bimodal des réalisations ${0, 1}$, vérification de l’absence totale de valeurs hors champ, et paramétrisation explicite de modèles de régression logistique prédictive pour imputer les valeurs binaires manquantes sous l’hypothèse de données manquantes au hasard (MAR, pour Missing at Random).
8. Statistiques descriptives pour variables dichotomiques
8.1 Fréquences, proportions et pourcentages cumulés
L’exploration statistique univariée d’une variable dichotomique se structure intégralement autour du dénombrement des effectifs d’occurrence de ses deux états exclusifs. Pour un échantillon de taille $N$, l’analyste détermine la fréquence absolue $n_1$ de la modalité d’intérêt ($X=1$) et la fréquence absolue $n_0$ de la modalité complémentaire ($X=0$), l’identité comptable imposant que $n_0 + n_1 = N$. À partir de ces effectifs bruts, on dérive la fréquence relative ou proportion empirique, universellement désignée par la lettre $p$ :
$$p = \frac{n_1}{N} \quad \text{et} \quad q = 1 – p = \frac{n_0}{N}$$
Ces proportions, lorsqu’elles sont multipliées par 100, s’expriment sous forme de pourcentages marginaux. Dans ce cadre univarié, le calcul de pourcentages cumulés n’a de réelle pertinence sémantique que dans la mesure où la variable dichotomique possède une nature ordinale déclarée (par exemple, quantifier le pourcentage d’individus n’ayant pas validé un critère diagnostique, puis le cumul exhaustif de 100 % incluant les individus l’ayant validé).
Toutefois, la simple communication de la proportion empirique ponctuelle $p$ s’avère insuffisante dans une démarche d’inférence scientifique rigoureuse ; celle-ci doit être obligatoirement encadrée par un intervalle de confiance reflétant la marge d’erreur d’échantillonnage pour un niveau de confiance fixé (habituellement $1 – \alpha = 0.95$). Si l’approximation normale de Wald ($\hat{p} \pm Z_{alpha/2} \sqrt{\frac{\hat{p}(1-\hat{p})}{N}}$) a été historiquement surutilisée en raison de sa commodité calculatoire, elle est aujourd’hui formellement proscrite pour les petits échantillons ou les proportions extrêmes en raison de ses défaillances de couverture empirique. On lui substitue désormais systématiquement l’intervalle de score de Wilson ou l’intervalle exact de Clopper-Pearson, fondé sur la distribution binomiale exacte :
$$\text{IC}_{\text{Wilson}} = \frac{\hat{p} + \frac{Z^2}{2N} \pm Z \sqrt{\frac{\hat{p}(1-\hat{p})}{N} + \frac{Z^2}{4N^2}}}{1 + \frac{Z^2}{N}}$$
8.2 Indices de tendance centrale et de dispersion binaire
La caractérisation de la tendance centrale et de la dispersion d’une variable dichotomique révèle une élégance algébrique singulière. Sur le plan qualitatif strict, le mode constitue l’unique mesure directe de tendance centrale autorisée : il correspond tout simplement à la modalité qui recueille la fréquence d’occurrence la plus élevée dans l’échantillon (la catégorie majoritaire). Si la proportion $p > 0.50$, la modalité codée $1$ est le mode ; si $p < 0.50$, c’est la modalité $0$ ; en cas d’équiprobabilité stricte ($p = 0.50$), la distribution est qualifiée de bimodale symétrique.
Sur le plan quantitatif, dès lors que les données sont codées selon la convention indicatrice canonique ${0, 1}$, l’espérance arithmétique converge vers la proportion $p$, autorisant l’évaluation formelle de la dispersion des scores individuels autour de cette valeur moyenne. La formule générale de la variance populationnelle s’écrit alors :
$$\sigma^2 = E[(X – E(X))^2] = P(X=1)(1 – p)^2 + P(X=0)(0 – p)^2$$
En remplaçant les probabilités d’occurrence par leurs valeurs analytiques respectives $p$ et $1-p$, l’expression se simplifie de façon spectaculaire :
$$\sigma^2 = p(1 – p)^2 + (1 – p)(-p)^2 = p(1 – p)[(1 – p) + p] = p(1 – p)$$
Cette relation mathématique canonique, $\sigma^2 = p(1 – p) = pq$, démontre que la variance d’une variable binaire est entièrement et exclusivement dépendante de sa moyenne. Cette interdépendance constitue une propriété structurelle majeure : il est rigoureusement impossible d’altérer la moyenne d’une distribution binaire sans modifier simultanément sa variance, ce qui distingue fondamentalement la loi de Bernoulli de la loi normale (où moyenne $\mu$ et variance $\sigma^2$ sont deux paramètres fonctionnellement indépendants). En dérivant cette fonction par rapport à $p$, on constate que la dérivée première ($1 – 2p$) s’annule pour $p = 0.50$. La variance binaire est donc maximale ($\sigma^2_{\max} = 0.5 \times 0.5 = 0.25$) lorsque la population est parfaitement scindée en deux moitiés égales, et s’effondre asymptotiquement vers zéro au fur et à mesure que l’une des classes devient ultra-minoritaire ($p to 0$ ou $p to 1$).
8.3 Tabulations croisées et tables de contingence 2×2
L’analyse conjointe de deux variables dichotomiques constitue le carrefour de la recherche bivariée en épidémiologie, en psychologie et en sociologie. Cette association est systématiquement organisée sous la forme d’une table de contingence $2 \times 2$ (ou tableau croisé à quatre cases), croisant les deux modalités de la variable d’exposition ou de traitement (lignes) avec les deux modalités de la variable d’issue clinique ou comportementale (colonnes) :
| Exposition / Groupe | Événement Présent ($Y = 1$) | Événement Absent ($Y = 0$) | Total Marginal |
|---|---|---|---|
| Exposé ($X = 1$) | $a$ (Vrais Positifs) | $b$ (Faux Positifs) | $a + b = n_1$ |
| Non-exposé ($X = 0$) | $c$ (Faux Négatifs) | $d$ (Vrais Négatifs) | $c + d = n_0$ |
| Total Marginal | $a + c = m_1$ | $b + d = m_0$ | $N = a + b + c + d$ |
À partir de cette matrice fondamentale se déploient trois niveaux d’analyse probabiliste. Les probabilités conjointes quantifient la proportion globale de participants situés à l’intersection spécifique de deux modalités (par exemple, $P(X=1 cap Y=1) = a / N$). Les probabilités marginales décrivent les distributions univariées globales de chaque variable isolée ($P(X=1) = (a+b)/N$ et $P(Y=1) = (a+c)/N$). Enfin, les probabilités conditionnelles évaluent la probabilité de survenue de l’issue clinique sous la condition expresse de l’appartenance à un groupe donné, fournissant le risque absolu chez les exposés ($R_1 = \frac{a}{a+b}$) et chez les non-exposés ($R_0 = \frac{c}{c+d}$).
Cette structure autorise l’extraction immédiate de deux mesures fondamentales d’association épidémiologique : le Risque Relatif (RR), défini comme le quotient des deux risques absolus ($RR = \frac{a/(a+b)}{c/(c+d)}$), et le Rapport de Cotes (ou Odds Ratio, OR). Ce dernier compare la cote de l’événement dans le premier groupe à celle du second groupe, et se calcule de façon extrêmement directe par le produit croisé des cellules de la table :
$$\text{OR} = \frac{\frac{a}{b}}{\frac{c}{d}} = \frac{a \times d}{b \times c}$$
L’invariance mathématique remarquable de l’Odds Ratio par rapport à la transposition des lignes et des colonnes en fait la mesure d’association privilégiée pour les études cas-témoins rétrospectives, où le calcul direct des véritables risques absolus est mathématiquement rendu impossible par le protocole d’échantillonnage.
9. Analyses d’association et inférence bivariée
9.1 Le test d’indépendance du Chi-deux et la correction de Yates
Pour déterminer si la distribution conjointe observée dans une table de contingence $2 \times 2$ traduit une association statistiquement significative ou si elle peut être raisonnablement attribuée aux simples fluctuations de l’échantillonnage aléatoire, la procédure inférentielle reine est le test d’indépendance du Chi-deux de Karl Pearson. Ce test repose sur la comparaison systématique des effectifs empiriquement observés ($O_{ij}$) au sein de chaque cellule avec les effectifs dits théoriques ou attendus ($E_{ij}$) sous l’hypothèse nulle ($H_0$) d’indépendance stochastique stricte entre les deux variables.
L’effectif théorique d’une cellule croisant la ligne $i$ et la colonne $j$ est dérivé du produit de leurs probabilités marginales respectives :
$$E_{ij} = \frac{\text{Total Ligne } i \times \text{Total Colonne } j}{N}$$
La statistique du Chi-deux s’obtient alors par la sommation standardisée des écarts quadratiques calculés sur les quatre cellules de la table :
$$\chi^2 = \sum_{i=1}^2 \sum_{j=1}^2 \frac{(O_{ij} – E_{ij})^2}{E_{ij}}$$
Pour une table $2 \times 2$, cette statistique suit asymptotiquement une loi du $\chi^2$ à un unique degré de liberté ($df = (r-1)(c-1) = (2-1)(2-1) = 1$). Néanmoins, dans la mesure où la loi continue du $\chi^2$ est employée pour approximer une distribution d’échantillonnage intrinsèquement discrète, Frank Yates a proposé en 1934 une modification algorithmique consistant à soustraire $0.5$ à la valeur absolue de chaque écart avant élévation au carré :
$$\chi^2_{\text{Yates}} = \sum_{i=1}^2 \sum_{j=1}^2 \frac{(|O_{ij} – E_{ij}| – 0.5)^2}{E_{ij}}$$
Bien que la correction de continuité de Yates ait été historiquement intégrée par défaut dans des progiciels comme SPSS, la littérature statistique contemporaine (notamment les travaux d’Alan Agresti) déconseille largement son usage routinier. Cette correction s’avère en pratique excessivement conservatrice, provoquant une chute injustifiée de la puissance statistique réelle et augmentant indûment le taux d’erreurs de type II, en particulier lorsque les effectifs marginaux sont équilibrés.
9.2 Le test exact de Fisher pour petits échantillons
Lorsque la taille globale de l’échantillon $N$ est très modeste ou que les fréquences marginales sont extrêmement déséquilibrées (aboutissant à des effectifs théoriques $E_{ij} < 5$ dans une ou plusieurs cellules), les propriétés asymptotiques du test du Chi-deux de Pearson s’effondrent. Dans ces circonstances, l’analyste doit impérativement délaisser les approximations asymptotiques et mobiliser le test exact de Fisher (Fisher’s Exact Test), introduit par Sir Ronald A. Fisher en 1935.
Le test exact de Fisher repose sur le conditionnement strict des marges de la table $2 \times 2$. En postulant que les totaux marginaux ($a+b$, $c+d$, $a+c$, $b+d$) sont fixes et immuables, l’espace probabiliste des réalisations des effectifs internes de la table suit rigoureusement une distribution hypergéométrique sans replacement. La probabilité exacte d’observer la configuration spécifique des effectifs internes ${a, b, c, d}$ conditionnellement aux marges s’exprime par le quotient combinatoire suivant :
$$P({a, b, c, d}) = \frac{\binom{a+b}{a} \binom{c+d}{c}}{\binom{N}{a+c}} = \frac{(a+b)! , (c+d)! , (a+c)! , (b+d)!}{a! , b! , c! , d! , N!}$$
L’évaluation de la significativité statistique ($p$-value) s’obtient alors en sommant les probabilités exactes de la table observée et de toutes les tables théoriques possibles qui présenteraient un déséquilibre en faveur de l’association encore plus extrême que celui constaté dans les données. Longtemps limité par la lourdeur des calculs factoriels pour les grands effectifs, le test exact de Fisher est désormais exécutable instantanément par les architectures computationnelles modernes et constitue l’étalon-or absolu de l’inférence bivariée sur variables dichotomiques en présence de faibles échantillons.
9.3 Coefficients de corrélation applicables aux données dichotomiques
L’estimation de l’amplitude d’une association bivariée implique de recourir à des coefficients de corrélation spécifiquement adaptés à la nature des variables impliquées. Lorsque le chercheur analyse l’association entre deux variables dichotomiques naturelles, le coefficient approprié est le coefficient Phi ($phi$). Sur le plan computationnel, $phi$ est strictement équivalent au coefficient de corrélation produit-moment de Pearson calculé sur deux vecteurs codés numériquement en ${0, 1}$, et il est directement lié à la statistique du Chi-deux par la relation fonctionnelle :
$$\phi = \sqrt{\frac{\chi^2}{N}} = \frac{ad – bc}{\sqrt{(a+b)(c+d)(a+c)(b+d)}}$$
Le coefficient $phi$ oscille entre $-1$ et $+1$ lorsque les distributions marginales des deux variables sont rigoureusement identiques ($p_X = p_Y$). Si les proportions marginales divergent, la borne théorique maximale de $phi$ se trouve mécaniquement compressée sous l’unité, ce qui constitue une limitation importante lors de la comparaison de sous-groupes hétérogènes.
Lorsque les deux variables dichotomiques analysées résultent de la discrétisation artificielle de deux continuums latents normalement distribués au sein de la population, l’emploi de $phi$ sous-estime systématiquement la force de la liaison. Il convient alors d’estimer la corrélation tétrachorique ($r_{tet}$). Développée par Karl Pearson en 1900, la corrélation tétrachorique modélise la table $2 \times 2$ comme une partition d’une distribution normale bivariée continue, estimant par le maximum de vraisemblance la corrélation linéaire sous-jacente qui aurait été observée si les construits n’avaient pas été artificiellement écrasés par un seuillage dichotomique.
Enfin, lorsque l’analyste cherche à corréler une variable dichotomique ($X in {0, 1}$) et une variable quantitative continue ($Y$), le coefficient formellement requis est la corrélation point-bisériale ($r_{pb}$). Sa formulation mathématique explicite sa dépendance directe à la différence des moyennes continues entre les deux groupes binaires :
$$r_{pb} = \frac{\bar{Y}_1 – \bar{Y}_0}{S_Y} \sqrt{p(1 – p)}$$
où $\bar{Y}_1$ et $\bar{Y}_0$ représentent respectivement les moyennes du groupe $1$ et du groupe $0$, $S_Y$ l’écart-type global de la variable continue, et $p$ la proportion d’individus dans le groupe $1$. La corrélation point-bisériale s’inscrit au cœur de la théorie classique des tests psychométriques pour évaluer l’indice de discrimination des items (la corrélation entre la réussite binaire à un item et le score total continu obtenu au test).
10. Modélisation multivariée : Régression logistique et variables binaires dépendantes
10.1 Inadaptation de la régression linéaire classique (MCO)
L’un des écueils méthodologiques les plus fréquents en analyse quantitative réside dans la tentative d’appliquer le modèle de régression linéaire classique par la méthode des moindres carrés ordinaires (MCO) lorsque la variable dépendante $Y$ est une variable dichotomique codée ${0, 1}$. Bien que ce modèle — désigné sous le terme de Modèle de Probabilité Linéaire (MPL) — conserve une certaine intuitivité descriptive, il viole de manière catastrophique les trois postulats statistiques fondamentaux garantissant la validité du théorème de Gauss-Markov.
Le premier vice rhédibitoire du MPL concerne l’inadéquation de son espace de prédiction. Une fonction de régression linéaire de la forme $\hat{Y} = \beta_0 + \sum \beta_j X_j$ se déploie sans contrainte le long de la droite réelle ($]-\infty, +\infty[$). Par conséquent, pour des valeurs extrêmes des prédicteurs $X$, le modèle prédit inévitablement des « probabilités » mathématiquement absurdes, rigoureusement inférieures à zéro ($\hat{p} < 0$) ou strictement supérieures à l’unité ($\hat{p} > 1$), ruinant toute tentative d’interprétation probabiliste rigoureuse.
Le second vice relève de la violation systématique de l’hypothèse d’homoscédasticité (variance constante des résidus). Comme démontré précédemment, la variance d’une variable binaire dépend intrinsèquement de son espérance selon la fonction $p(1-p)$. Pour un individu $i$ ayant une combinaison spécifique de prédicteurs $X_i$, la variance de son terme d’erreur conditionnel s’écrit formellement :
$$operatorname{Var}(\epsilon_i mid X_i) = P(Y_i=1 mid X_i)(1 – P(Y_i=1 mid X_i)) = (\beta^T X_i)(1 – \beta^T X_i)$$
Cette variance est fonctionnellement instable et varie d’un individu à un autre en fonction de ses valeurs prédictives, induisant une hétéroscédasticité structurelle totale. En découle une invalidation complète du calcul des erreurs-types des coefficients : les statistiques de Student et les valeurs de $p$ produites par le logiciel sont sévèrement biaisées, entraînant des décisions inférentielles totalement erronées.
Le troisième vice est la non-normalité absolue des termes d’erreur. Les résidus $\epsilon_i = Y_i – \hat{Y}_i$ ne peuvent prendre, pour une valeur fixée de $\hat{Y}_i$, que deux réalisations possibles : soit $1 – \hat{Y}_i$, soit $-\hat{Y}_i$. La distribution des erreurs est donc strictement discrète et bimodale, défiant de manière flagrante le postulat de normalité des résidus requis pour valider les tests d’hypothèse en petits et moyens échantillons.
10.2 Principes fondamentaux de la régression logistique binaire
Pour dépasser les apories fatales du Modèle de Probabilité Linéaire, la statistique multivariée contemporaine recourt universellement à la régression logistique binaire, formalisée par David Cox en 1958. Ce modèle appartient à la famille des Modèles Linéaires Généralisés (GLM) et repose sur l’application d’une fonction de lien logit chargée de compresser la dynamique continue du prédicteur linéaire au sein du domaine de définition probabiliste restreint $[0, 1]$.
La mécanique théorique procède en trois étapes mathématiques successives. On définit initialement la probabilité conditionnelle de succès $p = P(Y=1 mid X)$. On extrait ensuite la cote (odds), qui rapporte la probabilité de survenue de l’événement à sa probabilité d’échec complémentaire : $\text{odds} = \frac{p}{1-p}$. Enfin, on applique le logarithme népérien à cette cote pour former la transformation logit :
$$operatorname{logit}(p) = \ln\left(\frac{p}{1-p}\right) = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + dots + \beta_k X_k$$
En isolant algébriquement la probabilité $p$ par inversion de la fonction logit, on dérive l’équation de la courbe logistique sigmoïde :
$$p = \frac{1}{1 + e^{-(\beta_0 + \sum \beta_j X_j)}} = \frac{e^{\beta_0 + \sum \beta_j X_j}}{1 + e^{\beta_0 + \sum \beta_j X_j}}$$
Cette formulation garantit avec une rigueur absolue que quelle que soit l’ampleur des coefficients $\beta$ ou des valeurs prises par les prédicteurs $X$, la probabilité estimée $\hat{p}$ sera mathématiquement asymptotique à $0$ lorsque le terme linéaire tend vers $-\infty$, et asymptotique à $1$ lorsqu’il tend vers $+\infty$, sans jamais franchir les frontières de l’intervalle $[0, 1]$.
L’estimation des coefficients $\beta$ ne peut plus s’effectuer par la méthode matricielle des moindres carrés analytiques ; elle requiert la méthode d’optimisation numérique par le maximum de vraisemblance (Maximum Likelihood Estimation, MLE), généralement résolue par l’algorithme itératif de Newton-Raphson. L’interprétation sémantique des paramètres s’effectue en passant à l’exponentielle des coefficients : $e^{\beta_j}$ quantifie précisément l’Odds Ratio ajusté associé à une augmentation d’une unité de la variable explicative $X_j$, toutes les autres covariables du modèle étant maintenues strictement constantes.
10.3 Évaluation de l’ajustement du modèle et classification
L’évaluation de la qualité prédictive et de la validité d’un modèle de régression logistique repose sur une batterie d’indices spécifiques, dissociés des coefficients de détermination $R^2$ classiques. L’analyste examine en premier lieu la déviance résiduelle ($D = -2 ln(L)$, où $L$ est la vraisemblance maximale du modèle). La comparaison entre la déviance du modèle nul (sans régresseurs) et la déviance du modèle ajusté suit asymptotiquement une loi du $\chi^2$ et permet de réaliser le test du rapport de vraisemblance (Likelihood Ratio Test) pour juger de l’apport global de l’ensemble des prédicteurs.
Pour tester l’adéquation locale de l’ajustement aux données, le test d’ajustement de Hosmer-Lemeshow partitionne les participants en déciles de risque prédit (généralement 10 classes ordonnées de la probabilité estimée la plus faible à la plus forte) et compare par une statistique de type Chi-deux les fréquences observées et les fréquences prédites au sein de chaque décile. Une absence de significativité statistique ($p > 0.05$) atteste d’un bon calibrage probabiliste du modèle.
Sur le plan décisionnel, les probabilités continues prédites $\hat{p}_i in [0, 1]$ sont converties en classifications binaires réelles en fixant un seuil de coupure (conventionnellement $c = 0.50$). Cette discrétisation engendre une matrice de confusion qui permet d’extraire des métriques cliniques indispensables :
- Sensibilité (Recall) : Proportion de vrais positifs correctement détectés par le modèle ($VP / (VP + FN)$).
- Spécificité : Proportion d’individus sains ou négatifs correctement identifiés ($VN / (VN + FP)$).
- Valeur Prédictive Positive (Précision) : Probabilité qu’un individu classé positif présente réellement l’événement cible ($VP / (VP + FP)$).
- Exactitude globale (Accuracy) : Proportion totale de décisions correctes au sein de l’échantillon ($(VP + VN) / N$).
Pour s’affranchir de l’arbitraire du choix d’un seuil décisionnel unique ($0.50$), la performance globale du modèle est universellement résumée par la courbe ROC (Receiver Operating Characteristic), qui trace la sensibilité en ordonnée en fonction du complémentaire de la spécificité ($1 – \text{spécificité}$, ou taux de faux positifs) en abscisse pour l’infinité des seuils de coupure possibles. L’Aire Sous la Courbe (AUC), ou statistique $c$, condense cette courbe en un indice scalaire oscillant entre $0.50$ (discrimination nulle, équivalente au hasard d’un jet de pièce) et $1.00$ (discrimination séparatrice parfaite), fournissant l’indice synthétique d’excellence prédictive le plus robuste de la modélisation binaire multivariée.
11. Représentation graphique et visualisation des données dichotomiques
11.1 Visualisation univariée et distributions de proportions
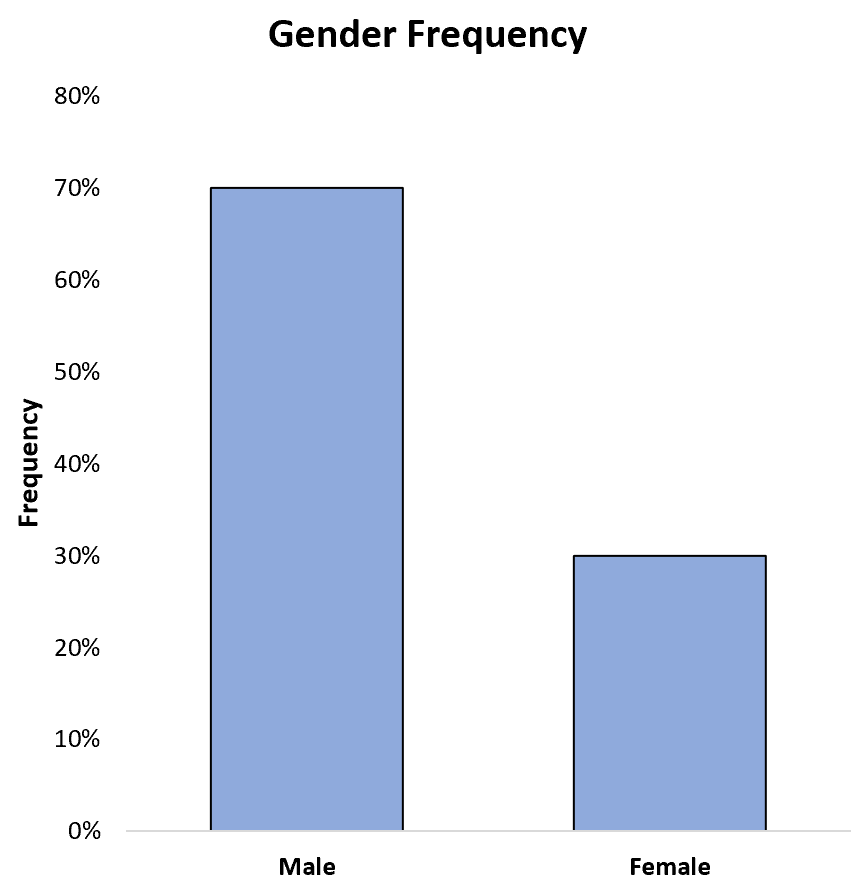
La communication scientifique et l’exploration de données relatives à des variables dichotomiques exigent des choix de visualisation adaptés aux contraintes cognitives humaines. Le mode de représentation graphique le plus classique pour une variable binaire univariée est le diagramme en barres simples (bar plot). Sur ce graphique, chaque catégorie est représentée par une barre rectangulaire dont la hauteur reflète fidèlement l’effectif absolu ($n$) ou la fréquence relative ($p$). L’ordonnée doit impérativement débuter à la valeur zéro ($y=0$) sous peine d’induire une distorsion cognitive sévère de l’amplitude relative des pourcentages visualisés.
À l’inverse, l’ergonomie visuelle et la sémiologie graphique contemporaines proscrivent catégoriquement l’usage des diagrammes circulaires (dits « camemberts » ou pie charts). Comme l’ont démontré Cleveland et McGill (1984) dans leurs travaux fondateurs sur la perception visuelle des données, l’œil humain évalue les distances linéaires et les hauteurs avec une précision géométrique infiniment supérieure à sa capacité à quantifier des surfaces ou des angles de secteurs angulaires. Une divergence de proportion subtile (par exemple 48 % contre 52 %) est immédiatement perçue sur un diagramme en barres, alors qu’elle s’avère cognitivement indétectable sur un diagramme circulaire sans ajout d’étiquettes chiffrées explicites.
Pour conférer une rigueur inférentielle accrue à la représentation descriptive, la méthode moderne privilégiée consiste à superposer aux barres de proportions des graphiques d’intervalles de confiance d’échantillonnage. En intégrant des barres d’erreur matérialisant l’intervalle de confiance de Wilson à 95 % autour de la proportion empirique ponctuelle, le chercheur informe instantanément le lecteur sur la précision métrologique de son estimation et sur la marge d’erreur inhérente à la taille de son effectif d’étude.
11.2 Visualisation bivariée et relations d’interdépendance
Dès lors que l’investigation s’étend à la relation bivariée croisant deux variables dichotomiques, les diagrammes en barres simples doivent évoluer vers des diagrammes en barres empilées normalisées à 100 % (100% stacked bar charts). Dans cette modalité, chaque barre transversale présente une hauteur constante (100 %) représentant un sous-groupe de la variable indépendante, et la barre est segmentée proportionnellement en deux blocs colorés matérialisant la répartition relative de la variable dépendante binaire. Cette visualisation permet une comparaison directe et immédiate des taux de prévalence ou de succès d’un groupe à un autre.
Un outil plus sophistiqué encore pour restituer l’équilibre global d’une table de contingence $2 \times 2$ est le diagramme en mosaïque (mosaic plot ou spineplot). Contrairement au diagramme empilé classique, le diagramme en mosaïque fait varier simultanément les deux dimensions spatiales du rectangle : la largeur des colonnes est proportionnelle aux effectifs marginaux de la première variable ($X$), tandis que la hauteur des subdivisions internes reflète les proportions conditionnelles de la seconde variable ($Y$). L’aire géométrique de chaque pavé rectangulaire est ainsi directement proportionnelle au nombre effectif d’observations contenues dans chaque case de la table, offrant une vue synoptique intégrale des données brutes et conditionnelles.
Enfin, lorsque le protocole vise à visualiser la distribution d’une variable quantitative continue stratifiée selon les deux modalités d’un groupe dichotomique (par exemple, le taux de cortisol salivaire chez les patients cliniques versus les témoins sains), l’analyste doit abandonner les diagrammes en barres de moyennes (dits dynamite plots) au profit de visualisations riches et non paramétriques. L’association de boîtes à moustaches (boxplots de Tukey) et de diagrammes en violon (violin plots) permet de restituer conjointement la médiane, les quartiles, les valeurs aberrantes et l’estimation de la densité par noyau de l’ensemble du profil distributionnel de chaque modalité binaire.
11.3 Visualisation diagnostique et prédictive en modélisation
Dans le registre de la modélisation statistique avancée, la visualisation des variables dichotomiques prend une dimension diagnostique et pronostique essentielle. Lors de l’ajustement d’une régression logistique univariée liant un prédicteur continu à une issue binaire, la figure maîtresse est le tracé de la courbe sigmoïde logistique. En reportant sur le graphique les points de données réels situés exclusivement aux ordonnées $Y=0$ et $Y=1$ (fréquemment agrémentés d’un léger « jittering » vertical aléatoire pour visualiser la densité des points superposés) et en superposant la fonction sigmoïde $p(X)$ modélisée, le chercheur offre une lecture limpide de la transition probabiliste au fur et à mesure de l’incrémentation du facteur continu.
Pour juger du pouvoir discriminant d’un modèle diagnostique, la courbe ROC s’impose comme le standard graphique universel. Elle trace la trajectoire de performance du modèle en reliant les coordonnées de sensibilité et de spécificité calculées sur l’intégralité du continuum des seuils possibles. Cette courbe est obligatoirement assortie de la diagonale de non-discrimination (la bissectrice $y=x$), symbolisant la performance d’un modèle aléatoire sans valeur prédictive ($AUC = 0.50$). L’écart géométrique vertical séparant la courbe observée de cette diagonale de référence matérialise visuellement le gain de diagnostic fourni par l’algorithme.
Enfin, pour synthétiser les résultats multivariés issus de régressions logistiques complexes ou de méta-analyses épidémiologiques, le standard de communication incontournable est le graphique en forêt (forest plot). Cette figure représente l’ensemble des prédicteurs sur l’axe vertical, tandis que l’axe horizontal, gradué sur une échelle logarithmique, affiche l’amplitude des Odds Ratios (OR). Chaque variable est visualisée par un point central ou un carré dont la dimension reflète son poids statistique, encadré par une ligne horizontale matérialisant son intervalle de confiance à 95 %. Une ligne verticale de référence positionnée sur l’unité ($\text{OR} = 1.00$) signale immédiatement l’absence d’effet ; tout intervalle de confiance traversant cette ligne axiale indique un prédicteur non significatif au seuil standard $\alpha = 0.05$.
12. Directives méthodologiques et pièges à éviter en pratique de recherche
12.1 Préservation de l’intégrité métrique des données lors de la collecte
Au terme de cette exploration métrologique, la directive méthodologique primordiale qui s’impose à tout chercheur en sciences empiriques peut être formulée sous forme d’un principe fondamental : toujours collecter les données au niveau métrique le plus élevé possible, et ne jamais dichotomiser prématurément lors de l’acquisition instrumentale. Si un phénomène psychologique, biologique ou social présente la moindre possibilité d’être capturé sous une forme quantitative continue ou ordinale fine, c’est impérativement cette granularité maximale qui doit être consignée dans le protocole de recueil initial.
Dans la conception des questionnaires d’auto-évaluation, il est méthodologiquement déconseillé de formuler des questions binaires rigides de type « Accord / Désaccord » ou « Oui / Non » pour sonder des attitudes complexes, des traits de personnalité ou des affects subjectifs. L’emploi d’échelles de Likert graduées en 5, 7 ou 9 points, voire d’échelles visuelles analogiques continues (VAS), doit être systématiquement préféré. Ce choix préserve l’intégralité de la variance interindividuelle et garantit une flexibilité analytique totale lors des étapes ultérieures de traitement : le chercheur disposera toujours de la liberté technique de compresser ses données en deux classes a posteriori si une contrainte pragmatique absolue l’impose, alors que l’opération inverse — reconstituer une granularité continue perdue à partir d’un recueil binaire originel — est mathématiquement impossible.
Cette exigence impose une documentation rigoureuse des instruments de recueil dans les rapports scientifiques. Le chercheur doit déclarer explicitement la forme originale sous laquelle chaque variable a été sollicitée auprès des participants, en explicitant le nombre de modalités de réponse, la formulation textuelle exacte des ancres sémantiques et les justifications théoriques ayant guidé le choix du niveau d’échelle.
12.2 Transparence analytique et pré-enregistrement des dichotomisations
Lorsque la dichotomisation d’une variable continue s’avère inévitable pour des motifs cliniques ou décisionnels impérieux, elle ne doit en aucun cas résulter d’un choix post-hoc opportuniste guidé par l’inspection des données brutes. Pour garantir l’intégrité du processus scientifique et prémunir les chercheurs contre les dérives insidieuses du HARKing (Hypothesizing After the Results are Known) et du p-hacking, l’ensemble des points de coupure prévus doit être rigoureusement consigné dans un protocole d’analyse pré-enregistré (preregistration) déposé sur des registres publics certifiés tels que l’Open Science Framework (OSF) ou ClinicalTrials.gov avant l’accès aux données.
Dans ce pré-enregistrement, le chercheur doit expliciter la justification rationnelle ou clinique étayant le seuil retenu (en s’appuyant sur des publications épidémiologiques antérieures indépendantes) et déclarer en amont les règles de traitement des valeurs limites situées exactement sur la frontière de scission. Si une analyse implique une dichotomisation exploratoire non planifiée en amont, celle-ci doit être catégoriquement signalée comme une « analyse secondaire post-hoc » dans le corps du manuscrit académique, avec interdiction stricte de la présenter comme un test d’hypothèse confirmatoire.
De surcroît, les bonnes pratiques de la recherche contemporaine exigent la réalisation systématique d’analyses de sensibilité métrologique. L’analyste doit réitérer l’ensemble de ses modélisations en décalant itérativement le point de coupure sélectionné (par exemple, en testant les effets avec le 40e, le 45e, le 50e, le 55e et le 60e centile) et en réinjectant la variable originelle sous sa forme continue continue dans un modèle linéaire généralisé. Si les conclusions scientifiques substantiellement tirées de l’étude s’effondrent dès que le seuil varie d’une fraction d’écart-type, le chercheur a le devoir d’en informer ses pairs, reconnaissant ainsi la fragilité empirique de l’artéfact de partitionnement.
12.3 Interprétation prudente des causalités et généralisabilité
La dernière mise en garde concerne l’interprétation des relations statistiques impliquant des prédicteurs dichotomiques dans les études observationnelles. L’existence d’une différence de proportions statistiquement significative ou d’un Odds Ratio spectaculaire entre deux groupes binaires ne constitue en aucune manière une preuve d’inférence causale directe. Les prédicteurs dichotomiques statuts (tels que le genre, le milieu d’habitation ou la présence d’une comorbidité) constituent fréquemment des marqueurs de substitution ou des « proxys » macroscopiques capturant une multitude de facteurs de confusion résiduels non mesurés (niveau socio-économique, exposition toxique environnementale, hygiène de vie, capitaux culturels).
Un autre défi analytique majeur émerge lorsque la variable dépendante binaire présente un déséquilibre d’effectifs extrême, souvent désigné sous l’étiquette de « données d’événements rares » (par exemple, un événement clinique d’intérêt n’affectant que 1 % ou 2 % des participants de l’échantillon). Dans cette situation, la régression logistique classique par maximum de vraisemblance produit une sous-estimation systématique de la probabilité de survenue de l’événement et peut générer des erreurs-types hautement instables. Le chercheur doit alors déployer des corrections algorithmiques avancées, telles que la régression logistique pénalisée de Firth (fondée sur la pénalisation de Jeffreys) ou des protocoles de rééchantillonnage stratifié pour garantir la robustesse des estimations.
En synthèse, la variable dichotomique constitue une arme métrologique à double tranchant : elle offre une puissance d’action, une netteté de classification et une communicabilité incomparables, mais exige en contrepartie une vigilance méthodologique infaillible. Seule une manipulation consciente de ses propriétés mathématiques, de ses limites inférentielles et de ses controverses historiques permet de l’ériger en un instrument d’élucidation scientifique au service de la vérité empirique.
Références
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
- American Psychiatric Association. (2013). Diagnostic and statistical manual of mental disorders (5th ed.). American Psychiatric Publishing. https://doi.org/10.1176/appi.books.9780890425596
- Boole, G. (1854). An investigation of the laws of thought on which are founded the mathematical theories of logic and probabilities. Walton and Maberly.
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984). Classification and regression trees. Wadsworth International Group.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cohen, J. (1983). The cost of dichotomization. Applied Psychological Measurement, 7(3), 249–253. https://doi.org/10.1177/014662168300700301
- Cox, D. R. (1958). The regression analysis of binary sequences. Journal of the Royal Statistical Society: Series B (Methodological), 20(2), 215–232. https://doi.org/10.1111/j.2517-6161.1958.tb00292.x
- Fechner, G. T. (1860). Elemente der Psychophysik. Breitkopf und Härtel.
- Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27–38. https://doi.org/10.1093/biomet/80.1.27
- Fisher, R. A. (1935). The logic of inductive inference. Journal of the Royal Statistical Society, 98(1), 39–82. https://doi.org/10.2307/2342435
- Green, D. M., & Swets, J. A. (1966). Signal detection theory and psychophysics. John Wiley & Sons.
- Guttman, L. (1944). A basis for scaling qualitative data. American Sociological Review, 9(2), 139–150. https://doi.org/10.2307/2086306
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- Irwin, J. R., & McClelland, G. H. (2003). Negative consequences of dichotomizing continuous predictor variables. Journal of Marketing Research, 40(3), 366–371. https://doi.org/10.1509/jmkr.40.3.366.19237
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
- Maxwell, S. E., & Delaney, H. D. (1993). Bivariate median splits and spurious statistical significance. Psychological Bulletin, 113(1), 181–190. https://doi.org/10.1037/0033-2909.113.1.181
- Pearson, K. (1900). Mathematical contributions to the theory of evolution. VII. On the correlation of characters not quantitatively measurable. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 195, 1–47. https://doi.org/10.1098/rsta.1900.0022
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Yates, F. (1934). Contingency tables involving small numbers and the $\chi^2$ test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604
- Yule, G. U. (1900). On the association of attributes in statistics: With illustrations from the material of the Childhood Society, &c. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 194, 257–319. https://doi.org/10.1098/rsta.1900.0019