
L’histoire de la pensée scientifique moderne est intimement liée à la quête rigoureuse des déterminismes causaux. Depuis les premières formalisations de la méthode inductive par Francis Bacon jusqu’aux développements contemporains de l’économétrie et de l’épidémiologie computationnelle, l’investigation empirique s’est heurtée à un défi méthodologique constant : la distinction fondamentale entre une cooccurrence phénoménologique et une relation de causalité effective. Dans la pratique quotidienne des sciences comportementales, biomédicales et sociales, l’observation d’une covariance mathématique entre deux grandeurs mesurables constitue bien souvent la première étape de la théorisation. Pourtant, cette régularité apparente dissimule fréquemment une réalité structurelle beaucoup plus complexe, gouvernée par des dynamiques non appréhendées par le chercheur.
Parmi les écueils qui jalonnent l’interprétation des données quantitatives, le concept de variable cachée — désigné dans la littérature anglo-saxonne sous le terme de lurking variable — occupe une place centrale. Loin de constituer une simple curiosité statistique ou un détail résiduel d’ajustement, la variable cachée incarne la fragilité de toute inférence probabiliste dès lors que le modèle théorique sous-jacent omet un pan du réel empirique. Lorsqu’elle demeure ignorée, cette variable invisible peut générer des illusions d’association absolue, masquer des effets substantiels réels, ou même provoquer des inversions directionnelles spectaculaires des résultats empiriques, défiant ainsi les intuitions initiales du praticien et du chercheur.
Le présent article propose une exploration exhaustive, théorique et appliquée de la problématique des variables cachées. En articulant les fondements de l’épistémologie quantitative, les paradigmes de l’inférence causale moderne formulés notamment par Judea Pearl, ainsi qu’une taxonomie comparative rigoureuse, cette contribution entend doter les chercheurs, étudiants et praticiens d’un cadre conceptuel robuste. À travers des exemples emblématiques issus des sciences du comportement, de la psychologie clinique, de la cognition et de la modélisation institutionnelle, nous analyserons les rouages de ces distorsions statistiques afin de dégager des protocoles méthodologiques préventifs et correctifs indispensables à la validité de la recherche contemporaine.
1. Introduction conceptuelle et définition théorique de la variable cachée
1.1 Définition formelle et caractéristiques fondamentales
Sur le plan formel, une variable cachée désigne une variable qui n’a pas été incluse dans le protocole d’observation, qui échappe à la métrologie mise en œuvre ou qui a été délibérément écartée du modèle explicatif initial, mais qui exerce néanmoins une influence déterminante sur les dynamiques étudiées. En d’autres termes, elle réside en dehors du champ perceptif formalisé par le chercheur tout en possédant une efficacité causale intrinsèque au sein du système étudié. Sa caractéristique primordiale réside dans sa propension à interagir simultanément avec la variable réputée indépendante (le prédicteur) et la variable réputée dépendante (le critère de résultat), créant ainsi une déformation artificielle de l’estimation de leur association.
Il importe de distinguer avec minutie l’invisibilité méthodologique de cette variable de son existence ontologique. Une variable cachée n’est ni un artefact imaginaire ni une abstraction spectrale : elle correspond à une dimension matérielle, biologique, psychologique ou environnementale concrète qui opère en arrière-plan sans avoir été opérationnalisée par les instruments de mesure. Sa non-mesure peut découler d’une limite technique de l’instrumentation, d’une lacune dans le corpus théorique guidant l’étude, ou encore d’une décision de conception expérimentale guidée par le principe de parcimonie mal appliqué.
Le rôle de cette variable dans la distorsion des estimations paramétriques est particulièrement délétère au sein des modèles linéaires généraux. Dans le cadre d’une régression linéaire ou logistique, l’exclusion d’un prédicteur pertinent corrélé aux variables explicatives retenues transfère directement sa variance au sein du terme d’erreur stochastique. Ce transfert altère substantiellement les propriétés des estimateurs : les coefficients de régression deviennent biaisés et non convergents, tandis que les coefficients de corrélation linéaire bivariée reflètent une grandeur hybride, mélange inextricable de la relation directe et de l’influence clandestine du facteur omis.
1.2 Origine terminologique et nuances sémantiques
L’expression anglo-saxonne lurking variable, popularisée dans la seconde moitié du vingtième siècle par des statisticiens pédagogues tels que David S. Moore, évoque l’idée métaphorique d’une entité qui « rôde » ou « se tapit dans l’ombre », prête à perturber l’interprétation des données. Dans l’espace académique francophone, les traductions varient selon les disciplines, oscillant entre les termes de « variable cachée », « variable sous-jacente », « variable tapie » ou encore « variable omise », ce dernier vocable étant préférentiellement adopté par la communauté des économètres et des modélisateurs en séries temporelles.
Il convient d’établir une distinction sémantique essentielle entre une variable cachée et une variable latente. Alors qu’une variable cachée renvoie généralement à une entité non observée qui contamine et invalide l’analyse par omission involontaire, la variable latente constitue une construction mathématique explicitement formalisée au sein de modèles factoriels ou d’équations structurelles pour représenter un construit théorique non directement mesurable (tel que l’intelligence fluide ou le névrosisme) à partir de plusieurs indicateurs manifestes. La variable latente est donc intentionnellement modélisée, alors que la variable cachée correspond à un angle mort épistémologique.
Historiquement, l’appréhension de ces variables a accompagné l’essor des statistiques inférentielles initié par Karl Pearson et Ronald Fisher. Dans le champ de l’épistémologie des sciences humaines, la reconnaissance des variables cachées a porté un coup fatal au réductionnisme empiriste naïf. Elle a forcé les chercheurs à admettre qu’un ensemble de données quantitatives ne porte jamais en lui-même sa propre explication causale, et que l’interprétation des régularités observées exige impérativement un cadre théorique préliminaire capable d’anticiper les facteurs non captés par les registres d’échantillonnage.
1.3 La place des variables cachées dans l’analyse causale contemporaine
La révolution théorique menée par Judea Pearl à travers les modèles de causalité structurelle (Structural Causal Models) a permis de doter le concept de variable cachée d’une clarification mathématique sans précédent. En rupture avec la simple tradition régressionniste, Pearl démontre que les outils algébriques standards sont structurellement inaptes à exprimer la causalité sans une modélisation explicite des flux génératifs des données. Dans cette optique, l’évaluation des variables cachées s’effectue au moyen de l’opérateur mathématique do(x), distinguant radicalement la simple observation probabiliste conditionnelle de l’intervention causale active.
Au cœur de cette formalisation se trouvent les diagrammes acycliques dirigés (Directed Acyclic Graphs ou DAG). Dans un DAG, les variables cachées sont usuellement schématisées sous forme de nœuds non observés (souvent cerclés en pointillés ou notés U pour Unobserved) d’où émergent des flèches directionnelles pointant simultanément vers deux variables d’intérêt manifeste, disons X et Y. Cette structure topologique, qualifiée de « bifurcation » ou de structure en fourche (fork), matérialise l’existence d’une cause commune non mesurée qui ouvre un chemin non causal (ou chemin de porte dérobée, backdoor path) entre X et Y, transmettant une covariance purement illusoire.
D’un point de vue statistique traditionnel, la présence d’une telle variable cachée viole directement l’hypothèse d’exogénéité stricte, qui postule l’indépendance conditionnelle entre les régresseurs et le terme d’erreur. Dès lors que cette indépendance est rompue en raison de la présence d’une variable causale dans le terme d’erreur corrélée avec les prédicteurs, le principe d’orthogonalité est anéanti. En conséquence, l’inférence causale probabiliste devient caduque, exposant l’analyste au risque d’attribuer à une intervention sur X des transformations systémiques qui dépendent en réalité entièrement des variations de la variable cachée U.
2. Distinction taxonomique : Variables cachées, confondantes et médiatrices
2.1 Variable cachée vs variable de confusion (confounding variable)
L’une des ambiguïtés les plus récurrentes dans la littérature scientifique réside dans l’interchangeabilité erronée des termes « variable cachée » et « variable confondante » (ou facteur de confusion). Il est impératif d’établir une ligne de démarcation épistémique précise : le terme de « variable cachée » qualifie l’état épistémologique d’un facteur, à savoir son invisibilité, son absence de mesure ou son omission du protocole expérimental. En revanche, le terme de « facteur de confusion » qualifie le rôle fonctionnel et relationnel qu’exerce une variable au sein d’une structure causale triangulaire donnée.
Par voie de conséquence, un facteur de confusion peut être parfaitement identifié, mesuré, voire contrôlé statistiquement au cours de l’analyse, cessant dès lors d’être une variable cachée. Inversement, une variable cachée opère comme un facteur de confusion précisément tant qu’elle demeure tapie dans l’angle mort de l’expérimentateur. Pour qu’une variable cachée agisse en tant que facteur de confusion, elle doit satisfaire trois critères épidémiologiques rigoureux : elle doit être statistiquement associée à la variable d’exposition (le prédicteur), elle doit constituer un facteur de risque ou de causalité autonome vis-à-vis de l’événement étudié (la variable dépendante), et elle ne doit en aucun cas se situer sur la trajectoire causale intermédiaire reliant l’exposition au résultat.
Lorsque la variable confondante est mesurée, la méthodologie offre une panoplie d’outils d’ajustement a posteriori — tels que la régression multivariée, la stratification de Mantel-Haenszel ou l’appariement par score de propension. Cependant, lorsqu’elle conserve son statut de variable cachée, aucun ajustement mathématique conventionnel n’est possible, laissant le coefficient de corrélation entièrement vulnérable à la distorsion induite par cette asymétrie non compensée.
2.2 Variable cachée vs variable médiatrice
La distinction entre une variable cachée intervenant comme facteur de confusion et une variable médiatrice touche au cœur même de la chaîne téléologique des causalités. Une variable médiatrice se définit par son insertion chronologique et fonctionnelle directe dans le cheminement causal reliant le facteur initial à son effet final : le schéma structural s’établit selon la séquence X → M → Y. Dans cette configuration, la variable intermédiaire M n’altère pas la réalité causale fondamentale de X sur Y ; elle en constitue l’instrument d’action, le vecteur d’extériorisation phénoménologique ou le mécanisme biologique ou cognitif sous-jacent.
Le risque méthodologique majeur survient lorsqu’un analyste assimile par erreur une cause commune sous-jacente (variable cachée formant une bifurcation X ← U → Y) à une chaîne de médiation (X → M → Y), ou réciproquement. Si une variable non mesurée est en réalité un médiateur, l’association entre X et Y demeure authentiquement causale, même si le mécanisme intermédiaire échappe à l’observation fine. À l’inverse, si l’on tente d’ajuster ou de « neutraliser » statistiquement une variable que l’on traite à tort comme un facteur de confusion alors qu’elle constitue un médiateur intrinsèque, on bloque indûment le flux causal légitime, conduisant à une sous-estimation dramatique de l’effet total de l’intervention.
La validation formelle d’un statut de médiation requiert le déploiement de protocoles statistiques différentiels, reposant historiquement sur les quatre étapes de régression formalisées par Baron et Kenny ou, de manière plus contemporaine, sur l’estimation des effets indirects par rééchantillonnage (bootstrapping) au sein de modèles de causalité contrefactuelle. L’omission d’une variable explicative dans ce contexte peut dissimuler l’existence de plusieurs voies de médiation concurrentes, altérant la compréhension des mécanismes d’action réels.
2.3 Variable cachée vs variable modératrice
Alors que la variable confondante s’intéresse à l’origine commune d’une corrélation et que la médiatrice décrit le mécanisme de transmission causale, la variable modératrice affecte la force, l’amplitude ou la direction de la relation existant entre la variable indépendante et la variable dépendante. Sur le plan statistique, la modération se traduit mathématiquement par un terme d’interaction au sein du modèle linéaire : l’impact marginal de X sur Y n’est plus constant, mais devient une fonction mathématique directe de la valeur prise par le modérateur Z.
Lorsqu’une variable agissant comme modérateur demeure cachée et non modélisée, les répercussions empiriques s’avèrent insidieuses. Le modèle standard postule une homogénéité des effets de traitement à travers l’ensemble de la population échantillonnée. Or, l’action clandestine d’un modérateur non pris en compte dissimule une hétérogénéité substantielle des effets. Dans certaines strates non répertoriées de l’échantillon, la relation peut s’avérer extrêmement robuste et positive, tandis que dans d’autres strates, elle peut être rigoureusement nulle, voire négative.
L’estimation globale non stratifiée aboutit alors à une moyenne trompeuse qui ne correspond à la réalité concrète d’aucun sous-groupe spécifique. De surcroît, cette méconnaissance ouvre la voie à des erreurs méthodologiques graves lors d’analyses post-hoc en sous-groupes, où l’analyste, constatant une instabilité inattendue des réplications empiriques, formule des hypothèses erronées d’attribution causale au lieu d’identifier la dynamique d’interaction sous-jacente qui module les variations observées du phénomène.
3. Mécanismes d’illusion statistique et biais d’interprétation
3.1 La création de corrélations fallacieuses (spurious correlations)
Le phénomène de corrélation fallacieuse — conceptualisé dès la fin du dix-neuvième siècle par le statisticien britannique Karl Pearson — représente l’un des symptômes les plus éclatants de l’interférence d’une variable cachée. Il décrit une configuration au sein de laquelle deux variables, totalement dissociées sur le plan fonctionnel et causal, manifestent une covariance empirique étroite, statistiquement significative et reproductible sur des séries de données longitudinales ou transversales. Cette régularité n’est en rien le reflet d’une dynamique d’attraction ou de causalité mutuelle : elle procède purement de la synchronie imposée par une troisième variable invisible qui gouverne de façon concomitante les deux indicateurs observés.
Le truisme populaire « corrélation n’est pas causalité » puise sa légitimité épistémique directement dans ce mécanisme de bifurcation factorielle. L’esprit humain, biologiquement configuré pour l’inférence heuristique et la détection de schémas réguliers, tend à projeter des relations d’implication directe là où n’opère qu’une dépendance stochastique passive. Dès lors qu’une variable cachée U croît ou décroît, ses ramifications simultanées sur X et Y créent une illusion cinétique parfaite d’interaction directe.
À l’ère contemporaine de l’apprentissage automatique et du Big Data, ce risque d’illusion statistique se trouve décuplé de manière exponentielle. L’exploitation aveugle de gigaoctets de données hautement multidimensionnelles favorise l’émergence d’un bruit statistique massif où des myriades de variables sans lien théorique présentent des corrélations artificiellement gonflées par l’influence ubiquitaire de variables démographiques, climatiques ou technologiques sous-jacentes non traitées, créant ce que Nassim Nicholas Taleb qualifie de prolifération de régularités illusoires.
3.2 L’atténuation ou le masquage d’une relation causale réelle
Si la variable cachée peut générer des associations fantômes, elle dispose réciproquement du pouvoir d’annihiler, aux yeux de l’observateur, des relations causales pourtant parfaitement authentiques et substantielles. Cette dynamique correspond au phénomène de suppression statistique, formalisé initialement dans les travaux de Paul Lazarsfeld. Dans cette situation, la corrélation bivariée brute entre un prédicteur X et un critère Y apparaît statistiquement non significative, voire rigoureusement égale à zéro, incitant le chercheur à rejeter précipitamment son hypothèse de travail.
Ce masquage survient lorsque la variable cachée est corrélée avec la variable indépendante et la variable dépendante selon des orientations contraires. Par exemple, si la variable cachée exerce un effet direct positif massif sur le critère d’évaluation tout en étant négativement corrélée avec le facteur de traitement, ces forces vectorielles opposées s’annulent algébriquement lors de l’agrégation des données. L’effet direct authentique de l’intervention est alors contrebalancé de manière invisible par la trajectoire indirecte induite par le facteur non contrôlé.
Les conséquences épistémologiques et sociétales de ce masquage sont dévastatrices, particulièrement dans la recherche biomédicale ou comportementale, où il induit des erreurs de type II (faux négatifs). Des molécules thérapeutiques prometteuses ou des programmes d’intervention psycho-éducatifs hautement bénéfiques peuvent être prématurément écartés et archivés par des comités d’évaluation scientifique simplement parce qu’un facteur sous-jacent hétérogène a étouffé la manifestation de leur efficacité clinique réelle au sein du groupe traité.
3.3 Le biais d’omission de variables et l’estimation paramétrique
Sur le plan de l’économétrie formelle, l’impact d’une variable cachée s’exprime avec une limpidité implacable à travers le théorème du biais d’omission de variable (Omitted Variable Bias). Considérons le modèle théorique exact reliant un vecteur de réponse Y à une variable observée X et une variable non observée Z :
Y = β0 + β1X + β2Z + ε
Si le chercheur ignore l’existence ou l’importance de Z et se borne à estimer le modèle linéaire réduit Y = α0 + α1X + u via la méthode des moindres carrés ordinaires (MCO), l’espérance mathématique du coefficient estimé α̂1 ne sera pas égale au véritable paramètre d’intérêt β1. L’algèbre matricielle démontre de façon irréfutable la relation suivante :
E(α̂1) = β1 + β2 × [Cov(X, Z) / Var(X)]
Cette égalité fondamentale met en lumière l’anatomie exacte du biais paramétrique. L’amplitude et le sens de la distorsion dépendent directement du produit entre l’impact intrinsèque de la variable cachée sur le critère (β2) et la régression auxiliaire de la variable cachée sur la variable explicative retenue. Si la variable cachée n’a aucun lien avec X (covariance nulle), le coefficient demeure non biaisé dans son espérance, bien que la variance résiduelle soit artificiellement accrue. En revanche, dès lors qu’il existe une corrélation entre X et la variable cachée Z, le coefficient α̂1 absorbe de manière indue une fraction de l’effet de Z, conduisant à des surestimations spectaculaires ou à des inversions de signe désastreuses pour la prise de décision.
4. Menaces méthodologiques sur la validité des recherches
4.1 Altération de la validité interne
La validité interne constitue la clé de voûte de toute démonstration scientifique empirique ; elle reflète le degré d’assurance méthodologique permettant d’affirmer que les variations observées sur la variable dépendante résultent exclusivement de la manipulation ou des oscillations de la variable indépendante. La présence insidieuse d’une variable cachée dynamite ce socle inférentiel en introduisant des explications concurrentes non maîtrisées. L’analyste se trouve dans l’incapacité logique d’attribuer de façon univoque l’effet mesuré au traitement expérimental.
Cette vulnérabilité compromet gravement la directionalité causale postulée par l’étude. Dans les designs quasi-expérimentaux ou observationnels longitudinaux, l’absence de contrôle sur les fluctuations environnementales, temporelles ou individuelles laisse la porte ouverte à une contamination systématique de l’espace de mesure. Le principe fondamental d’isolation, hérité du cartésianisme scientifique, stipule qu’une inférence n’est tenable que si toutes les autres causes potentielles demeurent neutralisées (clause ceteris paribus) ; or, la variable cachée viole précisément cette clause sans que l’expérimentateur n’en ait conscience.
Dès lors, les hypothèses rivales ne peuvent plus être formellement falsifiées au sens poppérien. L’observateur s’enferme dans une illusion de confirmation expérimentale, validant son modèle explicatif sur la base d’indices quantitatifs rigoureux, alors même que le moteur substantiel du phénomène étudié s’opère en marge de son paradigme d’enregistrement, rendant ses conclusions intrinsèquement fragiles face à toute tentative de déconstruction théorique.
4.2 Dégradation de la validité de construit
La validité de construit renvoie à l’adéquation épistémologique entre les dispositifs d’évaluation opérationnels mis en œuvre et les concepts théoriques abstraits qu’ils sont censés quantifier. Lorsqu’une variable cachée s’immisce dans l’environnement de recherche, elle distord cette chaîne de correspondance sémiotique. Le chercheur court le péril permanent d’attribuer un score ou une réaction à une propriété psychologique, cognitive ou sociologique spécifique, alors que l’indicateur reflète en réalité l’influence prépondérante d’un déterminant contextuel non théorisé.
Ce biais se manifeste avec une acuité singulière dans l’usage des échelles psychométriques et des tests comportementaux standardisés. Par exemple, si l’on tente d’évaluer la « propension à la coopération » au moyen d’un jeu économique expérimental sans mesurer la variable cachée que constitue l’« aisance financière préalable » du sujet, les choix comportementaux observés traduiront bien davantage la marge de sécurité matérielle du participant que son trait de personnalité prosocial. L’instrument enregistre le facteur d’arrière-plan tout en prétendant quantifier le construit psychologique focal.
Cette contamination invalide la validité divergente et la validité convergente des échelles de mesure. La variance commune captée par les matrices de corrélations factorielles n’émane plus de la cohérence interne du domaine théorique investigué, mais d’une source systématique externe non spécifiée. Le modèle de mesure se trouve ainsi structurellement corrompu, produisant des réifications conceptuelles illégitimes au détriment de la précision scientifique.
4.3 Limitation de la validité externe et de la reproductibilité
La crise contemporaine de la reproductibilité scientifique, qui ébranle profondément la psychologie, les neurosciences et les sciences de la santé, trouve l’un de ses moteurs les plus constants dans l’action invisible des variables cachées. La validité externe définit l’aptitude des inférences tirées d’une étude empirique singulière à être généralisées à d’autres populations, contextes écologiques ou périodes temporelles. Or, si les résultats d’une expérience dépendent d’un facteur d’arrière-plan ignoré qui n’était présent que fortuitement dans l’échantillon initial, l’effet s’effondrera inévitablement lors de toute tentative de réplication menée au sein d’un laboratoire différent.
Les variations infinitésimales des particularismes environnementaux ou institutionnels d’un site d’investigation à un autre suffisent à briser la régularité statistique postulée. Qu’il s’agisse de subtilités d’échantillonnage démographique, de différences de protocoles d’accueil des sujets, ou de variations climatiques ou saisonnières non rapportées dans la section méthodologique de la publication princeps, ces variables cachées constituent des modérateurs clandestins de l’effet de traitement.
Il en résulte une instabilité chronique de la littérature scientifique, caractérisée par des controverses méthodologiques stériles où différentes équipes de recherche s’opposent sur la réalité empirique d’un phénomène donné. Au lieu d’identifier la sensibilité extrême de l’objet d’étude à une distribution divergente de variables non observées d’un échantillon à l’autre, les chercheurs en viennent souvent à formuler des accusations d’incompétence technique ou de manipulation de données, occultant la véritable cause systémique du différend.
5. Exemples classiques et archétypaux hors contexte expérimental
5.1 La corrélation ventes de glaces et attaques de requins
L’exemple canonique le plus fréquemment mobilisé dans l’enseignement de l’épistémologie statistique pour illustrer la mécanique des variables cachées met en scène la corrélation positive substantielle et récurrente observée entre le volume des ventes de crèmes glacées sur les littoraux côtiers et la fréquence des attaques de squales recensées sur les mêmes zones géographiques au cours d’une année civile. Prise au premier degré dans une logique de causalité aveugle, cette association mathématique pourrait inciter un observateur naïf à suggérer que la consommation de glaces attire les prédateurs marins ou modifie chimiquement l’odeur corporelle des nageurs.
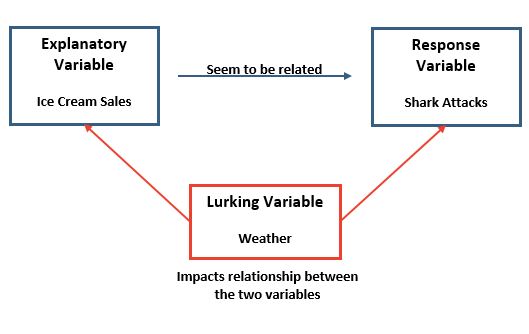
L’analyse rationnelle déconstruit instantanément cette aberration par la mise en évidence d’une variable cachée fondamentale : la température atmosphérique estivale, ou le climat saisonnier global. Lorsque les températures s’élèvent durant les mois d’été, deux comportements humains parfaitement distincts mais synchrones augmentent simultanément sous l’effet de cette cause thermique commune. D’une part, les vacanciers achètent des produits rafraîchissants pour réguler leur confort corporel. D’autre part, ils se rendent en masse sur les plages et pénètrent dans l’eau salée pour se baigner.
C’est donc la densité d’exposition humaine dans le milieu marin — elle-même conditionnée par la variable cachée météorologique — qui augmente de façon mécanique la probabilité probabiliste d’une rencontre fortuite avec un prédateur. Cet exemple, d’une simplicité désarmante sur le plan conceptuel, possède une immense portée pédagogique : il matérialise visuellement la façon dont une covariance absolue peut tromper un observateur qui refuserait de considérer les déterminants physiques entourant le cadre d’enregistrement des données.
5.2 Consommation de popcorn et fréquence des accidents de la circulation
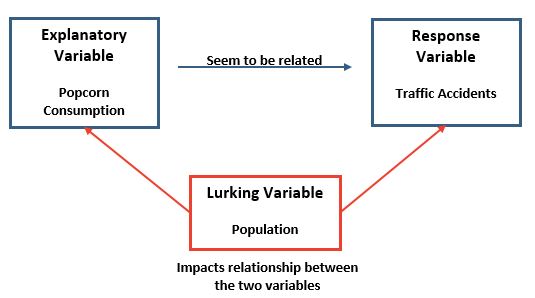
Un autre exemple archétypal de synchronie comportementale trompeuse réside dans l’association statistique positive que l’on peut détecter, dans les grandes métropoles occidentales, entre le tonnage de popcorn consommé au sein des complexes de divertissement et le nombre absolu d’accidents de la circulation automobile enregistrés par les services de police routière au cours d’intervalles horaires déterminés. Aucun lien causal direct et plausible ne saurait évidemment relier l’ingestion d’une céréale soufflée à l’altération subite des capacités motrices des conducteurs de véhicules motorisés.
Le facteur caché responsable de cette synchronie réside dans l’affluence temporelle liée au calendrier social hebdomadaire : les soirées du vendredi et du samedi. Durant ces créneaux spécifiques, les individus convergent massivement vers les cinémas, les lieux de spectacle et les pôles de divertissement, consommant de larges quantités d’aliments récréatifs tels que le popcorn. De manière concomitante, le réseau routier urbain et périurbain subit une densification critique de trafic aux heures tardives.
Cette sur-représentation du volume de circulation nocturne, fréquemment conjuguée à la fatigue physique acumulée au cours de la semaine et à une ingestion majorée de substances éthyliques lors de ces sorties festives, constitue le substrat causal exclusif de la sinistralité routière. Le popcorn et l’accidentologie ne partagent aucun flux d’influence mutuelle ; ils ne constituent que les excroissances phénoménologiques indépendantes d’une seule et même dynamique sociologique cachée gouvernant les rythmes d’occupation de l’espace public.
5.3 Taille des chaussures et niveau de lecture chez les enfants
Dans les cohortes d’élèves du système d’enseignement primaire, l’application d’un protocole psychométrique basique révèle invariablement une corrélation linéaire positive spectaculaire entre la pointure des chaussures portées par les enfants et leurs performances objectives lors de tests standardisés de décodage alphabétique, de compréhension textuelle et d’étendue lexicale. Une approche technocratique superficielle pourrait extrapolated de façon grotesque qu’allonger la voûte plantaire ou fournir des chaussures surdimensionnées stimulerait les compétences linguistiques de la jeunesse.
La variable cachée exclusive qui éclaire et résout instantanément ce pseudo-mystère est l’âge chronologique des sujets au sein du continuum développemental pédiatrique. Les élèves scolarisés au sein d’une école primaire s’échelonnent généralement de l’âge de 6 ans à l’âge de 11 ans. Au cours de cette fenêtre ontologique fondamentale, l’enfant traverse simultanément deux processus maturationnels indépendants dans leurs mécanismes, mais rigoureusement parallèles dans leur temporalité.
D’un côté, le développement biologique et ostéoarticulaire entraîne une croissance continue des extrémités physiques, dont les pieds. De l’autre, la maturation neurobiologique du cortex cérébral, combinée à l’accumulation cumulative d’heures d’instruction pédagogique dispensées par le corps professoral, développe de façon incrémentale les facultés de lecture. Cet exemple met en garde de façon éclatante les chercheurs en psychologie du développement contre l’erreur fatale consistant à négliger les variables ontogénétiques lorsqu’on analyse des populations en phase de transition structurale rapide.
6. Exemples appliqués en psychologie clinique et psychopathologie
6.1 Usage des réseaux sociaux et augmentation de la détresse dépressive
Le débat contemporain sur les répercussions de la numérisation massive sur la santé mentale des adolescents a produit une abondante littérature établissant une corrélation directe entre le temps quotidien passé sur les applications de réseaux sociaux et les scores quantifiés sur les échelles d’évaluation de la détresse dépressive ou des idéations suicidaires. Trop souvent, ces conclusions observationnelles sont présentées de manière simpliste dans le débat public comme la démonstration d’une relation de cause à effet immédiate, conduisant à des appels à la restriction technique aveugle.
Cependant, l’investigation clinique met en évidence une constellation de variables cachées majeures qui biaisent profondément cette relation apparente. L’isolement relationnel préexistant dans la vie réelle, l’existence d’un climat familial délétère ou maltraitant, ou encore une précarité affective systémique constituent autant de facteurs d’amont qui ne sont pas systématiquement intégrés dans les modèles multivariés. Un individu en proie à une solitude aiguë se tourne massivement vers les plateformes virtuelles pour chercher un palliatif relationnel, tout en développant simultanément des affects dépressifs majeurs.
De surcroît, la question de la causalité inverse et le rôle d’une variable cachée intermédiaire comme la détérioration profonde de l’architecture du sommeil (rythmes circadiens désynchronisés par l’anxiété ou le travail nocturne) créent une toile de fond intriquée. Si le temps d’écran est le reflet passif d’une tentative désespérée d’automédication sociale chez un sujet déjà profondément marginalisé, incriminer l’algorithme informatique sans traiter la détresse psychosociale originelle constitue une faute clinique alimentée par l’illusion de causalité univariée.
6.2 Alliance thérapeutique perçue et vitesse de rémission symptomatique
En psychothérapie empiriquement fondée, un postulat extrêmement répandu attribue la rapidité et la solidité de la réduction des symptômes psychopathologiques à la qualité intrinsèque de l’alliance thérapeutique — formalisée par le lien affectif et l’accordage sur les buts et les tâches entre le soignant et le patient. Des dizaines de méta-analyses confirment la corrélation positive indéniable entre un score élevé à l’inventaire d’alliance et l’amélioration clinique finale.
Néanmoins, une observation méthodologique intransigeante révèle l’omission récurrente de variables cachées émanant tant des dispositions structurales du patient que des attributs latents du praticien. Au niveau du patient, la motivation intrinsèque au changement, la flexibilité psychologique de base et la densité du réseau de soutien social extraclinique constituent des déterminants massifs qui facilitent simultanément l’établissement précoce d’une relation chaleureuse avec le soignant et la mobilisation de ressources psychiques autonomes favorisant la guérison hors du cabinet.
Du côté du clinicien, des variables non standardisées telles que l’expérience professionnelle générale ou le niveau d’empathie dispositionnelle agissent en coulisses. Plus grave encore, l’omission du contrôle de la sévérité initiale du trouble fausse l’analyse : les patients présentant des pathologies de la personnalité sévères ou des états dépressifs majeurs réfractaires manifestent structurellement plus de difficultés à évaluer positivement la relation thérapeutique tout en présentant une vitesse de rémission cliniquement lente, générant ainsi une illusion d’efficacité purement relationnelle.
6.3 Consommation de substances et comorbidités anxio-dépressives
L’épidémiologie psychiatrique met en évidence une association transversale quasi-universelle entre l’addiction aux substances psychoactives (alcool, cannabinoïdes, psychostimulants) et la présence aiguë de troubles anxieux et de dépressions unipolaires. Une lecture déterministe linéaire a longtemps conduit les soignants à concevoir ces tableaux soit comme la conséquence neurobiologique directe de la toxicité des molécules sur les circuits monoaminergiques cérébraux, soit, à l’opposé, comme le simple résultat passif d’une quête hédonique ayant mal tourné.
Cette modélisation rudimentaire échoue lamentablement en raison de la présence de variables cachées biopsychosociales profondes, au premier rang desquelles trônent les antécédents de traumatismes infantiles graves (abus physiques, négligences affectives chroniques) et les vulnérabilités génétiques à la dérégulation émotionnelle. L’exposition à un stress toxique durant les périodes sensibles du neurodéveloppement altère durablement le fonctionnement de l’axe hypothalamo-hypophyso-surrénalien (HPA).
Ce dérèglement neurobiologique profond engendre simultanément une hypersensibilité aux stimuli aversifs du quotidien (terrain anxio-dépressif) et une incapacité à réguler l’homéostasie hédonique sans recours à des béquilles chimiques externes (hypothèse de l’automédication de Khantzian). En omettant de mesurer l’impact de ces traumatismes initiaux et l’influence de l’environnement socio-économique délétère, les systèmes de classification diagnostique commettent une erreur d’attribution causale, traitant l’abus de substance et l’affect dépressif comme deux entités liées par causalité réciproque immédiate alors qu’ils sont les branches convergentes d’une même racine cachée.
7. Exemples appliqués en psychologie cognitive et neuropsychologie
7.1 Pratique d’exercices d’entraînement cérébral et maintien mnésique
L’industrie du brain training et des logiciels d’entraînement cognitif sur smartphone a connu une expansion financière fulgurante, étayée par des campagnes marketing vantant des corrélations éclatantes entre la pratique assidue de casse-têtes numérisés et la préservation des fonctions exécutives ou mnésiques chez les personnes vieillissantes. Les données corrélationnelles rapportées dans les études non contrôlées démontrent effectivement que les utilisateurs assidus d’exercices mentaux maintiennent des scores neuropsychologiques supérieurs à ceux de leurs pairs inactifs.
Cette inférence publicitaire occulte délibérément des variables cachées majeures liées à l’auto-sélection de l’échantillon d’utilisateurs. Les individus qui achètent et utilisent régulièrement ces applications logicielles possèdent en moyenne un niveau d’éducation initial significativement supérieur, un statut socio-économique plus élevé et une aisance technologique marquée. Cette réserve cognitive et matérielle préalable les protège indépendamment contre le déclin neuropathologique de la maladie d’Alzheimer et des démences apparentées.
De surcroît, l’engagement spontané dans ces activités dénote une curiosité intellectuelle et une motivation à l’apprentissage qui s’expriment également dans d’autres dimensions protectrices du mode de vie (pratique d’une activité physique régulière, alimentation équilibrée, réseau relationnel stimulant). Enfin, l’effet placebo psychologique induit par des attentes positives de performance participe au biais de mesure, l’amélioration se limitant généralement à une habileté procédurale spécifique au jeu sans aucun transfert lointain vers les capacités cognitives de la vie quotidienne.
7.2 Temps de réaction psychomoteur et prise de décision complexe
Dans les laboratoires de neuropsychologie expérimentale, les chercheurs analysent fréquemment les corrélations entre la vitesse d’exécution lors de tâches de temps de réaction élémentaire (temps de discrimination visuelle ou auditive) et la précision des choix stratégiques lors de paradigmes de prise de décision complexe sous contrainte de temps. Des théorisations hâtives en ont parfois conclu à l’existence d’une vitesse de traitement unifiée de l’architecture neuronale, postulant qu’un cortex plus rapide constitue ipso facto un cortex plus clairvoyant et stratégiquement supérieur.
Cette interprétation méconnaît l’action de variables physiologiques et dispositionnelles cachées d’une sensibilité extrême qui opèrent au moment même de la passation de l’épreuve. La qualité de la veille du participant, la dette chronique de sommeil ou la consommation subreptice et non documentée de stimulants psychoactifs (tels que la caféine ou la nicotine) quelques dizaines de minutes avant le protocole expérimental modifient drastiquement la latence psychomotrice tout en influençant le tonus attentionnel général.
Parallèlement, des facteurs affectifs situationnels exercent une interférence majeure : l’anxiété d’évaluation générée par le dispositif de test, ou le phénomène de menace du stéréotype chez certaines populations cibles, produit une surcharge de la mémoire de travail qui dégrade conjointement la réactivité motrice et la pondération des options de décision. Omettre ces paramètres biologiques et émotionnels transitoires revient à faire reposer l’évaluation des aptitudes intellectuelles supérieures sur des fluctuations périphériques de vigilance physiologique.
7.3 Bilinguisme précoce et flexibilité attentionnelle
L’hypothèse d’un « avantage bilingue » sur le fonctionnement du contrôle exécutif a déclenché des débats passionnés au cours des deux dernières décennies dans le champ des neurosciences cognitives. De nombreuses recherches affirmaient que le contrôle inhibiteur requis pour alterner entre deux codes linguistiques renforçait de manière permanente le réseau fronto-pariétal, octroyant aux sujets bilingues une flexibilité mentale supérieure lors d’épreuves cognitives de type tâche de Stroop ou tâche de Simon.
Toutefois, la réplication rigoureuse de ces résultats s’est heurtée à des difficultés structurelles majeures, mettant au jour l’impact massif de variables cachées sociodémographiques et culturelles qui parasitaient les études initiales. Dans de nombreux pays d’accueil, les cohortes bilingues issues de l’immigration présentent des caractéristiques hautement contrastées par rapport aux cohortes unilingues autochtones : profils d’acculturation spécifiques, biculturalisme stimulant, mais aussi, à l’inverse dans d’autres contextes, statuts socio-économiques très différents ou ségrégations institutionnelles.
Dans les études princeps soutenant l’avantage exécutif, les échantillons de bilingues étaient souvent issus de milieux universitaires favorisés ou de familles hautement qualifiées offrant un enrichissement langagier précoce et un capital éducatif disproportionné par rapport aux groupes de contrôle unilingues recrutés sans appariement sociodémographique strict. Lorsque ces variables cachées d’environnement familial et de niveau d’instruction parental sont méthodologiquement neutralisées, l’amplitude de l’avantage cognitif s’effondre de manière quasi-totale, démontrant que la flexibilité accrue relevait davantage du capital éducatif global que de la plasticité induite par le bilinguisme isolé.
8. Exemples appliqués en psychologie sociale et organisationnelle
8.1 Aménagement des bureaux en espace ouvert et productivité salariale
Au sein du management d’entreprise et de la sociologie des organisations contemporaines, le passage des configurations spatiales traditionnelles de bureaux cloisonnés vers des environnements en espace ouvert (open spaces) ou des bureaux partagés (flex offices) a fait l’objet de multiples évaluations quantitatives. Plusieurs études internes commanditées par des directions immobilières ou des cabinets de conseil ont initialement fait état de gains significatifs de rentabilité et d’agilité collective consécutivement à la reconfiguration des locaux professionnels.
Une analyse méthodique rigoureuse démasque immédiatement la présence d’une variable cachée omniprésente dans la dynamique organisationnelle : la restructuration managériale concomitante et le climat de pression hiérarchique. Très souvent, le déploiement d’une nouvelle architecture spatiale ne s’effectue pas en vase clos ; il s’inscrit au cœur d’un plan stratégique global impliquant une redéfinition des processus de travail, une numérisation accrue des tâches, voire des réductions d’effectifs déguisées générant une anxiété quant à la sécurité de l’emploi.
De plus, cette dynamique réactive le célèbre effet Hawthorne : les employés, pleinement conscients que leur environnement de travail est l’objet d’un projet pilote hautement médiatisé par la direction générale, modifient temporairement leurs habitudes de performance par désirabilité institutionnelle ou conformisme social. L’augmentation initiale de la productivité est donc attribuée à tort à la géométrie des cloisons, alors qu’elle découle de facteurs cachés d’injonction comportementale, masquant souvent par la même occasion une dégradation sévère et différée du bien-être psychosocial liée à la pollution auditive.
8.2 Sentiment d’appartenance groupale et adoption de comportements altruistes
Dans le domaine de la psychologie sociale des groupes, l’analyse corrélationnelle rapporte fréquemment une forte association positive entre le niveau de cohésion perçue au sein d’une collectivité (association, équipe sportive, cellule communautaire) et la fréquence d’actes prosociaux orientés vers l’entraide mutuelle ou le sacrifice individuel au profit du collectif. L’intuition théorique dominante propose que la fusion identitaire avec le groupe catalyse directement la générosité altruiste.
Cependant, ce schéma unilatéral fait abstraction de variables cachées dispositionnelles et normatives d’une importance capitale. Au niveau de la structure psychologique individuelle, le trait d’empathie dispositionnelle et la propension à la désirabilité sociale constituent des moteurs sous-jacents qui prédisposent un sujet à la fois à s’investir affectivement au sein d’un groupe humain et à manifester des comportements ostensiblement généreux pour valider son intégration morale.
Sur le plan environnemental, la présence de normes implicites de conformité et le contrôle social strict exercé de manière non verbale par la communauté conditionnent puissamment les conduites de générosité. Le don ou l’assistance n’émane pas nécessairement d’un élan spontané nourri par la cohésion affective, mais de la nécessité cachée de préserver son statut réputationnel et de prévenir l’ostracisme ou l’opprobre consécutifs au non-respect des règles tacites de solidarité de l’endogroupe.
8.3 Leadership transformationnel et réduction du turnover en entreprise
Les théories du comportement organisationnel ont largement valorisé le paradigme du leadership transformationnel — style de management charismatique caractérisé par la stimulation intellectuelle, la considération individualisée et la formulation d’une vision inspirante — en démontrant empiriquement sa corrélation inverse avec le taux de démission volontaire (turnover) du personnel subordonné. De nombreuses analyses en concluent qu’il suffit de former la chaîne d’encadrement à ce profil managérial pour juguler les fuites de talents.
Cette déduction déterministe ignore des variables macroéconomiques cachées décisives qui déterminent structurellement les flux de main-d’œuvre. L’état conjoncturel du marché du travail, le taux de chômage sectoriel et la rareté des opportunités d’emploi alternatives dans le bassin géographique de l’entreprise constituent le véritable goulot d’étranglement qui dicte la mobilité des salariés. Si les opportunités extérieures sont inexistantes, le turnover s’effondrera mécaniquement, quelle que soit la toxicité ou l’excellence de la direction.
Par ailleurs, d’autres variables cachées internes à l’organisation sont trop souvent négligées dans la modélisation statistique, à l’instar des grilles de compensation salariale globale, des avantages sociaux annexes et de la structure démographique moyenne (ancienneté, charges familiales des salariés). L’attribution exclusive de la rétention des talents aux compétences interpersonnelles du dirigeant procède donc d’une erreur d’omission méthodologique majeure, masquant des logiques économiques fondamentales de contrainte matérielle.
9. Le paradoxe de Simpson : Illustration paroxystique de la variable cachée
9.1 Définition mathématique et principe d’inversion des tendances
Le paradoxe de Simpson — initialement décrit par le mathématicien britannique Edward H. Simpson en 1951, bien que ses prémisses aient été esquissées dès 1899 par Karl Pearson et en 1903 par George Udny Yule — représente sans doute la manifestation la plus contre-intuitive et la plus fascinante de l’action dévastatrice d’une variable cachée sur l’analyse de données quantitatives. Il décrit une anomalie géométrique et statistique au sein de laquelle une corrélation, une association de proportions ou une tendance de régression observée de manière systématique au sein de plusieurs sous-groupes indépendants s’inverse totalement lorsque les données sont agrégées en une population unique.
Considérons sur le plan formel trois variables probabilistes : un facteur d’exposition binaire X (traitement ou groupe), un résultat binaire Y (succès ou échec), et une variable sous-jacente polytomique ou catégorielle non observée Z stratifiant l’échantillon en différentes strates k. Le paradoxe s’exprime par le système d’inégalités conditionnelles suivant :
P(Y = 1 | X = 1, Z = k) > P(Y = 1 | X = 0, Z = k) pour toute strate k,
tandis que lors de l’agrégation marginale, la relation subit une permutation directionnelle complète :
P(Y = 1 | X = 1) < P(Y = 1 | X = 0).
Ce basculement logique déroute le sens commun en prouvant mathématiquement qu’une intervention peut se révéler bénéfique pour chaque segment de la population pris individuellement, tout en apparaissant néfaste lorsqu’on évalue la collectivité dans sa globalité. La cause exclusive de cette illusion ne relève pas d’une erreur de calcul arithmétique, mais de l’omission structurelle de la variable de stratification cachée Z, qui pondère asymétriquement les effectifs selon les bras de comparaison, entraînant des décisions de politique publique désastreuses si l’agrégation aveugle est prise pour guide décisionnel.
9.2 Le cas historique des admissions universitaires de Berkeley (1973)
L’application empirique la plus célèbre du paradoxe de Simpson demeure sans conteste l’analyse des admissions aux cycles supérieurs de l’Université de Californie à Berkeley pour l’automne 1973. Les données globales agrégées révélaient une disparité flagrante : sur l’ensemble des candidats masculins, environ 44 % avaient été admis, contre seulement 35 % pour les candidates féminines. Face à un tel écart statistiquement significatif sur un échantillon de plusieurs milliers de personnes, l’administration universitaire et l’opinion publique suspectèrent immédiatement l’existence d’une discrimination institutionnelle systémique et hostile aux femmes.
Mandatée pour analyser scientifiquement le litige, l’équipe de statisticiens menée par Peter Bickel entreprit de désagréger les registres de candidature département par département. La révélation fut saisissante : dans la quasi-totalité des départements académiques considérés isolément, les femmes affichaient un taux d’admission soit égal, soit statistiquement supérieur à celui des hommes. L’avantage empirique s’était purement et simplement inversé à l’échelle granulaire.
La variable cachée fondamentale de cette controverse résidait dans le choix différentiel des départements de candidature selon le genre. Les femmes avaient postulé de manière disproportionnée dans des filières de sciences humaines et sociales extrêmement sélectives, dotées d’un nombre restreint de places et de taux d’acceptation structurellement très faibles. Inversement, les hommes avaient majoritairement déposé leurs dossiers dans les départements d’ingénierie, de physique ou de chimie, disposant de financements massifs et de taux d’admission particulièrement élevés. L’asymétrie globale résultait donc de la difficulté intrinsèque des programmes ciblés et non d’une partialité des jurys de sélection, démontrant la faillite de l’analyse bivariée brute.
9.3 Manifestations du paradoxe de Simpson dans les essais thérapeutiques
Dans la recherche biomédicale contemporaine et l’épidémiologie clinique, le paradoxe de Simpson représente un péril vital pour l’évaluation de l’efficacité pharmacologique. Un cas d’école documenté concerne la comparaison de l’efficacité de deux traitements (le traitement expérimental A et le protocole standard B) dans la résorption de calculs rénaux. Les données globales d’une célèbre étude observationnelle indiquaient un taux de succès brut supérieur pour le traitement standard B, suggérant son adoption préférentielle en pratique clinique.
Néanmoins, lorsque les épidémiologistes ont stratifié les patients selon une variable clinique cachée cruciale — la taille initiale des calculs rénaux (petits calculs d’un côté, gros calculs de l’autre) —, l’évaluation a révélé que le traitement innovant A surpassait nettement le protocole B tant chez les patients porteurs de petits calculs que chez les patients souffrant de calculs volumineux. Le protocole réputé inférieur à l’échelle agrégée s’avérait médicalement supérieur dans chaque sous-catégorie clinique.
Ce paradoxe découle du biais d’allocation empirique : face à des calculs de grande taille présentant un pronostic chirurgical sévère et complexe, les praticiens avaient instinctivement et majoritairement assigné le traitement innovant A, considéré comme plus puissant mais confronté à une base de départ beaucoup plus dégradée. Inversement, le traitement standard B avait été massivement administré aux cas bénins. La sévérité initiale de la pathologie constituait la variable cachée qui biaisait l’évaluation d’ensemble, rappelant l’impératif absolu d’une désagrégation rigoureuse de la gravité pronostique avant toute conclusion d’inefficacité thérapeutique.
10. Détection des variables cachées dans les études observationnelles
10.1 Analyse exploratoire et inspection visuelle des distributions
La découverte d’une variable cachée au sein d’un jeu de données observationnelles repose en premier lieu sur le flair méthodologique de l’analyste, soutenu par des techniques rigoureuses d’analyse exploratoire des données (Exploratory Data Analysis ou EDA) conceptualisées par John Tukey. L’examen des métriques de tendance centrale univariées (moyenne, écart-type) s’avère totalement insuffisant pour identifier une distorsion structurelle. Le chercheur doit impérativement déployer des outils de visualisation graphique multivariée pour sonder la morphologie intime de la distribution.
L’utilisation systématique de nuages de points multivariés (scatter plots), de matrices de corrélation visuelles et de graphiques de projection résiduelle permet de repérer des anomalies révélatrices de facteurs manquants. Une distribution manifestant une bimodalité prononcée ou une morphologie en amas disjoints au sein d’un échantillon théoriquement homogène signale presque infailliblement la présence d’une variable sous-jacente discrète non documentée qui divise la population en sous-groupes structurellement asymétriques.
De même, l’inspection visuelle des résidus de régression constitue une stratégie diagnostique de premier ordre. Si l’hypothèse de linéarité classique est respectée, le nuage des résidus projeté contre les valeurs prédites doit se répartir de façon stochastique sous la forme d’une bande horizontale homogène sans structure discernable. L’apparition d’un patron géométrique curviligne, d’une rupture structurelle de pente ou d’un phénomène d’hétéroscédasticité prononcée (variance résiduelle en entonnoir) indique formellement que le modèle a omis une composante essentielle de la variance qui organise la dynamique du phénomène en dehors du cadre spécifié.
10.2 Modélisation statistique avancée et ajustement multivarié
Lorsque le corpus théorique ou l’analyse exploratoire suggèrent l’influence potentielle de dimensions omises, l’économétrie et la biométrie proposent un ensemble sophistiqué de méthodologies d’ajustement multivarié pour en neutraliser mathématiquement l’interférence. L’introduction contrôlée de covariables de contrôle dans le cadre de modèles de régression multiple constitue l’approche la plus accessible, permettant de partialiser la variance partagée et d’évaluer l’effet marginal pur du prédicteur sous l’hypothèse d’absence d’autre confusion résiduelle.
Pour dépasser les limites de la régression conventionnelle face à des facteurs d’arrière-plan complexes, les modèles à équations structurelles (Structural Equation Modeling ou SEM) fournissent un cadre mathématique idéal. Ils permettent de formaliser explicitement des variables latentes non observées déduites d’une covariance commune entre plusieurs indicateurs manifestes, intégrant ainsi la variable cachée dans le système d’équations tout en purgeant les coefficients d’intérêt de son interférence parasitaire.
Dans les situations où la variable cachée est irrémédiablement inaccessible à la métrologie directe, l’analyste peut recourir à la méthode des variables instrumentales (IV). Un instrument valide est une variable Z qui influence l’exposition X sans posséder de lien causal direct avec la variable dépendante Y, et qui est rigoureusement indépendante des variables cachées résidant dans le terme d’erreur. Par ce mécanisme de double détente (estimation par les doubles moindres carrés), la variance endogène de X contaminée par le facteur caché est éliminée, isolant la composante exogène pour en extraire une estimation causale non biaisée.
10.3 Analyses de sensibilité et tests de robustesse
Même après le déploiement d’ajustements multivariés sophistiqués, l’ombre d’une confusion résiduelle non mesurée plane inévitablement sur toute recherche de nature non expérimentale. Pour évaluer la crédibilité scientifique de ses inférences face à l’hypothèse d’une variable cachée ignorée, la communauté académique a recours aux analyses de sensibilité contrefactuelles et au calcul de métriques d’immunité statistique standardisées.
Parmi ces outils contemporains développés par Tyler VanderWeele et ses collègues de l’Université Harvard, le concept de E-value s’est imposé comme une référence incontournable en épidémiologie causale. La E-value quantifie l’amplitude minimale d’association qu’une variable cachée hypothétique non observée devrait posséder simultanément avec le facteur d’exposition et le critère de réponse pour annuler entièrement l’effet estimé par l’étude. Si la E-value est extrêmement élevée, il devient très invraisemblable qu’un facteur caché d’une telle puissance ait pu échapper à la perspicacité des chercheurs, conférant ainsi un degré de robustesse élevé à la découverte.
D’autres approches reposent sur la simulation computationnelle de scénarios stochastiques (analyses de sensibilité de Rosenbaum), où l’on injecte artificiellement dans le jeu de données des distributions de variables omises hypothétiques dotées de corrélations variables. L’observateur teste ainsi la résistance de ses coefficients d’intérêt à ces perturbations contrôlées. Si l’effet statistique change d’orientation ou perd sa significativité dès l’introduction d’un micro-facteur caché à faible variance, l’inférence originelle doit être déclarée hautement fragile et sujette à caution épistémologique.
11. Stratégies méthodologiques expérimentales de neutralisation
11.1 La randomisation et l’assignation aléatoire
Si les outils statistiques d’ajustement a posteriori constituent des remparts indispensables pour les données d’observation, la panacée absolue pour neutraliser l’impact délétère des variables cachées réside dans la manipulation expérimentale active par l’assignation aléatoire (randomisation). Conceptualisée et formalisée dans les années 1920 par Sir Ronald Aylmer Fisher pour la recherche agronomique, l’assignation aléatoire des sujets entre les conditions de traitement et de contrôle constitue le fondement même de la méthode expérimentale moderne.
La puissance ontologique de la randomisation réside dans sa capacité probabiliste unique à briser tout lien fonctionnel entre le traitement administré et n’importe quelle caractéristique sous-jacente des unités expérimentales. Contrairement aux ajustements statistiques qui n’agissent que sur les facteurs préalablement identifiés et mesurés par le chercheur, l’assignation aléatoire distribue de manière statistiquement égale l’ensemble des variables cachées — qu’elles soient connues, insoupçonnées, mesurables ou totalement inaccessibles à la technologie contemporaine — au sein des différents bras d’intervention.
Il est toutefois crucial de ne pas confondre l’assignation aléatoire d’un échantillon avec l’échantillonnage probabiliste au sein d’une population globale. En outre, la randomisation ne constitue pas une garantie absolue d’équilibre au sein d’échantillons restreints : la loi des grands nombres ne s’appliquant que de façon asymptotique, des fluctuations d’échantillonnage aléatoires peuvent générer des déséquilibres fortuits sur des variables cachées critiques lorsque les cohortes comptent un faible nombre d’individus, justifiant le recours à des protocoles de randomisation stratifiée ou par blocs.
11.2 Protocoles de contrôle physique et d’isolation en laboratoire
Dans les sciences cognitives, la psychologie physiologique et les neurosciences fondamentales, la stratégie préventive contre les variables cachées privilégie l’isolation matérielle et environnementale au sein de laboratoires hautement contrôlés. L’objectif méthodologique est d’ériger une barrière hermétique entre le sujet expérimental et le monde extérieur afin de maintenir strictement invariantes toutes les dimensions contextuelles parasites susceptibles d’opérer comme des facteurs cachés perturbateurs.
Ce contrôle physique passe par la standardisation intégrale des paramètres physiques ambiants : insonorisation acoustique rigoureuse des cabines d’expérimentation, calibrage de la température au degré près, uniformisation de la luminance visuelle et recours à des protocoles d’administration informatique automatisés excluant toute intervention humaine improvisée. La synchronisation temporelle est également standardisée pour neutraliser les variations circadiennes de vigilance.
Sur le plan comportemental, le recours au contrebalancement de l’ordre de présentation des stimuli (par exemple via des carrés latins) neutralise les variables cachées d’apprentissage progressif, de sensibilisation ou de fatigue neuromusculaire. Enfin, l’utilisation incontournable des protocoles en double aveugle (double-blind) — où ni le participant ni l’expérimentateur administrateur ne connaissent l’assignation de condition — permet d’éliminer définitivement l’interférence insidieuse des attentes de l’expérimentateur, variable cachée comportementale majeure popularisée par Robert Rosenthal.
11.3 Plans factoriels et appariement par blocs
Lorsqu’un chercheur soupçonne fortement l’existence d’une variable spécifique susceptible d’exercer une action clandestine sur son protocole d’étude sans disposer de cohortes massives garantissant une randomisation parfaite, l’intégration délibérée de ce facteur au sein du plan expérimental constitue la stratégie d’ingénierie méthodologique par excellence. Cette transformation conceptuelle consiste à convertir une variable cachée redoutée en une variable indépendante explicite de plein exercice au sein d’un plan factoriel complet.
Dans cette configuration, l’échantillon est stratifié a priori selon les modalités de la variable identifiée (par exemple, le sexe biologique, les tranches d’âge chronologique ou des profils génétiques spécifiques) préalablement à la randomisation des conditions de traitement, créant ainsi des plans en blocs randomisés. Cette technique garantit que chaque strate d’intérêt comporte une proportion rigoureusement identique de sujets exposés et non exposés, éliminant par construction toute possibilité pour cette variable d’agir comme un facteur de confusion asymétrique.
Une variante paroxystique de ce principe réside dans le plan à mesures répétées ou plan intra-sujet (within-subject design). Dans ce modèle expérimental, chaque participant traverse l’ensemble des conditions expérimentales de l’étude, servant ainsi de son propre contrôle statistique absolu. L’ensemble des variables cachées invariantes attachées à l’individualité d’un sujet (son histoire développementale, son bagage génétique, sa structure de personnalité ou ses capacités intellectuelles fondamentales) sont ainsi mathématiquement neutralisées lors de la soustraction des conditions, chaque individu portant en lui-même l’équivalence parfaite de son arrière-plan biopsychologique.
12. Pratiques scientifiques rigoureuses et gestion des limites de la recherche
12.1 Transparence méthodologique et pré-enregistrement des études
L’assainissement de la pratique scientifique face aux ravages des variables cachées et de la flexibilité interprétative des analystes requiert une révolution des standards déontologiques de publication. Pendant des décennies, la liberté totale accordée aux chercheurs dans le traitement post-hoc de leurs bases de données a favorisé l’émergence de pratiques méthodologiquement toxiques, telles que la sélection opportuniste de covariables (covariate picking) ou le chalutage de données (data dredging ou p-hacking), où l’on introduit ou retire des variables d’ajustement jusqu’à l’obtention d’un seuil de significativité flatteur.
Pour juguler cette dérive épistémologique, le mouvement de la science ouverte a instauré la pratique du pré-enregistrement obligatoire des hypothèses et des plans d’analyse statistique sur des plateformes institutionnelles indépendantes (à l’instar de l’Open Science Framework ou de ClinicalTrials.gov) préalablement à toute collecte de données. Dans un protocole pré-enregistré, le chercheur doit spécifier de manière exhaustive et contraignante la liste des covariables qu’il intégrera dans ses équations de régression, justifiant leur rôle théorique a priori.
Cette distinction institutionnalisée entre analyses confirmatoires — rigoureusement cadrées et planifiées — et analyses exploratoires fortuites empêche l’analyste de maquiller la découverte d’une corrélation fallacieuse provoquée par une variable cachée en une prédiction théorique validée. De surcroît, la mise à disposition publique des données brutes (open data) et des scripts computationnels d’analyse permet à la communauté internationale de sonder les distributions à la recherche de facteurs tiers ignorés par l’équipe d’investigation initiale, matérialisant ainsi un idéal d’autocorrection collégiale.
12.2 Prise en compte des variables cachées dans la discussion des résultats
Une éthique de l’honnêteté intellectuelle en recherche quantitative implique la renonciation définitive aux conclusions dogmatiques d’implication causale unilatérale dès lors qu’un protocole ne réunit pas des conditions d’isolation quasi-parfaites. La section « Limites » d’une publication scientifique ne doit plus être conçue comme un appendice rhétorique formulé pour apaiser les relecteurs, mais comme le cœur critique où s’exprime la lucidité épistémologique des auteurs.
Dans ce cadre, les chercheurs doivent cartographier de façon transparente l’ensemble des facteurs potentiels d’amont ou contextuels qui n’ont pu être mesurés ou contrôlés lors de la passation de l’étude. Cette cartographie exige une évaluation pondérée de la façon dont ces variables cachées résiduelles auraient pu contaminer les métriques rapportées, soit en amplifiant artificiellement les coefficients de relation, soit en étouffant un effet authentique qui attend une future mise en lumière.
Ce devoir de réserve scientifique commande l’adoption d’une modération sémantique stricte. Les termes connotant une causalité mécanique directe (« démontre », « prouve », « provoque invariablement ») doivent s’effacer au profit d’une terminologie probabiliste respectueuse de la complexité multivariée (« suggère une association consistante », « indique une covariance compatible avec l’hypothèse sous réserve de contrôles ultérieurs »). Enfin, les auteurs doivent formuler des recommandations méthodologiques précises et ciblées, indiquant aux futures investigations empiriques les variables de fond qu’il sera impératif d’opérationnaliser et de modéliser pour clore les zones d’incertitude résiduelle.
12.3 Synthèse épistémologique : Vers une posture de vigilance continue
En dernière analyse, l’omniprésence potentielle des variables cachées renvoie la science moderne à sa propre condition épistémique : l’incomplétude inhérente de toute représentation modélisée de l’univers. Aucun système d’équations multivariées, aucune matrice de données massives ne parviendra jamais à encapsuler l’intégralité holistique de la réalité matérielle, biologique et sociale. Toute modélisation est par essence une réduction stylisée et parcimonieuse d’un monde d’une complexité vertigineuse.
Cette condition ontologique impose le dépassement définitif du positivisme naïf — qui assimile imprudemment le résultat mathématique immédiat à une vérité immuable — au profit d’un réalisme critique. Ce réalisme critique postule l’existence d’un monde réel structuré par des dynamiques causales profondes tout en reconnaissant les limites sémiotiques et instrumentales de nos registres de quantification. L’anticipation des variables cachées exige un dialogue permanent et décloisonné entre les disciplines, où la modélisation statistique avancée s’enrichit constamment des intuitions de l’anthropologie, de la sociologie, de la biologie évolutive et de l’histoire.
Pour les cliniciens, les décideurs politiques, les journalistes scientifiques et les praticiens de terrain, l’intégration intellectuelle intime du concept de variable cachée constitue l’antidote intellectuel suprême contre les dérives des simplifications démagogiques et des illusions technocratiques. Seule une vigilance sceptique, lucide et permanente face à ce qui rôde dans l’obscurité de nos mesures peut garantir à la démarche empirique sa grandeur méthodologique, son intégrité humaniste et sa mission ultime : éclairer les mécanismes authentiques du monde sans jamais se laisser abuser par les ombres trompeuses des corrélations fortuites.
Références
- Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
- Bickel, P. J., Hammel, E. A., & O’Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398–404. https://doi.org/10.1126/science.187.4175.398
- Fisher, R. A. (1935). The Design of Experiments. Oliver and Boyd.
- Moore, D. S., Notz, W. I., & Fligner, M. A. (2015). The Basic Practice of Statistics (7th ed.). W. H. Freeman.
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pearl, J., & Mackenzie, D. (2018). The Book of Why: The New Science of Cause and Effect. Basic Books.
- Pearson, K. (1897). Mathematical contributions to the theory of evolution.—On a form of spurious correlation which may arise when indices are used in the measurement of organs. Proceedings of the Royal Society of London, 60(359–367), 489–498. https://doi.org/10.1098/rspl.1896.0076
- Rosenbaum, P. R. (2002). Observational Studies (2nd ed.). Springer. https://doi.org/10.1007/978-1-4757-3692-2
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- VanderWeele, T. J., & Ding, P. (2017). Sensitivity analysis in observational research: Introducing the E-value. Annals of Internal Medicine, 167(4), 268–274. https://doi.org/10.7326/M16-2607
- Wooldridge, J. M. (2016). Introductory Econometrics: A Modern Approach (6th ed.). Cengage Learning.
- Yule, G. U. (1903). Notes on the theory of association of attributes in statistics. Biometrika, 2(2), 121–134. https://doi.org/10.1093/biomet/2.2.121