
Dans le paysage contemporain des sciences comportementales, cognitives et biomédicales, la modélisation de la complexité du réel constitue le défi méthodologique par excellence. L’époque où la recherche scientifique pouvait se satisfaire d’une approche univariée stricte, isolant une variable dépendante unique face aux manipulations d’un seul facteur causal selon le principe cartésien du « toutes choses étant égales par ailleurs », a cédé la place à une compréhension écosystémique des phénomènes. Les comportements humains, les mécanismes neurophysiologiques et les dynamiques sociales ne répondent presque jamais à des déterminismes linéaires simples ou isolés ; ils émergent au contraire de la confluence, de la synergie ou de l’inhibition mutuelle d’influences plurielles. C’est précisément pour répondre à cette exigence d’investigation multidimensionnelle que les plans factoriels ont été conceptualisés et perfectionnés au cours du XXe siècle, devenant la pierre angulaire de l’inférence causale moderne.
Parmi cette famille méthodologique, le plan factoriel 2×2 représente la structure expérimentale la plus fondamentale, la plus élégante et la plus fréquemment déployée. En croisant de manière exhaustive deux variables indépendantes comportant chacune deux modalités distinctes, cette architecture permet non seulement d’évaluer l’impact isolé de chaque variable — ce que la littérature statistique nomme les effets principaux —, mais elle offre surtout un accès empirique direct à leur potentiel effet d’interaction. Cette capacité à quantifier mathématiquement la mesure dans laquelle l’effet d’un déterminant dépend de la présence, de l’absence ou de l’intensité d’un second déterminant confère au plan 2×2 une supériorité épistémologique indéniable sur la juxtaposition de protocoles univariés successifs. Il transforme ce qui était autrefois considéré comme du « bruit » expérimental ou une variation contextuelle incontrôlée en un objet d’étude rigoureusement modélisé.
Le présent guide a pour vocation de dresser un panorama exhaustif, à la fois théorique, mathématique et appliqué, du devis factoriel 2×2. Destiné aux chercheurs, doctorants et méthodologistes soucieux d’asseoir leurs protocoles sur des bases inattaquables, ce traité aborde l’ensemble du cycle de vie d’une recherche factorielle : des fondements épistémologiques hérités des travaux agronomiques de Fisher jusqu’aux subtilités d’écriture académique prescrites par l’American Psychological Association (APA 7e édition), en passant par la formalisation sous le modèle linéaire général, les calculs de puissance statistique a priori et le traitement computationnel sous R et SPSS. À travers une analyse sans concession des écueils classiques tels que la dichotomisation abusive ou l’inflation de l’erreur de type I, ce document vise à fournir une référence francophone intégrale pour la conception, l’exécution et l’interprétation critique de vos designs factoriels.
1. Fondements épistémologiques et théoriques du plan factoriel 2×2
1.1 Définition structurelle et terminologie fondamentale
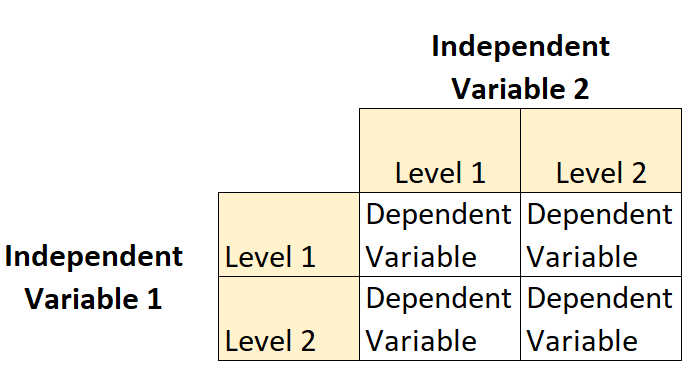
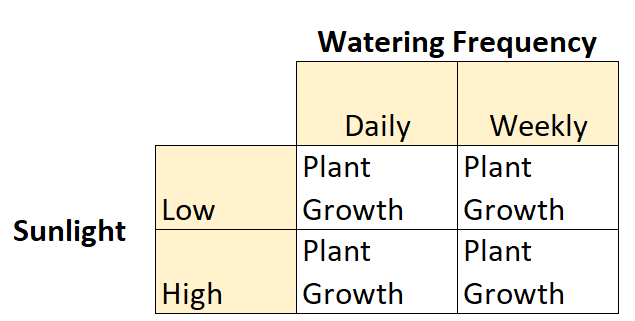
D’un point de vue structurel, le plan factoriel 2×2 se définit comme un protocole de recherche expérimental ou quasi-expérimental au sein duquel deux variables indépendantes (VI), désignées conventionnellement comme Facteur A et Facteur B, sont manipulées simultanément. Chacun de ces facteurs comporte rigoureusement deux modalités, niveaux ou conditions de traitement discrets. La caractéristique formelle première d’un tel agencement réside dans son caractère factoriel complet ou croisé : chaque modalité du facteur A est combinée de manière exhaustive avec chaque modalité du facteur B. Cette opération de produit cartésien élémentaire ($2 \times 2 = 4$) engendre exactement quatre cellules expérimentales uniques, représentant l’ensemble des conditions de traitement au sein desquelles les observations empiriques seront recueillies.
Cette approche se distingue fondamentalement du paradigme univarié unifactoriel traditionnel. Dans ce dernier, un chercheur évaluant deux facteurs potentiels serait contraint d’exécuter deux expérimentations successives et découplées (par exemple, tester l’effet du Facteur A sur un premier échantillon, puis l’effet du Facteur B sur un second échantillon indépendant). Ce découpage séquentiel suppose implicitement et de manière arbitraire que le Facteur B n’exerce aucune influence sur la réactivité du système face au Facteur A, une hypothèse de séparabilité qui s’avère bien souvent réfutée dans l’étude des systèmes vivants et psychologiques. Le plan factoriel 2×2 intègre cette complexité au cœur même de son dispositif analytique.
Enfin, le fonctionnement optimal de cette architecture repose sur la mesure d’au moins une variable dépendante (VD) continue, opérationnalisée sous la forme d’une métrique d’intervalle ou de rapport. La sensibilité de cette échelle de mesure continue est indispensable pour permettre l’agrégation statistique, le calcul des moyennes conditionnelles au sein des quatre cellules expérimentales, ainsi que l’évaluation des écarts-types résiduels nécessaires à l’analyse inférentielle paramétrique. La validité de l’inférence causale repose sur l’adéquation entre la nature continue de cette variable de réponse et les postulats de distribution linéaire qui sous-tendent les modèles d’analyse de variance.
1.2 Historique et évolution méthodologique dans la recherche expérimentale
L’émergence formelle des plans factoriels constitue l’une des révolutions statistiques majeures du premier quart du XXe siècle, dont l’impulsion séminale revient au statisticien et généticien britannique Ronald Aylmer Fisher. Durant ses travaux à la station expérimentale de Rothamsted, Fisher s’est trouvé confronté aux limites strictes de l’expérimentation agronomique classique. Jusqu’alors, le dogme dominant postulait qu’une recherche rigoureuse devait nécessairement isoler un facteur unique (par exemple, tester exclusivement l’apport en nitrate), maintenant l’ensemble des autres paramètres environnementaux constants. Fisher démontra avec éclat la non-viabilité écologique et l’inefficacité statistique de ce postulat : dans la nature, le rendement végétal ne dépend pas uniquement de l’azote de manière isolée, mais de la fertilisation azotée en fonction précise de la présence ou de l’absence d’arrosage ou de fumier.
Dans ses ouvrages fondateurs, notamment Statistical Methods for Research Workers (1925) et The Design of Experiments (1935), Fisher a posé les principes mathématiques de l’analyse de variance (ANOVA) et a plaidé avec force en faveur des plans factoriels. Il a démontré qu’en testant conjointement deux facteurs ou plus, non seulement le chercheur n’altérait pas la précision accordée à chacun d’eux, mais qu’il améliorait l’économie d’échantillonnage globale tout en dégageant pour la première fois la mesure formelle des interactions. Cette transition du paradigme réductionniste à facteur unique vers l’ingénierie multifactorielle a constitué un tournant épistémologique sans précédent.
Au fil des décennies, cette méthodologie s’est diffusée hors des champs de l’agronomie pour investir la psychologie scientifique naissante, la biomédecine et les sciences de l’éducation. Les standards de preuve empirique dans la recherche moderne se sont profondément reconfigurés autour de ces designs. Les revues à comité de lecture ont progressivement considéré que la simple mise en évidence d’un effet isolé ne suffisait plus à asseoir une théorie robuste ; il est désormais attendu que le protocole explicite les conditions contextuelles et les limites de généralisation de cet effet, une exigence que le plan factoriel 2×2 permet de satisfaire avec une remarquable concision.
1.3 Pertinence paradigmatique en psychologie cognitive et sociale
Dans le champ de la psychologie contemporaine, la prééminence du plan factoriel 2×2 s’explique d’abord par son avantage écologique indiscutable. Les processus cognitifs et les dynamiques de groupe n’opèrent jamais en vase clos. En intégrant simultanément deux déterminants comportementaux au sein d’une seule et même architecture empirique, le chercheur modélise une réalité psychologique infiniment plus crédible. Par exemple, étudier la rétention mnésique en faisant varier simultanément une stratégie d’encodage (visuel versus auditif) et le niveau d’éveil attentionnel (optimal versus dégradé) capture l’interaction réelle entre les capacités de l’appareil cognitif et les conditions environnementales fluctuantes de l’individu.
D’un point de vue logistique et méthodologique, le plan 2×2 permet une économie d’échantillonnage majeure. Si un chercheur désire tester deux hypothèses indépendantes avec une puissance statistique équivalente au moyen de deux protocoles univariés distincts, il devra mobiliser deux cohortes de participants distinctes. Dans un plan 2×2 équilibré, l’ensemble des observations sert à évaluer le premier facteur tout en servant simultanément à évaluer le second facteur. Cette propriété, qualifiée de « double emploi bienveillant » par les statisticiens, optimise considérablement les ressources humaines et matérielles des laboratoires sans consentir la moindre concession sur la précision de l’estimation de la variance résiduelle.
Sur le plan théorique, le plan 2×2 offre la matrice idéale pour opérationnaliser les théories de la modération et formaliser la nature conditionnelle des mécanismes psychologiques. Dans le cadre de la théorie psychosociale, la plupart des hypothèses ne postulent pas qu’un phénomène X produit universellement un comportement Y, mais stipulent que X produit Y sous certaines conditions Z, et produit l’effet inverse ou s’annule sous d’autres conditions W. Le plan 2×2 est l’instrument de réfutation et de validation empirique privilégié de ces propositions conditionnelles, matérialisant avec clarté mathématique ce que Kurt Lewin formalisait déjà dans sa célèbre conception selon laquelle le comportement est fonction de l’interaction constante entre la personne et son environnement.
2. Anatomie structurelle des variables dans une architecture factorielle 2×2
2.1 Caractérisation des variables indépendantes et de leurs modalités
L’intégrité scientifique d’un devis factoriel 2×2 repose en premier lieu sur la rigueur avec laquelle les variables indépendantes sont sélectionnées et délimitées. Par essence, une variable indépendante correspond à la dimension causale ou prédictive manipulée ou contrôlée par l’expérimentateur. Dans le cas précis du plan 2×2, cette variable doit être impérativement discrétisée en exactement deux modalités ou niveaux qualitatifs distincts. Ces modalités doivent être mutuellement exclusives (aucun participant ou unité d’observation ne peut appartenir simultanément aux deux niveaux du même facteur) et exhaustives pour le domaine d’observation circonscrit par l’hypothèse de travail.
Le choix des modalités repose sur l’établissement d’un contraste dichotomique net. Ce contraste peut s’incarner sous la forme d’une opposition de type présence versus absence d’une stimulation (par exemple, exposition à une musique de fond relaxante versus silence absolu), ou sous la forme de l’administration d’une intensité différentielle d’un même phénomène (par exemple, charge cognitive faible versus charge cognitive élevée). Il est impératif que les deux niveaux sélectionnés soient suffisamment contrastés pour susciter une variance fonctionnelle observable sans pour autant basculer dans des situations extrêmes irréalistes ou délétères qui détruiraient la validité écologique du paradigme.
Un critère méthodologique absolu pour la conception théorique du plan réside dans la recherche d’une indépendance orthogonale stricte entre les deux facteurs manipulés. Dans le protocole idéal, l’attribution ou l’appartenance d’un sujet à une modalité du Facteur A ne doit en aucun cas corréler ou dépendre de son appartenance à une modalité du Facteur B. Cette orthogonalité garantit que les axes de variance explorés par les deux déterminants sont parfaitement décorrélés a priori, assurant ainsi une décomposition mathématique univoque et non contaminée de la variance expliquée lors de la modélisation ultérieure.
2.2 Opérationnalisation de la variable dépendante continue
Si les variables indépendantes définissent la structure de l’intervention, la variable dépendante (VD) constitue le réceptacle observationnel où doit s’exprimer l’effet présumé de ces manipulations croisées. En psychométrie et en méthodologie expérimentale, l’opérationnalisation de cette VD exige la sélection d’indicateurs comportementaux, physiologiques ou psychologiques hautement sensibles et continus. Qu’il s’agisse d’un temps de réaction milliseconde par milliseconde, d’un taux de réponses correctes sur une épreuve mnésique, d’un niveau d’activité électrodermale ou d’un score composite extrait d’une échelle psychométrique validée (telle qu’une échelle de dépression ou d’anxiété de type Likert traitée comme métrique continue), l’indicateur doit être apte à capturer de fines gradations de la réponse humaine.
La sensibilité de la mesure conditionne directement la capacité du plan à révéler les variations subtiles induites par les traitements combinés. Une variable dépendante qui souffrirait d’un manque de granularité — par exemple une échelle trop grossière en trois points — conduirait inévitablement à masquer les légères inflexions de la trajectoire de réponse qui caractérisent les effets d’interaction. Les instruments doivent ainsi présenter une haute consistance interne (validée par des coefficients de fidélité tels que l’alpha de Cronbach ou l’oméga de McDonald) et une excellente stabilité temporelle pour éviter que les fluctuations attribuables aux erreurs de mesure n’engloutissent les variations expérimentales réelles.
La gestion des erreurs de mesure et le calibrage préalable des instruments psychologiques constituent une phase critique du déploiement expérimental. Les effets d’instrumentation, tels que la dérive du calibrage d’un capteur biométrique ou les ambiguïtés d’énoncés dans une passation sur support numérique, introduisent une variance d’erreur aléatoire ou systématique. Dans une modélisation factorielle, cette variance non contrôlée vient gonfler le dénominateur des ratios statistiques (l’erreur résiduelle quadratique), réduisant dramatiquement la probabilité de détecter des effets réels pourtant présents dans la population étudiée.
2.3 Différenciation entre facteurs manipulés et facteurs invoqués
Une distinction fondamentale, souvent négligée dans l’interprétation superficielle des devis 2×2, oppose les facteurs manipulés aux facteurs invoqués (ou quasi-expérimentaux). Un facteur est dit manipulé au sens expérimental pur lorsque l’expérimentateur détient le contrôle absolu sur l’assignation aléatoire des participants à l’une ou l’autre de ses modalités. L’administration d’un traitement pharmacologique actif versus un placebo, ou la présentation d’une consigne de cadrage positif versus négatif, constituent des archétypes de facteurs manipulés. Seule la manipulation expérimentale avec randomisation préalable permet de neutraliser les variables parasites et de fonder en toute rigueur une inférence de nature purement causale.
À l’opposé, un facteur invoqué renvoie à une caractéristique inhérente, préexistante et non modifiable des sujets d’étude, que le chercheur ne peut que constater et intégrer dans son modèle à titre de variable de classification. Les variables telles que le genre biologique, la catégorie socioprofessionnelle, la tranche d’âge, un diagnostic psychiatrique (ex. sujet diagnostiqué avec un trouble dépressif majeur versus individu neurotypique) ou des traits de personnalité stables (ex. fort versus faible niveau de névrosisme) constituent des facteurs invoqués. Lorsqu’un chercheur croise un facteur manipulé (ex. type de thérapie) avec un facteur invoqué (ex. haut vs bas niveau d’anxiété-trait), le design devient formellement un plan quasi-expérimental.
Cette distinction a des répercussions considérables sur la validité interne des conclusions tirées de l’étude. Lorsqu’un effet principal ou une interaction implique un facteur invoqué, il est strictement proscrit d’affirmer une relation de causalité directe entre ce facteur et la variable dépendante. En effet, l’absence de randomisation initiale rend impossible la certitude que la variation observée ne découle pas d’une tierce variable confondue intrinsèquement corrélée au trait invoqué (par exemple le niveau d’éducation, le statut socio-économique ou une prédisposition génétique non mesurée). Le chercheur doit faire preuve d’une grande prudence discursive, qualifiant ces liaisons d’associations différentielles plutôt que d’effets causaux au sens strict.
3. Les effets principaux : Conceptualisation, calcul et portée inférentielle
3.1 Définition mathématique et conceptuelle du premier effet principal
Dans l’architecture d’un plan factoriel 2×2, le premier effet principal quantifie l’influence globale et isolée du premier facteur indépendant (Facteur A) sur la variable dépendante, en agrégeant et en neutralisant l’influence de l’autre facteur (Facteur B). D’un point de vue conceptuel, cet effet correspond à la question suivante : le comportement ou la réponse psychologique des participants varie-t-il de manière significative selon qu’ils sont soumis à la première modalité ($A_1$) plutôt qu’à la seconde ($A_2$), si l’on fait totalement abstraction des modalités du facteur B auxquelles ils ont par ailleurs été exposés ?
Sur le plan computationnel, l’évaluation de cet effet repose sur la comparaison des moyennes marginales associées à chaque modalité du facteur A. Si l’on désigne par $\bar{Y}_{11}$, $\bar{Y}_{12}$, $\bar{Y}_{21}$ et $\bar{Y}_{22}$ les moyennes observées dans chacune des quatre cellules expérimentales (où le premier indice renvoie au niveau de A et le second au niveau de B), les moyennes marginales de A s’obtiennent par les formules suivantes :
$$\bar{Y}_{A1} = \frac{\bar{Y}_{11} + \bar{Y}_{12}}{2}$$
$$\bar{Y}_{A2} = \frac{\bar{Y}_{21} + \bar{Y}_{22}}{2}$$
L’effet principal de A se matérialise mathématiquement par la différence entre ces deux moyennes marginales : $\Delta_A = \bar{Y}_{A1} – \bar{Y}_{A2}$.
L’hypothèse statistique nulle ($H_0$) afférente à ce test stipule l’égalité parfaite des espérances marginales dans la population d’intérêt :
$$H_0 : \mu_{A1} = \mu_{A2} \quad \text{ou de façon équivalente} \quad H_0 : \mu_{A1} – \mu_{A2} = 0$$
Sur le plan psychologique, rejeter cette hypothèse nulle permet d’inférer que la manipulation du facteur A induit, en moyenne et toute chose égale par ailleurs, une modification systématique du processus mental ou comportemental étudié, conférant à ce déterminant un rôle explicatif global.
3.2 Définition et interprétation du second effet principal
Par symétrie mathématique et logique, le second effet principal correspond à l’impact général du Facteur B sur la variable dépendante, indépendamment des variations induites par le Facteur A. Il permet de déterminer si le passage de la modalité $B_1$ à la modalité $B_2$ engendre une variation systématique de la réponse empirique moyenne en neutralisant statistiquement le contexte imposé par les niveaux du facteur A. Ce paramètre constitue le second axe explicatif fondamental du plan 2×2.
Le calcul procède de façon analogue à celui exposé précédemment, en calculant cette fois-ci les moyennes marginales des colonnes de la matrice expérimentale :
$$\bar{Y}_{B1} = \frac{\bar{Y}_{11} + \bar{Y}_{21}}{2}$$
$$\bar{Y}_{B2} = \frac{\bar{Y}_{12} + \bar{Y}_{22}}{2}$$
L’ampleur de l’effet principal de B est alors traduite par le différentiel $\Delta_B = \bar{Y}_{B1} – \bar{Y}_{B2}$. L’hypothèse nulle associée postule que dans la population parente, la différence entre les deux conditions marginales est strictement nulle ($H_0 : \mu_{B1} = \mu_{B2}$).
L’isolation statistique de la variance propre au facteur B permet de comparer la force et la direction de son influence par rapport à celle du facteur A. En observant les sommes des carrés et les rapports de variance associés, le chercheur peut déduire quel déterminant possède le plus fort pouvoir prédictif sur le phénomène étudié, ouvrant la voie à une hiérarchisation relative des mécanismes psychologiques sous-jacents, à condition toutefois que les échelles de manipulation des deux facteurs présentent un degré d’équivalence écologique ou théorique raisonnable.
3.3 Limites interprétatives des effets principaux en présence d’interactions
L’une des fautes méthodologiques les plus sévères et pourtant les plus récurrentes dans la littérature empirique consiste à interpréter de façon isolée et péremptoire les effets principaux sans vérifier préalablement l’existence d’une interaction significative entre les facteurs. Cette défaillance analytique peut conduire à des conclusions totalement fallacieuses. En effet, une moyenne marginale n’est qu’un artefact mathématique : elle agrège des données issues de contextes expérimentaux différents. Si l’impact d’une variable change de sens ou d’amplitude selon le niveau de l’autre, affirmer que « le facteur A a un impact positif global » devient au mieux une généralisation abusive, au pire une contrevérité empirique.
Ce danger atteint son paroxysme lors de la survenue du phénomène d’annulation statistique, analogue dans sa mécanique au célèbre paradoxe de Simpson. Imaginons un cas théorique où l’administration d’un traitement $A$ augmente considérablement les performances de mémorisation chez les individus non stressés ($B_1$), mais diminue exactement dans les mêmes proportions ces mêmes performances chez les individus soumis à un stress intense ($B_2$). Lors de l’agrégation des scores pour tester l’effet principal de A, la moyenne marginale de la condition $A_1$ sera rigoureusement identique à celle de la condition $A_2$. Le test de l’effet principal conclura faussement à une absence totale d’influence du traitement ($F \approx 0, p \approx 1$), alors même que le traitement exerce un impact massif mais inversé selon le contexte physiologique du sujet.
C’est pourquoi la règle d’or de l’interprétation d’un plan factoriel réside dans le principe de primauté de l’interaction. L’analyste doit impérativement examiner en première instance la significativité et la configuration du terme d’interaction. Si ce dernier s’avère statistiquement significatif et d’ampleur substantielle, les effets principaux doivent immédiatement être frappés d’une réserve critique majeure : ils ne décrivent plus une loi générale de fonctionnement, mais une simple moyenne pondérée dont la pertinence psychologique s’efface devant la réalité conditionnelle mise en lumière par l’effet croisé.
4. L’effet d’interaction : Le cœur analytique du devis 2×2
4.1 Nature et définition formelle de l’interaction statistique
L’effet d’interaction représente la quintessence analytique du plan factoriel, sa véritable raison d’être méthodologique. Formellement, il existe une interaction statistique entre deux variables indépendantes lorsque l’amplitude, la force ou la direction de l’effet de l’un des facteurs sur la variable dépendante varie en fonction du niveau ou de la modalité spécifique adoptée par le second facteur. En d’autres termes, l’effet combiné des deux facteurs ne peut pas être prédit par la simple somme de leurs effets isolés : il y a rupture de l’additivité linéaire.
Dans le formalisme du modèle linéaire, l’additivité implique que si le facteur A produit un gain moyen de $\Delta_A$ unités et que le facteur B produit un gain moyen de $\Delta_B$ unités, alors la réunion des conditions expérimentales optimales ($A_1 B_1$) devrait produire exactement une amélioration égale à $\Delta_A + \Delta_B$. Lorsque la valeur moyenne empiriquement observée $\bar{Y}_{11}$ dévie significativement de cette prédiction additive théorique, cette non-additivité est mathématiquement attribuée au terme résiduel factoriel, qui constitue la composante d’interaction ($A \times B$). L’hypothèse nulle relative à l’interaction postule ainsi l’absence de non-additivité dans la population parente :
$$H_0 : (\mu_{11} – \mu_{12}) – (\mu_{21} – \mu_{22}) = 0 \quad \text{ou encore} \quad H_0 : (\mu_{11} – \mu_{21}) – (\mu_{12} – \mu_{22}) = 0$$
Sur le terrain de la psychologie théorique, l’interaction statistique est la traduction opérationnelle directe du concept de modération. Lorsqu’un chercheur observe une interaction $A \times B$ significative, il a démontré que le Facteur B agit comme un modérateur de la relation causale unissant le Facteur A à la réponse comportementale. Ce type de résultat permet de dépasser les modèles mécanistes simplistes pour formuler des propositions épistémologiquement riches du type : « Le sentiment de compétence n’accroît la motivation intrinsèque que si le climat organisationnel est perçu comme soutenant l’autonomie ; en contexte d’hypercontrôle managérial, ce gain de compétence demeure sans influence sur l’engagement ».
4.2 Typologie des interactions : Ordinales, désordonnées et croisées
L’interprétation théorique d’une interaction exige une caractérisation typologique précise de sa structure géométrique et fonctionnelle. La taxonomie classique distingue principalement trois grandes catégories de profils d’interaction :
- Les interactions ordinales : Dans ce cas de figure, l’effet du premier facteur va constamment dans la même direction à travers tous les niveaux du second facteur, mais son amplitude varie de manière substantielle. Par exemple, une technique d’apprentissage par rappel espacé améliore la performance chez les novices de 15 points, et améliore également la performance chez les experts, mais seulement de 3 points. La hiérarchie des conditions demeure strictement inchangée ($A_1$ reste supérieur à $A_2$ quel que soit le niveau de B), mais le degré de réactivité du système est quantitativement modulé. Dans cette configuration, les effets principaux conservent une certaine validité descriptive globale.
- Les interactions désordonnées (ou semi-croisées) : L’effet d’un facteur est présent et prononcé à un niveau précis du second facteur, mais disparaît complètement ou devient statistiquement indistinguable de zéro au second niveau de ce même facteur. Un exemple typique est un traitement médicamenteux expérimental qui améliore drastiquement la cognition chez des patients porteurs d’une mutation génétique spécifique, mais qui ne démontre rigoureusement aucun effet décelable chez les patients dépourvus de cette mutation.
- Les interactions croisées pures (disordinales) : Il s’agit du profil le plus spectaculaire et le plus instructif sur le plan théorique. La direction même de l’effet s’inverse de manière symétrique ou asymétrique d’une condition à l’autre. Le facteur A exerce une influence fortement positive sous la condition $B_1$, mais cette même manipulation devient délétère et exerce une influence négative sous la condition $B_2$. C’est dans ce profil spécifique que l’effet d’annulation des effets principaux mentionné antérieurement atteint sa manifestation la plus éclatante.
La distinction entre ces régimes d’interaction est fondamentale pour la validité du modèle. Une interaction croisée détruit complètement l’utilité théorique des effets principaux, contraignant l’expérimentateur à abandonner toute velléité d’énoncer une règle générale au profit d’un discours focalisé exclusivement sur la réactivité différentielle des cellules.
4.3 Représentation graphique des profils de moyennes et détection visuelle
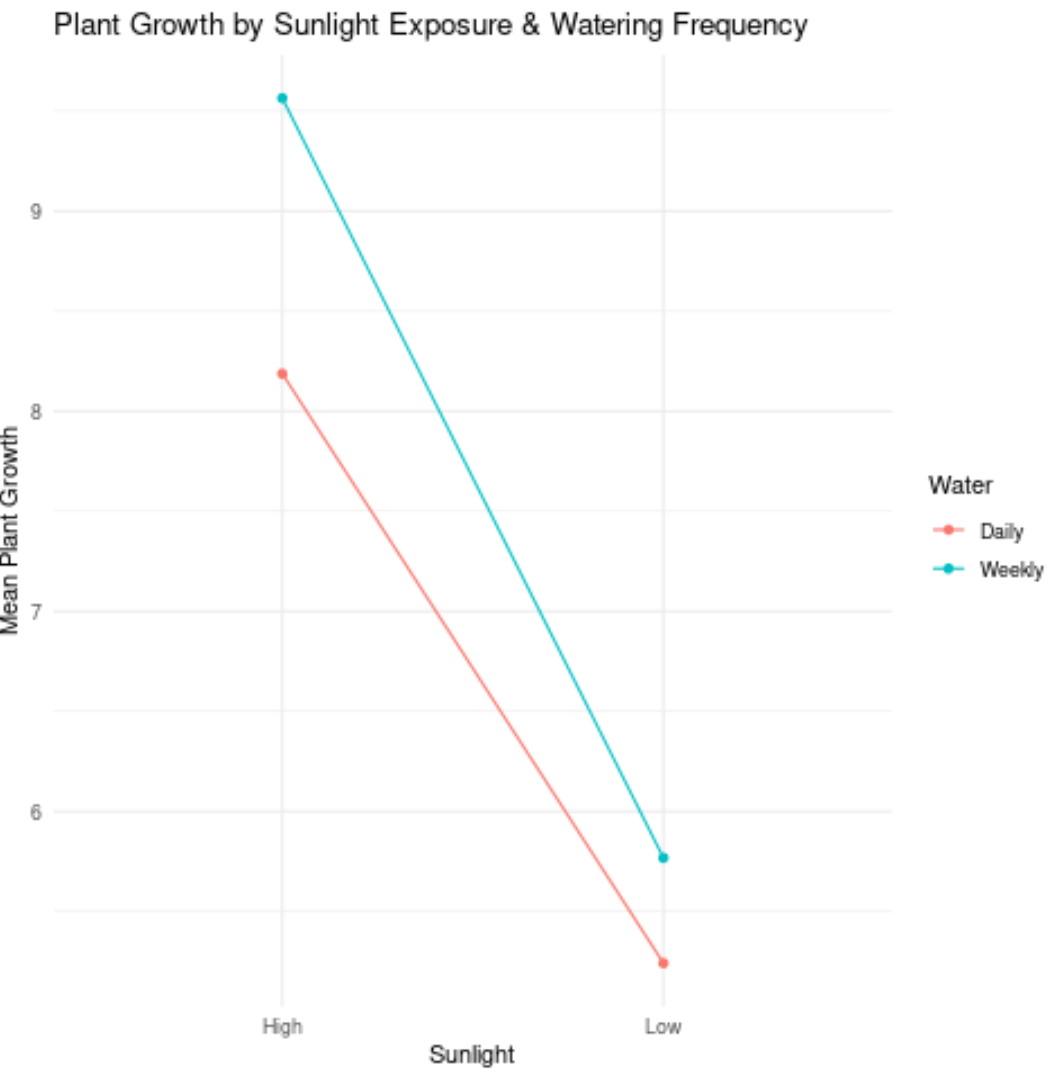
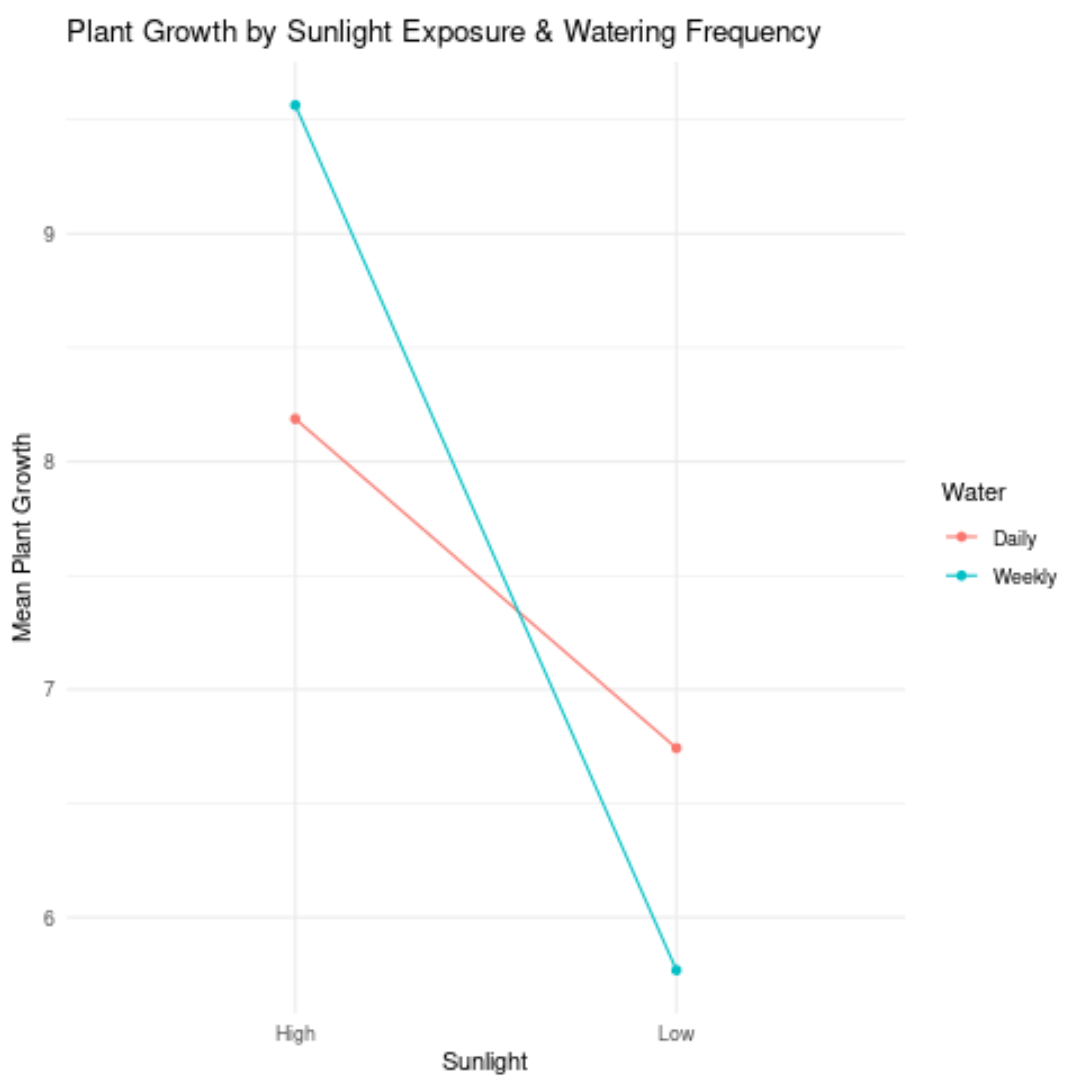
L’inspection graphique des données est une étape fondamentale de l’exploration analytique d’un devis factoriel 2×2. Traditionnellement, le graphique de profil (ou diagramme d’interaction) positionne les deux modalités de l’une des variables indépendantes (par exemple le facteur A) sur l’axe horizontal des abscisses ($X$), tandis que la variable dépendante continue est cartographiée sur l’axe vertical des ordonnées ($Y$). Les deux modalités du second facteur (facteur B) sont alors figurées par deux droites indépendantes reliant les moyennes conditionnelles respectives, accompagnées chacune de leurs barres d’erreur matérialisant l’erreur type de la moyenne ($SE$) ou les intervalles de confiance ($IC_{95%}$).
Le diagnostic visuel d’une interaction repose sur le critère géométrique de non-parallélisme des droites de réponse :
- Si les deux segments de droite sont rigoureusement parallèles dans les limites de la variabilité d’échantillonnage, le modèle est purement additif : il n’y a pas d’interaction perceptible, et les effets des deux facteurs opèrent de manière indépendante.
- Dès lors que les deux droites dévient visiblement de ce parallélisme — qu’elles convergent, divergent ou s’entrecroisent en forme de « X » —, la présence d’une interaction statistique est suspectée et doit être soumise au test de Fisher formel.
Cependant, l’interprétation visuelle requiert une grande circonspection méthodologique. Des écueils d’illusion perceptive peuvent facilement induire l’analyste en erreur. Une troncature artificielle de l’axe des ordonnées (par exemple un zoom excessif sur un intervalle de valeurs très restreint) peut faire apparaître un non-parallélisme saisissant pour des variations minimes qui ne s’avèreront que du simple bruit d’échantillonnage non significatif lors de l’ANOVA. Inversement, une échelle d’ordonnée excessivement écrasée masquera visuellement une divergence réelle. De surcroît, le chevauchement visuel des barres d’erreur ne constitue jamais une preuve formelle d’équivalence statistique sans l’exécution des tests inférentiels appropriés.
5. Typologies de plans factoriels 2×2 selon l’assignation des participants
5.1 Le plan inter-sujets (Between-Subjects Design)
Le plan factoriel 2×2 inter-sujets — également qualifié de devis à groupes indépendants — constitue la déclinaison classique de la méthodologie expérimentale. Dans cette configuration, chaque participant recruté est assigné de manière strictement aléatoire à l’une, et une seule, des quatre cellules expérimentales générées par le croisement des deux facteurs ($A_1 B_1$, $A_1 B_2$, $A_2 B_1$ ou $A_2 B_2$). Les quatre sous-groupes d’individus qui en résultent sont totalement exclusifs : aucun sujet n’est soumis à plus d’une combinaison de traitements au cours de la recherche.
Cette approche offre des atouts méthodologiques majeurs quant à la validité interne du protocole. En premier lieu, elle élimine purement et simplement tous les biais inhérents à la succession temporelle des épreuves :
- Absence totale d’effets d’ordre de passation ou d’effets de séquence.
- Éradication des phénomènes d’apprentissage, d’accoutumance cognitive ou de familiarisation avec les stimuli du test.
- Suppression des biais d’épuisement psychologique ou de fatigue cognitive qui parasitent fréquemment les protocoles longs.
- Impossibilité pour le sujet de deviner l’hypothèse sous-jacente par comparaison active entre les différentes conditions d’intervention.
Le revers méthodologique de cette architecture réside dans son coût humain et sa vulnérabilité à la variance interindividuelle. Pour maintenir une puissance statistique décente, le devis inter-sujets réclame un recrutement d’effectifs particulièrement volumineux, chaque individu ne produisant qu’un point de donnée unique. De plus, la variabilité naturelle intrinsèque aux participants (différences de capacités intellectuelles, de traits d’anxiété, de réactivité physiologique) intègre directement le compartiment de la variance résiduelle non expliquée. Cette variance d’erreur interindividuelle tend à réduire la taille d’effet observable et à rendre la détection des petites interactions plus complexe sur le plan statistique.
5.2 Le plan intra-sujets (Within-Subjects / Mesures répétées)
À l’extrême opposé se déploie le plan factoriel 2×2 intra-sujets, couramment désigné sous le terme d’analyse à mesures répétées. Dans ce dispositif, chaque participant de l’échantillon est exposé successivement à l’intégralité des quatre conditions expérimentales du devis. Chaque sujet devient ainsi son propre groupe témoin, produisant quatre mesures continues distinctes de la variable dépendante au fil du temps ou de la séquence expérimentale.
L’avantage principal de cette formule tient à son exceptionnelle puissance statistique et à son économie drastique en termes d’échantillonnage. En contrôlant parfaitement la variance interindividuelle — puisque les caractéristiques stables du participant (intelligence, patrimoine génétique, personnalité) restent identiques à travers les quatre cellules —, le modèle statistique extrait cette part colossale de variabilité du dénominateur d’erreur. Les sommes des carrés d’erreur résiduelle s’en trouvent drastiquement comprimées, autorisant la détection d’effets principaux et d’interactions même pour des échantillons numériques très réduits.
Néanmoins, le plan intra-sujets impose un niveau d’exigence logistique extrême pour neutraliser les redoutables effets de report (carryover effects) et de contamination séquentielle. L’exposition à la condition $A_1 B_1$ peut modifier irrémédiablement l’état interne du participant et biaiser sa réponse subséquente sous la condition $A_1 B_2$. L’expérimentateur doit impérativement instaurer un contrebalancement systématique strict de l’ordre de présentation des conditions (par exemple au moyen de permutations équilibrées ou de carrés latins). En outre, ce plan s’avère rigoureusement inapplicable lorsque l’administration d’un traitement induit un changement définitif et irréversible chez le sujet, comme une intervention psychopédagogique d’apprentissage conceptuel où le sujet ne peut « désapprendre » ce qui vient de lui être enseigné.
5.3 Le plan mixte ou split-plot (Mixed Factorial Design)
Le plan factoriel 2×2 mixte — souvent désigné dans la terminologie agronomique originelle par l’expression de design split-plot — représente un compromis architectural hautement efficient entre les logiques inter- et intra-sujets. Cette structure intègre formellement un facteur manipulé en inter-sujets (les participants sont répartis aléatoirement entre deux groupes exclusifs) et un second facteur administré en intra-sujets (tous les participants des deux groupes sont mesurés à travers les deux modalités de cette seconde variable).
Cette typologie constitue la structure reine des protocoles d’évaluation clinique et d’intervention thérapeutique en psychologie et en neuropsychologie. Le prototype emblématique de ce plan croise :
- Un facteur inter-sujets définissant l’appartenance à un groupe d’intervention : par exemple, Groupe Thérapeutique Actif versus Groupe Témoin / Liste d’attente (ou Groupe Clinique Pathologique vs Sujets Contrôles Sains).
- Un facteur intra-sujets temporel correspondant au moment d’évaluation : Mesure de base Pré-intervention (T1) versus Évaluation post-intervention (T2).
Dans ce contexte précis, la démonstration de l’efficacité d’une thérapie ne se lit ni dans l’effet principal du groupe (qui pourrait refléter une différence initiale préexistante), ni dans l’effet principal du temps (qui pourrait simplement traduire une rémission spontanée ou un effet de maturation historique), mais réside exclusivement dans la significativité statistique de l’interaction mixte Groupe $\times$ Temps. Cette interaction modélise mathématiquement une réduction des symptômes significativement plus accentuée au fil du temps dans le groupe actif par rapport au groupe témoin.
Toutefois, la modélisation mathématique d’un plan mixte s’avère plus sophistiquée que celle des plans purs. Le chercheur doit composer avec deux termes d’erreur résiduelle distincts au sein de l’ANOVA : un terme d’erreur inter-sujets dédié au test du facteur de groupe, et un terme d’erreur intra-sujets dédié au facteur temporel et à l’interaction mixte. De surcroît, le respect de l’homogénéité des matrices de covariance entre les sous-groupes (évaluée par le test M de Box) devient un prérequis fondamental pour préserver la validité du taux d’erreur de première espèce.
6. Modélisation statistique : L’ANOVA à deux facteurs (Two-Way ANOVA)
6.1 Équation du modèle linéaire général et décomposition de la variance
L’analyse de variance à deux facteurs reposant sur les fondements du Modèle Linéaire Général (GLM), elle formalise chaque observation individuelle à travers une équation de décomposition additive des sources d’influence. Pour un plan factoriel 2×2 inter-sujets équilibré, la valeur observée $Y_{ijk}$ pour le $k$-ième individu au sein de la modalité $i$ du facteur A et de la modalité $j$ du facteur B s’énonce mathématiquement ainsi :
$$Y_{ijk} = \mu + \alpha_i + \beta_j + (\alpha\beta)_{ij} + \varepsilon_{ijk}$$
Où :
- $\mu$ représente la grande moyenne théorique de la population générale, c’est-à-dire le point d’ancrage global de la mesure.
- $\alpha_i$ correspond à l’effet fixe différentiel de la modalité $i$ du Facteur A, sous la contrainte d’identification paramétrique usuelle $\sum \alpha_i = 0$.
- $\beta_j$ correspond à l’effet fixe différentiel de la modalité $j$ du Facteur B, sous la contrainte $\sum \beta_j = 0$.
- $(\alpha\beta)_{ij}$ désigne le paramètre d’interaction spécifique associant les modalités $i$ et $j$, quantifiant l’écart à la pure additivité, avec $\sum_i (\alpha\beta)_{ij} = 0$ et $\sum_j (\alpha\beta)_{ij} = 0$.
- $\varepsilon_{ijk}$ représente l’erreur aléatoire résiduelle associée à cet individu particulier, supposée indépendante et distribuée selon une loi normale centrée d’écart-type résiduel constant : $\varepsilon_{ijk} \sim \mathcal{N}(0, \sigma^2)$.
Cette architecture se traduit empiriquement par le partitionnement exhaustif de la somme totale des carrés des écarts ($SS_{Total}$). La variance brute de l’ensemble de l’échantillon est rigoureusement ventilée en quatre composantes orthogonales indépendantes :
$$SS_{Total} = SS_A + SS_B + SS_{AB} + SS_{Erreur}$$
Cette décomposition s’accompagne d’une partition équivalente des degrés de liberté ($dl$) associés. Si $N$ désigne la taille totale de l’échantillon et $n$ l’effectif au sein de chaque cellule expérimentale ($N = 4n$) :
- $dl_{Total} = N – 1$
- $dl_A = a – 1 = 2 – 1 = 1$
- $dl_B = b – 1 = 2 – 1 = 1$
- $dl_{AB} = (a – 1)(b – 1) = (1)(1) = 1$
- $dl_{Erreur} = N – ab = N – 4 = 4(n – 1)$
Chaque composante de variation factorielle ne mobilise ainsi qu’un unique degré de liberté au numérateur, ce qui confère au plan 2×2 une grande simplicité computationnelle.
6.2 Ratios F de Fisher et tests des hypothèses nulles
À partir des sommes de carrés et de leurs degrés de liberté respectifs, le protocole statistique dérive les carrés moyens ($MS$ pour Mean Squares), qui représentent les estimations des variances associées à chaque source. Chaque carré moyen s’obtient simplement par le ratio de la somme des carrés sur son degré de liberté propre :
$$MS_A = \frac{SS_A}{dl_A} = \frac{SS_A}{1} = SS_A, \quad MS_B = \frac{SS_B}{1} = SS_B, \quad MS_{AB} = \frac{SS_{AB}}{1} = SS_{AB}$$
$$MS_{Erreur} = \frac{SS_{Erreur}}{dl_{Erreur}} = \frac{SS_{Erreur}}{N – 4}$$
Le carré moyen de l’erreur résiduelle ($MS_{Erreur}$) constitue le dénominateur fondamental commun pour tester l’ensemble des hypothèses du modèle. Il fournit une estimation non biaisée de la variance intra-cellule $\sigma^2$, c’est-à-dire le niveau de bruit aléatoire inhérent aux différences interindividuelles ou aux imprécisions instrumentales au sein de conditions parfaitement identiques.
L’évaluation inférentielle s’effectue au moyen du ratio de variance $F$ théorisé par Fisher. Trois statistiques $F$ distinctes sont ainsi calculées pour tester indépendamment les trois hypothèses nulles du modèle :
$$F_A = \frac{MS_A}{MS_{Erreur}}, \quad F_B = \frac{MS_B}{MS_{Erreur}}, \quad F_{AB} = \frac{MS_{AB}}{MS_{Erreur}}$$
Sous l’hypothèse nulle d’absence d’effet, chacune de ces statistiques suit une distribution théorique de Fisher-Snedecor paramétrée par $1$ degré de liberté au numérateur et $N – 4$ degrés de liberté au dénominateur : $F \sim \mathcal{F}(1, N – 4)$. L’analyste compare le $F$ empirique obtenu à la valeur critique tabulée pour un seuil alpha prédéterminé (usuellement $\alpha = 0,05$), ou examine directement la $p$-valeur associée. Le rejet de l’hypothèse nulle est acté dès lors que la probabilité d’observer un tel ratio sous l’égide du seul hasard s’avère inférieure au seuil nominal fixé.
6.3 Postulats statistiques fondamentaux et tests diagnostiques
La validité des inférences probabilistes issues de l’ANOVA à deux facteurs repose sur le respect scrupuleux de trois postulats distributionnels majeurs. L’ignorance de ces conditions d’application peut dégrader l’intégrité du test, conduisant soit à une inflation dramatique du taux de faux positifs (erreur de type I), soit à une chute sévère de la puissance statistique (erreur de type II).
1. La normalité des résidus : Le modèle postule que les résidus d’estimation $\varepsilon_{ijk}$ se distribuent selon une loi normale au sein de chaque population correspondant aux cellules du devis. Le diagnostic formel s’appuie sur le test de normalité de Shapiro-Wilk appliqué sur les résidus standardisés du modèle global, ainsi que sur l’inspection visuelle des diagrammes quantile-quantile (Q-Q plots). Lorsque les résidus s’écartent modérément de la droite de normalité mais que les tailles d’échantillon par cellule sont strictement égales et supérieures à 20-30 observations, l’ANOVA démontre une robustesse remarquable grâce aux propriétés du théorème central limite.
2. L’homogénéité des variances (Homoscédasticité) : Ce postulat exige que la variance de l’erreur résiduelle soit rigoureusement identique à travers les quatre cellules expérimentales ($\sigma^2_{11} = \sigma^2_{12} = \sigma^2_{21} = \sigma^2_{22}$). Cette propriété est contrôlée formellement par le test de Levene (préférable sur la base de la médiane pour sa robustesse) ou le test de Bartlett. La violation de l’homoscédasticité devient particulièrement problématique en présence de plans non équilibrés : si la cellule à faible effectif présente la plus forte variance, le test $F$ standard devient trop libéral (inflation de faux positifs) ; inversement, si la plus grande cellule présente la plus forte variance, le test devient trop conservateur.
3. L’indépendance des observations : Il s’agit du postulat le plus critique et le moins robuste aux violations. Chaque observation recueillie au sein d’une cellule doit être totalement indépendante de toute autre observation. Tout regroupement spatial ou temporel (par exemple des sujets testés en dyades ou par salles de classe sans modélisation multiniveau) engendre une corrélation intraclasse qui invalide l’estimation des degrés de liberté de l’erreur et détruit la validité de la $p$-valeur calculée. Pour les mesures répétées, cette exigence s’étend au postulat de sphéricité (homogénéité de la variance des différences entre modalités), vérifié classiquement par le test de sphéricité de Mauchly.
7. Analyses post-hoc et décomposition des effets simples
7.1 Transition des effets omnibus aux effets principaux simples
L’obtention d’une statistique $F_{AB}$ significative pour le terme d’interaction constitue ce que la littérature nomme un test omnibus : elle atteste de façon globale que le modèle n’est pas purement additif, mais elle demeure totalement muette sur la localisation fine des différences conditionnelles. Face à une interaction significative, le chercheur doit obligatoirement interrompre l’interprétation des effets principaux globaux pour opérer une transition méthodologique vers l’analyse des effets principaux simples (ou effets simples).
Un effet principal simple correspond à l’impact de l’une des variables indépendantes évalué à un niveau fixe et déterminé de la seconde variable indépendante. Dans le cadre du plan 2×2, cette décomposition structurelle peut s’effectuer selon deux axes d’analyse orthogonaux :
- Tester l’effet du Facteur A au niveau spécifique $B_1$, puis tester indépendamment l’effet du Facteur A au niveau spécifique $B_2$.
- Ou symétriquement : tester l’effet du Facteur B au niveau spécifique $A_1$, puis tester l’effet du Facteur B au niveau spécifique $A_2$.
Le choix entre l’une ou l’autre de ces deux décompositions doit être dicté exclusivement par les questions théoriques et les hypothèses de recherche préalables de l’investigateur, et non par une exploration de données opportuniste. Sur le plan computationnel, l’analyse d’un effet simple procède par le partitionnement de la somme des carrés. La somme des carrés de l’effet simple de A à $B_1$ ($SS_{A \text{ at } B1}$) est calculée en comparant directement les moyennes des cellules 11 et 21, rapportée à la variance résiduelle globale ($MS_{Erreur}$) issue de l’ANOVA complète, ce qui permet de préserver l’ensemble des degrés de liberté résiduels pour le test d’inférence.
7.2 Procédures de comparaison multiple et contrôle du taux d’erreur
La multiplication des contrastes et des tests de significativité locaux lors de la décomposition des effets simples expose directement l’analyste au phénomène pernicieux de l’inflation de l’erreur de type I à l’échelle de la famille d’analyses (Familywise Error Rate). Si chaque comparaison individuelle est exécutée au seuil classique $\alpha = 0,05$, la probabilité cumulée de déclarer à tort au moins une différence comme statistiquement significative sur un ensemble de $c$ tests indépendants s’élève à $\alpha_{FW} = 1 – (1 – \alpha)^c$. Même dans un devis 2×2 où le nombre de tests simples demeure restreint ($c = 2$ ou $c = 4$), des procédures formelles de protection et d’ajustement sont rigoureusement recommandées.
Plusieurs stratégies de contrôle sont à la disposition du chercheur :
- La méthode de Bonferroni : Approche classique et hautement conservatrice, elle consiste à diviser le seuil nominal par le nombre total de comparaisons effectuées ($\alpha_{ajustacute{e}} = \alpha / c$). Bien qu’irréprochable sur le plan du contrôle strict des faux positifs, elle peut réduire excessivement la puissance statistique si les contrastes sont redondants.
- La procédure séquentielle de Holm-Bonferroni : Nettement supérieure à Bonferroni en termes de puissance, cette méthode classe les $p$-valeurs obtenues par ordre croissant et applique un seuil correcteur dégressif étape par étape. Elle assure un contrôle mathématique équivalent du risque de type I sans sacrifier inutilement la sensibilité de détection.
- Le test HSD de Tukey (Honestly Significant Difference) : Particulièrement adapté lorsque l’ensemble exhaustif des comparaisons par paires entre les quatre cellules du devis est conduit, il repose sur la distribution de l’étendue studentisée ($q$) et assure un contrôle exact du risque de type I à 5 % pour l’ensemble du volume des combinaisons deux à deux.
7.3 Formalisation sous l’angle de l’analyse de modération
Il est fondamental sur le plan conceptuel de réaliser que l’ANOVA factorielle 2×2 et le modèle de régression linéaire multiple avec terme de produit modérateur sont mathématiquement équivalents. Dans le paradigme contemporain unifié du modèle linéaire, le plan factoriel n’est rien d’autre qu’une régression multiple appliquée sur des variables indépendantes indicatrices (codées par exemple en contrastes orthogonaux -0,5 et +0,5, ou en codage binaire 0/1).
L’équation de régression modérée s’écrit formellement :
$$Y = \beta_0 + \beta_1 X_A + \beta_2 X_B + \beta_3 (X_A \times X_B) + \varepsilon$$
Dans cette formalisation :
- Le coefficient $\beta_1$ quantifie la pente conditionnelle du facteur A lorsque le facteur B est fixé à son point d’ancrage zéro.
- Le coefficient $\beta_2$ quantifie la pente conditionnelle du facteur B lorsque A est fixé à zéro.
- Le terme d’interaction $\beta_3$ capture l’ampleur exacte de la modération, correspondant strictement au coefficient de déviation des pentes simples.
Cette convergence épistémologique jette un pont fondamental entre la tradition expérimentale classique (qui recourt historiquement au vocabulaire de l’ANOVA et des « effets simples ») et la tradition observationnelle ou corrélationnelle (qui use de la sémantique de la régression et des « effets de modération »). Réaliser un test d’effets simples au sein d’une ANOVA revient très précisément à conduire une analyse de pentes simples (simple slopes analysis) telle que formalisée par Aiken et West dans l’analyse de régression. Cette vision unifiée enrichit considérablement l’aisance conceptuelle du chercheur lorsqu’il navigue entre différents devis méthodologiques.
8. Puissance statistique, taille d’effet et calcul d’échantillonnage
8.1 Estimation standardisée de la taille d’effet
Dans le paradigme inférentiel moderne, la seule présentation d’une $p$-valeur s’avère totalement insuffisante pour juger de la pertinence pratique ou théorique d’un résultat expérimental. Une valeur significative $p < 0,05$ peut refléter un phénomène psychologique d'amplitude majeure sur un échantillon restreint, ou au contraire découler d'une divergence totalement insignifiante rendue statistiquement décelable par l'emploi d'un effectif pléthorique. Il est donc obligatoire de quantifier la magnitude des effets au moyen d'indices standardisés d'ampleur d'effet.
Dans le cadre du plan factoriel 2×2, la métrique la plus universellement rapportée est l’Éta-carré partiel ($\eta_p^2$). Il représente la proportion de la variance totale de la variable dépendante qui est spécifiquement expliquée par la composante factorielle considérée, en extrayant et en neutralisant préalablement la variance capturée par les autres facteurs du modèle :
$$\eta_p^2 = \frac{SS_{Effet}}{SS_{Effet} + SS_{Erreur}}$$
Selon les conventions empiriques établies par Jacob Cohen dans ses travaux séminaux sur l’analyse de puissance, les repères de magnitude pour le $\eta_p^2$ s’établissent comme suit :
- Effet de faible amplitude : $\eta_p^2 \approx 0,01$ (représente environ 1 % de variance expliquée).
- Effet d’amplitude moyenne : $\eta_p^2 \approx 0,06$ (environ 6 % de variance expliquée).
- Effet de forte amplitude : $\eta_p^2 ge 0,14$ (14 % de variance expliquée ou plus).
Cependant, les méthodologistes avertis préfèrent fréquemment l’Oméga-carré partiel ($\omega_p^2$), particulièrement pour les petits échantillons. Contrairement à l’éta-carré partiel qui souffre d’un biais systématique de surestimation de la taille d’effet dans l’échantillon, l’oméga-carré partiel ajuste son calcul en intégrant l’erreur quadratique moyenne, fournissant une estimation non biaisée de la véritable variance expliquée dans la population parente :
$$\omega_p^2 = \frac{SS_{Effet} – (dl_{Effet} \times MS_{Erreur})}{SS_{Effet} + (N – dl_{Effet}) \times MS_{Erreur}}$$
Pour la décomposition des effets simples, la taille d’effet standardisée s’exprime idéalement au moyen du $d$ de Cohen, rapportant la différence directe entre les deux moyennes de cellules à l’écart-type résiduel combiné ($S_{pooled}$).
8.2 Détermination de la puissance statistique a priori
La puissance statistique ($1 – \beta$) quantifie la probabilité formelle pour un protocole expérimental de rejeter l’hypothèse nulle lorsque celle-ci est effectivement fausse dans la nature, c’est-à-dire de détecter un effet réel existant au sein de la population. Les standards contemporains exigent que cette puissance soit déterminée a priori, lors de la phase de conception du design, afin d’établir la taille d’échantillon minimale ($N$) requise pour atteindre une puissance cible de référence, conventionnellement fixée à $1 – \beta = 0,80$, voire $0,90$ pour des interventions à forts enjeux.
L’utilisation de logiciels spécialisés tels que G*Power est devenue incontournable. Dans le cadre d’un plan factoriel 2×2 inter-sujets, la planification via G*Power implique la sélection de la famille des tests $F$ (ANOVA: Special effects and interactions ou Fixed effects, special, main effects and interactions). Le chercheur doit spécifier :
- Le seuil de signification alpha (habituellement $\alpha = 0,05$).
- La puissance statistique désirée ($1 – \beta = 0,80$).
- Le nombre de degrés de liberté au numérateur ($df = 1$).
- Le nombre total de groupes ou de cellules ($4$).
- La taille d’effet standardisée escomptée, généralement convertie sous l’indice $f$ de Cohen ($f = \sqrt{\eta_p^2 / (1 – \eta_p^2)}$).
Une complexité fondamentale réside dans le fait que la taille d’échantillon requise ne sera pas identique selon que l’hypothèse de recherche cible un effet principal ou le terme d’interaction. De plus, dans les plans factoriels mixtes ou intra-sujets, le calcul dépend étroitement du coefficient de corrélation inter-mesures répétés ($r$) : plus la corrélation intra-sujet est élevée, plus la puissance augmente pour les facteurs intra et l’interaction, réduisant d’autant les besoins en effectifs globaux.
8.3 Le problème récurrent de la sous-puissance pour l’effet d’interaction
L’un des angles morts les plus dramatiques de la recherche empirique réside dans le problème chronique de la sous-puissance statistique lors de l’investigation des effets d’interaction. Une intuition naïve et pourtant répandue suggère qu’un échantillon calibré pour détecter un effet principal de moyenne amplitude avec une puissance de 80 % possédera une puissance équivalente pour détecter l’interaction. Cette présomption est mathématiquement erronée.
Comme l’ont formalisé de nombreux méthodologistes quantitatifs, lorsque l’on explore des interactions d’atténuation ou des interactions croisées subtiles au sein d’un plan 2×2, la taille d’effet de l’interaction est très fréquemment égale à la moitié, voire au quart, de celle des effets principaux correspondants. Or, la relation mathématique unissant la taille d’effet à l’échantillon nécessaire est quadratique : pour diviser la taille d’effet détectable par deux, il ne faut pas doubler l’échantillon, mais le quadrupler. Par conséquent, une étude qui requiert environ 128 sujets au total pour isoler un effet principal moyen peut exiger plus de 500 participants pour atteindre une puissance équivalente de 80 % sur son terme d’interaction !
Les conséquences de cette sous-puissance chronique sont catastrophiques pour la littérature scientifique :
- Multiplication des erreurs de type II : des interactions réelles sont systématiquement ignorées et déclarées « non significatives » faute d’une cohorte suffisante.
- Inflation des estimations de taille d’effet : en condition de faible puissance, les rares interactions qui parviennent à franchir le seuil d’arbitrage de 5 % souffrent de la « malédiction du vainqueur » (winner’s curse), surestimant grossièrement l’amplitude réelle du phénomène pour des raisons de fluctuation aléatoire.
Il est donc impératif de dimensionner les cohortes de recherche en se basant expressément sur l’hypothèse la plus exigeante en matière d’échantillonnage, à savoir presque systématiquement la détection de l’interaction.
9. Applications concrètes du plan 2×2 dans la recherche en psychologie
9.1 Exemple en psychologie cognitive : Apprentissage et niveau de vigilance
Pour illustrer la mise en œuvre pratique et le potentiel de découverte d’un devis factoriel 2×2, examinons une investigation classique en psychologie cognitive de la mémoire. Une équipe de recherche s’intéresse à l’optimisation des performances d’encodage mnésique chez l’adulte jeune et cherche à déterminer si l’efficacité d’une stratégie cognitive dépend de l’état physiologique de vigilance de l’individu.
L’architecture expérimentale s’articule comme suit :
- Facteur A (Stratégie mnésique, inter-sujets) : Deux modalités. Soit le participant utilise une stratégie d’autorépétition passive (maintien phonologique par répétition mentale brute d’une liste de 40 mots abstraits), soit une stratégie d’élaboration sémantique (intégration active des mots dans des phrases complexes ou formation d’images mentales visuelles).
- Facteur B (État physiologique d’éveil, inter-sujets) : Deux modalités. Soit le participant bénéficie d’une nuit de sommeil complète préservée (8 heures contrôlées par actigraphie), soit il est soumis à une privation totale de sommeil de 24 heures avant la passation.
- Variable dépendante : Le score absolu de rappel libre correct 48 heures plus tard, exprimé sur une échelle continue de 0 à 40 items.
L’hypothèse théorique sous-jacente postule une interaction désordonnée typique. Sous la condition de sommeil préservé, l’élaboration sémantique — reconnue pour mobiliser des réseaux préfrontaux profonds — devrait induire une performance de rappel considérablement supérieure à l’autorépétition passive. En revanche, en condition d’épuisement cognitif induit par la privation de sommeil, l’incapacité du système exécutif central à allouer les ressources attentionnelles nécessaires à l’élaboration complexe devrait complètement neutraliser l’avantage de cette dernière, réduisant la performance des deux groupes au même niveau minimal. L’analyse statistique consistera à confirmer le non-parallélisme des pentes et à tester l’effet simple de la stratégie séparément selon l’état de privation.
9.2 Exemple en psychologie clinique : Efficacité thérapeutique combinée
Dans le domaine de la psychiatrie et de la psychologie clinique fondée sur les preuves, le plan factoriel 2×2 constitue le standard international pour évaluer les protocoles d’intervention combinée ou multimodale, particulièrement dans le traitement des troubles de l’humeur comme le Trouble Dépressif Majeur (TDM).
Le devis méthodologique classique croise deux thérapeutiques distinctes :
- Facteur A (Psychothérapie structurée) : Modalité active (séances hebdomadaires de Thérapie Cognitive et Comportementale – TCC) versus Modalité contrôle (Liste d’attente avec suivi empathique non directif ou psychoéducation passive).
- Facteur B (Pharmacothérapie) : Modalité active (administration sous double aveugle d’un inhibiteur sélectif de la recapture de la sérotonine – ISRS) versus Modalité placebo (gélule inerte identique d’aspect).
- Variable dépendante : L’amplitude de la diminution des scores de dépression entre l’inclusion et la 12e semaine, mesurée par une échelle continue standardisée telle que l’Échelle de Dépression de Hamilton (HAM-D).
Ce protocole permet de disséquer avec une clarté remarquable les mécanismes d’action croisés :
- L’effet principal de la psychothérapie évalue l’utilité moyenne de la TCC, toutes médications confondues.
- L’effet principal pharmacologique évalue la supériorité biochimique absolue de l’ISRS sur le placebo.
- L’effet d’interaction clinique résout une question fondamentale : la co-administration des deux approches produit-elle une synergie sur-additive (l’alliance de la TCC et de l’antidépresseur engendre une baisse symptomatique significativement plus forte que l’addition de leurs bénéfices individuels respectifs) ou au contraire une redondance asymptotique (une fois l’antidépresseur actif administré, la TCC n’apporte aucun bénéfice marginal additionnel) ?
9.3 Exemple en psychologie sociale : Amorçage implicite et pression évaluative
Un autre paradigme illustrant la fécondité du design 2×2 se trouve dans l’étude des performances intellectuelles et des dynamiques de stéréotypes sociaux, singulièrement dans la mise en évidence du phénomène de menace du stéréotype théorisé par Steele et Aronson.
Le dispositif expérimental se structure de la façon suivante :
- Facteur A (Amorçage de stéréotype social) : Modalité neutre (les participants remplissent un questionnaire démographique sans référence identitaire) versus Modalité d’activation de stéréotype négatif (la consigne souligne préalablement et explicitement que l’épreuve met en jeu des compétences où le groupe d’appartenance des participants est traditionnellement jugé défavorisé).
- Facteur B (Contexte de pression évaluative) : Modalité faible enjeu (l’épreuve est présentée comme un simple calibrage d’exercices d’entraînement sans valeur diagnostique) versus Modalité fort enjeu (l’épreuve est solennellement décrite comme un test de mesure standardisé et prédictif de l’intelligence générale).
- Variable dépendante : Le pourcentage de résolution correcte à un test standardisé de raisonnement analytique de haut niveau.
Dans ce scénario psychosocial, l’hypothèse ne prévoit pas nécessairement d’effet principal pur de l’amorçage ni du contexte d’évaluation de manière isolée. L’hypothèse critique postule une interaction croisée ou une interaction de sur-vulnérabilité : l’activation implicite du stéréotype n’exerce aucun effet délétère tant que l’enjeu perçu reste anodin ; c’est précisément la conjonction du stéréotype négatif et de la situation d’évaluation à fort enjeu qui déclenche une anxiété d’évaluation paralysante, surcharge la mémoire de travail et provoque l’effondrement ciblé de la performance du groupe vulnérable.
10. Protocole de mise en œuvre pratique avec R et SPSS
10.1 Structuration matricielle des données : Format large versus format long
L’exécution computationnelle d’une analyse factorielle exige une organisation rigoureuse de la matrice de données en amont de toute modélisation. En science des données et en statistique computationnelle, deux architectures fondamentales s’opposent selon la nature du devis expérimental utilisé :
1. Le format large (Wide Format) : Dans cette structure tabulaire, chaque unité d’observation statistique (chaque individu participant) est représentée sur une seule et unique ligne de la matrice. Les colonnes définissent ses identifiants, ses variables d’assignation factorielle et ses scores dépendants. Le format large constitue la norme naturelle et absolue pour le traitement des plans factoriels inter-sujets sous la quasi-totalité des progiciels statistiques :
- Colonne 1 : Identifiant du sujet (ID : S01, S02, …).
- Colonne 2 : Variable factorielle A (ex. Traitement : Actif / Témoin).
- Colonne 3 : Variable factorielle B (ex. Sommeil : Repos / Privation).
- Colonne 4 : Variable dépendante continue (Score_Performance).
2. Le format long (Long Format / Tidy Data) : Dans cette configuration conforme aux principes de données ordonnées, chaque ligne du tableau représente une observation unique et répétée dans le temps ou l’espace. Si un participant a été mesuré dans quatre conditions différentes (comme dans un plan 2×2 intra-sujets), ce même individu occupera exactement quatre lignes successives dans le tableau de données :
- Colonne 1 : Identifiant du sujet (qui se répète quatre fois par bloc individuel).
- Colonne 2 : Niveau de la condition A pour cette mesure spécifique.
- Colonne 3 : Niveau de la condition B pour cette mesure spécifique.
- Colonne 4 : Valeur de la variable dépendante recueillie à cette occurrence.
Le pivotement matriciel entre ces deux formats (opéré couramment sous R via les fonctions pivot_longer() et pivot_wider() du package tidyr) est une étape préliminaire critique : les routines d’analyses mixtes ou intra-sujets modernes refusent systématiquement les formats larges rigides d’autrefois.
10.2 Syntaxe de modélisation et extraction des résultats sous R
Le langage de programmation statistique R constitue l’environnement open-source d’excellence pour l’exécution d’analyses factorielles avancées. Bien que la fonction de base aov() ou lm() permette d’ajuster une ANOVA factorielle, l’utilisation de packages dédiés à la recherche expérimentale, tels que afex (Analysis of Factorial Experiments), emmeans (Estimated Marginal Means) et ggplot2, garantit une conformité absolue avec les standards méthodologiques les plus rigoureux.
La formulation du modèle linéaire pour un plan inter-sujets s’articule canoniquement autour de la syntaxe de croisement intégral symbolisée par l’opérateur étoile *, qui indique à l’interpréteur de décomposer le modèle en facteurs principaux et en produit d’interaction :
modele <- lm(Score ~ FacteurA * FacteurB, data = dataset)
La dérivation correcte des sommes de carrés (spécifiquement de Type III pour neutraliser les déviations d’effectifs) s’opère idéalement via afex::aov_car() :
modele_afex <- aov_car(Score ~ FacteurA * FacteurB + Error(ID), data = dataset, type = 3)
L’extraction des décompositions fines d’effets simples et des contrastes post-hoc bénéficie de la puissance computationnelle du package emmeans :
emmeans(modele_afex, specs = pairwise ~ FacteurA | FacteurB, adjust = "holm")
Cette commande génère automatiquement l’évaluation de l’effet simple du Facteur A conditionnellement à chaque modalité du Facteur B, appliquant une correction séquentielle de Holm-Bonferroni sur les probabilités de rejet. Enfin, la modélisation graphique des profils d’interaction s’élabore avec une élégance visuelle totale sous ggplot2 au moyen de stat_summary(geom = "line"), stat_summary(geom = "point") et stat_summary(fun.data = mean_cl_normal, geom = "errorbar").
10.3 Procédure pas-à-pas et interprétation des sorties dans SPSS
Pour les utilisateurs de l’environnement IBM SPSS Statistics, la conduite d’une ANOVA à deux facteurs 2×2 mobilise l’interface du Modèle Linéaire Général (GLM). Le protocole opératoire pour un plan factoriel inter-sujets s’organise selon les étapes séquentielles suivantes :
- Dans la barre de menus principale, naviguer vers : Analyser > Modèle linéaire général > Univarié…
- Dans la fenêtre de dialogue contextuelle, faire glisser la variable dépendante continue dans le champ Variable dépendante. Insérer conjointement les deux variables de classification dans le champ Facteurs fixes.
- Accéder au sous-menu Modèle… : s’assurer que l’option Factoriel complet est active et vérifier que la méthode de sommation des carrés est explicitement paramétrée sur le Type III.
- Dans le sous-menu Graphiques… : positionner l’une des variables en Axe horizontal et la seconde en Lignes séparées, puis cliquer impérativement sur le bouton Ajouter pour générer la figure de profil avant de valider.
- Dans le sous-menu Options… : cocher les cases Statistiques descriptives, Estimations de la taille de l’effet (qui retournera le $\eta_p^2$) et Tests d’homogénéité (pour obtenir le diagnostic de Levene). Faire glisser le terme d’interaction dans le champ Afficher les moyennes pour.
- Pour programmer les effets simples directement (fonctionnalité non disponible en clic-bouton natif), coller la syntaxe et ajouter l’instruction explicite :
/EMMEANS = TABLES(FacteurA*FacteurB) COMPARE(FacteurA) ADJ(BONFERRONI).
L’analyse des tableaux de sortie exige une lecture méthodologique hiérarchisée. L’analyste examine d’abord le tableau du Test de l’égalité des variances des erreurs de Levene. Si la significativité est supérieure à 0,05, l’homoscédasticité est préservée. Il porte ensuite son attention sur le tableau central intitulé Tests des effets inter-sujets. La lecture doit impérativement remonter de la ligne d’interaction vers les effets principaux : isoler la ligne FacteurA * FacteurB, examiner sa valeur $F$, sa significativité bilatérale (colonne Sig.) et son $\eta_p^2$. Ce n’est qu’après avoir évalué ce terme que l’analyste décide si la lecture des lignes FacteurA et FacteurB conserve une validité scientifique ou si elle doit céder le pas au tableau des comparaisons d’effets simples codifié par la commande EMMEANS.
11. Biais méthodologiques courants, menaces à la validité et solutions
11.1 Déséquilibre des effectifs dans les cellules et plans non orthogonaux
Dans l’idéal expérimental théorique, un plan 2×2 est équilibré : chaque cellule expérimentale comporte un effectif identique de sujets ($n_{11} = n_{12} = n_{21} = n_{22} = n$). Cet équilibre parfait assure une propriété mathématique cruciale : l’orthogonalité stricte. Dans un plan orthogonal, les sommes de carrés associées au facteur A, au facteur B et à l’interaction sont totalement décorrélées et indépendantes. La décomposition de la variance s’effectue sans aucun chevauchement mathématique, et le partitionnement de la somme des carrés est absolu ($SS_{Total} = SS_A + SS_B + SS_{AB} + SS_{Erreur}$).
Cependant, dans la pratique empirique réelle — particulièrement dans la recherche clinique ou lors d’enquêtes de terrain —, il est fréquent d’observer une rupture d’équilibre due à des abandons en cours d’étude (attrition), des données manquantes aléatoires ou des contraintes de recrutement d’échantillon. Dès lors que les effectifs de cellules deviennent inégaux ($n_{ij} \neq n_{i’j’}$), le plan devient non orthogonal. Les facteurs indépendants se retrouvent artificiellement corrélés entre eux, ce qui engendre un problème méthodologique majeur : des fractions de variance expliquée se chevauchent et peuvent être attribuées arbitrairement à l’un ou l’autre des facteurs selon l’ordre dans lequel ils sont traités par l’algorithme.
Pour résoudre cette ambiguïté, la théorie statistique a développé différentes méthodes de calcul des sommes de carrés :
- Type I (Sommes des carrés séquentielles) : Les facteurs sont introduits successivement dans le modèle. Le Facteur A s’adjuge toute la variance possible, puis le Facteur B n’explique que le résidu non capté par A, et enfin l’interaction ne capture que ce qui subsiste. Ce calcul dépend directement de l’ordre d’entrée des variables dans la syntaxe et doit être rigoureusement proscrit dans les plans factoriels équilibrés ou déséquilibrés.
- Type II (Sommes des carrés hiérarchiques) : L’effet principal de A est testé après avoir contrôlé pour l’effet principal de B, et inversement, mais sans inclure l’interaction dans le modèle d’ajustement. Cette méthode maximise la puissance statistique pour les effets principaux, mais devient vulnérable en présence d’une interaction majeure.
- Type III (Sommes des carrés marginales partielles) : Il s’agit du standard universellement recommandé dans la quasi-totalité des disciplines de recherche expérimentale. Chaque terme du modèle (Facteur A, Facteur B et Interaction $A \times B$) est testé conditionnellement à l’ensemble de tous les autres termes présents. Chaque effet est ainsi évalué sur sa contribution de variance pure et unique, éliminant tout artefact d’ordre ou de corrélation induit par le déséquilibre numérique.
11.2 Effets de plancher et de plafond masquant les véritables interactions
L’une des menaces les plus insidieuses pesant sur la validité interne d’un design factoriel 2×2 réside dans l’émergence d’artéfacts de mesure liés à des effets de plancher ou de plafond. Ces biais méthodologiques surviennent lorsque l’instrument de mesure psychométrique ou comportemental utilisé présente des bornes de score extrêmes trop restreintes ou une sensibilité inadaptée aux extrémités de sa distribution.
Le mécanisme de distorsion s’opère de deux manières opposées :
- Création d’interactions artificielles ou fictives : Imaginons un test cognitif d’une difficulté extrême où la condition contrôle ($A_1$) produit des scores proches de zéro en raison de l’impossibilité matérielle de réussir les items (effet plancher). Si un traitement facilitateur ($A_2$) permet enfin aux participants d’accéder à des scores normaux, et que cette amélioration se manifeste différentiellement selon un facteur contextuel $B$, l’analyse statistique révélera une magnifique « interaction significative ». Or, cette non-additivité est purement artificielle : elle découle uniquement de la troncature arbitraire de l’instrument qui a empêché d’enregistrer des valeurs négatives sous la condition $A_1$, simulant une courbure fonctionnelle inexistante dans la réalité du phénomène latent.
- Masquage d’interactions réelles : Inversement, si une tâche d’évaluation est excessivement facile (effet plafond), les participants des deux modalités $A_1$ et $A_2$ plafonneront tous à un score parfait de 100 %. Toute divergence d’action théorique entre les conditions sera écrasée contre la limite supérieure du barème, conduisant le test $F$ d’interaction à une conclusion faussement négative ($p > 0,05$).
Pour conjurer ces distorsions, l’expérimentateur doit conduire des études pilotes rigoureuses afin de vérifier que la distribution des scores ne présente aucune agglomération suspecte d’individus aux bornes théoriques de l’échelle. En présence d’une asymétrie distributionnelle prononcée, des transformations mathématiques préalables (logarithmiques, racine carrée ou probit) ou le recours à des modélisations non linéaires de type régression tobit ou modèles mixtes généralisés pour variables bornées doivent impérativement être déployés.
11.3 Dichotomisation artificielle de variables continues
La volonté de concevoir à tout prix un plan factoriel 2×2 conduit fréquemment des chercheurs à commettre une erreur statistique préjudiciable : la dichotomisation artificielle de variables naturellement continues au moyen de la technique de scission par la médiane (Median Split) ou de la séparation en groupes extrêmes (ex. tiers supérieur vs tiers inférieur). Par exemple, un chercheur mesurant l’âge, le quotient intellectuel ou un trait d’anxiété sur une échelle continue décide de couper sa distribution en deux sous-groupes (« Jeunes » vs « Âgés », ou « Faible Anxiété » vs « Forte Anxiété ») afin de pouvoir insérer artificiellement cette variable comme le Facteur B d’une ANOVA 2×2.
Les démonstrations méthodologiques publiées depuis plusieurs décennies (notamment les travaux canoniques de Cohen, MacCallum et Maxwell) ont formellement établi que cette pratique est néfaste pour au moins trois raisons majeures :
- Une perte massive d’information et de puissance statistique : La scission par la médiane traite deux participants situés juste au-dessus et juste en dessous du point de coupure (ex. un score de 49 et un score de 51) comme s’ils étaient radicalement différents, tout en traitant un individu avec un score de 51 et un individu avec un score maximal de 100 comme s’ils étaient strictement identiques. Cette destruction délibérée de la variance continue entraîne une perte de puissance statistique estimée entre 30 % et 50 %, équivalant à jeter à la corbeille un tiers des participants de l’étude.
- L’inflation du risque de faux positifs (Type I) : Lorsque deux prédicteurs continus modérément corrélés sont tous deux dichotomisés artificiellement, les non-linéarités induites peuvent générer des interactions totalement illusoires, faisant émerger des effets significatifs qui ne sont que de purs artefacts statistiques.
- Le risque de distorsion de l’effet de modération : La modélisation de la véritable interaction continue en une table 2×2 grossière masque les courbures complexes de la surface de réponse tridimensionnelle.
La solution méthodologique contemporaine est catégorique : il ne faut jamais discrétiser artificiellement une variable continue. Si l’un de vos facteurs d’intérêt est une variable quantitative continue, vous devez abandonner l’ANOVA factorielle traditionnelle pour adopter la régression linéaire multiple continue modérée. Cette approche, traitée avec des variables centrées sur la moyenne et l’analyse de leurs produits d’interaction continus, modélise la modération avec une intégrité psychométrique et une puissance statistique infiniment supérieures.
12. Rédaction académique et communication des résultats selon les normes APA
12.1 Formulation textuelle rigoureuse des statistiques inférentielles
La diffusion scientifique des résultats d’un plan factoriel 2×2 est régie par les standards de style stricts de l’American Psychological Association (APA 7e édition). La rédaction textuelle doit conjuguer une transparence méthodologique absolue, une précision métrique millimétrée et une hiérarchie argumentative irréprochable. Le rapport statistique d’une ANOVA exige la mention systématique et ordonnée de plusieurs paramètres formels :
- Le nom du test inférentiel ($F$).
- Les degrés de liberté entre parenthèses : séparés par une virgule, le premier renvoie à la variance de l’effet ($1$), le second à la variance résiduelle ($N – 4$).
- La valeur empirique calculée du ratio $F$, arrondie à deux décimales.
- La $p$-valeur exacte rapportée à trois décimales (sauf en cas d’extrême significativité, notée $p < ,001$).
- La taille d’effet standardisée appropriée, typiquement l’éta-carré partiel ($\eta_p^2$) ou l’oméga-carré partiel ($\omega_p^2$), arrondie à deux ou trois décimales.
L’exposé narratif doit impérativement respecter la règle de primauté de l’interaction. Si cette dernière s’avère statistiquement significative, le paragraphe débute par sa qualification avant de décrire la décomposition conditionnelle des effets simples. Les formulations canoniques s’articulent selon les modèles académiques suivants :
Exemple de formulation pour un terme d’interaction :
« Une analyse de variance factorielle 2 (Stratégie : autorépétition vs élaboration) $\times$ 2 (État : sommeil préservé vs privation) inter-sujets a révélé un effet d’interaction statistiquement significatif entre la stratégie mnésique et l’état de veille, $F(1, 116) = 8,42$, $p = ,004$, $\eta_p^2 = ,07$, indiquant que l’efficacité de la stratégie dépendait de l’état physiologique du participant. »
Exemple de formulation pour la décomposition des effets simples :
« L’analyse des effets principaux simples avec ajustement de Holm a démontré que dans la condition de sommeil préservé, les participants ayant utilisé l’élaboration sémantique ont rappelé significativement plus de mots ($M = 28,40$, $ET = 4,12$) que ceux ayant eu recours à l’autorépétition ($M = 19,20$, $ET = 3,85$), $F(1, 116) = 24,15$, $p < ,001$, $d = 2,31$, $IC_{95%} [1,52, 3,10]$. En revanche, en condition de privation de sommeil, aucune différence statistiquement significative n'a été observée entre la stratégie d'élaboration ($M = 14,10$, $ET = 3,90$) et l'autorépétition ($M = 13,80$, $ET = 4,05$), $F(1, 116) = 0,08$, $p = ,778$, $d = 0,08$, $IC_{95%} [-0,43, 0,59]$. »
12.2 Conception de tableaux de synthèse conformes au style APA 7
L’intégration d’un tableau de synthèse factorielle offre une lisibilité immédiate que la seule prose textuelle ne peut garantir, particulièrement pour communiquer l’ensemble des moyennes de cellules et des marges. Le style APA impose des règles typographiques très strictes pour la mise en page tabulaire :
- Bannissement strict des séparateurs verticaux : Aucune ligne verticale ne doit jamais apparaître dans un tableau aux normes APA.
- Usage minimal des bordures horizontales : Seules trois bordures horizontales principales délimitent le tableau : une bordure sous le titre général, une bordure séparant les étiquettes de colonnes des données numériques, et une bordure inférieure fermant le corps du tableau avant les notes de bas de page.
- Richesse descriptive : Chaque cellule doit renseigner la moyenne ($M$), l’écart-type ($ET$ ou $SD$), ainsi que les bornes inférieures et supérieures de l’intervalle de confiance à 95 % ($IC_{95%}$), indispensable pour apprécier la stabilité des estimations.
Le tableau factoriel 2×2 se structure de façon matricielle canonique, présentant en lignes les niveaux du premier facteur, en colonnes les niveaux du second facteur, et réservant les lignes et colonnes terminales aux moyennes marginales combinées de chaque facteur indépendant. La note de tableau (débutant par l’italique Note.) précise la taille des sous-échantillons, la signification des abréviations métriques et les méthodes d’ajustement appliquées.
12.3 Élaboration de graphiques scientifiques informatifs et accessibles
La représentation visuelle d’un plan 2×2 dans un article scientifique ne doit pas être une simple redite illustrative, mais un instrument diagnostique de haute précision sémiotique. Deux formats d’affichage sont principalement plébiscités dans la recherche de pointe :
- Le diagramme de profils linéaires (Line Plot) : Idéal pour visualiser instantanément la modération grâce au parallélisme ou au croisement des segments reliant les moyennes conditionnelles.
- Le diagramme à barres ou diagramme de dispersion hybride : Combine des barres d’amplitude moyenne avec la superposition transparente de l’ensemble des points de dispersion individuels (jittered individual data points), garantissant une transparence absolue sur la variabilité réelle des observations sous-jacentes.
Les impératifs techniques d’un graphique conforme aux normes APA 7 et aux règles d’accessibilité universelle incluent :
- Barres d’erreur explicites : Toute moyenne figurée doit impérativement être accompagnée d’une barre d’erreur matérialisant soit l’erreur type de la moyenne ($\pm 1 SE$), soit l’intervalle de confiance à 95 % ($IC_{95%}$). La légende du graphique doit explicitement stipuler la métrique retenue.
- Lisibilité pour daltoniens (Colorblind-friendly) : Les courbes ou barres conditionnelles ne doivent jamais être différenciées uniquement par des teintes de vert et de rouge. L’utilisation de palettes perceptuellement uniformes et éprouvées (telles que les palettes Viridis ou ColorBrewer) est impérative. De plus, il convient de doubler l’encodage couleur par un encodage géométrique distinct : par exemple, associer une ligne continue avec des marqueurs circulaires pleins pour la première modalité, et une ligne pointillée avec des marqueurs triangulaires ouverts pour la seconde.
- Sobriété sémiotique : Suppression absolue des effets 3D artificiels, des ombrages inutiles ou des quadrillages d’arrière-plan trop contrastés qui polluent visuellement la lecture cognitive du signal de recherche.
Références
Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE Publications.
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19
Maxwell, S. E., & Delaney, H. D. (2004). Designing experiments and analyzing data: A model comparison perspective (2nd ed.). Lawrence Erlbaum Associates.
Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
Singmann, H., & Kellen, D. (2019). An introduction to the analysis of experimental data with R. In D. H. Sternberg & J. Funke (Eds.), The Oxford Handbook of Computational and Mathematical Psychology. Oxford University Press.
Steele, C. M., & Aronson, J. (1995). Stereotype threat and the intellectual test performance of African Americans. Journal of Personality and Social Psychology, 69(5), 797–811. https://doi.org/10.1037/0022-3514.69.5.797
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.