
Dans le champ de la recherche scientifique contemporaine, singulièrement au sein de la psychologie expérimentale et des sciences du comportement, la modélisation statistique ne constitue pas une simple formalité technique survenant au terme de l’investigation empirique. Elle représente le filtre épistémologique à travers lequel des postulats théoriques abstraits sont confrontés à la variabilité inhérente aux conduites humaines. Parmi l’arsenal des méthodes quantitatives à la disposition des chercheurs, l’analyse de variance factorielle à deux facteurs — couramment désignée sous le vocable d’ANOVA bidirectionnelle ou Two-Way ANOVA — occupe une place de choix. Sa capacité à dépasser la juxtaposition réductionniste d’analyses univariées simples pour appréhender la complexité des dynamiques interactives en fait un outil méthodologique irremplaçable pour quiconque souhaite explorer les déterminants multifactoriels de la cognition, de l’émotion ou de l’action.
Toutefois, la maîtrise mathématique ou computationnelle du modèle linéaire généralisé ne garantit nullement la qualité de sa transmission scientifique. L’avènement des crises de réplicabilité dans les sciences biomédicales et humaines a mis en exergue une exigence accrue de transparence, de précision et de conformité métrologique lors de la rédaction des comptes rendus statistiques. Rédiger la section « Résultats » d’une recherche impliquant une ANOVA à deux facteurs exige une articulation sans faille entre la description des distributions empiriques, la validation des postulats paramétriques sous-jacents, l’exposition hiérarchisée des statistiques inférentielles et l’exégèse rigoureuse des tailles d’effet. Un compte rendu lacunaire ou approximatif masque trop souvent des artefacts méthodologiques ou conduit les pairs à des inférences erronées.
Ce guide exhaustif a été conçu pour accompagner les chercheurs, doctorants et analystes de données dans la formalisation intégrale des résultats issus d’une ANOVA à deux facteurs, depuis l’exploration diagnostique des résidus jusqu’à la modélisation textuelle finale selon les préceptes de la 7e édition du manuel de publication de l’American Psychological Association (APA). Structuré de manière logique et didactique, ce manuel de référence décortique chaque paramètre requis, détaille les prises de décision face aux interactions complexes et propose des canevas rédactionnels directement transposables au sein de manuscrits destinés aux revues académiques de premier rang.
1. Introduction aux principes fondamentaux de l’ANOVA à deux facteurs en psychologie
1.1 Définition conceptuelle et utilité méthodologique
L’analyse de variance à deux facteurs s’enracine théoriquement dans le modèle linéaire général (GLM) développé initialement par Sir Ronald Fisher. Dans sa structure factorielle élémentaire, elle vise à disséquer la variance totale observée sur une variable réponse continue en plusieurs composantes distinctes et orthogonales : la variance attribuable au premier facteur systématique, celle induite par le second facteur, la variance résultant de la conjonction synergique ou antagoniste des deux facteurs (le terme d’interaction), et enfin la variance résiduelle non expliquée (l’erreur expérimentale intra-groupe). Cette approche permet de tester formellement si les moyennes d’échantillons stratifiés selon deux axes de classification distincts diffèrent de manière statistiquement significative au sein de la population parente.
Sur le plan structural, il convient de distinguer avec une rigueur absolue trois grandes typologies de plans factoriels. Le plan inter-sujets (ou factoriel complètement aléatoire, noté classiquement $S(A \times B)$) assigne chaque unité expérimentale à une seule et unique combinaison de niveaux des deux variables indépendantes, garantissant l’indépendance stricte des observations entre les cellules du plan. À l’opposé, le plan factoriel intra-sujets (ou à mesures répétées, noté $S \times A \times B$) soumet l’ensemble des participants à la totalité des croisements de conditions expérimentales, maximisant la puissance statistique par le contrôle de la variance interindividuelle au prix d’une gestion délicate des effets d’ordre et de report. Enfin, le plan factoriel mixte ou split-plot (noté $S(A) \times B$) conjugue un facteur inter-groupes et un facteur intra-sujets, configuration ubiquitaire dans les essais contrôlés randomisés évaluant l’efficacité d’une prise en charge thérapeutique à travers de multiples temps de mesure.
L’avantage méthodologique prépondérant de l’ANOVA factorielle par rapport à la réalisation séquentielle de deux ANOVA univariées à un facteur réside dans deux dimensions critiques : l’économie de puissance et l’identification de l’interaction. D’une part, l’introduction conjointe de deux facteurs permet d’isoler une part plus substantielle de variance expliquée, réduisant ainsi le carré moyen de l’erreur dans le dénominateur de la statistique de test $F$, ce qui accroît la sensibilité de la détection des effets réels. D’autre part, et c’est là son apport paradigmatique, l’ANOVA factorielle est la seule technique permettant de vérifier si l’impact d’une première variable indépendante est conditionné ou modulé par la modalité prise par la seconde, un phénomène que deux ANOVA isolées sont intrinsèquement incapables de déceler.
Dans la recherche expérimentale en psychologie, ce dispositif s’avère indispensable. Prenons le cas d’une étude en psychopharmacologie cognitive cherchant à évaluer l’impact d’une molécule nootropique sur la consolidation mnésique. Une approche naïve testerait isolément l’effet du traitement pharmacologique (Molécule vs Placebo) et l’effet de l’état de stress aigu (Stress induit vs Contrôle). L’expérimentation factorielle permet en réalité de découvrir que le traitement n’améliore la mémoire de travail que sous la condition de stress aigu, restant inopérant en condition basale : cette observation d’une interaction conditionnelle est au cœur des avancées théoriques majeures de la psychologie contemporaine.
1.2 Nature et articulation des variables à expliciter
L’opérationnalisation sans équivoque des variables constitue le socle de toute communication scientifique rigoureuse. Au sein d’une ANOVA à deux facteurs, la variable dépendante (VD) doit obligatoirement être de nature quantitative continue, mesurée à minima sur une échelle d’intervalles ou de rapports. Qu’il s’agisse d’un temps de réaction exprimé en millisecondes, d’un score composite à un inventaire standardisé d’anxiété comme le STAI-Y, ou d’une concentration salivaire de cortisol en nanomoles par litre, le métrique doit offrir des propriétés arithmétiques garantissant la validité du calcul de moyennes et de variances non biaisées.
Les variables indépendantes (VI), communément désignées comme les facteurs de l’analyse, doivent quant à elles être de nature catégorielle ou nominale, subdivisées en au moins deux modalités discrètes, exhaustives et mutuellement exclusives. La nomenclature scientifique identifie la structure du plan par le nombre de modalités de chaque facteur : un plan $2 \times 2$ examine deux facteurs possédant chacun deux niveaux (soit quatre cellules expérimentales), tandis qu’un plan $3 \times 4$ sollicite douze cellules distinctes. La clarification de ces statuts opératoires dans le texte doit préciser si les facteurs reposent sur une manipulation expérimentale active (e.g., type de consigne d’encodage) ou sur une stratification d’attributs quasi-expérimentale (e.g., tranche d’âge, génotype, statut clinique diagnostique).
Cette distinction typologique impose une formulation d’hypothèses d’une granularité chirurgicale dès la section introductive ou au début des résultats. Une ANOVA factorielle ne répond pas à une question générale, mais teste simultanément trois hypothèses nulles distinctes :
l’absence d’effet principal du facteur $A$ ($\mu_{A_1} = \mu_{A_2} = dots = \mu_{A_j}$),
l’absence d’effet principal du facteur $B$ ($\mu_{B_1} = \mu_{B_2} = dots = \mu_{B_k}$),
et l’absence d’effet d’interaction synergique ou antagoniste entre $A$ et $B$ ($(\mu_{jk} – \mu_{j.} – \mu_{.k} + \mu_{..}) = 0$ pour toutes les combinaisons). L’anticipation théorique de ces trois composantes structure l’ensemble de la logique démonstrative subséquente.
1.3 Structure générale du compte rendu statistique
La restitution académique d’une ANOVA bidirectionnelle obéit à un ordonnancement rhétorique et logique normalisé par les standards éditoriaux internationaux, à l’instar des directives du réseau EQUATOR et des manuels APA. Ce séquençage canonique débute invariablement par un exposé synthétique de l’architecture du plan d’analyse, identifiant précisément la variable dépendante et les deux facteurs catégoriels, accompagné de la justification de l’échantillon analysé et de la gestion des données manquantes. Immédiatement après, l’auteur a l’obligation métrologique de rendre compte de la vérification empirique des postulats mathématiques sous-jacents, condition sine qua non de la légitimité des tests inférentiels paramétriques.
Le corps du compte rendu doit ensuite opérer un arbitrage d’une grande finesse entre la synthèse descriptive et l’inférence statistique formelle. Il est impératif d’éviter l’écueil de la litanie numérique indigeste en articulant judicieusement les moyennes marginales, les moyennes cellulaires et leurs indices de dispersion respectifs avec les paramètres inférentiels de l’ANOVA ($F$, degrés de liberté, probabilité critique, et coefficients d’amplitude d’effet). La narration doit adopter une hiérarchie stricte : examen préliminaire de l’effet d’interaction, suivi des effets principaux si et seulement si l’interaction s’avère négligeable, ou déploiement des analyses d’effets simples lorsque l’interaction est avérée.
Enfin, cette démarche rédactionnelle doit incarner les plus hauts standards de la science ouverte (Open Science). La transparence du rapport statistique doit permettre à tout relecteur ou chercheur indépendant de reconstituer les tables d’ANOVA, de vérifier l’exactitude des calculs de carrés moyens et de reproduire intégralement les inférences à partir des statistiques de base fournies. La clarté stylistique et le rejet des formulations elliptiques concourent directement à l’assainissement méthodologique du corpus scientifique publié.
2. Vérification et compte rendu des postulats préalables
2.1 Normalité de la distribution des résidus
L’estimation des paramètres de l’ANOVA repose sur l’hypothèse fondamentale selon laquelle les résidus du modèle linéaire — c’est-à-dire l’écart entre le score observé pour un individu et la moyenne prédite de sa cellule d’appartenance — sont distribués de façon approximativement gaussienne au sein de chaque population parente. Il s’agit d’une méconception fréquente que de tester la normalité globale de la variable dépendante agglomérée, pratique à proscrire formellement car la distribution globale d’un mélange de sous-populations aux moyennes divergentes présente fréquemment une bimodalité artificielle qui n’invalide en rien le modèle factoriel.
L’investigation de la normalité requiert une approche duale combinant tests formels et diagnostics visuels. Sur le plan inférentiel, le test de Shapiro-Wilk constitue la méthode la plus puissante pour les échantillons restreints à modérés ($N < 50$ par cellule), tandis que le test de Kolmogorov-Smirnov assorti de la correction de Lilliefors peut être toléré sur des cohortes plus massives, bien que sa sensibilité excessive à des déviations triviales le rende parfois trompeur. En parallèle, l'inspection des graphiques quantile-quantile (Q-Q plots) des résidus standardisés et l'estimation des coefficients d'asymétrie (skewness) et d’aplatissement (kurtosis) fournissent une appréciation qualitative déterminante. En règle générale, des valeurs de skewness comprises entre $-1$ et $+1$, et de kurtosis entre $-2$ et $+2$, témoignent d’une normalité suffisante pour assurer la robustesse du test $F$.
Sur le plan rédactionnel, le manuscrit doit certifier ces vérifications par une phrase concise mais documentée :
« L’évaluation de la normalité des résidus a été conduite par l’inspection des diagrammes quantile-quantile et validée par le test de Shapiro-Wilk appliqué au sein de chaque condition expérimentale. L’absence de déviation significative à la normalité a été confirmée pour l’ensemble des cellules du plan, $W(30) ge ,96$, $p ge ,245$, avec des coefficients d’asymétrie demeurant strictement compris entre $-0,42$ et $+0,51$. »
2.2 Homogénéité des variances (Homoscédasticité)
Le postulat d’homogénéité des variances, ou homoscédasticité, postule que la variance de l’erreur résiduelle demeure constante à travers l’ensemble des sous-groupes définis par le croisement des deux facteurs ($\sigma_{11}^2 = \sigma_{12}^2 = dots = \sigma_{jk}^2$). Dans les plans factoriels équilibrés (comportant un nombre rigoureusement identique de participants par cellule, $n_{11} = n_{12} = n$), l’ANOVA se révèle remarquablement robuste à des entorses modérées à l’homoscédasticité. En revanche, dès lors que les effectifs cellulaires s’avèrent inégaux, une hétéroscédasticité substantielle altère drastiquement le taux d’erreur de première espèce ($\alpha$) : si les cellules aux effectifs réduits présentent les plus fortes variances, le test devient excessivement libéral, augmentant indûment le risque de faux positifs.
Le test diagnostique canonique est le test d’homogénéité de Levene. Il convient de préciser dans la méthodologie si le test de Levene a été calculé sur la base des déviations par rapport à la moyenne arithmétique ou par rapport à la médiane (variante robuste de Brown-Forsythe, préconisée en présence d’asymétries résiduelles légères). Le rapport doit consigner la statistique $F$ de Levene, ses degrés de liberté inter-groupes et résiduels, ainsi que la valeur $p$ exacte :
« L’homogénéité des variances a été vérifiée à l’aide du test de Levene basé sur la médiane, lequel n’a révélé aucune violation statistiquement significative de l’homoscédasticité à travers les six cellules factorielles, $F(5, 114) = 1,42$, $p = ,221$. »
En cas de violation caractérisée de ce postulat ($p < ,05$), le chercheur ne doit pas masquer cette anomalie. Il est alors attendu d'expliciter la stratégie corrective adoptée : application d'une transformation non linéaire stabilisatrice de variance (transformation logarithmique, racine carrée ou réciproque sur la variable dépendante), recours à des procédures d'ajustement non paramétriques, mise en œuvre d'une modélisation linéaire généralisée avec fonction de variance hétérogène, ou adoption de méthodes d'estimation par rééchantillonnage de type bootstrapping (e.g., 5 000 rééchantillons avec intervalles de confiance ajustés par la méthode BCa).
2.3 Indépendance des observations et gestion des données aberrantes
De l’ensemble des postulats conditionnant l’ANOVA, l’indépendance des observations est incontestablement le plus critique et le moins susceptible d’ajustement mathématique post-hoc. Toute dépendance sérielle ou groupale non modélisée (induite par l’administration collective d’un protocole en classe, des mesures répétées non spécifiées ou une proximité spatiotemporelle des passations) gonfle artificiellement les degrés de liberté effectifs et fausse dramatiquement les seuils de rejet de l’hypothèse nulle. La garantie de cette indépendance repose fondamentalement sur le devis expérimental, l’assignation aléatoire stricte des sujets et l’absence d’autocorrélation entre les unités d’observation.
Parallèlement, la détection des valeurs extrêmes ou aberrantes (outliers) constitue une étape préalable incontournable. Les données aberrantes univariées sont isolées par le repérage des scores $Z$ standardisés excédant les seuils conventionnels de $|Z| ge 3,29$ (correspondant à $p < ,001$) ou via l'analyse des diagrammes en boîte de Tukey identifiant les points situés au-delà de 1,5 fois l'écart interquartile. Dans un cadre factoriel, la détection multivariée s'effectue avantageusement par le calcul de la distance de Mahalanobis ou de la distance de Cook relative aux résidus du modèle, isolant les points de levier qui exercent une influence disproportionnée sur l'estimation des coefficients de variance.
La règle d’or déontologique est la transparence intégrale quant au sort réservé à ces observations extrêmes. Tout élagage ou remplacement de données doit être documenté, justifié et quantifié :
« L’examen des résidus standardisés a permis d’identifier une observation aberrante univariée au sein de la condition Contrôle/Stress élevé ($Z = 3,84$). Conformément au protocole pré-enregistré, ce score a été exclu des analyses principales en raison de son influence anormale sur l’estimation de la variance cellulaire. L’échantillon final effectif a ainsi été ramené à $N = 119$ participants. Une analyse de sensibilité subsidiaire incluant cette observation a été menée et confirme la stabilité des conclusions inférentielles du modèle principal. »
3. Les métriques statistiques obligatoires à rapporter
3.1 La statistique F et les degrés de liberté
L’ANOVA factorielle dérive formellement de la décomposition des sommes des carrés selon l’identité fondamentale du modèle :
$$SC_{Total} = SC_A + SC_B + SC_{A \times B} + SC_{Erreur}$$
Chacune de ces composantes de variation est ensuite rapportée à ses degrés de liberté ($ddl$) respectifs afin d’obtenir les carrés moyens ($CM$), lesquels représentent des variances estimées. La statistique inférentielle $F$ correspond au ratio canonique entre le carré moyen de l’effet considéré (facteur $A$, facteur $B$ ou interaction $A \times B$) et le carré moyen de l’erreur résiduelle :
$$F = \frac{CM_{Effet}}{CM_{Erreur}}$$
Rapporter une ANOVA sans consigner conjointement l’intégralité des degrés de liberté constitue une faute méthodologique majeure privant le lecteur de toute capacité de vérification. La formalisation standardisée impose d’énoncer le symbole de la statistique suivi immédiatement, entre parenthèses, des degrés de liberté de l’effet et des degrés de liberté de l’erreur, séparés par une virgule : $F(ddl_{Effet}, ddl_{Erreur})$. Dans le cadre d’un plan factoriel inter-sujets à deux facteurs comptant $J$ modalités pour le facteur $A$, $K$ modalités pour le facteur $B$, et un échantillon total de $N$ participants, les degrés de liberté se déclinent mathématiquement comme suit :
$ddl_A = J – 1$,
$ddl_B = K – 1$,
$ddl_{A \times B} = (J – 1)(K – 1)$,
et $ddl_{Erreur} = N – JK$.
Conformément aux normes typographiques scientifiques internationales, la valeur numérique attribuée à la statistique $F$ doit être systématiquement arrondie à deux décimales exactes (e.g., $F(1, 116) = 14,32$). L’omission des degrés de liberté d’erreur ou l’arrondi grossier à l’entier le plus proche sont formellement prohibés au sein des revues scientifiques à comité de lecture.
3.2 La valeur p et les seuils de significativité
La probabilité critique associée à la statistique $F$, désignée par la lettre $p$, quantifie la probabilité d’obtenir une valeur de test au moins aussi extrême que celle observée dans l’échantillon sous l’hypothèse nulle d’égalité des moyennes. L’époque révolue de l’informatique pré-analytique où les auteurs se contentaient de mentions dichotomes vagues telles que « $p < ,05$ » ou « NS » (non significatif) est définitivement close. Les standards éditoriaux contemporains imposent le rapport de la valeur $p$ exacte arrondie à trois décimales (e.g., $p = ,024$ ou $p = ,310$).
L’unique dérogation admise à cette règle de précision décimale concerne les probabilités infinitésimales générées par les progiciels statistiques (tels que R, SPSS ou JASP) sous la mention trompeuse « .000 ». Il est mathématiquement impossible pour une distribution de densité de probabilité continue d’atteindre une valeur nulle absolue. L’auteur doit alors convertir cette sortie logicielle sous la forme d’une inégalité rigoureuse : $p < ,001$.
Par ailleurs, la rédaction se doit d’adopter une posture épistémologique lucide face à l’interprétation de ces seuils. Il est crucial de dissocier formellement la significativité statistique — qui dépend intimement de la taille de l’échantillon analysé — de la pertinence clinique, théorique ou écologique de l’effet découvert. De surcroît, face à des valeurs de probabilité oscillant au voisinage immédiat du seuil alpha conventionnel (e.g., $p = ,048$ ou $p = ,053$), il est impératif de proscrire tout glissement sémantique fallacieux vers une prétendue « tendance à la significativité ». L’effet est soit rejeté au seuil prédéfini de 5 %, soit non rejeté, et son incertitude empirique doit être commentée avec circonspection et rigueur.
3.3 Statistiques descriptives associées par cellule
Un rapport statistique inférentiel amputé de ses fondations descriptives demeure une coquille vide inintelligible. Le lecteur doit être en mesure d’appréhender concrètement la direction, l’ampleur absolue et la dispersion des données brutes ayant alimenté la mécanique du test de Fisher. Il est donc impératif de renseigner pour chaque cellule factorielle, ainsi que pour les marges globales du plan :
la moyenne empirique arithmétique ($M$),
l’indice de dispersion standard, constitué préférentiellement par l’écart-type ($SD$) ou à défaut par l’erreur-type de la moyenne ($SE$),
et la taille effective de l’échantillon considéré ($n$).
La présentation de ces métriques descriptives doit s’effectuer de manière systématique au sein du corps du texte pour les plans simples, ou sous la forme d’un tableau synthétique pour les plans comportant de multiples cellules. L’auteur veillera à maintenir une cohérence absolue : si l’écart-type est adopté comme mesure de variabilité, il ne doit en aucun cas être substitué arbitrairement par l’erreur-type au fil des paragraphes sans notification explicite, ces deux statistiques véhiculant des significations profondément divergentes (l’écart-type quantifiant la dispersion intrinsèque des scores individuels autour de leur moyenne, tandis que l’erreur-type estime la précision de l’échantillonnage de la moyenne elle-même).
Dans la prose scientifique, l’intégration prendra la forme standardisée suivante :
« Les participants soumis à la thérapie cognitive-comportementale et présentant un niveau d’anxiété initial modéré ont rapporté des scores moyens de bien-être substantiellement plus élevés ($M = 64,30$, $SD = 7,85$, $n = 30$) comparativement aux sujets de la condition contrôle appariée ($M = 48,12$, $SD = 8,20$, $n = 30$). »
4. Normes typographiques et rédactionnelles APA (7e édition)
4.1 Règles de mise en forme des symboles statistiques
La 7e édition du manuel de publication de l’APA prescrit un ensemble de normes typographiques rigoureuses destinées à garantir l’uniformité visuelle et la lisibilité immédiate des articles scientifiques à travers le monde. La règle nodale énonce que toutes les lettres latines servant de symboles statistiques ou désignant des paramètres algébriques doivent être obligatoirement composées en italique. Sont ainsi assujettis à l’italique : F, p, t, z, M (moyenne), SD (écart-type), SE (erreur-type), N (taille totale de l’échantillon), n (taille d’un sous-échantillon ou d’une cellule), et R2. En revanche, les lettres grecques symbolisant des paramètres de population ou des indices spécifiques — à l’instar de $\eta_p^2$ (êta-carré partiel), $\omega^2$ (oméga-carré), $\alpha$ (risque d’erreur de type I) ou $\beta$ (risque d’erreur de type II) — ainsi que les indices en sous-sol ou en exposant (e.g., ddl, max, min) doivent demeurer en caractères romains droits.
Une seconde convention d’une importance capitale concerne l’omission du zéro initial devant la virgule décimale (ou le point décimal selon la langue de publication). La règle APA stipule que le zéro initial ne doit jamais être apposé devant un nombre qui ne peut théoriquement pas excéder l’unité. Par conséquent, les valeurs de probabilité critique (p) ainsi que les indices de taille d’effet fondés sur des proportions de variance partagée (tels que $\eta^2$ et $\eta_p^2$), dont l’amplitude est rigoureusement bornée entre 0 et 1, doivent s’écrire sans zéro introductif : on notera ainsi p = ,032 et $\eta_p^2$ = ,08, et non p = 0,032 ou $\eta_p^2$ = 0,08. À l’inverse, les paramètres statistiques dont la valeur théorique peut dépasser 1 — à l’instar du ratio F, de la moyenne M ou de l’écart-type SD — conservent impérativement leur zéro devant la virgule lorsque leur valeur est inférieure à l’unité (e.g., F(1, 80) = 0,74).
Enfin, la gestion des espaces autour des opérateurs mathématiques exige une rigueur constante : un espace insécable doit encadrer chaque signe arithmétique d’égalité (=), d’infériorité () lorsqu’ils expriment une relation d’équivalence ou de comparaison statistique (e.g., F(2, 54) = 4,18, p = ,020, $\eta_p^2$ = ,13).
4.2 Formulations textuelles canoniques selon l’APA
L’introduction d’un modèle factoriel au sein de la narration scientifique requiert une fluidité stylistique évitant les ruptures brutales entre l’exposition conceptuelle et l’étalage métrique. La formulation canonique débute par un syntagme précisant la nature exacte du modèle statistique sollicité, en déclinant explicitement la variable dépendante ainsi que les facteurs mobilisés et leur plan de croisement. Par exemple :
« Une analyse de variance (ANOVA) factorielle 2 (Type d’intervention : Thérapie brève vs Liste d’attente) $\times$ 3 (Niveau de sévérité du trouble : Léger, Modéré, Sévère) inter-sujets a été réalisée sur les scores d’incapacité fonctionnelle mesurés à l’issue du protocole expérimental. »
Dans l’enchaînement discursif, l’intégration des résultats inférentiels doit s’opérer au sein de la phrase sans interrompre la logique argumentative. Les blocs statistiques viennent corroborer une assertion théorique affirmative plutôt que de faire de la statistique le sujet grammatical exclusif de la proposition. Les standards contemporains encouragent l’usage judicieux de la voix active pour dynamiser la communication des découvertes scientifiques (« L’analyse révèle un effet principal… » ou « Les résultats mettent en évidence… »), tout en conservant la voix passive pour décrire les protocoles procéduraux normalisés.
Voici un modèle exemplaire de concision et de respect des normes APA :
« L’effet principal du type d’intervention s’est révélé statistiquement significatif, F(1, 114) = 18,65, p < ,001, $\eta_p^2$ = ,14, traduisant une réduction substantiellement plus marquée de l'incapacité fonctionnelle chez les patients ayant bénéficié de la thérapie brève (M = 22,41, SD = 5,12) comparativement aux individus assignés à la liste d’attente (M = 31,08, SD = 6,45). »
4.3 Cohérence globale entre le texte et les éléments visuels
Un écueil récurrent lors de la rédaction de la section Résultats consiste à dupliquer stérilement dans le corps du texte des cohortes entières de données descriptives ou de matrices inférentielles déjà consignées de manière exhaustive au sein de tableaux récapitulatifs ou de graphiques d’interaction. Les directives de l’APA imposent une stricte complémentarité sémiotique : le texte a pour mission de guider le regard du lecteur, de hiérarchiser l’importance scientifique des constats et d’élucider le sens substantiel des données, tandis que les tables et figures fournissent l’ancrage archivistique détaillé des métriques numériques.
Pour concrétiser cette synergie sans redondance verbeuse, l’auteur doit recourir à des renvois méthodologiques sobres et standardisés positionnés entre parenthèses au terme des assertions clés (e.g., « (voir Tableau 2) » ou « (voir Figure 1) »). Lorsque le lecteur est orienté vers un tableau matriciel complet des effets de l’ANOVA, il devient superflu de répéter dans le paragraphe chaque somme des carrés ou chaque carré moyen ; seuls les ratios F pivots, leurs probabilités associées et les métriques de taille d’effet directement articulées à la démonstration théorique doivent être mis en lumière dans le texte suivi.
De surcroît, le rédacteur veillera à purifier son discours de tout jargon computationnel superfétatoire. Énoncer qu’un « effet a été testé sous la commande GLM de SPSS » ou que « la significativité bilatérale a été calculée par le logiciel » constitue une pollution stylistique qui affaiblit la portée scientifique de l’écrit. L’exposition doit demeurer ancrée dans l’univers conceptuel de la discipline psychologique et de la statistique mathématique universelle.
5. L’effet d’interaction : Cœur analytique de l’ANOVA bidirectionnelle
5.1 Conceptualisation de l’effet modérateur/d’interaction
L’effet d’interaction constitue incontestablement la justification méthodologique et l’acmé conceptuelle de l’analyse de variance bidirectionnelle. D’un point de vue géométrique et mathématique, il se définit comme une rupture de parallélisme entre les profils de réponses à travers les strates expérimentales : l’impact de la variable indépendante $A$ sur la variable dépendante varie en direction ou en magnitude selon le niveau spécifique assigné à la variable indépendante $B$. Sur le plan théorique, l’interaction traduit l’existence d’une modération statistique, signifiant que la causalité liant un facteur à une conduite psychologique n’est pas absolue, mais conditionnelle et contextuelle.
Il est fondamental de classifier la nature fonctionnelle de l’interaction observée en distinguant les interactions ordinales des interactions désordinales (souvent qualifiées de croisées). Une interaction est dite ordinale lorsque la hiérarchie des moyennes associées aux modalités du facteur $A$ conserve la même orientation à chaque niveau du facteur $B$, bien que l’écart différentiel entre ces moyennes varie en amplitude (les lignes graphiques convergent ou divergent sans jamais s’entrecouper). À l’opposé, une interaction est dite désordinalisée lorsque les lignes de profil se croisent formellement : l’effet du facteur $A$ s’inverse purement et simplement selon le niveau du facteur $B$ (par exemple, un traitement qui s’avère hautement bénéfique pour les individus à anxiété modérée devient délétère pour les sujets à anxiété sévère).
Cette distinction engendre une règle analytique impérative : la priorité interprétative absolue doit être accordée au terme d’interaction sur les effets principaux omnibus. Lorsqu’une interaction significative — tout particulièrement désordinalisée — émerge du modèle factoriel, les effets principaux des deux facteurs pris isolément perdent très souvent leur pertinence théorique et peuvent s’avérer profondément trompeurs, voire artificiels, car ils masquent la réalité hétérogène des sous-populations sous un agrégat marginal illusoire.
5.2 Rapport statistique d’une interaction statistiquement significative
Dès lors que l’ANOVA révèle un terme d’interaction dont la probabilité critique franchit le seuil alpha conventionnel ($p < ,05$), le protocole de rédaction doit scrupuleusement acter cette découverte avant toute autre considération inférentielle. Le canevas textuel doit formuler explicitement la présence de l'interaction, spécifier les deux facteurs conjoints, et consigner le bloc métrique complet intégrant le ratio F, les degrés de liberté adéquats, la valeur p précise et l’estimation de la taille d’effet locale ($\eta_p^2$).
L’affirmation statistique de l’interaction doit être immédiatement suivie d’une clause méthodologique énonçant la conséquence directe de cette découverte : la suspension de l’interprétation des effets principaux globaux et le basculement obligatoire vers des analyses d’effets simples (ou simple main effects) afin de décomposer la structure intime de l’effet modérateur. Cette transition doit s’articuler avec clarté au sein du manuscrit :
« L’analyse de variance factorielle révèle un effet d’interaction statistiquement significatif et d’ampleur modérée entre le Type d’encadrement pédagogique et le Niveau de stress contextuel sur la performance au test de raisonnement logique, F(2, 174) = 6,84, p = ,001, $\eta_p^2$ = ,073. En raison de cette modulation significative de l’effet d’un facteur par le second, l’interprétation des effets principaux omnibus a été suspendue au profit d’une analyse décomposée des effets principaux simples du type d’encadrement à chaque niveau de stress. »
Cette structure argumentative démontre la maîtrise conceptuelle des modèles linéaires par l’analyste, garantissant aux examinateurs que les données ne feront pas l’objet de généralisations abusives non fondées sur les marges du plan.
5.3 Rapport statistique de l’absence d’interaction
À l’inverse, lorsque l’ANOVA produit un test d’interaction non significatif ($p ge ,05$), le cadre inférentiel s’en trouve radicalement simplifié. Cette absence de significativité atteste que le postulat de parallélisme des effets à travers les conditions ne peut être réfuté à la lumière des données collectées : l’influence exercée par le premier facteur indépendant ne diffère pas de manière statistiquement décelable à travers les modalités prises par le second facteur.
Dans ce contexte précis, le compte rendu statistique doit valider cette invariance en fournissant les métriques formelles associées au croisement des facteurs, attestant ainsi de leur indépendance mutuelle. Cette notification constitue le blanc-seing méthodologique autorisant l’auteur à se focaliser sans réserve sur l’explication et l’interprétation substantielle des deux effets principaux globaux marginalisés. La prose scientifique traduira ce constat selon le modèle suivant :
« Le terme d’interaction entre le Profil chronotypique (Matinal vs Vespéral) et la Modalité de privation de sommeil (Sommeil normal vs Privation partielle) ne s’est pas révélé statistiquement significatif, F(1, 96) = 0,38, p = ,539, $\eta_p^2$ = ,004. Ce parallélisme empirique confirme que l’impact de la privation de sommeil sur le temps de vigilance psychomotrice s’exerce de manière homogène quel que soit le chronotype des participants, autorisant l’examen direct des effets principaux des deux prédicteurs. »
6. Décomposition des interactions : Les effets principaux simples
6.1 Justification théorique et logique du découpage
L’émergence d’une interaction statistiquement significative pose un défi interprétatif immédiat : la variance de la variable dépendante ne peut plus être attribuée de manière univoque à l’un ou l’autre des facteurs. Tenter de décrire l’effet omnibus moyen du facteur $A$ équivaudrait à moyenner des comportements possiblement antagonistes, produisant une moyenne marginale dénuée de référent écologique réel. La logique scientifique impose dès lors de procéder au découpage du plan factoriel global en une série de sous-analyses univariées conditionnelles, désignées sous le terme d’effets principaux simples (simple main effects).
La sélection stratégique de l’axe de découpage — à savoir décider si l’on examine l’effet du facteur $A$ à chaque modalité du facteur $B$, ou l’effet du facteur $B$ à chaque modalité du facteur $A$ — ne relève pas d’un hasard calculatoire mais de la pertinence des hypothèses théoriques sous-jacentes. Si une étude porte sur l’efficacité d’un traitement thérapeutique ($A$, variable focale) modulée par le genre des patients ($B$, variable modératrice), il est conceptuellement logique de disséquer l’effet du traitement chez les femmes d’une part, et chez les hommes d’autre part, plutôt que l’inverse.
Sur le plan computationnel, chaque effet simple s’évalue en calculant la somme des carrés du facteur focal restreinte à une strate unique du facteur modérateur ($SC_{A \text{ pour } B_k}$). Cette variance conditionnelle est alors confrontée au carré moyen de l’erreur globale ($CM_{Erreur}$) issu du modèle factoriel complet initial — et non à la variance d’erreur d’un sous-modèle isolé —, ce qui permet de conserver le bénéfice d’une estimation de l’erreur résiduelle fondée sur l’ensemble des degrés de liberté de l’échantillon global.
6.2 Compte rendu écrit des analyses d’effets simples
La rédaction de cette décomposition doit faire preuve d’une clarté exemplaire. Le paragraphe d’analyse doit égrener successivement chaque sous-condition du facteur de stratification, en fournissant pour chacune la valeur de la statistique $F$ simple, ses degrés de liberté propres, la valeur de probabilité exacte ainsi que les moyennes conditionnelles associées. Il est indispensable d’indiquer si une procédure d’ajustement du seuil alpha (telle que la correction de Bonferroni ou de Sidak) a été appliquée lors de ces tests multiples conditionnels, afin d’immuniser l’analyse contre l’inflation du risque de fausse découverte.
Voici un canevas rédactionnel rigoureusement conforme aux normes internationales :
« Afin d’élucider la nature de l’effet d’interaction significatif, une décomposition en effets principaux simples a été menée pour évaluer l’effet du Type d’entraînement (Cognitif vs Aérobie) à chaque niveau de la Tranche d’âge, en appliquant un ajustement de Bonferroni pour contrôler le taux d’erreur familial ($\alpha_{ajusté} = ,025$). L’analyse révèle que chez les adultes âgés, le type d’entraînement exerce un effet simple hautement significatif sur la mémoire épisodique, F(1, 116) = 17,45, p < ,001, $\eta_p^2$ = ,131, les participants assignés au protocole cognitif affichant des performances substantiellement supérieures (M = 78,40, SD = 8,15) à ceux du groupe aérobie (M = 68,10, SD = 7,90). À l’inverse, chez les adultes jeunes, aucune différence statistiquement significative n’a été mise en évidence entre les deux modalités d’entraînement, F(1, 116) = 0,82, p = ,367, $\eta_p^2$ = ,007 (M = 84,20 vs M = 82,60). »
6.3 Comparaisons par paires au sein des effets simples
Lorsque le facteur focal soumis à la décomposition comporte plus de deux modalités discrètes (par exemple, trois stratégies pédagogiques décomposées selon deux niveaux de motivation), le constat d’un effet principal simple significatif demeure insuffisant : il constitue un test omnibus conditionnel qui atteste de l’existence d’au moins une divergence entre les trois moyennes, sans localiser précisément laquelle. Il devient alors impératif de pousser l’investigation méthodologique d’un cran supplémentaire en réalisant des comparaisons multiples par paires (tests t de Student pour échantillons indépendants ou contrastes polynomiaux) au sein de la tranche conditionnelle considérée.
Cette étape subséquente expose l’analyste à un risque accru de commettre une erreur de première espèce en raison de la démultiplication des tests statistiques. Le compte rendu se doit d’expliciter sans ambiguïté l’algorithme de contrôle du taux alpha mis en œuvre. La correction de Bonferroni (consistant à diviser le seuil critique nominal par le nombre total de comparaisons univariées effectuées) ou la procédure de Tukey-Kramer représentent les standards d’excellence à consigner dans le texte.
Un modèle de restitution de contrastes post-décomposition s’articulera ainsi :
« L’effet principal simple de la Stratégie d’apprentissage s’étant avéré significatif au sein du groupe à faible motivation, F(2, 114) = 8,92, p < ,001, $\eta_p^2$ = ,135, des comparaisons par paires ajustées selon la méthode de Bonferroni ont été entreprises. Celles-ci démontrent que la condition Apprentissage par le jeu engendre des scores de rétention significativement supérieurs à la condition Magistrale classique ($M_{diff} = 14,20$, $SE = 3,41$, p < ,001, IC à 95 % [5,85, 22,55]) ainsi qu'à la condition Autoformation ($M_{diff} = 10,15$, $SE = 3,38$, p = ,010, IC à 95 % [1,88, 18,42]). En revanche, aucune divergence statistique n’a été décelée entre les conditions Magistrale et Autoformation ($M_{diff} = 4,05$, $SE = 3,35$, p = ,689). »
7. Interprétation et rapport des effets principaux en l’absence d’interaction
7.1 Analyse de l’effet principal du premier facteur
Lorsque l’analyse factorielle atteste formellement l’absence d’interaction statistically significative entre les variables explicatives, l’expérimentateur bénéficie d’une opportunité théorique d’une grande valeur : le droit d’inférer des conclusions généralisables sur l’impact de chaque prédicteur pris isolément. L’effet principal du premier facteur capture l’influence exercée par cette variable sur la variable dépendante en moyennant ou en marginalisant l’ensemble des conditions définies par le second facteur.
Le compte rendu doit exposer l’effet omnibus de ce premier facteur à travers un modèle narratif affirmé. Il est essentiel de documenter les moyennes marginales estimées — accompagnées de leurs erreurs-types ou écarts-types agrégés — pour chacune des modalités du facteur, et non pas simplement les moyennes cellulaires disjointes. L’auteur doit souligner la constance de cet effet, signifiant au lecteur que le phénomène observé s’applique uniformément à travers toutes les strates représentées par le second prédicteur.
La formulation type répondra au schéma suivant :
« L’effet principal de l’Intensité lumineuse ambiante s’est avéré statistiquement significatif et de forte amplitude, F(1, 88) = 24,18, p < ,001, $\eta_p^2$ = ,216. Indépendamment de la condition sonore environnante, les participants exposés à un éclairage spectralement enrichi ont fait preuve d'une vitesse de traitement perceptif significativement supérieure (M = 412 ms, $SD = 38$) comparativement à ceux soumis à un éclairage incandescent conventionnel (M = 458 ms, $SD = 45$). »
7.2 Analyse de l’effet principal du second facteur
L’exposition de l’effet principal assigné au second facteur indépendant obéit à une rigueur d’alignement syntaxique et méthodologique strictement symétrique à celle adoptée pour le premier facteur. L’analyste se garde de toute asymétrie de rigueur métrique en consignant scrupuleusement la totalité des indicateurs inférentiels ($F$, degrés de liberté, probabilité $p$ exacte et fraction de variance expliquée $\eta_p^2$) et descriptifs correspondants.
Au-delà de la simple juxtaposition des résultats numériques, le paragraphe doit théoriser l’apport incrémentiel de ce second facteur au sein de l’architecture du modèle. Il convient de clarifier si ce second prédicteur exerce une action indépendante, additive ou concurrente vis-à-vis du premier prédicteur, consolidant ainsi la validité théorique du protocole expérimental :
« De manière concurrente et autonome, l’effet principal du Niveau de bruit de fond s’est révélé statistiquement significatif, F(1, 88) = 11,54, p = ,001, $\eta_p^2$ = ,116. Conformément aux hypothèses initiales, la présence d’un bruit blanc continu a détérioré globalement les performances de détection de cibles (M = 447 ms, $SD = 44$) par rapport à l’environnement silencieux (M = 423 ms, $SD = 41$). Ce résultat atteste de l’impact délétère de la charge auditive sur la vitesse motrice, indépendamment de la qualité de l’ambiance lumineuse. »
7.3 Procédure lorsque les facteurs comptent plus de deux modalités
Une complexité procédurale surgit dès lors qu’un effet principal significatif est détecté sur une variable indépendante structurée en trois modalités ordinales ou nominales ou davantage (e.g., Faible, Moyen, Élevé). Le ratio de Fisher omnibus valide formellement le fait que les trois moyennes marginales ne sont pas universellement superposables dans la population générale, mais ne renseigne en aucune façon sur les contrastes dyadiques spécifiques à l’origine du rejet de l’hypothèse nulle. Il est alors rigoureusement impossible de conclure dans le texte qu’une modalité surpasse une autre sans engager formellement des analyses comparatives complémentaires.
Deux trajectoires méthodologiques s’offrent alors au chercheur, lesquelles doivent être clairement nommées dans le rapport : les contrastes planifiés a priori (déterminés avant la collecte en accord avec des hypothèses théoriques déductives ciblées) ou les tests de comparaisons multiples post-hoc (explorant a posteriori l’intégralité des combinaisons binaires possibles). Le compte rendu doit présenter les écarts de moyennes ajustés, les erreurs-types et les intervalles de confiance à 95 % des différences :
« L’effet principal de la Durée d’immersion (Court vs Modéré vs Prolongé) s’est avéré significatif, F(2, 144) = 7,35, p = ,001, $\eta_p^2$ = ,093. Les analyses post-hoc appliquées sur les moyennes marginales avec correction de Tukey HSD démontrent que l’immersion prolongée produit un taux de mémorisation significativement moindre (M = 54,2 %, $SE = 2,1$) que l’immersion courte (M = 65,8 %, $SE = 2,0$, $p = ,001$, IC à 95 % de la différence [−18,4, −4,8]) et que l’immersion modérée (M = 62,4 %, $SE = 2,1$, $p = ,018$, IC à 95 % [−15,1, −1,3]). En revanche, les durées courte et modérée ne se distinguent pas de façon statistiquement significative ($p = ,442$). »
8. La taille de l’effet : Calcul, interprétation et présentation
8.1 Êta-carré partiel (η²p) : La métrique de référence
L’inférence statistique fondée sur la seule dichotomie du seuil de décision alpha subit des critiques méthodologiques justifiées depuis plusieurs décennies. La valeur p étant une fonction conjointe de la magnitude du phénomène et de la taille de l’échantillon analysé, une probabilité infinitésimale ($p < ,001$) peut résulter d'un effet infime capté au sein d'une cohorte gargantuesque. L'exigence fondamentale de la publication scientifique consiste désormais à renseigner systématiquement une estimation standardisée de la magnitude de l'effet, au premier rang desquelles trône l'êta-carré partiel ($\eta_p^2$).
Sur le plan computationnel, l’êta-carré partiel quantifie la proportion de variance de la variable dépendante qui est spécifiquement attribuable au facteur considéré, après avoir arithmétiquement extrait (ou « partialisé ») du dénominateur la variance expliquée par les autres termes du modèle factoriel :
$$\eta_p^2 = \frac{SC_{Effet}}{SC_{Effet} + SC_{Erreur}}$$
Il se distingue conceptuellement de l’êta-carré classique ($\eta^2$), lequel rapporte la variation de l’effet à la somme des carrés totale absolue ($SC_{Total}$). L’avantage méthodologique de $\eta_p^2$ dans les plans factoriels réside dans sa comparabilité à travers différents devis expérimentaux, car sa valeur n’est pas amoindrie artificiellement par l’adjonction d’autres prédicteurs au sein de l’équation générale.
Pour guider l’interprétation qualitative de cette métrique, les sciences comportementales s’appuient historiquement sur les conventions heuristiques définies par Jacob Cohen (1988) :
un $\eta_p^2 \approx ,01$ correspond à un effet de faible amplitude (représentant 1 % de la variance résiduelle expliquée),
un $\eta_p^2 \approx ,06$ traduit un effet d’ampleur modérée (6 % de variance),
et un $\eta_p^2 ge ,14$ signale un effet de forte amplitude (14 % ou plus de variance captée). L’analyste se doit d’intégrer cet étalonnage critique lors de la discussion de l’impact concret de ses résultats.
8.2 Alternatives et compléments : Oméga-carré (ω²) et Epsilon-carré (ε²)
En dépit de son omniprésence dans les logiciels commerciaux d’analyse statistique, l’êta-carré partiel souffre d’un vice métrologique structurel bien documenté : il s’agit d’un estimateur descriptif basé sur l’échantillon, affecté d’un biais systématique positif. En d’autres termes, $\eta_p^2$ tend à surestimer l’ampleur véritable de la force de l’association au sein de la population parente, un écueil qui devient particulièrement prononcé et dommageable dès lors que les effectifs cellulaires s’avèrent réduits ($n < 20$ par cellule).
Afin de pallier ce biais d’échantillonnage, la littérature méthodologique de pointe recommande de rapporter ou d’adjoindre l’oméga-carré partiel ($\omega_p^2$) ou l’epsilon-carré ($\epsilon^2$). L’oméga-carré partiel ajuste l’estimation de la variance en introduisant explicitement au sein de la formule le carré moyen de l’erreur résiduelle, corrigeant ainsi la tendance à l’inflation spontanée :
$$\omega_p^2 = \frac{ddl_{Effet} \times (F – 1)}{ddl_{Effet} \times (F – 1) + N}$$
Dans les échantillons de dimensions modestes, la divergence entre les deux indices peut se révéler saisissante : là où un modèle affichera un $\eta_p^2 = ,12$, son homologue non biaisé $\omega_p^2$ pourra s’établir à un modeste ,07. Rendre compte de l’oméga-carré témoigne d’une probité métrologique supérieure et d’une lucidité épistémologique quant à la portée réelle des données collectées :
« L’effet d’interaction s’est avéré significatif, F(1, 36) = 4,82, p = ,035. Bien que l’êta-carré partiel affiche une valeur apparente de $\eta_p^2 = ,118$, le calcul de l’estimateur non biaisé de population confirme un impact réel plus conservateur, $\omega_p^2 = ,089$. »
8.3 Intervalles de confiance pour la taille de l’effet
L’estimation ponctuelle d’une taille d’effet — qu’il s’agisse de $\eta_p^2$ ou de $\omega_p^2$ — demeure incomplète si elle n’est pas assortie d’une mesure de son incertitude stochastique d’échantillonnage. Le manuel de l’APA (7e éd.) stipule explicitement que la présentation d’intervalles de confiance pour les tailles d’effet constitue la meilleure pratique d’évaluation quantitative contemporaine. La détermination de ces intervalles pour des statistiques factorielles ne repose pas sur les distributions symétriques habituelles de Student ou de Gauss, mais sollicite des distributions de Fisher non centrales, nécessitant le recours à des algorithmes itératifs disponibles sous R (packages MBESS ou effectsize).
Une particularité métrologique essentielle doit être soulignée : alors qu’il est d’usage d’adopter des intervalles de confiance à 95 % pour les paramètres moyens univariés, les intervalles de confiance encadrant $\eta_p^2$ sont préférentiellement établis au seuil de 90 %. Cette recommandation découle du fait que le test F de l’ANOVA est un test unilatéral par construction (le carré moyen étant strictement positif, les déviations s’accumulent exclusivement dans la queue de distribution droite) : un intervalle de confiance à 90 % unilatéral correspond ainsi rigoureusement au seuil de rejet bilatéral conventionnel de $\alpha = ,05$.
La transcription formelle de l’intervalle dans la prose statistique se matérialisera sous la forme suivante :
« L’analyse révèle un effet principal prépondérant de l’Âge sur la latence de capture visuelle, F(1, 96) = 15,31, p < ,001, $\eta_p^2$ = ,137, IC à 90 % [,048, ,242]. L'amplitude de cet intervalle de confiance atteste que dans la population parente, la part de variance expliquée par le facteur chronologique est comprise avec une certitude statistique de 90 % entre 4,8 % et 24,2 %. »
9. Tests post-hoc et ajustements des comparaisons multiples
9.1 Sélection de la procédure de correction adéquate
L’étape des comparaisons multiples impose un arbitrage méthodique entre deux écueils probabilistes antinomiques : le risque de type I (l’inflation incontrôlée du taux d’erreur familial conduisant à déclarer des découvertes chimériques) et le risque de type II (un sur-ajustement excessivement conservateur privant l’investigateur de la détection d’effets expérimentaux réels). L’analyste se doit de justifier explicitement la technique d’ajustement mobilisée en fonction de la structure de ses données et des conditions de son échantillonnage.
Lorsque le postulat d’homogénéité des variances est rigoureusement respecté et que l’ensemble des comparaisons par paires entre toutes les modalités factorielles est envisagé, le test de Tukey (Honestly Significant Difference, Tukey HSD) s’impose comme la référence d’excellence pour sa balance optimale entre puissance et contrôle strict de l’erreur globale. Si l’expérimentateur ne cible qu’un contingent restreint de comparaisons orthogonales déduites formellement des hypothèses pré-enregistrées, la procédure de Bonferroni ou la méthode séquentielle de Holm-Bonferroni offrent une flexibilité et une puissance supérieures.
En revanche, dès lors que le diagnostic de Levene a révélé une hétéroscédasticité patente à travers les cellules factorielles, les tests de Tukey ou de Bonferroni standards sont méthodologiquement invalidés et conduisent à des taux d’erreur de première espèce prohibitifs. L’auteur doit alors spécifier le recours impératif au test de Games-Howell (ou à la correction de Dunnett T3), procédures robustes fondées sur une approximation des degrés de liberté de type Welch-Satterthwaite ne requérant aucune égalité des variances populationnelles.
9.2 Syntaxe rédactionnelle des contrastes multiples
La restitution écrite des analyses post-hoc doit obéir à une géométrie formelle stricte. Pour chaque dyade de modalités confrontée, le texte scientifique doit obligatoirement expliciter :
la différence brute moyenne estimée entre les conditions ($M_{diff}$),
l’erreur-type de cette différence ($SE$),
la valeur de probabilité critique ajustée ($p_{adj}$),
ainsi que l’intervalle de confiance à 95 % encadrant la différence de moyenne.
L’énoncé doit guider la lecture en hiérarchisant les contrastes significatifs et non significatifs sans masquer les amplitudes physiques des grandeurs évaluées :
« L’examen approfondi des comparaisons multiples via la procédure post-hoc de Tukey HSD démontre que la posologie Haute engendre une baisse significative du score symptomatique par rapport à la posologie Basse ($M_{diff} = -8,45$, $SE = 1,72$, $p_{adj} < ,001$, IC à 95 % [−12,56, −4,34]) ainsi qu'au Placebo ($M_{diff} = -12,80$, $SE = 1,70$, $p_{adj} < ,001$, IC à 95 % [−16,88, −8,72]). Toutefois, la divergence observée entre la posologie Basse et le Placebo ne franchit pas le seuil de significativité après ajustement ($M_{diff} = -4,35$, $SE = 1,71$, $p_{adj} = ,068$, IC à 95 % [−8,44, 0,26]). »
9.3 Prévention de l’inflation du risque de première espèce (alpha)
La démultiplication des tests statistiques constitue le terreau privilégié du « p-hacking » et de l’inflation stochastique du risque alpha. Si un modèle factoriel intègre par exemple un facteur à 4 modalités et un second à 3 modalités, l’exploration intégrale non régulée de l’ensemble des contrastes cellulaires simples et croisés peut engendrer plusieurs dizaines de tests univariés : sans correction, le taux de fausse alerte global dépasse rapidement 40 % à 50 %, détruisant toute crédibilité inférentielle.
Le compte rendu scientifique doit témoigner d’une étanchéité méthodologique absolue face à ce risque. L’auteur doit exposer sans fard la politique de contrôle adoptée :
« Afin de prévenir l’inflation du risque de première espèce induite par la multiplication des tests d’hypothèses, l’ensemble des analyses a posteriori a fait l’objet d’un contrôle strict du taux d’erreur par famille via la méthode de Holm-Bonferroni. Le lecteur est avisé que seules les valeurs de probabilité excédant le seuil alpha réajusté ont été qualifiées de significatives. Par ailleurs, une distinction formelle est opérée entre les deux contrastes primaires planifiés a priori — motivés par nos hypothèses confirmatoires — et les comparaisons exploratoires post-hoc menées subsidiairement. »
10. Présentation visuelle : Tableaux et graphiques de haute qualité
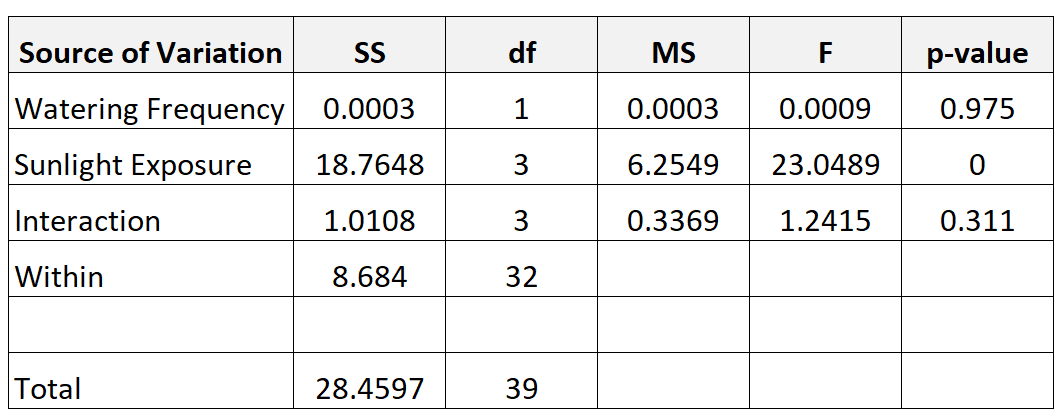
10.1 Conception d’un tableau récapitulatif d’ANOVA conforme à l’APA
La mise en page des matrices statistiques sous forme tabulaire obéit à des conventions typographiques immuables standardisées par l’APA. Un tableau de résultats d’ANOVA doit se distinguer par un dépouillement graphique absolu : l’usage des bordures verticales est formellement banni, et seules trois lignes horizontales principales doivent structurer l’espace (une ligne supérieure délimitant le haut de l’en-tête, une ligne inférieure séparant les intitulés de colonnes des données chiffrées, et une ligne terminale fermant le tableau avant les notes de bas de page).
Les colonnes indispensables d’un tableau récapitulatif complet d’ANOVA factorielle s’ordonnent impérativement de gauche à droite selon la séquence canonique :
Source (identifiant les facteurs, l’interaction, l’erreur et le total),
Somme des carrés (notée SS ou SC),
Degrés de liberté (notés df ou ddl),
Carré moyen (noté MS ou CM),
Statistique F,
Probabilité critique (notée p),
et enfin Taille de l’effet ($\eta_p^2$).
Sous le tableau, des notes de bas de page obligatoires définissent l’ensemble des abréviations métrologiques mobilisées et précisent, le cas échéant, les seuils conventionnels de significativité via un système d’astérisques standardisé ($^*p < ,05$, $^{**}p < ,01$, $^{***}p < ,001$). Ce dispositif visuel doit permettre une compréhension autonome de l'intégralité du modèle factoriel sans qu'il soit nécessaire pour le lecteur de se référer au corps du texte principal.
10.2 Graphiques d’interaction : Diagrammes en barres et graphiques linéaires
La restitution visuelle d’un plan factoriel à deux facteurs cristallise l’interprétation de la modération. Le choix de l’artefact graphique dépend intimement de la nature ontologique des variables indépendantes. Lorsque les deux facteurs sont rigoureusement catégoriels ou nominaux (e.g., Genre $\times$ Type d’intervention clinique), le diagramme en barres groupées constitue un médium visuel adapté. En revanche, dès lors qu’au moins l’un des deux facteurs présente une nature ordinale, temporelle ou quasi-continue (e.g., Doses de traitement, Paliers chronologiques d’apprentissage), le graphique linéaire — ou tracé des profils de moyennes — s’avère nettement supérieur pour donner à voir le croisement ou le parallélisme des fonctions empiriques.
Une figure scientifique d’ANOVA est méthodologiquement invalide si elle omet la matérialisation de l’incertitude métrique. Chaque moyenne figurée sur le graphique doit obligatoirement être flanquée de ses barres d’erreur directionnelles. L’auteur doit spécifier dans la légende de la figure la nature exacte de ces indices de variabilité : écarts-types ($SD$), erreurs-types de la moyenne ($SE$) ou, idéalement, intervalles de confiance à 95 % de la moyenne cellulaire ($IC_{95%}$).
Sur le plan ergonomique, la figure doit répondre aux préceptes contemporains d’accessibilité visuelle : proscription des palettes colorimétriques ambiguës au profit de nuanciers compatibles avec le daltonisme (tels que la palette Viridis), différentiation des lignes d’interaction par des textures contrastées (traits pleins, pointillés, tiretés) couplées à des symboles de points distincts (cercles pleins, carrés vides, triangles), et intégration directe d’une légende auto-explicative exempte de sigles abscons.
10.3 Articulation narrative et renvoi aux éléments visuels
L’intégration textuelle des figures et tableaux ne doit pas se réduire à un simple collage illustrationniste. L’articulation narrative doit valoriser le support visuel pour corroborer et fluidifier l’argumentaire théorique sans jamais récapituler servilement les coordonnées numériques déjà accessibles sur l’image. Le renvoi vers le support visuel s’insère au point névralgique de la déduction clinique ou fondamentale :
« L’inversion radicale du profil de réponse comportementale sous condition de haute interférence cognitive est illustrée à la Figure 2. Comme le donne à voir l’entrecroisement des pentes, l’effet bénéfique du rétrocontrôle visuel continu s’annule purement et simplement lorsque la tâche sollicite simultanément la boucle phonologique, confirmant visuellement la dynamique désordinalisée de l’interaction factorielle isolée par le modèle. »
Cette technique permet d’utiliser le support visuel comme un levier heuristique puissant, soutenant la transmission immédiate de configurations multidimensionnelles d’une haute complexité analytique.
11. Modèles de rédaction et cas d’application concrets en psychologie
11.1 Cas 1 : Étude expérimentale avec interaction significative
Contexte expérimental : Une recherche en psychologie clinique évalue l’efficacité relative de deux approches psychothérapeutiques (Facteur A : Thérapie Cognitive-Comportementale [TCC] vs Thérapie Humaniste) modulée par le niveau d’Anxiété-Trait initial des participants (Facteur B : Faible vs Élevé) sur le score global de rétablissement fonctionnel ($N = 120$ adultes, répartis équitablement dans un plan factoriel $2 \times 2$ inter-sujets).
Modèle de rédaction intégrale :
« Une analyse de variance (ANOVA) factorielle 2 (Type de psychothérapie : TCC vs Humaniste) $\times$ 2 (Niveau d’anxiété initial : Faible vs Élevé) inter-sujets a été réalisée sur les scores de rétablissement fonctionnel mesurés au terme des 12 semaines d’intervention. Les postulats de normalité des résidus (test de Shapiro-Wilk, $p ge ,210$) et d’homogénéité des variances (test de Levene basé sur la médiane, $F(3, 116) = 1,18$, $p = ,320$) ont été pleinement satisfaits. »
« L’analyse met en évidence un effet d’interaction statistiquement significatif et de forte amplitude entre le Type de psychothérapie et le Niveau d’anxiété initial, F(1, 116) = 14,82, p < ,001, $\eta_p^2$ = ,113, IC à 90 % [,038, ,207]. Conformément aux préconisations méthodologiques, l'interprétation des effets principaux omnibus a été suspendue afin de procéder à la décomposition de cette interaction en effets principaux simples du type de psychothérapie au sein de chaque strate d'anxiété, en appliquant un seuil alpha ajusté par la méthode de Bonferroni ($\alpha = ,025$). »
« Chez les patients présentant un niveau d’anxiété initial élevé, le type de psychothérapie exerce un effet simple hautement significatif sur le rétablissement fonctionnel, F(1, 116) = 22,64, p < ,001, $\eta_p^2$ = ,163. Les participants assignés à la TCC rapportent des scores de rétablissement substantiellement plus élevés (M = 72,40, $SD = 8,10$) que ceux ayant bénéficié de la thérapie humaniste (M = 60,15, $SD = 7,95$), soit un gain clinique moyen de 12,25 points (IC à 95 % [7,15, 17,35]). En revanche, chez les individus manifestant une anxiété initiale faible, aucune divergence statistiquement significative n’a été décelée entre les deux modalités thérapeutiques, F(1, 116) = 0,28, p = ,598, $\eta_p^2$ = ,002 (TCC : M = 65,30, $SD = 8,05$ ; Humaniste : M = 66,20, $SD = 8,20$). Ce profil interactif désordinalisé est représenté à la Figure 1. »
11.2 Cas 2 : Étude avec deux effets principaux significatifs sans interaction
Contexte expérimental : Une étude en ergonomie cognitive examine l’impact de la Privation de sommeil (Facteur A : Sommeil normal [8 h] vs Privation totale [24 h]) et de la Complexité cognitive d’une tâche de monitorage (Facteur B : Tâche univariée vs Tâche bivariée vs Tâche multivariée) sur le nombre d’erreurs d’omission ($N = 180$ opérateurs, plan factoriel $2 \times 3$ inter-sujets équilibré, $n = 30$ par cellule).
Modèle de rédaction intégrale :
« Une ANOVA factorielle 2 (Privation de sommeil : Témoin vs Privation) $\times$ 3 (Complexité de la tâche : Univariée vs Bivariée vs Multivariée) inter-sujets a été conduite sur le nombre d’erreurs d’omission enregistrées. Les vérifications préliminaires n’ont révélé aucune entorse substantielle à la normalité des résidus ni à l’homoscédasticité du modèle (Levene : F(5, 174) = 1,05, p = ,390). »
« L’interaction entre la Privation de sommeil et la Complexité de la tâche ne s’est pas révélée statistiquement significative, F(2, 174) = 0,54, p = ,584, $\eta_p^2$ = ,006. Ce résultat autorise l’interprétation directe des deux effets principaux du modèle factoriel. »
« En premier lieu, l’effet principal de la Privation de sommeil s’avère hautement significatif, F(1, 174) = 38,42, p < ,001, $\eta_p^2$ = ,181, IC à 90 % [,102, ,263]. Indépendamment de la complexité du protocole, les opérateurs soumis à 24 heures de veille continue ont commis significativement plus d'omissions (M = 14,80, $SE = 0,62$) que les participants ayant bénéficié d’une nuit de sommeil normale (M = 9,35, $SE = 0,62$). »
« En second lieu, l’effet principal de la Complexité de la tâche est également hautement significatif, F(2, 174) = 16,78, p < ,001, $\eta_p^2$ = ,162, IC à 90 % [,083, ,239]. Des comparaisons post-hoc menées via la procédure de Tukey HSD indiquent que la tâche multivariée induit un taux d'erreur significativement supérieur (M = 15,20, $SE = 0,76$) comparativement à la condition bivariée ($M = 11,85$, $SE = 0,76$, $p_{adj} = ,007$, IC à 95 % [0,82, 5,88]) ainsi qu’à la condition univariée ($M = 9,18$, $SE = 0,76$, $p_{adj} < ,001$, IC à 95 % [3,49, 8,55]). La différence entre les tâches bivariée et univariée franchit également le seuil de significativité ($p_{adj} = ,038$, IC à 95 % [0,12, 5,22]). Ces données descriptives et inférentielles sont récapitulées au Tableau 1. »
11.3 Cas 3 : Modèle entièrement non significatif
Contexte expérimental : Une étude randomisée en psychologie de la santé évalue l’impact d’une Brève campagne de psychoéducation digitale (Facteur A : Vidéo narrative vs Infographie interactive vs Contrôle neutre) et du Lieu de consultation (Facteur B : Milieu hospitalier vs Cabinet libéral) sur l’adhésion vaccinale ($N = 150$, plan $3 \times 2$ inter-sujets).
Modèle de rédaction intégrale :
« Les scores d’intention d’adhésion vaccinale ont été soumis à une ANOVA factorielle 3 (Format psychoéducatif : Vidéo vs Infographie vs Contrôle) $\times$ 2 (Lieu d’exercice : Hospitalier vs Libéral) inter-sujets. L’homogénéité des variances a été validée par le test de Levene, F(5, 144) = 0,89, p = ,489. L’analyse de puissance calculée a priori indiquait qu’un effectif de $N = 150$ offrait une puissance statistique adéquate ($1 – \beta = ,82$) pour détecter un effet d’ampleur moyenne ($\eta_p^2 = ,06$) au seuil $\alpha = ,05$. »
« L’analyse factorielle n’a mis en évidence aucun effet statistiquement significatif au sein du modèle global. Le terme d’interaction entre le Format psychoéducatif et le Lieu d’exercice s’est révélé non significatif, F(2, 144) = 0,15, p = ,861, $\eta_p^2$ = ,002, IC à 90 % [,000, ,021]. De même, l’effet principal du Format psychoéducatif n’a pas atteint le seuil de significativité, F(2, 144) = 1,12, p = ,329, $\eta_p^2$ = ,015, IC à 90 % [,000, ,053] (Vidéo : M = 5,12, $SD = 1,32$ ; Infographie : M = 4,85, $SD = 1,28$ ; Contrôle : M = 4,74, $SD = 1,35$). Enfin, l’effet principal du Lieu de consultation ne s’est pas montré significatif, F(1, 144) = 0,42, p = ,518, $\eta_p^2$ = ,003, IC à 90 % [,000, ,035] (Hospitalier : M = 4,84, $SD = 1,31$ ; Libéral : M = 4,97, $SD = 1,33$). »
« Ces résultats conduisent à ne pas rejeter l’hypothèse nulle. La faiblesse des tailles d’effet observées ($\eta_p^2 le ,015$), conjuguée à l’étroitesse des intervalles de confiance bornés au voisinage immédiat de zéro, suggère que dans les conditions de l’étude, ni le support informationnel ni l’environnement de délivrance de l’information n’exercent d’influence déterminante sur l’intention comportementale des usagers. »
12. Erreurs courantes, pièges d’interprétation et recommandations finales
12.1 Les erreurs logiques et statistiques fréquentes
L’erreur la plus dévastatrice — et malheureusement encore ubiquitaire dans les manuscrits soumis aux revues de psychologie — réside dans la tentative d’interprétation isolée des effets principaux en présence d’une interaction substantielle. Lorsqu’une modération significative gouverne le système de données, affirmer par exemple que « le traitement $A$ surpasse globalement le contrôle » relève d’une illusion d’agrégation si cet avantage s’inverse ou s’annule chez les sujets masculins ou chez les personnes âgées. L’effet d’interaction conditionne obligatoirement le statut sémantique des facteurs principaux : il rend caduque toute affirmation universelle non contextualisée.
Un second piège conceptuel majeur consiste à assimiler fallacieusement l’absence de significativité statistique ($p ge ,05$) à la démonstration de l’équivalence parfaite ou de l’égalité absolue entre les groupes. La statistique fréquentiste fisherienne ne teste que la plausibilité des données sous l’hypothèse nulle ; elle n’apporte jamais la preuve de la véracité de cette hypothèse nulle. Un résultat non significatif peut simplement découler d’un manque criant de puissance statistique (échantillon sous-dimensionné) ou d’une imprécision de mesure colossale. L’auteur doit se limiter à acter qu’aucune divergence n’a pu être mise en évidence, sans jamais affirmer que les conditions sont identiques, sauf à recourir formellement à des procédures de tests d’équivalence (telles que le protocole TOST, Two One-Sided Tests).
Enfin, sur le plan computationnel pur, l’omission des deux degrés de liberté distincts lors du compte rendu de la statistique F demeure une imperfection inadmissible. Rapporter un laconique « $F = 4,52$ » sans stipuler les degrés de liberté du numérateur ($ddl_{Effet}$) et du dénominateur ($ddl_{Erreur}$) prive le lecteur de la capacité élémentaire de restituer le design factoriel et de juger de la puissance de l’épreuve.
12.2 Les défauts de rédaction et de rigueur formelle
Parmi les défauts stylistiques et formels récurrents, l’abandon des statistiques descriptives fondamentales au profit exclusif de la métrique inférentielle représente une carence majeure. Rédiger une suite ininterrompue de valeurs F et p sans jamais spécifier la moyenne arithmétique ($M$) ni l’écart-type ($SD$) des cellules expérimentales interdit toute appréciation de la pertinence clinique des résultats et empêche l’intégration future de l’étude au sein de méta-analyses quantitatives.
Une autre négligence commune concerne l’escamotage complet des indices d’amplitude d’effet ou leur assignation mécanique sans réflexion critique. Se borner à décréter qu’un traitement est « statistiquement très signifiant » sur la base exclusive d’un $p < ,001$, en omettant de mentionner que la variable n'explique qu'un dérisoire $\eta_p^2 = ,008$ (moins de 1 % de la variance fonctionnelle), relève d'une rhétorique trompeuse. La discussion académique doit constamment confronter la significativité probabiliste à la taille de l'effet réelle et à son coût écologique ou pratique.
Enfin, l’incohérence interne entre le corps du manuscrit et les annexes tabulaires mine la crédibilité de l’analyste. Il est fréquent que des relecteurs avisés relèvent des discordances grossières entre les moyennes consignées dans le texte suivi et celles reportées sur les graphiques, ou entre les degrés de liberté déclarés dans l’échantillonnage introductif et ceux assignés au terme d’erreur de l’ANOVA : un audit méticuleux des chiffres s’impose avant tout envoi éditorial.
12.3 Liste de contrôle (Checklist) avant soumission académique
Afin de sécuriser la conformité métrologique et formelle d’un manuscrit avant sa soumission à une revue savante internationale, l’analyste est invité à vérifier point par point la grille d’auto-évaluation en dix points synthétisée ci-dessous :
- 1. Identification explicite du modèle : Le plan expérimental est-il formellement nommé avec exactitude (e.g., ANOVA factorielle $2 \times 3$ inter-sujets), en précisant sans équivoque la variable dépendante continue et les deux facteurs catégoriels ?
- 2. Vérification des postulats : La normalité des résidus (par cellule) et l’homoscédasticité (test de Levene) sont-elles formellement évaluées, documentées et accompagnées de leurs valeurs de test respectives ?
- 3. Données aberrantes et attrition : Le sort réservé aux valeurs aberrantes (détection, maintien ou exclusion) et la gestion des données manquantes sont-ils décrits avec une transparence absolue ?
- 4. Exhaustivité de la statistique de test : Chaque rapport du test de Fisher comporte-t-il obligatoirement la lettre F en italique, les deux degrés de liberté entre parenthèses, la valeur F arrondie à deux décimales, la valeur p exacte et la taille de l’effet ?
- 5. Typographie rigoureuse des p-values : Les probabilités sont-elles écrites sans zéro initial (e.g., p = ,024), les probabilités nulles proscrites au profit de p < ,001, et les tendances fallacieuses bannies ?
- 6. Tailles d’effet systématiques : L’êta-carré partiel ($\eta_p^2$) ou l’oméga-carré partiel ($\omega_p^2$) est-il consigné sans zéro initial pour chaque effet principal et interaction, idéalement assorti de son intervalle de confiance à 90 % ?
- 7. Richesse descriptive : Les moyennes empiriques ($M$) et écarts-types ($SD$) sont-ils systématiquement renseignés pour l’ensemble des cellules ou sous forme de marges globales cohérentes ?
- 8. Hiérarchie analytique respectée : L’effet d’interaction a-t-il été examiné prioritairement ? En cas de significativité, les effets simples ont-ils été décomposés avec ajustement rigoureux du seuil alpha (Bonferroni, Holm) ?
- 9. Qualité et conformité des visuels : Les tableaux respectent-ils les standards APA (trois lignes horizontales, zéro bordure verticale), et les graphiques comportent-ils impérativement leurs barres d’erreur explicitées ?
- 10. Reproductibilité et Open Science : Le manuscrit fournit-il l’accès transparent aux données brutes anonymisées et aux scripts d’analyse (R, syntaxe SPSS, fichiers JASP) via un dépôt institutionnel pérenne (OSF, Zenodo) ?
Le respect scrupuleux de cette armature méthodologique garantit non seulement l’acceptation fluide des manuscrits au sein des comités de lecture les plus exigeants, mais participe activement à la restauration de la rigueur épistémique et de la reproductibilité des sciences comportementales à l’échelle planétaire.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Howell, D. C. (2013). Statistical methods for psychology (8th ed.). Cengage Learning.
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Steiger, J. H. (2004). Beyond the F test: Effect size confidence intervals and tests of close fit in the analysis of variance and contrast analysis. Psychological Methods, 9(2), 164–182. https://doi.org/10.1037/1082-989X.9.2.164
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.