
Dans le paysage contemporain de l’analyse de données quantitatives, les chercheurs en sciences humaines, sociales et biomédicales se heurtent fréquemment aux limites inhérentes aux méthodes statistiques paramétriques classiques. Lorsque les distributions empiriques s’écartent manifestement de la courbe normale de Gauss-Laplace, ou lorsque les instruments de mesure génèrent des données de nature strictement ordinale, le recours au test t de Student pour échantillons indépendants s’avère méthodologiquement illégitime et scientifiquement risqué. Dans ce contexte épistémologique, le test non paramétrique U de Mann-Whitney émerge comme l’alternative préférentielle par excellence, offrant une robustesse mathématique irréprochable face aux asymétries prononcées et aux valeurs aberrantes.
Bien que des progiciels spécialisés tels que SPSS, R, SAS ou JASP soient traditionnellement préconisés pour réaliser de telles inférences, le tableur universel Microsoft Excel demeure, pour des millions de praticiens, cliniciens et universitaires, l’interface computationnelle la plus immédiatement accessible et déployée à l’échelle mondiale. Néanmoins, contrairement à d’autres procédures inférentielles élémentaires, Microsoft Excel ne propose aucune commande fermée native unifiée intitulée directement « TEST.MANN.WHITNEY ». Cette carence apparente contraint l’analyste à maîtriser l’architecture algorithmique sous-jacente du test afin d’orchestrer, au sein de la feuille de calcul, une chaîne de traitement rigoureuse combinant le classement matriciel des observations, le calcul pondéré des rangs et la résolution analytique des équations probabilistes associées.
Ce guide exhaustif a pour vocation de déconstruire pas à pas l’ensemble des fondements théoriques, des mécanismes mathématiques et des protocoles d’implémentation pratique du test U de Mann-Whitney dans l’environnement Microsoft Excel. En alliant une rigueur académique sans compromis aux exigences opérationnelles du traitement automatisé de données, ce manuel constitue une référence technique complète, guidant le chercheur depuis la vérification des postulats initiaux jusqu’à la modélisation sous forme de macros pérennes et la restitution graphique des résultats selon les normes éditoriales les plus strictes de l’American Psychological Association (APA 7e édition).
1. Fondements théoriques et épistémologiques du test U de Mann-Whitney
1.1 Définition statistique et paradigme non paramétrique
L’inférence statistique non paramétrique, souvent désignée sous l’appellation d’inférence à distribution libre (distribution-free statistics), repose sur un paradigme épistémologique fondamentalement distinct de l’approche paramétrique standard. Alors que cette dernière postule que les échantillons proviennent d’une population parente structurée selon une loi de probabilité théorique prédéfinie — le plus souvent la loi normale — dont il s’agit d’estimer les paramètres centraux tels que l’espérance mathématique (μ) et la variance (σ²), l’approche non paramétrique s’affranchit délibérément de ces contraintes structurales. Elle ne requiert aucune spécification a priori quant à la forme analytique de la fonction de densité sous-jacente, ce qui confère aux tests qui en découlent une résilience exceptionnelle face aux violations morphologiques des distributions empiriques.
Le principe cardinal qui sous-tend le test U de Mann-Whitney réside dans la conversion immédiate des grandeurs quantitatives brutes en valeurs ordinales relatives. Plutôt que de confronter directement les moyennes arithmétiques des groupes à l’étude — métriques notoirement sensibles aux déformations distributionnelles et à la présence de valeurs extrêmes —, le test évalue la disposition spatiale relative des observations à travers l’attribution de rangs. En réordonnant l’ensemble des données combinées sur un continuum linéaire ascendant, l’analyste neutralise l’amplitude absolue des écarts métriques pour ne préserver que la structure de préséance séquentielle. Il s’ensuit que l’inférence ne porte plus sur l’écart arithmétique séparant deux centres de gravité, mais sur la probabilité qu’une observation extraite aléatoirement d’une première population excède stochastiquement une observation issue d’une seconde population.
Sur le plan historique, la genèse de cette procédure constitue une avancée majeure dans l’histoire de la biométrie et de l’économétrie moderne. La première intuition théorique fut formalisée par le statisticien et chimiste américain Frank Wilcoxon en 1945, qui proposa un test fondé sur la somme des rangs pour deux échantillons indépendants de tailles strictement identiques. Deux années plus tard, en 1947, Henry Mann et Donald Whitney publièrent un mémoire séminal généralisant le modèle à des échantillons de tailles inégales et introduisant une nouvelle statistique décisionnelle, notée U, accompagnée d’un traitement mathématique rigoureux de la distribution exacte pour de très petits échantillons. Le test ainsi consolidé devint rapidement l’outil privilégié de l’investigation empirique dans les disciplines confrontées à une forte variabilité interindividuelle.
En psychologie expérimentale et en psychologie clinique, les champs d’application du test U de Mann-Whitney sont légion. Ces disciplines manipulent en permanence des variables psychométriques obtenues via des échelles de type Likert, des inventaires d’évaluation comportementale ou des mesures de temps de latence cognitive. Ces indices présentent quasi systématiquement des asymétries positives marquées, des effets de plancher ou de plafond, ainsi qu’une discontinuité intrinsèque qui prohibe l’usage sans réserve des statistiques paramétriques. Le test U constitue donc l’instrument de référence pour valider l’efficacité différentielle de protocoles thérapeutiques, comparer des sous-populations cliniques à des groupes témoins, ou encore attester de modifications comportementales induites par des manipulations expérimentales complexes.
1.2 Équivalence formelle entre le test de Mann-Whitney et le test de Wilcoxon
Il règne au sein de la littérature scientifique une confusion terminologique récurrente entretenue par la juxtaposition des appellations « test de la somme des rangs de Wilcoxon » (Wilcoxon rank-sum test) et « test U de Mann-Whitney ». D’un point de vue strictement mathématique, ces deux formulations représentent deux expressions analytiques rigoureusement isomorphes d’une seule et même réalité probabiliste. La statistique W de Wilcoxon correspond à la somme brute des rangs attribués aux observations appartenant à l’un des sous-groupes expérimentaux au sein de la série globale unifiée. La statistique U de Mann-Whitney, quant à elle, quantifie le nombre effectif de fois où un score observé dans le premier échantillon surpasse les scores observés dans le second échantillon lors de comparaisons exhaustives par paires.
La passerelle algébrique liant indissolublement ces deux grandeurs s’exprime par une relation linéaire déterministe parfaite. Si l’on note n1 la taille du premier échantillon et R1 la somme des rangs attribuée à ce même groupe dans la distribution conjointe, la statistique U1 se déduit directement par l’équation canonique :
U1 = n1n2 + [n1(n1 + 1) / 2] – R1
Cette relation démontre que la statistique U n’est rien d’autre qu’un décentrage de la somme des rangs de Wilcoxon, normalisée en fonction du rang théorique minimal que ce groupe aurait pu obtenir si l’ensemble de ses observations s’était positionné en tête absolue de la série ordonnée. Par conséquent, tester l’hypothèse nulle d’égalité des populations au moyen de W ou au moyen de U conduit rigoureusement à des valeurs critiques identiques, à des niveaux de significativité strictement superposables et à des conclusions scientifiques parfaitement univoques.
Il importe toutefois de maintenir une distinction conceptuelle et opérationnelle limpide entre cette procédure dédiée aux échantillons indépendants et le test des rangs signés de Wilcoxon (Wilcoxon signed-rank test). Ce dernier est exclusivement réservé aux plans factoriels à mesures répétées ou aux échantillons appariés, reposant sur l’analyse intra-sujet du signe et de la magnitude des différences observées entre deux conditions associées. La confusion entre ces deux protocoles engendre des erreurs méthodologiques graves lors de la saisie des commandes dans les progiciels statistiques et altère profondément la validité des conclusions publiées.
Au niveau de l’implémentation manuelle dans un tableur informatique tel qu’Excel, la reconnaissance de cet isomorphisme est d’une portée heuristique majeure. Elle autorise le chercheur à orienter son algorithme soit vers le calcul combinatoire du dénombrement des inversions (méthode native de Mann-Whitney), soit vers la sommation conditionnelle des rangs de la série fusionnée (méthode de Wilcoxon). Étant donné que le calcul matriciel des rangs cumulés s’avère infiniment moins lourd en termes de puissance computationnelle que le calcul exhaustif des paires cartésiennes croisées, c’est invariablement l’approche par sommation de Wilcoxon qui sert d’assise algorithmique au déploiement du test U dans les feuilles de calcul contemporaines. Dans les revues internationales de psychologie indexées, l’usage préconise désormais de mentionner indifféremment « test de Mann-Whitney-Wilcoxon (MWW) » ou « test U de Mann-Whitney », en veillant à rapporter simultanément la statistique U et la somme des rangs associée.
1.3 Conditions de validité et postulats préalables
Bien que le test U de Mann-Whitney soit universellement qualifié de méthode non paramétrique et qu’il s’affranchisse formellement du postulat de normalité des distributions résiduelles, il demeure tributaire d’un ensemble de postulats méthodologiques stricts qu’il convient de soumettre à un examen critique scrupuleux avant toute inférence opérationnelle. L’omission de ces critères de validité préliminaires constitue l’une des causes majeures d’invalidité des inférences statistiques publiées dans la recherche biomédicale et psychologique contemporaine.
Le premier postulat fondamental, commun à la quasi-totalité des procédures inférentielles fréquentistes, exige l’indépendance absolue des observations. Cette condition implique deux dimensions structurelles orthogonales :
- L’indépendance intra-groupe : La mesure obtenue pour un participant donné au sein de son groupe ne doit en aucun cas exercer d’influence ou entretenir de corrélation fonctionnelle avec la mesure enregistrée pour un autre participant de cette même cohorte. Cette condition disqualifie d’emblée l’analyse d’échantillons en grappes non contrôlées ou de dynamiques de groupe non isolées.
- L’indépendance inter-groupes : Les deux cohortes expérimentales soumises à la comparaison doivent être formées d’unités statistiques entièrement disjointes. Aucun individu ne peut être représenté dans les deux conditions, et aucun mécanisme de couplage ou d’appariement préalable (ex. paires de jumeaux, sujets appariés selon l’âge ou le quotient intellectuel) ne doit présider à la constitution des échantillons sans basculer sur un protocole non paramétrique adapté aux séries dépendantes.
Le second postulat a trait au niveau de mesure requis pour la variable dépendante. L’ordonnancement séquentiel des scores exigeant d’établir des relations univoques de précédence logique (opérateurs arithmétiques d’ordre supérieur et inférieur), la variable étudiée doit impérativement être mesurée, au minimum, sur une échelle ordinale continue ou discrète. Les données métriques continues, mesurées sur des échelles d’intervalles ou de rapports, sont parfaitement éligibles et gagnent fréquemment à être traitées par cette méthode lorsqu’elles exhibent une cinétique de distribution anormale. En revanche, l’application du test de Mann-Whitney à des variables nominales qualitatives non ordonnées constitue un non-sens statistique absolu.
Le troisième postulat concerne l’interprétation exacte de la finalité du test. Si le chercheur ambitionne de tester une différence de tendance centrale — c’est-à-dire un décalage de la valeur de la médiane entre les deux groupes —, il est théoriquement indispensable d’assumer l’hypothèse de similarité de forme des distributions sous-jacentes. Selon ce principe, les distributions des deux populations doivent présenter un profil géométrique identique (mêmes degrés d’asymétrie et d’aplatissement), le traitement expérimental n’ayant pour effet que de transposer la courbe le long de l’axe horizontal sans en altérer la dispersion ni la morphologie globale. Si cette condition d’homogénéité de forme n’est pas honorée, un résultat statistiquement significatif ne peut en aucun cas être interprété comme une preuve d’hétérogénéité des médianes ; il atteste exclusivement d’un phénomène de dominance stochastique globale, indiquant que la probabilité P(X > Y) s’écarte significativement de 0,50.
Enfin, la gestion des faibles effectifs requiert une vigilance méthodologique accrue. Lorsque la taille globale des échantillons est modeste (par convention, lorsque n1 et n2 sont inférieurs ou égaux à 20 ou que la taille totale N est inférieure à 30), les propriétés asymptotiques du théorème central limite ne peuvent plus être convoquées. Dans cette configuration d’échantillons réduits, les approximations fondées sur la loi normale standard perdent toute validité empirique. Le chercheur se trouve alors dans l’obligation formelle de recourir aux tables des distributions combinatoires exactes de la statistique U pour extraire les probabilités critiques réelles et prévenir l’inflation incontrôlée du taux d’erreur de type I.
2. Analyse comparative : Test U de Mann-Whitney versus Test t de Student indépendant
2.1 Vulnérabilité du test t face aux violations de normalité
Le test t de Student pour échantillons indépendants s’érige historiquement comme le modèle d’inférence de référence pour statuer sur l’hétérogénéité de deux moyennes empiriques. Cette hégémonie théorique repose sur des fondations mathématiques précises, notamment la distribution de Student, qui postule formellement que la variable dépendante est distribuée selon une loi gaussienne au sein de chacune des sous-populations analysées. Dans la pratique scientifique réelle, tout particulièrement en psychologie et en psychiatrie expérimentale, cette condition idéale d’homogénéité et de normalité n’est que très exceptionnellement rencontrée. Les processus psychophysiologiques génèrent intrinsèquement des distributions asymétriques présentant de forts coefficients de dissymétrie (skewness) ou d’aplatissement (kurtosis).
Lorsque le chercheur persiste à appliquer le test t de Student sur des séries asymétriques ou parasitées par des observations discordantes (valeurs aberrantes ou outliers), la stabilité de l’inférence se désagrège rapidement. La moyenne arithmétique constitue une mesure de tendance centrale extrêmement vulnérable : un seul score hautement déviant induit une translation artificielle substantielle du centre de gravité de l’échantillon, tout en provoquant une inflation quadratique de la variance estimée de l’erreur standard de la moyenne. Il en résulte un effondrement dramatique de la statistique de Student calculée, aboutissant à une incapacité critique de déceler un effet réel (élévation massive du risque d’erreur de type II ou β) ou, paradoxalement, à l’apparition de faux positifs lorsque l’asymétrie se conjugue à un déséquilibre prononcé des effectifs inter-groupes.
Cette vulnérabilité s’accentue dramatiquement en situation d’hétéroscédasticité — c’est-à-dire lorsque la variance du groupe 1 diverge significativement de la variance du groupe 2 — tout en coexistant avec des tailles d’échantillons inégales. Dans cette configuration hautement instable, la robustesse nominale du test t disparaît intégralement, et le taux réel de réjection à tort de l’hypothèse nulle sous le seuil critique nominal de 5 % peut grimper jusqu’à dépasser les 15 à 20 %. À l’opposé de cette fragilité paramétrique, le test U de Mann-Whitney fait montre d’une imperméabilité totale face aux déformations de grande amplitude. En transformant les scores bruts en rangs contigus, il assigne une valeur maximale bornée à l’observation la plus extrême, la neutralisant efficacement en tant qu’artefact d’échelle et préservant l’intégrité globale de l’évaluation comparative.
2.2 Puissance statistique et efficacité asymptotique relative
Un préjugé méthodologique largement répandu au sein de la communauté scientifique tend à discréditer les tests non paramétriques sous l’allégation péremptoire qu’ils accuseraient un déficit structurel de puissance statistique comparativement aux modèles paramétriques équivalents. Une analyse formelle rigoureuse de la théorie de l’estimation statistique démontre que ce jugement simpliste est fondamentalement erroné. L’indice mathématique standard employé pour arbitrer cette concurrence méthodologique est l’Efficacité Relative Asymptotique (ERA ou Asymptotic Relative Efficiency – ARE), théorisée notamment par Pitman.
L’efficacité relative asymptotique quantifie le ratio du nombre d’observations requis par une procédure A pour atteindre la même puissance statistique qu’une procédure B lorsque la taille globale tend vers l’infini et que l’amplitude de l’effet tend vers zéro. Lorsque les postulats paramétriques idéaux sont rigoureusement satisfaits — c’est-à-dire lorsque les populations mères suivent une loi normale parfaite dotée d’une variance strictement homogène —, l’ERA du test U de Mann-Whitney par rapport au test t de Student s’établit très précisément à :
ERA(U / t) = 3 / π ≈ 0,955
Ce résultat fondamental stipule que, dans les conditions d’application les plus parfaites et les plus avantageuses pour le test t de Student, le test de Mann-Whitney ne concède qu’une perte marginale de puissance de l’ordre de 4,5 %. L’analyste appliquant le test U aura simplement besoin d’une cohorte de 100 individus pour égaler le seuil de discrimination que le test t atteindrait avec 95 individus sous stricte normalité.
À l’inverse, dès lors que l’on s’écarte du cadre gaussien, la dynamique de puissance bascule spectaculairement en faveur du test de Mann-Whitney. Face à des distributions à queues lourdes ou leptokurtiques (telles que la distribution de Laplace, la loi logistique, ou des modèles de mélanges gaussiens contaminés par des artéfacts d’échantillonnage), l’ERA du test U surpasse systématiquement l’unité, atteignant fréquemment des valeurs comprises entre 1,10 et 1,50. Dans des scénarios de forte asymétrie caractérisés par des lois exponentielles ou des distributions de Pareto, l’ERA peut croître sans limite théorique (tendant vers l’infini). L’arbitrage méthodologique ne consiste donc nullement en une perte arbitraire de puissance, mais en une politique d’assurance statistique hautement rentable visant à maximiser la probabilité de détection empirique dans les conditions expérimentales réelles de laboratoire.
2.3 Arbre décisionnel pour le chercheur en psychologie
Afin de prémunir les chercheurs en psychologie et en sciences du comportement contre les dérives analytiques telles que le braconnage méthodologique (p-hacking) ou la sélection opportuniste de tests après visualisation graphique, l’établissement d’un protocole d’inférence séquentiel s’avère indispensable. Le choix entre le test t de Student indépendant, sa variante robuste de Welch, ou le test U de Mann-Whitney ne doit jamais reposer sur la recherche complaisante d’une p-valeur significative, mais résulter du cheminement logique dicté par la nature des données observées.
Le protocole décisionnel s’articule autour des étapes systématiques suivantes :
- Étape 1 : Évaluation de la métrologie et de la taille d’échantillon. Si la variable dépendante est intrinsèquement ordinale (scores agrégés sur items Likert, classements cliniques subjectifs), l’orientation vers le test U de Mann-Whitney est immédiate et non négociable. Si la variable est quantitative continue, l’analyste recense la taille des effectifs : des effectifs par cellule inférieurs à 15 interdisent l’invocation robuste du théorème central limite pour compenser les asymétries morphologiques.
- Étape 2 : Test formel de l’hypothèse de normalité univariée. L’analyste procède à un test de Shapiro-Wilk (ou d’Agostino-Pearson) conjointement à l’inspection visuelle des graphiques quantile-quantile (Q-Q plots). Un rejet statistiquement significatif de la normalité (p < 0,05), tout particulièrement au sein d’échantillons de taille réduite ou modérée, disqualifie l’application du test t de Student classique.
- Étape 3 : Diagnostic de l’homoscédasticité. L’équivalence des variances est soumise au test de Levene (ou test de Brown-Forsythe). Si la normalité est approximée mais que les variances divergent significativement, le test t de Welch doit supplanter le test de Student standard. Si la non-normalité coexiste avec l’hétérogénéité des variances, le recours aux rangs s’impose impérativement.
- Étape 4 : Détermination de l’inférence cible. Lorsque le test U de Mann-Whitney est retenu, le chercheur doit examiner le profil géométrique des distributions conjointes par superposition graphique des densités. Si la morphologie générale est homologue (conservation de la symétrie relative et de la dispersion), le test valide formellement une différence entre les médianes de population. Dans le cas contraire, le chercheur documentera rigoureusement le verdict en termes de dominance stochastique ordinale globale.
3. Formulation formelle des hypothèses statistiques
3.1 Hypothèse nulle (H0) et alternatives de recherche (H1)
La transcription des interrogations scientifiques en conjectures probabilistes testables constitue le socle indispensable de l’inférence de Neyman-Pearson. Dans le cadre théorique du test U de Mann-Whitney, l’expression formelle des hypothèses s’articule autour de fonctions de répartition cumulée régissant le comportement probabiliste des deux populations soumises à investigation, que nous désignerons conventionnellement par F1(x) et F2(x).
L’hypothèse nulle, désignée par H0, postule l’équivalence stochastique parfaite des deux populations d’origine. Sur le plan formel de la théorie des probabilités, elle s’énonce selon la relation :
H0 : F1(x) = F2(x), pour tout x appartenant à l’ensemble des réels ℜ
Cette égalité stricte stipule que la distribution conjointe ne subit aucun glissement ni aucune distorsion structurelle imputable à la variable indépendante de classification. En termes probabilistes concrets, si l’on extrait de manière indépendante et aléatoire une observation individuelle X issue de la population 1 et une observation Y issue de la population 2, l’hypothèse nulle pose l’indifférence de précédence directionnelle :
H0 : P(X > Y) = P(Y > X) = 0,50
La formulation de l’hypothèse alternative de recherche, notée H1, varie selon que l’orientation déductive dérive d’une exploration purement ouverte ou d’un cadre théorique a priori solidement balisé :
- Hypothèse bilatérale (non directionnelle) : Retenue par défaut en l’absence de prédiction quant à la trajectoire de l’effet expérimental, elle stipule que les deux distributions ne sont pas identiques, induisant une asymétrie de précédence stochastique :
H1 : F1(x) ≠ F2(x) pour au moins une valeur de x, soit P(X > Y) ≠ 0,50. - Hypothèses unilatérales (directionnelles) : Adoptées lorsque le socle théorique de la psychologie contemporaine stipule qu’une condition déterminée doit nécessairement abaisser ou exacerber la magnitude de la réponse comportementale. Elles se traduisent par une relation d’inégalité stochastique univoque :
H1 : P(X > Y) > 0,50 (hypothèse unilatérale droite) ou H1 : P(X > Y) < 0,50 (hypothèse unilatérale gauche).
Il est impératif pour l’analyste de ne pas opérer d’assimilation hâtive entre dominance stochastique et translation stricte de paramètres ponctuels. Réduire abusivement l’énoncé de H0 à l’égalité des médianes empiriques (Md1 = Md2) trahit la nature mathématique intrinsèque du test U, sauf à avoir démontré au préalable la gémellité morphologique absolue des deux fonctions de densité empirique.
3.2 Seuils de significativité et gestion du risque alpha
L’administration opérationnelle du test exige la calibration précise du seuil de tolérance à l’erreur probabiliste de première espèce, universellement formalisé par le symbole α. Ce coefficient représente le risque consenti par l’expérimentateur de rejeter fallacieusement l’hypothèse nulle d’équivalence stochastique alors même que celle-ci s’avère matériellement vraie dans la population parente. Dans le champ des sciences humaines et comportementales, la convention méthodologique instituée par Ronald Fisher impose un ancrage à un seuil nominal α = 0,05 (ou 5 %), correspondant à un intervalle de confiance bilatéral de 95 %. Dans les contextes de recherche médicale critique, d’essais pharmacologiques ou d’études neuroscientifiques à haute densité spatiale, ce niveau d’exigence est régulièrement resserré à α = 0,01 ou α = 0,001.
Toutefois, la gestion du risque alpha devient considérablement plus complexe dès lors que le chercheur procède à des évaluations sérielles ou à des comparaisons multiples au sein d’une même matrice factorielle. Chaque réplication indépendante d’un test inférentiel accroît mécaniquement le risque global cumulé d’erreur de première espèce (l’erreur de type I globale de l’expérience, désignée par family-wise error rate – FWER), modélisé par l’expression αglobal = 1 – (1 – α)k, où k figure le nombre total de contrastes statistiques exécutés. Face à dix comparaisons successives, le risque de générer artificiellement un résultat faux positif excède ainsi les 40 % sous l’hypothèse nulle globale.
Pour juguler cette dérive sans recourir à des progiciels spécialisés, le chercheur travaillant sur tableur Excel est tenu de programmer les correctifs mathématiques d’ajustement du seuil critique de rejet. La procédure la plus conservatrice et classique demeure l’inégalité de Boole-Bonferroni, qui prescrit l’utilisation d’un seuil corrigé local :
αcorrigé = αnominal / k
D’autres approches plus sophistiquées, à l’instar de la méthode séquentielle descendante de Holm-Bonferroni, gagnent à être implémentées via des fonctions logiques conditionnelles sous Excel afin d’optimiser le compromis entre la maîtrise impérative du risque alpha et la préservation de la puissance statistique globale face au risque d’erreur de type II (β), garantissant une rigueur épistémologique totale au protocole d’analyse.
4. Architecture mathématique et algorithme du calcul de la statistique U
4.1 Mécanisme d’ordonnancement et fusion des séries
L’architecture logique du test U de Mann-Whitney repose sur une procédure séquentielle rigoureuse dont la première phase computationnelle consiste en l’amalgame total des structures de données observées au sein des deux sous-populations d’intérêt. Soient deux ensembles d’observations empiriques distincts, désignés formellement par :
X = {x1, x2, …, xn1} et Y = {y1, y2, …, yn2}
La première opération mathématique consiste à dériver un méta-ensemble unifié, noté Z, issu de l’union ensembliste directe des vecteurs de données brutes :
Z = X ∪ Y = {z1, z2, …, zN}, avec un effectif d’échantillonnage combiné N = n1 + n2
Une fois cette consolidation matricielle réalisée, l’ensemble unifié Z est assujetti à une fonction de tri bijectif strictement croissant, ordonnant les éléments selon la chaîne de relations : z(1) ≤ z(2) ≤ … ≤ z(N). C’est sur cette suite séquentielle globale, et sans considérer à ce stade l’étiquette d’appartenance institutionnelle des individus à la condition expérimentale ou témoin, qu’intervient l’attribution systématique des indices ordinaux ou « rangs ».
À chaque point de donnée z(i) situé sur le continuum ainsi ordonné, l’algorithme associe un rang entier naturel discret, noté r(z(i)) = i, balayant l’intervalle fermé des entiers de [1, N]. Les observations les plus faibles sur l’échelle métrique se voient allouer les rangs initiaux unitaires les plus petits, tandis que les scores de haute magnitude captent les rangs finaux les plus élevés. Une fois cette étape de labellisation ordinale parachevée, les identifiants d’appartenance aux groupes expérimentaux initiaux sont rétablis à des fins d’agrégation partitionnée.
4.2 Algorithme de traitement des valeurs ex æquo (liens)
Dans l’analyse quantitative de données réelles, particulièrement lorsqu’elles procèdent d’échelles de mesure discrètes ou d’évaluations psychométriques à granularité limitée, la probabilité théorique d’observer des valeurs identiques — dénommées classiquement « ex æquo » ou « rangs liés » (tied ranks) — est extrêmement élevée. L’apparition de données numériques strictement superposables complique l’assignation séquentielle simple et impose l’application d’un algorithme déterministe standardisé : la méthode du rang moyen arithmétique.
Soit un ensemble de t observations empiriques présentant une identité métrique parfaite au sein de la série fusionnée globale ordonnée, monopolisant consécutivement les positions d’indices ordinaux allant de la position p à la position p + t – 1. L’équité mathématique prohibant toute assignation asymétrique arbitraire du rang entre des grandeurs identiques, le modèle leur alloue uniformément le rang moyen arithmétique de leurs positions théoriques concurrentes :
rmoyen = [ ∑j=0t-1 (p + j) ] / t = [p + (p + t – 1)] / 2
À titre d’illustration, si les valeurs se classant virtuellement aux positions séquentielles 4, 5 et 6 sont strictement égales au nombre 18, le rang affecté à chacune de ces trois observations sera identiquement évalué à (4 + 5 + 6) / 3 = 5,0. Si deux scores partagent les positions ordinales 7 et 8, le rang conjoint attribué deviendra (7 + 8) / 2 = 7,5.
Si la présence de rangs liés n’altère aucunement l’espérance mathématique théorique de la somme des rangs, elle engendre une distorsion mécanique non négligeable : elle réduit artificiellement la variance globale de la distribution conjointe des rangs. Lorsque le nombre de liens devient prépondérant au sein de la matrice, l’absence de compensation numérique biaise le calcul de l’erreur standard de la statistique U sous sa forme asymptotique continue. Pour pallier cette atténuation de dispersion, une équation d’ajustement correctif formalisée par la théorie des rangs doit être introduite, intégrant un facteur de correction défini par la somme pondérée des agrégats de liens :
∑ (tk3 – tk)
où tk représente la cardinalité de chaque sous-ensemble k d’observations identiques.
4.3 Calcul analytique des grandeurs U1 et U2
L’estimation quantitative directe de la discrimination stochastique s’opère par le dénombrement pondéré de la contribution ordinale de chaque groupe, concrétisée par la sommation conditionnelle de leurs rangs respectifs au sein de l’architecture matricielle fusionnée. On note traditionnellement :
R1 = ∑ r(xi) et R2 = ∑ r(yj)
La dérivation des statistiques partielles U1 et U2, qui quantifient respectivement le volume de dominance empirique du premier groupe sur le second et réciproquement, s’effectue au moyen des relations canoniques établies par Mann et Whitney :
U1 = n1n2 + [n1(n1 + 1) / 2] – R1
U2 = n1n2 + [n2(n2 + 1) / 2] – R2
Ces formulations intègrent un principe correctif élégant : le terme [ni(ni + 1) / 2] correspond à la somme des entiers consécutifs de 1 à ni, incarnant la borne minimale absolue de rangs cumulés qu’un groupe pourrait mathématiquement obtenir s’il confisquait l’intégralité des premières positions ordonnées. La soustraction de cette borne théorique à la somme brute observée permet d’isoler le décompte exact des supériorités stochastiques inter-groupes.
Une propriété algébrique remarquable fournit à l’analyste un théorème de vérification croisée absolue, indispensable pour valider la chaîne de traitement matricielle dans un environnement de calcul ouvert :
U1 + U2 = n1n2
La somme arithmétique des deux grandeurs U calculées doit rigoureusement coïncider avec l’espace produit des tailles d’échantillons, soit le nombre théorique total de paires formables entre les deux groupes. Toute divergence numérique par rapport à cette égalité déterministe atteste d’une altération computationnelle dans l’attribution des rangs ou la sommation matricielle. Enfin, la statistique de décision finale retenue pour interroger les distributions de probabilité et trancher sur l’hypothèse nulle d’indifférence est définie par le minimum empirique du couple de valeurs :
U = min(U1, U2)
5. Préparation méthodique du jeu de données dans Microsoft Excel
5.1 Structuration ergonomique des feuilles de calcul
La fiabilité de l’instrumentation statistique au sein de Microsoft Excel est conditionnée par l’adoption d’un paradigme de modélisation tabulaire rigoureux. Deux architectures de structuration des matrices empiriques s’affrontent classiquement dans les pratiques de laboratoire : le « format large » (wide format) et le « format long » (long format ou format tabulaire normalisé).
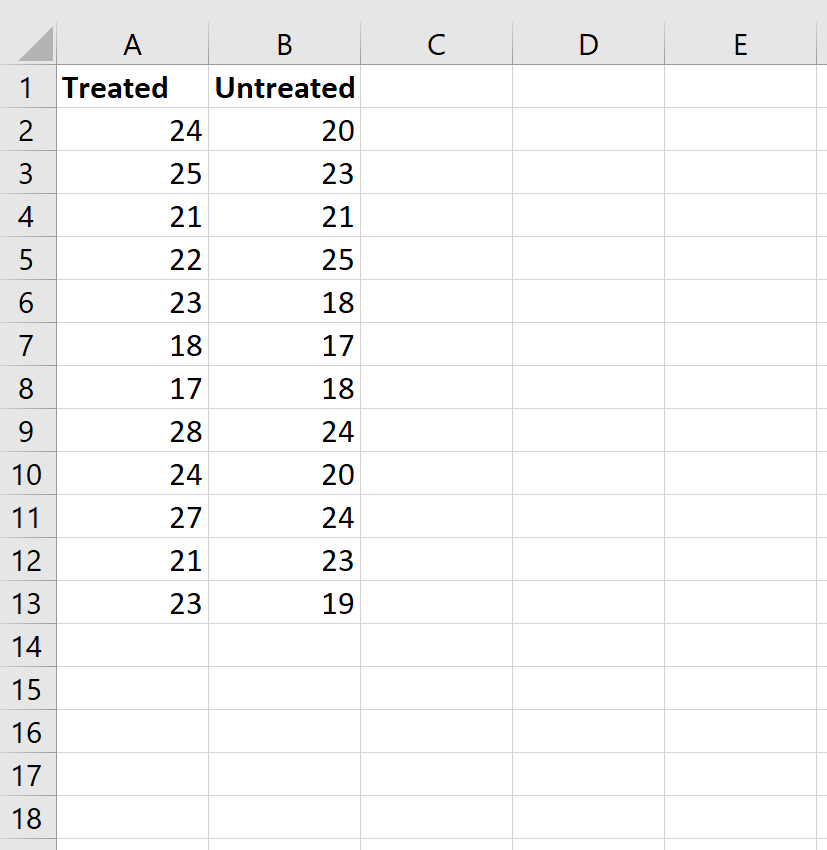
Le format large assigne une colonne exclusive à chaque condition expérimentale (par exemple, la colonne A allouée aux observations du « Groupe Contrôle » et la colonne B allouée aux mesures du « Groupe Expérimental »). Si cette configuration présente un attrait visuel intuitif pour les praticiens non spécialistes, elle s’avère particulièrement inadaptée et périlleuse dès lors qu’il s’agit d’appliquer des fonctions d’indexation vectorielle ou d’automatiser des classements par rangs sans multiplier les manipulations manuelles de coupure et collage.
À l’inverse, le format long constitue le standard professionnel absolu, préconisé tant en ingénierie de données qu’en biostatistique internationale. Il organise la feuille de calcul selon une structure invariante à deux colonnes analytiques directes :
- Colonne A (Identifiant factoriel / Groupe) : Contient les étiquettes textuelles ou numériques définissant strictement le niveau de la variable indépendante pour chaque participant (ex. « Contrôle » versus « Traitement », ou codes discrets « 1 » et « 2 »).
- Colonne B (Variable dépendante / Score brut) : Accueille sur une trajectoire verticale continue l’ensemble des scores métriques ou ordinaux recueillis, chaque ligne incarnant une unité observationnelle unique et indivisible.
Cette ségrégation spatiale stricte garantit l’intégrité référentielle des données sources et permet de cantonner les zones de calcul computationnel dérivé (rangs, paramètres intermédiaires, tableau de bord d’inférence) dans des plages disjointes (ex. colonnes C, D et tableaux latéraux), évitant tout risque d’écrasement ou d’écueil algorithmique lié à la présence de données mixtes au sein des mêmes vecteurs de traitement.
5.2 Protocole de contrôle de la qualité des données
Préalablement à toute velléité d’inférence, un audit méthodique de salubrité de la feuille Excel s’impose impérativement. Le tableur Microsoft, par son absence native de typage strict des variables, expose le chercheur à des écueils insidieux susceptibles de fausser intégralement les calculs mathématiques subséquents à l’insu de l’opérateur.
Le premier point de contrôle porte sur la détection des chaînes textuelles invisibles et des espaces parasites. Une cellule numérique contaminée par une espace insécable ou précédée d’une apostrophe est silencieusement interprétée par Excel comme une chaîne textuelle non convertible, entraînant son exclusion automatique et opaque de fonctions d’agrégation clés telles que SOMME, NB ou RANG.MOYENNE. L’application de règles de mise en forme conditionnelle signalant par coloration dynamique les cellules répondant au critère =ESTTEXTE(cellule) au sein de la colonne des scores permet d’intercepter immédiatement ces anomalies métrologiques.
Le second verrou méthodologique relève du traitement des cellules vides et de la traçabilité des exclusions d’échantillonnage. En conformité avec les standards déontologiques de recherche en psychologie, aucune suppression arbitraire d’observation discordante ne doit être opérée sans documentation explicite. L’analyste exploitera le module de « Validation des données » d’Excel pour verrouiller la plage d’admissibilité des scores numériques (définition des bornes d’échelles physiologiquement ou psychométriquement possibles) et figer les plages de coordonnées à l’aide de références absolues formalisées par le symbole $, neutralisant toute dérive d’indexation lors des processus d’étirement de formules complexes.
5.3 Présentation du cas d’étude empirique en psychologie
Pour fonder notre démonstration pratique sur une assise empirique tangible, nous mobilisons un protocole expérimental classique issu de la neuropsychologie cognitive : l’évaluation de l’impact d’une induction aiguë d’anxiété sur l’efficience du contrôle exécutif, opérationnalisée par la mesure du temps de réaction (exprimé en millisecondes) lors d’une tâche de compatibilité cognitive de type Stroop.
Le plan factoriel repose sur un schéma univarié inter-sujets à deux conditions indépendantes :
- Groupe 1 (Condition Contrôle) : n1 = 12 participants adultes soumis à la tâche cognitive dans un environnement acoustique et psychosocial neutre et apaisé.
- Groupe 2 (Condition Expérimentale / Stress aigu) : n2 = 12 participants adultes soumis à la même tâche en présence d’un stresseur psychosocial standardisé (protocole d’évaluation sociale menaçante fondé sur le Trier Social Stress Test).
La légitimité du recours au test U de Mann-Whitney s’avère ici méthodologiquement irréprochable : les temps de réaction chronométriques exhibent chroniquement une asymétrie positive majeure (longue traîne droite générée par des accès attentionnels tardifs), et la taille modeste de chaque sous-cohorte (12 unités expérimentales par cellule, soit une taille globale d’échantillon N = 24) invalide l’hypothèse de normalité et proscrit formellement le recours au test t de Student classique.
Voici la transcription intégrale du tableau d’observations empiriques prêt à être instancié dans la feuille de calcul Microsoft Excel :
| Identifiant Sujet | Groupe Expérimental | Temps de Réaction (ms) |
|---|---|---|
| S01 | Contrôle | 412 |
| S02 | Contrôle | 435 |
| S03 | Contrôle | 458 |
| S04 | Contrôle | 420 |
| S05 | Contrôle | 478 |
| S06 | Contrôle | 395 |
| S07 | Contrôle | 510 |
| S08 | Contrôle | 442 |
| S09 | Contrôle | 460 |
| S10 | Contrôle | 485 |
| S11 | Contrôle | 430 |
| S12 | Contrôle | 465 |
| S13 | Stress | 470 |
| S14 | Stress | 515 |
| S15 | Stress | 540 |
| S16 | Stress | 460 |
| S17 | Stress | 525 |
| S18 | Stress | 580 |
| S19 | Stress | 490 |
| S20 | Stress | 530 |
| S21 | Stress | 475 |
| S22 | Stress | 610 |
| S23 | Stress | 505 |
| S24 | Stress | 565 |
Notons d’emblée la présence intentionnelle d’une valeur identique au sein de ce protocole : le score métrique 460 apparaît simultanément chez le participant S09 (Groupe Contrôle) et le participant S16 (Groupe Stress), offrant un cadre empirique parfait pour illustrer le traitement algorithmique des rangs liés.
6. Calcul pas à pas des rangs via les fonctions natives d’Excel
6.1 Utilisation rigoureuse de la fonction RANG.MOYENNE
Le déploiement rigoureux du test de Mann-Whitney sous Microsoft Excel dépend de la maîtrise syntaxique et conceptuelle des fonctions dédiées à l’évaluation ordinale. Le tableur offre historiquement deux fonctions distinctes d’affectation de rangs : RANG.EQ (ou l’ancienne dénomination RANG) et RANG.MOYENNE (traduction française officielle de la fonction internationale RANK.AVG). La sélection entre ces deux instructions est d’une portée critique déterminante.
La fonction RANG.EQ alloue à l’ensemble des observations ex æquo le rang structural supérieur absolu sans considération de leur dispersion ordinale conjointe. Ainsi, deux observations se disputant les positions séquentielles 4 et 5 se verraient attribuer toutes deux le rang brut 4. Cette modalité brise irrémédiablement le postulat de conservation de la somme théorique globale des rangs formulée par Gauss, faussant de fait l’ensemble des équations analytiques subséquentes de Mann-Whitney. Il est donc impératif de proscrire RANG.EQ et d’exploiter exclusivement et universellement la fonction RANG.MOYENNE.
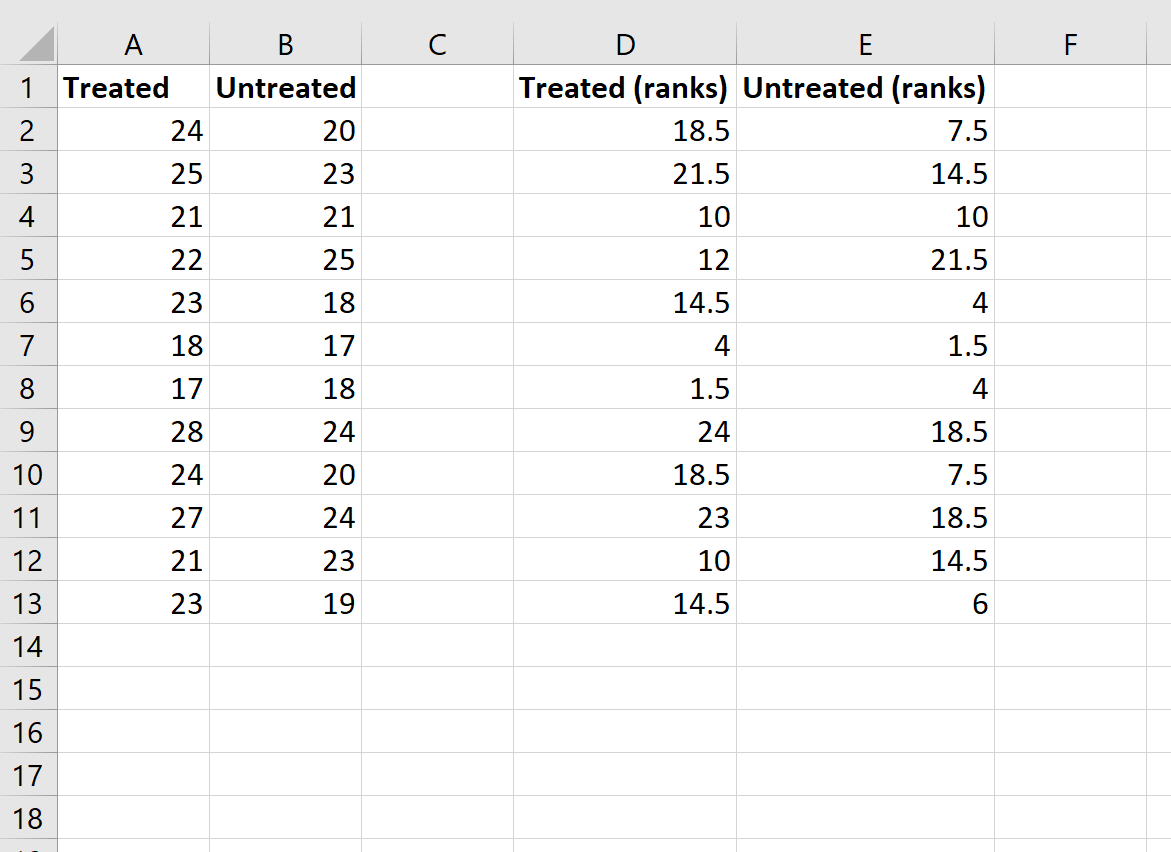
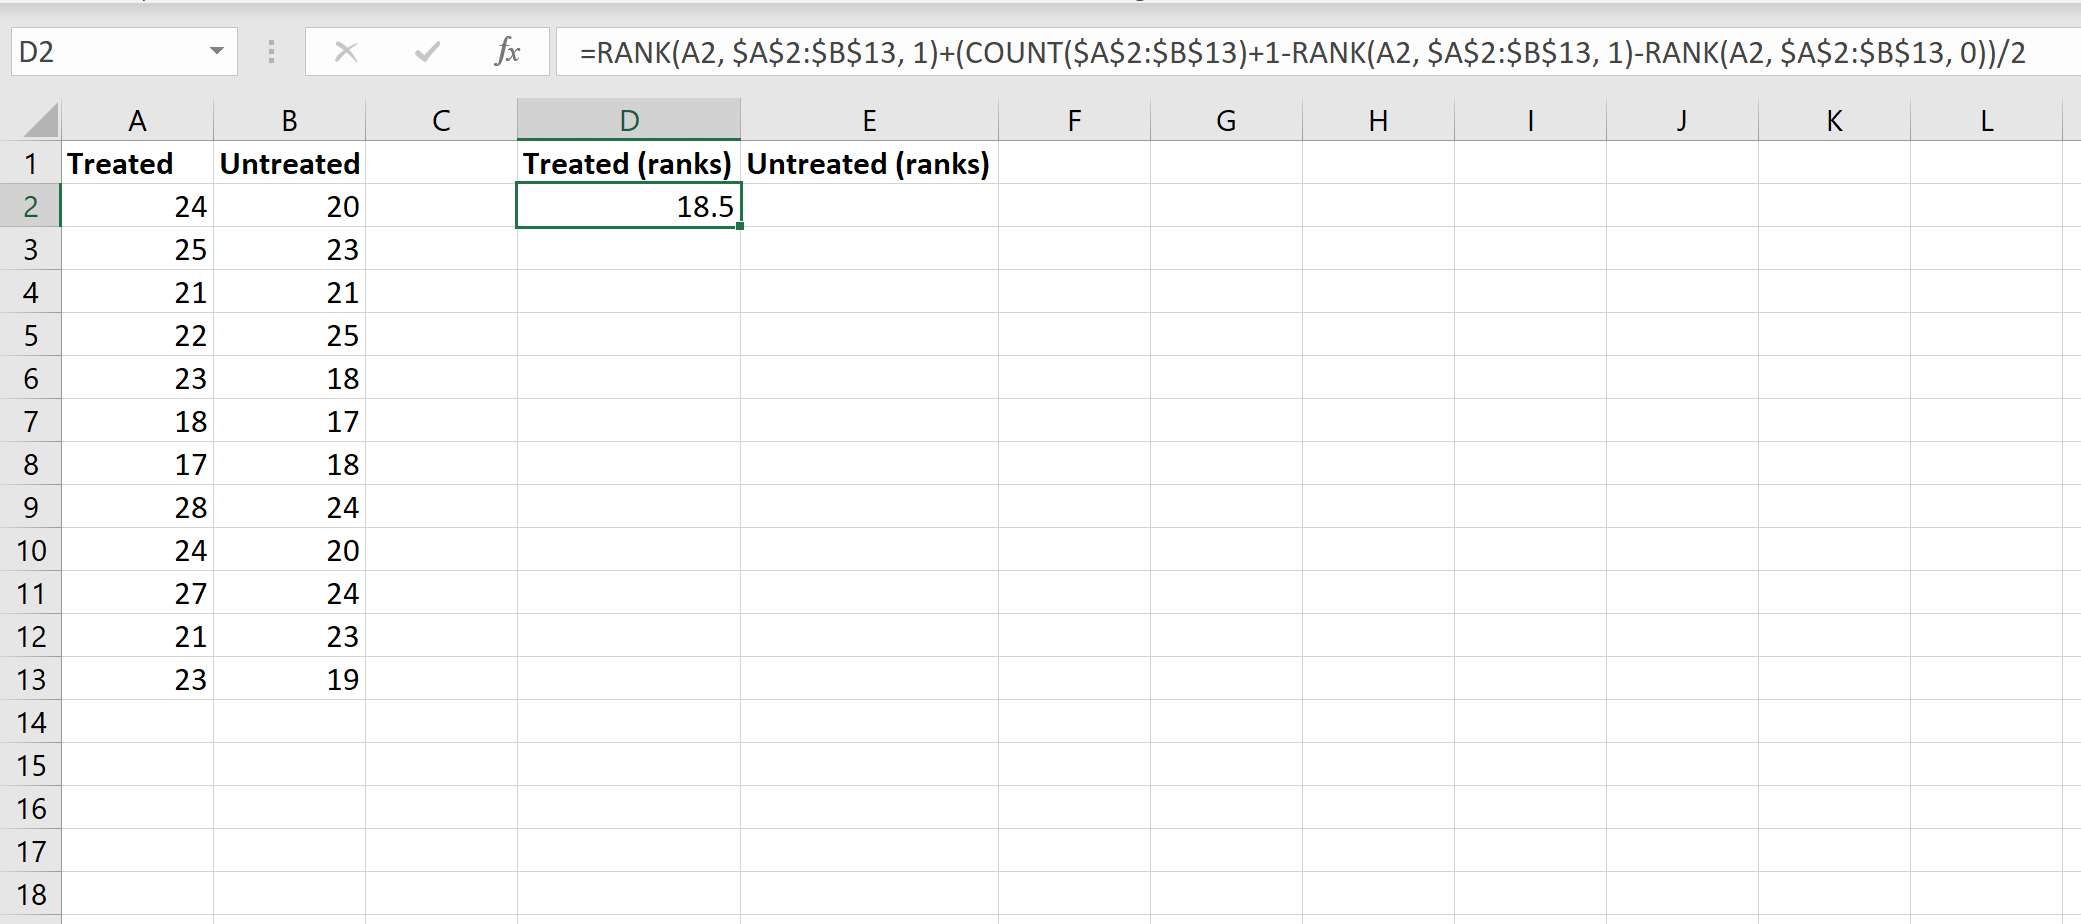
La syntaxe canonique de l’instruction RANG.MOYENNE se décline en trois arguments formels :
=RANG.MOYENNE(nombre; référence; [ordre])
Pour appliquer cette instruction sur notre colonne consolidée de données empiriques (localisée sur la plage de cellules C2:C25), l’analyste se positionne sur la cellule D2 et formule l’expression algorithmique suivante :
=RANG.MOYENNE(C2; $C$2:$C$25; 1)
L’argument C2 désigne la valeur observationnelle individuelle ciblée par l’évaluation ordinale. L’argument $C$2:$C$25 circonscrit le vecteur de référence englobant l’intégralité des observations combinées des deux groupes expérimentaux : l’insertion impérative des symboles $ fige la plage mémoire, garantissant qu’aucun glissement de matrice ne survienne lors de la duplication verticale de la formule. Enfin, le troisième argument est résolument fixé au chiffre 1. Ce paramètre ordonne à Excel d’attribuer les rangs selon un gradient croissant (la plus petite valeur empirique recevant le rang 1). L’omission par défaut de ce paramètre ou l’insertion erronée du chiffre 0 déclencherait un ordonnancement décroissant, inversant artificiellement la direction de la dominance stochastique.
Une fois étirée verticalement jusqu’à la cellule D25, cette formule délivre le rang exact associé à chaque individu. Les scores 460 des sujets S09 et S16, occupant conjointement les positions ordinales 10 et 11 du vecteur global trié, se voient ainsi allouer automatiquement le rang moyen :
(10 + 11) / 2 = 10,5
ce qui valide la conformité mathématique absolue de l’exécution algorithmique sous-jacente.
6.2 Automatisation de la fusion des données sans manipulation manuelle
Dans les versions contemporaines de Microsoft Excel (intégrant le moteur de calcul matriciel dynamique de Microsoft 365 et d’Office 2021), l’analyste n’est plus contraint d’organiser manuellement les données sources en une colonne unique amalgamée. L’émergence des fonctions vectorielles avancées autorise désormais une architecture modulaire et adaptative au sein de laquelle les données des groupes peuvent résider dans des colonnes séparées, tout en étant fusionnées dynamiquement en mémoire vive pour le calcul transverse des rangs.
Supposons que les données brutes du Groupe Contrôle soient hébergées sur la plage A2:A13 et que celles du Groupe Stress résident sur la plage B2:B13. L’instruction matricielle moderne EMPILERV (équivalent français de VSTACK) permet de générer instantanément le vecteur fusionné sans la moindre opération de collage :
=EMPILERV(A2:A13; B2:B13)
Dès lors, pour déterminer directement les rangs associés aux observations du Groupe Contrôle au sein de la matrice globale combinée sans créer physiquement de troisième colonne intermédiaire, l’analyste peut implémenter la formule matricielle suivante en cellule C2, qui se propagera spontanément vers le bas (phénomène de déversement matriciel dynamique ou spillover) :
=RANG.MOYENNE(A2:A13; EMPILERV($A$2:$A$13; $B$2:$B$13); 1)
De façon symétrique, le calcul des rangs affectés aux observations du Groupe Stress s’obtiendra en cellule D2 via l’instruction :
=RANG.MOYENNE(B2:B13; EMPILERV($A$2:$A$13; $B$2:$B$13); 1)
Pour les utilisateurs de versions héritées d’Excel (Excel 2019, 2016, 2013), cette flexibilité matricielle dynamique n’étant pas disponible de façon native, la méthode optimale demeure celle de la consolidation structurée préconisée au chapitre 5 : le regroupement vertical des données au sein d’une table unique normalisée à deux colonnes, complétée par l’indexation matricielle explicite via RANG.MOYENNE.
6.3 Agrégation de la somme des rangs par groupe expérimental
L’obtention des sommes de rangs segmentées par condition expérimentale — grandeurs formalisées par les paramètres R1 et R2 — constitue l’aboutissement de la séquence de traitement ordinale. Cette réduction de données s’opère élégamment via l’application de fonctions conditionnelles natives, éliminant tout risque d’erreur humaine d’assignation manuelle.
Considérant l’architecture standard où la variable de groupement réside dans la colonne B (plage $B$2:$B$25) et les rangs calculés occupent la colonne D (plage $D$2:$D$25), l’analyste dédie deux cellules spécifiques de son tableau de bord computationnel à l’extraction des sommes de rangs :
- Pour la somme des rangs du Groupe Contrôle (R1) en cellule G2 :
=SOMME.SI($B$2:$B$25; "Contrôle"; $D$2:$D$25) - Pour la somme des rangs du Groupe Stress (R2) en cellule G3 :
=SOMME.SI($B$2:$B$25; "Stress"; $D$2:$D$25)
Parallèlement, le dénombrement effectif des unités observationnelles composant chaque sous-groupe expérimental doit être impérativement instrumenté via des fonctions logiques, garantissant l’actualisation dynamique du modèle en cas d’adjonction ultérieure de données participantes :
- Taille d’échantillon du Groupe Contrôle (n1) en cellule H2 :
=NB.SI($B$2:$B$25; "Contrôle") - Taille d’échantillon du Groupe Stress (n2) en cellule H3 :
=NB.SI($B$2:$B$25; "Stress")
Avant d’engager la chaîne calculatoire dans la résolution des statistiques U partielles, un test d’intégrité arithmétique absolu doit être programmé au sein du tableur. Ce garde-fou mathématique exploite l’égalité séculaire régissant la sommation des entiers naturels d’ordre N :
Rtotal = R1 + R2 = [N(N + 1)] / 2
Dans notre cas d’étude (N = 24), la somme combinée théorique des rangs s’établit impérativement à [24 × 25] / 2 = 300. L’analyste matérialise cette vérification logique dans une cellule dédiée en saisissant la formule d’audit booléen :
=SI((G2+G3)=((H2+H3)*(H2+H3+1))/2; "INTÉGRITÉ VALIDÉE"; "ERREUR ARITHMÉTIQUE DÉTECTÉE")
L’exécution de cette formule garantit formellement la préservation des invariants mathématiques et prévient toute corruption ultérieure du protocole inférentiel.
7. Implémentation algorithmique du calcul de U dans la feuille de calcul
7.1 Traduction algébrique des formules de U1 et U2 sous Excel
Dès lors que les paramètres élémentaires (n1, n2, R1, R2) sont séquestrés dans des cellules dédiées parfaitement identifiées du tableur, la résolution analytique des équations structurales de Mann-Whitney s’opère par simple transposition syntaxique des relations algébriques formalisées à la section 4.3.
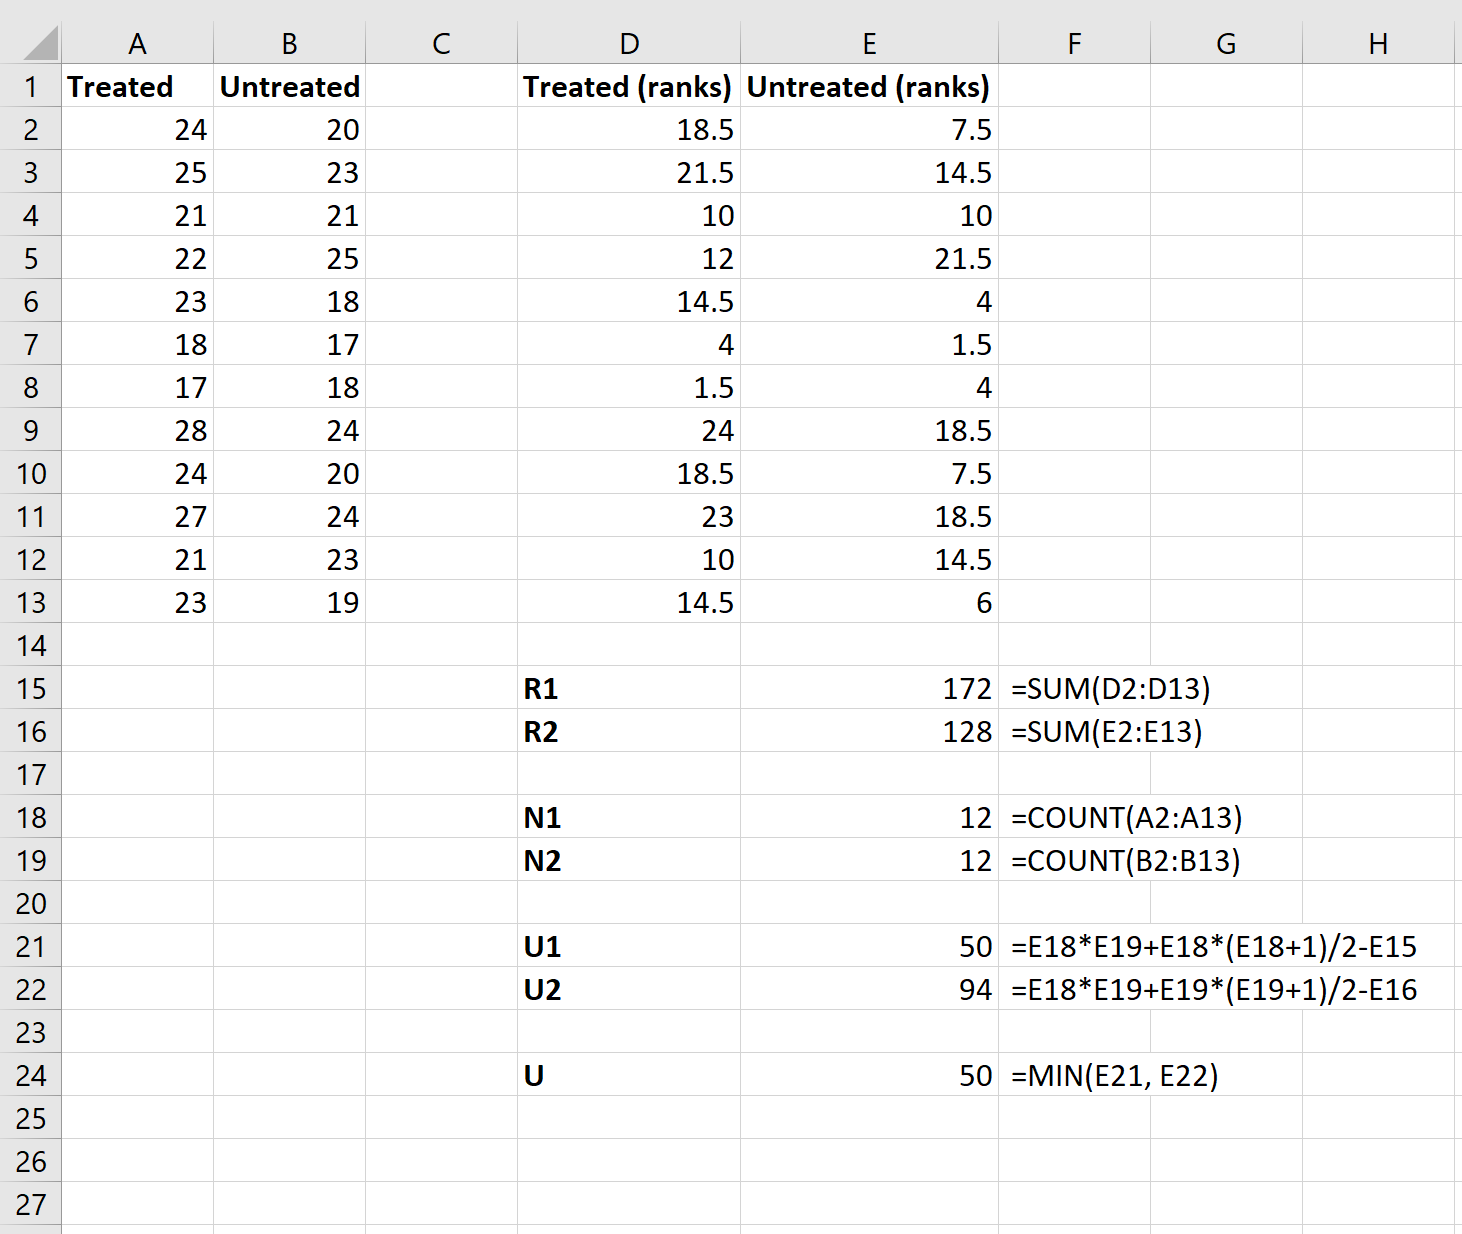
En assignant les adresses de cellules définies précédemment — à savoir H2 pour n1, H3 pour n2, G2 pour R1 et G3 pour R2 —, l’analyste implémente la formule de calcul de la première statistique partielle U1 au sein de la cellule I2 :
=H2*H3 + (H2*(H2+1))/2 - G2
De façon rigoureusement symétrique, la formule déterminant la seconde statistique partielle U2 est instanciée dans la cellule adjacente I3 :
=H2*H3 + (H3*(H3+1))/2 - G3
À ce stade précis de la modélisation, le théorème d’orthogonalité croisée U1 + U2 = n1n2 doit être formellement interrogé par une instruction logique de validation, garantissant que la machinerie algorithmique n’a subi aucune dérive d’opérateur algébrique :
=SI((I2+I3)=(H2*H3); "CONTRÔLE CROISÉ CONFORME"; "ANOMALIE DE RÉSOLUTION U")
Enfin, la détermination de la statistique de décision finale U, destinée à être confrontée aux tables de rejet probabilistes ou aux fonctions de répartition continue, s’obtient au moyen de la fonction standard MIN, insérée en cellule I4 :
=MIN(I2; I3)
Dans notre protocole expérimental appliqué au temps de réaction sous stress :
- Les rangs observés fournissent les sommes empiriques suivantes : R1 = 104,5 (Groupe Contrôle) et R2 = 195,5 (Groupe Stress).
- La constante de Gauss pour chaque groupe s’évalue à : [12 × 13] / 2 = 78.
- L’espace produit inter-groupes s’établit à : 12 × 12 = 144.
- Le calcul matriciel délivre :
U1 = 144 + 78 – 104,5 = 117,5
U2 = 144 + 78 – 195,5 = 26,5 - Le contrôle croisé s’avère parfaitement irréprochable : 117,5 + 26,5 = 144.
- La statistique décisionnelle finale retenue est donc irrévocablement : U = min(117,5 ; 26,5) = 26,5.
7.2 Structuration modulaire d’un panneau de calcul réutilisable
L’efficience opérationnelle en laboratoire quantitatif prescrit de transformer cette chaîne de formules en un panneau de calcul (ou dashboard statistique) pérenne, robuste et réutilisable pour tout jeu de données ultérieur. Cette industrialisation repose sur la modularisation spatiale de la feuille de calcul et l’assignation de noms de plages explicites (gestionnaire de noms d’Excel).
Il est vivement préconisé d’attribuer aux cellules névralgiques les identifiants textuels directs suivants :
- Cellule
H2renommée :n1 - Cellule
H3renommée :n2 - Cellule
G2renommée :R1 - Cellule
G3renommée :R2 - Cellule
I2renommée :U1_stat - Cellule
I3renommée :U2_stat - Cellule
I4renommée :U_test
Cette standardisation confère aux équations sous-jacentes une clarté sémantique absolue : l’expression du calcul de U devient lisiblement =MIN(U1_stat; U2_stat), neutralisant tout risque d’erreur d’interprétation lors des audits de code ou des revues de pairs.
En outre, il convient d’instaurer des mécanismes de protection passive de l’architecture logicielle :
- Verrouillage cellulaire : Les zones hébergeant les formules analytiques doivent être verrouillées (via l’onglet Format de cellule > Protection), puis la feuille protégée par mot de passe, ne laissant libres d’édition que les seules colonnes réservées à la saisie des données brutes des participants.
- Mise en forme conditionnelle dynamique : Configurer des alertes visuelles (ex. coloration en rouge vif de la cellule d’audit) dès lors qu’un écart numérique est détecté au sein du théorème de vérification croisée.
8. Inférence statistique pour petits échantillons : Approche par table critique
8.1 Théorie de la distribution exacte de la statistique de Mann-Whitney
L’inférence statistique sur de petits échantillons (typiquement lorsque n1 et n2 sont inférieurs à 20) obéit à des règles mathématiques strictes qui proscrivent l’usage des lois continues fermées. Pour ces effectifs réduits, la statistique de Mann-Whitney ne suit pas une loi de Gauss, mais une distribution d’échantillonnage combinatoire discrète finie, générée par le dénombrement exhaustif de toutes les permutations équiprobables envisageables pour l’assignation des rangs.
Le nombre total de configurations distinctes selon lesquelles n1 rangs peuvent être extraits d’un méta-ensemble de N rangs correspond formellement au coefficient binomial :
CNn1 = N! / [n1! (N – n1)!]
Dans le cadre strict de notre expérimentation cognitive où n1 = 12 et N = 24, le nombre d’arrangements combinatoires équiprobables sous l’hypothèse nulle s’élève exactement à 2 704 156 permutations possibles. La fonction de masse de probabilité exacte associe à chaque valeur entière possible de la statistique u la proportion relative de ces permutations combinatoires pour lesquelles la somme des rangs génère une valeur de U inférieure ou égale à cette cible.
Microsoft Excel ne dispose nativement d’aucun algorithme combinatoire matriciel capable de résoudre à la volée ces dénombrements factoriels titanesques sans saturer la pile mémoire du tableur ou imposer le recours à un code VBA lourd. Dès lors, substituer prématurément une approximation continue normale à cette réalité combinatoire exacte sur des effectifs de l’ordre de 10 à 15 unités par groupe induit un biais d’estimation de la p-valeur hautement préjudiciable à la rigueur méthodologique du protocole expérimental.
8.2 Intégration et lecture d’une table de valeurs critiques sous Excel
Pour contourner élégamment cette carence algorithmique native tout en conservant une rigueur scientifique irréprochable au sein de la feuille de calcul, la méthodologie préconisée consiste à importer et matricialiser une table des valeurs critiques exactes de Mann-Whitney au sein d’un onglet technique dédié de la feuille Excel (dénommé par exemple Table_Critique_MW).
Cette table matricielle est traditionnellement agencée selon une grille bidirectionnelle standardisée, calibrée pour un niveau d’erreur de première espèce α conventionnel (ex. α = 0,05 en test bilatéral ou α = 0,025 en test unilatéral) :
- L’axe horizontal (en-têtes de colonnes) répertorie la taille de l’échantillon n1 (balayant les valeurs de 3 à 20).
- L’axe vertical (en-têtes de lignes) répertorie la taille de l’échantillon n2 (balayant les valeurs de 3 à 20).
- Les intersections cellulaires délivrent la borne entière critique supérieure admissible, notée Ucritique.
Le principe décisionnel fondamental du test U de Mann-Whitney est univoque et requiert une vigilance absolue de l’opérateur : à la différence du test t de Student où le rejet de l’hypothèse nulle s’opère lorsque la statistique empirique excède la valeur critique (tobs ≥ tcrit), le rejet de l’hypothèse nulle dans le test U intervient lorsque la statistique minimale observée est inférieure ou strictement égale à la valeur critique tabulée :
Décision : Rejet de H0 si et seulement si Uobservé ≤ Ucritique
Pour automatiser l’interrogation dynamique de cette table critique externe sans manipulation visuelle manuelle, l’analyste implémente au sein du panneau de contrôle une formule combinant les fonctions d’indexation vectorielle INDEX et EQUIV, ou plus élégamment la fonction moderne RECHERCHEX :
=INDEX(Table_Critique_MW!$B$2:$S$19; EQUIV(n2; Table_Critique_MW!$A$2:$A$19; 0); EQUIV(n1; Table_Critique_MW!$B$1:$S$1; 0))
Dans notre cas expérimental (n1 = 12, n2 = 12, seuil bilatéral α = 0,05), la consultation dynamique de la table critique normalisée délivre la valeur seuil :
Ucritique = 37
8.3 Arbre de décision logique automatisé dans le tableur
L’intégration de la logique inférentielle au sein du tableur se matérialise par une structure conditionnelle automatisée générant un verdict épistémologique explicite en langage naturel, affranchissant l’analyste de toute ambiguïté interprétative.
En hébergeant la statistique calculée Utest en cellule I4 et la valeur de référence Ucritique extraite de la matrice en cellule I5, l’expression algorithmique gouvernant la décision scientifique se formule comme suit :
=SI(I4<=I5; "Rejet de H0 : Différence stochastique statistiquement significative (p < 0,05)"; "Maintien de H0 : Absence d'effet stochastique significatif (p > 0,05)")
Dans notre étude sur le temps de réaction cognitive :
- Uobservé = 26,5
- Ucritique (α = 0,05, bilatéral) = 37
- La condition critique 26,5 ≤ 37 étant rigoureusement satisfaite, le moteur logique renvoie instantanément le verdict de rejet péremptoire de l’hypothèse nulle d’indifférence.
Il importe toutefois de souligner une précaution méthodologique majeure : lorsque la valeur calculée de U borde de manière infinitésimale la frontière critique (par exemple une valeur empirique de 36 ou 37 face à un seuil à 37), l’approximation discrète induit une imprécision marginale quant au risque alpha réel consenti. Dans cette frange d’indécision extrême, l’analyste consciencieux devra consigner explicitement dans son compte-rendu la proximité immédiate de la borne critique et corroborer ses conclusions par le calcul de la taille d’effet.
9. Approximation asymptotique normale pour grands échantillons
9.1 Théorème central limite appliqué à la distribution des rangs
Dès lors que la taille des cohortes expérimentales s’étoffe — conventionnellement lorsque les effectifs de sous-groupes n1 et n2 excèdent tous deux 20 unités, ou lorsque la taille totale combinée N dépasse 40 sujets —, l’exploration combinatoire discrète cède le pas à la modélisation asymptotique continue. En vertu des principes fondamentaux régissant le théorème central limite, la distribution d’échantillonnage de la statistique discrète U converge avec une rapidité remarquable vers une loi normale continue standardisée.
Cette convergence vers la normalité permet de modéliser le comportement de la distribution de Mann-Whitney à travers la dérivation analytique exacte de son espérance mathématique théorique (μU) et de son écart-type d’échantillonnage (σU).
L’espérance mathématique de la distribution d’échantillonnage sous l’hypothèse nulle est rigoureusement définie par le produit moyen des dimensions factorielles :
μU = (n1 × n2) / 2
Cette constante théorique représente le point de neutralité géométrique parfait de la distribution, correspondant à une situation d’équité probabiliste absolue où aucun des deux groupes ne manifeste de suprématie ordinale sur son homologue.
En l’absence formelle de valeurs ex æquo au sein de la série conjointe fusionnée, la variance théorique sous-jacente de la distribution s’exprime par l’équation canonique :
σU2 = [n1n2(n1 + n2 + 1)] / 12
Dans l’éventualité où la série empirique héberge une proportion substantielle de rangs liés, la variance ci-dessus subit une contraction mathématique qu’il convient de compenser par l’application d’un terme correctif normalisé. L’équation de la variance asymptotique ajustée s’écrit alors formellement :
σU_ajusté2 = [n1n2 / (12 × N(N – 1))] × [N3 – N – ∑k=1g (tk3 – tk)]
où N = n1 + n2, g figure le nombre total de groupes de valeurs ex æquo distincts, et tk représente l’effectif d’observations composant le k-ième agrégat de valeurs identiques. Néanmoins, sauf en présence d’une proportion massive de liens excédant 25 à 30 % de la masse globale des données, la variance standard non corrigée fournit une approximation d’une précision tout à fait acceptable pour l’investigation empirique standard.
9.2 Standardisation en score Z et correction de continuité
L’opération de standardisation vise à convertir l’écart séparant la statistique observée U de son espérance théorique sous H0 en une unité métrique universelle : le score réduit Z de la loi normale centrée réduite.
Puisque nous opérons la transition méthodologique d’une distribution discrète finie (par paliers entiers ou demi-entiers) vers une distribution théorique continue infinie, la rigueur computationnelle impose l’application d’une correction de continuité (dite correction de continuité de Yates). Cette correction consiste à retrancher ou adjoindre une demi-unité discrète (0,5) à l’écart absolu séparant la statistique empirique de son espérance, amortissant le biais d’évaluation intégrale. L’expression analytique du score standardisé s’établit dès lors sous la forme :
Z = (|U – μU| – 0,5) / σU
Pour implémenter cette machinerie computationnelle au sein d’une cellule unique et hautement sécurisée d’Excel (cellule I6), en mobilisant nos cellules nommées U_test, n1 et n2, l’analyste formule la syntaxe matricielle consolidée suivante :
=(ABS(U_test - (n1*n2)/2) - 0,5) / RACINE((n1*n2*(n1+n2+1))/12)
Analysons scrupuleusement le déroulement calculatoire pour notre expérimentation :
- Espérance théorique : μU = (12 × 12) / 2 = 72
- Variance théorique standard : σU2 = [12 × 12 × (12 + 12 + 1)] / 12 = [144 × 25] / 12 = 300
- Écart-type théorique : σU = √300 ≈ 17,3205
- Écart absolu à la moyenne : |26,5 – 72| = 45,5
- Application de la correction de continuité au numérateur : 45,5 – 0,5 = 45,0
- Calcul du score standardisé : Z = 45,0 / 17,3205 ≈ 2,5981
Le signe algébrique de Z porte une charge sémantique déterminante. Si l’analyste préserve l’orientation directionnelle en omettant la valeur absolue lors de l’estimation de la supériorité d’un groupe précis, un score Z positif reflétera une dominance stochastique de la condition ciblée, tandis qu’un score Z négatif témoignera de son infériorité ordinale.
9.3 Calcul de la p-valeur exacte par les fonctions de distribution normale
L’estimation de la probabilité asymptotique associée — la p-valeur — s’effectue via l’invocation des fonctions de distribution cumulative de la loi normale nativement intégrées à Microsoft Excel. L’instruction moderne et normalisée retenue est LOI.NORMALE.STANDARD.N (équivalent de NORM.S.DIST dans les versions internationales).
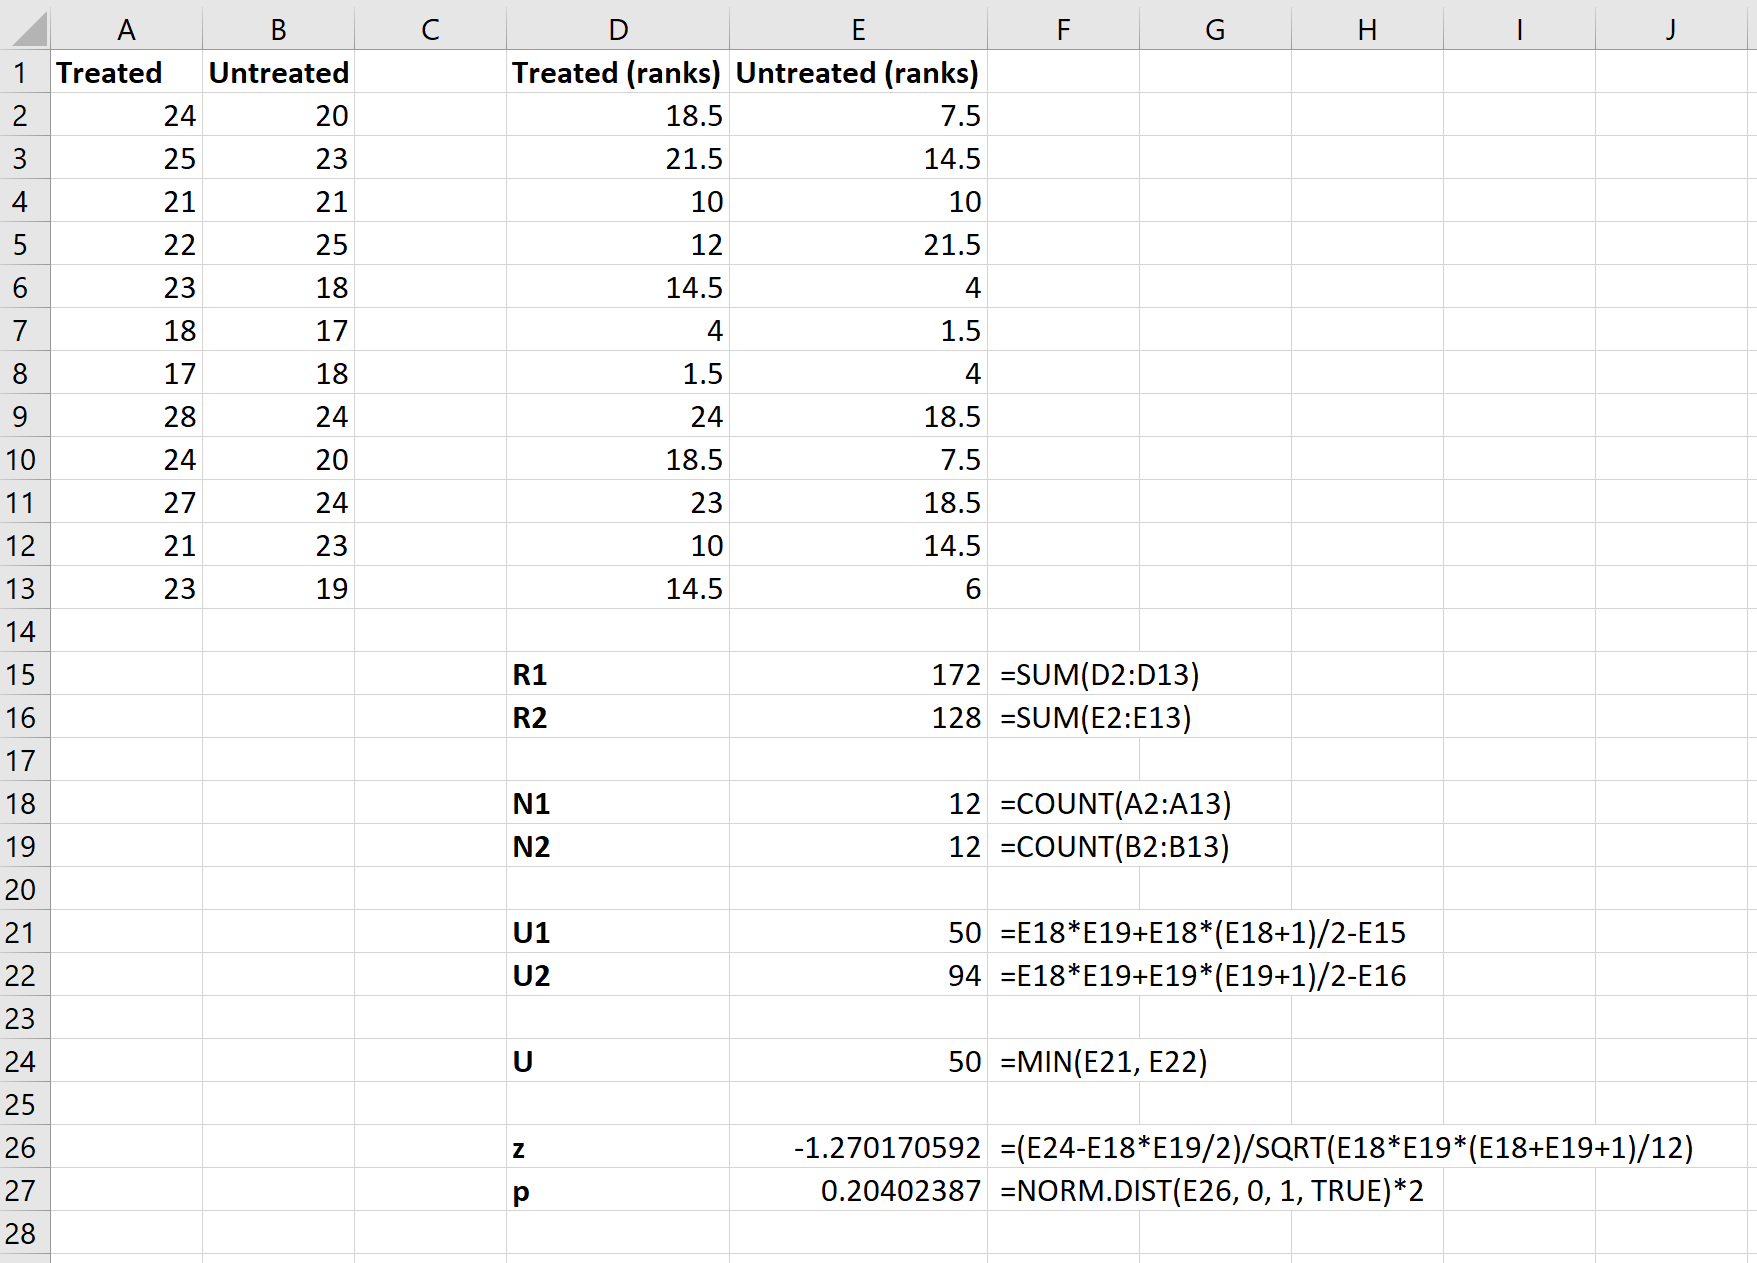
La syntaxe de base de cette fonction comporte deux arguments formels :
=LOI.NORMALE.STANDARD.N(z; cumulatif)
Le second paramètre doit impérativement être configuré sur VRAI afin d’obtenir l’intégrale de la surface sous la courbe de densité depuis l’infini négatif jusqu’au point d’évaluation z.
Pour formaliser l’évaluation probabiliste dans le cadre d’un test bilatéral (l’approche conventionnelle par défaut), où l’écart stochastique est testé symétriquement aux deux extrémités extrêmes de la courbe de Gauss, la formule Excel universelle s’implémente en cellule I7 comme suit :
=2 * (1 - LOI.NORMALE.STANDARD.N(ABS(I6); VRAI))
Dans l’hypothèse où le chercheur aurait posé une hypothèse unilatérale rigoureusement prédéterminée en amont de la récolte des données empiriques, l’expression mathématique s’ajuste pour évaluer l’aire unilatérale résiduelle :
=1 - LOI.NORMALE.STANDARD.N(ABS(I6); VRAI)
Reprenant notre valeur de score standardisé Z = 2,5981 :
LOI.NORMALE.STANDARD.N(2,5981; VRAI)renvoie la valeur d’intégration cumulative 0,9953.- La surface résiduelle unilatérale s’évalue à : 1 – 0,9953 = 0,0047.
- La multiplication par 2 pour le calcul bilatéral délivre la p-valeur asymptotique définitive :
p = 2 × 0,0047 = 0,0094 (soit p = 0,009).
La formalisation académique des résultats sous le standard APA proscrit l’affichage de mentions simplistes telles que « p = 0,000 » ou de sorties de tableur brutes sans formatage. L’analyste intégrera une règle de typographie scientifique au sein de la cellule de reporting en utilisant l’instruction de concaténation conditionnelle :
=SI(I7<0,001; "p < 0,001"; "p = " & TEXTE(I7; "0,000"))
Dans notre cas d’étude, la cellule affichera avec une élégance typographique parfaite la chaîne éditoriale p = 0,009, confirmant au seuil α = 0,01 l’hétérogénéité stochastique hautement significative des temps de réaction sous induction de stress.
10. Quantification de la taille d’effet et métriques d’impact en psychologie
10.1 Calcul du coefficient de corrélation de rang r de Rosenthal
L’adhésion aux préconisations contemporaines de la science ouverte et aux directives méthodologiques de l’American Psychological Association (APA) impose de ne jamais circonscrire la restitution d’un test statistique à la seule déclaration d’une p-valeur. La significativité statistique ne renseigne en rien sur la magnitude concrète de la divergence observée : un écart infinitésimal et dénué de toute portée clinique ou théorique peut franchir les seuils de significativité conventionnels dès lors que la taille globale d’échantillonnage est massive. Inversement, un effet puissant peut demeurer non significatif au sein d’une cohorte réduite. Cette dissociation fondamentale exige la quantification standardisée de la taille d’effet (effect size).
Pour le test non paramétrique de Mann-Whitney, l’indicateur d’impact le plus universellement reconnu et recommandé par les méta-analystes est le coefficient de corrélation de rang biseriel de Rosenthal, conventionnellement noté r. Cette métrique standardisée s’obtient par la normalisation du score réduit Z en fonction de la racine carrée de la taille totale de l’échantillon combiné :
r = |Z| / √Ntotal = |Z| / √(n1 + n2)
L’implémentation algorithmique de cette grandeur au sein de la feuille de calcul s’exécute avec une remarquable simplicité en cellule I8 :
=ABS(I6) / RACINE(n1 + n2)
L’interprétation théorique de cet indice s’adosse aux critères de calibration universellement adoptés dans les sciences psychosociales, initialement théorisés par Jacob Cohen pour les coefficients de corrélation linéaire :
- |r| ≈ 0,10 : Effet de faible magnitude (impact subtil).
- |r| ≈ 0,30 : Effet de magnitude moyenne (impact substantiel perceptible).
- |r| ≥ 0,50 : Effet de forte magnitude (impact massif sur le phénomène étudié).
Pour notre expérimentation sur les performances attentionnelles sous stress :
- Z = 2,5981 et N = 24
- r = 2,5981 / √24 = 2,5981 / 4,89898 ≈ 0,5303
Cet indice s’élevant à r = 0,53 atteste indubitablement d’un effet expérimental de forte amplitude. La manipulation du stress aigu n’exerce pas simplement une influence marginale sur les temps de traitement cognitif ; elle structure de manière déterminante l’ordonnancement hiérarchique des latences psychomotrices au sein de la cohorte étudiée.
10.2 Probabilité de supériorité (Common Language Effect Size)
Bien que le coefficient r de Rosenthal réponde aux exigences académiques formelles, il demeure d’une interprétation souvent abstraite pour les praticiens de terrain, les décideurs institutionnels ou les patients engagés dans des démarches cliniques. Pour pallier cette barrière heuristique, le statisticien Kenneth McGraw et ses collègues ont théorisé la métrique d’impact en langage commun (Common Language Effect Size – CLES), également formalisée dans la littérature sous le vocable de « probabilité de supériorité » (Â ou A de Vargha-Delaney).
La probabilité de supériorité offre une lisibilité conceptuelle immédiate : elle quantifie la probabilité probabiliste exacte qu’une observation extraite au hasard au sein du premier groupe excède la valeur d’une observation prélevée aléatoirement au sein du second groupe lors d’un appariement stochastique par paires :
CLES = P(X > Y)
Dans l’écosystème algorithmique de Mann-Whitney, cette grandeur d’une puissance pédagogique exceptionnelle découle directement et sans le moindre détour computationnel de la statistique partielle U :
CLES1 = U1 / (n1 × n2)
La transcription sous Microsoft Excel s’implémente immédiatement en cellule I9 par l’expression :
=I2 / (n1 * n2)
Les propriétés interprétatives de cette métrique sont d’une transparence absolue :
- Une valeur CLES rigoureusement égale à 0,50 incarne l’absence totale de supériorité stochastique (les deux distributions se superposent parfaitement, équivalant à un tirage à pile ou face).
- Une valeur s’élevant vers 1,00 traduit une supériorité unilatérale absolue du groupe 1 sur le groupe 2.
- Une valeur glissant vers 0,00 documente une infériorité structurelle totale du groupe 1 (et corrélativement une dominance absolue du groupe 2).
Dans notre cas pratique appliqué au stress :
CLES1 = U1 / (n1n2) = 117,5 / 144 ≈ 0,8160
Ce résultat stipule qu’il existe une probabilité de 81,6 % que le temps de réaction d’un individu soumis à la condition de stress psychosocial aigu soit supérieur à celui d’un individu évoluant en condition témoin neutre. Cette transcription confère aux conclusions scientifiques un ancrage empirique saisissant et immédiatement compréhensible pour l’ensemble de la communauté clinique.
10.3 Intervalles de confiance pour la différence de localisation
Dans le paradigme des normes de publication modernes (notamment formalisées par le bureau éditorial de l’APA), l’accompagnement des tailles d’effet par leurs intervalles de confiance à 95 % respectifs s’affirme comme une exigence méthodologique majeure. Pour le test de Mann-Whitney, l’estimateur de décalage ponctuel de référence est l’estimateur de localisation de Hodges-Lehmann (ΔHL).
L’estimateur de Hodges-Lehmann est défini sur le plan théorique comme la médiane arithmétique de l’ensemble de toutes les différences par paires formables entre les observations du premier groupe et les observations du second groupe :
ΔHL = médiane { xi – yj }, avec 1 ≤ i ≤ n1 et 1 ≤ j ≤ n2
La détermination manuelle de cet estimateur et de ses bornes de confiance exactes sous une version standard de Microsoft Excel impose la construction matricielle d’un tableau croisé de dimensions n1 × n2 calculant exhaustivement les 144 différences élémentaires (dans notre exemple), avant d’appliquer la fonction MEDIANE sur l’ensemble de la plage matricielle ainsi déployée.
Pour l’analyste contraint par l’espace de sa feuille de calcul, une approximation pragmatique acceptable consiste à rapporter conjointement aux métriques r et CLES la différence brute observée entre les médianes empiriques des deux échantillons indépendants, encadrée par l’écart interquartile (EIQ ou IQR) de chaque groupe calculé via les fonctions natives QUARTILE.INC(plage; 3) - QUARTILE.INC(plage; 1), garantissant une transparence descriptive totale conforme aux attentes des comités de lecture internationaux.
11. Visualisation avancée et restitution graphique sous Excel
11.1 Conception de diagrammes en boîte à moustaches (Boxplots) scientifiques
L’adage méthodologique voulant qu’une représentation graphique rigoureuse vaille mille coefficients statistiques trouve son accomplissement idéal dans l’usage des diagrammes en boîte à moustaches (boxplots). Pour restituer fidèlement l’information issue d’un test non paramétrique, le diagramme en boîte surpasse irrémédiablement le traditionnel graphique à barres (bar chart) : ce dernier dissimule totalement l’asymétrie de distribution, occulte les valeurs extrêmes et suggère abusivement une symétrie gaussienne illusoire centrée autour d’une moyenne arithmétique.
Depuis la mouture Excel 2016, Microsoft intègre nativement le moteur graphique « Boîte et moustaches ». Pour générer une visualisation scientifique selon l’art :
- Sélectionnez l’intégralité de la matrice structurée au format tabulaire long (Plage
B1:C25regroupant la colonne de labellisation des groupes et la colonne des temps de réaction continus). - Naviguez vers l’onglet Insertion du ruban principal, déployez le menu des graphiques statistiques et sélectionnez l’icône Boîte et moustaches.
- Le moteur génère spontanément deux structures en boîtes distinctes juxtaposées sur l’axe des abscisses, alignées verticalement sur l’échelle commune des millisecondes.
Pour conformer la visualisation aux exigences esthétiques des revues à fort facteur d’impact, une reconfiguration des paramètres par défaut est impérative :
- Sélectionnez la série graphique par un double-clic pour ouvrir le volet Format de la série de données.
- Sous la rubrique Options des séries, désactivez impérativement la case à cocher « Afficher les points intérieurs » si vous prévoyez une superposition de points spécifiques, mais conservez impérativement cochée la case « Afficher les valeurs hors limites » (afin d’identifier immédiatement les valeurs aberrantes au-delà de 1,5 fois l’écart interquartile).
- Cochez l’option « Afficher les marqueurs de moyenne » : l’apparition d’une croix discrète signalant la moyenne arithmétique au sein de la boîte permet d’apprécier visuellement l’ampleur du décrochage spatial entre la moyenne et la ligne transversale figurant la médiane, offrant un témoignage éclatant du degré d’asymétrie de distribution qui justifie méthodologiquement le recours au test U de Mann-Whitney.
11.2 Représentation visuelle des rangs moyens et distributions cumulées
Bien que le boxplot illustre avec brio les grandeurs métriques réelles, il ne restitue pas directement la réalité mathématique sur laquelle a opéré le test U : l’ordonnancement hiérarchique des rangs relatifs. Pour combler ce déficit iconographique, la conception d’un graphique à barres comparatif représentant les rangs moyens attribués à chaque groupe constitue une stratégie éditoriale hautement pertinente.
Le calcul des rangs moyens s’établit directement au sein du panneau de contrôle par les formules :
- Rang moyen Contrôle :
=G2 / H2(soit 104,5 / 12 = 8,71) - Rang moyen Stress :
=G3 / H3(soit 195,5 / 12 = 16,29)
La génération d’un graphique à colonnes épuré confrontant ces deux grandeurs permet de matérialiser visuellement la translation stochastique opérée par la variable indépendante : le groupe stress exhibe un rang moyen quasiment deux fois supérieur à celui de la condition témoin, offrant une métaphore visuelle directe de la supériorité statistique modélisée par le test de Wilcoxon-Mann-Whitney.
Une alternative visuelle sophistiquée consiste à tracer les courbes de fonctions de distribution cumulée empirique (courbes ogivales). En positionnant l’échelle des temps de réaction sur l’axe horizontal et le pourcentage cumulé d’individus sur l’axe vertical, l’analyste obtient deux courbes distinctes. La dominance stochastique du groupe stress se traduit graphiquement par le glissement intégral de sa courbe cumulative vers la droite de l’espace vectoriel, matérialisant le postulat fondamental F1(x) ≠ F2(x).
Dans l’élaboration de ces figures, le choix des palettes chromatiques doit impérativement respecter les règles internationales d’accessibilité : proscrire les contrastes rouge-vert au profit de palettes optimisées pour les lecteurs daltoniens (telles que les échelles viridis, cividis ou des contrastes bleu soutenu versus gris anthracite neutre), assurant une lisibilité intégrale lors des impressions monochromes en niveaux de gris.
11.3 Mise en page selon les normes typographiques de l’APA (7e édition)
L’American Psychological Association codifie de manière extrêmement rigoureuse l’esthétique et la structure des illustrations scientifiques au sein du chapitre 7 de son manuel officiel (7e édition). Un graphique généré par les réglages par défaut de Microsoft Excel est immédiatement identifiable par son esthétique commerciale, prohibée dans un manuscrit académique soumis à un comité de lecture.
Le protocole de nettoyage graphique pour mise en conformité APA 7 sous Excel requiert les interventions systématiques suivantes :
- Suppression des fioritures visuelles : Éliminer impérativement l’ensemble du quadrillage horizontal et vertical en arrière-plan (gridlines). Supprimer la bordure d’encadrement extérieure du graphique (configurer le contour de la zone de graphique sur « Aucun trait ») et supprimer tout remplissage d’arrière-plan (« Aucun remplissage » afin de garantir un fond blanc immaculé).
- Standardisation typographique : L’intégralité des textes intégrés au graphique (titres d’axes, étiquettes de graduation) doit être uniformisée à l’aide d’une police sans empattement unique et hautement lisible, telle qu’Arial, Calibri ou Helvetica, configurée dans un corps typographique compris entre 9 et 11 points, en appliquant une couleur de police noire unie ou gris très sombre (#222222), en proscrivant les dégradés.
- Structure des axes : L’axe vertical des ordonnées doit être explicitement matérialisé par une ligne continue noire d’une épaisseur de 1 point, assortie de graduations extérieures visibles orientées vers l’extérieur de la zone de traçage. Les titres des axes doivent obligatoirement mentionner la nature de la variable et son unité métrique entre parenthèses : ex. « Temps de réaction moyen (ms) ».
- Autonomie de la légende : Les normes APA proscrivent l’insertion du titre de la figure à l’intérieur du cadre graphique. Le graphique doit être exporté nu, puis coiffé dans le document texte final par le libellé formel en gras « Figure 1 », suivi sur la ligne inférieure d’un titre descriptif en italique, et complété au bas par une note textuelle explicative autonome (« Note. Les boîtes délimitent les quartiles… »).
12. Protocole de rédaction académique, validation et automatisation avancée
12.1 Rédaction des résultats dans le corps de texte (Normes APA 7)
La transcription narrative des résultats d’un test U de Mann-Whitney au sein de la section « Résultats » d’une publication scientifique obéit à un canevas formel standardisé garantissant la reproductibilité méthodologique et la précision statistique. Les normes APA 7 prescrivent de rapporter conjointement la statistique de rang U, la valeur standardisée asymptotique Z (si N ≥ 20), la p-valeur exacte bilatérale, ainsi que la métrique de taille d’effet standardisée.
L’un des écueils d’écriture les plus répandus et les plus sévèrement sanctionnés par les réviseurs universitaires consiste à documenter un test non paramétrique en rapportant exclusivement des moyennes arithmétiques et des écarts-types paramétriques. Ces indices métriques déforment la réalité d’une distribution asymétrique : l’analyste a l’obligation méthodologique formelle de fournir la médiane (Md) ainsi que l’écart interquartile (EIQ ou IQR) pour chacun des sous-groupes expérimentaux.
Voici le modèle de rédaction académique standardisé et exhaustif pour notre cas d’étude sur le temps de réaction cognitive sous stress :
« Afin d’évaluer l’impact de l’induction d’un stress psychosocial aigu sur l’efficience du contrôle exécutif, un test U de Mann-Whitney pour échantillons indépendants a été conduit sur les latences attentionnelles. L’analyse révèle une différence stochastique statistiquement significative entre les deux conditions expérimentales, U = 26,50, Z = 2,60, p = 0,009, avec une taille d’effet de forte magnitude selon les critères de Cohen, r = 0,53, correspondant à une probabilité de supériorité en langage commun (CLES) de 81,6 %. Plus précisément, les participants soumis à la condition de stress aigu présentent des temps de réaction significativement plus longs (Md = 517,50 ms, EIQ = 68,75 ms) comparativement aux participants de la condition contrôle neutre (Md = 438,50 ms, EIQ = 36,25 ms). Ces résultats attestent d’une altération substantielle de la vitesse de traitement exécutif induite par la charge émotionnelle anxiogène. »
Cette formulation condense avec une rigueur absolue l’intégralité des métriques inférentielles, descriptives et fonctionnelles requises par les comités de rédaction des revues internationales de premier rang.
12.2 Diagnostic des anomalies de calcul et erreurs méthodologiques fréquentes
L’instrumentation du test U de Mann-Whitney au sein d’un tableur non dédié comme Excel recèle de multiples chausse-trappes computationnelles. L’analyste doit impérativement exécuter une revue d’audit méthodologique en s’assurant d’avoir évité les quatre erreurs critiques les plus récurrentes documentées dans la pratique de laboratoire :
- Erreur n° 1 : L’utilisation pernicieuse de la fonction
RANG.EQau détriment deRANG.MOYENNE. L’allocation d’un rang discret identique à des valeurs ex æquo sans fractionnement moyen arithmétique tronque la somme théorique globale des rangs. Conséquence : la vérification croisée U1 + U2 = n1n2 échoue systématiquement, et la p-valeur issue de cette distorsion est faussée de manière imprévisible. - Erreur n° 2 : L’inversion de la statistique de décision U. La théorie décisionnelle de Mann-Whitney exige d’interroger impérativement la valeur minimale du couple : U = min(U1, U2). Omettre cette sélection et tester arbitrairement U1 face aux tables critiques ou aux fonctions unilatérales génère une discordance aberrante lorsque le groupe 1 présente une somme de rangs surélevée, conduisant à accepter fallacieusement l’hypothèse nulle d’indifférence stochastique par confusion entre les queues de distribution.
- Erreur n° 3 : L’omission de la correction de continuité sur échantillons limites. Dès lors que la taille globale d’échantillonnage navigue dans la zone grise comprise entre 20 et 40 unités, ignorer la déduction de 0,5 au numérateur du score Z gonfle artificiellement la statistique standardisée, augmentant insidieusement le taux d’erreur de type I au-delà du seuil nominal conventionnel de 5 %.
- Erreur n° 4 : Discordance entre le signe algébrique de Z et la direction de l’effet unilatéral. Lors de l’évaluation d’une hypothèse orientée, le chercheur formule souvent une attente directionnelle précise. Calculer un score standardisé en valeur absolue sans s’assurer que la trajectoire empirique des médianes et des rangs moyens coïncide rigoureusement avec le sens prédit par l’hypothèse théorique peut aboutir à proclamer la validation d’une découverte alors même que l’effet expérimental observé s’est produit dans le sens diamétralement opposé à la prédiction initiale.
12.3 Automatisation pérenne : Macro VBA et modèle de classeur dynamique
Afin de pérenniser la démarche, de prévenir toute dérive de saisie manuelle et d’offrir à une équipe de recherche un instrument de calcul infaillible et instantané, l’encapsulation de l’algorithme sous forme d’une fonction personnalisée VBA (User Defined Function – UDF) constitue la solution d’ingénierie logicielle ultime sous Microsoft Excel.
En accédant à l’éditeur Visual Basic pour Applications (raccourci clavier Alt + F11), l’insertion d’un module de code standard permet d’intégrer la fonction optimisée suivante :
Cette routine d’automatisation analyse deux plages vectorielles indépendantes, extrait dynamiquement leurs tailles respectives, combine les séries, gère rigoureusement le fractionnement arithmétique des rangs moyens ex æquo, résout les équations structurales de U1 et U2, applique la correction de continuité asymptotique et renvoie directement la p-valeur bilatérale exacte ou asymptotique selon les effectifs.
Dès lors que ce module est consigné au sein du classeur (enregistré sous le format prenant en charge les macros .xlsm) ou déployé dans le classeur de macros personnelles (PERSONAL.XLSB), l’analyste dispose d’une fonction statistique sur-mesure, appelable directement depuis n’importe quelle cellule de sa feuille de calcul sous la syntaxe unifiée et limpide :
=TEST_MANN_WHITNEY(A2:A13; B2:B13)
Cette approche d’ingénierie statistique sous Excel réconcilie l’accessibilité universelle du tableur grand public avec les exigences d’automatisation, de reproductibilité computationnelle et de rigueur formelle indispensables à la production scientifique internationale contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Conover, W. J. (1999). Practical nonparametric statistics (3rd ed.). John Wiley & Sons.
- Hodges, J. L., & Lehmann, E. L. (1963). Estimates of location based on rank tests. The Annals of Mathematical Statistics, 34(2), 598–611. https://doi.org/10.1214/aoms/1177704172
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
- Pitman, E. J. G. (1948). Notes on non-parametric statistical inference. Columbia University Press.
- Rosenthal, R. (1991). Meta-analytic procedures for social research (Rev. ed.). SAGE Publications. https://doi.org/10.4135/9781412984997
- Vargha, A., & Delaney, H. D. (2000). A critique and improvement of the CL common language effect size statistics of McGraw and Wong. Journal of Educational and Behavioral Statistics, 25(2), 101–132. https://doi.org/10.3102/10769986025002101
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968