
L’adage méthodologique « corrélation n’implique pas causalité » constitue l’un des piliers les plus fondamentaux et pourtant les plus régulièrement enfreints de l’analyse scientifique moderne, de la communication de masse et de la prise de décision politique. Dans une société contemporaine caractérisée par une surabondance exponentielle de données numériques (« big data ») et des outils de traitement algorithmique d’une puissance inédite, la capacité à détecter des régularités statistiques, des synchronisations ou des alignements de courbes s’est trouvée démultipliée. Pour autant, cette facilité computationnelle nouvelle ne résout en rien l’énigme épistémologique centrale qui taraude les philosophes des sciences depuis plusieurs siècles : comment distinguer la simple co-occurrence d’événements contingents d’une véritable relation générative, dans laquelle un phénomène en produit nécessairement un autre ?
La confusion entre corrélation et causalité ne relève pas seulement de la maladresse technique ou de l’incompétence méthodologique passagère. Elle plonge ses racines profondes dans l’architecture cognitive humaine, façonnée par des millénaires d’évolution pour repérer des motifs structurés au sein d’un environnement incertain et menaçant. Notre cerveau est une machine biologique conçue pour déduire du sens, tisser des trames narratives cohérentes et projeter des intentions téléologiques là où ne s’exprime parfois que la stricte variance stochastique du hasard. Lorsque cette prédisposition psychologique rencontre les impératifs du sensationnalisme médiatique — où un titre affirmant un lien direct d’action déclenche un engagement affectif et commercial bien supérieur à une prudente réserve probabiliste —, l’amalgame devient la norme plutôt que l’exception.
Le coût de cette confusion est considérable. Il se chiffre en milliards de deniers publics alloués à des interventions de santé publique inopérantes, en fausses pistes thérapeutiques préjudiciables aux patients, en régulations économiques contre-productives et en croyances populaires persistantes qui entravent l’émancipation rationnelle du corps social. Pour désamorcer ces dynamiques délétères, cet article propose une analyse approfondie des fondements épistémologiques et statistiques de la causalité, détaille les rouages psychologiques de notre vulnérabilité intellectuelle, déconstruit cinq exemples empiriques concrets et met à disposition une méthodologie rigoureuse pour évaluer avec acuité les allégations statistiques qui façonnent notre quotidien.
1. Fondements épistémologiques et statistiques : Définir la corrélation et la causalité
1.1 Définition mathématique et statistique de la corrélation
Sur le plan strictement formel, la corrélation désigne une mesure statistique décrivant la force et la direction d’une relation d’association mathématique entre deux variables aléatoires. Le modèle canonique le plus fréquemment utilisé est le coefficient de corrélation linéaire de Bravais-Pearson, noté usuellement r. Développé à la fin du XIXe siècle, ce paramètre s’obtient en divisant la covariance des deux variables d’intérêt par le produit de leurs écarts-types respectifs. Le résultat est une grandeur adimensionnelle normalisée, comprise strictement entre -1 et +1. Une valeur de +1 dénote une relation linéaire positive parfaite, où toute augmentation proportionnelle d’une variable s’accompagne d’une hausse parfaitement prédictible de la seconde ; une valeur de -1 traduit une relation linéaire négative tout aussi rigide ; tandis qu’une valeur nulle suggère l’absence totale de covariance linéaire. Toutefois, l’application aveugle de ce coefficient induit des écueils majeurs : Pearson est intrinsèquement aveugle aux relations non linéaires (une fonction parabolique en cloche peut donner un r égal à zéro alors même qu’il existe une dépendance déterministe totale entre les axes) et s’avère particulièrement hypersensible à la présence de valeurs aberrantes (« outliers »), capables d’engendrer artificiellement une corrélation élevée à partir d’un seul point déviant.
Pour parer à ces défaillances inhérentes à la modélisation paramétrique linéaire, les statisticiens emploient des mesures non paramétriques fondées sur les rangs relatifs des observations, au premier rang desquelles figurent le coefficient rho de Spearman et le tau de Kendall. Ces coefficients ne mesurent pas la linéarité stricte, mais la monotonicité, c’est-à-dire la tendance conjointe de deux variables à croître ou décroître ensemble, indépendamment de la forme spécifique de la courbe mathématique sous-jacente. Si ces approches rang-ordonnées capturent avec une plus grande résilience les dépendances asymptotiques ou exponentielles, elles partagent avec Pearson une limite conceptuelle infranchissable : elles sont toutes purement descriptives et bidirectionnelles. La symétrie mathématique est totale : la corrélation entre la variable X et la variable Y est strictement identique à celle reliant Y à X.
L’erreur épistémologique fondamentale consiste précisément à franchir illégitimement le fossé qui sépare la simple co-occurrence descriptive de l’interdépendance fonctionnelle ou mécanistique. Qu’une série statistique présente une trajectoire parallèle à une autre série au sein d’un espace vectoriel ne confère aucune information ontologique sur la dynamique physique, biologique ou sociologique qui les anime. Deux séries temporelles sans la moindre interaction matérielle peuvent osciller de concert sous l’effet de multiples facteurs exogènes ou du simple hasard mathématique. Confondre cette mesure métrique avec une nécessité causale découle d’un saut conceptuel que rien, dans l’appareil algébrique de la statistique descriptive, ne permet d’autoriser sans l’apport d’un modèle structurel préalable.
1.2 La nature épistémologique de la causalité
Disséquer la notion de causalité exige de quitter le domaine de l’algèbre pour s’immerger dans la philosophie des sciences. Historiquement, l’analyse moderne de la causalité trouve son acte de refondation dans l’œuvre empiriste de David Hume, et singulièrement dans son Traité de la nature humaine (1739). Le philosophe écossais y démontre qu’en observant deux événements réputés causalement reliés, nos organes sensoriels ne perçoivent en réalité que trois éléments fondamentaux : la contiguïté spatiale des entités en jeu, l’antériorité temporelle de la cause présumée sur l’effet consécutif, et la conjonction constante, c’est-à-dire la répétition systématique de leur succession temporelle. Jamais, affirme Hume, nous ne pouvons percevoir empiriquement le « lien de nécessité » qui forcerait l’effet à émerger de la cause. Dès lors, pour Hume, la causalité n’est pas une substance observable dans le monde extérieur, mais une habitude mentale, une projection psychologique inférée par notre esprit à force d’enregistrer des régularités temporelles.
Face au scepticisme humien, l’épistémologie contemporaine et la méthodologie statistique ont développé une approche rigoureuse pour opérationnaliser la causalité : la théorie contrefactuelle, principalement articulée par le philosophe David Lewis puis formalisée en statistique par Donald Rubin à travers le « Modèle Causal de Rubin » (Rubin Causal Model). Selon cette conceptualisation, affirmer que l’événement X a causé l’événement Y chez une unité expérimentale donnée revient à soutenir la proposition contrefactuelle suivante : si X ne s’était pas produit (toutes les autres conditions de l’univers demeurant rigoureusement identiques), alors Y ne se serait pas manifesté. Cette formulation met en lumière le « problème fondamental de l’inférence causale » : il est ontologiquement impossible d’observer simultanément pour un même individu le résultat consécutif à l’exposition d’un traitement et le résultat en l’absence de ce traitement au même instant. La science expérimentale moderne cherche donc à reconstituer artificiellement ce contrefactuel inobservable au moyen de groupes de comparaison statistiques interchangeables.
Une caractéristique primordiale et discriminante de la causalité réside dans son asymétrie temporelle et logique irréductible, qui tranche nettement avec la réciprocité symétrique de la corrélation. Si la variable X cause la variable Y, la manipulation active ou l’altération exogène de X entraînera inévitablement une modification de l’état de Y. Inversement, agir directement sur Y laissera X inchangé. Si allumer une allumette génère de la chaleur, appliquer de la chaleur extérieure sur l’embout d’une allumette éteinte ne reconstituera pas rétroactivement son état chimique d’origine intact. Cette flèche causale — intimement liée à la directionnalité de l’entropie thermodynamique et à l’ordonnancement temporel de l’univers — brise radicalement l’équivalence fonctionnelle des séries statistiques corrélées.
1.3 Les typologies de relations fallacieuses entre deux variables
Lorsque deux variables présentent un coefficient de corrélation statistiquement significatif sans pour autant maintenir un lien de cause à effet direct, cette association relève nécessairement de dynamiques perverses bien documentées par la théorie méthodologique. La première catégorie correspond à la corrélation purement accidentelle ou fortuite. Dans un univers peuplé de milliards de métriques mesurées en continu, la loi des grands nombres combinée aux fluctuations stochastiques garantit que deux séries statistiques distinctes présenteront fortuitement des profils de variabilité temporelle analogues sur un intervalle temporel restreint. Ces artefacts mathématiques, souvent documentés avec dérision dans les répertoires de données ouvertes, sont rigoureusement dépourvus de toute réalité physique ou empirique.
La deuxième typologie, infiniment plus insidieuse et fréquente dans le domaine des sciences sociales et biomédicales, concerne les relations médiées par une tierce variable non observée, masquée ou négligée, traditionnellement qualifiée de facteur de confusion. Dans cette configuration géométrique triadique, la variable dite « confondante » (Z) exerce simultanément une action causale directe sur la variable présumée cause (X) et sur la variable résultante (Y). L’analyste non averti, n’ayant collecté que les indicateurs X et Y, relève une covariance spectaculaire entre les deux et postule hâtivement l’existence d’un faisceau d’action unilatéral entre eux. En réalité, cette corrélation n’est que l’ombre portée de la variable latente sous-jacente, telle une marionnette dont les deux bras bougeraient de concert non point par coordination mutuelle, mais sous l’impulsion des mêmes ficelles tirées par une main invisible.
Enfin, la troisième typologie majeure repose sur l’écueil de la causalité inverse, situation dans laquelle une causalité effective existe bel et bien au sein du système étudié, mais dans le sens diamétralement opposé à celui déduit par l’observateur. Dans ce scénario, ce que le chercheur conceptualise comme l’effet résultant constitue en réalité la véritable force motrice originelle qui induit des variations dans l’exposition mesurée. Ce piège d’anamorphose causale survient fréquemment lors de l’analyse d’études transversales instantanées où la temporalité séquentielle des phénomènes n’est pas mesurée avec une résolution chronologique suffisante, menant à des interprétations aberrantes quant à la genèse réelle des dynamiques sous surveillance.
2. Le mécanisme psychologique de la confusion : Pourquoi le cerveau infère la causalité
2.1 La quête évolutive de sens et l’apophénie
L’inclination persistante de l’esprit humain à postuler des liens de cause à effet devant la moindre juxtaposition d’événements n’est pas une anomalie aléatoire de l’intelligence, mais un héritage adaptatif hérité de la sélection naturelle. Au cours de la phylogenèse de l’espèce humaine, la survie des hominidés dans des environnements hostiles et incertains dépendait de leur rapidité à repérer des régularités environnementales critiques : associer le bruissement d’un fourré à la présence d’un fauve redoutable, ou le passage d’un nuage sombre à l’imminence d’une averse diluvienne. Ce besoin a catalysé le développement de l’apophénie, définie en psychopathologie et en psychologie cognitive comme la tendance universelle à percevoir des motifs significatifs ou des liens intentionnels au sein de données aléatoires ou informes, processus dont la paréidolie visuelle est la manifestation la plus familière.
D’un point de vue purement évolutionniste, ce réflexe s’explique par l’asymétrie structurelle de la théorie de la détection du signal, conceptualisée notamment par Michael Shermer sous le terme d’« error management theory ». Deux types d’erreurs cognitives s’offrent à un organisme : commettre une erreur de type I (un faux positif), qui consiste à déceler un prédateur inexistant derrière une branche qui remue ; ou commettre une erreur de type II (un faux négatif), qui consiste à estimer que le bruissement résulte du simple vent alors qu’un tigre à dents de sabre s’y dissimule réellement. Le coût d’une erreur de type I est trivial (une poussée d’adrénaline éphémère et quelques calories dépensées à fuir inutilement), tandis que le coût d’une erreur de type II est fatal, signifiant l’élimination définitive du patrimoine génétique. Dès lors, la sélection naturelle a lourdement favorisé les cerveaux paranoïaques et ultra-sensibles à l’inférence causale, préférant sur-interpréter massivement les coïncidences plutôt que de risquer l’indifférence face à un danger réel.
Ce biais ancestral s’exprime dans notre rapport au monde moderne sous la forme d’un besoin irrépressible de récits téléologiques. Face à la contingence froide de la variance statistique, au chaos brownien du monde économique ou à la survenue aveugle d’une pathologie grave, le hasard stochastique est perçu comme insupportable par l’appareil psychique. Notre cognition réclame des coupables, des arcs narratifs linéaires articulant faute et châtiment, action et réaction. Trouver une cause rassure le sujet en lui donnant l’illusion qu’un phénomène est intelligible, prévisible et par conséquent maîtrisable.
2.2 Les heuristiques de jugement et les biais de raisonnement
Au-delà des déterminismes évolutifs primaires, le fonctionnement cognitif ordinaire est traversé par des raccourcis mentaux systématisés que la psychologie expérimentale nomme heuristiques de jugement. Parmi eux, l’heuristique de représentativité, documentée par Daniel Kahneman et Amos Tversky, pousse l’esprit à évaluer la probabilité d’un événement non pas sur la base de ses fréquences d’occurrence statistiques sous-jacentes (les probabilités a priori de Bayes), mais en fonction de son degré de ressemblance prototypique avec une catégorie préétablie. Si un comportement inhabituel ressemble superficiellement aux symptômes d’une maladie mentale ou si la consommation d’une substance naturelle rappelle les vertus prêtées à sa forme végétale, l’esprit en déduit immédiatement une relation causale directe, sans s’encombrer de protocoles probabilistes rigoureux.
Cette heuristique d’amorçage est consolidée par le ravageur biais de confirmation, par lequel l’individu sélectionne, mémorise, valorise et surinterprète activement les seules occurrences empiriques corroborant son hypothèse initiale, tout en oblitérant ou minimisant activement les innombrables contre-exemples qui l’infirmeraient. Si un sujet est intimement convaincu que les nuits de pleine lune provoquent une hausse spectaculaire des admissions dans les services d’urgence psychiatrique, il gravera d’un trait inaltérable dans sa mémoire de travail la nuit de garde chaotique ayant fortuitement coïncidé avec l’astre plein, tout en oubliant instantanément les dizaines de pleines lunes calmes et les nuits sans lune marquées par des afflux critiques de patients. Les données brutes ne sont plus des repères neutres, mais des instruments de justification rétrospective.
Ces déviances de l’entendement s’agrègent enfin au sein de l’illusion de contrôle, mise en exergue par Ellen Langer, où l’individu s’attribue faussement un pouvoir d’influence directe sur l’issue d’événements purement stochastiques. De la gestuelle superstitionnelle du joueur de dés jusqu’à la confiance aveugle de l’analyste financier estimant dicter les mouvements boursiers par ses indicateurs techniques contingents, la corrélation temporelle entre une action menée et un succès aléatoire immédiat suffit à ancrer dans l’appareil neuronal l’assurance fallacieuse d’une causalité agissante, récompensant le cerveau par une décharge dopaminergique gratifiante.
2.3 Le rôle du système 1 et du système 2 dans l’analyse critique
L’architecture cognitive duale popularisée par Daniel Kahneman dans ses travaux fondateurs sur l’économie comportementale offre une grille de lecture limpide pour appréhender la persistance de ces confusions. Le « Système 1 » opère de façon automatique, rapide, inconsciente et à un coût métabolique quasiment nul. C’est lui qui assure le décodage permanent du champ sensoriel, reliant instantanément deux stimuli contigus pour forger une micro-histoire cohérente. Lorsque le Système 1 perçoit l’association concomitante d’une baisse des impôts et d’une relance immédiate de la consommation, son algorithme par défaut produit une évidence : la baisse fiscale a relancé les ménages. Cette assignation narrative est instantanée, viscérale, exempte de doute méthodologique.
À l’opposé, le « Système 2 » incarne le mode de pensée réflexif, lent, délibéré, hautement analytique et énergétiquement vorace. C’est ce système logique qui dispose des compétences formelles requises pour suspendre le jugement spontané, interroger la représentativité de la cohorte observée, exiger la vérification des degrés de liberté, isoler les covariables résiduelles et explorer les hypothèses rivales. Cependant, parce que le cerveau biologique est un organe avare de glucose qui cherche continuellement à minimiser son effort computationnel, le Système 2 tend à demeurer passif ou à entrer en action uniquement pour rationaliser a posteriori les intuitions primaires fournies par le Système 1, validant ainsi la méprise causale au lieu de la déconstruire méthodologiquement.
Cette paresse cognitive endémique rend les récepteurs d’information particulièrement vulnérables aux logiques de l’économie de l’attention contemporaine. Les rédactions journalistiques, les agrégateurs de flux et les créateurs de contenu sur les plateformes numériques s’appuient délibérément sur des formulations rhétoriques percutantes pour maximiser les taux de clics (« clickbait »). Un titre d’article affirmant sans nuance « Consommer deux tasses de café par jour allonge l’espérance de vie de trois ans » exploite sans retenue les mécanismes intuitifs du Système 1. Une restitution scientifiquement probe (« Une observation longitudinale transversale révèle une corrélation statistiquement significative mais non ajustée entre le signalement déclaratif d’une prise de caféine et une réduction marginale de certains biomarqueurs inflammatoires ») exige une mobilisation laborieuse du Système 2, décourageant l’engagement de l’usager pressé.
3. Exemple 1 : Ventes de glaces et attaques de requins
3.1 L’observation statistique empirique
L’archétype par excellence utilisé dans les propédeutiques de statistique pour illustrer l’écueil du facteur de confusion concerne la relation singulière liant le volume des ventes de glaces artisanales et industrielles au nombre d’attaques mortelles ou non mortelles perpétrées par des squales le long des zones côtières tempérées. Si l’on compile avec minutie les relevés hebdomadaires collectés par les syndicats de marchands de glaces dans les stations balnéaires de Nouvelle-Galles du Sud en Australie ou sur les côtes floridiennes aux États-Unis, et qu’on les met en miroir avec les fiches d’incidents consignées dans l’International Shark Attack File sur plusieurs décennies, le résultat de la régression linéaire brute est saisissant. Les deux courbes évoluent dans une synchronie troublante : chaque pic de chiffre d’affaires des glaciers correspond rigoureusement à un accroissement proportionnel des morsures de requins recensées en mer.
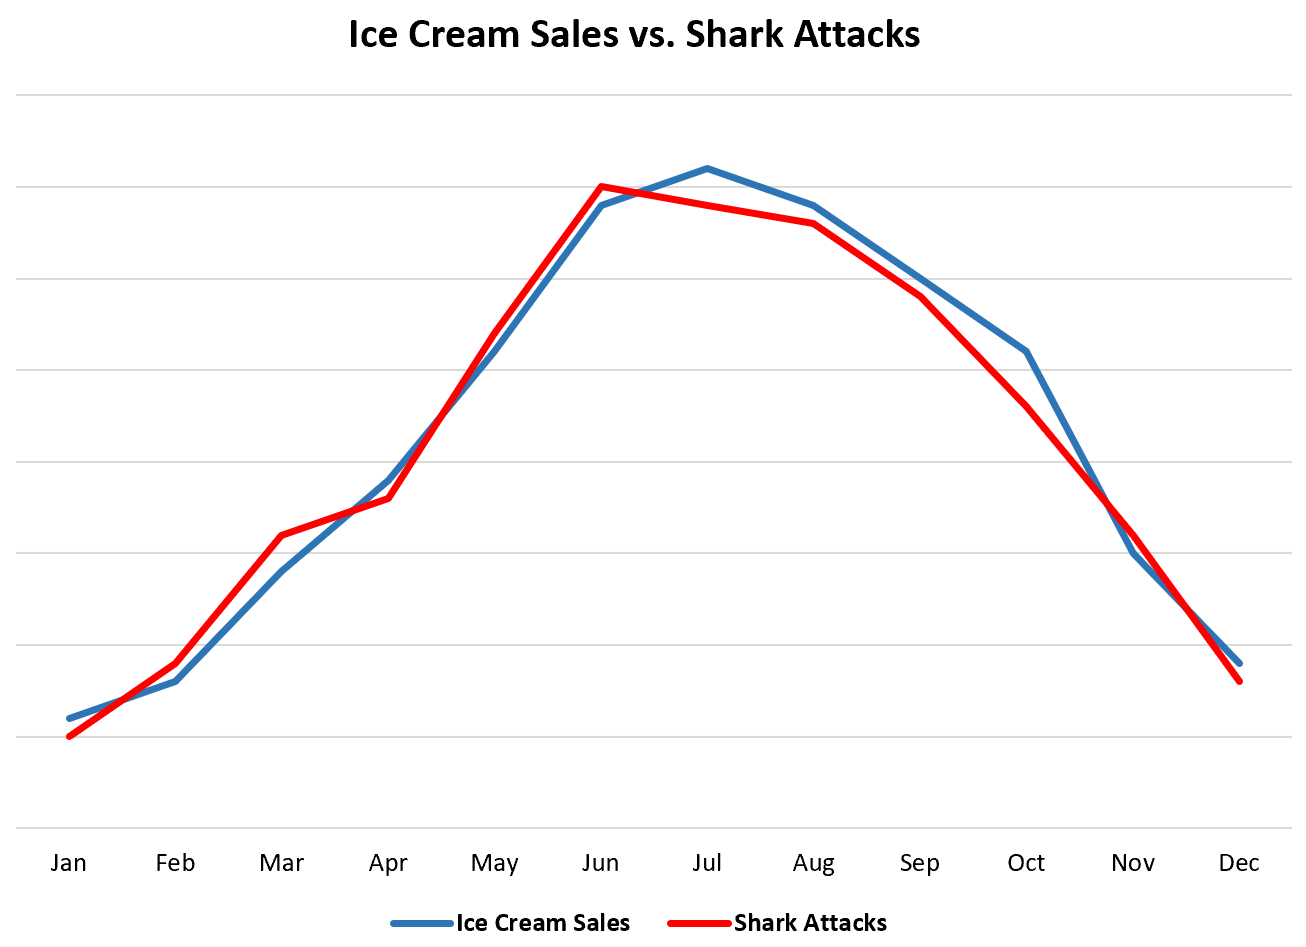
Le calcul du coefficient de corrélation linéaire de Bravais-Pearson entre ces deux séries statistiques renvoie régulièrement des valeurs oscillant entre +0,75 et +0,88 selon les saisons échantillonnées, affichant une valeur p infinitésimale largement inférieure au seuil critique conventionnel de 0,001. Sur le plan purement numérique, l’association est réputée solide, robuste et hautement significative. La modélisation mathématique brute indique ainsi avec une précision algorithmique exemplaire que l’achat de cornets de glace permet de prédire avec une marge d’erreur minimale les attaques de prédateurs marins à quelques centaines de mètres du rivage.
Pourtant, formuler la moindre conclusion causale unilatérale sur la base de ce calcul confine à l’absurdité la plus criante. Soutenir qu’ingérer de la crème glacée à la vanille modifie la physiologie sanguine du nageur au point de diffuser des phéromones gustatives captées à des kilomètres par les récepteurs sensoriels des ampoules de Lorenzini du grand requin blanc est une lubie biologique sans fondement. L’hypothèse inverse, stipulant que la vue traumatisante d’une attaque de requin au large déclenche chez les vacanciers terrifiés sur la plage une fringale compensatrice irrépressible pour des esquimaux au chocolat, ne résiste pas davantage à l’analyse élémentaire du comportement humain en situation de panique.
3.2 L’identification de la variable confondante : la température estivale
La résolution de cette énigme statistique ne réside nullement dans une mystérieuse dynamique endogène reliant les deux éléments de l’équation, mais dans l’introduction au modèle d’une troisième métrique demeurée jusqu’alors implicite et hors champ : la température atmosphérique estivale. Ce tiers facteur environnemental joue le rôle d’une variable confondante classique, exerçant simultanément un contrôle mécanique indépendant sur les deux comportements examinés.
D’un côté de la chaîne comportementale, l’avènement de l’été boréal ou austral génère une hausse marquée du thermomètre et de l’indice de chaleur (humidex). En réaction physiologique et hédonique directe à ce stress thermique, les populations cherchent le rafraîchissement thermique, provoquant une envolée mécanique et parfaitement documentée des achats de produits glacés et de boissons fraîches à proximité des zones de loisirs balnéaires. La température est donc la cause motrice directe, validée par la sociologie de la consommation et la physiologie humaine, de la hausse des courbes de vente chez les glaciers.
De l’autre côté, cette même chaleur accablante pousse des dizaines de milliers d’individus à quitter l’intérieur des terres pour converger vers le littoral océanique et s’immerger longuement dans les vagues côtières. Cette migration humaine modifie drastiquement la densité spatiale : le nombre absolu de corps humains flottant dans l’eau salée par mètre carré de littoral augmente de plusieurs ordres de grandeur comparativement aux froides journées de l’hiver. Or, les requins évoluent dans leur habitat naturel biologique habituel ; la probabilité d’une rencontre accidentelle ou d’une méprise prédatrice étant le produit mathématique direct du temps d’immersion humaine cumulé et du volume d’individus présents dans la zone d’activité des sélachimorphes, le nombre brut d’attaques s’accroît nécessairement sans que le comportement intrinsèque ou l’agressivité de l’animal n’aient subi la moindre modification.
3.3 Leçons méthodologiques tirées de cet archétype
L’illustration canonique des glaces et des requins fournit un cas d’école inestimable pour appréhender la vulnérabilité des inférences hâtives tirées de la covariation brute. Elle matérialise avec éclat la distinction entre la simple corrélation bivariée et la régression multivariée ajustée. Si un statisticien applique un protocole d’analyse par régression multiple en intégrant la variable « température moyenne de l’air » ou « densité de baigneurs enregistrée sur le littoral », le lien mathématique unissant les ventes de glaces et les morsures s’effondre instantanément pour atteindre un coefficient partiel nul. La variable confondante absorbe l’intégralité de la variance commune, révélant la nature fallacieuse de l’association initiale.
Ce cas pédagogique met en exergue l’impérieuse nécessité de la décomposition factorielle en modélisation économétrique et biomédicale. En l’absence d’une réflexion préalable sur les mécanismes d’engendrement physique et contextuel du phénomène étudié, les méthodes automatisées de fouille de données (« data mining ») courent le risque d’extraire des myriades de relations fallacieuses de cette nature, trompant l’observateur par la seule beauté géométrique d’un nuage de points aligné le long d’une droite de régression sans consistance ontologique.
La survie de cet exemple à travers les décennies d’enseignement universitaire tient à son caractère outrancier : l’absurdité du lien causal direct y est si éclatante que nul n’est tenté d’y adhérer de bonne foi. Cependant, sa véritable valeur intellectuelle est d’inciter à la vigilance lorsque la corrélation porte sur des objets où le lien causal paraît plausible à notre intuition mais où un mécanisme triangulaire tout aussi occulte produit l’association observée.
4. Exemple 2 : Diplômes de master délivrés et recettes du box-office
4.1 La présentation des séries temporelles agrégées
Dans le domaine des analyses socio-économiques à l’échelle macroscopique, le recours aux données temporelles cumulées constitue un terrain fertile pour la prolifération de déductions causales infondées. L’un des cas les plus emblématiques de co-mouvements statistiques concerne le parallèle tracé sur une échelle pluridécennale (typiquement entre 1970 et 2020 dans les pays de l’OCDE comme les États-Unis ou la France) entre l’accroissement continu du nombre total de diplômes universitaires de deuxième cycle (masters et doctorats) délivrés chaque année et la progression exponentielle des recettes globales générées par le box-office de l’industrie cinématographique en salles.
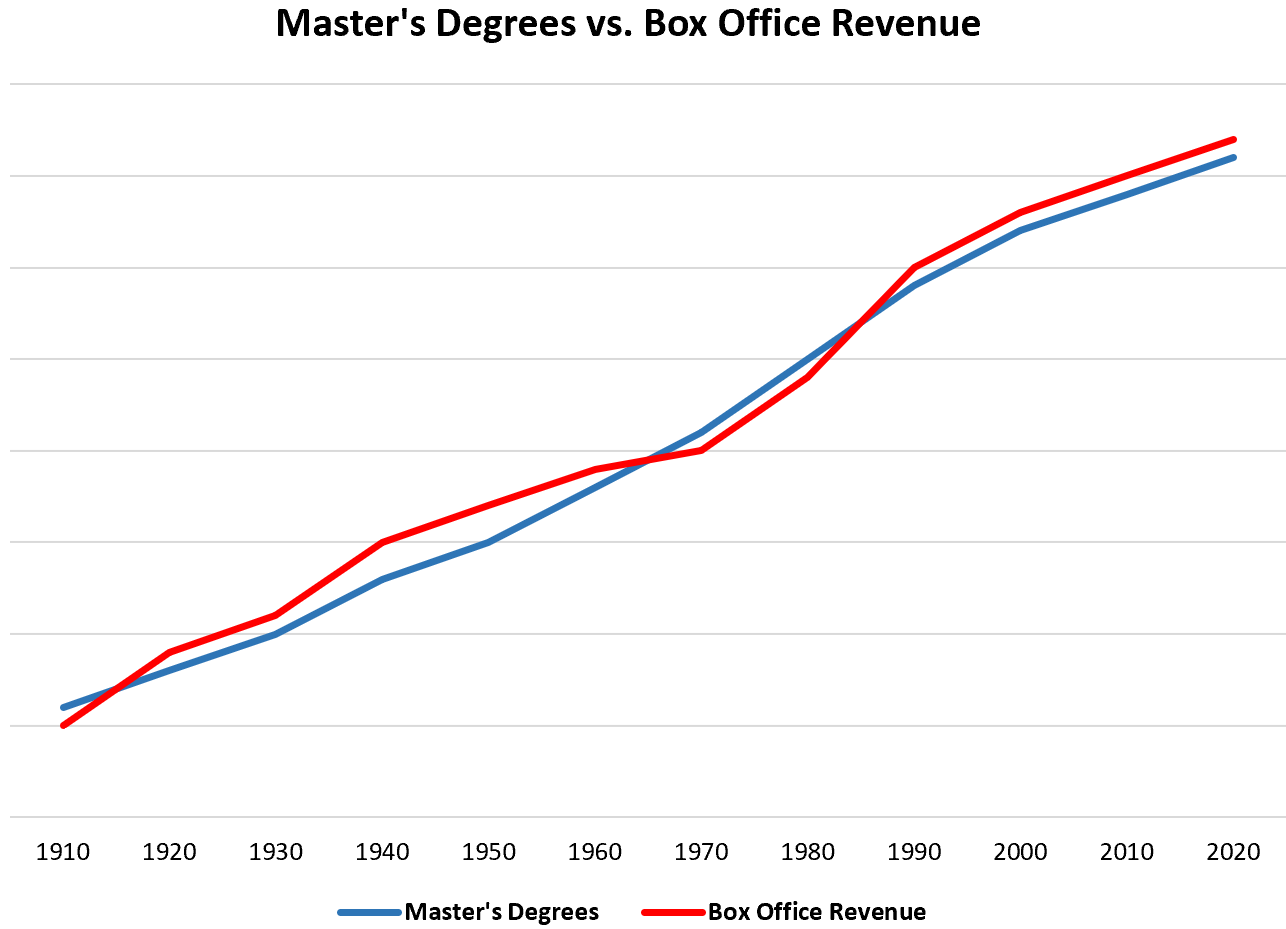
La superposition des deux tracés chronologiques est visuellement spectaculaire : d’année en année, à l’exception de soubresauts conjoncturels mineurs, les deux grandeurs affichent une trajectoire ascendante continue, quasi imperturbable. Une régression temporelle directe entre le volume d’étudiants coiffés de toges académiques et les milliards de dollars amassés par les blockbusters hollywoodiens affiche un coefficient de corrélation r tutoyant régulièrement 0,95. Une lecture superficielle et créative de ces données macroéconomiques pourrait inciter des analystes de la culture à théoriser l’existence d’une boucle vertueuse d’enrichissement civilisationnel : l’élévation du capital intellectuel global et le raffinement critique acquis durant les cursus universitaires stimuleraient le désir d’immersion culturelle, propulsant les jeunes diplômés vers les salles obscures pour y consommer massivement des créations cinématographiques, finançant par là même l’expansion de l’industrie du septième art.
Cette interprétation sophistiquée s’effondre dès lors que l’on examine de près les films qui génèrent la masse critique de ces revenus en salles. L’écrasante majorité des recettes mondiales n’est nullement drainée par un cinéma d’auteur complexe ou expérimental qui viendrait satisfaire une élite académique surdiplômée, mais par des franchises récréatives de divertissement de masse, ciblant prioritairement un public adolescent et familial. Établir une chaîne causale directe entre l’acquisition d’un master de biochimie moléculaire ou de droit constitutionnel et l’achat compulsif d’un ticket pour le dernier volet d’une franchise de super-héros relève d’une spéculation purement gratuite.
4.2 Les facteurs de confusion : croissance démographique et expansion économique
L’illusion d’une synergie directe entre le monde universitaire et le box-office mondial découle en réalité de l’action combinée et prolongée de mégatendances macro-historiques qui transforment simultanément l’ensemble des secteurs de nos sociétés contemporaines. Le premier moteur de cette double expansion n’est autre que la dynamique de croissance démographique globale conjuguée à la démocratisation continue de l’enseignement supérieur. Entre le milieu du XXe siècle et le premier quart du XXIe siècle, la population des nations industrialisées s’est accrue de plusieurs centaines de millions d’individus, tandis que les politiques publiques nationales ont systématiquement œuvré pour allonger la durée de scolarisation moyenne, transformant le passage par l’université — autrefois réservé à une aristocratie ou une haute bourgeoisie restreinte — en un horizon de masse indispensable à l’insertion sur le marché de l’emploi tertiaire.
Parallèlement, la seconde variable fondamentale réside dans l’expansion économique globale, mesurée par la hausse séculaire du produit intérieur brut (PIB) et modulée de manière impérieuse par l’inflation monétaire cumulée. Les chiffres affichés par le box-office au fil des décennies sont très souvent exprimés en dollars ou en euros courants, et non pas en valeur constante déflatée. Dès lors, le simple renchérissement mécanique du prix unitaire du billet de cinéma d’une décennie à l’autre fait gonfler artificiellement le montant nominal des recettes globales de l’industrie cinématographique, alors même que le volume effectif de spectateurs uniques par siège de projection peut parfois stagner ou régresser face à la concurrence féroce de la télévision hertzienne, puis de la vidéo à la demande.
En somme, ces deux secteurs d’activité n’ont fait qu’évoluer de concert au sein d’une même matrice environnementale : une société plus peuplée, plus urbanisée, disposant d’un volume global d’heures de temps libre accru, d’une liquidité financière élargie et orientée vers une économie de services et de loisirs marchands. Les diplômes et les billets de cinéma n’interagissent pas entre eux ; ils flottent simplement sur la marée montante commune de la modernisation socio-économique du second XXe siècle.
4.3 Le phénomène des tendances temporelles parallèles
Sur le plan de la théorie économétrique pure, cet exemple met le doigt sur l’une des pathologies les plus perverses de l’analyse empirique : le piège des variables non stationnaires affichant des tendances temporelles déterministes ou stochastiques parallèles, un phénomène identifié et formalisé magistralement par les économistes Clive Granger et Paul Newbold dans leur article séminal de 1974 sur les « régressions fallacieuses » (spurious regressions).
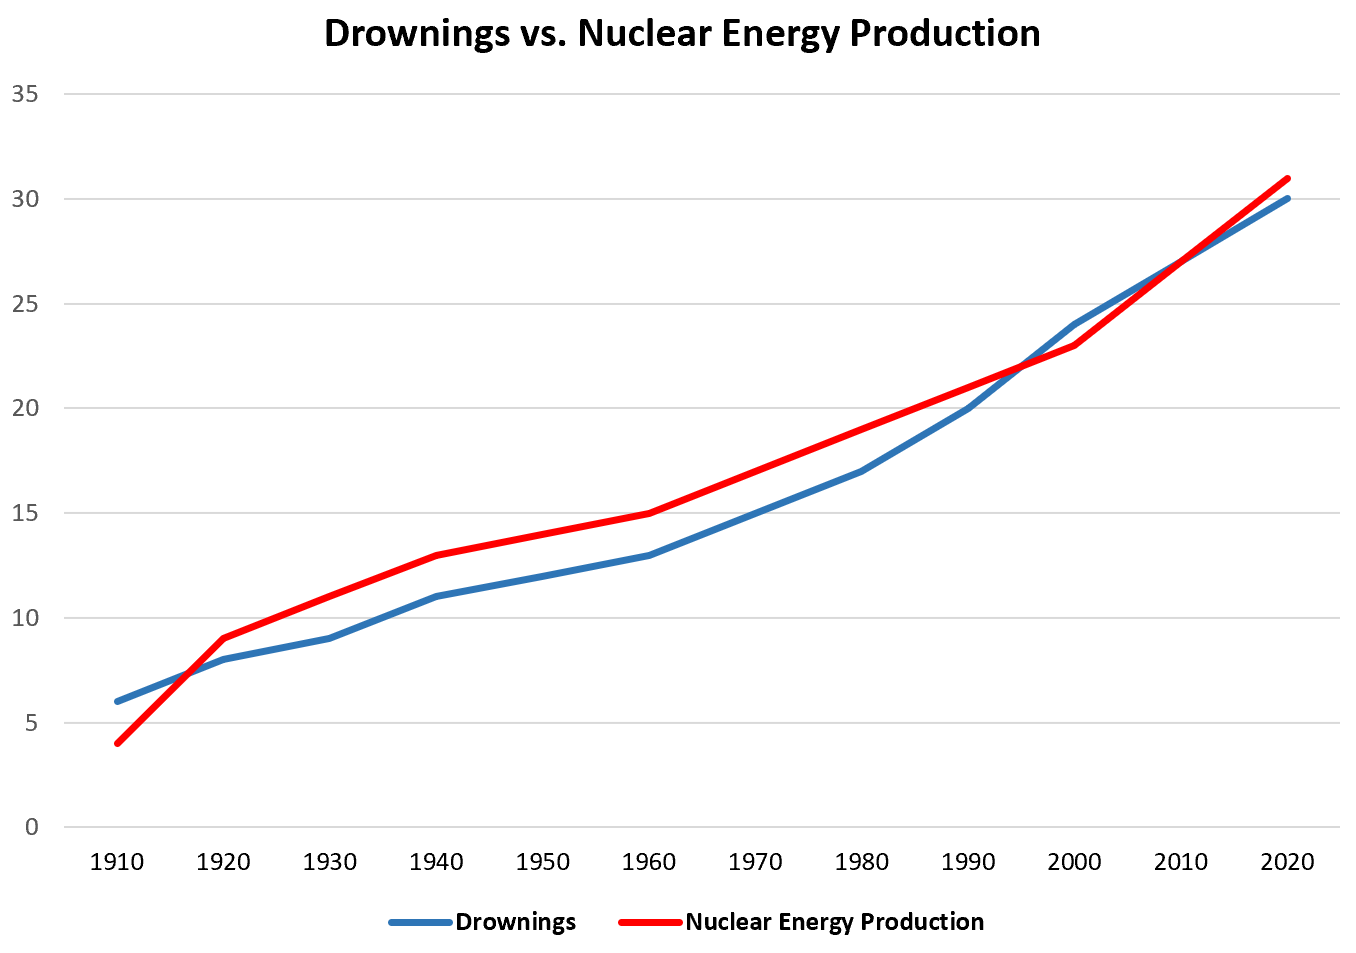
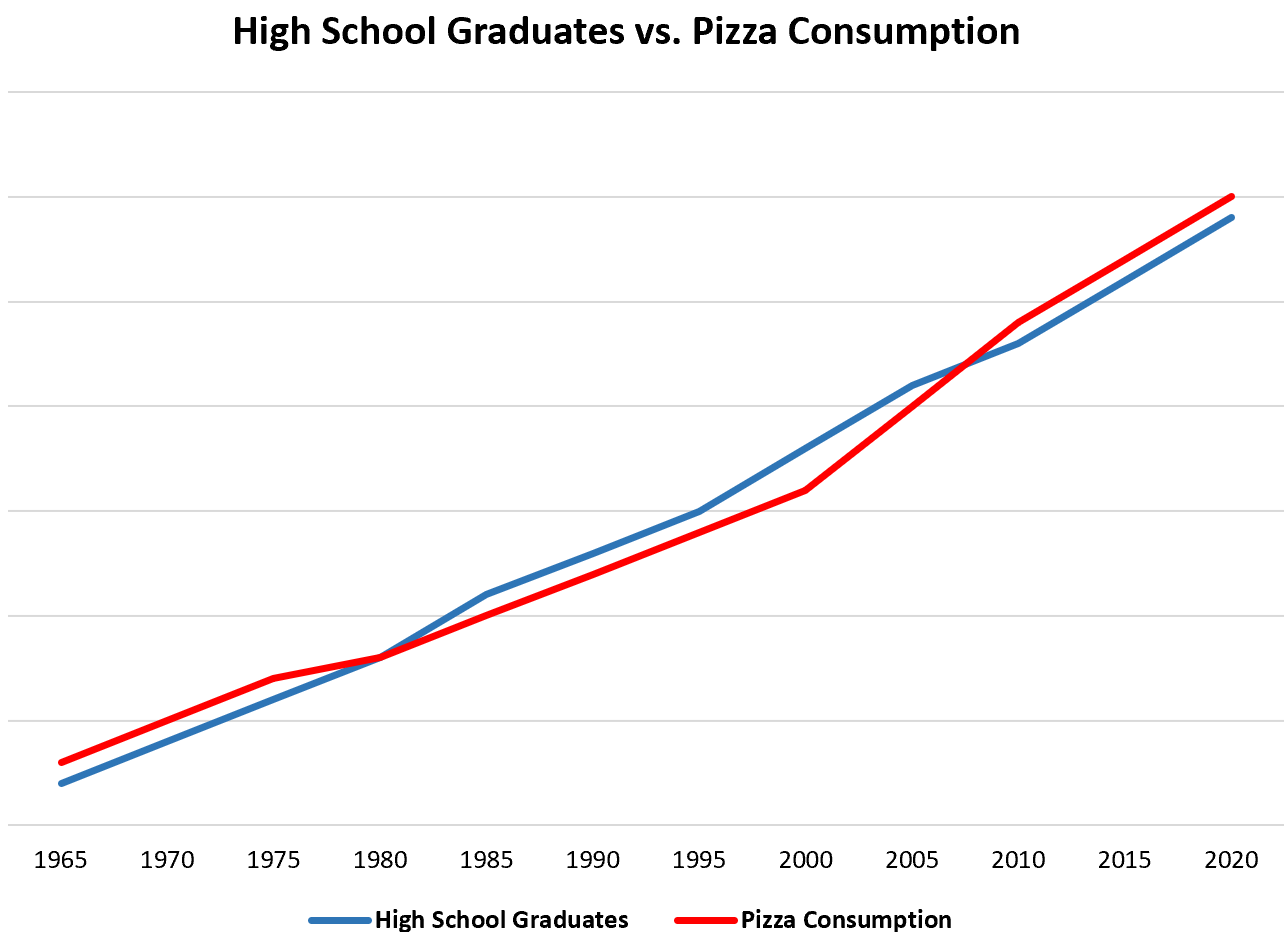
Granger et Newbold ont formellement démontré que lorsque deux séries temporelles indépendantes présentent chacune une tendance à la hausse (ou à la baisse) au fil du temps — ce que l’on qualifie en économétrie de processus non stationnaire de type « marche aléatoire avec dérive » —, l’application naïve des moindres carrés ordinaires produit de manière quasi certaine des coefficients de corrélation spectaculairement élevés, associés à des statistiques t d’apparence ultra-significatives et à des coefficients de détermination $R^2$ proches de l’unité. En réalité, le modèle n’estime rien d’autre que le passage du temps lui-même. Deux variables totalement indépendantes, telles que l’évolution de la consommation d’énergie nucléaire en Europe et le taux de divorce dans l’État du Maine, affichent des corrélations vertigineuses dès lors qu’elles partagent une tendance structurelle ascendante provoquée par des causes extérieures.
Pour immuniser l’analyse contre cet écueil de non-stationnarité, l’économétrie moderne exige systématiquement la décomposition préalable des séries temporelles. Il est impératif de « stationnariser » les données, notamment par la méthode de différentiation première (en modélisant les variations absolues ou relatives d’une année sur l’autre plutôt que les valeurs brutes cumulées) ou par le recours aux tests formels de co-intégration. Dès lors que l’on applique une différenciation aux séries des diplômés de master et des revenus du box-office, le lien statistique s’évapore : une année marquée par un pic historique de diplomation ne permet en aucun cas d’anticiper si le box-office connaîtra une récession ou une envolée durant le même exercice budgétaire.
5. Exemple 3 : Consommation de chocolat et obtention de prix Nobel
5.1 L’étude polémique de Messerli (2012) et ses conclusions apparentes
L’un des exemples les plus étourdissants de confusion méthodologique documentée au sein même de la littérature médicale internationale concerne la publication parue en 2012 dans la très prestigieuse revue The New England Journal of Medicine (NEJM), signée par le cardiologue suisse Franz H. Messerli. Dans cette note de recherche intitulée « Chocolate Consumption, Cognitive Function, and Nobel Laureates », l’auteur dressait un graphique bivarié mettant en relation la consommation annuelle moyenne de chocolat par habitant au sein de plus d’une vingtaine de nations et le nombre cumulé de lauréats du prix Nobel par tranche de dix millions d’habitants attribués à ces mêmes pays au cours de leur histoire moderne.
Le résultat graphique et mathématique exposé dans le papier affichait une puissance statistique époustouflante : le coefficient de corrélation linéaire de Pearson atteignait une valeur hors du commun de r = 0,791, avec un niveau de significativité p < 0,0001. En tête de peloton trônait la Suisse, affichant à la fois la consommation chocolatière la plus gargantuesque par citoyen et une densité de médaillés de Stockholm inégalée, tandis que des nations comme la Chine se trouvaient reléguées au bas du graphique sur les deux variables. Avec un sérieux professoral teinté d'une fine ironie que nombre de commentateurs ont manqué d'identifier immédiatement, Messerli avançait une chaîne mécanistique biologique plausible : le cacao est un aliment exceptionnellement riche en flavanols, des molécules polyphénoliques réputées pour leurs effets antioxydants, leur capacité à stimuler l'angiogenèse cérébrale, à accroître la plasticité synaptique et à préserver les fonctions cognitives supérieures. Il devenait alors tentant de conclure que gaver la population d'un pays de truffes et de tablettes de chocolat noir représentait une stratégie nationale hautement efficace pour décupler son génie scientifique collectif.
La publication déclencha une tempête médiatique planétaire sans précédent. D’innombrables agences de presse et médias généralistes s’emparèrent de l’information avec une absence totale d’esprit critique, titrant en première page que la consommation régulière de confiseries chocolatées constituait le secret biologique de l’intelligence suprême et des grandes percées scientifiques mondiales. Ce relais dénué de toute rigueur épistémique démontrait une fois encore l’empressement du grand public et des journalistes à valider des conclusions hédonistes dès lors qu’elles s’adossent au prestige institutionnel d’une revue biomédicale réputée intouchable.
5.2 La déconstruction par le produit intérieur brut et le développement socio-économique
L’effondrement de la théorie de Messerli ne requiert pourtant aucune contestation des effets réels des polyphénols sur l’endothélium vasculaire. Il suffit d’appliquer à cette corrélation nationale la grille d’analyse du facteur de confusion socio-économique. Le produit intérieur brut (PIB) par habitant, conjugué au niveau de développement technologique et institutionnel des pays étudiés, constitue la variable sous-jacente qui dicte de bout en bout l’agencement apparent des données de Messerli.
D’un côté, le chocolat d’artisanat ou de marque industrielle est un produit alimentaire transformé, non essentiel sur le plan nutritionnel primaire, et dont le coût unitaire demeure relativement élevé à l’échelle de la consommation de masse. Les populations qui consomment massivement du chocolat sur une base quotidienne sont des populations vivant dans des pays à très haut revenu, caractérisés par un pouvoir d’achat discrétionnaire étendu, une chaîne du froid logistiquement impeccable et un ancrage culturel tempéré (les climats froids d’Europe centrale et septentrionale favorisant historiquement l’appétence calorique pour le beurre de cacao).
De l’autre côté, l’obtention d’un prix Nobel de physique, de chimie ou de médecine ne relève aucunement d’une illumination cérébrale individuelle spontanée qui jaillirait chez un individu isolé au milieu d’un désert d’infrastructures. La recherche scientifique de pointe contemporaine est une industrie hautement capitalistique, nécessitant des décennies d’investissements publics et privés continus, l’accès à des synchrotrons, des salles blanches, des accélérateurs de particules, des séquenceurs génomiques de dernière génération et des bibliothèques de recherche d’une richesse colossale. Ce sont les pays dotés d’un PIB par habitant massif et stable depuis plus d’un siècle — la Suisse, la Suède, les États-Unis, l’Allemagne ou le Royaume-Uni — qui ont pu bâtir cet écosystème académique hors de portée des nations en développement. Le chocolat et les prix Nobel ne sont que deux manifestations distinctes d’un même état de fait macroéconomique : l’extrême richesse accumulée et la souveraineté technologique des puissances occidentales.
5.3 Le danger de la confusion écologique en épidémiologie
Au-delà de la mise en évidence du tiers facteur économique, la déconstruction de l’étude de Messerli met en lumière l’un des écueils méthodologiques les plus destructeurs de la recherche en épidémiologie : l’« erreur écologique » (ou confusion écologique), formalisée initialement par le sociologue William S. Robinson en 1950.
L’erreur écologique est un sophisme déductif qui consiste à déduire avec certitude un comportement, un trait physiologique ou une causalité au niveau de l’individu singulier à partir d’observations agrégées menées exclusivement à l’échelle de groupes sociaux, de régions administratives ou de populations nationales. Dans le cas de Messerli, nous disposons uniquement de données agrégées au niveau macro-territorial (le tonnage de chocolat importé ou produit divisé par la population nationale, mis en face du nombre total de médaillés du pays). Absolument aucune donnée individuelle n’est collectée au cours de ce protocole. Rien, dans les éléments recueillis par l’auteur, ne prouve que les chercheurs helvétiques ou britanniques ayant reçu la récompense royale à Stockholm consommaient personnellement la moindre parcelle de chocolat au quotidien.
Il est parfaitement plausible, sur le plan strictement logique, que les futurs lauréats du prix Nobel soient des individus présentant un régime alimentaire rigide, austère et totalement exempt de sucreries, évoluant au sein d’une population globale qui, elle, se gave de barres chocolatées. Projeter sur l’individu la moyenne arithmétique de sa communauté est un saut probabiliste fallacieux. Pour asseoir la moindre causalité entre absorption de cacao et génie intellectuel, la seule méthode valide consisterait à mener une étude de cohorte prospective individuelle, observant des cohortes de chercheurs comparables suivis pendant quarante ans, en contrôlant minutieusement leurs apports nutritionnels réels, leur patrimoine génétique, leur capital social et leurs moyens financiers de laboratoire.
6. Exemple 4 : Durée de sommeil et taux de mortalité toutes causes confondues
6.1 La courbe épidémiologique en U : sommeil prolongé et mortalité précoce
Dans l’univers touffu de l’épidémiologie observationnelle contemporaine, rares sont les questions de mode de vie ayant fait l’objet d’un volume de méta-analyses aussi pléthorique que la durée moyenne du repos nocturne et son impact sur la longévité humaine. Une observation récurrente, confirmée par des dizaines de cohortes regroupant des centaines de milliers d’individus suivis sur des décennies, met en lumière une courbe empirique fascinante de forme non linéaire : une courbe dite « en U » ou « en J ». Les personnes dormant environ sept à huit heures par nuit affichent le taux de survie le plus élevé. Sans surprise pour le corps médical, les personnes dormant moins de six heures par nuit manifestent une surmortalité statistiquement significative, explicable par les dysfonctionnements métaboliques et cardiovasculaires induits par le manque de sommeil chronique.
La perplexité des chercheurs survient lorsque l’on observe la branche droite de cette courbe épidémiologique : les sujets déclarant dormir régulièrement neuf heures, dix heures, voire onze heures ou davantage par vingt-quatre heures présentent une surmortalité toutes causes confondues encore plus prononcée, parfois supérieure de 30 % à 40 % à celle des dormeurs modérés. L’inférence causale naïve, abondamment reprise par la presse de vulgarisation médicale et par certains praticiens peu scrupuleux, a consisté à affirmer péremptoirement que « trop dormir est toxique pour l’organisme ». Selon cette rhétorique simpliste, le fait d’allonger mécaniquement le repos nocturne au-delà d’un certain seuil physiologique altérerait le tonus vagal, favoriserait l’engourdissement métabolique, accélérerait le déclin cognitif et conduirait prématurément au décès.
De telles conclusions hâtives ont engendré des recommandations de santé publique profondément anxiogènes et méthodologiquement viciées, suggérant aux individus fatigués de forcer leur réveil et de s’infliger une privation artificielle de sommeil dans l’espoir illusoire de maximiser leur espérance de vie. Ce contresens clinique illustre le péril tragique de transposer immédiatement une régression transversale en prescription comportementale individuelle sans en avoir décortiqué les soubassements physiopathologiques réels.
6.2 L’énigme de la causalité inverse et des comorbidités sous-jacentes
La vérité biomédicale sous-tendant cette corrélation alarmante réside en réalité dans une combinaison dévastatrice de causalité inverse et de confusion par comorbidité occulte. L’erreur d’interprétation première réside dans le postulat erroné selon lequel la longue durée de sommeil serait la cause primaire inductrice des dégradations somatiques, alors qu’elle n’en constitue dans l’immense majorité des situations que le symptôme clinique terminal.
Un organisme humain luttant activement contre une maladie chronique non diagnostiquée ou en phase d’aggravation silencieuse voit ses besoins en sommeil s’envoler de manière homéostatique. L’inflammation systémique de bas grade, la prolifération de cytokines pro-inflammatoires (telles que l’interleukine-1, l’interleukine-6 ou le facteur de nécrose tumorale TNF-alpha) associées aux pathologies néoplasiques occultes, aux maladies auto-immunes dégénératives ou aux phases prodromiques d’affections cardiovasculaires graves engendrent une fatigue chronique épuisante et une hypersomnolence compensatrice. Ce n’est pas le sommeil prolongé qui détruit la santé de l’individu ; c’est la pathologie mortifère tapie dans ses tissus qui force son organisme épuisé à réclamer dix heures de sommeil par nuit pour tenter vainement de réparer ses dommages cellulaires.
À ce mécanisme de causalité inverse s’agrège l’action puissante de variables confondantes socio-économiques et psychiatriques majeures. La dépression caractérisée majeure, les troubles bipolaires et l’isolement social profond sont des facteurs de risque majeurs de mortalité précoce (par suicide, dénutrition ou accidents cardiovasculaires) qui se manifestent cliniquement de façon fréquente par une clinophilie et une hypersomnie réfractaire. De surcroît, la précarité socio-économique extrême et le chômage de longue durée corrèlent à la fois avec un état de santé structurellement dégradé (accès déficient aux soins, alimentation déséquilibrée, tabagisme) et avec un temps passé au lit nettement plus élevé en raison de l’absence d’activité professionnelle structurante.
6.3 L’analyse stratifiée pour démêler les liens réels
Pour démasquer et neutraliser ce faisceau d’artifices statistiques, les épidémiologistes rigoureux doivent recourir à des protocoles d’analyse stratifiée et à des ajustements multivariés sophistiqués au sein d’échantillons longitudinaux suivis prospectivement sur des échelles de temps suffisamment étirées. La démarche méthodologique consiste à « nettoyer » l’échantillon initial de tous ses biais de sélection en amont.
Lorsqu’une équipe de recherche exclut méthodiquement de l’analyse toutes les personnes présentant des pathologies cardiovasculaires préexistantes, des antécédents de cancer, des scores élevés de dépression, ou celles dont le décès survient dans les trois à cinq premières années suivant l’inclusion dans l’étude (afin d’éliminer les maladies occultes déjà actives lors de la mesure initiale), la relation change radicalement de morphologie. La surmortalité présumée des gros dormeurs s’atténue de façon spectaculaire, voire s’annule complètement pour se fondre dans la variabilité biologique normale. De même, l’ajustement strict pour les biomarqueurs sanguins de l’inflammation (comme le dosage ultrasensible de la protéine C-réactive) et pour le niveau de revenu réel permet de ramener la longue durée de sommeil à ce qu’elle est fondamentalement : un précieux marqueur sentinelle de morbidité, et non une cause létale.
Cette distinction s’avère vitale en médecine préventive : avertir le clinicien qu’un patient dormant anormalement longtemps nécessite un bilan diagnostique complet pour identifier une potentielle affection sous-jacente est une démarche causale juste. En revanche, ordonner à ce même patient de mettre un réveil précoce pour écourter artificiellement ses nuits est une aberration médicale qui prive un organisme éprouvé du seul mécanisme réparateur dont il dispose pour préserver sa fragile homéostasie.
7. Exemple 5 : Utilisation des réseaux sociaux et détresse psychologique chez les adolescents
7.1 Le débat contemporain sur les écrans et la santé mentale
Aucune controverse de société contemporaine n’incarne avec autant d’acuité les dérives de l’interprétation causale que l’affrontement médiatique et scientifique autour de l’impact des écrans et des plateformes numériques sur la santé mentale de la jeunesse. Depuis le début des années 2010, une coïncidence temporelle spectaculaire est documentée dans l’ensemble du monde occidental : le déploiement planétaire du smartphone connecté et l’explosion de l’usage des réseaux sociaux (tels qu’Instagram, Snapchat, puis TikTok) se sont synchronisés avec une augmentation sans précédent des indicateurs de détresse psychologique chez les adolescents, marquée par une flambée des diagnostics d’anxiété généralisée, de dépressions sévères, de passages à l’acte auto-agressifs et d’hospitalisations pour idées suicidaires, singulièrement chez les jeunes filles.
Sous la plume de chercheurs influents et dans d’innombrables rapports publics, ce parallélisme temporel a été promu au rang de certitude mécanique unilatérale : les algorithmes prédateurs des géants de la « Silicon Valley » détruiraient la santé mentale de toute une génération. Pour étayer ce réquisitoire, les partisans de cette thèse s’appuient sur une constellation d’études observationnelles transversales révélant des coefficients de corrélation statistiquement significatifs entre le nombre d’heures déclarées passées sur un écran et des scores standardisés d’affliction psychologique. Les corrélations brutes relevées, bien que faibles à modérées (les valeurs de Pearson oscillant la plupart du temps entre r = 0,10 et r = 0,18), sont présentées à l’opinion publique comme le moteur exclusif d’une catastrophe sanitaire globale.
Cette rhétorique a nourri une panique morale classique, rappelant les réquisitoires historiques autrefois dressés contre l’émergence du roman populaire au XIXe siècle, de la radio, du jazz, de la bande dessinée, puis des jeux vidéo d’action. L’attribution causale exclusive aux outils technologiques offre aux responsables politiques et aux institutions éducatives une réponse séduisante de simplicité : réguler, interdire ou bannir les téléphones permettrait de restaurer instantanément la félicité psychologique de la jeunesse en faisant l’économie d’une remise en question des structures sociales, scolaires et environnementales contemporaines.
7.2 La bidirectionnalité et l’hypothèse de l’automédication numérique
L’écueil méthodologique central de la majorité des travaux dénonçant sans nuances le rôle des écrans réside dans leur conception unilatérale et simpliste de l’interaction humaine avec l’outil technologique, ignorant superbement les lois de la bidirectionnalité causale et l’hypothèse documentée de l’« automédication numérique ». Rien n’interdit de postuler — et les études longitudinales plus sophistiquées le confirment abondamment — que ce n’est pas nécessairement l’utilisation prolongée des plateformes qui génère la détresse, mais bien la détresse psychologique préexistante qui précipite les individus vulnérables vers l’hyper-connexion.
Un adolescent souffrant d’un terrain anxieux sévère, marginalisé au sein de son établissement scolaire, victime d’intimidation dans la cour de récréation ou en proie à un climat familial dysfonctionnel se réfugie fréquemment dans l’espace virtuel comme dans une bulle anesthésiante. Pour ce jeune en souffrance, les réseaux sociaux fournissent un espace de socialisation compensatoire, une zone de soutien par des pairs partageant ses angoisses, ou simplement une diversion cognitive permanente permettant d’échapper à un réel intolérable. L’écran fonctionne alors comme un analgésique numérique de fortune, de la même manière qu’un individu en dépression non prise en charge peut développer une addiction aux substances psychotropes. Mesurer l’utilisation numérique sans contrôler l’état de vulnérabilité affective initiale conduit à condamner l’antalgique plutôt qu’à diagnostiquer la blessure ontologique.
De plus, cette dynamique s’auto-alimente souvent par des boucles de rétroaction perverses : si un adolescent isolé consulte passivement des contenus anxiogènes ou compare son quotidien monotone aux mises en scène ultra-filtrées d’existences parfaites, un sentiment de dévalorisation peut s’ensuivre, amplifiant son repli social primitif et incitant à une consommation numérique plus accrue encore. Cette circularité systémique brise le paradigme linéaire de cause à effet unique promu par les lectures sensationalistes.
7.3 Les variables médiatrices et modératrices du bien-être adolescent
Une décomposition minutieuse des micro-mécanismes régissant le bien-être adolescent démontre que la métrique brute « temps d’écran » (screen time) est un indicateur épidémiologique creux et dénué de pertinence explicative propre. Les travaux conduits par des méthodologistes comme Amy Orben et Andrew Przybylski (2019) à l’Université d’Oxford — utilisant des techniques novatrices d’analyse par courbes de spécification sur des échantillons de dizaines de milliers de jeunes — ont révélé que la part de variance du bien-être adolescent expliquée par l’usage des technologies ne dépasse pas 0,4 %, une influence statistiquement comparable à celle de la consommation régulière de pommes de terre ou au port de lunettes de vue.
La véritable détérioration psychologique lorsqu’elle existe n’est pas causée directement par les photons de l’écran, mais médiée par des variables tierces beaucoup plus concrètes au premier rang desquelles trône la privation chronique de sommeil induite par l’usage des téléphones la nuit. Les notifications lumineuses, les sollicitations sociales tardives et le décalage de la phase circadienne privent les adolescents des phases indispensables de sommeil paradoxal et profond. C’est ce déficit de repos cérébral qui génère l’anxiété, la dépression et l’effondrement cognitif, et non le réseau social en soi. Si un adolescent utilise les réseaux sociaux deux heures par jour tout en maintenant une hygiène de sommeil irréprochable et une activité sportive régulière, l’impact délétère mesuré devient statistiquement indiscernable de zéro.
Enfin, la relation est régie par de puissantes variables modératrices contextuelles : la nature de l’usage (création active de liens versus consommation passive de flux publicitaires), la qualité du dialogue intrafamilial, et le sentiment de sécurité physique dans le monde réel. En focalisant toute l’attention sociétale sur un faux lien de causalité direct avec le smartphone, les pouvoirs publics s’exonèrent d’affronter des causes structurelles bien plus inconfortables : l’accroissement des inégalités, la pression sélective du système éducatif contemporain et la précarisation économique du cadre familial.
8. Analyse systémique : Variables confondantes, médiatrices et modératrices
8.1 La variable confondante (facteur de confusion)
Sur le plan formel de l’épidémiologie méthodologique et de la statistique mathématique, une variable confondante (ou facteur de confusion) se définit avec une rigueur absolue : il s’agit d’une variable Z qui possède une association causale avérée avec la variable d’exposition présumée X, tout en exerçant de façon entièrement indépendante une action causale sur la variable de résultat (ou « outcome ») Y, sans toutefois constituer un relais ou un jalon intermédiaire dans la chaîne causale reliant X à Y. Cette triade génère ce que l’on appelle une corrélation fallacieuse : la covariance brute mesurée entre X et Y n’est que la projection apparente de leurs relations causales respectives avec Z.
Pour clarifier et formaliser ces topologies causales, l’informaticien et philosophe des sciences Judea Pearl a révolutionné l’inférence causale moderne en introduisant le formalisme des graphes orientés acycliques (Directed Acyclic Graphs ou DAGs) et le puissant formalisme mathématique du « do-calculus ». Dans un DAG, les flèches vectorielles décrivent les chemins causaux non ambigus reliant les nœuds. Une variable confondante y apparaît comme la source d’un « chemin de traverse » (back-door path). Si l’on souhaite mesurer le véritable impact causal de X sur Y, il est théoriquement et mathématiquement impératif de « bloquer » ou de fermer ce chemin arrière par un contrôle méthodologique approprié. Ignorer un chemin ouvert équivaut à condamner d’emblée l’analyse statistique à l’illusion du faux lien.
Plusieurs stratégies méthodologiques permettent de neutraliser les effets délétères des facteurs de confusion. Au stade du recueil des données, l’appariement (matching) permet de constituer des groupes de sujets rigoureusement identiques sur toutes les caractéristiques de Z identifiées. Au stade de l’analyse rétrospective, le recours à la stratification multivariée ou aux modèles de régression multivariée ajuste la relation principale en intégrant la variable confondante dans la matrice des prédicteurs, ce qui revient à « conditionner » sur Z et à évaluer l’effet de X sur Y « toutes choses étant égales par ailleurs » (ceteris paribus).
8.2 La variable médiatrice : Le mécanisme intermédiaire
Il est fondamentalement critique de ne point confondre une variable confondante avec une variable médiatrice, sous peine de commettre une erreur méthodologique désastreuse pouvant aboutir à l’effacement artificiel d’une causalité pourtant bien réelle. Une variable médiatrice M ne parasite pas la relation causale de l’extérieur ; elle constitue au contraire le rouage interne, le véhicule matériel ou biologique par lequel l’effet de la cause X se transmet et s’exprime pour aboutir au résultat Y. La séquence causale est ici séquentielle et unidirectionnelle : X cause M, qui à son tour cause Y ($X to M to Y$).
Cette distinction a été conceptualisée et formalisée statistiquement dans un article fondateur de Reuben M. Baron et David A. Kenny (1986), qui a posé les jalons de l’analyse de黢 médiation moderne. L’objectif d’une analyse de médiation consiste à décomposer l’effet total d’une exposition en un « effet direct » (la part de variation de Y produite par X indépendamment de M) et un « effet indirect » (la part de variation de Y produite par X à travers l’altération de M). À titre d’illustration clinique : si l’on étudie l’impact de l’exercice physique aérobique régulier (X) sur la réduction de la mortalité par infarctus du myocarde (Y), la baisse de la pression artérielle systémique et l’amélioration du profil lipidique représentent des variables médiatrices fondamentales (M). L’effort physique modifie les fluides vasculaires, et cette modification protège les artères coronaires.
L’erreur d’un chercheur novice consisterait ici à « ajuster » statistiquement son modèle sur la pression artérielle comme s’il s’agissait d’un vulgaire facteur de confusion. En neutralisant mathématiquement la variable médiatrice, l’analyste détruit l’effet même qu’il cherche à observer : il bloque la tuyauterie interne par laquelle la cause agit. Comprendre la médiation est donc l’étape indispensable pour transformer une démonstration d’efficacité brute en une compréhension mécanistique profonde permettant de concevoir des thérapeutiques ciblées.
8.3 La variable modératrice : La modification d’effet
La troisième composante essentielle de la mécanique causale systémique est la variable modératrice (ou modificatrice d’effet). Contrairement au médiateur qui explique comment ou pourquoi un phénomène survient, et contrairement au facteur de confusion qui crée une relation fallacieuse de toutes pièces, le modérateur détermine quand, chez qui ou dans quelles conditions une relation causale opère, change de magnitude ou s’inverse.
Sur le plan de la modélisation statistique, la modération se traduit mathématiquement par une « interaction » entre deux variables indépendantes dans la prédiction de la variable dépendante. L’impact de la variable causale X sur le critère Y n’est plus une constante globale et universelle ; sa force, son signe arithmétique ou sa significativité deviennent conditionnels à la valeur spécifique prise par la variable modératrice W. Pour reprendre une métaphore pharmacologique : l’efficacité d’un médicament expérimental (X) sur la réduction d’une charge virale (Y) peut être massive et salvatrice chez les patients possédant un récepteur génétique particulier (W = 1), mais s’avérer strictement nulle, voire toxique, chez les patients dépourvus de ce récepteur (W = 0). Dans cet agencement, la configuration génétique ne cause ni l’administration du remède ni la clairance spontanée du virus ; elle modifie radicalement la réceptivité du terrain à la cause.
Négliger les variables modératrices expose les analystes à des généralisations hâtives et perverses. Une intervention éducative ou managériale peut être déclarée « scientifiquement inopérante » au vu d’une moyenne générale atone, masquant le fait qu’elle s’avère extraordinairement bénéfique pour un sous-groupe spécifique et néfaste pour un autre. L’identification rigoureuse des modérateurs est au cœur des avancées contemporaines de la médecine de précision, de la pharmacogénomique et de la pédagogie différenciée, évitant l’écueil d’une causalité réputée uniforme là où ne s’expriment que des réponses contingentes au contexte biologique ou social.
9. Le piège de la causalité inverse et le paradoxe de Simpson
9.1 La dynamique de causalité inverse (rétroaction causale)
La causalité inverse constitue une véritable chausse-trappe méthodologique qui prend au dépourvu quiconque interprète des associations sans une maîtrise absolue de la chronologie fine des phénomènes. Elle se manifeste lorsque la direction du vecteur d’influence empirique est l’exact opposé de celle que le bon sens intuitif ou la théorie postulée tend à envisager ($Y to X$ au lieu de $X to Y$). L’observateur prend la conséquence pour le déclencheur, transformant une réaction adaptative en agent toxique ou inversement.
Ce biais pullule dans les études nutritionnelles et comportementales fondées sur des questionnaires déclaratifs auto-administrés. Prenons le cas classique de la corrélation fréquemment observée entre la consommation régulière de sodas sans sucre à base d’édulcorants de synthèse et un taux d’obésité ou de diabète de type 2 significativement plus élevé. L’inférence causale sensationnaliste s’est empressée de décréter que l’aspartame dérègle le métabolisme insulinique et fait grossir les usagers. Une analyse séquentielle plus vigilante révèle que les individus ayant une prédisposition génétique au surpoids ou ayant déjà accumulé une masse adipeuse conséquente sont précisément ceux qui, sous la contrainte psychologique et médicale de surveiller leur poids, abandonnent les boissons sucrées traditionnelles au profit de boissons allégées. La maladie déclarée ou imminente dicte le changement diététique ; prétendre que la canette d’édulcorant a causé l’obésité initiale est une inversion complète des rôles ontologiques.
Pour déjouer ce piège chronologique au sein de jeux de données non expérimentaux, l’économétrie et l’épidémiologie ont développé des modélisations avancées, telles que les modèles de régression à panel croisé décalé (cross-lagged panel models). En mesurant les variables X et Y chez les mêmes individus à de multiples vagues temporelles successives ($T_1, T_2, T_3$), ces architectures statistiques permettent de confronter directement la force prédictive de $X(T_1)$ sur $Y(T_2)$ en contrôlant pour $Y(T_1)$, face à la force prédictive de $Y(T_1)$ sur $X(T_2)$ en contrôlant pour $X(T_1)$. Seule cette traçabilité longitudinale fine permet de trancher avec solidité sur la véritable préséance dynamique au sein des systèmes en interaction.
9.2 Le paradoxe de Simpson : L’inversion par l’agrégation
Parmi les curiosités mathématiques les plus spectaculaires et déconcertantes de l’analyse multivariée figure le paradoxe de Simpson (parfois nommé effet Yule-Simpson). Ce paradoxe désigne une configuration statistique stupéfiante dans laquelle une corrélation, une tendance ou une différence observée de façon constante et homogène au sein de plusieurs sous-groupes indépendants s’annule complètement, voire s’inverse de manière spectaculaire, dès lors que les données de ces sous-groupes sont agrégées et analysées à l’échelle globale de la population entière.
L’illustration historique et canonique la plus célèbre s’est déroulée à l’Université de Californie à Berkeley en 1973. Confrontée aux chiffres bruts annuels des admissions en cycles supérieurs, l’université fut menacée de poursuites judiciaires fédérales pour discrimination systémique de genre : les statistiques montraient que le taux d’admission globale des candidats masculins approchait les 44 %, tandis que celui des candidates féminines plafonnait à un modeste 35 %. Le différentiel statistique semblait écrasant et désignait un biais sexiste flagrant. Cependant, lorsque le statisticien Peter Bickel et son équipe décortiquèrent les admissions département par département (histoire, mathématiques, littérature, ingénierie), ils constatèrent avec stupéfaction que dans la quasi-totalité des facultés prises individuellement, le taux d’admission des femmes était légèrement supérieur ou rigoureusement identique à celui des hommes. Il n’existait aucune discrimination antiféminine locale ; au contraire, dans les cellules d’évaluation individuelles, les dossiers féminins étaient traités avec une neutralité exemplaire, voire un léger avantage.
L’explication de ce paradoxe résidait dans l’existence d’une variable de confusion majeure non prise en compte lors de l’agrégation globale : la sélectivité différentielle des départements choisis par les candidats selon leur genre. Les candidates postulaient en masse au sein des filières des sciences humaines et sociales, départements chroniquement sous-financés où les ratios de sélection étaient drastiques (parfois seulement 5 % ou 10 % de reçus pour des milliers de dossiers). À l’inverse, les candidats masculins s’orientaient massivement vers les départements d’ingénierie, de physique ou de chimie, richement dotés en bourses de laboratoire et offrant des taux d’admission très élevés (souvent plus de 60 % de reçus). Le taux global n’était donc que le reflet de la disparité d’attractivité des filières, et non de la politique d’admission des évaluateurs. Le paradoxe de Simpson démontre avec force qu’agréger hâtivement des échantillons hétérogènes sans contrôler leur distribution interne expose l’analyste à énoncer des verdicts sociologiques ou cliniques aux antipodes de la vérité structurelle des faits.
9.3 L’écueil de la causalité circulaire et des systèmes complexes
L’ensemble des écueils précédemment analysés s’enracine dans un paradigme épistémologique classique hérité de la mécanique newtonienne : le déterminisme linéaire unimodal. Dans ce cadre intellectuel traditionnel, on postule qu’une cause bien distincte X produit un effet isolable Y, de manière directe ou par le biais d’un canal intermédiaire. Or, la réalité concrète des systèmes biologiques, écologiques, économiques et psychopathologiques résiste viscéralement à cette simplification réductionniste : ils relèvent de la dynamique des systèmes complexes interconnectés, où triomphe la causalité circulaire et les boucles de rétroaction cybernétiques permanentes.
Dans un système complexe, l’état d’un nœud est simultanément cause et conséquence des états de tous les autres nœuds avec lesquels il maintient des connexions d’échange. Prenons l’exemple de la modélisation moderne des épisodes dépressifs majeurs en psychiatrie à travers l’approche en réseaux novatrice portée par des chercheurs comme Denny Borsboom. Le modèle médical traditionnel postulate qu’une entité sous-jacente latente unique (« la dépression ») cause de manière linéaire une série de symptômes répertoriés (insomnie, fatigue, ruminations cognitives, perte d’appétit, repli social). L’approche par réseau complexe démontre au contraire qu’il n’existe pas d’entité causale centrale cachée : les symptômes s’activent mutuellement au sein d’une boucle rétroactive dynamique. Une insomnie sévère provoquée par un deuil ponctuel engendre un épuisement biologique ; cette fatigue altère la régulation de l’humeur et précipite des ruminations négatives ; ces pensées d’échec coupent l’individu de son réseau amical, générant une angoisse existentielle majeure qui, en retour, aggrave l’insomnie de départ.
Tenter d’isoler dans ce circuit fermé un unique « facteur causal » et de le corréler linéairement à une issue relève d’une illusion méthodologique profonde. Les outils statistiques conventionnels fondés sur des modèles linéaires indépendants s’avèrent structurellement impuissants à capturer ces dynamiques non linéaires, où de minuscules perturbations initiales peuvent être amorties par des mécanismes d’homéostasie ou au contraire s’emballer de manière exponentielle par rétroaction positive (« effet papillon »). Comprendre la causalité exige ici de basculer vers les mathématiques de la dynamique des systèmes, la théorie des graphes et la modélisation à base d’agents.
10. L’arsenal méthodologique pour prouver la causalité
10.1 L’essai contrôlé randomisé (ECR) : Le standard d’excellence
Face à la multiplicité vertigineuse des biais d’observation, la méthode scientifique a forgé au cours du XXe siècle son outil d’investigation empirique le plus robuste et le plus redoutable pour établir la preuve irréfutable d’une causalité : l’essai contrôlé randomisé (ECR, ou Randomized Controlled Trial). Érigé au sommet de la pyramide des preuves en médecine factuelle (« evidence-based medicine ») sous l’impulsion de pionniers comme Sir Austin Bradford Hill et Archie Cochrane, l’ECR repose sur un principe mathématique d’une élégance absolue : la randomisation.
La randomisation consiste à répartir de façon purement stochastique (par tirage au sort algorithmique) les participants d’une étude entre un groupe d’intervention (qui recevra le traitement expérimental actif) et un groupe témoin (qui recevra un placebo d’apparence identique ou le traitement de référence existant). Dès lors que la taille de l’échantillon est statistiquement suffisante, la loi des grands nombres garantit que l’ensemble des caractéristiques individuelles des participants — qu’il s’agisse de l’âge, du sexe, du niveau socio-économique, mais surtout de l’infinité des facteurs de confusion génétiques, métaboliques et environnementaux, qu’ils soient connus, inconnus ou indétectables par les chercheurs — se distribuent de manière parfaitement homogène et équilibrée entre les deux bras de l’essai. Les deux groupes deviennent mathématiquement interchangeables : le groupe témoin incarne la concrétisation expérimentale parfaite du contrefactuel inobservable du groupe d’intervention.
Pour parachever ce dispositif et neutraliser les biais psychologiques d’attente, l’essai s’effectue dans des conditions idéales en « double aveugle » : ni le participant ni le clinicien qui évalue l’effet ne connaissent l’attribution du bras expérimental. Si, à l’issue du protocole, une divergence statistiquement significative émerge entre les deux cohortes quant au critère de jugement principal, toute explication par une variable confondante ou par une causalité inverse est formellement exclue par le design expérimental lui-même. La manipulation active de l’exposition étant la seule et unique différence asymétrique persistant entre les deux univers comparés, elle s’impose avec une certitude logique indépassable comme la cause directe du phénomène constaté.
Néanmoins, le recours à l’essai contrôlé randomisé se heurte à des frontières éthiques, matérielles et logistiques infranchissables. On ne peut concevoir d’assigner aléatoirement des populations saines à l’inhalation forcée de fumée de tabac pendant trente ans pour prouver de façon expérimentale la toxicité carcinogène de la cigarette, pas plus qu’on ne peut randomiser la pauvreté, la guerre civile, la pollution atmosphérique ou des traumatismes psychologiques d’enfance. Lorsque l’expérimentation délibérée met en péril l’intégrité morale ou physique des sujets, la science doit impérativement forger d’autres instruments d’inférence causale pour suppléer à l’interdit de la randomisation humaine.
10.2 Les critères de causalité de Bradford Hill
Confronté précisément à la nécessité de prouver sans équivoque le lien causal unissant la consommation tabagique au carcinome épidermoïde bronchique sans pouvoir recourir à un essai randomisé humain, l’épidémiologiste et statisticien britannique Sir Austin Bradford Hill formula en 1965 une grille heuristique mémorable composée de neuf critères pragmatiques. Ces repères ne doivent pas être appréhendés comme une liste de contrôle algorithmique rigide dont la validation intégrale serait indispensable, mais comme un faisceau convergent d’arguments scientifiques permettant de transformer une forte présomption d’association observationnelle en une déduction causale légitime.
Le premier critère capital est la temporalité : c’est le seul critère formellement non négociable, stipulant que l’exposition à la cause postulée doit obligatoirement précéder l’apparition de l’effet dans le temps. Le deuxième est la force de l’association, mesurée par l’ampleur du risque relatif ou de l’odds ratio : un risque multiplié par vingt ou trente (comme dans le cas des fumeurs massifs face au cancer du poumon) laisse peu de place à l’action exclusive d’un facteur de confusion discret, alors qu’un risque marginal de 1,10 exige une prudence extrême. Le troisième réside dans la relation dose-réponse (ou gradient biologique) : constater qu’une augmentation graduelle de l’exposition entraîne un accroissement proportionnel et monotone de la gravité ou de la fréquence de la maladie renforce considérablement l’hypothèse causale.
S’y ajoutent la constance (la réplication rigoureuse du même constat par des équipes indépendantes, dans des contextes géographiques et sur des populations différentes), la plausibilité biologique (la concordance de l’observation avec les lois connues de la biochimie et de la physiologie cellulaire), la cohérence globale avec l’histoire naturelle de l’affection, et la preuve par l’analogie avec d’autres agents pathogènes répertoriés. Le critère de spécificité (une cause unique associée à une maladie unique), bien qu’historiquement hérité des postulats microbiologiques de Koch sur les maladies infectieuses, est aujourd’hui considéré comme le plus fragile face aux maladies multifactorielles complexes. Enfin, la preuve expérimentale, lorsqu’elle est accessible (notamment par l’arrêt de l’exposition entraînant la réversion de l’effet), achève d’ancrer le diagnostic causal au cœur de l’empirisme médical.
10.3 Les quasi-expériences et l’inférence causale moderne
Pour contourner l’impossibilité de déployer des essais randomisés dans les champs complexes de l’économie, de la sociologie et de l’épidémiologie environnementale, les chercheurs ont mis au point une gamme raffinée de protocoles qualifiés de « quasi-expérimentaux ». Récompensées par le prix de la Banque de Suède en sciences économiques en mémoire d’Alfred Nobel attribué à David Card, Joshua Angrist et Guido Imbens en 2021, ces approches exploitent les « expériences naturelles », c’est-à-dire des chocs exogènes imprévus, des réformes institutionnelles arbitraires ou des frontières géopolitiques découpant des populations par ailleurs similaires, mimant ainsi les vertus de la randomisation en laboratoire.
Parmi ces approches méthodologiques figure la méthode des doubles différences (Difference-in-Differences). Elle consiste à mesurer la trajectoire temporelle d’un groupe d’intérêt exposé à une modification législative (par exemple la hausse du salaire minimum dans un État fédéré américain) en la comparant à celle d’un groupe témoin géographique contigu non affecté par cette réforme, permettant d’évacuer l’ensemble des tendances macroéconomiques contemporaines par soustraction de leurs pentes respectives. Autre joyau méthodologique : la régression sur discontinuité (Regression Discontinuity Design). Cette méthode tire profit de seuils administratifs stricts et arbitraires (un concours d’entrée accordé à une note de 10,00/20, ou une aide sociale conditionnée à un niveau de revenu précis). En comparant les individus situés infinitésimalement juste au-dessus du seuil à ceux situés infinitésimalement juste en dessous, on analyse deux cohortes que seule la contingence de quelques décimales sépare, isolant ainsi avec une grande pureté l’effet causal du statut conféré.
Dans le domaine biomédical, une application révolutionnaire de ce principe se matérialise à travers la méthode des variables instrumentales, singulièrement matérialisée par la randomisation mendélienne. Cette technique exploite le fait que lors de la méiose gamétique et de la fécondation, la transmission des allèles génétiques parentaux à la descendance s’effectue selon la seconde loi de Mendel de manière purement aléatoire. Si un polymorphisme génétique identifié dicte chez l’humain une propension physiologique permanente à métaboliser plus lentement l’alcool ou à présenter un taux d’acide urique sérique plus élevé tout au long de son existence, ce variant génétique peut être utilisé comme un « instrument statistique ». Ne pouvant être altéré par le mode de vie des sujets ni par la causalité inverse consécutive aux maladies d’adulte, l’allèle permet d’évaluer avec la rigueur d’un essai clinique à vie l’impact causal direct du biomarqueur sur les événements cliniques ultérieurs.
11. Les répercussions sociétales, médiatiques et médicales des conclusions causales erronées
11.1 Le sensationnalisme médiatique et la déformation de la science
L’incapacité récurrente de l’écosystème médiatique contemporain à traiter avec discernement la distinction fondamentale entre corrélation et causalité constitue une source structurelle de désinformation de masse. Dans une économie marchande de l’attention régie par la viralité numérique et la rentabilisation publicitaire à l’affichage, les subtilités méthodologiques, les réserves prudentes des chercheurs et les modélisations d’intervalles de confiance sont systématiquement perçues par les rédacteurs de flux d’actualité comme des obstacles à l’engagement du lectorat. Une dynamique d’altération éditoriale pernicieuse s’enclenche invariablement : là où l’article académique originel se borne scrupuleusement à formuler une « observation d’un lien d’association épidémiologique transversal sans possibilité de conclure à une imputabilité directe », le titre journalistique métamorphose l’information en un verbe d’action univoque, percutant et déterministe (« Le chocolat prévient la démence », « Les jeux vidéo rendent violent », « Le café guérit la dépression »).
Cette simplification spectaculaire ne trahit pas seulement les devoirs d’exactitude inhérents au journalisme scientifique ; elle provoque une érosion dramatique de la confiance du grand public envers les institutions de la recherche elle-même. Les usagers se trouvent quotidiennement soumis à un balancier d’injonctions contradictoires : telle semaine, la consommation d’œufs est présentée comme la cause fulgurante d’accidents vasculaires cérébraux par obstruction athéromateuse ; la semaine suivante, une autre étude corrélative d’observation proclame que manger des œufs protège le myocarde et accroît la longévité cognitive. Le citoyen profane, n’ayant accès ni aux protocoles méthodologiques sous-jacents ni à la compréhension de l’erreur écologique ou des facteurs confondants alimentaires, finit par conclure avec un cynisme désabusé que la science est une opinion fluctuante, incapable de cohérence, ce qui ouvre un boulevard aux discours conspirationnistes et aux pseudo-médecines alternatives exploitant ce discrédit institutionnel.
Ce dysfonctionnement est encore amplifié par la complicité involontaire de certaines agences de communication universitaires. Confrontées à la compétition internationale féroce pour l’obtention de dotations et à la logique pervertie du « publier ou périr » (publish or perish), de nombreuses institutions académiques rédigent des communiqués de presse sensationnalistes pour survendre l’impact sociétal potentiel de leurs cohortes observationnelles, court-circuitant ainsi la déontologie scientifique pour séduire les comités de subventions et les médias grand public.
11.2 Les erreurs désastreuses dans les politiques de santé publique
Lorsque la confusion entre corrélation et causalité s’immisce dans l’élaboration des politiques de santé publique et des directives médicales institutionnelles, ses répercussions cessent d’être de simples débats académiques pour se chiffrer en pertes humaines réelles et en gabegie massive de ressources collectives. L’histoire contemporaine de la médecine en conserve des traces indélébiles, dont l’une des plus traumatisantes demeure la gestion mondiale du traitement hormonal substitutif (THS) prescrit aux femmes ménopausées dans les années 1980 et 1990.
Pendant plus de deux décennies, d’immenses cohortes épidémiologiques observationnelles non randomisées, au premier rang desquelles la célèbre Nurses’ Health Study portant sur plus de 120 000 infirmières américaines, démontraient de façon éclatante que les femmes prenant un traitement hormonal œstroprogestatif présentaient un taux d’accidents coronariens mortels inférieur de 30 % à 50 % comparativement aux femmes non traitées. Persuadée d’avoir identifié une médication cardioprotectrice universelle, la communauté gynécologique et cardiologique mondiale prescrivit massivement le THS à des millions de patientes à titre de prévention primaire cardiovasculaire. Ce dogme régna jusqu’à la publication cataclysmique, en 2002, des données du vaste essai contrôlé randomisé conduit par la Women’s Health Initiative (WHI). Réalisé en double aveugle contre placebo auprès de plus de 16 000 femmes, l’essai révéla que le THS ne protégeait absolument pas les artères coronaires, mais provoquait au contraire une augmentation statistiquement significative des thromboses veineuses profondes, des embolies pulmonaires, des AVC et du risque de cancer du sein invasif.
La splendide « protection coronarienne » observée durant des décennies dans les cohortes observationnelles n’était qu’un colossal mirage statistique issu d’un facteur de confusion classique : le « biais de l’utilisateur sain » (healthy user bias). Les femmes prenant un THS dans les années 1980 appartenaient majoritairement à des strates socio-économiques élevées, possédaient une éducation supérieure, pratiquaient davantage d’exercice physique, suivaient une alimentation équilibrée et bénéficiaient d’un suivi médical régulier et rigoureux. C’était ce capital sanitaire global qui protégeait leur cœur, et non l’œstrogène synthétique qui leur était prescrit. Des dizaines de milliers d’accidents thromboemboliques et de décès iatrogènes évitables ont résulté directement de cette équivalence hâtivement dressée entre association d’observation et efficacité causale thérapeutique.
11.3 Les impacts en psychologie clinique et éducation
Le champ des sciences humaines, de la psychologie du développement et des politiques éducatives n’échappe pas à ces désillusions méthodologiques coûteuses. L’assimilation indue d’une corrélation à une relation de causalité directe y a nourri des mythes pédagogiques dévastateurs (« neuro-mythes ») et conduit à des interventions institutionnelles stériles.
Un cas d’école réside dans l’obsession politique déployée durant les années 1980 et 1990 autour de l’« estime de soi » chez les élèves. De multiples études psychométriques transversales avaient mis en lumière une forte corrélation positive entre un score élevé d’estime de soi auto-déclaré chez un enfant et sa réussite scolaire académique ultérieure, assortie d’une moindre délinquance adolescente. Postulant immédiatement que l’estime de soi était le moteur causal de la performance cognitive, de nombreux systèmes scolaires anglo-saxons modifièrent en profondeur leurs curricula pédagogiques, consacrant des budgets colossaux à des modules de valorisation systématique de l’enfant et à l’éradication de toute forme d’évaluation sélective afin de doper artificiellement ce sentiment de valeur personnelle. Les évaluations rigoureuses menées ultérieurement, notamment synthétisées par Roy Baumeister et ses pairs en 2003, ont démontré l’inanité complète de ces programmes : l’estime de soi s’est révélée n’être que la conséquence réflexive agréable d’un travail rigoureux et d’un succès authentique préalable (médié par les compétences parentales, le capital culturel et l’autodiscipline), et nullement la cause génératrice de l’intelligence académique. Gonfler artificiellement l’estime de soi sans accroître les compétences cognitives a simplement fabriqué des cohortes d’élèves narcissiques et désarmés face aux exigences intellectuelles concrètes.
De façon plus dramatique encore, les confusions causales dans le champ psychopathologique ont historiquement généré une culpabilisation parentale atroce. Que l’on songe aux décennies d’errance psychanalytique imputant la survenue de l’autisme infantile à la « froideur émotionnelle » supposée des mères (le concept toxique de la « mère réfrigérateur » forgé par Bruno Bettelheim). Parce qu’une mère confrontée aux anomalies d’interaction sociale d’un nourrisson autiste pouvait manifester de la détresse, de l’épuisement ou une distance en miroir, certains théoriciens ont affirmé avec aplomb que cette attitude maternelle était la cause mécanique originelle du retrait autistique. Des générations de mères ont été détruites par cette inférence criminelle, jusqu’à ce que la génétique moléculaire et les neurosciences contemporaines démontrent que l’autisme est un trouble précoce du neurodéveloppement d’origine génétique et épigénétique majeure, sur lequel les postures affectives parentales ordinaires n’exercent aucune responsabilité étiologique.
12. Guide pratique : Comment évaluer de manière critique les allégations statistiques
12.1 La grille d’analyse critique face à une publication de données
Face à l’avalanche permanente de chiffres, de pourcentages alarmants et d’infographies sensationnalistes diffusés par l’espace médiatique ou les réseaux sociaux, tout citoyen, étudiant ou professionnel éclairé se doit d’adopter une posture d’autodéfense intellectuelle systématique. Le premier réflexe de cette prophylaxie cognitive consiste à examiner impérativement le devis de recherche (le « design » expérimental) situé derrière l’allégation brandie. S’agit-il d’un simple recueil de données observationnelles transversales, d’un sondage auto-déclaré, d’une étude rétrospective cas-témoins, d’une vaste étude de cohorte prospective, ou d’un essai contrôlé randomisé en double aveugle mené contre comparateur actif ? Si la publication relève de la catégorie des études observationnelles, il est épistémologiquement impératif de disqualifier mentalement toute conclusion catégorique énoncée sous forme de cause d’action unilatérale.
Le second réflexe méthodologique impose de mener une traque active et obsessionnelle aux facteurs de confusion plausibles non neutralisés par le protocole. Face à toute association claironnée (« La pratique de telle activité X réduit le risque de telle pathologie Y de 40 % »), l’analyste critique doit s’interroger : quelles sont les caractéristiques invisibles qui différencient les individus adeptes de X de ceux qui s’en abstiennent ? Le niveau de revenu, le capital scolaire, la zone géographique d’habitation, le réseau relationnel ou le degré d’attention portée à sa propre santé ont-ils été strictement mesurés, appariés et intégrés aux modèles de régression multivariée ? Si la réponse est négative ou évasive, le doute méthodique doit prévaloir sur l’adhésion.
Enfin, le troisième pilier de cette grille d’analyse réside dans l’examen minutieux de la taille de l’échantillon, de sa représentativité réelle et de la robustesse de sa puissance statistique. Une corrélation établie sur un sous-échantillon microscopique de vingt ou trente participants (configuration courante dans les études d’imagerie cérébrale fonctionnelle ou d’expérimentation psychologique universitaire) est chroniquement vulnérable à l’aléa de sélection et aux variations d’échantillonnage extrêmes. Il convient de vérifier systématiquement si les auteurs ont procédé à des corrections pour tests multiples (telles que la correction de Bonferroni ou le contrôle du taux de fausses découvertes FDR) afin de s’assurer que le résultat isolé n’est pas simplement le produit stochastique d’une expédition de « pêche aux données » (p-hacking) consistant à tester cent variables en silence pour ne claironner que celle ayant fortuitement franchi le seuil arbitraire de significativité de p < 0,05.
12.2 La détection des marqueurs linguistiques de prudence épistémique
L’exercice de l’esprit critique requiert une sensibilité stylistique aiguë aux marqueurs rhétoriques et lexicaux mobilisés pour décrire les résultats d’une enquête empirique. Il existe une frontière sémantique infranchissable entre le vocabulaire de la pure association statistique et celui de la causalité active, frontière que les communicateurs habiles s’emploient régulièrement à brouiller par des contorsions stylistiques insidieuses.
L’observateur doit apprendre à repérer et cataloguer avec une précision entomologique les verbes d’action transitive qui affirment ou suggèrent insidieusement un rapport déterministe direct : « déclenche », « induit », « favorise », « provoque », « prévient », « accélère », « éradique » ou « détruit ». Lorsqu’un communiqué de presse emploie ces verbes pour commenter un modeste coefficient de corrélation linéaire issu d’une cohorte observationnelle, il s’agit d’une forfaiture sémantique. Les formulations rigoureuses et scientifiquement irréprochables doivent impérativement s’en tenir aux verbes d’accompagnement relationnel : « est associé à », « coïncide avec », « présente une covariance avec », « est corrélé à », « permet de prédire statistiquement dans les conditions observées ».
De surcroît, une attention aiguë doit être accordée aux modalisateurs de discours au sein des résumés d’articles (abstracts) et des conclusions académiques. L’absence de conditionnels, l’occultation des marges d’erreur, le refus d’envisager ouvertement des hypothèses rivales ou l’omission des limites méthodologiques reconnues par les pairs sont des drapeaux rouges épistémiques majeurs. La véritable rigueur scientifique ne se reconnaît pas à la force péremptoire de ses affirmations, mais à la transparence humble avec laquelle elle délimite le périmètre strict de sa propre validité interne et externe.
12.3 L’intégration de la pensée probabiliste dans la vie quotidienne
Au-delà de la dissection technique des données chiffrées, le désamorçage de la confusion entre corrélation et causalité exige une transformation profonde de notre rapport intime au monde : l’incorporation de la pensée probabiliste et bayésienne au cœur de nos raisonnements quotidiens. Vivre de manière rationnelle implique d’accepter une bonne fois pour toutes la part incompressible d’incertitude ontologique, de variance stochastique et de hasard brut qui gouverne les événements du cosmos physique, de la biologie humaine et des dynamiques sociales.
Pour immuniser son jugement contre les pièges de l’apophénie et du prêt-à-penser narratif, l’outil cognitif le plus puissant réside dans l’exercice systématique du réflexe contrefactuel. Chaque fois qu’une allégation ou qu’une expérience personnelle invite l’esprit à déduire qu’un facteur A a produit l’issue B (qu’il s’agisse de la prise d’une gélule homéopathique semblant avoir guéri un état grippal en quarante-huit heures, ou d’une décision managériale semblant avoir dynamisé les ventes d’une équipe commerciale), le sujet doit suspendre son assentiment immédiat pour formuler délibérément la question sacrificielle : « Que se serait-il passé exactement pour cet individu ou ce groupe, dans cet univers identique, si cet élément A n’avait pas été introduit ? » Rappeler que l’histoire naturelle d’une virose respiratoire banale conduit spontanément à la guérison immunitaire en quelques jours en l’absence de tout traitement permet d’évacuer instantanément l’illusion de causalité prêtée à la granule de sucre.
Cet apprentissage permanent de la retenue intellectuelle face aux évidences de surface constitue l’essence même de l’esprit des Lumières et de la rationalité scientifique. Selon le mot mémorable du physicien Richard Feynman : « Le premier principe est que vous ne devez pas vous duper vous-même, et vous êtes la personne la plus facile à duper. » Apprendre à dissocier la trajectoire parallèle de deux courbes statistiques de la mécanique causale profonde qui meut le réel est sans doute le premier et le plus fondamental des pas sur le chemin de cette liberté intellectuelle exigeante.
Références
Angrist, J. D., & Pischke, J.-S. (2009). Mostly Harmless Econometrics: An Empiricist’s Companion. Princeton University Press. https://doi.org/10.1515/9781400829828
Baron, R. M., & Kenny, D. A. (1986). The moderator-mediator variable distinction in social psychological research: Conceptual, strategic, and statistical considerations. Journal of Personality and Social Psychology, 51(6), 1173–1182. https://doi.org/10.1037/0022-3514.51.6.1173
Baumeister, R. F., Campbell, J. D., Krueger, J. I., & Vohs, K. D. (2003). Does high self-esteem cause better performance, interpersonal success, happiness, or healthier lifestyles? Psychological Science in the Public Interest, 4(1), 1–44. https://doi.org/10.1111/1529-1006.01431
Bickel, P. J., Hammel, E. A., & O’Connell, J. W. (1975). Sex bias in graduate admissions: Data from Berkeley. Science, 187(4175), 398–404. https://doi.org/10.1126/science.187.4175.398
Borsboom, D. (2017). A network approach to psychopathology. World Psychiatry, 16(1), 5–13. https://doi.org/10.1002/wps.20375
Granger, C. W., & Newbold, P. (1974). Spurious regressions in econometrics. Journal of Econometrics, 2(2), 111–120. https://doi.org/10.1016/0304-4076(74)90034-7
Hernán, M. A., & Robins, J. M. (2020). Causal Inference: What If. Chapman & Hall/CRC. https://www.hsph.harvard.edu/miguel-hernan/causal-inference-book/
Hill, A. B. (1965). The environment and disease: Association or causation? Proceedings of the Royal Society of Medicine, 58(5), 295–300. https://doi.org/10.1177/003591576505800505
Hume, D. (1739). A Treatise of Human Nature. John Noon.
Kahneman, D. (2011). Thinking, Fast and Slow. Farrar, Straus and Giroux.
Langer, E. J. (1975). The illusion of control. Journal of Personality and Social Psychology, 32(2), 311–328. https://doi.org/10.1037/0022-3514.32.2.311
Lewis, D. (1973). Causation. The Journal of Philosophy, 70(17), 556–567. https://doi.org/10.2307/2025310
Messerli, F. H. (2012). Chocolate consumption, cognitive function, and Nobel laureates. The New England Journal of Medicine, 367(16), 1562–1564. https://doi.org/10.1056/NEJMon1211064
Orben, A., & Przybylski, A. K. (2019). The association between adolescent well-being and digital technology use. Nature Human Behaviour, 3(2), 173–182. https://doi.org/10.1038/s41562-018-0506-1
Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
Pearl, J., & Mackenzie, D. (2018). The Book of Why: The New Science of Cause and Effect. Basic Books.
Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
Rubin, D. B. (1974). Estimating causal effects of treatments in randomized and nonrandomized studies. Journal of Educational Psychology, 66(5), 688–701. https://doi.org/10.1037/h0037350
Shermer, M. (2011). The Believing Brain: From Ghosts and Gods to Politics and Conspiracies—How We Construct Beliefs and Reinforce Them as Truths. Times Books.
Smith, G. D., & Ebrahim, S. (2003). ‘Mendelian randomization’: Can genetic epidemiology contribute to understanding environmental determinants of disease? International Journal of Epidemiology, 32(1), 1–22. https://doi.org/10.1093/ije/dyg070
Tversky, A., & Kahneman, D. (1974). Judgment under uncertainty: Heuristics and biases. Science, 185(4157), 1124–1131. https://doi.org/10.1126/science.185.4157.1124
Writing Group for the Women’s Health Initiative Investigators. (2002). Risks and benefits of estrogen plus progestin in healthy postmenopausal women: Principal results from the Women’s Health Initiative randomized controlled trial. JAMA, 288(3), 321–333. https://doi.org/10.1001/jama.288.3.321