
L’analyse statistique moderne repose sur une exigence fondamentale d’exactitude dans l’agrégation des données quantitatives. Dans les environnements corporatifs, épidémiologiques et économétriques contemporains, les observations brutes issues de processus de collecte automatisés ou d’enquêtes par sondage ne possèdent que très rarement une représentativité intrinsèque équivalente. Traiter chaque point de données avec le même niveau d’importance arithmétique revient fréquemment à occulter les structures sous-jacentes du phénomène observé, introduisant des biais d’agrégation susceptibles de fausser les prises de décision stratégiques et les inférences scientifiques. C’est dans ce contexte méthodologique rigoureux que le concept de moyenne pondérée s’impose non pas comme un simple raffinement algorithmique, mais comme un impératif épistémologique et analytique.
Le système SAS (Statistical Analysis System), développé initialement pour l’analyse agronomique et devenu la norme internationale en biostatistique, en modélisation financière et en actuariat, propose une panoplie d’outils particulièrement étendue pour résoudre ces problématiques de pondération. De la puissance déclarative du langage ensembliste via la procédure PROC SQL à la granularité séquentielle offerte par l’étape DATA, en passant par les procédures d’agrégation statistique optimisées telles que PROC MEANS, PROC SUMMARY et PROC SURVEYMEANS, la plateforme logicielle offre une flexibilité sans égale. La maîtrise de ces différentes approches permet aux statisticiens et ingénieurs de données de concilier exactitude mathématique, performance computationnelle sur des volumes massifs de données et auditabilité rigoureuse des chaînes de traitement.
Le présent traité propose une exploration exhaustive des paradigmes et des techniques algorithmiques nécessaires pour calculer une moyenne pondérée dans SAS. En articulant les fondements mathématiques rigoureux de l’estimation statistique avec les détails d’implémentation logicielle, ce document guide l’analyste à travers chaque étape opérationnelle, depuis l’ingestion et le contrôle d’intégrité des vecteurs de données jusqu’à l’optimisation des flux d’entrées-sorties sur des méga-bases de données, en passant par le traitement des valeurs atypiques et l’encapsulation macro-programmatique réutilisable.
1. Introduction théorique à la moyenne pondérée dans l’environnement SAS
1.1 Définition conceptuelle et pertinence statistique de la pondération
La distinction épistémologique entre la moyenne arithmétique simple et la moyenne pondérée réside dans l’abandon de l’hypothèse d’équipondération des unités d’observation. Dans une moyenne arithmétique classique, chaque observation se voit attribuer implicitement un coefficient unitaire équivalent, traduisant le postulat selon lequel chaque point d’échantillonnage apporte une fraction strictement identique d’information sur le paramètre populationnel sous-jacent. Or, dans les configurations empiriques réelles, cette hypothèse est fréquemment contredite par la réalité des processus générateurs de données. La moyenne pondérée résout cette limitation en assignant à chaque observation un facteur d’importance relative, souvent qualifié de poids, qui module sa contribution à la synthèse globale.
L’attribution de ces coefficients d’importance relative est indispensable dans de multiples domaines de la recherche quantitative. En psychométrie et en sciences comportementales, par exemple, lorsqu’une mesure agrège différentes épreuves cognitives dont la fidélité de mesure ou la saturation factorielle varie, l’application d’un poids proportionnel à la variance partagée permet d’estimer un score composite plus fidèle à la variable latente. De même, en économétrie de la consommation, le calcul d’un niveau moyen de prix pour un panier de biens nécessite impérativement de pondérer le coût unitaire de chaque transaction par les volumes de vente réels, sous peine de surévaluer drastiquement des biens marginaux très onéreux mais rarement acquis.
Dans le domaine des sondages stratifiés et de la statistique publique, l’impact des distorsions d’échantillonnage sur les estimations non pondérées s’avère particulièrement dévastateur. Lorsqu’une sous-population spécifique est intentionnellement suréchantillonnée dans un plan d’échantillonnage complexe pour des impératifs d’analyse locale, le calcul d’un estimateur moyen national non pondéré induit un biais de représentativité majeur. Les estimateurs pondérés interviennent alors comme un dispositif de calage sur marges et de redressement, rééquilibrant les proportions relatives de chaque strate au sein de l’espace inférentiel afin de reproduire fidèlement la structure sociodémographique de la population cible.
1.2 Architecture logicielle de SAS pour le calcul statistique
L’architecture interne du logiciel SAS est conçue pour exécuter des calculs analytiques de grande échelle avec une efficacité mémoire optimale. Au cœur de cette infrastructure se trouve le moteur de traitement multithread et le système de gestion de données orienté colonnes et lignes, optimisé pour la manipulation de volumes massifs dépassant les capacités d’allocation de la mémoire vive standard. Contrairement à des environnements de prototypage qui nécessitent le chargement intégral des jeux de données dans l’espace RAM, SAS gère des flux d’enregistrements séquentiels ou indexés à travers des structures de tampons sophistiquées, garantissant la stabilité computationnelle sur des téraoctets de données.
Sur le plan fonctionnel, l’environnement SAS repose sur une dualité complémentaire entre l’étape DATA procédurale et les procédures analytiques précompilées dites PROC. L’étape DATA offre un contrôle granulaire au niveau de chaque ligne de données au moyen d’une boucle implicite de lecture et d’écriture. Ce paradigme itératif permet d’implémenter des algorithmes sur mesure, d’effectuer des tests logiques complexes et de gérer des accumulateurs vectoriels avec une précision extrême. Parallèlement, les procédures analytiques telles que PROC MEANS ou PROC SUMMARY constituent des modules en langage compilé, hautement optimisés au niveau machine pour exécuter des agrégations statistiques multivariées avec des performances de traitement inégalées.
Au sein de cet écosystème, la procédure PROC SQL occupe une position charnière en intégrant le paradigme de l’algèbre relationnelle normalisée ANSI dans le monde analytique SAS. PROC SQL permet de formuler des requêtes déclaratives ensemblistes complexes, combinant jointures relationnelles, sous-requêtes imbriquées et fonctions d’agrégation d’une compacité remarquable. Cette coexistence de multiples paradigmes de programmation au sein d’une même plateforme confère à l’ingénieur SAS la possibilité de choisir l’approche la plus adaptée selon les contraintes de lisibilité du code, de maintenance technique et de performance temporelle des calculs statistiques.
2. Fondements mathématiques et formalisation de la moyenne pondérée
2.1 Formulation algébrique standard
D’un point de vue mathématique formel, soit un échantillon de n observations issues d’une population cible, caractérisé par un vecteur de variables d’intérêt Y = (y₁, y₂, …, yₙ)ᵀ appartenant à l’espace réel Rⁿ. À cet échantillon est adjoint un vecteur de facteurs de pondération strictement positifs ou nuls noté W = (w₁, w₂, …, wₙ)ᵀ. La moyenne pondérée, désignée conventionnellement par la notation ȳ_w, correspond au barycentre des valeurs observées, où chaque point géométrique est attiré vers les zones de concentration des masses relatives de pondération.
L’expression sommatoire fondamentale de cet estimateur scalaire s’énonce comme le rapport du produit scalaire des deux vecteurs sur la somme arithmétique des composantes du vecteur de pondération. Formellement, elle se définit par :
ȳ_w = ( ∑_{i=1}^{n} w_i · y_i ) / ( ∑_{i=1}^{n} w_i )
Dans un formalisme matriciel, cette équation s’exprime avec une élégance structurelle sous la forme :
ȳ_w = ( Wᵀ Y ) / ( Wᵀ 1ₙ )
où 1ₙ représente un vecteur colonne unitaire de dimension n. Cette écriture met en exergue le processus de normalisation implicite : chaque poids w_i peut être renormalisé en une proportion relative p_i = w_i / ( ∑_{j=1}^{n} w_j ), telle que la somme de ces coefficients renormalisés soit rigoureusement égale à l’unité (∑ p_i = 1). L’estimateur de la moyenne pondérée se réduit alors à une combinaison linéaire convexe directe des réalisations individuelles.
La validité mathématique de cette construction exige le respect impératif de deux conditions d’existence : la non-négativité stricte des pondérations individuelles (∀ i, w_i ≥ 0) pour préserver la propriété de barycentre interne au domaine de définition de Y, et la non-nullité de la masse totale de pondération (∑_{i=1}^{n} w_i > 0), condition nécessaire pour prévenir l’indétermination liée à une division par zéro. Lorsque ces postulats sont vérifiés, l’estimateur possède d’excellentes propriétés d’invariance d’échelle par rapport aux poids : la multiplication de l’ensemble du vecteur W par une constante scalaire positive quelconque laisse la moyenne pondérée strictement inchangée.
2.2 Types de pondérations rencontrés en analyse de données
L’interprétation statistique et le traitement computationnel de la moyenne pondérée dépendent étroitement de la nature ontologique des poids considérés. La littérature spécialisée, formalisée notamment dans les travaux de William G. Cochran sur la théorie des sondages, distingue trois grandes familles de pondérations aux propriétés théoriques distinctes : les poids de fréquence, les poids de sondage probabilistes et les poids analytiques de précision.
Les poids de fréquence, couramment désignés sous le terme de frequency weights et mobilisés via l’instruction FREQ dans SAS, représentent des multiplicateurs entiers indiquant le nombre exact de fois où une combinaison donnée de variables s’est manifestée à l’identique dans l’échantillon. Un enregistrement doté d’un poids de fréquence de 5 est conceptuellement équivalent à l’empilement strict de 5 lignes d’observations identiques dans la table de données. Par conséquent, la somme des poids de fréquence augmente mécaniquement la taille d’échantillon perçue (N = ∑ f_i), ce qui réduit la variance estimée de la moyenne et amplifie la puissance statistique des tests d’hypothèses en gonflant artificiellement les degrés de liberté.
À l’opposé, les poids d’échantillonnage ou poids de conception probabiliste (sampling weights ou design weights), formalisés par l’estimateur d’Horvitz-Thompson, correspondent à l’inverse de la probabilité d’inclusion de chaque unité dans l’échantillon (w_i = 1 / π_i). Ces poids reflètent le volume de la population cible qu’une observation donnée représente dans l’univers d’extrapolation. Enfin, les poids analytiques (analytic weights ou reliability weights) sont proportionnels à l’inverse de la variance de la mesure observée (w_i ∝ 1 / σ_i²). Utilisés dans l’estimation par les moindres carrés pondérés (WLS) et la méta-analyse, ils permettent d’accorder une autorité supérieure aux observations dont l’incertitude est minimale. Le choix erroné entre ces paradigmes sous SAS modifie radicalement le calcul de l’erreur type, de la matrice de variance-covariance et des intervalles de confiance associés à l’estimateur moyen.
3. Préparation et structuration du jeu de données expérimental dans SAS
3.1 Déclaration et instanciation de la table de données initiale
Afin de concrétiser les démarches programmatiques exposées tout au long de cet ouvrage, nous construisons un ensemble de données de référence simulant les transactions commerciales d’une entreprise de distribution. Ce jeu de données synthétique, bien que compact pour des impératifs pédagogiques d’auditabilité immédiate, intègre l’ensemble des caractéristiques structurelles rencontrées dans les problématiques industrielles : une variable nominale identifiant des agents commerciaux (sales_rep), une variable continue d’intérêt représentant le prix unitaire d’un article vendu (price) et une variable métrique d’intensité servant de coefficient de pondération, à savoir le volume d’unités transactées (amount).
L’instanciation de cette table au sein de la bibliothèque de travail temporaire WORK est orchestrée via une étape DATA intégrant la directive de saisie intégrée DATALINES. La structuration de l’étape de compilation SAS est explicitée ci-dessous :
DATA work.ventes_echantillon;
INPUT sales_rep $ price amount;
DATALINES;
A 10 3
A 14 2
A 8 7
B 12 11
B 9 15
;
RUN;
Dans ce segment d’instructions fondamentales, l’instruction INPUT effectue la déclaration typologique des colonnes. Le modificateur dollar ($) apposé à la suite du libellé sales_rep informe le compilateur que cette colonne doit être instanciée sous la forme d’une chaîne de caractères de longueur standard, tandis que les identifiants price et amount sont alloués sous la forme de variables numériques à virgule flottante sur 8 octets en conformité avec le standard IEEE 754. L’étape de lecture s’exécute à travers la boucle implicite itérant sur chaque enregistrement délimité par l’espace.
Pour attester de l’exactitude de l’instanciation physique et contrôler l’absence d’erreurs de troncature ou de conversion de types, la procédure standard PROC PRINT est exécutée avec la clause de numérotation d’observations :
PROC PRINT data=work.ventes_echantillon noobs;
RUN;
La sortie générée confirme la présence d’une table bidimensionnelle de 5 observations et 3 variables, prête pour les opérations d’analyse descriptive et d’agrégation matricielle.
3.2 Contrôle de l’intégrité structurelle des variables
Préalablement à toute manipulation computationnelle d’envergure, une phase rigoureuse d’audit de la qualité des données s’avère méthodologiquement indispensable. Dans le cadre précis du calcul d’une moyenne pondérée, cette démarche d’assurance qualité repose sur deux exigences cardinales : la validation de la complétude du vecteur de pondération et la vérification des plages de variation admissibles pour la variable cible.
L’inspection du vecteur amount doit impérativement certifier l’absence de valeurs nulles, négatives ou manquantes. Une valeur manquante au sein du vecteur de poids entraînerait l’exclusion automatique de l’observation concernée ou induirait une indétermination dans l’opérateur de cumul. De même, l’examen de la distribution empirique de la variable continue price permet de repérer d’éventuelles valeurs aberrantes dont l’interaction multiplicative avec un poids démesurément élevé exercerait un effet de levier excessif sur la valeur finale de l’estimateur.
La documentation des métadonnées associées à ces variables constitue également une bonne pratique essentielle régie par les standards de la recherche internationale. L’interrogation des tables de dictionnaires SAS, via la vue système dictionary.columns, permet d’extraire dynamiquement les attributs de format, de label et de codage afin de garantir la pérennité du pipeline analytique et sa conformité aux audits statistiques les plus stricts.
4. Méthode 1 : Calcul global d’une moyenne pondérée via PROC SQL
4.1 Syntaxe fondamentale et implémentation de la requête SQL
L’utilisation de la procédure PROC SQL représente une démarche particulièrement intuitive et élégante pour obtenir la moyenne pondérée globale d’un vecteur de données. En transposant les axiomes de la théorie des ensembles et du modèle relationnel dans l’architecture SAS, cette méthode permet de calculer le numérateur et le dénominateur de l’estimateur au sein d’une seule et même expression scalaire d’agrégation.
La syntaxe de base exploite la fonction d’agrégation SUM() appliquée de façon simultanée au produit croisé des colonnes et au vecteur de pondération univarié. La projection s’articule comme suit :
PROC SQL;
CREATE TABLE work.moyenne_ponderee_globale AS
SELECT SUM(price * amount) / SUM(amount) AS weighted_avg
FROM work.ventes_echantillon;
QUIT;
Dans ce bloc transactionnel, l’instruction CREATE TABLE ordonne à SAS de persister le résultat de la requête relationnelle dans une nouvelle table résidente en mémoire. La clause SELECT applique l’expression d’évaluation arithmétique price * amount au niveau de chaque ligne d’observation avant de soumettre les produits résultants à l’opérateur de sommation ensembliste SUM(). De manière concomitante, l’expression SUM(amount) calcule la masse totale des coefficients de pondération. L’opérateur de division scalaire génère alors la valeur synthétique finale, à laquelle est attribué l’alias d’exportation weighted_avg. L’instruction QUIT clôture la session de la procédure interactive.
4.2 Application empirique au jeu de données d’exemple
L’application rigoureuse de cette syntaxe à notre jeu de données expérimental permet de décomposer arithmétiquement le résultat obtenu. Détaillons les calculs intermédiaires effectués par le processeur d’exécution de PROC SQL :
- Observation 1 : 10 × 3 = 30
- Observation 2 : 14 × 2 = 28
- Observation 3 : 8 × 7 = 56
- Observation 4 : 12 × 11 = 132
- Observation 5 : 9 × 15 = 135
La sommation scalaire du numérateur produit : 30 + 28 + 56 + 132 + 135 = 381. Parallèlement, la sommation des poids associés au dénominateur établit le volume total à : 3 + 2 + 7 + 11 + 15 = 38. Le quotient arithmétique rigoureux de ces deux grandeurs scalaires est :
ȳ_w = 381 / 38 ≈ 9,70588235…
L’exécution de la procédure de restitution PROC PRINT confirme cette convergence numérique :
PROC PRINT data=work.moyenne_ponderee_globale noobs;
RUN;
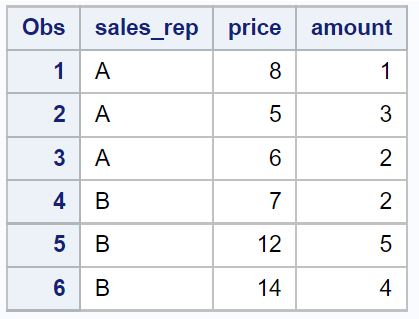
Pour appréhender l’intérêt fondamental de cette démarche pondérée, il convient de confronter ce résultat à la moyenne arithmétique simple non pondérée du vecteur des prix : ȳ = (10 + 14 + 8 + 12 + 9) / 5 = 53 / 5 = 10,6. L’écart quantitatif absolu est de 0,89412 unité monétaire. Cette divergence marquée découle directement du fait que les transactions caractérisées par les prix les plus bas (9 et 8) sont associées aux volumes de transaction les plus considérables (respectivement 15 et 7 unités). Ignorer la pondération conduirait dans ce cas précis à surestimer le prix unitaire moyen effectif des transactions de près de 9,2 %, introduisant une distorsion économique significative.
5. Décomposition analytique du processus computationnel sous PROC SQL
5.1 Ordre d’évaluation des expressions arithmétiques internes
L’évaluation d’une expression combinant des fonctions d’agrégation scalaires et des opérateurs arithmétiques élémentaires sous PROC SQL répond à une hiérarchie syntaxique et opératoire stricte, régie par les spécifications du standard ANSI SQL et les optimisations du compilateur de requêtes SAS. Comprendre cette mécanique séquentielle interne est indispensable pour prévenir tout comportement inattendu lors de traitements statistiques critiques.
Dans la construction SUM(price * amount) / SUM(amount), l’interpréteur de requêtes décompose le calcul en quatre phases distinctes. En premier lieu, lors de la lecture ligne à ligne ou du chargement vectoriel en mémoire tampon, l’opérateur de multiplication élémentaire (price * amount) est évalué de manière prioritaire pour chaque enregistrement individuel de la table. Si l’un des deux opérandes présente une valeur manquante au niveau de la ligne, l’expression multiplicative produit une valeur manquante intermédiaire pour cette ligne spécifique.
Dans un deuxième temps, le premier accumulateur d’agrégation recueille la somme de ces produits individuels validés, ignorant les valeurs manquantes conformément aux spécifications relationnelles de l’opérateur SUM(). Simultanément ou dans un registre parallèle, le second accumulateur de l’expression SUM(amount) agrège les composantes individuelles du vecteur de pondération. Une fois la table intégralement balayée, le moteur arithmétique procède enfin à la division des deux scalaires accumulés au sein du processeur de calcul en virgule flottante double précision, gérant dynamiquement les arrondis conformément aux directives de la norme IEEE 754 avant d’écrire la valeur finale dans le vecteur de sortie.
5.2 Optimisation des ressources mémoire lors de la requête
Le principal atout architectural de la formulation ensembliste réside dans la capacité du moteur PROC SQL à exécuter cette opération d’agrégation globale en une seule passe séquentielle sur les données (single-pass processing). Le compilateur identifie que la requête ne comporte aucune clause d’ordonnancement (ORDER BY) ni dépendance de sous-requête corrélée, ce qui lui permet d’instancier des accumulateurs d’agrégation immédiatement lors de l’accès aux pages de données sans avoir à réécrire de tables temporaires de travail sur le disque.
Sur le plan de l’allocation des tampons mémoire, SAS alloue par défaut un espace contrôlé par l’option système BUFSIZE et un nombre de tampons d’E/S défini par BUFNO. Lors de l’exécution de la commande d’agrégation, les blocs de données sont transférés séquentiellement depuis le disque dur ou le système de stockage réseau directement vers ces mémoires tampons d’entrée. Dès lors que les multiplications et additions sont répercutées dans les accumulateurs scalaires centraux, le bloc de mémoire tampon peut être immédiatement recyclé pour accueillir la page physique suivante. Cette stratégie garantit que la consommation de mémoire vive de la requête demeure strictement constante (O(1) en complexité spatiale), quel que soit le volume total de la table analysée, qu’elle comporte cinquante observations ou un demi-milliard d’enregistrements.
6. Méthode 2 : Calcul de la moyenne pondérée par sous-groupes avec PROC SQL
6.1 Théorie de la stratification et de la segmentation statistique
Dans les démarches empiriques avancées, l’estimation d’un paramètre global univarié s’avère fréquemment insuffisante pour capter l’hétérogénéité des structures comportementales ou économiques sous-jacentes. La stratification ou la segmentation d’un échantillon selon une ou plusieurs variables qualitatives catégorielles (telles que le représentant commercial, le centre hospitalier, le segment de marché ou la région géographique) répond à la nécessité théorique de modéliser des distributions conditionnelles locales.
Ce partitionnement de la population repose sur le théorème fondamental de décomposition de la variance d’Huygens, qui stipule que la variance totale d’une variable quantitative se décompose rigoureusement en la somme de la variance moyenne intra-groupe (qui mesure la dispersion résiduelle au sein de chaque strate) et de la variance inter-groupe (qui mesure l’écartement des moyennes des différentes strates par rapport à la moyenne générale barycentrique) :
Var(Y) = E[Var(Y|X)] + Var(E[Y|X])
Lorsque des facteurs de pondération interviennent au sein de chaque strate, le calcul conditionnel de la moyenne pondérée par sous-groupe préserve l’intégrité de la structure hiérarchique des données. L’évaluation locale de l’estimateur permet d’identifier si les disparités de performance observées globalement résultent d’une réelle supériorité structurelle d’une unité ou simplement d’un effet de composition d’échelle lié à la distribution différentielle des volumes ou des poids.
6.2 Syntaxe de l’instruction GROUP BY sous PROC SQL
La mise en œuvre computationnelle de cette décomposition par strates s’effectue dans PROC SQL par l’adjonction de la clause d’agrégation factorielle GROUP BY. Cette instruction modifie la sémantique de l’évaluation : au lieu de condenser l’intégralité de la table dans une cellule scalaire unique, le processeur de requêtes instancie un ensemble d’accumulateurs disjoints pour chaque valeur distincte de la variable de regroupement.
La formulation syntaxique canonique pour notre étude de cas est structurée de la manière suivante :
PROC SQL;
CREATE TABLE work.moyenne_ponderee_par_groupe AS
SELECT sales_rep,
SUM(price * amount) / SUM(amount) AS weighted_avg
FROM work.ventes_echantillon
GROUP BY sales_rep;
QUIT;
Dans ce modèle de requête, la variable sales_rep est explicitement sélectionnée aux côtés de l’estimateur pondéré. Le moteur SQL partitionne conceptuellement la table d’entrée en sous-ensembles homogènes correspondant aux modalités identifiées (dans notre exemple, les représentants A et B), exécute l’évaluation arithmétique de manière isolée au sein de chaque partition, puis compile une table de sortie récapitulative contenant exactement un enregistrement par niveau de la variable de segmentation.
6.3 Interprétation académique des résultats par groupe
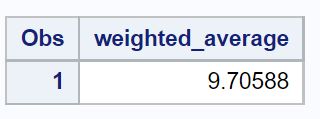
L’exécution de la procédure de contrôle tabulaire PROC PRINT met en lumière la distribution différentielle des moyennes pondérées selon le représentant commercial :
PROC PRINT data=work.moyenne_ponderee_par_groupe noobs;
RUN;
L’analyse des valeurs numériques obtenues révèle des écarts remarquables qui méritent une décomposition formelle :
Pour le représentant commercial A, la somme des produits montant par prix est : (10 × 3) + (14 × 2) + (8 × 7) = 30 + 28 + 56 = 114. La somme des coefficients de pondération associés est : 3 + 2 + 7 = 12. La moyenne pondérée conditionnelle s’élève donc rigoureusement à :
ȳ_{w, A} = 114 / 12 = 9,5000
Pour le représentant commercial B, la somme des produits est : (12 × 11) + (9 × 15) = 132 + 135 = 267. La somme des poids correspondants est : 11 + 15 = 26. L’estimateur pondéré conditionnel s’établit alors à :
ȳ_{w, B} = 267 / 26 ≈ 10,2692
La comparaison de ces indicateurs pondérés avec les moyennes arithmétiques simples respectives illustre l’importance méthodologique de l’analyse par sous-groupe. Pour le commercial A, la moyenne arithmétique simple est de (10 + 14 + 8) / 3 = 10,6667, soit une valeur sensiblement supérieure à sa moyenne pondérée (9,5000). Cette baisse significative s’explique par le poids prédominant de la transaction à 8 unités monétaires, qui concentre à elle seule plus de 58 % du volume d’activité du représentant. Pour le commercial B, la moyenne simple est de (12 + 9) / 2 = 10,5000, comparativement à une moyenne pondérée de 10,2692. En neutralisant les biais d’agrégation interne, l’analyste met en évidence que l’écart de tarification effective entre les deux agents n’est que de 0,7692 unité monétaire en faveur du représentant B, alors qu’une comparaison sommaire des moyennes brutes non pondérées concluait erronément à une tarification moyenne plus élevée pour le représentant A.
7. Gestion des données manquantes et des valeurs atypiques dans la pondération
7.1 Comportement de PROC SQL face aux valeurs NULL
L’irruption de données manquantes (désignées sous le concept de NULL en langage SQL standard et matérialisées par un point . pour les grandeurs numériques dans l’environnement SAS) pose des défis théoriques et algorithmiques majeurs lors du calcul d’agrégats statistiques pondérés. La rigueur analytique impose d’expliciter le traitement réservé à ces occurrences au sein du processeur de requêtes.
Sous PROC SQL, le comportement des fonctions d’agrégation d’ensemble vis-à-vis des données manquantes obéit aux règles de la logique ternaire relationnelle :
- Si la variable d’intérêt price présente une valeur manquante sur une ligne donnée alors que son poids amount est documenté, le produit arithmétique price * amount produit une valeur manquante intermédiaire. L’opérateur SUM() omet cette observation manquante au numérateur, mais l’expression du dénominateur SUM(amount) intégrerait quant à elle le poids de cette ligne si elle était calculée indépendamment sur l’ensemble de la table ! Cette asymétrie produirait une sous-estimation systématique dramatique de la moyenne pondérée en gonflant le dénominateur sans apport au numérateur.
- De même, si la valeur de pondération amount est manquante, le produit du numérateur est converti en valeur manquante et ignoré.
Pour immuniser le code contre ce risque d’asymétrie structurelle, il est impératif d’intégrer une clause de filtrage WHERE stricte assurant l’alignement bivarié complet des deux colonnes :
PROC SQL;
CREATE TABLE work.moyenne_nettoyee AS
SELECT sales_rep,
SUM(price * amount) / SUM(amount) AS weighted_avg
FROM work.ventes_echantillon
WHERE price IS NOT NULL AND amount IS NOT NULL
GROUP BY sales_rep;
QUIT;
L’application préalable de ce prédicat booléen garantit que seules les observations possédant une intégrité bivariée conjointe participent à la formation simultanée des agrégats du numérateur et du dénominateur, éliminant tout biais d’attrition asymétrique au sein du journal SAS.
7.2 Traitement des poids négatifs ou nuls
D’un point de vue méthodologique, l’attribution d’un coefficient de pondération négatif à une observation constitue une anomalie logique dans la quasi-totalité des cadres d’échantillonnage probabiliste. Un poids négatif déstabilise la positivité de la mesure spectrale et peut conduire à des situations aberrantes où la moyenne pondérée calculée s’établit en dehors de l’enveloppe convexe délimitée par le minimum et le maximum des observations de l’échantillon. De surcroît, si la somme arithmétique des poids converge vers zéro, l’opération de division aboutit à un débordement arithmétique ou à une valeur manquante non définie.
La prévention algorithmique de ces écueils opérationnels requiert l’intégration de clauses conditionnelles utilisant l’expression CASE WHEN au sein de la requête PROC SQL, ou la formulation d’un filtre restrictif sur la positivité stricte :
PROC SQL;
CREATE TABLE work.moyenne_ponderee_securisee AS
SELECT sales_rep,
CASE
WHEN SUM(CASE WHEN amount > 0 THEN amount ELSE 0 END) > 0
THEN SUM(CASE WHEN amount > 0 THEN price * amount ELSE 0 END) /
SUM(CASE WHEN amount > 0 THEN amount ELSE 0 END)
ELSE .
END AS weighted_avg
FROM work.ventes_echantillon
GROUP BY sales_rep;
QUIT;
Cette architecture défensive élimine toute instabilité numérique : si la somme des poids positifs d’une strate s’avère nulle ou négative, l’estimateur bascule élégamment vers une valeur manquante contrôlée sans interrompre la chaîne de production du traitement par lot.
8. Approche alternative : Implémentation via l’étape DATA et l’instruction RETAIN
8.1 Algorithme séquentiel de cumul itératif
Bien que l’approche relationnelle sous PROC SQL se distingue par sa concision déclarative, la méthode historique reposant sur l’étape DATA séquentielle demeure l’une des techniques fondamentales du répertoire SAS. Elle offre un contrôle déterministe absolu sur la mémoire, particulièrement apprécié lors de l’intégration d’algorithmes métier hautement paramétrés ou de calculs nécessitant des structures de rétention inter-enregistrements.
L’implémentation de cette logique requiert impérativement l’ordonnancement préalable des observations selon la variable de classification à l’aide de la procédure PROC SORT, condition indispensable à l’activation des variables automatiques de franchissement de frontières catégorielles FIRST.byvariable et LAST.byvariable :
PROC SORT data=work.ventes_echantillon out=work.ventes_triees;
BY sales_rep;
RUN;
Une fois la table ordonnée physiquement selon la clé primaire de stratification, l’étape DATA mobilise l’instruction RETAIN pour maintenir l’état des accumulateurs du numérateur et du dénominateur d’une itération à la suivante :
DATA work.moyenne_ponderee_data_step (keep=sales_rep weighted_avg);
SET work.ventes_triees;
BY sales_rep;
RETAIN sum_produits sum_poids 0;
/* Initialisation des accumulateurs au début de chaque sous-groupe */
IF FIRST.sales_rep THEN DO;
sum_produits = 0;
sum_poids = 0;
END;
/* Cumul conditionnel */
IF NOT MISSING(price) AND NOT MISSING(amount) AND amount > 0 THEN DO;
sum_produits + (price * amount);
sum_poids + amount;
END;
/* Calcul final et émission du résultat à la dernière ligne du groupe */
IF LAST.sales_rep THEN DO;
IF sum_poids > 0 THEN weighted_avg = sum_produits / sum_poids;
ELSE weighted_avg = .;
OUTPUT;
END;
RUN;
Dans ce segment algorithmique, l’instruction de somme implicite variable + expression assure automatiquement la persistance de l’état sans être réinitialisée à une valeur manquante au passage du vecteur de travail (Program Data Vector – PDV). Le bloc conditionnel adossé au marqueur FIRST.sales_rep remet à zéro les accumulateurs à l’entrée de chaque nouvelle strate, tandis que la directive LAST.sales_rep déclenche la division barycentrique et l’instruction OUTPUT, expulsant l’enregistrement synthétisé dans la table de destination.
8.2 Avantages programmatiques comparés de l’étape DATA
L’intérêt de l’étape DATA par rapport aux requêtes PROC SQL réside dans son aptitude à effectuer des calculs séquentiels d’une complexité algorithmique arbitraire sans nécessiter de lectures récursives de la table. Il devient aisé d’intégrer dans la même passe de lecture des calculs de moyennes pondérées glissantes, des vérifications conditionnelles multi-colonnes, la gestion de compteurs de contrôle ou encore l’évaluation conjointe d’indicateurs de dispersion sur mesure.
En matière d’efficience brute, lorsque les tables de données sont volumineuses mais déjà triées physiquement sur disque (ou partitionnées selon l’architecture du système de fichiers), l’étape DATA surpasse généralement PROC SQL. Elle élimine la surcharge liée à la phase d’optimisation de requêtes relationnelles et réduit l’empreinte mémoire à la stricte dimension des variables conservées dans le vecteur PDV. Toutefois, elle impose une discipline de programmation plus rigoureuse, matérialisée par l’obligation absolue de trier préalablement les données et de gérer manuellement la réinitialisation des variables d’état.
9. Calcul de moyennes pondérées via les procédures statistiques natives : PROC MEANS et PROC SUMMARY
9.1 Utilisation de l’instruction WEIGHT dans PROC MEANS
Les procédures statistiques compilées du noyau SAS, au premier rang desquelles figurent PROC MEANS et sa jumelle fonctionnelle PROC SUMMARY, constituent les vecteurs d’exécution privilégiés pour le calcul standardisé d’indicateurs descriptifs pondérés. Conçues spécifiquement pour l’agrégation numérique de haute intensité, elles intègrent nativement des algorithmes optimisés pour minimiser les erreurs d’arrondi sur les sommes de grands nombres.
Le paramétrage d’une analyse pondérée sous PROC MEANS repose sur la déclaration explicite de l’instruction WEIGHT. Il est ici fondamental de rappeler la divergence conceptuelle absolue entre l’instruction WEIGHT et l’instruction FREQ :
- L’instruction FREQ indique au compilateur que la variable associée représente un compte d’occurrences entières d’unités d’observation rigoureusement identiques. Elle modifie directement les degrés de liberté en posant N = ∑ freq_i, ce qui impacte le calcul de l’erreur type de la moyenne : SE = s / √N.
- L’instruction WEIGHT, quant à elle, définit des pondérations analytiques ou de précision proportionnelle. Elle utilise la valeur de pondération pour pondérer le calcul de la moyenne (ȳ_w) et de la variance, mais ne modifie pas artificiellement le nombre nominal d’observations indépendantes de l’échantillon pour le calcul des degrés de liberté standard, préservant ainsi l’intégrité inférentielle des tests d’hypothèses univariés.
La syntaxe canonique d’extraction vers une table pérenne sans affichage à l’écran est formulée ainsi :
PROC MEANS data=work.ventes_echantillon noprint;
VAR price;
WEIGHT amount;
OUTPUT OUT=work.moyenne_ponderee_proc_means
mean=weighted_avg
sumwgt=total_poids;
RUN;
Dans ce module d’instructions, la clause VAR identifie la variable quantitative cible, WEIGHT désigne le vecteur des facteurs d’échelle, et l’instruction OUTPUT OUT génère une table optimisée contenant la statistique d’intérêt sous le libellé weighted_avg ainsi que la somme cumulée des poids via le mot-clé sumwgt.
9.2 Application par sous-groupes avec l’instruction CLASS ou BY
L’extension de PROC MEANS au calcul par sous-groupes peut être réalisée selon deux stratégies distinctes : l’instruction CLASS ou l’instruction BY. Chacune répond à des contraintes computationnelles différentes.
L’utilisation de l’instruction CLASS constitue l’approche la plus souple et performante sur les jeux de données de taille modérée à grande, car elle ne requiert aucun tri physique préalable des données :
PROC MEANS data=work.ventes_echantillon noprint nway;
CLASS sales_rep;
VAR price;
WEIGHT amount;
OUTPUT OUT=work.moyenne_par_classe (drop=_type_ _freq_)
mean=weighted_avg;
RUN;
L’option NWAY force la procédure à ne restituer que le niveau d’interaction le plus fin défini par les variables de classe, occultant la ligne de synthèse générale (qui correspondrait à l’agrégat global non segmenté). En interne, SAS emploie une table de hachage ultra-rapide en mémoire vive pour indexer dynamiquement les modalités de la variable catégorielle sales_rep et y agréger les produits et poids correspondants.
À l’inverse, si le volume des données dépasse l’espace de la mémoire vive allouée pour la table de hachage, l’instruction BY couplée à une étape PROC SORT devient incontournable. Elle garantit un traitement séquentiel par blocs sans aucun risque de saturation de la mémoire vive (out-of-memory error), assurant une fiabilité parfaite pour l’analyse de méga-données en environnement de production.
10. Extension aux protocoles d’enquêtes complexes avec PROC SURVEYMEANS
10.1 Nécessité de la correction de sondage en recherche empirique
Dans le champ méthodologique des enquêtes probabilistes et de la recherche en santé publique, les données observées ne satisfont presque jamais à l’hypothèse canonique d’indépendance et d’identique distribution (i.i.d.). Les plans de sondage réels comportent fréquemment des caractéristiques de stratification a priori, d’échantillonnage en grappes (clustering) à plusieurs degrés et d’inégales probabilités d’inclusion corrigées par des poids de calage post-stratificatoire.
L’application d’une procédure conventionnelle telle que PROC MEANS ou PROC SQL à ces environnements produit une estimation ponctuelle correcte de la moyenne pondérée, mais génère une estimation totalement biaisée de l’erreur type et de la variance de l’estimateur. En effet, l’effet d’échantillonnage en grappes induit une corrélation intra-classe positive qui réduit la quantité réelle d’information indépendante contenue dans l’échantillon. Utiliser la formule classique de la variance conduit alors à sous-estimer systématiquement les erreurs types réelles, ce qui gonfle artificiellement le taux d’erreur de première espèce (rejet intempestif de l’hypothèse nulle d’égalité des moyennes) et produit des intervalles de confiance indûment étroits.
Pour résoudre cette défaillance théorique majeure, SAS intègre la procédure spécialisée PROC SURVEYMEANS, capable d’estimer sans biais les variances asymptotiques sous des plans de sondage complexes au moyen des techniques de linéarisation par série de Taylor ou de rééchantillonnage répété (jackknife, bootstrap ou réplication équilibrée répétée – BRR).
10.2 Paramétrage de la procédure PROC SURVEYMEANS
La mise en œuvre de PROC SURVEYMEANS requiert la spécification formelle de la structure de conception du plan d’échantillonnage au moyen d’instructions dédiées régissant les grappes, les strates et les coefficients d’expansion :
PROC SURVEYMEANS data=work.ventes_echantillon varmethod=taylor;
VAR price;
WEIGHT amount;
DOMAIN sales_rep;
ODS OUTPUT Domain=work.resultats_enquete_domaine;
RUN;
Dans cette architecture de commande, l’instruction WEIGHT déclare le vecteur des poids de sondage probabilistes. L’instruction fondamentale DOMAIN permet d’exécuter l’analyse sous-populationnelle par agent commercial sans recourir à un filtrage externe ou à une instruction BY. En statistique des sondages, le calcul d’un estimateur moyen sur une sous-population dont la taille est elle-même une variable aléatoire nécessite impérativement d’intégrer la variabilité stochastique du dénominateur d’échantillonnage dans le calcul de la variance par linéarisation de Taylor, démarche que seule l’instruction DOMAIN exécute avec exactitude théorique.
La table résultante exportée via le système ODS (Output Delivery System) met à la disposition des chercheurs non seulement la moyenne pondérée sans biais, mais également l’erreur type asymptotique corrigée de l’effet de plan (design effect), les degrés de liberté réels de l’enquête et les bornes des intervalles de confiance à 95 % respectant rigoureusement la méthodologie de l’inférence en population finie.
11. Optimisation des performances et robustesse du code pour les méga-données
11.1 Indexation et stratégies de traitement en mémoire
Lorsque le volume des tables de données atteint plusieurs dizaines de gigaoctets ou franchit le cap des centaines de millions d’enregistrements, les temps de réponse machine et la charge des systèmes d’entrées-sorties deviennent les contraintes prépondérantes de l’ingénierie statistique. L’optimisation algorithmique exige alors la mise en place d’architectures de stockage optimisées et le calibrage fin des paramètres d’exécution du moteur SAS.
L’une des stratégies fondamentales réside dans la création d’index simples ou composites sur les variables de regroupement. Un index structuré sous forme d’arbre B-tree (balanced tree) accélère considérablement le traitement de la clause GROUP BY sous PROC SQL ou de l’instruction CLASS sous PROC MEANS, en dispensant le système de balayer l’intégralité des enregistrements dans un ordre dispersé :
PROC DATASETS library=work nolist;
MODIFY ventes_echantillon;
INDEX CREATE sales_rep;
QUIT;
Parallèlement à l’indexation, le calibrage des options système de gestion des flux d’E/S au niveau de la session SAS s’avère déterminant :
OPTIONS bufsize=64k bufno=32;
L’extension de la taille des pages mémoire via BUFSIZE=64K permet de charger de vastes blocs séquentiels de lignes en une seule opération physique de lecture sur le disque de stockage, réduisant drastiquement le nombre d’interruptions d’entrées-sorties matérielles. L’élévation conjointe du nombre de tampons par BUFNO=32 fluidifie le pipeline de données en permettant au système de précharger les blocs suivants en mémoire vive pendant que le processeur exécute les opérations multiplicatives et de sommation sur le bloc courant.
Il convient également d’accorder une vigilance extrême à la précision des types numériques. Sous SAS, les variables numériques sont toutes stockées par défaut sous forme de nombres en virgule flottante double précision sur 8 octets. Réduire artificiellement la longueur de stockage des variables d’accumulation (LENGTH sum_produits 4;) dans une vaine tentative d’économiser de l’espace disque constitue une erreur technique critique : cela réduirait la mantisse à une précision insuffisante, générant de graves erreurs de troncature cumulative lors de l’addition de millions de produits pondérés.
11.2 Encapsulation dans une macro-procédure réutilisable
Afin de satisfaire aux impératifs d’industrialisation logicielle, de reproductibilité scientifique et de maintenance applicative, il est recommandé d’encapsuler la chaîne analytique au sein d’une macro SAS modulaire et paramétrée. Cette abstraction macro-programmatique doit intégrer des mécanismes de validation préventive de l’environnement d’exécution, garantissant l’existence des jeux de données, la conformité typologique des colonnes et la traçabilité des exécutions.
Le module de référence suivant illustre la conception d’une macro robuste dédiée au calcul d’une moyenne pondérée segmentée :
%MACRO calculate_weighted_mean(
data=,
var=,
weight=,
by=,
out=work.resultat_pondere
);
/* 1. Validation de l’existence de la table en entrée */
%IF NOT %SYSFUNC(exist(&data)) %THEN %DO;
%PUT %STR(ERR)OR: [MACRO CALCULATE_WEIGHTED_MEAN] La table &data est introuvable.;
%RETURN;
%END;
/* 2. Validation des paramètres obligatoires */
%IF &var = OR &weight = %THEN %DO;
%PUT %STR(ERR)OR: [MACRO CALCULATE_WEIGHTED_MEAN] Les parametres VAR et WEIGHT sont obligatoires.;
%RETURN;
%END;
/* 3. Execution de l’agregation via PROC SQL securisee */
PROC SQL;
CREATE TABLE &out AS
SELECT
%IF %LENGTH(&by) > 0 %THEN &by ,;
SUM(CASE WHEN &weight > 0 AND &var IS NOT NULL THEN &var * &weight ELSE 0 END) /
SUM(CASE WHEN &weight > 0 AND &var IS NOT NULL THEN &weight ELSE . END) AS weighted_mean,
SUM(CASE WHEN &weight > 0 AND &var IS NOT NULL THEN &weight ELSE 0 END) AS sum_weights,
COUNT(CASE WHEN &weight > 0 AND &var IS NOT NULL THEN &var END) AS valid_n
FROM &data
WHERE &weight > 0 AND &var IS NOT NULL
%IF %LENGTH(&by) > 0 %THEN GROUP BY &by ;;
QUIT;
%PUT %STR(NOTE): [MACRO CALCULATE_WEIGHTED_MEAN] Traitement execute avec succes vers la table &out.;
%MEND calculate_weighted_mean;
Cette macro illustre une intégration programmatique complète : elle vérifie dynamiquement les métadonnées système via la fonction macro %SYSFUNC(exist()), gère l’absence éventuelle de clause de regroupement au moyen d’aiguillages conditionnels macro-génératifs (%IF %LENGTH(&by) > 0), immunise le dénominateur contre les divisions par zéro et exporte simultanément l’estimateur de la moyenne, la somme totale des facteurs de pondération et le nombre effectif d’observations ayant contribué au calcul.
12. Synthèse méthodologique, validation croisée et recommandations pratiques
12.1 Matrice décisionnelle pour le choix de la méthode SAS
Face à la pluralité des mécanismes logiciels offerts par la plateforme SAS pour calculer une moyenne pondérée, l’ingénieur de données ou le biostatisticien doit opérer un arbitrage raisonné, guidé par les contraintes spécifiques de son projet analytique. Le tableau comparatif conceptuel suivant formalise les critères décisionnels prépondérants régissant le choix entre PROC SQL, PROC MEANS, l’étape DATA séquentielle et PROC SURVEYMEANS :
- PROC SQL : Recommandée pour la concision déclarative du code, l’intégration immédiate dans des flux relationnels combinant jointures et filtres, et l’auditabilité rapide par des analystes familiers du standard SQL. Méthode idéale pour des calculs d’agrégation d’entreprise standards sans modélisation de plans de sondage complexes.
- PROC MEANS / PROC SUMMARY : Recommandée pour le calcul statistique intensif sur de grands volumes de données. Offre une vitesse d’exécution algorithmique maximale grâce à son code machine compilé et à sa table de hachage interne optimisée (via l’instruction CLASS). Indispensable lorsque l’analyste requiert simultanément d’autres métriques statistiques pondérées (variance, écart-type, percentiles).
- Étape DATA avec RETAIN : Recommandée dès lors que le calcul de la moyenne s’inscrit au sein d’une chaîne algorithmique séquentielle sur mesure, exigeant des règles métier complexes, des tests logiques multiples entre observations successives ou la conservation d’états d’itération non linéaires.
- PROC SURVEYMEANS : Impérative en épidémiologie, en sociologie quantitative et en économétrie appliquée lorsque les données procèdent d’un échantillonnage non équiprobable à plusieurs degrés, avec présence de strates et de grappes. Seule approche méthodologiquement recevable pour la publication académique de tests d’inférence statistique et d’intervalles de confiance non biaisés.
12.2 Protocole de validation et assurance qualité des calculs
L’assurance qualité des résultats computationnels constitue la pierre angulaire de l’éthique de la recherche et de la gouvernance des données en entreprise. L’analyste rigoureux ne saurait se satisfaire de l’obtention d’un résultat numérique sans en avoir au préalable validé la reproductibilité absolue à travers un protocole de tests unitaires et de validation croisée.
Un protocole d’assurance qualité exhaustif s’articule autour de trois impératifs opérationnels :
- Vérification sur données synthétiques témoins : Exécution systématique du pipeline sur un jeu de données de référence restreint (tel que notre table work.ventes_echantillon), dont les propriétés barycentriques ont été calculées et vérifiées manuellement en double aveugle. Tout écart numérique au-delà de la tolérance d’arrondi flottant standard (10⁻¹²) signale une anomalie structurelle dans le code.
- Validation croisée inter-procédures : Confrontation systématique des tables de sortie générées respectivement par PROC SQL et PROC MEANS au moyen de la procédure de comparaison automatisée PROC COMPARE :
PROC COMPARE base=work.moyenne_ponderee_par_groupe
compare=work.moyenne_par_classe
criterion=1e-9;
RUN;
L’inspection du journal SAS généré par PROC COMPARE doit impérativement attester de la conformité stricte des vecteurs numériques analysés, sans divergence d’égalité de valeurs ni discordance d’attributs de formats.
- Audit des valeurs manquantes et des bornes spectrales : Contrôle final s’assurant que chaque valeur de moyenne pondérée estimée s’inscrit rigoureusement à l’intérieur de l’intervalle fermé délimité par la valeur minimale et la valeur maximale de la variable cible au sein de chaque strate : min(y_i) ≤ ȳ_w ≤ max(y_i). Toute transgression de cette borne fondamentale révèle la présence de coefficients de pondération négatifs non maîtrisés ou une division par zéro masquée.
En observant scrupuleusement ces démarches méthodologiques, les praticiens de la science des données garantissent à leurs modèles décisionnels et à leurs publications académiques un niveau d’intégrité, d’exactitude et de robustesse conforme aux exigences les plus élevées de la communauté statistique internationale.
Références
Cochran, W. G. (1977). Sampling Techniques (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Sampling+Techniques%2C+3rd+Edition-p-9780471162407
Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663–685. https://doi.org/10.1080/01621459.1952.10483446
IEEE. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). Institute of Electrical and Electronics Engineers. https://ieeexplore.ieee.org/document/8766229
Institut National de la Statistique et des Études Économiques. (2020). Méthodes de calage sur marges et traitement des données de sondage. Insee Méthodes. https://www.insee.fr/
Kish, L. (1965). Survey Sampling. John Wiley & Sons. https://www.wiley.com/
Lumley, T. (2010). Complex Surveys: A Guide to Analysis Using R. John Wiley & Sons. https://doi.org/10.1002/9780470580066
Särndal, C.-E., Swensson, B., & Wretman, J. (2003). Model Assisted Survey Sampling. Springer-Verlag. https://doi.org/10.1007/978-1-4612-4378-6
SAS Institute Inc. (2021). SAS/STAT 15.2 User’s Guide: The SURVEYMEANS Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/142/surveymeans.pdf
SAS Institute Inc. (2023). SAS 9.4 SQL Procedure User’s Guide (5th ed.). SAS Institute Inc. https://support.sas.com/documentation/cdl/en/sqlproc/69894/PDF/default/sqlproc.pdf
SAS Institute Inc. (2023). Base SAS 9.4 Procedures Guide: Statistical Procedures (6th ed.). SAS Institute Inc. https://support.sas.com/documentation/cdl/en/procstat/69629/PDF/default/procstat.pdf