
Dans le paysage contemporain de la science des données, de l’épidémiologie clinique et de l’économétrie appliquée, la représentation visuelle des données quantitatives et qualitatives constitue un jalon méthodologique incontournable. Loin d’être un simple artifice esthétique destiné à agrémenter des rapports techniques, la graphique statistique représente un instrument d’inférence exploratoire à part entière. Elle permet de synthétiser des distributions multidimensionnelles, d’identifier des ruptures d’homogénéité et de communiquer des résultats empiriques avec une clarté cognitive optimale. Au sein de l’écosystème logiciel du SAS Institute, réputé pour sa robustesse analytique et sa conformité rigoureuse aux normes réglementaires internationales, la transition des anciennes procédures graphiques vers le système ODS Graphics a marqué une évolution paradigmatique majeure. Cette modernisation a conféré aux analystes une puissance expressive accrue tout en automatisant la gestion des propriétés typographiques et géométriques indispensables aux publications scientifiques de haut niveau.
Le diagramme à barres demeure, par son apparente simplicité et son efficacité perceptuelle éprouvée, l’un des artefacts visuels les plus exploités pour l’analyse des variables discrètes et catégorielles. Qu’il s’agisse de comparer les fréquences d’apparition au sein de strates expérimentales indépendantes ou de synthétiser les valeurs agrégées d’une métrique continue selon des facteurs nominaux, sa structure cartésienne offre un décodage spatial direct fondé sur l’estimation de longueurs et de positions relatives. Toutefois, la conception d’un graphique scientifiquement irréprochable exige une maîtrise rigoureuse des instructions procédurales, une compréhension fine des mécanismes sous-jacents d’agrégation statistique et un respect scrupuleux des canons sémiotiques afin de prévenir toute distorsion interprétative. La procédure PROC SGPLOT s’impose aujourd’hui comme la clé de voûte de cette démarche dans l’environnement SAS, alliant une syntaxe modulaire intuitive à une flexibilité paramétrique étendue.
Le présent traité méthodologique se propose de disséquer de manière exhaustive la construction, la personnalisation et l’interprétation des diagrammes à barres sous SAS à travers trois approches fondamentales : le diagramme à barres simple, le diagramme à barres empilées et le diagramme à barres groupées. En s’appuyant sur un jeu de données expérimental contrôlé combinant variables catégorielles et métriques de performance, chaque méthode sera analysée sous l’angle de sa syntaxe formelle, de ses propriétés distributionnelles et de ses implications cognitives pour l’observateur. Au-delà des aspects programmatiques élémentaires, ce guide explorera les subtilités avancées de la mise en page, de la sémiotique chromatique, de l’intégration des mesures de dispersion et des protocoles d’exportation haute résolution, fournissant ainsi aux chercheurs et biostatisticiens un cadre opérationnel exhaustif pour valoriser leurs corpus de données empiriques.
1. Introduction à la visualisation de données catégorielles sous SAS avec PROC SGPLOT
1.1 Fondements théoriques de la représentation graphique en analyse quantitative
L’analyse exploratoire des données, conceptualisée historiquement par John Tukey, assigne à la représentation graphique un rôle heuristique prépondérant. Dans le contexte spécifique des variables catégorielles, qu’elles soient nominales ou ordinales, l’objectif fondamental de la visualisation réside dans la transcription spatiale fidèle des fréquences d’occurrence ou des métriques statistiques associées à des classes d’équivalence discrètes. Contrairement aux variables continues dont les distributions peuvent être caractérisées par des densités lisses ou des histogrammes continus, les données catégorielles imposent une discontinuité fondamentale dans l’espace de représentation. L’encodage visuel doit donc traduire cette orthogonalité logique sans induire d’artefacts relationnels fallacieux entre des modalités disjointes.
Les travaux fondateurs de William Cleveland et Robert McGill sur la perception graphique ont rigoureusement démontré que la précision avec laquelle l’œil humain extrait des informations quantitatives dépend directement du canal d’encodage géométrique employé. Selon leur hiérarchie perceptuelle psychophysique, le jugement de position le long d’une échelle commune constitue la tâche cognitive la plus précise, immédiatement suivie par l’évaluation des longueurs relatives. Les diagrammes à barres exploitent précisément cette synergie optimale : chaque modalité catégorielle est ancrée le long d’un axe nominal orthogonal, tandis que la valeur quantitative est matérialisée par une barre dont la longueur est proportionnelle à la grandeur mesurée, avec une origine rigoureusement fixée à zéro.
Cette supériorité structurelle explique pourquoi, dans la recherche comportementale, biomédicale et économique contemporaine, les diagrammes à barres supplantent systématiquement les diagrammes circulaires (dits camemberts ou pie charts). Ces derniers encodent l’information quantitative sous forme d’angles au centre, d’arcs de cercle et d’aires surfaciques, des canaux perceptuels dont le décodage par le cortex visuel humain est notoirement imprécis et sujet à d’importantes sous-estimations non linéaires. De surcroît, les normes de publication des revues scientifiques internationales à fort facteur d’impact préconisent explicitement l’abandon des représentations sectorielles au profit de barres cartésiennes étalonnées, garantes d’une reproductibilité analytique et d’une rigueur inférentielle conformes aux exigences académiques.
1.2 Présentation de la procédure PROC SGPLOT et de son architecture logicielle
Au cours des premières décennies d’existence du système SAS, la production graphique reposait presque exclusivement sur le module SAS/GRAPH et sur des procédures d’ancienne génération telles que PROC GCHART et PROC GPLOT. Bien que pionnières, ces procédures présentaient des limitations architecturales substantielles : une syntaxe verbeuse souvent déconnectée de la grammaire statistique moderne, une séparation fastidieuse entre la définition des dispositifs matériels (drivers) et les données, ainsi qu’une incapacité chronique à produire nativement des figures vectorielles directement intégrables dans des documents de publication sans un post-traitement laborieux. L’avènement de l’ODS Graphics (Output Delivery System) a constitué une véritable refonte structurelle, réconciliant la puissance de calcul sous-jacente du moteur SAS avec les paradigmes modernes de la visualisation de données.
Au cœur de cette architecture graphique moderne se trouve la procédure PROC SGPLOT (Statistical Graphics Plot). Conçue selon une philosophie modulaire inspirée des principes de la grammaire des graphiques théorisée par Leland Wilkinson, cette procédure permet d’empiler des couches géométriques (calques ou layers) sur un canevas analytique unique. Chaque instruction au sein de la procédure correspond à un type de tracé élémentaire, tel qu’une barre verticale, une courbe de lissage, un nuage de points ou un intervalle de dispersion. Cette approche déclarative libère l’analyste de la gestion microscopique du moteur de rendu : SAS détermine de manière autonome les échelles optimales, l’espacement des graduations, la gestion des collisions textuelles et l’attribution des contrastes chromatiques en fonction des styles ODS préalablement définis.
Sur le plan de l’efficacité informatique, PROC SGPLOT se distingue par une optimisation remarquable des algorithmes de calcul sous-jacents. La procédure traite les volumes de données massifs (dits Big Data) sans saturer la mémoire volatile de la session, en effectuant les opérations de réduction catégorielle, de tri et d’agrégation statistique en amont de la compilation graphique vectorielle. Par rapport aux approches graphiques antérieures, elle élimine la redondance des passes de lecture sur le disque tout en garantissant une compatibilité totale avec les formats de sortie contemporains tels que le SVG, le PDF vectoriel haute définition ou les formats matriciels non compressés comme le TIFF, assurant ainsi une pérennité technique essentielle pour les infrastructures d’analyse à grande échelle.
1.3 Distinction fondamentale entre barres verticales (VBAR) et horizontales (HBAR)
Dans la nomenclature syntaxique de la procédure PROC SGPLOT, la géométrie du diagramme à barres se décline principalement à travers deux instructions fondamentales : VBAR (barres verticales) et HBAR (barres horizontales). Bien que ces deux formes partagent le même principe mathématique de correspondance biunivoque entre une dimension discrète et une métrique scalaire, leur sélection n’est nullement arbitraire et procède d’un arbitrage méthodologique précis dicté par la nature des libellés catégoriels et les conditions de lecture du document final.
L’instruction VBAR projette les modalités de la variable indépendante sur l’axe des abscisses (axe horizontal $X$), tandis que la mesure quantitative (qu’il s’agisse d’un dénombrement fréquentiel ou d’une statistique d’échelle) est portée par l’axe des ordonnées (axe vertical $Y$). Cette configuration constitue la forme canonique la plus intuitive pour le lecteur occidental, habitué à associer une progression verticale à un accroissement d’intensité, de volume ou de fréquence. Elle est particulièrement recommandée lorsque la variable catégorielle possède un ordonnancement naturel, comme dans le cas d’une échelle de Likert, de strates d’âge successives ou de cohortes temporelles discrétisées. Cependant, sa contrainte majeure réside dans la largeur disponible sur l’axe horizontal : lorsque les étiquettes textuelles des catégories comportent un grand nombre de caractères, elles risquent de se chevaucher, contraignant le système graphique à adopter des stratégies d’évitement suboptimales telles que l’angulation à 45 degrés ou la troncature typographique.
À l’inverse, l’instruction HBAR inverse cette disposition cartésienne en assignant la variable catégorielle à l’axe vertical et la dimension métrique à l’axe horizontal. Cette orientation soulage considérablement la charge cognitive de lecture lorsque les catégories possèdent des intitulés longs, techniques ou descriptifs, comme des désignations nosologiques de la classification CIM-10, des protocoles thérapeutiques ou des intitulés organisationnels complexes. Les étiquettes peuvent alors être lues naturellement de gauche à droite sans rotation céphalique ni tension visuelle. En outre, dans le contexte des monographies universitaires, des thèses ou des rapports institutionnels imprimés au format portrait, la barre horizontale permet d’étendre la liste des catégories verticalement le long de la page sans dégrader la lisibilité ni comprimer artificiellement la largeur des éléments géométriques, garantissant ainsi une présentation éditoriale équilibrée.
2. Préparation et structure du jeu de données expérimental dans l’environnement SAS
2.1 Déclaration et instanciation du jeu de données via l’instruction DATA
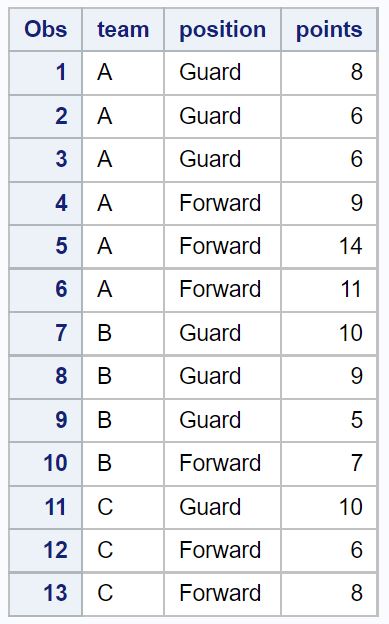
Toute modélisation graphique rigoureuse dans l’écosystème SAS débute par une instanciation méthodique de la table de travail au sein de l’environnement mémoire. Pour illustrer concrètement les trois méthodes de conception de diagrammes à barres, nous allons implémenter un jeu de données expérimental synthétique simulant le suivi des performances d’athlètes au sein d’une ligue sportive professionnelle. Cette table de travail, arbitrairement baptisée my_data, va intégrer des variables factorielles qualitatives et une variable de réponse quantitative, fournissant ainsi une base empirique idéale pour tester les différentes variantes de la procédure PROC SGPLOT.
La création de la table s’effectue classiquement au moyen de l’étape de programmation DATA. Nous utilisons l’instruction INPUT pour déclarer la nature et l’ordre des variables associées à chaque unité d’observation. Deux variables textuelles sont définies : l’équipe d’appartenance de l’athlète, désignée par la variable team, et le poste tactique occupé sur le terrain, encapsulé par la variable position. Le suffixe dollar ($) est explicitement accolé à leurs identifiants pour notifier à l’interpréteur SAS qu’il s’agit de variables de type chaîne de caractères (caractères alphanumériques). Enfin, une variable numérique continue, intitulée points, est intégrée pour consigner le score individuel ou l’indice de performance associé à chaque individu de l’échantillon. L’alimentation des données en ligne s’effectue ensuite par le biais de l’instruction DATALINES, assurant une portabilité absolue du script sans dépendance à un fichier plat externe.
Voici la formulation syntaxique intégrale permettant d’instancier ce jeu de données de référence au sein de la bibliothèque temporaire WORK :
data my_data;

  input team $ position $ points;

  datalines;

A Guard 12

A Guard 20

A Guard 22

A Forward 29

A Forward 24

B Guard 35

B Guard 34

B Forward 12

B Forward 15

B Forward 26

C Guard 18

C Guard 22

C Guard 25

C Forward 15

C Forward 19

;

run;
2.2 Analyse descriptive des variables d’intérêt : équipes, postes et métriques de performance
L’architecture interne de la table my_data repose sur un dispositif quasi-factoriel équilibré comprenant $N = 15$ observations individuelles. Ce volume d’échantillonnage, volontairement restreint à des fins de clarté pédagogique et de traçabilité calculatoire immédiate, permet d’examiner chaque cellule de croisement sans masquer les mécanismes sous-jacents d’agrégation statistique. L’échantillon intègre deux variables indépendantes discrètes et une variable dépendante quantitative continue, reflétant fidèlement les structures relationnelles classiquement observées dans les protocoles de recherche appliquée en sciences sociales, en épidémiologie ou en gestion de la performance.
La première variable indépendante, team, est un facteur nominal à trois modalités mutuellement exclusives : les équipes A, B et C. Chacune de ces équipes regroupe exactement 5 observations dans l’échantillon global, ce qui garantit une parfaite homogénéité des effectifs marginaux ($n_A = n_B = n_C = 5$). Cette équiprobabilité marginale permet d’évaluer directement l’impact des sous-structures internes sans distorsion induite par des déséquilibres d’échantillonnage initiaux.
La seconde variable qualitative, position, représente un sous-facteur dichotomique décrivant le rôle fonctionnel de l’athlète, décliné en deux modalités : Guard (arrière) et Forward (avant). L’examen de la distribution croisée révèle une structure intentionnellement asymétrique au sein des équipes. Pour l’équipe A, nous dénombrons 3 arrières et 2 avants. Pour l’équipe B, la structure s’inverse avec 2 arrières et 3 avants. Enfin, l’équipe C réplique la configuration de l’équipe A avec 3 arrières et 2 avants. Cette variabilité sous-jacente des effectifs cellulaires constituera un banc d’essai idéal pour comparer la lisibilité respective des diagrammes à barres empilées et des diagrammes groupés lors des analyses ultérieures.
Enfin, la variable points consigne une métrique de performance continue exprimée sur une échelle de rapport, prenant des valeurs entières comprises entre 12 et 35 unités. Sa distribution empirique globale présente une moyenne arithmétique de $\bar{X} = 21{,}87$ points avec une dispersion notable entre les strates factorielles. L’équipe B présente une polarisation particulièrement marquée, combinant des scores très élevés pour les arrières (34 et 35 points) et des scores modérés pour les avants (12, 15 et 26 points), tandis que les équipes A et C affichent des répartitions internes plus resserrées autour de leurs moyennes respectives.
2.3 Validation de l’intégrité structurelle des données à l’aide de PROC PRINT
Avant d’engager toute procédure de compilation graphique, une règle épistémologique fondamentale en programmation statistique consiste à valider formellement l’intégrité structurelle des données instanciées. Cette phase de contrôle qualité vise à détecter d’éventuelles erreurs de saisie, des valeurs manquantes non désirées ou des décalages d’attributs de colonnes provoqués par une mauvaise lecture des séparateurs de champs lors de l’exécution du bloc d’instructions INPUT.
Dans l’environnement SAS, la procédure de diagnostic la plus directe et la plus transparente est PROC PRINT. L’application de cette procédure au jeu de données my_data permet d’imprimer l’intégralité de la table dans la fenêtre de sortie standard ou dans la destination ODS active, en restituant la numérotation séquentielle des lignes d’observation ainsi que les métadonnées associées aux descripteurs de variables. Le code de vérification élémentaire s’énonce comme suit :
proc print data=my_data noobs;

run;
L’utilisation de l’option NOOBS supprime l’affichage de la colonne par défaut consignant le numéro d’observation, offrant ainsi un tableau synoptique compact composé des trois colonnes d’intérêt. L’inspection méticuleuse de la sortie générée dans le journal SAS (SAS Log) doit impérativement attester que 15 enregistrements ont été lus à partir de la mémoire tampon et qu’aucune variable n’a été initialisée avec des valeurs manquantes (représentées par un point pour les données numériques ou un espace blanc pour les chaînes de caractères). Dès lors que cette validation structurelle est formellement acquise, la table de travail my_data est réputée conforme pour l’application des procédures de visualisation statistique de haute précision.
3. Méthode 1 : Construction d’un diagramme à barres simple (Simple Bar Chart)
3.1 Syntaxe fondamentale de l’instruction VBAR pour l’évaluation des fréquences
La première méthode de visualisation catégorielle repose sur la construction d’un diagramme à barres simple, univarié et vertical. Dans l’écosystème procédural de PROC SGPLOT, l’instruction directrice assurant cette projection graphique est VBAR, abréviation transparente de Vertical Bar. Cette instruction requiert a minima la spécification d’une variable de classification catégorielle, portée en argument immédiat sans opérateur d’affectation complexe.
Sur le plan mécanique, lorsque l’instruction vbar team; est exécutée au sein du bloc proc sgplot data=my_data;, le compilateur graphique SAS active automatiquement son moteur d’agrégation fréquentielle interne. Il n’est nullement nécessaire de prétraiter la table au moyen d’une procédure PROC FREQ ou PROC MEANS pour calculer préalablement les occurrences marginales de chaque classe. SAS procède à un balayage exhaustif des vecteurs de données, identifie les niveaux d’équivalence discrets de la variable catégorielle spécifiée (ici, les modalités A, B et C), dénombre le volume total d’observations associées à chacune d’elles, puis génère dynamiquement l’échelle cartésienne correspondante.
Par défaut, l’axe vertical des ordonnées ($Y$) reçoit l’intitulé normalisé Frequency, et son intervalle numérique s’étend automatiquement de zéro jusqu’à une valeur plafond supérieure ou égale au dénombrement maximal observé dans l’échantillon, avec des incréments réguliers déterminés par un algorithme d’optimisation de l’affichage typographique. Les catégories de l’axe horizontal ($X$) sont ordonnées, par défaut, selon l’ordre alphanumérique standard de leurs valeurs textuelles formatées, garantissant ainsi un traitement prévisible et rigoureusement déterministe de la sortie visuelle.
3.2 Application pratique : Distribution fréquentielle des équipes d’observation
La mise en œuvre pratique de cette première modalité graphique sur notre jeu de données expérimental s’exprime à travers un script d’une remarquable concision. Il s’agit d’ordonner au moteur SAS de lire la table my_data et d’ériger les rectangles verticaux proportionnels au dénombrement de chaque équipe. La séquence syntaxique complète s’énonce comme suit :
proc sgplot data=my_data;

  vbar team;

run;
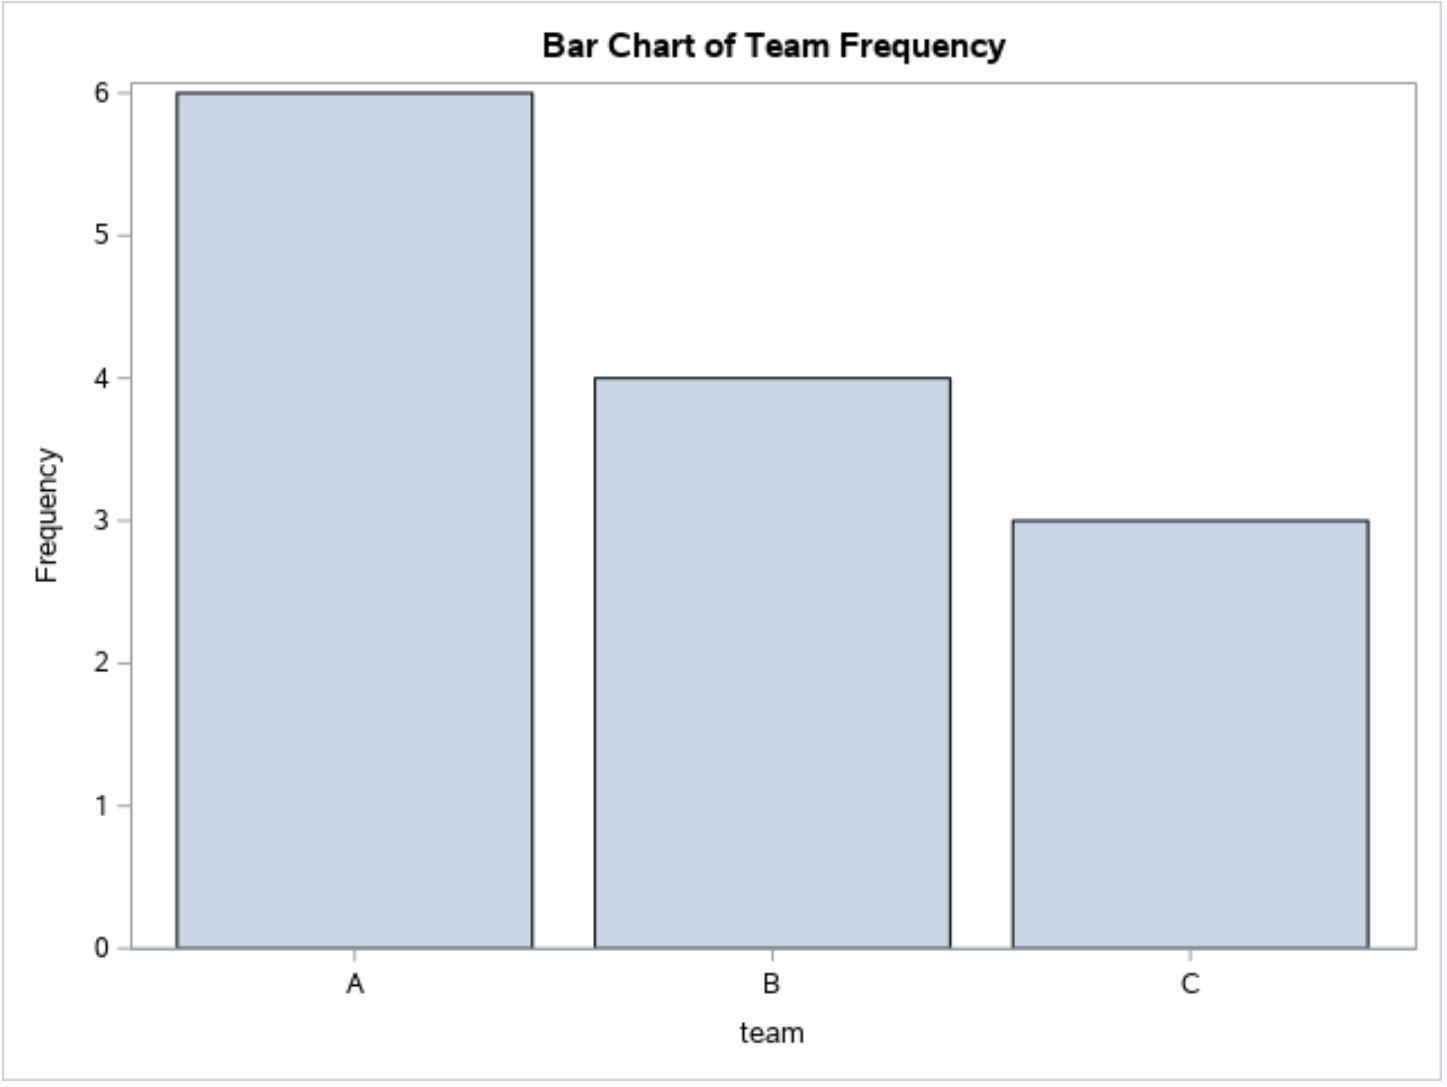
À l’exécution de cette requête, le moteur ODS Graphics délivre une figure constituée de trois colonnes rectangulaires distinctes, spatialement isolées les unes des autres par un espacement inter-barres harmonieux précalibré. L’axe des abscisses porte les identifiants catégoriels « A », « B » et « C », surmontés par le libellé de variable « team ». L’axe des ordonnées affiche une échelle métrique graduée de 0 à 5 unités avec un pas entier unitaire, reflétant fidèlement le dénombrement effectif de chaque groupe d’athlètes.
L’interprétation sémiotique de cette sortie visuelle est immédiate et sans équivoque : les trois barres culminent rigoureusement au niveau 5 de l’axe des ordonnées. Cette horizontalité parfaite des sommets rectangulaires confirme visuellement la symétrie absolue de l’échantillonnage marginal entre les trois équipes. Dans une perspective de communication scientifique, ce diagramme simple remplit parfaitement sa fonction de diagnostic préliminaire : il valide auprès des pairs et des évaluateurs que la variable de groupement primaire ne présente aucun biais d’attrition ou de sous-représentation susceptible d’invalider les comparaisons paramétriques ou non paramétriques subséquentes.
3.3 Intégration d’un titre formel et métadonnées avec l’instruction TITLE
Dans les protocoles de rédaction académique et d’édition scientifique, une figure autonome ne saurait être diffusée sans un système d’identification sémantique rigoureux. La traçabilité méthodologique exige que chaque artefact graphique explicite clairement la nature du phénomène observé, le périmètre de l’échantillon considéré et, le cas échéant, la temporalité de l’expérimentation. Dans le métalangage SAS, la contextualisation sémantique des sorties s’opère au moyen de l’instruction globale TITLE.
L’instruction TITLE se déploie selon une hiérarchie modulaire numérotée (allant de TITLE1 jusqu’à TITLE10), permettant de structurer des en-têtes complexes comprenant un titre principal général et des sous-titres analytiques précisant le contexte méthodologique. Bien qu’il s’agisse d’une instruction globale pouvant être déclarée n’importe où dans le programme, la bonne pratique de programmation statistique préconise de positionner l’instruction TITLE immédiatement en amont du bloc PROC SGPLOT auquel elle se rapporte, afin de préserver une lisibilité maximale du script source.
Considérons l’application suivante, enrichie d’un titre formel et d’une instruction de réinitialisation :
title1 "Répartition Fréquentielle de l'Échantillon par Équipe";

title2 height=10pt italic "Cohorte expérimentale de performance (N = 15)";

proc sgplot data=my_data;

  vbar team;

run;

title;
Dans cette formulation, l’option HEIGHT=10pt et le modificateur ITALIC appliqués au sous-titre garantissent une hiérarchisation visuelle élégante conforme aux exigences des presses universitaires. L’instruction finale title;, dépourvue de toute chaîne textuelle, joue un rôle fonctionnel critique : elle réinitialise immédiatement la mémoire des titres globaux dans la session SAS active. Cette étape prévient la rémanence indésirable de ces métadonnées sur les procédures statistiques exécutées ultérieurement au sein du même pipeline analytique.
4. Variante structurelle : Conversion vers un diagramme à barres horizontal (HBAR)
4.1 Implémentation technique de l’instruction HBAR
La transcription d’une distribution catégorielle d’un repère cartésien vertical vers un alignement horizontal constitue une opération d’une grande simplicité syntaxique au sein de PROC SGPLOT, mais d’une portée méthodologique considérable pour l’ergonomie visuelle. La mise en œuvre technique de cette transformation ne requiert aucune restructuration algébrique préalable de la matrice de données ni aucune transposition complexe via une procédure de réorganisation matricielle. Elle repose exclusivement sur la substitution de l’instruction VBAR par l’instruction HBAR.
Le compilateur graphique interprète l’instruction HBAR en appliquant une rotation de 90 degrés au plan géométrique de projection : les classes discrètes de la variable catégorielle spécifiée sont désormais positionnées sur l’axe vertical ($Y$), tandis que l’axe horizontal ($X$) devient l’échelle quantitative dédiée au dénombrement fréquentiel ou à l’agrégation de la variable de réponse. Les algorithmes d’ajustement automatique de l’échelle des graduations opèrent alors sur la largeur disponible du canevas graphique, exploitant l’espace horizontal pour étendre la portée métrique de l’axe quantitatif.
Le bloc d’instructions de base pour la conversion horizontale de notre étude fréquentielle se formalise de la façon suivante :
proc sgplot data=my_data;

  hbar team;

run;
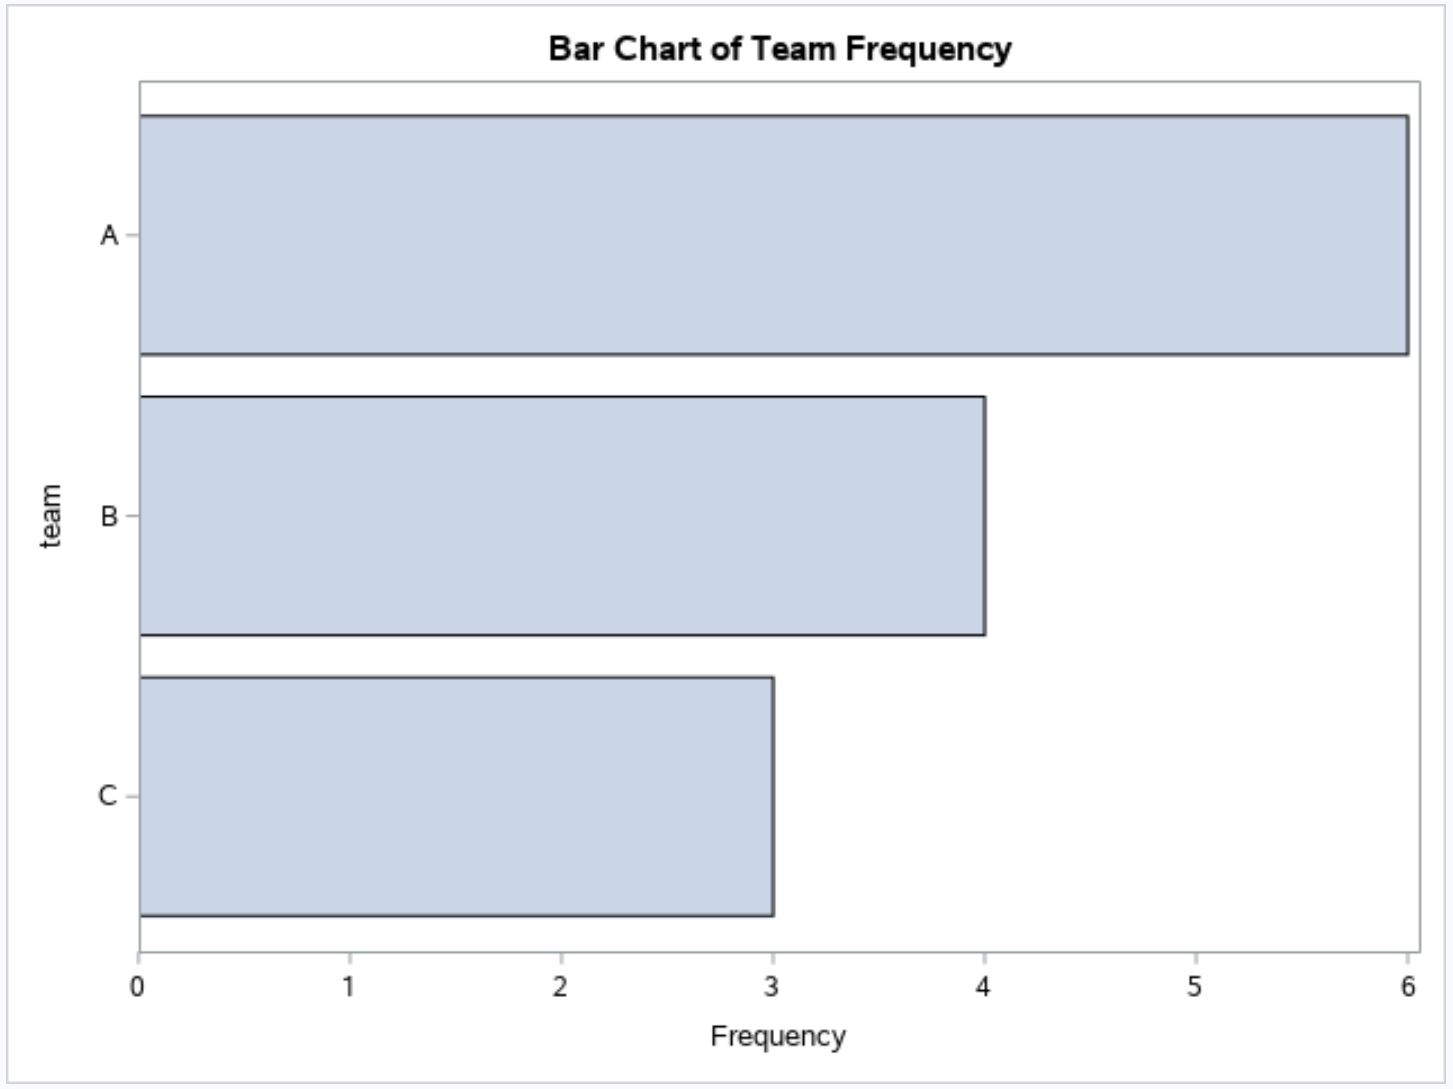
Cette commande engendre immédiatement une sortie dans laquelle les équipes A, B et C sont listées verticalement de haut en bas le long du bord gauche de la figure, les barres d’effectif s’étirant orthogonalement vers la droite jusqu’à la coordonnée horizontale $X = 5$. Le système graphique assure de façon autonome le recalcul des dimensions des rectangles pour conserver une surface optique harmonieuse en adéquation avec les proportions générales de la feuille de style sélectionnée.
4.2 Ergonomie cognitive et lisibilité des libellés catégoriels étendus
L’intérêt primordial de la variante horizontale réside dans l’optimisation des flux de lecture oculaire et la résolution des conflits typographiques spatiaux. En psychologie de la perception et en ergonomie cognitive, il est établi que le processus de lecture de l’être humain suit des trajectoires balistiques saccadiques hautement optimisées pour le texte aligné horizontalement, parallèlement au méridien visuel horizontal. Lorsque des étiquettes de catégories sur un diagramme vertical sont orientées verticalement ou inclinées à un angle oblique pour éviter les chevauchements, le temps de fixation oculaire s’accroît significativement et le taux d’erreur de décodage augmente de manière exponentielle, particulièrement chez les lecteurs non experts.
L’utilisation de l’instruction HBAR élimine radicalement cette friction perceptive en offrant aux libellés catégoriels un espace typographique longitudinal naturel le long de l’axe des ordonnées. Les intitulés longs, tels que des diagnostics médicaux complexes (par exemple : « Syndrome de détresse respiratoire aiguë de type précoce ») ou des descripteurs de variables socio-économiques étendus, peuvent être affichés dans leur intégralité sans recours à des abréviations cryptiques, sans réduction préjudiciable du corps de la police de caractères et sans superposition chaotique des glyphes.
De surcroît, l’alignement des étiquettes le long d’une marge verticale commune permet au système cognitif d’effectuer des comparaisons nominales immédiates grâce à la régularité du point d’ancrage textuel de gauche. Le regard n’a plus à alterner entre une lecture inclinée discontinue et un balayage métrique vertical : l’observateur parcourt la taxonomie catégorielle de haut en bas avec une fluidité naturelle, puis prolonge son regard horizontalement vers l’extrémité de chaque barre pour quantifier la grandeur associée, optimisant ainsi l’efficience globale de la restitution de l’information.
4.3 Ajustement des échelles et des proportions en affichage horizontal
Bien que l’instruction HBAR résolve brillamment la problématique de la lisibilité des libellés, elle introduit de nouvelles contraintes relatives à la gestion du ratio d’aspect (rapport largeur/hauteur ou aspect ratio) et à la densité géométrique des éléments de tracé. En affichage horizontal, un espacement vertical excessif entre les barres peut affaiblir la perception de proximité gestaltiste nécessaire à l’évaluation comparative des longueurs, tandis qu’un espacement insuffisant génère un encombrement visuel dense, impropre à la distinction nette des contours géométriques.
Le moteur ODS Graphics de SAS module automatiquement la hauteur des barres horizontales en fonction du nombre total de niveaux de la variable catégorielle et de la hauteur globale allouée au conteneur graphique. Toutefois, dans le cadre d’une intégration éditoriale rigoureuse, le programmeur doit fréquemment reprendre le contrôle direct de cette géométrie au moyen de l’option BARWIDTH, qui détermine la fraction de l’intervalle catégoriel occupée par la barre physique (une valeur typique de 0,7 à 0,8 offrant un équilibre visuel optimal), et de la configuration des dimensions globales du canevas d’exportation.
Une vigilance particulière doit être accordée à l’étendue de l’axe horizontal de réponse. Si la plage des valeurs est étroite mais que la largeur globale du tracé est excessive, les barres horizontales peuvent apparaître artificiellement allongées, créant une illusion d’amplitude disproportionnée chez le lecteur non averti. L’harmonisation des proportions vectorielles requiert donc une adéquation rigoureuse entre la résolution géométrique définie par l’instruction ODS GRAPHICS / WIDTH=... HEIGHT=... et l’amplitude effective des grandeurs représentées, garantissant une intégrité sémiotique absolue du rendu final.
5. Méthode 2 : Élaboration de diagrammes à barres empilées (Stacked Bar Charts)
5.1 Mise en œuvre analytique de l’option GROUP
Lorsque le protocole de recherche vise à explorer la structure interne d’une distribution à travers l’interaction simultanée de deux variables catégorielles distinctes, le diagramme à barres simple s’avère conceptuellement insuffisant. La deuxième méthode fondamentale consiste alors à construire un diagramme à barres empilées (Stacked Bar Chart). Dans la grammaire procédurale de PROC SGPLOT, cette décomposition multivariée s’opère par l’adjonction de l’option analytique GROUP= sur l’instruction de tracé VBAR ou HBAR.
Sur le plan algorithmique, l’option GROUP= ordonne au processeur graphique d’effectuer une double tabulation factorielle croisant la variable maîtresse d’abscisse avec la variable de stratification désignée. Plutôt que de synthétiser la classe d’abscisse sous la forme d’un bloc géométrique monolithique, SAS fragmente chaque barre en sous-segments rectangulaires adjacents superposés. La hauteur cumulée totale de la colonne correspond à la somme globale des fréquences ou des valeurs de la catégorie maîtresse, tandis que la hauteur propre de chaque sous-segment interne traduit la contribution quantitative spécifique de la sous-modalité correspondante.
L’implémentation formelle de cette stratification au sein de la procédure s’articule selon la formulation syntaxique générale suivante :
proc sgplot data=my_data;

  vbar variable_principale / group=variable_stratification;

run;
Par défaut, l’instruction VBAR applique une disposition empilée (empilement vertical ou stacking) dès lors que l’option GROUP= est renseignée sans modificateur d’affichage spatial concurrent. Concomitamment, le moteur ODS Graphics génère automatiquement une légende explicative exempte de redondance et applique une palette chromatique contrastée issue du style actif, permettant d’identifier sans ambiguïté les différents niveaux du facteur de regroupement.
5.2 Étude de cas : Ventilation des postes au sein de chaque structure d’équipe
Appliquons cette méthode de décomposition structurelle à notre échantillon expérimental afin d’étudier la ventilation des postes tactiques (position) au sein de chaque collectif sportif (team). La question analytique sous-jacente est d’évaluer si la parité globale d’effectif observée entre les trois équipes (5 athlètes chacune) dissimule ou non des disparités dans l’allocation des rôles tactiques sur le terrain.
Le code SAS permettant d’exécuter cette ventilation croisée s’énonce comme suit :
title "Ventilation Stratifiée des Postes par Équipe (Diagramme Empilé)";

proc sgplot data=my_data;

  vbar team / group=position;

run;

title;
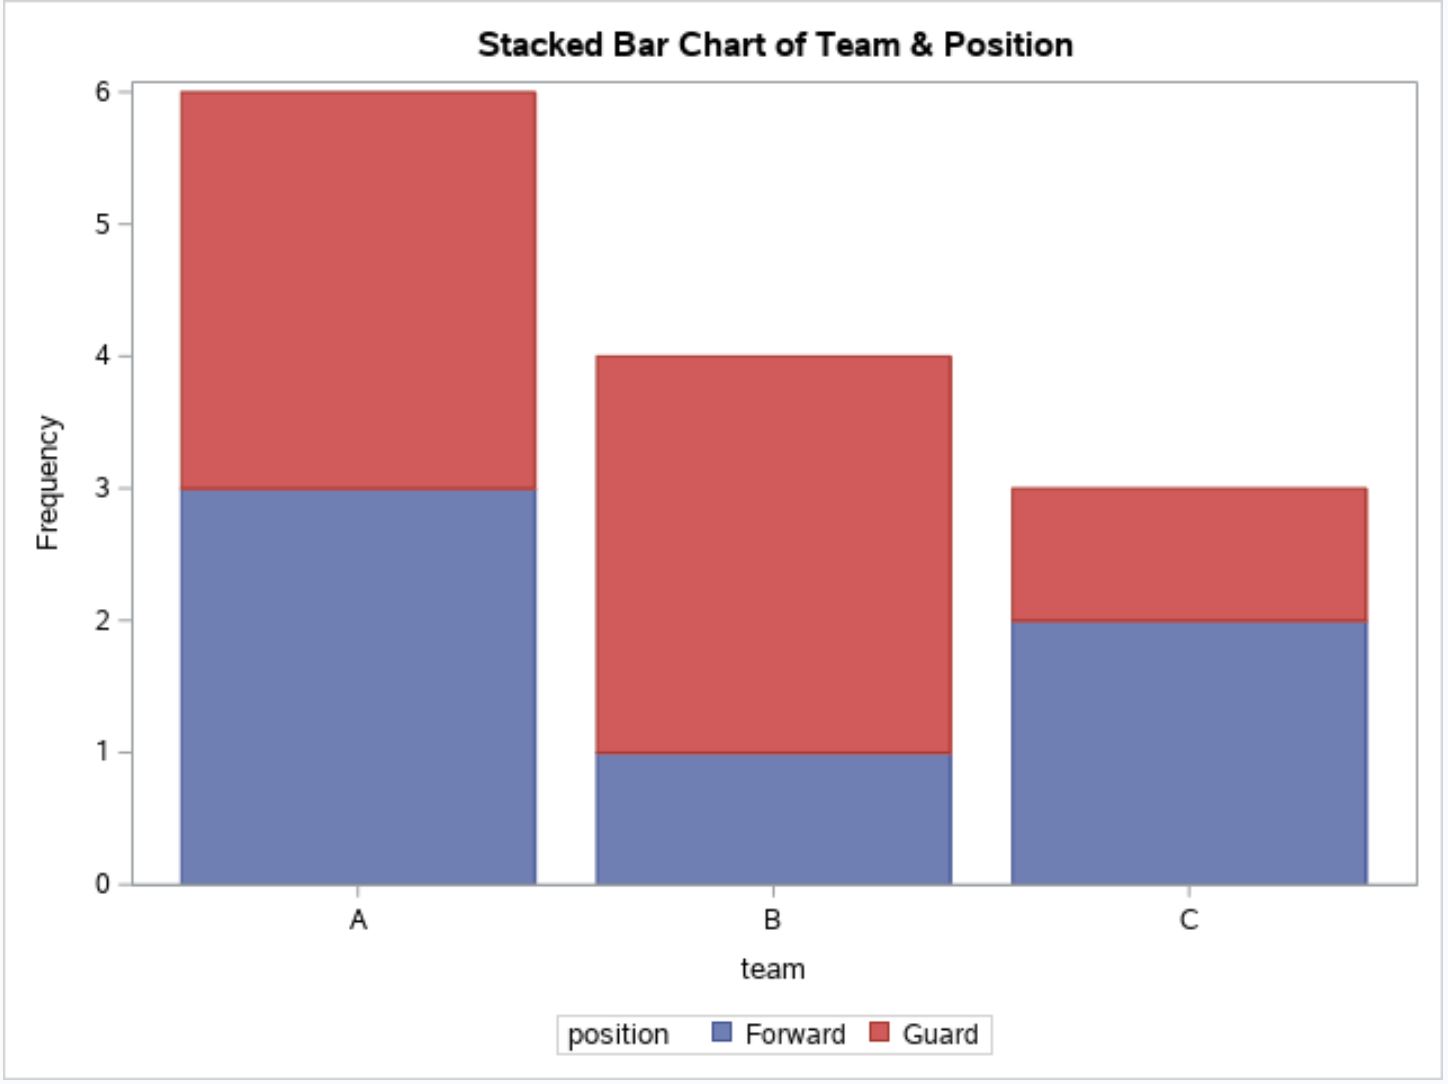
La figure générée présente une architecture visuelle révélatrice. Les trois barres associées aux équipes A, B et C conservent une hauteur totale parfaitement identique culminant à 5 unités sur l’axe des ordonnées, matérialisant ainsi la conservation des effectifs globaux marginaux. Toutefois, la morphologie interne des rectangles est désormais fragmentée en deux strates colorimétriques distinctes correspondant aux modalités « Forward » et « Guard ».
L’examen de cette segmentation interne révèle instantanément l’hétérogénéité structurelle des collectifs : pour les équipes A et C, le segment inférieur associé aux arrières culmine à 3 unités, surmonté par le segment des avants occupant les 2 unités restantes pour atteindre le plafond de 5. À l’inverse, pour l’équipe B, le segment des arrières ne s’élève qu’à 2 unités, tandis que la strate supérieure des avants s’étend sur 3 unités d’amplitude verticale. Cette décomposition permet ainsi de mettre immédiatement en lumière la divergence tactique de l’équipe B par rapport à ses homologues, une information qui demeurait totalement invisible lors de la modélisation univariée simple précédente.
5.3 Limites perceptuelles et risques d’interprétation des barres empilées
En dépit de son élégance synthétique indéniable pour la représentation des rapports de composition « partie-tout », le diagramme à barres empilées soulève des réserves méthodologiques majeures en matière de sémiotique graphique et de fidélité perceptive. Ces limitations, amplement documentées par Jacques Bertin et formalisées ultérieurement par les spécialistes de la perception quantitative, découlent du phénomène cognitif de la perte de référence basale commune (floating baseline bias).
Dans un tracé empilé, seule la sous-catégorie occupant la position basale inférieure du rectangle repose sur une ligne de base horizontale fixe et standardisée (la coordonnée $Y = 0$). L’observateur peut donc évaluer la hauteur de cette première composante avec une exactitude perceptive maximale, en mobilisant le jugement de position le long d’une échelle commune. En revanche, tous les segments situés aux étages supérieurs reposent sur des lignes de base flottantes et fluctuantes, déterminées par la somme variable des grandeurs sous-jacentes. Pour évaluer la magnitude de ces segments intermédiaires ou terminaux, le système cognitif de l’observateur est contraint d’abandonner l’estimation de position pour recourir à une estimation de longueur relative ou à un calcul arithmétique de soustraction visuelle mentale, une opération mentale significativement plus complexe et génératrice d’erreurs systématiques d’appréciation.
Il en résulte que la comparaison directe des sous-segments supérieurs entre plusieurs barres devient extrêmement périlleuse dès lors que les segments basaux ne sont pas strictement constants. De plus, les variations d’inclinaison des lignes de jonction visuelles entre strates adjacentes peuvent induire des illusions d’optique quant à l’importance relative des variations observées. Par conséquent, les recommandations actuelles en visualisation scientifique préconisent de réserver l’usage des barres empilées aux situations d’analyse où seule l’évolution du total global importe au premier chef, ou bien d’opter pour des diagrammes empilés normalisés à 100 % lorsque l’unique objectif réside dans l’analyse de parts relatives relatives sans considération des effectifs absolus.
6. Méthode 3 : Conception de diagrammes à barres groupées (Clustered Bar Charts)
6.1 Syntaxe de l’option GROUPDISPLAY=CLUSTER sous PROC SGPLOT
Pour pallier les écueils perceptuels inhérents à l’empilement vertical sans renoncer à l’analyse multivariée simultanée de deux facteurs catégoriels, la troisième méthode fondamentale repose sur la conception de diagrammes à barres groupées, également désignés sous l’appellation de diagrammes à barres juxtaposées ou Clustered Bar Charts. Cette technique rétablit une stricte rigueur géométrique en assurant que chaque cellule d’observation s’ancre directement sur la ligne de base commune à zéro.
L’implémentation de cette configuration spatiale dans PROC SGPLOT procède d’une extension directe de la syntaxe précédente. Il convient de combiner l’option GROUP= avec l’option de positionnement spatial GROUPDISPLAY=CLUSTER sur l’instruction de tracé (qu’elle soit VBAR ou HBAR). L’attribut CLUSTER modifie en profondeur la cinématique de rendu du moteur SAS : au lieu d’additionner les vecteurs de coordonnées pour empiler les rectangles le long d’une colonne unique, le système divise la largeur allouée à chaque catégorie de l’axe principal en sous-intervalles contigus, au sein desquels sont érigées des barres distinctes pour chaque niveau du facteur de groupement.
La formulation syntaxique canonique de cette approche comparative avancée s’énonce comme suit :
proc sgplot data=my_data;

  vbar variable_principale / group=variable_stratification groupdisplay=cluster;

run;
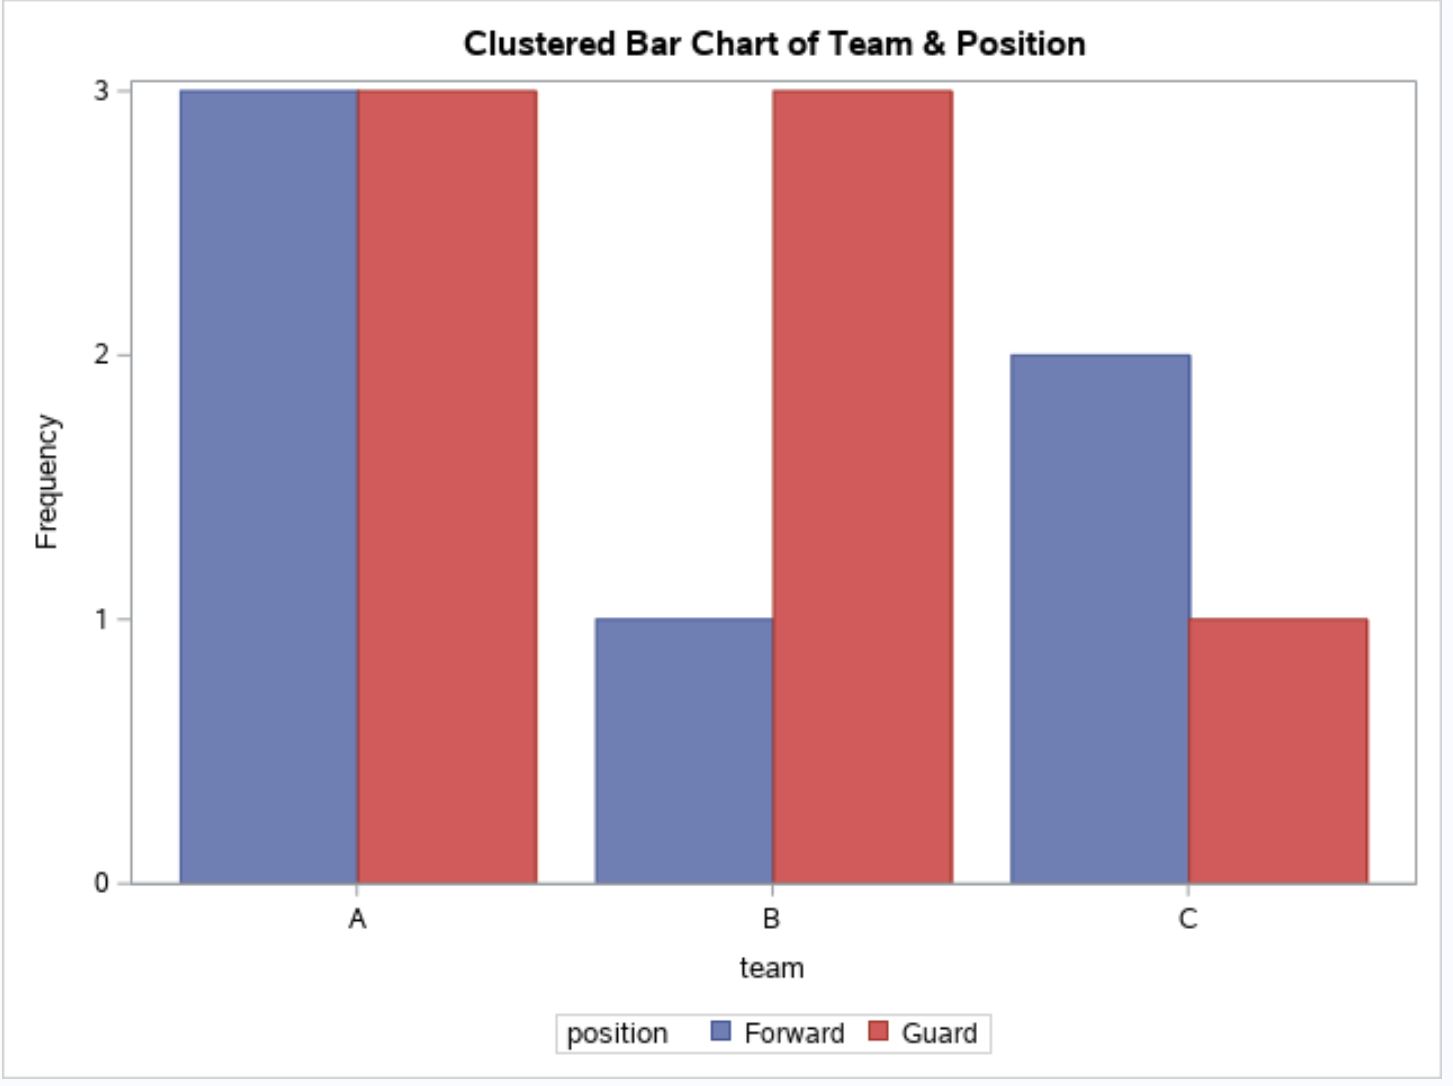
Cette commande active automatiquement un algorithme de partitionnement spatial qui calibre les marges latérales et les espaces intercalaires entre les grappes (clusters), de telle sorte que l’appartenance d’un ensemble de barres à une même modalité principale demeure visuellement évidente tout en garantissant une distinction physique nette entre les sous-groupes adjacents.
6.2 Analyse comparative multivariée des postes au sein des équipes
L’application de l’instruction GROUPDISPLAY=CLUSTER à notre étude comparative de la répartition des postes sportifs par équipe fournit un éclairage analytique supérieur, dépouillé de toute ambiguïté cognitive de lecture. Le bloc de code de soumission se structure selon le protocole suivant :
title "Comparaison Multivariée des Postes par Équipe (Barres Groupées)";

proc sgplot data=my_data;

  vbar team / group=position groupdisplay=cluster;

run;

title;
À l’affichage de la figure, l’espace cartésien se segmente harmonieusement en trois compartiments distincts identifiés par les étiquettes « A », « B » et « C ». Au sein de chaque grappe d’équipe, nous observons désormais deux barres distinctes, accolées l’une à l’autre mais nettement séparées par une bordure périphérique, reposant rigoureusement sur le plan d’abscisse $Y = 0$. La première barre, assignée à la modalité « Forward », arbore la couleur distinctive définie par le style pour le niveau 1, tandis que la seconde barre, associée à « Guard », revêt la teinte contrastée du niveau 2.
L’avantage comparatif de cette disposition est immédiat pour l’analyse inférentielle : l’observateur peut désormais comparer avec une égale précision analytique non seulement les effectifs internes d’une même équipe (comparaison intra-groupe), mais également la variation d’un poste donné d’une équipe à l’autre (comparaison inter-groupe). Il apparaît instantanément que la modalité « Forward » culmine à 2 unités pour l’équipe A, s’élève à 3 unités pour l’équipe B, puis redescend à 2 unités pour l’équipe C. Cette trajectoire en cloche de l’effectif des avants à travers les trois équipes est appréhendée avec une vitesse de traitement neuronal optimale, car l’œil opère exclusivement sur des jugements de position linéaire le long d’une échelle graduée constante.
6.3 Arbitrage méthodologique : Diagrammes groupés versus diagrammes empilés
Le choix entre un diagramme à barres empilées et un diagramme à barres groupées ne saurait relever d’une simple préférence cosmétique : il traduit un engagement épistémologique précis quant à la nature des questions de recherche auxquelles la figure se propose de répondre. L’analyste doit formuler son arbitrage méthodologique en confrontant les caractéristiques intrinsèques de ces deux artefacts aux objectifs communicationnels du rapport d’étude.
Le diagramme empilé excelle dans la restitution de la sommation globale et de la complétude proportionnelle : il est l’outil d’élection lorsque l’information dominante réside dans l’évolution du volume macroscopique total de chaque strate (par exemple, le budget global d’un département ministériel ou l’incidence brute totale d’une pathologie) et que la décomposition interne ne constitue qu’une information de second ordre destinée à illustrer l’agencement des composantes sans exiger une quantification différentielle ultra-précise de chacune d’elles.
À l’opposé, le diagramme groupé s’impose impérativement dès lors que l’hypothèse scientifique sous-jacente porte sur l’interaction factorielle, c’est-à-dire sur l’évaluation fine de la manière dont la réponse d’un sous-groupe varie sous l’influence du facteur principal. En ancrant chaque mesure sur l’axe d’abscisse zéro, le tracé groupé préserve l’intégrité absolue de la hiérarchie perceptuelle de Cleveland et McGill. Son coût spatial réside dans un élargissement horizontal substantiel de la figure : la multiplication des grappes et des sous-barres consomme davantage de bande passante visuelle sur le canevas, ce qui peut saturer l’espace utile si la variable de groupement comporte un nombre élevé de modalités. Dans ce dernier cas, une décomposition en petits multiples (Small Multiples) via l’instruction PANELBY de la procédure associée PROC SGPANEL pourra constituer une alternative architecturale plus robuste.
7. Agrégation de métriques continues : Au-delà du simple dénombrement fréquentiel
7.1 Spécification de variables de réponse continues avec l’option RESPONSE
Jusqu’à présent, les diagrammes modélisés ont fonctionné selon un mode de réduction fréquentielle primaire, où la hauteur des barres reflétait exclusivement le dénombrement brut des occurrences d’unités statistiques dans chaque case factorielle. Toutefois, dans la pratique empirique avancée, le diagramme à barres est omniprésent pour représenter des grandeurs métriques continues associées à des classes qualitatives, telles que des rendements moyens, des concentrations plasmatiques de principes actifs ou des scores d’évaluation standardisés. Dans la procédure PROC SGPLOT, cette transition fondamentale du dénombrement vers l’agrégation continue s’effectue par l’adjonction de l’option RESPONSE=.
L’option RESPONSE=nom_variable indique expressément au moteur SAS qu’il ne doit plus dénombrer les lignes de la table d’entrée, mais agréger les valeurs numériques contenues dans le vecteur scalaire spécifié. L’axe quantitatif subit alors une translation sémantique instantanée : il cesse d’afficher l’étiquette par défaut Frequency pour adopter le libellé formel ou le nom de la variable de réponse désignée. Le tracé résultant matérialise alors la distribution des grandeurs continues sous-jacentes à travers les niveaux de la variable de catégorisation portée sur l’axe orthogonal.
Considérons l’application de cette mécanique à notre jeu de données expérimental, en désignant la variable points comme mesure de réponse métrique associée aux équipes :
proc sgplot data=my_data;

  vbar team / response=points;

run;
À l’exécution de cette requête, le moteur de calcul SAS applique par défaut un opérateur d’accumulation arithmétique globale. Il calcule la somme de l’ensemble des points enregistrés par chaque équipe et érige une colonne verticale dont l’altitude correspond à ce total cumulé. Pour l’équipe A ($12 + 20 + 22 + 29 + 24$), la barre culmine à 107 unités ; pour l’équipe B ($35 + 34 + 12 + 15 + 26$), elle atteint 122 unités ; pour l’équipe C ($18 + 22 + 25 + 15 + 19$), elle s’établit à 99 unités. Cette sommation brute fournit une vision immédiate du volume d’impact global de chaque formation.
7.2 Calcul et affichage de la moyenne arithmétique via l’option STAT=MEAN
Dans une immense majorité de protocoles scientifiques, la somme cumulée brute ne constitue pas l’estimateur de tendance centrale le plus pertinent, notamment lorsque les effectifs cellulaires sont asymétriques ou lorsque la question biologique ou économique posée concerne l’intensité unitaire moyenne plutôt que le volume totalisé. Pour subordonner la hauteur des barres à un indicateur de tendance centrale standardisé, le programmeur doit faire appel à l’option de réduction statistique STAT=, configurée avec la valeur MEAN.
La déclaration conjointe de RESPONSE=points et de STAT=MEAN au sein de l’instruction VBAR modifie radicalement le moteur d’agrégation interne : SAS extrait la distribution conditionnelle de la variable de réponse pour chaque modalité factorielle, somme les valeurs observées, puis divise rigoureusement cette somme par l’effectif valide de chaque groupe :
$$\bar{Y}_j = \frac{1}{n_j} \sum_{i=1}^{n_j} Y_{ij}$$
La commande opérationnelle s’implémente comme suit :
title "Score Moyen Réalisé par Équipe (Estimateur de Tendance Centrale)";

proc sgplot data=my_data;

  vbar team / response=points stat=mean;

run;

title;
Sur la figure résultante, l’axe vertical des ordonnées adopte l’intitulé normalisé Mean of points. Les hauteurs des barres expriment désormais avec exactitude les espérances empiriques d’équipe : l’équipe A affiche une performance moyenne de $\bar{Y}_A = 21{,}4$ points, l’équipe B domine avec une moyenne de $\bar{Y}_B = 24{,}4$ points, tandis que l’équipe C enregistre une moyenne de $\bar{Y}_C = 19{,}8$ points. La comparaison graphique ne porte plus sur un stock d’unités cumulées mais sur un paramètre intensif directement comparable, autorisant une appréciation robuste des différences de performance relatives entre les groupes d’étude.
7.3 Exploitation des fonctions de cumul avec STAT=SUM et autres statistiques
La flexibilité paramétrique de l’option STAT= sous PROC SGPLOT ne se cantonne pas au dilemme élémentaire entre effectif brut et moyenne arithmétique. Le moteur ODS Graphics intègre un éventail diversifié d’opérateurs statistiques permettant d’adapter la sortie graphique à la nature exacte des distributions empiriques et aux conventions épistémologiques du domaine d’application considéré.
Parmi les valeurs autorisées pour l’attribut STAT=, citons notamment :
SUM: Force l’agrégation par sommation intégrale des valeurs de réponse associées à chaque cellule catégorielle (comportement par défaut lors de l’usage deRESPONSE=sans spécification statistique explicite).MEDIAN: Assignation de la hauteur de barre à la médiane distributionnelle conditionnelle. Cet estimateur robuste est hautement recommandé en présence de distributions fortement asymétriques ou contaminées par des valeurs aberrantes extrêmes (données de revenus, durées de survie, coûts hospitaliers), où la moyenne arithmétique subirait une distorsion sémiotique majeure.FREQ: Rétablissement forcé du dénombrement fréquentiel des observations, y compris lorsqu’une variable de pondération est déclarée.PERCENT: Conversion instantanée des dénombrements ou des grandeurs cumulées en pourcentages relatifs par rapport à la masse totale de l’échantillon, facilitant la mise en perspective normalisée des données sans nécessiter d’étape intermédiaire de calcul de ratios via une procédurePROC FREQ.
Sur le plan de la rigueur méthodologique, l’analyste doit impérativement veiller à expliciter l’opérateur statistique retenu, à la fois dans le titrage formel de la figure et dans les libellés d’axes. L’omission de cette précision sémantique expose l’observateur à des confusions cognitives sévères, comme la confusion classique entre une moyenne arithmétique d’intensité et un volume cumulatif total, faussant ainsi l’interprétation des dynamiques sous-jacentes du jeu de données.
8. Personnalisation esthétique et sémiotique graphique avec PROC SGPLOT
8.1 Contrôle des palettes chromatiques et du remplissage avec FILLATTRS
L’apparence visuelle d’un diagramme à barres ne saurait relever du pur caprice décoratif. En visualisation scientifique, la couleur est un vecteur sémantique de premier ordre qui remplit des fonctions d’identification taxonomique, de discrimination catégorielle et de focalisation attentionnelle. La procédure PROC SGPLOT offre un contrôle microscopique sur le traitement des surfaces au moyen de l’option d’attributs de remplissage FILLATTRS=, applicable directement sur les instructions VBAR ou HBAR.
L’option FILLATTRS=(COLOR=couleur) permet d’annuler les affectations chromatiques automatiques dérivées de la feuille de style ODS globale pour imposer une teinte spécifique, définie soit par son nom mnémonique standard (tel que STEEL, NAVY, GRAY, CX1B4F72), soit par son encodage hexadécimal rigoureux dans l’espace colorimétrique RVB (préfixé par CX dans la syntaxe SAS). Cette maîtrise précise est indispensable pour garantir la conformité des figures avec les chartes graphiques institutionnelles ou les critères d’accessibilité visuelle, notamment pour les personnes atteintes de déficits de la perception des couleurs (dyschromatopsies telles que la deutéranopie ou la protanopie).
Illustrons cette personnalisation sur un tracé de moyennes univarié :
proc sgplot data=my_data;

  vbar team / response=points stat=mean

              fillattrs=(color=cx2C3E50);

run;
Dans cet exemple, l’application d’un bleu nuit désaturé profond (CX2C3E50) confère à la figure un rendu d’une grande sobriété académique. Ce traitement chromatique neutre évite l’écueil des couleurs primaires trop saturées qui saturent inutilement la rétine du lecteur et détournent l’attention de la structure géométrique intrinsèque des données.
8.2 Définition rigoureuse des bordures géométriques avec OUTLINEATTRS
Un tracé dont les rectangles ne possèdent pas de délimitation périphérique nettement définie risque de souffrir d’un manque d’acuité optique, en particulier lors des impressions monochromes sur support papier ou lorsque des teintes adjacentes présentent des contrastes de luminance modérés. L’instruction OUTLINEATTRS= permet de configurer l’ensemble des descripteurs géométriques associés au contour linéaire de chaque barre.
Cette option accepte un triplet fondamental de sous-paramètres :
COLOR=: Définit la couleur du trait de contour (par exemple,BLACKou une nuance sombre dérivée du remplissage pour un rendu texturé haut de gamme).THICKNESS=: Détermine l’épaisseur du tracé linéaire en unités physiques d’affichage (exprimée couramment en points typographiques, tels que1ptou1.5pt, ou en pixels).PATTERN=: Spécifie le style de tracé de la bordure, offrant le choix entre une ligne continue unie (SOLID) ou des discontinuités géométriques réglées (DASH,DOT), bien que la ligne continue demeure la norme formelle de référence en matière de bordure de diagramme à barres.
L’intégration conjointe de FILLATTRS et OUTLINEATTRS s’articule comme suit :
proc sgplot data=my_data;

  vbar team / response=points stat=mean

              fillattrs=(color=cxD5D8DC)

              outlineattrs=(color=cx1A5276 thickness=1.5pt);

run;
Cette formulation applique un remplissage gris minéral très clair souligné par une bordure bleu acier incisive de 1,5 point. Cette structuration géométrique nette élimine tout effet de flou visuel aux frontières des blocs rectangulaires, prévenant l’apparition d’artefacts de moirage et garantissant une restitution vectorielle irréprochable lors des réductions d’échelle imposées par la mise en page en double colonne des articles scientifiques.
8.3 Gestion de la transparence et des motifs texturés avec TRANSPARENCY
L’un des apports majeurs de l’architecture moderne ODS Graphics par rapport à l’ancien moteur PROC GCHART réside dans la gestion native du canal alpha de composition, couramment désigné sous le terme d’opacité ou de transparence vectorielle. L’option TRANSPARENCY=, paramétrable sur une échelle continue allant de 0 (opacité totale, valeur par défaut) à 1 (transparence intégrale rendant l’élément géométrique invisible), offre des potentialités ergonomiques précieuses pour la mise en valeur des tracés complexes.
L’application d’un coefficient de semi-transparence modéré (typiquement compris entre 0,15 et 0,35) adoucit l’impact perceptuel global de surfaces étendues au sein du manuscrit. En atténuant la densité chromatique des rectangles, elle permet également de rendre visibles des éléments graphiques d’arrière-plan situés sur des plans géométriques sous-jacents, tels que des grilles de repérage cartésien continues (reference lines) ou des nuages de points individuels superposés en surimpression exploratoire.
Considérons l’application de cet attribut sur notre tracé expérimental :
proc sgplot data=my_data;

  vbar team / fillattrs=(color=navy) transparency=0.25;

run;
Ce réglage confère aux barres une texture aérée et élégante, tout en facilitant la cohabitation visuelle de la figure avec le texte courant d’un document PDF ou d’une page Web. L’analyste doit toutefois veiller à ne pas dépasser un seuil critique d’atténuation (au-delà de 0,5), sous peine d’affaiblir excessivement le contraste de luminance nécessaire à la discrimination immédiate des longueurs relatives par l’observateur.
9. Configuration des axes cartésiens et des échelles de mesure
9.1 Optimisation de l’axe catégoriel avec l’instruction XAXIS
Dans l’architecture de PROC SGPLOT, le contrôle typographique, structurel et spatial du système cartésien repose sur des instructions procédurales dédiées. Pour un diagramme vertical issu de VBAR, l’axe horizontal portant les classes discrètes est entièrement piloté par l’instruction XAXIS. Le recours à cette instruction est indispensable pour affranchir le graphique des comportements par défaut de SAS, qui affiche souvent des noms de variables bruts non formatés ou des dispositions de graduation sous-optimales.
L’optimisation formelle de l’axe horizontal comprend principalement la neutralisation ou la réécriture élégante de l’étiquette de variable au moyen de l’option LABEL=. Dans de nombreuses situations où les modalités catégorielles sont explicites par elles-mêmes (par exemple : « Équipe A », « Équipe B », « Équipe C »), la présence d’un libellé générique « team » sous l’axe constitue une redondance visuelle inutile (concept de chartjunk ou déchet graphique théorisé par Edward Tufte). L’utilisation de la syntaxe LABEL='' permet de supprimer purement et simplement ce label superflu, épurant ainsi l’espace graphique.
Par ailleurs, lorsque les étiquettes catégorielles sont denses, l’option FITPOLICY= fournit un mécanisme sophistiqué de gestion des conflits spatiaux. Cette option instruit le moteur SAS sur l’arbitrage automatique à opérer pour éviter la superposition des textes :
FITPOLICY=ROTATE: Applique une rotation angulaire contrôlée des étiquettes d’abscisse.FITPOLICY=STAGGER: Décale verticalement les étiquettes en quinconce sur deux niveaux horizontaux parallèles.FITPOLICY=TRUNCATE: Tronque les libellés trop longs au moyen de points de suspension standardisés.FITPOLICY=SPLIT: Fragmente les chaînes de caractères au niveau des espaces blancs ou de séparateurs définis pour les afficher sur plusieurs lignes verticales resserrées.
9.2 Standardisation de l’axe quantitatif de réponse avec l’instruction YAXIS
L’axe quantitatif vertical, configuré par l’instruction YAXIS pour un diagramme à barres de type VBAR, conditionne directement la validité scientifique de l’inférence visuelle. C’est sur cet axe que repose la fidélité de l’encodage des magnitudes numériques. Le programmeur doit exercer un contrôle direct sur son intervalle de variation et sur ses éléments de repérage optique.
L’option VALUES=(min TO max BY pas) constitue le paramètre maître de cette instruction. Elle permet de fixer explicitement les bornes minimale et maximale de l’échelle d’affichage, ainsi que l’incrément arithmétique régulier régissant la position des graduations majeures. Cette standardisation est particulièrement cruciale lorsque plusieurs graphiques distincts doivent être comparés côte à côte dans une même planche scientifique : l’égalisation manuelle des échelles verticales évite que deux groupes aux amplitudes dissemblables ne soient perçus comme équivalents en raison d’un auto-dimensionnement indépendant de leurs axes respectifs.
En outre, l’activation de l’option booléenne GRID instancie un quadrillage horizontal discret d’arrière-plan, aligné rigoureusement sur les graduations majeures de l’axe quantitatif. Cette grille fournit à l’œil un système de guidage géométrique essentiel pour projeter mentalement le sommet de chaque rectangle vers la valeur numérique exacte de l’ordonnée, réduisant ainsi considérablement la marge d’erreur d’estimation visuelle sans surcharger la clarté globale du canevas.
9.3 Contrôle typographique des libellés et des unités de mesure
L’excellence éditoriale d’une figure statistique s’évalue également à la cohérence de sa charte typographique. Par défaut, le moteur ODS Graphics applique des polices proportionnelles standardisées susceptibles de diverger des polices utilisées dans le corps du texte d’un manuscrit scientifique formel. Les sous-options d’attributs typographiques intégrées aux instructions d’axes permettent d’aligner rigoureusement ces paramètres sur les exigences des éditeurs.
Les attributs de libellés s’ajustent au moyen de LABELATTRS=, tandis que la typographie des graduations individuelles de l’axe est pilotée par VALUEATTRS=. Ces deux options autorisent la configuration fine des descripteurs suivants :
FAMILY=: Spécifie la famille typographique vectorielle de destination (par exemple :"Times New Roman"pour les revues médicales classiques,"Arial"ou"Helvetica"pour les supports modernes sans empattement).SIZE=: Définit la taille effective du corps de texte (par exemple :11ptpour les libellés maîtres,9ptpour les valeurs de graduation discrètes).WEIGHT=: Contrôle la graisse typographique (NORMAL,BOLD).STYLE=: Règle l’inclinaison des glyphes (NORMAL,ITALIC).
Considérons l’application de ces principes d’étalonnage cartésien sur notre tracé de moyennes :
proc sgplot data=my_data;

  vbar team / response=points stat=mean fillattrs=(color=cx34495E);

  xaxis label="Collectif Sportif Étudié"

        labelattrs=(family="Arial" size=10pt weight=bold)

        valueattrs=(family="Arial" size=9pt);

  yaxis label="Score Moyen Obtenu (Points)"

        values=(0 to 30 by 5) grid

        labelattrs=(family="Arial" size=10pt weight=bold)

        valueattrs=(family="Arial" size=9pt);

run;
Dans cette formalisation complète, l’axe vertical est rigoureusement ancré à l’origine absolue zéro, s’étend jusqu’à 30 points par sauts réguliers de 5 unités, et dispose d’une grille de repérage continue. Les unités de mesure sont explicitement précisées entre parenthèses dans le libellé d’ordonnée, éliminant tout doute quantitatif quant à la nature de la grandeur mesurée.
10. Étiquetage des données, gestion de la légende et ajout d’indicateurs de dispersion
10.1 Affichage direct des grandeurs numériques avec l’option DATALABEL
L’estimation visuelle de l’altitude d’un rectangle le long de l’axe des ordonnées, même facilitée par un quadrillage discret, impose toujours une charge cognitive d’interpolation approximative. Pour les publications techniques ou les tableaux de bord décisionnels où chaque unité numérique possède une valeur critique, il est hautement recommandé d’inscrire la grandeur scalaire exacte directement au contact de l’élément géométrique correspondant. Dans PROC SGPLOT, cette fonctionnalité d’étiquetage direct s’active via l’option DATALABEL.
L’insertion du mot-clé DATALABEL sur l’instruction VBAR commande l’affichage automatique des valeurs agrégées au sommet de chaque colonne rectangulaire. Pour un diagramme horizontal généré par HBAR, ces étiquettes sont positionnées immédiatement à droite de l’extrémité distale des barres. Le positionnement est calculé de manière dynamique par SAS afin d’éviter tout chevauchement avec les bordures physiques de la figure.
Pour affiner la présentation de ces étiquettes directes, le programmeur dispose de l’option DATALABELATTRS=, qui permet d’en harmoniser la typographie, ainsi que de mécanismes de formatage numérique sophistiqués. Lorsqu’une variable de réponse continue est agrégée sous forme de moyenne arithmétique via STAT=MEAN, SAS calcule par défaut des valeurs à décimales flottantes étendues. Pour restreindre cet affichage à un niveau de précision significatif sans encombrement inutile (par exemple, un seul chiffre après la virgule), il convient de déclarer un format statistique adéquat en amont ou d’exploiter les options de modélisation associées :
proc sgplot data=my_data;

  vbar team / response=points stat=mean

              datalabel datalabelattrs=(family="Arial" size=9pt weight=bold);

  format points 5.1;

run;
L’application du format 5.1 contraint l’affichage à une décimale unique arrondie, fournissant au lecteur une lecture numérique instantanée (par exemple : 21.4, 24.4, 19.8) sans saturer l’espace supérieur du graphique.
10.2 Configuration spatiale et sémantique de la légende via KEYLEGEND
Dès lors qu’un diagramme à barres intègre une seconde dimension catégorielle au moyen de l’option GROUP= (qu’il s’agisse d’un affichage empilé ou groupé), le moteur ODS Graphics génère automatiquement une légende identificatoire. Bien que l’agencement par défaut soit fonctionnel, il répond rarement aux normes esthétiques et spatiales requises par les revues académiques de premier plan. L’instruction procédurale dédiée KEYLEGEND permet de reprogrammer entièrement l’architecture spatiale et textuelle de cet élément sémiotique.
Par défaut, la légende est positionnée en marge inférieure externe de la zone de tracé, encapsulée dans une boîte rectangulaire fermée. L’instruction KEYLEGEND offre une grande latitude de paramétrage :
POSITION=: Détermine l’emplacement géographique de la boîte de légende sur le canevas (optionsBOTTOM,TOP,RIGHT,TOPRIGHT,BOTTOMLEFT, etc.).LOCATION=: Spécifie si la légende réside en dehors du champ cartésien des données (LOCATION=OUTSIDE, valeur par défaut) ou si elle est incorporée en surimpression directe à l’intérieur de l’espace vide du tracé (LOCATION=INSIDE), permettant ainsi d’économiser un espace vertical précieux sur la page.ACROSS=ouDOWN=: Règle le nombre de colonnes ou de lignes structurelles composant l’agencement des descripteurs de légende.NOBORDER: Supprime le trait de contour périphérique de la boîte de légende, allégeant la composition selon les préceptes du minimalisme graphique moderne.TITLE=: Permet de reformuler ou de supprimer entièrement l’en-tête textuel de la légende pour expliciter la signification conceptuelle du facteur de stratification.
L’intégration formelle de cette instruction se concrétise dans le fragment syntaxique suivant :
keylegend / position=topright location=inside across=1

           noborder title="Poste Tactique :";
Ce bloc insère la légende directement dans le quadrant supérieur droit non occupé du tracé, empile les modalités de groupement sur une colonne verticale unifiée et élimine toute boîte de délimitation encombrante, instaurant une relation visuelle directe et épurée entre le code chromatique et les données empiriques.
10.3 Ajout de barres d’erreur et d’intervalles de confiance
L’un des reproches méthodologiques les plus sévères adressés au diagramme à barres représentant des moyennes arithmétiques concerne son incapacité intrinsèque à rendre compte de la dispersion des observations sous-jacentes. Afficher un rectangle plein pour figurer une moyenne sans matérialiser la variance de l’échantillon constitue une omission scientifique majeure, susceptible de dissimuler des hétéroscédasticités flagrantes ou des chevauchements d’incertitude critiques. Pour remédier à cette lacune, PROC SGPLOT propose une intégration directe des barres d’erreur statistique au moyen de l’option LIMITSTAT=.
Applicable sur l’instruction VBAR lorsque STAT=MEAN est actif, l’option LIMITSTAT= permet de sélectionner l’indicateur de dispersion inférentielle le plus rigoureux en fonction du cadre expérimental :
LIMITSTAT=STDDEV: Ajoute une barre d’erreur matérialisant l’écart-type empirique ($s$) de l’échantillon, reflétant la variabilité brute de la distribution des observations individuelles autour de la moyenne.LIMITSTAT=STDERR: Calcule et projette l’erreur-type de la moyenne ($\text{SE} = s / \sqrt{n}$), indiquant la précision de l’estimateur de tendance centrale.LIMITSTAT=CLM: Érige un véritable intervalle de confiance bilatéral de la moyenne (par défaut à 95 % sous hypothèse de distribution normale ou de loi de Student), fondé sur la distribution $t$ pour l’échantillon considéré.
De surcroît, l’option complémentaire NUMSTD=valeur permet d’ajuster le multiplicateur d’échelle associé (par exemple pour afficher $\pm 2$ écarts-types), tandis que l’option ALPHA= module le seuil d’erreur de première espèce pour les intervalles de confiance (par exemple ALPHA=0.01 pour un intervalle à 99 %).
Voici l’implémentation opérationnelle complète d’un diagramme de moyennes intégrant des intervalles de confiance à 95 % :
title "Performance Moyenne par Équipe et Intervalles de Confiance à 95 %";

proc sgplot data=my_data;

  vbar team / response=points stat=mean

              limitstat=clm alpha=0.05

              fillattrs=(color=cx5DADE2) outlineattrs=(color=cx2874A6);

  yaxis label="Moyenne des Points Marqués" grid;

run;

title;
Sur la figure produite, chaque barre est désormais surmontée d’un segment vertical centré sur la moyenne, délimité par des encoches horizontales désignant les bornes inférieure et supérieure de l’intervalle de confiance. L’observateur scientifique peut ainsi vérifier instantanément si les intervalles de deux équipes se chevauchent ou non, obtenant dès la phase exploratoire une première indication visuelle quant à la significativité statistique potentielle des écarts de performance constatés.
11. Rigueur méthodologique et écueils d’interprétation en visualisation de données
11.1 Le piège de la troncature d’axe et la distorsion cognitive des grandeurs
Parmi l’ensemble des transgressions déontologiques et méthodologiques en matière d’inférence visuelle, la troncature de l’axe quantitatif d’un diagramme à barres constitue indiscutablement la faute la plus délétère. Le principe sémiotique absolu du diagramme à barres réside dans l’encodage de la grandeur par la longueur physique du rectangle. Par voie de conséquence, toute altération artificielle du point d’origine zéro de l’axe de mesure fausse de manière irréversible le ratio géométrique fondamental liant l’aire de la barre à la réalité de la mesure empirique.
Dans un ouvrage séminal, Edward Tufte a formalisé ce phénomène à travers le calcul du facteur de distorsion graphique (Lie Factor) :
$$\text{Facteur de Distorsion} = \frac{\text{Taille de l’effet représenté graphiquement}}{\text{Taille de l’effet réel dans les données}}$$
Lorsqu’un analyste tronque l’axe vertical d’un diagramme à barres (par exemple en faisant débuter l’axe des ordonnées à la valeur 18 au lieu de 0 pour comparer des moyennes oscillant entre 19{,}8 et 24{,}4 points), une différence objective de seulement 23 % entre deux groupes se traduit par une barre qui apparaît visuellement trois à quatre fois plus haute que l’autre. Le cerveau humain, conditionné pour interpréter spontanément la longueur totale du solide géométrique comme le volume de la variable, subit une distorsion cognitive sévère, surestimant considérablement l’ampleur de l’effet sous-jacent.
S’il est parfaitement légitime de resserrer l’échelle de mesure pour mettre en exergue des variations d’infime amplitude sur un nuage de points ou un tracé linéaire de série chronologique, cette pratique est formellement proscrite pour les diagrammes à barres. Si la variabilité microscopique d’une métrique d’échelle étroite constitue l’objet exclusif de la communication, le chercheur rigoureux doit renoncer au diagramme à barres pour s’orienter vers des tracés de points déconnectés du plancher (tels que le Cleveland Dot Plot formalisé via l’instruction DOT ou SCATTER sous PROC SGPLOT), qui n’engagent pas de métaphore visuelle de volume volumique et autorisent des échelles cartésiennes fenêtrées sans tromperie perceptuelle.
11.2 Distinction fondamentale entre diagrammes à barres et histogrammes
Une confusion épistémologique récurrente chez les utilisateurs novices des logiciels d’analyse quantitative réside dans l’assimilation fallacieuse du diagramme à barres (Bar Chart) à l’histogramme (Histogram). Bien que ces deux formes visuelles recourent superficiellement à des rectangles verticaux, elles répondent à des fondements mathématiques totalement orthogonaux et ne doivent en aucun cas être employées de manière interchangeable.
Le diagramme à barres est conçu pour l’évaluation de variables discrètes et catégorielles. Chaque barre matérialise une classe d’équivalence logique distincte et étanche. L’ordre des catégories sur l’abscisse peut être modifié (par ordre alphabétique, fréquentiel ou conventionnel) sans altérer la signification intrinsèque de la mesure. Pour matérialiser cette discontinuité fondamentale, les rectangles d’un diagramme à barres doivent impérativement être séparés par un espace blanc latéral standardisé. Dans PROC SGPLOT, cette géométrie discrète est implémentée par l’instruction VBAR.
À l’inverse, l’histogramme s’applique exclusivement à des variables numériques continues pour estimer leur fonction de densité de probabilité empirique sous-jacente. L’axe des abscisses représente une échelle métrique continue unidimensionnelle que le logiciel partitionne en intervalles de classes contigus (appelés bins). La surface de chaque rectangle est proportionnelle à la probabilité de présence des unités d’observation dans cet intervalle. Par conséquent, les barres d’un histogramme doivent obligatoirement être jointives et contiguës, sans le moindre espacement vide, pour traduire physiquement le continuum topologique de la variable mesurée. Dans la syntaxe SAS, ce tracé continu requiert l’appel explicite de l’instruction HISTOGRAM et ne saurait être modélisé via VBAR sans dénaturer la modélisation mathématique du corpus de données.
11.3 Gestion des cellules sans effectifs et des valeurs extrêmes
Lors du traitement de corpus empiriques réels, les analystes se heurtent fréquemment à la problématique des cellules factorielles vides (classes pour lesquelles aucune observation n’a été collectée) ou à la présence de valeurs hautement atypiques (outliers) qui s’écartent drastiquement de la masse distributionnelle principale. La gestion méthodique de ces singularités conditionne la robustesse de l’affichage sous PROC SGPLOT.
Lorsqu’un croisement factoriel via l’option GROUP= génère une combinaison sans effectif (par exemple, si l’équipe C ne comprenait aucun athlète au poste d’arrière), le comportement par défaut de la procédure peut omettre purement et simplement le niveau vacant ou comprimer la grappe d’affichage, rompant ainsi l’homogénéité visuelle de l’ensemble. Pour préserver une symétrie cartésienne rigoureuse, il convient d’associer des formats SAS spécifiques ou d’activer des options de complétude catégorielle telles que PRELOADFMT (en conjonction avec DISCRETE sur l’axe), forçant l’affichage physique d’un espace vide réservé pour la modalité manquante. Cette stratégie garantit que l’absence de données est perçue en tant qu’information statistique négative explicite plutôt que comme un oubli ou une anomalie de programmation.
Concernant les valeurs extrêmes sur des variables de réponse continues, leur présence au sein d’une catégorie peut gonfler artificiellement la moyenne arithmétique ou déformer démesurément l’échelle de mesure verticale de l’ensemble du graphique. Dans ce contexte, l’analyste doit impérativement documenter ces exclusions de manière transparente dans les notes méthodologiques de bas de figure (au moyen de l’instruction FOOTNOTE) ou privilégier la médiane (STAT=MEDIAN) complétée par un diagramme de dispersion composite pour préserver la vérité distributionnelle des observations.
12. Synthèse opérationnelle des 3 méthodes et protocoles d’exportation pour publication
12.1 Tableau synoptique comparatif des trois approches SAS PROC SGPLOT
Pour guider le biostatisticien ou l’analyste dans la sélection de l’architecture visuelle la plus adéquate face à un problème quantitatif donné, le tableau comparatif ci-dessous récapitule les propriétés structurelles, la syntaxe d’appel et les préconisations méthodologiques associées à chacune des trois grandes variantes de diagrammes à barres explorées dans ce traité :
| Méthode Graphique | Syntaxe PROC SGPLOT Maîtresse | Propriété Perceptive Principale | Usage Recommandé en Recherche |
|---|---|---|---|
| Diagramme Simple (Simple Bar Chart) | vbar var_x; hbar var_y; |
Excellente (estimation d’une longueur le long d’une base commune zéro). | Distribution univariée d’une variable catégorielle ou comparaison d’une métrique continue entre groupes indépendants. |
| Diagramme Empilé (Stacked Bar Chart) | vbar var_x / group=var_z; | Médiocre pour les strates supérieures (biais cognitif de ligne de base flottante). | Visualisation des relations « partie-tout » où seul le volume global cumulé constitue la priorité analytique absolue. |
| Diagramme Groupé (Clustered Bar Chart) | vbar var_x / group=var_z groupdisplay=cluster; | Optimale (tous les segments sont ancrés sur l’axe zéro commun). | Analyse comparative multivariée directe et identification rigoureuse des interactions factorielles croisées. |
Cette matrice met en relief la supériorité structurelle du diagramme groupé pour les comparaisons multivariées précises, tandis que le diagramme simple demeure l’outil le plus universel et le plus résistant aux contresens d’interprétation pour les corpus de complexité univariée.
12.2 Automatisation et reproductibilité via le langage Macro de SAS
Dans un contexte de production industrielle de rapports cliniques ou de synthèses épidémiologiques standardisées, la réécriture séquentielle de blocs PROC SGPLOT pour des dizaines de variables distinctes est une démarche inefficace et propice à l’introduction d’erreurs humaines. Le recours au puissant langage macro de SAS permet de paramétrer l’ensemble de la cinématique graphique au sein d’un composant logiciel réutilisable, garantissant une reproductibilité méthodologique parfaite et une standardisation immédiate des chartes visuelles de laboratoire.
Le module macro suivant illustre l’encapsulation d’une procédure PROC SGPLOT hautement personnalisée, acceptant en paramètres dynamiques la table d’entrée, les variables d’analyse, le type d’agrégation et le titre formel :
%macro generer_diagramme_barres(

    table_entree = my_data,

    var_abscisse = team,

    var_reponse  = points,

    statistique  = mean,

    couleur_hex  = cx2E4053,

    titre_figure = Score Moyen Standardisé par Collectif

);

  title1 font="Arial" bold height=12pt "&titre_figure";

  proc sgplot data=&table_entree;

    vbar &var_abscisse / response=&var_reponse stat=&statistique

                        fillattrs=(color=&couleur_hex)

                        outlineattrs=(color=black thickness=1pt)

                        datalabel;

    xaxis label="Catégories Factorielles" labelattrs=(weight=bold);

    yaxis grid label="Métrique Estimée (&statistique)" labelattrs=(weight=bold);

  run;

  title;

%mend generer_diagramme_barres;
Dès lors que ce bloc macro a été compilé dans la session de travail, le déploiement d’un diagramme standardisé s’opère par une simple invocation unitaire :
%generer_diagramme_barres(var_abscisse=team, var_reponse=points, statistique=mean);
Cette modularité opérationnelle assure un gain de productivité considérable pour les équipes de biostatistique tout en garantissant une homogénéité graphique absolue au fil des multiples itérations de rapports réglementaires.
12.3 Exportation haute résolution via les destinations ODS Graphics
L’aboutissement ultime de la production graphique réside dans son exportation physique vers des supports d’archivage ou de diffusion éditoriale. Les revues scientifiques de premier rang (telles que celles publiées par le groupe Nature, l’Elsevier ou l’Oxford University Press) imposent des exigences techniques très strictes concernant les figures soumises : format vectoriel pur (PDF, EPS, SVG) ou format matriciel non destructif (TIFF) bénéficiant d’une résolution spatiale minimale de 300 à 600 DPI (Dots Per Inch).
Pour répondre avec rigueur à ces contraintes de publication, la procédure PROC SGPLOT doit être pilotée au moyen d’instructions globales de configuration ODS GRAPHICS associées aux destinations appropriées (telles que ODS LISTING ou ODS PDF). L’encapsulation suivante matérialise le protocole d’exportation haute résolution d’une figure vectorielle prête pour l’édition scientifique :
/* Fermeture des destinations actives pour allègement mémoire */

ods _all_ close;
/* Configuration de l'environnement graphique haute définition */
ods listing gpath="C:SAS_ProjetsExportations" image_dpi=300;
ods graphics on / reset=all
imagefmt=tiff
imagename="Fig1_Barplot_Equipes"
width=16cm
height=10cm
noborder;
/* Exécution de la procédure graphique */
title1 font="Arial" bold "Figure 1 : Distribution des Scores Moyens par Collectif";
proc sgplot data=my_data;
vbar team / response=points stat=mean
fillattrs=(color=cx34495E)
outlineattrs=(color=black thickness=1pt)
limitstat=clm alpha=0.05;
xaxis label="Équipe Analysée" labelattrs=(size=10pt weight=bold);
yaxis label="Score Moyen (IC 95 %)" values=(0 to 30 by 5) grid
labelattrs=(size=10pt weight=bold);
run;
title;
/* Clôture et réinitialisation de l'environnement d'affichage */
ods listing close;
ods html;
Dans ce protocole maîtrisé, l’option IMAGE_DPI=300 garantit une résolution matricielle irréprochable au format TIFF, tandis que les paramètres WIDTH=16cm et HEIGHT=10cm fixent avec une exactitude métrique les dimensions physiques du fichier généré sur le disque de stockage. Le paramètre NOBORDER supprime l’inutile filet périphérique externe englobant le canevas, assurant une intégration transparente et professionnelle du fichier dans les gabarits de mise en page LaTeX, InDesign ou Microsoft Word de l’éditeur scientifique.
Références
Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Éditions de l’École des Hautes Études en Sciences Sociales (EHESS).
Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
Heath, D. (2018). Statistical Graphics in SAS: An Introduction to the SGPLOT Procedure. SAS Institute Inc.
Kuhfeld, W. F. (2010). Statistical Graphics in SAS: An Introduction to the Graph Template Language and the Statistical Graphics Procedures. SAS Institute Inc.
SAS Institute Inc. (2020). SAS/GRAPH 9.4: Statistical Graphics Procedures Guide, Sixth Edition. SAS Institute Inc. https://documentation.sas.com
Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0