
Dans l’édifice complexe des sciences humaines, de la médecine clinique, de la neuropsychologie et des sciences organisationnelles, la quantification rigoureuse des attributs psychologiques, comportementaux et cognitifs constitue un défi épistémologique permanent. Contrairement aux grandeurs physiques telles que la masse, la longueur ou la température thermodynamique, les dimensions psychologiques — qu’il s’agisse de l’intelligence fluide, de l’état dépressif sous-jacent, de l’anxiété situationnelle ou de l’efficience exécutive — demeurent des construits inobservables, qualifiés de variables latentes. Pour appréhender ces réalités intangibles avec une fidélité scientifique irréprochable, la psychométrie a développé un corpus méthodologique sophistiqué, au sein duquel la notion de validité occupe une place architectonique cardinale.
Parmi les multiples facettes de la validation instrumentale, la validité concourante (ou concurrent validity dans la tradition anglo-saxonne) s’impose comme une modalité incontournable de la validité liée au critère. Elle répond à une interrogation opérationnelle et pragmatique fondamentale : dans quelle mesure les résultats obtenus par un nouvel instrument d’évaluation concordent-ils fidèlement, de manière synchrone, avec ceux fournis par une mesure de référence établie, reconnue et administrée au cours de la même fenêtre temporelle ? Cette démarche empirique ne se résume pas à une simple juxtaposition de coefficients mathématiques ; elle constitue le fondement justificatif autorisant la substitution légitime d’outils lourds, invasifs, chronophages ou excessivement onéreux par des protocoles d’évaluation plus légers, économiques et accessibles.
Le présent traité propose une exploration exhaustive, théorique, méthodologique et appliquée de la validité concourante. À travers l’analyse de ses fondements épistémologiques, de ses mécanismes d’estimation statistique, de ses distinctions nettes avec la validité prédictive, ainsi que de ses nombreuses applications en psychiatrie, neuropsychologie, éducation et psychologie du travail, ce document offre aux chercheurs, cliniciens et praticiens une synthèse de référence pour concevoir, évaluer et interpréter des outils de mesure conformes aux exigences métrologiques contemporaines.
1. Introduction et fondements épistémologiques de la validité concourante
1.1 Le rôle de l’évaluation psychométrique dans la validation des construits
L’émergence historique de la psychométrie moderne, amorcée à la fin du XIXe siècle sous l’impulsion de pionniers tels que Francis Galton, James McKeen Cattell et Alfred Binet, a répondu à une exigence grandissante de scientificité appliquée aux fonctions mentales supérieures. Mesurer ce que l’on ne peut ni voir, ni peser, ni isoler au scalpel nécessite la formulation d’abstractions théoriques rigoureuses, désignées sous le terme de construits psychologiques. Un construit est une variable hypothétique inférée à partir d’observations comportementales régulières, verbales ou motrices. Dès lors, le problème fondamental de la mesure réside dans la démonstration de l’adéquation entre le comportement manifeste recueilli par le test et la réalité conceptuelle invisible que l’on prétend quantifier.
Dans cette perspective épistémologique, l’article fondateur de Lee Cronbach et Paul Meehl (1955) a constitué une véritable révolution de paradigme. Ces auteurs ont théorisé le réseau nomologique, conçu comme le système interconnecté de lois empiriques et conceptuelles reliant les construits théoriques entre eux et les associant à des manifestations observables. Pour qu’un test soit scientifiquement recevable, il ne suffit plus qu’il présente une cohérence interne apparente ; il doit prouver son insertion harmonieuse et robuste au sein de ce réseau relationnel. Les standards de testage psychologique ont ainsi progressivement abandonné l’illusion d’une vérité intrinsèque de l’outil pour embrasser une épistémologie de la validation continue, où chaque score est une hypothèse soumise à l’épreuve des faits.
Les conséquences pratiques et éthiques d’une mesure non validée s’avèrent considérables dans la prise de décision diagnostique et organisationnelle. Dans un cadre nosologique clinique, l’usage d’un inventaire de dépistage défaillant peut engendrer des faux négatifs préjudiciables à la survie du patient, ou des faux positifs induisant des thérapeutiques psychotropes injustifiées et anxiogènes. Dans l’arène des organisations, un test de recrutement dépourvu d’ancrage métrologique vérifié expose l’institution à des discriminations structurelles et à des erreurs d’allocation de capital humain délétères. La rigueur scientifique n’est donc pas une coquetterie académique, mais un impératif déontologique garantissant l’intégrité du jugement clinique et managérial.
1.2 Définition conceptuelle de la validité concourante au sein de la psychométrie
La validité concourante se définit formellement comme le degré d’association empirique et statistique observé entre les résultats fournis par un instrument de mesure nouvellement développé (ou adapté) et ceux issus d’une mesure critère reconnue et préexistante, lorsque les deux évaluations sont administrées simultanément ou dans un intervalle temporel suffisamment resserré pour exclure toute fluctuation spontanée de l’état du sujet. La spécificité temporelle de la concomitance constitue le trait distinctif de cette modalité : les deux instruments capturent l’état du phénomène psychologique au même instant t, neutralisant ainsi les artefacts développementaux, les rémissions spontanées ou les effets d’apprentissage à long terme.
Cette approche joue un rôle opérationnel de premier plan dans la substitution légitime d’instruments. En milieu de soins ou en recherche fondamentale, les mesures de référence — souvent désignées sous l’anglicisme de « Gold Standard » — sont fréquemment grevées de contraintes lourdes : examens invasifs, entretiens psychiatriques exhaustifs d’une durée de plusieurs heures, batteries neuropsychologiques hautement fatigantes ou dispositifs matériels excessivement coûteux. Démontrer une excellente validité concourante permet d’attester qu’une alternative plus brève, non invasive ou informatisée délivre une estimation qualitativement équivalente de l’état présent de l’individu, justifiant son adoption en pratique courante.
Toutefois, une distinction épistémologique cruciale s’impose : l’existence d’une corrélation mathématique élevée entre deux séries de scores ne saurait être assimilée de facto à une identité conceptuelle parfaite. La validité concourante apporte une preuve empirique de co-variation, mais l’inférence théorique concernant le phénomène sous-jacent requiert une contextualisation rationnelle. Deux tests peuvent corréler fortement sous l’effet de facteurs confondants partagés, sans pour autant mesurer exactement le même construit avec la même profondeur étiologique. Dès lors, l’évaluation de cette validité exige une analyse qui dépasse le simple coefficient pour interroger le sens de la relation observée.
1.3 Objectifs scientifiques et applicatifs de la démonstration de validité concourante
D’un point de vue pratique, la démonstration de la validité concourante poursuit des finalités méthodologiques diversifiées qui soutiennent l’optimisation des pratiques évaluatives. Le premier objectif réside dans la validation d’outils abrégés ou de formes courtes. Face à des patients vulnérables, des enfants en bas âge ou des populations cliniques en situation de fatigue sévère, administrer un inventaire complet de plusieurs centaines d’items se révèle irréalisable. La validation concourante d’un questionnaire court face à la forme intégrale garantit que le gain d’efficience temporelle ne se réalise pas au détriment de l’exactitude de la mesure.
Le deuxième objectif majeur concerne la confirmation de la fidélité de convergence vis-à-vis d’instruments cliniques de référence lors de l’adaptation transculturelle et linguistique. Lorsqu’un inventaire psychologique anglo-saxon de renommée mondiale est traduit et adapté dans la langue française, l’administration concomitante de l’outil adapté et d’une mesure locale préexistante valide l’universalité sémantique et métrologique des items dans le contexte socioculturel cible. Sans cette vérification synchrone, le risque d’introduire des distorsions herméneutiques majeures demeure particulièrement élevé.
Enfin, l’impératif contemporain de transition numérique oriente massivement les protocoles vers la validation concourante d’instruments dématérialisés. La transposition d’épreuves cognitives traditionnelles « papier-crayon » vers des plateformes logicielles, des tablettes tactiles ou des dispositifs de réalité virtuelle exige une preuve rigoureuse d’équivalence métrologique immédiate. Il s’agit de démontrer empiriquement que les nouvelles interfaces d’interaction n’altèrent pas la variance du construit étudié et n’introduisent aucun biais technique de manipulation, assurant ainsi une continuité parfaite des diagnostics cliniques.
2. Cadre théorique : la validité liée au critère et ses composantes
2.1 L’architecture tripartite traditionnelle de la validité psychométrique
Historiquement formalisée par les comités conjoints de l’American Psychological Association (APA) dans les années 1950, l’architecture psychométrique classique articulait l’examen de la qualité des tests autour d’un triptyque bien délimité : la validité de contenu, la validité de construit et la validité liée au critère. La validité de contenu interroge la représentativité et l’exhaustivité des items au regard du domaine conceptuel défini. La validité de construit examine dans quelle mesure le test s’insère fidèlement dans les hypothèses théoriques globales issues du réseau nomologique. Enfin, la validité liée au critère évalue l’efficacité pratique du test à reproduire ou anticiper un comportement concret ou une mesure externe objective.
Bien que cette distinction tripartite ait structuré des générations de manuels psychométriques, les théorisations contemporaines, menées notamment par Samuel Messick (1989, 1995), ont profondément unifié ce paysage. Messick a conceptualisé la validité non plus comme une juxtaposition de catégories étanches, mais comme un argument évaluatif unifié. Dans ce modèle contemporain, toute preuve de validité est fondamentalement une preuve de validité de construit. La démonstration empirique apportée par la corrélation avec un critère externe ne représente plus une entité isolée, mais une facette particulière de l’argumentation globale justifiant l’interprétation des scores et l’usage décisionnel qui en découle.
Il existe ainsi une interdépendance structurelle étroite entre l’éléchafaudage conceptuel d’un construit et sa validation par critère. Si un nouveau test prétendant mesurer l’anxiété sociale échoue à corréler de manière synchrone avec un entretien clinique diagnostique établi, cet échec empirique rétroagit directement sur la crédibilité théorique de l’instrument. La confrontation avec le critère agit comme un ancrage réaliste, empêchant la théorie psychologique de s’enfermer dans un solipsisme spéculatif auto-référentiel et garantissant la résonance du test avec les manifestations concrètes du comportement humain.
2.2 La validité liée au critère : définition et postulats
La validité liée au critère repose sur le postulat fondamental selon lequel la valeur d’un instrument réside dans sa capacité à se comporter conformément à des attentes mesurables vis-à-vis d’une variable extérieure indépendante, appelée critère. Ce critère externe constitue l’incarnation opérationnelle, standardisée et directement observable de la caractéristique ou du diagnostic que le test préliminaire vise à capturer. La force de l’inférence repose entièrement sur la qualité intrinsèque, l’objectivité et la pertinence clinique ou contextuelle de cet étalon de comparaison.
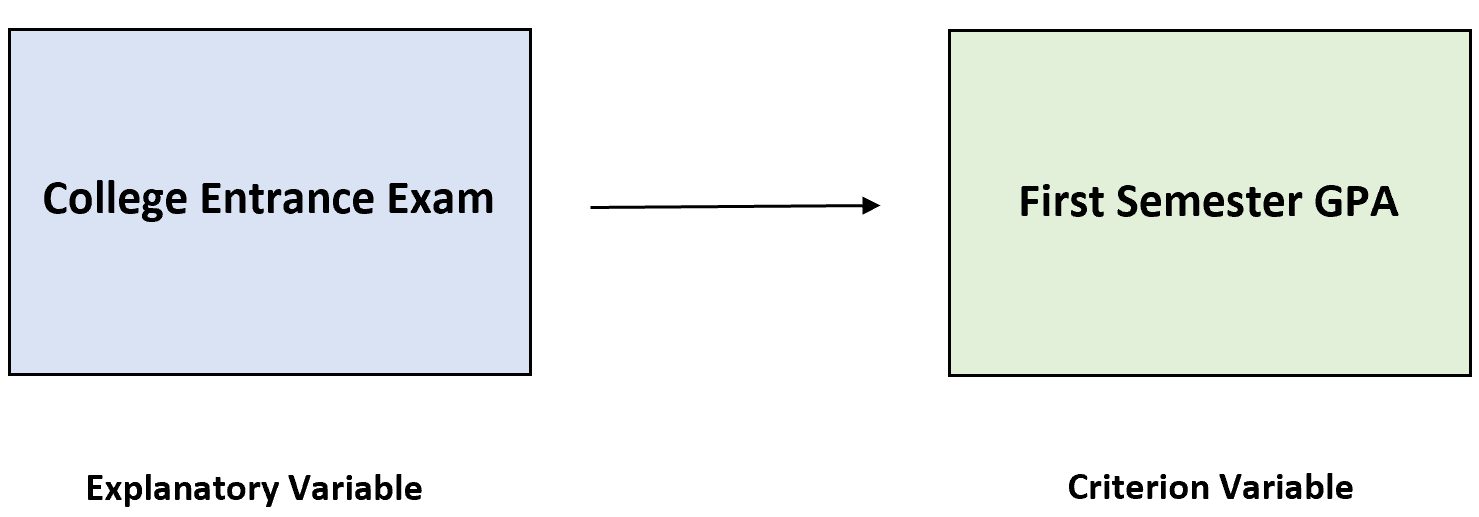
Une exigence méthodologique stricte de cette approche réside dans l’indépendance de mesure absolue entre la variable testée et la variable critère. Toute interpénétration méthodologique engendre ce que la littérature nomme la contamination du critère. Si l’évaluateur attribuant le score au critère a connaissance préalable des résultats obtenus par le sujet au nouveau test en phase d’expérimentation, sa cotation risque d’être inconsciemment orientée dans le sens d’une confirmation de l’outil, créant un artefact de circularité diagnostique. Pour garantir l’objectivité du modèle, le recueil du critère doit être hermétiquement isolé de l’administration du test analysé.
De surcroît, la validité liée au critère postule la stabilité psychométrique et la représentativité exhaustive de la population au sein de laquelle les données sont collectées. Un critère n’est valable que s’il est appliqué à un échantillon reflétant fidèlement l’hétérogénéité, les amplitudes de sévérité symptomatique et la diversité démographique de la population cible finale. Si le critère est recueilli auprès d’un sous-groupe hyper-spécifique ou homogène, l’estimation de la relation statistique s’en trouvera gravement altérée, limitant dramatiquement la portée opérationnelle des conclusions tirées.
2.3 Les deux branches : validité prédictive et validité concourante
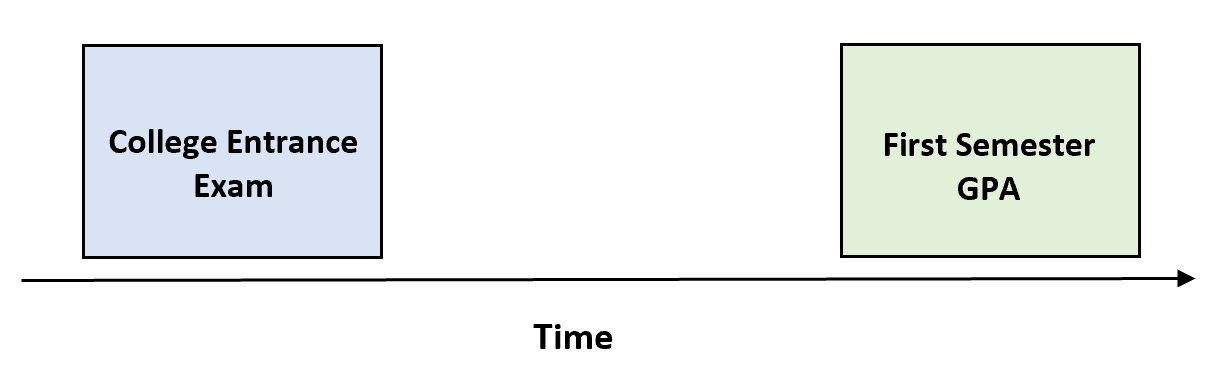
Au sein de la validité liée au critère, une dichotomie conceptuelle majeure sépare les approches selon l’orientation temporelle du vecteur de recueil des données. D’un côté se trouve la validité prédictive, dont le protocole s’inscrit dans un axe temporel longitudinal : le test est administré à un temps initial $T_0$, tandis que le critère externe n’est collecté qu’à un temps ultérieur $T_1$, après l’écoulement d’une période de latence pouvant varier de plusieurs semaines à plusieurs décennies. La question formulée est alors purement prospective : le score initial permet-il d’anticiper adéquatement une performance ou un événement futur ?
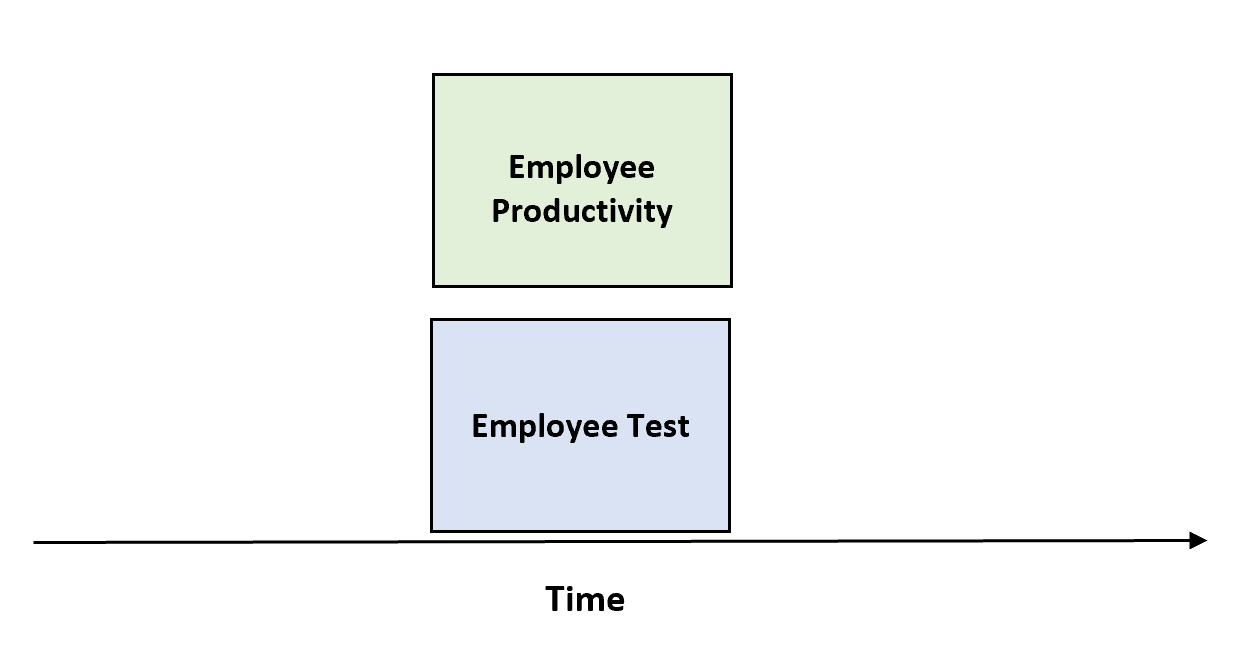
D’un autre côté, la validité concourante neutralise délibérément la flèche du temps chronologique. Les scores au nouvel instrument et les mesures du critère sont prélevés de manière synchrone, dans une fenêtre temporelle restreinte et contiguë ($T_0 \approx T_{\text{critère}}$). La problématique explorée ne relève pas de la prévision, mais du diagnostic instantané : le test parvient-il à refléter fidèlement la situation clinique, neuropsychologique ou aptitudinale actuelle de l’individu, telle qu’elle se manifeste au moment exact de la passation ?
Cette complémentarité temporelle entraîne des conséquences méthodologiques profondes sur la variance observée. Alors que la validité prédictive expose inévitablement les données à l’influence de variables parasites intercurrentes (maturation biologique, événements de vie imprévisibles, interventions thérapeutiques non contrôlées, attrition de l’échantillon), la validité concourante s’affranchit de ces bruits temporels. En éliminant l’intervalle temporel, elle isole la pure convergence métrologique d’état au détriment de l’observation des trajectoires développementales longitudinales.
3. Analyse comparative approfondie : validité concourante versus validité prédictive
3.1 Le paramètre temporel et l’intervalle d’administration
Le paramètre temporel constitue la ligne de démarcation architecturale entre les démarches prédictives et concourantes. Dans le paradigme concourant, l’administration est qualifiée de simultanée ou de quasi-simultanée. En pratique, cela implique que le sujet complète le nouveau test et subit l’évaluation du critère au cours de la même journée, ou idéalement au sein de la même session d’évaluation, avec de simples pauses standardisées pour limiter la fatigue cognitive. Cette synchronie élimine toute possibilité de changement réel de l’attribut psychologique évalué entre les deux mesures.
À l’inverse, l’approche prédictive exige par nature un délai temporel substantiel pour permettre au critère de se manifester organiquement. Qu’il s’agisse de mesurer la réussite académique universitaire à partir d’un test d’aptitude passé au lycée, d’anticiper la récidive criminelle sur cinq ans ou d’évaluer le risque de rechute dépressive après l’arrêt d’un traitement, le facteur temps introduit une source colossale d’hétérogénéité. La survenue d’événements médiateurs ou modérateurs complexifie inévitablement l’analyse mathématique de la corrélation.
Cette distinction temporelle a des répercussions directes sur l’intégrité de l’échantillonnage expérimental. Les études longitudinales de validité prédictive souffrent de manière chronique d’un risque élevé de mortalité expérimentale ou d’attrition différentielle : les participants déménagent, abandonnent l’étude, refusent de répondre lors des phases de suivi ou décèdent. Ce phénomène érode la puissance statistique et génère de redoutables biais de sélection. Le devis concourant, grâce à son recueil immédiat, neutralise quasi intégralement l’attrition, garantissant un contrôle logistique optimal sur l’intégralité de la cohorte initiale.
3.2 Différences de finalités diagnostiques et pronostiques
Les objectifs d’application clinique et décisionnelle orientent catégoriquement le choix entre ces deux modalités de validation. La validité concourante s’adresse de manière privilégiée aux problématiques d’état présent. Dans une unité d’urgences psychiatriques, le clinicien ne cherche pas prioritairement à modéliser la santé mentale du patient à dix ans, mais nécessite une clarification immédiate et robuste de l’état suicidaire ou psychotique présent. Un test de tri clinique (triage) validé de façon concourante face à une expertise psychiatrique complète permet d’orienter instantanément le patient vers une prise en charge adaptée.
En revanche, la validité prédictive répond à une logique pronostique et prospective. Dans le domaine de la sélection professionnelle, une direction des ressources humaines recrute un collaborateur en fonction de sa productivité future anticipée, de son potentiel d’apprentissage face à de nouveaux logiciels ou de sa rétention à long terme dans l’entreprise. Dans ce scénario, administrer un test corrélé uniquement avec l’état de stress actuel des employés déjà en poste offre un intérêt limité comparativement à une étude longitudinale prouvant que le score d’aptitude initiale prédit statistiquement les évaluations de performance semestrielles à venir.
Le choix des variables critères découle directement de ces finalités distinctes. Pour une validation concourante, le critère sera typiquement un score à une échelle de référence déjà validée, un diagnostic psychiatrique posé par consensus d’experts au jour J, ou un dosage biologique immédiat. Pour une validation prédictive, le critère se cristallisera sous forme de données d’occurrence différée : obtention d’un diplôme, maintien dans l’emploi après deux ans, survenue d’un infarctus du myocarde ou volume de ventes trimestrielles validé en fin d’exercice fiscal.
3.3 Avantages comparatifs et limites méthodologiques intrinsèques
L’avantage cardinal des protocoles de validité concourante réside dans leur remarquable économie de moyens et leur vélocité d’exécution. Les chercheurs et éditeurs de tests peuvent colliger l’ensemble des données nécessaires à la validation psychométrique en un temps record, sans avoir à financer des structures de suivi de cohorte étalées sur des années. Cette rapidité opérationnelle accélère significativement la mise à disposition d’outils de diagnostic de pointe dans les milieux appliqués.
Cependant, cette démarche recèle des vulnérabilités méthodologiques intrinsèques. La synchronisation temporelle des passations exacerbe la sensibilité des mesures aux variables parasites circonstancielles. Si un sujet se présente à la séance dans un état de privation de sommeil extrême, d’anxiété d’évaluation aiguë ou sous l’effet d’une substance psychoactive, cet état transitoire affectera de façon conjointe le nouveau test et le critère de comparaison. Cette covariation circonstancielle gonfle artificiellement le coefficient de corrélation, donnant l’illusion d’une excellente validité d’évaluation alors que les instruments partagent en réalité une variance d’erreur d’état momentanée.
De plus, la validité concourante est par essence incapable d’établir la moindre inférence de causalité directionnelle ou de certifier la stabilité diachronique des construits. Elle fournit une photographie instantanée mais demeure aveugle à la dynamique évolutive des individus, interdisant toute extrapolation prospective imprudente en l’absence de protocoles prédictifs complémentaires.
| Caractéristique | Validité concourante | Validité prédictive |
|---|---|---|
| Intervalle temporel | Simultané ou contigu ($T_0 \approx T_{\text{critère}}$) | Différé dans le temps ($T_0$ puis $T_1$, longitudinal) |
| Finalité dominante | Diagnostique, classification immédiate, tri | Pronostique, sélection, anticipation d’événements |
| Risque d’attrition | Quasi inexistant | Élevé (perte de vue des sujets dans le temps) |
| Sensibilité aux états passagers | Forte (fatigue, stress partagés entre les tests) | Faible (la variance d’état s’estompe avec le délai) |
| Coût et durée d’étude | Faible à modéré, résultats rapides | Élevé, exige un suivi méthodologique prolongé |
4. Méthodologie statistique d’évaluation de la validité concourante
4.1 Coefficients de corrélation et analyses bivariées
L’estimation quantitative de la validité concourante repose historiquement sur l’analyse de corrélation linéaire bivariée. Lorsque le nouveau test et l’instrument critère fournissent tous deux des variables continues mesurées sur des échelles d’intervalles ou de rapports, et que les distributions satisfont aux postulats de normalité bivariée, le coefficient de corrélation de Pearson ($r$) constitue l’étalon mathématique universellement employé. Il quantifie l’intensité et la direction de la relation linéaire entre les scores, oscillant théoriquement entre -1,00 et +1,00.
Dans les configurations où les distributions violent les postulats paramétriques — notamment en présence de distributions asymétriques fréquentes en psychopathologie ou lors du recueil de données purement ordinales (échelles de Likert à faible nombre d’échelons) —, le recours au coefficient rho de Spearman ($rho$) ou au tau de Kendall s’impose. Ces indices non paramétriques opèrent sur le rang des observations plutôt que sur les valeurs brutes, offrant une robustesse accrue face aux valeurs aberrantes ou aux déformations d’échantillonnage.
Lorsque le critère se présente sous une forme dichotomique (présence ou absence d’un trouble psychiatrique avéré selon les critères nosologiques du DSM-5), la méthodologie recourt aux corrélations bisériales de point ($r_{pb}$). Dans la communauté des sciences humaines et du comportement, l’interprétation des amplitudes d’effet fait l’objet de consensus bien établis : une corrélation critère inférieure à 0,30 est jugée marginale et insuffisante ; un coefficient compris entre 0,40 et 0,60 indique une validité concourante modérée à satisfaisante ; au-delà de 0,70, la validité concourante est considérée comme excellente, confirmant la pertinence de la substitution fonctionnelle de l’instrument.
4.2 Modélisation par régression linéaire et multiple
Bien que l’analyse bivariée offre un premier éclairage descriptif indispensable, la modélisation par régression linéaire affine considérablement l’évaluation psychométrique. Elle permet de quantifier avec exactitude la proportion de variance du critère directement expliquée par le nouvel outil, symbolisée par le coefficient de détermination ($R^2$). Par exemple, un coefficient de corrélation $r = 0,75$ signifie que le nouveau test explique approximativement 56,25 % de la variance observée du standard de référence, le reste relevant de la variance spécifique du critère ou de la variance d’erreur.
La régression multiple hiérarchique permet d’évaluer la validité incrémentale du nouveau test. Il s’agit de démontrer si le nouvel instrument apporte un gain substantiel de prédiction ou de concordance diagnostique au-delà des mesures préexistantes déjà disponibles dans la pratique clinique. En introduisant les prédicteurs classiques dans un premier bloc d’équations statistiques, puis en ajoutant le nouvel outil dans un second bloc, le chercheur examine si l’accroissement du $R^2$ ($\Delta R^2$) s’avère statistiquement significatif, justifiant ainsi l’apport pratique de l’innovation métrologique.
Une démarche rigoureuse exige impérativement un diagnostic approfondi des résidus de régression. L’examen graphique des résidus standardisés permet de vérifier l’absence d’hétéroscédasticité (non-constance de la variance d’erreur le long du spectre des scores) et d’identifier les potentielles non-linéarités sous-jacentes. Par ailleurs, lorsque plusieurs instruments concourants sont administrés au sein d’une batterie globale, l’analyse du facteur d’inflation de la variance (VIF) prévient les distorsions d’interprétation induites par la multicolinéarité sévère.
4.3 Matrices multitraits-multiméthodes (MTMM) et validité convergente-discriminante
Pour immuniser l’évaluation contre les illusions statistiques de corrélations superficielles, la méthodologie contemporaine s’appuie sur le paradigme fondamental de la matrice multitraits-multiméthodes (MTMM), formulé par Donald Campbell et Donald Fiske en 1959. Ce dispositif sophistiqué stipule que pour valider authentiquement un instrument, il est impératif de démontrer simultanément une forte association avec des mesures différentes du même trait (validité convergente) et une absence d’association significative avec des instruments mesurant des traits conceptuellement distincts, même s’ils partagent la même méthodologie d’administration (validité discriminante).
Une clarification terminologique majeure s’impose ici pour dissiper des confusions fréquentes dans la littérature : la validité concourante ne doit pas être purement et simplement assimilée à la validité convergente. La validité convergente relève de la validité de construit et explore la convergence théorique d’indicateurs multiples vers une même abstraction latente. La validité concourante est une modalité de la validité critère qui exige une synchronie temporelle rigoureuse vis-à-vis d’un étalon comportemental ou diagnostique indépendant. Dans une matrice MTMM, la validité concourante se matérialise dans les cellules croisant le même trait évalué au temps présent par deux méthodes rigoureusement distinctes et indépendantes.
L’utilisation de la modélisation en équations structurelles et de l’analyse factorielle confirmatoire (CFA) permet aujourd’hui de modéliser mathématiquement ces matrices complexes. Grâce à l’approche CTCM (Correlated Traits-Correlated Methods), le psychométricien parvient à scinder la variance totale observée en trois composantes mathématiques explicites : la variance véritable imputable au trait psychologique, la variance indésirable imputable à la méthode d’évaluation (variance de méthode), et la variance résiduelle d’erreur non systématique. Cette modélisation avancée purifie le coefficient de validité concourante en éliminant les artéfacts méthodologiques partagés.
5. La sélection critique du critère de référence (« Gold Standard »)
5.1 Critères d’excellence et fidélité du standard de comparaison
L’édification de toute preuve de validité concourante dépend intégralement de la solidité méthodologique du critère choisi comme étalon de comparaison. En psychométrie et en épidémiologie clinique, le Gold Standard (ou étalon-or) désigne la procédure de mesure la plus irréprochable, éprouvée et consensuelle disponible au sein de la communauté scientifique à un moment donné. Choisir un critère médiocre ou instable vicie l’ensemble du protocole expérimental, rendant les conclusions mathématiques dénuées de toute validité inférentielle.
Un principe mathématique fondamental régit cette dépendance : l’infidélité du critère atténue systématiquement le coefficient de validité empirique observé. Selon les équations canoniques de la théorie classique des tests, le coefficient de corrélation observé entre un test $X$ et un critère $Y$ ($r_{xy}$) est mathématiquement plafonné par la racine carrée du produit des coefficients de fidélité respectifs des deux instruments :
$$r_{xy(\text{observé})} le \sqrt{r_{xx’} \cdot r_{yy’}}$$
Si la fidélité du critère ($r_{yy’}$) est médiocre en raison d’un manque de consistance interne ou d’une mauvaise concordance inter-juges, la corrélation concourante observée s’effondrera artificiellement, conduisant le chercheur à rejeter à tort un test innovant qui était pourtant intrinsèquement excellent. La fameuse formule de correction pour atténuation de Spearman permet théoriquement d’estimer quelle serait la corrélation si les deux instruments étaient mesurés sans aucune erreur de mesure :
$$r_{x_t y_t} = \frac{r_{xy}}{\sqrt{r_{xx’} \cdot r_{yy’}}}$$
Néanmoins, l’application de cette formule fait l’objet de réserves dans les milieux de la régulation psychométrique, car elle manipule des estimations idéalisées qui ne reflètent pas les performances concrètes en contexte réel d’application.
5.2 La problématique de l’infaillibilité illusoire du critère
L’un des dilemmes les plus stimulants et déroutants de la psychométrie appliquée concerne la nature fondamentalement imparfaite des standards existants. Dans de nombreux domaines de la psychopathologie ou des neurosciences cognitives, il n’existe aucun critère biologique objectif absolu permettant d’établir la présence irréfutable d’une entité clinique. Les étalons-or reposent fréquemment sur des avis d’experts humains ou des entretiens semi-structurés qui, bien que rigoureux, conservent une part indépassable de subjectivité et d’erreur de mesure.
Ce constat engendre le paradoxe du test supérieur : comment valider un nouvel instrument métrologique qui possède potentiellement des qualités discriminatives supérieures à celles du critère de référence imparfait auquel on le confronte ? Si le nouveau test détecte des signaux cliniques ténus que le critère traditionnel laisse échapper en raison de sa grossièreté, ces vraies détections seront mathématiquement étiquetées comme des discordances ou des « faux positifs », dégradant injustement les scores de validité apparente du nouveau test.
Face à cette impasse épistémologique, la psychométrie computationnelle déploie désormais des modèles probabilistes sophistiqués, au premier rang desquels figurent les analyses de classes latentes sans étalon-or (Latent Class Analysis). Ces architectures mathématiques évaluent simultanément plusieurs tests imperfectifs sur une vaste cohorte et déduisent probabilistiquement l’état latent réel de l’individu ainsi que la sensibilité et la spécificité relatives de chaque instrument, affranchissant l’investigateur de l’obligation de sacraliser un critère imparfait.
5.3 Biais de contamination et d’indépendance de la mesure
La menace la plus sournoise pesant sur la démonstration de la validité concourante est sans conteste le biais de contamination du critère. Ce biais survient dès lors que l’évaluation du critère externe est, consciemment ou non, influencée par les connaissances ou les résultats découlant du nouveau test à valider. Par exemple, si un clinicien expérimenté mène un entretien psychiatrique critère tout en ayant sous les yeux le résultat obtenu quelques minutes auparavant par le patient à l’auto-questionnaire expérimental, son écoute et son diagnostic risquent de s’aligner par confirmation cognitive sur les données du test.
Ce phénomène détruit la validité de l’inférence en introduisant une circularité factice. La corrélation très élevée qui en découle n’est pas le reflet de l’adéquation objective de l’instrument au phénomène réel, mais l’enregistrement de l’influence de la première mesure sur la seconde. Pour conjurer cette contamination méthodologique, la règle déontologique et expérimentale absolue est l’implémentation d’un protocole en double insu (ou double aveugle strict) :
- L’examinateur qui administre ou cote le nouveau test doit ignorer l’état global et les antécédents du participant au regard du critère.
- L’expert évaluant le critère standard doit être totalement ignorant des performances ou des réponses fournies par le sujet au nouveau test.
- La passation des deux démarches doit être orchestrée par des équipes indépendantes garantissant une étanchéité hermétique des fichiers de recueil de données brutes jusqu’au déconfinement statistique final.
6. Exemples concrets en psychologie clinique et psychopathologie
6.1 Validation d’échelles courtes de dépistage dépressif
L’évaluation standardisée des troubles de l’humeur constitue l’un des territoires les plus emblématiques de l’application de la validité concourante. Dans les structures hospitalières générales ou les cabinets de médecine de premier recours, les praticiens sont confrontés à un impératif d’efficience diagnostique face à la prévalence massive des épisodes dépressifs majeurs. L’entretien psychiatrique approfondi fondé sur le Structured Clinical Interview for DSM (SCID), considéré comme un standard international indiscutable, requiert entre 45 et 90 minutes de passation par un clinicien hautement formé, ce qui en interdit l’usage systématique lors de consultations généralistes de quinze minutes.
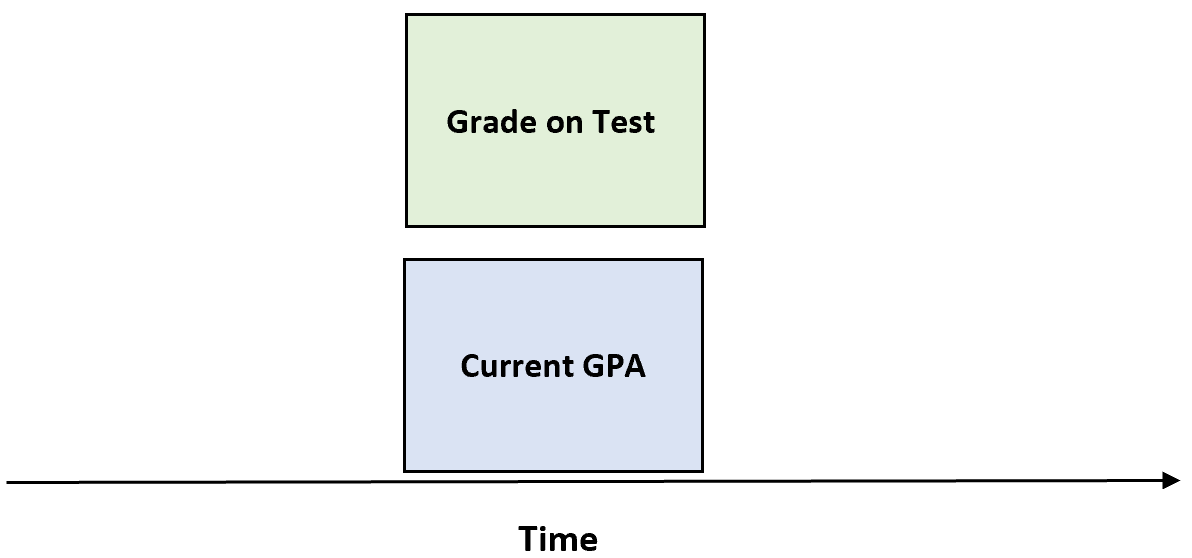
C’est dans ce contexte que le questionnaire d’auto-évaluation Patient Health Questionnaire-9 (PHQ-9), composé de seulement 9 items directement dérivés des critères diagnostiques nosologiques, a fait l’objet de vastes études de validité concourante. Lors de ces protocoles, les patients remplissent le PHQ-9 en salle d’attente, puis sont immédiatement conduits en salle d’entretien pour subir le SCID mené en aveugle par un psychiatre indépendant. Les études de validation ont mis en évidence un coefficient de corrélation bisériale de point élevé ($r_{pb} \approx 0,73$) ainsi qu’une remarquable concordance de classification catégorielle.
L’analyse fine s’opère par la modélisation des courbes ROC (Receiver Operating Characteristic). En fixant le score seuil optimal du PHQ-9 à 10 points sur un score maximal de 27, la validation concourante a attesté une sensibilité diagnostique immédiate de 88 % et une spécificité de 88 % par rapport au verdict posé le même jour par le SCID. Ces indices empiriques solides fournissent la caution scientifique permettant aux systèmes de santé du monde entier d’utiliser ce test bref en première ligne thérapeutique pour un repérage précoce et sécurisé.
6.2 Évaluation simultanée des troubles anxieux et phobiques
Un autre cas paradigmatique s’illustre dans la quantification de l’anxiété généralisée à travers l’échelle GAD-7 (Generalized Anxiety Disorder-7). Lors de son développement par Spitzer et ses collaborateurs, la validité concourante du GAD-7 a été vérifiée en le confrontant de manière synchrone à une batterie d’échelles reconnues de longue date, notamment l’Inventaire d’Anxiété de Beck (Beck Anxiety Inventory, BAI) et l’échelle d’anxiété de la Hospital Anxiety and Depression Scale (HADS-A), administrés lors d’une session clinique unique.
Les analyses bivariées ont révélé une corrélation concourante robuste de $r = 0,72$ entre le GAD-7 et le BAI, ainsi qu’une association de $r = 0,74$ avec la sous-échelle anxiété de la HADS. Ces convergences chiffrées immédiates ont apporté la preuve formelle que ce nouvel outil ultra-synthétique de 7 items captait la même sévérité symptomatique que des batteries plus composites de 21 items. Cependant, l’examen granulaire des matrices d’inter-corrélations d’items a révélé des nuances sémiologiques captivantes : le GAD-7 présente une plus forte corrélation avec les aspects cognitifs de l’anxiété (inquiétudes excessives, agitation mentale), tandis que le BAI sature davantage sur les manifestations neurovégétatives somatiques (palpitations, tremblements, sueurs).
Cette démonstration de validité concourante a permis de légitimer le GAD-7 dans la pratique clinique ambulatoire, allégeant la charge cognitive des patients souffrant d’anxiété sévère pour lesquels la passation d’inventaires denses et répétitifs constitue en soi une source de détresse psychique supplémentaire.
6.3 Diagnostic des troubles de la personnalité
La nosologie des troubles de la personnalité présente des défis de mesure considérables, en raison de l’enchevêtrement complexe entre la symptomatologie aiguë et les traits dispositionnels chroniques, souvent obscurcis par des mécanismes d’anosognosie ou de désirabilité sociale défensive. L’étalon diagnostique en psychopathologie de la personnalité s’incarne dans des protocoles d’entretiens semi-structurés très rigoureux, tels que le Structured Interview for DSM-IV Personality Disorders (SIDP-IV) ou l’IPDE (International Personality Disorder Examination).
Dans la quête d’inventaires auto-rapportés plus rapides, de nouveaux questionnaires de personnalité pathologique, inspirés notamment du modèle dimensionnel alternatif du DSM-5 (comme le PID-5, Personality Inventory for DSM-5), ont été soumis à des épreuves de validité concourante synchrone face à ces entretiens cliniques approfondis. Les coefficients d’association observés dans ce champ sont typiquement plus modérés que dans le cadre des troubles de l’humeur, oscillant régulièrement entre $r = 0,45$ et $r = 0,65$.
Cette modération statistique ne traduit pas nécessairement une faiblesse intrinsèque du test, mais reflète l’écart fondamental de méthode entre l’auto-évaluation introspective du sujet et le jugement clinique hétéro-attribué par l’expert. Les protocoles de validation concourante doivent ici obligatoirement intégrer la modélisation des comorbidités psychiatriques concomitantes : un état dépressif caractérisé présent au jour du test colore négativement l’ensemble des réponses au questionnaire de personnalité, un biais de distorsion cognitive immédiate que l’entretien clinique du standard parvient plus efficacement à neutraliser.
7. Exemples concrets en neuropsychologie et évaluation des fonctions cognitives
7.1 Validation d’outils de repérage rapide des démences
Le champ de la neuropsychologie du vieillissement illustre remarquablement l’utilité des devis de validité concourante à travers la confrontation historique entre le Mini-Mental State Examination (MMSE de Folstein) et la Montreal Cognitive Assessment (MoCA développée par Nasreddine). Alors que le MMSE régnait depuis les années 1970 comme le standard dominant de repérage cognitif en milieu hospitalier, ses limites diagnostiques flagrantes — en particulier un dramatique effet de plafond chez les personnes scolarisées et une insensibilité notoire aux dysfonctionnements exécutifs légers — ont motivé la création de la MoCA.
Lors de la phase princeps de validation, Nasreddine et son équipe ont administré le MMSE et la MoCA de manière concomitante à une vaste cohorte comprenant des sujets témoins sains, des patients souffrant de trouble cognitif léger (Mild Cognitive Impairment, MCI) et des patients atteints de maladie d’Alzheimer débutante à modérée. La corrélation concourante globale entre les deux instruments s’est établie à un niveau très élevé ($r = 0,87$), confirmant que les deux tests quantifient bien le déclin cognitif global au sein d’une même métrique dimensionnelle.
Cependant, l’analyse comparative fine de la validité concourante discriminative a révélé la suprématie de la MoCA : pour un score seuil conventionnel inférieur à 26/30, la MoCA présentait une sensibilité concourante de 90 % pour le diagnostic immédiat de MCI par rapport à un bilan neuropsychologique étendu indépendant, là où la sensibilité concourante du MMSE s’effondrait à seulement 18 %. Cette étude a révolutionné la pratique gériatrique mondiale en démontrant par la corrélation synchrone la supériorité d’un outil pourtant aussi bref que le standard antérieur.
7.2 Digitalisation des tests d’attention et de fonctions exécutives
L’essor de la neuropsychologie assistée par ordinateur a vu proliférer la numérisation sur tablette tactile de tests cognitifs traditionnels. L’épreuve reine de l’exploration de la flexibilité cognitive et de la vitesse de traitement est sans conteste le Trail Making Test (TMT, parties A et B), historiquement exécuté à l’aide d’une feuille de papier et d’un chronomètre à aiguille. Pour autoriser l’adoption clinique d’une variante sur tablette numérique, les concepteurs doivent apporter la preuve absolue d’une équivalence métrologique stricte par un protocole concourant.
Ces protocoles soumettent les sujets à une passation immédiate des deux versions (papier-crayon et tablette tactile) au cours de la même séance. La synchronisation temporelle est ici un impératif absolu, car les performances attentionnelles et exécutives subissent des fluctuations ultradiennes considérables sous l’effet du rythme circadien, de la glycémie, du niveau de vigilance ou de la prise médicamenteuse. Administrer les versions à 48 heures d’intervalle introduirait un biais temporel inacceptable.
Pour neutraliser l’effet d’apprentissage direct inhérent à la réitération de la tâche motrice, les chercheurs conçoivent des formes parallèles contrebalancées avec randomisation de l’ordre de passation (groupe 1 : papier puis tablette ; groupe 2 : tablette puis papier). Les corrélations concourantes observées ($r > 0,80$) confirment que la manipulation de l’interface tactile (stylet ou doigt sur écran en verre) ne modifie pas les processus neuro-cognitifs recrutés et que le temps de complétion digital reflète avec une fidélité optimale la performance analogique conventionnelle.
7.3 Évaluation du langage et des aphasies post-AVC
Dans la prise en charge d’urgence des accidents vasculaires cérébraux (AVC), l’évaluation orthophonique et aphasiologique immédiate en phase aiguë est cruciale pour guider les stimulations précoces et la plasticité cérébrale. Le standard d’évaluation complet repose sur des batteries lourdes comme le Boston Diagnostic Aphasia Examination (BDAE), dont la passation intégrale exige de multiples séances réparties sur plusieurs jours, ce qui est strictement incompatible avec l’extrême fatigabilité du patient alité en unité neurovasculaire.
Le développement de protocoles brefs d’évaluation du langage par télémédecine et applications mobiles a fait l’objet d’une validation concourante systématique au chevet des patients. En administrant un outil linguistique abrégé de dix minutes simultanément à une sous-section ciblée du bilan de Boston menée en aveugle, les chercheurs ont mis en évidence d’excellentes corrélations de rang pour la fluence verbale ($r = 0,82$) et la compréhension syntaxique ($r = 0,79$).
La validité concourante démontrée a permis d’instaurer des circuits de télé-expertise orthophonique dans les hôpitaux périphériques dépourvus de spécialistes permanents. Grâce à cette concordance immédiate prouvée, les équipes soignantes locales peuvent catégoriser le sous-type d’aphasie (Broca, Wernicke, de conduction) dès les premières heures suivant l’accident vasculaire et engager des thérapies ciblées sans attendre le transfert du patient vers un centre hospitalier universitaire.
8. Exemples concrets en psychologie du travail et des organisations
8.1 Tests de jugement situationnel et performance actuelle au poste
Dans l’univers des ressources humaines et de la psychologie organisationnelle, la sélection et la mobilité interne mobilisent massivement des tests de jugement situationnel (SJT). Ces instruments confrontent le sujet à des scénarios professionnels complexes et réalistes en lui demandant de choisir les réponses les plus appropriées parmi plusieurs options comportementales prédéfinies. Pour valider l’efficience d’un nouveau SJT avant son implémentation à grande échelle, les organisations privilégient très souvent une stratégie de validité concourante.
Le protocole consiste à administrer le SJT à une cohorte d’employés déjà en fonction dans l’organisation, et à mettre immédiatement leurs scores en corrélation avec des mesures objectives de leur performance au poste recueillies au cours de la même semaine. Le critère de performance peut agréger l’évaluation hiérarchique annuelle récente, les indicateurs clés de performance (KPI) mensuels ou le chiffre d’affaires individuel du trimestre écoulé. Une corrélation positive substantielle ($r \approx 0,35$ à $0,45$, ce qui constitue un effet très robuste dans les environnements professionnels réels) apporte la preuve que le test discrimine adéquatement les compétences organisationnelles présentes.
Toutefois, cette méthode concourante en psychologie du travail se heurte à une contrainte méthodologique structurelle : le phénomène de restriction de l’étendue (analysé en détail dans la section 10). L’échantillon d’employés en poste ne comprend pas les candidats éliminés lors des recrutements antérieurs, ni les individus licenciés pour incompétence. La variance des compétences y est donc beaucoup plus faible que dans la population générale, ce qui tend à comprimer artificiellement le coefficient de corrélation observé par rapport à ce qu’il serait lors d’une campagne de sélection réelle auprès de postulants externes diversifiés.
8.2 Mesure du bien-être au travail et de l’épuisement professionnel
La surveillance de la santé mentale au travail et la prévention des risques psychosociaux (RPS) contraignent les directions d’entreprises et les comités de santé et de sécurité à déployer des baromètres sociaux récurrents. Pour maximiser le taux de participation, les questionnaires administrés ne doivent pas dépasser quelques minutes, sous peine de susciter un rejet massif des salariés. Le standard mondial de mesure de l’épuisement professionnel demeure le Maslach Burnout Inventory (MBI), comprenant 22 items répartis en trois sous-échelles dimensionnelles : épuisement émotionnel, dépersonnalisation et accomplissement personnel.
La validation d’échelles ultra-courtes (par exemple des versions à 3 ou 6 items) a exigé des protocoles rigoureux de validité concourante. En soumettant des centaines de salariés à l’échelle courte et au MBI intégral dans un même formulaire informatisé anonyme, les chercheurs ont pu attester de corrélations concourantes exceptionnelles ($r > 0,85$ sur la dimension de l’épuisement émotionnel). De surcroît, la validité concourante a été simultanément mise à l’épreuve face à des critères objectifs immédiats : le taux d’absentéisme déclaré sur les six derniers mois, la fréquence des visites spontanées à la médecine du travail et le niveau de cortisol salivaire collecté lors de la même vacation.
Ces démarches confèrent une légitimité statistique irréfutable à l’utilisation de ces micro-échelles pour le monitoring régulier du climat organisationnel, tout en alertant les praticiens sur les limites inhérentes à l’authenticité des réponses : en milieu professionnel, la crainte de ruptures de confidentialité peut induire des biais de dissimulation que le format court, plus saillant, neutralise parfois moins bien qu’un inventaire clinique étendu.
8.3 Évaluation des compétences de leadership et d’intelligence émotionnelle
L’identification des hauts potentiels managériaux et le développement du leadership s’appuient fréquemment sur la quantification de l’intelligence émotionnelle (IE). Deux paradigmes s’opposent ici : les tests d’aptitude basés sur la performance objective (comme le MSCEIT, Mayer-Salovey-Caruso Emotional Intelligence Test) et les inventaires d’auto-évaluation basés sur la perception de soi (comme le trait d’IE mesuré par le TEIQue ou l’EQ-i).
Lorsqu’un nouveau test auto-rapporté de leadership émotionnel est conçu, sa validité concourante est soumise à l’épreuve suprême des évaluations à 360 degrés conduites simultanément. Les scores obtenus par le cadre au nouveau test sont confrontés aux évaluations anonymes de ses compétences comportementales quotidiennes fournies de façon concomitante par ses collaborateurs directs, ses pairs et ses supérieurs hiérarchiques. Les coefficients de corrélation concourante oscillent classiquement entre $r = 0,30$ et $r = 0,50$.
L’analyse des discordances au sein de ces études concourantes s’avère particulièrement instructive. Elle révèle les zones aveugles du leadership : certains managers obtiennent des scores auto-déclarés très élevés en régulation émotionnelle alors que l’évaluation 360 concourante démontre une hostilité relationnelle aiguë perçue par l’équipe. L’ancrage sur le critère externe hétéro-attribué permet d’assainir l’interprétation des scores d’auto-évaluation en mettant en lumière les illusions de supériorité illusoire (effet Dunning-Kruger).
9. Exemples concrets en psychologie de l’éducation et apprentissage
9.1 Évaluation rapide des habiletés de lecture chez l’enfant
Dans les systèmes scolaires, l’identification précoce des troubles spécifiques de l’apprentissage du langage écrit, telle la dyslexie développementale, est une condition sine qua non de la remédiation pédagogique efficace. Les batteries diagnostiques complètes administrées par les neuropsychologues ou les orthophonistes (telles que l’ODEDYS ou la BALE en francophonie) sont extrêmement denses et nécessitent plusieurs sessions individualisées, rendant impossible leur emploi pour le dépistage de masse au sein des classes de cours préparatoire ou élémentaire.
Des chercheurs en sciences de l’éducation ont dès lors développé des outils informatisés de dépistage rapide basés sur la fluence de lecture (lecture chronométrée de listes de mots réguliers, irréguliers et de pseudo-mots durant une minute chrono). La validité concourante de ces tests rapides a été démontrée en administrant au même groupe d’élèves, au cours de la même matinée d’école, le test de fluence d’une minute et une batterie analytique approfondie de précision et de compréhension de texte de deux heures.
La corrélation concourante s’est avérée particulièrement puissante ($r = 0,81$), attestant qu’à cet âge du développement cognitif, la vitesse d’accès au lexique mental et la précision du décodage phonologique prédisent de façon quasi symbiotique l’ensemble des habiletés linguistiques globales. L’absence de décalage temporel entre les mesures était ici un impératif d’une rigueur absolue : chez les jeunes enfants scolarisés, les gains développementaux et pédagogiques s’opèrent à un rythme hebdomadaire foudroyant. Un délai de quelques mois entre les tests aurait contaminé la corrélation par l’intervention de l’apprentissage normal de la lecture, détruisant la pureté de la validité de critère.
9.2 Mesure du raisonnement logique et potentiel intellectuel
L’estimation de l’efficience intellectuelle globale repose sur des échelles composites individualisées hautement standardisées, au premier rang desquelles trône la famille des échelles de David Wechsler, notamment la Wechsler Intelligence Scale for Children (actuellement dans sa version WISC-V). Cette batterie exhaustive mobilise une douzaine de sous-tests explorant cinq indices cognitifs majeurs et requiert un temps d’administration substantiel par un psychologue spécialisé.
Dans de multiples contextes de recherche ou de dépistage d’urgence, l’utilisation des Matrices Progressives de Raven (comme le SPM ou le CPM), épreuve non verbale de complétion de motifs géométriques ne durant que 30 à 45 minutes et administrable collectivement, sert d’alternative économique. La validité concourante des Matrices de Raven face au WISC a été documentée par des décennies d’investigations : la corrélation observée avec le Quotient Intellectuel Total (QIT) du WISC administré de manière contiguë se maintient historiquement à des niveaux très robustes, fluctuant entre $r = 0,65$ et $r = 0,78$.
L’analyse factorielle de cette validité concourante montre que les Matrices de Raven saturent massivement sur le facteur général (facteur $g$) et sur l’intelligence fluide ($Gf$) du modèle Cattell-Horn-Carroll (CHC). Cette forte concomitance empirique autorise les psychologues scolaires à utiliser les matrices pour évaluer le potentiel intellectuel chez des enfants allophones, récemment immigrés ou présentant des troubles sévères de l’expression verbale, tout en sachant que le score obtenu reflète avec une grande exactitude ce que donnerait une batterie complète de Wechsler le même jour.
9.3 Mesure de l’anxiété scolaire et de la motivation intrinsèque
La compréhension du désengagement académique et du phénomène de décrochage scolaire mobilise des modèles théoriques fondés sur l’autodétermination et l’anxiété de performance. Pour opérationnaliser ces construits, les chercheurs conçoivent des inventaires d’engagement scolaire destinés aux élèves. La validation de ces instruments soulève des difficultés méthodologiques majeures lorsqu’on cherche à ancrer le questionnaire sur des comportements réels et observables en situation de classe.
Pour fonder la validité concourante d’un nouvel inventaire d’engagement cognitif et émotionnel, des protocoles associent l’auto-questionnaire rempli par l’élève en fin de cours à une grille d’observation comportementale structurée complétée simultanément par un observateur tiers posté dans la classe. Cet observateur consigne en temps réel des indicateurs objectifs : temps passé le regard fixé sur la tâche, nombre de prises de parole spontanées, participation aux activités collectives et posture physique d’écoute.
Les résultats statistiques révèlent des corrélations modérées à fortes ($r = 0,52$ à $0,68$) entre le sentiment interne d’engagement rapporté par l’élève et la cotation comportementale immédiate effectuée par l’observateur indépendant. Cette démonstration de validité concourante certifie que le questionnaire ne mesure pas de simples déclarations d’intention désincarnées ou de la complaisance passive, mais s’aligne fidèlement sur l’investissement pédagogique effectif de l’élève au sein de son environnement écologique d’apprentissage.
10. Menaces méthodologiques et biais affectant la validité concourante
10.1 Le phénomène de restriction de l’étendue (Restriction of Range)
La restriction de l’étendue (ou restriction of range) représente l’une des anomalies statistiques les plus dévastatrices dans l’estimation de la validité concourante. Ce phénomène survient lorsque l’échantillon d’individus chez lesquels la corrélation est calculée ne présente pas la variabilité naturelle complète du construit présente dans la population générale, mais se trouve tronqué de façon systématique en amont.
Mathématiquement, le coefficient de corrélation de Pearson dépend directement de la variance des variables observées. Si un échantillon est artificiellement homogène, la variance observée ($s_x^2$) s’effondre, provoquant un affaissement spectaculaire et artificiel de la valeur du coefficient de corrélation calculé, même si la relation fonctionnelle fondamentale entre le test et le critère demeure rigoureusement parfaite. Ce cas de figure est omniprésent dans deux domaines majeurs :
- En sélection du personnel : Si l’on évalue la validité concourante d’un test d’aptitude cognitive auprès de cadres dirigeants déjà en poste au sein d’une entreprise technologique de pointe, la quasi-totalité de l’échantillon possède des scores situés dans le décile supérieur de la population. Les profils faibles ou moyens sont totalement absents. Le coefficient de validité observé peut chuter de $r = 0,60$ (valeur en population générale non sélectionnée) à $r = 0,18$ dans ce groupe homogène.
- En consultation clinique tertiaire spécialisée : Si l’on teste un nouveau questionnaire de dépression au sein d’une unité hospitalière dédiée exclusivement aux dépressions résistantes sévères, l’absence de sujets sains ou modérément dépressifs dans l’échantillon comprime dramatiquement la variance, masquant les qualités discriminatives réelles de l’instrument.
Pour remédier à cette distorsion, les psychométriciens appliquent les célèbres formules de correction de Thorndike (notamment la formule du cas 2 de Thorndike), qui permettent de réestimer mathématiquement la magnitude réelle de la corrélation en réinjectant l’écart-type connu de la population générale non sélectionnée :
$$R_{xy} = \frac{r_{xy} \left(\frac{S_x}{s_x}\right)}{\sqrt{1 – r_{xy}^2 + r_{xy}^2 \left(\frac{S_x^2}{s_x^2}\right)}}$$
où $s_x$ représente l’écart-type restreint de l’échantillon et $S_x$ l’écart-type complet de la population de référence.
10.2 La variance commune de méthode et les biais de réponse
Si la restriction de l’étendue sous-estime artificiellement la validité, la variance commune de méthode (Common Method Variance, CMV) produit rigoureusement l’effet inverse : elle induit un gonflement illusoire et trompeur du coefficient de validité concourante. Ce biais pernicieux survient lorsque le nouvel instrument et le critère de référence partagent la même approche de recueil de données, la même temporalité, le même contexte physique et le même format de réponse.
L’archétype de ce travers réside dans la validation concourante d’un nouvel auto-questionnaire au moyen d’un autre auto-questionnaire préexistant, tous deux présentés successivement sous forme d’échelles de Likert au sein d’un formulaire unique auto-administré en ligne. Dans une telle configuration, une fraction substantielle de la corrélation observée ($r$) ne s’explique aucunement par la convergence réelle des construits psychologiques sous-jacents, mais découle de la contamination par des styles de réponse partagés :
- Le biais d’acquiescement : La propension de certains individus à systématiquement approuver les propositions affirmatives (« Tout à fait d’accord »), quel que soit le contenu sémantique des phrases.
- La désirabilité sociale : La tendance adaptative ou défensive à se présenter sous un jour favorable, qui affecte simultanément les réponses fournies aux deux questionnaires durant la même séance.
- L’effet d’humeur momentané : Un état affectif transitoire au moment de la passation (colère, tristesse, enthousiasme) qui colore de manière synchrone l’ensemble des réponses données aux deux outils.
Pour neutraliser méthodologiquement la variance de méthode, le chercheur doit obligatoirement instaurer un hétérogénéité des méthodes (par exemple, confronter un auto-questionnaire à une hétéro-évaluation par des proches, un entretien clinique structuré ou une mesure biologique) et utiliser des protocoles d’administration contrebalancée avec des tâches interférentes neutres entre les deux évaluations.
10.3 Les problèmes d’échantillonnage et de représentativité
La validité concourante n’est jamais une propriété intrinsèque, immuable et figée d’un test ; elle est indissociable des caractéristiques sociodémographiques, cliniques et culturelles de la cohorte d’individus au sein de laquelle les données ont été empiriquement collectées. Un instrument qui présente une concordance exemplaire au sein d’une cohorte spécifique peut perdre toute pertinence métrologique lorsqu’il est transposé à une autre sous-population.
Un travers historique dénoncé dans la littérature internationale réside dans le recours abusif à des échantillons dits « WEIRD » (Western, Educated, Industrialized, Rich, and Democratic), très fréquemment composés d’étudiants en psychologie de premier cycle participant aux études pour valider des crédits universitaires. Tirer des conclusions générales sur la validité concourante d’un test de personnalité ou d’une échelle psychopathologique à partir d’un tel groupe homogène constitue une erreur de sur-généralisation épistémologique flagrante.
De plus, l’examen de l’invariance de mesure à travers les groupes démographiques (sexe, âge, niveau d’éducation, origine ethnoculturelle) représente un préalable incontournable. Si le critère ou le test présente un fonctionnement différentiel des items (Differential Item Functioning, DIF), le coefficient de validité concourante global masquera des disparités diagnostiques graves, conduisant à des erreurs de classification systématiques au détriment de certaines minorités sociodémographiques. Enfin, la taille de l’échantillon doit être rigoureusement planifiée : des effectifs squelettiques ($N < 50$) génèrent une imprécision statistique critique, traduite par des intervalles de confiance à 95 % excessivement larges interdisant toute conclusion scientifique ferme.
11. Guide pratique : protocole d’établissement d’une validité concourante rigoureuse
11.1 Étape 1 : Conception de l’architecture d’évaluation et choix du critère
L’établissement d’une validité concourante irréprochable exige une planification méthodologique méthodique en amont de toute collecte de données. La première démarche consiste en une revue systématique de la littérature scientifique ciblant les instruments existants au sein du domaine conceptuel. Le chercheur doit identifier l’étalon-or le plus solide, en évaluant méticuleusement ses qualités psychométriques préexistantes : fidélité test-retest ($r_{tt} > 0,80$), cohérence interne (alpha de Cronbach ou oméga de McDonald $> 0,85$), et validation de construit prouvée dans de multiples études indépendantes.
Dès cette étape fondatrice, des hypothèses de recherche explicites et directionnelles doivent être formalisées et idéalement pré-enregistrées sur des plateformes de science ouverte (telles que l’Open Science Framework, OSF). Il convient de spécifier précisément l’amplitude attendue du coefficient de validité concourante minimale (par exemple : $r ge 0,70$ pour une échelle alternative brève du même construit ; $0,40 le r le 0,60$ pour un test ciblant une dimension connexe mais distincte).
Enfin, le calcul a priori de la puissance statistique s’avère indispensable pour déterminer la taille minimale de l’échantillon ($N$). À l’aide de logiciels spécialisés (tels que G*Power), le chercheur configure l’analyse en fixant l’erreur de première espèce à $\alpha = 0,05$ et la puissance désirée à $1 – \beta = 0,80$ (ou idéalement 0,95). Pour détecter un effet de corrélation modéré ($r = 0,30$) avec une puissance de 95 %, un effectif d’au moins 138 participants est requis ; pour un effet robuste de $r = 0,60$, 30 participants peuvent suffire mathématiquement, bien que les standards contemporains recommandent des cohortes d’au moins 200 à 300 sujets pour stabiliser les matrices de corrélation face aux fluctuations d’échantillonnage.
11.2 Étape 2 : Standardisation stricte de la collecte des données
La seconde phase concerne l’administration concrète des instruments, qui doit faire l’objet d’une standardisation environnementale et procédurale millimétrée. Un manuel expérimental détaillé doit consigner les conditions matérielles du recueil : luminosité, insonorisation de la pièce de passation, ergonomie du mobilier, et consignes verbales transmises aux participants lues mot à mot pour neutraliser l’effet Rosenthal (attentes involontaires de l’expérimentateur).
Pour éliminer de manière systématique les effets d’ordre, de report (carryover effects) et de fatigue cognitive différentielle, la règle impérative est le contrebalancement complet de l’ordre d’administration des instruments :
- 50 % de l’échantillon, attribué par tirage au sort aléatoire, doit passer le nouveau test expérimental en premier, suivi après une pause standardisée de l’administration du critère de référence.
- Les 50 % restants de la cohorte doivent impérativement être soumis au critère de référence en premier, avant de compléter le nouvel outil expérimental.
Parallèlement, la mise en place d’un double aveugle rigoureux doit être matérialisée dans l’organigramme de la recherche : les cliniciens ou examinateurs en charge de la passation du critère standard ne doivent en aucun cas avoir accès aux scores générés par le sujet lors du nouveau test, et réciproquement. Enfin, une formation préalable approfondie des évaluateurs, couronnée par le calcul d’un coefficient d’accord inter-juges initial (de type Kappa de Cohen ou coefficient de corrélation intraclasse, ICC $> 0,85$), garantit l’homogénéité de la cotation tout au long de l’expérimentation.
11.3 Étape 3 : Traitement statistique et publication des résultats
Une fois la matrice de données consolidée et épurée, le traitement analytique commence obligatoirement par la vérification rigoureuse des postulats statistiques fondamentaux : tests de Shapiro-Wilk pour examiner la normalité univariée et bivariée, tracés Q-Q des résidus, et inspection minutieuse des diagrammes de dispersion pour repérer d’éventuelles relations curvilinéaires ou la présence de points aberrants influents (calcul de la distance de Cook).
Le reporting scientifique des résultats ne saurait se limiter à la simple mention d’une valeur $p$ de significativité (« $p < 0,05$ »), pratique désormais largement réprouvée par la communauté internationale. La publication doit impérativement fournir :
- Le coefficient de corrélation précis (Pearson, Spearman ou corrélation bisériale de point).
- L’intervalle de confiance à 95 % encadrant ce coefficient, reflétant la précision réelle de l’estimation.
- La matrice complète des statistiques descriptives (moyennes, écarts-types, asymétrie/skewness, aplatissement/kurtosis).
- Pour les tests à visée diagnostique catégorielle : la sensibilité, la spécificité, la valeur prédictive positive (VPP), la valeur prédictive négative (VPN), ainsi que l’aire sous la courbe (AUC) issue de l’analyse ROC avec son intervalle de confiance associé.
- Une régression linéaire multiple documentant la variance incrémentale ($\Delta R^2$) apportée par rapport aux alternatives déjà existantes.
La rédaction de l’article scientifique final doit scrupuleusement adhérer aux référentiels internationaux de transparence et de reproductibilité, tels que les directives STARD (Standards for Reporting Diagnostic Accuracy Studies) en épidémiologie clinique ou les recommandations métrologiques officielles de l’APA.
12. Conclusion, perspectives contemporaines et intégration aux standards de testage
12.1 Synthèse des apports fondamentaux de la validité concourante
Au terme de cette analyse approfondie, la validité concourante s’affirme comme une pierre angulaire opérationnelle de l’évaluation psychologique et diagnostique contemporaine. En s’ancrant dans une logique temporelle synchronique, elle apporte la caution empirique irréfutable autorisant le déploiement d’instruments de mesure plus concis, moins coûteux, non invasifs et mieux acceptés par les sujets évalués. Elle concrétise ainsi un équilibre vertueux entre la rigueur métrologique la plus exigeante et les contraintes pragmatiques du terrain clinique, éducatif ou professionnel.
Toutefois, la solidité d’une preuve de validité concourante dépend entièrement de la vigilance méthodologique déployée pour la produire. Sans un choix scrupuleux d’un critère de référence hautement fidèle, sans une étanchéité hermétique des procédures en double aveugle pour prévenir la contamination du critère, et sans une attention chirurgicale portée à l’hétérogénéité de l’échantillonnage, le coefficient mathématique obtenu risque de refléter des illusions méthodologiques plutôt qu’une équivalence fonctionnelle authentique. La validité concourante n’est jamais un blanc-seing accordé une fois pour toutes : elle constitue un maillon dynamique s’inscrivant dans l’argumentation globale et cumulative de la validité de construit.
12.2 L’évolution à l’ère de l’intelligence artificielle et du testing adaptatif
Le paysage de la psychométrie traverse aujourd’hui une transformation paradigmatique radicale sous l’effet conjoint de la puissance computationnelle, de l’intelligence artificielle (IA) et de la modélisation mathématique issue de la Théorie de la Réponse à l’Item (TRI). Les questionnaires linéaires statiques cèdent progressivement le pas au testing adaptatif informatisé (Computerized Adaptive Testing, CAT). Dans un CAT, l’algorithme sélectionne dynamiquement en temps réel les items présentés au sujet en fonction de la précision de ses réponses précédentes, convergeant vers une estimation mathématique exacte de son niveau latent ($\theta$) avec une économie d’items pouvant atteindre 70 %.
Dans ce contexte avant-gardiste, les protocoles de validité concourante connaissent un renouvellement conceptuel majeur. Il s’agit de valider de façon synchrone des algorithmes décisionnels autonomes face à des panels d’experts humains chevronnés. De surcroît, la nature même des critères externes se métamorphose : les tests sont désormais confrontés de manière concomitante au phénotypage numérique (analyse en flux continu des traces numériques de frappe sur smartphone, prosodie vocale captée par des microphones ambiants, mouvements oculaires enregistrés par des oculomètres intégrés aux casques de réalité virtuelle) et aux biomarqueurs neurophysiologiques (pupillométrie, variabilité de la fréquence cardiaque, potentiels évoqués cognitifs recueillis par électroencéphalographie nomade).
Cette convergence algorithmique soulève toutefois de redoutables défis éthiques et scientifiques. L’effet de « boîte noire » de certains modèles de machine learning (réseaux de neurones profonds) complique l’analyse du réseau nomologique : une corrélation concourante très élevée entre les prédictions d’une IA et un diagnostic psychiatrique clinique ne dispense pas de l’obligation d’expliquer les fondements théoriques sous-jacents de la décision algorithmique, conformément aux exigences de transparence et de déontologie médicale.
12.3 Alignement avec les normes internationales (APA, AERA, NCME)
Toute démarche d’évaluation psychométrique s’inscrit in fine dans un cadre normatif et réglementaire supranational extrêmement codifié. Les Standards for Educational and Psychological Testing, co-édités par l’American Educational Research Association (AERA), l’American Psychological Association (APA) et le National Council on Measurement in Education (NCME), constituent la référence mondiale régissant la conception, la distribution et l’usage des instruments de mesure psychologique.
Ces standards stipulent formellement que tout éditeur commercial de tests et tout laboratoire de recherche a l’obligation légale et déontologique de documenter de manière exhaustive, dans les manuels techniques accompagnant les outils, les preuves empiriques de validité liée au critère. Les coefficients de validité concourante doivent y être présentés de manière transparente, détaillant sans omission les caractéristiques démographiques de l’échantillon normatif, les critères externes utilisés, les matrices d’inter-corrélation complètes et les limites contextuelles d’interprétation des scores.
Pour le clinicien comme pour le praticien des ressources humaines, la responsabilité professionnelle est directement engagée. Choisir d’administrer un instrument dont les preuves de validité concourante sont absentes, périmées ou méthodologiquement fragiles constitue un manquement déontologique lourd, exposant l’usager à des décisions préjudiciables et le professionnel à des sanctions juridiques. Face à l’obsolescence inévitable des critères nosologiques et à l’évolution sociétale constante des populations, l’actualisation périodique des études de validité concourante demeure le garant indépassable de l’intégrité, de la dignité et de la valeur scientifique de l’évaluation humaine.
Références
- American Educational Research Association, American Psychological Association, & National Council on Measurement in Education. (2014). Standards for educational and psychological testing. American Educational Research Association. https://www.aera.net/Publications/Books/Standards-for-Educational-Psychological-Testing-2014-Edition
- Beck, A. T., Epstein, N., Brown, G., & Steer, R. A. (1988). An inventory for measuring clinical anxiety: Psychometric properties. Journal of Consulting and Clinical Psychology, 56(6), 893–897. https://doi.org/10.1037/0022-006X.56.6.893
- Campbell, D. T., & Fiske, D. W. (1959). Convergent and discriminant validation by the multitrait-multimethod matrix. Psychological Bulletin, 56(2), 81–105. https://doi.org/10.1037/h0046016
- Cronbach, L. J., & Meehl, P. E. (1955). Construct validity in psychological tests. Psychological Bulletin, 52(4), 281–302. https://doi.org/10.1037/h0040957
- Folstein, M. F., Folstein, S. E., & McHugh, P. R. (1975). « Mini-mental state »: A practical method for grading the cognitive state of patients for the clinician. Journal of Psychiatric Research, 12(3), 189–198. https://doi.org/10.1016/0022-3956(75)90026-6
- Kroenke, K., Spitzer, R. L., & Williams, J. B. (2001). The PHQ-9: Validity of a brief depression severity measure. Journal of General Internal Medicine, 16(9), 606–613. https://doi.org/10.1046/j.1525-1497.2001.016009606.x
- Maslach, C., Jackson, S. E., & Leiter, M. P. (1996). Maslach Burnout Inventory manual (3rd ed.). Consulting Psychologists Press.
- Messick, S. (1989). Validity. In R. L. Linn (Ed.), Educational measurement (3rd ed., pp. 13–103). Macmillan.
- Messick, S. (1995). Validity of psychological assessment: Validation of inferences from persons’ responses and performances as scientific inquiry into score meaning. American Psychologist, 50(9), 741–749. https://doi.org/10.1037/0003-066X.50.9.741
- Nasreddine, Z. S., Phillips, N. A., Bédirian, V., Charbonneau, S., Whitehead, V., Collin, I., Cummings, J. L., & Chertkow, H. (2005). The Montreal Cognitive Assessment, MoCA: A brief screening tool for mild cognitive impairment. Journal of the American Geriatrics Society, 53(4), 695–699. https://doi.org/10.1111/j.1532-5415.2005.53221.x
- Raven, J. (2000). The Raven’s Progressive Matrices: Change and stability over culture and time. Cognitive Psychology, 41(1), 1–48. https://doi.org/10.1006/cogp.1999.0735
- Spitzer, R. L., Kroenke, K., Williams, J. B., & Löwe, B. (2006). A brief measure for assessing generalized anxiety disorder: The GAD-7. Archives of Internal Medicine, 166(10), 1092–1097. https://doi.org/10.1001/archinte.166.10.1092
- Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.
- Wechsler, D. (2014). Wechsler Intelligence Scale for Children (5th ed.). NCS Pearson.