
Dans le champ de l’analyse stochastique et de la statistique inférentielle, la modélisation rigoureuse des variables catégorielles constitue un enjeu épistémologique et méthodologique fondamental. Alors que les fondations de la théorie des probabilités reposent traditionnellement sur des événements dichotomiques formalisés par l’épreuve de Bernoulli et la loi binomiale, la complexité intrinsèque des phénomènes naturels, comportementaux et sociaux exige un cadre analytique considérablement plus vaste. Les situations empiriques se résument rarement à une alternative binaire de type succès ou échec. Qu’il s’agisse de mesurer les réponses polytomiques d’un sujet face à un questionnaire psychométrique, d’évaluer le choix d’une marque par un consommateur ou d’analyser la répartition des allèles au sein d’un locus génétique complexe, le spectre des issues possibles dépasse largement le cadre d’une partition binaire.
La distribution multinomiale s’impose dès lors comme la généralisation canonique et multidimensionnelle de la loi binomiale. En permettant de modéliser des expériences aléatoires où chaque observation est classée de manière univoque parmi un ensemble fini de catégories mutuellement exclusives et collectivement exhaustives, cette loi de probabilité fournit la structure mathématique indispensable à l’analyse des vecteurs de comptage. Sa formulation élégante intègre harmonieusement la combinatoire des arrangements avec répétition et les contraintes géométriques du simplexe des probabilités, offrant ainsi aux chercheurs un outil polyvalent doté de propriétés asymptotiques remarquables.
Ce traité exhaustif a pour vocation d’explorer en profondeur l’architecture théorique, les propriétés analytiques, les méthodes d’estimation inférentielle et les applications empiriques de la distribution multinomiale. De ses axiomes probabilistes élémentaires jusqu’à son intégration dans les modèles cognitifs de pointe et les architectures computationnelles modernes en passant par les diagnostics de surdispersion, cette étude propose une synthèse rigoureuse destinée aux statisticiens, psychométriciens et modélisateurs du comportement souhaitant maîtriser l’ensemble des ramifications formelles de cette distribution fondamentale.
1. Fondements théoriques et définition de la distribution multinomiale
1.1 Origines conceptuelles et cadre probabiliste discret
L’origine formelle des processus polytomiques s’inscrit au cœur du développement de la théorie des probabilités classique, initiée par les travaux pionniers de Jacob Bernoulli et approfondie ultérieurement par Abraham de Moivre et Pierre-Simon de Laplace. Dans un univers probabilisé défini par le triplet classique, considérons une expérience aléatoire discrète dont l’espace d’échantillonnage fondamental est partitionné en un nombre fini k d’issues élémentaires mutuellement exclusives et collectivement exhaustives. Chaque tentative élémentaire ne peut donner lieu qu’à une seule et unique réalisation parmi ces k modalités distinctes. La répétition indépendante et identique de cette expérience fondamentale engendre un vecteur aléatoire de comptage dont les composantes décrivent le nombre de réalisations observées pour chaque modalité.
L’extension des processus stochastiques simples aux variables qualitatives polytomiques répond à la nécessité théorique de dépasser le cadre réducteur des indicatrices d’événements. Dans la théorie de la mesure, la modélisation d’une variable nominale ou ordinale à k états nécessite la transition d’une mesure borélienne unidimensionnelle à une mesure définie sur l’ensemble discret des vecteurs de dimension k. Cette démarche conceptuelle opère une rupture fondamentale avec les distributions univariées classiques. Alors qu’une variable univariée attribue un scalaire à chaque état du monde, la distribution multinomiale génère un vecteur aléatoire de dimension k, imposant une structure conjointe où la réalisation d’une modalité dépend mécaniquement, par contrainte globale d’effectif, de la distribution des autres composantes.
Cette distinction entre distributions univariées et multivariées modifie en profondeur la nature de l’espace d’échantillonnage. Dans le cas multinomial, la somme arithmétique des éléments du vecteur aléatoire est strictement égale au nombre total d’essais réalisés. Il s’ensuit que les réalisations marginales ne peuvent jamais être appréhendées comme des variables statistiquement indépendantes au sens fort, ce qui confère à la distribution multinomiale une place unique au confluent de l’analyse combinatoire, de la géométrie vectorielle et de la théorie classique des lois conjointes discrètes.
1.2 Structure combinatoire des événements polytomiques
La structure algébrique sous-jacente à la loi multinomiale repose sur l’analyse combinatoire des partitions d’ensembles finis. Lorsqu’une expérience globale consiste en la réalisation de n épreuves élémentaires indépendantes, le nombre total d’agencements séquentiels possibles donnant lieu à l’observation exacte de x1 réalisations de la première modalité, x2 de la seconde, et ainsi de suite jusqu’à xk réalisations de la k-ième modalité, est dicté par le coefficient multinomial. Ce coefficient généralise directement le coefficient binomial d’Euler et s’exprime sous la forme du quotient entre la factorielle du cardinal total et le produit des factorielles des effectifs marginaux :
Le partitionnement d’un ensemble de n observations indépendantes en k sous-ensembles disjoints constitue un problème canonique d’affectation combinatoire. Chaque séquence ordonnée d’issues possède une probabilité élémentaire qui dépend uniquement du produit des probabilités marginales élevées à la puissance de leur effectif respectif, en vertu de l’indépendance stochastique postulée entre les essais. Le coefficient multinomial joue le rôle indispensable de facteur de multiplicité géométrique, agrégeant l’ensemble des permutations indiscernables de séquences aboutissant au même vecteur de comptage final.
D’un point de vue géométrique, les paramètres probabilistes associés aux k modalités définissent un sous-espace vectoriel contraint nommé simplexe de probabilités standard. Cet ensemble convexe, délimité par l’hyperplan affine de sommation unitaire dans l’espace euclidien de dimension k, impose que la somme des probabilités marginales soit rigoureusement égale à l’unité tout en conservant une stricte non-négativité. Les réalisations de la distribution multinomiale peuvent ainsi être interprétées comme la projection discrète de trajectoires d’échantillonnage opérant sur la surface et à l’intérieur de ce simplexe géométrique fondamental.
1.3 Importance paradigmatique dans les sciences du comportement
Dans l’investigation empirique des sciences du comportement, de la psychologie cognitive et de la neuropsychologie, la quantification rigoureuse des choix multiples représente une nécessité méthodologique omniprésente. Lorsqu’un participant est confronté à un protocole expérimental requérant la sélection d’une alternative parmi un ensemble fermé de stimuli perceptifs, d’options motrices ou de catégories décisionnelles, les données brutes issues de la collecte se matérialisent invariablement sous la forme de fréquences de choix catégorielles polytomiques. Ignorer la nature multinomiale de ces vecteurs de comptage expose le chercheur à des biais d’inférence majeurs, notamment par l’oblitération des corrélations résiduelles induites par la finitude du nombre d’essais.
La formalisation rigoureuse des réponses qualitatives, qu’elles soient purement nominales (par exemple, le choix entre plusieurs stratégies de mémorisation) ou ordinales (telles que les degrés d’accord ou les intensités d’évaluation symptomatique), repose sur l’hypothèse générative selon laquelle le vecteur des choix observés procède d’un échantillonnage multinomial paramétré par un état latent de préférence ou d’activation mnésique. Les modèles de décision contemporains, incluant les théories de l’accumulation de preuves et les réseaux connexionnistes de classification, postulent que la probabilité d’activer une réponse spécifique converge vers un paramètre probabiliste multinomial sous-jacent.
Par conséquent, la distribution multinomiale ne se cantonne pas à une simple commodité descriptive d’algèbre probabiliste ; elle constitue le fondement épistémologique sur lequel reposent la modélisation des architectures de décision chez l’être humain, la validation expérimentale des théories du choix discret et la décomposition computationnelle des processus cognitifs sous-jacents aux comportements d’arbitrage face à des alternatives concurrentes.
2. De la distribution binomiale à la loi multinomiale : Une généralisation mathématique
2.1 L’épreuve de Bernoulli et la loi binomiale classique
Pour appréhender la mécanique profonde de la loi multinomiale, il convient de réexaminer la dynamique fondamentale de l’épreuve de Bernoulli. Une épreuve bernoullienne formalise une expérience stochastique élémentaire ne tolérant que deux états mutuellement exclusifs, conventionnellement désignés par le succès, codé 1, et l’échec, codé 0. La distribution de probabilité associée est régie par un unique paramètre scalaire p, représentant la probabilité de succès, la probabilité d’échec étant par complémentarité 1 – p. La répétition indépendante de n épreuves bernoulliennes identiques donne naissance à la variable aléatoire binomiale, qui quantifie la somme scalaire des succès accumulés au cours des n itérations.
Toutefois, la rigidité structurelle du cadre binomial limite son applicabilité aux phénomènes polytomiques. Dès lors qu’un système physique, biologique ou cognitif est susceptible de se stabiliser dans plus de deux configurations disjointes, la dichotomie bernoullienne impose une compression artificielle de l’information. Réduire un choix complexe à un ensemble de sous-choix binaires isolés détruit la structure de covariance conjointe et introduit des distorsions d’estimation notables, car l’occurrence d’une issue tierce altère simultanément les probabilités relatives des deux issues initialement considérées.
Sur le plan analytique, la distribution binomiale s’avère être un cas dégénéré et particulier de la distribution multinomiale. Lorsque le nombre de catégories k est fixé à deux, le vecteur aléatoire multinomial de dimension 2 se réduit mathématiquement à un couple de variables aléatoires où la seconde est entièrement déterminée par la soustraction de la première au nombre total d’essais. La loi binomiale classique émerge alors spontanément, tant au niveau de sa fonction de masse que de ses moments d’ordre supérieur, confirmant l’harmonie et la cohérence de l’extension multinomiale.
2.2 Généralisation algébrique aux espaces d’échantillonnage étendus
L’extension algébrique de la loi binomiale vers la distribution multinomiale repose sur la transition du théorème du binôme de Newton vers le théorème du multinôme. Dans l’algèbre élémentaire, le développement de l’expression (a + b) élevé à la puissance n engendre une somme pondérée par les coefficients binomiaux. Lorsque l’on étend cette décomposition à une somme de k termes arbitraires élevés à la puissance n, la formule du multinôme de Newton établit que :
Cette égalité polynomiale possède une analogie probabiliste immédiate et profonde. En substituant aux indéterminées algébriques les paramètres de probabilité associés à chacune des k issues élémentaires possibles, la somme de ces probabilités étant égale à un, l’élévation à la puissance n de cette somme unitaire vaut rigoureusement un. Le développement multinomial décompose ainsi l’unité probabiliste absolue en une somme finie de composantes discrètes, chacune correspondant exactement à la probabilité d’observer un profil spécifique d’effectifs marginaux.
Cette transition algébrique formalise le passage des variables aléatoires scalaires aux vecteurs aléatoires de comptage. Tout au long de ce processus d’échantillonnage polytomique, l’indépendance conditionnelle entre les tirages successifs est rigoureusement préservée : le résultat d’un tirage particulier ne modifie en rien la distribution de probabilité gouvernant les tirages ultérieurs, assurant ainsi la stationnarité du processus stochastique sur l’ensemble de la trajectoire expérimentale de taille n.
2.3 Comparaison structurelle des paramètres et des contraintes
L’analyse structurelle des espaces paramétriques met en lumière les contraintes géométriques qui différencient intrinsèquement les lois binomiales et multinomiales. Dans le cas binomial, l’espace des paramètres est un intervalle unidimensionnel compact délimité par l’intervalle fermé [0, 1]. En revanche, pour la distribution multinomiale à k modalités, l’espace des paramètres est initialement défini dans un espace vectoriel de dimension k, soumis à une contrainte holonome de sommation unitaire stricte :
Cette contrainte linéaire réduit immédiatement la dimensionnalité intrinsèque du problème. Bien que le vecteur des probabilités comporte formellement k composantes scalaires, seuls k – 1 paramètres sont libres d’évoluer de manière indépendante. La k-ième probabilité est invariablement déterminée par le complément à l’unité de la somme des k – 1 premières valeurs. Ce phénomène mathématique correspond à une perte d’un degré de liberté sur le plan statistique.
Les conséquences analytiques de cette réduction de dimension sont déterminantes pour l’inférence. L’espace paramétrique effectif se configure sous la forme d’un simplexe fermé de dimension k – 1. Toute dérivation analytique, qu’il s’agisse de la maximisation de la vraisemblance, du calcul des métriques d’information ou de la formulation des régions de confiance, doit obligatoirement intégrer cette frontière géométrique sous peine d’engendrer des projections probabilistes incohérentes ou situées hors du domaine de validité stochastique.
3. Formulation mathématique rigoureuse et fonction de masse de probabilité
3.1 Équation de la fonction de masse multinomiale
La caractérisation probabiliste complète d’un vecteur aléatoire discret régi par une loi multinomiale s’établit par le biais de sa fonction de masse conjointe. Soit un vecteur aléatoire discret X = (X1, X2, …, Xk) dont la réalisation s’écrit x = (x1, x2, …, xk), où chaque composante xi représente un entier naturel quantifiant le nombre d’occurrences de la modalité i au cours de n épreuves. La fonction de masse conjointe de probabilité est formellement définie par l’expression analytique suivante :
Cette formulation analytique se décompose en deux opérateurs mathématiques conjoints aux rôles distincts. Le premier terme, constitué du rapport factoriel, dénombre précisément toutes les configurations combinatoires possibles permettant de distribuer les n réalisations physiques parmi les k cellules disponibles, en neutralisant les permutations internes aux modalités qui demeurent indistinguables. Le second opérateur correspond au produit direct des probabilités élémentaires élevées à la puissance de leur fréquence de réalisation empirique respective, quantifiant ainsi la probabilité spécifique d’une séquence élémentaire unique non ordonnée.
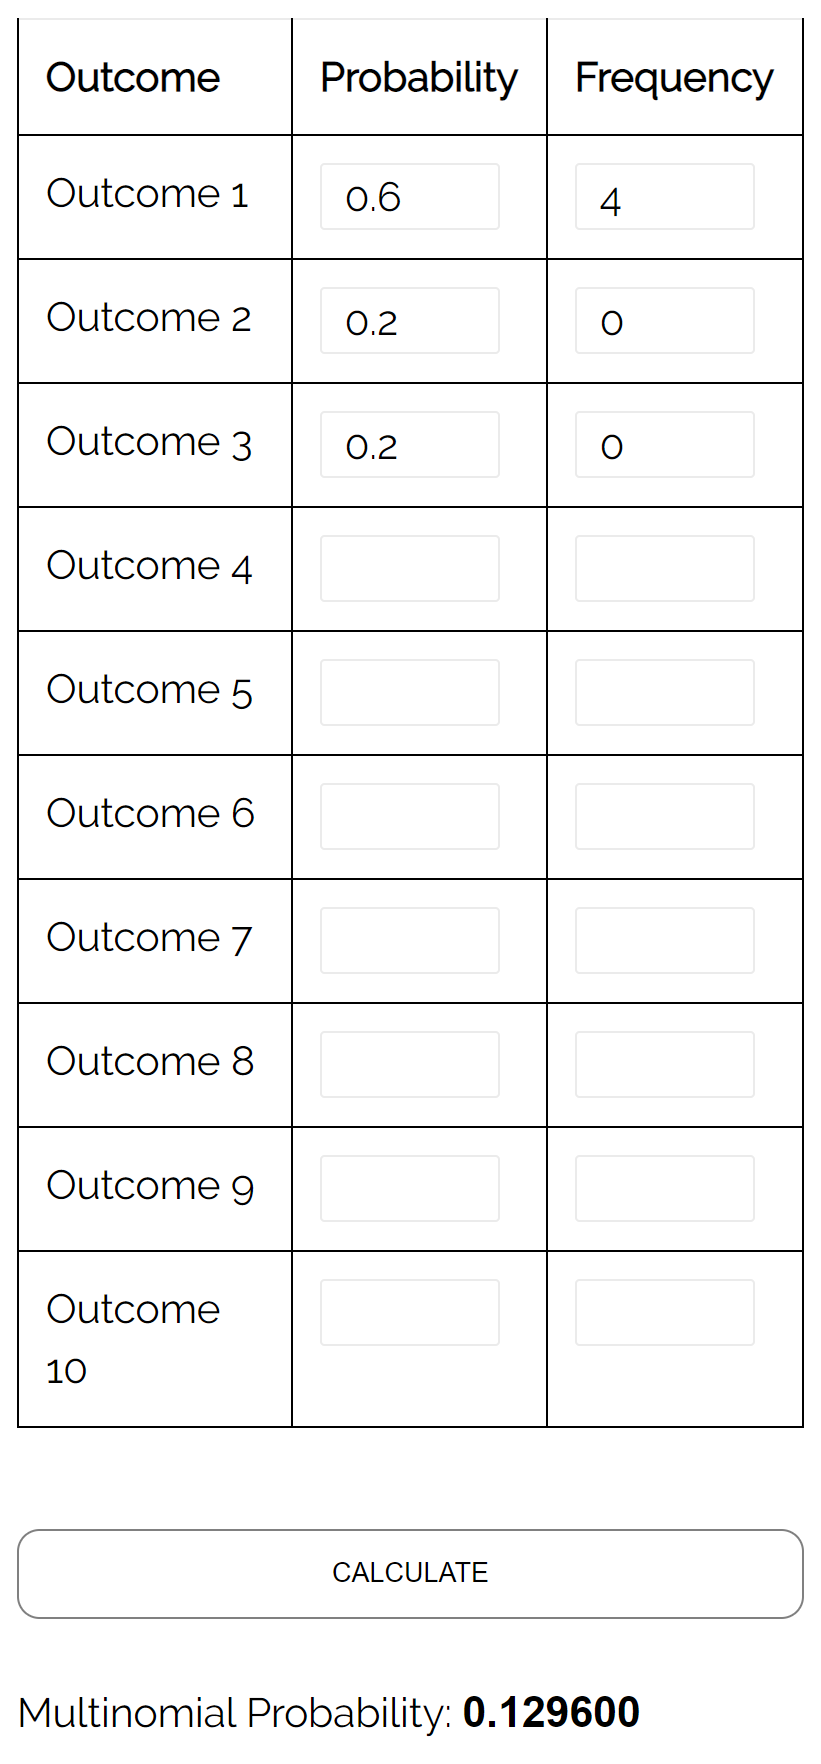
Lorsque la taille de l’échantillon n tend vers l’infini, le comportement asymptotique de cette fonction de masse est régi par des théorèmes limites fondamentaux. En appliquant la formule d’approximation de Stirling aux expressions factorielles, la fonction de masse multinomiale converge uniformément vers une densité normale multivariée dégénérée sur le simplexe de dimension k – 1, préfigurant l’applicabilité des approximations gaussiennes et des théorèmes de convergence en loi pour les grands effectifs d’échantillonnage.
3.2 Conditions de validité du domaine paramétrique
Pour que la fonction de masse multinomiale constitue une mesure de probabilité légitime au sens des axiomes de Kolmogorov, un ensemble strict de conditions aux limites et de contraintes structurelles doit être impérativement satisfait. En premier lieu, chaque élément du vecteur de paramètres de probabilité doit appartenir au domaine réel et satisfaire une condition de non-négativité stricte ou faible, telle que pour tout indice i compris entre 1 et k, le paramètre pi appartienne au sous-ensemble [0, 1].
En second lieu, la condition de fermeture de l’espace d’échantillonnage impose que la sommation des paramètres de probabilité soit rigoureusement égale à l’unité. Simultanément, sur le plan des réalisations numériques, chaque valeur marginale observée xi doit constituer un entier naturel positif ou nul, et la sommation de l’ensemble des composantes vectorielles doit reconstituer exactement le cardinal d’observation global n, ce qui formalise le support discret de la loi multinomiale :
La gestion rigoureuse des cas limites, notamment lorsqu’une fréquence observée xi est nulle, exige une attention mathématique particulière. En analyse combinatoire et en calcul infinitésimal, la convention arithmétique standard établit que la factorielle de zéro (0!) est rigoureusement égale à 1. De surcroît, dans l’évaluation du produit probabiliste, le terme pi élevé à la puissance zéro équivaut conventionnellement à 1, même lorsque le paramètre pi tend vers zéro, garantissant ainsi l’intégrité et la continuité algébrique de la fonction de masse sur l’ensemble de son domaine de définition.
3.3 Propriétés analytiques et fonction génératrice des moments
L’exploration des propriétés analytiques d’une distribution multivariée discrète est considérablement facilitée par l’étude de sa fonction génératrice des moments conjointe. Pour le vecteur aléatoire multinomial X, la fonction génératrice des moments, notée MX(t), est définie pour tout vecteur d’arguments réels t = (t1, t2, …, tk) par l’espérance mathématique de l’exponentielle du produit scalaire entre le vecteur aléatoire et le vecteur t. En exploitant la décomposition du multinôme de Newton, cette fonction prend une forme analytique particulièrement compacte :
Cette écriture algébrique élégante permet d’extraire la totalité des moments simples et conjoints de la distribution par l’application successive de dérivées partielles d’ordre quelconque. En dérivant partiellement le logarithme de cette fonction, nommé fonction génératrice des cumulants, par rapport aux variables ti et en évaluant le résultat au point où l’ensemble des arguments t s’annule, on obtient directement les espérances, variances et covariances du système multivarié sans recourir à de fastidieuses sommations combinatoires explicites.
Une propriété analytique remarquable réside dans la reproductibilité stochastique de la loi multinomiale pour des sous-échantillons conditionnels ou agrégés. Si l’on somme arbitrairement deux ou plusieurs catégories au sein d’un même ensemble pour former une nouvelle modalité combinée, le vecteur de comptage résultant suit fidèlement une nouvelle distribution multinomiale de dimension réduite, dont les paramètres de probabilité correspondent simplement à la somme arithmétique des probabilités marginales initiales associées aux modalités fusionnées.
4. Propriétés statistiques fondamentales : Espérance, variance et covariance
4.1 Espérance mathématique marginale de chaque modalité
L’obtention des moments marginaux du premier ordre fournit des indications cruciales sur le comportement moyen des variables de comptage associées à chaque modalité catégorielle. Pour un indice i arbitraire, l’espérance mathématique de la variable aléatoire marginale Xi peut être formellement démontrée par sommation directe sur l’ensemble du support discret, ou par le calcul de la dérivée première de la fonction génératrice des moments. L’évaluation de l’espérance théorique aboutit à la formule canonique :
Cette relation linéaire découle directement de la linéarité intrinsèque de l’opérateur d’espérance mathématique appliqué au vecteur multinomial. L’espérance du vecteur aléatoire X équivaut au produit scalaire de l’effectif global n par le vecteur de probabilités p. Cette propriété fondamentale démontre que l’espérance marginale d’une catégorie ne dépend que de sa propre probabilité d’occurrence et du nombre total d’essais, sans être mathématiquement affectée par la répartition des probabilités résiduelles entre les k – 1 autres catégories disponibles.
Dans les contextes appliqués aux sciences du comportement et à la recherche cognitive, l’espérance théorique représente la valeur centrale attendue lors d’une répétition asymptotique du protocole expérimental. Lorsqu’un chercheur soumet un échantillon d’individus à une tâche de choix à options multiples, les écarts systématiques entre les comptages empiriques moyens et ces espérances théoriques fournissent la base de la quantification des biais décisionnels ou des asymétries perceptives.
4.2 Structure de la variance marginale univariée
L’évaluation de la dispersion stochastique marginale autour de l’espérance théorique nécessite la dérivation formelle du moment centré d’ordre deux. Pour toute catégorie indicée par i, la variance de la variable aléatoire Xi s’établit analytiquement en soustrayant le carré de l’espérance mathématique à l’espérance du carré de la variable, ce qui se déduit par dérivation double de la fonction génératrice des moments. L’expression analytique de la variance marginale est donnée par :
L’examen de cette équation révèle une identité structurelle parfaite avec la variance d’une distribution binomiale classique de paramètres n et pi. Ce résultat mathématique fondamental s’explique par le fait que si l’on focalise l’attention analytique sur une catégorie unique i en agrégeant l’ensemble des k – 1 autres catégories dans une entité complémentaire unique assimilée à un « non-événement », l’expérience polytomique se collapse rigoureusement en une suite d’épreuves de Bernoulli dichotomiques de probabilité de succès pi.
L’impact de l’accroissement de la taille de l’échantillon n sur la dispersion univariée se caractérise par une double dynamique. D’une part, la variance absolue croît de manière strictement linéaire avec n, ce qui signifie que l’incertitude sur le comptage brut s’élargit. D’autre part, la variance de la fréquence relative empirique, obtenue en divisant le comptage par n, décroît de façon proportionnelle à l’inverse de la taille d’échantillon (1/n), illustrant l’application rigoureuse de la loi faible des grands nombres et garantissant la convergence asymptotique de la fréquence observée vers le paramètre probabiliste théorique sous-jacent.
4.3 Covariance et corrélation négative intrinsèque
La dimension multivariée de la distribution multinomiale s’exprime pleinement à travers l’étude des moments conjoints d’ordre deux, à savoir les covariances entre différentes composantes vectorielles. Soient deux modalités distinctes indicées par i et j, telles que l’indice i soit différent de j. La covariance théorique entre les variables aléatoires de comptage Xi et Xj s’obtient par la détermination de l’espérance de leur produit croisé à laquelle on soustrait le produit de leurs espérances individuelles :
La présence du signe négatif constitue la caractéristique structurelle primordiale de la loi multinomiale. D’un point de vue conceptuel, cette corrélation négative intrinsèque est une conséquence directe et inévitable de la contrainte holonome de sommation fixe : le nombre total de réalisations étant strictement borné par l’effectif n, toute occurrence supplémentaire enregistrée en faveur de la modalité i s’effectue nécessairement au détriment des ressources combinatoires disponibles pour l’ensemble des autres catégories concurrentes.
Cette structure de covariance permet d’élaborer la matrice de variance-covariance complète du système, souvent notée Σ, qui prend la forme matricielle suivante :
Où D(p) est la matrice diagonale dont les éléments sont les probabilités marginales, et ppT représente le produit tensoriel externe du vecteur de probabilités par lui-même. Sur le plan spectral, cette matrice carrée symétrique de dimension k possède la propriété déterminante d’être singulière et de rang exactement égal à k – 1. Le vecteur colonne constitué uniquement de valeurs unitaires forme le vecteur propre associé à la valeur propre nulle, reflétant mathématiquement le confinement de l’ensemble des trajectoires stochastiques sur l’hyperplan de dimension inférieure dicté par la contrainte de sommation.
5. Conditions d’application et hypothèses sous-jacentes du modèle
5.1 Indépendance mutuelle des épreuves élémentaires
L’édifice mathématique de la distribution multinomiale repose sur un ensemble d’hypothèses probabilistes strictes dont la violation invalide les inférences inférées à partir du modèle. La condition d’application la plus critique concerne l’indépendance mutuelle absolue entre les épreuves élémentaires successives constituant l’échantillon global de taille n. Au sens probabiliste de Borel-Cantelli, deux essais successifs indicés a et b sont stochastiquement indépendants si et seulement si la réalisation conjointe de n’importe quel événement sur ces deux essais est rigoureusement égale au produit de leurs probabilités marginales respectives.
Dans la conduite d’enquêtes psychosociales ou de protocoles expérimentaux, cette hypothèse se traduit par l’impératif d’invariance des réponses entre les différents sujets constituant la cohorte expérimentale. Si des interactions sociales, des phénomènes d’imitation, d’influence collective ou d’apprentissage vicariant surviennent au sein du groupe durant le recueil des données, les réalisations observées cessent d’être indépendantes. De même, les dépendances spatiales, écologiques ou contextuelles induisent des corrélations résiduelles qui violent l’axiome fondamental d’orthogonalité stochastique des épreuves.
Une problématique particulièrement aiguë émerge lors de l’application erronée de la distribution multinomiale standard à des plans d’expérimentation à mesures répétées. Lorsqu’un même participant fournit des réponses séquentielles polytomiques sur plusieurs dizaines d’essais, les dynamiques d’apprentissage, d’attention fluctuante ou de fatigue cognitive créent une dépendance intra-individuelle sévère, également désignée sous le concept d’autocorrélation temporelle. Dans une telle configuration, l’utilisation directe du modèle multinomial sans paramétrisation de cette structure sérielle aboutit inévitablement à une sous-estimation systématique des erreurs-types des estimations.
5.2 Homogénéité temporelle et stabilité des paramètres probabilistes
La seconde hypothèse structurelle fondamentale réside dans l’homogénéité temporelle des paramètres de probabilité, propriété souvent désignée sous le vocable de stationnarité probabiliste. Cette condition stipule que le vecteur de probabilités p = (p1, p2, …, pk) doit demeurer rigoureusement invariant et constant d’une épreuve à l’autre, depuis la première jusqu’à la n-ième itération. Le système générant les données aléatoires ne doit présenter aucune dérive paramétrique latente au cours du temps.
Dans l’ingénierie des protocoles en sciences humaines, le maintien de cette stabilité constitue un défi méthodologique permanent. L’intervention d’effets d’habituation, de consolidation mnésique ou d’épuisement mental chez les participants altère insidieusement la distribution sous-jacente des propensions de réponse au fil de l’expérience. Si la probabilité d’émettre une réponse i évolue au cours de la session de test, la distribution agrégée finale des comptages n’obéit plus à une loi multinomiale pure, mais correspond plutôt à une convolution hétérogène de lois multinomiales distinctes, générant un phénomène mécanique d’inflation de variance.
Le contrôle méthodologique de cette homogénéité exige la mise en place de contrebalancements expérimentaux stricts, l’insertion de pauses régulières pour dissiper la fatigue cognitive et la randomisation systématique de l’ordre de présentation des stimuli. De surcroît, les chercheurs doivent déployer des tests de stationnarité a posteriori, en segmentant les séries chronologiques de réponses catégorielles en fenêtres temporelles successives pour vérifier formellement l’absence de rupture structurelle dans l’estimation des fréquences marginales.
5.3 Tirage avec remise et approximation pour grands effectifs
La troisième exigence théorique concerne la nature du processus physique de prélèvement au sein de la population parente. Le modèle multinomial est le modèle exact des expériences de tirage avec remise, ou plus généralement des processus de génération infinis où le prélèvement d’une unité n’exerce aucune rétroaction informationnelle sur la composition probabiliste de la population résiduelle. Lorsque le tirage s’opère sans remise au sein d’une population de cardinal fini N, la probabilité d’occurrence des modalités varie dynamiquement après chaque prélèvement, et le processus stochastique est alors formellement régi par la distribution hypergéométrique multivariée.
Néanmoins, la mise en œuvre de la distribution hypergéométrique multivariée se heurte fréquemment à des complexités calculatoires substantielles. Dans les contextes où l’échantillonnage s’effectue sans remise au sein d’une population finie, les statisticiens recourent à une approximation par la distribution multinomiale, fondée sur des théorèmes limites asymptotiques. Cette approximation est considérée comme méthodologiquement valide et rigoureuse lorsque la taille de l’échantillon n est négligeable par rapport à la taille de la population globale N.
La règle empirique généralement admise en statistique méthodologique stipule que la fraction d’échantillonnage, définie par le ratio n/N, ne doit pas excéder le seuil critique de 5 % à 10 %. Sous cette condition de modération de l’échantillonnage, la probabilité conditionnelle d’altération de l’urne devient négligeable, et les erreurs d’approximation résiduelles commises en substituant la distribution multinomiale à la loi hypergéométrique multivariée se révèlent mathématiquement imperceptibles au regard des marges d’erreur stochastiques inhérentes à la taille n.
6. Démonstration pratique par l’exemple de tirage avec remise
6.1 Paramétrisation exacte du protocole expérimental classique
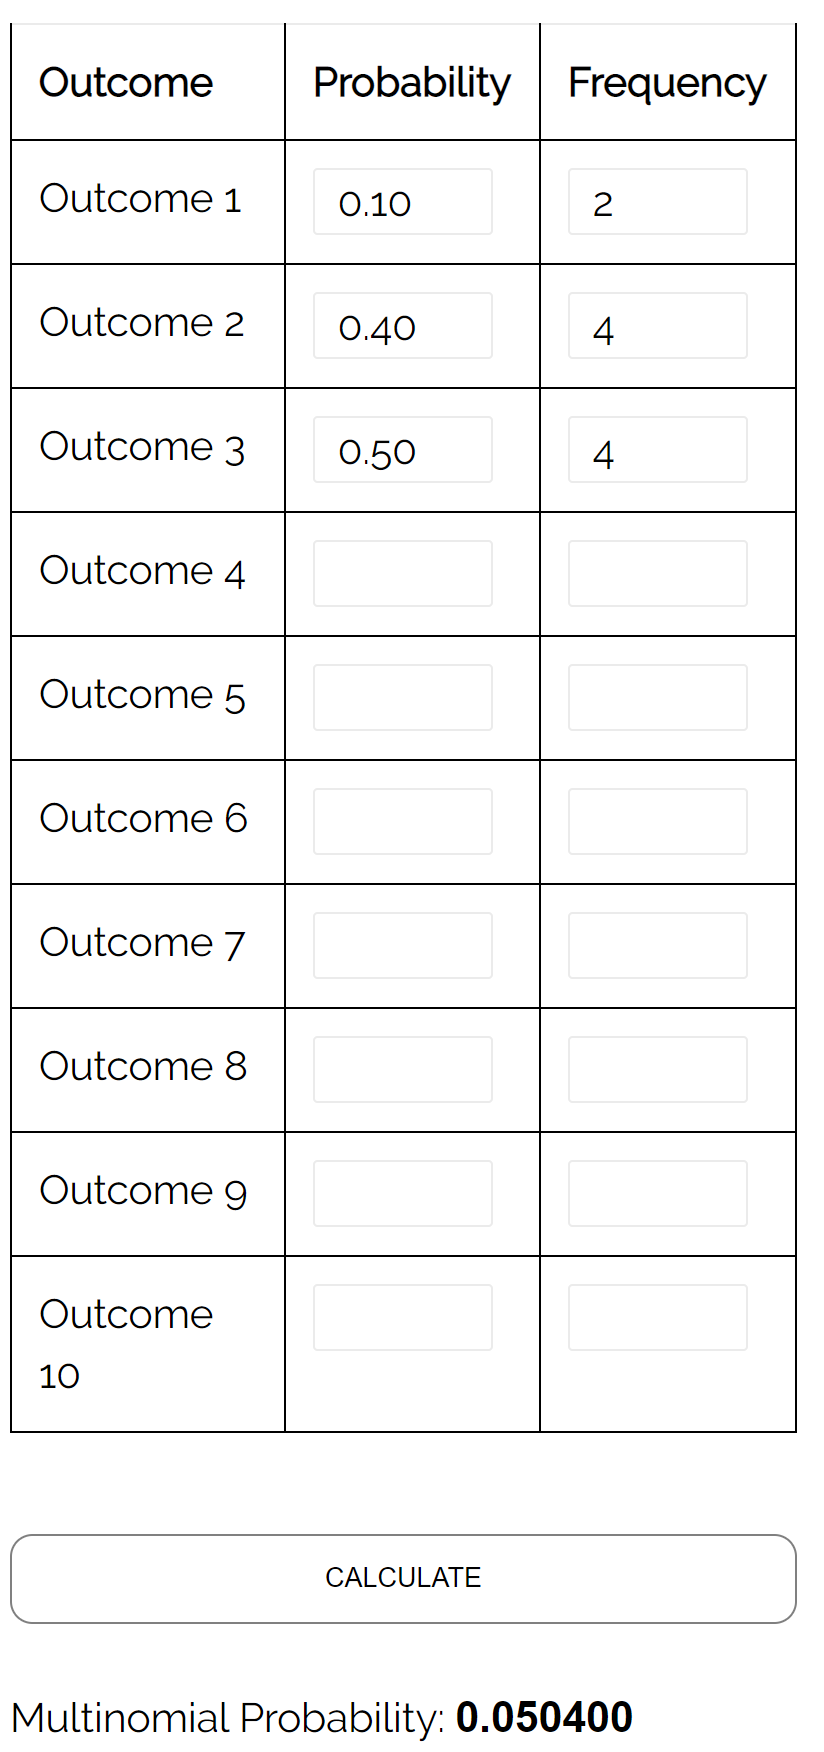
Afin d’ancrer les concepts mathématiques précédents dans une démonstration concrète et didactique, considérons l’expérience canonique de l’urne probabiliste. Soit une urne opaque contenant un ensemble fini et volumineux de billes colorées, réparties en trois modalités chromatiques distinctes et exhaustives : des billes rouges, des billes vertes et des billes bleues. Nous définissons ainsi un espace polytomique où le nombre de catégories est fixé à k = 3. La composition interne de l’urne est parfaitement étalonnée : elle contient initialement 50 billes rouges, 30 billes vertes et 20 billes bleues, soit un total cumulé de 100 billes.
Puisque chaque tirage individuel est immédiatement suivi d’une remise de la bille prélevée dans l’urne et d’un brassage complet, les probabilités marginales associées à chaque extraction demeurent strictement invariantes d’un essai à l’autre. Nous pouvons déterminer formellement le vecteur des paramètres de probabilité p = (prouge, pvert, pbleu) à partir des effectifs relatifs initiaux :
- Probabilité d’extraire une bille rouge : p1 = 50 / 100 = 0,50
- Probabilité d’extraire une bille verte : p2 = 30 / 100 = 0,30
- Probabilité d’extraire une bille bleue : p3 = 20 / 100 = 0,20
La sommation unitaire 0,50 + 0,30 + 0,20 = 1,00 confirme la validité probabiliste de l’espace paramétrique. Le protocole expérimental consiste à réaliser une série rigoureuse de n = 10 tirages consécutifs avec remise. L’objectif analytique consiste à calculer la probabilité exacte d’observer empiriquement le vecteur de comptage cible x = (xrouge = 5, xvert = 3, xbleu = 2), dont la somme arithmétique reconstitue précisément la taille de l’échantillon n = 10.
6.2 Calcul pas à pas de la probabilité exacte d’observation
L’évaluation quantitative de la probabilité d’observer ce vecteur de comptage spécifique s’effectue par l’application rigoureuse et séquentielle de la formule de la fonction de masse multinomiale. La première étape computationnelle consiste à déterminer le coefficient multinomial, qui quantifie le nombre exact de séquences distinctes d’extractions aboutissant au tirage combinatoire de cinq billes rouges, trois billes vertes et deux billes bleues :
Le calcul du numérateur fournit la factorielle de l’effectif global : 10! = 3 628 800. Pour le dénominateur, nous calculons le produit des factorielles marginales des effectifs cibles : 5! = 120, 3! = 6, et 2! = 2. Le produit combinatoire de ces trois termes équivaut à 120 × 6 × 2 = 1 440. En effectuant la division du numérateur par ce produit factoriel, nous obtenons le nombre total de permutations admissibles :
Il existe donc exactement 2 520 séquences chronologiques distinctes capables de générer ce résultat d’ensemble. La seconde étape du calcul requiert l’évaluation séquentielle des puissances probabilistes associées à chaque modalité catégorielle en vertu de l’indépendance conditionnelle des épreuves :
- Puissance probabiliste de la modalité rouge : p1x1 = (0,50)5 = 0,03125
- Puissance probabiliste de la modalité verte : p2x2 = (0,30)3 = 0,02700
- Puissance probabiliste de la modalité bleue : p3x3 = (0,20)2 = 0,04000
Le produit conjoint de ces probabilités élémentaires séquentielles équivaut à : 0,03125 × 0,02700 × 0,04000 = 0,00003375. Enfin, la multiplication finale du coefficient multinomial par ce produit probabiliste fournit la probabilité exacte d’observation : 2 520 × 0,00003375 = 0,08505. Il y a donc une probabilité exacte de 8,505 % d’observer rigoureusement cette répartition lors de la réalisation du protocole expérimental.
6.3 Analyse de sensibilité et variations paramétriques
L’analyse de sensibilité constitue une phase indispensable pour appréhender la dynamique stochastique du modèle multinomial face aux perturbations de ses conditions initiales. Si les caractéristiques de l’urne subissent une altération, par exemple en modifiant les proportions initiales vers une structure uniforme où chaque couleur possède une probabilité identique pi = 1/3, la probabilité d’observer le vecteur de comptage (5, 3, 2) évolue substantiellement. Sous cette nouvelle hypothèse paramétrique, le produit probabiliste devient (1/3)10 ≈ 0,000016935, conférant au même profil de comptage une probabilité d’observation finale de 2 520 × 0,000016935 ≈ 0,04268, soit une baisse de près de la moitié par rapport à la configuration d’origine.
Cette sensibilité paramétrique s’illustre visuellement par la projection de la fonction de densité discrète sur le simplexe bidimensionnel régulier délimité par les trois sommets catégoriels. La surface de ce simplexe triangulaire révèle un paysage de probabilités présentant un pic unique, ou mode global, localisé à proximité immédiate du vecteur des espérances théoriques E(X) = (10 × 0,5, 10 × 0,3, 10 × 0,2) = (5, 3, 2). Dans notre exemple initial, le vecteur cible correspondait précisément au mode de la distribution multinomiale, expliquant son intensité probabiliste relativement élevée au sein de l’espace combinatoire.
La comparaison numérique avec des vecteurs alternatifs met en évidence la décroissance rapide de la probabilité dès que l’on s’écarte du barycentre pondéré des paramètres. Par exemple, la probabilité d’observer une distribution fortement déséquilibrée telle que x‘ = (8, 1, 1) sous les paramètres initiaux (0,50, 0,30, 0,20) n’est que de :
Ce résultat quantifie formellement la rareté stochastique des trajectoires marginales extrêmes au sein du simplexe d’échantillonnage, confirmant la puissance du coefficient multinomial combiné aux puissances exponentielles pour concentrer la masse probabiliste autour de l’espérance asymptotique.
7. Estimation des paramètres : Méthode du maximum de vraisemblance
7.1 Construction de la fonction de vraisemblance multinomiale
Dans la quasi-totalité des investigations empiriques, le chercheur ne connaît pas a priori le vecteur théorique des probabilités p, mais observe en revanche un ensemble de réalisations empiriques concrétisées par le vecteur de comptage x = (x1, …, xk). Le problème inférentiel consiste dès lors à estimer les paramètres inconnus de la population parente à partir des observations recueillies. La méthode d’estimation par excellence dans le cadre paramétrique est celle du maximum de vraisemblance, formulée par Ronald Fisher.
Soit un vecteur de comptage multinomial observé x résultant de n épreuves indépendantes. La fonction de vraisemblance conjointe, notée L(p | x), exprime la plausibilité relative des différents vecteurs de paramètres p au vu des données observées. Elle s’écrit analytiquement de manière identique à la fonction de masse de probabilité, mais en considérant cette fois les données x comme des constantes fixes et le vecteur p comme la variable d’optimisation mathématique :
Afin de simplifier le traitement calculatoire et analytique, il est d’usage conventionnel d’appliquer une transformation logarithmique népérienne monotone à la fonction de vraisemblance. Cette opération engendre la fonction de log-vraisemblance, notée ℓ(p | x), qui convertit le produit combinatoire initial en une sommation algébrique linéaire, facilitant grandement les opérations ultérieures de dérivation mathématique :
Dans ce contexte d’optimisation mathématique, le premier terme logarithmique impliquant les factorielles de comptage ne dépend aucunement des composantes du vecteur de paramètres p. Par conséquent, il est régulièrement traité comme une constante additive non informative et omis lors des dérivations sans altérer en aucune façon la position spatiale de l’optimum global sur le simplexe.
7.2 Dérivation des estimateurs du maximum de vraisemblance
L’obtention analytique des estimateurs du maximum de vraisemblance pour le vecteur multinomial ne peut s’effectuer par une dérivation partielle directe sans contrainte, car les paramètres pi sont assujettis à la condition d’égalité stricte de sommation unitaire. La résolution rigoureuse de ce problème d’optimisation sous contrainte nécessite l’utilisation formelle de la méthode des multiplicateurs de Lagrange. Nous construisons à cet effet une fonction lagrangienne augmentée, introduisant un scalaire multiplicateur noté λ :
La détermination des extremums de cette fonction requiert l’annulation simultanée des dérivées partielles du lagrangien par rapport à chaque paramètre individuel pi et par rapport au multiplicateur λ. En calculant la dérivée partielle par rapport à une composante pi quelconque et en l’égalant à zéro, nous obtenons le système d’équations caractéristiques :
Cette relation fondamentale établit immédiatement que pour chaque modalité catégorielle, le paramètre optimal est directement proportionnel à son effectif observé : pi = xi / λ. Pour identifier la valeur analytique exacte du multiplicateur de Lagrange λ, il suffit de sommer cette égalité sur l’ensemble des k catégories en mobilisant la contrainte de fermeture :
Puisque la somme des pi vaut 1 et que la somme des comptages observés xi est égale à l’effectif global n, il s’ensuit immédiatement que le multiplicateur de Lagrange équivaut rigoureusement à la taille d’échantillon : λ = n. En substituant cette valeur dans l’équation de proportionnalité, nous dérivons l’estimateur du maximum de vraisemblance canonique :
Ce résultat mathématique capital démontre que l’estimateur du maximum de vraisemblance d’une modalité au sein de la distribution multinomiale coïncide parfaitement avec sa fréquence relative empirique observée au sein de l’échantillon. Cet estimateur présente l’ensemble des propriétés asymptotiques optimales : il est rigoureusement sans biais, convergent (consistant) au sens où sa variance s’annule à l’infini, et asymptotiquement efficace, atteignant la borne inférieure de Cramér-Rao.
7.3 Matrice d’information de Fisher et erreurs-types
Pour quantifier le degré de précision statistique et l’incertitude d’échantillonnage associés aux estimateurs du maximum de vraisemblance, il est indispensable de construire la matrice d’information de Fisher. Cette dernière est définie comme l’opposé de l’espérance mathématique de la matrice hessienne des dérivées partielles secondes de la fonction de log-vraisemblance. En dérivant une seconde fois la fonction de log-vraisemblance par rapport aux paramètres pi et pj, nous obtenons :
La matrice hessienne ne comporte aucun terme croisé pour i ≠ j, ce qui signifie que les dérivées partielles secondes hors-diagonale sont nulles. En prenant l’opposé de l’espérance mathématique de ces dérivées secondes et en rappelant que l’espérance de la variable aléatoire Xi est égale à n × pi, les éléments diagonaux de la matrice d’information de Fisher s’écrivent :
L’inversion de cette matrice d’information de Fisher fournit la matrice de variance-covariance asymptotique des estimateurs. En tenant compte de la réduction d’un degré de liberté imposée par la contrainte de normalisation unitaire, la variance asymptotique de l’estimateur de fréquence s’exprime sous la forme conventionnelle :
L’erreur-type asymptotique associée à l’estimation de chaque proportion multinomiale s’obtient alors par l’extraction de la racine carrée de cette variance d’échantillonnage divisée par n. Ces quantités constituent le socle computationnel indispensable à la construction des ellipses de confiance multivariées simultanées sur le simplexe de probabilités, permettant aux praticiens d’encadrer rigoureusement les proportions observées selon les normes de la statistique inférentielle classique.
8. Tests d’hypothèses et adéquation : Le test du khi-deux de Pearson
8.1 Rapprochement asymptotique vers la loi du khi-deux
L’une des contributions méthodologiques les plus influentes de Karl Pearson à la science statistique réside dans la démonstration mathématique reliant l’écart des effectifs observés d’une loi multinomiale à une distribution théorique continue du khi-deux. Considérons un vecteur de comptages empiriques X issu d’un échantillonnage multinomial de taille n, et posons une hypothèse nulle stipulant que les probabilités marginales de chaque modalité sont fixées à un vecteur théorique spécifique p(0) = (p1(0), …, pk(0)).
Pour mesurer la conformité des données empiriques à ce modèle théorique, Karl Pearson a formulé la statistique d’adéquation universelle fondée sur la standardisation quadratique des écarts entre les fréquences observées et les effectifs théoriques attendus (définis par Ei = n × pi(0)) :
Le théorème fondamental de Pearson établit que, lorsque la taille totale de l’échantillon n tend asymptotiquement vers l’infini sous l’hypothèse nulle, cette statistique quadratique discrète converge en loi vers une distribution continue du khi-deux (χ²). Cette convergence stochastique est rendue possible par l’approximation normale multivariée du vecteur de comptage sous-jacent combinée à la structure projective de la matrice de variance-covariance singulière de rang k – 1.
Le nombre de degrés de liberté associé à cette loi limite est rigoureusement fixé à k – 1 pour un test d’adéquation où les paramètres théoriques sont spécifiés a priori sans estimation empirique. Cette diminution unitaire du nombre de degrés de liberté reflète la contrainte linéaire globale selon laquelle la somme des écarts entre effectifs observés et théoriques est invariablement nulle :
8.2 Test du rapport de vraisemblance statistique
Une alternative formelle au test quadratique de Pearson repose sur le paradigme du rapport de vraisemblance statistique, aboutissant à la statistique usuellement désignée sous le symbole G² (ou statistique de déviance multinomiale). Ce test compare le niveau maximal de vraisemblance atteignable sous le modèle nul contraint L(p(0)) au niveau maximal de vraisemblance obtenu sous le modèle saturé L(p̂), où les paramètres correspondent librement aux fréquences relatives observées :
En développant analytiquement le logarithme de ce rapport de vraisemblances pour la fonction de masse multinomiale, nous aboutissons à l’expression classique de la statistique de déviance :
Le théorème de Wilks assure que sous l’hypothèse nulle, la statistique G² converge également vers une distribution du khi-deux avec k – 1 degrés de liberté lorsque la taille d’échantillon n croît vers l’infini. Sur le plan asymptotique, une décomposition en séries de Taylor de la fonction logarithmique révèle que la statistique de déviance G² et la statistique de Pearson χ² sont asymptotiquement équivalentes au premier ordre.
Toutefois, pour des échantillons de taille modérée, des divergences de sensibilité peuvent apparaître. La statistique G² présente une supériorité théorique indéniable dans le cadre des modèles linéaires généralisés et log-linéaires en raison de sa décomposabilité additive stricte pour les modèles emboîtés. En contrepartie, la statistique χ² de Pearson offre fréquemment une convergence vers sa loi limite du khi-deux plus rapide et plus robuste lorsque les effectifs attendus par cellule sont relativement faibles.
8.3 Seuils d’effectifs attendus et corrections d’échantillonnage
La validité des tests d’hypothèses asymptotiques sur la distribution multinomiale est tributaire du respect de conditions strictes relatives aux effectifs attendus par modalité. L’approximation continue du khi-deux pour une statistique fondamentalement discrète devient défaillante dès lors que la masse de probabilité théorique se concentre sur des effectifs théoriques trop clairsemés, créant des asymétries majeures dans la distribution de l’erreur quadratique.
La règle empirique la plus unanimement respectée dans la communauté statistique est la règle de Cochran. Ce critère stipule que le test du khi-deux de Pearson ne doit être jugé valide que si au moins 80 % des cellules affichent un effectif théorique attendu Ei supérieur ou égal à 5, et qu’aucune cellule individuelle ne présente un effectif attendu strictement inférieur à 1. Lorsque cette condition d’adéquation n’est pas remplie, le taux d’erreur de première espèce (l’alpha nominal) est significativement distordu, entraînant un risque élevé de rejet erroné de l’hypothèse nulle.
Face à des données catégorielles éparses ou des échantillons réduits, plusieurs stratégies méthodologiques s’imposent :
- Le regroupement théorique de catégories : Fusionner deux ou plusieurs modalités conceptuellement proches afin d’accroître l’effectif attendu de la cellule résultante, tout en adaptant à la baisse les degrés de liberté finaux.
- Le test multinomial exact : Procéder à une énumération combinatoire complète ou à un échantillonnage de Monte-Carlo pour déterminer la probabilité exacte d’observer une configuration au moins aussi extrême que celle recueillie, éliminant ainsi toute dépendance à l’approximation du khi-deux.
- La régularisation bayésienne des effectifs : Introduire des pseudo-comptes préalables (a priori de Laplace ou de Jeffreys) pour amortir la variabilité des cellules à faibles occurrences dans le cadre de modèles prédictifs.
9. Applications de la loi multinomiale en psychologie cognitive et comportementale
9.1 Modélisation des arbres de traitement multinomial (MPT)
Dans l’arsenal méthodologique de la psychologie cognitive expérimentale, les modèles d’arbres de traitement multinomial, désignés sous l’acronyme anglo-saxon MPT (Multinomial Processing Trees), représentent une avancée théorique majeure. Développés initialement par William Batchelder et David Riefer, les modèles MPT utilisent la distribution multinomiale pour sonder l’architecture interne inobservable de la mémoire, de la perception et du raisonnement humain à partir des fréquences de réponses catégorielles observables.
L’architecture d’un modèle MPT repose sur la décomposition d’un choix comportemental polytomique en un arbre de probabilités stochastique où chaque nœud latent représente un processus cognitif discret binaire (par exemple, le fait de récupérer une trace mnésique versus l’échec de récupération, ou la détection d’un signal versus l’absence de détection). La probabilité globale d’aboutir à une réponse observable spécifique correspond à la somme des produits des probabilités associées aux différents chemins menant à cette issue dans l’arbre. Le vecteur global des réponses observées est ensuite modélisé comme un échantillonnage multinomial paramétré par cette composition non-linéaire de probabilités latentes.
L’ajustement de ces modèles par le maximum de vraisemblance permet d’estimer des paramètres cognitifs purs et distincts, en éliminant les stratégies de compensation ou les biais de devinette qui masquent fréquemment la performance réelle des participants. Par exemple, dans les paradigmes de mémoire de source, les MPT séparent avec une précision analytique inégalée la capacité intrinsèque d’encodage de l’information contextuelle des simples heuristiques de décision utilisées par le sujet lorsqu’il est confronté à l’incertitude.
9.2 Prise de décision et théorie du choix probabiliste
L’analyse formelle des choix forcés discrets entre de multiples stimuli expérimentaux constitue un autre champ d’application paradigmatique de la loi multinomiale. Dans les contextes de décision en situation d’incertitude ou d’évaluation hédonique, les individus sont fréquemment amenés à arbitrer parmi un ensemble de k alternatives de valeurs et d’attributs hétérogènes. La distribution multinomiale sert alors de réceptacle d’observation stochastique pour valider les modèles mathématiques de choix probabiliste.
Ce paradigme s’enracine historiquement dans l’axiome de choix de R. Duncan Luce, qui postule que la probabilité relative de sélectionner une option spécifique parmi un ensemble dépend uniquement d’une échelle de ratio de valeurs sous-jacentes attribuées à ces alternatives, indépendamment de la présence ou de l’absence d’options tierces non pertinentes. Cette axiomatique conduit directement au célèbre modèle logit polytomique, dans lequel les probabilités multinomiales sont paramétrées par des fonctions logistiques exponentielles des utilités perçues :
Dans les expériences contemporaines couplant prise de décision et chronométrie mentale, l’analyse conjointe des choix catégoriels distribués selon une loi multinomiale et des distributions continues de temps de réaction permet de contraindre les modèles de diffusion ou d’accumulation de preuves à barrières multiples, offrant ainsi une compréhension unifiée de la dynamique temporelle et probabiliste de la prise de décision humaine.
9.3 Étude des biais attentionnels et catégorisation visuelle
Dans le domaine des neurosciences cognitives et de la psychologie de la vision, la distribution multinomiale s’est révélée indispensable à l’analyse computationnelle des patterns d’exploration visuelle et d’oculométrie (eye-tracking). Lorsqu’un sujet observe une scène visuelle complexe ou une interface graphique, son regard effectue une série séquentielle de fixations oculaires discrètes réparties sur un ensemble de k régions d’intérêt prédéfinies par l’expérimentateur.
Le nombre total de fixations enregistrées au cours d’une fenêtre temporelle donnée étant fini, le vecteur quantifiant le nombre de fixations dirigées vers chaque région d’intérêt constitue un vecteur aléatoire multinomial. La modélisation de cette répartition permet de tester rigoureusement l’existence de biais attentionnels automatiques, par exemple une capture visuelle préférentielle exercée par des stimuli à valence émotionnelle négative (tels que des visages menaçants ou des signaux d’alerte) comparativement à des stimuli neutres.
De surcroît, dans les protocoles d’assignation perceptuelle catégorielle où des participants doivent classer des formes visuelles ambiguës dans différentes catégories conceptuelles concurrentes, la loi multinomiale offre le cadre probabiliste requis pour valider les modèles de prototypes et d’exemplaires. L’analyse des fréquences d’assignation multinomiales permet ainsi de modéliser avec précision la géométrie de l’espace psychologique sous-jacent et les frontières décisionnelles élaborées par le système visuel.
10. Modélisation multinomiale en psychométrie et analyse des questionnaires
10.1 Analyse des échelles de Likert et réponses polytomiques
Dans l’élaboration et la validation des instruments psychométriques, la collecte de données repose de manière prépondérante sur des échelles de type Likert ou des formats de réponse gradués. Ces échelles présentent un ensemble fini et ordonné de modalités (telles que « pas du tout d’accord », « modérément d’accord », « totalement d’accord »). Traiter ces réponses polytomiques comme des variables continues numériques par simple affectation de valeurs entières arbitraires constitue une approximation méthodologique discutable, susceptible de masquer des non-linéarités sévères dans la mesure des construits psychologiques.
La théorie de la réponse aux items moderne résout ce dilemme en modélisant explicitement la probabilité d’occurrence de chaque modalité de réponse au moyen de distributions multinomiales sous-jacentes. Le modèle de réponse graduée de Samejima et le modèle nominal de Bock formalisent la probabilité conditionnelle qu’un individu doté d’un niveau de trait latent particulier sélectionne une modalité catégorielle spécifique. Chaque modalité d’un item psychométrique est ainsi régie par une fonction de réponse polytomique dont l’ensemble des issues forme un vecteur multinomial stochastique à somme unitaire.
Cette approche permet de conduire des analyses rigoureuses d’invariance de mesure, notamment en vérifiant si les paramètres de la distribution multinomiale associée à un item demeurent équivalents à travers différents sous-groupes de la population (selon le genre, la culture ou le statut clinique). Toute hétérogénéité non attribuable au trait latent révèle un fonctionnement différentiel de l’item, menaçant la validité transculturelle et diagnostique de l’instrument d’évaluation.
10.2 Modèles de régression logistique multinomiale
Lorsque la variable d’intérêt clinique ou comportementale se structure sous la forme d’une variable polytomique non ordonnée comportant plus de deux catégories, la régression logistique binaire standard s’avère inopérante. Dans ces circonstances, la régression logistique multinomiale (également appelée régression polytomique) s’impose comme la méthodologie d’analyse multivariée par excellence pour modéliser la distribution conditionnelle du vecteur catégoriel en fonction d’un ensemble de covariables explicatives continues ou discrètes.
Sur le plan mathématique, le modèle choisit une catégorie de référence (par exemple la modalité 1) et formule k – 1 équations de régression logistiques distinctes comparant chaque modalité à cette référence. Pour une modalité j donnée et un vecteur de prédicteurs z, le modèle s’exprime par la transformation logit polytomique :
Dans le domaine psychopathologique, cette modélisation s’applique avec un immense succès pour prédire l’assignation de patients à différents diagnostics psychiatriques disjoints (par exemple : absence de trouble, trouble dépressif caractérisé, trouble anxieux généralisé, ou trouble comorbide) sur la base de marqueurs biologiques, cognitifs et anamnestiques. L’interprétation des coefficients de régression s’effectue au travers des rapports de cotes relatifs (Relative Risk Ratios), quantifiant rigoureusement comment la variation unitaire d’une covariable multiplie la cote d’apparition d’un diagnostic spécifique par rapport au diagnostic de référence.
10.3 Analyse des profils latents et typologies cliniques
L’hétérogénéité clinique au sein d’une même catégorie diagnostique constitue l’un des défis majeurs de la psychiatrie contemporaine. L’analyse des classes latentes et l’analyse des profils latents catégoriels exploitent la théorie des mélanges finis de lois multinomiales pour identifier des sous-groupes non observés (latents) d’individus partageant des profils homogènes de réponses à travers une batterie d’indicateurs polytomiques.
Dans ce cadre stochastique, la population globale est postulée comme un mélange probabiliste de C classes latentes distinctes, chacune possédant son propre vecteur de paramètres multinomials. La probabilité conjointe d’un pattern de réponses catégorielles spécifique y correspond à la somme pondérée des probabilités conditionnelles multinomiales propres à chaque profil latent :
Où γc représente la proportion de prévalence de la classe latente c dans la population, et πj, yj | c désigne la probabilité multinomiale d’observer la réponse yj à l’item j pour un membre de cette classe. La détermination du nombre optimal de profils sous-jacents s’appuie sur des critères d’information stochastiques stricts, tels que le critère d’information bayésien (BIC) et le test de rapport de vraisemblance de Lo-Mendell-Rubin, permettant d’extraire des typologies phénotypiques objectives au sein de cohortes cliniques complexes.
11. Diagnostic des modèles multinomials et violations des postulats
11.1 Surdispersion statistique et modèles multinomials de Dirichlet
L’une des violations les plus pernicieuses et fréquentes des postulats du modèle multinomial réside dans l’apparition de la surdispersion (ou dispersion excessive). Cette anomalie stochastique survient lorsque la variance empiriquement observée des comptages marginaux au sein des données réelles surpasse systématiquement la variance théorique prédite par le modèle standard (n × pi × (1 – pi)). La surdispersion est généralement la résultante directe d’une hétérogénéité non observée au sein de la population étudiée, ou de corrélations positives résiduelles entre les épreuves successives.
Pour résoudre cette défaillance paramétrique, la théorie des probabilités propose d’enrichir le modèle par une structure hiérarchique continue, donnant naissance à la distribution de Dirichlet-multinomiale (ou loi multinomiale composée). Dans ce formalisme bayésien ou quasi-vraisemblable, le vecteur des paramètres de probabilité p n’est plus supposé rigoureusement déterministe et constant, mais est lui-même appréhendé comme une variable aléatoire continue distribuée sur le simplexe selon une loi de Dirichlet paramétrée par un vecteur d’hyper-paramètres α = (α1, …, αk) :
L’intégration de la distribution de Dirichlet au sein de la fonction de masse multinomiale engendre une distribution marginale composée dont la structure d’espérance demeure identique, mais dont la matrice de covariance intègre un facteur de surdispersion multiplicatif régulé par la somme des paramètres de Dirichlet. Ignorer cette surdispersion au sein d’une modélisation multinomiale standard induit une sous-estimation dramatique de la variance des estimateurs, augmentant artificiellement le taux de faux positifs lors des tests de significativité des paramètres.
11.2 Sous-dispersion et contraintes de dépendance négative accrue
Bien que moins fréquemment documentée que la surdispersion, la sous-dispersion constitue une autre distorsion structurelle importante. Elle se caractérise par une variance empirique des comptages observés strictement inférieure à la variance théorique postulée par la loi multinomiale. Ce phénomène émerge de processus sous-jacents contraignants qui imposent une régularité excessive ou des dépendances négatives anormalement fortes entre les réalisations élémentaires du système.
Dans les sciences cognitives et comportementales, des dynamiques de compétition attentionnelle exacerbée, des stratégies homéostatiques d’équilibrage de réponses chez les participants ou des processus de mémoire de travail à capacité ultra-restreinte peuvent induire de telles régularités non aléatoires. Lorsqu’un sujet s’interdit psychologiquement de répéter consécutivement une même issue polytomique, l’autonomie stochastique des essais est anéantie en faveur d’une alternance systématique sous-dispersée.
Le traitement analytique de la sous-dispersion nécessite le recours à des approches semi-paramétriques fondées sur la quasi-vraisemblance ou à l’adaptation de distributions multinomiales généralisées (telles que la distribution multinomiale de Conway-Maxwell). Les fonctions de quasi-vraisemblance permettent d’introduire un paramètre d’échelle scalaire ϕ < 1 directement au sein de la relation moyenne-variance, ajustant les matrices d'information sans nécessiter la formulation explicite d'une distribution de probabilité conjointe complète hautement complexe.
11.3 Données manquantes et attrition non aléatoire
L’apparition de données manquantes au sein de protocoles catégoriels longitudinaux ou transversaux pose des défis d’inférence considérables. Dans une expérience polytomique, l’absence de donnée ne se réduit pas à une case vide au sein d’une variable scalaire, mais altère directement la structure dimensionnelle du vecteur de comptage marginal et compromet la contrainte globale de sommation unitaire par individu.
Selon la taxonomie établie par Donald Rubin, les mécanismes générateurs d’absence se scindent en données manquantes complètement au hasard (MCAR), données manquantes au hasard conditionnel (MAR) et données manquantes non ignorables (MNAR). Si des participants d’un profil clinique spécifique ont une propension accrue à omettre de répondre à certaines modalités d’un questionnaire (mécanisme MNAR), l’estimation naïve des proportions multinomiales à partir des données complètes disponibles induit des biais d’échantillonnage substantiels, surévaluant systématiquement les modalités jugées socialement désirables ou moins stigmatisantes.
La résolution de ces biais requiert le déploiement de techniques de modélisation avancées :
- L’algorithme Espérance-Maximisation (EM) multinomial : Procédure itérative permettant de maximiser la fonction de log-vraisemblance en présence de composantes inobservées par intégration stochastique des espérances conditionnelles des comptages manquants.
- L’imputation multiple par équations chaînées (MICE) polytomique : Spécification de modèles de régression multinomiale séquentiels pour imputer de manière itérative les valeurs manquantes, préservant ainsi l’incertitude stochastique globale du système d’observation.
- Les modèles de sélection et de mélange par motif : Formalisation conjointe du processus de réponse multinomiale et du processus binaire d’attrition pour corriger l’estimation des probabilités dans les contextes de déperdition non ignorable.
12. Implémentation computationnelle et analyse de données sous R et Python
12.1 Procédures de calcul et simulation sous l’environnement R
L’environnement computationnel R constitue un écosystème de premier plan pour l’analyse stochastique et la modélisation des lois catégorielles. Dans le noyau de base du système, les fonctionnalités dédiées à la loi multinomiale sont encapsulées dans les fonctions canoniques dmultinom et rmultinom. La fonction dmultinom(x, size, prob) calcule la fonction de masse exacte pour un vecteur d’effectifs donné, tandis que rmultinom(n, size, prob) engendre un échantillonnage pseudo-aléatoire multivarié hautement optimisé par le biais d’algorithmes de décomposition séquentielle en sous-tirages conditionnels binomiaux.
Pour la modélisation avancée de données polytomiques observées au sein d’échantillons complexes, les packages spécialisés fournissent des structures d’analyse supérieures. Le package nnet implémente l’estimation par le maximum de vraisemblance de modèles logistiques multinomiaux au moyen de la fonction multinom(), interfaçable avec les syntaxes formulares standardisées de R. De manière plus générale, le package VGAM (Vector Generalized Additive Models) développé par Thomas Yee offre une infrastructure computationnelle exhaustive permettant d’ajuster des modèles multinomiaux à cotes proportionnelles, des modèles non proportionnels et des distributions de Dirichlet-multinomiales pour gérer la surdispersion.
La restitution visuelle et le diagnostic des écarts aux modèles multinomiaux s’appuient principalement sur les représentations graphiques en mosaïque, accessibles via les bibliothèques vcd (Visualizing Categorical Data) et ggplot2. Les diagrammes en mosaïque projettent les effectifs observés sous forme de pavages rectangulaires dont les dimensions relatives sont rigoureusement proportionnelles aux probabilités conditionnelles, les nuances chromatiques quantifiant l’amplitude des résidus de Pearson standardisés pour identifier visuellement les cellules en écart statistiquement significatif par rapport aux hypothèses multinomiales sous-jacentes.
12.2 Implémentation scientifique en langage Python
Le langage Python, au travers de sa pile computationnelle scientifique standard constituée de NumPy, SciPy et Statsmodels, propose des outils modulaires rigoureux pour l’intégration de la distribution multinomiale dans les pipelines d’apprentissage automatique et de recherche quantitative. Le module scipy.stats.multinomial fournit une classe complète dotée de méthodes vectorisées pour évaluer la fonction de masse de probabilité (pmf), le logarithme de la densité (logpmf) et la génération stochastique de variables aléatoires (rvs).
Dans le domaine de l’économétrie et de l’analyse comportementale, la bibliothèque Statsmodels permet l’estimation de régressions logistiques multinomiales au travers de la classe MNLogit. Cette implémentation fournit des rapports statistiques complets incluant la matrice hessienne inversée, les erreurs-types robustes de White ou de Huber-White, les valeurs de z-score et les niveaux de p-valeur associés à chaque covariable pour les différentes catégories relatives. Parallèlement, la bibliothèque scikit-learn propose une version régularisée de la classification multinomiale via l’estimateur LogisticRegression(multi_class='multinomial'), optimisée pour le traitement de jeux de données massifs par descente de gradient stochastique ou algorithmes quasi-newtoniens (L-BFGS).
Enfin, la robustesse statistique et l’évaluation de la puissance des tests multinomiaux en grands ou petits effectifs sont avantageusement étudiées par le recours à des simulations de Monte-Carlo vectorisées. En simulant des matrices d’échantillonnage de plusieurs centaines de milliers de réplications multinomiales sous différentes hypothèses alternatives, les modélisateurs évaluent précisément les distributions empiriques des statistiques de Pearson et de déviance G², garantissant un contrôle expérimental optimal en amont du recueil des données sur le terrain.
12.3 Bonnes pratiques de rapport statistique selon les normes académiques
La publication de recherches empiriques mobilisant la distribution multinomiale exige une rigueur de communication conforme aux standards internationaux de l’American Psychological Association (normes APA 7e édition). Lors de la présentation tabulaire des fréquences observées et des pourcentages associés, il est impératif de rapporter simultanément les effectifs bruts (n) et les proportions marginales normalisées pour chaque catégorie de réponse, en évitant toute troncature trompeuse des échelles d’axes graphiques.
L’inférence statistique sur les paramètres multinomiaux ne doit jamais se limiter à l’indication isolée d’une p-valeur issue d’un test global du khi-deux. Conformément aux directives académiques contemporaines, les auteurs doivent systématiquement renseigner :
- Les intervalles de confiance multivariés simultanés : Présenter des intervalles ajustés pour la multiplicité des comparaisons (utilisant par exemple la méthode de Bonferroni ou l’algorithme de Goodman) encadrant chaque probabilité marginale estimée p̂i.
- La taille d’effet standardisée : Rapporter des indices d’association adaptés aux tableaux polytomiques, tels que le V de Cramér ou le coefficient de contingence, accompagnés de leurs intervalles de confiance respectifs.
- L’adéquation globale du modèle : Pour les régressions multinomiales, communiquer la log-vraisemblance finale, le pseudo-R² de McFadden ou de Cox-Snell, ainsi que les critères d’information AIC et BIC pour faciliter les comparaisons de modèles concurrents.
Enfin, dans une démarche d’intégrité scientifique et de reproductibilité computationnelle absolue, il est fortement encouragé de déposer les scripts informatiques d’analyse (sous forme de notebooks Jupyter ou de scripts R documentés) ainsi que les matrices de comptages catégoriels anonymisées sur des plateformes d’archivage institutionnelles ouvertes (telles que l’Open Science Framework ou Zenodo), garantissant ainsi la traçabilité et la pérennité des résultats inférentiels produits.
Références
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
- Batchelder, W. H., & Riefer, D. M. (1999). Theoretical and empirical review of multinomial processing tree modeling. Psychonomic Bulletin & Review, 6(1), 57–86. https://doi.org/10.3758/BF03210812
- Bock, R. D. (1972). Estimating item parameters and latent ability when responses are scored in two or more nominal categories. Psychometrika, 37(1), 29–51. https://doi.org/10.1007/BF02291411
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Feller, W. (1968). An introduction to probability theory and its applications (Vol. 1, 3rd ed.). John Wiley & Sons.
- Goodman, L. A. (1965). On simultaneous confidence intervals for multinomial proportions. Technometrics, 7(2), 247–254. https://doi.org/10.1080/00401706.1965.10490252
- Johnson, N. L., Kemp, A. W., & Kotz, S. (2005). Univariate discrete distributions (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471715816
- Luce, R. D. (1959). Individual choice behavior: A theoretical analysis. John Wiley & Sons.
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in Econometrics (pp. 105–142). Academic Press.
- Mosimann, J. E. (1962). On the compound multinomial distribution, the multivariate β-distribution, and correlations among proportions. Biometrika, 49(1/2), 65–82. https://doi.org/10.2307/2333470
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Samejima, F. (1969). Estimation of latent ability using a response pattern of graded scores. Psychometrika Monograph Supplement, 34(4, Pt. 2), 1–100. https://doi.org/10.1007/BF03372160
- Wilks, S. S. (1938). The large-sample distribution of the likelihood ratio for testing composite hypotheses. The Annals of Mathematical Statistics, 9(1), 60–62. https://doi.org/10.1214/aoms/1177732360
- Yee, T. W. (2015). Vector generalized linear and additive models: With an implementation in R. Springer. https://doi.org/10.1007/978-1-4939-2818-7