
Dans le champ des sciences quantitatives contemporaines, qu’il s’agisse de l’épidémiologie clinique, de l’économétrie appliquée, de la psychométrie ou de la sociologie computationnelle, la modélisation statistique des processus décisionnels et des états discrets constitue un enjeu méthodologique de premier ordre. L’analyse des relations de dépendance fonctionnelle a longtemps été dominée par le cadre canonique des moindres carrés ordinaires. Toutefois, dès lors que le phénomène observé échappe au continuum métrique des distributions gaussiennes pour s’incarner dans des catégories distinctes — qu’il s’agisse de la présence ou de l’absence d’une pathologie, de l’adhésion à une modalité thérapeutique particulière, ou encore de l’évaluation graduée d’un niveau de détresse psychologique —, le modèle linéaire général classique s’avère non seulement inopérant, mais mathématiquement incohérent.
Pour surmonter ces impasses structurales, l’introduction des modèles linéaires généralisés (GLM) a marqué un tournant épistémologique et pratique décisif. En substituant aux hypothèses rigides de linéarité et d’homoscédasticité une approche probabiliste fondée sur la transformation logit et le principe du maximum de vraisemblance, la régression logistique s’est imposée comme la pierre angulaire de l’inférence multivariée appliquée aux variables qualitatives. Loin de constituer un édifice monolithique, cette famille méthodologique se déploie en une typologie tripartite rigoureusement conditionnée par la structure métrique de la variable à expliquer : les architectures binaire, multinomiale et ordinale.
Comprendre la logique interne, les conditions de validité paramétrique, les écueils interprétatifs et les déclinaisons empiriques de ces trois modélisations s’avère indispensable pour quiconque aspire à conduire des analyses de données probantes. Le présent traité propose une immersion exhaustive au sein de ces trois paradigmes. En explorant successivement leurs fondements mathématiques, leurs mécanismes de conversion probabiliste, leurs protocoles diagnostiques et leurs illustrations concrètes au sein de divers domaines des sciences empiriques, cet ouvrage vise à fournir aux chercheurs et analystes une boussole théorique et opérationnelle sans compromis sur la rigueur formelle.
1. Introduction aux fondements conceptuels de la régression logistique
1.1 Définition et rôle des variables dépendantes catégorielles
L’application d’un modèle de régression linéaire classique par la méthode des moindres carrés ordinaires (MCO) repose sur un corpus d’hypothèses distributionnelles strictes, formalisées notamment par le théorème de Gauss-Markov. Parmi celles-ci figurent l’hypothèse de linéarité de l’espérance conditionnelle, la normalité des résidus stochastiques et l’homoscédasticité, définie par une variance constante du terme d’erreur à travers toutes les valeurs prises par les prédicteurs. Lorsqu’un chercheur s’attache à prédire une variable dépendante qualitative ou catégorielle, ce cadre théorique s’effondre de manière irrévocable.
Considérons une variable de réponse binaire codée de manière booléenne (zéro ou un). Si l’on ajuste une droite des moindres carrés à une telle distribution, le modèle linéaire de probabilité (MLP) résultant présente deux failles structurelles majeures. En premier lieu, la variance du terme d’erreur dépend directement de la valeur de l’espérance conditionnelle : la variance résiduelle s’exprime sous la forme p(x)(1 – p(x)), où p(x) est la probabilité d’occurrence de l’événement conditionnellement aux prédicteurs. L’erreur est donc intrinsèquement hétéroscédastique, invalidant les calculs usuels des erreurs-types et les tests de significativité associés (tests de Student et de Fisher). En second lieu, la fonction linéaire n’étant soumise à aucune contrainte asymptotique, elle prédit inévitablement pour certaines combinaisons extrêmes des régresseurs des probabilités négatives ou strictement supérieures à l’unité, ce qui constitue une absurdité mathématique au regard des axiomes de Kolmogorov régissant la théorie des probabilités.
Pour résoudre cette incohérence, l’analyse multivariée s’est orientée vers le cadre unificateur des modèles linéaires généralisés formalisé par John Nelder et Robert Wedderburn. Au sein des GLM, la variable dépendante catégorielle n’est plus assimilée à une grandeur continue perturbée par un bruit gaussien, mais est appréhendée comme la réalisation d’une variable aléatoire discrète obéissant à une distribution appartenant à la famille exponentielle — en l’occurrence la distribution de Bernoulli pour les cas binaires, ou multinomiale pour les structures polytomiques. Le rôle de la variable dépendante est alors redéfini : l’objet de la modélisation n’est pas le score catégoriel direct, mais la probabilité conditionnelle sous-jacente associée à l’appartenance à une modalité donnée.
Dans les sciences comportementales, cognitives et médicales, la conceptualisation de ces variables qualitatives répond à la nécessité d’opérationnaliser des construits latents non directement observables. Qu’il s’agisse de caractériser la transition vers un trouble mental caractérisé, la réussite à une tâche psychométrique sous conditions chronométrées, ou l’observance thérapeutique, la variable catégorielle traduit le franchissement d’un seuil critique qualitatif. La modélisation statistique doit dès lors capturer avec exactitude cette nature discrète sans violer les contraintes de bornage inhérentes aux espaces de probabilités.
1.2 La transformation logit et la fonction sigmoïde
L’élégance formelle de la régression logistique réside dans sa capacité à opérer une passerelle mathématique entre un espace de prédicteurs linéaires non borné, variant théoriquement de l’infini négatif à l’infini positif, et un espace de probabilités strictement restreint à l’intervalle ouvert ]0, 1[. Cette liaison repose sur deux concepts interdépendants : le rapport de cotes, communément désigné sous le terme anglo-saxon d’odds, et la transformation logarithmique de ce rapport, baptisée transformation logit.
Soit p la probabilité qu’un événement survienne conditionnellement à un vecteur de covariables X. La cote (ou odds) est définie par le quotient de la probabilité de survenue de l’événement sur la probabilité de son non-avènement, soit : Cote = p / (1 – p). Alors que p évolue au sein de l’intervalle [0, 1], la cote s’étend sur l’ensemble des réels positifs non nuls [0, +inf[. Bien que cette métrique lève la borne supérieure, elle demeure contrainte par une borne inférieure à zéro et présente une asymétrie marquée. L’application du logarithme népérien à cette cote — c’est-à-dire le calcul de ln[p / (1 – p)] — génère la fonction logit. Cette dernière projette de façon bijective l’intervalle de probabilité ]0, 1[ sur la droite réelle tout entière ]-inf, +inf[, réalisant ainsi la linéarisation souhaitée : logit(p) = ln(p / (1 – p)) = beta_0 + beta_1 * X_1 + … + beta_k * X_k.
En inversant algébriquement la fonction logit, on obtient la fonction logistique standard, fréquemment appelée courbe sigmoïde. L’expression de la probabilité conditionnelle s’écrit alors de façon explicite : p = 1 / [1 + exp(-(beta_0 + sum(beta_j * X_j)))]. Cette courbe sigmoïdale présente des propriétés mathématiques remarquables. Sa dérivée première est strictement positive, assurant une croissance monotone, et atteint son point d’inflexion maximal lorsque p = 0,5, ce qui correspond à un logit égal à zéro. Asymptotiquement, la courbe converge vers zéro lorsque la combinaison linéaire tend vers l’infini négatif, et vers un lorsqu’elle tend vers l’infini positif. Ce comportement non linéaire reflète fidèlement la réalité empirique : aux extrémités des distributions, une augmentation d’une unité sur une variable explicative génère une variation marginale de probabilité infinitésimale, tandis qu’au centre de la distribution, le même accroissement produit un impact maximal sur la bascule de l’événement.
L’estimation des paramètres beta du modèle logistique ne peut être accomplie par la méthode fermée des moindres carrés en raison de la nature non linéaire des probabilités résultantes. On recourt donc au principe d’estimation par le maximum de vraisemblance (MLE, pour Maximum Likelihood Estimation). La fonction de vraisemblance exprime la probabilité conjointe d’observer l’échantillon empirique collecté en fonction des paramètres inconnus du modèle. Sous l’hypothèse d’indépendance des observations, cette fonction prend la forme d’un produit des probabilités individuelles de Bernoulli. Afin de simplifier la résolution analytique, on applique le logarithme népérien à cette expression pour maximiser la log-vraisemblance (log-likelihood). L’annulation des dérivées premières par rapport aux coefficients génère un système d’équations non linéaires transcendantes dépourvu de solution analytique directe. L’optimisation numérique est dès lors déléguée à des algorithmes itératifs puissants, tels que l’algorithme de Newton-Raphson ou la méthode de score de Fisher, qui convergent par approximations successives vers le vecteur de paramètres rendant maximale la vraisemblance de l’échantillon observé.
1.3 Importance de la méthode dans la recherche quantitative
La primauté de la régression logistique dans la recherche quantitative moderne découle de sa polyvalence méthodologique et de sa robustesse inférentielle face aux exigences des plans de recherche observationnels et expérimentaux. En épidémiologie et en psychopathologie quantitative, elle offre un outil d’investigation sans équivalent pour quantifier les associations étiologiques tout en neutralisant l’effet de biais d’assignation ou de distribution.
Un avantage capital de cette méthode réside dans son aptitude à intégrer simultanément des covariables de natures métriques radicalement divergentes. Un même modèle prédictif peut agréger sans distorsion mathématique des prédicteurs continus (par exemple l’âge du participant, la concentration sérique d’un biomarqueur ou le score brut obtenu à une échelle psychométrique standardisée), des régresseurs discrets issus de comptages, ainsi que des variables qualitatives nominales ou ordinales codées sous forme d’indicatrices binaires (variables muettes ou dummy variables). Cette souplesse d’architecture préserve l’intégrité structurelle des données brutes, éliminant le besoin de catégorisations artificielles et dommageables pour la puissance statistique.
Par ailleurs, au sein des protocoles observationnels où la randomisation stricte s’avère matériellement ou éthiquement impossible, le contrôle des variables confusionnelles constitue le défi majeur de l’inférence causale. La régression logistique permet d’isoler l’effet spécifique d’une variable d’intérêt clinique ou comportementale sur la cote de survenue d’un état, en maintenant mathématiquement constants les niveaux des facteurs confondants identifiés. En fournissant des estimations conditionnelles ajustées, elle prévient l’émergence d’artefacts statistiques tels que le paradoxe de Simpson. Enfin, la translucidité de sa métrique de sortie — l’Odds Ratio (OR) — en fait le standard universel de communication scientifique pour qualifier l’intensité de l’association entre un prédicteur et une issue clinique binaire ou polytomique.
2. Typologie générale : binaire, multinomiale et ordinale
2.1 Critères taxonomiques fondés sur l’échelle de mesure
L’arbre décisionnel guidant la sélection du modèle logistique adéquat est exclusivement tributaire de la structure algébrique et sémantique de l’échelle de mesure employée pour opérationnaliser la variable critère (dépendante). Selon la nature relationnelle unissant les différentes modalités de cette variable, trois architectures modélisatrices se distinguent nettement.
La première configuration, structurellement la plus élémentaire, correspond à l’échelle nominale dichotomique stricte, donnant lieu à la régression logistique binaire. Dans ce schéma, la variable dépendante ne peut assumer que deux états mutuellement exclusifs et conjointement exhaustifs. L’espace d’échantillonnage de la réponse reflète une logique bivalente : présence versus absence d’une entité clinique, échec versus réussite d’un individu à un test d’aptitude, ou maintien versus désengagement au sein d’une cohorte longitudinale. La polarité des deux modalités est conventionnellement formalisée par les valeurs numériques zéro (absence de l’événement cible) et un (survenue de l’événement cible).
La deuxième configuration émerge lorsque l’espace catégoriel s’élargit pour accueillir trois modalités ou davantage, sans qu’aucun ordre hiérarchique, séquentiel ou quantitatif ne puisse leur être assigné de façon univoque. Il s’agit du domaine de la régression logistique multinomiale. Les catégories observées correspondent à des classes purement qualitatives, distinctes et indépendantes. Les exemples typiques englobent le choix d’un traitement psychothérapeutique de prédilection parmi plusieurs écoles théoriques (psychanalyse, thérapie comportementale et cognitive, approche systémique), la sélection d’un mode de transport urbain, ou encore l’orientation professionnelle vers des filières académiques hétérogènes. Tenter d’ordonner de telles classes introduirait une distorsion sémantique arbitraire faussant intégralement l’analyse.
La troisième configuration traite des variables qualitatives polytomiques présentant une structure interne rigoureusement ordonnée, justifiant l’application de la régression logistique ordinale. Dans cette modalité de mesure, les catégories de réponse possèdent une métrique directionnelle intrinsèque : chaque modalité successive dénote un degré plus élevé ou plus faible du phénomène appréhendé que la modalité qui la précède. Toutefois, contrairement aux variables quantitatives continues mesurées sur des échelles d’intervalles ou de rapports, les distances séparant les catégories adjacentes demeurent inconnues et fondamentalement inégales. L’évaluation de la satisfaction thérapeutique (allant de « très insatisfait » à « très satisfait »), la stadification clinique d’une sévérité symptomatique (légère, modérée, sévère) ou l’exploitation d’items sur une échelle de Likert constituent les archétypes de cette taxonomie ordinale.
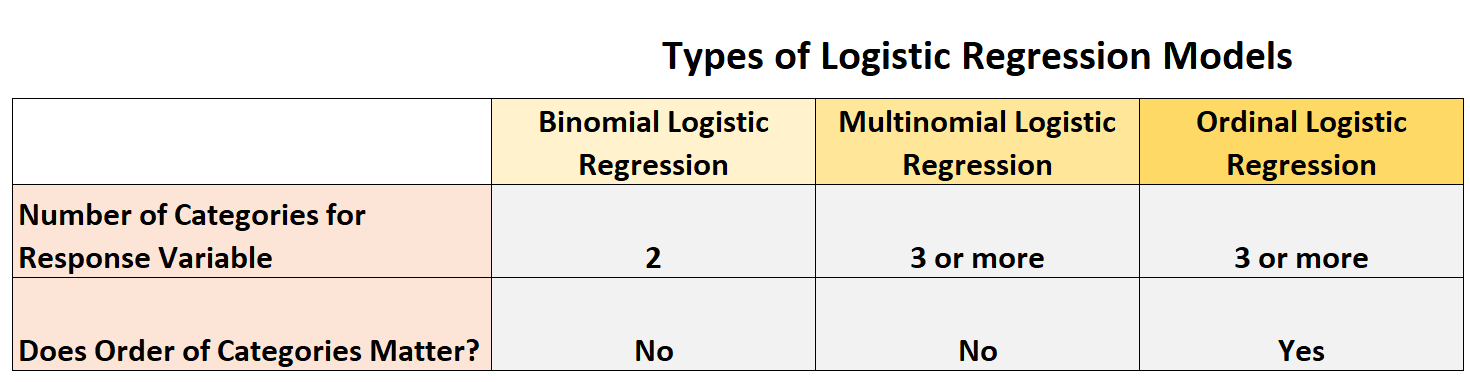
2.2 Tableau synoptique comparatif des trois architectures
Pour appréhender d’un coup d’œil les divergences formelles et empiriques qui structurent ces trois modèles, le tableau synoptique ci-dessous synthétise leurs propriétés distinctives, depuis la formalisation de leur fonction de lien jusqu’aux contraintes paramétriques qui leur sont propres.
| Dimension d’analyse | Logistique binaire | Logistique multinomiale | Logistique ordinale (Cotes proportionnelles) |
|---|---|---|---|
| Nature de la variable Y | Dichotomique (2 modalités exclusives : 0, 1) | Polytomique nominale (K ≥ 3 modalités non ordonnées) | Polytomique ordinale (K ≥ 3 modalités avec hiérarchie sous-jacente) |
| Nombre d’équations estimées | Une équation unique de logit | K – 1 équations logit simultanées | K – 1 équations cumulatives simultanées |
| Fonction de lien principale | Logit standard : ln[p / (1 – p)] | Logits généralisés ancrés sur une modalité de référence | Logits cumulatifs : ln[P(Y ≤ k) / P(Y > k)] |
| Paramètres structurels | Une constante (alpha) et un vecteur de pentes (beta) | K – 1 constantes et K – 1 vecteurs de pentes distincts | K – 1 seuils de coupure ordonnés (alpha_k) et un unique vecteur de pentes (beta) |
| Hypothèse paramétrique clé | Linéarité du logit pour les variables continues | Indépendance des alternatives non pertinentes (IIA) | Parallélisme des pentes (cotes proportionnelles) |
| Métrique d’effet rapportée | Odds Ratio (OR) binaire | Ratio de Risques Relatifs (RRR) par rapport à la base | Odds Ratio Cumulatif invariant à travers les seuils |
L’analyse de ce tableau met en lumière une fracture théorique fondamentale dans la gestion des paramètres de régression. Alors que le modèle multinomial libère totalement les pentes pour chaque niveau de comparaison au prix d’une inflation substantielle du nombre de paramètres à estimer (multipliant les coefficients par K – 1), le modèle ordinal standard contraint les pentes régulatrices des covariables à l’invariance stricte à travers toutes les partitions cumulatives. Cette distinction entraîne des conséquences directes sur la parcimonie du modèle et sur les exigences de puissance d’échantillonnage.
2.3 Critères de décision pour le choix du modèle optimal
L’arbitrage entre ces trois approches ne saurait résulter d’une simple convenance computationnelle : il engage directement la validité écologique et statistique des inférences produites. L’investigateur doit procéder à un examen méthodique de la métrique intrinsèque de la variable dépendante avant toute spécification algorithmique.
Une pratique encore trop fréquente au sein de la littérature quantitative consiste à opérer une dichotomisation artificielle d’une variable polytomique ordinale — par exemple, en scindant un score de dépression en deux groupes arbitraires séparés par la médiane ou par un seuil clinique conventionnel. Les travaux méthodologiques contemporains ont formellement démontré que cette stratégie détruit irréversiblement une part considérable de l’information statistique contenue dans la distribution originelle. La dichotomisation artificielle diminue considérablement la puissance statistique, induit une sous-estimation substantielle de la taille des effets réels, et accroît le risque d’introduire des erreurs de classification non différentielles. Si la variable de réponse possède intrinsèquement trois niveaux de gravité ou davantage, l’usage du modèle ordinal s’impose théoriquement de plein droit face au modèle binaire.
À l’inverse, l’application irréfléchie d’un modèle multinomial à une variable ordonnée engendre un coût d’efficience statistique non négligeable. En ignorant délibérément l’information relative au rang des modalités, le modèle multinomial traite les catégories ordonnées comme des entités indépendantes non connectées. Il en résulte une dispersion inutile des degrés de liberté, une diminution drastique de la précision des estimations (élargissement des intervalles de confiance) et une interprétation cognitivement fragmentée des dynamiques d’élévation d’un niveau à l’autre. Le modèle multinomial ne doit donc être retenu pour des variables ordonnées que si et seulement si l’hypothèse de parallélisme du modèle ordinal est formellement et irrémédiablement réfutée par les données empiriques.
3. La régression logistique binaire : principes théoriques
3.1 Architecture formelle et équation logit
L’architecture de la régression logistique binaire prend sa source dans la théorie des probabilités appliquées à la distribution de Bernoulli. Soit une variable de réponse aléatoire discrète Y_i associée à une observation individuelle i (pour i variant de 1 à N), pouvant prendre la valeur 1 avec une probabilité conditionnelle p_i, ou la valeur 0 avec une probabilité complémentaire 1 – p_i. Le vecteur ligne des variables explicatives associées à cette observation est dénoté X_i = [1, X_i1, X_i2, …, X_ik], incluant le terme unitaire dédié à l’interception.
La formulation algébrique fondamentale du modèle logistique binaire s’exprime dans l’espace non borné des log-odds :
logit(p_i) = ln[ p_i / (1 – p_i) ] = beta_0 + sum_{j=1}^{k} (beta_j * X_ij) = X_i * beta
Dans cette formulation, beta représente le vecteur colonne des paramètres structuraux de régression à estimer. L’équation établit que le logarithme du rapport de cotes est une fonction strictement linéaire des covariables. Pour transiter de cet espace abstrait vers l’espace concret des probabilités estimées, on applique la transformation réciproque par exponentiation, conduisant à la formulation fonctionnelle de la sigmoïde :
p_i = E(Y_i | X_i) = exp(X_i * beta) / [ 1 + exp(X_i * beta) ] = 1 / [ 1 + exp(-X_i * beta) ]
Dans cette modélisation, le terme d’erreur stochastique epsilon_i n’apparaît pas sous la forme additive homoscédastique familière des modèles MCO (Y = X*beta + epsilon). L’aléa stochastique est directement gouverné par la loi de probabilité conditionnelle de Bernoulli elle-même : Y_i | X_i ~ B(p_i). La variance d’échantillonnage de la réponse dépend fonctionnellement de la moyenne conditionnelle : Var(Y_i | X_i) = p_i * (1 – p_i). Cette liaison intrinsèque entre la moyenne et la variance impose une modélisation non linéaire exacte et justifie le rejet de toute approche fondée sur la minimisation d’une somme quadratique des résidus.
3.2 Interprétation statistique des coefficients estimés
La dérivation et l’interprétation des paramètres estimés constituent un volet fondamental de l’analyse. Contrairement aux coefficients d’une régression linéaire qui traduisent directement la variation absolue moyenne de la variable dépendante par unité d’accroissement du prédicteur, les coefficients beta d’un modèle logistique quantifient une variation dans l’échelle logarithmique des cotes.
Le terme constant du modèle, beta_0 (l’interception), reflète la valeur attendue du logit lorsque l’ensemble des prédicteurs continus et indicatrices centrées du modèle sont simultanément fixés à zéro. En calculant l’exponentielle de cette constante, exp(beta_0), le statisticien accède à la « cote de base » (baseline odds) d’occurrence de l’événement cible pour la population de référence présentant un vecteur nul de covariables.
Les coefficients de pente, dénotés beta_j, capturent l’incrément additif apporté au logit pour chaque augmentation marginale d’une unité de la variable explicative X_j, toutes choses égales par ailleurs (ceteris paribus). Pour conférer à ces valeurs une signification concrète dans le langage de l’évaluation des risques et des propensions comportementales, on procède à leur exponentiation systématique. La quantité exp(beta_j) correspond à l’Odds Ratio (OR), ou rapport de cotes ajusté associé au prédicteur j :
OR_j = exp(beta_j) = [ p(X_j + 1) / (1 – p(X_j + 1)) ] / [ p(X_j) / (1 – p(X_j)) ]
L’évaluation de la directionnalité et de l’ampleur de l’effet s’articule autour de trois régimes distincts :
- Association nulle : Si beta_j = 0, alors exp(beta_j) = 1. La cote de survenue de l’événement est rigoureusement identique quel que soit le niveau du prédicteur ; il n’existe aucune dépendance conditionnelle mesurable entre X_j et l’issue.
- Association positive (Facteur de risque ou d’augmentation) : Si beta_j > 0, alors exp(beta_j) > 1. Chaque augmentation d’une unité sur X_j multiplie la cote d’occurrence de l’événement cible par la valeur de l’OR. Une valeur de beta_j = 0,693 correspond approximativement à un OR de 2, indiquant un doublement de la cote de survenue de l’événement par unité supplémentaire de prédicteur.
- Association négative (Facteur de protection ou de diminution) : Si beta_j < 0, alors 0 < exp(beta_j) < 1. Chaque incrément unitaire sur le régresseur réduit la cote de l’événement cible. À titre d’illustration, un beta_j = -0,693 livre un OR de 0,50, traduisant une division par deux de la cote de bascule.
3.3 Qualité de l’ajustement et indices prédictifs
L’évaluation métrologique d’un modèle logistique binaire requiert la conjonction d’indices statistiques globaux d’ajustement et de mesures concrètes de calibration et de discrimination classificationnelle.
Le point d’ancrage de l’inférence globale repose sur la déviance du modèle, définie par D = -2 * ln(L), où L représente la vraisemblance maximisée de l’échantillon. La comparaison d’un modèle saturé (parfaitement ajusté aux données avec autant de paramètres que d’observations) et du modèle spécifié sous-tend la déviance résiduelle. L’efficacité collective des prédicteurs est mesurée par le Test du Rapport de Vraisemblance (Likelihood Ratio Test, ou G^2), qui confronte la déviance du modèle nul (ne comportant que la constante) à celle du modèle complet : G^2 = D_nul – D_complet = -2 * [ ln(L_0) – ln(L_complet) ]. Sous l’hypothèse nulle d’inutilité prédictive des k prédicteurs, cette statistique suit asymptotiquement une distribution du Khi-deux de Pearson à k degrés de liberté.
L’absence de résidus gaussiens interdit le calcul du coefficient de détermination R^2 classique fondé sur la variance expliquée. Pour pallier cette lacune, plusieurs métriques de substitution, désignées sous le vocable de Pseudo R-deux, ont été théorisées :
- Le R^2 de McFadden : Établi comme R^2_McFadden = 1 – [ln(L_complet) / ln(L_0)], il quantifie l’amélioration proportionnelle de la log-vraisemblance. Dans la pratique empirique, des valeurs comprises entre 0,20 et 0,40 témoignent déjà d’un ajustement hautement performant.
- Le R^2 de Cox et Snell : Fondé sur le test du rapport de vraisemblance, il prend la forme R^2_CS = 1 – (L_0 / L_complet)^(2/N). Son principal inconvénient réside dans son incapacité structurelle à atteindre la borne théorique de 1, même en cas d’ajustement parfait.
- Le R^2 de Nagelkerke (ou Cragg-Uhler) : Il pallie la limite précédente en divisant le R^2 de Cox et Snell par sa valeur maximale théorique possible (1 – L_0^(2/N)), fournissant ainsi un indice standardisé oscillant fidèlement entre 0 et 1.
Au-delà des métriques d’ajustement global, l’efficience pratique d’un modèle binaire est appréhendée au moyen de sa matrice de confusion, obtenue en croisant les états empiriques observés avec les classifications prédites par le modèle après application d’un seuil de décision (traditionnellement fixé à p = 0,50). Cette matrice permet l’extraction de deux grandeurs fondamentales : la sensibilité (la propension du modèle à détecter correctement les cas réels positifs) et la spécificité (la capacité à écarter rigoureusement les vrais négatifs). En faisant varier ce seuil d’assignation de 0 à 1, on trace la courbe caractéristique du fonctionnement du récepteur (Courbe ROC). L’aire sous cette courbe (AUC pour Area Under the Curve), équivalente à la statistique de concordance C de Harrell, résume la capacité discriminante globale du système : une AUC de 0,50 dénote une absence totale de discrimination (équivalente au tirage à pile ou face), tandis qu’une AUC supérieure à 0,80 consacre une discrimination excellente, culminant à 1,0 pour une séparation absolue sans chevauchement.
4. Exemples appliqués de régression logistique binaire
4.1 Exemple 1 : Prédiction de la réussite au recrutement professionnel
Afin d’illustrer la mécanique computationnelle et l’interprétation concrète d’une régression logistique binaire, analysons une étude empirique menée dans le champ de la psychologie du travail et de la gestion des ressources humaines. Une organisation multinationale souhaite modéliser les déterminants sous-jacents à l’embauche définitive de cadres supérieurs à l’issue d’un processus sélectif rigoureux. La cohorte d’analyse comprend 450 candidats évalués de manière standardisée.
La variable dépendante catégorielle est codée de façon binaire : Embauche = 1 si le candidat est formellement retenu à l’issue du comité de sélection, et Embauche = 0 dans le cas contraire. Trois covariables explicatives sont intégrées au modèle :
- Intelligence émotionnelle (IE) : Variable continue standardisée (score centré-réduit allant théoriquement de -3 à +3).
- Quotient intellectuel (QI) : Variable continue standardisée (score centré-réduit).
- Expérience professionnelle pertinente (EXP) : Variable continue discrète quantifiant le nombre d’années d’exercice dans des fonctions managériales similaires.
L’estimation par le maximum de vraisemblance livre les paramètres présentés dans le tableau synthétique suivant :
| Prédicteur | Coefficient (B) | Erreur-type (SE) | Statistique de Wald | p-valeur | Odds Ratio (exp(B)) | IC 95% pour l’OR |
|---|---|---|---|---|---|---|
| Constante (beta_0) | -2,145 | 0,312 | 47,26 | < 0,001 | 0,117 | — |
| Intelligence Émotionnelle (IE) | 0,845 | 0,154 | 30,11 | < 0,001 | 2,328 | [1,721 ; 3,149] |
| Quotient Intellectuel (QI) | 0,512 | 0,148 | 11,97 | < 0,001 | 1,669 | [1,249 ; 2,230] |
| Expérience (EXP) | 0,185 | 0,042 | 19,40 | < 0,001 | 1,203 | [1,108 ; 1,307] |
L’équation de régression dans l’espace logit s’établit formellement comme suit : logit(p) = -2,145 + 0,845*(IE) + 0,512*(QI) + 0,185*(EXP). La constante (-2,145) indique que pour un candidat présentant des scores moyens en IE et QI (0) et aucune expérience préalable (EXP = 0), la cote de base d’être embauché n’est que de 0,117. En convertissant cette cote en probabilité brute via la formule p = 0,117 / (1 + 0,117), on constate que ce profil ne détient qu’une probabilité théorique de sélection de 10,48 %.
L’analyse des Odds Ratios apporte un éclairage substantiel sur l’impact comparatif des facteurs humains. L’intelligence émotionnelle démontre l’effet le plus prononcé : toutes choses égales par ailleurs, chaque accroissement d’un écart-type sur l’échelle de l’IE multiplie la cote d’embauche par 2,328 (soit une élévation de 132,8 % de la cote). Le quotient intellectuel, bien que hautement significatif sur le plan statistique (p < 0,001), présente un effet plus modéré, multipliant la cote d’embauche par 1,669 (+ 66,9 % par écart-type). Enfin, chaque année supplémentaire d’expérience managériale accroît la cote d’embauche d’un facteur de 1,203 (+ 20,3 % par an).
Pour appréhender l’impact de ces paramètres au niveau individuel, projetons la probabilité d’embauche d’un candidat exceptionnel affichant une IE supérieure de 1,5 écart-type au-dessus de la moyenne, un QI supérieur de 1,0 écart-type, et 8 années d’expérience terrain. Le logit prédit est calculé comme : logit(p) = -2,145 + (0,845 * 1,5) + (0,512 * 1,0) + (0,185 * 8) = -2,145 + 1,2675 + 0,512 + 1,480 = 1,1145. En injectant ce logit dans la fonction sigmoïde, on dérive la probabilité prédite : p = 1 / [1 + exp(-1,1145)] = 1 / [1 + 0,3281] = 0,7530, soit 75,3 % de chances d’accéder au poste convoité.
4.2 Exemple 2 : Diagnostic de l’état dépressif caractérisé
Considérons à présent une étude épidémiologique en psychopathologie portant sur l’identification des facteurs d’émergence d’un Épisode Dépressif Majeur (EDM) au sein d’une cohorte médicale suivie en soins primaires (N = 820). Le critère d’évaluation clinique est une variable binaire mesurée par une entrevue diagnostique structurée : Présence_EDM = 1, Absence_EDM = 0.
Le modèle intègre trois covariables spécifiques recueillies lors d’un bilan prédictif initial :
- Stress perçu (PSS-10) : Échelle continue graduée de 0 à 40 points.
- Score de rumination mentale (RRS) : Échelle continue évaluant les réponses ruminatives, graduée de 22 à 88 points.
- Indice de sévérité de l’insomnie (ISI) : Échelle clinique continue évaluant les perturbations nocturnes, de 0 à 28 points.
Le paramétrage du modèle produit un coefficient pour le score d’insomnie de beta_ISI = 0,112 (SE = 0,024, p < 0,001), conférant un OR ajusté de exp(0,112) = 1,118 (IC 95% [1,067 ; 1,172]). Du point de vue de la clinique médicale, cela signifie que pour chaque incrément d’un point unique sur l’échelle d’insomnie de l’ISI, la cote d’être diagnostiqué avec un épisode dépressif majeur augmente de 11,8 %, indépendamment du niveau de stress et de rumination du patient. Si l’on compare deux individus différant de 5 points sur l’échelle d’insomnie, l’effet cumulé s’élève à exp(5 * 0,112) = exp(0,560) = 1,751, soit une cote de risque majorée de 75,1 %.
Le score de rumination mentale affiche un coefficient beta_RRS = 0,058 (SE = 0,011, p < 0,001, OR = 1,060), tandis que le stress perçu révèle beta_PSS = 0,084 (SE = 0,019, p < 0,001, OR = 1,088). L’absence de multicolinéarité excessive (facteurs d’inflation de variance tous inférieurs à 1,8) garantit la stabilité de ces estimations étiologiques. Ce modèle démontre une capacité discriminante clinique remarquable, matérialisée par une aire sous la courbe ROC (AUC) de 0,862 (IC 95% [0,834 ; 0,890]). Cette discrimination élevée confirme la pertinence d’associer ces trois dimensions pour dépister précocement les populations vulnérables dans les structures de première ligne.
4.3 Exemple 3 : Observance d’un protocole psychothérapeutique
Le désengagement précoce ou le décrochage (dropout) thérapeutique constitue un problème critique dans la prise en charge des troubles anxieux et addictifs. Dans cette troisième illustration, des cliniciens-chercheurs évaluent les déterminants de l’observance thérapeutique au sein d’un protocole standardisé de thérapie comportementale et cognitive en 16 séances (N = 310 participants). La variable d’intérêt est l’observance complète, codée Adhésion = 1 si le patient a validé l’intégralité du cycle de séances, et Abandon = 0 si une rupture unilatérale du suivi s’est produite avant la huitième séance.
Les prédicteurs modélisés incluent :
- Alliance thérapeutique initiale (WAI) : Score mesuré lors de la troisième séance (allant de 12 à 84 points).
- Soutien social perçu (MSPSS) : Échelle de 1 à 7 points.
- Sévérité symptomatique initiale (BSI) : Score global d’intensité psychologique mesuré à l’admission.
L’estimation met en exergue le rôle fondamental de la relation thérapeutique précoce : beta_Alliance = 0,078 (SE = 0,015, p < 0,001, OR = 1,081). Ainsi, chaque élévation d’un point du score d’alliance thérapeutique lors de la séance 3 accroît de 8,1 % la cote de maintien et de complétion du traitement jusqu’à son terme. L’effet du soutien social est également favorable (beta = 0,380, SE = 0,110, p < 0,001, OR = 1,462), traduisant une augmentation de 46,2 % de la cote d’observance par point d’accroissement du sentiment d’intégration sociale. À l’inverse, la sévérité initiale des symptômes exerce un effet d’érosion significatif sur la rétention : beta_Sévérité = -0,420 (SE = 0,135, p = 0,002, OR = 0,657), indiquant qu’à chaque unité additionnelle de détresse brute à l’entrée, la cote d’achèvement de la prise en charge est réduite d’environ 34,3 %.
Dans un tel contexte d’intervention préventive, le calibrage du seuil de classification décisionnelle s’avère capital. L’assignation binaire standard utilisant un seuil à p = 0,50 se révèle sous-optimale : elle favorise la spécificité au détriment de la sensibilité, laissant échapper un nombre substantiel de patients susceptibles de décrocher. En abaissant le seuil critique à p = 0,35, les cliniciens sacrifient marginalement la spécificité mais optimisent la sensibilité du modèle (qui passe de 64 % à 89 %). Cette stratégie permet d’identifier avec exactitude les personnes les plus exposées au risque d’abandon précoce, ouvrant la voie à des protocoles de remédiation relationnelle et de soutien renforcé dès les premières semaines de traitement.
5. La régression logistique multinomiale : principes théoriques
5.1 Modélisation des choix polytomiques sans ordre
Lorsque la variable dépendante catégorielle Y comporte K modalités distinctes avec K > 2 et qu’aucune structure d’ordonnancement hiérarchique ne lie ces classes, le cadre binaire s’avère structurellement insuffisant. La régression logistique multinomiale, théorisée initialement dans le champ des choix discrets par Daniel McFadden, généralise le principe du logit en formulant un système d’équations logistiques simultanées.
Pour une variable polytomique à K alternatives, l’espace des probabilités conditionnelles est régi par la contrainte de fermeture stochastique : sum_{k=1}^{K} p_ik = 1, où p_ik désigne la probabilité que l’individu i choisisse ou appartienne à la catégorie k. Afin de résoudre l’indétermination du système tout en garantissant que les probabilités somment exactement à l’unité, le modèle désigne arbitrairement l’une des catégories comme la catégorie de référence (ou classe pivot), conventionnellement dénotée modalité 1 ou modalité K.
Le modèle spécifie alors K – 1 équations de logit indépendantes comparant simultanément chacune des modalités restantes à la modalité de référence choisie (désignons ici la catégorie 1 comme base) :
ln[ p_ik / p_i1 ] = beta_{0(k)} + sum_{j=1}^{m} (beta_{j(k)} * X_ij) = X_i * beta_{(k)} (pour tout k = 2, …, K)
Dans ce formalisme, chaque équation possède son propre terme constant beta_{0(k)} et son propre vecteur de pentes beta_{(k)}. Les coefficients décrivent le taux de variation des log-odds de choisir la catégorie k plutôt que la catégorie de base 1. Pour convertir ces log-ratios en probabilités catégorielles pures, on utilise la formulation probabiliste connue sous le nom d’opérateur ou fonction softmax :
p_ik = exp(X_i * beta_{(k)}) / [ 1 + sum_{m=2}^{K} exp(X_i * beta_{(m)}) ] (pour k = 2, …, K)
p_i1 = 1 / [ 1 + sum_{m=2}^{K} exp(X_i * beta_{(m)}) ] (pour la modalité de référence 1)
Cette expression garantit de façon structurelle que pour toute configuration du vecteur de covariables X_i, chaque probabilité conditionnelle individuelle demeure strictement confinée dans l’intervalle ouvert ]0, 1[ et que leur somme exhaustive égale rigoureusement un.
5.2 Rôle et désignation de la catégorie de référence
L’ancrage sur une catégorie de base pivot joue un rôle purement mathématique de normalisation. Le choix de la modalité retenue comme pivot n’altère en rien les prédictions finales de probabilité p_ik, ni la déviance résiduelle globale, ni la significativité omnibus du modèle. Toutefois, ce choix conditionne radicalement l’architecture des coefficients estimés, leur signe et leur interprétation substantielle.
Par exponentiation des coefficients propres à chaque équation, le chercheur n’obtient plus un simple Odds Ratio binaire, mais un Ratio de Risques Relatifs (RRR, pour Relative Risk Ratio), fréquemment désigné sous le terme de ratio de cotes polytomique :
RRR_k|ref = exp(beta_{j(k)}) = [ p_ik(X_j + 1) / p_iref(X_j + 1) ] / [ p_ik(X_j) / p_iref(X_j) ]
Un RRR supérieur à 1 stipule que l’accroissement d’une unité sur le régresseur X_j majore la probabilité d’appartenir à la modalité k comparativement à la modalité pivot. Un RRR inférieur à 1 indique au contraire que l’élévation du prédicteur favorise préférentiellement l’appartenance à la catégorie de référence.
Une propriété d’invariance algébrique fondamentale de la régression multinomiale réside dans la possibilité de dériver sans ré-estimer le modèle complet la comparaison directe unissant deux modalités non référentielles quelconques (par exemple la catégorie 3 face à la catégorie 2). En vertu des lois de composition des logarithmes, on a : ln[ p_i3 / p_i2 ] = ln[ p_i3 / p_i1 ] – ln[ p_i2 / p_i1 ] = X_i * (beta_{(3)} – beta_{(2)}). Le vecteur de coefficients caractérisant le contraste direct de la modalité 3 face à la modalité 2 équivaut simplement à la soustraction vectorielle des coefficients estimés dans les équations respectives adossées au pivot 1. L’erreur-type de ce nouveau contraste est dérivée à partir de la matrice de covariance asymptotique des paramètres originels par : SE(beta_{(3)} – beta_{(2)}) = sqrt[ Var(beta_{(3)}) + Var(beta_{(2)}) – 2 * Cov(beta_{(3)}, beta_{(2)}) ].
5.3 Hypothèse d’indépendance des alternatives non pertinentes (IIA)
La validité théorique de la régression logistique multinomiale repose sur un postulat axiomatique formulé par Duncan Luce : l’hypothèse d’indépendance des alternatives non pertinentes (dite hypothèse IIA, pour Independence of Irrelevant Alternatives). Selon cette hypothèse, le rapport des cotes de choix entre deux modalités spécifiques quelconques (p_j / p_k) doit demeurer rigoureusement constant et invariant, que d’autres alternatives soient ajoutées, supprimées ou modifiées au sein du panel de choix proposé.
Cette hypothèse est célèbre pour son illustration paroxystique : le paradoxe du bus rouge et du bus bleu conceptualisé par Daniel McFadden. Imaginons des usagers urbains devant choisir initialement entre deux modes de transport : la voiture personnelle (V) et un bus rouge (BR), avec une probabilité égale p(V) = 0,5 et p(BR) = 0,5, fixant le ratio de cotes à p(V) / p(BR) = 1. Supposons maintenant que la régie de transport introduise un nouveau mode : un bus bleu (BB), parfaitement identique au bus rouge sous tous les rapports à l’exception exclusive de sa couleur de carrosserie. En toute logique humaine, les usagers indifférents à la teinte du bus répartiront leurs préférences entre les deux bus, maintenant le choix de l’automobile intact : p(V) = 0,5, p(BR) = 0,25, p(BB) = 0,25. Or, en vertu de l’hypothèse IIA inhérente au modèle multinomial, le ratio p(V) / p(BR) doit demeurer impérativement égal à 1, ce qui force le modèle à prédire p(V) = 1/3, p(BR) = 1/3 et p(BB) = 1/3. Le modèle multinomial standard échoue ici de façon flagrante en surestimant dramatiquement la propension globale à emprunter le bus au détriment de l’automobile.
Deux procédures empiriques permettent de tester formellement la viabilité de l’hypothèse IIA au sein d’un échantillon :
- Le test de Hausman-McFadden : Cette procédure compare les estimations vectorielles du modèle complet à celles d’un modèle restreint dans lequel une ou plusieurs catégories d’issue ont été délibérément exclues. Si l’hypothèse IIA tient, les paramètres associés aux modalités préservées ne doivent pas fluctuer de façon statistiquement significative. La divergence entre les estimateurs est évaluée par une forme quadratique suivant asymptotiquement une distribution du Khi-deux.
- Le test de Small-Hsiao : Il s’agit d’une alternative fondée sur le fractionnement de l’échantillon en sous-groupes aléatoires et la comparaison croisée des log-vraisemblances restreintes et non restreintes.
Lorsque l’hypothèse IIA est formellement violée (indiquant des corrélations résiduelles prononcées ou une substituabilité asymétrique entre certaines catégories d’issue), le modèle logistique multinomial standard doit être rejeté. L’analyste doit alors s’orienter vers des familles modélisatrices plus complexes autorisant des matrices de corrélation d’erreurs non nulles, telles que le logit emboîté (Nested Logit), le modèle probit multinomial, ou encore les modèles à classes latentes mixtes (Mixed Logit Models).
6. Exemples appliqués de régression logistique multinomiale
6.1 Exemple 1 : Typologie des styles d’attachement chez l’adulte
Pour ancrer ces concepts théoriques au cœur de la psychologie différentielle et du développement adulte, examinons une étude explorant les déterminants psychologiques prédisant la typologie de l’attachement amoureux chez de jeunes adultes (N = 600). La variable dépendante polytomique catégorise les individus selon la classification canonique de Bartholomew et Horowitz :
- Catégorie 1 : Style Sécure (choisie comme catégorie de référence pivot).
- Catégorie 2 : Style Anxieux-Préoccupé.
- Catégorie 3 : Style Évitant-Détaché.
Deux prédicteurs continus standardisés sont examinés : le score de trauma infantile rétrospectif (CTQ) et le niveau d’estime de soi globale (Rosenberg). Le système est formalisé par K – 1 = 2 équations logistiques simultanées estimées en référence au style Sécure.
| Contraste comparatif | Prédicteur | B | SE | Wald | p-valeur | RRR (exp(B)) | IC 95% du RRR |
|---|---|---|---|---|---|---|---|
| Anxieux vs Sécure (Pivot) | Constante | -0,421 | 0,145 | 8,43 | 0,004 | 0,656 | — |
| Trauma Infantile (CTQ) | 0,682 | 0,121 | 31,78 | < 0,001 | 1,978 | [1,559 ; 2,509] | |
| Estime de Soi (ES) | -0,915 | 0,138 | 43,96 | < 0,001 | 0,401 | [0,306 ; 0,525] | |
| Évitant vs Sécure (Pivot) | Constante | -0,285 | 0,140 | 4,14 | 0,042 | 0,752 | — |
| Trauma Infantile (CTQ) | 0,495 | 0,118 | 17,59 | < 0,001 | 1,640 | [1,301 ; 2,068] | |
| Estime de Soi (ES) | -0,210 | 0,115 | 3,33 | 0,068 | 0,811 | [0,647 ; 1,016] |
L’analyse des Ratios de Risques Relatifs révèle des configurations étiologiques divergentes. Dans le premier bloc comparatif (Anxieux versus Sécure), l’exposition aux traumas infantiles majore substantiellement la propension à développer un attachement anxieux : pour chaque élévation d’un écart-type sur le score CTQ, le ratio de risque relatif d’appartenir à la modalité anxieuse plutôt qu’à la modalité sécure est multiplié par 1,978 (+ 97,8 %). Parallèlement, une estime de soi solide joue un rôle protecteur marqué : chaque écart-type supplémentaire sur l’échelle d’estime de soi réduit de près de 60 % le risque relatif de développer un pattern anxieux comparativement au style sécure (RRR = 0,401).
Dans le second bloc (Évitant versus Sécure), le trauma précoce constitue également un facteur favorisant (RRR = 1,640, p < 0,001). Toutefois, un contraste majeur apparaît concernant l’estime de soi : le coefficient n’atteint pas le seuil canonique de significativité statistique (p = 0,068, RRR = 0,811, avec un intervalle de confiance englobant l’unité [0,647 ; 1,016]). Contrairement aux individus anxieux dont la détresse est fortement médiatisée par l’effondrement du sentiment de valeur personnelle, les individus évitants maintiennent une forme d’autonomie défensive préservant artificiellement leur estime d’eux-mêmes en regard des pairs sécures.
En mobilisant les propriétés additives des logits, nous pouvons calculer la comparaison directe non tabulée opposant le profil Anxieux au profil Évitant : beta_{Anxieux vs Évitant} = beta_{Anxieux vs Sécure} – beta_{Évitant vs Sécure}. Pour l’estime de soi, ce contraste spécifique est calculé par : -0,915 – (-0,210) = -0,705. L’exponentiation de cette différence livre un RRR direct de exp(-0,705) = 0,494 (p < 0,001). Cette dérivation démontre qu’à chaque augmentation d’un écart-type d’estime de soi, la probabilité d’arborer un profil anxieux plutôt qu’évitant est diminuée de plus de la moitié, éclairant avec finesse la structure de personnalité différentielle des sujets.
6.2 Exemple 2 : Choix d’orientation académique post-baccalauréat
En sociologie de l’éducation, l’arbitrage opéré par les bacheliers lors de leur transition vers l’enseignement supérieur offre un champ d’application privilégié pour la régression logistique multinomiale. Considérons un échantillon représentatif de 1 200 lycéens de terminale observés dans leur choix d’orientation vers trois voies distinctes :
- 1 : Filières Scientifiques et Technologiques (ST).
- 2 : Sciences Humaines, Sociales et Lettres (SHSL).
- 3 : Écoles d’Art et Filières Créatives (ART).
La filière Scientifique (ST) est désignée comme la catégorie de référence pivot. Le modèle intègre deux prédicteurs de compétences cognitives : le score au test d’habileté spatiale (SPATIAL) et le score au test d’aptitude verbale (VERBAL), ainsi qu’une covariable contextuelle : l’indice socio-économique familial (ISE, standardisé).
L’estimation multinomiale démontre que le score spatial réduit considérablement la cote relative d’orientation vers les humanités par rapport aux sciences dures : beta_{SPATIAL (SHSL vs ST)} = -0,854 (p < 0,001, RRR = 0,426). Un lycéen présentant d’excellentes capacités d’abstraction spatiale est donc plus de deux fois moins enclin à opter pour les lettres que pour les sciences. Inversement, une compétence verbale supérieure inverse radicalement cette tendance : beta_{VERBAL (SHSL vs ST)} = 0,721 (p < 0,001, RRR = 2,056), doublant le risque relatif d’adhésion aux filières littéraires comparativement aux sciences.
Concernant l’arbitrage vers les disciplines créatives (ART vs ST), le raisonnement spatial n’exerce aucun effet inhibiteur significatif (p = 0,214), mais l’indice socio-économique révèle un effet de classe déterminant : beta_{ISE (ART vs ST)} = 0,412 (p = 0,002, RRR = 1,510). Ce résultat quantifie comment l’élévation du capital économique et culturel des parents favorise l’assomption de cursus artistiques aux débouchés perçus comme plus incertains, comparativement aux cursus scientifiques valorisés pour leur sécurité institutionnelle.
6.3 Exemple 3 : Sélection d’une stratégie de régulation émotionnelle
Dans le domaine des neurosciences affectives et de la psychologie cognitive, les chercheurs analysent comment des individus soumis à un stresseur aigu adoptent préférentiellement une stratégie de régulation parmi trois options d’ajustement comportemental exclusives :
- 1 : Réévaluation cognitive (catégorie pivot).
- 2 : Suppression expressive (inhibition motrice et faciale des émotions).
- 3 : Distraction active (déviation attentionnelle vers une tâche concurrente).
Les covariables examinées chez 420 participants soumis à un protocole de stress social expérimental (le Trier Social Stress Test) incluent : l’intensité de la menace perçue (évaluation cognitive continue de 1 à 10) et le niveau du trait de personnalité Neuroticisme mesuré par le NEO-PI-R.
L’estimation des logits multinomiales révèle que sous une perception de menace extrême, la propension à maintenir une stratégie adaptative de réévaluation cognitive s’effondre. Le coefficient liant la menace perçue au choix de la suppression expressive face à la réévaluation s’élève à beta_Menace = 0,342 (p < 0,001, RRR = 1,408). Pour chaque incrément d’un point sur l’échelle de menace, le ratio de probabilité d’inhiber son expressivité plutôt que de réévaluer le contexte augmente de 40,8 %. Par ailleurs, le trait de névrosisme oriente massivement les choix vers la distraction active par rapport à la réévaluation : beta_Neuroticisme = 0,580 (p < 0,001, RRR = 1,786). Ces résultats formels mettent en évidence les contraintes directes exercées par la surcharge cognitive et les traits affectifs sur l’accès aux stratégies de régulation émotionnelle élaborées.
7. La régression logistique ordinale : principes théoriques
7.1 Fondements de l’approche par seuils latents
L’architecture de la régression logistique ordinale répond à une élégante conceptualisation théorique : l’hypothèse d’une variable latente sous-jacente continue non observable, conventionnellement désignée sous le symbole Y*. Cette construction épistémologique postule que le phénomène étudié possède une continuité fondamentale dans la réalité, mais que l’outil de mesure empirique (par exemple une échelle ordinale ou un système de classification clinique) ne parvient à capturer cette intensité qu’à travers une suite discrète de seuils de coupure successifs.
Soit Y_i une variable dépendante ordinale assumant K modalités ordonnées codées 1, 2, …, K. On postule l’existence d’une variable continue inobservée Y*_i modélisée par une relation linéaire canonique : Y*_i = X_i * beta + epsilon_i, où le terme d’erreur résiduel epsilon_i suit une distribution logistique standard de moyenne 0 et de variance pi^2 / 3. L’espace continu de Y* est partitionné par K – 1 seuils critiques (également nommés points de coupure ou cutpoints), notés alpha_1, alpha_2, …, alpha_{K-1}, astreints à une condition stricte d’ordre croissant : -inf < alpha_1 < alpha_2 < … < alpha_{K-1} < +inf.
Le mécanisme d’observation discret qui fait le pont entre la grandeur continue latente et le score ordinal empirique s’exprime par le système d’inégalités suivant :
- Y_i = 1 si Y*_i ≤ alpha_1
- Y_i = 2 si alpha_1 < Y*_i ≤ alpha_2
- …
- Y_i = K si Y*_i > alpha_{K-1}
Dans ce paradigme, la spécification la plus rigoureuse et la plus féconde est le modèle des cotes proportionnelles cumulatives (Cumulative Odds Model). Au lieu de modéliser des probabilités de classes individuelles disjointes, ce modèle analyse la probabilité cumulée que la réponse d’un individu n’excède pas un certain seuil k : P(Y_i ≤ k). Le logit cumulatif s’exprime alors mathématiquement par :
logit[ P(Y_i ≤ k | X_i) ] = ln[ P(Y_i ≤ k | X_i) / P(Y_i > k | X_i) ] = alpha_k – X_i * beta (pour tout k = 1, …, K – 1)
Une convention d’écriture alternative très courante dans les progiciels statistiques formule le logit en inversant la direction de l’inégalité : logit[ P(Y_i > k | X_i) ] = X_i * beta – alpha_k. Quelle que soit la syntaxe computationnelle retenue, les seuils alpha_k assument le rôle de constantes mobiles découpant la distribution ordinale, tandis que le vecteur beta capture l’impact net des prédicteurs sur la dynamique de transition le long du continuum latent.
7.2 Hypothèse des lignes parallèles (cotes proportionnelles)
La puissance et la parcimonie du modèle de régression ordinale à cotes proportionnelles reposent sur une contrainte paramétrique extrêmement stricte : l’hypothèse des lignes parallèles, souvent appelée hypothèse des pentes communes ou de cotes proportionnelles (Proportional Odds Assumption).
Cette hypothèse postule que l’effet de chaque variable explicative X_j sur le logarithme de la cote cumulative est strictement invariant, quel que soit le point de coupure k considéré à travers la hiérarchie ordinale. Algébriquement, le coefficient beta_j ne comporte aucun indice k : il demeure parfaitement identique, que l’on modélise la probabilité de se situer au niveau 1 par rapport aux niveaux supérieurs (2, 3, …, K), ou la probabilité de se situer aux niveaux inférieurs (1, 2, …, K-1) par rapport au niveau terminal K. Les courbes de logit cumulatives tracées en fonction des covariables sont donc rigoureusement parallèles, ne différant d’un niveau de partition à l’autre que par une translation constante déterminée par l’écartement des seuils alpha_k.
Cette contrainte présente un avantage interprétatif exceptionnel : elle produit un Odds Ratio cumulatif unique par covariable pour l’ensemble des catégories ordonnées. Soit OR_j = exp(beta_j). Cet indice synthétise en un chiffre unique l’ampleur avec laquelle le prédicteur majore (ou diminue) la cote d’atteindre un stade plus élevé sur l’échelle de mesure, comparativement à l’ensemble des stades inférieurs combinés.
Toutefois, ce gain de parcimonie expose l’analyste à des risques méthodologiques substantiels en cas d’acceptation erronée de l’hypothèse. Si l’effet réel d’un prédicteur opère de manière différentielle le long de l’échelle — par exemple, si une intervention thérapeutique permet de faire basculer aisément des patients d’une dépression « sévère » à un état « modéré », mais s’avère totalement inopérante pour assurer la transition d’un état « modéré » à une rémission « complète » —, contraindre le modèle à une pente unique masque la dynamique clinique sous-jacente et conduit à des prédictions fallacieuses.
7.3 Tests de vérification de l’hypothèse de parallélisme
Face au caractère contraignant du postulat des cotes proportionnelles, l’investigateur doit soumettre ses données à une batterie de tests diagnostiques formels avant de valider l’interprétation des paramètres ordinaux.
Le test de référence le plus puissant et le plus complet est le test du score de Brant (Brant Test). Développé spécifiquement pour le modèle logistique ordinal cumulatif, il repose sur le principe du test de score de Rao. L’algorithme ajuste un modèle multinomial non contraint équivalent (estimant K – 1 pentes distinctes pour chaque covariable) et compare de façon matricielle la variance de ces paramètres libres avec le vecteur contraint du modèle à cotes proportionnelles. Le test de Brant produit à la fois une statistique globale omnibus testant le respect simultané de l’hypothèse pour l’ensemble du système d’équations, ainsi que des tests univariés spécifiques évaluant le respect du parallélisme variable par variable. Une p-valeur inférieure au seuil de 0,05 conduit au rejet de l’hypothèse nulle d’égalité des pentes, signalant qu’au moins un prédicteur exerce des effets hétérogènes le long des seuils de coupure.
Une alternative courante est le Test du Rapport de Vraisemblance pour lignes parallèles (Likelihood Ratio Test). Cette méthode compare directement la log-vraisemblance du modèle ordinal standard contraint (L_contraint) à celle d’un modèle logistique polytomique généralisé sans contrainte d’égalité de pente (L_libre). La statistique de test s’écrit : D_parallèle = -2 * [ ln(L_contraint) – ln(L_libre) ]. Cette statistique suit asymptotiquement une loi du Khi-deux dont le nombre de degrés de liberté est calculé par df = (K – 2) * p, où K est le nombre de modalités ordonnées et p le nombre de régresseurs.
En présence d’une réfutation empirique avérée de l’hypothèse de parallélisme, plusieurs stratégies de repli s’offrent à l’analyste :
- Le modèle à cotes proportionnelles partielles (Partial Proportional Odds Model) : Ce compromis autorise les variables explicatives violant le parallélisme à posséder des coefficients distincts selon les seuils alpha_k, tout en maintenant la contrainte d’invariance sur les prédicteurs pour lesquels l’hypothèse est empiriquement confirmée.
- Le modèle logit ordinal stéréotype (Stereotype Ordinal Regression) : Formulé par John Anderson, ce modèle assouplit les contraintes en estimant des poids de mise à l’échelle unidimensionnels pour chaque modalité ordonnée.
- Le basculement vers la régression multinomiale non ordonnée : Bien que cette approche sacrifie l’information relative au rang, elle élimine tout risque de biais paramétrique lié à la violation du parallélisme.
8. Exemples appliqués de régression logistique ordinale
8.1 Exemple 1 : Niveaux de sévérité du burnout académique
Afin d’opérationnaliser le modèle des cotes proportionnelles, étudions une recherche en psychologie éducationnelle analysant la prévalence et la sévérité du syndrome d’épuisement académique au sein d’une cohorte de 520 étudiants en médecine. L’évaluation est structurée selon une échelle ordinale à trois niveaux d’intensité croissante :
- Niveau 1 : Épuisement faible (Faible).
- Niveau 2 : Épuisement modéré (Modéré).
- Niveau 3 : Épuisement sévère (Sévère).
Le modèle intègre deux prédicteurs psychométriques continus : la charge de travail perçue (évaluation continue de 10 à 50 points) et le sentiment d’auto-efficacité académique (GSE, échelle de 10 à 40 points). Avant toute interprétation des effets, le test de Brant est exécuté : il livre une statistique de Khi-deux omnibus de 2,41 (df = 2, p = 0,299), confirmant que l’hypothèse des cotes proportionnelles est pleinement respectée sur l’ensemble des prédicteurs.
| Paramètre | Coefficient (B) | Erreur-type (SE) | Statistique t / Wald | p-valeur | Odds Ratio Cumulatif | IC 95% pour l’OR |
|---|---|---|---|---|---|---|
| Seuil 1 [Faible | Modéré] (alpha_1) | 1,842 | 0,412 | 4,47 | < 0,001 | — | — |
| Seuil 2 [Modéré | Sévère] (alpha_2) | 4,615 | 0,485 | 9,51 | < 0,001 | — | — |
| Charge de travail perçue | 0,094 | 0,016 | 5,87 | < 0,001 | 1,099 | [1,065 ; 1,134] |
| Auto-efficacité (GSE) | -0,128 | 0,021 | -6,09 | < 0,001 | 0,880 | [0,844 ; 0,917] |
L’estimation paramétrique révèle la dynamique directionnelle gouvernant le passage aux stades de gravité supérieure. En observant le coefficient de la charge de travail (beta = 0,094, p < 0,001), l’Odds Ratio cumulatif est dérivé par exp(0,094) = 1,099. En vertu de l’invariance proportionnelle, cette valeur s’interprète de la manière suivante : pour chaque augmentation d’un point sur l’échelle de charge de travail, la cote cumulée d’appartenir à un niveau de burnout plus élevé (c’est-à-dire être dans la classe « Modéré ou Sévère » par rapport à « Faible », ou être dans la classe « Sévère » par rapport à « Faible ou Modéré ») s’accroît uniformément de 9,9 %.
À l’inverse, l’auto-efficacité exerce un puissant effet protecteur le long de l’ensemble de la hiérarchie clinique : beta = -0,128, générant un OR cumulatif de 0,880 (IC 95% [0,844 ; 0,917]). Chaque élévation d’une unité d’auto-efficacité réduit de 12,0 % la cote cumulative d’atteindre un stade d’épuisement supérieur. Les seuils de coupure latents (alpha_1 = 1,842 et alpha_2 = 4,615) respectent formellement la condition d’ordonnancement croissant stricte, fournissant la base mathématique indispensable pour projeter les courbes de probabilités cumulatives prédites pour n’importe quelle trajectoire étudiante.
8.2 Exemple 2 : Évaluation sur échelle de Likert de la satisfaction thérapeutique
Les protocoles d’assurance qualité en milieu hospitalier s’appuient couramment sur des échelles d’appréciation subjective ordinales. Dans cette étude, 750 patients hospitalisés évaluent la qualité des soins reçus au moment de leur sortie sur une échelle de Likert standard en 5 points :
- 1 : Très insatisfait
- 2 : Insatisfait
- 3 : Neutre / Mitigé
- 4 : Satisfait
- 5 : Très satisfait
Les déterminants analysés intègrent : le score d’empathie perçue du personnel soignant (échelle continue de 0 à 20 points), la clarté des explications médicales transmises (échelle de 0 à 10) et la réduction des symptômes douloureux rapportée au cours du séjour (en pourcentage d’amélioration clinique, variant de 0 à 100 %).
Le modèle ordinal à cotes proportionnelles produit un coefficient hautement significatif pour l’empathie soignante : beta_Empathie = 0,215 (SE = 0,028, p < 0,001, OR cumulatif = 1,240). Cela établit formellement que chaque point supplémentaire attribué à l’empathie perçue majore uniformément de 24,0 % la cote de basculer vers un palier de satisfaction supérieur (par exemple, la cote de répondre « Très satisfait » versus l’ensemble des réponses inférieures, ou la cote d’exprimer au moins une satisfaction modérée versus les avis négatifs). De même, le soulagement symptomatique présente un OR cumulatif de 1,032 par pourcent d’amélioration (soit + 37,0 % de cote favorable pour chaque gain clinique substantiel de 10 % d’atténuation de la douleur). Les 4 seuils latents estimés découpent le continuum de perception hospitalière en segments équilibrés, validant la pertinence de ce découpage ordinal sans écraser les nuances expressives des usagers.
8.3 Exemple 3 : Stades de changement comportemental face aux addictions
Dans la recherche sur les comportements addictifs et le sevrage tabagique, le modèle transthéorique du changement formulé par Prochaska et DiClemente opérationnalise la motivation des patients sous forme de stades séquentiels successifs :
- Stade 1 : Précontemplation (aucun projet d’arrêt dans les six mois).
- Stade 2 : Contemplation (intention d’arrêt envisagée mais ambivalence marquée).
- Stade 3 : Préparation et Action (décision arrêtée et amorce des modifications comportementales).
L’étude analyse une cohorte de 480 fumeurs chroniques sollicitant un centre de tabacologie. Les prédicteurs cognitifs sont : la balance décisionnelle (score d’évaluation des bénéfices perçus de l’arrêt, standardisé) et le sentiment d’efficacité personnelle face aux pulsions (score SE de 0 à 100 points).
L’estimation logistique ordinale livre un coefficient pour la balance décisionnelle de beta = 0,742 (SE = 0,098, p < 0,001, OR cumulatif = 2,100). Cela démontre qu’à chaque progression d’un écart-type sur la balance des bénéfices cognitifs, les patients voient leur cote doubler (multipliée par 2,10) d’avancer d’au moins un stade le long de la trajectoire motivationnelle vers le sevrage. Le score d’auto-efficacité face aux pulsions révèle quant à lui un coefficient beta = 0,031 (SE = 0,006, p < 0,001, OR cumulatif = 1,031). Ainsi, chaque tranche de 10 points additionnels d’auto-efficacité perçue multiplie par 1,357 (+ 35,7 %) la cote cumulative de s’engager activement dans la transition du stade de précontemplation vers la contemplation, ou de la contemplation vers l’action directe, fournissant un guide d’intervention motivationnelle ciblé pour les cliniciens.
9. Diagnostics, hypothèses et validation des modèles
9.1 Vérification des hypothèses fondamentales communes
L’infaillibilité des inférences tirées d’un modèle logistique — qu’il soit binaire, multinomial ou ordinal — dépend de la validation scrupuleuse d’un ensemble de postulats distributionnels et structurels partagés.
La première exigence méthodologique concerne l’indépendance des observations. L’erreur stochastique associée à une unité d’analyse ne doit présenter aucune dépendance sérielle, spatiale ou hiérarchique avec celle d’une autre unité. Lorsque les données sont intrinsèquement nichées — par exemple des mesures répétées chez un même patient au fil du temps (longitudinales) ou des élèves regroupés au sein de classes scolaires —, l’hypothèse d’indépendance est violée. Cette corrélation intragroupe induit une sous-estimation systématique des erreurs-types des coefficients, gonflant artificiellement les taux de réjection de type I (faux positifs). Dans de tels contextes, le recours aux modèles linéaires généralisés à effets mixtes (GLMM) ou aux équations d’estimation généralisées (GEE) devient impératif.
La deuxième condition est la linéarité dans le logit pour toutes les covariables quantitatives continues incluses dans l’équation. Alors que le modèle logistique est intrinsèquement non linéaire dans l’espace des probabilités, il postule une relation strictement linéaire entre chaque prédicteur continu et le logarithme du rapport de cotes. La vérification empirique de cette linéarité s’effectue couramment au moyen de la procédure de Box-Tidwell. Ce test diagnostique intègre au modèle régresseur des termes d’interaction de la forme X * ln(X). Si le terme d’interaction s’avère statistiquement significatif au test de Wald, l’hypothèse de linéarité dans le logit est rejetée pour la variable testée. L’analyste doit alors recourir à des transformations polynomiales, à des splines cubiques restreintes ou à la discrétisation théoriquement justifiée du prédicteur incriminé.
Enfin, la présence de multicolinéarité sévère entre les régresseurs constitue un facteur d’instabilité mathématique majeur. Si deux prédicteurs ou davantage partagent une variance commune excessive, les erreurs-types de leurs coefficients respectifs explosent, rendant les estimations instables et hautement sensibles à la moindre variation de l’échantillon. La détection repose sur l’examen de la tolérance et des Facteurs d’Inflation de la Variance (VIF, pour Variance Inflation Factor). Bien que développés initialement pour le cadre MCO, des VIF excédant le seuil conventionnel de 5 (ou une tolérance inférieure à 0,20) signalent une colinéarité toxique nécessitant la suppression, la fusion ou la factorisation dimensionnelle (par analyse en composantes principales) des prédicteurs redondants.
9.2 Détection des données influentes et valeurs aberrantes
L’estimation par le maximum de vraisemblance est particulièrement sensible à l’influence disproportionnée que peuvent exercer certaines observations atypiques ou aberrantes logées au sein de l’espace multivarié.
L’évaluation des résidus s’articule autour de deux grandeurs standardisées complémentaires :
- Les résidus de Pearson standardisés : Définis par r_P_i = (Y_i – p_i) / sqrt[ p_i * (1 – p_i) * (1 – h_ii) ], où h_ii représente l’effet de levier (leverage) tiré de la matrice chapeau. Ces résidus quantifient l’écart ponctuel entre la modalité observée et la probabilité prédite normalisé par son écart-type.
- Les résidus de déviance standardisés : Fondés sur la contribution individuelle de chaque observation à la log-vraisemblance globale. Des valeurs absolues excédant le seuil critique de |2,5| ou |3,0| désignent des sujets mal calibrés par le modèle, dont le profil réel défie substantiellement la prédiction algorithmique.
Pour mesurer l’influence réelle exercée par ces points sur la géométrie des coefficients finaux, les analystes calculent l’adaptation logistique de la distance de Cook ou la statistique DfBeta. La mesure DfBeta quantifie la variation vectorielle subie par un coefficient de régression spécifique beta_j lorsque l’observation i est délibérément exclue de l’échantillon d’estimation. Une valeur de DfBeta excédant |1,0| sur une observation signale une influence excessive altérant à elle seule la magnitude du paramètre.
Un cas pathologique récurrent dans l’estimation logistique est le phénomène de séparation complète ou de quasi-séparation des données (quasi-complete separation). Cet incident survient lorsqu’un prédicteur catégoriel ou continu permet de partitionner de façon parfaitement déterministe la variable dépendante (par exemple, si tous les individus au-dessus d’un certain score présentent systématiquement l’événement Y = 1). Dans cette configuration, la fonction de vraisemblance ne converge plus, les algorithmes numériques divergent vers l’infini, et les logiciels génèrent des coefficients gigantesques assortis d’erreurs-types invraisemblables (par exemple beta = 42,15 avec un SE = 18 430). La remédiation moderne à cette impasse fait appel à la méthode de pénalisation de Firth, une procédure de vraisemblance pénalisée qui introduit une fonction de biais correctrice au sein du processus de maximisation numérique, produisant des estimations finies, stables et convergentes même en contexte de séparation absolue.
9.3 Évaluation du calibrage et de la discrimination
La validation globale d’un modèle prédictif repose sur une dissociation conceptuelle stricte entre deux propriétés métrologiques complémentaires : la discrimination et le calibrage (ou étalonnage).
Le calibrage évalue l’exactitude numérique globale des probabilités prédites, en vérifiant si la proportion observée d’événements correspond aux prédictions statistiques à travers différents strates de risque. L’outil historique le plus diffusé pour tester cette propriété est le test de Hosmer-Lemeshow. Cette procédure segmente l’échantillon en sous-groupes ordonnés selon les probabilités prédites (traditionnellement 10 déciles) et calcule une statistique de Khi-deux confrontant les effectifs observés et attendus dans chaque compartiment. Une p-valeur non significative (p > 0,05) indique une concordance statistique adéquate entre prédictions et observations réelles. Toutefois, la méthodologie contemporaine a formulé des critiques sévères à l’encontre du test de Hosmer-Lemeshow : sa puissance est excessivement sensible au découpage arbitraire du nombre de sous-groupes, il s’avère incapable de pénaliser adéquatement le surapprentissage dans les grands échantillons, et il ne détecte pas certaines instabilités locales. On lui substitue désormais avantageusement le tracé de courbes de calibration empiriques continues (courbes flexibles ajustées par régressions non paramétriques de type LOESS), accompagnées du calcul de la pente et de l’interception de calibration (calibration slope et calibration intercept), où une pente théorique idéale de 1,0 et un intercept de 0 signalent un calibrage parfait.
La discrimination, à l’opposé, quantifie la capacité intrinsèque du modèle à ranger les individus de manière ordonnée le long de l’axe des risques, de sorte qu’un individu développant réellement l’événement cible se voie systématiquement assigner une probabilité prédite supérieure à celle d’un individu demeurant indemne. Cette propriété est mesurée par l’indice de concordance C de Harrell, strictement équivalent dans le cas binaire à l’aire sous la courbe ROC (AUC). Une discrimination est jugée acceptable entre 0,70 et 0,80, excellente entre 0,80 et 0,90, et exceptionnelle au-delà de 0,90. Dans les protocoles cliniques opérationnels, l’arbitrage du point de coupure optimal sur cette courbe ne doit pas reposer aveuglément sur la maximisation de l’indice de Youden (Sensibilité + Spécificité – 1), mais doit intégrer formellement les coûts relatifs asymétriques des faux négatifs et des faux positifs au sein de l’environnement décisionnel concerné.
10. Interprétation comparative avancée des rapports de cotes
10.1 Distinction sémantique et mathématique : cotes, risques et probabilités
Une confusion épistémologique et terminologique chronique au sein de la littérature biomédicale et des sciences sociales concerne la distinction entre le concept de probabilité, de cote (odds), de risque relatif (RR) et de rapport de cotes (OR). Bien que ces vocables soient fréquemment amalgamés dans le discours profane, ils répondent à des formalisations mathématiques distinctes.
La probabilité p représente le quotient des cas favorables sur le total des cas possibles, bornée rigoureusement par 0 et 1. La cote exprime le ratio p / (1 – p), mesurant l’avantage relatif de la survenue face à la non-survenue. Le Risque Relatif (RR), utilisé au sein des études de cohortes prospectives, quantifie le rapport direct de deux probabilités conditionnelles : RR = p(exposé) / p(non exposé). À l’inverse, l’Odds Ratio (OR), issu de la régression logistique et des plans cas-témoins, quantifie le rapport de deux cotes : OR = [ p_1 / (1 – p_1) ] / [ p_0 / (1 – p_0) ].
Le piège interprétatif réside dans l’assimilation abusive de l’Odds Ratio au Risque Relatif. L’OR ne constitue une approximation acceptable du RR que sous l’égide exclusive de l’hypothèse de l’événement rare (rare disease assumption), c’est-à-dire lorsque la prévalence de l’événement étudié dans la population n’excède pas 5 à 10 %. Dès lors que l’événement cible devient modérément ou hautement prévalent (par exemple un taux d’échec scolaire de 30 % ou un trouble anxieux touchant 25 % d’un groupe clinique), l’Odds Ratio s’écarte exponentiellement du Risque Relatif : il surestime de manière spectaculaire l’ampleur apparente de l’association si le coefficient est positif, et la sous-estime s’il est négatif. Un chercheur qui affirmerait, à la suite d’un modèle logistique générant un OR de 3,0 pour un événement touchant 40 % de la population, que les sujets exposés ont « trois fois plus de risques » de développer l’état cible commet une erreur d’interprétation grave : le risque relatif réel correspondant est en réalité inférieur à 1,7.
Pour rétablir la rigueur scientifique dans la communication des résultats, l’analyste dispose de formules de conversion mathématique directes reliant l’Odds Ratio au Risque Relatif corrigé en présence d’une prévalence de base connue p_0 : RR = OR / [ (1 – p_0) + (p_0 * OR) ]. En complément, la restitution des effets marginaux moyens (AME, pour Average Marginal Effects) permet de traduire les variations du logit en variations absolues de probabilités brutes (en points de pourcentage), une métrique accessible et non exposée aux biais d’interprétation inhérents aux rapports de cotes.
10.2 Analyse des effets d’interaction et de modération
L’exploration des modérations empiriques implique l’intégration de termes d’interaction multiplicatifs au sein du prédicteur linéaire. Soit le modèle incluant deux variables X_1 et X_2 et leur terme croisé : logit(p) = beta_0 + beta_1 * X_1 + beta_2 * X_2 + beta_3 * (X_1 * X_2).
Dans l’espace linéaire des logits, l’interprétation formelle du terme d’interaction demeure conventionnelle : beta_3 mesure la variation du coefficient de pente de X_1 pour chaque incrément d’une unité de X_2. Toutefois, dès lors que l’on projette ces résultats dans l’espace naturel des probabilités prédites p, une divergence fondamentale émerge entre la modélisation linéaire classique et les modèles non linéaires généralisés, mise en lumière par les travaux économétriques d’Ai et Norton. En raison de la courbure sigmoïdale de la fonction logistique, l’effet marginal de l’interaction dans l’espace des probabilités ne correspond pas à l’exponentiation de beta_3 : il dépend fonctionnellement de l’ensemble des covariables du modèle et peut s’avérer statistiquement significatif et non nul même si beta_3 est rigoureusement égal à zéro, ou afficher un signe opposé à beta_3 pour certains sous-groupes d’individus.
Pour éviter toute déduction trompeuse, l’analyse d’une modération au sein d’une régression logistique requiert la formalisation et la représentation graphique des effets marginaux conditionnels moyens. L’analyste trace l’évolution de la probabilité conditionnelle prédite en fonction des différentes strates du modérateur (par exemple à la moyenne, à plus un écart-type et à moins un écart-type), accompagnées de leurs bandes de confiance calculées par la méthode delta, offrant une lecture directe et non ambiguë de la cinétique d’interaction.
10.3 Traitement des variables indépendantes catégorielles multiclasses
Lorsque des prédicteurs qualitatifs polytomiques comportant M catégories (M ≥ 3) sont intégrés au sein d’un modèle logistique, leur conversion matricielle requiert un schéma de codage paramétrique univoque.
Le protocole standard est le codage par indicatrices (dummy coding ou codage de référence). Dans cette spécification, une des M modalités de la covariable est désignée comme le groupe témoin de référence, et M – 1 variables binaires indicatrices sont injectées dans l’équation. Chaque coefficient estimé beta_m quantifie alors la variation du log-odds propre à la catégorie m strictement par rapport à la catégorie témoin retenue. Une approche alternative est le codage d’effets (effect coding), qui contraint la somme des coefficients associés aux catégories à égaler zéro : dans ce schéma, chaque coefficient beta_m n’est plus contrasté par rapport à une modalité pivot, mais reflète la divergence par rapport à la grande moyenne non pondérée de l’ensemble des modalités du facteur.
Pour évaluer si une variable qualitative multiclasse exerce un impact prédictif réel sur l’issue, l’analyste ne doit pas s’en remettre à la lecture fragmentée des p-valeurs individuelles de chaque variable indicatrice. La pertinence d’un tel facteur doit être jugée au moyen d’un test omnibus simultané évaluant la nullité conjointe des M – 1 coefficients associés. Ce test peut être opéré soit par un test de Wald multidimensionnel fondé sur la sous-matrice de variance-covariance des paramètres du facteur, soit, plus rigoureusement encore, par un test du rapport de vraisemblance comparant le modèle complet au modèle restreint exempt de l’ensemble des indicatrices du prédicteur.
11. Arbre décisionnel et écueils méthodologiques majeurs
11.1 Algorithme de sélection entre les trois approches
Pour systématiser le choix d’un modèle dans la pratique quantitative, l’algorithme de sélection séquentiel suivant résume les étapes analytiques critiques :
- Étape 1 : Examen de la cardinalité de la variable de réponse (Y) :
- Si Y présente exactement deux modalités exclusives (K = 2), orienter l’analyse vers la régression logistique binaire.
- Si Y comporte trois modalités ou davantage (K ≥ 3), franchir l’étape 2.
- Étape 2 : Évaluation de la structure métrique et directionnelle :
- Si les catégories de réponse sont de nature purement qualitative sans relation de hiérarchie ni de progression monotone naturelle, opter directement pour la régression logistique multinomiale (sous réserve du respect de l’hypothèse IIA).
- Si les catégories s’ordonnent le long d’un continuum d’intensité, de sévérité ou d’appréciation subjective, postuler initialement un modèle de régression logistique ordinale à cotes proportionnelles et franchir l’étape 3.
- Étape 3 : Évaluation diagnostique de l’hypothèse de parallélisme :
- Exécuter le test de Brant et le test du rapport de vraisemblance omnibus.
- Si l’hypothèse d’invariance des pentes est acceptée (p > 0,05), valider et interpréter le modèle ordinal à cotes proportionnelles.
- Si l’hypothèse est réfutée pour un sous-ensemble restreint de variables, ajuster un modèle à cotes proportionnelles partielles.
- Si l’hypothèse de parallélisme est massivement rejetée pour la majorité des régresseurs et que la taille d’échantillon le permet, basculer vers la régression multinomiale en traitant temporairement les rangs comme des classes qualitatives indépendantes pour éliminer tout biais d’estimation.
11.2 Écueils fréquents dans le traitement des échelles psychométriques
L’exploitation quantitative des échelles d’évaluation psychologique et des questionnaires d’attitudes est encombrée d’erreurs méthodologiques récurrentes compromettant la validité des conclusions publiées.
Le premier écueil consiste en l’assimilation abusive des échelles de Likert à des variables continues. Bien qu’un consensus tolère l’usage de modèles linéaires pour des scores composites sommés agrégeant au moins 5 à 8 items ordonnés sur un large spectre distributionnel, l’analyse d’un item individuel isolé à 4 ou 5 points au moyen d’une régression MCO linéaire constitue une faute méthodologique avérée. L’inégalité flagrante des intervalles séparant les degrés subjectifs (« Tout à fait d’accord », « D’accord », « Neutre ») et la troncature structurelle des extrémités introduisent une distorsion des erreurs-types et conduisent à des inférences invalides. La régression logistique ordinale s’impose comme le modèle d’élection pour analyser des réponses isolées issues d’items ordinaux.
Le deuxième écueil majeur est le biais des événements rares (rare events bias). Lorsqu’une variable dépendante binaire présente un déséquilibre distributionnel prononcé — par exemple une tentative de suicide ou la survenue d’une maladie orpheline touchant moins de 1 à 2 % de la cohorte —, l’estimation conventionnelle par le maximum de vraisemblance souffre d’un biais asymptotique systématique démontré par Gary King et Langche Zeng. Le modèle sous-estime considérablement la probabilité prédite de l’événement cible et produit des coefficients tronqués. La remédiation consiste à appliquer l’algorithme de régression logistique pour événements rares (méthode de Firth ou correction de King-Zeng), qui ajuste analytiquement le gradient de la log-vraisemblance par une pénalité invariante à l’échelle.
11.3 Biais d’échantillonnage et taille minimale requise
La puissance statistique et la stabilité numérique d’une régression logistique ne sont pas gouvernées par la taille globale de l’échantillon N, mais par la distribution du nombre d’événements observés dans la modalité la moins fréquente de la variable dépendante.
La règle empirique historique, formulée par Peduzzi et ses collaborateurs, préconise un ratio minimal de 10 à 20 Événements Par Variable (EPV, pour Events Per Variable). Soit un modèle logistique binaire intégrant 6 paramètres de régression explicatifs : si la prévalence de l’événement cible est de 10 %, le modèle nécessite d’observer au moins 60 à 120 événements positifs au sein du groupe minoritaire, imposant un volume d’échantillonnage global N variant de 600 à 1 200 individus. L’inobservation de ce principe d’EPV engendre une instabilité majeure des algorithmes itératifs, un gonflement exponentiel de l’erreur-type des coefficients et l’apparition de faux positifs par surapprentissage paramétrique (overfitting).
Dans le cas des régressions multinomiales et ordinales, cette exigence s’accroît d’un ordre de grandeur. Pour le modèle multinomial, la règle de l’EPV doit s’appliquer individuellement à l’intérieur de chaque compartiment catégoriel K face à la modalité pivot. Si une modalité ne rassemble qu’une poignée de sujets, l’équation correspondante s’effondrera dans une quasi-séparation. Les recommandations modernes appuyées sur les simulations de Monte-Carlo préconisent d’atteindre un seuil d’au moins 25 à 50 observations réelles dans la cellule catégorielle la plus modeste avant d’envisager la spécification d’un modèle multinomial stable.
12. Implémentation computationnelle et protocoles de publication
12.1 Implémentation sous les principaux environnements statistiques
L’exécution computationnelle de ces trois modélisations au sein des environnements d’analyse de données actuels fait appel à des syntaxes rigoureuses et des modules dédiés au sein des écosystèmes R, Python et SPSS.
Au sein de l’environnement R, le paradigme binaire s’exécute nativement au travers du moteur GLM en spécifiant la famille de Bernoulli : glm(Y ~ X1 + X2, family = binomial(link = "logit"), data = dataset). Pour la régression multinomiale, le package de référence est nnet via sa fonction multinom(Y ~ X1 + X2, data = dataset), complété par le package mlogit qui autorise la gestion fine des choix discrets conditionnels. Pour la logistique ordinale, deux extensions dominent la pratique : le package MASS avec sa fonction canonique polr(Y ~ X1 + X2, method = "logistic", Hess = TRUE) et le package ordinal avec la commande clm(). Le test formel de Brant s’exécute dans R via la fonction brant() issue de la bibliothèque éponyme.
Sous Python, les analystes s’orientent vers deux bibliothèques majeures selon l’objectif poursuivi. Pour une visée inférentielle et académique livrant l’ensemble des tables de tests et erreurs-types asymptotiques, la bibliothèque statsmodels s’impose via les classes Logit pour le binaire et MNLogit pour le multinomial. Pour l’analyse ordinale, le module OrderedModel de statsmodels.miscmodels.ordinal_model prend en charge l’estimation par seuils latents cumulatifs. Pour une finalité prédictive orientée apprentissage automatique, le module LogisticRegression de scikit-learn permet d’ajuster tant des modèles binaires que multinomiaux (via l’argument multi_class='multinomial'), en intégrant nativement des régularisations pénalisées L1 (Lasso) ou L2 (Ridge).
Dans l’interface logicielle SPSS, les procédures sont distinctement segmentées au sein du menu d’analyse de régression : la commande Régression logistique binaire pilote le modèle à deux modalités, le menu Régression logistique multinomiale (commande NOMREG) gère les polytomies nominales en permettant la fixation explicite de la catégorie pivot, tandis que la procédure Régression ordinale (commande PLUM, pour Polytomous Log-Linear Universal Models) ajuste les cotes proportionnelles cumulatives et restitue par défaut le test du rapport de vraisemblance pour l’hypothèse des lignes parallèles.
12.2 Normes de restitution des résultats selon les standards académiques
La rédaction scientifique et la soumission d’articles empiriques intégrant des régressions logistiques obéissent aux prescriptions normatives strictes définies par l’American Psychological Association (Normes APA 7th edition) et les déclarations internationales STROBE pour les études observationnelles.
La présentation académique des résultats ne saurait se limiter au signalement exclusif des valeurs p. Le corps de texte et le tableau synthétique doivent impérativement compiler les paramètres structuraux suivants pour chaque variable explicative incluse :
- Le coefficient de régression non standardisé (B) reflétant la pente dans l’échelle logit.
- L’erreur-type associée au coefficient (SE ou ES), métrique fondamentale de la précision d’estimation.
- La statistique d’inférence univariée (statistique de Wald z ou Chi-deux de Wald) accompagnée de son degré de liberté exact et de sa p-valeur bilatérale.
- L’Odds Ratio ajusté (exp(B)), ou le RRR pour le modèle multinomial, ou l’OR cumulatif pour le modèle ordinal.
- L’intervalle de confiance à 95 % encadrant l’Odds Ratio (IC 95 % de l’OR). L’inclusion systématique de cet intervalle est obligatoire selon les standards internationaux pour qualifier la précision de l’effet.
En en-tête ou en note de bas de tableau, l’auteur doit consigner de manière exhaustive les métriques d’évaluation globale : la déviance résiduelle (-2 Log-vraisemblance), la statistique du test du rapport de vraisemblance (Chi-deux omnibus du modèle), les indices de Pseudo R-deux (au minimum le R^2 de Cox & Snell et le R^2 de Nagelkerke), le résultat chiffré du test de calibration de Hosmer-Lemeshow (avec effectif de groupes), ainsi que l’indice de concordance C de Harrell (aire sous la courbe ROC). Pour les modèles ordinaux, le signalement explicite du résultat du test de Brant ou du test de parallélisme constitue une exigence de transparence méthodologique inconditionnelle.
12.3 Reproductibilité et transparence des analyses empiriques
L’essor contemporain du mouvement pour la science ouverte (Open Science) redéfinit les exigences d’intégrité entourant l’application de la régression logistique. La transparence de la recherche quantitative impose de rendre auditables l’intégralité des pipelines de traitement ayant conduit des données brutes aux inférences finales.
Cette démarche requiert la mise à disposition publique, au sein d’entrepôts de données certifiés (tels que l’Open Science Framework ou Zenodo), des scripts de code computationnels entièrement commentés et documentés. Tout arbitrage statistique intervenu au cours de l’analyse — qu’il s’agisse de l’élimination d’observations atypiques fondée sur les résidus d’influence, du choix d’un codage particulier de la catégorie de référence, ou de la méthode de traitement des données manquantes — doit être explicité avec une traçabilité totale.
Concernant les données manquantes, le recours naïf à la suppression par liste complète (listwise deletion) doit être proscrit dès lors que l’attrition excède 5 % des observations, sous peine d’induire des biais de sélection substantiels. L’analyste moderne privilégiera l’application de l’imputation multiple par équations chaînées (MICE). L’estimation logistique est alors répétée à travers l’ensemble des bases de données imputées, et les paramètres finaux sont agrégés selon les règles formelles de combinaison de Rubin, garantissant une intégration adéquate de l’incertitude liée à l’imputation au sein des erreurs-types des Odds Ratios rapportés.
Références
Agresti, A. (2010). Analysis of Ordinal Categorical Data (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9780470594001
Agresti, A. (2013). Categorical Data Analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249688
Ai, C., & Norton, E. C. (2003). Interaction terms in logit and probit models. Economics Letters, 80(1), 123-129. https://doi.org/10.1016/S0165-1765(03)00032-6
American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171-1178. https://doi.org/10.2307/2532457
Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27-38. https://doi.org/10.1093/biomet/80.1.27
Harrell, F. E. (2015). Regression Modeling Strategies: With Applications to Linear Models, Logistic and Ordinal Regression, and Survival Analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
Hausman, J., & McFadden, D. (1984). Specification tests for the multinomial logit model. Econometrica, 52(5), 1219-1240. https://doi.org/10.2307/1910997
Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied Logistic Regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
King, G., & Zeng, L. (2001). Logistic regression in rare events data. Political Analysis, 9(2), 137-163. https://doi.org/10.1093/oxfordjournals.pan.a004868
Long, J. S. (1997). Regression Models for Categorical and Limited Dependent Variables. SAGE Publications.
McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in Econometrics (pp. 105-142). Academic Press.
Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373-1379. https://doi.org/10.1016/S0895-4356(96)00236-3