
L’analyse de variance à mesures répétées, couramment désignée sous l’acronyme d’ANOVA intra-sujets, constitue l’un des piliers méthodologiques les plus sophistiqués et les plus fréquemment mobilisés au sein des sciences quantitatives contemporaines, tout particulièrement en psychologie expérimentale, en neurosciences cognitives et en biomédecine. En permettant d’observer les mêmes unités expérimentales à travers de multiples conditions de traitement ou au fil d’étapes temporelles successives, ce modèle linéaire généralisé offre un levier analytique remarquable pour disséquer les mécanismes sous-jacents aux changements comportementaux et physiologiques. La puissance intrinsèque de cette approche réside dans sa capacité à neutraliser les variations idiosyncrasiques inter-individuelles, transformant ainsi chaque participant en son propre témoin et maximisant de ce fait la sensibilité statistique face aux effets expérimentaux réels.
Toutefois, la validité déductive et la force inférentielle de l’ANOVA à mesures répétées reposent sur une architecture théorique rigoureuse dont les fondations mathématiques sont conditionnées par des postulats stricts. Dans la pratique empirique, ces conditions de validité sont fréquemment reléguées au rang de formalités administratives ou purement ignorées par les chercheurs, induisant une fragilisation pernicieuse de la littérature scientifique. L’omission ou la vérification superficielle des conditions d’application expose les analyses à des distorsions sévères du taux nominal d’erreur de première espèce, augmentant dramatiquement la probabilité de déclarer des découvertes fallacieuses ou, inversement, d’étouffer des effets authentiques sous un bruit résiduel mal modélisé. Cette vulnérabilité épistémologique prend une résonance critique dans le contexte actuel de la crise de la réplicabilité, où la rigueur des inférences statistiques est scrutée avec une exigence renouvelée.
Le présent traité méthodologique propose une exploration exhaustive, approfondie et didactique des trois postulats cardinaux qui régissent l’analyse de variance intra-sujets : l’indépendance des observations inter-sujets, la normalité de la distribution des résidus et la sphéricité de la matrice de variance-covariance. À travers une déconstruction systématique de leurs assises mathématiques, de leurs manifestations concrètes dans les plans factoriels, de leurs outils diagnostiques dédiés et des protocoles de remédiation contemporains, cette contribution vise à fournir aux chercheurs, statisticiens et étudiants avancés une feuille de route définitive pour garantir l’intégrité, la robustesse et la pérennité de leurs inférences empiriques.
1. Introduction méthodologique à l’ANOVA à mesures répétées en psychologie
1.1 Fondements conceptuels des plans intra-sujets
L’architecture des plans d’expérience en psychologie expérimentale et en sciences du comportement repose traditionnellement sur une dichotomie fondamentale entre les devis inter-sujets (mesures indépendantes) et les devis intra-sujets (mesures répétées). Dans un plan à mesures indépendantes, chaque participant est assigné de façon exclusive à un niveau unique du facteur expérimental. Cette structure impose une contrainte majeure : la variabilité totale observée sur la variable dépendante est lourdement tributaire des dissemblances préexistantes entre les individus, englobant des facteurs aussi disparates que les capacités cognitives de base, la personnalité, l’âge, l’état de fatigue ou les caractéristiques sociodémographiques. Ces fluctuations idiosyncrasiques intègrent directement la composante d’erreur du modèle, réduisant drastiquement le ratio signal/bruit.
À l’inverse, le modèle intra-sujets exploite un paradigme élégant dans lequel chaque participant est exposé successivement à l’ensemble des modalités du ou des facteurs manipulés. D’un point de vue de la décomposition de la variance, la variabilité totale n’est plus simplement partitionnée entre la variance inter-groupes et la variance intra-groupe (erreur résiduelle). Le modèle d’ANOVA à mesures répétées permet d’isoler explicitement la variabilité imputable aux différences inter-individuelles stables, formalisée sous la forme d’une somme des carrés inter-sujets ($SS_{sujets}$). En soustrayant cette composante substantielle de l’erreur globale, la somme des carrés résiduelle ($SS_{erreur}$) se trouve drastiquement allégée, ne reflétant plus que les fluctuations aléatoires intra-individuelles et les interactions imprévisibles entre les sujets et les traitements.
Cette réduction drastique de l’erreur résiduelle confère au plan à mesures répétées une puissance statistique considérablement supérieure à celle d’un plan inter-sujets équivalent pour une taille d’échantillon donnée. Sur le plan logistique et méthodologique, ce gain d’efficacité se traduit par une économie appréciable d’échantillonnage, un atout inestimable lors de l’étude de populations cliniques rares, d’enfants en bas âge ou de protocoles d’imagerie cérébrale fonctionnelle particulièrement onéreux. De surcroît, dans les recherches développementales, d’apprentissage ou psychopharmacologiques, l’évaluation longitudinale de la trajectoire d’une même entité biologique ou cognitive constitue l’unique moyen de capturer la dynamique temporelle fine des phénomènes psychologiques sans la distorsion d’un biais d’échantillonnage transversal.
1.2 Rôle et importance des postulats statistiques fondamentaux
La puissance et la flexibilité mathématique de l’ANOVA à mesures répétées ne sont pas accordées sans contrepartie formelle. Le modèle linéaire général dont elle découle repose sur un ensemble d’hypothèses probabilistes concernant la structure sous-jacente des variables et la distribution des termes d’erreur. Dans l’écosystème inférentiel neyman-pearsonien, ces postulats représentent les conditions axiomatiques sous lesquelles les distributions d’échantillonnage théoriques de la statistique $F$ de Snedecor demeurent rigoureusement exactes. Dès lors que ces axiomes sont compromis, les tables de probabilité standard perdent leur calibrage mathématique, induisant des distorsions imprévisibles entre la distribution théorique du test et sa distribution empirique effective sous l’hypothèse nulle.
La conséquence la plus délétère d’une violation non maîtrisée des postulats réside dans la dérive du taux nominal d’erreur de première espèce, conventionnellement fixé à $\alpha = 0,05$. Selon la nature et la sévérité de l’infraction méthodologique, le risque effectif de rejeter à tort l’hypothèse nulle d’absence d’effet peut grimper de manière exponentielle, atteignant dans certains scénarios critiques des niveaux inacceptables supérieurs à 20 % ou 30 %. Une telle libéralité du test fabrique des faux positifs en chaîne, saturant la littérature de prétendues découvertes d’effets cognitifs ou thérapeutiques qui s’avèrent impossibles à répliquer dans des laboratoires indépendants. Réciproquement, certaines violations méthodologiques peuvent induire un biais conservateur excessif, gonflant artificiellement le taux d’erreur de deuxième espèce ($\beta$) et condamnant des recherches exploratoires pionnières à l’insignifiance statistique faute d’une puissance adéquate.
Assurer le respect des postulats statistiques ne se résume donc pas à une simple vérification de routine exécutée mécaniquement sur un progiciel d’analyse de données ; il s’agit d’un impératif épistémologique qui garantit la validité de construit et la crédibilité empirique des inférences scientifiques. La robustesse méthodologique conditionne directement la fidélité des estimations des tailles d’effet (telles que l’êta-carré partiel $\eta_p^2$ ou le d de Cohen intra-sujets) et la précision des intervalles de confiance associés. Ce n’est qu’à travers une vigilance méthodologique scrupuleuse que le chercheur peut affirmer que les régularités observées dans ses données reflètent des processus psychologiques authentiques plutôt que des artefacts computationnels nés d’une distorsion de la mécanique d’échantillonnage.
1.3 Aperçu structurel des trois exigences probabilistes
L’exécution licite et non biaisée d’une ANOVA à mesures répétées est subordonnée au respect simultané de trois exigences distributionnelles et structurelles fondamentales. Chacune de ces conditions opère à un niveau distinct de l’architecture du plan expérimental, ciblant l’indépendance de l’échantillonnage, la forme de la dispersion des erreurs et la géométrie multidimensionnelle des covariances entre les niveaux factoriels répétés.
Le premier postulat concerne l’indépendance des observations inter-sujets. Si la modélisation assume et organise délibérément la dépendance entre les mesures issues d’un même individu à travers les différentes conditions expérimentales, elle exige de manière irrévocable que les paires d’observations prélevées entre des participants distincts soient rigoureusement indépendantes d’un point de vue stochastique. Cela implique que la réponse, la performance ou l’état résiduel d’un individu $A$ n’exerce aucune influence directe ou médiée sur les résultats de l’individu $B$. Cette exigence d’orthogonalité entre les blocs de mesures constitue la condition primordiale de l’échantillonnage aléatoire simple.
Le deuxième postulat impose la normalité de la distribution des résidus. Au sein du modèle intra-sujets, cette exigence stipule que les termes d’erreur résiduelle associés à chaque cellule du devis expérimental, ou plus spécifiquement les distributions des scores de différence construits entre chaque paire de conditions, doivent suivre une distribution gaussienne multivariée. Bien que le modèle linéaire bénéficie d’une réputation de robustesse relative conférée par le théorème central limite, l’asymétrie sévère ou l’aplatissement anormal des distributions résiduelles au sein d’échantillons de taille restreinte peuvent lourdement altérer le calcul des carrés moyens et compromettre les décisions inférentielles subséquentes.
Le troisième postulat, emblématique et singulier aux architectures intra-sujets comportant trois niveaux ou plus, est la sphéricité de la matrice de variance-covariance. Formalisée géométriquement par Box, Mauchly et Huynh, la sphéricité exige que les variances de toutes les différences possibles calculées entre les paires de niveaux du facteur répété soient strictement homogènes dans la population cible. Cette condition de circularité matricielle, fréquemment confondue avec la simple homogénéité des variances du modèle inter-sujets, représente le postulat le plus vulnérable et le plus systématiquement enfreint dans la recherche comportementale, nécessitant la mise en œuvre de corrections correctives spécialisées ou la réorientation vers des alternatives de modélisation plus flexibles.
2. Le postulat d’indépendance : Définition et mécanismes théoriques
2.1 Clarification conceptuelle de l’indépendance en plan intra-sujets
La formulation du concept d’indépendance statistique au sein des plans à mesures répétées soulève fréquemment une confusion terminologique chez les praticiens de la recherche empirique. Par définition, un plan intra-sujets est expressément conçu pour capturer et modéliser une dépendance statistique sérielle ou fonctionnelle : les mesures prélevées de manière répétée chez un même individu sont positivement corrélées, reflétant la stabilité de son équipement biologique, cognitif et mnémonique au cours de la session expérimentale. Cette corrélation intra-sujet n’enfreint aucunement le modèle ; elle en constitue au contraire la force motrice permettant d’extraire la variance liée aux traits stables des individus.
Le postulat d’indépendance concerne exclusivement la relation stochastique unissant les unités expérimentales primaires entre elles. Sur le plan mathématique, le terme d’erreur résiduelle $\epsilon_{ik}$ associé à la performance du sujet $i$ dans la condition $k$ doit satisfaire la propriété fondamentale de nullité de la covariance avec le terme d’erreur $\epsilon_{jk}$ de tout autre sujet $j$ pour toute condition $k$. En d’autres termes, pour tout couple d’indices où $i \neq j$ :
$$operatorname{Cov}(\epsilon_{ik}, \epsilon_{jk}) = 0$$
Cette indépendance conditionnelle signifie que la connaissance de l’erreur de prédiction ou de la déviation expérimentale d’un individu particulier n’apporte rigoureusement aucune information prédictive quant à la direction ou à la magnitude de l’erreur commise par un autre participant. Ce postulat garantit l’isolation physique, psychologique et computationnelle des trajectoires individuelles au sein du laboratoire ou du terrain expérimental.
2.2 Sources courantes de dépendance non désirée en psychologie
Bien que conceptuellement limpide, la préservation d’une indépendance rigoureuse inter-sujets est continuellement menacée par les contraintes matérielles et les pratiques logistiques de la collecte de données en sciences humaines. L’une des sources les plus prégnantes de contamination réside dans la passation collective d’épreuves en laboratoire informatique ou en milieu académique. Lorsque des participants sont installés au sein d’une même pièce pour accomplir une tâche cognitive chronométrée, des interactions auditives involontaires (bruits de frappe sur le clavier, soupirs, ajustements posturaux) et des indices visuels périphériques peuvent instaurer une synchronisation comportementale subtile. L’atmosphère de la salle ou un climat de compétition tacite crée une corrélation artificielle entre les erreurs des participants présents lors d’une même session.
Une seconde source critique relève de l’échantillonnage en grappes (cluster sampling) non pris en compte dans le modèle linéaire. En milieu scolaire, organisationnel ou clinique, les participants sont souvent recrutés au sein d’unités sociales préexistantes telles que des classes d’élèves, des équipes de travail ou des services hospitaliers spécialisés. Les élèves partageant un même enseignant sont soumis à des méthodes pédagogiques identiques, un climat de classe homogène et des normes partagées, ce qui engendre une communauté de variance résiduelle. Traiter ces participants comme des observations atomiques indépendantes constitue une faute méthodologique majeure, car les résidus au sein d’une même grappe présentent invariablement une interdépendance positive.
Enfin, les effets temporels induits par l’expérimentateur représentent un vecteur pernicieux de dépendance sérielle inter-sujets. Au fil d’une journée de recueil de données, la fatigue progressive de l’opérateur de recherche, sa familiarisation croissante avec le script d’instructions, ou encore des fluctuations thermiques et hygrométriques de l’environnement de test peuvent exercer une dérive systématique sur les mesures des participants successifs. Si l’expérimentateur se montre plus chaleureux et précis avec les premiers sujets du matin et plus impatient avec les derniers participants de l’après-midi, une autocorrélation temporelle s’insinue dans la série d’échantillonnage, violant frontalement le postulat d’indépendance inter-sujets.
2.3 Conséquences théoriques de l’autocorrélation résiduelle
Parmi l’ensemble des postulats probabilistes sous-tendant l’analyse de variance, celui de l’indépendance inter-sujets est sans conteste le plus fondamental et le moins tolérant aux déviations. Lorsque les résidus inter-sujets présentent une corrélation non nulle, l’estimateur de la variance d’échantillonnage de la moyenne cesse d’être exact et subit une sous-estimation systématique et sévère. La formule conventionnelle de l’erreur type de la moyenne, $\sigma / \sqrt{N}$, est dérivée sous la stricte condition d’une covariance nulle entre les observations ; si cette covariance est positive, la véritable variabilité d’échantillonnage est substantiellement plus large que celle présumée par le logiciel statistique.
Cette sous-estimation de la variance résiduelle se propage directement au dénominateur du ratio $F$ de l’ANOVA. En conséquence, la statistique $F$ observée est gonflée de manière artificielle, catapultant le taux d’erreur de type I bien au-delà de sa valeur nominale fixée à 5 %. Des simulations computationnelles robustes ont démontré de longue date qu’une corrélation intraclasse inter-sujets résiduelle d’à peine 0,10 au sein de petits groupes peut faire bondir le risque réel d’erreur de première espèce à des niveaux compris entre 15 % et 40 %, détruisant tout contrôle statistique rigoureux sur la production de faux positifs.
Sur le versant théorique, cette distorsion mathématique invalide irrévocablement la structure causale attribuée aux manipulations expérimentales. Les inférences dérivées du modèle linéaire reposent sur l’attribution de la variance expliquée aux seules conditions manipulées une fois l’erreur aléatoire soustraite. Si l’erreur intègre des dépendances contextuelles non modélisées, les conclusions tirées sur les processus cognitifs, émotionnels ou neurophysiologiques étudiés deviennent fallacieuses, menant à l’établissement de relations fonctionnelles chimériques.
3. Diagnostic et vérification de l’indépendance des observations
3.1 Évaluation du protocole et conception expérimentale
Contrairement aux postulats de normalité ou de sphéricité qui se prêtent à une batterie de tests d’adéquation statistiques standardisés, la détection de la violation de l’indépendance ne peut reposer de manière exclusive sur l’analyse de données a posteriori. L’évaluation de l’indépendance constitue avant tout un acte d’audit méthodologique qui s’exerce sur la structure même du protocole expérimental et sur le protocole d’échantillonnage déployé en amont de toute modélisation numérique. La question nodale que le chercheur doit formuler est la suivante : la réponse d’un participant donné a-t-elle pu être influencée, directement ou indirectement, par l’identité ou la performance d’un autre participant ?
Cet audit impose une vérification rigoureuse de l’isolement physique et psychologique des participants pendant la phase d’administration de la tâche. Dans un laboratoire expérimental, cela requiert l’utilisation de cabines insonorisées individuelles ou d’écrans séparateurs opaques empêchant tout regard périphérique sur les moniteurs voisins, ainsi que l’utilisation de casques antibruit pour bloquer les signaux acoustiques extérieurs. En outre, le chercheur doit examiner avec soin la procédure de contre-balancement des ordres de passation. L’usage de plans en carrés latins équilibrés ou de randomisations complètes des séquences intra-sujets permet de prévenir l’émergence d’effets d’ordre ou de report systématiques qui pourraient se confondre avec des corrélations sérielles inter-sujets.
Lorsque la recherche se déploie en contexte écologique ou institutionnel, l’audit de la conception expérimentale doit documenter rigoureusement les unités d’échantillonnage primaires. Il est impératif d’identifier la présence d’une hiérarchie d’emboîtement (par exemple, des patients répartis au sein de différentes cliniques ou assignés à des thérapeutes spécifiques). Si de telles configurations structurelles sont détectées et que le chercheur persiste à appliquer un modèle d’ANOVA intra-sujets standard sans ajustement structurel, l’hypothèse d’indépendance inter-sujets est de facto rompue par construction expérimentale.
3.2 Détection statistique des dépendances sérielles
Bien que l’examen méthodologique du devis prime, des investigations analytiques quantitatives permettent d’interroger les résidus standardisés afin d’y repérer des traces palpables d’interdépendance non modélisée. Lorsque les données ont été recueillies de manière séquentielle dans le temps ou ordonnées selon un paramètre spatial ou contextuel continu, le statisticien peut solliciter le classique test de Durbin-Watson. Initialement conçu pour l’analyse des séries temporelles en économétrie, ce test évalue l’hypothèse nulle selon laquelle les résidus ordonnés ne présentent aucune autocorrélation d’ordre 1 :
$$d = \frac{\sum_{t=2}^{N} (e_t – e_{t-1})^2}{\sum_{t=1}^{N} e_t^2}$$
Une valeur de $d$ substantiellement inférieure à 2 signale une autocorrélation positive entre les unités successives, attestant d’une dérive progressive de la mesure au fil des passations, tandis qu’une valeur supérieure à 2 indique une autocorrélation négative.
Une démarche complémentaire consiste à examiner visuellement et formellement la fonction d’autocorrélation (ACF) des résidus du modèle linéaire. Le calcul des coefficients d’autocorrélation pour divers retards temporels (lags) permet d’identifier des périodicités cachées dans le recueil des données, révélant par exemple l’influence cyclique de changements d’opérateurs ou de conditions thermiques au sein du laboratoire. Si les barres d’autocorrélation excèdent les intervalles de confiance à 95 % de Bartlet autour de zéro, l’indépendance temporelle doit être révoquée.
Dans les configurations d’échantillonnage groupé, la quantification formelle de la non-indépendance s’effectue via l’estimation du coefficient de corrélation intraclasse (ICC). L’ICC quantifie la proportion de la variance totale de la variable d’intérêt qui est attribuable à l’appartenance aux grappes ou groupes environnementaux partagés :
$$\rho = \frac{\sigma_{entre-groupes}^2}{\sigma_{entre-groupes}^2 + \sigma_{intra-groupe}^2}$$
L’observation d’un ICC s’écartant même modestement de zéro (par exemple $rho > 0,05$) apporte la démonstration empirique irréfutable que le postulat d’indépendance inter-sujets est violé, rendant caduque l’application de l’ANOVA intra-sujets standard sous peine de produire des inférences statistiques erronées.
4. Solutions méthodologiques et modélisations alternatives face à la non-indépendance
4.1 Ajustements de la structure expérimentale
Face à la détection avérée ou au risque structurel d’une violation de l’indépendance inter-sujets, la première ligne de défense réside dans la modification préventive ou corrective du protocole expérimental et de l’unité de calcul statistique. Lorsque des dépendances contextuelles sont inévitables en raison de contraintes logistiques (telles que la nécessité d’entraîner des groupes de sujets de manière conjointe), la refactorisation du plan d’expérience peut permettre de sauver la validité du modèle. Cela consiste à élever le facteur de nuisance contextuel (par exemple la session de passation ou l’expérimentateur) au rang de variable indépendante inter-sujets à part entière, transformant ainsi l’ANOVA intra-sujets simple en un plan mixte incluant ce facteur de contrôle de bloc.
Une alternative radicale mais rigoureuse consiste à procéder à l’agrégation mathématique des unités d’observation non indépendantes au niveau de l’unité de regroupement supérieure. Si les participants au sein d’une grappe (comme une salle de classe) interagissent inévitablement, le chercheur peut calculer la moyenne de la performance des participants de chaque grappe pour chacune des conditions répétées. L’analyse de variance à mesures répétées est ensuite exécutée en considérant la grappe elle-même (l’école ou le groupe de travail) comme l’unité expérimentale individuelle ($N = \text{nombre de grappes}$). Bien que cette démarche réduise substantiellement les degrés de liberté statistiques nominaux, elle rétablit l’indépendance stochastique absolue des unités soumises à l’analyse et garantit la maîtrise rigoureuse du taux d’erreur de première espèce.
Sur le plan de l’échantillonnage opérationnel, le recours à une randomisation stratifiée et contrainte des assignations d’expérimentateurs et des horaires d’évaluation permet de rompre mécaniquement toute co-dépendance entre les séquences temporelles et les niveaux des variables étudiées. En veillant à ce que les différents niveaux du facteur intra-sujets soient administrés de manière rigoureusement contre-balancée et uniformément distribuée dans le temps et l’espace expérimental, le chercheur dilue les perturbations sérielles résiduelles, empêchant leur cristallisation en biais systématique au détriment d’une modalité expérimentale particulière.
4.2 Transition vers les modèles multiniveaux et mixtes
Lorsque la structure de dépendance est inhérente à l’objet de recherche et que l’agrégation des scores détruirait une granularité d’information précieuse, l’abandon pur et simple de l’ANOVA intra-sujets classique au profit des modèles linéaires mixtes (Linear Mixed Models ou LMM) représente la solution contemporaine par excellence. Contrairement à l’ANOVA à mesures répétées qui nécessite l’indépendance stricte des observations entre les unités de niveau 1, les modèles linéaires à effets mixtes intègrent explicitement la dépendance hiérarchique au sein de leur matrice de variance-covariance probabiliste.
Dans un cadre multiniveau, le chercheur spécifie simultanément des effets fixes (représentant les paramètres d’intérêt de la manipulation expérimentale) et des effets aléatoires (représentant les variations stochastiques à multiples échelons). L’inclusion d’ordonnées à l’origine aléatoires (random intercepts) pour chaque individu et pour chaque grappe de niveau supérieur permet de partitionner formellement la variance entre les strates. Le modèle capture ainsi la corrélation intra-groupe et intra-sujet de manière simultanée :
$$Y_{tij} = \beta_{0} + u_{0j} + v_{0ij} + \beta_1 X_{tij} + \epsilon_{tij}$$
Où $u_{0j}$ capture la variabilité de la grappe $j$, $v_{0ij}$ celle de l’individu $i$ au sein de la grappe, et $\epsilon_{tij}$ représente l’erreur résiduelle unique à l’occasion $t$.
Par ailleurs, les modèles linéaires mixtes s’affranchissent de l’exigence d’indépendance temporelle en autorisant la modélisation directe de structures de covariances résiduelles hautement sophistiquées. Le statisticien peut spécifier une structure d’autocorrélation autorégressive de premier ordre, AR(1), où la corrélation entre deux résidus décroît de manière exponentielle en fonction de la distance temporelle qui les sépare :
$$operatorname{Corr}(\epsilon_t, \epsilon_{t+k}) = \rho^k$$
Cette approche hybride préserve l’intégralité de la puissance statistique de l’échantillon tout en protégeant les estimateurs des coefficients de régression et leurs erreurs types contre les ravages de l’autocorrélation, offrant une souplesse méthodologique infiniment supérieure à celle de l’ANOVA classique.
5. Le postulat de normalité : Fondements et implications mathématiques
5.1 Nature de la normalité dans le cadre intra-sujets
Le postulat de normalité est sans nul doute l’une des exigences les plus récurrentes du paradigme paramétrique, mais sa définition exacte dans le cadre spécifique de l’ANOVA à mesures répétées fait l’objet de contresens chroniques dans les publications empiriques. Une méconnaissance répandue consiste à tester la normalité de la variable dépendante brute agrégée sur l’ensemble des participants et des conditions, ou à l’inverse, à exiger la normalité des distributions isolées à l’intérieur de chaque cellule expérimentale. Or, sur le plan formel de la théorie des modèles linéaires, le postulat de normalité porte exclusivement sur la distribution des termes d’erreur résiduelle du modèle statistique.
Dans un plan factoriel à mesures répétées, l’erreur résiduelle correspond à la part de la variabilité qui n’est expliquée ni par les différences moyennes stables entre les sujets (l’effet principal des participants), ni par les manipulations expérimentales (l’effet principal du facteur intra-sujets), ni par d’éventuelles covariables continues. Le modèle assume que ce vecteur de résidus suit une distribution gaussienne théorique d’espérance nulle et de variance d’erreur définie, notée $boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, boldsymbol{\Sigma})$. Dès lors que le plan se décompose en contrastes pairwise (paires de conditions), cette condition implique directement que les distributions des scores de différence construits entre chaque couple de modalités doivent présenter une allure univariée et multivariée rigoureusement gaussienne.
Il convient de situer cette exigence à la lumière du Théorème Central Limite (TCL). En vertu des propriétés asymptotiques du TCL, la distribution d’échantillonnage de la moyenne converge vers une distribution normale lorsque la taille d’échantillon ($N$) tend vers l’infini, indépendamment de la forme de la distribution de la variable sous-jacente dans la population mère. Ainsi, dans les devis disposant d’un effectif substantiel (typiquement supérieur à 50 ou 100 participants selon la complexité du devis), l’ANOVA à mesures répétées bénéficie d’une robustesse notable face aux modiques entorses à la normalité des résidus. En revanche, lorsque les effectifs sont réduits ($N < 20$), situation omniprésente en neurosciences comportementales et en neuropsychologie clinique, le TCL ne peut opérer pleinement son rôle protecteur, exposant l'inférence à des distorsions préjudiciables.
5.2 Impact des déviations : Asymétrie et aplatissement
Lorsque la distribution des résidus s’éloigne notablement du profil symétrique en cloche de la courbe de Gauss, cette non-normalité se manifeste principalement sous deux formes géométriques distinctes : l’asymétrie (skewness) et l’aplatissement ou épaississement des queues de distribution (kurtosis). Chacune de ces anomalies exerce une influence différentielle sur l’anatomie computationnelle de l’ANOVA à mesures répétées.
L’asymétrie résiduelle, qu’elle soit positive (étalement vers les valeurs élevées, fréquente dans les mesures de temps de réaction chronométriques) ou négative (étalement vers les valeurs basses, classique lors d’effets de plafond sur des épreuves de mémoire), produit une distorsion systématique dans le positionnement de la moyenne arithmétique. La moyenne devenant excessivement sensible aux valeurs situées dans la longue queue de distribution, les estimations des effets intra-sujets se trouvent biaisées, ne reflétant plus adéquatement la tendance centrale du comportement modal des sujets. Lorsque l’asymétrie n’est pas uniforme à travers tous les niveaux du facteur répété (par exemple, une distribution symétrique dans la condition de contrôle mais fortement asymétrique sous stress cognitif intense), le calcul de la somme des carrés de l’effet subit une distorsion non linéaire qui peut soit masquer des effets cruciaux, soit faire émerger des différences statistiques purement artificielles.
L’aplatissement excessif, et tout particulièrement la leptocurticité caractérisée par des queues de distribution épaisses (heavy-tailed distributions), représente une menace plus insidieuse pour l’ANOVA. Les distributions leptocurtiques génèrent une fréquence de valeurs déviantes bien plus élevée que ce que prédit la loi normale standard. Cette prolifération d’écarts sporadiques gonfle disproportionnellement l’estimation de la variance d’erreur résiduelle ($MS_{erreur}$), laquelle figure au dénominateur du ratio $F$. Il en résulte une perte aiguë de puissance statistique : le test $F$ devient excessivement conservateur, échouant à détecter des variations de moyennes pourtant cliniquement ou scientifiquement signifiantes. À l’extrême, face à des distributions multimodales traduisant la présence de sous-populations hétérogènes non identifiées (par exemple des stratégies cognitives divergentes), la statistique $F$ perd totalement sa légitimité inférentielle.
5.3 Vulnérabilité aux données aberrantes (outliers)
L’existence de valeurs atypiques ou données aberrantes (outliers) constitue l’un des mécanismes générateurs les plus fréquents de violation de la normalité dans les devis à mesures répétées. Dans le contexte univarié, un outlier correspond à une observation dont la déviation par rapport à la moyenne du groupe ou de la cellule factorielle excède de loin les attentes probabilistes raisonnables. La détection classique s’opère par le calcul des scores centrés réduits (scores $Z$), où toute observation dépassant le seuil critique de $|Z| > 3,0$ ou $3,29$ (correspondant à une probabilité d’occurrence inférieure à $p = 0,001$ sous la loi normale) est identifiée comme suspecte, ou alternativement par la règle de Tukey basée sur l’écart interquartile ($1,5 \times IQR$ pour les outliers modérés, $3,0 \times IQR$ pour les outliers extrêmes).
Dans les plans intra-sujets, la problématique prend une dimension nettement plus pernicieuse sous la forme d’observations atypiques multivariées. Un individu peut présenter des scores parfaitement anodins et acceptables lorsqu’ils sont analysés de manière isolée au sein de chaque niveau factoriel, mais exhiber un patron de changement intra-individuel hautement improbable entre les conditions. La détection de ces configurations déviantes requiert la mobilisation d’indicateurs de distance multidimensionnels, au premier rang desquels figure la distance de Mahalanobis ($D^2$). Celle-ci mesure la distance séparant le vecteur de réponses d’un individu du centre de gravité multivarié (le centroïde de l’échantillon), en intégrant explicitement la matrice de variance-covariance empirique :
$$D_i^2 = (\mathbf{x}_i – \bar{\mathbf{x}})’ \mathbf{S}^{-1} (\mathbf{x}_i – \bar{\mathbf{x}})$$
Une distance de Mahalanobis excédant la valeur critique de la distribution du chi-deux ($\chi^2$) pour un nombre de degrés de liberté égal au nombre de niveaux du facteur intra-sujets signale un profil multivarié aberrant qui fausse l’estimation des corrélations sérielles du modèle.
Le chercheur doit impérativement opérer une distinction épistémologique et étiologique entre deux catégories d’outliers : les erreurs matérielles de mesure (dysfonctionnement d’un capteur électroencéphalographique, inattention manifeste d’un participant ayant appuyé sur la mauvaise touche par inadvertance, erreur de transcription informatique) et la variabilité psychologique authentique (un individu exceptionnellement rapide ou hyper-réactif émotionnellement). Alors que la première catégorie commande une élimination ou une correction mécanique, la seconde recèle souvent une information théorique fondamentale qu’une épuration aveugle priverait de visibilité scientifique.
6. Procédures diagnostiques de la normalité
6.1 Méthodes graphiques qualitatives
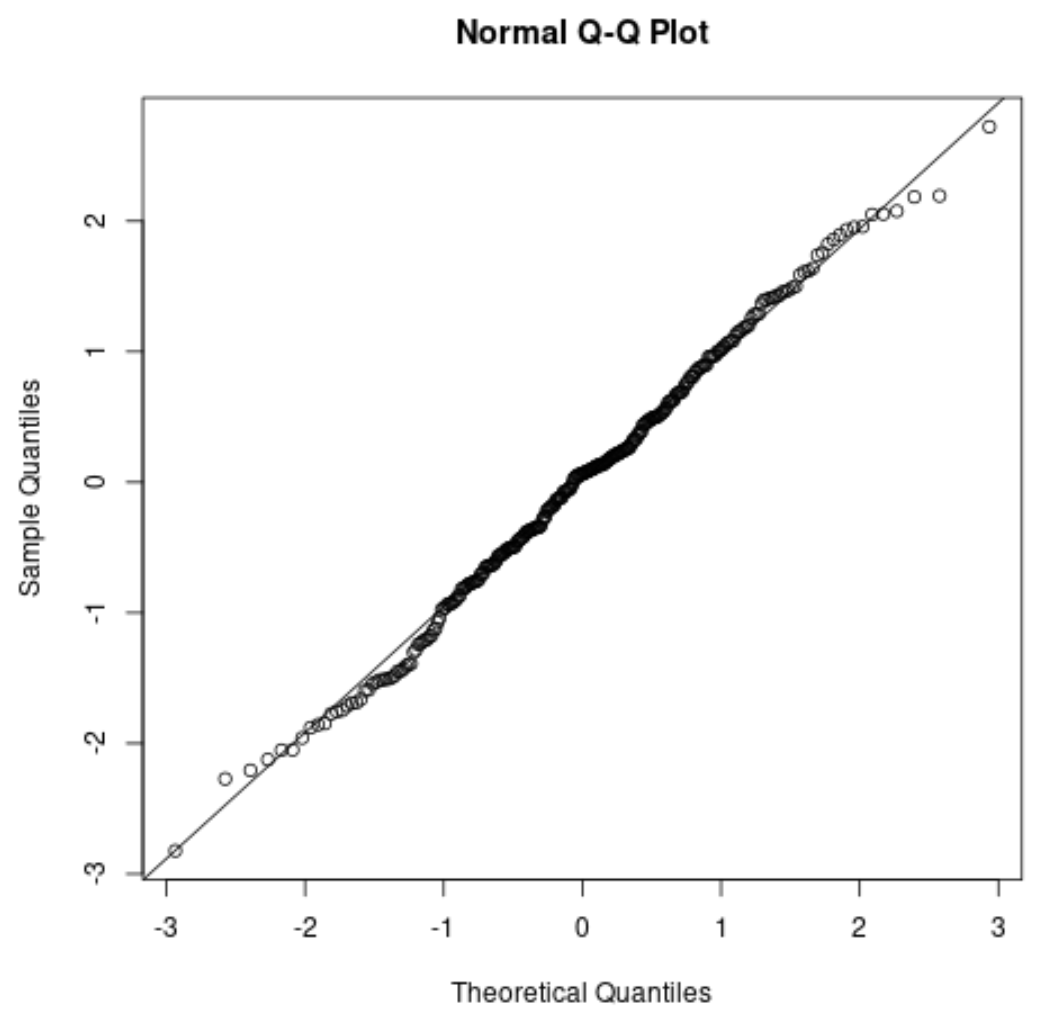
L’évaluation rigoureuse du postulat de normalité en amont d’une ANOVA à mesures répétées ne saurait être réduite à la seule lecture binaire d’un test statistique formel. Le consensus contemporain en méthodologie quantitative consacre la suprématie de l’inspection visuelle raisonnée au moyen d’outils graphiques calibrés. La méthode diagnostique reine demeure le diagramme quantile-quantile (Q-Q plot), appliqué aux résidus standardisés du modèle linéaire ou aux scores de différence entre les niveaux factoriels. Le Q-Q plot confronte les quantiles empiriques observés au sein de l’échantillon aux quantiles théoriques attendus sous une loi normale idéale.
L’interprétation clinique d’un Q-Q plot est intuitive : si la normalité est préservée, les points expérimentaux viennent s’aligner avec précision le long d’une droite diagonale à 45 degrés. Les déviations spécifiques par rapport à cette trajectoire linéaire cartographient la morphologie exacte de l’anomalie. Une courbure en forme de « S » ou de « banane » indique une asymétrie marquée (la direction de l’inflexion désignant une asymétrie positive ou négative), tandis qu’un décollement systématique des points aux deux extrémités de la ligne droite met en évidence la présence de queues épaisses caractéristiques d’une leptocurticité problématique.
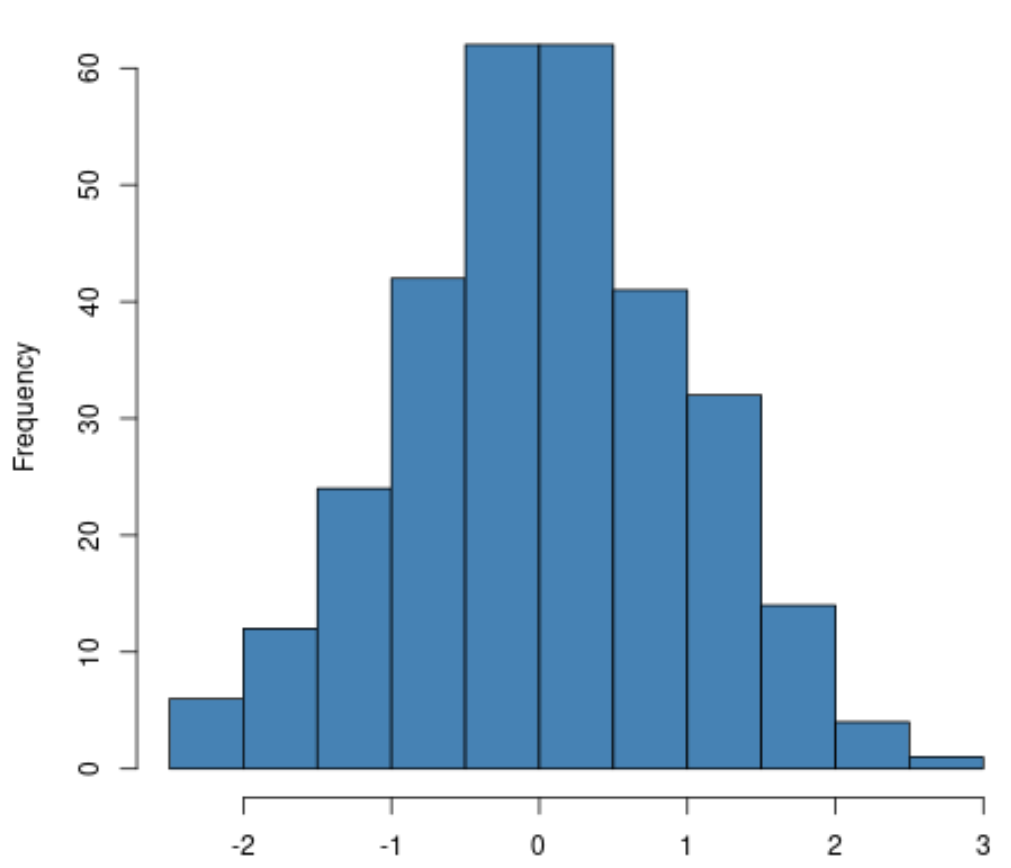
Ce diagnostic qualitatif gagne à être enrichi par la visualisation conjointe d’histogrammes de fréquence des résidus, sur lesquels le chercheur superpose le tracé de la densité gaussienne théorique correspondante. Cette juxtaposition permet d’apprécier immédiatement les déficits de symétrie ou les anomalies de hauteur du pic central. Enfin, le recours systématique aux boîtes à moustaches (boxplots) construites pour chaque niveau du facteur intra-sujets et pour les scores de contrastes offre une vue synthétique de la médiane, de la dispersion interquartile et de la présence de valeurs isolées, facilitant l’identification rapide des sujets dont le profil perturbe l’adéquation paramétrique globale.
6.2 Tests d’adéquation formels et seuils empiriques
En complément indispensable de l’analyse visuelle, l’évaluation de la normalité s’appuie fréquemment sur des tests d’hypothèse formels destinés à quantifier la probabilité que les données observées soient issues d’une population gaussienne. Pour les échantillons de taille petite à modérée ($N < 50$), le standard méthodologique absolu est le test de Shapiro-Wilk ($W$). Ce test calcule le ratio entre l’estimateur de la variance dérivé d’une combinaison linéaire ordonnée des statistiques de rang et l’estimateur conventionnel de la somme des carrés. Une valeur de $W$ proche de 1 témoigne d’une parfaite adéquation gaussienne ; dès lors que la statistique s’affaisse et que la valeur $p$ associée chute sous le seuil critique conventionnel (généralement $\alpha = 0,05$), l’hypothèse nulle de normalité est rejetée.
Pour des échantillons de taille plus conséquente, la littérature mobilise occasionnellement le test de Kolmogorov-Smirnov. Toutefois, dans sa forme élémentaire, ce test s’avère inapproprié lorsque les paramètres de moyenne et de variance de la population ne sont pas fixés théoriquement a priori mais estimés à partir de l’échantillon lui-même. Le chercheur doit ainsi impérativement exiger la version ajustée par la correction de Lilliefors, qui recalibre la distribution d’échantillonnage de la statistique de distance $D_{\max}$ pour tenir compte de l’estimation empirique des paramètres gaussiens.
Au-delà de ces tests d’adéquation omnibus, le diagnostic analytique requiert le calcul formel des coefficients d’asymétrie (skewness de Fisher-Pearson) et d’aplatissement (kurtosis excédentaire). Pour valider l’adéquation opérationnelle sous un angle quantitatif, les praticiens utilisent couramment des ratios critiques standardisés :
$$Z_{skewness} = \frac{\text{Skewness}}{SE_{skewness}} \quad \text{et} \quad Z_{kurtosis} = \frac{\text{Kurtosis}}{SE_{kurtosis}}$$
Sous l’hypothèse de normalité asymptotique, ces valeurs $Z$ suivent approximativement une loi normale centrée réduite. L’observation d’un ratio excédant l’intervalle critique de $[-1,96 ; +1,96]$ (pour un seuil de 5 %) ou $[-2,58 ; +2,58]$ (pour un seuil de 1 %) signale une déviation statistiquement significative imposant une vigilance accrue.
6.3 Prudence face à la sur-interprétation des tests d’adéquation
Malgré leur apparence de rigueur mathématique irréfutable, les tests d’adéquation formels de la normalité (Shapiro-Wilk, Lilliefors, Anderson-Darling) doivent être maniés avec un recul épistémologique critique en raison de propriétés d’échantillonnage paradoxales qui piègent fréquemment les chercheurs non avertis. Ces paradoxes découlent directement de la mécanique de la puissance statistique des tests d’hypothèse nulle en fonction de l’effectif $N$.
Dans les contextes de grands échantillons (par exemple $N > 200$ ou $300$ participants, fréquents dans les études en ligne ou les cohortes épidémiologiques), les tests formels deviennent hypersensibles à des micro-déviations triviales de la distribution empirique par rapport au modèle gaussien idéal. Un test de Shapiro-Wilk pourra ainsi afficher une p-valeur hautement significative ($p < 0,001$) face à une légère asymétrie totalement anodine qui n'exerce rigoureusement aucun impact pratique sur le taux d'erreur ou la validité de la statistique $F$ de l'ANOVA intra-sujets (en vertu de la robustesse garantie par le Théorème Central Limite). Rejeter l'ANOVA paramétrique sur la base exclusive d'un tel résultat relève d'un excès de purisme méthodologique contre-productif.
Inversement, dans les contextes de très faibles effectifs ($N 0,10$, conduisant à l’acceptation erronée de l’hypothèse nulle de normalité faute de preuves suffisantes. En conclusion, les tests statistiques d’adéquation ne doivent jamais être employés comme un tribunal aveugle et décisionnel autonome ; ils doivent s’articuler harmonieusement avec l’examen visuel des Q-Q plots et l’évaluation de la magnitude concrète des indices d’asymétrie et d’aplatissement.
7. Remédiations face aux violations de la normalité
7.1 Transformations mathématiques de données
Lorsqu’une violation substantielle du postulat de normalité est diagnostiquée au sein d’un échantillon modeste, la stratégie de remédiation traditionnelle la plus élégante consiste à appliquer une transformation mathématique non linéaire à la variable dépendante continue. L’objectif fondamental de cette opération est de modifier l’espacement relatif des observations afin de comprimer l’une des queues de distribution, rétablissant ainsi la symétrie et l’homogénéité des résidus sans altérer l’ordre ordinal des performances des sujets.
Pour les distributions exhibant une asymétrie positive marquée, la transformation logarithmique (déclinée sous sa forme népérienne $ln(Y)$ ou décimale $\log_{10}(Y)$) constitue l’antidote privilégié. Elle compresse énergiquement les scores extrêmement élevés tout en étirant les écarts entre les scores faibles. Lorsque les données comportent des zéros stricts, une constante additive unitaire est préalablement adjointe : $log(Y + 1)$. Pour une asymétrie positive modérée, la transformation par racine carrée ($\sqrt{Y}$) offre un nivellement plus doux, particulièrement recommandé pour les données issues de processus de comptage ou de fréquences comportementales rares (loi de Poisson sous-jacente). En présence d’une asymétrie positive violente, la transformation réciproque ou inverse ($1/Y$) comprime drastiquement la traîne, bien qu’elle opère une inversion de la direction de l’échelle qui exige une reconfiguration des contrastes.
Pour s’affranchir d’un tâtonnement empirique arbitraire, le chercheur peut solliciter la famille des transformations paramétriques de Box-Cox. Cette procédure computationnelle sophistiquée identifie par maximisation de vraisemblance la valeur optimale du paramètre de puissance $lambda$ permettant de rapprocher au plus près la distribution empirique d’un idéal gaussien :
$$Y^{(\lambda)} = \begin{\cases} \frac{Y^\lambda – 1}{\lambda} &a\mp; \text{si } \lambda \neq 0 \ln(Y) &a\mp; \text{si } \lambda = 0 \end{\cases}$$
Toutefois, le recours aux transformations de données soulève des réserves épistémologiques non négligeables quant à l’interprétabilité des résultats. En modifiant l’échelle de mesure, les différences de moyennes calculées dans l’espace transformé (par exemple sur des logarithmes de millisecondes) perdent leur correspondance directe avec les unités physiques ou psychologiques d’origine. Les inférences doivent être reconverties dans l’échelle initiale par le biais de moyennes géométriques ou de rétromutations (back-transformation), ce qui complexifie la communication des tailles d’effet brutes.
7.2 Approches non paramétriques
Lorsque la structure des données défie toute tentative de normalisation par transformation mathématique, ou lorsque la variable dépendante d’origine est de nature ordinale (échelles de Likert à granularité étroite, classements hiérarchiques), le basculement vers des paradigmes statistiques non paramétriques devient impératif. Le substitut universellement reconnu à l’ANOVA à mesures répétées à un facteur est le test de Friedman (souvent désigné sous l’appellation d’ANOVA bidirectionnelle par rangs de Friedman).
Le fonctionnement algorithmique du test de Friedman est fondé sur une opération préalable de conversion : pour chaque participant individuel (chaque bloc), les scores obtenus à travers les $k$ conditions répétées sont convertis en rangs croissants, variant de $1$ à $k$. Le test examine ensuite si les sommes des rangs associées à chaque condition ($\bar{R}_j$) divergent significativement de la distribution uniforme théorique attendue sous l’hypothèse nulle. La statistique du test, distribuée asymptotiquement selon une loi du $\chi^2$ à $k – 1$ degrés de liberté, est définie par :
$$\chi_F^2 = \frac{12}{N k (k + 1)} \sum_{j=1}^k R_j^2 – 3 N (k + 1)$$
Dans les configurations méthodologiques plus complexes impliquant des plans en blocs incomplets équilibrés (où chaque participant n’est pas exposé à l’intégralité des conditions en raison de contraintes de temps ou de fatigue cognitive), le test de Durbin prend le relais méthodologique du test de Friedman en ajustant formellement l’espérance des sommes de rangs à la taille incomplète des sous-ensembles expérimentaux.
Bien que ces approches non paramétriques possèdent l’avantage souverain d’une immunité totale face aux déviations de la normalité et à la présence d’outliers extrêmes, elles s’accompagnent d’un coût méthodologique substantiel. La substitution des scores continus métriques par de simples rangs ordinaux détruit une masse considérable d’informations quantitatives relatives à la magnitude des écarts inter-conditions. Il en résulte une érosion de la puissance statistique dès lors que les données sous-jacentes étaient modérément proches d’une distribution normale. De surcroît, le test de Friedman ne permet pas d’analyser aisément les devis factoriels complexes impliquant des interactions multidirectionnelles (plans mixtes split-plot), restreignant son usage aux questions de recherche unidimensionnelles.
7.3 Techniques de rééchantillonnage et méthodes robustes
Face au dilemme classique opposant l’interprétabilité complexe des données transformées à la perte d’information des tests non paramétriques basés sur les rangs, la statistique moderne a développé un troisième paradigme fondé sur le rééchantillonnage et l’estimation robuste. Ces approches contemporaines s’affranchissent des hypothèses de distributionnalité rigide tout en préservant l’intégrité métrique des échelles de mesure originales.
Au cœur de cette panoplie figure le bootstrapping non paramétrique. Appliquée aux contrastes intra-sujets, la méthode du bootstrap consiste à générer un grand nombre d’échantillons synthétiques (typiquement $B = 5,000$ ou $10,000$) par tirage aléatoire avec remise parmi les vecteurs multidimensionnels de réponses des participants originaux. Pour chaque itération de rééchantillonnage, la statistique d’intérêt (différence de moyennes ou ratio $F$) est recalculée. La compilation de ces réplicats engendre une distribution d’échantillonnage empirique directe, exempte de toute assomption gaussienne théorique. Le chercheur en dérive des intervalles de confiance robustes corrigés et accélérés (BCa bootstrap intervals), permettant de statuer sur la significativité statistique de l’effet d’une manière imperméable à l’asymétrie résiduelle.
Une alternative analytique remarquable consiste à substituer les paramètres classiques par des statistiques robustes, notamment sous la formalisation de Rand Wilcox. Cette approche propose de remplacer la moyenne arithmétique et la variance standard par des moyennes tronquées (trimmed means, par exemple à 20 %) ou des M-estimateurs de Huber au sein du calcul des contrastes intra-sujets. En neutralisant le poids excessif des 20 % de valeurs les plus extrêmes situées dans chaque traîne de distribution, les moyennes tronquées restaurent un contrôle impeccable de l’erreur de type I et offrent une puissance statistique supérieure face à des distributions leptocurtiques ou asymétriques. L’ANOVA robuste ainsi configurée transcende les limitations des méthodes paramétriques classiques tout en maintenant le focus d’analyse sur l’architecture factorielle complète du plan expérimental.
8. Le postulat de sphéricité : Définition conceptuelle et géométrique
8.1 Compréhension théorique de la sphéricité
Le postulat de sphéricité constitue la condition mathématique la plus singulière, la plus méconnue et la plus lourdement violée au sein des modèles factoriels à mesures répétées. Dans la taxonomie des concepts statistiques, les praticiens commettent fréquemment l’erreur de calquer sur l’ANOVA intra-sujets la condition d’homoscédasticité propre à l’ANOVA inter-sujets (l’égalité des variances entre les groupes indépendants de Levene). Or, le cadre intra-sujets transcende cette simple homogénéité scalaire pour englober la géométrie matricielle multidimensionnelle régissant les relations de variance et de covariance entre les conditions dépendantes.
Formellement, la sphéricité exige l’égalité stricte des variances de toutes les différences possibles calculées entre chaque paire de niveaux du facteur intra-sujets. Considérons un plan d’expérience impliquant un facteur répété comportant $k$ modalités distinctes ($T_1, T_2, dots, T_k$). Le modèle génère $k(k – 1) / 2$ variables de différence potentielles en soustrayant les scores de chaque paire de conditions pour l’ensemble des participants. Le postulat de sphéricité impose que dans la population de référence, la variance de la variable $(T_A – T_B)$ soit rigoureusement identique à la variance de la variable $(T_A – T_C)$, laquelle doit être égale à celle de $(T_B – T_C)$, et ainsi de suite pour l’ensemble des combinaisons par paires :
$$operatorname{Var}(T_j – T_m) = operatorname{Constante} \quad \forall ; j \neq m$$
D’un point de vue matriciel et géométrique, cette exigence est formalisée par la condition de circularité démontrée par Huynh et Feldt ainsi que par Rouanet et Lépine. Si l’on transforme le vecteur de données initial par une matrice orthogonale de contrastes orthonormés de rang $k – 1$, la matrice de variance-covariance résultante doit être strictement scalaire, c’est-à-dire proportionnelle à la matrice identité ($\sigma^2 \mathbf{I}$). Les projections vectorielles des réponses sur chaque dimension de contraste doivent posséder une dispersion sphérique parfaitement uniforme dans l’espace euclidien multidimensionnel, d’où l’attribution historique du vocable géométrique de « sphéricité ».
Il est crucial de noter qu’un plan intra-sujets comportant strictement $k = 2$ niveaux factoriels n’est jamais concerné par le postulat de sphéricité. En effet, avec deux conditions, il n’existe qu’une seule et unique variable de différence possible ($T_1 – T_2$) ; une variance unique ne pouvant être comparée à aucune autre, le postulat est mathématiquement et obligatoirement satisfait par définition triviale. La sphéricité ne devient une exigence contraignante et potentiellement violable qu’à partir de $k ge 3$ niveaux factoriels répétés.
8.2 La condition de compound symmetry (symétrie composée)
Dans l’exploration théorique des matrices de dispersion, la sphéricité entretient une parenté conceptuelle étroite mais asymétrique avec la condition plus restrictive de symétrie composée (compound symmetry). Une matrice de variance-covariance $boldsymbol{\Sigma}$ présente une symétrie composée si et seulement si elle satisfait simultanément deux critères rigides :
- Toutes les variances associées à chaque niveau individuel du facteur répété sont strictement égales entre elles sur la diagonale principale de la matrice :
$$\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2 = \sigma^2$$ - Toutes les covariances unissant les paires distinctes de niveaux sont rigoureusement identiques entre elles sur l’ensemble des éléments hors-diagonale :
$$operatorname{Cov}(T_j, T_m) = \sigma_{jm} = \sigma_0 \quad \forall ; j \neq m$$
Mathématiquement, la symétrie composée constitue une condition suffisante mais non strictement nécessaire pour que la sphéricité soit respectée. La démonstration de cette relation d’implication découle de la formule fondamentale régissant la variance d’une différence entre deux variables aléatoires dépendantes :
$$operatorname{Var}(T_j – T_m) = operatorname{Var}(T_j) + operatorname{Var}(T_m) – 2operatorname{Cov}(T_j, T_m)$$
Si la condition de symétrie composée est satisfaite, cette expression devient immédiatement :
$$operatorname{Var}(T_j – T_m) = \sigma^2 + \sigma^2 – 2\sigma_0 = 2(\sigma^2 – \sigma_0) = \text{Constante}$$
Dans ce scénario, toutes les variances de différence sont mathématiquement contraintes à l’égalité, confirmant que la symétrie composée engendre infailliblement la sphéricité.
Néanmoins, la réciproque est formellement inexacte : une matrice peut violer outrageusement l’égalité des variances marginales et l’égalité des covariances élémentaires, tout en satisfaisant rigoureusement le critère de sphéricité. Il suffit pour cela que les disparités de covariances compensent exactement les écarts de variances individuelles de telle sorte que la formule $operatorname{Var}(T_j) + operatorname{Var}(T_m) – 2operatorname{Cov}(T_j, T_m)$ demeure constante pour toute paire d’indices. Bien que ces configurations géométriques dites de Huynh-Feldt pures soient relativement rares dans la pratique comportementale, leur existence mathématique démontre que restreindre le diagnostic à la seule inspection de la symétrie composée constitue un réductionnisme théorique inapproprié.
8.3 Impact dramatique de l’asphéricité sur l’inférence statistique
L’asphéricité (la rupture de la condition d’égalité des variances des scores de différence) exerce des répercussions désastreuses sur la mécanique inférentielle du modèle d’ANOVA intra-sujets standard. Au cœur du test $F$, la statistique est formulée comme le rapport entre le carré moyen du traitement ($MS_{effet}$) et le carré moyen résiduel moyen ($MS_{erreur}$). Dans les équations d’espérance mathématique, le dénominateur $MS_{erreur}$ est calibré sous l’hypothèse explicite d’une matrice sphérique, représentant une synthèse globale pondérée des variances d’erreur associées à chaque contraste élémentaire.
Lorsque la sphéricité est enfreinte, cette synthèse globale devient un estimateur biaisé de l’erreur applicable aux contrastes particuliers. Dès lors, le dénominateur du ratio $F$ omnipotent a tendance à sous-estimer sévèrement la variance d’échantillonnage effective de l’effet global manipulé. Cette sous-estimation mécanique gonfle artificiellement la statistique $F$ observée, provoquant une distorsion majeure de sa distribution d’échantillonnage empirique par rapport à la loi théorique de Fisher-Snedecor programmée dans les logiciels de calcul.
La conséquence immédiate de cette distorsion est une inflation spectaculaire du taux nominal d’erreur de première espèce ($\alpha$). Dans des conditions de violation modérée à sévère, un chercheur opérant sous un seuil nominal de $\alpha = 0,05$ peut être exposé à un risque réel de commettre une erreur de type I oscillant entre 10 % et 18 %, voire supérieur à 25 % dans les architectures expérimentales comportant un nombre élevé de niveaux factoriels répétés. Le modèle devient hyper-libéral, validant des effets expérimentaux sans fondement empirique réel.
Par ailleurs, cette asphéricité induit une vulnérabilité asymétrique entre le test global (omnibus) et les contrastes planifiés a priori. Alors que le test global omnipotent s’effondre en termes de validité inférentielle, les contrastes individuels focalisés (tels que des contrastes polynomiaux linéaires ou quadratiques) peuvent s’affranchir du postulat de sphéricité si et seulement s’ils sont testés en utilisant leur terme d’erreur résiduelle propre plutôt que le terme d’erreur résiduelle agrégé du modèle global, une distinction méthodologique fondamentale trop souvent occultée dans les manuels élémentaires.
9. Détection empirique de l’asphéricité
9.1 Le test de sphéricité de Mauchly
Pour statuer de manière formelle sur l’adéquation d’une matrice de données aux exigences géométriques du modèle intra-sujets, la communauté statistique mobilise classiquement le test de sphéricité de Mauchly (introduit par J.W. Mauchly en 1940). Ce test évalue l’hypothèse nulle ($H_0$) selon laquelle la matrice de variance-covariance des contrastes orthonormés normalisés est rigoureusement proportionnelle à une matrice identité, attestant d’une sphéricité parfaite dans la population mère, contre l’hypothèse alternative ($H_1$) d’une déviation asphérique.
La mécanique computationnelle du test de Mauchly repose sur le calcul d’une statistique désignée par la lettre $W$. Cette statistique est formulée comme le rapport entre le déterminant de la matrice de covariance transformée $\mathbf{S}^*$ et la trace de cette même matrice élevée à la puissance de sa dimensionnalité :
$$W = \frac{|\mathbf{S}^*|}{\left[ \frac{operatorname{tr}(\mathbf{S}^*)}{k – 1} \right]^{k – 1}}$$
D’un point de vue analytique, la statistique $W$ compare la moyenne géométrique des valeurs propres de la matrice à leur moyenne arithmétique. Si la matrice est parfaitement sphérique, toutes ses valeurs propres sont strictement égales ; le déterminant et la trace normalisée coïncident parfaitement, fixant la valeur de $W$ à exactement $1,00$. Au fur et à mesure que la matrice s’éloigne de la circularité idéale, les valeurs propres divergent, provoquant l’effondrement de la valeur de $W$ vers zéro ($0 le W le 1$). La statistique de test transformée suit asymptotiquement une distribution du $\chi^2$ à $[(k – 1)(k – 2) / 2] – 1$ degrés de liberté.
Lorsque la valeur $p$ associée à la statistique $W$ de Mauchly est inférieure au seuil conventionnel ($p < 0,05$), le statisticien rejette formellement l'hypothèse nulle de sphéricité et conclut à la présence d'une asphéricité requérant une intervention corrective immédiate. Inversement, une p-valeur supérieure à 0,05 incite traditionnellement à conserver le modèle paramétrique non corrigé.
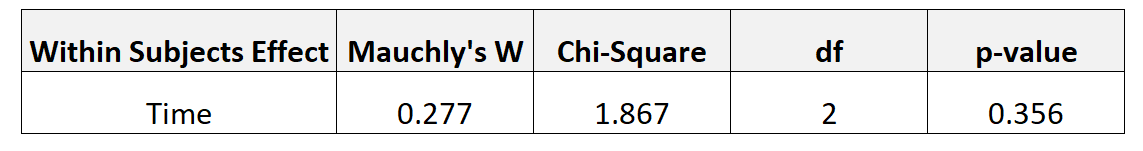
Cependant, le test de Mauchly fait l’objet de réserves sévères au sein de la psychométrie contemporaine en raison d’une double pathologie d’échantillonnage similaire à celle rencontrée lors des tests de normalité. D’une part, le test de Mauchly démontre une hypersensibilité extrême aux violations de la normalité multivariée : une légère déviation gaussienne non pénalisante pour l’ANOVA suffit à provoquer le rejet erroné de la sphéricité. D’autre part, face à des échantillons de taille modeste ($N < 25$), le test souffre d'une impuissance statistique notoire, échouant fréquemment à détecter des violations d'asphéricité massives qui menacent pourtant gravement le taux de faux positifs.
9.2 Indices d’écart à la sphéricité (Epsilon)
Face à la nature purement dichotomique et fragile du test d’hypothèse de Mauchly, les statisticiens ont développé une métrique continue standardisée permettant de quantifier directement le degré substantiel de distorsion de la sphéricité au sein de la matrice de données. Cette mesure de l’écart à la circularité est universalisée sous le terme d’epsilon ($epsilon$).
L’indice $epsilon$ mesure le degré d’homogénéité des valeurs propres de la matrice de covariance des différences. Dans un contexte de perfection sphérique théorique absolue, l’indice $epsilon$ atteint sa borne supérieure exacte :
$$\epsilon = 1,00$$
À l’inverse, lorsque l’asphéricité atteint son intensité maximale concevable d’un point de vue mathématique, $epsilon$ ne s’effondre pas à zéro, mais converge vers une borne inférieure théorique strictement déterminée par le nombre de modalités $k$ du facteur intra-sujets :
$$\epsilon_{\min} = \frac{1}{k – 1}$$
Cette formulation révèle une propriété algébrique cruciale : plus le nombre de niveaux d’un facteur intra-sujets est élevé, plus la vulnérabilité mathématique potentielle à l’asphéricité est dramatique. Ainsi, pour un plan à 3 modalités, l’epsilon le plus bas possible est de $1 / (3 – 1) = 0,50$ ; pour un devis complexe impliquant 6 mesures répétées successives, la borne inférieure s’affaisse à $1 / (6 – 1) = 0,20$, ouvrant la porte à des distorsions d’erreur de première espèce d’une extrême gravité.
L’évaluation de la magnitude de l’indice $epsilon$ fournit au chercheur un baromètre objectif continu permettant de dépasser la simple décision tout-ou-rien du test de Mauchly. Il offre une estimation non biaisée de la sévérité du biais qui affectera le ratio $F$, guidant la sélection du facteur d’ajustement requis pour restaurer la neutralité probabiliste du test.
10. Correction statistique de l’asphéricité
10.1 La correction de Greenhouse-Geisser (G-G)
La découverte de la vulnérabilité du ratio $F$ face à l’asphéricité a conduit les statisticiens S.W. Greenhouse et J.E. Geisser à élaborer dès 1959 une procédure de réconciliation probabiliste devenue la référence majeure des logiciels contemporains : la correction de Greenhouse-Geisser. Le coup de génie de cette méthode réside dans la préservation intégrale des valeurs numériques de la statistique $F$ observée et des sommes de carrés calculées ; l’ajustement opère exclusivement sur les degrés de liberté ($df$) de la distribution théorique de référence.
Au lieu de comparer la statistique $F$ observée à la distribution de Fisher standard régie par ses degrés de liberté initiaux du numérateur $df_{effet} = k – 1$ et du dénominateur $df_{erreur} = (k – 1)(N – 1)$, la correction applique un facteur multiplicatif d’amortissement égal à l’estimation de l’indice $\hat{\epsilon}_{GG}$ :
$$df’_{effet} = \hat{\epsilon}_{GG} \times (k – 1) \quad \text{et} \quad df’_{erreur} = \hat{\epsilon}_{GG} \times (k – 1)(N – 1)$$
Comme $\hat{\epsilon}_{GG}$ est obligatoirement inférieur ou égal à 1, cette multiplication réduit mécaniquement les degrés de liberté des deux termes. Cette diminution des $df$ déplace le seuil critique de la valeur de $F$ vers la droite sur la courbe de densité théorique et augmente la valeur $p$ associée, neutralisant l’inflation indésirable des faux positifs et ramenant le taux d’erreur de première espèce au voisinage exact de sa valeur nominale de 5 %.
Cependant, l’estimateur de Greenhouse-Geisser est reconnu pour manifester un profil technique conservateur, particulièrement marqué au sein d’échantillons de petite taille ($N < 30$). En tendant à sous-estimer la valeur réelle d'epsilon dans la population, la correction de G-G peut sur-corriger les degrés de liberté, érodant inutilement la puissance statistique du test. La règle de consensus méthodologique universelle formulée par Maxwell et Delaney stipule que l'utilisation prioritaire de la correction de Greenhouse-Geisser s'impose impérativement dès lors que l'indice $\hat{\epsilon}$ estimé est strictement inférieur à 0,75, témoignant d’une déviation modérée à sévère que seule une pénalisation substantielle permet de juguler efficacement.
10.2 La correction de Huynh-Feldt (H-F)
Pour remédier au conservatisme excessif de l’ajustement de Greenhouse-Geisser lorsque les données ne présentent qu’une violation modeste de la sphéricité, Huynh et Feldt ont proposé en 1976 un estimateur alternatif d’epsilon, noté $\tilde{\epsilon}_{HF}$. L’algorithme de Huynh-Feldt incorpore un ajustement de second degré calculé à partir de l’estimateur de Greenhouse-Geisser, de la taille de l’échantillon $N$ et du nombre de niveaux factoriels $k$ :
$$\tilde{\epsilon}_{HF} = \frac{N (k – 1) \hat{\epsilon}_{GG} – 2}{(k – 1) \left[ (N – 1) – (k – 1) \hat{\epsilon}_{GG} \right]}$$
Cette formulation mathématique est conçue pour corriger le biais de sous-estimation de $\hat{\epsilon}_{GG}$. En conséquence, l’estimateur $\tilde{\epsilon}_{HF}$ affiche systématiquement une valeur numérique supérieure à celle de son homologue de Greenhouse-Geisser. En pénalisant moins drastiquement les degrés de liberté du modèle, la correction de Huynh-Feldt préserve au maximum la puissance statistique du test, réduisant le risque de commettre une erreur de deuxième espèce tout en maintenant le taux de faux positifs à un niveau sécurisé.
Une particularité computationnelle singulière de la correction de Huynh-Feldt réside dans sa propension occasionnelle à dépasser la borne supérieure théorique de l’unité ($\tilde{\epsilon}_{HF} > 1,00$), notamment lorsque l’échantillon de données est très proche d’une circularité parfaite tout en intégrant des fluctuations d’échantillonnage aléatoires. Face à cette aberration probabiliste, la totalité des progiciels statistiques (SPSS, R, SAS) appliquent un plafonnement impératif à 1,00. Conformément aux préconisations contemporaines, la correction de Huynh-Feldt est officiellement recommandée lorsque l’estimation de l’indice epsilon excède 0,75, offrant le compromis le plus harmonieux entre protection de l’erreur $\alpha$ et acuité de détection des effets expérimentaux.
10.3 L’approche de la borne inférieure (Lower-Bound Correction)
Dans l’éventail des stratégies d’ajustement des degrés de liberté, l’approche dite de la borne inférieure (Lower-Bound Correction), conceptualisée à l’origine par Geisser et Greenhouse, incarne le niveau de conservatisme le plus extrême envisageable dans l’analyse de données paramétriques. Cette approche fait l’impasse complète sur le calcul empirique matriciel de $\hat{\epsilon}$ à partir de l’échantillon et choisit délibérément d’appliquer la correction la plus sévère possible, fondée sur l’hypothèse déterministe d’une rupture d’asphéricité maximale théorique.
Pour ce faire, le facteur multiplicatif appliqué aux degrés de liberté est directement fixé à la borne théorique minimale :
$$\epsilon = \frac{1}{k – 1}$$
Sous cette pénalisation maximale, les degrés de liberté du numérateur s’effondrent de manière spectaculaire :
$$df’_{effet} = \frac{1}{k – 1} \times (k – 1) = 1$$
Tandis que les degrés de liberté résiduels au dénominateur sont ramenés à :
$$df’_{erreur} = \frac{1}{k – 1} \times (k – 1)(N – 1) = N – 1$$
Le modèle intra-sujets complexe à $k$ niveaux se trouve ainsi computationnellement réduit à l’équivalent statistique minimal d’une simple comparaison bivariée à 1 degré de liberté au numérateur.
L’usage de la borne inférieure engendre une pénalisation titanesque qui décime la puissance statistique de l’expérimentation. Son champ d’application légitime demeure extrêmement restreint : elle peut être sollicitée lors d’analyses ultra-conservatrices exploratoires, ou à titre de vérification heuristique de premier niveau (« si l’effet survit au test de la borne inférieure, il est inattaquable quelle que soit la sévérité de l’asphéricité sous-jacente »). Cependant, son application indiscriminée en routine méthodologique doit être fermement proscrite au profit des corrections empiriques calibrées de G-G et H-F.
11. Paradigmes analytiques alternatifs face à l’asphéricité
11.1 L’approche MANOVA intra-sujets (Profil Analysis)
Face aux complexités et aux approximations inhérentes aux ajustements univariés des degrés de liberté, de nombreux méthodologistes préconisent le basculement intégral vers une analyse multivariée de variance (MANOVA intra-sujets), également désignée sous l’appellation d’analyse de profil. Le principe fondamental de la MANOVA consiste à transformer les $k$ mesures répétées d’un même participant en un ensemble vectoriel de $k – 1$ scores de différence orthogonaux linéarisés, traités simultanément en tant que multiples variables dépendantes interconnectées.
La distinction épistémologique et computationnelle majeure entre l’ANOVA univariée et la MANOVA réside dans le fait que la MANOVA ne requiert absolument aucun postulat de sphéricité. Au lieu de contraindre les variances des différences à une identité scalaire globale unique, le modèle multivarié estime librement et indépendamment la totalité des éléments de la matrice de variance-covariance non structurée ($boldsymbol{\Sigma}$). Les statistiques multivariées usuelles (le Lambda de Wilks $Lambda$, la Trace de Pillai $V$, ou la Trace de Hotelling-Lawley) testent si le centroïde multidimensionnel des scores de différence s’écarte significativement du vecteur nul, s’affranchissant totalement des géométries circulaires imposées par l’ANOVA univariée.
Cependant, cette émancipation du postulat de sphéricité s’accompagne d’une contrepartie statistique non négligeable : une vulnérabilité aiguë à la taille d’échantillon. Pour que la MANOVA soit calculable sur le plan mathématique matriciel, la condition impérative $N ge k$ doit être satisfaite (l’effectif doit impérativement excéder le nombre de conditions pour éviter une singularité de la matrice inverse). De surcroît, des recherches comparatives poussées ont démontré que lorsque la violation de sphéricité est faible ou modérée ($epsilon > 0,85$), ou lorsque l’échantillon est de taille modeste ($N 50$) et une asphéricité dévastatrice ($epsilon < 0,70$).
11.2 Les modèles linéaires mixtes (LMM / HLM)
Dans le paysage méthodologique du XXIe siècle, la réponse analytique la plus élégante, polyvalente et supérieure face aux faiblesses de l’ANOVA intra-sujets réside dans la modélisation linéaire mixte (Linear Mixed-Effects Models). Là où l’ANOVA force l’analyste à un arbitrage binaire insatisfaisant entre un modèle univarié sphérique contraint et un modèle multivarié totalement non structuré, les modèles mixtes autorisent une personnalisation sur-mesure de la structure de dépendance et de dispersion des données.
Dans l’environnement computationnel des modèles mixtes (implémentés via des packages de pointe tels que `lme4` ou `nlme` sous R, ou les procédures `MIXED` sous SPSS et SAS), le chercheur peut formellement comparer, via des critères d’information d’Akaike (AIC) et bayésiens (BIC), une multiplicité de matrices de variance-covariance résiduelles :
- La matrice de symétrie composée standard (homologue à l’assomption de l’ANOVA non corrigée) ;
- La matrice autorégressive de premier ordre AR(1), particulièrement adaptée aux devis longitudinaux où la corrélation s’érode avec l’écart temporel ;
- La matrice de Toeplitz, qui assume des covariances identiques par bandes de distance temporelle ;
- La matrice hétérogène (CSH ou ARH(1)), autorisant des variances inégales tout en modélisant des corrélations structurées ;
- La matrice non structurée (UN), libérant intégralement l’ensemble des paramètres comme en MANOVA.
Outre cette maestria dans la gestion de l’asphéricité, les modèles mixtes apportent une solution décisive au fléau des données manquantes. Dans une ANOVA intra-sujets conventionnelle, la survenue d’une seule mesure manquante au sein d’un bloc de six conditions entraîne l’éviction définitive et totale du participant de l’ensemble de l’analyse (procédure dite de listwise deletion), ce qui induit une perte de puissance désastreuse et expose les inférences à un biais de sélection d’échantillonnage majeur. Les modèles linéaires mixtes exploitent l’estimation par maximisation de la vraisemblance restreinte (REML), permettant d’intégrer l’ensemble des observations disponibles sans supprimer les participants incomplets. Cette résilience mathématique, conjuguée à leur capacité à modéliser sans effort des trajectoires temporelles non linéaires continues, consacre les modèles mixtes comme le successeur privilégié de l’ANOVA à mesures répétées classique.
12. Protocole décisionnel et recommandations pratiques de reporting
12.1 Arbre de décision séquentiel pour le praticien
Pour guider le chercheur confronté à l’analyse de données intra-sujets, la mise en œuvre d’un protocole séquentiel standardisé permet de garantir la rigueur de chaque arbitrage analytique. Ce protocole se déploie en trois phases chronologiques interdépendantes :
Étape 1 : Diagnostic structurel de l’échantillonnage et vérification de l’indépendance. L’analyste procède en amont à un audit minutieux du dispositif expérimental. Les passations ont-elles été conduites individuellement en conditions strictement contrôlées ? En cas de passation collective ou d’échantillonnage par grappes, le calcul d’un ICC s’impose. Si l’ICC est significativement supérieur à zéro, l’ANOVA intra-sujets classique doit être formellement abandonnée au profit d’un modèle linéaire mixte avec ordonnées aléatoires par cluster.
Étape 2 : Exploration distributionnelle et vérification de la normalité. L’analyste extrait les résidus standardisés du modèle ou génère les scores de différence entre chaque paire de conditions. Cette étape requiert l’inspection systématique des diagrammes quantile-quantile (Q-Q plots) et l’évaluation des coefficients d’asymétrie et d’aplatissement. Si $N < 50$, le test de Shapiro-Wilk est exécuté sur les contrastes résiduels. Face à une asymétrie marquée, une transformation mathématique (Box-Cox) ou une modélisation basée sur le rééchantillonnage bootstrap doit être priorisée.
Étape 3 : Investigation matricielle de la sphéricité et sélection corrective. Pour tout facteur comportant trois modalités ou plus ($k ge 3$), l’analyste consulte le test de sphéricité de Mauchly conjointe à l’estimation des coefficients $\hat{\epsilon}_{GG}$ et $\tilde{\epsilon}_{HF}$. Trois branches décisionnelles émergent :
- Si le test de Mauchly est non significatif ($p ge 0,05$) et que $\hat{\epsilon} \approx 1,00$, l’ANOVA univariée standard non corrigée est validée.
- Si le test de Mauchly est statistiquement significatif ($p < 0,05$) et que l'estimation de l'epsilon de Greenhouse-Geisser est strictement inférieure à 0,75 ($\hat{\epsilon}_{GG} < 0,75$), l'application de la correction de Greenhouse-Geisser devient obligatoire.
- Si le test de Mauchly est significatif mais que l’estimation d’epsilon est modérée à élevée ($\hat{\epsilon} ge 0,75$), l’analyste retient prioritairement la correction de Huynh-Feldt afin d’optimiser la puissance statistique tout en jugulant le risque d’erreur $\alpha$.
12.2 Standards de publication académique (Normes APA 7)
L’intégrité de la dissémination scientifique requiert une transparence absolue dans la formalisation textuelle des résultats statistiques au sein des revues savantes. Les directives de l’American Psychological Association (APA 7th edition) imposent des normes formelles strictes pour la transcription des tests d’ANOVA intra-sujets ayant subi des procédures d’ajustement.
Lorsqu’une correction d’asphéricité a été appliquée, les degrés de liberté théoriques entiers sont convertis en degrés de liberté décimaux fractionnaires reflétant l’action multiplicatrice directe du paramètre d’amortissement epsilon. Le chercheur a l’obligation de mentionner explicitement le modèle de correction sollicité, la statistique d’asphéricité de Mauchly ainsi que la valeur exacte de l’epsilon retenu. La formulation textuelle standardisée adopte la structure canonique suivante :
« L’analyse de variance à mesures répétées à un facteur a révélé un effet principal significatif du temps d’exposition sur la performance cognitive, après application de la correction de Greenhouse-Geisser pour pallier une violation substantielle du postulat de sphéricité (Mauchly $W = 0,54$, $p < 0,001$, $\hat{\epsilon}_{GG} = 0,68$), $F(1,36, 39,44) = 8,72$, $p = 0,003$, $\eta_p^2 = 0,23$. »
Il est impératif d’observer dans cet exemple prototypique que les degrés de liberté initiaux du modèle (qui étaient de 2 pour le numérateur et de 58 pour le dénominateur sur la base de $N = 30$ et $k = 3$) ont été rigoureusement multipliés par l’estimateur $\hat{\epsilon} = 0,68$, engendrant les valeurs décimales ajustées $df = (1,36 ; 39,44)$. Par ailleurs, les auteurs doivent s’abstenir de rapporter des formulations vagues telles que « les postulats ont été respectés » et divulguer de manière transparente la gestion opérationnelle des outliers (méthode de détection, seuils Z ou Mahalanobis retenus, justification théorique des éventuelles exclusions de données).
12.3 Synthèse comparative des choix analytiques
Pour achever ce panorama méthodologique, il est salutaire de mettre en perspective les arbitrages statistiques sous la forme d’une confrontation raisonnée entre leurs coûts et leurs bénéfices inférentiels. Le tableau ci-dessous récapitule les compromis fondamentaux entre la robustesse face aux violations des postulats, le contrôle du taux nominal d’erreur de première espèce ($\alpha$) et la puissance statistique brute :
| Modèle Statistique | Sensibilité aux Postulats | Maîtrise Erreur Type I | Puissance Statistique | Recommandation Préférentielle |
|---|---|---|---|---|
| ANOVA non corrigée | Extrême (asphéricité, dépendance) | Très mauvaise si $epsilon < 1$ (inflation $\alpha$) | Optimale uniquement si sphéricité pure | À proscrire dès que $k ge 3$ sans test d’adéquation préalable |
| ANOVA Greenhouse-Geisser | Insensible à l’asphéricité | Excellente (légèrement conservatrice) | Modérée sur petits échantillons ($N < 20$) | Standard absolu dès que $\hat{\epsilon} < 0,75$ |
| ANOVA Huynh-Feldt | Insensible à l’asphéricité | Excellente (calibrage optimal) | Élevée (supérieure à G-G) | Choix d’excellence lorsque $\hat{\epsilon} ge 0,75$ |
| MANOVA intra-sujets | Exempte de sphéricité (normalité requise) | Excellente si $N ge k + 10$ | Faible sur petits échantillons, haute sur grands | Grands échantillons ($N > 50$) et asphéricité sévère |
| Test de Friedman | Non paramétrique (libre de loi) | Excellente | Dégradée sur données continues normales | Échelles ordinales, scores à forte asymétrie incurable |
| Modèles Mixtes (LMM) | Flexibilité totale des covariances | Excellente et adaptative | Maximale (tolère les données manquantes) | Plans longitudinaux, hiérarchiques et écologiques |
En conclusion de ce parcours approfondi, la maîtrise des trois postulats de l’ANOVA à mesures répétées — indépendance, normalité, sphéricité — apparaît non comme une contrainte bureaucratique imposée par le formalisme mathématique, mais bien comme l’artisanat fondamental garantissant l’intégrité de l’édifice scientifique. En intégrant ces principes au cœur de leur routine expérimentale, les chercheurs confèrent à leurs découvertes la rigueur statistique indispensable à l’avènement d’une science cumulative, reproductible et théoriquement féconde.
Références
- Box, G. E. P. (1954). Some theorems on quadratic forms applied in the study of analysis of variance problems, II. Effects of inequality of variance and of correlation between errors in the two-way classification. The Annals of Mathematical Statistics, 25(3), 484–498. https://doi.org/10.1214/aoms/1177728717
- Geisser, S., & Greenhouse, S. W. (1958). An extension of Box’s results on the use of the $F$ distribution in multivariate analysis. The Annals of Mathematical Statistics, 29(3), 885–891. https://doi.org/10.1214/aoms/1177706545
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1970). Conditions under which mean square ratios in repeated measurements designs have exact $F$-distributions. Journal of the American Statistical Association, 65(332), 1582–1589. https://doi.org/10.1080/01621459.1970.10481187
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Mauchly, J. W. (1940). Significance test for sphericity of a normal $n$-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731909
- Maxwell, S. E., & Delaney, H. D. (2004). Designing experiments and analyzing data: A model comparison perspective (2nd ed.). Lawrence Erlbaum Associates.
- Rouanet, H., & Lépine, D. (1970). Comparison between treatments in a repeated-measurement design: ANOVA and multivariate methods. The British Journal of Mathematical and Statistical Psychology, 23(2), 147–163. https://doi.org/10.1111/j.2044-8317.1970.tb00448.x
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Vasey, M. W., & Thayer, J. F. (1987). The problem of sphericity in repeated measures designs: An overview of the problem, tests, and alternative solutions. Psychophysiology, 24(4), 479–486. https://doi.org/10.1111/j.1469-8986.1987.tb00324.x
- Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press. https://doi.org/10.1016/C2010-0-67044-1