
Dans le champ de la modélisation statistique appliquée et de la recherche empirique quantitative, la validation des postulats sous-jacents aux modèles linéaires constitue une étape incontournable, conditionnant la validité interne de toute conclusion inférentielle. Parmi ces exigences fondamentales, l’hypothèse selon laquelle les résidus ou les variables dépendantes suivent une loi normale occupe une place centrale. Bien que le théorème central limite offre une garantie asymptotique robuste lorsque les effectifs d’échantillonnage deviennent particulièrement volumineux, de nombreuses investigations cliniques, psychométriques, agronomiques ou économétriques opèrent sur des cohortes d’effectifs restreints à modérés. Dans de telles configurations expérimentales, l’invocation aveugle des propriétés asymptotiques expose le chercheur à des distorsions sévères du taux d’erreur de première espèce, réduisant drastiquement la fiabilité des tests paramétriques usuels tels que le test t de Student ou l’analyse de variance univariée.
Face à cet impératif méthodologique, le test de normalité conçu par Samuel Sanford Shapiro et Martin Wilk en 1965 s’est imposé au fil des décennies comme l’étalon-or des tests d’adéquation pour l’évaluation de la gaussianité. Fondé sur l’étude rigoureuse du ratio de variance dérivé des statistiques d’ordre, ce test surpasse systématiquement en puissance statistique ses homologues classiques, qu’il s’agisse du test de Kolmogorov-Smirnov, de la modification de Lilliefors ou du critère d’Anderson-Darling, en particulier face à des distributions asymétriques ou dotées de queues lourdes. Cependant, l’exécution rigoureuse de ce test nécessite un cadre informatique hautement standardisé, capable de manipuler avec une précision numérique absolue les matrices de covariance des statistiques d’ordre et de calculer les valeurs p exactes ou approchées par des algorithmes optimisés.
Le système SAS (Statistical Analysis System) représente, au sein des environnements académiques, de l’industrie pharmaceutique et des agences de régulation internationales, la référence par excellence pour l’analyse statistique certifiée et reproductible. À travers sa procédure universelle d’analyse univariée, le logiciel intègre nativement le calcul de la statistique de Shapiro-Wilk et déploie un ensemble d’outils analytiques et graphiques permettant d’en affiner l’interprétation. Ce guide complet a pour vocation de décortiquer, avec une rigueur académique et pratique approfondie, les fondements théoriques, la mise en œuvre logicielle pas à pas, la décomposition des tables de sortie et les arbitrages décisionnels qu’implique l’évaluation de la normalité via le test de Shapiro-Wilk sous SAS.
1. Introduction aux postulats de normalité et au test de Shapiro-Wilk dans SAS
1.1 Le postulat de distribution normale en recherche quantitative
L’édifice des statistiques paramétriques repose en grande partie sur l’hypothèse de gaussianité des variables étudiées ou des perturbations aléatoires qui affectent les processus observés. Dans le cadre du modèle linéaire général, l’estimation des paramètres par la méthode des moindres carrés ordinaires ne requiert pas formellement la normalité pour garantir l’absence de biais et la variance minimale des estimateurs, ainsi que l’établit le théorème de Gauss-Markov. Néanmoins, dès lors que le statisticien souhaite procéder à une inférence statistique formelle, c’est-à-dire construire des intervalles de confiance exacts ou tester des hypothèses de recherche par l’intermédiaire des statistiques de Student ou de Fisher-Snedecor, la distribution normale des erreurs devient un prérequis théorique fondamental.
La violation de cette condition préalable engendre des répercussions asymétriques selon la nature de la distribution empirique observée. Dans l’analyse de données psychologiques, éducatives ou biomédicales, les distributions mesurées présentent fréquemment des asymétries positives marquées ou des leptocurtoses prononcées résultant d’effets de plancher ou de plafond. Lorsqu’un test paramétrique est appliqué à des données violant gravement le postulat de normalité sans que la taille d’échantillon ne permette de mobiliser le théorème central limite, le taux nominal d’erreur de première espèce (alpha) se trouve fréquemment altéré. Le chercheur court alors le risque de rejeter indûment des hypothèses nulles légitimes ou, à l’inverse, d’accroître de façon incontrôlée l’erreur de type II (bêta), minorant la puissance statistique de ses expérimentations.
Il convient de maintenir une distinction épistémologique stricte entre la distribution théorique gaussienne, entité mathématique abstraite caractérisée par sa fonction de densité symétrique en cloche dépendant exclusivement de son espérance et de sa variance, et la distribution empirique issue de l’échantillonnage expérimental. Aucune variable concrète issue de l’observation humaine ou biologique ne suit rigoureusement, à l’échelle infinitésimale, une loi normale parfaite. L’évaluation de la normalité ne consiste donc pas à prouver une identité ontologique absolue, mais à déterminer si la distribution observée s’écarte de la loi normale théorique avec une magnitude suffisante pour compromettre la validité des inférences paramétriques subséquentes.
1.2 Origine et spécificité statistique du test de Shapiro-Wilk
Le test de Shapiro-Wilk a été formellement introduit par les statisticiens Samuel Sanford Shapiro et Martin Wilk dans leur publication princeps de 1965 parue dans la revue Biometrika. Leur objectif consistait à élaborer un test d’adéquation spécifiquement calibré pour l’hypothèse de normalité, capable de s’affranchir des limitations notoires des tests génériques d’adéquation de la fonction de répartition empirique, tels que le test de Kolmogorov-Smirnov. Contrairement aux approches basées sur l’écart maximal absolu entre une courbe théorique et une courbe observée, l’approche de Shapiro et Wilk repose sur une comparaison structurelle interne de la variance de l’échantillon.
Le principe fondamental du test repose sur le calcul d’un ratio entre deux estimateurs distincts de la variance de la population parente. Le dénominateur de la statistique est constitué de la somme classique des carrés des écarts à la moyenne empirique, qui fournit un estimateur sans biais de la variance, que la population soit gaussienne ou non. Le numérateur, quant à lui, est calculé à partir d’une combinaison linéaire optimale des statistiques d’ordre de l’échantillon, dont les coefficients de pondération sont dérivés des espérances mathématiques, des variances et des covariances des statistiques d’ordre d’une loi normale standard. Si les données proviennent effectivement d’une population gaussienne, ces deux estimateurs convergent vers la même grandeur et leur ratio approche l’unité. Tout écart morphologique substantiel induit une minoration de ce ratio.
De multiples investigations empiriques et études de simulation par méthode de Monte-Carlo ont documenté la supériorité systématique de la puissance statistique du test de Shapiro-Wilk face à un spectre très étendu de distributions alternatives. Cette supériorité s’avère particulièrement écrasante sur les petits effectifs (échantillons de taille inférieure à cinquante observations) et les effectifs modérés. Là où d’autres procédures restent incapables de détecter des déviations modérées de symétrie ou des aplatissements anormaux, la statistique de Shapiro-Wilk démontre une sensibilité exceptionnelle, ce qui lui confère son statut d’outil d’évaluation préférentiel dans les protocoles d’analyse quantitative rigoureux.
1.3 Le rôle du logiciel SAS dans l’analyse inférentielle
Dans l’écosystème international de l’analyse computationnelle des données, le logiciel SAS occupe une place prépondérante, tout particulièrement au sein des essais cliniques régulés par la Food and Drug Administration (FDA) et l’Agence Européenne des Médicaments (EMA), ainsi que dans les départements de biostatistique et d’économétrie appliquée. Cette prééminence s’explique par la standardisation absolue de ses procédures, sa validation algorithmique continue et la traçabilité intégrale des chaînes de traitement analytique qu’il permet de déployer. L’exécution de calculs inférentiels au sein d’un environnement validé garantit que les approximations numériques requises par les tests complexes sont opérées selon les standards académiques les plus exigeants.
Pour le calcul de la statistique de Shapiro-Wilk, notée habituellement W, SAS intègre de manière native les algorithmes perfectionnés de Royston, développés au début des années 1990 pour étendre la portée du test d’origine aux échantillons pouvant atteindre plusieurs milliers d’observations, tout en fournissant une approximation hautement précise de la valeur p. Cette intégration native décharge l’analyste de l’approximation manuelle des vecteurs de pondération et assure une fiabilité numérique parfaite des probabilités critiques associées aux valeurs calculées.
Au sein de l’architecture SAS, la procédure PROC UNIVARIATE constitue le véhicule privilégié pour l’audit complet des distributions quantitatives. Si d’autres modules, tels que la procédure PROC MEANS ou PROC SUMMARY, permettent l’extraction rapide de statistiques récapitulatives élémentaires, seule PROC UNIVARIATE déploie la machinerie statistique exhaustive nécessaire à l’évaluation formelle de l’adéquation distributionnelle. Elle combine en une exécution unique le calcul des coefficients de forme, les tests d’hypothèse formels et la génération de diagnostics graphiques haute résolution, offrant ainsi une plateforme d’investigation univariée sans équivalent.
2. Fondements mathématiques et formulation des hypothèses statistiques
2.1 Formulation formelle des hypothèses nulle et alternative
L’exécution de tout test d’adéquation distributionnelle s’inscrit dans le cadre épistémologique de l’inférence par test d’hypothèse nulle formalisé par Ronald Fisher, Jerzy Neyman et Egon Pearson. Dans le contexte du test de Shapiro-Wilk, l’espace des hypothèses est structuré autour d’une hypothèse nulle stricte et d’une hypothèse alternative générale. L’hypothèse nulle, traditionnellement désignée par la notation H0, stipule formellement que l’échantillon aléatoire observé provient d’une population parente distribuée selon une loi normale d’espérance mathématique mu et de variance sigma carrée indéterminées.
À l’opposé, l’hypothèse alternative, notée HA ou H1, stipule que la fonction de distribution sous-jacente de la population parente ne suit pas une loi normale. Il importe de souligner le caractère non directionnel et omnibus de cette hypothèse alternative : elle ne postule aucun profil alternatif spécifique, englobant indifféremment des déviations imputables à une asymétrie unilatérale, à une bimodalité latente, à un écrasement de la voûte distributionnelle (platycurtose) ou à la présence de queues de distribution épaisses et lourdes (leptocurtose).
D’un point de vue épistémologique, le maintien de l’hypothèse nulle à l’issue de l’analyse ne constitue en aucune manière la preuve mathématique que la distribution empirique est parfaitement gaussienne. En logique de l’inférence statistique, l’absence de rejet de H0 indique exclusivement que les données collectées n’apportent pas un niveau de preuve suffisant pour rejeter la conformité au modèle normal, compte tenu de la variance d’échantillonnage et de la puissance du test. Cette nuance conceptuelle est fondamentale : le chercheur conclut à la compatibilité opérationnelle de ses données avec le modèle normal, autorisant ainsi l’usage consécutif des techniques inférentielles paramétriques standard.
2.2 Structure mathématique de la statistique W
L’expression analytique de la statistique de Shapiro-Wilk repose sur le tri ordonné préalable des n observations constituant l’échantillon empirique. Soit un échantillon de variables aléatoires indépendantes et identiquement distribuées, noté x_1, x_2, jusqu’à x_n. La première étape algorithmique consiste à ordonner ces observations par ordre de grandeur croissant, générant ainsi la suite ordonnée x_(1) ≤ x_(2) ≤ … ≤ x_(n), où x_(1) représente le minimum de l’échantillon et x_(n) son maximum absolu.
La statistique W est formellement définie par l’équation suivante :
W = ( ∑ [ a_i * x_(i) ] )^2 / ∑ [ (x_i – x_barre)^2 ]
Dans cette formulation, le dénominateur représente la somme des carrés des écarts de chaque observation individuelle par rapport à la moyenne arithmétique de l’échantillon, notée x_barre. Cette composante correspond au numérateur standard de la variance empirique non corrigée. Le numérateur du ratio représente quant à lui le carré d’une combinaison linéaire spécifique des statistiques d’ordre observées. Les coefficients a_i constituent un vecteur de pondérations optimales déterminé mathématiquement par l’expression vectorielle :
a’ = ( m’ * V^(-1) ) / [ ( m’ * V^(-1) * V^(-1) * m )^(1/2) ]
où m représente le vecteur des espérances mathématiques des statistiques d’ordre d’un échantillon de taille n extrait d’une loi normale standardisée, et V symbolise la matrice de variance-covariance de ces mêmes statistiques d’ordre. En vertu de cette construction mathématique rigoureuse, la statistique W est structurellement bornée sur un intervalle continu compris strictement entre 0 et 1. Une valeur de W égale ou infinitésimalement proche de 1 traduit une concordance linéaire idéale entre les quantiles observés et les espérances des quantiles d’une loi normale, attestant d’une adéquation parfaite au modèle gaussien.
2.3 Fixation du seuil de significativité alpha
La prise de décision statistique automatisée exige la définition préalable d’un seuil de risque critique, universellement désigné par la lettre grecque alpha. Par convention académique quasi universelle, ce seuil est fixé à 0,05 dans la majorité des publications scientifiques et des protocoles d’investigation quantitative. Ce seuil indique que le statisticien accepte une probabilité de 5 % de rejeter à tort l’hypothèse nulle de normalité alors que la population parente est rigoureusement gaussienne (erreur de type I).
Toutefois, la rigidité de cette convention mérite d’être nuancée en fonction des impératifs méthodologiques spécifiques à chaque domaine de recherche. Lorsque l’objectif consiste à vérifier un postulat en amont d’analyses paramétriques particulièrement sensibles à la non-normalité, certains méthodologistes préconisent d’adopter un seuil alpha plus conservateur, fixé par exemple à 0,10. L’élévation du seuil alpha a pour effet mécanique d’augmenter la puissance du test de Shapiro-Wilk, permettant ainsi de détecter des déformations plus subtiles de la distribution qui pourraient fragiliser l’interprétation d’un modèle linéaire complexe.
À l’inverse, dans les protocoles exploratoires reposant sur des effectifs limités mais intrinsèquement marqués par une forte variabilité comportementale ou écologique, un seuil d’adéquation trop libéral peut induire des rejets systématiques de la normalité pour des déviations pourtant sans conséquence pratique sur les tests robustes. Le calibrage du seuil alpha ne doit donc jamais résulter d’un automatisme mécanique, mais d’une réflexion concertée intégrant la taille de l’échantillon, la résistance des modèles statistiques subséquents et le coût épistémologique respectif des erreurs d’inférence de type I et de type II.
3. Préparation de l’environnement SAS et saisie des données empiriques
3.1 Création d’une table de données avec l’étape DATA
Toute manipulation statistique au sein du système SAS débute par la structuration rigoureuse de l’environnement de données via l’étape d’ingénierie préliminaire dénommée « étape DATA » (DATA step). Cette phase programmatique permet de définir la table SAS réceptrice, d’allouer les espaces mémoire nécessaires et de déclarer les attributs typologiques des variables qui feront l’objet de l’évaluation inférentielle. La modularité de cette étape autorise aussi bien la simulation stochastique de données que l’encodage manuel de jeux d’observations expérimentales.
L’initialisation d’une table de données s’effectue au moyen de l’instruction DATA, immédiatement suivie du nom attribué à la table SAS temporaire ou permanente. Pour déclarer les variables d’intérêt, le chercheur fait appel à l’instruction INPUT. Dans le contexte de l’audit de normalité, les variables cibles doivent impérativement être spécifiées comme des grandeurs quantitatives continues. En l’absence de suffixe textuel tel que le signe dollar, SAS attribue automatiquement le type numérique à virgule flottante double précision à chaque colonne déclarée, garantissant ainsi l’exactitude des calculs de variance subséquents.
L’incorporation directe des observations au sein du programme est orchestrée par le bloc d’instructions DATALINES (ou son synonyme historique CARDS). Cette instruction signale à l’interpréteur SAS que les lignes subséquentes contiennent exclusivement des enregistrements de données brutes, délimités par des espaces standard. Chaque ligne correspond à une unité statistique distincte, terminée par un point-virgule terminal après la dernière valeur. Ce mode de saisie garantit un contrôle visuel immédiat sur le jeu d’essai avant de soumettre les données à l’analyse formelle.
3.2 Importation de jeux de données externes dans SAS
Dans la pratique contemporaine de la recherche, les données empiriques proviennent rarement d’une saisie programmatique directe au sein de l’éditeur SAS ; elles sont le plus souvent issues de bases relationnelles, de fichiers délimités au format texte (CSV) ou de classeurs tabulaires Microsoft Excel. L’intégration de ces jeux de données volumineux nécessite l’emploi de la procédure spécialisée PROC IMPORT, qui automatise la lecture des fichiers externes tout en préservant l’intégrité de la structure tabulaire originelle.
L’appel de la procédure requiert la spécification rigoureuse du chemin d’accès physique du fichier source via l’option DATAFILE=, l’assignation de la table réceptrice via l’option OUT=, et la déclaration explicite du pilote d’importation au moyen de l’option DBMS= (telle que CSV, XLSX ou TAB). Afin d’assurer une traçabilité irréprochable de la métrique, l’option GETNAMES=YES ordonne au compilateur d’extraire la première ligne du fichier externe pour baptiser automatiquement les variables de la table SAS. La gestion fine des séparateurs de colonnes et des séparateurs décimaux (points ou virgules selon les normes régionales) doit faire l’objet d’une vigilance méticuleuse afin d’éviter la troncature silencieuse de données quantitatives.
La validation de l’intégrité structurelle des variables numériques importées constitue un impératif méthodologique absolu. Une chaîne de caractères égarée au sein d’une colonne de mesures de laboratoire ou de scores psychologiques contraint le module d’importation à convertir l’intégralité de la variable en format alphanumérique. Or, une variable de type caractère ne peut en aucun cas être traitée par les algorithmes de la statistique de Shapiro-Wilk. La consultation attentive du journal d’exécution (SAS Log) permet de vérifier que chaque variable continue a bien été interprétée sous sa forme numérique canonique.
3.3 Inspection préliminaire du jeu de données avec PROC PRINT
Préalablement à toute démarche de modélisation ou de vérification des postulats distributionnels, une inspection préliminaire de la table SAS nouvellement constituée s’avère indispensable. La procédure élémentaire PROC PRINT constitue l’outil de diagnostic visuel de premier niveau le plus efficient pour s’assurer de la parfaite adéquation entre le modèle conceptuel de données et la réalité de la table matérialisée en mémoire de travail.
L’exécution de base s’articule autour de l’instruction PROC PRINT DATA=nom_table; RUN;. Pour les cohortes volumineuses, il est hautement recommandé d’adjoindre l’option de restriction (OBS=20) afin de limiter l’affichage aux vingt premiers enregistrements de la table. Cette inspection tabulaire permet d’authentifier instantanément la validité des étiquettes de colonnes, de vérifier le bon alignement des données et de repérer d’éventuels décalages survenus lors de la lecture des lignes d’enregistrements.
Cette étape exploratoire permet également d’identifier la présence de cellules vides ou de marqueurs de valeurs manquantes (représentées par un point typographique unique dans l’environnement SAS). La détection précoce des données manquantes est capitale, car la procédure PROC UNIVARIATE gère l’exclusion des valeurs absentes de manière casuistique (observation par observation). Le chercheur doit connaître précisément l’effectif effectif (N valide) sur lequel reposera le test de Shapiro-Wilk afin de ne pas fausser son interprétation de la puissance statistique mobilisée.
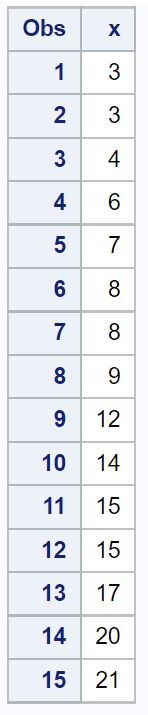
4. Exécution pas à pas du test de Shapiro-Wilk avec PROC UNIVARIATE
4.1 Syntaxe fondamentale de la procédure PROC UNIVARIATE
L’accès à la panoplie des tests d’adéquation et au calcul explicite de la statistique W de Shapiro-Wilk est gouverné par la procédure d’analyse univariée la plus perfectionnée de SAS : PROC UNIVARIATE. La syntaxe canonique minimale requiert l’invocation du mot-clé de la procédure couplé à la désignation explicite du jeu de données source à l’aide de l’argument DATA=, suivi immédiatement de l’option spécifique commandant l’exécution des tests de gaussianité.
Le déclencheur fondamental des calculs d’adéquation à la loi normale réside dans l’adjonction de l’option NORMAL (ou de son équivalent graphique NORMALTEST) directement au sein de l’instruction d’ouverture. La formulation s’énonce selon le schéma formel :
PROC UNIVARIATE DATA=ma_table NORMAL;
L’omission de cette option conduirait SAS à générer un rapport purement descriptif (mesures de tendance centrale, indices de dispersion, quantiles et valeurs extrêmes) tout en omettant délibérément la batterie des quatre tests d’hypothèse formels relatifs à la normalité. Enfin, conformément aux normes syntaxiques du langage de programmation SAS, la clôture impérative de l’instruction s’opère par la commande RUN;, laquelle déclenche la compilation immédiate et l’exécution séquentielle du bloc dans le processeur analytique.
4.2 Sélection des variables cibles avec l’instruction VAR
Bien que l’instruction PROC UNIVARIATE puisse s’exécuter sans spécification supplémentaire, une telle pratique est formellement proscrite dans un cadre d’analyse de données rigoureux. En l’absence de l’instruction subordonnée VAR, SAS tente d’appliquer l’ensemble de ses algorithmes descriptifs et inférentiels à chaque variable numérique présente dans la table d’entrée, incluant les identifiants de sujets, les codes catégoriels arbitraires ou les variables d’horodatage.
L’instruction VAR joue un rôle déterminant de ciblage méthodologique. Elle restreint l’opération de calcul à la seule métrique continue dont l’adéquation distributionnelle doit être vérifiée préalablement à une analyse plus poussée. Par exemple, pour examiner le score obtenu à une échelle d’anxiété clinique ou la concentration sérique d’un biomarqueur, le code adoptera la structure unitaire :
PROC UNIVARIATE DATA=ma_table NORMAL;
VAR score_anxiete;
RUN;
La puissance syntaxique de l’instruction VAR permet également le traitement simultané mais strictement compartimenté de multiples grandeurs au sein d’une seule invocation de la procédure. Il suffit d’énumérer séquentiellement l’ensemble des variables cibles (par exemple : VAR variable1 variable2 variable3;). SAS produira alors un audit exhaustif et indépendant pour chaque dimension métrique spécifiée, garantissant une efficience d’exécution computationnelle maximale tout en préservant l’étanchéité des sorties statistiques pour chaque variable analysée.
4.3 Optimisation des options de sortie pour l’analyse académique
Par défaut, l’exécution brute de PROC UNIVARIATE produit un volume considérable d’informations tabulaires au sein du visualiseur de résultats. Cette verbosité algorithmique englobe cinq sections standardisées : les moments d’échantillon, les paramètres de localisation et de variabilité, les tests élémentaires d’hypothèse de centrage, les quantiles empiriques et les valeurs extrêmes d’observation. Dans le cadre ciblé de la validation du postulat de normalité, cette profusion de tableaux peut encombrer inutilement l’espace de travail et compliquer l’extraction rapide des paramètres décisionnels.
Pour rationaliser l’affichage et cibler exclusivement le tableau d’adéquation, SAS met à disposition son puissant système de sélection d’objets de données (Output Delivery System, ou ODS). En insérant l’instruction ODS SELECT TestsForNormality; en amont immédiat de la procédure, l’analyste contraint SAS à masquer l’ensemble des sorties secondaires pour n’afficher formellement que la matrice contenant les statistiques de test d’adéquation et leurs valeurs p associées. Cette démarche écarte toute dispersion visuelle superflue.
Dans une perspective d’intégration au sein de chaînes de traitement automatisées ou de méta-analyses, il est également possible de rediriger directement les valeurs calculées de la statistique de Shapiro-Wilk vers une nouvelle table SAS réutilisable. Cette persistance des résultats s’opère par l’utilisation conjointe de l’instruction ODS OUTPUT TestsForNormality=table_normalite;. Cette configuration permet d’archiver, de trier ou d’intégrer dynamiquement la statistique W et la probabilité critique au sein de tableaux récapitulatifs automatisés, garantissant un flux de travail rigoureusement reproductible.
5. Décomposition et analyse de la table de sortie « Tests for Normality »
5.1 Identification de la section spécifique aux tests de normalité
Dès lors que l’option NORMAL a été adjointe à l’instruction PROC UNIVARIATE, le flux de résultats génère une section distincte et hautement structurée intitulée textuellement « Tests for Normality » (ou « Tests de normalité » dans les versions francisées du système). Il est crucial de dissocier formellement cette section des autres blocs de statistiques descriptives, tels que le tableau des « Moments » ou celui des « Basic Statistical Measures ».
La table ODS TestsForNormality adopte une configuration matricielle standardisée à quatre colonnes d’information. La première colonne identifie le nom officiel du test statistique appliqué. La deuxième colonne précise la lettre conventionnelle désignant la statistique calculée. La troisième colonne livre la valeur numérique scalaire de la statistique estimée sur l’échantillon. Enfin, la quatrième colonne, identifiée par l’expression mathématique p Value, restitue la probabilité exacte d’observer une telle valeur sous l’empire strict de l’hypothèse nulle.
SAS fournit simultanément quatre tests distincts au sein de cette table unifiée : le test de Shapiro-Wilk, le test de Kolmogorov-Smirnov, le test de Cramér-von Mises et le test d’Anderson-Darling. L’analyste doit impérativement focaliser son attention méthodologique sur la toute première ligne de ce tableau, laquelle est exclusivement réservée à la statistique W de Shapiro-Wilk pour tout échantillon dont la taille ne dépasse pas 2 000 observations (limite pouvant être modulée selon les versions de SAS).
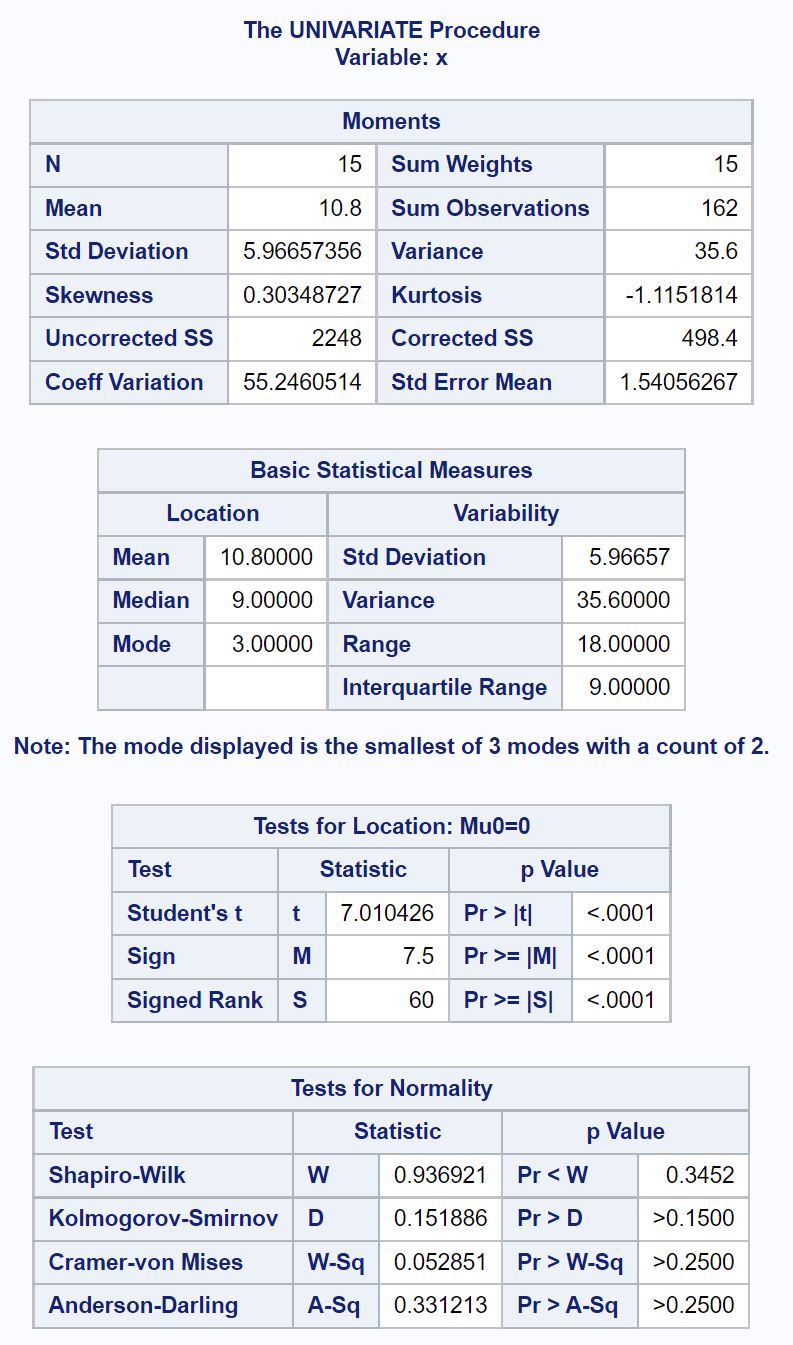
5.2 Lecture de la statistique W de Shapiro-Wilk
Sur la première ligne du tableau matriciel, sous l’intitulé « Shapiro-Wilk », la colonne désignant la statistique affiche la lettre majuscule W. Immédiatement à sa droite, la cellule de la colonne « Statistic » présente la magnitude numérique du coefficient calculé par l’algorithme. Cette valeur scalaire constitue l’indicateur synthétique fondamental du niveau de conformité de l’échantillon empirique vis-à-vis du profil gaussien théorique.
Comme explicité dans le cadre des fondements mathématiques, la statistique W est structurellement bornée entre 0 et 1. L’interprétation clinique et méthodologique de ce chiffre débute par l’évaluation de sa proximité physique avec la limite supérieure unitaire. Une statistique W s’élevant à 0,9850 traduit une proximité géométrique remarquable entre les quantiles ordonnés de l’échantillon et ceux attendus d’une loi normale. Les espérances des statistiques d’ordre coïncident presque parfaitement avec les données observées.
À l’inverse, l’observation d’une statistique W modeste, chutant par exemple sous le seuil de 0,9000 ou 0,8500, constitue un signal d’alerte direct indiquant une déformation morphologique substantielle de la distribution des données. Cette chute du coefficient W reflète une disproportion entre la variance classique de l’échantillon et l’estimateur fondé sur la combinaison linéaire pondérée des statistiques d’ordre, matérialisant la présence d’une asymétrie structurée, d’une concentration anormale autour du centre ou d’une dispersion excessive au niveau des extrémités distributionnelles.
5.3 Extraction et interprétation de la valeur p (Pr < W)
Le paramètre ultime régissant la décision d’inférence statistique réside dans la dernière cellule de la ligne Shapiro-Wilk, codée par la formule mathématique Pr < W (qui traduit formellement la notion de valeur p ou p-value). Cette métrique quantifie la probabilité exacte d’obtenir, par le seul jeu des fluctuations aléatoires d’échantillonnage issu d’une population normale, une valeur de la statistique de Shapiro-Wilk au moins aussi faible (donc au moins aussi divergente de la normalité) que celle mesurée sur les données réelles.
Il est indispensable de maîtriser la syntaxe typographique spécifique employée par SAS pour retranscrire ces probabilités. Lorsque la valeur p calculée est supérieure à un millième, le logiciel imprime la valeur décimale standard précédée d’un zéro ou directement d’un point décimal (par exemple : 0.2458 ou 0.0821). L’analyste peut alors comparer directement ce nombre à virgule flottante au risque alpha prédéterminé.
En revanche, lorsque la non-conformité de la distribution empirique est particulièrement aiguë, la probabilité d’adéquation devient infinitésimale. Dans cette configuration, SAS n’affiche pas une chaîne infinie de zéros mais emploie la notation conventionnelle de troncature Pr < W < 0.0001 (ou <.0001). L’apparition de ce symbole signale un écart à la loi normale d’une magnitude statistique extrême, éliminant quasi totalement l’hypothèse d’une fluctuation fortuite et contraignant l’expérimentateur à rejeter sans ambiguïté la normalité des données.
6. Interprétation formelle des résultats et prise de décision statistique
6.1 Critères formels de rejet ou de non-rejet de l’hypothèse nulle
La formalisation de la conclusion inférentielle procède de l’application scrupuleuse de la règle de décision de Neyman-Pearson, confrontant la probabilité empirique observée (valeur p) au seuil de signification théorique alpha préalablement arrêté, fixé conventionnellement à 0,05. Le protocole de décision est strictement binaire :
- Règle de rejet : Si la valeur p (Pr < W) est strictement inférieure au seuil alpha critique (p < 0,05), l’analyste est formellement tenu de rejeter l’hypothèse nulle H0. La conclusion méthodologique énonce que la distribution observée s’écarte de façon statistiquement significative de la loi normale au seuil de risque de 5 %.
- Règle de non-rejet : Si la valeur p (Pr < W) est supérieure ou égale au seuil alpha critique (p ≥ 0,05), l’analyste ne dispose pas de preuves statistiques suffisantes pour infirmer l’hypothèse nulle. H0 est dès lors maintenue, et les données sont considérées comme raisonnablement congruentes avec une distribution gaussienne.
Il importe de réitérer un avertissement méthodologique majeur : franchir le seuil des 0,05 en direction du non-rejet ne signifie en aucun cas que la normalité de la distribution a été formellement « démontrée ». Une telle interprétation procèderait d’une méconnaissance du fonctionnement asymétrique des tests d’hypothèse nulle. La conclusion scientifiquement rigoureuse consiste à déclarer que l’hypothèse de normalité n’est pas contredite par les données disponibles, autorisant ainsi l’emploi des procédures statistiques paramétriques qui reposent sur ce prérequis.
6.2 Exemple d’application concrète : non-rejet de la normalité
Afin de concrétiser le processus décisionnel, examinons le cas empirique d’un chercheur mesurant le temps de réponse cognitif (en millisecondes) au sein d’une cohorte expérimentale composée de trente participants adultes (N = 30). Après exécution de la procédure PROC UNIVARIATE assortie de l’option NORMAL, l’inspection de la table TestsForNormality révèle les estimations numériques suivantes sur la ligne de Shapiro-Wilk : une statistique W = 0,9371 et une probabilité critique Pr < W = 0,3452.
L’évaluation quantitative débute par la confrontation directe de la valeur p au seuil d’admissibilité standard de 0,05. Puisque la probabilité observée s’élève à 0,3452, elle dépasse très largement le seuil critique d’inférence (p > 0,05). De surcroît, la statistique W égale à 0,9371 demeure dans une proximité immédiate avec la borne théorique unitaire, indiquant que le ratio de variance issu des statistiques d’ordre n’enregistre aucune distorsion critique par rapport au modèle théorique.
La décision méthodologique finale consiste donc à maintenir l’hypothèse nulle de gaussianité. L’expérimentateur valide la conformité opérationnelle de son vecteur de temps de réaction avec les postulats du modèle linéaire. Il est par conséquent pleinement fondé à mobiliser les outils d’inférence paramétrique conventionnels, tels qu’un test t de Student pour échantillons indépendants ou une analyse de variance univariée (ANOVA), sans craindre une détérioration de la robustesse de ses intervalles de confiance ou du niveau de risque de première espèce.
6.3 Rédaction standardisée des résultats selon les normes APA
La communication des résultats statistiques au sein des revues scientifiques internationales exige une conformité rigoureuse avec les canons rédactionnels standardisés édictés par l’American Psychological Association (normes APA, 7e édition). Une simple mention déclarant que « les données étaient normales » s’avère méthodologiquement inacceptable aux yeux des pairs évaluateurs. Le chercheur est tenu de documenter explicitement le test employé, la valeur précise de la statistique d’échantillonnage, la taille de l’effectif valide et la valeur p exacte.
Sur le plan typographique et formel, les lettres symbolisant les statistiques et les probabilités doivent être composées en caractères italiques (par exemple, W pour la statistique de Shapiro-Wilk et p pour la probabilité critique). La valeur de W s’énonce avec deux ou trois décimales après la virgule, tandis que la valeur p ne prend aucun zéro préalable lorsque sa valeur théorique ne peut excéder 1. Un modèle d’intégration textuelle optimal se présente sous la structure narrative suivante :
« L’adéquation de la distribution des scores d’anxiété à la loi normale a été rigoureusement évaluée à l’aide du test de Shapiro-Wilk au moyen de la procédure PROC UNIVARIATE sous SAS. L’analyse révèle que la distribution ne s’écarte pas de façon statistiquement significative du modèle gaussien, W(30) = 0,94, p = 0,345. Par conséquent, les postulats distributionnels requis pour l’application des procédures paramétriques sont respectés. »
7. Analyse comparative : Shapiro-Wilk face aux autres tests de normalité dans SAS
7.1 Comparaison avec le test de Kolmogorov-Smirnov (D)
La procédure PROC UNIVARIATE de SAS fournit systématiquement, en deuxième ligne de sa table d’adéquation, le test de Kolmogorov-Smirnov, repéré par la lettre statistique D. L’architecture computationnelle de ce test diffère radicalement de celle de Shapiro-Wilk. Il ne repose pas sur une décomposition de variance des statistiques d’ordre, mais sur le calcul de la distance maximale verticale absolue constatée entre la fonction de répartition empirique par échelons de l’échantillon, F_n(x), et la fonction de répartition continue théorique spécifiée, F_0(x).
Une spécificité technique fondamentale de l’implémentation SAS réside dans l’ajustement systématique de ce test lorsque les paramètres de la population parente (espérance et variance) ne sont pas postulés a priori mais estimés directement à partir des données d’échantillon. Dans ce cas de figure omniprésent en pratique, SAS applique automatiquement la correction de Lilliefors, adaptant la distribution de la statistique D pour éviter une sous-estimation critique des valeurs p réelles.
Néanmoins, la littérature méthodologique et les études de puissance comparée démontrent sans équivoque la faiblesse statistique structurelle du test de Kolmogorov-Smirnov, même assorti de la correction de Lilliefors, dès lors qu’il est confronté à des échantillons d’effectifs modestes ou intermédiaires. Le test souffre d’un manque d’acuité prononcé pour détecter les anomalies situées dans les queues de distribution, concentrant sa sensibilité quasi exclusivement au voisinage immédiat de la médiane de la variable, ce qui le rend inférieur à la statistique W pour valider les postulats des modèles linéaires.
7.2 Comparaison avec les tests d’Anderson-Darling et de Cramér-von Mises
Pour pallier les lacunes intrinsèques du test de Kolmogorov-Smirnov, la famille des tests basés sur la fonction de répartition empirique s’est enrichie des critères quadratiques pondérés de Cramér-von Mises (noté W-Sq dans les sorties SAS) et d’Anderson-Darling (noté A-Sq). Ces deux indicateurs évaluent non plus l’écart unitaire maximal, mais l’intégrale de la somme des carrés des écarts entre la fonction observée et la fonction théorique sur l’ensemble du domaine de définition.
Le test de Cramér-von Mises accorde un poids uniforme à l’ensemble des écarts observés, fournissant une évaluation globale de la silhouette distributionnelle. Le test d’Anderson-Darling introduit pour sa part une fonction de pondération mathématique spécifique qui affecte un poids disproportionné aux divergences survenant aux extrémités de la distribution (dans les queues inférieure et supérieure). Cette particularité confère au test d’Anderson-Darling une sensibilité aiguë pour identifier les anomalies leptocurtiques et la présence d’observations périphériques extrêmes.
Le choix du test le plus pertinent dépend de la nature théorique des risques d’invalidation du modèle linéaire. Si le statisticien s’inquiète prioritairement de l’épaississement des queues de distribution susceptible d’invalider le calcul des écarts-types résiduels, le test d’Anderson-Darling constitue un complément analytique d’une valeur inestimable. Toutefois, d’un point de vue de l’adéquation globale d’une variable continue, aucune de ces variantes quadratiques ne surpasse de manière pérenne la polyvalence et la puissance omnibus démontrées par l’algorithme de Shapiro-Wilk.
7.3 Synthèse de la robustesse méthodologique selon la littérature
La question de la suprématie méthodologique entre les divers tests d’adéquation a fait l’objet d’un consensus scientifique solide à travers une multitude d’études de Monte-Carlo publiées au cours des quatre dernières décennies. Les travaux comparatifs de référence menés notamment par Stephens, puis confirmés par Razali et Wah en 2011, établissent de manière formelle que le test de Shapiro-Wilk délivre la puissance statistique empirique la plus élevée parmi tous les tests d’adéquation univariés face à la quasi-totalité des alternatives non gaussiennes (distributions de Cauchy, log-normales, uniformes, bimodalités et lois exponentielles asymétriques).
Cette dominance s’atténue uniquement lorsque les tailles d’échantillons deviennent particulièrement volumineuses (par exemple N > 2 000), situation dans laquelle les propriétés de Shapiro-Wilk rejoignent asymptotiquement celles du test d’Anderson-Darling. Dès lors, les directives des associations statistiques internationales et les comités de relecture des revues médicales et biométriques recommandent explicitement de désigner Shapiro-Wilk comme l’indicateur décisionnel primaire pour l’examen des données univariées de recherche.
Un dilemme classique survient lorsque l’analyste fait face à des résultats contradictoires au sein de la table matricielle SAS, par exemple lorsqu’un test d’Anderson-Darling rejette significativement la normalité alors que le test de Shapiro-Wilk délivre une valeur p légèrement supérieure à 0,05. Face à une telle divergence, le consensus de bonne pratique méthodologique enjoint au chercheur d’arbitrer en faveur de la statistique W, tout en procédant à un examen visuel approfondi des diagnostics graphiques pour comprendre la morphologie précise des écarts identifiés par les autres tests.
8. Diagnostic visuel complémentaire de la normalité sous SAS
8.1 Génération et interprétation du diagramme quantile-quantile (Q-Q Plot)
L’évaluation de la normalité ne saurait se réduire à l’examen exclusif d’une probabilité critique issue d’un test formel. Une approche méthodologique mature conjugue impérativement le verdict du test de Shapiro-Wilk à un examen visuel qualitatif de la structure distributionnelle. Au sein de la procédure PROC UNIVARIATE, l’outil de diagnostic graphique par excellence est le diagramme quantile-quantile, communément désigné sous l’acronyme Q-Q Plot.
Le déclenchement de ce graphique à haute résolution s’opère par l’adjonction de l’instruction QQPLOT, obligatoirement complétée par la directive d’ajustement distributionnel / NORMAL. Afin d’inscrire sur le graphique la droite théorique de référence dont les paramètres de localisation et d’échelle sont estimés à partir des données de l’échantillon, la syntaxe préconisée s’énonce :
PROC UNIVARIATE DATA=ma_table;
VAR ma_mesure;
QQPLOT ma_mesure / NORMAL(MU=EST SIGMA=EST);
RUN;
L’interprétation visuelle s’appuie sur la trajectoire des points figurant les quantiles empiriques observés face à la droite théorique matérialisant la loi normale. Si la distribution empirique est parfaitement gaussienne, les points s’alignent rigoureusement le long de cette diagonale. Une courbure générale en forme de « U » signale une asymétrie marquée de la distribution. En revanche, une configuration sinusoïdale en forme de « S » atteste d’un phénomène de queues de distribution lourdes ou légères : des points décrochant vers le bas à l’extrémité gauche et vers le haut à l’extrémité droite matérialisent une leptocurtose sévère avec excès de valeurs extrêmes.
8.2 Superposition d’une courbe normale sur l’histogramme empirique
L’histogramme de fréquences empiriques demeure la représentation visuelle la plus intuitive pour appréhender la silhouette générale d’une série de données quantitatives. Toutefois, l’interprétation d’un histogramme brut est fréquemment trompeuse en raison de la sensibilité du tracé au nombre d’intervalles de classe retenu. Pour transformer l’histogramme en un instrument de diagnostic formel de la normalité, SAS offre la capacité de projeter la densité théorique d’une loi gaussienne directement par-dessus les barres de fréquence de l’échantillon.
Cette visualisation s’obtient au moyen de l’instruction HISTOGRAM couplée à l’option de modélisation théorique / NORMAL. Le compilateur SAS calcule automatiquement les paramètres d’espérance et d’écart-type de l’échantillon pour tracer une courbe en cloche continue aux proportions strictement ajustées sur la superficie totale de l’histogramme empirique :
PROC UNIVARIATE DATA=ma_table;
VAR ma_mesure;
HISTOGRAM ma_mesure / NORMAL;
RUN;
L’analyste examine attentivement le degré de concordance entre le profil des barres réelles et l’enveloppe théorique lissée. Cette inspection permet de vérifier l’absence de bimodalité ou de polymodalité latente (présence de multiples sommets distincts qui trahiraient le mélange hétérogène de sous-populations cliniques non distinguées). Toutefois, l’observateur doit faire preuve de prudence face aux échantillons de taille réduite (N < 30), où l’arbitraire du découpage en classes masque fréquemment la structure sous-jacente des données.
8.3 Analyse des coefficients d’asymétrie (Skewness) et d’aplatissement (Kurtosis)
En étroite complémentarité avec le test de Shapiro-Wilk et les diagnostics visuels, l’analyse paramétrique formelle des coefficients de forme d’ordre supérieur apporte une clarification mathématique précieuse sur l’origine exacte d’un éventuel rejet de la normalité. La procédure PROC UNIVARIATE restitue systématiquement ces indicateurs dans son tableau initial intitulé « Moments » : le coefficient d’asymétrie (Skewness) et le coefficient d’aplatissement ou de voussure (Kurtosis).
SAS implémente les définitions non biaisées de Fisher-Pearson pour le calcul de ces indices :
- Le coefficient d’asymétrie (Skewness) : Une distribution normale théorique présente un coefficient d’asymétrie rigoureusement nul. Une valeur positive indique un étirement de la queue de distribution vers les valeurs élevées (asymétrie à droite), fréquemment associée à des variables biologiques à plancher fixe (comme la glycémie ou le temps de réaction). Une valeur négative traduit une traînée prononcée vers les valeurs faibles.
- Le coefficient d’aplatissement (Kurtosis) : Dans SAS, cet indicateur est restitué sous forme de kurtosis excessif (ou excès d’aplatissement), calibré de sorte qu’une loi normale exacte présente une valeur égale à zéro. Une valeur positive substantielle dénote une distribution leptocurtique (queue épaisse, pic central aigu), tandis qu’une valeur négative signale une distribution platycurtique (voûte aplatie, déficit d’observations extrêmes).
Dans la littérature méthodologique, les seuils empiriques d’admissibilité pour considérer qu’une variable ne s’écarte pas de façon critique du profil gaussien se situent généralement dans un intervalle compris entre -1,0 et +1,0 (ou plus libéralement entre -2,0 et +2,0 dans certains contextes d’ingénierie sociale). L’analyse conjointe de ces indices et de la statistique de Shapiro-Wilk offre une vision tridimensionnelle parfaite : la statistique W confirme ou infirme la gaussianité globale, tandis que les coefficients de Fisher en désignent les déformations structurelles précises.
9. Stratégies méthodologiques face au rejet de la normalité
9.1 Recours aux transformations mathématiques univariées
Lorsque le test de Shapiro-Wilk rejette formellement l’hypothèse de normalité (p < 0,05) et que les graphiques confirment une déformation structurelle incompatible avec l’emploi d’un modèle paramétrique, la première voie d’action méthodologique consiste à appliquer une fonction mathématique univariée aux données brutes afin de stabiliser la variance et de symétriser la distribution empirique.
Pour les variables affectées d’une asymétrie positive marquée, la transformation la plus classique et éprouvée demeure l’application du logarithme (soit népérien via la fonction SAS LOG(x), soit décimal via LOG10(x)). Si les données contiennent des valeurs strictement nulles, le praticien optera pour la translation standard LOG(x + 1). Lorsque l’asymétrie positive est d’intensité modérée, la transformation par racine carrée (SQRT(x)) s’avère souvent suffisante. À l’opposé, les distributions extrêmement asymétriques peuvent requérir l’application de la fonction inverse (1 / x).
Pour rationaliser le choix de la transformation optimale sans recourir à des ajustements empiriques itératifs, le chercheur peut mobiliser la famille des transformations puissance de Box-Cox. SAS permet d’estimer algorithmiquement le paramètre lambda optimal de cette transformation via la procédure spécialisée PROC TRANSREG :
PROC TRANSREG DATA=ma_table;
MODEL BOXCOX(ma_variable / CONVENIENT) = IDENTITY(identifiant);
RUN;
Cette modélisation identifie mathématiquement la puissance qui maximise la vraisemblance de normalité des résidus. Il convient toutefois de souligner l’inconvénient inhérent à toute transformation : les grandeurs transformées altèrent l’échelle de mesure originale, compliquant l’interprétation clinique et biomédicale directe des paramètres estimés.
9.2 Bascule vers l’inférence non paramétrique
Lorsque les données résistent aux tentatives de transformation mathématique, ou lorsque l’analyste refuse d’altérer l’échelle de mesure d’origine pour préserver l’interprétabilité clinique, l’alternative classique consiste à renoncer à l’inférence paramétrique pour adopter les méthodes fondées sur les rangs (statistiques non paramétriques). Ces approches s’affranchissent totalement de l’hypothèse de gaussianité de la population parente.
Dans l’écosystème SAS, la procédure dédiée à l’inférence non paramétrique univariée et multigroupes est PROC NPAR1WAY. Elle propose des équivalents méthodologiques directs pour les designs expérimentaux courants :
- En lieu et place du test t de Student pour deux échantillons indépendants, la procédure permet d’exécuter le test de la somme des rangs de Wilcoxon (analogue mathématique strict du test de Mann-Whitney) via l’instruction PROC NPAR1WAY DATA=ma_table WILCOXON; CLASS groupe; VAR score; RUN;.
- Pour les designs impliquant trois groupes ou davantage (substitut de l’ANOVA univariée), la procédure calcule automatiquement la statistique de Kruskal-Wallis, qui évalue si les distributions des rangs diffèrent significativement selon les modalités du facteur d’intérêt.
Toutefois, cette transition vers le paradigme non paramétrique implique un compromis méthodologique formel : l’hypothèse testée cesse de porter sur les moyennes arithmétiques pour se focaliser sur la dominance stochastique ou sur la médiane des distributions ordinales. De surcroît, les tests non paramétriques présentent une puissance statistique généralement inférieure à celle des tests paramétriques lorsque l’effectif est faible et que la déviation de normalité n’était que modérée.
9.3 Méthodes de rééchantillonnage et modèles robustes
Une alternative contemporaine aux tests non paramétriques classiques réside dans l’adoption des techniques de rééchantillonnage stochastique, en premier lieu le bootstrap non paramétrique. Cette approche algorithmique consiste à générer plusieurs milliers de sous-échantillons par tirage aléatoire avec remise à partir du jeu de données original. Elle permet d’estimer empiriquement la distribution d’échantillonnage exacte de n’importe quelle statistique d’intérêt (moyenne, différence de moyennes ou coefficients de régression) sans formuler le moindre postulat sur la loi de probabilité de la population parente. SAS permet d’orchestrer ces itérations avec une flexibilité totale via la procédure PROC SURVEYSELECT combinée aux capacités macro-analytiques du logiciel.
Parallèlement, la régression robuste et les modèles linéaires généralisés offrent une réponse méthodologique directe aux violations de normalité. Plutôt que de contraindre arbitrairement une variable asymétrique à se conformer à un modèle gaussien, l’expérimentateur modélise explicitement la distribution réelle de sa métrique au sein de la famille exponentielle (loi Gamma, loi de Poisson, loi binomiale négative ou log-normale).
Cette modélisation avancée s’articule élégamment au sein de SAS à travers les procédures PROC GENMOD et PROC GLIMMIX. En spécifiant explicitement la distribution de probabilité congruente avec le phénomène mesuré via l’option DIST= (par exemple DIST=GAMMA pour des coûts hospitaliers ou des durées de rétablissement), le chercheur préserve l’intégrité de son modèle théorique d’action tout en garantissant des taux d’erreur de première espèce rigoureusement contrôlés, sans subir les contraintes artificielles de l’inférence gaussienne conventionnelle.
10. Analyses stratifiées et traitement multi-groupes dans SAS
10.1 Évaluation de la normalité intra-groupe avec l’instruction BY
Dans la grande majorité des designs expérimentaux factoriels et des essais cliniques randomisés, le postulat de normalité ne doit pas être évalué sur la variable dépendante agglomérée à l’échelle de l’échantillon global, mais sur la distribution des résidus de chaque cellule expérimentale ou, de manière équivalente, à l’intérieur de chaque groupe de traitement pris individuellement. L’agglomération injustifiée d’observations issues de sous-populations dotées d’espérances mathématiques distinctes produit artificiellement une bimodalité ou un étalement trompeur de la distribution combinée, conduisant à un rejet fallacieux de l’adéquation au test de Shapiro-Wilk.
Pour conduire une évaluation stratifiée de la normalité par modalité factorielle, SAS propose l’instruction BY au sein de la procédure PROC UNIVARIATE. Toutefois, l’utilisation de cette instruction impose un prérequis d’ingénierie de données strict : la table source doit être physiquement ordonnée selon la variable de stratification avant l’appel analytique. Ce tri préalable s’opère impérativement via la procédure PROC SORT :
PROC SORT DATA=mes_donnees OUT=donnees_triees;
BY groupe_traitement;
RUN;
Une fois le tri exécuté, l’appel de PROC UNIVARIATE structuré avec l’instruction BY groupe_traitement; commande à SAS de partitionner l’analyse en autant de sous-processus hermétiques qu’il existe de modalités au sein du facteur. Le logiciel génère alors une table TestsForNormality distincte pour chaque sous-groupe, permettant d’authentifier si l’hypothèse de gaussianité intra-groupe est uniformément respectée dans l’ensemble des branches de l’essai expérimental.
10.2 Utilisation de l’instruction CLASS comme alternative flexible
Bien que l’instruction BY offre une partition efficace de l’analyse, SAS intègre une directive plus souple au sein de la procédure PROC UNIVARIATE : l’instruction CLASS. Contrairement à l’instruction BY, la commande CLASS ne nécessite aucun tri physique préalable des données via PROC SORT. Le moteur analytique de SAS opère en interne l’indexation dynamique nécessaire pour séparer les observations selon les niveaux de classification déclarés.
La syntaxe canonique mobilisant cette alternative s’énonce selon le schéma programmatique suivant :
PROC UNIVARIATE DATA=mes_donnees NORMAL;
CLASS groupe_clinique;
VAR biomarqueur_continu;
RUN;
L’utilisation de l’instruction CLASS présente des avantages analytiques majeurs : elle permet de générer des sorties visuelles comparatives immédiates. Lorsqu’elle est combinée avec des instructions de tracé telles que QQPLOT ou HISTOGRAM, SAS génère des panneaux graphiques alignés côte à côte (ou superposés dans un même référentiel visuel). Cette disposition permet une comparaison visuelle directe entre le groupe témoin et le groupe expérimental. L’analyste peut ainsi confronter en un coup d’œil les statistiques W de Shapiro-Wilk respectives de chaque groupe tout en identifiant si l’un des bras du protocole présente une morphologie anormale nécessitant un ajustement ciblé.
10.3 Automatisation des tests sur un grand nombre de variables avec les macros SAS
Dans les contextes contemporains de criblage épidémiologique, d’analyse omique ou d’exploration de batteries de questionnaires psychométriques comprenant plusieurs dizaines, voire centaines de dimensions d’échelle, l’écriture manuelle d’instructions répétitives devient inefficace et source d’erreurs d’encodage. Le langage des macros SAS (SAS Macro Facility) permet d’automatiser l’itération des tests de Shapiro-Wilk et de synthétiser les sorties au sein d’un tableau unifié.
La conception d’une macro-commande paramétrée s’appuie sur la définition d’un bloc délimité par %MACRO et %MEND, encapsulant une boucle itérative (%DO) ou exploitant les vues de dictionnaires système (telles que SASHELP.VCOLUMN) pour extraire dynamiquement les noms des variables numériques d’intérêt. À chaque cycle de la boucle, la macro soumet la variable active à l’exécution de PROC UNIVARIATE tout en capturant silencieusement la table TestsForNormality via l’instruction ODS OUTPUT.
À l’issue de l’exécution itérative, l’ensemble des fragments tabulaires est assemblé au moyen d’une étape DATA procédant par concaténation (SET). Le chercheur dispose dès lors d’un fichier récapitulatif unique répertoriant pour chaque métrique étudiée le nom de la variable, la valeur scalaire de la statistique W et la probabilité critique exacte. Il devient alors possible d’appliquer des corrections méthodologiques pour tests multiples (ajustement de Bonferroni ou contrôle du taux de fausse découverte via la méthode de Benjamini-Hochberg) afin de préserver la rigueur de l’inférence face à l’inflation du risque d’erreur de première espèce inhérente aux analyses exploratoires de masse.
11. Limites empiriques, puissance statistique et pièges méthodologiques
11.1 L’effet de la taille de l’échantillon sur la sensibilité du test
L’interprétation de la statistique de Shapiro-Wilk ne doit jamais s’abstraire d’un paramètre déterminant : l’effectif d’échantillonnage N. Comme tout test fondé sur le formalisme de l’hypothèse nulle, la puissance du test de Shapiro-Wilk est directement proportionnelle à la taille de l’échantillon analysé, ce qui engendre des pièges d’interprétation méthodologique diamétralement opposés selon la magnitude de la cohorte.
Sur les très grands échantillons (typiquement lorsque N dépasse plusieurs centaines ou plusieurs milliers d’observations), le test développe une hyper-sensibilité critique. À ce niveau de puissance statistique, des déviations infimes, mathématiquement négligeables et dépourvues de la moindre incidence pratique sur la validité des modèles linéaires généraux (telles qu’une légère courbure imperceptible au niveau des centiles extrêmes), induisent systématiquement des valeurs de p < 0,0001. L’application servile de la règle de rejet conduirait le chercheur à disqualifier à tort l’usage de tests paramétriques, alors même que le théorème central limite garantit la normalité asymptotique de la distribution des moyennes d’échantillon.
À l’inverse, face à des échantillons de taille réduite (N < 20 ou N < 15), situation fréquente dans les phases précoces d’essais cliniques ou les protocoles de neuro-imagerie fonctionnelle, le test de Shapiro-Wilk souffre d’une sous-puissance statistique notoire. Dans cette configuration, des données présentant une non-normalité substantielle peuvent produire une statistique W associée à une valeur p supérieure à 0,05 par simple incapacité d’échantillonnage à franchir le seuil d’admissibilité statistique. L’analyste ne doit donc jamais considérer un non-rejet sur petit échantillon comme une garantie infaillible de gaussianité, et doit impérativement compléter son audit par l’examen minutieux des diagrammes quantile-quantile.
11.2 Vulnérabilité face aux données aberrantes (Outliers)
La statistique W de Shapiro-Wilk présente une sensibilité aiguë à la présence d’observations discordantes ou aberrantes (outliers). L’équation fondamentale du test montre que la somme des carrés des écarts à la moyenne figurant au dénominateur est quadratique ; en conséquence, une unique valeur extrême décalée de plusieurs écarts-types par rapport à la masse centrale de l’échantillon gonfle ce terme de manière disproportionnée, entraînant une chute brutale de la statistique W et provoquant un rejet catégorique de la normalité.
Pour prévenir ce biais d’évaluation, la procédure PROC UNIVARIATE génère systématiquement une section de diagnostic intitulée « Extreme Observations ». Ce tableau répertorie les cinq valeurs les plus basses et les cinq valeurs les plus élevées de l’échantillon, accompagnées de leurs identifiants de ligne respectifs. L’analyste peut ainsi identifier instantanément si la non-normalité décrétée par le test de Shapiro-Wilk résulte d’une asymétrie générale de la population ou de la présence isolée d’une observation pathologique consécutive à une erreur de mesure, un dysfonctionnement instrumental ou une faute de saisie typographique.
Face à un point aberrant avéré, le chercheur doit arbitrer entre plusieurs démarches méthodologiques documentées. Si l’observation résulte d’un artéfact expérimental incontestable, son exclusion formelle est pleinement légitime. En revanche, si la donnée reflète une mesure biologique ou humaine authentique bien qu’extrême, son effacement arbitraire constitue une faute scientifique. Dans cette situation, le recours à la winsorisation (remplacement de la valeur extrême par le centile acceptable le plus proche) ou l’orientation vers des procédures de modélisation linéaire robuste constitue la solution méthodologique la plus équilibrée.
11.3 Spécificités liées aux données discrètes et échelles de Likert
Un écueil méthodologique fréquent dans les sciences sociales, psychologiques et managériales réside dans l’application inappropriée du test de Shapiro-Wilk à des variables discrètes ou à des échelles de mesure de type Likert (par exemple, des échelles de réponse graduées de 1 à 5 ou de 1 à 7). Sur le plan théorique, la dérivation mathématique du test de Shapiro-Wilk repose expressément sur le postulat d’une variable parente continue mesurable sur une échelle d’intervalles ou de rapports.
Lorsque le test est confronté à des données discrètes, le phénomène mécanique d’apparition d’ex æquo fréquents (ties), c’est-à-dire la présence d’observations multiples partageant rigoureusement la même valeur numérique, brise la bijection d’ordre continue postulée par l’algorithme. Cette concentration discrète perturbe le calcul de la covariance des statistiques d’ordre et provoque une dégradation artificielle de la statistique W, conduisant fréquemment à des rejets abusifs de l’hypothèse nulle alors même que le construit psychométrique sous-jacent peut opérer de manière satisfaisante au regard des modèles linéaires.
En conséquence, les méthodologistes recommandent d’éviter d’appliquer le test de Shapiro-Wilk sur des items isolés d’échelles de Likert. L’évaluation de la normalité redevient pertinente et méthodologiquement valide uniquement lorsque plusieurs items ordinaux sont combinés par sommation ou moyennage pour constituer un score composite continu. Sous réserve que le nombre de classes de valeurs distinctes formées par le score global soit suffisamment étendu, le théorème central limite et le lissage du score composite justifient alors pleinement l’application du test de Shapiro-Wilk pour évaluer la distribution de cette métrique globale.
12. Guide récapitulatif des bonnes pratiques et script SAS standardisé
12.1 Modèle de code SAS complet, optimisé et documenté
Afin de fournir aux chercheurs et biostatisticiens un outil directement opérationnel, hautement standardisé et conforme aux meilleures pratiques de reproductibilité du code, le script SAS intégral ci-dessous illustre l’enchaînement complet des étapes : préparation structurée de l’échantillon, tri préalable, calcul optimisé du test de Shapiro-Wilk par sous-groupe, filtrage des sorties via le système ODS et génération des représentations graphiques diagnostiques.
/* Étape 1 : Structuration des données empiriques au sein de la table SAS */
DATA cohorte_clinique;
INPUT identifiant $ groupe_trt $ score_efficacite @@;
DATALINES;
S01 Placebo 42.1 S02 Placebo 39.5 S03 Placebo 41.2 S04 Placebo 38.8 S05 Placebo 43.5
S06 Placebo 40.0 S07 Placebo 41.8 S08 Placebo 39.1 S09 Placebo 44.2 S10 Placebo 40.9
S11 Traite 48.5 S12 Traite 51.2 S13 Traite 49.8 S14 Traite 53.0 S15 Traite 47.9
S16 Traite 50.4 S17 Traite 52.1 S18 Traite 48.9 S19 Traite 51.5 S20 Traite 50.1
;
RUN;
/* Étape 2 : Tri physique de la table en vue de l’analyse stratifiée */
PROC SORT DATA=cohorte_clinique OUT=cohorte_trie;
BY groupe_trt;
RUN;
/* Étape 3 : Exécution du test de Shapiro-Wilk avec sélection ODS et diagnostics visuels */
ODS GRAPHICS ON;
ODS SELECT TestsForNormality QQPlot Histogram;
PROC UNIVARIATE DATA=cohorte_trie NORMAL;
BY groupe_trt;
VAR score_efficacite;
HISTOGRAM score_efficacite / NORMAL(COLOR=RED W=2);
QQPLOT score_efficacite / NORMAL(MU=EST SIGMA=EST COLOR=BLUE W=2);
ODS OUTPUT TestsForNormality=resultats_normalite;
RUN;
ODS GRAPHICS OFF;
Ce script assure l’isolation stricte de la table TestsForNormality tout en archivant les métriques scalaires au sein d’une table dédiée (resultats_normalite). Les visualisations générées fournissent une documentation visuelle immédiate permettant d’étayer et de vérifier les conclusions issues des valeurs numériques du test.
12.2 Protocole séquentiel d’audit de normalité pour le chercheur
Afin de structurer la démarche méthodologique au sein d’une publication académique ou d’un rapport réglementaire, l’analyste gagne à suivre un protocole d’audit séquentiel en trois étapes distinctes :
- Étape 1 : Nettoyage et inspection descriptive initiale. Avant de lancer les tests formels, l’analyste examine le volume de données manquantes et consulte les cinq plus petites et cinq plus grandes valeurs via PROC UNIVARIATE. Les coefficients d’asymétrie (Skewness) et d’aplatissement (Kurtosis) de Fisher sont calculés afin d’évaluer la proximité globale de la distribution avec la plage théorique standard [-1 ; +1].
- Étape 2 : Exécution conjointe du test de Shapiro-Wilk et examen visuel. Le test de Shapiro-Wilk est exécuté au sein de chaque cellule expérimentale ou groupe de traitement au moyen de PROC UNIVARIATE (option NORMAL). En parallèle, le diagramme quantile-quantile (Q-Q Plot) est systématiquement généré afin de vérifier si d’éventuels écarts statistiques identifiés par la p-value correspondent à des distorsions globales de la distribution ou à quelques observations isolées.
- Étape 3 : Détermination formelle du parcours analytique. Si la statistique W est proche de 1 et que p ≥ 0,05 (sans déviation majeure visible sur le Q-Q Plot), la normalité opérationnelle est retenue : le chercheur peut mobiliser ses tests paramétriques standard (ANOVA, régressions, tests t). En cas de rejet avéré (p < 0,05) confirmé visuellement sur un échantillon de taille petite à modérée, l’analyste s’oriente soit vers une transformation mathématique documentée (logarithme, Box-Cox), soit vers l’inférence non paramétrique (PROC NPAR1WAY), soit vers un modèle linéaire généralisé adapté à la distribution réelle des données (PROC GLIMMIX).
12.3 Critères d’évaluation de la qualité méthodologique en relecture par les pairs
L’intégrité de la recherche quantitative contemporaine repose sur des critères d’évaluation méthodologique exigeants lors de la relecture par les pairs (peer review). Les revues scientifiques de premier rang rejettent de plus en plus fréquemment les manuscrits se bornant à affirmer sans preuve que « les postulats de normalité ont été vérifiés ». L’analyste doit faire preuve d’une transparence absolue dans la description de son protocole d’évaluation préalable.
Le chercheur est tenu de nommer précisément le test d’adéquation mobilisé (en l’espèce, le test de Shapiro-Wilk) et d’en justifier la pertinence au regard de la taille de sa cohorte. En cas de maintien de l’hypothèse nulle, le texte doit documenter la statistique d’échantillon W et la valeur p exacte, complétées par la mention de l’inspection conjointe des diagrammes quantile-quantile. En cas de violation avérée de la normalité, la publication doit expliciter avec précision la stratégie d’adaptation méthodologique adoptée (transformation mathématique, passage aux rangs ou régression robuste), garantissant ainsi la validité interne des conclusions scientifiques présentées.
Enfin, la conservation rigoureuse et la mise à disposition éventuelle du code source SAS, incluant les procédures de vérification des postulats, constitue l’un des piliers cardinaux du mouvement pour la science ouverte et la reproductibilité computationnelle. La capacité pour un auditeur externe ou un relecteur de réexécuter à l’identique la séquence d’analyse depuis l’étape DATA jusqu’aux tables ODS de PROC UNIVARIATE confère aux conclusions expérimentales un niveau de fiabilité et d’autorité scientifique incontestable.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anderson, T. W., & Darling, D. A. (1954). A test of goodness of fit. Journal of the American Statistical Association, 49(268), 765–769. https://doi.org/10.1080/01621459.1954.10501232
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Royston, P. (1992). Approximating the Shapiro-Wilk W-test for non-normality. Statistics and Computing, 2(3), 117–119. https://doi.org/10.1007/BF01891203
- SAS Institute Inc. (2023). Base SAS 9.4 Procedures Guide: Statistical Procedures (5th ed.). SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/base/
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Stephens, M. A. (1974). EDF statistics for goodness of fit and some comparisons. Journal of the American Statistical Association, 69(347), 730–737. https://doi.org/10.1080/01621459.1974.10480196