
L’inférence statistique constitue la pierre angulaire de la méthode scientifique dans les sciences contemporaines du comportement. Lorsque les psychologues expérimentaux et les neuroscientifiques conçoivent des protocoles empiriques visant à sonder la cognition, les dynamiques affectives ou l’efficacité d’interventions thérapeutiques, ils se heurtent inévitablement à la nature stochastique de leurs observations. Dans cet environnement marqué par le bruit expérimental et la variabilité interindividuelle, le test de Student demeure l’un des outils analytiques les plus largement mobilisés. Cependant, le calcul d’une statistique t brute ne représente qu’une étape intermédiaire du raisonnement inférentiel. Pour prendre une décision méthodologique éclairée et statuer sur la validité d’une hypothèse de recherche, les chercheurs doivent transformer cette valeur métrique en une probabilité conditionnelle standardisée : la fameuse valeur p.
La transition d’une statistique t vers une valeur p cristallise l’essence même de l’approche néo-fisherienne et neyman-pearsonienne de la recherche quantitative. Une statistique t informe sur l’ampleur d’un écart standardisé entre un effet observé et une prédiction nulle ; la valeur p quantifie la rareté probabiliste d’un tel écart sous l’hypothèse qu’aucun effet réel n’existe au sein de la population parente. Maîtriser les différentes méthodes permettant d’extraire cette valeur p à partir d’une statistique t donnée ne relève pas d’une simple gymnastique technique. C’est une compétence fondamentale requise pour garantir l’intégrité analytique, décrypter les résultats publiés dans la littérature académique internationale et contourner les pièges interprétatifs qui jalonnent l’évaluation quantitative des phénomènes humains.
Ce guide exhaustif a pour ambition d’explorer de manière approfondie les trois grandes méthodologies employées pour déterminer une valeur p à partir d’une statistique t : les calculateurs automatisés en ligne, les tables de distribution imprimées historiques et les environnements de programmation scientifique moderne. À travers l’analyse méticuleuse d’un cas d’école récurrent en psychologie expérimentale — une statistique empirique t égale à 1,441 associée à 13 degrés de liberté sous une hypothèse unilatérale droite —, nous examinerons les soubassements théoriques, la dynamique mathématique des courbes de distribution, les critères d’application clinique et les exigences contemporaines de la science ouverte imposées par l’American Psychological Association.
1. Fondements théoriques : De la statistique t à la valeur p en psychologie expérimentale
1.1 Le rôle du test d’hypothèse dans l’inférence psychologique
Dans l’architecture de la recherche quantitative en psychologie, le test d’hypothèse opère comme un filtre épistémologique contre l’illusion de causalité. Les devis expérimentaux, qu’ils portent sur l’amorçage attentionnel, la consolidation mnésique ou l’impact de psychothérapies cognitivo-comportementales, reposent sur la formulation rigoureuse de deux conjectures antagonistes : l’hypothèse nulle (notée H0) et l’hypothèse alternative (notée H1). L’hypothèse nulle postule conventionnellement l’absence d’effet systématique, postulant que les disparités constatées entre différentes conditions expérimentales proviennent exclusivement de fluctuations aléatoires d’échantillonnage. À l’inverse, l’hypothèse alternative affirme la présence d’une relation substantielle ou d’une divergence populationnelle attribuable aux variables indépendantes manipulées par le chercheur.
Pour dépasser la simple intuition clinique ou l’inspection visuelle des données, il s’avère impératif de quantifier avec une extrême rigueur l’écart existant entre les observations empiriques recueillies et ce modèle théorique stipulé sous H0. Face à la labilité inhérente aux comportements humains, caractérisée par des artefacts physiologiques, des biais cognitifs et des traits de personnalité hétérogènes, le chercheur doit arbitrer entre deux régimes de variabilité : la variance intergroupe (attribuable au traitement expérimental) et la variance intragroupe (résiduelle ou d’erreur). Le test d’hypothèse statistique fournit le cadre probabiliste standardisé nécessaire pour formaliser cet arbitrage, conditionnant la reproductibilité et la solidité des inférences produites dans les revues à comité de lecture en psychologie cognitive et sociale.
1.2 Définition formelle de la statistique t de Student
L’origine mathématique de la statistique t remonte aux travaux pionniers de William Sealy Gosset, chimiste et statisticien chez Guinness qui publia ses découvertes sous le pseudonyme académique de « Student » en 1908. Gosset cherchait à résoudre un problème récurrent dans l’industrie brassicole : comment évaluer rigoureusement la qualité des matières premières à partir d’échantillons de taille très restreinte, sans connaître a priori la véritable variance de la population globale ? La loi normale, qui nécessite la connaissance exacte de la variance de la population ($\sigma^2$), introduisait des sous-estimations massives de l’incertitude lorsque l’écart-type de l’échantillon ($s$) était substitué à $\sigma$.
Sur le plan analytique, la statistique t de Student se définit comme le quotient normalisé reliant une estimation ponctuelle à son erreur type :
$$t = \frac{\bar{X} – \mu_0}{s / \sqrt{N}}$$
Dans cette formulation canonique pour un échantillon unique, $\bar{X}$ représente la moyenne empirique observée, $\mu_0$ la valeur attendue sous l’hypothèse nulle, $s$ l’écart-type corrigé de l’échantillon et $N$ le volume total des participants. Lorsque deux conditions indépendantes sont comparées, le numérateur devient la différence entre les deux moyennes d’échantillons ($\bar{X}_1 – \bar{X}_2$) tandis que le dénominateur correspond à l’erreur type de la différence de moyennes calculée à partir de la variance combinée. La grandeur t traduit donc directement le nombre d’erreurs types séparant le résultat empirique de la prédiction théorique nulle. Contrairement à la statistique z qui requiert un paramètre d’écart-type populationnel fixe et intangible, t intègre formellement l’incertitude liée à l’estimation empirique de la dispersion des scores.
1.3 La nature probabiliste de la valeur p (p-value)
La valeur p représente la probabilité mathématique d’obtenir une statistique de test au moins aussi extrême que celle effectivement mesurée dans l’échantillon, en posant comme postulat fondamental que l’hypothèse nulle est rigoureusement exacte. Formellement, elle s’énonce comme :
$$p = P(T ge t_{\text{obs}} mid H_0)$$
dans le cas d’une épreuve unilatérale orientée vers les valeurs positives, ou :
$$p = P(|T| ge |t_{\text{obs}}| mid H_0)$$
dans l’éventualité d’un devis bilatéral symétrique.
Il persiste dans l’enseignement supérieur une confusion conceptuelle pernicieuse : la valeur p ne mesure en aucun cas la probabilité a posteriori que l’hypothèse nulle soit vraie compte tenu des données ($P(H_0 mid D)$), ni la probabilité que les résultats observés soient le fruit pur du hasard. Elle quantifie exclusivement la probabilité des données observées conditionnellement à l’exactitude du modèle nul ($P(D mid H_0)$). Le seuil de signification conventionnel, désigné par la lettre grecque alpha ($\alpha$), fréquemment fixé à 0,05 ou 0,01 dans la communauté psychologique, sert de critère de démarcation décisionnel a priori. Si p s’avère strictement inférieur à $\alpha$, le chercheur rejette formellement l’hypothèse nulle ; dans le cas contraire, il conclut à l’absence d’éléments statistiques probants permettant d’évincer le postulat nul, sans toutefois pouvoir affirmer que ce dernier est définitivement validé.
2. Anatomie de la distribution t : Degrés de liberté et directionnalité du test
2.1 L’influence structurelle des degrés de liberté (df)
Le paramètre structurel qui gouverne intégralement le comportement d’une loi de Student est constitué par ses degrés de liberté, communément notés df (pour degrees of freedom) ou $\nu$. Dans le cadre des devis psychométriques, les degrés de liberté correspondent au nombre de dimensions indépendantes selon lesquelles les données empiriques peuvent varier librement autour des paramètres estimés. Pour un test t sur échantillon unique ou pour des mesures répétées sur $N$ participants, nous avons $df = N – 1$, car le calcul préalable de la moyenne de l’échantillon contraint mathématiquement la dernière observation à adopter une valeur unique pour préserver la somme nulle des déviations.
L’effet géométrique des degrés de liberté sur la densité de probabilité de Student est profond. Lorsque df est de faible magnitude, l’incertitude inhérente à l’estimation de la variance résiduelle se traduit par un aplatissement du sommet de la cloche et un épaississement notable des queues de distribution, un phénomène nommé leptokurticité relative par rapport à la loi normale. Les probabilités associées aux événements extrêmes sont alors substantiellement plus élevées. Au fur et à mesure que les effectifs augmentent et que df tend vers l’infini, la distribution t converge asymptotiquement vers la loi normale standardisée $\mathcal{N}(0, 1)$, rendant l’écart d’estimation entre $s$ et $\sigma$ de plus en plus négligeable.
2.2 Tests unilatéraux (un test à une queue) versus tests bilatéraux (à deux queues)
Le choix architectural entre une approche unilatérale (à une queue) et bilatérale (à deux queues) repose sur des justifications théoriques, épistémologiques et éthiques préétablies. Un test unilatéral est scientifiquement recevable uniquement lorsque le chercheur postule a priori, sur la base d’un corpus conceptuel dense ou d’éléments neurobiologiques consolidés, que l’effet ne peut s’exprimer que dans une orientation unique et vectorisée (par exemple, une facilitation du temps de réaction ou une réduction systématique de l’anxiété préopératoire). Toute variation dans la direction opposée est alors théoriquement assimilée à l’action exclusive du bruit résiduel.
Sur le plan mathématique, cette distinction modifie radicalement l’allocation de la zone de rejet critique $\alpha$. Dans un test bilatéral, le risque d’erreur de type I est subdivisé de manière symétrique : $\alpha / 2$ est dévolu à la queue gauche et $\alpha / 2$ à la queue droite. En revanche, dans un test unilatéral droit, la totalité du seuil $\alpha$ (par exemple 0,05) est massée dans l’extrémité supérieure de la distribution. Pour illustrer concrètement ce principe à travers notre point de repère analytique, considérons une statistique expérimentale $t = 1{,}441$ adossée à $df = 13$. Dans une configuration unilatérale droite, la valeur p s’obtient en intégrant la fonction de densité de 1,441 jusqu’à l’infini positif. Reconfigurer a posteriori un test bilatéral en test unilatéral après avoir observé les données constitue une faute déontologique sévère nommée p-hacking, augmentant insidieusement le taux réel de faux positifs au-delà du seuil nominal déclaré.
2.3 Comportement asymptotique de la distribution d’échantillonnage
L’étude comparée de l’aire sous la courbe démontre à quel point la forme de la distribution modifie l’estimation des probabilités résiduelles. Pour une statistique $t = 1{,}441$, le calcul de la probabilité cumulée unilatérale sous une loi normale classique $\mathcal{N}(0, 1)$ donnerait :
$$P(Z > 1{,}441) \approx 0{,}0748$$
Cependant, sous une distribution de Student associée à 13 degrés de liberté, la probabilité cumulée réelle s’élève à 0,08662. Cet écart d’environ 0,0118 illustre le poids supérieur des queues de distribution provoqué par la modeste taille d’échantillon ($N = 14$ pour un groupe unique), soulignant l’obligation méthodologique de recourir explicitement aux lois de Student dès que la taille de cohorte ne franchit pas les seuils asymptotiques traditionnels ($N > 30$ ou $N > 100$).
En outre, l’exactitude des calculs de probabilité repose sur le respect des postulats fondamentaux régissant le modèle de Student : l’indépendance statistique des observations et la normalité de la distribution parente dont sont issus les scores. Si les résidus d’une expérience psychologique manifestent une asymétrie marquée (skewness) ou un aplatissement excessif (kurtosis), l’aire sous la courbe théorique se désynchronise de la distribution réelle des données empiriques, faussant la valeur p générée, qu’elle soit issue d’un calculateur, d’une table ou d’un script informatique.
3. Méthode 1 : L’utilisation des calculateurs statistiques automatisés en ligne
3.1 Avantages des outils numériques interactifs pour les chercheurs
L’avènement des technologies web a démocratisé l’accès à des algorithmes d’intégration numérique ultra-performants via des plateformes statistiques en ligne spécialisées. Ces interfaces évitent aux praticiens cliniciens et aux étudiants de manipuler des tables physiques volumineuses ou de procéder à des installations complexes d’environnements de développement comme R, Python ou SAS sur leurs postes de travail. La célérité offerte par les calculateurs interactifs autorise des vérifications instantanées lors du dépouillement exploratoire de protocoles expérimentaux.
Au-delà de leur maniabilité ergonomique, ces calculateurs réduisent considérablement le risque d’erreur humaine lié à la lecture manuelle d’abaques complexes. Ils fournissent une précision décimale absolue, couramment jusqu’à six ou huit chiffres après la virgule, une finesse technique indispensable lorsqu’il s’agit d’extraire des statistiques de référence pour les méta-analyses contemporaines. De surcroît, les meilleures plateformes intègrent un affichage vectoriel dynamique visualisant l’aire exacte sous la courbe de Student correspondant à la valeur t saisie, renforçant la compréhension intuitive de la probabilité résiduelle rejetée.
3.2 Paramétrage précis du calculateur avec les données sources
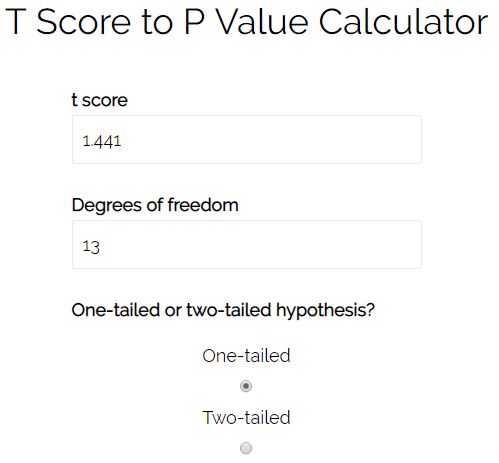
Pour dériver avec rigueur la valeur p à l’aide d’un calculateur statistique en ligne, le protocole opératoire requiert une saisie méthodique de trois composantes fondamentales : la statistique observée, les degrés de liberté et l’orientation mathématique de l’hypothèse.
- Saisie de la statistique empirique : L’utilisateur commence par inscrire la valeur obtenue lors du traitement préliminaire des données au sein du champ dédié au score t, à savoir scrupuleusement $1{,}441$. Il convient de veiller à l’utilisation correcte du séparateur décimal (généralement un point dans les calculateurs anglophones :
1.441). - Définition des degrés de liberté : Dans l’espace assigné aux degrees of freedom (df), le chercheur renseigne l’entier relatif associé à son protocole, qui s’élève ici précisément à $13$.
- Spécification de l’orientation du test : Le menu déroulant du calculateur propose généralement trois configurations spatiales : bilatérale (two-tailed), unilatérale gauche (one-tailed left) ou unilatérale droite (one-tailed right). Conformément à l’hypothèse conceptuelle selon laquelle la performance moyenne est supérieure à la norme nulle, l’option unilatérale droite doit être impérativement sélectionnée.
- Vérification des filtres de transformation : Certains calculateurs algorithmiques appliquent automatiquement une valeur absolue à la statistique t. Le chercheur doit valider que le signe de sa statistique initiale est scrupuleusement préservé pour ne pas inverser l’intégration unilatérale.
3.3 Analyse de la sortie numérique et vérification de conformité
Une fois les paramètres validés par le moteur du calculateur en ligne, l’interface renvoie instantanément la probabilité cumulative intégrée. Dans le cas spécifique de notre objet d’étude ($t = 1{,}441$ et $df = 13$), le résultat généré affiche une valeur p unilatérale droite très exacte de :
$$p = 0{,}08662$$
Ce chiffre indique que sous l’hypothèse nulle, il subsiste très exactement 8,662 % de chances d’obtenir une statistique t égale ou supérieure à 1,441 par simple fluctuation aléatoire d’échantillonnage.
Le chercheur scrupuleux doit opérer un contrôle de conformité immédiat. Si le calculateur avait renvoyé une valeur de 0,91338, cela signifierait que l’outil a intégré l’aire située à gauche du seuil ($P(T le 1{,}441)$) au lieu de l’aire supérieure située dans la queue droite. Par ailleurs, il demeure indispensable d’archiver le nom de la plateforme numérique ainsi que la bibliothèque sous-jacente exploitée (telle que des wrappers WebAssembly de bibliothèques C standard ou des implémentations JavaScript dérivées de l’algorithme Cephes) pour documenter la traçabilité méthodologique des résultats préliminaires.
4. Méthode 2 : L’utilisation rigoureuse des tables statistiques de Student
4.1 Structure organisationnelle et typologie des tables de distribution t
Bien que l’informatique ait supplanté le calcul manuel au quotidien, la manipulation des tables statistiques imprimées de Student demeure une exigence académique universelle, indispensable pour l’apprentissage conceptuel et l’évaluation critique d’articles hors connexion. Historiquement conçues par Ronald Fisher et Frank Yates, ces tables synthétisent l’espace continu de la loi de Student sous forme d’une matrice bidimensionnelle discrète.
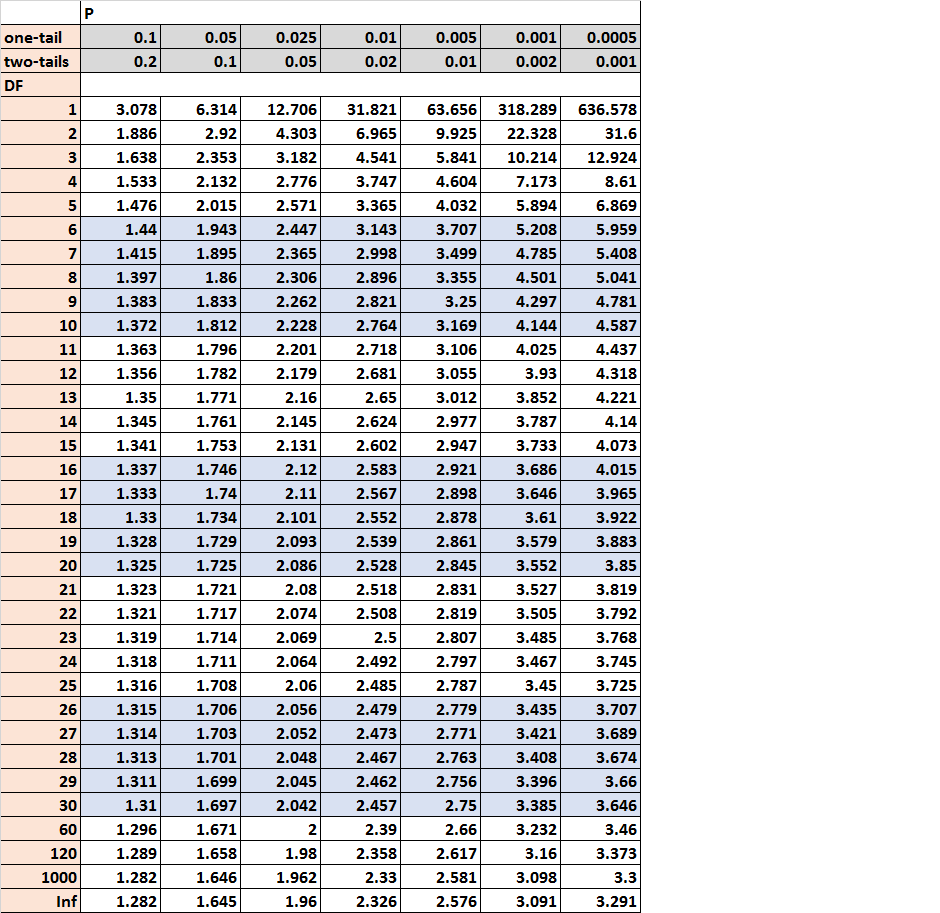
Dans l’immense majorité des manuels de référence en psychométrie, la topologie spatiale d’une table t obéit à une architecture standardisée : les lignes horizontales répertorient les degrés de liberté successifs (de 1 à 30, puis par paliers de 10 jusqu’à l’infini asymptotique $\infty$), tandis que les colonnes verticales correspondent à des seuils de probabilité prédéterminés nommés valeurs critiques ($\alpha = 0{,}10$, $0{,}05$, $0{,}025$, $0{,}01$, $0{,}001$). Deux en-têtes sont fréquemment superposés au sommet du tableau, précisant explicitement si la ligne d’alpha s’applique à un test unilatéral (one-tail) ou bilatéral (two-tail). Pour notre cas d’étude, la première opération consiste à localiser rigoureusement la ligne transversale correspondant à $df = 13$.
4.2 Localisation de la statistique t et encadrement de la valeur p
Contrairement aux calculateurs numériques qui fournissent une métrique continue, une table statistique fonctionne par encadrement ordinal discontinu. Après s’être positionné sur la rangée $df = 13$, le chercheur parcourt visuellement la série de valeurs critiques de gauche à droite afin d’insérer sa valeur observée $t = 1{,}441$ entre deux jalons consécutifs répertoriés dans la table académique.
L’examen minutieux de la ligne $df = 13$ révèle les valeurs critiques unilatérales suivantes :
- Pour une probabilité unilatérale $\alpha = 0{,}10$, la valeur critique est $t_{0{,}10; 13} = 1{,}350$.
- Pour une probabilité unilatérale $\alpha = 0{,}05$, la valeur critique est $t_{0{,}05; 13} = 1{,}771$.
La statistique observée se situe sans ambiguïté entre ces deux bornes structurelles :
$$1{,}350 < 1{,}441 < 1{,}771$$
Étant donné que la fonction de répartition cumulative est strictement monotone croissante, l’aire résiduelle dans la queue droite décroît à mesure que la statistique t s’accroît. Par conséquent, nous pouvons déduire l’inégalité fondamentale encadrant rigoureusement la valeur p empirique :
$$0{,}05 < p < 0{,}10$$
Cette information synthétique suffit d’ores et déjà pour prendre une décision catégorielle vis-à-vis d’un seuil conventionnel fixé à $\alpha = 0{,}05$ : la valeur p étant strictement supérieure à 5 %, l’hypothèse nulle ne peut être rejetée.
4.3 Technique d’interpolation linéaire pour une meilleure précision manuelle
Lorsqu’un chercheur ne dispose que d’une table papier mais souhaite obtenir une estimation décimale plus serrée de la valeur p sans recourir à l’ordinateur, l’interpolation linéaire offre une approximation géométrique pragmatique. Cette technique fait l’hypothèse locale que la fonction de survie de la distribution t se comporte approximativement comme un segment de droite rectiligne entre les deux valeurs critiques répertoriées.
La formule standard d’interpolation linéaire appliquée à l’encadrement des probabilités s’énonce comme suit :
$$p \approx p_1 + \frac{t_{\text{obs}} – t_1}{t_2 – t_1} \times (p_2 – p_1)$$
En substituant nos données empiriques et tabulaires dans l’équation :
- $t_1 = 1{,}350$ correspondant à $p_1 = 0{,}10$
- $t_2 = 1{,}771$ correspondant à $p_2 = 0{,}05$
- $t_{\text{obs}} = 1{,}441$
Le calcul s’articule pas à pas :
$$p \approx 0{,}10 + \frac{1{,}441 – 1{,}350}{1{,}771 – 1{,}350} \times (0{,}05 – 0{,}10)$$
$$p \approx 0{,}10 + \frac{0{,}091}{0{,}421} \times (-0{,}05)$$
$$p \approx 0{,}10 + (0{,}21615 \times -0{,}05) \approx 0{,}10 – 0{,}01081 = 0{,}08919$$
L’estimation issue de l’interpolation linéaire manuelle fournit $p \approx 0{,}0892$. Confrontée à la valeur numérique exacte de 0,08662, l’erreur absolue n’est que de 0,00257 (soit un quart de pourcent). Cette divergence marginale découle de la courbure convexe naturelle de la fonction de densité de Student le long de sa queue décroissante. Pour des analyses non automatisées, l’interpolation linéaire manuelle constitue un outil d’une remarquable utilité heuristique.
5. Méthode 3 : Le calcul programmatique et automatisé via les scripts de recherche
5.1 Mise en œuvre dans l’environnement statistique R
Dans l’écosystème de la recherche quantitative internationale, le langage R s’est imposé comme la référence absolue pour le traitement analytique des données de laboratoire. Il intègre nativement une famille complète de fonctions dédiées à la loi de Student : dt (densité), pt (fonction de répartition cumulative), qt (quantiles) et rt (génération pseudo-aléatoire). Pour déterminer la valeur p d’une statistique t, c’est la fonction de probabilité cumulative pt() qui est sollicitée.
Par défaut, la fonction pt(q, df) calcule l’intégrale de $-\infty$ jusqu’à la borne $q$, c’est-à-dire l’aire sous la courbe située à gauche du paramètre indiqué. Dans le cas d’un test unilatéral droit, le statisticien doit impérativement spécifier l’argument booléen lower.tail = FALSE. L’instruction formelle s’écrit :
La commande exécutable en console est : pt(q = 1.441, df = 13, lower.tail = FALSE).
L’exécution de cette commande renvoie immédiatement dans la console le résultat en haute précision : 0.08662452. L’intérêt méthodologique majeur de R réside dans l’automatisation intégrale des flux analytiques : cette instruction peut être directement imbriquée dans un script RMarkdown ou Quarto, extrayant les degrés de liberté et les scores t à partir de structures de données dynamiques sans nécessiter aucune ressaisie manuelle, éliminant ainsi les risques d’erreurs typographiques.
5.2 Implémentation sous Python avec les modules scientifiques
Avec l’essor de la science des données, de l’apprentissage automatique et des neurosciences computationnelles, Python est devenu un pilier analytique incontournable grâce à son module scientifique scipy.stats. Ce paquetage mathématique dispose d’une classe d’objets stochastiques t implémentant avec rigueur les intégrations de la distribution de Student.
Pour calculer la queue de distribution supérieure sans perte de précision numérique, il est formellement recommandé d’exploiter la fonction de survie (survival function, notée sf), qui évalue directement $1 – \text{CDF}(t)$ par des approximations de fractions continues hautement optimisées, plutôt que de soustraire la valeur cumulative de 1 :
L’instruction Python s’articule comme suit : from scipy import stats; p_value = stats.t.sf(1.441, df=13).
Cette syntaxe retourne la valeur décimale 0.08662451996515865. L’emploi de la fonction sf protège le calcul contre les problèmes de dérive de virgule flottante (floating-point cancellation errors), un écueil informatique critique lorsque l’on traite de très grands échantillons ou des valeurs t extrêmement élevées ($t > 8$) pour lesquelles la probabilité résiduelle approche les limites de précision de la machine.
5.3 Calcul au sein des tableurs généralistes (Microsoft Excel, Google Sheets)
Pour les travaux pédagogiques, les vérifications logistiques rapides ou les utilisateurs ne maîtrisant pas la programmation en ligne de commande, les tableurs tels que Microsoft Excel ou Google Sheets offrent une accessibilité immédiate. Au fil des évolutions de leurs moteurs de calcul, les dénominations de fonctions ont été rationalisées pour correspondre aux normes internationales d’analyse statistique.
Dans les versions actuelles des tableurs, la fonction dédiée à l’intégration de la queue supérieure d’une loi de Student est libellée en français sous la nomenclature :
=LOI.STUDENT.DROITE(x; degres_liberte)
Pour notre exemple canonique, la formule exacte à saisir dans une cellule est :
=LOI.STUDENT.DROITE(1,441; 13)
Dans un tableur configuré en langue anglaise, la syntaxe équivalente est =T.DIST.RT(1.441, 13). Le tableur renvoie avec exactitude la valeur 0,086625. Les chercheurs doivent demeurer vigilants quant aux paramètres régionaux de leurs machines : l’utilisation d’un point au lieu d’une virgule comme séparateur décimal dans une suite bureautique francophone génère couramment une erreur d’évaluation syntaxique de type #VALEUR!.
6. Intégration dans les logiciels spécialisés en sciences psychologiques
6.1 Génération de la valeur p dans IBM SPSS Statistics
IBM SPSS Statistics demeure un standard historique solidement ancré dans les départements universitaires de psychologie à travers le monde. Lorsque l’utilisateur exécute un test t pour échantillons indépendants ou pour échantillons appariés via le menu déroulant Analyser > Comparer les moyennes, SPSS génère un tableau synthétique contenant la statistique t observée, les degrés de liberté réels et une colonne intitulée « Sig. (bilatérale) » (ou « Two-Sided p » dans les éditions récentes).
Une précaution interprétative majeure s’impose ici : SPSS calcule historiquement la valeur p sous un postulat bilatéral symétrique par défaut. Si le modèle expérimental du chercheur est fondé sur une hypothèse directionnelle a priori vérifiée par les données (la différence de moyennes s’oriente dans le sens stipulé par H1), il est méthodologiquement impératif de diviser par deux la significativité bilatérale fournie par le logiciel pour obtenir la valeur p unilatérale exacte. Dans les versions modernes (SPSS v28 et supérieures), le logiciel présente désormais explicitement les probabilités unilatérales (« One-Sided p ») aux côtés des probabilités bilatérales. Pour calculer manuellement une valeur p unilatérale personnalisée à partir d’une statistique t brute sous SPSS sans relancer le test complet, les chercheurs peuvent faire appel à la commande de syntaxe :
COMPUTE p_val = 1 - CDF.T(1.441, 13). EXECUTE.
6.2 Traitement moderne via JASP et Jamovi pour la science ouverte
Dans le sillage du mouvement international en faveur de la science ouverte et de la transparence méthodologique, de nouveaux logiciels d’analyse statistique libres et gratuits ont émergé, au premier rang desquels figurent JASP (développé sous l’égide de l’Université d’Amsterdam) et Jamovi. Ces deux environnements ergonomiques s’appuient en arrière-plan sur la puissance du moteur R tout en fournissant une interface utilisateur graphique épurée et interactive.
Ces logiciels contemporains se distinguent par une gestion native et explicite des hypothèses directes dans leurs boîtes de dialogue. Lors de la configuration d’un test t, l’utilisateur coche directement une case stipulant la direction de l’effet attendu :
- « Mesure 1 $ne$ Mesure 2 » (test bilatéral standard) ;
- « Mesure 1 > Mesure 2 » (test unilatéral supérieur) ;
- « Mesure 1 < Mesure 2 » (test unilatéral inférieur).
Cette paramétrisation a priori garantit que les sorties dynamiques affichent sans ambiguïté la valeur p unilatérale exacte ($p = 0{,}087$), formatée immédiatement selon les exigences typographiques de l’APA. De surcroît, ces plateformes offrent la possibilité d’adjoindre instantanément à l’analyse fréquentiste classique son pendant bayésien (le facteur de Bayes), facilitant la comparaison épistémologique au sein d’un même document de synthèse exportable au format PDF ou HTML.
6.3 Audit et recoupement des résultats entre différents moteurs logiciels
L’intégrité de l’analyse statistique impose une exigence de reproductibilité computationnelle stricte : un résultat empirique calculé sous un environnement donné doit être rigoureusement identique lorsqu’il est audité via un autre logiciel. Pour notre cas empirique ($t = 1{,}441$, $df = 13$, unilatéral droit), le tableau de recoupement cross-plateforme s’établit avec une cohérence parfaite :
Le comparatif révèle une convergence absolue des estimations :
- R (fonction pt) : $p = 0{,}0866245$
- Python (scipy.stats.t.sf) : $p = 0{,}0866245$
- Excel (LOI.STUDENT.DROITE) : $p = 0{,}086625$
- JASP / Jamovi : $p = 0{,}087$ (arrondi APA à 3 décimales)
- Calculateur en ligne standard : $p = 0{,}08662$
Les divergences mineures ne s’observent qu’à partir de la sixième ou septième décimale et sont imputables aux algorithmes numériques d’approximation sous-jacents (développements en séries de Taylor, fractions continues ou quadratures adaptatives de Gauss-Kronrod). Il est par conséquent indispensable de spécifier dans les sections méthodologiques des articles académiques le logiciel utilisé ainsi que son numéro de version exact afin d’assurer l’auditabilité totale du traitement statistique.
7. Analyse mathématique comparée de l’exemple de référence (t = 1,441, df = 13)
7.1 Démonstration pas-à-pas avec intégration analytique
D’un point de vue analytique, la recherche d’une valeur p unilatérale correspond au calcul de l’intégrale définie de la fonction de densité de probabilité de Student, notée $f(t; \nu)$, sur le domaine s’étendant de la valeur empirique observée jusqu’à l’infini :
$$p = P(T > 1{,}441) = \int_{1{,}441}^{+\infty} f(t; 13) , dt$$
La fonction de densité de probabilité $f(t; \nu)$ d’une loi de Student à $\nu$ degrés de liberté est régie par l’expression mathématique suivante :
$$f(t; \nu) = \frac{\Gamma\left(\frac{\nu + 1}{2}\right)}{\sqrt{\nu \pi} , \Gamma\left(\frac{\nu}{2}\right)} \left(1 + \frac{t^2}{\nu}\right)^{-\frac{\nu + 1}{2}}$$
où $\Gamma(z)$ désigne la fonction Gamma d’Euler. En insérant notre paramètre structurel $\nu = 13$ degrés de liberté, le coefficient multiplicateur de normalisation devient :
$$C = \frac{\Gamma(7)}{\sqrt{13 \pi} , \Gamma(6{,}5)} \approx 0{,}38914$$
L’intégrale de probabilité s’écrit alors formellement :
$$p = 0{,}38914 \int_{1{,}441}^{+\infty} \left(1 + \frac{t^2}{13}\right)^{-7} , dt$$
La résolution analytique de cette intégrale s’effectue traditionnellement par substitution trigonométrique ou par transformation vers la fonction bêta incomplète régularisée :
$$I_x(a, b) = \frac{\text{B}(x; a, b)}{\text{B}(a, b)}$$
En posant la variable transformée :
$$x = \frac{\nu}{\nu + t^2} = \frac{13}{13 + 1{,}441^2} = \frac{13}{13 + 2{,}07648} = \frac{13}{15{,}07648} \approx 0{,}86227$$
La valeur de la queue droite s’exprime alors exactement par l’identité :
$$p = \frac{1}{2} I_x\left(\frac{\nu}{2}, \frac{1}{2}\right) = \frac{1}{2} I_{0{,}86227}(6{,}5, 0{,}5) \approx 0{,}08662$$
Cette dérivation formelle démontre l’équivalence absolue existant entre la surface géométrique délimitée sous la cloche de Student au-delà de l’abscisse 1,441 et le résultat probabiliste fourni par les trois méthodes examinées.
7.2 Variation du cas : Impact d’un test bilatéral sur cette même statistique
Considérons à présent la réévaluation du même ensemble de données empiriques sous une hypothèse non directionnelle bilatérale. L’hypothèse nulle $H_0$ énonce toujours l’égalité des moyennes ($\mu_1 = \mu_2$), mais l’hypothèse alternative $H_1$ postule simplement que les deux moyennes sont inégales ($\mu_1 ne \mu_2$), sans préjuger du sens de l’écart.
Sous cette formulation, un résultat est jugé aussi extrême ou plus extrême que le résultat observé s’il s’écarte d’au moins 1,441 unité d’erreur type du centre nul, que cet écart se produise dans le sens positif ($t ge 1{,}441$) ou dans le sens négatif ($t le -1{,}441$). En vertu de la symétrie parfaite de la loi de Student autour de l’origine zéro, l’intégrale globale est strictement égale au double de l’intégrale unilatérale :
$$p_{\text{bilatérale}} = P(|T| ge 1{,}441) = 2 \times P(T ge 1{,}441) = 2 \times 0{,}0866245 = 0{,}173249$$
Le passage d’une perspective unilatérale à une perspective bilatérale modifie drastiquement le profil décisionnel du résultat statistique. Tandis qu’une probabilité unilatérale de 0,087 se situait à proximité relative du seuil de 5 % (souvent qualifiée de marginale dans les publications anciennes), la valeur bilatérale de 0,173 s’en éloigne très largement. Plus d’un sixième des échantillons théoriques sous l’hypothèse nulle présenteront une dispersion au moins aussi large par simple variabilité stochastique, rendant indéfendable toute tentative de rejeter l’hypothèse nulle.
7.3 Simulation de la variation des degrés de liberté pour une même valeur t
Une erreur récurrente chez les chercheurs débutants consiste à considérer la statistique t comme une mesure autonome de l’intensité d’un effet, détachée de la taille d’échantillon. Pour réfuter cette fausse conception, observons la trajectoire de la valeur p unilatérale pour une statistique rigoureusement constante ($t = 1{,}441$) lorsque les degrés de liberté progressent :
- Pour $df = 5$ ($N \approx 6$) : $p = \text{pt}(1{,}441, 5, \text{lower.tail=FALSE}) = 0{,}10464$
- Pour $df = 13$ ($N \approx 14$, notre cas de base) : $p = 0{,}08662$
- Pour $df = 30$ ($N \approx 31$) : $p = 0{,}07998$
- Pour $df = 100$ ($N \approx 101$) : $p = 0{,}07635$
- Pour $df = 1000$ ($N \approx 1001$) : $p = 0{,}07498$
- Pour $df to \infty$ (loi normale asymptotique $\mathcal{N}(0, 1)$) : $p = P(Z > 1{,}441) = 0{,}07479$
Cette simulation numérique met en lumière une réalité fondamentale : même en multipliant massivement la taille de l’échantillon par près de cent, une statistique $t = 1{,}441$ ne parviendra jamais à franchir le seuil d’inférence de $\alpha = 0{,}05$ sous une loi normale, la borne asymptotique inférieure plafonnant à $p \approx 0{,}0748$. Elle souligne la distinction indispensable entre la significativité statistique, gouvernée conjointement par $t$ et $df$, et la taille de l’effet intrinsèque qui reflète la magnitude psychologique réelle du phénomène sous étude.
8. Interprétation clinique et expérimentale de la valeur p en psychologie
8.1 Application du seuil de décision alpha = 0,05 au cas d’étude
Dans l’analyse quantitative de notre cas d’étude ($t = 1{,}441$, $df = 13$, $p = 0{,}087$ en test unilatéral), la règle de décision inférentielle impose une confrontation sans équivoque avec le seuil critique conventionnel préalablement fixé à $\alpha = 0{,}05$. Puisque la valeur p obtenue satisfait l’inégalité formelle :
$$p = 0{,}08662 > 0{,}05$$
la conclusion méthodologique s’impose avec force : le chercheur est dans l’obligation formelle d’échouer à rejeter l’hypothèse nulle. D’un point de vue épistémologique rigoureux, les données expérimentales ne fournissent pas de preuves suffisantes pour attester que le traitement appliqué induit une amélioration mesurable par rapport à la condition contrôle.
Il importe de proscrire expressément de la rédaction scientifique les circonlocutions rhétoriques fallacieuses trop souvent relevées dans les manuscrits soumis, telles que l’affirmation d’une « tendance vers la significativité statistique » ou d’un « effet quasi-significatif ». Selon les préceptes formulés par la communauté méthodologique internationale, un résultat fréquentiste est dichotomique dans sa décision opérationnelle : il franchit ou ne franchit pas le seuil $\alpha$. Qualifier une probabilité de 0,087 de « quasi-significative » relève d’un biais d’interprétation motivé qui nuit à la crédibilité scientifique de la psychologie expérimentale.
8.2 Distinction entre signification statistique et pertinence clinique
La valeur p souffre d’une incapacité structurelle majeure : elle ne livre aucune information sur la magnitude de l’effet clinique ou psychologique étudié. Une valeur $p = 0{,}001$ peut masquer une modification comportementale infinitésimale et dénuée de tout intérêt thérapeutique si elle a été obtenue auprès d’une cohorte colossale de 10 000 participants. Inversement, une valeur $p = 0{,}087$ recueillie sur un échantillon restreint de 14 sujets peut correspondre à un bénéfice clinique potentiellement substantiel qui a simplement manqué de puissance pour atteindre le seuil de rejet nominal.
Pour dépasser cette limite inhérente, le calcul standardisé de la taille d’effet — notamment le d de Cohen — s’avère indispensable. Le d de Cohen se dérive directement de la statistique t et des effectifs :
$$d = \frac{t}{\sqrt{N}} = \frac{1{,}441}{\sqrt{14}} \approx \frac{1{,}441}{3{,}7417} \approx 0{,}385$$
Une taille d’effet $d = 0{,}39$ représente un effet modéré dans les nomenclatures usuelles en psychologie. L’estimation doit s’accompagner de l’intervalle de confiance à 95 % entourant la différence des moyennes. Cet intervalle permet de délimiter la plage des valeurs populationnelles plausibles et met en relief le niveau d’incertitude associé à l’estimation, guidant bien plus sûrement les psychiatres et psychologues cliniciens que la seule lecture mécanique de la valeur p.
8.3 Les risques inhérents aux erreurs de décision inférentielle
L’inférence statistique s’opère perpétuellement sous un régime d’incertitude probabiliste irréductible, exposant le chercheur à deux périls symétriques :
- L’erreur de type I (faux positif) : Rejeter à tort l’hypothèse nulle alors qu’elle est en réalité vraie dans la population globale. Le risque maximal est borné a priori par le niveau de significativité $\alpha$ (généralement 5 %).
- L’erreur de type II (faux négatif) : Échouer à rejeter l’hypothèse nulle alors qu’un effet réel existe effectivement au sein de la population. Ce risque probabiliste, noté $\beta$, est inversement proportionnel à la puissance statistique du test ($1 – \beta$).
Dans notre cas de figure ($t = 1{,}441$, $df = 13$), avec un échantillon total de seulement 14 observations et un effet réel d’amplitude modérée ($d \approx 0{,}39$), la puissance statistique a posteriori d’un test t unilatéral au seuil $\alpha = 0{,}05$ n’est approximativement que de 38 %. Il existait donc une probabilité d’erreur de type II $\beta \approx 62$ % de manquer un effet réel par simple manque d’effectifs. Cette situation illustre le drame des études expérimentales dites « sous-puissancées » en psychologie : le chercheur court un risque majeur d’enterrer une piste thérapeutique prometteuse en raison d’une cohorte initiale trop étriquée pour dissiper le brouillard stochastique.
9. Erreurs fréquentes et pièges analytiques lors de la dérivation de p
9.1 Confusion entre tests unilatéraux et bilatéraux dans la littérature
L’un des dysfonctionnements les plus fréquemment sanctionnés lors du processus de révision par les pairs (peer-review) réside dans la manipulation opportuniste de la directionnalité du test. Il n’est pas rare de constater qu’un auteur, confronté à un résultat bilatéral non significatif ($p = 0{,}173$), opère un basculement tardif vers un test unilatéral afin de présenter un chiffre ($p = 0{,}087$) artificiellement rapproché du seuil fatidique de 0,05, voire inférieur à 0,05 dans certains scénarios limites.
Une telle pratique contrevient frontalement à l’éthique de la recherche scientifique à moins que l’hypothèse unilatérale n’ait été formellement préenregistrée dans un registre d’accès public (comme Open Science Framework ou ClinicalTrials.gov) avant l’engagement de la collecte des données. Par ailleurs, une erreur technique inverse s’observe couramment chez les étudiants : oublier de doubler la valeur de probabilité issue d’une table unilatérale lorsque la question de recherche fondamentale portait sur une déviation bidirectionnelle non orientée. La transparence éditoriale impose de déclarer explicitement la directionnalité choisie dans le texte du manuscrit.
9.2 Erreurs relatives aux degrés de liberté selon le devis expérimental
L’attribution erronée des degrés de liberté constitue un facteur majeur de distorsion lors du calcul de la valeur p. Les degrés de liberté ne se déduisent pas de façon uniforme à partir du nombre total de sujets, mais dépendent fondamentalement de l’architecture du devis expérimental mis en œuvre :
- Devis à mesures répétées (intra-sujets) : Si une cohorte unique de 14 participants est mesurée avant et après une induction émotionnelle, les degrés de liberté s’élèvent à $df = N – 1 = 14 – 1 = 13$. Notre calcul $p = 0{,}087$ s’applique rigoureusement à cette configuration.
- Devis à groupes indépendants (inter-sujets) : Si l’expérience met en parallèle deux groupes distincts (par exemple, un groupe témoin et un groupe expérimental) comptant chacun 14 participants ($N_{\text{total}} = 28$), les degrés de liberté cumulés s’élèvent alors à $df = N_1 + N_2 – 2 = 14 + 14 – 2 = 26$. L’évaluation de la même statistique $t = 1{,}441$ avec $df = 26$ conduirait à $p = 0{,}0807$. Confondre les deux devis aboutirait à une distorsion du calcul probabiliste.
La situation se complexifie davantage lorsque les variances des deux groupes indépendants s’avèrent hétérogènes (hétéroscédasticité). L’application du test t de Welch requiert l’approximation de Welch-Satterthwaite, qui génère des degrés de liberté fractionnaires (non entiers, par exemple $df = 21{,}43$). Tenter d’utiliser une table imprimée classique devient alors illusoire, rendant l’utilisation des calculateurs programmatiques indispensable.
9.3 Arrondis hâtifs et déclarations imprécises des résultats
Dans les pratiques rédactionnelles désuètes, les résultats d’analyses étaient régulièrement tronqués sous forme d’inégalités binaires rudimentaires : p < 0.05 ou l’expression générique NS (pour non-significatif). Cette occultation de la valeur continue dégrade l’information scientifique et interdit l’inclusion ultérieure de l’article dans des méta-analyses quantitatives rigoureuses. De nos jours, les manuels de style internationaux imposent de rapporter la valeur p exacte avec deux ou trois décimales significatives ($p = 0{,}087$).
Une méprise analytique particulièrement lourde de sens consiste à recopier mécaniquement la sortie textuelle générée par les anciens logiciels statistiques lorsque la probabilité calculée est infinitésimale. Des programmes comme SPSS affichent fréquemment la mention tronquée .000. Écrire dans un rapport de recherche que « $p = 0{,}000$ » constitue un non-sens probabiliste absolu, car cela reviendrait à affirmer l’impossibilité métaphysique totale d’observer les données sous le modèle nul. La norme académique stipule qu’il convient de retranscrire toute valeur inférieure à un millième sous la notation stricte :
$$p < 0{,}001$$
10. Au-delà de la valeur p : Les recommandations modernes de l’APA et de l’ASA
10.1 La déclaration de l’American Statistical Association sur les valeurs p
Face à la crise de la reproductibilité qui a secoué les sciences comportementales au cours de la dernière décennie, l’American Statistical Association (ASA) a publié une prise de position officielle historique en 2016 (Wasserstein & Lazar, 2016), actualisée en 2019, visant à encadrer drastiquement les dérives interprétatives entourant l’usage de la valeur p. L’ASA met formellement en garde la communauté scientifique contre plusieurs dogmes réducteurs :
- Une valeur p ne mesure en aucun cas la probabilité que l’hypothèse de recherche examinée soit vraie, ni que les données aient été générées purement au hasard.
- Les conclusions scientifiques et les décisions politiques ou cliniques ne doivent en aucun cas reposer exclusivement sur le franchissement mécanique d’un seuil statistique arbitraire comme $\alpha = 0{,}05$.
- L’inférence statistique authentique requiert une divulgation exhaustive de l’ensemble des analyses entreprises, excluant toute sélection partiale des tests significatifs au détriment des résultats nuls (cherry-picking).
L’institution souligne que la valeur p ne renseigne en rien sur la pertinence d’un modèle ni sur l’ampleur pragmatique d’un résultat. Cette réorientation épistémologique majeure incite les chercheurs en psychologie à concevoir des analyses plus riches, contextuelles et prudentes, reléguant le « culte du p < 0,05 » au rang de vestige méthodologique dépassé.
10.2 Complémentarité obligatoire : Tailles d’effet et puissance a priori
En parfaite harmonie avec les préceptes de l’ASA, le manuel de publication de l’American Psychological Association (APA, 7e édition) a rendu obligatoire l’adjonction systématique d’indices standardisés de taille d’effet (le d de Cohen, le g de Hedges ou le $\eta^2$ partiel) pour accompagner toute statistique de test rapportée dans les revues académiques. L’objectif est de dissocier formellement la puissance métrologique de la significativité contextuelle.
Dans cette perspective réformée, la démarche scientifique rigoureuse commence bien en amont de la récolte des données, par le biais d’un calcul de puissance a priori. À l’aide de progiciels spécialisés tels que G*Power, le chercheur détermine le volume d’échantillon $N$ mathématiquement requis pour détecter un effet d’une amplitude clinique jugée minimale avec une puissance nominale satisfaisante (traditionnellement $1 – \beta = 0{,}80$ ou $0{,}90$) au seuil fixé $\alpha = 0{,}05$. Dans notre cas d’étude, pour parvenir à identifier un effet modéré attendu ($d = 0{,}39$) comme statistiquement significatif au seuil unilatéral de 5 % avec 80 % de puissance, l’analyse prospective révèle qu’il aurait fallu mobiliser au minimum 41 participants par condition, et non 14. Ce dimensionnement anticipé constitue désormais le garant méthodologique de toute publication rigoureuse.
10.3 L’alternative de l’inférence bayésienne pour le test t
Pour s’émanciper des impasses inhérentes au cadre fréquentiste, une proportion grandissante de psychologues expérimentaux privilégie aujourd’hui l’inférence bayésienne. Dans le paradigme bayésien, le chercheur n’évalue pas la probabilité des données sachant une hypothèse nulle fixe ($P(D mid H_0)$), mais quantifie la plausibilité relative respective des deux modèles concurrents au moyen du Facteur de Bayes (noté $BF_{10}$ ou $BF_{01}$).
Appliqué à notre exemple ($t = 1{,}441$, $df = 13$, orienté), un test t bayésien reposant sur une loi a priori de Cauchy standardisée (échelle $r = 0{,}707$) génère approximativement :
$$BF_{10} \approx 1{,}18$$
Ce résultat s’interprète de manière transparente : les données empiriques recueillies sont seulement 1,18 fois plus probables sous l’hypothèse alternative $H_1$ que sous l’hypothèse nulle $H_0$. Selon la classification méthodologique de Jeffreys, un facteur de Bayes compris entre 1 et 3 qualifie une preuve « anecdotique » ou « insensible », équivalant à une absence totale de données probantes. Contrairement à la valeur p classique qui est incapable de « prouver » l’absence d’effet sans commettre de sophisme, l’approche bayésienne permettrait d’estimer $BF_{01}$ pour quantifier formellement le soutien empirique accordé à l’hypothèse nulle d’invariance comportementale.
11. Comparatif critique des trois méthodes pour obtenir une valeur p
11.1 Critères de vitesse, précision et reproductibilité
Le choix de la méthodologie employée pour dériver une valeur p à partir d’une statistique t dépend étroitement de la finalité opératoire du chercheur, qu’il s’agisse d’un contrôle d’étape rapide en laboratoire, de l’évaluation critique d’un tiré à part imprimé ou de la production d’un manuscrit empirique destiné à une revue internationale à fort impact. Chacune des approches présente des propriétés distinctives au regard des trois critères cardinaux de l’analyse métrologique moderne :
- Les calculateurs automatisés en ligne : Ils excellent sur le plan de la rapidité d’exécution et de l’intuitivité cognitive, proposant une visualisation graphique immédiate et une excellente résolution numérique. Ils s’avèrent idéaux pour les contrôles ponctuels et les phases d’apprentissage. En contrepartie, ils demeurent vulnérables aux erreurs de saisie manuelle et n’offrent aucune traçabilité intégrée dans un protocole d’analyse reproductible.
- Les tables statistiques imprimées : Outils historiques par excellence, elles ne requièrent aucune source d’énergie ni connexion informatique, favorisant une compréhension intuitive de l’ordonnancement des valeurs critiques. Cependant, leur précision intrinsèque est bridée par la discrétisation des colonnes d’alpha, ne livrant généralement qu’un simple intervalle ordinal ($0{,}05 < p < 0{,}10$) à moins de recourir à l'interpolation linéaire manuelle.
- Les scripts de programmation (R, Python, syntaxes spécialisées) : Ils représentent le standard scientifique optimal pour la recherche institutionnelle. Bien qu’ils exigent des compétences techniques préalables en codage, ils garantissent une reproductibilité totale, une précision machine en virgule flottante et une insertion fluide au sein de flux d’analyses collaboratifs ouverts et auditables.
11.2 Tableau récapitulatif des avantages et limites méthodologiques
Afin de structurer le choix opérationnel du praticien ou de l’étudiant en sciences humaines et sociales, le tableau comparatif ci-dessous synthétise les compromis analytiques associés à chaque vecteur de calcul :
| Méthodologie | Précision Décimale | Vitesse Opératoire | Traçabilité / Science Ouverte | Niveau d’Expertise Requis | Usage Privilégié |
|---|---|---|---|---|---|
| Calculateur en ligne | Élevée (5 à 8 décimales) | Instantanée | Faible (saisie manuelle volatile) | Novice à intermédiaire | Dépouillement rapide, contrôle exploratoire |
| Table de Student physique | Faible (intervalle ou estimation linéaire) | Modérée (recherche manuelle) | Nulle (aucun historique machine) | Débutant (cadre didactique) | Enseignement théorique, examens académiques |
| Script de recherche (R, Python) | Maximale (virgule flottante double) | Automatisée à l’exécution | Absolue (scripts archivables, Markdown) | Avancé (compétences de code) | Publications APA, méta-analyses, science ouverte |
Pour toute soumission d’article empirique de haut niveau, il est formellement recommandé d’exclure les méthodes manuelles et de privilégier des scripts documentés, audités au préalable par recoupement croisé entre plusieurs moteurs logiciels indépendants.
12. Guide pratique de rédaction académique des résultats de test t
12.1 Formatage standard selon les normes APA (7e édition)
L’American Psychological Association édicte des règles typographiques et syntaxiques particulièrement strictes pour la communication des tests d’inférence statistique. La restitution textuelle d’un test t doit synthétiser de façon univoque l’ensemble des paramètres nécessaires à la compréhension métrique et critique du protocole.
Le patron formel canonique s’agence selon la structure suivante :
t(degrés de liberté) = valeur t observée, p = valeur p exacte, directionnalité du test, taille d’effet standardisée.
Les directives typographiques imposent les prescriptions normatives suivantes :
- Les symboles statistiques latins doivent obligatoirement figurer en italique : t, p, d, N, M, SD. Les symboles grecs ($\alpha$, $\beta$, $\eta^2$) demeurent en revanche en romain droit.
- Conformément aux conventions de l’anglais scientifique et de l’APA, lorsque la valeur d’une statistique ne peut théoriquement pas excéder le chiffre 1 (ce qui est intrinsèquement le cas des probabilités p et des corrélations r), le zéro initial précédent le séparateur décimal doit être supprimé dans les manuscrits anglophones (ex. : p = .087). Dans les manuscrits de langue française respectant les normes de l’imprimerie nationale, la virgule et le zéro initial sont typographiquement préservés (ex. : p = 0,087).
- La statistique t est arrondie conventionnellement à deux décimales, tandis que la valeur p exacte est présentée avec trois décimales significatives.
La transcription formelle de notre cas d’étude s’énonce donc textuellement :
t(13) = 1,44, p = 0,087 (unilatéral), d = 0,39.
12.2 Exemples concrets de formulations narratives pour manuscrits
L’intégration narrative des résultats quantitatifs au sein du corpus d’un article universitaire doit concilier rigueur mathématique et lisibilité psychologique. Les statistiques brutes ne doivent jamais être présentées de façon isolée, mais adossées aux indices de tendance centrale (moyennes, M) et de dispersion (écarts-types, SD) des groupes expérimentaux respectifs.
Voici un modèle rédactionnel adapté pour formaliser un échec de rejet de l’hypothèse nulle sans recourir au lexique proscrit de la tendance :
« Les participants soumis au programme d’entraînement attentionnel informatisé ont présenté une vitesse moyenne de traitement cognitif numériquement supérieure (M = 452 ms, SD = 48) à celle observée chez les participants du groupe contrôle sur liste d’attente (M = 431 ms, SD = 53). Néanmoins, cette amélioration ne s’est pas avérée statistiquement significative au seuil unilatéral spécifié a priori, t(13) = 1,44, p = 0,087, d = 0,39, IC à 95 % [-9,32, 51,32]. Ces données préliminaires ne permettent pas d’écarter l’hypothèse nulle selon laquelle la différence observée résulte de fluctuations stochastiques d’échantillonnage au sein de cette cohorte restreinte. »
Cette articulation narrative articule la description empirique sans survendre le résultat, offrant une restitution conforme aux standards de sincérité scientifique promus par les comités éditoriaux contemporains.
12.3 Checklist finale avant la soumission d’analyses basées sur la statistique t
Avant d’expédier un manuscrit pour évaluation par les pairs ou de valider un mémoire de recherche doctorale, le chercheur méthodique procède à une vérification rigoureuse des points cardinaux suivants :
- Alignement conceptuel et directionnel : La direction du test (unilatéral ou bilatéral) a-t-elle été formellement stipulée avant la prise de connaissance des données d’échantillonnage, idéalement au sein d’un protocole préenregistré ?
- Exactitude des degrés de liberté : Les degrés de liberté rapportés correspondent-ils strictement à la structure du devis (N – 1 pour mesures répétées ; N1 + N2 – 2 pour groupes indépendants avec homogénéité des variances ; correction de Welch en cas d’hétéroscédasticité) ?
- Intégrité du calcul de probabilité : La valeur p a-t-elle été auditée sur un calculateur ou un script validé, en évitant l’écueil de la retranscription tronquée de
.000? - Complétude des métriques d’impact : La valeur p est-elle systématiquement escortée par la statistique t exacte, les degrés de liberté, un indice de taille d’effet standardisé (ex. d de Cohen) et son intervalle de confiance à 95 % ?
- Reproductibilité computationnelle : Le script de calcul (fichier .R, notebook Jupyter ou syntaxe SPSS/JASP) est-il rigoureusement commenté et déposé dans un référentiel public de science ouverte (ex. : OSF, Zenodo) pour garantir la réplication intégrale des conclusions par les pairs ?
L’observation scrupuleuse de cette démarche transforme la simple recherche d’une valeur p en un acte méthodologique cohérent, robuste et transparent, garantissant l’élévation des standards de rigueur au sein des sciences psychologiques contemporaines.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Gosset, W. S. [Student]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Wasserstein, R. L., Schirm, A. L., & Lazar, N. A. (2019). Moving to a world beyond “p < 0.05”. The American Statistician, 73(sup1), 1–19. https://doi.org/10.1080/00031305.2019.1583913