
L’analyse inférentielle des variables qualitatives constitue un pilier méthodologique fondamental dans la recherche contemporaine, tout particulièrement au sein des sciences biomédicales, de l’épidémiologie clinique et de la psychologie quantitative. Lorsque les chercheurs s’intéressent aux associations potentielles entre deux variables catégorielles réparties au sein d’un tableau de contingence, le réflexe analytique prédominant consiste traditionnellement à mobiliser le test du Chi-deux d’indépendance de Pearson. Néanmoins, la validité mathématique de cette épreuve repose sur une approximation asymptotique qui postule que la taille de l’échantillon tend vers l’infini, garantissant ainsi que la distribution de la statistique observée converge convenablement vers une loi théorique continue du Chi-deux. Dans les contextes expérimentaux ou quasi-expérimentaux caractérisés par des cohortes restreintes, des populations cliniques rares ou des distributions d’effectifs fortement asymétriques, cette hypothèse asymptotique s’effondre, exposant l’analyste à des distorsions sévères du taux d’erreur de première espèce et à des conclusions inférentielles potentiellement erronées.
Face à ces défaillances structurelles des méthodes approximatives, le recours aux procédures exactes s’impose non pas comme une simple alternative de commodité, mais comme un impératif épistémologique et méthodologique. Conçu pour calculer la probabilité exacte d’observer la configuration empirique obtenue (ou une configuration plus extrême) sans faire appel à une quelconque approximation de grands échantillons, le test exact de Ronald A. Fisher représente la solution par excellence pour les tables de dimension 2×2 et leurs généralisations multi-catégorielles. En exploitant les propriétés combinatoires de la distribution hypergéométrique discrète sous l’hypothèse de fixité des marges, ce test garantit un contrôle nominal strict de l’erreur alpha, quelle que soit la petitesse de la cohorte analysée, y compris en présence de cases totalement désertes.
Dans le paysage des logiciels statistiques professionnels dédiés à la recherche de pointe, l’environnement SAS (Statistical Analysis System) s’est imposé comme une référence industrielle et académique majeure grâce à la puissance, la robustesse algorithmique et la reproductibilité de ses procédures, notamment via le module SAS/STAT et sa célèbre procédure PROC FREQ. L’objectif de cet article est d’offrir un guide exhaustif, théorique et opérationnel, destiné aux chercheurs, méthodologistes et biostatisticiens désireux de maîtriser la mise en œuvre, l’évaluation et l’interprétation du test exact de Fisher sous SAS. En articulant les fondements mathématiques sous-jacents, les stratégies de codage avancées, l’analyse détaillée des sorties numériques et les directives internationales de publication selon les normes de l’American Psychological Association (APA 7e édition), ce guide permettra d’aborder avec une rigueur absolue le traitement des données catégorielles sur petits échantillons.
1. Fondements théoriques et épistémologiques du test exact de Fisher
1.1 Origine historique et principe probabiliste de Ronald Fisher
L’émergence du test exact de Fisher plonge ses racines dans les débats méthodologiques foisonnants des années 1930 à la station expérimentale de Rothamsted en Angleterre. L’anecdote fondatrice, immortalisée par Ronald Aylmer Fisher dans son ouvrage séminal de 1935 intitulé The Design of Experiments, met en scène une collègue biologiste, Muriel Bristol, qui affirmait être capable de discerner gustativement si le lait avait été versé dans la tasse avant ou après l’infusion du thé. Afin de soumettre cette allégation empirique à une épreuve de réfutation rigoureuse, Fisher conçut un protocole expérimental à l’aveugle comprenant huit tasses préparées : quatre avec le lait versé en premier, et quatre avec le thé versé en premier, présentées dans un ordre aléatoire. Le sujet connaissait parfaitement la composition globale de l’épreuve (quatre tasses de chaque modalité), ce qui fixait a priori les totaux marginaux du tableau de contingence 2×2 qui en résultait.
Pour évaluer la probabilité que la dégustatrice réussisse par pur hasard l’identification correcte d’un nombre déterminé de tasses, Fisher s’est affranchi des approximations continues en exploitant la loi de probabilité hypergéométrique discrète. Sous l’hypothèse nulle d’absence totale de pouvoir discriminant, la probabilité d’obtenir une configuration spécifique d’effectifs conjoints $a, b, c, d$ dans une table 2×2, sachant les marges de lignes $(a+b), (c+d)$ et les marges de colonnes $(a+c), (b+d)$ pour un effectif total $N$, est régie par la formule combinatoire suivante :
$$P = \frac{\binom{a+b}{a} \binom{c+d}{c}}{\binom{N}{a+c}} = \frac{(a+b)! (c+d)! (a+c)! (b+d)!}{N! , a! , b! , c! , d!}$$
La rupture épistémologique introduite par Fisher réside dans l’abandon complet de l’hypothèse asymptotique. Alors que les statisticiens de l’époque, influencés par Karl Pearson, s’appuyaient sur des approximations gaussiennes ou des distributions du Chi-deux nécessitant de grands échantillons pour converger mathématiquement, Fisher a démontré qu’il était possible de calculer une probabilité conditionnelle exacte, exempte de tout biais d’approximation. Historiquement, cette méthode a trouvé ses premières applications déterminantes dans les sciences agricoles et génétiques, avant d’essaimer dans les protocoles de recherche en sciences humaines et biomédicales où les contraintes d’échantillonnage interdisent tout recours aux asymptotes.
1.2 Pertinence du test en méthodologie de la recherche psychologique
Au sein de la méthodologie de la recherche en psychologie, en psychiatrie clinique et en neurosciences cognitives, les praticiens sont fréquemment confrontés à des contraintes structurelles d’échantillonnage qui rendent l’application des tests d’association standards non seulement illégitime, mais scientifiquement risquée. L’étude de populations cliniques spécifiques, telles que les individus présentant des troubles psychopathologiques à prévalence exceptionnellement faible (par exemple, le syndrome de Cotard, les états dissociatifs atypiques ou certaines variantes ultra-rares de la catatonie), implique souvent des cohortes totales qui n’excèdent guère une vingtaine ou une trentaine de sujets à l’échelle d’une institution hospitalière ou d’un consortium interuniversitaire.
Dans ce type d’échantillonnage restreint, la répartition des participants au sein d’un croisement bivarié (par exemple, la présence d’une réponse clinique favorable selon la présence ou l’absence d’un biomarqueur génétique ou neuropsychologique spécifique) engendre quasi inévitablement des cellules à très faible effectif, parfois même nulles. Alors que le test du Chi-deux de Pearson voit sa loi limite invalidée par ces effectifs clairsemés, le test exact de Fisher assure une étanchéité méthodologique absolue. Il maintient rigoureusement l’intégrité de l’inférence sans exiger l’exclusion artificielle de sujets atypiques ou le regroupement hasardeux de catégories conceptuellement distinctes.
De surcroît, les protocoles quasi-expérimentaux en sciences humaines souffrent fréquemment de déséquilibres sévères dans l’assignation naturelle des sujets. Lorsque les chercheurs étudient des cohortes de détenus en milieu carcéral ou des enfants placés en institutions d’aide sociale, les tailles respectives des sous-groupes sont imposées par des facteurs écologiques externes impossibles à manipuler. Le test de Fisher démontre une robustesse remarquable face à ces déséquilibres numériques marqués, préservant la validité interne des conclusions relatives à l’existence ou à l’absence d’une association statistique significative.
1.3 Le principe des marginales fixes et le conditionnement statistique
Le fondement probabiliste du test de Fisher repose intégralement sur le postulat du conditionnement par rapport aux totaux marginaux observés du tableau de contingence. Dans la taxonomie des plans expérimentaux, on distingue classiquement trois modèles d’échantillonnage pour une table 2×2 : le modèle où aucune marge n’est fixée à l’avance (échantillonnage poissonnien global), le modèle où une seule marge est fixée par le protocole (échantillonnage multinomial ou binomial indépendant, comme dans un essai clinique comparant deux groupes de tailles prédéterminées face à un événement dichotomique), et le modèle dit à « double marge fixe » ou hypergéométrique (où les totaux des lignes et les totaux des colonnes sont constants a priori).
En pratique empirique, l’expérience de la dégustation de thé constitue l’un des rares cas où les deux marginales sont rigoureusement fixées par le protocole expérimental. Dans l’immense majorité des recherches observationnelles ou cliniques, une seule marginale (au mieux) est fixée par le chercheur. Pourtant, le test de Fisher procède en traitant mathématiquement les deux marginales observées comme si elles avaient été fixées à l’avance. Ce conditionnement statistique sur les marginales observées transforme les paramètres de nuisance inconnus (tels que la probabilité basale de survenue de l’événement d’intérêt dans la population) en constantes arithmétiques, permettant ainsi d’isoler exclusivement le paramètre d’association d’intérêt, à savoir le rapport de cotes (odds ratio).
Ce conditionnement génère un espace d’échantillonnage constitué de l’ensemble fini des tableaux de contingence envisageables ayant exactement les mêmes totaux marginaux de lignes et de colonnes que la table empirique. L’évaluation inférentielle s’opère par permutations combinatoires au sein de cet ensemble discret. Cependant, cette élégance probabiliste a une conséquence statistique majeure : le test exact de Fisher devient inhéremment conservateur. Étant donné que la distribution hypergéométrique sous-jacente est strictement discrète, la probabilité cumulée des configurations extrêmes ne peut prendre qu’un ensemble discontinu de valeurs réelles. Par conséquent, le taux d’erreur de première espèce effectif est presque toujours strictement inférieur au seuil nominal théorique de 5 % (souvent de l’ordre de 2 % à 4 %), ce qui entraîne une perte modérée de puissance statistique par rapport aux tests asymptotiques non conditionnels idéalisés.
2. Cadre décisionnel et formulation des hypothèses statistiques
2.1 Formalisation rigoureuse des hypothèses nulle et alternative
Toute démarche d’inférence statistique valide exige une formalisation axiomatique sans équivoque des hypothèses confrontées lors de l’épreuve empirique. Dans le contexte de l’analyse bivariée d’un tableau de contingence croisant deux variables aléatoires nominales polytomiques ou dichotomiques $X$ et $Y$, l’hypothèse nulle, désignée conventionnellement par $H_0$, postule l’indépendance stochastique stricte entre les deux attributs dans la population parente. Sur le plan de la théorie de la mesure et des probabilités conjointes, cette indépendance s’exprime formellement pour chaque cellule $(i, j)$ par l’égalité :
$$P(X = i \cap Y = j) = P(X = i) \times P(Y = j)$$
L’hypothèse alternative, notée $H_1$, soutient à l’inverse qu’il existe une dépendance statistique ou une structure d’association non fortuite entre les distributions des deux variables, impliquant qu’au moins un couple de modalités viole cette factorisation probabiliste. Dans le cadre précis d’une table de contingence binaire 2×2, cette confrontation conceptuelle se traduit de manière élégante et universelle par l’intermédiaire du rapport de cotes théorique de population, traditionnellement symbolisé par la lettre grecque $\theta$ (thêta) :
$$\theta = \frac{P(Y=1 mid X=1) / P(Y=0 mid X=1)}{P(Y=1 mid X=2) / P(Y=0 mid X=2)} = \frac{p_{11} , p_{22}}{p_{12} , p_{21}}$$
Dès lors, le cadre décisionnel s’articule autour du positionnement de ce paramètre scalaire par rapport à l’unité :
- Hypothèse nulle ($H_0$) : $\theta = 1$ (absence d’effet, indépendance complète entre l’exposition et le statut, la cote de survenue de l’événement étant rigoureusement équivalente entre les deux groupes).
- Hypothèse alternative bilatérale ($H_1$) : $\theta \neq 1$ (présence d’une association directionnelle non spécifiée, la survenue de l’événement étant soit favorisée, soit inhibée par la modalité d’exposition).
- Hypothèses alternatives unilatérales ($H_1$) : $\theta > 1$ (association positive, augmentation spécifique du risque ou des chances) ou $\theta < 1$ (association négative, effet protecteur ou sous-représentation systématique).
2.2 Seuil de significativité alpha et règles de rejet
Le rejet ou le maintien de l’hypothèse nulle d’indépendance repose sur la confrontation systématique de la valeur-p exacte (calculée par la sommation combinatoire des probabilités hypergéométriques des tables au moins aussi extrêmes que la table observée) avec un seuil de significativité prédéterminé, classiquement fixé à $\alpha = 0{,}05$ dans la majorité des paradigmes de recherche en sciences humaines et biomédicales. Ce seuil correspond au plafond acceptable de tolérance vis-à-vis du risque de rejeter à tort l’hypothèse nulle alors qu’elle est vérifiée dans la population générale (erreur de type I).
Le calcul formel de la valeur-p bilatérale exacte de Fisher dans SAS obéit à la définition rigoureuse établie par Fisher lui-même. Soit $P_{obs}$ la probabilité hypergéométrique associée à la table empirique observée sous $H_0$. La valeur-p bilatérale correspond à la somme des probabilités de l’ensemble des configurations tabulaires théoriquement réalisables partageant les mêmes marges fixes dont la probabilité individuelle d’occurrence est inférieure ou égale à cette valeur observed, soit :
$$p_{\text{bilatérale}} = \sum_{k : P(k) le P_{\text{obs}}} P(k)$$
La règle de décision binaire s’énonce ainsi : si la valeur-p bilatérale obtenue est strictement inférieure au seuil critique fixé a priori ($p le \alpha$), le chercheur rejette formellement $H_0$ et conclut à l’existence d’une association statistiquement significative entre les variables. Si $p > \alpha$, les données empiriques ne fournissent pas de preuves suffisantes pour invalider l’hypothèse d’indépendance stochastique. En raison de la discrétisation inhérente à l’espace combinatoire, le chercheur doit constamment intégrer le fait que le risque de commettre une erreur de type II (ne pas rejeter $H_0$ alors qu’un effet réel existe) peut être modérément amplifié par la nature intrinsèquement prudente du test de Fisher.
2.3 Postulats et conditions préalables d’application
Bien que le test exact de Fisher soit une méthode non paramétrique affranchie des postulats de normalité distributionnelle, d’homoscédasticité ou de linéarité qui caractérisent les modèles d’analyse de variance ou de régression linéaire, son application valide demeure subordonnée à plusieurs contraintes structurelles fondamentales qu’il convient d’examiner avec minutie en phase de conception expérimentale :
- Indépendance mutuelle stricte des observations : Chaque unité statistique (patient, sujet expérimental, animal de laboratoire) ne doit contribuer qu’une seule et unique fois à une seule cellule du tableau de contingence. L’inclusion de mesures répétées longitudinales ou de données appariées (comme dans les devis pré-test/post-test sur les mêmes sujets) constitue une violation directe du postulat d’indépendance, requérant alors des tests spécifiques tels que le test de McNemar ou les modèles d’équations d’estimation généralisées (GEE).
- Discrétion et exhaustivité des catégories : Les variables d’intérêt doivent être découpées en modalités qualitatives nominales ou ordinales parfaitement mutuellement exclusives et collectivement exhaustives. Un individu ne peut appartenir à deux modalités simultanément, et aucun individu de l’échantillon ne doit être dépourvu de classification.
- Cohérence du plan d’échantillonnage avec le conditionnement : Bien que la théorie conditionnelle de Fisher permette de contourner l’absence de fixation délibérée des deux marges, l’interprétation causale des résultats demeure étroitement liée à la nature de l’échantillonnage (cohorte prospective, étude cas-témoins transversale ou échantillonnage transversal sans assignation).
3. Comparaison méthodologique : Fisher exact versus Chi-deux de Pearson
3.1 La règle de Cochran et la défaillance asymptotique du Chi-deux
La légitimité mathématique du test du Chi-deux de Pearson dépend de la précision avec laquelle la distribution multinomiale sous-jacente des effectifs d’échantillonnage converge vers la distribution continue du $\chi^2$ de Wald. En 1952 et 1954, le biostatisticien William G. Cochran a formulé des critères empiriques célèbres d’applicabilité devenus la référence standard dans la littérature méthodologique internationale : le test du Chi-deux asymptotique de Pearson est considéré comme valide si aucun effectif théorique attendu ($E_{ij} = \frac{R_i \times C_j}{N}$) n’est strictement inférieur à 1, et si au maximum 20 % des cellules du tableau de contingence présentent un effectif théorique inférieur à 5.
Lorsque la règle de Cochran est enfreinte, l’approximation asymptotique devient profondément instable. Dans les petits échantillons, la variance de la statistique du Chi-deux de Pearson s’écarte substantiellement de sa valeur théorique asymptotique ($2 \times \text{ddl}$), provoquant soit une inflation dramatique de l’erreur de type I (faux positifs induits par des cellules marginales très faibles), soit une déflation imprévisible de la puissance statistique. Pour pallier cette lacune sur les tables 2×2, Frank Yates avait proposé en 1934 une « correction de continuité » soustrayant 0,5 à la valeur absolue de l’écart entre effectif observé et effectif attendu :
$$\chi^2_{\text{Yates}} = \sum \frac{(|O_{ij} – E_{ij}| – 0{,}5)^2}{E_{ij}}$$
Toutefois, une abondante littérature biométrique a démontré que la correction de Yates constitue un remède imparfait. Elle tend souvent à surcorriger l’approximation, engendrant un conservatisme excessif qui diminue drastiquement la sensibilité du test sans apporter les garanties formelles d’exactitude probabiliste inhérentes au calcul combinatoire combiné de Fisher.
3.2 Avantages comparatifs du test de Fisher sur petits échantillons
Le premier avantage comparatif du test exact de Fisher réside dans son indépendance absolue vis-à-vis de la taille d’échantillon globale $N$. La probabilité calculée étant issue d’un dénombrement combinatoire exact de l’espace échantillonnal conditionné, la validité nominale de la conclusion statistique est mathématiquement garantie, que l’effectif total soit de $N = 12$ ou de $N = 1,200$. Cette caractéristique confère aux inférences une robustesse inattaquable face aux critiques relatives à la représentativité asymptotique.
Le second atout décisif concerne le traitement transparent des cellules à effectif nul ($O_{ij} = 0$). Dans les tests asymptotiques, la présence d’un zéro dans une cellule pose des problèmes computationnels et théoriques considérables, interdisant le calcul direct de rapports asymptotiques non biaisés sans recourir à des artifices de pseudocomptages arbitraires (comme l’ajout d’une constante de Haldane-Anscombe de 0,5). Le test de Fisher intègre naturellement ces cellules vides au sein de la fonction de masse hypergéométrique sans nécessiter aucune altération artificielle des données réelles.
Enfin, en psychométrie exploratoire et lors de la phase préliminaire d’étalonnage d’outils d’évaluation clinique, les protocoles pilotes requièrent fréquemment des analyses discriminantes entre des groupes de patients aux dimensions restreintes. Le test exact de Fisher garantit alors aux chercheurs la préservation de la rigueur inférentielle, éliminant les artéfacts statistiques d’invalidation asymptotique qui polluent régulièrement les études exploratoires menées sur petits effectifs.
3.3 Matrice décisionnelle pour le choix du test sous SAS
Pour guider le praticien dans l’écosystème analytique de SAS, il est impératif d’établir un algorithme décisionnel standardisé déterminant le choix entre le test asymptotique du Chi-deux et le test exact de Fisher :
- Étape 1 : Analyse des dimensions du tableau : Si la table est strictement de dimension 2×2, examiner les effectifs attendus calculés automatiquement par l’instruction
TABLES / CHISQdans la procédurePROC FREQ. - Étape 2 : Vérification de la règle de Cochran : Si un seul effectif attendu $E_{ij}$ est inférieur à 5 dans une table 2×2, basculer impérativement vers l’interprétation des sorties exactes générées par l’instruction
EXACT FISHERou l’optionFISHER. - Étape 3 : Traitement des tables de dimensions étendues ($r \times c$) : Si le tableau comporte plus de deux lignes ou plus de deux colonnes et que plus de 20 % des cellules théoriques sont inférieures à 5, l’approximation du Chi-deux classique doit être abandonnée au profit de l’extension de Freeman-Halton du test de Fisher.
- Étape 4 : Gestion de la puissance et du compromis d’échantillonnage : Lorsque $N$ est très volumineux ($N > 500$) et que tous les effectifs attendus dépassent largement les seuils critiques, le Chi-deux de Pearson standard et le test de Fisher convergent vers des valeurs-p rigoureusement identiques, rendant le calcul exact redondant mais toujours mathématiquement valide.
Il convient de souligner que SAS affiche par défaut un message d’avertissement explicite au sein du journal d’exécution (SAS Log) et de la fenêtre de résultats lorsque les critères minimaux de Cochran sont compromis, incitant directement l’utilisateur à inspecter le tableau de contingence avec prudence ou à invoquer l’instruction EXACT.
4. Structuration et encodage des données catégorielles dans SAS
4.1 Création d’un jeu de données brut avec l’étape DATA
La première modalité d’intégration de données catégorielles au sein du système SAS consiste à encoder les observations au niveau individuel (données désagrégées ou microdonnées). Dans ce paradigme de saisie, chaque ligne du flux d’entrée correspond rigoureusement à un sujet expérimental unique ou à une unité statistique distincte. L’étape DATA de SAS permet d’ingérer ces enregistrements bruts avec une flexibilité syntaxique optimale grâce à l’instruction fondamentale INPUT.
La déclaration des variables qualitatives nominales nécessite l’adjonction explicite du modificateur typologique dollar ($) immédiatement après le nom de l’identifiant dans l’instruction INPUT, signalant ainsi au compilateur SAS que les vecteurs d’entrée doivent être stockés sous forme de chaînes de caractères alphanumériques et non comme des scalaires numériques continus. Parallèlement, l’instruction LABEL offre l’opportunité d’associer des métadonnées descriptives exhaustives aux variables, améliorant considérablement la lisibilité et l’auto-documentation des sorties graphiques et tabulaires générées par les procédures statistiques ultérieures.
L’exemple de script SAS suivant illustre la création rigoureuse d’une table individuelle au sein de la bibliothèque de travail temporaire WORK :
DATA travail_recherche;
INPUT Identifiant $ Genre $ Reponse_Traitement $;
LABEL Genre = ‘Genre biologique du participant’
Reponse_Traitement = ‘Statut de reponse therapeutique’;
DATALINES;
SUBJ01 M Succes
SUBJ02 M Echec
SUBJ03 F Succes
SUBJ04 F Succes
SUBJ05 M Echec
;
RUN;
Cette approche désagrégée est courante dans les registres hospitaliers ou les bases de données institutionnelles où chaque patient dispose d’une ligne d’observation tracée individuellement avec ses covariables spécifiques.
4.2 Encodage par tableau de contingence agrégé et variable de fréquence
Lors de l’exploitation de données secondaires, de revues systématiques de la littérature ou de méta-analyses, le chercheur dispose fréquemment des effectifs déjà compilés et condensés sous la forme d’un tableau de contingence matriciel 2×2. Réencoder manuellement chaque participant individuel représenterait une tâche chronophage et propice aux erreurs de transcription. SAS résout cette problématique grâce à la structure d’encodage agrégée associée à une variable de pondération fréquentielle.
Dans ce modèle, la table SAS ne comporte qu’un nombre restreint de lignes, correspondant exactement au produit cartésien des modalités des variables croisées (soit exactement quatre observations pour un tableau 2×2). Chaque observation contient l’indication des modalités respectives des deux facteurs qualitatifs, complétée impérativement par une variable numérique spécifiant la fréquence absolue observée (l’effectif conjoint de la cellule). La lecture de ces blocs s’effectue traditionnellement via l’instruction séquentielle DATALINES (ou son équivalent historique CARDS) :
DATA table_agregee;
INPUT Exposition $ Pathologie $ Frequence;
LABEL Exposition = ‘Statut dexposition au facteur environnemental’
Pathologie = ‘Presence du diagnostic psychopathologique’
Frequence = ‘Nombre de sujets observes’;
DATALINES;
Expose Malade 8
Expose Sain 2
NonExpose Malade 3
NonExpose Sain 12
;
RUN;
La présence de la variable Frequence nécessite une prise en compte impérative lors de l’exécution de la procédure analytique. Si l’analyste omet d’indiquer à SAS que chaque ligne représente une agrégation de plusieurs entités, le logiciel interprétera la table comme contenant seulement quatre individus au total, faussant irrémédiablement l’ensemble de l’inférence combinatoire.
4.3 Contrôle d’intégrité et validation des données en amont
Avant d’engager les calculs probabilistes du test exact de Fisher, un protocole strict de vérification d’intégrité des données s’avère indispensable pour prémunir le chercheur contre les biais de codage silencieux. Les erreurs typographiques au sein des variables de caractères constituent le risque prédominant : une modalité accidentellement encodée « Succes » avec une majuscule et « succes » avec une minuscule sera traitée par SAS comme deux catégories mutuellement exclusives distinctes, transformant à l’insu du statisticien une table 2×2 en un tableau 3×2 erroné.
La mise en œuvre préliminaire de la procédure PROC FREQ sur les variables univariées permet de cartographier instantanément la répartition des niveaux factoriels et d’isoler les doublons sémantiques. Par ailleurs, la gestion des valeurs manquantes (représentées par un point pour les données numériques ou un espace pour les chaînes de caractères) doit être rigoureusement explicitée. Par défaut, SAS applique une exclusion par observation (listwise deletion) : toute observation présentant une valeur manquante sur l’une des variables du croisement est bannie de l’analyse tabulaire.
Enfin, l’exécution systématique d’une procédure d’impression contrôlée PROC PRINT constitue un garde-fou élémentaire assurant la validation visuelle des structures dimensionnelles et des étiquettes associées avant tout calcul probabiliste formel :
PROC PRINT DATA=table_agregee NOOBS;
RUN;
5. Syntaxe SAS et exécution de la procédure PROC FREQ pour Fisher
5.1 Architecture standard de la procédure PROC FREQ
Le traitement des distributions croisées et l’inférence des tableaux de contingence relèvent nativement au sein de l’environnement SAS de la procédure PROC FREQ. Cette procédure généraliste combine au sein d’un même moteur logiciel des fonctionnalités d’agrégation descriptive univariée, de croisement matriciel multidimensionnel et de calcul d’une vaste panoplie de statistiques d’association non paramétriques et exactes.
L’architecture syntaxique de base implique l’invocation de l’instruction PROC FREQ, suivie de la désignation de la source de données au moyen de l’argument DATA=nom_de_la_table. Le cœur analytique est formalisé au travers de l’instruction TABLES, qui définit la structure bivariée soumise à l’investigation. La syntaxe TABLES VariableLigne * VariableColonne; instruit le compilateur de construire la matrice de contingence correspondante, en disposant les modalités de la première variable sur l’axe vertical (lignes) et celles de la seconde variable sur l’axe horizontal (colonnes).
Lorsque les données sources ont été préalablement structurées sous une modalité condensée, l’intégration de l’instruction auxiliaire WEIGHT devient une obligation algorithmique catégorique. L’instruction WEIGHT VariablePoids; commande au moteur de calcul de répliquer virtuellement chaque enregistrement à concurrence de la valeur scalaire entière portée par le champ désigné, reconstituant fidèlement la structure globale de l’échantillon empirique initial.
5.2 Options dédiées au test exact de Fisher
Dans l’écosystème SAS, le déclenchement des routines computationnelles dédiées au test de Fisher peut s’effectuer selon deux modalités distinctes au niveau de l’instruction TABLES ou de l’instruction explicite EXACT :
- L’option d’instruction
TABLES / FISHER: L’adjonction de l’argument direct/ FISHERà la fin de l’instructionTABLESspécifie à la procédure de calculer et d’afficher le test exact de Fisher. Dans les versions modernes de SAS, si le tableau est de dimension strictement 2×2, cette option active la dérivation complète des probabilités unilatérales et bilatérales du test. - L’instruction dédiée
EXACT FISHER;: Cette formulation séparée, disposée sous l’instructionTABLES, représente la norme recommandée en programmation SAS avancée. Elle offre un découplage conceptuel net entre la spécification descriptive de la table et la sollicitation des algorithmes exacts combinatoires. Elle s’avère absolument indispensable dès lors que l’on traite de tables de contingence étendues de dimension $r \times c$. - L’option conjointe
TABLES / CHISQ: Il est couramment recommandé d’associer l’optionCHISQà l’analyse. Cette option commande le calcul concomitant des métriques du Chi-deux asymptotique de Pearson, de la déviance du rapport de vraisemblance, de la statistique corrigée de Yates et des coefficients d’association nominaux, permettant une confrontation immédiate entre les indices asymptotiques et la valeur-p exacte de Fisher au sein du rapport de sortie.
La commande opérationnelle complète se structure donc de la manière suivante :
PROC FREQ DATA=table_agregee;
TABLES Exposition * Pathologie / CHISQ;
WEIGHT Frequence;
EXACT FISHER;
RUN;
5.3 Paramètres d’optimisation et contrôle de l’affichage ODS
Par défaut, l’exécution d’un tableau croisé dans la procédure PROC FREQ sature l’espace visuel de restitution en superposant dans chaque cellule quatre métriques superposées : l’effectif absolu observé (Frequency), le pourcentage par rapport à l’échantillon global (Percent), le pourcentage marginal relatif à la ligne (Row Pct) et le pourcentage marginal relatif à la colonne (Col Pct). Cette surabondance d’informations nuit à la lisibilité analytique immédiate.
Pour clarifier la présentation, SAS permet d’adjoindre des options de filtrage visuel au niveau de l’instruction TABLES :
NOPERCENT: Supprime l’affichage du pourcentage de cellule calculé sur l’effectif total global.NOROW: Supprime l’affichage des pourcentages de profils en ligne.NOCOL: Supprime l’affichage des pourcentages de profils en colonne.
Parallèlement, le système de distribution des sorties ODS (Output Delivery System) permet de capturer sélectivement les seuls segments tabulaires d’intérêt scientifique afin d’éviter la génération de volumineux rapports inutiles. En utilisant l’instruction ODS SELECT FishersExact;, l’analyste restreint l’affichage écran à la stricte table contenant les valeurs-p et métriques exactes de Fisher. De plus, l’instruction ODS OUTPUT FishersExact = resultats_fisher; permet de persister ces résultats numériques directement dans une nouvelle table de données SAS, autorisant ainsi l’automatisation ultérieure d’exports vers des environnements de reporting externes ou des classeurs de synthèse.
6. Étude de cas empirique : Analyse de l’association Genre et Affiliation politique
6.1 Contexte de l’expérimentation et données de terrain
Afin de contextualiser de manière concrète l’ensemble de ces préceptes computationnels, nous considérerons une recherche empirique menée au sein d’un département de sciences politiques et de psychologie sociale. L’investigation porte sur l’existence potentielle d’une divergence de positionnement idéologique en fonction de l’identification de genre au sein d’un séminaire d’élites académiques composé d’un échantillon restreint de $N = 25$ étudiants universitaires avancés.
La variable prédictive $X$ correspond au « Genre » biologique ou assigné, catégorisée de manière dichotomique en [Femme, Homme]. La variable critère dépendante $Y$ documente l’« Affiliation politique » dominante déclarée par les sujets, décomposée en deux mouvements principaux au sein de cette sous-cohorte : [Démocrate, Républicain]. Les données de terrain recueillies lors de l’enquête anonymisée ont mis en lumière la structure de contingence observée suivante :
- Sur un total de 14 femmes interrogées, 11 expriment une adhésion au mouvement Démocrate, tandis que 3 déclarent une sensibilité Républicaine.
- Sur un contingent de 11 hommes inclus dans l’enquête, 3 s’identifient au courant Démocrate, alors que 8 manifestent un positionnement Républicain.
Le calcul immédiat des effectifs théoriques attendus sous l’hypothèse nulle d’indépendance stochastique révèle la criticité méthodologique du tableau : l’effectif attendu dans la cellule croisant le genre masculin et l’affiliation démocrate est de $E_{21} = \frac{11 \times 14}{25} = 6{,}16$, tandis que pour la modalité conjointe des femmes républicaines, il n’est que de $E_{12} = \frac{14 \times 11}{25} = 6{,}16$, et pour les hommes républicains de $E_{22} = \frac{11 \times 11}{25} = 4{,}84$. L’existence d’une cellule théorique strictement inférieure à 5 enfreint formellement la règle stricte de Cochran, prohibant l’usage du Chi-deux classique de Pearson et imposant le recours exclusif au test exact de Fisher.
6.2 Script SAS intégral pour l’analyse de l’exemple
Le programme exécutable SAS ci-dessous structure l’ensemble de la démarche : saisie rigoureuse de la contingence empirique via une étape DATA agrégée, paramétrage fin des métadonnées contextuelles, et exécution probabiliste sous PROC FREQ avec activation ciblée des options exactes et de contrôle de la mise en page.
/* ===============================================================
PROGRAMME SAS : ETUDE PILOTE GENRE ET AFFILIATION POLITIQUE
METHODOLOGIE : TEST EXACT DE FISHER SUR PETIT ECHANTILLON (N=25)
AUTEUR : METHODOLOGISTE QUANTITATIF
=============================================================== */
/* Etape 1 : Saisie et structuration de la contingence agregee */
DATA etude_politique;
INPUT Genre $ Affiliation $ Nombre_Sujets;
LABEL Genre = « Genre de l’etudiant »
Affiliation = « Affiliation doctrinale declaree »
Nombre_Sujets = « Effectif absolu conjoint »;
DATALINES;
Femme Democrate 11
Femme Republicain 3
Homme Democrate 3
Homme Republicain 8
;
RUN;
/* Etape 2 : Execution analytique complete sous PROC FREQ */
TITLE1 « Analyse de la relation Genre et Affiliation Politique »;
TITLE2 « Evaluation combinatoire exacte de Fisher »;
PROC FREQ DATA=etude_politique;
TABLES Genre * Affiliation / CHISQ NOCOL NOPERCENT RELRISK;
WEIGHT Nombre_Sujets;
EXACT FISHER;
RUN;
TITLE; /* Reinitialisation des bandeaux de sortie */
6.3 Vérification des journaux d’exécution SAS (SAS Log)
La discipline de programmation sous SAS exige d’inspecter scrupuleusement la fenêtre du journal d’exécution (SAS Log) avant toute interprétation des sorties visuelles. Le journal constitue le témoin exclusif de la validité computationnelle de la séquence logicielle. L’analyste doit y vérifier la séquence formelle suivante :
- Statut de compilation de l’étape DATA : Confirmation que les 4 enregistrements issus de l’instruction
DATALINESont été correctement lus et qu’aucune variable n’a subi de troncature non sollicitée par dépassement de longueur par défaut. - Validation des effectifs traités dans PROC FREQ : Le message du journal doit impérativement attester :
NOTE: 4 observations luessuivi deNOTE: Somme des poids (WEIGHT) = 25. Si la somme des pondérations ne correspond pas exactement à $N = 25$, cela témoignerait d’une altération de la variable fréquentielle ou de la présence d’une cellule manquante. - Absence absolue d’avertissements critiques (WARNINGS) : SAS ne doit renvoyer aucune erreur de syntaxe ni d’avertissement de dépassement de capacité d’allocation mémoire, garantissant que les routines combinatoires exactes ont convergé sans interruption.
7. Interprétation pas à pas des résultats et sorties SAS
7.1 Analyse du tableau de contingence restitué
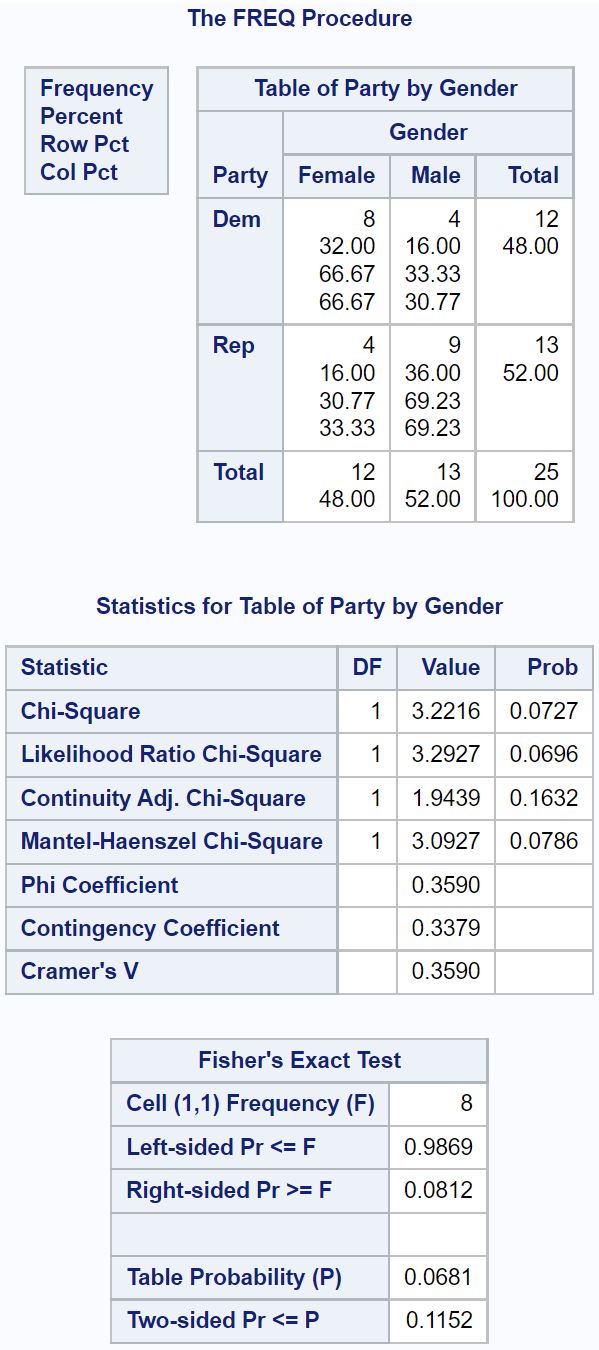
À l’issue de l’exécution du code ci-dessus, le premier tableau délivré dans la fenêtre de sortie de SAS restitue la matrice de contingence empirique épurée des bruits statistiques superflus grâce aux commandes d’inhibition NOCOL et NOPERCENT. Le tableau croisé se présente sous la configuration structurelle suivante :
Le croisement met en évidence que sur les 14 femmes constituant la première strate d’exposition, 78,57 % (11/14) s’identifient comme Démocrates, tandis que seulement 21,43 % (3/14) affichent une préférence Républicaine. Inversement, au sein du contingent masculin composé de 11 sujets, l’inclination s’inverse de manière symétrique : seuls 27,27 % (3/11) d’entre eux adoptent l’étiquette Démocrate, alors qu’une majorité substantielle de 72,73 % (8/11) déclare un positionnement Républicain.
L’observation des totaux marginaux horizontaux (14 et 11) et verticaux (14 Démocrates et 11 Républicains pour l’ensemble de l’échantillon global de 25 participants) souligne le caractère quasi équilibré des strates marginales. Cette inspection descriptive suggère l’existence d’une dissymétrie comportementale marquée entre les genres, mais requiert l’évaluation de la table probabiliste de Fisher pour statuer si cette divergence apparente relève d’une régularité statistique ou du simple aléa de l’échantillonnage.
7.2 Décodage de la section ‘Fisher’s Exact Test’ de SAS
Immédiatement consécutive aux métriques asymptotiques globales du Chi-deux de Pearson (dont SAS spécifie dans une note de bas de page que 50 % des cellules ont un effectif attendu inférieur à 5, confirmant l’invalidation formelle du $\chi^2$ asymptotique), la procédure affiche l’encadré spécifique intitulé Fisher’s Exact Test. Ce bloc contient quatre estimateurs scalaires fondamentaux qu’il convient de décoder méticuleusement :
- Probabilité de la table observée ($P$) : La première ligne renvoie
Cell (1,1) Frequency (F) = 11et la probabilité ponctuelle hypergéométrique associéeTable Probability (P) = 0.00947. Cette valeur indique que, sous l’hypothèse nulle d’indépendance et compte tenu de la fixité des marges observées, la probabilité exacte d’observer rigoureusement cette répartition conjointe d’effectifs (11, 3, 3, 8) n’est que de 0,95 % environ. - Test unilatéral gauche (Left-sided Pr <= P) : SAS affiche une valeur-p de
0.9989. Ce chiffre correspond à la sommation cumulée des probabilités hypergéométriques des tables présentant un effectif dans la cellule (1,1) inférieur ou égal à la valeur observée 11 (c’est-à-dire pour $a in [0, 1, …, 11]$). Cette valeur élevée démontre l’absence totale de sous-représentation des femmes démocrates. - Test unilatéral droit (Right-sided Pr >= P) : La valeur-p unilatérale droite indiquée par SAS est de
0.01053. Elle cumule les probabilités des configurations où l’effectif de la cellule (1,1) est supérieur ou égal à 11 ($a in [11, 12, 13, 14]$). Cela confirme que la surreprésentation des femmes démocrates dans l’échantillon est exceptionnellement improbable sous l’hypothèse du hasard pur ($p \approx 0{,}011$). - Test bilatéral exact (Two-sided Pr <= P) : La métrique décisionnelle pivotale s’établit à
0.02476. Elle représente la somme des probabilités de toutes les tables théoriquement admissibles dont la probabilité d’occurrence propre est inférieure ou égale à $P_{\text{obs}} = 0{,}00947$.
7.3 Décision statistique et conclusion psychologique appliquée
L’arbitrage décisionnel s’opère par la confrontation directe de la valeur-p bilatérale exacte de Fisher ($p = 0{,}0248$) au seuil de significativité conventionnel fixé a priori à $\alpha = 0{,}05$. Dans la mesure où la valeur-p empirique est strictement inférieure au seuil critique ($p < 0{,}05$), l’analyste se trouve dans l’obligation méthodologique de rejeter l’hypothèse nulle d’indépendance stochastique ($H_0$) et d’embrasser formellement l’hypothèse alternative ($H_1$).
Sur le plan conceptuel et théorique, cette conclusion confirme l’existence d’une association statistiquement significative entre le genre des participants et leur sensibilité doctrinale au sein de la cohorte universitaire évaluée. L’hypothèse selon laquelle les disparités numériques observées découlaient d’un simple artéfact lié à la petite taille de l’échantillon se trouve réfutée sur le plan probabiliste. L’analyste psychologue conclut que le genre structure de manière différenciée les attitudes politiques déclarées dans ce contexte expérimental, les femmes présentant une propension significativement plus élevée à s’affilier au courant Démocrate en comparaison des hommes.
8. Tests unilatéraux versus bilatéraux dans l’environnement SAS
8.1 Fondements épistémologiques des hypothèses directionnelles
La distinction entre une approche unilatérale (one-tailed) et une approche bilatérale (two-tailed) ne relève pas d’une commodité statistique visant à diviser artificiellement par deux une valeur-p pour franchir un seuil de publication, mais d’un ancrage théorique et épistémologique préalable. Une hypothèse non directionnelle (bilatérale) postule l’existence d’une hétérogénéité ou d’une dépendance sans préjuger du sens du gradient : les femmes pourraient être significativement plus Démocrates ou significativement plus Républicaines que les hommes.
À l’inverse, l’hypothèse directionnelle (unilatérale) découle d’un cadre théorique contraignant fondé sur la littérature scientifique préexistante ou sur des modèles déductifs robustes prédisant spécifiquement la direction de l’association avant tout recueil de données de terrain. En termes d’allocation probabiliste, le test bilatéral distribue le risque d’erreur alpha de 5 % sur les deux queues de la distribution d’échantillonnage discrète, alors que le test unilatéral concentre l’intégralité de la zone de rejet critique $\alpha$ sur une seule extrémité distributionnelle.
8.2 Identification et sélection de la p-valeur unilatérale adéquate
L’une des difficultés récurrentes rencontrées par les utilisateurs de la procédure PROC FREQ sous SAS réside dans l’identification correcte de la sortie unilatérale concordant avec la théorisation initiale. SAS fournit systématiquement dans sa restitution standard deux lignes unilatérales distinctes : Left-sided Pr <= P et Right-sided Pr >= P. La sélection de la ligne adéquate ne doit jamais se faire de manière opportuniste en sélectionnant la plus petite valeur affichée, mais en fonction du croisement factoriel structuré dans la matrice :
- Le test unilatéral gauche (Left-sided) : Il teste l’hypothèse d’une sous-représentation systématique dans la cellule (1,1). Il convient de le mobiliser si le chercheur postulait a priori que les femmes devaient être sous-représentées parmi les partisans Démocrates. Face à notre valeur de
0.9989, l’hypothèse de sous-représentation est catégoriquement invalidée. - Le test unilatéral droit (Right-sided) : Il teste spécifiquement l’hypothèse d’une surreprésentation directionnelle dans la cellule (1,1). Si la théorie stipulait a priori que le statut féminin s’associait positivement à l’adhésion Démocrate, la métrique adéquate correspond précisément à cette sortie unilatérale droite, affichant un résultat significatif robuste de $p = 0{,}0105$.
Il est fondamental de rappeler que la structuration des modalités par SAS dépend de l’ordre de tri par défaut (alphabétique pour les chaînes de caractères). Ainsi, « Femme » précède « Homme » et « Democrate » précède « Republicain », situant automatiquement le croisement Femme-Démocrate au niveau de la première cellule matricielle $A = (1,1)$.
8.3 Risques méthodologiques liés à l’usage a posteriori des tests unilatéraux
La pratique consistant à inspecter les sorties bilatérales d’un modèle SAS, à constater une non-significativité marginale (par exemple, un $p = 0{,}07$), puis à basculer rétroactivement vers l’interprétation de la valeur-p unilatérale (affichant alors un $p = 0{,}035$) pour revendiquer une découverte empirique constitue un biais méthodologique majeur connu sous le vocable de p-hacking ou d’ajustement opportuniste post-hoc.
Les comités éditoriaux des revues savantes internationales de psychologie et de biomédecine imposent des standards de recevabilité drastiques : en l’absence de pré-enregistrement formel et public du protocole de recherche (détaillant explicitement le recours anticipé à une épreuve unilatérale et justifiant la direction d’effet attendue), toute inférence catégorielle doit impérativement être rapportée sur la base de la valeur-p bilatérale. Le test bilatéral de Fisher demeure ainsi la métrique universelle d’objectivité statistique recommandée par défaut sous SAS.
9. Extension du test exact de Fisher aux tables de contingence r x c
9.1 Complexité combinatoire et algorithme de Freeman-Halton
Lorsque le design de recherche implique des variables polytomiques comportant plus de deux modalités, le tableau de contingence prend la forme matricielle étendue de dimension $r \times c$, où $r$ correspond au nombre de lignes et $c$ au nombre de colonnes (par exemple, trois catégories socio-professionnelles croisées avec quatre niveaux de détresse psychologique). Dans ce cas, la formulation analytique historique de Fisher pour les tables 2×2 ne peut s’appliquer directement sous sa forme élémentaire.
L’extension mathématique formelle du principe de Fisher aux dimensions supérieures a été formalisée par G. H. Freeman et J. H. Halton en 1951. Sous l’hypothèse nulle de marginales fixées, la probabilité conjointe exacte de l’ensemble matriciel d’effectifs observés ${n_{ij}}$ est régie par une distribution multinomiale-hypergéométrique généralisée :
$$P({n_{ij}}) = \frac{\prod_{i=1}^r (n_{i\cdot}!) , \prod_{j=1}^c (n_{\cdot j}!)}{N! , \prod_{i=1}^r \prod_{j=1}^c (n_{ij}!)}$$
L’obstacle majeur de l’approche de Freeman-Halton réside dans l’explosion combinatoire de l’espace échantillonnal. Pour des tables de dimension moyenne comportant des marges substantielles, le nombre total de tables admissibles peut se chiffrer en millions, voire en milliards. Pour résoudre cette contrainte algorithmique, SAS intègre des routines de dénombrement par réseaux d’optimisation (Network Algorithms) conçues à l’origine par Cyrus Mehta et Nitin Patel, permettant d’élaguer les branches de permutations arborescentes non informatives et de dériver la valeur-p exacte sans saturer les ressources computationnelles.
9.2 Configuration syntaxique SAS pour grands tableaux
Pour commander l’exécution de l’algorithme exact de Freeman-Halton sur un tableau de contingence de dimensions arbitraires $r \times c$, l’adjonction de l’option FISHER au sein de l’instruction TABLES s’avère insuffisante dans les anciennes versions de SAS et doit être supplantée par l’instruction explicite EXACT FISHER;. Cette déclaration ordonne au compilateur d’allouer les structures dynamiques requises pour les algorithmes de Mehta et Patel.
En présence de matrices volumineuses et d’effectifs modérément élevés, les routines combinatoires peuvent solliciter des volumes de mémoire vive considérables et engendrer des temps d’exécution prolongés. Deux paramètres d’optimisation avancée peuvent être spécifiés au niveau de l’instruction EXACT :
ALLOC = nombre: Permet de configurer manuellement le volume de mémoire vive alloué à la création des structures de réseaux pour le dénombrement combinatoire de Freeman-Halton, évitant ainsi les arrêts prématurés pour insuffisance de mémoire.MAXTIME = secondes: Fixe un seuil temporel maximal d’exécution algorithmique au-delà duquel SAS interrompt la recherche combinatoire exhaustive si la convergence s’avère excessivement longue, restituant alors l’état d’avancement du calcul ou basculant vers une approximation par simulation.
La commande SAS s’écrit formellement ainsi pour un croisement 3×3 :
PROC FREQ DATA=donnees_psychiatriques;
TABLES Categorie_Diagnostique * Statut_Insertion / CHISQ;
EXACT FISHER / MAXTIME=300;
RUN;
9.3 Interprétation globale et analyses post-hoc multi-cellulaires
La sortie fournie par l’algorithme de Freeman-Halton dans SAS renvoie une valeur-p exacte globale d’indépendance pour l’ensemble du tableau $r \times c$. Une valeur-p globale statistiquement significative ($p < 0{,}05$) conduit légitimement au rejet de l’hypothèse d’indépendance globale. Toutefois, à l’instar d’un test F omnibus dans une analyse de variance factorielle à multiples niveaux, ce résultat global ne permet aucunement d’identifier quelles sont les sous-catégories ou les cellules matricielles spécifiques responsables de la rupture d’indépendance.
Pour localiser la source de l’association au sein d’une table étendue, le chercheur doit procéder à des partitions secondaires structurées, matérialisées par des contrastes post-hoc sous la forme de sous-tables de contingence 2×2 contrastant deux modalités sélectionnées d’une variable face à deux modalités de l’autre. Lors de la mise en œuvre de ces tests exacts de Fisher partiels sériels, il est impératif d’appliquer une correction statistique pour le contrôle de l’inflation de l’erreur globale de type I due à la multiplicité des comparaisons.
La procédure la plus standard consiste à appliquer la correction conservative de Bonferroni, divisant le seuil alpha nominal par le nombre total de comparaisons partielles explorées ($k$) :
$$\alpha_{\text{ajusté}} = \frac{\alpha}{k}$$
Des approches plus récentes et plus puissantes, telles que le contrôle du taux de fausses découvertes (False Discovery Rate, FDR) de Benjamini-Hochberg, peuvent également être programmées sous SAS pour évaluer les sous-contingences de manière séquentielle.
10. Tailles d’effet et indices d’association complémentaires sous SAS
10.1 Calcul et interprétation de l’Odds Ratio exact
La formulation d’une inférence statistique rigoureuse ne saurait se limiter à l’énonciation binaire d’une valeur-p. En épidémiologie psychiatrique et en psychologie de la santé, la quantification de l’amplitude clinique de l’association requiert l’estimation du rapport de cotes (Odds Ratio, OR). Alors que les procédures asymptotiques dérivent l’intervalle de confiance de l’OR par la transformation logarithmique de Woolf (reposant sur l’erreur standard asymptotique $SE(\ln(OR)) = \sqrt{1/a + 1/b + 1/c + 1/d}$), cette méthode génère des bornes hautement imprécises et asymétriques sur des cohortes réduites.
Pour obtenir l’Odds Ratio exact non conditionnel et ses intervalles de confiance exacts basés sur la distribution hypergéométrique non centrale, l’analyste doit ajouter l’option OR (ou RELRISK) dans l’instruction TABLES et invoquer EXACT OR; sous SAS :
PROC FREQ DATA=etude_politique;
TABLES Genre * Affiliation / OR;
WEIGHT Nombre_Sujets;
EXACT OR;
RUN;
Dans notre étude empirique (où les femmes affichent une répartition de 11/3 et les hommes de 3/8), le rapport de cotes empirique observé est de :
$$OR = \frac{11 \times 8}{3 \times 3} = \frac{88}{9} \approx 9{,}78$$
SAS dérive l’intervalle de confiance exact à 95 % de cet OR, renvoyant approximativement l’intervalle $[1{,}31 ,;, 93{,}48]$. Étant donné que cet intervalle de confiance exact exclut strictement la valeur unitaire neutre 1,0, il corrobore sans ambiguïté le rejet de l’hypothèse nulle d’indépendance prononcé lors du test bilatéral de Fisher.
10.2 Coefficients d’association nominale : Phi et V de Cramer
Pour mesurer l’intensité de la corrélation nominale sur une échelle standardisée adimensionnelle comprise entre 0 et 1, SAS propose l’estimation de coefficients statistiques dérivés de la métrique du Chi-deux au travers de l’option CHISQ :
- Le coefficient Phi ($phi$) : Réservé exclusivement aux tables de dimension binaire 2×2, il correspond formellement à la corrélation produit-moment de Pearson calculée sur deux indicatrices binaires dichotomiques :
$$\phi = \sqrt{\frac{\chi^2}{N}}$$
Dans notre étude de cas ($N = 25$, avec une statistique de Pearson sans correction $\chi^2 = 6{,}5097$), on obtient un coefficient $\phi \approx 0{,}51$. Selon les seuils conventionnels formalisés par Jacob Cohen pour les sciences comportementales, une valeur supérieure à 0,50 désigne une taille d’effet substantielle (large effect size). - Le V de Cramér ($V$) : Dès lors que les dimensions du tableau dépassent le cadre 2×2 (tables $r \times c$), le coefficient Phi devient instable et peut dépasser l’unité. L’analyste s’oriente alors vers le $V$ de Cramér, qui intègre les dimensions de la grille par la formule :
$$V = \sqrt{\frac{\chi^2}{N \times \min(r-1, c-1)}}$$
Ce coefficient standardise la magnitude de l’association sur l’intervalle $[0, 1]$, autorisant ainsi les comparaisons inter-études sur des protocoles aux découpages de catégories hétérogènes.
10.3 Dissociation impérative entre significativité statistique et clinique
L’un des écueils majeurs dans la formation méthodologique réside dans la confusion entre significativité statistique (attestée par une valeur-p inférieure à 0,05) et significativité clinique ou pratique. La valeur-p est une fonction conjointe de la magnitude réelle de l’effet dans la population et de la taille totale de l’échantillon empirique observé. Sur un échantillon minuscule, un effet clinique majeur (tel qu’un rapport de cotes de 4,0) peut échouer à atteindre le seuil de significativité conventionnel de 5 % par manque de puissance statistique (erreur de type II).
Inversement, sur des bases de données massives (Big Data en santé publique) comportant des dizaines de milliers d’enregistrements, une association totalement dérisoire et sans portée clinique concrète (comme un $OR = 1{,}04$) générera une valeur-p extrêmement faible ($p < 0{,}0001$) du fait d’une hyper-puissance algorithmique. Il est donc indispensable de dissocier formellement la significativité statistique — qui répond strictement à la question : « Est-il improbable que cette configuration d’effectifs soit attribuable aux fluctuations aléatoires d’échantillonnage ? » — de la taille d’effet standardisée, qui répond à la question pragmatique : « Quelle est l’ampleur et la pertinence pratique de la liaison observée ? ».
11. Directives de publication académique et reporting aux normes APA
11.1 Règles formelles de rédaction de l’APA (7e édition)
L’American Psychological Association (APA), au travers de la septième édition de son manuel de publication officiel, prescrit des normes typographiques et structurelles extrêmement précises pour l’exposition des tests exacts non paramétriques. Ces standards garantissent la transparence et la reproductibilité des analyses quantitatives au sein des revues scientifiques internationales à comité de lecture.
Contrairement au test du Chi-deux de Pearson qui requiert de rapporter la statistique $\chi^2$, le nombre de degrés de liberté et l’effectif global selon le formatage $\chi^2(\text{ddl}, N = dots) = dots$, le test exact de Fisher ne comporte pas de degrés de liberté formels ni de statistique de test standardisée dans la restitution usuelle. Les directives éditoriales imposent dès lors :
- D’indiquer textuellement et formellement qu’un test exact de Fisher a été mobilisé en lieu et place du test du Chi-deux asymptotique en raison de la présence d’effectifs théoriques attendus insuffisants violant les prérequis d’échantillonnage de Cochran.
- De spécifier explicitement la nature unilatérale ou bilatérale de l’épreuve retenue (la modalité bilatérale étant le standard de référence académique par défaut).
- De consigner la valeur-p exacte exacte sans recourir à des inégalités approximatives (telles que $p < 0{,}05$), sauf dans les cas exceptionnels où la probabilité exacte dérivée est strictement inférieure au millième, auquel cas la graphie normée s’énonce p < .001. En langue anglaise (ou selon les règles de stylistique de la revue ciblée), le zéro précédent la décimale est traditionnellement omis pour les probabilités bornées à l’unité.
- D’accompagner obligatoirement l’énoncé de la valeur-p de la taille totale de l’échantillon ($N$), des effectifs et proportions de chaque case, et d’un indicateur standardisé d’amplitude d’effet (rapport de cotes ou coefficient d’association) enrichi de son intervalle de confiance à 95 %.
11.2 Conception de tableaux statistiques prêts pour soumission
La conception visuelle des tableaux de données sous les normes APA 7e édition exige le respect de contraintes géométriques et typographiques strictes, bannissant catégoriquement l’esthétique par défaut des tableurs généralistes ou les quadrillages intégrals. Un tableau d’association catégorielle prêt pour publication académique obéit aux canons formels suivants :
- Absence intégrale de filets verticaux : Aucun séparateur vertical ne doit cloisonner les colonnes.
- Utilisation restrictive des filets horizontaux : Seules trois bordures horizontales continues parcourent la table : une ligne supérieure fermant le bandeau en-tête, une ligne inférieure délimitant les étiquettes de colonnes, et une ligne finale inférieure fermant la matrice au-dessus des notes explicatives.
- Clarté de la hiérarchisation : Les modalités factorielles doivent être clairement identifiées avec indication conjointe des fréquences absolues ($n$) et des fréquences relatives (pourcentages en lignes ou en colonnes selon la conceptualisation expérimentale).
- Notes de bas de tableau exhaustives : Une note générale (débutant par le terme en italique Note.) doit expliciter les abréviations, déclarer la méthode probabiliste exacte mobilisée, et rappeler la nature bilatérale de l’inférence.
Voici un modèle structurel de tableau conforme pour notre étude :
Tableau 1
Répartition de l’affiliation doctrinale selon le genre des participants (N = 25)
| Genre | Démocrate n (%) | Républicain n (%) | Total n (%) |
|---|---|---|---|
| Femme | 11 (78,6 %) | 3 (21,4 %) | 14 (100,0 %) |
| Homme | 3 (27,3 %) | 8 (72,7 %) | 11 (100,0 %) |
| Total | 14 (56,0 %) | 11 (44,0 %) | 25 (100,0 %) |
Note. Les pourcentages sont calculés en ligne. Le test exact de Fisher (bilatéral) a révélé une association statistiquement significative entre le genre et l’affiliation doctrinale, p = .025, rapport de cotes (OR) = 9,78, IC 95 % [1,31 ; 93,48].
11.3 Modèles de phrases types pour la section Résultats
Pour assurer une intégration stylistique fluide et académiquement irréprochable au sein de la section « Résultats » d’un manuscrit soumis à publication, les formulations rédactionnelles peuvent s’inspirer des modèles validés ci-dessous :
Modèle 1 : Forme standard pour résultat statistiquement significatif :
« En raison de la présence d’effectifs théoriques attendus inférieurs à cinq au sein de plusieurs cellules du croisement bivarié (25 % des cellules sous le seuil de Cochran), le test exact de Fisher bilatéral a été mobilisé pour examiner la relation entre le genre des participants et leur affiliation doctrinale. L’analyse révèle une association statistiquement significative entre les deux variables (N = 25, p = .025). La cote d’adhésion au mouvement démocrate s’avère nettement plus élevée chez les femmes (78,6 %) que chez les hommes (27,3 %), avec un rapport de cotes substantiel de 9,78 (IC 95 % exact [1,31, 93,48]), traduisant une taille d’effet élevée selon les critères de Cohen (coefficient Phi $\phi = 0{,}51$). »
Modèle 2 : Forme standard pour résultat statistiquement non significatif :
« Un test exact de Fisher bilatéral a été exécuté afin d’évaluer l’impact du programme d’intervention neuropsychologique sur le statut de rémission à six mois (cohorte clinique N = 18). Les résultats indiquent qu’il n’existe pas de différence statistiquement significative entre le groupe expérimental et le groupe contrôle concernant la proportion de sujets en rémission (66,7 % contre 44,4 % ; p = .637, test exact de Fisher bilatéral, OR = 2,50, IC 95 % exact [0,32, 22,78]). Ces observations empiriques ne permettent pas d’invalider l’hypothèse nulle d’indépendance clinique à ce stade d’échantillonnage. »
12. Dépannage, messages d’erreur et diagnostics avancés dans SAS
12.1 Gestion des dépassements de mémoire et temps de calcul infini
Lors de la transition d’un tableau 2×2 vers des matrices multi-catégorielles denses ($r \times c$) comportant des effectifs marginaux volumineux, l’exécution combinatoire sous la syntaxe EXACT FISHER; peut heurter de plein fouet le mur de la complexité combinatoire. Dans cette configuration, le système SAS cesse de progresser et émet dans le journal d’exécution un message d’erreur bloquant de saturation : ERROR: Out of memory during network computation for exact test.
Pour dépasser cette limitation matérielle sans renoncer à la rigueur de l’inférence non asymptotique, la stratégie biostatistique optimale consiste à substituer au calcul exact déterministe exhaustif une approximation stochastique par simulation de Monte Carlo. Cette approche s’active simplement au moyen de l’option MC adjointe à l’instruction EXACT. L’algorithme échantillonne aléatoirement un nombre colossal de tables de contingence potentielles partageant les mêmes marges et estime la valeur-p exacte avec une précision contrôlée, quantifiée par un intervalle de confiance empirique :
PROC FREQ DATA=grande_matrice;
TABLES Symptome * Traitement / CHISQ;
EXACT FISHER / MC SE N=1000000 ALPHA=0.01;
RUN;
L’argument N=1000000 spécifie à SAS de simuler un million de permutations tabulaires indépendantes, l’option SE commande l’impression de l’erreur standard de la valeur-p estimée, et ALPHA=0.01 calibre un intervalle de confiance à 99 % autour de la valeur-p approchée, offrant une garantie d’approximation quasiment indiscernable de la valeur-p exacte formelle.
12.2 Erreurs courantes d’encodage et diagnostics syntaxiques
Le travail de diagnostic statistique sous SAS révèle plusieurs anomalies récurrentes chez les praticiens, générant des résultats biaisés sans déclencher pour autant d’erreurs visibles de syntaxe :
- Omission de l’instruction WEIGHT : Lorsqu’on travaille sur une table agrégée comportant une colonne de fréquences, l’omission involontaire de la commande
WEIGHT NomVariable;est l’erreur la plus fréquente. SAS traite alors chaque ligne de contingence comme une observation unique ($N = 4$ pour une table 2×2). Si le journal affiche une taille globale de cohorte manifestement découplée de votre échantillon réel, inspectez immédiatement la présence de l’instructionWEIGHT. - Confusion entre cellules à effectif zéro et valeurs manquantes : Dans un jeu de données agrégé, une cellule de contingence ne comportant aucun sujet observé ne doit en aucun cas être encodée avec un point de valeur manquante (
.) dans le champ de fréquence. SAS exclurait automatiquement la ligne, effaçant une cellule structurelle du tableau. Il est impératif d’assigner formellement la valeur numérique scalaire0et d’ajouter l’optionZEROSà l’instructionWEIGHT(soitWEIGHT NomVariable / ZEROS;) pour forcer le compilateur à intégrer les cases vides au sein des algorithmes matriciels combinatoires. - Altération de l’orientation par le paramètre ORDER : L’ordre d’affichage des modalités factorielles détermine l’affectation de la cellule (1,1) et, par conséquent, le sens des valeurs-p unilatérales et de l’Odds Ratio. Par défaut, SAS trie par ordre alphabétique croissant (
ORDER=INTERNAL). L’usage de l’optionPROC FREQ ORDER=DATApermet d’imposer au logiciel l’ordre séquentiel d’apparition des modalités au fil des lignes d’entrée de l’étapeDATA, évitant les inversions inopportunes de polarité factorielle.
12.3 Validation croisée et pérennité du code analytique
Dans un contexte de renforcement mondial des exigences de reproductibilité scientifique (initiative Open Science), il est hautement recommandé de procéder à une validation croisée systématique des scripts SAS critiques à l’aide d’environnements d’analyse indépendants. L’environnement open-source R offre une plateforme de comparaison standard via sa fonction native :
fisher.test(matrix(c(11, 3, 3, 8), nrow = 2, byrow = TRUE))
La confirmation d’une stricte identité numérique des valeurs-p bilatérales entre la fonction R et la procédure PROC FREQ de SAS valide l’étanchéité du pipeline de traitement statistique.
Par ailleurs, pour les chercheurs et bio-informaticiens confrontés au traitement itératif de dizaines de marqueurs cliniques sur de petits échantillons, la structuration de macros SAS paramétrées permet d’automatiser l’exécution reproductible du test exact de Fisher. L’encapsulation de la procédure au sein d’une macro modulaire telle que présentée ci-dessous illustre le niveau de standardisation attendu dans un laboratoire d’analyse de données avancées :
%MACRO ExecuterFisher(TableEntree=, VarLigne=, VarCol=, VarPoids=);
PROC FREQ DATA=&TableEntree;
TABLES &VarLigne * &VarCol / CHISQ NOCOL NOPERCENT;
%IF %LENGTH(&VarPoids) > 0 %THEN %DO;
WEIGHT &VarPoids / ZEROS;
%END;
EXACT FISHER;
ODS OUTPUT FishersExact = SortieExacte; RUN;
%MEND ExecuterFisher;
Cette approche unifiée assure une reproductibilité totale du protocole d’analyse, prévient les erreurs de retranscription manuelle, et garantit la conformité méthodologique absolue de chaque étape du test exact de Fisher sous l’environnement SAS.
Références
Agresti, A. (1992). A survey of exact inference for contingency tables. Statistical Science, 7(1), 131–153. https://doi.org/10.1214/ss/1177011454
Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons.
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cochran, W. G. (1952). The $\chi^2$ test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
Cochran, W. G. (1954). Some methods for strengthening the common $\chi^2$ tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Fisher, R. A. (1922). On the interpretation of $\chi^2$ from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1/2), 141–149. https://doi.org/10.2307/2332323
Mehta, C. R., & Patel, N. R. (1983). A network algorithm for performing Fisher’s exact test in $r \times c$ contingency tables. Journal of the American Statistical Association, 78(382), 427–434. https://doi.org/10.1080/01621459.1983.10477989
SAS Institute Inc. (2020). SAS/STAT 15.2 user’s guide: The FREQ procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
Yates, F. (1934). Contingency tables involving small numbers and the $\chi^2$ test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604