
L’analyse computationnelle des données au sein des tableurs modernes constitue l’un des piliers opérationnels de la prise de décision empirique, tant dans le milieu académique que dans les environnements industriels. Google Sheets, en tant qu’environnement infonuagique collaboratif et distribué, repose sur un moteur d’évaluation réactif capable de traiter des volumes substantiels d’informations tabulaires. Parmi les opérations statistiques fondamentales, le dénombrement conditionnel occupe une place prépondérante, servant de fondement à la réduction dimensionnelle, au calcul de distributions fréquentielles et à la filtration d’échantillons stratifiés. Cependant, la fonction native consacrée à cette tâche élémentaire, la fonction NB.SI (ou COUNTIF dans sa nomenclature anglo-saxonne), présente une rigidité structurelle intrinsèque qui déroute fréquemment les analystes lorsqu’il s’agit de modéliser des critères logiques disjonctifs, communément formalisés par l’opérateur booléen « OU ».
La syntaxe canonique de la fonction NB.SI a été originellement conçue selon un paradigme d’évaluation scalaire stricte, où une plage de cellules univariée est soumise à un critère unique de prédication. Dès lors que la question de recherche ou le besoin d’extraction implique la capture d’observations satisfaisant une condition parmi un ensemble de conditions alternatives non exclusives ou mutuellement exclusives, l’architecture fonctionnelle standard se heurte à une limitation conceptuelle majeure. L’incompatibilité de l’opérateur booléen OU au sein de l’argument de critère de NB.SI génère des comportements inattendus, allant de l’évaluation erronée à l’interruption du calcul par des anomalies de typage. Cette friction algorithmique impose aux praticiens de dépasser les approches intuitives pour adopter des architectures matricielles avancées ou des reformulations ensemblistes rigoureuses.
Comprendre la mécanique sous-jacente au dénombrement conditionnel disjonctif dans Google Sheets requiert une exploration approfondie de la théorie des ensembles, des mécanismes de vectorisation permis par l’encapsulation matricielle, et des alternatives analytiques offertes par les moteurs de requêtes relationnelles intégrés. Cet article se propose de décortiquer de manière exhaustive les fondements mathématiques, les contraintes d’implémentation logicielle, les solutions canoniques par constantes matricielles, ainsi que les paradigmes avancés de traitement de données textuelles, numériques et chronologiques. À travers une analyse comparative des performances computationnelles et des risques d’erreurs logiques silencieuses, ce guide offre un cadre méthodologique complet pour maîtriser le dénombrement disjonctif à grande échelle.
1. Fondements théoriques du dénombrement conditionnel sous Google Sheets
1.1 Définition formelle et mécanique computationnelle de la fonction NB.SI
La fonction NB.SI opère comme un opérateur de réduction statistique univarié dont l’objectif est d’extraire la cardinalité d’un sous-ensemble d’observations répondant à une assertion logique spécifique. D’un point de vue algorithmique, l’exécution de NB.SI requiert deux arguments fondamentaux : la plage de référence, matérialisée par un vecteur continu ou une matrice bidimensionnelle de cellules, et le critère, qui constitue le prédicat d’évaluation scalaire. Lorsque le graphe de calcul de Google Sheets initialise l’évaluation de cette fonction, le processeur itère sur chaque élément de la structure de données transmise en entrée, comparant séquentiellement la valeur de la cellule courante au gabarit logique défini par l’utilisateur.
L’évaluation des prédicats scalaires au sein du moteur de calcul repose sur un système d’analyse lexicale interne qui convertit implicitement les types de données afin d’effectuer des tests d’équivalence, d’inégalité ou de correspondance partielle. Cependant, ce moteur fonctionne historiquement sous une logique conjonctive implicite lorsque plusieurs cellules sont examinées en cascade, mais demeure strictement limité à une granularité unaire pour son critère. En d’autres termes, chaque itération teste une unique hypothèse logique. Le comportement des types de données sous-jacents, qu’ils soient de nature textuelle, numérique, booléenne ou chronologique, influe directement sur la phase de coercition des types. Une divergence infime entre le type attendu par le prédicat et la représentation en mémoire de la cellule conduit inévitablement à un rejet de l’observation, réduisant ainsi la valeur d’incrémentation du compteur terminal à zéro.
1.2 La problématique de l’opérateur disjonctif dans les fonctions d’agrégation standard
L’écueil analytique le plus prégnant lors de la manipulation de NB.SI réside dans l’incompatibilité structurelle de l’opérateur disjonctif booléen représenté par la fonction OU (ou OR). Si un utilisateur tente d’imbriquer l’expression logique OU à l’intérieur du paramètre de critère de NB.SI, le moteur d’évaluation échoue à distribuer cette disjonction sur la plage cible. Cet échec découle du fait que la fonction OU est une fonction d’agrégation globale : elle évalue l’ensemble des arguments qui lui sont transmis et renvoie un résultat booléen unique scalaire, soit VRAI soit FAUX, avant même que la fonction NB.SI ne commence l’itération sur les cellules de la plage.
Cette évaluation prématurée et non vectorisée corrompt la logique de la requête. Le critère transmis à NB.SI devient un simple booléen statique, ce qui conduit la fonction de comptage à rechercher littéralement la valeur VRAI ou FAUX au sein de la plage de données, au lieu de rechercher les modalités individuelles spécifiées. Dans les jeux de données observationnelles complexes, ce mécanisme génère des erreurs silencieuses particulièrement pernicieuses : la feuille de calcul ne renvoie aucun message d’erreur d’exécution explicite, mais produit une valeur numérique égale à zéro ou largement sous-estimée. Pour contourner cette limite architecturale, une reformulation mathématique rigoureuse de la sélection s’avère indispensable, transposant le problème du plan purement logique au plan de l’union des ensembles statistiques.
1.3 Théorie des ensembles appliquée au filtrage des données tabulaires
La modélisation de la disjonction logique dans les environnements de feuilles de calcul trouve sa justification théorique dans la théorie axiomatique des ensembles. Considérons une population statistique globale notée $\Omega$, représentée par l’ensemble des lignes d’un tableau de données. Soient deux sous-ensembles $A$ et $B$ d’observations appartenant à $\Omega$, définis respectivement par la satisfaction d’un critère $C_1$ et d’un critère $C_2$. La cardinalité de l’union de ces deux ensembles, qui correspond au nombre total d’observations satisfaisant l’assertion logique « $C_1$ OU $C_2$ », est régie par le principe d’inclusion-exclusion, également connu sous le nom de formule du crible de Poincaré.
Sur le plan algébrique, cette relation fondamentale s’exprime par l’égalité suivante : la mesure de l’union de $A$ et $B$ est égale à la somme de la mesure de $A$ et de la mesure de $B$, diminuée de la mesure de leur intersection conjointe. Lorsque les critères $C_1$ et $C_2$ portent sur une même variable catégorielle univariée et représentent des modalités distinctes et exclusives (par exemple, le statut marital d’un individu ne pouvant être simultanément « Célibataire » et « Marié »), l’intersection est strictement vide. Les ensembles sont dits disjoints, et l’opération de dénombrement se simplifie en une addition arithmétique directe des cardinaux respectifs. En revanche, dès lors que les critères s’appliquent à des dimensions multidimensionnelles ou à des prédicats non exclusifs, la neutralisation de l’intersection devient un impératif mathématique pour prévenir tout sur-dénombrement fallacieux.
2. Limites structurelles de NB.SI et genèse de la solution matricielle
2.1 Analyse critique des limitations de NB.SI face aux critères multiples
L’analyse des spécifications logicielles de Google Sheets révèle que NB.SI a été conçue à l’origine pour émuler le comportement de fonctions d’anciennes suites bureautiques, où la mémoire vive et la puissance processeur étaient restreintes. Cette dette technique se traduit par une incapacité native à gérer des structures de critères multidimensionnelles sans artifice syntaxique. Face à ce constat, les développeurs ont ultérieurement introduit la fonction NB.SI.ENS (ou COUNTIFS). Toutefois, cette dernière a été spécifiquement programmée pour répondre à une logique conjonctive d’intersection stricte : elle n’incrémente le compteur que si l’ensemble des conditions formulées au travers de multiples plages s’avèrent simultanément vérifiées pour une même ligne d’observation.
Par conséquent, NB.SI.ENS se révèle totalement inopérante pour résoudre des requêtes disjonctives au sein d’une même plage de données. Si un praticien renseigne la même plage à deux reprises dans NB.SI.ENS en lui assignant deux critères distincts mutuellement exclusifs, la fonction recherchera une cellule qui possède simultanément ces deux états, ce qui constitue une impossibilité logique et aboutira invariablement à un décompte nul. Cette contrainte engendre une surcharge cognitive notable chez l’utilisateur, qui se trouve contraint de multiplier les ramifications conditionnelles ou de construire des colonnes auxiliaires redondantes, altérant la propreté du modèle de données sous-jacent et augmentant la surface d’exposition aux erreurs de modélisation.
2.2 Introduction au paradigme de la formule matricielle
Pour dépasser l’évaluation scalaire sans dénaturer la structure des données, l’adoption du paradigme matriciel s’impose comme la solution computationnelle la plus élégante. Au cœur de cette approche réside la fonction ArrayFormula, un modificateur de contexte d’exécution qui force le moteur de Google Sheets à vectoriser les opérations qui, par défaut, ne traitent que des valeurs uniques. L’application d’un contexte matriciel modifie fondamentalement la cinématique d’évaluation : au lieu d’alimenter une fonction avec une valeur atomique pour en extraire une réponse atomique, l’environnement transmet des vecteurs entiers et exécute les calculs de manière parallèle.
Dans le contexte du dénombrement disjonctif, l’encapsulation vectorielle permet de transformer un argument de critère traditionnellement scalaire en un vecteur horizontal ou vertical de requêtes. Lorsque NB.SI reçoit une plage continue en premier argument et un vecteur de critères multiples en second argument, elle ne tente plus de fusionner ces critères via une évaluation booléenne unitaire. Elle opère une distribution du calcul : la fonction est exécutée de manière itérative en mémoire vive pour chaque composante du vecteur de critères, produisant instantanément une série de résultats intermédiaires correspondant aux cardinaux de chaque sous-groupe ciblé.
2.3 Structure conceptuelle de la combinaison SOMME et NB.SI
La transmission d’un vecteur de critères à la fonction NB.SI génère en sortie une structure de données non plus scalaire, mais matricielle, contenant autant de valeurs numériques qu’il y a de critères disjonctifs spécifiés. Pour consolider cette pluralité de dénombrements partiels en une valeur unique représentant la totalité des occurrences répondant à l’assertion disjonctive, l’intervention d’une fonction de réduction terminale s’avère indispensable. C’est à ce niveau précis qu’intervient la fonction SOMME (ou SUM).
Le couplage structurel entre SOMME et NB.SI constitue une architecture canonique d’une efficacité remarquable. Le tableau multidimensionnel temporaire généré par NB.SI est directement intercepté par SOMME, qui procède à la sommation arithmétique de l’ensemble des composantes vectorielles. Cette approche présente des avantages algorithmiques majeurs comparativement à des scripts personnalisés ou à des boucles de programmation itératives : l’opération est entièrement compilée et exécutée au sein du noyau C++ optimisé de Google Sheets, garantissant une vitesse d’exécution maximale et une occupation minimale de la mémoire volatile du navigateur hôte.
3. L’architecture canonique : ArrayFormula, SOMME et constantes matricielles
3.1 Décomposition de la syntaxe fondamentale
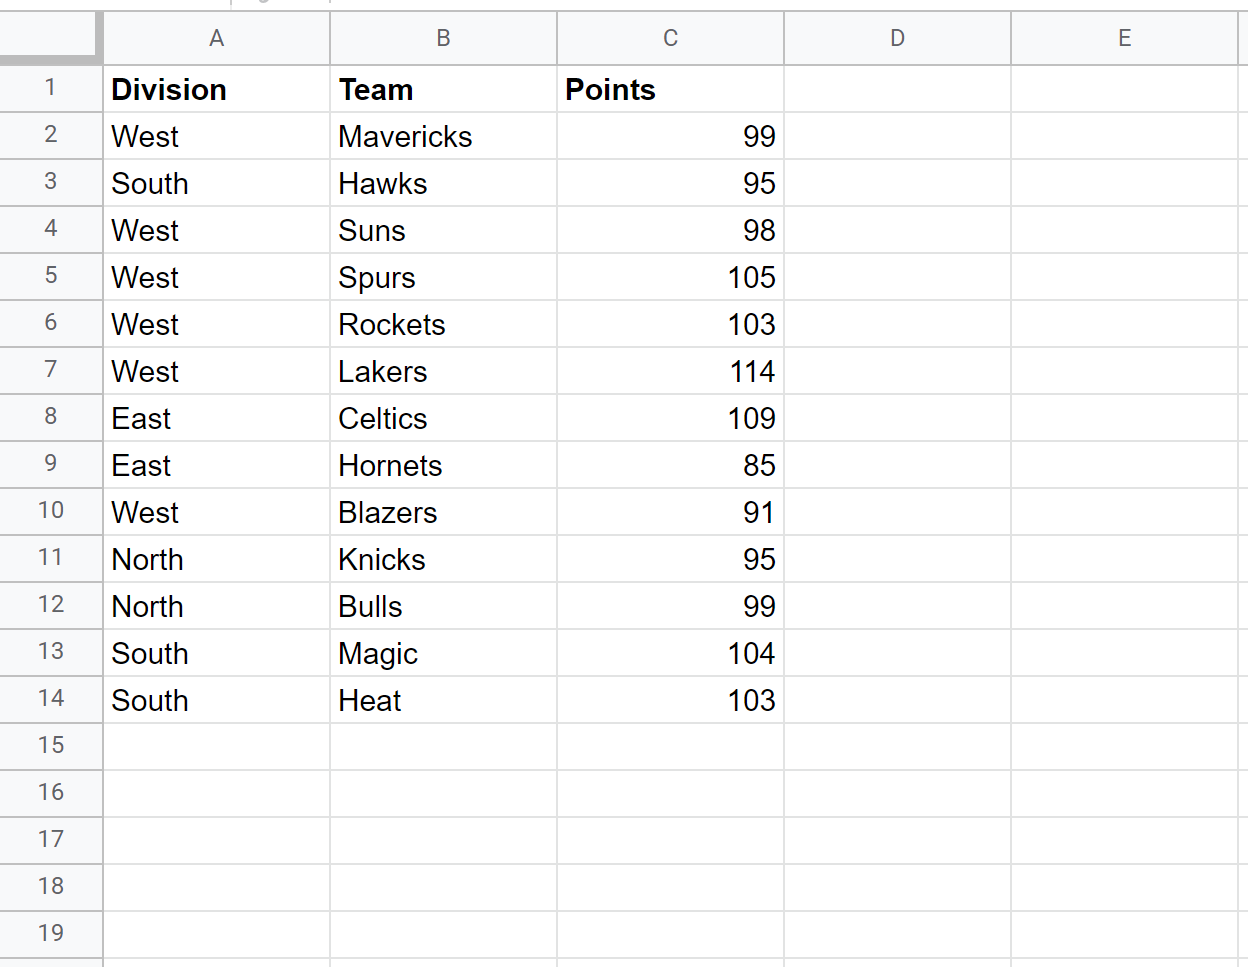
L’expression canonique la plus condensée pour dénombrer des occurrences selon une logique disjonctive repose sur l’assemblage de trois éléments distincts : l’opérateur d’agrégation, la fonction de comptage conditionnel et la constante matricielle encadrée par des accolades. L’expression générale prend la forme suivante : SOMME(ArrayFormula(NB.SI(Plage; {« CritèreA », « CritèreB »}))) ou, plus couramment dans les versions récentes de Google Sheets grâce à la coercition matricielle implicite de certaines fonctions combinées : ArrayFormula(SOMME(NB.SI(Plage; {« CritèreA », « CritèreB »}))).
L’ordre d’évaluation syntaxique suit une hiérarchie stricte régie par l’imbrication des parenthèses. En premier lieu, l’analyseur syntaxique identifie la constante matricielle délimitée par les accolades. Ensuite, la fonction NB.SI traite la plage référencée en appliquant séparément chacun des éléments de cette matrice de critères. Enfin, la fonction SOMME effectue la synthèse scalaire. Il convient de souligner que selon les paramètres régionaux du classeur (notamment la distinction entre les conventions francophones utilisant la virgule décimale et les conventions anglo-saxonnes reposant sur le point décimal), les séparateurs d’arguments et de matrices varient. Dans un classeur configuré pour la France, le point-virgule sépare traditionnellement les arguments des fonctions, tandis que la barre oblique inversée ou le point-virgule peut délimiter les lignes d’une matrice, et la virgule ou la barre oblique inversée ses colonnes.
3.2 Rôle et manipulation des constantes matricielles littérales
Les constantes matricielles littérales constituent le vecteur d’injection directe des valeurs cibles dans le flux de traitement de la formule. Enfermées entre accolades, ces listes d’éléments permettent d’éviter le recours à des plages physiques externes pour stocker les modalités recherchées. La manipulation de ces constantes requiert toutefois une rigueur syntaxique absolue quant au traitement des types de données. Les chaînes de caractères alphabétiques ou alphanumériques doivent impérativement être encadrées de guillemets doubles droits, à défaut de quoi l’interpréteur syntaxique générerait une erreur d’analyse en tentant d’interpréter le terme comme un nom de fonction ou une plage nommée non définie.
Par ailleurs, la sensibilité à la casse n’est pas appliquée par défaut lors de l’évaluation textuelle dans NB.SI : le terme « Alpha » et le terme « alpha » seront traités de manière identique par l’algorithme de comparaison standard. Concernant l’encodage, l’intégrité référentielle des données doit être rigoureusement préservée. L’insertion d’espaces superflus à l’intérieur des guillemets modifierait irrémédiablement le gabarit de comparaison, induisant une disparité invisible entre la constante matricielle et les données brutes présentes dans la plage cible.
3.3 Flux d’exécution de la formule au sein du moteur d’évaluation
L’analyse dynamique du flux de traitement exécuté par le moteur de Google Sheets permet de décomposer précisément le cycle de vie de l’évaluation d’une formule matricielle disjonctive. Dès l’activation de la cellule calculée, le système alloue un espace mémoire temporaire pour recueillir le résultat de l’expansion vectorielle. La plage de données source est lue en une seule passe, optimisant ainsi les entrées/sorties relatives à la mémoire vive.
Le moteur projette ensuite la matrice de critères sur les données. Si la matrice contient $k$ critères, le moteur génère un vecteur horizontal de dimension $1 \times k$ contenant les décomptes partiels respectifs. Dans une configuration sans agrégateur, ce vecteur tenterait de déborder sur les cellules adjacentes (phénomène de spill). La présence de la fonction SOMME à la racine de l’expression intercepte ce débordement potentiel : la fonction absorbe l’intégralité du tableau intermédiaire et réalise une réduction vectorielle par sommation séquentielle. Le résultat consolidé est alors instancié sous forme d’une valeur scalaire unique au sein de la cellule hébergeant la formule, libérant immédiatement la mémoire allouée aux calculs intermédiaires.
4. Application empirique aux variables textuelles catégorielles
4.1 Protocole de filtrage sur étiquettes qualitatives disjonctives
L’application la plus fréquente du dénombrement disjonctif concerne les variables qualitatives nominales au sein de bases de données de gestion ou de registres opérationnels. Considérons une colonne répertoriant la localisation géographique de transactions commerciales, où chaque enregistrement correspond à une métropole spécifique. L’analyste souhaitant isoler la masse transactionnelle issue exclusivement de pôles régionaux particuliers – par exemple « Lyon », « Marseille » ou « Toulouse » – doit mettre en œuvre un filtrage sur des étiquettes mutuellement exclusives.
La formule s’articulera ainsi : ArrayFormula(SOMME(NB.SI(B2:B5000; {« Lyon », « Marseille », « Toulouse »}))). Dans ce contexte, aucune transaction ne pouvant avoir été réalisée simultanément dans deux villes distinctes au sein d’une même ligne d’enregistrement, les catégories sont strictement étanches. Il convient toutefois de porter une attention méticuleuse à la présence éventuelle d’espaces insécables ou de variations diacritiques non standardisées dans les données brutes. Une phase de normalisation textuelle préalable via des fonctions de nettoyage est vivement recommandée pour garantir que les chaînes de comparaison correspondent exactement à la représentation binaire des entrées du classeur.
4.2 Traitement des réponses à modalités multiples en sciences sociales
Dans le domaine de l’analyse sociologique et des sciences du comportement, les enquêtes d’opinion déploient fréquemment des questions à choix catégoriels fermés, réparties sur des colonnes distinctes ou consolidées sous forme de codes taxonomiques. Supposons un protocole d’échantillonnage psychologique où les sujets sont catégorisés selon des profils de réactivité émotionnelle codifiés par des identifiants stricts tels que « ANX-1 », « ANX-2 » ou « DEP-A ». L’analyste peut éprouver le besoin d’agréger ces sous-groupes sans altérer la taxonomie originale ni fusionner physiquement les colonnes de données.
Le dénombrement disjonctif permet de mesurer instantanément la prévalence cumulée de ces profils au sein de la cohorte d’étude. En spécifiant ArrayFormula(SOMME(NB.SI(Cohorte!C2:C1200; {« ANX-1 », « ANX-2 », « DEP-A »}))), la métrique renvoyée quantifie précisément l’ensemble des individus présentant au moins l’une de ces caractéristiques nosographiques. Ce procédé offre une flexibilité remarquable pour recalibrer dynamiquement les groupes d’intérêt sans avoir à reconstruire la structure de codage d’origine de l’instrument psychométrique, garantissant la traçabilité intégrale de l’échantillon d’analyse.
4.3 Gestion des caractères génériques dans les contextes disjonctifs
Le moteur d’évaluation de la fonction NB.SI supporte nativement l’emploi de métacaractères de substitution, couramment qualifiés de caractères génériques ou wildcards. Cette fonctionnalité étend considérablement la puissance d’expression des critères disjonctifs. Le point d’interrogation (?) correspond rigoureusement à n’importe quel caractère alphanucléique unique, tandis que l’astérisque (*) capture une chaîne de caractères arbitraire de longueur indéfinie, y compris une chaîne vide.
Dans un contexte où les données textuelles présentent des variantes morphologiques, syntaxiques ou lexicales (par exemple des préfixes sectoriels ou des suffixes terminologiques), l’association des caractères génériques aux matrices disjonctives permet d’effectuer des filtrages par famille de termes. Par exemple, la syntaxe ArrayFormula(SOMME(NB.SI(D2:D800; {« *Nord* », « *Sud* »}))) agrégera toutes les cellules mentionnant ces orientations cardinales. Toutefois, cette méthodologie introduit un risque substantiel de collision et de sur-dénombrement : si une cellule contient la chaîne « Pôle Nord et Sud », elle correspondra simultanément aux deux prédicats, conduisant à un double comptage non désiré si les deux motifs sont évalués indépendamment. L’utilisation de caractères génériques dans les disjonctions matricielles exige ainsi un contrôle préalable strict de l’orthogonalité des gabarits textuels.
5. Application empirique aux variables numériques et quantitatives
5.1 Dénombrement sur listes discrètes de valeurs numériques
L’application de la disjonction logique aux variables quantitatives discrètes obéit à des règles de typage qui diffèrent sensiblement de celles régissant les chaînes de texte. Lorsqu’il s’agit de dénombrer l’occurrence de scores spécifiques au sein d’une distribution de données discrètes (par exemple, des notes entières obtenues à une échelle psychométrique standardisée), les valeurs numériques ne doivent pas être entourées de guillemets au sein de la constante matricielle, sous peine d’induire une coercition textuelle superflue, bien que Google Sheets tente fréquemment une conversion implicite.
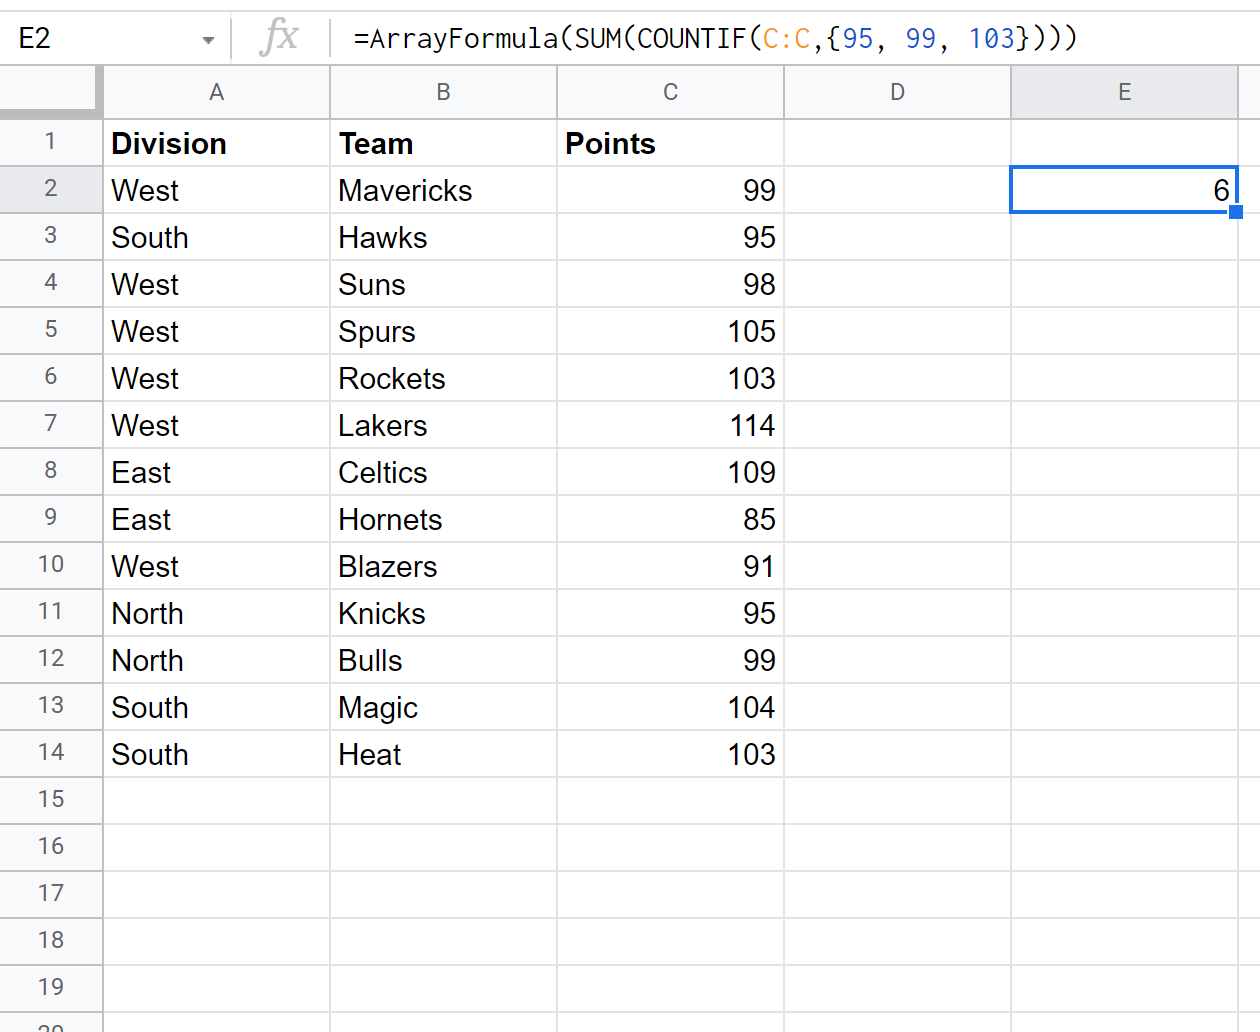
La formule s’écrit de manière épurée : ArrayFormula(SOMME(NB.SI(E2:E1000; {12, 15, 18}))). Dans cette configuration, le moteur de calcul compare les valeurs numériques selon une précision en virgule flottante conforme au standard IEEE 754. Une vigilance particulière s’impose lorsque les données proviennent de calculs antérieurs ayant introduit des fractions décimales infimes : une valeur de 12,000000000000002 ne sera pas identifiée comme égale à 12 par le comparateur scalaire de NB.SI. Il est par conséquent impératif d’arrondir rigoureusement les variables quantitatives en amont de l’évaluation conditionnelle disjonctive pour prévenir les omissions silencieuses de comptage.
5.2 Combinaisons disjonctives d’intervalles numériques
La formalisation de critères disjonctifs portant sur des opérateurs de comparaison d’inégalité (strictement supérieur, inférieur ou égal, etc.) impose une adaptation syntaxique spécifique. Puisque les opérateurs de comparaison tels que « > » ou « <= » nécessitent une représentation textuelle dans la syntaxe de NB.SI, ils doivent être concaténés avec les valeurs numériques correspondantes à l'intérieur des guillemets.
Cependant, le dénombrement disjonctif d’intervalles numériques distincts (par exemple, identifier les observations extrêmes caractérisées par un score strictement inférieur à 10 OU strictement supérieur à 90) met en lumière la limitation de la constante matricielle simple. Si l’on écrit ArrayFormula(SOMME(NB.SI(F2:F500; {« 90 »}))), le calcul s’avère parfaitement valide et exact car les deux intervalles considérés sont mutuellement disjoints : aucune valeur réelle ne peut être simultanément inférieure à 10 et supérieure à 90. En revanche, si un analyste tente d’évaluer des intervalles sécants (par exemple, inférieur à 50 OU supérieur à 30), la simple sommation matricielle comptabilisera deux fois toutes les observations comprises entre 30 et 50. La segmentation des classes de scores d’évaluation impose donc une vérification absolue de la disjonction topologique des intervalles paramétrés.
5.3 Application aux séries temporelles et données calendaires
Dans l’architecture de Google Sheets, les dates et les estampilles temporelles sont stockées sous la forme de numéros de série séquentiels continus, dont le point zéro correspond conventionnellement au 30 décembre 1899. Une date correspond à la partie entière de ce nombre flottant, tandis que la partie décimale représente la fraction de journée écoulée. Cette conversion implicite facilite grandement les comparaisons mathématiques, mais génère des chausse-trapes lors du paramétrage des critères disjonctifs.
Pour dénombrer des observations survenues au cours de cohortes temporelles spécifiques et non contiguës (par exemple, des jours fériés ou des fenêtres expérimentales discontinues), l’usage de dates littérales au format texte à l’intérieur de la constante matricielle peut provoquer des erreurs d’interprétation selon la localisation régionale du tableur (confusion entre le format jour/mois/année et mois/jour/année). La méthodologie la plus robuste consiste à injecter des numéros de série numériques ou à employer des fonctions de conversion de dates explicites. Par exemple, pour dénombrer les événements survenus soit le 1er janvier 2024, soit le 14 juillet 2024, il est recommandé de formuler les critères à l’aide de la fonction DATE, en concaténant les données au sein d’une structure vectorielle adaptée.
6. L’alternative de la disjonction arithmétique par addition de fonctions
6.1 Fondements de l’addition arithmétique des fonctions NB.SI
Avant la popularisation des formules matricielles et la généralisation des constantes entre accolades, l’approche universelle pour traduire une disjonction logique consistait à décomposer l’expression en une suite d’additions arithmétiques d’instances distinctes de NB.SI. Ce modèle élémentaire repose sur l’équivalence fondamentale entre l’opérateur logique OU appliqué à des prédicats disjoints et l’addition arithmétique des résultats de ces prédicats pris isolément : Cardinal($A cup B$) = Cardinal($A$) + Cardinal($B$) si $A cap B = emptyset$.
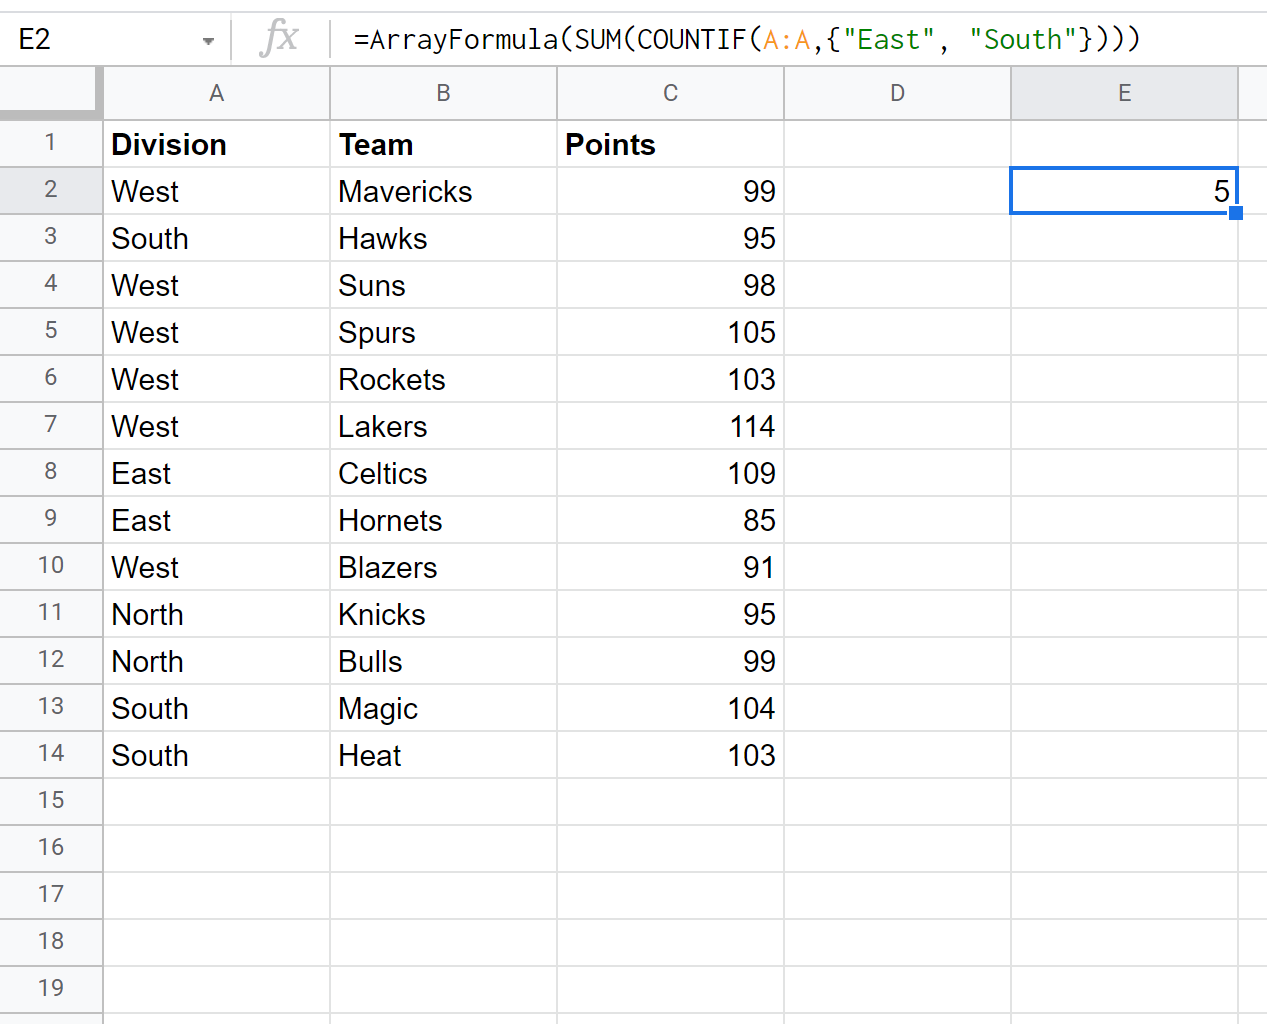
La syntaxe résultante adopte la forme suivante : NB.SI(A2:A100; « Critère1 ») + NB.SI(A2:A100; « Critère2 ») + NB.SI(A2:A100; « Critère3 »). Cette structure possède une clarté algorithmique évidente qui en fait l’alternative de choix pour les équipes pluridisciplinaires ou les praticiens peu familiers avec la logique tensorielle des matrices. Elle ne requiert aucun préfixe matriciel particulier et fonctionne de manière déterministe sur toutes les versions de tableurs existantes, assurant une portabilité maximale du code de calcul pour la reproductibilité scientifique des analyses.
6.2 Évaluation comparative des performances et de la lisibilité
Sur le plan de l’architecture logicielle, le choix entre l’addition arithmétique de fonctions scalaires et la formule matricielle condensée implique des arbitrages techniques substantiels. Lorsque le nombre de critères disjonctifs demeure restreint (deux ou trois modalités), l’addition de fonctions distinctes offre une lisibilité immédiate et simplifie le débogage manuel, chaque terme de l’addition pouvant être évalué et isolé visuellement dans l’interface.
Néanmoins, cette approche souffre d’une dégradation linéaire marquée de sa maintenabilité à mesure que l’éventail des critères s’élargit. Si une analyse exige d’agréger quinze modalités distinctes, la formule se transforme en une chaîne syntaxique kilométrique, vulnérable aux erreurs de saisie, aux omissions typographiques et aux ruptures de parenthèses lors des phases d’édition collaborative. Sur le plan computationnel, bien que le moteur de Google Sheets optimise les lectures en mémoire cache, multiplier les appels indépendants à la fonction NB.SI oblige l’analyseur à instancier plusieurs contextes d’évaluation séparés, là où la formule matricielle traite l’ensemble des critères au sein d’un seul pipeline d’exécution vectoriel.
6.3 Gestion des intersections et risques de double comptage
La limite critique de l’addition arithmétique apparaît avec acuité dès lors que l’on abandonne le cadre des critères strictement mutuellement exclusifs pour aborder des disjonctions portant sur des variables orthogonales ou des prédicats sécants. Si un analyste tente de quantifier le nombre d’individus qui sont soit des « Cadres » (colonne A) OU qui possèdent un revenu « > 50000 » (colonne B), la formule arithmétique naïve NB.SI(A2:A100; « Cadre ») + NB.SI(B2:B100; « >50000 ») produit un résultat systématiquement biaisé.
En effet, tout individu cumulant les deux attributs – un cadre percevant plus de cinquante mille euros – sera dénombré une première fois dans le premier terme, puis une seconde fois dans le second terme. Pour restaurer l’exactitude de la mesure statistique, la formule du crible de Poincaré doit être implémentée manuellement par la soustraction de l’intersection conjonctive calculée via la fonction NB.SI.ENS : NB.SI(A2:A100; « Cadre ») + NB.SI(B2:B100; « >50000 ») – NB.SI.ENS(A2:A100; « Cadre »; B2:B100; « >50000 »). Cette modélisation, bien que rigoureuse, augmente considérablement la complexité syntaxique et constitue une source fréquente d’erreurs méthodologiques dans les environnements de reporting empiriques.
7. Paradigmes avancés : exploitation conjointe de FILTER et QUERY
7.1 Utilisation de la fonction FILTER avec l’opérateur d’addition booléenne
Lorsque la structure dimensionnelle du problème dépasse le cadre d’un critère textuel simple au sein d’une seule colonne, les fonctions matricielles NB.SI atteignent leurs limites opérationnelles. L’environnement Google Sheets offre alors un paradigme nettement plus puissant fondé sur l’utilisation combinée des fonctions FILTER et d’agrégation quantitative telle que LIGNES (ou ROWS) ou NBVAL (ou COUNTA). La fonction FILTER permet d’extraire un sous-ensemble d’enregistrements en appliquant des expressions logiques vectorisées directement sur les plages d’entrée.
L’aspect fondamental de FILTER dans la résolution des requêtes disjonctives repose sur l’algèbre booléenne arithmétique : l’opérateur de multiplication (*) émule l’intersection logique conjonctive (ET), tandis que l’opérateur d’addition (+) émule la disjonction logique (OU). Ainsi, la formule LIGNES(FILTER(A2:A1000; (B2:B1000 = « ModalitéA ») + (C2:C1000 >= 50))) filtre l’ensemble des lignes pour lesquelles soit la colonne B vérifie la modalité requise, soit la colonne C franchit le seuil quantitatif. Ce mécanisme gère nativement et parfaitement l’exclusion des doubles comptages : l’addition booléenne produit la valeur 1 pour une condition vérifiée, et la valeur 2 si les deux conditions sont satisfaites ; or, FILTER traite toute valeur strictement positive (non nulle) comme un signal de sélection VRAI sans dupliquer la ligne de données sous-jacente.
Il importe toutefois de prémunir cette architecture contre les cas de figure où aucune observation ne remplit l’assertion logique formulée. En l’absence de concordance, FILTER renvoie l’erreur standard #N/A (indiquant qu’aucune valeur ne correspond aux critères), ce qui entraîne la défaillance immédiate de la fonction d’encapsulation LIGNES. L’encapsulation dans un gestionnaire d’exception de type SIERREUR (ou IFERROR) constitue donc un impératif d’ingénierie pour garantir le renvoi de la valeur zéro en l’absence de données éligibles : SIERREUR(LIGNES(FILTER(A2:A1000; (B2:B1000 = « ModalitéA ») + (C2:C1000 >= 50))); 0).
7.2 Mobilisation de l’API de requête QUERY pour le traitement ensembliste
Pour la manipulation de structures tabulaires assimilables à des tables relationnelles, l’API intégrée via la fonction QUERY représente le standard industriel le plus robuste. QUERY s’appuie sur une version allégée du langage de requête Google Visualization API Query Language, offrant une syntaxe déclarative inspirée du langage SQL. Cette approche dissocie entièrement la formulation de la logique d’extraction de la topologie physique de la feuille de calcul.
La formulation d’une disjonction s’effectue alors au moyen de la clause textuelle WHERE combinée à l’opérateur natif OR. Par exemple, la syntaxe QUERY(A1:F50000; « SELECT COUNT(A) WHERE B = ‘Lyon’ OR B = ‘Marseille’ LABEL COUNT(A) » ») délègue l’intégralité du calcul d’agrégation au moteur de requête interne. Ce dernier exécute la disjonction, élimine les redondances éventuelles et renvoie le décompte unitaire sous forme d’une cellule unique sans en-tête superflu grâce à la neutralisation opérée par le mot-clé LABEL.
L’avantage cardinal de QUERY réside dans sa capacité à traiter des volumes imposants de données structurées avec une lisibilité conceptuelle incomparable. Toutefois, sa sensibilité rigide au typage impose une vigilance extrême : QUERY déduit le type de données prédominant d’une colonne (numérique ou textuel) sur la base d’un échantillonnage de ses premières lignes. Si une colonne comporte des types mixtes, les cellules minoritaires peuvent être converties en valeurs nulles par le moteur d’inférence, faussant ainsi les décomptes conditionnels disjonctifs.
7.3 Tableau comparatif méthodologique des architectures d’évaluation
Le choix d’une architecture de dénombrement disjonctif ne doit pas résulter du hasard, mais d’une analyse multicritère tenant compte de la volumétrie des données, de la dynamicité des plages cibles, de la maintenance logicielle et de la consommation des cycles processeur. L’évaluation comparative des différentes stratégies développées met en lumière des profils d’efficience contrastés.
La méthode canonique par constante matricielle SOMME(NB.SI(Plage; {C1, C2})) excelle par sa compacité extrême et sa rapidité d’exécution sur des listes fermées de modalités univariées au sein de volumes de données modérés à élevés (jusqu’à 100 000 cellules). Elle montre cependant une rigidité absolue dès lors que les critères doivent être instanciés à partir d’autres cellules dynamiques ou que la disjonction implique plusieurs colonnes distinctes.
L’addition arithmétique de fonctions NB.SI reste la technique la plus accessible et universellement interprétable, idéale pour les documents d’audit transparents ou les débutants, mais devient contre-productive au-delà de trois conditions et incapable de gérer seule des critères non disjoints. L’architecture FILTER combinée à l’addition booléenne constitue la solution la plus polyvalente pour les filtrages multivariés complexes, au prix d’un coût de recalcul légèrement supérieur lors des modifications de cellules. Enfin, la fonction QUERY représente l’arme absolue pour les architectures de données massives de type entrepôt de données (data warehouse) ou reporting centralisé, sous réserve d’une stricte propreté et d’un typage homogène des colonnes sources.
8. Reconnaissance de motifs complexes par expressions régulières
8.1 L’alternative REGEXMATCH combinée aux fonctions matricielles
Le traitement des variables textuelles non entièrement normalisées, des champs de saisie libre ou des terminologies semi-structurées requiert un niveau de granularité que les caractères génériques standard de NB.SI ne peuvent offrir. Dans cette perspective, la mobilisation des expressions régulières (Regex) à travers la fonction REGEXMATCH constitue une avancée méthodologique substantielle. La théorie des automates réguliers sous-jacente permet de définir des gabarits disjonctifs au moyen du métacaractère de barre verticale (|), agissant comme un opérateur disjonctif textuel natif au sein d’une seule expression formelle.
En associant cette capacité à la fonction matricielle SOMMEPROD (ou SUMPRODUCT) ou à la combinaison ArrayFormula et SOMME, l’analyste obtient un évaluateur disjonctif de haute précision. La syntaxe canonique prend la forme suivante : SOMMEPROD(REGEXMATCH(A2:A5000; « (?i)asthme|bronchite|allergie ») * 1). Dans cette structure, l’instruction modificateur (?i) active l’insensibilité à la casse, neutralisant tout écueil lié aux majuscules accidentelles. La fonction REGEXMATCH évalue l’ensemble de la plage textuelle et renvoie un vecteur de booléens (VRAI ou FAUX), transformé immédiatement en vecteur binaire de 1 et de 0 par la multiplication arithmétique unitaire (* 1). La sommation scalaire finale restitue l’exact cardinal des cellules contenant l’une quelconque de ces pathologies.
8.2 Comparaison fonctionnelle entre NB.SI générique et REGEXMATCH
La divergence fonctionnelle entre l’usage des caractères génériques au sein de NB.SI et l’implémentation de REGEXMATCH repose principalement sur la gestion des délimiteurs lexicaux et la complexité des motifs. Avec NB.SI, l’instruction « *car* » identifiera indifféremment les termes « carte », « encart », « placard » ou « autocar », créant un halo de sur-sélection impossible à restreindre sans complexification extrême de la formule.
À l’inverse, REGEXMATCH autorise l’intégration des ancres de début et de fin de mot ou de chaîne (telles que b en syntaxe d’expression régulière standard compatible PCRE ou RE2 employée par Google). La chaîne de recherche « b(Nord|Sud)b » garantira de manière absolue que seules les occurrences strictes des mots isolés « Nord » ou « Sud » seront capturées, à l’exclusion systématique des mots composés dérivés tels que « Nordique » ou « Soudain ». Néanmoins, cette précision algorithmique s’accompagne d’une sensibilité accrue : une expression régulière syntaxiquement mal formée (parenthèse non fermée, caractère réservé non échappé) déclenchera immédiatement une erreur fatale #VALUE! invalidant l’ensemble de la feuille de calcul.
8.3 Cas d’usage : codage de données qualitatives et verbales
Le traitement des verbatims d’utilisateurs ou des réponses ouvertes lors de protocoles expérimentaux en psychologie cognitive illustre la pertinence opérationnelle de cette approche. Supposons une étude qualitative recueillant les réactions spontanées de sujets face à un stimulus anxiogène. Les participants emploient une diversité de termes quasi-synonymes pour désigner un état de stress émotionnel, tels que « peur », « angoisse », « panique », « inquiétude » ou « frayeur ».
Plutôt que d’écrire une formule NB.SI matricielle étirée contenant une multitude de chaînes avec astérisques, l’analyste compile l’ensemble du réseau sémantique au sein d’une unique expression régulière : ArrayFormula(SOMME(N(REGEXMATCH(B2:B2000; « (?i)b(peur|angoisse|panique|inquiétude|frayeur)b »)))). La fonction univariée N() assure la coercition sécurisée des booléens en entiers numériques. Cette méthodologie garantit une automatisation fluide du pré-traitement qualitatif, tout en permettant aux chercheurs d’auditer et d’adapter le filtre lexical en modifiant simplement une chaîne de caractères compacte.
9. Dynamisation des critères par références cellulaires externes
9.1 Remplacement des constantes littérales par des plages de critères dynamiques
L’encapsulation de constantes matricielles codées en dur (hardcoded) entre accolades, bien que rapide et fonctionnelle, représente une violation flagrante des bonnes pratiques de l’ingénierie des données tabulaires. L’intégration de valeurs littérales directement à l’intérieur des formules fige la logique de calcul et exige une intervention humaine manuelle au sein du code de la feuille dès lors que la nomenclature ou les objectifs d’analyse évoluent. La véritable robustesse d’un tableau de bord réside dans sa capacité à dynamiser l’évaluation disjonctive en la liant à des plages de cellules physiques externes éditables par l’utilisateur.
Cependant, injecter une plage verticale de critères (par exemple Z1:Z5) directement dans le second argument d’une fonction NB.SI matricielle peut induire des déséquilibres dimensionnels. Si la plage de données est un vecteur colonne vertical ($N \times 1$) et que la plage de critères est également configurée comme un vecteur colonne vertical ($M \times 1$), le moteur de calcul de Google Sheets peut tenter d’exécuter un alignement ligne à ligne au lieu d’une expansion matricielle orthogonale complète. Pour forcer le moteur à comparer chaque cellule de la plage cible à l’intégralité de la liste des critères, il est fréquemment requis d’orthogonaliser la matrice de critères au moyen de la fonction TRANSPOSE : ArrayFormula(SOMME(NB.SI(A2:A1000; TRANSPOSE(Z1:Z5)))). Cette transformation bidimensionnelle ($N \times 1$ contre $1 \times M$) génère une matrice intermédiaire complète d’évaluations qui est ensuite réduite à un scalaire unique par la fonction SOMME.
9.2 Implémentation d’une table de référence paramétrique
Pour assurer la pérennité architecturale d’un modèle d’analyse quantitatif, la séparation stricte entre la couche de données brutes, la couche de contrôle paramétrique et la couche d’affichage analytique doit être respectée. La mise en place d’une table de référence paramétrique dédiée formalise cette distinction. L’analyste définit un onglet spécifique (par exemple « Parametres_Filtres ») dans lequel sont répertoriées les modalités catégorielles d’intérêt.
En associant cette zone à des mécanismes de validation de données (menus déroulants normalisés), l’insertion, la modification ou la suppression de modalités disjonctives n’implique plus aucune altération des formules mathématiques de calcul. Les cellules cibles exploitent des plages nommées dynamiques ou des références ouvertes sécurisées. Ainsi, le modèle s’adapte instantanément aux variations des protocoles de collecte, éliminant tout risque d’altération accidentelle des expressions matricielles par des utilisateurs finaux non techniciens.
9.3 Approches alternatives avec EQUIV et NB.SI pour listes étendues
Lorsque la table de critères disjonctifs ne contient plus trois ou quatre éléments, mais englobe des dizaines voire des centaines de codes de référence (par exemple le recoupement d’une cohorte de patients avec une nomenclature internationale de maladies répertoriant cinquante codes distincts), l’évaluation matricielle de NB.SI combinée à TRANSPOSE peut subir un écueil de dimensionnalité, générant une matrice intermédiaire de plusieurs millions de cellules virtuelles en mémoire vive.
Dans ce scénario de volumétrie avancée, la reformulation de la requête par le prisme de la recherche d’appartenance vectorielle constitue une alternative computationnelle infiniment supérieure. Au lieu de demander à NB.SI de tester chaque critère sur la plage, on teste si les éléments de la plage appartiennent à la table de critères au moyen de la fonction EQUIV (ou MATCH). La formule s’articule alors ainsi : SOMMEPROD(ESTNUM(EQUIV(A2:A50000; Parametres!A1:A100; 0))). La fonction EQUIV effectue une recherche exacte et renvoie l’indice de position si l’élément est présent, ou une erreur #N/A dans le cas contraire. La fonction ESTNUM (ou ISNUMBER) convertit ces réponses en un vecteur logique, et SOMMEPROD en assure l’agrégation finale. Cette méthode réduit la complexité mémoire à un traitement strictly linéaire d’une efficacité algorithmique remarquable.
10. Typologie des erreurs, diagnostics syntaxiques et pièges fréquents
10.1 Résolution des erreurs de syntaxe de type #ERROR!, #VALUE! et #N/A
Le déploiement de formules matricielles disjonctives s’accompagne inévitablement de confrontations avec les codes d’anomalies renvoyés par l’analyseur de Google Sheets. L’erreur générique #ERROR! signale quasi-systématiquement une rupture lexicale : parenthèse orpheline, guillemets asymétriques ou, cas le plus fréquent dans les environnements internationaux, confusion entre les séparateurs d’arguments (virgule versus point-virgule). Si les paramètres du classeur sont configurés pour une syntaxe utilisant la virgule comme séparateur de paramètres, l’usage du point-virgule brisera l’arbre syntaxique.
L’erreur #VALUE! traduit quant à elle une inadéquation structurelle ou dimensionnelle dans les opérandes. Elle se manifeste fréquemment lorsque l’utilisateur tente d’appliquer des opérateurs scalaires stricts à l’intérieur d’une matrice sans l’enveloppe protectrice d’ArrayFormula, ou lors d’une tentative de concaténation de plages de dimensions hétérogènes. Enfin, l’anomalie #N/A reflète l’incapacité d’une fonction de recherche interne à localiser une clé. Dans les architectures matricielles combinées, l’apparition d’un unique #N/A au sein d’une matrice intermédiaire contamine l’ensemble de la chaîne de réduction : la fonction SOMME finale renverra immanquablement #N/A. L’insertion circonspecte de la fonction SIERREUR pour neutraliser spécifiquement les concordances absentes permet de rétablir la somme globale tout en préservant la validité du modèle.
10.2 Élimination des erreurs logiques silencieuses de comptage
Contrairement aux erreurs de syntaxe qui interrompent le calcul de manière visible, les erreurs logiques silencieuses sont les plus périlleuses pour l’intégrité de la recherche scientifique et de la modélisation financière car elles délivrent un nombre erroné drapé dans l’apparence de la validité. La première cause d’erreur silencieuse réside dans la présence de résidus textuels non imprimables, principalement des espaces en tête ou en fin de chaîne au sein des données collectées. Une cellule contenant « Paris » (avec une espace terminale) sera systématiquement rejetée par le critère « Paris ». L’application préventive de la fonction SUPPRESPACE (ou TRIM) sur les colonnes sources représente le protocole standard d’éradication de ces artefacts.
La seconde cause majeure concerne les critères englobants provoquant des redondances disjonctives. Si un analyste construit une disjonction arithmétique ou matricielle contenant à la fois le critère « Fr* » et le critère « France », toute cellule hébergeant le mot « France » satisfera simultanément aux deux prédicats, aboutissant à un double dénombrement insidieux. Pour auditer la fiabilité d’une formule disjonctive, l’ingénierie méthodologique préconise de confronter le résultat à un dénombrement de contrôle : la somme des décomptes disjonctifs individuels ne doit jamais excéder l’effectif total de la cohorte analysée.
10.3 Comportement face aux cellules vides et valeurs manquantes
La gestion des cellules dépourvues de contenu constitue un défi récurrent dans l’analyse de jeux de données empiriques. Dans l’écosystème Google Sheets, il convient de distinguer conceptuellement une cellule vierge (non initialisée) d’une cellule contenant une chaîne vide (« ») générée par le retour conditionnel d’une formule antérieure. Si un critère disjonctif inclut un gabarit visant à identifier les données manquantes, l’utilisation de l’argument littéral « » au sein d’une matrice NB.SI peut produire des aberrations de décompte.
De surcroît, si la formule disjonctive est formulée pour capturer des inégalités (par exemple les valeurs strictement inférieures à un certain seuil numérique), le moteur de calcul peut interpréter les cellules vides comme des zéros numériques, gonflant artificiellement l’agrégat résultant. Pour préserver l’intégrité de l’échantillon analysé, les critères doivent explicitement formuler l’exclusion des valeurs nulles, ou s’appuyer sur des filtres préalables éliminant les lignes non renseignées au moyen de l’expression conditionnelle ESTVIDE (ou ISBLANK).
11. Optimisation computationnelle et passages à l’échelle
11.1 Efficacité algorithmique sur les méga-matrices de données
L’exécution de feuilles de calcul traitant des centaines de milliers de lignes impose une considération rigoureuse de la complexité algorithmique temporelle, couramment formalisée par la notation grand O. Une formule NB.SI standard appliquée à une plage de dimension $N$ avec un critère unique opère selon une complexité linéaire $\mathcal{O}(N)$. Lorsqu’une matrice disjonctive de $k$ critères est injectée, la complexité computationnelle théorique s’établit à $\mathcal{O}(k \times N)$.
L’erreur computationnelle la plus destructrice consiste à déclarer des plages de données ouvertes englobant l’intégralité d’une colonne de feuille de calcul (par exemple A:A au lieu de A2:A10000). Dans Google Sheets, une référence de colonne complète force le moteur à allouer des structures de suivi sur l’ensemble des lignes existantes du classeur (souvent jusqu’à la limite maximale autorisée de plusieurs millions de cellules). Cela induit un ralentissement drastique de la vitesse de recalcul dynamique lors de chaque modification transactionnelle. Délimiter rigoureusement les coordonnées extrêmes des plages d’analyse constitue le premier levier d’optimisation des performances du processeur hôte.
11.2 Optimisation de la mémoire vive et de la bande passante cloud
L’infrastructure de Google Sheets repose sur une architecture client-serveur hautement distribuée. Les calculs lourds sont exécutés sur les serveurs distants de Google, puis les deltas de synchronisation sont transmis via le réseau au navigateur web client qui assure le rendu de l’interface graphique. Une formule matricielle excessivement complexe ou dispersée à travers des milliers de cellules dupliquées sature rapidement la mémoire vive allouée au fil d’exécution JavaScript du navigateur.
Pour concevoir des classeurs éco-efficients et réactifs, les analystes doivent privilégier la consolidation des formules disjonctives : une formule matricielle unique calculant l’ensemble des distributions fréquentielles d’un tableau est infiniment préférable à une multitude de cellules individuelles abritant des formules répétitives. Par ailleurs, pour les jeux de données statistiques historiques non soumis à des flux de données en continu, il est vivement recommandé de figer périodiquement les calculs consolidés en convertissant les formules en valeurs statiques via l’opération de collage spécialisé, soulageant ainsi durablement les cycles de maintenance du graphe de dépendances.
11.3 Stratégies d’indexation et structuration des modèles de données
Lorsque la complexité d’extraction atteint des sommets, l’optimisation ne relève plus de la syntaxe des formules, mais de la topologie même du modèle de données. L’introduction de colonnes auxiliaires de pré-calcul booléen représente une technique éprouvée de délestage computationnel. Plutôt que de contraindre une formule terminale à réévaluer en continu des conditions disjonctives complexes à plusieurs branches, l’analyste instancie une colonne dédiée qui évalue une fois pour toutes la condition lors de l’insertion de chaque ligne d’enregistrement.
Cette dénormalisation contrôlée transforme une opération de dénombrement disjonctif complexe à la volée en une simple sommation arithmétique d’indicateurs binaires préalablement matérialisés. Le coût processeur lors de la consultation analytique s’en trouve réduit à un parcours unitaire linéaire instantané. Cette architecture modulaire s’aligne parfaitement sur les principes de conception des bases de données relationnelles professionnelles et garantit une stabilité exemplaire aux systèmes de bord académiques et industriels volumineux.
12. Applications pratiques en méthodologie de recherche quantitative
12.1 Application à l’analyse de données psychométriques et comportementales
Dans le champ de la recherche quantitative en psychologie et en neurosciences computationnelles, la segmentation des profils comportementaux implique de manipuler des échelles d’évaluation composites (telles que les inventaires de personnalité ou les échelles de dépistage clinique de type Likert). L’analyste se trouve régulièrement confronté à l’obligation d’isoler des cohortes de sujets manifestant des configurations de détresse psychologique divergentes mais d’importance diagnostique équivalente.
Supposons un protocole évaluant la vulnérabilité au stress post-traumatique où l’inclusion dans le groupe clinique requiert que l’individu présente soit un score d’intrusion supérieur au percentile 85, soit un score d’évitement supérieur au même percentile. Le recours à l’architecture FILTER avec addition booléenne permet de quantifier immédiatement l’échantillon d’intérêt sans déperdition d’information méthodologique : LIGNES(FILTER(Sujets!A2:A500; (Sujets!G2:G500 >= 85) + (Sujets!H2:H500 >= 85))). Cette approche garantit la stricte reproductibilité computationnelle des critères de sélection empirique nécessaires à la publication des résultats selon les critères scientifiques internationaux.
12.2 Automatisation des tableaux de bord d’analyse d’enquêtes expérimentales
Le pilotage longitudinal d’études épidémiologiques ou de panels de consommateurs requiert la maintenance de tableaux de bord automatisés synthétisant les indicateurs de suivi et d’attrition (taux d’abandon). Les chercheurs doivent agréger dynamiquement les métriques d’interruption de protocole selon des profils démographiques hétérogènes, tels que les tranches d’âge minoritaires ou les zones géographiques d’accès difficile.
En couplant les formules matricielles disjonctives à des sélecteurs de cellules dynamiques et à des générateurs graphiques intégrés, le tableau de bord met à jour instantanément les distributions de fréquences et les graphiques en barres correspondants dès la saisie de nouvelles réponses dans le formulaire de collecte en ligne associé. Cette synchronisation en temps réel permet aux coordinateurs de recherche de détecter précocement les déséquilibres d’échantillonnage et de redresser les quotas d’administration avant la clôture définitive des protocoles d’expérimentation de terrain.
12.3 Protocole de documentation et d’audit des formules disjonctives
L’intégrité d’un classeur d’analyse quantitative repose in fine sur sa capacité à être vérifié, audité et reproduit par des pairs indépendants. Les formules matricielles complexes manipulant des constantes disjonctives cryptiques constituent fréquemment des boîtes noires impénétrables pour les réviseurs scientifiques si elles sont dépourvues de documentation contextuelle.
Il est donc impératif d’instaurer des protocoles de standardisation stricts : chaque cellule abritant une logique disjonctive non triviale doit être documentée au moyen de commentaires de cellules standardisés explicitant la logique ensembliste adoptée. L’analyste doit consigner dans un dictionnaire de données les motifs réguliers ou les tables de critères exploitées. De plus, avant toute exportation des métriques agrégées vers des environnements statistiques tiers (tels que R, Python, SPSS ou Stata), un audit croisé comparant les sommes calculées dans Google Sheets aux résultats d’extractions en scripts de commande garantira une validité computationnelle absolue à la chaîne de traitement empirique.
Références
- Benninga, S. (2014). Financial modeling (4th ed.). MIT Press.
- Google. (2024). Aide Éditeurs Google Docs : Fonction NB.SI. Support Google. https://support.google.com/docs/answer/3093480
- Google. (2024). Aide Éditeurs Google Docs : Fonction FILTER. Support Google. https://support.google.com/docs/answer/3093197
- Google. (2024). Aide Éditeurs Google Docs : Fonction QUERY. Support Google. https://support.google.com/docs/answer/3093343
- Google. (2024). Aide Éditeurs Google Docs : Fonction REGEXMATCH. Support Google. https://support.google.com/docs/answer/3098292
- Google. (2024). Aide Éditeurs Google Docs : Utiliser des tableaux dans Google Sheets (ArrayFormula). Support Google. https://support.google.com/docs/answer/3093275
- Halvorson, M. (2020). Microsoft Excel data analysis and business modeling (6th ed.). Microsoft Press.
- Lipschutz, S. (1998). Théorie des ensembles et concepts élémentaires. McGraw-Hill.
- Walkenbach, J. (2015). Excel 2016 formulas. John Wiley & Sons.