
L’essor des applications infonuagiques a profondément transformé la manipulation, l’analyse et la gouvernance des données opérationnelles. Au sein de cet écosystème en perpétuelle mutation, la suite bureautique de Google s’est distinguée par l’intégration d’outils analytiques sophistiqués capables de rivaliser avec des systèmes de gestion de bases de données relationnelles traditionnels. Parmi ces instruments de calcul, la fonction QUERY de Google Sheets constitue indéniablement le composant le plus puissant et le plus élégant sur le plan computationnel. En permettant l’exécution d’instructions déclaratives calquées sur la syntaxe SQL, elle libère l’utilisateur des contraintes inhérentes aux formules matricielles imbriquées et aux manipulations manuelles répétitives, instaurant un paradigme où la description du résultat prime sur l’algorithme d’extraction.
Au cœur de cette architecture analytique réside la clause GROUP BY, un opérateur fondamental de l’algèbre relationnelle dédié au partitionnement et à la réduction dimensionnelle des ensembles de données. Alors qu’une simple extraction par projection ou restriction se contente d’isoler ou de filtrer des n-uplets d’enregistrements sans altérer leur granularité originelle, l’agrégation via le partitionnement catégoriel transforme substantiellement la géométrie des données. Elle condense une multiplicité de faits individuels en métriques synthétiques hautement informatives, telles que des moyennes arithmétiques, des sommes pondérées ou des dénombrements d’occurrences. Cette capacité de synthèse s’avère indispensable pour le pilotage de la performance, la modélisation financière et l’exploration de corpus statistiques volumineux.
Néanmoins, la maîtrise de la clause GROUP BY au sein de Google Sheets requiert une compréhension rigoureuse de ses fondements théoriques, de sa syntaxe formelle et de ses contraintes d’exécution spécifiques. Conçue autour de l’API de visualisation de Google, cette technologie impose une discipline conceptuelle stricte quant au typage des colonnes, à l’articulation logique des clauses et au traitement des valeurs manquantes. L’objectif de cette étude exhaustive est d’offrir une déconstruction intégrale des mécanismes sous-jacents à l’agrégation relationnelle dans Google Sheets, en guidant le praticien de l’analyse de données depuis les théorèmes de partitionnement jusqu’aux architectures de tableaux de bord dynamiques et aux protocoles avancés d’optimisation computationnelle.
1. Introduction théorique et fondements de la fonction QUERY avec la clause GROUP BY
1.1 Origine et paradigme du langage Google Visualization API Query Language
L’intégration de la fonction QUERY au sein de Google Sheets découle historiquement du développement de la Google Visualization API. Conçue initialement pour alimenter de manière standardisée des composants graphiques interactifs sur le Web, cette interface de programmation nécessitait un moteur de requêtage universel, léger et indépendant des moteurs de stockage sous-jacents. Plutôt que de développer une syntaxe propriétaire ésotérique, les ingénieurs de Google ont délibérément calqué leur architecture sur le standard SQL (Structured Query Language), adoptant une approche déclarative qui a révolutionné la modélisation au sein des tableurs traditionnels.
Le parallélisme conceptuel entre le langage SQL standard et la syntaxe de QUERY repose sur les principes fondateurs de l’algèbre relationnelle formulés par Edgar F. Codd. Dans ce cadre, la clause GROUP BY joue un rôle pivot dans la réduction dimensionnelle. Elle permet de transmuter une relation initiale caractérisée par un niveau de granularité élémentaire (où chaque ligne correspond à un événement unitaire ou à une transaction atomique) en une nouvelle relation condensée. Cette réduction repose sur une partition mathématique de l’ensemble des tuples en classes d’équivalence définies par des attributs catégoriels partagés.
Toutefois, contrairement aux moteurs SGBD d’entreprise tels que PostgreSQL ou Oracle qui reposent sur des schémas rigides préalablement compilés, Google Sheets applique un mécanisme d’inférence de schéma à la volée. Cette particularité impose le respect strict de l’intégrité relationnelle et du typage des colonnes sources. Le moteur d’évaluation inspecte la distribution des données afin d’assigner à chaque colonne un type de données prédominant, ce qui conditionne la validité des opérations ultérieures de regroupement et de calcul synthétique.
1.2 Architecture fondamentale de la formule QUERY
L’invocation de la fonction QUERY au sein d’une cellule de feuille de calcul s’articule autour d’une signature normalisée comportant trois paramètres distincts : la plage de données source, la commande textuelle de requête, et le paramètre optionnel définissant le nombre de lignes d’en-tête. La décomposition formelle de cette signature s’écrit sous la forme standardisée =QUERY(données, requête, [en-têtes]). Le premier argument désigne l’espace matriciel bidimensionnel contenant les faits bruts, qui peut être formulé sous forme de références directes de cellules ou de matrices virtuelles générées par d’autres fonctions telles que FILTER ou ARRAYFORMULA.
Le second argument représente la chaîne textuelle de commande, exécutée par le parseur interne de l’API de visualisation. Cette instruction doit impérativement respecter une séquence logique ordonnée de clauses : SELECT, WHERE, GROUP BY, PIVOT, ORDER BY, LIMIT, OFFSET, LABEL, et FORMAT. Toute inversion dans la disposition séquentielle de ces instructions génère une erreur d’évaluation syntaxique immédiate. Cette rigueur impose une structuration intellectuelle où la délimitation de la projection spatiale précède systématiquement la logique de réduction de dimension.
Le troisième argument, trop souvent sous-estimé, explicite la quantité de lignes réservées aux métadonnées d’en-tête. La détection automatique appliquée par défaut peut entraîner des erreurs d’interprétation critiques, notamment lorsqu’une colonne comporte des typages mixtes. Selon la règle heuristique de la majorité appliquée par Google Sheets, si une colonne contient à la fois des valeurs numériques et des chaînes textuelles, le type minoritaire est systématiquement converti en valeur nulle lors de l’exécution de la requête. Cela souligne l’importance d’une rigueur absolue dans la préparation et la sanctuarisation de la structure tabulaire source.
1.3 Mécanisme abstrait de l’agrégation de données
D’un point de vue conceptuel et mathématique, le partitionnement opéré par GROUP BY consiste à diviser un ensemble de données de cardinalité N en k sous-ensembles mutuellement exclusifs et conjointement exhaustifs. Chaque sous-ensemble regroupe l’ensemble des enregistrements partageant une valeur identique pour les attributs de regroupement spécifiés. Une fois cette partition établie, le moteur applique une opération d’effondrement dimensionnel qui projette l’ensemble des tuples d’un sous-ensemble vers un tuple unique représentatif au sein de la table de sortie.
Cette projection mathématique engendre une contrainte formelle inéluctable : tout attribut extrait qui ne participe pas activement à la définition des classes d’équivalence (c’est-à-dire qui ne figure pas explicitement dans la liste des colonnes de regroupement) doit obligatoirement être encapsulé au sein d’une fonction d’agrégation. Cette obligation découle du principe de cohérence structurelle : en l’absence d’agrégation scalaire, le moteur serait confronté à l’indécidabilité de sélectionner une valeur arbitraire parmi les multiples enregistrements formant la classe d’équivalence.
Sur le plan des performances computationnelles, le recours à la clause GROUP BY surpasse très largement l’emploi de formules matricielles itératives traditionnelles combinant les fonctions UNIQUE, FILTER, et SUMIF. Tandis que l’imbrication de formules multiples sollicite le moteur de calcul de Google Sheets de manière exponentielle en multipliant les passes de balayage sur la mémoire vive, la clause GROUP BY résout l’intégralité du partitionnement en un seul passage algorithmique optimisé fondé sur des tables de hachage internes, réduisant drastiquement la latence d’exécution sur les volumétries conséquentes.
2. Anatomie syntaxique stricte de la clause GROUP BY
2.1 Règles d’association entre la clause SELECT et la clause GROUP BY
L’interaction entre les clauses SELECT et GROUP BY est régie par la règle d’or relationnelle, principe immuable selon lequel toute colonne figurant dans la liste de projection sans faire l’objet d’un traitement d’agrégation doit obligatoirement être déclarée dans la clause de partitionnement. Si un analyste tente de formuler une requête dans laquelle une colonne catégorielle est projetée directement alors qu’une autre colonne fait l’objet d’une sommation, sans que la première ne soit intégrée au regroupement, le moteur interrompt le traitement et retourne une erreur explicite interdisant l’affichage de valeurs granulaires non consolidées.
Les conséquences structurelles de l’omission d’une colonne dans la clause de partitionnement se traduisent par la rupture immédiate de la dimensionnalité matricielle. Le parseur ne peut pas juxtaposer un vecteur scalaire agrégé constitué de quelques lignes avec une série de données brutes contenant des milliers d’observations. L’ordre d’exécution logique interne de la requête impose que le filtrage initial (WHERE) soit exécuté en premier lieu, suivi immédiatement de la segmentation des données (GROUP BY), avant que les fonctions d’agrégation arithmétiques ne soient calculées sur chaque fragment, pour enfin permettre à la clause SELECT de composer la vue finale.
Il existe toutefois un cas particulier remarquable : l’omission totale de la clause SELECT lors d’une agrégation implicite. Lorsqu’une requête spécifie uniquement des agrégats sans déclarer formellement les colonnes de regroupement au niveau du SELECT, ou inversement lorsqu’elle omet le SELECT au profit d’un traitement algorithmique pur, le moteur peut générer une table résultante compacte contenant uniquement les valeurs agrégées. Toutefois, pour garantir l’intelligibilité des tableaux de bord en entreprise, il demeure indispensable de déclarer explicitement dans le SELECT les dimensions de regroupement conjointement aux indicateurs synthétisés.
2.2 Gestion rigoureuse de la casse et sensibilité des identifiants
La formulation syntaxique des identifiants de colonnes au sein du moteur QUERY requiert une précision typographique absolue. Lorsque la plage de données est passée sous la forme d’une référence directe standard (par exemple de la cellule A1 à la cellule F100), les colonnes doivent obligatoirement être désignées par des lettres majuscules d’imprimerie correspondant à leurs coordonnées d’origine dans la feuille de calcul (A, B, C, etc.). L’utilisation de lettres minuscules entraîne systématiquement une erreur de syntaxe, le parseur interne n’effectuant aucune conversion automatique de casse pour les identifiants structurels.
Une distinction fondamentale doit être opérée lorsque la source de données fait l’objet d’une encapsulation matricielle entre accolades ou provient d’une fonction intermédiaire. Dès lors que la plage source est convertie en tableau virtuel, la référence absolue aux lettres alphabétiques est désactivée au profit d’une notation indicée stricte de type Col1, Col2, Col3. Dans cette configuration, la sensibilité à la casse demeure absolue : la première lettre « C » doit impérativement être capitalisée tandis que les lettres suivantes doivent être en minuscules, toute déviation telle que « col1 » ou « COL1 » provoquant l’échec immédiat de la compilation de la requête.
Afin de préserver la maintenabilité et la lisibilité du code au sein des organisations, il est vivement conseillé d’adopter des règles de formatage uniformes. L’usage systématique de retours à la ligne au sein de la chaîne de texte de la requête, combiné à l’emploi de majuscules pour les mots-clés réservés du langage (SELECT, WHERE, GROUP BY, ORDER BY, LABEL) et d’une indentation rigoureuse, permet d’isoler visuellement les erreurs d’identifiants et simplifie considérablement les audits de formules complexes réalisés par des tiers.
2.3 Paramétrage exact de la ligne d’en-tête
Le troisième argument de la fonction QUERY, souvent négligé par les praticiens, gouverne la façon dont le moteur d’évaluation sépare les métadonnées descriptives du corpus de données analytiques. Si cet argument est omis, Google Sheets active un algorithme de devinette heuristique qui tente d’identifier si la première ligne possède un profil de distribution différent des lignes subséquentes. Cependant, si la première ligne de données contient des données textuelles tout comme l’en-tête, le moteur fusionne fréquemment la ligne descriptive avec la première classe d’équivalence du GROUP BY, corrompant irrémédiablement les calculs d’agrégation.
La fixation formelle de la valeur numérique 1 pour ce troisième paramètre permet de sanctuariser définitivement la ligne supérieure comme contenant les étiquettes de colonnes. Dès lors, le moteur exclut ces cellules de toute opération arithmétique ou de tri, tout en les utilisant comme dénominations par défaut pour les colonnes de sortie générées par la requête. Cette précaution neutralise le risque de voir une chaîne de texte descriptive telle que « Département » être intégrée comme une modalité réelle au sein d’une consolidation budgétaire.
Inversement, lorsque l’on manipule des segments matriciels issus de sous-calculs ou de découpages dynamiques dépourvus de toute métadonnée textuelle, il est impératif de déclarer explicitement la valeur 0 pour ce paramètre d’en-tête. Cette directive informe le parseur que chaque ligne de la matrice source constitue une observation exploitable. Omettre cette précaution conduirait le moteur à sacrifier la première ligne de faits purs pour la convertir arbitrairement en libellé de colonne, faussant irrémédiablement les métriques de sommation et de dénombrement.
3. Les fonctions d’agrégation arithmétiques fondamentales : avg() et sum()
3.1 Calcul de moyennes pondérées et arithmétiques avec avg()
La fonction avg() au sein du moteur de requêtes effectue le calcul de la moyenne arithmétique simple pour chaque sous-groupe défini par la clause GROUP BY. D’un point de vue mathématique, elle réalise la somme des valeurs discrètes associées à un segment dimensionnel donné et divise cette somme par l’effectif total des observations valides au sein de ce même segment. Cette fonction ne prend en compte que les attributs purement numériques, rejetant les valeurs booléennes ou textuelles résiduelles qui auraient échappé aux filtres préalables.
Une attention méticuleuse doit être accordée au comportement de avg() face aux cellules dépourvues de contenu. Contrairement à une croyance répandue, le moteur n’assimile pas une cellule vide à une valeur nulle valant zéro. Les enregistrements vides sont purement et simplement exclus du dénominateur arithmétique. Cette distinction revêt une importance critique dans les analyses empiriques : si l’on évalue la performance moyenne d’employés commerciaux, l’absence de saisie ne pénalise pas la moyenne, tandis que la présence explicite du chiffre 0 abaisse mécaniquement le résultat du sous-ensemble.
Dans le cadre d’une étude portant sur les performances sportives au sein d’une ligue professionnelle, l’application de la clause combinée select B, avg(D) group by B permet d’extraire instantanément la moyenne de points inscrits par joueur pour chaque franchise. Toutefois, le résultat brut généré par le moteur produit fréquemment des fractions décimales étendues non conformes aux exigences de présentation professionnelle. Pour pallier cette dispersion, il est d’usage soit d’encapsuler la formule QUERY globale au sein d’une fonction ROUND, soit d’adjoindre en fin de requête la clause FORMAT afin de figer la précision décimale souhaitée sans dénaturer la valeur sous-jacente.
3.2 Consolidation volumétrique et financière au moyen de sum()
La fonction sum() implémente l’algorithme d’accumulation additive des composantes numériques associées aux modalités de regroupement. Elle constitue l’épine dorsale des reportings financiers, du suivi de la facturation et du contrôle de gestion au sein des organisations. Son rôle consiste à parcourir de manière itérative chaque enregistrement rattaché à une classe de partitionnement pour en agréger le contenu au sein d’un accumulateur scalaire à haute précision.
Bien que Google Sheets gère nativement des volumes de données substantiels, la manipulation d’accumulations financières à grande échelle expose l’analyste aux anomalies classiques inhérentes à la norme IEEE 754 régissant la représentation arithmétique des nombres à virgule flottante. Lors de l’agrégation de millions d’enregistrements comprenant des décimales infinitésimales, des erreurs d’arrondi binaire peuvent survenir. L’analyste rigoureux veillera à appliquer des fonctions de troncature ou des règles d’arrondi formelles au terme du traitement pour garantir l’équilibre parfait des bilans comptables.
Considérons à titre d’illustration le calcul du chiffre d’affaires consolidé ventilé par secteur géographique ou par division opérationnelle. La requête select C, sum(E) group by C effectue la consolidation exhaustive des flux financiers. Il est capital de souligner que la fonction sum() gère avec une rigueur absolue la coexistence de valeurs positives et négatives : les débits viennent naturellement réduire les crédits au sein de l’accumulateur. Cette caractéristique assure la parfaite conformité de la consolidation analytique avec les règles de la comptabilité générale en partie double.
3.3 Interactions croisées entre avg() et sum() au sein d’une même requête
L’une des manifestations les plus éclatantes de l’élégance du langage QUERY réside dans sa capacité à orchestrer simultanément des fonctions d’agrégation arithmétiques de natures divergentes au sein d’une instruction unique. Il est parfaitement licite d’intégrer dans la clause SELECT à la fois la volumétrie globale consolidée et la tendance centrale correspondante, par exemple via l’instruction unifiée select B, sum(D), avg(D) group by B. Cette écriture produit une matrice résultante à trois colonnes sans nécessiter le moindre balayage redondant des tables sources.
Cette approche conjointe garantit une cohérence d’échelle primordiale lors de l’interprétation des données de gestion. Un total absolu élevé issu d’une fonction sum() peut masquer une performance unitaire médiocre si le volume sous-jacent d’occurrences est disproportionné. La juxtaposition immédiate de l’indicateur avg() rétablit la granularité analytique nécessaire à une prise de décision éclairée en mettant en lumière la contribution moyenne par unité d’observation au sein de chaque strate d’activité.
Sur le plan de l’optimisation des temps de calcul, l’appel conjoint d’agrégations arithmétiques multiples au sein d’une seule formule QUERY est infiniment supérieur à la création de colonnes de formules distinctes juxtaposées dans la feuille de calcul. Le moteur de Google Sheets effectue le partitionnement des données une seule fois en mémoire cache, puis applique les différents accumulateurs arithmétiques de manière synchrone sur chaque groupe identifié. Cette rationalisation de l’accès aux données minimise l’empreinte mémoire et prévient les ralentissements d’affichage des classeurs complexes.
4. Les fonctions d’agrégation d’inventaire et de bornage : count(), min() et max()
4.1 Dénombrement d’occurrences via la fonction count()
La fonction count() est l’instrument dédié au recensement statistique et au contrôle d’inventaire au sein des ensembles catégorisés. Sur le plan opérationnel, il convient de distinguer impérativement le dénombrement appliqué à des champs numériques de celui ciblant des chaînes textuelles. Alors que le SQL standard propose des variantes syntaxiques sophistiquées telles que COUNT(*), le langage QUERY de Google Sheets applique la fonction count() spécifiquement à une colonne donnée, en ignorant systématiquement toutes les cellules dont le contenu est formellement nul ou indéfini.
Cette particularité opérationnelle offre un levier puissant pour évaluer l’exhaustivité de la complétion des données au sein des services administratifs. Si une requête agrège un effectif selon l’identifiant d’un département en comptabilisant une colonne d’adresses électroniques, la formule select A, count(D) group by A ne renverra pas le nombre brut de fiches salariés rattachées au département, mais strictement le volume d’enregistrements possédant une adresse renseignée. Pour obtenir l’effectif physique exhaustif d’un collectif de travail, il est impératif d’appliquer l’opérateur de dénombrement à une clé primaire non nullable, comme le matricule de l’employé.
Un défi récurrent concerne la simulation de l’instruction COUNT(DISTINCT ...), qui brille par son absence native dans le répertoire fonctionnel de QUERY. Lorsqu’un analyste doit dénombrer le volume de clients uniques ayant passé commande au sein de diverses succursales régionales, l’usage d’une simple clause count(B) group by A comptabilise les commandes totales et non les acheteurs individuels. La résolution élégante de ce problème structurel impose l’usage d’une requête imbriquée à deux étages : une première passe relationnelle déduplique les couples succursale-client, tandis que la requête parente procède au dénombrement agrégé final.
4.2 Détection des extrêmes avec les fonctions min() et max()
L’identification des valeurs d’amplitude critique constitue une composante essentielle de l’analyse exploratoire des données. Les fonctions d’agrégation min() et max() parcourent chaque classe d’équivalence définie par le GROUP BY pour en extraire respectivement la borne inférieure et la borne supérieure. Cette opération s’applique de manière universelle sur des variables d’intervalles, qu’il s’agisse de métriques financières, de notations techniques ou de chronométrages d’opérations logistiques.
L’utilité de ces opérateurs atteint sa pleine puissance analytique lorsqu’ils sont appliqués à des dimensions temporelles. Dans l’écosystème Google Sheets, les dates sont stockées en interne sous la forme de nombres séquentiels représentant le nombre de jours écoulés depuis le point d’origine du 30 décembre 1899. Par conséquent, appliquer l’instruction select B, min(C), max(C) group by B sur une table de transactions horodatées permet d’isoler en une passe unique la date de première activation d’un compte client ainsi que la date de sa dernière interaction commerciale enregistrée.
Il est également capital de noter que les fonctions de bornage s’exécutent avec succès sur des séries textuelles en s’appuyant sur l’ordre lexicographique standard défini par la table des caractères Unicode. Bien que cet usage soit moins fréquent que le bornage numérique, il permet de résoudre avec élégance des requêtes spécifiques consistant à déterminer, pour chaque catégorie hiérarchique, le premier ou le dernier libellé selon le classement alphabétique, sans recourir à des tris matriciels préliminaires laborieux.
4.3 Synthèse globale d’un tableau de bord par combinaison des métriques d’inventaire
L’intégration harmonieuse des métriques de dénombrement et d’encadrement au sein d’une formulation QUERY unifiée permet d’ériger des tableaux de synthèse statistique d’une densité informationnelle remarquable. Une instruction structurée sous la forme select B, count(A), min(C), max(C), avg(C) group by B condense en un espace matriciel extrêmement réduit l’effectif total d’un échantillon, ses valeurs planchers et plafonds ainsi que sa tendance centrale moyenne pour chaque strate observée.
Cette cartographie multidimensionnelle offre une vision immédiate de la dispersion des performances. Dans une organisation commerciale, comparer le plancher et le plafond des marges générées par une équipe de vente tout en observant son effectif total permet de détecter instantanément des anomalies de distribution ou des disparités d’efficience opérationnelle majeures qu’une simple moyenne arithmétique aurait totalement dissimulées.
Sur le plan de l’intégrité globale du système d’information, la combinaison de ces indicateurs d’inventaire fournit un dispositif d’autocontrôle mathématique permanent. La somme totale des dénombrements partiels renvoyés par la fonction count() pour chaque segment doit rigoureusement concorder avec le volume global des lignes de faits initiales, permettant ainsi à l’auditeur de valider l’absence de perte de données ou de partitions malencontreusement exclues lors de la phase de filtrage préalable.
5. Agrégation univariée : Regroupement appliqué à une colonne unique
5.1 Structure méthodologique du regroupement simple
L’agrégation univariée représente la forme la plus élémentaire et la plus couramment déployée du partitionnement relationnel. Elle consiste à segmenter un jeu de données selon les modalités d’une unique variable explicative catégorielle. La table brute d’origine subit une projection selon laquelle toutes les lignes partageant la même chaîne de caractères ou le même code d’identification au sein d’une colonne désignée sont condensées en un enregistrement synthétique unique dans la vue finale.
L’analyse textuelle de la requête type =QUERY(A1:D12, "select B, avg(D) group by B", 1) permet d’éclairer le flux d’évaluation séquentiel orchestré par le moteur. Le parseur isole la colonne B comme clé de partitionnement primaire. Il analyse la totalité de la plage de cellules A1:D12, identifie l’ensemble des modalités uniques présentes dans la colonne B, alloue en mémoire un tableau de synthèse dimensionné à hauteur de ce nombre de modalités, puis procède à l’accumulation et à la division arithmétique des valeurs correspondantes situées dans la colonne D pour chaque modalité identifiée.
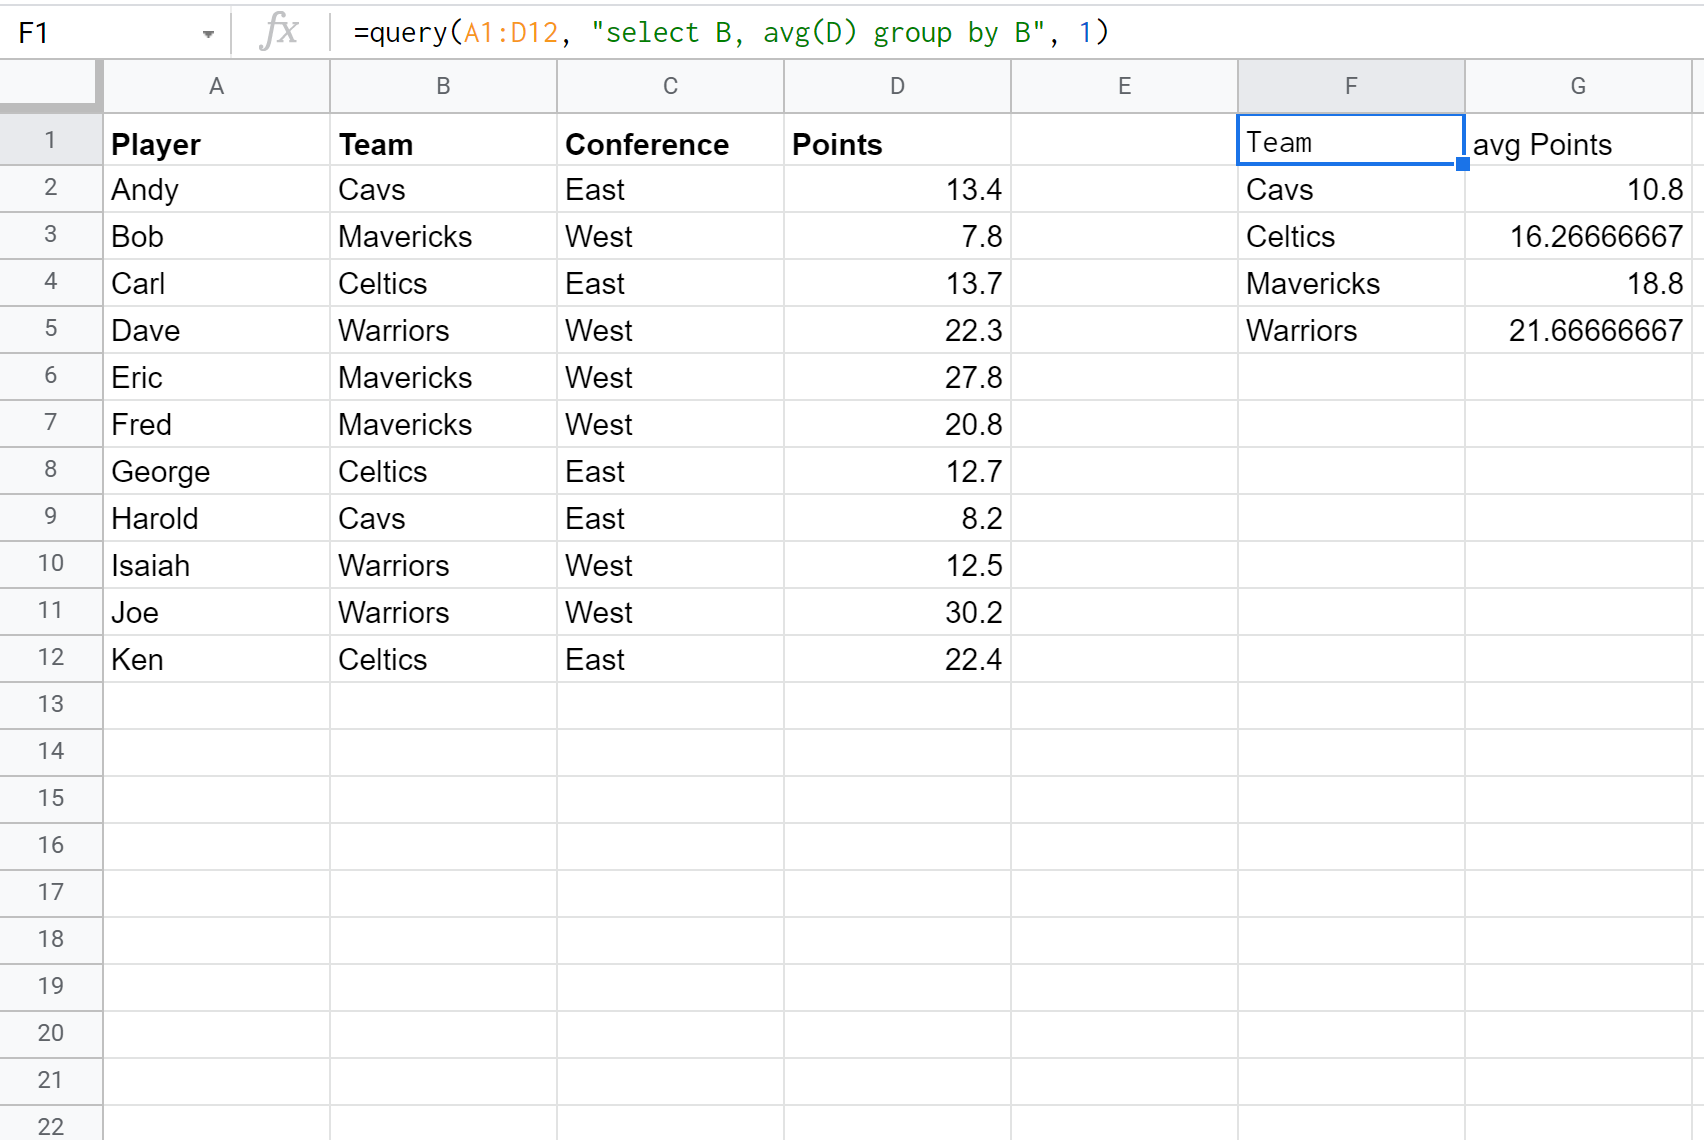
Au terme de cette exécution, la table résultante garantit formellement l’unicité stricte de chaque modalité de la colonne B. La structure matricielle produite se caractérise par une lisibilité parfaite : la première colonne dresse l’inventaire dédupliqué des catégories d’observation, tandis que la seconde expose la métrique calculée correspondante. Cette architecture constitue la fondation de tout tableau de bord d’entreprise cherchant à synthétiser des flux volumineux d’informations disparates en indicateurs d’aide à la décision.
5.2 Exemple pratique appliqué au domaine sportif : Analyse des équipes
Pour illustrer de manière concrète l’intérêt opérationnel d’une agrégation univariée, considérons une étude de cas appliquée à l’analyse de données sportives issues d’une ligue de basket-ball professionnelle comme la NBA. Supposons une table d’observation s’étendant sur la plage A1:D12, où la colonne A répertorie le patronyme des athlètes, la colonne B désigne la franchise d’appartenance (par exemple Celtics, Lakers, Cavaliers), la colonne C indique le poste occupé sur le terrain, et la colonne D consigne la moyenne de points inscrits par match au cours de la saison régulière.
Si la direction technique souhaite quantifier l’efficacité offensive moyenne produite par chaque organisation sportive, la formulation de la commande d’agrégation prend la forme suivante : =QUERY(A1:D12, "select B, avg(D) group by B", 1). Le moteur de requêtes regroupe l’ensemble des joueurs contractuellement affiliés aux Cavaliers, effectue la sommation de leurs points individuels et divise ce montant par le nombre de joueurs composant l’effectif des Cavaliers renseigné dans la table, répétant l’opération à l’identique pour les Celtics et les Lakers.
L’interprétation analytique des résultats produits exige toutefois une grande prudence méthodologique de la part de l’analyste. Si l’effectif échantillonné pour une équipe donnée ne comporte qu’une vedette offensive tandis que la franchise concurrente présente un échantillon complet incluant des remplaçants au temps de jeu limité, la moyenne brute obtenue peut induire un biais d’échantillonnage sévère. Cet exemple illustre la nécessité de coupler fréquemment l’indicateur d’agrégation arithmétique avec la fonction count() pour apprécier la représentativité statistique du volume de faits sous-jacent.
5.3 Exploitation des agrégations textuelles et nominales
L’application d’un regroupement univarié sur des attributs nominaux révèle fréquemment des défaillances insoupçonnées dans la qualité des données sources. En effet, le moteur QUERY traite les chaînes de texte avec une rigueur absolue au niveau binaire. Par conséquent, deux entrées visuellement analogues mais comportant des disparités mineures au niveau de leur typographie seront inexorablement segmentées en deux classes d’équivalence distinctes lors de l’exécution de la clause GROUP BY.
La problématique la plus récurrente réside dans la présence pernicieuse d’espaces résiduels insérés en fin de chaîne de caractères lors de saisies manuelles. Une chaîne de texte encodée sous la forme "Lakers " (avec un espace terminal invisible à l’écran) ne sera jamais fusionnée avec l’enregistrement rigoureux "Lakers". Le tableau synthétique issu de la requête affichera alors deux lignes distinctes pour la même entité, divisant la masse des données et ruinant l’exactitude de la sommation globale.
Pour immuniser les processus de calcul contre cette fragmentation artificielle des groupes, une phase impérative d’assainissement des données doit être opérée en amont. L’utilisation combinée des fonctions de manipulation textuelle de Google Sheets, telles que TRIM (qui supprime les espaces superflus situés en tête et en queue de chaîne) et UPPER (qui standardise l’intégralité des caractères en majuscules), permet de normaliser les descripteurs catégoriels avant de soumettre la plage épurée à l’analyse relationnelle de la clause GROUP BY.
6. Agrégation multivariée : Regroupement matriciel sur colonnes multiples
6.1 Concept et hiérarchie du regroupement à plusieurs dimensions
L’agrégation multivariée transpose les principes du partitionnement relationnel à un espace à deux dimensions ou plus, permettant le croisement simultané de plusieurs facteurs discriminants. Dans cette configuration, une classe d’équivalence n’est plus déterminée par l’égalité d’une modalité isolée, mais par la concordance parfaite d’un tuple de valeurs issu de la combinaison ordonnée des colonnes déclarées dans la clause de partitionnement.
L’ordre déclaratif des variables au sein de la clause GROUP BY revêt une importance conceptuelle majeure pour l’arborescence résultante. Lorsque l’analyste écrit une clause telle que group by B, C, il instaure une hiérarchie analytique descendante : le moteur commence par isoler les macro-groupes formés par les modalités de la colonne B, puis subdivise chacun de ces macro-groupes en micro-groupes en fonction des variations enregistrées dans la colonne C. Bien que le calcul mathématique global produise les mêmes valeurs numériques finales quel que soit l’ordre des colonnes de regroupement, la structure d’ordonnancement visuel et logique de la matrice dépend étroitement de cette déclaration séquentielle initiale.
Cette approche à plusieurs niveaux permet de cartographier avec une finesse chirurgicale la distribution des indicateurs de performance. Cependant, le passage à une granularité supérieure requiert une vigilance constante pour éviter les collisions sémantiques. Les catégories emboîtées de manière rigoureuse au sein du système organisationnel (comme un service strictement rattaché à une direction générale) génèrent un partitionnement naturel, tandis que le croisement de variables transversales indépendantes peut produire une multitude de sous-ensembles de taille réduite dont l’interprétation statistique requiert une prudence méthodologique accrue.
6.2 Exemple pratique : Regroupement croisé par Équipe et Conférence
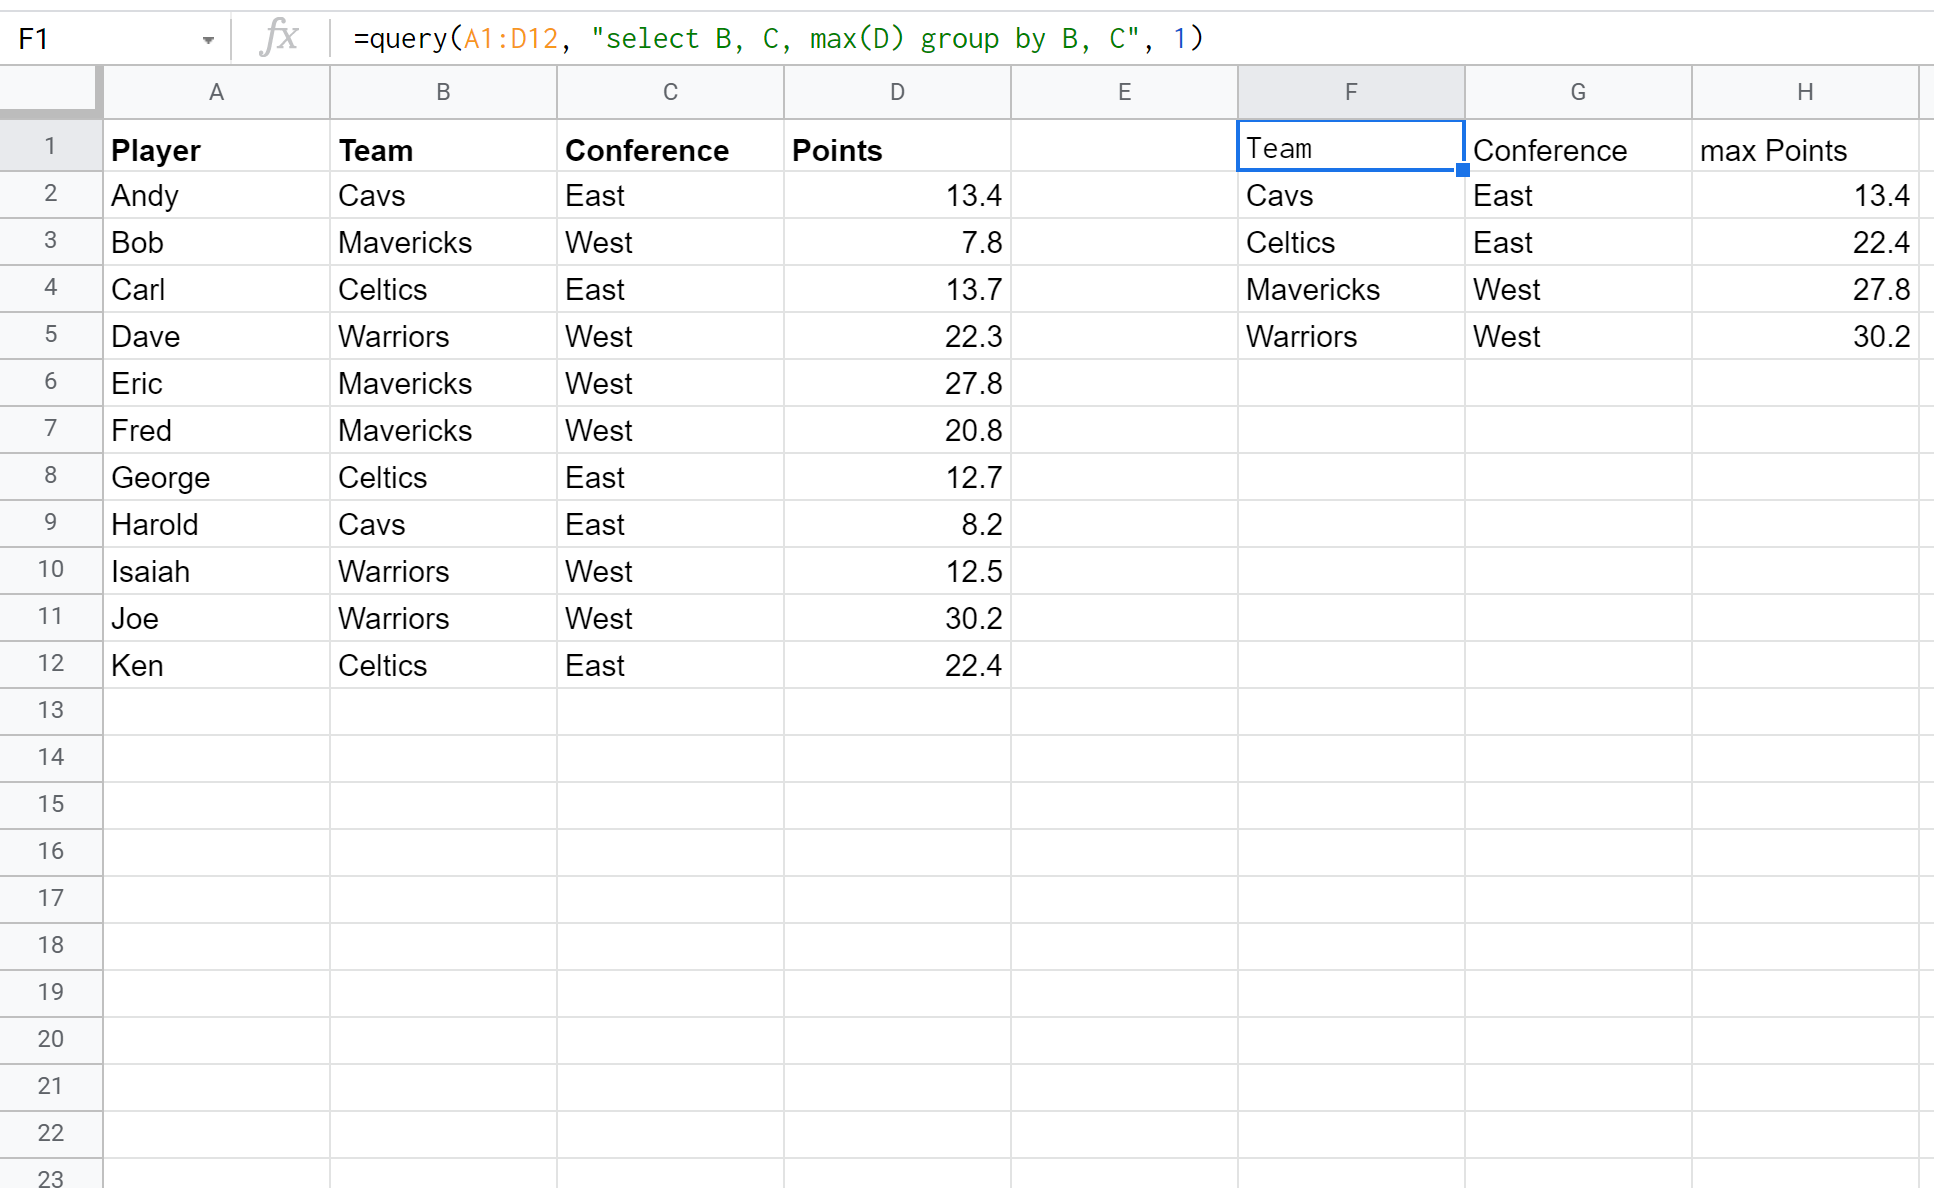
Afin de concrétiser le déploiement d’un regroupement multivarié, reprenons notre base de données sportives élargie à cinq colonnes (A:E), incluant désormais l’affiliation géographique de chaque formation. La colonne B désigne l’équipe, la colonne C indique la Conférence d’appartenance (Conférence Est ou Conférence Ouest), la colonne D mentionne le poste de jeu, et la colonne E consigne le nombre de points marqués par match. L’objectif analytique consiste à identifier le score de pointe individuel absolu enregistré au sein de chaque organisation sportive tout en maintenant la traçabilité géographique régionale.
La formulation syntaxique de la requête s’établit dès lors de la façon suivante : =QUERY(A1:E20, "select B, C, max(E) group by B, C", 1). En exécutant cette commande, le moteur évalue chaque enregistrement de manière multidimensionnelle. Il identifie les intersections factorielles uniques formées par le couple Équipe-Conférence. Ainsi, un enregistrement associant les « Celtics » à la « Conférence Est » constituera une clé d’agrégation composite spécifique, au sein de laquelle la fonction max(E) identifiera la valeur de crête réalisée par le meilleur marqueur individuel de cette structure collective.
Le résultat généré restitue une table à double entrée virtuelle d’une clarté exemplaire. Chaque ligne produite garantit que le sous-ensemble représenté est unique pour la combinaison exacte des deux premiers paramètres d’identification. Si, par inadvertance méthodologique ou lors d’une restructuration de ligue, une équipe venait à changer de conférence au cours de la saison et possédait des enregistrements distincts sous chaque label régional, le moteur produirait immédiatement deux lignes distinctes pour cette même franchise, alertant instantanément l’observateur sur cette discontinuité historique dans les données d’observation.
6.3 Considérations ergonomiques et dimensionnelles
L’accroissement du nombre de dimensions intégrées au sein de la clause GROUP BY induit une complexification géométrique de la matrice d’affichage. Ce phénomène mathématique, connu sous l’appellation d’explosion combinatoire, se manifeste dès lors que l’on croise des variables possédant de nombreuses modalités respectives. Si l’on applique une clause de partitionnement articulée sur quatre colonnes contenant chacune une vingtaine de catégories divergentes, le nombre potentiel de lignes résultantes peut atteindre plusieurs dizaines de milliers d’enregistrements, détruisant tout bénéfice synthétique de la requête.
Face à une telle profusion de données condensées, il devient nécessaire de procéder à un arbitrage ergonomique entre une sortie tabulaire séquentielle générée par la fonction QUERY et une représentation sous forme de table de contingence bidimensionnelle (tableau croisé dynamique). Si la restitution brute de QUERY s’avère optimale pour injecter des données précalculées dans d’autres pipelines algorithmiques de calcul, la lecture humaine directe d’une table QUERY multivariée à plus de deux dimensions s’avère cognitivement fastidieuse.
Pour préserver l’ergonomie opérationnelle des classeurs de synthèse, l’analyste aguerri déploie des stratégies d’élagage préventif. Il peut être judicieux de condenser les modalités marginales ou à faible occurrence sous un label commun « Autres » en amont de la requête, ou d’encapsuler la requête au sein d’un filtre conditionnel visant à ne retenir que les combinaisons factorielles franchissant un seuil critique d’activité, prévenant ainsi la surcharge cognitive des décideurs finaux.
7. Interaction séquentielle avec la clause WHERE : Filtrage préalable à l’agrégation
7.1 L’ordre d’évaluation logique : WHERE versus HAVING
Dans l’architecture classique des systèmes de bases de données relationnelles conformes à la norme SQL, il existe une distinction fonctionnelle stricte entre le filtrage préliminaire appliqué aux enregistrements individuels (opéré par la clause WHERE) et le filtrage appliqué a posteriori aux indicateurs calculés après consolidation (opéré par la clause HAVING). Or, au sein du langage Google Visualization API Query Language, la clause HAVING n’existe tout simplement pas sur le plan natif. Cette absence structurelle constitue un piège conceptuel majeur pour les développeurs formés au SQL traditionnel.
Le traitement des données au sein de QUERY s’effectue selon un ordre d’évaluation logique linéaire rigide. La clause WHERE intervient systématiquement avant l’exécution du GROUP BY. Son rôle consiste à restreindre l’espace d’observation initial en éliminant immédiatement tous les enregistrements bruts qui ne satisfont pas aux critères booléens déclarés. Par conséquent, il est formellement impossible d’intégrer une fonction d’agrégation arithmétique au sein de la clause WHERE initiale (une expression telle que where avg(D) > 20 déclenchera une erreur fatale d’évaluation).
Le flux de traitement impose donc une trajectoire séquentielle immuable : le moteur charge la table source en mémoire, applique les filtres discriminants de la clause WHERE ligne par ligne sur les données atomiques, procède ensuite au partitionnement des lignes survivantes selon les termes de la clause GROUP BY, applique les fonctions d’agrégation arithmétiques requises sur ces sous-ensembles homogènes, et formate enfin la projection finale spécifiée par le SELECT.
7.2 Construction de filtres avancés couplés au GROUP BY
L’association d’un filtrage en amont rigoureux avec une clause de partitionnement catégoriel permet d’affiner l’échantillonnage statistique avec une grande finesse. La clause WHERE accepte une variété d’opérateurs logiques fondamentaux (AND, OR, NOT) combinables au moyen de parenthèses de priorité algébrique, ainsi que des opérateurs de comparaison d’inégalités et des prédicats textuels avancés tels que starts with, ends with, ou contains.
Considérons une situation d’audit managérial où l’on souhaite quantifier la performance moyenne des titulaires d’une organisation sportive en excluant les contributions anecdotiques. La formulation select B, avg(D) where C = 'Titulaire' and E > 20 group by B illustre la synergie entre les clauses. Le moteur écarte d’emblée les athlètes remplaçants ainsi que toute observation relative à un joueur ayant évolué moins de 20 minutes au cours de la rencontre. L’agrégation GROUP BY qui succède à ce filtre opère exclusivement sur une population strictement ciblée, garantissant la pertinence opérationnelle des moyennes calculées.
Une bonne pratique incontournable lors de la conception de filtres couplés à un regroupement consiste à exclure explicitement les enregistrements incomplets ou corrompus. L’adjonction systématique de la directive where A is not null au sein du corps de la requête garantit que les cellules orphelines présentes dans la colonne clé ne viendront pas parasiter la matrice finale sous la forme d’un groupe vide illégitime positionné en tête des résultats consolidés.
7.3 Technique de double requête (QUERY imbriquée) pour simuler la clause HAVING
L’absence de clause HAVING native au sein de Google Sheets n’interdit aucunement la mise en place d’un filtrage post-agrégation. Pour contourner cette limitation apparente, l’ingénierie relationnelle recourt à la technique élégante de la double requête imbriquée, consistant à encapsuler une première instruction d’agrégation au sein d’une seconde requête d’évaluation qui traite la table résultante intermédiaire comme s’il s’agissait d’une table de données brutes.
La mise en œuvre de cette architecture nécessite une rigueur syntaxique scrupuleuse, particulièrement dans la désignation des attributs. Puisque la source de données de la requête externe est le produit dynamique généré par la requête interne, le système d’identification par lettres alphabétiques (A, B, C) n’est plus valide et cède la place à la notation indicée Col1, Col2. La formule structurée s’écrit dès lors sous la forme suivante : =QUERY(QUERY(A1:D12, "select B, avg(D) group by B", 1), "select Col1, Col2 where Col2 > 15", 1).
Dans ce schéma computationnel à deux étages, la requête interne procède au partitionnement catégoriel et calcule la moyenne de points par organisation. La table synthétique intermédiaire produite en mémoire vive est ensuite soumise à la requête externe, qui applique un filtre discriminant strict sur la colonne Col2 (contenant les moyennes précalculées). Seules les organisations sportives franchissant le seuil critique d’efficience fixé à plus de 15 points subsistent dans le livrable final. Bien que cette technique sollicite davantage de ressources processeur lors des phases de recalcul, elle résout intégralement l’absence du filtre HAVING tout en préservant l’automatisation complète de la chaîne analytique.
8. Restructuration et esthétique des données agrégées : Clauses ORDER BY et LABEL
8.1 Hiérarchisation des résultats au moyen de la clause ORDER BY
Une restitution brute issue d’une opération de regroupement est, par définition, ordonnée de manière arbitraire selon l’ordre d’apparition initiale des modalités au sein de la table source ou selon un tri lexicographique spontané de la clé de partitionnement. Dans une optique de reporting exécutif et de diagnostic décisionnel, une telle disposition s’avère lacunaire. L’application de la clause ORDER BY permet de structurer méthodiquement la matrice finale en hiérarchisant les résultats selon une logique de tri ascendante (ASC) ou descendante (DESC).
La règle fondamentale gouvernant l’emploi de la clause ORDER BY en présence d’un GROUP BY impose que la clé de tri soit elle-même une composante du regroupement ou le résultat d’une fonction d’agrégation. Ainsi, pour classer des franchises sportives de la plus performante à la moins prolifique sur le plan offensif, la requête doit ordonner explicitement le flux sur la fonction elle-même : select B, avg(D) group by B order by avg(D) desc. Tenter d’ordonner la sortie finale selon une colonne individuelle non agrégée violerait immédiatement les principes d’intégrité relationnelle et provoquerait une interruption immédiate du calcul.
Il est parfaitement envisageable de déclarer des critères de tri multiples au sein de la clause d’ordonnancement pour arbitrer les situations d’égalité statistique. En formulant une instruction telle que order by sum(E) desc, B asc, l’analyste prescrit une hiérarchisation prioritaire fondée sur le volume financier total ou le score cumulé, tout en garantissant un classement alphabétique rigoureux pour départager les entités affichant une performance strictement identique, conférant ainsi un professionnalisme irréprochable au livrable final.
8.2 Personnalisation sémantique des en-têtes via la clause LABEL
Par défaut, le moteur de visualisation de Google Sheets génère des libellés de colonnes automatisés qui reflètent fidèlement la syntaxe algorithmique sous-jacente des fonctions appelées. Une requête exécutant select B, avg(D) group by B produira inéluctablement une seconde colonne surmontée de l’en-tête disgracieux et technique avg Points ou avg(). Cette typographie rudimentaire nuit gravement à la présentation des tableaux de bord institutionnels et nécessite des interventions manuelles chronophages si elle n’est pas corrigée au niveau du code de la requête.
La clause LABEL remédie définitivement à cette imperfection en autorisant la réattribution sémantique dynamique des en-têtes directement au sein de la chaîne de texte d’instruction. La syntaxe requiert de cibler précisément l’agrégat concerné et de lui adjoindre la désignation textuelle personnalisée encadrée d’apostrophes simples : select B, avg(D) group by B label avg(D) 'Moyenne de l'équipe'. Le moteur procède à la substitution immédiate du libellé d’affichage sans modifier la nature arithmétique de la colonne calculée.
Une technique avancée hautement prisée lors de la conception d’interfaces graphiques épurées consiste à neutraliser intégralement les en-têtes générés pour les intégrer au sein d’une structure visuelle préformatée par l’analyste. Pour éliminer totalement la ligne descriptive de sortie sans impacter le corps des données agrégées, il suffit d’assigner une chaîne vide au descripteur de label : label B '', avg(D) ''. Cette instruction efface purement et simplement les étiquettes par défaut, facilitant l’imbrication transparente du résultat au sein de grilles de mise en page préétablies.
8.3 Formatage typologique avec la clause FORMAT
L’ultime étape d’optimisation de la vue agrégée concerne le formatage des valeurs numériques restituées. Bien que l’interface standard de Google Sheets permette d’appliquer des formats de cellules a posteriori via le menu contextuel, cette mise en forme manuelle est fréquemment réinitialisée ou corrompue lorsque la taille de la matrice QUERY fluctue dynamiquement au gré des modifications apportées aux données d’origine. L’intégration de la clause FORMAT au sein de la requête elle-même immunise durablement l’affichage contre ces dégradations visuelles.
La syntaxe de la clause FORMAT respecte les conventions des masques numériques traditionnels des tableurs. Pour formater une moyenne financière agrégée avec un séparateur de milliers et deux décimales, l’instruction s’enrichit de la directive suivante : format avg(D) '#,##0.00'. De la même manière, pour restituer une proportion sous la forme d’un pourcentage clairement lisible, le masque format sum(E) '0.0%' effectuera la conversion d’affichage requise tout en préservant la précision native de la valeur décimale sous-jacente en mémoire vive.
L’exploitation conjointe des clauses sélectives, des opérateurs de regroupement, des instructions de tri, de renommage de labels et de masquage formel permet d’aboutir à des expressions compactes d’une puissance expressive totale : =QUERY(A1:E100, "select B, sum(C), avg(C) group by B order by sum(C) desc label sum(C) 'Total Facturé', avg(C) 'Panier Moyen' format sum(C) '#,##0 €', avg(C) '#,##0.00 €'", 1). En une seule formule matricielle, l’analyste réalise ce qui requérait autrefois des dizaines de lignes de programmation procédurale complexe.
9. Traitement des anomalies, valeurs nulles et erreurs syntaxiques fréquentes
9.1 Diagnostic des erreurs d’analyse (#VALUE!) et messages de syntaxe
Le déploiement de requêtes relationnelles avancées confronte inévitablement l’utilisateur à des messages d’erreur énigmatiques générés par le parseur de Google Sheets, matérialisés dans la cellule par l’indicateur d’échec #VALUE!. Le survol du curseur sur cette cellule révèle généralement une infobulle fournissant une piste diagnostique souvent rédigée en anglais technique. Parmi ces anomalies, la rupture d’évaluation structurelle signalée par le message « CANNOT_GROUP_WITHOUT_AGGREGATING » représente l’écueil le plus fréquent : elle sanctionne systématiquement l’omission d’une colonne de projection directe au sein de la clause GROUP BY.
Une autre source prépondérante d’échec syntaxique découle de la gestion fautive des délimiteurs textuels. La chaîne globale de la requête étant elle-même délimitée par des guillemets doubles traditionnels, toute sous-chaîne textuelle ou libellé de label doit impérativement être encapsulé au moyen de guillemets simples (apostrophes). L’oubli d’une apostrophe de fermeture ou l’insertion malencontreuse d’une apostrophe au sein d’un mot français non échappé (par exemple l’écriture naïve de 'Chiffre d'affaires' au lieu de 'Chiffre d'affaires') brise instantanément l’analyse lexicale du parseur interne.
Enfin, les erreurs relatives à l’incompatibilité des types de données au sein d’une même colonne provoquent des comportements erratiques particulièrement pernicieux. Si une colonne de référence contient majoritairement des valeurs numériques mais que quelques lignes comportent des mentions textuelles résiduelles telles que « N/A » ou « En attente », le moteur convertit silencieusement ces cellules textuelles en valeurs nulles en vertu de la règle de majorité à 80 %. Ces données deviennent invisibles pour les opérations de regroupement arithmétique subséquentes, générant des écarts d’audit comptable difficiles à identifier pour un œil non averti.
9.2 Gestion des cellules vides et des enregistrements manquants
L’apparition intempestive d’une ligne d’agrégation orpheline, dépourvue de descripteur catégoriel et positionnée tout en haut de la table de restitution, constitue un phénomène classique qui déconcerte les analystes débutants. Cette anomalie graphique résulte presque toujours de la définition d’une plage source excessivement large (comme la sélection d’une colonne entière de type A2:D) englobant des centaines de cellules vierges situées sous le corpus de données effectif.
Le moteur d’évaluation traite l’absence d’information comme une modalité d’équivalence légitime au sens mathématique. Il regroupe donc scrupuleusement l’intégralité des cellules vides en une classe d’agrégation unique, générant une ligne synthétique dédiée affichant un libellé vide associé à des métriques nulles ou à zéro. Pour éliminer radicalement cette pollution visuelle, le protocole standard impose l’insertion systématique d’une condition d’intégrité formelle au sein de la clause WHERE, formulée sous la forme explicite where A is not null.
Une attention spécifique doit également être accordée aux espaces typographiques résiduels invisibles. Une cellule ne contenant qu’une simple pression sur la barre d’espace n’est pas reconnue comme nulle par le prédicat is not null. Elle échappe donc au filtrage et donne naissance à une classe d’équivalence indépendante qui apparaît visuellement vide à l’écran tout en portant des totaux arithmétiques substantiels. Seul un nettoyage systématique des données fuentes via des fonctions de purge textuelle permet de prémunir durablement les requêtes contre ce parasitage informationnel.
9.3 Résilience et tolérance aux pannes des requêtes dynamiques
Dans un contexte d’exploitation industrielle où les feuilles de calcul sont partagées de manière collaborative entre des dizaines d’intervenants aux compétences hétérogènes, la sanctuarisation de la robustesse computationnelle constitue un impératif d’ingénierie fondamental. Une modification inopinée apportée à la feuille source, telle que la suppression d’une colonne ou l’insertion de lignes non conformes, peut anéantir instantanément la mécanique de restitution d’un tableau de bord de direction.
Le premier niveau de protection consiste à encapsuler systématiquement l’appel de la fonction QUERY au sein d’une instruction de gestion d’exception de type IFERROR. La formulation =IFERROR(QUERY(...), "Aucune donnée disponible pour les critères sélectionnés") garantit une dégradation gracieuse de l’interface utilisateur en cas de rupture de syntaxe ou d’absence temporaire de données éligibles, évitant l’affichage anxiogène des codes d’erreurs techniques aux yeux des dirigeants opérationnels.
Le second niveau de résilience cible la vulnérabilité intrinsèque des identifiants statiques de colonnes alphabétiques (A, B, C). Si un collaborateur insère une colonne descriptive supplémentaire au milieu du tableau de faits, la colonne des montants initialement située en D migre mécaniquement en E, rendant la requête initiale select B, sum(D) group by B immédiatement erronée ou génératrice d’incongruités arithmétiques. Pour neutraliser définitivement ce risque structurel, il est recommandé de substituer aux identifiants statiques des matrices dynamiques générées par des fonctions matricielles associées à la notation indicée Col1, Col2, assurant une parfaite imperméabilité aux dérives dimensionnelles de la grille source.
10. Comparaison analytique : QUERY GROUP BY versus Tableaux Croisés Dynamiques et formules natives
10.1 Confrontation technique avec les Tableaux Croisés Dynamiques (TCD)
L’arbitrage entre l’emploi de la fonction QUERY dotée de la clause GROUP BY et le recours aux tableaux croisés dynamiques (TCD) graphiques constitue l’un des débats méthodologiques les plus structurants dans la pratique de Google Sheets. Le tableau croisé dynamique offre une interface utilisateur visuelle et ergonomique d’une grande accessibilité, permettant aux utilisateurs non techniciens de manipuler les dimensions par de simples opérations de glisser-déposer et de profiter de mécanismes de regroupement temporel natifs très intuitifs (regroupement par année, trimestre ou mois en un clic).
Toutefois, la formule QUERY écrase son homologue graphique dès lors que l’on évalue les critères d’automatisation continue, de compacité architecturale et de scalabilité. Un tableau croisé dynamique génère une couche d’abstraction logicielle lourde qui surcharge considérablement le fichier de calcul et requiert parfois des actualisations forcées lors d’évolutions complexes du schéma. À l’inverse, la fonction QUERY recalcule instantanément ses matrices à la moindre modification d’une cellule source, sans intervention manuelle et avec une empreinte computationnelle remarquablement allégée.
Par ailleurs, la sortie produite par un tableau croisé dynamique est une entité graphique fermée, difficilement exploitable en tant que source de données secondaire pour d’autres algorithmes d’analyse. La fonction QUERY, quant à elle, déverse une véritable matrice dynamique de cellules réutilisables immédiatement par d’autres formules mathématiques matricielles, s’insérant de manière transparente dans des architectures logiques modulaires et des flux de travail entièrement automatisés.
10.2 Confrontation avec la famille des fonctions SUMIFS, AVERAGEIFS et UNIQUE
L’approche concurrente la plus fréquente consiste à assembler manuellement un tableau de synthèse en combinant la fonction matricielle UNIQUE (pour extraire la liste dédupliquée des modalités d’une dimension) avec une série de formules verticales répétitives exploitant la famille des conditions arithmétiques comme SUMIFS, COUNTIFS ou AVERAGEIFS. Cette méthodologie artisanale présente néanmoins des vulnérabilités de maintenance considérables au sein des grandes entreprises.
Sur le plan de l’élégance logicielle et de la verbosité du code, l’approche modulaire atomise la logique de calcul sur des centaines de cellules individuelles. Si la plage de données s’accroît et que la formule de sommation conditionnelle n’a pas été préalablement étendue vers le bas sur une hauteur suffisante, le tableau devient silencieusement incomplet. À l’opposé, la fonction QUERY représente une solution monolithique globale : une seule formule inscrite dans la cellule supérieure gauche pilote l’expansion bidimensionnelle intégrale de la synthèse matricielle avec une robustesse absolue.
Il existe néanmoins une limitation théorique intrinsèque au moteur QUERY qui impose ponctuellement le recours aux formules natives : le répertoire des agrégats supportés par l’API de visualisation demeure restreint aux opérations classiques (somme, moyenne, dénombrement, min, max). Si une analyse statistique exige le calcul de grandeurs plus sophistiquées comme la médiane, le mode, ou un écart-type pondéré, la clause GROUP BY se révèle impuissante. Dans ce contexte précis, la composition hybride exploitant la fonction UNIQUE couplée à des formules natives de dispersion statistique redevient la seule issue méthodologique viable.
10.3 Critères d’arbitrage pour le choix de la méthode de modélisation
Pour déterminer de manière objective et rationnelle l’instrument de calcul le plus adapté à un scénario opérationnel donné, l’analyste de données d’entreprise gagne à évaluer ses besoins à travers une grille multicritères standardisée examinant la maintenabilité, l’évolutivité volumétrique et le niveau d’interactivité requis.
Le critère de maintenabilité par des tiers milite parfois pour la simplicité graphique des tableaux croisés dynamiques si le classeur est destiné à être administré par des équipes métiers dépourvues de toute culture de la syntaxe SQL. L’introduction d’instructions QUERY complexes peut susciter un rejet ergonomique et accroître la dépendance technique envers le concepteur de la feuille. En revanche, si le classeur relève d’un système de production centralisé, la rigueur programmatique de QUERY assure une sanctuarisation du calcul contre les dégradations involontaires de formules.
Enfin, sous l’angle de l’automatisation avancée et de l’intégration dans des chaînes applicatives via Google Apps Script, l’universalité textuelle de la fonction QUERY confère un avantage décisif. Il devient aisé pour un script d’injecter ou de modifier dynamiquement la chaîne textuelle d’une requête au sein d’une formule pour actualiser des dizaines de métriques simultanément, ce qui s’avère infiniment plus complexe et instable à orchestrer sur les structures internes rigides des tableaux croisés dynamiques natifs.
11. Techniques avancées : Données dynamiques, plages ouvertes et calculs dérivés
11.1 Gestion des plages de données infinies (Open-ended ranges)
L’un des atouts les plus remarquables de Google Sheets réside dans sa capacité à gérer des plages de référence infinies, dites ouvertes, formulées sans borne inférieure fixe (par exemple A2:D au lieu de A2:D500). Cette écriture permet d’intégrer automatiquement dans le périmètre d’analyse tout nouvel enregistrement saisi au fil du temps dans le tableau de collecte, sans jamais devoir réajuster manuellement les coordonnées spatiales de la formule.
Toutefois, l’application directe de la clause GROUP BY sur une plage ouverte génère inéluctablement une saturation dimensionnelle causée par le balayage de milliers de lignes vierges résiduelles positionnées au fond de la grille. En l’absence d’une discipline de filtrage rigoureuse, le moteur alloue inutilement des cycles d’horloge processeur pour évaluer ces espaces vides, dégradant la réactivité globale du tableur lors des phases de saisie interactive.
Pour neutraliser efficacement cet impact computationnel tout en conservant le bénéfice de l’évolutivité dynamique, l’analyste doit instaurer une clause de verrouillage au sein de la condition de filtrage. L’instruction formelle =QUERY(A2:D, "select B, sum(C) where A is not null group by B", 0) constitue la signature standard par excellence. Le prédicat booléen coupe court à l’évaluation dès qu’il rencontre des lignes privées d’identifiant, permettant un recalcul quasi instantané même sur des classeurs de collecte accueillant un flux continu de plusieurs dizaines de milliers d’enregistrements.
11.2 Requêtes dynamiques pilotées par des listes déroulantes et variables de cellules
Pour conférer à un tableau de bord une dimension véritablement interactive, il est possible de concevoir des requêtes dont la syntaxe s’ajuste dynamiquement en fonction des sélections opérées par l’utilisateur au travers de menus déroulants de validation de données. Cette prouesse repose sur la concaténation algorithmique de chaînes de caractères au moyen de l’opérateur perluète (&).
Imaginons une cellule de contrôle G1 contenant une liste déroulante permettant de choisir entre une agrégation par « Équipe » (colonne B) ou par « Poste » (colonne C). L’analyste peut orchestrer l’ajustement dynamique de la clause de partitionnement en formulant la requête suivante : =QUERY(A1:E100, "select " & G1 & ", avg(E) group by " & G1, 1). Dès que l’utilisateur modifie la valeur de la cellule de commande, la chaîne textuelle soumise au parseur est reconstruite à la volée, déclenchant la réagrégation instantanée de la vue matricielle sous une nouvelle perspective dimensionnelle.
La mise en œuvre de cette dynamique requiert une attention chirurgicale dans la gestion des guillemets d’encadrement lors de l’injection de variables textuelles au sein de la clause WHERE. Si l’on filtre les résultats sur une modalité textuelle désignée en cellule G2, l’analyste doit impérativement réintroduire les apostrophes de délimitation indispensables au parseur : "where B = '" & G2 & "' group by B". Toute défaillance dans ce découpage concaténé déclenche une erreur syntaxique immédiate, soulignant l’importance d’une validation rigoureuse des entrées utilisateurs.
11.3 Utilisation d’opérations mathématiques scalaires combinées à l’agrégation
L’analyse financière et logistique exige fréquemment le calcul d’indicateurs de synthèse composites fondés sur des ratios arithmétiques entre grandeurs consolidées. Un exemple récurrent concerne le calcul d’un prix de vente moyen pondéré, qui ne correspond en aucun cas à la moyenne arithmétique simple des prix individuels, mais au quotient strict de la somme globale des chiffres d’affaires divisée par la somme globale des volumes physiques d’unités écoulées.
Le moteur Google Visualization API Query Language autorise l’intégration directe d’opérations scalaires combinant plusieurs fonctions d’agrégation au sein de la clause SELECT : select B, sum(C) / sum(D) group by B label sum(C) / sum(D) 'Prix Moyen Pondéré'. L’accumulateur procède d’abord au partitionnement des faits par modalité de la colonne B, calcule en parallèle les deux sommations respectives, puis effectue la division scalaire sur chaque groupe unitaire avant de projeter la métrique résultante dans la grille d’affichage.
Il importe néanmoins de garder à l’esprit les limites computationnelles intrinsèques du parseur : il est totalement proscrit d’imbriquer une fonction d’agrégation à l’intérieur d’une autre fonction d’agrégation (une syntaxe erronée telle que sum(avg(C)) provoque un rejet catégorique). De surcroît, le moteur ne gérant pas nativement la capture de l’erreur de division par zéro au sein des expressions scalaires personnalisées, l’analyste doit obligatoirement prémunir sa source de données contre les dénominateurs nuls au moyen d’un filtre préalable where D > 0 afin de sanctuariser la continuité de calcul de la feuille matricielle.
12. Cas d’études et protocoles de déploiement pour l’analyse de données réelles
12.1 Modélisation financière : Synthèse des dépenses budgétaires par centre de coûts
Dans le domaine du contrôle de gestion et de la modélisation comptable, l’audit périodique de l’exécution budgétaire exige la confrontation de volumes massifs d’écritures hétérogènes face à des enveloppes d’allocations prévisionnelles. Considérons un grand livre comptable d’entreprise consigné sur la plage A1:G10000, comprenant la date de transaction (colonne A), l’imputation analytique du centre de coûts (colonne B), le code de typologie de dépense (colonne C), le montant engagé (colonne D), et le statut d’approbation managériale (colonne E).
Pour déployer un rapport de synthèse auditable ventilé par département et par nature de charge, l’analyste formule une instruction d’agrégation hautement hiérarchisée : =QUERY(A1:G10000, "select B, C, sum(D), avg(D), count(D) where E = 'Approuvé' and A >= date '2024-01-01' group by B, C order by B asc, sum(D) desc label sum(D) 'Total Engagé', avg(D) 'Montant Moyen', count(D) 'Nombre d'Actes' format sum(D) '#,##0 €', avg(D) '#,##0.00 €'", 1).
Cette commande sophistiquée réalise en un traitement unitaire l’isolation des dépenses validées pour l’exercice comptable 2024, partitionne les flux selon l’arborescence analytique des centres de coûts et des catégories d’achats, et déploie instantanément la masse financière totale, le coût unitaire moyen d’engagement ainsi que le volume d’opérations traitées. Les contrôleurs de gestion bénéficient ainsi d’une visibilité absolue sur les centres de surconsommation budgétaire, avec une traçabilité totale garantie par l’intégrité relationnelle sous-jacente.
12.2 Analyse de performance commerciale et suivi logistique
L’optimisation des chaînes de distribution multicanales repose sur la surveillance constante des délais de transit et de l’efficience des partenaires de transport. Supposons une table logistique consignant les expéditions de marchandises sur la plage A1:F50000, où la colonne B identifie l’entrepôt logistique d’expédition, la colonne C le transporteur mandaté (par exemple DHL, FedEx, UPS), la colonne D le délai d’acheminement effectif en jours ouvrés, et la colonne E la valeur marchande du fret.
La direction des opérations logistiques peut établir une matrice comparative de performance en exécutant la requête unifiée suivante : =QUERY(A1:F50000, "select B, C, count(E), avg(D), max(D), sum(E) where D is not null group by B, C order by B asc, avg(D) asc label count(E) 'Colis Traités', avg(D) 'Délai Moyen (Jours)', max(D) 'Délai Critique', sum(E) 'Valeur Fret' format avg(D) '0.0', sum(E) '#,##0 €'", 1).
La lecture de ce tableau permet d’arbitrer objectivement l’allocation des flux de marchandises. Si un transporteur affiche un volume important de colis acheminés mais que son délai critique (max(D)) révèle des ruptures de service inacceptables sur un entrepôt spécifique, la direction logistique peut réorienter contractuellement ses volumes vers des opérateurs concurrents présentant des moyennes de fluidité plus résilientes, consolidant ainsi la satisfaction des clients finaux tout en maîtrisant les coûts de transport.
12.3 Recherche empirique et sciences sociales : Agrégation de réponses à des enquêtes
L’exploitation de corpus d’enquêtes sociologiques ou de sondages d’opinion implique le traitement de vastes matrices de questionnaires codifiés sous la forme d’échelles psychométriques ordinales, comme les échelles de Likert graduées de 1 (Désaccord total) à 5 (Accord total). Considérons une base d’étude académique s’étendant de A1:H2500, où la colonne B renseigne la tranche d’âge de l’enquêté, la colonne C son statut socioprofessionnel, et les colonnes D à G ses niveaux d’adhésion respectifs face à divers énoncés thématiques.
Dans le cadre d’un protocole de valorisation scientifique, la standardisation et la synthèse des résultats selon les strates sociodémographiques d’intérêt s’opèrent par le déploiement de la requête relationnelle suivante : =QUERY(A1:H2500, "select B, C, count(A), avg(D), avg(E) where B is not null and C is not null group by B, C order by B asc, C asc label count(A) 'Échantillon (n)', avg(D) 'Score Moyen Thème A', avg(E) 'Score Moyen Thème B' format avg(D) '0.00', avg(E) '0.00'", 1).
Cette modélisation dégage instantanément les profils sociologiques contrastés en associant à chaque strate un volume effectif d’enquêtés permettant de valider les seuils de représentativité statistique minimale requise pour l’inférence. L’analyste écarte systématiquement les non-réponses au moyen des clauses de restriction sur les valeurs nulles, aboutissant à une table de données épurée prête pour l’exportation vers des suites logicielles d’analyse factorielle avancée ou pour une intégration directe sous forme de tableaux académiques au sein de publications scientifiques formelles.
Références
- Codd, E. F. (1970). A relational model of data for large shared data banks. Communications of the ACM, 13(6), 377-387. https://doi.org/10.1145/362384.362685
- Google Developers. (2023). Google Visualization API Query Language (Version 0.7). Google Developers Reference Guide. https://developers.google.com/chart/interactive/docs/querylanguage
- Google Workspace Support. (2024). Fonction QUERY : Aide Google Docs. Centre d’aide Google. https://support.google.com/docs/answer/3093343
- Date, C. J. (2004). An introduction to database systems (8th ed.). Pearson Education.
- Silberschatz, A., Korth, H. F., & Sudarshan, S. (2020). Database system concepts (7th ed.). McGraw-Hill Education.
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.