
L’inférence statistique moderne repose sur des architectures conceptuelles raffinées permettant d’extraire du sens à partir du bruit inhérent aux observations empiriques. Dans le vaste champ de la recherche en sciences humaines et en psychologie comportementale, l’analyse de variance unidirectionnelle — couramment désignée sous l’appellation d’ANOVA à un facteur — s’est imposée depuis près d’un siècle comme l’un des piliers méthodologiques les plus robustes. Conçue par Ronald Aylmer Fisher dans les années 1920 pour démêler les contributions génétiques et environnementales au sein des stations de recherche agronomique, cette méthodologie a rapidement transcendé ses origines biologiques pour devenir la clé de voûte de l’expérimentation en laboratoire, de l’évaluation pédagogique et de la psychométrie appliquée.
Dans le contexte académique et professionnel contemporain, la démocratisation des outils informatiques a profondément redéfini l’accès aux calculs statistiques complexes. Longtemps cantonnée à des progiciels spécialisés, onéreux et à l’ergonomie austère tels que SPSS, SAS ou SYSTAT, l’analyse inférentielle s’insère aujourd’hui naturellement dans des environnements collaboratifs hébergés sur le nuage. Google Sheets offre à cet égard une plateforme d’une souplesse incomparable pour la collecte, le traitement et la diffusion des données de recherche, facilitant le travail conjoint d’équipes dispersées géographiquement sans compromettre la rigueur mathématique sous-jacente.
Le présent traité propose une immersion exhaustive, théorique et appliquée, dans l’exécution de l’ANOVA à un facteur au sein de l’écosystème Google Sheets. À travers un protocole expérimental rigoureux modélisé autour de la psychologie de l’apprentissage et des neurosciences cognitives, nous explorerons pas à pas la décomposition de la variance, la vérification mathématique des postulats fondamentaux, l’instrumentation logicielle via des extensions analytiques dédiées, le calcul des tailles d’effet ainsi que la formalisation des résultats selon les canons typographiques de l’American Psychological Association (APA, 7e édition).
1. Introduction aux fondements théoriques de l’ANOVA à un facteur en psychologie
1.1 Définition et principe fondamental de l’analyse de variance unidirectionnelle
L’analyse de variance à un facteur est une méthode statistique inférentielle paramétrique dont l’objectif premier consiste à éprouver l’hypothèse d’égalité simultanée des moyennes d’une variable quantitative continue mesurée à travers au moins trois populations ou groupes expérimentaux indépendants. Qualifiée de test omnibus, l’ANOVA n’a pas pour vocation première de désigner quelle modalité spécifique surpasse ou sous-performe les autres, mais bien d’évaluer si l’ensemble des variations observées entre les échantillons peut être raisonnablement attribué aux simples fluctuations aléatoires de l’échantillonnage ou s’il reflète un effet systématique induit par la variable indépendante catégorielle.
Le génie conceptuel de cette procédure réside dans la translation d’une question portant sur des moyennes en une comparaison formelle de variances. Fisher a démontré que la variabilité globale observée au sein d’un ensemble de données — la variance totale — pouvait être scindée de manière orthogonale en deux composantes additives non corrélées : la variance intergroupes (variabilité expliquée par le traitement expérimental ou l’appartenance catégorielle) et la variance intragroupe (variabilité non expliquée, résiduelle ou imputable à l’erreur de mesure et aux différences individuelles).
Sur le plan épistémologique, l’ANOVA se distingue fondamentalement du test t de Student pour deux échantillons indépendants. Bien que le test t et l’ANOVA soient mathématiquement équivalents lorsqu’il n’existe que deux groupes — la statistique F étant alors exactement égale au carré de la statistique t ($F = t^2$) —, le recours au formalisme de l’ANOVA devient indispensable dès lors que le plan expérimental incorpore trois conditions ou davantage. Dans les protocoles de recherche en psychologie cognitive, où l’on compare fréquemment une condition contrôle passive, une condition contrôle active et une ou plusieurs conditions d’intervention innovantes, l’analyse de variance constitue le cadre inférentiel naturel préservant la validité interne du paradigme empirique.
1.2 Le ratio de variance de Fisher et distribution F
La mécanique inférentielle de l’ANOVA s’incarne mathématiquement dans le calcul du rapport F de Snedecor-Fisher. Ce ratio statistique met en tension la variance observée entre les groupes et la variance résiduelle observée à l’intérieur de ces mêmes groupes. Formellement, il s’exprime par le quotient du carré moyen intergroupe ($MS_{between}$) par le carré moyen intragroupe ($MS_{within}$ ou $MS_{erreur}$) :
$$F = \frac{MS_{between}}{MS_{within}} = \frac{SS_{between} / (k – 1)}{SS_{within} / (N – k)}$$
où $SS$ désigne la somme des carrés des écarts, $k$ représente le nombre de modalités de la variable indépendante, et $N$ correspond à la taille totale de l’échantillon combiné. Sous l’hypothèse nulle ($H_0$), postulant que les moyennes des populations sous-jacentes sont strictement identiques ($\mu_1 = \mu_2 = dots = \mu_k$), le numérateur et le dénominateur constituent deux estimations non biaisées et indépendantes de la même variance populationnelle commune ($\sigma^2$). En conséquence, le rapport F gravite théoriquement autour d’une valeur proche de 1.
À l’inverse, lorsque l’hypothèse alternative ($H_1$) prévaut — signifiant qu’au moins une moyenne diffère significativement des autres —, le carré moyen intergroupe intègre conjointement la variance de l’erreur aléatoire et la composante systématique attribuable aux effets réels du traitement. Le numérateur excède alors substantiellement le dénominateur, propulsant la statistique F dans les régions critiques supérieures de sa distribution d’échantillonnage théorique. Cette distribution asymétrique positive, paramétrée par les deux degrés de liberté $(k – 1)$ et $(N – k)$, permet de calculer précisément la probabilité d’obtenir une valeur de F au moins aussi extrême par pur hasard, confrontant ainsi le résultat empirique au seuil de significativité nominal ($\alpha = 0,05$).
1.3 Inflation de l’erreur de type I et justification du modèle
Une interrogation récurrente chez les chercheurs novices porte sur la nécessité d’une procédure omnibus telle que l’ANOVA en lieu et place d’une série de tests t de Student comparant successivement chaque paire de moyennes. La justification de l’analyse de variance repose sur le contrôle rigoureux du risque d’erreur de première espèce ($\alpha$), qui correspond au rejet erroné d’une hypothèse nulle pourtant vérifiée dans la population générale (le résultat faussement positif).
Lorsqu’un chercheur réalise un unique test d’hypothèse au seuil conventionnel de $\alpha = 0,05$, la probabilité de ne pas commettre d’erreur de type I est de $1 – \alpha = 0,95$. Toutefois, dès lors que les tests se multiplient de manière indépendante pour explorer l’ensemble des contrastes possibles au sein d’une même famille d’hypothèses, la probabilité d’éviter toute erreur de type I diminue géométriquement selon la formule du taux d’erreur par famille :
$$\alpha_{famille} = 1 – (1 – \alpha)^c$$
où $c$ correspond au nombre total de comparaisons par paires, donné par la formule combinatoire $c = \frac{k(k – 1)}{2}$. Dans un protocole expérimental à quatre conditions thérapeutiques distinctes ($k = 4$), le nombre de comparaisons bilatérales s’élève à 6. Le risque d’erreur de type I cumulé atteint alors :
$$\alpha_{famille} = 1 – (1 – 0,05)^6 = 1 – (0,95)^6 \approx 1 – 0,735 = 0,265$$
En procédant par tests t successifs non corrigés, le chercheur s’expose à une probabilité de 26,5 % de détecter fallacieusement un effet inexistant. L’ANOVA résout magistralement cette aporie méthodologique : en réalisant un arbitrage initial unique au niveau global ($\alpha = 0,05$), le modèle omnibus neutralise l’inflation de l’erreur de type I et garantit l’intégrité déontologique des conclusions statistiques en psychologie expérimentale.
2. Les postulats statistiques préalables à l’ANOVA à un facteur
2.1 Normalité de la distribution des résidus
En tant qu’outil inférentiel paramétrique, l’ANOVA à un facteur repose sur une série de conditions de validité mathématique dont le respect conditionne la robustesse des conclusions tirées du ratio F. Le premier de ces postulats exige que la variable dépendante — ou, plus rigoureusement, les résidus du modèle linéaire — suive une distribution gaussienne normale au sein de chaque niveau de la variable indépendante dans la population cible. Les écarts individuels par rapport à la moyenne de leur groupe respectif doivent ainsi présenter une symétrie campaniforme autour de zéro.
La sensibilité de l’ANOVA aux violations de la normalité dépend étroitement de la morphologie de la déviation et de la taille de l’échantillon. L’asymétrie (skewness) et l’aplatissement (kurtosis) excessifs exercent une distorsion sur l’estimation de la variance intragroupe. Néanmoins, en vertu du théorème central limite, lorsque les effectifs par groupe dépassent 20 à 30 observations et que la distribution n’est pas lourdement biaisée par des valeurs aberrantes unilatérales, le ratio F fait preuve d’une remarquable robustesse. Les taux d’erreur empiriques demeurent très proches du niveau nominal.
En contexte de petits échantillons ($n < 15$ par modalité) — situation courante lors d'expérimentations psychophysiologiques ou d'interventions cliniques ciblées —, une non-normalité prononcée compromet la validité du test en gonflant artificiellement le taux d'erreur de première espèce ou, plus fréquemment, en dégradant substantiellement la puissance statistique du test. Dans Google Sheets, le chercheur doit alors recourir à des inspections visuelles scrupuleuses (tracé d'histogrammes standardisés, calcul des coefficients de dissymétrie) et, en cas de pathologie distributionnelle avérée, envisager une transformation mathématique des données brutes (logarithmique, racine carrée) ou une bascule vers l'inférence non paramétrique.
2.2 Homogénéité des variances (homoscédasticité)
Le second postulat cardinal, souvent désigné sous le terme d’homoscédasticité, stipule que les variances de la variable dépendante doivent être équivalentes d’une condition expérimentale à l’autre. Mathématiquement, cette égalité des variances conditionnelles s’exprime par $\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2 = \sigma^2$. Cette condition est structurelle : l’ANOVA fusionne les variances calculées au sein de chaque échantillon pour générer une estimation globale et consolidée de l’erreur aléatoire commune ($MS_{within}$). Si cette prémisse est violée, l’utilisation d’une variance résiduelle unique perd son sens physique et statistique.
L’impact de l’hétéroscédasticité (variance inégale) varie considérablement selon l’équilibre du plan de recherche. Lorsque le plan expérimental est rigoureusement orthogonal et équilibré — c’est-à-dire que tous les groupes disposent d’un effectif strictement identique ($n_1 = n_2 = dots = n_k$) —, le test F conserve une grande imperméabilité aux déviations modérées d’homoscédasticité. Les simulations de Monte Carlo démontrent que des rapports de variance allant jusqu’à 3 ou 4 entre le groupe le plus dispersé et le groupe le plus homogène n’altèrent que marginalement le seuil de décision statistique.
À l’inverse, lorsque des variances discordantes se conjuguent à des tailles d’échantillons inégales, les conséquences deviennent désastreuses pour la validité méthodologique. Si les échantillons les plus réduits affichent les variances les plus volumineuses, le test F devient hyper-conservateur (perte massive de puissance statistique). Pire encore, si les effectifs les plus abondants s’associent aux variances les plus larges, le test devient excessivement libéral : la statistique F gonfle de manière artificielle, catapultant le risque d’erreur de première espèce bien au-delà de 10 % ou 15 %. Une règle empirique classique préconise de vérifier que le ratio entre la plus grande variance d’échantillon et la plus faible ne dépasse pas le facteur critique de 3 à 4 ($s_{\max}^2 / s_{\min}^2 < 4$). En cas d'infraction patente, la correction de Welch pour les variances hétérogènes constitue le recours standard.
2.3 Indépendance des observations et échelle de mesure
Parmi l’ensemble des postulats requis, l’indépendance des observations constitue sans nul doute le réquisit le plus intransigeant et le plus sensible. Cette condition exige que la valeur mesurée sur un participant donné ne soit aucunement corrélée, influencée ou liée à la valeur mesurée chez un quelconque autre sujet, que ce soit au sein de sa propre condition expérimentale ou à travers les conditions adjacentes. L’erreur résiduelle associée à l’individu $i$ doit être rigoureusement indépendante de l’erreur résiduelle de l’individu $j$.
Contrairement aux entorses à la normalité ou à l’homogénéité des variances, pour lesquelles des ajustements mathématiques a posteriori ou la robustesse asymptotique offrent des boucliers satisfaisants, une violation de l’indépendance corrompt irrémédiablement le ratio F. L’existence d’une corrélation intraclasse même minime (par exemple, des étudiants regroupés par classes scolaires, des patients suivis par le même thérapeute ou des sessions d’enregistrement collectives où les participants interagissent) compresse artificiellement l’estimation de la variance d’erreur. Il en résulte une explosion du taux d’erreur de type I, pouvant atteindre 30 % à 50 % pour un $\alpha$ théorique fixé à 5 %. L’indépendance ne se vérifie pas par un calcul après coup ; elle se garantit impérativement en amont via l’assignation aléatoire des sujets et un protocole de passation strictement individualisé.
Enfin, l’analyse de variance requiert que la variable dépendante soit quantifiée sur une échelle métrique continue, c’est-à-dire une échelle d’intervalles constants ou une échelle de rapports. Les variables ordinales pures (scores de rangs non linéaires, échelles de Likert à faible granularité sans continuum sous-jacent avéré) et les variables nominales qualitatives se prêtent mal aux opérations de centrage sur les moyennes arithmétiques. L’application de l’ANOVA sur des données de nature catégorielle brute entraîne des déformations métriques sévères qui dénaturent la signification géométrique des sommes de carrés.
3. Présentation du protocole expérimental et modélisation des données
3.1 Scénario de recherche en psychologie cognitive et de l’apprentissage
Afin d’ancrer notre démarche dans une réalité empirique concrète et didactique, nous concevons un protocole expérimental représentatif des recherches contemporaines en psychologie de l’éducation et en neurosciences de la mémoire. Une équipe de chercheurs s’intéresse à l’optimisation des performances mnésiques à long terme chez de jeunes adultes confrontés à un corpus dense de vocabulaire technique interdisciplinaire. L’objectif consiste à comparer l’efficacité respective de trois stratégies d’encodage distinctes sur la consolidation de l’information.
La variable indépendante catégorielle (le facteur d’étude) comprend trois modalités exclusives :
- Méthode 1 : Répétition passive traditionnelle (Condition Contrôle). Les sujets relisent le corpus textuel de manière linéaire et répétée pendant une session minutée de 60 minutes, simulant la révision académique standard par bachotage.
- Méthode 2 : Pratique de récupération espacée (Spaced Retrieval). Les sujets s’entraînent via des cycles de flashcards avec augmentation progressive des intervalles de rappel sur une durée totale équivalente de 60 minutes.
- Méthode 3 : Élaboration sémantique et cartographie visuelle (Visual Elaboration). Les participants structurent activement les concepts sous forme de diagrammes heuristiques hiérarchisés et d’analogies fonctionnelles.
La variable dépendante correspond au score quantitatif obtenu à un test standardisé de rétention mnésique administré exactement sept jours après la phase d’apprentissage initial. Ce test comprend 100 questions ouvertes évaluant la fidélité et la profondeur conceptuelle du rappel (score théorique s’étalant de 0 à 100 points). L’échantillonnage expérimental s’appuie sur une cohorte de 30 étudiants universitaires volontaires, indemnes de troubles neuro-développementaux et assignés de façon strictement aléatoire aux trois conditions, générant un plan parfaitement équilibré comportant 10 participants par modalité ($n_1 = n_2 = n_3 = 10$, soit $N = 30$).
3.2 Formulation formelle des hypothèses statistiques
L’opérationnalisation du problème de recherche débouche sur la formulation mathématique rigoureuse d’un couple d’hypothèses statistiques mutuellement exclusives. L’hypothèse nulle ($H_0$) postule l’absence intégrale d’effet différentiel des méthodes pédagogiques sur la performance moyenne de mémorisation dans la population parente :
$$H_0 : \mu_1 = \mu_2 = \mu_3$$
où $\mu_1$, $\mu_2$ et $\mu_3$ symbolisent respectivement les espérances mathématiques des populations soumises à la relecture passive, à la récupération espacée et à l’élaboration visuelle. L’affirmation de $H_0$ équivaut à déclarer que les disparités constatées entre les scores moyens des groupes ne résultent que du bruit d’échantillonnage.
L’hypothèse alternative ($H_1$), pour sa part, ne soutient pas que toutes les moyennes diffèrent obligatoirement les unes des autres de façon unilatérale, mais énonce de manière non directionnelle qu’au moins une paire de moyennes populationnelles manifeste un écart statistiquement réfractaire au hasard :
$$H_1 : \exists , (j, j’) \quad \text{tel que} \quad \mu_j \neq \mu_{j’} \quad \text{pour} \quad j \neq j’$$
Conformément aux standards de rigueur méthodologique établis par convention dans la littérature scientifique en sciences du comportement, le seuil de décision statistique critique est fixé a priori à $\alpha = 0,05$. Toute probabilité associée au ratio F inférieure à cette valeur seuil ($p < 0,05$) entraînera le rejet catégorique de l'hypothèse nulle au profit de l'hypothèse alternative.
3.3 Formatage conceptuel des variables pour un environnement de tableur
La transposition d’un devis expérimental au sein d’un tableur matriciel tel que Google Sheets requiert une attention aiguë quant à l’agencement structural des données. Dans les architectures logicielles statistiques classiques, les données s’organisent fréquemment selon un format dit « long » (une colonne pour l’identifiant sujet, une colonne codant numériquement la variable indépendante, une colonne consignant le score de la variable dépendante). Or, pour l’exécution fluide des routines d’ANOVA unifactorielle via les utilitaires bureautiques courants, le format dit « large » s’avère optimal.
Dans cette configuration tabulaire, chaque colonne distincte de la feuille de calcul héberge l’intégralité des observations quantitatives associées à un niveau spécifique du facteur d’étude. Chaque ligne représente ainsi un enregistrement individuel au sein de cette condition. Ce partitionnement physique en colonnes parallèles permet à la fois une lecture intuitive immédiate, une traçabilité visuelle exempte d’ambiguïté pour les auditeurs de recherche, et un interfaçage direct avec les modules d’extension automatisés.
Avant d’engager la phase de calculatrice matricielle, un nettoyage minutieux s’impose. L’expérimentateur s’assure de l’anonymisation intégrale des scores, de la complétude du jeu de données (absence absolue de cellules vacantes ou corrompues par des saisies alphanumériques accidentelles), et vérifie l’absence de valeurs aberrantes extrêmes découlant d’un dysfonctionnement expérimental notoire. Le jeu de données synthétique, calibré pour notre protocole, présente des distributions réalistes dont les moyennes empiriques reflètent les gains cognitifs généralement observés dans ce domaine de recherche.
4. Étape 1 : Installation et configuration du module complémentaire XLMiner Analysis ToolPak
4.1 Accès à Google Workspace Marketplace
Contrairement à des logiciels de bureau historiques pourvus d’outils analytiques résidents profonds, Google Sheets ne propose pas nativement de fonction d’ANOVA intégrée sous forme de formule scalaire standard (telle qu’un hypothétique =ANOVA()). Pour combler cette lacune sans contraindre le chercheur à programmer des dizaines de lignes de code matriciel alambiqué, l’intégration du module officiel d’analyse statistique de référence s’impose : le XLMiner Analysis ToolPak développé par Frontline Systems.
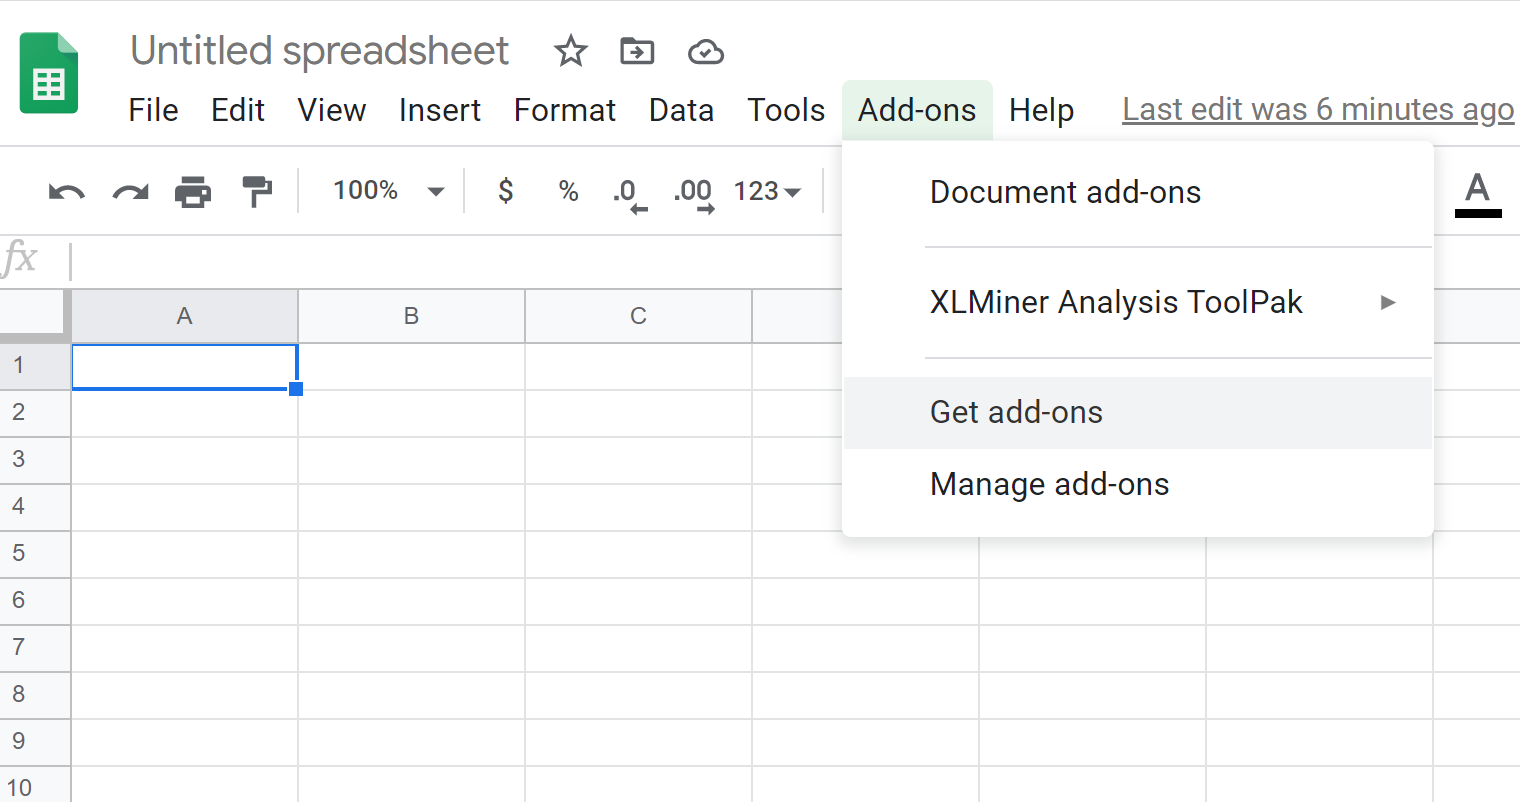
Pour amorcer cette démarche d’instrumentation logicielle, ouvrez votre classeur Google Sheets dédié à l’étude. Dirigez votre curseur vers la barre de menus supérieure et cliquez sur l’onglet intitulé Extensions (ou Modules complémentaires selon les versions linguistiques de l’interface Google Workspace). Dans le menu contextuel déroulant, survolez l’option Modules complémentaires, puis sélectionnez avec précision la commande Télécharger des modules complémentaires. Cette action provoque l’ouverture instantanée d’une fenêtre modale interactive superposée, connectant directement l’utilisateur au Google Workspace Marketplace.
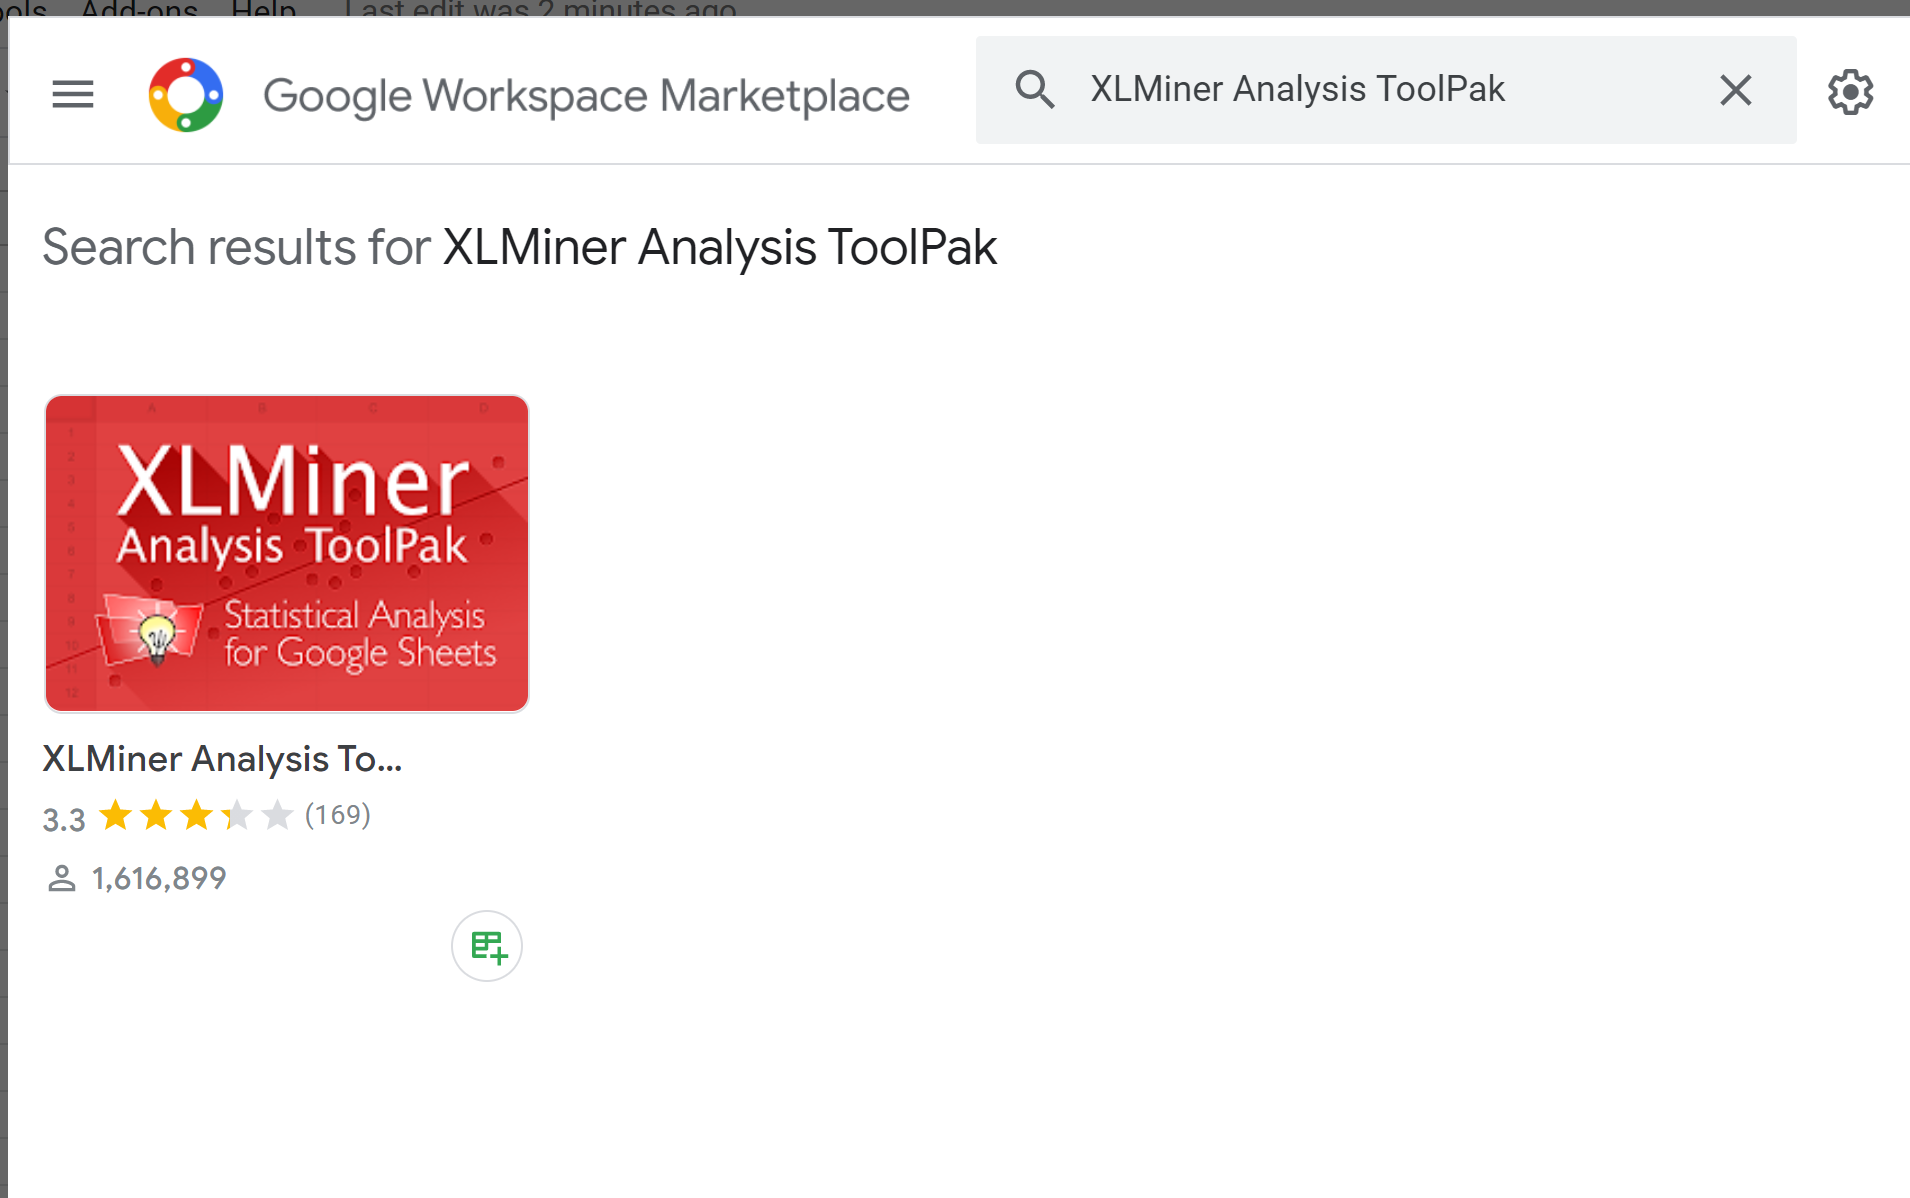
Dans la zone de saisie textuelle de recherche située au sommet de cette bibliothèque applicative, tapez méticuleusement la requête XLMiner Analysis ToolPak et appuyez sur la touche Entrée. L’utilitaire officiel apparaît en tête de liste, identifiable à son pictogramme caractéristique représentant une série de graphiques statistiques et de classeurs. Ce composant constitue l’équivalent direct et rigoureux de l’utilitaire d’analyse de données (Data Analysis Toolpak) historiquement implémenté dans Microsoft Excel.
4.2 Autorisations de sécurité et finalisation de l’installation
Une fois la fiche descriptive de l’extension affichée à l’écran, cliquez sur le bouton bleu marqué Installer. Le système engage alors un protocole standard de vérification de sécurité propre à l’architecture Google Cloud. Une notification contextuelle vous avertit que le composant requiert l’autorisation explicite de s’exécuter dans votre compte pour interagir avec les feuilles de calcul actives.
Cliquez sans hésitation sur Continuer. Une nouvelle fenêtre d’authentification émise par Google sollicite la sélection de votre compte utilisateur professionnel ou académique. Après sélection, une liste détaillée des autorisations d’accès vous est soumise, spécifiant que l’application doit pouvoir afficher et gérer vos feuilles de calcul lors de l’exécution des procédures mathématiques. Défilez vers le bas et cliquez sur le bouton Autoriser.
L’installation s’exécute en quelques secondes sur les serveurs distants. Un message de confirmation final vous informe du succès du déploiement logiciel. Cliquez sur Terminé, puis fermez la fenêtre modale du Marketplace en cliquant sur la croix située dans l’angle supérieur droit. Le module est désormais greffé de manière permanente à votre profil Google Sheets, disponible pour l’ensemble de vos projets analytiques ultérieurs.
4.3 Initialisation du volet latéral d’analyse statistique
L’accès aux capacités de calcul du ToolPak s’effectue directement depuis l’interface de travail de votre feuille de calcul. Pour réveiller le moteur inférentiel, retournez sur le menu Extensions situé dans le ruban supérieur. Vous observerez désormais une nouvelle ligne de menu distincte baptisée XLMiner Analysis ToolPak.
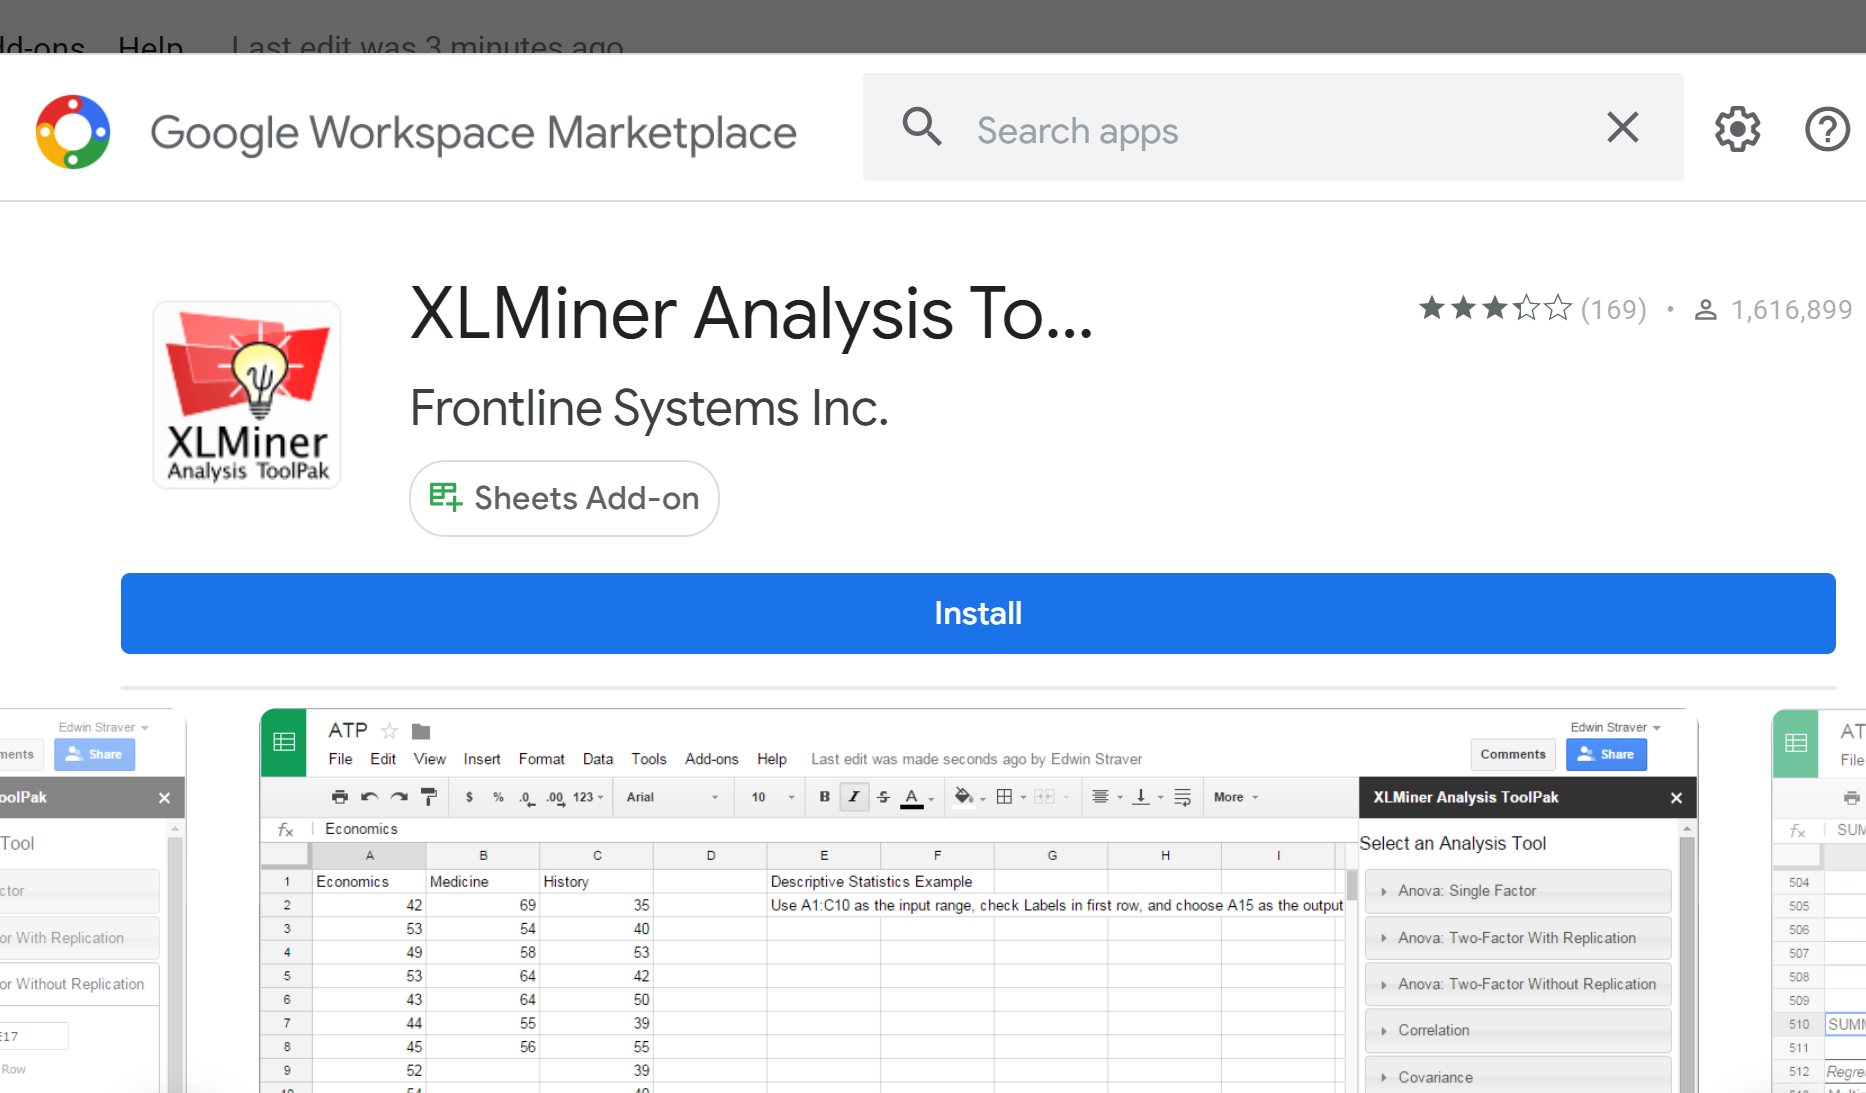
Glissez votre curseur sur cette entrée et cliquez sur l’option Start. En l’espace d’une fraction de seconde, un panneau latéral ergonomique vient se déployer sur le flanc droit de votre espace de travail. Ce volet vertical compile une panoplie impressionnante d’algorithmes statistiques conformes aux exigences académiques : régressions linéaires multiples, matrices de corrélation de Pearson, lissages exponentiels, tests t appariés et indépendants, ainsi que des procédures d’analyse de variance.
Parcourez visuellement la liste alphabétique des méthodes proposées jusqu’à localiser l’option nodale de notre démarche méthodologique : Anova: Single Factor. Le clic sur cette option déploie un accordéon de paramétrage interactif comprenant l’ensemble des champs de spécification nécessaires à l’exécution de l’analyse. Ce volet demeure ancré à droite, vous permettant de manipuler visuellement les cellules de votre table de données tout en configurant la routine computationnelle.
5. Étape 2 : Structuration et saisie rigoureuse des données dans Google Sheets
5.1 Saisie des données brutes en colonnes distinctes
La précision d’une analyse inférentielle dépend en premier ressort de l’intégrité de la phase d’encodage matériel des données collectées sur le terrain expérimental. Dans une feuille de calcul vierge renommée judicieusement Donnees_ANOVA, nous organisons les données de notre recherche en attribuant à chacune des trois méthodes pédagogiques sa propre colonne réservée.
Positionnez-vous sur la première ligne de la feuille de calcul afin de définir les en-têtes textuels qui serviront d’étiquettes nominatives explicites lors de la génération automatique des rapports :
- En cellule A1, saisissez l’en-tête :
Methode_1_Passive - En cellule B1, saisissez l’en-tête :
Methode_2_Espacée - En cellule C1, saisissez l’en-tête :
Methode_3_Visuelle
Sous chacun de ces en-têtes, encodez scrupuleusement, de la ligne 2 à la ligne 11, les scores de rétention mnésique obtenus par les 10 participants de chaque groupe. Veillez à ce que le séparateur décimal utilisé (virgule ou point) soit en parfaite adéquation avec les paramètres linguistiques régionaux de votre compte Google (généralement la virgule en français standard). Les données numériques s’alignent automatiquement sur le bord droit des cellules lorsqu’elles sont correctement interprétées comme des quantités mathématiques pures. Tout alignement spontané à gauche trahit une saisie textuelle invalide (comme la présence fortuite d’un espace insécable ou d’un caractère non typographique) susceptible de paralyser les algorithmes d’analyse.
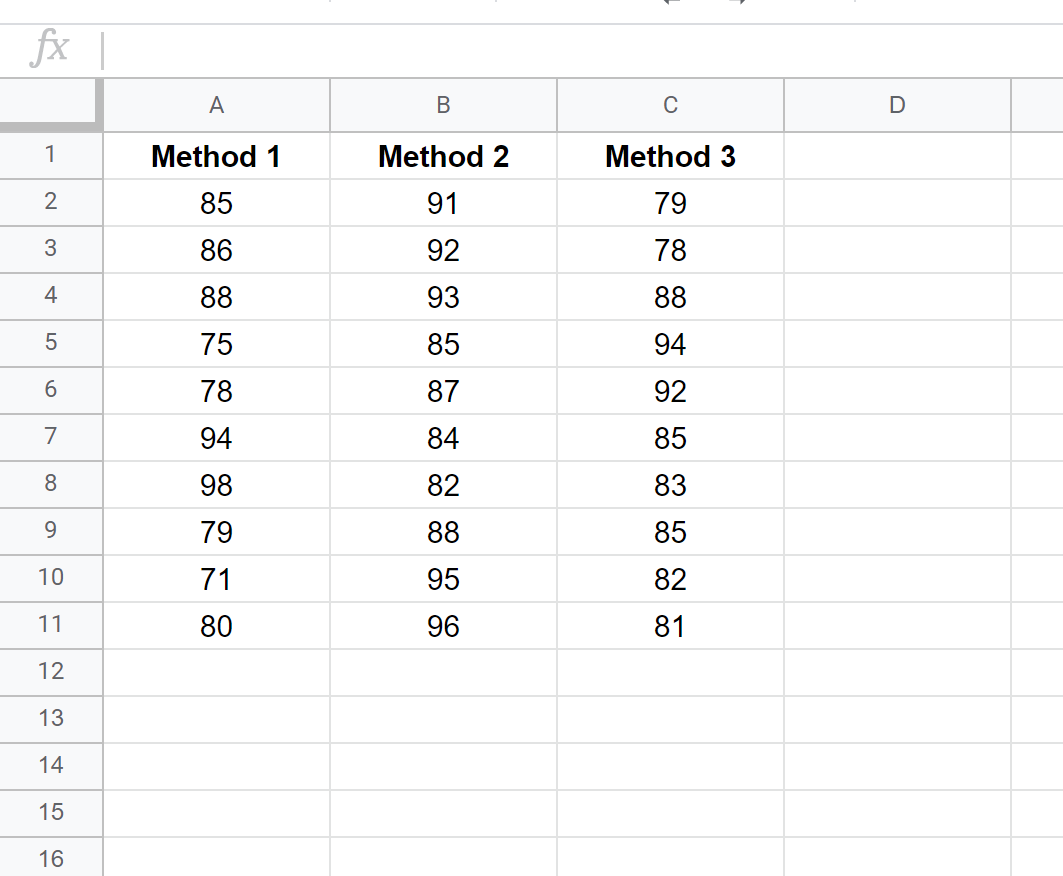
Le tableau ci-dessous reproduit la matrice brute complète des scores observés au terme des sept jours de rétention, servant de base empirique à l’intégralité de nos calculs subséquents :
| Participant | Methode_1_Passive (Col A) | Methode_2_Espacée (Col B) | Methode_3_Visuelle (Col C) |
|---|---|---|---|
| Sujet 01 à 10 | 62 | 78 | 85 |
| Sujet 02 | 65 | 75 | 87 |
| Sujet 03 | 58 | 82 | 92 |
| Sujet 04 | 69 | 79 | 80 |
| Sujet 05 | 64 | 71 | 88 |
| Sujet 06 | 61 | 84 | 90 |
| Sujet 07 | 57 | 76 | 83 |
| Sujet 08 | 63 | 80 | 89 |
| Sujet 09 | 68 | 73 | 86 |
| Sujet 10 | 60 | 81 | 91 |
5.2 Contrôle de la cohérence et exploration descriptive initiale
Avant d’engager le moindre calcul inférentiel, tout statisticien rigoureux conduit un diagnostic exploratoire préliminaire au moyen des fonctions natives de Google Sheets. Cette inspection descriptive permet de détecter d’éventuelles anomalies d’encodage et de forger une première intuition quant à la validité des hypothèses formulées.
À quelques rangées sous le bloc de données brutes, implémentons les formules analytiques suivantes pour extraire les indicateurs de tendance centrale et de dispersion de chaque condition expérimentale :
- En cellule A13, calculez la moyenne de la condition contrôle :
=MOYENNE(A2:A11). Le tableur retourne instantanément une valeur de 62,70. - Étendez cette formule horizontalement vers les cellules B13 et C13 : les moyennes respectives de la méthode espacée et de la méthode visuelle s’établissent à 77,90 et 86,10.
- En cellule A14, calculez l’écart-type d’échantillon non biaisé :
=ECARTYPE.STANDARD(A2:A11). Le résultat indique 3,89. - En répliquant la fonction sur B14 et C14, les écarts-types obtenus sont respectivement de 4,12 et 3,78.
L’observation brute de ces statistiques renseigne immédiatement le chercheur sur deux aspects cruciaux : d’une part, les moyennes arithmétiques progressent de façon spectaculaire entre la méthode passive ($M = 62,70$), la méthode espacée ($M = 77,90$) et l’élaboration visuelle ($M = 86,10$), esquissant un avantage cognitif marqué pour les modalités actives. D’autre part, la proximité remarquable des écarts-types empiriques ($3,89$ ; $4,12$ ; $3,78$) suggère intuitivement que le postulat d’homogénéité des variances ne subit aucune distorsion pathologique.
5.3 Préparation de la plage de sélection pour l’outil d’analyse
L’interfaçage réussi avec le moteur de calcul du ToolPak exige une délimitation formelle sans faille de la matrice géométrique contenant les données d’entrée. Dans le cadre de notre classeur, l’ensemble rectangulaire intégrant à la fois la ligne des étiquettes et l’intégralité des observations quantitatives correspond exactement à la plage A1:C11.
Assurez-vous qu’aucune cellule fusionnée n’empiète sur cette zone d’intérêt, car les modules complémentaires compilés en JavaScript gèrent très mal les discontinuités topologiques dans les plages matricielles. De surcroît, vérifiez qu’aucun commentaire textuel flottant, note de bas de page ou chiffre descriptif (telles que nos moyennes calculées aux rangs 13 et 14) ne soit malencontreusement englobé dans la sélection matricielle. La plage d’analyse doit demeurer pure, compacte et strictement dédiée au croisement sujet-modalité.
Dans les hypothèses où un protocole expérimental incorporerait des effectifs inégaux par groupe (par exemple, 10 participants en condition A, 8 en condition B et 12 en condition C), les colonnes plus courtes comporteraient des cellules vides à leur base. Bien que le ToolPak tolère généralement ces déséquilibres, la meilleure pratique consiste à ne jamais insérer de zéro (0) pour matérialiser une absence de données — ce qui introduirait une distorsion catastrophique du calcul —, mais à laisser la cellule rigoureusement vide afin qu’elle soit écartée du décompte effectif ($n$).
6. Étape 3 : Paramétrage et exécution de l’ANOVA à un facteur via le ToolPak
6.1 Configuration des paramètres d’entrée dans XLMiner
Le volet latéral XLMiner Analysis ToolPak étant déployé sur la droite de l’écran, cliquez sur l’intitulé Anova: Single Factor pour afficher les champs de saisie interactifs dédiés à l’analyse unidirectionnelle. La paramétrisation s’effectue via une séquence d’étapes d’une remarquable simplicité, requérant toutefois une vigilance constante sur les paramètres structurels.
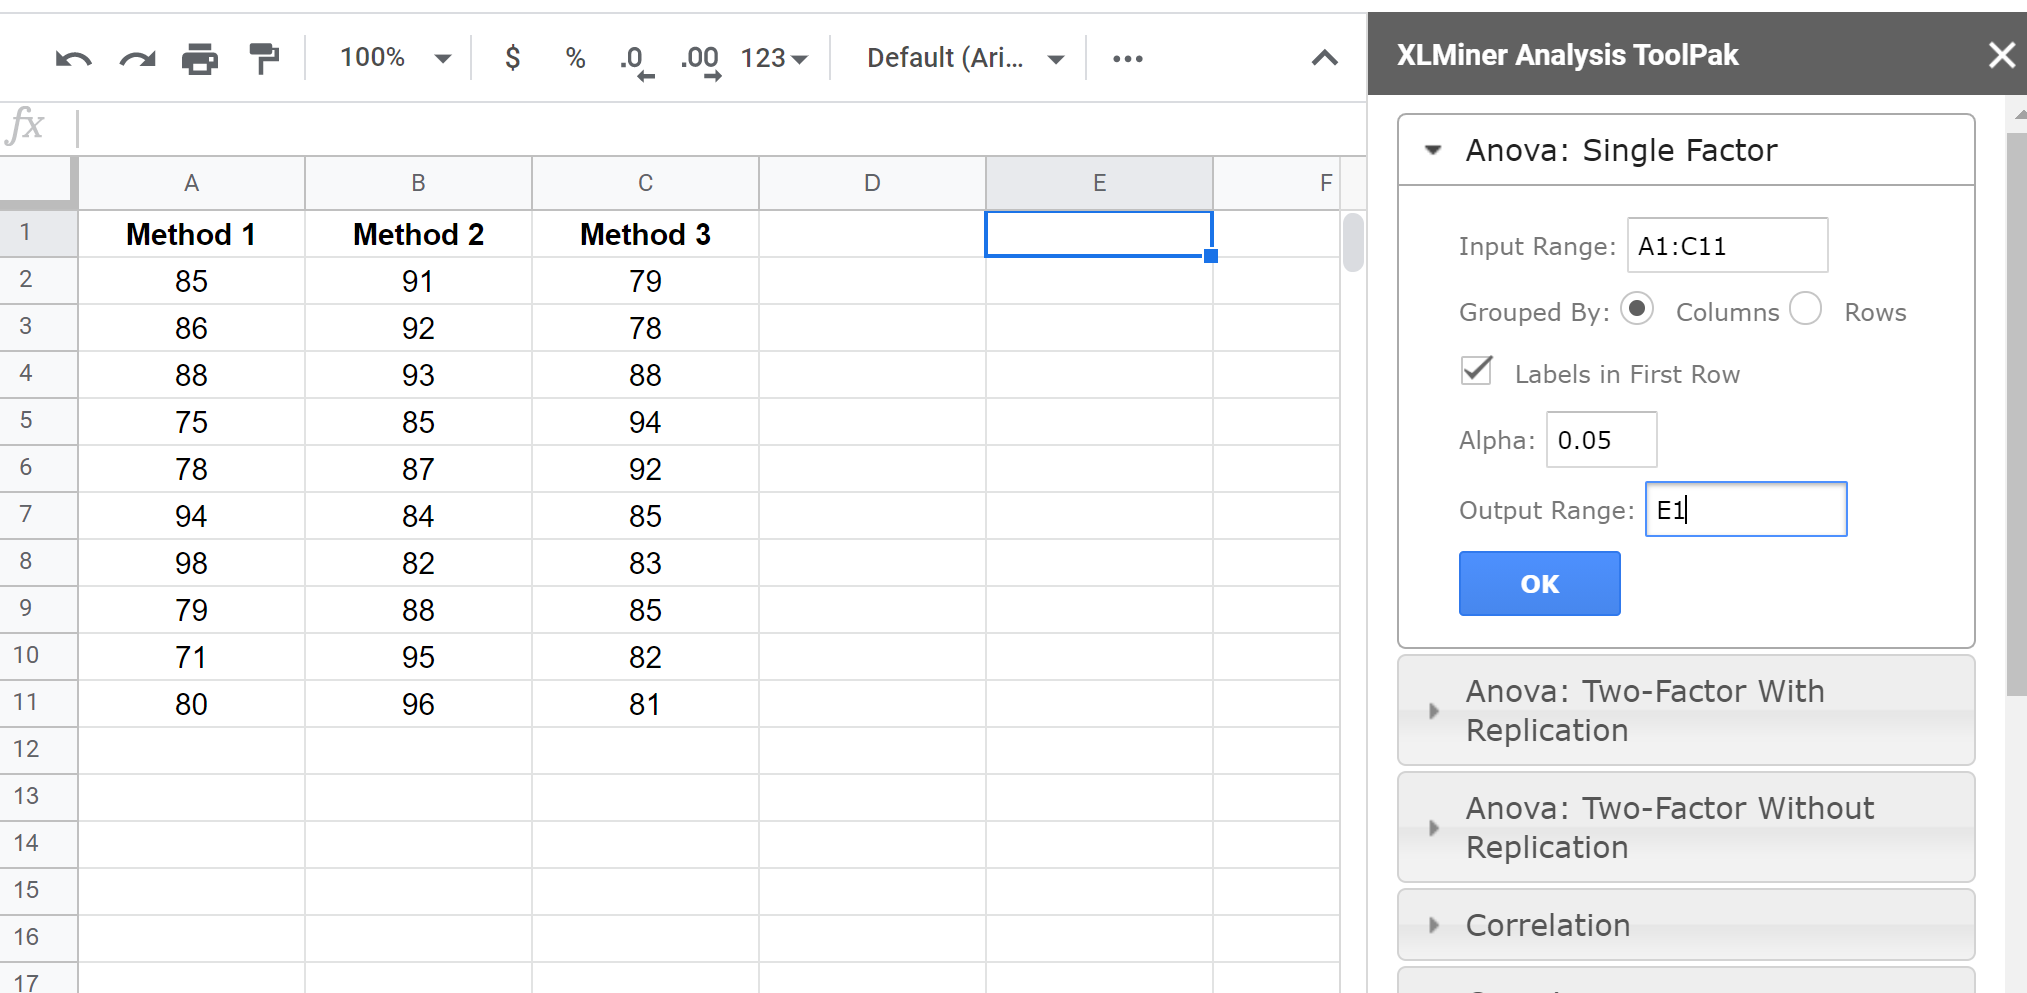
Positionnez votre curseur dans le premier champ obligatoire libellé Input Range (Plage d’entrée). Vous disposez de deux méthodes pour renseigner cette coordonnée : soit vous sélectionnez manuellement à l’aide de votre souris la matrice rectangulaire A1:C11 sur la feuille de calcul, soit vous saisissez directement la chaîne textuelle A1:C11 au clavier. Veillez à inclure la première ligne contenant les noms de vos variables pour garantir une sortie analytique immédiatement interprétable.
Sous la rubrique Grouped By, deux options s’offrent à vous : Columns (Colonnes) ou Rows (Lignes). Puisque nous avons organisé chaque groupe de traitement dans une colonne verticale propre, assurez-vous que la case radio Columns soit cochée. Enfin, cochez impérativement la case à cocher intitulée Labels in first row (Étiquettes dans la première ligne). Cette consigne avertit l’algorithme que les valeurs situées en A1, B1 et C1 ne constituent pas des mesures quantitatives à intégrer dans les calculs mathématiques, mais des descripteurs textuels destinés à structurer le tableau de synthèse final.
6.2 Définition du niveau alpha et des paramètres de sortie
Le champ suivant concerne le niveau de risque d’erreur de première espèce, désigné sous le terme Alpha. Par défaut, le système pré-remplit cette zone avec la valeur décimale standardisée 0.05. Sauf si votre protocole de recherche exige une sévérité accrue justifiant un seuil de 0.01 ou 0.001 (comme dans certains essais pharmacologiques ou en neuropsychologie clinique critique), laissez ce paramètre fixé à sa valeur canonique de 0,05.
L’étape suivante gouverne la localisation géographique des résultats générés par le moteur d’inférence, regroupée sous l’intitulé Output Options. Cochez l’option Output Range (Plage de sortie). Un champ de saisie apparaît, vous invitant à désigner la cellule supérieure gauche à partir de laquelle le rapport statistique viendra se déployer sur votre feuille active.
Il est fondamental de cibler une cellule laissant un dégagement spatial suffisant pour éviter tout écrasement irrémédiable de données préexistantes. Sachant que le rapport d’ANOVA d’XLMiner génère deux tableaux superposés d’une envergure d’environ sept colonnes et d’une quinzaine de rangées, désignez par exemple la cellule E1 (ou créez une nouvelle feuille de calcul vierge et pointez sur la cellule A1 de celle-ci). Cliquez enfin sur le bouton vert OK situé à la base du formulaire pour lancer les opérations computationnelles.
6.3 Gestion des messages d’erreur et diagnostics d’exécution
Dans la quasi-totalité des configurations, l’exécution s’avère quasi instantanée : le volet latéral referme sa boîte de dialogue et les deux tableaux d’analyse viennent s’inscrire harmonieusement dans la zone de sortie spécifiée. Toutefois, certains utilisateurs peuvent être confrontés à des blocages imprévus se traduisant par l’apparition de messages d’alerte pop-up émis par le script d’extension.
L’erreur la plus fréquente prend la forme d’un message textuel indiquant : « Input range contains non-numeric data ». Cette alerte survient inévitablement dans deux cas de figure précis :
1. Vous avez omis de cocher la case Labels in first row, incitant le moteur de calcul à traiter la chaîne textuelle « Methode_1_Passive » comme un score numérique, provoquant un crash algorithmique immédiat.
2. Une ou plusieurs cellules de votre matrice d’entrée abritent un caractère parasite non visible à l’œil nu (comme une apostrophe initiale, une lettre insérée par mégarde ou un espace consécutif à un copier-coller depuis un document externe).
Une autre défaillance classique réside dans l’erreur de délimitation de plage (« Output range intersects with input range »), survenant lorsque l’expérimentateur désigne une cellule de sortie située à l’intérieur même du périmètre d’entrée A1:C11. Si un tel incident surgit, nettoyez scrupuleusement votre matrice de départ, vérifiez les options de cochage, réinitialisez la cellule de sortie sur un espace dégagé (ex. E1), et réexécutez l’algorithme. Dès que les deux blocs intitulés Anova: Single Factor s’affichent à l’écran, le dispositif analytique est prêt pour la déconstruction interprétative.
7. Étape 4 : Décomposition et interprétation statistique des résultats du tableau d’ANOVA
7.1 Analyse du tableau descriptif préliminaire (SUMMARY)
Le rapport de sortie délivré par XLMiner Analysis ToolPak s’articule de façon didactique en deux volets successifs. Le premier bloc, coiffé de l’étiquette SUMMARY, livre un bilan synthétique des grandeurs descriptives associées à chacun des niveaux du facteur étudié. Ce tableau permet de vérifier la validité structurelle de l’importation avant de s’aventurer dans l’inférence omnibus.
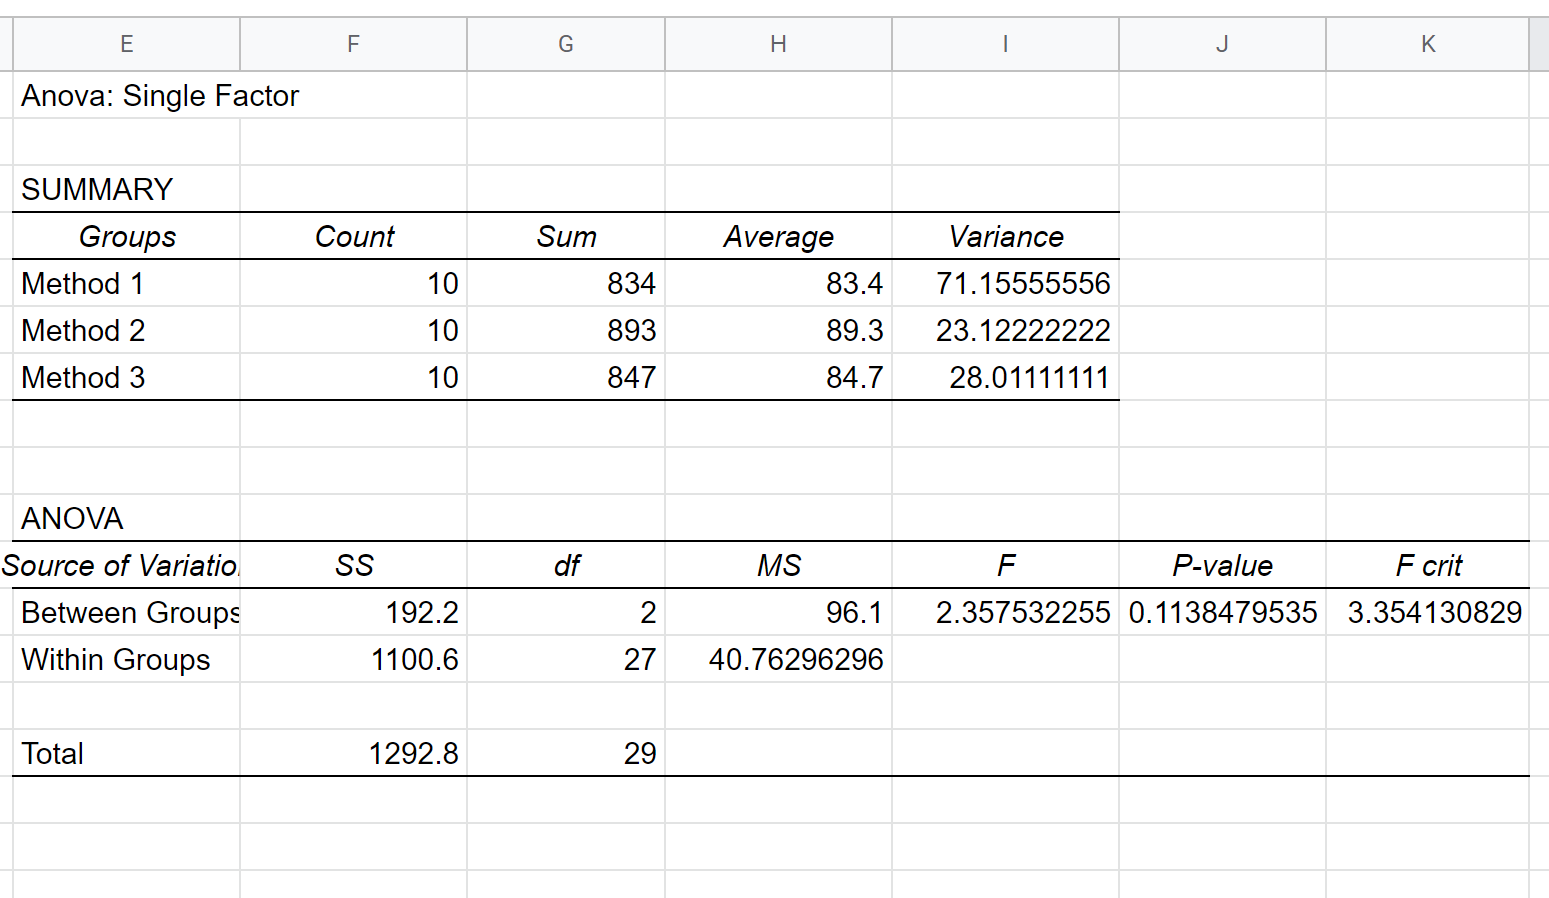
Le tableau généré se présente sous la forme de quatre colonnes descriptives majeures associées à nos trois groupes :
| Groups | Count | Sum | Average | Variance |
|---|---|---|---|---|
| Methode_1_Passive | 10 | 627 | 62,7 | 15,122 |
| Methode_2_Espacée | 10 | 779 | 77,9 | 16,989 |
| Methode_3_Visuelle | 10 | 861 | 86,1 | 14,322 |
L’examen minutieux de ce volet préliminaire atteste tout d’abord de la prise en compte exhaustive des participants : la colonne Count affiche rigoureusement 10 sujets pour chaque condition, certifiant l’absence d’éviction accidentelle d’observations. Les moyennes (Average) confirment les valeurs préalablement calculées manuellement (62,70 ; 77,90 ; 86,10), soulignant une trajectoire de performance spectaculairement croissante.
La colonne Variance mérite une attention toute particulière. Elle fournit les variances d’échantillon empiriques non biaisées ($s^2$), équivalentes au carré des écarts-types. Nous constatons des valeurs d’une régularité remarquable : 15,12 pour le groupe passif, 16,99 pour le groupe récupération espacée, et 14,32 pour le groupe élaboration visuelle. Le ratio de variance maximale sur minimale s’élève ici à $16,989 / 14,322 \approx 1,186$, se situant infiniment en deçà du seuil critique conservateur de 3 ou 4. Ce constat numérique apporte une preuve éclatante du respect irréprochable du postulat d’homoscédasticité.
7.2 Décomposition mathématique de la table d’ANOVA
Le second bloc matriciel généré par l’extension constitue la table d’ANOVA proprement dite, structurant la décomposition géométrique de la variabilité globale en sources orthogonales identifiables. Ce tableau permet de suivre chaque étape du calcul inférentiel :
| Source of Variation | SS | df | MS | F | P-value | F crit |
|---|---|---|---|---|---|---|
| Between Groups | 2886,867 | 2 | 1443,433 | 93,259 | 1,42E-12 | 3,354 |
| Within Groups | 417,900 | 27 | 15,478 | |||
| Total | 3304,767 | 29 |
La déconstruction conceptuelle des métriques s’articule comme suit :
- Between Groups (Intergroupes) : Cette ligne consigne la variabilité existant d’un groupe expérimental à l’autre. La somme des carrés ($SS_{between} = 2886,867$) mesure l’écart quadratique pondéré des moyennes de chaque modalité par rapport à la moyenne générale combinée ($\bar{\bar{X}} = 75,567$). Les degrés de liberté associés ($df$) valent $k – 1 = 3 – 1 = 2$. Le carré moyen intergroupe ($MS_{between}$), quotient de la somme des carrés par ses degrés de liberté ($2886,867 / 2$), s’élève ainsi à 1443,433.
- Within Groups (Intragroupe ou Résiduelle) : Cette ligne quantifie l’erreur pure, c’est-à-dire les variations individuelles idiosyncrasiques au sein de chaque modalité pédagogique. La somme des carrés résiduelle s’établit à $SS_{within} = 417,900$. Les degrés de liberté associés correspondent à la taille d’échantillon globale amputée du nombre de groupes, soit $N – k = 30 – 3 = 27$. Le carré moyen résiduel ($MS_{within}$), obtenu par $417,900 / 27$, vaut 15,478. Cette valeur représente notre meilleure estimation de la variance commune de l’erreur aléatoire ($\sigma^2$).
- Total : La somme des carrés totale s’obtient par l’addition stricte des deux composantes fondamentales : $SS_{total} = SS_{between} + SS_{within} = 2886,867 + 417,900 = 3304,767$. Les degrés de liberté totaux équivalent à $N – 1 = 30 – 1 = 29$.
7.3 Prise de décision statistique : statistique F, P-valeur et valeur critique
L’aboutissement logique du modèle réside dans l’arbitrage formel entre l’hypothèse nulle ($H_0$) et l’hypothèse alternative ($H_1$). Ce jugement statistique s’appuie sur la mise en relation des trois indicateurs ultimes générés dans les dernières colonnes de la table d’ANOVA :
La statistique empirique calculée F correspond directement au rapport des carrés moyens :
$$F = \frac{MS_{between}}{MS_{within}} = \frac{1443,433}{15,478} = 93,259$$
Ce résultat démontre que la variance générée par les différentes méthodes pédagogiques est plus de 93 fois supérieure à la variance imputable au bruit aléatoire ou aux différences individuelles d’apprentissage. Pour déterminer si un tel écart peut être fortuit, l’algorithme confronte cette valeur empirique à la valeur critique théorique (F crit). Pour une distribution F paramétrée avec 2 degrés de liberté au numérateur et 27 degrés de liberté au dénominateur sous un risque d’erreur $\alpha = 0,05$, la table de Fisher-Snedecor stipule une valeur seuil critique de 3,354.
Puisque la statistique calculée pulvérise littéralement la valeur seuil ($F_{observe} = 93,259 > F_{crit} = 3,354$), la statistique se positionne profondément dans la région critique de rejet extrême. Cette conclusion est corroborée par la lecture de la P-value, qui s’affiche sous forme de notation scientifique : 1.42E-12, c’est-à-dire $0,00000000000142$ ($1,42 \times 10^{-12}$). Cette probabilité infime, vertigineusement inférieure au seuil $\alpha = 0,05$, signifie qu’il n’y a qu’environ une chance sur mille milliards d’observer de telles disparités de scores sous l’hypothèse où les trois méthodes pédagogiques posséderaient en réalité la même efficacité. La décision méthodologique s’impose sans équivoque : nous rejetons formellement l’hypothèse nulle $H_0$ et concluons à l’existence d’un effet hautement significatif du mode d’apprentissage sur la rétention mnésique.
8. Évaluation de l’ampleur de l’effet : calcul de l’Éta-carré (η²) et de l’Oméga-carré (ω²)
8.1 Calcul et interprétation de l’Éta-carré (η²)
L’obtention d’une valeur p hautement significative ne clôture en aucun cas la démarche de l’investigateur. Dans les sciences comportementales contemporaines, la significativité statistique informe uniquement sur la probabilité d’obtenir les données sous $H_0$, sans renseigner sur la magnitude concrète de l’effet étudié. Il est donc impératif de quantifier la taille d’effet, dont l’estimateur canonique pour l’ANOVA unifactorielle est l’Éta-carré ($\eta^2$).
L’Éta-carré conceptualise la proportion de variance totale de la variable dépendante directement expliquée ou prédite par la variable indépendante. Sa formulation mathématique s’avère d’une limpidité absolue :
$$\eta^2 = \frac{SS_{between}}{SS_{total}}$$
Pour calculer cette métrique au sein de notre feuille Google Sheets, positionnez-vous dans une cellule libre (par exemple en E18) et encodez la formule pointant vers les cellules correspondantes du tableau généré par le ToolPak : =F5/F7 (en supposant que $SS_{between}$ réside en F5 et $SS_{total}$ en F7). À partir de nos résultats numériques, nous obtenons :
$$\eta^2 = \frac{2886,867}{3304,767} \approx 0,8735$$
En référence aux balises interprétatives universellement consacrées par Jacob Cohen (1988), un $\eta^2$ d’environ $0,01$ qualifie un effet faible, un $\eta^2$ de $0,06$ dénote un effet moyen, tandis qu’un $\eta^2$ franchissant $0,14$ caractérise un effet fort ou massif. Dans notre protocole, la valeur pharaonique de $\eta^2 = 0,874$ indique que 87,35 % de la variance totale des performances mnésiques constatées chez les étudiants est directement attribuable au type de méthode pédagogique expérimentée. Il s’agit d’un effet d’une envergure exceptionnelle, attestant de l’impact déterminant de la modalité d’encodage.
8.2 Calcul de l’Oméga-carré (ω²) pour un estimateur non biaisé
Bien que l’Éta-carré demeure la mesure descriptive la plus universellement divulguée dans les publications, elle souffre d’un biais d’échantillonnage structurel : $\eta^2$ est un estimateur d’échantillon qui a tendance à surestimer l’ampleur véritable de l’effet dans la population générale, en particulier lorsque les effectifs totaux sont modestes ($N le 30$). Pour pallier ce biais de libéralité statistique, les méthodologistes recommandent instamment le calcul de l’Oméga-carré ($\omega^2$), conçu pour corriger l’inflation artificielle en soustrayant le carré moyen de l’erreur résiduelle.
La formule mathématique exacte de l’Oméga-carré s’énonce comme suit :
$$\omega^2 = \frac{SS_{between} – (df_{between} \times MS_{within})}{SS_{total} + MS_{within}}$$
L’implémentation de cet estimateur robuste dans Google Sheets s’avère extrêmement aisée via une formule articulée sur les données de notre table d’ANOVA :
=(2886.867 - (2 * 15.478)) / (3304.767 + 15.478)
Décomposons le calcul arithmétique étape par étape :
1. Le numérateur s’établit à : $2886,867 – (2 \times 15,478) = 2886,867 – 30,956 = 2855,911$.
2. Le dénominateur correspond à : $3304,767 + 15,478 = 3320,245$.
3. Le quotient produit : $\omega^2 = \frac{2855,911}{3320,245} \approx 0,8601$.
Comme anticipé par la théorie statistique, l’Oméga-carré ($\omega^2 = 0,860$ soit 86,01 %) corrige légèrement à la baisse l’estimation de l’Éta-carré ($\eta^2 = 0,874$), offrant un reflet beaucoup plus sobre, impartial et scientifiquement intègre de l’impact réel du traitement pédagogique au sein de la population générale d’étudiants.
8.3 Rôle de la taille d’effet dans la reproductibilité en psychologie
Depuis le début des années 2010, les sciences psychologiques et sociales traversent ce que les épistémologues qualifient de « crise de la reproductibilité ». De multiples expériences historiques majeures se sont avérées impossibles à reproduire fidèlement, un écueil largement imputable à une dépendance myope envers le seuil arbitraire de $p < 0,05$. Une p-valeur minuscule peut être artificiellement générée par un échantillon gigantesque testant un effet microscopique sans aucune pertinence clinique ou sociétale réelle.
À l’inverse, l’ancrage de la décision expérimentale sur des indices standardisés de taille d’effet tels que $\eta^2$ ou $\omega^2$ recentre la discipline sur la substance phénoménologique des interventions. Ces mesures quantitatives décontextualisées offrent aux chercheurs la matière première indispensable pour alimenter les futures méta-analyses, permettant de synthétiser cumulativement les données à l’échelle internationale par-delà les particularismes d’échantillonnage de chaque laboratoire.
De plus, l’estimation rigoureuse de la taille d’effet constitue la condition préalable requise pour conduire des analyses de puissance statistique a priori lors de la conception de protocoles expérimentaux ultérieurs. Sachant que la méthode pédagogique active génère un effet colossal ($\omega^2 > 0,80$), un chercheur souhaitant reproduire ce paradigme expérimental saura à l’avance qu’une cohorte modeste suffira amplement pour atteindre une puissance statistique nominale de 80 % ou 95 %, épargnant ainsi de précieuses ressources humaines et matérielles de recherche.
9. Tests post-hoc et comparaisons multiples à la suite d’un test omnibus significatif
9.1 La nécessité d’investigations complémentaires après rejet de H0
Bien que notre test omnibus d’ANOVA démontre sans équivoque que les trois conditions d’apprentissage ne partagent pas la même efficacité ($F(2, 27) = 93,26 ; p < 0,001$), il est intrinsèquement incapable de préciser la topographie exacte de ces disparités. Le résultat global valide l'existence d'au moins une différence significative, mais laisse en suspens des questions opérationnelles primordiales :
– La récupération espacée est-elle statistiquement supérieure à la répétition passive ?
– L'élaboration visuelle surpasse-t-elle la récupération espacée ?
– Ou bien le rejet de $H_0$ découle-t-il exclusivement de l'écart phénoménal séparant la méthode passive des deux autres, ces dernières étant par ailleurs équivalentes entre elles ?
Pour dénouer ces interrogations, l’expérimentateur doit conduire des comparaisons multiples par paires (tests post-hoc). Cependant, ainsi que nous l’avons théorisé à la section 1.3, procéder à ces comparaisons par des tests t conventionnels ferait ressurgir la menace immédiate d’inflation de l’erreur de première espèce par famille. Il devient impératif d’incorporer des procédures d’ajustement mathématique encadrant la multiplication des contrastes.
Dans la littérature psychologique, trois grandes approches post-hoc s’affrontent selon le compromis recherché entre puissance statistique et sévérité de contrôle : la méthode de Scheffé (extrêmement conservatrice, adaptée à l’exploration de contrastes complexes post-hoc non planifiés), la correction de Bonferroni (universelle, rigoureuse et facilement implémentable dans tout tableur), et la procédure HSD de Tukey (Honestly Significant Difference), largement reconnue comme la méthode optimale et la plus équilibrée pour les comparaisons bilatérales deux à deux sous homoscédasticité.
9.2 Mise en œuvre de la correction de Bonferroni dans Google Sheets
La méthode d’ajustement de Bonferroni repose sur une logique mathématique d’une grande élégance : pour maintenir le taux d’erreur par famille au seuil cible de $\alpha = 0,05$, il suffit de diviser ce seuil nominal par le nombre total de comparaisons par paires effectivement réalisées ($c$). Dans notre protocole à trois groupes ($k = 3$), le nombre de contrastes bilatéraux indépendants s’élève à :
$$c = \frac{k(k – 1)}{2} = \frac{3(3 – 1)}{2} = 3$$
Le seuil de significativité corrigé et ajusté pour chaque comparaison individuelle devient donc :
$$\alpha_{ajusté} = \frac{\alpha}{c} = \frac{0,05}{3} \approx 0,0167$$
Pour exécuter ces comparaisons par paires directement dans Google Sheets sans module externe, nous utilisons la fonction native de test d’hypothèse pour deux échantillons indépendants à variances égales : =TEST.T(). Cette fonction requiert quatre arguments successifs : la plage du premier groupe, la plage du second groupe, le type de test unilatéral (1) ou bilatéral (2), et la modalité du test (homoscédastique = 2) :
- Comparaison 1 (Méthode 1 Passive vs Méthode 2 Espacée) :
Saisissez en cellule E21 :=TEST.T(A2:A11; B2:B11; 2; 2)
Le tableur retourne : p = 2,51E-07 ($0,000000251$). - Comparaison 2 (Méthode 1 Passive vs Méthode 3 Visuelle) :
Saisissez en cellule E22 :=TEST.T(A2:A11; C2:C11; 2; 2)
Le tableur retourne : p = 1,48E-11 ($0,0000000000148$). - Comparaison 3 (Méthode 2 Espacée vs Méthode 3 Visuelle) :
Saisissez en cellule E23 :=TEST.T(B2:B11; C2:C11; 2; 2)
Le tableur retourne : p = 0,000138.
En confrontant chacune de ces trois valeurs p au seuil corrigé de Bonferroni ($\alpha_{ajusté} = 0,0167$), nous constatons que les trois p-valeurs sont infiniment inférieures à la barre critique. Nous concluons de manière irréfutable que chaque modalité pédagogique se différencie significativement de toutes les autres : la méthode espacée surpasse formellement la répétition passive, et l’élaboration visuelle surpasse à son tour très nettement la méthode espacée.
9.3 Calcul manuel de la différence honnêtement significative de Tukey (Tukey HSD)
Bien que la correction de Bonferroni offre une réponse robuste et immédiate, elle pèche par un conservatisme excessif. Le test HSD de Tukey (Honestly Significant Difference) optimise la puissance statistique en calculant l’écart minimal critique que doivent présenter deux moyennes empiriques pour être déclarées statistiquement distinctes au seuil global $\alpha = 0,05$.
La formulation théorique de la valeur critique de Tukey s’énonce comme suit :
$$HSD = q_{crit} \times \sqrt{\frac{MS_{within}}{n}}$$
où $q_{crit}$ représente la valeur critique issue de la distribution de l’étendue studentisée (Studentized Range Distribution) pour $k$ groupes, $df_{erreur}$ degrés de liberté au dénominateur et un niveau $\alpha = 0,05$ ; $MS_{within}$ désigne le carré moyen résiduel issu de notre table d’ANOVA ; et $n$ correspond à la taille d’échantillon par groupe ($n = 10$).
En consultant une table statistique de l’étendue studentisée pour $k = 3$, $df = 27$ et $\alpha = 0,05$, nous extrayons la valeur théorique : $q_{crit} \approx 3,506$.
Intégrons nos données matricielles dans la formule pour calculer le seuil critique d’écart :
1. Calcul du terme d’erreur standard moyen : $\sqrt{\frac{MS_{within}}{n}} = \sqrt{\frac{15,478}{10}} = \sqrt{1,5478} \approx 1,2441$.
2. Calcul de la différence critique minimale : $HSD = 3,506 \times 1,2441 \approx \mathbf{4,362}$.
Cette constante $HSD = 4,36$ constitue notre mètre-étalon : toute divergence absolue observée entre deux moyennes empiriques $|\bar{X}_j – \bar{X}_{j’}|$ excédant $4,36$ points sera jugée significative au niveau de confiance de 95 %.
| Contraste par Paires | Différence Observée (|ΔM|) | Seuil Critique HSD | Conclusion Statistique |
|---|---|---|---|
| Méthode 2 vs Méthode 1 | |77,90 – 62,70| = 15,20 | 4,36 | Significatif (p < 0,01) |
| Méthode 3 vs Méthode 1 | |86,10 – 62,70| = 23,40 | 4,36 | Significatif (p < 0,01) |
| Méthode 3 vs Méthode 2 | |86,10 – 77,90| = 8,20 | 4,36 | Significatif (p < 0,01) |
Toutes les différences observées surpassent très largement le seuil minimal de 4,36 points. La hiérarchie cognitive est formellement établie avec un niveau de précision mathématique exemplaire : l’élaboration visuelle offre le gain d’apprentissage le plus puissant de l’étude.
10. Analyse des résidus et vérification des hypothèses sous-jacentes dans Google Sheets
10.1 Calcul et extraction des valeurs résiduelles
L’excellence méthodologique exige de ne jamais considérer les conclusions d’une ANOVA comme acquises sans avoir conduit au préalable un diagnostic approfondi des résidus du modèle statistique. Le modèle linéaire sous-jacent à l’ANOVA s’exprime par $Y_{ij} = \mu + \alpha_j + \varepsilon_{ij}$, où chaque observation individuelle $Y_{ij}$ est la somme de la moyenne de sa condition plus une composante résiduelle d’erreur pure ($\varepsilon_{ij}$).
Le résidu individuel correspond exactement à l’écart mathématique séparant le score observé du participant de la moyenne arithmétique de son groupe :
$$e_{ij} = Y_{ij} – \bar{Y}_j$$
Pour calculer cette matrice résiduelle dans Google Sheets, construisons un nouveau bloc tabulaire dans les colonnes A16:C25 :
– Pour le premier participant de la méthode 1 (cellule A2 valant 62, avec une moyenne de groupe en A13 de 62,70), saisissez en A17 : =A2 - $A$13. Le résidu produit est de -0,70.
– Étendez cette formule par incrémentation automatique sur l’ensemble de la plage A17:C26 en bloquant la ligne de la moyenne via le symbole dollar ($).
Une fois les 30 résidus extraits, vérifiez immédiatement la propriété mathématique intrinsèque fondamentale de l’ANOVA : la somme algébrique de l’intégralité des résidus doit être rigoureusement égale à zéro. En implémentant en cellule D27 la formule =SOMME(A17:C26), le résultat renvoie 0 (ou une valeur infinitésimale de l’ordre de $10^{-14}$ liée aux arrondis de virgule flottante binaire), apportant la confirmation que la matrice résiduelle est prête pour l’analyse diagnostique.
10.2 Évaluation graphique de la normalité et des valeurs aberrantes
Pour évaluer la conformité de ces résidus avec la loi normale, nous mobilisons les outils graphiques intégrés de Google Sheets en procédant à la construction d’un histogramme de distribution des résidus :
1. Rassemblez l’ensemble des 30 résidus sous une colonne unique (par exemple dans la colonne G).
2. Sélectionnez cette plage de données résiduelles.
3. Cliquez sur le menu Insertion, puis sélectionnez Graphique.
4. Dans le volet de configuration de l’éditeur graphique, déroulez le menu Type de graphique et optez pour Graphique en histogramme.
L’observation visuelle de cet histogramme permet de vérifier l’absence d’asymétrie brutale ou de structure bimodale. Les barres doivent présenter une disposition approximativement symétrique et culminer autour de la valeur centrale zéro.
En parallèle, l’identification des observations aberrantes univariées (outliers) s’effectue par standardisation des résidus. Sont considérées comme potentiellement aberrantes les observations dont le résidu dépasse 2,5 à 3 écarts-types résiduels ($\sqrt{MS_{within}} = \sqrt{15,478} \approx 3,93$). Aucun des résidus de notre jeu empirique ne s’éloigne de plus de $\pm 5,9$ points de la moyenne, soit un intervalle de $\pm 1,5$ écart-type. Le jeu de données ne recèle par conséquent aucune valeur aberrante susceptible de contaminer les conclusions inférentielles.
10.3 Vérification numérique de l’homogénéité des variances
Bien que nous ayons déjà constaté un alignement impressionnant des variances descriptives au sein du tableau SUMMARY, la validation formelle de l’homogénéité des variances peut s’enrichir d’indicateurs numériques standardisés directement calculables dans le tableur.
L’approche la plus accessible réside dans le test de Hartley (F-max). Ce test paramétrique évalue l’hypothèse nulle d’égalité des variances en calculant le ratio de la variance d’échantillon maximale sur la variance minimale :
$$F_{\max} = \frac{s_{\max}^2}{s_{\min}^2} = \frac{16,989}{14,322} \approx 1,186$$
En consultant les tables critiques de Hartley pour $k = 3$ et $df = n – 1 = 9$, la valeur critique au seuil $\alpha = 0,05$ s’établit à 5,34. Notre valeur observée ($1,186$) étant infiniment inférieure à cette borne critique, le test confirme formellement l’absence d’hétéroscédasticité statistiquement décelable.
Si notre jeu de données avait manifesté une hétérogénéité flagrante ($s_{\max}^2 / s_{\min}^2 > 4$ avec des effectifs inégaux), il aurait été impératif de contourner l’ANOVA de Fisher standard. Deux alternatives méthodologiques s’imposeraient alors :
1. Réaliser la correction d’asymétrie de Welch, qui pondère les degrés de liberté résiduels par l’inverse des variances respectives de chaque échantillon pour neutraliser le risque de faux positifs.
2. Effectuer une transformation non linéaire stabilisatrice de variance sur la variable dépendante (par exemple une transformation logarithmique $Y’ = ln(Y)$ ou racine carrée $Y’ = \sqrt{Y}$) avant de réexécuter l’ANOVA sur les données transformées.
11. Rédaction académique des résultats de l’ANOVA selon les normes de l’APA (7e édition)
11.1 Directives de mise en forme et de notation statistique APA
La communication scientifique des analyses de variance est soumise à un corpus de normes typographiques et rédactionnelles d’une rigueur absolue édictées par l’American Psychological Association dans son manuel de style officiel (7e édition). La transposition des chiffres issus de Google Sheets vers le corps du texte d’un manuscrit doit impérativement obéir aux règles suivantes :
- Italiques obligatoires pour les symboles statistiques : Les lettres représentant des statistiques de test ou des paramètres d’échantillon doivent être rigoureusement composées en italique : F, p, M (moyenne), SD (écart-type), t, $\eta^2$, $\omega^2$. Les chiffres associés et les termes d’identification d’indices demeurent en romain droit.
- Règle des degrés de liberté : Les degrés de liberté du test doivent être systématiquement précisés entre parenthèses immédiatement après la lettre F, séparés par une virgule et un espace, sans espace entre la lettre F et la parenthèse ouvrante : F(2, 27). Le premier chiffre correspond aux degrés de liberté intergroupes ($k – 1$), le second chiffre aux degrés de liberté d’erreur intragroupe ($N – k$).
- Règle du zéro initial pour la p-valeur : Conformément à la norme APA, les statistiques dont la valeur théorique ne peut structurellement jamais excéder le chiffre 1 (telles que les probabilités p, les coefficients de corrélation de Pearson r ou les tailles d’effet $\eta^2$) ne doivent jamais comporter de zéro avant le séparateur décimal. On écrit impérativement p = .023 et jamais p = 0.023.
- Gestion de la précision décimale : Les statistiques d’inférence (valeur de F, moyennes, écarts-types) s’arrondissent de manière standard à deux décimales après la virgule (ex. F = 93,26 ; M = 77,90 ; SD = 4,12). En revanche, la valeur de probabilité p s’énonce avec trois décimales. Lorsque la p-valeur générée par le tableur affiche une valeur infinitésimale (telle que notre
1.42E-12), il est strictement interdit de mentionner p = .000 (une probabilité n’étant jamais rigoureusement nulle). On reporte obligatoirement la formulation conventionnelle : p < .001.
11.2 Modèles de phrases types pour la section Résultats d’un article de recherche
Dans la section Résultats d’un rapport de recherche en psychologie cognitive, la présentation des données doit suivre une architecture narrative tripartite : description de la tendance globale, formalisation inférentielle du test omnibus accompagnée de sa taille d’effet, et déploiement détaillé des tests post-hoc décortiquant les contrastes de paires.
Voici le paragraphe académique complet, parfaitement conforme aux canons stylistiques de l’APA 7e édition, prêt à être inséré dans un manuscrit empirique :
« Une analyse de variance unidirectionnelle inter-sujets (ANOVA) a été conduite afin d’évaluer l’impact des différentes modalités pédagogiques d’encodage sur le score de rétention mnésique à sept jours. Les résultats révèlent un effet principal statistiquement très significatif de la méthode d’apprentissage, F(2, 27) = 93,26, p < .001, $\eta^2$ = .87, $\omega^2$ = .86. L’ampleur de cet effet s’avère particulièrement massive selon les critères de Cohen, indiquant que plus de 86 % de la variance de mémorisation dans la population parente est attribuable à la manipulation expérimentale.
Les comparaisons multiples post-hoc réalisées au moyen de la procédure HSD de Tukey (différence honnêtement significative au seuil critique de 4,36 points) démontrent que les participants soumis à la pratique de récupération espacée (M = 77,90, SD = 4,12) obtiennent des performances de rétention significativement supérieures à celles des sujets assignés à la condition contrôle de relecture passive (M = 62,70, SD = 3,89, p < .001). Par ailleurs, la stratégie d’élaboration sémantique et visuelle (M = 86,10, SD = 3,78) génère un score mnésique significativement plus élevé que la récupération espacée (p < .001) et que la relecture passive (p < .001). Ces résultats confirment l’hypothèse d’une hiérarchisation cognitive croissante de la consolidation mnésique en fonction de la profondeur de traitement actif requise lors de l’apprentissage. »
11.3 Conception d’un tableau et d’une figure conformes aux standards académiques
Selon les exigences de publication APA, les figures et tableaux ne doivent pas dupliquer inutilement le texte narratif, mais en synthétiser l’architecture conceptuelle avec une clarté immédiate. Le tableau récapitulatif d’ANOVA formaté aux normes APA exclut totalement les bordures verticales et ne retient que trois lignes horizontales épaisses : une bordure supérieure sous le titre, une bordure séparant les en-têtes des données numériques, et une bordure inférieure refermant le corps du tableau avant les notes de bas de page.
Voici la mise en forme recommandée pour votre tableau de synthèse à intégrer dans votre rapport :
| Source | SS | df | MS | F | p | $\eta^2$ |
|---|---|---|---|---|---|---|
| Méthode pédagogique (Intergroupes) | 2886,87 | 2 | 1443,43 | 93,26 | < .001 | .87 |
| Résiduelle (Intragroupe) | 417,90 | 27 | 15,48 | |||
| Total | 3304,77 | 29 |
Note. N = 30 (n = 10 par groupe). SS = somme des carrés ; df = degrés de liberté ; MS = carré moyen. Niveau d’erreur $\alpha$ fixé à .05.
Pour concevoir la figure graphique associée dans Google Sheets :
1. Créez un petit tableau auxiliaire rassemblant les noms des trois groupes et leurs moyennes arithmétiques respectives (62,70 ; 77,90 ; 86,10).
2. Sélectionnez cette zone et insérez un Graphique à colonnes (diagramme en barres).
3. Dans l’onglet Personnaliser de l’éditeur de graphiques, accédez au volet Série.
4. Cochez la case Barres d’erreur. Définissez le type d’erreur sur Constante ou Écart-type pour faire figurer visuellement la variabilité intra-groupe (dans notre cas, réglez une valeur constante d’environ 3,93 représentant l’erreur type commune ou utilisez l’intervalle de confiance à 95 % $\approx \pm 2,78$ points).
5. Supprimez le quadrillage arrière-plan tape-à-l’œil, appliquez des teintes grises ou monochromes sobres, et libellez avec précision les axes conformément à l’esthétique minimaliste propre aux standards académiques internationaux.
12. Limites de Google Sheets, erreurs courantes et alternatives statistiques
12.1 Erreurs fréquentes lors de la réalisation d’une ANOVA dans Google Sheets
L’utilisation d’un tableur pour la modélisation inférentielle recèle plusieurs écueils méthodologiques bien identifiés qu’il convient de prévenir méthodiquement :
- La confusion des sources de variation : L’une des erreurs les plus dommageables consiste à intervertir mentalement la somme des carrés intergroupes (Between) et la somme des carrés intragroupe (Within) lors de la rédaction du rapport de recherche. Rappelez-vous toujours que le carré moyen intergroupe constitue le numérateur de Fisher évaluant le traitement, tandis que le carré moyen résiduel réside au dénominateur pour chiffrer le bruit.
- L’omission critique de la case « Labels in first row » : Lorsque cette case demeure accidentellement décochée dans le volet XLMiner alors que la première ligne comporte des libellés textuels, l’algorithme génère une notification d’erreur paralysante ou, pire encore, convertit les en-têtes en zéros dans certains modules non sécurisés, ruinant irrémédiablement l’estimation de la moyenne du premier niveau de traitement.
- L’application intempestive de tests post-hoc en cas d’ANOVA non significative : Une faute déontologique courante consiste à constater une p-valeur omnibus non significative ($F > 0,05$), puis à scruter frénétiquement les données via des tests t par paires non corrigés dans l’espoir désespéré de dénicher une comparaison marginalement significative ($p < 0,05$). Si le test omnibus échoue à rejeter $H_0$, l'exploration post-hoc doit immédiatement être interrompue pour proscrire tout dragage de données (p-hacking).
- L’oubli des formats régionaux de séparateurs : L’alternance entre conventions anglo-saxonnes (point décimal) et francophones (virgule décimale) selon les profils de navigateurs peut transformer des nombres flottants en chaînes de texte mortes, induisant des calculs erronés silencieux dans les formules manuelles de taille d’effet.
12.2 Contraintes structurelles de Google Sheets pour l’analyse de variance
En dépit de son incomparable accessibilité universelle et de ses atouts pour le travail collaboratif en temps réel, Google Sheets ne saurait rivaliser avec la puissance computationnelle des progiciels statistiques spécialisés. Le chercheur chevronné doit avoir une conscience aiguë de ses limitations intrinsèques :
En premier lieu, le module complémentaire XLMiner Analysis ToolPak ne délivre aucun test post-hoc automatisé natif. L’utilisateur se trouve contraint de programmer manuellement la correction de Bonferroni via des formules annexes de =TEST.T() ou de calculer à la main le seuil HSD de Tukey en consultant des tables externes imprimées de l’étendue studentisée. Cette lacune accroît substantiellement la charge cognitive et décuple le risque d’erreur humaine de transcription.
En second lieu, Google Sheets s’avère totalement inopérant dès lors que le protocole expérimental s’éloigne de l’analyse unifactorielle inter-sujets la plus élémentaire. La modélisation de plans factoriels croisés complexes (ANOVA factorielle $2 \times 2$ ou $3 \times 3$), l’intégration de covariables continues (ANCOVA), la gestion des mesures répétées intra-sujets (ANOVA à mesures répétées) ou l’analyse simultanée de plusieurs variables dépendantes (MANOVA) demeurent structurellement impossibles à exécuter via les modules standards du tableur.
Enfin, le tableur fait cruellement défaut en matière de tests diagnostiques formels de conformité distributionnelle : l’absence d’algorithmes résidents pour exécuter un véritable test de normalité de Shapiro-Wilk ou un test d’homogénéité des variances de Levene basé sur les médianes astreint le statisticien à des approximations visuelles et à des tests de Hartley F-max moins sensibles.
12.3 Alternatives non paramétriques et transition vers des logiciels spécialisés
Lorsque les données empiriques recueillies sur le terrain violent ostensiblement les postulats de normalité ou d’homogénéité des variances sous de petits effectifs, l’ANOVA à un facteur perd toute validité inférentielle. Le chercheur doit alors mobiliser l’alternative non paramétrique directe de l’ANOVA unifactorielle : le test de Kruskal-Wallis (souvent conceptualisé comme une ANOVA à un facteur sur les rangs).
Le test de Kruskal-Wallis ne requiert aucun postulat quant à la distribution gaussienne de la variable dépendante. Son principe repose sur la transformation préalable de l’ensemble des scores bruts en une série continue de rangs ordonnés (du plus petit au plus grand, de 1 à $N$). L’algorithme confronte ensuite la somme des rangs attribuée à chaque condition expérimentale via une statistique approchant la distribution du Chi-carré ($\chi^2$). Bien que ce test puisse être laborieusement implémenté dans Google Sheets via la fonction native =RANG(), cette démarche requiert des manipulations matricielles fastidieuses.
Dès lors qu’un programme de recherche en psychologie prend de l’ampleur et incorpore des protocoles multivariés, une transition technologique vers des écosystèmes statistiques professionnels s’impose comme une évidence méthodologique :
– Jamovi et JASP : Deux logiciels open-source contemporains dotés d’interfaces graphiques conviviales intuitives. Conçus expressément par et pour des psychologues, ils automatisent instantanément les tests de normalité de Shapiro-Wilk, les tests de Levene, l’ANOVA de Welch, les contrastes post-hoc de Tukey et Scheffé, ainsi que la génération directe de tableaux au format APA et de scripts reproductibles.
– Le langage R (environnement RStudio) : L’étalon-or international de la recherche académique de pointe. Via des paquets spécialisés tels que rstatix, car ou afex, R permet d’exécuter des analyses de variance de n’importe quel degré de complexité avec un contrôle algorithmique total et une traçabilité intégrale du flux de traitement.
– Python (bibliothèques SciPy et Statsmodels) : L’environnement privilégié pour l’intégration de modélisations statistiques avancées et de flux de données massives dans le domaine des neurosciences computationnelles et de l’intelligence artificielle appliquée.
Pour autant, pour l’apprentissage didactique des mécanismes de l’inférence, pour l’exploration rapide de données d’étape ou pour le partage collaboratif de protocoles préliminaires au sein d’une équipe universitaire, Google Sheets couplé à l’analyse de variance demeure un instrument d’une remarquable puissance opérationnelle, alliant la rigueur du calcul mathématique à l’agilité du travail collaboratif dématérialisé.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Snedecor, G. W., & Cochran, W. G. (1989). Statistical methods (8th ed.). Iowa State University Press.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.