
La recherche scientifique en psychologie et en sciences du comportement repose sur un impératif fondamental : produire des connaissances empiriques valides, reproductibles et généralisables au-delà des limites étroites du laboratoire d’expérimentation. Qu’il s’agisse d’évaluer l’efficacité différentielle d’une psychothérapie cognitivo-comportementale face à la dépression majeure, d’explorer les mécanismes neurocognitifs sous-jacents à l’attention sélective, ou encore de mesurer l’impact de l’épuisement professionnel sur le climat organisationnel, le chercheur se heurte invariablement à une contrainte ontologique. L’univers des entités humaines qu’il aspire à modéliser est trop vaste, fluide et hétérogène pour être appréhendé dans sa totalité. L’accès direct à l’ensemble des esprits, des conduites et des subjectivités relève de l’illusion métaphysique.
Face à cet horizon infranchissable, l’art et la science de l’échantillonnage s’imposent comme la clé de voûte de toute démarche d’investigation quantitative ou qualitative. Échantillonner ne se résume nullement à collecter de manière opportuniste un groupe d’individus consentants au détour d’un couloir universitaire ou via les réseaux sociaux numériques. Il s’agit d’une opération méthodologique hautement formalisée, régie par les principes stricts de la théorie des probabilités et de l’épistémologie critique. Choisir un plan d’échantillonnage, c’est définir rigoureusement la nature du lien logique qui autorisera le passage du particulier au général, de la fraction observée à l’ensemble invisible mais théorisé.
Le présent traité propose une exploration exhaustive des différentes méthodes d’échantillonnage mobilisées en psychologie contemporaine. En décortiquant les logiques sous-jacentes aux démarches probabilistes et non probabilistes, ce document offre aux chercheurs, cliniciens et étudiants une boussole analytique pour concevoir des protocoles de recueil de données exempts d’artefacts systématiques. De l’échantillonnage aléatoire simple aux techniques sophistiquées d’échantillonnage piloté par les répondants, chaque méthode sera examinée à la lumière de ses fondements mathématiques, de ses exigences logistiques, de ses illustrations cliniques concrètes et des compromis scientifiques inhérents à son déploiement sur le terrain.
1. Introduction aux méthodes d’échantillonnage en recherche psychologique
1.1 La nécessité de l’échantillonnage face à l’impossibilité du recensement
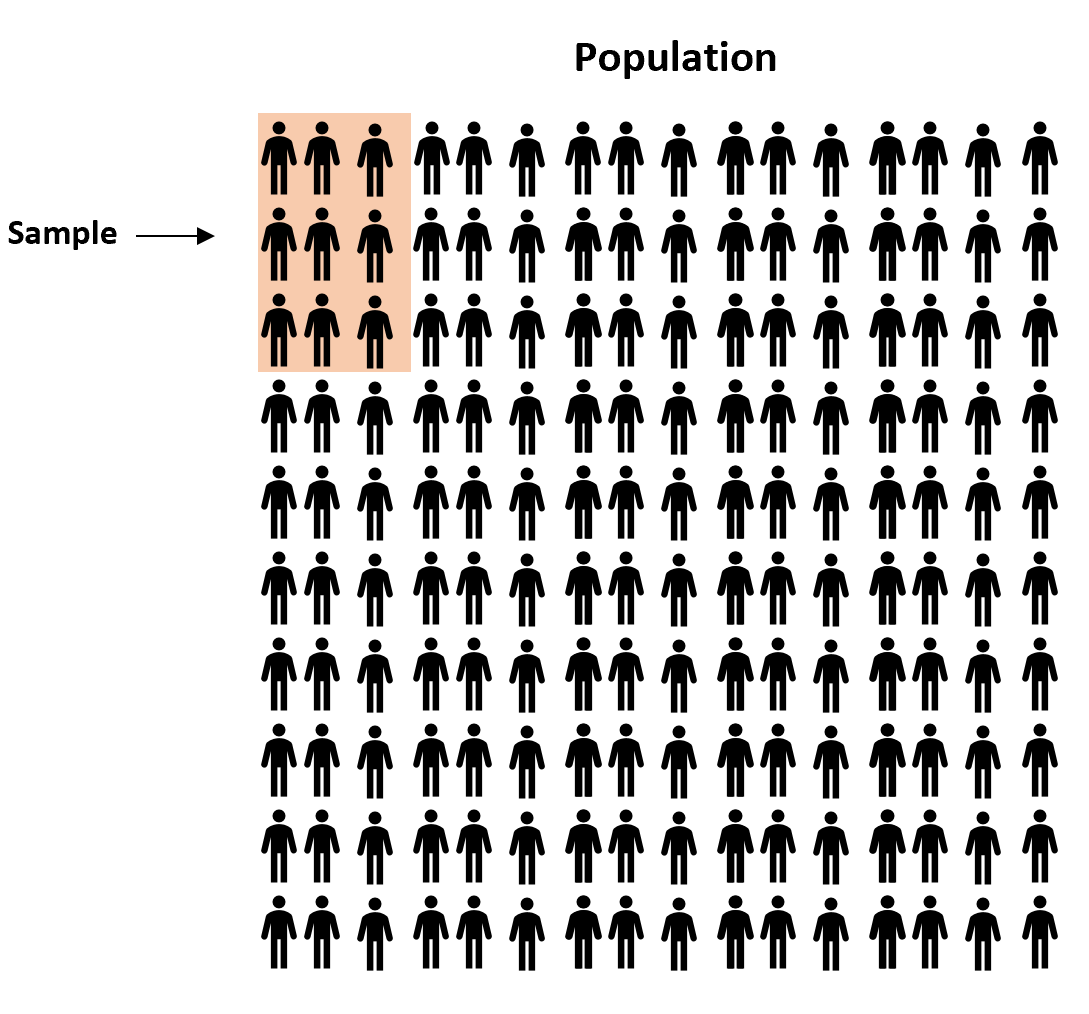
L’ambition première de la recherche empirique consiste à formuler des énoncés vérifiables portant sur des populations définies d’individus partageant des attributs psychologiques, cliniques ou sociodémographiques communs. Toutefois, procéder à un recensement exhaustif de ladite population s’avère, dans l’immense majorité des contextes expérimentaux, une impossibilité absolue. Les contraintes matérielles, financières et temporelles dressent un obstacle infranchissable. Évaluer chaque adulte francophone présentant un trouble dépressif caractérisé requerrait des budgets colossaux, des décennies de passation clinique et des infrastructures logistiques hors de portée de la communauté scientifique internationale. De surcroît, le temps nécessaire à un tel recensement rendrait les premières données obsolètes avant même la clôture de la collecte, altérant la validité de l’observation sous l’effet des évolutions sociétales et nosographiques.
Dès lors, l’échantillonnage constitue la solution paradigmatique indispensable. Il s’articule autour du concept d’inférence statistique, qui agit comme un pont mathématique reliant un sous-ensemble fini et manipulable d’observations empiriques — l’échantillon — à l’entité théorique globale que constitue la population cible. Ce mécanisme inférentiel ne fonctionne de manière légitime que si la méthode d’extraction garantit une correspondance structurelle fidèle entre la partie et le tout. En psychologie, où les objets d’étude sont des construits latents non directement observables tels que l’intelligence, la résilience, l’anxiété ou l’extraversion, la précision de la mesure dépend intimement de la représentativité du groupe évalué.
La moindre distorsion dans le recrutement risque d’introduire des variances parasites qui masqueront ou déformeront les liens fonctionnels entre les variables. L’estimation des paramètres de population, tels que la moyenne d’un score psychométrique ou l’ampleur d’un coefficient de corrélation, requiert donc un plan de sondage capable de minimiser l’erreur aléatoire tout en supprimant l’erreur systématique.
1.2 Objectifs de représentativité et validité externe en psychologie
Au cœur de la démarche méthodologique réside la quête de la représentativité, condition sine qua non de la validité externe des conclusions scientifiques. La validité externe désigne le degré auquel les relations observées entre des variables au sein d’une recherche expérimentale ou corrélationnelle peuvent être étendues à d’autres contextes, d’autres moments et, surtout, d’autres populations d’individus. Dans le champ de la psychologie clinique et cognitive, cette exigence s’articule étroitement avec la préservation de la validité écologique. Les chercheurs doivent garantir que les comportements observés lors de tests standardisés informatisés ou d’entretiens structurés reflètent adéquatement les dynamiques psychiques réelles déployées par les individus dans leur environnement de vie quotidien.
L’atténuation des erreurs systématiques constitue le défi majeur de cette représentativité. Un biais de sélection induit inévitablement une menace pour la généralisabilité des résultats, produisant ce que les méthodologues nomment des artefacts de laboratoire. Par exemple, si une tâche mesurant la mémoire de travail est administrée exclusivement à des individus particulièrement motivés ou possédant des compétences métacognitives supérieures à la moyenne, les inférences quant aux capacités mnésiques de l’être humain en général seront biaisées par excès. L’architecture de la recherche en psychologie doit ainsi opérer un équilibre permanent entre le contrôle expérimental interne — consistant à neutraliser les variables parasites en milieu confiné — et la représentativité externe qui exige l’inclusion d’une variabilité humaine authentique et diversifiée.
1.3 Évolution épistémologique des pratiques d’échantillonnage scientifique
L’histoire de la psychologie scientifique témoigne d’une mutation épistémologique profonde quant aux exigences d’échantillonnage. Aux prémices de la discipline, à la fin du XIXe siècle, les pionniers tels que Wilhelm Wundt à Leipzig ou Hermann Ebbinghaus recouraient fréquemment à l’auto-observation ou à l’examen d’un effectif microscopique composé de collaborateurs académiques. L’étude de cas unique a longtemps constitué la norme pour élucider l’architecture de la psyché humaine, sous le postulat implicite selon lequel les mécanismes élémentaires de la perception ou de la mémoire possédaient une invariance universelle ne nécessitant aucun déploiement d’échantillonnage statistique à grande échelle.
Cette vision a volé en éclats sous l’influence combinée de la psychométrie différentielle initiée par Francis Galton, des travaux théoriques de Ronald Fisher sur la randomisation et des avancées de la théorie moderne des probabilités formalisée par Jerzy Neyman et William Cochran. La communauté des psychologues a progressivement intégré la réalité incontournable des variations interindividuelles et l’obligation de construire des plans de sondage capables de capturer cette variance. Au XXIe siècle, la discipline fait face à de nouvelles mutations sous l’impulsion des méga-données (big data) et de la collecte de données numériques à distance. Si la prolifération de plateformes d’expérimentation en ligne permet d’atteindre des tailles d’échantillons inédites de plusieurs dizaines de milliers de répondants, elle soulève avec acuité la question de la qualité de la sélection. Des masses impressionnantes de données mal échantillonnées génèrent simplement des erreurs hautement significatives du point de vue de la valeur p, réaffirmant la primauté incontestable de la rigueur du protocole d’échantillonnage sur le simple volume quantitatif des observations.
2. Les fondements conceptuels : population cible, cadre d’échantillonnage et échantillon
2.1 Distinction entre population théorique et population accessible
Pour qu’un processus d’échantillonnage conserve sa robustesse conceptuelle, le chercheur doit opérer une distinction nette entre plusieurs niveaux d’agrégation humaine. Le premier niveau est la population cible ou théorique, qui représente la collection exhaustive de toutes les unités d’observation auxquelles la recherche s’intéresse abstraitement et pour lesquelles les conclusions ont vocation à être vraies. Cette population est délimitée de manière stricte par des critères d’inclusion et d’exclusion théoriquement motivés. Par exemple, la population cible d’une étude sur les répercussions du harcèlement moral au travail pourrait être formalisée comme l’ensemble des salariés du secteur tertiaire en activité au sein des pays de l’Union européenne.
Toutefois, confronté aux limites géographiques et administratives du terrain, le chercheur doit identifier la population accessible, c’est-à-dire le sous-ensemble de la population cible qui peut être concrètement approché et répertorié pour la conduite de l’enquête. Dans l’exemple précédent, la population accessible pourra être restreinte aux salariés du secteur tertiaire enregistrés auprès des services de médecine du travail d’une région métropolitaine donnée. L’écart entre la population théorique et la population accessible constitue la première source potentielle de divergence méthodologique. Si la population accessible possède des caractéristiques distinctives non mesurées — par exemple une protection syndicale plus forte ou un accès privilégié à des soins préventifs —, toute tentative de généraliser les constats à l’échelle de la population théorique mondiale sera compromise dès l’origine du protocole.
2.2 La base de sondage : constitution et anomalies structurelles
La base de sondage, également désignée sous le terme de cadre d’échantillonnage, matérialise l’opérationnalisation de la population accessible sous la forme d’un inventaire matériel ou d’un registre énumératif de toutes les unités susceptibles d’être sélectionnées lors de la procédure de tirage. Dans les recherches en psychologie de la santé ou de l’éducation, ce cadre prend fréquemment la forme d’une liste officielle d’étudiants inscrits dans une université, du fichier des patients d’un service hospitalier sectorisé, ou de l’annuaire des membres d’une association professionnelle. La validité du tirage dépend directement de l’adéquation structurelle entre cette base énumérative et la population accessible réelle.
Trois anomalies majeures peuvent corrompre irrémédiablement la qualité d’une base de sondage :
- La sous-couverture : Survient lorsque des segments entiers de la population accessible sont exclus de la liste de manière systématique (par exemple, un registre d’étudiants omettant les personnes en enseignement à distance ou en congé maladie de longue durée).
- La sur-couverture : Implique l’incorporation indue d’unités qui n’appartiennent pas à la population cible (par exemple, la présence de personnels administratifs ou d’anciens diplômés dans un fichier d’étudiants actifs).
- La présence de doublons ou de grappes fantômes : Se manifeste par la répétition d’une même entité sous des identifiants multiples, ce qui accroît artificiellement sa probabilité d’inclusion lors d’un tirage au sort.
Avant d’exécuter la moindre randomisation, les chercheurs doivent soumettre la base de sondage à des protocoles rigoureux de dédoublonnage, de vérification des critères d’admissibilité et de purge des informations obsolètes.
2.3 L’unité d’échantillonnage versus l’unité d’analyse
Une confusion méthodologique fréquente consiste à assimiler l’unité d’échantillonnage à l’unité d’analyse, alors que ces deux entités correspondent à des fonctions distinctes au sein du protocole d’investigation. L’unité d’échantillonnage désigne l’élément concret qui est prélevé ou tiré au sort lors du déploiement du plan de sondage. L’unité d’analyse, quant à elle, fait référence au niveau spécifique où les données sont collectées, mesurées et agrégées statistiquement pour tester les hypothèses du chercheur. Dans les plans de sondage univariés traditionnels, ces deux composantes coïncident souvent : le chercheur tire au sort des individus isolés et analyse les scores psychométriques de ces mêmes individus.
Néanmoins, les structures de données en psychologie sociale, organisationnelle et du développement sont fréquemment hiérarchiques ou imbriquées (nested). Dans une recherche portant sur la transmission de l’angoisse parentale aux enfants, l’unité d’échantillonnage retenue dans la base de sondage municipale peut être le ménage ou le foyer familial. En revanche, l’unité d’analyse peut être l’enfant (niveau 1) imbriqué au sein de la dyade parentale (niveau 2). Ne pas distinguer ces deux concepts engendre des erreurs analytiques majeures, notamment la violation de l’hypothèse d’indépendance statistique des observations. Deux enfants issus d’une même cellule familiale partagent un environnement et des prédispositions génétiques communes ; traiter leurs scores comme des données strictement indépendantes au sein d’une régression classique conduirait à sous-estimer artificiellement les erreurs types et à gonfler le risque d’erreur de première espèce (rejet erroné de l’hypothèse nulle).
3. Typologie générale : méthodes probabilistes versus méthodes non probabilistes
3.1 Principes cardinaux de l’échantillonnage probabiliste
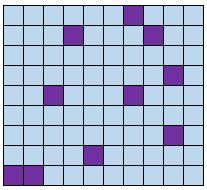
Les méthodes d’échantillonnage se divisent fondamentalement en deux paradigmes épistémologiques irréductibles : les approches probabilistes et les approches non probabilistes. L’échantillonnage probabiliste repose sur un postulat mathématique intangible : chaque unité composant la population cible doit disposer d’une probabilité d’inclusion rigoureusement non nulle, connue d’avance ou calculable formellement à chaque étape de la sélection. Cette condition structurelle élimine radicalement l’arbitraire du chercheur au moment du choix des participants. La randomisation pure agit ici comme un désactivateur des biais cognitifs et des préférences personnelles de l’investigateur, garantissant que les caractéristiques individuelles des sujets ne modulent en rien leur chance d’intégrer le groupe d’étude.
Sur le plan analytique, seule l’approche probabiliste confère la légitimité théorique d’employer les lois fondamentales de la statistique inférentielle, à l’instar du théorème central limite. C’est elle qui autorise le calcul rigoureux de l’erreur type, de la marge d’erreur admissible et la construction d’intervalles de confiance statistiquement valides autour des estimateurs. Sans probabilité d’inclusion connue, la notion même d’intervalle de confiance à 95 % perd tout fondement mathématique rigoureux, car la distribution théorique d’échantillonnage devient mathématiquement indéterminée.
3.2 Caractéristiques et justifications de l’approche non probabiliste
À l’inverse, l’échantillonnage non probabiliste désigne toute stratégie de recrutement dans laquelle les unités ne sont pas sélectionnées au moyen d’un processus de tirage aléatoire à probabilités maîtrisées. Dans cette configuration, la sélection s’opère sur la base de critères pragmatiques : la disponibilité immédiate des individus, le consentement spontané, l’accessibilité géographique, ou le jugement subjectif de l’investigateur quant à la pertinence clinique de tel ou tel profil. Par voie de conséquence, certaines unités de la population cible subissent une probabilité d’inclusion nulle sans que le chercheur ne puisse le quantifier, tandis que d’autres bénéficient d’une surreprésentation invisible.
Malgré l’impossibilité théorique d’appliquer des démarches d’inférence statistique généralisatrice stricte à une population mère, les méthodes non probabilistes occupent une place fondamentale dans l’écosystème de la recherche psychologique. Elles s’imposent comme des options légitimes lors des phases exploratoires d’un programme scientifique, lorsqu’il s’agit de générer de nouvelles hypothèses, de tester la faisabilité opérationnelle d’un paradigme de laboratoire complexe, ou d’explorer les significations subjectives associées à un trouble psychopathologique émergent à travers des méthodologies qualitatives approfondies. De même, face à des populations hautement stigmatisées ou numériquement infinitésimales pour lesquelles aucune base de sondage n’existe — telles que les personnes souffrant de paraphilies rares ou les survivants de traumatismes extrêmes —, l’approche non probabiliste constitue souvent l’unique modalité d’accès empirique envisageable.
3.3 Grille d’arbitrage méthodologique entre rigueur inférentielle et faisabilité
Le choix entre méthode probabiliste et non probabiliste résulte d’une négociation permanente entre idéal méthodologique et contraintes du monde réel. L’investigateur doit arbitrer entre la rigueur inférentielle — qui garantit que les observations sont transposables à la collectivité — et la faisabilité logistique de son dessein expérimental. Les plans probabilistes requièrent l’existence d’une base de sondage exhaustive, le déploiement de protocoles de relance lourds pour contrer la non-réponse, des budgets considérables et des délais d’exécution étendus qui peuvent compromettre la viabilité d’un projet de recherche financé sur des durées courtes.
La grille d’arbitrage s’articule autour de l’objectif scientifique prioritaire assigné à l’étude. Si la question de recherche vise à quantifier des paramètres de prévalence — par exemple, établir le taux de prévalence de la dépression post-partum au sein d’une nation —, le recours au probabilisme est incontournable sous peine de produire des chiffres dénués de toute validité publique. En revanche, si la recherche cherche à isoler un mécanisme fondamental du fonctionnement humain — tel que la mise en évidence de l’effet Stroop dans le traitement automatisé des couleurs et des signaux linguistiques —, la représentativité sociodémographique probabiliste de l’échantillon devient secondaire par rapport à la puissance du contrôle expérimental interne. Le tableau suivant synthétise les points de tension guidant cet arbitrage structurel :
- Ressources financières et temporelles : Les approches probabilistes imposent des coûts élevés de constitution de base et de relance ; les approches non probabilistes offrent une grande célérité pour des coûts marginaux réduits.
- Nature de la question de recherche : Mesure d’indicateurs populationnels vs analyse de mécanismes causaux en laboratoire ou recueil phénoménologique.
- Risque d’artefacts statistiques : Élevé dans les approches de convenance en raison des biais d’auto-sélection ; strictement contrôlé dans les approches probabilistes via la formalisation des erreurs d’échantillonnage.
4. L’échantillonnage aléatoire simple : théorie et mise en œuvre
4.1 Définition théorique et principe d’équiprobabilité
L’échantillonnage aléatoire simple (EAS) représente la forme archétypale et la plus pure de l’échantillonnage probabiliste. Sur le plan théorique, il se définit par une condition d’équiprobabilité symétrique : chaque unité appartenant à la population cible de taille $N$ dispose rigoureusement de la même probabilité d’être incluse dans l’échantillon de taille $n$. Cette probabilité mathématique s’exprime par le ratio constant :
$$P = \frac{n}{N}$$
De surcroît, le principe s’étend aux groupements : toute combinaison possible de $n$ unités distinctes issues de cette population possède une chance exactement identique d’être le sous-ensemble sélectionné pour l’investigation.
L’échantillonnage aléatoire simple peut être exécuté selon deux variantes : avec remise (tirage bernoullien où chaque individu peut être sélectionné plusieurs fois) ou sans remise. Dans la pratique quasi-exclusive de la recherche en psychologie, le tirage sans remise est privilégié, un individu ne pouvant faire l’objet de multiples passations expérimentales identiques sans que sa participation initiale ne contamine ses réponses ultérieures (effet d’apprentissage ou de lassitude). L’atout analytique suprême de l’EAS réside dans sa garantie d’absence totale de biais structurel : l’espérance mathématique de la moyenne d’un échantillon aléatoire simple est formellement égale à la moyenne réelle de la population cible, conférant aux estimateurs une neutralité irréprochable.
4.2 Procédures opérationnelles de randomisation
La mise en œuvre pratique d’un échantillonnage aléatoire simple exige un protocole d’une neutralité technologique absolue. Il est méthodologiquement exclu de se fier à une subjectivité humaine pour déclarer qu’une sélection est « due au hasard ». Historiquement, les chercheurs recouraient à des tables physiques de nombres aléatoires publiées sous forme d’ouvrages spécialisés (telles que la table des 100 000 chiffres aléatoires de la RAND Corporation). Ces procédés manuels ont été supplantés par l’usage d’algorithmes déterministes d’une extrême sophistication, capables de produire des suites de nombres pseudo-aléatoires cryptographiquement sûres, à l’instar de l’algorithme du Mersenne Twister intégré dans la plupart des environnements statistiques modernes.
L’opérationnalisation se déroule selon une séquence algorithmique codifiée dans des logiciels de référence comme R, Python ou SPSS :
- Chaque sujet inscrit dans la base de sondage se voit attribuer un identifiant numérique entier unique et continu allant de $1$ à $N$.
- Un générateur de nombres pseudo-aléatoires est initialisé à l’aide d’une graine de randomisation documentée (seed), assurant la reproductibilité computationnelle de la recherche par d’autres équipes de pairs.
- Le script exécute l’extraction simultanée de $n$ identifiants sans remise, isolant ainsi la cohorte d’étude définitive.
Cette standardisation garantit que l’assignation échappe totalement au contrôle conscient ou inconscient de l’équipe de recherche.
4.3 Exemple d’application en psychologie cognitive
Imaginons un programme de recherche en psychologie cognitive fondamentale visant à évaluer l’impact des alertes visuelles de smartphones sur les performances d’attention soutenue auprès des étudiants de premier cycle universitaire en France. La population cible est définie exhaustivement par l’ensemble des étudiants inscrits dans une licence générale spécifique sur le territoire national, soit une base de sondage institutionnelle de $N = 50,000$ personnes répertoriées au sein d’une base ministérielle accessible aux chercheurs.
Pour cette expérimentation de laboratoire, l’équipe détermine, par un calcul préalable de puissance, qu’un échantillon de $n = 200$ participants est requis. Un script R attribue un index de 1 à 50 000 aux entrées du fichier, puis génère 200 clés uniques. Les étudiants sélectionnés sont ensuite convoqués individuellement pour passer la tâche d’attention de type Continuous Performance Test (CPT). La force de cette procédure réside dans la neutralisation a priori des facteurs confusionnels non mesurés : la variabilité liée au quotient intellectuel, au chronotype (sujet du matin ou du soir), au niveau de privation de sommeil ou au niveau de revenu socio-économique est répartie de manière stochastique équilibrée entre le groupe sélectionné et l’ensemble de la population mère. L’analyse ultérieure vérifiera simplement que les distributions démographiques majeures observées dans le groupe de 200 étudiants ne s’écartent pas statistiquement des paramètres connus de la cohorte nationale des 50 000.
4.4 Atouts analytiques et limitations pratiques
L’avantage cardinal de l’échantillonnage aléatoire simple réside dans son élégance mathématique et sa remarquable clarté conceptuelle. L’absence de pondérations statistiques complexes simplifie considérablement la modélisation ultérieure des données : les calculs de moyennes, de variances, les tests paramétriques (comme le test t de Student ou les analyses de variance ANOVA) s’appliquent directement sur les observations brutes sans nécessiter d’ajustements statistiques liés au plan de sondage (design effect = 1).
En revanche, cette méthode se heurte à des contraintes pratiques souvent rédhibitoires. En premier lieu, elle suppose la possession d’une liste nominative parfaite, actualisée et sans faille de l’ensemble de la population cible, une ressource d’une rareté extrême en dehors des cadres institutionnels restreints (milieu hospitalier fermé, universités, armée). En second lieu, l’EAS s’avère extrêmement coûteux et logistiquement inefficace lorsque la population est géographiquement dispersée. Sélectionner 200 participants par EAS sur l’ensemble d’un pays exige de déployer des expérimentateurs dans des centaines de localités isolées ou de défrayer le déplacement de sujets provenant de régions lointaines pour les faire venir au laboratoire. Enfin, l’EAS est peu performant pour analyser des sous-groupes minoritaires : si une variable clé ne concerne que 2 % de la population générale, un échantillon de 200 personnes n’intégrera en moyenne que 4 individus concernés, interdisant toute comparaison statistique robuste de cette sous-catégorie.
5. L’échantillonnage systématique : mécanismes et applications
5.1 Calcul du pas de sondage et point de départ aléatoire
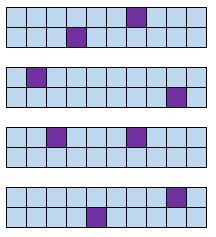
L’échantillonnage systématique s’apparente à une déclinaison mécanique et simplifiée de l’échantillonnage aléatoire. Il s’applique lorsque les unités de la base de sondage sont répertoriées sous forme d’une liste linéaire continue ou se présentent séquentiellement dans un flux temporel régulier. Le mécanisme repose sur le calcul d’un pas de sondage, conventionnellement noté $k$, déterminé par le rapport arithmétique entre l’effectif global de la base de sondage $N$ et l’effectif souhaité pour l’échantillon $n$ :
$$k = \frac{N}{n}$$
L’exigence probabiliste cardinale de cette méthode réside dans l’obligation de déterminer le point de départ — la première unité — au moyen d’un tirage aléatoire strict entre 1 et $k$. Soit un entier aléatoire $r$ compris entre $1$ et $k$ tiré au sort à l’aide d’un algorithme. L’échantillon sera alors constitué de la séquence exhaustive des éléments occupant les positions $r$, $r + k$, $r + 2k$, $r + 3k$, et ainsi de suite jusqu’à l’atteinte de la taille $n$. Dès que le nombre de départ $r$ est fixé, le sort de toutes les autres unités de la base est mathématiquement déterminé. Cette procédure réduit de façon spectaculaire la complexité computationnelle de la sélection sur le terrain, ne réclamant la génération que d’une seule et unique valeur aléatoire.
5.2 Exemple concret en psychologie clinique ambulatoire
Considérons l’évaluation des symptômes anxiodépressifs chez des patients adultes consultants au sein d’un vaste centre médico-psychologique (CMP) métropolitain sur une période consécutive de six mois. Les archives de l’établissement permettent d’estimer avec précision que la file active de nouveaux arrivants sur ce semestre sera d’environ $N = 2,500$ patients. L’équipe médicale souhaite colliger un échantillon représentatif de $n = 500$ usagers pour une batterie d’évaluations psychométriques approfondies sans désorganiser l’accueil clinique quotidien.
Le pas d’échantillonnage est immédiatement calculé :
$$k = \frac{2500}{500} = 5$$
Un tirage aléatoire initial entre 1 et 5 désigne le chiffre $r = 3$. Dès lors, le secrétariat administratif met en œuvre une consigne immuable : le 3e patient se présentant au centre sera invité à participer à l’étude, puis le 8e ($3+5$), le 13e, le 18e, et ainsi de suite. Ce dispositif s’intègre harmonieusement dans le déroulement chronologique des admissions. Les professionnels n’ont nul besoin de recourir à un tirage au sort complexe chaque matin ; la rigueur du recueil repose uniquement sur la tenue irréprochable du registre d’arrivée, tout en évitant que le clinicien ne sélectionne inconsciemment les patients qui lui semblent les plus coopératifs ou les plus stables émotionnellement.
5.3 Le piège de la périodicité et des cycles sous-jacents
Nonobstant sa séduisante simplicité d’exécution, l’échantillonnage systématique recèle un piège méthodologique redoutable capable de vicier irrémédiablement la représentativité des données : le phénomène de résonance périodique. Ce risque émerge avec une intensité maximale lorsque la liste ordonnée ou le flux d’événements renferme un cycle temporel ou structurel occulte dont la longueur coïncide exactement avec le pas de sondage $k$, ou avec l’un de ses multiples entiers.
Dans l’exemple clinique d’un centre ambulatoire ouvert cinq jours par semaine, si le flux des consultations est soumis à une organisation hebdomadaire stricte — par exemple, les lundis étant dédiés aux urgences psychiatriques de décompensation aiguë, et les jeudis aux suivis chroniques de réhabilitation psychosociale —, un pas d’échantillonnage malencontreusement fixé à $k = 5$ ou un multiple entraînerait une sélection systématique du même jour de la semaine. Si le point de départ tombe un lundi, l’échantillon sera artificiellement hypertrophié en cas de détresse psychique aiguë, conduisant à une surestimation dramatique de la sévérité symptomatologique globale de la patientèle. Pour se prémunir contre ce vice caché, les chercheurs doivent auditer méthodologiquement la structure de classement de la base de sondage et, si un ordonnancement cyclique est suspecté, préférer une permutation aléatoire intégrale de la liste avant d’appliquer le pas de sélection, ou s’orienter vers une randomisation simple.
6. L’échantillonnage stratifié : homogénéité intra-groupe et représentativité
6.1 Principes de segmentation en strates mutuellement exclusives
L’échantillonnage stratifié intervient pour résoudre l’un des angles morts majeurs du tirage aléatoire simple : le risque de disparités d’échantillonnage au sein de variables sociodémographiques ou cliniques dont l’influence théorique sur le phénomène étudié est déjà solidement établie dans la littérature. Le principe cardinal consiste à diviser la population globale en sous-groupes appelés strates, caractérisés par une double propriété :
- Les strates doivent être mutuellement exclusives (chaque individu appartient à une et une seule strate) et collectivement exhaustives (l’union des strates regroupe l’ensemble complet de la population).
- La segmentation doit chercher à maximiser l’homogénéité intra-strate (les individus au sein d’une même strate se ressemblent fortement au regard de la variable de segmentation) et l’hétérogénéité inter-strates (les strates diffèrent nettement les unes des autres).
Une fois cette typologie établie dans la base de sondage, le chercheur exécute un échantillonnage aléatoire indépendant au sein de chacune des strates identifiées. L’apport statistique de cette approche est considérable : en contrôlant la variance liée aux variables de stratification, la variance résiduelle au sein de chaque sous-groupe se trouve drastiquement réduite. L’erreur type de l’estimateur global est mécaniquement inférieure à celle qu’aurait générée un échantillon aléatoire simple de taille identique, optimisant ainsi la précision globale de l’évaluation.
6.2 Stratification proportionnelle versus non proportionnelle
La mise en œuvre de la stratification impose un choix quant à la règle d’allocation des effectifs à extraire au sein de chaque strate :
Dans l’échantillonnage stratifié proportionnel, la fraction de sondage $f = \frac{n}{N}$ demeure strictement invariable d’une strate à l’autre. Le poids relatif de chaque strate au sein de l’échantillon final est un décalque mathématique exact de son poids dans la population cible. Si une population d’étudiants comprend 70 % de femmes et 30 % d’hommes, un échantillon stratifié proportionnel de 1 000 sujets sélectionnera aléatoirement 700 femmes au sein de la strate féminine et 300 hommes au sein de la strate masculine. Cette modalité évite d’introduire des pondérations correctives a posteriori lors du calcul des statistiques descriptives globales.
Dans l’échantillonnage stratifié non proportionnel, le chercheur modifie délibérément les fractions de sondage entre les strates afin de répondre à des exigences analytiques spécifiques. Cette option s’impose impérativement lorsqu’un sous-groupe de la population présente un effectif marginal — par exemple, des minorités de genre ou des individus atteints d’une variante génétique très rare —. Dans un plan proportionnel, ces segments marginaux n’auraient bénéficié que d’un nombre infime d’observations, interdisant toute estimation statistique intra-groupe fiable. Le chercheur opère alors un sur-échantillonnage (oversampling) de la strate minoritaire pour lui conférer une puissance statistique suffisante. En contrepartie, lors du traitement agrégé des données visant à refléter la population générale, l’analyste se trouve dans l’obligation méthodologique stricte d’introduire des coefficients de pondération statistique (pondérations par l’inverse de la probabilité de sélection) afin de neutraliser cette déformation volontaire et rétablir la sincérité des paramètres de population.
6.3 Exemple d’étude en psychologie du travail
Illustrons cette méthodologie par une vaste recherche conduite en psychologie du travail et des organisations, dédiée à la mesure de l’épuisement professionnel (burnout) au sein d’un groupe industriel multinational de construction navale comptant $N = 12,000$ employés. La littérature démontre de manière récurrente que le risque et la nature du burnout varient substantiellement selon la position occupée dans la hiérarchie organisationnelle et les contraintes physiques du poste de travail. L’équipe de recherche isole deux critères majeurs pour croiser sa stratification : la catégorie socioprofessionnelle (Cadres de direction, Personnel d’encadrement intermédiaire, Ouvriers d’atelier) et les modalités de travail (Travail de jour posté, Travail en équipes alternées dites « 3×8 »).
Cette typologie génère 6 strates distinctes. Supposons que les ouvriers en 3×8 représentent 50 % de la masse salariale ($N_1 = 6,000$), tandis que les cadres de direction n’en représentent que 5 % ($N_2 = 600$). Pour une étude mobilisant $n = 1,200$ collaborateurs :
- Si le choix est proportionnel, l’équipe tirera au sort 60 cadres (5 % de 1 200) et 600 ouvriers postés en horaires décalés (50 % de 1 200).
- Constatant que 60 cadres est un effectif trop exigu pour stabiliser des modèles complexes d’équations structurelles sur le leadership toxique, les chercheurs optent pour un plan non proportionnel : ils prélèvent 200 cadres (sur-échantillonnage massif) et 400 ouvriers postés.
L’étude analyse ainsi avec une finesse équivalente les déterminants spécifiques du stress chez les cadres tout en réajustant le poids de chaque profil lors de la publication du diagnostic de santé mentale global de l’entreprise.
6.4 Bilan coût-bénéfice de la stratification
L’échantillonnage stratifié s’affirme comme le modèle d’élection en termes d’efficience statistique : il maximise la précision des estimateurs tout en autorisant l’exploration simultanée d’hypothèses transversales globales et d’analyses différentielles au sein des sous-ensembles. En garantissant que des composantes cruciales du corps social ne sont pas évincées par les aléas de la chance, il rassure le chercheur sur la représentativité morphologique de son groupe d’étude.
Néanmoins, son déploiement logistique implique des exigences considérables. La première contrainte réside dans la nécessité absolue de disposer d’informations démographiques ou cliniques préalables sur chaque membre de la base de sondage avant même de débuter l’expérience. Si l’on souhaite stratifier sur la symptomatologie dépressive de base ou le revenu familial, ces variables doivent être préalablement documentées pour l’intégralité du fichier, ce qui est rarement le cas en dehors de registres institutionnels très détaillés. De plus, la gestion se complexifie de façon géométrique dès que l’on croise plusieurs variables de segmentation. Si l’on multiplie l’âge (4 tranches), le genre (2 modalités), le niveau d’instruction (3 paliers) et le statut d’emploi (3 types), le protocole aboutit à $4 \times 2 \times 3 \times 3 = 72$ cellules de stratification distinctes. L’implémentation du tirage au sort indépendant et le suivi des inclusions au sein de 72 sous-listes parallèles représentent un défi de gestion de données nécessitant des ressources d’encadrement méthodologique considérables.
7. L’échantillonnage en grappes : logistique territoriale et analyses multi-niveaux
7.1 Fondements de l’unité collective d’échantillonnage
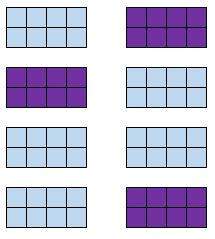
Dans de multiples champs de la recherche psychologique appliquée, le chercheur se trouve dans l’incapacité pratique d’établir une liste exhaustive des individus isolés constituant la population cible, alors même qu’il est en mesure d’obtenir facilement l’inventaire des groupements naturels ou institutionnels au sein desquels ces individus sont regroupés. L’échantillonnage en grappes (cluster sampling) repose sur ce décalage structurel : l’unité d’échantillonnage primaire tirée au sort n’est plus l’individu autonome, mais une entité collective préexistante — la grappe — telle qu’une école, un hôpital psychiatrique, une caserne militaire, un atelier d’usine ou une circonscription géographique délimitée.
L’architecture de l’échantillonnage en grappes répond à des exigences exactement inverses à celles de la stratification :
- Chaque grappe idéale doit être la plus hétérogène possible en son sein (reproduisant en miniature la diversité complexe de la population totale).
- Les grappes doivent être les plus homogènes possible entre elles (deux écoles ou deux hôpitaux tirés au sort doivent afficher des compositions globales comparables pour éviter les distorsions majeures).
L’avantage opérationnel déterminant de cette méthode est d’ordre économique et géographique. Au lieu de mobiliser des assistants de recherche sur des centaines de sites disséminés pour administrer une batterie de tests à des individus isolés, l’équipe concentre ses protocoles d’intervention au sein d’un nombre restreint de sites sélectionnés, réduisant drastiquement les coûts logistiques de déplacement et de supervision des passations.
7.2 Approches à un degré et à plusieurs degrés (multi-étapes)
La sélection en grappes se décline en différentes structures hiérarchiques selon la profondeur du processus de prélèvement. Dans un échantillonnage en grappes à un degré, les chercheurs tirent au sort un ensemble de grappes dans l’inventaire institutionnel, puis intègrent dans l’étude la totalité absolue des individus résidant ou travaillant au sein des grappes élues. Si dix collèges sont tirés au sort sur un territoire, tous les élèves sans exception de ces dix établissements feront l’objet de l’évaluation.
À l’inverse, l’échantillonnage multi-degrés (ou à plusieurs étapes) introduit une succession hiérarchisée d’actes d’échantillonnage à l’intérieur des groupements préalablement retenus. Par exemple, dans un plan à deux degrés :
- Premier degré (unités primaires) : Tirage au sort aléatoire d’un sous-ensemble d’établissements de santé mentale au sein du territoire national.
- Deuxième degré (unités secondaires) : Au sein de chaque établissement désigné, tirage au sort aléatoire d’un nombre fini de services cliniques ou directement d’une fraction des patients hospitalisés.
Cette approche gigogne peut comporter trois ou quatre paliers successifs dans les grandes enquêtes épidémiologiques internationales (par exemple : région $\rightarrow$ ville $\rightarrow$ quartier $\rightarrow$ ménage $\rightarrow$ individu). Ce déploiement en cascade impose des précautions méthodologiques très strictes quant à la modélisation statistique des données, ces dernières ne pouvant plus être traitées comme issues d’un tirage aléatoire simple en raison de la présence d’une corrélation intra-classe substantielle.
7.3 Exemple de recherche en psychologie du développement scolaire
Illustrons les enjeux concrets de cette démarche à travers une recherche en psychologie du développement scolaire explorant les relations entre le climat relationnel en milieu scolaire et l’émergence de comportements de harcèlement entre pairs. La population cible est constituée de l’ensemble des 40 000 élèves scolarisés dans les collèges publics d’un département donné. Obtenir la liste nominative centralisée de 40 000 adolescents afin de réaliser un tirage aléatoire simple est administrativement irréalisable pour des motifs de confidentialité et de secret statistique.
La base de sondage des unités primaires est, en revanche, immédiatement disponible : le répertoire officiel des 80 collèges du département. L’équipe scientifique sélectionne aléatoirement $k = 15$ collèges selon une procédure probabiliste proportionnelle à la taille de leurs effectifs. Dans un plan à deux degrés, les investigateurs tirent ensuite au sort quatre classes par établissement sélectionné, puis administrent un questionnaire sociométrique et psychologique standardisé à l’ensemble des élèves de ces classes. Le recueil s’opère de façon sécurisée en présence de psychologues scolaires dans un cadre collectif contrôlé. Cependant, cette configuration fait émerger un biais de proximité relationnelle évident : les élèves d’une même classe partagent des enseignants identiques, un règlement intérieur commun et des dynamiques socio-affectives locales qui homogénéisent artificiellement leurs réponses, violant frontalement le postulat d’indépendance des observations.
7.4 L’effet de plan et la perte d’efficacité statistique
L’écueil analytique fondamental de l’échantillonnage en grappes réside dans la présence universelle d’une ressemblance accrue entre les unités appartenant à la même unité collective. Cette homogénéité interne est quantifiée par le coefficient de corrélation intra-classe (noté $rho$ ou ICC). L’ICC mesure la part de variance totale d’une variable psychologique qui est attribuable aux variations entre les grappes plutôt qu’aux variations entre les individus au sein d’une même grappe. Plus l’ICC est élevé, plus les observations issues d’une même entité collective sont redondantes d’un point de vue de l’information statistique apportée.
Cette redondance se traduit formellement par ce que les méthodologues nomment l’effet de plan (Design Effect, noté $Deff$), qui quantifie le facteur d’inflation de la variance de l’estimateur par rapport à un échantillon aléatoire simple de taille équivalente :
$$Deff = 1 + (m – 1)\rho$$
où $m$ représente la taille moyenne d’une grappe. Si l’on évalue des classes de 25 élèves ($m = 25$) et que la corrélation intra-classe pour une échelle d’anxiété scolaire est de $rho = 0,10$, l’effet de plan est de :
$$Deff = 1 + (25 – 1) \times 0,10 = 1 + 2,4 = 3,4$$
Ce résultat théorique signifie que la variance de l’échantillonnage est multipliée par 3,4 par rapport à un tirage purement aléatoire, ce qui équivaut à diviser l’effectif effectif d’échantillon par cette même valeur ($n_{effectif} = \frac{n}{Deff}$). Les données doivent impérativement être traitées à l’aide de modèles linéaires mixtes ou multi-niveaux (HLM), sous peine d’obtenir des valeurs $p$ drastiquement sous-estimées et d’aboutir à des conclusions faussement positives.
8. L’échantillonnage de convenance : praticité clinique et limites méthodologiques
8.1 Mécanisme de sélection par accessibilité immédiate
Aux antipodes de la sophistication probabiliste se situe l’échantillonnage de convenance, de loin la modalité la plus massivement documentée et pratiquée dans l’histoire de la psychologie empirique. Cette méthode non probabiliste repose sur un mécanisme fondamentalement pragmatique : les participants sont enrôlés dans le protocole de recherche sur le seul critère de leur accessibilité géographique, relationnelle, administrative ou numérique immédiate au moment où l’investigation est déployée. L’échantillon est constitué des individus qui se trouvent spontanément « sous la main » du chercheur.
Les atouts opérationnels de la convenance sont évidents : elle n’exige aucune base de sondage préalable, n’implique aucun calcul mathématique de tirage, affiche des coûts d’exécution financiers proches de zéro et permet une agrégation foudroyante de données en quelques jours. Pour un jeune chercheur ou une équipe dépourvue de dotations budgétaires lourdes, l’échantillonnage de convenance offre la possibilité d’amorcer un travail de terrain sans délai. Toutefois, cette accessibilité débridée se paie au prix d’un renoncement complet à la représentativité statistique. L’échantillon de convenance ne peut en aucun cas être considéré comme un microcosme impartial de la population d’intérêt, les mécanismes de participation étant exclusivement sous-tendus par des facteurs de proximité et de sélection spontanée non contrôlés.
8.2 Exemple typique : le recours aux cohortes d’étudiants en psychologie
Le cas paradigmatique de l’échantillon de convenance réside dans la mobilisation universelle des étudiants inscrits en première et deuxième années de licence de psychologie pour alimenter les recherches des laboratoires universitaires. Pendant des décennies, d’innombrables départements de psychologie ont instauré des systèmes formalisés dits de « banques de sujets », octroyant des crédits académiques de validation de cours (ou points bonus) aux étudiants en contrepartie d’un certain nombre d’heures passées à se soumettre à des tâches expérimentales informatisées ou à des batteries de tests de personnalité.
Cette pratique produit une homogénéité extrême et profondément artificielle du profil des répondants. Les échantillons universitaires sont systématiquement dominés par des femmes (reflétant la surreprésentation féminine marquée dans ces filières d’enseignement supérieur), d’une tranche d’âge étroitement circonscrite entre 18 et 23 ans, dotées d’un niveau d’instruction supérieur à la moyenne nationale et issues de milieux socio-économiques favorisés. Plus problématique encore, ces sujets acquièrent au fil des semestres une familiarité aiguë avec les protocoles psychologiques (l’effet de clairvoyance du sujet), modifiant leurs conduites comportementales pour satisfaire ou contrecarrer les attentes implicites de l’expérimentateur (caractéristiques de la demande). Extrapoler les lois du fonctionnement émotionnel, moral ou perceptif de l’humanité à partir d’un groupe aussi idiosyncrasique pose un problème épistémologique majeur.
8.3 Le biais des populations WEIRD et l’impératif de prudence
La surutilisation des échantillons de convenance universitaires a été l’objet d’une déconstruction sans concession initiée par le psychologue Joseph Henrich et ses collègues dans leur article historique sur le paradoxe des populations WEIRD (acronyme désignant les sociétés Western, Educated, Industrialized, Rich, Democratic). L’analyse démontrait que près de 96 % des échantillons expérimentaux publiés dans les revues d’élite de la discipline (notamment celles de l’American Psychological Association) provenaient de pays occidentaux représentant moins de 12 % de la population planétaire, et qu’au sein de ces pays, les étudiants formaient l’écrasante majorité du matériel humain analysé.
Cette distorsion compromet gravement l’universalité postulée des modèles théoriques produits en psychologie. De nombreux mécanismes cognitifs fondamentaux que l’on considérait comme des invariants universels de l’espèce humaine — tels que les susceptibilités aux illusions d’optique élémentaires (par exemple l’illusion de Müller-Lyer), les styles de raisonnement analytique versus holistique, les conduites d’altruisme économique au jeu de l’ultimatum ou la structure factorielle de la personnalité à travers le modèle du Big Five — se révèlent être des spécificités culturelles atypiques des populations occidentales éduquées. Les comités de rédaction des revues scientifiques de premier rang exigent désormais des chercheurs qu’ils explicitent rigoureusement dans une section dédiée les contraintes sur la généralisabilité de leurs résultats (déclarations de type Constraints on Generality — COG) et cessent d’employer un langage universaliste lorsque les données émanent d’un simple échantillon de convenance occidental.
9. L’échantillonnage par quotas : équilibrage démographique sans randomisation
9.1 Élaboration des matrices de quotas sociodémographiques
L’échantillonnage par quotas constitue la tentative non probabiliste la plus élaborée pour singer les vertus de la représentativité structurelle sans supporter les lourdeurs organisationnelles d’un tirage au sort probabiliste. Largement démocratisée par l’industrie des instituts de sondage d’opinion et d’études de marché, cette méthode repose sur un postulat pragmatique : si un échantillon reproduit fidèlement les proportions exactes d’une population cible au regard d’un ensemble de variables démographiques clés, alors il sera raisonnablement représentatif de cette même population pour les autres dimensions psychologiques ou comportementales investiguées.
L’implémentation opérationnelle impose la construction d’une matrice de quotas :
- Le chercheur identifie les distributions démographiques réelles de la population de référence en s’appuyant sur les données actualisées des organismes officiels de statistique publique (comme l’Insee en France). Les variables classiquement mobilisées englobent le sexe biologique, les tranches d’âge, le niveau de diplôme, la catégorie socioprofessionnelle (CSP) et le lieu de résidence (taille de l’agglomération ou région administrative).
- Ces proportions sont transposées en objectifs quantitatifs précis au sein de l’échantillon global de taille $n$. Si les femmes âgées de 40 à 59 ans de catégorie ouvrière représentent 6,2 % de la population nationale, un quota de 62 individus répondant exactement à ces caractéristiques cumulées sera attribué pour une enquête de $n = 1,000$ personnes.
- Le recrutement sur le terrain ou via des panels en ligne se poursuit de façon continue jusqu’au remplissage intégral de chaque case de la matrice. Dès qu’un contingent est saturé, tout candidat potentiel présentant ces attributs est éliminé du protocole, l’effort d’inclusion se focalisant sur les cellules encore vacantes.
9.2 Comparaison approfondie avec l’échantillonnage stratifié
Il existe une tentation fréquente d’assimiler l’échantillonnage par quotas à l’échantillonnage stratifié en raison de leur analogie morphologique superficielle : les deux approches découpent la population globale en sous-groupes définis selon des caractéristiques croisées et cherchent à assurer une répartition conforme aux proportions réelles de ces groupes. Pourtant, ces deux démarches appartiennent à des univers épistémologiques radicalement antagonistes.
La divergence fondamentale tient au mode d’affectation des individus au sein des strates ou des cellules de quotas :
- Dans l’échantillonnage stratifié, la sélection au sein de chaque strate est rigoureusement probabiliste : elle s’effectue par un tirage au sort fondé sur une base énumérative exhaustive garantissant une probabilité d’inclusion calculable pour tous.
- Dans l’échantillonnage par quotas, la sélection interne aux cellules est non probabiliste : elle repose entièrement sur la liberté d’action de l’enquêteur ou sur l’auto-sélection spontanée des personnes inscrites sur des panels en ligne rémunérés.
Cette différence induit des conséquences méthodologiques profondes. Dans la méthode des quotas, l’enquêteur de terrain sélectionne préférentiellement les personnes les plus souriantes, les plus faciles à aborder, ou celles résidant dans des zones aisées et sécurisantes. Même si la matrice de quotas est scrupuleusement honorée sur le papier, l’échantillon subit une distorsion systématique sur des facteurs non contrôlés tels que la sociabilité, la disponibilité temporelle, l’anxiété sociale ou le sentiment d’utilité collective. De plus, aucun calcul formel d’intervalle de confiance n’est théoriquement légitime sur des données de quotas, bien que la vulgarisation médiatique enfreigne allègrement cette règle élémentaire de la statistique inférentielle.
9.3 Exemple d’évaluation en psycho-sociologie d’opinion
Soit une recherche en psychosociologie de la santé mentale mesurant l’évolution de la stigmatisation sociale associée à la schizophrénie dans l’opinion publique nationale. Devant l’urgence de collecter des données avant le lancement d’une campagne gouvernementale de sensibilisation, les chercheurs mandatent un institut de sondage pour interroger un échantillon de $n = 1,200$ citoyens âgés de 18 ans et plus via des interfaces web interactives.
La stratification par quotas croise trois variables : le genre (Homme/Femme), quatre tranches d’âge (18-24, 25-49, 50-64, 65 et plus) et l’activité professionnelle (actifs occupés, chômeurs, inactifs/retraités). Le système informatique ventile les répondants issus d’un panel propriétaire de 200 000 panélistes indemnisés à la tâche. Les quotas sont comblés en moins de 48 heures. Toutefois, l’analyse critique du profil des participants révèle une surreprésentation invisible d’individus ultra-connectés, disposant d’un temps libre substantiel et affichant une appétence pour l’évaluation psychométrique. De surcroît, les personnes présentant un niveau d’illettrisme numérique ou une hostilité marquée envers les sollicitations institutionnelles — précisément les segments de la population susceptibles d’entretenir les préjugés les plus stéréotypés à l’égard des troubles psychiatriques — ont refusé ou ignoré l’invitation. La validité des scores de tolérance sociale se trouve ainsi artificiellement rehaussée par le biais d’auto-sélection inhérent aux panels de convenance régis par des quotas.
10. L’échantillonnage au jugé ou intentionnel : sélection d’experts et cas critiques
10.1 Variantes stratégiques de l’échantillonnage raisonné
L’échantillonnage au jugé, également dénommé échantillonnage intentionnel ou raisonné (purposive sampling), s’affranchit délibérément de toute prétention à la représentativité statistique démographique pour privilégier la pertinence théorique ou clinique des profils incorporés. Dans cette modalité, le chercheur sélectionne proactivement des unités d’observation spécifiques sur la base de sa compétence d’expert, guidé par le postulat que ces cas particuliers détiennent des caractéristiques qualitatives ou des trajectoires biographiques incomparables pour répondre à la question scientifique posée.
L’échantillonnage raisonné se ramifie en une pluralité de variantes stratégiques formalisées :
- L’échantillonnage de cas extrêmes ou déviants : Vise l’inclusion d’individus manifestant des scores ou des comportements situés aux marges exceptionnelles de la courbe de Gauss (par exemple des personnes d’une résilience spectaculaire face à l’adversité, ou des génies de la mémoire synesthésique), afin d’explorer les limites fonctionnelles de la cognition humaine.
- L’échantillonnage de cas typiques : Cherche à isoler des sujets incarnant la normalité moyenne d’une condition (par exemple, le profil moyen d’un patient souffrant d’agoraphobie débutante) pour dresser un tableau clinique narratif sans prétention de modélisation mathématique.
- L’échantillonnage par variation maximale : Consiste à sélectionner délibérément des profils les plus contrastés et hétérogènes possibles sur plusieurs axes conceptuels afin d’identifier des invariants phénoménologiques stables qui transcendent la diversité contextuelle.
10.2 Exemple d’investigation en neuropsychologie et résilience
Considérons une recherche neuropsychologique de pointe portant sur les corrélats neurobiologiques de l’invulnérabilité psychologique face aux traumatismes de guerre extrêmes. La population d’intérêt théorique est constituée de vétérans des forces armées ayant été exposés de manière prolongée à des combats d’une létalité extrême et ayant assisté à la perte violente de leurs compagnons d’armes.
Plutôt que d’administrer des questionnaires aléatoires à des centaines de soldats mobilisés, l’équipe de neuropsychiatrie déploie une stratégie d’échantillonnage intentionnel de cas critiques et extrêmes. Sur la base d’un audit de dossiers médicaux militaires exhaustifs, les investigateurs identifient scrupuleusement 25 officiers et soldats d’élite présentant deux critères conjoints exceptionnels :
- Avoir survécu à un nombre documenté d’accrochages au feu hautement létaux.
- Afficher des scores de zéro absolu sur les échelles d’évaluation du Trouble de Stress Post-Traumatique (ESPT) et de dépression sur une période de suivi longitudinal de dix ans après le retour des théâtres d’opérations.
Les profils intermédiaires — les individus développant des symptômes modérés ou transitoires — sont volontairement et méthodologiquement écartés du design expérimental. L’inclusion exclusive de ces 25 sujets « d’acier » permet de pratiquer des explorations d’imagerie par résonance magnétique fonctionnelle (IRMf) haute résolution et des dosages neuroendocriniens ciblés sur le volume de l’hippocampe et l’activité de l’amygdale. Cette stratégie intentionnelle offre une puissance heuristique sans équivalent pour décrypter des mécanismes de régulation biologique qui se trouveraient totalement dissous et indétectables au sein d’un échantillon aléatoire large dominé par la masse des cas ordinaires.
10.3 Rôle et limites de la subjectivité de l’investigateur
La puissance de l’échantillonnage intentionnel repose entièrement sur la lucidité théorique, l’épaisseur de l’expertise clinique et la probité méthodologique du chercheur. Si le diagnostic d’expert repose sur des critères diagnostiques et sémiologiques standardisés, le ciblage des cas critiques enrichit considérablement la modélisation psychologique. En contrepartie, cette méthode confère un pouvoir d’arbitrage discrétionnaire considérable à l’investigateur, exposant l’ensemble de la recherche à la menace insidieuse des biais de confirmation.
Si le chercheur est prisonnier d’une conception théorique préconçue quant à la nature d’un phénomène, il risque de ne sélectionner que les profils de sujets qui corroborent spectaculairement son hypothèse de départ, évacuant inconsciemment comme « non pertinents » des cas atypiques qui viendraient contredire sa modélisation. De surcroît, la représentativité probabiliste étant inexistante, aucune généralisation paramétrique n’est concevable. Les conclusions issues d’un échantillon raisonné doivent toujours être formulées sous la forme de transférabilités conceptuelles hypothétiques plutôt que d’affirmations quantitatives universelles. Afin de préserver la crédibilité scientifique du processus, il est indispensable d’instaurer des démarches de réflexivité documentée, d’audit méthodologique par des tiers indépendants et de décrire avec une transparence clinique totale les critères opérationnels ayant présidé à l’inclusion de chaque cas.
11. L’échantillonnage par boule de neige : investigation des populations marginalisées ou cliniques rares
11.1 Dynamique d’accès aux populations invisibles ou stigmatisées
L’échantillonnage par boule de neige (snowball sampling), ou échantillonnage en chaîne relationnelle, représente une stratégie d’investigation conçue pour pénétrer des segments de population qualifiés de « cachés », « invisibles » ou « difficiles à atteindre » (hard-to-reach populations). Ces groupes se caractérisent par le fait qu’ils ne figurent dans aucun registre administratif, qu’ils s’adonnent à des conduites frappées d’une sévère désapprobation morale ou pénale, ou qu’ils sont unis par des pathologies psychiatriques extrêmement rares et dissimulées.
La dynamique d’échantillonnage procède de façon séquentielle par capillarité réticulaire :
- L’investigateur doit identifier un noyau microscopique d’individus pionniers — appelés « graines » (seeds) — appartenant sans ambiguïté à la sous-culture ou à la catégorie clinique visée. L’accès à ces graines pionnières exige la construction patiente d’une relation de confiance thérapeutique ou ethnographique, souvent médiée par des éducateurs de rue, des travailleurs sociaux ou des associations communautaires de pairs.
- Après avoir participé aux entretiens ou aux tests psychométriques, ces sujets initiaux sont invités à mobiliser leur propre capital social et relationnel en orientant les chercheurs vers d’autres membres de leur réseau partageant les mêmes spécificités.
- Les nouveaux contacts inclus parrainent à leur tour leurs pairs, déclenchant une expansion exponentielle de la taille de l’échantillon semblable à la course d’une boule de neige dévalant une pente.
11.2 L’échantillonnage piloté par les répondants (RDS) comme raffinement
Bien que l’échantillonnage par boule de neige classique ait rendu d’inestimables services à la sociologie clinique et à la psychologie sociale des déviances, il souffre d’un biais méthodologique structurel débilitant : le biais d’homophilie. Les individus ont tendance à parrainer des pairs qui leur ressemblent intimement en termes d’âge, de convictions ou d’intensité de leur comportement déviant, tandis que les membres plus isolés d’un réseau demeurent invisibles. De plus, les sujets possédant un capital social expansif sont surreprésentés par rapport à leurs pairs solitaires, distordant profondément la composition du groupe d’étude.
Pour conférer une rigueur mathématique et une portée inférentielle à cette technique, le sociologue Douglas Heckathorn a formalisé l’échantillonnage piloté par les répondants (Respondent-Driven Sampling ou RDS). Le RDS convertit la simple chaîne relationnelle empirique en un modèle probabiliste rigoureux adossé à la théorie des chaînes de Markov :
- Le chercheur limite strictement le pouvoir de parrainage de chaque répondant en lui confiant un nombre restreint et numéroté de coupons de recrutement (généralement 3 coupons physiques ou jetons cryptographiques uniques).
- Un système d’incitation financière duale et éthique est instauré : le participant reçoit une première compensation pour sa propre passation psychométrique, puis une seconde gratification pour chaque pair qu’il parvient à recruter et qui finalise le protocole.
- Le chercheur enregistre pour chaque individu la taille déclarée de son réseau personnel d’interconnaissance dans la population cible.
L’algorithme de calcul du RDS exploite ces données pour pondérer statistiquement les observations par l’inverse de la taille du réseau personnel des individus et éliminer mathématiquement l’influence des graines initiales lorsque les chaînes de parrainage atteignent un niveau d’équilibre asymptotique après 5 ou 6 vagues successives de recrutement.
11.3 Exemple de recherche en addictologie
Considérons une étude en psychologie clinique de l’addiction dédiée à l’investigation des mécanismes de dissociation cognitive et des comorbidités anxieuses chez les usagers réguliers de nouvelles substances psychoactives (NPS, communément désignées sous l’appellation de drogues de synthèse de synthèse ou « sels de bain »). Ces molécules, souvent commercialisées sous le manteau sur le dark web, échappent aux structures traditionnelles de prise en charge en addictologie. Les usagers forment une population fermée, méfiante à l’extrême envers toute institution étatique, redoutant des poursuites judiciaires ou une stigmatisation destructrice de leur statut professionnel.
L’équipe d’addictologie initie un protocole RDS en identifiant cinq usagers-graines par l’entremise d’une association de réduction des risques en milieu festif électro underground. Les conditions de secret absolu et d’anonymisation numérique (utilisation d’identifiants hachés cryptés) sont présentées. Chaque participant reçoit 3 coupons codés. Au bout de six mois d’expansion des chaînes, l’échantillon final réunit 240 usagers réguliers de NPS, déployés sur des vagues de parrainage ayant atteint une profondeur de 8 niveaux de génération. Grâce à la modélisation statistique du RDS, l’équipe parvient à neutraliser les distorsions induites par le fait que les premières graines étaient issues d’un milieu socio-économique particulièrement bohème, restituant une estimation de la prévalence des troubles psychotiques induits au sein de cette sous-population avec une précision méthodologique inégalée par toute autre méthode de terrain.
12. Erreurs d’échantillonnage, biais méthodologiques et critères de choix en psychologie
12.1 Taxonomie des erreurs : erreur d’échantillonnage et erreurs de mesure
Tout praticien de la recherche psychologique quantitative doit concevoir ses résultats comme le produit conjoint d’un signal théorique réel et d’une quantité inévitable de bruits parasites. L’écart entre l’estimation issue de l’échantillon et la valeur paramétrique véritable de la population s’articule autour de deux grandes composantes qu’il convient de distinguer avec une rigueur absolue :
L’erreur d’échantillonnage stochastique (ou fluctuation d’échantillonnage) : Elle résulte mécaniquement de la nature aléatoire de l’inclusion des individus. Même en menant un tirage aléatoire simple parfait, deux échantillons de 100 individus prélevés dans la même population ne produiront jamais exactement la même moyenne d’anxiété. Cette erreur aléatoire est mathématiquement modélisable par l’erreur type ; elle est prévisible et décroît proportionnellement à la racine carrée de la taille de l’échantillon ($SE propto \frac{1}{\sqrt{n}}$).
Les erreurs non liées à l’échantillonnage (erreurs systématiques ou biais) : Elles ne relèvent pas du hasard mais d’une faille méthodologique structurelle au sein de la chaîne de recueil de données. Contrairement à l’erreur stochastique, elles ne se réduisent aucunement par une simple augmentation de la taille de l’échantillon ; collecter un million de réponses biaisées produit simplement une estimation fausse avec une marge d’erreur infinitésimale. Ces biais incluent :
- Le biais de non-réponse et d’attrition : Les individus qui refusent de répondre ou qui abandonnent une étude longitudinale au fil du temps possèdent des caractéristiques psychologiques distinctes (plus fort isolement social, détresse psychique plus élevée) de ceux qui persévèrent.
- Le biais de désirabilité sociale : Tendance des répondants à déformer leurs réponses pour se conformer aux normes valorisées par le corps social.
- Les biais de couverture : Dysfonctionnements de la base de sondage omettant des composantes clés de la collectivité.
Pour pallier ces déformations non stochastiques, les statisticiens recourent à des méthodes sophistiquées de redressement a posteriori, telles que le calage sur marges et l’imputation multiple par équations chaînées (MICE) pour traiter les données manquantes sans tronquer la structure de covariance des mesures.
12.2 Détermination de la taille de l’échantillon et calcul de puissance statistique
L’une des défaillances historiques les plus pénalisantes de la recherche empirique en psychologie a été la prolifération d’études sous-puissantes (underpowered studies), reposant sur des échantillons trop exigus pour détecter de façon fiable les phénomènes étudiés. Pour pallier ce problème méthodologique, la planification scientifique contemporaine exige la réalisation systématique d’un calcul de puissance statistique a priori (a priori power analysis).
Le calcul de puissance permet de dimensionner l’échantillon $n$ nécessaire pour rejeter à bon droit l’hypothèse nulle ($H_0$) lorsqu’elle est fausse, protégeant ainsi l’expérimentateur contre l’erreur de deuxième espèce (l’erreur $\beta$, consistant à ne pas détecter un effet réel). La puissance d’un test statistique conventionnellement requise dans les standards méthodologiques internationaux de l’American Psychological Association est fixée à :
$$1 – \beta = 0,80 \quad \text{(ou } 0,90 \text{ dans les contextes cliniques critiques)}$$
Pour exécuter cette détermination — généralement au moyen d’outils logiciels de référence tels que G*Power —, l’investigateur doit impérativement définir trois paramètres théoriques interdépendants :
- Le seuil de signification alpha ($\alpha$) : Fixé quasi universellement à $0,05$ (probabilité de déclarer un faux positif).
- La taille de l’effet escomptée : Grandeur standardisée mesurant l’amplitude de la différence ou de l’association recherchée (par exemple le $d$ de Cohen pour les comparaisons de moyennes, ou le $r$ de Pearson pour les corrélations). L’évaluation de cette taille d’effet doit être déduite de méta-analyses antérieures robustes ou de la pertinence clinique minimale théoriquement signifiante, et non fantasmée de façon irréaliste.
- La dispersion de la variable dépendante : Degré de variabilité intrinsèque mesuré sur les instruments de recueil psychométriques retenus.
Justifier formellement l’effectif planifié en amont de toute inclusion constitue le garant méthodologique fondamental d’une science reproductible, prévenant à la fois le gaspillage de ressources humaines sur des effectifs pléthoriques inutiles et l’impasse scientifique de travaux trop étriqués pour conclure.
12.3 Matrice décisionnelle pour sélectionner la méthode d’échantillonnage idoine
La sélection d’une méthode d’échantillonnage ne doit jamais résulter d’une habitude académique passive ou de la reproduction acritique de pratiques de laboratoire antérieures. Elle exige la mise en place d’une délibération méthodologique outillée, intégrant conjointement le niveau de maturité épistémologique de l’objet d’étude, la nature du paradigme analytique projeté et la faisabilité empirique réelle. La matrice synthétique ci-dessous met en miroir les déterminants opérationnels structurant cette prise de décision stratégique :
1. Cas d’usage privilégié de l’échantillonnage probabiliste :
- Objectif : Quantification de paramètres sociodémographiques ou épidémiologiques dans la population générale (taux d’anxiété prévalente, normes d’étalonnage psychométrique d’une batterie de tests de QI).
- Ressources indispensables : Disponibilité d’une base de sondage exhaustive, financements pour déplacements ou relances, délais temporels de plusieurs mois ou années.
- Choix de la déclinaison : Aléatoire simple si la base est homogène et concentrée ; Stratifié si des sous-groupes clés doivent être comparés ou ont une faible prévalence ; En grappes ou multi-degrés si la dispersion géographique est majeure et que la base nominative individuelle est inaccessible mais groupée dans des institutions répertoriées.
2. Cas d’usage privilégié de l’échantillonnage non probabiliste :
- Objectif : Exploration préliminaire d’une théorie, analyse qualitative d’expériences vécues subjectives, mise à l’épreuve de tâches cognitives en laboratoire hautement contrôlées, ou recherche sur des populations masquées et hautement vulnérables.
- Ressources : Délais très contraints, absence totale de bases institutionnelles, budgets opérationnels limités.
- Choix de la déclinaison : Par convenance pour tester la faisabilité d’une batterie de tâches cognitives élémentaires ; Par quotas si l’on souhaite une simulation démographique rapide sans prétention inférentielle formelle ; Au jugé / intentionnel pour traquer des cas atypiques ou d’experts critiques ; Par boule de neige ou RDS pour cartographier des comportements clandestins ou des pathologies rares au sein de réseaux fermés.
La recherche scientifique en psychologie ne se réduit pas à une quête aveugle d’un probabilisme abstrait impossible à concrétiser sur tous les terrains. Elle réside dans la cohérence transparente entre le dispositif d’échantillonnage mis en œuvre, le traitement statistique déployé et l’humilité épistémologique des conclusions tirées par le chercheur au terme de son travail.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
Heckathorn, D. D. (1997). Respondent-driven sampling: A new approach to the study of hidden populations. Social Problems, 44(2), 174–199. https://doi.org/10.2307/3096941
Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2–3), 61–83. https://doi.org/10.1017/S0140525X0999152X
Kish, L. (1965). Survey sampling. John Wiley & Sons.
Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). SAGE Publications.
Simons, D. J., Shoda, Y., & Lindsay, D. S. (2017). Constraints on generality (COG): A proposed addition to all empirical papers. Perspectives on Psychological Science, 12(6), 1123–1128. https://doi.org/10.1177/1745691617708630