
La modélisation stochastique constitue le socle fondamental sur lequel reposent l’inférence quantitative, la psychométrie moderne et l’analyse computationnelle des comportements. Dès lors qu’un chercheur ou un praticien recueille des données empiriques, qu’il s’agisse de temps de réaction, de scores à des batteries cognitives standardisées ou du dénombrement d’actes comportementaux discrets, il est confronté à la nécessité de choisir une distribution théorique de référence. Ce choix méthodologique n’a rien d’un formalisme anodin : postuler la loi régissant les observations détermine la validité des estimations paramétriques, la précision des erreurs types et, en dernière analyse, l’exactitude des conclusions scientifiques tirées de l’expérimentation.
Au cœur de l’arsenal probabiliste se détachent deux constructions mathématiques majeures, dont l’omniprésence traverse l’ensemble des sciences naturelles et humaines : la distribution normale, immortalisée par sa courbe en cloche symétrique, et la distribution de Poisson, modèle par excellence des événements discrets et sporadiques. Si la première règne sans partage sur la théorie classique des erreurs d’observation et l’étalonnage psychométrique, la seconde offre une structure rigoureuse pour capturer les processus de comptage survenant dans un continuum temporel ou spatial défini. Malgré leur notoriété respective, la distinction épistémologique et technique entre ces deux distributions demeure fréquemment méconnue ou malmenée dans la pratique de la recherche empirique.
Confondre ces deux paradigmes ou substituer indûment un modèle continu à un processus discret engendre des dérives méthodologiques sévères : prédictions aberrantes de valeurs négatives pour des occurrences réelles, sous-estimation systématique de l’erreur de type I, ou encore distorsion des relations fonctionnelles sous-jacentes. L’objectif de cet article exhaustif est de disséquer de manière comparative et rigoureuse les architectures mathématiques, les hypothèses sous-jacentes, les propriétés d’asymétrie et de dispersion, ainsi que les implications computationnelles de la loi de Poisson et de la loi normale. À travers un éclairage ancré en psychologie expérimentale, en neurosciences et en biostatistique, nous fournirons les clés théoriques et empiriques nécessaires pour arbitrer avec discernement entre ces deux piliers de l’analyse stochastique.
1. Fondements conceptuels et épistémologie des distributions de probabilité
1.1 Origine historique et genèse mathématique des deux lois
L’histoire de la distribution normale s’enracine dans les tentatives réitérées des mathématiciens du XVIIIe et du XIXe siècle de formaliser la régularité émergeant du désordre apparent. Sa première formulation est attribuée à Abraham de Moivre qui, en 1738, dans la seconde édition de The Doctrine of Chances, démontre que la distribution binomiale symétrique peut être approchée par une courbe continue exponentielle lorsque le nombre d’épreuves devient infiniment grand. Plus tard, Pierre-Simon de Laplace étend ce résultat fondamental en établissant la version primitive du théorème central limite, conférant à cette courbe une portée universelle pour le calcul des probabilités des sommes de variables aléatoires indépendantes.
Néanmoins, c’est l’astronome et mathématicien Carl Friedrich Gauss qui lui confère son statut canonique en 1809 dans ses travaux sur le mouvement des corps célestes. Gauss introduit la distribution comme la loi théorique décrivant la dispersion des erreurs d’observation instrumentale autour d’une valeur réelle inconnue, démontrant que la moyenne arithmétique constitue l’estimateur le plus vraisemblable si et seulement si les erreurs suivent cette forme quadratique exponentielle. Dès lors désignée sous le vocable de courbe de Gauss ou loi normale, elle s’impose comme l’archétype des phénomènes continus résultant d’une myriade de perturbations infinitésimales et additives.
À l’opposé de cette recherche des grands équilibres symétriques, la distribution de Poisson trouve sa genèse dans un questionnement juridique et sociologique. Formulée en 1837 par le mathématicien français Siméon Denis Poisson dans son traité magistral intitulé Recherches sur la probabilité des jugements en matière criminelle et en matière civile, elle vise à modéliser la survenue de jugements erronés rendus par des jurys d’assises. Poisson cherche à quantifier la probabilité d’événements caractérisés par une rareté intrinsèque au sein d’un grand nombre d’opportunités, dérivant une loi limite de la binomiale lorsque la probabilité individuelle d’occurrence tend vers zéro tandis que la taille de l’échantillon tend vers l’infini.
Cette divergence d’origine cristallise une séparation épistémologique profonde : tandis que la loi normale naît pour décrire les erreurs de mesure autour d’un barycentre stable, la loi de Poisson émerge pour appréhender la fréquence d’événements ponctuels discrets et sporadiques. Dans l’histoire de la psychométrie et des sciences quantitatives du comportement, ces deux paradigmes ont façonné des approches méthodologiques distinctes : la psychophysique et les tests d’aptitude ont adopté la métrique gaussienne pour ordonner les compétences continues, alors que la psychologie opérante et la chronométrie comportementale ont exploité le modèle poissonnien pour quantifier le débit d’actes observables.
1.2 Rôle des distributions théoriques en modélisation psychologique
Dans les sciences du comportement, les distributions statistiques ne doivent pas être appréhendées comme de simples artifices descriptifs ou de commodes lissages géométriques des données brutes. Elles fonctionnent avant tout comme des modèles génératifs idéalisés, c’est-à-dire des formulations mathématiques explicites postulant la nature des mécanismes stochastiques ayant présidé à l’émergence des observations empiriques. La quantification de l’incertitude psychologique, qu’il s’agisse de la fluctuation de l’attention sélective, de la variabilité interindividuelle des compétences verbales ou de la récurrence de comportements compulsifs, requiert un cadre formel qui explicite comment l’aléa interagit avec les paramètres structurels du sujet.
Sous le paradigme gaussien, les variables cognitives et affectives sont généralement conceptualisées comme des agrégats résultant d’une infinité de micro-composantes biologiques, environnementales et motivationnelles non observables. Le score composite à un test d’intelligence fluide ou le niveau d’anxiété état-trait est ainsi perçu comme la résultante sommative de déterminants génétiques et d’influences expérientielles indépendantes, conférant à la distribution normale une plausibilité théorique séduisante étayée par le théorème central limite. La normalité devient alors l’hypothèse par défaut guidant la standardisation et l’évaluation psychométrique.
Cependant, l’adéquation méthodologique entre l’observation empirique et le modèle probabiliste choisi exige une vigilance épistémologique constante. Assigner une loi normale à une variable représentant le nombre de conduites agressives manifestées par des enfants en milieu scolaire constitue une aberration conceptuelle : le comportement agressif ne découle pas d’une addition symétrique d’erreurs continues, mais d’un processus ponctuel déclenché de manière intermittente dans le temps. Le recours abusif au postulat de normalité en sciences humaines expose le chercheur à des risques épistémiques majeurs, incluant la distorsion des estimations d’effet, l’invalidation des tests d’hypothèses et l’invisibilisation systématique des dynamiques sous-jacentes propres aux phénomènes de comptage.
1.3 Objectifs analytiques et taxonomiques de la comparaison
L’ambition taxonomique de cette confrontation théorique réside dans l’élaboration d’une cartographie analytique exhaustive permettant de discriminer sans ambiguïté les contextes de pertinence de chaque modèle. Il s’agit en premier lieu de répertorier de manière méthodique les divergences morphologiques fondamentales qui séparent une loi de masse univariée définie sur les entiers naturels d’une fonction de densité continue définie sur l’ensemble des nombres réels. Cette distinction d’ordre ontologique gouverne l’ensemble des propriétés algébriques subséquentes, des moments statistiques aux fonctions génératrices des moments.
Il convient également d’établir des critères de sélection explicites et opérationnels pour orienter la démarche du chercheur confronté à des données quantitatives complexes. L’analyste doit être en mesure de déterminer à quel moment une échelle de mesure, bien que constituée de valeurs numériques, refuse légitimement l’application de la métrique normale pour exiger un traitement poissonnien, ou inversement, dans quelles conditions asymptotiques une variable de comptage peut être assimilée à une variable continue sans dégrader la robustesse de l’inférence. Ces critères incluent l’espace d’échantillonnage, la présence d’une borne naturelle inférieure, le rapport moyenne-variance et la structure de l’hétérogénéité d’échantillonnage.
Enfin, cette démarche comparative éclaire les conséquences théoriques et computationnelles qui accompagnent le passage d’une distribution à l’autre. Qu’il s’agisse de l’estimation des paramètres par le maximum de vraisemblance, de la construction des intervalles de confiance ou de la formulation des modèles de régression multivariée, le choix de la distribution conditionnelle modifie en profondeur la nature de la fonction de coût optimisée et l’interprétation substantielle des coefficients. En clarifiant ces mécanismes sous-jacents, cette analyse entend prémunir le chercheur contre les simplifications méthodologiques préjudiciables à la reproductibilité scientifique.
2. La distribution de Poisson : Architecture mathématique et postulats
2.1 Formulation mathématique et fonction de masse de probabilité
La distribution de Poisson est une loi de probabilité discrète qui modélise le nombre d’occurrences d’un événement au cours d’un intervalle temporel, spatial ou volumétrique prédéfini. Si nous désignons par la variable aléatoire discrète X le nombre total d’événements observés, son comportement stochastique est gouverné par sa fonction de masse de probabilité (PMF, pour Probability Mass Function), dont l’expression analytique s’écrit formellement :
P(X = k) = (λ^k * e^(-λ)) / k!
Dans cette formulation élégante, la variable k représente un entier non négatif appartenant au support dénombrable {0, 1, 2, 3, …}, signifiant que le phénomène peut théoriquement survenir un nombre indéterminé de fois sans borne supérieure fixe. Le symbole e désigne la constante de Néper, base naturelle du logarithme népérien valant approximativement 2,71828, tandis que k! représente la factorielle de l’entier k, soit le produit cumulé des entiers de 1 à k (avec par convention 0! = 1). La présence de cette factorielle au dénominateur assure que la somme infinie des probabilités pour toutes les valeurs possibles de k converge strictement vers 1, en vertu du développement en série entière de l’exponentielle : Σ (λ^k / k!) = e^λ.
Le paramètre unique lambda (λ) constitue la clé de voûte de cette architecture mathématique. Il s’agit d’un nombre réel strictement positif (λ > 0) qui caractérise simultanément l’intensité du processus générateur et l’espérance mathématique de la variable aléatoire. Ce paramètre capture le rythme moyen auquel les événements se produisent au sein de l’intervalle unitaire de référence. Dès lors que l’on s’intéresse à la probabilité cumulée que le nombre d’événements ne dépasse pas un seuil discret k_max, le calcul requiert la sommation arithmétique directe des probabilités ponctuelles : P(X ≤ k_max) = Σ_{k=0}^{k_max} (λ^k * e^(-λ)) / k!, une opération discrète fondamentale qui ne fait intervenir aucune intégrale différentielle.
2.2 Postulats fondamentaux du processus ponctuel de Poisson
Pour qu’un phénomène empirique puisse être modélisé avec rigueur par la distribution de Poisson, le mécanisme sous-jacent doit satisfaire à quatre postulats théoriques stricts découlant de la théorie des processus ponctuels stochastiques homogènes. Le premier postulat est celui de l’homogénéité temporelle ou spatiale : le taux d’occurrence sous-jacent, formalisé par le paramètre d’intensité λ, doit demeurer rigoureusement constant tout au long de la période d’enregistrement. Si la propension du phénomène à se manifester fluctue au gré du temps (par exemple en raison de la fatigue ou d’effets circadiens chez un sujet), le processus cesse d’être homogène et relève dès lors d’un processus de Poisson non homogène.
Le deuxième postulat réside dans l’indépendance absolue des occurrences survenant au sein d’intervalles de temps ou d’espace disjoints. La survenue d’un événement à un instant t ne doit en aucun cas altérer, positivement ou négativement, la probabilité d’émergence d’un nouvel événement à l’instant t + δ. Si la manifestation d’un comportement engendre une période réfractaire au cours de laquelle le comportement est inhibé, ou si au contraire elle induit un effet d’amorçage facilitateur augmentant la probabilité d’une répétition immédiate, l’hypothèse de mémoire nulle (propriété sans mémoire) est violée, rendant le modèle poissonnien inapplicable sous sa forme pure.
Le troisième postulat est la condition d’atomicité, souvent qualifiée d’hypothèse de rareté locale infinitésimale. Lorsque l’intervalle de temps δt tend vers zéro, la probabilité qu’exactement deux événements ou plus se produisent de manière simultanée dans ce micro-intervalle est un infiniment petit d’ordre supérieur à δt, formalisé par la notation o(δt). En d’autres termes, les événements doivent survenir de façon isolée et distincte, excluant les survenues en grappes simultanées ou les agrégations instantanées. Enfin, la stationnarité stochastique garantit que la distribution de probabilité du nombre d’événements observés dans un intervalle ne dépend exclusivement que de la durée de cet intervalle et non de sa localisation absolue sur l’axe du temps.
2.3 Interprétation sémantique en psychologie expérimentale
Dans le domaine de la psychologie expérimentale et des neurosciences comportementales, la loi de Poisson s’impose comme l’outil privilégié de quantification dès lors que les données résultent d’un processus d’échantillonnage temporel d’actes comportementaux discrets. Considérons, à titre d’illustration clinique, l’enregistrement de la fréquence des accès de colère ou des épisodes d’automutilation chez des adolescents hospitalisés au sein d’une unité psychiatrique fermée. Le nombre d’épisodes par semaine pour chaque patient constitue une variable de comptage pure, où chaque crise est un événement discret identifiable, survenant à des instants imprévisibles au sein d’une période d’observation contrôlée.
En neuropsychologie computationnelle et en électrophysiologie unitaire, la loi de Poisson trouve une incarnation biologique d’une précision remarquable dans la modélisation des trains de potentiels d’action émis par les neurones corticaux. Lorsque des électrodes intracellulaires enregistrent l’activité d’une cellule pyramidale du cortex visuel en réponse à un stimulus statique, la décharge neuronale est fréquemment conceptualisée comme un processus de Poisson homogène. Le nombre de potentiels d’action émis par tranche de 100 millisecondes obéit à la loi de Poisson, permettant d’extraire la fréquence moyenne d’encodage neural de l’information tout en tenant compte de la variabilité stochastique intrinsèque aux canaux ioniques synaptiques.
De surcroît, les paradigmes de vigilance et d’attention soutenue, tels que les tests de performance continue (CPT), exploitent couramment cette distribution pour appréhender les fautes de performance. Le comptage des erreurs d’omission (omettre de presser le bouton lors de la présentation de la cible) ou des lapsus verbaux au cours d’une épreuve d’interférence stroopienne prolongée constitue une suite d’événements rares et discrets. Modéliser ces défaillances cognitives par un paramètre d’intensité poissonnien λ offre une estimation fine de la fatigabilité attentionnelle du sujet, affranchie des postulats erronés de symétrie et de continuité.
3. La distribution normale : Architecture mathématique et symétrie gaussienne
3.1 Formulation de la densité de probabilité et paramètres régulateurs
La distribution normale, souvent qualifiée de distribution de Gauss-Laplace, régit l’organisation stochastique des variables aléatoires continues définies sur l’ensemble de la droite réelle. Contrairement aux lois discrètes qui attribuent des probabilités non nulles à des points isolés, une variable continue X suivant une loi normale ne possède pas de fonction de masse, mais une fonction de densité de probabilité (PDF, pour Probability Density Function), dont la formalisation analytique classique s’exprime ainsi :
f(x) = (1 / (σ * √(2π))) * exp(-0,5 * ((x – μ) / σ)²)
Dans cette équation emblématique, la variable x s’étend sur le continuum infini des réels ]-∞, +∞[. Deux constantes universelles y jouent un rôle structural : le nombre π, rapport géométrique entre la circonférence et le diamètre d’un cercle, et le nombre d’Euler e. L’intégration de cette fonction sur l’intégralité de son domaine de définition est rigoureusement égale à 1, assurant la condition impérative de normalisation probabiliste, un résultat dont la démonstration analytique requiert le calcul célèbre de l’intégrale de Gauss dans le plan polaire.
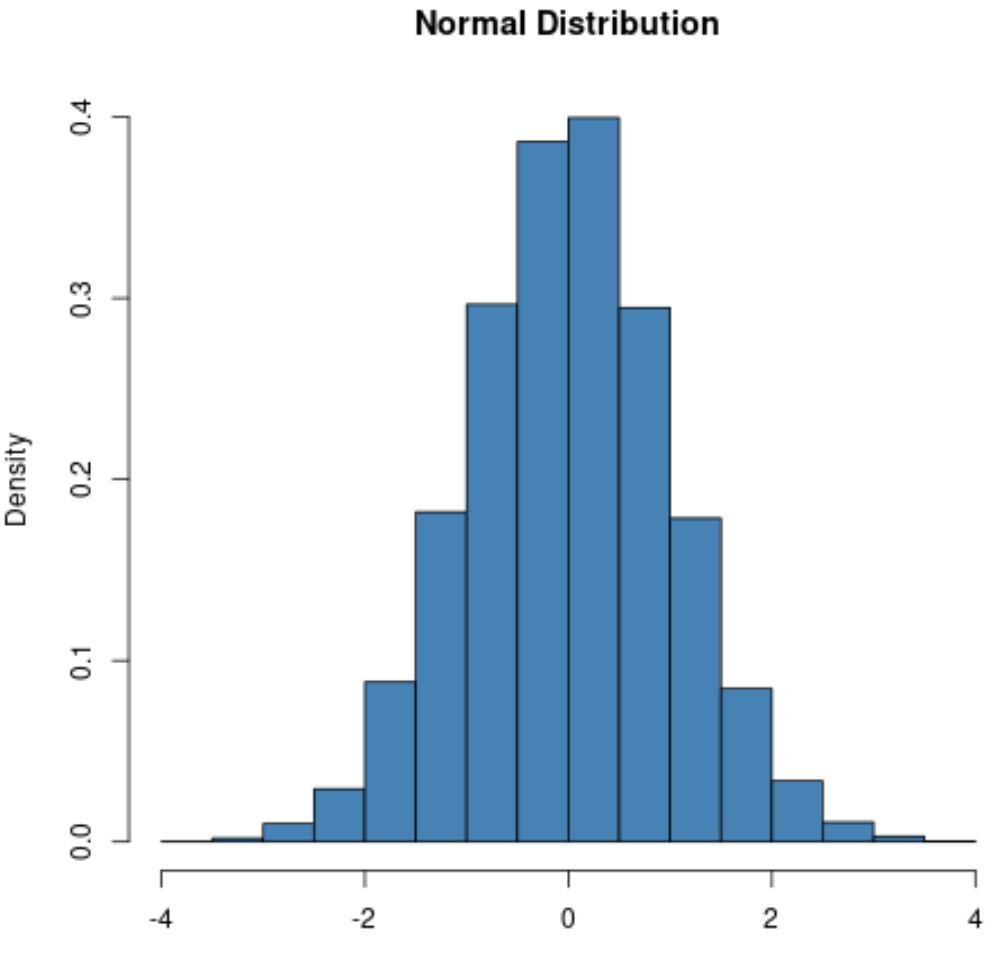
L’architecture de cette distribution repose sur deux paramètres régulateurs indépendants qui dictent intégralement sa morphologie : l’espérance mathématique μ et l’écart-type σ (ou sa version quadratique, la variance σ²). Le paramètre μ constitue le paramètre de position ; il détermine le centre de gravité géométrique de la courbe le long de l’axe des abscisses, correspondant simultanément au sommet absolu de la densité. Le paramètre σ, quant à lui, est le paramètre d’échelle ; il quantifie l’étalement horizontal de la distribution et régit l’aplatissement de la cloche. Plus σ est élevé, plus la courbe s’évase horizontalement et s’abaisse verticalement, tandis qu’une valeur faible de σ produit un pic élancé et resserré autour de μ.
Une conséquence fondamentale de la nature continue de la loi normale réside dans l’impossibilité théorique d’attribuer une probabilité non nulle à une valeur isolée x. En calcul intégral, la probabilité d’un point géométrique élémentaire est nulle : P(X = x) = ∫_{x}^{x} f(u) du = 0. La probabilité ne prend de sens empirique et mathématique que sur un intervalle continu défini par deux bornes [a, b], représentée par l’aire sous la courbe : P(a ≤ X ≤ b) = ∫_{a}^{b} f(x) dx. Cette distinction conceptuelle sépare de façon infranchissable l’univers de l’intégration continue de celui de la sommation discrète poissonnienne.
3.2 Morphologie géométrique et règle empirique de Gauss
La géométrie de la densité gaussienne se singularise par une symétrie axiale parfaite par rapport à la droite verticale d’abscisse x = μ. Cette propriété d’invariance par réflexion implique une coïncidence mathématique rigide : la moyenne arithmétique (μ), la médiane (la valeur séparant l’aire sous la courbe en deux moitiés égales de 50 %) et le mode (le point culminant de la densité) sont strictement identiques. L’absence totale de dissymétrie confère à la courbe sa forme caractéristique de cloche équilibrée, dénuée de tout glissement vers la gauche ou vers la droite.
L’examen des dérivées première et seconde de la fonction de densité révèle l’existence de deux points d’inflexion morphologiques majeurs. Ces points d’inflexion, où la concavité de la courbe passe d’une allure concave tournée vers le bas à une allure convexe tournée vers le haut, sont localisés précisément aux coordonnées x = μ – σ et x = μ + σ. La distance géométrique séparant le sommet central de l’un ou l’autre de ces points d’inflexion est exactement égale à un écart-type, fournissant une interprétation visuelle directe du paramètre d’échelle σ au sein de l’espace de dispersion des données.
Cette morphologie sous-tend la célèbre règle empirique dite des 68-95-99,7, qui quantifie la concentration probabiliste des observations autour de la tendance centrale. L’intégration de la fonction de densité révèle qu’exactement 68,27 % de l’aire totale sous la cloche est comprise dans l’intervalle [μ – σ, μ + σ]. Cet espace s’élargit pour contenir 95,45 % des observations dans l’intervalle [μ – 2σ, μ + 2σ], et atteint 99,73 % dans la plage [μ – 3σ, μ + 3σ]. Au-delà de ces trois écarts-types, les queues de distribution s’étendent de façon asymptotique vers l’infini négatif et l’infini positif, sans jamais toucher l’axe horizontal, postulant théoriquement l’existence d’événements arbitrairement extrêmes, bien que leur survenue soit infinitésimalement improbable.
3.3 Centralité théorique en psychométrie et mesure des traits latents
En psychométrie et en théorie de la mesure psychologique, la distribution normale occupe une place paradigmatique quasi hégémonique. Sa puissance analytique provient notamment de sa propriété de standardisation linéaire : toute variable aléatoire continue X distribuée selon N(μ, σ²) peut être convertie en une variable normale centrée réduite Z suivant la loi N(0, 1) au moyen de la transformation z = (X – μ) / σ. Cette métrique standardisée, communément appelée note Z ou score z, exprime l’écart d’une performance individuelle par rapport à la moyenne du groupe de référence en unités d’écart-type, rendant directement comparables des épreuves aux formats hétérogènes.
L’application la plus illustre de cette architecture réside dans l’étalonnage des échelles d’intelligence globale de David Wechsler (WAIS, WISC). Les concepteurs de ces instruments ont conventionnellement imposé une transformation normalisatrice fixant la moyenne de la population de référence à μ = 100 et l’écart-type à σ = 15. En vertu des propriétés géométriques de la loi normale, un praticien peut déduire immédiatement qu’un quotient intellectuel (QI) égal à 130 se positionne exactement à +2 écarts-types au-dessus de la moyenne, délimitant le seuil supérieur des 2,27 % des individus les plus efficients de la cohorte selon cette métrique.
Cette omniprésence repose sur le postulat théorique de la continuité dimensionnelle des construits psychologiques sous-jacents, désignés sous le terme de traits latents. Qu’il s’agisse de l’extraversion, de la tolérance à la frustration ou du névrosisme, les modèles factoriels de la psychologie différentielle font l’hypothèse que ces dispositions psychologiques varient le long d’un continuum infini et granulaire. La loi normale est alors adoptée comme le modèle de mesure idéal pour caractériser la distribution de ces traits au sein d’une population homogène, les écarts individuels étant interprétés comme des variations continues et équilibrées autour d’un phénotype comportemental moyen.
4. Nature ontologique des variables : Discrète versus Continue
4.1 L’espace d’échantillonnage discret de la loi de Poisson
La distinction la plus irréductible entre la loi de Poisson et la loi normale relève de la nature ontologique de leur espace d’échantillonnage, c’est-à-dire de l’ensemble des valeurs admissibles que peut théoriquement endosser la variable aléatoire. Pour la distribution de Poisson, ce support mathématique est formellement circonscrit à l’ensemble des entiers naturels :
Supp(X) = ℕ = {0, 1, 2, 3, …, +∞}
Cette contrainte structurelle implique une incompatibilité conceptuelle absolue avec toute valeur fractionnaire, décimale ou négative. Une variable modélisée par une loi de Poisson quantifie des entités indivisibles qui ne peuvent être que dénombrées au moyen d’un processus de comptage arithmétique. Il est par définition impossible d’observer 2,75 vocalisations agressives ou -1 hésitation verbale lors d’une tâche d’élocution.
Le caractère dénombrable de cet ensemble confère à la variable une granularité discontinue : entre deux états consécutifs k et k + 1, il n’existe aucune valeur intermédiaire permise par le modèle probabiliste. Cette discrétisation ontologique gouverne le mode de calcul des événements composés. Le calcul de la probabilité d’un ensemble de réalisations empiriques s’opère par une sommation arithmétique directe et exacte des probabilités élémentaires associées à chaque point de masse. Dès lors, l’espace des possibles est un ensemble de marches d’escalier discontinues, où chaque saut d’amplitude correspond à la masse de probabilité allouée à une réalisation entière précise.
4.2 Le continuum dimensionnel de la loi normale
À l’opposé du support discret poissonnien, la distribution normale évolue dans un continuum dimensionnel non borné, dont le support s’étend sur la totalité de la droite réelle :
Supp(X) = ℝ = ]-∞, +∞[
Cette propriété implique qu’entre deux valeurs quelconques de la variable, aussi proches soient-elles sur le plan métrique, il existe théoriquement une infinité indénombrable d’autres valeurs intermédiaires réalisables. La modélisation gaussienne postule que le phénomène mesuré ne procède pas par sauts discontinus, mais s’écoule de manière continue et fluide le long d’un axe dimensionnel sans rupture.
Cette architecture continue impose une distance épistémologique majeure entre la grandeur théorique idéale et sa concrétisation instrumentale empirique. Dans les faits, aucun appareil de mesure psychologique ou chronométrique ne possède une résolution infinie : un chronomètre de laboratoire discrétise inévitablement le temps de réaction en millisecondes entières, et un questionnaire psychométrique enregistre des réponses par échelons discrets. Pourtant, le modèle gaussien postule que cette discrétisation n’est qu’un artefact d’observation imputable à la précision limitée de l’outil technique, le construit sous-jacent (le temps cognitif de traitement de l’information) demeurant une quantité continue rigoureusement non discrète.
Cette continuité impose le recours systématique aux intégrales pour toute évaluation probabiliste. Il n’est plus question d’évaluer la masse d’un point géométrique isolé, mais de calculer l’intégrale d’une densité de surface sur une bande de confiance ou un intervalle de tolérance donné. Ce saut conceptuel redéfinit la nature même de la vraisemblance, qui cesse d’être une probabilité empirique directe pour devenir une valeur différentielle de densité géométrique.
4.3 Conséquences computationnelles de la nature de la variable
Les divergences d’espace d’échantillonnage engendrent des conséquences computationnelles profondes lors de la manipulation algébrique et informatique de ces deux modèles. La disparité la plus immédiate concerne la distinction fonctionnelle entre la fonction de masse de probabilité (PMF) et la fonction de densité de probabilité (PDF). Dans le cas poissonnien, la valeur f(k) renvoyée par la PMF représente littéralement une probabilité exacte comprise dans l’intervalle fermé [0, 1]. En revanche, pour la loi normale, la valeur de densité f(x) issue de la PDF peut parfaitement excéder la valeur 1 dès lors que l’écart-type σ est suffisamment petit (notamment pour σ < 1 / √(2π) ≈ 0,3989), rappelant que la densité n’est pas une probabilité mais une mesure de concentration locale par unité de longueur.
Une autre distinction computationnelle critique concerne la gestion rigoureuse des bornes dans le calcul des probabilités cumulées. Dans le cadre continu de la distribution normale, la probabilité d’un point isolé étant strictement nulle, il en résulte une équivalence absolue entre inégalités strictes et inégalités larges :
P(X ≤ c) = P(X < c)
Dans l’univers discret de Poisson, cette équivalence s’effondre totalement. Omettre d’intégrer la valeur de la borne modifie substantiellement le résultat obtenu, puisque :
P(X ≤ k) = P(X < k) + P(X = k)
Cette disparité algorithmique impose une attention extrême lors de la programmation de tests statistiques ou du paramétrage de seuils de décision clinique. Par ailleurs, les algorithmes d’estimation par le maximum de vraisemblance (MLE) reposent sur des fonctions de log-vraisemblance dissemblables : sommation de logarithmes de masses factorielles pour Poisson, optimisation quadratique des moindres carrés pour la loi normale. Cette distinction structurelle conditionne l’ensemble de la convergence computationnelle des modèles.
5. Paramétrisation et moments statistiques : Monoparamétrique versus Biparamétrique
5.1 La propriété d’équidispersion de la loi de Poisson
L’un des traits les plus singuliers de la distribution de Poisson réside dans sa nature strictement monoparamétrique. L’ensemble de son comportement probabiliste, de sa localisation centrale à sa dispersion en passant par son étirement morphologique, est assujetti à la valeur d’un unique paramètre : λ. Cette dépendance structurelle se traduit par une contrainte analytique rigoureuse connue sous le nom de propriété d’équidispersion :
E(X) = Var(X) = λ
Cette égalité stricte entre l’espérance mathématique E(X) et la variance de la variable Var(X) constitue une signature distinctive de la loi de Poisson pure. Elle implique que la variabilité des données n’est pas un facteur indépendant, mais une fonction directe de leur niveau moyen. Par voie de conséquence, l’écart-type d’une variable de Poisson est inexorablement lié à sa moyenne par la relation déterministe σ = √λ. Dès lors qu’un phénomène présente une moyenne empirique élevée, sa dispersion absolue croît de manière proportionnelle, interdisant toute modification de la variabilité qui n’altérerait pas concomitamment la tendance centrale.
Cette contrainte a des répercussions considérables sur le plan de la validation analytique. Dans la recherche expérimentale, le calcul du ratio entre la variance observée et la moyenne observée au sein d’un échantillon (couramment désigné sous le terme d’indice de dispersion ou ratio de variance de Fisher) sert de test de conformité initial pour valider l’adéquation au processus de Poisson pur. Un ratio s’écartant substantiellement de la valeur unitaire signale immédiatement que les postulats stochastiques sous-jacents sont compromis par des mécanismes annexes non contrôlés.
5.2 Indépendance structurelle de la moyenne et de la variance chez Gauss
À l’opposé de cette interdépendance poissonnienne, la distribution normale se définit par une structure biparamétrique élégante qui découple entièrement le paramètre de position (μ) du paramètre d’échelle (σ²). Ce découplage mathématique garantit que la variabilité d’une distribution normale est conceptuellement et fonctionnellement orthogonale à son espérance :
E(X) = μ et Var(X) = σ²
Cette indépendance confère au modèle gaussien une souplesse de modélisation incomparable. Deux populations de sujets peuvent ainsi présenter exactement la même moyenne d’efficience cognitive (μ = 100) tout en affichant des niveaux de variabilité interindividuelle radicalement hétérogènes (par exemple σ₁ = 5 versus σ₂ = 25). Inversement, un traitement expérimental peut déplacer le centre de gravité d’une distribution sans en affecter aucunement la variance globale, une propriété postulée par la quasi-totalité des modèles factoriels additifs et des analyses de variance classiques (ANOVA).
Cette indépendance structurelle est étayée par un théorème statistique de premier ordre : le théorème de Basu. Dans le cadre d’un échantillonnage gaussien, la moyenne empirique de l’échantillon (X̄) et la variance empirique (s²) constituent des statistiques indépendantes au sens probabiliste du terme. La connaissance de la moyenne de l’échantillon ne fournit rigoureusement aucune information prédictive quant à la magnitude de sa dispersion. Cette propriété d’orthogonalité est le pilier sur lequel reposent la dérivation exacte de la distribution du t de Student et la décomposition de la variance d’échantillonnage de Fisher, simplifiant considérablement l’inférence statistique sur les paramètres continus.
5.3 Anomalies de dispersion : Surdispersion et sous-dispersion
L’obligation d’équidispersion imposée par la loi de Poisson se heurte fréquemment à la complexité des données réelles, conduisant à des anomalies de dispersion majeures que tout analyste doit savoir diagnostiquer. La première anomalie, de loin la plus fréquente dans les études comportementales et cliniques, est la surdispersion stochastique (en anglais, overdispersion), caractérisée par une variance empirique qui surpasse largement l’espérance mathématique :
Var(X) > E(X)
La surdispersion émerge presque invariablement lorsque la population échantillonnée présente une hétérogénéité non observée, c’est-à-dire lorsque le paramètre d’intensité sous-jacent λ n’est pas fixe mais varie lui-même d’un individu à l’autre en fonction de caractéristiques génétiques, environnementales ou historiques non mesurées par l’expérimentateur. L’agrégation de ces sous-populations hétérogènes génère une variance globale gonflée qui excède les bornes du modèle poissonnien. L’échec du modèle de Poisson simple en présence de surdispersion nécessite alors le recours à des alternatives distributionnelles plus complexes, telles que la loi binomiale négative.
À l’inverse, la sous-dispersion (underdispersion) caractérise les situations empiriques où la variance observée est strictement inférieure à la moyenne du groupe :
Var(X) < E(X)
Ce phénomène, bien que plus rare, se manifeste couramment dans les protocoles comportementaux impliquant des mécanismes d’inhibition active, de régulation homéostatique ou de concurrence temporelle. Si la survenue d’un acte moteur inhibe temporairement l’apparition du suivant (mécanisme de période réfractaire), les occurrences se distribuent de façon plus régulière et prévisible que ne le prévoit le hasard poissonnien pur, comprimant artificiellement la variance empirique. Il convient de souligner que ces anomalies de dispersion n’ont aucun sens au sein de la théorie normale classique, puisque cette dernière ne postule aucune relation prédéterminée entre son espérance et son échelle de dispersion.
6. Asymétrie, aplatissement et géométrie des distributions
6.1 Le coefficient d’asymétrie (Skewness)
La géométrie comparée de la loi de Poisson et de la loi normale s’apprécie avec une acuité particulière à travers l’analyse de leurs moments statistiques d’ordre supérieur, au premier rang desquels figure le coefficient d’asymétrie normalisé de Fisher (skewness, noté γ₁). Pour la loi de Poisson de paramètre λ, le calcul algébrique du troisième moment centré rapporte une asymétrie positive structurelle, dont la formulation explicite dépend exclusivement du paramètre d’intensité :
γ₁ = 1 / √λ
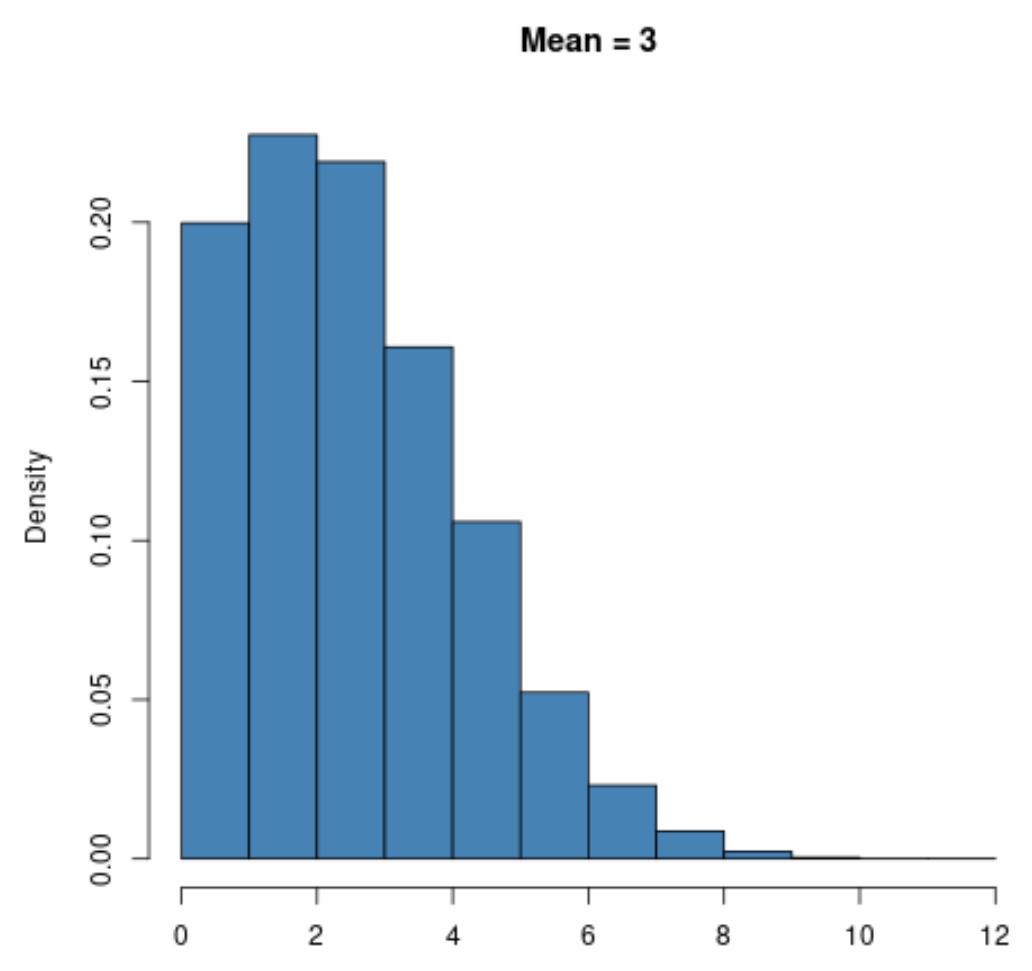
Cette relation démontre que la distribution de Poisson n’est jamais rigoureusement symétrique pour toute valeur finie de λ. Comme le paramètre λ est strictement positif, le coefficient d’asymétrie demeure invariablement supérieur à zéro (γ₁ > 0). Lorsque l’intensité λ est faible, typiquement pour λ < 2, le terme 1 / √λ prend des proportions considérables, provoquant un étirement prononcé de la queue de distribution vers la droite. Les masses de probabilité se concentrent massivement sur les petites valeurs entières (0, 1, 2) tandis qu’une longue traîne asymétrique se déploie vers les valeurs élevées.
À l’opposé de ce profil asymétrique évolutif, la distribution normale se singularise par une symétrie invariante et absolue. Quel que soit le couple de paramètres (μ, σ) retenu, le troisième moment centré d’une variable gaussienne est rigoureusement nul, conférant à la courbe un coefficient d’asymétrie immuable :
γ₁ = 0
Cette symétrie constante a des répercussions cruciales lors de l’estimation des percentiles extrêmes dans les cohortes comportementales. Alors qu’une variable normale projette exactement les mêmes proportions d’observations au-delà de +2 écarts-types et en deçà de -2 écarts-types, une variable de comptage poissonnienne produit une asymétrie prononcée : elle interdit toute observation en deçà de zéro tout en autorisant une traîne supérieure d’événements extrêmes, une réalité géométrique capitale pour l’identification des profils atypiques en psychiatrie.
6.2 Le coefficient d’aplatissement (Kurtosis) et l’épaisseur des queues
Le quatrième moment centré standardisé régit le coefficient d’aplatissement (kurtosis, noté β₂ ou sous sa forme d’excès d’aplatissement γ₂ = β₂ – 3). Ce paramètre quantifie l’épaisseur relative des queues de distribution par rapport à la masse centrale, fournissant une indication critique de la propension d’un modèle stochastique à engendrer des valeurs extrêmes ou aberrantes. Pour la distribution normale, le kurtosis brut est universellement égal à 3, ce qui correspond à un excès d’aplatissement rigoureusement nul :
γ₂ = 0
En vertu de cette propriété géométrique invariable, la distribution normale sert d’étalon mésokurtique absolu dans la théorie statistique générale : toute loi dont le kurtosis excède 3 est qualifiée de leptokurtique (queues lourdes et pic central acéré), tandis qu’une loi affichant un kurtosis inférieur à 3 est désignée comme platykurtique (épaules renflées et allure aplatie).
Dans ce cadre comparatif, la distribution de Poisson révèle une nature leptokurtique intrinsèque. Son excès d’aplatissement s’exprime par une relation inversement proportionnelle à son paramètre d’intensité :
γ₂ = 1 / λ
Pour de faibles intensités poissonniennes, l’excès d’aplatissement devient très élevé (par exemple γ₂ = 2 lorsque λ = 0,5), signifiant que la masse probabiliste est violemment focalisée sur un point d’origine tout en propulsant une queue droite dont l’épaisseur relative dépasse largement celle d’une distribution gaussienne équivalente. En psychométrie expérimentale, cette propriété confère au modèle de Poisson une sensibilité et une résilience accrues face aux valeurs observées atypiques, là où le postulat mésokurtique de la loi normale tend à traiter à tort ces événements sporadiques comme des erreurs de mesure aberrantes (outliers) appelant une éviction artificielle.
6.3 Profils morphologiques pour de faibles valeurs de paramètres
L’observation empirique des profils morphologiques pour des valeurs ténues de paramètres illustre la rupture visuelle totale qui sépare ces deux lois fondamentales. Considérons le cas d’une variable de Poisson caractérisée par une intensité λ < 1, situation fréquente en épidémiologie psychiatrique ou en génétique comportementale lors de l’étude de phénotypes rarissimes (par exemple, le nombre d’épisodes de catalepsie par an). Dans cette configuration, la distribution ne prend nullement une forme campaniforme ou symétrique :
Pour λ = 0,3, les probabilités élémentaires calculées via la fonction de masse donnent P(X = 0) ≈ 0,7408, P(X = 1) ≈ 0,2222, P(X = 2) ≈ 0,0333, et P(X = 3) ≈ 0,0033. Le profil visuel sur un histogramme de fréquences observées se traduit par une allure en L, strictement décroissante et hyper-asymétrique, où le mode statistique est ancré de façon prépondérante sur la valeur zéro. L’existence d’une cloche ou d’un équilibre quelconque autour de l’espérance est totalement absente.
En miroir, la loi normale conserve rigoureusement son profil univarié unimodal symétrique en cloche quel que soit le calibrage de son espérance μ et de son écart-type σ. Même si l’on assigne artificiellement une espérance faible μ = 0,3 avec un écart-type unitaire σ = 1, l’architecture gaussienne continue d’étendre ses branches bilatérales de part et d’autre de 0,3, postulant formellement qu’environ 38 % de l’aire sous la courbe réside dans le cadran des valeurs négatives. Pour des grandeurs comportementales concrètes, cette constance morphologique gaussienne induit une contradiction physique majeure : elle engendre une masse théorique massive pour des grandeurs qui ne sauraient physiquement descendre en deçà du seuil du zéro.
7. Théorèmes limites, convergence et approximation normale
7.1 La loi de Poisson comme limite de la loi binomiale
Pour comprendre les connexions unissant les lois fondamentales du calcul stochastique, il convient de retracer la dérivation classique connue sous le nom de théorème limite de Poisson, ou loi des événements rares. Soit une variable aléatoire binomiale X ~ B(n, p) représentant le nombre de succès observés au cours de n épreuves de Bernoulli indépendantes, la probabilité de succès à chaque épreuve élémentaire étant égale à p. Supposons que le nombre d’épreuves n tende vers l’infini tandis que la probabilité élémentaire p tende simultanément vers zéro, de telle sorte que le produit de ces deux grandeurs demeure une constante finie strictement positive :
λ = n * p
En développant le coefficient binomial combinatoire au sein de la formule de la loi binomiale et en utilisant la limite classique (1 – λ/n)^n → e^(-λ) lorsque n → +∞, on démontre de manière analytique que la fonction de masse binomiale converge ponctuellement vers l’expression formelle de la loi de Poisson :
lim_{n → ∞, p → 0} [ n! / (k! * (n – k)!) ] * p^k * (1 – p)^(n – k) = (λ^k * e^(-λ)) / k!
Ce théorème fondamental fournit une justification mécanistique élégante à l’usage de la distribution de Poisson dans l’étude des cohortes humaines étendues. Lorsqu’un comportement exceptionnel (comme l’émergence d’une phobie spécifique très rare ou le passage à l’acte suicidaire) est surveillé au sein d’une immense population (n très grand), et que chaque individu dispose d’une probabilité infime mais uniforme de déclencher cet événement (p très petit), le nombre total d’occurrences au sein du groupe ne relève pas de la loi normale, mais d’une loi de Poisson pure de paramètre λ = n * p. Ce mécanisme se distingue radicalement de l’approximation de Moivre-Laplace, qui exige quant à elle que le produit n * p tende vers l’infini pour faire converger la binomiale vers la loi de Gauss.
7.2 Convergence asymptotique de la distribution de Poisson vers la normale
Bien que conceptuellement étanches pour de petits paramètres, la loi de Poisson et la loi normale entretiennent une relation de convergence asymptotique directe lorsque l’intensité stochastique franchit des seuils élevés. En vertu des propriétés d’additivité de la distribution de Poisson, une variable aléatoire X ~ Poisson(λ) peut être formellement décomposée comme la sommation arithmétique de m variables aléatoires indépendantes et identiquement distribuées (i.i.d.) X_i, suivant chacune une loi de Poisson élémentaire de paramètre λ_i = λ / m :
X = Σ_{i=1}^{m} X_i
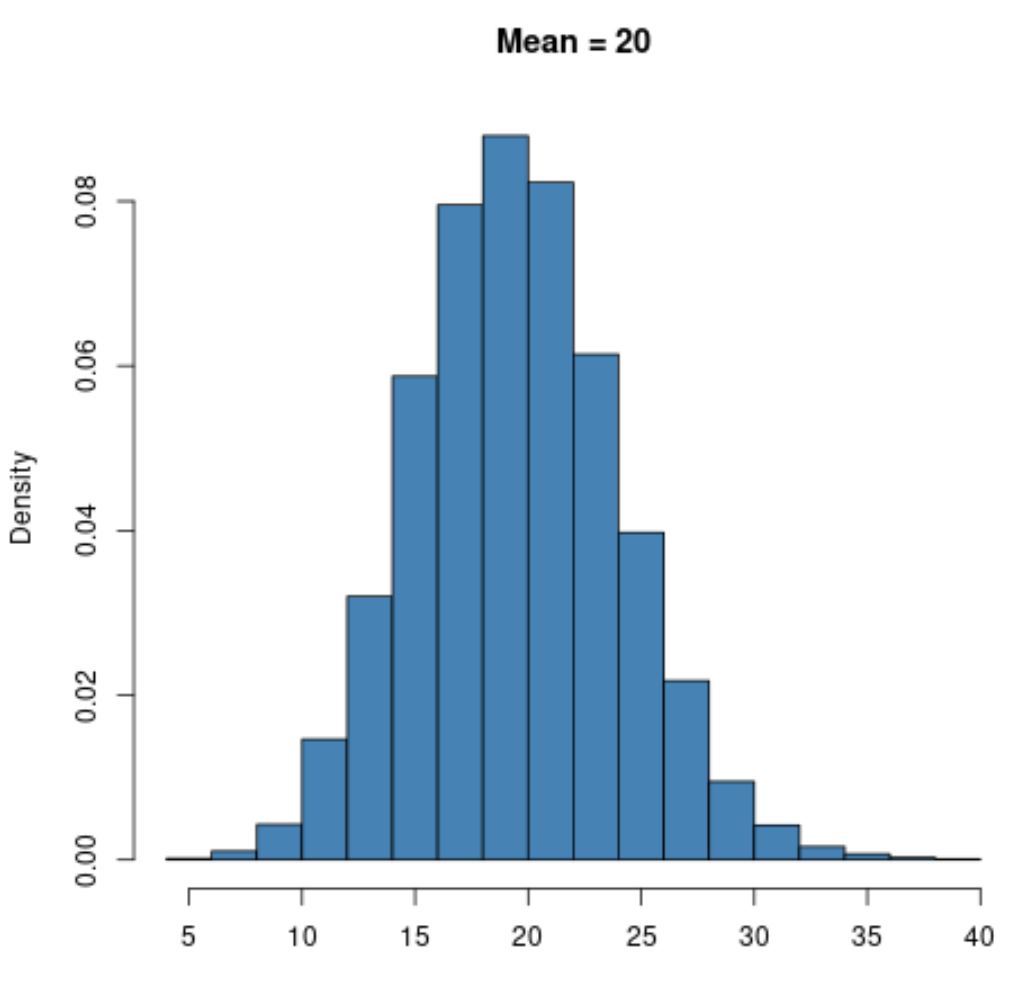
Dès lors que le paramètre λ croît vers des valeurs arbitrairement élevées (ce qui équivaut à laisser m tendre vers l’infini), le Théorème Central Limite (TCL) s’applique sans restriction à cette somme stochastique. En conséquence, la variable centrée et réduite Z = (X – λ) / √λ converge en loi vers une distribution normale standard N(0, 1) lorsque λ → +∞. Sur le plan géométrique, l’asymétrie positive γ₁ = 1/√λ et l’excès de kurtosis γ₂ = 1/λ s’évanouissent simultanément vers zéro, métamorphosant la silhouette asymétrique discontinue en une cloche mésokurtique quasi continue.
Dans la pratique méthodologique et psychométrique, la question du seuil d’admissibilité de cette approximation normale est primordiale. Les manuels d’introduction suggèrent fréquemment qu’une valeur de λ ≥ 10 suffit pour autoriser une approximation continue. Toutefois, pour une précision psychométrique rigoureuse garantissant le contrôle des risques d’erreur dans les queues de distribution, les statisticiens recommandent de n’exploiter la substitution gaussienne qu’à compter de seuils plus conservateurs :
λ ≥ 20 ou λ ≥ 30
En deçà de ces valeurs, l’asymétrie résiduelle demeure trop marquée, et substituer un modèle gaussien à la loi de Poisson produit une déformation substantielle de l’estimation des percentiles supérieurs.
7.3 La correction de continuité en calcul stochastique
Lorsqu’un chercheur exploite la convergence asymptotique pour approcher une loi de Poisson discrète par une distribution normale continue N(λ, λ), il réalise un saut ontologique entre un espace d’échantillonnage dénombrable et une droite réelle continue. Cette transition impose l’application d’un ajustement algorithmique correctif appelé la correction de continuité (ou correction de Yates). En effet, dans le modèle discret, la probabilité d’obtenir une valeur entière précise k est portée par la masse isolée en k, alors que dans le continuum gaussien, cette valeur k est assimilée à un segment élémentaire d’intervalle centré sur k, délimité par les bornes réelles [k – 0,5 ; k + 0,5].
Par conséquent, pour calculer la probabilité cumulée P(X ≤ k) d’une variable poissonnienne au moyen de la fonction de répartition normale Φ(z), l’analyste ne doit pas intégrer jusqu’à k, mais prolonger la surface continue jusqu’à l’extrémité supérieure de l’intervalle représentatif de k, soit k + 0,5 :
P(X ≤ k) ≈ Φ( (k + 0,5 – λ) / √λ )
De façon symétrique, l’évaluation de la probabilité ponctuelle discrète P(X = k) s’obtient en mesurant l’aire comprise entre les deux limites du bloc élémentaire : P(X = k) ≈ Φ((k + 0,5 – λ)/√λ) – Φ((k – 0,5 – λ)/√λ). L’omission de cette correction de continuité de 0,5 unité engendre une erreur d’approximation non négligeable, particulièrement lorsque λ se situe dans les zones frontières intermédiaires (10 ≤ λ ≤ 25). Cette distorsion fausse le calcul des puissances statistiques d’échantillonnage et amplifie artificiellement le risque de commettre une erreur d’inférence de type I lors des tests de signification clinique bilatéraux.
8. Modélisation linéaire et régression : Deux paradigmes d’analyse
8.1 Le modèle linéaire général gaussien (MCO et ANOVA)
L’hégémonie historique de la distribution normale dans l’analyse quantitative découle de son articulation privilégiée avec le modèle linéaire général (GLM classique), opéré via l’estimation par les Moindres Carrés Ordinaires (MCO), dont découlent directement l’analyse de régression linéaire, les tests t de Student et l’analyse de variance (ANOVA). Dans ce cadre analytique traditionnel, la variable dépendante observée Y est décomposée en une composante déterministe prédictible et une composante stochastique résiduelle non observée :
Y = Xβ + ε, avec ε ~ N(0, σ²I)
Le postulat architectural impératif qui conditionne la validité des inférences statistiques réside dans l’hypothèse de normalité des résidus : les perturbations aléatoires ε doivent être distribuées selon une loi normale centrée d’espérance nulle et de variance d’erreur homogène (hypothèse d’homoscédasticité). La fonction de lien unissant la moyenne conditionnelle de la variable réponse aux prédicteurs est la fonction identité : E(Y|X) = Xβ. Ce formalisme implique que chaque incrément unitaire d’un régresseur x_j produit un effet purement additif sur l’espérance de la variable dépendante, sans distorsion dimensionnelle.
Lorsque ces hypothèses sont satisfaites, le théorème de Gauss-Markov démontre avec élégance que les estimateurs des coefficients obtenus par les moindres carrés sont les meilleurs estimateurs linéaires non biaisés (BLUE). Cependant, les tests de significativité des paramètres (tests F de Fisher-Snedecor et tests t des coefficients) reposent formellement sur l’hypothèse de normalité résiduelle. Si cette condition fait défaut — ce qui est structurellement le cas dès lors que la variable réponse Y est une variable discrète de comptage contrainte par une borne inférieure —, les inférences analytiques se trouvent fragilisées, produisant des intervalles de confiance fallacieux et des degrés de liberté distordus.
8.2 La régression de Poisson au sein des modèles linéaires généralisés (GLM)
Pour traiter avec rigueur les données de dénombrement sans recourir aux contraintes artificielles du formalisme gaussien, Nelder et Wedderburn ont élaboré en 1972 le cadre unifié des Modèles Linéaires Généralisés (GLM). Au sein de ce méta-modèle mathématique, la variable dépendante de comptage Y n’est plus assujettie à une décomposition résiduelle additive normale, mais est directement assignée à la famille exponentielle de distributions sous la forme d’une loi de Poisson conditionnelle :
Y | X ~ Poisson(λ(X))
Puisque le paramètre d’intensité poissonnien λ doit obligatoirement demeurer strictement positif (λ > 0) pour préserver la consistance physique du comptage, la fonction de lien identité du modèle gaussien ne peut être retenue, au risque de prédire des moyennes conditionnelles négatives. Le modèle de régression de Poisson adopte dès lors conventionnellement la fonction de lien canonique logarithmique naturelle :
ln(λ) = Xβ ⇔ λ = exp(Xβ) = exp(β₀ + β₁X₁ + … + β_p X_p)
Cette formulation exponentielle garantit une interprétation éminemment non linéaire et multiplicative de l’effet des variables explicites. Un accroissement unitaire du prédicteur X_j ne modifie pas l’espérance de façon additive, mais multiplie l’intensité attendue des événements par un facteur scalaire exp(β_j). En biostatistique et en psychologie clinique, cette quantité transformée exp(β_j) est désignée sous le nom de ratio de taux d’incidence (IRR, pour Incidence Rate Ratio), offrant une métrique d’impact comportemental intuitive et rigoureusement protégée contre les aberrations prédictives négatives.
En outre, l’optimisation des paramètres β ne peut plus être résolue de manière exacte par les moindres carrés algébriques ordinaires. Elle requiert la formulation explicite de la fonction de log-vraisemblance poissonnienne, résolue numériquement par des algorithmes itératifs de Newton-Raphson ou des moindres carrés itérativement repondérés (IRLS). Cette divergence algorithmique matérialise le gouffre technique séparant le paradigme additif gaussien de l’analyse stochastique des processus de flux.
8.3 Solutions méthodologiques aux violations des postulats
L’application brute de la régression de Poisson en recherche empirique se heurte toutefois de plein fouet au postulat d’équidispersion conditionnelle : Var(Y|X) = E(Y|X) = λ. Lorsque les résidus présentent une surdispersion substantielle imputable à une variance excédentaire, l’estimation des coefficients β par la régression de Poisson demeure asymptotiquement sans biais, mais les erreurs types associées sont sévèrement sous-estimées, conduisant à une inflation dramatique des faux positifs statistiques. Face à cette violation structurelle, plusieurs solutions méthodologiques avancées s’imposent :
La première solution consiste à abandonner la loi de Poisson simple au profit du modèle de régression binomiale négative (NegBin). En introduisant un paramètre de dispersion gamma supplémentaire α régissant la variabilité résiduelle, la variance s’exprime selon une fonction quadratique flexible : Var(Y|X) = λ + α * λ². Ce modèle absorbe l’hétérogénéité non observée sans distordre l’échelle de mesure originale.
La seconde solution s’applique lorsque l’échantillon comporte une surreprésentation massive de valeurs nulles, impossible à modéliser par une simple distribution poissonnienne ou binomiale négative standard. Les modèles à inflation de zéros, tels que le modèle ZIP (Zero-Inflated Poisson) et ZINB (Zero-Inflated Negative Binomial), fractionnent l’échantillon en deux sous-processus génératifs distincts : un modèle logistique qui prédit l’appartenance à un groupe de « zéros structurels » incompressibles (sujets insensibles au phénomène étudié), et un modèle de comptage tronqué modélisant les occurrences chez les individus actifs.
Enfin, l’arbitrage formel entre ces architectures concurrentes repose sur l’évaluation de la déviance résiduelle standardisée et l’analyse de critères de pénalisation de la complexité paramétrique, notamment le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC) :
AIC = -2 * ln(L) + 2k
où L désigne la vraisemblance maximisée et k le nombre de paramètres libres estimés. Un modèle binomial négatif ou ZIP affichant une réduction substantielle de l’AIC par rapport au modèle de Poisson standard (communément une différence ΔAIC > 10) commande impérativement son adoption dans les publications scientifiques de référence.
9. Applications différentielles en psychologie et neurosciences
9.1 Phénomènes psychologiques modélisés par la loi de Poisson
L’application rigoureuse de la loi de Poisson trouve un champ d’expression privilégié dans l’observation naturaliste et l’évaluation expérimentale de patterns comportementaux sporadiques. Un exemple canonique réside dans l’analyse de la fréquence hebdomadaire des épisodes de panique chez des patients pris en charge dans le cadre de thérapies cognitives et comportementales (TCC). Dans ce protocole, chaque crise d’angoisse aiguë constitue une rupture discrète survenant dans le temps continu de la vie quotidienne. La moyenne empirique de ces crises étant souvent faible (par exemple λ = 1,4 épisode par semaine), modéliser l’effet d’une restructuration cognitive par un modèle de Poisson fournit un coefficient d’atténuation d’incidence (IRR) cliniquement interprétable, alors qu’une ANOVA postulant la normalité risquerait d’extrapoler des prédictions absurdes de fréquences d’attaques négatives en post-traitement.
Un autre cas paradigmatique concerne les études de neuropsychologie attentionnelle ciblant les troubles du spectre de l’attention avec ou sans hyperactivité (TDAH). Lors d’une épreuve informatisée d’inhibition motrice de type Go/No-Go d’une durée de 20 minutes, le dénombrement des erreurs de commission (appuyer de façon impulsive sur la touche lors d’un stimulus d’interdiction No-Go) représente une variable de comptage pure. Chaque impulsion motrice inadéquate est un événement discret émergeant d’un fond d’inhibition continue, répondant parfaitement à l’hypothèse de rareté locale d’un processus poissonnien.
Dans le domaine de l’éthologie humaine et de la psychologie du développement, l’observation en milieu scolaire de la fréquence des interactions verbales proactives manifestées par des enfants présentant des troubles du spectre de l’autisme (TSA) relève de cette même logique stochastique. L’évaluation de l’efficacité d’un protocole d’entraînement aux compétences sociales s’appuie sur le décompte de ces événements discrets par session d’enregistrement de 45 minutes, où l’intervalle temporel sert de variable d’exposition (offset logarithmique) au sein d’une modélisation poissonnienne rigoureuse.
9.2 Construits psychologiques régis par la loi normale
Inversement, un vaste pan de la recherche expérimentale et différentielle mobilise des construits latents dont la nature épistémologique s’harmonise idéalement avec le continuum gaussien. L’archétype universel de cette modélisation réside dans l’analyse des scores composites obtenus aux batteries d’évaluation psychologique standardisées, telles que les matrices progressives de Raven ou l’échelle d’efficience mnésique de Wechsler (WMS). Le score final n’est pas appréhendé comme le comptage brut d’items isolés, mais comme l’émergence d’une fonction psychologique continue résultant de l’interaction coordonnée de multiples sous-systèmes cognitifs (vitesse d’encodage, capacité de la mémoire de travail, flexibilité mentale), justifiant l’application de la théorie limite d’agrégation normale.
En psychométrie de la personnalité, l’opérationnalisation dimensionnelle des traits selon le modèle des Big Five (Ouverture, Conscienciosité, Extraversion, Agréabilité, Névrosisme) par l’intermédiaire de questionnaires de type NEO-PI-R repose sur l’hypothèse fondamentale que ces dimensions fondamentales se distribuent de manière symétrique et continue dans la population générale. Les scores d’échelle, obtenus par l’agrégation de dizaines d’items continus ou pseudo-continus, sont convertis en percentiles et en scores standardisés T (μ = 50, σ = 10) qui postulent explicitement l’invariance mésokurtique de la loi normale.
Enfin, en neurosciences cognitives, l’analyse des signaux hémodynamiques captés par Imagerie par Résonance Magnétique fonctionnelle (IRMf) s’effectue quasi exclusivement sous le paradigme gaussien. L’amplitude du signal BOLD (Blood-Oxygen-Level Dependent) au sein d’un voxel anatomique représente une variation continue de ratio d’oxyhémoglobine résultant de millions de décharges synaptiques agrégées. Les logiciels de cartographie statistique paramétrique (SPM) modélisent ces variations de signal continu sous la forme d’un modèle linéaire général gaussien, exploitant la théorie des champs aléatoires gaussiens pour corriger le seuil de significativité des grappes de voxels activés.
9.3 Zones frontières et dilemmes de modélisation
Entre la pureté conceptuelle des comptages d’événements et le continuum des traits latents standardisés s’étend une zone méthodologique grise où le choix de modélisation suscite d’âpres débats académiques. L’exemple le plus controversé concerne le traitement analytique des échelles d’évaluation de Likert courtes (typiquement des échelles à 4 ou 5 points d’ancrage : « Pas du tout d’accord » à « Tout à fait d’accord »). Une part prépondérante de la littérature applique machinalement des régressions linéaires MCO ou des ANOVA à ces indicateurs ordinaux, en postulant une approximation continue gaussienne. Cependant, si les réponses sont fortement polarisées vers l’un des ancrages extrêmes, cette approximation s’effondre : l’indicateur se comporte davantage comme une variable discrète asymétrique, justifiant une approche par régression ordinale ou par des modèles de dénombrement d’approbations.
Un autre dilemme méthodologique réside dans l’analyse des temps d’attente séparant deux comportements consécutifs au sein d’un protocole expérimental. Si le nombre d’occurrences comportementales dans une heure relève de la distribution discrète de Poisson de paramètre λ, le temps d’attente infinitésimal T séparant l’émergence de deux événements consécutifs bascule ipso facto dans le registre continu, gouverné non pas par une loi normale, mais par une distribution exponentielle de paramètre λ :
f(t) = λ * e^(-λt), pour t ≥ 0
Confondre le taux de fréquence poissonnien avec la durée inter-événements continue induit des confusions de modélisation récurrentes. Enfin, les effets de plancher (floor effects) et de plafond (ceiling effects) introduisent une déformation morphologique artificielle majeure. Lorsqu’un test cognitif s’avère excessivement difficile pour un groupe clinique, une proportion massive de participants échoue à la quasi-totalité des épreuves, compressant les scores contre la borne inférieure zéro. Bien que le phénomène mesuré soit un construit d’aptitude continue, la distribution observée perd toute symétrie normale pour singer l’asymétrie décroissante d’une loi de Poisson, imposant des modèles tobit ou des régressions tronquées pour restaurer la vérité inférentielle.
10. Erreurs méthodologiques fréquentes dans la recherche académique
10.1 L’application indue du modèle gaussien aux données de comptage
L’une des dérives les plus persistantes au sein de la recherche quantitative en sciences humaines réside dans l’application machinale des modèles de régression linéaire par moindres carrés ordinaires à des variables de dénombrement comportemental. Cette pratique fautive, souvent perpétuée par l’illusion que le modèle linéaire généralisé est universellement robuste aux entorses distributionnelles, induit des distorsions mathématiques et empiriques irréparables. Le premier écueil réside dans la violation de la frontière ontologique du domaine de définition : le modèle linéaire gaussien pose par essence que l’espérance conditionnelle peut s’étendre sur l’ensemble ]-∞, +∞[.
Dès lors qu’un chercheur évalue un traitement comportemental sur une population présentant un faible taux initial d’occurrences d’un comportement dysfonctionnel (par exemple un taux moyen λ = 1,2 geste répétitif par heure), la droite de régression linéaire projettera inéluctablement, pour les individus bénéficiant des scores les plus favorables aux prédicteurs thérapeutiques, des estimations prédictives négatives (par exemple -0,8 crise par heure). Ces prédictions dépourvues de signification physique discréditent l’ensemble de la validité de prédiction du modèle.
Le second préjudice statistique concerne la violation absolue de l’hypothèse fondamentale d’homoscédasticité. Comme nous l’avons explicité, les variables de comptage sont structurellement hétéroscédastiques en raison du lien mécanique liant leur dispersion à leur intensité. En ignorant cette interdépendance, l’algorithme des moindres carrés pondère de façon erronée les résidus de forte magnitude. Il en résulte une sous-estimation systématique et sévère de la matrice de variance-covariance des coefficients estimés, comprimant artificiellement les erreurs types et gonflant dramatiquement le taux d’erreur de type I. Des variables totalement inopérantes sont ainsi déclarées statistiquement significatives à des seuils p < 0,05, alimentant directement la crise de la reproductibilité scientifique.
10.2 L’écueil de la transformation arbitraire des données
Face à l’évidence de l’asymétrie positive des variables de comptage, la réponse historique traditionnelle a consisté à appliquer des transformations mathématiques ad hoc aux données brutes pour tenter de forcer leur normalisation géométrique. Les manipulations les plus répandues incluent la transformation par la racine carrée (Y* = √Y), la transformation de Freeman-Tukey (Y* = √Y + √(Y+1)), ou encore la transformation logarithmique standard avec addition d’une constante arbitraire (Y* = ln(Y + 1)) pour pallier l’indétermination mathématique du logarithme de zéro :
ln(0) = -∞
Bien que ces démarches correctives aient été largement recommandées dans les manuels méthodologiques du XXe siècle avant l’avènement de la puissance computationnelle moderne, la littérature biostatistique contemporaine en a démontré les failles rédhibitoires. En premier lieu, la transformation d’une variable dénature irrémédiablement l’échelle de mesure clinique d’origine. Les coefficients issus d’une régression opérée sur des logarithmes ou des racines carrées cessent d’exprimer des variations directes du nombre d’actes comportementaux réels, rendant l’interprétation substantielle et la méta-analyse des tailles d’effet particulièrement ardues pour les praticiens.
En second lieu, l’adjonction d’une constante arbitraire (+1, ou pire +0,01 ou +0,5) lors d’une transformation logarithmique exerce une influence disproportionnée et arbitraire sur les résultats du modèle dès lors que l’échantillon contient une proportion substantielle de valeurs nulles. La magnitude de la constante choisie altère directement la structure des résidus et modifie substantiellement la significativité des tests statistiques. De surcroît, la transformation ne garantit nullement la restauration de l’homoscédasticité et engendre fréquemment une hétéroscédasticité artificielle inversée. La communauté statistique internationale préconise désormais de manière unanime l’abandon des transformations empiriques aveugles au profit de la modélisation explicite de la structure générative des données via les modèles linéaires généralisés (GLM Poisson ou NegBin).
10.3 Ignorance de l’excès de zéros et surdispersion cachée
Une erreur méthodologique plus insidieuse consiste à déployer un modèle de Poisson conventionnel sans procéder à une investigation diagnostique rigoureuse de l’excès de zéros et de la surdispersion latente. Dans l’observation clinique des comportements, l’enregistrement d’une valeur zéro ne découle pas invariablement d’un processus stochastique unique. L’analyste doit impérativement distinguer deux entités ontologiquement divergentes : les « zéros d’échantillonnage » et les « zéros structurels » :
Un zéro d’échantillonnage survient lorsqu’un sujet, susceptible de manifester le comportement étudié sous certaines conditions dynamiques, n’a simplement pas déclenché d’occurrence au cours de la fenêtre temporelle restreinte de l’expérimentation par le jeu ordinaire de l’aléa poissonnien. En revanche, un zéro structurel (ou zéro vrai) émane d’un sujet qui, en raison de déterminants neurobiologiques, cognitifs ou environnementaux stricts, se trouve dans l’impossibilité physique ou psychologique absolue de manifester le comportement (par exemple, un score d’épisodes de panique rigoureusement nul chez un individu ne présentant aucune réactivité anxieuse pathologique).
Ignorer cette dualité structurelle et forcer l’ajustement d’un modèle poissonnien standard produit une surdispersion cachée sévère. L’excès de zéros tire artificiellement le paramètre de taux global λ vers des valeurs anormalement basses, tout en faussant l’évaluation de la dispersion résiduelle. Pour éviter cet écueil, le chercheur doit déployer des outils de diagnostic spécifiques, tels que le test de surdispersion de Cameron-Trivedi, et recourir formellement au test de Vuong. Ce test de ratio de vraisemblance non emboîté permet d’arbitrer objectivement entre un modèle poissonnien classique et un modèle avec inflation de zéros (ZIP), prévenant ainsi les conclusions biaisées induites par une mauvaise appréciation du profil des participants non actifs.
11. Implémentation computationnelle et analyse pratique sous R et Python
11.1 Modélisation comparative et syntaxe sous R
L’environnement statistique R offre une panoplie exhaustive d’outils algorithmiques permettant d’illustrer la divergence pratique entre l’approche linéaire gaussienne et la modélisation poissonnienne. Considérons un jeu de données psychométriques dans lequel la variable dépendante erreurs_attention quantifie le nombre d’omissions commises lors d’une tâche continue, en fonction de l’âge du sujet et de son niveau de stress perçu. L’estimation erronée par les moindres carrés ordinaires s’exécute via la syntaxe native du modèle linéaire :
modele_gauss <- lm(erreurs_attention ~ age + stress, data = dataset_clinique)
Cette commande postule implicitement que les résidus s’agrègent selon une loi normale N(0, σ²). À l’inverse, l’ajustement rigoureux par la régression de Poisson requiert le recours à la fonction des modèles linéaires généralisés glm(), en spécifiant formellement la famille stochastique et sa fonction de lien canonique associée :
modele_poisson <- glm(erreurs_attention ~ age + stress, family = poisson(link = "log"), data = dataset_clinique)
Pour statuer sur la validité du postulat d’équidispersion, l’analyste exploite la bibliothèque spécialisée AER et met en œuvre le test de surdispersion de Cameron et Trivedi au moyen de la directive :
library(AER); dispersiontest(modele_poisson, alternative = "greater")
Si la p-valeur de ce test rejette l’hypothèse nulle d’équidispersion en démontrant la significativité du paramètre α, l’analyste bascule sans délai vers la régression binomiale négative optimisée dans le package MASS via la fonction glm.nb(erreurs_attention ~ age + stress, data = dataset_clinique). De surcroît, le package moderne DHARMa permet d’effectuer un diagnostic visuel standardisé des résidus quantiles simulés par ré-échantillonnage de Monte-Carlo, révélant sans ambiguïté les déviations de distribution qui échappent aux graphiques résiduels gaussiens conventionnels.
11.2 Traitement de données comportementales sous Python
L’écosystème scientifique du langage Python permet de reproduire cette rigueur analytique en couplant les bibliothèques scientifiques scipy.stats, statsmodels et seaborn. L’exploration théorique des deux lois s’appuie en premier lieu sur les modules dédiés de scipy.stats. La génération d’une densité de probabilité gaussienne continue s’obtient au moyen de scipy.stats.norm.pdf(x, loc=mu, scale=sigma), tandis que la fonction de masse poissonnienne discrète s’exécute via scipy.stats.poisson.pmf(k, mu=lambda_param), matérialisant instantanément la distinction entre les arguments de localisation spatiale et l’argument d’intensité unique.
Pour la modélisation statistique multivariée des cohortes cliniques, la bibliothèque statsmodels.formula.api fournit un pendant rigoureux aux syntaxes de R. L’estimation d’un modèle de régression de Poisson s’implémente par le code analytique suivant :
import statsmodels.formula.api as smf

import statsmodels.api as sm

modele_poisson_py = smf.glm('erreurs_attention ~ age + stress', data=df, family=sm.families.Poisson()).fit()
L’extraction des Ratios de Taux d’Incidence (IRR) et de leurs intervalles de confiance à 95 % s’opère par l’exponentiation vectorielle directe des paramètres estimés et de la matrice de covariance : np.exp(modele_poisson_py.params) et np.exp(modele_poisson_py.conf_int()). Par ailleurs, la librairie statsmodels.discrete.discrete_model met à disposition les architectures spécialisées ZeroInflatedPoisson et NegativeBinomial, autorisant une comparaison systématique de la vraisemblance algorithmique face au modèle des Moindres Carrés Ordinaires implanté via smf.ols().
11.3 Vérification des diagnostics post-estimation
Une modélisation stochastique ne saurait être considérée comme achevée sans un contrôle exhaustif des diagnostics de performance post-estimation. Dans le cadre gaussien, la vérification de la normalité des résidus s’appuie sur le tracé de diagrammes quantile-quantile (Q-Q plots) et l’exécution de tests statistiques formels tels que le test de Shapiro-Wilk ou le test d’Anderson-Darling. Toutefois, une précaution méthodologique majeure s’impose : sur des échantillons comportementaux de grande taille (typiquement N > 500), ces tests d’adéquation deviennent excessivement sensibles aux déviations microscopiques non substantielles, rejetant systématiquement l’hypothèse de normalité pour des asymétries sans gravité clinique.
Dans l’univers des GLM de Poisson, l’évaluation de la qualité d’ajustement délaisse les résidus bruts au profit des résidus de Pearson standardisés et des résidus de déviance. Les résidus de déviance mesurent la contribution individuelle de chaque observation empirique à la déviance totale du modèle (le double de l’écart de log-vraisemblance entre le modèle saturé parfait et le modèle estimé) :
d_i = sign(y_i – λ̂_i) * √(2 * [y_i * ln(y_i / λ̂_i) – (y_i – λ̂_i)])
L’examen minutieux des valeurs résiduelles de déviance d_i permet de repérer instantanément les observations atypiques exerçant un effet de levier excessif sur l’estimation des coefficients de taux. Enfin, la puissance prédictive comparée des modèles concurrents (Gaussien MCO, Poisson GLM, Binomial Négatif) doit être impérativement arbitrée au moyen de procédures de validation croisée k-fold répétée (par exemple 10-fold cross-validation), en évaluant l’erreur quadratique moyenne de prédiction (RMSE) ou l’erreur absolue médiane (MAE) sur des sous-échantillons de test indépendants non exposés lors de l’apprentissage algorithmique.
12. Arbre décisionnel pour le chercheur et synthèse comparative
12.1 Critères d’arbitrage méthodologique entre loi de Poisson et loi normale
Afin de guider l’analyste dans le dédale des choix méthodologiques et distributionnels, il est impératif d’opérationnaliser la décision stochastique sous la forme d’un arbre décisionnel séquentiel. La première interrogation discriminante porte sur la nature de l’espace métrique : la variable réponse résulte-t-elle formellement d’un dénombrement d’occurrences discontinues au sein d’une unité spatio-temporelle bien délimitée, ou émane-t-elle de l’évaluation d’un continuum dimensionnel granulaire ? Si la variable constitue un comptage pur ancré sur les entiers naturels {0, 1, 2, …}, la loi de Poisson s’impose comme le candidat distributionnel prioritaire d’intention, excluant par principe la loi normale.
La deuxième interrogation examine l’amplitude de l’espérance mathématique ou du taux d’occurrence moyen observé au sein de l’échantillon. Si la moyenne empirique est faible (typiquement λ < 10), la distribution empirique est inexorablement marquée par une asymétrie positive prononcée et une troncature naturelle à zéro, interdisant toute approximation gaussienne sous peine d’induire des distorsions prédictives majeures. Si, en revanche, la moyenne empirique excède largement ces seuils (λ ≥ 30) et qu’aucune contrainte de troncature ne déforme les observations, le théorème central limite autorise une approximation par la distribution normale, sous réserve de la mise en œuvre rigoureuse de la correction de continuité.
La troisième étape de l’arbitrage méthodologique évalue la structure de dispersion conditionnelle : le ratio variance-moyenne de l’échantillon respecte-t-il l’équidispersion stricte (Var ≈ Moyenne) ? En cas d’hétérogénéité d’échantillonnage provoquant une surdispersion patente, le chercheur doit renoncer au modèle de Poisson simple pour bifurquer vers la distribution binomiale négative. De façon parallèle, la présence d’une proportion anormalement dense de valeurs nulles impose l’arbitrage en faveur d’un modèle à inflation de zéros (ZIP ou ZINB). Ce cheminement logique séquentiel prémunit l’expérimentateur contre les biais d’analyse et assure l’alignement ontologique parfait entre le construit étudié et le formalisme stochastique déployé.
12.2 Tableau récapitulatif des divergences structurelles
Le tableau analytique ci-dessous synthétise de manière exhaustive les propriétés fondamentales, les moments d’ordre supérieur et les caractéristiques opérationnelles qui séparent rigoureusement la distribution de Poisson de la distribution normale :
| Caractéristique analytique | Distribution de Poisson | Distribution normale |
|---|---|---|
| Nature de la variable | Discrète (support dénombrable) | Continue (continuum dimensionnel) |
| Support mathématique | ℕ = {0, 1, 2, 3, …, +∞} | ℝ = ]-∞, +∞[ |
| Paramètres régulateurs | Monoparamétrique : λ > 0 (intensité) | Biparamétrique : μ ∈ ℝ (position), σ > 0 (échelle) |
| Espérance mathématique E(X) | λ | μ |
| Variance Var(X) | λ (équidispersion structurelle stricte) | σ² (totale indépendance vis-à-vis de μ) |
| Fonction stochastique de base | Fonction de masse (PMF) : probabilités ponctuelles | Fonction de densité (PDF) : intégration continue |
| Coefficient d’asymétrie (Skewness) | γ₁ = 1 / √λ (asymétrie positive toujours > 0) | γ₁ = 0 (symétrie bilatérale stricte invariable) |
| Excès d’aplatissement (Kurtosis) | γ₂ = 1 / λ (leptokurtique, queues épaisses pour petit λ) | γ₂ = 0 (mésokurtique universel, référence absolue) |
| Relation moyenne – variance | Indissociable : Var(X) = E(X) | Orthogonale : Théorème de Basu |
| Cadre de régression (GLM) | Lien Log : ln(λ) = Xβ, Ratios de Taux d’Incidence | Lien Identité : E(Y) = Xβ, Moindres Carrés Ordinaires |
| Limites de troncature | Bornée naturellement à gauche par zéro | Non bornée théoriquement (traînes infinies bilatérales) |
| Tests d’inférence canoniques | Test de Wald, Ratio de vraisemblance, Déviance | Test t de Student, Test F de Fisher, ANOVA MCO |
Ce tableau constitue un repère de référence conforme aux normes de rigueur méthodologique édictées par l’American Psychological Association (APA). Il met en exergue l’impossibilité conceptuelle d’interchanger arbitrairement ces deux modèles sans altérer les postulats régulateurs de la métrique d’observation.
12.3 Perspectives futures en modélisation computationnelle du comportement
L’évolution contemporaine des sciences quantitatives du comportement tend à dépasser la dichotomie rigide entre le pur dénombrement poissonnien et le continuum gaussien idéal à travers l’émergence d’architectures computationnelles hybrides. L’une des avancées les plus fécondes réside dans le développement des modèles linéaires généralisés à effets mixtes (GLMM). Ces modèles permettent de coupler des distributions conditionnelles de Poisson ou binomiales négatives à des distributions a priori normales régissant les variations interindividuelles latentes (effets aléatoires), unifiant harmonieusement la variabilité intra-individuelle des processus de comptage et l’hétérogénéité continue des populations étudiées.
Parallèlement, la statistique computationnelle bayésienne, propulsée par les algorithmes d’échantillonnage de Monte-Carlo par chaînes de Markov (MCMC) et le compilateur probabiliste Stan, affranchit le chercheur de la dépendance aux théorèmes limites asymptotiques. Les analyses bayésiennes permettent d’intégrer des fonctions de vraisemblance poissonniennes personnalisées tout en modélisant explicitement l’incertitude épistémique sur les paramètres d’échelle à travers des lois gaussiennes multivariées conjuguées.
Enfin, la recherche de pointe en psychométrie computationnelle explore activement les familles distributionnelles flexibles de Tweedie ainsi que les réseaux de neurones probabilistes (Deep Probabilistic Modeling). Les modèles de dispersion de Tweedie englobent la loi normale et la loi de Poisson comme des cas particuliers extrêmes d’une même famille exponentielle continue, autorisant une transition mathématique fluide entre des masses discrètes de zéros et un continuum strictement positif. Ces innovations computationnelles promettent de renouveler en profondeur l’analyse des signaux neurobiologiques et comportementaux, en substituant à l’arbitrage binaire une modélisation adaptative d’une fidélité empirique sans précédent.
Références
Agresti, A. (2015). Foundations of linear and generalized linear models. John Wiley & Sons. https://doi.org/10.1002/9781118730034
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716-723. https://doi.org/10.1109/TAC.1974.1100705
Cameron, A. C., & Trivedi, P. K. (2013). Regression analysis of count data (2e éd.). Cambridge University Press. https://doi.org/10.1017/CBO9781139013567
De Moivre, A. (1738). The doctrine of chances: Or, a method of calculating the probabilities of events in play (2e éd.). H. Woodfall.
Gauss, C. F. (1809). Theoria motus corporum coelestium in sectionibus conicis solem ambientium. Perthes et Besser.
Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1-14. https://doi.org/10.2307/1269547
Laplace, P. S. (1812). Théorie analytique des probabilités. Courcier.
McCullagh, P., & Nelder, J. A. (1989). Generalized linear models (2e éd.). Chapman & Hall/CRC. https://doi.org/10.1007/978-1-4899-3242-6
Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier.
Vuong, Q. H. (1989). Likelihood ratio tests for model selection and non-nested hypotheses. Econometrica, 57(2), 307-333. https://doi.org/10.2307/1912557
Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.