
L’analyse des données catégorielles constitue un pilier fondamental de la recherche empirique en sciences humaines, sociales et médicales. Dans les protocoles de recherche en psychologie clinique, en psychopathologie, en neuropsychologie ou en psychiatrie, les investigateurs se trouvent très fréquemment confrontés à des designs méthodologiques impliquant des variables qualitatives dichotomiques ou nominales. Qu’il s’agisse de mesurer la présence ou l’absence d’une rémission symptomatique après une intervention psychothérapeutique, d’évaluer l’apparition d’un comportement à risque chez des adolescents ou de quantifier l’efficacité d’un protocole pharmacologique expérimental, la mise en relation de deux variables qualitatives s’opère traditionnellement au moyen de tableaux de contingence croisant les modalités observées.
Pendant plusieurs décennies, le test du Chi-deux d’indépendance de Pearson a représenté la procédure inférentielle hégémonique pour déterminer s’il existe une association statistiquement significative entre deux variables catégorielles. Toutefois, la validité de ce test repose sur des approximations mathématiques asymptotiques qui exigent de larges effectifs d’échantillonnage. Dès lors que les effectifs théoriques attendus au sein des cellules de la table de contingence s’avèrent trop restreints — situation quasi systématique lors de l’étude de pathologies rares, de populations cliniques spécifiques ou d’échantillons préliminaires exploratoires —, l’approximation du Chi-deux s’effondre, générant des distorsions majeures de l’erreur de type I. C’est précisément à cette aporie méthodologique que répond le test exact de Fisher, une approche mathématique rigoureuse qui calcule directement la probabilité exacte d’observer la répartition constatée sous l’hypothèse d’indépendance.
Le logiciel IBM SPSS Statistics propose des environnements algorithmiques puissants et automatisés pour mettre en œuvre cette procédure d’inférence exacte. Cependant, l’utilisation éclairée de cet outil exige une maîtrise parfaite des conditions d’application, de la configuration des variables, de l’articulation entre données brutes et données pondérées, ainsi qu’une interprétation nuancée des sorties logicielles. Ce guide exhaustif a pour vocation d’accompagner les chercheurs, cliniciens, doctorants et analystes de données dans la maîtrise complète du test exact de Fisher sous SPSS, depuis ses fondements théoriques et mathématiques jusqu’à sa retranscription académique conforme aux normes internationales les plus exigeantes.
1. Introduction et fondements théoriques du test exact de Fisher en psychologie
1.1 Définition et principes fondamentaux du test exact de Fisher
Le test exact de Fisher, formulé initialement par le statisticien et généticien britannique Sir Ronald Aylmer Fisher dans son ouvrage séminal The Design of Experiments publié en 1935, est une méthode d’inférence non paramétrique spécifiquement conçue pour tester l’indépendance de deux variables qualitatives dichotomiques. L’impulsion initiale de ce développement théorique trouve son origine dans la célèbre expérience de pensée de la « dame dégustant le thé » (the lady tasting tea), au cours de laquelle une collègue affirmait être capable de discerner si le lait avait été versé dans la tasse avant ou après l’infusion du thé. Pour tester cette assertion de manière empirique sans recourir à des approximations distributionnelles continues douteuses sur un échantillon infime (huit tasses au total), Fisher formalisa le calcul combinatoire exact des permutations possibles.
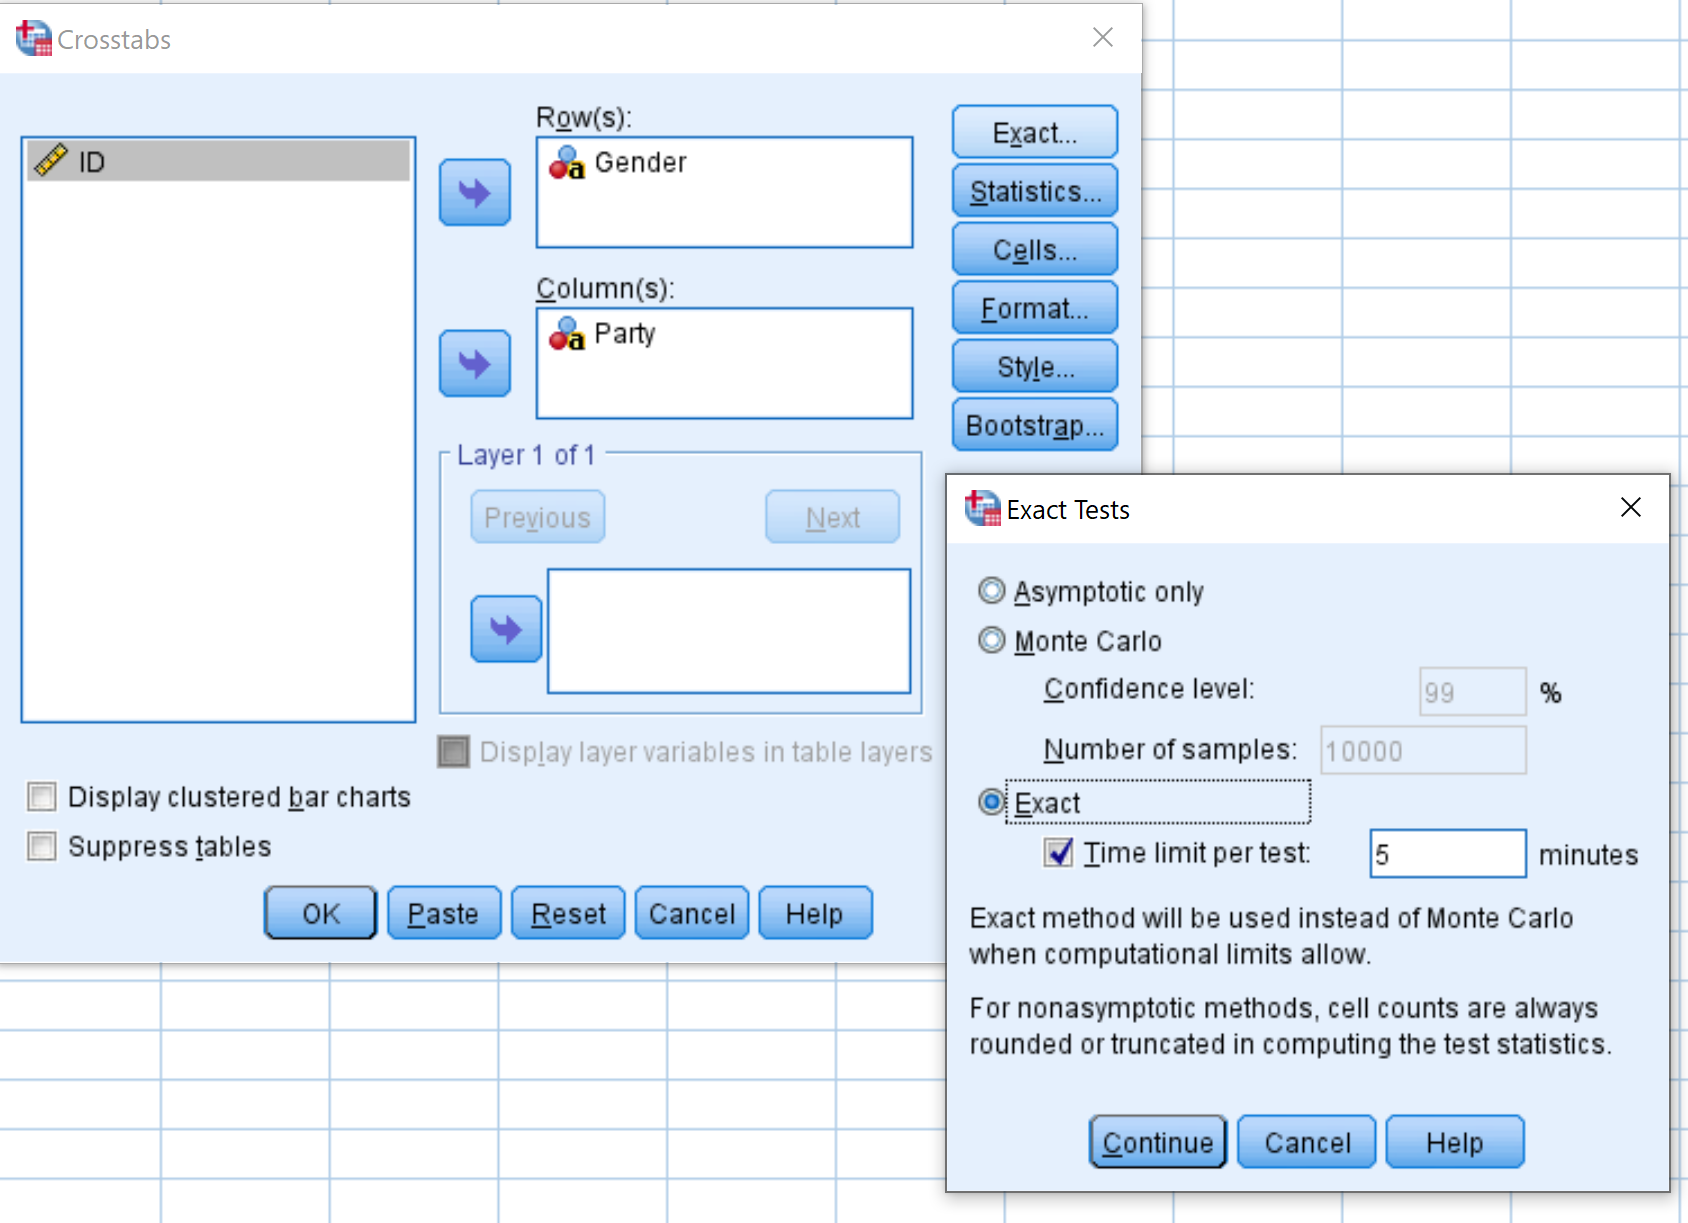
Sur le plan mathématique, le test exact de Fisher ne s’appuie pas sur une distribution limite continue comme la loi du Chi-deux, mais sur la loi hypergéométrique. Cette distribution discrète modélise la probabilité d’obtenir un nombre donné de succès lors de tirages simultanés sans remise au sein d’une population finie constituée d’éléments répartis en deux catégories mutuellement exclusives. Dans le cadre d’un tableau de contingence 2×2, le modèle considère que les totaux marginaux (les sommes des lignes et les sommes des colonnes) sont fixes ou conditionnellement fixés par le protocole expérimental. Dès lors, la probabilité exacte d’observer une configuration cellulaire spécifique sous l’hypothèse nulle d’indépendance se formule directement à l’aide de coefficients binomiaux et de factorielles.
La distinction conceptuelle entre un test asymptotique et un test exact s’avère fondamentale pour la rigueur méthodologique. Un test asymptotique, tel que le Chi-deux de Pearson ou le test du rapport de vraisemblance, présume que la taille de l’échantillon tend vers l’infini ($N to \infty$). Dans cette perspective limite, la statistique de test converge vers une distribution théorique connue. Lorsque l’échantillon est volumineux, cette approximation offre une précision exemplaire. À l’inverse, un test exact ne repose sur aucune hypothèse de convergence à l’infini : il dénombre l’ensemble fini des arrangements combinatoires compatibles avec les marges observées et additionne les probabilités ponctuelles de toutes les tables dont la configuration s’avère aussi ou plus extrême que celle constatée dans l’échantillon empirique. Il n’existe donc aucune perte d’information ni approximation probabiliste liée à la taille de l’échantillon.
1.2 Comparaison entre le Chi-deux de Pearson et le test exact de Fisher
La confrontation mathématique entre le test du Chi-deux d’indépendance de Pearson et le test exact de Fisher met en exergue les failles inhérentes aux méthodes basées sur de larges échantillons lorsqu’elles sont appliquées de manière indue à des micro-cohortes. La statistique du Chi-deux de Pearson repose sur l’écart quadratique normalisé entre les fréquences observées ($O_{ij}$) et les fréquences théoriques attendues ($E_{ij}$), calculée selon la formule standard :
$$\chi^2 = \sum \frac{(O_{ij} – E_{ij})^2}{E_{ij}}$$
Cette sommation ne suit rigoureusement une distribution théorique de Chi-deux à $(r-1)(c-1)$ degrés de liberté que si le théorème central limite opère pleinement au sein de chaque cellule. Lorsque les effectifs totaux sont faibles, ou que les proportions marginales sont particulièrement asymétriques, les fréquences théoriques $E_{ij}$ diminuent considérablement. Dès lors, le dénominateur de chaque terme cellulaire devient très petit, provoquant une instabilité numérique majeure : la statistique $\chi^2$ gonfle artificiellement, ou au contraire, sa distribution discrète sous-jacente s’écarte radicalement de la courbe continue théorique du Chi-deux.
Cette inadéquation mathématique se traduit concrètement par une distorsion sévère du taux d’erreur de première espèce ($\alpha$). Selon la configuration des marges, le Chi-deux asymptotique peut devenir excessivement libéral, rejetant à tort l’hypothèse nulle et conduisant à des faux positifs cliniques désastreux, ou à l’inverse excessivement conservateur dans certaines zones de rejet. Le test exact de Fisher, en éliminant toute modélisation continue, garantit que le risque réel d’erreur de type I ne dépasse jamais le seuil nominal choisi ($\alpha = 0,05$ ou $\alpha = 0,01$). Son caractère non paramétrique absolu découle du fait qu’il n’impose aucune hypothèse distributionnelle sur la population source, faisant de lui l’étalon-or mathématique pour les matrices 2×2 à faibles volumes.
1.3 Pertinence méthodologique dans la recherche clinique et psychologique
Dans l’écosystème de la recherche en psychologie clinique, en psychopathologie expérimentale et en neurosciences comportementales, la constitution de vastes échantillons probabilistes représentatifs relève souvent de l’utopie logistique, financière ou éthique. Les chercheurs travaillent régulièrement sur des populations présentant des troubles d’une prévalence extrêmement faible au sein de la population générale, tels que les troubles dissociatifs de l’identité, les états de stress post-traumatique complexes consécutifs à des traumatismes de guerre spécifiques, les troubles psychotiques à début très précoce ou certaines anomalies génétiques rares associées à des phénotypes neurodéveloppementaux particuliers (comme le syndrome de Williams ou le syndrome de Prader-Willi).
Parallèlement, l’évaluation d’événements indésirables graves ou de comportements critiques à très basse fréquence — tels que les tentatives de suicide sous protocole psychothérapeutique, les passages à l’acte hétéro-agressifs en unité fermée ou les arrêts prématurés de traitement pour intolérance psychologique sévère — génère inévitablement des tables de contingence composées de cellules dont les effectifs observés sont nuls ou marginaux. Dans ces configurations, l’application d’un test asymptotique classique est formellement proscrite en raison de son invalidité statistique.
Le test exact de Fisher confère une robustesse inférentielle incontestable aux protocoles quasi-expérimentaux à petits groupes, aux études pilotes (feasibility trials) et aux plans factoriels menés dans des contextes hospitaliers de recours. En permettant d’extraire des conclusions statistiques fiables à partir de cohortes composées de seulement 15 à 30 participants, il autorise l’avancée de la découverte clinique là où d’autres méthodes d’analyse statistique condamneraient les chercheurs à l’indécidabilité méthodologique ou à la surinterprétation purement narrative de pourcentages descriptifs trompeurs.
2. Conditions d’application et hypothèses statistiques préalables
2.1 Nature et échelle de mesure des variables étudiées
Le déploiement rigoureux du test exact de Fisher repose sur le respect scrupuleux de postulats métrologiques stricts concernant la nature des données collectées. En premier lieu, la procédure exige l’utilisation de deux variables catégorielles. Dans la configuration classique et optimale du test, ces variables doivent être qualitatives nominales dichotomiques, c’est-à-dire composées d’exactement deux modalités mutuellement exclusives et collectivement exhaustives. Ces modalités peuvent refléter des états naturels (ex. Présence vs Absence d’un diagnostic clinique, Sexe biologique : Homme vs Femme) ou des conditions d’assignation expérimentale (ex. Groupe Intervention Psychothérapeutique vs Groupe Contrôle sur liste d’attente).
Il demeure tout à fait envisageable d’appliquer le test exact de Fisher à des variables initialement mesurées sur une échelle ordinale (par exemple, un niveau de sévérité symptomatique catégorisé en « Léger », « Modéré » et « Sévère ») ou continue (comme le score brut obtenu à une échelle d’évaluation de la dépression), à la condition expresse que ces variables soient préalablement dichotomisées selon un seuil clinique ou théorique validé (ex. score inférieur ou supérieur au score seuil clinique conventionnel). Cette pratique de dichotomisation, bien qu’entraînant une perte inhérente de variance et de puissance statistique, permet de répondre à des questions décisionnelles binaires nettes.
L’exigence structurale centrale réside dans l’indépendance mutuelle stricte des catégories au sein de chaque variable : un participant donné ne peut en aucun cas appartenir simultanément à plus d’une cellule de la table de contingence. La structure bivariée 2×2 constitue le cadre d’élection du test de Fisher dans sa forme analytique standard sous SPSS, garantissant que chaque individu de la cohorte est classé de manière univoque dans l’un des quatre quadrants formés par l’intersection des deux variables.
2.2 La règle de Cochran et le problème des effectifs théoriques faibles
L’indication préférentielle ou obligatoire du test exact de Fisher par rapport au Chi-deux de Pearson s’évalue principalement à l’aune des critères probabilistes énoncés par le statisticien William Gemmell Cochran en 1952 et 1954. La célèbre règle de Cochran stipule que l’approximation asymptotique du Chi-deux est considérée comme valide et robuste si, et seulement si, deux conditions cumulatives sont scrupuleusement respectées au sein de la matrice théorique des données :
- Aucune cellule de la table de contingence ne doit présenter un effectif théorique attendu ($E_{ij}$) strictement inférieur à 1.
- Pas plus de 20 % des cellules de l’ensemble de la table ne doivent présenter un effectif théorique attendu ($E_{ij}$) inférieur à 5.
Dans le cas spécifique d’une table de contingence bivariée 2×2, la matrice ne comporte au total que quatre cellules distinctes. En conséquence mécanique, la présence d’une seule cellule affichant un effectif théorique inférieur à 5 représente immédiatement 25 % des cellules de la table (1 sur 4), ce qui enfreint instantanément le second critère de Cochran. Il est fondamental de souligner que cette règle ne s’applique pas aux effectifs observés réels ($O_{ij}$), mais exclusivement aux effectifs théoriques attendus sous l’hypothèse d’indépendance. La fréquence attendue pour une cellule située à l’intersection de la ligne $i$ et de la colonne $j$ est déterminée par le produit de son total marginal de ligne ($R_i$) et de son total marginal de colonne ($C_j$), divisé par la taille totale de l’échantillon ($N$) :
$$E_{ij} = \frac{R_i \times C_j}{N}$$
Le logiciel SPSS calcule automatiquement ces valeurs théoriques lors de la génération des tableaux croisés. Dès lors que l’une de ces valeurs descend sous le seuil de 5 dans un tableau 2×2, le chercheur doit obligatoirement écarter la valeur asymptotique du Chi-deux de Pearson et reporter exclusivement le résultat fourni par le test exact de Fisher.
2.3 Indépendance des observations et échantillonnage
Au-delà de la distribution des fréquences théoriques, le test exact de Fisher repose sur une hypothèse méthodologique non négociable : l’indépendance absolue des observations entre les sujets. Chaque unité expérimentale incluse dans le protocole doit contribuer à la table de contingence pour une observation et une seule. Cela signifie que l’appartenance d’un sujet à une catégorie donnée ne doit en aucune manière influencer ou déterminer l’appartenance d’un autre sujet à cette même catégorie ou à une autre. Ce postulat exclut formellement les structures d’échantillonnage en grappes non contrôlées, les réseaux d’influence sociale directe au sein de dyades, ou l’inclusion de plusieurs membres d’une même fratrie sans modélisation hiérarchique appropriée.
De surcroît, le test de Fisher est intrinsèquement inadapté aux plans expérimentaux à mesures répétées, aux études longitudinales mesurant le statut clinique d’un même individu « avant » et « après » traitement, ainsi qu’aux protocoles d’appariement cas-témoins individualisés. Pour ces architectures dépendantes, l’utilisation du test de Fisher entraînerait une sous-estimation ou une surestimation dramatique de la variance réelle, faussant irrémédiablement l’inférence. Les données catégorielles appariées relèvent d’autres modélisations dédiées, au premier rang desquelles figure le test de McNemar.
Sur le plan de la théorie de l’échantillonnage, le modèle mathématique de Fisher postule conditionnellement la fixité des marges de lignes et de colonnes. En recherche expérimentale pure, la taille des groupes (ex. 15 patients sous thérapie A et 15 patients sous thérapie B) est fixée a priori par l’expérimentateur, tandis que le nombre total de rémissions et d’échecs émerge des observations empiriques. Bien que seule une marge soit strictement fixée par le plan dans de nombreux contextes cliniques (échantillonnage multinomial ou de Poisson conditionnel), la théorie statistique contemporaine a amplement démontré que le conditionnement par rapport aux deux marges observées demeure l’approche la plus prudente et optimale pour tester l’indépendance sans introduire de paramètres de nuisance inconnus.
2.4 Formulation formelle des hypothèses statistiques
L’implémentation du test exact de Fisher exige la spécification formalisée d’un couple d’hypothèses statistiques mutuellement exclusives. Dans le cadre général de l’analyse d’association bivariée, l’hypothèse nulle ($H_0$) postule l’indépendance stochastique parfaite entre la variable indépendante (ligne) et la variable dépendante (colonne). Exprimée en termes de probabilités conditionnelles, $H_0$ énonce que la probabilité d’appartenir à une catégorie de la variable dépendante est rigoureusement identique quelle que soit la modalité considérée de la variable indépendante :
$$H_0 : P(Y = 1 mid X = 1) = P(Y = 1 mid X = 2)$$
En termes de paramètres d’association épidémiologique et clinique, cette hypothèse nulle équivaut strictement à stipuler que le rapport de cotes (Odds Ratio, $OR$) dans la population sous-jacente est égal à l’unité :
$$H_0 : OR = 1$$
L’hypothèse alternative ($H_1$), quant à elle, peut être formulée selon deux perspectives distinctes selon le cadre théorique de la recherche :
- Hypothèse alternative bilatérale (non directionnelle) : Elle postule l’existence d’une association ou d’une dépendance entre les deux variables, sans préjuger du sens de cette relation ($H_1 : P(Y = 1 mid X = 1) \neq P(Y = 1 mid X = 2)$ ou $H_1 : OR \neq 1$). Le chercheur envisage indifféremment que le traitement puisse augmenter ou détériorer le taux de rémission par rapport au groupe témoin.
- Hypothèse alternative unilatérale (directionnelle) : Elle postule une relation orientée étayée par une littérature robuste préalable ou des impératifs mécanistiques rigides ($H_1 : OR > 1$ ou $H_1 : OR < 1$). Par exemple, l'investigateur émet l'hypothèse formelle que la nouvelle psychothérapie produit un taux de rémission strictement supérieur à l'intervention standard.
Comme nous l’examinerons ultérieurement, SPSS fournit simultanément les probabilités exactes unilatérales et bilatérales dans ses sorties de calcul. Le choix entre ces deux approches doit obligatoirement être consigné dans le protocole de recherche avant l’inspection des données, afin de prévenir toute dérive vers des pratiques de sélection opportuniste de significativité (p-hacking).
3. Structuration et encodage des données dans SPSS
3.1 Organisation en données brutes individuelles (Format désagrégé)
L’organisation des fichiers de données au sein de l’environnement SPSS conditionne directement la capacité du logiciel à exécuter le test exact de Fisher sans biais d’agrégation. Le format de structuration le plus conventionnel en recherche empirique est le format désagrégé ou individuel. Dans cette architecture, la matrice de données contenue dans la Vue des données (Data View) consacre chaque ligne horizontale à un participant ou une unité observationnelle unique. Si l’étude porte sur 35 patients cliniques, le fichier SPSS doit afficher rigoureusement 35 lignes distinctes.
Dans ce format standard, la première colonne est systématiquement réservée à un identifiant unique (variable nommée conventionnellement ID ou Sujet). Cette pratique garantit la traçabilité des observations et facilite le contrôle qualité lors de l’audit des données. Les colonnes subséquentes hébergent les mesures opérationnelles : une colonne dédiée à la variable explicative ou prédictive (par exemple Groupe_Therapie) et une colonne dédiée à la variable critère ou d’issue (par exemple Remission_Clinique).
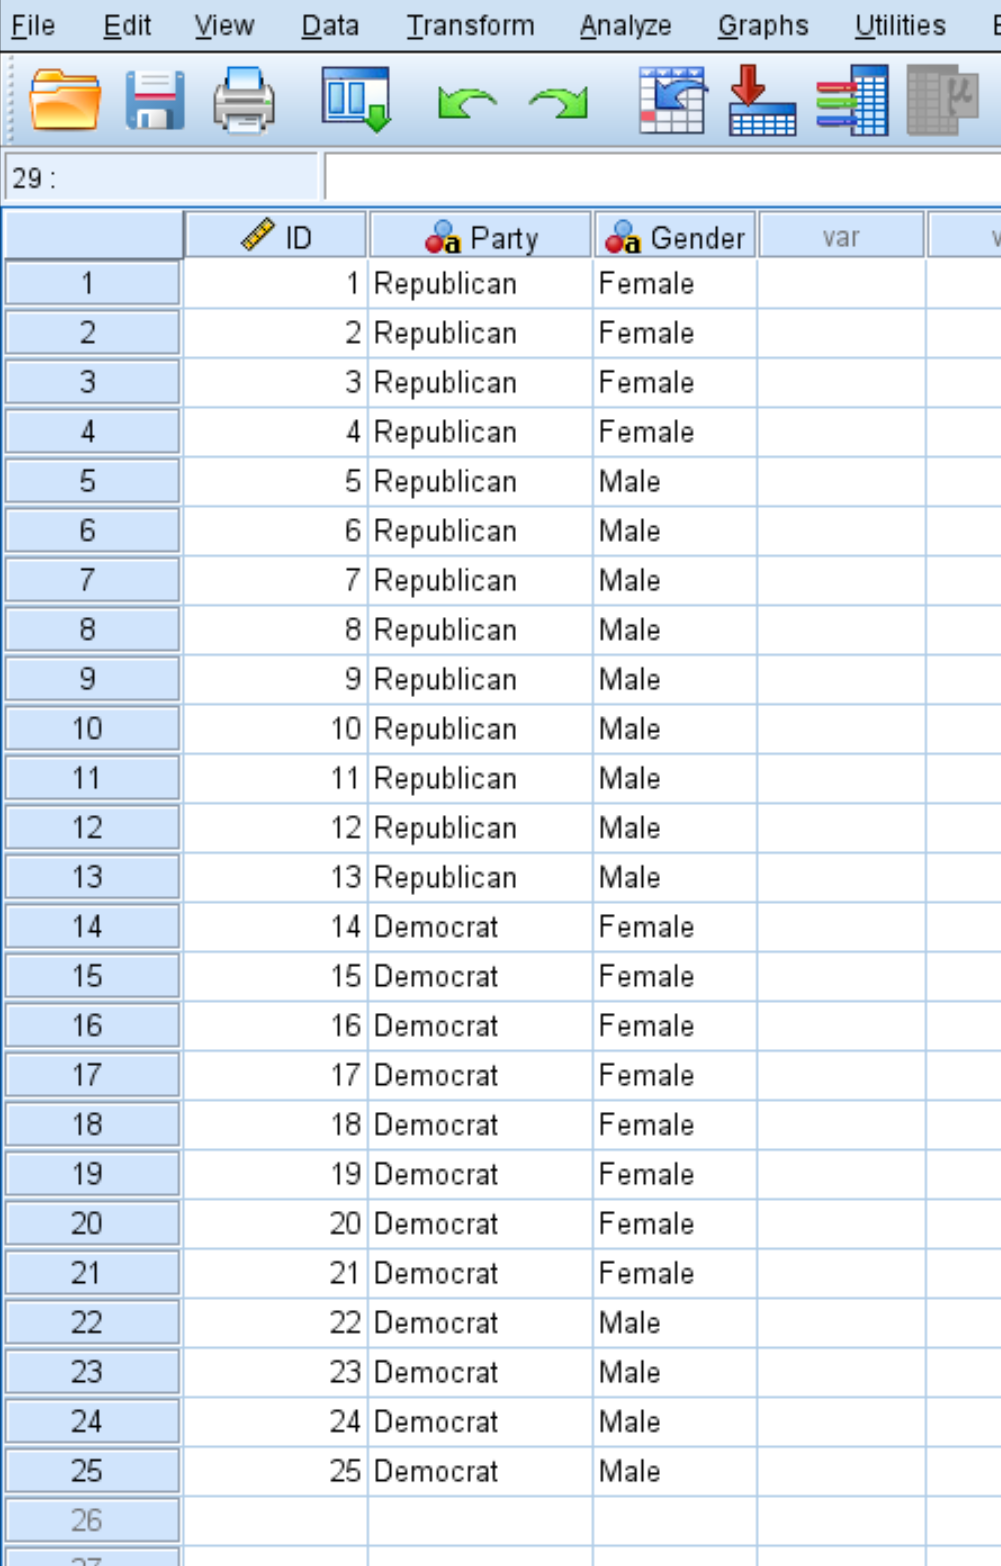
Chaque cellule de la matrice de données ne contient ainsi qu’une valeur numérique codifiée correspondant à l’état du sujet considéré. Cette organisation en données brutes individuelles présente l’avantage décisif d’autoriser l’intégration de covariables multiples (âge, sexe, score d’anxiété initial) au sein du même fichier de travail, permettant d’envisager sans restructuration ultérieure le passage vers des analyses multivariées ou des modélisations de régression logistique binaire.
3.2 Paramétrage des variables dans la Vue des variables
Une fois les colonnes d’encodage établies, le paramétrage métrologique précis s’effectue dans l’onglet Vue des variables (Variable View) de SPSS. Une configuration irréprochable prévient les erreurs de calcul algorithmique et garantit la clarté sémiotique des sorties graphiques et tabulaires générées par le logiciel. Pour chacune des deux variables destinées au tableau croisé, plusieurs paramètres fondamentaux doivent être configurés avec rigueur :
- Nom : Attribuer un nom court, explicite, dépourvu d’espaces et de caractères spéciaux (ex.
Traitement,Evolution). - Type : Choisir impérativement le type Numérique. Bien que SPSS autorise l’encodage de variables sous forme de chaînes de caractères (String), cette pratique est formellement déconseillée car elle alourdit le temps d’exécution des algorithmes exacts et peut désactiver certaines options d’estimation de la taille d’effet.
- Étiquette : Saisir une description textuelle détaillée qui apparaîtra dans les en-têtes des tableaux d’éditions (ex. « Condition thérapeutique administrée », « Statut de rémission à 6 mois post-intervention »).
- Valeurs : Définir avec précision le libellé associé à chaque code numérique au sein de la boîte de dialogue Étiquettes de valeurs. Par convention standardisée en biostatistique : attribuer la valeur
0à l’absence de l’événement ou au groupe témoin (ex.0 = Contrôle / Placebo,0 = Non-rémission) et la valeur1à la présence du phénomène d’intérêt ou au groupe expérimental (ex.1 = TCC Expérimentale,1 = Rémission complète). Une codification alternative1et2demeure parfaitement fonctionnelle. - Manquant : Spécifier de manière explicite les valeurs numériques discrètes affectées aux données manquantes d’origine utilisateur (ex.
999 = Donnée non documentée,998 = Abandon thérapeutique). Cette étape garantit que ces observations ne seront pas intégrées de manière erronée dans les totaux de contingence. - Mesure : Sélectionner expressément l’échelle de mesure Nominale (symbolisée par trois diagrammes circulaires colorés) ou Ordinale. Cette indication informe les procédures internes d’automatisation de SPSS sur le statut qualitatif de la variable.
3.3 Organisation en données pondérées (Format de tableau résumé)
Dans de nombreuses situations professionnelles, le chercheur ou le statisticien ne dispose pas du fichier micro-données brut individuel, mais uniquement d’un tableau résumé issu d’un article scientifique publié, d’un rapport épidémiologique institutionnel ou d’un registre hospitalier agrégé. SPSS permet de reproduire et d’analyser ce type de configuration en saisissant directement la table de contingence 2×2 compacte, laquelle ne comportera alors que quatre lignes de données au total.
Pour structurer correctement ce format agrégé, l’utilisateur doit créer un fichier comportant exactement trois variables numériques distinctes :
- Une première variable codant la modalité de la ligne (ex.
Condition: 1 = Médicament, 2 = Placebo). - Une deuxième variable codant la modalité de la colonne (ex.
Guerison: 1 = Succès, 2 = Échec). - Une troisième variable représentant la fréquence d’apparition conjointe, c’est-à-dire le nombre de sujets observés dans cette intersection spécifique (ex. variable
EffectifouPoids).
La matrice dans la Vue des données prend alors l’apparence compacte suivante :
| Ligne | Condition | Guerison | Effectif |
|---|---|---|---|
| 1 | 1 | 1 | 12 |
| 2 | 1 | 2 | 3 |
| 3 | 2 | 1 | 4 |
| 4 | 2 | 2 | 11 |
L’écueil méthodologique le plus sévère et le plus fréquent commis par les analystes débutants lors de l’utilisation de ce format résumé consiste à lancer immédiatement l’analyse sans instruire le logiciel de la nature fréquentielle de la troisième colonne. Sans instruction préalable, SPSS interprète la table comme une cohorte de 4 participants au total (une ligne par individu !). Pour corriger cette lecture, il est impératif d’activer la pondération en naviguant dans la barre supérieure des menus :
Données > Pondérer les observations… (Data > Weight Cases…)
Dans la fenêtre modale qui apparaît, cocher l’option Pondérer les observations par (Weight cases by), transférer la variable Effectif dans le champ d’assignation nommé Variable de fréquence (Frequency Variable), puis valider en cliquant sur le bouton OK. Dès cet instant, la mention « Pondération activée » (Weight On) s’affiche de manière permanente dans le coin inférieur droit de la barre d’état de l’interface SPSS, garantissant que l’échantillon total sera désormais comptabilisé à sa juste dimension ($N = 30$ dans notre exemple).
4. Procédure pas à pas pour exécuter le test dans SPSS
4.1 Accès au menu des tableaux croisés
L’exécution de la procédure statistique croisant deux variables catégorielles s’initie au sein du module des statistiques descriptives d’IBM SPSS. Que vos données soient encodées sous forme désagrégée brute ou sous forme de résumé pondéré, le protocole de navigation dans l’interface graphique est strictement superposable.
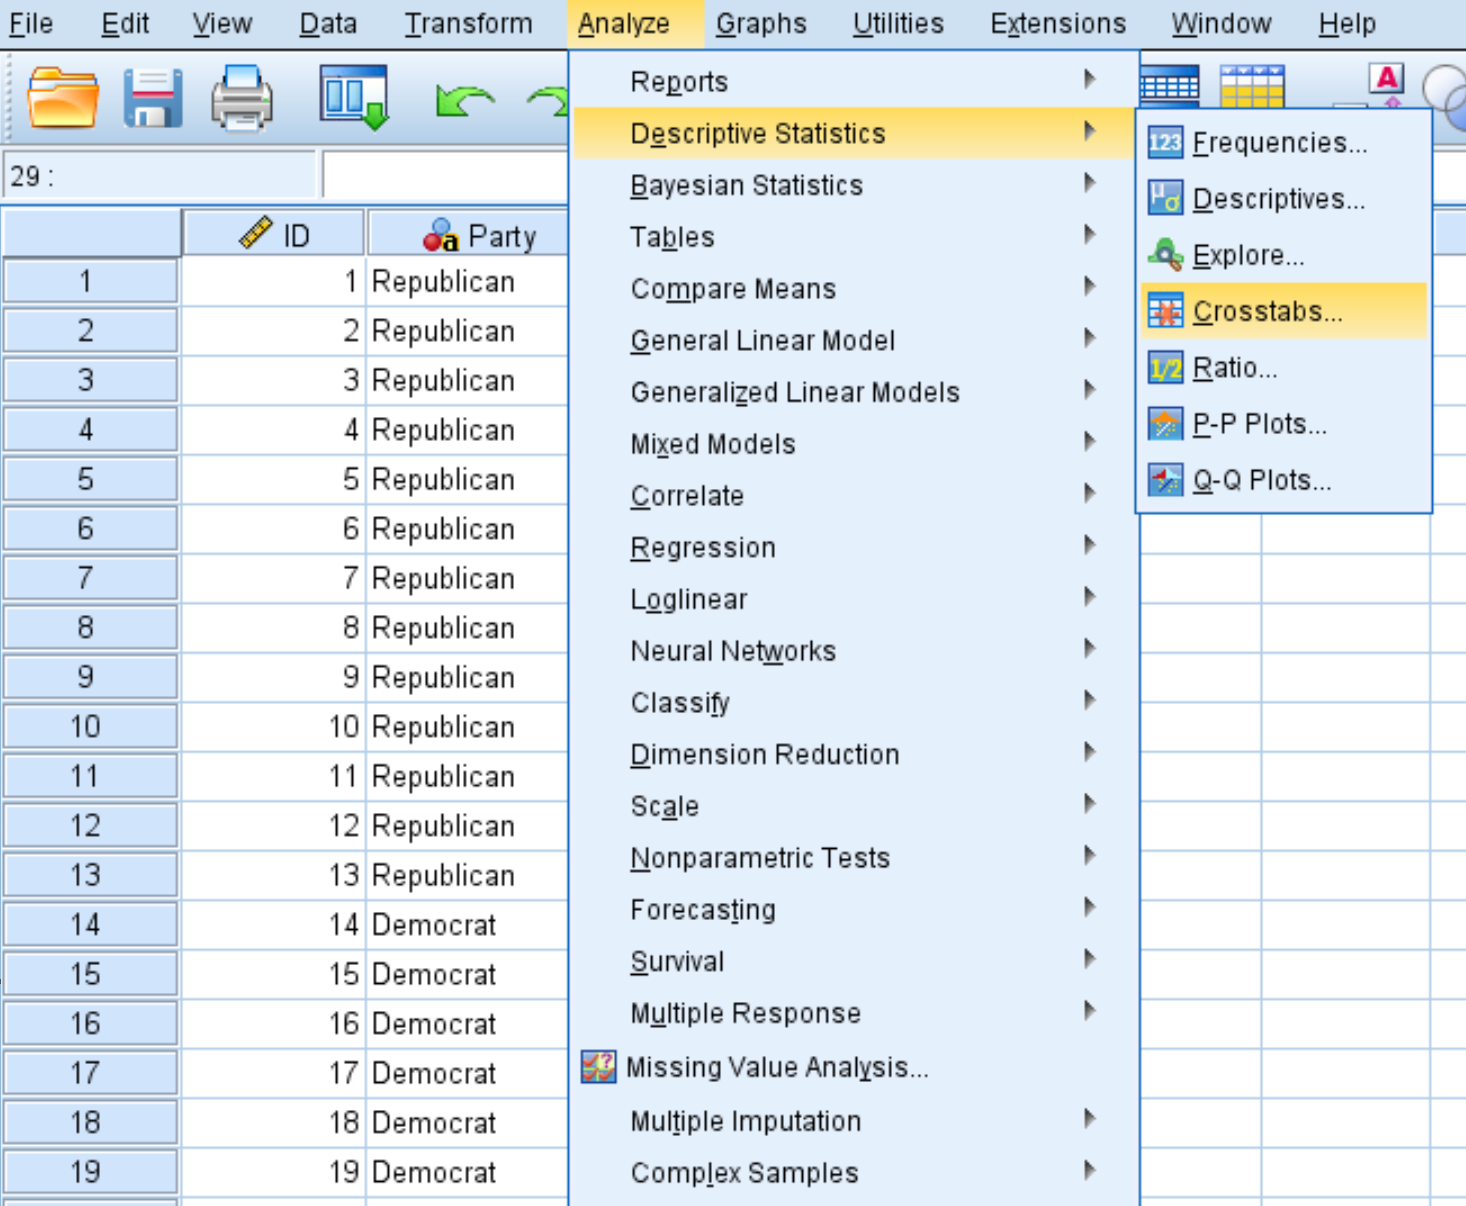
Pour ouvrir le module approprié, parcourez l’arborescence des menus déroulants selon le chemin suivant :
Analyse > Statistiques descriptives > Tableaux croisés… (Analyze > Descriptive Statistics > Crosstabs…)
Cette commande ouvre la boîte de dialogue principale intitulée Tableaux croisés. La zone de gauche liste exhaustivement l’ensemble des variables disponibles dans le jeu de données actif. Deux zones principales de réception rectangulaires occupent le centre de l’interface :
- Lignes (Rows) : Sélectionnez votre variable indépendante, explicative ou de regroupement (ex.
Groupe_Traitement) dans la liste de gauche et cliquez sur la flèche contextuelle supérieure pour l’insérer dans ce champ. - Colonnes (Columns) : Sélectionnez votre variable dépendante, d’issue ou de critère clinique (ex.
Remission) et insérez-la dans ce second champ via la flèche correspondante.
Bien que l’inversion des lignes et des colonnes ne modifie en rien la valeur numérique de la probabilité exacte de Fisher sous l’hypothèse d’indépendance, le respect de cette convention méthodologique (Variable Indépendante en ligne, Variable Dépendante en colonne) facilite considérablement le calcul et la lecture cognitive des pourcentages descriptifs intra-groupes.
4.2 Sélection des options statistiques appropriées
L’assignation des variables ne suffit pas à déclencher le calcul inférentiel : par défaut, SPSS ne génère qu’une simple table descriptive de comptage. Pour paramétrer l’analyse inférentielle, cliquez sur le bouton interactif Statistiques… (Statistics…) situé sur le flanc droit supérieur de la boîte de dialogue principale des tableaux croisés.
Une fenêtre secondaire intitulée Tableaux croisés : Statistiques se déploie à l’écran. Dans cet espace de sélection :
- Cochez impérativement la case intitulée Chi-deux (Chi-square). Il s’agit d’une spécificité cardinale de l’architecture logicielle de SPSS : il n’existe pas de bouton intitulé isolément « Test exact de Fisher » au sein de ce menu. C’est l’activation de la procédure du Chi-deux qui enclenche automatiquement le calcul sous-jacent du test de Fisher pour tous les tableaux présentant une dimension 2×2.
- Dans la section des mesures d’association nominales, cochez la case Phi et V de Cramer (Phi and Cramer’s V). Ces métriques fournissent des estimations standardisées indispensables de la taille d’effet associées à l’intensité de la relation observée.
- Dans cette même interface, il est particulièrement recommandé de cocher l’option Risque (Risk). Cette commande donne l’instruction à SPSS de calculer le rapport de cotes (Odds Ratio) ainsi que le risque relatif (Relative Risk) accompagnés de leurs intervalles de confiance respectifs à 95 %, des paramètres capitaux pour la publication clinique.
Cliquez ensuite sur le bouton Poursuivre (Continue) pour enregistrer ces préférences et revenir à la boîte de dialogue initiale.
4.3 Configuration du bouton Exact pour les versions avancées
Dans les versions contemporaines d’IBM SPSS Statistics intégrant le module Exact Tests, un bouton spécifiquement dédié intitulé Exact… est accessible sur le flanc supérieur droit de la boîte de dialogue principale, juste au-dessus du bouton Statistiques.
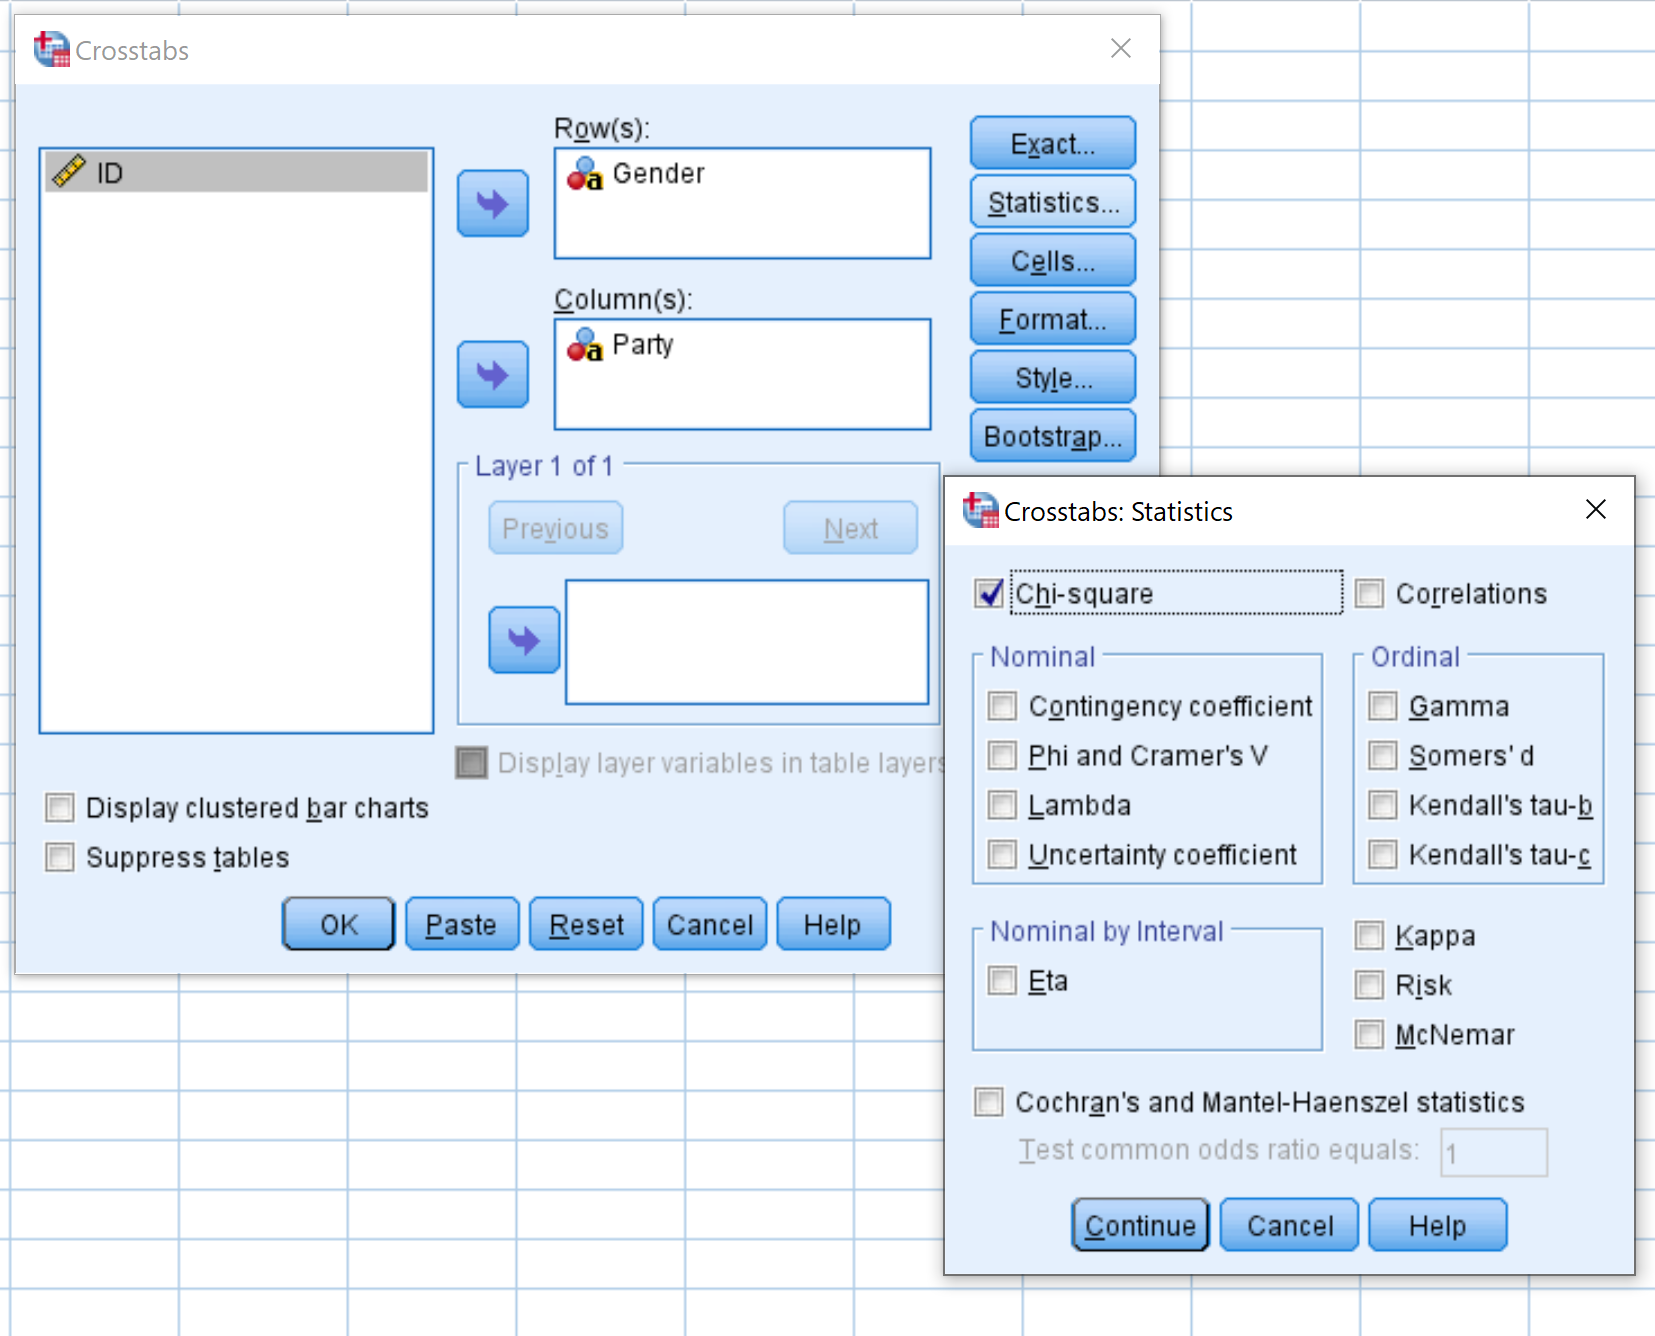
En cliquant sur ce bouton Exact…, la fenêtre Méthodes de calcul des tests exacts (Exact Tests) s’affiche. Elle soumet à l’utilisateur trois modes computationnels distincts :
- Asymptotique uniquement (Asymptotic only) : Ce mode applique les formules classiques de convergence vers la loi du Chi-deux sans exécuter d’algorithmes combinatoires lourds. Pour un tableau 2×2 standard, SPSS affichera tout de même la ligne du test de Fisher, mais désactivera les calculs exacts sur les extensions multidimensionnelles.
- Méthode de Monte-Carlo (Monte Carlo) : Cette approche estime la probabilité exacte par rééchantillonnage stochastique répété à partir d’un nombre déterminé de tables de contingence aléatoires respectant strictement les marges observées. Elle s’avère particulièrement utile lorsque les matrices sont volumineuses ($r \times c$) et que le temps de calcul exact devient prohibitif pour le processeur.
- Exact (Exact) : Cette option calcule de manière exhaustive et déterministe la probabilité mathématique absolue de la configuration sous la loi hypergéométrique.
Pour un tableau de contingence de format 2×2, il convient de cocher l’option Exact. Dans ce même panneau, le paramètre Limite de temps par test (Time limit per test) est fixé par défaut à 5 minutes (300 secondes), ce qui est largement suffisant pour les tables 2×2 dont la résolution combinatoire est quasi instantanée. Validez ce choix en cliquant sur Poursuivre.
4.4 Affichage des pourcentages et effectifs attendus dans Cellules
Pour parachever le paramétrage et s’assurer d’une interprétabilité clinique totale du tableau croisé, il est fondamental de ne pas se limiter à l’affichage des fréquences brutes. Cliquez sur le bouton Cellules… (Cells…) situé dans la boîte de dialogue principale.
La fenêtre modale Tableaux croisés : Affichage des cellules offre de multiples options de personnalisation d’affichage. Les sélections suivantes sont formellement préconisées pour une analyse rigoureuse :
- Dans la section Comptages (Counts) : Vérifiez que la case Observés (Observed) est cochée, et cochez expressément la case Effectifs attendus (Expected). L’affichage des effectifs attendus ($E_{ij}$) permettra d’attester publiquement de la violation ou du respect de la règle de Cochran.
- Dans la section Pourcentages (Percentages) : Cochez impérativement la case Ligne (Row). L’activation des pourcentages en ligne permet d’observer directement la proportion d’individus présentant l’événement au sein de chaque groupe expérimental séparé, autorisant une comparaison clinique immédiate. Selon vos objectifs, vous pouvez également cocher les pourcentages en colonne ou totaux.
- Dans la section Résidus (Residuals) : Cochez l’option Ajustés standardisés (Adjusted standardized). Ces résidus suivent asymptotiquement une loi normale centrée réduite $\mathcal{N}(0, 1)$ et permettent d’identifier précisément quelles cellules dévient de manière significative des prédictions du modèle d’indépendance (une valeur absolue supérieure à $|1,96|$ dénotant un écart significatif au seuil $\alpha = 0,05$).
Validez ces options en cliquant sur Poursuivre, puis lancez le calcul global en cliquant sur le bouton OK au sein de la fenêtre principale.
5. Gestion des tableaux de contingence supérieurs à 2×2 (Tables r x c)
5.1 L’extension Freeman-Halton du test exact de Fisher
Bien que le test exact de Fisher soit universellement réputé pour son application aux tables de contingence dichotomiques 2×2, les chercheurs en psychologie sont très fréquemment confrontés à des protocoles expérimentaux impliquant des structures plus complexes : des tables comportant $r$ lignes et $c$ colonnes ($r \times c$), telles que des matrices 2×3 (ex. deux groupes comparés sur trois niveaux d’amélioration clinique) ou 3×3 (ex. trois orientations thérapeutiques croisées avec trois typologies d’attachement chez l’adulte).
Face à ces tables multidimensionnelles à faibles effectifs cellulaires, l’approximation du Chi-deux de Pearson s’avère tout aussi invalide qu’en format 2×2 dès lors que plus de 20 % des cellules affichent un effectif théorique inférieur à 5. La solution mathématique rigoureuse a été formulée en 1951 par G. H. Freeman et J. H. Halton à travers l’extension Freeman-Halton du test exact de Fisher. Cette procédure généralise la loi hypergéométrique multivariée pour évaluer la probabilité exacte d’observer une distribution donnée de fréquences cellulaires sous l’hypothèse nulle d’indépendance, conditionnellement aux marges vectorielles observées :
$$P = \frac{\left( \prod_{i=1}^r R_i! \right) \left( \prod_{j=1}^c C_j! \right)}{N! \prod_{i=1}^r \prod_{j=1}^c O_{ij}!}$$
Toutefois, le déploiement de cette formule se heurte à une barrière computationnelle majeure : la complexité combinatoire exponentielle. Alors qu’une table 2×2 ne présente qu’un seul degré de liberté (la fixation arbitraire d’une cellule détermine l’ensemble des trois autres sous marges fixes), une table $r \times c$ dispose de $(r-1)(c-1)$ degrés de liberté. Le nombre d’arrangements matriciels possibles satisfaisant les marges fixes croît de manière vertigineuse, exigeant des ressources de calcul massives qui peuvent saturer les processeurs informatiques dès que les effectifs marginaux augmentent modérément.
5.2 Recours à l’échantillonnage de Monte-Carlo dans SPSS
Afin de contourner l’impasse calculatoire inhérente à l’extension exhaustive de Freeman-Halton sur des tables volumineuses ou à marges intermédiaires, IBM SPSS Statistics intègre une solution algorithmique d’une remarquable élégance : l’échantillonnage de Monte-Carlo. Cette méthode stochastique ne cherche pas à inventorier la totalité mathématique des millions de tables compatibles, mais génère aléatoirement un nombre massif d’échantillons virtuels sous la contrainte des marges marginales observées.
Pour mettre en œuvre cette approche sous SPSS lorsque le calcul exact s’avère trop long ou refuse de s’exécuter :
- Accédez au bouton Exact… au sein du menu des tableaux croisés.
- Sélectionnez le bouton radio Méthode de Monte-Carlo (Monte Carlo).
- Définissez le Niveau de confiance souhaité pour l’encadrement de l’estimation (paramétrez-le idéalement à 99 % pour une robustesse académique maximale).
- Indiquez le Nombre d’échantillons (Number of samples). La valeur par défaut de 10 000 offre une bonne approximation, mais il est hautement recommandé d’élever ce paramètre à 100 000 échantillons dans les protocoles de recherche soumis à publication internationale, afin de réduire drastiquement l’erreur d’échantillonnage de simulation.
Dans les sorties SPSS, le tableau des résultats n’affiche pas une probabilité exacte ponctuelle unique, mais une signification estimée par Monte-Carlo, rigoureusement encadrée par un intervalle de confiance à 99 % (bornes inférieure et supérieure). Si la borne supérieure de cet intervalle de confiance demeure strictement inférieure au seuil alpha critique de 0,05, le chercheur peut conclure avec une certitude statistique absolue au rejet de l’hypothèse nulle d’indépendance, nonobstant la nature clairsemée des données initiales.
5.3 Stratégies de regroupement des modalités de variables
Face à des tables multidimensionnelles clairsemées générant des cellules vides ($O_{ij} = 0$) ou des effectifs théoriques quasi nuls ($E_{ij} < 1$), une stratégie analytique alternative consiste à opérer un regroupement raisonné des modalités (collapsing categories). Cette pratique vise à fusionner deux ou plusieurs catégories conceptuellement proches afin d’accroître mécaniquement les effectifs par cellule et de restaurer une distribution fréquentielle équilibrée.
Cette manœuvre de fusion ne doit cependant jamais être guidée par l’opportunisme statistique ou la volonté artificielle d’atteindre le seuil de significativité. Elle requiert une double justification impérative :
- Une cohérence clinique et théorique intrinsèque : Les modalités fusionnées doivent partager une proximité sémantique indiscutable. Par exemple, au sein d’une variable évaluant le statut tabagique initialement découpé en « Non-fumeur », « Fumeur occasionnel » et « Fumeur quotidien lourd », il peut s’avérer scientifiquement légitime de regrouper les deux dernières modalités sous le label global « Consommateurs de tabac ».
- Le respect de la validité interne : La fusion de modalités ne doit pas masquer une hétérogénéité qualitative cruciale pour l’interprétation des résultats psychologiques sous-jacents.
Sous SPSS, le regroupement s’exécute de manière reproductible via le menu :
Transformer > Recoder dans des variables différentes… (Transform > Recode into Different Variables…)
Cette procédure garantit l’intégrité de la variable initiale dans le fichier source tout en générant une nouvelle variable synthétique recodée (par exemple passage d’un format initial 3×3 à un format consolidé 2×2), sur laquelle le test exact de Fisher standard pourra être déployé avec une puissance statistique décuplée.
6. Interprétation rigoureuse des sorties et résultats SPSS
6.1 Validation de l’échantillon et tableau récapitulatif des observations
L’exécution de la procédure des tableaux croisés dans SPSS génère une suite ordonnée d’éditions graphiques dans la fenêtre de sortie (Output Viewer). Le premier tableau affiché est systématiquement le Récapitulatif de traitement des observations (Case Processing Summary). Bien que fréquemment négligé par les utilisateurs inexpérimentés, ce tableau constitue un point d’étape de contrôle qualité méthodologique obligatoire.
Ce tableau détaille précisément :
- Le nombre absolu et le pourcentage d’observations Valides (Valid Cases) intégrées dans le calcul combinatoire.
- Le nombre et le pourcentage d’observations Manquantes (Missing Cases) exclues de l’analyse, que cette exclusion découle de données absentes du système (cellules vides) ou de codes de valeurs manquantes définis par l’utilisateur.
- L’effectif Total des lignes compilées.
Le chercheur doit impérativement auditer ce tableau pour vérifier la concordance exacte entre la taille effective de l’échantillon recruté et l’échantillon réellement analysé. L’identification imprévue d’un volume substantiel d’observations manquantes doit alerter sur d’éventuelles anomalies d’encodage ou imposer une analyse préalable des mécanismes de déperdition de données (données manquantes complètement au hasard MCAR, au hasard MAR, ou non-aléatoires MNAR) avant toute conclusion définitive.
6.2 Analyse descriptive des proportions dans le tableau croisé
Le second tableau généré par la procédure est le Tableau croisé bivarié (Crosstabulation). C’est dans cette matrice structurée que réside l’intelligibilité clinique première du phénomène étudié. L’examen attentif des pourcentages intra-groupes (pourcentages en ligne) permet de matérialiser concrètement la direction et la magnitude brute de l’effet avant même la consultation des indices de significativité inférentielle.
Trois niveaux de lecture doivent être consécutivement menés au sein de cette table :
- La confrontation des pourcentages conditionnels : Par exemple, si l’on examine le taux de rémission clinique au sein d’une cohorte comparant une nouvelle psychothérapie cognitivo-comportementale intégrative (Groupe Expérimental) à un suivi psychiatrique standard (Groupe Contrôle), on comparera le pourcentage de sujets en rémission au sein de la ligne 1 au pourcentage analogue au sein de la ligne 2. Un écart visuel substantiel (par exemple 73,3 % vs 26,7 %) préfigure la présence d’une association directionnelle forte.
- La confrontation des effectifs observés et attendus : Pour chaque cellule, SPSS juxtapose le nombre effectif de cas constatés ($O_{ij}$) et le nombre de cas que l’on s’attendrait théoriquement à constater ($E_{ij}$) si l’hypothèse nulle d’absence totale de relation était vraie. Un surplus d’effectifs observés dans les cellules de rémission du groupe expérimental, couplé à un déficit d’effectifs observés dans les cellules d’échec, matérialise visuellement la dynamique de la relation.
- L’inspection des résidus ajustés standardisés : Si cette option a été cochée dans le sous-menu Cellules, des valeurs résiduelles excédant le seuil critique de $\pm 1,96$ permettent d’isoler avec précision les sous-groupes cellulaires qui contribuent de manière déterminante à l’inflexion statistique globale de la table.
6.3 Lecture de la table des tests du Chi-deux et de la ligne de Fisher
Le troisième tableau produit, intitulé Tests du Chi-deux (Chi-Square Tests), concentre le cœur décisionnel de l’évaluation inférentielle. Dans le cas d’une matrice 2×2, ce tableau empile plusieurs lignes statistiques concurrentes : Chi-deux de Pearson, Correction de continuité (de Yates), Rapport de vraisemblance, Test exact de Fisher, et Association linéaire par linéaire.
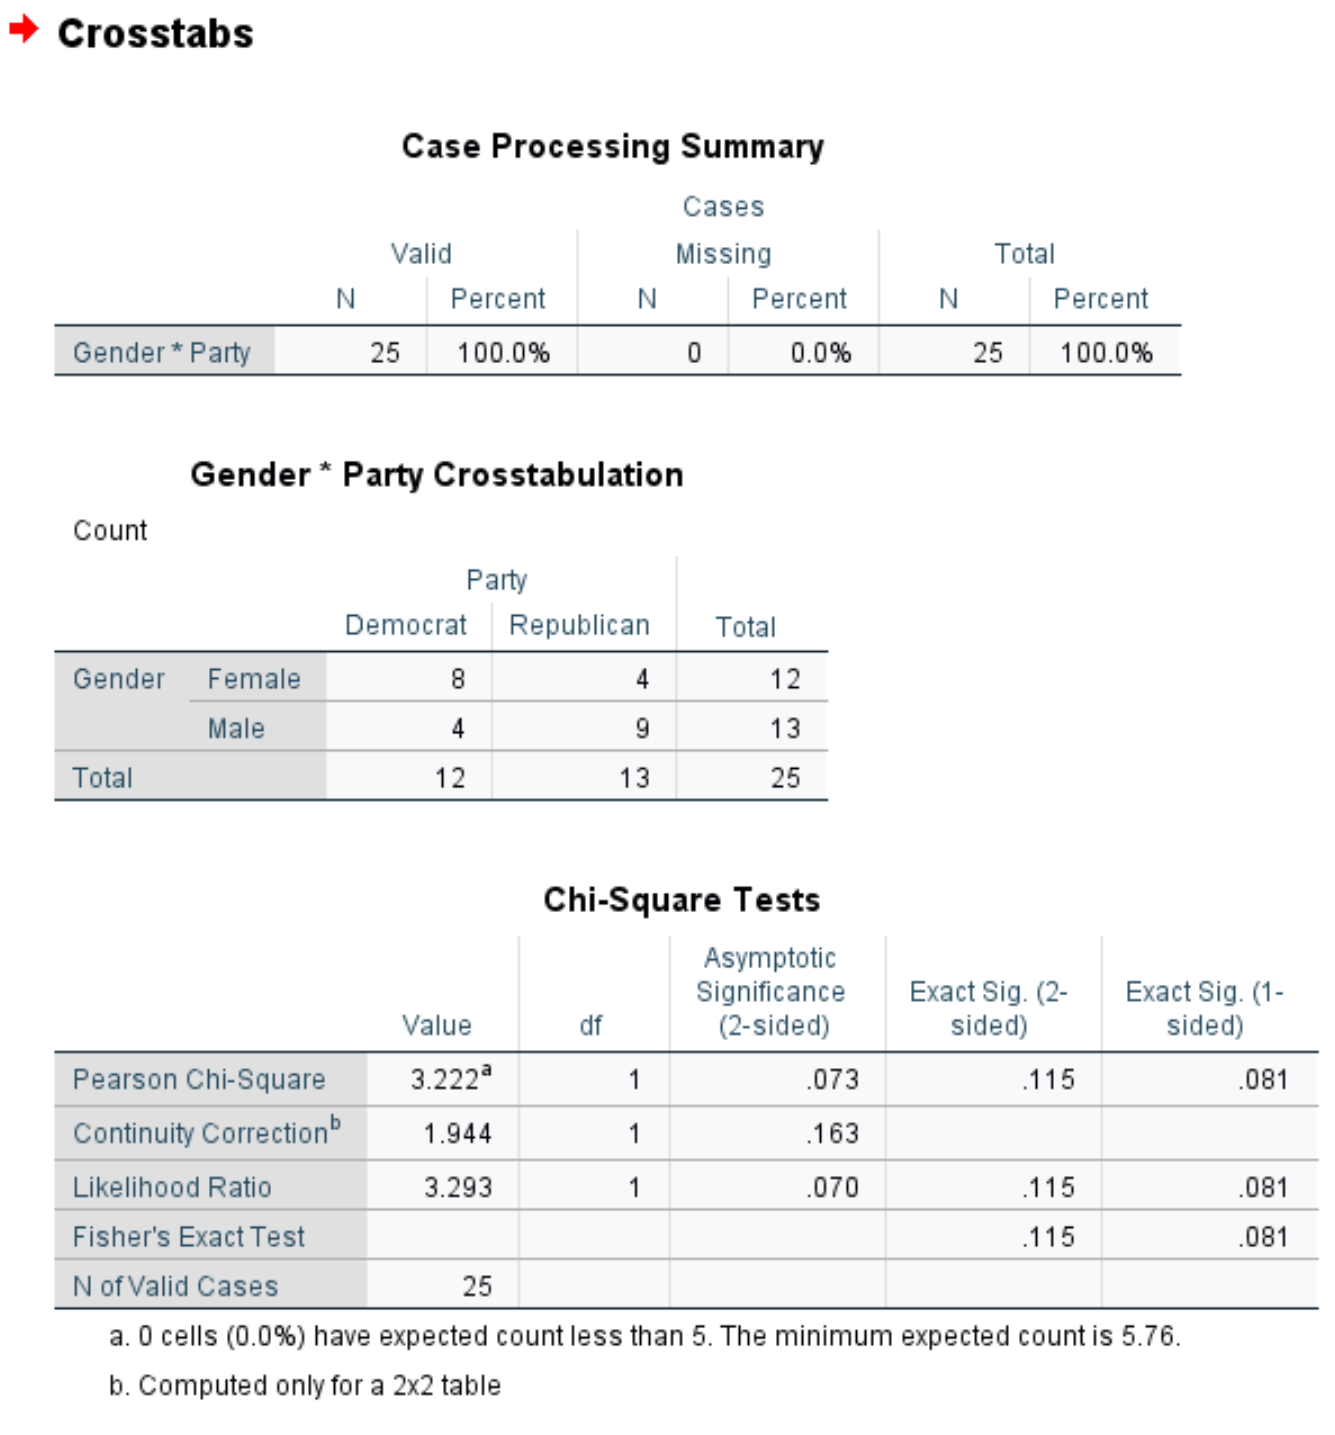
La validation du recours légitime au test exact de Fisher s’opère en premier lieu par l’inspection de la note de bas de tableau (a) positionnée sous la matrice. Cette mention textuelle automatique fournit un diagnostic formel de l’état des fréquences théoriques. Elle se structure invariablement selon le modèle suivant :
« a. X cellules (XX,X %) ont un effectif théorique inférieur à 5. L’effectif théorique minimal est de X,XX. »
Dès lors que ce texte révèle qu’au moins une cellule affiche un effectif théorique inférieur à 5 (dépassant immédiatement le seuil de 20 % dans une table 2×2) ou que l’effectif théorique minimal est inférieur à 1, le critère de Cochran est officiellement violé. Dans ces conditions impérieuses, le chercheur doit totalement ignorer la ligne supérieure du Chi-deux de Pearson ainsi que la ligne de la Correction de continuité, pour diriger exclusivement son attention analytique sur la ligne désignée : Test exact de Fisher (Fisher’s Exact Test).
Dans la ligne consacrée au test exact de Fisher, la colonne intitulée Valeur (Value) demeure souvent vierge ou affiche une valeur non interprétable directement comme une statistique paramétrique standard. Contrairement au Chi-deux qui produit un score d’écart quadratique ($\chi^2$) associé à des degrés de liberté, le test de Fisher calcule directement des probabilités sans passer par une métrique de déviation intermédiaire continue. L’évaluation repose donc exclusivement sur les colonnes de probabilité associées.
6.4 Différenciation entre p-valeur bilatérale et unilatérale
Au sein de la ligne Test exact de Fisher, la matrice d’éditions d’IBM SPSS Statistics délivre deux estimations probabilistes distinctes, situées dans les colonnes d’extrémité droite :
- Signification bilatérale exacte (Exact Sig. 2-sided) : Cette valeur $p$ correspond au test d’hypothèse non directionnel. Elle cumule la probabilité exacte de la table observée avec les probabilités de l’ensemble de toutes les tables hypothétiques concevables ayant les mêmes marges et dont la probabilité d’occurrence hypergéométrique est inférieure ou égale à celle de la table observée. Il s’agit de la valeur d’évaluation standard, conventionnelle et obligatoire dans la quasi-totalité des publications académiques internationales.
- Signification unilatérale exacte (Exact Sig. 1-sided) : Cette valeur $p$ évalue la probabilité cumulée des tables disposant des mêmes marges qui s’écartent dans la direction clinique spécifique postulée a priori (soit une accumulation exclusive dans le sens d’une supériorité d’un traitement).
La règle décisionnelle s’articule rigoureusement face au seuil d’erreur de première espèce nominal conventionnel, généralement fixé à $\alpha = 0,05$ :
- Si la Signification bilatérale exacte est strictement inférieure à 0,05 ($p < 0,05$), l'investigateur rejette formellement l'hypothèse nulle d'indépendance ($H_0$). Il conclut qu'il existe une association statistiquement significative entre les deux variables catégorielles étudiées au sein de la population cible.
- Si la Signification bilatérale exacte est supérieure ou égale à 0,05 ($p ge 0,05$), l’investigateur échoue à rejeter l’hypothèse nulle. Les données empiriques ne permettent pas d’attester d’une relation statistiquement dépendante entre les deux facteurs au seuil de confiance retenu.
Le recours à la valeur unilatérale (1-sided) ne peut en aucun cas constituer un artifice d’ajustement a posteriori pour déclarer significatif un résultat affichant une valeur bilatérale marginale (ex. $p_{\text{bilatéral}} = 0,08$ versus $p_{\text{unilatéral}} = 0,04$). L’adoption d’un seuil unilatéral exige une justification théorique inattaquable formalisée préalablement au recueil des données dans un protocole d’enregistrement public (ex. pré-enregistrement sur l’Open Science Framework ou ClinicalTrials.gov). En l’absence d’un tel pré-enregistrement, la valeur bilatérale fait seule autorité scientifique.
7. Mesures d’association et estimation de la taille d’effet
7.1 Calcul et interprétation du coefficient Phi
L’obtention d’une probabilité statistiquement significative ($p < 0,05$) confirme l'existence d'une association non imputable aux simples fluctuations d'échantillonnage aléatoire, mais n'apporte aucune information quantifiée sur l'intensité clinique ou l'ampleur de cette liaison. En psychologie comme en recherche médicale, l'obligation méthodologique de rapporter la taille d’effet (effect size) est devenue incontournable. Pour une table de contingence bivariée 2×2, la métrique standardisée privilégiée est le coefficient Phi ($phi$).
Sur le plan algébrique, le coefficient Phi est équivalent au coefficient de corrélation produit-moment de Pearson calculé sur deux variables binaires encodées numériquement par les valeurs 0 et 1. Il dérive directement de la statistique du Chi-deux selon la relation mathématique :
$$\phi = \sqrt{\frac{\chi^2}{N}}$$
Le coefficient Phi évolue au sein d’un intervalle compris théoriquement entre 0 (indépendance absolue) et 1 (dépendance fonctionnelle parfaite). Pour guider l’interprétation qualitative de cette magnitude en psychologie et sciences du comportement, les balises heuristiques proposées par Jacob Cohen (1988) font référence dans la littérature internationale :
- $\phi \approx 0,10$ : Taille d’effet faible (association subtile).
- $\phi \approx 0,30$ : Taille d’effet moyenne (association modérée, perceptible à l’observation clinique).
- $phi ge 0,50$ : Taille d’effet forte (association prononcée, d’une portée diagnostique ou thérapeutique majeure).
Une mise en garde métrologique s’impose néanmoins : le coefficient Phi ne peut atteindre sa borne théorique maximale de 1,0 que si les distributions marginales des deux variables sont rigoureusement identiques (par exemple un ratio 50/50 sur les lignes et 50/50 sur les colonnes). Lorsque les totaux marginaux sont très fortement dissymétriques (par exemple 90/10 sur une variable et 50/50 sur l’autre), la valeur maximale accessible par $phi$ se trouve mathématiquement bridée à un niveau nettement inférieur, ce qui impose une interprétation prudente de sa magnitude brute.
7.2 Utilisation du V de Cramer pour les tableaux multidimensionnels
Lorsque la structure du tableau de contingence excède le format 2×2 pour embrasser des matrices d’ordre supérieur ($r \times c$, comme une table 2×3 ou 3×3), le coefficient Phi standard cesse d’être borné à l’unité supérieure et perd toute standardisation métrique. Il convient alors de mobiliser le V de Cramer ($V$), qui introduit un terme de correction ajusté sur le nombre de dimensions de la matrice.
La formulation algébrique du V de Cramer s’établit comme suit :
$$V = \sqrt{\frac{\chi^2}{N \times \min(r – 1, c – 1)}}$$
Où $r$ représente le nombre total de lignes, $c$ le nombre total de colonnes, et $min(r – 1, c – 1)$ désigne le plus petit des deux degrés de liberté marginaux. Grâce à cette normalisation dimensionnelle, le V de Cramer demeure rigoureusement circonscrit entre 0 et 1, quelle que soit la complexité d’extension de la table de contingence.
L’évaluation de la magnitude du V de Cramer exige un ajustement des critères de Cohen en fonction des degrés de liberté effectifs du système ($df^* = \min(r – 1, c – 1)$). Pour un tableau comportant $df^* = 2$ (par exemple une table 3×3), les seuils conventionnels d’interprétation deviennent :
- Effet faible : $V \approx 0,07$
- Effet moyen : $V \approx 0,21$
- Effet fort : $V ge 0,35$
Dans la fenêtre d’éditions d’IBM SPSS, les coefficients Phi et V de Cramer sont regroupés au sein d’une table unique intitulée Mesures symétriques (Symmetric Measures). Dans le cas d’une matrice 2×2, leurs valeurs numériques sont strictement identiques.
7.3 Rapport de cotes (Odds Ratio) et son intervalle de confiance
En épidémiologie psychiatrique et en psychologie clinique factuelle (Evidence-Based Psychology), le paramètre roi de quantification de la taille d’effet binaire est sans conteste le Rapport de cotes ou Odds Ratio ($OR$). Contrairement aux coefficients de corrélation, l’Odds Ratio exprime l’amplification relative des chances d’apparition d’un événement au sein d’un groupe exposé ou expérimental par rapport à un groupe témoin non exposé.
Dans une table 2×2 structurée selon le croisement conventionnel :
| Condition | Événement Présent (Succès) | Événement Absent (Échec) |
|---|---|---|
| Groupe Expérimental | a | b |
| Groupe Contrôle | c | d |
Le rapport de cotes se calcule de manière élémentaire par le produit croisé des cellules :
$$OR = \frac{a / b}{c / d} = \frac{a \times d}{b \times c}$$
L’interprétation clinique de l’Odds Ratio s’articule autour de la valeur pivot de référence 1,0 :
- $OR = 1,0$ : Indépendance parfaite. La cote de survenue de l’événement est rigoureusement identique entre les deux groupes.
- $OR > 1,0$ : La cote de survenue de l’événement est accrue dans le premier groupe (par exemple, un $OR = 3,5$ indique que les patients traités ont 3,5 fois plus de chances relatives de connaître une rémission que les témoins).
- $OR < 1,0$ : La cote de survenue de l’événement est amoindrie dans le premier groupe, signalant un effet protecteur ou réducteur.
Dans les sorties SPSS, l’estimation de ce paramètre s’observe dans le tableau intitulé Estimation du risque (Risk Estimate), accessible si la case Risque a été cochée dans les options statistiques. La première ligne, libellée Rapport des cotes pour [Variable] (Odds Ratio), délivre la valeur ponctuelle de l’OR ainsi que son Intervalle de confiance à 95 % (IC 95 %). L’analyse de cet intervalle de confiance s’avère hautement informative : si l’intervalle de confiance à 95 % inclut la valeur 1,0 (par exemple IC 95 % [0,85 ; 6,40]), cela confirme que l’association n’est pas statistiquement significative au seuil $\alpha = 0,05$. À l’inverse, un intervalle excluant totalement la valeur 1,0 (par exemple IC 95 % [1,25 ; 8,90]) atteste de la significativité statistique de l’effet avec une précision métrologique formalisée.
8. Rédaction des résultats selon les normes de l’APA (7e édition)
8.1 Directives typographiques et statistiques de l’APA
La communication scientifique dans les revues internationales de psychologie et de sciences du comportement obéit aux normes strictes édictées par l’American Psychological Association (APA Style Manual, 7e édition). La retranscription du test exact de Fisher obéit à des règles typographiques et structurelles précises qu’il convient d’appliquer scrupuleusement :
- Mise en italique des symboles statistiques : Toutes les lettres latines symbolisant des paramètres statistiques ou des estimations d’échantillon doivent obligatoirement être composées en italique : p, N, OR. En revanche, les lettres grecques ($phi$) ou les acronymes formés de plusieurs lettres latines conservent une typographie droite conventionnelle dans certains contextes, bien que l’abréviation de l’Odds Ratio en italique (OR) soit la règle standard sous l’APA 7.
- Suppression du zéro initial pour les métriques bornées à l’unité : Selon les directives explicites de l’APA, une statistique dont la valeur mathématique ne peut jamais excéder le nombre 1,0 ne doit jamais être précédée d’un zéro avant le séparateur décimal. Cette règle s’applique impérativement à la valeur de probabilité (écrire p = .032 et non pas p = 0.032) ainsi qu’au coefficient Phi (écrire $phi$ = .42 et non pas $phi$ = 0.42). En revanche, pour les métriques pouvant dépasser l’unité, telles que l’Odds Ratio, le zéro initial doit être rigoureusement maintenu (ex. OR = 0.65 ou OR = 3.20).
- Précision décimale : Les valeurs de p doivent être rapportées avec une précision de trois décimales (ex. p = .014). Si le logiciel SPSS affiche une valeur extrême libellée « .000 », ne rédigez jamais « p = .000 » (une probabilité n’étant jamais strictement nulle), mais stipulez formellement : p < .001. Les tailles d'effet, pourcentages et rapports de cotes se rapportent classiquement avec deux décimales.
- Absence de degrés de liberté pour le test de Fisher : Contrairement aux tests du Chi-deux ou aux analyses de variance, le test exact de Fisher ne dispose pas d’une statistique de distribution continue ni de degrés de liberté formels à insérer entre parenthèses. On rapporte directement le nom explicite du test, la taille totale de l’échantillon ($N$), la valeur de probabilité exacte et la taille d’effet.
8.2 Formulations textuelles académiques types
L’intégration des résultats au sein du corps de texte de la section Résultats d’un article académique doit associer avec fluidité les indicateurs de tendance descriptive, les indices inférentiels et les mesures d’amplitude clinique. Voici deux modèles canoniques rédigés selon les standards académiques francophones conformes aux préconisations de l’APA 7e édition :
Modèle d’énoncé pour un résultat statistiquement significatif :
« Une analyse par tableau croisé a été réalisée pour examiner l’impact de l’intervention thérapeutique sur la rémission clinique des patients. En raison de la présence d’effectifs théoriques attendus inférieurs à 5 dans 25 % des cellules de la table de contingence, le test exact de Fisher bilatéral a été appliqué. Les résultats révèlent une association statistiquement significative entre le type de traitement administré et le statut de rémission à l’issue du protocole (Test exact de Fisher, N = 26, p = .028, bilatéral). La proportion de patients parvenant à une rémission complète s’avère substantiellement plus élevée au sein du groupe ayant bénéficié de la thérapie cognitivo-comportementale intégrative (76,9 %, n = 10/13) comparativement au groupe recevant le suivi standard (30,8 %, n = 4/13). L’ampleur de cette relation correspond à une taille d’effet moyenne à forte selon les critères conventionnels de Cohen (coefficient Phi ϕ = .46). L’analyse du rapport de cotes confirme que les participants du groupe expérimental présentent une cote de rémission significativement accrue par rapport aux participants témoins (OR = 7,50, IC 95 % [1,22, 46,08]). »
Modèle d’énoncé pour un résultat non significatif :
« L’existence d’une éventuelle dépendance entre la survenue d’abandons thérapeutiques précoces et l’historique de traumatismes infantiles a été investiguée au moyen d’un tableau de contingence 2×2. Compte tenu de la taille réduite de l’échantillon entraînant un effectif théorique minimal de 2,4 cas, le test exact de Fisher a été privilégié. L’analyse ne met en évidence aucune association statistiquement significative entre l’exposition à un traumatisme infantile et le risque d’abandon prématuré du suivi (Test exact de Fisher, N = 24, p = .386, bilatéral). Les taux de défection observés ne diffèrent pas de manière probante entre les patients exposés (27,3 %, n = 3/11) et les patients non exposés (15,4 %, n = 2/13), matérialisant une taille d’effet négligeable (ϕ = .15, OR = 2,06, IC 95 % [0,27, 15,85]). »
8.3 Présentation des résultats sous forme de tableau APA
Lorsque l’article compile plusieurs comparaisons catégorielles ou intègre des descriptions fréquentielles riches, la présentation sous forme tabulaire est préconisée par l’APA. Selon les normes typographiques de l’APA 7, un tableau statistique ne doit comporter aucune bordure verticale, et limiter les bordures horizontales à trois lignes principales : une ligne sous le titre du tableau, une ligne délimitant la rangée d’en-tête des colonnes, et une ligne clôturant la base du tableau avant les notes de bas de page.
Tableau 1
Distribution des rémissions cliniques selon la condition thérapeutique
| Condition | Rémission n (%) | Échec n (%) | Total N | p (Fisher) | $phi$ | OR [IC 95 %] |
|---|---|---|---|---|---|---|
| Thérapie Intégrative | 10 (76,9 %) | 3 (23,1 %) | 13 | .028 | .46 | 7,50 [1,22 ; 46,08] |
| Suivi Standard | 4 (30,8 %) | 9 (69,2 %) | 13 |
Note. N = 26. Les valeurs de p correspondent au test exact de Fisher bilatéral compte tenu d’un effectif théorique attendu minimal de 4,50 par cellule. $phi$ = coefficient Phi ; OR = Rapport de cotes (Odds Ratio) ; IC = Intervalle de confiance.
9. Étude de cas guidée : Exemple clinique en psychologie
9.1 Contextualisation clinique et formulation du problème
Pour ancrer ces développements théoriques dans la réalité opérationnelle de la pratique de recherche, examinons une étude clinique pilote menée dans un service hospitalier spécialisé dans la prise en charge des traumatismes psychiques complexes. L’équipe d’investigation souhaite évaluer l’efficacité préliminaire d’un nouveau protocole d’intervention combinant l’EMDR (Eye Movement Desensitization and Reprocessing) et des techniques de neurofeedback chez des patients présentant un Trouble de Stress Post-Traumatique (TSPT) sévère et résistant aux approches pharmacologiques conventionnelles.
En raison du caractère hautement spécifique de la population clinique et des contraintes logistiques du centre hospitalier, la cohorte d’étude est volontairement restreinte à $N = 22$ participants adultes. Les patients sont assignés par randomisation simple à deux conditions :
- Groupe Expérimental (EMDR + Neurofeedback) : $n_1 = 11$ patients.
- Groupe Témoin Actif (Thérapie de Soutien conventionnelle) : $n_2 = 11$ patients.
À l’issue des 12 semaines d’intervention, le statut clinique est réévalué par un clinicien indépendant en aveugle à l’aide de l’entretien clinique structuré CAPS-5 (Clinician-Administered PTSD Scale). Le critère d’issue primaire est dichotomique : présence ou absence d’une rémission clinique complète (définie par la perte formelle des critères diagnostiques du TSPT du DSM-5).
Les données empiriques observées se répartissent comme suit :
- Groupe Expérimental : 8 patients atteignent la rémission complète, 3 patients demeurent non-répondeurs.
- Groupe Contrôle : 2 patients atteignent la rémission complète, 9 patients demeurent non-répondeurs.
Le calcul immédiat des effectifs théoriques attendus sous l’hypothèse nulle révèle que pour la modalité rémission, l’effectif attendu au sein de chaque groupe s’établit à :
$$E = \frac{11 \times 10}{22} = 5,0$$
Cependant, si l’on imagine une légère variation d’échantillonnage ou un effectif total marginalement inférieur, ou encore en examinant les marges des échecs ($E = 6,0$), on constate que les effectifs oscillent à la frontière critique des seuils de Cochran. L’application du test exact de Fisher s’impose de manière indiscutable pour garantir la validité absolue de l’inférence.
9.2 Exécution intégrale dans SPSS avec les commandes de syntaxe
L’analyste dispose de deux voies pour instruire l’exécution de l’analyse sous SPSS : l’interface graphique par fenêtres de dialogue (telle que détaillée en Section 4) ou l’utilisation directe du langage de commande de syntaxe SPSS (.sps). La syntaxe offre des garanties inégalées en termes de rapidité, de reproductibilité scientifique et de transparence méthodologique.
Dans l’éditeur de syntaxe d’IBM SPSS Statistics, le script complet permettant de configurer la matrice pondérée et d’exécuter le test exact de Fisher avec calcul de la taille d’effet et des intervalles de confiance se formule de la manière suivante :
DATA LIST FREE / Traitement (F1.0) Remission (F1.0) Frequence (F3.0).
BEGIN DATA.
1 1 8
1 0 3
0 1 2
0 0 9
END DATA.
VARIABLE LABELS
Traitement « Protocole Thérapeutique Administré »
Remission « Statut de Rémission Post-Intervention ».
VALUE LABELS
Traitement 1 « EMDR + Neurofeedback » 0 « Thérapie de Soutien » /
Remission 1 « Rémission Complète » 0 « Absence de Rémission ».
WEIGHT BY Frequence.
CROSSTABS
/TABLES=Traitement BY Remission
/FORMAT=AVALUE TABLES
/STATISTICS=CHISQ PHI RISK
/CELLS=COUNT EXPECTED ROW ASRESID
/METHOD=EXACT.
L’instruction /METHOD=EXACT force le logiciel à déployer les algorithmes combinatoires complets de la loi hypergéométrique. En surlignant l’intégralité de ce texte dans l’éditeur de syntaxe et en cliquant sur l’icône verte Exécuter la sélection (le triangle vert), le processeur de commandes SPSS traite instantanément la requête sans afficher le moindre message d’alerte ou d’erreur dans le journal (Log).
9.3 Décryptage clinique complet de l’output obtenu
L’analyse des tableaux de sortie générés par SPSS dans le cadre de notre étude clinique sur le TSPT met en relief les éléments statistiques décisifs suivants :
- Tableau descriptif croisé : Le taux de rémission atteint 72,7 % (8/11) chez les patients bénéficiant du protocole expérimental EMDR + Neurofeedback, contre seulement 18,2 % (2/11) chez les patients assignés à la thérapie de soutien conventionnelle. Les résidus standardisés ajustés s’établissent à $+2,6$ pour les rémissions du groupe expérimental et à $-2,6$ pour les rémissions du groupe témoin, démontrant une déviation substantielle ($> |1,96|$) par rapport au modèle d’indépendance statistique.
- Tableau des tests du Chi-deux : La note textuelle de bas de tableau informe que 2 cellules (soit 50,0 % des cellules) présentent un effectif attendu inférieur ou égal à 5,0. Cette mention disqualifie officiellement la ligne du Chi-deux de Pearson ($\chi^2 = 6,55$). L’investigateur se focalise sur la ligne Test exact de Fisher :
- La Signification bilatérale exacte (Exact Sig. 2-sided) s’affiche à p = .030.
- La Signification unilatérale exacte (Exact Sig. 1-sided) s’affiche à p = .019.
- Tableau des mesures symétriques et du risque :
- Le coefficient Phi affiche une valeur de $phi$ = .546, signalant une taille d’effet particulièrement vigoureuse selon les critères de Cohen ($ge .50$).
- L’Odds Ratio dans la table d’estimation du risque est évalué à OR = 12,00 avec un intervalle de confiance à 95 % s’étendant de [1,42 ; 101,36].
La valeur de probabilité bilatérale étant strictement inférieure au seuil conventionnel ($p = .030 < .05$), le rejet de l'hypothèse nulle ($H_0$) est formellement acté.
9.4 Conclusions cliniques et implications diagnostiques
Sur le plan translationnel et clinique, ce résultat atteste de la supériorité préliminaire significative de l’intervention combinant l’EMDR et le neurofeedback sur la réduction symptomatique fondamentale du stress post-traumatique complexe par rapport à un accompagnement psychologique de soutien. L’Odds Ratio de 12,00, bien que doté d’un intervalle de confiance étendu inhérent à la taille modeste de l’échantillon ([1,42 ; 101,36]), indique que les patients traités par l’approche innovante ont une cote de rémission complète 12 fois plus élevée que celle observée sous condition témoin.
Néanmoins, la rigueur épistémologique commande d’interpréter ces conclusions avec lucidité. La précision métrologique de l’effet demeure limitée par la faible puissance intrinsèque d’un effectif global de 22 participants. Si le test exact de Fisher protège scrupuleusement l’investigateur contre l’inflation de l’erreur de type I (faux positifs), il ne peut à lui seul immuniser l’étude contre le phénomène de l’erreur de type M (exagération de la magnitude de la taille d’effet, également connue sous le nom de « malédiction du vainqueur » ou winner’s curse). L’implication diagnostique et institutionnelle directe de cette étude de faisabilité réside dans la légitimation méthodologique d’un essai clinique randomisé multicentrique à large échelle, conçu pour consolider la validité écologique et externe de ces premières découvertes prometteuses.
10. Erreurs courantes et pièges méthodologiques dans SPSS
10.1 Confusion entre le test de Fisher et la correction de continuité de Yates
L’une des méprises historiques les plus tenaces dans l’enseignement de la statistique appliquée concerne l’assimilation erronée du test exact de Fisher à la Correction de continuité de Yates. Formulée en 1934 par Frank Yates, cette correction consiste à retrancher arbitrairement la valeur 0,5 à la valeur absolue de l’écart entre effectif observé et effectif attendu au sein de la formule classique du Chi-deux de Pearson :
$$\chi^2_{\text{Yates}} = \sum \frac{(|O_{ij} – E_{ij}| – 0,5)^2}{E_{ij}}$$
L’objectif avoué de Yates était de réduire l’erreur d’approximation résultant du calquage d’une distribution théorique continue sur des probabilités cellulaires discrètes. Toutefois, une abondante littérature statistique internationale contemporaine a rigoureusement démontré que la correction de continuité de Yates est excessivement conservatrice : elle produit des valeurs de probabilité systématiquement trop élevées, pénalisant indûment la puissance statistique du test et majorant drastiquement le risque de commettre une erreur de seconde espèce ($\beta$).
Le test exact de Fisher ne constitue en aucune façon une variante ou un sous-produit de la formule de Yates : il s’agit d’une démarche paradigmatique totalement différente, fondée sur le calcul direct de la distribution hypergéométrique sans aucun artifice de soustraction continue. Dans les sorties SPSS, la ligne Correction de continuité (Continuity Correction) doit être purement et simplement délaissée au profit exclusif de la ligne Test exact de Fisher.
10.2 Application erronée sur des échantillons appariés
Un écueil méthodologique récurrent en psychopathologie clinique réside dans l’utilisation inconsidérée du test exact de Fisher sur des données dépendantes ou appariées. Cette situation survient classiquement lorsqu’un chercheur administre une évaluation diagnostique avant une psychothérapie (Temps 1 : Dépression Présente/Absente) et réitère la même évaluation chez les mêmes individus après l’intervention (Temps 2 : Dépression Présente/Absente).
Croiser ces deux mesures dans un tableau 2×2 sous SPSS et exécuter le test de Fisher constitue une violation méthodologique grave du postulat fondamental d’indépendance des observations. En agissant ainsi, le chercheur traite les deux évaluations d’un même individu comme s’il s’agissait de deux sujets distincts et indépendants, ce qui fausse radicalement les calculs d’erreur type et invalide totalement l’inférence hypergéométrique.
Dans toute architecture expérimentale à mesures répétées bivariées, la procédure légitime à solliciter sous SPSS est le Test de McNemar (accessible en cochant la case McNemar dans le menu des statistiques des tableaux croisés). Le test de McNemar se concentre exclusivement sur les paires discordantes (sujets changeant de statut entre le Temps 1 et le Temps 2) pour déterminer si l’évolution s’opère dans une direction asymétrique significative.
10.3 Mauvaise sélection entre probabilité unilatérale et bilatérale
Le piège de la sélection opportuniste de la valeur de significativité dans les sorties SPSS (colonne Exact Sig. 1-sided versus Exact Sig. 2-sided) représente une source majeure de non-reproductibilité en psychologie. Confronté à une valeur bilatérale marginalement non significative, comme $p_{\text{bilatéral}} = .072$, l’investigateur est fréquemment tenté de consulter la colonne unilatérale affichant $p_{\text{unilatéral}} = .036$, et d’en déduire à tort l’existence d’un résultat publiable.
Cette pratique contrevient directement aux canons épistémologiques de la démarche scientifique. L’adoption d’un test unilatéral double artificiellement la zone de rejet dans une seule queue de distribution, multipliant par deux le risque d’erreur de première espèce si l’hypothèse de directionnalité s’avère erronée. Elle n’est méthodologiquement recevable que si l’investigateur avait posé une hypothèse formelle et exclusive sur le plan a priori. En l’absence de protocole validé antérieurement à la collecte des données, la valeur bilatérale constitue le seul indicateur décisionnel licite.
10.4 Oubli de la pondération lors de la saisie de tables agrégées
Comme souligné en Section 3.3, la manipulation de matrices réduites à 4 lignes soulève un risque d’erreur opérationnelle extrêmement fréquent sous SPSS : l’oubli pur et simple de l’activation de la commande Pondérer les observations.
Les conséquences de cette omission sont spectaculaires et dévastatrices pour l’analyse :
- SPSS considère que la taille totale de l’échantillon est de $N = 4$ (chaque ligne comptant pour 1 individu).
- Le tableau récapitulatif affiche $N = 4$ au lieu de l’effectif réel (par exemple $N = 150$).
- Le test de Fisher produit une valeur non significative ($p = 1,000$), le logiciel concluant à l’absence de preuve statistique sur un échantillon infime de quatre personnes.
Pour prémunir vos recherches contre cette bavure, instituez une règle de contrôle qualité systématique : examinez toujours en première intention le tableau Récapitulatif de traitement des observations dans la sortie SPSS pour valider que le nombre total de cas valides coïncide rigoureusement avec la sommation réelle de vos fréquences observées.
11. Alternatives et approches analytiques complémentaires
11.1 Régression logistique exacte pour données clairsemées
Si le test exact de Fisher résout de manière éclatante l’analyse de dépendance bivariée en petit échantillon, il manifeste une limite structurale inhérente : son incapacité absolue à contrôler des variables de confusion ou à modéliser des interactions multifactorielles complexes. Dans un essai clinique réel, il est fréquent que l’effet du traitement soit potentiellement biaisé par l’âge des participants, la durée d’évolution de la pathologie ou la présence de comorbidités psychiatriques.
Dans un grand échantillon, ce contrôle multivarié s’effectue classiquement par le biais de la régression logistique binaire standard. Toutefois, en petit échantillon ou en présence de quasi-séparation parfaite des données (par exemple aucune récidive dans l’un des bras thérapeutiques), la méthode d’estimation par maximum de vraisemblance standard échoue, produisant des coefficients et des erreurs types gigantesques qui tendent vers l’infini.
L’alternative méthodologique avancée consiste à déployer la régression logistique exacte ou la méthode de régression logistique pénalisée de Firth. Ces algorithmes, accessibles sous SPSS via des extensions de syntaxe Python ou R intégrées (comme la procédure SPSSINC FIRTHLOG), introduisent une pénalisation sur la fonction de vraisemblance afin de converger vers des estimations finies, permettant d’étendre la philosophie de l’inférence exacte au cadre de la modélisation multivariée contrôlée.
11.2 Tests de permutation et rééchantillonnage (Bootstrap)
Le test exact de Fisher s’inscrit au sein d’une famille méthodologique plus vaste : les tests de permutation (ou tests de randomisation). Le principe directeur de ces approches consiste à réarranger de façon itérative les étiquettes de groupes assignées aux observations pour dériver empiriquement la distribution de la statistique de test sous l’hypothèse d’échangeabilité des sujets.
Parallèlement, les méthodes de rééchantillonnage non paramétrique par Bootstrap constituent une ressource de plus en plus populaire sous IBM SPSS Statistics. En activant le module Bootstrap (accessible via le bouton dédié présent dans la majorité des boîtes de dialogue de SPSS), le logiciel procède à des milliers de rééchantillonnages avec remise au sein des données observées.
Cette démarche permet d’estimer des intervalles de confiance corrigés pour le biais et accélérés (BCa confidence intervals) pour des indices d’association tels que le coefficient Phi ou l’Odds Ratio, sans dépendre des hypothèses de normalité asymptotique de distribution des erreurs types. La confrontation des résultats du test exact de Fisher avec les intervalles de confiance obtenus par bootstrap permet au chercheur de jauger la stabilité computationnelle de ses conclusions empiriques.
11.3 Approche bayésienne pour les tables de contingence
Au cours des deux dernières décennies, la recherche en sciences psychologiques a été traversée par une transition épistémologique majeure plaidant pour l’intégration des statistiques bayésiennes en complément ou substitution de l’inférence fréquentiste conventionnelle (fondée sur la seule valeur de p). Les limites bien documentées de la valeur de p — notamment son incapacité formelle à quantifier le niveau d’évidence en faveur de l’hypothèse nulle ($H_0$) — trouvent une réponse analytique directe dans cette approche.
IBM SPSS Statistics intègre désormais un module complet d’inférence bayésienne pour les tables de contingence bivariées :
Analyse > Statistiques bayésiennes > Modèles log-linéaires… (ou via les tables croisées selon les versions)
L’analyse bayésienne permet de calculer le Facteur de Bayes ($BF_{10}$ ou $BF_{01}$) sous des lois a priori de Poisson ou multinomiales (souvent paramétrées par des distributions conjuguées de Dirichlet). Le facteur de Bayes fournit un ratio d’évidence explicite :
- Un $BF_{10} = 8,4$ indique que les données empiriques recueillies sont 8,4 fois plus probables sous l’hypothèse alternative d’association que sous l’hypothèse nulle d’indépendance (évidence modérée à forte).
- Inversement, si le test de Fisher fréquentiste produit une valeur non significative ($p = .24$), le calcul du $BF_{01}$ permet d’évaluer directement le degré d’évidence empirique soutenant activement l’hypothèse d’absence d’effet ($H_0$), ce qu’une valeur de p classique est intrinsèquement incapable de formaliser.
12. Bonnes pratiques, reproductibilité et puissance statistique
12.1 Calcul de puissance a priori et analyse de sensibilité avec G*Power
L’une des vulnérabilités épistémologiques majeures des protocoles reposant sur le test exact de Fisher réside dans la faiblesse fréquente de leur puissance statistique ($1 – \beta$). La puissance représente la probabilité de rejeter l’hypothèse nulle lorsque celle-ci est effectivement fausse dans la population sous-jacente. L’administration d’un test exact sur un échantillon restreint ($N < 30$) sans calcul prévisionnel expose la recherche à un risque massif de faux négatifs (incapacité à détecter un effet clinique qui existe pourtant dans la réalité thérapeutique).
Pour circonscrire ce danger, la planification expérimentale doit intégrer un calcul de taille d’échantillon a priori à l’aide de logiciels spécialisés reconnus internationalement, au premier rang desquels figure G*Power (Faul et al., 2007). Dans l’interface de G*Power :
- Sélectionner la famille de tests : Exact.
- Sélectionner le test statistique : Proportions : Inequality, two independent groups (Fisher’s exact test).
- Définir le type d’analyse : A priori: Compute required sample size.
- Paramétrer les proportions attendues dans chaque groupe ($p_1$ et $p_2$), le seuil $\alpha$ (0,05) et la puissance cible minimale ($1 – \beta = 0,80$).
Lorsque le recrutement est contraint par des limitations cliniques insurmontables empêchant d’atteindre l’effectif idéal (par exemple limitation stricte à $N = 25$ patients), il est impératif de conduire une analyse de sensibilité a posteriori (Sensitivity Analysis). Cette démarche formalise explicitement la taille d’effet minimale que le protocole était capable de détecter avec 80 % de puissance, offrant un cadre interprétatif transparent qui évite de conclure à l’inefficacité d’un traitement lorsque l’étude manquait simplement de sensibilité statistique.
12.2 Gestion de la syntaxe SPSS pour une recherche reproductible
La reproductibilité computationnelle constitue l’exigence suprême de la science ouverte (Open Science). La navigation exclusive par menus déroulants et clics de souris sous SPSS est intrinsèquement opaque, instable et propice à des erreurs humaines non documentées. L’adoption des scripts de syntaxe (.sps) s’impose comme une bonne pratique incontournable dans tout laboratoire académique moderne.
Un script de syntaxe SPSS dédié au test de Fisher doit être scrupuleusement structuré, commenté et archivé. Il convient d’utiliser systématiquement l’étoile (*) pour introduire des lignes de commentaires descriptifs précisant la date d’exécution, le nom de l’investigateur, les hypothèses testées et la justification du choix du test exact :
* =========================================================.
* PROTOCOLE DE RECHERCHE CLINIQUE : ETUDE PTSD-2023.
* SCRIPT : Analyse d’association bivariée par test exact de Fisher.
* JUSTIFICATION : Violation de la règle de Cochran (E_ij < 5).
* DATE D’ANALYSE : Novembre 2023.
* =========================================================.
CROSSTABS
/TABLES=Groupe BY Evolution_Clinique
/FORMAT=AVALUE TABLES
/STATISTICS=CHISQ PHI RISK
/CELLS=COUNT EXPECTED ROW ASRESID
/METHOD=EXACT.
L’archivage conjoint des données brutes dépersonnalisées et du fichier de syntaxe (.sps) au sein d’entrepôts de données certifiés (tels que le Consortium des Archives de Données en Sciences Sociales, Zenodo ou OSF) assure la pérennité et la vérifiabilité intégrale de la recherche.
12.3 Transparence scientifique et conformité aux standards de publication
L’adhésion aux lignes directrices internationales pour le rapport des études scientifiques — telles que les directives CONSORT (Consolidated Standards of Reporting Trials) pour les essais randomisés ou STROBE (Strengthening the Reporting of Observational Studies in Epidemiology) pour les études observationnelles — impose des obligations strictes de transparence lors de la restitution des analyses catégorielles.
Dans vos manuscrits soumis à publication, veillez à respecter systématiquement les standards déontologiques suivants :
- Divulgation intégrale des données cellulaires brutes : Fournissez impérativement les dénombrements cellulaires complets ($O_{ij}$) au sein du texte ou sous forme de tableau, afin de permettre aux pairs et aux méta-analystes de recalculer indépendamment les métriques d’association.
- Rapportage explicite des conditions d’application : Ne mentionnez pas laconiquement « le test de Fisher a été utilisé », mais exposez ouvertement les critères méthodologiques précis ayant dicté ce choix (ex. « le test exact de Fisher a été substitué au Chi-deux de Pearson en raison de la présence d’un effectif attendu inférieur à 5 dans 50 % des cellules de la table de contingence »).
- Concordance entre planification et analyse : Précisez sans ambiguïté si le choix d’un test bilatéral ou unilatéral découlait d’une hypothèse formulée a priori dans le protocole initial, garantissant ainsi l’intégrité épistémologique de votre démarche scientifique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1952). The $\chi^2$ test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
- Cochran, W. G. (1954). Some methods for strengthening the common $\chi^2$ tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27–38. https://doi.org/10.1093/biomet/80.1.27
- Fisher, R. A. (1922). On the interpretation of $\chi^2$ from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1/2), 141–149. https://doi.org/10.2307/2332323
- IBM Corporation. (2021). IBM SPSS Exact Tests. IBM Corp. https://www.ibm.com/docs/en/spss-statistics/
- McHugh, M. L. (2013). The Chi-square test of independence. Biochemia Medica, 23(2), 143–149. https://doi.org/10.11613/BM.2013.018
- Yates, F. (1934). Contingency tables involving small numbers and the $\chi^2$ test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604