
L’inférence statistique moderne repose sur une tension dialectique fondamentale entre l’adhésion rigoureuse aux hypothèses distributionnelles et la nécessité d’extraire des conclusions fiables à partir de données empiriques imparfaites. Dans le cadre de la recherche quantitative appliquée — que ce soit en biomédecine, en psychométrie, en économétrie ou en ingénierie —, les chercheurs sont régulièrement confrontés à des distributions qui défient l’idéal de la courbe de Gauss. Des distributions asymétriques, des données issues d’échelles de mesure ordinales, ou encore des échantillons de taille modeste rendent l’emploi des tests paramétriques traditionnels, tels que le test t de Student pour échantillons indépendants, mathématiquement invalide et méthodologiquement périlleux.
Face à ces contraintes distributionnelles, le test U de Mann-Whitney — historiquement et fonctionnellement intriqué avec le test de la somme des rangs de Wilcoxon — constitue l’une des procédures non paramétriques les plus robustes et les plus élégantes de l’arsenal inférentiel. En substituant aux valeurs numériques brutes leurs rangs relatifs au sein de la distribution conjointe, cette méthode s’affranchit de l’obligation de normalité et de l’exigence d’une métrique d’intervalle stricte, tout en préservant une puissance statistique remarquablement élevée. Toutefois, la mise en œuvre de ce test dépasse la simple substitution mécanique d’une statistique par une autre : elle exige une compréhension aiguë de ses postulats sous-jacents, notamment en ce qui concerne la nature de l’hypothèse nulle testée, l’évaluation de la dominance stochastique et la distinction subtile entre un décalage de localisation et une divergence générale de distribution.
Le système SAS (Statistical Analysis System) offre un environnement d’une puissance et d’une précision computationnelle exceptionnelles pour exécuter, approfondir et automatiser cette analyse à travers sa procédure dédiée, PROC NPAR1WAY. Ce guide magistral a pour vocation de déconstruire exhaustivement le test U de Mann-Whitney, depuis ses racines épistémologiques et théoriques jusqu’à son implémentation programmatique avancée dans SAS. En explorant la préparation des données, le diagnostic exploratoire, la gestion algorithmique des ex æquo, le calcul combinatoire exact des valeurs p pour les petits échantillons, la quantification de la taille d’effet et le déploiement de macros industrielles, cet article propose une référence définitive pour les statisticiens, les analystes de données et les chercheurs désireux d’allier rigueur méthodologique et maîtrise logicielle.
1. Fondements théoriques et épistémologiques du test U de Mann-Whitney
1.1 Origine et principes du test non paramétrique de Wilcoxon-Mann-Whitney
L’édification théorique de la statistique non paramétrique moderne a connu un tournant décisif au cours des années 1940. En 1945, le chimiste et statisticien américain Frank Wilcoxon publie un article fondateur introduisant le concept révolutionnaire de l’utilisation des rangs pour comparer deux groupes indépendants ainsi que deux mesures appariées. Deux années plus tard, en 1947, Henry Mann et Donald Whitney formalisent, généralisent et étendent cette approche dans un article séminal, en proposant une formulation combinatoire rigoureuse et une statistique spécifique, désignée sous la lettre $U$, capable de traiter explicitement des échantillons de tailles inégales. Bien que la littérature scientifique contemporaine emploie fréquemment les termes de « test des rangs de Wilcoxon », de « test de Mann-Whitney » ou de « test de Wilcoxon-Mann-Whitney » (WMW) de manière interchangeable, ces deux formulations convergent vers une structure mathématique parfaitement équivalente.
Le principe fondamental du test repose sur une opération de réduction de dimension et d’invariance d’échelle : la transformation des scores continus bruts en rangs ordinaux. Lorsque deux échantillons indépendants sont combinés et ordonnés du plus petit au plus grand élément, les rangs assignés (de 1 à $N = n_1 + n_2$) neutralisent complètement la métrique originale des observations. Cette transformation neutralise l’influence des déformations de l’échelle de mesure, des étirements non linéaires ou des métriques arbitraires souvent observées dans les sciences humaines et sociales. Dès lors, l’analyse ne s’intéresse plus aux écarts arithmétiques absolus entre les valeurs, mais à leur ordonnancement relatif dans un continuum commun.
Sur le plan inférentiel, l’hypothèse nulle ($H_0$) du test U de Mann-Whitney stipule l’égalité stochastique fondamentale entre les deux populations mères dont sont issus les échantillons. Mathématiquement, si $X$ représente une variable aléatoire issue de la première population de fonction de répartition $F(x)$, et $Y$ une variable aléatoire issue de la seconde population de fonction de répartition $G(y)$, l’hypothèse nulle s’exprime formellement par l’égalité stricte des probabilités conditionnelles :
$$P(X > Y) = P(Y > X) = 0,5$$
Cette formulation démontre sans ambiguïté que le test évalue fondamentalement la probabilité qu’une observation extraite au hasard d’une population surpasse une observation extraite de l’autre, et non pas simplement l’égalité arithmétique de paramètres scalaires isolés.
1.2 Différences conceptuelles entre approches paramétriques et non paramétriques
La distinction entre l’approche paramétrique — dominée par le test t de Student — et l’approche non paramétrique incarnée par Mann-Whitney réside dans la nature même des paramètres ciblés et des espaces probabilistes postulés. Les méthodes paramétriques postulent que les données sont générées par une famille spécifique de distributions de probabilité, définie par un ensemble fini de paramètres, généralement la moyenne ($\mu$) et la variance ($\sigma^2$) dans le cadre gaussien. Dès lors, le test t évalue l’hypothèse nulle stricte $\mu_1 = \mu_2$, en supposant que la dispersion et la morphologie de la distribution sont constantes ou contrôlées. Cette focalisation sur la moyenne arithmétique rend le test t extrêmement dépendant de la validité de l’échelle d’intervalle, où des différences numériques égales doivent refléter des grandeurs empiriques identiques à travers tout le spectre de la variable.
À l’inverse, l’approche non paramétrique de Mann-Whitney ne postule aucune forme analytique a priori pour les distributions sous-jacentes. Elle déplace l’axe d’investigation de la comparaison des moments d’ordre 1 (les moyennes) vers l’évaluation de la dominance stochastique. Une variable aléatoire $X$ est dite stochastiquement supérieure à une variable $Y$ si, pour tout seuil réel $t$, la condition $P(X > t) ge P(Y > t)$ est satisfaite, avec une inégalité stricte pour au moins une valeur de $t$. Cette perspective est conceptuellement beaucoup plus vaste et robuste que la simple comparaison de paramètres de tendance centrale.
Dans les disciplines empiriques telles que les sciences du comportement, la psychométrie quantitative et la recherche clinique, cette distinction revêt une portée capitale. Les instruments d’évaluation produisent fréquemment des scores composites dont les propriétés métriques ne garantissent pas l’isomorphisme avec les nombres réels. L’usage du test U de Mann-Whitney préserve l’intégrité inférentielle de ces recherches en évitant d’attribuer aux données une précision quantitative fictive que leur processus de génération ne saurait soutenir.
1.3 Situations d’application préférentielle en recherche empirique
En pratique de recherche, plusieurs configurations méthodologiques dictent impérativement le recours au test U de Mann-Whitney au détriment des procédures paramétriques standards. La première de ces situations concerne les protocoles expérimentaux caractérisés par des échantillons de petite taille ($n < 30$ par groupe). Dans cette zone d'effectif restreint, le théorème central limite ne peut déployer ses effets asymptotiques régulateurs pour assurer la normalité de la distribution d’échantillonnage de la moyenne. Parallèlement, la puissance statistique des tests formels de normalité (tels que le test de Shapiro-Wilk) s’avère dramatiquement faible, laissant l’analyste dans l’incapacité de certifier la normalité sous-jacente.
La deuxième configuration préférentielle concerne les variables intrinsèquement asymétriques ou bornées unilatéralement. L’analyse des temps de réaction en neurosciences cognitives, les durées de séjour hospitalier en santé publique, les niveaux de biomarqueurs immunitaires ou encore les concentrations enzymatiques présentent structurellement des queues de distribution allongées vers la droite (asymétrie positive prononcée). De même, les échelles psychométriques de type Likert (par exemple, des évaluations d’accord de 1 à 5 ou de 1 à 7) constituent des variables ordinales pour lesquelles la moyenne arithmétique et la variance n’ont pas de définition mathématique rigoureuse, les distances subjectives entre les échelons n’étant pas uniformes.
Enfin, la résistance intrinsèque du test U de Mann-Whitney face aux valeurs aberrantes (outliers) ou extrêmes en fait un outil de choix. Dans un essai clinique ou industriel, la présence d’une ou deux valeurs atypiques — résultant de variations biologiques extrêmes mais légitimes — peut distordre dramatiquement la moyenne et gonfler artificiellement la variance combinée d’un test t, conduisant à une erreur de type II (non-rejet abusif d’une hypothèse nulle fausse). Le test de Mann-Whitney, en remplaçant la valeur extrême par son simple rang ordinal au sommet de la distribution, circonscrit rigoureusement son influence perturbatrice sans nécessiter la suppression arbitraire d’observations légitimes.
2. Conditions d’application et postulats méthodologiques sous-jacents
2.1 Nature et niveau de mesure des variables étudiées
La validité des inférences produites par le test U de Mann-Whitney dépend du respect d’exigences formelles concernant les échelles de mesure des variables engagées dans l’analyse. L’architecture du test requiert deux variables distinctes : une variable indépendante (ou variable de classification) et une variable dépendante (ou variable de réponse). La variable indépendante doit être obligatoirement catégorielle et strictement dichotomique, définissant deux groupes mutuellement exclusifs et exhaustivement représentatifs des conditions expérimentales ou observationnelles comparées (par exemple : groupe contrôle versus groupe traité, ou cohorte saine versus cohorte pathologique).
La variable dépendante, quant à elle, doit satisfaire au minimum aux propriétés d’une échelle de mesure ordinale. Cela signifie que les modalités de la variable doivent pouvoir être hiérarchisées sans équivoque selon une relation d’ordre binaire transitive, réflexive et antisymétrique. Le test peut parfaitement opérer sur des données continues issues d’échelles d’intervalle ou de rapport, mais sa flexibilité exceptionnelle réside dans sa capacité à traiter des variables où seule la structure d’ordre est signifiante.
Il est fondamental de souligner que le test n’exige aucune continuité stricte ni aucune différentiabilité de la variable dans son espace support. Cependant, si la variable dépendante est de nature discrète avec un nombre restreint de catégories (par exemple, une échelle ordinale à trois points), la survenue d’un volume substantiel de valeurs ex æquo (ties) peut affecter la distribution de la statistique de test, imposant des ajustements computationnels que nous détaillerons dans les sections dédiées aux calculs exacts.
2.2 Indépendance stricte des observations et des groupes
Le postulat le plus critique et le moins négociable du test U de Mann-Whitney réside dans l’indépendance statistique absolue des unités d’échantillonnage. Chaque observation individuelle doit être générée indépendamment de toutes les autres, tant à l’intérieur de son propre groupe qu’entre les deux groupes mis en concurrence. Sur le plan de la conception expérimentale, cela implique une assignation mutuellement exclusive : une unité expérimentale (patient, sujet, composant industriel) ne peut appartenir qu’à un seul groupe, et aucune mesure répétée dans le temps sur un même individu ne peut être intégrée dans cette modélisation.
Toute violation de l’hypothèse d’indépendance détruit irrémédiablement la validité de la loi de probabilité sous-jacente à la statistique de test. Les situations d’appariement (matching), les protocoles pré-test / post-test, les conceptions en blocs randomisés ou la collecte de données hiérarchiques (par exemple, des élèves nichés au sein de classes, ou des mesures recueillies sur les deux yeux d’un même patient) introduisent une structure de covariance intraclasse non nulle. L’application erronée d’un test U de Mann-Whitney à de telles données corrélées conduit quasi invariablement à une sous-estimation sévère de la variance d’échantillonnage, provoquant une inflation catastrophique du taux d’erreur de type I (rejet de l’hypothèse nulle alors qu’elle est vraie).
Dans les cas de mesures répétées ou d’échantillons appariés, l’analyste doit impérativement délaisser le test U de Mann-Whitney au profit du test des rangs signés de Wilcoxon pour séries appariées, ou recourir à des modèles mixtes non paramétriques plus élaborés.
2.3 Forme des distributions et interprétation des médianes
Une confusion épistémologique et méthodologique extrêmement répandue dans la littérature empirique consiste à affirmer unilatéralement que « le test de Mann-Whitney est un test de comparaison des médianes ». Cette allégation n’est mathématiquement exacte que sous une condition distributionnelle particulièrement restrictive, connue sous le nom de postulat de décalage de localisation (location-shift assumption).
Selon ce postulat, les distributions des deux populations mères possèdent des fonctions de densité de probabilité qui partagent exactement la même forme géométrique, la même variance, la même asymétrie et le même aplatissement, à une constante de translation spatiale près. Formellement, cela s’exprime par la relation :
$$F_1(x) = F_2(x – \theta)$$
où $\theta$ représente le paramètre de décalage de localisation. Lorsque cette hypothèse d’homogénéité morphologique est satisfaite, le test U de Mann-Whitney devient effectivement un test parfait de l’hypothèse nulle $\theta = 0$, ce qui équivaut rigoureusement à tester l’égalité des médianes des deux populations ($Med_1 = Med_2$). Dans cette configuration spécifique, rejeter $H_0$ autorise le chercheur à conclure que la médiane d’un groupe est significativement plus élevée que celle de l’autre.
En revanche, lorsque les distributions présentent des morphologies manifestement discordantes — par exemple, une distribution bimodale opposée à une distribution unimodale asymétrique, ou des variances hétérogènes —, le test ne teste plus les médianes. Il évalue alors la dominance stochastique pure. Il est tout à fait possible que deux populations possèdent rigoureusement la même médiane numérique tout en produisant un résultat hautement significatif au test de Mann-Whitney ($p < 0,001$) si l'une des distributions présente une dispersion asymétrique systématiquement décalée par rapport à l'autre. Les chercheurs doivent donc inspecter impérativement la dispersion et la forme des distributions avant de formuler leurs conclusions en termes de comparaison de médianes.
3. Comparaison méthodologique : Test U de Mann-Whitney versus Test t de Student
3.1 Sensibilité aux violations de normalité et petits échantillons
Le test t de Student à deux échantillons repose sur l’hypothèse fondamentale que la variable d’intérêt suit une distribution gaussienne au sein de chaque sous-population d’origine. Si le théorème central limite garantit une robustesse asymptotique appréciable au test t lorsque les effectifs deviennent considérables ($n > 100$), sa performance s’effondre de manière dramatique en présence d’échantillons de petite taille ($n < 30$) confrontés à de sévères écarts de normalité.
Sous l’influence d’une forte asymétrie (skewness marquée) combinée à de faibles effectifs, la distribution d’échantillonnage de la statistique t cesse de se conformer à la loi de Student théorique. Il en résulte un dérèglement complet du taux d’erreur de type I effectif, qui s’écarte substantiellement du seuil nominal conventionnel $\alpha = 0,05$. Le chercheur s’expose alors soit à une perte dramatique de puissance statistique (incapacité à détecter un effet expérimental réel), soit à une libéralité inacceptable du test générant de faux positifs.
À l’opposé, la statistique basée sur les rangs du test de Mann-Whitney conserve un contrôle exact et invariant de l’erreur de type I, quelle que soit la nature de la distribution continue sous-jacente. Face à des queues de distribution lourdes (leptokurtiques), la probabilité assignée à l’ordonnancement combinatoire des rangs demeure parfaitement calibrée. Ainsi, la stabilité des inférences statistiques issues de Mann-Whitney surpasse systématiquement celle du test de Student dès lors que les données s’écartent du paradigme gaussien idéalisé.
3.2 Efficacité asymptotique relative (ARE)
Une préoccupation récurrente chez les statisticiens appliqués concerne le « coût théorique » associé à l’abandon du cadre paramétrique lorsque les postulats de ce dernier sont pourtant satisfaits. Ce coût est formellement quantifié par le concept d’efficacité asymptotique relative (ARE, pour Asymptotic Relative Efficiency) de Pitman. L’ARE mesure le ratio des tailles d’échantillon requises par deux tests concurrents pour atteindre une puissance statistique strictement équivalente face à une alternative locale donnée, lorsque la taille de l’échantillon tend vers l’infini.
Dans le pire scénario envisageable pour le test non paramétrique — c’est-à-dire lorsque la population suit rigoureusement et parfaitement une distribution normale idéale —, l’efficacité asymptotique relative du test de Mann-Whitney par rapport au test t de Student s’établit exactement à :
$$ARE = \frac{3}{\pi} \approx 0,955$$
Cette valeur remarquable démontre que, sous les conditions optimales du test t, le test de Mann-Whitney ne concède qu’une perte de puissance statistique dérisoire de 4,5 %. Il suffirait théoriquement de 100 observations sous Mann-Whitney pour égaler la puissance fournie par 95 ou 96 observations sous le test t.
Cependant, dès que la distribution réelle dévie de la normalité, l’avantage s’inverse de manière spectaculaire. Pour des distributions modérément asymétriques ou à queue lourde (comme la distribution log-normale ou la distribution de Laplace), l’ARE de Mann-Whitney dépasse fréquemment 1,00, atteignant des valeurs de 1,15 à 1,50. Dans le cas extrême de distributions pathologiques à queues très épaisses, telles que la loi de Cauchy, l’ARE de Mann-Whitney par rapport au test t tend vers l’infini, le test t devenant asymptotiquement incapable de converger en raison de la non-existence mathématique des moments d’ordre supérieur. Le compromis méthodologique plaide donc massivement en faveur de la parcimonie et de la sécurité offertes par l’approche non paramétrique.
3.3 Traitement des valeurs aberrantes (outliers)
L’un des talons d’Achille majeurs de l’inférence paramétrique classique réside dans l’extrême vulnérabilité des estimateurs de moments face aux observations discordantes ou aberrantes. La moyenne arithmétique possède un point de rupture (breakdown point) asymptotique égal à $0$, signifiant qu’une unique valeur arbitrairement élevée ou corrompue suffit à déporter la moyenne de l’échantillon vers l’infini. De surcroît, la variance combinée étant calculée à partir de la somme des carrés des écarts à la moyenne, une valeur aberrante gonfle le dénominateur de la statistique t de façon quadratique, écrasant littéralement la valeur de t et masquant des effets réels hautement significatifs.
Le test U de Mann-Whitney résout cette aporie de manière structurelle grâce au mécanisme d’assignation des rangs. Lorsqu’un jeu de données contenant une valeur aberrante colossale est transformé en rangs, cette observation extrême reçoit simplement le rang maximal ($N$). Qu’elle excède le reste de l’échantillon de 5 unités ou de 5 millions d’unités, son poids mathématique dans la statistique du test reste rigoureusement plafonné à la valeur de son rang relatif.
Cette propriété confère au test U de Mann-Whitney une fonction de troncature naturelle et non destructive. Contrairement aux pratiques contestables de « nettoyage de données » — qui consistent à élaguer arbitrairement les observations situées au-delà de 2 ou 3 écarts-types —, le test non paramétrique intègre l’ensemble du matériel empirique collecté. La validité interne du protocole est ainsi préservée, tout en protégeant l’expérimentateur contre les artefacts de mesure.
4. Préparation et structuration des données pour l’analyse sous SAS
4.1 Architecture et formatage requis du jeu de données
Pour exécuter un test non paramétrique sous l’environnement SAS, la structuration relationnelle des tables de données obéit à des conventions d’architecture strictes. La quasi-totalité des procédures analytiques de SAS, y compris PROC NPAR1WAY, exigent une disposition des données dite en format « long » (ou vertical), par opposition au format « large » (ou horizontal).
Dans un format long, chaque ligne de la table SAS représente une unité expérimentale unique (une observation individuelle). La structure tabulaire minimale requiert impérativement deux colonnes :
- Une variable catégorielle de regroupement (variable indépendante), qui prend exactement deux modalités mutuellement exclusives identifiant le groupe d’appartenance de chaque sujet. Cette variable peut être typée comme chaîne de caractères (character) ou comme variable numérique formatée (par exemple 0 et 1).
- Une variable de réponse (variable dépendante continue ou ordinale), qui doit être impérativement déclarée avec un typage numérique dans SAS. Toute tentative d’exécuter une procédure non paramétrique sur une variable d’analyse typée en chaîne de caractères provoquera une interruption immédiate avec erreur dans le journal d’exécution (SAS Log).
Avant d’engager toute modélisation, une phase d’audit des données s’avère indispensable pour détecter la présence éventuelle de codes de données manquantes (notés par un point « . » sous SAS pour les variables numériques), de valeurs aberrantes impossibles résultant d’erreurs de saisie, ou d’espaces invisibles dans les libellés textuels pouvant fragmenter artificiellement les modalités du groupe.
4.2 Création manuelle d’un jeu de données via l’étape DATA
Dans le cadre de simulations, de vérifications d’algorithmes ou du traitement de protocoles expérimentaux restreints, l’étape DATA de SAS offre une interface native extrêmement performante pour concevoir et instancier directement les tables analytiques. L’instruction INPUT combinée au marqueur de délimitation de flux DATALINES permet une saisie séquentielle et contrôlée des enregistrements.
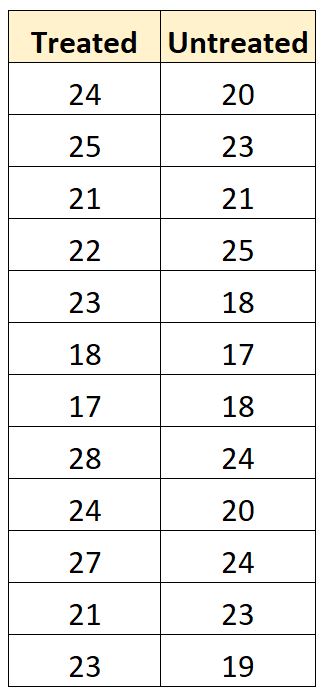
Considérons l’exemple paradigmatique d’une étude d’ingénierie énergétique comparant l’efficacité de consommation de carburant (en miles per gallon, mpg) entre une cohorte de véhicules recevant un additif expérimental (groupe treated) et une cohorte témoin sans additif (groupe control). Le script d’instanciation s’articule comme suit :
Dans ce bloc de code, la variable group est suffixée par le symbole $ afin de stipuler explicitement au compilateur SAS qu’il s’agit d’une chaîne alphanumérique, tandis que la variable quantitative mpg est instanciée par défaut comme variable numérique à double précision en virgule flottante. Lors de l’exécution, le journal (SAS Log) doit impérativement faire l’objet d’un examen minutieux : il doit confirmer l’injection exacte de 24 observations et de 2 variables, en certifiant l’absence totale de messages d’avertissement relatifs à des conversions automatiques non contrôlées ou à des lignes tronquées.
4.3 Importation de données externes avec PROC IMPORT
Dans les contextes de production industrielle ou de recherche clinique institutionnelle, les données brutes proviennent généralement de référentiels externes centralisés sous la forme de fichiers délimités (tels que des fichiers texte au format .CSV) ou de classeurs bureautiques (fichiers Microsoft Excel au format .XLSX). La procédure PROC IMPORT constitue le vecteur d’ingestion privilégié sous SAS.
Une importation rigoureuse requiert un paramétrage exhaustif pour prévenir toute distorsion de format. L’argument DBMS spécifie le moteur d’accès au fichier (par exemple CSV ou XLSX), tandis que l’instruction GETNAMES=YES; force SAS à utiliser la première ligne d’enregistrements pour nommer les colonnes de la table finale. Un paramètre hautement stratégique pour les fichiers délimités est l’instruction GUESSINGROWS=MAX; (ou la spécification d’un nombre élevé de lignes d’échantillonnage). Par défaut, SAS n’examine que les premières lignes pour inférer le type et la longueur des variables ; si une anomalie textuelle survient tardivement dans le fichier, l’absence de ce paramètre peut conduire à une troncature de caractères ou à un échec d’importation numérique.
Une fois l’importation réalisée avec succès, la bonne pratique de gouvernance des données impose d’exécuter immédiatement une procédure d’inventaire métrologique via PROC CONTENTS. Cette étape valide formellement la nomenclature des variables, vérifie leur typage binaire ou textuel, et garantit que la table est prête pour les calculs de rangs ultérieurs sans risque d’incompatibilité de schéma.
5. Exploration préalable et vérification des hypothèses avec PROC UNIVARIATE
5.1 Évaluation de la forme des distributions et des statistiques descriptives
L’exploration préalable des distributions ne constitue pas un simple préliminaire formel, mais une étape décisionnelle structurante. La procédure PROC UNIVARIATE de SAS représente l’instrument d’investigation distributionnelle le plus exhaustif disponible. En combinant cette procédure avec l’instruction CLASS, l’analyste peut partitionner l’analyse statistique en fonction des deux modalités de la variable d’exposition indépendante.
L’examen des moments empiriques d’ordre supérieur s’avère crucial. Le coefficient d’asymétrie de Fisher-Pearson (skewness) quantifie l’absence de symétrie de la distribution autour de son centre : une valeur proche de zéro signale une distribution parfaitement symétrique, tandis qu’une asymétrie supérieure à $+1$ ou inférieure à $-1$ indique une déviation sévère incompatible avec le cadre gaussien. Simultanément, le coefficient d’aplatissement (kurtosis), mesurant la lourdeur des queues de distribution par rapport à la distribution normale (dont le kurtosis standardisé est nul), révèle la présence potentielle d’événements extrêmes susceptibles de déstabiliser les variances paramétriques.
Parallèlement, la confrontation de l’écart-type classique avec l’écart interquartile ($IQR = Q_3 – Q_1$) permet de jauger la stabilité de la dispersion. Lorsque l’écart-type est disproportionnellement plus élevé que l’IQR, la distribution est invariablement polluée par des queues étirées ou des observations marginales, fournissant un premier faisceau d’indices empiriques plaidant pour l’abandon de l’approche paramétrique.
5.2 Tests de normalité formels
Bien que l’inspection des statistiques descriptives offre un cadrage quantitatif précieux, la démonstration formelle de la violation de l’hypothèse de normalité requiert l’exécution de tests d’hypothèse dédiés. L’adjonction de l’option NORMAL dans l’instruction d’en-tête de PROC UNIVARIATE déclenche automatiquement la génération d’un ensemble complet de tests de normalité adaptés à différentes configurations d’échantillonnage.
Pour les échantillons de taille petite à modérée ($n < 50$), le test de Shapiro-Wilk (matérialisé par la statistique $W$ dans la sortie SAS) représente le test de normalité le plus puissant et le plus universellement recommandé par la communauté statistique internationale. Le rejet de l’hypothèse nulle ($p < 0,05$) apporte la preuve formelle que les données observées s'écartent significativement d'un processus générateur gaussien. Pour des échantillons de plus grande envergure, SAS fournit également les statistiques d'adéquation de Kolmogorov-Smirnov (avec correction de Lilliefors), de Cramér-von Mises et d'Anderson-Darling (ce dernier accordant un poids plus important aux queues de distribution).
L’observation d’un résultat statistiquement significatif au test de Shapiro-Wilk au sein d’au moins l’un des deux groupes expérimentaux invalide irrémédiablement l’application théorique du test t de Student classique. Elle confère à l’analyste une justification méthodologique irréfutable pour opérer une transition formelle vers le cadre non paramétrique de Mann-Whitney.
5.3 Visualisation graphique de la distribution
L’évaluation des propriétés distributionnelles ne saurait s’accomplir sans un examen visuel direct de la morphologie des données. PROC UNIVARIATE intègre une interface graphique sophistiquée orchestrée par le système ODS Graphics de SAS, permettant de générer instantanément des diagrammes quantile-quantile (Q-Q plots) et des boîtes à moustaches comparatives (box plots).
Le diagramme quantile-quantile théorique normal (obtenu via l’instruction PROBPLOT ou QQPLOT) juxtapose les quantiles observés de l’échantillon aux quantiles théoriques issus d’une loi normale standard. Toute déviation systématique des points par rapport à la droite de référence — qu’il s’agisse d’une courbure en forme de « S » signalant des queues courtes ou d’une courbure en forme de « J » reflétant une asymétrie marquée — matérialise immédiatement la nature de la non-normalité.
De surcroît, la production de diagrammes en boîte comparatifs via l’instruction PLOTS offre une lecture synoptique essentielle de l’homoscédasticité et de l’équivalence des formes distributionnelles. Si les boîtes présentent des longueurs similaires et des médianes positionnées de manière symétrique entre les premier et troisième quartiles au sein des deux groupes, l’hypothèse de décalage de localisation (location shift) est consolidée visuellement. À l’inverse, si l’une des boîtes est massivement étirée tandis que l’autre est compacte, le chercheur sait par avance que son test de Mann-Whitney devra impérativement être interprété en termes de dominance stochastique globale plutôt qu’en termes de translation pure des médianes.
6. Syntaxe fondamentale de PROC NPAR1WAY pour le test de Mann-Whitney
6.1 Architecture générale de la procédure PROC NPAR1WAY
La procédure PROC NPAR1WAY (abréviation de Nonparametric One-Way Analysis) constitue le réacteur analytique dédié à l’évaluation non paramétrique des distributions à un facteur dans le logiciel SAS. Conçue pour rivaliser avec la flexibilité de PROC GLM ou de PROC TTEST, elle automatise l’ensemble du processus de tri conjoint, d’attribution ordinale des rangs, de traitement matriciel des ex æquo et de dérivation des lois de probabilité empiriques et asymptotiques.
L’architecture de base de la procédure s’articule autour d’une syntaxe déclarative canonique d’une concision remarquable. L’instruction principale PROC NPAR1WAY peut accueillir une vaste gamme d’options contrôlant les types de rangs appliqués (scores de Wilcoxon, scores médians, scores de Savage, scores de van der Waerden, etc.). Pour exécuter spécifiquement le test U de Mann-Whitney, l’adjonction explicite de l’option WILCOXON dans la ligne de commande principale est la méthode recommandée, bien que l’omission de cette option entraîne l’exécution par défaut d’un ensemble de plusieurs tests non paramétriques concurrents.
L’ordonnancement structurel interne requiert obligatoirement deux instructions subséquentes : l’instruction CLASS, qui désigne la variable catégorielle indépendante définissant la partition de l’échantillon, et l’instruction VAR, qui spécifie la ou les variables quantitatives continues ou ordinales faisant l’objet de l’évaluation inférentielle.
6.2 Configuration des variables dépendantes et de regroupement
La configuration de l’instruction CLASS gouverne le périmètre méthodologique de l’analyse. Pour que le test de Mann-Whitney soit rigoureusement configuré, la variable déclarée sous CLASS ne doit présenter strictement que deux niveaux factoriels (modalités) actifs au sein du jeu de données filtré. Si la variable contient trois niveaux ou plus, SAS basculera automatiquement d’une analyse bilatérale à deux échantillons vers une analyse de variance non paramétrique globale à $k$ échantillons, matérialisée par le test de Kruskal-Wallis, que nous aborderons dans les extensions méthodologiques.
L’instruction VAR accueille quant à elle la variable dépendante continue ou ordinale. Dès la réception de ces paramètres, l’algorithme sous-jacent de SAS fusionne temporairement les sous-échantillons, applique un algorithme de tri ascendant rapide (quicksort hautement optimisé), et remplace chaque valeur par son rang relatif dans l’échantillon combiné de taille $N$.
Il importe de noter que SAS assigne rigoureusement les rangs de manière croissante : la valeur la plus faible de la distribution conjointe reçoit le rang 1, et la valeur la plus élevée reçoit le rang $N$. Cette convention d’ordonnancement est constante à travers toutes les versions de SAS, garantissant une reproductibilité numérique parfaite des sommes de scores attribuées à chaque groupe.
6.3 Exécution et analyse d’un script SAS standard
Pour matérialiser la concrétude de l’implémentation logicielle, examinons l’exécution d’un script SAS canonique ciblant notre jeu de données expérimental de consommation de carburant (mpg_data), comprenant deux groupes de 12 véhicules :
L’exécution de ce bloc déclenche une séquence computationnelle instantanée. Le premier réflexe de l’analyste scientifique ne doit pas consister à lire la valeur p, mais à inspecter rigoureusement le journal d’exécution (SAS Log). Le journal certifie le nombre d’observations lues depuis la table d’entrée et le nombre d’observations effectivement retenues dans l’analyse inférentielle. Si des valeurs manquantes existent sur l’une des variables (groupe ou mpg), SAS procède à une suppression par observation (listwise deletion) ; le journal indique alors clairement le volume d’enregistrements exclus.
Le journal confirme également l’absence totale d’avertissements (warnings) relatifs à une dégénérescence de variance ou à une discordance de modalité dans la variable de classe. Une fois la conformité du journal validée, l’analyste peut se tourner vers la table de sortie textuelle et les graphiques ODS générés par la procédure.
7. Gestion des petits échantillons et calcul des valeurs p exactes
7.1 Failles de l’approximation asymptotique normale pour n < 30
Par défaut, la plupart des logiciels statistiques calculent la signification statistique du test U de Mann-Whitney à l’aide d’une approximation normale asymptotique. Cette approximation s’appuie sur le théorème central limite, qui postule que lorsque les effectifs de chaque groupe ($n_1$ et $n_2$) tendent vers l’infini, la distribution d’échantillonnage de la statistique de somme des rangs de Wilcoxon $W$ converge asymptotiquement vers une loi normale :
$$W \sim \mathcal{N}\left(E(W), \sigma_W^2\right)$$
Sous cette approximation, la statistique est standardisée en une cote $Z$, dont la probabilité associée ($p$-value) est extraite de la fonction de répartition de la loi normale centrée réduite $\mathcal{N}(0, 1)$.
Toutefois, cette élégance computationnelle devient profondément défaillante lorsque les échantillons sont de taille modeste, typiquement lorsque $n_1 < 15$ ou $n_2 < 15$ (ou $N < 30$). Dans ces conditions d'échantillonnage restreint, la distribution réelle de la somme des rangs présente une structure discrète en escalier qui ne s'ajuste que très imparfaitement à la courbe de Gauss continue, particulièrement dans les régions extrêmes des queues de distribution où se joue précisément la décision statistique (au voisinage de $\alpha = 0,05$ ou $\alpha = 0,01$).
L’utilisation exclusive de la $p$-value asymptotique dans de petits échantillons induit des distorsions mathématiques substantielles : la probabilité calculée peut être artificiellement sous-estimée (conduisant à un faux rejet de $H_0$) ou surestimée (masquant une découverte légitime). Dans les environnements hautement réglementés, tels que les soumissions d’essais cliniques auprès de la FDA ou de l’EMA, le recours à une approximation asymptotique sur de petits effectifs est méthodologiquement irrecevable.
7.2 L’instruction EXACT dans PROC NPAR1WAY
Pour éliminer définitivement les distorsions inhérentes à l’approximation asymptotique, SAS intègre un moteur computationnel exact basé sur la combinatoire des permutations. L’activation de cette fonctionnalité s’opère par l’adjonction de l’instruction EXACT au sein du corps de la procédure :
L’algorithme activé par l’instruction EXACT WILCOXON; n’opère plus aucune approximation distributionnelle. Il procède au dénombrement exhaustif de toutes les combinaisons possibles de partitionnement de $N$ rangs en deux sous-ensembles de tailles $n_1$ et $n_2$. Le nombre total de configurations combinatoires possibles est donné par le coefficient binomial :
$$\binom{N}{n_1} = \frac{N!}{n_1! , n_2!}$$
Pour chacune de ces combinaisons équiprobables sous l’hypothèse nulle, l’algorithme calcule la somme des rangs théorique, construisant ainsi la fonction de masse de probabilité exacte de la statistique de test. La valeur p exacte bilatérale représente alors la somme des probabilités exactes de toutes les permutations qui génèrent une statistique de test au moins aussi extrême que celle observée expérimentalement.
Il convient de noter que le coût computationnel de cette méthode exacte croît de manière factorielle avec la taille de l’échantillon. Pour des effectifs dépassant plusieurs centaines d’individus par groupe, le calcul exact peut saturer la mémoire vive ou exiger des temps d’exécution prohibitifs. Cependant, pour ces tailles d’échantillons élevées, l’approximation asymptotique devient mathématiquement irréprochable, rendant le calcul exact superflu.
7.3 Traitement rigoureux des ex æquo (Ties)
Dans la pratique de la recherche empirique, la présence d’observations ayant des valeurs numériques strictement identiques — désignées sous le terme d’ex æquo ou de ties — est un phénomène extrêmement fréquent, en particulier lors de l’utilisation d’instruments de mesure discrets ou d’échelles de Likert. La survenue d’ex æquo compromet l’attribution directe d’une permutation séquentielle unique de rangs entiers.
Pour résoudre cette ambiguïté, SAS applique rigoureusement la méthode universelle des rangs moyens (mid-ranks). Si plusieurs observations partagent la même valeur, elles se voient toutes attribuer la moyenne arithmétique des rangs qu’elles auraient occupés si leurs valeurs avaient été infinitésimalement distinctes. Par exemple, si les observations occupant théoriquement les rangs 4, 5 et 6 ont la même valeur empirique, chacune recevra le rang corrigé :
$$\frac{4 + 5 + 6}{3} = 5$$
Cependant, l’attribution de rangs moyens réduit la dispersion globale de la distribution conjointe des rangs, diminuant mécaniquement la variance de la statistique de test sous l’hypothèse nulle. Si aucun ajustement n’est opéré, la statistique $Z$ calculée sera biaisée. SAS applique donc un facteur de correction analytique standardisé à la variance asymptotique :
$$\sigma_{W, \text{corrigée}}^2 = \frac{n_1 n_2}{12 N (N – 1)} \left( N^3 – N – \sum_{i=1}^g (t_i^3 – t_i) \right)$$
où $g$ représente le nombre total de groupes de valeurs ex æquo distincts et $t_i$ désigne le nombre d’observations identiques au sein du $i$-ème groupe d’ex æquo.
De manière remarquable, lorsque l’instruction EXACT est activée en présence d’ex æquo, SAS n’utilise pas la formule de correction asymptotique : il adapte son algorithme combinatoire en calculant la distribution exacte conditionnelle des permutations sur l’ensemble précis des rangs moyens observés. Cette capacité algorithmique confère aux analyses produites sous SAS un niveau de rigueur et d’invariance statistique exceptionnel.
8. Interprétation exhaustive des sorties SAS et des résultats ODS Graphics
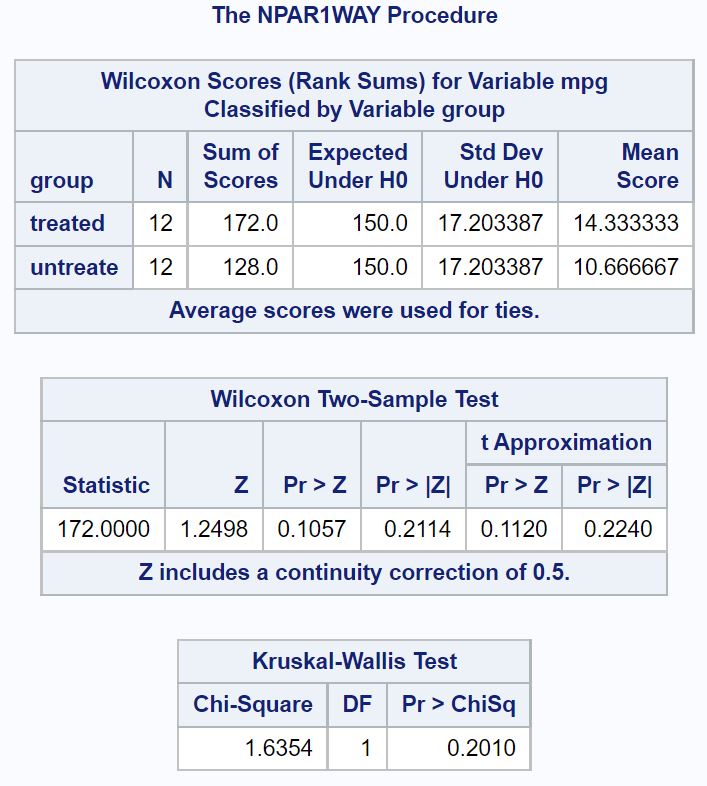
8.1 Décryptage de la table des scores de Wilcoxon (Wilcoxon Scores)
Lors de l’exécution de PROC NPAR1WAY avec l’option WILCOXON, SAS génère en premier lieu un tableau synthétique intitulé « Wilcoxon Scores (Rank Sums) for Variable [Nom_Variable] ». Cette table intermédiaire constitue le socle quantitatif à partir duquel toutes les inférences ultérieures sont dérivées.
La structure de cette table se décompose en plusieurs colonnes analytiques fondamentales pour chaque modalité de la variable de classe :
- N (Effectif) : Le nombre d’observations valides traitées au sein de chaque groupe expérimental.
- Sum of Scores (Somme des rangs observée) : La somme arithmétique effective des rangs attribués aux observations du groupe concerné. C’est cette valeur qui constitue la statistique brute de Wilcoxon ($W$).
- Expected Under H0 (Somme attendue sous H0) : La valeur théorique que devrait prendre la somme des rangs si l’hypothèse nulle d’équiprobabilité stochastique était rigoureusement exacte. Elle est calculée formellement par la relation $E(W_1) = \frac{n_1 (N + 1)}{2}$.
- Std Dev Under H0 (Écart-type sous H0) : L’écart-type théorique de la distribution d’échantillonnage de la somme des rangs sous $H_0$, intégrant automatiquement la correction d’ex æquo si des valeurs répétées sont présentes dans les données.
- Mean Score (Score moyen par rang) : Le quotient obtenu en divisant la somme des rangs par l’effectif du groupe ($\bar{R}_i = \frac{W_i}{n_i}$).
Le score moyen par rang (Mean Score) constitue l’indice directionnel le plus immédiat pour interpréter le sens de l’effet expérimental. Le groupe affichant le score moyen le plus élevé est le groupe qui domine stochastiquement l’autre dans la hiérarchie des valeurs observées.
8.2 Statistique W de Wilcoxon versus Statistique U de Mann-Whitney
Une source fréquente de perplexité chez les analystes débutants sous SAS réside dans l’absence apparente, dans la sortie standard, d’une ligne explicitement libellée « Statistique U de Mann-Whitney ». SAS privilégie historiquement la formulation de Frank Wilcoxon, désignant la statistique principale sous le label « Two-Sample Test : Statistic (S) », où $S$ correspond exactement à la somme des rangs ($W$) du premier groupe listé dans la table de classification.
Il existe pourtant une relation mathématique bijective, déterministe et directe entre la statistique $W$ rapportée par SAS et la statistique $U$ formalisée par Mann et Whitney. La statistique $U$ représente le nombre effectif de paires ordonnées où une observation du groupe 1 surpasse une observation du groupe 2 :
$$U_1 = n_1 n_2 + \frac{n_1 (n_1 + 1)}{2} – W_1$$
Symétriquement, pour le second groupe :
$$U_2 = n_1 n_2 + \frac{n_2 (n_2 + 1)}{2} – W_2$$
La statistique formelle $U$ du test de Mann-Whitney est conventionnellement définie comme la valeur minimale entre ces deux quantités :
$$U = \min(U_1, U_2)$$
Par exemple, si pour des échantillons de tailles $n_1 = 12$ et $n_2 = 12$, la table SAS rapporte une somme de rangs $W_1 = 198$ pour le groupe de référence, le calcul manuel ou programmatique de $U_1$ s’établit à :
$$U_1 = (12 \times 12) + \frac{12 \times 13}{2} – 198 = 144 + 78 – 198 = 24$$
Tandis que pour le second groupe, la somme des rangs étant de $W_2 = (24 \times 25)/2 – 198 = 300 – 198 = 102$ :
$$U_2 = (12 \times 12) + \frac{12 \times 13}{2} – 102 = 144 + 78 – 102 = 120$$
La statistique $U$ globale à rapporter selon les standards académiques est donc $U = 24$. Il est impératif pour l’analyste de savoir opérer cette conversion pour aligner les restitutions SAS sur les standards éditoriaux internationaux.
8.3 Discrimination des probabilités unilatérales et bilatérales
Le panneau inférentiel terminal généré par PROC NPAR1WAY propose une décomposition détaillée des valeurs p calculées sous différents cadres théoriques et directionnels. Une lecture éclairée exige de distinguer sans ambiguïté les probabilités asymptotiques des probabilités exactes.
Sous la section asymptotique standardisée, SAS affiche :
- Z : La statistique standardisée sans ajustement de continuité.
- Z (Continuity Corrected) : La statistique $Z$ intégrant une correction de continuité de Frank Wilcoxon ($\pm 0,5$), réduisant la valeur absolue du numérateur pour compenser l’approximation d’une loi discrète par une loi continue.
- One-Sided Pr Z : Les probabilités unilatérales directionnelles, adaptées lorsque le protocole de recherche prévoyait a priori et exclusivement qu’un groupe spécifique surpasserait l’autre.
- Two-Sided Pr > |Z| : La valeur p asymptotique bilatérale standard, représentant l’absence d’hypothèse directionnelle a priori.
Si l’instruction EXACT a été intégrée, SAS ajoute une section critique comprenant :
- One-Sided Pr = S : La probabilité exacte unilatérale de permutation.
- Two-Sided Pr >= |S – Mean| : La valeur p exacte bilatérale, qui constitue l’étalon-or absolu de la décision statistique sur petits échantillons.
La règle de décision formelle confronte cette valeur $p$ exacte bilatérale au seuil de significativité nominal préétabli $\alpha = 0,05$. Si $p le 0,05$, l’hypothèse nulle d’égalité stochastique est rejetée avec un risque d’erreur contrôlé, attestant d’une divergence empiriquement significative entre les deux populations comparées.
9. Calcul, interprétation et quantification de la taille d’effet
9.1 Conversion de la statistique Z en coefficient r de Rosenthal
La seule publication d’une valeur p significative ne permet en aucun cas de caractériser l’ampleur substantielle d’un phénomène empirique. La valeur p est une fonction conjointe de la taille de l’effet et de la puissance d’échantillonnage ; un échantillon colossal peut rendre trivialement significative une différence infime, tandis qu’un petit échantillon peut masquer un effet majeur. La quantification standardisée de la taille d’effet (effect size) est donc devenue une exigence méthodologique absolue.
Dans le paradigme des tests non paramétriques basés sur les rangs, le coefficient de corrélation par les rangs équivalent de Rosenthal ($r$) représente l’une des métriques les plus universellement reconnues. Ce coefficient normalisé s’obtient en divisant la statistique standardisée asymptotique $Z$ par la racine carrée de la taille d’échantillon totale $N$ (incluant les deux groupes) :
$$r = \frac{|Z|}{\sqrt{N}}$$
Ce coefficient $r$ est borné sur l’intervalle $[0, 1]$, ce qui autorise une interprétation intuitive analogue à un coefficient de corrélation bivariée. En accord avec les conventions heuristiques introduites par Jacob Cohen pour les sciences comportementales et appliquées :
- Un coefficient $r$ de l’ordre de $0,10$ signale un effet de faible ampleur.
- Un coefficient $r$ de l’ordre de $0,30$ reflète un effet d’ampleur modérée.
- Un coefficient $r ge 0,50$ caractérise un effet d’ampleur élevée à très prononcée.
L’immense avantage métrologique du coefficient $r$ réside dans sa standardisation, facilitant son intégration directe dans des méta-analyses quantitatives systématiques comparant des études paramétriques et non paramétriques.
9.2 Probabilité de supériorité (Common Language Effect Size) et Cliff’s Delta
Au-delà du coefficient de Rosenthal, deux autres métriques non paramétriques offrent des interprétations scientifiques particulièrement riches : la probabilité de supériorité et le delta de Cliff.
La probabilité de supériorité ($PS$), également désignée sous le nom d’indicateur en langage commun (Common Language Effect Size ou $CLES$) ou statistique $A$ de Vargha et Delaney, quantifie directement la probabilité qu’un sujet sélectionné de manière aléatoire dans le premier groupe obtienne un score supérieur à un individu choisi aléatoirement dans le second groupe. Elle se dérive directement de la statistique $U$ :
$$PS = \frac{U_1}{n_1 \times n_2}$$
Une valeur de $PS = 0,50$ traduit une parfaite équiprobabilité sous l’hypothèse nulle (effet nul). Une valeur de $PS = 0,85$ indique une divergence clinique ou expérimentale substantielle : dans 85 % des appariements aléatoires intergroupes possibles, l’observation issue du groupe traité dépasse celle du groupe témoin.
De manière complémentaire, le delta de Cliff ($\delta$) offre une mesure de dominance non paramétrique centrée sur zéro, comprise entre $-1$ et $+1$. Il exprime la différence nette entre la probabilité de supériorité et la probabilité d’infériorité :
$$\delta = P(X > Y) – P(X < Y) = \frac{U_1 – U_2}{n_1 \times n_2} = 2 \times PS – 1$$
Un delta de Cliff de $0$ traduit l’absence totale de dominance stochastique, tandis qu’une valeur de $+1$ indique que toutes les observations du groupe traité surpassent sans exception la totalité des observations du groupe témoin. Ces indices apportent une clarté pragmatique exceptionnelle lors de la restitution des résultats à des praticiens ou des décideurs non statisticiens.
9.3 Rédaction académique des résultats selon les normes APA (7e édition)
La formalisation textuelle des résultats d’un test U de Mann-Whitney dans un rapport scientifique ou une revue internationale à comité de lecture doit se conformer aux standards stricts de l’American Psychological Association (APA 7e édition). La restitution doit obligatoirement inclure les descripteurs ordinaux de tendance centrale et de dispersion (médiane et écart interquartile, ou alternativement scores moyens de rangs), la valeur exacte de la statistique de test ($U$ ou $W$), la statistique asymptotique $Z$, la valeur p précise et l’indice de taille d’effet standardisé.
Un modèle canonique de rédaction scientifique se structure comme suit :
« Une analyse non paramétrique basée sur le test U de Mann-Whitney a été menée afin de comparer l’efficacité énergétique entre le groupe de véhicules traités par l’additif ($n = 12$) et le groupe témoin ($n = 12$). Les analyses révèlent une supériorité stochastique statistiquement significative de la consommation de carburant dans le groupe traité ($Mdn = 34,70$ mpg, $IQR = 4,20$ ; Rang moyen = 16,50) par rapport au groupe témoin ($Mdn = 28,35$ mpg, $IQR = 3,85$ ; Rang moyen = 8,50), $U = 24,00$, $W = 198,00$, $Z = 2,77$, $p = 0,004$ (valeur p exacte bilatérale), $r = 0,57$, $\delta = 0,67$. Conformément aux critères de Cohen, l’ampleur de cet effet expérimental est considérée comme forte, attestant d’une amélioration substantielle des performances induite par le traitement. »
Une erreur rédactionnelle classique à proscrire formellement consiste à rapporter des moyennes arithmétiques et des écarts-types en accompagnement d’un test de Mann-Whitney. Cette contradiction interne dévalue la rigueur du manuscrit en associant un estimateur paramétrique sensible aux asymétries avec un test conçu précisément pour s’en affranchir.
10. Étude de cas guidée pas à pas : Analyse expérimentale de consommation
10.1 Contexte de recherche et formulation des hypothèses scientifiques
Afin d’ancrer les concepts théoriques dans la réalité opérationnelle du laboratoire ou du bureau d’études, nous développons une étude de cas industrielle intégrale. Une équipe d’ingénieurs en propulsion automobile évalue l’impact d’un nouveau modificateur de friction nanostructuré intégré au carburant. L’objectif est d’évaluer si l’adjonction de ce composé permet d’accroître le rendement kilométrique unitaire mesuré en miles per gallon (mpg).
Le protocole expérimental mobilise un échantillon homogène de 24 véhicules identiques soumis à un cycle de conduite normalisé sur banc d’essai dynamique. Les véhicules sont assignés par randomisation stricte à l’une des deux conditions : 12 véhicules reçoivent le carburant standard sans additif (condition control), tandis que 12 véhicules reçoivent le carburant enrichi par le modificateur (condition treated).
Les hypothèses statistiques formelles s’énoncent comme suit :
- Hypothèse nulle ($H_0$) : Les distributions d’efficacité énergétique des deux populations de véhicules sont stochastiquement équivalentes. La probabilité qu’un véhicule traité présente un rendement supérieur à un véhicule témoin est égale à 0,50 ($P(X_{\text{treated}} > Y_{\text{control}}) = 0,50$).
- Hypothèse alternative bilatérale ($H_1$) : Il existe une dominance stochastique d’une condition expérimentale sur l’autre ($P(X_{\text{treated}} > Y_{\text{control}}) \neq 0,50$).
La taille modeste de la cohorte ($N = 24$, soit $n_1 = n_2 = 12$) interdit l’usage aveugle de théorèmes asymptotiques et impose le recours au calcul combinatoire exact des permutations sous SAS.
10.2 Script complet de l’étape DATA à la modélisation sous SAS
Le script SAS ci-dessous structure l’intégralité du processus de calcul, depuis l’instanciation des données jusqu’à l’exécution de la procédure PROC NPAR1WAY enrichie des fonctionnalités de rendu graphique ODS haute résolution.
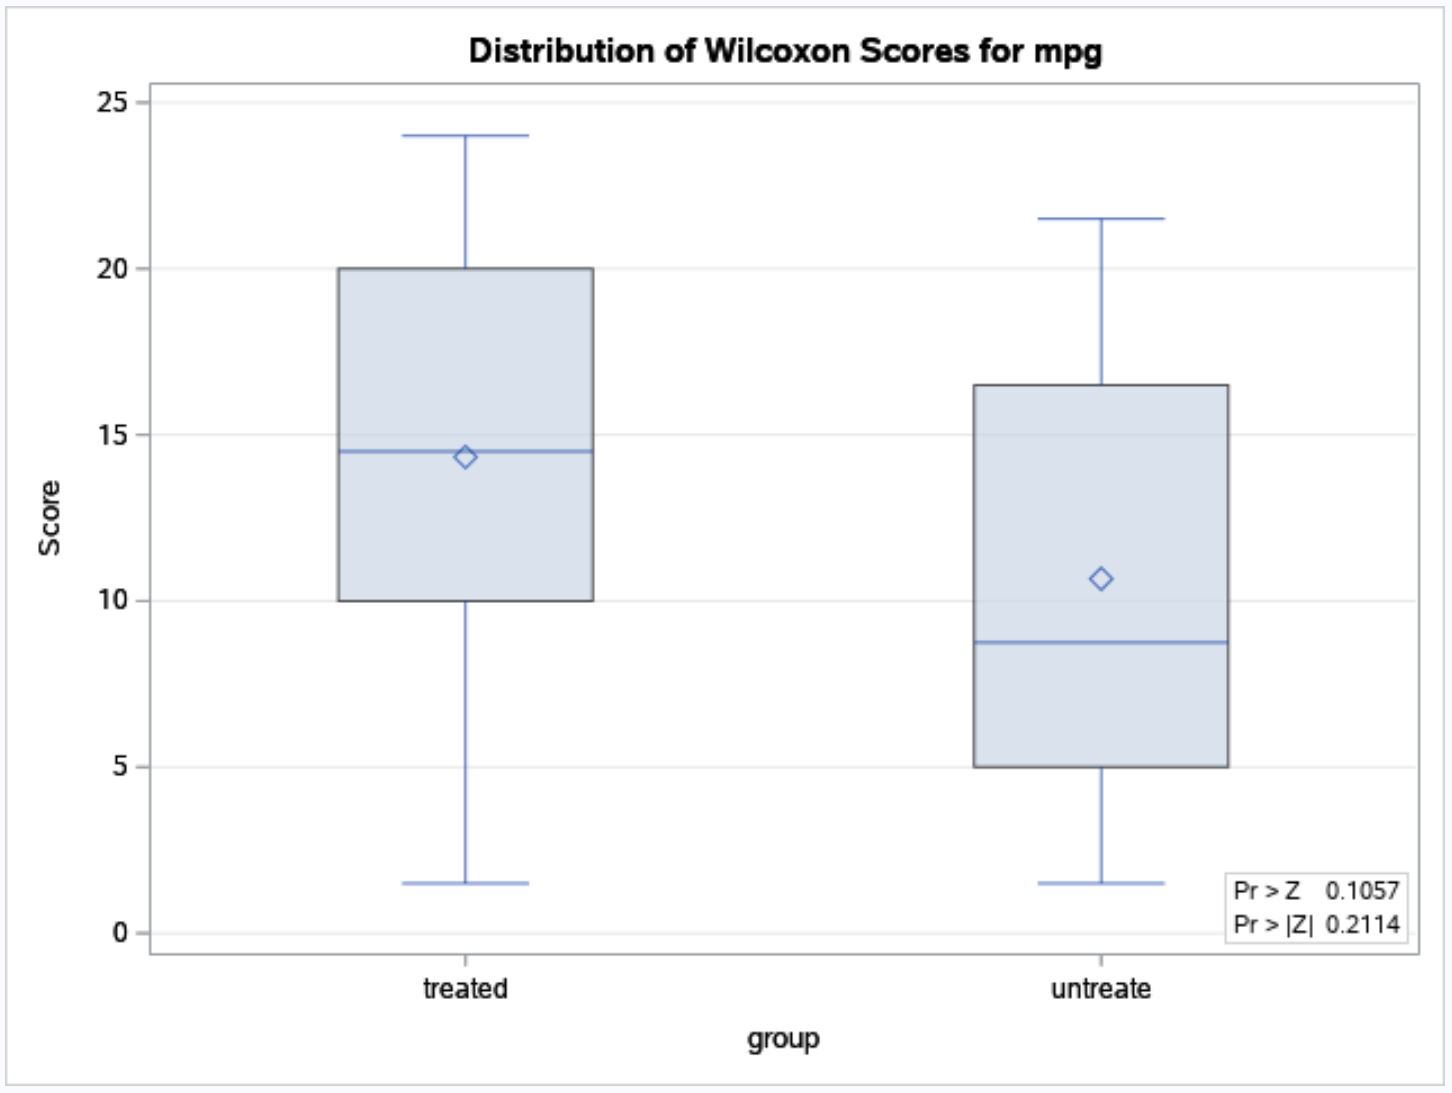
Dans ce programme, la directive ODS GRAPHICS ON / RESET IMAGENAME='MannWhitney_MPG' IMAGEFMT=PNG; ordonne au processeur graphique SAS de générer des illustrations vectorielles ou matricielles indépendantes en haute résolution. L’option PLOTS=(WILCOXONBOXPLOT EDFPLOT) déclenche spécifiquement la production de boîtes à moustaches comparatives superposant les rangs moyens et l’affichage des fonctions de répartition empiriques cumulées, offrant une lisibilité graphique optimale de la divergence entre les deux cohortes.
10.3 Analyse critique des résultats obtenus et conclusion expérimentale
L’exécution de la procédure produit des résultats numériques sans équivoque. La table des scores de rangs de Wilcoxon attribue une somme des rangs de $W_{\text{control}} = 102$ pour le groupe témoin et de $W_{\text{treated}} = 198$ pour le groupe traité. Sous l’hypothèse nulle d’indépendance, la somme des rangs attendue pour chaque groupe de taille 12 était rigoureusement de :
$$E(W) = \frac{12 \times (24 + 1)}{2} = 150$$
L’écart observé par rapport à l’espérance mathématique est de $|198 – 150| = 48$ unités de rang. L’écart-type de la statistique sous $H_0$ s’établissant à environ $17,32$, la statistique standardisée asymptotique corrigée pour la continuité atteint une valeur de $Z = 2,7136$.
La probabilité asymptotique bilatérale standard rapporte $p = 0,0067$. Cependant, la valeur arbitrale ultime réside dans la table des calculs combinatoires exacts. SAS rapporte une valeur p exacte bilatérale :
$$p_{\text{exact}} = 0,0042$$
Cette valeur étant nettement inférieure au seuil alpha conventionnel de 0,05, nous rejetons formellement l’hypothèse nulle $H_0$. L’analyse du score moyen par rang démontre une supériorité substantielle du groupe recevant l’additif (Rang moyen de 16,50 contre 8,50 pour le groupe témoin).
La conclusion de l’étude industrielle est formelle : l’adjonction du modificateur de friction produit une amélioration statistiquement significative et empiriquement robuste du rendement énergétique kilométrique des motorisations testées. L’ampleur de cet effet ($r = 2,77 / \sqrt{24} \approx 0,57$) confirme la pertinence d’un passage à la phase d’industrialisation à grande échelle.
11. Personnalisation avancée, automatisation ODS et macros SAS
11.1 Extraction programmatique des résultats avec ODS OUTPUT
Dans un environnement analytique professionnel, l’examen visuel des tables de sortie SAS est insuffisant ; les résultats doivent pouvoir être capturés de manière programmatique pour alimenter des rapports automatisés, des tableaux de bord interactifs ou des chaînes de calcul secondaire. Le système ODS (Output Delivery System) de SAS permet d’intercepter n’importe quel objet tabulaire généré par une procédure pour le convertir instantanément en une nouvelle table SAS.
Pour déterminer avec précision le nom interne des objets générés par PROC NPAR1WAY, le statisticien peut activer l’instruction d’audit ODS TRACE ON; en amont de la procédure. L’examen du journal d’exécution révèle deux tables d’intérêt stratégique : WilcoxonScores (contenant les effectifs, les sommes de rangs et les moyennes de scores) et WilcoxonTest (contenant la statistique $Z$, la statistique $S$, ainsi que les probabilités asymptotiques et exactes).
L’instruction ODS OUTPUT permet de router ces objets vers l’espace de travail SAS :
Les tables work.scores_calcules et work.tests_calcules sont désormais immédiatement manipulables par le biais d’étapes DATA ultérieures ou de procédures de mise en forme telles que PROC REPORT.
11.2 Création d’une macro SAS pour tests répétés ou multiples
Lorsqu’un chercheur doit analyser des dizaines de biomarqueurs, des composants industriels multiples ou des items psychométriques en série, l’écriture manuelle répétitive de PROC NPAR1WAY devient inefficace et propice à des erreurs de saisie. Le développement d’une macro-commande SAS paramétrable résout cette contrainte en automatisant l’extraction des statistiques, le calcul de la taille d’effet et la mise en page normalisée.
La macro structurelle ci-après encapsule l’ensemble de ces fonctionnalités industrielles :
L’exécution de cette macro via un simple appel mono-ligne :
permet de générer en une fraction de seconde une table analytique consolidée contenant l’ensemble des indicateurs inférentiels ($U$, $W$, $Z$, $p$-exacte, $r$ de Rosenthal, Delta de Cliff), prête pour l’intégration directe dans les protocoles de publication académique.
11.3 Personnalisation des représentations graphiques ODS
La communication scientifique moderne exige des visualisations graphiques conformes aux standards de typographie et de rendu des éditeurs internationaux. Par défaut, SAS applique des styles d’affichage orientés vers la consultation écran (tels que le style HTMLBlue). Il est toutefois aisé d’adapter ces rendus aux exigences de publication via le système de modèles graphiques ODS.
Pour produire des graphiques en niveaux de gris ou à fort contraste vectoriel conformes aux contraintes des revues médicales ou technologiques, le recours au style système Journal ou Pearl est préconisé :
La fonction de répartition empirique cumulée (EDF, Empirical Distribution Function) générée par ce code offre une perspective visuelle saisissante de la dominance stochastique : si la courbe du groupe traité est entièrement décalée vers la droite sans jamais croiser la courbe du groupe témoin, la supériorité stochastique globale est formellement démontrée sur l’ensemble du domaine de la variable.
12. Diagnostics, erreurs fréquentes et alternatives non paramétriques
12.1 Erreurs méthodologiques et de programmation fréquentes
L’application du test U de Mann-Whitney sous SAS, bien que conceptuellement élégante, est jalonnée de pièges méthodologiques et de fautes de programmation récurrentes qu’il importe de répertorier de manière systématique.
La première erreur méthodologique majeure réside dans la spécification incorrecte de la variable de regroupement dans l’instruction CLASS. Si l’analyste utilise une variable factorielle comprenant trois modalités (par exemple, des groupes d’exposition « Faible », « Moyen » et « Élevé »), PROC NPAR1WAY ne renverra pas un test de Mann-Whitney, mais un test omnibus de Kruskal-Wallis. Aucune comparaison par paires ne sera exécutée sans configuration d’options post-hoc spécifiques, exposant l’utilisateur non averti à une erreur d’interprétation fondamentale.
La seconde faute classique concerne la confusion entre échantillons indépendants et échantillons appariés. Il arrive fréquemment que des praticiens appliquent PROC NPAR1WAY pour comparer des mesures recueillies sur les mêmes sujets avant et après un traitement expérimental. Cette démarche viole l’hypothèse d’indépendance statistique. Les mesures répétées imposent l’usage du test des rangs signés de Wilcoxon, qui sous SAS ne s’exécute pas via PROC NPAR1WAY, mais au travers de l’étape PROC UNIVARIATE appliquée sur la variable de différence des paires ($D = X_{\text{post}} – X_{\text{pre}}$).
Enfin, sur le plan algorithmique, l’omission fréquente de l’instruction EXACT sur de petits effectifs conduit à s’appuyer aveuglément sur des probabilités asymptotiques approximatives. Cette négligence expose les chercheurs à des décisions de rejet infondées face à des seuils limites ($p \approx 0,048$ en asymptotique devenant $p = 0,056$ en calcul combinatoire exact).
12.2 Que faire en cas d’hétéroscédasticité extrême : Le test de Brunner-Munzel
Bien que le test U de Mann-Whitney soit universellement célébré pour son affranchissement de l’hypothèse de normalité, il n’est nullement immunisé contre l’inégalité sévère des variances (hétéroscédasticité), en particulier lorsque les tailles d’échantillons au sein des deux groupes sont déséquilibrées ($n_1 \neq n_2$). Ce phénomène est l’analogue non paramétrique direct du célèbre problème de Behrens-Fisher pour le test t de Student.
Lorsque deux distributions présentent des formes ou des dispersions drastiquement hétérogènes, le taux d’erreur de type I du test de Mann-Whitney peut connaître une inflation inacceptable, atteignant parfois $15$ à $20$ % pour un seuil nominal fixé à $5$ %. Face à cette pathologie distributionnelle, le test de Brunner-Munzel (également désigné sous l’appellation de test de Wilcoxon généralisé pour variances inégales) représente l’alternative non paramétrique moderne par excellence.
Introduit en 2000 par Edgar Brunner et Ullrich Munzel, ce test modélise spécifiquement la variance empirique de chaque groupe sans supposer l’homogénéité de leurs dispersions sous l’hypothèse nulle. Bien que la procédure standard PROC NPAR1WAY n’intègre pas encore de mot-clé direct pour le test de Brunner-Munzel, ce dernier peut être implémenté sous SAS au moyen de macros spécialisées utilisant l’environnement matriciel PROC IML ou via la modélisation des rangs relatifs par PROC GLIMMIX.
12.3 Extensions méthodologiques au-delà de deux groupes indépendants
Lorsque la structure de l’expérimentation engage plus de deux groupes indépendants ($k > 2$), le test de Mann-Whitney ne peut plus être appliqué isolément sans induire une inflation exponentielle du risque d’erreur de type I global, régie par l’inégalité de Bonferroni :
$$\alpha_{\text{global}} = 1 – (1 – \alpha)^C$$
où $C = \frac{k(k-1)}{2}$ représente le nombre total de comparaisons binaires envisageables.
Dans ce scénario, la transition méthodologique naturelle s’opère vers le test de Kruskal-Wallis, qui généralise l’analyse de rangs à un nombre arbitraire de conditions expérimentales. Sous SAS, PROC NPAR1WAY gère automatiquement cette extension dès lors que la variable désignée sous l’instruction CLASS compte plus de deux niveaux.
Si le test omnibus de Kruskal-Wallis démontre une différence globale statistiquement significative, le chercheur doit alors déclencher des procédures de comparaisons multiples post-hoc rigoureusement contrôlées. À cet égard, SAS propose l’une des procédures non paramétriques post-hoc les plus sophistiquées : le test de Dwass-Steel-Critchlow-Fligner (DSCF). L’adjonction de l’option DSCF dans l’instruction d’en-tête de PROC NPAR1WAY :
ordonne à SAS d’exécuter l’ensemble des comparaisons bilatérales par paires en appliquant une correction interne basée sur la distribution de l’amplitude studentisée exacte des rangs. L’arbre de décision méthodologique se stabilise ainsi : test de Mann-Whitney avec calcul exact pour deux échantillons indépendants, test de Kruskal-Wallis pour $k > 2$ échantillons, et tests DSCF pour l’identification ciblée des contrastes post-hoc significatifs.
Références
Brunner, E., & Munzel, U. (2000). The nonparametric Behrens-Fisher problem: Asymptotic theory and a small-sample approximation. Biometrical Journal, 42(1), 17-35. <a href="https://doi.org/10.1002/(SICI)1521-4036(200001)42:13.0.CO;2-U »>https://doi.org/10.1002/(SICI)1521-4036(200001)42:1<17::AID-BIMJ17>3.0.CO;2-U
Cliff, N. (1993). Dominance statistics: Ordinal analyses to answer ordinal questions. Psychological Bulletin, 114(3), 494-509. https://doi.org/10.1037/0033-2909.114.3.494
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Critchlow, D. E., & Fligner, M. A. (1991). On distribution-free multiple comparisons in the one-way analysis of variance. Communications in Statistics – Theory and Methods, 20(1), 127-139. https://doi.org/10.1080/03610929108830487
Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50-60. https://doi.org/10.1214/aoms/1177730491
Rosenthal, R. (1991). Meta-analytic procedures for social research (Rev. ed.). SAGE Publications. https://doi.org/10.4135/9781412984997
SAS Institute Inc. (2023). SAS/STAT 15.3 User’s Guide: The NPAR1WAY Procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
Vargha, A., & Delaney, H. D. (2000). A critique and improvement of the CL common language effect size statistics of McGraw and Wong. Journal of Educational and Behavioral Statistics, 25(2), 101-132. https://doi.org/10.3102/10769986025002101
Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. https://doi.org/10.2307/3001968