
Dans le champ contemporain de la science des données et de la biostatistique, l’analyse descriptive constitue la pierre angulaire incontournable de tout protocole d’investigation empirique. Avant d’échafauder des modèles prédictifs sophistiqués, d’ajuster des régressions logistiques multivariées ou d’implanter des algorithmes d’apprentissage automatique, le statisticien doit impérativement appréhender la structure intrinsèque de ses données. Cette étape exploratoire permet d’évaluer la qualité du recueil, de cartographier la distribution des variables et d’identifier les anomalies de mesure. Au sein de l’écosystème logiciel SAS (Statistical Analysis System), qui demeure la référence absolue dans l’industrie pharmaceutique, la recherche clinique et les grandes institutions statistiques publiques, la procédure PROC FREQ s’impose comme l’outil d’élection pour quantifier, croiser et soumettre à l’épreuve de l’inférence les variables discrètes et catégorielles.
La puissance de cette procédure réside dans sa polyvalence exceptionnelle, alliant une sobriété syntaxique remarquable à une profondeur analytique de haut niveau. Capable de traiter avec une efficacité computationnelle optimale des bases de données massives comptant plusieurs millions d’enregistrements, la procédure PROC FREQ ne se limite pas à un simple dénombrement d’occurrences. Elle fournit un ensemble complet d’indicateurs de dispersion, d’estimations de proportions, d’intervalles de confiance asymptotiques et exacts, ainsi qu’une batterie exhaustive de tests d’hypothèses sur l’indépendance, l’homogénéité et la concordance des variables observées. Maîtriser ses multiples facettes représente une compétence fondamentale pour tout analyste soucieux de rigueur méthodologique et de reproductibilité scientifique.
Le présent guide a été conçu pour offrir une immersion exhaustive et progressive dans l’art de concevoir, d’interpréter et de valoriser des tables de fréquences univariées, bivariées et multidimensionnelles sous SAS. À travers l’étude approfondie de la base de données épidémiologique standardisée sashelp.BirthWgt, chaque concept théorique sera illustré par des cas d’usage concrets, des extraits de syntaxe rigoureusement commentés et une analyse critique des métriques produites. Des mécanismes fondamentaux de calcul aux optimisations de mémoire sur très grands volumes, en passant par la gestion délicate des données manquantes et le respect des normes internationales de publication scientifique (notamment celles de l’American Psychological Association), ce traité méthodologique accompagnera le chercheur vers une maîtrise intégrale de la distribution de ses données qualitatives.
1. Introduction fondamentale à l’analyse des fréquences sous SAS et procédure PROC FREQ
1.1 Rôle méthodologique des tables de fréquences en recherche quantitative
L’exploration univariée représente la phase liminaire indispensable de toute démarche de modélisation statistique. Dans le cadre des variables catégorielles, qu’elles soient purement qualitatives nominales ou hiérarchisées sous forme ordinale, l’évaluation de la distribution empirique conditionne l’ensemble des choix méthodologiques ultérieurs. Ignorer cette étape expose l’analyste à des écueils majeurs, tels que l’ajustement de modèles instables ou la formulation d’inférences erronées en raison de la sparsité matricielle. Une distribution empirique asymétrique, caractérisée par une catégorie résiduelle ne concentrant qu’une fraction marginale des observations, induit des phénomènes de quasi-séparation ou de séparation complète lors de l’estimation des paramètres par le maximum de vraisemblance.
En épidémiologie comportementale, en sociologie quantitative et en psychométrie, la table de fréquences remplit une fonction régulatrice essentielle pour valider la représentativité de l’échantillonnage. Elle permet de vérifier si les quotas démographiques définis dans le protocole de recherche ont été scrupuleusement respectés et si certains sous-groupes vulnérables ne sont pas victimes d’une sous-représentation critique. Cette vérification précoce offre la possibilité de redresser l’échantillon par des pondérations statistiques adaptées ou d’orienter le recrutement vers des strates spécifiques avant la clôture définitive des enquêtes sur le terrain.
De surcroît, le tableau de distribution constitue un outil diagnostique irremplaçable pour détecter d’éventuelles dérives de codage ou des artefacts instrumentaux. Lorsque des échelles d’évaluation psychométrique ou des questionnaires standardisés sont administrés, l’observation d’un effet plancher ou d’un effet plafond se manifeste immédiatement à la lecture des proportions marginales. La mise en évidence d’une telle concentration d’observations sur les bornes extrêmes d’une échelle ordinale contraint le chercheur à reconsidérer la sensibilité discriminante de son instrument de mesure avant d’entreprendre des analyses de variance ou des modélisations par équations structurelles.
1.2 Présentation technique de la procédure PROC FREQ dans SAS
Au sein de l’architecture logicielle de SAS Base, la procédure PROC FREQ occupe une position nodale dédiée au traitement des attributs qualitatifs. Tandis que la procédure PROC MEANS est spécifiquement calibrée pour synthétiser les grandeurs continues à travers le calcul d’espérances mathématiques, d’écarts-types, de variances et d’étendues interquartiles, PROC FREQ prend en charge le traitement des variables discontinues. Elle structure les données individuelles en tables de contingence dimensionnelles, dénombrant les occurrences associées à chaque modalité et établissant les distributions de probabilités empiriques correspondantes.
Le moteur sous-jacent de PROC FREQ se distingue par son haut degré d’optimisation computationnelle. Lors de l’exécution d’une étape de dénombrement, la procédure met en œuvre des algorithmes de hachage et de partitionnement de mémoire vive permettant d’agréger les données avec une empreinte mémoire particulièrement restreinte. Contrairement à d’autres environnements de calcul qui chargent l’intégralité des tables brutes dans des matrices denses d’objets, SAS opère une lecture séquentielle optimisée des tables enregistrées sur disque, ne conservant en mémoire centrale que les compteurs d’occurrences associés aux clés de modalité uniques.
Cette distinction conceptuelle entre structures continues et discrètes confère à PROC FREQ une robustesse singulière dans le traitement des ensembles de données massifs (Big Data). La procédure est capable d’absorber des volumétries excédant plusieurs dizaines de gigaoctets sans saturer la mémoire vive de la machine hôte. Au-delà du simple comptage, elle intègre un module de calcul inférentiel sophistiqué capable de dériver instantanément les erreurs-types de proportions, les tests de conformité multinomiale et les statistiques non paramétriques associées aux structures tabulaires.
1.3 Présentation de la base de référence sashelp.BirthWgt
Afin d’ancrer les démonstrations de ce guide dans un cadre empirique réaliste et immédiatement reproductible par tout utilisateur disposant d’un environnement SAS standard, nous exploiterons la table de données intégrée sashelp.BirthWgt. Ce jeu de données volumineux rassemble un échantillon probabiliste de 100 000 observations obstétricales et néonatales, issu des registres d’état civil des services de santé publique américains. Cette cohorte offre une profondeur statistique idéale pour appréhender les enjeux de distribution des facteurs sociodémographiques et périnataux.
La table se structure autour de plusieurs variables catégorielles fondamentales. La variable Race documente l’appartenance ethnoculturelle maternelle déclinée en plusieurs modalités d’enregistrement administratif. La variable AgeGroup segmente l’âge de la mère au moment de l’accouchement en tranches chronologiques distinctes, permettant d’analyser la maturité reproductive. La variable binaire LowBirthWgt enregistre le diagnostic d’insuffisance pondérale à la naissance (définie médicalement par un poids fœtal strictement inférieur à 2 500 grammes), représentant une variable de résultat clinique majeure. Enfin, la variable binaire Smoke qualifie l’exposition active de la mère au tabagisme durant la période gestationnelle.
Cette base de données constitue un archétype d’application épidémiologique. Elle encapsule simultanément des problématiques d’équilibre démographique, des disparités de santé publique et des relations de confusion potentielles entre comportements à risque et issues cliniques défavorables. La multiplicité de ses variables et la taille substantielle de son échantillon permettront de mettre en lumière aussi bien les propriétés fondamentales des tables univariées que la subtilité des croisements multidimensionnels stratifiés.
2. Exploration préliminaire des données avec PROC PRINT
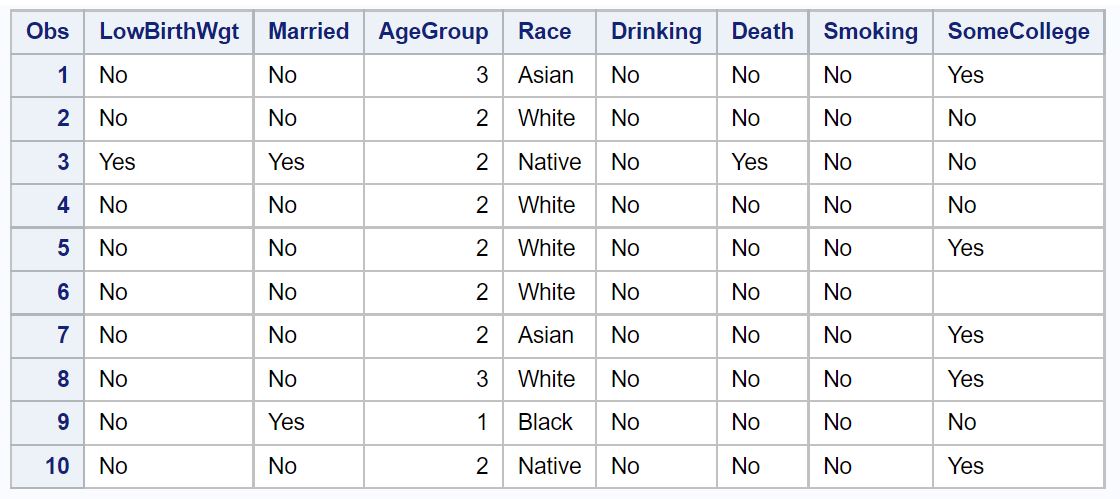
2.1 Inspection des premières observations avec l’instruction obs=10
Préalablement à toute opération de synthèse agrégée, une inspection visuelle directe des enregistrements bruts s’impose comme une mesure élémentaire de précaution méthodologique. L’instruction système de restriction du nombre d’enregistrements constitue la méthode la plus élégante pour examiner l’agencement interne d’une table sans saturer le tampon d’affichage. Sous SAS, l’association de la procédure PROC PRINT avec l’option de jeu de données (obs=10) permet de matérialiser instantanément un aperçu structural des dix premières lignes de la base observée.
Le bloc de commande s’articule selon la formulation canonique suivante : proc print data=sashelp.BirthWgt (obs=10); run;. L’exécution de cette directive sollicite le moteur d’accès SAS pour extraire les dix premiers vecteurs d’observation et les restituer sous la forme d’un tableau bidimensionnel dans la destination de sortie active de l’Output Delivery System (ODS). Cette démarche préliminaire permet de certifier que le chemin d’accès à la bibliothèque est fonctionnel, que la table n’est pas verrouillée par un processus concurrent et que la structure générale des colonnes correspond aux spécifications attendues.
L’affichage généré met en lumière la séquence ordonnée des variables, les en-têtes de colonnes officiellement assignés, ainsi que la nature des valeurs alphanumériques ou numériques stockées. Ce premier contact visuel permet de vérifier la présence de préfixes, d’espaces superflus ou de caractères invisibles qui pourraient altérer les routines de dénombrement catégoriel ultérieures. Il permet également d’observer la variabilité intrinsèque des enregistrements d’une ligne à l’autre au sein de l’échantillon natif.
2.2 Identification de la nature des variables catégorielles
L’examen minutieux de la sortie d’exploration permet de distinguer formellement la nature typologique des variables qualitatives sous revue. En statistique appliquée, une frontière nette sépare les variables nominales des variables ordinales. Une variable nominale pure, à l’instar de la variable Race, établit une partition de la population en catégories mutuellement exclusives et exhaustivement observables, sans qu’aucune relation d’ordre naturel, de préséance ou de hiérarchie métrique ne puisse être postulée entre les différentes modalités.
Inversement, les variables ordinales possèdent une structure sous-jacente intrinsèquement ordonnée. Dans notre jeu de référence, la variable AgeGroup illustre cette catégorie : les tranches d’âge s’échelonnent selon un continuum temporel irréversible, où chaque modalité est conceptuellement supérieure à la précédente. Dans le système SAS, cette distinction est influencée par la manière dont la variable est encodée en machine. Une variable peut être stockée sous forme de chaîne de caractères (type Character) ou sous forme de valeur numérique entière couplée à un format d’affichage (type Numeric avec format d’étiquette assigné).
Cette caractéristique de stockage a des conséquences directes sur le comportement analytique du logiciel. Si une variable ordinale est stockée sous une forme textuelle arbitraire, SAS procèdera par défaut à un tri purement lexicographique lors de la construction des tables de fréquences. Ce mécanisme ordonnera les modalités selon l’alphabet (par exemple, en classant la modalité descriptive d’un niveau intermédiaire avant celle d’un niveau élémentaire), altérant l’intelligibilité des distributions cumulées. L’identification précoce de ces formats permet d’anticiper la nécessité de recourir à des formats numériques sous-jacents ou à des options de tri spécifiques.
2.3 Contrôle qualité initial et détection des valeurs atypiques
La revue préliminaire des données avec PROC PRINT remplit également une fonction de contrôle de qualité des données (data quality assurance). Même au sein de bases institutionnelles réputées stables, des incohérences lexicales peuvent s’introduire : variations de casse entre majuscules et minuscules (par exemple, la coexistence de libellés tels que « Fumeur » et « fumeur »), présence d’espaces insécables en queue de chaîne de caractères, ou utilisation hétérogène de libellés pour désigner une même réalité physiologique. Pour le moteur SAS, deux chaînes différant d’un unique caractère ou d’une simple variation de casse constituent des modalités distinctes et seront décomptées dans des lignes séparées.
De plus, l’observation directe permet de repérer visuellement les conventions retenues pour coder l’absence de réponse. Selon les standards des organismes producteurs de données, les valeurs manquantes peuvent être indiquées par des points standards du moteur SAS pour les variables numériques, par des blancs pour les variables caractères, ou encore par des codes explicites arbitraires tels que « 999 », « Inconnu », « Non renseigne » ou « NA ». Si ces codes numériques sont traités sans précaution par une procédure d’analyse, le logiciel les assimilera à des valeurs valides et faussera l’évaluation des proportions réelles.
Lorsque cette phase d’inspection décèle des anomalies formelles ou des ambiguïtés structurelles, le statisticien doit impérativement intercaler une étape de nettoyage des données (Data Step) avant de solliciter les outils de dénombrement. Ce travail préalable de recodage, de standardisation des chaînes de caractères via des fonctions dédiées (telles que UPCASE, TRIM ou STRIP) et d’imputation formelle des codes d’absence de données garantit l’intégrité de toutes les tables de distribution qui seront construites en aval.
3. Création d’une table de fréquences univariée simple
3.1 Syntaxe fondamentale de l’instruction TABLES
L’architecture syntaxique régissant la mise en œuvre de la procédure PROC FREQ se caractérise par une logique déclarative modulaire standardisée. Le bloc d’instructions élémentaire requiert l’invocation de la commande de procédure, la définition de la table de données d’entrée, la spécification explicite des variables à dénombrer au moyen de l’instruction TABLES, et l’instruction d’exécution RUN. Cette structure constitue le gabarit fondamental à partir duquel se greffent l’ensemble des options analytiques avancées.
L’instruction TABLES détermine la géométrie de la synthèse à opérer. Lorsque l’analyste y déclare une variable isolée sans aucun opérateur de croisement ni délimiteur d’options, la procédure interprète cette directive comme une demande de calcul univarié à une dimension. Il convient de souligner que le système SAS requiert une rigueur formelle absolue dans le placement du point-virgule terminal : l’omission de ce délimiteur ou son insertion prématurée avant la spécification des variables entraîne une interruption immédiate de la compilation du bloc avec génération d’un message d’erreur d’analyse syntaxique dans le journal.
L’instruction TABLES accepte une liste indéfinie de variables séparées par de simples espaces. Il est essentiel de comprendre que la juxtaposition de plusieurs noms de variables au sein de cette instruction (par exemple, TABLES VarA VarB;) n’induit aucun croisement bivarié entre elles, mais déclenche la production successive et indépendante de plusieurs tables de fréquences univariées au cours de la même étape de calcul. Cette spécificité syntaxique offre une grande concision d’écriture pour explorer simultanément l’ensemble des dimensions descriptives d’un fichier de données.
3.2 Exemple pas à pas sur la variable Race du jeu BirthWgt
Pour illustrer la mise en pratique immédiate de cette syntaxe sur notre base de référence, considérons l’analyse de la répartition ethnoculturelle des mères enregistrées dans la cohorte. Le programme SAS s’énonce avec une grande clarté :
proc freq data=sashelp.BirthWgt;

    tables Race;

run;
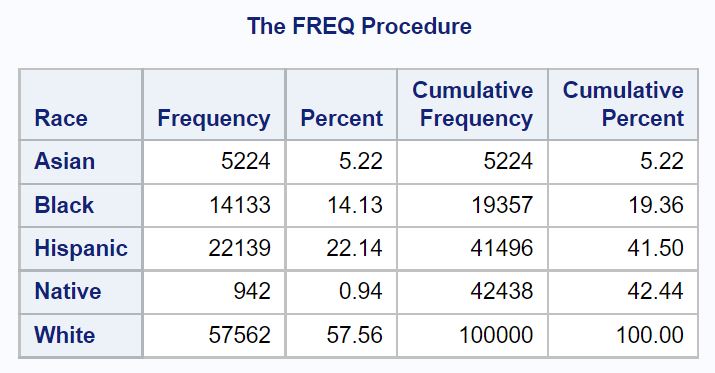
Lors de la soumission de cette séquence, le superviseur d’exécution de SAS engage un protocole rigoureux documenté pas à pas dans la fenêtre du journal d’exécution (SAS Log). Le journal confirme d’abord l’ouverture de la table sashelp.BirthWgt en mode lecture seule, certifie la conformité de la variable Race par rapport au dictionnaire interne du jeu de données, puis alloue dynamiquement les blocs de mémoire nécessaires à l’enregistrement des niveaux distincts rencontrés. Le journal imprime enfin le temps d’exécution CPU et le temps réel d’horloge consacrés au traitement des 100 000 enregistrements, attestant de l’efficacité de la compilation.
Le résultat produit par la procédure se matérialise sous la forme d’un tableau à double entrée rigoureusement calibré. Chaque modalité identifiée dans la colonne Race est assignée à une ligne dédiée. En face de chaque catégorie, SAS aligne systématiquement quatre colonnes de résultats analytiques : l’effectif absolu (Frequency), le pourcentage relatif par rapport au total valide (Percent), l’effectif cumulé progressif (Cumulative Frequency) et la proportion cumulée correspondante (Cumulative Percent). Aucune erreur ni aucun avertissement ne venant troubler le journal, la distribution peut être exploitée immédiatement pour l’interprétation substantielle.
3.3 Génération de tables univariées multiples en une seule passe
Dans le cours d’un projet de recherche quantitative d’envergure, l’analyste doit généralement synthétiser plusieurs dizaines de variables qualitatives distinctes. Déclarer une procédure PROC FREQ indépendante pour chaque variable s’avérerait inefficace sur le plan programmatique et pénalisant sur le plan computationnel, car cela imposerait au moteur SAS de réitérer autant de lectures complètes du fichier de données sur le disque dur.
L’optimisation consiste à rassembler toutes les variables d’intérêt au sein d’une unique instruction TABLES, comme l’illustre le bloc programmatique suivant :
proc freq data=sashelp.BirthWgt;

    tables Race Smoke LowBirthWgt AgeGroup;

run;
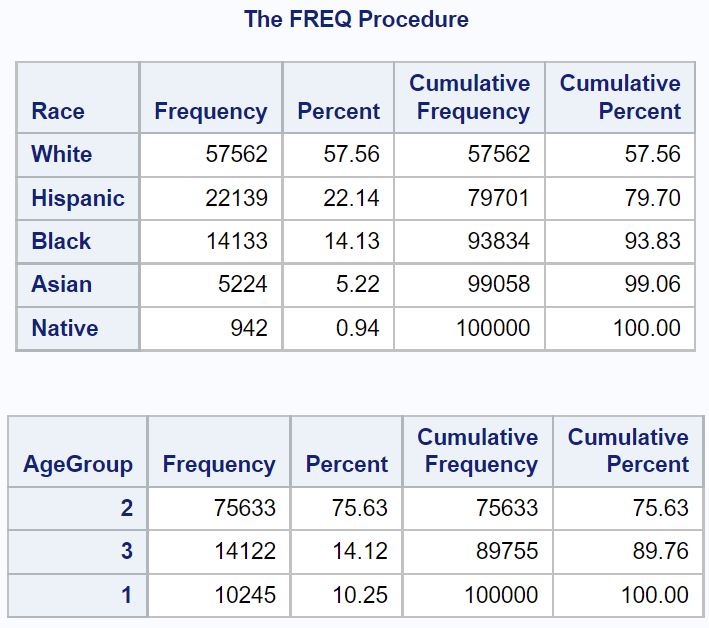
Cette formulation permet à SAS de scanner la table de données en une seule passe séquentielle. Durant cette lecture unique, les compteurs de fréquences associés à chacune des quatre variables spécifiées sont incrémentés simultanément en mémoire centrale. Cette méthode réduit considérablement les opérations d’entrées-sorties physiques (I/O), préservant ainsi les ressources du serveur d’analyse lors du traitement de jeux de données massifs.
Dans l’interface de restitution de l’Output Delivery System (ODS), les résultats sont présentés sous forme d’une succession ordonnée de tables indépendantes, chacune dotée de ses propres métriques et de ses métadonnées descriptives. Cette organisation séquentielle facilite l’extraction modulaire des sorties vers des documents bureautiques ou des classeurs de synthèse, tout en garantissant une traçabilité analytique sans faille pour l’ensemble du profil sociodémographique et clinique de la population sous étude.
4. Interprétation détaillée des quatre métriques standards de SAS
4.1 La fréquence absolue (Frequency)
La fréquence absolue, identifiée sous l’en-tête standard Frequency dans les restitutions de SAS, correspond au dénombrement arithmétique brut des occurrences observées pour chaque modalité discrète au sein de l’échantillon analysé. Sur le plan formel, si l’on considère une variable nominale partitionnée en un nombre k de modalités mutuellement exclusives, la fréquence absolue de la i-ème modalité représente la somme scalaire de toutes les lignes d’observations satisfaisant rigoureusement à cette condition catégorielle.
Dans le cadre de l’exécution menée sur la table sashelp.BirthWgt pour la variable Race, l’examen de la colonne des fréquences révèle des effectifs bruts contrastés selon les groupes ethnoculturels. À titre d’illustration empirique, la modalité désignant les mères d’origine hispanique affiche un décompte d’exactement 22 139 observations. Cette grandeur brute constitue la mesure primaire d’abondance du groupe au sein de la base de données. Elle traduit le volume réel d’individus sur lequel reposent l’ensemble des inférences statistiques ultérieures relatives à ce segment de population.
La validation formelle de la distribution impose que la sommation arithmétique de l’ensemble des fréquences absolues rapportées sur chaque ligne coïncide rigoureusement avec l’effectif global des données valides, soit un total consolidé de 100 000 observations dans notre cohorte de référence en l’absence de données manquantes. Toute divergence entre cette sommation marginale et l’effectif théorique attendu de la cohorte constitue l’indice irréfutable de la présence de valeurs non renseignées ou d’enregistrements exclus par des conditions de filtrage préalables.
4.2 Le pourcentage relatif (Percent)
La métrique dénommée Percent exprime la proportion standardisée que représente l’effectif d’une modalité spécifique par rapport à la taille totale de l’échantillon d’analyse valide. Son calcul dérive de l’application directe du ratio classique : la fréquence absolue de la catégorie considérée est divisée par l’effectif total cumulé des observations valides, le quotient résultant étant ensuite multiplié par cent afin de transposer la fraction sur une échelle centésimale standardisée.
En reprenant l’exemple concret du sous-groupe des mères hispaniques dans la base de données obstétricale, l’observation de 22 139 cas rapportée à l’ensemble des 100 000 patientes de l’étude donne lieu à un pourcentage relatif de précisément 22,14 % après application des algorithmes d’arrondi décimal du système SAS. Cette statistique normalisée neutralise la dépendance à la taille brute de l’échantillon, permettant ainsi d’effectuer des comparaisons épidémiologiques rigoureuses avec d’autres registres hospitaliers ou d’autres juridictions sanitaires ayant inclus des volumes d’observations différents.
Par défaut, la procédure PROC FREQ restitue les pourcentages avec une précision fixée à deux décimales, appliquant la règle conventionnelle d’arrondi arithmétique vers le chiffre le plus proche. Il importe que le chercheur garde à l’esprit que, par suite de ces mécanismes d’arrondi individuel sur chaque modalité, la sommation théorique des pourcentages d’une table univariée peut occasionnellement osciller entre 99,99 % et 100,01 %. Ce phénomène purement calculatoire ne constitue nullement une anomalie statistique, mais reflète la troncature inhérente à la représentation en virgule flottante au sein des systèmes informatiques.
4.3 La fréquence cumulée (Cumulative Frequency)
L’indicateur Cumulative Frequency traduit le mécanisme de sommation séquentielle, ligne par ligne, des effectifs absolus enregistrés depuis la première modalité jusqu’au niveau d’analyse considéré dans la hiérarchie d’affichage de la table. Pour la première ligne d’un tableau, la fréquence cumulée est mathématiquement identique à la fréquence absolue simple. Pour chaque échelon suivant, elle intègre la fréquence de la ligne courante à l’accumulation des effectifs des catégories qui la précèdent immédiatement.
Toutefois, l’interprétation substantive de la fréquence cumulée exige une grande rigueur méthodologique quant à l’échelle de mesure sous-jacente. Cette métrique ne possède de validité conceptuelle que si la variable examinée appartient au domaine des échelles ordinales, pour lesquelles l’ordonnancement séquentiel des niveaux d’affichage traduit une progression réelle, un degré croissant ou une hiérarchie temporelle. Appliquer et commenter une fréquence cumulée sur une variable nominale pure telle que l’origine ethnoculturelle (Race) ou le statut marital relève d’une hérésie analytique, car l’ordre d’empilement des catégories y est conventionnel et dépourvu de signification ordinale.
En revanche, lorsque la fréquence cumulée est déployée sur la variable AgeGroup, elle prend tout son sens clinique et épidémiologique. Elle permet de quantifier avec exactitude le volume absolu de mères n’ayant pas dépassé une borne d’âge spécifique, offrant ainsi une visibilité directe sur la concentration démographique des femmes très jeunes ou, inversement, sur la prévalence des maternités tardives au sein de la cohorte suivie.
4.4 Le pourcentage cumulé (Cumulative Percent)
Le pourcentage cumulé, désigné par la mention Cumulative Percent, formalise la progression centésimale de la somme des fréquences relatives au fur et à mesure du parcours des modalités de la variable. Il s’obtient en divisant la fréquence cumulée de la modalité courante par l’effectif total d’observations valides de la cohorte, puis en multipliant cette valeur par cent. Cette colonne culmine impérativement à la valeur de 100,00 % sur la ligne terminale de la table, marquant l’épuisement exhaustif de l’échantillon analysé.
Cette grandeur statistique s’avère particulièrement précieuse dans le champ de la psychométrie, de l’évaluation de la qualité de vie et de la validation d’échelles de sévérité clinique. Elle permet en effet de déterminer empiriquement des percentiles, des quartiles ou des seuils de démarcation (cut-off points). En présence d’un score d’évaluation clinique ordonné, l’observation du pourcentage cumulé permet d’identifier instantanément le niveau de sévérité en deçà duquel se regroupent, par exemple, 50 % (la médiane empirique) ou 75 % (le troisième quartile) des individus sous surveillance.
Dans l’analyse des tranches d’âge maternelles de notre jeu de référence, le pourcentage cumulé permet d’affirmer d’un simple regard quelle proportion exacte de la cohorte est constituée de mères appartenant aux classes d’âges inférieures à un repère donné. Cela facilite grandement la rédaction de profils démographiques synthétiques destinés aux décideurs sanitaires, sans nécessiter de retraitements arithmétiques secondaires sous un logiciel tableur.
5. Gestion des valeurs manquantes dans les tables de fréquences
5.1 Comportement par défaut de SAS face aux données manquantes
L’omission d’information constitue une problématique récurrente et complexe dans l’analyse de données réelles, qu’elle résulte d’un refus de réponse, d’une défaillance instrumentale ou d’une perte de suivi. Par défaut, la procédure PROC FREQ adopte une approche conservatrice et standardisée vis-à-vis des valeurs manquantes. Lorsqu’un enregistrement comporte une valeur non renseignée sur la variable ciblée par l’instruction TABLES, SAS exclut automatiquement cette observation du corps principal de la table de contingence.
En conséquence de cette exclusion implicite, les calculs de fréquences relatives (pourcentages simples) et de proportions cumulées reposent exclusivement sur l’effectif des cas dits complets ou valides. Afin de maintenir la transparence méthodologique du traitement, la procédure appose systématiquement une note textuelle explicite immédiatement sous le tableau produit. Cette mention indique précisément le volume absolu d’observations écartées de la distribution au moyen de la formule consacrée : « Frequency Missing = X ».
Bien que cette modalité de fonctionnement par défaut permette de préserver le dénominateur analytique pour l’estimation de proportions cliniques pures, elle recèle des risques d’interprétation majeurs si l’analyste n’y prête pas attention. Si le mécanisme régissant l’absence d’information n’est pas de type complètement aléatoire au sens de Rubin (Missing Completely at Random [MCAR]), l’éviction pure et simple de ces données sans caractérisation approfondie introduit un biais d’attrition substantiel, susceptible de fausser dramatiquement les conclusions épidémiologiques tirées de l’étude.
5.2 Inclusion des données manquantes dans les totaux avec l’option MISSING
Pour neutraliser l’exclusion automatique des observations incomplètes et analyser la non-réponse comme une composante structurelle du recueil de données, SAS propose l’option MISSING. Cette option se greffe directement sur l’instruction TABLES, positionnée immédiatement à la suite du symbole barre oblique (slash), conformément au schéma programmatique suivant :
proc freq data=sashelp.BirthWgt;

    tables Race / missing;

run;
L’adjonction de ce paramètre modifie en profondeur la dynamique de calcul de la procédure. Au lieu d’être reléguées en note d’avertissement de bas de page, les valeurs manquantes se voient attribuer une ligne à part entière au sein du corps du tableau de fréquences. Cette ligne apparaît généralement en tête de distribution, matérialisée par un point pour les données numériques ou par un espace vide pour les données textuelles.
L’impact statistique majeur de l’option MISSING réside dans la redéfinition du dénominateur global de calcul. Dès lors que l’effectif des données manquantes est intégré dans le total de référence de l’échantillon, les pourcentages relatifs associés à l’ensemble des modalités valides diminuent proportionnellement. Cette méthode s’avère indispensable pour quantifier avec précision le taux d’attrition, évaluer la complétude des formulaires de recueil clinique (Case Report Forms) et documenter les défaillances de suivi dans les cohortes longitudinales en recherche observationnelle.
5.3 Affichage informatif sans distorsion des pourcentages avec MISSPRINT
Il se présente fréquemment des situations méthodologiques où le chercheur souhaite visualiser explicitement le volume des données manquantes dans la table finale, tout en refusant catégoriquement que ce contingent n’altère le dénominateur de calcul des pourcentages des modalités valides. Cette exigence est particulièrement prégnante dans les rapports d’essais cliniques destinés aux autorités de régulation du médicament, où les taux d’efficacité doivent impérativement être exprimés au sein de la seule population évaluable.
Pour répondre à ce besoin précis, SAS intègre l’option MISSPRINT dans l’instruction TABLES. Sa déclaration s’opère selon une logique similaire : tables Race / missprint;. Lorsqu’elle est activée, cette commande demande à la procédure de faire figurer une ligne dédiée aux valeurs manquantes dans le tableau et d’en afficher l’effectif absolu dans la colonne Frequency. Toutefois, la procédure s’abstient rigoureusement d’inscrire des valeurs dans les colonnes Percent, Cumulative Frequency et Cumulative Percent sur cette ligne spécifique.
Le tableau comparatif suivant synthétise les divergences de traitement opérées par SAS selon l’instruction déclarée :
- Comportement par défaut (Sans options) : Les valeurs manquantes sont totalement absentes du tableau principal ; elles sont quantifiées dans une note de bas de page isolée. Le dénominateur de pourcentage équivaut strictement aux observations valides.
- Option MISSING : Les valeurs manquantes constituent une catégorie de réponse formelle au sein du tableau. Elles reçoivent des fréquences et des pourcentages complets. Le dénominateur inclut l’intégralité des observations renseignées et non renseignées.
- Option MISSPRINT : Les valeurs manquantes figurent visuellement au tableau sous l’angle du dénombrement absolu uniquement. Leurs pourcentages demeurent vierges et le dénominateur des modalités valides reste totalement préservé de toute distorsion.
6. Personnalisation et filtrage des sorties numériques
6.1 Suppression des pourcentages et cumuls avec NOPERCENT et NOCUM
La présentation standard des résultats délivrée par PROC FREQ, avec ses quatre métriques systématiques par modalité, engendre une densité informationnelle parfois superflue. Dans les publications biomédicales ou les rapports institutionnels soumis à des contraintes de calibrage éditorial drastiques, les comités de lecture exigent fréquemment l’épuration des tableaux afin de ne faire figurer que les effectifs observés bruts, ou d’éluder des cumuls dépourvus de pertinence clinique.
La procédure SAS offre une flexibilité de paramétrage permettant de neutraliser sélectivement chaque colonne de résultat. Les options NOPERCENT et NOCUM s’inscrivent précisément dans cette optique de simplification visuelle. Leur intégration conjointe dans l’instruction TABLES s’illustre par la syntaxe suivante :
proc freq data=sashelp.BirthWgt;

    tables Race / nocum nopercent;

run;
L’exécution de cette commande dépouille la sortie de ses colonnes de pourcentages relatifs, de fréquences cumulées et de pourcentages cumulés. Le tableau résultant ne préserve que la liste ordonnée des catégories et leur effectif absolu respectif (Frequency). Cette configuration épurée répond parfaitement aux normes de concision graphique des revues internationales tout en prévenant les erreurs de surinterprétation des cumuls sur les échelles de nature purement nominale.
6.2 Modification de l’ordre d’affichage des modalités avec l’option ORDER=
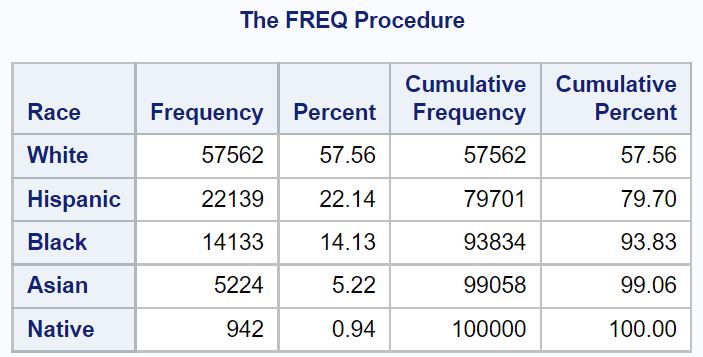
Le système de tri par défaut exploité par SAS dans l’agencement des modalités repose sur la valeur interne brute des données (ORDER=INTERNAL) ou sur leurs libellés mis en forme alphabétiquement (ORDER=FORMATTED). Dans de nombreuses analyses sociologiques ou études de marché, l’analyste privilégie toutefois une hiérarchisation fondée sur l’importance quantitative des groupes, consistant à faire apparaître en premier lieu la catégorie regroupant le plus grand nombre d’individus et à reléguer les groupes marginaux en queue de tableau.
Pour reconfigurer ce comportement, l’option ORDER= doit être spécifiée directement au niveau de l’instruction maîtresse PROC FREQ. L’instruction admet quatre arguments opérationnels distincts :
- ORDER=FREQ : Ordonne l’affichage des modalités par ordre décroissant de fréquence absolue, plaçant immédiatement la modalité majoritaire au sommet du tableau.
- ORDER=DATA : Conserve scrupuleusement l’ordre d’apparition chronologique des catégories tel qu’il se structure dans la séquence d’enregistrement de la base source.
- ORDER=INTERNAL : Applique un ordonnancement fondé sur les valeurs sous-jacentes brutes non formatées (tri numérique direct ou tri lexical machine).
- ORDER=FORMATTED : Structure les lignes selon l’ordre alphabétique ascendant des libellés textuels conférés par les formats d’affichage SAS.
À titre d’exemple, la commande proc freq data=sashelp.BirthWgt order=freq; tables Race; run; réorganisera la table de telle sorte que le groupe ethnique prédominant apparaîtra sur la ligne initiale, suivi séquentiellement des autres communautés selon une stricte monotonie décroissante de leurs effectifs. Cette présentation offre une synthèse immédiate pour les présentations de synthèse exécutive.
6.3 Application de formats personnalisés avec PROC FORMAT
L’une des fonctionnalités les plus puissantes de l’architecture SAS réside dans le découplage étanche entre les données élémentaires stockées et leur représentation visuelle au moyen de formats définis par l’utilisateur. La procédure PROC FORMAT permet d’instaurer des dictionnaires de recodage virtuel sans modifier la moindre valeur physique dans la base de référence, préservant ainsi totalement l’intégrité de la table maîtresse.
Supposons que nous souhaitions regrouper les multiples modalités d’âge de la variable AgeGroup en une typologie simplifiée opposant la maternité précoce à la maternité standard et tardive. Nous déclarerons d’abord un format personnalisé avant de le lier à la procédure de fréquence :
proc format;

    value $typemere

        "<18" = "Adolescente / Risque élevé"

        "18-19", "20-24", "25-29", "30-34" = "Tranche conventionnelle"

        "35-39", "40+" = "Maternité tardive";

run;
proc freq data=sashelp.BirthWgt;
format AgeGroup $typemere.;
tables AgeGroup;
run;
À l’exécution, PROC FREQ agrège instantanément les effectifs des différentes sous-catégories sous leurs nouvelles étiquettes respectives. La table générée ne comportera plus que les trois classes agrégées formalisées dans le bloc VALUE. Ce procédé d’agrégation à la volée évite la création redondante de tables intermédiaires dans la bibliothèque de travail (WORK), optimisant de manière substantielle l’espace de stockage sur disque et la clarté du code opérationnel.
7. Création de tables de contingence bivariées (croisements 2×2 et R x C)
7.1 Syntaxe du produit croisé pour l’analyse bidimensionnelle
Dès lors que l’investigation s’oriente vers la mise en évidence d’une relation de dépendance, d’une association épidémiologique ou d’une covariation entre deux caractéristiques qualitatives, l’analyse univariée cède la place à la contingence bidimensionnelle. Sous SAS, la construction d’une table de croisement bidimensionnelle (de dimension 2×2 ou plus généralement Lignes x Colonnes, notée R x C pour Rows by Columns) s’effectue au moyen de l’opérateur astérisque (*) intercalé entre les deux variables au sein de l’instruction TABLES.
La convention syntaxique s’établit selon la règle formelle : TABLES VariableLigne * VariableColonne;. Dans notre étude de cas, l’exploration de la corrélation potentielle entre l’origine ethnoculturelle maternelle (Race) et la survenue d’un faible poids néonatal (LowBirthWgt) s’exprime au travers du programme suivant :
proc freq data=sashelp.BirthWgt;

    tables Race * LowBirthWgt;

run;
La topologie de sortie se métamorphose en une matrice rectangulaire d’agencement bidimensionnel. Les différentes catégories de la variable déclarée à gauche de l’astérisque délimitent les rangées horizontales du tableau, tandis que les modalités de la variable inscrite à droite structurent les colonnes verticales. À l’intersection de chaque rangée et de chaque colonne se trouve une cellule de contingence représentant la conjonction des deux attributs cliniques pour un sous-groupe spécifique de patientes.
7.2 Décomposition des pourcentages de ligne, colonne et totaux
Par défaut, la procédure PROC FREQ inscrit dans chaque cellule d’intersection d’une table croisée un bloc complet de quatre grandeurs statistiques distinctes, organisées verticalement selon une clé de lecture immuable explicitée dans un cartouche d’en-tête :
- Cell Frequency : L’effectif conjoint brut d’observations présentant simultanément la modalité de la ligne et celle de la colonne correspondante.
- Percent (Pourcentage global) : La proportion d’individus situés dans la cellule rapportée à la taille intégrale de l’échantillon d’étude (N total).
- Row Pct (Pourcentage en ligne) : La proportion conditionnelle calculée par rapport à l’effectif marginal total de la ligne considérée. Il traduit le risque conditionnel ou la distribution relative au sein de cette sous-population.
- Col Pct (Pourcentage en colonne) : La proportion conditionnelle calculée par rapport à l’effectif marginal total de la colonne considérée. Il permet de caractériser le profil de recrutement au sein de ce groupe de résultat.
La distinction conceptuelle entre le Row Pct et le Col Pct est fondamentale en analyse épidémiologique. En positionnant la variable d’exposition (par exemple, le tabagisme Smoke) en ligne et l’événement clinique (LowBirthWgt) en colonne, le pourcentage en ligne exprime directement le taux d’incidence cumulée de l’événement défavorable parmi les sujets exposés comparativement aux non-exposés. Inversement, le pourcentage en colonne indique quelle proportion des nouveau-nés hypotrophes était issue de mères fumeuses, renvoyant à la fraction attribuable dans l’échantillon.
7.3 Simplification visuelle des tables croisées
Bien que la profusion des pourcentages conditionnels enrichisse la table de contingence, elle nuit gravement à la lisibilité générale dès lors que la matrice comporte un nombre élevé de lignes et de colonnes. Pour clarifier la restitution visuelle et diriger l’attention du lecteur vers la seule dimension analytique pertinente, SAS permet d’inhiber spécifiquement chaque composante de la cellule au moyen d’options dédiées : NOROW (suppression des pourcentages en ligne), NOCOL (suppression des pourcentages en colonne) et NOPERCENT (suppression des pourcentages sur le grand total).
Ainsi, le programme tables Race * LowBirthWgt / norow nopercent; restreindra l’information cellulaire à l’effectif observé et au pourcentage en colonne. Si l’analyste désire uniquement obtenir la matrice brute des comptes d’effectifs, l’emploi cumulé de ces trois directives produira un tableau épuré ne contenant qu’un nombre unique par cellule.
Par ailleurs, pour les tables de contingence de grande dimension impliquant des dizaines de modalités, la disposition matricielle classique s’avère malcommode à consulter. SAS offre l’option LIST ou l’option CROSSLIST. L’option / LIST transmute la grille matricielle bidimensionnelle en une liste linéaire verticale continue, restituant pour chaque croisement unique de catégories sa fréquence brute et son pourcentage global, à l’image d’une table univariée classique. Cette disposition est particulièrement adaptée aux flux d’exportation vers des banques de données externes.
8. Tables de fréquences multidimensionnelles et stratifiées
8.1 Structuration des tables à trois voies et plus
La recherche étiologique et les études observationnelles se heurtent systématiquement à la complexité des facteurs d’exposition et aux biais de confusion. Pour explorer les interactions complexes ou contrôler l’influence d’une variable tierce sur la liaison observée entre deux attributs primaires, l’analyste doit étendre la contingence vers des tables à trois voies ou d’ordres supérieurs (n-way tables). Sous SAS, cette opération s’exprime en enchaînant plusieurs opérateurs de croisement au sein de la clause TABLES : TABLES Strate * Exposition * Issue;.
Considérons l’évaluation du lien entre l’origine ethnique (Race) et l’insuffisance pondérale fœtale (LowBirthWgt), en contrôlant pour le statut tabagique de la mère (Smoke). La commande s’énonce :
proc freq data=sashelp.BirthWgt;

    tables Smoke * Race * LowBirthWgt;

run;
Dans cette arborescence multidimensionnelle, la variable mentionnée en première position (ici, Smoke) agit comme une variable de contrôle ou de stratification. PROC FREQ procède au fractionnement mathématique de l’échantillon en autant de sous-populations distinctes qu’il existe de modalités dans cette variable primaire. Pour chaque niveau de tabagisme rencontré (fumeuse versus non-fumeuse), le logiciel génère une table de contingence bidimensionnelle 2×2 indépendante croisant l’origine ethnoculturelle et le poids de naissance. Ce mécanisme permet d’évaluer visuellement si l’amplitude de l’association clinique se maintient de façon constante à travers les différents sous-groupes comportementaux.
8.2 Stratification formelle via l’instruction BY
Une alternative élégante à la spécification des croisements multidimensionnels directs réside dans le recours à l’instruction structurante BY. Contrairement à l’opérateur astérisque qui gère la hiérarchie au sein du moteur interne de l’instruction TABLES, l’instruction BY segmente physiquement l’exécution de la procédure en blocs indépendants pour chaque modalité de la variable de tri déclarée.
La mobilisation de l’instruction BY impose toutefois un prérequis strict au sein du compilateur SAS : le jeu de données d’entrée doit impérativement avoir été trié en amont selon les variables de stratification déclarées, sous peine de provoquer une interruption immédiate avec émission d’une anomalie fatale dans le journal d’exécution. Le flux de travail s’articule donc en deux étapes programmatiques conjointes :
proc sort data=sashelp.BirthWgt out=Work.BirthWgt_Sorted;

    by Smoke;

run;
proc freq data=Work.BirthWgt_Sorted;
by Smoke;
tables Race * LowBirthWgt;
run;
Sur le plan de l’optimisation, le recours à la clause BY sur un fichier préalablement ordonné s’avère souvent plus économique en mémoire vive que l’instruction TABLES multidimensionnelle, car SAS n’a pas besoin de maintenir l’ensemble des structures d’agrégation simultanément en mémoire. De surcroît, dans la fenêtre de visualisation ODS, chaque strate donne lieu à une section autonome introduite par un en-tête dédié, ce qui améliore la lisibilité documentaire des rapports médico-économiques volumineux.
8.3 Lecture critique des phénomènes paradoxaux (Paradoxe de Simpson)
L’analyse approfondie des distributions stratifiées constitue un rempart indispensable contre des illusions statistiques redoutables, au premier rang desquelles figure le célèbre paradoxe de Simpson. Ce phénomène se caractérise par une situation où une association statistique observée au niveau global agrégé d’une population se trouve totalement inversée, neutralisée ou substantiellement amplifiée dès lors que la population est désagrégée et analysée au sein de ses strates constituantes sous l’influence d’un facteur de confusion masqué.
En épidémiologie périnatale, un croisement agrégé brut entre un groupe démographique et la survie néonatale peut suggérer une surmortalité apparente dans une classe de population donnée. Toutefois, lorsque l’on stratifie la table de fréquences par une variable intermédiaire majeure comme la prématurité extrême ou le poids de naissance, il n’est pas rare de constater que la relation s’inverse rigoureusement : au sein de chaque strate clinique homogène, le sous-groupe initialement défavorisé affiche en réalité un taux de survie supérieur à celui de la population générale.
La stratification systématique au moyen de PROC FREQ permet de mettre immédiatement en lumière ces retournements de tendance. Face à de tels paradoxes, le chercheur s’abstiendra formellement d’interpréter le tableau unifié global et articulera ses conclusions autour des estimateurs ajustés, prévenant ainsi la diffusion de déductions causales infondées qui pourraient induire des politiques de santé publique inappropriées.
9. Tests statistiques d’association associés aux tables de fréquences
9.1 Le test du Chi-deux d’indépendance avec l’option CHISQ
Au-delà de la dimension purement descriptive, la procédure PROC FREQ intègre une panoplie de fonctionnalités inférentielles destinées à tester formellement les hypothèses statistiques d’indépendance entre variables discrètes. Le test classique du Chi-deux de Pearson constitue le pilier de ces démarches bivariées. Son activation s’opère par l’adjonction de l’option CHISQ à la suite de l’instruction TABLES :
proc freq data=sashelp.BirthWgt;

    tables Smoke * LowBirthWgt / chisq;

run;
L’hypothèse nulle ($H_0$) postule une indépendance stochastique parfaite entre l’exposition maternelle au tabac et la prévalence d’un poids de naissance insuffisant, signifiant que la distribution conditionnelle du poids fœtal est rigoureusement invariable selon le comportement tabagique maternel. Pour mettre cette assertion à l’épreuve, SAS calcule d’abord les effectifs théoriques attendus (sous l’hypothèse de non-liaison) pour chaque cellule de la matrice, selon la formule standard : effectif théorique = (total marginal de la ligne × total marginal de la colonne) / taille totale de l’échantillon.
La statistique du Chi-deux de Pearson synthétise la déviation quadratique relative entre les effectifs empiriquement observés et ces effectifs théoriques attendus. La procédure PROC FREQ compile ensuite la valeur exacte de la statistique calculée, le nombre de degrés de liberté associé (déterminé par la formule $(R – 1) \times (C – 1)$) et la probabilité critique asymptotique (p-value). Une p-value inférieure au seuil alpha conventionnel de 0,05 autorise le rejet de l’hypothèse nulle en faveur d’une association statistiquement significative entre les deux phénomènes observés.
9.2 Test exact de Fisher pour faibles effectifs
L’inférence asymptotique délivrée par le test du Chi-deux repose sur des approximations distributionnelles qui perdent toute validité théorique lorsque les effectifs de l’échantillon sont modestes ou que la table présente une sparsité prononcée. Selon la règle empirique de Cochran, si plus de 20 % des cellules de contingence présentent un effectif théorique attendu inférieur à cinq individus, ou si une cellule quelconque affiche un effectif attendu inférieur à un, la p-value asymptotique calculée par le Chi-deux est sujette à distorsion et majore le risque d’erreur de type I.
Dans ce contexte de fragilité statistique, le test exact de Fisher s’impose comme la solution méthodologique optimale. Sur une table de contingence de dimension 2×2, SAS compile automatiquement le test exact de Fisher dès lors que l’option CHISQ est déclarée dans la syntaxe. Le calcul repose sur la distribution hypergéométrique conditionnelle, dénombrant de manière combinatoire la probabilité exacte d’observer la configuration de données recueillie, ou une configuration plus extrême, en conservant les marges de lignes et de colonnes strictement fixes.
Lorsque l’analyse implique des tables matricielles d’ordres supérieurs (tables R x C), le test de Fisher n’est plus calculé par défaut en raison de la complexité algorithmique exponentielle de l’énumération des permutations de matrices. Pour forcer SAS à dériver cette probabilité exacte sur des structures polytomiques étendues, le statisticien intègre une instruction indépendante dédiée : EXACT FISHER;. Cette directive déclenche des algorithmes d’énumération en réseau qui garantissent la robustesse de l’inférence, y compris au sein de cohortes cliniques restreintes de maladies rares.
9.3 Mesures de force d’association et coefficients dérivés
Une erreur courante en biostatistique consiste à assimiler une valeur de p-value infinitésimale issue d’un test du Chi-deux à une démonstration de force d’association causale intense. La statistique du Chi-deux étant proportionnelle à la taille d’échantillon $N$, un échantillon massif de 100 000 patientes comme celui de sashelp.BirthWgt engendrera quasi systématiquement des p-values hautement significatives ($p < 0,0001$), y compris pour des variations d’effectifs négligeables et sans portée clinique réelle. Il est donc impératif de quantifier l’intensité de la relation au moyen de coefficients de taille d’effet dédiés.
L’adjonction des options MEASURES et RELRISK débloque un arsenal d’indicateurs épidémiologiques essentiels :
- Rapport de cotes (Odds Ratio – OR) : Mesure fondamentale des études cas-témoins calculant le ratio de probabilités subjectives qu’un événement survienne au sein du groupe exposé par rapport au groupe non-exposé, enrichi de ses intervalles de confiance asymptotiques à 95 %.
- Risque Relatif (Relative Risk – RR) : Ratio direct d’incidences cumulées entre deux groupes, indispensable dans les protocoles de cohortes prospectives.
- V de Cramér : Indicateur adimensionnel d’intensité d’association normalisé sur un intervalle borné entre 0 (indépendance absolue) et 1 (dépendance fonctionnelle complète), calculé pour des matrices de dimensions arbitraires.
- Coefficient Phi ($phi$) : Dérivé du Chi-deux applicable aux tables quadratiques 2×2, assimilable à un coefficient de corrélation de Pearson entre deux variables indicatrices binaires.
L’interprétation conjointe de ces métriques permet de dépasser la simple dichotomie de significativité statistique pour ancrer l’analyse dans le domaine de la pertinence clinique pratique, évaluant l’amplitude réelle de l’impact des expositions sanitaires examinées.
10. Exportation et intégration des tables de fréquences
10.1 Génération de tables de données SAS avec l’option OUT=
Si la consultation visuelle des résultats dans l’environnement interactif de SAS constitue la première étape de l’analyse, l’intégration des fréquences dans des chaînes de traitement automatisées exige leur transcription sous forme de jeux de données SAS structurés. L’instruction TABLES intègre à cet effet l’option OUT=, qui ordonne l’écriture immédiate des agrégats calculés au sein d’une table cible enregistrée dans la bibliothèque de travail ou dans un référentiel permanent.
La formulation canonique de cette instruction se déploie selon le modèle suivant :
proc freq data=sashelp.BirthWgt noprint;

    tables Race * LowBirthWgt / out=Work.ResultatsFreq outrep;

run;
L’activation concomitante de l’option globale NOPRINT sur la commande PROC FREQ permet d’inhiber la génération des rapports dans l’ODS, optimisant les cycles processeur lorsque seule la création de la table sous-jacente est visée. La table de sortie créée (ici, ResultatsFreq) hérite des colonnes d’origine qualifiant le croisement, complétées systématiquement par deux variables générées automatiquement par le moteur SAS : COUNT (hébergeant l’effectif absolu d’occurrences) et PERCENT (enregistrant la proportion relative).
L’argument additionnel OUTREP ordonne au logiciel de faire figurer explicitement les totaux de lignes et de colonnes dans la structure exportée. La table obtenue peut ensuite être immédiatement exploitée pour alimenter des étapes de mise en forme conditionnelle, servir de table d’entrée pour des procédures de modélisation avancée ou subir des opérations de jointure (MERGE) au sein d’un entrepôt de données décisionnel.
10.2 Routage des résultats via l’ODS (Output Delivery System)
L’Output Delivery System (ODS) représente l’architecture unifiée de SAS dédiée à la capture, au filtrage et à la conversion typographique des sorties d’analyse. Au lieu de subir passivement la diffusion monolithique de tous les calculs programmés, l’analyste peut sélectionner avec précision le tableau exact qu’il désire valoriser en faisant appel à l’instruction ODS SELECT, couplée au nom d’objet interne attribué par la procédure.
Pour une table de fréquences univariée, l’objet système porte le libellé OneWayFreqs ; pour une table de contingence bivariée, il répond à l’identifiant CrossTabFreqs. La redirection de ces entités vers des fichiers publiables dans des formats bureautiques s’effectue au moyen des destinations ODS telles que RTF (compatible avec les traitements de texte), PDF (destiné à l’archivage réglementaire scellé) ou EXCEL, comme l’illustre la séquence suivante :
ods rtf file="C:RapportsFrequences_Maternite.rtf" style=Journal;

ods select CrossTabFreqs;
proc freq data=sashelp.BirthWgt;
tables Race * LowBirthWgt / chisq;
run;
ods rtf close;
Le commutateur typographique style=Journal applique instantanément une feuille de style académique monochrome épurée, respectant scrupuleusement les exigences des comités de lecture scientifiques internationaux : suppression des quadrillages saturés, typographie avec empattements équilibrée et centrage normalisé des grandeurs numériques. Ce mécanisme d’exportation garantit une conformité directe avec les standards éditoriaux sans nécessiter de retouches manuelles ultérieures.
10.3 Visualisation graphique native avec ODS GRAPHICS
Bien que l’analyse chiffrée matricielle offre une précision arithmétique indispensable, la transmission des résultats auprès d’un public multidisciplinaire gagne considérablement à s’appuyer sur des représentations graphiques claires. L’activation de la couche graphique haute résolution de SAS s’opère par la directive globale ODS GRAPHICS ON;. Dès lors que cette passerelle est opérationnelle, la procédure PROC FREQ devient capable de tracer automatiquement des graphiques d’association via l’option PLOTS= rattachée à l’instruction TABLES.
La déclaration de l’option de traçage s’illustre selon la syntaxe suivante :
ods graphics on;

proc freq data=sashelp.BirthWgt;

    tables Race * LowBirthWgt / plots=freqplot(type=barchart scale=percent twoway=stacked);

run;

ods graphics off;
Ce bloc de commande demande à SAS de matérialiser un diagramme en barres empilées représentant la répartition proportionnelle du faible poids de naissance au travers des différentes strates ethnoculturelles. Le paramètre scale=percent garantit que l’ordonnée représente les fréquences relatives normalisées plutôt que des volumes bruts, prévenant ainsi les illusions visuelles imputables aux déséquilibres d’effectifs entre les groupes de référence. Le fichier graphique généré sous vectorisation dynamique présente une netteté idéale pour les posters scientifiques ou les synthèses exécutives.
11. Optimisation des performances sur volumétries massives
11.1 Gestion de la mémoire vive et bufferisation avec l’option PAGE
Lorsqu’elle est déployée sur des gisements de données massifs excédant plusieurs dizaines de millions d’enregistrements (tels que des bases de remboursements d’assurance maladie ou des flux de télémétrie industrielle), la procédure PROC FREQ peut rencontrer des goulots d’étranglement imputables aux transferts physiques entre le sous-système de disques de stockage et la mémoire vive. L’optimisation des performances dépend alors d’une gestion ciblée des mémoires tampons de lecture (buffers).
L’emploi d’options système d’entrées-sorties permet d’accélérer significativement les temps de traitement. L’option BUFSIZE= associée à BUFNO= alloue des blocs de lecture contigus de taille élargie, minimisant les micro-interruptions matérielles de lecture de têtes de disques. Conjointement, au sein de l’étape procédurale, le statisticien veillera à restreindre le spectre d’analyse aux stricts attributs nécessaires en mobilisant la clause (KEEP=...) directement sur le jeu de données d’entrée :
proc freq data=sashelp.BirthWgt (keep=Race LowBirthWgt);

    tables Race * LowBirthWgt;

run;
Cette directive évite au moteur SAS de charger en mémoire de travail les colonnes non sollicitées par l’instruction TABLES, préservant ainsi la bande passante du bus système. De surcroît, l’application préalable de techniques de compression de tables de données (telles que les options COMPRESS=YES ou COMPRESS=BINARY) divise l’espace d’encombrement physique sur disque, accélérant la lecture séquentielle par le sous-système de stockage lors du balayage de populations massives.
11.2 Utilisation de l’instruction WEIGHT pour données pré-agrégées
Dans de nombreuses architectures de bases de données distribuées, les informations ne sont pas transmises sous forme de micro-données individuelles ligne par ligne, mais sous la forme de données de comptage synthétiques pré-agrégées. Dans cette configuration compacte, chaque ligne représente un profil catégoriel unique associé à une variable numérique dénombrant le total d’individus partageant scrupuleusement ces mêmes caractéristiques.
Pour traiter ces structures agrégées sans devoir procéder à une expansion artificielle et coûteuse de la table ligne par ligne, SAS met à disposition l’instruction WEIGHT. Considérons une table compacte dénommée SyntheseClinique comportant trois colonnes : Traitement, Guerison et la variable de comptage Effectif. La commande d’analyse s’articule comme suit :
proc freq data=SyntheseClinique;

    weight Effectif;

    tables Traitement * Guerison / chisq;

run;
La présence de la directive WEIGHT instruit la procédure d’utiliser la grandeur contenue dans la variable spécifiée comme facteur de réplication arithmétique direct de chaque modalité. L’ensemble des calculs de dénombrement marginal, des proportions relatives, des statistiques de Chi-deux de Pearson et de leurs degrés de liberté associés est rigoureusement identique aux résultats qui auraient été obtenus en déployant la procédure sur une table brute étendue de millions de lignes individuelles. Le gain de temps d’exécution et l’économie d’espace de stockage sur disque s’avèrent considérables, le traitement s’opérant alors en une fraction de seconde.
11.3 Traitement parallèle et multithreading sous SAS Viya et SAS 9.4
Les versions récentes de l’environnement analytique SAS, incluant les déclinaisons modernes de SAS 9.4 et la plateforme en mémoire distribuée Cloud Analytic Services (CAS) de SAS Viya, intègrent des capacités natives de multithreading asynchrone pour les opérations de dénombrement. La procédure PROC FREQ est conçue pour exploiter pleinement les architectures multiprocesseurs et les fermes de serveurs multicœurs.
L’activation du multithreading s’opère généralement par l’intermédiaire de l’option système globale OPTIONS THREADS;. Sous cette configuration, SAS partitionne automatiquement le jeu de données en segments de blocs logiques et assigne le balayage de chaque bloc à des cœurs processeur distincts au sein de l’unité centrale de traitement. Chaque fil d’exécution (thread) construit sa propre table de hachage locale de fréquences en mémoire centrale. À l’issue du balayage complet des flux d’enregistrements, un processus superviseur agrège les compteurs partiels pour former la structure de contingence globale consolidée.
Il importe toutefois que le statisticien intègre une réserve méthodologique touchant à la reproductibilité stricte de l’ordonnancement interne sous exécution multithreadée : lorsque des tris arbitraires de type ORDER=DATA sont sollicités, la variabilité infinitésimale de complétion entre les différents threads de calcul peut induire de subtiles modifications de l’ordre d’affichage des modalités d’une exécution à l’autre. Pour garantir une reproductibilité absolue des rapports dans les cadres réglementaires stricts, l’analyste privilégiera systématiquement des clés d’ordonnancement explicites reposant sur ORDER=FORMATTED ou ORDER=INTERNAL.
12. Bonnes pratiques académiques et pièges courants à éviter
12.1 Erreurs d’interprétation des pourcentages cumulés
L’écueil interprétatif le plus couramment relevé dans la littérature scientifique débutante réside dans l’exploitation non critique des métriques cumulées sur des échelles dépourvues d’ordre intrinsèque. La présentation conjointe et standardisée des colonnes Cumulative Frequency et Cumulative Percent par la procédure PROC FREQ incite parfois des auteurs à formuler des commentaires dépourvus de sens méthodologique sur des variables nominales pures.
À titre d’exemple, énoncer à la lecture d’un croisement sur la variable Race qu’« exactement 74,5 % des mères interrogées appartiennent aux trois premières catégories répertoriées dans la table » ne possède aucune validité épidémiologique. L’ordre de succession de ces catégories dans la table n’étant déterminé que par une convention de tri alphabétique ou un arbitrage de codage arbitraire, toute agrégation cumulée dépend de cet agencement subjectif et ne reflète aucune progression clinique réelle.
Le statisticien rigoureux doit donc s’astreindre à une vigilance constante : pour toute variable nominale, l’option NOCUM doit impérativement être déclarée au sein de l’instruction TABLES pour neutraliser l’affichage de ces colonnes et prévenir tout contresens d’interprétation chez les lecteurs finaux de l’étude.
12.2 Gestion rigoureuse du sur-échantillonnage et de la pondération d’enquête
Une confusion méthodologique fréquente concerne la distinction fondamentale entre l’instruction WEIGHT et l’instruction FREQ, ainsi que leurs limites face aux plans d’échantillonnage complexes. L’instruction FREQ exige impérativement des valeurs entières positives représentant un compte physique d’individus réels, tandis que l’instruction WEIGHT autorise l’utilisation de valeurs décimales continues pour pondérer chaque observation par un facteur de représentativité sociologique ou d’ajustement aux non-réponses.
Toutefois, mobiliser l’instruction WEIGHT au sein de la procédure PROC FREQ standard pour analyser des données issues d’une enquête complexe stratifiée avec sur-échantillonnage de sous-populations induit des biais d’inférence majeurs. En effet, PROC FREQ traite la somme des poids de sondage comme s’il s’agissait d’une taille d’échantillon empirique réelle issue d’un tirage aléatoire simple. Cette distorsion artificielle majore massivement les degrés de liberté, réduit indûment la variance d’échantillonnage et produit des p-values de test de Chi-deux artificiellement petites, exposant la recherche à un risque élevé de faux positifs.
Dès lors que les données sont issues d’un protocole d’échantillonnage probabiliste complexe comportant des grappes, des strates de stratification et des facteurs de pondération d’enquête, l’usage de PROC FREQ doit être proscrit au profit de sa déclinaison méthodologiquement adaptée : la procédure PROC SURVEYFREQ. Cette dernière intègre des algorithmes de linéarisation par séries de Taylor ou des techniques de rééchantillonnage (jackknife, bootstrap) pour estimer correctement la variance complexe et délivrer des tests statistiques valides.
12.3 Guide de rédaction standardisé des résultats selon les normes APA
La communication des analyses de fréquences dans les manuscrits scientifiques obéit aux exigences de formatage édictées par les normes de publication internationales, notamment celles de l’American Psychological Association (APA 7th edition). Ces standards visent à concilier une précision analytique absolue avec une sobriété visuelle facilitant la lecture critique par les pairs.
Dans le corps du texte, l’association d’un effectif absolu et d’une proportion relative s’exprime selon le standard typographique universel N (%). À titre d’exemple : « La cohorte comprenait une proportion notable de mères hispaniques, N = 22 139 (22,14 %), comparativement aux mères issues d’autres origines ». Notons que la lettre désignant la taille d’échantillon ou le sous-effectif s’inscrit impérativement en italique majuscule ou minuscule selon le contexte d’échantillonnage (N pour la cohorte intégrale, n pour une fraction sous-jacente de l’échantillon).
Pour la restitution d’un test d’indépendance du Chi-deux, le formatage canonique normalisé impose d’expliciter le symbole de la statistique en lettre grecque ou son abréviation stylisée en italique, suivi entre parenthèses du nombre de degrés de liberté et de l’effectif d’analyse total, avant de préciser la valeur empirique du test et le niveau exact de probabilité critique :
χ²(1, N = 100 000) = 485,32, p < ,001, V = ,07.
Les règles de l’APA proscrivent rigoureusement l’adjonction d’un zéro avant la virgule pour les probabilités critiques (p) et les coefficients de corrélation qui ne peuvent mathématiquement jamais excéder la valeur unitaire. Enfin, le chercheur évitera tout écueil de redondance : les valeurs documentées au sein d’un tableau synthétique synoptique ne doivent en aucun cas être réitérées exhaustivement dans le corps du texte narratif, ce dernier devant se focaliser exclusivement sur les enseignements cliniques majeurs et les contrastes épidémiologiques substantiels mis au jour par l’analyse.
Références
- Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Categorical+Data+Analysis%2C+3rd+Edition-p-9780470463635
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- SAS Institute Inc. (2021). Base SAS 9.4 procedures guide: Statistical procedures (5th ed.). SAS Institute Inc. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/procstat/procstat_freq_syntax01.htm
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Stokes, M. E., Davis, C. S., & Koch, G. G. (2012). Categorical data analysis using SAS (3rd ed.). SAS Institute Inc. https://support.sas.com/en/books/categorized-books/categorical-data-analysis-using-sas.html