
Dans le vaste champ de l’inférence statistique appliquée aux sciences empiriques, l’évaluation de la conformité entre des observations réelles et un modèle théorique préétabli constitue une démarche fondamentale. Qu’il s’agisse de vérifier si la répartition des naissances suit une régularité hebdomadaire stricte, de tester l’équilibre de transmission des allèles selon les lois mendéliennes ou de s’assurer de l’équiprobabilité de choix d’un consommateur face à un ensemble de stimuli, le chercheur se trouve confronté à la nécessité de valider des distributions multinomiales. C’est précisément à cette fin que Karl Pearson a élaboré en 1900 l’épreuve d’adéquation du khi-deux, une méthode non paramétrique devenue l’un des piliers de l’analyse quantitative moderne.
L’environnement logiciel SAS (Statistical Analysis System) offre une plateforme computationnelle d’une puissance et d’une rigueur exceptionnelles pour mettre en œuvre cette modélisation. Grâce à ses procédures hautement optimisées, notamment la procédure PROC FREQ, SAS permet non seulement d’exécuter des tests d’adéquation univariés sous une hypothèse d’équiprobabilité standard, mais aussi d’intégrer des grilles théoriques personnalisées asymétriques, de traiter des données pondérées à grande échelle et de générer des diagnostics exhaustifs sur les écarts observés. La maîtrise de ces instructions constitue un savoir-faire essentiel pour quiconque souhaite allier rigueur épistémologique et efficacité analytique dans le traitement de données qualitatives.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, biostatisticiens, data scientists et étudiants avancés dans l’apprentissage méthodique du test d’adéquation du khi-deux au sein de l’écosystème SAS. Depuis les fondements mathématiques et probabilistes sous-jacents jusqu’à la rédaction normalisée des résultats selon les standards académiques internationaux, chaque étape est disséquée avec précision. À travers une étude de cas concrète articulée autour de l’affluence de clients au cours d’une semaine commerciale, nous explorerons l’écriture du code, le décryptage des sorties analytiques, le calcul des tailles d’effet, le diagnostic des violations d’hypothèses et les stratégies d’optimisation syntaxique nécessaires à une pratique statistique sans faille.
1. Fondements théoriques et épistémologiques du test d’adéquation du khi-deux
1.1 Définition formelle et objet statistique de l’épreuve d’adéquation
Le test d’adéquation du khi-deux de Pearson, couramment désigné sous le terme anglo-saxon de Goodness of Fit Test, est une épreuve d’hypothèse non paramétrique conçue pour déterminer si la distribution de fréquences empiriques observée sur un échantillon d’unités statistiques concorde avec une distribution théorique ou attendue postulée a priori. Contrairement aux procédures d’analyse bivariées ou multivariées, ce test s’applique strictement à une seule variable qualitative discrète, qu’elle soit de nature nominale ou ordinale, partitionnée en un nombre fini de catégories disjointes. L’investigation porte sur l’ensemble de la variable considérée comme un système fermé d’événements élémentaires.
Sur le plan probabiliste, le mécanisme sous-jacent repose sur l’hypothèse que les observations recueillies sont issues d’un tirage aléatoire suivant une loi multinomiale caractérisée par un vecteur de probabilités théoriques. Chaque modalité de la variable possède une probabilité théorique d’occurrence désignée sous la notation conventionnelle pi. Dès lors que l’échantillon comprend un effectif total N, la fréquence absolue attendue pour chaque catégorie se déduit directement par le produit arithmétique de la taille de l’échantillon par la probabilité associée à cette catégorie. Le test procède ainsi à une confrontation terme à terme entre chaque fréquence observée et sa contrepartie théorique sous l’hypothèse de validité du modèle.
Il est impératif d’établir une différenciation épistémologique stricte entre le test d’adéquation univarié, le test d’indépendance du khi-deux et le test d’homogénéité. Tandis que le test d’adéquation confronte une variable unique à une norme probabiliste externe et fixe, le test d’indépendance croise deux variables qualitatives recueillies conjointement sur une population unique afin d’évaluer l’existence d’une association statistique. Enfin, le test d’homogénéité compare la distribution d’une variable qualitative à travers plusieurs sous-populations indépendantes prédéfinies. Bien que ces trois déclinaisons partagent un formalisme algébrique convergent fondé sur les écarts quadratiques, leurs implications méthodologiques, le calcul de leurs degrés de liberté et la structure des données d’entrée diffèrent fondamentalement.
1.2 Formulation mathématique de la statistique de test
La statistique de test proposée par Pearson repose sur la sommation pondérée des carrés des déviations entre les comptages empiriques observés, notés O pour Observed, et les effectifs théoriques attendus, notés E pour Expected. L’expression générale s’énonce comme la somme, étendue à l’ensemble des k modalités de la variable, du quotient de la différence au carré entre l’effectif observé et l’effectif théorique par l’effectif théorique correspondant. Cette division normalisatrice confère à chaque écart quadratique une dimension relative à l’importance théorique de la classe, évitant ainsi que les modalités dotées d’effectifs massifs ne dominent artificiellement le résultat global.
Chaque terme composant cette sommation constitue un écart quadratique réduit élémentaire. Lorsque la taille de l’échantillon tend vers l’infini, la distribution d’échantillonnage de cette somme de variables aléatoires converge en loi vers la distribution continue théorique du khi-deux. Cette propriété remarquable découle directement de l’application du théorème central limite aux composantes multinomiales normalisées. Ainsi, sous l’hypothèse nulle d’adéquation parfaite, la statistique empirique calculée se comporte asymptotiquement comme une variable aléatoire gouvernée par une loi de densité paramétrée par son nombre de degrés de liberté.
La détermination du nombre de degrés de liberté, communément abrégé sous le sigle DDL ou DF pour Degrees of Freedom, obéit à une règle arithmétique rigide. Dans la configuration classique où la distribution théorique est intégralement spécifiée ex nihilo sans nécessiter l’estimation préalable de paramètres à partir de l’échantillon, le nombre de degrés de liberté est égal au nombre de catégories k diminué d’une unité, soit k moins un. Cette perte d’un degré de liberté reflète la contrainte linéaire universelle stipulant que la somme des effectifs attendus doit impérativement égaler la taille totale de l’échantillon N. Si, dans des applications plus complexes, m paramètres distributionnels doivent être estimés à partir des données observées (comme la moyenne d’une loi de Poisson discrétisée), le nombre de degrés de liberté résiduels s’établit formellement à k moins un moins m.
1.3 Pertinence méthodologique en sciences du comportement et psychologie
Dans le champ des sciences comportementales, de la psychologie cognitive et de la recherche clinique, le test d’adéquation du khi-deux répond à des exigences méthodologiques de premier ordre. Une première application majeure réside dans la vérification de l’équiprobabilité ou de l’uniformité des préférences au sein de protocoles de choix forcé. Lorsqu’un chercheur soumet des participants à k stimuli visuels, auditifs ou gustatifs concurrents sans incitation préalable, l’hypothèse nulle postule une indifférence cognitive se traduisant par une distribution uniforme où chaque stimulus a une probabilité égale d’être sélectionné. L’épreuve de Pearson permet de rejeter formellement l’équiprobabilité et d’attester de l’existence d’un biais attentionnel ou perceptif structurel.
Une seconde fonction méthodologique cruciale concerne le contrôle de l’équilibre des procédures de randomisation au sein d’essais contrôlés randomisés. Lorsqu’un protocole assigne séquentiellement des sujets à différents groupes expérimentaux (par exemple, bras contrôle, traitement actif standard et traitement innovant), il est indispensable de s’assurer a posteriori que l’assignation aléatoire n’a pas introduit de biais d’allocation disproportionné entre les cohortes. Le test d’adéquation permet de valider empiriquement que les proportions observées d’individus assignés à chaque condition expérimentale ne s’écartent pas de manière statistiquement significative des ratios d’allocation prévus par le protocole initial.
Enfin, en psychométrie et en sociologie quantitative, cette technique intervient de façon systématique pour s’assurer de la représentativité d’un échantillon d’enquête vis-à-vis d’une population cible connue. Lorsque les données de recensement national fournissent la répartition exacte de la population générale selon des critères sociodémographiques clés, tels que les catégories socio-professionnelles ou le niveau d’éducation, l’adéquation du khi-deux permet de vérifier formellement que l’échantillon stratifié recruté reflète fidèlement la structure sociologique parente. Tout écart significatif imposera alors l’application de coefficients de pondération corrective avant toute généralisation des conclusions cliniques ou psychométriques.
2. Hypothèses statistiques et conditions d’application préalables
2.1 Exigences relatives à l’échantillonnage et aux effectifs théoriques
La validité des conclusions issues d’un test d’adéquation du khi-deux repose sur le strict respect de conditions d’application probabilistes fondamentales. Au premier rang de ces exigences figure l’indépendance mutuelle absolue de l’ensemble des observations composant l’échantillon. Chaque unité d’observation ne doit contribuer qu’une seule et unique fois à une seule et unique catégorie du tableau de fréquences. Les plans de mesures répétées, les données appariées ou les situations où un même sujet est évalué longitudinalement à plusieurs reprises violent délibérément cette hypothèse et requièrent des modélisations alternatives adaptées, à l’instar du test de McNemar ou des équations d’estimation généralisées.
La seconde condition incontournable concerne la magnitude des effectifs attendus sous l’hypothèse nulle. Dans la mesure où la loi continue du khi-deux ne constitue qu’une approximation asymptotique de la distribution multinomiale discrète sous-jacente, cette convergence n’est satisfaisante que si les effectifs théoriques sont suffisamment volumineux. Le critère le plus largement accepté dans la communauté statistique est la règle empirique de William Cochran : pour un test d’adéquation comportant plus de deux modalités, aucun effectif théorique ne doit être inférieur à un, et au moins 80 pour cent des catégories doivent présenter un effectif théorique supérieur ou égal à cinq. Dans le cas particulier où la variable ne comporte que deux catégories (un degré de liberté), tous les effectifs théoriques doivent obligatoirement dépasser le seuil de cinq.
La méconnaissance ou la violation de ces conditions relatives aux effectifs attendus produit une distorsion sévère du taux d’erreur de première espèce, noté alpha. Lorsque les effectifs théoriques sont excessivement faibles, la variance de la statistique de Pearson subit une inflation disproportionnée, conduisant fréquemment à des rejets abusifs de l’hypothèse nulle alors même que celle-ci est vérifiée dans la population parente. Pour remédier à cette vulnérabilité avant de procéder aux calculs d’inférence, le statisticien peut envisager deux approches : le regroupement logique de modalités adjacentes ou, plus rigoureusement dans SAS, l’abandon de l’approximation asymptotique au profit du calcul des distributions d’échantillonnage exactes.
2.2 Nature et échelle de mesure des variables étudiées
L’application rigoureuse de l’épreuve d’adéquation impose une réflexion approfondie sur la nature ontologique et l’échelle métrologique de la variable examinée. Le système de classification adopté doit satisfaire deux principes logiques invariables : les catégories doivent être mutuellement exclusives, interdisant à un individu statistique d’appartenir simultanément à plus d’une modalité, et collectivement exhaustives, garantissant que chaque unité observée trouve sans ambiguïté sa place au sein du système de classification proposé. L’omission d’une catégorie potentielle vicie irrémédiablement l’estimation de l’effectif global N et fausse l’intégralité du calcul des probabilités théoriques.
Bien que le test s’adresse nativement aux variables qualitatives nominales pures (telles que le groupe sanguin, l’appartenance géographique ou la typologie de diagnostic psychopathologique), il est régulièrement employé sur des variables qualitatives ordinales ou des variables quantitatives continues discrétisées en classes d’amplitudes définies. Dans ce dernier cas, une vigilance accrue s’impose. L’épreuve d’adéquation standard de Pearson est par nature omnibus : elle évalue une déviation globale par rapport au modèle sans tenir compte de l’ordre hiérarchique intrinsèque existant entre les modalités ordinales. Dès lors, le test omnibus peut s’avérer sous-optimal en termes de puissance statistique si la déviation empirique suit une tendance directionnelle monotone ordonnée.
Par ailleurs, la transformation d’une échelle continue en variable catégorielle expose l’analyse au risque majeur de biais d’agrégation. Le choix arbitraire des bornes de découpage des classes peut masquer des hétérogénéités internes substantielles ou, à l’inverse, fabriquer artificiellement des écarts distributionnels factices. Dès lors qu’une variable quantitative fait l’objet d’un découpage catégoriel, le statisticien doit justifier le choix des intervalles sur des critères théoriques éprouvés ou recourir à des tests d’adéquation spécifiques aux variables continues, à l’instar des tests de Kolmogorov-Smirnov, de Cramer-von Mises ou d’Anderson-Darling disponibles au sein de la procédure PROC UNIVARIATE de SAS.
2.3 Énoncé rigoureux des hypothèses nulle (H0) et alternative (H1)
Toute démarche d’inférence statistique nécessite la formalisation explicite et univoque d’un couple d’hypothèses rivales. L’hypothèse nulle, canoniquement notée H0, formalise l’énoncé de conformité absolue selon lequel la distribution des probabilités multinomiales dans la population cible coïncide rigoureusement avec la distribution théorique spécifiée par le modèle d’intérêt. Dans sa déclinaison la plus élémentaire, celle de l’équiprobabilité uniforme, H0 postule que la probabilité d’occurrence p1 est égale à p2, elle-même égale à l’ensemble des k probabilités, soit exactement la fraction un sur k pour chaque modalité.
Cependant, l’hypothèse nulle ne se limite nullement au cas de l’uniformité. Elle peut spécifier un vecteur probabiliste hautement asymétrique issu d’un cadre théorique déterministe, d’une série chronologique historique ou d’un modèle mathématique spécifique. Par exemple, sous l’hypothèse de transmission génétique mendélienne lors d’un croisement dihybride, H0 formulera que les quatre phénotypes résultants respectent scrupuleusement les probabilités proportionnelles respectives de neuf seizièmes, trois seizièmes, trois seizièmes et un seizième. Quelle que soit la complexité de ce vecteur, la somme des probabilités théoriques articulées sous H0 doit obligatoirement être égale à l’unité.
À l’opposé, l’hypothèse alternative, désignée par H1, adopte une nature omnibus et non directionnelle. Elle énonce simplement qu’au moins l’une des probabilités empiriques de la population dévie de la probabilité théorique postulée sous H0. Il ne s’agit donc pas d’une hypothèse unilatérale prédisant le sens de l’écart sur une modalité ciblée, mais d’une hypothèse bilatérale globale attestant de la rupture de l’adéquation générale du modèle. La décision statistique s’opère par le calcul de la probabilité critique p-valeur sous la distribution du khi-deux à k moins un degrés de liberté. En psychologie expérimentale et dans les sciences sociales, le seuil de signification conventionnel alpha est traditionnellement fixé à 0,05, déterminant une zone de rejet critique au-delà de laquelle la discordance entre données empiriques et prédictions théoriques ne peut raisonnablement plus être attribuée aux seules fluctuations d’échantillonnage aléatoire.
3. Préparation et structuration de l’environnement de travail dans SAS
3.1 Organisation de la session SAS et configuration des bibliothèques
Une mise en œuvre rigoureuse d’analyses quantitatives sous SAS requiert une organisation méthodique de l’espace de travail et la configuration préliminaire des paramètres d’environnement. Le moteur SAS repose sur une architecture duale distinguant la bibliothèque de travail temporaire, universellement nommée WORK, des bibliothèques d’archivage permanentes. Toutes les tables de données allouées au sein de la bibliothèque WORK sont automatiquement purgées à la clôture de la session logicielle. Pour des projets d’envergure nécessitant la pérennité et la traçabilité des manipulations, il est indispensable de formaliser l’assignation d’une bibliothèque permanente à l’aide de l’instruction LIBNAME, reliant un alias SAS à un répertoire physique sécurisé du système d’exploitation.
En amont de toute exécution statistique, il est fortement conseillé de calibrer les options globales d’affichage à l’aide de l’instruction OPTIONS. Des paramètres tels que LINESIZE=120 et PAGESIZE=60 permettent de contraindre la largeur et la longueur des sorties textuelles imprimées dans le journal ou l’afficheur SAS, évitant ainsi les coupures de lignes inopportunes dans les tableaux statistiques volumineux. De surcroît, l’adjonction des paramètres NODATE et NONUMBER permet d’épurer les bordures de documents des horodatages et des numérotations automatiques, garantissant une meilleure lisibilité pour l’intégration ultérieure dans des rapports scientifiques institutionnels.
Enfin, l’architecture moderne de SAS tire parti du système de diffusion ODS, signifiant Output Delivery System. L’environnement ODS intercepte l’ensemble des résultats bruts générés par les procédures de calcul pour les convertir en sorties graphiques, tabulaires ou paginées dans une vaste gamme de formats standardisés (tels que HTML, PDF, RTF ou feuilles de calcul XML). L’activation méthodique de l’instruction ODS LISTING CLOSE couplée à l’ouverture sélective de destinations vectorielles ou typographiques permet au chercheur de maîtriser intégralement la restitution visuelle de ses tableaux de contingence univariés et d’assurer une mise en page impeccable des résultats statistiques.
3.2 Différenciation des formats d’entrée : données brutes versus données agrégées
L’ingénierie des données sous SAS s’articule autour de deux structures matricielles fondamentales pour l’évaluation des distributions catégorielles : le format des données individuelles non consolidées (données brutes) et le format des données synthétiques agrégées (données de comptage). Comprendre les propriétés formelles de ces deux configurations est primordial pour configurer adéquatement les procédures d’analyse sous-jacentes et optimiser les ressources de traitement de la machine.
Le format de données brutes représente la forme d’enregistrement la plus immédiate en sortie de recueil d’enquête ou d’expérimentation clinique. Dans ce schéma structurel, chaque observation physique (un individu, un patient, un client) occupe une ligne distincte au sein de la table SAS. La variable catégorielle d’intérêt figure sous forme d’une colonne unitaire contenant le label textuel ou le code numérique identifiant la modalité observée pour cette unité spécifique. Si une étude porte sur un échantillon de dix mille participants, la table de données comportera rigoureusement dix mille observations. Bien que très intuitif, ce schéma peut engendrer une consommation substantielle de mémoire vive et ralentir les cycles d’écriture sur disque lorsque les effectifs atteignent des ordres de grandeur massifs.
À l’inverse, le format de données agrégées procède à une compression substantielle de l’information préalable à l’analyse. Dans cette modélisation, la table SAS ne contient qu’exactement autant de lignes qu’il existe de modalités disjointes k au sein de la variable catégorielle. Une première colonne conserve la nomenclature des catégories, tandis qu’une seconde colonne de nature quantitative accueille les effectifs absolus cumulés constatés sur l’ensemble de l’échantillon pour chacune desdites catégories. Comme nous le détaillerons dans les sections suivantes, l’exploitation d’une table agrégée dans SAS impose l’utilisation explicite de l’instruction WEIGHT dans la procédure PROC FREQ afin d’indiquer au compilateur que chaque ligne représente une répétition multiple et non une unité d’échantillonnage singulière.
4. Étape 1 : Création et importation de la table de données SAS
4.1 Implémentation de l’étape DATA pour le jeu de données d’exemple
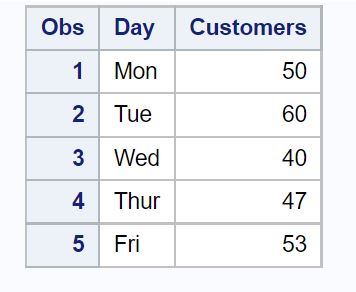
Afin de concrétiser l’ensemble de la démarche méthodologique sur un cas empirique représentatif, nous allons formaliser une étude portant sur les variations hebdomadaires d’affluence au sein d’une enseigne de commerce de détail. Le gestionnaire de l’établissement postule historiquement une répartition équiprobable de ses clients du lundi au vendredi, supposant que le flux d’acheteurs demeure uniforme au cours des jours ouvrés. Sur une semaine spécifique d’observation, un comptage exhaustif a recensé un effectif total de 200 clients, répartis comme suit : 50 clients le lundi, 60 le mardi, 40 le mercredi, 47 le jeudi et 53 le vendredi. Nous adoptons ici un schéma de données agrégées particulièrement compact.
L’initialisation de ce jeu de données s’opère dans SAS au moyen de l’étape DATA élémentaire. L’instruction d’ouverture DATA suivie de l’identifiant my_data instancie la création d’une nouvelle table au sein de l’espace de travail WORK. Immédiatement après, l’instruction INPUT spécifie le modèle de lecture des colonnes. Afin de lire le jour de la semaine sous forme de chaîne de caractères alphanumériques, le nom de variable Day est suivi du modificateur dollar ($). La seconde variable, nommée Customers, n’est suivie d’aucun caractère spécial, signalant au compilateur SAS son statut de variable quantitative numérique continue.
La transmission directe des valeurs s’opère par l’instruction DATALINES (ou son équivalent sémantique CARDS), suivie immédiatement par les enregistrements séquentiels combinant jour et effectif, chaque ligne étant scrupuleusement terminée par un retour chariot. Le bloc de données se clôture de façon impérative par une ligne isolée contenant un point-virgule terminal, suivie de l’instruction RUN. Cette dernière constitue le point de synchronisation fondamental qui déclenche formellement la phase de compilation et d’exécution séquentielle de l’étape DATA par le superviseur SAS, générant une table en mémoire parfaitement calibrée pour les étapes procédurales ultérieures.
4.2 Examen et vérification structurelle via la procédure PROC PRINT
Une règle cardinale de la pratique statistique sous SAS stipule qu’aucune modélisation inférentielle ne doit être exécutée sans un audit visuel préalable de la structure interne des données importées. La procédure la plus directe pour accomplir ce contrôle qualité élémentaire est la procédure PROC PRINT. L’invocation d’un bloc simple constitué des instructions proc print data=my_data; run; déclenche l’affichage exhaustif des lignes de la table courante dans la fenêtre de sortie ODS active.
Cet examen préliminaire a pour premier objet de valider l’absence totale de valeurs manquantes (valeurs désignées sous SAS par un point pour les données numériques ou un espace vide pour les données caractères). La présence fortuite d’une modalité non renseignée dans la colonne Day ou d’un effectif absent au sein de la variable Customers conduirait à l’exclusion silencieuse de la ligne concernée lors de l’exécution de PROC FREQ, introduisant une distorsion catastrophique dans l’effectif global N et compromettant la pertinence mathématique du test d’adéquation.
Par ailleurs, la procédure PROC PRINT permet de confirmer que les catégories textuelles ont été intégrées sans altération de casse ni d’espacement involontaire. Dans SAS, une chaîne de caractères telle que « Lundi » contenant une espace finale parasite serait traitée par l’interpréteur comme une modalité distincte de la chaîne standard « Lundi », conduisant à la création factice d’une sixième modalité au lieu des cinq attendues. Cet examen rapide du journal d’exécution (SAS LOG) et de la table imprimée garantit l’intégrité nominale absolue du support analytique avant toute inférence statistique.
4.3 Alternatives d’acquisition de données externes dans SAS
Dans la pratique contemporaine de l’analyse de données, les praticiens sont fréquemment amenés à manipuler des volumes d’information substantiellement plus imposants que ceux autorisés par une saisie directe via l’instruction DATALINES. SAS propose une suite d’utilitaires hautement performants pour importer des fichiers de données stockés sous des formats externes standardisés, au premier rang desquels figurent les formats délimités par des virgules ou points-virgules (fichiers CSV) et les classeurs tabulaires Microsoft Excel (fichiers XLSX).
La méthode canonique d’ingestion automatisée de fichiers externes repose sur l’utilisation de la procédure PROC IMPORT. Cette procédure autonome analyse dynamiquement les premières lignes du fichier source afin d’en déduire automatiquement la structure des colonnes, le délimiteur de champs, ainsi que les types informatiques (numériques ou alphanumériques). Lors de l’importation de fichiers CSV ou XLSX contenant des variables qualitatives destinées à un test d’adéquation, il convient de porter une attention scrupuleuse à l’option GUESSINGROWS. En paramétrant cette option à sa valeur maximale (GUESSINGROWS=MAX), le chercheur contraint SAS à sonder l’intégralité du fichier externe plutôt que de borner son analyse aux vingt premières lignes, éliminant ainsi le risque d’une troncature accidentelle de la longueur des libellés de catégories.
Après chaque exécution de la procédure PROC IMPORT, une inspection approfondie du journal d’exécution (SAS LOG) demeure indispensable. Le statisticien doit vérifier avec acuité l’absence de tout message de type WARNING ou NOTE signalant des conversions de type erronées ou des pertes de précision numérique. La validation des longueurs de chaînes assignées par défaut (longueur $CHAR) s’avère critique : si un label de modalité dépasse la longueur allouée, SAS opère une troncature silencieuse qui pourrait fusionner accidentellement deux modalités conceptuellement distinctes présentant un préfixe textuel similaire.
5. Exploration descriptive initiale et validation des données d’échantillon
5.1 Calcul préalable des paramètres descriptifs élémentaires
Préalablement au déclenchement des mécanismes d’inférence probabiliste, la démarche méthodologique impose une exploration descriptive exhaustive de la distribution d’échantillon. Cette phase a pour premier objectif d’établir l’effectif cumulé total N par la sommation arithmétique des effectifs observés au sein des différentes classes. Dans notre exemple commercial, la somme des clients comptabilisés du lundi au vendredi (50 + 60 + 40 + 47 + 53) s’établit rigoureusement à un total général de N = 200 individus statistiques.
À partir de cet effectif global, le calcul de la moyenne arithmétique théorique par cellule s’impose sous le modèle d’équiprobabilité uniforme. La division de la taille de l’échantillon par le nombre de modalités k (soit 200 divisé par 5) détermine une fréquence théorique attendue uniforme d’exactement 40 clients par jour. La confrontation descriptive primaire entre les effectifs empiriques et cette valeur de référence révèle immédiatement des déviations : le mercredi coïncide rigoureusement avec l’attente théorique (40 clients), tandis que le mardi affiche un excédent notable de 20 clients (soit 60 observés), et le lundi un surplus de 10 clients (50 observés). Le jeudi (47) et le vendredi (53) se positionnent également au-dessus de la ligne théorique de base.
L’évaluation de la dispersion brute des effectifs autour de la moyenne théorique fournit une première indication heuristique sur le degré de divergence globale du système. Le calcul des écarts simples (O moins E) et de la variance inter-catégories permet au chercheur d’anticiper si les déviations constatées relèvent d’un bruit stochastique modéré, intrinsèque à tout échantillonnage aléatoire, ou si la dispersion suggère une asymétrie substantielle méritant un test formel d’adéquation avec une probabilité critique élevée de rejet.
5.2 Représentation graphique exploratoire dans SAS
L’exploration visuelle des profils catégoriels constitue une étape d’une importance diagnostique majeure. Au sein de SAS, le module ODS Graphics met à disposition des chercheurs la procédure PROC SGPLOT, un outil graphique de pointe doté d’une syntaxe déclarative élégante et d’une précision de rendu irréprochable. Pour représenter adéquatement des données de fréquences pondérées, l’utilisation conjointe de l’instruction VBAR et de l’option RESPONSE s’avère particulièrement appropriée.
Dans un script dédié, l’appel à la procédure proc sgplot data=my_data; couplé à l’instruction vbar Day / response=Customers; permet d’ériger un diagramme en bâtons vertical restituant fidèlement l’amplitude des effectifs pour chaque jour de la semaine. Pour enrichir la portée analytique de cette visualisation, l’intégration de l’instruction REFLINE permet de tracer une ligne horizontale de référence traversant le graphique à la coordonnée y=40, matérialisant visuellement le seuil théorique d’équiprobabilité attendu sous l’hypothèse nulle.
Une telle construction visuelle permet au statisticien d’identifier instantanément la géométrie des déviations distributionnelles. Les barres s’élevant nettement au-dessus de la ligne de référence, à l’instar de celle du mardi, signalent des foyers d’affluence préférentielle, tandis que l’alignement strict du mercredi sur le seuil théorique illustre une adéquation locale parfaite. Cette contextualisation graphique préliminaire facilite grandement l’interprétation ultérieure des résidus standardisés et protège l’analyste contre les conclusions hâtives déconnectées de la réalité matérielle des données.
6. Étape 2 : Exécution de la procédure PROC FREQ pour le test d’adéquation
6.1 Structure fondamentale de l’instruction PROC FREQ
Le cœur computationnel du traitement des tables de contingence et des distributions de fréquences univariées dans SAS réside dans la célèbre procédure PROC FREQ. Cette procédure générale d’analyse non paramétrique propose une panoplie d’outils statistiques allant des simples comptages combinatoires jusqu’aux tests d’association les plus sophistiqués. Pour initier un test d’adéquation du khi-deux, la syntaxe commence par l’instruction maîtresse proc freq data=my_data;, désignant formellement la table source devant faire l’objet des calculs.
L’instruction TABLES constitue la directive opérationnelle centrale au sein de PROC FREQ. Elle assigne le rôle statistique des variables et spécifie la structure du tableau à construire. Dans le cadre d’un test d’adéquation univarié, la syntaxe requiert la déclaration du nom de la variable catégorielle unique d’étude, sans croisement bidimensionnel, sous la forme directe tables Day;. Cette directive intime à SAS l’ordre de ventiler les observations à travers l’ensemble des modalités exhaustives contenues dans la variable Day.
Comme pour tout bloc procédural SAS, la séquence syntaxique se termine obligatoirement par l’instruction RUN, suivie d’un point-virgule terminal. Dès la détection de cette instruction par le compilateur, la procédure alloue les vecteurs de travail en mémoire vive, extrait les données de la table spécifiée, procède au tri interne des modalités et génère les tables de fréquences primaires selon les directives configurées. En l’absence de toute option additionnelle, PROC FREQ produira un tableau univarié descriptif comprenant les effectifs bruts, les pourcentages relatifs, ainsi que les fréquences et pourcentages cumulés.
6.2 Rôle crucial de la clause CHISQ sur l’instruction TABLES
Par défaut, l’instruction TABLES d’une procédure PROC FREQ se limite à une restitution purement descriptive de la distribution d’échantillon. Pour basculer d’une simple tabulation vers une démarche d’inférence statistique et forcer le calcul de l’épreuve d’adéquation de Pearson, le chercheur doit obligatoirement adjoindre l’option CHISQ après une barre oblique de séparation sur l’instruction TABLES, adoptant ainsi la formulation canonique tables Day / chisq;.
L’adjonction de ce modificateur CHISQ déclenche une transformation radicale du moteur d’évaluation de SAS. Pour une analyse à une seule dimension (une variable univariée), SAS interprète automatiquement l’option CHISQ non pas comme un test d’indépendance bivarié, mais spécifiquement comme un test d’adéquation du khi-deux (One-Way Chi-Square Goodness of Fit Test). Sous son paramétrage standard, le logiciel postule automatiquement une hypothèse nulle d’équiprobabilité stricte entre toutes les modalités détectées dans la table.
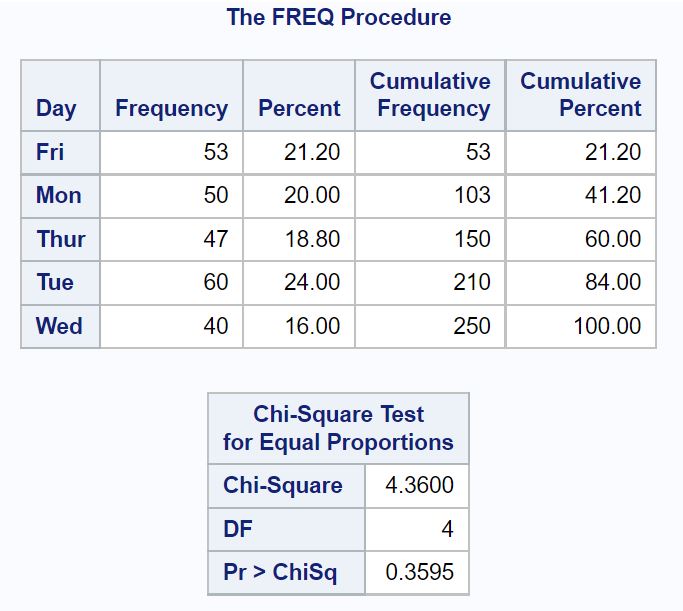
Le moteur génère alors deux objets de sortie distincts et hautement structurés au sein du rapport ODS. D’une part, il enrichit le tableau de fréquences principal d’un bloc diagnostique détaillant la fréquence théorique attendue pour chaque classe, ainsi que la contribution locale de chaque modalité à la statistique globale. D’autre part, il produit un tableau synthétique dédié, titré Chi-Square Test for Equal Proportions, qui restitue la valeur numérique exacte de la statistique de Pearson, les degrés de liberté associés, la probabilité critique p-valeur correspondante, ainsi que la statistique alternative du rapport de vraisemblance (Likelihood Ratio Chi-Square).
6.3 Pondération des catégories via l’instruction WEIGHT
L’utilisation de données agrégées impose l’adjonction d’une directive syntaxique supplémentaire sans laquelle l’intégralité des calculs statistiques s’avérerait fausse : l’instruction WEIGHT. Dans notre table de travail my_data, chaque jour de la semaine n’est matérialisé que par une seule ligne physique dans la structure SAS. Si la procédure PROC FREQ était exécutée directement sans instruction de pondération, le logiciel traiterait chaque ligne comme représentant un unique individu statistique, concluant erronément à un échantillon global de N = 5 clients avec un client pour chaque jour ouvré.
Pour contourner cet écueil et restituer la volumétrie réelle de l’échantillon d’enquête, l’instruction weight Customers; doit être impérativement insérée entre la déclaration de procédure et l’instruction RUN. Le mot-clé WEIGHT instruit SAS de considérer la variable Customers comme une fréquence de répétition exacte pour chaque ligne correspondante. Dans le traitement mathématique sous-jacent, le compilateur multiplie virtuellement chaque enregistrement par la valeur entière de son poids, reconstituant ainsi instantanément la distribution des 200 clients observés.
Il importe de distinguer l’instruction WEIGHT de l’instruction alternative FREQ au sein de SAS. Bien que dans le cadre d’entiers positifs stricts comme nos effectifs de comptage, WEIGHT et FREQ aboutissent à des estimations numériques rigoureusement identiques pour le test du khi-deux, l’instruction FREQ tronque par convention les nombres à leur partie entière et rejette strictement les valeurs négatives ou nulles. L’instruction WEIGHT, quant à elle, tolère les pondérations fractionnaires dans d’autres procédures modélisatrices, bien que PROC FREQ impose une troncature entière pour le calcul probabiliste exact de Pearson. Dans le contexte des tables de fréquences univariées agrégées, l’usage de WEIGHT Customers ou de FREQ Customers constitue donc la norme programmatique incontournable.
7. Décryptage approfondi de la syntaxe SAS : TABLES, CHISQ et WEIGHT
7.1 Paramétrage des options d’affichage de tableaux dans PROC FREQ
L’affichage par défaut de la procédure PROC FREQ est conçu pour être exhaustif, présentant pour chaque cellule l’effectif absolu, le pourcentage relatif par rapport à la taille totale N, ainsi que les fréquences et pourcentages cumulés. Si cette richesse descriptive s’avère utile lors des phases de débogage préliminaire, elle surcharge inutilement les rapports de recherche finaux et complique l’extraction rapide de l’information statistique pertinente. SAS met à disposition une suite d’options de masquage sélectif permettant d’élaguer les tableaux de sortie.
En enrichissant l’instruction TABLES des options NOPERCENT et NOCUM (par exemple, tables Day / chisq nopercent nocum;), le statisticien désactive immédiatement la production des pourcentages globaux et des lignes de cumul progressif. La table résultante n’affiche plus que les effectifs observés, les effectifs attendus sous l’hypothèse nulle et les contributions quadratiques associées, ce qui clarifie considérablement la restitution tabulaire pour les comités de lecture académiques ou les présentations managériales.
Un autre paramètre déterminant réside dans l’instruction de tri ORDER= configurée directement sur l’en-tête PROC FREQ. Par défaut, SAS ordonne les modalités des variables alphanumériques selon l’ordre alphabétique standard de leurs valeurs formatées (ce qui placerait pour notre exemple : Jeudi, Lundi, Mardi, Mercredi, Vendredi). Cet agencement arbitraire brise la continuité chronologique naturelle de la semaine commerciale. En spécifiant l’option proc freq data=my_data order=data;, le statisticien force SAS à traiter et afficher les catégories strictement selon leur ordre d’apparition séquentiel dans la table de données d’origine, restaurant ainsi la cohérence logique du flux hebdomadaire.
7.2 Contrôle des décimales et formatage des tables de sortie
La présentation professionnelle des résultats statistiques requiert un contrôle strict du formatage typographique des valeurs affichées, notamment en matière de décimales pour les effectifs attendus et les probabilités critiques. L’intégration de la procédure PROC FORMAT permet de définir des dictionnaires de formats personnalisés que l’on applique ensuite aux variables à l’aide de l’instruction FORMAT au sein de PROC FREQ, garantissant une harmonisation parfaite des désignations catégorielles.
Pour aller plus loin dans la maîtrise des sorties et s’affranchir de l’encombrement des rapports bruts, le système ODS de SAS déploie une puissance de ciblage chirurgicale au travers des instructions ODS SELECT et ODS OUTPUT. Chaque tableau produit par une procédure SAS possède un nom interne standardisé (un objet ODS). Dans le cadre d’un test d’adéquation univarié sous PROC FREQ, le tableau principal de comptage porte le nom OneWayFreqs, tandis que le tableau des statistiques inférentielles du test s’intitule OneWayChiSq.
En insérant l’instruction ods select OneWayChiSq; en amont de l’appel procédural, le praticien contraint SAS à occulter totalement les tableaux de fréquences descriptives pour ne restituer à l’écran que le bloc décisionnel contenant la statistique du khi-deux et sa p-valeur. De surcroît, l’instruction ods output OneWayChiSq=work.mes_statistiques; permet d’exporter directement les métriques calculées dans une table SAS pérenne. Cette fonctionnalité ouvre la voie à une automatisation complète des calculs ultérieurs, tels que l’extraction programmatique de la statistique du khi-deux pour alimenter des algorithmes de calcul de taille d’effet ou des chaînes d’intégration continue de rapports automatisés.
8. Définition de distributions théoriques personnalisées avec l’option TESTP
8.1 Sortir de l’hypothèse d’équiprobabilité par défaut
Bien que l’hypothèse nulle d’uniformité (équiprobabilité) constitue la configuration par défaut de l’option CHISQ dans PROC FREQ, de nombreuses problématiques scientifiques et expérimentales imposent de confronter la distribution empirique à des modèles théoriques asymétriques. L’hypothèse de proportions égales ne reflète en effet qu’un cas particulier du test d’adéquation univarié. Dans une pluralité de contextes empiriques, les probabilités théoriques attendues sous H0 résultent d’un étalonnage préalable, de distributions démographiques nationales ou de prédictions formelles dérivées de corpus théoriques spécifiques.
Considérons, à titre d’illustration, une modélisation épidémiologique où la vulnérabilité à une affection clinique est supposée se distribuer de manière hétérogène à travers trois classes d’âge : les jeunes adultes (probabilité attendue de 20 pour cent), les adultes d’âge moyen (50 pour cent) et les seniors (30 pour cent). Soumettre un échantillon de patients à un test d’équiprobabilité attribuant un tiers des observations à chaque groupe constituerait une erreur méthodologique rédhibitoire qui masquerait la véritable nature des divergences cliniques observées.
Pour adresser ces situations complexes, SAS intègre un mécanisme de paramétrage explicite des probabilités théoriques. Il permet au chercheur d’abandonner l’équiprobabilité standard pour injecter son propre vecteur probabiliste. Ce mécanisme transforme PROC FREQ en un instrument d’évaluation d’une souplesse absolue, apte à vérifier l’adéquation de n’importe quel modèle discret univarié issu de la théorie des probabilités ou de l’expérimentation de terrain.
8.2 Syntaxe pratique et règles d’utilisation de TESTP=(…)
L’opérationnalisation d’une distribution théorique personnalisée dans PROC FREQ s’effectue au moyen de l’option TESTP=(…), directement greffée sur l’instruction TABLES en complément de l’option CHISQ. La syntaxe générale prend la forme tables MaVariable / chisq testp=(p1, p2, …, pk);, où les valeurs pi représentent les pourcentages théoriques postulés pour chaque niveau successif de la variable d’étude.
L’utilisation de l’option TESTP obéit à deux règles syntaxiques et mathématiques absolues imposées par le compilateur SAS. La première contrainte stipule que la sommation de l’ensemble des proportions spécifiées entre parenthèses doit être rigoureusement égale à 100 si l’on emploie des pourcentages, ou à 1 si l’on renseigne des fractions probabilistes décimales. Tout écart par rapport à cette somme unitaire entraîne l’interruption immédiate de l’exécution procédurale avec inscription d’un message d’erreur bloquant dans le journal SAS LOG.
La seconde règle, source fréquente d’erreurs méthodologiques chez les praticiens non avertis, concerne l’alignement séquentiel des probabilités. SAS assigne les valeurs du vecteur TESTP aux modalités de la variable d’intérêt selon l’ordre interne de tri de ces modalités au sein de la procédure. Dès lors, si la procédure fonctionne sous son ordre de tri alphabétique par défaut, la première proportion p1 sera inévitablement affectée à la modalité apparaissant en premier par ordre alphabétique, et non à celle apparaissant en tête de la table de données brute. Pour éviter toute inversion dramatique d’attribution probabiliste, il est vivement recommandé de combiner l’option ORDER=DATA avec TESTP=(…) ou de valider avec une rigueur absolue la concordance entre la séquence des proportions déclarées et l’ordre d’affichage des modalités dans le tableau descriptif produit par SAS.
8.3 Application à un cas asymétrique en psychologie expérimentale
Pour illustrer la mise en œuvre empirique de distributions asymétriques, considérons une étude en neuro-ergonomie comportementale examinant le temps de réaction des opérateurs face à trois interfaces visuelles d’alerte : l’interface Alpha, l’interface Bêta et l’interface Gamma. La littérature théorique et les modèles biomécaniques de saillance sensorielle prédisent que, sous des conditions d’attention standardisées, les opérateurs devraient orienter préférentiellement leur premier regard vers Alpha dans 50 pour cent des cas, vers Bêta dans 35 pour cent des situations, et vers Gamma dans seulement 15 pour cent des occurrences.
L’échantillon expérimental recueilli auprès de 100 participants rapporte une distribution empirique constatant 45 sélections pour Alpha, 40 sélections pour Bêta et 15 sélections pour Gamma. L’instruction SAS dédiée s’articulera sous la forme tables Interface / chisq testp=(50, 35, 15); en s’assurant préalablement que les interfaces sont triées dans l’ordre Alpha, Bêta, puis Gamma. Lors de l’exécution, SAS calcule les effectifs attendus sous H0 en appliquant ces ratios spécifiques à la taille N (soit respectivement 50, 35 et 15 sujets attendus).
La confrontation entre les effectifs observés (45, 40, 15) et attendus (50, 35, 15) génère alors une statistique de Pearson reflétant strictement l’écart au modèle de saillance théorique. En comparant les résultats de cette modélisation asymétrique avec ceux qu’aurait produits un test d’équiprobabilité standard (qui aurait postulé 33,33 pour cent d’attente pour chaque interface), le chercheur préserve la validité écologique de sa démarche et évite de rejeter à tort un modèle théorique robuste en raison d’une modélisation statistique inadaptée.
9. Analyse détaillée et interprétation des sorties statistiques SAS
9.1 Lecture des résultats du tableau d’adéquation univarié
L’exécution de la procédure PROC FREQ enrichie de l’option CHISQ génère au sein de l’afficheur ODS un premier tableau fondamental structurant les métriques univariées de chaque classe. Ce tableau présente, pour chaque jour de la semaine dans notre exemple commercial, quatre colonnes clés : l’effectif observé (Frequency), l’effectif théorique attendu sous H0 (Expected), l’écart brut entre observation et prédiction (Deviation), et la contribution quadratique spécifique de la catégorie à la statistique globale (Chi-Square Contribution).
L’examen minutieux de ce tableau permet d’identifier précisément l’architecture de la variabilité empirique au sein de l’échantillon de 200 clients. Les effectifs attendus sont rigoureusement fixés à 40,000 pour chaque modalité sous l’hypothèse d’uniformité. Les déviations s’établissent donc à +10 pour le lundi, +20 pour le mardi, 0 pour le mercredi, +7 pour le jeudi et +13 pour le vendredi. On note immédiatement que le mardi et le vendredi concentrent les divergences positives les plus accentuées, suggérant une propension marquée de la clientèle à privilégier ces journées spécifiques.
La colonne des contributions au khi-deux révèle la part relative de responsabilité de chaque cellule dans le résultat global du test. Calculée comme le quotient de la déviation au carré par l’effectif attendu, la contribution s’élève à 2,500 pour le lundi (100 divisé par 40), 10,000 pour le mardi (400 divisé par 40), 0,000 pour le mercredi (0 divisé par 40), 1,225 pour le jeudi (49 divisé par 40) et 4,225 pour le vendredi (169 divisé par 40). Il apparaît avec une netteté statistique indiscutable que la journée du mardi génère à elle seule plus de la moitié de l’ampleur totale de la statistique empirique, constituant le moteur principal de l’asymétrie constatée.
9.2 Interprétation de la statistique du khi-deux et du degré de liberté
Le second bloc de résultats fourni par SAS, intitulé Chi-Square Test for Equal Proportions, synthétise les grandeurs d’inférence décisionnelle globale. La première métrique mise en exergue est la valeur numérique sommative de la statistique de Pearson (Chi-Square). Dans notre cas d’étude, cette valeur s’obtient par l’addition exacte des contributions locales déterminées précédemment : 2,500 + 10,000 + 0,000 + 1,225 + 4,225 = 17,950. Cette grandeur quantitative mesure l’éloignement global absolu entre la distribution observée des clients et l’hypothèse d’équiprobabilité hebdomadaire.
La ligne immédiatement consécutive indique la valeur des degrés de liberté, désignée sous l’acronyme DF pour Degrees of Freedom. Conformément aux règles d’inférence établies, la variable Day comprenant cinq modalités discrètes (k = 5) et aucune estimation de paramètre n’ayant été requise à partir de l’échantillon, le nombre de degrés de liberté résiduels s’élève rigoureusement à DF = 5 – 1 = 4. Cette grandeur détermine la fonction de densité de probabilité théorique continue du khi-deux sur laquelle va être projetée la statistique observée de 17,950.
Pour apprécier la significativité de cette statistique en dehors de la p-valeur automatisée, le chercheur peut confronter la valeur calculée de 17,950 au seuil critique tabulé pour 4 degrés de liberté au seuil de risque standard de 5 pour cent (alpha = 0,05). Dans les tables probabilistes conventionnelles, la valeur critique seuil pour un test bilatéral à DF = 4 s’établit à 9,488. Étant donné que la statistique empirique observée (17,950) excède très largement le seuil critique d’invalidation (17,950 est supérieur à 9,488), l’échantillon d’observations se situe profondément ancré au sein de la zone de rejet critique de l’hypothèse nulle.
9.3 Évaluation de la p-valeur (Pr > ChiSq)
La décision inférentielle formelle repose sur la ligne identifiée dans la sortie SAS par le libellé probabiliste Pr > ChiSq. Cette valeur numérique correspond rigoureusement à l’intégrale de la fonction de densité du khi-deux à 4 degrés de liberté calculée depuis la valeur de la statistique observée (17,950) jusqu’à l’infini positif. Elle quantifie précisément la probabilité d’obtenir, par le seul fait des fluctuations d’échantillonnage aléatoire, une statistique du khi-deux au moins aussi extrême que celle observée, sous l’hypothèse vérifiée où les clients fréquenteraient le magasin de manière parfaitement équiprobable au cours de la semaine.
Dans l’analyse exécutée sur nos données d’exemple, SAS affiche une p-valeur égale à 0,0013. Ce résultat indique qu’il n’existe qu’environ treize chances sur dix mille de constater une telle hétérogénéité d’affluence sous la stricte hypothèse de validité de l’équiprobabilité postulée par le commerçant. En comparant formellement cette valeur observée au seuil conventionnel alpha fixé à 0,05 (ou même à un seuil conservateur de 0,01), le constat est sans équivoque : la p-valeur observée est très inférieure au seuil alpha critique (p = 0,0013 < 0,05).
La règle de décision statistique standard s’applique dès lors dans toute sa rigueur : l’hypothèse nulle H0 d’équiprobabilité des visites de clients au cours des jours ouvrés de la semaine est formellement rejetée au profit de l’hypothèse alternative H1. L’analyste conclut avec un degré de confiance supérieur à 99,8 pour cent que l’affluence de la clientèle au sein de ce magasin de détail est structurellement et significativement asymétrique à travers les jours de la semaine considérée.
10. Prise de décision statistique et calcul de la taille d’effet
10.1 Conclusion inférentielle relative au cas de l’affluence du magasin
Le rejet statistique sans équivoque de l’hypothèse nulle entraîne des conséquences managériales et opérationnelles immédiates pour la gestion commerciale de l’établissement étudié. L’affirmation historique du gestionnaire postulant un volume constant et uniforme de chalands du lundi au vendredi est formellement invalidée par l’épreuve d’adéquation. Les données démontrent une polarisation marquée de l’activité, caractérisée par une surreprésentation massive de la fréquentation lors de la journée du mardi (60 clients observés contre 40 attendus), complétée par un pic secondaire lors du vendredi (53 clients).
D’un point de vue logistique et organisationnel, ce diagnostic inférentiel impose une révision substantielle de la planification des ressources humaines et des opérations de réapprovisionnement des stocks. Maintenir une dotation uniforme en personnel d’accueil et de vente tout au long de la semaine constitue une allocation inefficace des ressources. La direction du point de vente gagne à réorienter les effectifs pour renforcer la présence en magasin le mardi et le vendredi, tout en allégeant la charge de personnel lors des journées structurellement plus calmes telles que le mercredi.
Il convient néanmoins de rappeler une mise en garde méthodologique fondamentale concernant la nature de la décision statistique en cas de non-rejet. Si, dans une configuration empirique alternative, la statistique du khi-deux avait conduit à une p-valeur supérieure à 0,05, cette absence de significativité statistique n’aurait en aucun cas constitué une preuve formelle d’équiprobabilité stricte. En épistémologie statistique, une absence de preuve n’équivaut jamais à une preuve d’absence. Un non-rejet indique simplement que les déviations constatées sont d’une magnitude compatible avec le jeu normal du hasard pour la taille d’échantillon considérée, maintenant l’hypothèse nulle dans le champ du plausible sans jamais la prouver péremptoirement.
10.2 Calcul de la taille d’effet : le V de Cramer et l’indice w de Cohen
L’obtention d’une p-valeur statistiquement significative informe sur l’existence d’une déviation non imputable au hasard, mais ne renseigne en aucune manière sur l’ampleur pratique ou la magnitude concrète de cette déviation. En effet, sur un échantillon gigantesque comprenant des dizaines de milliers d’observations, la moindre fluctuation marginale insignifiante d’un point de vue opérationnel sera déclarée hautement significative (p < 0,001). C’est pourquoi la communauté scientifique contemporaine, alignée sur les préconisations de l’American Psychological Association, impose systématiquement la restitution conjointe d’un indicateur standardisé de taille d’effet.
Pour le test d’adéquation du khi-deux univarié, la métrique standard de référence préconisée par Jacob Cohen est l’indice w de Cohen, algébriquement équivalent au V de Cramer univarié. Cet indice de corrélation multinomiale sans dimension se définit mathématiquement comme la racine carrée du quotient de la statistique empirique du khi-deux par la taille totale N de l’échantillon. Pour notre étude d’affluence, le calcul s’opère par la division de la statistique obtenue (17,950) par l’effectif N (200), soit 0,08975, dont la racine carrée livre un indice w d’environ 0,300 (arrondi au millième le plus proche).
La grille de lecture conventionnelle établie par Cohen pour le test d’adéquation qualifie un effet d’indice w proche de 0,10 comme un effet faible, un indice avoisinant 0,30 comme un effet modéré ou moyen, et une valeur supérieure ou égale à 0,50 comme un effet de grande magnitude. Avec une valeur calculée d’exactement w = 0,300, notre étude se positionne rigoureusement sur le seuil d’un effet modéré. L’asymétrie de la fréquentation n’est donc pas un artefact technique dû à la sensibilité d’un échantillon hypertrophié, mais traduit un phénomène comportemental d’une intensité concrète et opérationnelle tangible.
Ce calcul peut être entièrement automatisé au sein de SAS à l’aide d’une étape DATA secondaire connectée à la table de sortie ODS capturée préalablement :
Il suffit d’extraire la variable ChiSq de la table exportée et de lui appliquer la formule w = sqrt(ChiSq / 200). La programmation séquentielle de cette étape permet d’intégrer dynamiquement la taille d’effet directement dans les tables finales sans recourir à des calculs manuels externes susceptibles d’introduire des erreurs d’arrondi.
10.3 Analyse de la puissance a posteriori et prospective
La robustesse des inférences quantitatives requiert une évaluation rigoureuse de la puissance statistique, définie comme le complémentaire à l’unité du risque d’erreur de deuxième espèce (noté 1 moins bêta). La puissance mesure la capacité probabiliste d’un protocole expérimental à détecter une divergence d’une magnitude donnée dès lors que celle-ci est réellement présente dans la population parente. SAS met à la disposition des chercheurs une procédure dédiée d’une précision remarquable : la procédure PROC POWER.
Dans le cadre d’un test d’adéquation univarié, la procédure PROC POWER dispose d’instructions spécialisées permettant de conduire des analyses de sensibilité a posteriori ou de planification prospective de taille d’échantillon. En spécifiant l’instruction ONESAMPLEFREQ (ou par approximation via les modules de tables génériques), le praticien peut renseigner le vecteur des probabilités théoriques sous H0, le vecteur des probabilités anticipées sous H1, le seuil de risque alpha et la taille de l’échantillon N afin de déterminer la puissance effectivement déployée lors de l’étude.
Pour des investigations futures, l’analyse prospective s’avère encore plus déterminante. Si un chercheur envisage de répliquer l’étude d’affluence dans une autre succursale commerciale en ciblant la détection d’un effet modéré de Cohen (w = 0,30) avec une puissance standard rigoureuse de 80 pour cent (1 – bêta = 0,80) à un seuil de signification de 5 pour cent (alpha = 0,05) pour une variable à 4 degrés de liberté, la procédure PROC POWER calculera l’effectif minimal exact requis. Pour cette configuration précise, la résolution numérique démontre qu’un effectif d’environ 133 observations est nécessaire pour garantir une sensibilité suffisante, validant a posteriori que notre échantillon de 200 individus disposait d’une puissance confortable supérieure à 90 pour cent pour invalider l’hypothèse d’uniformité.
11. Diagnostic des violations d’hypothèses et alternatives méthodologiques dans SAS
11.1 Traitement des faibles effectifs par les tests exacts
L’une des limitations intrinsèques les plus redoutables du test d’adéquation de Pearson réside dans sa dépendance fondamentale vis-à-vis des approximations asymptotiques. Dès lors que la taille totale de l’échantillon N est restreinte ou que la distribution comporte des catégories très rares, les effectifs théoriques attendus sous H0 peuvent s’effondrer en deçà du seuil critique de Cochran (effectifs théoriques inférieurs à 5). Dans une telle configuration, la convergence vers la loi du khi-deux n’est plus mathématiquement assurée, induisant une distorsion majeure des probabilités critiques calculées.
Pour surmonter radicalement cet obstacle sans biaiser l’analyse, SAS intègre des algorithmes d’énumération combinatoire exacte basés sur l’extension du test exact multinomial de Fisher-Freeman-Halton. L’activation de cette méthode s’opère avec une simplicité déconcertante dans la procédure PROC FREQ par l’insertion de l’instruction indépendante exact chisq;. Cette directive ordonne au compilateur d’abandonner l’approximation de la densité continue et de calculer la p-valeur exacte par le dénombrement probabiliste de toutes les configurations matricielles possibles conditionnées par les marges observées.
Le tableau de sortie ODS produit alors une ligne analytique supplémentaire libellée Exact Pr >= ChiSq. Cette probabilité combinatoire exacte remplace l’approximation asymptotique et garantit une maîtrise absolue du taux d’erreur de première espèce, même en présence d’effectifs théoriques unitaires ou inférieurs à 3. Lorsque la combinatoire matricielle devient excessivement complexe sur de très grandes tables, SAS permet d’adjoindre l’option MC à l’instruction EXACT pour obtenir une approximation par simulation de Monte Carlo d’une précision statistique extrême tout en préservant le temps de calcul machine.
11.2 Regroupement empirique des modalités adjacentes
Face à la détection d’effectifs attendus déficitaires, une stratégie corrective classique et pragmatique consiste à opérer un regroupement raisonné de classes élémentaires. En agrégeant deux ou plusieurs modalités adjacentes présentant de faibles fréquences d’apparition, le statisticien augmente mécaniquement l’effectif absolu de la modalité combinée résultante, restaurant ainsi la conformité de l’échantillon vis-à-vis de la règle de Cochran relative aux effectifs minimaux supérieurs à cinq.
La mise en œuvre de cette consolidation sous SAS s’exécute de manière élégante sans altérer le jeu de données d’origine grâce aux formats personnalisés de la procédure PROC FORMAT. Par exemple, si les journées du jeudi et du vendredi présentaient des effectifs trop étiques, un format de regroupement nommé $JOURFMT peut leur assigner une étiquette commune unique telle que « Fin_de_Semaine ». L’application de ce format dans l’instruction format Day$JOURFMT.; au sein de la procédure PROC FREQ force le moteur à fusionner immédiatement les deux niveaux sans nécessiter de réécriture de la table de données.
Il convient néanmoins de souligner les contreparties méthodologiques et conceptuelles de cette pratique d’agrégation. La fusion de catégories engendre systématiquement la perte d’un degré de liberté pour chaque classe fusionnée (réduisant le nombre total de classes k), ce qui modifie la sensibilité du test. Plus grave encore, le regroupement de modalités cliniquement ou fonctionnellement hétérogènes peut masquer des dynamiques réelles et introduire un biais de spécification conceptuel. Tout regroupement de classes doit donc impérativement être dicté par une logique théorique substantielle et non par une simple complaisance mathématique visant à satisfaire artificiellement les critères de Cochran.
11.3 Alternatives non paramétriques et modélisations généralisées
L’analyse des fréquences catégorielles ne se cantonne pas à la procédure PROC FREQ. Dans une perspective de modélisation statistique avancée, le test d’adéquation univarié s’inscrit au sein d’un cadre théorique intégrateur plus large : la famille des modèles linéaires généralisés (GLM), et plus spécifiquement la régression de Poisson et la modélisation log-linéaire. SAS met à disposition des analystes la procédure PROC GENMOD pour exécuter ces modélisations avec une flexibilité conceptuelle inégalée.
Lorsqu’un test d’adéquation est paramétré dans PROC GENMOD, la variable de comptage (Customers) est modélisée comme une variable réponse suivant une distribution de Poisson gouvernée par un lien logarithmique (dist=poisson link=log). L’hypothèse nulle d’uniformité revient à tester un modèle n’incorporant qu’un simple terme d’interception (intercept-only model), ou un modèle avec offset représentant les effectifs attendus sous H0. La déviance globale du modèle (Deviance) calculée par la procédure GENMOD converge asymptotiquement vers la statistique du khi-deux du rapport de vraisemblance.
Le recours à la procédure PROC GENMOD présente des avantages méthodologiques considérables dès lors que l’on souhaite dépasser les limites du test d’adéquation univarié standard. Elle autorise notamment l’intégration simultanée de covariables d’ajustement continues (par exemple, la température météorologique extérieure lors de chaque journée d’observation), la prise en charge des phénomènes de surdispersion statistique via des lois binomiales négatives, et la modélisation d’effets d’autocorrélation temporelle. L’analyste bénéficie ainsi d’un continuum méthodologique fluide reliant l’épreuve élémentaire de Pearson aux architectures prédictives multivariées les plus sophistiquées.
12. Rédaction des résultats selon les normes académiques et APA
12.1 Standardisation formelle de l’écriture statistique APA 7
La communication des résultats statistiques au sein des revues scientifiques internationales exige le respect scrupuleux des normes de standardisation édictées par l’American Psychological Association dans sa septième édition (manuel APA 7). Ces normes imposent un format typographique universel et une précision d’information garantissant l’intelligibilité, la reproductibilité et l’évaluation critique des calculs inférentiels par la communauté des pairs.
La restitution canonique d’un test d’adéquation du khi-deux univarié doit comporter, dans un ordre séquentiel strict, l’identification du symbole statistique, les degrés de liberté, la taille totale N de l’échantillon entre parenthèses, la valeur numérique exacte de la statistique de test calculée, la probabilité critique p-valeur correspondante, et l’estimation standardisée de la taille d’effet accompagnée de son indice. Sur le plan typographique, les symboles statistiques désignés par des lettres latines ou grecques (tels que N, p, w, ainsi que le symbole du khi-carré) doivent obligatoirement être composés en caractères italiques.
Conformément à ces préceptes, la rédaction institutionnelle des résultats obtenus dans notre étude d’affluence s’articulera de la manière suivante dans le corps de texte d’un article scientifique :
« Un test d’adéquation du khi-deux de Pearson a été conduit afin de déterminer si la fréquentation de la clientèle d’un magasin de détail se distribuait de manière uniforme à travers les cinq jours ouvrés de la semaine. L’analyse des fréquences observées met en évidence un rejet statistiquement significatif de l’hypothèse d’équiprobabilité hebdomadaire, avec une statistique du khi-carré à quatre degrés de liberté sur un échantillon de 200 clients s’élevant à 17,95 pour une probabilité critique p égale à 0,001. La taille d’effet standardisée correspondante, mesurée par l’indice w de Cohen, s’établit à 0,30, attestant d’une divergence empirique d’amplitude modérée par rapport au modèle uniforme théorique. Les données révèlent une concentration préférentielle marquée des flux de clientèle lors de la journée du mardi (avec 60 observations recensées pour 40 attendues) ainsi que du vendredi (53 observés), tandis que l’affluence du mercredi se conforme rigoureusement aux prédictions théoriques du modèle. »
12.2 Présentation tabulaire et graphique des résultats académiques
En complément d’une restitution narrative fluide, l’intégration d’un tableau synthétique d’adéquation renforce l’impact démonstratif des publications académiques. Selon les standards APA 7, ce tableau doit éviter les lignes verticales de séparation et ne comporter que trois lignes horizontales majeures : au sommet du tableau, sous la rangée des en-têtes de colonnes, et immédiatement à la base du tableau après la ligne des totaux cumulés.
Le tableau doit croiser méthodiquement les modalités de la variable d’étude avec quatre indicateurs essentiels : la fréquence absolue observée, le pourcentage empirique correspondant, la fréquence théorique attendue sous le modèle H0, ainsi que le résidu standardisé (ou résidu ajusté de Pearson). L’intégration de cette dernière grandeur est particulièrement précieuse : calculé comme le quotient de la déviation (O moins E) par la racine carrée de l’effectif attendu E, le résidu standardisé se comporte asymptotiquement comme un score standard Z de loi normale centrée réduite. Toute cellule présentant un résidu supérieur à +1,96 ou inférieur à -1,96 (au seuil de 5 pour cent) peut ainsi être explicitement signalée comme une source de divergence locale statistiquement significative, guidant le lecteur dans l’interprétation post-hoc des anomalies distributionnelles.
Enfin, l’exportation des visualisations graphiques issues de PROC SGPLOT vers des formats vectoriels de haute résolution (tels que les formats SVG, PDF vectoriel ou EPS) permet de préserver la netteté des polices de caractères et des lignes de démarcation lors de la photocomposition typographique finale de l’article. L’écueil classique consistant à interpréter une p-valeur significative comme l’indice d’une supériorité de toutes les catégories par rapport aux attentes est ainsi totalement dissipé grâce à la convergence synergique d’un tableau d’adéquation résiduel rigoureux et d’une représentation graphique impeccablement calibrée sous SAS.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Cochran, W. G. (1952). The chi-square test of goodness of fit. The Annals of Mathematical Statistics, 23(3), 315–345. https://doi.org/10.1214/aoms/1177729380
Cochran, W. G. (1954). Some methods for strengthening the common chi-square tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1/2), 141–149. https://doi.org/10.2307/2332323
Greenwood, P. E., & Nikulin, M. S. (1996). A guide to chi-squared testing. John Wiley & Sons.
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine Series 5, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
SAS Institute Inc. (2021). SAS/STAT 15.2 user’s guide: The FREQ procedure. SAS Institute Inc. https://support.sas.com/documentation/onlinedoc/stat/
Stokes, M. E., Davis, C. S., & Koch, G. G. (2012). Categorical data analysis using SAS (3rd ed.). SAS Institute Inc.