
Dans l’écosystème du traitement analytique et de la programmation statistique sous SAS (Statistical Analysis System), la manipulation de données séquentielles et temporelles constitue une exigence fondamentale pour les méthodologistes, les biostatisticiens et les ingénieurs de données. Contrairement aux approches ensemblistes propres aux bases de données relationnelles régies par le formalisme SQL, le moteur de calcul du système SAS repose traditionnellement sur le concept du cycle d’étape de données (Data Step), qui procède à une lecture itérative, enregistrement par enregistrement. Dans ce paradigme séquentiel strict, l’évaluation de dynamiques temporelles, le calcul de taux de variation ou encore la modélisation de dépendances sérielles exigent un mécanisme permettant de s’affranchir de l’isolement de l’observation courante pour accéder aux états antérieurs de la mémoire système.
La fonction LAG constitue précisément la passerelle algorithmique native conçue par l’éditeur pour répondre à ce besoin méthodologique. En permettant d’interroger la valeur prise par une variable lors d’une ou de plusieurs itérations précédentes de l’étape DATA, elle offre une élégance syntaxique incomparable pour la dérivation de prédicteurs autorégressifs, la détection de transitions qualitatives ou l’analyse des trajectoires individuelles dans les études de cohortes. Toutefois, sous une apparente simplicité d’emploi, la fonction LAG dissimule une architecture interne sophistiquée, régie par des structures de données en file d’attente dont la méconnaissance constitue l’une des sources les plus prolifiques d’anomalies logiques et de biais statistiques chez les praticiens, notamment lors de son imbrication dans des structures de contrôle conditionnelles.
Le présent traité propose une analyse exhaustive et rigoureuse de la fonction LAG au sein de l’environnement SAS. En partant des fondements théoriques de sa cinématique d’exécution jusqu’aux modélisations avancées pour données longitudinales, cet article détaille les spécificités de son interaction avec le vecteur de données du programme (Program Data Vector), décortique le piège classique de l’exécution conditionnelle, formalise son articulation avec le traitement par sous-groupes (clauses BY), et expose les stratégies palliatives pour simuler des fonctions prospectives (LEAD). À travers des cas concrets, des formulations mathématiques et des recommandations architecturales de premier ordre, ce guide a pour vocation de fournir aux analystes une maîtrise absolue de cet outil cardinal de la manipulation séquentielle de données.
1. Introduction à la fonction LAG dans SAS : Fondements conceptuels et syntaxe
1.1 Définition et rôle fondamental de la fonction LAG
La fonction LAG se définit dans l’environnement SAS comme une primitive de manipulation de séries de données dont l’objet est de renvoyer la valeur prise par une variable lors d’une observation précédant l’observation en cours d’évaluation. Dans le cadre de l’ingénierie statistique, la plupart des métriques ne prennent leur sens que par comparaison relative : l’évaluation d’un niveau d’hémoglobine glyquée chez un patient diabétique n’offre une valeur clinique complète que si elle est mise en perspective avec la mesure relevée au trimestre précédent ; de même, l’analyse d’un cours financier requiert la quantification de sa variation marginale par rapport à la clôture de la veille. La fonction LAG répond à cet impératif en matérialisant un pont logique entre l’état temporel présent, conventionnellement désigné par t, et un état temporel rétrospectif désigné par t-k, où k représente l’ordre de décalage temporel.
Sur le plan théorique, l’analyse séquentielle sous SAS opère une distinction fondamentale entre la lecture séquentielle du flux de données et l’accès direct aux mémoires tampons du système. Lorsqu’un Data Step s’exécute, le curseur d’entrée pointe de manière unidirectionnelle du début vers la fin de la table source. Il n’existe pas, dans la syntaxe élémentaire du Data Step, de mécanisme permettant de « rembobiner » la lecture d’une ligne sans réinitialiser entièrement la structure du flux. La fonction LAG intervient ici non pas en déplaçant le curseur physique de lecture vers l’arrière, mais en interceptant et en mémorisant les valeurs au fur et à mesure que celles-ci traversent le système d’exécution. Ce mécanisme permet d’émuler un accès bidirectionnel virtuel au sein d’un moteur d’exécution purement linéaire et séquentiel.
Dans le domaine de la modélisation longitudinale, de l’économétrie et de l’analyse des séries temporelles, cette capacité constitue le fondement du calcul des termes d’autocorrélation et de la stationnarisation des séries. En écologie comportementale ou en pharmaco-épidémiologie, où les sujets sont suivis de façon répétée dans le temps, la fonction LAG permet de construire des prédicteurs d’inertie, c’est-à-dire d’estimer dans quelle mesure la réponse passée influence la trajectoire future, tout en évitant les biais de prospective (look-ahead bias) qui corrompraient l’intégrité de l’inférence causale.
1.2 Syntaxe formelle et structure des arguments
La signature canonique de la fonction LAG s’articule autour d’une nomenclature stricte et universelle au sein du langage SAS. Sa déclaration opérationnelle adopte la formulation générique suivante :
variable_cible = LAG<n>(variable_source);
Dans cette expression, variable_source représente le champ issu de la table de données ou du vecteur de travail dont on souhaite capturer l’occurrence historique, tandis que variable_cible désigne la nouvelle variable qui recevra la valeur décalée. L’indice optionnel n spécifie la profondeur de l’antériorité recherchée. Lorsque cet indice est omis (syntaxe LAG(variable_source)), SAS lui attribue par défaut la valeur unitaire n = 1, ce qui correspond à l’observation immédiatement antérieure. Lorsque l’analyse exige d’observer des horizons plus lointains, la syntaxe incorpore un entier positif non nul allant de 1 jusqu’à des ordres élevés, tels que LAG2(x), LAG3(x) ou LAG12(x).
La fonction présente une polymorphie intrinsèque en ce qu’elle tolère indistinctement des variables sources de type numérique ou de type caractère. Lors de la phase de compilation du Data Step, SAS inspecte la nature de la variable passée en paramètre et attribue automatiquement à la variable cible le type de données correspondant. Si la variable source est une chaîne de caractères définie avec une longueur spécifique, SAS alloue par défaut à la variable cible une longueur identique afin d’éviter toute troncature silencieuse. De surcroît, les formats d’affichage (tels que DATE9., DATETIME20. ou des formats monétaires) ne sont pas automatiquement propagés à la variable réceptrice : celle-ci hérite uniquement du type sous-jacent (nombre en virgule flottante double précision ou chaîne d’octets), obligeant le programmeur rigoureux à lui associer explicitement une instruction de formatage si une restitution visuelle standardisée est requise.
Il importe de souligner la différence structurelle entre un appel conventionnel de LAG sans paramètre numérique et les formulations indicées. L’appel sans suffixe numérique est strictement synonyme de LAG1. Cependant, l’argument transmis entre parenthèses doit impérativement être un nom de variable unique ou une expression scalaire valide ; il ne peut en aucun cas s’agir d’une liste abrégée de variables (telle que x1-x10) sans l’emploi préalable de structures itératives vectorielles de type tableau (ARRAY), comme nous l’examinerons ultérieurement.
1.3 Comportement initial lors de la première observation
L’application d’un décalage temporel vers le passé soulève inévitablement la question de la condition aux limites initiale : quelle valeur doit être retournée pour la toute première observation d’une table de données, alors qu’aucun événement antérieur n’a encore été traité par le système ? Conformément aux principes de l’algèbre relationnelle et de la logique booléenne implémentée dans SAS, la fonction LAG génère systématiquement une valeur manquante (missing value) pour l’observation initiale lors d’un appel à LAG1.
Cette valeur manquante se matérialise sous la forme d’un point simple (.) pour les variables numériques et sous la forme d’une chaîne vide ou d’espaces blancs pour les variables de type caractère. Sur le plan architectural, cette initialisation résulte de l’état de la mémoire allouée à la pile interne de la fonction : avant que la première itération du Data Step ne commence, la structure d’accueil de la fonction est initialisée avec des marqueurs d’absence de données. Ce n’est qu’à l’issue de l’exécution de la ligne de code contenant l’instruction LAG que la valeur courante de la variable source est poussée dans cette mémoire, devenant ainsi disponible pour l’itération subséquente.
Les conséquences arithmétiques de cette valeur manquante inaugurale sont majeures et doivent être anticipées lors de l’écriture des équations différentielles ou des taux d’évolution. Si un développeur applique une soustraction naïve de la forme delta = valeur - LAG(valeur);, la première ligne du jeu de données produira inéluctablement une valeur manquante pour la variable delta, car toute opération arithmétique impliquant une valeur manquante propage indéfiniment cet état manquant selon les règles de propagation arithmétique de SAS. Pour vérifier formellement cet état de transition lors du développement, le recours à l’instruction d’audit PUTLOG au sein du journal SAS (Log) permet de visualiser avec une granularité chirurgicale le contenu exact de la variable source et de sa projection décalée dès le premier cycle d’exécution :
DATA _NULL_;

  SET sashelp.class(OBS=2);

  age_prec = LAG(age);

  PUTLOG "Cycle N=" _N_ "Age courant=" age "Age précédent=" age_prec;

RUN;
Dans cet extrait, la consultation du journal confirmera sans ambiguïté qu’au cycle _N_ = 1, la variable age_prec contient la valeur manquante standard, tandis qu’au cycle _N_ = 2, elle adopte avec fidélité la valeur prise par la variable age lors de la première observation.
2. Mécanisme d’exécution interne : Piles FIFO et Program Data Vector (PDV)
2.1 Architecture de la file d’attente (Queue) de la fonction LAG
Pour comprendre en profondeur les subtilités et les anomalies potentielles associées à la fonction LAG, il est indispensable d’explorer son architecture sous-jacente au niveau du compilateur SAS. Contrairement à une idée reçue tenace, la fonction LAG ne consulte pas le disque dur, ne réinterroge pas la table SAS d’origine et ne fouille pas dans le Program Data Vector (PDV) des itérations antérieures. En réalité, chaque occurrence textuelle de la fonction LAG dans le code source d’un Data Step provoque l’instanciation, par le compilateur, d’une file d’attente dédiée de type First-In, First-Out (FIFO, ou premier entré, premier sorti).
Cette structure en file d’attente possède une profondeur exactement égale à l’entier n spécifié dans le nom de la fonction (la profondeur étant égale à 1 pour la fonction LAG standard). Le fonctionnement de cette file obéit à deux opérations simultanées déclenchées exclusivement lorsque le flux d’exécution franchit la ligne d’instruction :
- Opération de sortie (Pop) : La fonction extrait la valeur qui séjourne au sommet de la file d’attente depuis le plus grand nombre d’itérations et la retourne au programme appelant afin qu’elle soit affectée à la variable cible.
- Opération d’entrée (Push) : La fonction capture la valeur actuelle de l’argument passé en paramètre et l’insère à la base de la file d’attente, poussant les éléments préexistants vers la sortie.
Il est fondamental de noter que l’allocation de cette pile est strictement liée à l’emplacement physique du jeton textuel de la fonction dans le script compilé. Si un programmeur écrit trois fois l’instruction LAG(x) à des endroits distincts du code, SAS génère en coulisse trois files d’attente totalement indépendantes les unes des autres, chacune possédant son propre historique et son propre cycle de remplissage. Cette indépendance structurelle garantit qu’une pile ne pollue pas la mémoire d’une autre, mais implique corollairement que la synchronisation des données dépend de façon rigide de l’ordre séquentiel d’évaluation des instructions lors de l’exécution.
2.2 Interaction avec le cycle de vie du Program Data Vector
Le Program Data Vector (PDV) représente la zone de mémoire vive temporaire structurée par SAS lors de la phase de compilation pour héberger l’ensemble des variables d’une observation donnée pendant son traitement. Le cycle de vie du PDV se décompose en une phase d’initialisation, une phase de lecture (généralement via l’instruction SET, MERGE ou INPUT), une phase de transformation algorithmique, une phase d’écriture dans la table de destination (instruction OUTPUT implicite ou explicite), et enfin une phase de réinitialisation des variables non retenues (fixées à des valeurs manquantes à chaque nouveau cycle de l’étape DATA).
L’interaction entre la pile FIFO de la fonction LAG et le PDV obéit à une étanchéité protectrice remarquable. Tandis que les variables ordinaires résidant dans le PDV voient leur contenu potentiellement écrasé ou remis à blanc à l’amorce d’une nouvelle itération de boucle, les éléments stockés au sein de la file d’attente interne de LAG échappent totalement à cette réinitialisation cyclique. La pile conserve sa substance indépendamment du statut des drapeaux du PDV. Dès lors, lorsque la fonction est sollicitée, elle opère un transfert depuis sa mémoire privée protégée vers l’emplacement désigné au sein du PDV pour la variable cible.
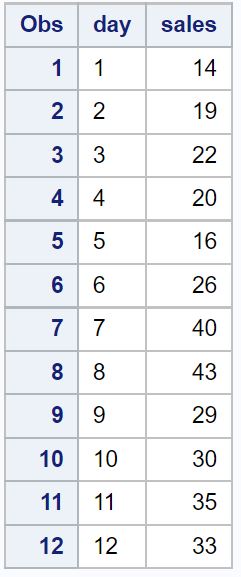
Cette persistance au sein de la pile garantit l’intégrité séquentielle des calculs même lorsque des opérations complexes de filtrage, de suppression d’enregistrements (via l’instruction DELETE) ou d’écritures conditionnelles multiples surviennent au cours du traitement. Néanmoins, elle crée une dépendance critique vis-à-vis du flux de contrôle : si l’instruction contenant le LAG est ignorée au cours d’un cycle donné, le transfert de données n’a pas lieu et la file d’attente demeure figée dans l’état exact où elle se trouvait lors de son dernier passage en exécution.
2.3 Distinction cruciale entre mémoire d’exécution et mémoire de stockage
Une confusion classique chez les analystes débutants consiste à assimiler la mémoire d’une table SAS stockée sur un disque physique ou dans un cache d’entrée-sortie aux structures volatiles sollicitées par le compilateur. La pile FIFO de la fonction LAG constitue une mémoire d’exécution éphémère. Elle ne possède aucune adresse mémoire adressable directement par le développeur ; il est strictement impossible de manipuler le pointeur de cette file par le biais de macro-variables ou d’opérateurs de bas niveau sans déclencher l’appel formel de la fonction.
Sur le plan de l’allocation des ressources computationnelles, la consommation mémoire induite par la fonction LAG demeure remarquablement faible pour des ordres scalaires usuels (de 1 à 100), car chaque cellule de la file ne requiert que la taille standard de stockage d’une variable en double précision (8 octets) ou la longueur déclarée d’une chaîne de caractères (par exemple quelques dizaines d’octets). En conséquence, le coût machine d’un appel standard est dominé par les instructions de copie de registres processeur plutôt que par la pression exercée sur la mémoire vive (RAM) globale du serveur.
Toutefois, dans le contexte du traitement de mégadonnées (Big Data) impliquant des centaines de millions d’enregistrements, la multiplication effrénée d’appels à des fonctions de retards profonds (par exemple LAG1000 répété sur des dizaines de colonnes) peut induire une micro-fragmentation de la mémoire et dégrader l’efficacité des caches de niveau 1 et 2 (L1/L2 Cache Misses) du microprocesseur. Pour le diagnostic de ces scénarios extrêmes, SAS met à disposition des options d’exécution avancées telles que FULLSTIMER et MEMRPT, qui permettent d’auditer avec une acuité millimétrique le temps CPU et la mémoire consommée spécifiquement par chaque étape DATA procédant à des opérations de décalage intensives.
3. Implémentation d’un décalage d’ordre un (LAG1) : Cas pratique pas à pas
3.1 Création du jeu de données d’expérimentation
Afin de matérialiser ces concepts théoriques au sein d’un cadre expérimental reproductible, considérons la création d’une cohorte clinique simulée évaluant la pression artérielle systolique d’un patient au cours de journées consécutives d’hospitalisation. Nous concevons ce jeu de données en utilisant la syntaxe fondamentale du Data Step associée à l’instruction de saisie directe DATALINES (ou son équivalent historique CARDS) :
DATA suivi_clinique;

  INPUT jour_mesure pas_systolique statut_patient $12.;

  DATALINES;

1 120 Stable

2 125 Stable

3 142 Hypertension

4 138 Surveillance

5 122 Stable

6 118 Stable

;

RUN;
L’exécution de ce bloc génère dans la bibliothèque temporaire WORK une table structurée comportant six enregistrements et trois variables : jour_mesure (numérique continue), pas_systolique (numérique continue exprimée en millimètres de mercure) et statut_patient (chaîne de caractères à longueur fixe de 12 octets). L’emploi préalable de la procédure de contrôle standardisée PROC PRINT permet de s’assurer de l’intégrité de la structure tabulaire avant toute dérivation mathématique :
PROC PRINT DATA=suivi_clinique NOOBS;

RUN;
L’examen des métadonnées via la procédure PROC CONTENTS atteste de l’allocation correcte des descripteurs de variables, confirmant que le moteur SAS a configuré les longueurs natives et qu’aucune anomalie de conversion de caractères n’est venue altérer le flux d’entrée.
3.2 Application du décalage LAG1 sur une variable continue
L’objectif analytique consiste à associer, sur chaque ligne d’observation, la valeur de pression artérielle mesurée le jour précédent, de façon à préparer le terrain pour l’évaluation de la déstabilisation hémodynamique du sujet. Pour ce faire, nous mettons en œuvre une nouvelle étape DATA faisant appel à l’opérateur d’assignation unitaire :
DATA suivi_clinique_lag;

  SET suivi_clinique;

  pas_veille = LAG(pas_systolique);

RUN;
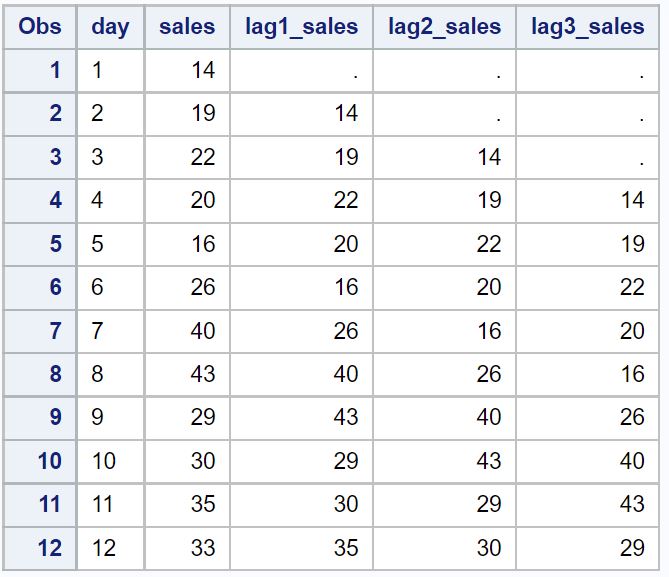
À l’issue de cette exécution, nous pouvons observer la redistribution rigoureuse des valeurs au sein du tableau résultant :
| jour_mesure | pas_systolique | statut_patient | pas_veille |
|---|---|---|---|
| 1 | 120 | Stable | . |
| 2 | 125 | Stable | 120 |
| 3 | 142 | Hypertension | 125 |
| 4 | 138 | Surveillance | 142 |
| 5 | 122 | Stable | 138 |
| 6 | 118 | Stable | 122 |
L’inspection analytique de ce tableau confirme avec clarté les prédictions théoriques : à la première ligne (jour_mesure = 1), la variable pas_veille affiche la valeur manquante numérique universelle représentée par le point. Pour les observations ultérieures 2 à 6, chaque valeur de la colonne pas_veille correspond rigoureusement à la valeur de pas_systolique située à la ligne t-1. La traçabilité de l’information historique est ainsi assurée de manière fluide, permettant ultérieurement des calculs d’écart sans nécessiter d’auto-jointures relationnelles complexes.
3.3 Application du décalage LAG1 sur des variables catégorielles
L’utilisation de la fonction LAG ne se limite pas aux séries chronologiques quantitatives ; elle s’avère tout aussi déterminante dans le traitement des chaînes de caractères pour identifier les changements d’état qualitatif, comme le passage d’une phase de rémission à une phase d’aggravation clinique. Considérons le décalage de la variable statut_patient :
DATA suivi_statut_lag;

  LENGTH statut_veille $12.;

  SET suivi_clinique;

  statut_veille = LAG(statut_patient);

RUN;
Une précaution syntaxique indispensable a été introduite dans ce code : l’instruction préliminaire LENGTH statut_veille $12.;. En l’absence de cette déclaration explicite de longueur, SAS détermine la taille de la nouvelle variable lors de sa toute première rencontre dans la phase de compilation. Si l’assignation reposait sur une fonction complexe ou une concaténation tronquée, la longueur allouée par défaut pourrait ne pas correspondre à l’espace requis, provoquant la troncature irrémédiable des chaînes de caractères les plus longues lors de leur passage dans la pile.
En observant la table produite, le premier enregistrement héberge une chaîne de caractères vide (indiquée visuellement par un blanc). À l’enregistrement numéro 3, la variable statut_patient prend la valeur « Hypertension » tandis que statut_veille rapporte fidèlement l’état « Stable » issu du jour 2. Cette juxtaposition permet au biostatisticien d’écrire immédiatement des expressions booléennes de transition telles que IF statut_patient ne statut_veille THEN transition_flag = 1;, instrumentant ainsi la détection automatisée d’événements nosologiques critiques au sein du dossier patient informatisé.
4. Décalages d’ordres supérieurs : Utilisation des fonctions LAG2 à LAGn
4.1 Syntaxe et spécificités de la famille LAGn
L’analyse des phénomènes dynamiques requiert fréquemment l’investigation de retards supérieurs à l’ordre immédiat t-1. Dans les cycles épidémiologiques hebdomadaires, l’évaluation du report de transmission impose souvent de comparer la situation d’un jour précis à celle observée sept jours plus tôt (t-7). Pour adresser ce besoin, SAS dispose de la famille native de fonctions indicées désignées sous le vocable LAGn, où l’indice numérique n peut théoriquement croître jusqu’à des profondeurs considérables (couramment jusqu’à LAG100).
Le principe mécanique de la fonction LAGn demeure identique à celui de LAG1, à l’exception près de la dimension de sa pile interne FIFO. Pour un appel à LAGn(x), SAS initialise une file comportant n cellules de stockage. Par conséquent, lors des n premières itérations au cours desquelles l’instruction est exécutée, la sortie de la pile ne peut retourner aucune valeur préexistante : elle restitue consécutivement n valeurs manquantes. Ce n’est qu’à partir de la (n+1)-ième exécution que la file commence à refouler la première valeur utile collectée lors du démarrage du traitement.
Une erreur récurrente consiste à tenter de chaîner syntaxiquement les fonctions, par exemple sous la forme LAG(LAG(x)), dans l’espoir de simuler un décalage d’ordre deux. Bien que cette formulation puisse sembler mathématiquement séduisante sous l’angle de la composition fonctionnelle, elle introduit une complexité inutile et engendre deux files d’attente distinctes connectées en cascade dans le PDV. L’usage exclusif de la forme standardisée LAG2(x) est formellement prescrit : elle optimise le graphe d’exécution compilé, prévient la dégradation des temps de traitement et assure une lisibilité documentaire irréprochable du script d’analyse.
4.2 Exemple d’application séquentielle multi-horizons
Pour illustrer la mise en œuvre pratique de plusieurs horizons de retard au sein d’une même unité de calcul, développons un scénario de surveillance épidémiologique enregistrant le nombre d’admissions quotidiennes aux urgences au cours d’une dizaine de journées :
DATA admissions_urgences;

  INPUT jour admissions @@;

  DATALINES;

1 14 2 18 3 22 4 25 5 30 6 28 7 35 8 40 9 42 10 38

;

RUN;
DATA admissions_multi_horizons;
SET admissions_urgences;
adm_lag1 = LAG1(admissions);
adm_lag2 = LAG2(admissions);
adm_lag3 = LAG3(admissions);
RUN;
L’observation détaillée de la table admissions_multi_horizons met en lumière la cascade temporelle progressive des cellules d’historique :
| jour | admissions | adm_lag1 | adm_lag2 | adm_lag3 |
|---|---|---|---|---|
| 1 | 14 | . | . | . |
| 2 | 18 | 14 | . | . |
| 3 | 22 | 18 | 14 | . |
| 4 | 25 | 22 | 18 | 14 |
| 5 | 30 | 25 | 22 | 18 |
| 6 | 28 | 30 | 25 | 22 |
Comme l’illustre rigoureusement ce tableau, la colonne adm_lag1 présente une seule valeur manquante à l’origine, la colonne adm_lag2 en présente deux, et la colonne adm_lag3 en exhibe trois. À partir du quatrième jour (jour = 4), la fenêtre glissante d’historique est intégralement garnie, rendant possible l’application de calculs de moyennes mobiles locales ou de profils de dérivées secondes pour quantifier l’accélération de l’afflux hospitalier.
4.3 Limites pratiques et alternatives algorithmiques aux très grands ordres
Bien que la flexibilité de SAS permette d’invoquer théoriquement des indices élevés tels que LAG365 pour comparer des données journalières d’une année sur l’autre, cette approche présente de sérieuses limites opérationnelles. En premier lieu, la multiplication manuelle d’instructions de décalage individuel conduit à un code verbeux, sujet aux erreurs typographiques et difficilement maintenable lors des évolutions des spécifications du protocole d’analyse.
En second lieu, lorsqu’il s’agit de générer une famille complète de retards successifs (par exemple construire simultanément LAG1 jusqu’à LAG30 pour ajuster un modèle autorégressif distribué), l’écriture séquentielle de trente instructions distinctes devient archaïque. L’approche méthodologique recommandée réside alors dans l’interfaçage de la fonction LAG avec des structures matricielles de type ARRAY adossées à des boucles itératives contrôlées :
DATA retards_multiples;

  SET admissions_urgences;

  ARRAY tab_admissions_lag(5) lag_adm1 - lag_adm5;

  /* Note architecturale : Ne jamais placer LAG directement dans une boucle DO */

  lag_adm1 = LAG1(admissions);

  lag_adm2 = LAG2(admissions);

  lag_adm3 = LAG3(admissions);

  lag_adm4 = LAG4(admissions);

  lag_adm5 = LAG5(admissions);

RUN;
Une mise en garde capitale s’impose ici : un programmeur ne doit jamais chercher à compacter cette syntaxe en écrivant une boucle DO i = 1 TO 5; tab_admissions_lag(i) = LAG(admissions); END;. En effet, dans cette construction erronée, l’instruction textuelle unique LAG(admissions) serait appelée cinq fois par enregistrement au sein de la même itération du Data Step, corrompant instantanément la pile FIFO en y empilant cinq fois la même valeur présente, ce qui réduirait à néant toute la logique d’étalement temporel recherchée. Lorsque les dimensions temporelles deviennent massives, le recours à des jointures SQL non équivalentes ou à des procédures spécialisées de séries temporelles (comme la procédure PROC EXPAND sous le module SAS/ETS) s’avère conceptuellement supérieur.
5. Le piège classique de l’exécution conditionnelle de la fonction LAG
5.1 Analyse de l’anomalie liée aux blocs IF-THEN
L’écueil le plus redoutable et le plus insidieux dans l’utilisation de la fonction LAG réside sans conteste dans sa soumission à une structure de contrôle conditionnelle de type IF condition THEN variable = LAG(source);. Pratiquement tout développeur SAS a, au moins une fois dans sa carrière, produit des tables de résultats faussées en raison d’une mauvaise appréhension des mécanismes sous-jacents à cette construction syntaxique.
Le dysfonctionnement ne provient pas d’un défaut de conception du compilateur SAS, mais d’une méprise conceptuelle de l’utilisateur relative à la nature de la fonction. L’analyste présume fréquemment que l’instruction signifie : « Récupère la valeur que possédait la variable source lors de la dernière observation qui satisfaisait la condition logique ». Or, la pile FIFO ne s’exécute pas au moment de la génération de l’observation source, mais exclusivement au moment où le thread d’exécution évalue l’expression LAG elle-même.
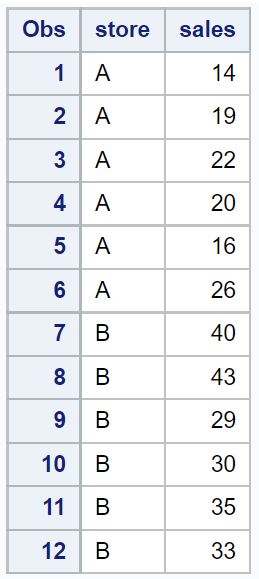
Par conséquent, lorsque la clause conditionnelle IF est évaluée à faux, l’instruction dépendante THEN est purement et simplement sautée par le flux d’exécution. La file d’attente FIFO interne n’est ni lue, ni alimentée. Elle conserve son état inchangé. Plus grave encore : lorsque, plusieurs itérations plus tard, la condition redevient vraie, la fonction LAG s’exécute enfin, mais elle extrait de sa pile la valeur qui y avait été insérée lors de la dernière fois où la condition était vraie, ignorant totalement les valeurs qui ont transité dans le PDV durant tous les cycles intermédiaires ! Ce phénomène crée une désynchronisation masquée dévastatrice entre l’échelle temporelle réelle des observations et l’indice des valeurs stockées dans la mémoire de retards.
5.2 La règle d’or architecturale : Exécution inconditionnelle
Pour éliminer de manière absolue tout risque de corruption silencieuse des séries de données, l’ingénierie logicielle sous SAS impose une règle d’or immuable : l’invocation de la fonction LAG doit impérativement s’opérer de manière inconditionnelle, à la racine du Program Data Vector. La séparation formelle entre l’opération d’échantillonnage temporel (la capture dans la pile) et la logique métier conditionnelle (l’assignation ou le filtrage) constitue la seule garantie d’intégrité algorithmique.
Considérons l’exemple d’un protocole où nous souhaitons affecter la valeur décalée de la pression artérielle uniquement pour les enregistrements relatifs à un protocole actif :
Structure défectueuse (Anti-Pattern) :
/* CODE ERRONÉ - À PROSCRIRE ABSOLUMENT */

DATA resultat_invalide;

  SET cohorte;

  IF protocole = "Actif" THEN pas_precedente = LAG(pas_systolique);

RUN;
Structure saine et standardisée (Best Practice) :
/* CODE VALIDE ET RIGOUREUX */

DATA resultat_conforme;

  SET cohorte;

  /* 1. Exécution inconditionnelle garantissant la cadence séquentielle */

  valeur_tampon_lag = LAG(pas_systolique);
/* 2. Application de la logique d'assignation sélective */
IF protocole = "Actif" THEN DO;
pas_precedente = valeur_tampon_lag;
END;
ELSE DO;
pas_precedente = .;
END;
DROP valeur_tampon_lag;
RUN;
Dans la seconde structure, la file d’attente FIFO est mise à jour avec une constance absolue à chaque franchissement de ligne, garantissant que valeur_tampon_lag reflète rigoureusement l’observation chronologique t-1. La condition métier n’intervient qu’en aval pour décider si cette valeur historique doit être exploitée ou écartée, assurant ainsi une synchronisation temporelle parfaite exempte de tout glissement d’indices.
5.3 Techniques de contournement avancées pour décalages sélectifs
Il se présente néanmoins des situations méthodologiques où le chercheur souhaite délibérément capturer la valeur de la dernière observation validant un critère précis (par exemple, connaître la valeur du dernier dosage biologique d’un patient quelle que soit la date de ce dosage, en ignorant les visites médicales intermédiaires où aucun prélèvement n’a eu lieu). Dans ce cas très particulier, l’alimentation sélective de la pile est le comportement intentionnellement recherché.
Pour mettre en œuvre un tel échantillonnage sélectif tout en préservant la transparence du code, deux approches méthodologiques se distinguent. La première consiste à filtrer au préalable la population en amont via une clause WHERE ou une étape DATA de sous-sélection :
/* Approche par réduction d'espace vectoriel préalable */

DATA dosages_uniquement;

  SET suivi_global;

  WHERE dosage_biologique IS NOT MISSING;

  dosage_precedent = LAG(dosage_biologique);

RUN;
Dans ce scénario, le Data Step ne traite que les lignes filtrées ; la fonction LAG s’exécute donc inconditionnellement au sein de cette sous-population, ce qui confère au décalage une cohérence interne parfaite. La seconde approche, si l’ensemble des lignes doit être conservé dans la table finale, consiste à abandonner l’usage de la fonction LAG au profit d’une structure d’accumulation basée sur l’instruction RETAIN, dont le comportement lors de conditions logiques s’avère dénué de tout effet de bord masqué :
DATA synthese_dosages;

  SET suivi_global;

  RETAIN dernier_dosage_valide .;

  dosage_reference = dernier_dosage_valide;

  IF dosage_biologique IS NOT MISSING THEN dernier_dosage_valide = dosage_biologique;

RUN;
6. Traitement par sous-groupes : Utilisation conjointe de LAG et de l’instruction BY
6.1 Nécessité du tri préalable et variables automatiques FIRST. et LAST.
Dans la quasi-totalité des études biomédicales ou des bases de données d’entreprises, les données ne forment pas une série chronologique unique mais se composent de multiples sous-séries associées à des unités statistiques indépendantes : des patients, des centres hospitaliers, des départements ou des clients. L’application aveugle de la fonction LAG sur une table regroupant plusieurs entités engendre un problème critique d’intégrité désigné sous le terme de contamination inter-groupes.
Sans précaution particulière, la fonction LAG applique le décalage de manière mécanique entre la dernière ligne du patient A et la première ligne du patient B qui lui succède immédiatement dans l’ordre physique du fichier. Le patient B se voit alors attribuer comme valeur historique antérieure la mesure clinique finale du patient A, une aberration méthodologique susceptible d’invalider l’ensemble des inférences statistiques tirées de l’étude.
La neutralisation de ce risque repose sur l’exploitation des capacités de partitionnement offertes par l’instruction BY au sein de l’étape DATA, laquelle requiert obligatoirement un tri préalable des données via la procédure PROC SORT :
PROC SORT DATA=mesures_patients OUT=mesures_triees;

  BY patient_id date_visite;

RUN;
Lorsqu’une clause BY patient_id; est intégrée dans un Data Step exploitant une table préalablement ordonnée, le compilateur SAS crée automatiquement deux variables temporaires booléennes dans le PDV : FIRST.patient_id et LAST.patient_id. La variable FIRST.patient_id adopte la valeur 1 pour l’enregistrement qui inaugure un nouveau groupe d’identifiant et retombe à 0 pour tous les enregistrements subséquents appartenant au même individu. Ces indicateurs dynamiques constituent la sentinelle algorithmique indispensable pour gérer l’étanchéité de nos calculs séquentiels.
6.2 Réinitialisation des décalages aux frontières de groupes
L’application rigoureuse de la fonction LAG au sein d’un traitement par sous-groupes impose de réinitialiser explicitement la variable cible à une valeur manquante dès lors que le traitement franchit la frontière séparant deux entités distinctes. Cette réinitialisation garantit que la première observation de chaque sujet est traitée comme une origine absolue d’observation, exempte de toute interférence avec le sujet précédent.
Considérons l’implémentation formelle suivante appliquée à une cohorte multi-sujets :
DATA mesures_groupees_lag;

  SET mesures_triees;

  BY patient_id;
/* Étape 1 : Appel inconditionnel de la fonction LAG */
mesure_tampon = LAG(score_clinique);
/* Étape 2 : Rupture délibérée de la mémoire à la frontière du groupe */
IF FIRST.patient_id THEN DO;
score_precedent = .;
END;
ELSE DO;
score_precedent = mesure_tampon;
END;
DROP mesure_tampon;
RUN;
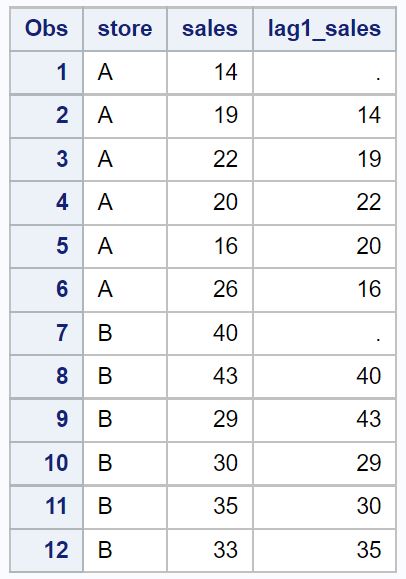
Cette architecture respecte scrupuleusement la cinématique interne de SAS. La fonction LAG s’exécute à chaque ligne, absorbant la valeur courante dans sa pile FIFO afin que la chaîne temporelle ne subisse aucune perturbation. Immédiatement après, l’interrupteur logique IF FIRST.patient_id intercepte la transition d’identifiant : si le système commence l’évaluation d’un nouveau patient, la variable score_precedent est forcée à la valeur manquante (.), neutralisant avec succès la valeur résiduelle extraite de la pile qui appartenait au patient précédent. Pour toutes les observations ultérieures du même patient, la condition FIRST est fausse et la valeur tampon issue de la pile est transmise à la variable définitive.
6.3 Gestion des sous-groupes hiérarchiques multiples
Dans de nombreuses architectures de recherche clinique, les protocoles adoptent des structures hiérarchiques imbriquées (Nestings complexes), telles que centre_id > patient_id > cycle_traitement > visite_jour. L’application de la fonction LAG dans de tels environnements exige une rigueur redoublée dans l’ordonnancement de l’évaluation logique des bornes de sous-groupes.
En vertu des règles de traitement du système SAS, lorsqu’une instruction BY déclare une série de variables hiérarchiques (BY centre_id patient_id cycle_traitement;), toute rupture survenant à un niveau hiérarchique supérieur entraîne obligatoirement et automatiquement la réinitialisation de l’ensemble des indicateurs subordonnés. En d’autres termes, si FIRST.centre_id = 1, alors FIRST.patient_id et FIRST.cycle_traitement sont obligatoirement égaux à 1, même si par coïncidence numérique le numéro d’identification du patient est identique d’un centre à l’autre.
Pour assurer la robustesse algorithmique sur des cohortes hautement déséquilibrées (unbalanced panels) comportant un nombre variable de visites par patient, le développeur doit toujours indexer la réinitialisation de la mémoire sur la variable BY correspondant à la granularité la plus fine du groupe d’intérêt :
DATA suivi_hierarchique_securise;

  SET donnees_multicentriques;

  BY centre_id patient_id cycle_traitement;


  dose_precedente_cycle = LAG(dose_administree);


  /* Réinitialisation étanche à l'échelle du patient et du cycle */

  IF FIRST.cycle_traitement THEN dose_precedente_cycle = .;

RUN;
Ce patron de programmation assure que dès lors qu’un nouveau cycle thérapeutique débute pour un individu donné—ou a fortiori dès lors que l’on bascule sur un nouveau patient ou un nouveau centre d’investigation clinique—la valeur de référence est systématiquement assainie, évitant ainsi des erreurs d’attribution de posologie antécédente.
7. Calculs dérivés : Variations absolues, taux d’évolution et indicateurs temporels
7.1 Calcul de la différence première (First Difference)
L’une des finalités analytiques majeures motivant l’emploi d’opérateurs de retard réside dans l’obtention de la différence première, formalisée mathématiquement par l’équation standard :
$$\Delta y_t = y_t – y_{t-1}$$
Cette transformation constitue l’étape fondamentale d’élimination des tendances stochastiques dans la modélisation autorégressive intégrée moyenne mobile (ARIMA) et dans l’étude des processus de diffusion. Sous SAS, la transcription algorithmique directe s’exprime à travers l’opération arithmétique :
delta_valeur = valeur - LAG(valeur);
Toutefois, les ingénieurs système de SAS ont développé une fonction optimisée dédiée spécifiquement à cet usage matriciel : la fonction DIF. Syntactiquement équivalente à l’expression arithmétique soustractive, la fonction DIF(x) retourne directement la différence entre la valeur courante de x et son décalage d’ordre un. De manière analogue à LAG, elle dispose de variantes indicées telles que DIF2(x) ou DIFn(x), qui calculent rigoureusement la quantité x(t) – x(t-n) :
DATA verification_differences;

  SET suivi_clinique;

  delta_arithmetique = pas_systolique - LAG(pas_systolique);

  delta_fonction_dif = DIF(pas_systolique);

RUN;
L’utilisation de la primitive DIF présente un avantage indéniable en termes de clarté syntaxique et de concision du code source. Sur le plan de la cinématique d’exécution, la fonction DIF encapsule sa propre file d’attente FIFO et obéit aux mêmes règles absolues relatives à l’exécution conditionnelle : elle ne doit jamais être encapsulée dans un bloc IF-THEN non maîtrisé sous peine de désynchroniser la soustraction sérielle.
7.2 Calcul des taux de croissance et pourcentages de variation
Si la différence absolue quantifie l’amplitude brute d’une variation, l’économie de la santé et la pharmaco-économie privilégient les grandeurs sans dimension, mesurées par le taux de variation relatif exprimé en pourcentage :
$$\text{Taux}_t = \left(\frac{y_t – y_{t-1}}{y_{t-1}}\right) \times 100$$
La transcription informatique de cette équation sous SAS doit être conduite avec une prudence méthodologique absolue en raison du danger mathématique de la division par zéro ou de la division par une valeur manquante. Si la valeur décalée au dénominateur est nulle ou absente, l’interpréteur SAS déclenche l’émission d’un message d’erreur d’opération mathématique invalide (Division by zero detected) dans le journal d’exécution et affecte une valeur manquante au résultat.
Pour immuniser le traitement contre ce type d’interruption logicielle, le calcul doit faire l’objet d’une structure de vérification défensive :
DATA calcul_taux_croissance;

  SET suivi_clinique;

  valeur_prec = LAG(pas_systolique);
IF NOT MISSING(valeur_prec) AND valeur_prec NE 0 THEN DO;
pct_evolution = ((pas_systolique - valeur_prec) / valeur_prec);
END;
ELSE DO;
pct_evolution = .;
END;
FORMAT pct_evolution PERCENT8.2;
RUN;
L’association de l’instruction FORMAT pct_evolution PERCENT8.2; permet à SAS d’assurer la conversion d’affichage en multipliant la fraction par 100 et en adjoignant le symbole typographique du pourcentage lors des sorties tabulaires ou graphiques, tout en conservant la précision réelle en virgule flottante sous-jacente pour les calculs d’agrégation subséquents.
7.3 Détection d’événements discrets et de changements d’état
Au-delà des métriques continues, la fonction LAG constitue le vecteur privilégié pour concevoir des variables de marquage binaire (Flags) matérialisant des franchissements de seuils critiques (Threshold crossing) ou des basculements qualitatifs majeurs au sein de cohortes suivies longitudinalement.
Considérons l’identification automatisée d’un événement indésirable grave défini par le passage subit d’une pression artérielle normale (< 140 mmHg) à un état de crise hypertensive (≥ 140 mmHg) :
DATA detection_crise;

  SET suivi_clinique;

  BY patient_id;

  pas_anterieure = LAG(pas_systolique);
/* Initialisation par défaut de l'indicateur d'incident */
flag_crise_hypertensive = 0;
/* Évaluation sécurisée excluant la première visite */
IF NOT FIRST.patient_id AND NOT MISSING(pas_anterieure) THEN DO;
IF pas_anterieure < 140 AND pas_systolique >= 140 THEN DO;
flag_crise_hypertensive = 1;
END;
END;
RUN;
La distribution empirique de ces événements de transition peut être auditée sans délai au moyen de la procédure statistique descriptive PROC FREQ :
PROC FREQ DATA=detection_crise;

  TABLES flag_crise_hypertensive / MISSPRINT NOCUM;

RUN;
Ce formalisme garantit que les observations inaugurales de chaque patient ne génèrent pas de faux signaux positifs du fait de l’absence de valeur antérieure, fournissant un jeu de données propre et standardisé prêt pour l’analyse de survie ou l’ajustement de modèles à risques proportionnels de Cox.
8. Applications empiriques aux données longitudinales en sciences comportementales
8.1 Analyse des séries chronologiques individuelles (N-of-1 designs)
Les protocoles de recherche contemporains en psychologie expérimentale et en médecine comportementale s’appuient régulièrement sur des devis de recherche à sujet unique (N-of-1 designs). Dans ces dispositifs, un individu unique est suivi de manière intensive à travers des centaines de mesures répétées afin d’évaluer la cinétique de sa réponse psychologique face à une intervention spécifique ou à un protocole d’exposition contrôlé.
Au cœur de ces analyses réside l’estimation de l’inertie psychologique, conceptualisée comme la propension des états affectifs à persister d’un instant temporel à l’autre. Sur le plan statistique, cette inertie est opérationnalisée par le coefficient d’autocorrélation d’ordre 1 extrait d’un modèle autorégressif de forme :
$$\text{Affection}_t = \beta_0 + \beta_1 \times \text{Affection}_{t-1} + \epsilon_t$$
Pour construire la base analytique sous SAS, la fonction LAG intervient pour créer le terme régresseur décalé :
DATA serie_psychometrique;

  SET donnees_suivi_journalier;

  score_affect_lag1 = LAG(score_affect_negatif);

  IF _N_ = 1 THEN DELETE; /* Élimination formelle du point initial */

RUN;
PROC REG DATA=serie_psychometrique;
MODEL score_affect_negatif = score_affect_lag1;
RUN;
QUIT;
Le paramètre $\beta_1$ estimé par la procédure de régression linéaire PROC REG quantifie avec précision l’indice d’autorégulation émotionnelle du sujet : un coefficient significativement proche de 1 témoigne d’une rigidité psychologique prononcée et d’une résistance à l’extinction du stress, tandis qu’un coefficient proche de 0 illustre une excellente homéostasie psychique.
8.2 Modélisation de l’évaluation écologique momentanée (EMA)
L’évaluation écologique momentanée (Ecological Momentary Assessment – EMA) constitue l’un des domaines les plus prolifiques pour l’utilisation des fonctions de retard. Dans ce paradigme, les sujets reçoivent des notifications aléatoires sur leur smartphone plusieurs fois par jour afin d’évaluer leur anxiété ou leur craving en temps réel dans leur environnement naturel. Cette modalité de collecte produit des données séquentielles caractérisées par des intervalles temporels irréguliers.
Dans un tel contexte, l’application aveugle d’une fonction LAG induit un biais conceptuel grave : comparer une mesure prise à 14h00 à celle prise à 13h30 (écart de 30 minutes) n’a pas la même signification clinique que de la comparer à une mesure prise la veille au soir à 22h00 (séparée par une nuit de sommeil de 16 heures). Il devient alors impératif de combiner le décalage de la métrique avec le décalage synchrone de l’horodatage précis pour évaluer la distance physique temporelle :
DATA preparation_ema;

  SET mesures_smartphones;

  BY patient_id;
temps_precedent = LAG(horodatage_visite);
craving_precedent = LAG(score_craving);
IF FIRST.patient_id THEN DO;
temps_precedent = .;
craving_precedent = .;
ecart_minutes = .;
END;
ELSE DO;
/* Calcul de la différence temporelle en minutes via INTCK */
ecart_minutes = INTCK('MINUTE', temps_precedent, horodatage_visite);
END;
/* Filtrage méthodologique : conservation exclusive des paires <= 180 min */
IF ecart_minutes > 180 THEN craving_precedent = .;
RUN;
Cette approche hybride associe la fonction LAG pour la saisie structurelle du signal historique et la fonction chronologique INTCK pour conditionner la validité clinique du décalage, garantissant que seules les transitions intra-journalières proximales alimentent l’inférence causale.
8.3 Préparation des prédicteurs autorégressifs pour modèles mixtes
Lors de l’analyse de cohortes longitudinales multicentriques englobant des milliers d’observations répétées, la procédure de modélisation linéaire mixte PROC MIXED représente l’étalon-or méthodologique. Elle permet de dissocier les effets fixes populationnels des trajectoires aléatoires propres à chaque individu.
L’introduction d’un prédicteur retardé au sein d’une équation mixte (modèle autorégressif à effets mixtes) exige une prévention rigoureuse des biais d’anticipation. En intégrant dans l’étape DATA préliminaire la variable décalée y(t-1), le modélisateur prépare la structure nécessaire pour estimer l’effet intra-individuel pur en neutralisant la composante inter-individuelle moyenne :
PROC MIXED DATA=preparation_ema METHOD=REML;

  CLASS patient_id condition_traitement;

  MODEL score_craving = craving_precedent condition_traitement / SOLUTION DDFM=KENWARDROGER;

  RANDOM INTERCEPT / SUBJECT=patient_id TYPE=UN;

  REPEATED / SUBJECT=patient_id TYPE=AR(1);

RUN;
Dans cette architecture empirique, l’utilisation conjointe d’une covariable retardée dérivée par la fonction LAG et d’une structure de covariance résiduelle autorégressive de type AR(1) au sein de l’instruction REPEATED offre une flexibilité sans égale : elle capture simultanément la dynamique directe de la rétroaction séquentielle et la persistance stochastique du bruit résiduel.
9. Analyse comparative : Fonction LAG versus RETAIN et Tableaux Temporaires
9.1 Mise en parallèle fonctionnelle entre LAG et RETAIN
L’instruction RETAIN et la fonction LAG constituent les deux piliers historiques de la programmation séquentielle sous SAS, mais leurs mécanismes fondamentaux et leurs philosophies architecturales divergent radicalement. Alors que LAG matérialise une file d’attente FIFO autonome qui se met à jour par échantillonnage au passage de l’instruction, l’instruction RETAIN intervient directement sur le cycle de vie du Program Data Vector en désactivant la remise à blanc systématique d’une variable à l’amorce de chaque nouveau cycle DATA.
Le tableau ci-dessous explicite les divergences structurales entre ces deux concepts fondamentaux :
| Critère de comparaison | Fonction LAG | Instruction RETAIN |
|---|---|---|
| Mécanisme sous-jacent | File d’attente FIFO mémoire éphémère | Persistance d’état dans le PDV |
| Exécution conditionnelle | Fortement déconseillée (risque d’anomalie silencieuse) | Parfaitement adaptée et naturelle |
| Décalages d’ordres élevés | Native et directe (LAGn) |
Exige la création manuelle de multiples variables de relais |
| Accès au passé lointain | Limité par la dimension statique déclarée de la pile | Permet la conservation indéfinie d’une valeur sentinelle |
Le recours à RETAIN s’avère supérieur dès lors que la valeur historique de référence ne doit pas être extraite de la ligne précédente immédiate, mais doit représenter le dernier événement notable ayant satisfait une condition complexe passée (comme la conservation de la date d’entrée dans l’étude tout au long des lignes de suivi ultérieures).
9.2 Utilisation de tableaux temporaires (_TEMPORARY_) pour les décalages longs
Lorsque les exigences de l’analyse imposent de manipuler des fenêtres temporelles rétrospectives étendues (par exemple calculer une médiane glissante sur les 180 derniers jours) ou lorsque l’empreinte disque doit être rigoureusement minimisée, l’emploi de fonctions LAG répétées (LAG1 à LAG180) devient prohibitif sur le plan computationnel. Dans ce contexte, la mise en œuvre d’un tampon circulaire à l’aide d’un tableau temporaire (ARRAY _TEMPORARY_) constitue la solution algorithmique optimale.
Les variables déclarées avec l’attribut _TEMPORARY_ résident en mémoire vive, possèdent l’attribut de rétention automatique (RETAIN implicite), et ne sont jamais écrites dans la table SAS finale générée, libérant ainsi totalement le système des opérations coûteuses d’entrée-sortie disque :
DATA calcul_tampon_circulaire;

  SET mesures_continues;

  /* Déclaration d'un tampon circulaire de taille 5 */

  ARRAY historique(5) _TEMPORARY_;


  /* Détermination de l'indice circulaire d'écriture */

  indice_circulaire = MOD(_N_ - 1, 5) + 1;


  /* Extraction de la valeur d'il y a 5 cycles si le tampon est plein */

  IF _N_ > 5 THEN valeur_retard_5 = historique(indice_circulaire);

  ELSE valeur_retard_5 = .;


  /* Écriture de la valeur présente dans la cellule libérée */

  historique(indice_circulaire) = mesure_valeur;

RUN;
Ce patron algorithmique offre une complexité temporelle unitaire en $O(1)$ pour l’insertion et l’accès, tout en s’affranchissant totalement des files FIFO figées du compilateur LAG.
9.3 Matrice de décision méthodologique pour le choix de la méthode
Afin de guider l’architecte de données et le programmeur dans le choix de la technologie la plus adaptée à leur problématique d’analyse séquentielle, nous avons synthétisé les critères d’arbitrage au sein d’une matrice décisionnelle formelle :
- Choisir la fonction LAG : Pour tout décalage linéaire d’ordre faible ou modéré ($n le 10$) sur des séries ordonnées complètes, lorsque le décalage doit s’exécuter inconditionnellement à chaque ligne du fichier ou au sein de blocs BY strictement étanchéifiés par
FIRST.variable. - Choisir l’instruction RETAIN : Pour le transport de valeurs de statut non systématiques, la persistance de constantes d’état ou l’échantillonnage conditionnel asynchrone fondé sur des règles logiques complexes dépendant d’événements distants.
- Choisir les tableaux _TEMPORARY_ : Pour le calcul de statistiques de fenêtres glissantes de grande dimension ($n > 20$), le calcul matriciel intensif sur des millions d’enregistrements et les architectures haute performance soumises à de strictes contraintes d’optimisation de mémoire cache.
10. Simulation d’une fonction LEAD (valeur future) dans SAS en l’absence de primitive native
10.1 Compréhension de l’absence de fonction LEAD directe dans SAS Base
L’une des interrogations les plus fréquentes formulées par les analystes initiés au standard SQL (notamment aux fonctions de fenêtrage conformes à la norme ANSI SQL:2003) concerne l’inexistence apparente d’une fonction symétrique LEAD dans le langage SAS Base standard. Alors que LAG permet d’interroger le passé ($t-1$), il n’existe pas de commande native permettant d’écrire directement valeur_future = LEAD(valeur);.
Cette asymétrie résulte de la nature ontologique fondamentale du compilateur du Data Step de SAS. Le moteur d’exécution a été originellement conçu pour fonctionner sous des contraintes matérielles sévères, en minimisant l’empreinte en mémoire vive par la lecture unitaire et unidirectionnelle du pointeur de fichier d’entrée. Lorsque le curseur d’exécution se trouve sur l’enregistrement t, le système ne charge pas d’avance les octets de l’enregistrement t+1 dans le PDV. L’interpréteur ne peut « deviner » le futur sans qu’une instruction programmatique explicite n’ordonne au pointeur de lecture de progresser dans la structure physique de la table.
10.2 Méthode du double SET avec décalage de pointeur (POINT= ou FIRSTOBS=)
La méthode la plus performante, la plus élégante et la plus éprouvée au sein de la communauté des développeurs SAS pour émuler une fonction LEAD repose sur la technique dite du « double SET » exploitant l’option de démarrage de lecture FIRSTOBS=2.
Cette approche consiste à ouvrir deux flux de lecture simultanés sur la même table source au sein du même Data Step : le premier flux lit la table ligne par ligne à partir du début (observation 1), tandis que le second flux lit la même table mais avec une avance d’une ligne, débutant son extraction à la deuxième observation :
DATA donnees_avec_lead;

  /* Flux 1 : Lecture normale de l'enregistrement courant */

  SET suivi_clinique;


  /* Flux 2 : Lecture avancée capturant l'enregistrement t+1 */

  IF _N_ < total_obs THEN DO;

    SET suivi_clinique(FIRSTOBS=2 KEEP=pas_systolique RENAME=(pas_systolique=pas_futur)) NOBS=total_obs;

  END;

  ELSE DO;

    /* À la dernière observation, le futur n'existe pas : affectation manquante */

    pas_futur = .;

  END;

RUN;
Cette structure impose une attention particulière à la condition _N_ < total_obs associée à l’option de métadonnées NOBS=total_obs. En l’absence de cette clause de verrouillage, le second SET tenterait de lire au-delà de la fin physique du fichier (End-of-File) lors de la dernière observation, ce qui provoquerait l’arrêt prématuré et immédiat du Data Step avant même que la dernière ligne du premier flux n’ait pu être écrite dans la table cible ! Grâce à ce garde-fou, la ligne terminale reçoit proprement une valeur manquante pour la variable pas_futur, reproduisant rigoureusement le comportement standard d’une fonction LEAD native.
10.3 Alternative par tri inverse ou procédure SQL
Pour les programmeurs privilégiant les architectures descriptives ou réticents à la manipulation des pointeurs de fichiers, deux autres alternatives de contournement s’offrent à l’ingénieur :
L’approche par inversion de chronologie : Elle consiste à inverser l’ordre des enregistrements via PROC SORT en appliquant un tri descendant sur la variable temporelle, à appliquer la fonction LAG classique (qui agit alors conceptuellement comme un LEAD sur la série originelle), puis à réinverser la table par un tri ascendant final :
/* 1. Tri descendant */

PROC SORT DATA=suivi_clinique OUT=tri_inverse;

  BY DESCENDING jour_mesure;

RUN;
/* 2. Application du LAG classique */
DATA lead_via_lag;
SET tri_inverse;
pas_futur = LAG(pas_systolique);
RUN;
/* 3. Rétablissement de la chronologie initiale */
PROC SORT DATA=lead_via_lag OUT=table_finale;
BY jour_mesure;
RUN;
Bien que conceptuellement infaillible, cette méthode génère un coût computationnel considérable sur de grands volumes de données en raison des deux opérations de tri externe sur disque qu’elle impose.
L’approche SQL par auto-jointure non équivalente : Elle exploite l’interfaçage avec le moteur relationnel PROC SQL pour associer directement les lignes $t$ et $t+1$ :
PROC SQL;

  CREATE TABLE lead_sql AS

  SELECT a.*, b.pas_systolique AS pas_futur

  FROM suivi_clinique AS a

  LEFT JOIN suivi_clinique AS b

    ON a.jour_mesure = b.jour_mesure - 1;

QUIT;
Cette formulation est particulièrement lisible, mais suppose que l’incrément temporel soit rigoureusement régulier et unitaire, ce qui n’est pas garanti dans toutes les bases de données d’observation.
11. Diagnostic des erreurs courantes, cas limites et gestion des valeurs manquantes
11.1 Propagation indésirable des valeurs manquantes et stratégies d’atténuation
L’un des défis opérationnels les plus constants dans le traitement des séries chronologiques réside dans la gestion des données manquantes préexistantes au sein de la table d’entrée. Lorsqu’une variable source contient elle-même un point (.), l’application d’un décalage temporel transfère fidèlement cette absence de données vers l’observation suivante.
Si des calculs arithmétiques chaînés sont appliqués (par exemple la somme de la valeur présente et de ses deux retards : somme = valeur + LAG1(valeur) + LAG2(valeur);), la présence d’une seule valeur manquante au sein du triplet entraîne la conversion automatique de l’ensemble de la somme en valeur manquante, créant ce que les statisticiens nomment un effet domino de contamination. Pour pallier ce comportement indésirable, l’emploi des fonctions statistiques d’agrégation de base (telles que SUM ou MEAN) est vivement recommandé :
DATA sommation_robuste;

  SET series_temporelles;

  retard1 = LAG1(valeur);

  retard2 = LAG2(valeur);
/* L'opérateur + propage les valeurs manquantes */
somme_naive = valeur + retard1 + retard2;
/* La fonction SUM ignore les valeurs manquantes si au moins un élément existe */
somme_securisee = SUM(valeur, retard1, retard2);
RUN;
Dans cette structure, SUM n’exclut pas les calculs mais agrège les éléments effectivement renseignés, assurant une continuité de traitement tout en respectant les exigences de robustesse analytique.
11.2 Erreurs de typage et incompatibilité d’attributs de variables
L’analyse des journaux d’exécution (SAS Log) révèle fréquemment l’apparition de messages d’avertissement de type NOTE: Numeric values have been converted to character values ou inversement. Ces alertes surviennent quasi systématiquement lorsque la variable réceptrice a été préalablement déclarée avec un type divergent de celui de la variable source transmise à la fonction LAG.
SAS tente d’opérer une conversion implicite au moment de l’exécution, ce qui non seulement pénalise lourdement le temps processeur en contraignant la machine à invoquer des routines de transtypage dynamique d’octets, mais peut également induire des pertes de précision numérique dramatiques sur les nombres réels à virgule flottante ou masquer des erreurs de formatage.
La standardisation du code impose de procéder impérativement à des conversions explicites en amont de l’appel à la fonction LAG par le biais des fonctions universelles INPUT (conversion caractère vers numérique) ou PUT (conversion numérique vers chaîne textuelle) :
DATA conversion_conforme;

  SET donnees_brutes;

  /* Conversion explicite sécurisée */

  pas_num = INPUT(pas_caractere, BEST12.);

  pas_num_lag1 = LAG(pas_num);

RUN;
11.3 Gestion des jeux de données de taille unitaire ou vide
L’extrême robustesse d’un pipeline de production se mesure à sa résilience face aux cas limites (Edge cases). Deux scénarios d’exécution singuliers mettent fréquemment en échec les programmes mal défendus : les jeux de données totalement vides (0 observation) et les jeux de données ne contenant qu’une seule ligne (1 observation).
Lorsqu’une table source ne comporte aucune ligne, le Data Step initialise le PDV, constate l’absence immédiate de données sur l’instruction SET et clôture la boucle sans jamais exécuter la moindre instruction algorithmique. Aucune anomalie n’est générée, mais la table de sortie demeure vierge. En revanche, lorsqu’une table ne contient qu’une seule observation, l’instruction LAG est exécutée exactement une fois. Par définition architecturale de la file FIFO, elle retourne inévitablement une valeur manquante.
Si la logique du programme en aval suppose implicitement l’existence d’une variation pour calculer des indicateurs critiques, l’analyste doit intégrer des structures conditionnelles basées sur le descripteur de comptage du dictionnaire SAS :
DATA _NULL_;

  IF 0 THEN SET suivi_clinique NOBS=nb_lignes;

  CALL SYMPUTX('NB_OBS', nb_lignes);

  STOP;

RUN;
%MACRO auditer_donnees;
%IF &NB_OBS < 2 %THEN %DO;
%PUT WARNING: Le jeu de données ne dispose pas d'une profondeur temporelle suffisante pour l'analyse des retards.;
%END;
%ELSE %DO;
DATA sortie_validee;
SET suivi_clinique;
pas_prec = LAG(pas_systolique);
RUN;
%END;
%MEND auditer_donnees;
%auditer_donnees;
Cette approche macro-analytique protège la chaîne de production automatisée contre les interruptions intempestives et certifie que les procédures statistiques ultérieures ne s’exécutent que sur des structures de données mathématiquement viables.
12. Bonnes pratiques de programmation, optimisation et standardisation de code
12.1 Règles stylistiques et documentation pour la maintenance du code
La pérennité et l’auditabilité des programmes statistiques au sein des organisations hautement réglementées (telles que l’industrie pharmaceutique sous les directives de la FDA ou le secteur bancaire sous les normes Bâle III) requièrent l’adoption de conventions stylistiques irréprochables.
Pour l’usage des fonctions de retards, la nomenclature des variables dérivées doit obligatoirement expliciter de manière non ambiguë la nature de la variable source et la profondeur exacte de l’horizon de retard appliqué. L’adoption d’un formalisme standardisé de type <nom_source>_lag<n> (ex. pas_lag1, glycemie_lag7) doit être systématiquement privilégiée au détriment d’appellations floues ou génériques telles que anc_valeur ou temp.
De surcroît, chaque bloc de décalage doit être documenté par des commentaires décrivant explicitement l’unité temporelle sous-jacente et les hypothèses de gestion des ruptures :
/*-------------------------------------------------------------------*

| PROJET : ÉTUDE DE COHORTE CARDIOVASCULAIRE                         |

| OBJET  : Calcul du décalage journalier (t-1) de la PAS             |

| RÈGLE  : Réinitialisation obligatoire à chaque nouveau patient     |

*-------------------------------------------------------------------*/

DATA etude_standardisee;

  SET mesures_triees;

  BY patient_id date_visite;
/* Capture inconditionnelle */
pas_systolique_lag1 = LAG1(pas_systolique);
/* Étanchéité de la cohorte */
IF FIRST.patient_id THEN pas_systolique_lag1 = .;
LABEL pas_systolique_lag1 = "PAS de la visite antérieure (mmHg)";
RUN;
12.2 Optimisation des performances sur des volumétries massives
Lorsque le volume des enregistrements atteint des dizaines ou des centaines de millions de lignes, l’impact cumulé des micro-opérations d’écriture au sein du Program Data Vector peut dégrader significativement les temps de traitement CPU et saturer les canaux d’entrée-sortie de l’infrastructure de stockage.
Pour maximiser le débit de traitement (Throughput) lors de l’usage intensif de fonctions LAG, plusieurs optimisations de bas niveau doivent être déployées :
- Élagage drastique via DROP et KEEP : Toute variable intermédiaire ayant servi à capturer des valeurs décalées pour des calculs dérivés doit être impérativement éliminée de la table finale au moyen de l’instruction
DROP, allégeant ainsi le volume d’écriture physique sur disque. - Conditionnement des formats dans la table finale : Éviter d’associer des formats d’affichage lourds au sein de tables intermédiaires ; réserver l’assignation des formats pour les tables de restitution finales destinées au reporting.
- Ajustement de la taille des mémoires tampons d’entrée-sortie : L’utilisation conjointe de l’option système
BUFSIZE=etBUFNO=permet d’accroître la quantité de blocs disques chargés simultanément en RAM, réduisant la latence globale lors des itérations successives du Data Step exécutant des fonctions de décalage.
12.3 Synthèse globale et arbre décisionnel pour l’analyse séquentielle
Pour parachever ce manuel de référence, nous synthétisons les étapes clés régissant la manipulation de séries temporelles sous SAS au sein d’une check-list d’assurance qualité opérationnelle :
- La table source a-t-elle été rigoureusement ordonnée par les variables de partitionnement et de chronologie (
PROC SORT) ? - L’instruction
LAGouLAGnest-elle invoquée de manière strictement inconditionnelle, hors de tout blocIF-THEN? - L’étanchéité des calculs entre sujets indépendants est-elle certifiée par l’instruction
BYcouplée à la réinitialisationIF FIRST.id THEN lag_var = .;? - La division par zéro ou par valeur manquante est-elle explicitement neutralisée lors du calcul des taux d’évolution relatifs ?
- Dans le cas d’une simulation prospective (LEAD), la condition terminale d’arrêt du fichier a-t-elle été verrouillée pour éviter l’interruption prématurée du traitement ?
En observant scrupuleusement ces règles architecturales et méthodologiques, les analystes de données, biostatisticiens et chercheurs garantissent la totale intégrité statistique de leurs dérivations séquentielles, transformant la fonction LAG d’une source potentielle d’anomalies en un puissant levier d’investigation longitudinale au sein du système SAS.
Références
Allison, P. D. (2014). Event history and survival analysis: Second edition. SAGE Publications.
Cody, R. (2018). Cody’s data cleaning techniques using SAS: Third edition. SAS Institute Inc. https://support.sas.com/en/books.html
Delwiche, L. D., & Slaughter, S. J. (2019). The little SAS book: A primer (6th ed.). SAS Institute Inc.
Diggle, P. J., Heagerty, P., Liang, K. Y., & Zeger, S. L. (2002). Analysis of longitudinal data (2nd ed.). Oxford University Press. https://doi.org/10.1093/acprof:oso/9780198524847.001.0001
Fitzmaurice, G. M., Laird, N. M., & Ware, J. H. (2011). Applied longitudinal analysis (2nd ed.). John Wiley & Sons.
SAS Institute Inc. (2020). SAS® 9.4 Functions and CALL Routines: Reference. SAS Institute Inc. https://documentation.sas.com/
SAS Institute Inc. (2021). SAS® 9.4 Language Reference: Concepts. SAS Institute Inc. https://documentation.sas.com/
Singer, J. D., & Willett, J. B. (2003). Applied longitudinal data analysis: Modeling change and event occurrence. Oxford University Press. https://doi.org/10.1093/acprof:oso/9780195152968.001.0001