
Dans l’écosystème du traitement analytique des données et de l’informatique décisionnelle, le progiciel SAS (Statistical Analysis System) s’est imposé depuis plusieurs décennies comme un standard de référence au sein des industries pharmaceutiques, financières, assurantielles et de la recherche publique. La manipulation précise et rigoureuse des structures de données matricielles constitue le socle opérationnel sur lequel repose toute inférence statistique ou modélisation prédictive subséquente. Au sein de cet édifice méthodologique, la capacité à segmenter, filtrer et expurger les observations non pertinentes représente une compétence élémentaire mais cruciale pour tout analyste, statisticien ou ingénieur de données.
La gestion du cycle de vie des enregistrements au cours de l’exécution d’un programme SAS mobilise des concepts d’architecture interne sophistiqués, notamment le fonctionnement séquentiel de l’étape DATA (Data Step) et l’interaction dynamique avec la mémoire vive via le vecteur de données de programme (Program Data Vector ou PDV). Contrairement à de simples filtres visuels appliqués dans des tableurs grand public, la suppression de lignes dans SAS répond à des règles de compilation et d’exécution déterministes qui conditionnent directement l’intégrité référentielle, les temps de calcul machine et l’espace de stockage sur disque.
Cet article propose une exploration méthodique, théorique et appliquée des mécanismes présidant à la suppression conditionnelle d’observations dans SAS. À travers l’étude approfondie de trois cas d’école progressifs — allant de l’élimination univariée simple à la disjonction logique complexe —, nous analyserons comment exploiter l’instruction DELETE, tout en mettant en perspective cette approche avec les paradigmes concurrents ou complémentaires que sont le sous-ensemble conditionnel (Subsetting IF), la clause d’optimisation WHERE et les requêtes relationnelles via la procédure PROC SQL.
1. Introduction aux mécanismes de filtrage et de suppression de données dans SAS
1.1 Importance de l’épuration des données dans le pipeline analytique
Au cœur de la démarche empirique en science des données, la qualité des résultats statistiques dépend intrinsèquement de la pureté du matériau informationnel mobilisé, principe universellement résumé par l’adage « garbage in, garbage out ». L’épuration des données, loin de constituer une simple formalité technique, s’inscrit comme une étape pivot de la gouvernance des données. Éliminer des observations aberrantes, exclure des unités d’échantillonnage ne satisfaisant pas aux critères d’inclusion d’un protocole clinique, ou purger des doublons administratifs permet de garantir la robustesse des estimateurs statistiques, tels que la moyenne, la variance ou les coefficients de régression.
Sur le plan conceptuel, il est primordial d’établir une distinction formelle entre la suppression physique des données et leur filtrage programmatique temporaire. La suppression physique implique une modification définitive du support de persistance, entraînant la libération de blocs d’espace disque et la destruction irréversible des enregistrements ciblés, une opération qui requiert des protocoles stricts de sécurisation et d’audit. À l’opposé, le filtrage programmatique, prédominant dans les étapes de transformation SAS, consiste à extraire un sous-ensemble d’enregistrements d’une table source réputée immuable afin de générer une nouvelle table dérivée. Cette approche préserve le jeu de données primaire et garantit la traçabilité intégrale du pipeline analytique.
L’optimisation des flux de données engendre également des répercussions directes sur l’architecture matérielle sous-jacente. Dans des environnements traitant des volumes massifs (Big Data), conserver des lignes superflues au fil de dizaines d’étapes DATA successives sature inutilement la mémoire vive (RAM) allouée aux tampons de calcul et encombre le sous-système d’entrées-sorties (I/O). En restreignant le volume d’observations dès les phases initiales de la manipulation, l’analyste allège considérablement la charge computationnelle et réduit les temps de rotation des traitements par lots (batch processing).
1.2 Présentation des concepts d’observation et de variable dans le système SAS
Le système SAS structure l’information sous la forme d’une table rectangulaire bidimensionnelle, désignée sous le terme technique de table SAS (ou SAS Data Set). Cette structure bidirectionnelle s’articule rigoureusement autour de deux axes fondamentaux : les colonnes, désignées sous l’appellation de variables, et les lignes horizontales, qualifiées formellement d’observations. Chaque variable incarne une dimension descriptive ou une caractéristique quantitative ou qualitative, définie par un nom, un type strict (numérique ou caractère), une longueur en octets, ainsi que des attributs optionnels de format d’affichage et d’étiquetage sémantique.
D’un point de vue fonctionnel, une observation constitue un vecteur d’attributs individuels rattachés à une unité statistique distincte, qu’il s’agisse d’un patient au sein d’un essai clinique, d’une transaction bancaire ou d’une pièce industrielle. Dans l’écosystème SAS, la manipulation de ces observations ne s’opère pas globalement comme dans une algèbre matricielle pure, mais selon un paradigme itératif et séquentiel hérité de la conception des systèmes d’exploitation sur gros systèmes (mainframes). Le compilateur SAS lit la table d’entrée enregistrement par enregistrement, applique les règles de gestion formulées par le programmeur, puis décide souverainement de l’écriture ou du rejet de chaque ligne.
Cette logique séquentielle induit que toute action de suppression n’est pas exécutée rétroactivement sur l’ensemble de la table, mais s’évalue dynamiquement à l’instant précis où l’observation courante franchit le flux de traitement du compilateur. Comprendre cette granularité individuelle s’avère indispensable pour appréhender pourquoi et comment une condition logique peut intercepter une observation pour empêcher sa propagation vers la table de sortie.
1.3 Vue d’ensemble des trois paradigmes conditionnels de suppression
La logique d’exclusion des observations s’articule généralement autour de trois grands paradigmes conditionnels, dont la complexité formelle croît avec le nombre de dimensions évaluées simultanément. Le premier paradigme repose sur une approche déterministe univariée. Dans ce schéma, l’exclusion d’une ligne est subordonnée à l’évaluation d’un prédicat unique appliqué à une variable singulière, par exemple l’appartenance d’un sujet à un groupe témoin spécifique ou le franchissement d’un seuil métrique d’âge. C’est le niveau le plus accessible et le plus direct du filtrage de données.
Le deuxième paradigme met en œuvre une logique conjonctive cumulative, articulée autour de l’opérateur booléen AND. L’élimination d’une observation ne survient que si cette dernière satisfait simultanément une pluralité de conditions restrictives distinctes. Cette stratégie d’intersection logique permet d’isoler des sous-populations très précises présentant une conjonction de critères critiques, tout en maintenant dans le flux d’analyse les observations qui n’enfreignent qu’une partie de ces conditions. Elle exige une rigueur analytique accrue afin de ne pas exclure indûment des données par une accumulation mal calibrée de contraintes.
Enfin, le troisième paradigme mobilise une logique disjonctive alternative, matérialisée par l’opérateur booléen OR. Ici, la suppression devient hautement sélective ou inclusive selon la perspective : dès lors qu’un seul critère parmi un ensemble de conditions indépendantes est validé, l’enregistrement est immédiatement éjecté du circuit de production. Cette méthode s’avère redoutable pour purger de larges cohortes de données polluées ou pour appliquer des filtres de sécurité stricts, mais elle expose également le développeur à des risques accrus d’hyper-filtrage involontaire si les règles d’exclusion ne sont pas strictement circonscrites.
2. Architecture du Data Step : cycle d’exécution et traitement séquentiel
2.1 Le Program Data Vector (PDV) et son rôle dans la sélection
Pour maîtriser la suppression de lignes dans SAS, il est nécessaire de décortiquer les mécanismes intimes du Program Data Vector (PDV). Le PDV est une zone tampon dédiée au sein de la mémoire vive allouée par le système d’exécution lors de la phase de compilation d’une étape DATA. Sa fonction principale consiste à contenir, de manière séquentielle et ordonnée, l’ensemble des valeurs des variables pour une observation unique au cours de son traitement. Le PDV accueille non seulement les variables issues des tables sources déclarées dans l’instruction SET, mais également les variables temporaires calculées et les variables automatiques du système, telles que _N_ (compteur d’itérations de la boucle DATA) et _ERROR_ (drapeau signalant les erreurs d’exécution).
Le cycle de vie du PDV obéit à un algorithme immuable : initialisation de l’espace mémoire, lecture des valeurs depuis la table d’entrée, exécution séquentielle des instructions de manipulation ligne par ligne, écriture automatique de l’état final du vecteur dans la table de destination, puis réinitialisation des variables non conservées avant l’itération suivante. Dans cette dynamique, les instructions conditionnelles jouent le rôle de sentinelles. Lorsqu’une instruction de suppression est rencontrée, le compilateur court-circuite le flux d’exécution standard avant que l’ordre d’écriture sur disque ne soit émis.
L’évaluation des prédicats s’opère donc directement sur les valeurs instanciées au sein du PDV à un instant t. Si les valeurs présentes dans cette mémoire tampon satisfont aux critères d’exclusion définis par le développeur, le destin de l’observation courante bascule instantanément, garantissant que les données non désirées ne franchiront jamais la barrière de persistance du jeu de données final.
2.2 Sémantique et fonctionnement de l’instruction DELETE
L’instruction DELETE est l’outil programmatique dédié par excellence à l’interruption du traitement de l’enregistrement en cours au sein de l’étape DATA. Sa sémantique opérationnelle est radicale mais élégante : lorsqu’une clause conditionnelle formulée sous la structure IF condition THEN DELETE; est évaluée à vrai (soit une valeur booléenne différente de zéro et non manquante en langage SAS), l’exécution de l’étape DATA pour l’itération courante s’interrompt immédiatement.
Cette interruption signifie que toutes les instructions subséquentes situées en aval de l’instruction DELETE dans le corps de l’étape DATA sont purement et simplement ignorées pour cette observation spécifique. Plus fondamentalement encore, l’action automatique d’écriture de fin de boucle — qui transfère le contenu du PDV vers le fichier de données physique sur disque — est court-circuitée. La ligne présente dans le tampon mémoire est ainsi écartée sans laisser de trace dans la table réceptrice.
Simultanément à ce rejet, le pointeur d’exécution du système SAS est réinitialisé et renvoyé à la ligne supérieure de l’étape DATA pour amorcer l’itération suivante (correspondant à l’incrémentation de la variable automatique _N_). Le PDV est alors réinitialisé conformément aux attributs des variables, et l’enregistrement suivant est extrait de la table source. Il s’agit donc d’une suppression préventive de la persistance, agissant comme un régulateur de flux au cœur du moteur de traitement.
2.3 Différences fondamentales entre DELETE, OUTPUT implicite et STOP
Une confusion fréquente chez les programmeurs SAS débutants ou intermédiaires réside dans la distinction entre les instructions DELETE, OUTPUT et STOP, qui gouvernent toutes le flux d’exécution séquentiel mais selon des desseins totalement divergents. Par défaut, une étape DATA applique un mécanisme d’OUTPUT implicite : en l’absence de commande d’écriture spécifique, le système exécute une instruction OUTPUT invisible juste avant l’instruction RUN;, garantissant que chaque ligne lue et traitée soit transcrite dans la table de sortie. L’instruction DELETE a précisément pour fonction d’annuler cet OUTPUT implicite pour l’itération courante.
À l’inverse, dès lors qu’un développeur insère une instruction OUTPUT explicite dans le code, le comportement par défaut est désactivé. Dans cette configuration, seules les observations explicitement désignées par l’instruction OUTPUT sont écrites. Par conséquent, l’utilisation de DELETE devient conceptuellement redondante ou contradictoire dans une architecture régie par des OUTPUT conditionnels explicites, où la non-exécution de l’instruction d’écriture équivaut structurellement à une suppression.
Enfin, l’instruction STOP opère à une échelle radicalement différente. Alors que DELETE se contente d’écarter l’observation courante pour passer immédiatement à la suivante, STOP ordonne l’interruption complète, immédiate et définitive de l’étape DATA globale. L’utilisation de STOP fige la table de sortie dans son état courant, empêche la lecture de toutes les observations restantes dans le jeu de données d’entrée et force la clôture abrupte du programme. Il s’agit d’une instruction de contrôle d’urgence ou de terminaison prématurée sur condition critique, qui ne saurait être substituée à une instruction d’épuration sélective comme DELETE.
3. Mise en place de l’environnement : le jeu de données de référence
3.1 Création du jeu de données synthétique original_data
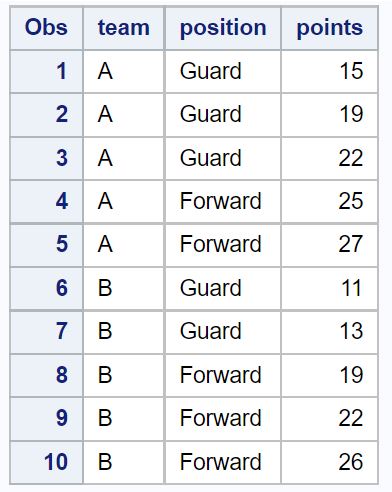
Afin de fournir une assise empirique indiscutable et directement reproductible à nos développements méthodologiques, nous établissons un environnement expérimental contrôlé reposant sur la création d’un jeu de données synthétique baptisé original_data. Ce tableau condense les dimensions classiques rencontrées dans des problématiques réelles de gestion ou d’analyse sportive, tout en conservant une taille matricielle réduite autorisant un suivi pas à pas des transformations au sein du PDV.
La structure de cette table est initiée via l’instruction DATA original_data;, suivie de la directive d’entrée INPUT qui définit la topologie des colonnes. Nous instancions trois variables aux caractéristiques complémentaires :
team: une variable alphanumérique (matérialisée par le modificateur de type$) représentant l’entité organisationnelle d’appartenance d’un athlète (modalités ‘A’ ou ‘B’).position: une variable alphanumérique (également typée$) désignant le rôle tactique assigné sur le terrain (‘Guard’, ‘Forward’, ou ‘Center’).points: une variable quantitative discrète, codée sous format numérique standard, enregistrant le volume cumulé d’unités de score validées par le sujet.
L’intégration des données brutes au sein même du script est concrétisée par le bloc DATALINES; (ou CARDS; selon les conventions historiques), permettant au compilateur de charger une matrice de huit observations représentatives directement dans la mémoire de traitement. Le script de création s’articule comme suit :
Programme d’initialisation du jeu de données d’origine :
data original_data;

  input team $ position $ points;

  datalines;

A Guard 14

A Guard 8

A Forward 22

A Forward 30

B Guard 24

B Guard 12

B Forward 18

B Center 10

;

run;
3.2 Inspection préliminaire des données avec PROC PRINT
L’intégrité de la table synthétique doit faire l’objet d’une validation visuelle et programmatique systématique avant l’application de tout filtre destructif ou transformateur. Sous l’environnement SAS, la procédure de diagnostic immédiat la plus élémentaire et la plus éprouvée demeure la procédure d’affichage PROC PRINT. Cette dernière permet de transcrire directement vers le gestionnaire de sortie (Output Delivery System ou ODS) l’intégralité du contenu tabulaire du jeu de données ciblé.
L’exécution de la séquence d’instructions suivante permet d’éditer la structure primaire :
proc print data=original_data;

run;
Cette instruction génère un compte rendu standardisé comportant neuf colonnes d’affichage, dont la colonne technique implicite Obs servant d’identifiant ordinal d’affichage (numérotation séquentielle de 1 à 8). L’inspection de cette édition confirme que l’équipe ‘A’ rassemble quatre athlètes : deux au poste de ‘Guard’ (affichant respectivement 14 et 8 points) et deux au poste de ‘Forward’ (enregistrant des scores notables de 22 et 30 points). Parallèlement, l’équipe ‘B’ présente un effectif équivalent de quatre individus distribués sur trois rôles tactiques distincts : deux ‘Guard’ (24 et 12 points), un ‘Forward’ (18 points) et un ‘Center’ (10 points).
Cette distribution bimodale parfaitement équilibrée entre les équipes, couplée à une dispersion contrôlée des scores continus, offre un terrain d’investigation idéal pour évaluer la précision chirurgicale de nos règles d’élimination ultérieures.
3.3 Objectifs pédagogiques des cas d’usage illustratifs
La sélection rigoureuse de ces huit enregistrements n’est pas fortuite ; elle obéit à une architecture pédagogique pensée pour démontrer sans ambiguïté les trois comportements cardinaux de l’instruction DELETE. Chaque cas d’usage mobilisera un prisme logique particulier visant à sculpter la table d’origine afin d’isoler des sous-populations spécifiques.
L’objectif sous-jacent consiste à fournir une démonstration empirique de la réduction de dimensionnalité des lignes, tout en sensibilisant le lecteur aux invariants structurels : quelles que soient les lignes retranchées, l’intégrité typologique et sémantique des colonnes (variables team, position, points) demeure inaltérée. En instaurant une base comparative unifiée sur ce jeu de données commun, les variations de syntaxe permettront de mettre en lumière avec une clarté absolue le mécanisme intime de dissociation entre conditions conjonctives et disjonctives.
4. Méthode 1 : Suppression de lignes selon une condition unique
4.1 Formulation syntaxique de la condition simple IF-THEN DELETE
La formulation syntaxique de la suppression conditionnelle simple constitue la brique de base de la manipulation de flux dans l’étape DATA. Elle s’articule autour de la syntaxe élémentaire :
IF variable = valeur THEN DELETE;
D’un point de vue grammatical, cette structure se décompose en trois éléments clés. D’abord, le mot-clé IF, qui amorce l’évaluation d’un prédicat relationnel. Ensuite, l’expression de comparaison, qui confronte le contenu de la variable courante chargée dans le PDV à une constante littérale ou numérique via un opérateur d’égalité (symbolisé par = ou par le mnémonique standard EQ). Enfin, la proposition consécutive THEN, immédiatement subordonnée à l’action d’interruption DELETE.
Il est fondamental de rappeler la stricte sensibilité à la casse (majuscules et minuscules) ainsi que la gestion rigoureuse de la typologie des chaînes de caractères au sein de l’interpréteur SAS. Si la variable cible est de type caractère, la constante comparative doit obligatoirement être encapsulée entre apostrophes simples ou guillemets doubles. Une incohérence dans le respect de la casse (par exemple tester team = 'a' au lieu de team = 'A') se solderait inévitablement par un échec silencieux : aucune condition n’étant jamais validée, aucune suppression ne serait opérée, sans que le compilateur ne génère pour autant le moindre message d’erreur syntaxique.
4.2 Exemple 1 : Élimination ciblée des observations de l’équipe A
Pour illustrer ce premier paradigme, nous formulons une règle d’exclusion déterministe radicale : nous souhaitons purger intégralement l’échantillon de toute présence d’éléments affiliés à l’équipe ‘A’. Cette opération revient à créer une table dérivée, baptisée conventionnellement new_data, qui contiendra exclusivement les lignes appartenant aux structures concurrentes.
Le code SAS permettant d’opérer cette transformation se déploie selon l’enchaînement canonique suivant :
data new_data;

  set original_data;

  if team = 'A' then delete;

run;
Lors de la soumission de ce bloc, le superviseur SAS initialise l’étape DATA. L’instruction set original_data; établit le canal d’entrée en lecture séquentielle vers notre table synthétique. Pour chacune des huit observations, les variables sont copiées dans le PDV. Arrivé à la ligne 3, le processeur évalue l’égalité logique. Pour les observations 1 à 4, la variable team contenant la chaîne de caractères ‘A’, l’expression booléenne renvoie la valeur 1 (vrai). L’instruction DELETE est alors exécutée immédiatement. Le reste de l’étape est ignoré, aucune écriture ne survient dans new_data, et le système passe à l’itération suivante.
L’examen minutieux du journal d’exécution (SAS Log) fournit la confirmation formelle de cette dynamique mécanique, en affichant des métriques d’I/O explicites : le journal atteste formellement que 8 observations ont été lues depuis la table ORIGINAL_DATA, tandis que la table NEW_DATA n’en a enregistré que 4 en sortie physique.
4.3 Analyse empirique et validation du jeu de données résultant
L’attestation programmatique délivrée par le journal doit être corroborée par une inspection directe du contenu de la table new_data au moyen de la procédure PROC PRINT :
proc print data=new_data;

run;
L’exécution de cette procédure dresse le tableau récapitulatif des données persistantes. Le résultat affiché confirme la conformité totale de la transformation avec les spécifications analytiques requises :
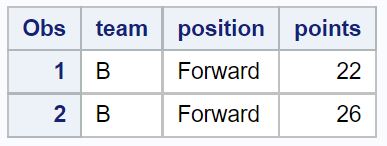
Seules subsistent les quatre lignes rattachées originellement à l’équipe ‘B’ : les deux profils de ‘Guard’ (comptabilisant 24 et 12 points), le profil de ‘Forward’ (18 points) ainsi que l’unique profil de ‘Center’ (10 points). La colonne Obs du rapport de sortie réassigne une numérotation continue de 1 à 4 à ces observations conservées, soulignant ainsi la création d’un index d’affichage séquentiel propre à la nouvelle entité de stockage.
Il est à noter que l’opération s’est déroulée sans aucune altération transversale : les colonnes position et points de chaque enregistrement de l’équipe ‘B’ ont conservé leur valeur exacte, démontrant l’indépendance dimensionnelle du filtrage de lignes par rapport à l’intégrité vectorielle des colonnes conservées.
5. Méthode 2 : Suppression de lignes selon plusieurs conditions cumulatives
5.1 Logique conjonctive et utilisation de l’opérateur AND
Dans la pratique analytique avancée, l’exclusion d’enregistrements requiert fréquemment la prise en compte de contextes multidimensionnels. L’élimination mécanique sur un critère binaire unique s’avère souvent trop grossière, risquant d’éliminer des données précieuses qui ne présenteraient pas de dysfonctionnement global. C’est ici qu’intervient la logique conjonctive, matérialisée dans le langage de programmation SAS par l’opérateur booléen AND (ou son équivalent symbolique &).
Sur le plan formel de l’algèbre booléenne, l’opérateur AND formalise une intersection logique stricte entre deux ou plusieurs propositions propositionnelles. La table de vérité associée stipule que l’expression globale (Proposition_1 AND Proposition_2) ne peut être évaluée à l’état vrai que si et seulement si chacune des sous-propositions élémentaires est elle-même rigoureusement vraie. Dès lors que l’un quelconque des prédicats s’avère faux, l’expression entière bascule à l’état faux (0 dans l’arithmétique logique de SAS).
Dans le cadre de l’instruction IF condition_1 AND condition_2 THEN DELETE;, l’action d’élimination de la ligne courante est donc soumise à une contrainte de déclenchement particulièrement restrictive. Une observation échappera à la suppression dès lors qu’elle manquera de satisfaire ne serait-ce qu’un seul des critères formulés dans la chaîne conjonctive. Par ailleurs, il convient de souligner que SAS applique les règles standards de préséance des opérateurs logiques et arithmétiques, les opérateurs de comparaison relationnelle (tels que =, <, >=) possédant une priorité d’évaluation supérieure à celle des opérateurs booléens de liaison.
5.2 Exemple 2 : Suppression basée sur l’appartenance à l’équipe et un seuil métrique
Considérons à présent un cas d’usage où la règle d’épuration affine considérablement le niveau de sélection. Supposons que le protocole de recherche n’impose plus d’exclure indistinctement tous les membres de l’équipe ‘A’, mais uniquement ceux dont le rendement offensif est jugé insuffisant, matérialisé par un total de points strictement inférieur au seuil de 20 unités. Les athlètes hautement performants de l’équipe ‘A’ doivent en revanche impérativement demeurer au sein de la cohorte d’analyse, tout comme l’intégralité du personnel composant l’équipe ‘B’.
Le déploiement de cette règle conjonctive s’opère par le script d’étape DATA suivant :
data new_data;

  set original_data;

  if team = 'A' and points < 20 then delete;

run;
Analysons pas à pas le déroulement algorithmique au sein du PDV lors de la lecture des enregistrements de original_data :
- Observation 1 (‘A’, ‘Guard’, 14) :
team = 'A'est VRAI ;points < 20(14 < 20) est VRAI. VRAI AND VRAI donne VRAI. L’instructionDELETEest déclenchée. La ligne est écartée. - Observation 2 (‘A’, ‘Guard’, 8) :
team = 'A'est VRAI ;points < 20(8 < 20) est VRAI. Déclenchement deDELETE. La ligne est écartée. - Observation 3 (‘A’, ‘Forward’, 22) :
team = 'A'est VRAI ;points < 20(22 < 20) est FAUX. VRAI AND FAUX donne FAUX. L’instructionDELETEest court-circuitée. L’observation poursuit son cycle et fait l’objet d’unOUTPUTimplicite vers la table réceptrice. - Observation 4 (‘A’, ‘Forward’, 30) :
team = 'A'est VRAI ;points < 20(30 < 20) est FAUX. VRAI AND FAUX donne FAUX. Préservation et écriture de la ligne. - Observations 5 à 8 (Équipe ‘B’) : Pour l’ensemble de ces enregistrements, le premier prédicat
team = 'A'est évalué à FAUX. Par conséquent, en vertu du principe de court-circuit logique (short-circuit evaluation), le compilateur n’a même pas besoin de valider le niveau de la variablepoints: l’expression globale est irrémédiablement FAUSSE. L’instructionDELETEn’est jamais activée, et toutes les observations de l’équipe ‘B’ sont intégralement transférées versnew_data.
5.3 Vérification statistique des exclusions et des rétentions
L’application d’un contrôle de conformité via l’exécution de la procédure standardisée :
proc print data=new_data;

run;
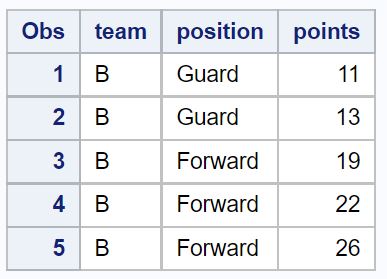
permet de certifier la justesse de l’opération. L’édition résultante met en évidence une table résiduelle comportant très exactement 6 observations sur les 8 présentes initialement.
Le jeu de données épuré consigne en son sein :
- L’observation numéro 3 d’origine : l’athlète ‘Forward’ de l’équipe ‘A’ affichant 22 points.
- L’observation numéro 4 d’origine : l’athlète ‘Forward’ de l’équipe ‘A’ affichant 30 points.
- Les quatre observations complètes rattachées à l’équipe ‘B’, incluant notamment le joueur ‘Guard’ cumulant seulement 12 points ainsi que le joueur ‘Center’ crédité de 10 points.
Ce résultat démontre la robustesse de l’opérateur AND : bien que des membres de l’équipe ‘B’ présentent des volumes de points inférieurs au seuil de 20, leur non-satisfaction de la clause team = 'A' les a totalement immunisés contre la directive d’exclusion. Seul le noyau précis d’individus cumulant les deux handicaps a été purgé de la structure finale.
6. Méthode 3 : Suppression de lignes selon une condition disjonctive
6.1 Logique disjonctive et utilisation de l’opérateur OR
Le troisième axe méthodologique aborde la suppression sous l’angle de la réunion logique, formalisée par l’opérateur disjonctif OR (ou son pendant symbolique la barre verticale |, voire le point d’exclamation selon les tables de caractères régionales). La logique disjonctive opère un renversement complet du filtre de sécurité par rapport à la logique conjonctive étudiée précédemment.
Dans l’univers des propositions booléennes, l’énoncé (Condition_A OR Condition_B) est évalué à VRAI dès lors qu’au moins une des conditions constituantes est satisfaite. La seule et unique configuration menant à un résultat global faux requiert l’invalidation simultanée et absolue de toutes les conditions testées. Appliqué à une instruction DELETE, l’opérateur OR déploie une puissance de suppression maximale : il suffit qu’une ligne présente une anomalie isolée ou réponde à un seul critère de non-conformité pour être immédiatement éjectée du traitement.
Cette grande permissivité dans le déclenchement de la suppression expose toutefois l’ingénieur à des dérives méthodologiques sévères désignées sous le terme d’hyper-filtrage. Si la formulation d’un filtre disjonctif manque de discernement, de vastes pans de données parfaitement exploitables peuvent être détruits accidentellement. Il est donc recommandé d’exercer une vigilance extrême lors de l’assemblage de multiples clauses OR au sein d’une même étape DATA.
6.2 Exemple 3 : Élimination par modalité catégorielle ou seuil numérique
Afin de mettre en exergue les effets radicaux d’une clause disjonctive, nous formulons la règle de gestion suivante : nous ordonnons la suppression de toute observation qui appartient soit à l’équipe ‘A’ (indépendamment de son volume de points), SOIT qui présente un total de points strictement inférieur à 15 (quelle que soit son affiliation d’équipe).
Le code d’implémentation de cette étape DATA se formalise comme suit :
data new_data;

  set original_data;

  if team = 'A' or points < 15 then delete;

run;
L’exécution de ce script soumet chaque ligne du jeu de données original_data à une double grille de lecture implacable :
- Secteur de l’équipe ‘A’ (Observations 1 à 4) : Pour ces quatre lignes, le premier terme de la disjonction (
team = 'A') est irrévocablement VRAI. En conséquence, l’instructionDELETEs’exécute de façon inconditionnelle sans même solliciter l’examen de la valeur de la variablepoints. Ainsi, les joueurs ‘Forward’ crédités de 22 et 30 points, qui avaient été préservés lors de l’application de la méthode 2, sont ici impitoyablement exclus du jeu de sortie. - Secteur de l’équipe ‘B’ (Observations 5 à 8) : Pour ces lignes, le prédicat catégoriel
team = 'A'renvoie la valeur FAUX. L’évaluation se poursuit donc nécessairement sur le second membre de la disjonction : le prédicat métriquepoints < 15.- L’observation 5 (Guard, 24 points) présente
points < 15FAUX. FAUX OR FAUX aboutit à FAUX. L’observation survit et est inscrite dans la table finale. - L’observation 6 (Guard, 12 points) présente
points < 15VRAI. FAUX OR VRAI aboutit à VRAI. L’instructionDELETEest appelée : la ligne est supprimée. - L’observation 7 (Forward, 18 points) présente
points < 15FAUX. FAUX OR FAUX aboutit à FAUX. L’observation est conservée. - L’observation 8 (Center, 10 points) présente
points < 15VRAI. FAUX OR VRAI aboutit à VRAI. Déclenchement deDELETE: la ligne est supprimée.
- L’observation 5 (Guard, 24 points) présente
6.3 Évaluation comparative des résultats d’extraction
L’édition finale du contenu de la table résultante via PROC PRINT révèle l’ampleur de la contraction dimensionnelle opérée :
proc print data=new_data;

run;
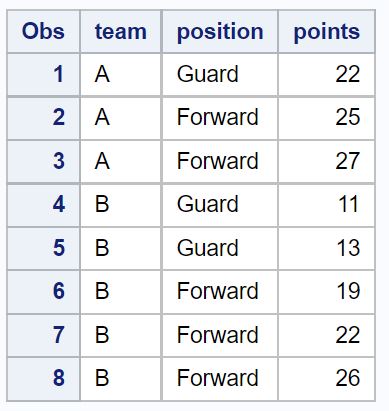
Le rapport synthétique confirme que la table new_data est désormais réduite à seulement deux observations :
- L’observation correspondant au joueur ‘Guard’ de l’équipe ‘B’ totalisant 24 points.
- L’observation relative au joueur ‘Forward’ de l’équipe ‘B’ totalisant 18 points.
Cette visualisation met en lumière la cartographie de l’espace échantillonnal résiduel post-filtrage. La clause OR a agi comme une double herse : la totalité de l’équipe ‘A’ a été balayée par la première branche du test, tandis que 50 % de l’effectif de l’équipe ‘B’ a été concomitamment anéanti par la seconde branche du filtre numérique. Cet exemple souligne avec netteté l’importance d’une modélisation rigoureuse des besoins avant d’arrêter le choix syntaxique d’une conjonction ou d’une disjonction.
7. Approche duale : L’alternative de conservation explicite (Subsetting IF)
7.1 Principe du Subsetting IF : Syntaxe et inversion logique
En programmation SAS, la résolution d’un problème algorithmique emprunte rarement une voie exclusive. Aux côtés du paradigme négatif consistant à désigner explicitement les observations à détruire (IF condition THEN DELETE;), il existe une approche duale rigoureusement symétrique reposant sur le paradigme positif de conservation : le Subsetting IF (ou instruction IF de sous-ensemblement).
La syntaxe canonique du Subsetting IF se distingue par sa concision extrême :
IF expression_logique;
Remarquons l’absence totale des mots-clés THEN et DELETE. L’instruction s’achève immédiatement par un point-virgule après la déclaration de la condition. Sa sémantique se définit comme suit : si l’expression logique est évaluée à VRAI, le traitement de l’étape DATA se poursuit normalement jusqu’à l’écriture finale de l’observation ; en revanche, si l’expression est évaluée à FAUX, le traitement de la ligne s’arrête instantanément et l’enregistrement est ignoré, ce qui correspond fonctionnellement à l’exécution sous-jacente d’un DELETE.
Ce basculement conceptuel mobilise directement les fondements de la logique formelle, et plus particulièrement le théorème de De Morgan. Selon ce principe fondamental, la négation d’une conjonction équivaut à la disjonction des négations, et réciproquement. Dès lors, pour transcrire fidèlement une suppression conditionnelle en règle de conservation, le développeur doit opérer une inversion complète des opérateurs relationnels et une transposition minutieuse des connecteurs booléens AND et OR.
7.2 Traduction rigoureuse des trois exemples en logique de conservation
Afin de matérialiser cette équivalence formelle, transposons rigoureusement les trois cas d’usage précédemment explorés via l’instruction DELETE dans la syntaxe duale du Subsetting IF :
Transposition de l’Exemple 1 (Suppression univariée simple) :
Le code initial if team = 'A' then delete; vise à écarter l’équipe ‘A’. Sa formulation duale positive consiste à ordonner la conservation stricte des équipes non égales à ‘A’ (ou directement égales à ‘B’) :
data new_data_subset1;

  set original_data;

  if team ^= 'A'; /* Syntaxe équivalente : if team = 'B'; */

run;
Transposition de l’Exemple 2 (Suppression conjonctive) :
Le code initial déclarait : if team = 'A' and points < 20 then delete;. En vertu de la première loi de De Morgan, la négation de (A et B) est (non A ou non B). Pour conserver les observations valides, nous devons formuler que nous préservons toute ligne qui N’appartient PAS à l’équipe ‘A’ OU qui affiche des points SUPÉRIEURS OU ÉGAUX à 20 :
data new_data_subset2;

  set original_data;

  if team ^= 'A' or points >= 20;

run;
Transposition de l’Exemple 3 (Suppression disjonctive) :
Le script d’origine statuait : if team = 'A' or points < 15 then delete;. En vertu de la seconde loi de De Morgan, la négation de (A ou B) devient (non A et non B). Ainsi, nous devons exiger simultanément que l’équipe soit DIFFÉRENTE de ‘A’ ET que le total de points soit SUPÉRIEUR OU ÉGAL à 15 :
data new_data_subset3;

  set original_data;

  if team ^= 'A' and points >= 15;

run;
Les trois tables générées par ces instructions s’avèrent strictement identiques bit à bit à celles issues des scripts exploitant l’instruction DELETE, attestant de la symétrie mathématique absolue des deux paradigmes.
7.3 Performance comparée : Subsetting IF versus DELETE
Sur le plan purement informatique, de nombreux praticiens s’interrogent sur les écarts potentiels d’efficacité d’exécution entre le Subsetting IF et le binôme IF-THEN DELETE. Des analyses de profilage bas niveau conduites sur le compilateur SAS indiquent que ces deux constructions génèrent des instructions machine intermédiaires quasiment indistinguables.
En effet, lors de la phase de compilation du Data Step, l’expression if condition; est traduite en interne par une directive de saut conditionnel équivalente à if NOT(condition) goto skip_output;, ce qui constitue très exactement l’architecture d’exécution matérialisée par if condition then delete;. Dès lors, les écarts en termes de temps processeur (CPU) consommé ou d’occupation de la mémoire tampon demeurent infinitésimaux et statistiquement non significatifs, même sur des volumétries massives de plusieurs dizaines de millions d’enregistrements.
L’arbitrage entre ces deux approches relève par conséquent d’un choix stylistique et ergonomique. En milieu institutionnel et dans la recherche biostatistique, le Subsetting IF est largement plébiscité en raison de son élégance laconique et de sa clarté positive : il documente explicitement au lecteur du code ce qui est gardé dans la table finale. À l’opposé, l’instruction DELETE se montre plus intuitive pour formaliser des protocoles d’exclusion stricts rédigés sous la forme d’arbres décisionnels d’invalidation séquentielle.
8. Comparaison computationnelle : Instruction WHERE vs Instruction IF
8.1 Niveau d’intervention : Moteur d’entrée (Engine) vs Data Step
L’un des chapitres les plus critiques de l’optimisation sous SAS réside dans la distinction fondamentale entre le filtrage opéré par l’instruction IF (incluant DELETE) et celui assuré par la clause WHERE. Si les deux commandes aboutissent en apparence à des tables de sortie identiques, leurs mécanismes d’intervention sous le capot reposent sur des couches logicielles diamétralement différentes.
L’instruction IF / DELETE opère exclusivement au sein de l’étape DATA, pendant la phase d’exécution du compilateur. Cela signifie obligatoirement que l’enregistrement doit être extrait physiquement du disque de stockage par le sous-système d’E/S (moteur d’accès ou engine), transféré à travers les tampons du système, puis instancié dans le PDV avant de pouvoir être évalué et éventuellement détruit. Le coût computationnel de lecture physique et d’alimentation mémoire est donc intégralement consommé pour chaque ligne, même si cette dernière est éliminée un millième de seconde plus tard.
À l’inverse, l’instruction WHERE intervient en amont, au niveau même du moteur d’accès à la table (Engine Layer). Le moteur de données SAS évalue la clause WHERE directement lors de la lecture des blocs d’enregistrements sur le disque ou dans la couche d’indexation. Si une ligne ne valide pas les critères formulés dans le WHERE, elle n’est jamais chargée dans le PDV. Ce mécanisme prévient toute instanciation superflue et économise de précieuses ressources de calcul processeur et de bande passante bus mémoire.
8.2 Suppression indirecte via la clause WHERE dans une étape DATA
L’exploitation de la clause WHERE dans une étape DATA s’apparente à une suppression préventive ou indirecte : au lieu d’éliminer une observation préalablement chargée, on refuse tout simplement de lui ouvrir la porte d’entrée de la mémoire active. La transposition de notre exemple univarié prend alors la forme suivante :
data new_data;

  set original_data;

  where team ^= 'A';

run;
Outre ses gains monumentaux en matière de performance sur de grands volumes, l’instruction WHERE met à disposition du développeur une collection d’opérateurs relationnels hautement expressifs indisponibles ou plus lourds à implémenter dans une syntaxe IF standard, parmi lesquels :
- L’opérateur
INoptimisé pour les listes de valeurs discrètes :where team in ('B', 'C', 'D');. - L’opérateur de borne continue
BETWEEN ... AND:where points between 15 and 30;. - L’opérateur d’évaluation de chaînes partielles
CONTAINS(ou l’opérateur point d’interrogation?) permettant des analyses de sous-chaînes directes sans recourir à la fonctionINDEX. - L’opérateur de recherche phonétique ou d’évaluation de masques via le mot-clé
LIKE.
8.3 Arbre décisionnel : Choisir entre DELETE conditionnel et clause WHERE
Le tableau décisionnel suivant explicite les conditions d’arbitrage méthodologique entre l’emploi du binôme IF condition THEN DELETE; et le recours à la clause WHERE :
Le choix de l’instruction WHERE s’impose de façon incontournable lorsque :
- Toutes les variables ciblées par la condition de filtrage préexistent déjà dans la ou les tables sources lues par l’instruction
SET,MERGEouMODIFY. - Le jeu de données source possède un volume substantiel et dispose potentiellement d’un index simple ou composé sur les variables discriminantes.
- Le filtrage doit être appliqué directement au sein d’une procédure statistique (ex.
PROC MEANS,PROC REG) sans nécessiter la création intermédiaire d’une étape DATA d’extraction sur disque.
À l’opposé, le recours impératif au IF condition THEN DELETE; (ou au Subsetting IF) devient strictement obligatoire lorsque :
- La règle de suppression dépend d’une variable dynamique créée, modifiée ou calculée au sein même de l’étape DATA courante (le moteur d’accès sous-jacent
WHEREne pouvant pas connaître l’existence de variables qui ne résident pas encore physiquement sur disque). - Le filtre met en œuvre des variables système automatiques SAS telles que le numéro d’observation
_N_ou des variables indicatrices de première/dernière modalité générées par l’instructionBY(ex.first.variableoulast.variable). - Le prédicat conditionnel implique des fonctions complexes non supportées par la couche du moteur
WHEREou dépend de l’état séquentiel accumulé au fil des enregistrements antérieurs via l’instructionRETAIN.
9. Gestion des valeurs manquantes et pièges logiques associés
9.1 Le comportement des valeurs manquantes numériques dans les comparaisons
L’un des pièges les plus dévastateurs et fréquents en langage SAS réside dans la mécanique interne de valorisation des données manquantes numériques (représentées visuellement par un point .). Dans la hiérarchie ordinale interne de SAS, la valeur manquante standard est modélisée par le système comme la valeur numérique la plus basse qui puisse exister dans l’univers de calcul (inférieure à n’importe quel nombre négatif, soit l’équivalent de moins l’infini).
Considérons l’impact catastrophique de cette convention sur une règle de suppression en apparence anodine : supposons qu’un analyste souhaite supprimer tous les joueurs dont le score est strictement inférieur à 10 points en codant :
if points < 10 then delete;
Si la variable points contient une valeur manquante pour un individu (par exemple en raison d’un forfait médical n’ayant pas permis d’enregistrer de performance), l’inégalité . < 10 sera évaluée à VRAI par le compilateur. En conséquence, l’observation sera détruite sans sommation. Si la volonté du statisticien était d’isoler les faibles scores tout en maintenant impérativement les observations non renseignées pour une analyse ultérieure de données imputées, le résultat se trouve irrémédiablement faussé.
Pour neutraliser ce comportement pervers, il est impératif d’adopter une stratégie de programmation défensive en encapsulant le test dans une double contrainte positive ou en utilisant la fonction sécurisée MISSING() :
if not missing(points) and points < 10 then delete;

/* Ou formulation alternative par encadrement ordinal : */

if . < points < 10 then delete;
9.2 Traitement des chaînes de caractères vides ou manquantes
Pour les variables de type caractère, la modalité manquante se traduit dans l’environnement SAS par une chaîne constituée exclusivement d’un ou plusieurs espaces blancs (blank characters). Sur le plan syntaxique, cette valeur s’exprime conventionnellement par deux apostrophes accolées '' ou par un espace simple protégé ' '.
Lorsqu’un test conditionnel d’égalité est formalisé sous la tournure if team = '' then delete;, le compilateur SAS compare la chaîne stockée dans le PDV à une chaîne vide. Toutefois, il convient d’observer que l’opérateur d’égalité standard sous SAS complète automatiquement la chaîne la plus courte avec des espaces blancs pour atteindre la longueur physique de la variable déclarée. Dès lors, si une variable team définie d’une longueur de 8 octets ne contient que des espaces, le test team = '' sera rigoureusement évalué à VRAI, déclenchant l’exécution de la suppression.
Pour garantir l’hermétisme et la lisibilité du code applicatif, l’emploi de la fonction native MISSING() doit être systématiquement érigé en bonne pratique. Cette fonction universelle accepte indifféremment des arguments typés numériques ou caractères, renvoyant la valeur booléenne 1 dès lors que le champ est non renseigné, exemptant ainsi le programmeur des subtilités d’alignement d’espaces.
9.3 Bonnes pratiques pour fiabiliser les filtres complexes
Dès lors que les règles de gestion d’une organisation exigent la juxtaposition de conditions logiques mixtes entremêlant des conjonctions AND, des disjonctions OR et des évaluations de valeurs manquantes, la lisibilité et l’intégrité du code SAS sont menacées par les règles implicites d’associativité et de préséance des opérateurs.
La règle d’or consiste à bannir toute ambiguïté en appliquant un parenthésage explicite et systématique de chaque bloc logique unitaire. L’écriture :
if (team = 'A' and points < 20) or (team = 'B' and points < 10) then delete;
offre une clarté absolue quant à l’ordre d’évaluation mathématique souhaité, isolant hermétiquement les sous-ensembles décisionnels, là où l’omission des parenthèses forcerait le compilateur à appliquer ses règles internes de précédence, induisant un risque majeur d’erreur de logique invisible lors de la relecture par les pairs.
Enfin, sur le plan des manipulations de chaînes, l’adjonction de fonctions d’assainissement textuel telles que STRIP() (qui élimine simultanément les espaces de tête et de queue) ou UPCASE() (qui convertit uniformément en majuscules pour neutraliser les disparités de saisie) confère une résilience absolue aux prédicats de suppression conditionnelle :
if upcase(strip(team)) = 'A' and points < 20 then delete;
10. Suppression de lignes via la procédure PROC SQL
10.1 La commande DELETE FROM sous le paradigme relationnel
L’écosystème SAS intègre de façon totalement native les normes du langage de requête structuré au travers de la procédure PROC SQL. Cette composante permet aux ingénieurs et analystes issus du monde des bases de données relationnelles (SGBDR) d’interagir avec les tables SAS selon une syntaxe conforme aux standards ANSI SQL. Dans ce paradigme, la destruction de lignes ne s’opère plus par un filtrage séquentiel dans un PDV avec écriture dans une table tierce, mais par une action de suppression directe in situ au sein de la table ciblée via la commande DELETE FROM.
La grammaire générale de cette directive relationnelle s’énonce comme suit :
proc sql;

  delete from nom_table

  where condition_de_suppression;

quit;
Ce changement de paradigme entraîne une conséquence structurelle majeure : la commande DELETE FROM ne crée pas de nouveau jeu de données. Elle modifie directement la table physique originelle sur disque, retirant de manière définitive les observations répondant aux critères du prédicat WHERE.
10.2 Implémentation des trois exemples à travers la syntaxe SQL
Afin de mettre en exergue la translation syntaxique entre l’étape DATA et l’environnement relationnel, examinons la mise en œuvre de nos trois règles d’épuration via PROC SQL. Notons qu’au préalable, une copie de sécurité de original_data devra être opérée sous peine de perdre irrémédiablement le jeu d’essai initial.
Exécution relationnelle de l’Exemple 1 (Condition univariée) :
proc sql;

  delete from work.table_sql1

  where team = 'A';

quit;
Exécution relationnelle de l’Exemple 2 (Condition conjonctive) :
proc sql;

  delete from work.table_sql2

  where team = 'A' and points < 20;

quit;
Exécution relationnelle de l’Exemple 3 (Condition disjonctive) :
proc sql;

  delete from work.table_sql3

  where team = 'A' or points < 15;

quit;
Le journal SAS associé à PROC SQL documente l’opération avec une formulation caractéristique du vocabulaire relationnel, spécifiant textuellement par exemple : NOTE: 4 rows were deleted from WORK.TABLE_SQL1.
10.3 Considérations relatives à l’intégrité et au verrouillage des tables
L’utilisation de la procédure PROC SQL pour supprimer des enregistrements impose une analyse rigoureuse des risques en matière de concurrence d’accès et d’intégrité logicielle. Étant donné que la commande DELETE FROM altère directement le fichier physique .sas7bdat sur le système de fichiers, le gestionnaire de stockage SAS place un verrouillage exclusif (exclusive lock) sur la table durant toute la durée de la transaction.
Ce verrou empêche tout autre utilisateur ou processus parallèle de lire ou d’écrire dans la table jusqu’à la libération actée par l’instruction QUIT;. Si le programme s’interrompt brutalement au milieu de l’opération (panne de serveur, interruption utilisateur ou saturation de l’espace disque temporaire), la table peut se retrouver dans un état instable ou partiellement purgée, sans mécanisme natif de rollback transactionnel complet, à moins d’avoir préalablement configuré des fonctionnalités de journalisation avancées (SAS Audit Trails).
Dès lors, dans le cadre de pipelines de production automatisés, l’approche séquentielle de l’étape DATA classique (qui lit depuis une table A immuable pour écrire proprement dans une nouvelle table B) est généralement privilégiée pour sa sécurité opérationnelle, reléguant la directive PROC SQL DELETE à des phases de maintenance de tables maîtresses ou de bases de données transactionnelles hébergées sur des moteurs distants via SAS/ACCESS.
11. Optimisation des performances et scalabilité sur données massives
11.1 Optimisation des entrées-sorties et allocation de mémoire
Lorsque le volume de données franchit le seuil des gigaoctets ou des téraoctets, l’impact computationnel des décisions de programmation devient prédominant. L’optimisation des flux d’élimination de lignes doit impérativement s’accompagner d’une rationalisation de la dimensionnalité des colonnes. Il est contre-productif de charger dans le PDV des dizaines de variables inutiles pour ensuite supprimer des lignes sur la base d’un critère unique.
L’utilisation concertée de l’option de table DROP= ou KEEP= directement sur l’instruction de lecture SET permet d’alléger drastiquement la largeur vectorielle du PDV. En combinant cette réduction horizontale avec un filtrage vertical immédiat, le système minimise drastiquement les transferts de pages mémoire depuis le disque physique.
Parallèlement, la configuration fine des paramètres système régissant les tampons d’E/S s’avère déterminante. L’ajustement des options système BUFSIZE= (qui régit la taille physique des blocs de transfert de données en octets) et BUFNO= (qui définit le nombre de tampons alloués en mémoire vive pour anticiper les lectures et écritures) permet d’optimiser l’efficience de l’étape DATA lors du traitement de volumétries extrêmes, évitant que le processeur ne passe l’essentiel de son temps en attente d’accès aux disques de stockage.
11.2 Exploitation des index SAS pour accélérer les opérations conditionnelles
L’utilisation d’un index SAS simple ou composite constitue un vecteur d’accélération majeur lorsqu’il est couplé à une clause de filtrage WHERE (bien qu’il demeure inopérant pour accélérer directement une instruction IF THEN DELETE; séquentielle dans un Data Step classique). Un index est un fichier technique annexe (extension .sas7bndx) qui maintient une cartographie arborescente (de type B-Tree) reliant les valeurs des variables clés aux numéros physiques exacts des observations correspondantes dans la table de données.
Lorsque le compilateur SAS évalue une clause WHERE adossée à une variable indexée, il sollicite son optimiseur interne. Si ce dernier détermine que la sélectivité de la requête est suffisante (c’est-à-dire que la condition n’isole ou n’exclut qu’une faible proportion du volume global de la table, classiquement moins de 15 à 20 %), le moteur d’accès contourne intégralement la lecture séquentielle de la table. Il saute directement, d’adresse physique en adresse physique, vers les enregistrements éligibles.
Il importe toutefois de souligner le coût caché inhérent aux index : la création et la maintenance dynamique d’un index consomment des ressources processeur notables lors des écritures, et un index dégradé par de multiples suppressions partielles nécessite des opérations périodiques de réindexation via la procédure PROC DATASETS pour conserver son avantage compétitif.
11.3 Gestion des tables volumineuses avec les tables de compression et les vues
Dans les infrastructures modernes de traitement de données, la persistance physique systématique d’une nouvelle table dérivée après chaque opération de suppression conditionnelle génère une explosion des coûts d’infrastructure de stockage. Deux fonctionnalités natives du système SAS permettent d’atténuer drastiquement ce gouffre matériel : la compression binaire et les vues de données.
L’activation de l’option de table (COMPRESS=YES) ou (COMPRESS=BINARY) lors de la génération de la table de sortie permet de condenser substantiellement l’espace occupé sur disque grâce à des algorithmes de compression de type Run-Length Encoding (RLE) ou Huffman. Lorsqu’une étape DATA filtre une table compressée, le gain de bande passante lié au transfert d’un fichier réduit compense très largement la légère surcharge de temps processeur dévolue à la décompression à la volée des blocs d’observations.
D’autre part, la création d’une vue de données SAS (SAS DATA View) via la directive syntaxique DATA nom_vue / VIEW=nom_vue; offre une alternative d’une élégance suprême :
data view_epuree / view=view_epuree;

  set original_data;

  if team = 'A' and points < 20 then delete;

run;
Dans ce scénario, aucun fichier de données physique n’est matérialisé sur disque. La vue stocke uniquement la logique compilée de l’algorithme de suppression. Dès lors qu’une procédure analytique ultérieure (telle qu’une régression PROC LOGISTIC) sollicite la vue view_epuree, le moteur d’exécution déclenche l’étape DATA à la volée, alimentant directement le pipeline de calcul de la procédure en flux continu sans consommer le moindre mégaoctet d’espace de persistance permanent.
12. Validation, audit et assurance qualité des tables épurées
12.1 Diagnostic approfondi par l’inspection du journal SAS (SAS Log)
Dans toute méthodologie analytique rigoureuse, la soumission d’un script ne s’achève jamais à la simple visualisation du résultat tabulaire : l’inspection exhaustive du journal d’exécution (SAS Log) constitue une exigence déontologique et technique fondamentale. Le journal est la boîte noire attestant de la validité mathématique et systémique des opérations de filtrage.
L’analyste doit vérifier méthodiquement les lignes informatives standardisées émises par le moteur :
NOTE: There were X observations read from the data set LIB.ORIGINAL_DATA.: Permet de certifier que la source n’a subi aucune troncature inattendue et que l’effectif d’entrée correspond scrupuleusement aux registres initiaux.NOTE: The data set WORK.NEW_DATA has Y observations and Z variables.: La confrontation arithmétique entre l’effectif d’entrée X et l’effectif de sortie Y doit concorder précisément avec la volumétrie attendue résultant des calculs d’exclusion théoriques (X – Rejets = Y).- Absence impérative de messages signalés par les préfixes
WARNING:ouNOTE: Mathematical operations could not be performed, qui démasquent souvent des conversions implicites sauvages de caractères en variables numériques lors de l’évaluation des prédicats relationnels.
12.2 Vérification automatisée de conformité avec PROC COMPARE
Pour auditer de manière indiscutable l’impact d’une suppression conditionnelle, le recours à la procédure de contrôle croisé PROC COMPARE constitue le standard de référence dans les protocoles d’assurance qualité industrielle (particulièrement sous réglementation FDA pour les essais cliniques pharmaceutiques).
Cette procédure permet de confronter directement le jeu de données d’origine avec le jeu résultant post-suppression, ou de comparer deux jeux de données épurés issus de syntaxes alternatives (par exemple valider empiriquement qu’un script utilisant DELETE génère une structure rigoureusement identique bit à bit à un script utilisant le Subsetting IF) :
proc compare base=new_data compare=new_data_subset2 listall;

run;
L’édition générée délivre une certification automatisée : elle analyse la concordance globale des métadonnées, vérifie l’absence de dérive sur les formats ou labels des variables, et confirme que l’ensemble des enregistrements résiduels partagent des valeurs vectorielles strictement indifférenciables, fournissant une preuve auditable de non-régression analytique.
12.3 Protocole de documentation et de traçabilité dans la recherche académique
La reproductibilité computationnelle représente l’un des piliers contemporains de la crédibilité de la recherche scientifique. Lorsque des lignes sont soustraites d’un ensemble de données dans le cadre d’études épidémiologiques, macroéconomiques ou sociologiques, la documentation exhaustive de ces exclusions ne saurait être laissée au hasard de commentaires parcellaires.
Il convient d’adopter un protocole de programmation structuré intégrant :
- Un bloc d’en-tête standardisé au sommet du script DATA consignant l’identité de l’auteur, la date d’exécution, la référence institutionnelle du protocole et la justification scientifique explicite des critères d’exclusion retenus.
- Le respect scrupuleux du principe d’immutabilité du jeu de données brut d’origine : les instructions directes de suppression physique in-situ de type
PROC SQL; DELETE FROM original_data;doivent être formellement proscrites des protocoles académiques au profit d’étapes de génération dérivée permettant de remonter à tout moment à la source primaire. - La génération systématique de diagrammes de flux d’inclusion/exclusion (conformes aux standards CONSORT dans les essais biomédicaux), documentant avec exactitude à chaque étape de filtrage le nombre d’observations écartées et le motif logique spécifique de leur élimination.
Références
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- Food and Drug Administration. (2020). Data Standards for Study Data: Statistical Considerations and Formatting Guidelines. U.S. Department of Health and Human Services. https://www.fda.gov
- SAS Institute Inc. (2021). SAS® 9.4 Statements: Reference (Fifth Edition). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2023). Base SAS® Procedures Guide: Statistical Procedures. SAS Institute Inc.
- Schulz, K. F., Altman, D. G., & Moher, D. (2010). CONSORT 2010 Statement: updated guidelines for reporting parallel group randomised trials. BMJ, 340, c332. https://doi.org/10.1136/bmj.c332
- Stoltzfus, J. C. (2011). Logistic Regression: A Brief Primer. Academic Emergency Medicine, 18(10), 1099–1104. https://doi.org/10.1111/j.1553-2712.2011.01185.x