
L’analyse statistique moderne et le traitement de données à haute dimension reposent sur des fondements algorithmiques rigoureux où chaque opération arithmétique élémentaire peut influencer de manière déterminante la validité des résultats finaux. Au sein du système SAS (Statistical Analysis System), environnement de référence pour l’analyse biostatistique, la modélisation économétrique et la recherche épidémiologique, la manipulation des valeurs continues requiert une maîtrise approfondie des fonctions de discrétisation numérique. Bien que l’arrondi d’un nombre puisse sembler être une opération élémentaire relevant du simple sens commun arithmétique, sa transposition computationnelle engage des architectures logicielles complexes, des considérations de précision binaire en virgule flottante et des implications théoriques majeures sur la structure de variance des jeux de données traités.
Le statisticien ou le programmeur SAS se trouve constamment confronté à la nécessité d’arbitrer entre la fidélité absolue des mesures continues et le besoin pragmatique de simplifier les représentations scalaires à des fins de synthèse, de conformité aux normes de publication ou d’harmonisation métrique. Un mauvais choix méthodologique dans l’arrondi peut introduire des biais systématiques d’estimation, modifier artificiellement la distribution d’une variable réponse, fausser les tests d’hypothèses inférentielles ou engendrer des erreurs d’instabilité numérique cumulatives au cours de procédures itératives de maximisation de la vraisemblance.
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes d’arrondi numérique offerts par SAS, en décortiquant les fonctions canoniques que sont ROUND, FLOOR, CEIL et INT. À travers une progression méthodique, quatre cas de figure programmatiques concrets illustreront les transformations numériques standard, allant de la simplification à l’entier le plus proche jusqu’à l’agrégation par multiples spécifiques, tout en éclairant les mécanismes internes de la norme de calcul binaire et leurs répercussions méthodologiques sur l’analyse de données empiriques.
1. Introduction aux fonctions d’arrondi dans l’environnement SAS
1.1 Importance de la précision numérique en analyse statistique
Dans l’ingénierie des données et la recherche quantitative, la précision numérique constitue la pierre angulaire de toute inférence valide. L’application d’une règle d’arrondi ou de troncature ne se résume pas à une simple modification esthétique de la présentation des résultats ; elle modifie substantiellement la nature mathématique des variables sous-jacentes. Lorsqu’une variable continue est arrondie, une composante d’erreur stochastique ou déterministe est introduite dans le système d’observation. Cette erreur de discrétisation peut être formalisée comme une perturbation résiduelle dont la variance s’agrège à la variance propre du phénomène mesuré, induisant des conséquences directes sur les statistiques descriptives élémentaires telles que la moyenne empirique, l’écart-type et les moments d’ordre supérieur comme l’asymétrie et l’aplatissement.
Dans les études empiriques, en particulier dans les domaines biomédicaux et psychométriques, la standardisation des échelles métriques requiert un équilibre subtil entre résolution instrumentale et bruit de mesure. Conserver un nombre excessif de décimales issues d’instruments de mesure physiques peut engendrer une fausse impression de précision, capturant un bruit instrumental dénué de signification théorique. À l’inverse, une troncature trop agressive élimine la variabilité informative requise pour détecter des associations subtiles au moyen de modèles de régression multivariés. La préservation de la validité interne des modèles quantitatifs dépend directement de la capacité du statisticien à maintenir un rapport signal-sur-bruit optimal à travers les étapes de transformation numérique.
De surcroît, la gestion des erreurs d’arrondi cumulatives représente un défi critique au sein des procédures algorithmiques itératives, telles que l’algorithme de Newton-Raphson utilisé dans les procédures SAS PROC LOGISTIC ou PROC MIXED. Lorsqu’une variable intermédiaire subit des arrondis prématurés au sein d’un cycle de calcul intensif, les écarts infinitésimaux s’amplifient de manière exponentielle, pouvant aboutir à une non-convergence de la matrice d’information de Fisher ou à des estimations aberrantes des erreurs types. Une compréhension théorique des fonctions d’arrondi est donc indispensable avant toute manipulation de données sensibles au sein de la mémoire vive du compilateur SAS.
1.2 Aperçu de la fonction ROUND et des fonctions associées
L’architecture logicielle de SAS fournit un éventail complet d’opérateurs mathématiques conçus pour moduler la précision des valeurs réelles. Au cœur de cet arsenal figure la fonction ROUND, reconnue pour sa flexibilité algorithmique supérieure. Contrairement aux fonctions d’arrondi rudimentaires observées dans d’autres environnements de calcul qui ne permettent qu’un passage à l’entier le plus proche, la fonction ROUND de SAS incorpore un argument d’unité de discrétisation hautement configurable. Cette spécificité permet de redéfinir dynamiquement l’échelle de troncature, qu’il s’agisse de fractions décimales infinitésimales ou de blocs scalaires d’envergure macroscopique.
Parallèlement à la fonction ROUND, le langage SAS implémente des opérateurs déterministes directionnels fondamentaux : les fonctions FLOOR, CEIL et INT. Chacune de ces fonctions répond à une axiomatique mathématique distincte. Alors que ROUND évalue la distance euclidienne relative d’un nombre par rapport aux points d’une grille discrète prédéfinie, les fonctions FLOOR et CEIL projettent systématiquement la valeur vers des bornes topologiques fermées, respectivement le plancher inférieur et le plafond supérieur. La fonction INT, quant à elle, opère une troncature directionnelle stricte vers zéro, générant un comportement asymétrique selon le signe algébrique de l’argument d’entrée.
La mise en œuvre de ces fonctions transcende les frontières architecturales du système SAS. Elles sont pleinement compatibles avec les variables numériques à virgule flottante en double précision standard et trouvent leur utilité aussi bien au sein de l’étape séquentielle DATA qu’à travers les instructions déclaratives du langage PROC SQL. Dans ce dernier, la fonction ROUND optimise les jointures sur clés numériques calculées et facilite les agrégations de rapports décisionnels. Cette ubiquité opérationnelle fait de la maîtrise des arrondis un prérequis universel pour tout architecte de données opérant sur la plateforme SAS.
2. Préparation des données d’étude : Création du jeu de données de référence
2.1 Définition programmatique du DATA step original
Afin de fournir une démonstration empirique reproductible, transparente et rigoureusement étayée, il convient d’établir un environnement de données contrôlé. La construction programmatique d’un jeu de données de référence permet d’isoler les propriétés mathématiques des fonctions d’arrondi sur un spectre diversifié de valeurs numériques. Pour ce faire, nous employons une étape séquentielle classique, formalisée par l’instruction DATA, assignant l’objet résultant à une table nommée original_data au sein de la bibliothèque de travail temporaire WORK.
L’instruction INPUT est paramétrée pour capturer une variable continue unique dénommée value. Cette variable accueille une série de scalaires spécifiquement calibrés pour tester les limites computationnelles des algorithmes SAS : nombres décimaux standards, valeurs infinitésimales inférieures à l’unité, nombres avec développements décimaux répétés, et grandeurs scalaires supérieures à cinquante. L’intégration du bloc DATALINES (ou CARDS dans les versions historiques de SAS) permet d’injecter directement un vecteur de dix observations représentatives dans le flux d’exécution.
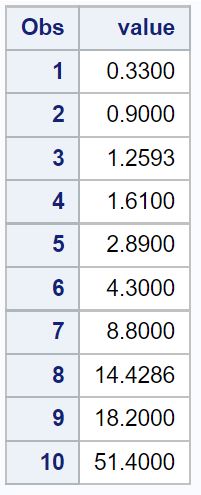
L’exécution de cette structure est matérialisée par l’instruction RUN, qui signale au compilateur SAS la fin du bloc d’instructions et déclenche la phase d’exécution ligne par ligne au sein du vecteur de données du programme, communément appelé Program Data Vector (PDV). Les dix valeurs sélectionnées pour cette étude méthodique sont les suivantes : 0.33, 0.9, 1.2593, 1.61, 2.89, 4.0, 8.8, 14.4286, 18.2 et 51.4. Ce panel offre un échantillonnage idéal pour scruter la réactivité des algorithmes face à des seuils critiques de fractionnement décimal.
Le code complet pour initialiser cet environnement d’essai s’articule ainsi :
data original_data;
input value;
datalines;
0.33
0.9
1.2593
1.61
2.89
4.0
8.8
14.4286
18.2
51.4
;
run;
2.2 Inspection des observations via PROC PRINT
Une fois l’étape d’instanciation achevée, la validation de l’intégrité structurelle de la table est une exigence absolue du contrôle de qualité analytique. L’emploi de la procédure canonique PROC PRINT permet d’inspecter l’état exact des données stockées dans la mémoire vive sans appliquer d’artifices de présentation textuelle ou d’étiquettes déformantes. Cette étape vérifie que l’analyseur lexical de SAS n’a pas introduit de troncature prématurée lors de la phase de conversion des chaînes de caractères brutes en représentations numériques à virgule flottante IEEE 754.
L’instruction s’exécute de manière épurée via le bloc suivant :
proc print data=original_data noobs;
run;
L’option NOOBS supprime l’affichage de la colonne des numéros d’observation, focalisant l’analyse uniquement sur les valeurs scalaires intrinsèques. La consultation du journal d’exécution (le SAS Log) constitue une étape obligatoire de cette vérification. Le journal confirme le succès de l’opération en attestant que la table WORK.ORIGINAL_DATA compte exactement dix observations et une variable numérique. L’absence de messages d’alerte (WARNING) ou de conversion implicite (NOTE: Numeric values have been converted to character) atteste de la parfaite propreté du jeu d’essai.
L’analyse descriptive des valeurs limites met en évidence une dispersion s’étendant d’un minimum de 0.33 à un maximum de 51.4. Ce gradient permet d’évaluer le comportement des fonctions d’arrondi tant sur les petites valeurs soumises à de forts effets de seuil (comme 0.33 qui bascule vers zéro ou un selon l’opérateur) que sur des grandeurs de dizaines (14.4286 ou 51.4) où l’impact relatif des décimales sur l’ordre de grandeur global est radicalement distinct.
3. Méthode 1 : Arrondir à l’entier le plus proche avec la fonction ROUND
3.1 Principe algorithmique de l’arrondi standard à l’entier
L’arrondi standard à l’entier le plus proche constitue l’opération de simplification la plus fréquemment requise en traitement de signal et en gestion des enquêtes quantitatives. Son principe théorique repose sur la métrique euclidienne unidimensionnelle : pour un nombre réel donné, la fonction cherche l’entier relatif qui minimise la distance absolue le séparant de ce point. La complexité inhérente à cette définition réside dans le traitement des valeurs équidistantes, désignées sous le vocable de demi-entiers (points médians terminés exactement par la fraction 0.5).
Dans la fonction ROUND de SAS, lorsqu’aucun second argument n’est fourni de manière explicite par l’analyste, le système applique un argument d’unité par défaut strictement égal à 1. La règle arithmétique conventionnelle adoptée par le compilateur SAS pour les nombres positifs est l’arrondi vers le haut au demi-entier : si la partie fractionnaire est strictement inférieure à 0.5, le nombre est abaissé à l’entier inférieur ; si la partie fractionnaire est supérieure ou égale à 0.5, le nombre est promu à l’entier supérieur. Ce comportement symétrique est toutefois ajusté en arithmétique signée pour prévenir des biais systématiques lors du traitement de distributions symétriques contenant des valeurs négatives.
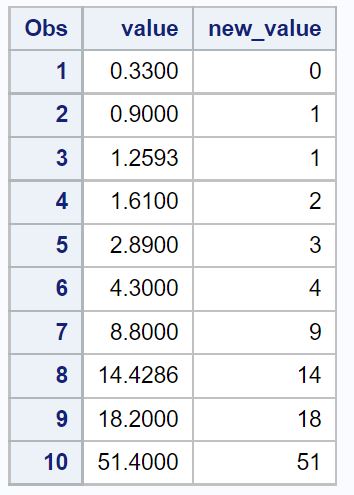
L’impact de cette règle sur notre jeu d’échantillons est formellement prévisible : une valeur comme 0.33 présentant une composante fractionnaire sous le seuil critique converge vers 0. Les observations telles que 0.9, 1.61 ou 8.8 voient leurs résidus dépasser la borne médiane de 0.5 et sont donc respectivement translatées vers les entiers 1, 2 et 9. La valeur 4.0, représentant déjà un point de grille exact, demeure structurellement invariable. Ce mécanisme garantit une transition déterministe optimale vers une échelle de nombres entiers.
3.2 Implémentation du code SAS pour l’arrondi à l’entier
La mise en œuvre programmatique de cette première méthode s’opère par la dérivation d’une nouvelle table de données baptisée new_data, garantissant la préservation absolue des vecteurs d’entrée au sein de la table d’origine. Au sein de cette nouvelle étape DATA, nous instancions une nouvelle colonne nommée new_value qui résulte de l’évaluation scalaire de l’instruction round(value).
Le bloc de code complet s’écrit de la façon suivante :
data new_data;
set original_data;
new_value = round(value);
run;
proc print data=new_data noobs;
run;
L’exécution de la procédure PROC PRINT produit un état comparatif clair entre les valeurs originelles et les grandeurs discrétisées. En examinant point par point la table résultante, nous constatons que l’observation 1.2593 devient 1, l’observation 2.89 devient 3, l’observation 14.4286 devient 14, l’observation 18.2 devient 18, et l’observation maximale 51.4 est ramenée à 51. La comparaison met en lumière la suppression intégrale des développements décimaux, le système stockant désormais en mémoire les entiers mathématiques exacts sous forme de flottants à mantisse entière.
3.3 Cas d’usage psychométriques et interprétation
Dans la recherche psychologique et les sciences du comportement, l’arrondi à l’entier le plus proche répond à des contraintes de mesurabilité strictes. Lors de l’évaluation de traits latents via la théorie de réponse aux items (TRI) ou des modèles d’équations structurelles, les algorithmes produisent régulièrement des estimations factorielles sous forme de variables continues standardisées (scores thêta). Bien que ces scores possèdent d’excellentes propriétés statistiques pour la modélisation mathématique, ils sont inutilisables sous cette forme dans les contextes appliqués, tels que la sélection des candidats ou le bilan neuropsychologique.
La conversion de ces scores continus en indices discrets entiers permet aux praticiens d’aligner les résultats sur des grilles d’interprétation standardisées (comme les scores sur l’échelle de Wechsler ou les indices d’aptitude générale). De même, lors du recueil de données chronométriques, la simplification des temps de réponse moyens en millisecondes entières facilite la communication des profils cognitifs aux patients et aux comités cliniques sans surcharger les rapports diagnostiques d’informations parasites.
Toutefois, cette simplification nécessite une grande vigilance méthodologique. L’analyste doit impérativement évaluer la perte de granularité induite sur la variance observée. Discrétiser une variable continue compacte son spectre spectral, ce qui a pour corollaire de réduire artificiellement la magnitude des corrélations bivariées ultérieures, un phénomène bien documenté dans la littérature psychométrique sous l’appellation d’atténuation due à la discrétisation d’échelle.
4. Méthode 2 : Arrondir à un nombre spécifique de décimales
4.1 Syntaxe de l’argument d’arrondi décimal (.1, .01, .001)
Dans de multiples disciplines analytiques, éliminer l’intégralité des décimales est inacceptable en raison de l’écrasement informationnel qui en résulte. L’architecture de la fonction ROUND résout cette problématique grâce à l’incorporation d’un second argument optionnel, formellement appelé round-off unit (l’unité d’arrondi). Ce paramètre définit la finesse de la maille du treillis numérique sur lequel la variable continue doit être projetée.
Pour calibrer l’arrondi à une décimale exacte, le second paramètre de la fonction doit être renseigné avec la constante numérique 0.1 (ou .1). Pour calibrer un arrondi à deux décimales, la constante 0.01 est transmise, et pour une précision au millième, la constante 0.001 est employée. L’algorithme interne de SAS ne se contente pas de tronquer les caractères textuels affichés ; il réalise une mise à l’échelle arithmétique rigoureuse en multipliant virtuellement la valeur d’entrée par l’inverse de l’unité (soit 10, 100 ou 1000), en appliquant l’arrondi à l’entier sur cette grandeur intermédiaire, puis en divisant le produit obtenu par ce même coefficient multiplicateur.
Cette approche paramétrique confère une flexibilité opérationnelle totale, permettant d’adapter la résolution numérique aux exigences analytiques sans devoir recourir à des formules artisanales de multiplication et division en chaîne, sources régulières d’instabilités binaires.
4.2 Déploiement du programme SAS multi-décimal
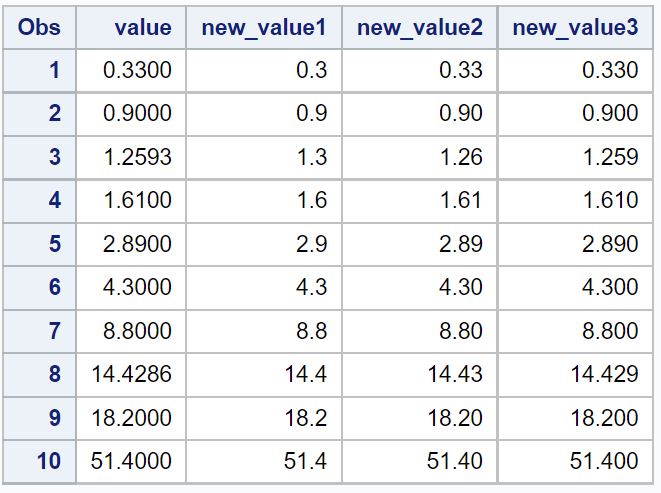
Pour illustrer la modulation simultanée des précisions décimales au sein d’une même structure de données, nous déployons une étape DATA qui génère trois variables distinctes : new_value1 (arrondie au dixième), new_value2 (arrondie au centième) et new_value3 (arrondie au millième). Cette approche permet de visualiser l’évolution morphologique des nombres selon la finesse du filtre appliqué.
Le code SAS s’implémente selon le schéma suivant :
data new_data;
set original_data;
new_value1 = round(value, 0.1);
new_value2 = round(value, 0.01);
new_value3 = round(value, 0.001);
run;
proc print data=new_data noobs;
run;
L’observation détaillée des résultats met en lumière le traitement des valeurs complexes de notre échantillon. Considérons l’observation 1.2593 : avec une unité de 0.1, elle devient 1.3 ; avec une unité de 0.01, le troisième chiffre après la virgule (9) commande un basculement vers le haut, donnant 1.26 ; avec 0.001, le quatrième chiffre (3) étant inférieur à cinq, elle se stabilise à 1.259. Le même raffinement s’observe pour l’observation 14.4286, qui évolue séquentiellement vers 14.4, 14.43 et 14.429.
L’alignement rigoureux des colonnes obtenu par la procédure PROC PRINT confirme l’absence de biais d’asymétrie sur les résidus d’arrondi : les erreurs résiduelles locales sont uniformément distribuées dans l’intervalle [-d/2, +d/2], où d représente l’unité d’arrondi choisie.
4.3 Applications empiriques en recherche comportementale
La structuration standardisée des décimales est un impératif pour la communication scientifique dans les revues à comité de lecture. Les directives émises par l’American Psychological Association (normes APA) imposent des contraintes méthodologiques strictes sur la restitution des paramètres statistiques. L’estimation des coefficients de corrélation linéaire de Pearson, des indices de régression standardisés bêta et des coefficients de consistance interne (alpha de Cronbach) requiert un arrondi systématique à exactement deux décimales.
En revanche, le formatage des probabilités critiques associées aux tests d’hypothèses, communément appelées les p-values, exige une granularité plus fine. Les standards scientifiques modernes préconisent un arrondi à trois décimales (par exemple, p = 0.024) afin de permettre une appréciation précise de la marge de rejet de l’hypothèse nulle. Si une valeur p est inférieure à 0.001, elle n’est pas arrondie à zéro, mais rapportée comme p < 0.001 pour signifier la borne inférieure de résolution.
L’usage programmé de la fonction ROUND avec les arguments 0.01 et 0.001 permet d’automatiser cette standardisation dès la phase d’extraction des données, évitant ainsi les erreurs humaines de retranscription manuelle qui polluent fréquemment les synthèses méta-analytiques contemporaines.
5. Méthode 3 : Tronquer vers l’entier inférieur avec FLOOR et vers l’entier supérieur avec CEIL
5.1 Mécanique théorique des fonctions de plancher et de plafond
Au-delà de l’arrondi centré sur le point médian, l’analyse numérique nécessite fréquemment l’utilisation d’opérateurs topologiques directionnels stricts. Ces opérateurs sont formalisés en mathématiques fondamentales par les concepts de partie entière par défaut et par excès, transposés dans l’écosystème SAS sous les dénominations de fonctions FLOOR (plancher) et CEIL (plafond). Contrairement à ROUND, ces fonctions ignorent la proximité relative de la fraction décimale par rapport à l’entier supérieur ou inférieur ; elles obéissent à des critères d’ordre stricts au sens de la théorie des ensembles ordonnés.
La fonction FLOOR associe à tout nombre réel x le plus grand entier relatif inférieur ou égal à x. Algébriquement, cela se traduit par : pour tout x appartenant à R, FLOOR(x) est l’unique entier k appartenant à Z tel que k <= x < k + 1. À l’opposé, la fonction CEIL renvoie le plus petit entier relatif supérieur ou égal à x, formalisé par : pour tout x appartenant à R, CEIL(x) est l’unique entier k appartenant à Z tel que k – 1 < x <= k.
Ces définitions ont une conséquence cruciale sur le traitement des nombres réels selon leur signe. Pour les valeurs positives, FLOOR équivaut à une suppression pure et simple du développement décimal, tandis que CEIL incrémente la partie entière dès qu’une composante fractionnaire résiduelle non nulle est détectée. Sur les valeurs négatives, cette dynamique s’inverse visuellement : FLOOR(-1.2) produit -2, car -2 est strictement inférieur à -1.2, alors que CEIL(-1.2) produit -1. Enfin, pour les scalaires déjà rigoureusement entiers, les deux fonctions renvoient la valeur d’origine sans modification.
5.2 Codage SAS comparatif : new_value1 = floor(value) et new_value2 = ceil(value)
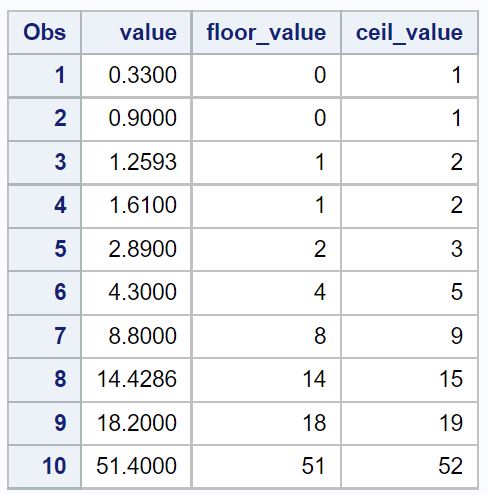
Pour mettre en relief la divergence fonctionnelle absolue entre ces deux opérateurs, nous construisons une étape DATA comparant systématiquement leurs effets sur notre jeu de données. Le programme génère deux vecteurs d’évaluation : new_value1 par l’instruction floor(value) et new_value2 via l’instruction ceil(value).
Le code complet pour exécuter cette confrontation est rédigé ainsi :
data new_data;
set original_data;
new_value1 = floor(value);
new_value2 = ceil(value);
run;
proc print data=new_data noobs;
run;
L’inspection des résultats dans le tableau de sortie révèle des contrastes majeurs. Prenons l’observation 0.33 : là où l’arrondi standard ROUND la stabilisait à 0, FLOOR la maintient à 0 tandis que CEIL la propulse immédiatement à 1. Sur l’observation 2.89, bien que la fraction décimale soit très proche de 3, FLOOR la force impérativement à descendre à 2, tandis que CEIL renvoie 3. Pour la valeur 51.4, FLOOR produit 51 et CEIL retourne 52.
La seule observation où FLOOR et CEIL convergent vers un résultat identique est 4.0, produisant toutes deux la valeur exacte 4. Ce comportement illustre le comportement asymptotique des deux fonctions : dès qu’une décimale infinitésimale (par exemple 4.0000001) s’ajoute à un entier, la fonction CEIL bascule instantanément vers l’entier supérieur, soulignant son extrême sensibilité aux résidus fractionnaires.
5.3 Utilisations concrètes dans les protocoles expérimentaux
En psychologie expérimentale et en recherche biomédicale, les fonctions FLOOR et CEIL répondent à des nécessités de gestion de protocole qui échappent aux règles d’arrondi conventionnelles. La fonction FLOOR est fondamentale pour déterminer le nombre d’unités expérimentales achevées de manière cumulative. Dans un protocole d’évaluation de la mémoire de travail où un participant doit compléter des blocs d’essais d’une durée fixe de 5 minutes, si un sujet s’arrête après 14.8 minutes, l’instruction completed_blocks = floor(14.8 / 5); renvoie 2 blocs complets. Appliquer la fonction ROUND dans ce cas aurait erronément crédité le participant de 3 blocs, invalidant l’analyse de performance sous contrainte d’achèvement strict.
Inversement, la fonction CEIL trouve son utilité dans l’allocation des ressources et la logistique expérimentale. Si un investigateur clinique doit indemniser des volontaires sur la base d’heures entières entamées, ou commander des flacons de réactifs conditionnés par unités insécables, la fonction CEIL s’impose. Par exemple, si l’administration d’un test nécessite 1.1 flacon de soluté, l’instruction vials_needed = ceil(1.1); garantit la réservation de 2 flacons complets, écartant tout risque de rupture de protocole.
Ces deux opérateurs permettent ainsi de modéliser avec une fidélité mathématique parfaite des barèmes d’évaluation non symétriques et des règles de décision discrètes au sein des bases de données complexes.
6. Méthode 4 : Arrondir au multiple le plus proche (dizaines, centaines et multiples personnalisés)
6.1 Logique de l’argument d’échelle supérieur à 1
Une caractéristique majeure de la fonction ROUND sous SAS réside dans sa capacité à opérer sur des échelles numériques macroscopiques en acceptant des arguments d’unité strictement supérieurs à l’unité. La plupart des analystes limitent intuitivement l’usage du second argument à des fractions décimales (0.1, 0.01), ignorant que ce paramètre accueille n’importe quel scalaire positif non nul. Cette fonctionnalité élargit considérablement les capacités de réduction dimensionnelle des variables continues.
Lorsque le second paramètre de ROUND est configuré avec la constante 10, l’algorithme redéfinit son treillis de projection : le nombre d’entrée est arrondi à la dizaine la plus proche. Une unité configurée à 100 déplace les points de convergence vers les multiples stricts de la centaine (0, 100, 200, etc.). Mathématiquement, l’opération revient à diviser la variable x par la constante d’échelle K, à appliquer l’arrondi standard à l’entier sur le quotient résultant, puis à remultiplier ce résultat par K : ROUND(x, K) = ROUND(x / K, 1) * K.
Cette propriété s’applique avec une souplesse totale aux multiples personnalisés non décimaux, tels que des paliers de 5, 25 ou 50 unités. Cette polyvalence offre aux biostatisticiens un outil de catégorisation continue direct, supprimant le besoin de longues chaînes conditionnelles composées d’instructions IF-THEN-ELSE imbriquées.
6.2 Mise en œuvre SAS pour les regroupements par dizaines et centaines
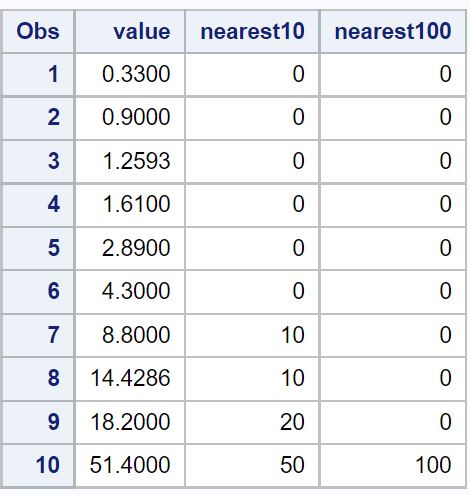
L’implémentation de regroupements scalaires par dizaines et par centaines s’opère directement au sein du DATA step en exploitant les arguments 10 et 100. Dans le programme ci-dessous, la variable new_value1 capture la projection à la dizaine, tandis que new_value2 matérialise l’agrégation à la centaine la plus proche.
Le bloc d’instructions s’exécute selon la structure canonique suivante :
data new_data;
set original_data;
new_value1 = round(value, 10);
new_value2 = round(value, 100);
run;
proc print data=new_data noobs;
run;
L’analyse comparative des sorties produites par PROC PRINT est hautement instructive. Examinons en premier lieu l’action de l’argument 10. Les valeurs initiales 0.33, 0.9, 1.2593, 1.61, 2.89 et 4.0 sont toutes inférieures au seuil médian d’arrondi de 5 : elles sont par conséquent toutes écrasées vers la valeur 0. L’observation 8.8 franchit la barrière médiane et se voit projetée vers 10. La valeur 14.4286, se trouvant en deçà de 15, est ramenée à 10, alors que 18.2 franchit le seuil et converge vers 20. La valeur 51.4 est quant à elle stabilisée à 50.
Lors de l’évaluation de la variable new_value2 (arrondie à la centaine), l’effet de filtrage est encore plus marqué. La totalité des observations comprises entre 0.33 et 18.2 est instantanément ramenée à 0. L’observation maximale 51.4, se situant au-delà du seuil critique de 50.0, bascule vers la valeur 100. Cette transformation illustre la puissance de l’argument d’échelle pour lisser les fluctuations mineures au profit de tendances macroscopiques nettes.
6.3 Pertinence dans l’agrégation des scores et la constitution de cohortes
Dans l’analyse épidémiologique et la sociométrie quantitative, la manipulation de variables continues individuelles pose d’importants défis méthodologiques, notamment en matière de confidentialité des données et de dispersion statistique. L’arrondi par multiples supérieurs s’avère un vecteur particulièrement puissant pour agréger des distributions d’âges chronologiques au sein de grandes cohortes. En utilisant l’instruction decade_group = round(age, 10);, les participants de 45 à 54 ans sont directement agrégés autour de la valeur médiane 50, simplifiant l’analyse descriptive préliminaire.
Dans le domaine des études organisationnelles, cette technique simplifie la gestion des effectifs de passation au sein d’institutions ou d’unités de production hétérogènes. Les tailles d’établissements peuvent être arrondies aux cinquantaines ou aux centaines les plus proches (round(workforce, 50)) pour neutraliser le bruit des variations journalières de personnel tout en préservant la hiérarchie structurelle des strates organisationnelles.
De surcroît, lors des phases exploratoires portant sur des volumes massifs de données (mégadonnées ou registres administratifs nationaux), l’arrondi par multiples opère une réduction dimensionnelle efficace qui accélère l’exécution des procédures de stratification et la création de cartes thermiques de densité bidimensionnelle.
7. Analyse comparative approfondie : Différences computationnelles entre ROUND, FLOOR, CEIL et INT
7.1 Tableau matriciel des comportements selon les quadrants numériques
Pour appréhender exhaustivement le comportement de l’architecture numérique de SAS, il est nécessaire de formaliser une analyse matricielle confrontant les quatre fonctions de manipulation scalaire : ROUND, FLOOR, CEIL et la fonction tronquante INT. Ces opérateurs ne réagissent pas de manière symétrique selon la polarité du nombre traité et sa proximité relative avec zéro.
Le tableau ci-dessous synthétise les transformations opérées par chacune de ces fonctions appliquées à des valeurs scalaires archétypales réparties sur les différents quadrants de la droite des réels :
| Valeur d’entrée (x) | ROUND(x) | FLOOR(x) | CEIL(x) | INT(x) |
|---|---|---|---|---|
| 2.75 | 3 | 2 | 3 | 2 |
| 2.25 | 2 | 2 | 3 | 2 |
| 2.50 | 3 | 2 | 3 | 2 |
| 0.00 | 0 | 0 | 0 | 0 |
| -0.45 | 0 | -1 | 0 | 0 |
| -2.25 | -2 | -3 | -2 | -2 |
| -2.50 | -3 | -3 | -2 | -2 |
| -2.75 | -3 | -3 | -2 | -2 |
L’analyse différentielle la plus instructive porte sur la divergence fondamentale entre la fonction FLOOR et la fonction INT sur les nombres négatifs. Alors que FLOOR applique strictement la définition mathématique en cherchant l’entier inférieur (faisant passer -2.25 à -3), la fonction INT opère une troncature pure de la composante fractionnaire en tronquant vers zéro, aboutissant à -2. La fonction INT agit donc comme un miroir asymétrique de FLOOR sur les positifs et de CEIL sur les négatifs.
7.2 Conséquences sur l’estimation de la moyenne et de la variance
Le choix d’une fonction scalaire parmi ces quatre options induit des répercussions fondamentales sur les propriétés asymptotiques des estimateurs statistiques. L’application systématique des fonctions FLOOR ou CEIL sur une série d’échantillons continus introduit un biais d’estimation unilatéral prédictible et sévère sur l’espérance mathématique de la variable. Puisque FLOOR tronque systématiquement vers le bas, l’espérance mathématique de la variable transformée subit un biais négatif moyen égal à 0.5 unité sous l’hypothèse d’une distribution uniforme des décimales sur [0, 1]. Réciproquement, CEIL induit un biais positif strict d’amplitude équivalente.
À l’opposé, la fonction standard ROUND est spécifiquement conçue pour préserver de manière quasi optimale l’espérance mathématique du processus générateur de données. Comme les valeurs fractionnaires inférieures à 0.5 sont tirées vers le bas tandis que celles supérieures ou égales à 0.5 sont propulsées vers le haut, les perturbations locales s’annulent mutuellement sur des échantillons de grande taille, garantissant que l’espérance de l’erreur d’arrondi est asymptotiquement nulle : E[ROUND(X) – X] = 0.
Cependant, en ce qui concerne la variance d’échantillonnage, la situation est plus complexe. L’arrondi n’opère pas comme un simple filtre passe-bas passif. La variance de la variable discrétisée incorpore la variance intrinsèque du phénomène augmentée d’un terme résiduel d’arrondi, traditionnellement modélisé par la correction de Sheppard (qui postule l’ajout d’une variance d’erreur de discrétisation égale à d^2 / 12, où d est l’intervalle d’arrondi). L’emploi imprudent de fonctions biaisées comme FLOOR ou INT fausse ces relations structurelles et compromet la puissance statistique des tests d’hypothèses paramétriques (tests t de Student, modèles ANOVA et régressions linéaires généralisées), accroissant le risque de commettre une erreur de type I ou de type II selon la structure des résidus.
8. Précision en virgule flottante et comportement interne du processeur SAS
8.1 La norme IEEE 754 et la représentation binaire des réels
Pour tout ingénieur de données et biostatisticien opérant sous SAS, il est capital de comprendre que l’ordinateur ne calcule pas en base dix, mais en base deux, conformément à la norme internationale IEEE 754 relative à l’arithmétique en virgule flottante. Par défaut, sur les architectures matérielles modernes 64 bits exécutant le système SAS, les variables numériques occupent huit octets (64 bits) de stockage au sein du Program Data Vector. Cette empreinte alloue un bit pour le signe algébrique, onze bits pour l’exposant polarisé, et cinquante-deux bits pour la mantisse fractionnaire (la précision significative).
Cette architecture matérielle implique une limite théorique majeure : les fractions décimales finies en base dix qui ne possèdent pas de puissance négative de deux dans leur décomposition binaire deviennent des fractions périodiques infinies en base deux. À l’instar de la fraction 1/3 qui génère un développement infini en base décimale (0.3333…), des valeurs familières telles que 0.1, 0.2 ou 0.01 ne peuvent pas être représentées de manière rigoureusement exacte en binaire flottant à double précision. Elles sont donc approximées par le processeur au bit le plus proche.
Ces micro-résidus sous-jacents, imperceptibles lors d’un affichage textuel sommaire, peuvent générer des comportements inattendus lors des opérations arithmétiques comparatives. Une valeur résultant d’une chaîne de calcul peut valoir en mémoire interne 0.49999999999999994 au lieu du 0.5 théorique attendu. Si la fonction standard ROUND est appliquée sur ce résidu flottant, elle évaluera le nombre comme strictement inférieur à la borne médiane et le basculera vers zéro au lieu de le promouvoir vers l’entier un, créant une anomalie logique dans la chaîne de traitement.
8.2 Techniques de stabilisation numérique et fonction FUZZ
Conscients de cette contrainte inhérente à l’architecture informatique, les concepteurs du compilateur SAS ont intégré des mécanismes de tolérance heuristique au sein des fonctions mathématiques, communément désignés sous le terme de fuzzing. La fonction ROUND n’applique pas une coupure binaire stricte et brute ; elle incorpore une marge de tolérance infinitésimale (un facteur de fuzz calibré par défaut autour de 1E-12) conçue pour absorber le bruit de virgule flottante. Si un scalaire calculé se trouve à une distance infinitésimale d’un demi-entier, le compilateur procède à une régularisation automatique vers le haut avant d’exécuter l’arrondi.
Dans les contextes de calcul intensif impliquant des soustractions de nombres quasi identiques (phénomène d’annulation catastrophique) ou des divisions itératives complexes, l’analyste peut stabiliser manuellement ses expressions au moyen de la fonction explicite FUZZ. La fonction FUZZ tronque tout résidu delta inférieur au seuil de tolérance machine directement vers l’entier ou la décimale la plus proche. L’articulation canonique s’exprime par des constructions du type :
adjusted_value = round(fuzz(raw_calculated_value), 0.01);
Cette approche préventive est particulièrement cruciale avant l’exécution de requêtes logiques conditionnelles exploitant les opérateurs d’égalité stricte (IF value = 1.0 ou WHERE value EQ 0.5). En remplaçant les tests d’égalité stricte par des évaluations stabilisées par la fonction ROUND ou en intégrant des tests de comparaison par intervalle avec une tolérance delta définie (IF abs(value – target) < 1e-9), le statisticien garantit l’invariance et la reproductibilité absolue de ses filtres de données sur des environnements matériels distribués.
9. Applications statistiques et psychométriques de l’arrondi dans SAS
9.1 Gestion des échelles de Likert et des inventaires de personnalité
En psychométrie appliquée et en sociologie quantitative, la mesure de concepts latents repose quasi systématiquement sur des instruments psychométriques exploitant des échelles de réponse ordinales de type Likert (généralement graduées de 1 à 5, ou de 1 à 7). Lors des analyses factorielles confirmatoires ou des procédures de modélisation en classes latentes conduites au moyen des procédures PROC FACTOR ou PROC CALIS, l’analyste synthétise ces items élémentaires sous la forme de dimensions communes. Les scores factoriels bruts calculés pour chaque individu constituent des variables métriques continues hautement fractionnées.
Pour exploiter ces profils factoriels dans un cadre clinique ou lors de bilans de compétences professionnels, ces valeurs continues doivent être translatées vers des grilles psychométriques étalonnées universelles, à l’instar des échelles de stanines (Standard Nines, réparties sur 9 intervalles discrets de 1 à 9) ou des échelles de stens (Standard Tens, graduées de 1 à 10, centrées sur 5.5). La procédure nécessite une transformation numérique précise combinant centrage-réduction des scores factoriels, mise à l’échelle métrique, puis application méthodique de la fonction ROUND :
sten_score = round(5.5 + (standardized_latent_factor * 2.0));
if sten_score < 1 then sten_score = 1;
if sten_score > 10 then sten_score = 10;
Cette modélisation logicielle garantit que les scores étalonnés respectent scrupuleusement les contraintes de support borné propres aux inventaires psychométriques standardisés. Une telle discrétisation contrôlée préserve la fidélité test-retest de l’instrument en éliminant les variations micro-scalaires qui ne reflètent aucune évolution clinique tangible chez le patient ou le sujet évalué.
9.2 Standardisation des indices de performance et chronométriques
Dans les neurosciences cognitives et les études de temps de réaction informatisées, la collecte d’événements comportementaux via des claviers de réponse ou des oculomètres (eye-trackers) génère des jeux de données chronométriques au millième de seconde près. Toutefois, les systèmes d’exploitation conventionnels introduisent un bruit instrumental matériel aléatoire (latence de transmission USB, rafraîchissement d’écran à 60 Hz ou 144 Hz) qui entache la précision brute enregistrée.
L’utilisation judicieuse de la fonction ROUND permet de filtrer ce bruit instrumental en projetant les temps de réaction enregistrés vers des multiples opérationnels conformes aux limites réelles de la perception et du traitement de l’information par le système nerveux central. Par exemple, l’arrondi vers des mailles de 5 ou 10 millisecondes (harmonized_rt = round(raw_reaction_time, 10);) homogénéise les vecteurs d’apprentissage sans détériorer la structure temporelle des réponses cognitives.
Cette harmonisation temporelle produit un bénéfice direct lors de la phase de détection des valeurs aberrantes (outliers) au moyen de la médiane et de l’écart absolu à la médiane (MAD) au sein de la procédure PROC ROBUSTREG. En lissant le bruit haute fréquence, la fonction ROUND stabilise les bornes de troncature et évite d’exclure arbitrairement des essais comportementaux légitimes situés à la lisière des frontières de décision statistique.
10. Bonnes pratiques de codage et pièges fréquents dans la manipulation des arrondis
10.1 Ordre d’exécution et préservation des données sources
Dans l’ingénierie logicielle appliquée aux environnements SAS, la règle d’or absolue pour la manipulation de données consiste à maintenir une séparation imperméable entre les données sources primaires et les variables dérivées issues de calculs mathématiques. L’erreur la plus fréquente commise par les développeurs débutants consiste à écraser la variable numérique originale directement au sein de l’étape DATA :
/* ERREUR GRAVE DE CONCEPTION */
data analysis_dataset;
set analysis_dataset;
value = round(value, 0.1);
run;
Cette approche est proscrite dans un environnement réglementé (conforme aux exigences de la FDA ou de l’EMA). Dès l’instant où la variable originale est écrasée par son approximation arrondie, la traçabilité des données est compromise. Tout calcul subséquent nécessitant la distribution originelle complète (comme un test d’ajustement de normalité ou une analyse de sensibilité) devient techniquement impossible sans réexécuter l’ensemble de la chaîne d’importation depuis les fichiers sources.
La bonne pratique de programmation exige la création systématique d’une nouvelle variable au nommage transparent (par exemple val_rounded_d1 ou value_r10), documentée rigoureusement au moyen de l’instruction LABEL, tout en gérant explicitement le traitement des valeurs manquantes. Si une observation possède une valeur manquante standard (.) ou spéciale (.A à .Z), les fonctions ROUND, FLOOR et CEIL propagent naturellement la valeur manquante sans générer d’erreur de compilation, garantissant la cohérence référentielle du flux :
data clean_study;
set raw_study;
if not missing(score) then score_rounded = round(score, 0.01);
else score_rounded = .;
label score_rounded = « Score brut arrondi au centième le plus proche »;
run;
10.2 Optimisation des performances logicielles sur de volumineux ensembles de données
Lorsque le volume de données atteint plusieurs dizaines ou centaines de millions d’enregistrements (comme dans le cas des données de facturation médicale ou des relevés de capteurs industriels), le coût computationnel des fonctions mathématiques scalaires devient un déterminant majeur de l’efficacité logicielle. Bien que la fonction ROUND soit optimisée en assembleur dans le moteur d’exécution de SAS, son application répétée sur des dizaines de colonnes numériques simultanées peut ralentir considérablement le traitement global.
Pour optimiser la vitesse de calcul, il convient de vectoriser les traitements en exploitant la puissance des tableaux SAS (instructions ARRAY). L’emploi d’un tableau permet d’itérer de manière hautement compacte sur un groupe de variables cibles au moyen d’une boucle DO séquentielle exécutée directement au sein du compilateur, réduisant l’overhead associé à la résolution syntaxique unitaire :
data optimized_dataset;
set massive_dataset;
array raw_metrics[*] metric1 – metric20;
array rnd_metrics[*] r_metric1 – r_metric20;
do i = 1 to dim(raw_metrics);
rnd_metrics[i] = round(raw_metrics[i], 0.01);
end;
drop i;
run;
En parallèle, l’ingénieur de données doit arbitrer judicieusement entre le calcul dynamique au sein d’une vue (VIEW) ou la persistance sur disque. Si les variables arrondies ne sont utilisées qu’une seule fois dans une procédure de restitution finale, l’emploi d’une étape PROC SQL ou d’une vue DATA step évite les phases d’entrées/sorties (I/O) sur disque dur, qui représentent le goulet d’étranglement le plus sévère sur les infrastructures serveurs de grande échelle.
11. Formatage d’affichage versus transformation numérique des valeurs arrondies
11.1 Différence fondamentale entre stockage interne et restitution visuelle
L’un des écueils conceptuels les plus fréquents en programmation SAS réside dans la confusion entre la transformation physique d’un nombre en mémoire et la modulation de sa représentation visuelle à travers le système de formats d’affichage. Il est primordial de comprendre que l’application d’un format de présentation ne modifie en aucun cas la valeur sous-jacente stockée dans la mémoire binaire du système.
Considérons l’instruction suivante au sein d’une étape de données :
data visual_demo;
x = 1.2593;
format x 8.2;
run;
Lorsque la procédure PROC PRINT inspecte cette table, elle affiche visuellement la valeur 1.26. Pour un lecteur non averti, la variable semble avoir été rigoureusement arrondie au centième. Pourtant, sur le plan matériel, les huit octets alloués à la variable x contiennent toujours la représentation binaire IEEE 754 complète de 1.2593. Si cette variable x est ultérieurement injectée dans une opération arithmétique (par exemple total = x * 1000;), le résultat retourné sera 1259.3, et non 1260.0. Cet écart peut engendrer des incohérences comptables ou des divergences statistiques majeures au sein de rapports financiers audités.
La règle méthodologique est claire : si l’objectif poursuivi est de modifier la valeur pour les calculs analytiques subséquents, la transformation physique via la fonction ROUND est rigoureusement impérative. À l’inverse, si l’objectif réside uniquement dans l’esthétique d’un tableau de reporting imprimé sans modification des équations inférentielles du modèle, l’usage des formats standards (8.2, 12.4, DOLLAR14.2) doit être privilégié pour préserver l’intégralité de la précision sous-jacente.
11.2 Création de formats personnalisés via PROC FORMAT
Pour exploiter pleinement la synergie entre transformation numérique et présentation visuelle, l’environnement SAS propose la procédure PROC FORMAT. Cette procédure permet à l’architecte de données de concevoir des dictionnaires de formatage capables de projeter des intervalles continus vers des étiquettes sémantiques textuelles ou des catégories discrètes ordonnées, complétant ainsi l’action des fonctions d’arrondi numérique.
Une configuration classique consiste à appliquer un arrondi physique initial à l’entier au moyen de ROUND, puis à assigner un format catégoriel personnalisé pour faciliter la ventilation d’échantillons au sein de la procédure d’analyse croisée PROC FREQ :
proc format;
value age_strata
low – 25 = « Cohorte Jeune (<= 25 ans) »
26 – 50 = « Cohorte Intermédiaire (26-50 ans) »
51 – high = « Cohorte Sénior (>= 51 ans) »;
run;
data categorized_cohorts;
set original_data;
age_discrete = round(value);
format age_discrete age_strata.;
run;
proc freq data=categorized_cohorts;
tables age_discrete;
run;
Cette articulation programmatique illustre la complémentarité des outils SAS : la fonction ROUND assainit et discrétise le signal numérique continu en amont, tandis que le format personnalisé valorise l’information pour l’interprétation clinique ou managériale en aval sans complexifier le modèle de données relationnel.
12. Synthèse opérationnelle et recommandations pour les analyses de données complexes
12.1 Arbre de décision pour le choix de la méthode d’arrondi optimale
Afin de structurer les choix méthodologiques des statisticiens au sein de pipelines de production analytique complexes, un arbre de décision rigoureux peut être formalisé pour déterminer l’opérateur arithmétique adéquat en fonction des finalités de l’étude :
1. La variable est-elle destinée à des calculs ultérieurs ou exclusivement à l’affichage ?
– Si affichage exclusif : Appliquer un format SAS (ex. 8.2) sans altération physique des données.
– Si calculs ultérieurs : Procéder à une transformation par fonction mathématique.
2. Quelle est la contrainte méthodologique sur la distribution de l’erreur ?
– Minimisation stricte du biais sur l’espérance mathématique : Employer impérativement ROUND(x, unité).
– Comptabilisation d’unités complétées ou seuils conservateurs d’exposition toxique : Employer FLOOR(x).
– Facturation d’unités entamées, surcoûts logistiques ou dimensionnement capacitaire : Employer CEIL(x).
– Troncature absolue indépendante du quadrant pour extraction de préfixes entiers : Employer INT(x).
3. Quelle est la granularité métrique requise par le protocole scientifique ?
– Alignement sur des unités fractionnaires régulières : Configurer le second paramètre de ROUND à 0.1, 0.01 ou 0.001.
– Constitution de macro-strates ou d’intervalles décennaux : Configurer le second paramètre de ROUND à 10, 50 ou 100.
4. Présence de nombres négatifs au sein de la distribution :
– Vérifier impérativement le comportement directionnel de FLOOR et INT afin d’éviter tout basculement asymétrique des bornes inférieures de l’échantillon.
12.2 Check-list méthodologique pour le statisticien sous SAS
Avant de valider définitivement un programme d’analyse de données et de basculer des résultats vers un rapport de recherche ou une soumission réglementaire, le programmeur SAS doit exécuter une série de contrôles méthodologiques normalisés :
- Vérification systématique du journal d’exécution (SAS Log) : Contrôler l’absence totale de messages de troncature involontaire, de conversions implicites entre types alphanumériques et numériques, et d’erreurs de dépassement d’amplitude en virgule flottante.
- Conservation rigoureuse des données brutes : S’assurer qu’aucune instruction d’écrasement unitaire (variable = round(variable)) n’a été déployée, garantissant une reproductibilité totale des chaînes de calcul depuis la table source.
- Contrôle de stabilité de l’espérance mathématique : Comparer la moyenne empirique de la variable avant et après application de la fonction ROUND au moyen de la procédure PROC MEANS. L’écart entre les deux moyennes doit converger vers zéro et ne pas dépasser la moitié de l’unité d’arrondi sélectionnée.
- Inspection des quantiles extrêmes : Vérifier que les opérations de plancher (FLOOR) ou de plafond (CEIL) n’ont pas fait basculer des observations sentinelles au-delà des valeurs limites théoriquement admissibles par l’échelle de mesure.
- Audit des conditions de test logique : Éradiquer l’usage des opérateurs d’égalité stricte (= ou EQ) sur des grandeurs issues de calculs fractionnaires continus sans stabilisation préalable via ROUND ou comparaison par encadrement d’epsilon.
- Documentation intégrée : Assigner des étiquettes explicites (LABEL) décrivant l’unité et la règle d’arrondi appliquée à chaque variable dérivée au sein du dictionnaire de métadonnées du jeu de données final.
Le respect scrupuleux de ces exigences algorithmiques et méthodologiques garantit que le traitement des variables scalaires au sein de l’environnement SAS s’effectue dans des conditions optimales de rigueur, de stabilité et de transparence scientifique, préservant la validité des modèles d’inférence statistique face aux contraintes du calcul numérique moderne.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Goldberg, D. (1991). What every computer scientist should know about floating-point arithmetic. ACM Computing Surveys, 23(1), 5-48. https://doi.org/10.1145/103162.103163
- IEEE Computer Society. (2019). IEEE Standard for Floating-Point Arithmetic (IEEE Std 754-2019). IEEE. https://doi.org/10.1109/IEEESTD.2019.8766229
- SAS Institute Inc. (2021). SAS 9.4 Functions and CALL Routines: Reference (5th ed.). SAS Institute Inc. https://documentation.sas.com/
- Sheppard, W. F. (1898). On the calculation of the most probable values of frequency-constants, for data arranged according to equidistant division of a scale. Proceedings of the London Mathematical Society, s1-29(1), 353-380. https://doi.org/10.1112/plms/s1-29.1.353
- Wicklin, R. (2013). Statistical Programming with SAS/IML Software. SAS Institute Inc.