
L’analyse quantitative des données en sciences comportementales, cognitives et biomédicales repose très largement sur l’application des modèles linéaires généraux. Qu’il s’agisse de déployer une régression multiple pour identifier les prédicteurs de l’engagement au travail, de structurer une analyse de variance factorielle pour évaluer l’efficacité de thérapies cognitives ou de modéliser des trajectoires longitudinales, les praticiens invoquent quasi-systématiquement des outils paramétriques. Ces algorithmes partagent un postulat fondamental : la distribution gaussienne des variables ou, plus précisément, la normalité et l’homoscédasticité de leurs résidus. Or, la réalité empirique du laboratoire ou du terrain clinique contredit de façon quasi-systématique cette idéalisation mathématique. Les temps de réaction, les scores de latence cognitive, les dénombrements d’erreurs neuropsychologiques, les indicateurs d’anxiété ou les marqueurs hormonaux présentent une asymétrie positive prononcée, une variabilité proportionnelle à l’intensité de la réponse et une queue de distribution étirée vers les extrêmes.
Face à ces distorsions distributionnelles, le chercheur ou le psychomètre se trouve confronté à un arbitrage méthodologique complexe. L’abandon pur et simple des statistiques paramétriques au profit de tests de rangs non paramétriques entraîne une perte notable de puissance statistique, réduit la capacité à détecter des interactions d’ordre supérieur et appauvrit l’interprétabilité des tailles d’effet. Inversement, l’application brutale de modèles linéaires à des données asymétriques et hétéroscédastiques gonfle de manière incontrôlée l’erreur de type I, biaise les erreurs-types et produit des intervalles de confiance invalides. C’est précisément pour surmonter cette impasse que les statisticiens George Box et David Cox ont proposé en 1964 une méthode universelle et élégante : la transformation de puissance paramétrique Box-Cox. En introduisant un paramètre continu d’ajustement, noté Lambda (λ), cette méthodologie permet de corriger l’asymétrie, de stabiliser la variance et de rapprocher la distribution observée d’une courbe normale sans devoir recourir à des choix heuristiques désordonnés.
Bien que cette technique soit intégrée nativement dans des environnements de programmation tels que R, SAS ou Python, sa mise en œuvre pas à pas dans Microsoft Excel offre une valeur heuristique, pédagogique et méthodologique inégalée. Excel décompose la « boîte noire » algorithmique en une série d’opérations transparentes : du tri ordonné au calcul des quantiles théoriques normaux, en passant par l’estimation numérique du paramètre optimal par le Solveur ou la méthode de Filliben. Ce tutoriel exhaustif détaille chaque phase de l’implémentation de la transformation de Box-Cox dans Excel, en articulant les fondements mathématiques rigoureux, les exigences psychométriques des sciences du comportement et les fonctionnalités avancées de modélisation sur tableur.
1. 1. Fondements théoriques de la transformation de Box-Cox en sciences du comportement
1.1 1.1 Le postulat de normalité en psychométrie et statistiques inférentielles
Dans l’architecture de l’inférence statistique moderne, le théorème de Gauss-Markov et le formalisme des modèles linéaires généraux attribuent un rôle central à la loi normale. Cette dépendance théorique découle de la structure des estimateurs des moindres carrés ordinaires, dont l’optimalité asymptotique (absence de biais et variance minimale) requiert formellement l’indépendance et la distribution gaussienne des erreurs stochastiques. En psychométrie et en neurosciences computationnelles, cette exigence est pourtant constamment violée. Les comportements humains ne se déploient pas selon des lois symétriques parfaites ; ils sont assujettis à des contraintes biologiques, physiologiques et écologiques qui introduisent des asymétries irréductibles.
Lorsque les données empiriques s’écartent significativement de la normalité, les tests paramétriques traditionnels tels que le test t de Student et l’ANOVA subissent une dégradation pernicieuse de leurs propriétés inférentielles. L’hétéroscédasticité — c’est-à-dire la non-constance de la variance des résidus à travers les niveaux de la variable explicative — engendre des distorsions critiques dans l’estimation de l’erreur-type. En conséquence, les seuils de décision fixés par convention (typiquement alpha = 0,05) perdent leur étalonnage réel : le risque de rejeter à tort l’hypothèse nulle d’égalité des moyennes peut atteindre 15 % à 20 % selon l’intensité de l’asymétrie, conduisant à une crise de réplication majeure dans la littérature empirique.
Cette vulnérabilité théorique est particulièrement aiguë dans le domaine des chronométries mentales et des échelles d’évaluation neuropsychologiques. Les temps de réaction (TR), paradigme fondamental de la psychologie cognitive, sont intrinsèquement limités par un plancher physiologique infranchissable (approximativement 100 à 150 millisecondes pour des influx sensoriels simples), tandis que leur borne supérieure demeure ouverte, capturant des phénomènes de distraction, de défaillance attentionnelle ou de fatigue. La distribution résultante adopte de manière caractéristique une forme ex-gaussienne ou log-normale, hautement leptokurtique et asymétrique à droite. L’agrégation aveugle de telles métriques sous la forme de moyennes arithmétiques constitue une faute méthodologique que la transformation de variables a vocation à neutraliser.
1.2 1.2 Définition et principe de la famille de transformations de Box-Cox
L’avancée méthodologique décisive formulée par George Box et David Cox en 1964 réside dans la formulation d’une famille continue et paramétrique de transformations de puissance. Avant cette publication séminale, le chercheur confronté à des données biaisées recourait à des expédients empiriques disjoints : l’extraction de la racine carrée pour stabiliser des variables de Poisson, la transformation logarithmique pour compresser les asymétries multiplicatives, ou la transformation inverse pour linéariser des taux de productivité. Ces approches fragmentaires manquaient cruellement d’un cadre statistique unifié permettant d’évaluer la qualité relative des ajustements.
La famille de Box-Cox résout cette fragmentation en encapsulant l’ensemble de ces métriques discontinues au sein d’une fonction mathématique unique gouvernée par un seul paramètre continu, désigné par la lettre grecque Lambda (λ). Le principe opérationnel fondamental repose sur la modification progressive de la courbure de la fonction de transfert : selon la magnitude et le signe attribués à λ, l’opérateur mathématique dilate sélectivement les distances entre les observations situées dans les zones de faible densité ou, au contraire, comprime les écarts entre les scores extrêmes situés dans la queue de distribution. Cette déformation géométrique de l’espace métrique opère une régularisation contrôlée de la morphologie distributionnelle.
L’objectif ultime de cette procédure est d’identifier, parmi une infinité continue de valeurs possibles pour λ, celle qui maximise la vraisemblance statistique que la série transformée soit issue d’une population parente distribuée selon la loi normale de Laplace-Gauss. Il s’agit dès lors d’un problème d’optimisation mathématique continu : au lieu d’imposer a priori une loi de transformation à l’échantillon comportemental, le praticien permet aux données d’exprimer leur propre morphologie optimale, garantissant à la fois l’homoscédasticité des résidus et la symétrie requise pour l’application sans faille des modèles inférentiels ultérieurs.
1.3 1.3 Pertinence de l’utilisation d’Excel pour les modélisations empiriques
L’utilisation de Microsoft Excel pour conduire une modélisation statistique avancée telle que la transformation de Box-Cox suscite parfois des réserves au sein des laboratoires rompus aux syntaxes R ou Python. Pourtant, l’environnement matriciel d’un tableur présente des vertus pédagogiques et scientifiques exceptionnelles. Les progiciels statistiques spécialisés fonctionnent fréquemment comme des boîtes noires cryptiques : une seule commande exécute l’estimation du paramètre, applique la fonction de puissance et génère un graphique sans que le chercheur ne saisisse les étapes sous-jacentes de la mécanique matricielle. Cette automatisation opaque peut masquer des anomalies numériques profondes, des violations d’hypothèses limites ou des aberrations de calcul.
À l’inverse, modéliser la transformation de Box-Cox dans Excel impose de décomposer explicitement chaque composante de la chaîne inférentielle. L’analyste doit allouer des colonnes spécifiques au classement ordinal des observations, implémenter formellement les équations de probabilités cumulées selon les approximations de Hazen ou de Blom, formuler les fonctions conditionnelles de puissance et articuler les cellules de dérivation des scores Z théoriques. Cette granularité visuelle et dynamique permet d’observer en temps réel l’impact de l’oscillation du paramètre λ sur l’aplatissement de la courbe, l’alignement de la droite de Henry et la variation de la corrélation linéaire.
Par ailleurs, la traçabilité intégrale et l’accessibilité universelle du tableur répondent aux impératifs actuels de la science ouverte et de la reproductibilité des analyses. Une feuille de calcul rigoureusement paramétrée permet à n’importe quel évaluateur ou collaborateur de vérifier les formules appliquées cellule par cellule, d’auditer la gestion des zéros ou des données manquantes, et de tester la robustesse des solutions d’optimisation sans nécessiter la compilation d’un environnement informatique complexe ou la maîtrise de langages de script textuels.
2. 2. Formulation mathématique et comportement du paramètre Lambda (λ)
2.1 2.1 L’équation standard par morceaux de Box-Cox
D’un point de vue analytique, la transformation de Box-Cox conventionnelle est définie comme une fonction par morceaux continue par rapport à la variable observée y et au paramètre d’ajustement λ. Pour toute observation individuelle yi issue d’un échantillon univarié, la métrique transformée yi(λ) s’exprime selon la formulation formelle suivante :
y(λ) = (yλ – 1) / λ si λ ≠ 0
y(λ) = ln(y) si λ = 0
L’intégration du terme soustractif (-1) au numérateur et la division par le paramètre λ ne constituent pas de simples ajustements esthétiques. Dans une transformation de puissance naïve de type y’ = yλ, la fonction présente une discontinuité fondamentale lorsque λ s’approche de zéro, la valeur s’effondrant uniformément vers la constante 1 pour toute valeur de y. En appliquant la règle de L’Hôpital pour évaluer la limite mathématique lorsque λ tend vers zéro, on démontre rigoureusement la convergence continue :
lim (λ → 0) [(yλ – 1) / λ] = lim (λ → 0) [(d/dλ (eλ ln(y) – 1)) / (d/dλ (λ))] = ln(y)
Cette élégante formulation garantit la stricte continuité de la transformation à travers tout le spectre des réels. Néanmoins, cette équation impose une contrainte mathématique non négociable : la variable d’origine doit être strictement positive, soit yi > 0 pour tout i. En effet, l’élévation d’un nombre négatif à une puissance fractionnaire quelconque engendre des nombres complexes incompatibles avec les espaces euclidiens réels, tandis que le logarithme népérien d’un nombre nul ou négatif est indéfini dans le corps des réels. Lorsque les séries comportementales comportent des zéros naturels ou des valeurs négatives, il devient indispensable d’adjoindre une constante de translation c telle que (y + c) > 0.
2.2 2.2 Typologie des transformations selon les valeurs canoniques de Lambda
L’universalité de la méthode de Box-Cox réside dans sa capacité à subsumer les transformations mathématiques usuelles de la statistique descriptive en modulant un continuum scalaire. Certaines valeurs spécifiques du paramètre λ correspondent à des opérations géométriques classiques bien documentées en analyse de données :
- λ = 1,00 : Invariance linéaire. Lorsque Lambda est égal à 1, l’expression se réduit à y(1) = y – 1. À une simple translation unitaire près, la distribution conserve rigoureusement sa géométrie d’origine, son coefficient d’asymétrie et ses rapports de dispersion. Cela indique que les données brutes satisfont déjà adéquatement aux conditions de normalité.
- λ = 0,50 : Transformation racine carrée. L’expression devient proportionnelle à 2(√y – 1). Cette opération compresse modérément la queue droite de la distribution et s’avère optimale pour les variables issues de processus de Poisson, telles que le comptage d’erreurs mnésiques, d’omissions motrices ou d’incidents comportementaux par unité de temps.
- λ = 0,00 : Transformation logarithmique népérienne. La fonction bascule sur ln(y). C’est l’arme de prédilection contre les distributions présentant une forte asymétrie positive avec variance proportionnelle au carré de la moyenne, typique des latences motrices, des salaires ou des indices de charge mentale.
- λ = -0,50 : Transformation inverse de la racine carrée. Correspondant à (1/√y – 1) / (-0,5), elle infléchit violemment les distributions hautement dissymétriques où subsistent des observations extrêmement éloignées.
- λ = -1,00 : Transformation inverse ou réciproque. Réduite à 1 – (1/y), cette modalité transforme conceptuellement des unités temporelles de latence (secondes par tâche) en unités de vélocité ou de vitesse de traitement (tâches par seconde), rétablissant fréquemment la normalité dans les tests de fluidité cognitive.
2.3 2.3 Propriétés analytiques et conservation de l’ordre monotone
Une préoccupation légitime des méthodologistes réside dans la préservation de la structure relationnelle interne des données après manipulation mathématique. À cet égard, la transformation de Box-Cox jouit d’une propriété fondamentale : elle constitue une fonction strictement monotone croissante pour toute valeur finie de λ, pourvu que y > 0. Sa dérivée première par rapport à y s’écrit en effet :
d/dy [y(λ)] = d/dy [(yλ – 1) / λ] = yλ – 1
Puisque la base y est strictement positive, la quantité yλ – 1 est rigoureusement supérieure à zéro pour l’ensemble des réels. Cette stricte positivité de la dérivée implique mathématiquement l’invariance absolue du rang : si un sujet A obtient un score supérieur à un sujet B dans l’espace métrique brut (yA > yB), cette hiérarchie est scrupuleusement maintenue dans l’espace transformé (yA(λ) > yB(λ)). Aucun croisement de rangs n’est possible, ce qui garantit l’intégrité ordinale des profils psychométriques.
En revanche, la transformation modifie de façon non linéaire les distances relatives séparant les individus. C’est précisément cette non-linéarité contrôlée qui neutralise l’asymétrie (skewness) en resserrant les écarts entre les observations marginales supérieures tout en dilatant les intervalles dans la partie basse ou centrale de l’échelle. Simultanément, cette déformation géométrique module le coefficient d’aplatissement (kurtosis), rabotant les queues de distribution excessives (effet leptokurtique) pour ramener le profil morphologique vers la cloche mésokurtique théorique de la loi normale.
3. 3. Prérequis et préparation du jeu de données dans Microsoft Excel
3.1 3.1 Audit préalable des scores psychologiques bruts
Avant d’initier toute formule de calcul sur la grille Excel, un audit rigoureux des données brutes s’impose pour valider la conformité du vecteur d’observation avec les prérequis algorithmiques. L’étape la plus critique réside dans la vérification de la stricte positivité de la variable cible. Dans les contextes d’évaluation clinique ou psychologique, il n’est pas rare de manipuler des échelles comportant un zéro absolu (par exemple, zéro faute à un test d’inhibition de Stroop) ou même des scores différentiels négatifs résultant de soustractions expérimentales.
Si la série contient des valeurs nulles ou négatives, l’exécution directe de l’algorithme générera immédiatement des erreurs de calcul non résolubles du type #NOMBRE! ou produira des valeurs aberrantes. La méthode universelle pour surmonter cette contrainte consiste à intégrer une constante de translation scalaire, traditionnellement désignée par c. La formulation devient alors (y + c)(λ). La constante c doit être choisie avec parcimonie : elle doit être strictement supérieure à la valeur absolue du minimum observé de la série, sans être démesurément grande afin de ne pas écraser artificiellement l’asymétrie relative de la variable.
Parallèlement, cet audit doit comporter un examen approfondi des données aberrantes univariées. Si la transformation de Box-Cox est conçue pour régulariser des queues de distribution épaisses, elle demeure sensible à la présence de données aberrantes générées par des erreurs d’encodage matériel ou des artefacts méthodologiques. Un point situé à plusieurs dizaines d’écarts-types de la moyenne peut contraindre l’algorithme d’optimisation à adopter une valeur de λ excessivement distordue, biaisant la normalisation de la vaste majorité de l’échantillon. Un nettoyage préliminaire basé sur l’inspection graphique des distributions brutes s’avère donc impératif.
3.2 3.2 Structuration spatiale de la feuille de calcul
La réussite d’une modélisation analytique sous Excel dépend de la clarté de l’architecture de la feuille de calcul. Une disposition confuse mêlant entrées, paramètres et calculs intermédiaires compromet la traçabilité et décuple le risque de références circulaires involontaires. Il convient d’adopter une organisation modulaire stricte, segmentée en trois zones fonctionnelles distinctes :
- La zone des paramètres et indicateurs scalaires : Il est recommandé de réserver les colonnes supérieures gauches (par exemple, les cellules
D1:E6) pour consigner les variables de contrôle : la constante de décalage c, la taille d’échantillon N, la valeur courante du paramètre Lambda, ainsi que les cellules d’évaluation de la cible d’optimisation (corrélation de Filliben ou log-vraisemblance). - La matrice des vecteurs de données ordonnées : Les colonnes principales doivent être séquentiellement organisées pour refléter le flux de travail mathématique :
- Colonne A : Identifiant unique du sujet (ID).
- Colonne B : Score psychologique brut (y).
- Colonne C : Score translaté si requis (y + c).
- Colonne D : Rang ordinal croissant (i).
- Colonne E : Données brutes ordonnées de façon croissante.
- Colonne F : Probabilités cumulées empiriques pi.
- Colonne G : Variable transformée par Box-Cox y(λ).
- Colonne H : Quantiles théoriques normaux (Scores Z correspondants).
- L’espace d’attribution de plages nommées : Afin d’accroître la robustesse syntaxique des formules et d’éviter les erreurs de recopie, il est vivement conseillé d’utiliser le Gestionnaire de noms d’Excel (accessible via le ruban Formules). Nommer la cellule contenant le paramètre d’essai
Param_Lambdaet les plages de donnéesVecteur_Y,Vecteur_TransfetVecteur_Zsimplifie la rédaction des équations matricielles.
3.3 3.3 Configuration des options de calcul d’Excel
La précision de l’estimation d’un paramètre continu par itération numérique requiert un étalonnage adéquat du moteur d’exécution d’Excel. En premier lieu, assurez-vous impérativement que le mode de calcul est paramétré sur « Automatique ». Pour ce faire, naviguez dans le menu Fichier > Options > Formules et cochez « Automatique » sous la rubrique Mode de calcul. Si ce mode est positionné sur « Manuel », toute modification apportée manuellement ou algorithmiquement à la cellule Param_Lambda ne répercutera pas ses effets sur les colonnes dépendantes, neutralisant toute démarche d’optimisation.
Deuxièmement, l’utilisateur doit impérativement vérifier l’activation du complément analytique de référence : le Solveur Excel. Ce module d’optimisation non linéaire n’est pas activé par défaut lors de l’installation standard d’Office. Son déploiement nécessite d’accéder à Fichier > Options > Compléments, de sélectionner « Compléments Excel » dans la liste déroulante inférieure, de cliquer sur « Atteindre… », puis de cocher explicitement « Complément Solveur » ainsi que l’« Utilitaire d’analyse ». La présence confirmée du bouton Solveur dans l’onglet Données atteste de la bonne configuration de la plateforme.
Enfin, il convient de veiller à la gestion des seuils d’arrondi numérique. L’estimation des scores Z théoriques dans les queues de distribution implique des quantiles infinitésimaux susceptibles de générer des instabilités si la précision est artificiellement bridée. Il est préférable de laisser les formats de cellules en mode « Standard » ou « Nombre » avec au moins 4 à 6 décimales affichées, sachant qu’en interne, le moteur de calcul d’Excel opère sous la norme IEEE 754 en virgule flottante double précision (environ 15 chiffres significatifs).
4. 4. Étape 1 : Saisie, nettoyage et formatage des données brutes
4.1 4.1 Encodage des observations empiriques
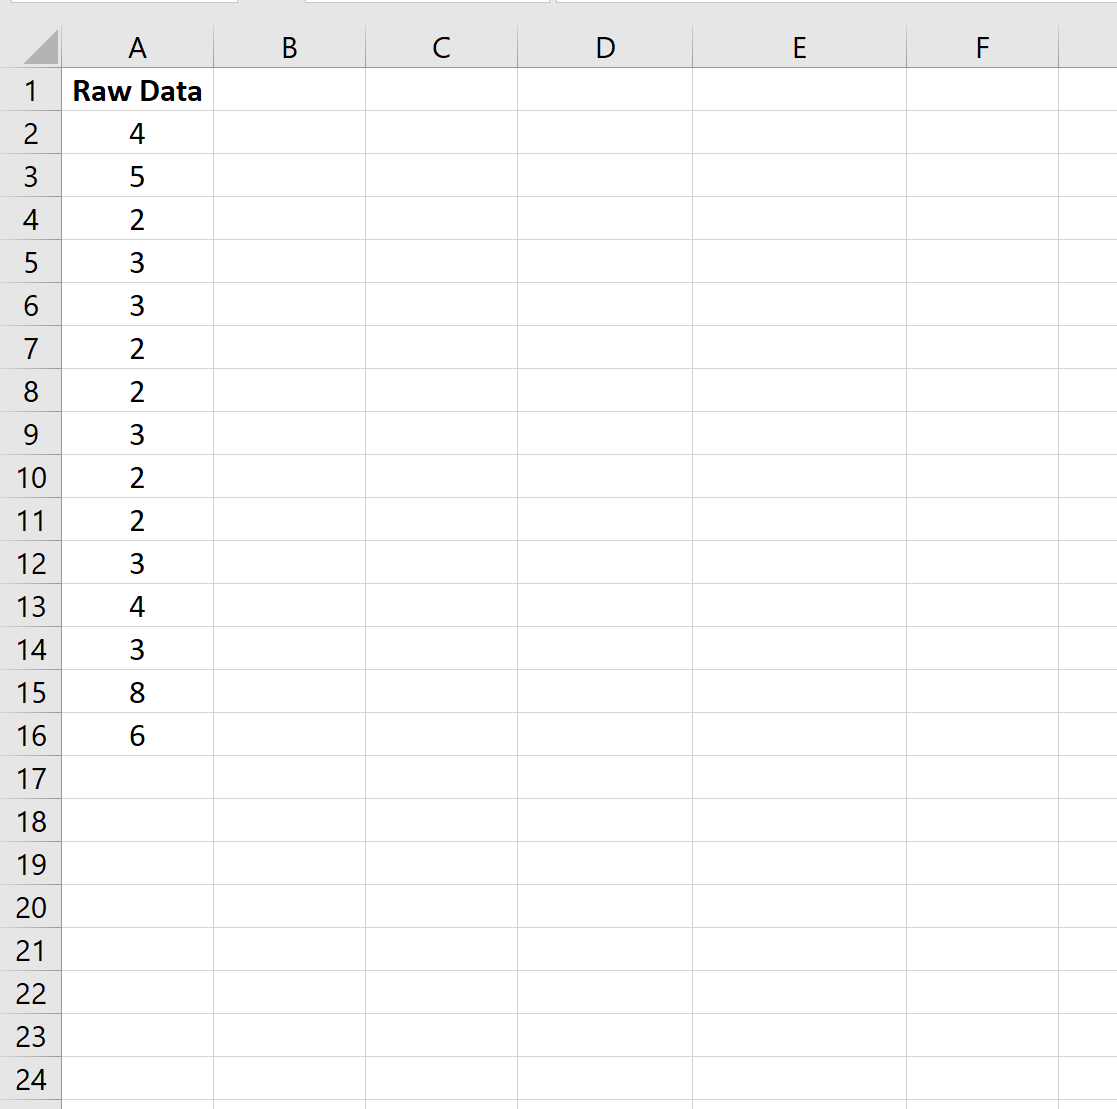
L’implémentation opérationnelle débute par l’importation ou la saisie méticuleuse des scores expérimentaux dans la première colonne de la feuille de calcul. Prenons comme fil conducteur empirique une étude en psychologie cognitive évaluant les temps de réaction (en millisecondes) chez un groupe d’individus soumis à une tâche d’attention soutenue avec distracteurs visuels complexes. Ces données, par essence, présentent une asymétrie marquée vers la droite en raison de quelques latences prolongées correspondant à des micro-sommeils attentionnels.
L’insertion s’opère dans la plage B2:B101 pour un échantillon type de N = 100 participants, la ligne 1 étant systématiquement allouée aux étiquettes de colonnes (par exemple, B1: "Score_Brut_y"). Lors de cette phase d’encodage, l’attention méthodologique doit se focaliser sur l’uniformité typographique des séparateurs décimaux. Selon les localisations régionales du système d’exploitation, l’emploi du point décimal au lieu de la virgule transforme insidieusement les valeurs numériques en chaînes textuelles invisibles pour les fonctions de calcul statistique, provoquant des erreurs #VALEUR! silencieuses.
Chaque ligne d’observation doit correspondre strictement à une unité d’analyse unique et indépendante (sujet ou essai expérimental isolé). L’attribution conjointe d’un identifiant numérique continu dans la colonne A (plage A2:A101) garantit la traçabilité de l’échantillon initial, prévenant toute perte d’appariement lors des opérations de tri et de réordonnancement matriciel ultérieures.
4.2 4.2 Traitement des données manquantes
L’existence de cellules vides ou de valeurs incomplètes au sein du vecteur étudié fausse mécaniquement l’estimation de la taille d’échantillon N, faussant par ricochet l’ensemble des probabilités cumulées dérivées des rangs de classement. En psychométrie computationnelle sur tableur, l’intégrité de la série univariée doit être assurée en amont de toute équation différentielle.
Deux politiques de gestion des données manquantes s’offrent au modélisateur. La première, recommandée ici en raison de la nature univariée de la transformation de normalisation, est l’exclusion systématique par liste (listwise deletion) : toute ligne présentant une valeur absente est préalablement extraite du tableau pour ne retenir qu’un vecteur continu d’observations effectives. La seconde approche, applicable si la perte de puissance est rédhibitoire, consiste en l’imputation par la médiane ou par un algorithme d’espérance-maximisation calculé en amont. En aucun cas une cellule manquante ne doit être convertie en zéro, sous peine d’altérer catastrophiquement la distribution et d’interdire l’application de la fonction logarithmique.
Pour assurer la dynamique computationnelle du modèle sans réécriture constante des formules en cas de variation de la taille d’échantillon, la cellule E1 doit recevoir la formule déterminant le dénombrement effectif d’observations numériques valides via la fonction native :
=NB(B2:B101)
Cette cellule, baptisée Taille_N dans le gestionnaire de noms, fournira le dénominateur fondamental pour le calcul de l’ensemble des rangs statistiques ultérieurs.
4.3 4.3 Évaluation descriptive initiale de l’asymétrie
Avant d’initier la moindre déformation métrique, le diagnostic formel de non-normalité doit être objectivé au moyen des indicateurs statistiques descriptifs du troisième et quatrième moment centré. Excel dispose de fonctions intrinsèques permettant d’apprécier quantitativement les pathologies de la distribution d’origine.
Dans un panneau de contrôle réservé à cet effet (par exemple, les cellules K2:K6), l’analyste implémente successivement :
- La moyenne arithmétique :
=MOYENNE(B2:B101) - La médiane empirique :
=MEDIANE(B2:B101) - L’écart-type d’échantillon :
=ECARTYPE.STANDARD(B2:B101) - Le coefficient d’asymétrie de Fisher :
=COEFFICIENT.ASYMETRIE(B2:B101) - Le coefficient d’aplatissement (kurtosis excess) :
=COEFFICIENT.APLATISSEMENT(B2:B101)
L’analyse comparée de la moyenne et de la médiane constitue le premier symptôme révélateur : dans une distribution gaussienne théorique, ces deux grandeurs convergent parfaitement vers la même valeur. Un différentiel significatif — par exemple une moyenne de 650 ms face à une médiane de 520 ms — matérialise une asymétrie positive substantielle. Cette observation est corroborée par la fonction COEFFICIENT.ASYMETRIE : toute valeur supérieure à +0,5 (ou inférieure à -0,5) signale un écart modéré à la symétrie, tandis qu’un coefficient dépassant +1,0 caractérise une asymétrie sévère interdisant l’usage non corrigé des tests paramétriques. La fonction COEFFICIENT.APLATISSEMENT calcule quant à elle l’excès de kurtosis par rapport à la loi normale (qui vaut 0 sous cette convention) ; une valeur fortement positive met en exergue des queues de distribution lourdes qui nécessiteront une correction de puissance prononcée.
5. 5. Étape 2 : Tri des valeurs et calcul des rangs percentiles
5.1 5.1 Création de la colonne d’index ordonnée
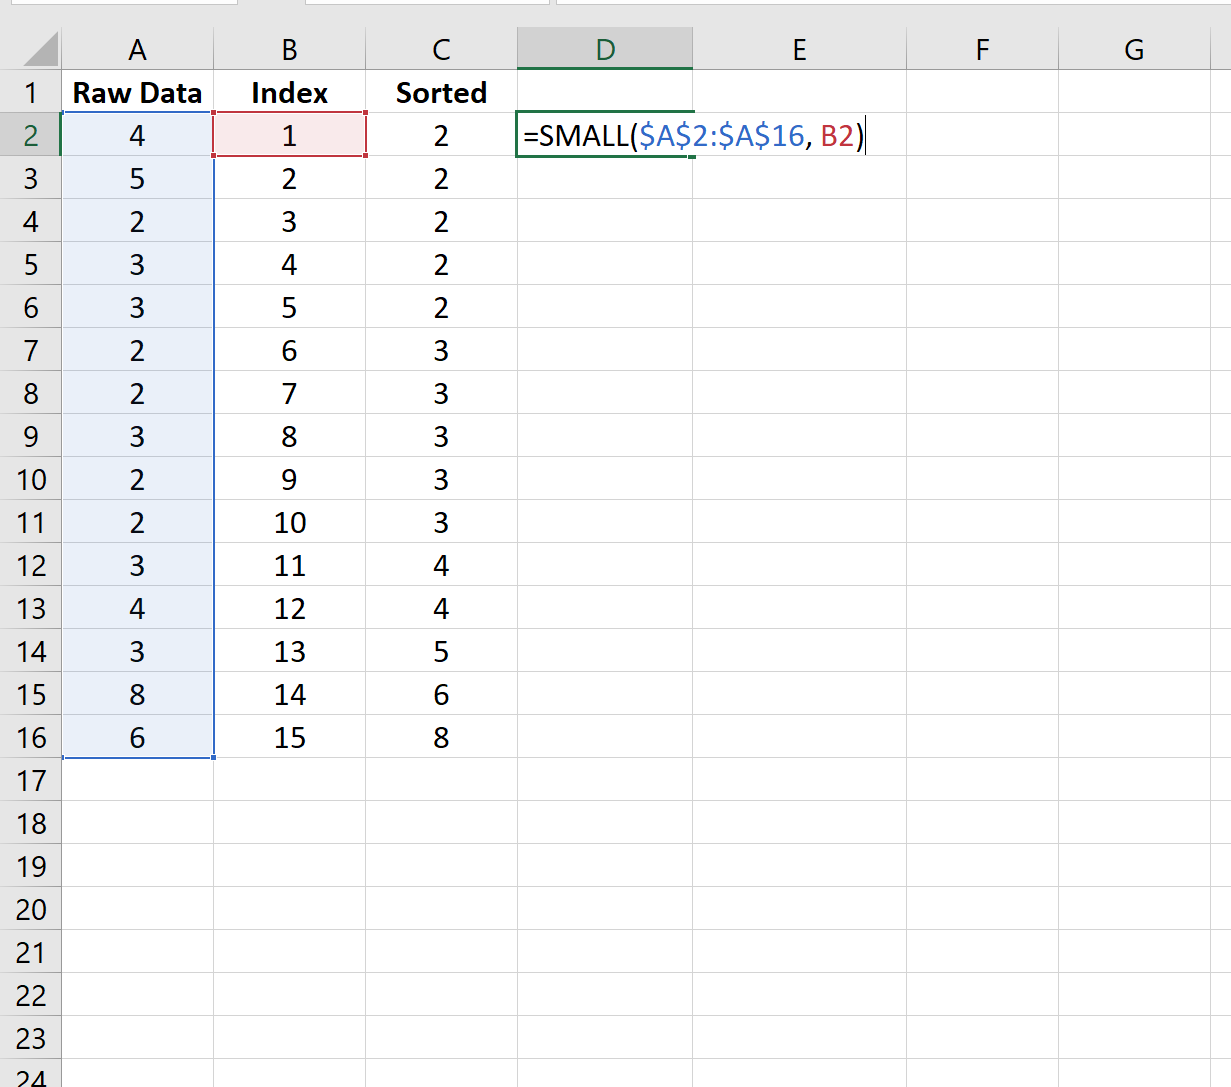
L’approche la plus intuitive, rigoureuse et visuelle pour optimiser le paramètre de Box-Cox dans Excel repose sur l’exploitation du théorème de normalité de Filliben et la construction de la droite de Henry au moyen du diagramme Quantile-Quantile (Q-Q Plot). La première exigence mécanique de cette procédure statistique impose un ordonnancement strict des observations expérimentales par ordre de grandeur croissante.
Pour matérialiser cet alignement, l’analyste alloue la colonne D à l’indexation séquentielle de rang, notée i. Dans la cellule D2, inscrivez la valeur 1, puis dans la cellule D3, la formule =D2+1, avant d’étirer cette incrémentation jusqu’à la cellule D101 afin de générer une suite d’entiers continus de 1 à 100. Cette colonne matérialise le rang statistique i de chaque observation.
Dans les versions contemporaines de Microsoft Excel (intégrant le moteur de tableaux dynamiques d’Office 365 ou Excel 2021), l’ordonnancement de la variable brute s’exécute de façon totalement dynamique en inscrivant dans la cellule E2 la formule matricielle suivante :
=TRIER(B2:B101; 1; 1)
Pour les versions antérieures d’Excel ne disposant pas de la fonction matricielle TRIER, l’équivalent s’obtient en utilisant dans la cellule E2 la fonction d’extraction de rang : =PETITE.VALEUR($B$2:$B$101; D2), formule recopiée vers le bas jusqu’à la ligne 101. Cette étape est d’une importance capitale : sans cet agencement monotone croissant, tout croisement avec les quantiles normaux théoriques produira un diagramme incohérent et empêchera le calcul de la corrélation d’alignement.
5.2 5.2 Détermination des fréquences cumulées empiriques
Une fois les scores ordonnés du plus petit au plus grand, il est nécessaire d’associer à chaque rang i une probabilité cumulée empirique, c’est-à-dire une estimation non paramétrique de la proportion de la population théorique située en deçà de cette valeur. L’estimation naïve consistant à diviser simplement le rang par l’effectif total (pi = i / N) est méthodologiquement erronée : pour l’observation maximale où i = N, la probabilité cumulée atteindrait 1,00 (100 %), ce qui conduirait à un quantile normal infini lors du calcul inverse ultérieur.
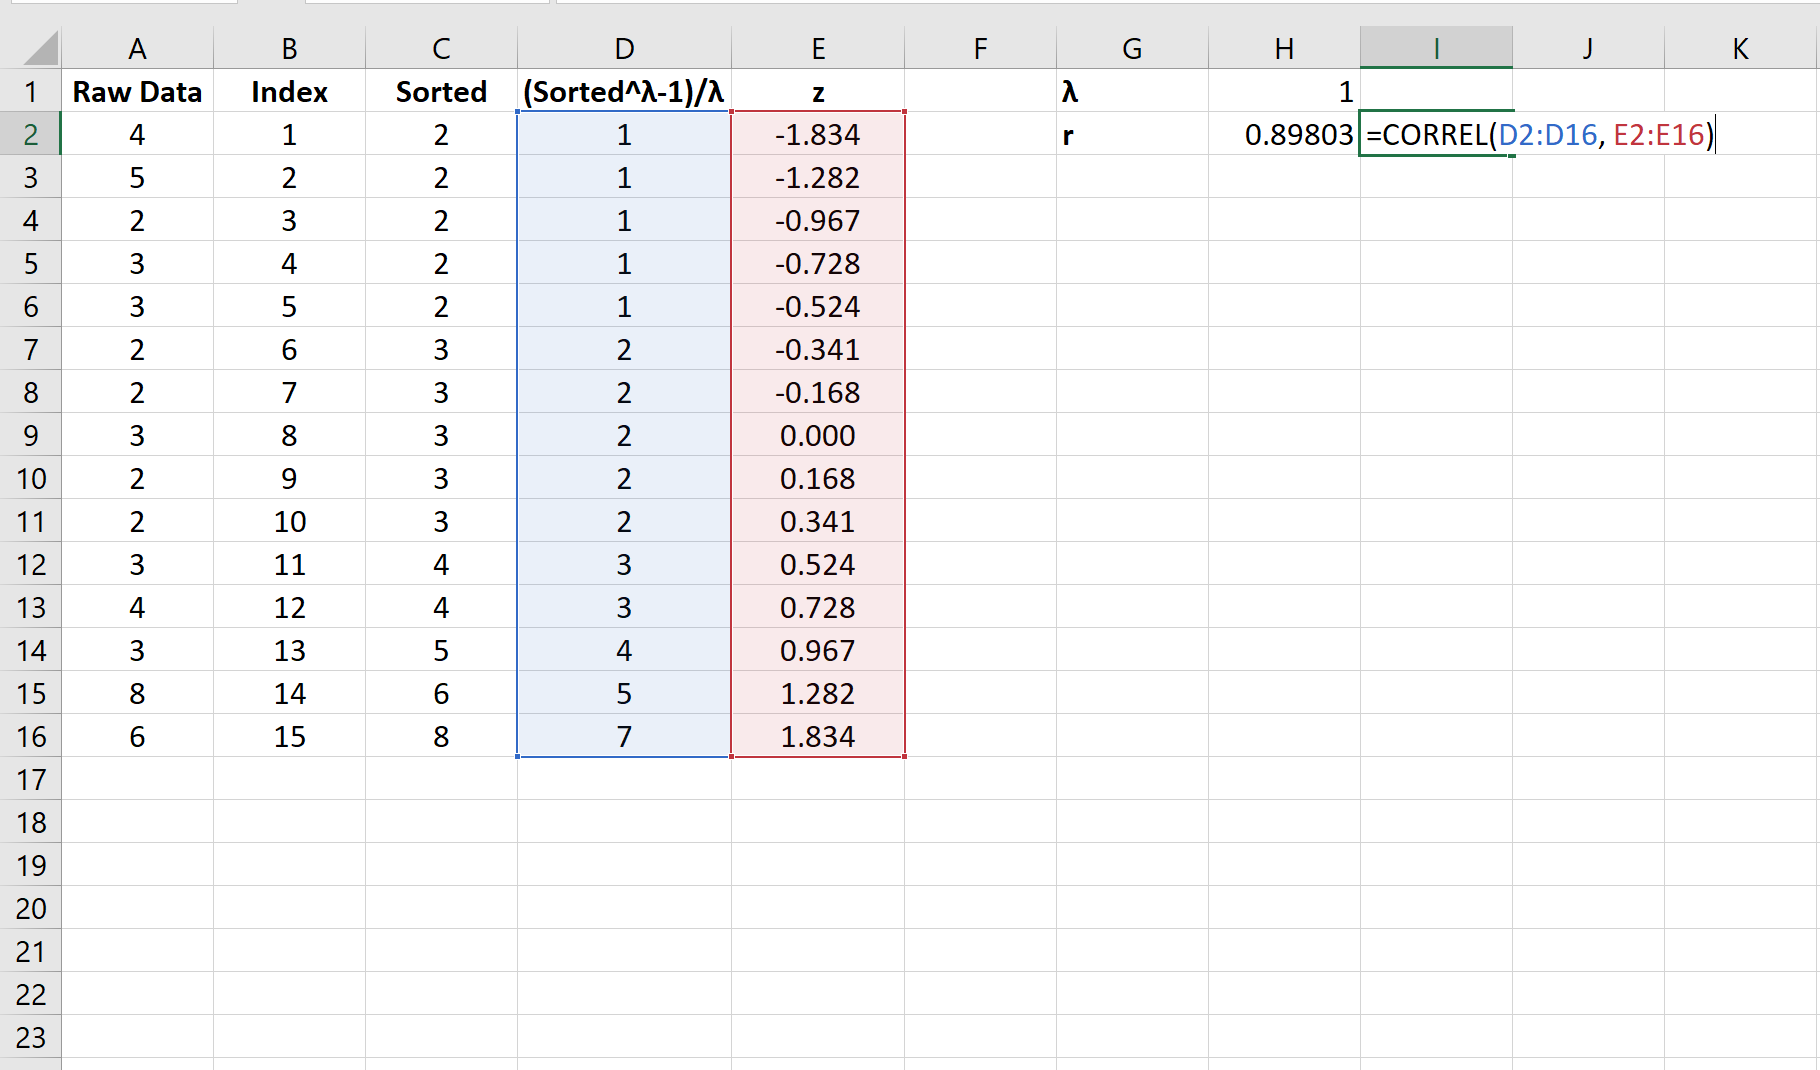
La littérature statistique offre plusieurs formules de tracé (plotting positions) adaptées à l’évaluation de la normalité :
- La formulation symétrique classique de Hazen : pi = (i – 0,5) / N
- L’approximation optimale de Blom : pi = (i – 0,375) / (N + 0,25)
- La formule de Weibull : pi = i / (N + 1)
Dans le cadre de l’ingénierie de Box-Cox sur tableur, l’estimateur de Hazen offre un compromis remarquable entre simplicité algébrique et robustesse non biaisée pour les distributions gaussiennes. Dans la cellule F2, formulez l’équation suivante :
=(D2 – 0,5) / $E$1
où D2 représente le rang ordinal i et $E$1 la référence absolue à la taille de l’échantillon N. En propageant cette formule jusqu’à la ligne 101, vous obtenez un vecteur continu de percentiles empiriques parfaitement borné dans l’intervalle ouvert ]0, 1[, s’échelonnant pour N = 100 de 0,005 à 0,995.
5.3 5.3 Prévention des discontinuités aux bornes extrêmes
L’utilisation de positions de tracé rigoureusement calibrées protège le modèle contre l’apparition d’asymptotes infinies. La fonction de répartition inverse de la loi normale tend vers l’infini négatif lorsque la probabilité s’approche de zéro absolu, et vers l’infini positif lorsqu’elle atteint un. En adoptant la constante de centrage -0,5 au numérateur, on assure une symétrie parfaite de part et d’autre de la médiane de l’échantillon.
Pour vérifier l’absence d’aberration aux bornes, un contrôle rapide doit confirmer que la somme de la première et de la dernière probabilité cumulée équivaut rigoureusement à l’unité :
p1 + pN = (1 – 0,5)/N + (N – 0,5)/N = (0,5 + N – 0,5)/N = N/N = 1
Cette propriété de symétrie garantit que les queues de distribution gauche et droite seront traitées de manière rigoureusement équilibrée lors de l’alignement normatif. De surcroît, cette configuration prévient formellement tout risque de déclenchement d’erreurs d’indétermination mathématique au sein de la fonction d’inversion statistique d’Excel, assurant ainsi la fluidité des cycles d’itérations automatisés lors de l’étape de résolution numérique.
6. 6. Étape 3 : Implémentation de la fonction Box-Cox avec un Lambda provisoire
6.1 6.1 Déclaration du paramètre d’essai arbitraire
Le cœur computationnel de la modélisation réside dans l’application de la fonction de transformation aux scores ordonnés. Puisque la valeur optimale de Lambda est initialement inconnue, la méthodologie impose de déclarer une cellule paramétrique dédiée qui servira de réceptacle à une valeur de départ provisoire.
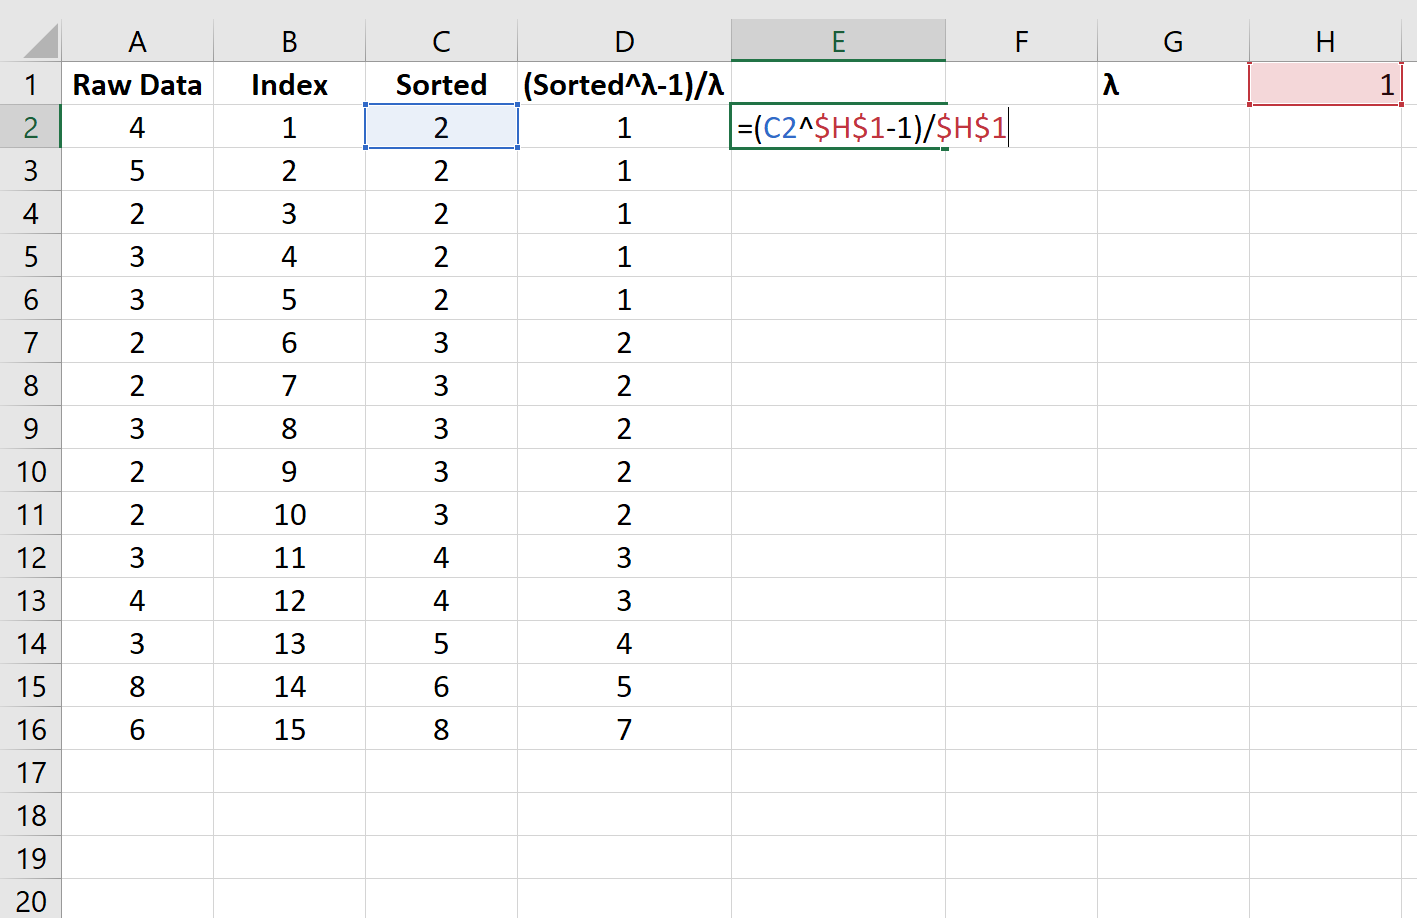
Désignez la cellule D1 comme la cellule opératoire du paramètre Lambda et attribuez-lui arbitrairement la valeur initiale 1,0. L’assignation de la valeur 1,0 constitue une convention scientifique pertinente : elle correspond à l’hypothèse nulle d’invariance d’échelle, postulant que les données brutes ne subissent aucune déformation géométrique préalable. L’analyste pourra ainsi auditer la distorsion basale du jeu de données avant que le solveur ne commence ses itérations adaptatives.
Pour garantir la stabilité du calcul matriciel lors de l’étirement des formules le long de la colonne, il est crucial d’utiliser systématiquement l’adressage absolu $D$1 (ou de faire appel au nom de variable Param_Lambda précédemment défini). Toute omission du signe dollar engendrerait un décalage vertical destructeur de la référence paramétrique au fil des lignes.
6.2 6.2 Rédaction de la formule conditionnelle sous Excel
Comme démontré dans la section théorique 2.1, l’équation de Box-Cox change de structure lorsque Lambda devient rigoureusement nul, basculant d’une fonction de puissance vers un logarithme népérien afin de préserver la continuité. Pour retranscrire cette dualité analytique dans la grille de calcul sans risquer une division fatale par zéro, la formule appliquée à la variable ordonnée doit impérativement exploiter la fonction conditionnelle SI.
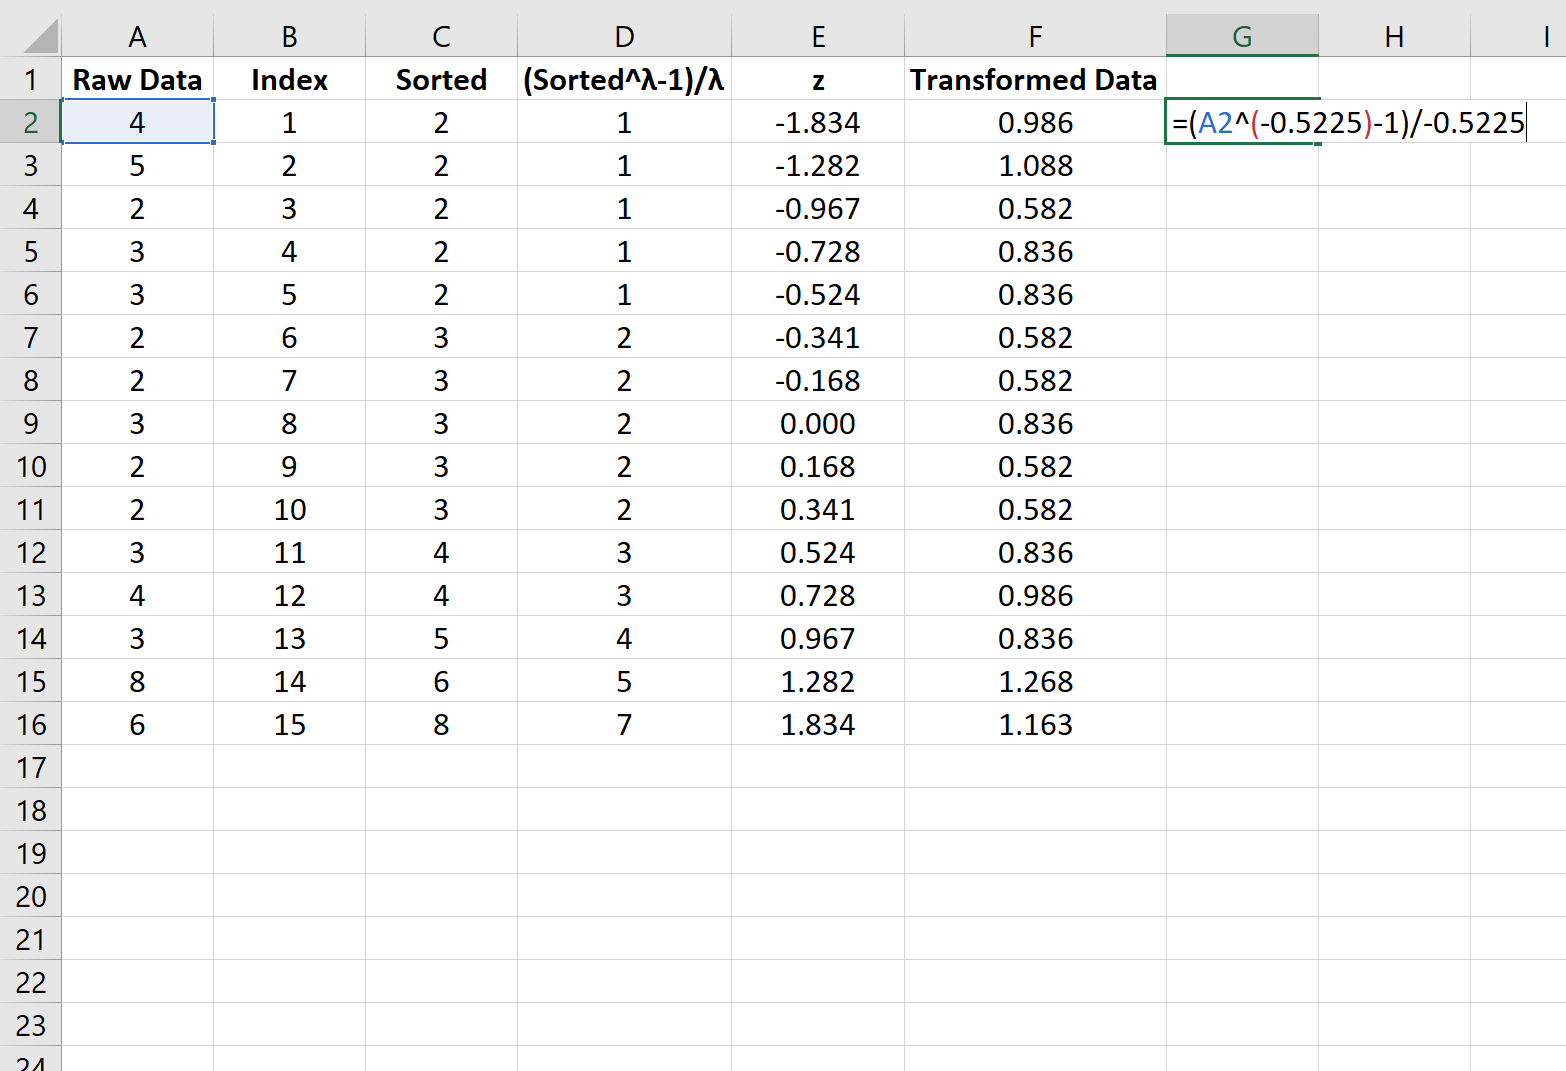
Positionnez-vous sur la cellule G2, représentant la première valeur transformée de la série, et saisissez l’expression rigoureuse suivante :
=SI($D$1=0; LN(E2); ((E2^$D$1) – 1) / $D$1)
Étendez cette formule de la cellule G2 jusqu’à la cellule G101 par double-clic sur la poignée de recopie inférieure droite. Analysons les opérations sous-jacentes :
- Si la cellule
$D$1est égale à 0, la condition logique est validée : Excel extrait immédiatement le logarithme népérien de la valeur ordonnée enE2au moyen de la fonction nativeLN. - Si la cellule
$D$1prend une valeur quelconque différente de 0 (qu’elle soit positive ou négative, entière ou décimale), l’argument de faux est exécuté : le tableur élève la valeurE2à la puissance$D$1, retranche 1 au résultat, puis divise l’ensemble par$D$1.
L’avantage d’une telle syntaxe réside dans sa réactivité dynamique absolue : saisissez immédiatement la valeur 0 dans la cellule D1, et l’intégralité de la colonne G basculera instantanément en échelle logarithmique naturelle sans la moindre intervention manuelle.
6.3 6.3 Gestion des erreurs potentielles de calcul
Lors de la manipulation de puissances réelles sur tableur, certaines configurations mathématiques peuvent provoquer des interruptions d’exécution. L’erreur la plus prévalente est l’apparition du code d’erreur #NOMBRE!. Ce dysfonctionnement survient quasi-systématiquement dans deux cas de figure majeurs :
En premier lieu, si la variable brute originale en E2 possède une valeur négative ou nulle et que l’utilisateur assigne à Lambda une valeur fractionnaire ou nulle, le moteur mathématique d’Excel échoue à calculer la racine d’un nombre négatif ou le logarithme de zéro. D’où l’absolue nécessité, rappelée à la section 3.1, d’opérer sur une colonne préalablement translatée (y + c) garantissant une stricte positivité.
En second lieu, l’exploration par le Solveur de valeurs extrêmes de Lambda (par exemple λ > 50 ou λ < -50) sur des scores bruts élevés peut excéder la limite de calcul en virgule flottante d’Excel (approximativement 1,79 × 10308), déclenchant un dépassement de capacité (overflow). Bien que ces plages extrêmes ne fassent aucun sens sur le plan psychométrique, il est possible de prémunir le modèle contre tout blocage algorithmique en encapsulant la formule dans un test de contingence préventif :
=SIERREUR(SI($D$1=0; LN(E2); ((E2^$D$1)-1)/$D$1); « Erreur_Domaine »)
Cette précaution garantit qu’une instabilité numérique locale n’interrompra pas brutalement la macro-commande ou le moteur de recherche itératif lors de la phase d’optimisation automatisée.
7. 7. Étape 4 : Dérivation des scores théoriques Z et alignement normatif
7.1 7.1 Calcul des quantiles théoriques normaux
L’étape charnière pour formaliser le diagnostic de normalité consiste à déterminer la position théorique exacte qu’occuperait chaque observation si elle appartenait à une distribution gaussienne idéale présentant la même distribution cumulative empirique. Ces positions théoriques s’expriment sous la forme de quantiles réduits, universellement appelés scores Z.
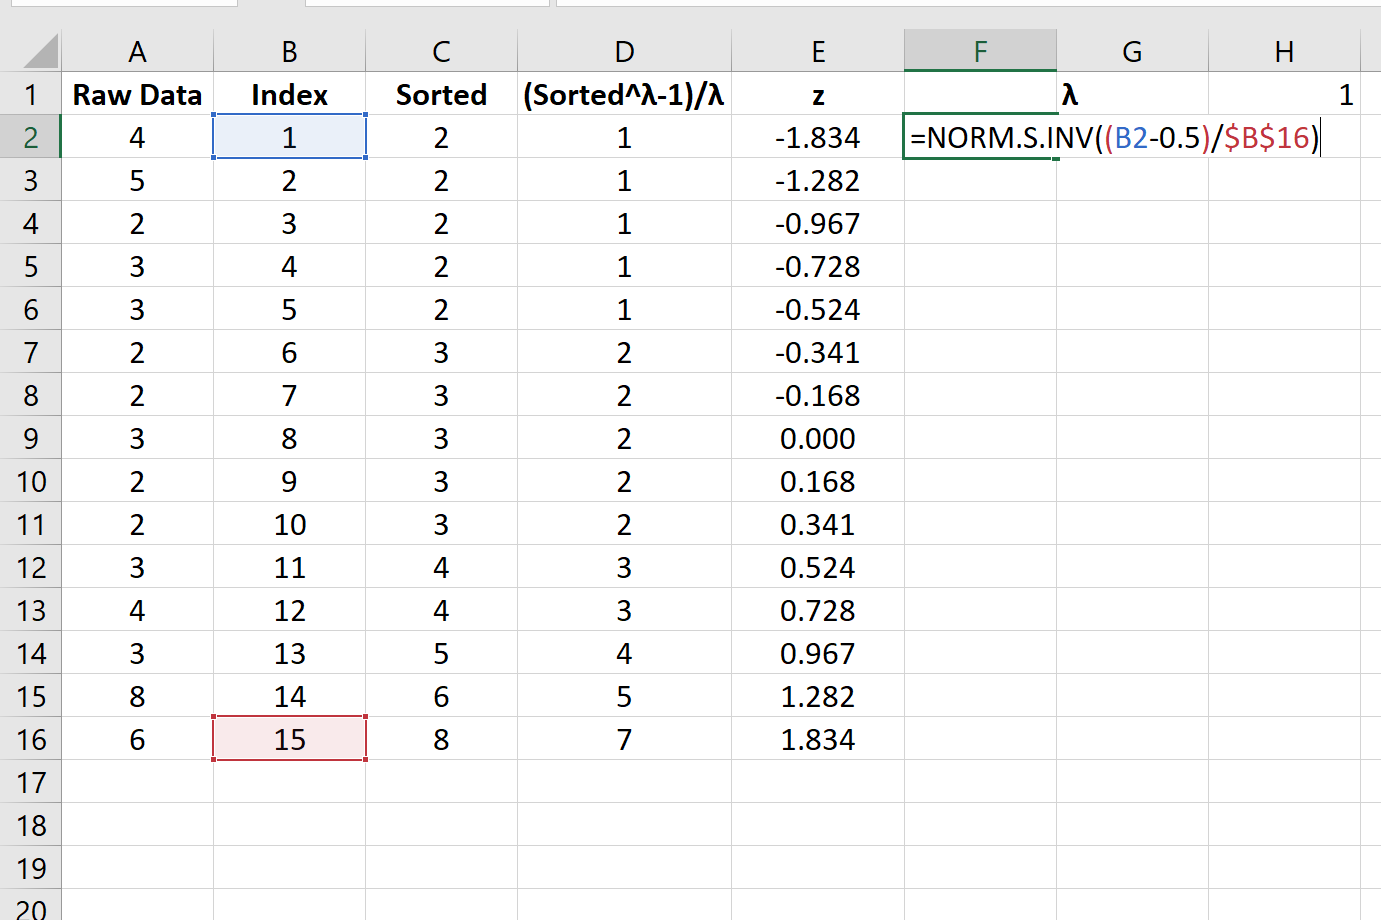
Dans la théorie psychométrique classique, le score Z quantifie l’écart séparant une observation donnée de la moyenne de référence, exprimé en unités d’écart-type : Z = (y – µ) / σ. Pour dériver ces valeurs idéales à partir des probabilités cumulées calculées en colonne F, nous faisons appel à la fonction de distribution cumulative normale standard inverse implémentée dans Excel.
Dans la cellule H2, saisissez l’expression suivante :
=LOI.NORMALE.STANDARD.INVERSE(F2)
puis étendez la sélection jusqu’en H101. Pour une fréquence cumulée médiane de p = 0,50, la fonction renvoie rigoureusement 0,00, matérialisant l’axe de symétrie gaussien. Pour les rangs inférieurs (p < 0,50), les scores Z s’échelonnent dans les valeurs négatives (jusqu’à environ -2,58 pour le 0,5e percentile d’une série de 100 observations), tandis qu’ils progressent symétriquement vers des valeurs positives pour les percentiles supérieurs.
7.2 7.2 Visualisation du diagramme quantile-quantile (Q-Q Plot)
La confrontation de la série transformée empirique avec les scores Z théoriques trouve son incarnation visuelle la plus puissante dans la construction d’un diagramme Quantile-Quantile (Q-Q Plot), connu historiquement sous le nom de droite de Henry. Ce graphique permet d’évaluer de façon continue l’adéquation d’une distribution à la loi normale.
Pour générer ce diagnostic graphique sous Microsoft Excel :
- Sélectionnez la plage des quantiles normaux théoriques
H2:H101, puis, en maintenant la touche Ctrl enfoncée, sélectionnez la plage des valeurs transforméesG2:G101. - Rendez-vous dans l’onglet Insertion du ruban, cliquez sur le groupe Graphiques, puis choisissez Insérer un graphique en nuage de points (X, Y) en sélectionnant le type « Nuage de points avec marqueurs uniquement ».
- Structurez le graphique en plaçant conventionnellement les scores théoriques Z en abscisse (axe horizontal X) et les données transformées de Box-Cox en ordonnée (axe vertical Y).
- Cliquez sur n’importe quel point de la série dans le graphique, effectuez un clic droit et choisissez « Ajouter une courbe de tendance… ». Cochez le modèle « Linéaire » et cochez l’option « Afficher le coefficient de détermination (R²) sur le graphique ».
L’interprétation qualitative est d’une grande limpidité : si la variable distribuée est parfaitement normale, l’ensemble des points s’aligne de façon rectiligne et continue le long de la droite de régression. Si la variable brute souffre d’asymétrie positive avec λ = 1, le nuage de points adopte une courbure exponentielle ascendante caractéristique, révélant la sous-estimation systématique des scores dans la partie médiane et leur explosion dans la queue droite.
7.3 7.3 Modélisation mathématique du critère d’optimalité
L’inspection visuelle du Q-Q Plot, bien qu’irremplaçable sur le plan qualitatif, ne permet pas de déterminer à elle seule la valeur optimale de Lambda avec une précision de quatre décimales. Il est nécessaire d’objectiver mathématiquement l’alignement géométrique des points en une métrique scalaire unique pouvant servir de fonction objectif pour un algorithme d’optimisation numérique.
C’est ici qu’intervient le théorème de normalité formalisé par James Filliben en 1975. Filliben a démontré que le coefficient de corrélation linéaire de Pearson standard calculé entre les observations ordonnées transformées y(λ) et les quantiles normaux théoriques Z mesure rigoureusement la linéarité du diagramme Q-Q Plot. Plus le coefficient de corrélation r(y(λ), Z) s’approche de la valeur théorique maximale de 1,000, plus la distribution sous-jacente s’aligne fidèlement sur une loi normale.
Le problème de l’estimation de Box-Cox se transmue alors en un problème d’optimisation élégant et accessible : trouver la valeur scalaire de Lambda qui maximise le coefficient d’alignement linéaire entre la série transformée et la métrique gaussienne standard. L’analyste s’émancipe ainsi des équations différentielles matricielles complexes pour se concentrer sur l’optimisation directe d’un coefficient de corrélation bivarié sur sa feuille de calcul.
8. 8. Étape 5 : Calcul du coefficient de corrélation et métriques d’adéquation
8.1 8.1 Implémentation de la fonction COEFFICIENT.CORRELATION
La quantification numérique du critère de Filliben s’opère au moyen de la fonction native d’Excel dédiée au calcul de l’indice de Pearson. Cette formule va agir comme le baromètre d’évaluation de la normalité de notre série de données.
Dans la zone de contrôle de la feuille (par exemple la cellule D3), adjacente à la cellule de paramètre Lambda, entrez l’instruction suivante :
=COEFFICIENT.CORRELATION(G2:G101; H2:H101)
Nommez cette cellule Cible_Correlation. Lorsque la valeur de Param_Lambda (en D1) est fixée à 1,0 (données non transformées), observez attentivement le chiffre renvoyé. Sur des données de temps de réaction asymétriques, ce coefficient oscillera fréquemment entre 0,8500 et 0,9400, illustrant quantitativement la distorsion de l’échantillon par rapport au modèle linéaire normatif.
Sur le plan des seuils critiques, la littérature statistique établit que pour un échantillon de N = 100, un coefficient de corrélation au Q-Q Plot inférieur à 0,987 conduit au rejet formel de l’hypothèse de normalité au seuil de significativité de 5 %. L’objectif de la transformation est donc de propulser cet indice au-delà de 0,990, voire 0,995, garantissant un alignement quasi-parfait des résidus empiriques sur l’épure théorique.
8.2 8.2 Formulation alternative basée sur la log-vraisemblance
Bien que la maximisation du coefficient de corrélation de Filliben soit la méthode la plus directe et didactique dans un environnement tableur, il convient de mentionner la formulation canonique originelle proposée par Box et Cox : l’estimation par le Maximum de Vraisemblance (MLE, pour Maximum Likelihood Estimation). Pour une série univariée, le profil de log-vraisemblance concentrée, noté L(λ), s’exprime selon l’équation :
L(λ) = – (N / 2) · ln(σ̂²(λ)) + (λ – 1) · ∑ ln(yi)
où σ̂²(λ) représente la variance empirique de la variable transformée y(λ) calculée avec le diviseur N, et la somme finale agrège les logarithmes népériens des observations brutes d’origine. Cette formulation combine deux forces antagonistes :
- Le premier terme pénalise la dispersion résiduelle de la distribution transformée à mesure que la variance se modifie ;
- Le second terme, appelé Jacobien de la transformation, agit comme un facteur d’échelle régulateur empêchant la variance de s’effondrer artificiellement vers zéro lorsque λ adopte des valeurs fortement négatives.
Sous Excel, l’implémentation de la log-vraisemblance nécessite de calculer la somme des logarithmes des données brutes en cellule K8 via =SOMMEPROD(LN(B2:B101)), d’évaluer la variance de la colonne transformée en cellule K9 via =VAR.P(G2:G101), puis de compiler l’équation complète en K10. Bien que conceptuellement plus lourde à mettre en œuvre que la corrélation de Filliben, la méthode du maximum de vraisemblance converge vers des valeurs de Lambda quasi-identiques sur des échantillons de taille modérée à grande, tout en ouvrant la voie au calcul d’intervalles de confiance basés sur le test du rapport de vraisemblance.
8.3 8.3 Surveillance des paramètres de dispersion
L’un des pièges statistiques inhérents aux transformations de puissance réside dans l’altération drastique des échelles de mesure et des amplitudes de variance. Lorsque le paramètre Lambda s’écarte significativement de 1, l’écart-type de la série transformée G2:G101 subit une compression ou une expansion artificielle spectaculaire qui n’a rien à voir avec un changement intrinsèque de variabilité psychologique.
Par exemple, si les scores bruts sont exprimés en millisecondes (avec des valeurs de l’ordre de 600 et un écart-type de 120), l’application d’un paramètre λ = -0,20 fera chuter les valeurs transformées dans un intervalle compris entre 1,5 et 2,8, réduisant l’écart-type à une fraction décimale minime. Inversement, un Lambda de 2,5 dilatera les valeurs dans des grandeurs exponentielles. Pour conserver un étalonnage rigoureux et éviter que l’analyste ne confonde compression d’échelle et stabilisation de variance, il est instructif d’insérer dans le panneau de contrôle une cellule calculant le coefficient de variation de la variable transformée ainsi que son écart-type via la formule :
=ECARTYPE.STANDARD(G2:G101)
Cette veille métrique s’assure que le processus d’optimisation ne conduit pas à un écrasement d’échelle induisant des instabilités numériques lors de la restitution finale des grandeurs d’intérêt.
9. 9. Étape 6 : Optimisation numérique du paramètre Lambda via les outils Excel
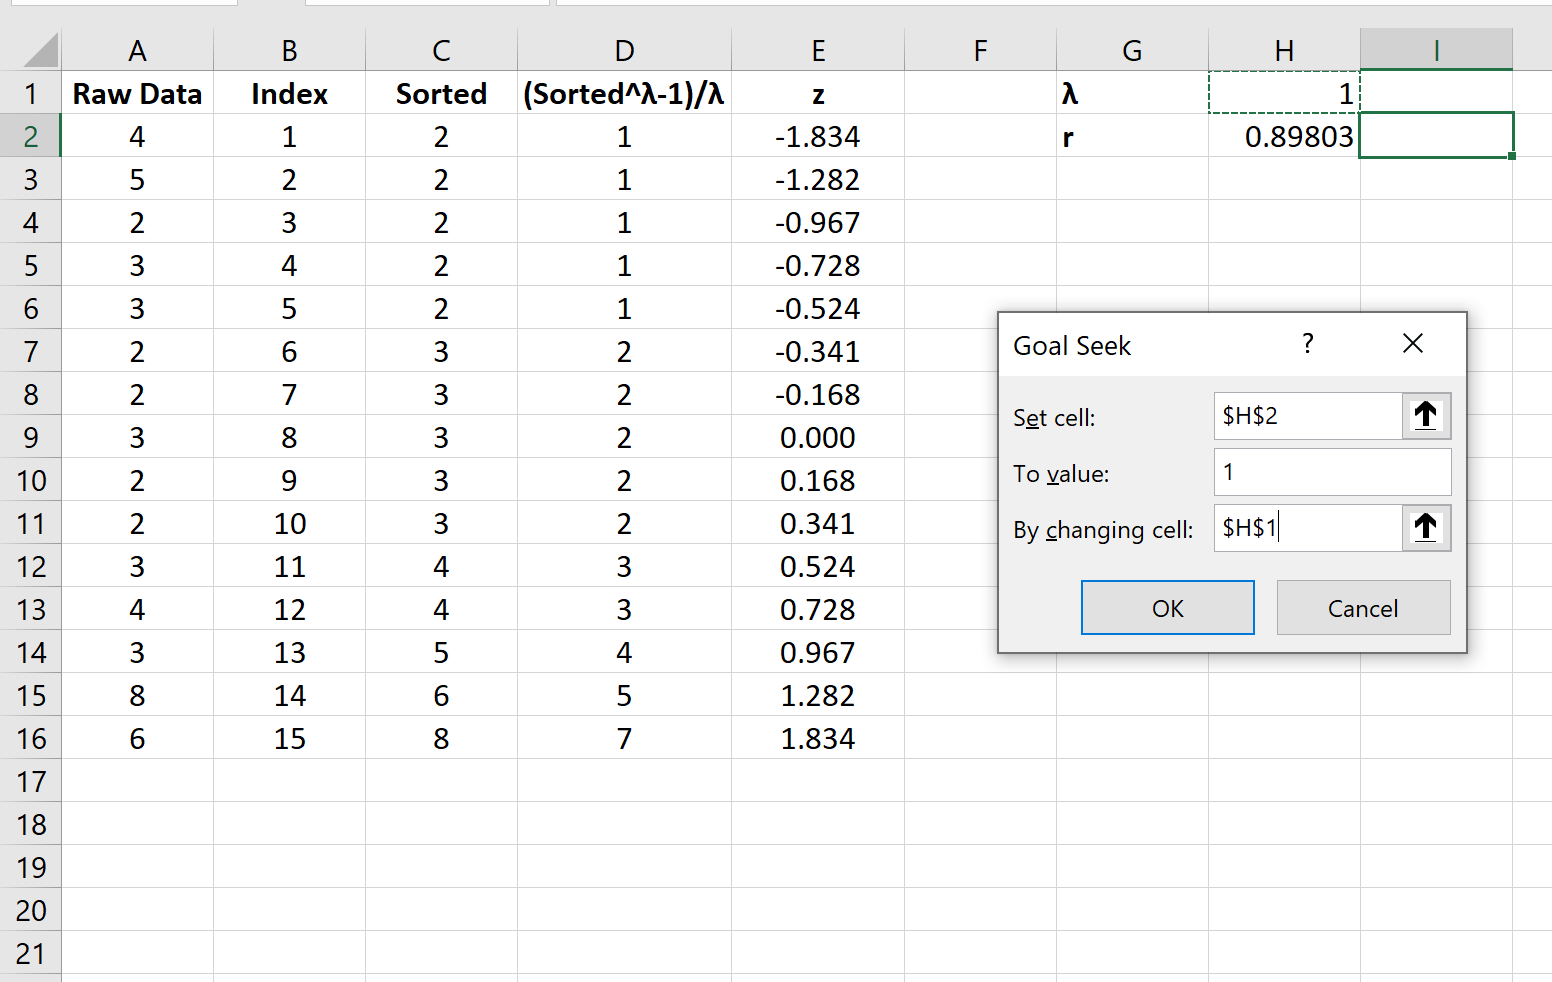
9.1 9.1 Exploitation de l’outil Valeur cible (Goal Seek)
Pour déterminer le paramètre Lambda sans recourir à des ajustements empiriques manuels, Microsoft Excel met à disposition un premier moteur itératif simple : l’outil Valeur cible (accessible via le ruban Données > Outils de données > Analyse de scénarios > Valeur cible…).
La procédure s’articule comme suit dans l’interface de dialogue :
- Cellule à définir : Sélectionnez la cellule contenant le coefficient de corrélation, à savoir
$D$3. - Valeur à atteindre : Saisissez manuellement la valeur
1,000. Bien qu’une corrélation empirique de 1,000 exacte soit théoriquement inatteignable sur des données réelles, l’algorithme va tenter d’approcher ce maximum asymptotique d’aussi près que possible. - Cellule à modifier : Pointez vers la cellule contenant le paramètre Lambda provisoire,
$D$1.
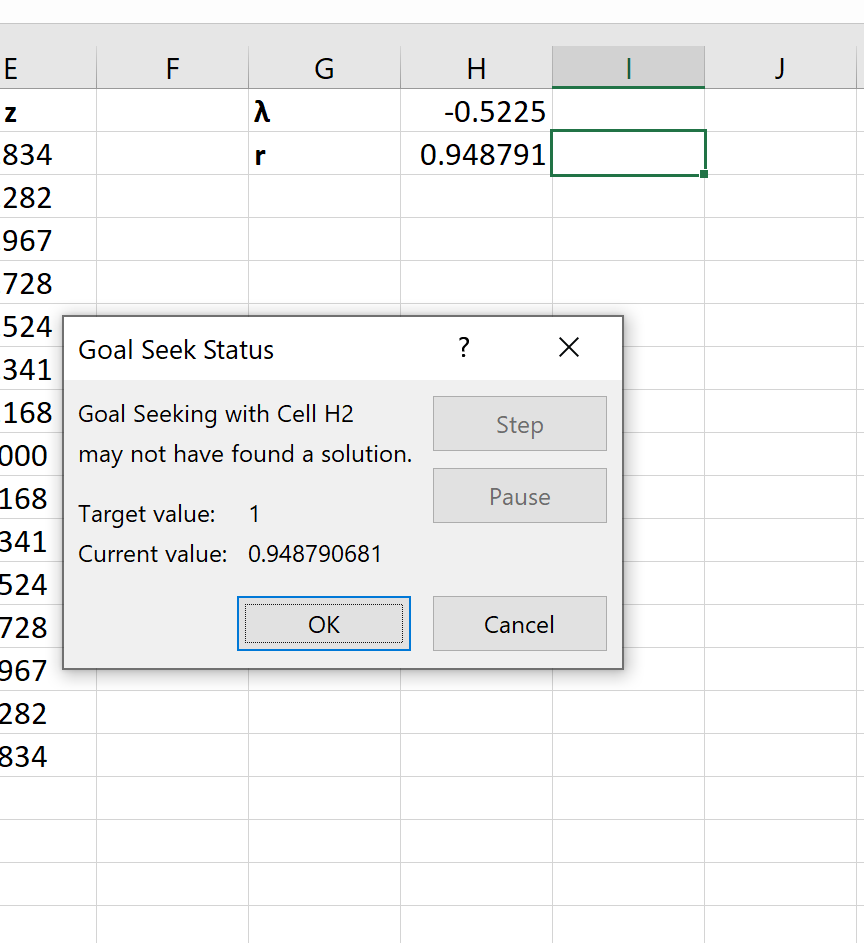
Lorsque vous validez en cliquant sur « OK », le moteur Valeur cible engage un algorithme unidimensionnel séquentiel (apparenté à la méthode de la sécante) qui fait varier la cellule D1 par incréments successifs jusqu’à ce que la corrélation se stabilise. Cependant, l’outil Valeur cible présente des faiblesses structurelles documentées : il ne gère pas les contraintes d’intervalles bornés et interrompt souvent ses itérations prématurément dès qu’il rencontre un plateau de variation inférieur au seuil de précision par défaut (0,001). C’est pourquoi son usage doit être réservé à une première approximation dégrossie, la validation définitive requérant l’intervention du Solveur non linéaire.
9.2 9.2 Utilisation avancée du complément Solveur
Le Solveur Excel constitue le véritable moteur d’optimisation numérique pour calibrer scientifiquement la transformation de Box-Cox. Contrairement à la Valeur cible, le Solveur permet de définir explicitement des fonctions objectifs de maximisation pure sous contraintes mathématiques rigoureuses.
Ouvrez le Solveur (onglet Données > Analyse > Solveur) et configurez méticuleusement les paramètres au sein de la fenêtre de dialogue :
- Objectif à définir : Indiquez la cellule de corrélation
$D$3(ou la cellule de log-vraisemblance si vous avez opté pour l’approche MLE). - Type d’optimisation : Cochez impérativement le bouton radio Max (Maximiser). Il s’agit de trouver le sommet de la fonction de profil.
- Cellules variables : Renseignez la cellule
$D$1(notre paramètre Lambda). - Ajout de contraintes : Afin de circonscrire l’espace de recherche à des grandeurs scientifiquement plausibles et d’éviter les dépassements de capacité arithmétique, cliquez sur « Ajouter » et spécifiez :
$D$1 >= -5(Borne inférieure de plausibilité psychométrique)$D$1 <= 5(Borne supérieure)
- Résolution des variables sans contrainte : Décochez impérativement la case « Rendre les variables sans contraintes non négatives ». En effet, le paramètre Lambda de Box-Cox doit pouvoir explorer librement les valeurs négatives si l’asymétrie empirique exige une transformation inverse.
- Sélection du moteur de résolution : Choisissez dans le menu déroulant l’algorithme GRG non linéaire (Generalized Reduced Gradient). Cet algorithme est parfaitement adapté aux surfaces d’optimisation continues et différentiables, garantissant une convergence robuste vers l’optimum global.
Cliquez enfin sur « Résoudre ». En une fraction de seconde, le Solveur fait converger la cellule $D$1 vers la valeur exacte maximisant l’alignement linéaire de la distribution. Un message de validation apparaît : « Le Solveur a trouvé une solution. Toutes les contraintes et conditions d’optimalité sont satisfaites. » Conservez la solution proposée.
9.3 9.3 Validation de la convergence et analyse de sensibilité
Une bonne pratique méthodologique impose de tester la stabilité de la solution algorithmique obtenue face à différentes conditions initiales, afin d’écarter le risque d’un piégeage dans un optimum local. Pour conduire cette analyse de sensibilité, modifiez manuellement la valeur de D1 en lui assignant successivement des valeurs arbitraires éloignées telles que -2,0, puis +3,0, et réexécutez le Solveur à chaque itération. Si l’algorithme converge invariablement vers le même point stationnaire (par exemple λ = 0,2148), la globalité de l’optimum est validée empiriquement.
Une interrogation récurrente concerne l’arbitrage entre l’adoption stricte du Lambda optimal calculé à plusieurs décimales (par exemple λ = 0,2148) et son arrondi pragmatique vers une valeur canonique standard de la nomenclature statistique. En règle générale :
- Si l’intervalle de confiance à 95 % de Lambda (ou une tolérance visuelle de corrélation de moins de 0,002 point) englobe une valeur standard telle que 0,00 (logarithme) ou 0,50 (racine carrée), il est grandement préférable d’adopter formellement la valeur canonique arrondie. L’avantage heuristique et conceptuel est substantiel : il est infiniment plus aisé de justifier et d’interpréter une échelle logarithmique ou racine carrée dans un rapport clinique ou une publication scientifique qu’une puissance fractionnaire obscure de 0,2148.
- Si la morphologie distributionnelle requiert impérativement un coefficient spécifique éloigné des repères usuels pour recouvrer la normalité, l’analyste conservera le Lambda précis généré par le Solveur en documentant explicitement la procédure d’optimisation dans ses protocoles d’analyse.
10. 10. Diagnostic statistique rigoureux post-transformation
10.1 10.1 Réévaluation des moments d’ordre supérieur
Une fois le paramètre Lambda optimisé et répercuté dynamiquement sur la colonne G, l’analyste doit attester méthodologiquement de la restauration de la normalité au moyen d’un diagnostic quantitatif post-transformation complet. Ce contrôle débute par la réévaluation des coefficients de Fisher appliqués au nouveau vecteur G2:G101.
Dans votre zone d’analyse comparative, calculez les métriques post-transformation :
- Nouveau coefficient d’asymétrie :
=COEFFICIENT.ASYMETRIE(G2:G101) - Nouveau coefficient d’aplatissement :
=COEFFICIENT.APLATISSEMENT(G2:G101)
L’effet stabilisateur de l’algorithme de Box-Cox apparaît alors avec une acuité spectaculaire : une asymétrie initiale de +1,85 sera typiquement ramenée dans un intervalle neutre compris entre -0,10 et +0,10, attestant d’une distribution remarquablement symétrique autour de son centre de gravité. Parallèlement, l’aplatissement excédentaire converge vers 0, confirmant la résorption des queues de distribution lourdes qui menaçaient l’intégrité des erreurs-types dans les modèles linéaires.
10.2 10.2 Mise en œuvre de tests formels d’adéquation dans Excel
Au-delà de la simple appréciation des moments descriptifs, la validation scientifique de l’opération requiert la mise en œuvre de tests d’hypothèse formels confirmant que l’échantillon transformé ne s’écarte plus significativement de la loi normale. Deux approches rigoureuses peuvent être directement codées au sein du tableur.
La première s’appuie directement sur le test de normalité dérivé de Filliben, dont la statistique d’épreuve est précisément le coefficient de corrélation r obtenu en cellule D3. En confrontant cette statistique aux tables de valeurs critiques établies pour la taille N correspondante, l’analyste vérifie formellement le non-rejet de l’hypothèse nulle : un coefficient r supérieur au seuil critique de 0,987 (pour N = 100 à alpha = 0,05) confirme l’adhésion parfaite au modèle gaussien.
La seconde méthode consiste à implémenter le célèbre test de Jarque-Bera, dont l’avantage opérationnel réside dans sa combinaison explicite du coefficient d’asymétrie (noté S) et de l’aplatissement (noté K). La statistique de Jarque-Bera suit asymptotiquement une loi du Khi-deux à 2 degrés de liberté sous l’hypothèse nulle de normalité :
JB = (N / 6) · [ S² + ((K)² / 4) ]
Dans la feuille Excel, affectez une cellule au calcul de cette statistique au moyen de la formule :
=($E$1 / 6) * (PUISSANCE(COEFFICIENT.ASYMETRIE(G2:G101); 2) + (PUISSANCE(COEFFICIENT.APLATISSEMENT(G2:G101); 2) / 4))
Puis, déterminez la p-value associée dans la cellule adjacente en sollicitant la loi du Khi-deux unilatérale à droite :
=LOI.KHIDEUX.DROITE(Cellule_JB; 2)
Une p-value nettement supérieure au seuil canonique de 0,05 (atteignant fréquemment 0,70 à 0,90 après transformation de Box-Cox optimale) atteste rigoureusement que les données transformées ne violent plus le postulat de normalité, levant toute hypothèque sur la validité des modélisations paramétriques ultérieures.
10.3 10.3 Inspection graphique comparative avant/après
Pour parachever l’audit diagnostique et valoriser les résultats dans une publication empirique, il convient de générer une double confrontation graphique avant/après intervention.
D’une part, l’actualisation du diagramme Quantile-Quantile (Q-Q Plot) configuré à l’étape 4 offre une démonstration visuelle éclatante : la courbe asymétrique initiale a laissé place à une trajectoire de points strictement coalescents avec la droite de régression linéaire, le coefficient de détermination R² affiché sur le graphique frôlant désormais l’unité (R² > 0,99).
D’autre part, la création de deux histogrammes comparatifs juxtaposés — l’un représentant la distribution des scores bruts B2:B101 et l’autre celle des scores transformés G2:G101 (via l’outil Histogramme de l’Utilitaire d’analyse ou l’insertion native d’un graphique à barres) — permet de visualiser instantanément la métamorphose distributionnelle : la longue traîne dissymétrique droite originelle a été harmonieusement absorbée, redéployant l’ensemble des effectifs sous une courbe en cloche symétrique typique du modèle de Laplace-Gauss.
11. 11. Interprétation psychométrique et re-transformation des résultats
11.1 11.1 Signification théorique des échelles modifiées
Bien que la transformation de Box-Cox résolve magistralement les contraintes mathématiques d’ajustement inférentiel, elle pose un défi épistémologique et psychométrique de premier ordre : la perte de l’intelligibilité directe de l’unité de mesure. Dans le domaine clinique, un score de latence brute de 650 millisecondes ou une mesure de cortisol salivaire de 18 nmol/L possèdent une signification biologique et fonctionnelle immédiatement compréhensible pour le praticien.
À l’inverse, si l’on applique un paramètre optimal de λ = -0,40, la métrique transformée s’exprime selon l’unité abstraite (y-0,4 – 1) / (-0,4), aboutissant à une valeur numérique dénuée de référent physique direct. Rédiger un compte-rendu diagnostique ou neuropsychologique en affirmant que « la performance moyenne du patient est de 2,14 unités de puissance Box-Cox » constituerait une absurdité déroutante pour la communauté scientifique et les praticiens de santé.
L’analyste quantitatif doit donc opérer une distinction stricte entre deux espaces fonctionnels : l’espace de modélisation mathématique, au sein duquel s’exécutent les estimations de variance, les régressions et les tests d’hypothèse sans distorsion résiduelle, et l’espace de communication psychométrique, qui exige la restitution des indicateurs synthétiques dans leur échelle métrique originelle.
11.2 11.2 Transformation inverse (Back-transformation) des statistiques inférentielles
Pour restituer aux résultats statistiques leur signification concrète dans l’échelle d’origine, le modélisateur doit mobiliser les équations algébriques de transformation inverse (également désignée sous le terme de rétro-transformation). Ces formules inversent rigoureusement l’opérateur de Box-Cox en fonction de la valeur de Lambda retenue :
y = (λ · y(λ) + 1)1 / λ si λ ≠ 0
y = exp(y(λ)) si λ = 0
Si une constante de décalage c a été préalablement incorporée lors de la phase de préparation, l’estimation finale imposera évidemment la soustraction de cette constante : y = (λ · y(λ) + 1)1 / λ – c.
Cependant, une erreur conceptuelle majeure menace ici le statisticien non averti : l’inégalité de Jensen. Dans toute transformation non linéaire, l’application directe de la fonction inverse à la moyenne arithmétique de la variable transformée ne reconstitue pas la moyenne arithmétique des données d’origine :
E[g(Y)] ≠ g(E[Y])
En réalité, la rétro-transformation de la moyenne calculée dans l’espace normalisé renvoie une estimation convergente de la médiane de la population d’origine (ou de la moyenne géométrique dans le cas spécifique de l’échelle logarithmique). Dans les distributions asymétriques comportementales, la médiane constitue du reste un estimateur de tendance centrale infiniment plus robuste et représentatif que la moyenne polluée par les valeurs extrêmes.
En ce qui concerne les intervalles de confiance à 95 %, la procédure est d’une remarquable élégance : l’analyste calcule les bornes inférieure et supérieure de l’intervalle dans l’espace transformé (Moyenne ± 1,96 × Erreur-Type), où le postulat de normalité garantit leur rigoureuse symétrie théorique. Ensuite, il rétro-transforme individuellement chacune de ces deux bornes dans l’espace métrique d’origine via l’équation inverse. L’intervalle de confiance final résultant dans l’échelle brute sera asymétrique autour de la médiane rétablie, épousant fidèlement la morphologie intrinsèque de la réalité psychologique observée.
11.3 11.3 Intégration dans des analyses psychométriques ultérieures
Les bénéfices de l’assainissement distributionnel par Box-Cox ne se cantonnent pas aux comparaisons univariées ; ils irradient positivement l’ensemble des méthodologies multivariées déployées en sciences cognitives et sociales.
Dans le cadre de la modélisation par régression linéaire multiple, l’intégration de prédicteurs ou de variables critères préalablement stabilisés par Box-Cox prévient les biais d’estimation des coefficients de pente et élimine la structure hétéroscédastique du diagramme des résidus, assurant que l’erreur de prédiction ne varie pas en fonction du niveau d’aptitude des sujets.
Dans le domaine de l’analyse de variance factorielle (ANOVA), la normalisation des sous-groupes expérimentaux restaure la puissance statistique du test F de Snedecor, maximisant la probabilité de détecter des interactions complexes entre variables indépendantes qui demeuraient jusqu’alors masquées par le bruit distributionnel.
Enfin, en psychométrie différentielle et validation d’échelles, l’évaluation des coefficients de corrélation linéaire de Pearson entre items ou construits latents présuppose une distribution multinormale. L’application préalable de Box-Cox rectifie l’atténuation artificielle des corrélations induite par des profils d’asymétries divergentes (effet d’asymétrie croisée), conférant aux matrices d’analyses factorielles confirmatoires (AFC) et aux modèles d’équations structurelles (SEM) une stabilité mathématique optimale.
12. 12. Limites méthodologiques, erreurs fréquentes et solutions de contournement
12.1 12.1 Écueils algorithmiques courants lors de l’implémentation dans Excel
L’exécution de la transformation de Box-Cox sur tableur n’est pas exempte de pièges computationnels qui peuvent compromettre la validité des conclusions statistiques.
Le premier écueil réside dans la gestion des données ex-aequo (ties). Lorsque la variable empirique comporte de nombreux doublons parfaits (par exemple des temps de réaction identiques arrondis à l’unité), le classement séquentiel arbitraire de ces valeurs sur des rangs distincts i induit une distorsion artificielle dans la droite de Henry, attribuant des scores théoriques Z divergents à une même valeur empirique. Si la proportion d’ex-aequo est substantielle, il convient d’attribuer aux rangs la valeur moyenne de leur rang conjoint avant d’extraire les fréquences cumulées empiriques.
Le second dysfonctionnement tient aux défaillances de convergence de l’outil Valeur cible d’Excel. En présence de surfaces de vraisemblance aplaties ou présentant un plateau asymptotique, la Valeur cible peut s’interrompre après 100 itérations sans converger vers une précision acceptable, renvoyant un Lambda fallacieux proche de sa valeur de départ. Pour pallier ce problème, il faut privilégier systématiquement le Solveur GRG non linéaire en renforçant les tolérances de convergence (fixées à 0,0001 dans les options avancées du Solveur).
Enfin, le non-verrouillage absolu des cellules de référence dans les formules conditionnelles (oubli des signes $ sur $D$1) constitue une source récurrente d’erreurs invisibles lors du déploiement matriciel, faussant la quasi-totalité des vecteurs calculés.
12.2 12.2 Limites inhérentes à la famille de Box-Cox
En dépit de son élégance mathématique, la transformation de Box-Cox standard n’est pas une panacée universelle capable de redresser toutes les formes d’irrégularités statistiques.
Sa limitation structurelle majeure réside dans son inefficacité face aux distributions bimodales ou multimodales. La transformation de puissance est une fonction strictement monotone qui dilate ou comprime un continuum unidirectionnel ; elle est incapable de scinder un second mode ou de fusionner des sous-populations hétérogènes. Lorsqu’un échantillon psychologique présente une bimodalité prononcée (révélant par exemple l’existence de deux stratégies cognitives distinctes chez les participants), contraindre les données dans un moule Box-Cox produit des artefacts d’écrasement sans conférer la moindre normalité au système.
Une seconde vulnérabilité majeure concerne la sensibilité aux données aberrantes sévères (extreme outliers). La fonction de vraisemblance étant gouvernée par la variance résiduelle des moindres carrés, une seule observation aberrante extrême située à six écarts-types peut contraindre l’algorithme d’optimisation à sélectionner une valeur de Lambda excessivement déformée afin de compenser ce seul point, pénalisant la structure des 99 % d’observations saines restantes. Il est donc indispensable d’accompagner toute modélisation d’une inspection préalable des leviers d’influence (distance de Cook).
Enfin, le manque d’invariance d’échelle face à l’adjonction d’une constante de translation c (arbitraire) constitue une faiblesse théorique bien connue : le choix subjectif de la valeur scalaire de c influe directement sur l’estimation finale du Lambda optimal, ce qui limite la comparabilité absolue des études recourant à des translations discordantes.
12.3 12.3 Alternatives statistiques disponibles lorsque Box-Cox échoue
Lorsque le jeu de données comportementales s’avère réfractaire à la transformation de Box-Cox standard ou présente des propriétés violant ses postulats opératoires, le méthodologiste doit se tourner vers des paradigmes de substitution plus résilients :
- La transformation de Yeo-Johnson (2000) : Il s’agit de l’extension moderne la plus éclatante de Box-Cox. La fonction de Yeo-Johnson modifie l’expression algébrique pour autoriser nativement l’intégration de valeurs nulles ou strictement négatives sans nécessiter l’ajout d’une constante de translation arbitraire, tout en conservant la continuité et l’invariance de rang. Son implémentation sous Excel requiert une formule conditionnelle à quatre branches, mais offre une robustesse remarquable sur les données différentielles d’apprentissage.
- Les Modèles Linéaires Généralisés (GLM) : Plutôt que de forcer une déformation géométrique artificielle des observations brutes pour satisfaire aux exigences du modèle linéaire classique, le paradigme GLM (inauguré par Nelder et Wedderburn) modélise directement la loi de distribution sous-jacente de la variable (loi Gamma pour les latences continues, loi de Poisson ou Binomiale Négative pour les dénombrements d’erreurs) au moyen d’une fonction de lien appropriée (lien log ou lien réciproque). Cette approche conserve l’intégrité de l’échelle d’origine tout en respectant la structure stochastique du phénomène.
- Les approches non paramétriques modernes et le Rééchantillonnage (Bootstrap) : Lorsque la taille d’échantillon est restreinte ou que la forme distributionnelle défie toute caractérisation analytique, l’estimation des intervalles de confiance et des contrastes d’hypothèses par la méthode du bootstrap percentile ou bias-corrected (BCa) s’affranchit totalement du postulat de normalité des résidus, offrant une alternative inférentielle d’une robustesse mathématique irréprochable.
Références
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Filliben, J. J. (1975). The probability plot correlation coefficient test for normality. Technometrics, 17(1), 111–117. https://doi.org/10.1080/00401706.1975.10489279
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review / Revue Internationale de Statistique, 55(2), 163–172. https://doi.org/10.2307/1403192
- Micceri, T. (1989). The unicorn, the normal curve, and other improbable creatures. Psychological Bulletin, 105(1), 156–166. https://doi.org/10.1037/0033-2909.105.1.156
- National Institute of Standards and Technology. (2012). NIST/SEMATECH e-Handbook of Statistical Methods: Box-Cox Transformation. U.S. Department of Commerce. https://www.itl.nist.gov/div898/handbook/eda/section3/eda336.htm
- Osborne, J. W. (2010). Improving your data transformations: Bias correction for reverse score transformations. Practical Assessment, Research, and Evaluation, 15(12), 1–9. https://doi.org/10.7275/qbpc-h453
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591–611. https://doi.org/10.2307/2333709
- Yeo, I. K., & Johnson, R. A. (2000). A new family of power transformations to improve normality or symmetry. Biometrika, 87(4), 954–959. https://doi.org/10.1093/biomet/87.4.954