
L’analyse exploratoire de données constitue le socle fondamental sur lequel repose l’ensemble de la démarche inférentielle en statistique moderne. Parmi la multitude d’outils visuels développés au cours du vingtième siècle pour disséquer les distributions empiriques, la boîte à moustaches s’est imposée comme un standard universel incontournable au sein de la communauté scientifique, des laboratoires pharmaceutiques et des centres de recherche en sciences humaines. Conçue à l’origine par le statisticien John Tukey dans son ouvrage séminal consacré à l’exploration des données, cette représentation graphique condense en un schéma géométrique d’une remarquable concision les propriétés fondamentales d’asymétrie, de tendance centrale, de dispersion et de valeurs aberrantes propres à un échantillon continu.
Néanmoins, dans le contexte des plans expérimentaux contemporains, l’analyse univariée isolée montre rapidement ses limites face à la complexité des problématiques scientifiques. Qu’il s’agisse d’évaluer l’efficacité différentielle d’une molécule thérapeutique à travers plusieurs groupes de traitement, de comparer l’expression de biomarqueurs transcriptomiques à travers différents phénotypes cellulaires, ou de mesurer des rendements agricoles selon diverses combinaisons agronomiques, le chercheur doit impérativement confronter simultanément plusieurs distributions au sein d’un repère orthonormé unique. Cette mise en parallèle visuelle soulève d’importantes questions méthodologiques liées à la mise à l’échelle, à l’alignement des axes, à la surcharge perceptive et à la rigueur de l’encodage sémiotique des variables.
Le langage statistique R offre un environnement d’une puissance exceptionnelle pour répondre à cette exigence analytique. Grâce à la coexistence harmonieuse de son moteur graphique natif historique et de l’écosystème moderne de la grammaire des graphiques incarné par la bibliothèque ggplot2, R permet de modéliser, transformer et restituer graphiquement des plans d’échantillonnage d’une grande complexité. Ce guide propose une immersion technique, théorique et appliquée, destinée aux analystes, bio-statisticiens et chercheurs désireux de maîtriser la composition de boîtes à moustaches multiples sur un graphique unifié dans l’environnement R, en respectant les standards de rigueur méthodologique et de publication académique les plus exigeants.
1. Fondements théoriques de la boîte à moustaches et pertinence en analyse comparative
1.1 Définition et composantes du résumé à cinq nombres de Tukey
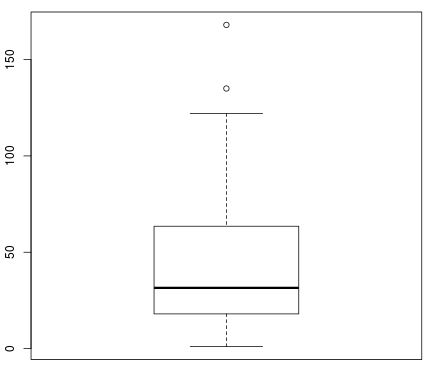
La boîte à moustaches repose sur le paradigme du résumé à cinq nombres (five-number summary) théorisé par John Tukey en 1977. Ce résumé se compose du minimum empirique, du premier quartile (Q1 ou 25e centile), de la médiane (Q2 ou 50e centile), du troisième quartile (Q3 ou 75e centile) et du maximum empirique. Dans l’implémentation algorithmique de R, ces valeurs correspondent par défaut au type 7 de la fonction standard d’estimation des quantiles continus, formalisant une interpolation linéaire entre les rangs des observations ordonnées de l’échantillon. La boîte centrale matérialise le corps de la distribution en délimitant l’intervalle interquartile, désigné couramment sous l’acronyme IQR (Interquartile Range), qui quantifie l’étendue couverte par les 50 % centraux de la population observée, selon la relation mathématique stricte IQR = Q3 – Q1.
La délimitation des moustaches supérieure et inférieure obéit à une règle heuristique robuste visant à isoler les fluctuations d’échantillonnage classiques des écarts singuliers susceptibles d’altérer les estimations paramétriques. Tukey a défini des seuils stricts, qualifiés de barrières intérieures, positionnés à 1,5 fois l’IQR au-delà des quartiles. Ainsi, la barrière intérieure supérieure se situe à Q3 + 1,5 * IQR, tandis que la barrière intérieure inférieure est établie à Q1 – 1,5 * IQR. Les moustaches ne s’étendent pas nécessairement jusqu’à ces limites calculées théoriques, mais s’arrêtent à la valeur observée la plus extrême située à l’intérieur de ces bornes. Toute observation franchissant ces frontières est formellement identifiée comme une valeur atypique modérée, matérialisée par un symbole ponctuel distinct sur le graphique.
Une distinction méthodologique essentielle doit être opérée entre les anomalies modérées et les valeurs aberrantes extrêmes. Celles-ci sont définies comme franchissant les barrières extérieures, fixées à 3,0 fois l’IQR au-delà de Q1 et Q3, soit respectivement Q1 – 3 * IQR et Q3 + 3 * IQR. Dans les applications cliniques et industrielles, cette catégorisation permet d’isoler rapidement les erreurs manifestes de saisie instrumentale des variations biologiques réelles mais hautement improbables. La supériorité opérationnelle de cette approche sur la métrique classique de la moyenne et de l’écart-type réside dans sa très haute résistance aux asymétries distributionnelles : le point de rupture de la médiane atteint 50 %, ce qui garantit qu’une proportion substantielle de contaminations aberrantes ne viendra pas modifier dramatiquement la lecture visuelle de la tendance centrale, à l’inverse de la moyenne arithmétique dont le point de rupture est nul.
1.2 Intérêt de la juxtaposition de plusieurs distributions sur un même repère
La juxtaposition de plusieurs boîtes à moustaches au sein d’un axe commun transcende la simple description univariée pour devenir un instrument puissant d’inférence visuelle comparative. Lorsqu’un chercheur observe simultanément cinq ou dix sous-populations alignées horizontalement ou verticalement, son système cognitif effectue spontanément une série d’opérations comparatives d’une grande complexité. Il évalue les décalages de niveau médian pour juger de la supériorité ou de la non-infériorité d’une condition expérimentale, tout en scrutant la longueur relative des boîtes (IQR) et l’amplitude des moustaches afin de déterminer si un traitement modifie la dispersion ou l’hétérogénéité intrinsèque des réponses mesurées.
Cette confrontation graphique simultanée joue un rôle déterminant dans l’évaluation empirique des postulats préalables à la modélisation statistique avancée, notamment l’analyse de variance univariée (ANOVA) et les modèles de régression linéaire généralisée. L’un des postulats cardinaux de ces modèles réside dans l’homoscédasticité, c’est-à-dire l’homogénéité des variances résiduelles à travers l’ensemble des strates factorielles. Une simple inspection d’une série de boîtes juxtaposées permet de détecter immédiatement d’éventuelles violations de cette hypothèse : des hauteurs de boîtes radicalement dissemblables signalent une hétéroscédasticité manifeste, orientant le chercheur vers des alternatives robustes, à l’instar de l’ANOVA de Welch, des régressions hétéroscédastiques ou de transformations stabilisatrices de variance.
Dans le domaine des protocoles multifactoriels et du suivi de cohortes longitudinales, la visualisation unifiée concrétise le principe d’économie cognitive théorisé par Edward Tufte. Au lieu de disséminer l’information dans une succession de graphiques individuels disjoints qui obligeraient le lecteur à retenir mentalement les repères d’échelle et les amplitudes d’axe, la boîte à moustaches groupée mobilise une échelle de référence constante. Cette architecture graphique optimise la détection des interactions croisées, met en exergue les effets de seuil temporels et permet d’appréhender instantanément si une dynamique observée est le reflet d’une dérive générale de la cohorte ou simplement l’artefact d’une poignée de sujets hautement divergents.
2. Préparation, structuration et nettoyage des données dans l’environnement R
2.1 Transformation des données : confrontation des formats large et long
L’une des pierres d’achoppement les plus courantes lors de la conception de boîtes à moustaches multiples sous R réside dans l’inadéquation entre la structure tabulaire des données et les exigences fonctionnelles des moteurs de rendu graphique. Les données empiriques sont fréquemment collectées sous une forme tabulaire dite large (wide format), où chaque colonne représente une condition expérimentale, une variable dépendante temporelle ou un traitement distinct, chaque ligne correspondant à un sujet ou une unité observationnelle. Bien que ce format soit intuitif lors de la saisie manuelle sur tableur, il s’avère particulièrement inadapté à la modélisation relationnelle moderne adoptée par les packages statistiques de R.
Pour construire un graphique comparatif élégant et dynamique, il est impératif de restructurer le jeu de données vers le format long (long format ou tidy data). Dans cette organisation normalisée, formalisée par Hadley Wickham, chaque colonne incarne une variable théorique unique, et chaque ligne représente une observation atomique. Ainsi, l’ensemble des mesures continues issues de conditions multiples doit être agrégé au sein d’une seule et même colonne de mesure (souvent désignée sous le terme de réponse ou de valeur), tandis qu’une colonne distincte est dédiée à l’identification de la modalité factorielle correspondante (la condition, le temps ou le groupe d’appartenance).
Cette métamorphose s’opère de manière déterministe grâce aux fonctionnalités du package tidyr, intégré à l’écosystème tidyverse. L’utilisation de la fonction pivot_longer permet de spécifier explicitement les colonnes sources à agréger, le nom de la variable catégorielle de destination (via l’argument names_to) et le nom de la variable continue réceptrice (via values_to). Cette conversion vectorielle simplifie radicalement les appels syntaxiques ultérieurs, tant pour les formules du système de base que pour la cartographie esthétique de ggplot2. La présence d’une colonne de facteurs unique facilite l’interopérabilité avec les fonctions de modélisation mathématique standard telles que lm ou aov, garantissant une cohérence absolue entre l’analyse descriptive visuelle et les tests inférentiels.
2.2 Typage des variables catégorielles et gestion des niveaux de facteurs
Une fois les données agencées au format long, l’attention méthodologique doit se porter sur le typage interne des vecteurs catégoriels au sein de la structure de données. Dans R, les chaînes de caractères brutes (character) sont traitées par défaut selon un ordre alphanumérique strict lors de la génération graphique. Or, cet ordonnancement lexicographique automatique est fréquemment dépourvu de signification analytique. Par exemple, une variable décrivant des posologies médicales (Faible, Modérée, Élevée) se verrait arbitrairement affichée dans l’ordre alphabétique Élevée, Faible, Modérée, perturbant immédiatement la lisibilité du gradient d’effet recherché.
La conversion explicite de ces vecteurs indépendants en objets de classe factor constitue donc une phase incontournable de la préparation. L’application de la fonction as.factor transforme la variable, mais l’utilisation de la commande factor assortie de l’argument levels permet d’imposer de manière déterministe l’agencement séquentiel des modalités sur l’axe des abscisses. Cette maîtrise de l’ordre d’affichage permet de disposer en première position le groupe contrôle ou placebo, suivi séquentiellement des différentes doses incrémentales, guidant l’œil du lecteur dans une logique cognitive naturelle de comparaison par rapport à la référence expérimentale.
Au-delà de l’ordonnancement, la gestion des facteurs implique le recodage explicite des libellés de chaque modalité. Les identifiants concis ou codés utilisés lors de l’acquisition des données brutes en laboratoire méritent d’être traduits en dénominations scientifiques complètes, exemptes d’abréviations cryptiques, afin d’optimiser l’interprétabilité directe des axes graphiques. Dans les protocoles longitudinaux ou transversaux impliquant des grandeurs ordinales, la déclaration rigoureuse d’un facteur ordonné (via l’argument ordered = TRUE) assure une conservation de la hiérarchie mathématique intrinsèque, tout en prévenant les erreurs d’interprétation lors de l’exportation des visualisations vers des revues scientifiques à comité de lecture.
2.3 Traitement rigoureux des données manquantes et valeurs atypiques
L’intégrité sémiotique d’une boîte à moustaches dépend fondamentalement de la rigueur appliquée au filtrage des données manquantes (valeurs NA dans l’interpréteur R). La présence d’incomplétudes dans les séries d’observations continuous ne doit jamais être passée sous silence ou traitée de manière purement mécanique. Sur le plan de la théorie statistique, il convient de poser un diagnostic préalable sur la nature du mécanisme sous-jacent à ces absences, en distinguant les données manquantes complètement au hasard (MCAR), les données dépendantes d’autres variables observées (MAR), et les données résultant d’un mécanisme non aléatoire (MNAR), où la propension à l’absence est corrélée à la valeur de la mesure elle-même.
L’utilisation indiscriminée d’outils d’élimination brutale comme la fonction na.omit sur l’ensemble d’un tableau peut introduire des biais de sélection dramatiques en éliminant des lignes qui contiennent par ailleurs des informations valides pour d’autres facteurs. Il est méthodologiquement préférable d’appliquer des filtres de suppression ciblés à l’échelle de la paire de variables concernée par la boîte à moustaches spécifique, ou de configurer les arguments internes de gestion des omissions au sein même des primitives de calcul graphique. Ce filtrage localisé préserve l’effectif maximal pour chacune des distributions comparées sans corrompre la validité interne du dispositif.
Pour assurer une transparence méthodologique absolue, chaque boîte à moustaches tracée devrait idéalement être documentée par l’indication précise de la taille résiduelle de son échantillon (la valeur effective n). Lorsque des valeurs aberrantes sont détectées par l’algorithme des seuils de Tukey, le chercheur doit résister à la tentation de les expurger arbitrairement du graphique sans justification expérimentale étayée. À moins qu’une investigation matérielle ne confirme une panne d’appareillage ou une coquille de transcription avérée, ces valeurs extrêmes constituent des éléments empiriques cruciaux dont la présence informe directement sur la variabilité extrême du phénomène biologique ou social investigué.
3. Tracé de boîtes à moustaches multiples via le moteur graphique natif (Base R)
3.1 Syntaxe par formule pour la stratification univariée
Le système graphique natif de R, accessible sans le chargement de bibliothèques tierces, demeure une référence majeure en matière de calcul statistique pour sa frugalité, sa rapidité d’exécution et sa stabilité au fil des décennies. Pour construire une série de boîtes à moustaches parallèles à partir d’un ensemble de données structuré au format long, l’approche préférentielle repose sur l’utilisation de l’opérateur tilde (~), qui formalise une écriture sous forme de modèle de régression univarié reliant une variable continue dépendante à un facteur explicatif discret.
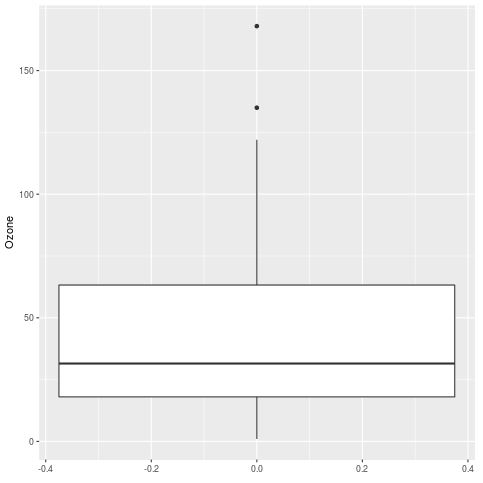
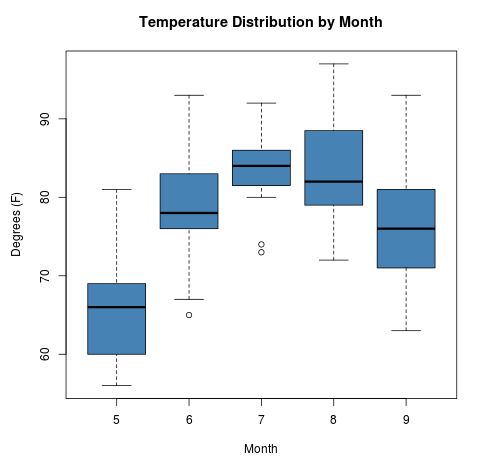
La syntaxe canonique se structure sous la forme variable_continue ~ variable_groupe, passée comme premier argument à la fonction primitive boxplot(), conjointement à la spécification du jeu de données source via le paramètre data. Pour illustrer concrètement cette démarche, l’exploitation du jeu de données interne airquality offre un exemple classique : en déclarant l’expression Ozone ~ Month, l’interpréteur découpe automatiquement la distribution des concentrations d’ozone selon les différents mois de l’année répertoriés dans la base, produisant de manière instantanée cinq boîtes juxtaposées le long de l’abscisse horizontale.
L’exécution de la fonction boxplot() ne se borne pas à restituer un canevas visuel dans le dispositif graphique actif ; elle retourne également un objet invisible de type liste qui renferme l’intégralité des computations statistiques sous-jacentes. En assignant la sortie de la fonction à un identifiant, l’analyste peut inspecter des composants cruciaux tels que stats (matrice contenant les cinq nombres de Tukey pour chaque modalité), n (le vecteur des effectifs non manquants par sous-groupe), conf (les intervalles de confiance théoriques de chaque médiane) et out (la liste exhaustive des observations qualifiées de valeurs aberrantes). Cette double nature — graphique et calculatoire — confère au moteur natif un avantage substantiel lors des phases d’audit rapide des données massives.
3.2 Combinaison simultanée de vecteurs indépendants
Bien que l’écriture par formule constitue le paradigme d’excellence lorsque les mesures résident dans un tableau unique au format long, les réalités du travail d’analyse statistique imposent parfois de manipuler des vecteurs indépendants disjoints, stockés sous la forme d’objets distincts dans l’environnement global de travail. Le moteur graphique natif de R répond à cette exigence par sa capacité intrinsèque à recevoir une énumération directe de vecteurs numériques passés comme arguments positionnels séparés au sein de la commande boxplot().
Considérons une situation où un praticien dispose de trois vecteurs quantitatifs indépendants nommés respectivement controle, traitement_faible et traitement_fort, pouvant résulter de sessions expérimentales asynchrones ou d’échantillonnages de tailles inégales. L’instruction boxplot(controle, traitement_faible, traitement_fort) opère une concaténation visuelle instantanée. Le moteur statistique calibre automatiquement l’axe orthogonal des ordonnées en recherchant l’étendue globale minimale et maximale à travers l’ensemble des séries transmises, épargnant à l’utilisateur le fastidieux calcul manuel des limites d’échelle.
Alternativement, il est tout à fait possible de rassembler ces échantillons hétérogènes au sein d’une structure de liste nommée avant de transmettre cette dernière à la fonction graphique. Cette technique s’avère particulièrement puissante lorsque le nombre de groupes à confronter est variable ou déterminé de manière dynamique par des routines algorithmiques préalables. Cependant, cette approche vectorielle présente une limite méthodologique sévère : elle ne permet pas d’intégrer nativement des stratifications factorielles croisées complexes, chaque vecteur étant traité comme une entité étanche, coupée de tout métadonnées de cohorte ou d’interaction multidimensionnelle.
4. Personnalisation avancée des boîtes à moustaches en R de base
4.1 Contrôle chromatique, palettes et codage visuel
La personnalisation graphique dans l’environnement de base repose sur un système d’arguments positionnels et nommés offrant un contrôle direct sur le rendu pixelisé ou vectoriel. L’attribution des couleurs s’effectue principalement à l’aide de l’argument col, qui accepte des vecteurs de chaînes de caractères représentant des noms de couleurs standardisés, des codes hexadécimaux ou des identifiants numériques issus de la palette courante. Lorsqu’un vecteur de couleurs est transmis à une commande générant des boîtes multiples, R applique une règle de recyclage cyclique si le nombre de nuances fournies est inférieur au nombre de boîtes à dessiner.
L’utilisation de palettes perceptuellement uniformes et universellement lisibles s’impose comme une nécessité absolue pour éviter les distorsions d’interprétation induites par des disparités artificielles de saturation ou de luminance. L’intégration des packages spécialisés tels que RColorBrewer ou viridisLite permet d’extraire des palettes de haute tenue académique, directement injectables dans l’argument col du traceur natif. Ainsi, l’emploi de nuances issues de la palette viridis assure une différentiation optimale des groupes, y compris pour les lecteurs présentant des déficiences de la vision des couleurs (protanopie, deutéranopie).
La sémantique visuelle gagne souvent à être renforcée par une modulation coordonnée du paramètre border, qui régit la couleur des lignes structurelles de la boîte, de la ligne médiane et des moustaches terminales. Il est ainsi envisageable d’attribuer un remplissage pastel très transparent aux boîtes représentatives de cohortes témoins tout en saturant vigoureusement la teinte des bordures des groupes recevant une intervention active, créant une hiérarchie perceptive immédiate qui guide l’attention du lecteur vers les contrastes expérimentaux décisifs.
4.2 Typographie, orientation spatiale et configuration des axes
Dans de nombreuses disciplines scientifiques, les désignations textuelles des modalités expérimentales se révèlent trop volumineuses pour être affichées lisiblement le long de l’axe des abscisses horizontal sans se chevaucher de façon anarchique. Le moteur natif de R permet de résoudre cette contrainte spatiale par le biais du paramètre horizontal = TRUE. Cette commutation modifie radicalement la disposition spatiale en projetant les groupes le long de l’axe vertical des ordonnées, offrant ainsi un espace textuel étendu pour l’impression horizontale des étiquettes descriptives sans aucune troncature.
Lorsque le maintien d’un affichage vertical conventionnel demeure impératif, le contrôle de l’orientation angulaire des libellés s’effectue via l’argument las (label style). Une valeur de las = 1 force l’ensemble des textes d’axe à adopter une orientation horizontale permanente, tandis que las = 2 pivote les étiquettes de manière strictement perpendiculaire à la trajectoire de l’axe, permettant de déployer des libellés verticaux sous chaque boîte. L’application de cette rotation impose corrélativement un réajustement des marges périphériques du repère graphique, opération que l’on orchestre à l’aide de la primitive par(mar = c(bas, gauche, haut, droite)), afin d’éviter que le bas des inscriptions textuelles ne soit rogné par les limites extérieures de la fenêtre graphique.
L’enrichissement typographique s’achève par la spécification des titres principaux, des sous-titres et des désignations des axes grâce aux arguments main, sub, xlab et ylab. Il convient d’adopter une formulation rigoureusement descriptive, intégrant de manière systématique les unités métriques de mesure entre parenthèses le long de l’axe continu, garantissant ainsi que la boîte à moustaches puisse être appréhendée comme une unité d’information auto-suffisante dans le corps d’un mémoire ou d’un article scientifique.
4.3 Personnalisation des composantes anatomiques de la boîte
Le traceur de base dissimule une collection de paramètres avancés conçus pour modifier l’anatomie même des représentations de Tukey afin d’y incorporer des dimensions d’information supplémentaires. Le paramètre logique varwidth = TRUE constitue l’une des extensions les plus séduisantes sur le plan statistique : lorsqu’il est activé, la largeur géométrique de chaque boîte individuelle est rendue proportionnelle à la racine carrée de l’effectif numérique réel du groupe correspondant. Cette modulation permet d’alerter immédiatement l’observateur sur une disparité d’échantillonnage sévère entre les strates, tempérant l’enthousiasme face à une faible dispersion observée au sein d’un groupe en réalité sous-représenté.
Une autre innovation méthodologique remarquable réside dans l’intégration d’encoches de part et d’autre de la ligne médiane via l’argument notch = TRUE. Ces encoches formalisent un intervalle de confiance approché autour de la médiane, calculé selon la formule asymptotique standard de McGill, Tukey et Larsen : médiane ± 1,58 * IQR / sqrt(n). Cette construction permet d’effectuer un test de comparaison non paramétrique visuel direct : si les encoches de deux boîtes adjacentes ne présentent aucun chevauchement vertical, l’analyste dispose d’une indication probante que les médianes de ces deux populations diffèrent de manière statistiquement significative au seuil empirique d’environ 5 %.
Enfin, la géométrie des éléments d’extrémité et des marqueurs ponctuels s’ajuste par l’intermédiaire des options range et pch. L’argument range, configuré par défaut à 1,5, autorise la reconfiguration des seuils de Tukey, pouvant être étendu à 3,0 pour masquer les anomalies mineures et ne cibler que les déviations pathologiques majeures. Le symbole graphique attribué aux valeurs aberrantes se personnalise grâce au paramètre pch (par exemple un losange évidé ou une croix pleine), tandis que l’appel complémentaire à la commande d’annotation de bas niveau abline(h = valeur_seuil, lty = 2, col = « red ») trace des lignes de référence horizontales indispensables pour signaler des limites de détection instrumentale ou des seuils d’intervention clinique.
5. Architecture graphique de ggplot2 appliquée aux boîtes à moustaches
5.1 Principes de la grammaire des graphiques pour la distribution groupée
La bibliothèque logicielle ggplot2, développée par Hadley Wickham, repose sur les fondements mathématiques et sémiotiques de la grammaire des graphiques formulée à l’origine par Leland Wilkinson. Contrairement à l’approche impérative du moteur graphique de base qui consiste à dessiner des éléments successifs sur une toile de pixels passive, ggplot2 adopte une philosophie déclarative où un graphique résulte de l’assemblage cohérent de couches indépendantes (layers). Chaque couche articule un ensemble de données sous forme de tableau unifié, un système de coordonnées spatiales, et une correspondance esthétique (aesthetic mapping) qui associe les variables du jeu de données aux dimensions visuelles perceptibles de l’image.
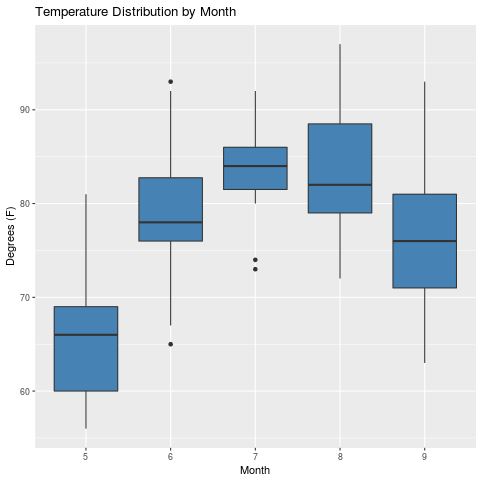
Pour construire une série de boîtes à moustaches multiples au sein de ce paradigme, le flux de programmation s’initialise systématiquement par l’appel à la fonction ggplot(), au sein de laquelle on spécifie le tableau de données source ainsi que la fonction de mappage aes(). L’axe des abscisses (x) accueille obligatoirement la variable discrète formalisant la stratification factorielle, tandis que l’axe des ordonnées (y) est assigné au vecteur numérique continu dont on cherche à comparer les distributions. Cette instanciation préliminaire prépare un canevas vectoriel géométriquement calibré, prêt à recevoir la concrétisation graphique de la statistique de distribution.
L’adjonction de la couche de rendu s’opère par l’opérateur d’addition (+) en appelant la géométrie dédiée geom_boxplot(). En coulisses, cette géométrie invoque une transformation statistique sous-jacente nommée stat_boxplot(), qui prend en charge l’exécution rigoureuse des calculs de Tukey : tris par strate, dénombrement des effectifs, extraction des quantiles et détection des valeurs aberrantes. Un atout méthodologique capital de cette architecture réside dans l’héritage universel : les variables esthétiques déclarées au niveau global de l’instruction ggplot() sont transmises par cascade à l’ensemble des couches géométriques superposées ultérieurement, à moins qu’une surcharge locale explicite ne vienne en redéfinir les assignations pour une géométrie particulière.
5.2 Contrôle précis des propriétés géométriques
L’ajustement morphologique des boîtes au sein de geom_boxplot() s’effectue par une série d’arguments statiques, déclarés directement à l’intérieur de la fonction géométrique et en dehors de la déclaration aes(), car ils s’appliquent de manière uniforme à l’ensemble des éléments tracés sans dépendre des variations d’une variable du jeu de données. Le paramètre width, par exemple, régit la largeur relative occupée par chaque boîte le long de la tranche d’espace allouée à chaque modalité d’abscisse. Une réduction de cette valeur à 0,5 confère au tracé une structure élancée, particulièrement appréciable lorsqu’un grand nombre de cohortes expérimentales s’alignent le long de l’axe, prévenant l’impression visuelle d’étouffement spatial.
L’épaisseur des traits composant les contours de la boîte, les moustaches d’extrémité et la marque de la médiane est minutieusement calibrée via le paramètre linewidth (successeur moderne de l’argument déprécié size pour les géométries filaires dans les versions récentes de ggplot2). Une valeur comprise entre 0,6 et 0,8 point assure généralement un compromis parfait entre précision typographique et lisibilité lors des réductions d’échelle imposées par les maquettes éditoriales des journaux scientifiques. Conjointement, le paramètre alpha ajuste le degré d’opacité du remplissage interne des boîtes, autorisant une transparence partielle qui prépare élégamment le terrain pour la superposition ultérieure de points de dispersion individuels.
À l’instar du système de base, geom_boxplot() supporte pleinement la construction d’encoches de confiance pour la médiane au moyen de la directive logique notch = TRUE. L’amplitude géométrique de l’étranglement ainsi formé peut être ajustée via l’argument notchwidth, dont la valeur par défaut est fixée à 0,5. ggplot2 intègre en outre une sécurité méthodologique essentielle : lorsque la taille de l’échantillon au sein d’une boîte est trop restreinte, provoquant une situation où l’intervalle de confiance calculé excède les limites physiques des quartiles (créant des encoches qui débordent de la boîte elle-même), la bibliothèque émet un message d’avertissement documenté invitant l’analyste à la prudence quant à la robustesse des conclusions comparatives ainsi visualisées.
6. Représentation de plans factoriels complexes à deux facteurs ou plus
6.1 Groupement bivarié par assignation esthétique du remplissage
La puissance d’expression de la grammaire de ggplot2 prend toute son envergure lorsqu’il s’agit de représenter des dispositifs expérimentaux croisés, où l’effet d’une variable quantitative dépend de deux facteurs discrets concomitants (par exemple, un protocole mesurant une réponse métabolique en fonction d’un traitement pharmacologique administré selon deux régimes alimentaires distincts). Dans un tel scénario, la boîte à moustaches multiple ne doit plus simplement juxtaposer des groupes isolés, mais ségréguer des sous-ensembles appariés.
Cette complexification analytique s’implémente avec une grande élégance syntaxique en introduisant le second facteur explicatif au sein de la correspondance esthétique via l’argument fill = facteur_secondaire. Dès lors que cette liaison est établie, ggplot2 segmente automatiquement chaque catégorie présente sur l’axe des abscisses (x) en autant de sous-boîtes qu’il existe de modalités dans le facteur de remplissage secondaire. Par défaut, la bibliothèque applique un mécanisme d’évitement latéral spatial rigoureux formalisé par l’argument position = position_dodge(preserve = « total »), qui aligne côte à côte les boîtes relevant d’une même modalité primaire.
Dans les jeux de données expérimentaux caractérisés par un déséquilibre d’échantillonnage où certaines combinaisons de modalités sont totalement absentes d’une strate, la préservation des espacements visuels peut devenir critique. L’ajustement du paramètre position_dodge(preserve = « single ») garantit que la largeur individuelle des boîtes résiduelles demeure rigoureusement constante, évitant qu’une boîte isolée ne s’étire maladroitement sur toute la largeur allouée au motif que ses comparses de strate sont inexistantes. Cette rigueur géométrique s’accompagne d’une génération entièrement automatisée d’une légende chromatique hiérarchisée, éliminant tout risque d’ambiguïté dans l’attribution des traitements.
6.2 Gestion des interactions factorielles croisées
Lorsque le plan d’expérience intègre des interactions factorielles de haut niveau ou que l’imbrication côte à côte via le remplissage chromatique ne permet pas d’exprimer clairement la structure séquentielle du protocole, une stratégie alternative consiste à fusionner explicitement les variables catégorielles le long de l’axe structural principal. La fonction interne de R interaction() offre à ce titre un levier d’une grande efficacité méthodologique.
En assignant à l’axe des abscisses l’expression x = interaction(facteur_temps, facteur_dose, sep = » : « ), ggplot2 subdivise la ligne de base en toutes les combinaisons factorielles possibles, créant une séquence exhaustive de boîtes à moustaches indépendantes. Cette écriture permet d’appliquer des tris personnalisés sur la séquence ordonnée des combinaisons, permettant par exemple de présenter l’ensemble des doses pour le temps 0, puis l’ensemble des doses pour le temps 24 heures, révélant sans distorsion la cinétique globale du phénomène observé.
L’exploitation de ces structures croisées facilite grandement l’interprétation des effets principaux et des synergies expérimentales. Le chercheur peut vérifier d’un coup d’œil si la variation induite par la seconde variable est constante à travers tous les niveaux de la première (absence apparente d’interaction statistique, les profils de boîtes évoluant de manière parallèle) ou si l’amplitude de la réponse s’effondre ou s’inverse dans une modalité spécifique, signalant une interaction hautement significative qui orientera la rédaction formelle des modèles de contraste dans la suite du rapport d’analyse.
7. Techniques de facettage pour l’exploration multi-panneaux
7.1 Partitionnement monodimensionnel avec facet_wrap()
Bien que la juxtaposition de boîtes multiples au sein d’un tracé unifié soit une technique puissante, la multiplication des facteurs expérimentaux ou des strates de cohortes finit par induire une saturation visuelle dommageable (l’effet de fouillis ou visual clutter). Lorsque le nombre total de distributions à comparer dépasse la douzaine, le partitionnement en petits multiples (small multiples) constitue la solution ergonomique la plus rigoureuse. Au sein de ggplot2, ce partitionnement monodimensionnel est orchestré de façon experte par la commande facet_wrap().
L’opérateur de facettage segmente le jeu de données sous-jacent en fonction des niveaux d’une variable de conditionnement spécifique, puis génère une matrice de sous-graphiques autonomes partageant des échelles structurelles communes. La déclaration s’effectue au moyen de la syntaxe par formule ~ variable_partition. L’analyste conserve la maîtrise absolue de l’organisation géométrique de l’espace imprimé en spécifiant les arguments nrow ou ncol, dictant le nombre précis de lignes et de colonnes qui composeront la grille finale de publication.
Chaque sous-panneau ainsi créé est coiffé d’une bande de titre distinctive (strip text), dont la typographie, l’encadrement et la couleur d’arrière-plan peuvent être finement paramétrés dans les options de thème global. Cette approche excelle particulièrement lors de la restitution de tests toxicologiques ou pharmacologiques conduits en parallèle sur une pluralité d’organes cibles ou de lignées cellulaires : chaque facette accueille la série de boîtes à moustaches doses-réponses d’un tissu spécifique, rendant les comparaisons d’effets d’une clarté exemplaire tout en maintenant une parfaite harmonisation stylistique.
7.2 Matrice factorielle croisée avec facet_grid()
Pour les dispositifs expérimentaux structurés selon un plan factoriel complet à deux dimensions croisées, la fonction facet_grid() substitue au partitionnement séquentiel une disposition matricielle stricte. La syntaxe adopte la formule canonique facteur_ligne ~ facteur_colonne, créant une grille bidimensionnelle rigide où chaque cellule correspond à l’intersection exacte d’une modalité de ligne et d’une modalité de colonne, au sein de laquelle s’affiche la distribution des mesures continues sous forme de boîtes à moustaches.
L’enjeu méthodologique cardinal lors de l’emploi de facet_grid() réside dans la gestion des échelles d’axes via l’argument scales. Par défaut, la fonction impose scales = « fixed », contraignant chaque sous-panneau à adopter scrupuleusement les mêmes bornes d’abscisse et d’ordonnée. Cette standardisation absolue est indispensable pour préserver la fidélité des comparaisons de dispersion et de tendance centrale entre les conditions : un centimètre d’écart vertical traduit rigoureusement la même amplitude métrique partout sur la page. Toutefois, dans les analyses exploratoires impliquant des biomarqueurs ou des scores psychométriques dont les échelles de grandeurs varient d’un facteur 100 ou 1000 d’une ligne à l’autre, l’activation prudente de l’option scales = « free_y » autorise chaque rangée à calibrer son échelle de mesure, évitant l’écrasement visuel complet des strates à faibles amplitudes.
Cette méthodologie trouve une application de premier ordre dans les études psychométriques et sociologiques à large échelle, où des scores composites de dépression ou de résilience sont confrontés à des profils catégorisés conjointement par tranches d’âge en lignes et par genre en colonnes. La grille structurelle offre une lisibilité immédiate qui surpasse toute tentative de compactage sur un seul graphique, permettant d’identifier sans ambiguïté les régularités phénotypiques et les anomalies locales propres à chaque sous-groupe démographique étudié.
8. Enrichissement informationnel : superposition de données individuelles et statistiques
8.1 Intégration des points individuels bruts par dispersion aléatoire
En dépit de son efficacité incontestée, la boîte à moustaches traditionnelle présente une vulnérabilité épistémologique majeure : elle demeure incapable de révéler la structure de densité intime de la distribution sous-jacente. Deux populations présentant des profils strictement identiques en termes de résumé à cinq nombres (mêmes quartiles, même médiane) peuvent posséder des réalités physiques totalement opposées, l’une étant unimodale et symétrique, l’autre étant profondément bimodale, masquant une scission de la cohorte en deux sous-groupes fonctionnels. Ce phénomène aveugle peut induire des erreurs d’interprétation tragiques lors de l’évaluation clinique de thérapies novatrices.
Pour remédier à cette cécité géométrique, la démarche méthodologique moderne préconise la superposition directe de l’ensemble des points d’observations bruts par-dessus les boîtes à moustaches au moyen de la géométrie geom_jitter(). Cette fonction introduit un bruit statistique aléatoire contrôlé le long de l’axe horizontal, désenchevêtrant les points qui se chevaucheraient au même niveau d’ordonnée. L’ajustement scrupuleux des paramètres width (idéalement fixé à 0,2 pour éviter que les points ne débordent de l’emprise spatiale de leur boîte respective) et height = 0 (afin de préserver rigoureusement l’intégrité de la mesure continue sans introduire de déviation artificielle sur l’axe y) s’avère indispensable.
Une précaution technique impérative doit être scrupuleusement respectée lors de cette superposition : il faut impérativement neutraliser l’affichage natif des valeurs aberrantes au sein de la couche géométrique principale en déclarant geom_boxplot(outlier.shape = NA). Si cette neutralisation était omise, les observations extrêmes franchissant les seuils de Tukey se trouveraient dessinées deux fois : une première fois comme composante formelle de la boîte, et une seconde fois en tant que points dispersés de la couche de jittering, induisant un doublon visuel susceptible de fausser l’appréciation visuelle de la densité extrême.
8.2 Ajout d’indicateurs paramétriques complémentaires
Le dialogue sémiotique entre statistiques non paramétriques (médiane, quartiles de Tukey) et métriques paramétriques gaussiennes classiques (moyenne arithmétique, erreur-type) enrichit considérablement la profondeur analytique d’une boîte à moustaches. Bien que la médiane fournisse une mesure robuste du centre de gravité empirique, la moyenne demeure la référence opératoire dans de nombreux cadres d’analyse économique et d’essais cliniques régulés. La visualisation conjointe de ces deux métriques permet d’appréhender d’un regard l’asymétrie de la distribution : une moyenne nettement supérieure à la médiane indique immédiatement une queue de distribution étirée vers les valeurs positives (right-skewed).
La bibliothèque ggplot2 permet d’automatiser cette hybridation au moyen de la primitive statistique stat_summary(). En associant les arguments fun = « mean », geom = « point », shape = 23 (un losange géométrique plein) et une couleur vive contrastée, la moyenne arithmétique vient se positionner exactement au cœur de chaque boîte. On peut prolonger cette démarche en adjoignant des barres d’erreur paramétriques via fun.data = « mean_cl_normal » ou mean_se, intégrant de manière unifiée l’estimation de l’intervalle de confiance paramétrique au sein d’une structure initialement dédiée aux quantiles.
Enfin, pour conférer à la figure une transparence scientifique irréprochable, l’analyste peut imprimer textuellement l’effectif résiduel exact de chaque groupe d’échantillons (la mention n = …) immédiatement au-dessous ou au-dessus de chaque boîte. Cet ajout s’effectue harmonieusement par l’appel à stat_summary() en exploitant une fonction personnalisée qui retourne la cardinalité du sous-vecteur, projetée sous forme d’étiquettes textuelles via geom = « text », évitant ainsi au lecteur de devoir consulter fastidieusement les tableaux annexes du manuscrit pour vérifier la puissance statistique locale.
8.3 Hybridation avec les graphiques en violon (Raincloud Plots)
Pour les publications de pointe en neurosciences, génomique et sciences comportementales, l’état de l’art de la visualisation descriptive a évolué vers des représentations composites intégrant le lissage par noyau de la densité de probabilité, plus connues sous l’appellation de graphiques en nuage de pluie (raincloud plots) ou d’hybrides violon-boîte. Cette technique combine au sein d’un même espace de coordonnées la densité lissée (le violon), la métrique condensée des cinq nombres (la boîte à moustaches) et la réalité empirique brute (le nuage de points).
Dans R, cette architecture se concrétise en coordonnant l’appel à la fonction geom_violin(trim = FALSE, alpha = 0.4) avec une micro-boîte à moustaches nichée en son cœur via geom_boxplot(width = 0.1, fill = « white », outlier.shape = NA). L’étendue volumétrique du violon dessine la silhouette continue des probabilités de présence des observations, rendant immédiatement évidentes les distributions bimodales, les constrictions locales et les aplatissements kéviformes que la boîte seule dissimule. La micro-boîte centrale apporte l’ancrage chiffré objectif des seuils quartilaires.
La réussite de ces compositions sophistiquées dépend d’une hiérarchisation visuelle stricte afin de ne pas submerger l’observateur sous un enchevêtrement illisible de tracés. L’utilisation d’une géométrie de demi-violon (disponible via des extensions spécialisées telles que gghalves ou see), couplée à un décalage spatial horizontal des points individuels disposés sous la forme d’une pluie de gouttelettes régulières, parachève un chef-d’œuvre de clarté métrologique, plébiscité par les méthodologistes les plus exigeants pour l’analyse des données de temps de réaction et d’expression phénotypique.
9. Gestion experte des valeurs aberrantes et cas pathologiques
9.1 Identification, extraction et marquage distinctif des outliers
L’un des apports majeurs de la modélisation sous R réside dans l’accès programmatique direct aux objets identifiés comme des valeurs aberrantes lors de la compilation de la boîte à moustaches. Il est scientifiquement inconsidéré de se satisfaire de l’affichage d’un point isolé à l’extrémité d’une figure sans chercher à identifier formellement l’unité observationnelle ou le patient auquel il se rapporte. L’environnement natif permet d’extraire instantanément ces données par la commande boxplot.stats(vecteur)$out, qui isole les composantes scalaires ayant franchi les barrières intérieures de Tukey.
Au sein de la syntaxe de ggplot2, la personnalisation esthétique de ces entités s’opère directement au niveau des arguments de geom_boxplot() grâce aux paramètres outlier.colour, outlier.shape, outlier.size et outlier.alpha. En configurant par exemple outlier.colour = « firebrick », outlier.shape = 8 et outlier.size = 2.5, le statisticien attire explicitement l’œil de l’auditoire sur ces points singuliers, soulignant leur rôle potentiel dans les instabilités de modélisation futures.
Pour conférer une dimension contextuelle maximale, la bibliothèque d’annotation ggrepel permet de superposer des étiquettes textuelles intelligentes qui s’écartent automatiquement des points pour éviter les superpositions d’encre. En couplant un filtrage conditionnel sur les identifiants d’échantillons correspondant aux valeurs aberrantes de Tukey avec l’instruction geom_text_repel(), on fait apparaître directement le numéro d’anonymat du patient ou la référence du lot industriel à côté du marqueur d’anomalie, accélérant considérablement les diagnostics d’investigation en comité de surveillance clinique.
9.2 Ajustement aux distributions fortement asymétriques et tronquées
Les distributions empiriques réelles s’écartent fréquemment du modèle gaussien symétrique, exhibant des profils fortement asymétriques (skewed distributions) caractérisés par des queues lourdes et des troncatures physiques (valeurs strictement positives, telles que les concentrations sériques, les revenus financiers ou les temps de survie). L’application mécanique des seuils de Tukey standard (± 1,5 * IQR) sur de tels échantillons produit des artefacts méthodologiques sévères : la moustache supérieure devient disproportionnellement courte tandis qu’une nuée de points est étiquetée à tort comme aberrante du côté étiré, alors qu’ils relèvent de la dynamique normale d’une loi log-normale ou de Weibull.
Face à cette distorsion, l’analyste dispose de deux stratégies de redressement mathématique. La première consiste à appliquer une transformation continue des coordonnées via l’instruction scale_y_continuous(trans = « log10 ») ou trans = « sqrt » au sein de ggplot2. Il est fondamental de comprendre la distinction conceptuelle majeure entre la transformation de l’axe spatial et la transformation préalable des données brutes : la transformation de l’échelle spatiale préserve le calcul des quantiles sur les grandeurs réelles originelles tout en comprimant harmonieusement la projection géométrique visuelle, conservant ainsi la pleine interprétabilité des unités physiques réelles sur les graduations de l’axe.
La seconde approche, hautement rigoureuse sur le plan non paramétrique, consiste à employer l’algorithme de la boîte à moustaches ajustée développé par Hubert et Vandervieren (2008), implémenté dans le package spécialisé robustbase via la fonction adjbox(). Cet algorithme substitue au facteur constant 1,5 une fonction exponentielle dépendant du medcouple (MC), une statistique robuste mesurant l’asymétrie intrinsèque de la distribution. Les barrières intérieures deviennent asymétriques, s’allongeant du côté de la queue épaisse et se rétractant du côté opposé, éliminant ainsi les détections d’aberrations fantômes générées par la non-normalité structurelle des données.
10. Stylisation académique et conformité aux standards de publication (normes APA)
10.1 Définition d’un thème minimaliste adapté à l’édition scientifique
Les rendus visuels bruts générés par défaut par les moteurs logiciels ne répondent que rarement aux standards typographiques et graphiques draconiens exigés par les comités de rédaction des revues scientifiques de premier rang. Le célèbre arrière-plan quadrillé gris perle standard de ggplot2, bien que pertinent pour l’exploration interactive sur écran, est universellement proscrit dans l’édition académique en raison de sa consommation excessive d’encre et du bruit visuel qu’il injecte dans la lecture des données. Les normes éditoriales, à l’instar de celles formulées dans le manuel de publication de l’American Psychological Association (APA 7e édition), réclament une frugalité esthétique maximale.
L’application immédiate du thème prédéfini theme_classic() ou theme_minimal() constitue le premier pas vers cette mise en conformité. Ce réglage élimine intégralement la trame grise d’arrière-plan, supprime les lignes de grille secondaires superflues et rétablit des lignes d’axes noires nettes et orthogonales. Pour satisfaire rigoureusement aux préceptes de l’APA, il convient de compléter cette base par une surcharge minutieuse au sein de la fonction theme() : fixation d’une police avec ou sans empattement standardisée (Arial, Times New Roman), ajustement de la taille des caractères des étiquettes d’axe à 10 points et des titres d’axe à 12 points, et orientation des textes d’ordonnées parallèlement à l’axe pour un confort de lecture optimal.
À l’échelle d’un laboratoire ou d’un consortium de recherche, la meilleure pratique de programmation consiste à encapsuler ces spécifications vectorielles au sein d’une fonction R sur-mesure (par exemple, mon_theme_apa()). Cette modularité logicielle garantit que l’ensemble des figures produites par les différents co-auteurs d’un manuscrit partageront une signature graphique rigoureusement identique, prévenant les disparités de graissage de ligne ou de gabarits d’étiquettes qui dégradent la perception de professionnalisme lors de l’évaluation par les pairs.
10.2 Accessibilité universelle et conformité chromatique
La dimension éthique et légale de l’accessibilité dans la communication scientifique impose de concevoir des visualisations compréhensibles par l’intégralité de la communauté des chercheurs, y compris les individus présentant des altérations congénitales de la vision trichromatique. L’emploi de palettes associant de manière binaire le rouge et le vert, longtemps toléré par la coutume, est désormais formellement banni des publications d’impact international, ces nuances se confondant en une boue chromatique indifférenciée sous l’effet du daltonisme.
L’intégration des échelles chromatiques de la famille viridis (accessible nativement dans ggplot2 via l’instruction scale_fill_viridis_d(option = « viridis ») ou option = « plasma ») répond parfaitement à cette exigence métrologique. Ces échelles ont été modélisées mathématiquement pour assurer un gradient de luminance parfaitement monotone du plus sombre au plus clair : même lorsqu’un manuscrit est imprimé sur support papier en niveaux de gris par un lecteur ou photocopié, les contrastes relatifs entre les différentes boîtes à moustaches demeurent rigoureusement intacts sans perte d’information.
Pour parachever cette démarche inclusive, la bonne pratique sémiotique impose de ne jamais faire reposer l’encodage de l’information sur la seule variable chromatique. Le statisticien averti combinera toujours la modulation de la couleur avec des discriminants morphologiques ou géométriques orthogonaux : l’espacement distinctif des sous-groupes, l’insertion de symboles ponctuels différenciés pour les moyennes (cercles, carrés, losanges, triangles), ou encore l’application de motifs de hachures vectorielles subtiles, garantissant une robustesse interprétative totale quel que soit le canal de reproduction visuelle employé.
11. Exportation haute résolution et intégration dans les flux de travail reproductibles
11.1 Exportation programmatique et contrôle dimensionnel
La finalisation d’une boîte à moustaches comparative franchit son ultime étape critique lors de son exportation depuis l’environnement de calcul R vers un fichier autonome destiné à l’imprimeur ou à la plateforme de soumission éditoriale. L’utilisation manuelle de la fonctionnalité d’enregistrement de l’interface graphique de RStudio (Export -> Save as Image) est à proscrire catégoriquement dans une démarche de recherche rigoureuse : cette méthode manuelle n’est pas traçable, ne conserve aucune trace des dimensions exactes imposées et génère des rendus variables selon la résolution propre du moniteur physique de l’utilisateur.
La pratique canonique repose exclusivement sur l’automatisation programmatique via la fonction ggsave() pour les objets ggplot2, ou l’encapsulation entre un périphérique graphique vectoriel (tels que pdf() ou svg()) et sa fermeture hermétique par la commande dev.off() pour le système natif. L’analyste doit arbitrer entre deux familles technologiques de formats : le vectoriel pur (PDF, SVG, EPS) et le matriciel ou raster (TIFF, PNG). Pour les figures de type boîte à moustaches, le format vectoriel est infiniment supérieur car il encode les lignes, les polygones et les glyphes typographiques sous forme d’instructions mathématiques, garantissant un agrandissement infini sans aucune pixellisation.
Lorsqu’un éditeur exige impérativement un format matriciel (généralement le TIFF sans compression avec pertes), la commande ggsave doit obligatoirement être configurée avec un argument de résolution spatiale strict dpi = 300 (valeur minimale universelle pour les graphiques au trait, souvent portée à 600 DPI pour les revues du groupe Nature). Les dimensions géométriques doivent être calibrées non pas en pixels, mais en unités physiques réelles (centimètres ou pouces) correspondant au gabarit de la maquette cible : une colonne standard (environ 8,5 cm) ou une pleine page double colonne (environ 17,5 cm), assurant que les étiquettes textuelles conservent leur corps typographique exact sans écrasement proportionnel lors de l’intégration dans l’épreuve finale.
11.2 Intégration dynamique dans les documents R Markdown et Quarto
L’idéal moderne de la recherche reproductible tel que promu par les fondations pour la science ouverte repose sur l’intégration harmonieuse du code de traitement statistique et du texte narratif au sein de documents computationnels dynamiques via R Markdown ou son successeur de nouvelle génération Quarto. Cette approche assure une traçabilité intégrale : si une nouvelle cohorte de données de laboratoire vient enrichir le jeu de données préliminaire, la recompilation du document régénère automatiquement les boîtes à moustaches avec leurs quantiles et annotations d’effectifs actualisés, sans aucune manipulation manuelle sujette à l’erreur humaine.
La calibration de la restitution graphique au sein de ces documents s’opère par le biais des options de blocs de code (chunk options). Il convient de configurer avec une rigueur métrologique les directives d’en-tête de bloc : fig.width et fig.height pour fixer les dimensions physiques de rendu du canevas, fig.align = « center » pour l’équilibrage typographique sur la page, et out.width = « 100% » pour contraindre la largeur relative de l’élément dans le document final compilé en HTML ou LaTeX. La légende scientifique s’insère nativement via fig.cap = « … », ce qui permet à l’interpréteur de générer automatiquement la numérotation ordonnée des figures et de gérer les références croisées dynamiques au sein du corps du manuscrit.
Pour les analyses complexes exploitant des bases de données volumineuses dont le tracé des quantiles peut requérir des dizaines de secondes de calcul arithmétique, l’activation pragmatique de l’option cache = TRUE permet de figer les résultats temporaires sur disque tant que le bloc de code amont n’a subi aucune altération textuelle. Ce dispositif accélère considérablement les cycles de révision rédactionnelle tout en garantissant que l’utilisateur travaille en permanence sur une chaîne de causalité algorithmique inviolable reliant l’enregistrement instrumental brut à la figure finale publiée.
12. Diagnostics des erreurs récurrentes et bonnes pratiques de programmation
12.1 Résolution des pièges syntaxiques fréquents
Même les programmeurs expérimentés se heurtent régulièrement à des comportements visuels inattendus lors de la conception de boîtes à moustaches complexes sous R. L’une des anomalies les plus pernicieuses survient lors de l’utilisation erronée de l’argument esthétique de regroupement aes(group = …). Lorsque l’abscisse (x) est constituée d’une variable numérique discrète (par exemple l’année ou le numéro de visite d’un patient) sans que celle-ci n’ait été formellement convertie en facteur, ggplot2 échoue silencieusement à subdiviser les données et dessine une unique boîte géante fusionnant l’ensemble des années. Pour corriger cette dérive, il est impératif soit d’encapsuler la variable dans l’expression x = factor(annee), soit de déclarer explicitement aes(x = annee, group = annee) afin d’ordonner au moteur de segmenter le calcul par millésime.
Un second piège classique concerne le recadrage spatial des axes de coordonnées. Un utilisateur souhaitant zoomer sur une région d’intérêt vertical pour mieux observer la médiane aura tendance à employer la commande ylim(borne_inf, borne_sup) ou scale_y_continuous(limits = c(…)). Cette manipulation est méthodologiquement dangereuse : ces fonctions éliminent purement et simplement du tableau de données sous-jacent toutes les observations tombant en dehors de la plage spécifiée avant d’exécuter la statistique. Par conséquent, les quartiles de Tukey, l’IQR et les moustaches se trouvent recalculés sur un échantillon amputé, falsifiant gravement la représentation de la distribution originelle. La seule méthode d’agrandissement conforme consiste à utiliser coord_cartesian(ylim = c(borne_inf, borne_sup)), qui opère un véritable zoom optique a posteriori sans exclure aucune valeur du calcul statistique fondamental.
Enfin, la confusion récurrente entre les arguments esthétiques fill et colour engendre d’incessants conflits stylistiques dans l’application de ggplot2. Le paramètre colour (ou color) régit exclusivement le dessin vectoriel des éléments linéaires, à savoir la bordure extérieure de la boîte, les traits des moustaches et la teinte des points aberrants. Le paramètre fill régit quant à lui le polygone surfacique interne de la boîte. L’affectation d’une palette chromatique à la mauvaise esthétique se traduit par des bordures colorées enserrant un intérieur uniformément blanc ou grisé, à l’opposé du remplissage dense recherché par l’analyste.
12.2 Optimisation des performances sur des volumétries massives
À l’ère des mégadonnées (Big Data), de la bio-informatique unicellulaire et de l’Internet des objets, les ensembles de données à traiter peuvent fréquemment dénombrer plusieurs dizaines de millions d’enregistrements individuels. Tenter de tracer une boîte à moustaches enrichie de ses points bruts par geom_jitter() sur un volume de cinq millions de lignes constitue une faute technique rédhibitoire : le moteur graphique tentera d’allouer en mémoire des millions de polygones microscopiques, provoquant soit un effondrement complet de la mémoire vive (Out Of Memory crash), soit la génération d’un fichier vectoriel PDF monstrueux de plusieurs gigaoctets, totalement impossible à ouvrir ou à manipuler par les logiciels de mise en page éditoriale.
Lorsque la volumétrie atteint de telles amplitudes, plusieurs optimisations architecturales doivent être impérativement déployées. La première consiste à réaliser l’ensemble des opérations de restructuration tabulaire, de filtrage et de typage factoriel en amont via le moteur ultra-performant de la bibliothèque data.table, dont la manipulation par référence en mémoire évite les duplications massives de structures typiques des approches conventionnelles. L’extraction des résumés à cinq nombres peut même être précalculée avec data.table, avant de transmettre ces seules métriques résumées à des géométries légères de type geom_boxplot(stat = « identity »).
Si la visualisation de la densité ponctuelle sous-jacente demeure requise sur ces masses d’informations colossales, il convient d’abandonner le jittering naïf au profit de techniques d’échantillonnage aléatoire contrôlé (par exemple ne tracer qu’un sous-échantillon aléatoire représentatif de 10 000 points bruts par boîte), ou d’intégrer des couches de densité hexagonale bidimensionnelle régularisée via geom_hex(). Cette discipline algorithmique garantit la fluidité computationnelle des chaînes de traitement, préserve la frugalité énergétique des calculs scientifiques et assure que le document publié restera consultable de manière fluide et instantanée sur l’ensemble des supports informatiques contemporains.
Références
- Hubert, M., & Vandervieren, E. (2008). An adjusted boxplot for skewed distributions. Computational Statistics & Data Analysis, 52(12), 5186-5201. https://doi.org/10.1016/j.csda.2007.11.008
- McGill, R., Tukey, J. W., & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12-16. https://doi.org/10.2307/2683468
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1-23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0